Przewodnik po kwantyzacji modeli: od podstaw do produkcyjnego serwowania

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Ten przewodnik jest przeznaczony dla inżynierów wdrażających modele językowe, którzy chcą zmniejszyć zużycie pamięci lub przyspieszyć serwowanie. Dowiesz się, jak wybrać, co skompresować, dopasować format liczbowy do sprzętu i runtime’u oraz porównać pamięć, opóźnienie i jakość wyników przed wdrożeniem. Przewodnik obejmuje też osobne kontrole potrzebne dla modeli dyfuzyjnych do generowania obrazów.
Kwantyzacja zmniejsza liczbę bitów używanych dla wag, aktywacji lub KV cache. Wagi to parametry modelu wyuczone podczas treningu. Aktywacje to wartości pośrednie obliczane dla każdego wejścia. Key-value (KV) cache przechowuje wartości z wcześniejszych token, aby można je było ponownie wykorzystać podczas generowania. Kompresja wag może sprawić, że model zmieści się w pamięci GPU, ale zostanie za mało miejsca na długą rozmowę. To, co kompresujesz, oraz kod GPU, który to wykonuje, decydują o tym, które ograniczenie się zmniejszy.
Zacznij od ustalenia, co sprawia, że żądanie jest wolne lub zbyt duże. Przetwarzanie wejściowego prompt nazywa się prefill, a generowanie odpowiedzi token po token to decode. Prefill może być ograniczony przez arytmetykę GPU, a decode przez szybkość ładowania wag z pamięci. Pamięć GPU mogą też wyczerpać wagi modelu i rosnący KV cache. Pierwsza tabela łączy te problemy z możliwymi rozwiązaniami, a dalsze sekcje wyjaśniają arytmetykę i kontrole potrzebne przed wdrożeniem.
Niższa liczba bitów to dopiero kandydat. Decyzja wymaga wyników jakości zadań oraz pomiarów serwowania dla modelu, runtime’u i ruchu, których użyjesz. Przytoczone tu benchmarki to opublikowane wyniki innych zespołów oraz jeden krótki przebieg z repozytorium towarzyszącego.
Krótkie porównanie artefaktów i metod znajdziesz w LLM Quantization Formats.
1. Wąskie gardła i formaty startowe
Zanim wybierzesz liczbę bitów, ustal, co ogranicza obciążenie. Może to być pamięć na wagi modelu, moc obliczeniowa w prefill, przepustowość w decode albo KV cache, a nie sama precyzja numeryczna.
Notacja używana w przepisach serwowania
- W4A16 przechowuje wagi w formie 4-bitowej i zachowuje aktywacje w precyzji 16-bitowej. Ogólniej W{x}A{y} oznacza precyzję wag i aktywacji w obsługiwanych operacjach, zwykle w mnożeniu macierzy. W8A8 używa 8-bitowych wag i aktywacji w tych operacjach, ale nie określa automatycznie typu danych, w jakim przechowywany jest każdy tensor w runtime.
- FP8, INT8, INT4, NF4 to formaty liczbowe. Określają, jakie wartości da się reprezentować.
- GPTQ, AWQ, SmoothQuant, QuaRot to algorytmy. Określają, jak przekształcić wytrenowany model do formatu o niższej precyzji.
- GGUF to format pliku, który przechowuje tensory i metadane dla GGML oraz runtime’ów w stylu
llama.cpp. Plik GGUF może zawierać nieskwantyzowane typy tensorów, takie jakF16,BF16czyF32, a także kodowania skwantyzowane. Do presetów należąQ4_K_M,Q5_K_M,Q8_0,IQ*,TQ*iMXFP4. O wyborze kwantyzacji decyduje kodowanie tensorów. SamoGGUFnie opisuje przepisu serwowania FP8 W8A8 w stylu CUDA. - KV cache to cache uwagi używany podczas generowania. Przechowuje wcześniejsze klucze i wartości, dzięki czemu model nie przelicza całej rozmowy przy każdym token.
- Kwantyzacja KV cache przechowuje tensory aktywacji kluczy i wartości w formacie cache o niższej precyzji, takim jak FP8, INT8, INT4 lub INT2, zależnie od obsługi w runtime. To coś innego niż prefix caching, PagedAttention czy offload, które decydują, czy wpisy cache są ponownie wykorzystywane, jak są alokowane i gdzie leżą.
- GEMM to ogólne mnożenie macierzy (general matrix multiply). Większość czasu inferencji transformera schodzi na mnożeniu macierzy.
Co jest kwantyzowane
Przepis wybiera, które tensory skompresować. Zwykle wygląda to tak:
| Tensor | Zwykle kwantyzowany? | Dlaczego |
|---|---|---|
| Wagi warstw liniowych | Tak, w przepisach W4A16 i W8A8 | Wagi są stałe po treningu, więc ich skale można obliczyć offline. |
| Aktywacje | Tylko w przepisach W8A8, W4A8 lub W4A4 | Zmieniają się z każdym wejściem, więc potrzebują skal kalibrowanych lub wyznaczanych w runtime. |
| KV cache | Opcjonalnie, osobne ustawienie runtime’u | Rośnie z kontekstem i batchem; omawia go sekcja 6. |
Embeddings i lm_head | Zwykle pozostają w 16 bitach | Przepisy LLM Compressor wymieniają lm_head w ignore; sekcja 8 opisuje to wyłączenie. |
| Diffusion VAE i enkodery tekstu | W pierwszym teście pozostają w 16 bitach | Sekcja 10 testuje je osobno od sieci odszumiającej. |
Wąskie gardła i punkt startowy
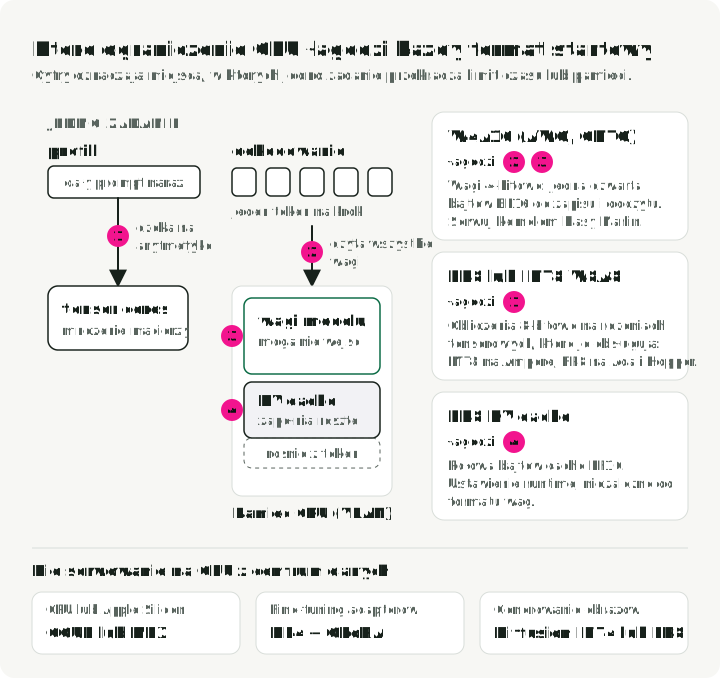
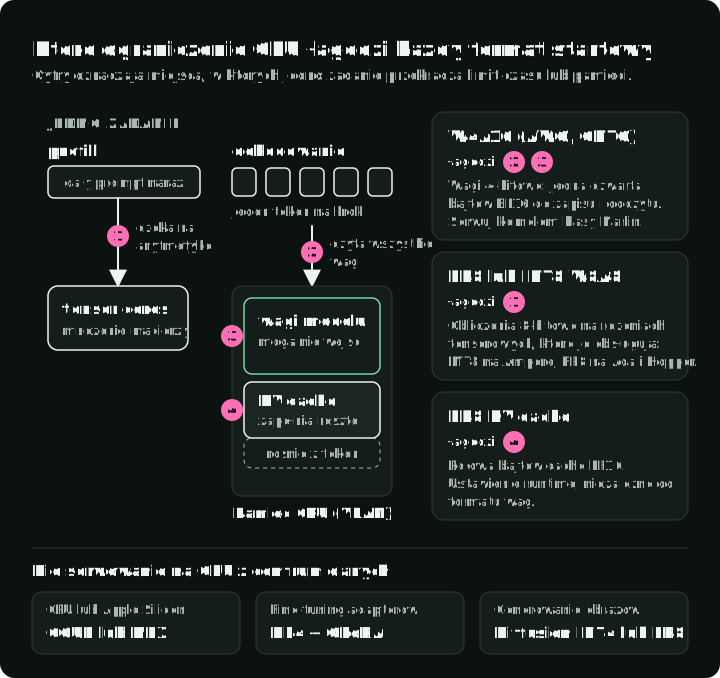
Tabela łączy typowe wąskie gardła z formatem startowym. Używa notacji z powyższej listy.
| Jeśli problemem jest | Zacznij od | Typowe narzędzia | Sprawdź przed wdrożeniem |
|---|---|---|---|
| Wagi modelu nie mieszczą się w VRAM | Kwantyzacja samych wag W4A16 | AWQ lub GPTQ z llm-compressor albo GPTQModel | Perpleksja, kodowanie, rozumowanie, wykonywanie instrukcji |
| Serwowanie o wysokiej przepustowości jest ograniczone obliczeniami | FP8 lub INT8 W8A8 | FP8 PTQ, SmoothQuant, TensorRT-LLM, vLLM | Przepustowość, czas do pierwszego token (TTFT), dokładność zadań |
| Długi kontekst lub duża współbieżność wypełnia GPU | Kwantyzacja KV cache | vLLM, TensorRT-LLM lub Transformers QuantizedCache | Wyszukiwanie w długim kontekście, opóźnienie, bezpieczeństwo i jakość |
| Lokalna inferencja na CPU, Apple Silicon lub desktopie | Pliki GGUF z lokalnymi kodowaniami tensorów | llama.cpp, Ollama, LM Studio, MLX | Opóźnienie prompt, zużycie RAM, wybrane kodowanie tensorów i subiektywna jakość wyników |
| Fine-tuning adapterów musi zmieścić się na jednym GPU | NF4 / QLoRA | bitsandbytes, peft | Strata fine-tuning i jakość scalonego modelu |
| Potok generowania obrazów jest zbyt duży lub zbyt wolny | INT4 lub FP8 dla modeli dyfuzyjnych | SVDQuant, Nunchaku, torchao, NVIDIA ModelOpt | Artefakty wizualne, zgodność z prompt, opóźnienie, VRAM |
Rysunek zaznacza, gdzie jedno żądanie na GPU do serwowania przekracza limit czasu lub pamięci i który format startowy łagodzi każde z tych ograniczeń. Dolny wiersz obejmuje przypadki inne niż serwowanie na GPU z centrum danych.
2. Kwantyzacja to kontrolowane zaokrąglanie
Kwantyzacja odwzorowuje wartości o wysokiej precyzji na mniejszy zbiór reprezentowalnych wartości. Taką podstawową definicję przyjmują zarówno Hugging Face Optimum, jak i TensorRT-LLM. Oszczędzasz pamięć i przepustowość, ale wprowadzasz błąd zaokrąglenia.
INT4 daje tylko 16 dyskretnych wartości, więc odwzorowanie 16-bitowych wag BF16 na tę siatkę powoduje błąd zaokrąglenia. Metody kwantyzacji oceniają zaokrąglenie po tym, jak zmienia wyjście warstwy, a nie same wagi. GPTQ szacuje, jak decyzje o zaokrągleniu wpływają na to wyjście, i koryguje pozostałe wagi, żeby zmniejszyć błąd. AWQ wykorzystuje zaobserwowane aktywacje, by wskazać ważne grupy wag, zwane kanałami, i przeskalowuje je przed zaokrągleniem. Dobre odwzorowanie oszczędza pamięć przy niewielkiej utracie jakości. Złe psuje rozumowanie, wykonywanie instrukcji lub wierność wizualną.
Odwzorowanie symetryczne i asymetryczne
Zgodnie z afinicznym odwzorowaniem używanym w popularnych przewodnikach po kwantyzacji kwantyzacja odwzorowuje ciągłą wartość zmiennoprzecinkową na dyskretną siatkę.
- i to wybrane dolna i górna granica zmiennoprzecinkowa.
- to oryginalna wartość o wysokiej precyzji.
- to wartość skwantyzowana.
- to skala, czyli rozmiar kroku.
- to punkt zerowy, czyli całkowita pozycja reprezentująca
0.0. - to docelowy zakres całkowity. Ten symetryczny przykład używa , co daje 15 wartości i dokładnie reprezentuje zero. Inne formaty INT4 ze znakiem wykorzystują wszystkie 16 wartości, na przykład .
Kwantyzacja symetryczna centruje siatkę wokół zera i ustawia :
Jest to przyjazne dla sprzętu, ponieważ matematyka w runtime nie musi odejmować przesunięcia punktu zerowego. Stos kwantyzacji PyTorch udostępnia te afiniczne wybory skali i punktu zerowego jako podstawowe parametry kwantyzacji w torchao.
Kwantyzacja asymetryczna przesuwa siatkę, aby pokryć zakresy skośne:
Przesunięta siatka może lepiej zachować aktywacje wyłącznie dodatnie, ale przesunięcie dodaje pracy, chyba że kernel dobrze sobie z nim radzi.
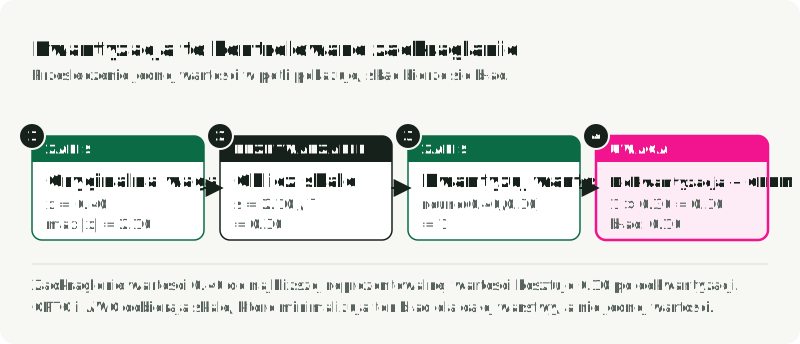
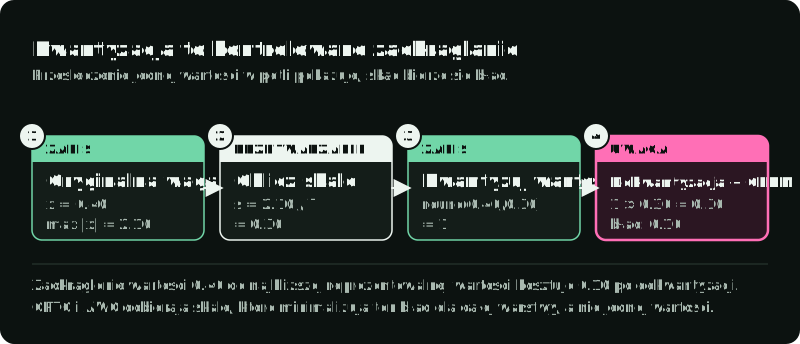
Rysunek pokazuje przypadek symetryczny: maksymalna wartość bezwzględna 2,10 daje skalę 0,30, więc waga 0,40 zaokrągla się do liczby całkowitej 1. Dekwantyzacja mnoży zapisaną liczbę całkowitą przez skalę, aby odzyskać przybliżoną wartość 0,30. Różnica względem 0,40 to błąd zaokrąglenia.
Granularność skali: tensor, kanał, grupa
Współczynnik skali może obejmować cały tensor wag, jeden kanał albo małą grupę wartości. Dokumentacja FP8 KV cache w vLLM stosuje to samo rozróżnienie między strategiami skal na tensor i na głowicę uwagi. Mniejsze grupy zwykle lepiej zachowują jakość, ale wymagają więcej metadanych skal.
| Granularność skali | Co dzieli jedną skalę | Wpływ na jakość i wykonanie |
|---|---|---|
| Na tensor | Cała macierz wag | Przechowuje mało metadanych, ale jedna wartość odstająca może rozciągnąć siatkę i zmniejszyć precyzję w całej warstwie. |
| Na kanał | Jeden wiersz wyjściowy | Chroni kanały o wąskim zakresie przed dzieleniem szerszego zakresu innego kanału. Wiele 8-bitowych ścieżek wag używa tej granularności. |
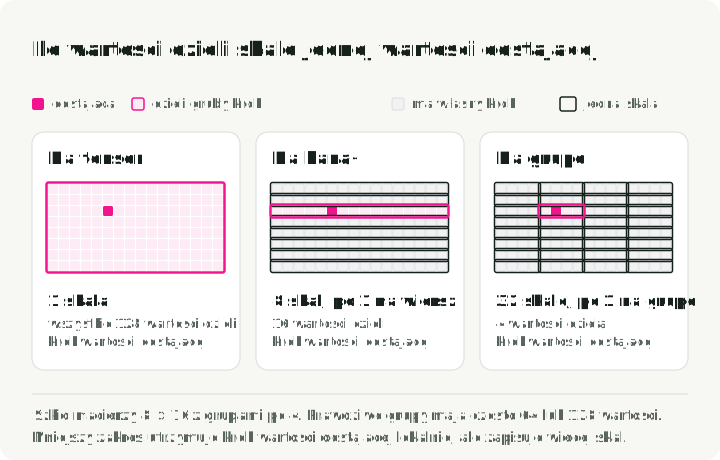
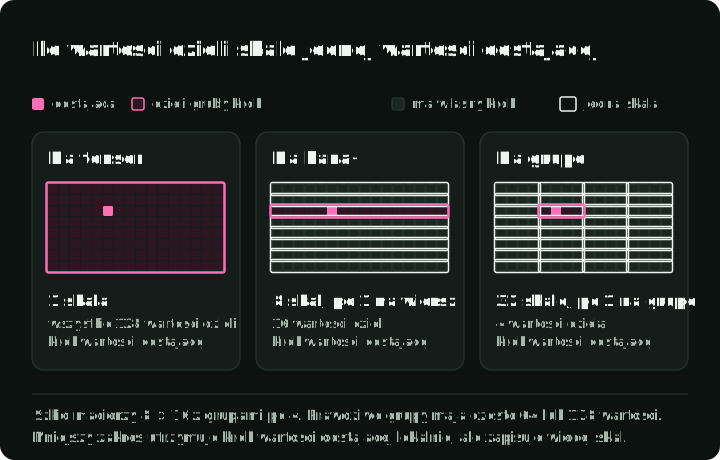
| Na grupę | Blok w wierszu, często 64 lub 128 wartości | Ogranicza wartość odstającą do małego bloku kosztem większej liczby skal. AutoGPTQ używa group_size=128 w swoich przykładach GPTQ. |
Rysunek umieszcza jedną wartość odstającą w małej macierzy poglądowej i liczy, ile wartości dzieli jej skalę przy każdym wyborze.
Wagi są statyczne, więc ich skale można obliczyć offline, zanim załadujesz model. Aktywacje zmieniają się z każdym token, więc ich zakresy zależą od obciążenia.
| Skalowanie aktywacji | Kiedy runtime wybiera skalę | Zaleta | Tryb awarii lub koszt |
|---|---|---|---|
| Statyczne | Offline, ze zbioru kalibracyjnego | Unika obliczania skali podczas inferencji. | Prompt spoza skalibrowanej długości lub rozkładu mogą obciąć skoki aktywacji i pogorszyć wyniki. |
| Dynamiczne | Podczas każdego przejścia w przód | Dostosowuje się do bieżących wartości aktywacji i mieszanki prompt. | Obliczanie zakresów w każdej warstwie dodaje pracy i wymaga zoptymalizowanych kerneli. |
KV cache leży pomiędzy tymi przypadkami: klucze i wartości to aktywacje obliczane w runtime, a potem przechowywane dla kolejnych token, więc potrzebują własnych skal. Sekcja 6 opisuje, jak runtime’y je przechowują.
PTQ i QAT zachodzą na różnych etapach
Kwantyzacja po treningu, czyli PTQ, kompresuje wytrenowany model post factum. Trening świadomy kwantyzacji, czyli QAT, wystawia model na szum kwantyzacji podczas treningu, żeby mógł się do niego dostosować.
| Metoda | Kiedy uczone są zakresy | Użyj, gdy | Koszt |
|---|---|---|---|
| PTQ samych wag | Offline, dla statycznych wag | Model się nie mieści lub decode jest ograniczony przepustowością | Aktywacje nadal działają w 16 bitach |
| Statyczne PTQ | Offline, z prompt kalibracyjnych | Chcesz szybkie serwowanie W8A8 | Dane kalibracyjne muszą odpowiadać produkcji |
| Dynamiczne PTQ | W runtime, per batch lub ścieżka aktywacji | Rozkłady wejść bardzo się różnią | Dodatkowa praca w runtime i węższa obsługa sprzętu |
| QAT | Podczas treningu | PTQ psuje jakość wrażliwego modelu | Pełna infrastruktura treningowa i znacznie więcej obliczeń |
Dane kalibracyjne muszą przypominać ruch, który będziesz obsługiwać. Na przykład ścieżka kalibracji KV cache w vLLM używa wyselekcjonowanego zbioru danych przez llm-compressor. Jeśli prompt produkcyjne to długie ślady RAG, krótkie akapity z Wikipedii mogą nie wywołać zakresów aktywacji, które te ślady powodują. W przypadku statycznych skal aktywacji lub cache kalibracja wybiera zakresy. W GPTQ i AWQ aktywacje kalibracyjne decydują też o tym, jak zaokrąglana lub przeskalowywana jest każda waga, więc kalibracja na krótkich tekstach może ukształtować zapisane wagi. Prawdziwe prompt o długim kontekście mogą dawać inne wzorce aktywacji. Ewaluacje kwantyzacji w długim kontekście mierzą to ryzyko bezpośrednio.
3. Formaty liczbowe determinują wymagania sprzętowe
Format liczbowy określa, jakie wartości model może reprezentować w pamięci. Wydajne obliczenia wymagają kerneli runtime i wsparcia sprzętu dla tej samej liczby bitów i tego samego formatu. TensorRT-LLM dokumentuje zarówno listę przepisów, jak i macierz wsparcia sprzętowego.
| Format | Rozmiar na wartość | Dobry domyślny wybór dla | Główny punkt uwagi |
|---|---|---|---|
| BF16 / FP16 | 2 bajty | Bazowa inferencja i serwowanie zgodne z treningiem | Duże zużycie VRAM i duży ruch na przepustowości pamięci |
| FP8 | 1 bajt | Serwowanie W8A8 o wysokiej przepustowości na Ada, Hopper, Blackwell | Wymaga natywnych rdzeni tensorowych FP8 i wsparcia w runtime |
| INT8 | 1 bajt | Serwowanie W8A8 na starszym lub nie-NVIDIA sprzęcie | Wartości odstające aktywacji i wrażliwość na statyczną kalibrację |
| INT4 | 0,5 bajta | W4A16, gdy głównym ograniczeniem jest pamięć wag | Strata jakości w mniejszych modelach lub modelach silnie rozumujących |
| FP4 / NVFP4 | ~0,5 bajta | Eksperymenty na Blackwell i wczesne ścieżki serwowania | Wymagania kompilatora i runtime’u zależne od sprzętu |
| Kodowania / presety GGUF w llama.cpp | Zmienny | Lokalna inferencja na CPU, Apple Silicon, desktopie i urządzeniach edge | GGUF to kontener. Kodowanie tensorów to wybór kwantyzacji. |
| NF4 | 0,5 bajta | Trening adapterów QLoRA | Zwykle zły format eksportu do serwowania produkcyjnego |
BF16 i FP16 używają po 16 bitów, ale rozkładają precyzję inaczej, więc zawodzą inaczej. BF16 zachowuje 8-bitowy zakres wykładnika FP32 i trudniej o przepełnienie. FP16 ma więcej bitów mantysy i węższy zakres wykładnika, więc skoki aktywacji wymagają większej uwagi. Ewaluacja Kurtica i in. wprost używa BF16 jako punktu odniesienia przy porównywaniu formatów serwowania FP8, INT8 i INT4.
FP8 ma dwa popularne warianty. E4M3 daje większą precyzję i zwykle służy do wag i aktywacji w przejściu w przód. E5M2 daje większy zakres dynamiczny i bardziej nadaje się do gradientów lub niestabilnych ścieżek aktywacji. vLLM udostępnia oba typy danych KV cache, FP8 E4M3 i E5M2. W badaniu Kurtica i in. z ACL 2025, „Give Me BF16 or Give Me Death”, FP8 W8A8 był praktycznie bezstratny dla rodziny Llama-3.1 w ponad 500 000 ewaluacji. Wynik dotyczy tej rodziny modeli, tego zestawu ewaluacji i tej konfiguracji serwowania. Każde wdrożenie wymaga własnej kontroli jakości przed wydaniem.
Blackwell dodaje formaty mikroskalowania, takie jak MXFP8 i NVFP4. Zamiast jednej skali dla całego tensora lub wiersza mikroskalowanie używa drobnych bloków. Opis NVFP4 od NVIDIA przedstawia 4-bitowe wartości zmiennoprzecinkowe w blokach po 16, ze skalami FP8 i nadrzędną skalą FP32. Podejście to ma dać rozmiar zbliżony do INT4 przy zachowaniu zmiennoprzecinkowym. Wymaga jednak pasującej architektury sprzętowej, kompilatora i wsparcia w runtime, dlatego TensorRT-LLM podaje wsparcie FP4 i FP8 według generacji GPU.
4. Kwantyzacja samych wag a kwantyzacja wag i aktywacji
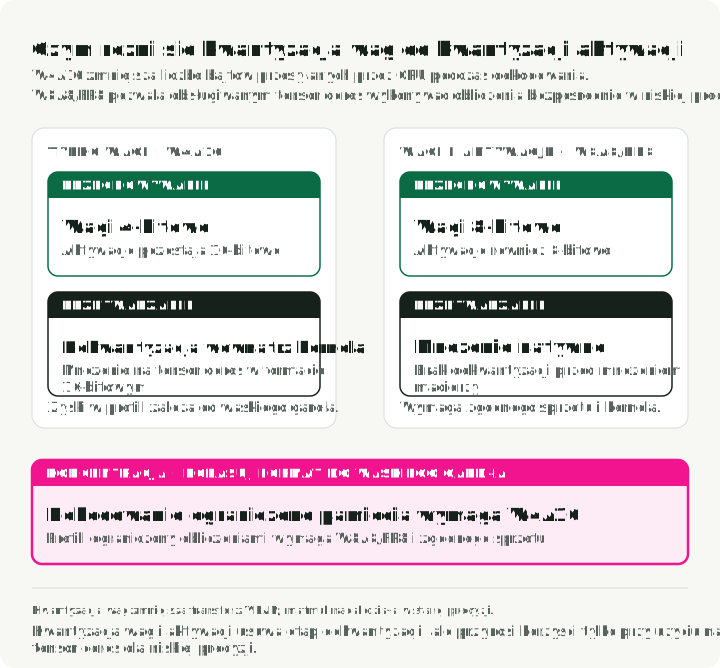
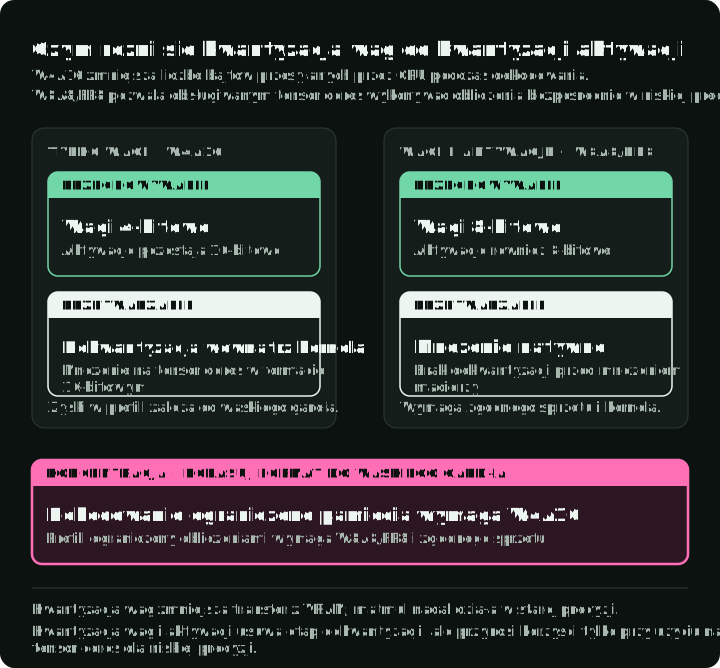
Notacja WxAy opisuje precyzję wag i aktywacji, które inaczej obciążają GPU podczas inferencji. Rysunek śledzi wagi z VRAM przez kernel do rdzeni tensorowych dla BF16, W4A16 i W8A8.
Podczas prefill model przetwarza prompt wejściowy. Ta faza jest zwykle ograniczona obliczeniami, ponieważ GPU wykonuje duże mnożenia macierzy, dlatego przepisy W8A8 FP8/INT8 mają znaczenie dla serwowania nastawionego na przepustowość.
Podczas decode model generuje jeden token naraz. Ta faza jest często ograniczona przepustowością pamięci, ponieważ GPU stale ładuje wagi z VRAM, aby wytworzyć następny token. Prace skupione na samych wagach, takie jak GPTQ i AWQ, odpowiadają na tę presję, zmniejszając liczbę bajtów wag.
W4A16 kompresuje wagi i zachowuje aktywacje w BF16 lub FP16. GPU ładuje mniej bajtów wag, a następnie dekwantyzuje je z powrotem do formy o wyższej precyzji na potrzeby mnożenia. Pomaga to w decode i w problemach z mieszczeniem się w pamięci. Prefill ograniczony obliczeniami może zyskać niewiele, ponieważ matematyka macierzowa nadal działa w 16 bitach.
W8A8 kompresuje wagi oraz tensory aktywacji używane przez obsługiwane kernele mnożenia macierzy. Jeśli sprzęt ma natywne rdzenie tensorowe niskiej precyzji, silnik serwujący może wykonywać mnożenie macierzy bezpośrednio w FP8 lub INT8. FP8 może więc pomóc w serwowaniu o wysokiej przepustowości, zmniejszając ruch pamięci i korzystając z szybszej arytmetyki. KV cache ma własne ustawienie przechowywania, więc sprawdź osobno typ danych cache lub implementację cache w runtime.
W przebiegu zapisanym w repozytorium towarzyszącym (RTX 4090, vLLM 0.23.0, jedno powtórzenie z 64 wygenerowanymi token) Qwen3-8B z dynamiczną kwantyzacją FP8 online w vLLM wygenerował 122 tok/s wobec 85 tok/s dla BF16 i załadował 8,8 GiB wag zamiast 15,3 GiB. Dodanie FP8 KV cache obniżyło wynik do 49 tok/s. Przebieg jest zbyt krótki, by ustalać na jego podstawie pojemność, ale pokazuje, że każde ustawienie wymaga własnego pomiaru.
5. Algorytmy a kernele runtime
Algorytmy kwantyzacji (takie jak GPTQ czy AWQ) określają, jak wagi modelu są odwzorowywane na niższą precyzję. Kernele runtime (takie jak Marlin czy własne kernele vLLM) to niskopoziomowy kod GPU, który wykonuje mnożenie macierzy. Mocno skompresowany model będzie szybki tylko wtedy, gdy istnieje zoptymalizowany kernel dla jego konkretnego formatu kwantyzacji.
Przepis serwowania wskazuje po jednym elemencie z każdej warstwy: algorytm (GPTQ, AWQ), format checkpoint (compressed-tensors, GGUF), runtime (vLLM, llama.cpp) i kernel (Marlin). Ten sam checkpoint AWQ może działać z bardzo różną prędkością, zależnie od kernela.
Wykres zestawia każdy 4-bitowy checkpoint z kernelem Marlin i bez niego w jednym opublikowanym benchmarku. Tabela poniżej dodaje perpleksję i TTFT.
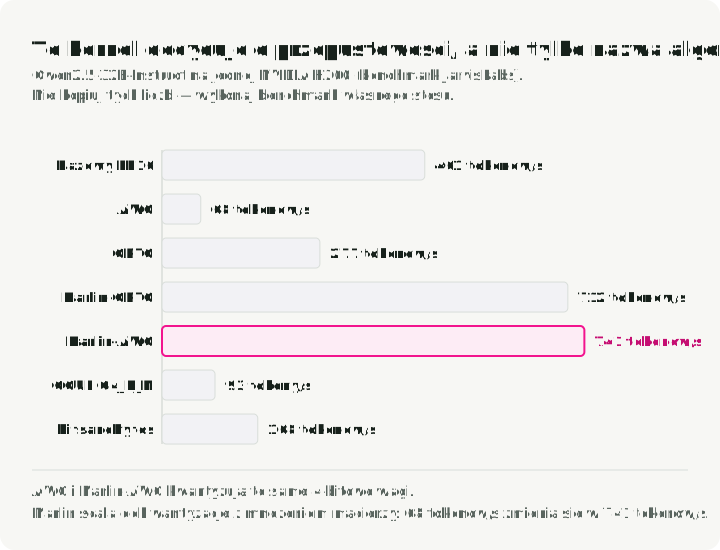
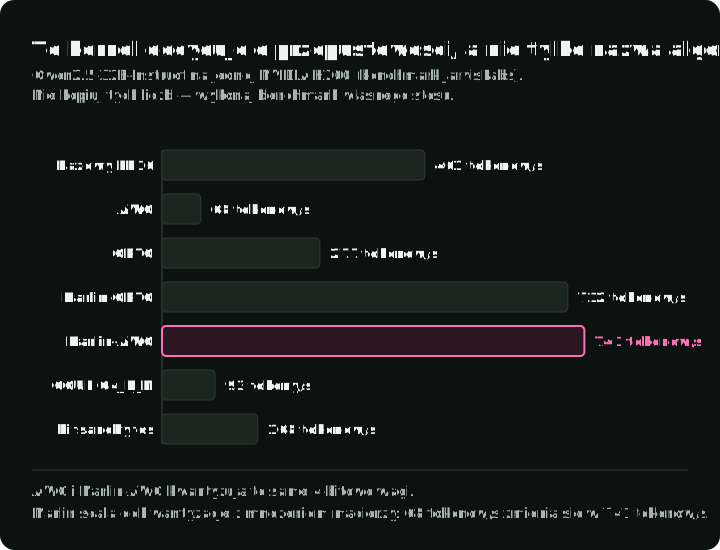
Benchmark vLLM od JarvisLabs uruchomił Qwen2.5-32B-Instruct na NVIDIA H200. Perpleksja mierzy, jak dobrze model przewiduje tekst testowy; niższa wartość jest lepsza. HumanEval pass@1 mierzy skuteczność w zadaniach kodowych przy jednym wygenerowanym rozwiązaniu. Output tokens/s mierzy przepustowość generowania, a mean TTFT średni czas oczekiwania na pierwszy token wyjściowy:
| Kwantyzacja / kernel | Perpleksja Wikitext-2 ↓ | HumanEval pass@1 ↑ | Output tokens/s | Mean TTFT |
|---|---|---|---|---|
| FP16 baseline | 6.56 | 56.1% | 461 tok/s | 57.7 ms |
| AWQ | 6.84 | 51.8% | 68 tok/s | 277.8 ms |
| GPTQ | 6.90 | 46.3% | 277 tok/s | 107.1 ms |
| Marlin-GPTQ | 6.97 | 45.7% | 712 tok/s | 51.9 ms |
| Marlin-AWQ | 6.84 | 51.8% | 741 tok/s | 73.5 ms |
| GGUF Q4_K_M | 6.74 | 51.8% | 93 tok/s | 958.0 ms |
| bitsandbytes | 6.67 | 51.8% | 168 tok/s | 135.3 ms |
Test prędkości dostawcy używa 200 prompt ShareGPT, maksymalnej współbieżności 10 i ziarna 42. Jakość pochodzi z osobnych przebiegów Wikitext-2 i HumanEval. Raport nie podaje wersji vLLM ani rewizji modeli, więc są to wyniki zgłoszone przez dostawcę, a nie niezależnie odtworzone porównanie. Pokazują węższy wniosek: nazwa algorytmu w checkpoint nie mówi, jak szybkie będzie serwowanie.
Na przykład AWQ i Marlin-AWQ używają tych samych 4-bitowych wag. Implementacja Marlin jest znacznie szybsza, ponieważ jej kernel CUDA łączy dekwantyzację i mnożenie macierzy w jedną, mocno zoptymalizowaną operację GPU.
Do własnego porównania najpierw utwórz lub pobierz checkpoint AWQ zgodny z vLLM pod poniższą ścieżką; te polecenia nie kwantyzują modelu. Zainstaluj build vLLM obsługiwany przez Twoje GPU, a następnie uruchom serwer w jednym terminalu:
vllm serve ./outputs/Qwen2.5-32B-Instruct-AWQ-W4A16 \
  --served-model-name qwen2.5-32b-awq \
  --host 127.0.0.1 \
  --port 8000
Zostaw ten serwer uruchomiony. W drugim terminalu użyj vllm bench serve z prawdziwym tokenizerem, podanym osobno od aliasu modelu w API:
vllm bench serve \
  --backend openai \
  --base-url http://127.0.0.1:8000 \
  --endpoint /v1/completions \
  --model qwen2.5-32b-awq \
  --tokenizer Qwen/Qwen2.5-32B-Instruct \
  --dataset-name random \
  --num-prompts 200 \
  --random-input-len 1024 \
  --random-output-len 256 \
  --random-range-ratio 0 \
  --max-concurrency 10 \
  --seed 42
To syntetyczny test obciążeniowy, w którym każde żądanie ma około 1024 token wejściowych i 256 wyjściowych. Nie odtwarza on tabeli ShareGPT ani nie testuje jakości. Powtórz go dla baseline’u i każdego przygotowanego checkpoint z tym samym tokenizerem, długościami, ziarnem i współbieżnością. Zapisz rzeczywiste liczby token i zainstalowaną wersję vLLM. Te przykłady poleceń wymagają przygotowanego checkpoint i docelowego GPU.
Śledź przepustowość, TTFT, opóźnienie między token (czas między kolejnymi token), zużycie pamięci i jakość zadań. Gdy część z tych wskaźników zmienia się w przeciwnych kierunkach, ten kompromis trzeba zauważyć przed wdrożeniem.
Porównanie algorytmów kwantyzacji
Te metody rozwiązują różne problemy kompresji:
| Algorytm | Typowy format | Co stara się zachować | Główny koszt |
|---|---|---|---|
| GPTQ | W4A16 | Wyjście warstwy, na podstawie estymat Hessjanu, jak zmiana wag wpływa na błąd wyjścia | Wolna kalibracja i bardziej złożone przetwarzanie |
| AWQ | W4A16 / W4A8 | Ważne kanały aktywacji | Wymaga kalibracji i połączonych kerneli serwowania |
| SmoothQuant | W8A8 | Zachowanie aktywacji INT8 przez przeniesienie skali wartości odstających do wag | Strojenie skal dla każdego modelu |
| QuaRot / SpinQuant | W4A4 / W4A8 | Mniejszy wpływ wartości odstających aktywacji dzięki rotacjom | Złożoność rotacji w runtime |
| HQQ | W4A16 / W2A16 | Szybka kompresja samych wag bez kalibracji | Przy bardzo niskiej liczbie bitów jakość wymaga kontroli na zadaniach końcowych |
| QLoRA (NF4) | NF4 | Pamięć potrzebna do treningu adapterów | Niezbyt dobry wybór domyślny do serwowania |
| K-quanty / IQ-quanty GGUF w llama.cpp | Mieszane niskobitowe kodowania tensorów | Jakość lokalnej inferencji na bajt | Nie zaprojektowano do serwowania wsadowego w chmurze |
| RTN (round-to-nearest) | W8A16 / FP8 | Nic poza skalą; bez danych kalibracyjnych | Duża strata jakości przy 4 bitach; używaj jako baseline’u |
| FP8 dynamic | W8A8 FP8 | Zakres aktywacji na token w runtime; bez danych kalibracyjnych | Wymaga rdzeni tensorowych FP8; starsze GPU mogą nie przyspieszyć |
AutoGPTQ został zarchiwizowany w kwietniu 2025, a AutoAWQ został zarchiwizowany i oficjalnie wycofany w maju 2025. Dla nowych checkpoint compressed-tensors obsługiwanych przez vLLM zacznij od llm-compressor. Użyj GPTQModel, gdy potrzebujesz aktywnej ścieżki GPTQ z Marlin, Machete, opcjami pamięci dla MoE lub offloadem na dysk.
Przycinanie i destylacja również obniżają koszt serwowania, ale w osobnych procesach. Rzadkość strukturalna 2:4 usuwa wagi według wzorca, który mogą wykorzystać rzadkie rdzenie tensorowe NVIDIA. Destylacja trenuje mniejszy model-ucznia, aby naśladował większy, co może dobrze działać w wąskich zadaniach. Włącz którąkolwiek z tych ścieżek do listy kandydatów tylko wtedy, gdy projekt udźwignie dodatkową pracę nad przycinaniem lub treningiem.
6. Pamięć serwowania to więcej niż wagi
Skompresowany checkpoint to tylko część pamięci zajmowanej podczas serwowania. Zanim zdecydujesz, czy kwantyzacja wag wystarczy, oszacuj cały runtime. PagedAttention wskazuje KV cache jako duży składnik pamięci serwowania.
Kwantyzacja offline może być ograniczona do jednej warstwy naraz. Narzędzia takie jak llm-compressor potrafią załadować blok transformera, wykonać kalibrację i obliczenia kwantyzacji, zapisać skompresowany blok i przejść dalej. Dzięki temu szczytowe użycie pamięci GPU jest bliższe największej aktywnej warstwie plus buforom kalibracji. Nadal potrzebujesz RAM-u CPU i miejsca na dysku na źródłowy checkpoint, ale GPU nie zawsze musi przechowywać cały model BF16.
Szczytowe użycie pamięci GPU podczas kwantyzacji offline może wyglądać mniej więcej tak:
Rysunek przedstawia oba budżety w jednej skali, z szacunkiem dla Qwen3-8B W4A16 z repozytorium towarzyszącego z sekcji 9. Lewy panel to zadanie offline; prawy to to, co musi pozostać na GPU podczas serwowania.
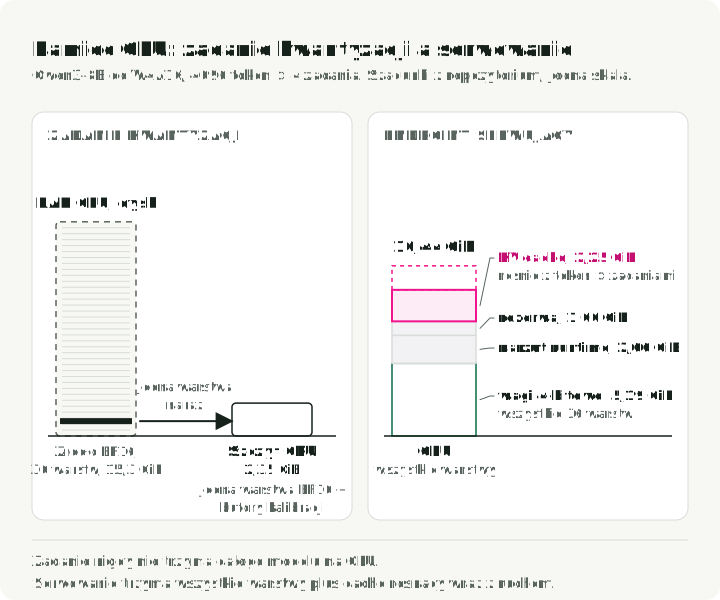
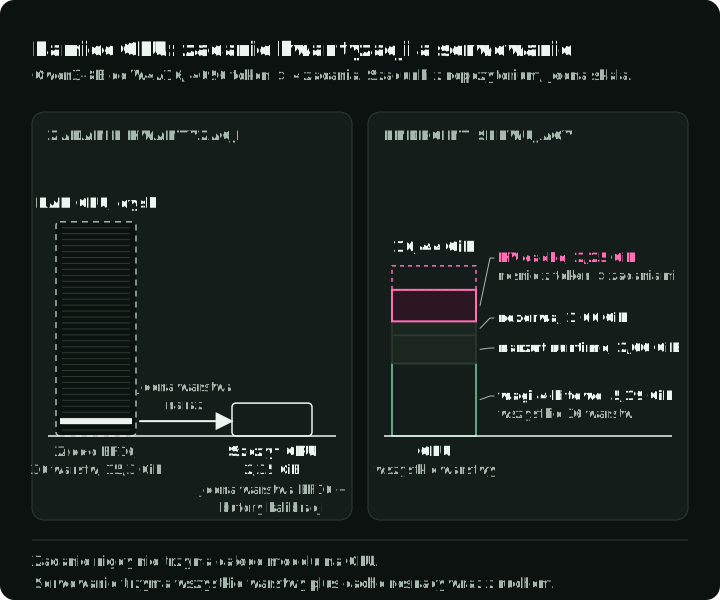
Przy serwowaniu w całości na GPU wszystkie skompresowane wagi muszą zmieścić się w serwujących GPU razem z KV cache i buforami runtime’u. Offload wag zmniejsza zajętość GPU kosztem transferów. KV cache rośnie wraz z długością kontekstu i liczbą aktywnych żądań w batchu. Dla jednolitych warstw uwagi i żądań równej długości jego rozmiar danych wynosi w przybliżeniu:
Ta estymata pomija narzut alokatora, metadane skal cache i współdzielone prefiksy. Dla żądań o różnej długości zastąp sumą ich długości w cache.
Gdzie:
- to liczba warstw.
- to liczba głowic uwagi key-value. Grouped-query attention zmniejsza ją, pozwalając wielu głowicom zapytań współdzielić mniej głowic KV.
- to wymiar każdej głowicy, często 128 lub 256.
- to token prompt plus wygenerowane token.
- to aktywny batch serwowania.
- wynosi 2 dla BF16 lub FP16 i 1 dla FP8 lub INT8. Tryb FP8 KV cache w vLLM to przykład stosu serwowania, którego używa ten artykuł.
Kwantyzacja KV cache zmienia przechowywanie, a ponowne użycie zmienia alokację
KV cache można kwantyzować podczas inferencji. Każdy krok decode wytwarza tensory aktywacji K i V dla nowego token. Model W8A8 może już używać FP8 lub INT8 dla obsługiwanych obliczeń projekcji, ale cache pozostaje osobnym obiektem przechowywania.
Wiele stosów serwowania trzyma ten obiekt w typie danych modelu lub cache. Aby to zmienić, włącz typ danych KV cache, użyj checkpoint ze skalami cache lub wybierz skwantyzowaną implementację cache.
Gdy kwantyzacja KV cache jest włączona, silnik zapisuje wpisy jako reprezentację o niższej precyzji plus skale. Późniejsza uwaga albo dekwantyzuje cache wewnątrz swojego kernela, albo, w niektórych backendach, wykonuje część operacji uwagi w domenie skwantyzowanej.
Stabilna dokumentacja Quantized KV Cache w vLLM udostępnia to wprost przez kv_cache_dtype="fp8" lub --kv-cache-dtype fp8. vLLM obsługuje formaty cache FP8 E4M3 i E5M2 oraz strategie skal na tensor i na głowicę uwagi. Może używać skal domyślnych lub kalibracji na zbiorze danych przez llm-compressor. Z FlashAttention 3 vLLM może też wykonywać operacje uwagi w domenie FP8, kwantyzując oprócz kluczy i wartości także zapytania. Aby włączyć cache FP8 dla modelu:
vllm serve Qwen/Qwen3-8B --kv-cache-dtype fp8 --max-model-len 32768TensorRT-LLM udostępnia FP8 KV cache przez KvCacheConfig(dtype='fp8') i wymienia FP8 KV cache oraz NVFP4 KV cache jako przepisy kwantyzacji odrębne od kwantyzacji wag i aktywacji. Hugging Face Transformers ma również ścieżkę QuantizedCache przez cache_implementation="quantized", przy czym hqq obsługuje formaty cache int2, int4 i int8, a quanto obsługuje int2 i int4.
Zwykły KV caching przechowuje wcześniejsze klucze i wartości, by nie przeliczać ich ponownie. Prefix caching ponownie wykorzystuje bloki cache w różnych żądaniach z tym samym prefiksem. PagedAttention zmniejsza fragmentację i usprawnia alokację, a offload KV przenosi bloki cache między poziomami pamięci. Te kombinacje zależą od runtime’u. QuantizedCache w Hugging Face nie obsługuje offloadu. vLLM dokumentuje swój skwantyzowany KV cache osobno od prefix cachingu i innych funkcji zarządzania cache. Każdą kombinację sprawdź w runtime’ie, który wdrażasz.
Ryzyko dla jakości też różni się od PTQ samych wag. Kwantyzacja KV cache wprowadza błąd do stanu uwagi odczytywanego w każdym kolejnym kroku decode. Przetestuj osobno wyszukiwanie w długim kontekście, zachowanie w wielu turach, bezpieczeństwo i odmowy, format korzystania z narzędzi oraz opóźnienie wyjścia. KVQuant, KIVI i badanie FP8 KV cache w vLLM oceniają kwantyzację KV cache jako odrębny problem.
Przykład pokazuje, kiedy cache staje się większy niż wagi. Weźmy Llama-3.1-70B (80 warstw, 8 głowic KV, wymiar głowicy 128) obsługującą 8 żądań po 32 768 token:
def kv_cache_gb(layers, kv_heads, head_dim, tokens, batch, bytes_per_value):
    return 2 * layers * kv_heads * head_dim * tokens * batch * bytes_per_value / 1e9

# Llama-3.1-70B: 80 layers, 8 KV heads, head dimension 128
for name, nbytes in [("BF16", 2), ("FP8", 1)]:
    print(name, round(kv_cache_gb(80, 8, 128, 32_768, 8, nbytes), 1), "GB")
Wypisuje BF16 85.9 GB i FP8 42.9 GB. Przy tym obciążeniu cache BF16 (86 GB) jest większy niż wagi INT4: około 40 GB po doliczeniu skal grup i 16-bitowych embeddings, wobec 35 GB, które tabela z sekcji 7 podaje dla samych wartości 4-bitowych. FP8 cache oszczędza 43 GB; przejście wag z BF16 na INT4 oszczędza około 100 GB. Najpierw więc kwantyzuje się tu wagi, a cache jest największym pozostałym składnikiem. Wykres układa wagi i cache w stos po każdym kroku.
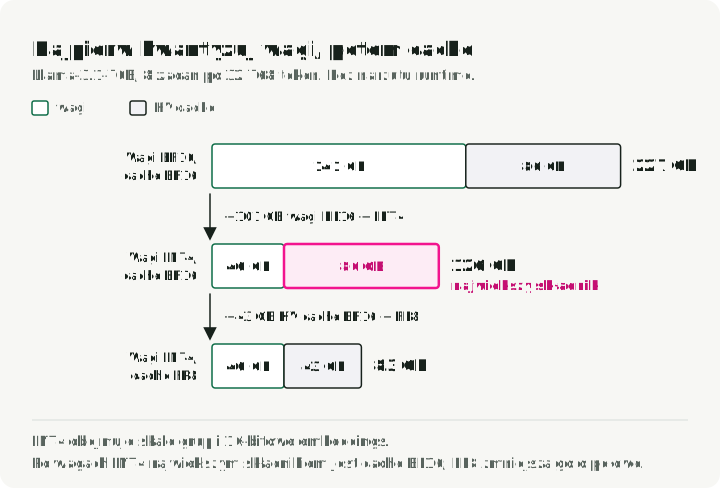
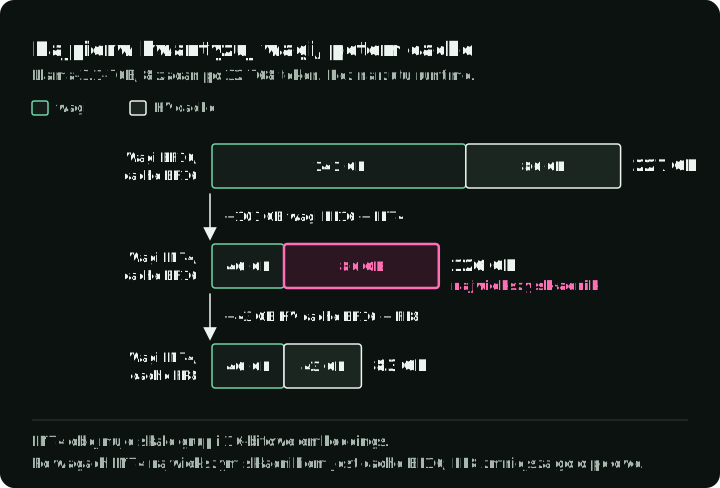
Porównaj, ile pamięci oszczędziłaby każda zmiana w Twoim modelu. Użyj powyższego równania cache z tym samym batchem i długością kontekstu dla obecnego i proponowanego typu danych cache. Odejmij proponowany rozmiar od obecnego. To samo zrób dla dwóch rozważanych formatów wag. Na przykład porównaj oszczędność z przejścia z BF16 na FP8 cache z oszczędnością z przejścia wag z BF16 na INT4. Najpierw przetestuj opcję o większej szacowanej oszczędności, o ile runtime ją obsługuje. Następnie zmierz rzeczywiste zużycie pamięci i jakość; żadna z estymat nie uwzględnia wszystkich alokacji runtime’u.
7. Rozmiar wag i wsparcie GPU
Rozmiar wag łatwo oszacować na podstawie liczby parametrów i precyzji przechowywania, tą samą metodą co w omówieniach pamięci serwowania wokół KV cache:
| Rozmiar modelu | Wagi BF16 | Wagi FP8 / INT8 | Wagi INT4 |
|---|---|---|---|
| 7B / 8B | ~14-16 GB | ~7-8 GB | ~3,5-4 GB |
| 14B | ~28 GB | ~14 GB | ~7 GB |
| 32B / 34B | ~64-68 GB | ~32-34 GB | ~16-17 GB |
| 70B | ~140 GB | ~70 GB | ~35 GB |
| 109B MoE | ~218 GB łącznie | ~109 GB | ~55 GB |
Kolumna INT4 liczy tylko wartości 4-bitowe. Skale grup dodają kilka procent, a embeddings i lm_head trzymane w 16 bitach dodają więcej. W Qwen3-8B te dwie macierze zajmują po około 1,2 GB w BF16. Estymata W4A16 z repozytorium towarzyszącego, 5,19 GiB, utrzymuje 12% parametrów w 16 bitach, aby je uwzględnić.
Przy ustalonym budżecie pamięci większy model w 4 bitach może pokonać mniejszy model w 16 bitach. Dettmers i Zettlemoyer stwierdzili, że precyzja 4-bitowa jest niemal zawsze optymalna pod względem dokładności zero-shot na łączny bit modelu, dla modeli BLOOM, OPT, Pythia i GPT-2 od 19M do 176B parametrów. Badanie mierzyło tylko dokładność zero-shot, więc przed wyborem przetestuj własne zadania.
Modele mixture-of-experts mogą aktywować mniej parametrów na token, ale pełny zestaw wag nadal musi gdzieś leżeć, chyba że runtime obsługuje offload. Macierz wsparcia kwantyzacji TensorRT-LLM traktuje rodziny modeli MoE jako cele wdrożenia z własnymi obsługiwanymi przepisami.
Sprzęt wdrożeniowy ogranicza, które formaty kwantyzacji są dostępne:
- Serwowanie na CPU zależy od instrukcji wektorowych, takich jak AVX-512 lub AMX. Praktyczną ścieżką jest plik GGUF ładowany przez
llama.cpp. - Apple Silicon używa pamięci zunifikowanej, więc lokalne modele mogą korzystać z dużej wspólnej puli RAM zamiast dedykowanego VRAM. GGUF i
llama.cpppozostają popularną lokalną ścieżką runtime, ponieważ GGUF jest zbudowany dla executorów GGML. MLX to druga popularna ścieżka:mlx_lm.convert --model <model> -qdomyślnie zapisuje model MLX 4-bitowy, a--q-bits 8zapisuje 8-bitowy. Przed wyborem porównaj szybkość i jakość na tych samych prompt. - NVIDIA Ampere obsługuje ścieżki serwowania INT8 na rdzeniach tensorowych, ale nie natywną matematykę FP8 W8A8 na rdzeniach tensorowych. Typowe wybory to kwantyzacja samych wag W4A16 lub statyczne INT8, zgodnie z macierzą wsparcia sprzętowego TensorRT-LLM.
- NVIDIA Ada i Hopper obsługują ścieżki serwowania FP8 w TensorRT-LLM. Serwowanie FP8 W8A8 warto na tych GPU przetestować.
- NVIDIA Blackwell dodaje NVFP4 i wsparcie mikroskalowania, ale ścieżka programowa nadal ma znaczenie. Wczesne stosy niskobitowych formatów zmiennoprzecinkowych traktuj jako zależne od wersji.
8. Kalibracja i ewaluacja przed wdrożeniem
Model, który się ładuje, przeszedł jedynie test wstępny. Wdrożenie wymaga kontroli jakości i serwowania dla docelowego obciążenia. Najnowsze ewaluacje kwantyzacji podają różne wyniki dla serwowania LLM, zadań w długim kontekście i modeli silnie rozumujących.
Rysunek pokazuje, dokąd trafiają próbki kalibracyjne, a dokąd próbki ewaluacyjne wyłączone ze zbioru kalibracyjnego.
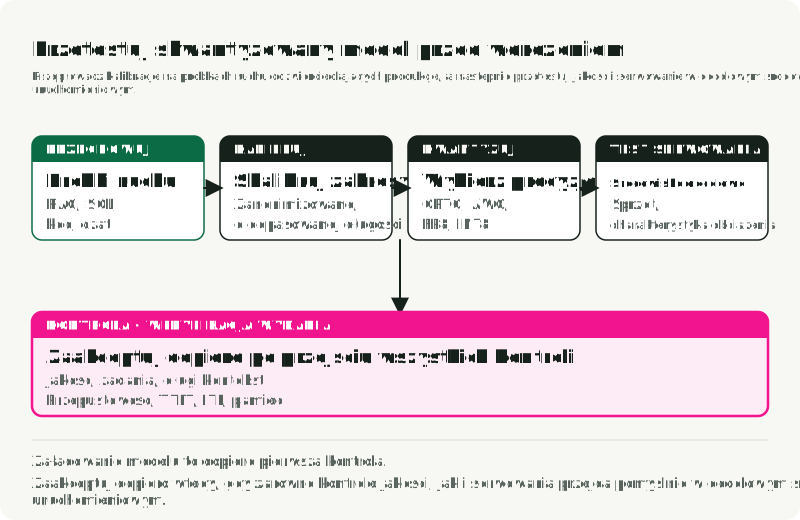
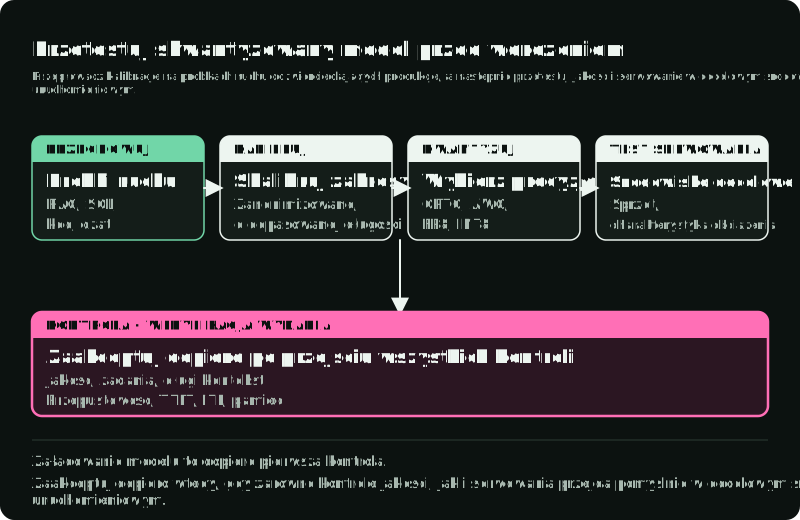
Najpierw wybierz przepis. Gdy wymaga on kalibracji, użyj prompt podobnych do produkcyjnych. HQQ i FP8 dynamic, na przykład, nie potrzebują zbioru kalibracyjnego, więc rysunek pokazuje ścieżkę pomijającą kalibrację. Przykłady ewaluacyjne trzymaj osobno od próbek kalibracyjnych, aby końcowe porównanie testowało zachowanie na danych odłożonych do ewaluacji. Dla przepisów wymagających kalibracji:
- Uwzględnij ślady RAG, zapytania SQL, historie agentów, zadania kodowe, ładunki wywołań narzędzi i prompt systemowe z docelowego obciążenia. Statyczne PTQ zależy od tego, czy dane kalibracyjne odpowiadają rozkładowi produkcyjnemu.
- Dopasuj długości sekwencji. Krótkie, jednoturowe prompt nie ujawnią zachowania aktywacji w długim kontekście.
- Trzymaj
embed_tokensilm_headw wyższej precyzji, jeśli metoda lub runtime na to pozwala; to częsty wzorzec wyłączeń w przepisach LLM Compressor. - Użyj dość próbek, by ustabilizować zakresy aktywacji. Przykład KV cache w vLLM ustawia
NUM_CALIB_SAMPLES = 512. Traktuj to jako jeden udokumentowany przykład, a nie uniwersalną liczbę. Właściwa liczba próbek zależy od metody, modelu, długości sekwencji i obciążenia produkcyjnego. - Zanim użyjesz logów produkcyjnych, usuń z nich sekrety i prywatne dane użytkowników.
W ewaluacji testuj zarówno jakość języka, jak i zachowanie serwowania:
- Perpleksja na standardowym korpusie wychwytuje ogólne pogorszenie jakości języka, ale benchmark JarvisLabs dobrze przypomina, że perpleksja i przepustowość mogą zmieniać się inaczej.
- Zadania domenowe wychwytują awarie, które perpleksja ukrywa. Użyj HumanEval do kodowania, MMLU do wiedzy ogólnej oraz AIME lub MATH-500 do rozumowania matematycznego, gdy te dziedziny mają znaczenie.
- Kontrole formatu mają znaczenie w systemach agentowych. Testuj zgodność z JSON Schema, wyjście w markdown, kształt wywołań narzędzi i zachowanie przy odmowach, ponieważ ewaluacje skwantyzowanych modeli mogą przeoczyć awarie na poziomie aplikacji, nawet gdy zbiorcza dokładność w benchmarkach wygląda stabilnie.
- Testy długiego kontekstu wychwytują szkody od kwantyzacji KV cache. Needle-in-a-haystack jest prymitywny, ale wyniki kwantyzacji w długim kontekście pokazują, dlaczego takie kontrole powinny poprzedzać wdrożenie.
- Testy obciążeniowe powinny raportować przepustowość, TTFT, opóźnienie między token, utrzymywalną współbieżność i szczytowe użycie pamięci GPU.
vllm bench servemierzy przepustowość i opóźnienie. Pamięć GPU zbieraj osobno, z telemetrii GPU lub serwera. Zmieniaj współbieżność względem założonych limitów opóźnienia i błędów, by znaleźć poziom utrzymywalny; współbieżność zaobserwowana w jednym przebiegu nie ustala pojemności.
W aplikacji RAG przy porównywaniu generatora bazowego i skwantyzowanego trzymaj stałe pytania i pobrane dowody. Takie porównanie izoluje zmianę generatora. Następnie uruchom cały potok, aby sprawdzić wynik serwowania, korzystając z przewodnika po ewaluacji RAG, by odróżnić błędy wyszukiwania od odpowiedzi bez pokrycia w źródłach. W przypadku agenta sprawdź też, czy te same zadania kończą się poprawnymi wywołaniami narzędzi i akceptowalnymi skutkami ubocznymi. Sam mniejszy checkpoint nie odpowiada na żadne z tych pytań.
Modele rozumujące testuj na zadaniach wieloetapowych. Kwantyzacja poniżej 4 bitów lub W4A4 bez rotacji może pogorszyć dokładność rozumowania, nawet gdy bazowa perpleksja wygląda stabilnie; to główne ostrzeżenie badania skwantyzowanych modeli rozumujących.
9. Przepływ pracy z repozytorium towarzyszącym
Repozytorium towarzyszące, slavadubrov/model-compression-demo, czyni proces decyzyjny powtarzalnym. Używa uv i skupia się na planowaniu, przepisach, próbnych przebiegach (dry run) oraz konfiguracjach benchmarków opartych na tych samych źródłach co ten artykuł: vLLM, LLM Compressor, TensorRT-LLM i prace o algorytmach.
Sklonuj je i sprawdź obsługiwane algorytmy:
git clone https://github.com/slavadubrov/model-compression-demo.git
cd model-compression-demo
git checkout 62da4539793ac3a93e94e8551a063c7681561099
uv run python demo.py list-algorithms
Te polecenia planowania używają tylko biblioteki standardowej Pythona. Zacznij od planowania i szacowania rozmiaru:
uv run python demo.py plan \
  --model-preset qwen3-8b \
  --goal fit-memory \
  --hardware ampere \
  --context 4096 \
  --concurrency 4

uv run python demo.py estimate \
  --model-preset qwen3-8b \
  --scheme w4a16 \
  --context 4096 \
  --concurrency 4
plan wybiera dla tego celu GPTQ W4A16 i wypisuje dwa budżety z sekcji 6: docelowe 10,44 GiB na serwowanie oraz szczytowe 2,35 GiB na GPU dla zadania kwantyzacji warstwa po warstwie. estimate rozbija budżet serwowania na składniki:
Architecture:     Qwen3 8B (built-in preset from official Hugging Face config)
Layers/hidden/KV: 36 / 4096 / 0.250
Note:             Causal text-generation checkpoint suitable for the text-only harness.
Scheme:           w4a16
Weights:          5.19 GiB
KV cache:         2.25 GiB
Runtime overhead: 2.00 GiB
Safety buffer:    1.00 GiB
Total target:     10.44 GiB
Weights i KV cache to pierwsze dwa składniki równania pamięci serwowania z sekcji 6. Runtime overhead i Safety buffer to zapas przyjęty w repozytorium towarzyszącym na aktywacje i narzut silnika. Linia KV cache to wzór na cache dla Qwen3-8B z 36 warstwami, 8 głowicami KV i wymiarem głowicy 128 przy 4096 token i 4 równoległych żądaniach.
Następnie wypisz przepis i podejrzyj kwantyzację, zanim zużyjesz czas GPU:
uv run python demo.py recipe --algorithm gptq-w4a16

uv run python demo.py quantize \
  --algorithm gptq-w4a16 \
  --model Qwen/Qwen3-8B \
  --dry-run
Polecenie recipe wypisuje kod llm-compressor, który uruchamia krok kwantyzacji:
from llmcompressor import oneshot
from llmcompressor.modifiers.quantization import GPTQModifier

recipe = GPTQModifier(
    scheme="W4A16",
    targets="Linear",
    ignore=["lm_head"],
)

oneshot(
    model="Qwen/Qwen3-8B",
    dataset="wikitext",
    dataset_config_name="wikitext-2-raw-v1",
    recipe=recipe,
    output_dir="outputs/Qwen3-8B-W4A16",
    max_seq_length=4096,
    num_calibration_samples=256,
)
targets i ignore decydują, które warstwy dostają wagi 4-bitowe; num_calibration_samples i max_seq_length to wybory kalibracyjne z sekcji 8. WikiText to domyślny zbiór do testu wstępnego; dla prawdziwego checkpoint podaj --calibration-file z prompt podobnymi do produkcyjnych.
Przepis GPTQ zapisuje checkpoint compressed-tensors. GPTQ to algorytm, a nie format checkpoint, więc vLLM rozpoznaje format z samego checkpoint, bez flagi --quantization, jak w oficjalnym przykładzie W4A16.
Aby skwantyzować, uruchom make install-compression. vLLM potrzebuje własnego środowiska, ponieważ jego zależności kolidują z llm-compressor: uruchom make install-serving, a potem używaj .venv-vllm/bin/vllm dla poleceń serve i bench.
Serwuj i testuj każdy checkpoint względem baseline’u RTN W8A16 z tabeli algorytmów. Uruchom quantize bez --dry-run dla gptq-w4a16 i rtn-w8a16, aby zapisać outputs/Qwen3-8B-W4A16 i outputs/Qwen3-8B-W8A16. Polecenie benchmark-plan z repozytorium towarzyszącego zapisuje do pliku JSON polecenie serwowania i polecenie benchmarku dla każdego checkpoint. Aby przeprowadzić porównanie ręcznie, uruchom serwer W4A16 w jednym terminalu:
.venv-vllm/bin/vllm serve outputs/Qwen3-8B-W4A16 --host 127.0.0.1 --port 8000W drugim terminalu uruchom to samo syntetyczne obciążenie co w sekcji 5:
.venv-vllm/bin/vllm bench serve \
  --backend openai \
  --base-url http://127.0.0.1:8000 \
  --endpoint /v1/completions \
  --model outputs/Qwen3-8B-W4A16 \
  --tokenizer Qwen/Qwen3-8B \
  --dataset-name random \
  --num-prompts 200 \
  --random-input-len 1024 \
  --random-output-len 256 \
  --random-range-ratio 0 \
  --max-concurrency 10 \
  --seed 42
Zatrzymaj serwer, a potem uruchom oba polecenia ponownie z outputs/Qwen3-8B-W8A16, czyli baseline’em RTN W8A16, zamiast outputs/Qwen3-8B-W4A16.
Na koniec porównaj model bazowy i skompresowany względem jawnych progów:
uv run python demo.py quality-eval \
  --base-model Qwen/Qwen3-8B \
  --compressed-model outputs/Qwen3-8B-W4A16 \
  --mode all \
  --lm-eval-task hellaswag \
  --lm-eval-limit 50 \
  --max-perplexity-delta-pct 5 \
  --output-json reports/qwen3-8b-w4a16-quality.json
Wykonuj pracę po kolei: zaplanuj cel, oszacuj pamięć, przepuść przepis w trybie dry run, przetestuj serwowanie, a potem porównaj jakość z progami. Ta kolejność odpowiada rozdzieleniu w tym artykule między szacowaniem pamięci, benchmarkowaniem runtime’u i ewaluacją jakości.
10. Modele dyfuzyjne wymagają osobnej ścieżki
Potoki dyfuzyjne i diffusion-transformer mają inne zachowanie aktywacji niż autoregresyjne LLM. SVDQuant traktuje kwantyzację modeli dyfuzyjnych jako osobny problem wartości odstających aktywacji.
Autoregresyjne LLM generują jeden token naraz. Modele dyfuzyjne wykonują powtarzane kroki odszumiania, a rozkłady ich aktywacji zmieniają się w trakcie procesu, co Q-Diffusion opisuje dla wyjść sieci odszumiającej w kolejnych krokach czasowych. Standardowa 4-bitowa kwantyzacja LLM może zaoszczędzić pamięć modelu dyfuzyjnego, a jednocześnie wprowadzić poważne artefakty wizualne. Metody nastawione na dyfuzję, takie jak SVDQuant / Nunchaku i kwantyzacja dyfuzji w NVIDIA ModelOpt, odpowiadają na ten odmienny wzorzec aktywacji.
W potoku latent diffusion enkoder tekstu reprezentuje prompt. Sieć odszumiająca, taka jak diffusion transformer (DiT) lub U-Net, wielokrotnie aktualizuje skompresowaną reprezentację obrazu zwaną latentem. Variational autoencoder (VAE) przekształca te reprezentacje latentne w obrazy i z powrotem. Te komponenty pełnią różne role, więc ich precyzję testuj osobno.
Poniższe zasady traktuj jako ostrożne heurystyki, a nie uniwersalne ustawienia domyślne. Potok, komponent, model i runtime wymagają osobnych testów:
- Przy pierwszym porównaniu trzymaj VAE w 16 bitach. Niższą precyzję testuj tylko wtedy, gdy metoda i docelowy potok ją potwierdzają.
- Najpierw spróbuj szkieletu DiT lub U-Net, ponieważ często ma największy udział parametrów. Sprawdź pamięć, opóźnienie i jakość obrazu dla docelowego potoku. Metody kwantyzacji dyfuzji przyjmują to samo podejście na poziomie komponentów.
- Enkodery tekstu traktuj osobno. Kwantyzacja T5-XXL lub CLIP może wpłynąć na zgodność z prompt lub renderowanie tekstu w danym potoku, więc oceń je niezależnie, zamiast zakładać zachowanie typowe dla transformerów.
- Używaj metod uwzględniających dyfuzję, takich jak SVDQuant, gdy głównym problemem są wartości odstające aktywacji.
- Oceniaj na obrazach, a nie metrykach tekstowych. Sprawdź zgodność z prompt, renderowanie tekstu, odcienie skóry, balans kolorów, drobne szczegóły, opóźnienie i VRAM. Aby porównać z potokiem 16-bitowym, zmierz LPIPS lub PSNR między sparowanymi obrazami (to samo ziarno) oraz CLIP score lub ImageReward dla zgodności z prompt, jak w ewaluacji SVDQuant. Potem przejrzyj trudne przypadki na oko.
Jeśli zbiór ewaluacyjny zawiera tylko proste lub typowe prompt, przeoczysz awarie w przypadkach brzegowych. Dodaj trudne przypadki: mały tekst, dłonie, powtarzające się obiekty, ustrukturyzowane układy i prompt z ograniczeniami negatywnymi, ponieważ awarie kwantyzacji dyfuzji widać na obrazie, a nie w perpleksji modelu językowego.
11. Domyślne ustawienia produkcyjne
Rysunek umieszcza pierwszą próbę dla każdego typu wdrożenia na osi szerokości bitowej, razem z następnym testem i warunkiem jego wykonania. Każda nadal wymaga kontroli z sekcji 8.
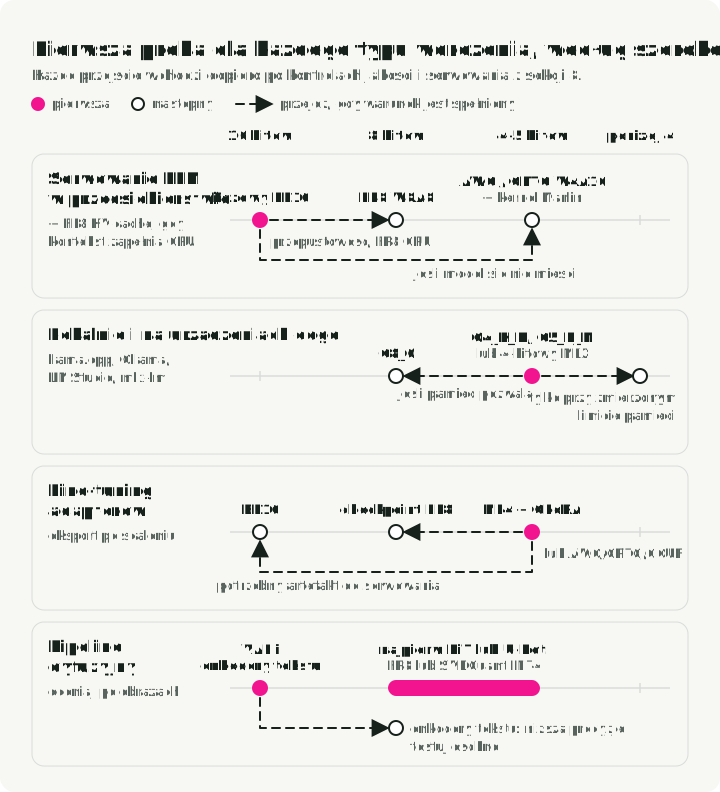
Dla serwowania LLM w przedsiębiorstwie zacznij od baseline’u BF16 w dokładnie tym silniku serwującym, którego zamierzasz użyć. Jeśli celem jest przepustowość i GPU to obsługuje, przetestuj FP8 W8A8. Jeśli model się nie mieści, przetestuj W4A16 z AWQ lub GPTQ i kernelami klasy Marlin. Jeśli długi kontekst lub współbieżność wypełnia GPU, przetestuj FP8 KV cache. Wdróż skompresowaną wersję tylko wtedy, gdy przejdą zarówno kontrole jakości, jak i serwowania.
Dla lokalnej inferencji i inferencji na urządzeniach edge zacznij od pliku GGUF z Q4_K_M lub Q5_K_M albo od 4-bitowego modelu MLX na Macu. Przejdź na Q8_0, gdy pozwala na to pamięć, i porównaj jakość zadań. Kodowań poniżej 4 bitów używaj tylko przy zmierzonym limicie pamięci.
Do fine-tuning użyj NF4 z QLoRA, aby trenować adaptery przy mniejszym zużyciu pamięci. Oceń adapter w aplikacji przed scaleniem. Po scaleniu wyeksportuj i oceń artefakt serwowania, którego potrzebujesz: plik GGUF zgodny z llama.cpp, checkpoint AWQ/GPTQ/compressed-tensors, checkpoint FP8 albo BF16.
Dla modeli dyfuzyjnych kwantyzuj najpierw odszumiacz, trzymaj VAE w 16 bitach i testuj enkodery tekstu osobno, jak w sekcji 10. Porównuj sparowane obrazy z tym samym ziarnem i przeglądaj trudne prompt na oko.
12. Uruchom następne porównanie
Zachowaj baseline BF16 i porównaj z nim jednego obsługiwanego skompresowanego kandydata na tych samych zadaniach ze zbioru odłożonego do ewaluacji i tym samym ruchu. Zanim go uruchomisz, zapisz, jaką utratę jakości i jakie opóźnienie akceptujesz. Mierz szczytową pamięć, nie tylko szybkość: użyteczny wynik to informacja, czy kandydat usuwa Twoje wąskie gardło w tych granicach.
Bibliografia
- JarvisLabs vLLM Benchmarks: JarvisLabs, vLLM Quantization Complete Guide and Benchmarks, 2026. JarvisLabs.
- Hugging Face Optimum Quantization Guide: Hugging Face, Quantization conceptual guide. Dokumentacja.
- vLLM Quantization Docs: projekt vLLM, Quantization. Dokumentacja.
- vLLM Quantized KV Cache Docs: projekt vLLM, Quantized KV Cache. Dokumentacja.
- vLLM Benchmark Docs: projekt vLLM, vllm bench serve. Dokumentacja.
- LLM Compressor Docs: projekt vLLM, LLM Compressor. Dokumentacja.
- GPTQModel: ModelCloud, GPTQModel. GitHub.
- TensorRT-LLM Quantization: NVIDIA, TensorRT-LLM Quantization. Dokumentacja.
- NVIDIA NVFP4: NVIDIA, Introducing NVFP4 for Efficient and Accurate Low-Precision Inference. Blog.
- Hugging Face QuantizedCache: Hugging Face, Cache strategies: Quantized cache. Dokumentacja.
- NVIDIA Model Optimizer: NVIDIA, Model Optimizer. GitHub.
- torchao Quantization: PyTorch, torchao quantization overview. Dokumentacja.
- bitsandbytes Quantization: Hugging Face, bitsandbytes. Dokumentacja.
- HQQ: Dropbox, Half-Quadratic Quantization. GitHub.
- PEFT: Hugging Face, Parameter-Efficient Fine-Tuning. Dokumentacja.
- Ollama: Ollama, lokalne środowisko uruchamiania modeli. Strona.
- LM Studio: LM Studio, lokalne środowisko AI. Strona.
- Status AutoGPTQ: Repozytorium AutoGPTQ, zarchiwizowane w kwietniu 2025. GitHub.
- Status AutoAWQ: Repozytorium AutoAWQ, zarchiwizowane i wycofane w maju 2025. GitHub.
- GPTQ: Frantar et al., GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, ICLR 2023. arXiv:2210.17323.
- Marlin: Frantar et al., MARLIN: Mixed-Precision Auto-Regressive Parallel Inference on Large Language Models, arXiv:2408.11743. arXiv:2408.11743.
- AWQ: Lin et al., AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration, MLSys 2024. arXiv:2306.00978.
- SmoothQuant: Xiao et al., SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models, ICML 2023. arXiv:2211.10438.
- QuaRot: Ashkboos et al., QuaRot: Outlier-Free 4-Bit Inference in Rotated LLMs, NeurIPS 2024. arXiv:2404.00456.
- SpinQuant: Meta AI Research, SpinQuant: LLM Quantization with Learned Rotations, arXiv:2405.16406. arXiv:2405.16406.
- QLoRA / NF4: Dettmers et al., QLoRA: Efficient Finetuning of Quantized LLMs, NeurIPS 2023. arXiv:2305.14314.
- SVDQuant / Nunchaku: MIT HAN Lab, SVDQuant: Absorbing Outliers by Low-Rank Components for 4-Bit Diffusion Models, ICLR 2025. arXiv:2411.05007, Nunchaku.
- vLLM PagedAttention: Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention, SOSP 2023. arXiv:2309.06180.
- Grouped-Query Attention: Ainslie et al., GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, EMNLP 2023. arXiv:2305.13245.
- vLLM FP8 KV Cache: Kubler, Kurtic, Wilkinson et al., The State of FP8 KV-Cache and Attention Quantization in vLLM, blog vLLM, kwiecień 2026. vLLM Blog.
- KIVI: Liu et al., KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache, ICML 2024. arXiv:2402.02750.
- KVQuant: Hooper et al., KVQuant: Towards 10 Million Context Length LLM Inference with KV Cache Quantization, NeurIPS 2024. arXiv:2401.18079.
- LLM Serving Evaluation: Kurtic et al., “Give Me BF16 or Give Me Death”? Accuracy-Performance Trade-Offs in LLM Quantization, ACL 2025. arXiv:2411.02355.
- Long-context Quantization Evaluation: Mekala et al., Does quantization affect models’ performance on long-context tasks?, arXiv:2505.20276. arXiv:2505.20276.
- Reasoning Evaluation: Quantization Hurts Reasoning? An Empirical Study on Quantized Reasoning Models, arXiv:2504.04823. arXiv:2504.04823.
- 2:4 Sparsity: Mishra et al., Accelerating Sparse Deep Neural Networks, arXiv:2104.08378. arXiv:2104.08378.
- k-bit Scaling Laws: Dettmers and Zettlemoyer, The case for 4-bit precision: k-bit Inference Scaling Laws, ICML 2023. arXiv:2212.09720.
- Q-Diffusion: Li et al., Q-Diffusion: Quantizing Diffusion Models, ICCV 2023. arXiv:2302.04304.
- MLX LM: Apple ml-explore, mlx-lm. GitHub.
- HumanEval: OpenAI, HumanEval. GitHub.
- MMLU: Hendrycks et al., Measuring Massive Multitask Language Understanding. arXiv:2009.03300.
- MATH-500: Hugging Face H4, MATH-500. Dataset.
- GGUF i llama.cpp: ggml-org, GGUF file format i llama.cpp. GGUF, llama.cpp.
- Hugging Face GGUF Docs: Hugging Face, GGUF. Dokumentacja.
- Repozytorium towarzyszące: slavadubrov/model-compression-demo.