Metryki ewaluacji RAG: wyszukiwanie, reranking, generowanie

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Ten przewodnik jest dla inżynierów, którzy utrzymują lub oceniają systemy retrieval-augmented generation (RAG). Wiąże awarie w parsowaniu dokumentów, filtrowaniu, wyszukiwaniu, etapie reranking i generowaniu z metryką, która każdą z nich wykrywa. Pokazuje też, które testy uruchamiać przed wydaniem, a które monitorują ruch produkcyjny.
System RAG z błędnymi filtrami trafności może działać miesiącami bez żadnego alertu operacyjnego. Nadal zwraca odpowiedzi i mieści się w celu opóźnień, ale odpowiedzi opierają się na niepełnych dowodach. Stratę ujawnia Recall@k liczony względem pierwotnego zbioru wzorcowego dokumentów dostępnych dla użytkownika. Dashboardy opóźnień i dostępności jej nie pokażą.
Chcesz przejść od razu do kodu?
Uruchamialne repozytorium
slavadubrov/rag-evals-demorozdziela wyszukiwanie na SciFact, generowanie na oznaczonych syntetycznych danych QA i kontrole offline na stałych danych testowych.make evaluruchamia wyszukiwanie, diagnostykę filtrów i odtwarzanie wyników testowych generowania pomake index.make benchmarkprzeszukuje ustawienia dzielenia na fragmenty i embeddings bez wywołań API; porównanie dwóch modeli OpenAI wymaga klucza API i flagi--live(zob. część 8). Notatniki 00–09 obejmują wyszukiwanie, filtrowanie, generowanie i przykłady systemowe. Demo używa wbudowanego Qdrant i nie wymaga Dockera.
Tabela decyzyjna ewaluacji RAG
Zacznij od tej tabeli, zanim wybierzesz framework. Właściwa metryka zależy od trybu awarii, który chcesz wykryć, a nie od nazwy narzędzia.
| Pytanie | Rodzina metryk | Stosuj, gdy | Uważaj na |
|---|---|---|---|
| Czy parsowanie zachowało źródło? | Kompletność ekstrakcji, pokrycie tabel i rysunków | Do korpusu trafiają PDF-y, slajdy, skany i strony HTML | Czysto wyglądający tekst może gubić podpisy, przypisy lub strukturę tabel |
| Czy wyszukiwanie znalazło właściwe dowody? | Recall@k, nDCG@k, MRR, context precision/recall | Możesz oznaczyć trafne chunki lub dokumenty | Twardy filtr metadanych może usunąć właściwy dokument, zanim ruszy ranking |
| Czy reranking poprawił krótką listę? | Przyrost jakości rerankera, Precision@1, różnica nDCG | Po wyszukiwaniu działają modele cross-encoder lub rankery LLM | Mierz opóźnienie i koszt razem ze wzrostem jakości |
| Czy odpowiedź wykorzystała dowody? | Faithfulness, groundedness, poparcie cytowań | Odpowiedź cytuje dokumenty lub podaje fakty z kontekstu | Faithfulness nie diagnozuje złego parsowania ani złego wyszukiwania |
| Czy system jest stabilny na produkcji? | Drift, regeneracje, fallback, opóźnienie p95, koszt odpowiedzi | Ruch zmienia się po starcie | Telemetria produkcyjna wymaga próbkowanej oceny ludzi, by pozostać skalibrowana |
Krótsze porównanie narzędzi znajdziesz w artykule Najlepsze narzędzia do ewaluacji RAG: Ragas, DeepEval i TruLens.
Część 1: Zdefiniuj sukces przed architekturą
Przygotuj zbiór ewaluacyjny przed diagramem architektury. Każdy późniejszy wybór komponentu dostaje wtedy mierzalny cel.
Nie wybierzesz między BM25 a wyszukiwaniem gęstym, chunkingiem rekurencyjnym a semantycznym ani Cohere Rerank a BGE, dopóki nie wiesz, co optymalizujesz. „Lepsze odpowiedzi” to nie metryka. Przykładowe wymaganie wydaniowe: „faithfulness ≥ 0,85 na zbiorze wzorcowym 200 zapytań obejmującym nasze trzy najważniejsze intencje, przy opóźnieniu p95 < 1,5 s i wskaźniku fałszywych wykluczeń filtra < 2%”. Liczby są tu przykładowe; ważne, że jakość, pokrycie, opóźnienie i filtrowanie mają jawne progi.
Zdefiniuj harness, zanim napiszesz kod wyszukiwania. Pierwszy harness będzie błędny i będziesz go poprawiać. Poprawienie metryki kosztuje dużo mniej niż poprawienie systemu, który już wdrożyłeś.
Trzy warstwy pipeline’u i dwa tryby uruchamiania
Ewaluacja produkcyjna ma trzy warstwy pipeline’u. Ewaluacja ingestu pyta, czy korpus i indeks zachowują źródło. Ewaluacja w czasie zapytania pyta, czy przepisywanie, filtrowanie, wyszukiwanie, reranking i składanie kontekstu znalazły właściwe dowody. Ewaluacja odpowiedzi i produkcji pyta, czy odpowiedź wykorzystała te dowody i czy jakość utrzymuje się przy żywym ruchu. Zlej warstwy w jeden wynik, a błąd normalizacji może zniknąć w akceptowalnej ocenie odpowiedzi.
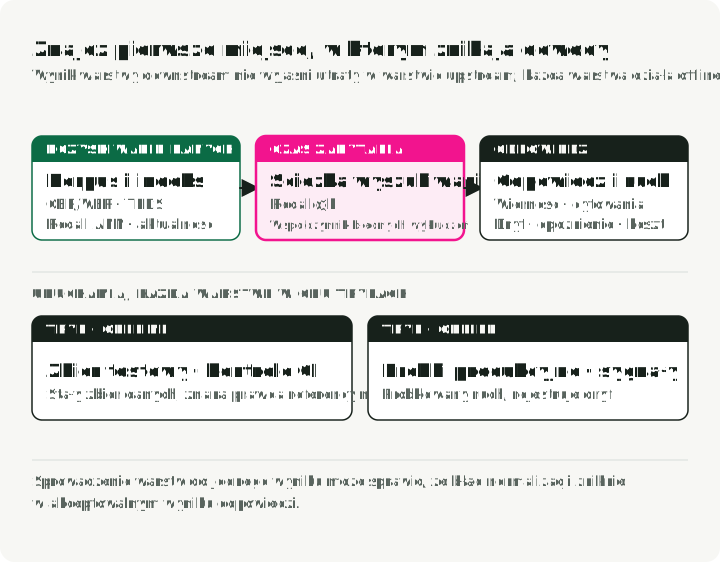
Warstwy opisują, gdzie występuje awaria. Offline i online opisują, kiedy i na jakich danych działa test. Ewaluacja offline używa stałego zbioru ze znanym wzorcem; jest powtarzalna i należy do wyboru komponentów, porównań A/B i testów CI, które mogą zablokować zmianę. Ewaluacja online ocenia próbkę żywego ruchu i rejestruje regeneracje, czas przebywania na odpowiedzi, jawne opinie i rzeczywisty drift zapytań. Jest bardziej zaszumiona i trudniejsza do zinstrumentowania.
Używaj obu trybów tam, gdzie pomagają: stałe korpusy i zbiory zapytań czynią regresje powtarzalnymi, a próbki żywych śladów ujawniają awarie świeżości i drift.
Na poziomie komponentów a end-to-end
Są dwa częste błędy. Sama ewaluacja end-to-end mówi, że system działa źle, ale nie gdzie. Sama ewaluacja komponentów może pokazać, że każda część przechodzi test, a cały system nadal zawodzi. Rozwiązaniem jest kilka głównych metryk end-to-end do decyzji go/no-go plus metryki komponentów do diagnozy. Metryki wyszukiwania wychwytują regresje retrievera. Metryki generowania wychwytują regresje generatora. Poprawność odpowiedzi end-to-end wychwytuje błędy integracji.
Frameworki referencyjne (opiniotwórczy przegląd)
| Framework | Najlepszy w | Gdzie zawodzi |
|---|---|---|
| RAGAS | Wspólne słownictwo dla faithfulness, answer relevancy i context precision/recall (metryki) | Koszt sędziego LLM; nieprzejrzyste składniki wyniku przy debugowaniu; zmiany wersji |
| ARES | Sędzia-klasyfikator dopasowany do zadania, jeśli trening i anotacja są warte kosztu (artykuł); podana precyzja zależy od benchmarku | Cięższa konfiguracja; trzeba faktycznie trenować modele |
| TruLens | Funkcje feedbacku powiązane ze śladami i integracja z OpenTelemetry (projekt) | Mniej gotowych metryk specyficznych dla RAG niż w RAGAS |
| DeepEval | Integracja z narzędziami do uruchamiania testów i własne metryki (projekt) | Intensywne użycie sędziego LLM = skoki kosztów |
| Arize Phoenix | Tracing, eksperymenty na zbiorach danych oraz gotowe lub własne ewaluatory RAG/agentów (dokumentacja ewaluacji) | Rubryki domenowe i progi sędziego nadal wymagają lokalnej kalibracji |
| TREC 2024 RAG Track | Publiczny benchmark do oceny nuggetów (AutoNuggetizer), oceny poparcia i płynności na MS MARCO Segment v2.1 | Nie jest narzędziem uruchomieniowym; to benchmark do kalibracji |
Mój domyślny stos to RAGAS dla słownika metryk, DeepEval do testów CI, Phoenix do tracingu produkcyjnego oraz własny kod dla metryk specyficznych dla ontologii. Wybierz framework, który ułatwia własne metryki.
Przy wyborze benchmarku dopasuj zadanie, zanim spojrzysz na ranking. BEIR, MTEB i MIRACL nadal są użytecznymi punktami odniesienia dla wyszukiwania. Dodaj testy możliwości, których one nie potwierdzają:
- Aktualny end-to-end RAG: TREC 2026 RAG Track używa zapytań narracyjnych i ClimbMix-400b, zastępując MS MARCO v2.1, i odsyła do zestawu narzędzi ewaluacyjnych RAGDoll. Tematy z 2026 roku są opublikowane; oceny jeszcze nie. Używaj tematów do eksperymentów, nie jako ocenionego rankingu. Protokoły z 2024 i 2025 roku opisane niżej wiąż z ich własnymi korpusami i ocenami.
- Pytania techniczne o zmieniający się kod: FreshStack łączy pytania zadane przez ludzi na Stack Overflow, korpusy repozytoriów i oceny nuggetów. Opublikowana migawka i mechanizm budowania nowych korpusów to dwie różne rzeczy; przypnij rewizję repozytorium i datę pytania.
- Obrazy niosące część pytania lub dowodu: MM-BRIGHT rozdziela wyszukiwanie tekst–tekst, multimodalne–tekst, multimodalne–obraz i multimodalne–multimodalne. Oceniaj właściwe zadanie osobno. Sam tekst z OCR może pomijać to, co wnosi wykres lub zrzut ekranu.
Te benchmarki poszerzają pokrycie; nie zastępują wersjonowanego zbioru zapytań z twojej aplikacji, w którym uwzględniono tylko dostępne dokumenty.
Część 2: Zmapuj punkty ewaluacji
Gdy odpowiedź jest błędna lub nieuzasadniona, prześledź dokument wzorcowy przez cztery kontrole z rysunku, od lewej do prawej. Pierwszy etap, na którym go brakuje, wskazuje metrykę do sprawdzenia w pierwszej kolejności i część artykułu, która ją omawia.
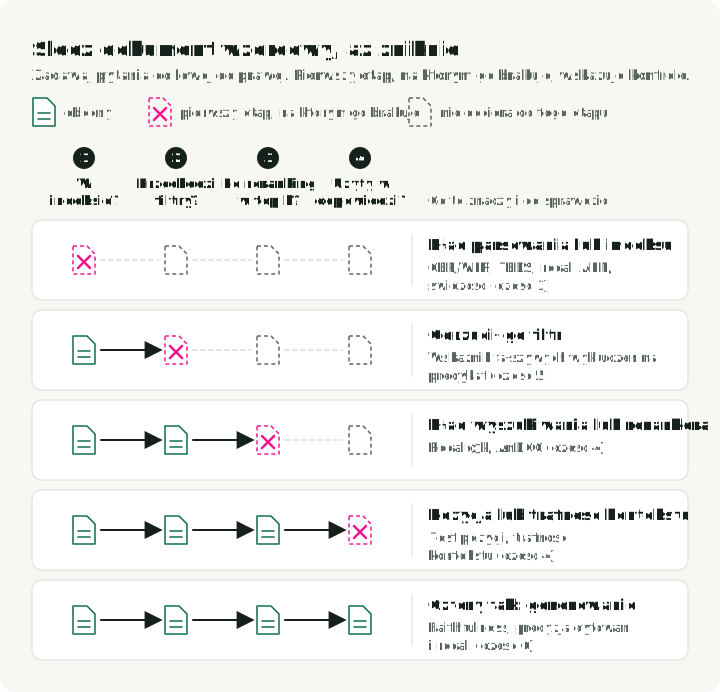
Straty na wcześniejszych etapach ograniczają jakość późniejszych: złe parsowanie ogranicza wyszukiwanie, a złe wyszukiwanie ogranicza reranking i generowanie. Faithfulness mierzy odpowiedź, nigdy przyczynę na wcześniejszym etapie.
Część 3: Ewaluacja ingestu
Wiele produkcyjnych awarii RAG zaczyna się w ingeście. System działa na czystych dokumentach testowych, a potem zawodzi na prawdziwych PDF-ach, skanach, tabelach i nieuporządkowanych stronach korpusu.
Pozyskiwanie i parsowanie dokumentów
Co mierzyć:
-
Kontrola długości ekstrakcji:
extracted_chars / expected_charsdla każdej klasy dokumentów sygnalizuje podejrzane zmiany długości, ale zduplikowany lub błędny tekst nadal może dać 1,0. Porównaj wyrównany tekst z ręcznie oczyszczonym wzorcem, szukając pominięć i podmian, a potem osobno sprawdź przypisy, podpisy, zawartość tabel i kolejność czytania. -
Dokładność OCR: CER (Character Error Rate) i WER (Word Error Rate), standardowe metryki rozpoznawania mowy i OCR:
gdzie , , to podstawienia, usunięcia i wstawienia na poziomie znaków, a to liczba znaków we wzorcu (indeks oznacza wersję dla słów). Nie stosuj jednej granicy CER do każdego korpusu. Skalibruj ją według klasy dokumentów i straty jakości odpowiedzi. Tekst drukowany, pismo odręczne i materiał wielojęzyczny mają różne profile błędów. Licz za pomocą
jiwer(jiwer.cer(refs, hyps),jiwer.wer(refs, hyps)) lubevaluatez Hugging Face. Publiczne benchmarki dla korpusów ewaluacyjnych to FUNSD i SROIE.from jiwer import cer, wer refs = ["Mars has two moons, Phobos and Deimos."] hyps = ["Mars has two m00ns, Phobos and Deirnos."] print(f"CER = {cer(refs, hyps):.3f}") # CER = 0.105 print(f"WER = {wer(refs, hyps):.3f}") # WER = 0.286 -
Wierność ekstrakcji tabel: TEDS (Tree-Edit-Distance-based Similarity) mierzy, jak blisko wzorca jest przewidziane drzewo tabeli HTML, normalizując przez rozmiar większego drzewa. Wzór z Zhong et al., 2020 (PubTabNet):
TEDS uwzględnia zarówno strukturę (wiersze, kolumny, scalenia), jak i zawartość komórek. TEDS-S pomija zawartość i ocenia tylko strukturę. Implementacja referencyjna:
src/metric.pyz PubTabNet (korzysta zapted). Korpusy ewaluacyjne: PubTabNet, FinTabNet i SciTSR. Proste parsery często zawodzą na tabelach. Zmierz je, zanim im zaufasz. -
Zachowanie układu i struktury: kolejność nagłówków, spójność list, kolejność czytania w wielokolumnowych PDF-ach. Do oznaczonego benchmarku użyj DocLayNet. Gotowe porównanie może obejmować parser elementów, taki jak
unstructured, bibliotekę PDF, taką jakpymupdf, oraz wybrany pipeline Docling. Docling oferuje ścieżki standardową i VLM; zapisz, którą testujesz.
Porównuj różne rodziny parserów, na przykład bazowy Tesseract, model OCR oparty na VLM i kandydata od dostawcy. Najlepsze modele OCR porównuje obecne opcje. Użyj warstwowej próbki rzeczywistych klas dokumentów przy stałym DPI, obejmującej czyste skany, zdjęcia, tabele, tekst wielojęzyczny, matematykę i pismo odręczne. Podaj CER lub WER dla każdej klasy oraz TEDS dla stron z tabelami.
Czyszczenie i normalizacja
-
Dokładność usuwania boilerplate: precision/recall względem ręcznie oznaczonych fragmentów boilerplate. Agresywne usuwanie gubi trafną treść; zbyt łagodne zanieczyszcza embeddings. Narzędzia do porównania:
trafilatura,jusText,Resiliparse. Barbaresi (2021) porównuje Trafilaturę z rozwiązaniami bazowymi, w tym jusText; Resiliparse to osobny kandydat, a nie system oceniany w tym artykule. -
Normalizacja Unicode: odsetek dokumentów dających identyczne wyniki NFC i NFKC (liczony za pomocą
unicodedata.normalizeze standardowej biblioteki) to przydatny sygnał dryfu form zgodności. Nie wykrywa niewidocznych punktów kodowych ignorowanych domyślnie ani podobnie wyglądających znaków z różnych pism: tych pierwszych szukaj jawnie, a dla drugich zastosuj politykę lub detektor Unicode confusables, jeśli wchodzą w zakres. -
Dokładność wykrywania języka: F1 na oznaczonej próbce wielojęzycznej. Kluczowa dla indeksów wielojęzycznych. Użyj
fasttext-langdetect(lid.176od Facebooka),lingua-pylubcld3. FLORES-200 dostarcza tekst ewaluacyjny w 200 językach, ale fragment testowy powinien wynikać z rzeczywistego miksu języków na produkcji. -
Skuteczność deduplikacji (MinHash / LSH): precision/recall detektora prawie-duplikatów względem ręcznie oznaczonego zbioru. Idea: oszacuj podobieństwo Jaccarda między zbiorami shingli dokumentów za pomocą losowych permutacji haszujących (Broder, 1997) i grupuj prawie-duplikaty metodą LSH banding (Indyk & Motwani, 1998). Przeskanuj liczbę haszy i próg Jaccarda na swoim korpusie. Śledź wskaźnik fałszywych scaleń (psuje odpowiedzi) osobno od wskaźnika pominiętych scaleń (marnuje miejsce w indeksie).
datasketchdostarcza implementację użytą niżej; jej parametry są przykładowe:from datasketch import MinHash, MinHashLSH def shingles(text: str, k: int = 5) -> set[str]: text = text.lower() return {text[i:i + k] for i in range(len(text) - k + 1)} def to_minhash(text: str, num_perm: int = 128) -> MinHash: m = MinHash(num_perm=num_perm) for s in shingles(text): m.update(s.encode("utf-8")) return m docs = { "d1": "Mars has two moons, Phobos and Deimos.", "d2": "Mars has two moons, Phobos and Deimos!", # near-dup "d3": "Curiosity rover landed on Mars in 2012.", } lsh = MinHashLSH(threshold=0.8, num_perm=128) for did, text in docs.items(): lsh.insert(did, to_minhash(text)) print(sorted(lsh.query(to_minhash(docs["d1"])))) # ['d1', 'd2'] -
Usuwanie PII: precision i recall liczone osobno dla każdego typu encji (e-maile, numery SSN, imiona i nazwiska, adresy). Błędy recall tworzą ryzyko zgodności z przepisami; błędy precision pogarszają jakość odpowiedzi. Punkt pracy ustal z działem prawnym. Kandydaci to Microsoft Presidio,
scrubadublub model NER dostrojony na oznaczonym zbiorze.
Chunking steruje jakością wyszukiwania
Chunking zmienia to, jakie dowody trafiają do odpowiedzi. W benchmarku dostawcy NVIDIA z 2025 roku chunking na poziomie strony dał najwyższą średnią dokładność odpowiedzi end-to-end w testowanym układzie, ponieważ zachował tabele i wykresy jako całe jednostki. To mierzy dokładność odpowiedzi, a nie recall wyszukiwania. Traktuj ten wynik jako dowód dla testowanego korpusu, a nie uniwersalnego zwycięzcę.
Chunking semantyczny grupuje sąsiednie zdania według podobieństwa embeddings i tnie na granicach, gdzie zdania są niepodobne. Realizują go SemanticChunker z LangChain i SemanticSplitterNodeParser z LlamaIndex. Może poprawić recall względem stałych okien, gdy liczą się granice tematów.
RecursiveCharacterTextSplitter z LangChain domyślnie próbuje podwójnych znaków nowej linii, pojedynczych, spacji, a potem poszczególnych znaków: ["\n\n", "\n", " ", ""]. Nie rozpoznaje granic zdań bez odpowiednich separatorów lub narzędzia uwzględniającego zdania. Domyślne length_function=len liczy znaki. Aby przetestować 400–512 tokens na fragment z nakładaniem 10–20 %, użyj funkcji liczącej tokens. Porównaj te początkowe ustawienia z innymi wartościami na zbiorze wzorcowym.
Metryki do śledzenia:
- Spójność chunków: , gdzie to embeddings zdań. Zdrowe chunki są wewnętrznie podobne, a na granicach niepodobne. Licz za pomocą
sentence-transformersicosine_similarityzscikit-learn. - Jakość granic: ręczna ocena „czy to sensowne cięcie?” na próbce oraz kontrola strukturalna, czy chunki nie rozcinają tabel, list ani numerowanych sekcji.
- Optymalny rozmiar chunka: przeskanuj rozmiary wyrażone liczbą tokens (128, 256, 512, 1024) i wykreśl Recall@k względem rozmiaru na swoim zbiorze wzorcowym. Wybierz najmniejszy rozmiar, po którym Recall@k przestaje rosnąć.
- Skuteczność nakładki: przeskanuj nakładkę 0, 10, 20 i 30% jako siatkę startową i zmierz Recall@k. Przestań zwiększać nakładkę, gdy lokalna krzywa recall się wypłaszcza lub koszt duplikacji przewyższa zysk.
- Wierność atrybucji chunków: odsetek chunków zachowujących weryfikowalny wskaźnik źródła (numer strony, kotwica sekcji, ID dokumentu). Audytowalność tego wymaga.
- Późny a wczesny chunking: late chunking (Günther et al., 2024) osadza cały dokument, a potem go segmentuje, zachowując globalny kontekst (implementacja referencyjna w
jina-embeddings-v3). Contextual Retrieval (Anthropic, 2024) dołącza do każdego chunka kontekst wygenerowany przez LLM. Oba podejścia zwiększają koszt. Zmierz je na swoim korpusie, zanim któreś przyjmiesz.
Moja opinia: chunking strukturalny (podział według nagłówków, tabel i sekcji — realizowany przez parsery takie jak unstructured.io lub przez przejście po AST, które parser już zbudował) jest niedoceniany. Jeśli dokumenty mają strukturę, wykorzystaj ją, zanim dodasz heurystyki oparte na podobieństwie. Dzielenie rekurencyjne po znakach to punkt odniesienia; chunking semantyczny jest wart narzutu głównie na nieustrukturyzowanej prozie.
Ekstrakcja i wzbogacanie metadanych
- Precision/recall/F1 dla NER: dla każdego typu encji, na oznaczonym podzbiorze. Standard w stylu CoNLL/MUC. Licz za pomocą
seqeval(from seqeval.metrics import f1_score) dla wersji uwzględniającej tagi BIO/IOB lub scikit-learn dla porównań zbiorów zakresów. Kanoniczne korpusy referencyjne to CoNLL-2003 i OntoNotes 5.0. - F1 ekstrakcji relacji: jeszcze ważniejsze dla systemów opartych na ontologii. Oznacz ręcznie zbiór warstwowany według typu relacji i klasy dokumentu. TACRED i DocRED to publiczne benchmarki; kandydaci na implementację to
opennrei pipeline’y relacjispaCy. - Dokładność ekstrakcji tytułów i nagłówków: dokładne dopasowanie oraz znormalizowane podobieństwo Levenshteina () względem wzorca —
python-Levenshteinlubrapidfuzzdają oba jednym wywołaniem. - Zachowanie metadanych hierarchicznych: odsetek chunków, które poprawnie zachowują sekcję nadrzędną, dokument nadrzędny i ścieżkę przodków. Ta metryka rozstrzyga, czy twój RAG odpowie na pytania typu „co mówi potomek polityki X?”.
Generowanie embeddings
- Benchmarki wyboru modelu: jako punkty odniesienia użyj wyników zadań wyszukiwania z MTEB, BEIR do generalizacji zero-shot i MIRACL do wyszukiwania wielojęzycznego. MTEB dla wyszukiwania zwykle podaje nDCG@10; inne rodziny zadań używają innych metryk. Pakiet Pythona MTEB uruchamia benchmarki lokalnie. Przeniesienie wyniku z angielskiego MTEB na język o mniejszych zasobach traktuj jako hipotezę do sprawdzenia na oznaczonym zbiorze tego języka.
- Ewaluacja domenowa: nie traktuj pozycji w ogólnym rankingu jako wyniku dla swojej domeny. Zacznij od kilkuset oznaczonych zapytań (200–500) obejmujących główne typy zapytań; część 9 pokazuje, jak sprawdzić, czy to wystarcza. Potem uszereguj na nim modele kandydatów za pomocą
ranxlubpytrec_eval. Zbiór domenowy może odwrócić kolejność z rankingu, więc razem z wynikiem publikuj fragment zbioru, protokół wyszukiwania i przedział ufności. - Wykrywanie dryfu embeddings: porównaj dwie kolekcje embeddings: stałą próbkę referencyjną i bieżącą próbkę kroczącą. Maximum mean discrepancy (MMD) sprawdza, czy ich rozkłady się różnią. Inna opcja to zwalidowany klasyfikator wytrenowany do odróżniania próbek referencyjnych od bieżących. Dywergencja Kullbacka–Leiblera (KL) porównuje rozkłady prawdopodobieństwa, więc wymaga jawnego estymatora, np. wybranych histogramów; surowe współrzędne embedding nie są prawdopodobieństwami. Mierz też stabilność najbliższych sąsiadów dla stałego zbioru sond.
evidentlyialibi-detectimplementują detektory oparte na modelach i statystyczne. Badanie porównawcze Evidently to ocena jednego dostawcy; porównaj metody na znanych przesunięciach we własnych embeddings. - Wielowektorowe a jednowektorowe: late interaction zachowuje reprezentacje na poziomie tokens zamiast zwijać każdy dokument do jednego wektora; ColBERT to kanoniczny projekt, z implementacjami referencyjnymi w RAGatouille i PyLate. Bogatsza reprezentacja zwiększa koszt indeksu i wyszukiwania. Zanim to przyjmiesz, porównaj jakość, rozmiar danych i opóźnienie z bazową wersją jednowektorową na tym samym zbiorze domenowym.
Budowa indeksu
- Recall@k przy przybliżeniu: porównaj indeks przybliżonych najbliższych sąsiadów (ANN) z dokładnym brute-force przy tym samym k — w FAISS to
IndexHNSWFlat(lubIndexIVFFlat) kontraIndexFlatIP/IndexFlatL2. Na początek wymagaj Recall@10 co najmniej 0,95 względem wyszukiwania dokładnego, a potem zaostrz lub rozluźnij próg na podstawie jakości odpowiedzi. Projektann-benchmarksśledzi krzywe Pareto recall–QPS dla różnych bibliotek. - Strojenie HNSW: HNSW (Hierarchical Navigable Small World) to warstwowy graf bliskości; zob. Malkov & Yashunin, 2018. Implementują go
hnswlib,IndexHNSWFlatz FAISS i większość baz wektorowych. HNSW ma trzy pokrętła:M(liczba połączeń w grafie),efConstruction(szerokość listy kandydatów przy budowie) iefSearch(szerokość listy kandydatów przy zapytaniu). Wartości startowe:M16–32 iefConstruction100–200; potem zwiększajefSearch, aż Recall@10 względem wyszukiwania dokładnego przestanie rosnąć. Przewodnik po parametrach hnswlib podaje, żeM12–48 pasuje do większości zastosowań, i daje test dlaefConstruction: gdyefjest równeefConstruction, a recall dlaMnajbliższych sąsiadów jest poniżej 0,9, graf można jeszcze ulepszyć. - Strojenie IVF: IVF (Inverted File index — podziel wektory za pomocą k-means na
nlistkomórek, a przy zapytaniu przeszukajnprobenajbliższych komórek; zob.IndexIVFFlatiIndexIVFPQw FAISS). Wytyczne FAISS dotyczące wyboru indeksu sugerują 4√N do 16√N komórek dla N wektorów jako początkowenlist. Przeskanujnlistinprobewzględem recall wyszukiwania dokładnego i opóźnienia. Zapytania z filtrami testuj osobno, bo rodziny indeksów i bazy wektorowe różnie implementują przechodzenie z filtrem. - Opóźnienie świeżości aktualizacji: czas od zatwierdzenia dokumentu do możliwości jego wyszukania. Śledź p50 i p99. W systemach z wymogami regulacyjnymi śledź też odsetek zapytań obsłużonych przez nieaktualne indeksy.
Część 4: Ewaluacja w czasie zapytania
Ścieżka czasu zapytania zawiera metryki diagnozujące drogę wyszukiwania. Sam Recall@k nie pokaże, czy awarię spowodowało przepisywanie, filtrowanie, reranking czy składanie kontekstu.
Rozumienie i przepisywanie zapytań
- Jakość rozszerzania zapytań: przyrost Recall@k na zbiorze wzorcowym, zapytanie rozszerzone względem surowego. Przed testem określ minimalny użyteczny zysk i jego niepewność. Jeśli rozszerzanie nie spełnia tego wymagania, nie uzasadnia swojego opóźnienia i kosztu. Klasyczne punkty odniesienia PRF (pseudo-relevance feedback), takie jak RM3 i Bo1, nadal są dobrą kontrolą poprawności; rozszerzanie oparte na LLM musi je pokonać.
- Ewaluacja HyDE: HyDE (Gao et al., 2022) każe LLM wygenerować hipotetyczną odpowiedź, osadza ją i wyszukuje na jej podstawie. Dodaje to wywołanie generowania, a to wywołanie może zmyślić treść, która odciąga wyszukiwanie od tematu. Zmierz Recall@10 osobno na wycinkach w domenie, poza domeną i o niskiej pewności, a potem zdecyduj, czy HyDE należy do ścieżki domyślnej, do awaryjnej, czy w ogóle.
- Generowanie wielu zapytań: Recall@k sumy N przepisań względem pojedynczego zapytania. Przeskanuj N i wybierz punkt na swojej granicy recall–opóźnienie. Implementacje:
MultiQueryRetrieverz LangChain,QueryFusionRetrieverz LlamaIndex. - Dokładność klasyfikacji intencji: standardowe precision/recall/F1 dla każdej intencji (licz za pomocą
sklearn.metrics.classification_report), ale najważniejsza jest poprawność routingu — czy uruchamiany jest właściwy pipeline? - Routing adaptacyjny: Adaptive-RAG (Jeong et al., NAACL 2024) uzasadnia, że nie każde zapytanie zasługuje na tę samą strategię wyszukiwania. Mierz dokładność routera jako problem klasyfikacji na oznaczonym zbiorze „nie wymaga wyszukiwania / jednorazowe / iteracyjne”.
Wyszukiwanie iteracyjne wymaga testu end-to-end z budżetem
Agent może wyszukać, obejrzeć wynik i wyszukać ponownie, zamiast pobierać jedną stałą listę top-k. Domena banking_knowledge w tau2-bench przełącza wyszukiwanie flagą --retrieval-config: brak bazy wiedzy, cała baza wiedzy w kontekście, wyszukiwanie BM25 lub oparte na embeddings, narzędzie powłoki w piaskownicy albo BM25, wyszukiwanie gęste i powłoka razem. W porównaniu lokalnym daj wyszukiwaniu jednorazowemu i iteracyjnemu ten sam kwalifikujący się korpus oraz jawne limity czasu, liczby tokens modelu i wywołań narzędzi. Zapisuj każde zapytanie i dowody widziane w każdej turze; oceniaj końcowe pokrycie dowodów, poprawność odpowiedzi, poparcie cytowań i awarie z wyczerpanym budżetem. Więcej wywołań wyszukiwania pomaga tylko wtedy, gdy dodatkowe dowody poprawiają odpowiedź w tych limitach.
retrieval/iterative.py z repozytorium towarzyszącego uruchamia podane przepisania zapytań w jawnych budżetach wywołań, czasu i liczby tokens. Dla agentów, które same wybierają wyszukiwania, Ewaluacja agentów AI: od śladów wykonania do zestawów testów opisuje, jak oceniać trajektorię, a nie tylko odpowiedź.
Metryki wyszukiwania
To metryki bazowe. Jeśli ich nie śledzisz, nie wiesz, czy wyszukiwanie się poprawia.
| Metryka | Co mierzy | Kiedy stosować |
|---|---|---|
| Recall@k | ułamek trafnych dokumentów zapytania zwróconych w top k | gdy liczy się pominięcie dowolnej części zbioru trafnych dokumentów |
| Precision@k | odsetek trafnych dokumentów w top k | gdy wąskim gardłem jest okno kontekstu |
| MRR | średnia z 1/rank pierwszego trafnego dokumentu | gdy użytkownicy patrzą tylko na top-1 lub top-3 |
| nDCG@k | zysk ważony ocenami trafności z dyskontem za pozycję | standardowa metryka wyszukiwania dla stopniowanej trafności |
| MAP | średnia po zapytaniach ze średniej precyzji | gdy zależy ci na całej uszeregowanej liście |
| Hit Rate@k | czy co najmniej jeden trafny dokument pojawia się w top k | uśrednij wynik binarny po zapytaniach jako szybką kontrolę poprawności |
| Coverage | odsetek dokumentów wzorcowych kiedykolwiek pobranych w zapytaniach | wychwytuje systematyczne luki w indeksie |
Wzory, dla porządku (trafność binarna ze zbiorem trafnych dokumentów dla zapytania i , gdy -ty pobrany dokument należy do ):
Dla stopniowanej trafności ; binarny nDCG to szczególny przypadek użyty w kodzie niżej. MAP to średnia po zapytaniach z . Wyprowadzenia: Manning, Raghavan, Schütze, Introduction to Information Retrieval, rozdział 8.
W kodzie produkcyjnym użyj ranx, pytrec_eval lub ir_measures — implementują całą rodzinę metryk TREC i poprawnie obsługują stopniowaną trafność. Jako początkowe progi wydaniowe repozytorium towarzyszące ustawia Recall@10 ≥ 0,85 i MRR ≥ 0,6 (w .env.example, stosowane z --quality-gates). Potem dostrój je na swoim zbiorze wzorcowym względem jakości odpowiedzi i kosztu pominięcia.
Tutaj k liczy unikalne ID dokumentów. Odrzucaj duplikaty zamiast dawać powtórzonemu dokumentowi dodatkowy zysk. W eksperymentach z chunkingiem zadeklaruj, czy k liczy chunki, czy zdeduplikowane dokumenty nadrzędne, i porównaj też dowody dostarczone w stałym budżecie wyrażonym liczbą tokens. Ten sam recall dokumentów może ukrywać bardzo różną jakość kontekstu.
Harness do tych metryk jest krótki. Uruchomisz go w notebooku, zanim wybierzesz bazę wektorową.
from math import log2
from statistics import mean

# synthetic gold set: query_id -> set of relevant doc ids
gold = {
    "q1": {"d3"},
    "q2": {"d7", "d2"},
    "q3": {"d11"},
    "q4": {"d5"},
}

# ranked retrieval results: query_id -> ranked list of doc ids (top-10)
runs = {
    "q1": ["d8", "d3", "d1", "d4", "d2", "d9", "d6", "d10", "d12", "d13"],
    "q2": ["d2", "d6", "d4", "d7", "d1", "d3", "d8", "d11", "d5", "d9"],
    "q3": ["d11", "d2", "d3", "d4", "d1", "d6", "d7", "d8", "d10", "d12"],
    "q4": ["d1", "d2", "d3", "d6", "d8", "d9", "d10", "d12", "d13", "d14"],
}

def recall_at_k(ranked, gold_set, k):
    if k <= 0 or len(ranked) != len(set(ranked)):
        raise ValueError("require positive k and unique document IDs")
    if not gold_set:
        return 0.0
    hit = sum(1 for d in ranked[:k] if d in gold_set)
    return hit / len(gold_set)

def reciprocal_rank(ranked, gold_set):
    if len(ranked) != len(set(ranked)):
        raise ValueError("require unique document IDs")
    # MRR contribution per query: 1/rank of the first relevant doc.
    for rank, d in enumerate(ranked, start=1):
        if d in gold_set:
            return 1.0 / rank
    return 0.0

def ndcg_at_k(ranked, gold_set, k):
    if k <= 0 or len(ranked) != len(set(ranked)):
        raise ValueError("require positive k and unique document IDs")
    # binary relevance: rel ∈ {0, 1}
    gains = [1.0 if d in gold_set else 0.0 for d in ranked[:k]]
    dcg = sum(g / log2(i + 2) for i, g in enumerate(gains))
    # ideal DCG: all gold docs ranked first, capped by k
    n_gold_in_topk = min(k, len(gold_set))
    idcg = sum(1.0 / log2(i + 2) for i in range(n_gold_in_topk))
    return dcg / idcg if idcg else 0.0

K = 5
print(f"Recall@{K}: {mean(recall_at_k(runs.get(q, []), gold[q], K) for q in gold):.3f}")
print(f"MRR:       {mean(reciprocal_rank(runs.get(q, []), gold[q]) for q in gold):.3f}")
print(f"nDCG@{K}:  {mean(ndcg_at_k(runs.get(q, []), gold[q], K) for q in gold):.3f}")
# Recall@5: 0.750
# MRR:       0.625
# nDCG@5:    0.627
# Duplicate and missing runs are tested in the companion's tests/test_audit_contracts.py.
Agregat iteruje po wszystkich oczekiwanych zapytaniach i traktuje brakujący przebieg jako pusty. Ten przykład przypisuje zero zapytaniom z pustym wzorcem; w prawdziwym zestawie oznacz je jako osobny wycinek odpowiadalności z własnym mianownikiem, zamiast traktować zero jako zmierzony recall. Oprócz wyników zgłaszaj przekroczenia czasu i brakujące przebiegi.
Uruchamiaj szybki podzbiór przy każdym PR, a pełny zbiór wzorcowy przed wydaniem (część 9 podaje rozmiary startowe). Blokuj scalenie, gdy metryka wybrana z góry przekroczy swój budżet regresji.
Repozytorium towarzyszące utrwala liczby powyżej (Recall@5 = 0.750, MRR = 0.625, nDCG@5 = 0.627) testem jednostkowym w tests/test_retrieval_metrics.py. Notebook 01 wykonuje ten przykład z k=5, a następnie raportuje Recall@10, MRR i nDCG@10 na wycinku SciFact; nie przeszukuje wartości k. Narzędzie ewaluacyjne o strukturze produkcyjnej znajduje się w evaluation/retrieval.py.
Wyszukiwanie hybrydowe i reciprocal rank fusion
BM25 to rzadki scorer leksykalny łączący dopasowanie dokładnych terminów, ważenie terminów i normalizację długości. Jest dostępny w rank_bm25, Elasticsearch, OpenSearch i większości silników wyszukiwania.
Reciprocal Rank Fusion (Cormack, Clarke i Buettcher, SIGIR 2009) łączy rankingi BM25 i gęsty według pozycji. Oryginalne ustawienie k=60 to dobry punkt wyjścia. RRF nie zależy od wartości wyników, co pozwala uniknąć normalizacji między ścieżkami, której wymaga interpolacja liniowa. Jeśli zbiór oznaczony jest dość duży, by oszacować stabilną różnicę, przetestuj też kombinację wypukłą i dostrój α.
Moja hipoteza: wyszukiwanie hybrydowe plus reranker cross-encoder może pomagać w korpusach technicznych, logach i kodzie. Zysk może być mały w korpusach silnie semantycznych. Mierz względem ścieżek tylko gęstej i tylko rzadkiej, bo słaba konfiguracja fuzji może wypaść gorzej niż każde z wejść. Notebook SciFact z repozytorium towarzyszącego to jeden ograniczony test, a nie ogólny wynik.
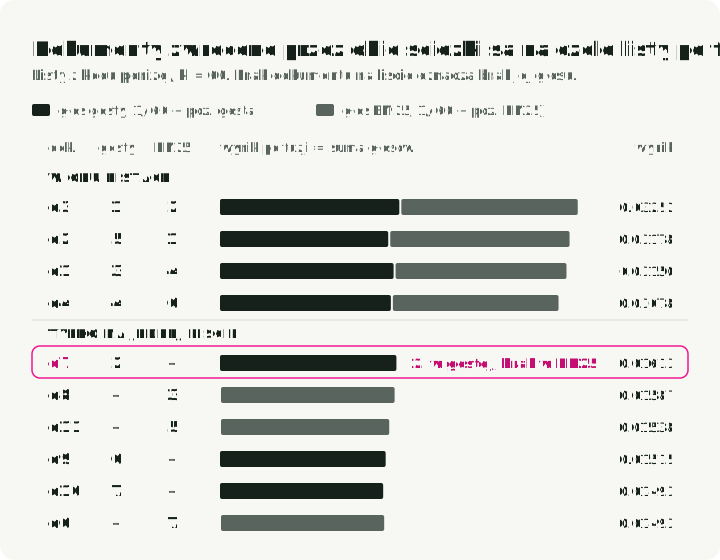
Wykres używa dwóch uporządkowanych list z kodu poniżej. Każda ścieżka dodaje 1/(60 + pozycja) dla każdego dokumentu, który zwraca, więc na czele są cztery dokumenty obecne w obu listach. d7 jest drugi na liście gęstej, ale nie ma go na liście BM25, więc spada na piąte miejsce.
Implementacja mieści się w kilku liniach.
from collections import defaultdict

# two retrieval lanes: dense embeddings and BM25.
dense  = ["d3", "d7", "d1", "d4", "d2", "d9", "d10"]
sparse = ["d2", "d3", "d8", "d1", "d11", "d4", "d6"]

def rrf(rankings: list[list[str]], k: int = 60) -> list[tuple[str, float]]:
    """Reciprocal Rank Fusion (Cormack et al., SIGIR 2009).

    score(d) = sum over rankings of 1 / (k + rank(d))
    Score-agnostic: only rank position matters. k=60 is the canonical default.
    """
    scores: dict[str, float] = defaultdict(float)
    if k <= 0:
        raise ValueError("k must be positive")
    for ranking in rankings:
        if len(ranking) != len(set(ranking)):
            raise ValueError("each ranking must contain unique document IDs")
        for rank, doc in enumerate(ranking, start=1):
            scores[doc] += 1.0 / (k + rank)
    return sorted(scores.items(), key=lambda kv: kv[1], reverse=True)

fused = rrf([dense, sparse], k=60)
for doc, score in fused[:5]:
    print(f"{doc}  score={score:.5f}")
# d3  score=0.03252   <- rank 1 dense, rank 2 sparse
# d2  score=0.03178   <- rank 5 dense, rank 1 sparse
# d1  score=0.03150
assert [doc for doc, _ in fused[:3]] == ["d3", "d2", "d1"]
Zauważ, czego RRF nie robi: nigdy nie patrzy na surowe wyniki podobieństwa. Jeśli retriever umieści dokument na pozycji 2, ten głos jest wart 1 / (60 + 2) niezależnie od surowego wyniku. Retriever gęsty zwracający cosinus 0,98 i ścieżka BM25 zwracająca wynik 17,4 nie są bezpośrednio porównywalne. Normalizacja z-score i min-max usuwa różnice skali afinicznej, ale żadna nie kalibruje wyniku jako trafności. Wartości odstające, kształt rozkładu i zbiór kandydatów nadal wpływają na znormalizowane wartości, a więc na wynik fuzji. Każdą kombinację opartą na wynikach waliduj na oznaczonych zapytaniach.
Wyszukiwanie hybrydowe + RRF na SciFact: notebook 02 porównuje wyszukiwanie gęste, BM25 i RRF za pomocą zagregowanych Recall@10, MRR i nDCG@10. Moduł łączenia o strukturze produkcyjnej znajduje się w retrieval/hybrid_rrf.py; tests/test_rrf.py utrwala kanoniczną kolejność d3 / d2 / d1 dla k=60.
Reranking
- ΔnDCG / ΔMRR: przyrost względem braku etapu reranking, na twoim zbiorze wzorcowym, na głębokości, której aplikacja naprawdę używa. Licz, uruchamiając metryki wyszukiwania z rerankerem i bez niego na identycznych zbiorach kandydatów.
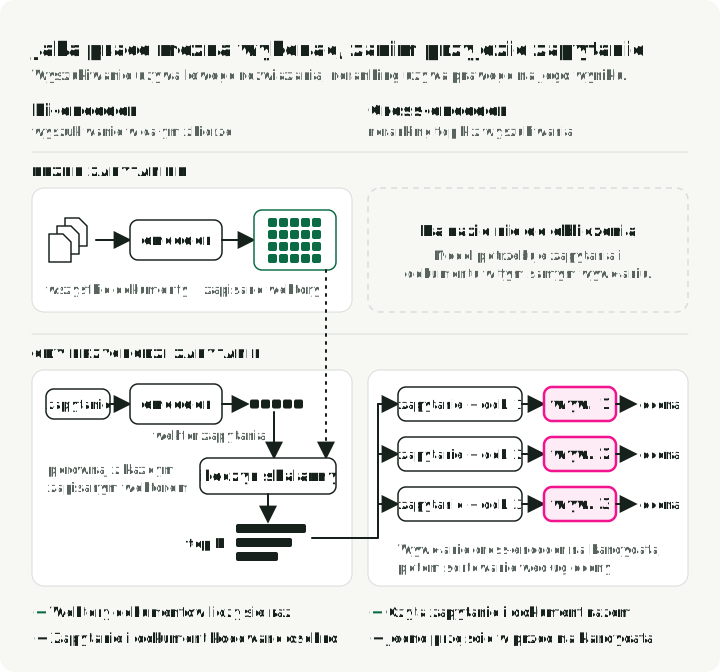
- Cross-encoder a bi-encoder: bi-encoder osadza zapytanie i dokument niezależnie (jeden wektor na stronę) i ocenia iloczynem skalarnym; cross-encoder łączy zapytanie z dokumentem i wykonuje jeden przebieg w przód, w którym uwaga obejmuje oba teksty naraz. Modele cross-encoder płacą jednym przebiegiem na kandydata za bogatszą interakcję zapytanie–dokument; różnicę pokazuje rysunek niżej. Implementacja referencyjna:
CrossEncoderzsentence-transformers. Mierz trafność i opóźnienie na nazwanym sprzęcie, przy danym rozmiarze batcha i głębokości kandydatów; nie przenoś wyniku jednego modelu ani usługi zarządzanej do innego środowiska. - Listwise a pointwise: pointwise ocenia każdą parę (zapytanie, dokument) niezależnie; listwise ocenia całą listę kandydatów łącznie, więc model może porównywać kandydatów. Oceń oba podejścia na tych samych zbiorach kandydatów. Progi wyników kalibruj dla każdego modelu i korpusu, zamiast uznawać opublikowany przykład za przenośny.
Na rysunku porównaj dwa pasma czasu. Bi-encoder koduje każdy dokument przed jakimkolwiek zapytaniem i zapisuje wektory; gdy przychodzi zapytanie, koduje tylko samo zapytanie. Cross-encoder nie ma nic do obliczenia przed zapytaniem. Czyta zapytanie i dokument w jednym wywołaniu modelu, więc działa raz na kandydata i tylko na krótkiej liście, którą zwróciło wyszukiwanie.
Poniższy kod ocenia trzech kandydatów dla jednego zapytania za pomocą modelu cross-encoder BGE:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("BAAI/bge-reranker-v2-m3")  # Reproducible baseline, not a latest-model ranking

query = "How do I rotate database credentials in production?"
candidates = [
    "Production database credentials are rotated via Vault every 30 days.",
    "The new logo was unveiled at the all-hands meeting.",
    "To rotate prod DB creds, run the `rotate-secrets` GitHub Action.",
]

scores = reranker.predict([(query, c) for c in candidates])
ranked = sorted(zip(candidates, scores), key=lambda x: -x[1])
for doc, score in ranked:
    print(f"{score:+.3f}  {doc}")
Powyższy kod BGE to mały punkt odniesienia. W aktualnym porównaniu uwzględnij Cohere Rerank 4.0 fast/pro dla zarządzanego, wielojęzycznego rankingu tekstu albo Qwen3-VL-Reranker 2B/8B, gdy zapytania lub dokumenty zawierają obrazy, zrzuty ekranu albo wideo. Podawaj jawnie modalności zadań, głębokość kandydatów, limity wejścia, instrukcje i sprzęt.
Reranker często pomaga w podstawowym pipeline’ie RAG, ale nie jest gwarantowaną wygraną. Zmierz jego ΔPrecision@1 i ΔnDCG na swoim zbiorze wzorcowym, a zostaw go tylko wtedy, gdy zysk mieści się w budżecie opóźnienia i kosztu. Porównaj ten zmierzony zysk z mniejszymi zmianami w wyszukiwaniu, zanim wybierzesz następną optymalizację. BM25 vs embeddings vs rerankers to krótszy przewodnik po wyborze każdej warstwy stosu rankingowego.
Notebook 03 raportuje P@10 przed i po etapie reranking przez cross-encoder na SciFact oraz ΔnDCG@10; moduł: retrieval/reranker.py. Moduł evaluation/reranking.py porównuje rerankery na identycznych pulach kandydatów.
Budowa kontekstu i zagubienie w środku
Wiele awarii typu „dobre wyszukiwanie, zła odpowiedź” zaczyna się w budowie kontekstu.
- Trafność kontekstu:
ContextRelevancez Ragas ocenia dostarczoną listę kontekstów za pomocą dwóch prompts i znormalizowanych ocen; nie jest to wynik dla pojedynczego chunka. Do diagnostyki chunków oceniaj jawnie każdą parę zapytanie–chunk, na przykład modelem cross-encoder, i podawaj rozkład przy lokalnie skalibrowanym progu. - Pokrycie cytowań dostarczonego kontekstu: liczba różnych dostarczonych chunków, które zacytowano, podzielona przez liczbę różnych dostarczonych chunków. Przypadki z pustym kontekstem zgłaszaj osobno. Ten obserwowalny wskaźnik zastępczy mówi, które chunki dostały cytowania, a nie które model wewnętrznie wykorzystał ani czy cytowania popierają jego twierdzenia. Poparcie cytowań sprawdzaj osobno i porównaj pokrycie z jakością odpowiedzi i kosztem użycia tokens.
- Wykrywanie zagubienia w środku: syntetyczna ewaluacja, w której umieszczasz chunk wzorcowy na pozycjach {pierwsza, środkowa, ostatnia} długiego kontekstu i mierzysz poprawność odpowiedzi. Cytowane badanie Liu et al. (TACL 2024) opisuje degradację w kształcie litery U w swoich warunkach długiego kontekstu. Ten sam wzorzec w obecnym modelu traktuj jako hipotezę do sprawdzenia. Środki zaradcze: zrób reranking, a potem przestaw top-k tak, by chunk z najwyższą oceną był pierwszy lub ostatni (robi to dokładnie
LongContextReorderz LangChain), albo mocno skompresuj chunki ze środka. Mierz ewaluacją warstwowaną według pozycji, a nie tylko wynikiem zagregowanym. Działającą ewaluację warstwowaną według pozycji znajdziesz w notebooku 06 (moduł:evaluation/lost_in_middle.py). - Kompresja kontekstu: podawaj współczynnik kompresji (tokens na wejściu / tokens na wyjściu) razem z poprawnością odpowiedzi. Narzędzia to m.in.
ContextualCompressionRetrieverz LangChain i LongLLMLingua. Z góry określ największą akceptowalną utratę poprawności na podstawie ryzyka aplikacji i budżetu tokens, a konfiguracje, które ją przekroczą, odrzucaj.
Część 5: Wskaźnik fałszywych wykluczeń filtra
Ta metryka ma własną sekcję, ponieważ zagregowane wyniki wyszukiwania nie przypiszą pominięcia filtrowi trafności. Filtry kwalifikowalności oceniaj osobno względem uprawnień wywołującego; dokument spoza tego zbioru musi pozostać wykluczony.
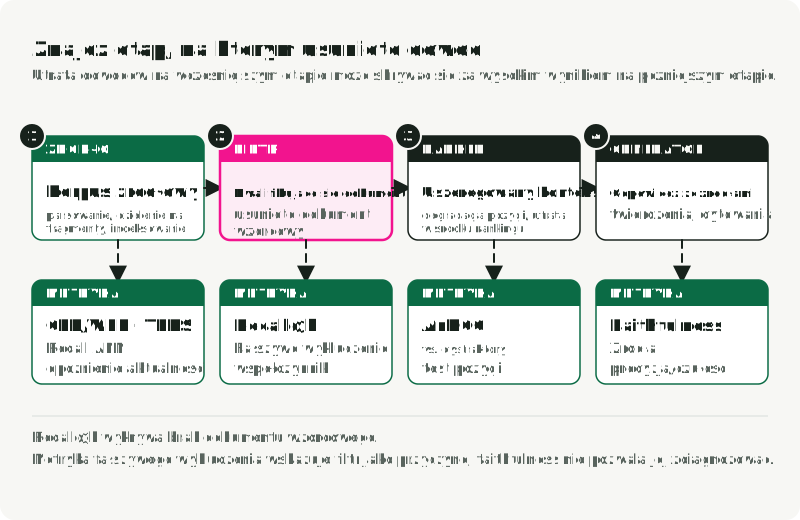
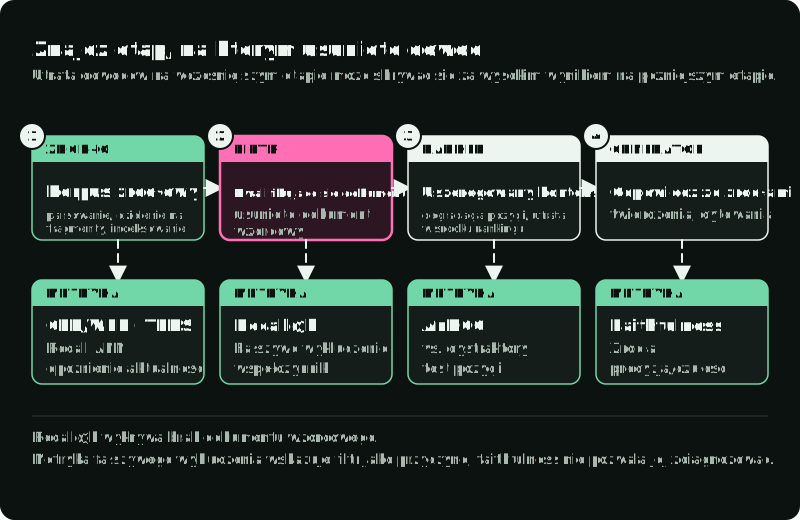
Twardy predykat trafności, taki jak product = Y AND locale = en-US, może sprowadzić efektywny recall do zera wśród dokumentów, które wywołujący może zobaczyć. Poprawnie zaimplementowany Recall@k wychwytuje stratę, bo jego mianownik pozostaje pierwotnym zbiorem kwalifikujących się trafnych dokumentów. Nie mówi jednak, czy pominięcie spowodował filtr, retriever czy ranker. Faithfulness ocenia twierdzenia względem pobranego kontekstu. Nadal może ocenić jako poparte twierdzenia oparte na tym niepełnym kontekście, ale nie zdiagnozuje przyczyny w filtrze ani w wyszukiwaniu. Pusta odmowa może nie dać żadnych twierdzeń i wynik NaN, zależnie od implementacji; nie traktuj tego jako dowodu, że faithfulness zatwierdziło odmowę.
Diagram pokazuje opisany niżej przykład. Kontrola uprawnień usuwa d3, który należy do innego najemcy; to wykluczenie jest poprawne. Filtr trafności usuwa następnie dokument wzorcowy dla q1 i q3. Recall@10 spada do 50% i rejestruje spadek; dopiero wskaźnik fałszywych wykluczeń, również 50%, przypisuje go predykatowi. Ewaluator, który odbudowuje zbiór wzorcowy po filtrowaniu, zgłasza 100%.
Metryka
filter_false_exclusion_rate =
    (# queries where all gold docs were excluded by metadata filter) /
    (# queries with at least one entitlement-eligible gold doc)
Ta definicja na poziomie zapytania liczy wykluczenia katastrofalne: nie przeżywa żaden kwalifikujący się trafny dokument. Przed oceną przetnij zbiór wzorcowy każdego zapytania ze zbiorem uprawnień wywołującego; dokument niekwalifikujący się nie jest fałszywym wykluczeniem. Dla zapytań z wieloma dokumentami wzorcowymi standardowy Recall@k nadal ujawnia stratę częściową; jeśli ta granica ma znaczenie, dodaj wskaźnik wykluczeń na dokument. Aby policzyć którykolwiek wskaźnik, potrzebujesz (a) ID dokumentów wzorcowych dla każdego zapytania ewaluacyjnego i (b) instrumentacji, która loguje zastosowane predykaty filtra, a nie tylko końcowe wyniki. Jako początkowy próg repozytorium towarzyszące przyjmuje wskaźnik fałszywych wykluczeń co najwyżej 2%; dostrój go do kosztu wykluczenia poprawnej odpowiedzi i przedziału ufności twojej próbki produkcyjnej.
Oto działająca implementacja. Porównuje poprawny standardowy recall z nieprawidłowym ewaluatorem, który redefiniuje trafność po filtrowaniu.
# A small worked example where relevance predicates remove eligible documents.
docs = [
    {"id": "d1", "tenant": "acme",   "locale": "en-US"},
    {"id": "d2", "tenant": "acme",   "locale": "en-GB"},
    {"id": "d3", "tenant": "globex", "locale": "en-US"},
    {"id": "d4", "tenant": "acme",   "locale": "en-US"},
    {"id": "d5", "tenant": "acme",   "locale": "de-DE"},
    {"id": "d6", "tenant": "acme",   "locale": "fr-FR"},
]

# Tenant isolation is an eligibility invariant, not a relevance experiment.
# Verify it independently before evaluating relevance preferences.
eligible_docs = [d for d in docs if d["tenant"] == "acme"]
assert {d["id"] for d in eligible_docs} == {"d1", "d2", "d4", "d5", "d6"}

queries = [
    # the gold doc lives in en-GB but the dynamic filter forced en-US
    {"qid": "q1", "gold": {"d2"}, "filter": lambda d: d["locale"] == "en-US"},
    # the gold doc is correctly within the tenant filter
    {"qid": "q2", "gold": {"d4"}, "filter": lambda d: d["tenant"] == "acme"},
    # the gold doc lives in fr-FR but the dynamic filter forced en-US
    {"qid": "q3", "gold": {"d6"}, "filter": lambda d: d["locale"] == "en-US"},
    # the gold doc passes the filter (de-DE locale match)
    {"qid": "q4", "gold": {"d5"}, "filter": lambda d: d["locale"] == "de-DE"},
]

def filter_false_exclusion_rate(queries, eligible_docs):
    n_with_gold, n_excluded = 0, 0
    eligible_ids = {d["id"] for d in eligible_docs}
    for q in queries:
        eligible_gold = q["gold"] & eligible_ids
        if not eligible_gold:
            continue
        n_with_gold += 1
        survivors = {d["id"] for d in eligible_docs if q["filter"](d)}
        if not (eligible_gold & survivors):
            n_excluded += 1
    if not n_with_gold:
        raise ValueError("false-exclusion rate needs queries with eligible gold")
    return n_excluded / n_with_gold, n_with_gold

rate, eligible_query_count = filter_false_exclusion_rate(queries, eligible_docs)
print(f"filter_false_exclusion_rate = {rate:.2%}")
# filter_false_exclusion_rate = 50.00%
print(f"eligible queries = {eligible_query_count} / {len(queries)}")
# eligible queries = 4 / 4

# Correct Recall@k keeps the original eligible gold set as its denominator.
def standard_recall_at_k(queries, eligible_docs, k=10):
    recalls = []
    eligible_ids = {d["id"] for d in eligible_docs}
    for q in queries:
        eligible_gold = q["gold"] & eligible_ids
        if not eligible_gold:
            continue
        # demo only: the survivor set stands in for a ranked run.
        # A real harness ranks the survivors first, then slices to k.
        survivors = [d for d in eligible_docs if q["filter"](d)][:k]
        survivor_ids = {d["id"] for d in survivors}
        recalls.append(len(eligible_gold & survivor_ids) / len(eligible_gold))
    return sum(recalls) / len(recalls) if recalls else 0.0

print(f"standard recall@10 = {standard_recall_at_k(queries, eligible_docs):.2%}")
# standard recall@10 = 50.00%

# INVALID: rebuilding the gold set after filtering changes the question.
# It drops queries whose relevant documents did not survive, then scores 100%.
def invalid_recall_over_filtered_gold(queries, eligible_docs, k=10):
    recalls = []
    all_doc_ids = {d["id"] for d in eligible_docs}
    for q in queries:
        all_survivors = {d["id"] for d in eligible_docs if q["filter"](d)}
        filtered_gold = q["gold"] & all_doc_ids & all_survivors
        if not filtered_gold:
            continue
        top_k_ids = set(list(all_survivors)[:k])
        recalls.append(len(filtered_gold & top_k_ids) / len(filtered_gold))
    return sum(recalls) / len(recalls) if recalls else 0.0

invalid = invalid_recall_over_filtered_gold(queries, eligible_docs)
print(f"INVALID recall (filtered gold) = {invalid:.2%}")
# INVALID recall (filtered gold) = 100.00%

assert rate == 0.5
assert standard_recall_at_k(queries, eligible_docs) == 0.5
assert invalid == 1.0
# Unauthorized gold and an empty denominator are tested in the companion's
# tests/test_audit_contracts.py.
Funkcja zwraca wskaźnik i liczbę zapytań z kwalifikującym się dokumentem wzorcowym. Jeśli ten mianownik jest pusty, funkcja zgłasza wyjątek zamiast podawać uspokajające zero; wymagana kontrola wydaniowa musi to traktować jako brak dowodów. Zapytania tylko z nieautoryzowanym dokumentem wzorcowym pozostają w osobnych testach uprawnień.
Połowa zapytań traci dokument wzorcowy przez filtr, więc poprawny Recall@10 spada do 50%. Ten wynik wychwytuje objaw, ale nie przypisuje przyczyny. Wskaźnik fałszywych wykluczeń pokazuje, że predykat usunął dwie odpowiedzi, zanim ruszył retriever. Celowo nieprawidłowy ewaluator podaje 100% tylko dlatego, że wyrzuca te porażki ze swojego zbioru wzorcowego. Żaden model nie odzyska dokumentu, który odfiltrowano.
tests/test_filter_exclusion.py::test_50_percent_exclusion_rate z repozytorium towarzyszącego oraz pierwszy przykład w notebook 04 używają starszych danych testowych z pięcioma dokumentami, które również dają 50 %, ale q3 jest tam wykluczone przez izolację tenantów. Te dane nie odtwarzają powyższego przykładu z uprawnionymi dokumentami wzorcowymi. Notatnik 04 uruchamia też diagnostykę filtrów SciFact z syntetycznymi metadanymi. Obecny evaluation/filter_exclusion.py przyjmuje osobny predykat autoryzacji i stały zbiór uprawnionych dokumentów wzorcowych oraz obejmuje precyzję i pełność predykatu.
Metryka towarzysząca: precision i recall predykatu
Gdy filtrowanie jest dynamiczne (na przykład LLM wyciąga predykaty filtra z zapytania), traktuj ekstraktor predykatów jak model klasyfikacyjny i oceniaj go tak samo. Mierz precision i recall predykatu na oznaczonym zbiorze par (query, correct predicate). Wskaźnik błędów predykatu nie przekłada się wprost na tę samą stratę punktów w recall wyszukiwania; zmierz, jak często te błędy wykluczają dokument wzorcowy. Gdy twardy filtr usunie dokument wzorcowy, żaden reranking nie pomoże.
Filtry kwalifikowalności a preferencje trafności
Autoryzacja, izolacja tenantów, jurysdykcja prawna i stan publikacji decydują, czy dokument może trafić do zbioru kandydatów. Zostaw je jako twarde filtry i waliduj niezależnie; Recall@k, wskaźnik fałszywych wykluczeń i precyzja trafności nie uprawniają do ich rozluźnienia.
Dla preferencji trafności, takiej jak ustawienia regionalne, aktualność lub wersja, porównaj twardy predykat z miękkim podbiciem na tych samych kwalifikujących się zapytaniach ze zbioru walidacyjnego. Dwie reguły rozstrzygają wynik:
- Reguły dostępu (autoryzacja, tenant, jurysdykcja, status publikacji) są zawsze twardymi filtrami.
- Każda inna preferencja jest miękkim podbiciem, chyba że przejdzie zmierzony test niżej. Wtedy może stać się twardym predykatem.
Pseudokod podaje test dla reguły 2:
For each relevance preference F:
  hard_recall_F  = retrieval_recall@k with F as a hard filter
  soft_recall_F  = retrieval_recall@k with F as a +0.X rerank boost
  hard_precision = relevant_in_top_k / k under hard filter
  soft_precision = relevant_in_top_k / k under soft boost
  precision_gain = hard_precision - soft_precision
  precision_gain_CI = paired-query uncertainty interval for precision_gain
  exclusion_rate = % of queries where the gold doc was filtered out (hard)

Pre-register Δ_min, ε, and recall_loss_max for this workflow.
Use a hard predicate only if:
  lower_bound(precision_gain_CI) >= Δ_min
  AND exclusion_rate <= ε
  AND hard_recall - soft_recall >= -recall_loss_max.
Otherwise prefer a soft boost.
Minimalny użyteczny przyrost precyzji, przedział niepewności, ε i granicę utraty recall wybierz na podstawie szkody z wykluczenia skądinąd kwalifikującej się odpowiedzi, korzyści z większej precyzji i rozmiaru próbki walidacyjnej. Zacznij od ε równego 1–2% i obniż je tam, gdzie pominięta odpowiedź jest kosztowna.
Część 6: Ewaluacja generowania
Metryki wyszukiwania mówią, że system mógł odpowiedzieć poprawnie. Nie mówią, że odpowiedział. Lukę wypełniają metryki generowania.
Faithfulness i groundedness
Faithfulness w RAGAS rozkłada odpowiedź na atomowe twierdzenia (krótkie, samodzielne stwierdzenia faktów), a potem weryfikuje każde z nich względem pobranego kontekstu za pomocą sędziego LLM:
Faithfulness sprawdza poparcie w dostarczonych dowodach; nie ustala, że dowody są poprawne ani że wystarczą do odpowiedzi na pytanie. Odpowiedzi bez twierdzeń zapisuj osobno i podawaj ich liczbę, zamiast przyznawać pustej odpowiedzi doskonałe faithfulness.
Aktualna dokumentacja Ragas zaleca poniższe API kolekcji. W projekcie uv zainstaluj ragas i openai poleceniem uv add ragas openai, ustaw OPENAI_API_KEY i zapisz to jako skrypt uruchamiany przez uv run. Skrypt wywołuje dostawcę i generuje jego opłaty; wynik pochodzi od sędziego i nie jest deterministyczną stałą. Przypnij rozwiązane zależności w pliku blokady.
import asyncio

from openai import AsyncOpenAI, omit
from ragas.llms import llm_factory
from ragas.metrics.collections import Faithfulness

async def main():
    async with AsyncOpenAI() as client:
        # Ragas 0.4.3 sends max_tokens by default; GPT-5.6 models need max_completion_tokens.
        llm = llm_factory(
            "gpt-5.6-terra", client=client, reasoning_effort="none",
            max_tokens=omit, max_completion_tokens=1024,
            temperature=omit, top_p=omit,
        )
        scorer = Faithfulness(llm=llm)
        result = await scorer.ascore(
            user_input="How many moons does Mars have?",
            response="Mars has two moons, Phobos and Deimos.",
            retrieved_contexts=["Mars has two moons named Phobos and Deimos."],
        )
        print(result.value)

if __name__ == "__main__":
    asyncio.run(main())
Ten przykład używa jako sędziego GPT-5.6 Terra; fabryka Ragas przekazuje argumenty modelu. Porównaj fałszywe zaliczenia, fałszywe oblania i koszt sędziego z ocenami ludzi, zanim zastąpisz tańszego sędziego, którego już sprawdziłeś względem etykiet.
Tabela frameworków w części 1 wymienia też answer relevancy i context precision. To samo API kolekcji ocenia obie z tym samym llm. AnswerRelevancy przyjmuje dodatkowo model embeddings, na przykład embedding_factory("openai", model="text-embedding-3-small", client=client) z ragas.embeddings.base. ContextPrecision wymaga w ascore odpowiedzi wzorcowej reference. Każdy wynik odpowiada na inne pytanie: faithfulness pyta, czy kontekst popiera odpowiedź, answer relevancy pyta, czy odpowiedź dotyczy pytania, a context precision pyta, czy trafny kontekst jest na początku rankingu.
Aby zbudować własny scorer, zachowaj strukturę wyodrębnij–zweryfikuj–zagreguj. Ekstrakcja to wywołanie LLM, które dzieli odpowiedź na twierdzenia; weryfikacja to model NLI (natural-language inference) lub sędzia LLM. Waliduj ekstrakcję i wynikanie osobno oraz zapisuj oceny bez twierdzeń lub zakończone błędem. Na przykład odpowiedź z 4 twierdzeniami, z których 3 są poparte, dostaje wynik 3/4 = 0,75. Odpowiedź z 0 twierdzeń nie jest oceniana.
Notebook 05 uruchamia offline stały przykład o Marsie z przybliżeniem leksykalnym; nie sprawdza ono wynikania semantycznego. Jego moduł evaluation/faithfulness.py implementuje też ekstrakcję i weryfikację twierdzeń przez SGR. Zestaw generation ocenia oznaczone syntetyczne dane QA z --suite generation --live. Repozytorium używa tylko modeli OpenAI. gpt-5.6-luna domyślnie generuje i ocenia; --judge-model gpt-5.6-terra zmienia model oceniający. Oba modele pochodzą od jednego dostawcy, więc repozytorium pokazuje proces oceny, a nie porównanie rodzin modeli.
Specjalistyczną alternatywą dla LLM-as-judge jest HHEM-2.1-Open (Hughes Hallucination Evaluation Model, Vectara), klasyfikator dostrojony do wykrywania halucynacji. Jego karta modelu opisuje checkpoint, surowy wynik 0–1, który zwraca, oraz wyniki zrównoważonej dokładności na AggreFact i RAGTruth. Nie publikuje domyślnego progu decyzji, więc jego wybór należy do ciebie. Traktuj to jako dowody z karty modelu, a nie gwarancję dla twojego korpusu: przed wdrożeniem skalibruj próg na lokalnych etykietach i porównaj go z wybranym sędzią.
Ewaluacja faktów atomowych
FActScore (Min et al., EMNLP 2023) rozkłada długie generacje na fakty atomowe, wyszukuje dowody dla każdego faktu, oznacza każdy jako supported / not-supported i podaje odsetek poparty:
Implementacja referencyjna: shmsw25/FActScore. Pierwotna ewaluacja skupiała się na biografiach z Wikipedią jako źródłem dowodów. Adaptacje do streszczeń lub innych długich tekstów wymagają lokalnej weryfikacji ekstrakcji twierdzeń, pokrycia dowodami i ocen potwierdzenia. Powtarzane banalne fakty mogą zawyżać wynik, a pojedynczo prawdziwe zdania mogą tworzyć mylącą odpowiedź. MontageLie (EMNLP 2025) testuje tę słabość przez mylące relacje i kolejność prawdziwych zdań. VeriScore obsługuje twierdzenia z niezbędnymi zastrzeżeniami; filtr Core pomaga zapobiegać dodawaniu faktów dla podniesienia wyniku.
Dokładność cytowań
Śledź precision cytowań (zacytowane fragmenty faktycznie popierają twierdzenie) i recall cytowań (twierdzenia, które powinny być zacytowane, są zacytowane):
TREC 2024 RAG Track definiuje powtarzalny protokół oceny poparcia. Thakur et al. (SIGIR 2025) podają około 56% zgodności z ocenami ludzi wystawionymi od zera i 72% w innym warunku, w którym ludzie poprawiali predykcje LLM. Ten drugi wynik to anotacja wspomagana, a nie niezależny dowód lepszej dokładności sędziego. Przy liczbie zawsze podawaj warunek anotacji. Jako automatyczne przybliżenie ALCE (Gao et al., EMNLP 2023) implementuje precision/recall cytowań z weryfikacją opartą na NLI.
Poprawność odpowiedzi, kompletność, odmowa
- Poprawność odpowiedzi względem wzorca: dla krótkich odpowiedzi może wystarczyć exact match lub token-F1;
evaluate.load("squad")z Hugging Face liczy oba, a pakietbert-scoreliczy BERTScore. Dla dłuższych odpowiedzi sprawdzaj relacje faktograficzne, encje, wielkości, negację i wymagane informacje względem sprawdzonych wzorców. BERTScore i cosinus embeddings mierzą podobieństwo; błędna liczba lub negacja może zachować wysoki wynik.AnswerCorrectnessz Ragas łączy porównanie faktów z podobieństwem, zamiast utożsamiać jedno z drugim. - Kompletność przez nuggety: nugget to trafna jednostka informacji; nuggety kluczowe odróżnia się od opcjonalnych, ale przydatnych. Pytanie o datę założenia może wymagać roku; nazwisko założyciela nie jest automatycznie wymagane. AutoNuggetizer tworzy i dopracowuje nuggety na podstawie ocenionych pul dokumentów, a potem sprawdza ich obecność w wygenerowanych odpowiedziach. Jego wstępny raport z TREC 2024 objął 21 tematów i 45 przebiegów. Przegląd TREC 2025, opublikowany w marcu 2026, rozszerza protokół na zapytania narracyjne i ocenia trafność wyszukiwania, kompletność odpowiedzi i atrybucję. To publiczne protokoły ewaluacji, a nie dowód, że każdy produkcyjny system RAG potrzebuje tej samej rubryki nuggetów.
- Zachowanie przy odmowie: oznacz, czy dostarczone dowody pozwalają odpowiedzieć, a potem zmierz odsetek poprawnych odmów wśród wszystkich odmów oraz odsetek odmów wśród przypadków, w których należało się powstrzymać. NoMIRACL (Findings of EMNLP 2024) testuje odporność na trafne i nietrafne dostarczone fragmenty; nie dowodzi, że cały korpus nie zawiera odpowiedzi. We własnym zestawie oddziel braki wyszukiwania od zapytań naprawdę spoza zakresu.
Weryfikacja po generowaniu
Najtańsze zyski w niezawodności często dają deterministyczne kontrole po generowaniu, a nie większe modele.
-
Flaga nieznanej encji: zapisuj ciągi nazw własnych z odpowiedzi, których nie ma w znormalizowanym ciągu kontekstu (na przykład
entszespaCyplus dokładne dopasowanie). To tania, domenowa flaga nieznanych ciągów encji, a nie kontrola ugruntowania: nie ustali tożsamości, relacji, negacji, czasu ani pochodzenia. Zanim użyjesz jej do zatwierdzenia wydania, zmierz jej precision i recall na lokalnych etykietach, a do weryfikacji zachowaj wynikanie na poziomie twierdzeń lub ocenę ludzi.W tym przykładzie flaga nie znajduje nieznanej encji, choć odpowiedź mówi coś przeciwnego niż kontekst.
def unseen_entity_flag(answer: str, context: str, entities: list[str]) -> bool: return any(entity.lower() not in context.lower() for entity in entities) context = "Paris was not founded in 1994." answer = "Paris was founded in 1994." assert not unseen_entity_flag(answer, context, ["Paris"]) claim_supported = False # human label or an NLI verdict, not the lexical flag assert not claim_supported -
Weryfikacja twierdzeń: wyodrębnij twierdzenia, uruchom NLI względem kontekstu, odrzuć lub oznacz każde poniżej progu. Modele NLI jako faithfulness:
cross-encoder/nli-deberta-v3-large,MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli. Dodaje opóźnienie. Warto w dziedzinach o wysokiej stawce. -
Samospójność (Wang et al., ICLR 2023): próbkuj wiele generacji przy temperaturze > 0; podaj wskaźnik zgodności (np. odsetek generacji zgodnych z odpowiedzią modalną lub parowy BERTScore); liczbę próbek wybierz z krzywej stabilność–koszt, a odpowiedzi o niskiej zgodności oznacz do przeglądu przez człowieka.
-
Kalibracja pewności: zbierz zwerbalizowaną pewność („Jak bardzo jesteś pewien, 0–1?”) i porównaj z rzeczywistą poprawnością na zbiorze ewaluacyjnym. Wykreśl krzywą kalibracji i podaj Expected Calibration Error: , gdzie to przedziały pewności. Implementacje:
netcal,torchmetrics.CalibrationError. Model deklarujący pewność 0,9 powinien mieć rację w około 90% porównywalnych przypadków; zmierz tę lukę zamiast zakładać kalibrację.
Część 7: Ewaluacja RAG opartego na ontologii
Standardowe metryki powyżej obejmują RAG na otwartym korpusie. Jeśli twój RAG wyszukuje względem uporządkowanej ontologii, taksonomii lub grafu wiedzy, te metryki są potrzebne, ale niewystarczające. Przykłady to produkty w katalogu, schorzenia w SNOMED, komponenty w BOM i techniki bezpieczeństwa w MITRE ATT&CK. Musisz też mierzyć warstwę ontologii.
Dokładność łączenia encji
Pierwsze zadanie to przypisanie wzmianki z zapytania do encji ontologii („Aspirin” → wikidata:Q18216, „the 737” → aircraft:Boeing_737).
- Precision/recall/F1 na poziomie wzmianek: standardowo, względem wzorcowych zakresów wzmianek (licz za pomocą
seqevallub komparatora zbiorów zakresów). - Dokładność ujednoznaczniania: jaki odsetek poprawnie wykrytych wzmianek trafia do właściwego ID encji? Publiczne punkty odniesienia to ReFinED, REL i GENRE; benchmarki takie jak AIDA-CoNLL i BELB pokazują, że wyniki różnią się między systemami i domenami.
- Obsługa NIL: precision/recall dla „encji nie ma w ontologii”. Mierz nadmierne łączenie z bliskimi, ale błędnymi encjami osobno od poprawnego powstrzymania się.
Ewaluacja uwzględniająca hierarchię
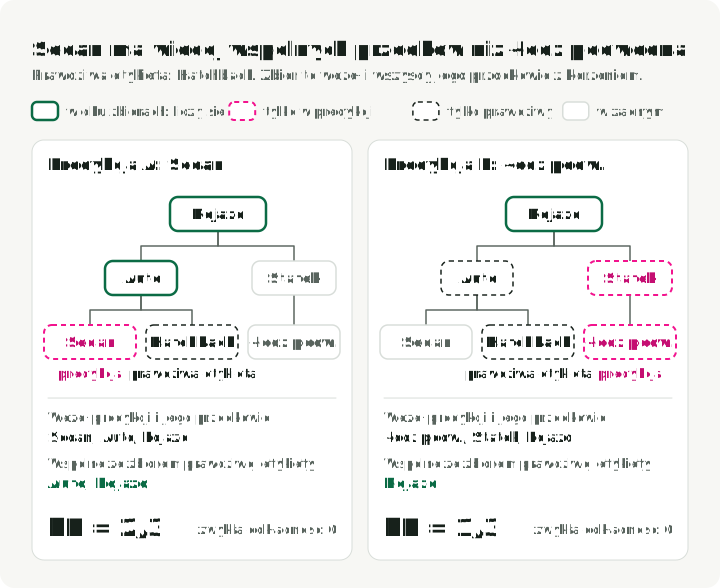
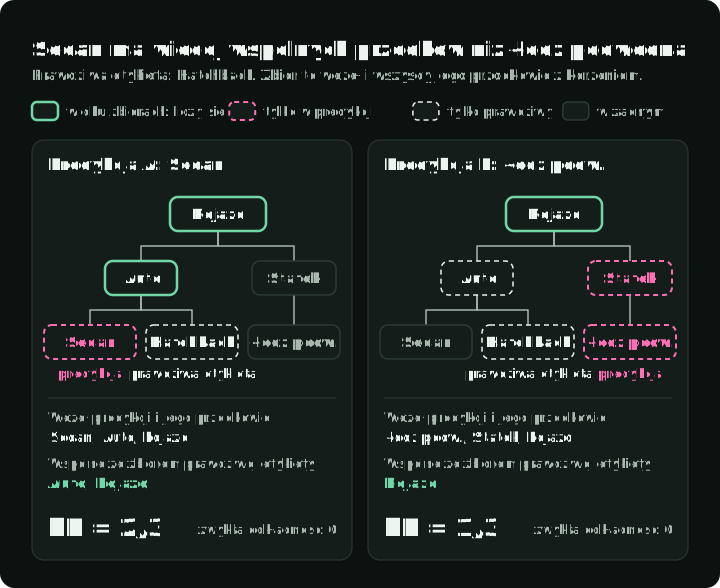
Zwykła dokładność traktuje „przewidziano Sedan, gdy prawdą jest Hatchback” tak samo jak „przewidziano Okręt podwodny, gdy prawdą jest Hatchback”. Te błędy nie są równe. Na diagramie Sedan dzieli z prawdziwą etykietą dwa z trzech węzłów, a Okręt podwodny tylko korzeń; hierarchiczna precision niżej zamienia to pokrycie w wynik.
-
Hierarchiczne precision/recall/F1 (Kosmopoulos et al., 2015): uznają wspólnych przodków w DAG ontologii. Niech to przewidziany węzeł wraz ze wszystkimi przodkami, a to prawdziwy węzeł wraz ze wszystkimi przodkami:
Zaimplementuj to za pomocą
networkxna grafie ontologii: rozszerz każdą predykcję i każdą etykietę o jej przodków, a potem policz powyższe części wspólne zbiorów. -
Podobieństwo Wu-Palmera między przewidzianą a wzorcową encją w taksonomii (Wu & Palmer, 1994):
gdzie LCA to najniższy wspólny przodek w taksonomii. Dostępne od ręki w NLTK dla WordNet (
from nltk.corpus import wordnet as wn; wn.synset("car.n.01").wup_similarity(wn.synset("truck.n.01"))); dla własnych taksonomii policz LCA za pomocąnetworkx. -
Wskaźnik pomyłek z rodzeństwem i rodzicem: śledź osobno pomyłki z rodzeństwem, rodzicami i potomkami —
count_sibling / total_errors,count_parent / total_errors,count_descendant / total_errors. Na sprawdzonych przykładach przetestuj, czy błędy z rodzeństwem wynikają z niejednoznacznych wzmianek, a błędy z rodzicem z nadmiernego uogólniania.
Wskaźnik fałszywych wykluczeń filtra (powtórka, teraz krytyczny)
W systemach opartych na ontologii twarde filtry często pochodzą z samej ontologii („wyszukuj tylko dokumenty z tagiem kategorii X”). Wskaźnik wykluczeń (zdefiniowany w części 5) staje się głównym sygnałem poprawności. Błędna predykcja kategorii może wyzerować recall; wskaźnik wykluczeń przypisuje tę stratę filtrowi.
Zgodność generowania z ograniczeniami
Gdy wyjście musi być zgodne z ontologią (każda nazwa encji w odpowiedzi musi być poprawnym członkiem ontologii; każdy predykat musi pochodzić z zamkniętego słownika), mierz:
- Wskaźnik poprawności schematu: odsetek wyjść, które da się sparsować i zwalidować względem schematu ontologii. Waliduj za pomocą
jsonschemalubpydantic. JSONSchemaBench to publiczny benchmark dla ogólnych ustrukturyzowanych danych wyjściowych; dla schematów specyficznych dla ontologii zbuduj własny walidator. - Zgodność ze słownikiem: odsetek nazwanych encji w wyjściu, które są poprawnymi ID ontologii — jednoliniowe sprawdzenie przynależności do zbioru względem zamkniętego słownika.
- Zgodność semantyczna: składniowo poprawne wyjście nadal może wskazać błędną, choć poprawną encję. Łącz zgodność z poprawnością odpowiedzi końcowej.
Frameworki dekodowania z ograniczeniami (Outlines, XGrammar, Guidance, OpenAI Structured Outputs) mają wymuszać poprawność schematu. JSONSchemaBench porównuje wydajność, pokrycie i jakość między implementacjami. Uruchom ponownie jego przypadki zgodne z twoimi schematami i backendem serwującym, bo pokrycie i opóźnienie zależą od obu.
Audytowalność
Dla systemów opartych na ontologii, w których odpowiedzi podlegają przeglądowi:
- Kompletność cytowań: odsetek twierdzeń faktograficznych z co najmniej jednym weryfikowalnym cytowaniem.
- Głębokość pochodzenia: odsetek cytowań, które prowadzą aż do dokumentu źródłowego ze stabilnym ID, a nie tylko do skrótu chunka.
- Wskaźnik powtarzalności: ponowne uruchomienie tego samego zapytania na ustalonej migawce zwraca tę samą odpowiedź. Przypnij wersję modelu, środowisko uruchomieniowe, konfigurację dekodowania i seed, a wymagany wskaźnik powtórzeń ustal na podstawie potrzeb audytowych procesu. Sama temperatura zero nie gwarantuje determinizmu. Rozbieżność może pochodzić z generowania, środowiska serwującego lub dowolnego wcześniejszego etapu.
Część 8: Ewaluacja na poziomie systemu
Całościowa jakość odpowiedzi
- LLM-as-judge (Zheng et al., NeurIPS 2023): skalowalne podejście do ewaluacji opartej na modelu. G-Eval (Liu et al., EMNLP 2023) generuje kroki ewaluacji z zadania i kryteriów, a potem waży poziomy ocen prawdopodobieństwami tokens tych poziomów: . To prawdopodobieństwa, a nie logarytmy prawdopodobieństw. Zgodność zależy od sędziego, zadania, treści prompt i zbioru kalibracyjnego.
- Preferencja parami: pokaż sędziemu odpowiedź A i odpowiedź B; zapisz preferencję. Zastępuje to ocenę bezwzględną decyzją porównawczą, ale nadal wymaga kalibracji względem preferencji ludzi. MT-Bench podał zgodność sędziego GPT-4 powyżej 80% zarówno z preferencjami ludzi, jak i ze zgodnością między ludźmi, w warunkach swojego benchmarku; nie przenoś tego wskaźnika na inną domenę bez kalibracji.
LLM-as-judge ma realne błędy systematyczne:
- Błąd pozycji: zmierz wrażliwość na kolejność na przypadkach oznaczonych przez ludzi dla wybranego sędziego i zadania. Randomizacja lub agregacja z zamienioną kolejnością może pomagać niektórym parom model/zadanie, ale zachowaj którekolwiek z nich tylko wtedy, gdy poprawia lokalną zgodność z ludźmi; kontrolowane badanie z 2026 uznało zamianę pozycji za szkodliwą w swoich przypadkach adwersarialnych.
- Błąd rozwlekłości: sędziowie mogą mylić długość z jakością. Cytowane kontrolowane badanie z 2026, wersja 2 wykazało zróżnicowane zachowanie na parach z rozbudowaniem: trzech sędziów wolało dłuższe odpowiedzi, Claude wolał zwięzłe, a GPT-4o był w przybliżeniu neutralny. Wszystkich pięciu sędziów dobrze radziło sobie w kontrolach z obcięciem. Te wyniki zależą od benchmarku, więc powiedz sędziemu, jak traktować kompletność i wypełniacze, a potem podaj wyniki z kontrolą długości na własnej rubryce.
- Ryzyko faworyzowania własnych odpowiedzi: Zheng et al. zaobserwowali o 10% wyższy odsetek wygranych własnych dla GPT-4 i o 25% wyższy dla Claude-v1 w swoich danych, ale uznali, że ograniczone dane i małe różnice nie pozwalają ustalić błędu samowzmocnienia. Porównaj sędziów z tej samej i z różnych rodzin względem lokalnych ocen ludzi; wybierz lepiej skalibrowanego sędziego, zamiast zakładać, że któryś układ jest bezpieczny.
Praktyczny przepis: wybierz sędziego na danych kalibracyjnych oznaczonych przez ludzi, zamaskuj tożsamość modeli, zmierz wrażliwość na kolejność i określ politykę długości w rubryce. Powtarzaj przypadki tylko wtedy, gdy dodatkowe próbki istotnie zmniejszają niepewność. W ewaluacjach o wysokiej stawce porównaj sędziów z tej samej i z różnych rodzin i przeanalizuj rozbieżności względem ocen ludzi.
Schema-Guided Reasoning dla sędziów
Swobodne wyjście to jedno ze źródeł zmienności przebiegów sędziego. Dwa przebiegi dla tej samej odpowiedzi mogą inaczej uporządkować rubrykę i dać różne wyniki. Schema-Guided Reasoning (SGR) czyni tę rubrykę jawną: zdefiniuj etapy ewaluacji jako schemat Pydantic, a potem użyj wyjścia z ograniczeniami przez Outlines, XGrammar, ustrukturyzowane dane wyjściowe vLLM lub response_format z OpenAI, aby wymusić obsługiwane ograniczenia schematu. Kolejność pól może pomóc recenzentowi w sprawdzeniu zapisu, ale nie dowodzi, że model przeszedł etapy w tej kolejności.
W ewaluacji RAG schemat rozkłada ocenę na jawne, audytowalne pola, zamiast pozwalać modelowi skoczyć od razu do liczby:
from pydantic import BaseModel, Field, ValidationError, model_validator
from typing import Literal

class FaithfulnessJudgment(BaseModel):
    extracted_claims: list[str] = Field(
        description="Atomic factual claims in the answer, one per item."
    )
    supported_claims: list[str] = Field(
        description="Subset of extracted_claims that are entailed by the context."
    )
    unsupported_claims: list[str] = Field(
        description="Subset that is NOT entailed by the context."
    )
    outcome: Literal["scored", "no_claims"]
    failure_mode: Literal[
        "none", "fabrication", "overgeneralization", "wrong_entity", "stale_fact"
    ]
    rationale: str

    @model_validator(mode="after")
    def require_claim_partition(self):
        for claims in (self.extracted_claims, self.supported_claims, self.unsupported_claims):
            if any(not claim.strip() for claim in claims):
                raise ValueError("claims must contain non-whitespace text")
        extracted = set(self.extracted_claims)
        supported = set(self.supported_claims)
        unsupported = set(self.unsupported_claims)
        if not extracted:
            if supported or unsupported or self.outcome != "no_claims":
                raise ValueError("an empty extraction must be a no_claims outcome")
            return self
        if (
            len(extracted) != len(self.extracted_claims)
            or len(supported) != len(self.supported_claims)
            or len(unsupported) != len(self.unsupported_claims)
            or supported & unsupported
            or supported | unsupported != extracted
            or self.outcome != "scored"
        ):
            raise ValueError("verdict lists must be a complete, disjoint claim partition")
        return self

    @property
    def score(self) -> float | None:
        if not self.extracted_claims:
            return None
        return len(self.supported_claims) / len(self.extracted_claims)

valid = FaithfulnessJudgment(
    extracted_claims=["Mars has two moons", "Mars has a thick atmosphere"],
    supported_claims=["Mars has two moons"],
    unsupported_claims=["Mars has a thick atmosphere"],
    outcome="scored",
    failure_mode="fabrication",
    rationale="The atmosphere claim lacks support.",
)
assert valid.score == 0.5
empty = FaithfulnessJudgment(
    extracted_claims=[],
    supported_claims=[],
    unsupported_claims=[],
    outcome="no_claims",
    failure_mode="none",
    rationale="Score refusal correctness separately.",
)
assert empty.score is None
try:
    FaithfulnessJudgment(
        extracted_claims=["Mars has two moons"],
        supported_claims=["Mars has two moons"],
        unsupported_claims=["Mars has two moons"],
        outcome="scored",
        failure_mode="none",
        rationale="Contradictory verdict.",
    )
except ValidationError:
    pass
else:
    raise AssertionError("overlapping verdicts must fail validation")
Ten poglądowy kontrakt liczy wynik dopiero wtedy, gdy listy werdyktów tworzą pełny, rozłączny podział wyodrębnionych twierdzeń. Wynik bez twierdzeń nie ma oceny faithfulness i musi zostać poza agregatem faithfulness; podaj jego liczbę i oceń poprawność odmów osobno, aby powstrzymanie się od odpowiedzi nie poprawiało po cichu średniej. Zachowaj te kontrole semantyczne w produkcji; wyjście z ograniczeniami gwarantuje kształt, a nie bezstronny werdykt. Model Pydantic sprawia też, że zmiana rubryki jest widoczna jako różnica w kodzie, a kalibracja przez ludzi testuje samą ocenę.
Działa to dla każdego sędziego opartego na rubryce, nie tylko dla faithfulness. Preferencja parami, poparcie cytowań i poprawność odmów też na tym zyskują.
Notebook 07 mierzy obciążenie pozycją przez wywołania parami z odwróconą kolejnością. Jego moduł evaluation/llm_judge.py implementuje też punktową ocenę przez SGR. Uruchomienia parami pokazują oba porządki odpowiedzi i raportują spójność po zamianie. Punktowy model oceniający zwraca jedną liczbę całkowitą; nie jest to metoda G-Eval ważona prawdopodobieństwami. Ponieważ oba modele pochodzą od jednego dostawcy, pomiar preferencji własnego modelu nadal wymaga modelu oceniającego z innej rodziny, porównanego z lokalnymi etykietami ludzkimi.
Opóźnienie i koszt
- p50, p95, p99 na każdym etapie pipeline’u. Rozsądny start: p95 dla SLO i p99 dla alertów; zmień oba, gdy poznasz ścieżkę użytkownika, wolumen ruchu i budżet błędów.
- Time-to-first-token a całkowity czas generowania. Użytkowników obchodzi TTFT w strumieniowym UX.
- Podział na etapy: wyszukiwanie, reranking, generowanie, postprocessing. Użyj śladu, by znaleźć ogon opóźnień, zamiast zakładać, który etap go spowodował; przy porównywaniu przebiegów zapisuj urządzenie i rozmiar batcha rerankera.
- Łączny $/zapytanie = embedding + wyszukiwanie + reranking + generowanie + amortyzowane przechowywanie. Śledź p50 i p99; w długim ogonie ucieka budżet.
- Wskaźniki trafień w cache w cache embeddings, cache wyszukiwania i KV cache. Ustaw osobne cele na podstawie obserwowanej powtarzalności, polityki unieważniania i kosztu unikniętego na każdej warstwie.
Notebook 08 pokazuje p50/p95/p99 dla etapu retrieve instrumentowanego przez evaluation/runner.py. Moduł evaluation/latency.py może podsumować inne etapy, jeśli jawnie je zinstrumentujesz. make benchmark przeszukuje ustawienia dzielenia na fragmenty i embeddings bez wywołań API. Porównanie LLM wymaga klucza OpenAI i uv run python -m rag_evals.scripts.benchmark --skip-chunking --skip-embedding --live.
Testy A/B
- Jednostka randomizacji: najpierw określ wynik, który chcesz oszacować. Potem zapytaj, czy wcześniejsze odpowiedzi mogą zmienić późniejsze zachowanie i czy przypisana jednemu użytkownikowi wersja może wpłynąć na doświadczenie innego. Używaj przypisania na użytkownika lub sesję, gdy wielokrotna ekspozycja może zmienić zachowanie albo stworzyć niespójny UX. Przypisanie na zapytanie jest uzasadnione tylko wtedy, gdy te efekty są pomijalne, a analiza modeluje powtarzane obserwacje.
- Metryki główne, ochronne i eksploracyjne: zarejestruj je z góry. Metrykę główną wybierz na podstawie wyniku produktowego; zastępcze miary satysfakcji to kciuki, regeneracje i czas przebywania. Opóźnienie i koszt traktuj jako metryki ochronne, gdy ograniczają doświadczenie.
- Wielkość próby: przed startem wykonaj analizę mocy na podstawie minimalnego efektu wartego wykrycia, bazowej wariancji, jednostki przypisania i reguły zatrzymania.
Część 9: Budowa zbioru testowego
Metryka jest tak dobra, jak zbiór testowy, na którym działa. Jeśli twój zbiór wzorcowy obejmuje trzy intencje, a ruch produkcyjny dwanaście, Recall@10 mierzy tylko te trzy. Co gorsza, zbiór testowy dopasowany do łatwych pytań („Jaka jest polityka zwrotów w firmie?”) może zatwierdzić system, który zawodzi na trudnych („Kwalifikowalność zwrotu przy częściowym anulowaniu według unijnych przepisów o prawach konsumenta, rozliczonym w EUR, dla klienta w Irlandii?”). Wynik zagregowany rośnie, a system nadal zawodzi w ważnej części ruchu produkcyjnego.
Niekompletne etykiety trafności mogą zniekształcać recall w obu kierunkach. Jeśli prawdziwy zbiór trafnych dokumentów to {a, b}, a etykiety zawierają tylko {a}, pobranie {a} daje 1,0 zamiast 0,5; pobranie {b} daje zero zamiast 0,5. Wersjonuj oceny i sprawdzaj nowo pobrane, nieocenione dowody, zanim zinterpretujesz różnicę.
Zbuduj zbiór testowy wokół rzeczywistego rozkładu zapytań i trudności. Potem wybierz metryki, które reagują na docelowe tryby awarii, i dostrajaj system względem nich.
Generowanie zapytań syntetycznych
Użyj LLM do generowania pytań z korpusu:
- Na chunk: „Wygeneruj 3 pytania, które użytkownik mógłby zadać, a na które odpowiada ten chunk.”
- Wieloetapowe: wylosuj dwa chunki, wygeneruj pytanie wymagające obu.
- Adwersarialne: generuj pytania z encjami-dystraktorami, niemal zduplikowanymi sformułowaniami i niejednoznacznymi wzmiankami.
Generowanie testów w Ragas używa scenariuszy opartych na grafie z zapytaniami jedno- i wieloetapowymi oraz konkretnymi lub abstrakcyjnymi potrzebami informacyjnymi. DataMorgana generuje konfigurowalne syntetyczne benchmarki w kategoriach użytkowników i pytań. Dane syntetyczne przydają się na zimnym starcie i do testowania pokrycia. Nie zastąpią prawdziwych zapytań użytkowników.
Budowa zbioru wzorcowego
Zbiór wzorcowy opiera się na danych opracowanych przez ludzi.
- Pobierz próbkę prawdziwych zapytań użytkowników (lub symulowanych, jeśli jesteś przed startem), warstwowaną według intencji.
- Poproś ekspertów dziedzinowych (SME), by odpowiedzieli na każde pytanie i wskazali dokumenty zawierające odpowiedź.
- Zacznij od kilkuset zapytań (200–500) i sprawdź przedział. Przy 200 zapytaniach i odsetku zaliczeń około 0,8 przedział 95% wynosi około ±5,5 punktu (1,96 × √(0,8 × 0,2 / 200)). Jeśli zmiana, którą chcesz wykryć, jest mniejsza, dodaj zapytania do wycinków, które rozstrzygają o wydaniu.
- Dodaj sprawdzone zapytania produkcyjne (część 10), gdy kontrole dryfu lub nowe typy zapytań pokażą lukę w macierzy pokrycia niżej.
Trzymaj osobno cztery zbiory:
- Deweloperski: strojenie prompts, k i chunkingu.
- Kalibracja sędziego: etykiety ludzi, które sprawdzają sędziego.
- Wydaniowy: oceniany raz dla każdego kandydata, nigdy nie służy do strojenia.
- Monitoring: świeży ruch produkcyjny, przeglądany w ciemno.
Przed podziałem grupuj wspólne dokumenty źródłowe i sesje. Gdy zapytanie lub etykieta pokieruje strojeniem, staje się danymi deweloperskimi, więc zbiór wydaniowy użyty do strojenia staje się danymi deweloperskimi. Zarezerwuj nietknięte przypadki do walidacji wybranej konfiguracji i sędziego.
Zapisuj wersje korpusu, zapytań, etykiet trafności i polityki, jednostkę k, budżet dostarczonego kontekstu, rewizje scorera i sędziego oraz reguły agregacji. Porównuj różnice parowane dla każdego zapytania na tej samej populacji, z niepewnością i liczebnością wycinków. Uwzględnij każde oczekiwane zapytanie: przekroczenie czasu, brakujący wynik lub nieoceniona odpowiedź sędziego muszą pozostać widoczne w rozliczeniu ukończeń i błędów. Nie pozwól, by wynik wydania poprawiał się przez ciche porzucanie porażek. ARES oferuje podejście badawcze z automatycznymi sędziami, walidacją przez ludzi i prediction-powered inference do szacunków systemu, gdy anotacji jest mało; sprawdzony lokalny zestaw można zacząć prościej.
Adwersarialne zbiory testowe
- Kontrfaktyki: zamień kluczowe encje w zapytaniu. Czy system pobiera właściwe chunki dla zamienionego zapytania?
- Dystraktory: zapytania, w których korpus zawiera wiarygodną, ale błędną odpowiedź, której nie należy pobierać. Tak obciąża system RGB (Chen et al., AAAI 2024): odporność na szum, odrzucanie negatywne, integracja informacji i odporność na kontrfaktyki.
- Negacja i kwantyfikatory: zapytania ze słowami „nie”, „z wyjątkiem” i „tylko”. Retrievery gęste często sobie z nimi nie radzą.
- Poza zakresem: zapytania bez odpowiedzi w korpusie. System powinien powiedzieć „nie wiem”, a nie halucynować. NoMIRACL dostarcza testy trafności i odpowiadalności na poziomie fragmentów; dodaj osobne etykiety spoza zakresu na poziomie korpusu. Oceniaj powstrzymywanie się od odpowiedzi jawnie na swoich produkcyjnych typach zapytań.
Pokrycie i ciągła ewaluacja
- Zbuduj macierz pokrycia: intencja zapytania × typ dokumentu × gałąź ontologii. Jedno zapytanie na komórkę to początkowy spis pokrycia, a nie dość mocy statystycznej do decyzji wydaniowej. Puste komórki ujawniają brak pokrycia; wypełnione wycinki dobierz do niepewności, którą możesz tolerować.
- Początkowa kadencja: podzbiór około 50 zapytań przy każdym PR, pełny zbiór wzorcowy co noc lub dla każdego kandydata na wydanie oraz cotygodniowe kontrole dryfu na próbce produkcyjnej.
make eval-fastz repozytorium towarzyszącego uruchamia podzbiór 50 zapytań. Zmień harmonogram, gdy poznasz koszt ewaluacji i tempo zmian ruchu. - Dla dryfu użyj kroczącej próbki produkcyjnej i warstwuj według opinii, zamiast po cichu zmieniać rozkład docelowy.
Część 10: Monitoring produkcyjny
Zestaw ewaluacyjny, który wdrażasz, opisuje system w chwili startu. Ruch produkcyjny zmienia się potem.
Opinie niejawne i jawne
- Traktuj zdarzenia niejawne jako sygnały kandydujące, a nie dodatnie lub ujemne KPI jakości, dopóki nie skorelują się ze ślepą oceną lub jawną opinią na lokalnej próbce.
- Współczynnik kliknięć / otwarć zacytowanych źródeł (jeśli interfejs je udostępnia).
- Czas przebywania na odpowiedzi.
- Wskaźnik regeneracji: odsetek odpowiedzi, o które użytkownik pyta ponownie lub każe je powtórzyć. Traktuj go jako jeden sygnał niezadowolenia i skalibruj względem sprawdzonych rozmów.
- Kopiowanie / udostępnianie / eksport: kandydujące sygnały niejawne, które mogą oznaczać użyteczność, weryfikację, przekazanie dalej lub niezadowolenie. Zmierz ich związek i przedział ufności, zanim przypiszesz kierunek.
- Wzorce pytań uzupełniających: użyj „Na pewno?” lub „A co z X?” jako warstw przeglądu, a potem oznacz ich związek z nieufnością lub niezaspokojoną potrzebą.
- Kciuk w górę/w dół z opcjonalnymi kategoriami powodów (błędna, niepełna, nie na temat, szkodliwa, wolna). Edycje w treści mogą zachować więcej kontekstu diagnostycznego; oceń tę wartość na sprawdzonych próbkach.
Wykrywanie dryfu
- Dryf zapytań: porównaj embeddings zapytań z oknem referencyjnym za pomocą MMD lub zwalidowanego klasyfikatora referencja–bieżące. KL wymaga zdefiniowanego estymatora prawdopodobieństwa, np. wybranych histogramów; surowe współrzędne embedding nie są prawdopodobieństwami. Skalibruj alarmy na znanych przesunięciach, a potem sprawdź dotknięte wycinki.
- Dryf embeddings: przypnij reprezentację i zbiór sond, a potem mierz stabilność sąsiadów i jakość wyszukiwania. Różne wersje modelu nie muszą mieć tych samych wymiarów ani wspólnej bazy współrzędnych, więc cosinus między wersjami może nie mieć sensu. Migruj enkodery zapytań i dokumentów razem, oceń nowy indeks i zachowaj wersjonowane migawki do wycofania.
- Dryf wydajności: śledź w czasie metryki odpowiadające produkcyjnym (wskaźnik regeneracji według intencji). Nagłe i stopniowe przesunięcia sugerują różne hipotezy, ale ich kształt nie ustala przyczyny; sprawdź zmiany w danych, ruchu, u dostawcy, w politykach i we wdrożeniach.
Ewaluacja w cieniu i człowiek w pętli
Uruchom system kandydujący równolegle z produkcyjnym, porównaj wyjścia offline i nie serwuj ich użytkownikom. To może ujawnić regresje przed startem. Inferencja w cieniu nadal zużywa zasoby i może wywoływać narzędzia: odizoluj zasoby, wyłącz zapisy i sprawdź, czy porównanie nie pogarsza opóźnień produkcyjnych.
Dla przeglądu z człowiekiem w pętli (HITL):
- Próbkuj wyjścia o niskiej pewności do kolejki przeglądu.
- Dołącz losową próbkę ruchu produkcyjnego do ślepego przeglądu; 1–2% ruchu to stawka startowa, dostosowana do wolumenu ruchu, ryzyka i możliwości recenzentów.
- Oprócz próbki losowej nadpróbkuj wyjścia z kciukiem w dół do przeglądu.
- Użyj sprawdzonych wyjść do rozszerzania zbioru wzorcowego.
Zachowaj próbkę losową: bez niej zbiór wzorcowy zyskuje tylko odpowiedzi, na które użytkownicy się poskarżyli.
Minimalny zestaw zabezpieczeń
Priorytety alertów i progi dobierz na podstawie szkody dla użytkownika, SLO i zwalidowanej skuteczności detektorów. Kandydujące sygnały:
- Wynik faithfulness/HHEM poniżej progu na kroczącej próbce produkcyjnej.
- Opóźnienie p95 powyżej SLO.
- Wskaźnik fałszywych wykluczeń filtra powyżej progu (na próbce).
- Wskaźnik regeneracji poza lokalnie skalibrowanym pasmem kontrolnym, które uwzględnia rozmiar okna, ruch, sezonowość i budżet fałszywych alarmów.
- Koszt/zapytanie powyżej budżetu.
Pierwsza reguła triażu: alert bez zmiany kodu lub modelu wskazuje dryf; alert tuż po wydaniu wskazuje regresję. Potwierdź jedno i drugie w śladach i dotkniętych wycinkach, bo wdrożenie może zbiegać się z dryfem ruchu, a zmiana u dostawcy lub w danych może nastąpić bez wydania aplikacji.
Zastrzeżenia
- Cele są lokalne, nie uniwersalne. Wartości startowe w tym przewodniku, w tym progi repozytorium towarzyszącego, to pierwsze ustawienia do dostrojenia na twoich danych. Liczby poglądowe to wyniki przykładów. Progi wydaniowe skalibruj do swojej domeny, stawki, niepewności zbioru ewaluacyjnego i oczekiwań użytkowników.
- Obszar frameworków szybko się zmienia. Wersje HHEM, nazwy metryk RAGAS, karty modeli i kolejność w rankingach mogą się zmienić po publikacji. Sprawdź ponownie podane źródło i zmierz od nowa, zanim się zobowiążesz.
- Liczby zgodności LLM-as-judge mają zastrzeżenia. Wartość 80% dla GPT-4 kontra ludzie pochodzi z warunków MT-Bench / Chatbot Arena. Ten wynik nie ustala zgodności w niszowej domenie ani na wycinku adwersarialnym. Używaj sędziów, by ocenić więcej przypadków, niż ludzie zdołają przejrzeć, i dalej ręcznie przeglądaj próbkę.
- Przyrosty z benchmarków dostawców często nie dają się niezależnie odtworzyć. Odtwórz je na własnych danych, zanim uwierzysz w liczbę, zwłaszcza dla nowszych rerankerów i systemów OCR.
- Żadna metryka nie zastępuje patrzenia na wyjścia. Zacznij od przeczytania co tydzień 50 losowych odpowiedzi produkcyjnych. Metryki skalują ten nawyk; nie zastępują go.
Źródła
Frameworki i benchmarki
- Es et al., Ragas: Automated Evaluation of Retrieval Augmented Generation, 2023.
- Dokumentacja RAGAS i GitHub.
- Saad-Falcon et al., ARES: An Automated Evaluation Framework for Retrieval-Augmented Generation Systems, NAACL 2024.
- TruLens, DeepEval, Arize Phoenix.
- Thakur et al., BEIR: A Heterogenous Benchmark for Zero-shot Evaluation of Information Retrieval Models, NeurIPS 2021.
- MTEB Leaderboard.
- TREC 2024 RAG Track.
- Pradeep et al., Initial Nugget Evaluation Results for the TREC 2024 RAG Track with the AutoNuggetizer Framework, 2024.
Wyszukiwanie i ranking
- Cormack, Clarke, Buettcher, Reciprocal Rank Fusion Outperforms Condorcet and Individual Rank Learning Methods, SIGIR 2009.
- Gao et al., Precise Zero-Shot Dense Retrieval Without Relevance Labels (HyDE), 2022.
- Jeong et al., Adaptive-RAG: Learning to Adapt Retrieval-Augmented Large Language Models through Question Complexity, NAACL 2024.
- Anthropic, Introducing Contextual Retrieval, wrzesień 2024.
- Günther et al., Late Chunking: Contextual Chunk Embeddings Using Long-Context Embedding Models, 2024.
Generowanie, faithfulness, sędziowie
- Min et al., FActScore: Fine-grained Atomic Evaluation of Factual Precision in Long Form Text Generation, EMNLP 2023.
- Liu et al., Lost in the Middle: How Language Models Use Long Contexts, TACL 2024.
- Chen et al., Benchmarking Large Language Models in Retrieval-Augmented Generation (RGB), AAAI 2024.
- Vectara, HHEM-2.1-Open hallucination evaluation model.
- Zheng et al., Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, NeurIPS 2023.
- Thakur et al., Support Evaluation for the TREC 2024 RAG Track: Comparing Human versus LLM Judges, SIGIR 2025.
- Thakur et al., Knowing When You Don’t Know: A Multilingual Relevance Assessment Dataset for Robust Retrieval-Augmented Generation, Findings of EMNLP 2024.
- Geng et al., JSONSchemaBench: A Rigorous Benchmark of Structured Outputs for Language Models, 2025.
- Kosmopoulos et al., Evaluation Measures for Hierarchical Classification: a unified view and novel approaches, 2015.
Dryf i produkcja
- Evidently, Embedding drift detection methods compared.
Kod towarzyszący
slavadubrov/rag-evals-demo— uruchamialne narzędzie ewaluacyjne rozdzielające wyszukiwanie na SciFact, generowanie na oznaczonych syntetycznych danych QA i kontrole offline na stałych danych testowych, z przeszukiwaniem ustawień dzielenia na fragmenty i embeddings oraz opcjonalnym porównaniem na żywo dwóch modeli OpenAI. Notatniki 00–09 objaśniają procesy; testy jednostkowe utrwalają wybrane obliczone przykłady, a starsze dane testowe filtra używają innej uprawnionej populacji. Wbudowany indeks Qdrant działa bez Dockera.