RAG-evaluatiemetrics: retrieval, reranking, generatie

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Dit naslagwerk is voor engineers die systemen met retrieval-augmented generation (RAG) beheren of beoordelen. Het koppelt fouten in documentparsing, filtering, retrieval, reranking en generatie aan de metric die elke fout aanwijst. Het laat ook zien welke checks vóór de release draaien en welke het live verkeer bewaken.
Een RAG-systeem met kapotte relevantiefilters kan maandenlang draaien zonder dat een operationele alert afgaat. Het geeft nog steeds antwoorden en haalt zijn latency-doel, maar die antwoorden berusten op onvolledig bewijs. Recall@k tegen de oorspronkelijke gold set van toegestane documenten maakt het verlies zichtbaar. Dashboards voor latency en beschikbaarheid doen dat niet.
Direct code draaien?
De uitvoerbare repository
slavadubrov/rag-evals-demoscheidt SciFact-retrieval, generatie op gelabelde synthetische QA en offline controles met vaste testgegevens.make evalvoert namake indexretrieval, filterdiagnostiek en het opnieuw afspelen van generatie-testresultaten uit.make benchmarkvarieert chunking- en embedding-instellingen zonder API-aanroepen; de vergelijking van twee OpenAI-models vereist een API-key en de vlag--live(zie deel 8). Notebooks 00–09 behandelen retrieval, filtering, generatie en systeemvoorbeelden. De demo gebruikt ingebouwde Qdrant en vereist geen Docker.
Beslistabel voor RAG-evaluatie
Gebruik deze tabel als startpunt voordat je een framework kiest. De juiste metric hangt af van de fout die je wilt vangen, niet van de naam van de tool.
| Vraag | Metricfamilie | Gebruik dit wanneer | Let op |
|---|---|---|---|
| Heeft parsing de bron behouden? | Extraction completeness, dekking van tabellen en figuren | PDF’s, slides, scans en HTML-pagina’s komen in het corpus | Schoon ogende tekst kan toch bijschriften, voetnoten of tabelstructuur missen |
| Heeft retrieval het juiste bewijs gevonden? | Recall@k, nDCG@k, MRR, context precision/recall | Je kunt relevante chunks of documenten labelen | Een hard metadatafilter kan het juiste document verwijderen vóórdat het ranken begint |
| Heeft reranking de shortlist verbeterd? | Reranker uplift, Precision@1, nDCG-delta | Cross-encoders of LLM-rankers staan na de retrieval | Meet latency en kosten samen met de kwaliteitswinst |
| Heeft het antwoord het bewijs gebruikt? | Faithfulness, groundedness, citatieondersteuning | Het antwoord citeert documenten of stelt feiten uit de context | Faithfulness kan slechte parsing of slechte retrieval niet diagnosticeren |
| Is het systeem stabiel in productie? | Drift, regeneratie, fallback, p95-latency, kosten per antwoord | Het verkeer verandert na de lancering | Productietelemetrie heeft gesampelde menselijke review nodig om gekalibreerd te blijven |
Voor een kortere vergelijking van tools, zie Beste tools voor RAG-evaluatie: Ragas, DeepEval en TruLens.
Deel 1: Bepaal succes vóór de architectuur
Schrijf de eval set vóór het architectuurdiagram. Zo heeft elke latere keuze voor een component een meetbaar doel.
Je kunt niet kiezen tussen BM25 en dense retrieval, recursive en semantic chunking, of Cohere Rerank en BGE zolang je niet weet waarvoor je optimaliseert. “Betere antwoorden” is geen metric. Een voorbeeld van een releasevereiste is “faithfulness ≥ 0,85 op een golden set van 200 queries die onze top drie intents dekt, met p95-latency < 1,5 s en een filter false-exclusion rate < 2%.” De getallen zijn plaatsvervangers; waar het om gaat is dat kwaliteit, dekking, latency en filtering expliciete drempels hebben.
Bepaal de harness voordat je de retrievalcode schrijft. De eerste harness is fout en je past hem later aan. Een metric aanpassen is veel goedkoper dan een systeem aanpassen dat al in productie draait.
Drie pipelinelagen en twee runmodi
Productie-evaluatie kent drie pipelinelagen. Ingestion-evaluatie vraagt of het corpus en de index de bron behouden. Query-time-evaluatie vraagt of herschrijven, filteren, retrieval, reranking en contextopbouw het juiste bewijs hebben gevonden. Antwoord- en productie-evaluatie vraagt of het antwoord dat bewijs heeft gebruikt en of de kwaliteit standhoudt onder live verkeer. Voeg je de lagen samen tot één score, dan kan een normalisatiebug verdwijnen in een acceptabele antwoordscore.
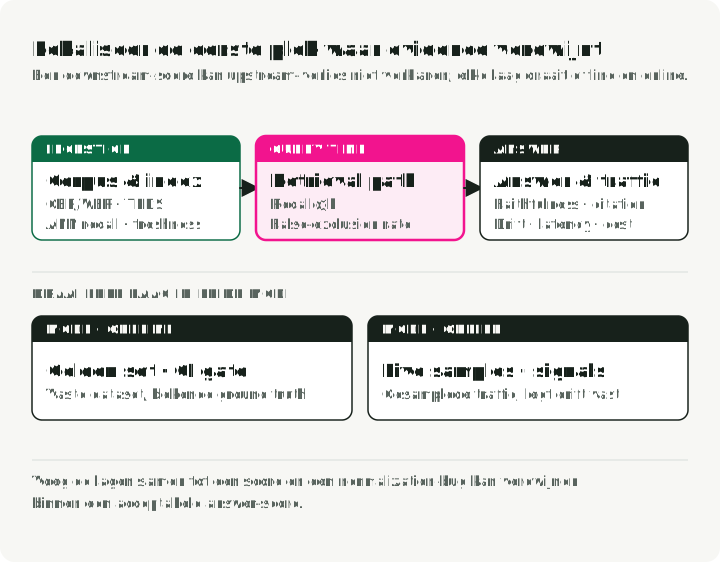
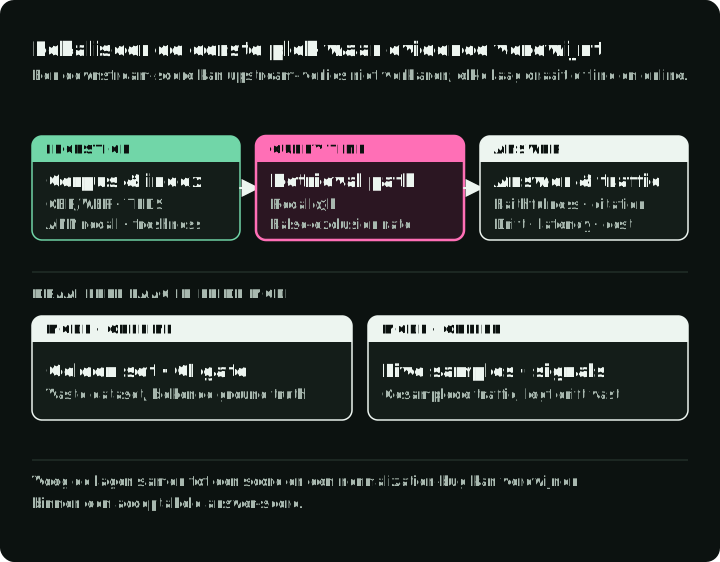
Die lagen beschrijven waar een fout optreedt. Offline en online beschrijven wanneer en op welke data de check draait. Offline-evaluatie gebruikt een vaste dataset met bekende ground truth; ze is reproduceerbaar en hoort thuis bij componentselectie, A/B-vergelijkingen en CI-checks die een wijziging kunnen blokkeren. Online-evaluatie scoort gesampeld live verkeer en legt regeneratie, verblijftijd, expliciete feedback en echte query-drift vast. Ze is ruisiger en moeilijker te instrumenteren.
Gebruik beide modi waar ze helpen: vaste corpora en queryverzamelingen maken regressies reproduceerbaar; gesampelde live traces leggen freshness-fouten en drift bloot.
Per component versus end-to-end
Er zijn twee veelgemaakte fouten. Alleen end-to-end evalueren zegt dat het systeem kapot is, maar niet waar. Alleen componenten evalueren kan laten zien dat elk onderdeel slaagt terwijl het hele systeem faalt. De oplossing is een paar end-to-end-metrics voor go/no-go-beslissingen, plus componentmetrics voor diagnose. Retrievalmetrics vangen regressies van de retriever. Generationmetrics vangen regressies van de generator. End-to-end answer correctness vangt integratiefouten.
De referentieframeworks (een eigenzinnige rondleiding)
| Framework | Sterk in | Waar het tekortschiet |
|---|---|---|
| RAGAS | Een gedeeld vocabulaire voor faithfulness, answer relevancy en context precision/recall (metrics) | Kosten van de LLM-judge; ondoorzichtige scorecomponenten bij debuggen; versiewijzigingen |
| ARES | Een taakspecifieke classifier als judge, als training en annotatie de kosten waard zijn (paper); de gerapporteerde precision is aan de benchmark gebonden | Zwaardere opzet; je moet echt models trainen |
| TruLens | Feedbackfuncties gekoppeld aan traces en OpenTelemetry-integratie (project) | Minder kant-en-klaar voor RAG-specifieke metrics dan RAGAS |
| DeepEval | Integratie met test runners en eigen metrics (project) | Zwaar LLM-judge-gebruik = kostenpieken |
| Arize Phoenix | Tracing, datasetexperimenten en kant-en-klare of eigen RAG-/agent-evaluators (evaluatiedocs) | Domeinrubrics en judge-drempels moeten nog lokaal gekalibreerd worden |
| TREC 2024 RAG Track | Openbare benchmark voor nugget-evaluatie (AutoNuggetizer), supportevaluatie en vloeiendheid op MS MARCO Segment v2.1 | Geen runtime-tool; een benchmark om tegen te kalibreren |
Mijn standaardstack is RAGAS voor het metricvocabulaire, DeepEval voor CI-checks, Phoenix voor productietracing, plus eigen code voor ontologiespecifieke metrics. Kies het framework dat eigen metrics makkelijk maakt.
Kies bij benchmarks eerst de taak en lees daarna pas het leaderboard. BEIR, MTEB en MIRACL blijven bruikbare retrievalbaselines. Voeg tests toe voor capaciteiten die zij niet vaststellen:
- Actuele end-to-end RAG: de TREC 2026 RAG Track gebruikt narratieve queries en ClimbMix-400b in plaats van MS MARCO v2.1, en verwijst naar de RAGDoll-evaluatietoolkit. De topics van 2026 zijn vrijgegeven; de beoordelingen nog niet. Gebruik de topics voor experimenten, niet als beoordeeld leaderboard. Houd de protocollen van 2024 en 2025 hieronder gekoppeld aan hun eigen corpora en beoordelingen.
- Technische vragen over evoluerende code: FreshStack combineert door mensen gestelde Stack Overflow-vragen, repositorycorpora en nugget-beoordelingen. De vrijgegeven snapshot en de machinerie om nieuwe corpora te bouwen zijn verschillende dingen; pin de repositoryrevisie en de datum van de vragen.
- Afbeeldingen die een deel van de vraag of het bewijs dragen: MM-BRIGHT scheidt text-to-text-, multimodal-to-text-, multimodal-to-image- en multimodal-to-multimodal-retrieval. Score de relevante taak apart. OCR-tekst alleen kan weglaten wat een grafiek of screenshot toevoegt.
Deze benchmarks vergroten de dekking; ze vervangen de geschikte, geversioneerde queryset uit je eigen applicatie niet.
Deel 2: Breng de evaluatiepunten in kaart
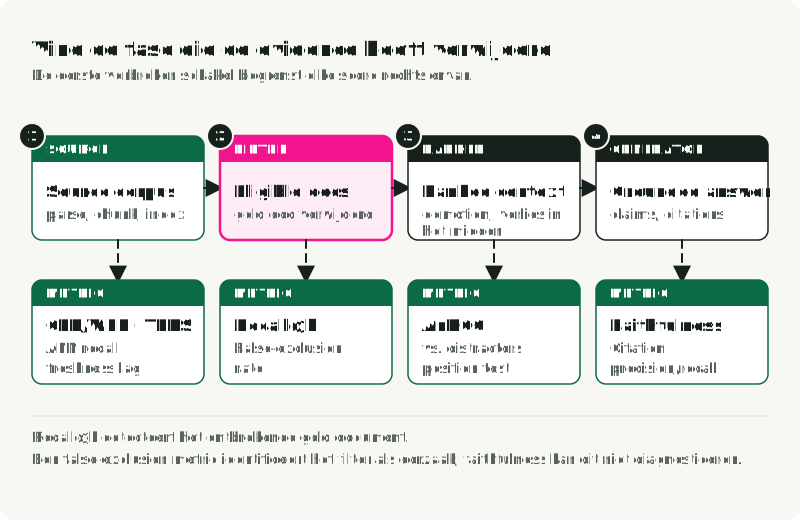
Als een antwoord fout of niet onderbouwd is, volg dan het gouden document door de vier checks in de figuur, van links naar rechts. De eerste fase waarin het ontbreekt, noemt de metric om als eerste te controleren en het deel van dit artikel dat erover gaat.
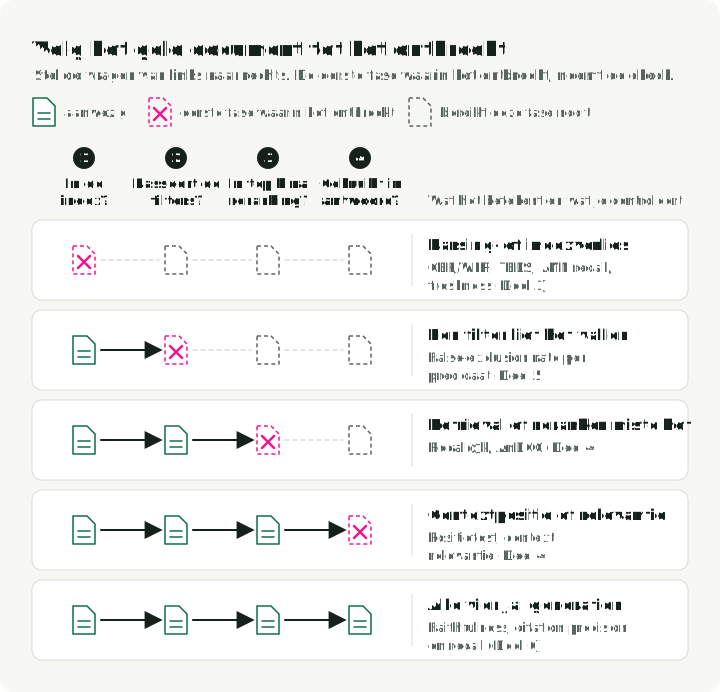
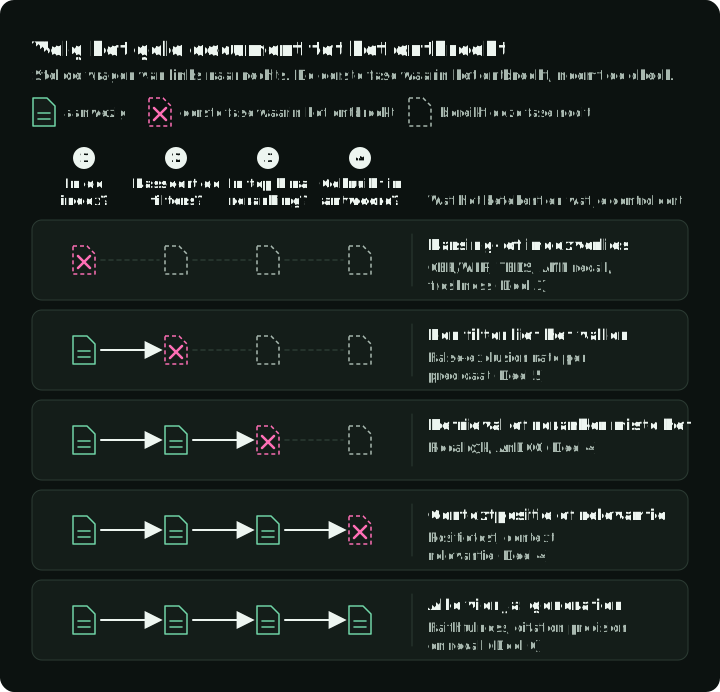
Verliezen stroomopwaarts begrenzen de kwaliteit stroomafwaarts: slechte parsing begrenst retrieval, en slechte retrieval begrenst reranking en generatie. Faithfulness meet het antwoord, nooit de oorzaak stroomopwaarts.
Deel 3: Ingestion-evaluatie
Veel RAG-fouten in productie beginnen bij ingestion. Het systeem werkt op schone testdocumenten en faalt dan op echte PDF’s, scans, tabellen en rommelige corpuspagina’s.
Documentacquisitie en parsing
Wat je meet:
-
Sanity check op extractielengte:
extracted_chars / expected_charsper documentklasse signaleert verdachte lengteverschillen, maar dubbele of verkeerde tekst kan nog steeds 1,0 scoren. Vergelijk uitgelijnde tekst met een met de hand opgeschoonde referentie op weglatingen en vervangingen, en controleer voetnoten, bijschriften, tabelinhoud en leesvolgorde apart. -
OCR-nauwkeurigheid: CER (Character Error Rate) en WER (Word Error Rate), de standaardmetrics voor spraak en OCR:
waarbij , , de substituties, deleties en inserties op tekenniveau zijn en het aantal tekens in de referentie is (subscript voor de woordversie). Pas niet één CER-grens toe op elk corpus. Kalibreer hem per documentklasse en per verlies in het uiteindelijke antwoord. Gedrukte tekst, handschrift en meertalig materiaal hebben verschillende foutprofielen. Bereken het met
jiwer(jiwer.cer(refs, hyps),jiwer.wer(refs, hyps)) of met Hugging Faceevaluate. Voor evaluatiecorpora zijn FUNSD en SROIE openbare benchmarks.from jiwer import cer, wer refs = ["Mars has two moons, Phobos and Deimos."] hyps = ["Mars has two m00ns, Phobos and Deirnos."] print(f"CER = {cer(refs, hyps):.3f}") # CER = 0.105 print(f"WER = {wer(refs, hyps):.3f}") # WER = 0.286 -
Betrouwbaarheid van tabelextractie: TEDS (Tree-Edit-Distance-based Similarity) meet hoe dicht een voorspelde HTML-tabelboom bij de referentie ligt, genormaliseerd op de grootte van de grootste boom. Uit Zhong et al., 2020 (PubTabNet):
TEDS gebruikt zowel structuur (rijen, kolommen, spans) als celinhoud. TEDS-S laat de inhoud weg en scoort alleen de structuur. Referentie-implementatie:
src/metric.pyvan PubTabNet (gebruikt onderhuidsapted). Als evaluatiecorpora zie je PubTabNet, FinTabNet en SciTSR. Naïeve parsers falen vaak op tabellen. Benchmark ze voordat je ze vertrouwt. -
Behoud van layout en structuur: volgorde van koppen, intacte lijsten, leesvolgorde in PDF’s met meerdere kolommen. Gebruik DocLayNet als gelabelde benchmark. Een kant-en-klare vergelijking kan een elementparser als
unstructured, een PDF-library alspymupdfen een gekozen Docling-pipeline omvatten. Docling kent standaard- en VLM-paden; noteer welk pad je test.
Vergelijk afzonderlijke parserfamilies, bijvoorbeeld een Tesseract-baseline, een OCR-model op basis van een VLM en je kandidaat-leverancier. Beste models voor OCR vergelijkt de huidige opties. Gebruik een gestratificeerde steekproef van echte documentklassen met een vaste DPI, inclusief schone scans, foto’s, tabellen, meertalige tekst, wiskunde en handschrift. Rapporteer CER of WER per klasse en TEDS voor tabelpagina’s.
Opschonen en normalisatie
-
Nauwkeurigheid van boilerplateverwijdering: precision/recall tegen door mensen gelabelde boilerplate-spans. Agressieve verwijdering haalt relevante inhoud weg; luie verwijdering vervuilt de embeddings. Tools om te vergelijken:
trafilatura,jusText,Resiliparse. Barbaresi (2021) vergelijkt Trafilatura met baselines waaronder jusText; Resiliparse is een aparte kandidaat en geen systeem dat in dat paper is geëvalueerd. -
Unicode-normalisatie: het percentage documenten waarvan NFC en NFKC dezelfde uitvoer geven (berekend met de stdlib-functie
unicodedata.normalize) is een bruikbaar signaal voor drift in compatibiliteitsvormen. Het ziet geen onzichtbare of standaard genegeerde codepunten en ook geen lookalikes uit andere schriften: scan expliciet op het eerste en pas een beleid of detector voor Unicode confusables toe wanneer het tweede binnen de scope valt. -
Nauwkeurigheid van taaldetectie: F1 op een gelabelde meertalige steekproef. Cruciaal voor meertalige indexen. Gebruik
fasttext-langdetect(lid.176van Facebook),lingua-pyofcld3. FLORES-200 levert evaluatietekst in 200 talen, maar je werkelijke taalmix in productie moet bepalen welk deel je test. -
Effectiviteit van deduplicatie (MinHash / LSH): precision/recall van je detector voor bijna-duplicaten tegen een met de hand gelabelde set. Het idee eronder: schat de Jaccard-gelijkenis tussen shingle-sets van documenten met random-permutatiehashes (Broder, 1997) en groepeer bijna-duplicaten met LSH-banding (Indyk & Motwani, 1998). Doorloop het aantal hashes en de Jaccard-drempel op je eigen corpus. Volg het percentage foutieve samenvoegingen (verstoort antwoorden) apart van het percentage gemiste samenvoegingen (verspilt indexruimte).
datasketchlevert de implementatie hieronder; de parameters zijn illustratief:from datasketch import MinHash, MinHashLSH def shingles(text: str, k: int = 5) -> set[str]: text = text.lower() return {text[i:i + k] for i in range(len(text) - k + 1)} def to_minhash(text: str, num_perm: int = 128) -> MinHash: m = MinHash(num_perm=num_perm) for s in shingles(text): m.update(s.encode("utf-8")) return m docs = { "d1": "Mars has two moons, Phobos and Deimos.", "d2": "Mars has two moons, Phobos and Deimos!", # near-dup "d3": "Curiosity rover landed on Mars in 2012.", } lsh = MinHashLSH(threshold=0.8, num_perm=128) for did, text in docs.items(): lsh.insert(did, to_minhash(text)) print(sorted(lsh.query(to_minhash(docs["d1"])))) # ['d1', 'd2'] -
PII-scrubbing: precision en recall, apart berekend per entiteitstype (e-mailadressen, BSN’s, namen, adressen). Recallfouten veroorzaken compliancerisico; precisionfouten schaden de antwoordkwaliteit. Bepaal het werkpunt samen met het juridische team. Mogelijke tools zijn Microsoft Presidio,
scrubadubof een met fine-tuning aangepast NER-model op een gelabelde set.
Chunking bepaalt de retrievalkwaliteit
Chunking bepaalt welk bewijs het antwoord bereikt. In NVIDIA’s leveranciersbenchmark uit 2025 haalde chunking op paginaniveau de hoogste gemiddelde end-to-end antwoordnauwkeurigheid in de geteste opzet, doordat tabellen en grafieken als geheel bewaard bleven. Dat meet antwoordnauwkeurigheid, geen retrieval recall. Zie dat resultaat als bewijs voor het geteste corpus, niet als universele winnaar.
Semantic chunking groepeert aangrenzende zinnen op embeddinggelijkenis en knipt bij ongelijke grenzen. LangChain’s SemanticChunker en LlamaIndex’ SemanticSplitterNodeParser implementeren deze strategie. Het kan de recall verbeteren ten opzichte van vaste vensters wanneer onderwerpgrenzen ertoe doen.
De RecursiveCharacterTextSplitter van LangChain probeert standaard dubbele regeleinden, enkele regeleinden, spaties en dan afzonderlijke tekens: ["\n\n", "\n", " ", ""]. Hij herkent geen zinsgrenzen zonder geschikte scheidingstekens of een splitter die zinnen herkent. De standaardwaarde length_function=len telt tekens. Gebruik voor 400–512 tokens per chunk met 10–20 % overlap een functie die tokens telt. Vergelijk deze begininstellingen met andere waarden op je golden set.
Metrics om te volgen:
- Chunkcoherentie: , waarbij zinsembeddings zijn. Gezonde chunks zijn intern gelijkend en aan de grens ongelijk. Bereken het met
sentence-transformerspluscosine_similarityvanscikit-learn. - Kwaliteit van grenzen: door mensen gelabeld “is dit een zinvolle snede?” op een steekproef, plus een structurele check dat chunks geen tabellen, lijsten of genummerde secties doorknippen.
- Optimale chunkgrootte: doorloop tokengroottes (128, 256, 512, 1024) en zet Recall@k uit tegen de grootte op je golden set. Kies de kleinste grootte waarna Recall@k niet meer verbetert.
- Effectiviteit van overlap: doorloop overlap van 0, 10, 20 en 30% als startraster en meet Recall@k. Stop met meer overlap wanneer de lokale recallcurve vlak wordt of de kosten van duplicatie zwaarder wegen dan de winst.
- Herleidbaarheid van chunks: percentage chunks dat een controleerbare bronverwijzing behoudt (paginanummer, sectie-anker, document-ID). Auditbaarheid vereist dit.
- Late versus early chunking: late chunking (Günther et al., 2024) embedt het hele document en segmenteert daarna, waardoor de globale context behouden blijft (referentie-implementatie in
jina-embeddings-v3). Contextual Retrieval (Anthropic, 2024) voegt door een LLM gegenereerde context toe vóór elke chunk. Beide kosten extra. Benchmark op je eigen corpus voordat je een van beide invoert.
Mijn mening: structurele chunking (splitsen op koppen, tabellen en secties, geïmplementeerd door parsers als unstructured.io of door de AST te doorlopen die je parser al heeft gemaakt) wordt te weinig gebruikt. Als je documenten structuur hebben, gebruik die dan voordat je gelijkenisheuristieken toevoegt. Recursive character splitting is de baseline; semantic chunking is de extra moeite vooral waard bij ongestructureerde lopende tekst.
Metadata-extractie en verrijking
- NER precision/recall/F1: per entiteitstype, op een gelabelde subset. Standaard in CoNLL/MUC-stijl. Bereken met
seqeval(from seqeval.metrics import f1_score) voor de versie die BIO/IOB-tags begrijpt, of met scikit-learn voor vergelijking van span-sets. CoNLL-2003 en OntoNotes 5.0 zijn de gangbare referentiecorpora. - Relation extraction F1: nog belangrijker voor systemen met een ontologie als basis. Label met de hand een set die gestratificeerd is naar relatietype en documentklasse. TACRED en DocRED zijn openbare benchmarks; mogelijke implementaties zijn
opennreen de relatiepipelines vanspaCy. - Nauwkeurigheid van titel-/kopextractie: exacte match plus genormaliseerde Levenshtein-gelijkenis () tegen de ground truth —
python-Levenshteinofrapidfuzzgeven beide in één aanroep. - Behoud van hiërarchische metadata: percentage chunks dat zijn bovenliggende sectie, bovenliggende document en ancestry-pad correct behoudt. Deze metric bepaalt of je RAG vragen kan beantwoorden als “wat zegt het kind van beleid X?”.
Embeddings genereren
- Benchmarks voor modelselectie: gebruik de retrievalresultaten van MTEB, BEIR voor zero-shot-generalisatie en MIRACL voor meertalige retrieval als vergelijkingspunten. MTEB-retrieval rapporteert meestal nDCG@10; andere taakfamilies gebruiken andere metrics. Het MTEB-Python-package draait de benchmarks lokaal. Beschouw de overdracht van Engelse MTEB-resultaten naar een taal met minder bronnen als een hypothese die je test op de gelabelde set van die taal.
- Domeinspecifieke evaluatie: zie een algemene benchmarkpositie niet als domeinresultaat. Begin met enkele honderden gelabelde queries (200–500) over je belangrijkste querytypen; Deel 9 laat zien hoe je controleert of dat genoeg is. Rangschik daarna de kandidaatmodels opnieuw op die set met
ranxofpytrec_eval. Een domeinset kan de volgorde van een leaderboard omkeren, dus publiceer het datasetdeel, het retrievalprotocol en het betrouwbaarheidsinterval bij het resultaat. - Detectie van embeddingdrift: vergelijk twee verzamelingen embeddings: een vaste referentiesteekproef en een voortschrijdende actuele steekproef. Maximum mean discrepancy (MMD) toetst of hun verdelingen verschillen. Een andere optie is een gevalideerde classifier die referentie van actuele samples leert onderscheiden. Kullback–Leibler (KL)-divergentie vergelijkt kansverdelingen en vraagt dus om een expliciete schatter, zoals gekozen histogrammen; ruwe embeddingcoördinaten zijn geen kansen. Meet ook de stabiliteit van nearest neighbors voor een vaste probe-set.
evidentlyenalibi-detectimplementeren modelgebaseerde en statistische detectoren. De vergelijkende studie van Evidently is één evaluatie van een leverancier; vergelijk methoden op bekende verschuivingen in je eigen embeddings. - Multi-vector versus single-vector: late interaction behoudt representaties op tokenniveau in plaats van elk document tot één vector samen te drukken; ColBERT is het canonieke ontwerp, met referentie-implementaties in RAGatouille en PyLate. Die rijkere representatie verhoogt de kosten van index en retrieval. Vergelijk kwaliteit, opslag en latency met een single-vector-baseline op dezelfde domeinset voordat je ervoor kiest.
Indexopbouw
- Recall@k onder benadering: vergelijk de approximate-nearest-neighbour (ANN)-index met een exacte brute-force-baseline bij dezelfde k — in FAISS is dat
IndexHNSWFlat(ofIndexIVFFlat) tegenoverIndexFlatIP/IndexFlatL2. Eis als eerste check een Recall@10 van minstens 0,95 tegen exacte zoekresultaten en stel die daarna bij op basis van de kwaliteit van de downstream-antwoorden. Het projectann-benchmarksvolgt de Pareto-curves voor recall en QPS over libraries heen. - HNSW tunen: HNSW (Hierarchical Navigable Small World) is een gelaagde nabijheidsgraaf; zie Malkov & Yashunin, 2018. Het is geïmplementeerd in
hnswlib, inIndexHNSWFlatvan FAISS en in de meeste vector databases. HNSW heeft drie knoppen:M(fan-out van de graaf),efConstruction(breedte van de kandidatenlijst bij het bouwen) enefSearch(breedte van de kandidatenlijst bij een query). Beginwaarden:Mvan 16–32 enefConstructionvan 100–200; verhoog daarnaefSearchtot Recall@10 tegen exacte zoekresultaten niet meer verbetert. De parametergids van hnswlib zegt datMvan 12–48 voor de meeste toepassingen past en geeft een check voorefConstruction: metefgelijk aanefConstructionbetekent een recall onder 0,9 voor deMdichtstbijzijnde buren dat de graaf nog beter kan. - IVF tunen: IVF (Inverted File index — verdeel vectoren met k-means over
nlistcellen en scan bij een query denprobedichtstbijzijnde cellen; zieIndexIVFFlatenIndexIVFPQvan FAISS). De indexrichtlijnen van FAISS stellen 4√N tot 16√N cellen voor bij N vectoren als beginwaarde voornlist. Doorloopnlistennprobetegen de recall van exacte zoekresultaten en de latency. Benchmark gefilterde queries apart, omdat indexfamilies en vector databases filters op verschillende manieren doorlopen. - Freshness-vertraging: tijd van documentcommit tot vindbaarheid. Volg p50 en p99. Bij systemen met wettelijke eisen volg je ook het percentage queries dat tegen verouderde indexen is beantwoord.
Deel 4: Query-time-evaluatie
De query-time-laag bevat de metrics die een retrievalpad diagnosticeren. Recall@k alleen kan niet laten zien of herschrijven, filteren, reranking of contextopbouw de fout veroorzaakte.
Queryinterpretatie en herschrijven
- Kwaliteit van query-expansie: Recall@k-winst op je golden set, uitgebreide query tegenover ruwe query. Leg vóór het testen vast hoeveel winst minimaal nuttig is en hoeveel onzekerheid daarbij hoort. Haalt expansie die eis niet, dan rechtvaardigt ze haar latency en kosten niet. Klassieke PRF-baselines (pseudo-relevance feedback) zoals RM3 en Bo1 blijven bruikbare sanity checks; expansie met een LLM moet ze verslaan.
- HyDE-evaluatie: HyDE (Gao et al., 2022) laat de LLM een hypothetisch antwoord genereren, embedt dat en zoekt daarmee. Het voegt een generatie-call toe, en die call kan inhoud verzinnen die de retrieval van het onderwerp afleidt. Meet Recall@10 apart op in-domain-, out-of-domain- en low-confidence-slices en kies dan of het in het standaardpad, in een fallback of nergens thuishoort.
- Multi-query generatie: Recall@k van de unie van N herschrijvingen tegenover één query. Doorloop N en kies een punt op je recall–latency-frontier. Implementaties: LangChain’s
MultiQueryRetriever, LlamaIndex’QueryFusionRetriever. - Nauwkeurigheid van intentclassificatie: standaard precision/recall/F1 per intent (bereken met
sklearn.metrics.classification_report), maar de bepalende metric is routingcorrectheid — wordt de juiste downstream-pipeline aangeroepen? - Adaptieve routing: Adaptive-RAG (Jeong et al., NAACL 2024) betoogt dat niet elke query dezelfde retrievalstrategie verdient. Volg de nauwkeurigheid van de router als classificatieprobleem tegen een gelabelde set “geen retrieval nodig / one-shot / iteratief.”
Iteratief zoeken vraagt een end-to-end test met budget
Een agent kan zoeken, een resultaat bekijken en opnieuw zoeken, in plaats van één vaste top-k-lijst op te halen. Het domein banking_knowledge in tau2-bench wisselt van retrieval met de vlag --retrieval-config: geen kennisbank, de hele kennisbank in de context, BM25- of embeddingzoeken, een sandboxed shell-tool, of BM25, dense search en de shell samen. Geef voor een lokale vergelijking one-shot en iteratieve retrieval hetzelfde toegestane corpus en expliciete limieten voor tijd, modeltokens en tool calls. Leg elke query en het bewijs dat in elke beurt is gezien vast; score de dekking van het uiteindelijke bewijs, de correctheid van het antwoord, de ondersteuning door citaties en fouten door uitgeputte budgetten. Meer zoekcalls zijn alleen nuttig als het extra bewijs het antwoord binnen die limieten verbetert.
retrieval/iterative.py uit de companion draait aangeleverde queryherformuleringen onder expliciete budgetten voor calls, tijd en tokens. Voor agents die hun eigen zoekopdrachten kiezen, behandelt Evaluatie van AI agents: van traces naar testsuites hoe je het traject scoort en niet alleen het antwoord.
Retrievalmetrics
Dit zijn de basismetrics. Als je ze niet volgt, kun je niet zien of retrieval beter wordt.
| Metric | Wat het meet | Wanneer gebruiken |
|---|---|---|
| Recall@k | deel van de relevante documenten van een query dat in de top k staat | gebruik wanneer het missen van een deel van de relevante set telt |
| Precision@k | percentage van de top k dat relevant is | nuttig wanneer het context window de bottleneck is |
| MRR | gemiddelde van 1/rang van het eerste relevante document | wanneer gebruikers alleen naar de top 1 of top 3 kijken |
| nDCG@k | positiegewogen winst, gewogen naar relevantiegraad | standaard retrievalmetric voor gegradeerde relevantie |
| MAP | gemiddelde over queries van de average precision | wanneer de hele gerangschikte lijst telt |
| Hit Rate@k | of ten minste één relevant document in de top k staat | neem het gemiddelde van het binaire resultaat over queries voor een snelle sanity metric |
| Coverage | percentage golden-documenten dat ooit over alle queries is opgehaald | vangt systematische gaten in de index |
De formules ter referentie (binaire relevantie met relevante set voor query , en als het -de opgehaalde document in zit):
Bij gegradeerde relevantie is ; binaire nDCG is het speciale geval dat in de code hieronder wordt gebruikt. MAP is het gemiddelde over queries van . Zie Manning, Raghavan, Schütze, Introduction to Information Retrieval, hoofdstuk 8 voor de afleidingen.
Gebruik voor productiecode ranx, pytrec_eval of ir_measures — ze implementeren de hele TREC-metricfamilie en verwerken gegradeerde relevantie correct. Als eerste releasegates levert de companion-repo Recall@10 ≥ 0,85 en MRR ≥ 0,6 mee (in .env.example, toegepast met --quality-gates). Stem ze daarna op je golden set af tegen de kwaliteit van downstream-antwoorden en de kosten van een gemiste treffer.
Hier telt k unieke document-ID’s. Wijs duplicaten af in plaats van een herhaald document extra winst te geven. Verklaar bij chunkingexperimenten of k chunks telt of ontdubbelde bovenliggende documenten, en vergelijk ook het bewijs dat binnen een vast tokenbudget wordt aangeleverd. Dezelfde documentrecall kan zeer verschillende contextkwaliteit verbergen.
De testharness hiervoor is kort. Je kunt hem vanuit een notebook draaien voordat je een vector database hebt gekozen.
from math import log2
from statistics import mean

# synthetic gold set: query_id -> set of relevant doc ids
gold = {
    "q1": {"d3"},
    "q2": {"d7", "d2"},
    "q3": {"d11"},
    "q4": {"d5"},
}

# ranked retrieval results: query_id -> ranked list of doc ids (top-10)
runs = {
    "q1": ["d8", "d3", "d1", "d4", "d2", "d9", "d6", "d10", "d12", "d13"],
    "q2": ["d2", "d6", "d4", "d7", "d1", "d3", "d8", "d11", "d5", "d9"],
    "q3": ["d11", "d2", "d3", "d4", "d1", "d6", "d7", "d8", "d10", "d12"],
    "q4": ["d1", "d2", "d3", "d6", "d8", "d9", "d10", "d12", "d13", "d14"],
}

def recall_at_k(ranked, gold_set, k):
    if k <= 0 or len(ranked) != len(set(ranked)):
        raise ValueError("require positive k and unique document IDs")
    if not gold_set:
        return 0.0
    hit = sum(1 for d in ranked[:k] if d in gold_set)
    return hit / len(gold_set)

def reciprocal_rank(ranked, gold_set):
    if len(ranked) != len(set(ranked)):
        raise ValueError("require unique document IDs")
    # MRR contribution per query: 1/rank of the first relevant doc.
    for rank, d in enumerate(ranked, start=1):
        if d in gold_set:
            return 1.0 / rank
    return 0.0

def ndcg_at_k(ranked, gold_set, k):
    if k <= 0 or len(ranked) != len(set(ranked)):
        raise ValueError("require positive k and unique document IDs")
    # binary relevance: rel ∈ {0, 1}
    gains = [1.0 if d in gold_set else 0.0 for d in ranked[:k]]
    dcg = sum(g / log2(i + 2) for i, g in enumerate(gains))
    # ideal DCG: all gold docs ranked first, capped by k
    n_gold_in_topk = min(k, len(gold_set))
    idcg = sum(1.0 / log2(i + 2) for i in range(n_gold_in_topk))
    return dcg / idcg if idcg else 0.0

K = 5
print(f"Recall@{K}: {mean(recall_at_k(runs.get(q, []), gold[q], K) for q in gold):.3f}")
print(f"MRR:       {mean(reciprocal_rank(runs.get(q, []), gold[q]) for q in gold):.3f}")
print(f"nDCG@{K}:  {mean(ndcg_at_k(runs.get(q, []), gold[q], K) for q in gold):.3f}")
# Recall@5: 0.750
# MRR:       0.625
# nDCG@5:    0.627
# Duplicate and missing runs are tested in the companion's tests/test_audit_contracts.py.
De aggregatie loopt over alle verwachte queries en behandelt een ontbrekende run als leeg. Dit voorbeeld kent aan queries zonder gold een nul toe; markeer die in een echte suite als apart beantwoordbaarheidsdeel met een eigen noemer, in plaats van de nul als gemeten recall te behandelen. Rapporteer ook timeouts en ontbrekende runs, niet alleen scores.
Draai bij elke PR een snelle subset en vóór de release de volledige golden set (Deel 9 geeft beginwaarden voor de groottes). Blokkeer een merge wanneer een vooraf gekozen metric zijn regressiebudget overschrijdt.
De bijbehorende repository legt de cijfers hierboven (Recall@5 = 0.750, MRR = 0.625, nDCG@5 = 0.627) vast met een unit-test in tests/test_retrieval_metrics.py. Notebook 01 voert dit voorbeeld met k=5 uit en rapporteert daarna Recall@10, MRR en nDCG@10 op een SciFact-deelset; het varieert k niet. De harness met een opzet voor productie staat in evaluation/retrieval.py.
Hybrid retrieval en reciprocal rank fusion
BM25 is een sparse lexicale scorer die exacte termmatching, termgewichten en lengtenormalisatie combineert. Het is beschikbaar in rank_bm25, Elasticsearch, OpenSearch en de meeste zoekmachines.
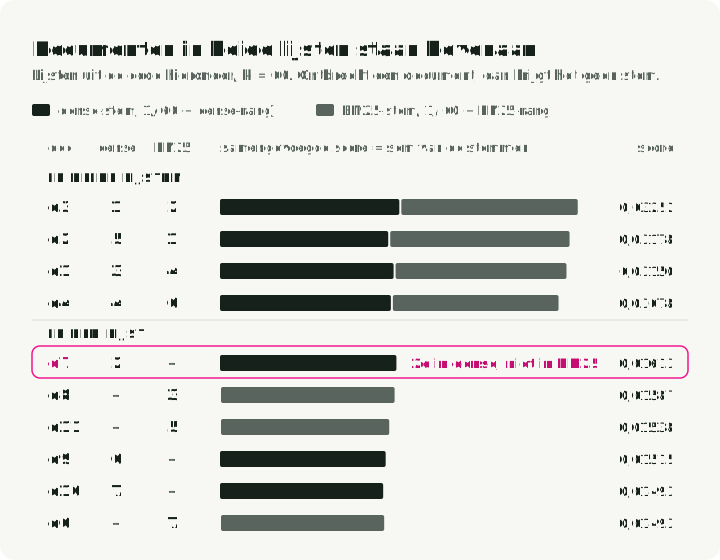
Reciprocal Rank Fusion (Cormack, Clarke en Buettcher, SIGIR 2009) combineert BM25- en dense-rankings op positie. De oorspronkelijke instelling k=60 is een bruikbare baseline. RRF is score-agnostisch, waardoor de normalisatie tussen lanes die lineaire interpolatie vraagt niet nodig is. Test met een gelabelde set die groot genoeg is voor een stabiele delta ook een convexe combinatie en stem α af.
Mijn hypothese is dat hybrid retrieval plus een cross-encoder-reranker kan helpen bij technische corpora, logachtige corpora en codecorpora. Bij sterk semantische corpora kan de winst klein zijn. Meet tegen de dense-only- en sparse-only-lanes, omdat een slechte fusieconfiguratie slechter kan presteren dan elk van de twee invoeren. Het SciFact-notebook van de companion is één begrensde test, geen algemeen resultaat.
De grafiek gebruikt de twee gerangschikte lijsten uit de code hieronder. Elke lane telt voor elk document dat ze teruggeeft 1/(60 + rang) op, dus de vier documenten in beide lijsten staan bovenaan. d7 staat in de dense-lijst tweede, maar komt niet voor in de BM25-lijst, dus zakt naar de vijfde plek.
De implementatie past in een paar regels.
from collections import defaultdict

# two retrieval lanes: dense embeddings and BM25.
dense  = ["d3", "d7", "d1", "d4", "d2", "d9", "d10"]
sparse = ["d2", "d3", "d8", "d1", "d11", "d4", "d6"]

def rrf(rankings: list[list[str]], k: int = 60) -> list[tuple[str, float]]:
    """Reciprocal Rank Fusion (Cormack et al., SIGIR 2009).

    score(d) = sum over rankings of 1 / (k + rank(d))
    Score-agnostic: only rank position matters. k=60 is the canonical default.
    """
    scores: dict[str, float] = defaultdict(float)
    if k <= 0:
        raise ValueError("k must be positive")
    for ranking in rankings:
        if len(ranking) != len(set(ranking)):
            raise ValueError("each ranking must contain unique document IDs")
        for rank, doc in enumerate(ranking, start=1):
            scores[doc] += 1.0 / (k + rank)
    return sorted(scores.items(), key=lambda kv: kv[1], reverse=True)

fused = rrf([dense, sparse], k=60)
for doc, score in fused[:5]:
    print(f"{doc}  score={score:.5f}")
# d3  score=0.03252   <- rank 1 dense, rank 2 sparse
# d2  score=0.03178   <- rank 5 dense, rank 1 sparse
# d1  score=0.03150
assert [doc for doc, _ in fused[:3]] == ["d3", "d2", "d1"]
Let op wat RRF niet doet: het kijkt nooit naar de ruwe similarity-scores. Zet een retriever een document op positie 2, dan is die stem 1 / (60 + 2) waard, welke ruwe score daar ook toe leidde. Een dense retriever die een cosinus van 0,98 teruggeeft en een BM25-lane die score 17,4 geeft, zijn niet direct vergelijkbaar. Z-score- en min-max-normalisatie verwijderen affiene schaalverschillen, maar geen van beide kalibreert een score als relevantie. Uitschieters, de vorm van de verdeling en de kandidatenset beïnvloeden de genormaliseerde waarden nog steeds en daarmee het fusieresultaat. Valideer elke scoregebaseerde combinatie op gelabelde queries.
Hybride retrieval + RRF op SciFact: notebook 02 vergelijkt dense retrieval, BM25 en RRF met geaggregeerde Recall@10, MRR en nDCG@10. De fusiemodule met een opzet voor productie staat in retrieval/hybrid_rrf.py; tests/test_rrf.py legt de canonieke volgorde d3 / d2 / d1 vast bij k=60.
Reranking
- ΔnDCG / ΔMRR: winst ten opzichte van geen reranking, op je golden set, op de diepte die je applicatie echt gebruikt. Bereken het door je retrievalmetrics met en zonder reranker te draaien op identieke kandidatensets.
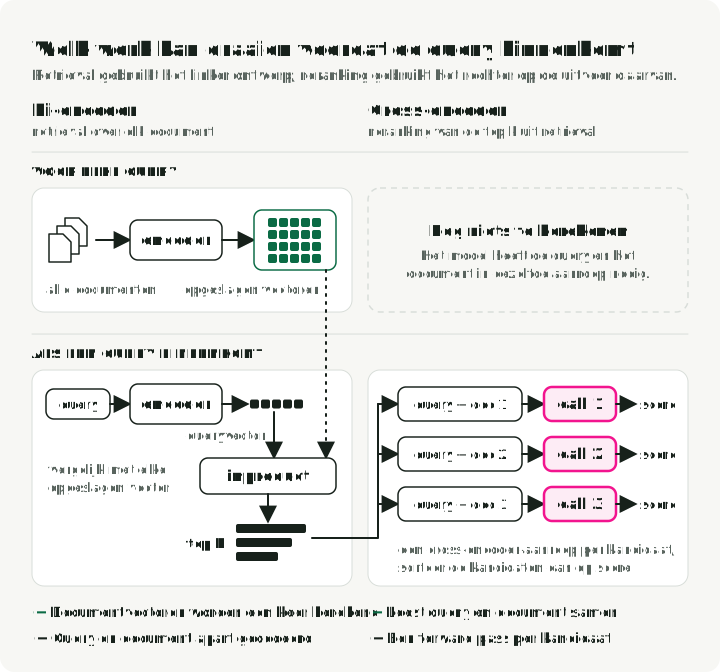
- Cross-encoder versus bi-encoder: een bi-encoder embedt query en document onafhankelijk (één vector per kant) en scoort met een inwendig product; een cross-encoder voegt query+document samen en draait één forward pass met attention over beide. Cross-encoders ruilen een forward pass per kandidaat in voor rijkere interactie tussen query en document; de figuur hieronder toont het verschil. Referentie-implementatie:
CrossEncodervansentence-transformers. Benchmark relevantie en latency op benoemde hardware, batchgrootte en kandidaatdiepte; neem het resultaat van het ene model of de ene managed service niet over naar een andere omgeving. - Listwise versus pointwise: pointwise scoort elk (query, document)-paar onafhankelijk; listwise scoort de hele kandidatenlijst samen, zodat het model kandidaten kan vergelijken. Evalueer beide op dezelfde kandidatensets. Kalibreer elke scoredrempel per model en corpus in plaats van een gepubliceerd voorbeeld als overdraagbaar te beschouwen.
Vergelijk in de figuur de twee tijdbanden. De bi-encoder codeert elk document vóór er een query is en slaat de vectoren op; als er een query binnenkomt, codeert hij alleen de query. De cross-encoder hoeft vooraf niets te berekenen. Hij leest query en document in één modelaanroep, dus draait hij eenmaal per kandidaat en alleen op de korte lijst die retrieval teruggeeft.
De code hieronder scoort drie kandidaten voor één query met een BGE cross-encoder:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("BAAI/bge-reranker-v2-m3")  # Reproducible baseline, not a latest-model ranking

query = "How do I rotate database credentials in production?"
candidates = [
    "Production database credentials are rotated via Vault every 30 days.",
    "The new logo was unveiled at the all-hands meeting.",
    "To rotate prod DB creds, run the `rotate-secrets` GitHub Action.",
]

scores = reranker.predict([(query, c) for c in candidates])
ranked = sorted(zip(candidates, scores), key=lambda x: -x[1])
for doc, score in ranked:
    print(f"{score:+.3f}  {doc}")
De BGE-code hierboven is een kleine baseline. Voor een actuele vergelijking neem je Cohere Rerank 4.0 fast/pro mee voor managed meertalige tekstranking, of Qwen3-VL-Reranker 2B/8B wanneer queries of documenten afbeeldingen, screenshots of video bevatten. Houd taakmodaliteiten, kandidaatdiepte, invoerlimieten, instructies en hardware expliciet.
Een reranker helpt vaak bij een eenvoudige RAG-pipeline, maar is geen gegarandeerde winst. Meet zijn ΔPrecision@1 en ΔnDCG op je golden set en houd hem alleen als de winst binnen het budget voor latency en kosten past. Vergelijk die gemeten winst met kleinere retrievalwijzigingen voordat je de volgende optimalisatie kiest. BM25 vs embeddings vs rerankers geeft een kortere gids voor het kiezen van elke laag van de rankingstack.
Notebook 03 rapporteert P@10 voor en na cross-encoder-reranking op SciFact, plus ΔnDCG@10; module: retrieval/reranker.py. De module evaluation/reranking.py vergelijkt rerankers op identieke kandidaatsets.
Contextopbouw en lost-in-the-middle
Veel gevallen van “goede retrieval, slecht antwoord” beginnen bij de contextopbouw.
- Contextrelevantie: Ragas
ContextRelevancebeoordeelt de aangeleverde contextlijst met twee prompts en genormaliseerde beoordelingen; het is geen score per chunk. Score voor chunkdiagnose elk query–chunk-paar expliciet, bijvoorbeeld met een cross-encoder, en rapporteer de verdeling onder een lokaal gekalibreerde drempel. - Citatiedekking van de aangeleverde context: aantal verschillende aangeleverde chunks dat is geciteerd, gedeeld door het aantal verschillende aangeleverde chunks. Rapporteer gevallen met lege context apart. Deze waarneembare proxy zegt welke chunks citaties kregen, niet welke het model intern gebruikte of of de citaties de beweringen ondersteunen. Controleer de ondersteuning door citaties apart en vergelijk de dekking met antwoordkwaliteit en tokenkosten.
- Detectie van lost-in-the-middle: een synthetische eval waarin je de gold chunk op de posities {eerste, middelste, laatste} van een lange context zet en de correctheid van het antwoord meet. De aangehaalde studie van Liu et al. (TACL 2024) rapporteert U-vormige achteruitgang onder hun long-contextcondities. Zie hetzelfde patroon in een actueel model als hypothese om te testen. Mitigaties: rerank en herschik daarna de top-k zodat de chunk met de hoogste score eerst of laatst komt (LangChain’s
LongContextReorderdoet precies dat), of comprimeer de middelste chunks agressief. Meet met een eval die per positie is gestratificeerd, niet alleen met een totaalscore. Een uitgewerkte, uitvoerbare eval per positie staat in notebook 06 (module:evaluation/lost_in_middle.py). - Context compression: rapporteer de compressieratio (invoertokens / uitvoertokens) naast de correctheid van het antwoord. Tools zijn onder meer LangChain’s
ContextualCompressionRetrieveren LongLLMLingua. Bepaal vooraf het grootste acceptabele correctheidsverlies uit het risico van de applicatie en het tokenbudget, en verwerp configuraties die dat overschrijden.
Deel 5: De filter false-exclusion rate
Deze metric krijgt een eigen sectie, omdat totale retrievalscores een gemiste treffer niet aan een relevantiefilter kunnen toeschrijven. Evalueer toelatingsfilters apart tegen de rechten van de aanroeper; een document buiten die set moet uitgesloten blijven.
Een hard relevantiepredicaat zoals product = Y AND locale = en-US kan de effectieve recall tot nul terugbrengen onder de documenten die de aanroeper mag zien. Correct geïmplementeerde Recall@k vangt dat verlies, omdat de noemer de oorspronkelijke set toegestane relevante documenten blijft. Hij zegt niet of het filter, de retriever of de ranker de misser veroorzaakte. Faithfulness toetst beweringen aan de opgehaalde context. Het kan nog steeds beweringen scoren die door die onvolledige context worden ondersteund, maar kan de oorzaak in filter of retrieval niet diagnosticeren. Een lege weigering kan geen uitspraken en NaN opleveren, afhankelijk van de implementatie; zie dat niet als bewijs dat faithfulness de weigering goedkeurde.
Het diagram volgt het uitgewerkte voorbeeld hieronder. De toelatingscheck verwijdert d3, dat bij een andere tenant hoort; die uitsluiting is correct. Het relevantiefilter verwijdert daarna het gouden document voor q1 en q3. Recall@10 daalt naar 50% en registreert de daling; alleen de false-exclusion rate, ook 50%, schrijft haar toe aan het predicaat. Een evaluator die de gouden set na het filteren opnieuw opbouwt, rapporteert 100%.
De metric
filter_false_exclusion_rate =
    (# queries where all gold docs were excluded by metadata filter) /
    (# queries with at least one entitlement-eligible gold doc)
Deze definitie op queryniveau telt catastrofale uitsluitingen: geen enkel toegestaan relevant document blijft over. Snijd de gold set van elke query met de rechtenset van de aanroeper voordat je scoort; een niet-toegestaan document is geen valse uitsluiting. Bij queries met meerdere gold-documenten laat standaard Recall@k nog steeds gedeeltelijk verlies zien; voeg een uitsluitingspercentage per document toe als die grens ertoe doet. Om beide percentages te berekenen heb je nodig: (a) ground-truth-document-ID’s voor elke eval-query en (b) instrumentatie die de toegepaste filterpredicaten logt, niet alleen de uiteindelijke resultaten. Als eerste gate gebruikt de companion een false-exclusion rate van hoogstens 2%; stem die af op de kosten van het uitsluiten van een geldig antwoord en op het betrouwbaarheidsinterval van je productiesteekproef.
Hier is een werkende implementatie. Ze vergelijkt correcte standaardrecall met een ongeldige evaluator die relevantie na het filteren opnieuw definieert.
# A small worked example where relevance predicates remove eligible documents.
docs = [
    {"id": "d1", "tenant": "acme",   "locale": "en-US"},
    {"id": "d2", "tenant": "acme",   "locale": "en-GB"},
    {"id": "d3", "tenant": "globex", "locale": "en-US"},
    {"id": "d4", "tenant": "acme",   "locale": "en-US"},
    {"id": "d5", "tenant": "acme",   "locale": "de-DE"},
    {"id": "d6", "tenant": "acme",   "locale": "fr-FR"},
]

# Tenant isolation is an eligibility invariant, not a relevance experiment.
# Verify it independently before evaluating relevance preferences.
eligible_docs = [d for d in docs if d["tenant"] == "acme"]
assert {d["id"] for d in eligible_docs} == {"d1", "d2", "d4", "d5", "d6"}

queries = [
    # the gold doc lives in en-GB but the dynamic filter forced en-US
    {"qid": "q1", "gold": {"d2"}, "filter": lambda d: d["locale"] == "en-US"},
    # the gold doc is correctly within the tenant filter
    {"qid": "q2", "gold": {"d4"}, "filter": lambda d: d["tenant"] == "acme"},
    # the gold doc lives in fr-FR but the dynamic filter forced en-US
    {"qid": "q3", "gold": {"d6"}, "filter": lambda d: d["locale"] == "en-US"},
    # the gold doc passes the filter (de-DE locale match)
    {"qid": "q4", "gold": {"d5"}, "filter": lambda d: d["locale"] == "de-DE"},
]

def filter_false_exclusion_rate(queries, eligible_docs):
    n_with_gold, n_excluded = 0, 0
    eligible_ids = {d["id"] for d in eligible_docs}
    for q in queries:
        eligible_gold = q["gold"] & eligible_ids
        if not eligible_gold:
            continue
        n_with_gold += 1
        survivors = {d["id"] for d in eligible_docs if q["filter"](d)}
        if not (eligible_gold & survivors):
            n_excluded += 1
    if not n_with_gold:
        raise ValueError("false-exclusion rate needs queries with eligible gold")
    return n_excluded / n_with_gold, n_with_gold

rate, eligible_query_count = filter_false_exclusion_rate(queries, eligible_docs)
print(f"filter_false_exclusion_rate = {rate:.2%}")
# filter_false_exclusion_rate = 50.00%
print(f"eligible queries = {eligible_query_count} / {len(queries)}")
# eligible queries = 4 / 4

# Correct Recall@k keeps the original eligible gold set as its denominator.
def standard_recall_at_k(queries, eligible_docs, k=10):
    recalls = []
    eligible_ids = {d["id"] for d in eligible_docs}
    for q in queries:
        eligible_gold = q["gold"] & eligible_ids
        if not eligible_gold:
            continue
        # demo only: the survivor set stands in for a ranked run.
        # A real harness ranks the survivors first, then slices to k.
        survivors = [d for d in eligible_docs if q["filter"](d)][:k]
        survivor_ids = {d["id"] for d in survivors}
        recalls.append(len(eligible_gold & survivor_ids) / len(eligible_gold))
    return sum(recalls) / len(recalls) if recalls else 0.0

print(f"standard recall@10 = {standard_recall_at_k(queries, eligible_docs):.2%}")
# standard recall@10 = 50.00%

# INVALID: rebuilding the gold set after filtering changes the question.
# It drops queries whose relevant documents did not survive, then scores 100%.
def invalid_recall_over_filtered_gold(queries, eligible_docs, k=10):
    recalls = []
    all_doc_ids = {d["id"] for d in eligible_docs}
    for q in queries:
        all_survivors = {d["id"] for d in eligible_docs if q["filter"](d)}
        filtered_gold = q["gold"] & all_doc_ids & all_survivors
        if not filtered_gold:
            continue
        top_k_ids = set(list(all_survivors)[:k])
        recalls.append(len(filtered_gold & top_k_ids) / len(filtered_gold))
    return sum(recalls) / len(recalls) if recalls else 0.0

invalid = invalid_recall_over_filtered_gold(queries, eligible_docs)
print(f"INVALID recall (filtered gold) = {invalid:.2%}")
# INVALID recall (filtered gold) = 100.00%

assert rate == 0.5
assert standard_recall_at_k(queries, eligible_docs) == 0.5
assert invalid == 1.0
# Unauthorized gold and an empty denominator are tested in the companion's
# tests/test_audit_contracts.py.
De functie geeft de rate terug en het aantal queries met toegestane gold. Is die noemer leeg, dan geeft ze een fout in plaats van een geruststellende nul; een verplichte releasecheck moet dat behandelen als ontbrekend bewijs. Queries met alleen niet-toegestane gold horen in aparte tests voor rechten.
De helft van de queries verliest zijn gold-document aan het filter, dus correcte Recall@10 zakt naar 50%. Die score vangt het symptoom, maar kan het niet toeschrijven. De false-exclusion rate laat zien dat het predicaat twee antwoorden verwijderde voordat de retriever draaide. De opzettelijk ongeldige evaluator meldt alleen 100% omdat hij die mislukkingen uit zijn gold set weglaat. Geen model kan een document terughalen dat is weggefilterd.
tests/test_filter_exclusion.py::test_50_percent_exclusion_rate uit de bijbehorende repository en het eerste voorbeeld in notebook 04 gebruiken oudere testgegevens met vijf documenten die ook 50 % opleveren, maar q3 wordt daar door tenant-isolatie uitgesloten. Die gegevens reproduceren het voorbeeld hierboven met toegestane gold-documenten niet. Notebook 04 voert ook SciFact-filterdiagnostiek met synthetische metadata uit. De huidige evaluation/filter_exclusion.py accepteert een afzonderlijk autorisatiepredicaat en een vaste set toegestane gold-documenten en bevat predicaatprecision en -recall.
Bijbehorende metric: predicate precision en recall
Wanneer filtering dynamisch is (bijvoorbeeld doordat een LLM filterpredicaten uit de query haalt), behandel je de predicaatextractor als classificatiemodel en evalueer je hem als zodanig. Meet predicate precision en recall tegen een gelabelde set van (query, correct predicate)-paren. Een foutpercentage in predicaten vertaalt zich niet direct in hetzelfde verlies aan retrieval-recall; meet hoe vaak die fouten een gold-document uitsluiten. Zodra een hard filter het gold-document verwijdert, helpt geen enkele reranking meer.
Toelatingsfilters versus relevantievoorkeuren
Autorisatie, tenantisolatie, rechtsgebied en publicatiestatus bepalen of een document in de kandidatenset mag komen. Houd ze als harde filters en valideer ze onafhankelijk; Recall@k, de false-exclusion rate en relevantie-precision rechtvaardigen niet dat je ze versoepelt.
Vergelijk voor een relevantievoorkeur zoals locale, recentheid of versie een hard predicaat met een soft boost op dezelfde toegestane queries uit een achtergehouden set. Twee regels bepalen de uitkomst:
- Toegangsregels (autorisatie, tenant, rechtsgebied, publicatiestatus) zijn altijd harde filters.
- Elke andere voorkeur is een soft boost, tenzij de gemeten test hieronder slaagt. Dan mag ze een hard predicaat worden.
De pseudocode geeft de test voor regel 2:
For each relevance preference F:
  hard_recall_F  = retrieval_recall@k with F as a hard filter
  soft_recall_F  = retrieval_recall@k with F as a +0.X rerank boost
  hard_precision = relevant_in_top_k / k under hard filter
  soft_precision = relevant_in_top_k / k under soft boost
  precision_gain = hard_precision - soft_precision
  precision_gain_CI = paired-query uncertainty interval for precision_gain
  exclusion_rate = % of queries where the gold doc was filtered out (hard)

Pre-register Δ_min, ε, and recall_loss_max for this workflow.
Use a hard predicate only if:
  lower_bound(precision_gain_CI) >= Δ_min
  AND exclusion_rate <= ε
  AND hard_recall - soft_recall >= -recall_loss_max.
Otherwise prefer a soft boost.
Kies de minimaal nuttige precisiewinst, het onzekerheidsinterval, ε en de grens voor recallverlies op basis van de schade van het uitsluiten van een anders toegestaan antwoord, het voordeel van extra precision en de grootte van de achtergehouden steekproef. Begin met een ε van 1–2% en verlaag die waar een gemist antwoord duur is.
Deel 6: Generation-evaluatie
Retrievalmetrics zeggen dat het systeem correct kon antwoorden. Ze zeggen niet dat het dat ook deed. Generationmetrics dichten dat gat.
Faithfulness en groundedness
RAGAS faithfulness splitst het antwoord in atomaire claims (korte, op zichzelf staande feitelijke uitspraken) en verifieert elke claim daarna met een LLM-judge tegen de opgehaalde context:
Faithfulness controleert de ondersteuning in het aangeleverde bewijs; het stelt niet vast dat het bewijs juist is of volstaat om de vraag te beantwoorden. Leg antwoorden zonder claims apart vast en rapporteer hun aantal in plaats van een leeg antwoord perfecte faithfulness te geven.
De actuele Ragas-documentatie beveelt de collections-API hieronder aan. Installeer in een uv-project ragas en openai met uv add ragas openai, stel OPENAI_API_KEY in en sla dit op als script dat je met uv run draait. Het doet calls naar de provider en brengt de bijbehorende kosten met zich mee; de score is een judge-resultaat, geen deterministische verwachte constante. Pin de opgeloste dependencies in je lockfile.
import asyncio

from openai import AsyncOpenAI, omit
from ragas.llms import llm_factory
from ragas.metrics.collections import Faithfulness

async def main():
    async with AsyncOpenAI() as client:
        # Ragas 0.4.3 sends max_tokens by default; GPT-5.6 models need max_completion_tokens.
        llm = llm_factory(
            "gpt-5.6-terra", client=client, reasoning_effort="none",
            max_tokens=omit, max_completion_tokens=1024,
            temperature=omit, top_p=omit,
        )
        scorer = Faithfulness(llm=llm)
        result = await scorer.ascore(
            user_input="How many moons does Mars have?",
            response="Mars has two moons, Phobos and Deimos.",
            retrieved_contexts=["Mars has two moons named Phobos and Deimos."],
        )
        print(result.value)

if __name__ == "__main__":
    asyncio.run(main())
Dit voorbeeld gebruikt GPT-5.6 Terra als judge; de Ragas-factory geeft modelargumenten door. Vergelijk de valse goedkeuringen, valse afkeuringen en kosten van de judge met menselijke labels voordat je een goedkopere judge vervangt die je al aan labels hebt getoetst.
De frameworktabel in Deel 1 noemt ook answer relevancy en context precision. Dezelfde collections-API scoort beide met dezelfde llm. AnswerRelevancy neemt ook een embeddingmodel, bijvoorbeeld embedding_factory("openai", model="text-embedding-3-small", client=client) uit ragas.embeddings.base. ContextPrecision heeft in ascore een reference-antwoord nodig. Elke score beantwoordt een andere vraag: faithfulness vraagt of de context het antwoord ondersteunt, answer relevancy of het antwoord op de vraag ingaat, en context precision of de relevante context bovenaan staat.
Behoud voor een eigen scorer de structuur extraheren–verifiëren–aggregeren. Extractie is een LLM-call die het antwoord in claims splitst; verificatie is een NLI-model (natural-language inference) of een LLM-judge. Valideer extractie en entailment apart en leg mislukte beoordelingen en antwoorden zonder claims vast. Een antwoord met 4 claims, waarvan er 3 worden ondersteund, scoort bijvoorbeeld 3/4 = 0,75. Een antwoord met 0 claims wordt niet gescoord.
Notebook 05 voert offline een vast Mars-voorbeeld uit met een lexicale benadering; die controleert geen semantische gevolgtrekking. De module evaluation/faithfulness.py implementeert ook claimextractie en -verificatie met SGR. De suite generation evalueert gelabelde synthetische QA met --suite generation --live. De repository gebruikt alleen OpenAI-models. gpt-5.6-luna genereert en beoordeelt standaard; --judge-model gpt-5.6-terra verandert de judge. Beide models komen van één aanbieder, dus de repository toont de judge-workflow en geen vergelijking tussen modelfamilies.
Een speciaal gebouwd alternatief voor LLM-as-judge is HHEM-2.1-Open (Hughes Hallucination Evaluation Model, Vectara), een classifier die met fine-tuning is aangepast voor hallucinatiedetectie. De modelcard beschrijft de checkpoint, de ruwe score van 0–1 die het model afgeeft en resultaten voor balanced accuracy op AggreFact en RAGTruth. Er is geen standaarddrempel gepubliceerd, dus die kiezen is jouw taak. Zie dit als bewijs uit de modelcard, niet als garantie voor je corpus: kalibreer de drempel op lokale labels en vergelijk hem met je gekozen judge vóór de uitrol.
Evaluatie op atomaire feiten
FActScore (Min et al., EMNLP 2023) splitst lange gegenereerde tekst in atomaire feiten, haalt per feit bewijs op, labelt elk feit als supported / not-supported en rapporteert het ondersteunde deel:
Referentie-implementatie: shmsw25/FActScore. De oorspronkelijke evaluatie richtte zich op biografieën met Wikipedia als bewijs. Aanpassing aan samenvattingen of andere lange teksten vereist lokale verificatie van claimextractie, bewijsdekking en ondersteuningsbeoordelingen. Herhaalde triviale feiten kunnen de score verhogen, en afzonderlijk ware uitspraken kunnen samen een misleidend antwoord vormen. MontageLie (EMNLP 2025) test dit met misleidende relaties en volgordes tussen ware uitspraken. VeriScore verwerkt claims met noodzakelijke kwalificaties; de filter Core helpt voorkomen dat extra feiten de score verhogen.
Citatienauwkeurigheid
Volg citation precision (geciteerde spans ondersteunen de claim echt) en citation recall (claims die geciteerd moeten worden, zijn dat ook):
De TREC 2024 RAG Track definieert een reproduceerbaar protocol voor supportevaluatie. Thakur et al. (SIGIR 2025) rapporteren ongeveer 56% overeenstemming met menselijke oordelen die van nul af zijn gemaakt en 72% onder een andere conditie waarin mensen LLM-voorspellingen achteraf bewerkten. Dat laatste is ondersteunde annotatie en geen onafhankelijk bewijs dat de judge nauwkeuriger werd. Houd de annotatieconditie bij het getal. Als geautomatiseerde benadering implementeert ALCE (Gao et al., EMNLP 2023) citation precision/recall met NLI-gebaseerde verificatie.
Correctheid, volledigheid en weigering van antwoorden
- Correctheid van het antwoord tegen een referentie: exact match of token-F1 kan passen bij korte antwoorden;
evaluate.load("squad")van Hugging Face berekent beide en het packagebert-scoreberekent BERTScore. Controleer bij langere antwoorden feitelijke relaties, entiteiten, hoeveelheden, ontkenning en vereiste informatie tegen beoordeelde referenties. BERTScore en embeddingcosinus meten gelijkenis; een verkeerd getal of een ontkenning kan een hoge score laten staan. RagasAnswerCorrectnesscombineert feitelijke vergelijking met gelijkenis en stelt die twee niet gelijk. - Volledigheid via nuggets: een nugget is een relevante informatie-eenheid, waarbij vitale nuggets worden onderscheiden van optionele nuttige. Een vraag naar een oprichtingsdatum vereist misschien het jaar; de naam van de oprichter is niet automatisch vereist. AutoNuggetizer bouwt en verfijnt nuggets uit beoordeelde documentpools en controleert daarna of ze in gegenereerde antwoorden voorkomen. Het eerste TREC 2024-rapport omvatte 21 topics en 45 runs. Het TREC 2025-overzicht, gepubliceerd in maart 2026, breidt het protocol uit naar narratieve queries en evalueert retrievalrelevantie, volledigheid van antwoorden en attributie. Dit zijn openbare evaluatieprotocollen, geen bewijs dat elk RAG-systeem in productie dezelfde nuggetrubric nodig heeft.
- Weigergedrag: label of het aangeleverde bewijs een antwoord toelaat en meet dan het aandeel correcte weigeringen onder alle weigeringen en het aandeel weigeringen onder de gevallen die zich moeten onthouden. NoMIRACL (Findings of EMNLP 2024) test de robuustheid tegen relevante en niet-relevante aangeleverde passages; het bewijst niet dat het hele corpus geen antwoord bevat. Scheid in je eigen suite retrievalmissers van queries die echt buiten de scope vallen.
Verificatie na generatie
De goedkoopste winst in betrouwbaarheid komt vaak van deterministische controles achteraf, niet van grotere models.
-
Vlag voor onbekende entiteiten: noteer entiteitsnamen in het antwoord die ontbreken in een genormaliseerde contextstring (bijvoorbeeld
entsvanspaCyplus exacte matching). Dit is een goedkope, domeinspecifieke vlag voor onbekende entiteitsstrings en geen grounding-check: hij kan identiteit, relatie, ontkenning, tijd of herkomst niet vaststellen. Meet zijn precision en recall op lokale labels voordat je hem gebruikt om een release goed te keuren, en houd claimgewijze entailment of menselijke review voor de verificatie.In dit voorbeeld vindt de vlag geen onbekende entiteit, hoewel het antwoord het tegendeel van de context zegt.
def unseen_entity_flag(answer: str, context: str, entities: list[str]) -> bool: return any(entity.lower() not in context.lower() for entity in entities) context = "Paris was not founded in 1994." answer = "Paris was founded in 1994." assert not unseen_entity_flag(answer, context, ["Paris"]) claim_supported = False # human label or an NLI verdict, not the lexical flag assert not claim_supported -
Claimverificatie: extraheer claims, draai NLI tegen de context en laat elke claim onder de drempel mislukken of markeer hem. NLI-models voor faithfulness:
cross-encoder/nli-deberta-v3-large,MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli. Voegt latency toe. De moeite waard in domeinen met hoge belangen. -
Self-consistency (Wang et al., ICLR 2023): sample meerdere generatie-resultaten bij temperatuur > 0; rapporteer de overeenstemming (bijvoorbeeld het aandeel generatie-resultaten dat het modale antwoord geeft, of paarsgewijze BERTScore); kies het aantal samples uit de curve van stabiliteit tegenover kosten en markeer antwoorden met lage overeenstemming voor menselijke review.
-
Confidence-calibration: verzamel verbaal geuite zekerheid (“Hoe zeker ben je, 0–1?”) en vergelijk die met de werkelijke correctheid op de eval set. Zet een kalibratiecurve uit en rapporteer de Expected Calibration Error: , waarbij de confidence-bins zijn. Implementaties:
netcal,torchmetrics.CalibrationError. Een model dat een zekerheid van 0,9 meldt, moet in ongeveer 90% van de vergelijkbare gevallen gelijk hebben; meet het verschil in plaats van calibration aan te nemen.
Deel 7: Evaluatie van RAG op basis van een ontologie
De standaardmetrics hierboven dekken RAG op een open corpus. Haalt je RAG op tegen een gestructureerde ontologie, taxonomie of knowledge graph, dan zijn die metrics noodzakelijk maar niet genoeg. Voorbeelden zijn producten in een catalogus, aandoeningen in SNOMED, onderdelen in een BOM en beveiligingstechnieken in MITRE ATT&CK. Je moet ook de ontologielaag meten.
Nauwkeurigheid van entity linking
De eerste taak is een vermelding in een query koppelen aan een ontologie-entiteit (“Aspirine” → wikidata:Q18216, “de 737” → aircraft:Boeing_737).
- Precision/recall/F1 op vermeldingsniveau: standaard, tegen gold-spans van vermeldingen (bereken met
seqevalof een vergelijker van span-sets). - Nauwkeurigheid van disambiguatie: welk deel van de correct gedetecteerde vermeldingen wordt aan de juiste entiteits-ID gekoppeld? Openbare referenties zijn onder meer ReFinED, REL en GENRE; benchmarks als AIDA-CoNLL en BELB laten zien dat resultaten per systeem en domein verschillen.
- Omgang met NIL: precision/recall op “entiteit staat niet in de ontologie”. Meet overlinking naar bijna-juiste, verkeerde entiteiten apart van correcte onthouding.
Hiërarchiebewuste evaluatie
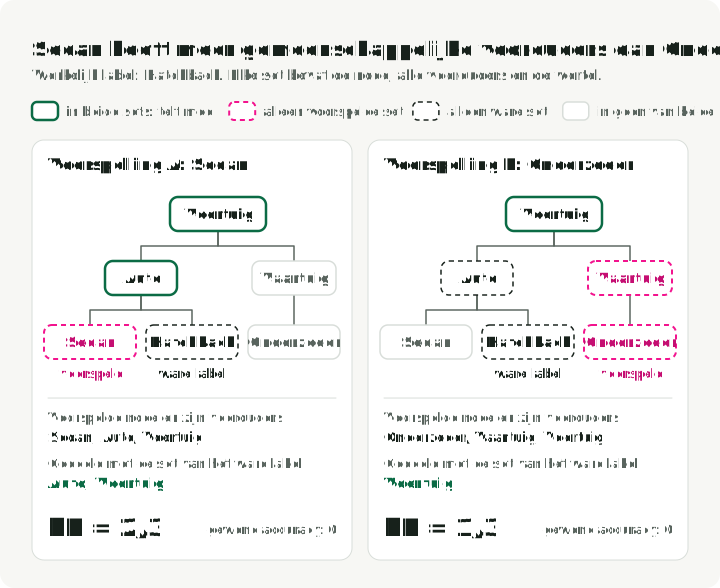
Gewone accuracy behandelt “Sedan voorspeld terwijl Hatchback klopt” gelijk aan “Submarine voorspeld terwijl Hatchback klopt”. Die fouten zijn niet gelijk. In het diagram deelt Sedan twee van zijn drie knopen met het ware label en Onderzeeër alleen de wortel; de hiërarchische precision hieronder zet die overlap om in een score.
-
Hiërarchische precision/recall/F1 (Kosmopoulos et al., 2015): geef krediet voor gedeelde voorouders in de DAG van de ontologie. Met de voorspelde knoop plus al zijn voorouders en de ware knoop plus al zijn voorouders:
Implementeer met
networkxop de ontologiegraaf: vul elke voorspelling en elk label aan met zijn voorouders en neem daarna de overlap van de verzamelingen hierboven. -
Wu-Palmer-gelijkenis tussen de voorspelde en de gold-entiteit in de taxonomie (Wu & Palmer, 1994):
waarbij LCA de laagste gemeenschappelijke voorouder in de taxonomie is. Standaard beschikbaar in NLTK voor WordNet (
from nltk.corpus import wordnet as wn; wn.synset("car.n.01").wup_similarity(wn.synset("truck.n.01"))); bereken voor eigen taxonomieën de LCA metnetworkx. -
Verwarringspercentage tussen siblings en parents: volg verwarringen met siblings, parents en kinderen apart —
count_sibling / total_errors,count_parent / total_errors,count_descendant / total_errors. Gebruik beoordeelde voorbeelden om te toetsen of siblingfouten uit dubbelzinnige vermeldingen komen of parentfouten uit overgeneralisatie.
Filter false-exclusion rate (herhaling, nu cruciaal)
In systemen op basis van een ontologie komen harde filters vaak uit de ontologie zelf (“haal alleen documenten op met categorie X”). De exclusion-rate-metric (gedefinieerd in Deel 5) wordt een primair correctheidssignaal. Een verkeerde categorievoorspelling kan de recall op nul zetten; de exclusion rate schrijft dat verlies toe aan het filter.
Conformiteit van constrained generatie
Wanneer je uitvoer aan een ontologie moet voldoen (elke entiteitsnaam in het antwoord moet een geldig lid van de ontologie zijn; elk predicaat moet uit een gesloten vocabulaire komen), meet je:
- Schema validity rate: percentage uitvoer dat parset en valideert tegen het ontologieschema. Valideer met
jsonschemaofpydantic. JSONSchemaBench is de openbare benchmark voor algemene structured output; bouw voor ontologiespecifieke schema’s je eigen validator. - Vocabulary conformance: percentage benoemde entiteiten in de uitvoer dat geldige ontologie-ID’s zijn — een controle op lidmaatschap van een verzameling tegen de gesloten vocabulaire, in één regel.
- Semantische conformiteit: een syntactisch geldige uitvoer kan nog steeds de verkeerde maar geldige entiteit kiezen. Combineer conformiteit met de correctheid van het downstream-antwoord.
Frameworks voor constrained decoding (Outlines, XGrammar, Guidance, OpenAI Structured Outputs) zijn bedoeld om schemageldigheid af te dwingen. JSONSchemaBench vergelijkt efficiëntie, dekking en kwaliteit over implementaties heen. Draai de cases die bij je schema’s en je serving-backend passen opnieuw, omdat dekking en latency van beide afhangen.
Auditbaarheid
Voor systemen op basis van een ontologie waarvan de antwoorden worden beoordeeld:
- Volledigheid van citaties: percentage feitelijke claims met ten minste één verifieerbare citatie.
- Herkomstdiepte: percentage citaties dat helemaal terug te herleiden is tot een brondocument met een stabiele ID, en niet alleen tot een chunk-hash.
- Reproduceerbaarheid: dezelfde query opnieuw draaien op een vaste snapshot geeft hetzelfde antwoord. Pin de modelversie, de runtime, de decodingconfiguratie en de seed, en stel het vereiste herhaalpercentage vast uit de auditbaarheidsbehoeften van de workflow. Temperatuur nul alleen garandeert geen determinisme. Een afwijking kan uit generatie komen, uit de serving-runtime of uit elke eerdere stap.
Deel 8: Evaluatie op systeemniveau
Algemene antwoordkwaliteit
- LLM-as-judge (Zheng et al., NeurIPS 2023): een schaalbare, modelgebaseerde evaluatiemethode. G-Eval (Liu et al., EMNLP 2023) genereert evaluatiestappen uit de taak en de criteria en weegt daarna de beoordelingsniveaus met hun tokenkansen: . Dit zijn kansen, geen logkansen. De overeenstemming hangt af van de judge, de taak, de prompt en de calibration-dataset.
- Pairwise preference: leg de judge antwoord A tegenover antwoord B voor en noteer de voorkeur. Dit vervangt een absolute beoordeling door een vergelijkende beslissing, maar heeft nog steeds calibration tegen menselijke voorkeuren nodig. MT-Bench rapporteerde dat een GPT-4-judge in zijn benchmarkcondities in meer dan 80% van de gevallen overeenkwam met zowel menselijke voorkeuren als met de overeenstemming tussen mensen; neem dat percentage niet zonder calibration over naar een ander domein.
LLM-as-judge heeft echte biases:
- Position bias: meet de gevoeligheid voor volgorde op door mensen gelabelde gevallen voor de gekozen judge en taak. Randomisatie of aggregatie met omgewisselde volgorde kan bij sommige combinaties van model en taak helpen, maar behoud een van beide alleen als ze de lokale overeenstemming met mensen verbetert; de gecontroleerde studie van 2026 vond dat het omwisselen van posities schadelijk was in haar adversariële gevallen.
- Verbosity bias: judges kunnen lengte met kwaliteit verwarren. De aangehaalde gecontroleerde studie van 2026, versie 2 vond heterogeen gedrag bij uitbreidingsparen: drie judges verkozen langere antwoorden, Claude verkoos beknopte antwoorden en GPT-4o was ongeveer neutraal. Alle vijf presteerden goed op truncatiecontroles. Die resultaten zijn aan de benchmark gebonden, dus vertel je judge hoe hij volledigheid en opvulling moet behandelen en rapporteer daarna de prestaties gecorrigeerd voor lengte op je eigen rubric.
- Risico van zelfvoorkeur: Zheng et al. zagen in hun data een 10% hogere zelf-winstrate voor GPT-4 en een 25% hogere voor Claude-v1, maar concludeerden dat beperkte data en kleine verschillen geen zelfbevoordeling konden aantonen. Vergelijk judges uit dezelfde en uit andere families met lokale menselijke labels; kies de beter gekalibreerde judge in plaats van aan te nemen dat een van beide opstellingen veilig is.
Praktisch recept: kies een judge op basis van door mensen gelabelde calibration data, maskeer modelidentiteiten, meet de gevoeligheid voor volgorde en leg het lengtebeleid vast in de rubric. Herhaal gevallen alleen als de extra samples de onzekerheid wezenlijk verkleinen. Vergelijk bij evaluaties met hoge belangen judges uit dezelfde en uit andere families en analyseer meningsverschillen tegen menselijke labels.
Schema-Guided Reasoning voor judges
Vrije uitvoer is één bron van variatie in judge-runs. Twee runs op hetzelfde antwoord kunnen de rubric verschillend ordenen en verschillende scores geven. Schema-Guided Reasoning (SGR) maakt die rubric expliciet: definieer de evaluatiestappen als Pydantic-schema en gebruik daarna structured output via Outlines, XGrammar, vLLM structured outputs of OpenAI response_format om de ondersteunde schemabeperkingen af te dwingen. De volgorde van velden kan een reviewer helpen het record te inspecteren, maar bewijst niet dat het model de stappen in die volgorde heeft doorlopen.
Voor RAG-evaluatie splitst het schema het oordeel in expliciete, controleerbare velden in plaats van het model direct naar een getal te laten springen:
from pydantic import BaseModel, Field, ValidationError, model_validator
from typing import Literal

class FaithfulnessJudgment(BaseModel):
    extracted_claims: list[str] = Field(
        description="Atomic factual claims in the answer, one per item."
    )
    supported_claims: list[str] = Field(
        description="Subset of extracted_claims that are entailed by the context."
    )
    unsupported_claims: list[str] = Field(
        description="Subset that is NOT entailed by the context."
    )
    outcome: Literal["scored", "no_claims"]
    failure_mode: Literal[
        "none", "fabrication", "overgeneralization", "wrong_entity", "stale_fact"
    ]
    rationale: str

    @model_validator(mode="after")
    def require_claim_partition(self):
        for claims in (self.extracted_claims, self.supported_claims, self.unsupported_claims):
            if any(not claim.strip() for claim in claims):
                raise ValueError("claims must contain non-whitespace text")
        extracted = set(self.extracted_claims)
        supported = set(self.supported_claims)
        unsupported = set(self.unsupported_claims)
        if not extracted:
            if supported or unsupported or self.outcome != "no_claims":
                raise ValueError("an empty extraction must be a no_claims outcome")
            return self
        if (
            len(extracted) != len(self.extracted_claims)
            or len(supported) != len(self.supported_claims)
            or len(unsupported) != len(self.unsupported_claims)
            or supported & unsupported
            or supported | unsupported != extracted
            or self.outcome != "scored"
        ):
            raise ValueError("verdict lists must be a complete, disjoint claim partition")
        return self

    @property
    def score(self) -> float | None:
        if not self.extracted_claims:
            return None
        return len(self.supported_claims) / len(self.extracted_claims)

valid = FaithfulnessJudgment(
    extracted_claims=["Mars has two moons", "Mars has a thick atmosphere"],
    supported_claims=["Mars has two moons"],
    unsupported_claims=["Mars has a thick atmosphere"],
    outcome="scored",
    failure_mode="fabrication",
    rationale="The atmosphere claim lacks support.",
)
assert valid.score == 0.5
empty = FaithfulnessJudgment(
    extracted_claims=[],
    supported_claims=[],
    unsupported_claims=[],
    outcome="no_claims",
    failure_mode="none",
    rationale="Score refusal correctness separately.",
)
assert empty.score is None
try:
    FaithfulnessJudgment(
        extracted_claims=["Mars has two moons"],
        supported_claims=["Mars has two moons"],
        unsupported_claims=["Mars has two moons"],
        outcome="scored",
        failure_mode="none",
        rationale="Contradictory verdict.",
    )
except ValidationError:
    pass
else:
    raise AssertionError("overlapping verdicts must fail validation")
Dit illustratieve contract berekent de score pas als de oordeellijsten een volledige, disjuncte partitie van de geëxtraheerde claims vormen. Een uitkomst zonder claims heeft geen faithfulness-score en moet buiten het faithfulness-gemiddelde blijven; rapporteer het aantal en score de correctheid van weigeringen apart, zodat onthoudingen het gemiddelde niet ongemerkt kunnen verbeteren. Behoud die semantische checks in productie; structured output garandeert de vorm, geen onbevooroordeeld oordeel. Het Pydantic-model maakt een wijziging in de rubric ook zichtbaar als code-diff, terwijl calibration door mensen het oordeel zelf toetst.
Dit werkt voor elke judge op basis van een rubric, niet alleen voor faithfulness. Pairwise preference, citatieondersteuning en correctheid van weigeringen profiteren allemaal van dezelfde aanpak.
Notebook 07 meet positievertekening met paarsgewijze aanroepen die de volgorde omkeren. De module evaluation/llm_judge.py implementeert ook pointwise SGR-scoring. Paarsgewijze runs tonen beide antwoordvolgordes en rapporteren de consistentie na verwisseling. De pointwise judge geeft één gehele score terug; dit is niet de met waarschijnlijkheden gewogen G-Eval-methode. Omdat beide models van één aanbieder komen, vereist het meten van zelfvoorkeur nog steeds een judge uit een andere modelfamilie, vergeleken met lokale menselijke labels.
Latency en kosten
- p50, p95, p99 bij elke pipelinestap. Een redelijk begin is p95 voor de SLO en p99 voor alerting; pas een van beide aan zodra je het gebruikerstraject, het verkeersvolume en het foutbudget kent.
- Time-to-first-token versus de totale generatietijd. Gebruikers geven om TTFT bij streaming-UX.
- Uitsplitsing per stap: retrieval, reranking, generatie, nabewerking. Gebruik de trace om de staart te lokaliseren in plaats van aan te nemen welke stap hem veroorzaakte; noteer bij het vergelijken van runs het apparaat en de batchgrootte van de reranker.
- Totaal $/query = embedding + retrieval + rerank + generatie + afgeschreven opslag. Volg p50 en p99; in de lange staart gaat het budget heen.
- Cache hit rates op het niveau van embeddingcache, retrievalcache en KV cache. Stel aparte doelen vast uit de waargenomen herhaling, het invalidatiebeleid en de kosten die elke laag bespaart.
Notebook 08 toont p50/p95/p99 voor de door evaluation/runner.py geïnstrumenteerde stap retrieve. De module evaluation/latency.py kan andere stappen samenvatten als je ze expliciet instrumenteert. make benchmark varieert chunking- en embedding-instellingen zonder API-aanroepen. De LLM-vergelijking vereist een OpenAI-key en uv run python -m rag_evals.scripts.benchmark --skip-chunking --skip-embedding --live.
A/B-testen
- Randomisatie-eenheid: bepaal eerst de uitkomst die je wilt schatten. Vraag dan of eerdere antwoorden later gedrag kunnen veranderen en of de toegewezen versie van de ene gebruiker de ervaring van een andere kan beïnvloeden. Gebruik toewijzing per gebruiker of per session wanneer herhaalde blootstelling gedrag kan veranderen of een inconsistente UX kan geven. Toewijzing per query is alleen verdedigbaar als die effecten verwaarloosbaar zijn en de analyse herhaalde waarnemingen modelleert.
- Primaire, guardrail- en verkennende metrics: leg ze vooraf vast. Kies de primaire maat uit het productresultaat; proxies voor tevredenheid zijn onder meer duimpjes, regeneration-resultaten en verblijftijd. Behandel latency en kosten als guardrails wanneer ze de ervaring begrenzen.
- Steekproefgrootte: doe vóór de lancering een poweranalyse op basis van het kleinste effect dat het detecteren waard is, de variantie van de baseline, de toewijzingseenheid en de stopregel.
Deel 9: Opbouw van de testset
Een metric is zo goed als de testset waarop hij draait. Dekt je golden set drie intents en omvat het productieverkeer er twaalf, dan meet Recall@10 alleen die drie intents. Erger nog: een testset die op makkelijke vragen is afgestemd (“Wat is het retourbeleid van het bedrijf?”) kan een systeem goedkeuren dat op de moeilijke faalt (“Komt een klant in Ierland die in EUR is gefactureerd in aanmerking voor terugbetaling bij gedeeltelijke annulering onder de Europese consumentenregels?”). De totaalscore stijgt terwijl het systeem op een belangrijk deel van het productieverkeer blijft falen.
Onvolledige relevantielabels kunnen recall in beide richtingen vertekenen. Is de ware relevante set {a, b} maar bevatten de labels alleen {a}, dan scoort het ophalen van {a} 1,0 in plaats van 0,5; het ophalen van {b} scoort nul in plaats van 0,5. Versioneer de beoordelingen en bekijk nieuw opgehaald, nog niet beoordeeld bewijs voordat je een delta interpreteert.
Bouw de testset eerst rond de echte querydistributie en moeilijkheid. Kies daarna metrics die reageren op de beoogde faalpatronen en stem het systeem daarop af.
Synthetische queries genereren
Gebruik een LLM om vragen uit je corpus te genereren:
- Per chunk: “Genereer 3 vragen die een gebruiker kan stellen en die deze chunk beantwoordt.”
- Multi-hop: sample twee chunks en genereer een vraag die beide vereist.
- Adversarieel: genereer vragen met afleidende entiteiten, bijna-dubbele formuleringen en dubbelzinnige vermeldingen.
Ragas test generatie gebruikt scenario’s op basis van een graaf met single-hop- en multi-hop-queries en specifieke of abstracte informatiebehoeften. DataMorgana genereert configureerbare synthetische benchmarks over gebruikers- en vraagcategorieën. Synthetische data is nuttig voor cold starts en dekkingstests. Ze kan echte gebruikersqueries niet vervangen.
Opbouw van de golden dataset
Door mensen samengestelde data vormt de basis van de golden set.
- Sample echte gebruikersqueries (of gesimuleerde, als je nog niet gelanceerd bent), gestratificeerd naar intent.
- Laat SME’s elke vraag beantwoorden en aanwijzen welk(e) document(en) het antwoord bevatten.
- Begin met enkele honderden queries (200–500) en controleer het interval. Bij 200 queries en een slagingspercentage rond 0,8 is het 95%-interval ongeveer ±5,5 punten (1,96 × √(0,8 × 0,2 / 200)). Is de verandering die je moet detecteren kleiner, voeg dan queries toe aan de slices die de release bepalen.
- Voeg beoordeelde productiequeries toe (Deel 10) wanneer driftchecks of nieuwe querytypen een gat in de dekkingsmatrix hieronder laten zien.
Houd vier sets gescheiden:
- Ontwikkeling: stem prompts, k en chunking af.
- Judge-calibration: menselijke labels die de judge controleren.
- Release: één keer gescoord per kandidaat, nooit gebruikt om af te stemmen.
- Monitoring: vers productieverkeer, blind beoordeeld.
Groepeer gedeelde brondocumenten en sessions voordat je splitst. Zodra een query of label het afstemmen stuurt, is het ontwikkeldata, dus een releaseset die voor tuning wordt gebruikt, wordt ontwikkeldata. Reserveer onaangeroerde gevallen om de gekozen configuratie en judge te valideren.
Leg de versies van corpus, queries, relevantielabels en beleid vast, plus de eenheid van k, het budget voor aangeleverde context, de revisies van scorer en judge en de aggregatieregels. Vergelijk gepaarde deltas per query op dezelfde populatie, met onzekerheid en aantallen per slice. Neem elke verwachte query mee: een timeout, ontbrekend resultaat of niet-scorebaar judge-antwoord moet zichtbaar blijven in de boekhouding van voltooiing en fouten. Laat een releasescore niet beter worden door mislukkingen ongemerkt weg te laten. ARES biedt een onderzoeksaanpak met geautomatiseerde judges, menselijke validatie en prediction-powered inference voor systeemschattingen wanneer annotatie schaars is; een beoordeelde lokale suite kan eenvoudiger beginnen.
Adversariële testsets
- Counterfactuals: verwissel belangrijke entiteiten in de query. Haalt het systeem voor de verwisselde query de juiste chunks op?
- Distractors: queries waarbij het corpus een aannemelijk maar fout antwoord bevat dat niet opgehaald mag worden. Dit is wat RGB (Chen et al., AAAI 2024) op de proef stelt: robuustheid tegen ruis, afwijzing van negatieve gevallen, integratie van informatie en robuustheid tegen counterfactuals.
- Ontkenning en kwantoren: queries met “niet”, “behalve” en “alleen”. Dense retrievers hebben hier vaak moeite mee.
- Buiten de scope: queries zonder antwoord in het corpus. Het systeem moet “dat weet ik niet” zeggen en niet hallucineren. NoMIRACL levert tests voor relevantie en beantwoordbaarheid op passageniveau; voeg aparte labels voor buiten-de-scope op corpusniveau toe. Evalueer onthouding expliciet op je eigen querytypen in productie.
Dekking en continue evaluatie
- Bouw een dekkingsmatrix: query-intent × documenttype × ontologietak. Eén query per cel is een eerste inventaris van de dekking en geeft onvoldoende statistische kracht voor een releasebeslissing. Lege cellen leggen ontbrekende dekking bloot; dimensioneer de gevulde slices naar de onzekerheid die je kunt dragen.
- Beginschema: een subset van ongeveer 50 queries bij elke PR, de volledige golden set ‘s nachts of bij elke release candidate, en wekelijks driftchecks op een productiesteekproef.
make eval-fastvan de companion draait de subset van 50 queries. Pas het schema aan zodra je de kosten van de evaluatie kent en weet hoe snel het verkeer verandert. - Gebruik voor drift een voortschrijdende productiesteekproef en stratificeer op feedback in plaats van de doelverdeling ongemerkt te veranderen.
Deel 10: Productiemonitoring
De eval-suite die je uitlevert beschrijft het systeem bij de lancering. Het productieverkeer verandert daarna.
Impliciete en expliciete feedback
- Behandel impliciete gebeurtenissen als kandidaatsignalen, niet als positieve of negatieve kwaliteits-KPI’s, totdat ze op een lokale steekproef correleren met geblindeerde review of expliciete feedback.
- Click-through-/openingsrate op geciteerde bronnen (als je UI ze toont).
- Verblijftijd op het antwoord.
- Regeneratierate: percentage antwoorden dat de gebruiker opnieuw vraagt of laat overdoen. Zie het als één signaal van ontevredenheid en kalibreer het tegen beoordeelde gesprekken.
- Kopieer-/deel-/exportrates: kandidaat-impliciete signalen die nut, verificatie, overdracht of ontevredenheid kunnen vertegenwoordigen. Meet hun samenhang en betrouwbaarheidsinterval voordat je er een richting aan toekent.
- Vervolgpatronen: gebruik “Weet je het zeker?” of “Maar hoe zit het met X?” als reviewstrata en label daarna hun samenhang met wantrouwen of een onopgeloste behoefte.
- Duimpje omhoog/omlaag met optionele redencategorieën (fout, onvolledig, off-topic, schadelijk, traag). Inline bewerkingen kunnen meer diagnostische context bewaren; beoordeel die waarde op beoordeelde samples.
Driftdetectie
- Query-drift: vergelijk query-embeddings met een referentievenster met MMD of een gevalideerde classifier voor referentie tegenover actueel. KL vraagt om een gedefinieerde kansschatter, zoals gekozen histogrammen; ruwe embeddingcoördinaten zijn geen kansen. Kalibreer alarmen op bekende verschuivingen en inspecteer daarna de getroffen slices.
- Embedding-drift: pin een representatie en een probe-set en meet daarna de stabiliteit van buren en de retrievalkwaliteit. Verschillende modelversies hoeven geen dimensies of coördinatenbasis te delen, dus cosinus tussen versies kan betekenisloos zijn. Migreer query- en documentencoders samen, evalueer de nieuwe index en bewaar geversioneerde snapshots voor rollback.
- Prestatiedrift: volg metrics die in productie het equivalent zijn (regeneratierate per intent) in de tijd. Plotselinge en geleidelijke verschuivingen wijzen op verschillende hypotheses, maar hun vorm stelt de oorzaak niet vast; inspecteer wijzigingen in data, verkeer, provider, beleid en deployment.
Shadow-evaluatie en human-in-the-loop
Draai het kandidaatsysteem parallel aan productie, vergelijk de uitvoer offline en lever hem niet aan gebruikers. Dit kan regressies vóór de lancering blootleggen. Shadow-inference verbruikt nog steeds capaciteit en kan tools aanroepen: isoleer resources, onderdruk schrijfacties en controleer dat de vergelijking de latency in productie niet verslechtert.
Voor review met human-in-the-loop (HITL):
- Sample uitvoer met lage confidence naar een reviewwachtrij.
- Neem een willekeurige steekproef van het productieverkeer op voor blinde review; 1–2% van het verkeer is een beginpercentage, aan te passen aan verkeersvolume, risico en reviewcapaciteit.
- Sample uitvoer met een duimpje omlaag oververtegenwoordigd voor review, naast de willekeurige steekproef.
- Gebruik beoordeelde uitvoer om de golden set uit te breiden.
Behoud de willekeurige steekproef: zonder die krijgt de golden set alleen antwoorden waarover gebruikers hebben geklaagd.
De minimale set guardrails
Kies prioriteiten en drempels voor alerts op basis van de schade voor gebruikers, de SLO’s en de gevalideerde prestaties van detectoren. Kandidaatsignalen zijn onder meer:
- Faithfulness-/HHEM-score onder de drempel op een voortschrijdende productiesteekproef.
- p95-latency boven de SLO.
- Filter false-exclusion rate boven de drempel (op basis van een steekproef).
- Regeneratierate buiten een lokaal gekalibreerde controleband die rekening houdt met venstergrootte, verkeer, seizoenspatronen en budget voor valse alarmen.
- Kosten/query boven het budget.
Een eerste triageregel: een alert zonder wijziging in code of model wijst op drift; een alert direct na een release wijst op een regressie. Bevestig beide in traces en getroffen slices, want een deployment kan samenvallen met verkeersdrift en een wijziging bij een provider of in de data kan optreden zonder applicatierelease.
Kanttekeningen
- Doelen zijn lokaal, niet universeel. De beginwaarden in deze gids, inclusief de gates van de companion, zijn eerste instellingen om op je eigen data af te stemmen. De illustratieve getallen zijn uitgewerkte resultaten. Kalibreer releasedrempels op je domein, de belangen, de onzekerheid van de evaluatieset en de verwachtingen van gebruikers.
- Het frameworklandschap verandert snel. Versies van HHEM, namen van RAGAS-metrics, modelcards en de volgorde op leaderboards kunnen na publicatie verschuiven. Controleer de gelinkte bron opnieuw en benchmark opnieuw voordat je je vastlegt.
- Cijfers voor overeenstemming van LLM-as-judge hebben kanttekeningen. Het cijfer van 80% voor GPT-4 tegenover mensen komt uit de omstandigheden van MT-Bench / Chatbot Arena. Dat resultaat stelt geen overeenstemming vast voor een nichedomein of een adversariële slice. Gebruik judges om meer gevallen te scoren dan mensen kunnen beoordelen en blijf een steekproef met de hand nakijken.
- Winst uit leveranciersbenchmarks is vaak niet onafhankelijk reproduceerbaar. Reproduceer op je eigen data voordat je een getal gelooft, vooral voor nieuwere rerankers en OCR-systemen.
- Geen enkele metric vervangt het bekijken van de uitvoer. Begin met elke week 50 willekeurige productieantwoorden te lezen. De metrics schalen die gewoonte op; ze vervangen haar niet.
Referenties
Frameworks en benchmarks
- Es et al., Ragas: Automated Evaluation of Retrieval Augmented Generation, 2023.
- RAGAS documentation and GitHub.
- Saad-Falcon et al., ARES: An Automated Evaluation Framework for Retrieval-Augmented Generation Systems, NAACL 2024.
- TruLens, DeepEval, Arize Phoenix.
- Thakur et al., BEIR: A Heterogenous Benchmark for Zero-shot Evaluation of Information Retrieval Models, NeurIPS 2021.
- MTEB Leaderboard.
- TREC 2024 RAG Track.
- Pradeep et al., Initial Nugget Evaluation Results for the TREC 2024 RAG Track with the AutoNuggetizer Framework, 2024.
Retrieval en ranking
- Cormack, Clarke, Buettcher, Reciprocal Rank Fusion Outperforms Condorcet and Individual Rank Learning Methods, SIGIR 2009.
- Gao et al., Precise Zero-Shot Dense Retrieval Without Relevance Labels (HyDE), 2022.
- Jeong et al., Adaptive-RAG: Learning to Adapt Retrieval-Augmented Large Language Models through Question Complexity, NAACL 2024.
- Anthropic, Introducing Contextual Retrieval, september 2024.
- Günther et al., Late Chunking: Contextual Chunk Embeddings Using Long-Context Embedding Models, 2024.
Generation, faithfulness, judges
- Min et al., FActScore: Fine-grained Atomic Evaluation of Factual Precision in Long Form Text Generation, EMNLP 2023.
- Liu et al., Lost in the Middle: How Language Models Use Long Contexts, TACL 2024.
- Chen et al., Benchmarking Large Language Models in Retrieval-Augmented Generation (RGB), AAAI 2024.
- Vectara, HHEM-2.1-Open hallucination evaluation model.
- Zheng et al., Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, NeurIPS 2023.
- Thakur et al., Support Evaluation for the TREC 2024 RAG Track: Comparing Human versus LLM Judges, SIGIR 2025.
- Thakur et al., Knowing When You Don’t Know: A Multilingual Relevance Assessment Dataset for Robust Retrieval-Augmented Generation, Findings of EMNLP 2024.
- Geng et al., JSONSchemaBench: A Rigorous Benchmark of Structured Outputs for Language Models, 2025.
- Kosmopoulos et al., Evaluation Measures for Hierarchical Classification: a unified view and novel approaches, 2015.
Drift en productie
- Evidently, Embedding drift detection methods compared.
Companioncode
slavadubrov/rag-evals-demo: uitvoerbare harness die SciFact-retrieval, generatie op gelabelde synthetische QA en offline controles met vaste testgegevens scheidt, met chunking- en embedding-sweeps en een optionele livevergelijking van twee OpenAI-models. Notebooks 00–09 leggen de processen uit; unit-tests leggen geselecteerde uitgewerkte voorbeelden vast, terwijl de oudere filtertestgegevens een andere toegestane populatie gebruiken. De ingebouwde Qdrant-index werkt zonder Docker.