Metriken für RAG: Retrieval, Reranking, Generation

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Diese Referenz richtet sich an Engineers, die Retrieval-Augmented-Generation-Systeme (RAG) betreiben oder evaluieren. Sie ordnet Fehler beim Dokument-Parsing, Filtern, Retrieval, Reranking und bei der Generation der Metrik zu, die den jeweiligen Fehler erkennt. Außerdem zeigt sie, welche Checks vor dem Release laufen und welche den Live-Traffic überwachen.
Ein RAG-System mit fehlerhaften Relevanzfiltern kann monatelang laufen, ohne einen operativen Alert auszulösen. Es liefert weiter Antworten und hält sein Latency-Ziel ein, aber die Antworten stützen sich auf unvollständige Belege. Recall@k gegen das ursprüngliche Gold-Set der zulässigen Dokumente zeigt den Verlust. Latency- und Verfügbarkeits-Dashboards zeigen ihn nicht.
Direkt zum Code springen?
Das ausführbare Repository
slavadubrov/rag-evals-demotrennt SciFact-Retrieval, Generation auf gelabelten synthetischen QA-Daten und Offline-Prüfungen mit Testdaten.make evalführt nachmake indexRetrieval, Filterdiagnosen und die Wiedergabe gespeicherter Generation-Testfälle aus.make benchmarkvariiert Chunking- und Embedding-Einstellungen ohne API-Aufrufe; der Vergleich zweier OpenAI-Modelle braucht einen API-Key und das Flag--live(siehe Teil 8). Die Notebooks 00–09 behandeln Retrieval, Filterung, Generation und Systembeispiele. Die Demo nutzt eingebettetes Qdrant und braucht kein Docker.
Entscheidungstabelle für die RAG-Evaluation
Diese Tabelle ist der Ausgangspunkt, bevor du ein Framework wählst. Die passende Metrik hängt vom Fehlermodus ab, den du erkennen willst, nicht vom Namen des Tools.
| Frage | Metrikfamilie | Einsatz, wenn | Worauf zu achten ist |
|---|---|---|---|
| Hat das Parsing die Quelle erhalten? | Extraktionsvollständigkeit, Abdeckung von Tabellen und Abbildungen | PDFs, Folien, Scans und HTML-Seiten in den Korpus gelangen | Sauber wirkender Text kann Bildunterschriften, Fußnoten oder Tabellenstruktur verlieren |
| Hat das Retrieval die richtigen Belege gefunden? | Recall@k, nDCG@k, MRR, Context Precision/Recall | du relevante Chunks oder Dokumente labeln kannst | Ein harter Metadatenfilter kann das richtige Dokument entfernen, bevor das Ranking beginnt |
| Hat das Reranking die Shortlist verbessert? | Reranker-Uplift, Precision@1, nDCG-Delta | Cross-Encoder oder LLM-Ranker nach dem Retrieval laufen | Latency und Kosten zusammen mit dem Qualitätsgewinn messen |
| Hat die Antwort die Belege genutzt? | Faithfulness, Groundedness, Zitatbelege | die Antwort Dokumente zitiert oder Fakten aus dem Kontext nennt | Faithfulness diagnostiziert weder schlechtes Parsing noch schlechtes Retrieval |
| Ist das System in Produktion stabil? | Drift, Regenerierung, Fallback, p95-Latency, Kosten pro Antwort | sich der Traffic nach dem Launch ändert | Produktionstelemetrie braucht stichprobenartige menschliche Prüfung, um kalibriert zu bleiben |
Einen kürzeren Tool-Vergleich bietet Beste Tools für die RAG-Evaluation: Ragas, DeepEval und TruLens.
Teil 1: Erfolg definieren, bevor die Architektur steht
Entwirf das Eval-Set vor dem Architekturdiagramm. Es gibt jeder späteren Komponentenentscheidung ein messbares Ziel.
Zwischen BM25 und dichtem Retrieval, rekursivem und semantischem Chunking oder Cohere Rerank und BGE lässt sich nicht entscheiden, solange unklar ist, was optimiert wird. „Bessere Antworten” ist keine Metrik. Eine beispielhafte Release-Anforderung lautet: „Faithfulness ≥ 0,85 auf einem Golden Set mit 200 Queries für unsere drei wichtigsten Intents, mit p95-Latency < 1,5 s und einer False-Exclusion-Rate des Filters < 2 %.” Die Zahlen sind Platzhalter. Wichtig ist, dass Qualität, Abdeckung, Latency und Filterung explizite Schwellenwerte haben.
Definiere das Harness, bevor du den Retrieval-Code schreibst. Das erste Harness wird falsch sein, und du wirst es überarbeiten. Eine Metrik zu überarbeiten ist viel billiger, als ein bereits ausgeliefertes System zu überarbeiten.
Drei Pipeline-Schichten und zwei Ausführungsmodi
Die Evaluation in Produktion hat drei Pipeline-Schichten. Die Ingestion-Evaluation fragt, ob Korpus und Index die Quelle erhalten. Die Query-Time-Evaluation fragt, ob Umformulierung, Filterung, Retrieval, Reranking und Kontextaufbau die richtigen Belege gefunden haben. Die Antwort- und Produktionsevaluation fragt, ob die Antwort diese Belege genutzt hat und ob die Qualität unter Live-Traffic hält. Wer die Schichten zu einem einzigen Score zusammenfasst, kann einen Normalisierungsfehler in einem akzeptablen Antwort-Score verbergen.
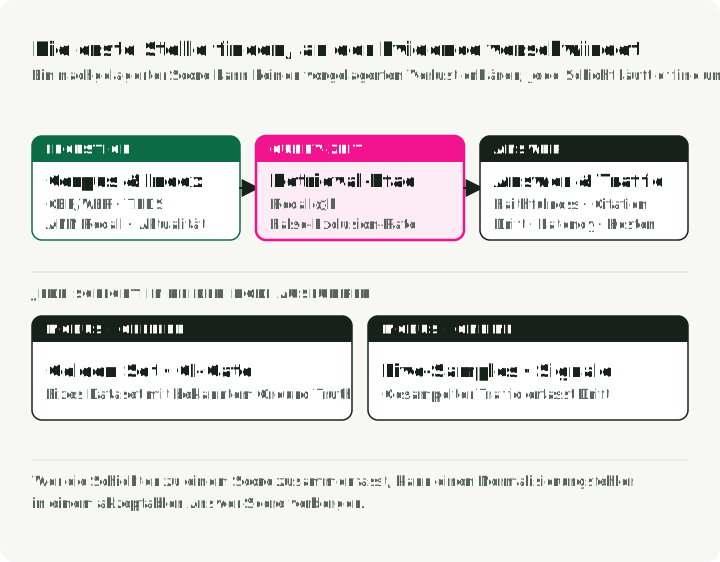
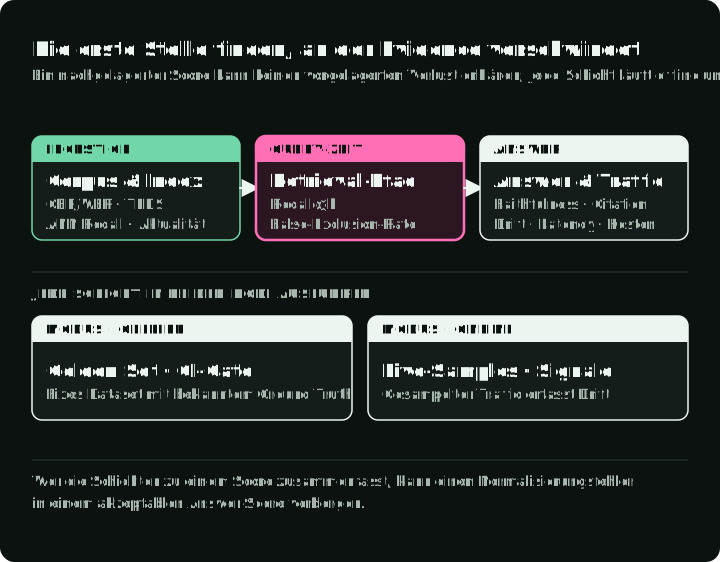
Diese Schichten beschreiben, wo ein Fehler auftritt. Offline und online beschreiben, wann und gegen welche Daten der Check läuft. Die Offline-Evaluation nutzt ein festes Dataset mit bekannter Ground Truth. Sie ist reproduzierbar und gehört in die Komponentenauswahl, in A/B-Vergleiche und in CI-Checks, die eine Änderung blockieren können. Die Online-Evaluation bewertet Stichproben des Live-Traffics und erfasst Regenerierung, Verweildauer, explizites Feedback und echte Query-Drift. Sie ist verrauschter und schwerer zu instrumentieren.
Nutze beide Modi dort, wo sie helfen: Feste Korpora und Query-Sets machen Regressionen reproduzierbar; Stichproben aus Live-Traces zeigen Aktualitätsfehler und Drift.
Komponentenebene vs. Ende-zu-Ende
Es gibt zwei verbreitete Fehler. Eine reine Ende-zu-Ende-Evaluation zeigt, dass das System kaputt ist, aber nicht wo. Eine reine Komponentenevaluation kann zeigen, dass jedes Teil besteht, während das Gesamtsystem trotzdem versagt. Die Lösung sind wenige Ende-zu-Ende-Kennzahlen für Go/No-go-Entscheidungen plus Komponentenmetriken für die Diagnose. Retrieval-Metriken fangen Regressionen im Retriever ab. Generation-Metriken fangen Regressionen im Generator ab. Die Ende-zu-Ende-Korrektheit der Antwort fängt Integrationsfehler ab.
Die Referenz-Frameworks (eine meinungsstarke Tour)
| Framework | Stärke | Schwäche |
|---|---|---|
| RAGAS | Ein gemeinsames Vokabular für Faithfulness, Answer Relevancy und Context Precision/Recall (Metriken) | Kosten des LLM-Judge; undurchsichtige Score-Komponenten beim Debugging; Versionswechsel |
| ARES | Ein aufgabenspezifischer Klassifikator als Judge, wenn Training und Annotation den Aufwand wert sind (Paper); die berichtete Precision gilt nur für den Benchmark | Aufwendigeres Setup; die Models müssen tatsächlich trainiert werden |
| TruLens | Feedback-Funktionen, die mit Traces verknüpft sind, und OpenTelemetry-Integration (Projekt) | Bei RAG-spezifischen Metriken weniger vollständig ausgestattet als RAGAS |
| DeepEval | Integration in Test-Runner und eigene Metriken (Projekt) | Starke LLM-Judge-Nutzung = Kostenspitzen |
| Arize Phoenix | Tracing, Dataset-Experimente und vorgefertigte oder eigene RAG- und Agent-Evaluatoren (Evaluation-Doku) | Domänenrubriken und Judge-Schwellenwerte brauchen weiterhin lokale Calibration |
| TREC 2024 RAG Track | Öffentlicher Benchmark für Nugget-Evaluation (AutoNuggetizer), Support-Evaluation und Flüssigkeit auf MS MARCO Segment v2.1 | Kein Laufzeit-Tool, sondern ein Benchmark zum Kalibrieren |
Mein Standard-Stack ist RAGAS für das Metrikvokabular, DeepEval für CI-Checks, Phoenix für Tracing in Produktion und eigener Code für ontologiespezifische Metriken. Wähle das Framework, mit dem sich eigene Metriken leicht bauen lassen.
Bei der Wahl eines Benchmarks gilt: erst die Aufgabe abgleichen, dann das Leaderboard lesen. BEIR, MTEB und MIRACL bleiben nützliche Retrieval-Baselines. Ergänze Tests für Fähigkeiten, die sie nicht abdecken:
- Aktuelles Ende-zu-Ende-RAG: Der TREC 2026 RAG Track nutzt narrative Queries und ClimbMix-400b statt MS MARCO v2.1 und verlinkt das Evaluation-Toolkit RAGDoll. Die Topics für 2026 sind veröffentlicht, die Relevanzurteile noch nicht. Nutze die Topics für Experimente, nicht als bewertetes Leaderboard. Die Protokolle von 2024 und 2025 weiter unten bleiben an ihre eigenen Korpora und Urteile gebunden.
- Technische Fragen zu sich entwickelndem Code: FreshStack kombiniert von Menschen gestellte Stack-Overflow-Fragen, Repository-Korpora und Nugget-Urteile. Der veröffentlichte Snapshot und die Werkzeuge zum Aufbau neuer Korpora sind zwei verschiedene Dinge; fixiere die Repository-Revision und das Datum der Fragen.
- Bilder, die einen Teil der Frage oder der Belege tragen: MM-BRIGHT trennt Text-zu-Text-, multimodal-zu-Text-, multimodal-zu-Bild- und multimodal-zu-multimodal-Retrieval. Bewerte die jeweils relevante Aufgabe getrennt. OCR-Text allein kann auslassen, was ein Diagramm oder ein Screenshot beiträgt.
Diese Benchmarks erweitern die Abdeckung; sie ersetzen nicht das zulässige, versionierte Query-Set deiner Anwendung.
Teil 2: Evaluationspunkte abbilden
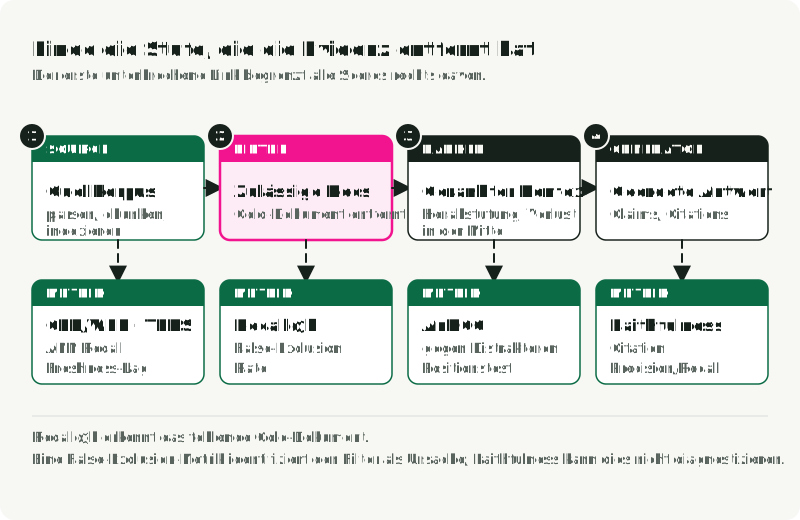
Wenn eine Antwort falsch oder unbelegt ist, verfolge das Gold-Dokument von links nach rechts durch die vier Prüfungen in der Abbildung. Die erste Stufe, in der es fehlt, nennt die Metrik, die du zuerst prüfst, und den Teil dieses Artikels, der sie behandelt.
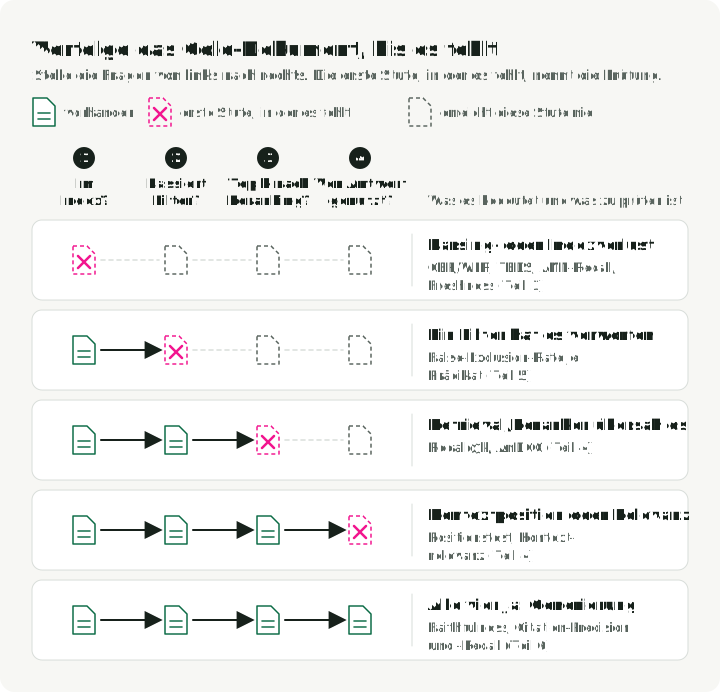
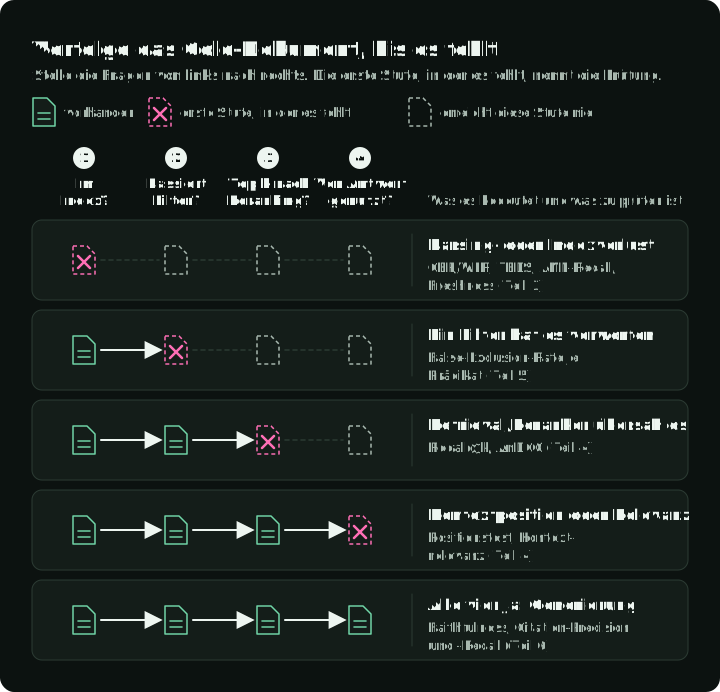
Verluste weiter vorn in der Pipeline begrenzen die Qualität weiter hinten: Schlechtes Parsing begrenzt das Retrieval, und schlechtes Retrieval begrenzt Reranking und Generation. Faithfulness misst die Antwort, nie die vorgelagerte Ursache.
Teil 3: Ingestion-Evaluation
Viele Fehler von RAG in Produktion beginnen in der Ingestion. Das System funktioniert mit sauberen Testdokumenten und scheitert dann an echten PDFs, Scans, Tabellen und unordentlichen Korpusseiten.
Dokumenterfassung und Parsing
Was zu messen ist:
-
Plausibilitätsprüfung der Extraktionslänge:
extracted_chars / expected_charspro Dokumentklasse markiert auffällige Längenänderungen, aber doppelter oder falscher Text kann trotzdem 1,0 erreichen. Vergleiche ausgerichteten Text mit einer von Hand bereinigten Referenz auf Auslassungen und Ersetzungen und prüfe Fußnoten, Bildunterschriften, Tabelleninhalt und Lesereihenfolge getrennt. -
OCR-Genauigkeit: CER (Character Error Rate) und WER (Word Error Rate), die Standardmetriken für Spracherkennung und OCR:
Dabei sind , , die Substitutionen, Löschungen und Einfügungen auf Zeichenebene, und ist die Zeichenzahl der Referenz (der Index steht für die Wortvariante). Wende nicht dieselbe CER-Grenze auf jeden Korpus an. Kalibriere sie pro Dokumentklasse und am Antwortverlust im weiteren Verlauf. Gedruckter Text, Handschrift und mehrsprachiges Material haben unterschiedliche Fehlerprofile. Berechne die Werte mit
jiwer(jiwer.cer(refs, hyps),jiwer.wer(refs, hyps)) oder mitevaluatevon Hugging Face. Als Evaluationskorpora sind FUNSD und SROIE öffentliche Benchmarks.from jiwer import cer, wer refs = ["Mars has two moons, Phobos and Deimos."] hyps = ["Mars has two m00ns, Phobos and Deirnos."] print(f"CER = {cer(refs, hyps):.3f}") # CER = 0.105 print(f"WER = {wer(refs, hyps):.3f}") # WER = 0.286 -
Treue der Tabellenextraktion: TEDS (Tree-Edit-Distance-based Similarity) misst, wie nah ein vorhergesagter HTML-Tabellenbaum an der Referenz liegt, normiert auf die Größe des größeren Baums. Aus Zhong et al., 2020 (PubTabNet):
TEDS berücksichtigt Struktur (Zeilen, Spalten, Spans) und Zellinhalt. TEDS-S entfernt den Inhalt und bewertet nur die Struktur. Referenzimplementierung:
src/metric.pyvon PubTabNet (nutzt internapted). Als Evaluationskorpora siehe PubTabNet, FinTabNet und SciTSR. Einfache Parser scheitern oft an Tabellen. Mache einen Benchmark, bevor du ihnen vertraust. -
Erhalt von Layout und Struktur: Reihenfolge der Überschriften, Intaktheit von Listen, Lesereihenfolge bei mehrspaltigen PDFs. Nutze DocLayNet als gelabelten Benchmark. Ein Vergleich mit fertigen Werkzeugen kann einen Element-Parser wie
unstructured, eine PDF-Bibliothek wiepymupdfund eine ausgewählte Docling-Pipeline umfassen. Docling bietet Standard- und VLM-Pfade; halte fest, welchen du testest.
Vergleiche unterschiedliche Parser-Familien, zum Beispiel eine Tesseract-Baseline, ein VLM-basiertes OCR-Modell und deinen Kandidaten vom Anbieter. Die besten Models für OCR vergleicht die aktuellen Optionen. Nutze eine stratifizierte Stichprobe echter Dokumentklassen mit fester DPI, darunter saubere Scans, Fotos, Tabellen, mehrsprachiger Text, Formeln und Handschrift. Berichte CER oder WER pro Klasse und TEDS für Tabellenseiten.
Bereinigung und Normalisierung
-
Genauigkeit der Boilerplate-Entfernung: Precision/Recall gegen von Menschen gelabelte Boilerplate-Abschnitte. Aggressives Entfernen verwirft relevanten Inhalt; nachlässiges Entfernen verunreinigt die Embeddings. Zu vergleichende Tools:
trafilatura,jusText,Resiliparse. Barbaresi (2021) vergleicht Trafilatura mit Baselines wie jusText; Resiliparse ist ein eigener Kandidat und kein System, das in diesem Paper bewertet wird. -
Unicode-Normalisierung: Der Anteil der Dokumente, bei denen NFC und NFKC identische Ergebnisse liefern (berechnet mit
unicodedata.normalizeaus der Standardbibliothek), ist ein brauchbares Signal für Drift bei Kompatibilitätsformen. Er erkennt keine unsichtbaren oder standardmäßig ignorierbaren Codepoints und keine skriptübergreifenden Lookalikes: Suche die ersten explizit und wende für die zweiten eine Unicode-Confusables-Richtlinie oder einen Detektor an, wenn sie relevant sind. -
Genauigkeit der Spracherkennung: F1 auf einer gelabelten mehrsprachigen Stichprobe. Entscheidend für mehrsprachige Indizes. Nutze
fasttext-langdetect(lid.176von Facebook),lingua-pyodercld3. FLORES-200 liefert Evaluationstext in 200 Sprachen, aber die Sprachmischung deiner Produktion sollte den Testausschnitt bestimmen. -
Wirksamkeit der Deduplizierung (MinHash / LSH): Precision/Recall deines Detektors für Beinahe-Duplikate gegen eine von Hand gelabelte Menge. Die Grundidee: Die Jaccard-Ähnlichkeit zwischen den Shingle-Mengen zweier Dokumente wird über Hashes mit zufälligen Permutationen geschätzt (Broder, 1997), und Beinahe-Duplikate werden per LSH-Banding in Buckets gruppiert (Indyk & Motwani, 1998). Variiere die Anzahl der Hashes und den Jaccard-Schwellenwert auf deinem Korpus. Verfolge die Rate falscher Zusammenführungen (verfälscht Antworten) getrennt von der Rate verpasster Zusammenführungen (verschwendet Indexplatz).
datasketchliefert die Implementierung, die unten verwendet wird; die Parameter sind Beispielwerte:from datasketch import MinHash, MinHashLSH def shingles(text: str, k: int = 5) -> set[str]: text = text.lower() return {text[i:i + k] for i in range(len(text) - k + 1)} def to_minhash(text: str, num_perm: int = 128) -> MinHash: m = MinHash(num_perm=num_perm) for s in shingles(text): m.update(s.encode("utf-8")) return m docs = { "d1": "Mars has two moons, Phobos and Deimos.", "d2": "Mars has two moons, Phobos and Deimos!", # near-dup "d3": "Curiosity rover landed on Mars in 2012.", } lsh = MinHashLSH(threshold=0.8, num_perm=128) for did, text in docs.items(): lsh.insert(did, to_minhash(text)) print(sorted(lsh.query(to_minhash(docs["d1"])))) # ['d1', 'd2'] -
PII-Bereinigung: Precision und Recall, getrennt pro Entitätstyp berechnet (E-Mails, Sozialversicherungsnummern, Namen, Adressen). Recall-Fehler erzeugen Compliance-Risiko; Precision-Fehler schaden der Antwortqualität. Lege den Arbeitspunkt gemeinsam mit der Rechtsabteilung fest. Mögliche Tools sind Microsoft Presidio,
scrubaduboder ein feinabgestimmtes NER-Modell auf einer gelabelten Menge.
Chunking bestimmt die Retrieval-Qualität
Chunking verändert, welche Belege die Antwort erreichen. In NVIDIAs Anbieter-Benchmark von 2025 erreichte Chunking auf Seitenebene im getesteten Aufbau die höchste durchschnittliche Ende-zu-Ende-Antwortgenauigkeit, weil Tabellen und Diagramme als ganze Einheiten erhalten blieben. Das misst die Antwortgenauigkeit, nicht den Retrieval-Recall. Verstehe das Ergebnis als Beleg für den getesteten Korpus und nicht als universellen Gewinner.
Semantisches Chunking gruppiert benachbarte Sätze nach Embedding-Ähnlichkeit und schneidet an unähnlichen Grenzen. SemanticChunker von LangChain und SemanticSplitterNodeParser von LlamaIndex setzen diese Strategie um. Es kann den Recall gegenüber festen Fenstern verbessern, wenn thematische Grenzen eine Rolle spielen.
Der RecursiveCharacterTextSplitter von LangChain probiert standardmäßig doppelte Zeilenumbrüche, einfache Zeilenumbrüche, Leerzeichen und dann einzelne Zeichen: ["\n\n", "\n", " ", ""]. Satzgrenzen erkennt er nur mit geeigneten Trennzeichen oder einem satzbasierten Splitter. Der Standard length_function=len zählt Zeichen. Für 400–512 Tokens pro Chunk mit 10–20 % Überlappung brauchst du eine Funktion, die Tokens zählt. Vergleiche diese Startwerte mit anderen Einstellungen auf deinem Golden Set.
Metriken, die zu verfolgen sind:
- Chunk-Kohärenz: , wobei Satz-Embeddings sind. Gesunde Chunks sind innen ähnlich und an den Grenzen unähnlich. Berechne sie mit
sentence-transformersundcosine_similarityausscikit-learn. - Qualität der Grenzen: ein von Menschen gelabeltes „Ist das ein sinnvoller Schnitt?” auf einer Stichprobe, dazu eine strukturelle Prüfung, dass Chunks keine Tabellen, Listen oder nummerierten Abschnitte zerteilen.
- Optimale Chunk-Größe: Variiere die Größe in Tokens (128, 256, 512, 1024) und trage Recall@k über der Größe auf deinem Golden Set auf. Wähle die kleinste Größe, ab der Recall@k nicht mehr steigt.
- Wirksamkeit der Überlappung: Variiere die Überlappung mit 0, 10, 20 und 30 % als Startraster und messe Recall@k. Erhöhe die Überlappung nicht weiter, wenn die lokale Recall-Kurve abflacht oder die Kosten der Duplikation den Gewinn übersteigen.
- Treue der Chunk-Zuordnung: Anteil der Chunks, die einen prüfbaren Quellverweis behalten (Seitenzahl, Abschnittsanker, Dokument-ID). Nachvollziehbarkeit setzt das voraus.
- Spätes vs. frühes Chunking: Late Chunking (Günther et al., 2024) bettet das gesamte Dokument ein und segmentiert danach, wodurch der globale Kontext erhalten bleibt (Referenzimplementierung in
jina-embeddings-v3). Contextual Retrieval (Anthropic, 2024) stellt jedem Chunk einen vom LLM erzeugten Kontext voran. Beides kostet zusätzlich. Mache einen Benchmark auf deinem Korpus, bevor du eines von beiden einführst.
Meine Meinung: Strukturelles Chunking (Aufteilung nach Überschriften, Tabellen und Abschnitten, umgesetzt von Parsern wie unstructured.io oder durch Durchlaufen des AST, den dein Parser ohnehin erzeugt hat) wird zu selten genutzt. Wenn deine Dokumente Struktur haben, nutze sie, bevor du Ähnlichkeitsheuristiken ergänzt. Rekursives Zeichen-Splitting ist die Baseline; semantisches Chunking lohnt den Mehraufwand vor allem bei unstrukturierter Prosa.
Extraktion und Anreicherung von Metadaten
- NER-Precision/Recall/F1: pro Entitätstyp, auf einer gelabelten Teilmenge. Standard im Stil von CoNLL/MUC. Berechne mit
seqeval(from seqeval.metrics import f1_score) die Variante, die BIO/IOB-Tags berücksichtigt, oder mit scikit-learn für Vergleiche von Span-Mengen. CoNLL-2003 und OntoNotes 5.0 sind die kanonischen Referenzkorpora. - F1 der Relationsextraktion: bei Systemen mit Ontology noch wichtiger. Labele von Hand eine Menge, die nach Relationstyp und Dokumentklasse stratifiziert ist. TACRED und DocRED sind öffentliche Benchmarks; mögliche Implementierungen sind
opennreund Relationspipelines vonspaCy. - Genauigkeit der Titel- und Überschriftenextraktion: Exact Match plus normalisierte Levenshtein-Ähnlichkeit () gegen die Ground Truth.
python-Levenshteinoderrapidfuzzliefern beides in einem Aufruf. - Erhalt hierarchischer Metadaten: Anteil der Chunks, die ihren übergeordneten Abschnitt, ihr übergeordnetes Dokument und ihren Vorfahrenpfad korrekt behalten. Diese Metrik entscheidet, ob dein RAG Fragen wie „Was sagt das Kind von Richtlinie X?” beantworten kann.
Embedding-Erzeugung
- Benchmarks zur Modellauswahl: Nutze die Retrieval-Ergebnisse von MTEB, BEIR für Zero-Shot-Generalisierung und MIRACL für mehrsprachiges Retrieval als Vergleichspunkte. MTEB-Retrieval berichtet üblicherweise nDCG@10; andere Aufgabenfamilien nutzen andere Metriken. Das MTEB-Python-Paket führt die Benchmarks lokal aus. Betrachte die Übertragung von englischem MTEB auf eine Sprache mit weniger Ressourcen als Hypothese, die du auf dem gelabelten Set dieser Sprache testest.
- Domänenspezifische Evaluation: Behandle den Rang in einem allgemeinen Benchmark nicht als Ergebnis für deine Domäne. Beginne mit einigen hundert gelabelten Queries (200–500) über deine wichtigsten Query-Typen; Teil 9 zeigt, wie du prüfst, ob das reicht. Ordne die Kandidatenmodelle darauf mit
ranxoderpytrec_evalneu. Ein Domänen-Set kann die Reihenfolge eines Leaderboards umkehren; veröffentliche daher zusammen mit dem Ergebnis den Dataset-Ausschnitt, das Retrieval-Protokoll und das Konfidenzintervall. - Erkennung von Embedding-Drift: Vergleiche zwei Sammlungen von Embeddings: eine feste Referenzstichprobe und eine gleitende aktuelle Stichprobe. Maximum Mean Discrepancy (MMD) testet, ob sich ihre Verteilungen unterscheiden. Eine weitere Option ist ein validierter Klassifikator, der darauf trainiert ist, Referenz- von aktuellen Stichproben zu unterscheiden. Die Kullback-Leibler-Divergenz (KL) vergleicht Verteilungen von Zufallsvariablen und braucht daher einen expliziten Schätzer, etwa gewählte Histogramme; rohe Embedding-Koordinaten sind keine Wahrscheinlichkeiten. Miss außerdem die Stabilität der nächsten Nachbarn für eine feste Probe-Menge.
evidentlyundalibi-detectimplementieren modellbasierte und statistische Detektoren. Die Vergleichsstudie von Evidently ist eine Anbieter-Evaluation; vergleiche die Methoden an bekannten Verschiebungen in deinen eigenen Embeddings. - Multi-Vektor vs. Einzelvektor: Late Interaction erhält Repräsentationen auf Token-Ebene, statt jedes Dokument auf einen Vektor zu reduzieren; ColBERT ist das kanonische Design, mit Referenzimplementierungen in RAGatouille und PyLate. Diese reichhaltigere Repräsentation erhöht die Kosten für Index und Retrieval. Vergleiche Qualität, Speicherbedarf und Latency auf demselben Domänen-Set mit einer Einzelvektor-Baseline, bevor du sie einführst.
Indexaufbau
- Recall@k unter Approximation: Vergleiche den Index mit approximativer Nächste-Nachbarn-Suche (ANN) bei gleichem k mit einer exakten Brute-Force-Baseline. In FAISS ist das
IndexHNSWFlat(oderIndexIVFFlat) gegenIndexFlatIP/IndexFlatL2. Verlange als ersten Check einen Recall@10 von mindestens 0,95 gegenüber der exakten Suche und verschärfe oder lockere ihn dann anhand der Antwortqualität im weiteren Verlauf. Das Projektann-benchmarksverfolgt Pareto-Kurven von Recall über QPS für verschiedene Bibliotheken. - HNSW-Tuning: HNSW (Hierarchical Navigable Small World) ist ein geschichteter Nachbarschaftsgraph; siehe Malkov & Yashunin, 2018. Er ist in
hnswlib, imIndexHNSWFlatvon FAISS und in den meisten Vector Databases implementiert. HNSW bietet drei Stellgrößen:M(Fan-out des Graphen),efConstruction(Breite der Kandidatenliste beim Aufbau) undefSearch(Breite der Kandidatenliste bei der Query). Startwerte:Mvon 16–32 undefConstructionvon 100–200; erhöhe dannefSearch, bis Recall@10 gegenüber der exakten Suche nicht mehr steigt. Der Parameterleitfaden von hnswlib nenntMvon 12–48 für die meisten Anwendungen und gibt einen Check fürefConstructionan: Liegt beiefgleichefConstructionder Recall für dieMnächsten Nachbarn unter 0,9, lässt sich der Graph noch verbessern. - IVF-Tuning: IVF (Inverted File Index: Vektoren werden mit k-Means in
nlistZellen partitioniert, und zur Query-Zeit werden dienprobenächsten Zellen durchsucht; sieheIndexIVFFlatundIndexIVFPQin FAISS). Die FAISS-Richtlinien zur Indexwahl empfehlen als Startwert fürnlist4√N bis 16√N Zellen bei N Vektoren. Variierenlistundnprobegegen den Recall der exakten Suche und die Latency. Teste gefilterte Queries getrennt, weil Indexfamilien und Vector Databases das Durchlaufen mit Filter unterschiedlich umsetzen. - Verzögerung bis zur Aktualität: Zeit vom Commit eines Dokuments bis zu seiner Auffindbarkeit. Verfolge p50 und p99. Bei Systemen mit regulatorischen Anforderungen verfolge zusätzlich den Anteil der Queries, die gegen veraltete Indizes beantwortet werden.
Teil 4: Evaluation zur Query-Zeit
Die Query-Time-Spur enthält die Metriken, die einen Retrieval-Pfad diagnostizieren. Recall@k allein zeigt nicht, ob Umformulierung, Filterung, Reranking oder Kontextaufbau den Fehler verursacht haben.
Query-Verständnis und Umformulierung
- Qualität der Query-Expansion: Recall@k-Uplift auf deinem Golden Set, expandierte Query gegen rohe Query. Lege den minimal nützlichen Gewinn und seine Unsicherheit vor dem Test fest. Erreicht die Expansion diese Anforderung nicht, rechtfertigt sie ihre Latency und Kosten nicht. Klassische PRF-Baselines (Pseudo-Relevance Feedback) wie RM3 und Bo1 bleiben nützliche Plausibilitätschecks; LLM-basierte Expansion muss sie schlagen.
- HyDE-Evaluation: HyDE (Gao et al., 2022) lässt das LLM eine hypothetische Antwort erzeugen, bettet sie ein und sucht damit. Das fügt einen Generierungsaufruf hinzu, und dieser Aufruf kann Inhalte erfinden, die das Retrieval vom Thema abbringen. Miss Recall@10 getrennt auf Slices innerhalb der Domäne, außerhalb der Domäne und mit geringer Konfidenz, und entscheide dann, ob HyDE in den Standardpfad, in einen Fallback oder in keines von beiden gehört.
- Multi-Query-Generierung: Recall@k der Vereinigung von N Umformulierungen gegen die einzelne Query. Variiere N und wähle einen Punkt auf deiner Recall-Latency-Grenzkurve. Implementierungen:
MultiQueryRetrievervon LangChain,QueryFusionRetrievervon LlamaIndex. - Genauigkeit der Intent-Klassifikation: Standard-Precision/Recall/F1 pro Intent (berechnet mit
sklearn.metrics.classification_report), aber die entscheidende Metrik ist die Routing-Korrektheit: Wird die richtige nachgelagerte Pipeline aufgerufen? - Adaptives Routing: Adaptive-RAG (Jeong et al., NAACL 2024) argumentiert, dass nicht jede Query dieselbe Retrieval-Strategie verdient. Verfolge die Genauigkeit des Routers als Klassifikationsproblem gegen ein gelabeltes Set aus „braucht kein Retrieval / einmalig / iterativ”.
Iterative Suche braucht einen Ende-zu-Ende-Test mit Budget
Ein Agent kann suchen, ein Ergebnis prüfen und erneut suchen, statt eine feste Top-k-Liste abzurufen. Die Domäne banking_knowledge in tau2-bench schaltet das Retrieval mit dem Flag --retrieval-config um: keine Wissensbasis, die gesamte Wissensbasis im Kontext, BM25- oder Embedding-Suche, ein Shell-Tool in einer Sandbox oder BM25, dichte Suche und Shell zusammen. Für einen lokalen Vergleich bekommen einmaliges und iteratives Retrieval denselben zulässigen Korpus und explizite Grenzen für Zeit, Modell-Tokens und Tool Calls. Protokolliere jede Query und die in jedem Schritt gesehenen Belege; bewerte die Abdeckung der finalen Belege, die Korrektheit der Antwort, die Zitatbelege und Fehler durch ausgeschöpftes Budget. Mehr Suchaufrufe sind nur nützlich, wenn die zusätzlichen Belege die Antwort innerhalb dieser Grenzen verbessern.
retrieval/iterative.py im Begleit-Repository führt vorgegebene Query-Umformulierungen unter expliziten Budgets für Aufrufe, Zeit und Tokens aus. Für Agents, die ihre Suchen selbst wählen, zeigt Evaluation von AI Agents: von Traces zu Testsuites, wie man die Trajektorie und nicht nur die Antwort bewertet.
Retrieval-Metriken
Das sind die Basismetriken. Wenn du sie nicht verfolgst, kannst du nicht erkennen, ob sich das Retrieval verbessert.
| Metrik | Was sie misst | Wann sie sich eignet |
|---|---|---|
| Recall@k | Anteil der relevanten Dokumente einer Query, die in den Top k erscheinen | wenn es zählt, dass kein Teil der relevanten Menge fehlt |
| Precision@k | Prozentsatz der Top k, die relevant sind | nützlich, wenn das Context Window der Bottleneck ist |
| MRR | Mittelwert von 1/Rang des ersten relevanten Dokuments | wenn Nutzer nur die Top 1 oder Top 3 ansehen |
| nDCG@k | positionsabgezinster Gewinn, gewichtet nach Relevanzgraden | Standardmetrik des Retrievals bei abgestufter Relevanz |
| MAP | Mittelwert der Average Precision über alle Queries | wenn dir die gesamte Rangliste wichtig ist |
| Hit Rate@k | ob mindestens ein relevantes Dokument in den Top k erscheint | das binäre Ergebnis über Queries mitteln für eine schnelle Plausibilitätsmetrik |
| Coverage | Prozentsatz der Golden-Dokumente, die über alle Queries je abgerufen wurden | erkennt systematische Lücken im Index |
Die Formeln zur Referenz (binäre Relevanz mit der Menge relevanter Dokumente für Query , und , wenn das -te abgerufene Dokument in liegt):
Bei abgestufter Relevanz gilt ; binäres nDCG ist der Spezialfall, der im Code unten verwendet wird. MAP ist der Mittelwert über die Queries von . Für Herleitungen siehe Manning, Raghavan, Schütze, Introduction to Information Retrieval, Kapitel 8.
Nutze für Produktionscode ranx, pytrec_eval oder ir_measures. Sie implementieren die gesamte TREC-Metrikfamilie und behandeln abgestufte Relevanz korrekt. Als anfängliche Release-Gates liefert das Begleit-Repository Recall@10 ≥ 0,85 und MRR ≥ 0,6 (in .env.example, angewendet mit --quality-gates). Stimme sie danach auf deinem Golden Set auf die Antwortqualität im weiteren Verlauf und die Kosten eines Fehlers ab.
Hier zählt k eindeutige Dokument-IDs. Weise Duplikate zurück, statt einem wiederholten Dokument zusätzlichen Gewinn zu geben. Lege bei Chunking-Experimenten fest, ob k Chunks oder deduplizierte übergeordnete Dokumente zählt, und vergleiche zusätzlich die Belege, die innerhalb eines festen Token-Budgets geliefert werden. Derselbe Dokument-Recall kann sehr unterschiedliche Kontextqualität verbergen.
Das Test-Harness dafür ist kurz. Du kannst es aus einem Notebook ausführen, bevor du eine Vector Database gewählt hast.
from math import log2
from statistics import mean

# synthetic gold set: query_id -> set of relevant doc ids
gold = {
    "q1": {"d3"},
    "q2": {"d7", "d2"},
    "q3": {"d11"},
    "q4": {"d5"},
}

# ranked retrieval results: query_id -> ranked list of doc ids (top-10)
runs = {
    "q1": ["d8", "d3", "d1", "d4", "d2", "d9", "d6", "d10", "d12", "d13"],
    "q2": ["d2", "d6", "d4", "d7", "d1", "d3", "d8", "d11", "d5", "d9"],
    "q3": ["d11", "d2", "d3", "d4", "d1", "d6", "d7", "d8", "d10", "d12"],
    "q4": ["d1", "d2", "d3", "d6", "d8", "d9", "d10", "d12", "d13", "d14"],
}

def recall_at_k(ranked, gold_set, k):
    if k <= 0 or len(ranked) != len(set(ranked)):
        raise ValueError("require positive k and unique document IDs")
    if not gold_set:
        return 0.0
    hit = sum(1 for d in ranked[:k] if d in gold_set)
    return hit / len(gold_set)

def reciprocal_rank(ranked, gold_set):
    if len(ranked) != len(set(ranked)):
        raise ValueError("require unique document IDs")
    # MRR contribution per query: 1/rank of the first relevant doc.
    for rank, d in enumerate(ranked, start=1):
        if d in gold_set:
            return 1.0 / rank
    return 0.0

def ndcg_at_k(ranked, gold_set, k):
    if k <= 0 or len(ranked) != len(set(ranked)):
        raise ValueError("require positive k and unique document IDs")
    # binary relevance: rel ∈ {0, 1}
    gains = [1.0 if d in gold_set else 0.0 for d in ranked[:k]]
    dcg = sum(g / log2(i + 2) for i, g in enumerate(gains))
    # ideal DCG: all gold docs ranked first, capped by k
    n_gold_in_topk = min(k, len(gold_set))
    idcg = sum(1.0 / log2(i + 2) for i in range(n_gold_in_topk))
    return dcg / idcg if idcg else 0.0

K = 5
print(f"Recall@{K}: {mean(recall_at_k(runs.get(q, []), gold[q], K) for q in gold):.3f}")
print(f"MRR:       {mean(reciprocal_rank(runs.get(q, []), gold[q]) for q in gold):.3f}")
print(f"nDCG@{K}:  {mean(ndcg_at_k(runs.get(q, []), gold[q], K) for q in gold):.3f}")
# Recall@5: 0.750
# MRR:       0.625
# nDCG@5:    0.627
# Duplicate and missing runs are tested in the companion's tests/test_audit_contracts.py.
Das Aggregat läuft über alle erwarteten Queries und behandelt einen fehlenden Lauf als leer. Dieses Beispiel weist Queries ohne Gold-Dokument den Wert null zu; in einer echten Suite markiere sie als eigenen Slice zur Beantwortbarkeit mit eigenem Nenner, statt die Null als gemessenen Recall zu behandeln. Berichte Timeouts und fehlende Läufe zusätzlich zu den Scores.
Führe bei jedem PR eine schnelle Teilmenge aus und vor dem Release das gesamte Golden Set (Teil 9 nennt Startgrößen). Blockiere einen Merge, wenn eine vorab gewählte Metrik ihr Regressionsbudget überschreitet.
Das Begleit-Repository fixiert die Zahlen oben (Recall@5 = 0.750, MRR = 0.625, nDCG@5 = 0.627) mit einem Unit-Test in tests/test_retrieval_metrics.py. Notebook 01 führt dieses Beispiel mit k=5 aus und berichtet dann Recall@10, MRR und nDCG@10 auf einem SciFact-Ausschnitt; es variiert k nicht. Das produktionsnahe Harness steht in evaluation/retrieval.py.
Hybrides Retrieval und Reciprocal Rank Fusion
BM25 ist ein spärlicher lexikalischer Scorer, der exakte Termübereinstimmung, Termgewichtung und Längennormalisierung kombiniert. Er ist in rank_bm25, Elasticsearch, OpenSearch und den meisten Suchmaschinen verfügbar.
Reciprocal Rank Fusion (Cormack, Clarke und Buettcher, SIGIR 2009) kombiniert BM25- und dichte Rankings nach Position. Die ursprüngliche Einstellung k=60 ist eine nützliche Baseline. RRF ignoriert Score-Werte und vermeidet damit die Normalisierung über Spuren hinweg, die lineare Interpolation verlangt. Teste mit einem gelabelten Set, das groß genug für ein stabiles Delta ist, auch eine konvexe Kombination und stimme α ab.
Meine Hypothese ist, dass hybrides Retrieval plus ein Cross-Encoder-Reranker bei technischen Korpora, Log-Korpora und Code-Korpora helfen kann. Bei stark semantischen Korpora kann der Gewinn klein sein. Miss gegen die rein dichte und die rein spärliche Spur, weil eine schlechte Fusionskonfiguration schlechter abschneiden kann als jede der beiden Eingaben. Das SciFact-Notebook des Begleit-Repositorys ist ein begrenzter Test, kein allgemeines Ergebnis.
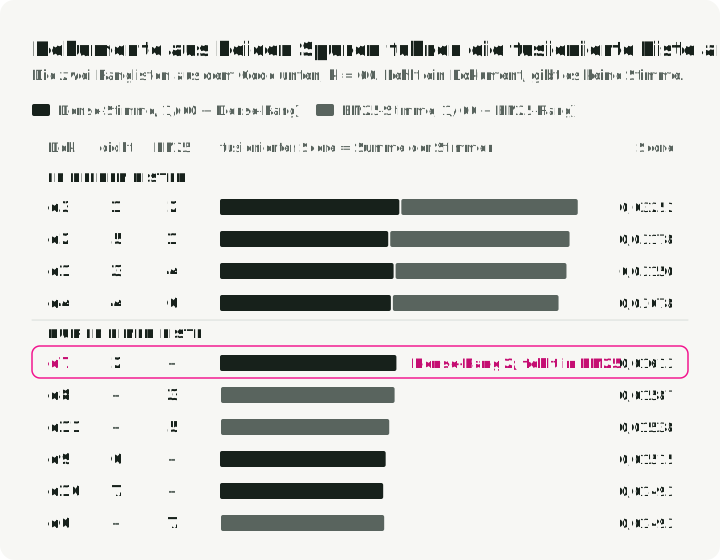
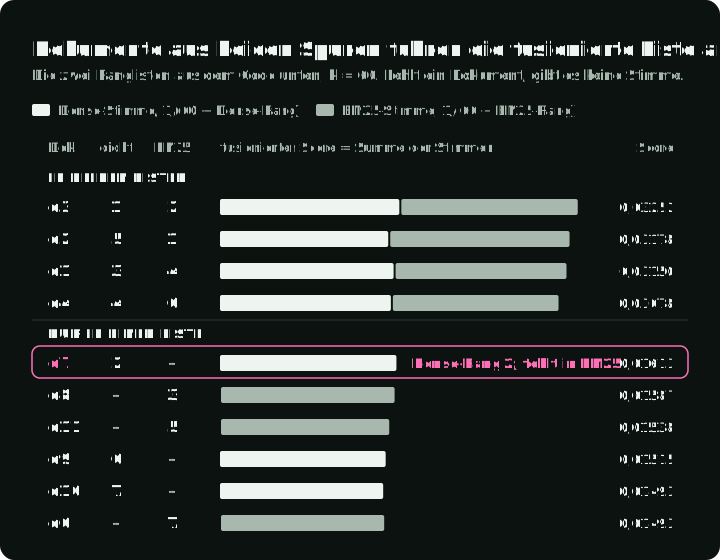
Das Diagramm nutzt die beiden Ranglisten aus dem Code unten. Jede Spur addiert für jedes zurückgegebene Dokument 1/(60 + Rang), sodass die vier Dokumente in beiden Listen vorn liegen. d7 steht in der dichten Liste auf Rang zwei, fehlt aber in der BM25-Liste und fällt deshalb auf Rang fünf.
Die Implementierung passt in wenige Zeilen.
from collections import defaultdict

# two retrieval lanes: dense embeddings and BM25.
dense  = ["d3", "d7", "d1", "d4", "d2", "d9", "d10"]
sparse = ["d2", "d3", "d8", "d1", "d11", "d4", "d6"]

def rrf(rankings: list[list[str]], k: int = 60) -> list[tuple[str, float]]:
    """Reciprocal Rank Fusion (Cormack et al., SIGIR 2009).

    score(d) = sum over rankings of 1 / (k + rank(d))
    Score-agnostic: only rank position matters. k=60 is the canonical default.
    """
    scores: dict[str, float] = defaultdict(float)
    if k <= 0:
        raise ValueError("k must be positive")
    for ranking in rankings:
        if len(ranking) != len(set(ranking)):
            raise ValueError("each ranking must contain unique document IDs")
        for rank, doc in enumerate(ranking, start=1):
            scores[doc] += 1.0 / (k + rank)
    return sorted(scores.items(), key=lambda kv: kv[1], reverse=True)

fused = rrf([dense, sparse], k=60)
for doc, score in fused[:5]:
    print(f"{doc}  score={score:.5f}")
# d3  score=0.03252   <- rank 1 dense, rank 2 sparse
# d2  score=0.03178   <- rank 5 dense, rank 1 sparse
# d1  score=0.03150
assert [doc for doc, _ in fused[:3]] == ["d3", "d2", "d1"]
Beachte, was RRF nicht tut: Es betrachtet nie die rohen Ähnlichkeitswerte. Setzt ein Retriever ein Dokument auf Position 2, ist diese Stimme 1 / (60 + 2) wert, egal welcher Rohwert sie erzeugt hat. Ein dichter Retriever mit Kosinus 0,98 und eine BM25-Spur mit Score 17,4 sind nicht direkt vergleichbar. Z-Score- und Min-Max-Normalisierung beseitigen affine Skalenunterschiede, aber keine von beiden kalibriert einen Score als Relevanz. Ausreißer, Verteilungsform und die Kandidatenmenge beeinflussen die normalisierten Werte weiterhin und damit auch das Fusionsergebnis. Validiere jede scorebasierte Kombination an gelabelten Queries.
Hybrid + RRF auf SciFact: notebook 02 vergleicht dichtes Retrieval, BM25 und RRF anhand von aggregiertem Recall@10, MRR und nDCG@10. Die produktionsnahe Fusion steht in retrieval/hybrid_rrf.py; tests/test_rrf.py fixiert die kanonische Reihenfolge d3 / d2 / d1 bei k=60.
Reranking
- ΔnDCG / ΔMRR: Uplift gegenüber dem Lauf ohne Reranking, auf deinem Golden Set, in der Tiefe, die deine Anwendung tatsächlich nutzt. Berechne ihn, indem du deine Retrieval-Metriken mit und ohne Reranker auf identischen Kandidatenmengen ausführst.
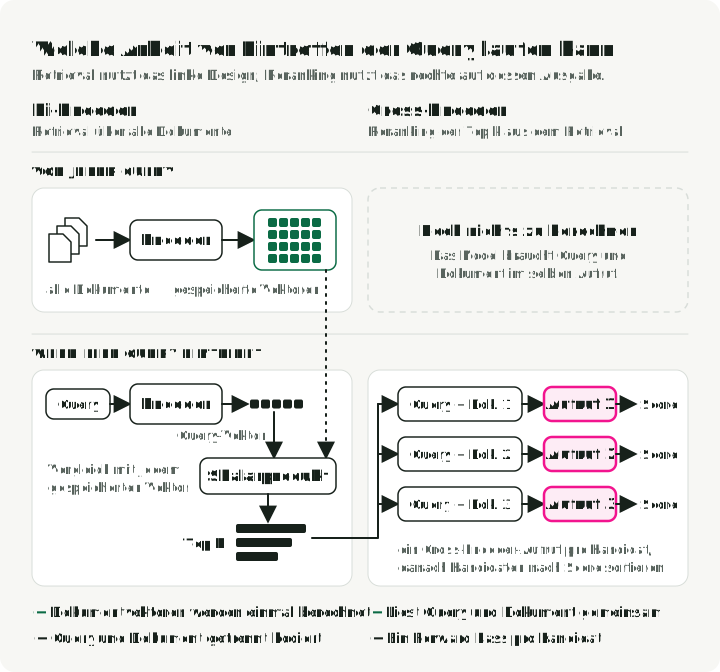
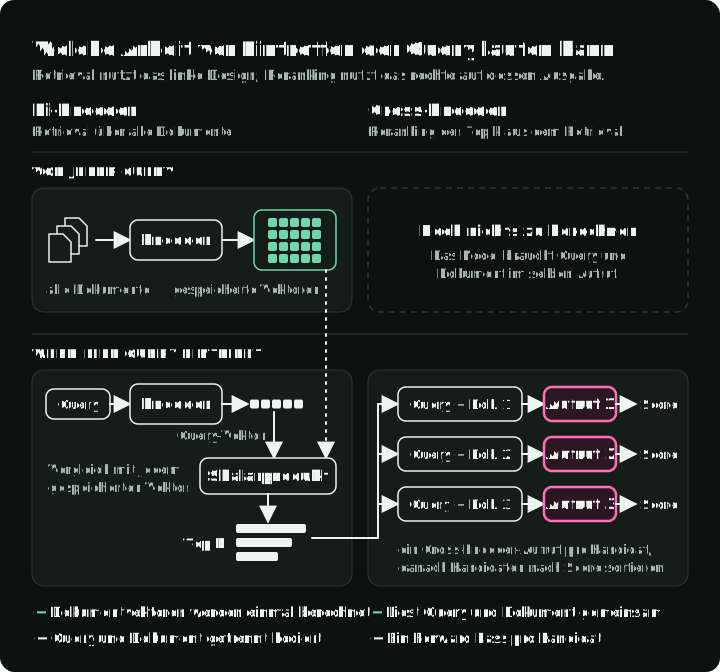
- Cross-Encoder vs. Bi-Encoder: Ein Bi-Encoder bettet Query und Dokument unabhängig voneinander ein (ein Vektor pro Seite) und bewertet über das Skalarprodukt; ein Cross-Encoder verkettet Query und Dokument und führt einen einzelnen Forward Pass aus, der über beide hinweg gemeinsam Attention anwendet. Cross-Encoder tauschen einen Forward Pass pro Kandidat gegen eine reichere Interaktion zwischen Query und Dokument; die Abbildung unten zeigt den Unterschied. Referenzimplementierung:
CrossEncoderaussentence-transformers. Miss Relevanz und Latency auf benannter Hardware, mit Batch-Größe und Kandidatentiefe; übertrage das Ergebnis eines Models oder eines verwalteten Dienstes nicht auf eine andere Umgebung. - Listwise vs. pointwise: Pointwise bewertet jedes Paar (Query, Dokument) unabhängig; listwise bewertet die gesamte Kandidatenliste gemeinsam, sodass das Model Kandidaten vergleichen kann. Evaluiere beides auf denselben Kandidatenmengen. Kalibriere jeden Score-Schwellenwert pro Model und Korpus, statt ein veröffentlichtes Beispiel als übertragbar zu behandeln.
Vergleiche in der Abbildung die beiden Zeitbereiche. Der Bi-Encoder kodiert jedes Dokument vor jeder Query und speichert die Vektoren; trifft eine Query ein, kodiert er nur die Query. Der Cross-Encoder hat vor der Query nichts zu berechnen. Er liest Query und Dokument in einem Modellaufruf, läuft also einmal pro Kandidat und nur auf der kurzen Liste, die das Retrieval zurückgibt.
Der folgende Code bewertet drei Kandidaten für eine Query mit einem BGE-Cross-Encoder:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("BAAI/bge-reranker-v2-m3")  # Reproducible baseline, not a latest-model ranking

query = "How do I rotate database credentials in production?"
candidates = [
    "Production database credentials are rotated via Vault every 30 days.",
    "The new logo was unveiled at the all-hands meeting.",
    "To rotate prod DB creds, run the `rotate-secrets` GitHub Action.",
]

scores = reranker.predict([(query, c) for c in candidates])
ranked = sorted(zip(candidates, scores), key=lambda x: -x[1])
for doc, score in ranked:
    print(f"{score:+.3f}  {doc}")
Der BGE-Code oben ist eine kleine Baseline. Für einen aktuellen Vergleich nimm Cohere Rerank 4.0 fast/pro für verwaltetes mehrsprachiges Text-Ranking oder Qwen3-VL-Reranker 2B/8B auf, wenn Queries oder Dokumente Bilder, Screenshots oder Video enthalten. Halte Aufgabenmodalitäten, Kandidatentiefe, Eingabegrenzen, Anweisungen und Hardware explizit fest.
Ein Reranker hilft einer einfachen RAG-Pipeline oft, ist aber kein garantierter Gewinn. Miss sein ΔPrecision@1 und ΔnDCG auf deinem Golden Set und behalte ihn nur, wenn der Gewinn sein Latency- und Kostenbudget übersteigt. Vergleiche diesen gemessenen Gewinn mit kleineren Retrieval-Änderungen, bevor du die nächste Optimierung wählst. BM25 vs embeddings vs rerankers bietet eine kürzere Anleitung zur Wahl jeder Schicht des Ranking-Stacks.
Notebook 03 berichtet P@10 vor und nach Cross-Encoder-Reranking auf SciFact sowie ΔnDCG@10; Modul: retrieval/reranker.py. Das Modul evaluation/reranking.py vergleicht Reranker auf identischen Kandidatenmengen.
Kontextaufbau und Lost-in-the-Middle
Viele Fehler vom Typ „gutes Retrieval, schlechte Antwort” beginnen im Kontextaufbau.
- Kontextrelevanz:
ContextRelevancevon Ragas beurteilt die gelieferte Kontextliste mit zwei Prompts und normalisierten Bewertungen; es ist kein Score pro Chunk. Für Diagnosen auf Chunk-Ebene bewerte jedes Paar aus Query und Chunk explizit, etwa mit einem Cross-Encoder, und berichte die Verteilung unter einem lokal kalibrierten Schwellenwert. - Zitatabdeckung des gelieferten Kontexts: Anzahl der verschiedenen gelieferten Chunks, die zitiert werden, geteilt durch die Anzahl der verschiedenen gelieferten Chunks. Berichte Fälle mit leerem Kontext getrennt. Dieser beobachtbare Proxy sagt, welche Chunks Zitate erhielten, nicht welche das Model intern genutzt hat und ob die Zitate seine Aussagen stützen. Prüfe die Zitatbelege getrennt und vergleiche die Abdeckung mit Antwortqualität und Token-Kosten.
- Erkennung von Lost-in-the-Middle: ein synthetischer Eval, bei dem du den Gold-Chunk an die Positionen {erste, mittlere, letzte} eines langen Kontexts legst und die Korrektheit der Antwort misst. Die zitierte Studie von Liu et al. (TACL 2024) berichtet unter ihren Long-Context-Bedingungen eine U-förmige Verschlechterung. Behandle dasselbe Muster bei einem aktuellen Model als Hypothese, die zu testen ist. Gegenmaßnahmen: Reranke und ordne die Top k so um, dass der Chunk mit dem höchsten Score zuerst oder zuletzt steht (
LongContextReordervon LangChain macht genau das), oder komprimiere mittlere Chunks stark. Miss mit einem nach Position stratifizierten Eval, nicht nur mit einem aggregierten Score. Ein ausgearbeiteter, ausführbarer Eval mit Stratifizierung nach Position liegt in Notebook 06 (Modul:evaluation/lost_in_middle.py). - Context Compression: Berichte das Kompressionsverhältnis (Eingabe-Tokens / Ausgabe-Tokens) zusammen mit der Korrektheit der Antwort. Tools sind unter anderem
ContextualCompressionRetrievervon LangChain und LongLLMLingua. Lege den größten akzeptablen Korrektheitsverlust anhand des Risikos der Anwendung und des Token-Budgets vorab fest und verwirf Konfigurationen, die ihn überschreiten.
Teil 5: Die False-Exclusion-Rate des Filters
Diese Metrik bekommt einen eigenen Abschnitt, weil aggregierte Retrieval-Scores einen Fehltreffer nicht einem Relevanzfilter zuordnen können. Evaluiere Zulässigkeitsfilter getrennt gegen die Berechtigungen des Aufrufers; ein Dokument außerhalb dieser Menge muss ausgeschlossen bleiben.
Ein hartes Relevanzprädikat wie product = Y AND locale = en-US kann den effektiven Recall unter den Dokumenten, die der Aufrufer sehen darf, auf null senken. Korrekt implementiertes Recall@k erfasst den Verlust, weil sein Nenner die ursprüngliche Menge der zulässigen relevanten Dokumente bleibt. Es sagt dir nicht, ob Filter, Retriever oder Ranker den Fehltreffer verursacht haben. Faithfulness beurteilt Aussagen gegen den abgerufenen Kontext. Sie kann Aussagen weiterhin als belegt bewerten, die dieser unvollständige Kontext stützt, kann aber die Ursache im Filter oder im Retrieval nicht diagnostizieren. Eine leere Verweigerung kann je nach Implementierung keine Aussagen und NaN ergeben; werte das nicht als Beleg, dass Faithfulness die Verweigerung gebilligt hat.
Das Diagramm zeigt das folgende durchgerechnete Beispiel. Die Berechtigungsprüfung entfernt d3, das zu einem anderen Mandanten gehört; dieser Ausschluss ist korrekt. Der Relevanzfilter entfernt dann das Gold-Dokument für q1 und q3. Recall@10 fällt auf 50 % und registriert den Abfall; erst die False-Exclusion-Rate, ebenfalls 50 %, ordnet ihn dem Prädikat zu. Ein Evaluator, der die Gold-Menge nach dem Filtern neu aufbaut, meldet 100 %.
Die Metrik
filter_false_exclusion_rate =
    (# queries where all gold docs were excluded by metadata filter) /
    (# queries with at least one entitlement-eligible gold doc)
Diese Definition auf Query-Ebene zählt katastrophale Ausschlüsse: Kein zulässiges relevantes Dokument überlebt. Schneide vor dem Scoring die Gold-Menge jeder Query mit der Berechtigungsmenge des Aufrufers; ein nicht zulässiges Dokument ist kein falscher Ausschluss. Bei Queries mit mehreren Gold-Dokumenten zeigt Standard-Recall@k weiterhin Teilverluste; ergänze eine Exklusionsrate pro Dokument, wenn diese Grenze eine Rolle spielt. Um eine der beiden Raten zu berechnen, brauchst du (a) die Ground-Truth-Dokument-IDs für jede Eval-Query und (b) Instrumentierung, die die angewendeten Filterprädikate protokolliert, nicht nur die Endergebnisse. Als Start-Gate nutzt das Begleit-Repository eine False-Exclusion-Rate von höchstens 2 %; stimme sie auf die Kosten des Ausschlusses einer gültigen Antwort und auf das Konfidenzintervall deiner Produktionsstichprobe ab.
Hier ist eine funktionierende Implementierung. Sie vergleicht den korrekten Standard-Recall mit einem ungültigen Evaluator, der die Relevanz nach dem Filtern neu definiert.
# A small worked example where relevance predicates remove eligible documents.
docs = [
    {"id": "d1", "tenant": "acme",   "locale": "en-US"},
    {"id": "d2", "tenant": "acme",   "locale": "en-GB"},
    {"id": "d3", "tenant": "globex", "locale": "en-US"},
    {"id": "d4", "tenant": "acme",   "locale": "en-US"},
    {"id": "d5", "tenant": "acme",   "locale": "de-DE"},
    {"id": "d6", "tenant": "acme",   "locale": "fr-FR"},
]

# Tenant isolation is an eligibility invariant, not a relevance experiment.
# Verify it independently before evaluating relevance preferences.
eligible_docs = [d for d in docs if d["tenant"] == "acme"]
assert {d["id"] for d in eligible_docs} == {"d1", "d2", "d4", "d5", "d6"}

queries = [
    # the gold doc lives in en-GB but the dynamic filter forced en-US
    {"qid": "q1", "gold": {"d2"}, "filter": lambda d: d["locale"] == "en-US"},
    # the gold doc is correctly within the tenant filter
    {"qid": "q2", "gold": {"d4"}, "filter": lambda d: d["tenant"] == "acme"},
    # the gold doc lives in fr-FR but the dynamic filter forced en-US
    {"qid": "q3", "gold": {"d6"}, "filter": lambda d: d["locale"] == "en-US"},
    # the gold doc passes the filter (de-DE locale match)
    {"qid": "q4", "gold": {"d5"}, "filter": lambda d: d["locale"] == "de-DE"},
]

def filter_false_exclusion_rate(queries, eligible_docs):
    n_with_gold, n_excluded = 0, 0
    eligible_ids = {d["id"] for d in eligible_docs}
    for q in queries:
        eligible_gold = q["gold"] & eligible_ids
        if not eligible_gold:
            continue
        n_with_gold += 1
        survivors = {d["id"] for d in eligible_docs if q["filter"](d)}
        if not (eligible_gold & survivors):
            n_excluded += 1
    if not n_with_gold:
        raise ValueError("false-exclusion rate needs queries with eligible gold")
    return n_excluded / n_with_gold, n_with_gold

rate, eligible_query_count = filter_false_exclusion_rate(queries, eligible_docs)
print(f"filter_false_exclusion_rate = {rate:.2%}")
# filter_false_exclusion_rate = 50.00%
print(f"eligible queries = {eligible_query_count} / {len(queries)}")
# eligible queries = 4 / 4

# Correct Recall@k keeps the original eligible gold set as its denominator.
def standard_recall_at_k(queries, eligible_docs, k=10):
    recalls = []
    eligible_ids = {d["id"] for d in eligible_docs}
    for q in queries:
        eligible_gold = q["gold"] & eligible_ids
        if not eligible_gold:
            continue
        # demo only: the survivor set stands in for a ranked run.
        # A real harness ranks the survivors first, then slices to k.
        survivors = [d for d in eligible_docs if q["filter"](d)][:k]
        survivor_ids = {d["id"] for d in survivors}
        recalls.append(len(eligible_gold & survivor_ids) / len(eligible_gold))
    return sum(recalls) / len(recalls) if recalls else 0.0

print(f"standard recall@10 = {standard_recall_at_k(queries, eligible_docs):.2%}")
# standard recall@10 = 50.00%

# INVALID: rebuilding the gold set after filtering changes the question.
# It drops queries whose relevant documents did not survive, then scores 100%.
def invalid_recall_over_filtered_gold(queries, eligible_docs, k=10):
    recalls = []
    all_doc_ids = {d["id"] for d in eligible_docs}
    for q in queries:
        all_survivors = {d["id"] for d in eligible_docs if q["filter"](d)}
        filtered_gold = q["gold"] & all_doc_ids & all_survivors
        if not filtered_gold:
            continue
        top_k_ids = set(list(all_survivors)[:k])
        recalls.append(len(filtered_gold & top_k_ids) / len(filtered_gold))
    return sum(recalls) / len(recalls) if recalls else 0.0

invalid = invalid_recall_over_filtered_gold(queries, eligible_docs)
print(f"INVALID recall (filtered gold) = {invalid:.2%}")
# INVALID recall (filtered gold) = 100.00%

assert rate == 0.5
assert standard_recall_at_k(queries, eligible_docs) == 0.5
assert invalid == 1.0
# Unauthorized gold and an empty denominator are tested in the companion's
# tests/test_audit_contracts.py.
Die Funktion gibt die Rate und die Anzahl der Queries mit zulässigem Gold-Dokument zurück. Ist dieser Nenner leer, löst sie eine Exception aus, statt eine beruhigende Null zu melden; ein erforderlicher Release-Check muss das als fehlenden Nachweis behandeln. Queries, die nur nicht autorisierte Gold-Dokumente haben, bleiben in separaten Berechtigungstests.
Die Hälfte der Queries verliert ihr Gold-Dokument an den Filter, daher fällt das korrekte Recall@10 auf 50 %. Dieser Score fängt das Symptom ab, kann es aber nicht zuordnen. Die False-Exclusion-Rate zeigt, dass das Prädikat zwei Antworten entfernt hat, bevor der Retriever lief. Der absichtlich ungültige Evaluator meldet nur deshalb 100 %, weil er diese Fehlschläge aus seiner Gold-Menge streicht. Kein Model kann ein Dokument wiederherstellen, das herausgefiltert wurde.
tests/test_filter_exclusion.py::test_50_percent_exclusion_rate im Begleit-Repository und das erste Beispiel in notebook 04 verwenden ältere Testdaten mit fünf Dokumenten, die ebenfalls 50 % ergeben, aber q3 wird dort durch Mandantentrennung ausgeschlossen. Diese Testdaten reproduzieren das obige Beispiel mit zulässigen Gold-Dokumenten nicht. Notebook 04 führt außerdem SciFact-Filterdiagnosen mit synthetischen Metadaten aus. Das aktuelle evaluation/filter_exclusion.py akzeptiert ein separates Autorisierungsprädikat und ein festes Set zulässiger Gold-Dokumente und enthält Precision/Recall des Prädikats.
Begleitmetrik: Precision und Recall des Prädikats
Wenn die Filterung dynamisch ist (zum Beispiel extrahiert ein LLM Filterprädikate aus der Query), behandle den Prädikat-Extraktor als Klassifikationsmodell und evaluiere ihn als solches. Miss Precision und Recall des Prädikats gegen ein gelabeltes Set aus Paaren (query, correct predicate). Eine Fehlerrate beim Prädikat entspricht nicht direkt demselben Punktverlust beim Retrieval-Recall; miss, wie oft diese Fehler ein Gold-Dokument ausschließen. Sobald ein harter Filter das Gold-Dokument entfernt hat, hilft kein Reranking mehr.
Zulässigkeitsfilter vs. Relevanzpräferenzen
Autorisierung, Tenant-Isolation, rechtliche Zuständigkeit und Veröffentlichungsstatus bestimmen, ob ein Dokument in die Kandidatenmenge gelangen darf. Halte sie als harte Filter und validiere sie unabhängig; Recall@k, False-Exclusion-Rate und Relevanz-Precision rechtfertigen keine Lockerung.
Bei einer Relevanzpräferenz wie Locale, Aktualität oder Version vergleiche ein hartes Prädikat mit einem weichen Boost auf denselben zurückgehaltenen, zulässigen Queries. Zwei Regeln entscheiden das Ergebnis:
- Zugriffsregeln (Autorisierung, Tenant, Zuständigkeit, Veröffentlichungsstatus) sind immer harte Filter.
- Jede andere Präferenz ist ein weicher Boost, es sei denn, der gemessene Test unten wird bestanden. Dann darf sie ein hartes Prädikat werden.
Der Pseudocode gibt den Test für Regel 2 an:
For each relevance preference F:
  hard_recall_F  = retrieval_recall@k with F as a hard filter
  soft_recall_F  = retrieval_recall@k with F as a +0.X rerank boost
  hard_precision = relevant_in_top_k / k under hard filter
  soft_precision = relevant_in_top_k / k under soft boost
  precision_gain = hard_precision - soft_precision
  precision_gain_CI = paired-query uncertainty interval for precision_gain
  exclusion_rate = % of queries where the gold doc was filtered out (hard)

Pre-register Δ_min, ε, and recall_loss_max for this workflow.
Use a hard predicate only if:
  lower_bound(precision_gain_CI) >= Δ_min
  AND exclusion_rate <= ε
  AND hard_recall - soft_recall >= -recall_loss_max.
Otherwise prefer a soft boost.
Wähle den minimal nützlichen Precision-Gewinn, das Unsicherheitsintervall, ε und die Grenze für den Recall-Verlust anhand des Schadens, eine sonst zulässige Antwort auszuschließen, des Nutzens zusätzlicher Precision und der Größe der zurückgehaltenen Stichprobe. Beginne mit einem ε von 1–2 % und senke es dort, wo eine verpasste Antwort teuer ist.
Teil 6: Generationsevaluation
Retrieval-Metriken sagen dir, dass das System korrekt antworten könnte. Sie sagen dir nicht, dass es das getan hat. Generation-Metriken schließen diese Lücke.
Faithfulness und Groundedness
RAGAS Faithfulness zerlegt die Antwort in atomare Claims (kurze, in sich geschlossene Tatsachenaussagen) und prüft jeden davon über einen LLM-Judge gegen den abgerufenen Kontext:
Faithfulness prüft die Stützung durch die gelieferten Belege; sie belegt nicht, dass die Belege korrekt oder ausreichend sind, um die Frage zu beantworten. Erfasse Antworten ohne Claims getrennt und berichte ihre Anzahl, statt einer leeren Antwort perfekte Faithfulness zuzuweisen.
Die aktuelle Ragas-Dokumentation empfiehlt die Collections-API unten. Installiere in einem uv-Projekt ragas und openai mit uv add ragas openai, setze OPENAI_API_KEY und speichere das als Skript, das du mit uv run ausführst. Es ruft einen Anbieter auf und verursacht dessen Kosten; der Score ist ein Judge-Ergebnis, keine deterministische Erwartungskonstante. Fixiere die aufgelösten Abhängigkeiten in deiner Lockfile.
import asyncio

from openai import AsyncOpenAI, omit
from ragas.llms import llm_factory
from ragas.metrics.collections import Faithfulness

async def main():
    async with AsyncOpenAI() as client:
        # Ragas 0.4.3 sends max_tokens by default; GPT-5.6 models need max_completion_tokens.
        llm = llm_factory(
            "gpt-5.6-terra", client=client, reasoning_effort="none",
            max_tokens=omit, max_completion_tokens=1024,
            temperature=omit, top_p=omit,
        )
        scorer = Faithfulness(llm=llm)
        result = await scorer.ascore(
            user_input="How many moons does Mars have?",
            response="Mars has two moons, Phobos and Deimos.",
            retrieved_contexts=["Mars has two moons named Phobos and Deimos."],
        )
        print(result.value)

if __name__ == "__main__":
    asyncio.run(main())
Dieses Beispiel nutzt GPT-5.6 Terra als Judge; die Ragas-Factory reicht Modellargumente weiter. Vergleiche die falschen Freigaben, falschen Ablehnungen und Kosten des Judge mit menschlichen Labels, bevor du einen günstigeren Judge ersetzt, den du bereits gegen Labels geprüft hast.
Die Framework-Tabelle in Teil 1 nennt auch Answer Relevancy und Context Precision. Dieselbe Collections-API bewertet beide mit demselben llm. AnswerRelevancy nimmt zusätzlich ein Embedding Model entgegen, zum Beispiel embedding_factory("openai", model="text-embedding-3-small", client=client) aus ragas.embeddings.base. ContextPrecision braucht in ascore eine Referenzantwort (reference). Jeder Score beantwortet eine andere Frage: Faithfulness fragt, ob der Kontext die Antwort stützt, Answer Relevancy fragt, ob die Antwort die Frage behandelt, und Context Precision fragt, ob der relevante Kontext zuerst rankt.
Wer einen eigenen Scorer baut, behält die Struktur aus Extrahieren, Verifizieren und Aggregieren bei. Die Extraktion ist ein LLM-Aufruf, der die Antwort in Claims zerlegt; die Verifikation übernimmt ein NLI-Modell (Natural Language Inference) oder ein LLM-Judge. Validiere Extraktion und Entailment getrennt und erfasse Fälle ohne Claims oder mit fehlgeschlagener Beurteilung. Beispiel: Eine Antwort mit 4 Claims, von denen 3 belegt sind, erhält 3/4 = 0,75. Eine Antwort mit 0 Claims wird nicht bewertet.
Notebook 05 führt offline ein festes Mars-Beispiel mit einem lexikalischen Näherungsverfahren aus; dieses prüft keine semantische Folgerung. Sein Modul evaluation/faithfulness.py implementiert auch Claim-Extraktion und Verifikation mit SGR. Die Testsuite generation bewertet gelabelte synthetische QA-Daten mit --suite generation --live. Das Begleit-Repository nutzt nur OpenAI-Modelle. gpt-5.6-luna generiert und bewertet standardmäßig; --judge-model gpt-5.6-terra ändert den Judge. Beide Models stammen von einem Anbieter; das Repository zeigt den Judge-Workflow, keinen Vergleich verschiedener Modellfamilien.
Eine spezialisierte Alternative zu LLM-as-Judge ist HHEM-2.1-Open (Hughes Hallucination Evaluation Model, Vectara), ein für die Erkennung von Hallucination feinabgestimmter Klassifikator. Seine Model Card dokumentiert den Checkpoint, den rohen Score zwischen 0 und 1, den er ausgibt, und Ergebnisse der Balanced Accuracy auf AggreFact und RAGTruth. Er veröffentlicht keine Standard-Entscheidungsgrenze; eine zu wählen ist deine Aufgabe. Verstehe diese Angaben als Belege der Model Card, nicht als Garantie für deinen Korpus: Kalibriere den Schwellenwert an lokalen Labels und vergleiche ihn vor dem Deployment mit dem von dir gewählten Judge.
Evaluation mit atomaren Fakten
FActScore (Min et al., EMNLP 2023) zerlegt lange generierte Texte in atomare Fakten, ruft pro Fakt Belege ab, labelt jeden als supported / not-supported und berichtet den Anteil der belegten:
Referenzimplementierung: shmsw25/FActScore. Die ursprüngliche Evaluation konzentrierte sich auf Biografien mit Wikipedia als Belegquelle. Anpassungen an Zusammenfassungen oder andere längere Textformen brauchen eine lokale Prüfung von Claim-Extraktion, Belegabdeckung und Unterstützungsurteilen. Wiederholte triviale Fakten können den Score erhöhen, und einzeln wahre Aussagen können zusammen eine irreführende Antwort bilden. MontageLie (EMNLP 2025) prüft diese Schwäche durch täuschende Beziehungen und Reihenfolgen wahrer Aussagen. VeriScore verarbeitet Claims mit notwendigen Einschränkungen; der Filter Core hilft, das Hinzufügen unnötiger Fakten zu verhindern.
Zitatgenauigkeit
Verfolge Citation Precision (zitierte Textstellen stützen den Claim tatsächlich) und Citation Recall (Claims, die zitiert werden sollten, werden es):
Der TREC 2024 RAG Track definiert ein reproduzierbares Protokoll zur Support-Evaluation. Thakur et al. (SIGIR 2025) berichten rund 56 % Übereinstimmung mit Urteilen, die Menschen von Grund auf gefällt haben, und 72 % unter einer anderen Bedingung, bei der Menschen LLM-Vorhersagen nachbearbeitet haben. Letzteres ist unterstützte Annotation und kein unabhängiger Beleg für eine bessere Genauigkeit des Judge. Halte die Annotationsbedingung bei der Zahl fest. Als automatische Näherung implementiert ALCE (Gao et al., EMNLP 2023) Citation Precision/Recall mit NLI-basierter Verifikation.
Korrektheit, Vollständigkeit und Verweigerung der Antwort
- Korrektheit der Antwort gegen eine Referenz: Exact Match oder Token-F1 können für kurze Antworten genügen;
evaluate.load("squad")von Hugging Face berechnet beides, und das Paketbert-scoreberechnet BERTScore. Prüfe bei längeren Antworten faktische Relationen, Entitäten, Mengenangaben, Negation und erforderliche Informationen gegen geprüfte Referenzen. BERTScore und Embedding-Kosinus messen Ähnlichkeit; eine falsche Zahl oder eine Negation kann einen hohen Score erhalten.AnswerCorrectnessvon Ragas kombiniert den faktischen Vergleich mit Ähnlichkeit, statt beides gleichzusetzen. - Vollständigkeit über Nuggets: Ein Nugget ist eine relevante Informationseinheit, wobei erforderliche Nuggets von optional nützlichen unterschieden werden. Eine Frage nach dem Gründungsdatum kann das Jahr verlangen; der Name des Gründers ist nicht automatisch erforderlich. AutoNuggetizer erstellt und verfeinert Nuggets aus beurteilten Dokumentpools und prüft dann ihr Vorhandensein in erzeugten Antworten. Der erste Bericht zu TREC 2024 umfasste 21 Topics und 45 Läufe. Der TREC-2025-Überblick, veröffentlicht im März 2026, erweitert das Protokoll auf narrative Queries und bewertet Retrieval-Relevanz, Vollständigkeit der Antwort und Attribution. Das sind öffentliche Evaluationsprotokolle, kein Beleg dafür, dass jedes RAG-System in Produktion dieselbe Nugget-Rubrik braucht.
- Verweigerungsverhalten: Labele, ob die gelieferten Belege eine Antwort zulassen, und miss dann korrekte Verweigerungen unter allen Verweigerungen sowie Verweigerungen unter den Fällen, in denen verzichtet werden soll. NoMIRACL (Findings of EMNLP 2024) testet die Robustheit gegenüber relevanten und nicht relevanten gelieferten Passagen; es beweist nicht, dass der gesamte Korpus keine Antwort enthält. Trenne in deiner eigenen Suite Retrieval-Fehltreffer von Queries, die wirklich außerhalb des Umfangs liegen.
Verifikation nach der Generation
Die günstigsten Zuverlässigkeitsgewinne kommen oft aus deterministischen Nachprüfungen, nicht aus größeren Models.
-
Flag für unbekannte Entitäten: Erfasse Zeichenfolgen benannter Entitäten in der Antwort, die in einer normalisierten Kontextzeichenfolge fehlen (zum Beispiel
entsvonspaCyplus exakter Abgleich). Das ist ein günstiges, domänenspezifisches Flag für unbekannte Entitätszeichenfolgen, keine Grounding-Prüfung: Es kann weder Identität, Relation, Negation, Zeit noch Herkunft feststellen. Miss Precision und Recall an lokalen Labels, bevor du es zur Freigabe eines Releases nutzt, und behalte Entailment auf Claim-Ebene oder menschliche Prüfung für die Verifikation bei.In diesem Beispiel findet das Flag keine unbekannte Entität, obwohl die Antwort das Gegenteil des Kontexts sagt.
def unseen_entity_flag(answer: str, context: str, entities: list[str]) -> bool: return any(entity.lower() not in context.lower() for entity in entities) context = "Paris was not founded in 1994." answer = "Paris was founded in 1994." assert not unseen_entity_flag(answer, context, ["Paris"]) claim_supported = False # human label or an NLI verdict, not the lexical flag assert not claim_supported -
Claim-Verifikation: Extrahiere Claims, führe NLI gegen den Kontext aus und lass alles unterhalb eines Schwellenwerts durchfallen oder markiere es. NLI-Modelle für Faithfulness:
cross-encoder/nli-deberta-v3-large,MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli. Erhöht die Latency. Lohnt sich in Domänen mit hohem Risiko. -
Self-Consistency (Wang et al., ICLR 2023): Ziehe mehrere Generierungen bei Temperatur > 0; berichte die Übereinstimmungsrate (z. B. den Anteil der Generierungen, die der häufigsten Antwort entsprechen, oder paarweises BERTScore); wähle die Stichprobenzahl anhand der Kurve aus Stabilität und Kosten und markiere Antworten mit geringer Übereinstimmung für die menschliche Prüfung.
-
Calibration der Konfidenz: Erfasse verbalisierte Konfidenz („Wie sicher bist du, 0–1?”) und vergleiche sie mit der tatsächlichen Korrektheit auf dem Eval-Set. Zeichne eine Kalibrierungskurve und berichte den Expected Calibration Error: , wobei die Konfidenz-Bins sind. Implementierungen:
netcal,torchmetrics.CalibrationError. Ein Model, das 0,9 Konfidenz meldet, sollte in etwa 90 % vergleichbarer Fälle richtig liegen; miss die Lücke, statt Calibration anzunehmen.
Teil 7: Evaluation von Ontology-grounded RAG
Die Standardmetriken oben decken RAG über einen offenen Korpus ab. Wenn dein RAG gegen eine strukturierte Ontology, Taxonomie oder einen Knowledge Graph abruft, sind diese Metriken notwendig, aber nicht ausreichend. Beispiele sind Produkte in einem Katalog, Erkrankungen in SNOMED, Komponenten in einer Stückliste und Sicherheitstechniken in MITRE ATT&CK. Du musst auch die Ontology-Schicht messen.
Genauigkeit des Entity Linking
Die erste Aufgabe ist, eine Erwähnung in der Query einer Entität der Ontology zuzuordnen („Aspirin” → wikidata:Q18216, „die 737” → aircraft:Boeing_737).
- Precision/Recall/F1 auf Mention-Ebene: Standard, gegen Gold-Spans für Erwähnungen (berechne mit
seqevaloder einem Vergleich von Span-Mengen). - Genauigkeit der Disambiguierung: Welcher Anteil der korrekt erkannten Erwähnungen wird der richtigen Entitäts-ID zugeordnet? Öffentliche Referenzen sind ReFinED, REL und GENRE; Benchmarks wie AIDA-CoNLL und BELB zeigen, dass die Ergebnisse je nach System und Domäne variieren.
- Umgang mit NIL: Precision/Recall bei „Entität nicht in der Ontology”. Miss Over-Linking auf ähnliche, aber falsche Entitäten getrennt von korrektem Verzicht.
Hierarchiebewusste Evaluation
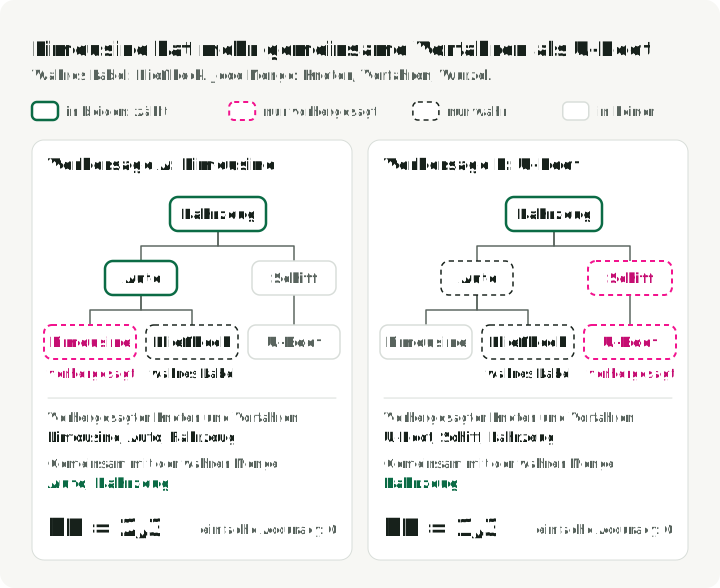
Einfache Accuracy behandelt „Limousine vorhergesagt, wenn die Wahrheit Fließheck ist” genauso wie „U-Boot vorhergesagt, wenn die Wahrheit Fließheck ist”. Diese Fehler wiegen nicht gleich. Im Diagramm teilt die Limousine zwei ihrer drei Knoten mit dem wahren Label, das U-Boot nur die Wurzel; die hierarchische Precision unten macht aus dieser Überlappung einen Score.
-
Hierarchische Precision/Recall/F1 (Kosmopoulos et al., 2015): Anerkennt gemeinsame Vorfahren im DAG der Ontology. Dabei ist der vorhergesagte Knoten plus alle seine Vorfahren und der wahre Knoten plus alle seine Vorfahren:
Setze das mit
networkxauf dem Graphen der Ontology um: Ergänze jede Vorhersage und jedes Label um seine Vorfahren und bilde dann die Mengenüberlappungen oben. -
Wu-Palmer-Ähnlichkeit zwischen vorhergesagter und Gold-Entität in der Taxonomie (Wu & Palmer, 1994):
Dabei ist LCA der niedrigste gemeinsame Vorfahre in der Taxonomie. In NLTK für WordNet sofort verfügbar (
from nltk.corpus import wordnet as wn; wn.synset("car.n.01").wup_similarity(wn.synset("truck.n.01"))); bei eigenen Taxonomien berechne den LCA mitnetworkx. -
Verwechslungsrate bei Geschwistern und Eltern: Verfolge Verwechslungen mit Geschwistern, Eltern und Kindern getrennt:
count_sibling / total_errors,count_parent / total_errors,count_descendant / total_errors. Teste anhand geprüfter Beispiele, ob Fehler bei Geschwistern von mehrdeutigen Erwähnungen kommen oder Fehler bei Eltern von Übergeneralisierung.
False-Exclusion-Rate des Filters (Wiederaufnahme, jetzt kritisch)
Bei Systemen mit Ontology kommen harte Filter oft aus der Ontology selbst („rufe nur Dokumente mit Kategorie X ab”). Die Exklusionsrate (definiert in Teil 5) wird zum primären Korrektheitssignal. Eine falsche Kategorievorhersage kann den Recall auf null setzen; die Exklusionsrate ordnet diesen Verlust dem Filter zu.
Konformität bei eingeschränkter Generierung
Wenn deine Ausgabe einer Ontology entsprechen muss (jeder Entitätsname in der Antwort muss ein gültiges Mitglied der Ontology sein; jedes Prädikat muss aus einem geschlossenen Vokabular stammen), miss:
- Rate der Schema-Gültigkeit: Prozentsatz der Ausgaben, die sich parsen lassen und gegen das Schema der Ontology validieren. Validiere mit
jsonschemaoderpydantic. JSONSchemaBench ist der öffentliche Benchmark für allgemeine Structured Outputs; für ontologiespezifische Schemas baue einen eigenen Validator. - Konformität des Vokabulars: Prozentsatz der benannten Entitäten in der Ausgabe, die gültige IDs der Ontology sind. Das ist eine einzeilige Prüfung auf Mengenzugehörigkeit gegen das geschlossene Vokabular.
- Semantische Konformität: Eine syntaktisch gültige Ausgabe kann trotzdem die falsche, aber gültige Entität wählen. Kombiniere die Konformität mit der Korrektheit der Antwort im weiteren Verlauf.
Frameworks für Constrained Decoding (Outlines, XGrammar, Guidance, OpenAI Structured Outputs) sind darauf ausgelegt, Schema-Gültigkeit durchzusetzen. JSONSchemaBench vergleicht Effizienz, Abdeckung und Qualität über Implementierungen hinweg. Führe die Fälle erneut aus, die zu deinen Schemas und deinem Serving-Backend passen, denn Abdeckung und Latency hängen von beiden ab.
Nachvollziehbarkeit
Für Systeme mit Ontology, deren Antworten geprüft werden:
- Vollständigkeit der Zitate: Prozentsatz der faktischen Claims mit mindestens einem prüfbaren Zitat.
- Provenienztiefe: Prozentsatz der Zitate, die sich bis zu einem Quelldokument mit stabiler ID zurückverfolgen lassen, nicht nur bis zu einem Chunk-Hash.
- Reproduzierbarkeitsrate: Dieselbe Query liefert bei einem festen Snapshot dieselbe Antwort. Fixiere Modellversion, Runtime, Decoding-Konfiguration und Seed und lege die erforderliche Wiederholungsrate anhand der Anforderungen an die Nachvollziehbarkeit des Workflows fest. Temperatur null allein garantiert keinen Determinismus. Eine Abweichung kann aus der Generation, der Serving-Runtime oder einer beliebigen vorgelagerten Stufe stammen.
Teil 8: Evaluation auf Systemebene
Ganzheitliche Antwortqualität
- LLM-as-Judge (Zheng et al., NeurIPS 2023): ein skalierbarer modellbasierter Evaluationsansatz. G-Eval (Liu et al., EMNLP 2023) erzeugt aus Aufgabe und Kriterien Evaluationsschritte und gewichtet dann Bewertungsstufen mit ihren Token-Wahrscheinlichkeiten: . Das sind Wahrscheinlichkeiten, keine Log-Wahrscheinlichkeiten. Die Übereinstimmung hängt von Judge, Aufgabe, Prompt und Kalibrierungsset ab.
- Paarweise Präferenz: Lege dem Judge Antwort A gegen Antwort B vor und erfasse die Präferenz. Das ersetzt eine absolute Bewertung durch eine vergleichende Entscheidung, braucht aber weiterhin Calibration gegen menschliche Präferenzen. MT-Bench berichtete unter seinen Benchmark-Bedingungen eine Übereinstimmung des GPT-4-Judge von über 80 % sowohl mit menschlichen Präferenzen als auch zwischen Menschen; übertrage diese Rate nicht ohne Calibration auf eine andere Domäne.
LLM-as-Judge hat echte Verzerrungen:
- Positionsverzerrung: Miss die Empfindlichkeit gegenüber der Reihenfolge an von Menschen gelabelten Fällen für den gewählten Judge und die gewählte Aufgabe. Zufällige Reihenfolge oder Aggregation über vertauschte Reihenfolgen kann bei manchen Paaren aus Model und Aufgabe helfen, aber behalte beides nur, wenn es die lokale Übereinstimmung mit Menschen verbessert; die kontrollierte Studie von 2026 fand das Vertauschen der Position bei ihren adversarialen Fällen schädlich.
- Verbosity-Verzerrung: Judges können Länge mit Qualität verwechseln. Die zitierte kontrollierte Studie von 2026, Version 2 fand heterogenes Verhalten bei Paaren mit Erweiterung: Drei Judges bevorzugten längere Antworten, Claude bevorzugte knappe Antworten, und GPT-4o war ungefähr neutral. Alle fünf schnitten bei Kontrollen mit Kürzung gut ab. Diese Ergebnisse gelten nur für den Benchmark; sage deinem Judge also, wie er Vollständigkeit und Füllmaterial behandeln soll, und berichte dann die längenkontrollierte Leistung auf deiner eigenen Rubrik.
- Risiko der Selbstpräferenz: Zheng et al. beobachteten in ihren Daten eine um 10 % höhere Selbstgewinnrate bei GPT-4 und eine um 25 % höhere bei Claude-v1, schlossen aber, dass begrenzte Daten und kleine Unterschiede keine Selbstbevorzugung belegen können. Vergleiche Judges aus derselben und aus anderen Modellfamilien mit lokalen menschlichen Labels; wähle den besser kalibrierten Judge, statt eine der beiden Anordnungen für sicher zu halten.
Praktisches Rezept: Wähle einen Judge anhand von von Menschen gelabelten Kalibrierungsdaten, maskiere die Identität der Models, miss die Empfindlichkeit gegenüber der Reihenfolge und lege die Längenregel in der Rubrik fest. Wiederhole Fälle nur, wenn die zusätzlichen Stichproben die Unsicherheit spürbar senken. Vergleiche bei Evaluationen mit hohem Risiko Judges aus derselben und aus anderen Modellfamilien und analysiere Abweichungen gegen menschliche Labels.
Schema-Guided Reasoning für Judges
Freitext-Ausgabe ist eine Quelle für Schwankungen bei Judge-Läufen. Zwei Läufe gegen dieselbe Antwort können die Rubrik unterschiedlich ordnen und verschiedene Scores liefern. Schema-Guided Reasoning (SGR) macht diese Rubrik explizit: Definiere die Evaluationsstufen als Pydantic-Schema und erzwinge dann über Constrained Output mit Outlines, XGrammar, vLLM Structured Outputs oder response_format von OpenAI die unterstützten Schema-Beschränkungen. Die Reihenfolge der Felder kann einem Prüfer helfen, den Datensatz zu inspizieren, beweist aber nicht, dass das Model die Stufen in dieser Reihenfolge durchdacht hat.
Für RAG-Evals zerlegt das Schema das Urteil in explizite, prüfbare Felder, statt das Model direkt zu einer Zahl springen zu lassen:
from pydantic import BaseModel, Field, ValidationError, model_validator
from typing import Literal

class FaithfulnessJudgment(BaseModel):
    extracted_claims: list[str] = Field(
        description="Atomic factual claims in the answer, one per item."
    )
    supported_claims: list[str] = Field(
        description="Subset of extracted_claims that are entailed by the context."
    )
    unsupported_claims: list[str] = Field(
        description="Subset that is NOT entailed by the context."
    )
    outcome: Literal["scored", "no_claims"]
    failure_mode: Literal[
        "none", "fabrication", "overgeneralization", "wrong_entity", "stale_fact"
    ]
    rationale: str

    @model_validator(mode="after")
    def require_claim_partition(self):
        for claims in (self.extracted_claims, self.supported_claims, self.unsupported_claims):
            if any(not claim.strip() for claim in claims):
                raise ValueError("claims must contain non-whitespace text")
        extracted = set(self.extracted_claims)
        supported = set(self.supported_claims)
        unsupported = set(self.unsupported_claims)
        if not extracted:
            if supported or unsupported or self.outcome != "no_claims":
                raise ValueError("an empty extraction must be a no_claims outcome")
            return self
        if (
            len(extracted) != len(self.extracted_claims)
            or len(supported) != len(self.supported_claims)
            or len(unsupported) != len(self.unsupported_claims)
            or supported & unsupported
            or supported | unsupported != extracted
            or self.outcome != "scored"
        ):
            raise ValueError("verdict lists must be a complete, disjoint claim partition")
        return self

    @property
    def score(self) -> float | None:
        if not self.extracted_claims:
            return None
        return len(self.supported_claims) / len(self.extracted_claims)

valid = FaithfulnessJudgment(
    extracted_claims=["Mars has two moons", "Mars has a thick atmosphere"],
    supported_claims=["Mars has two moons"],
    unsupported_claims=["Mars has a thick atmosphere"],
    outcome="scored",
    failure_mode="fabrication",
    rationale="The atmosphere claim lacks support.",
)
assert valid.score == 0.5
empty = FaithfulnessJudgment(
    extracted_claims=[],
    supported_claims=[],
    unsupported_claims=[],
    outcome="no_claims",
    failure_mode="none",
    rationale="Score refusal correctness separately.",
)
assert empty.score is None
try:
    FaithfulnessJudgment(
        extracted_claims=["Mars has two moons"],
        supported_claims=["Mars has two moons"],
        unsupported_claims=["Mars has two moons"],
        outcome="scored",
        failure_mode="none",
        rationale="Contradictory verdict.",
    )
except ValidationError:
    pass
else:
    raise AssertionError("overlapping verdicts must fail validation")
Dieser Beispielvertrag berechnet den Score erst, nachdem die Urteilslisten eine vollständige, disjunkte Partition der extrahierten Claims bilden. Ein Ergebnis ohne Claims hat keinen Faithfulness-Score und muss aus dem Faithfulness-Aggregat herausbleiben; berichte seine Anzahl und bewerte die Korrektheit der Verweigerung getrennt, damit Verzichte den Durchschnitt nicht unbemerkt verbessern. Behalte diese semantischen Prüfungen in Produktion bei; Constrained Output garantiert die Form, kein unverzerrtes Urteil. Das Pydantic-Modell macht außerdem eine Änderung der Rubrik als Code-Diff sichtbar, während die menschliche Calibration das Urteil selbst testet.
Das funktioniert für jeden rubrikbasierten Judge, nicht nur für Faithfulness. Paarweise Präferenz, Zitatbelege und Korrektheit der Verweigerung profitieren alle von derselben Behandlung.
Notebook 07 misst Positionsverzerrung durch paarweise Aufrufe mit vertauschter Reihenfolge. Sein Modul evaluation/llm_judge.py implementiert auch punktweises SGR-Scoring. Paarweise Läufe präsentieren beide Antwortreihenfolgen und berichten die Konsistenz beim Vertauschen. Der punktweise Judge gibt einen ganzzahligen Score zurück; das ist nicht die wahrscheinlichkeitsgewichtete G-Eval-Methode. Da beide Models von einem Anbieter stammen, braucht die Messung der Selbstpräferenz weiterhin einen Judge aus einer anderen Modellfamilie, verglichen mit lokalen menschlichen Labels.
Latency und Kosten
- p50, p95, p99 in jeder Pipeline-Stufe. Ein vernünftiger Start ist p95 für das SLO und p99 für Alerts; ändere beides, sobald du die User Journey, das Traffic-Volumen und das Fehlerbudget kennst.
- Time-to-First-Token vs. gesamte Generierungszeit. Nutzer achten bei Streaming-UX auf TTFT.
- Aufschlüsselung nach Stufen: Retrieval, Reranking, Generation, Nachbearbeitung. Nutze den Trace, um das lange Ende der Verteilung zu lokalisieren, statt anzunehmen, welche Stufe es verursacht; erfasse beim Vergleich von Läufen das Gerät und die Batch-Größe des Rerankers.
- Gesamtkosten pro Query in $ = Embedding + Retrieval + Reranking + Generation + anteiliger Speicher. Verfolge p50 und p99; am langen Ende der Verteilung geht das Budget drauf.
- Cache-Trefferraten beim Embedding-Cache, beim Retrieval-Cache und auf der Ebene des KV cache. Setze getrennte Ziele anhand der beobachteten Wiederholung, der Invalidierungsrichtlinie und der auf jeder Ebene eingesparten Kosten.
Notebook 08 zeigt p50/p95/p99 für die durch evaluation/runner.py instrumentierte Stufe retrieve. Das Modul evaluation/latency.py kann andere Stufen zusammenfassen, wenn du sie explizit instrumentierst. make benchmark variiert Chunking- und Embedding-Einstellungen ohne API-Aufrufe. Der LLM-Vergleich braucht einen OpenAI-Key und uv run python -m rag_evals.scripts.benchmark --skip-chunking --skip-embedding --live.
A/B-Tests
- Einheit der Randomisierung: Definiere zuerst das Ergebnis, das du schätzen willst. Frage dann, ob frühere Antworten späteres Verhalten verändern können und ob die zugewiesene Version eines Nutzers die Erfahrung eines anderen beeinflussen kann. Nutze Zuweisung pro Nutzer oder pro Session, wenn wiederholte Exposition das Verhalten verändern oder eine inkonsistente UX erzeugen kann. Zuweisung pro Query ist nur vertretbar, wenn diese Effekte vernachlässigbar sind und die Analyse wiederholte Beobachtungen modelliert.
- Primäre Metriken, Guardrails, explorative Metriken: Lege sie vorab fest. Wähle die primäre Kennzahl anhand des Produktergebnisses; Zufriedenheits-Proxys sind unter anderem Daumen, Regenerierungen und Verweildauer. Behandle Latency und Kosten als Guardrails, wenn sie die Erfahrung einschränken.
- Stichprobengröße: Führe vor dem Start eine Poweranalyse durch, ausgehend vom kleinsten sinnvoll erkennbaren Effekt, der Baseline-Varianz, der Zuweisungseinheit und der Stoppregel.
Teil 9: Aufbau des Testsets
Eine Metrik ist nur so gut wie das Testset, auf dem sie läuft. Deckt dein Golden Set drei Intents ab und der Produktions-Traffic zwölf, misst Recall@10 nur diese drei Intents. Schlimmer noch: Ein Testset, das sich auf leichte Fragen („Wie lautet die Rückerstattungsrichtlinie des Unternehmens?”) überanpasst, kann ein System freigeben, das bei schweren Fragen scheitert („Anspruch auf Rückerstattung bei teilweiser Stornierung nach EU-Verbraucherrecht, in EUR abgerechnet, für einen Kunden in Irland?”). Der aggregierte Score steigt, während das System bei einem wichtigen Teil des Produktions-Traffics weiter versagt.
Unvollständige Relevanzlabels können den Recall in beide Richtungen verzerren. Ist die wahre relevante Menge {a, b}, die Labels enthalten aber nur {a}, erreicht das Abrufen von {a} 1,0 statt 0,5; das Abrufen von {b} erreicht null statt 0,5. Versioniere die Urteile und prüfe neu abgerufene, nicht beurteilte Belege, bevor du ein Delta interpretierst.
Baue das Testset zuerst um die reale Query-Verteilung und den Schwierigkeitsgrad. Wähle dann Metriken, die auf die Zielfehlermodi reagieren, und stimme das System darauf ab.
Synthetische Query-Generierung
Lass ein LLM Fragen aus deinem Korpus erzeugen:
- Pro Chunk: „Erzeuge 3 Fragen, die ein Nutzer stellen könnte und die dieser Chunk beantwortet.”
- Multi-Hop: Ziehe zwei Chunks und erzeuge eine Frage, die beide braucht.
- Adversarial: Erzeuge Fragen mit ablenkenden Entitäten, Beinahe-Duplikaten in der Formulierung und mehrdeutigen Erwähnungen.
Die Testgenerierung von Ragas nutzt graphbasierte Szenarien mit Single-Hop- und Multi-Hop-Queries und mit spezifischem oder abstraktem Informationsbedarf. DataMorgana erzeugt konfigurierbare synthetische Benchmarks über Nutzer- und Fragekategorien hinweg. Synthetische Daten sind nützlich für Cold Starts und Tests der Abdeckung. Echte Nutzer-Queries können sie nicht ersetzen.
Aufbau des Golden Datasets
Von Menschen kuratierte Daten bilden die Grundlage des Golden Sets.
- Ziehe echte Nutzer-Queries (oder simulierte, wenn vor dem Launch), stratifiziert nach Intent.
- Lass SMEs jede Frage beantworten und angeben, welche Dokumente die Antwort enthalten.
- Beginne mit einigen hundert Queries (200–500) und prüfe das Intervall. Bei 200 Queries und einer Erfolgsrate um 0,8 beträgt das 95-%-Intervall etwa ±5,5 Punkte (1,96 × √(0,8 × 0,2 / 200)). Ist die Änderung, die du erkennen musst, kleiner, füge Queries zu den Slices hinzu, die über das Release entscheiden.
- Ergänze geprüfte Produktions-Queries (Teil 10), wenn Drift-Checks oder neue Query-Typen eine Lücke in der Abdeckungsmatrix unten zeigen.
Halte vier Sets getrennt:
- Entwicklung: Prompts, k und Chunking abstimmen.
- Judge-Calibration: menschliche Labels, die den Judge prüfen.
- Release: pro Kandidat einmal bewertet, nie zum Tuning verwendet.
- Monitoring: frischer Produktions-Traffic, blind geprüft.
Gruppiere gemeinsame Quelldokumente und Sessions, bevor du aufteilst. Sobald eine Query oder ein Label das Tuning leitet, sind es Entwicklungsdaten; ein Release-Set, das zum Tuning dient, wird also zu Entwicklungsdaten. Reserviere unberührte Fälle, um die gewählte Konfiguration und den Judge zu validieren.
Halte Korpus-, Query-, Relevanzlabel- und Richtlinienversionen fest, dazu die Einheit von k, das Budget für gelieferten Kontext, die Revisionen von Scorer und Judge und die Aggregationsregeln. Vergleiche gepaarte Deltas pro Query auf derselben Population, mit Unsicherheit und Slice-Anzahlen. Beziehe jede erwartete Query ein: Ein Timeout, ein fehlendes Ergebnis oder eine nicht bewertbare Judge-Antwort muss in der Abschluss- und Fehlerstatistik sichtbar bleiben. Lass einen Release-Score nicht besser werden, indem Fehlschläge stillschweigend wegfallen. ARES bietet einen Forschungsansatz mit automatisierten Judges, menschlicher Validierung und Prediction-Powered Inference für Systemschätzungen, wenn Annotation knapp ist; eine geprüfte lokale Suite kann einfacher beginnen.
Adversariale Testsets
- Kontrafaktische Fälle: Tausche Schlüsselentitäten in der Query aus. Ruft das System für die getauschte Query die richtigen Chunks ab?
- Ablenker: Queries, bei denen der Korpus eine plausible, aber falsche Antwort enthält, die nicht abgerufen werden darf. Das testet RGB (Chen et al., AAAI 2024) unter Belastung: Robustheit gegen Rauschen, Zurückweisung bei fehlender Antwort, Informationsintegration und kontrafaktische Robustheit.
- Negation und Quantoren: Queries mit „nicht”, „außer” und „nur”. Dichte Retriever tun sich damit oft schwer.
- Außerhalb des Umfangs: Queries, auf die der Korpus keine Antwort enthält. Das System sollte „Ich weiß es nicht” sagen und keine Hallucination erzeugen. NoMIRACL liefert Tests zu Relevanz und Beantwortbarkeit auf Passagenebene; ergänze separate Labels für Anfragen außerhalb des Umfangs auf Korpusebene. Evaluiere den Verzicht explizit auf deinen Query-Typen aus der Produktion.
Abdeckung und kontinuierliche Evaluation
- Baue eine Abdeckungsmatrix: Query-Intent × Dokumenttyp × Zweig der Ontology. Eine Query pro Zelle ist ein Startinventar der Abdeckung, nicht genug statistische Power für eine Release-Entscheidung. Leere Zellen zeigen fehlende Abdeckung; dimensioniere die gefüllten Slices passend zur Unsicherheit, die du tolerieren kannst.
- Startrhythmus: eine Teilmenge von etwa 50 Queries bei jedem PR, das gesamte Golden Set nachts oder bei jedem Release-Kandidaten und wöchentliche Drift-Checks auf einer Produktionsstichprobe.
make eval-fastdes Begleit-Repositorys führt die Teilmenge mit 50 Queries aus. Ändere den Rhythmus, sobald du die Kosten der Evaluation kennst und weißt, wie schnell sich der Traffic ändert. - Nutze für Drift eine gleitende Produktionsstichprobe und stratifiziere nach Feedback, statt die Zielverteilung stillschweigend zu ändern.
Teil 10: Monitoring in Produktion
Die Eval-Suite, die du auslieferst, beschreibt das System zum Launch. Der Produktions-Traffic ändert sich danach.
Implizites und explizites Feedback
- Behandle implizite Ereignisse als Kandidatensignale, nicht als positive oder negative Qualitäts-KPIs, bis sie auf einer lokalen Stichprobe mit verblindeter Prüfung oder explizitem Feedback korrelieren.
- Klickrate / Öffnungsrate bei zitierten Quellen (wenn deine UI sie anbietet).
- Verweildauer bei der Antwort.
- Regenerierungsrate: Prozentsatz der Antworten, die der Nutzer erneut stellt oder vom System neu erzeugen lässt. Behandle sie als ein Signal für Unzufriedenheit und kalibriere sie an geprüften Unterhaltungen.
- Kopier-, Teil- und Exportraten: implizite Kandidatensignale, die Nützlichkeit, Verifikation, Übergabe oder Unzufriedenheit bedeuten können. Miss ihren Zusammenhang und das Konfidenzintervall, bevor du eine Richtung zuweist.
- Folgemuster: Nutze „Bist du sicher?” oder „Aber was ist mit X?” als Strata für die Prüfung und labele dann ihren Zusammenhang mit Misstrauen oder ungelöstem Bedarf.
- Daumen hoch/runter mit optionalen Kategorien für den Grund (falsch, unvollständig, am Thema vorbei, schädlich, langsam). Direkte Bearbeitungen können mehr diagnostischen Kontext erhalten; bewerte diesen Wert an geprüften Stichproben.
Erkennung von Drift
- Query-Drift: Vergleiche Query-Embeddings mit einem Referenzfenster über MMD oder einen validierten Klassifikator für Referenz gegen aktuell. KL braucht einen definierten Wahrscheinlichkeitsschätzer, etwa gewählte Histogramme; rohe Embedding-Koordinaten sind keine Wahrscheinlichkeiten. Kalibriere Alarme an bekannten Verschiebungen und untersuche dann die betroffenen Slices.
- Embedding-Drift: Fixiere eine Repräsentation und eine Probe-Menge und miss dann die Stabilität der Nachbarn und die Retrieval-Qualität. Verschiedene Modellversionen müssen weder Dimensionen noch eine Koordinatenbasis teilen, daher kann Kosinus über Versionen hinweg bedeutungslos sein. Migriere Query- und Dokument-Encoder gemeinsam, evaluiere den neuen Index und halte versionierte Snapshots für ein Rollback vor.
- Performance-Drift: Verfolge produktionsnahe Metriken (Regenerierungsrate pro Intent) über die Zeit. Plötzliche und allmähliche Verschiebungen legen unterschiedliche Hypothesen nahe, aber ihre Form belegt nicht die Ursache; untersuche Änderungen an Daten, Traffic, Anbieter, Richtlinien und Deployment.
Shadow-Evaluation und Human-in-the-Loop
Lasse das Kandidatensystem parallel zur Produktion laufen, vergleiche die Ausgaben offline und liefere sie nicht an Nutzer aus. So lassen sich Regressionen vor dem Launch aufdecken. Shadow Inference verbraucht weiterhin Kapazität und kann Tools aufrufen: Isoliere Ressourcen, unterdrücke Schreibzugriffe und prüfe, dass der Vergleich die Latency der Produktion nicht verschlechtert.
Für die Prüfung durch Menschen (Human-in-the-Loop, HITL):
- Ziehe Ausgaben mit geringer Konfidenz in eine Prüfwarteschlange.
- Nimm eine Zufallsstichprobe des Produktions-Traffics für die blinde Prüfung auf; 1–2 % des Traffics sind eine Startrate, angepasst an Traffic-Volumen, Risiko und Kapazität der Prüfer.
- Ziehe Ausgaben mit Daumen runter zusätzlich zur Zufallsstichprobe überproportional für die Prüfung heran.
- Nutze geprüfte Ausgaben, um das Golden Set zu erweitern.
Behalte die Zufallsstichprobe: Ohne sie enthält das Golden Set nur Antworten, über die sich Nutzer beschwert haben.
Das minimale Guardrail-Set
Wähle Prioritäten und Schwellenwerte für Alerts anhand des Schadens für Nutzer, der SLOs und der validierten Leistung der Detektoren. Kandidatensignale sind:
- Faithfulness-/HHEM-Score unter dem Schwellenwert auf einer gleitenden Produktionsstichprobe.
- p95-Latency über dem SLO.
- False-Exclusion-Rate des Filters über dem Schwellenwert (stichprobenbasiert).
- Regenerierungsrate außerhalb eines lokal kalibrierten Kontrollbands, das Fenstergröße, Traffic, Saisonalität und Budget für Fehlalarme berücksichtigt.
- Kosten pro Query über dem Budget.
Eine erste Triage-Regel: Ein Alert ohne Code- oder Modelländerung deutet auf Drift; ein Alert direkt nach einem Release deutet auf eine Regression. Bestätige beides in Traces und betroffenen Slices, denn ein Deployment kann mit Traffic-Drift zusammenfallen, und eine Änderung beim Anbieter oder in den Daten kann ohne Release der Anwendung auftreten.
Einschränkungen
- Ziele sind lokal, nicht universell. Die Startwerte in diesem Leitfaden, einschließlich der Gates des Begleit-Repositorys, sind erste Einstellungen, die du auf deinen eigenen Daten abstimmst. Die Beispielzahlen sind durchgerechnete Ergebnisse. Kalibriere Release-Schwellenwerte auf deine Domäne, den Einsatz, die Unsicherheit des Evaluationssets und die Erwartungen der Nutzer.
- Der Framework-Bereich bewegt sich schnell. HHEM-Versionen, Metriknamen in RAGAS, Model Cards und die Reihenfolge in Leaderboards können sich nach der Veröffentlichung ändern. Prüfe die verlinkte Quelle erneut und mache neue Benchmarks, bevor du dich festlegst.
- Zahlen zur Übereinstimmung von LLM-as-Judge haben Einschränkungen. Die 80 % Übereinstimmung zwischen GPT-4 und Menschen stammen aus den Bedingungen von MT-Bench / Chatbot Arena. Dieses Ergebnis belegt keine Übereinstimmung in einer Nischendomäne oder auf einem adversarialen Slice. Nutze Judges, um mehr Fälle zu bewerten, als Menschen prüfen können, und prüfe weiterhin eine Stichprobe von Hand.
- Verbesserungen aus Benchmarks von Anbietern lassen sich oft nicht unabhängig reproduzieren. Reproduziere sie auf deinen eigenen Daten, bevor du einer Zahl glaubst, besonders bei neueren Rerankern und OCR-Systemen.
- Keine Metrik ersetzt den Blick auf die Ausgaben. Beginne damit, jede Woche 50 zufällige Antworten aus der Produktion zu lesen. Die Metriken skalieren diese Gewohnheit; sie ersetzen sie nicht.
Referenzen
Frameworks und Benchmarks
- Es et al., Ragas: Automated Evaluation of Retrieval Augmented Generation, 2023.
- RAGAS-Dokumentation und GitHub.
- Saad-Falcon et al., ARES: An Automated Evaluation Framework for Retrieval-Augmented Generation Systems, NAACL 2024.
- TruLens, DeepEval, Arize Phoenix.
- Thakur et al., BEIR: A Heterogenous Benchmark for Zero-shot Evaluation of Information Retrieval Models, NeurIPS 2021.
- MTEB Leaderboard.
- TREC 2024 RAG Track.
- Pradeep et al., Initial Nugget Evaluation Results for the TREC 2024 RAG Track with the AutoNuggetizer Framework, 2024.
Retrieval und Ranking
- Cormack, Clarke, Buettcher, Reciprocal Rank Fusion Outperforms Condorcet and Individual Rank Learning Methods, SIGIR 2009.
- Gao et al., Precise Zero-Shot Dense Retrieval Without Relevance Labels (HyDE), 2022.
- Jeong et al., Adaptive-RAG: Learning to Adapt Retrieval-Augmented Large Language Models through Question Complexity, NAACL 2024.
- Anthropic, Introducing Contextual Retrieval, September 2024.
- Günther et al., Late Chunking: Contextual Chunk Embeddings Using Long-Context Embedding Models, 2024.
Generation, Faithfulness, Judges
- Min et al., FActScore: Fine-grained Atomic Evaluation of Factual Precision in Long Form Text Generation, EMNLP 2023.
- Liu et al., Lost in the Middle: How Language Models Use Long Contexts, TACL 2024.
- Chen et al., Benchmarking Large Language Models in Retrieval-Augmented Generation (RGB), AAAI 2024.
- Vectara, HHEM-2.1-Open hallucination evaluation model.
- Zheng et al., Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, NeurIPS 2023.
- Thakur et al., Support Evaluation for the TREC 2024 RAG Track: Comparing Human versus LLM Judges, SIGIR 2025.
- Thakur et al., Knowing When You Don’t Know: A Multilingual Relevance Assessment Dataset for Robust Retrieval-Augmented Generation, Findings of EMNLP 2024.
- Geng et al., JSONSchemaBench: A Rigorous Benchmark of Structured Outputs for Language Models, 2025.
- Kosmopoulos et al., Evaluation Measures for Hierarchical Classification: a unified view and novel approaches, 2015.
Drift und Produktion
- Evidently, Embedding drift detection methods compared.
Begleitcode
slavadubrov/rag-evals-demo: ausführbares Harness, das SciFact-Retrieval, Generation auf gelabelten synthetischen QA-Daten und Offline-Prüfungen mit Testdaten trennt, mit Chunking- und Embedding-Sweeps und optionalem Live-Vergleich zweier OpenAI-Modelle. Die Notebooks 00–09 erklären die Abläufe; Unit-Tests fixieren ausgewählte durchgerechnete Beispiele, während die älteren Filter-Testdaten eine andere Menge zulässiger Dokumente verwenden. Der eingebettete Qdrant-Index läuft ohne Docker.