Métricas de avaliação de RAG: retrieval, reranking e geração

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Para engenheiros que operam ou avaliam sistemas de retrieval-augmented generation (RAG), esta referência associa as falhas no parsing de documentos, na filtragem, no retrieval, no reranking e na geração à métrica que identifica cada uma. Mostra também que verificações correm antes do lançamento e quais monitorizam o tráfego em produção.
Um sistema RAG com filtros de relevância defeituosos pode funcionar durante meses sem disparar um alerta operacional. Continua a devolver respostas e cumpre o objetivo de latência, mas as respostas assentam em evidência incompleta. O Recall@k face ao conjunto gold elegível original expõe a perda. Os painéis de latência e disponibilidade não.
Quer avançar e executar código?
O repositório executável
slavadubrov/rag-evals-demosepara a recuperação em SciFact, a geração com QA sintética anotada e as verificações offline com dados de teste fixos.make evalexecuta recuperação, diagnóstico de filtros e reprodução dos resultados de geração apósmake index.make benchmarkvaria parâmetros de divisão em fragmentos e embeddings sem chamadas API; comparar dois modelos OpenAI exige uma chave API e a opção--live(ver parte 8). Os notebooks 00–09 cobrem recuperação, filtragem, geração e exemplos do sistema. A demonstração usa Qdrant integrado e não exige Docker.
Tabela de decisão para avaliação de RAG
Use esta tabela como ponto de partida antes de escolher um framework. A métrica certa depende do modo de falha que quer detetar, não do nome da ferramenta.
| Pergunta | Família de métricas | Use quando | Atenção a |
|---|---|---|---|
| O parsing preservou a fonte? | Completude da extração, cobertura de tabelas e figuras | PDFs, slides, digitalizações e páginas HTML entram no corpus | Texto com bom aspeto pode ter perdido legendas, notas de rodapé ou estrutura de tabelas |
| O retrieval encontrou a evidência certa? | Recall@k, nDCG@k, MRR, context precision/recall | É possível etiquetar chunks ou documentos relevantes | Um filtro rígido de metadata pode remover o documento correto antes de o ranking começar |
| O reranking melhorou a lista curta? | Ganho do reranker, Precision@1, diferença de nDCG | Cross-encoders ou rankers com LLM vêm depois do retrieval | Meça a latência e o custo juntamente com o ganho de qualidade |
| A resposta usou a evidência? | Faithfulness, groundedness, suporte das citações | A resposta cita documentos ou afirma factos do contexto | A faithfulness não diagnostica parsing nem retrieval defeituosos |
| O sistema é estável em produção? | Drift, regeneração, fallback, latência p95, custo por resposta | O tráfego muda após o lançamento | A telemetria de produção precisa de revisão humana por amostragem para se manter calibrada |
Para uma comparação mais curta de ferramentas, veja Melhores ferramentas de avaliação de RAG: Ragas, DeepEval e TruLens.
Parte 1: Defina o sucesso antes da arquitetura
Elabore o conjunto de avaliação antes do diagrama de arquitetura. Dá a cada escolha posterior de componente um objetivo mensurável.
Não pode escolher entre BM25 e retrieval denso, entre chunking recursivo e semântico, ou entre Cohere Rerank e BGE enquanto não souber o que está a otimizar. “Melhores respostas” não é uma métrica. Um requisito de lançamento ilustrativo é “faithfulness ≥ 0,85 num golden set de 200 queries que cobre as nossas três principais intenções, com latência p95 < 1,5 s e taxa de falsa exclusão pelo filtro < 2%.” Os números são valores provisórios; o importante é que a qualidade, a cobertura, a latência e a filtragem tenham limiares explícitos.
Defina o harness antes de escrever o código de retrieval. O primeiro harness vai estar errado e vai revê-lo. Rever uma métrica custa muito menos do que rever um sistema que já pôs em produção.
Três camadas do pipeline e dois modos de execução
A avaliação em produção tem três camadas de pipeline. A avaliação da ingestão pergunta se o corpus e o índice preservam a fonte. A avaliação em tempo de query pergunta se a reescrita, a filtragem, o retrieval, o reranking e a montagem do contexto encontraram a evidência certa. A avaliação da resposta e da produção pergunta se a resposta usou essa evidência e se a qualidade se mantém com tráfego real. Se juntar as camadas numa única pontuação, um erro de normalização pode desaparecer dentro de uma pontuação de resposta aceitável.
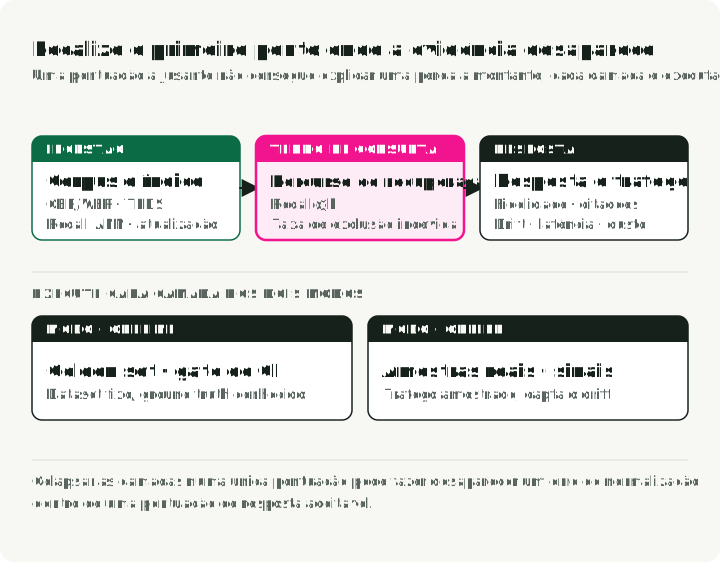
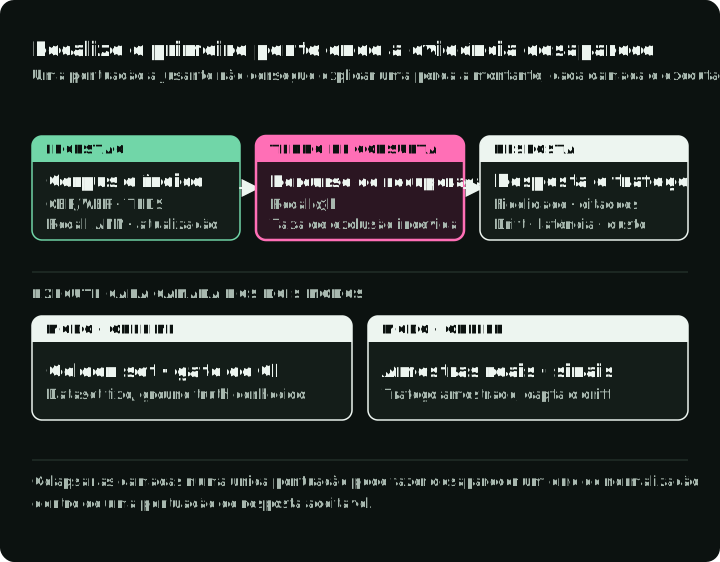
Estas camadas descrevem onde ocorre uma falha. Offline e online descrevem quando e sobre que dados a verificação corre. A avaliação offline usa um dataset fixo com verdade de referência conhecida; é reprodutível e pertence à escolha de componentes, às comparações A/B e às verificações de CI que podem bloquear uma alteração. A avaliação online pontua uma amostra do tráfego real e regista regeneração, tempo de permanência, feedback explícito e drift real das queries. É mais ruidosa e mais difícil de instrumentar.
Use os dois modos onde ajudam: corpora e conjuntos de queries fixos tornam as regressões reprodutíveis; traces reais amostrados expõem falhas de atualidade e drift.
Ao nível dos componentes vs. end-to-end
Há dois erros comuns. A avaliação só end-to-end diz que o sistema está avariado, mas não onde. A avaliação só por componente pode mostrar todas as partes a passar enquanto o sistema completo continua a falhar. A solução é ter algumas métricas end-to-end principais para decisões de avançar ou parar, mais métricas por componente para diagnóstico. As métricas de retrieval apanham regressões do retriever. As métricas de geração apanham regressões do gerador. A correção end-to-end da resposta apanha falhas de integração.
Os frameworks de referência (uma visita opinativa)
| Framework | Melhor em | Onde falha |
|---|---|---|
| RAGAS | Um vocabulário comum para faithfulness, answer relevancy e context precision/recall (métricas) | Custo do LLM como juiz; componentes da pontuação opacos ao depurar; mudanças de versão |
| ARES | Um juiz classificador específico da tarefa, se o treino e a anotação compensarem o custo (artigo); a precisão reportada depende do benchmark | Configuração mais pesada; é preciso treinar modelos a sério |
| TruLens | Funções de feedback ligadas aos traces e integração com OpenTelemetry (projeto) | Menos completo do que o RAGAS em métricas específicas de RAG |
| DeepEval | Integração com test runners e métricas personalizadas (projeto) | Uso intensivo de LLM como juiz = picos de custo |
| Arize Phoenix | Tracing, experiências com datasets e avaliadores de RAG/agentes prontos ou personalizados (documentação de avaliação) | As rubricas de domínio e os limiares do juiz continuam a precisar de calibração local |
| TREC 2024 RAG Track | Benchmark público para avaliação por nuggets (AutoNuggetizer), avaliação de suporte e fluência sobre o MS MARCO Segment v2.1 | Não é uma ferramenta de runtime; é um benchmark para calibrar |
A minha stack por omissão é o RAGAS para o vocabulário de métricas, o DeepEval para verificações de CI, o Phoenix para tracing em produção, mais código próprio para métricas específicas da ontologia. Escolha o framework que facilita as métricas personalizadas.
Na escolha de benchmarks, ajuste-os à tarefa antes de ler o leaderboard. BEIR, MTEB e MIRACL continuam a ser boas bases de comparação para retrieval. Acrescente testes para capacidades que eles não estabelecem:
- RAG end-to-end atual: o TREC 2026 RAG Track usa queries narrativas e o ClimbMix-400b, substituindo o MS MARCO v2.1, e liga ao toolkit de avaliação RAGDoll. Os tópicos de 2026 já foram divulgados; os julgamentos ainda não foram publicados. Use os tópicos para experiências, não como um leaderboard avaliado. Mantenha os protocolos de 2024 e 2025 abaixo associados aos seus próprios corpora e julgamentos.
- Perguntas técnicas sobre código em evolução: o FreshStack combina perguntas do Stack Overflow feitas por humanos, corpora de repositórios e julgamentos por nuggets. O snapshot publicado e o mecanismo para construir novos corpora são coisas diferentes; fixe a revisão do repositório e a data das perguntas.
- Imagens que contêm parte da pergunta ou da evidência: o MM-BRIGHT separa retrieval texto-para-texto, multimodal-para-texto, multimodal-para-imagem e multimodal-para-multimodal. Pontue cada tarefa relevante em separado. O texto de OCR sozinho pode omitir o que um gráfico ou uma captura de ecrã acrescenta.
Estes benchmarks alargam a cobertura; não substituem o conjunto de queries elegível e versionado da sua aplicação.
Parte 2: Mapeie os pontos de avaliação
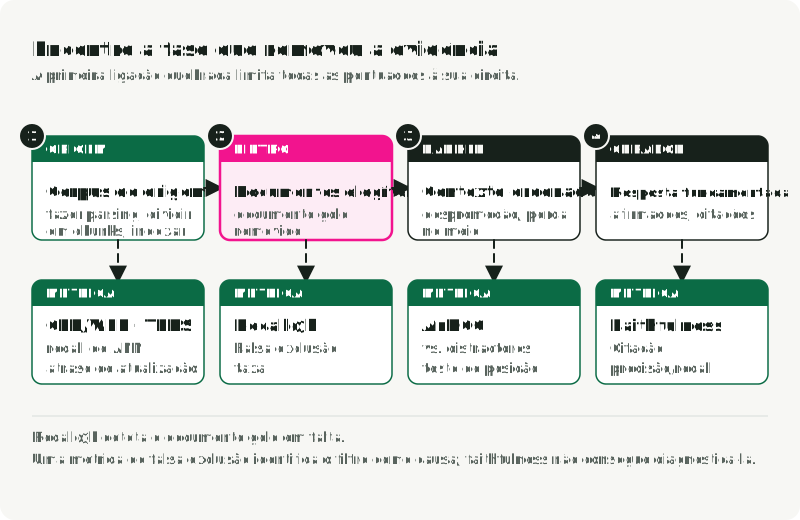
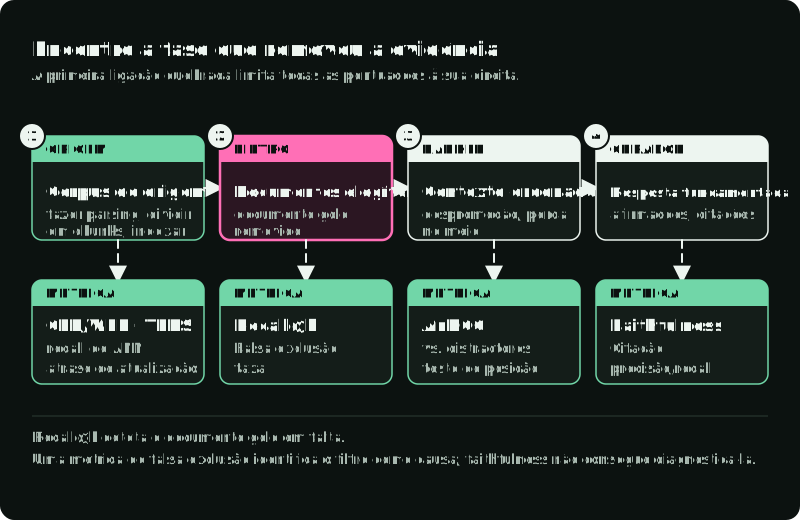
Quando uma resposta está errada ou sem suporte, siga o documento de referência pelas quatro verificações da figura, da esquerda para a direita. A primeira etapa em que ele falta indica a métrica a verificar primeiro e a parte deste artigo que a cobre.
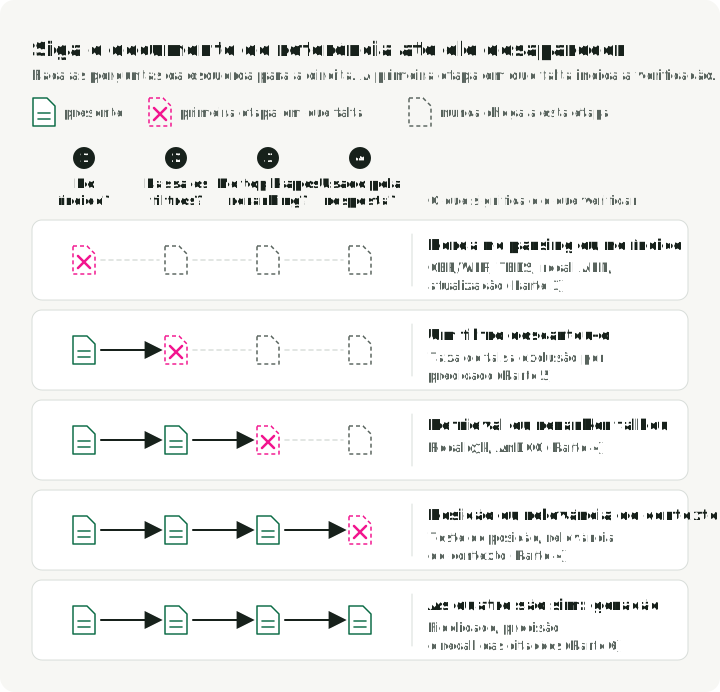
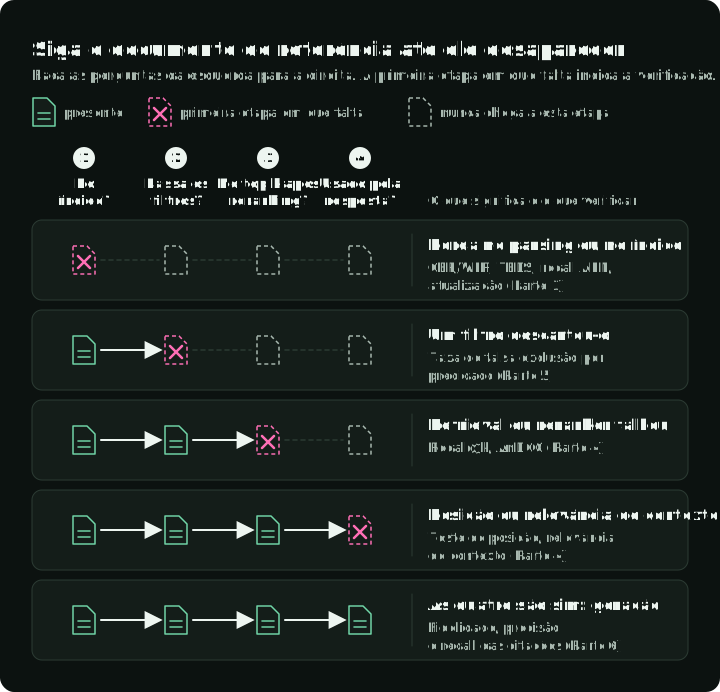
As perdas a montante limitam a qualidade a jusante: um parsing mau limita o retrieval, e um retrieval mau limita o reranking e a geração. A faithfulness mede a resposta, nunca a causa a montante.
Parte 3: Avaliação da ingestão
Muitas falhas de RAG em produção começam na ingestão. O sistema funciona com documentos de teste limpos e depois falha com PDFs reais, digitalizações, tabelas e páginas de corpus desarrumadas.
Aquisição e parsing de documentos
O que medir:
-
Verificação do comprimento extraído:
extracted_chars / expected_charspor classe de documento sinaliza alterações suspeitas de comprimento, mas texto duplicado ou errado pode ainda assim pontuar 1,0. Compare o texto alinhado com uma referência limpa à mão para encontrar omissões e substituições, e depois verifique em separado notas de rodapé, legendas, conteúdo de tabelas e ordem de leitura. -
Precisão do OCR: CER (Character Error Rate) e WER (Word Error Rate), as métricas padrão de fala e OCR:
onde , , são substituições, eliminações e inserções ao nível do caráter e é o número de carateres da referência (o índice indica a versão ao nível da palavra). Não aplique o mesmo limite de CER a todos os corpora. Calibre-o por classe de documento e pela perda de qualidade da resposta a jusante. Texto impresso, manuscrito e material multilingue têm perfis de erro diferentes. Calcule com
jiwer(jiwer.cer(refs, hyps),jiwer.wer(refs, hyps)) ou com oevaluatedo Hugging Face. Para corpora de avaliação, FUNSD e SROIE são benchmarks públicos.from jiwer import cer, wer refs = ["Mars has two moons, Phobos and Deimos."] hyps = ["Mars has two m00ns, Phobos and Deirnos."] print(f"CER = {cer(refs, hyps):.3f}") # CER = 0.105 print(f"WER = {wer(refs, hyps):.3f}") # WER = 0.286 -
Fidelidade da extração de tabelas: o TEDS (Tree-Edit-Distance-based Similarity) mede a proximidade entre a árvore HTML de uma tabela prevista e a de referência, normalizada pelo tamanho da maior árvore. De Zhong et al., 2020 (PubTabNet):
O TEDS usa a estrutura (linhas, colunas, spans) e o conteúdo das células. O TEDS-S remove o conteúdo e pontua apenas a estrutura. Implementação de referência:
src/metric.pydo PubTabNet (usaaptedpor baixo). Para corpora de avaliação, veja o PubTabNet, o FinTabNet e o SciTSR. Os parsers ingénuos falham muitas vezes nas tabelas. Faça benchmark antes de confiar neles. -
Preservação do layout e da estrutura: ordem dos títulos, integridade das listas, ordem de leitura em PDFs com várias colunas. Use o DocLayNet como benchmark etiquetado. Uma comparação com ferramentas prontas pode abranger um parser de elementos como o
unstructured, uma biblioteca de PDF como opymupdfe um pipeline Docling selecionado. O Docling oferece caminhos padrão e VLM; registe qual deles testa.
Compare famílias de parsers distintas, por exemplo uma base com Tesseract, um modelo de OCR baseado em VLM e o candidato do seu fornecedor. Melhores modelos de OCR compara as opções atuais. Use uma amostra estratificada de classes reais de documentos com um DPI fixo, incluindo digitalizações limpas, fotografias, tabelas, texto multilingue, matemática e manuscrito. Reporte o CER ou o WER por classe e o TEDS para as páginas com tabelas.
Limpeza e normalização
-
Precisão da remoção de boilerplate: precision/recall face a spans de boilerplate etiquetados por humanos. Uma remoção agressiva elimina conteúdo relevante; uma remoção tímida polui os embeddings. Ferramentas a comparar:
trafilatura,jusText,Resiliparse. Barbaresi (2021) compara o Trafilatura com referências que incluem o jusText; o Resiliparse é um candidato à parte, não um sistema avaliado nesse artigo. -
Normalização Unicode: a percentagem de documentos que produzem resultados NFC e NFKC idênticos (calculada com o
unicodedata.normalizeda biblioteca padrão) é um sinal útil de drift nas formas de compatibilidade. Não deteta pontos de código invisíveis ou ignoráveis por omissão, nem sósias entre escritas: procure os primeiros de forma explícita e aplique uma política ou um detetor de confusables do Unicode quando os segundos estiverem no âmbito. -
Precisão da deteção de idioma: F1 numa amostra multilingue etiquetada. Crítico para índices multilingues. Use
fasttext-langdetect(olid.176do Facebook),lingua-pyoucld3. O FLORES-200 fornece texto de avaliação em 200 idiomas, mas a mistura de idiomas da sua produção deve determinar a fatia de teste. -
Eficácia da deduplicação (MinHash / LSH): precision/recall do seu detetor de quase-duplicados face a um conjunto etiquetado à mão. A ideia de base: estimar a semelhança de Jaccard entre conjuntos de shingles de documentos através de hashes de permutações aleatórias (Broder, 1997) e agrupar os quase-duplicados com bandas de LSH (Indyk & Motwani, 1998). Varie o número de hashes e o limiar de Jaccard no seu corpus. Acompanhe a taxa de fusões erradas (corrompe respostas) em separado da taxa de fusões em falta (desperdiça espaço no índice). O
datasketchfornece a implementação usada abaixo; os parâmetros são ilustrativos:from datasketch import MinHash, MinHashLSH def shingles(text: str, k: int = 5) -> set[str]: text = text.lower() return {text[i:i + k] for i in range(len(text) - k + 1)} def to_minhash(text: str, num_perm: int = 128) -> MinHash: m = MinHash(num_perm=num_perm) for s in shingles(text): m.update(s.encode("utf-8")) return m docs = { "d1": "Mars has two moons, Phobos and Deimos.", "d2": "Mars has two moons, Phobos and Deimos!", # near-dup "d3": "Curiosity rover landed on Mars in 2012.", } lsh = MinHashLSH(threshold=0.8, num_perm=128) for did, text in docs.items(): lsh.insert(did, to_minhash(text)) print(sorted(lsh.query(to_minhash(docs["d1"])))) # ['d1', 'd2'] -
Remoção de PII: precision e recall, calculados em separado por tipo de entidade (emails, números de segurança social, nomes, moradas). Erros de recall criam risco de conformidade; erros de precision prejudicam a qualidade das respostas. Defina o ponto de operação com a equipa jurídica. As ferramentas candidatas incluem o Microsoft Presidio, o
scrubadubou um modelo de NER com fine-tuning num conjunto etiquetado.
O chunking controla a qualidade do retrieval
O chunking altera a evidência que chega à resposta. No benchmark de 2025 da NVIDIA, de um fornecedor, o chunking ao nível da página alcançou a maior exatidão média das respostas end-to-end na configuração testada, porque preservou tabelas e gráficos como unidades inteiras. Isso mede a exatidão da resposta, não o recall do retrieval. Trate esse resultado como evidência para o corpus testado, não como um vencedor universal.
O chunking semântico agrupa frases adjacentes por semelhança de embeddings e corta nas fronteiras dissimilares. O SemanticChunker do LangChain e o SemanticSplitterNodeParser do LlamaIndex implementam esta estratégia. Pode melhorar o recall face a janelas fixas quando as fronteiras temáticas importam.
O RecursiveCharacterTextSplitter do LangChain tenta, por defeito, quebras de linha duplas, simples, espaços e depois caracteres individuais: ["\n\n", "\n", " ", ""]. Não deteta limites de frases sem separadores adequados ou um divisor que os reconheça. O valor por defeito length_function=len conta caracteres. Para experimentar 400–512 tokens por fragmento com sobreposição de 10–20 %, use uma função que conte tokens. Compare estes parâmetros iniciais com outros valores no seu conjunto de referência.
Métricas a acompanhar:
- Coerência dos chunks: , onde são embeddings de frases. Chunks saudáveis são semelhantes por dentro e dissimilares na fronteira. Calcule com
sentence-transformersmais ocosine_similaritydoscikit-learn. - Qualidade das fronteiras: etiquetagem humana de “este corte faz sentido?” numa amostra, mais uma verificação estrutural de que os chunks não partem tabelas, listas nem secções numeradas.
- Tamanho ideal do chunk: varie o tamanho em tokens (128, 256, 512, 1024) e trace o Recall@k em função do tamanho no seu golden set. Escolha o menor tamanho a partir do qual o Recall@k deixa de melhorar.
- Eficácia da sobreposição: varie a sobreposição em 0, 10, 20 e 30% como grelha inicial e meça o Recall@k. Pare de aumentar a sobreposição quando a curva local de recall estabilizar ou o custo da duplicação superar o ganho.
- Fidelidade da atribuição dos chunks: percentagem de chunks que mantêm uma referência de origem verificável (número de página, âncora de secção, ID do documento). A auditabilidade exige isto.
- Chunking tardio vs. precoce: o late chunking (Günther et al., 2024) gera o embedding do documento completo e só depois o segmenta, preservando o contexto global (implementação de referência no
jina-embeddings-v3). O Contextual Retrieval (Anthropic, 2024) acrescenta a cada chunk um contexto gerado por LLM. Ambos aumentam o custo. Faça benchmark no seu corpus antes de adotar qualquer um.
A minha opinião: o chunking estrutural (dividir por títulos, tabelas e secções, implementado por parsers como o unstructured.io ou percorrendo a AST que o seu parser já produziu) é subaproveitado. Se os seus documentos têm estrutura, use-a antes de acrescentar heurísticas de semelhança. A divisão recursiva por carateres é a base; o chunking semântico só compensa o custo adicional sobretudo em prosa não estruturada.
Extração e enriquecimento de metadata
- Precision/recall/F1 de NER: por tipo de entidade, num subconjunto etiquetado. Estilo padrão CoNLL/MUC. Calcule com o
seqeval(from seqeval.metrics import f1_score) para a versão que reconhece etiquetas BIO/IOB, ou com o scikit-learn para comparações de conjuntos de spans. O CoNLL-2003 e o OntoNotes 5.0 são os corpora de referência canónicos. - F1 da extração de relações: ainda mais importante em sistemas assentes em ontologias. Etiquete à mão um conjunto estratificado por tipo de relação e classe de documento. O TACRED e o DocRED são benchmarks públicos; as implementações candidatas incluem o
opennree os pipelines de relações dospaCy. - Precisão da extração de título e cabeçalhos: correspondência exata mais semelhança de Levenshtein normalizada () face à verdade de referência;
python-Levenshteinourapidfuzzdão as duas numa só chamada. - Preservação da metadata hierárquica: percentagem de chunks que mantêm corretamente a secção-mãe, o documento-mãe e o caminho de ascendentes. É a métrica que decide se o seu RAG consegue responder a perguntas do tipo “o que diz o filho da política X?”.
Geração de embeddings
- Benchmarks de seleção de modelos: use os resultados de retrieval do MTEB, o BEIR para generalização zero-shot e o MIRACL para retrieval multilingue como pontos de comparação. O retrieval no MTEB reporta normalmente o nDCG@10; outras famílias de tarefas usam outras métricas. O pacote Python do MTEB executa os benchmarks localmente. Trate a transferência do MTEB em inglês para um idioma com menos recursos como uma hipótese a testar no conjunto etiquetado desse idioma.
- Avaliação específica do domínio: não trate a posição num benchmark geral como resultado de domínio. Comece com algumas centenas de queries etiquetadas (200–500) que cubram os seus principais tipos de query; a Parte 9 mostra como verificar se chega. Depois reordene os modelos candidatos nesse conjunto com o
ranxou opytrec_eval. Um conjunto de domínio pode inverter a ordem de um leaderboard, por isso publique a fatia do dataset, o protocolo de retrieval e o intervalo de confiança com o resultado. - Deteção de drift de embeddings: compare duas coleções de embeddings: uma amostra de referência fixa e uma amostra atual móvel. A discrepância máxima da média (MMD) testa se as distribuições diferem. Outra opção é um classificador validado, treinado para distinguir amostras de referência de amostras atuais. A divergência de Kullback–Leibler (KL) compara distribuições de probabilidade, pelo que precisa de um estimador explícito, como histogramas escolhidos; as coordenadas brutas dos embeddings não são probabilidades. Meça também a estabilidade dos vizinhos mais próximos num conjunto fixo de sondas. O
evidentlye oalibi-detectimplementam detetores baseados em modelos e estatísticos. O estudo comparativo da Evidently é uma avaliação de um fornecedor; compare os métodos em desvios conhecidos nos seus próprios embeddings. - Multi-vetor vs. vetor único: a interação tardia preserva representações ao nível do token em vez de comprimir cada documento num só vetor; o ColBERT é o desenho canónico, com implementações de referência no RAGatouille e no PyLate. Essa representação mais rica aumenta o custo do índice e do retrieval. Compare a qualidade, o armazenamento e a latência com uma base de vetor único no mesmo conjunto de domínio antes de a adotar.
Construção do índice
- Recall@k sob aproximação: compare o índice de vizinhos mais próximos aproximado (ANN) com uma base exata de força bruta ao mesmo k; no FAISS, é
IndexHNSWFlat(ouIndexIVFFlat) vs.IndexFlatIP/IndexFlatL2. Como primeira verificação, exija um Recall@10 de pelo menos 0,95 face à pesquisa exata e depois aperte ou relaxe esse valor consoante a qualidade das respostas a jusante. O projetoann-benchmarksacompanha curvas de Pareto de recall e QPS entre bibliotecas. - Ajuste do HNSW: o HNSW (Hierarchical Navigable Small World) é um grafo de proximidade em camadas; veja Malkov & Yashunin, 2018. Está implementado no
hnswlib, noIndexHNSWFlatdo FAISS e na maioria das bases de dados vetoriais. O HNSW expõe três parâmetros:M(ramificação do grafo),efConstruction(largura de candidatos na construção) eefSearch(largura de candidatos na query). Valores iniciais:Mentre 16 e 32 eefConstructionentre 100 e 200; depois aumente oefSearchaté o Recall@10 face à pesquisa exata deixar de melhorar. O guia de parâmetros do hnswlib diz que umMentre 12 e 48 serve para a maioria dos usos e dá uma verificação para oefConstruction: comefigual aefConstruction, um recall abaixo de 0,9 para osMvizinhos mais próximos significa que o grafo ainda pode melhorar. - Ajuste do IVF: IVF (Inverted File index: divide os vetores com k-means em
nlistcélulas e, na query, percorre asnprobecélulas mais próximas; vejaIndexIVFFlateIndexIVFPQdo FAISS). As orientações de índices do FAISS sugerem 4√N a 16√N células para N vetores comonlistinicial. Varienlistenprobeface ao recall e à latência da pesquisa exata. Faça benchmark das queries filtradas em separado, porque as famílias de índices e as bases de dados vetoriais implementam a travessia com filtros de maneiras diferentes. - Atraso de atualização: tempo desde o commit do documento até ele poder ser recuperado. Acompanhe p50 e p99. Em sistemas com requisitos regulamentares, acompanhe também a percentagem de queries servidas com índices desatualizados.
Parte 4: Avaliação em tempo de query
A faixa de tempo de query contém as métricas que diagnosticam um caminho de retrieval. O Recall@k sozinho não consegue mostrar se foi a reescrita, a filtragem, o reranking ou a montagem do contexto que causou a falha.
Compreensão e reescrita da query
- Qualidade da expansão da query: ganho de Recall@k no seu golden set, query expandida vs. query original. Defina de antemão o ganho mínimo útil e a sua incerteza antes de testar. Se a expansão não cumprir esse requisito, não justifica a sua latência e o seu custo. As bases clássicas de PRF (pseudo-relevance feedback), como o RM3 e o Bo1, continuam a ser boas verificações básicas; a expansão com LLM tem de as superar.
- Avaliação do HyDE: o HyDE (Gao et al., 2022) gera uma resposta hipotética com o LLM, calcula o seu embedding e faz o retrieval com ele. Acrescenta uma chamada de geração, e essa chamada pode inventar conteúdo que desvia o retrieval do tema. Meça o Recall@10 em separado nas fatias dentro do domínio, fora do domínio e de baixa confiança, e depois decida se pertence ao caminho por omissão, a um fallback ou a nenhum dos dois.
- Geração de várias queries: Recall@k da união de N reescritas vs. query única. Varie N e escolha um ponto na sua fronteira de recall e latência. Implementações: o
MultiQueryRetrieverdo LangChain, oQueryFusionRetrieverdo LlamaIndex. - Precisão da classificação de intenção: precision/recall/F1 padrão por intenção (calcule com
sklearn.metrics.classification_report), mas a métrica que decide é a correção do encaminhamento: o pipeline certo a jusante é invocado? - Encaminhamento adaptativo: o Adaptive-RAG (Jeong et al., NAACL 2024) defende que nem todas as queries merecem a mesma estratégia de retrieval. Acompanhe a exatidão do encaminhador como um problema de classificação face a um conjunto etiquetado de “não precisa de retrieval / numa só passagem / iterativo”.
A pesquisa iterativa precisa de um teste end-to-end com orçamento
Um agente pode pesquisar, inspecionar um resultado e pesquisar de novo, em vez de recuperar uma lista fixa de top-k. O domínio banking_knowledge do tau2-bench muda o retrieval com a flag --retrieval-config: sem base de conhecimento, a base de conhecimento completa no contexto, pesquisa BM25 ou por embeddings, uma ferramenta de shell em sandbox, ou BM25, pesquisa densa e shell em conjunto. Para uma comparação local, dê ao retrieval numa só passagem e ao retrieval iterativo o mesmo corpus elegível e limites explícitos de tempo, tokens do modelo e tool calls. Registe cada query e a evidência vista em cada turno; pontue a cobertura final de evidência, a correção da resposta, o suporte das citações e as falhas por orçamento esgotado. Mais chamadas de pesquisa só são úteis quando a evidência adicional melhora a resposta dentro desses limites.
O retrieval/iterative.py do repositório de apoio executa reformulações de query fornecidas com orçamentos explícitos de chamadas, tempo e tokens. Para agentes que escolhem as suas próprias pesquisas, Avaliação de agentes de AI: de traces a suites de testes explica como pontuar a trajetória e também a resposta.
Métricas de retrieval
Estas são as métricas de base. Se não as acompanhar, não consegue saber se o retrieval está a melhorar.
| Métrica | O que mede | Quando usar |
|---|---|---|
| Recall@k | fração dos documentos relevantes de uma query devolvidos no top k | use quando falhar qualquer parte do conjunto relevante importa |
| Precision@k | percentagem do top-k que é relevante | útil quando a janela de contexto é o gargalo |
| MRR | média de 1/posição do primeiro documento relevante | quando os utilizadores só olham para o top-1 ou o top-3 |
| nDCG@k | ganho com desconto por posição, ponderado por graus de relevância | métrica de retrieval padrão para relevância graduada |
| MAP | média sobre as queries da precisão média | quando interessa a lista ordenada inteira |
| Hit Rate@k | se pelo menos um documento relevante aparece no top k | faça a média do resultado binário entre queries para uma métrica rápida de verificação |
| Coverage | percentagem de documentos gold alguma vez recuperados em todas as queries | deteta falhas sistemáticas no índice |
As fórmulas, para referência (relevância binária com conjunto relevante para a query , e se o -ésimo documento recuperado pertencer a ):
Para relevância graduada, ; o nDCG binário é o caso especial usado no código abaixo. O MAP é a média sobre as queries de . Veja Manning, Raghavan, Schütze, Introduction to Information Retrieval, capítulo 8, para as derivações.
Para código de produção, use o ranx, o pytrec_eval ou o ir_measures: implementam toda a família de métricas do TREC e tratam corretamente a relevância graduada. Como limiares iniciais de lançamento, o repositório de apoio traz Recall@10 ≥ 0,85 e MRR ≥ 0,6 (em .env.example, aplicados com --quality-gates). Depois ajuste-os no seu golden set face à qualidade das respostas a jusante e ao custo de uma falha.
Aqui, k conta IDs de documento únicos. Rejeite duplicados em vez de dar ganho extra a um documento repetido. Em experiências de chunking, declare se k conta chunks ou documentos-mãe deduplicados, e compare também a evidência fornecida dentro de um orçamento fixo de tokens. O mesmo recall de documentos pode esconder qualidades de contexto muito diferentes.
O harness de teste para estas métricas é curto. Pode executá-lo num notebook antes de ter escolhido uma base de dados vetorial.
from math import log2
from statistics import mean

# synthetic gold set: query_id -> set of relevant doc ids
gold = {
    "q1": {"d3"},
    "q2": {"d7", "d2"},
    "q3": {"d11"},
    "q4": {"d5"},
}

# ranked retrieval results: query_id -> ranked list of doc ids (top-10)
runs = {
    "q1": ["d8", "d3", "d1", "d4", "d2", "d9", "d6", "d10", "d12", "d13"],
    "q2": ["d2", "d6", "d4", "d7", "d1", "d3", "d8", "d11", "d5", "d9"],
    "q3": ["d11", "d2", "d3", "d4", "d1", "d6", "d7", "d8", "d10", "d12"],
    "q4": ["d1", "d2", "d3", "d6", "d8", "d9", "d10", "d12", "d13", "d14"],
}

def recall_at_k(ranked, gold_set, k):
    if k <= 0 or len(ranked) != len(set(ranked)):
        raise ValueError("require positive k and unique document IDs")
    if not gold_set:
        return 0.0
    hit = sum(1 for d in ranked[:k] if d in gold_set)
    return hit / len(gold_set)

def reciprocal_rank(ranked, gold_set):
    if len(ranked) != len(set(ranked)):
        raise ValueError("require unique document IDs")
    # MRR contribution per query: 1/rank of the first relevant doc.
    for rank, d in enumerate(ranked, start=1):
        if d in gold_set:
            return 1.0 / rank
    return 0.0

def ndcg_at_k(ranked, gold_set, k):
    if k <= 0 or len(ranked) != len(set(ranked)):
        raise ValueError("require positive k and unique document IDs")
    # binary relevance: rel ∈ {0, 1}
    gains = [1.0 if d in gold_set else 0.0 for d in ranked[:k]]
    dcg = sum(g / log2(i + 2) for i, g in enumerate(gains))
    # ideal DCG: all gold docs ranked first, capped by k
    n_gold_in_topk = min(k, len(gold_set))
    idcg = sum(1.0 / log2(i + 2) for i in range(n_gold_in_topk))
    return dcg / idcg if idcg else 0.0

K = 5
print(f"Recall@{K}: {mean(recall_at_k(runs.get(q, []), gold[q], K) for q in gold):.3f}")
print(f"MRR:       {mean(reciprocal_rank(runs.get(q, []), gold[q]) for q in gold):.3f}")
print(f"nDCG@{K}:  {mean(ndcg_at_k(runs.get(q, []), gold[q], K) for q in gold):.3f}")
# Recall@5: 0.750
# MRR:       0.625
# nDCG@5:    0.627
# Duplicate and missing runs are tested in the companion's tests/test_audit_contracts.py.
O agregado percorre todas as queries esperadas e trata uma execução em falta como vazia. Este exemplo atribui zero às queries sem gold; numa suite real, marque-as como uma fatia separada de capacidade de resposta, com o seu próprio denominador, em vez de tratar o zero como recall medido. Reporte também os timeouts e as execuções em falta, e não só as pontuações.
Execute um subconjunto rápido em cada PR e o golden set completo antes do lançamento (a Parte 9 dá tamanhos iniciais). Bloqueie um merge quando uma métrica escolhida de antemão ultrapassar o seu orçamento de regressão.
O repositório complementar fixa os valores acima (Recall@5 = 0.750, MRR = 0.625, nDCG@5 = 0.627) num teste unitário em tests/test_retrieval_metrics.py. Notebook 01 executa este exemplo com k=5 e depois apresenta Recall@10, MRR e nDCG@10 num subconjunto de SciFact; não varia k. O harness com estrutura de produção está em evaluation/retrieval.py.
Retrieval híbrido e reciprocal rank fusion
O BM25 é uma função de pontuação lexical esparsa que combina correspondência exata de termos, ponderação de termos e normalização do comprimento. Está disponível em rank_bm25, Elasticsearch, OpenSearch e na maioria dos motores de pesquisa.
O Reciprocal Rank Fusion (Cormack, Clarke e Buettcher, SIGIR 2009) combina os rankings do BM25 e do retrieval denso pela posição. O valor original k=60 é uma boa base. O RRF é indiferente à escala das pontuações, o que evita a normalização entre faixas exigida pela interpolação linear. Com um conjunto etiquetado grande o suficiente para estimar uma diferença estável, teste também uma combinação convexa e ajuste o α.
A minha hipótese é que o retrieval híbrido mais um reranker cross-encoder pode ajudar em corpora técnicos, de logs e de código. O ganho pode ser pequeno em corpora fortemente semânticos. Meça face às faixas só densa e só esparsa, porque uma má configuração de fusão pode ficar abaixo de qualquer uma das entradas. O notebook do SciFact do repositório de apoio é um teste limitado, não um resultado geral.
O gráfico usa as duas listas ordenadas do código abaixo. Cada faixa soma 1/(60 + posição) por cada documento que devolve, pelo que os quatro documentos presentes nas duas listas lideram. O d7 fica em segundo na lista densa mas não está na lista BM25, por isso cai para quinto.
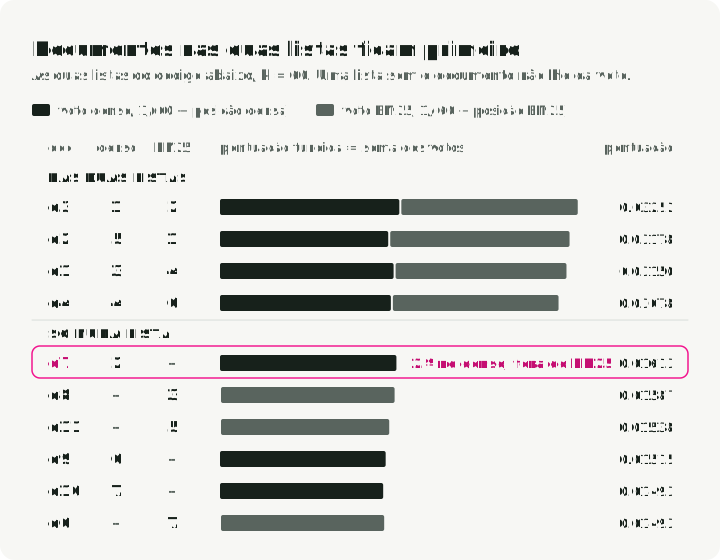
A implementação cabe em poucas linhas.
from collections import defaultdict

# two retrieval lanes: dense embeddings and BM25.
dense  = ["d3", "d7", "d1", "d4", "d2", "d9", "d10"]
sparse = ["d2", "d3", "d8", "d1", "d11", "d4", "d6"]

def rrf(rankings: list[list[str]], k: int = 60) -> list[tuple[str, float]]:
    """Reciprocal Rank Fusion (Cormack et al., SIGIR 2009).

    score(d) = sum over rankings of 1 / (k + rank(d))
    Score-agnostic: only rank position matters. k=60 is the canonical default.
    """
    scores: dict[str, float] = defaultdict(float)
    if k <= 0:
        raise ValueError("k must be positive")
    for ranking in rankings:
        if len(ranking) != len(set(ranking)):
            raise ValueError("each ranking must contain unique document IDs")
        for rank, doc in enumerate(ranking, start=1):
            scores[doc] += 1.0 / (k + rank)
    return sorted(scores.items(), key=lambda kv: kv[1], reverse=True)

fused = rrf([dense, sparse], k=60)
for doc, score in fused[:5]:
    print(f"{doc}  score={score:.5f}")
# d3  score=0.03252   <- rank 1 dense, rank 2 sparse
# d2  score=0.03178   <- rank 5 dense, rank 1 sparse
# d1  score=0.03150
assert [doc for doc, _ in fused[:3]] == ["d3", "d2", "d1"]
Repare no que o RRF não faz: nunca olha para as pontuações de semelhança em bruto. Se um retriever põe um documento na posição 2, esse voto vale 1 / (60 + 2), seja qual for a pontuação em bruto que o produziu. Um retriever denso que devolve um cosseno de 0,98 e uma faixa BM25 que devolve uma pontuação de 17,4 não são diretamente comparáveis. A normalização por z-score e a normalização min-max eliminam diferenças de escala afins, mas nenhuma calibra uma pontuação como relevância. Valores atípicos, a forma da distribuição e o conjunto de candidatos continuam a afetar os valores normalizados e, portanto, o resultado da fusão. Valide qualquer combinação baseada em pontuações com queries etiquetadas.
Recuperação híbrida + RRF em SciFact: notebook 02 compara recuperação densa, BM25 e RRF com Recall@10, MRR e nDCG@10 agregados. O módulo de fusão com estrutura de produção está em retrieval/hybrid_rrf.py; tests/test_rrf.py fixa a ordem canónica d3 / d2 / d1 com k=60.
Reranking
- ΔnDCG / ΔMRR: ganho face à ausência de reranking, no seu golden set, à profundidade que a sua aplicação realmente usa. Calcule executando as suas métricas de retrieval com e sem o reranker sobre conjuntos de candidatos idênticos.
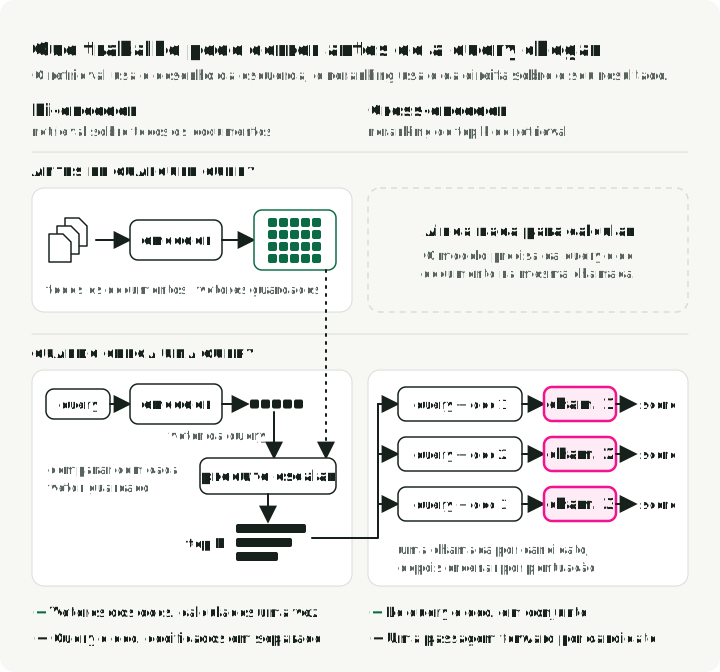
- Cross-encoder vs. bi-encoder: um bi-encoder gera o embedding da query e do documento de forma independente (um vetor de cada lado) e pontua pelo produto escalar; um cross-encoder concatena query e documento e executa uma única passagem que atende a ambos em conjunto. Os cross-encoders trocam uma passagem por candidato por uma interação query–documento mais rica; a figura abaixo mostra a diferença. Implementação de referência:
CrossEncoderdosentence-transformers. Faça benchmark da relevância e da latência com hardware, tamanho de batch e profundidade de candidatos indicados; não transfira o resultado de um modelo ou serviço gerido para outro ambiente. - Listwise vs. pointwise: o pointwise pontua cada par (query, documento) de forma independente; o listwise pontua a lista de candidatos inteira em conjunto, para que o modelo possa comparar candidatos. Avalie ambos nos mesmos conjuntos de candidatos. Calibre qualquer limiar de pontuação por modelo e por corpus, em vez de tratar um exemplo publicado como portável.
Na figura, compare as duas faixas de tempo. O bi-encoder codifica todos os documentos antes de qualquer query e guarda os vetores; quando chega uma query, codifica apenas a query. O cross-encoder não tem nada para calcular antes da query. Lê a query e o documento numa só chamada ao modelo, por isso corre uma vez por candidato e só sobre a lista curta que o retrieval devolve.
O código abaixo pontua três candidatos para uma query com um cross-encoder BGE:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("BAAI/bge-reranker-v2-m3")  # Reproducible baseline, not a latest-model ranking

query = "How do I rotate database credentials in production?"
candidates = [
    "Production database credentials are rotated via Vault every 30 days.",
    "The new logo was unveiled at the all-hands meeting.",
    "To rotate prod DB creds, run the `rotate-secrets` GitHub Action.",
]

scores = reranker.predict([(query, c) for c in candidates])
ranked = sorted(zip(candidates, scores), key=lambda x: -x[1])
for doc, score in ranked:
    print(f"{score:+.3f}  {doc}")
O código BGE acima é uma pequena base de comparação. Para uma comparação atual, inclua o Cohere Rerank 4.0 fast/pro para ranking de texto multilingue gerido, ou o Qwen3-VL-Reranker 2B/8B quando as queries ou os documentos incluem imagens, capturas de ecrã ou vídeo. Mantenha explícitos as modalidades da tarefa, a profundidade de candidatos, os limites de entrada, as instruções e o hardware.
Um reranker costuma ajudar um pipeline RAG básico, mas não é um ganho garantido. Meça o seu ΔPrecision@1 e ΔnDCG no seu golden set e mantenha-o apenas se o ganho compensar o orçamento de latência e custo. Compare esse ganho medido com alterações mais pequenas no retrieval antes de escolher a próxima otimização. BM25 vs embeddings vs rerankers dá um guia mais curto para escolher cada camada da stack de ranking.
Notebook 03 apresenta P@10 antes e depois do reranking por cross-encoder em SciFact, além de ΔnDCG@10; módulo: retrieval/reranker.py. O módulo evaluation/reranking.py compara rerankers em conjuntos de candidatos idênticos.
Construção do contexto e lost-in-the-middle
Muitas falhas do tipo “bom retrieval, má resposta” começam na construção do contexto.
- Relevância do contexto: o
ContextRelevancedo Ragas avalia a lista de contexto fornecida com dois prompts e classificações normalizadas; não é uma pontuação por chunk. Para diagnóstico por chunk, pontue cada par query–chunk explicitamente, por exemplo com um cross-encoder, e reporte a distribuição com um limiar calibrado localmente. - Cobertura de citações do contexto fornecido: chunks fornecidos distintos que foram citados, a dividir pelos chunks fornecidos distintos. Reporte em separado os casos de contexto vazio. Este indicador observável diz que chunks receberam citações, não quais o modelo usou internamente nem se as citações sustentam as suas afirmações. Verifique o suporte das citações em separado e compare a cobertura com a qualidade da resposta e o custo em tokens.
- Deteção de lost-in-the-middle: avaliação sintética em que coloca o chunk gold nas posições {primeira, meio, última} de um contexto longo e mede a correção da resposta. O estudo de Liu et al. (TACL 2024) citado reporta degradação em forma de U nas suas condições de contexto longo. Trate o mesmo padrão num modelo atual como uma hipótese a testar. Mitigações: fazer reranking e depois reordenar o top-k de modo que o chunk com a pontuação mais alta fique em primeiro ou em último (o
LongContextReorderdo LangChain faz exatamente isto), ou comprimir agressivamente os chunks do meio. Meça com uma avaliação estratificada por posição, não só com uma pontuação agregada. Uma avaliação estratificada por posição, completa e executável, está no notebook 06 (módulo:evaluation/lost_in_middle.py). - Compressão de contexto: reporte a taxa de compressão (tokens de entrada / tokens de saída) juntamente com a correção da resposta. As ferramentas incluem o
ContextualCompressionRetrieverdo LangChain e o LongLLMLingua. Defina de antemão a maior perda aceitável de correção, a partir do risco da aplicação e do orçamento de tokens, e rejeite as configurações que a ultrapassem.
Parte 5: A taxa de falsa exclusão pelo filtro
Esta métrica tem uma secção própria porque as pontuações agregadas de retrieval não conseguem atribuir uma falha a um filtro de relevância. Avalie os filtros de elegibilidade em separado, face aos direitos de acesso de quem faz a query; um documento fora desse conjunto tem de continuar excluído.
Um predicado de relevância rígido como product = Y AND locale = en-US pode reduzir a zero o recall efetivo entre os documentos que o utilizador pode ver. Um Recall@k corretamente implementado apanha a perda porque o seu denominador continua a ser o conjunto original de documentos relevantes elegíveis. Mas não diz se foi o filtro, o retriever ou o ranker que causou a falha. A faithfulness avalia afirmações face ao contexto recuperado. Pode ainda pontuar afirmações sustentadas por esse contexto incompleto, mas não consegue diagnosticar a causa no filtro ou no retrieval. Uma recusa vazia pode não produzir afirmações e dar NaN, consoante a implementação; não a trate como evidência de que a faithfulness aprovou a recusa.
O diagrama percorre o exemplo resolvido abaixo. A verificação de direitos de acesso remove o d3, que pertence a outro tenant; essa exclusão está correta. O filtro de relevância remove depois o documento de referência de q1 e q3. O Recall@10 desce para 50% e regista a queda; só a taxa de falsa exclusão, também 50%, a atribui ao predicado. Um avaliador que reconstrói o conjunto de referência depois da filtragem indica 100%.
A métrica
filter_false_exclusion_rate =
    (# queries where all gold docs were excluded by metadata filter) /
    (# queries with at least one entitlement-eligible gold doc)
Esta definição ao nível da query conta exclusões catastróficas: nenhum documento relevante elegível sobrevive. Faça a interseção do conjunto gold de cada query com o conjunto de direitos de acesso de quem a faz antes de pontuar; um documento não elegível não é uma falsa exclusão. Em queries com vários documentos gold, o Recall@k padrão continua a expor a perda parcial; acrescente uma taxa de exclusão por documento se esse limite importar. Para calcular qualquer das taxas, precisa de (a) IDs de documentos de verdade de referência para cada query de avaliação e (b) instrumentação que registe os predicados de filtro aplicados, não apenas os resultados finais. Como limiar inicial, o repositório de apoio usa uma taxa de falsa exclusão de no máximo 2%; ajuste-a ao custo de excluir uma resposta válida e ao intervalo de confiança da sua amostra de produção.
Segue-se uma implementação funcional. Compara o recall padrão correto com um avaliador inválido que redefine a relevância depois da filtragem.
# A small worked example where relevance predicates remove eligible documents.
docs = [
    {"id": "d1", "tenant": "acme",   "locale": "en-US"},
    {"id": "d2", "tenant": "acme",   "locale": "en-GB"},
    {"id": "d3", "tenant": "globex", "locale": "en-US"},
    {"id": "d4", "tenant": "acme",   "locale": "en-US"},
    {"id": "d5", "tenant": "acme",   "locale": "de-DE"},
    {"id": "d6", "tenant": "acme",   "locale": "fr-FR"},
]

# Tenant isolation is an eligibility invariant, not a relevance experiment.
# Verify it independently before evaluating relevance preferences.
eligible_docs = [d for d in docs if d["tenant"] == "acme"]
assert {d["id"] for d in eligible_docs} == {"d1", "d2", "d4", "d5", "d6"}

queries = [
    # the gold doc lives in en-GB but the dynamic filter forced en-US
    {"qid": "q1", "gold": {"d2"}, "filter": lambda d: d["locale"] == "en-US"},
    # the gold doc is correctly within the tenant filter
    {"qid": "q2", "gold": {"d4"}, "filter": lambda d: d["tenant"] == "acme"},
    # the gold doc lives in fr-FR but the dynamic filter forced en-US
    {"qid": "q3", "gold": {"d6"}, "filter": lambda d: d["locale"] == "en-US"},
    # the gold doc passes the filter (de-DE locale match)
    {"qid": "q4", "gold": {"d5"}, "filter": lambda d: d["locale"] == "de-DE"},
]

def filter_false_exclusion_rate(queries, eligible_docs):
    n_with_gold, n_excluded = 0, 0
    eligible_ids = {d["id"] for d in eligible_docs}
    for q in queries:
        eligible_gold = q["gold"] & eligible_ids
        if not eligible_gold:
            continue
        n_with_gold += 1
        survivors = {d["id"] for d in eligible_docs if q["filter"](d)}
        if not (eligible_gold & survivors):
            n_excluded += 1
    if not n_with_gold:
        raise ValueError("false-exclusion rate needs queries with eligible gold")
    return n_excluded / n_with_gold, n_with_gold

rate, eligible_query_count = filter_false_exclusion_rate(queries, eligible_docs)
print(f"filter_false_exclusion_rate = {rate:.2%}")
# filter_false_exclusion_rate = 50.00%
print(f"eligible queries = {eligible_query_count} / {len(queries)}")
# eligible queries = 4 / 4

# Correct Recall@k keeps the original eligible gold set as its denominator.
def standard_recall_at_k(queries, eligible_docs, k=10):
    recalls = []
    eligible_ids = {d["id"] for d in eligible_docs}
    for q in queries:
        eligible_gold = q["gold"] & eligible_ids
        if not eligible_gold:
            continue
        # demo only: the survivor set stands in for a ranked run.
        # A real harness ranks the survivors first, then slices to k.
        survivors = [d for d in eligible_docs if q["filter"](d)][:k]
        survivor_ids = {d["id"] for d in survivors}
        recalls.append(len(eligible_gold & survivor_ids) / len(eligible_gold))
    return sum(recalls) / len(recalls) if recalls else 0.0

print(f"standard recall@10 = {standard_recall_at_k(queries, eligible_docs):.2%}")
# standard recall@10 = 50.00%

# INVALID: rebuilding the gold set after filtering changes the question.
# It drops queries whose relevant documents did not survive, then scores 100%.
def invalid_recall_over_filtered_gold(queries, eligible_docs, k=10):
    recalls = []
    all_doc_ids = {d["id"] for d in eligible_docs}
    for q in queries:
        all_survivors = {d["id"] for d in eligible_docs if q["filter"](d)}
        filtered_gold = q["gold"] & all_doc_ids & all_survivors
        if not filtered_gold:
            continue
        top_k_ids = set(list(all_survivors)[:k])
        recalls.append(len(filtered_gold & top_k_ids) / len(filtered_gold))
    return sum(recalls) / len(recalls) if recalls else 0.0

invalid = invalid_recall_over_filtered_gold(queries, eligible_docs)
print(f"INVALID recall (filtered gold) = {invalid:.2%}")
# INVALID recall (filtered gold) = 100.00%

assert rate == 0.5
assert standard_recall_at_k(queries, eligible_docs) == 0.5
assert invalid == 1.0
# Unauthorized gold and an empty denominator are tested in the companion's
# tests/test_audit_contracts.py.
A função devolve a taxa e o número de queries com gold elegível. Se esse denominador for zero, lança uma exceção em vez de reportar um zero tranquilizador; uma verificação de lançamento obrigatória tem de tratar isso como evidência em falta. As queries com apenas gold não autorizado ficam em testes de direitos de acesso separados.
Metade das queries perde o documento gold para o filtro, pelo que o Recall@10 correto cai para 50%. Essa pontuação apanha o sintoma, mas não o atribui. A taxa de falsa exclusão mostra que o predicado removeu duas respostas antes de o retriever correr. O avaliador deliberadamente inválido reporta 100% apenas porque descarta essas falhas do seu conjunto gold. Nenhum modelo consegue recuperar um documento que foi filtrado.
tests/test_filter_exclusion.py::test_50_percent_exclusion_rate do repositório complementar e o primeiro exemplo de notebook 04 usam dados de teste antigos com cinco documentos que também dão 50 %, mas a sua q3 é excluída pelo isolamento entre tenants. Esses dados não reproduzem o exemplo acima com documentos de referência autorizados. O notebook 04 também executa diagnósticos de filtragem em SciFact com metadados sintéticos. O evaluation/filter_exclusion.py atual aceita um predicado de autorização separado e um conjunto fixo de documentos de referência autorizados, e inclui precisão e recall do predicado.
Métrica complementar: precision e recall dos predicados
Quando a filtragem é dinâmica (por exemplo, um LLM extrai os predicados de filtro da query), trate o extrator de predicados como um modelo de classificação e avalie-o como tal. Meça a precision e o recall dos predicados face a um conjunto etiquetado de pares (query, correct predicate). Uma taxa de erro de predicados não se traduz diretamente na mesma perda de pontos no recall do retrieval; meça com que frequência esses erros excluem um documento gold. Quando um filtro rígido remove o documento gold, nenhum reranking ajuda.
Filtros de elegibilidade vs. preferências de relevância
A autorização, o isolamento de tenants, a jurisdição legal e o estado de publicação determinam se um documento pode entrar no conjunto de candidatos. Mantenha-os como filtros rígidos e valide-os de forma independente; o Recall@k, a taxa de falsa exclusão e a precision de relevância não autorizam o seu relaxamento.
Para uma preferência de relevância como o idioma, a atualidade ou a versão, compare um predicado rígido com um reforço suave nas mesmas queries elegíveis de validação. Duas regras decidem o resultado:
- As regras de acesso (autorização, tenant, jurisdição, estado de publicação) são sempre filtros rígidos.
- Qualquer outra preferência é um reforço suave, a não ser que o teste medido abaixo seja passado. Nesse caso, pode passar a predicado rígido.
O pseudocódigo dá o teste da regra 2:
For each relevance preference F:
  hard_recall_F  = retrieval_recall@k with F as a hard filter
  soft_recall_F  = retrieval_recall@k with F as a +0.X rerank boost
  hard_precision = relevant_in_top_k / k under hard filter
  soft_precision = relevant_in_top_k / k under soft boost
  precision_gain = hard_precision - soft_precision
  precision_gain_CI = paired-query uncertainty interval for precision_gain
  exclusion_rate = % of queries where the gold doc was filtered out (hard)

Pre-register Δ_min, ε, and recall_loss_max for this workflow.
Use a hard predicate only if:
  lower_bound(precision_gain_CI) >= Δ_min
  AND exclusion_rate <= ε
  AND hard_recall - soft_recall >= -recall_loss_max.
Otherwise prefer a soft boost.
Escolha o ganho mínimo útil de precision, o intervalo de incerteza, o ε e o limite de perda de recall a partir do dano de excluir uma resposta que seria elegível, do benefício da precision adicional e da dimensão da amostra de validação. Comece com um ε de 1–2% e baixe-o onde uma resposta falhada for cara.
Parte 6: Avaliação da geração
As métricas de retrieval dizem que o sistema podia responder corretamente. Não dizem que respondeu. As métricas de geração cobrem essa lacuna.
Faithfulness e groundedness
A faithfulness do RAGAS decompõe a resposta em afirmações atómicas (declarações factuais curtas e autónomas) e depois verifica cada uma face ao contexto recuperado através de um LLM como juiz:
A faithfulness verifica o suporte na evidência fornecida; não estabelece que a evidência esteja correta nem que chegue para responder à pergunta. Registe em separado as respostas sem afirmações e reporte o seu número, em vez de atribuir faithfulness perfeita a uma resposta vazia.
A documentação atual do Ragas recomenda a API de collections abaixo. Num projeto uv, instale ragas e openai com uv add ragas openai, defina OPENAI_API_KEY e guarde isto como um script para executar com uv run. Faz chamadas ao fornecedor e incorre nos respetivos custos; a pontuação é o resultado de um juiz, não uma constante esperada e determinística. Fixe as dependências resolvidas no seu lockfile.
import asyncio

from openai import AsyncOpenAI, omit
from ragas.llms import llm_factory
from ragas.metrics.collections import Faithfulness

async def main():
    async with AsyncOpenAI() as client:
        # Ragas 0.4.3 sends max_tokens by default; GPT-5.6 models need max_completion_tokens.
        llm = llm_factory(
            "gpt-5.6-terra", client=client, reasoning_effort="none",
            max_tokens=omit, max_completion_tokens=1024,
            temperature=omit, top_p=omit,
        )
        scorer = Faithfulness(llm=llm)
        result = await scorer.ascore(
            user_input="How many moons does Mars have?",
            response="Mars has two moons, Phobos and Deimos.",
            retrieved_contexts=["Mars has two moons named Phobos and Deimos."],
        )
        print(result.value)

if __name__ == "__main__":
    asyncio.run(main())
Este exemplo usa o GPT-5.6 Terra como juiz; a factory do Ragas reencaminha os argumentos do modelo. Compare as falsas aprovações, as falsas reprovações e o custo do juiz com etiquetas humanas antes de substituir um juiz mais barato que já tenha verificado face a etiquetas.
A tabela de frameworks na Parte 1 refere também a answer relevancy e a context precision. A mesma API de collections pontua ambas com o mesmo llm. A AnswerRelevancy recebe também um modelo de embeddings, por exemplo embedding_factory("openai", model="text-embedding-3-small", client=client) de ragas.embeddings.base. A ContextPrecision precisa de uma resposta reference em ascore. Cada pontuação responde a uma pergunta diferente: a faithfulness pergunta se o contexto sustenta a resposta, a answer relevancy pergunta se a resposta aborda a pergunta, e a context precision pergunta se o contexto relevante fica em primeiro lugar.
Para construir o seu próprio avaliador, mantenha a estrutura extrair–verificar–agregar. A extração é uma chamada a um LLM que divide a resposta em afirmações; a verificação é feita por um modelo de NLI (natural-language inference) ou por um LLM como juiz. Valide a extração e a implicação em separado e registe os julgamentos sem afirmações ou falhados. Por exemplo, uma resposta com 4 afirmações, 3 delas sustentadas, tem a pontuação 3/4 = 0.75. Uma resposta com 0 afirmações não é pontuada.
Notebook 05 executa offline um exemplo fixo sobre Marte com uma aproximação lexical; esta não verifica a implicação semântica. O seu módulo evaluation/faithfulness.py implementa também extração e verificação de afirmações com SGR. A suite generation avalia QA sintética anotada com --suite generation --live. O repositório usa apenas modelos OpenAI. gpt-5.6-luna gera e avalia por defeito; --judge-model gpt-5.6-terra muda o avaliador. Os dois modelos são do mesmo fornecedor, pelo que o repositório mostra o processo do avaliador e não uma comparação entre famílias.
Uma alternativa específica ao LLM como juiz é o HHEM-2.1-Open (Hughes Hallucination Evaluation Model, da Vectara), um classificador com fine-tuning para deteção de alucinações. A sua ficha de modelo documenta o checkpoint, a pontuação bruta de 0 a 1 que emite e os resultados de exatidão equilibrada no AggreFact e no RAGTruth. Não publica um limiar de decisão por omissão, pelo que escolher um fica consigo. Trate isto como evidência da ficha de modelo, não como garantia no seu corpus: calibre o limiar com etiquetas locais e compare-o com o juiz que escolheu antes de o pôr em produção.
Avaliação por factos atómicos
O FActScore (Min et al., EMNLP 2023) decompõe gerações longas em factos atómicos, recupera evidência para cada facto, etiqueta cada um como supported / not-supported e reporta a fração sustentada:
Implementação de referência: shmsw25/FActScore. A avaliação original centrou-se em biografias com a Wikipedia como fonte de evidência. Adaptá-la a resumos ou a outros textos longos exige verificar localmente a extração de afirmações, a cobertura de evidência e os juízos de suporte. Factos triviais repetidos podem aumentar a pontuação, e afirmações verdadeiras individualmente podem formar uma resposta enganadora. MontageLie (EMNLP 2025) testa esta fraqueza com relações e ordens enganosas entre afirmações verdadeiras. VeriScore trata afirmações com os qualificadores necessários; o filtro Core ajuda a evitar acrescentar factos para aumentar a pontuação.
Exatidão das citações
Acompanhe a precision das citações (os spans citados sustentam de facto a afirmação) e o recall das citações (as afirmações que deviam ser citadas são-no):
O TREC 2024 RAG Track define um protocolo reprodutível de avaliação de suporte. Thakur et al. (SIGIR 2025) reportam cerca de 56% de concordância com julgamentos humanos feitos de raiz e 72% numa condição diferente, em que humanos pós-editaram previsões de LLMs. Esta última é anotação assistida, não evidência independente de uma melhoria na exatidão do juiz. Mantenha a condição de anotação associada ao número. Para uma aproximação automática, o ALCE (Gao et al., EMNLP 2023) implementa precision/recall das citações com verificação baseada em NLI.
Correção, completude e recusa da resposta
- Correção da resposta face a uma referência: a correspondência exata ou o F1 por token podem servir para respostas curtas;
evaluate.load("squad")do Hugging Face calcula ambos, e o pacotebert-scorecalcula o BERTScore. Para respostas mais longas, verifique relações factuais, entidades, quantidades, negação e informação obrigatória face a referências revistas. O BERTScore e o cosseno de embeddings medem semelhança; um número errado ou uma negação podem manter uma pontuação alta. AAnswerCorrectnessdo Ragas combina comparação factual com semelhança, em vez de as equiparar. - Completude por nuggets: um nugget é uma unidade de informação relevante, distinguindo-se os nuggets vitais dos opcionais úteis. Uma pergunta sobre a data de fundação pode exigir o ano; o nome do fundador não é automaticamente obrigatório. O AutoNuggetizer constrói e refina nuggets a partir de conjuntos de documentos julgados e depois verifica a sua presença nas respostas geradas. O seu relatório inicial do TREC 2024 abrangeu 21 tópicos e 45 execuções. A visão geral do TREC 2025, publicada em março de 2026, alarga o protocolo a queries narrativas e avalia a relevância do retrieval, a completude da resposta e a atribuição. Estes são protocolos públicos de avaliação, não evidência de que todos os sistemas RAG em produção precisem da mesma rubrica de nuggets.
- Comportamento de recusa: etiquete se a evidência fornecida permite uma resposta, e depois meça as recusas corretas entre todas as recusas e as recusas entre os casos em que o sistema devia abster-se. O NoMIRACL (Findings of EMNLP 2024) testa a robustez face a passagens fornecidas relevantes e não relevantes; não prova que o corpus inteiro não tenha resposta. Separe, na sua própria suite, as falhas de retrieval das queries genuinamente fora do âmbito.
Verificação pós-geração
Os ganhos de fiabilidade mais baratos vêm muitas vezes de verificações determinísticas posteriores, não de modelos maiores.
-
Sinalizador de entidades não vistas: registe as cadeias de entidades nomeadas na resposta que estão ausentes de uma cadeia de contexto normalizada (por exemplo, as
entsdospaCymais correspondência exata). É um sinalizador barato e específico do domínio para cadeias de entidades não vistas, não uma verificação de grounding: não consegue estabelecer identidade, relação, negação, tempo nem proveniência. Meça a sua precision e o seu recall com etiquetas locais antes de o usar para aprovar um lançamento, e mantenha a implicação ao nível da afirmação ou a revisão humana para a verificação.Neste exemplo o sinalizador não encontra nenhuma entidade não vista, embora a resposta diga o contrário do contexto.
def unseen_entity_flag(answer: str, context: str, entities: list[str]) -> bool: return any(entity.lower() not in context.lower() for entity in entities) context = "Paris was not founded in 1994." answer = "Paris was founded in 1994." assert not unseen_entity_flag(answer, context, ["Paris"]) claim_supported = False # human label or an NLI verdict, not the lexical flag assert not claim_supported -
Verificação de afirmações: extraia afirmações, execute NLI face ao contexto e reprove ou sinalize as que ficarem abaixo do limiar. Modelos de NLI como faithfulness:
cross-encoder/nli-deberta-v3-large,MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli. Acrescenta latência. Vale a pena em domínios de risco elevado. -
Autoconsistência (Wang et al., ICLR 2023): amostre várias gerações com temperatura > 0; reporte a taxa de concordância (por exemplo, a proporção de gerações que coincidem com a resposta modal, ou o BERTScore par a par); escolha o número de amostras a partir da curva de estabilidade e custo e sinalize respostas com baixa concordância para revisão humana.
-
Calibração da confiança: recolha a confiança verbalizada (“Quão confiante está, de 0 a 1?”) e compare-a com a correção real no conjunto de avaliação. Trace uma curva de calibração e reporte o Expected Calibration Error: , onde são os grupos por nível de confiança. Implementações:
netcal,torchmetrics.CalibrationError. Um modelo que reporta 0,9 de confiança deve acertar em cerca de 90% dos casos comparáveis; meça a diferença em vez de assumir calibração.
Parte 7: Avaliação de RAG baseado em ontologias
As métricas padrão acima cobrem RAG sobre corpus aberto. Se o seu RAG faz retrieval sobre uma ontologia, taxonomia ou grafo de conhecimento estruturados, essas métricas são necessárias mas não suficientes. Exemplos: produtos num catálogo, condições no SNOMED, componentes numa lista de materiais e técnicas de segurança no MITRE ATT&CK. Também tem de medir a camada da ontologia.
Exatidão da ligação de entidades
A primeira tarefa é mapear uma menção na query para uma entidade da ontologia (“Aspirina” → wikidata:Q18216, “o 737” → aircraft:Boeing_737).
- Precision/recall/F1 ao nível da menção: padrão, face a spans de menções gold (calcule com
seqevalou com um comparador de conjuntos de spans). - Exatidão da desambiguação: das menções detetadas corretamente, que fração é mapeada para o ID de entidade certo? As referências públicas incluem o ReFinED, o REL e o GENRE; benchmarks como o AIDA-CoNLL e o BELB mostram que os resultados variam com o sistema e o domínio.
- Tratamento de NIL: precision/recall em “entidade não existe na ontologia”. Meça em separado a ligação excessiva a entidades próximas mas erradas e a abstenção correta.
Avaliação com consciência da hierarquia
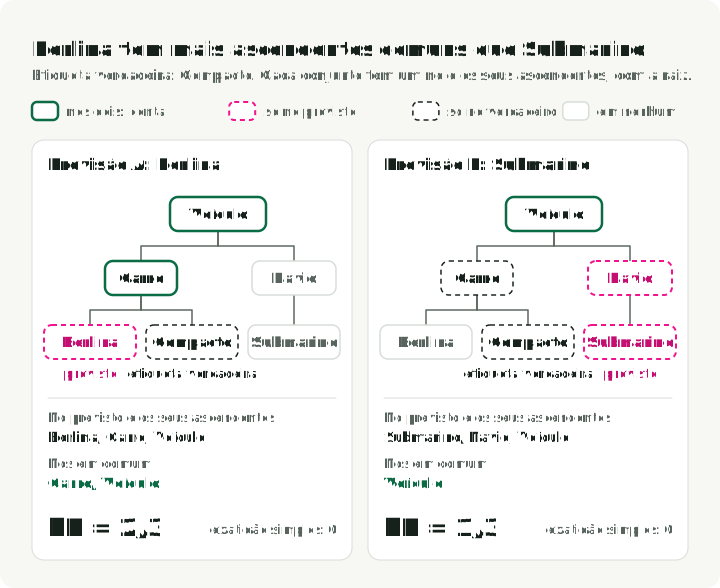
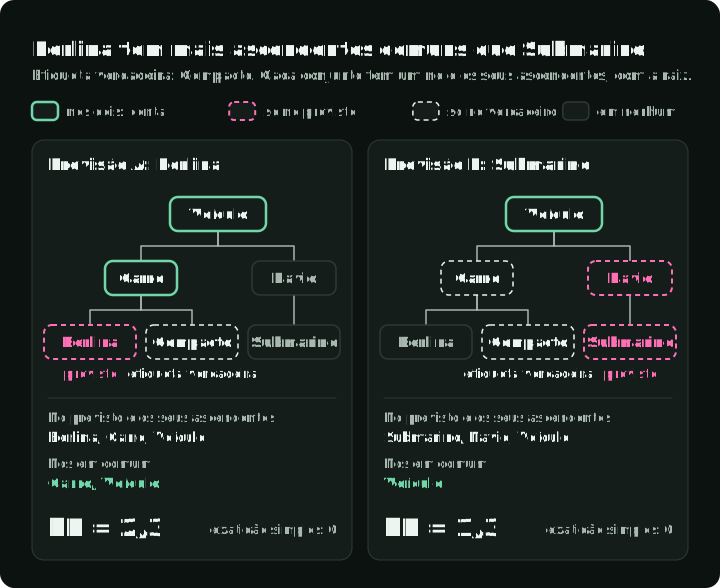
A exatidão simples trata “previu Sedan quando a verdade é Hatchback” da mesma forma que “previu Submarino quando a verdade é Hatchback”. Estes erros não são iguais. No diagrama, o Berlina partilha dois dos seus três nós com a etiqueta verdadeira, e o Submarino partilha apenas a raiz; a precision hierárquica abaixo transforma essa sobreposição numa pontuação.
-
Precision/recall/F1 hierárquicos (Kosmopoulos et al., 2015): dão crédito aos ascendentes partilhados no DAG da ontologia. Sendo o nó previsto mais todos os seus ascendentes e o nó verdadeiro mais todos os seus ascendentes:
Implemente com o
networkxsobre o grafo da ontologia: aumente cada previsão e cada etiqueta com os seus ascendentes e depois calcule as sobreposições de conjuntos acima. -
Semelhança de Wu-Palmer entre a entidade prevista e a entidade gold na taxonomia (Wu & Palmer, 1994):
onde LCA é o ascendente comum mais baixo na taxonomia. Disponível de origem no NLTK para a WordNet (
from nltk.corpus import wordnet as wn; wn.synset("car.n.01").wup_similarity(wn.synset("truck.n.01"))); para taxonomias personalizadas, calcule o LCA com onetworkx. -
Taxa de confusão entre irmãos e ascendentes: acompanhe em separado as confusões com irmãos, ascendentes diretos e descendentes:
count_sibling / total_errors,count_parent / total_errors,count_descendant / total_errors. Use exemplos revistos para testar se os erros com irmãos vêm de menções ambíguas ou se os erros com ascendentes vêm de sobregeneralização.
Taxa de falsa exclusão pelo filtro (retomada, agora crítica)
Em sistemas baseados em ontologias, os filtros rígidos vêm muitas vezes da própria ontologia (“recuperar apenas documentos etiquetados com a categoria X”). A métrica da taxa de exclusão (definida na Parte 5) passa a ser um sinal principal de correção. Uma previsão errada de categoria pode reduzir o recall a zero; a taxa de exclusão atribui essa perda ao filtro.
Conformidade da geração restringida
Quando a sua saída tem de respeitar uma ontologia (cada nome de entidade na resposta tem de ser um membro válido da ontologia; cada predicado tem de vir de um vocabulário fechado), meça:
- Taxa de validade do esquema: percentagem de saídas que são analisadas e validadas face ao esquema da ontologia. Valide com o
jsonschemaou opydantic. O JSONSchemaBench é o benchmark público para structured output geral; para esquemas específicos de uma ontologia, construa o seu próprio validador. - Conformidade com o vocabulário: percentagem de entidades nomeadas na saída que são IDs válidos da ontologia; é uma verificação de pertença a um conjunto, numa linha, face ao vocabulário fechado.
- Conformidade semântica: uma saída sintaticamente válida pode ainda escolher a entidade errada mas válida. Associe a conformidade à correção da resposta a jusante.
Os frameworks de constrained decoding (Outlines, XGrammar, Guidance, OpenAI Structured Outputs) destinam-se a impor a validade do esquema. O JSONSchemaBench compara a eficiência, a cobertura e a qualidade entre implementações. Volte a executar os seus casos que correspondam aos seus esquemas e ao seu backend de serving, porque a cobertura e a latência dependem de ambos.
Auditabilidade
Para sistemas baseados em ontologias cujas respostas são sujeitas a revisão:
- Completude das citações: percentagem de afirmações factuais com pelo menos uma citação verificável.
- Profundidade da proveniência: percentagem de citações que remontam até um documento de origem com um ID estável, e não apenas um hash de chunk.
- Taxa de reprodutibilidade: executar de novo a mesma query num snapshot fixo devolve a mesma resposta. Fixe a versão do modelo, o runtime, a configuração de decoding e a seed, e depois defina a taxa de repetição exigida a partir das necessidades de auditabilidade do fluxo de trabalho. Só a temperatura zero não garante determinismo. Uma falha pode vir da geração, do runtime de serving ou de qualquer etapa a montante.
Parte 8: Avaliação ao nível do sistema
Qualidade holística da resposta
- LLM como juiz (Zheng et al., NeurIPS 2023): uma abordagem de avaliação baseada em modelos e escalável. O G-Eval (Liu et al., EMNLP 2023) gera passos de avaliação a partir da tarefa e dos critérios e depois pondera os níveis de classificação pelas suas probabilidades de token: . São probabilidades, não log-probabilidades. A concordância depende do juiz, da tarefa, do prompt e do conjunto de calibração.
- Preferência par a par: apresente ao juiz a resposta A vs. a resposta B; registe a preferência. Isto substitui uma classificação absoluta por uma decisão comparativa, mas continua a precisar de calibração face a preferências humanas. O MT-Bench reportou uma concordância do juiz GPT-4 acima de 80% tanto com as preferências humanas como entre humanos, nas condições do seu benchmark; não transfira essa taxa para outro domínio sem calibração.
O LLM como juiz tem enviesamentos reais:
- Enviesamento de posição: meça a sensibilidade à ordem em casos etiquetados por humanos para o juiz e a tarefa selecionados. A aleatorização ou a agregação com ordem trocada podem ajudar em alguns pares modelo/tarefa, mas mantenha qualquer das duas só quando melhorar a concordância humana local; o estudo controlado de 2026 concluiu que a troca de posições foi prejudicial nos seus casos adversariais.
- Enviesamento de verbosidade: os juízes podem confundir comprimento com qualidade. O estudo controlado de 2026, versão 2 citado encontrou comportamento heterogéneo em pares de expansão: três juízes preferiram respostas mais longas, o Claude preferiu respostas concisas e o GPT-4o foi aproximadamente neutro. Os cinco tiveram bom desempenho nos controlos de truncagem. Estes resultados dependem do benchmark, por isso diga ao seu juiz como tratar a completude e o enchimento, e reporte depois o desempenho com controlo de comprimento na sua própria rubrica.
- Risco de autopreferência: Zheng et al. observaram uma taxa de vitórias próprias 10% mais alta no GPT-4 e 25% mais alta no Claude-v1 nos seus dados, mas concluíram que os dados limitados e as diferenças pequenas não permitiam estabelecer um enviesamento de autovalorização. Compare juízes da mesma família e de famílias diferentes com etiquetas humanas locais; escolha o juiz mais bem calibrado em vez de assumir que qualquer das disposições é segura.
Receita prática: selecione um juiz com dados de calibração etiquetados por humanos, oculte as identidades dos modelos, meça a sensibilidade à ordem e declare a política de comprimento na rubrica. Repita os casos apenas quando as amostras adicionais reduzirem de forma material a incerteza. Em avaliações de risco elevado, compare juízes da mesma família e de famílias diferentes e analise as discordâncias face a etiquetas humanas.
Schema-Guided Reasoning para juízes
A saída livre é uma fonte de variação nas execuções do juiz. Duas execuções sobre a mesma resposta podem organizar a rubrica de maneira diferente e produzir pontuações diferentes. O Schema-Guided Reasoning (SGR) torna essa rubrica explícita: defina as etapas de avaliação como um esquema Pydantic e use depois saída restringida através do Outlines, do XGrammar, dos structured outputs do vLLM ou do response_format da OpenAI para impor as restrições de esquema suportadas. A ordem dos campos pode ajudar um revisor a inspecionar o registo, mas não prova que o modelo raciocinou pelas etapas nessa ordem.
Para a avaliação de RAG, o esquema decompõe o julgamento em campos explícitos e auditáveis, em vez de deixar o modelo saltar diretamente para um número:
from pydantic import BaseModel, Field, ValidationError, model_validator
from typing import Literal

class FaithfulnessJudgment(BaseModel):
    extracted_claims: list[str] = Field(
        description="Atomic factual claims in the answer, one per item."
    )
    supported_claims: list[str] = Field(
        description="Subset of extracted_claims that are entailed by the context."
    )
    unsupported_claims: list[str] = Field(
        description="Subset that is NOT entailed by the context."
    )
    outcome: Literal["scored", "no_claims"]
    failure_mode: Literal[
        "none", "fabrication", "overgeneralization", "wrong_entity", "stale_fact"
    ]
    rationale: str

    @model_validator(mode="after")
    def require_claim_partition(self):
        for claims in (self.extracted_claims, self.supported_claims, self.unsupported_claims):
            if any(not claim.strip() for claim in claims):
                raise ValueError("claims must contain non-whitespace text")
        extracted = set(self.extracted_claims)
        supported = set(self.supported_claims)
        unsupported = set(self.unsupported_claims)
        if not extracted:
            if supported or unsupported or self.outcome != "no_claims":
                raise ValueError("an empty extraction must be a no_claims outcome")
            return self
        if (
            len(extracted) != len(self.extracted_claims)
            or len(supported) != len(self.supported_claims)
            or len(unsupported) != len(self.unsupported_claims)
            or supported & unsupported
            or supported | unsupported != extracted
            or self.outcome != "scored"
        ):
            raise ValueError("verdict lists must be a complete, disjoint claim partition")
        return self

    @property
    def score(self) -> float | None:
        if not self.extracted_claims:
            return None
        return len(self.supported_claims) / len(self.extracted_claims)

valid = FaithfulnessJudgment(
    extracted_claims=["Mars has two moons", "Mars has a thick atmosphere"],
    supported_claims=["Mars has two moons"],
    unsupported_claims=["Mars has a thick atmosphere"],
    outcome="scored",
    failure_mode="fabrication",
    rationale="The atmosphere claim lacks support.",
)
assert valid.score == 0.5
empty = FaithfulnessJudgment(
    extracted_claims=[],
    supported_claims=[],
    unsupported_claims=[],
    outcome="no_claims",
    failure_mode="none",
    rationale="Score refusal correctness separately.",
)
assert empty.score is None
try:
    FaithfulnessJudgment(
        extracted_claims=["Mars has two moons"],
        supported_claims=["Mars has two moons"],
        unsupported_claims=["Mars has two moons"],
        outcome="scored",
        failure_mode="none",
        rationale="Contradictory verdict.",
    )
except ValidationError:
    pass
else:
    raise AssertionError("overlapping verdicts must fail validation")
Este contrato ilustrativo calcula a pontuação apenas depois de as listas de veredictos formarem uma partição completa e disjunta das afirmações extraídas. Um resultado sem afirmações não tem pontuação de faithfulness e tem de ficar fora do agregado de faithfulness; reporte a sua contagem e pontue a correção da recusa em separado, para que as abstenções não melhorem a média em silêncio. Preserve essas verificações semânticas em produção; a saída restringida garante a forma, não um veredicto sem enviesamento. O modelo Pydantic também torna uma alteração da rubrica visível como um diff de código, enquanto a calibração humana testa o próprio julgamento.
Isto funciona para qualquer juiz baseado em rubrica, não só para a faithfulness. A preferência par a par, o suporte das citações e a correção das recusas beneficiam do mesmo tratamento.
Notebook 07 mede o enviesamento de posição com chamadas por pares que invertem a ordem. O seu módulo evaluation/llm_judge.py implementa também pontuação individual com SGR. As execuções por pares apresentam ambas as ordens de resposta e indicam a consistência após a troca. O avaliador individual devolve um inteiro; não é o método G-Eval ponderado por probabilidades. Como ambos os modelos são do mesmo fornecedor, medir a autopreferência continua a exigir um avaliador de outra família comparado com anotações humanas locais.
Latência e custo
- p50, p95, p99 em cada etapa do pipeline. Um bom começo é o p95 para o SLO e o p99 para alertas; altere qualquer dos dois quando conhecer o percurso do utilizador, o volume de tráfego e o orçamento de erros.
- Time-to-first-token vs. tempo total de geração. Os utilizadores importam-se com o TTFT na experiência de streaming.
- Decomposição por etapa: retrieval, reranking, geração, pós-processamento. Use o trace para localizar a cauda em vez de assumir qual a etapa que a causou; registe o dispositivo e o tamanho de batch do reranker ao comparar execuções.
- $/query total = embedding + retrieval + reranking + geração + armazenamento amortizado. Acompanhe p50 e p99; é na cauda longa que o orçamento se gasta.
- Taxas de acerto da cache na cache de embeddings, na cache de retrieval e ao nível da KV cache. Defina objetivos separados a partir da repetição observada, da política de invalidação e do custo evitado em cada camada.
Notebook 08 apresenta p50/p95/p99 para a etapa retrieve instrumentada por evaluation/runner.py. O módulo evaluation/latency.py pode resumir outras etapas quando as instrumenta explicitamente. make benchmark varia parâmetros de divisão em fragmentos e embeddings sem chamadas API. A comparação de LLM exige uma chave OpenAI e uv run python -m rag_evals.scripts.benchmark --skip-chunking --skip-embedding --live.
Testes A/B
- Unidade de aleatorização: defina primeiro o resultado que quer estimar. Depois pergunte se respostas anteriores podem alterar o comportamento posterior e se a versão atribuída a um utilizador pode afetar a experiência de outro. Use atribuição por utilizador ou por sessão quando a exposição repetida puder alterar o comportamento ou criar uma experiência inconsistente. A atribuição por query só é defensável quando esses efeitos são desprezáveis e a análise modela as observações repetidas.
- Métricas primárias, de salvaguarda e exploratórias: registe-as de antemão. Escolha a medida primária a partir do resultado do produto; os indicadores de satisfação incluem polegares para cima ou para baixo, regenerações e tempo de permanência. Trate a latência e o custo como salvaguardas quando limitam a experiência.
- Tamanho da amostra: faça a análise de potência antes de lançar, a partir do efeito mínimo que vale a pena detetar, da variância de base, da unidade de atribuição e da regra de paragem.
Parte 9: Construção do conjunto de teste
Uma métrica só vale o que vale o conjunto de teste em que corre. Se o seu golden set cobre três intenções e o tráfego de produção abrange doze, o Recall@10 mede apenas essas três intenções. Pior, um conjunto de teste ajustado a perguntas fáceis (“Qual é a política de reembolso da empresa?”) pode aprovar um sistema que falha nas difíceis (“Elegibilidade para reembolso numa anulação parcial ao abrigo das regras europeias de direitos do consumidor, faturada em EUR, para um cliente na Irlanda?”). A pontuação agregada sobe enquanto o sistema continua a falhar numa parte importante do tráfego de produção.
Etiquetas de relevância incompletas podem distorcer o recall nos dois sentidos. Se o verdadeiro conjunto relevante é {a, b} mas as etiquetas só contêm {a}, recuperar {a} pontua 1,0 em vez de 0,5; recuperar {b} pontua zero em vez de 0,5. Versione os julgamentos e reveja a evidência recém-recuperada e ainda não julgada antes de interpretar uma diferença.
Construa primeiro o conjunto de teste em torno da distribuição real de queries e da dificuldade. Depois escolha as métricas que respondem aos modos de falha visados e ajuste o sistema face a elas.
Geração sintética de queries
Use um LLM para gerar perguntas a partir do seu corpus:
- Por chunk: “Gere 3 perguntas que um utilizador possa fazer e que este chunk responda.”
- Multi-hop: amostre dois chunks e gere uma pergunta que exija ambos.
- Adversarial: gere perguntas com entidades distratoras, formulações quase duplicadas e menções ambíguas.
A geração de testes do Ragas usa cenários baseados em grafos, com queries de um só salto e de vários saltos e necessidades de informação específicas ou abstratas. O DataMorgana gera benchmarks sintéticos configuráveis por categorias de utilizadores e de perguntas. Os dados sintéticos são úteis para arranques a frio e testes de cobertura. Não substituem queries de utilizadores reais.
Construção do golden dataset
Os dados revistos por humanos formam a base do golden set.
- Amostre queries reais de utilizadores (ou simuladas, se estiver antes do lançamento) estratificadas por intenção.
- Peça a especialistas do domínio que respondam a cada pergunta e identifiquem que documento(s) contêm a resposta.
- Comece com algumas centenas de queries (200–500) e verifique o intervalo. Com 200 queries e uma taxa de aprovação perto de 0,8, o intervalo de 95% é de cerca de ±5,5 pontos (1,96 × √(0,8 × 0,2 / 200)). Se a alteração que precisa de detetar for menor, acrescente queries às fatias que decidem o lançamento.
- Acrescente queries de produção revistas (Parte 10) quando as verificações de drift ou novos tipos de query mostrarem uma lacuna na matriz de cobertura abaixo.
Mantenha quatro conjuntos separados:
- Desenvolvimento: ajustar prompts, k e chunking.
- Calibração do juiz: etiquetas humanas que verificam o juiz.
- Lançamento: pontuado uma vez por candidato, nunca usado para ajuste.
- Monitorização: tráfego de produção recente, revisto às cegas.
Agrupe os documentos de origem e as sessões partilhados antes de dividir. Quando uma query ou uma etiqueta guia o ajuste, passa a ser dado de desenvolvimento, por isso um conjunto de lançamento usado para ajuste passa a ser de desenvolvimento. Reserve casos intocados para validar a configuração escolhida e o juiz.
Registe as versões do corpus, das queries, das etiquetas de relevância e da política, a unidade de k, o orçamento de contexto fornecido, as revisões do avaliador e do juiz e as regras de agregação. Compare diferenças emparelhadas por query sobre a mesma população, com incerteza e contagens por fatia. Inclua todas as queries esperadas: um timeout, um resultado em falta ou uma resposta do juiz que não pode ser pontuada têm de continuar visíveis na contabilidade de conclusão e de erros. Não deixe a pontuação de lançamento melhorar por descartar falhas em silêncio. O ARES oferece uma abordagem de investigação com juízes automáticos, validação humana e inferência potenciada por previsões para estimar o desempenho do sistema quando a anotação é escassa; uma suite local revista pode começar de forma mais simples.
Conjuntos de teste adversariais
- Contrafactuais: troque entidades-chave na query. O sistema recupera os chunks certos para a query trocada?
- Distratores: queries em que o corpus contém uma resposta plausível mas errada que não deve ser recuperada. É isto que o RGB (Chen et al., AAAI 2024) põe à prova: robustez ao ruído, rejeição negativa, integração de informação e robustez contrafactual.
- Negação e quantificadores: queries com “não”, “exceto” e “apenas”. Os retrievers densos têm muitas vezes dificuldades com isto.
- Fora do âmbito: queries sem resposta no corpus. O sistema deve dizer “não sei”, não alucinar. O NoMIRACL fornece testes de relevância e de capacidade de resposta ao nível da passagem; acrescente etiquetas separadas de fora do âmbito ao nível do corpus. Avalie a abstenção de forma explícita nos seus tipos de query de produção.
Cobertura e avaliação contínua
- Construa uma matriz de cobertura: intenção da query × tipo de documento × ramo da ontologia. Uma query por célula é um inventário inicial de cobertura, não potência estatística suficiente para uma decisão de lançamento. As células vazias expõem cobertura em falta; dimensione as fatias preenchidas para a incerteza que consegue tolerar.
- Cadência inicial: um subconjunto de cerca de 50 queries em cada PR, o golden set completo todas as noites ou em cada candidato a lançamento, e verificações de drift semanais sobre uma amostra de produção. O
make eval-fastdo repositório de apoio executa o subconjunto de 50 queries. Altere o calendário quando conhecer o custo da avaliação e a rapidez com que o tráfego muda. - Para o drift, use uma amostra de produção móvel e estratifique por feedback em vez de alterar em silêncio a distribuição-alvo.
Parte 10: Monitorização em produção
A suite de avaliação que entrega descreve o sistema no momento do lançamento. O tráfego de produção muda depois disso.
Feedback implícito e explícito
- Trate os eventos implícitos como sinais candidatos, não como KPIs de qualidade positivos ou negativos, até que se correlacionem com revisão cega ou feedback explícito numa amostra local.
- Taxa de cliques / aberturas nas fontes citadas (se a sua interface as expuser).
- Tempo de permanência na resposta.
- Taxa de regeneração: percentagem de respostas que o utilizador volta a pedir ou que pede ao sistema para refazer. Trate-a como um sinal de insatisfação e calibre-a face a conversas revistas.
- Taxas de copiar / partilhar / exportar: sinais implícitos candidatos que podem representar utilidade, verificação, passagem a outra pessoa ou insatisfação. Meça a sua associação e o intervalo de confiança antes de atribuir uma direção.
- Padrões de seguimento: use “Tem a certeza?” ou “Mas e quanto a X?” como estratos de revisão e depois etiquete a sua associação com desconfiança ou com uma necessidade por resolver.
- Polegar para cima/baixo com categorias de motivo opcionais (errado, incompleto, fora do tema, prejudicial, lento). As edições em linha podem preservar mais contexto de diagnóstico; avalie esse valor em amostras revistas.
Deteção de drift
- Drift das queries: compare os embeddings das queries com uma janela de referência usando MMD ou um classificador validado de referência contra atual. A KL exige um estimador de probabilidade definido, como histogramas escolhidos; as coordenadas brutas dos embeddings não são probabilidades. Calibre os alarmes com desvios conhecidos e depois inspecione as fatias afetadas.
- Drift dos embeddings: fixe uma representação e um conjunto de sondas e meça a estabilidade dos vizinhos e a qualidade do retrieval. Versões diferentes de um modelo não têm de partilhar dimensões nem uma base de coordenadas, por isso o cosseno entre versões pode não fazer sentido. Migre juntos os codificadores de queries e de documentos, avalie o novo índice e mantenha snapshots versionados para rollback.
- Drift de desempenho: acompanhe ao longo do tempo métricas equivalentes às de produção (taxa de regeneração por intenção). Desvios súbitos e graduais sugerem hipóteses diferentes, mas a sua forma não estabelece a causa; inspecione alterações nos dados, no tráfego, no fornecedor, nas políticas e no deployment.
Avaliação em sombra e human-in-the-loop
Execute o sistema candidato em paralelo com a produção, compare as saídas offline e não as sirva aos utilizadores. Isto pode expor regressões antes do lançamento. A inferência em sombra continua a consumir capacidade e pode invocar ferramentas: isole recursos, suprima escritas e verifique que a comparação não degrada a latência de produção.
Para a revisão human-in-the-loop (HITL):
- Amostre as saídas de baixa confiança para uma fila de revisão.
- Inclua uma amostra aleatória do tráfego de produção para revisão cega; 1–2% do tráfego é uma taxa inicial, ajustada ao volume de tráfego, ao risco e à capacidade dos revisores.
- Sobreamostre as saídas com polegar para baixo para revisão, a par da amostra aleatória.
- Use as saídas revistas para alargar o golden set.
Mantenha a amostra aleatória: sem ela, o golden set só ganha respostas de que os utilizadores se queixaram.
O conjunto mínimo de salvaguardas
Escolha as prioridades e os limiares dos alertas a partir do dano para o utilizador, dos SLOs e do desempenho validado dos detetores. Os sinais candidatos incluem:
- Pontuação de faithfulness/HHEM abaixo do limiar numa amostra de produção móvel.
- Latência p95 acima do SLO.
- Taxa de falsa exclusão pelo filtro acima do limiar (com base em amostra).
- Taxa de regeneração fora de uma banda de controlo calibrada localmente, que tenha em conta o tamanho da janela, o tráfego, a sazonalidade e o orçamento de falsos alertas.
- Custo/query acima do orçamento.
Uma primeira regra de triagem: um alerta sem alteração de código ou de modelo aponta para drift; um alerta logo a seguir a um lançamento aponta para uma regressão. Confirme qualquer dos casos nos traces e nas fatias afetadas, porque um deployment pode coincidir com drift de tráfego, e uma alteração de fornecedor ou de dados pode ocorrer sem um lançamento da aplicação.
Ressalvas
- Os objetivos são locais, não universais. Os valores iniciais deste guia, incluindo os limiares do repositório de apoio, são pontos de partida a ajustar com os seus próprios dados. Os números ilustrativos são resultados de exemplo. Calibre os limiares de lançamento ao seu domínio, ao que está em jogo, à incerteza do conjunto de avaliação e às expectativas dos utilizadores.
- O espaço dos frameworks muda depressa. As versões do HHEM, os nomes das métricas do RAGAS, as fichas de modelo e a ordem dos leaderboards podem mudar depois da publicação. Volte a verificar a fonte ligada e refaça o benchmark antes de se comprometer.
- Os números de concordância do LLM como juiz vêm com ressalvas. O valor de 80% do GPT-4 face a humanos vem das condições do MT-Bench / Chatbot Arena. Esse resultado não estabelece concordância num domínio de nicho ou numa fatia adversarial. Use juízes para pontuar mais casos do que as pessoas conseguem rever e continue a rever uma amostra à mão.
- Os ganhos de benchmarks de fornecedores muitas vezes não são reproduzíveis de forma independente. Reproduza nos seus próprios dados antes de acreditar num número, sobretudo em rerankers e sistemas de OCR mais recentes.
- Nenhuma métrica substitui olhar para as saídas. Comece por ler 50 respostas de produção aleatórias por semana. As métricas dão escala a esse hábito; não o substituem.
Referências
Frameworks e benchmarks
- Es et al., Ragas: Automated Evaluation of Retrieval Augmented Generation, 2023.
- RAGAS documentation and GitHub.
- Saad-Falcon et al., ARES: An Automated Evaluation Framework for Retrieval-Augmented Generation Systems, NAACL 2024.
- TruLens, DeepEval, Arize Phoenix.
- Thakur et al., BEIR: A Heterogenous Benchmark for Zero-shot Evaluation of Information Retrieval Models, NeurIPS 2021.
- MTEB Leaderboard.
- TREC 2024 RAG Track.
- Pradeep et al., Initial Nugget Evaluation Results for the TREC 2024 RAG Track with the AutoNuggetizer Framework, 2024.
Retrieval e ranking
- Cormack, Clarke, Buettcher, Reciprocal Rank Fusion Outperforms Condorcet and Individual Rank Learning Methods, SIGIR 2009.
- Gao et al., Precise Zero-Shot Dense Retrieval Without Relevance Labels (HyDE), 2022.
- Jeong et al., Adaptive-RAG: Learning to Adapt Retrieval-Augmented Large Language Models through Question Complexity, NAACL 2024.
- Anthropic, Introducing Contextual Retrieval, setembro de 2024.
- Günther et al., Late Chunking: Contextual Chunk Embeddings Using Long-Context Embedding Models, 2024.
Geração, faithfulness e juízes
- Min et al., FActScore: Fine-grained Atomic Evaluation of Factual Precision in Long Form Text Generation, EMNLP 2023.
- Liu et al., Lost in the Middle: How Language Models Use Long Contexts, TACL 2024.
- Chen et al., Benchmarking Large Language Models in Retrieval-Augmented Generation (RGB), AAAI 2024.
- Vectara, HHEM-2.1-Open hallucination evaluation model.
- Zheng et al., Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, NeurIPS 2023.
- Thakur et al., Support Evaluation for the TREC 2024 RAG Track: Comparing Human versus LLM Judges, SIGIR 2025.
- Thakur et al., Knowing When You Don’t Know: A Multilingual Relevance Assessment Dataset for Robust Retrieval-Augmented Generation, Findings of EMNLP 2024.
- Geng et al., JSONSchemaBench: A Rigorous Benchmark of Structured Outputs for Language Models, 2025.
- Kosmopoulos et al., Evaluation Measures for Hierarchical Classification: a unified view and novel approaches, 2015.
Drift e produção
- Evidently, Embedding drift detection methods compared.
Código de apoio
slavadubrov/rag-evals-demo: harness executável que separa recuperação em SciFact, geração com QA sintética anotada e verificações offline com dados de teste fixos, com variação de parâmetros de divisão em fragmentos e embeddings e comparação em direto opcional entre dois modelos OpenAI. Os notebooks 00–09 explicam os processos; os testes unitários fixam exemplos calculados selecionados, enquanto os dados antigos do filtro usam uma população autorizada diferente. O índice Qdrant integrado funciona sem Docker.