Метрики оценки RAG: retrieval, реранкинг, генерация

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Этот справочник для инженеров, которые эксплуатируют или оценивают системы RAG (retrieval-augmented generation). Он сопоставляет сбои в разборе документов, фильтрации, retrieval, реранкинге и генерации с метрикой, которая каждый из них выявляет. Он также показывает, какие проверки выполняются до релиза, а какие следят за живым трафиком.
Система RAG со сломанными фильтрами релевантности может месяцами работать без единого операционного алерта. Она по-прежнему отвечает и укладывается в целевую латентность, но ответы опираются на неполные данные. Потерю покажет Recall@k, посчитанный по исходному набору эталонных документов, которым запрос вправе пользоваться. Дашборды латентности и доступности её не покажут.
Хотите пропустить теорию и запустить код?
Исполняемый репозиторий
slavadubrov/rag-evals-demoразделяет retrieval на SciFact, генерацию на размеченных синтетических QA-данных и офлайн-проверки на фиксированных тестовых данных.make evalзапускает retrieval, диагностику фильтров и повторное воспроизведение тестовых результатов генерации послеmake index.make benchmarkперебирает настройки чанкинга и эмбеддингов без вызовов API; сравнению двух моделей OpenAI нужны API-ключ и флаг--live(см. часть 8). Ноутбуки 00–09 охватывают retrieval, фильтрацию, генерацию и системные примеры. Демо использует встроенный Qdrant и не требует Docker.
Таблица решений по оценке RAG
Начинайте с этой таблицы, а уже потом выбирайте фреймворк. Подходящая метрика зависит от сбоя, который вы хотите поймать, а не от названия инструмента.
| Вопрос | Семейство метрик | Когда применять | На что обратить внимание |
|---|---|---|---|
| Парсинг сохранил источник? | Полнота извлечения, покрытие таблиц и рисунков | В корпус попадают PDF, слайды, сканы и HTML-страницы | Чистый на вид текст всё равно может потерять подписи, сноски или структуру таблиц |
| Retrieval нашёл нужные данные? | Recall@k, nDCG@k, MRR, context precision/recall | Вы можете разметить релевантные чанки или документы | Жёсткий фильтр по метаданным может убрать верный документ до начала ранжирования |
| Реранкинг улучшил короткий список? | Прирост от реранкера, Precision@1, дельта nDCG | После retrieval стоят кросс-энкодеры или LLM-ранкеры | Вместе с приростом качества измеряйте латентность и стоимость |
| Ответ опирается на найденные данные? | Faithfulness, groundedness, поддержка цитат | Ответ цитирует документы или ссылается на факты из контекста | Faithfulness не диагностирует плохой парсинг или плохой retrieval |
| Система стабильна в продакшене? | Дрейф, регенерации, фолбэки, p95 латентности, стоимость ответа | После запуска меняется трафик | Продакшен-телеметрию нужно калибровать на выборочной ручной проверке |
Короткое сравнение инструментов: Лучшие инструменты оценки RAG: Ragas, DeepEval и TruLens.
Часть 1. Определите успех до выбора архитектуры
Составьте набор для оценки раньше, чем нарисуете архитектуру. Он даёт каждому следующему выбору компонента измеримую цель.
Пока вы не знаете, что оптимизируете, выбирать между BM25 и плотным retrieval, рекурсивным и семантическим чанкингом, Cohere Rerank и BGE бессмысленно. «Ответы получше» — не метрика. Пример требования к релизу: «faithfulness ≥ 0,85 на золотом наборе из 200 запросов, покрывающем три главных интента, при p95 латентности < 1,5 с и доле ложных исключений фильтром < 2%». Числа здесь условные; важно, что у качества, покрытия, латентности и фильтрации есть явные пороги.
Определите харнесс до того, как напишете код retrieval. Первый харнесс окажется неверным, и вы его пересмотрите. Пересмотреть метрику намного дешевле, чем систему, которую вы уже выпустили.
Три слоя пайплайна и два режима запуска
В оценке продакшен-системы три слоя пайплайна. Оценка ингестии проверяет, сохраняют ли корпус и индекс источник. Оценка на этапе запроса проверяет, нашли ли нужные данные переписывание запроса, фильтрация, retrieval, реранкинг и сборка контекста. Оценка ответа и продакшена проверяет, использовал ли ответ эти данные и держится ли качество на живом трафике. Если свести слои в одну оценку, ошибка нормализации может раствориться в приемлемой оценке ответа.
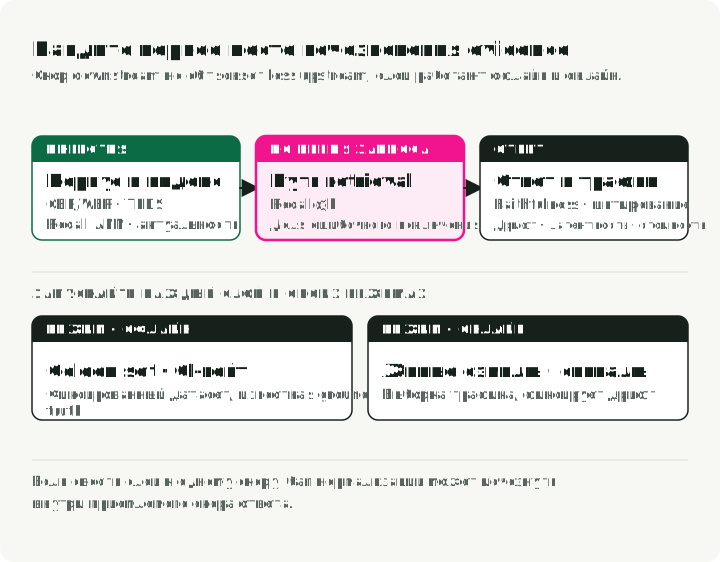
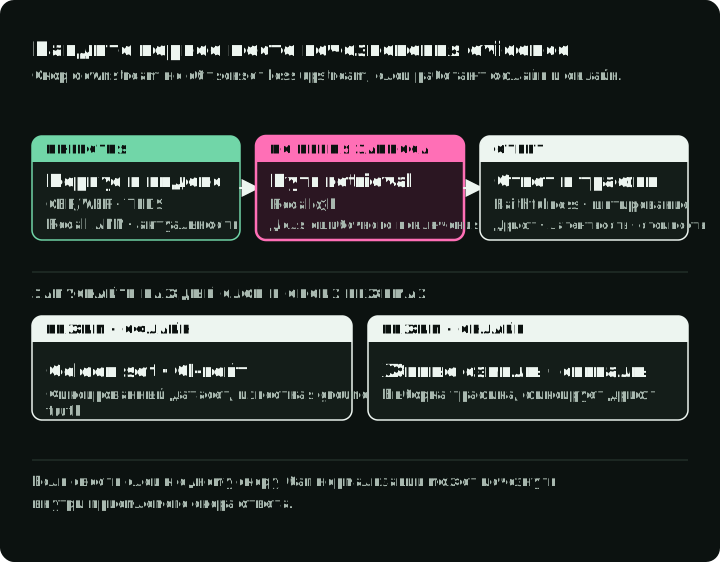
Слои описывают, где происходит сбой. Офлайн и онлайн описывают, когда и на каких данных запускается проверка. Офлайн-оценка работает на фиксированном датасете с известной разметкой; она воспроизводима и подходит для выбора компонентов, A/B-сравнений и CI-проверок, которые могут заблокировать изменение. Онлайн-оценка проверяет выборку живого трафика и фиксирует регенерации, время просмотра, явную обратную связь и реальный дрейф запросов. Она шумнее, и инструментировать её сложнее.
Используйте оба режима там, где они помогают: фиксированные корпуса и наборы запросов делают регрессии воспроизводимыми; выборка живых трейсов показывает сбои актуальности и дрейф.
Покомпонентная и сквозная оценка
Есть две типичные ошибки. Только сквозная оценка говорит, что система сломана, но не где. Только покомпонентная может показывать, что каждая часть проходит проверку, пока вся система всё равно отказывает. Решение: несколько главных сквозных метрик для решений «выпускать или нет» плюс покомпонентные метрики для диагностики. Метрики retrieval ловят регрессии ретривера. Метрики генерации ловят регрессии генератора. Сквозная корректность ответа ловит сбои интеграции.
Референсные фреймворки (обзор с моим мнением)
| Фреймворк | В чём силён | Где слабеет |
|---|---|---|
| RAGAS | Общий словарь для faithfulness, answer relevancy и context precision/recall (метрики) | Стоимость LLM-джаджа; непрозрачные компоненты оценки при отладке; смена версий |
| ARES | Классификатор-джадж под конкретную задачу, если обучение и разметка оправдывают затраты (статья); заявленная точность привязана к бенчмарку | Сложнее настроить; модели придётся действительно обучать |
| TruLens | Feedback-функции, привязанные к трейсам, и интеграция с OpenTelemetry (проект) | Меньше готовых метрик именно для RAG, чем в RAGAS |
| DeepEval | Интеграция с тест-раннером и собственные метрики (проект) | Активное использование LLM-джаджа = скачки стоимости |
| Arize Phoenix | Трейсинг, эксперименты на датасетах, готовые и собственные эвалуаторы для RAG и агентов (документация по оценке) | Доменные рубрики и пороги джаджа всё равно нужно калибровать локально |
| TREC 2024 RAG Track | Публичный бенчмарк для nugget-оценки (AutoNuggetizer), оценки поддержки утверждений и беглости на MS MARCO Segment v2.1 | Не рантайм-инструмент, а бенчмарк для калибровки |
Мой стек по умолчанию: RAGAS ради словаря метрик, DeepEval для CI-проверок, Phoenix для продакшен-трейсинга и собственный код для метрик по онтологии. Выбирайте фреймворк, в котором легко писать собственные метрики.
Выбирая бенчмарк, сначала сопоставьте задачу, а потом смотрите на лидерборд. BEIR, MTEB и MIRACL остаются полезными базовыми уровнями для retrieval. Добавьте тесты для возможностей, которые они не подтверждают:
- Современный сквозной RAG: TREC 2026 RAG Track использует повествовательные запросы и ClimbMix-400b вместо MS MARCO v2.1 и ссылается на набор инструментов оценки RAGDoll. Темы 2026 года опубликованы; оценки асессоров ещё нет. Используйте темы для экспериментов, но не как лидерборд с готовой разметкой. Протоколы 2024 и 2025 годов ниже привязаны к своим корпусам и оценкам.
- Технические вопросы к меняющемуся коду: FreshStack сочетает вопросы со Stack Overflow, заданные людьми, корпуса репозиториев и nugget-оценки. Выпущенный снапшот и механизм сборки новых корпусов — разные вещи; зафиксируйте ревизию репозитория и дату вопроса.
- Изображения, которые несут часть вопроса или данных: MM-BRIGHT разделяет retrieval «текст — текст», «мультимодальный запрос — текст», «мультимодальный запрос — изображение» и «мультимодальный запрос — мультимодальный документ». Оценивайте нужную задачу отдельно. Один лишь текст после OCR может потерять то, что даёт график или скриншот.
Эти бенчмарки расширяют покрытие, но не заменяют версионированный набор запросов вашего приложения, в котором учтены только допустимые документы.
Часть 2. Карта точек оценки
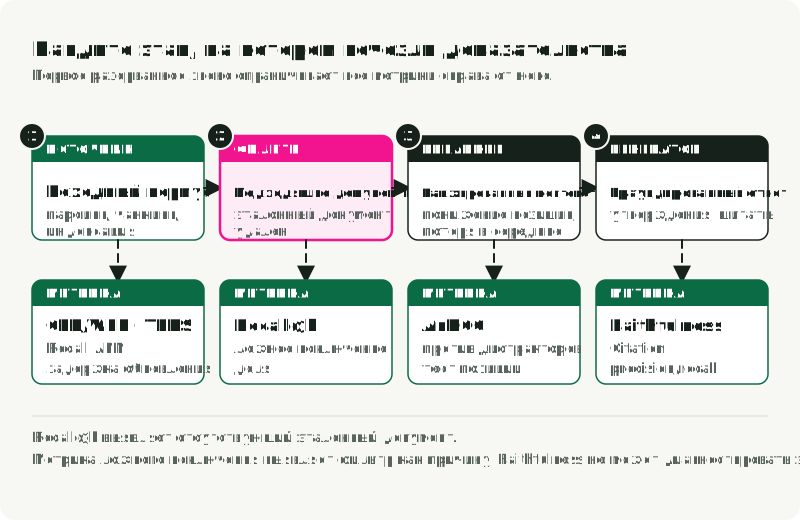
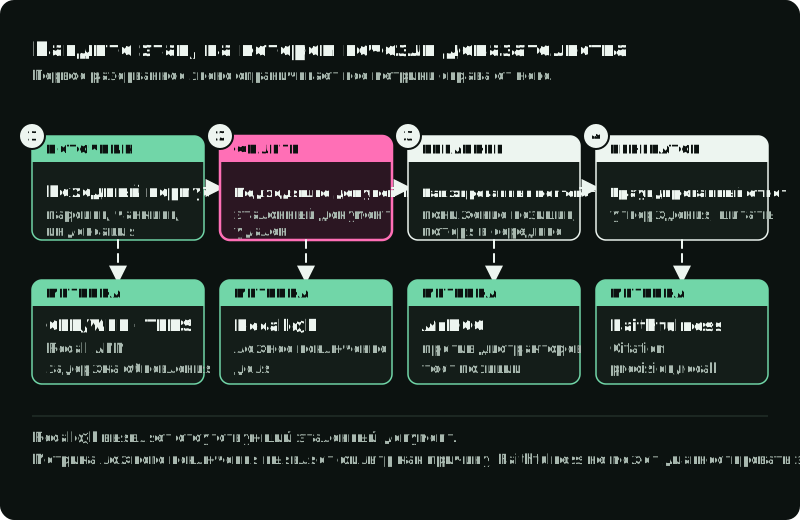
Если ответ неверен или не подтверждён, пройдите по четырём проверкам на рисунке слева направо с эталонным документом. Первая стадия, где его нет, называет метрику, которую проверять первой, и часть статьи, где она разобрана.
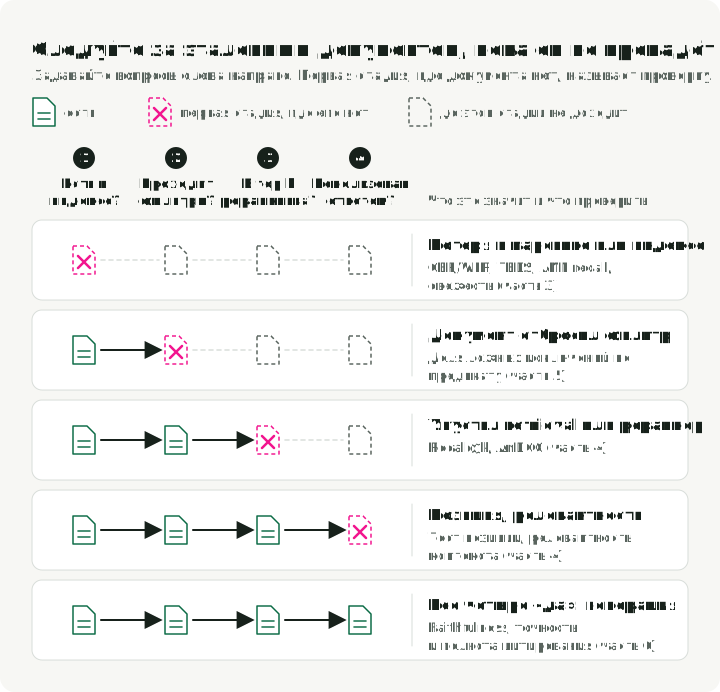
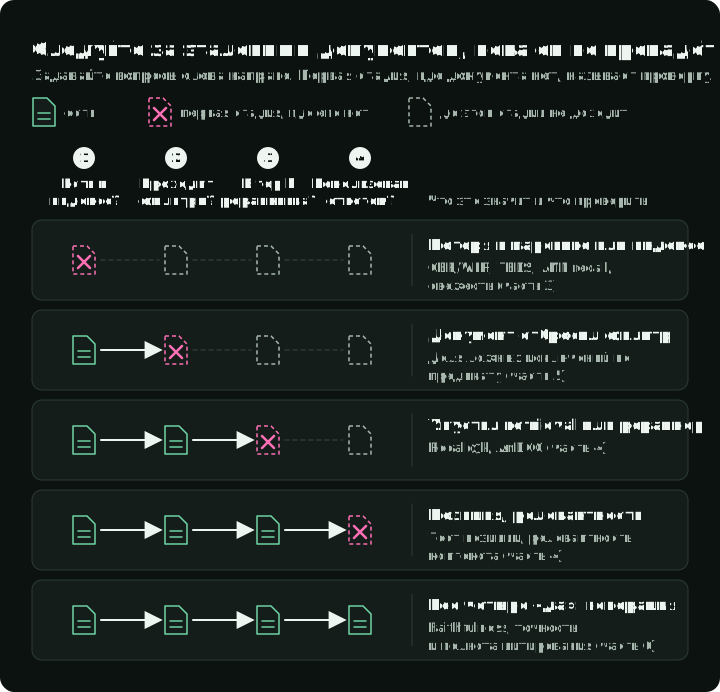
Потери выше по пайплайну ограничивают качество ниже: плохой парсинг ограничивает retrieval, а плохой retrieval ограничивает реранкинг и генерацию. Faithfulness измеряет ответ, но не причину выше по пайплайну.
Часть 3. Оценка ингестии
Многие сбои RAG в продакшене начинаются в ингестии. Система работает на чистых тестовых документах, а потом ломается на реальных PDF, сканах, таблицах и неряшливых страницах корпуса.
Получение и парсинг документов
Что измерять:
-
Проверка длины извлечённого текста:
extracted_chars / expected_charsпо классам документов выявляет подозрительные изменения длины, но дублированный или неверный текст всё равно может дать 1,0. Сравните выровненный текст с вручную очищенным эталоном, чтобы найти пропуски и подстановки, а сноски, подписи, содержимое таблиц и порядок чтения проверьте отдельно. -
Точность OCR: CER (Character Error Rate) и WER (Word Error Rate), стандартные метрики для распознавания речи и OCR:
где , , — подстановки, удаления и вставки на уровне символов, а — число символов в эталоне (индекс для версии по словам). Не применяйте одну границу CER ко всем корпусам. Калибруйте её по классу документов и по тому, насколько падает качество ответов на последующих этапах. У печатного текста, рукописного и многоязычного материала разные профили ошибок. Считайте через
jiwer(jiwer.cer(refs, hyps),jiwer.wer(refs, hyps)) или через Hugging Faceevaluate. Публичные бенчмарки для оценочных корпусов: FUNSD и SROIE.from jiwer import cer, wer refs = ["Mars has two moons, Phobos and Deimos."] hyps = ["Mars has two m00ns, Phobos and Deirnos."] print(f"CER = {cer(refs, hyps):.3f}") # CER = 0.105 print(f"WER = {wer(refs, hyps):.3f}") # WER = 0.286 -
Точность извлечения таблиц: TEDS (Tree-Edit-Distance-based Similarity) показывает, насколько предсказанное HTML-дерево таблицы близко к эталону, с нормировкой на размер большего дерева. Из Zhong et al., 2020 (PubTabNet):
TEDS учитывает и структуру (строки, столбцы, объединённые ячейки), и содержимое ячеек. TEDS-S отбрасывает содержимое и оценивает только структуру. Референсная реализация:
src/metric.pyиз PubTabNet (внутри используетapted). Корпуса для оценки: PubTabNet, FinTabNet и SciTSR. Наивные парсеры часто ошибаются на таблицах. Проверьте их бенчмарком, прежде чем доверять. -
Сохранность разметки и структуры: порядок заголовков, целостность списков, порядок чтения в многоколоночных PDF. Для размеченного бенчмарка используйте DocLayNet. Готовые решения можно сравнить так: парсер элементов вроде
unstructured, PDF-библиотека вродеpymupdfи выбранный пайплайн Docling. У Docling есть стандартный путь и путь на VLM; запишите, какой из них вы тестируете.
Сравнивайте разные семейства парсеров, например базовый Tesseract, OCR-модель на VLM и вашего кандидата-вендора. Лучшие OCR-модели сравнивает актуальные варианты. Возьмите стратифицированную выборку реальных классов документов с фиксированным DPI: чистые сканы, фотографии, таблицы, многоязычный текст, формулы и рукопись. Сообщайте CER или WER по каждому классу и TEDS для страниц с таблицами.
Очистка и нормализация
-
Точность удаления шаблонного текста: precision/recall относительно размеченных людьми фрагментов шаблонного текста. Агрессивное удаление выбрасывает нужное содержимое; ленивое засоряет эмбеддинги. Что сравнить:
trafilatura,jusText,Resiliparse. Barbaresi (2021) сравнивает Trafilatura с базовыми методами, включая jusText; Resiliparse — отдельный кандидат, а не система, которую оценивали в этой статье. -
Нормализация Unicode: доля документов, у которых результаты NFC и NFKC совпадают (считается стандартной функцией
unicodedata.normalize), — полезный сигнал дрейфа совместимых форм. Он не обнаруживает невидимые и игнорируемые по умолчанию кодовые точки, а также похожие символы из разных письменностей: первые ищите явным сканированием, а для вторых применяйте политику Unicode confusables или детектор, если это входит в задачу. -
Точность определения языка: F1 на размеченной многоязычной выборке. Критична для многоязычных индексов. Используйте
fasttext-langdetect(lid.176от Facebook),lingua-pyилиcld3. FLORES-200 даёт тексты для оценки на 200 языках, но тестовый срез должен определяться реальным языковым составом вашего продакшена. -
Эффективность дедупликации (MinHash / LSH): precision/recall вашего детектора почти-дубликатов на вручную размеченном наборе. Основная идея: оценить сходство Жаккара между множествами шинглов документов с помощью хэшей со случайными перестановками (Broder, 1997) и собрать почти-дубликаты в корзины через LSH banding (Indyk & Motwani, 1998). Переберите число хэшей и порог Жаккара на своём корпусе. Отслеживайте долю ложных слияний (портит ответы) отдельно от доли пропущенных слияний (тратит место в индексе). Реализацию из примера ниже даёт
datasketch; параметры в нём условные:from datasketch import MinHash, MinHashLSH def shingles(text: str, k: int = 5) -> set[str]: text = text.lower() return {text[i:i + k] for i in range(len(text) - k + 1)} def to_minhash(text: str, num_perm: int = 128) -> MinHash: m = MinHash(num_perm=num_perm) for s in shingles(text): m.update(s.encode("utf-8")) return m docs = { "d1": "Mars has two moons, Phobos and Deimos.", "d2": "Mars has two moons, Phobos and Deimos!", # near-dup "d3": "Curiosity rover landed on Mars in 2012.", } lsh = MinHashLSH(threshold=0.8, num_perm=128) for did, text in docs.items(): lsh.insert(did, to_minhash(text)) print(sorted(lsh.query(to_minhash(docs["d1"])))) # ['d1', 'd2'] -
Удаление PII: precision и recall, посчитанные отдельно по каждому типу сущностей (email, номера социального страхования, имена, адреса). Ошибки recall создают риск для комплаенса; ошибки precision вредят качеству ответов. Рабочую точку согласуйте с юристами. Среди кандидатов: Microsoft Presidio,
scrubadubили дообученная NER-модель на размеченном наборе.
Чанкинг определяет качество retrieval
Чанкинг меняет то, какие данные доходят до ответа. В вендорском бенчмарке NVIDIA 2025 года чанкинг по страницам дал наибольшую среднюю сквозную точность ответов в проверенной конфигурации, потому что таблицы и графики сохранялись целиком. Это точность ответа, а не recall retrieval. Считайте этот результат свидетельством для проверенного корпуса, а не универсальным победителем.
Семантический чанкинг группирует соседние предложения по сходству эмбеддингов и режет по границам, где сходство падает. Эту стратегию реализуют SemanticChunker в LangChain и SemanticSplitterNodeParser в LlamaIndex. Когда важны границы тем, он может улучшить recall по сравнению с окнами фиксированного размера.
RecursiveCharacterTextSplitter из LangChain по умолчанию пробует двойные переводы строки, одинарные переводы строки, пробелы, затем отдельные символы: ["\n\n", "\n", " ", ""]. Он не распознаёт границы предложений без подходящих разделителей или сплиттера, учитывающего предложения. Значение по умолчанию length_function=len считает символы. Чтобы попробовать 400–512 токенов на чанк с перекрытием 10–20 %, используйте функцию подсчёта токенов. Сравните эти начальные настройки с другими значениями на эталонном наборе.
Метрики для отслеживания:
- Когерентность чанков: , где — эмбеддинги предложений. У здоровых чанков сходство внутри высокое, а на границе низкое. Считайте через
sentence-transformersиcosine_similarityизscikit-learn. - Качество границ: разметка людьми на выборке «это разумный разрез?» плюс структурная проверка, что чанки не разрезают таблицы, списки и нумерованные разделы.
- Оптимальный размер чанка: переберите размеры в токенах (128, 256, 512, 1024) и постройте график Recall@k от размера на своём золотом наборе. Берите наименьший размер, после которого Recall@k перестаёт расти.
- Эффективность перекрытия: переберите перекрытие 0, 10, 20 и 30% как стартовую сетку и измерьте Recall@k. Перестаньте увеличивать перекрытие, когда локальная кривая recall выходит на плато или стоимость дублирования превышает выигрыш.
- Точность атрибуции чанков: доля чанков, сохранивших проверяемую ссылку на источник (номер страницы, якорь раздела, ID документа). Для аудита это обязательно.
- Поздний и ранний чанкинг: late chunking (Günther et al., 2024) сначала эмбеддит весь документ, а потом режет его, сохраняя глобальный контекст (референсная реализация в
jina-embeddings-v3). Contextual Retrieval (Anthropic, 2024) добавляет к каждому чанку контекст, сгенерированный LLM. Оба подхода повышают стоимость. Проверьте их на своём корпусе, прежде чем применять.
Моё мнение: структурный чанкинг (разрезание по заголовкам, таблицам и разделам, которое реализуют парсеры вроде unstructured.io или обход AST, уже построенного вашим парсером) используют недостаточно. Если у документов есть структура, примените её раньше, чем добавлять эвристики по сходству. Рекурсивное разрезание по символам — базовый уровень; семантический чанкинг стоит накладных расходов в основном на неструктурированной прозе.
Извлечение и обогащение метаданных
- Precision/recall/F1 для NER: по каждому типу сущностей на размеченном подмножестве. Стандарт в духе CoNLL/MUC. Считайте через
seqeval(from seqeval.metrics import f1_score) для варианта, учитывающего BIO/IOB-теги, или через scikit-learn для сравнения множеств спанов. Канонические референсные корпуса: CoNLL-2003 и OntoNotes 5.0. - F1 извлечения отношений: для систем на основе онтологии это ещё важнее. Разметьте вручную набор, стратифицированный по типам отношений и классам документов. Публичные бенчмарки: TACRED и DocRED; среди кандидатов на реализацию —
opennreи пайплайны отношений вspaCy. - Точность извлечения названий и заголовков: точное совпадение плюс нормализованное сходство Левенштейна () относительно эталона —
python-Levenshteinилиrapidfuzzдают оба значения одним вызовом. - Сохранность иерархических метаданных: доля чанков, которые верно хранят родительский раздел, родительский документ и путь предков. Эта метрика решает, сможет ли ваш RAG ответить на вопросы вида «что говорит дочерний пункт политики X?».
Генерация эмбеддингов
- Бенчмарки для выбора модели: берите в качестве точек сравнения результаты MTEB по retrieval-задачам, BEIR для zero-shot обобщения и MIRACL для многоязычного retrieval. MTEB для retrieval обычно приводит nDCG@10; другие семейства задач используют другие метрики. Python-пакет MTEB запускает бенчмарки локально. Перенос результата с английского MTEB на язык с меньшими ресурсами считайте гипотезой, которую нужно проверить на размеченном наборе этого языка.
- Доменная оценка: не принимайте место в общем бенчмарке за результат в вашей области. Начните с нескольких сотен размеченных запросов (200–500) по основным типам запросов; часть 9 показывает, как проверить, достаточно ли этого. Затем ранжируйте на нём модели-кандидаты через
ranxилиpytrec_eval. Доменный набор может перевернуть порядок в лидерборде, поэтому публикуйте вместе с результатом срез датасета, протокол retrieval и доверительный интервал. - Обнаружение дрейфа эмбеддингов: сравнивайте две коллекции эмбеддингов: фиксированную эталонную выборку и скользящую текущую. Maximum mean discrepancy (MMD) проверяет, различаются ли их распределения. Другой вариант — проверенный классификатор, обученный отличать эталонные образцы от текущих. Дивергенция Кульбака — Лейблера (KL) сравнивает распределения вероятностей, поэтому ей нужен явный оценщик, например заданные гистограммы; сырые координаты эмбеддингов вероятностями не являются. Измеряйте также стабильность ближайших соседей на фиксированном наборе пробных запросов.
evidentlyиalibi-detectреализуют детекторы на моделях и статистические детекторы. Сравнительное исследование Evidently — это оценка одного вендора; сравнивайте методы на известных сдвигах в ваших собственных эмбеддингах. - Мультивекторное и одновекторное представление: late interaction сохраняет представления на уровне токенов, а не сворачивает каждый документ в один вектор; ColBERT — каноническая схема, референсные реализации есть в RAGatouille и PyLate. Более богатое представление увеличивает стоимость индекса и retrieval. Прежде чем принимать его, сравните качество, объём хранилища и латентность с одновекторным базовым вариантом на том же доменном наборе.
Построение индекса
- Recall@k при приближённом поиске: сравните индекс приближённого поиска ближайших соседей (ANN) с точным перебором при том же k — в FAISS это
IndexHNSWFlat(илиIndexIVFFlat) противIndexFlatIP/IndexFlatL2. Для первой проверки требуйте Recall@10 не ниже 0,95 относительно точного поиска, а затем ужесточайте или ослабляйте порог по качеству ответов ниже по пайплайну. Проектann-benchmarksотслеживает кривые Парето recall–QPS по библиотекам. - Настройка HNSW: HNSW (Hierarchical Navigable Small World) — многослойный граф близости; см. Malkov & Yashunin, 2018. Он реализован в
hnswlib, вIndexHNSWFlatиз FAISS и в большинстве векторных БД. У HNSW три параметра:M(число связей узла графа),efConstruction(ширина набора кандидатов при построении) иefSearch(ширина набора кандидатов при запросе). Стартовые значения:Mот 16 до 32 иefConstructionот 100 до 200; затем повышайтеefSearch, пока Recall@10 относительно точного поиска не перестанет расти. Руководство по параметрам hnswlib говорит, чтоMот 12 до 48 подходит для большинства задач, и даёт проверку дляefConstruction: если приef, равномefConstruction, recall дляMближайших соседей ниже 0,9, граф ещё можно улучшить. - Настройка IVF: IVF (Inverted File index — векторы разбиваются k-means на
nlistячеек, а при запросе просматриваютсяnprobeближайших ячеек; см.IndexIVFFlatиIndexIVFPQв FAISS). Руководство FAISS по выбору индекса предлагает в качестве стартовогоnlistот 4√N до 16√N ячеек для N векторов. Переберитеnlistиnprobeотносительно recall точного поиска и латентности. Запросы с фильтрами тестируйте отдельно: разные семейства индексов и векторные БД обходят фильтры по-разному. - Задержка актуальности обновлений: время от коммита документа до момента, когда его можно найти. Отслеживайте p50 и p99. Для систем с регуляторными требованиями отслеживайте также долю запросов, обслуженных по устаревшим индексам.
Часть 4. Оценка на этапе запроса
Здесь собраны метрики, которые диагностируют путь retrieval. Один лишь Recall@k не покажет, что вызвало сбой: переписывание запроса, фильтрация, реранкинг или сборка контекста.
Понимание и переписывание запроса
- Качество расширения запроса: прирост Recall@k на вашем золотом наборе, расширенный запрос против исходного. До теста задайте минимальный полезный прирост и его неопределённость. Если расширение не дотягивает до этого требования, оно не оправдывает свою латентность и стоимость. Классические базовые варианты на основе PRF (pseudo-relevance feedback), такие как RM3 и Bo1, остаются полезной проверкой здравого смысла; расширение на основе LLM должно их превзойти.
- Оценка HyDE: HyDE (Gao et al., 2022) просит LLM сгенерировать гипотетический ответ, эмбеддит его и ищет по нему. Это добавляет вызов генерации, а он может выдумать содержимое, которое уведёт retrieval от темы. Измерьте Recall@10 отдельно на срезах внутри области, вне области и с низкой уверенностью, а затем решите, где ему место: в пути по умолчанию, в фолбэке или нигде.
- Генерация нескольких запросов: Recall@k по объединению N переформулировок против одного запроса. Переберите N и выберите точку на вашей границе «recall — латентность». Реализации:
MultiQueryRetrieverв LangChain,QueryFusionRetrieverв LlamaIndex. - Точность классификации интента: стандартные precision/recall/F1 по каждому интенту (считаются через
sklearn.metrics.classification_report), но главная метрика — корректность роутинга: вызывается ли нужный нижестоящий пайплайн? - Адаптивный роутинг: Adaptive-RAG (Jeong et al., NAACL 2024) обосновывает, что не каждому запросу нужна одна и та же стратегия retrieval. Отслеживайте точность роутера как задачу классификации на размеченном наборе с классами «retrieval не нужен / одним шагом / итеративный».
Итеративному поиску нужен сквозной тест с бюджетом
Агент может искать, смотреть результат и искать снова, а не получать один фиксированный список top-k. Домен banking_knowledge в tau2-bench переключает retrieval флагом --retrieval-config: без базы знаний, вся база знаний в контексте, поиск BM25 или по эмбеддингам, shell-инструмент в сэндбоксе или BM25, плотный поиск и shell вместе. Для локального сравнения дайте одношаговому и итеративному retrieval один и тот же допустимый корпус и явные лимиты по времени, токенам модели и числу tool calls. Записывайте каждый запрос и свидетельства, которые были видны на каждом шаге; оценивайте итоговое покрытие свидетельств, корректность ответа, поддержку цитатами и сбои из-за исчерпанного бюджета. Лишние вызовы поиска полезны, только если добавленные свидетельства улучшают ответ в этих пределах.
retrieval/iterative.py из репозитория-компаньона выполняет заданные переформулировки запроса при явных бюджетах на вызовы, время и токены. Если агент сам выбирает поисковые запросы, оценку траектории вместе с ответом разбирает статья Оценка ИИ-агентов: от трейсов к тестовым наборам.
Метрики retrieval
Это базовые метрики. Если вы их не отслеживаете, вы не узнаете, улучшается ли retrieval.
| Метрика | Что измеряет | Когда применять |
|---|---|---|
| Recall@k | доля релевантных документов запроса, вернувшихся в top k | когда важно не потерять ни одной части релевантного набора |
| Precision@k | процент релевантных среди top-k | полезна, когда боттлнеком служит контекстное окно |
| MRR | среднее значение 1/rank первого релевантного документа | когда пользователи смотрят только top-1 или top-3 |
| nDCG@k | прирост с дисконтом по позиции, взвешенный по оценкам релевантности | стандартная метрика retrieval для градуированной релевантности |
| MAP | среднее по запросам значение average precision | когда важен весь ранжированный список |
| Hit Rate@k | попал ли в top k хотя бы один релевантный документ | усредните бинарный результат по запросам для быстрой проверки |
| Coverage | процент золотых документов, хотя бы раз найденных по всем запросам | выявляет систематические пробелы в индексе |
Формулы для справки (бинарная релевантность с релевантным набором для запроса ; , если -й найденный документ входит в ):
Для градуированной релевантности ; бинарный nDCG — частный случай, который используется в коде ниже. MAP — среднее по запросам значение . Выводы формул см. в Manning, Raghavan, Schütze, Introduction to Information Retrieval, глава 8.
В продакшен-коде используйте ranx, pytrec_eval или ir_measures: они реализуют всё семейство метрик TREC и корректно обрабатывают градуированную релевантность. В качестве стартовых порогов релиза репозиторий-компаньон задаёт Recall@10 ≥ 0,85 и MRR ≥ 0,6 (в .env.example, включаются флагом --quality-gates). Затем подберите их на своём золотом наборе по качеству ответов ниже по пайплайну и цене промаха.
Здесь k считает уникальные ID документов. Отклоняйте дубликаты, а не начисляйте повторному документу дополнительный прирост. В экспериментах с чанкингом укажите, считает ли k чанки или дедуплицированные родительские документы, и сравните также свидетельства, переданные в рамках фиксированного бюджета токенов. Одинаковый recall по документам может скрывать очень разное качество контекста.
Тестовый харнесс для этих метрик короткий. Его можно запустить из ноутбука ещё до выбора векторной БД.
from math import log2
from statistics import mean

# synthetic gold set: query_id -> set of relevant doc ids
gold = {
    "q1": {"d3"},
    "q2": {"d7", "d2"},
    "q3": {"d11"},
    "q4": {"d5"},
}

# ranked retrieval results: query_id -> ranked list of doc ids (top-10)
runs = {
    "q1": ["d8", "d3", "d1", "d4", "d2", "d9", "d6", "d10", "d12", "d13"],
    "q2": ["d2", "d6", "d4", "d7", "d1", "d3", "d8", "d11", "d5", "d9"],
    "q3": ["d11", "d2", "d3", "d4", "d1", "d6", "d7", "d8", "d10", "d12"],
    "q4": ["d1", "d2", "d3", "d6", "d8", "d9", "d10", "d12", "d13", "d14"],
}

def recall_at_k(ranked, gold_set, k):
    if k <= 0 or len(ranked) != len(set(ranked)):
        raise ValueError("require positive k and unique document IDs")
    if not gold_set:
        return 0.0
    hit = sum(1 for d in ranked[:k] if d in gold_set)
    return hit / len(gold_set)

def reciprocal_rank(ranked, gold_set):
    if len(ranked) != len(set(ranked)):
        raise ValueError("require unique document IDs")
    # MRR contribution per query: 1/rank of the first relevant doc.
    for rank, d in enumerate(ranked, start=1):
        if d in gold_set:
            return 1.0 / rank
    return 0.0

def ndcg_at_k(ranked, gold_set, k):
    if k <= 0 or len(ranked) != len(set(ranked)):
        raise ValueError("require positive k and unique document IDs")
    # binary relevance: rel ∈ {0, 1}
    gains = [1.0 if d in gold_set else 0.0 for d in ranked[:k]]
    dcg = sum(g / log2(i + 2) for i, g in enumerate(gains))
    # ideal DCG: all gold docs ranked first, capped by k
    n_gold_in_topk = min(k, len(gold_set))
    idcg = sum(1.0 / log2(i + 2) for i in range(n_gold_in_topk))
    return dcg / idcg if idcg else 0.0

K = 5
print(f"Recall@{K}: {mean(recall_at_k(runs.get(q, []), gold[q], K) for q in gold):.3f}")
print(f"MRR:       {mean(reciprocal_rank(runs.get(q, []), gold[q]) for q in gold):.3f}")
print(f"nDCG@{K}:  {mean(ndcg_at_k(runs.get(q, []), gold[q], K) for q in gold):.3f}")
# Recall@5: 0.750
# MRR:       0.625
# nDCG@5:    0.627
# Duplicate and missing runs are tested in the companion's tests/test_audit_contracts.py.
Агрегат проходит по всем ожидаемым запросам и считает отсутствующий прогон пустым. В этом примере запросам с пустым золотым набором присваивается ноль; в реальном наборе вынесите такие запросы в отдельный срез отвечаемости со своим знаменателем, а не считайте этот ноль измеренным recall. Сообщайте о таймаутах и отсутствующих прогонах наравне с оценками.
На каждый PR запускайте быстрое подмножество, а перед релизом — полный золотой набор (часть 9 называет стартовые размеры). Блокируйте слияние, когда заранее выбранная метрика выходит за свой бюджет регрессии.
Репозиторий примеров фиксирует точные числа выше (Recall@5 = 0.750, MRR = 0.625, nDCG@5 = 0.627) юнит-тестом в tests/test_retrieval_metrics.py. Notebook 01 выполняет этот пример с k=5, затем показывает Recall@10, MRR и nDCG@10 на срезе SciFact; перебора k в нём нет. Харнесс, приближённый к продакшену, находится в evaluation/retrieval.py.
Гибридный retrieval и reciprocal rank fusion
BM25 — разреженная лексическая функция оценки, которая сочетает точное совпадение терминов, взвешивание терминов и нормализацию по длине. Она есть в rank_bm25, Elasticsearch, OpenSearch и в большинстве поисковых движков.
Reciprocal Rank Fusion (Cormack, Clarke и Buettcher, SIGIR 2009) объединяет ранжирования BM25 и плотного поиска по позиции. Исходная настройка k=60 — полезный базовый вариант. RRF не зависит от значений оценок, поэтому не требует нормализации между потоками, как линейная интерполяция. Если размеченный набор достаточно велик, чтобы оценить устойчивую дельту, проверьте также выпуклую комбинацию и подберите α.
Моя гипотеза: гибридный retrieval плюс реранкер-кросс-энкодер может помочь на технических корпусах, корпусах логов и кода. На сильно семантических корпусах выигрыш может быть небольшим. Сравнивайте с потоками только плотного и только разреженного поиска, потому что плохая конфигурация объединения может оказаться хуже любого из входов. Ноутбук с SciFact из репозитория — это один ограниченный тест, а не общий результат.
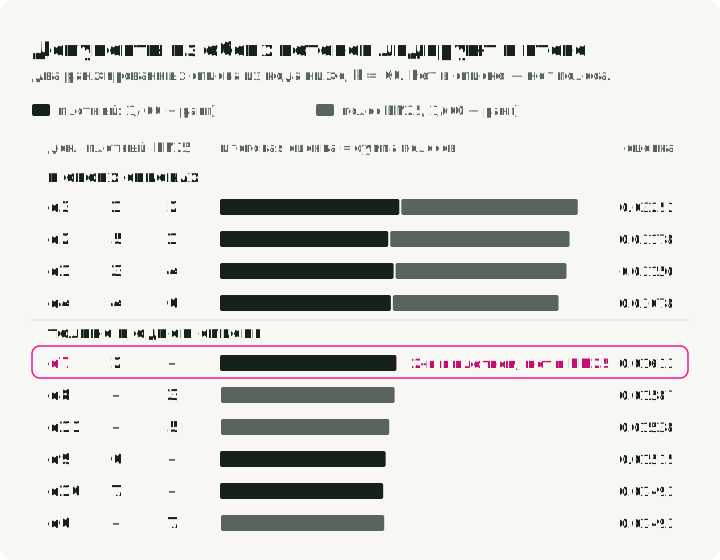
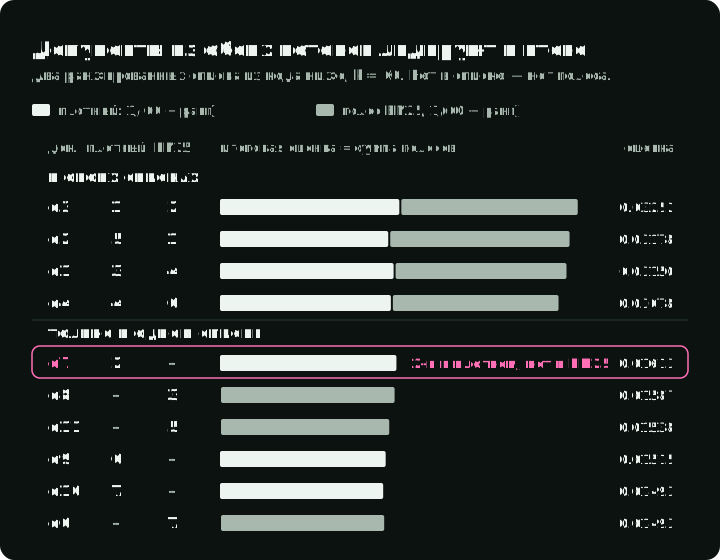
График использует два ранжированных списка из кода ниже. Каждый поток добавляет 1/(60 + ранг) за каждый документ, который он возвращает, поэтому четыре документа, попавшие в оба списка, лидируют. d7 занимает второе место в плотном списке, но его нет в списке BM25, поэтому он опускается на пятое.
Реализация умещается в несколько строк.
from collections import defaultdict

# two retrieval lanes: dense embeddings and BM25.
dense  = ["d3", "d7", "d1", "d4", "d2", "d9", "d10"]
sparse = ["d2", "d3", "d8", "d1", "d11", "d4", "d6"]

def rrf(rankings: list[list[str]], k: int = 60) -> list[tuple[str, float]]:
    """Reciprocal Rank Fusion (Cormack et al., SIGIR 2009).

    score(d) = sum over rankings of 1 / (k + rank(d))
    Score-agnostic: only rank position matters. k=60 is the canonical default.
    """
    scores: dict[str, float] = defaultdict(float)
    if k <= 0:
        raise ValueError("k must be positive")
    for ranking in rankings:
        if len(ranking) != len(set(ranking)):
            raise ValueError("each ranking must contain unique document IDs")
        for rank, doc in enumerate(ranking, start=1):
            scores[doc] += 1.0 / (k + rank)
    return sorted(scores.items(), key=lambda kv: kv[1], reverse=True)

fused = rrf([dense, sparse], k=60)
for doc, score in fused[:5]:
    print(f"{doc}  score={score:.5f}")
# d3  score=0.03252   <- rank 1 dense, rank 2 sparse
# d2  score=0.03178   <- rank 5 dense, rank 1 sparse
# d1  score=0.03150
assert [doc for doc, _ in fused[:3]] == ["d3", "d2", "d1"]
Обратите внимание, чего RRF не делает: он никогда не смотрит на исходные значения сходства. Если ретривер ставит документ на вторую позицию, этот голос стоит 1 / (60 + 2) независимо от того, какое исходное значение его дало. Плотный ретривер с косинусом 0,98 и поток BM25 с оценкой 17,4 напрямую несравнимы. Нормализация z-оценкой и min-max убирает различия в аффинном масштабе, но ни та, ни другая не калибрует значение как релевантность. Выбросы, форма распределения и набор кандидатов всё равно влияют на нормализованные значения, а значит и на результат объединения. Любую комбинацию на основе оценок проверяйте на размеченных запросах.
Гибридный retrieval + RRF на SciFact: notebook 02 сравнивает плотный retrieval, BM25 и RRF по агрегированным Recall@10, MRR и nDCG@10. Модуль объединения результатов, приближённый к продакшену, находится в retrieval/hybrid_rrf.py; tests/test_rrf.py фиксирует канонический порядок d3 / d2 / d1 при k=60.
Реранкинг
- ΔnDCG / ΔMRR: прирост относительно варианта без реранкинга на вашем золотом наборе, на той глубине, которую приложение реально использует. Считайте, запуская метрики retrieval с реранкером и без него на одинаковых наборах кандидатов.
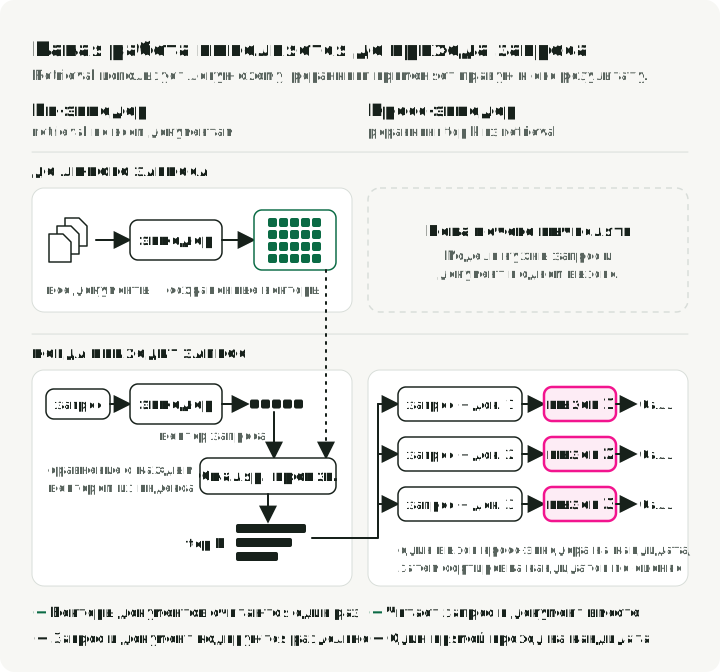
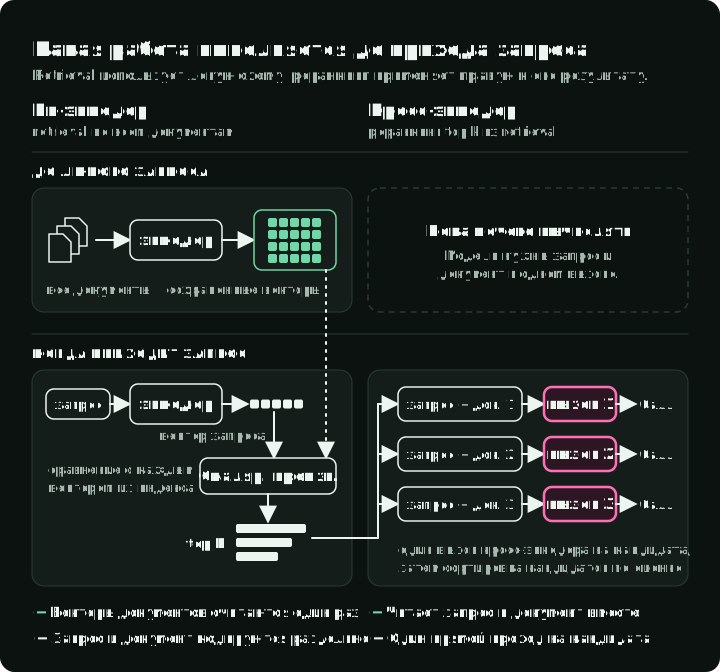
- Кросс-энкодер и би-энкодер: би-энкодер эмбеддит запрос и документ независимо (по одному вектору с каждой стороны) и оценивает скалярным произведением; кросс-энкодер склеивает запрос и документ и делает один прямой проход, в котором модель смотрит на обоих сразу. Кросс-энкодеры платят одним прямым проходом на кандидата за более богатое взаимодействие запроса и документа; разницу показывает рисунок ниже. Референсная реализация:
CrossEncoderизsentence-transformers. Измеряйте релевантность и латентность на конкретном железе, при конкретном размере батча и глубине кандидатов; не переносите результат одной модели или управляемого сервиса в другую среду. - Listwise и pointwise: pointwise оценивает каждую пару (запрос, документ) независимо; listwise оценивает весь список кандидатов целиком, чтобы модель могла сравнивать кандидатов между собой. Оцените оба подхода на одних и тех же наборах кандидатов. Порог оценки калибруйте для каждой модели и корпуса, а не считайте опубликованный пример переносимым.
На рисунке сравните две временные полосы. Би-энкодер кодирует все документы до любого запроса и сохраняет векторы; когда приходит запрос, он кодирует только запрос. Кросс-энкодеру до запроса нечего вычислять. Он читает запрос и документ за один вызов модели, поэтому запускается один раз на кандидата и только на коротком списке, который вернул retrieval.
Код ниже оценивает трёх кандидатов для одного запроса с помощью кросс-энкодера BGE:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("BAAI/bge-reranker-v2-m3")  # Reproducible baseline, not a latest-model ranking

query = "How do I rotate database credentials in production?"
candidates = [
    "Production database credentials are rotated via Vault every 30 days.",
    "The new logo was unveiled at the all-hands meeting.",
    "To rotate prod DB creds, run the `rotate-secrets` GitHub Action.",
]

scores = reranker.predict([(query, c) for c in candidates])
ranked = sorted(zip(candidates, scores), key=lambda x: -x[1])
for doc, score in ranked:
    print(f"{score:+.3f}  {doc}")
Код BGE выше — небольшой базовый вариант. Для актуального сравнения добавьте Cohere Rerank 4.0 fast/pro для управляемого многоязычного ранжирования текста или Qwen3-VL-Reranker 2B/8B, если запросы или документы содержат изображения, скриншоты или видео. Явно фиксируйте модальности задач, глубину кандидатов, лимиты входа, инструкции и железо.
Реранкер часто помогает базовому пайплайну RAG, но выигрыш не гарантирован. Измерьте его ΔPrecision@1 и ΔnDCG на золотом наборе и оставьте реранкер, только если выигрыш укладывается в бюджет латентности и стоимости. Прежде чем выбирать следующую оптимизацию, сравните этот измеренный выигрыш с эффектом от менее крупных изменений retrieval. BM25, эмбеддинги и реранкеры — более короткое руководство по выбору каждого слоя стека ранжирования.
Notebook 03 показывает P@10 до и после реранкинга кросс-энкодером на SciFact, а также ΔnDCG@10; модуль: retrieval/reranker.py. Модуль evaluation/reranking.py сравнивает реранкеры на одинаковых наборах кандидатов.
Сборка контекста и lost-in-the-middle
Многие сбои вида «retrieval хороший, ответ плохой» начинаются при сборке контекста.
- Релевантность контекста: Ragas
ContextRelevanceоценивает переданный список контекста двумя промптами и нормализованными рейтингами; это не оценка по каждому чанку. Для диагностики по чанкам оценивайте каждую пару запрос — чанк явно, например кросс-энкодером, и сообщайте распределение при локально откалиброванном пороге. - Покрытие цитированием переданного контекста: число различных переданных чанков, на которые есть цитаты, делённое на число различных переданных чанков. Случаи с пустым контекстом показывайте отдельно. Этот наблюдаемый прокси показывает, на какие чанки сослались, но не какие из них модель использовала внутри и не подтверждают ли цитаты её утверждения. Поддержку цитатами проверяйте отдельно, а покрытие сравнивайте с качеством ответа и стоимостью токенов.
- Обнаружение lost-in-the-middle: синтетический эвал, в котором вы помещаете золотой чанк на позиции {первая, средняя, последняя} длинного контекста и измеряете корректность ответа. Цитируемое исследование Liu et al. (TACL 2024) сообщает о U-образной деградации в условиях его длинного контекста. Тот же эффект в актуальной модели считайте гипотезой, которую нужно проверить. Меры: реранкинг и затем перестановка top-k так, чтобы чанк с наивысшей оценкой оказался первым или последним (именно это делает
LongContextReorderиз LangChain), или агрессивное сжатие средних чанков. Измеряйте стратифицированным по позиции эвалом, а не только суммарной оценкой. Рабочий запускаемый эвал со стратификацией по позиции лежит в ноутбуке 06 (модуль:evaluation/lost_in_middle.py). - Сжатие контекста: указывайте степень сжатия (входные токены / выходные токены) вместе с корректностью ответа. Инструменты:
ContextualCompressionRetrieverиз LangChain и LongLLMLingua. Заранее определите наибольшую допустимую потерю корректности исходя из риска приложения и бюджета токенов и отвергайте конфигурации, которые её превышают.
Часть 5. Доля ложных исключений фильтром
Этой метрике посвящён отдельный раздел, потому что суммарные оценки retrieval не позволяют отнести промах на счёт фильтра релевантности. Фильтры допуска оценивайте отдельно, относительно прав вызывающего; документ вне этого набора должен оставаться исключённым.
Жёсткий предикат релевантности вроде product = Y AND locale = en-US может обнулить эффективный recall среди документов, которые вызывающему разрешено видеть. Корректно реализованный Recall@k ловит потерю, потому что его знаменатель остаётся исходным набором допустимых релевантных документов. Но он не говорит, что вызвало промах: фильтр, ретривер или ранкер. Faithfulness оценивает утверждения относительно найденного контекста. Она всё ещё может засчитать утверждения, подтверждённые этим неполным контекстом, но не диагностирует причину в фильтре или retrieval. Пустой отказ может не дать ни одного утверждения и NaN — в зависимости от реализации; не принимайте это за свидетельство, что faithfulness одобрила отказ.
Диаграмма разбирает пример ниже. Проверка прав доступа убирает d3, который принадлежит другому тенанту; это исключение корректно. Затем фильтр релевантности убирает эталонный документ для q1 и q3. Recall@10 падает до 50% и регистрирует падение; только доля ложных исключений, тоже 50%, относит его на счёт предиката. Эвалуатор, который пересобирает эталонный набор после фильтрации, сообщает 100%.
Метрика
filter_false_exclusion_rate =
    (# queries where all gold docs were excluded by metadata filter) /
    (# queries with at least one entitlement-eligible gold doc)
Это определение на уровне запросов считает катастрофические исключения: ни один допустимый релевантный документ не выживает. Перед оценкой пересеките золотой набор каждого запроса с набором прав вызывающего; недопустимый документ ложным исключением не считается. Для запросов с несколькими золотыми документами стандартный Recall@k по-прежнему показывает частичную потерю; если эта граница важна, добавьте долю исключений по документам. Для любой из двух долей нужны (а) ID эталонных документов для каждого запроса эвала и (б) инструментирование, которое логирует применённые предикаты фильтров, а не только итоговые результаты. В качестве стартового порога компаньон-репозиторий использует долю ложных исключений не выше 2%; подбирайте её по стоимости исключения верного ответа и по доверительному интервалу вашей продакшен-выборки.
Вот рабочая реализация. Она сравнивает корректный стандартный recall с некорректным эвалуатором, который переопределяет релевантность после фильтрации.
# A small worked example where relevance predicates remove eligible documents.
docs = [
    {"id": "d1", "tenant": "acme",   "locale": "en-US"},
    {"id": "d2", "tenant": "acme",   "locale": "en-GB"},
    {"id": "d3", "tenant": "globex", "locale": "en-US"},
    {"id": "d4", "tenant": "acme",   "locale": "en-US"},
    {"id": "d5", "tenant": "acme",   "locale": "de-DE"},
    {"id": "d6", "tenant": "acme",   "locale": "fr-FR"},
]

# Tenant isolation is an eligibility invariant, not a relevance experiment.
# Verify it independently before evaluating relevance preferences.
eligible_docs = [d for d in docs if d["tenant"] == "acme"]
assert {d["id"] for d in eligible_docs} == {"d1", "d2", "d4", "d5", "d6"}

queries = [
    # the gold doc lives in en-GB but the dynamic filter forced en-US
    {"qid": "q1", "gold": {"d2"}, "filter": lambda d: d["locale"] == "en-US"},
    # the gold doc is correctly within the tenant filter
    {"qid": "q2", "gold": {"d4"}, "filter": lambda d: d["tenant"] == "acme"},
    # the gold doc lives in fr-FR but the dynamic filter forced en-US
    {"qid": "q3", "gold": {"d6"}, "filter": lambda d: d["locale"] == "en-US"},
    # the gold doc passes the filter (de-DE locale match)
    {"qid": "q4", "gold": {"d5"}, "filter": lambda d: d["locale"] == "de-DE"},
]

def filter_false_exclusion_rate(queries, eligible_docs):
    n_with_gold, n_excluded = 0, 0
    eligible_ids = {d["id"] for d in eligible_docs}
    for q in queries:
        eligible_gold = q["gold"] & eligible_ids
        if not eligible_gold:
            continue
        n_with_gold += 1
        survivors = {d["id"] for d in eligible_docs if q["filter"](d)}
        if not (eligible_gold & survivors):
            n_excluded += 1
    if not n_with_gold:
        raise ValueError("false-exclusion rate needs queries with eligible gold")
    return n_excluded / n_with_gold, n_with_gold

rate, eligible_query_count = filter_false_exclusion_rate(queries, eligible_docs)
print(f"filter_false_exclusion_rate = {rate:.2%}")
# filter_false_exclusion_rate = 50.00%
print(f"eligible queries = {eligible_query_count} / {len(queries)}")
# eligible queries = 4 / 4

# Correct Recall@k keeps the original eligible gold set as its denominator.
def standard_recall_at_k(queries, eligible_docs, k=10):
    recalls = []
    eligible_ids = {d["id"] for d in eligible_docs}
    for q in queries:
        eligible_gold = q["gold"] & eligible_ids
        if not eligible_gold:
            continue
        # demo only: the survivor set stands in for a ranked run.
        # A real harness ranks the survivors first, then slices to k.
        survivors = [d for d in eligible_docs if q["filter"](d)][:k]
        survivor_ids = {d["id"] for d in survivors}
        recalls.append(len(eligible_gold & survivor_ids) / len(eligible_gold))
    return sum(recalls) / len(recalls) if recalls else 0.0

print(f"standard recall@10 = {standard_recall_at_k(queries, eligible_docs):.2%}")
# standard recall@10 = 50.00%

# INVALID: rebuilding the gold set after filtering changes the question.
# It drops queries whose relevant documents did not survive, then scores 100%.
def invalid_recall_over_filtered_gold(queries, eligible_docs, k=10):
    recalls = []
    all_doc_ids = {d["id"] for d in eligible_docs}
    for q in queries:
        all_survivors = {d["id"] for d in eligible_docs if q["filter"](d)}
        filtered_gold = q["gold"] & all_doc_ids & all_survivors
        if not filtered_gold:
            continue
        top_k_ids = set(list(all_survivors)[:k])
        recalls.append(len(filtered_gold & top_k_ids) / len(filtered_gold))
    return sum(recalls) / len(recalls) if recalls else 0.0

invalid = invalid_recall_over_filtered_gold(queries, eligible_docs)
print(f"INVALID recall (filtered gold) = {invalid:.2%}")
# INVALID recall (filtered gold) = 100.00%

assert rate == 0.5
assert standard_recall_at_k(queries, eligible_docs) == 0.5
assert invalid == 1.0
# Unauthorized gold and an empty denominator are tested in the companion's
# tests/test_audit_contracts.py.
Функция возвращает долю и число запросов с допустимым золотым документом. Если этот знаменатель пуст, она выбрасывает исключение, а не сообщает успокаивающий ноль; обязательная проверка релиза должна считать это отсутствием данных. Запросы только с недоступными золотыми документами остаются в отдельных тестах прав доступа.
Половина запросов теряет золотой документ из-за фильтра, поэтому корректный Recall@10 падает до 50%. Эта оценка ловит симптом, но не может назвать причину. Доля ложных исключений показывает, что предикат убрал два ответа ещё до запуска ретривера. Намеренно некорректный эвалуатор показывает 100% лишь потому, что выбрасывает эти провалы из своего золотого набора. Ни одна модель не вернёт документ, который отфильтрован.
tests/test_filter_exclusion.py::test_50_percent_exclusion_rate из репозитория примеров и первый пример в notebook 04 используют старые тестовые данные из пяти документов, которые тоже дают 50 %, но q3 в них исключён изоляцией тенантов. Эти данные не воспроизводят приведённый выше пример с допустимыми эталонными документами. Ноутбук 04 также выполняет диагностику фильтров SciFact с синтетическими метаданными. Текущий evaluation/filter_exclusion.py принимает отдельный предикат авторизации и фиксированный набор допустимых эталонных документов и включает precision/recall предиката.
Парная метрика: precision и recall предикатов
Когда фильтрация динамическая (например, LLM извлекает предикаты фильтра из запроса), относитесь к экстрактору предикатов как к классификатору и оценивайте его соответственно. Измеряйте precision и recall предикатов на размеченном наборе пар (query, correct predicate). Доля ошибок предикатов не переносится напрямую в такую же потерю recall в retrieval; измеряйте, как часто эти ошибки исключают золотой документ. Когда жёсткий фильтр убрал золотой документ, никакой реранкинг не поможет.
Фильтры допуска и предпочтения по релевантности
Авторизация, изоляция арендаторов, правовая юрисдикция и статус публикации определяют, может ли документ попасть в набор кандидатов. Оставляйте их жёсткими фильтрами и проверяйте независимо; Recall@k, доля ложных исключений и precision по релевантности не дают права их ослаблять.
Для предпочтения по релевантности, такого как локаль, свежесть или версия, сравните жёсткий предикат с мягким бустом на одних и тех же отложенных допустимых запросах. Результат определяют два правила:
- Правила доступа (авторизация, арендатор, юрисдикция, статус публикации) всегда остаются жёсткими фильтрами.
- Любое другое предпочтение остаётся мягким бустом, пока не пройдёт измеренную проверку ниже. После успешной проверки оно может стать жёстким предикатом.
Псевдокод задаёт проверку для правила 2:
For each relevance preference F:
  hard_recall_F  = retrieval_recall@k with F as a hard filter
  soft_recall_F  = retrieval_recall@k with F as a +0.X rerank boost
  hard_precision = relevant_in_top_k / k under hard filter
  soft_precision = relevant_in_top_k / k under soft boost
  precision_gain = hard_precision - soft_precision
  precision_gain_CI = paired-query uncertainty interval for precision_gain
  exclusion_rate = % of queries where the gold doc was filtered out (hard)

Pre-register Δ_min, ε, and recall_loss_max for this workflow.
Use a hard predicate only if:
  lower_bound(precision_gain_CI) >= Δ_min
  AND exclusion_rate <= ε
  AND hard_recall - soft_recall >= -recall_loss_max.
Otherwise prefer a soft boost.
Минимально полезный прирост precision, доверительный интервал, ε и допустимую потерю recall выбирайте исходя из вреда от исключения допустимого ответа, пользы от повышения precision и размера отложенной выборки. Начните с ε в 1–2% и снижайте её там, где пропущенный ответ обходится дорого.
Часть 6. Оценка генерации
Метрики retrieval говорят, что система могла бы ответить верно. Они не говорят, что она ответила верно. Этот пробел закрывают метрики генерации.
Faithfulness и groundedness
RAGAS faithfulness разбивает ответ на атомарные утверждения (короткие самодостаточные фактические высказывания), а затем проверяет каждое относительно найденного контекста с помощью LLM-джаджа:
Faithfulness проверяет поддержку в переданных данных; она не устанавливает, что эти данные верны или достаточны для ответа на вопрос. Ответы без утверждений фиксируйте отдельно и указывайте их число, а не присваивайте пустому ответу идеальную faithfulness.
Актуальная документация Ragas рекомендует API collections из примера ниже. В проекте на uv установите ragas и openai командой uv add ragas openai, задайте OPENAI_API_KEY и сохраните код как скрипт для запуска через uv run. Пример делает вызовы к провайдеру и расходует деньги; оценка — это результат джаджа, а не детерминированная ожидаемая константа. Зафиксируйте разрешённые зависимости в lock-файле.
import asyncio

from openai import AsyncOpenAI, omit
from ragas.llms import llm_factory
from ragas.metrics.collections import Faithfulness

async def main():
    async with AsyncOpenAI() as client:
        # Ragas 0.4.3 sends max_tokens by default; GPT-5.6 models need max_completion_tokens.
        llm = llm_factory(
            "gpt-5.6-terra", client=client, reasoning_effort="none",
            max_tokens=omit, max_completion_tokens=1024,
            temperature=omit, top_p=omit,
        )
        scorer = Faithfulness(llm=llm)
        result = await scorer.ascore(
            user_input="How many moons does Mars have?",
            response="Mars has two moons, Phobos and Deimos.",
            retrieved_contexts=["Mars has two moons named Phobos and Deimos."],
        )
        print(result.value)

if __name__ == "__main__":
    asyncio.run(main())
В этом примере в роли джаджа используется GPT-5.6 Terra; фабрика Ragas передаёт аргументы модели дальше. Прежде чем заменять более дешёвого джаджа, который вы уже проверили по разметке, сравните ложные успехи, ложные провалы и стоимость нового джаджа с оценками людей.
В таблице фреймворков в части 1 названы ещё answer relevancy и context precision. Тот же API collections оценивает обе метрики с тем же llm. AnswerRelevancy дополнительно принимает эмбеддинг-модель, например embedding_factory("openai", model="text-embedding-3-small", client=client) из ragas.embeddings.base. ContextPrecision требует в ascore эталонный ответ reference. Каждая оценка отвечает на свой вопрос: faithfulness спрашивает, подтверждает ли контекст ответ, answer relevancy — отвечает ли ответ на вопрос, а context precision — стоит ли релевантный контекст в ранжировании первым.
Чтобы написать собственный скорер, сохраните структуру «извлечь — проверить — агрегировать». Извлечение — это вызов LLM, который разбивает ответ на утверждения; проверка — это NLI-модель (natural-language inference) или LLM-джадж. Валидируйте извлечение и следование (entailment) отдельно и фиксируйте ответы без утверждений и неудавшиеся вердикты. Например, ответ с 4 утверждениями, 3 из которых подтверждены, получает 3/4 = 0.75. Ответ с 0 утверждений не оценивается.
Notebook 05 выполняет фиксированный пример о Марсе офлайн с лексической приближённой оценкой; она не проверяет семантическое следование. Его модуль evaluation/faithfulness.py также реализует извлечение и проверку утверждений через SGR. Набор тестов generation оценивает размеченные синтетические QA-данные с --suite generation --live. Репозиторий использует только модели OpenAI. По умолчанию gpt-5.6-luna генерирует ответы и выступает джаджем; --judge-model gpt-5.6-terra меняет джаджа. Обе модели от одного провайдера, поэтому репозиторий показывает джадж-воркфлоу, а не сравнение разных семейств моделей.
Специализированная альтернатива LLM-as-judge — HHEM-2.1-Open (Hughes Hallucination Evaluation Model от Vectara), классификатор, дообученный для обнаружения галлюцинаций. Его карточка модели описывает чекпоинт, исходную оценку от 0 до 1, которую он выдаёт, и результаты по сбалансированной точности на AggreFact и RAGTruth. Порога решения по умолчанию он не публикует, так что выбирать его вам. Считайте это свидетельством из карточки модели, а не гарантией для вашего корпуса: откалибруйте порог на локальной разметке и сравните с выбранным джаджем до деплоя.
Оценка по атомарным фактам
FActScore (Min et al., EMNLP 2023) разбивает длинные генерации на атомарные факты, находит свидетельства для каждого факта, помечает каждый как supported / not-supported и сообщает долю подтверждённых:
Эталонная реализация: shmsw25/FActScore. Исходная оценка охватывала биографии с Wikipedia в качестве источника доказательств. Для адаптации к кратким изложениям или другим длинным текстам нужно локально проверить извлечение утверждений, полноту доказательств и оценки подтверждённости. Повторяющиеся тривиальные факты могут повысить оценку, а отдельные верные утверждения — вместе составить вводящий в заблуждение ответ. MontageLie (EMNLP 2025) проверяет эту слабость через обманчивые связи и порядок верных утверждений. VeriScore обрабатывает утверждения с необходимыми уточнениями; фильтр Core помогает предотвратить добавление лишних фактов ради оценки.
Точность цитирования
Отслеживайте precision цитирования (цитируемые фрагменты действительно подтверждают утверждение) и recall цитирования (утверждения, которые нужно процитировать, процитированы):
TREC 2024 RAG Track задаёт воспроизводимый протокол оценки поддержки. Thakur et al. (SIGIR 2025) сообщают о примерно 56% согласия с оценками людей, сделанными с нуля, и о 72% при другом условии, когда люди доредактировали предсказания LLM. Второе — это ассистированная разметка, а не независимое свидетельство того, что точность джаджа выросла. Храните условие разметки рядом с числом. Для автоматического приближения ALCE (Gao et al., EMNLP 2023) реализует precision и recall цитирования с проверкой на основе NLI.
Корректность, полнота и отказы в ответе
- Корректность ответа относительно эталона: для коротких ответов подойдут точное совпадение или token-F1; Hugging Face
evaluate.load("squad")считает оба, а пакетbert-scoreсчитает BERTScore. Для более длинных ответов проверяйте фактические отношения, сущности, количества, отрицание и обязательную информацию по проверенным эталонам. BERTScore и косинус эмбеддингов измеряют сходство; неверное число или отрицание могут сохранить высокую оценку. RagasAnswerCorrectnessсочетает фактическое сравнение со сходством, а не приравнивает их. - Полнота через nuggets: nugget — это релевантная единица информации; обязательные nuggets отличают от необязательных полезных. Вопрос о дате основания может требовать год; имя основателя не обязательно. AutoNuggetizer строит и уточняет nuggets по пулам оценённых документов, а затем проверяет их наличие в сгенерированных ответах. Его первый отчёт по TREC 2024 охватывал 21 тему и 45 прогонов. Обзор TREC 2025, опубликованный в марте 2026 года, расширяет протокол на повествовательные запросы и оценивает релевантность retrieval, полноту ответа и атрибуцию. Это публичные протоколы оценки, а не доказательство того, что каждой продакшен-системе RAG нужна такая же рубрика nuggets.
- Поведение при отказе: разметьте, позволяют ли переданные данные дать ответ, затем измерьте долю верных отказов среди всех отказов и долю отказов среди случаев, где нужно воздержаться. NoMIRACL (Findings of EMNLP 2024) проверяет устойчивость на релевантных и нерелевантных переданных фрагментах; это не доказывает, что во всём корпусе нет ответа. В собственном наборе отделяйте промахи retrieval от запросов, действительно лежащих вне области.
Проверка после генерации
Самый дешёвый рост надёжности часто даёт детерминированная постпроверка, а не более крупные модели.
-
Флаг невиданной сущности: фиксируйте строки именованных сущностей в ответе, которых нет в нормализованной строке контекста (например,
entsизspaCyплюс точное сопоставление). Это дешёвый доменный флаг невиданных строк сущностей, а не проверка граундинга: он не может установить тождество, отношение, отрицание, время или происхождение. Измерьте его precision и recall на локальной разметке, прежде чем использовать для одобрения релиза, а для проверки сохраните проверку следования (entailment) на уровне утверждений или ручную проверку.В этом примере флаг не находит невиданной сущности, хотя ответ говорит обратное тому, что сказано в контексте.
def unseen_entity_flag(answer: str, context: str, entities: list[str]) -> bool: return any(entity.lower() not in context.lower() for entity in entities) context = "Paris was not founded in 1994." answer = "Paris was founded in 1994." assert not unseen_entity_flag(answer, context, ["Paris"]) claim_supported = False # human label or an NLI verdict, not the lexical flag assert not claim_supported -
Проверка утверждений: извлеките утверждения, прогоните NLI относительно контекста, отклоняйте или помечайте всё, что ниже порога. NLI-модели для faithfulness:
cross-encoder/nli-deberta-v3-large,MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli. Добавляет латентность. Оправдано для областей с высокой ценой ошибки. -
Self-consistency (Wang et al., ICLR 2023): сэмплируйте несколько генераций при температуре > 0; сообщайте долю согласия (например, долю генераций, совпадающих с модальным ответом, или попарный BERTScore); число сэмплов выбирайте по кривой «стабильность — стоимость» и помечайте ответы с низким согласием для ручной проверки.
-
Калибровка уверенности: собирайте вербализованную уверенность («Насколько вы уверены, от 0 до 1?») и сравнивайте с реальной корректностью на наборе эвала. Постройте калибровочную кривую и сообщайте Expected Calibration Error: , где — интервалы уверенности. Реализации:
netcal,torchmetrics.CalibrationError. Модель, сообщающая уверенность 0,9, должна быть права примерно в 90% сопоставимых случаев; измеряйте разрыв, а не предполагайте калибровку.
Часть 7. Оценка RAG на основе онтологии
Стандартные метрики выше относятся к RAG на открытом корпусе. Если ваш RAG ищет по структурированной онтологии, таксономии или графу знаний, эти метрики необходимы, но недостаточны. Примеры: товары в каталоге, состояния в SNOMED, компоненты в спецификации материалов (BOM) и техники атак в MITRE ATT&CK. Нужно измерять и слой онтологии.
Точность связывания сущностей
Первая задача — сопоставить упоминание в запросе с сущностью онтологии («Аспирин» → wikidata:Q18216, «737-й» → aircraft:Boeing_737).
- Precision/recall/F1 на уровне упоминаний: стандартные, относительно эталонных спанов упоминаний (считайте через
seqevalили сравнением множеств спанов). - Точность снятия неоднозначности: какая доля верно найденных упоминаний сопоставлена с правильным ID сущности? Публичные референсы: ReFinED, REL и GENRE; бенчмарки вроде AIDA-CoNLL и BELB показывают, что результаты зависят от системы и области.
- Обработка NIL: precision/recall для случая «сущности нет в онтологии». Излишнее связывание с близкими, но неверными сущностями измеряйте отдельно от корректного воздержания.
Иерархически чувствительная оценка
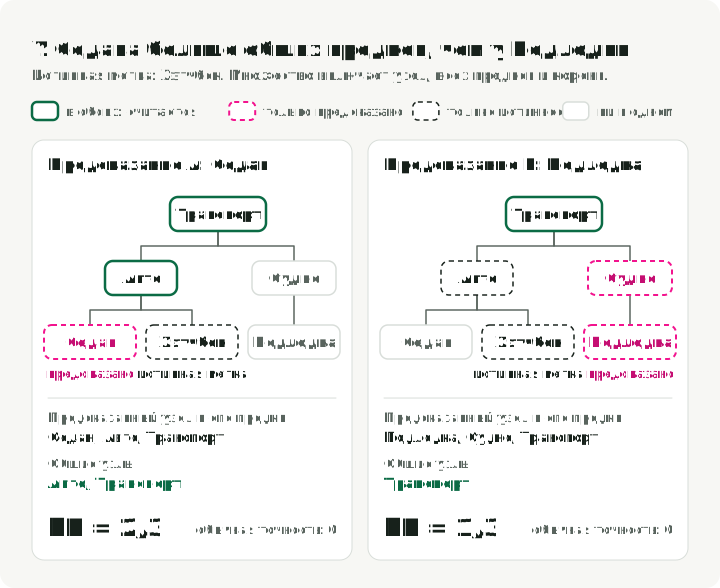
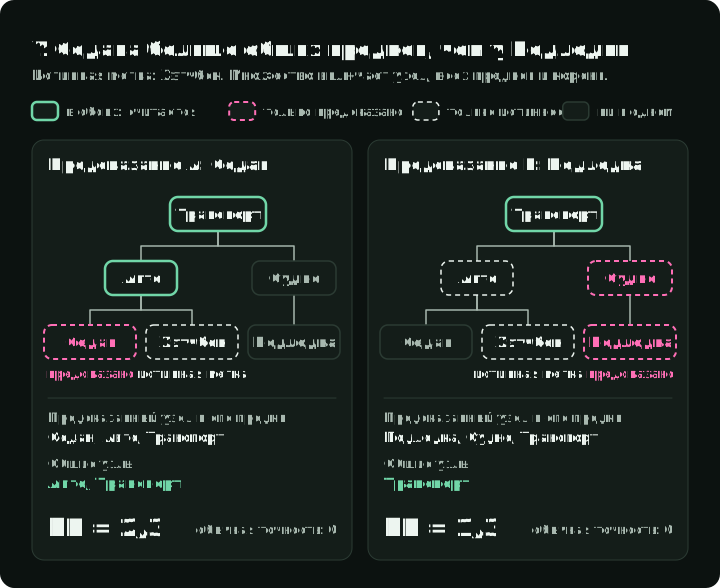
Обычная точность одинаково наказывает за «предсказали Седан, а верный ответ Хэтчбек» и за «предсказали Подводная лодка, а верный ответ Хэтчбек». Эти ошибки неравнозначны. На диаграмме Седан делит с верной меткой два из трёх узлов, а Подводная лодка — только корень; иерархическая precision ниже превращает это пересечение в оценку.
-
Иерархические precision/recall/F1 (Kosmopoulos et al., 2015): засчитывают общих предков в DAG онтологии. Пусть — предсказанный узел вместе со всеми его предками, а — верный узел вместе со всеми его предками:
Реализуйте через
networkxна графе онтологии: дополните каждое предсказание и каждую метку их предками, а затем возьмите пересечения множеств из формул выше. -
Сходство Ву — Палмера между предсказанной и эталонной сущностью в таксономии (Wu & Palmer, 1994):
где LCA — наименьший общий предок в таксономии. Из коробки доступно в NLTK для WordNet (
from nltk.corpus import wordnet as wn; wn.synset("car.n.01").wup_similarity(wn.synset("truck.n.01"))); для собственных таксономий считайте LCA черезnetworkx. -
Доля путаницы с соседними и родительскими узлами: отдельно отслеживайте путаницу с сестринскими, родительскими и дочерними узлами —
count_sibling / total_errors,count_parent / total_errors,count_descendant / total_errors. На проверенных примерах выясните, возникают ли ошибки с сестринскими узлами из-за неоднозначных упоминаний, а ошибки с родительскими — из-за чрезмерного обобщения.
Доля ложных исключений фильтром (повтор, теперь критично)
В системах на основе онтологии жёсткие фильтры часто берутся из самой онтологии («искать только документы с категорией X»). Метрика доли исключений (определена в части 5) становится главным сигналом корректности. Неверно предсказанная категория может обнулить recall; доля исключений относит эту потерю на счёт фильтра.
Соответствие ограниченной генерации
Когда вывод должен соответствовать онтологии (каждое название сущности в ответе должно быть допустимым элементом онтологии; каждый предикат должен браться из закрытого словаря), измеряйте:
- Доля валидных по схеме выводов: доля выводов, которые разбираются и проходят проверку по схеме онтологии. Проверяйте через
jsonschemaилиpydantic. JSONSchemaBench — публичный бенчмарк для structured output общего вида; для схем под конкретную онтологию напишите собственный валидатор. - Соответствие словарю: доля именованных сущностей в выводе, которые являются допустимыми ID онтологии — проверка принадлежности к множеству закрытого словаря в одну строку.
- Семантическое соответствие: синтаксически валидный вывод всё равно может выбрать неверную, но допустимую сущность. Сочетайте проверку соответствия с корректностью итогового ответа.
Фреймворки constrained decoding (Outlines, XGrammar, Guidance, OpenAI Structured Outputs) предназначены для обеспечения валидности по схеме. JSONSchemaBench сравнивает эффективность, покрытие и качество разных реализаций. Перезапустите его кейсы, соответствующие вашим схемам и бэкенду сервинга, потому что покрытие и латентность зависят от обоих.
Аудируемость
Для систем на основе онтологии, ответы которых проходят проверку:
- Полнота цитирования: доля фактических утверждений хотя бы с одной проверяемой цитатой.
- Глубина происхождения: доля цитат, которые прослеживаются до исходного документа со стабильным ID, а не только до хэша чанка.
- Доля воспроизводимости: повторный запуск того же запроса на фиксированном снапшоте возвращает тот же ответ. Зафиксируйте версию модели, рантайм, конфигурацию декодирования и seed, а затем задайте требуемую долю повторов исходя из потребностей аудита в вашем процессе. Одна лишь нулевая температура не гарантирует детерминизм. Расхождение может возникнуть при генерации, в рантайме сервинга или на любой стадии выше.
Часть 8. Оценка системы целиком
Общее качество ответа
- LLM-as-judge (Zheng et al., NeurIPS 2023): масштабируемый подход к оценке на основе модели. G-Eval (Liu et al., EMNLP 2023) генерирует шаги оценки из задачи и критериев, а затем взвешивает уровни рейтинга по вероятностям их токенов: . Это вероятности, а не логарифмы вероятностей. Согласие зависит от джаджа, задачи, промпта и калибровочного набора.
- Попарное предпочтение: покажите джаджу ответ A и ответ B и запишите предпочтение. Это заменяет абсолютную оценку сравнительным решением, но всё равно требует калибровки относительно человеческих предпочтений. MT-Bench сообщил о согласии джаджа GPT-4 выше 80% как с человеческими предпочтениями, так и между людьми в условиях своего бенчмарка; не переносите эту долю на другую область без калибровки.
У LLM-as-judge есть реальные смещения:
- Смещение по позиции: измерьте чувствительность к порядку на размеченных людьми случаях для выбранного джаджа и задачи. Рандомизация или агрегация по обоим порядкам может помочь некоторым парам модель/задача, но оставляйте любой из приёмов, только если он улучшает согласие с людьми на ваших данных; контролируемое исследование 2026 года показало, что перестановка позиций вредна на его состязательных случаях.
- Смещение в пользу многословия: джаджи могут путать длину с качеством. Цитируемое контролируемое исследование 2026 года, версия 2 обнаружило неоднородное поведение на парах с расширением: три джаджа предпочитали более длинные ответы, Claude предпочитал краткие, а GPT-4o был примерно нейтрален. Все пять хорошо справились с контрольными случаями с усечением. Эти результаты привязаны к бенчмарку, поэтому объясните джаджу, как относиться к полноте и воде, а затем сообщайте качество с поправкой на длину по собственной рубрике.
- Риск самопредпочтения: Zheng et al. наблюдали на 10% более высокую долю побед собственных ответов GPT-4 и на 25% более высокую долю побед собственных ответов Claude-v1 в своих данных, но заключили, что ограниченные данные и малые различия не позволяют установить смещение в пользу себя. Сравнивайте джаджей из одного и из разных семейств с локальной разметкой людей; выбирайте лучше откалиброванного джаджа, а не считайте безопасным какой-либо из вариантов.
Практический рецепт: выберите джаджа на размеченных людьми калибровочных данных, скройте идентичность моделей, измерьте чувствительность к порядку и пропишите политику по длине в рубрике. Повторяйте случаи, только когда дополнительные сэмплы заметно снижают неопределённость. Для ответственных оценок сравните джаджей из одного и из разных семейств и разберите расхождения относительно разметки людей.
Schema-Guided Reasoning для джаджей
Свободная форма вывода — один из источников разброса в запусках джаджа. Два запуска на одном и том же ответе могут по-разному организовать рубрику и дать разные оценки. Schema-Guided Reasoning (SGR) делает рубрику явной: определите этапы оценки как схему Pydantic, а затем примените constrained output через Outlines, XGrammar, structured outputs в vLLM или response_format в OpenAI, чтобы обеспечить поддерживаемые ограничения схемы. Порядок полей может помочь проверяющему изучать запись, но не доказывает, что модель рассуждала по этапам именно в этом порядке.
Для эвала RAG схема раскладывает суждение на явные, проверяемые поля, а не позволяет модели сразу выдать число:
from pydantic import BaseModel, Field, ValidationError, model_validator
from typing import Literal

class FaithfulnessJudgment(BaseModel):
    extracted_claims: list[str] = Field(
        description="Atomic factual claims in the answer, one per item."
    )
    supported_claims: list[str] = Field(
        description="Subset of extracted_claims that are entailed by the context."
    )
    unsupported_claims: list[str] = Field(
        description="Subset that is NOT entailed by the context."
    )
    outcome: Literal["scored", "no_claims"]
    failure_mode: Literal[
        "none", "fabrication", "overgeneralization", "wrong_entity", "stale_fact"
    ]
    rationale: str

    @model_validator(mode="after")
    def require_claim_partition(self):
        for claims in (self.extracted_claims, self.supported_claims, self.unsupported_claims):
            if any(not claim.strip() for claim in claims):
                raise ValueError("claims must contain non-whitespace text")
        extracted = set(self.extracted_claims)
        supported = set(self.supported_claims)
        unsupported = set(self.unsupported_claims)
        if not extracted:
            if supported or unsupported or self.outcome != "no_claims":
                raise ValueError("an empty extraction must be a no_claims outcome")
            return self
        if (
            len(extracted) != len(self.extracted_claims)
            or len(supported) != len(self.supported_claims)
            or len(unsupported) != len(self.unsupported_claims)
            or supported & unsupported
            or supported | unsupported != extracted
            or self.outcome != "scored"
        ):
            raise ValueError("verdict lists must be a complete, disjoint claim partition")
        return self

    @property
    def score(self) -> float | None:
        if not self.extracted_claims:
            return None
        return len(self.supported_claims) / len(self.extracted_claims)

valid = FaithfulnessJudgment(
    extracted_claims=["Mars has two moons", "Mars has a thick atmosphere"],
    supported_claims=["Mars has two moons"],
    unsupported_claims=["Mars has a thick atmosphere"],
    outcome="scored",
    failure_mode="fabrication",
    rationale="The atmosphere claim lacks support.",
)
assert valid.score == 0.5
empty = FaithfulnessJudgment(
    extracted_claims=[],
    supported_claims=[],
    unsupported_claims=[],
    outcome="no_claims",
    failure_mode="none",
    rationale="Score refusal correctness separately.",
)
assert empty.score is None
try:
    FaithfulnessJudgment(
        extracted_claims=["Mars has two moons"],
        supported_claims=["Mars has two moons"],
        unsupported_claims=["Mars has two moons"],
        outcome="scored",
        failure_mode="none",
        rationale="Contradictory verdict.",
    )
except ValidationError:
    pass
else:
    raise AssertionError("overlapping verdicts must fail validation")
Этот иллюстративный контракт вычисляет оценку только после того, как списки вердиктов образуют полное непересекающееся разбиение извлечённых утверждений. У исхода «нет утверждений» нет оценки faithfulness, и он должен оставаться вне агрегата faithfulness; указывайте число таких исходов и оценивайте корректность отказов отдельно, чтобы воздержания не улучшали среднее незаметно. Сохраните эти семантические проверки в продакшене; constrained output гарантирует форму, но не беспристрастный вердикт. Модель Pydantic также делает изменение рубрики видимым как дифф кода, а человеческая калибровка проверяет само суждение.
Это работает для любого джаджа на основе рубрики, а не только для faithfulness. Попарное предпочтение, поддержка цитатами и корректность отказов выигрывают от той же обработки.
Notebook 07 измеряет позиционное смещение парными вызовами с перестановкой ответов. Его модуль evaluation/llm_judge.py также реализует поточечное оценивание через SGR. Парные запуски показывают оба порядка ответов и сообщают согласованность после перестановки. Поточечный джадж возвращает одну целочисленную оценку; это не метод G-Eval со взвешиванием по вероятностям. Поскольку обе модели от одного провайдера, для измерения предпочтения собственной модели всё ещё нужен джадж из другого семейства, сопоставленный с локальными человеческими метками.
Латентность и стоимость
- p50, p95, p99 на каждой стадии пайплайна. Разумный старт: p95 для SLO и p99 для алертов; меняйте их, когда поймёте пользовательский сценарий, объём трафика и бюджет ошибок.
- Time-to-first-token и общее время генерации. Для стриминга пользователям важен TTFT.
- Разбивка по стадиям: retrieval, реранкинг, генерация, постобработка. Ищите хвост по трейсу, а не предполагайте, какая стадия его вызвала; сравнивая запуски, записывайте устройство и размер батча реранкера.
- Всего $/запрос = эмбеддинг + retrieval + реранкинг + генерация + амортизированное хранение. Отслеживайте p50 и p99; бюджет уходит в длинный хвост.
- Доля попаданий в кэш на уровнях кэша эмбеддингов, кэша retrieval и KV cache. Ставьте отдельные цели, исходя из наблюдаемой повторяемости, политики инвалидации и стоимости, которую экономит каждый слой.
Notebook 08 показывает p50/p95/p99 для этапа retrieve, инструментированного в evaluation/runner.py. Модуль evaluation/latency.py может обобщать другие этапы, если вы явно добавите их инструментирование. make benchmark перебирает настройки чанкинга и эмбеддингов без вызовов API. Сравнению LLM нужны ключ OpenAI и uv run python -m rag_evals.scripts.benchmark --skip-chunking --skip-embedding --live.
A/B-тестирование
- Единица рандомизации: сначала определите результат, который хотите оценить. Затем спросите себя, могут ли прежние ответы изменить последующее поведение и может ли назначенная одному пользователю версия влиять на опыт другого. Используйте назначение по пользователю или по сессии, когда повторное воздействие может изменить поведение или создать несогласованный UX. Назначение по запросу оправданно, только когда эти эффекты пренебрежимо малы, а анализ учитывает повторные наблюдения.
- Основные, защитные и исследовательские метрики: зафиксируйте их заранее. Основную меру выбирайте по продуктовому результату; прокси удовлетворённости — лайки, регенерации и время просмотра. Латентность и стоимость считайте защитными метриками, когда они ограничивают пользовательский опыт.
- Размер выборки: проведите анализ мощности до запуска, исходя из минимального эффекта, который стоит обнаружить, базовой дисперсии, единицы назначения и правила остановки.
Часть 9. Построение тестового набора
Метрика хороша лишь настолько, насколько хорош тестовый набор, на котором она считается. Если ваш золотой набор покрывает три интента, а продакшен-трафик охватывает двенадцать, Recall@10 измеряет только эти три интента. Хуже того, тестовый набор, переобученный на лёгкие вопросы («Какова политика возврата в компании?»), может одобрить систему, которая проваливает трудные («Право на возврат при частичной отмене по правилам защиты прав потребителей ЕС, счёт в евро, клиент из Ирландии?»). Суммарная оценка растёт, а система по-прежнему подводит важную часть продакшен-трафика.
Неполная разметка релевантности может исказить recall в любую сторону. Если истинный релевантный набор — {a, b}, а разметка содержит только {a}, то выдача {a} даёт 1,0 вместо 0,5, а выдача {b} даёт ноль вместо 0,5. Версионируйте оценки релевантности и просматривайте вновь найденные неоценённые документы, прежде чем интерпретировать дельту.
Сначала постройте тестовый набор по реальному распределению запросов и их сложности. Затем выберите метрики, которые реагируют на целевые сбои, и настраивайте систему по ним.
Генерация синтетических запросов
Используйте LLM, чтобы генерировать вопросы по вашему корпусу:
- По чанкам: «Сгенерируй 3 вопроса, которые мог бы задать пользователь и на которые отвечает этот чанк».
- Multi-hop: возьмите два чанка и сгенерируйте вопрос, требующий обоих.
- Состязательные: генерируйте вопросы с отвлекающими сущностями, почти дублирующими формулировками, неоднозначными упоминаниями.
Генерация тестов в Ragas использует сценарии на основе графа с single-hop и multi-hop запросами и с конкретными или абстрактными информационными потребностями. DataMorgana генерирует настраиваемые синтетические бенчмарки по категориям пользователей и вопросов. Синтетические данные полезны для холодного старта и проверки покрытия. Они не заменяют реальные запросы пользователей.
Построение золотого датасета
Золотой набор опирается на данные, подобранные людьми.
- Возьмите выборку реальных запросов пользователей (или имитированных, если до запуска), стратифицированную по интенту.
- Пусть эксперты предметной области (SME) ответят на каждый вопрос и укажут, в каких документах есть ответ.
- Начните с нескольких сотен запросов (200–500) и проверьте интервал. При 200 запросах и доле успехов около 0,8 95%-й интервал составляет примерно ±5,5 пункта (1,96 × √(0,8 × 0,2 / 200)). Если изменение, которое нужно обнаружить, меньше, добавьте запросы в срезы, от которых зависит решение о релизе.
- Добавляйте проверенные продакшен-запросы (часть 10), когда проверки дрейфа или новые типы запросов показывают пробел в матрице покрытия ниже.
Держите четыре набора раздельно:
- Разработка: настройка промптов, k и чанкинга.
- Калибровка джаджа: человеческая разметка, которая проверяет джаджа.
- Релиз: оценивается один раз для каждого кандидата, никогда не используется для настройки.
- Мониторинг: свежий продакшен-трафик, проверяется вслепую.
Перед разбиением сгруппируйте общие исходные документы и сессии. Как только запрос или разметка направили настройку, это данные для разработки, поэтому релизный набор, использованный для настройки, становится набором для разработки. Оставьте нетронутые случаи, чтобы проверить выбранную конфигурацию и джаджа.
Записывайте версии корпуса, запросов, разметки релевантности и политики, единицу k, бюджет переданного контекста, ревизии скореров и джаджей и правила агрегации. Сравнивайте парные дельты по запросам на одной и той же выборке, с неопределённостью и числом элементов в срезах. Включайте каждый ожидаемый запрос: таймаут, отсутствующий результат или невозможный для оценки ответ джаджа должны оставаться видимыми в учёте завершений и ошибок. Не позволяйте релизной оценке расти за счёт тихого отбрасывания сбоев. ARES предлагает исследовательский подход с автоматическими джаджами, проверкой людьми и prediction-powered inference для оценок системы при нехватке разметки; проверенный локальный набор можно начать проще.
Состязательные тестовые наборы
- Контрфактические запросы: поменяйте в запросе ключевые сущности. Находит ли система верные чанки для изменённого запроса?
- Отвлекающие данные: запросы, для которых корпус содержит правдоподобный, но неверный ответ, который не должен находиться. Именно это проверяет на устойчивость RGB (Chen et al., AAAI 2024): устойчивость к шуму, отклонение негативных случаев, интеграцию информации и контрфактическую устойчивость.
- Отрицание и кванторы: запросы со словами «не», «кроме» и «только». Плотные ретриверы часто с ними не справляются.
- Вне области: запросы, ответа на которые в корпусе нет. Система должна сказать «не знаю», а не галлюцинировать. NoMIRACL даёт тесты релевантности и отвечаемости на уровне фрагментов; добавьте отдельные метки «вне области» на уровне корпуса. Оценивайте воздержание явно на ваших типах продакшен-запросов.
Покрытие и непрерывная оценка
- Постройте матрицу покрытия: интент запроса × тип документа × ветвь онтологии. Один запрос на ячейку — это стартовая опись покрытия, а не достаточная статистическая мощность для решения о релизе. Пустые ячейки показывают недостающее покрытие; размер заполненных срезов подбирайте под ту неопределённость, которую вы готовы терпеть.
- Стартовый график: подмножество примерно из 50 запросов на каждый PR, полный золотой набор ночью или на каждого кандидата в релиз и проверки дрейфа раз в неделю на продакшен-выборке.
make eval-fastв репозитории-компаньоне запускает подмножество из 50 запросов. Меняйте график, когда узнаете стоимость оценки и скорость изменения трафика. - Для дрейфа используйте скользящую продакшен-выборку и стратифицируйте по обратной связи, а не меняйте целевое распределение незаметно.
Часть 10. Мониторинг в продакшене
Набор эвалов, который вы выпускаете, описывает систему на момент запуска. После этого продакшен-трафик меняется.
Неявная и явная обратная связь
- Считайте неявные события кандидатами в сигналы, а не положительными или отрицательными KPI качества, пока они не коррелируют со слепой проверкой или явной обратной связью на локальной выборке.
- Доля кликов / открытий цитируемых источников (если ваш интерфейс их показывает).
- Время просмотра ответа.
- Доля регенераций: процент ответов, которые пользователь переспрашивает или просит систему переделать. Считайте её одним из сигналов неудовлетворённости и калибруйте по проверенным диалогам.
- Доли копирования / отправки / экспорта: кандидаты в неявные сигналы, которые могут означать пользу, проверку, передачу дальше или неудовлетворённость. Измерьте их связь и доверительный интервал, прежде чем приписывать им направление.
- Паттерны уточнений: используйте «Вы уверены?» или «А как насчёт X?» как страты для проверки, затем разметьте их связь с недоверием или неудовлетворённой потребностью.
- Лайк/дизлайк с необязательными категориями причин (неверно, неполно, не по теме, вредно, медленно). Правки прямо в тексте могут сохранить больше диагностического контекста; оцените эту пользу на проверенных выборках.
Обнаружение дрейфа
- Дрейф запросов: сравнивайте эмбеддинги запросов с эталонным окном через MMD или проверенный классификатор «эталон против текущего». KL требует определённого оценщика вероятностей, например заданных гистограмм; сырые координаты эмбеддингов вероятностями не являются. Откалибруйте тревоги на известных сдвигах, затем изучите затронутые срезы.
- Дрейф эмбеддингов: зафиксируйте представление и набор пробных запросов, затем измеряйте стабильность соседей и качество retrieval. У разных версий модели размерности и базис координат могут не совпадать, поэтому косинус между версиями может не иметь смысла. Мигрируйте энкодеры запросов и документов вместе, оцените новый индекс и сохраняйте версионированные снапшоты для отката.
- Дрейф качества: отслеживайте во времени продакшен-аналоги метрик (доля регенераций по интентам). Внезапные и постепенные сдвиги подсказывают разные гипотезы, но их форма не устанавливает причину; изучите изменения в данных, трафике, провайдере, политике и деплое.
Теневая оценка и человек в контуре
Запускайте систему-кандидата параллельно с продакшеном, сравнивайте результаты офлайн и не показывайте их пользователям. Так можно выявить регрессии до запуска. Теневой инференс всё равно потребляет ресурсы и может вызывать инструменты: изолируйте ресурсы, отключите запись и проверьте, что сравнение не ухудшает латентность продакшена.
Для проверки с человеком в контуре (HITL):
- Отправляйте выводы с низкой уверенностью в очередь на проверку.
- Включайте случайную выборку продакшен-трафика для слепой проверки; стартовая доля — 1–2% трафика, её подстраивают под объём трафика, риск и возможности проверяющих.
- Дополнительно к случайной выборке берите на проверку больше выводов с дизлайками.
- Используйте проверенные выводы, чтобы расширять золотой набор.
Сохраняйте случайную выборку: без неё золотой набор пополняется только ответами, на которые пожаловались пользователи.
Минимальный набор гардрейлов
Приоритеты и пороги алертов выбирайте по вреду для пользователя, SLO и проверенному качеству детекторов. Кандидаты в сигналы:
- Оценка faithfulness/HHEM ниже порога на скользящей продакшен-выборке.
- p95 латентности выше SLO.
- Доля ложных исключений фильтром выше порога (по выборке).
- Доля регенераций вне локально откалиброванного контрольного коридора, который учитывает размер окна, трафик, сезонность и бюджет ложных тревог.
- Стоимость запроса выше бюджета.
Первое правило сортировки: тревога без изменения кода или модели указывает на дрейф; тревога сразу после релиза указывает на регрессию. Подтверждайте любую из версий по трейсам и затронутым срезам, потому что деплой может совпасть с дрейфом трафика, а изменения у провайдера или в данных могут случиться без релиза приложения.
Оговорки
- Целевые значения локальны, а не универсальны. Стартовые значения в этом руководстве, включая пороги репозитория-компаньона, — это первые настройки, которые нужно подбирать на ваших данных. Иллюстративные числа — это результаты разобранных примеров. Калибруйте пороги релиза под вашу область, ставки, неопределённость оценочного набора и ожидания пользователей.
- Пространство фреймворков быстро меняется. Версии HHEM, названия метрик RAGAS, карточки моделей и порядок в лидербордах могут измениться после публикации. Перепроверьте источник по ссылке и повторите бенчмарк, прежде чем принимать решение.
- У цифр согласия LLM-as-judge есть оговорки. Показатель 80% для GPT-4 и людей получен в условиях MT-Bench / Chatbot Arena. Этот результат не доказывает согласия в узкой области или на состязательном срезе. Используйте джаджей, чтобы оценить больше случаев, чем могут проверить люди, и продолжайте вручную проверять выборку.
- Прирост из вендорских бенчмарков часто не воспроизводится независимо. Воспроизведите на своих данных, прежде чем верить числу, особенно для новых реранкеров и OCR-систем.
- Ни одна метрика не заменяет чтение выводов. Начните с того, чтобы каждую неделю читать 50 случайных продакшен-ответов. Метрики масштабируют эту привычку, но не заменяют её.
Источники
Фреймворки и бенчмарки
- Es et al., Ragas: Automated Evaluation of Retrieval Augmented Generation, 2023.
- RAGAS documentation and GitHub.
- Saad-Falcon et al., ARES: An Automated Evaluation Framework for Retrieval-Augmented Generation Systems, NAACL 2024.
- TruLens, DeepEval, Arize Phoenix.
- Thakur et al., BEIR: A Heterogenous Benchmark for Zero-shot Evaluation of Information Retrieval Models, NeurIPS 2021.
- MTEB Leaderboard.
- TREC 2024 RAG Track.
- Pradeep et al., Initial Nugget Evaluation Results for the TREC 2024 RAG Track with the AutoNuggetizer Framework, 2024.
Retrieval и ранжирование
- Cormack, Clarke, Buettcher, Reciprocal Rank Fusion Outperforms Condorcet and Individual Rank Learning Methods, SIGIR 2009.
- Gao et al., Precise Zero-Shot Dense Retrieval Without Relevance Labels (HyDE), 2022.
- Jeong et al., Adaptive-RAG: Learning to Adapt Retrieval-Augmented Large Language Models through Question Complexity, NAACL 2024.
- Anthropic, Introducing Contextual Retrieval, сентябрь 2024.
- Günther et al., Late Chunking: Contextual Chunk Embeddings Using Long-Context Embedding Models, 2024.
Генерация, faithfulness, джаджи
- Min et al., FActScore: Fine-grained Atomic Evaluation of Factual Precision in Long Form Text Generation, EMNLP 2023.
- Liu et al., Lost in the Middle: How Language Models Use Long Contexts, TACL 2024.
- Chen et al., Benchmarking Large Language Models in Retrieval-Augmented Generation (RGB), AAAI 2024.
- Vectara, HHEM-2.1-Open hallucination evaluation model.
- Zheng et al., Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, NeurIPS 2023.
- Thakur et al., Support Evaluation for the TREC 2024 RAG Track: Comparing Human versus LLM Judges, SIGIR 2025.
- Thakur et al., Knowing When You Don’t Know: A Multilingual Relevance Assessment Dataset for Robust Retrieval-Augmented Generation, Findings of EMNLP 2024.
- Geng et al., JSONSchemaBench: A Rigorous Benchmark of Structured Outputs for Language Models, 2025.
- Kosmopoulos et al., Evaluation Measures for Hierarchical Classification: a unified view and novel approaches, 2015.
Дрейф и продакшен
- Evidently, Embedding drift detection methods compared.
Код-компаньон
slavadubrov/rag-evals-demo— исполняемый харнесс, разделяющий retrieval на SciFact, генерацию на размеченных синтетических QA-данных и офлайн-проверки на фиксированных тестовых данных, с перебором настроек чанкинга и эмбеддингов и необязательным живым сравнением двух моделей OpenAI. Ноутбуки 00–09 объясняют процессы; юнит-тесты фиксируют выбранные разобранные примеры, а старые тестовые данные фильтра используют другую совокупность допустимых документов. Встроенный индекс Qdrant работает без Docker.