Métriques d’évaluation du RAG : retrieval, reranking, génération

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Pour les ingénieurs qui exploitent ou évaluent des systèmes de génération augmentée par retrieval (RAG), cette référence relie les défaillances du parsing des documents, du filtrage, du retrieval, du reranking et de la génération à la métrique qui identifie chacune d’elles. Elle indique aussi quelles vérifications s’exécutent avant la mise en production et lesquelles surveillent le trafic réel.
Un système RAG dont les filtres de pertinence sont défaillants peut tourner pendant des mois sans déclencher la moindre alerte opérationnelle. Il renvoie toujours des réponses et respecte sa cible de latence, mais ces réponses reposent sur des éléments de preuve incomplets. Le Recall@k calculé sur l’ensemble gold éligible d’origine révèle cette perte. Les dashboards de latence et de disponibilité, non.
Envie de passer directement au code ?
Le dépôt exécutable
slavadubrov/rag-evals-demosépare la recherche sur SciFact, la génération sur des QA synthétiques annotées et les vérifications hors ligne sur des données de test fixes.make evalexécute la recherche, les diagnostics de filtrage et la relecture des résultats de génération aprèsmake index.make benchmarkfait varier les paramètres de découpage et d’embeddings sans appel API ; comparer deux modèles OpenAI nécessite une clé API et l’option--live(voir la partie 8). Les notebooks 00–09 couvrent la recherche, le filtrage, la génération et des exemples système. La démo utilise Qdrant embarqué et ne nécessite pas Docker.
Tableau de décision pour l’évaluation d’un RAG
Utilisez ce tableau comme point de départ avant de choisir un framework. La bonne métrique dépend du mode de défaillance que vous cherchez à détecter, pas du nom de l’outil.
| Question | Famille de métriques | À utiliser quand | Point d’attention |
|---|---|---|---|
| Le parsing a-t-il préservé la source ? | Exhaustivité de l’extraction, couverture des tableaux et des figures | Des PDF, des présentations, des scans et des pages HTML entrent dans le corpus | Un texte d’apparence propre peut tout de même perdre des légendes, des notes de bas de page ou la structure d’un tableau |
| Le retrieval a-t-il trouvé les bons éléments de preuve ? | Recall@k, nDCG@k, MRR, context precision/recall | Vous pouvez étiqueter les chunks ou les documents pertinents | Un filtre de métadonnées strict peut écarter le bon document avant le début du classement |
| Le reranking a-t-il amélioré la présélection ? | Gain du reranker, Precision@1, delta de nDCG | Des cross-encoders ou des rankers LLM interviennent après le retrieval | Mesurez la latence et le coût en même temps que le gain de qualité |
| La réponse s’appuie-t-elle sur les éléments de preuve ? | Faithfulness, groundedness, support des citations | La réponse cite des documents ou énonce des faits tirés du contexte | La faithfulness ne peut pas diagnostiquer un mauvais parsing ni un mauvais retrieval |
| Le système est-il stable en production ? | Drift, régénération, fallback, latence p95, coût par réponse | Le trafic évolue après le lancement | La télémétrie de production a besoin d’une revue humaine par échantillonnage pour rester calibrée |
Pour une comparaison d’outils plus courte, voir Meilleurs outils d’évaluation du RAG : Ragas, DeepEval et TruLens.
Partie 1 : définir le succès avant l’architecture
Rédigez le jeu d’évaluation avant le schéma d’architecture. Il donne à chaque choix de composant ultérieur une cible mesurable.
Vous ne pouvez pas choisir entre BM25 et le retrieval dense, entre un chunking récursif et un chunking sémantique, ou entre Cohere Rerank et BGE tant que vous ne savez pas ce que vous optimisez. « De meilleures réponses » n’est pas une métrique. Voici un exemple d’exigence de mise en production : « faithfulness ≥ 0,85 sur un golden set de 200 requêtes couvrant nos trois principales intentions, avec une latence p95 < 1,5 s et un taux de fausse exclusion par le filtre < 2 % ». Ces chiffres sont des valeurs indicatives ; l’essentiel est que la qualité, la couverture, la latence et le filtrage aient des seuils explicites.
Définissez le harness avant d’écrire le code de retrieval. Le premier harness sera faux, et vous le réviserez. Réviser une métrique coûte bien moins cher que réviser un système déjà livré.
Trois couches de pipeline et deux modes d’exécution
L’évaluation en production comporte trois couches de pipeline. L’évaluation de l’ingestion demande si le corpus et l’index préservent la source. L’évaluation au moment de la requête demande si la réécriture, le filtrage, le retrieval, le reranking et l’assemblage du contexte ont trouvé les bons éléments de preuve. L’évaluation des réponses et de la production demande si la réponse s’est appuyée sur ces éléments et si la qualité tient sous trafic réel. Si vous fusionnez les couches en un seul score, un bug de normalisation peut disparaître dans un score de réponse acceptable.
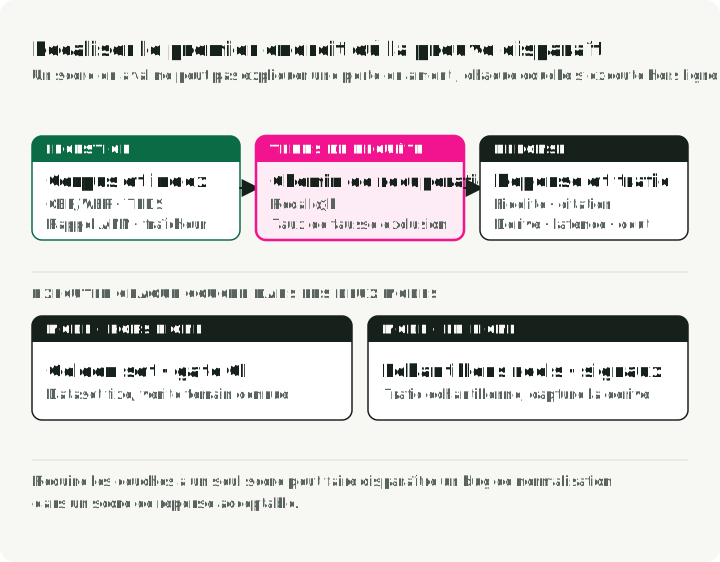
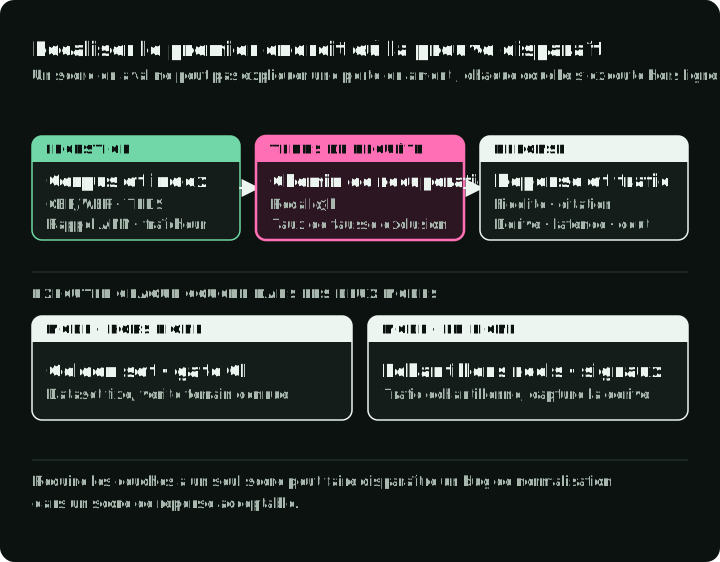
Ces couches indiquent où se produit une défaillance. Hors ligne et en ligne indiquent quand et sur quelles données la vérification s’exécute. L’évaluation hors ligne utilise un dataset figé dont la vérité terrain est connue ; elle est reproductible et sert à la sélection des composants, aux comparaisons A/B et aux contrôles de CI capables de bloquer un changement. L’évaluation en ligne note un échantillon du trafic réel et capture la régénération, le temps de lecture, le feedback explicite et le drift réel des requêtes. Elle est plus bruitée et plus difficile à instrumenter.
Utilisez les deux modes là où ils aident : des corpus et des jeux de requêtes figés rendent les régressions reproductibles ; des traces réelles échantillonnées révèlent les défaillances de fraîcheur et le drift.
Au niveau des composants vs. de bout en bout
Il y a deux erreurs courantes. Une évaluation uniquement de bout en bout indique que le système est en panne, mais pas où. Une évaluation uniquement par composant peut montrer que chaque pièce réussit alors que le système complet échoue. La solution : quelques métriques de bout en bout pour les décisions go/no-go, plus des métriques par composant pour le diagnostic. Les métriques de retrieval détectent les régressions du retriever. Les métriques de génération détectent les régressions du générateur. L’exactitude des réponses de bout en bout détecte les défaillances d’intégration.
Les frameworks de référence (tour d’horizon assumé)
| Framework | Point fort | Point faible |
|---|---|---|
| RAGAS | Un vocabulaire commun pour la faithfulness, l’answer relevancy et la context precision/recall (métriques) | Coût du LLM-judge ; composantes du score opaques au débogage ; changements entre versions |
| ARES | Un juge de type classifieur propre à la tâche, si l’entraînement et l’annotation valent leur coût (article) ; la précision annoncée dépend du benchmark | Mise en place plus lourde ; il faut réellement entraîner des modèles |
| TruLens | Fonctions de feedback liées aux traces et intégration d’OpenTelemetry (projet) | Moins complet que RAGAS sur les métriques propres au RAG |
| DeepEval | Intégration au lanceur de tests et métriques personnalisées (projet) | Usage intensif d’un LLM-judge = pics de coût |
| Arize Phoenix | Tracing, expériences sur des datasets et évaluateurs RAG/agent prêts à l’emploi ou personnalisés (documentation d’évaluation) | Les grilles propres au domaine et les seuils du juge demandent toujours une calibration locale |
| TREC 2024 RAG Track | Benchmark public pour l’évaluation par nuggets (AutoNuggetizer), l’évaluation du support et la fluidité sur MS MARCO Segment v2.1 | Ce n’est pas un outil d’exécution ; c’est un benchmark sur lequel se calibrer |
Ma pile par défaut : RAGAS pour le vocabulaire des métriques, DeepEval pour les contrôles de CI, Phoenix pour le tracing en production, plus du code sur mesure pour les métriques propres à l’ontologie. Choisissez le framework qui facilite les métriques personnalisées.
Pour choisir un benchmark, faites d’abord correspondre la tâche avant de lire le classement. BEIR, MTEB et MIRACL restent de bonnes références de base pour le retrieval. Ajoutez des tests pour les capacités qu’ils n’établissent pas :
- RAG de bout en bout actuel : le TREC 2026 RAG Track utilise des requêtes narratives et ClimbMix-400b, qui remplace MS MARCO v2.1, et renvoie vers la boîte à outils d’évaluation RAGDoll. Ses sujets 2026 sont publiés ; les jugements ne le sont pas encore. Utilisez les sujets pour des expériences, pas comme un classement jugé. Gardez les protocoles 2024 et 2025 ci-dessous liés à leurs propres corpus et jugements.
- Questions techniques sur du code qui évolue : FreshStack combine des questions Stack Overflow posées par des humains, des corpus de dépôts et des jugements par nuggets. Son instantané publié et son outillage de construction de nouveaux corpus sont deux choses différentes ; figez la révision du dépôt et la date des questions.
- Images qui portent une partie de la question ou des éléments de preuve : MM-BRIGHT distingue le retrieval texte-vers-texte, multimodal-vers-texte, multimodal-vers-image et multimodal-vers-multimodal. Évaluez séparément la tâche concernée. Le texte issu de l’OCR seul peut omettre ce qu’apporte un graphique ou une capture d’écran.
Ces benchmarks étendent la couverture ; ils ne remplacent pas le jeu de requêtes éligible et versionné de votre application.
Partie 2 : cartographier les points d’évaluation
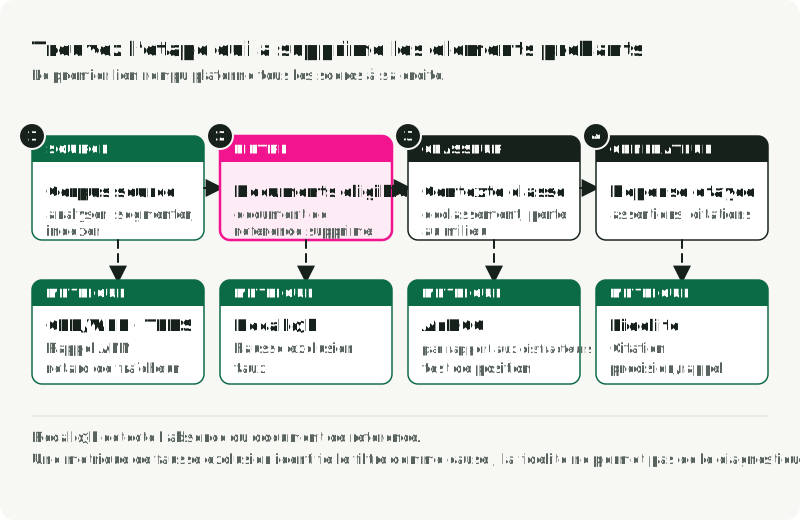
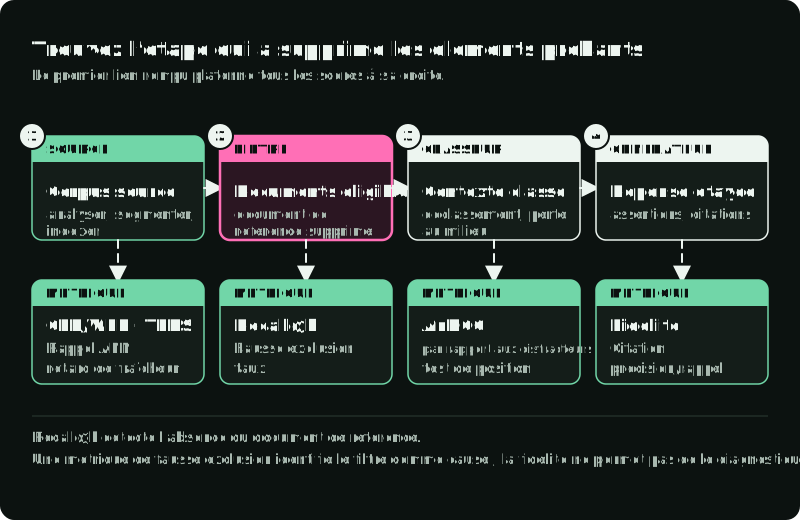
Quand une réponse est fausse ou non étayée, suivez le document de référence à travers les quatre vérifications de la figure, de gauche à droite. La première étape où il manque désigne la métrique à vérifier en premier et la partie de cet article qui la traite.
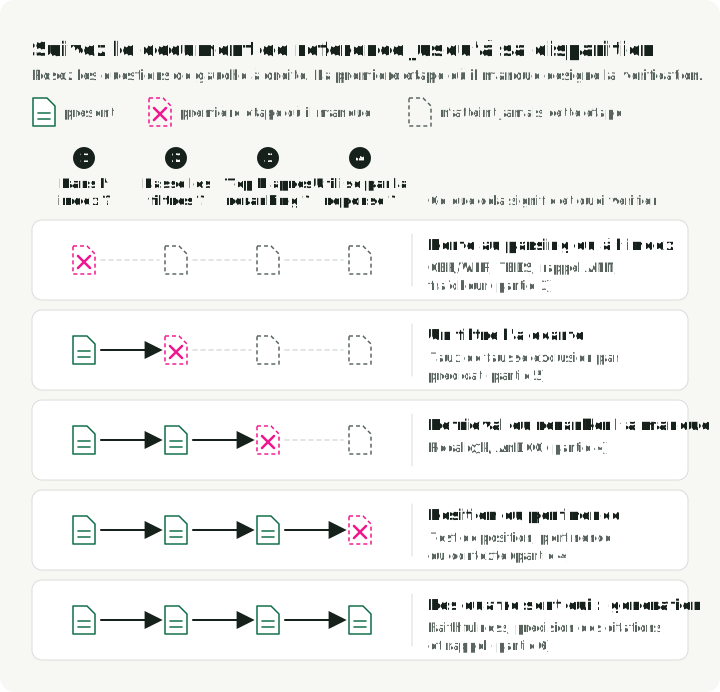
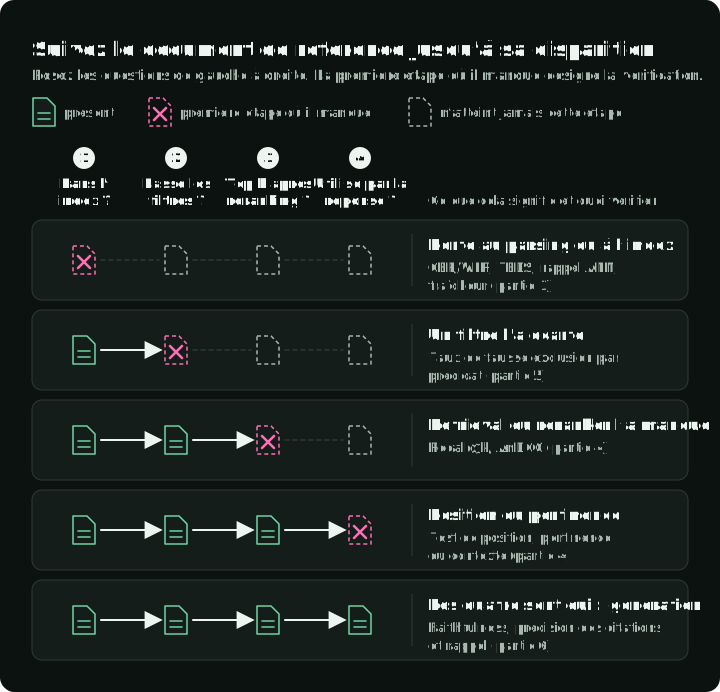
Les pertes en amont limitent la qualité en aval : un mauvais parsing limite le retrieval, et un mauvais retrieval limite le reranking et la génération. La faithfulness mesure la réponse, jamais la cause en amont.
Partie 3 : évaluation de l’ingestion
De nombreuses défaillances de RAG en production commencent à l’ingestion. Le système fonctionne sur des documents de test propres, puis échoue sur de vrais PDF, des scans, des tableaux et des pages de corpus en désordre.
Acquisition et parsing des documents
Ce qu’il faut mesurer :
-
Contrôle de cohérence de la longueur extraite :
extracted_chars / expected_charspar classe de document signale les écarts de longueur suspects, mais un texte dupliqué ou erroné peut tout de même obtenir 1,0. Comparez le texte aligné à une référence nettoyée à la main pour détecter les omissions et les substitutions, puis vérifiez séparément les notes de bas de page, les légendes, le contenu des tableaux et l’ordre de lecture. -
Précision de l’OCR : CER (Character Error Rate) et WER (Word Error Rate), les métriques standard de la reconnaissance vocale et de l’OCR :
où , , sont les substitutions, suppressions et insertions au niveau des caractères, et est le nombre de caractères de la référence (l’indice désigne la version au niveau des mots). N’appliquez pas la même limite de CER à tous les corpus. Calibrez-la par classe de document et selon la perte de qualité des réponses en aval. Le texte imprimé, l’écriture manuscrite et les contenus multilingues ont des profils d’erreur différents. Calculez-le avec
jiwer(jiwer.cer(refs, hyps),jiwer.wer(refs, hyps)) ou avecevaluatede Hugging Face. Pour les corpus d’évaluation, FUNSD et SROIE sont des benchmarks publics.from jiwer import cer, wer refs = ["Mars has two moons, Phobos and Deimos."] hyps = ["Mars has two m00ns, Phobos and Deirnos."] print(f"CER = {cer(refs, hyps):.3f}") # CER = 0.105 print(f"WER = {wer(refs, hyps):.3f}") # WER = 0.286 -
Fidélité de l’extraction des tableaux : le TEDS (Tree-Edit-Distance-based Similarity) mesure la proximité entre l’arbre HTML d’un tableau prédit et celui de la référence, normalisée par la taille du plus grand arbre. D’après Zhong et al., 2020 (PubTabNet) :
Le TEDS prend en compte à la fois la structure (lignes, colonnes, fusions de cellules) et le contenu des cellules. Le TEDS-S supprime le contenu et ne note que la structure. Implémentation de référence :
src/metric.pyde PubTabNet (qui utiliseapteden interne). Pour les corpus d’évaluation, voir PubTabNet, FinTabNet et SciTSR. Les parseurs naïfs échouent souvent sur les tableaux. Mesurez avant de leur faire confiance. -
Préservation de la mise en page et de la structure : ordre des titres, intégrité des listes, ordre de lecture sur les PDF multicolonnes. Utilisez DocLayNet comme benchmark annoté. Une comparaison avec des outils prêts à l’emploi peut inclure un parseur d’éléments comme
unstructured, une bibliothèque PDF commepymupdfet un pipeline Docling choisi. Docling propose des chemins standard et VLM ; notez lequel vous testez.
Comparez des familles de parseurs distinctes, par exemple une référence Tesseract, un modèle d’OCR fondé sur un VLM et votre candidat éditeur. Meilleurs modèles OCR compare les options actuelles. Utilisez un échantillon stratifié de vraies classes de documents à un DPI fixe, avec des scans propres, des photos, des tableaux, du texte multilingue, des formules et de l’écriture manuscrite. Rapportez le CER ou le WER par classe, et le TEDS pour les pages de tableaux.
Nettoyage et normalisation
-
Précision de la suppression du boilerplate : précision et rappel par rapport à des segments de boilerplate étiquetés par des humains. Une suppression agressive retire du contenu pertinent ; une suppression timide pollue les embeddings. Outils à comparer :
trafilatura,jusText,Resiliparse. Barbaresi (2021) compare Trafilatura à des références dont jusText ; Resiliparse est un candidat distinct, pas un système évalué dans cet article. -
Normalisation Unicode : le pourcentage de documents qui produisent des sorties NFC et NFKC identiques (calculées avec
unicodedata.normalizede la bibliothèque standard) est un indicateur utile de dérive des formes de compatibilité. Il ne détecte pas les points de code invisibles ou ignorés par défaut, ni les caractères d’aspect identique issus d’autres écritures : recherchez les premiers explicitement, et appliquez une politique ou un détecteur de confusables Unicode quand les seconds sont dans le périmètre. -
Précision de la détection de langue : F1 sur un échantillon multilingue étiqueté. Essentiel pour les index multilingues. Utilisez
fasttext-langdetect(lelid.176de Facebook),lingua-pyoucld3. FLORES-200 fournit du texte d’évaluation dans 200 langues, mais c’est votre répartition réelle des langues en production qui doit déterminer la tranche de test. -
Efficacité de la déduplication (MinHash / LSH) : précision et rappel de votre détecteur de quasi-doublons par rapport à un jeu étiqueté à la main. L’idée sous-jacente : estimer la similarité de Jaccard entre des ensembles de shingles de documents avec hachages issus de permutations aléatoires (Broder, 1997), puis regrouper les quasi-doublons par bandes LSH (Indyk & Motwani, 1998). Faites varier le nombre de hachages et le seuil de Jaccard sur votre corpus. Suivez séparément le taux de fusions erronées (qui corrompt les réponses) et le taux de fusions manquées (qui gaspille de l’espace d’index).
datasketchfournit l’implémentation utilisée ci-dessous ; ses paramètres sont indicatifs :from datasketch import MinHash, MinHashLSH def shingles(text: str, k: int = 5) -> set[str]: text = text.lower() return {text[i:i + k] for i in range(len(text) - k + 1)} def to_minhash(text: str, num_perm: int = 128) -> MinHash: m = MinHash(num_perm=num_perm) for s in shingles(text): m.update(s.encode("utf-8")) return m docs = { "d1": "Mars has two moons, Phobos and Deimos.", "d2": "Mars has two moons, Phobos and Deimos!", # near-dup "d3": "Curiosity rover landed on Mars in 2012.", } lsh = MinHashLSH(threshold=0.8, num_perm=128) for did, text in docs.items(): lsh.insert(did, to_minhash(text)) print(sorted(lsh.query(to_minhash(docs["d1"])))) # ['d1', 'd2'] -
Suppression des PII : précision et rappel, calculés séparément par type d’entité (e-mails, numéros de sécurité sociale, noms, adresses). Les erreurs de rappel créent un risque de conformité ; les erreurs de précision dégradent la qualité des réponses. Fixez le point de fonctionnement avec l’équipe juridique. Les outils candidats incluent Microsoft Presidio,
scrubadubou un modèle de NER fine-tuné sur un jeu étiqueté.
Le chunking contrôle la qualité du retrieval
Le chunking change les éléments de preuve qui atteignent la réponse. Dans le benchmark éditeur de NVIDIA de 2025, le chunking par page a obtenu la meilleure exactitude moyenne des réponses de bout en bout dans la configuration testée, car il préservait les tableaux et les graphiques comme des unités entières. Cela mesure l’exactitude des réponses, pas le rappel du retrieval. Considérez ce résultat comme un élément de preuve pour le corpus testé, pas comme un vainqueur universel.
Le chunking sémantique regroupe des phrases adjacentes selon la similarité de leurs embeddings et coupe aux frontières peu similaires. SemanticChunker de LangChain et SemanticSplitterNodeParser de LlamaIndex implémentent cette stratégie. Il peut améliorer le rappel par rapport à des fenêtres fixes quand les frontières thématiques comptent.
Le RecursiveCharacterTextSplitter de LangChain essaie par défaut les doubles sauts de ligne, les sauts simples, les espaces, puis les caractères individuels : ["\n\n", "\n", " ", ""]. Il ne détecte les limites de phrases qu’avec des séparateurs adaptés ou un découpeur qui les reconnaît. La valeur par défaut length_function=len compte les caractères. Pour tester 400–512 tokens par fragment avec 10–20 % de chevauchement, utilisez une fonction qui compte les tokens. Comparez ces paramètres initiaux à d’autres valeurs sur votre jeu de référence.
Métriques à suivre :
- Cohérence des chunks : , où sont des embeddings de phrases. Des chunks sains sont similaires en interne et dissemblables à leurs frontières. Calculez-la avec
sentence-transformersetcosine_similaritydescikit-learn. - Qualité des frontières : étiquetage humain « cette coupure est-elle sensée ? » sur un échantillon, plus un contrôle structurel vérifiant que les chunks ne coupent ni les tableaux, ni les listes, ni les sections numérotées.
- Taille de chunk optimale : faites varier la taille en tokens (128, 256, 512, 1024) et tracez le Recall@k en fonction de la taille sur votre golden set. Choisissez la plus petite taille au-delà de laquelle le Recall@k cesse de s’améliorer.
- Efficacité du chevauchement : faites varier le chevauchement à 0, 10, 20 et 30 % comme grille de départ et mesurez le Recall@k. Arrêtez d’augmenter le chevauchement quand la courbe locale du rappel s’aplatit ou quand le coût de la duplication dépasse le gain.
- Fidélité de l’attribution des chunks : pourcentage de chunks qui conservent un pointeur de source vérifiable (numéro de page, ancre de section, identifiant du document). L’auditabilité l’exige.
- Chunking tardif vs. précoce : le chunking tardif (Günther et al., 2024) calcule l’embedding du document entier puis le segmente, ce qui préserve le contexte global (implémentation de référence dans
jina-embeddings-v3). Contextual Retrieval (Anthropic, 2024) ajoute en tête de chaque chunk un contexte généré par un LLM. Les deux ajoutent un coût. Mesurez sur votre corpus avant d’adopter l’un ou l’autre.
Mon opinion : le chunking structurel (découper selon les titres, les tableaux et les sections, ce qu’implémentent des parseurs comme unstructured.io ou le parcours de l’AST que votre parseur a déjà produit) est sous-utilisé. Si vos documents ont une structure, exploitez-la avant d’ajouter des heuristiques de similarité. Le découpage récursif par caractères est la référence de base ; le chunking sémantique ne vaut son surcoût que sur de la prose non structurée.
Extraction et enrichissement des métadonnées
- Précision, rappel et F1 du NER : par type d’entité, sur un sous-ensemble étiqueté. Style standard CoNLL/MUC. Calculez avec
seqeval(from seqeval.metrics import f1_score) pour la version qui comprend les étiquettes BIO/IOB, ou avec scikit-learn pour des comparaisons d’ensembles d’empans. CoNLL-2003 et OntoNotes 5.0 sont les corpus de référence canoniques. - F1 de l’extraction de relations : encore plus important pour les systèmes fondés sur une ontologie. Étiquetez à la main un jeu stratifié par type de relation et par classe de document. TACRED et DocRED sont des benchmarks publics ; les implémentations candidates incluent
opennreet les pipelines de relations despaCy. - Précision de l’extraction des titres et intertitres : correspondance exacte plus similarité de Levenshtein normalisée () par rapport à la vérité terrain ;
python-Levenshteinourapidfuzzfournissent les deux en un seul appel. - Préservation des métadonnées hiérarchiques : pourcentage de chunks qui conservent correctement leur section parente, leur document parent et leur chemin d’ascendance. C’est la métrique qui décide si votre RAG sait répondre à des questions du type « que dit l’enfant de la politique X ? ».
Génération des embeddings
- Benchmarks de sélection de modèle : utilisez les résultats de MTEB sur les tâches de retrieval, BEIR pour la généralisation zero-shot et MIRACL pour le retrieval multilingue comme points de comparaison. MTEB rapporte couramment le nDCG@10 pour le retrieval ; les autres familles de tâches utilisent d’autres métriques. Le package Python MTEB exécute les benchmarks en local. Considérez le transfert de l’anglais MTEB vers une langue moins dotée comme une hypothèse à tester sur le jeu étiqueté de cette langue.
- Évaluation propre au domaine : ne prenez pas le rang d’un benchmark généraliste pour un résultat dans votre domaine. Commencez par quelques centaines de requêtes étiquetées (200 à 500) couvrant vos principaux types de requêtes ; la partie 9 montre comment vérifier si c’est suffisant. Reclassez ensuite les modèles candidats dessus avec
ranxoupytrec_eval. Un jeu propre au domaine peut inverser l’ordre d’un classement ; publiez donc la tranche du dataset, le protocole de retrieval et l’intervalle de confiance avec le résultat. - Détection du drift des embeddings : comparez deux collections d’embeddings, un échantillon de référence figé et un échantillon courant glissant. La maximum mean discrepancy (MMD) teste si leurs distributions diffèrent. Une autre option est un classifieur validé, entraîné à distinguer les échantillons de référence des échantillons courants. La divergence de Kullback–Leibler (KL) compare des distributions de probabilité ; elle nécessite donc un estimateur explicite, comme des histogrammes choisis, car les coordonnées brutes d’un embedding ne sont pas des probabilités. Mesurez aussi la stabilité des plus proches voisins sur un jeu de sondes fixe.
evidentlyetalibi-detectimplémentent des détecteurs fondés sur des modèles et des détecteurs statistiques. L’étude comparative d’Evidently est une évaluation d’un éditeur ; comparez les méthodes sur des changements connus dans vos propres embeddings. - Multi-vecteur vs. vecteur unique : l’interaction tardive conserve des représentations au niveau des tokens au lieu de réduire chaque document à un seul vecteur ; ColBERT en est la conception canonique, avec des implémentations de référence dans RAGatouille et PyLate. Cette représentation plus riche augmente le coût de l’index et du retrieval. Comparez la qualité, le stockage et la latence à une référence à vecteur unique sur le même jeu de domaine avant de l’adopter.
Construction de l’index
- Recall@k sous approximation : comparez l’index de plus proches voisins approximatifs (ANN) à une référence exacte par force brute au même k ; dans FAISS, il s’agit de
IndexHNSWFlat(ouIndexIVFFlat) contreIndexFlatIP/IndexFlatL2. Comme premier contrôle, exigez un Recall@10 d’au moins 0,95 par rapport à la recherche exacte, puis resserrez ou assouplissez ce seuil selon la qualité des réponses en aval. Le projetann-benchmarkssuit les courbes de Pareto rappel–QPS pour plusieurs bibliothèques. - Réglage de HNSW : HNSW (Hierarchical Navigable Small World) est un graphe de proximité en couches ; voir Malkov & Yashunin, 2018. Il est implémenté dans
hnswlib, dansIndexHNSWFlatde FAISS et dans la plupart des bases vectorielles. HNSW expose trois paramètres :M(nombre de voisins par nœud du graphe),efConstruction(largeur de la liste de candidats à la construction) etefSearch(largeur de la liste de candidats à la requête). Valeurs de départ :Mde 16 à 32 etefConstructionde 100 à 200 ; augmentez ensuiteefSearchjusqu’à ce que le Recall@10 par rapport à la recherche exacte cesse de s’améliorer. Le guide des paramètres de hnswlib indique qu’unMde 12 à 48 convient à la plupart des usages et donne un contrôle pourefConstruction: aveceffixé àefConstruction, un rappel inférieur à 0,9 pour lesMplus proches voisins signifie que le graphe peut encore s’améliorer. - Réglage d’IVF : IVF (Inverted File index : partitionne les vecteurs avec k-means en
nlistcellules, puis, à la requête, parcourt lesnprobecellules les plus proches ; voirIndexIVFFlatetIndexIVFPQdans FAISS). Les recommandations d’index de FAISS suggèrent de 4√N à 16√N cellules pour N vecteurs commenlistde départ. Faites variernlistetnprobeen regard du rappel de la recherche exacte et de la latence. Mesurez les requêtes filtrées séparément, car les familles d’index et les bases vectorielles implémentent différemment le parcours avec filtre. - Délai de fraîcheur de la mise à jour : temps écoulé entre le commit d’un document et sa disponibilité au retrieval. Suivez p50 et p99. Pour les systèmes soumis à des exigences réglementaires, suivez aussi le pourcentage de requêtes servies sur des index périmés.
Partie 4 : évaluation au moment de la requête
La voie du moment de la requête regroupe les métriques qui diagnostiquent un chemin de retrieval. Le Recall@k seul ne peut pas montrer si la réécriture, le filtrage, le reranking ou l’assemblage du contexte a causé la défaillance.
Compréhension et réécriture de la requête
- Qualité de l’expansion de requête : gain de Recall@k sur votre golden set, requête étendue contre requête brute. Définissez à l’avance le gain minimal utile et son incertitude avant de tester. Si l’expansion n’atteint pas cette exigence, elle ne justifie pas sa latence ni son coût. Les références classiques de PRF (pseudo-relevance feedback) comme RM3 et Bo1 restent de bons contrôles de cohérence ; une expansion fondée sur un LLM doit les battre.
- Évaluation de HyDE : HyDE (Gao et al., 2022) fait générer une réponse hypothétique par le LLM, calcule son embedding et recherche avec celui-ci. Cela ajoute un appel de génération, et cet appel peut inventer du contenu qui détourne le retrieval du sujet. Mesurez le Recall@10 séparément sur les tranches dans le domaine, hors domaine et à faible confiance, puis décidez si HyDE a sa place dans le chemin par défaut, dans un fallback, ou nulle part.
- Génération de requêtes multiples : Recall@k de l’union de N réécritures contre la requête unique. Faites varier N et choisissez un point sur votre frontière rappel–latence. Implémentations :
MultiQueryRetrieverde LangChain,QueryFusionRetrieverde LlamaIndex. - Précision de la classification d’intention : précision, rappel et F1 standard par intention (à calculer avec
sklearn.metrics.classification_report), mais la métrique décisive est la justesse du routage : le bon pipeline en aval est-il invoqué ? - Routage adaptatif : Adaptive-RAG (Jeong et al., NAACL 2024) soutient que toutes les requêtes ne méritent pas la même stratégie de retrieval. Suivez la précision du routeur comme un problème de classification sur un jeu étiqueté « sans retrieval / en un coup / itératif ».
La recherche itérative nécessite un test de bout en bout budgété
Un agent peut chercher, examiner un résultat, puis chercher à nouveau, au lieu de récupérer une liste top-k fixe. Le domaine banking_knowledge de tau2-bench change de mode de retrieval avec l’option --retrieval-config : pas de base de connaissances, la base complète dans le contexte, une recherche BM25 ou par embeddings, un outil shell en sandbox, ou BM25, recherche dense et shell ensemble. Pour une comparaison locale, donnez au retrieval en un coup et au retrieval itératif le même corpus éligible et des limites explicites de temps, de tokens du modèle et de tool calls. Enregistrez chaque requête et les éléments de preuve vus à chaque tour ; évaluez la couverture finale des éléments de preuve, l’exactitude de la réponse, le support des citations et les échecs par budget épuisé. Davantage d’appels de recherche ne sont utiles que si les éléments de preuve ajoutés améliorent la réponse dans ces limites.
Le fichier retrieval/iterative.py du dépôt compagnon exécute des reformulations de requêtes fournies sous des budgets explicites d’appels, de temps et de tokens. Pour les agents qui choisissent eux-mêmes leurs recherches, Évaluation des agents AI : des traces aux suites de tests explique comment évaluer la trajectoire en plus de la réponse.
Métriques de retrieval
Ce sont les métriques de base. Si vous ne les suivez pas, vous ne pouvez pas savoir si le retrieval s’améliore.
| Métrique | Ce qu’elle mesure | Quand l’utiliser |
|---|---|---|
| Recall@k | fraction des documents pertinents d’une requête renvoyés dans le top k | quand l’absence de n’importe quelle partie de l’ensemble pertinent compte |
| Precision@k | pourcentage du top k qui est pertinent | utile quand la fenêtre de contexte est le goulot d’étranglement |
| MRR | moyenne de 1/rang du premier document pertinent | quand les utilisateurs ne regardent que le top 1 ou le top 3 |
| nDCG@k | gain actualisé selon la position et pondéré par les niveaux de pertinence | métrique de retrieval standard pour une pertinence graduée |
| MAP | moyenne sur les requêtes de la précision moyenne | quand c’est toute la liste classée qui vous importe |
| Hit Rate@k | indique si au moins un document pertinent apparaît dans le top k | moyennez le résultat binaire sur les requêtes pour un contrôle de cohérence rapide |
| Coverage | pourcentage de documents gold jamais récupérés sur l’ensemble des requêtes | détecte les lacunes systématiques de l’index |
Les formules, pour référence (pertinence binaire avec l’ensemble pertinent pour la requête , et si le -ième document récupéré appartient à ) :
Pour une pertinence graduée, ; le nDCG binaire est le cas particulier utilisé dans le code ci-dessous. Le MAP est la moyenne sur les requêtes de . Pour les démonstrations, voir Manning, Raghavan, Schütze, Introduction to Information Retrieval, chapitre 8.
Pour du code de production, utilisez ranx, pytrec_eval ou ir_measures : ils implémentent toute la famille de métriques TREC et gèrent correctement la pertinence graduée. Comme seuils de départ pour la mise en production, le dépôt compagnon fournit Recall@10 ≥ 0,85 et MRR ≥ 0,6 (dans .env.example, appliqués avec --quality-gates). Ajustez-les ensuite sur votre golden set en fonction de la qualité des réponses en aval et du coût d’un échec.
Ici, k compte des identifiants de documents uniques. Rejetez les doublons plutôt que d’accorder un gain supplémentaire à un document répété. Pour les expériences de chunking, indiquez si k compte des chunks ou des documents parents dédupliqués, et comparez aussi les éléments de preuve fournis dans un budget de tokens fixe. Un même rappel au niveau du document peut cacher des qualités de contexte très différentes.
Le harness de test pour ces métriques est court. Vous pouvez l’exécuter depuis un notebook avant même d’avoir choisi une base vectorielle.
from math import log2
from statistics import mean

# synthetic gold set: query_id -> set of relevant doc ids
gold = {
    "q1": {"d3"},
    "q2": {"d7", "d2"},
    "q3": {"d11"},
    "q4": {"d5"},
}

# ranked retrieval results: query_id -> ranked list of doc ids (top-10)
runs = {
    "q1": ["d8", "d3", "d1", "d4", "d2", "d9", "d6", "d10", "d12", "d13"],
    "q2": ["d2", "d6", "d4", "d7", "d1", "d3", "d8", "d11", "d5", "d9"],
    "q3": ["d11", "d2", "d3", "d4", "d1", "d6", "d7", "d8", "d10", "d12"],
    "q4": ["d1", "d2", "d3", "d6", "d8", "d9", "d10", "d12", "d13", "d14"],
}

def recall_at_k(ranked, gold_set, k):
    if k <= 0 or len(ranked) != len(set(ranked)):
        raise ValueError("require positive k and unique document IDs")
    if not gold_set:
        return 0.0
    hit = sum(1 for d in ranked[:k] if d in gold_set)
    return hit / len(gold_set)

def reciprocal_rank(ranked, gold_set):
    if len(ranked) != len(set(ranked)):
        raise ValueError("require unique document IDs")
    # MRR contribution per query: 1/rank of the first relevant doc.
    for rank, d in enumerate(ranked, start=1):
        if d in gold_set:
            return 1.0 / rank
    return 0.0

def ndcg_at_k(ranked, gold_set, k):
    if k <= 0 or len(ranked) != len(set(ranked)):
        raise ValueError("require positive k and unique document IDs")
    # binary relevance: rel ∈ {0, 1}
    gains = [1.0 if d in gold_set else 0.0 for d in ranked[:k]]
    dcg = sum(g / log2(i + 2) for i, g in enumerate(gains))
    # ideal DCG: all gold docs ranked first, capped by k
    n_gold_in_topk = min(k, len(gold_set))
    idcg = sum(1.0 / log2(i + 2) for i in range(n_gold_in_topk))
    return dcg / idcg if idcg else 0.0

K = 5
print(f"Recall@{K}: {mean(recall_at_k(runs.get(q, []), gold[q], K) for q in gold):.3f}")
print(f"MRR:       {mean(reciprocal_rank(runs.get(q, []), gold[q]) for q in gold):.3f}")
print(f"nDCG@{K}:  {mean(ndcg_at_k(runs.get(q, []), gold[q], K) for q in gold):.3f}")
# Recall@5: 0.750
# MRR:       0.625
# nDCG@5:    0.627
# Duplicate and missing runs are tested in the companion's tests/test_audit_contracts.py.
L’agrégation parcourt toutes les requêtes attendues et traite une exécution manquante comme vide. Cet exemple attribue zéro aux requêtes dont l’ensemble gold est vide ; dans une vraie suite, marquez-les comme une tranche distincte d’« answerability » avec son propre dénominateur, au lieu de traiter ce zéro comme un rappel mesuré. Rapportez aussi les timeouts et les exécutions manquantes, pas seulement les scores.
Exécutez un sous-ensemble rapide à chaque PR et le golden set complet avant la mise en production (partie 9 donne des tailles de départ). Bloquez une fusion quand une métrique choisie à l’avance dépasse son budget de régression.
Le dépôt compagnon fixe les chiffres ci-dessus (Recall@5 = 0.750, MRR = 0.625, nDCG@5 = 0.627) par un test unitaire dans tests/test_retrieval_metrics.py. Notebook 01 exécute cet exemple avec k=5, puis rapporte Recall@10, MRR et nDCG@10 sur un sous-ensemble de SciFact ; il ne fait pas varier k. Le harness conçu comme en production est dans evaluation/retrieval.py.
Retrieval hybride et fusion des rangs réciproques
BM25 est un scoreur lexical creux qui combine la correspondance exacte des termes, la pondération des termes et la normalisation par la longueur. Il est disponible dans rank_bm25, Elasticsearch, OpenSearch et la plupart des moteurs de recherche.
La Reciprocal Rank Fusion (Cormack, Clarke et Buettcher, SIGIR 2009) combine les classements BM25 et dense selon la position. Le réglage d’origine k=60 est une référence de départ utile. La RRF ne dépend pas des scores, ce qui évite la normalisation entre voies qu’exige l’interpolation linéaire. Avec un jeu étiqueté assez grand pour estimer un delta stable, testez aussi une combinaison convexe et ajustez α.
Mon hypothèse est que le retrieval hybride associé à un reranker de type cross-encoder peut aider sur les corpus techniques, de logs et de code. Le gain peut être faible sur les corpus très sémantiques. Mesurez par rapport aux voies dense seule et creuse seule, car une mauvaise configuration de fusion peut faire moins bien que l’une ou l’autre. Le notebook SciFact du dépôt compagnon est un test borné, pas un résultat général.
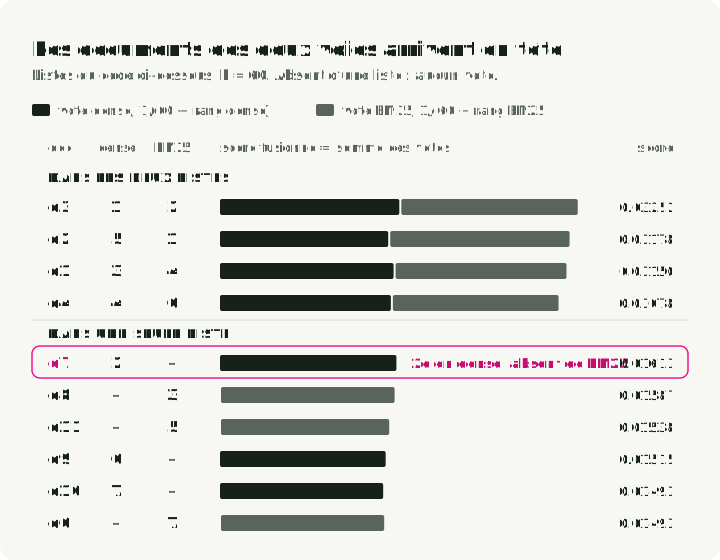
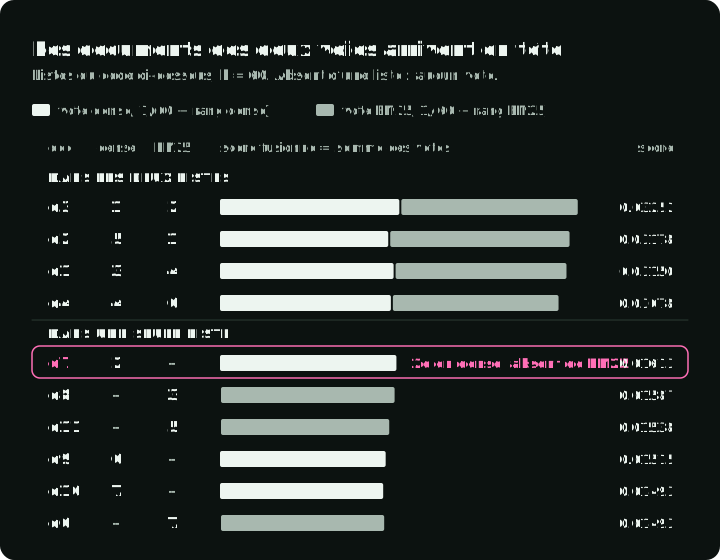
Le graphique reprend les deux listes classées du code ci-dessous. Chaque voie ajoute 1/(60 + rang) pour chaque document qu’elle renvoie, donc les quatre documents présents dans les deux listes arrivent en tête. d7 est deuxième dans la liste dense mais absent de la liste BM25, donc il tombe à la cinquième place.
L’implémentation tient en quelques lignes.
from collections import defaultdict

# two retrieval lanes: dense embeddings and BM25.
dense  = ["d3", "d7", "d1", "d4", "d2", "d9", "d10"]
sparse = ["d2", "d3", "d8", "d1", "d11", "d4", "d6"]

def rrf(rankings: list[list[str]], k: int = 60) -> list[tuple[str, float]]:
    """Reciprocal Rank Fusion (Cormack et al., SIGIR 2009).

    score(d) = sum over rankings of 1 / (k + rank(d))
    Score-agnostic: only rank position matters. k=60 is the canonical default.
    """
    scores: dict[str, float] = defaultdict(float)
    if k <= 0:
        raise ValueError("k must be positive")
    for ranking in rankings:
        if len(ranking) != len(set(ranking)):
            raise ValueError("each ranking must contain unique document IDs")
        for rank, doc in enumerate(ranking, start=1):
            scores[doc] += 1.0 / (k + rank)
    return sorted(scores.items(), key=lambda kv: kv[1], reverse=True)

fused = rrf([dense, sparse], k=60)
for doc, score in fused[:5]:
    print(f"{doc}  score={score:.5f}")
# d3  score=0.03252   <- rank 1 dense, rank 2 sparse
# d2  score=0.03178   <- rank 5 dense, rank 1 sparse
# d1  score=0.03150
assert [doc for doc, _ in fused[:3]] == ["d3", "d2", "d1"]
Notez ce que la RRF ne fait pas : elle ne regarde jamais les scores de similarité bruts. Si un retriever place un document en position 2, ce vote vaut 1 / (60 + 2), quel que soit le score brut qui l’a produit. Un retriever dense renvoyant un cosinus de 0,98 et une voie BM25 renvoyant un score de 17,4 ne sont pas directement comparables. La normalisation par z-score et par min-max supprime les différences d’échelle affines, mais aucune des deux ne calibre un score comme une pertinence. Les valeurs aberrantes, la forme de la distribution et l’ensemble de candidats influencent encore les valeurs normalisées, donc le résultat de la fusion. Validez toute combinaison fondée sur les scores avec des requêtes étiquetées.
Recherche hybride + RRF sur SciFact : notebook 02 compare la recherche dense, BM25 et RRF avec Recall@10, MRR et nDCG@10 agrégés. Le module de fusion conçu comme en production est dans retrieval/hybrid_rrf.py ; tests/test_rrf.py fixe l’ordre canonique d3 / d2 / d1 pour k=60.
Reranking
- ΔnDCG / ΔMRR : gain par rapport à l’absence de reranking, sur votre golden set, à la profondeur que votre application utilise réellement. Calculez-le en exécutant vos métriques de retrieval avec et sans le reranker sur des ensembles de candidats identiques.
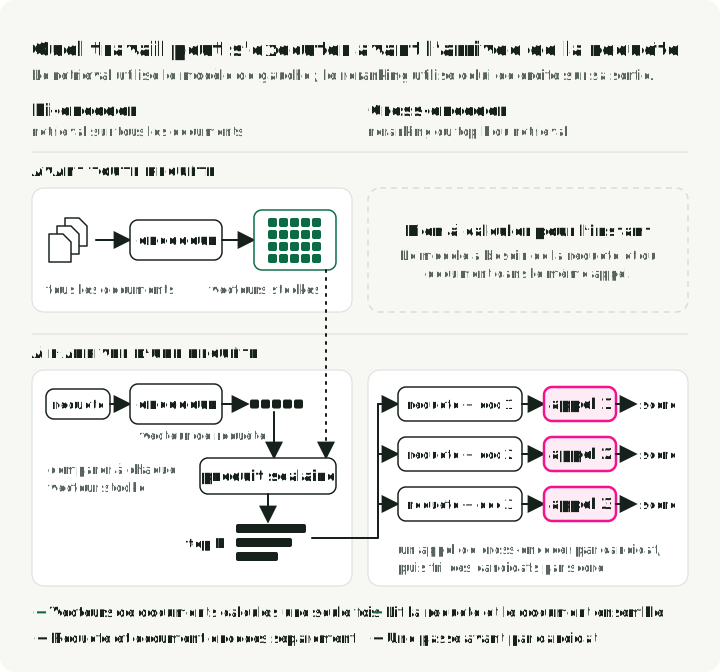
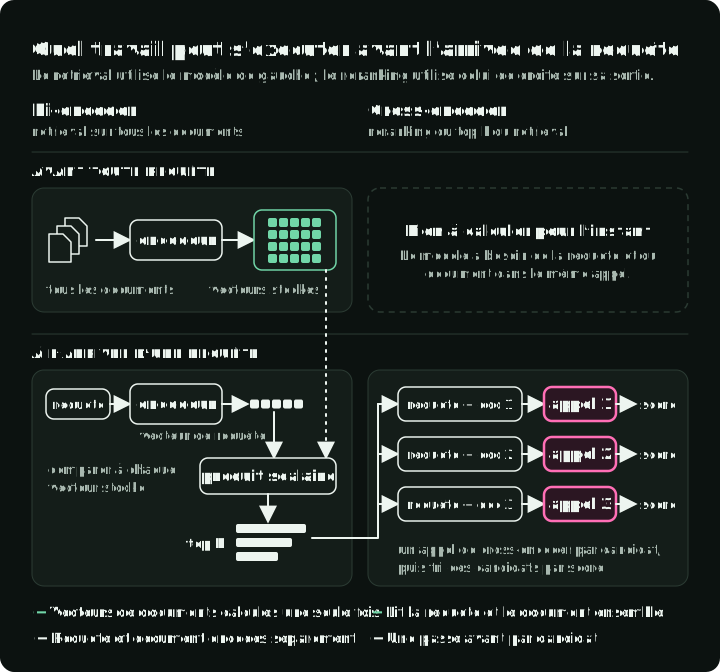
- Cross-encoder vs. bi-encoder : un bi-encoder calcule l’embedding de la requête et celui du document indépendamment (un vecteur par côté) et note par produit scalaire ; un cross-encoder concatène requête et document et exécute une seule passe avant qui porte l’attention sur les deux conjointement. Les cross-encoders échangent une passe avant par candidat contre une interaction requête–document plus riche ; la figure ci-dessous montre la différence. Implémentation de référence :
CrossEncoderdesentence-transformers. Mesurez la pertinence et la latence sur un matériel nommé, avec une taille de batch et une profondeur de candidats précisées ; ne transposez pas le résultat d’un modèle ou d’un service managé à un autre environnement. - Listwise vs. pointwise : l’approche pointwise note chaque paire (requête, document) indépendamment ; l’approche listwise note toute la liste de candidats conjointement, de sorte que le modèle peut comparer les candidats. Évaluez les deux sur les mêmes ensembles de candidats. Calibrez tout seuil de score par modèle et par corpus au lieu de tenir un exemple publié pour transposable.
Dans la figure, comparez les deux bandes de temps. Le bi-encoder encode chaque document avant toute requête et stocke les vecteurs ; quand une requête arrive, il encode seulement la requête. Le cross-encoder n’a rien à calculer avant la requête. Il lit la requête et le document en un seul appel de modèle, donc il s’exécute une fois par candidat et seulement sur la liste courte que renvoie le retrieval.
Le code ci-dessous note trois candidats pour une requête avec un cross-encoder BGE :
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("BAAI/bge-reranker-v2-m3")  # Reproducible baseline, not a latest-model ranking

query = "How do I rotate database credentials in production?"
candidates = [
    "Production database credentials are rotated via Vault every 30 days.",
    "The new logo was unveiled at the all-hands meeting.",
    "To rotate prod DB creds, run the `rotate-secrets` GitHub Action.",
]

scores = reranker.predict([(query, c) for c in candidates])
ranked = sorted(zip(candidates, scores), key=lambda x: -x[1])
for doc, score in ranked:
    print(f"{score:+.3f}  {doc}")
Le code BGE ci-dessus est une petite référence de base. Pour une comparaison actuelle, incluez Cohere Rerank 4.0 fast/pro pour un classement de texte multilingue managé, ou Qwen3-VL-Reranker 2B/8B quand les requêtes ou les documents incluent des images, des captures d’écran ou des vidéos. Précisez explicitement les modalités de la tâche, la profondeur de candidats, les limites d’entrée, les instructions et le matériel.
Un reranker aide souvent un pipeline RAG de base, mais ce n’est pas un gain garanti. Mesurez son ΔPrecision@1 et son ΔnDCG sur votre golden set, puis ne le gardez que si le gain dépasse son budget de latence et de coût. Comparez ce gain mesuré à celui de changements de retrieval plus modestes avant de choisir la prochaine optimisation. BM25 vs embeddings vs rerankers propose un guide plus court pour choisir chaque couche de la pile de classement.
Notebook 03 rapporte P@10 avant et après le reranking par cross-encoder sur SciFact, ainsi que ΔnDCG@10 ; module : retrieval/reranker.py. Le module evaluation/reranking.py compare les rerankers sur des ensembles de candidats identiques.
Construction du contexte et lost-in-the-middle
De nombreux cas de « bon retrieval, mauvaise réponse » commencent à la construction du contexte.
- Pertinence du contexte :
ContextRelevancede Ragas juge la liste de contextes fournie à l’aide de deux prompts et de notes normalisées ; ce n’est pas un score par chunk. Pour un diagnostic par chunk, évaluez explicitement chaque paire requête–chunk, par exemple avec un cross-encoder, et rapportez la distribution sous un seuil calibré localement. - Couverture des citations dans le contexte fourni : nombre de chunks fournis distincts cités divisé par le nombre de chunks fournis distincts. Rapportez séparément les cas de contexte vide. Cet indicateur observable dit quels chunks ont reçu des citations, pas lesquels le modèle a utilisés en interne, ni si les citations étayent ses affirmations. Vérifiez le support des citations séparément et comparez la couverture à la qualité des réponses et au coût en tokens.
- Détection du lost-in-the-middle : évaluation synthétique où vous placez le chunk gold aux positions {première, milieu, dernière} d’un long contexte et mesurez l’exactitude de la réponse. L’étude citée de Liu et al. (TACL 2024) rapporte une dégradation en U dans ses conditions de long contexte. Considérez le même schéma sur un modèle actuel comme une hypothèse à tester. Atténuations : reranker puis réordonner le top-k pour que le chunk le mieux noté soit en premier ou en dernier (le
LongContextReorderde LangChain fait exactement cela), ou compresser fortement les chunks du milieu. Mesurez avec une évaluation stratifiée par position, pas seulement avec un score agrégé. Une évaluation stratifiée par position complète et exécutable se trouve dans le notebook 06 (module :evaluation/lost_in_middle.py). - Compression du contexte : rapportez le taux de compression (tokens en entrée / tokens en sortie) avec l’exactitude de la réponse. Les outils incluent
ContextualCompressionRetrieverde LangChain et LongLLMLingua. Définissez à l’avance la perte d’exactitude maximale acceptable à partir du risque de l’application et du budget de tokens, puis rejetez les configurations qui la dépassent.
Partie 5 : taux de fausse exclusion par le filtre
Cette métrique a sa propre section parce que les scores de retrieval agrégés ne peuvent pas imputer un échec à un filtre de pertinence. Évaluez les filtres d’éligibilité séparément, par rapport aux droits d’accès de l’appelant ; un document hors de cet ensemble doit rester exclu.
Un prédicat de pertinence strict comme product = Y AND locale = en-US peut ramener le rappel effectif à zéro parmi les documents que l’appelant a le droit de voir. Un Recall@k correctement implémenté détecte la perte, car son dénominateur reste l’ensemble d’origine des documents pertinents éligibles. Il ne dit pas si le filtre, le retriever ou le ranker a causé l’échec. La faithfulness juge les affirmations par rapport au contexte récupéré. Elle peut tout de même noter comme étayées des affirmations appuyées sur ce contexte incomplet, mais elle ne peut pas diagnostiquer la cause côté filtre ou retrieval. Un refus vide peut ne produire aucune affirmation et un NaN, selon l’implémentation ; ne le prenez pas pour la preuve que la faithfulness a approuvé le refus.
Le schéma suit l’exemple détaillé ci-dessous. La vérification des droits d’accès retire d3, qui appartient à un autre tenant ; cette exclusion est correcte. Le filtre de pertinence retire ensuite le document de référence de q1 et de q3. Le Recall@10 tombe à 50 % et enregistre la baisse ; seul le taux de fausse exclusion, lui aussi à 50 %, l’attribue au prédicat. Un évaluateur qui reconstruit l’ensemble de référence après le filtrage affiche 100 %.
La métrique
filter_false_exclusion_rate =
    (# queries where all gold docs were excluded by metadata filter) /
    (# queries with at least one entitlement-eligible gold doc)
Cette définition au niveau de la requête compte les exclusions catastrophiques : aucun document pertinent éligible ne survit. Croisez l’ensemble gold de chaque requête avec l’ensemble de droits de l’appelant avant de noter ; un document non éligible n’est pas une fausse exclusion. Pour les requêtes à plusieurs documents gold, le Recall@k standard révèle toujours une perte partielle ; ajoutez un taux d’exclusion par document si cette frontière compte. Pour calculer l’un ou l’autre taux, il vous faut (a) les identifiants de documents de vérité terrain pour chaque requête d’évaluation et (b) une instrumentation qui journalise les prédicats de filtre appliqués, pas seulement les résultats finaux. Comme seuil de départ, le dépôt compagnon utilise un taux de fausse exclusion d’au plus 2 % ; ajustez-le selon le coût d’exclure une réponse valide et l’intervalle de confiance de votre échantillon de production.
Voici une implémentation fonctionnelle. Elle compare le rappel standard correct à un évaluateur invalide qui redéfinit la pertinence après filtrage.
# A small worked example where relevance predicates remove eligible documents.
docs = [
    {"id": "d1", "tenant": "acme",   "locale": "en-US"},
    {"id": "d2", "tenant": "acme",   "locale": "en-GB"},
    {"id": "d3", "tenant": "globex", "locale": "en-US"},
    {"id": "d4", "tenant": "acme",   "locale": "en-US"},
    {"id": "d5", "tenant": "acme",   "locale": "de-DE"},
    {"id": "d6", "tenant": "acme",   "locale": "fr-FR"},
]

# Tenant isolation is an eligibility invariant, not a relevance experiment.
# Verify it independently before evaluating relevance preferences.
eligible_docs = [d for d in docs if d["tenant"] == "acme"]
assert {d["id"] for d in eligible_docs} == {"d1", "d2", "d4", "d5", "d6"}

queries = [
    # the gold doc lives in en-GB but the dynamic filter forced en-US
    {"qid": "q1", "gold": {"d2"}, "filter": lambda d: d["locale"] == "en-US"},
    # the gold doc is correctly within the tenant filter
    {"qid": "q2", "gold": {"d4"}, "filter": lambda d: d["tenant"] == "acme"},
    # the gold doc lives in fr-FR but the dynamic filter forced en-US
    {"qid": "q3", "gold": {"d6"}, "filter": lambda d: d["locale"] == "en-US"},
    # the gold doc passes the filter (de-DE locale match)
    {"qid": "q4", "gold": {"d5"}, "filter": lambda d: d["locale"] == "de-DE"},
]

def filter_false_exclusion_rate(queries, eligible_docs):
    n_with_gold, n_excluded = 0, 0
    eligible_ids = {d["id"] for d in eligible_docs}
    for q in queries:
        eligible_gold = q["gold"] & eligible_ids
        if not eligible_gold:
            continue
        n_with_gold += 1
        survivors = {d["id"] for d in eligible_docs if q["filter"](d)}
        if not (eligible_gold & survivors):
            n_excluded += 1
    if not n_with_gold:
        raise ValueError("false-exclusion rate needs queries with eligible gold")
    return n_excluded / n_with_gold, n_with_gold

rate, eligible_query_count = filter_false_exclusion_rate(queries, eligible_docs)
print(f"filter_false_exclusion_rate = {rate:.2%}")
# filter_false_exclusion_rate = 50.00%
print(f"eligible queries = {eligible_query_count} / {len(queries)}")
# eligible queries = 4 / 4

# Correct Recall@k keeps the original eligible gold set as its denominator.
def standard_recall_at_k(queries, eligible_docs, k=10):
    recalls = []
    eligible_ids = {d["id"] for d in eligible_docs}
    for q in queries:
        eligible_gold = q["gold"] & eligible_ids
        if not eligible_gold:
            continue
        # demo only: the survivor set stands in for a ranked run.
        # A real harness ranks the survivors first, then slices to k.
        survivors = [d for d in eligible_docs if q["filter"](d)][:k]
        survivor_ids = {d["id"] for d in survivors}
        recalls.append(len(eligible_gold & survivor_ids) / len(eligible_gold))
    return sum(recalls) / len(recalls) if recalls else 0.0

print(f"standard recall@10 = {standard_recall_at_k(queries, eligible_docs):.2%}")
# standard recall@10 = 50.00%

# INVALID: rebuilding the gold set after filtering changes the question.
# It drops queries whose relevant documents did not survive, then scores 100%.
def invalid_recall_over_filtered_gold(queries, eligible_docs, k=10):
    recalls = []
    all_doc_ids = {d["id"] for d in eligible_docs}
    for q in queries:
        all_survivors = {d["id"] for d in eligible_docs if q["filter"](d)}
        filtered_gold = q["gold"] & all_doc_ids & all_survivors
        if not filtered_gold:
            continue
        top_k_ids = set(list(all_survivors)[:k])
        recalls.append(len(filtered_gold & top_k_ids) / len(filtered_gold))
    return sum(recalls) / len(recalls) if recalls else 0.0

invalid = invalid_recall_over_filtered_gold(queries, eligible_docs)
print(f"INVALID recall (filtered gold) = {invalid:.2%}")
# INVALID recall (filtered gold) = 100.00%

assert rate == 0.5
assert standard_recall_at_k(queries, eligible_docs) == 0.5
assert invalid == 1.0
# Unauthorized gold and an empty denominator are tested in the companion's
# tests/test_audit_contracts.py.
La fonction renvoie le taux et le nombre de requêtes ayant un gold éligible. Si ce dénominateur est vide, elle lève une exception au lieu de rapporter un zéro rassurant ; un contrôle de mise en production obligatoire doit y voir une preuve manquante. Les requêtes dont le gold n’est pas autorisé restent dans des tests de droits d’accès distincts.
La moitié des requêtes perdent leur document gold à cause du filtre, donc le Recall@10 correct tombe à 50 %. Ce score détecte le symptôme mais ne peut pas l’attribuer. Le taux de fausse exclusion montre que le prédicat a retiré deux réponses avant l’exécution du retriever. L’évaluateur volontairement invalide rapporte 100 % uniquement parce qu’il écarte ces échecs de son ensemble gold. Aucun modèle ne peut retrouver un document qui a été filtré.
tests/test_filter_exclusion.py::test_50_percent_exclusion_rate du dépôt compagnon et le premier exemple de notebook 04 utilisent d’anciennes données de test à cinq documents qui donnent aussi 50 %, mais q3 y est exclue par l’isolation des tenants. Ces données ne reproduisent pas l’exemple ci-dessus avec les documents de référence autorisés. Le notebook 04 exécute aussi des diagnostics de filtrage sur SciFact avec des métadonnées synthétiques. Le evaluation/filter_exclusion.py actuel accepte un prédicat d’autorisation distinct et un ensemble fixe de documents de référence autorisés, et inclut la précision et le rappel du prédicat.
Métrique complémentaire : précision et rappel du prédicat
Quand le filtrage est dynamique (par exemple, un LLM extrait les prédicats de filtre de la requête), traitez l’extracteur de prédicats comme un modèle de classification et évaluez-le comme tel. Mesurez la précision et le rappel du prédicat sur un jeu étiqueté de paires (query, correct predicate). Un taux d’erreur de prédicat ne se traduit pas directement par la même perte de points de rappel du retrieval ; mesurez la fréquence à laquelle ces erreurs excluent un document gold. Une fois qu’un filtre strict a retiré le document gold, aucun reranking n’y change rien.
Filtres d’éligibilité vs. préférences de pertinence
Les autorisations, l’isolation des tenants, la juridiction légale et l’état de publication déterminent si un document peut entrer dans l’ensemble de candidats. Gardez-les comme des filtres stricts et validez-les indépendamment ; le Recall@k, le taux de fausse exclusion et la précision de pertinence n’autorisent pas leur assouplissement.
Pour une préférence de pertinence telle que la langue, la fraîcheur ou la version, comparez un prédicat strict à un boost souple sur les mêmes requêtes éligibles mises de côté. Deux règles décident du résultat :
- Les règles d’accès (autorisation, tenant, juridiction, statut de publication) sont toujours des filtres stricts.
- Toute autre préférence est un boost souple, sauf si le test mesuré ci-dessous est réussi. Elle peut alors devenir un prédicat strict.
Le pseudo-code donne le test de la règle 2 :
For each relevance preference F:
  hard_recall_F  = retrieval_recall@k with F as a hard filter
  soft_recall_F  = retrieval_recall@k with F as a +0.X rerank boost
  hard_precision = relevant_in_top_k / k under hard filter
  soft_precision = relevant_in_top_k / k under soft boost
  precision_gain = hard_precision - soft_precision
  precision_gain_CI = paired-query uncertainty interval for precision_gain
  exclusion_rate = % of queries where the gold doc was filtered out (hard)

Pre-register Δ_min, ε, and recall_loss_max for this workflow.
Use a hard predicate only if:
  lower_bound(precision_gain_CI) >= Δ_min
  AND exclusion_rate <= ε
  AND hard_recall - soft_recall >= -recall_loss_max.
Otherwise prefer a soft boost.
Choisissez le gain de précision minimal utile, l’intervalle d’incertitude, ε et la borne de perte de rappel selon le préjudice d’exclure une réponse par ailleurs éligible, le bénéfice d’une précision accrue et la taille de l’échantillon mis de côté. Commencez avec un ε de 1 à 2 %, et baissez-le là où une réponse manquée coûte cher.
Partie 6 : évaluation de la génération
Les métriques de retrieval indiquent que le système pouvait répondre correctement. Elles n’indiquent pas qu’il l’a fait. Les métriques de génération comblent cet écart.
Faithfulness et groundedness
La faithfulness de RAGAS décompose la réponse en affirmations atomiques (énoncés factuels courts et autonomes), puis vérifie chacune par rapport au contexte récupéré à l’aide d’un LLM-judge :
La faithfulness vérifie le support dans les éléments de preuve fournis ; elle n’établit pas que ces éléments sont corrects ni suffisants pour répondre à la question. Enregistrez séparément les réponses sans affirmation et rapportez leur nombre, au lieu d’attribuer une faithfulness parfaite à une réponse vide.
La documentation actuelle de Ragas recommande l’API collections ci-dessous. Dans un projet uv, installez ragas et openai avec uv add ragas openai, définissez OPENAI_API_KEY et enregistrez ceci sous forme de script à lancer avec uv run. Il effectue des appels au fournisseur et entraîne leurs frais ; le score est une sortie du juge, pas une valeur attendue déterministe. Figez les dépendances résolues dans votre lockfile.
import asyncio

from openai import AsyncOpenAI, omit
from ragas.llms import llm_factory
from ragas.metrics.collections import Faithfulness

async def main():
    async with AsyncOpenAI() as client:
        # Ragas 0.4.3 sends max_tokens by default; GPT-5.6 models need max_completion_tokens.
        llm = llm_factory(
            "gpt-5.6-terra", client=client, reasoning_effort="none",
            max_tokens=omit, max_completion_tokens=1024,
            temperature=omit, top_p=omit,
        )
        scorer = Faithfulness(llm=llm)
        result = await scorer.ascore(
            user_input="How many moons does Mars have?",
            response="Mars has two moons, Phobos and Deimos.",
            retrieved_contexts=["Mars has two moons named Phobos and Deimos."],
        )
        print(result.value)

if __name__ == "__main__":
    asyncio.run(main())
Cet exemple utilise GPT-5.6 Terra comme juge ; la factory de Ragas transmet les arguments du modèle. Comparez les faux positifs, les faux négatifs et le coût du juge à des étiquettes humaines avant de remplacer un juge moins cher que vous avez déjà vérifié par rapport à des étiquettes.
Le tableau des frameworks de la partie 1 nomme aussi l’answer relevancy et la context precision. La même API collections note les deux avec le même llm. AnswerRelevancy prend aussi un modèle d’embedding, par exemple embedding_factory("openai", model="text-embedding-3-small", client=client) depuis ragas.embeddings.base. ContextPrecision nécessite une réponse reference dans ascore. Chaque score répond à une question différente : la faithfulness demande si le contexte étaye la réponse, l’answer relevancy demande si la réponse traite la question, et la context precision demande si le contexte pertinent est classé en premier.
Pour construire votre propre scoreur, gardez la structure extraire–vérifier–agréger. L’extraction est un appel LLM qui découpe la réponse en affirmations ; la vérification est un modèle de NLI (natural-language inference) ou un LLM-judge. Validez séparément l’extraction et l’implication, et enregistrez les jugements sans affirmation ou en échec. Par exemple, une réponse de 4 affirmations dont 3 sont étayées obtient 3/4 = 0,75. Une réponse de 0 affirmation n’est pas notée.
Notebook 05 exécute hors ligne un exemple fixe sur Mars avec une approximation lexicale ; celle-ci ne vérifie pas l’implication sémantique. Son module evaluation/faithfulness.py implémente aussi l’extraction et la vérification des affirmations avec SGR. La suite generation évalue des QA synthétiques annotées avec --suite generation --live. Le dépôt utilise uniquement des modèles OpenAI. gpt-5.6-luna génère et juge par défaut ; --judge-model gpt-5.6-terra change le juge. Les deux modèles viennent du même fournisseur : le dépôt montre le processus du juge, pas une comparaison entre familles.
Une alternative conçue à cet effet au LLM-as-judge est HHEM-2.1-Open (Hughes Hallucination Evaluation Model, Vectara), un classifieur fine-tuné pour la détection d’hallucinations. Sa model card documente le checkpoint, le score brut de 0 à 1 qu’il émet et des résultats d’exactitude équilibrée sur AggreFact et RAGTruth. Elle ne publie aucun seuil de décision par défaut, donc en choisir un vous revient. Voyez ces chiffres comme des éléments de preuve de la model card, pas comme une garantie sur votre corpus : calibrez le seuil sur des étiquettes locales et comparez-le au juge que vous avez choisi avant le déploiement.
Évaluation par faits atomiques
FActScore (Min et al., EMNLP 2023) décompose les générations longues en faits atomiques, récupère des éléments de preuve pour chaque fait, étiquette chacun supported / not-supported et rapporte la fraction étayée :
Implémentation de référence : shmsw25/FActScore. L’évaluation initiale portait sur des biographies avec Wikipedia comme source de preuves. L’adapter à des résumés ou à d’autres textes longs demande une vérification locale de l’extraction des affirmations, de la couverture des preuves et des jugements de soutien. Des faits triviaux répétés peuvent augmenter le score, et des affirmations vraies séparément peuvent composer une réponse trompeuse. MontageLie (EMNLP 2025) teste cette faiblesse avec des relations et des ordres trompeurs entre affirmations vraies. VeriScore traite les affirmations avec leurs précisions nécessaires ; le filtre Core aide à éviter l’ajout de faits pour augmenter le score.
Exactitude des citations
Suivez la précision des citations (les passages cités étayent réellement l’affirmation) et le rappel des citations (les affirmations qui doivent être citées le sont) :
Le TREC 2024 RAG Track définit un protocole reproductible d’évaluation du support. Thakur et al. (SIGIR 2025) rapportent environ 56 % d’accord avec des jugements humains établis de zéro et 72 % dans une condition différente où des humains ont post-édité des prédictions de LLM. Cette dernière est une annotation assistée, pas une preuve indépendante d’une amélioration de l’exactitude du juge. Gardez la condition d’annotation attachée au chiffre. Pour une approximation automatisée, ALCE (Gao et al., EMNLP 2023) implémente la précision et le rappel des citations avec une vérification fondée sur le NLI.
Justesse, complétude et refus
- Justesse de la réponse par rapport à une référence : la correspondance exacte ou le F1 au niveau des tokens peuvent convenir aux réponses courtes ;
evaluate.load("squad")de Hugging Face calcule les deux, et le packagebert-scorecalcule le BERTScore. Pour les réponses plus longues, vérifiez les relations factuelles, les entités, les quantités, les négations et les informations requises par rapport à des références relues. Le BERTScore et le cosinus d’embeddings mesurent la similarité ; un nombre ou une négation erronés peuvent conserver un score élevé.AnswerCorrectnessde Ragas combine la comparaison factuelle et la similarité, sans les confondre. - Complétude par nuggets : un nugget est une unité d’information pertinente, les nuggets indispensables se distinguant des nuggets utiles mais facultatifs. Une question sur une date de fondation peut exiger l’année ; le nom du fondateur n’est pas automatiquement requis. AutoNuggetizer construit et affine des nuggets à partir de pools de documents jugés, puis vérifie leur présence dans les réponses générées. Son rapport initial sur TREC 2024 couvrait 21 sujets et 45 exécutions. La synthèse TREC 2025, publiée en mars 2026, étend le protocole aux requêtes narratives et évalue la pertinence du retrieval, la complétude des réponses et l’attribution. Ce sont des protocoles d’évaluation publics, pas la preuve que tout système RAG de production a besoin de la même grille de nuggets.
- Comportement de refus : étiquetez si les éléments de preuve fournis permettent de répondre, puis mesurez la part de refus corrects parmi tous les refus et la part de refus parmi les cas où le système devrait s’abstenir. NoMIRACL (Findings of EMNLP 2024) teste la robustesse face à des passages fournis pertinents et non pertinents ; il ne prouve pas que le corpus entier ne contient aucune réponse. Dans votre propre suite, séparez les échecs de retrieval des requêtes réellement hors périmètre.
Vérification post-génération
Les gains de fiabilité les moins chers viennent souvent de vérifications déterministes après coup, pas de modèles plus grands.
-
Indicateur d’entité inconnue : relevez les chaînes d’entités nommées de la réponse qui sont absentes d’une chaîne de contexte normalisée (par exemple,
entsdespaCyplus une correspondance exacte). C’est un indicateur peu coûteux et propre au domaine pour les chaînes d’entités inconnues, pas un contrôle d’ancrage : il ne peut établir ni l’identité, ni la relation, ni la négation, ni la date, ni la provenance. Mesurez sa précision et son rappel sur des étiquettes locales avant de l’utiliser pour approuver une mise en production, et conservez une vérification d’implication au niveau des affirmations ou une revue humaine.Dans cet exemple, l’indicateur ne trouve aucune entité inconnue, alors que la réponse dit le contraire du contexte.
def unseen_entity_flag(answer: str, context: str, entities: list[str]) -> bool: return any(entity.lower() not in context.lower() for entity in entities) context = "Paris was not founded in 1994." answer = "Paris was founded in 1994." assert not unseen_entity_flag(answer, context, ["Paris"]) claim_supported = False # human label or an NLI verdict, not the lexical flag assert not claim_supported -
Vérification des affirmations : extrayez les affirmations, exécutez un NLI contre le contexte, et faites échouer ou signalez toute affirmation sous le seuil. Modèles de NLI pour la faithfulness :
cross-encoder/nli-deberta-v3-large,MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli. Ajoute de la latence. À envisager pour les domaines à enjeux élevés. -
Auto-cohérence (Wang et al., ICLR 2023) : échantillonnez plusieurs générations à une température > 0 ; rapportez le taux d’accord (par exemple, la proportion de générations qui correspondent à la réponse modale, ou le BERTScore par paires) ; choisissez le nombre d’échantillons à partir de la courbe stabilité–coût et signalez les réponses à faible accord pour une revue humaine.
-
Calibration de la confiance : recueillez une confiance verbalisée (« Quel est votre niveau de confiance, de 0 à 1 ? ») et comparez-la à l’exactitude réelle sur le jeu d’évaluation. Tracez une courbe de calibration et rapportez l’Expected Calibration Error : , où sont les tranches de confiance. Implémentations :
netcal,torchmetrics.CalibrationError. Un modèle qui annonce une confiance de 0,9 devrait avoir raison dans environ 90 % des cas comparables ; mesurez l’écart au lieu de supposer la calibration.
Partie 7 : évaluation d’un RAG fondé sur une ontologie
Les métriques standard ci-dessus couvrent le RAG sur corpus ouvert. Si votre RAG effectue son retrieval sur une ontologie structurée, une taxonomie ou un graphe de connaissances, ces métriques sont nécessaires mais insuffisantes. Les exemples incluent des produits dans un catalogue, des pathologies dans SNOMED, des composants dans une nomenclature (BOM) et des techniques de sécurité dans MITRE ATT&CK. Vous devez aussi mesurer la couche d’ontologie.
Précision de l’entity linking
La première tâche consiste à associer une mention de la requête à une entité de l’ontologie (« Aspirin » → wikidata:Q18216, « the 737 » → aircraft:Boeing_737).
- Précision, rappel et F1 au niveau des mentions : standard, par rapport à des empans de mentions gold (à calculer avec
seqevalou un comparateur d’ensembles d’empans). - Précision de la désambiguïsation : parmi les mentions correctement détectées, quelle fraction est associée au bon identifiant d’entité ? Les références publiques incluent ReFinED, REL et GENRE ; des benchmarks comme AIDA-CoNLL et BELB montrent que les résultats varient selon le système et le domaine.
- Gestion des NIL : précision et rappel sur « entité absente de l’ontologie ». Mesurez séparément le sur-liage vers des entités proches mais fausses et l’abstention correcte.
Évaluation tenant compte de la hiérarchie
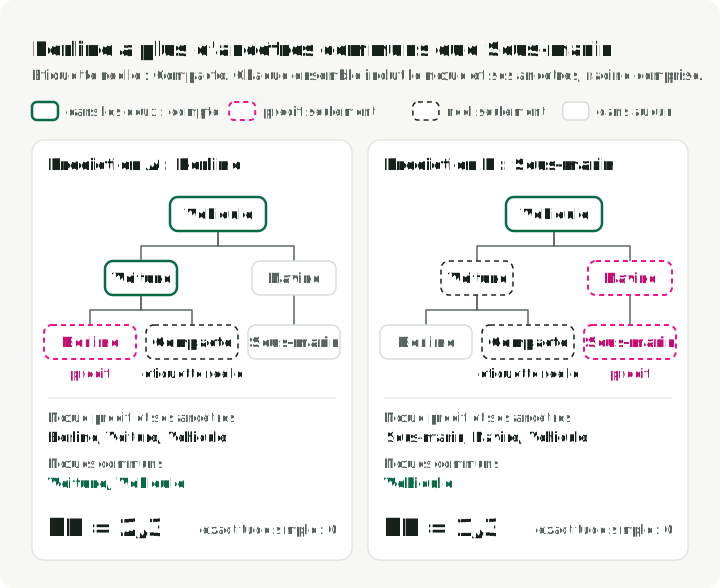
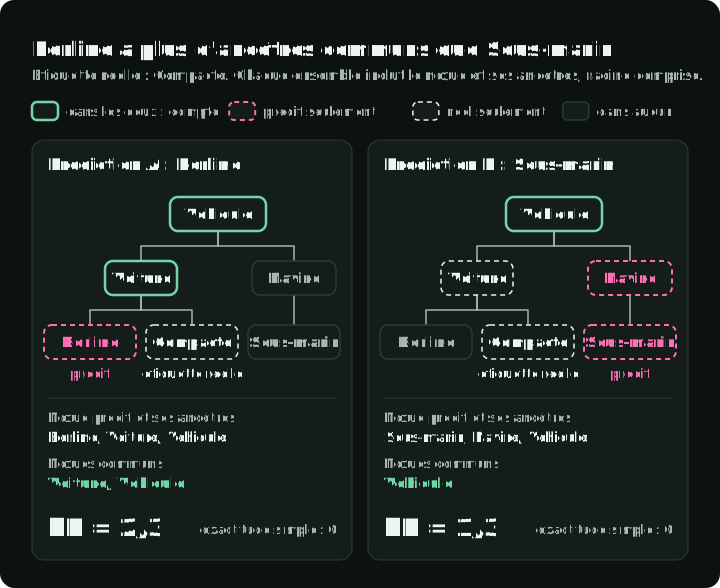
L’exactitude simple traite « Sedan prédit alors que la vérité est Hatchback » comme « Submarine prédit alors que la vérité est Hatchback ». Ces erreurs ne sont pas équivalentes. Dans le schéma, Berline partage deux de ses trois nœuds avec l’étiquette vraie, et Sous-marin ne partage que la racine ; la précision hiérarchique ci-dessous transforme ce recouvrement en score.
-
Précision, rappel et F1 hiérarchiques (Kosmopoulos et al., 2015) : créditez les ancêtres partagés dans le DAG de l’ontologie. Avec le nœud prédit plus tous ses ancêtres et le nœud vrai plus tous ses ancêtres :
Implémentez avec
networkxsur le graphe de l’ontologie : complétez chaque prédiction et chaque étiquette avec ses ancêtres, puis calculez les recouvrements d’ensembles ci-dessus. -
Similarité de Wu-Palmer entre l’entité prédite et l’entité gold dans la taxonomie (Wu & Palmer, 1994) :
où LCA est le plus proche ancêtre commun dans la taxonomie. Disponible directement dans NLTK pour WordNet (
from nltk.corpus import wordnet as wn; wn.synset("car.n.01").wup_similarity(wn.synset("truck.n.01"))) ; pour des taxonomies personnalisées, calculez le LCA avecnetworkx. -
Taux de confusion entre frères et parents : suivez séparément les confusions avec des frères, des parents et des enfants :
count_sibling / total_errors,count_parent / total_errors,count_descendant / total_errors. Utilisez des exemples relus pour tester si les erreurs entre frères viennent de mentions ambiguës ou si les erreurs de parent viennent d’une sur-généralisation.
Taux de fausse exclusion par le filtre (rappel, désormais critique)
Dans les systèmes fondés sur une ontologie, les filtres stricts viennent souvent de l’ontologie elle-même (« ne récupérer que les documents étiquetés avec la catégorie X »). La métrique du taux d’exclusion (définie dans la partie 5) devient un signal de justesse primaire. Une mauvaise prédiction de catégorie peut mettre le rappel à zéro ; le taux d’exclusion attribue cette perte au filtre.
Conformité de la génération contrainte
Quand votre sortie doit se conformer à une ontologie (chaque nom d’entité de la réponse doit être un membre valide de l’ontologie ; chaque prédicat doit provenir d’un vocabulaire fermé), mesurez :
- Taux de validité du schéma : pourcentage de sorties qui s’analysent et se valident par rapport au schéma de l’ontologie. Validez avec
jsonschemaoupydantic. JSONSchemaBench est le benchmark public pour les structured outputs en général ; pour les schémas propres à une ontologie, construisez votre propre validateur. - Conformité au vocabulaire : pourcentage d’entités nommées de la sortie qui sont des identifiants d’ontologie valides ; un simple contrôle d’appartenance à un ensemble sur le vocabulaire fermé.
- Conformité sémantique : une sortie syntaxiquement valide peut tout de même choisir une entité fausse mais valide. Associez la conformité à l’exactitude des réponses en aval.
Les frameworks de constrained decoding (Outlines, XGrammar, Guidance, OpenAI Structured Outputs) sont conçus pour imposer la validité du schéma. JSONSchemaBench compare l’efficacité, la couverture et la qualité entre implémentations. Relancez ses cas qui correspondent à vos schémas et à votre backend de serving, car la couverture et la latence dépendent des deux.
Auditabilité
Pour les systèmes fondés sur une ontologie dont les réponses sont soumises à revue :
- Exhaustivité des citations : pourcentage d’affirmations factuelles avec au moins une citation vérifiable.
- Profondeur de provenance : pourcentage de citations qui remontent jusqu’à un document source avec un identifiant stable, et pas seulement jusqu’à un hash de chunk.
- Taux de reproductibilité : relancer la même requête sur un instantané fixe renvoie la même réponse. Figez la version du modèle, le runtime, la configuration de décodage et la graine, puis fixez le taux de répétition requis selon les besoins d’auditabilité du workflow. Une température à zéro ne garantit pas à elle seule le déterminisme. Un écart peut venir de la génération, du runtime de serving ou de n’importe quelle étape en amont.
Partie 8 : évaluation au niveau système
Qualité globale des réponses
- LLM-as-judge (Zheng et al., NeurIPS 2023) : une approche d’évaluation par modèle qui passe à l’échelle. G-Eval (Liu et al., EMNLP 2023) génère des étapes d’évaluation à partir de la tâche et des critères, puis pondère les niveaux de notation par leurs probabilités de tokens : . Ce sont des probabilités, pas des log-probabilités. L’accord dépend du juge, de la tâche, du prompt et du jeu de calibration.
- Préférence par paires : présentez au juge la réponse A contre la réponse B ; enregistrez la préférence. Cela remplace une note absolue par une décision comparative, mais exige toujours une calibration par rapport aux préférences humaines. MT-Bench a rapporté un accord du juge GPT-4 supérieur à 80 %, à la fois avec les préférences humaines et avec l’accord entre humains, dans les conditions de son benchmark ; ne transposez pas ce taux à un autre domaine sans calibration.
Le LLM-as-judge présente de vrais biais :
- Biais de position : mesurez la sensibilité à l’ordre sur des cas étiquetés par des humains, pour le juge et la tâche choisis. La randomisation ou l’agrégation avec ordre inversé peut aider pour certains couples modèle/tâche, mais ne conservez l’une ou l’autre que si elle améliore l’accord avec les humains en local ; l’étude contrôlée de 2026 a jugé l’inversion de position néfaste sur ses cas adversariaux.
- Biais de verbosité : les juges peuvent confondre longueur et qualité. L’étude contrôlée de 2026, version 2, citée ici, a observé des comportements hétérogènes sur les paires d’expansion : trois juges préféraient les réponses plus longues, Claude préférait les réponses concises, et GPT-4o était à peu près neutre. Les cinq ont bien réussi les contrôles par troncature. Ces résultats dépendent du benchmark ; indiquez donc à votre juge comment traiter la complétude et le remplissage, puis rapportez la performance à longueur contrôlée sur votre propre grille.
- Risque d’auto-préférence : Zheng et al. ont observé un taux de victoire sur ses propres réponses supérieur de 10 % pour GPT-4 et de 25 % pour Claude-v1 dans leurs données, mais ont conclu que les données limitées et les petits écarts ne permettaient pas d’établir un biais d’auto-valorisation. Comparez des juges de la même famille et de familles différentes à des étiquettes humaines locales ; choisissez le juge le mieux calibré au lieu de supposer que l’un ou l’autre dispositif est sûr.
Recette pratique : choisissez un juge sur des données de calibration étiquetées par des humains, masquez l’identité des modèles, mesurez la sensibilité à l’ordre et énoncez la politique de longueur dans la grille. Répétez les cas uniquement quand les échantillons supplémentaires réduisent sensiblement l’incertitude. Pour les évaluations à enjeux élevés, comparez des juges de la même famille et de familles différentes, et analysez les désaccords par rapport aux étiquettes humaines.
Schema-Guided Reasoning pour les juges
La sortie libre est l’une des sources de variation entre exécutions d’un juge. Deux exécutions sur la même réponse peuvent organiser la grille différemment et produire des scores différents. Schema-Guided Reasoning (SGR) rend cette grille explicite : définissez les étapes d’évaluation sous forme de schéma Pydantic, puis utilisez une sortie contrainte via Outlines, XGrammar, les structured outputs de vLLM ou le response_format d’OpenAI pour imposer les contraintes de schéma prises en charge. L’ordre des champs peut aider un relecteur à inspecter l’enregistrement, mais il ne prouve pas que le modèle a raisonné selon ces étapes dans cet ordre.
Pour l’évaluation d’un RAG, le schéma décompose le jugement en champs explicites et auditables, au lieu de laisser le modèle passer directement à un nombre :
from pydantic import BaseModel, Field, ValidationError, model_validator
from typing import Literal

class FaithfulnessJudgment(BaseModel):
    extracted_claims: list[str] = Field(
        description="Atomic factual claims in the answer, one per item."
    )
    supported_claims: list[str] = Field(
        description="Subset of extracted_claims that are entailed by the context."
    )
    unsupported_claims: list[str] = Field(
        description="Subset that is NOT entailed by the context."
    )
    outcome: Literal["scored", "no_claims"]
    failure_mode: Literal[
        "none", "fabrication", "overgeneralization", "wrong_entity", "stale_fact"
    ]
    rationale: str

    @model_validator(mode="after")
    def require_claim_partition(self):
        for claims in (self.extracted_claims, self.supported_claims, self.unsupported_claims):
            if any(not claim.strip() for claim in claims):
                raise ValueError("claims must contain non-whitespace text")
        extracted = set(self.extracted_claims)
        supported = set(self.supported_claims)
        unsupported = set(self.unsupported_claims)
        if not extracted:
            if supported or unsupported or self.outcome != "no_claims":
                raise ValueError("an empty extraction must be a no_claims outcome")
            return self
        if (
            len(extracted) != len(self.extracted_claims)
            or len(supported) != len(self.supported_claims)
            or len(unsupported) != len(self.unsupported_claims)
            or supported & unsupported
            or supported | unsupported != extracted
            or self.outcome != "scored"
        ):
            raise ValueError("verdict lists must be a complete, disjoint claim partition")
        return self

    @property
    def score(self) -> float | None:
        if not self.extracted_claims:
            return None
        return len(self.supported_claims) / len(self.extracted_claims)

valid = FaithfulnessJudgment(
    extracted_claims=["Mars has two moons", "Mars has a thick atmosphere"],
    supported_claims=["Mars has two moons"],
    unsupported_claims=["Mars has a thick atmosphere"],
    outcome="scored",
    failure_mode="fabrication",
    rationale="The atmosphere claim lacks support.",
)
assert valid.score == 0.5
empty = FaithfulnessJudgment(
    extracted_claims=[],
    supported_claims=[],
    unsupported_claims=[],
    outcome="no_claims",
    failure_mode="none",
    rationale="Score refusal correctness separately.",
)
assert empty.score is None
try:
    FaithfulnessJudgment(
        extracted_claims=["Mars has two moons"],
        supported_claims=["Mars has two moons"],
        unsupported_claims=["Mars has two moons"],
        outcome="scored",
        failure_mode="none",
        rationale="Contradictory verdict.",
    )
except ValidationError:
    pass
else:
    raise AssertionError("overlapping verdicts must fail validation")
Ce contrat illustratif ne calcule le score qu’une fois que les listes de verdicts forment une partition complète et disjointe des affirmations extraites. Un résultat sans affirmation n’a pas de score de faithfulness et doit rester hors de l’agrégat de faithfulness ; rapportez son nombre et évaluez séparément la justesse des refus, pour que les abstentions ne puissent pas améliorer la moyenne en silence. Conservez ces contrôles sémantiques en production ; la sortie contrainte garantit la forme, pas un verdict sans biais. Le modèle Pydantic rend aussi un changement de grille visible sous forme de diff de code, tandis que la calibration humaine teste le jugement lui-même.
Cela fonctionne pour toute grille de juge, pas seulement la faithfulness. La préférence par paires, le support des citations et la justesse des refus bénéficient tous du même traitement.
Notebook 07 mesure le biais de position avec des appels par paires inversant l’ordre. Son module evaluation/llm_judge.py implémente aussi la notation individuelle avec SGR. Les exécutions par paires présentent les deux ordres de réponse et rapportent la cohérence après permutation. Le juge individuel renvoie un score entier ; ce n’est pas la méthode G-Eval pondérée par les probabilités. Comme les deux modèles viennent du même fournisseur, mesurer l’autopréférence nécessite encore un juge d’une autre famille comparé aux annotations humaines locales.
Latence et coût
- p50, p95, p99 à chaque étape du pipeline. Un point de départ raisonnable est p95 pour le SLO et p99 pour l’alerte ; changez l’un ou l’autre une fois que vous connaissez le parcours utilisateur, le volume de trafic et le budget d’erreur.
- Time-to-first-token vs. durée totale de génération. Les utilisateurs se soucient du TTFT pour l’expérience en streaming.
- Décomposition par étape : retrieval, reranking, génération, post-traitement. Utilisez la trace pour localiser la queue de distribution au lieu de supposer quelle étape l’a causée ; notez le périphérique et la taille de batch du reranker quand vous comparez des exécutions.
- Total $/requête = embedding + retrieval + rerank + génération + stockage amorti. Suivez p50 et p99 ; la longue traîne est l’endroit où part le budget.
- Taux de succès du cache au niveau du cache d’embeddings, du cache de retrieval et du KV cache. Fixez des cibles distinctes à partir de la répétition observée, de la politique d’invalidation et du coût évité à chaque couche.
Notebook 08 affiche p50/p95/p99 pour l’étape retrieve instrumentée par evaluation/runner.py. Le module evaluation/latency.py peut résumer d’autres étapes si vous les instrumentez explicitement. make benchmark fait varier les paramètres de découpage et d’embeddings sans appel API. La comparaison des LLM nécessite une clé OpenAI et uv run python -m rag_evals.scripts.benchmark --skip-chunking --skip-embedding --live.
Tests A/B
- Unité de randomisation : définissez d’abord le résultat que vous voulez estimer. Demandez-vous ensuite si les réponses précédentes peuvent changer le comportement ultérieur, et si la version attribuée à un utilisateur peut affecter l’expérience d’un autre. Utilisez une attribution par utilisateur ou par session quand une exposition répétée peut modifier le comportement ou créer une UX incohérente. L’attribution par requête n’est défendable que si ces effets sont négligeables et si l’analyse modélise les observations répétées.
- Métriques primaires, garde-fous et exploratoires : enregistrez-les à l’avance. Choisissez la mesure primaire à partir du résultat produit ; les indicateurs de satisfaction incluent les pouces, les régénérations et le temps de lecture. Traitez la latence et le coût comme des garde-fous quand ils contraignent l’expérience.
- Taille d’échantillon : faites une analyse de puissance avant le lancement, à partir de l’effet minimal qui vaut la peine d’être détecté, de la variance de référence, de l’unité d’attribution et de la règle d’arrêt.
Partie 9 : construction du jeu de test
Une métrique ne vaut que ce que vaut le jeu de test sur lequel elle s’exécute. Si votre golden set couvre trois intentions et que le trafic de production en couvre douze, le Recall@10 ne mesure que ces trois intentions. Pire, un jeu de test sur-ajusté à des questions faciles (« Quelle est la politique de remboursement de l’entreprise ? ») peut approuver un système qui échoue sur les questions difficiles (« Éligibilité au remboursement d’une annulation partielle selon les règles européennes de protection des consommateurs, facturée en EUR, pour un client en Irlande ? »). Le score agrégé monte alors que le système continue d’échouer sur une part importante du trafic de production.
Des étiquettes de pertinence incomplètes peuvent fausser le rappel dans un sens comme dans l’autre. Si le vrai ensemble pertinent est {a, b} mais que les étiquettes ne contiennent que {a}, récupérer {a} donne 1,0 au lieu de 0,5 ; récupérer {b} donne zéro au lieu de 0,5. Versionnez les jugements et relisez les nouveaux éléments de preuve récupérés mais non jugés avant d’interpréter un delta.
Construisez d’abord le jeu de test autour de la distribution réelle des requêtes et de leur difficulté. Choisissez ensuite des métriques qui réagissent aux modes de défaillance visés, et ajustez le système en fonction d’elles.
Génération synthétique de requêtes
Utilisez un LLM pour générer des questions à partir de votre corpus :
- Par chunk : « Génère 3 questions qu’un utilisateur pourrait poser et auxquelles ce chunk répond. »
- Multi-hop : échantillonnez deux chunks, générez une question qui exige les deux.
- Adversarial : générez des questions avec des entités distractrices, des formulations quasi identiques, des mentions ambiguës.
La génération de tests de Ragas utilise des scénarios fondés sur un graphe, avec des requêtes à un ou plusieurs sauts et des besoins d’information spécifiques ou abstraits. DataMorgana génère des benchmarks synthétiques configurables selon des catégories d’utilisateurs et de questions. Les données synthétiques sont utiles pour le démarrage à froid et les tests de couverture. Elles ne remplacent pas de vraies requêtes d’utilisateurs.
Construction du golden dataset
Des données organisées par des humains constituent la base du golden set.
- Échantillonnez de vraies requêtes d’utilisateurs (ou simulées avant le lancement), stratifiées par intention.
- Demandez à des experts métier (SME) de répondre à chaque question et d’identifier le ou les documents qui contiennent la réponse.
- Commencez avec quelques centaines de requêtes (200 à 500) et vérifiez l’intervalle. Avec 200 requêtes et un taux de réussite proche de 0,8, l’intervalle à 95 % est d’environ ±5,5 points (1,96 × √(0,8 × 0,2 / 200)). Si le changement à détecter est plus petit, ajoutez des requêtes aux tranches qui décident de la mise en production.
- Ajoutez des requêtes de production relues (partie 10) quand des contrôles de drift ou de nouveaux types de requêtes révèlent une lacune dans la matrice de couverture ci-dessous.
Gardez quatre ensembles séparés :
- Développement : réglage des prompts, de k et du chunking.
- Calibration du juge : étiquettes humaines qui vérifient le juge.
- Mise en production : noté une seule fois par candidat, jamais utilisé pour le réglage.
- Monitoring : trafic de production récent, relu en aveugle.
Regroupez les documents sources et les sessions communs avant de découper. Dès qu’une requête ou une étiquette guide le réglage, elle devient une donnée de développement ; un ensemble de mise en production utilisé pour le réglage devient donc une donnée de développement. Réservez des cas intacts pour valider la configuration choisie et le juge.
Enregistrez les versions du corpus, des requêtes, des étiquettes de pertinence et de la politique, l’unité de k, le budget de contexte fourni, les révisions du scoreur et du juge, et les règles d’agrégation. Comparez les deltas par requête appariés sur la même population, avec l’incertitude et le nombre d’éléments par tranche. Incluez chaque requête attendue : un timeout, un résultat manquant ou une réponse du juge impossible à noter doivent rester visibles dans le décompte des exécutions terminées et des erreurs. Ne laissez pas un score de mise en production s’améliorer en écartant les échecs en silence. ARES propose une approche de recherche qui combine des juges automatisés, une validation humaine et de l’inférence assistée par prédiction (prediction-powered inference) pour estimer les performances des systèmes quand l’annotation est rare ; une suite locale relue peut démarrer plus simplement.
Jeux de test adversariaux
- Contrefactuels : échangez les entités clés de la requête. Le système récupère-t-il les bons chunks pour la requête modifiée ?
- Distracteurs : requêtes pour lesquelles le corpus contient une réponse plausible mais fausse qui ne doit pas être récupérée. C’est ce que RGB (Chen et al., AAAI 2024) met à l’épreuve : robustesse au bruit, rejet négatif, intégration d’informations et robustesse contrefactuelle.
- Négation et quantificateurs : requêtes avec « pas », « sauf » et « uniquement ». Les retrievers denses y échouent souvent.
- Hors périmètre : requêtes sans réponse dans le corpus. Le système doit dire « je ne sais pas », pas halluciner. NoMIRACL fournit des tests de pertinence et d’answerability au niveau des passages ; ajoutez des étiquettes distinctes de hors-périmètre au niveau du corpus. Évaluez explicitement l’abstention sur vos types de requêtes de production.
Couverture et évaluation continue
- Construisez une matrice de couverture : intention de requête × type de document × branche de l’ontologie. Une requête par cellule est un inventaire de couverture de départ, pas une puissance statistique suffisante pour une décision de mise en production. Les cellules vides révèlent une couverture manquante ; dimensionnez les tranches remplies selon l’incertitude que vous pouvez tolérer.
- Cadence de départ : un sous-ensemble d’environ 50 requêtes à chaque PR, le golden set complet chaque nuit ou à chaque release candidate, et des contrôles de drift chaque semaine sur un échantillon de production. Le
make eval-fastdu dépôt compagnon exécute le sous-ensemble de 50 requêtes. Changez le calendrier une fois que vous connaissez le coût de l’évaluation et la vitesse d’évolution du trafic. - Pour le drift, utilisez un échantillon de production glissant et stratifiez par feedback au lieu de modifier en silence la distribution cible.
Partie 10 : monitoring en production
La suite d’évaluation que vous livrez décrit le système au moment du lancement. Le trafic de production évolue ensuite.
Feedback implicite et explicite
- Traitez les événements implicites comme des signaux candidats, pas comme des KPI de qualité positifs ou négatifs, tant qu’ils ne sont pas corrélés à une revue en aveugle ou à un feedback explicite sur un échantillon local.
- Taux de clic / d’ouverture sur les sources citées (si votre interface les expose).
- Temps de lecture de la réponse.
- Taux de régénération : pourcentage de réponses que l’utilisateur repose ou qu’il demande au système de refaire. Traitez-le comme un signal d’insatisfaction parmi d’autres et calibrez-le sur des conversations relues.
- Taux de copie / partage / export : signaux implicites candidats qui peuvent traduire l’utilité, la vérification, la transmission ou l’insatisfaction. Mesurez leur association et leur intervalle de confiance avant de leur attribuer une direction.
- Schémas de relance : utilisez « Êtes-vous sûr ? » ou « Et qu’en est-il de X ? » comme strates de revue, puis étiquetez leur association avec la méfiance ou un besoin non résolu.
- Pouce vers le haut/bas avec des catégories de raison facultatives (faux, incomplet, hors sujet, nuisible, lent). Les modifications en ligne peuvent conserver davantage de contexte de diagnostic ; évaluez cette valeur sur des échantillons relus.
Détection du drift
- Drift des requêtes : comparez les embeddings des requêtes à une fenêtre de référence avec la MMD ou un classifieur validé référence-contre-courant. La KL exige un estimateur de probabilité défini, comme des histogrammes choisis ; les coordonnées brutes d’un embedding ne sont pas des probabilités. Calibrez les alarmes sur des changements connus, puis inspectez les tranches touchées.
- Drift des embeddings : figez une représentation et un jeu de sondes, puis mesurez la stabilité des voisins et la qualité du retrieval. Des versions de modèle différentes n’ont pas besoin de partager les mêmes dimensions ni la même base de coordonnées, donc le cosinus entre versions peut n’avoir aucun sens. Migrez ensemble les encodeurs de requêtes et de documents, évaluez le nouvel index et conservez des instantanés versionnés pour un retour arrière.
- Drift des performances : suivez dans le temps les métriques équivalentes en production (taux de régénération par intention). Les changements soudains et progressifs suggèrent des hypothèses différentes, mais leur forme n’établit pas la cause ; inspectez les changements de données, de trafic, de fournisseur, de politique et de déploiement.
Shadow evaluation et human-in-the-loop
Exécutez le système candidat en parallèle de la production, comparez les sorties hors ligne et ne les servez pas aux utilisateurs. Cela peut révéler des régressions avant le lancement. L’inférence en shadow consomme tout de même de la capacité et peut invoquer des outils : isolez les ressources, supprimez les écritures et vérifiez que la comparaison ne dégrade pas la latence de production.
Pour la revue human-in-the-loop (HITL) :
- Échantillonnez les sorties à faible confiance dans une file de revue.
- Incluez un échantillon aléatoire du trafic de production pour une revue en aveugle ; 1 à 2 % du trafic est un taux de départ, à ajuster selon le volume de trafic, le risque et la capacité des relecteurs.
- Suréchantillonnez les sorties avec pouce vers le bas pour la revue, en plus de l’échantillon aléatoire.
- Utilisez les sorties relues pour étendre le golden set.
Gardez l’échantillon aléatoire : sans lui, le golden set ne gagne que des réponses dont les utilisateurs se sont plaints.
Le jeu minimal de guardrails
Choisissez les priorités et les seuils d’alerte selon le préjudice pour l’utilisateur, les SLO et la performance validée des détecteurs. Les signaux candidats incluent :
- Score de faithfulness/HHEM sous le seuil sur un échantillon de production glissant.
- Latence p95 au-dessus du SLO.
- Taux de fausse exclusion par le filtre au-dessus du seuil (sur échantillon).
- Taux de régénération hors d’une bande de contrôle calibrée localement, qui tient compte de la taille de la fenêtre, du trafic, de la saisonnalité et du budget de fausses alertes.
- Coût/requête au-dessus du budget.
Une première règle de triage : une alerte sans changement de code ou de modèle pointe vers un drift ; une alerte juste après une release pointe vers une régression. Confirmez l’un ou l’autre dans les traces et les tranches touchées, car un déploiement peut coïncider avec un drift du trafic, et un changement chez le fournisseur ou dans les données peut survenir sans release de l’application.
Réserves
- Les cibles sont locales, pas universelles. Les valeurs de départ de ce guide, y compris les seuils du dépôt compagnon, sont des premiers réglages à ajuster sur vos propres données. Les chiffres indicatifs sont des résultats d’exemples. Calibrez les seuils de mise en production selon votre domaine, les enjeux, l’incertitude du jeu d’évaluation et les attentes des utilisateurs.
- L’écosystème des frameworks évolue vite. Les versions de HHEM, les noms des métriques RAGAS, les model cards et l’ordre des classements peuvent changer après la publication. Revérifiez la source liée et refaites vos mesures avant de vous engager.
- Les chiffres d’accord du LLM-as-judge viennent avec des réserves. Le chiffre de 80 % d’accord entre GPT-4 et les humains provient des conditions de MT-Bench / Chatbot Arena. Ce résultat n’établit pas l’accord sur un domaine de niche ni sur une tranche adversariale. Utilisez les juges pour noter plus de cas que les humains ne peuvent en relire, et continuez de relire un échantillon à la main.
- Les gains annoncés par les éditeurs dans leurs benchmarks ne sont souvent pas reproductibles de façon indépendante. Reproduisez sur vos propres données avant de croire un chiffre, en particulier pour les rerankers et les systèmes d’OCR récents.
- Aucune métrique ne remplace la lecture des sorties. Commencez par lire 50 réponses de production tirées au hasard chaque semaine. Les métriques passent cette habitude à l’échelle ; elles ne la remplacent pas.
Références
Frameworks et benchmarks
- Es et al., Ragas: Automated Evaluation of Retrieval Augmented Generation, 2023.
- Documentation de RAGAS et GitHub.
- Saad-Falcon et al., ARES: An Automated Evaluation Framework for Retrieval-Augmented Generation Systems, NAACL 2024.
- TruLens, DeepEval, Arize Phoenix.
- Thakur et al., BEIR: A Heterogenous Benchmark for Zero-shot Evaluation of Information Retrieval Models, NeurIPS 2021.
- MTEB Leaderboard.
- TREC 2024 RAG Track.
- Pradeep et al., Initial Nugget Evaluation Results for the TREC 2024 RAG Track with the AutoNuggetizer Framework, 2024.
Retrieval et ranking
- Cormack, Clarke, Buettcher, Reciprocal Rank Fusion Outperforms Condorcet and Individual Rank Learning Methods, SIGIR 2009.
- Gao et al., Precise Zero-Shot Dense Retrieval Without Relevance Labels (HyDE), 2022.
- Jeong et al., Adaptive-RAG: Learning to Adapt Retrieval-Augmented Large Language Models through Question Complexity, NAACL 2024.
- Anthropic, Introducing Contextual Retrieval, septembre 2024.
- Günther et al., Late Chunking: Contextual Chunk Embeddings Using Long-Context Embedding Models, 2024.
Génération, faithfulness et juges
- Min et al., FActScore: Fine-grained Atomic Evaluation of Factual Precision in Long Form Text Generation, EMNLP 2023.
- Liu et al., Lost in the Middle: How Language Models Use Long Contexts, TACL 2024.
- Chen et al., Benchmarking Large Language Models in Retrieval-Augmented Generation (RGB), AAAI 2024.
- Vectara, HHEM-2.1-Open hallucination evaluation model.
- Zheng et al., Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, NeurIPS 2023.
- Thakur et al., Support Evaluation for the TREC 2024 RAG Track: Comparing Human versus LLM Judges, SIGIR 2025.
- Thakur et al., Knowing When You Don’t Know: A Multilingual Relevance Assessment Dataset for Robust Retrieval-Augmented Generation, Findings of EMNLP 2024.
- Geng et al., JSONSchemaBench: A Rigorous Benchmark of Structured Outputs for Language Models, 2025.
- Kosmopoulos et al., Evaluation Measures for Hierarchical Classification: a unified view and novel approaches, 2015.
Drift et production
- Evidently, Embedding drift detection methods compared.
Code compagnon
slavadubrov/rag-evals-demo: harness exécutable séparant recherche sur SciFact, génération sur QA synthétiques annotées et vérifications hors ligne sur données de test fixes, avec variation des paramètres de découpage et d’embeddings et comparaison en direct facultative de deux modèles OpenAI. Les notebooks 00–09 expliquent les processus ; les tests unitaires fixent certains exemples chiffrés, tandis que les anciennes données de filtrage utilisent une autre population autorisée. L’index Qdrant embarqué fonctionne sans Docker.