Métricas de evaluación de RAG: recuperación, reranking y generación

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Esta referencia está pensada para quienes operan o evalúan sistemas de generación aumentada por recuperación (RAG). Relaciona los fallos en el parsing de documentos, el filtrado, la recuperación, el reranking y la generación con la métrica que identifica cada uno. También indica qué comprobaciones se ejecutan antes de lanzar y cuáles vigilan el tráfico real.
Un sistema RAG con filtros de relevancia rotos puede funcionar durante meses sin disparar ninguna alerta operativa. Sigue devolviendo respuestas y cumple su objetivo de latencia, pero esas respuestas se apoyan en evidencia incompleta. El Recall@k calculado sobre el conjunto de referencia original de documentos elegibles revela la pérdida. Los paneles de latencia y disponibilidad, no.
¿Quieres saltar al código y ejecutarlo?
El repositorio ejecutable
slavadubrov/rag-evals-demosepara la recuperación en SciFact, la generación sobre QA sintética etiquetada y las comprobaciones offline con datos de prueba fijos.make evalejecuta recuperación, diagnóstico de filtros y reproducción de resultados de generación trasmake index.make benchmarkbarre ajustes de chunking y embeddings sin llamadas a API; comparar dos modelos de OpenAI requiere una clave de API y la opción--live(véase la parte 8). Los notebooks 00–09 cubren recuperación, filtrado, generación y ejemplos del sistema. La demo usa Qdrant integrado y no requiere Docker.
Tabla de decisión para la evaluación de RAG
Usa esta tabla como punto de partida antes de elegir un framework. La métrica adecuada depende del modo de fallo que quieras detectar, no del nombre de la herramienta.
| Pregunta | Familia de métricas | Úsala cuando | Ten cuidado con |
|---|---|---|---|
| ¿El parsing conservó la fuente? | Completitud de la extracción, cobertura de tablas y figuras | Al corpus entran PDF, presentaciones, escaneos y páginas HTML | Un texto de aspecto limpio puede haber perdido pies de figura, notas al pie o tablas |
| ¿La recuperación encontró la evidencia? | Recall@k, nDCG@k, MRR, precisión y recall del contexto | Puedes etiquetar fragmentos o documentos relevantes | Un filtro duro de metadatos puede eliminar el documento correcto antes de empezar a ordenar |
| ¿El reranking mejoró la lista corta? | Mejora del reranker, Precision@1, diferencia de nDCG | Hay cross-encoders o rankers LLM después de la recuperación | Mide la latencia y el coste junto con la mejora de calidad |
| ¿La respuesta usó la evidencia? | Fidelidad (faithfulness), anclaje (groundedness), respaldo de las citas | La respuesta cita documentos o afirma hechos del contexto | La fidelidad no diagnostica un parsing o una recuperación deficientes |
| ¿El sistema es estable en producción? | Deriva, regeneración, fallback, latencia p95, coste por respuesta | El tráfico cambia después del lanzamiento | La telemetría de producción necesita revisión humana por muestreo para seguir calibrada |
Para una comparación más breve de herramientas, consulta Las mejores herramientas de evaluación de RAG: Ragas, DeepEval y TruLens.
Parte 1: Define el éxito antes de la arquitectura
Redacta el conjunto de evaluación antes del diagrama de arquitectura. Así cada decisión posterior sobre un componente tiene un objetivo medible.
No puedes elegir entre BM25 y recuperación densa, entre chunking recursivo y semántico, o entre Cohere Rerank y BGE hasta que sepas qué optimizas. “Mejores respuestas” no es una métrica. Un requisito de lanzamiento ilustrativo es “fidelidad ≥ 0,85 en un conjunto de oro de 200 consultas que cubra nuestras tres intenciones principales, con latencia p95 < 1,5 s y tasa de falsa exclusión del filtro < 2 %”. Sus cifras son marcadores de posición; lo importante es que la calidad, la cobertura, la latencia y el filtrado tengan umbrales explícitos.
Define el harness antes de escribir el código de recuperación. El primer harness saldrá mal y lo revisarás. Revisar una métrica cuesta mucho menos que revisar un sistema que ya has puesto en producción.
Tres capas del pipeline y dos modos de ejecución
La evaluación en producción tiene tres capas de pipeline. La evaluación de la ingesta pregunta si el corpus y el índice conservan la fuente. La evaluación en tiempo de consulta pregunta si la reescritura, el filtrado, la recuperación, el reranking y el ensamblado del contexto encontraron la evidencia correcta. La evaluación de la respuesta y de producción pregunta si la respuesta usó esa evidencia y si la calidad se mantiene con tráfico real. Si colapsas las capas en una sola puntuación, un fallo de normalización puede quedar oculto dentro de una puntuación de respuesta aceptable.
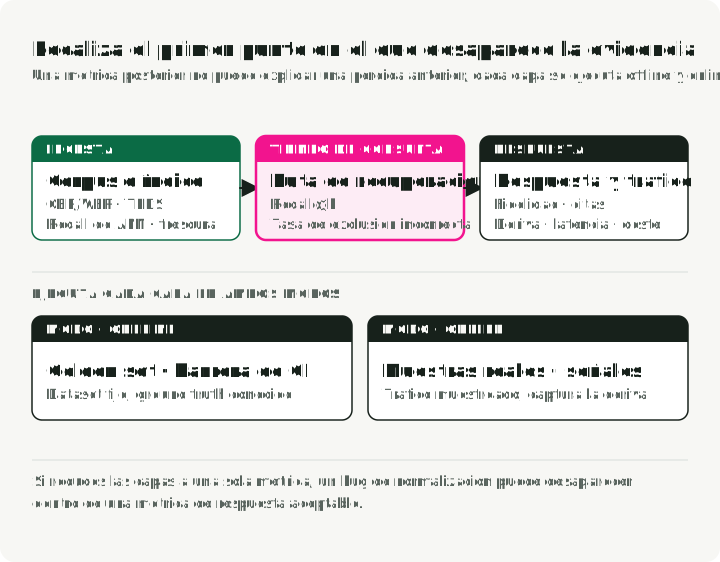
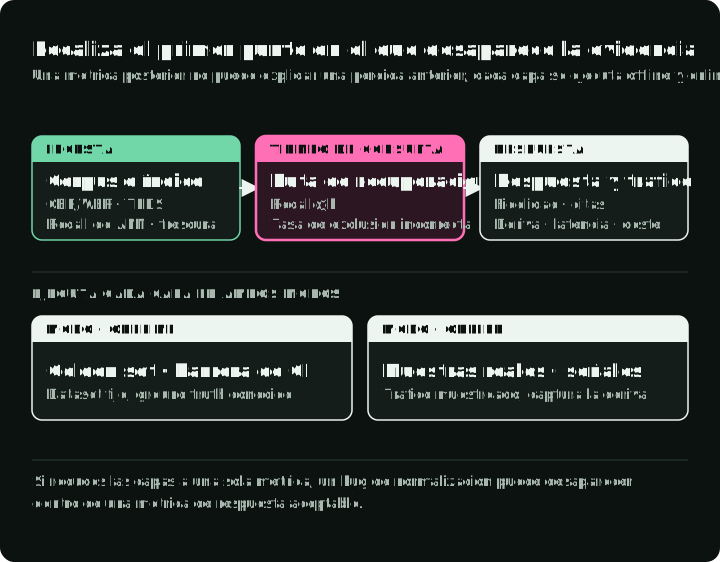
Esas capas describen dónde ocurre un fallo. Offline y online describen cuándo se ejecuta la comprobación y con qué datos. La evaluación offline usa un dataset fijo con verdad de referencia conocida; es reproducible y encaja en la selección de componentes, las comparaciones A/B y las comprobaciones de CI que pueden bloquear un cambio. La evaluación online puntúa una muestra del tráfico real y registra regeneraciones, tiempo de permanencia, comentarios explícitos y la deriva real de las consultas. Es más ruidosa y más difícil de instrumentar.
Usa ambos modos donde ayuden: los corpus y los conjuntos de consultas fijos hacen reproducibles las regresiones; las trazas reales muestreadas revelan fallos de frescura y deriva.
Por componentes frente a end-to-end
Hay dos errores habituales. Evaluar solo end-to-end indica que el sistema falla, pero no dónde. Evaluar solo por componentes puede mostrar todas las piezas en verde mientras el sistema completo sigue fallando. La solución es combinar unas pocas métricas end-to-end principales para decidir si se lanza con métricas por componente para diagnosticar. Las métricas de recuperación detectan regresiones del recuperador. Las métricas de generación detectan regresiones del generador. La corrección de la respuesta end-to-end detecta fallos de integración.
Los frameworks de referencia (recorrido con opinión)
| Framework | Lo que mejor hace | Dónde falla |
|---|---|---|
| RAGAS | Un vocabulario común para fidelidad, relevancia de la respuesta y precisión/recall del contexto (métricas) | Coste del LLM como juez; componentes de la puntuación opacos al depurar; cambios de versión |
| ARES | Un juez clasificador específico de la tarea, si compensa el coste de entrenamiento y anotación (artículo); su precisión publicada depende del benchmark | Configuración más pesada; hay que entrenar modelos de verdad |
| TruLens | Funciones de feedback enlazadas a las trazas e integración con OpenTelemetry (proyecto) | Menos métricas específicas de RAG listas para usar que RAGAS |
| DeepEval | Integración con ejecutores de pruebas y métricas personalizadas (proyecto) | Uso intensivo de LLM como juez = picos de coste |
| Arize Phoenix | Trazado, experimentos con datasets y evaluadores de RAG y de agentes, predefinidos o personalizados (documentación de evaluación) | Las rúbricas del dominio y los umbrales del juez siguen necesitando calibración local |
| TREC 2024 RAG Track | Benchmark público para la evaluación por nuggets (AutoNuggetizer), la evaluación del respaldo y la fluidez sobre MS MARCO Segment v2.1 | No es una herramienta de ejecución; es un benchmark con el que calibrar |
Mi pila por defecto es RAGAS para el vocabulario de métricas, DeepEval para las comprobaciones de CI, Phoenix para el trazado en producción y código propio para las métricas específicas de la ontología. Elige el framework que facilite las métricas personalizadas.
Para elegir un benchmark, empieza por la tarea antes de mirar la clasificación. BEIR, MTEB y MIRACL siguen siendo buenas bases de referencia para la recuperación. Añade pruebas para las capacidades que no establecen:
- RAG end-to-end actual: el TREC 2026 RAG Track usa consultas narrativas y ClimbMix-400b, que sustituye a MS MARCO v2.1, y enlaza el kit de evaluación RAGDoll. Sus temas de 2026 ya están publicados; los juicios, todavía no. Usa los temas para experimentar, no como una clasificación con juicios. Mantén los protocolos de 2024 y 2025 que aparecen más abajo vinculados a sus propios corpus y juicios.
- Preguntas técnicas sobre código en evolución: FreshStack combina preguntas de Stack Overflow formuladas por personas, corpus de repositorios y juicios por nuggets. La instantánea publicada y la maquinaria para construir corpus nuevos son cosas distintas; fija la revisión del repositorio y la fecha de las preguntas.
- Imágenes que aportan parte de la pregunta o de la evidencia: MM-BRIGHT separa la recuperación de texto a texto, de multimodal a texto, de multimodal a imagen y de multimodal a multimodal. Puntúa cada tarea relevante por separado. El texto de un OCR por sí solo puede omitir lo que aporta un gráfico o una captura de pantalla.
Estos benchmarks amplían la cobertura; no sustituyen el conjunto de consultas elegibles y versionado de tu aplicación.
Parte 2: Mapea los puntos de evaluación
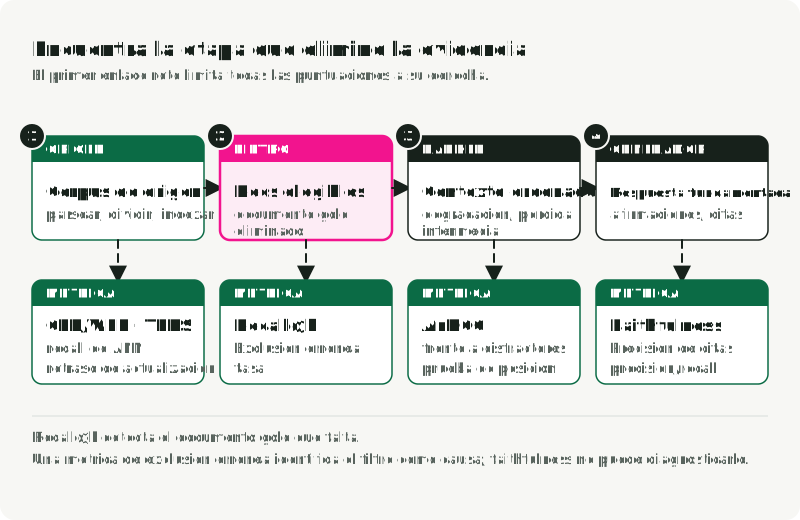
Cuando una respuesta es incorrecta o no tiene respaldo, sigue el documento de referencia por las cuatro comprobaciones de la figura, de izquierda a derecha. La primera etapa en la que falta indica qué métrica revisar primero y qué parte de este artículo la cubre.
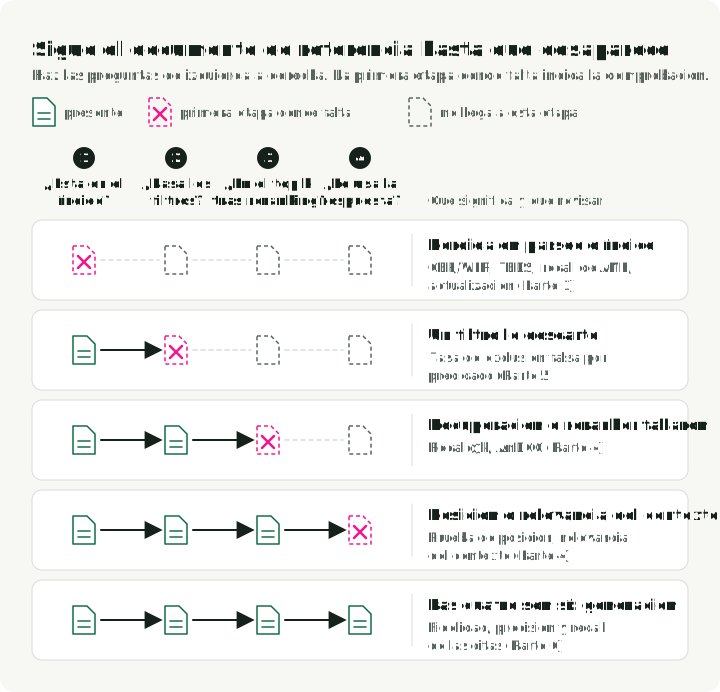
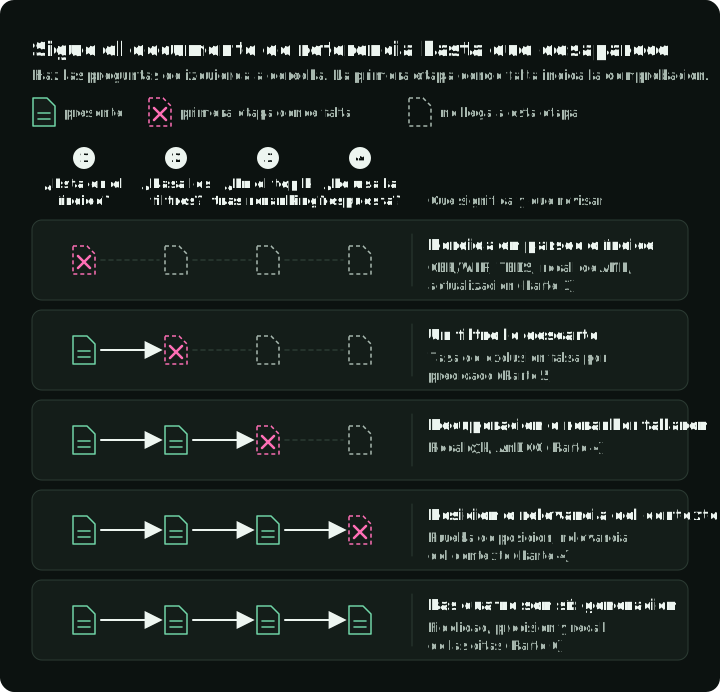
Las pérdidas aguas arriba limitan la calidad aguas abajo: un mal parsing limita la recuperación, y una mala recuperación limita el reranking y la generación. La fidelidad mide la respuesta, nunca la causa aguas arriba.
Parte 3: Evaluación de la ingesta
Muchos fallos de RAG en producción empiezan en la ingesta. El sistema funciona con documentos de prueba limpios y luego falla con PDF reales, escaneos, tablas y páginas de corpus desordenadas.
Adquisición y parsing de documentos
Qué medir:
-
Comprobación de coherencia de la longitud extraída:
extracted_chars / expected_charspor clase de documento señala cambios de longitud sospechosos, pero un texto duplicado o erróneo aún puede puntuar 1,0. Compara el texto alineado con una referencia limpiada a mano para detectar omisiones y sustituciones, y revisa por separado las notas al pie, los pies de figura, el contenido de las tablas y el orden de lectura. -
Precisión del OCR: CER (Character Error Rate, tasa de error de caracteres) y WER (Word Error Rate, tasa de error de palabras), las métricas estándar de voz y OCR:
donde , , son las sustituciones, eliminaciones e inserciones a nivel de carácter y es el número de caracteres de la referencia (el subíndice indica la versión por palabras). No apliques un único umbral de CER a todos los corpus. Calíbralo por clase de documento y por pérdida de calidad en la respuesta final. El texto impreso, la escritura a mano y el material multilingüe tienen perfiles de error distintos. Calcúlalo con
jiwer(jiwer.cer(refs, hyps),jiwer.wer(refs, hyps)) o conevaluatede Hugging Face. Como corpus de evaluación, FUNSD y SROIE son benchmarks públicos.from jiwer import cer, wer refs = ["Mars has two moons, Phobos and Deimos."] hyps = ["Mars has two m00ns, Phobos and Deirnos."] print(f"CER = {cer(refs, hyps):.3f}") # CER = 0.105 print(f"WER = {wer(refs, hyps):.3f}") # WER = 0.286 -
Fidelidad de la extracción de tablas: TEDS (Tree-Edit-Distance-based Similarity, similitud basada en la distancia de edición de árboles) mide cuánto se acerca el árbol de una tabla HTML predicha a la referencia, normalizado por el tamaño del árbol mayor. Procede de Zhong et al., 2020 (PubTabNet):
TEDS usa tanto la estructura (filas, columnas, celdas combinadas) como el contenido de las celdas. TEDS-S elimina el contenido y puntúa solo la estructura. Implementación de referencia:
src/metric.pyde PubTabNet (usaaptedpor debajo). Como corpus de evaluación, consulta PubTabNet, FinTabNet y SciTSR. Los parsers ingenuos suelen fallar con las tablas. Haz un benchmark antes de fiarte de ellos. -
Conservación del diseño y la estructura: orden de los encabezados, integridad de las listas, orden de lectura en PDF de varias columnas. Usa DocLayNet como benchmark etiquetado. Una comparación con herramientas listas para usar puede abarcar un parser de elementos como
unstructured, una biblioteca de PDF comopymupdfy un pipeline de Docling concreto. Docling ofrece rutas estándar y rutas con VLM; anota cuál pruebas.
Compara familias de parsers distintas, por ejemplo una línea base con Tesseract, un modelo de OCR basado en VLM y el candidato de tu proveedor. Los mejores modelos de OCR compara las opciones actuales. Usa una muestra estratificada de clases reales de documentos con un DPI fijo, que incluya escaneos limpios, fotos, tablas, texto multilingüe, matemáticas y escritura a mano. Informa del CER o el WER de cada clase y del TEDS de las páginas con tablas.
Limpieza y normalización
-
Precisión de la eliminación de texto repetitivo (boilerplate): precisión y recall frente a tramos de boilerplate etiquetados por personas. Una eliminación agresiva descarta contenido relevante; una eliminación perezosa contamina los embeddings. Herramientas que comparar:
trafilatura,jusText,Resiliparse. Barbaresi (2021) compara Trafilatura con líneas base que incluyen jusText; Resiliparse es un candidato aparte, no un sistema evaluado en ese artículo. -
Normalización Unicode: el porcentaje de documentos cuyas salidas NFC y NFKC coinciden (calculado con
unicodedata.normalizede la biblioteca estándar) es una señal útil de deriva de las formas de compatibilidad. No detecta los puntos de código invisibles o ignorables por defecto ni los homógrafos entre escrituras: busca los primeros de forma explícita y aplica una política o un detector de confusables de Unicode cuando los segundos entren en el alcance. -
Precisión de la detección de idioma: F1 sobre una muestra multilingüe etiquetada. Es fundamental en los índices multilingües. Usa
fasttext-langdetect(ellid.176de Facebook),lingua-pyocld3. FLORES-200 aporta texto de evaluación en 200 idiomas, pero la mezcla de idiomas de tu producción debe determinar el subconjunto de prueba. -
Eficacia de la deduplicación (MinHash / LSH): precisión y recall de tu detector de casi duplicados frente a un conjunto etiquetado a mano. La idea de fondo: estimar la similitud de Jaccard entre los conjuntos de shingles de los documentos mediante hashes de permutaciones aleatorias (Broder, 1997) y agrupar los casi duplicados con bandas LSH (Indyk y Motwani, 1998). Recorre el número de hashes y el umbral de Jaccard sobre tu corpus. Mide por separado la tasa de fusiones erróneas (corrompe las respuestas) y la tasa de fusiones omitidas (desperdicia espacio del índice).
datasketchaporta la implementación que se usa a continuación; sus parámetros son ilustrativos:from datasketch import MinHash, MinHashLSH def shingles(text: str, k: int = 5) -> set[str]: text = text.lower() return {text[i:i + k] for i in range(len(text) - k + 1)} def to_minhash(text: str, num_perm: int = 128) -> MinHash: m = MinHash(num_perm=num_perm) for s in shingles(text): m.update(s.encode("utf-8")) return m docs = { "d1": "Mars has two moons, Phobos and Deimos.", "d2": "Mars has two moons, Phobos and Deimos!", # near-dup "d3": "Curiosity rover landed on Mars in 2012.", } lsh = MinHashLSH(threshold=0.8, num_perm=128) for did, text in docs.items(): lsh.insert(did, to_minhash(text)) print(sorted(lsh.query(to_minhash(docs["d1"])))) # ['d1', 'd2'] -
Depuración de datos personales (PII): precisión y recall, calculados por separado para cada tipo de entidad (correos electrónicos, SSN, nombres, direcciones). Los errores de recall generan riesgo de cumplimiento normativo; los errores de precisión perjudican la calidad de las respuestas. Fija el punto de operación con el equipo jurídico. Entre las herramientas candidatas están Microsoft Presidio,
scrubadubo un modelo de NER con fine-tuning sobre un conjunto etiquetado.
El chunking determina la calidad de la recuperación
El chunking cambia qué evidencia llega a la respuesta. En el benchmark de proveedor de NVIDIA de 2025, el chunking por páginas logró la mayor exactitud media de respuesta end-to-end en la configuración probada, porque conservaba las tablas y los gráficos como unidades completas. Eso mide la exactitud de la respuesta, no el recall de la recuperación. Trata ese resultado como evidencia para el corpus probado, no como un ganador universal.
El chunking semántico agrupa frases contiguas por similitud de embeddings y corta donde se vuelven distintas. El SemanticChunker de LangChain y el SemanticSplitterNodeParser de LlamaIndex implementan esta estrategia. Puede mejorar el recall frente a las ventanas fijas cuando importan los límites temáticos.
El RecursiveCharacterTextSplitter de LangChain prueba por defecto saltos de línea dobles, simples, espacios y caracteres individuales: ["\n\n", "\n", " ", ""]. No detecta límites de frases salvo que configures separadores adecuados o uses un divisor que los reconozca. Su valor por defecto length_function=len cuenta caracteres. Para probar 400–512 tokens por fragmento con un solapamiento del 10–20 %, usa una función que cuente tokens. Compara estos ajustes iniciales con otros valores en tu conjunto de referencia.
Métricas que seguir:
- Coherencia de los fragmentos: , donde son embeddings de frases. Los fragmentos sanos son similares por dentro y distintos en el límite. Calcúlala con
sentence-transformersy la funcióncosine_similaritydescikit-learn. - Calidad de los límites: una muestra etiquetada por personas con la pregunta “¿es un corte razonable?”, más una comprobación estructural de que los fragmentos no parten tablas, listas ni secciones numeradas.
- Tamaño óptimo del fragmento: recorre varios tamaños en tokens (128, 256, 512, 1024) y representa el Recall@k frente al tamaño sobre tu conjunto de oro. Elige el menor tamaño a partir del cual el Recall@k deja de mejorar.
- Eficacia del solapamiento: recorre solapamientos de 0, 10, 20 y 30 % como cuadrícula inicial y mide el Recall@k. Deja de aumentar el solapamiento cuando la curva local de recall se aplane o el coste de la duplicación supere la ganancia.
- Fidelidad de la atribución de fragmentos: porcentaje de fragmentos que conservan una referencia verificable a su origen (número de página, ancla de sección, ID de documento). La auditabilidad lo exige.
- Chunking tardío frente a temprano: el chunking tardío (late chunking, Günther et al., 2024) genera los embeddings del documento completo y después lo segmenta, con lo que conserva el contexto global (implementación de referencia en
jina-embeddings-v3). Contextual Retrieval (Anthropic, 2024) antepone a cada fragmento un contexto generado por un LLM. Ambos añaden coste. Haz un benchmark sobre tu corpus antes de adoptar cualquiera de los dos.
Mi opinión: el chunking estructural (dividir por encabezados, tablas y secciones, que implementan parsers como unstructured.io o que se logra recorriendo el AST que tu parser ya produjo) se usa menos de lo que merece. Si tus documentos tienen estructura, aprovéchala antes de añadir heurísticas de similitud. La división recursiva por caracteres es la línea base; el chunking semántico solo compensa su sobrecoste, sobre todo, con prosa no estructurada.
Extracción y enriquecimiento de metadatos
- Precisión, recall y F1 de NER: por tipo de entidad, sobre un subconjunto etiquetado. Estilo estándar de CoNLL y MUC. Calcúlalos con
seqeval(from seqeval.metrics import f1_score) para la versión que entiende las etiquetas BIO/IOB, o con scikit-learn para comparar conjuntos de tramos. CoNLL-2003 y OntoNotes 5.0 son los corpus de referencia canónicos. - F1 de extracción de relaciones: aún más importante en sistemas anclados en ontologías. Etiqueta a mano un conjunto estratificado por tipo de relación y por clase de documento. TACRED y DocRED son benchmarks públicos; entre las implementaciones candidatas están
opennrey los pipelines de relaciones despaCy. - Precisión de la extracción de títulos y encabezados: coincidencia exacta más similitud de Levenshtein normalizada () frente a la verdad de referencia;
python-Levenshteinorapidfuzzte dan ambas en una sola llamada. - Conservación de los metadatos jerárquicos: porcentaje de fragmentos que conservan correctamente su sección padre, su documento padre y su ruta de ascendientes. Esta métrica decide si tu RAG puede responder preguntas del tipo “¿qué dice el hijo de la política X?”.
Generación de embeddings
- Benchmarks para elegir el modelo: usa los resultados de MTEB en tareas de recuperación, BEIR para la generalización zero-shot y MIRACL para la recuperación multilingüe como puntos de comparación. MTEB suele informar del nDCG@10 en recuperación; otras familias de tareas usan otras métricas. El paquete de Python de MTEB ejecuta los benchmarks en local. Trata la transferencia de MTEB en inglés a un idioma con menos recursos como una hipótesis que probar con el conjunto etiquetado de ese idioma.
- Evaluación específica del dominio: no tomes la posición en una clasificación general como un resultado de tu dominio. Empieza con unos cientos de consultas etiquetadas (200–500) que cubran tus tipos de consulta principales; la Parte 9 muestra cómo comprobar si eso basta. Después reordena los modelos candidatos sobre ese conjunto con
ranxopytrec_eval. Un conjunto del dominio puede invertir el orden de una clasificación, así que publica junto con el resultado el subconjunto del dataset, el protocolo de recuperación y el intervalo de confianza. - Detección de deriva de los embeddings: compara dos colecciones de embeddings: una muestra de referencia fija y una muestra actual móvil. La discrepancia máxima de medias (MMD) comprueba si sus distribuciones difieren. Otra opción es un clasificador validado, entrenado para distinguir las muestras de referencia de las actuales. La divergencia de Kullback–Leibler (KL) compara distribuciones de probabilidad, así que necesita un estimador explícito, como histogramas elegidos; las coordenadas crudas de un embedding no son probabilidades. Mide también la estabilidad de los vecinos más cercanos para un conjunto fijo de sondas.
evidentlyyalibi-detectimplementan detectores estadísticos y basados en modelos. El estudio comparativo de Evidently es una evaluación de un proveedor; compara los métodos con desplazamientos conocidos en tus propios embeddings. - Multivector frente a vector único: la interacción tardía conserva las representaciones a nivel de token en lugar de colapsar cada documento en un solo vector; ColBERT es el diseño canónico, con implementaciones de referencia en RAGatouille y PyLate. Esa representación más rica aumenta el coste del índice y de la recuperación. Compara calidad, almacenamiento y latencia con una línea base de vector único sobre el mismo conjunto del dominio antes de adoptarla.
Construcción del índice
- Recall@k bajo aproximación: compara el índice de vecinos más cercanos aproximados (ANN) con una línea base exacta de fuerza bruta con el mismo k; en FAISS, eso es
IndexHNSWFlat(oIndexIVFFlat) frente aIndexFlatIP/IndexFlatL2. Como primera comprobación, exige un Recall@10 de al menos 0,95 frente a la búsqueda exacta y luego endurécelo o relájalo según la calidad de la respuesta final. El proyectoann-benchmarksregistra curvas de Pareto de recall frente a QPS para distintas bibliotecas. - Ajuste de HNSW: HNSW (Hierarchical Navigable Small World) es un grafo de proximidad por capas; véase Malkov y Yashunin, 2018. Está implementado en
hnswlib, en elIndexHNSWFlatde FAISS y en la mayoría de las bases de datos vectoriales. HNSW expone tres parámetros:M(ramificación del grafo),efConstruction(anchura de candidatos al construir) yefSearch(anchura de candidatos al consultar). Valores iniciales:Mde 16–32 yefConstructionde 100–200; después subeefSearchhasta que el Recall@10 frente a la búsqueda exacta deje de mejorar. La guía de parámetros de hnswlib indica que unMde 12–48 sirve para la mayoría de los usos y propone una comprobación paraefConstruction: si conefigual aefConstructionel recall de losMvecinos más cercanos queda por debajo de 0,9, el grafo todavía puede mejorar. - Ajuste de IVF: IVF (Inverted File index) reparte los vectores en
nlistceldas con k-means y, al consultar, recorre lasnprobeceldas más cercanas; véanseIndexIVFFlateIndexIVFPQde FAISS. Las pautas de índices de FAISS sugieren de 4√N a 16√N celdas para N vectores comonlistinicial. Recorrenlistynprobefrente al recall de la búsqueda exacta y la latencia. Evalúa las consultas con filtro por separado, porque cada familia de índices y cada base de datos vectorial implementa el recorrido con filtros de forma distinta. - Retraso de frescura de las actualizaciones: tiempo desde que se confirma un documento hasta que se puede recuperar. Mide p50 y p99. En los sistemas con requisitos regulatorios, mide también el porcentaje de consultas servidas con índices obsoletos.
Parte 4: Evaluación en tiempo de consulta
El carril de tiempo de consulta contiene las métricas que diagnostican una ruta de recuperación. El Recall@k por sí solo no puede mostrar si la causa del fallo fue la reescritura, el filtrado, el reranking o el ensamblado del contexto.
Comprensión y reescritura de consultas
- Calidad de la expansión de consultas: mejora del Recall@k sobre tu conjunto de oro, consulta expandida frente a consulta original. Define de antemano la ganancia mínima útil y su incertidumbre, antes de probar. Si la expansión no cumple ese requisito, no justifica su latencia ni su coste. Las líneas base clásicas de PRF (pseudo-relevance feedback, retroalimentación por pseudorrelevancia), como RM3 y Bo1, siguen siendo comprobaciones básicas útiles; la expansión basada en LLM tiene que superarlas.
- Evaluación de HyDE: HyDE (Gao et al., 2022) genera una respuesta hipotética con el LLM, calcula su embedding y recupera con él. Añade una llamada de generación, y esa llamada puede inventar contenido que desvíe la recuperación del tema. Mide el Recall@10 por separado en los subconjuntos dentro del dominio, fuera del dominio y de baja confianza, y decide después si pertenece a la ruta por defecto, a un fallback o a ninguna de las dos.
- Generación de varias consultas: Recall@k de la unión de N reformulaciones frente a una sola consulta. Recorre varios valores de N y elige un punto de tu frontera de recall frente a latencia. Implementaciones: el
MultiQueryRetrieverde LangChain y elQueryFusionRetrieverde LlamaIndex. - Precisión de la clasificación de intenciones: precisión, recall y F1 estándar por intención (se calculan con
sklearn.metrics.classification_report), pero la métrica que importa es la corrección del enrutamiento: ¿se invoca el pipeline correcto aguas abajo? - Enrutamiento adaptativo: Adaptive-RAG (Jeong et al., NAACL 2024) defiende que no todas las consultas merecen la misma estrategia de recuperación. Mide la precisión del enrutador como un problema de clasificación sobre un conjunto etiquetado de “no necesita recuperación / una sola pasada / iterativa”.
La búsqueda iterativa necesita una prueba end-to-end con presupuesto
Un agente puede buscar, inspeccionar un resultado y volver a buscar, en lugar de recuperar una única lista fija de los k primeros. El dominio banking_knowledge de tau2-bench cambia la recuperación con el indicador --retrieval-config: sin base de conocimiento, con toda la base de conocimiento en el contexto, con búsqueda BM25 o por embeddings, con una herramienta de shell en un sandbox, o con BM25, búsqueda densa y shell a la vez. Para una comparación local, da a la recuperación de una sola pasada y a la iterativa el mismo corpus elegible y límites explícitos de tiempo, tokens del modelo y tool calls. Registra cada consulta y la evidencia que se vio en cada turno; puntúa la cobertura final de la evidencia, la corrección de la respuesta, el respaldo de las citas y los fallos por presupuesto agotado. Más llamadas de búsqueda solo son útiles cuando la evidencia añadida mejora la respuesta dentro de esos límites.
El módulo retrieval/iterative.py del repositorio complementario ejecuta reformulaciones de consulta suministradas bajo presupuestos explícitos de llamadas, tiempo y tokens. Para los agentes que eligen sus propias búsquedas, Evaluación de agentes de AI: de las trazas a las suites de pruebas explica cómo puntuar la trayectoria además de la respuesta.
Métricas de recuperación
Estas son las métricas base. Si no las mides, no puedes saber si la recuperación está mejorando.
| Métrica | Qué mide | Cuándo usarla |
|---|---|---|
| Recall@k | fracción de los documentos relevantes de una consulta que aparecen en los k primeros | cuando importa que no falte ninguna parte del conjunto relevante |
| Precision@k | porcentaje de los k primeros que son relevantes | útil cuando la ventana de contexto es el cuello de botella |
| MRR | media de 1/posición del primer documento relevante | cuando los usuarios solo miran el primero o los tres primeros |
| nDCG@k | ganancia con descuento por posición, ponderada por grados de relevancia | métrica estándar de recuperación para relevancia graduada |
| MAP | media sobre las consultas de la precisión promedio | cuando importa toda la lista ordenada |
| Hit Rate@k | si al menos un documento relevante aparece entre los k primeros | promedia el resultado binario entre consultas para una métrica rápida de comprobación |
| Cobertura | porcentaje de documentos de oro recuperados alguna vez en todas las consultas | detecta lagunas sistemáticas del índice |
Las fórmulas, como referencia (relevancia binaria con el conjunto relevante de la consulta , y si el -ésimo documento recuperado pertenece a ):
Para relevancia graduada, ; el nDCG binario es el caso particular que se usa en el código siguiente. MAP es la media sobre las consultas de . Para las derivaciones, véase el capítulo 8 de Manning, Raghavan y Schütze, Introduction to Information Retrieval.
Para el código de producción, usa ranx, pytrec_eval o ir_measures: implementan toda la familia de métricas de TREC y manejan correctamente la relevancia graduada. Como umbrales iniciales de lanzamiento, el repositorio complementario incluye Recall@10 ≥ 0,85 y MRR ≥ 0,6 (en .env.example, que se aplican con --quality-gates). Después ajústalos sobre tu conjunto de oro frente a la calidad de la respuesta final y al coste de un fallo.
Aquí, k cuenta ID de documento únicos, sin repetidos. Rechaza los duplicados en lugar de dar una ganancia adicional a un documento repetido. En los experimentos de chunking, declara si k cuenta fragmentos o documentos padre deduplicados, y compara también la evidencia suministrada dentro de un presupuesto fijo de tokens. Un mismo recall de documentos puede ocultar calidades de contexto muy distintas.
El harness de pruebas para esto es corto. Puedes ejecutarlo desde un notebook antes de haber elegido siquiera una base de datos vectorial.
from math import log2
from statistics import mean

# synthetic gold set: query_id -> set of relevant doc ids
gold = {
    "q1": {"d3"},
    "q2": {"d7", "d2"},
    "q3": {"d11"},
    "q4": {"d5"},
}

# ranked retrieval results: query_id -> ranked list of doc ids (top-10)
runs = {
    "q1": ["d8", "d3", "d1", "d4", "d2", "d9", "d6", "d10", "d12", "d13"],
    "q2": ["d2", "d6", "d4", "d7", "d1", "d3", "d8", "d11", "d5", "d9"],
    "q3": ["d11", "d2", "d3", "d4", "d1", "d6", "d7", "d8", "d10", "d12"],
    "q4": ["d1", "d2", "d3", "d6", "d8", "d9", "d10", "d12", "d13", "d14"],
}

def recall_at_k(ranked, gold_set, k):
    if k <= 0 or len(ranked) != len(set(ranked)):
        raise ValueError("require positive k and unique document IDs")
    if not gold_set:
        return 0.0
    hit = sum(1 for d in ranked[:k] if d in gold_set)
    return hit / len(gold_set)

def reciprocal_rank(ranked, gold_set):
    if len(ranked) != len(set(ranked)):
        raise ValueError("require unique document IDs")
    # MRR contribution per query: 1/rank of the first relevant doc.
    for rank, d in enumerate(ranked, start=1):
        if d in gold_set:
            return 1.0 / rank
    return 0.0

def ndcg_at_k(ranked, gold_set, k):
    if k <= 0 or len(ranked) != len(set(ranked)):
        raise ValueError("require positive k and unique document IDs")
    # binary relevance: rel ∈ {0, 1}
    gains = [1.0 if d in gold_set else 0.0 for d in ranked[:k]]
    dcg = sum(g / log2(i + 2) for i, g in enumerate(gains))
    # ideal DCG: all gold docs ranked first, capped by k
    n_gold_in_topk = min(k, len(gold_set))
    idcg = sum(1.0 / log2(i + 2) for i in range(n_gold_in_topk))
    return dcg / idcg if idcg else 0.0

K = 5
print(f"Recall@{K}: {mean(recall_at_k(runs.get(q, []), gold[q], K) for q in gold):.3f}")
print(f"MRR:       {mean(reciprocal_rank(runs.get(q, []), gold[q]) for q in gold):.3f}")
print(f"nDCG@{K}:  {mean(ndcg_at_k(runs.get(q, []), gold[q], K) for q in gold):.3f}")
# Recall@5: 0.750
# MRR:       0.625
# nDCG@5:    0.627
# Duplicate and missing runs are tested in the companion's tests/test_audit_contracts.py.
El agregado recorre todas las consultas esperadas y trata una ejecución ausente como vacía. Este ejemplo asigna cero a las consultas sin evidencia de oro; en una suite real, márcalas como un subconjunto aparte de contestabilidad, con su propio denominador, en lugar de tratar ese cero como un recall medido. Informa de los tiempos de espera agotados y de las ejecuciones ausentes además de las puntuaciones.
Ejecuta un subconjunto rápido en cada PR y el conjunto de oro completo antes del lanzamiento (la Parte 9 da tamaños iniciales). Bloquea una fusión cuando una métrica elegida de antemano supere su presupuesto de regresión.
El repositorio complementario fija las cifras anteriores (Recall@5 = 0.750, MRR = 0.625, nDCG@5 = 0.627) mediante una prueba unitaria en tests/test_retrieval_metrics.py. Notebook 01 ejecuta este ejemplo con k=5 y después muestra Recall@10, MRR y nDCG@10 en un subconjunto de SciFact; no barre k. El harness con estructura de producción está en evaluation/retrieval.py.
Recuperación híbrida y fusión de rangos recíprocos
BM25 es un puntuador léxico disperso que combina la coincidencia exacta de términos, la ponderación de términos y la normalización por longitud. Está disponible en rank_bm25, Elasticsearch, OpenSearch y la mayoría de los motores de búsqueda.
La fusión de rangos recíprocos (Reciprocal Rank Fusion, RRF; Cormack, Clarke y Buettcher, SIGIR 2009) combina los rankings de BM25 y de la búsqueda densa según la posición. El ajuste original k=60 es una línea base útil. RRF no depende de las puntuaciones, lo que evita la normalización entre carriles que exige la interpolación lineal. Si dispones de un conjunto etiquetado lo bastante grande para estimar una diferencia estable, prueba también una combinación convexa y ajusta α.
Mi hipótesis es que la recuperación híbrida junto con un reranker cross-encoder puede ayudar en corpus técnicos, de tipo log y de código. La ganancia puede ser pequeña en corpus muy semánticos. Mide frente a los carriles solo denso y solo disperso, porque una mala configuración de la fusión puede rendir peor que cualquiera de las dos entradas. El notebook de SciFact del repositorio complementario es una prueba acotada, no un resultado general.
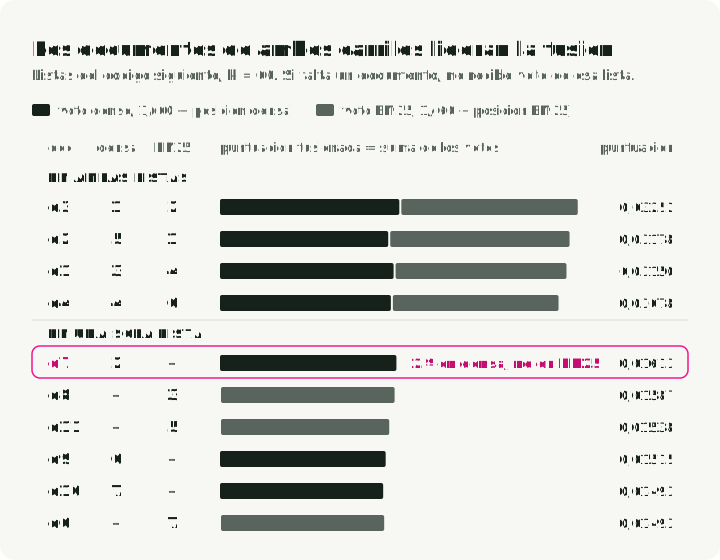
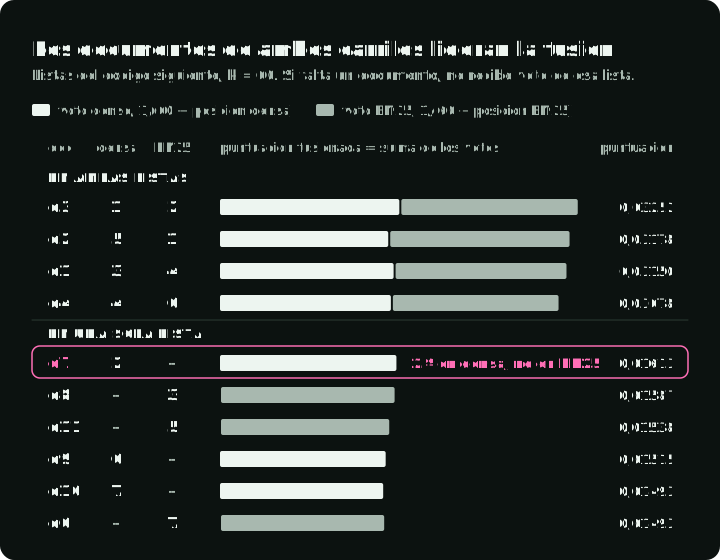
El gráfico usa las dos listas ordenadas del código siguiente. Cada carril suma 1/(60 + posición) por cada documento que devuelve, así que los cuatro documentos presentes en ambas listas van en cabeza. d7 ocupa el segundo puesto en la lista densa pero no está en la lista BM25, así que cae al quinto.
La implementación cabe en unas pocas líneas.
from collections import defaultdict

# two retrieval lanes: dense embeddings and BM25.
dense  = ["d3", "d7", "d1", "d4", "d2", "d9", "d10"]
sparse = ["d2", "d3", "d8", "d1", "d11", "d4", "d6"]

def rrf(rankings: list[list[str]], k: int = 60) -> list[tuple[str, float]]:
    """Reciprocal Rank Fusion (Cormack et al., SIGIR 2009).

    score(d) = sum over rankings of 1 / (k + rank(d))
    Score-agnostic: only rank position matters. k=60 is the canonical default.
    """
    scores: dict[str, float] = defaultdict(float)
    if k <= 0:
        raise ValueError("k must be positive")
    for ranking in rankings:
        if len(ranking) != len(set(ranking)):
            raise ValueError("each ranking must contain unique document IDs")
        for rank, doc in enumerate(ranking, start=1):
            scores[doc] += 1.0 / (k + rank)
    return sorted(scores.items(), key=lambda kv: kv[1], reverse=True)

fused = rrf([dense, sparse], k=60)
for doc, score in fused[:5]:
    print(f"{doc}  score={score:.5f}")
# d3  score=0.03252   <- rank 1 dense, rank 2 sparse
# d2  score=0.03178   <- rank 5 dense, rank 1 sparse
# d1  score=0.03150
assert [doc for doc, _ in fused[:3]] == ["d3", "d2", "d1"]
Fíjate en lo que RRF no hace: nunca mira las puntuaciones de similitud en bruto. Si un recuperador coloca un documento en la posición 2, ese voto vale 1 / (60 + 2), sea cual sea la puntuación bruta que lo produjo. Un recuperador denso que devuelve un coseno de 0,98 y un carril BM25 que devuelve una puntuación de 17,4 no son directamente comparables. La normalización z-score y la min-max eliminan las diferencias de escala afines, pero ninguna calibra una puntuación como relevancia. Los valores atípicos, la forma de la distribución y el conjunto de candidatos siguen afectando a los valores normalizados y, por tanto, al resultado de la fusión. Valida cualquier combinación basada en puntuaciones con consultas etiquetadas.
Recuperación híbrida + RRF en SciFact: notebook 02 compara recuperación densa, BM25 y RRF mediante Recall@10, MRR y nDCG@10 agregados. El módulo de fusión con estructura de producción está en retrieval/hybrid_rrf.py; tests/test_rrf.py fija el orden canónico d3 / d2 / d1 con k=60.
Reranking
- ΔnDCG / ΔMRR: mejora sobre no hacer reranking, en tu conjunto de oro, a la profundidad que tu aplicación usa de verdad. Se calcula ejecutando tus métricas de recuperación con y sin el reranker sobre conjuntos de candidatos idénticos.
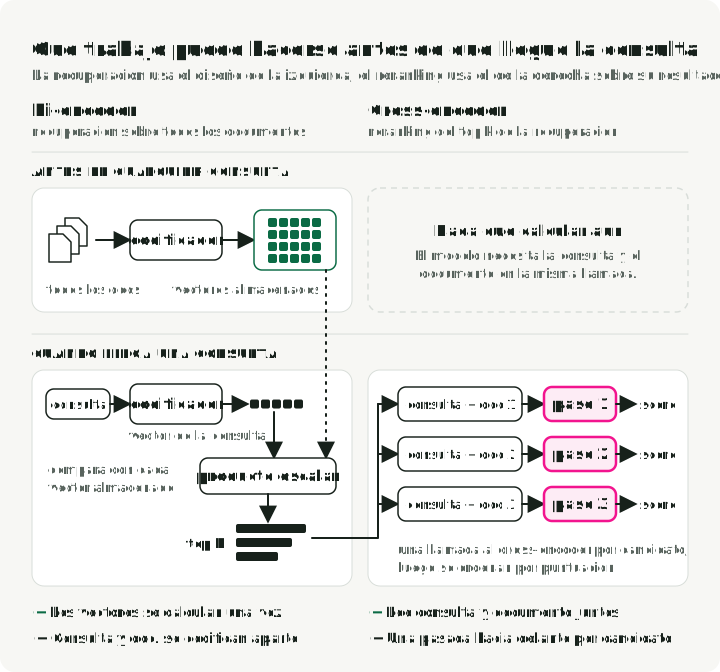
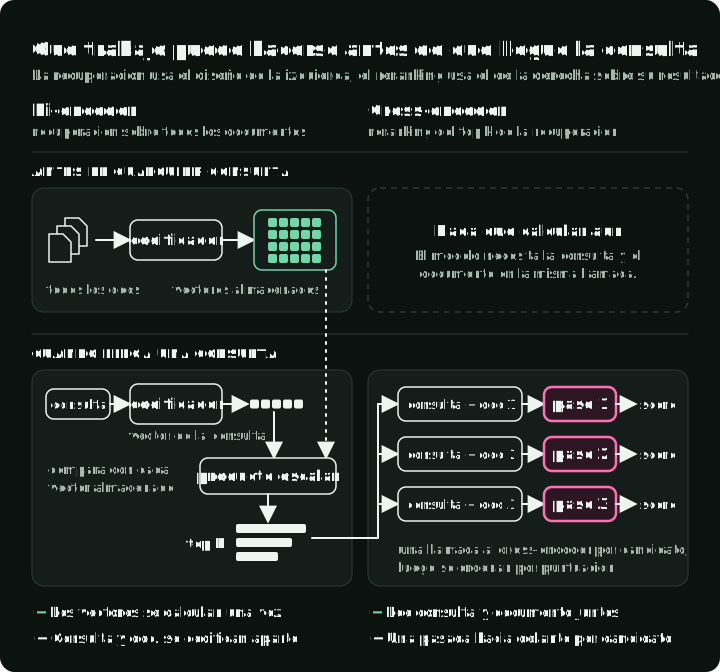
- Cross-encoder frente a bi-encoder: un bi-encoder calcula el embedding de la consulta y del documento de forma independiente (un vector por lado) y puntúa con el producto escalar; un cross-encoder concatena consulta y documento y ejecuta una sola pasada que atiende a ambos de forma conjunta. Los cross-encoders cambian una pasada por candidato a cambio de una interacción más rica entre consulta y documento; la figura siguiente muestra la diferencia. Implementación de referencia:
CrossEncoderdesentence-transformers. Mide la relevancia y la latencia con un hardware, un tamaño de lote y una profundidad de candidatos concretos; no traslades el resultado de un modelo o servicio gestionado a otro entorno. - Listwise frente a pointwise: el enfoque pointwise puntúa cada par (consulta, documento) de forma independiente; el listwise puntúa la lista completa de candidatos de forma conjunta para que el modelo pueda compararlos. Evalúa ambos sobre los mismos conjuntos de candidatos. Calibra cualquier umbral de puntuación por modelo y por corpus en lugar de tratar un ejemplo publicado como si fuera portable.
En la figura, compara las dos franjas de tiempo. El bi-encoder codifica todos los documentos antes de cualquier consulta y almacena los vectores; cuando llega una consulta, codifica solo la consulta. El cross-encoder no tiene nada que calcular antes de la consulta. Lee la consulta y el documento en una sola llamada al modelo, de modo que se ejecuta una vez por candidato y solo sobre la lista corta que devuelve la recuperación.
El código siguiente puntúa tres candidatos para una consulta con un cross-encoder BGE:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("BAAI/bge-reranker-v2-m3")  # Reproducible baseline, not a latest-model ranking

query = "How do I rotate database credentials in production?"
candidates = [
    "Production database credentials are rotated via Vault every 30 days.",
    "The new logo was unveiled at the all-hands meeting.",
    "To rotate prod DB creds, run the `rotate-secrets` GitHub Action.",
]

scores = reranker.predict([(query, c) for c in candidates])
ranked = sorted(zip(candidates, scores), key=lambda x: -x[1])
for doc, score in ranked:
    print(f"{score:+.3f}  {doc}")
El código BGE anterior es una línea base pequeña. Para una comparación actual, incluye Cohere Rerank 4.0 fast/pro para el ranking gestionado de texto multilingüe, o Qwen3-VL-Reranker 2B/8B cuando las consultas o los documentos incluyan imágenes, capturas de pantalla o vídeo. Mantén explícitas las modalidades de la tarea, la profundidad de candidatos, los límites de entrada, las instrucciones y el hardware.
Un reranker suele ayudar a un pipeline RAG básico, pero no es una victoria garantizada. Mide su ΔPrecision@1 y su ΔnDCG sobre tu conjunto de oro y consérvalo solo si la mejora supera su presupuesto de latencia y de coste. Compara esa mejora medida con la de cambios de recuperación más pequeños antes de elegir la siguiente optimización. BM25, embeddings y rerankers ofrece una guía más breve para elegir cada capa de la pila de ranking.
Notebook 03 muestra P@10 antes y después del reranking con un cross-encoder en SciFact, además de ΔnDCG@10; módulo: retrieval/reranker.py. El módulo evaluation/reranking.py compara rerankers sobre grupos idénticos de candidatos.
Construcción del contexto y lost-in-the-middle
Muchos fallos de “buena recuperación, mala respuesta” empiezan en la construcción del contexto.
- Relevancia del contexto:
ContextRelevancede Ragas juzga la lista de contexto suministrada con dos prompts y valoraciones normalizadas; no es una puntuación por fragmento. Para diagnosticar fragmentos, puntúa explícitamente cada par consulta–fragmento, por ejemplo con un cross-encoder, e informa de la distribución con un umbral calibrado localmente. - Cobertura de citas del contexto suministrado: fragmentos suministrados distintos que se citan, divididos por los fragmentos distintos suministrados. Informa por separado de los casos de contexto vacío. Este indicador observable dice qué fragmentos recibieron citas, no cuáles usó internamente el modelo ni si las citas respaldan sus afirmaciones. Comprueba el respaldo de las citas por separado y compara la cobertura con la calidad de la respuesta y el coste en tokens.
- Detección de lost-in-the-middle: una evaluación sintética en la que colocas el fragmento de oro en las posiciones {primera, media, última} de un contexto largo y mides la corrección de la respuesta. El estudio citado de Liu et al. (TACL 2024) informa de una degradación en forma de U en sus condiciones de contexto largo. Trata el mismo patrón en un modelo actual como una hipótesis que probar. Mitigaciones: aplicar reranking y luego reordenar los k primeros para que el fragmento mejor puntuado quede el primero o el último (el
LongContextReorderde LangChain hace exactamente esto), o comprimir con agresividad los fragmentos intermedios. Mide con una evaluación estratificada por posición, no solo con una puntuación agregada. En el notebook 06 hay una evaluación estratificada por posición, completa y ejecutable (módulo:evaluation/lost_in_middle.py). - Compresión del contexto: informa del ratio de compresión (tokens de entrada / tokens de salida) junto con la corrección de la respuesta. Entre las herramientas están el
ContextualCompressionRetrieverde LangChain y LongLLMLingua. Define de antemano la mayor pérdida de corrección aceptable según el riesgo de la aplicación y su presupuesto de tokens, y rechaza las configuraciones que la superen.
Parte 5: Tasa de falsa exclusión del filtro
Esta métrica tiene su propia sección porque las puntuaciones agregadas de recuperación no pueden atribuir un fallo a un filtro de relevancia. Evalúa los filtros de elegibilidad por separado frente a los permisos de quien consulta; un documento fuera de ese conjunto debe seguir excluido.
Un predicado de relevancia duro como product = Y AND locale = en-US puede reducir a cero el recall efectivo entre los documentos que quien consulta tiene permitido ver. Un Recall@k bien implementado detecta la pérdida porque su denominador sigue siendo el conjunto original de documentos relevantes elegibles. No indica si el fallo lo causó el filtro, el recuperador o el ranker. La fidelidad juzga las afirmaciones frente al contexto recuperado. Aun así puede puntuar las afirmaciones que ese contexto incompleto respalda, pero no puede diagnosticar la causa en el filtro o en la recuperación. Una negativa vacía puede no producir ninguna declaración y dar NaN, según la implementación; no la tomes como prueba de que la fidelidad aprobó la negativa.
El diagrama recorre el ejemplo práctico siguiente. La comprobación de permisos elimina d3, que pertenece a otro tenant; esa exclusión es correcta. Después, el filtro de relevancia elimina el documento de referencia de q1 y de q3. El Recall@10 baja al 50% y registra la caída; solo la tasa de exclusión falsa, también del 50%, la atribuye al predicado. Un evaluador que reconstruye el conjunto de referencia tras el filtrado informa del 100%.
La métrica
filter_false_exclusion_rate =
    (# queries where all gold docs were excluded by metadata filter) /
    (# queries with at least one entitlement-eligible gold doc)
Esta definición a nivel de consulta cuenta las exclusiones catastróficas: no sobrevive ningún documento relevante elegible. Intersecta el conjunto de oro de cada consulta con el conjunto de permisos de quien consulta antes de puntuar; un documento no elegible no es una falsa exclusión. En las consultas con varios documentos de oro, el Recall@k estándar sigue mostrando la pérdida parcial; añade una tasa de exclusión por documento si ese límite te importa. Para calcular cualquiera de las dos tasas necesitas (a) los ID de documento de referencia de cada consulta de evaluación y (b) instrumentación que registre los predicados de filtro aplicados, no solo los resultados finales. Como umbral inicial, el repositorio complementario usa una tasa de falsa exclusión de como máximo el 2 %; ajústala según el coste de excluir una respuesta válida y el intervalo de confianza de tu muestra de producción.
Esta es una implementación que funciona. Compara el recall estándar correcto con un evaluador inválido que redefine la relevancia después de filtrar.
# A small worked example where relevance predicates remove eligible documents.
docs = [
    {"id": "d1", "tenant": "acme",   "locale": "en-US"},
    {"id": "d2", "tenant": "acme",   "locale": "en-GB"},
    {"id": "d3", "tenant": "globex", "locale": "en-US"},
    {"id": "d4", "tenant": "acme",   "locale": "en-US"},
    {"id": "d5", "tenant": "acme",   "locale": "de-DE"},
    {"id": "d6", "tenant": "acme",   "locale": "fr-FR"},
]

# Tenant isolation is an eligibility invariant, not a relevance experiment.
# Verify it independently before evaluating relevance preferences.
eligible_docs = [d for d in docs if d["tenant"] == "acme"]
assert {d["id"] for d in eligible_docs} == {"d1", "d2", "d4", "d5", "d6"}

queries = [
    # the gold doc lives in en-GB but the dynamic filter forced en-US
    {"qid": "q1", "gold": {"d2"}, "filter": lambda d: d["locale"] == "en-US"},
    # the gold doc is correctly within the tenant filter
    {"qid": "q2", "gold": {"d4"}, "filter": lambda d: d["tenant"] == "acme"},
    # the gold doc lives in fr-FR but the dynamic filter forced en-US
    {"qid": "q3", "gold": {"d6"}, "filter": lambda d: d["locale"] == "en-US"},
    # the gold doc passes the filter (de-DE locale match)
    {"qid": "q4", "gold": {"d5"}, "filter": lambda d: d["locale"] == "de-DE"},
]

def filter_false_exclusion_rate(queries, eligible_docs):
    n_with_gold, n_excluded = 0, 0
    eligible_ids = {d["id"] for d in eligible_docs}
    for q in queries:
        eligible_gold = q["gold"] & eligible_ids
        if not eligible_gold:
            continue
        n_with_gold += 1
        survivors = {d["id"] for d in eligible_docs if q["filter"](d)}
        if not (eligible_gold & survivors):
            n_excluded += 1
    if not n_with_gold:
        raise ValueError("false-exclusion rate needs queries with eligible gold")
    return n_excluded / n_with_gold, n_with_gold

rate, eligible_query_count = filter_false_exclusion_rate(queries, eligible_docs)
print(f"filter_false_exclusion_rate = {rate:.2%}")
# filter_false_exclusion_rate = 50.00%
print(f"eligible queries = {eligible_query_count} / {len(queries)}")
# eligible queries = 4 / 4

# Correct Recall@k keeps the original eligible gold set as its denominator.
def standard_recall_at_k(queries, eligible_docs, k=10):
    recalls = []
    eligible_ids = {d["id"] for d in eligible_docs}
    for q in queries:
        eligible_gold = q["gold"] & eligible_ids
        if not eligible_gold:
            continue
        # demo only: the survivor set stands in for a ranked run.
        # A real harness ranks the survivors first, then slices to k.
        survivors = [d for d in eligible_docs if q["filter"](d)][:k]
        survivor_ids = {d["id"] for d in survivors}
        recalls.append(len(eligible_gold & survivor_ids) / len(eligible_gold))
    return sum(recalls) / len(recalls) if recalls else 0.0

print(f"standard recall@10 = {standard_recall_at_k(queries, eligible_docs):.2%}")
# standard recall@10 = 50.00%

# INVALID: rebuilding the gold set after filtering changes the question.
# It drops queries whose relevant documents did not survive, then scores 100%.
def invalid_recall_over_filtered_gold(queries, eligible_docs, k=10):
    recalls = []
    all_doc_ids = {d["id"] for d in eligible_docs}
    for q in queries:
        all_survivors = {d["id"] for d in eligible_docs if q["filter"](d)}
        filtered_gold = q["gold"] & all_doc_ids & all_survivors
        if not filtered_gold:
            continue
        top_k_ids = set(list(all_survivors)[:k])
        recalls.append(len(filtered_gold & top_k_ids) / len(filtered_gold))
    return sum(recalls) / len(recalls) if recalls else 0.0

invalid = invalid_recall_over_filtered_gold(queries, eligible_docs)
print(f"INVALID recall (filtered gold) = {invalid:.2%}")
# INVALID recall (filtered gold) = 100.00%

assert rate == 0.5
assert standard_recall_at_k(queries, eligible_docs) == 0.5
assert invalid == 1.0
# Unauthorized gold and an empty denominator are tested in the companion's
# tests/test_audit_contracts.py.
La función devuelve la tasa y el número de consultas con evidencia de oro elegible. Si ese denominador está vacío, lanza una excepción en lugar de informar de un cero tranquilizador; una comprobación de lanzamiento obligatoria debe tratarlo como falta de evidencia. Las consultas con evidencia de oro solo no autorizada se quedan en pruebas de permisos aparte.
La mitad de las consultas pierden su documento de oro por culpa del filtro, así que el Recall@10 correcto cae al 50 %. Esa puntuación detecta el síntoma, pero no puede atribuirlo. La tasa de falsa exclusión muestra que el predicado eliminó dos respuestas antes de que el recuperador se ejecutara. El evaluador deliberadamente inválido informa del 100 % solo porque descarta esos fallos de su conjunto de oro. Ningún modelo puede recuperar un documento que se filtró.
tests/test_filter_exclusion.py::test_50_percent_exclusion_rate del repositorio complementario y el primer ejemplo de notebook 04 usan datos de prueba antiguos de cinco documentos que también dan un 50 %, pero su q3 queda excluida por el aislamiento entre tenants. Esos datos no reproducen el ejemplo anterior con documentos de referencia autorizados. El notebook 04 también ejecuta diagnósticos de filtros en SciFact con metadatos sintéticos. El evaluation/filter_exclusion.py actual acepta un predicado de autorización separado y un conjunto fijo de documentos de referencia autorizados e incluye precisión y exhaustividad del predicado.
Métrica complementaria: precisión y recall del predicado
Cuando el filtrado es dinámico (por ejemplo, un LLM extrae los predicados de filtro de la consulta), trata el extractor de predicados como un modelo de clasificación y evalúalo como tal. Mide la precisión y el recall del predicado frente a un conjunto etiquetado de pares (query, correct predicate). Una tasa de error de predicados no se traslada directamente a la misma pérdida de puntos en el recall de la recuperación; mide con qué frecuencia esos errores excluyen un documento de oro. Cuando un filtro duro elimina el documento de oro, ningún reranking ayuda.
Filtros de elegibilidad frente a preferencias de relevancia
La autorización, el aislamiento entre tenants, la jurisdicción legal y el estado de publicación determinan si un documento puede entrar en el conjunto de candidatos. Mantenlos como filtros duros y valídalos de forma independiente; ni el Recall@k, ni la tasa de falsa exclusión, ni la precisión de relevancia autorizan a relajarlos.
Para una preferencia de relevancia como el idioma regional, la actualidad o la versión, compara un predicado duro con un refuerzo suave (soft boost) sobre las mismas consultas elegibles reservadas para la evaluación. Dos reglas deciden el resultado:
- Las reglas de acceso (autorización, tenant, jurisdicción, estado de publicación) son siempre filtros duros.
- Cualquier otra preferencia es un refuerzo suave, salvo que supere la prueba medida siguiente. En ese caso puede pasar a ser un predicado duro.
El pseudocódigo da la prueba de la regla 2:
For each relevance preference F:
  hard_recall_F  = retrieval_recall@k with F as a hard filter
  soft_recall_F  = retrieval_recall@k with F as a +0.X rerank boost
  hard_precision = relevant_in_top_k / k under hard filter
  soft_precision = relevant_in_top_k / k under soft boost
  precision_gain = hard_precision - soft_precision
  precision_gain_CI = paired-query uncertainty interval for precision_gain
  exclusion_rate = % of queries where the gold doc was filtered out (hard)

Pre-register Δ_min, ε, and recall_loss_max for this workflow.
Use a hard predicate only if:
  lower_bound(precision_gain_CI) >= Δ_min
  AND exclusion_rate <= ε
  AND hard_recall - soft_recall >= -recall_loss_max.
Otherwise prefer a soft boost.
Elige la ganancia mínima útil de precisión, el intervalo de incertidumbre, ε y el límite de pérdida de recall según el daño de excluir una respuesta que de otro modo sería elegible, el beneficio de la precisión añadida y el tamaño de la muestra reservada. Empieza con una ε del 1–2 % y redúcela donde un fallo de respuesta sea costoso.
Parte 6: Evaluación de la generación
Las métricas de recuperación indican que el sistema podría responder bien. No indican que lo hizo. Las métricas de generación cubren esa laguna.
Fidelidad y anclaje
La fidelidad (faithfulness) de RAGAS descompone la respuesta en afirmaciones atómicas (declaraciones factuales breves y autocontenidas) y verifica cada una frente al contexto recuperado mediante un LLM como juez:
La fidelidad comprueba el respaldo en la evidencia suministrada; no establece que la evidencia sea correcta ni suficiente para responder a la pregunta. Registra por separado las respuestas sin afirmaciones e informa de cuántas hay, en lugar de asignar fidelidad perfecta a una respuesta vacía.
La documentación actual de Ragas recomienda la API de colecciones que se muestra a continuación. En un proyecto de uv, instala ragas y openai con uv add ragas openai, define OPENAI_API_KEY y guarda este código como un script que ejecutar con uv run. Hace llamadas al proveedor y genera sus cargos; la puntuación es el resultado de un juez, no una constante esperada determinista. Fija las dependencias resueltas en tu lockfile.
import asyncio

from openai import AsyncOpenAI, omit
from ragas.llms import llm_factory
from ragas.metrics.collections import Faithfulness

async def main():
    async with AsyncOpenAI() as client:
        # Ragas 0.4.3 sends max_tokens by default; GPT-5.6 models need max_completion_tokens.
        llm = llm_factory(
            "gpt-5.6-terra", client=client, reasoning_effort="none",
            max_tokens=omit, max_completion_tokens=1024,
            temperature=omit, top_p=omit,
        )
        scorer = Faithfulness(llm=llm)
        result = await scorer.ascore(
            user_input="How many moons does Mars have?",
            response="Mars has two moons, Phobos and Deimos.",
            retrieved_contexts=["Mars has two moons named Phobos and Deimos."],
        )
        print(result.value)

if __name__ == "__main__":
    asyncio.run(main())
Este ejemplo usa GPT-5.6 Terra como juez; la factoría de Ragas reenvía los argumentos del modelo. Compara los falsos aprobados, los falsos suspensos y el coste del juez con etiquetas humanas antes de sustituir un juez más barato que ya hayas contrastado con etiquetas.
La tabla de frameworks de la Parte 1 también menciona la relevancia de la respuesta y la precisión del contexto. La misma API de colecciones puntúa ambas con el mismo llm. AnswerRelevancy necesita además un modelo de embeddings, por ejemplo embedding_factory("openai", model="text-embedding-3-small", client=client) de ragas.embeddings.base. ContextPrecision necesita una respuesta reference en ascore. Cada puntuación responde a una pregunta distinta: la fidelidad pregunta si el contexto respalda la respuesta, la relevancia de la respuesta pregunta si la respuesta aborda la pregunta, y la precisión del contexto pregunta si el contexto relevante queda en los primeros puestos.
Para construir tu propio puntuador, conserva la estructura de extraer, verificar y agregar. La extracción es una llamada a un LLM que divide la respuesta en afirmaciones; la verificación la hace un modelo de NLI (inferencia del lenguaje natural) o un LLM como juez. Valida por separado la extracción y la implicación, y registra los juicios sin afirmaciones o fallidos. Por ejemplo, una respuesta con 4 afirmaciones, 3 de ellas respaldadas, obtiene 3/4 = 0,75. Una respuesta con 0 afirmaciones no se puntúa.
Notebook 05 ejecuta offline un ejemplo fijo sobre Marte con una aproximación léxica; esta no verifica la implicación semántica. Su módulo evaluation/faithfulness.py también implementa extracción y verificación de afirmaciones con SGR. La batería generation evalúa QA sintética etiquetada con --suite generation --live. El repositorio usa solo modelos de OpenAI. gpt-5.6-luna genera y evalúa por defecto; --judge-model gpt-5.6-terra cambia el juez. Ambos modelos son de un proveedor, por lo que el repositorio muestra el flujo del juez y no una comparación entre familias.
Una alternativa diseñada a propósito frente al LLM como juez es HHEM-2.1-Open (Hughes Hallucination Evaluation Model, de Vectara), un clasificador con fine-tuning para detectar alucinaciones. Su ficha del modelo documenta el checkpoint, la puntuación en bruto de 0 a 1 que emite y los resultados de precisión equilibrada en AggreFact y RAGTruth. No publica ningún límite de decisión por defecto, así que elegirlo te corresponde a ti. Trata esos datos como evidencia de la ficha del modelo, no como una garantía sobre tu corpus: calibra el umbral con etiquetas locales y compáralo con el juez que hayas elegido antes del despliegue.
Evaluación por hechos atómicos
FActScore (Min et al., EMNLP 2023) descompone las generaciones largas en hechos atómicos, recupera evidencia para cada hecho, etiqueta cada uno como supported / not-supported e informa de la fracción respaldada:
Implementación de referencia: shmsw25/FActScore. La evaluación original se centró en biografías con Wikipedia como evidencia. Adaptarla a resúmenes u otros textos largos exige verificar localmente la extracción de afirmaciones, la cobertura de evidencia y los juicios de respaldo. Los hechos triviales repetidos pueden inflar la puntuación, y afirmaciones individualmente verdaderas pueden formar una respuesta engañosa. MontageLie (EMNLP 2025) prueba esta debilidad mediante relaciones y órdenes engañosos entre afirmaciones verdaderas. VeriScore trata afirmaciones con los matices necesarios; el filtro Core ayuda a evitar añadir hechos para inflar la puntuación.
Precisión de las citas
Mide la precisión de las citas (los tramos citados respaldan de verdad la afirmación) y el recall de las citas (las afirmaciones que deberían citarse, se citan):
El TREC 2024 RAG Track define un protocolo reproducible de evaluación del respaldo. Thakur et al. (SIGIR 2025) informan de un acuerdo de aproximadamente el 56 % con los juicios humanos emitidos desde cero y del 72 % en una condición distinta, en la que las personas poseditaban las predicciones del LLM. Esta última es una anotación asistida, no una evidencia independiente de que mejore la precisión del juez. Mantén la condición de anotación junto a la cifra. Como aproximación automática, ALCE (Gao et al., EMNLP 2023) implementa la precisión y el recall de las citas con verificación basada en NLI.
Corrección de la respuesta, completitud y negativa a responder
- Corrección de la respuesta frente a una referencia: la coincidencia exacta o el F1 por tokens pueden servir para respuestas cortas;
evaluate.load("squad")de Hugging Face calcula ambos, y el paquetebert-scorecalcula BERTScore. Para respuestas más largas, comprueba las relaciones factuales, las entidades, las cantidades, las negaciones y la información requerida frente a referencias revisadas. BERTScore y el coseno de embeddings miden similitud; un número erróneo o una negación pueden conservar una puntuación alta.AnswerCorrectnessde Ragas combina la comparación factual con la similitud en lugar de equipararlas. - Completitud mediante nuggets: un nugget es una unidad de información relevante, y se distinguen los nuggets vitales de los útiles pero opcionales. Una pregunta sobre una fecha de fundación puede exigir el año; el nombre del fundador no es obligatorio automáticamente. AutoNuggetizer construye y refina nuggets a partir de conjuntos de documentos juzgados y comprueba después su presencia en las respuestas generadas. Su informe inicial de TREC 2024 cubrió 21 temas y 45 ejecuciones. El resumen de TREC 2025, publicado en marzo de 2026, extiende el protocolo a consultas narrativas y evalúa la relevancia de la recuperación, la completitud de la respuesta y la atribución. Son protocolos públicos de evaluación, no una prueba de que todo sistema RAG de producción necesite la misma rúbrica de nuggets.
- Comportamiento de negativa: etiqueta si la evidencia suministrada permite responder y mide después las negativas correctas entre todas las negativas y las negativas entre los casos en los que se debería abstenerse. NoMIRACL (Findings of EMNLP 2024) prueba la robustez frente a pasajes suministrados relevantes y no relevantes; no demuestra que todo el corpus carezca de respuesta. En tu propia suite, separa los fallos de recuperación de las consultas realmente fuera de alcance.
Verificación posterior a la generación
Las mejoras de fiabilidad más baratas suelen venir de comprobaciones posteriores deterministas, no de modelos más grandes.
-
Marca de entidades no vistas: registra las cadenas de entidades con nombre de la respuesta que no aparecen en una cadena de contexto normalizada (por ejemplo,
entsdespaCymás coincidencia exacta). Es una marca barata y específica del dominio para cadenas de entidades no vistas, no una comprobación de anclaje: no puede establecer identidad, relación, negación, tiempo ni procedencia. Mide su precisión y su recall con etiquetas locales antes de usarla para aprobar un lanzamiento, y conserva la implicación a nivel de afirmación o la revisión humana para la verificación.En este ejemplo la marca no encuentra ninguna entidad no vista, aunque la respuesta dice lo contrario que el contexto.
def unseen_entity_flag(answer: str, context: str, entities: list[str]) -> bool: return any(entity.lower() not in context.lower() for entity in entities) context = "Paris was not founded in 1994." answer = "Paris was founded in 1994." assert not unseen_entity_flag(answer, context, ["Paris"]) claim_supported = False # human label or an NLI verdict, not the lexical flag assert not claim_supported -
Verificación de afirmaciones: extrae las afirmaciones, ejecuta NLI frente al contexto y haz fallar o marca cualquiera que quede por debajo del umbral. Modelos de NLI como medida de fidelidad:
cross-encoder/nli-deberta-v3-large,MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli. Añade latencia. Merece la pena en dominios de alto riesgo. -
Autoconsistencia (Wang et al., ICLR 2023): muestrea varias generaciones con temperatura > 0; informa de la tasa de acuerdo (por ejemplo, la proporción de generaciones que coinciden con la respuesta modal, o el BERTScore por pares); elige el número de muestras a partir de la curva de estabilidad frente a coste y marca las respuestas con poco acuerdo para revisión humana.
-
Calibración de la confianza: recoge la confianza verbalizada (“¿Qué grado de confianza tienes, de 0 a 1?”) y compárala con la corrección real en el conjunto de evaluación. Representa una curva de calibración e informa del Expected Calibration Error: , donde son los grupos por nivel de confianza. Implementaciones:
netcal,torchmetrics.CalibrationError. Un modelo que declara una confianza de 0,9 debería acertar en aproximadamente el 90 % de los casos comparables; mide la diferencia en lugar de suponer que está calibrado.
Parte 7: Evaluación de RAG anclado en una ontología
Las métricas estándar anteriores cubren el RAG de corpus abierto. Si tu RAG recupera frente a una ontología, una taxonomía o un grafo de conocimiento estructurados, esas métricas son necesarias, pero no suficientes. Algunos ejemplos son los productos de un catálogo, las enfermedades en SNOMED, los componentes de una lista de materiales (BOM) y las técnicas de seguridad de MITRE ATT&CK. También necesitas medir la capa de la ontología.
Precisión del enlazado de entidades
La primera tarea es asignar una mención de la consulta a una entidad de la ontología (“Aspirin” → wikidata:Q18216, “the 737” → aircraft:Boeing_737).
- Precisión, recall y F1 a nivel de mención: estándar, frente a los tramos de mención de referencia (se calculan con
seqevalo con un comparador de conjuntos de tramos). - Precisión de la desambiguación: de las menciones detectadas correctamente, ¿qué fracción se asigna al ID de entidad correcto? Entre las referencias públicas están ReFinED, REL y GENRE; benchmarks como AIDA-CoNLL y BELB muestran que los resultados varían según el sistema y el dominio.
- Gestión de NIL: precisión y recall para “entidad que no está en la ontología”. Mide por separado el enlazado excesivo a entidades parecidas pero erróneas y la abstención correcta.
Evaluación consciente de la jerarquía
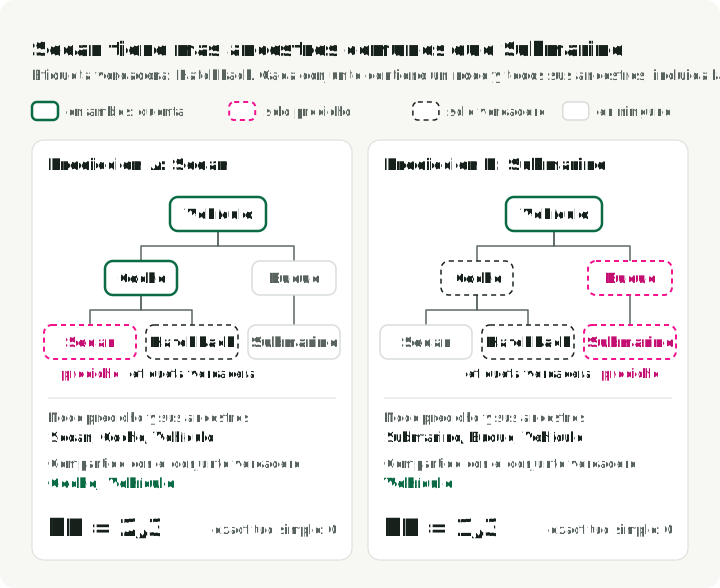
La exactitud simple trata “predijo Sedán cuando la verdad es Hatchback” igual que “predijo Submarino cuando la verdad es Hatchback”. Esos errores no son iguales. En el diagrama, Sedán comparte dos de sus tres nodos con la etiqueta verdadera, y Submarino solo comparte la raíz; la precisión jerárquica siguiente convierte ese solapamiento en una puntuación.
-
Precisión, recall y F1 jerárquicos (Kosmopoulos et al., 2015): dan crédito a los ancestros compartidos en el DAG de la ontología. Con el nodo predicho más todos sus ancestros y el nodo verdadero más todos sus ancestros:
Impleméntalo con
networkxsobre el grafo de la ontología: amplía cada predicción y cada etiqueta con sus ancestros y calcula después los solapamientos de conjuntos anteriores. -
Similitud de Wu-Palmer entre la entidad predicha y la de referencia en la taxonomía (Wu y Palmer, 1994):
donde LCA es el ancestro común más bajo en la taxonomía. Está disponible de serie en NLTK para WordNet (
from nltk.corpus import wordnet as wn; wn.synset("car.n.01").wup_similarity(wn.synset("truck.n.01"))); para taxonomías propias, calcula el LCA connetworkx. -
Tasa de confusión entre hermanos y padres: mide por separado las confusiones con hermanos, padres e hijos:
count_sibling / total_errors,count_parent / total_errors,count_descendant / total_errors. Usa ejemplos revisados para comprobar si los errores con hermanos proceden de menciones ambiguas o si los errores con padres proceden de una generalización excesiva.
Tasa de falsa exclusión del filtro (repaso, ahora crítica)
En los sistemas anclados en una ontología, los filtros duros suelen proceder de la propia ontología (“recupera solo documentos etiquetados con la categoría X”). La métrica de la tasa de exclusión (definida en la Parte 5) pasa a ser una señal principal de corrección. Una predicción de categoría errónea puede reducir el recall a cero; la tasa de exclusión atribuye esa pérdida al filtro.
Conformidad de la generación restringida
Cuando tu salida debe ajustarse a una ontología (cada nombre de entidad de la respuesta debe ser un miembro válido de la ontología; cada predicado debe proceder de un vocabulario cerrado), mide:
- Tasa de validez del esquema: porcentaje de salidas que se parsean y validan frente al esquema de la ontología. Valida con
jsonschemaopydantic. JSONSchemaBench es el benchmark público de structured output general; para esquemas específicos de una ontología, construye tu propio validador. - Conformidad del vocabulario: porcentaje de entidades con nombre de la salida que son ID válidos de la ontología; una comprobación de pertenencia a un conjunto, de una línea, frente al vocabulario cerrado.
- Conformidad semántica: una salida sintácticamente válida puede elegir igualmente una entidad válida pero equivocada. Combina la conformidad con la corrección de la respuesta final.
Los frameworks de constrained decoding (Outlines, XGrammar, Guidance, OpenAI Structured Outputs) están diseñados para imponer la validez del esquema. JSONSchemaBench compara la eficiencia, la cobertura y la calidad entre implementaciones. Vuelve a ejecutar los casos que coincidan con tus esquemas y con tu backend de serving, porque la cobertura y la latencia dependen de ambos.
Auditabilidad
Para los sistemas anclados en una ontología cuyas respuestas se someten a revisión:
- Completitud de las citas: porcentaje de afirmaciones factuales con al menos una cita verificable.
- Profundidad de la procedencia: porcentaje de citas que se resuelven hasta un documento de origen con un ID estable, y no solo hasta el hash de un fragmento.
- Tasa de reproducibilidad: al volver a ejecutar la misma consulta sobre una instantánea fija se obtiene la misma respuesta. Fija la versión del modelo, el runtime, la configuración de decodificación y la semilla, y establece después la tasa de repetición requerida según las necesidades de auditabilidad del flujo de trabajo. Una temperatura cero no garantiza por sí sola el determinismo. Un fallo puede proceder de la generación, del runtime de serving o de cualquier etapa anterior.
Parte 8: Evaluación a nivel de sistema
Calidad global de la respuesta
- LLM como juez (Zheng et al., NeurIPS 2023): un enfoque de evaluación escalable basado en modelos. G-Eval (Liu et al., EMNLP 2023) genera pasos de evaluación a partir de la tarea y los criterios y pondera después los niveles de valoración por la probabilidad de sus tokens: . Son probabilidades, no log-probabilidades. El grado de acuerdo depende del juez, de la tarea, del prompt y del conjunto de calibración.
- Preferencia por pares: presenta al juez la respuesta A frente a la respuesta B y registra su preferencia. Esto sustituye una valoración absoluta por una decisión comparativa, pero sigue necesitando calibración frente a las preferencias humanas. MT-Bench informó de un acuerdo del juez GPT-4 superior al 80 %, tanto con las preferencias humanas como entre humanos, en las condiciones de su benchmark; no traslades esa tasa a otro dominio sin calibrar.
El LLM como juez tiene sesgos reales:
- Sesgo de posición: mide la sensibilidad al orden con casos etiquetados por personas para el juez y la tarea elegidos. La aleatorización o la agregación con el orden intercambiado pueden ayudar en algunos pares de modelo y tarea, pero conserva cualquiera de las dos solo si mejora el acuerdo local con las personas; el estudio controlado de 2026 encontró que intercambiar las posiciones era perjudicial en sus casos adversarios.
- Sesgo de verbosidad: los jueces pueden confundir la longitud con la calidad. El estudio controlado de 2026, versión 2, citado antes, encontró un comportamiento heterogéneo en los pares de expansión: tres jueces prefirieron las respuestas más largas, Claude prefirió las concisas y GPT-4o fue aproximadamente neutral. Los cinco rindieron bien en los controles de truncamiento. Esos resultados dependen del benchmark, así que indica a tu juez cómo tratar la completitud y el relleno, y después informa del rendimiento con la longitud controlada sobre tu propia rúbrica.
- Riesgo de autopreferencia: Zheng et al. observaron en sus datos una tasa de victorias propias un 10 % mayor en GPT-4 y un 25 % mayor en Claude-v1, pero concluyeron que los datos limitados y las diferencias pequeñas no permitían establecer un sesgo de autoensalzamiento. Compara jueces de la misma familia y de otras familias con etiquetas humanas locales; elige el juez mejor calibrado en lugar de suponer que cualquiera de las dos disposiciones es segura.
Receta práctica: elige un juez con datos de calibración etiquetados por personas, enmascara la identidad de los modelos, mide la sensibilidad al orden y declara la política de longitud en la rúbrica. Repite los casos solo cuando las muestras adicionales reduzcan de forma apreciable la incertidumbre. En las evaluaciones de alto riesgo, compara jueces de la misma familia y de otras familias, y analiza los desacuerdos frente a las etiquetas humanas.
Schema-Guided Reasoning para jueces
La salida de formato libre es una fuente de variación entre ejecuciones del juez. Dos ejecuciones sobre la misma respuesta pueden organizar la rúbrica de forma distinta y producir puntuaciones diferentes. Schema-Guided Reasoning (SGR) hace explícita esa rúbrica: define las etapas de evaluación como un esquema de Pydantic y usa después una salida restringida mediante Outlines, XGrammar, los structured outputs de vLLM o el response_format de OpenAI para imponer las restricciones de esquema admitidas. El orden de los campos puede ayudar a quien revisa a inspeccionar el registro, pero no demuestra que el modelo razonara por las etapas en ese orden.
En la evaluación de RAG, el esquema descompone el juicio en campos explícitos y auditables, en lugar de dejar que el modelo salte directamente a un número:
from pydantic import BaseModel, Field, ValidationError, model_validator
from typing import Literal

class FaithfulnessJudgment(BaseModel):
    extracted_claims: list[str] = Field(
        description="Atomic factual claims in the answer, one per item."
    )
    supported_claims: list[str] = Field(
        description="Subset of extracted_claims that are entailed by the context."
    )
    unsupported_claims: list[str] = Field(
        description="Subset that is NOT entailed by the context."
    )
    outcome: Literal["scored", "no_claims"]
    failure_mode: Literal[
        "none", "fabrication", "overgeneralization", "wrong_entity", "stale_fact"
    ]
    rationale: str

    @model_validator(mode="after")
    def require_claim_partition(self):
        for claims in (self.extracted_claims, self.supported_claims, self.unsupported_claims):
            if any(not claim.strip() for claim in claims):
                raise ValueError("claims must contain non-whitespace text")
        extracted = set(self.extracted_claims)
        supported = set(self.supported_claims)
        unsupported = set(self.unsupported_claims)
        if not extracted:
            if supported or unsupported or self.outcome != "no_claims":
                raise ValueError("an empty extraction must be a no_claims outcome")
            return self
        if (
            len(extracted) != len(self.extracted_claims)
            or len(supported) != len(self.supported_claims)
            or len(unsupported) != len(self.unsupported_claims)
            or supported & unsupported
            or supported | unsupported != extracted
            or self.outcome != "scored"
        ):
            raise ValueError("verdict lists must be a complete, disjoint claim partition")
        return self

    @property
    def score(self) -> float | None:
        if not self.extracted_claims:
            return None
        return len(self.supported_claims) / len(self.extracted_claims)

valid = FaithfulnessJudgment(
    extracted_claims=["Mars has two moons", "Mars has a thick atmosphere"],
    supported_claims=["Mars has two moons"],
    unsupported_claims=["Mars has a thick atmosphere"],
    outcome="scored",
    failure_mode="fabrication",
    rationale="The atmosphere claim lacks support.",
)
assert valid.score == 0.5
empty = FaithfulnessJudgment(
    extracted_claims=[],
    supported_claims=[],
    unsupported_claims=[],
    outcome="no_claims",
    failure_mode="none",
    rationale="Score refusal correctness separately.",
)
assert empty.score is None
try:
    FaithfulnessJudgment(
        extracted_claims=["Mars has two moons"],
        supported_claims=["Mars has two moons"],
        unsupported_claims=["Mars has two moons"],
        outcome="scored",
        failure_mode="none",
        rationale="Contradictory verdict.",
    )
except ValidationError:
    pass
else:
    raise AssertionError("overlapping verdicts must fail validation")
Este contrato ilustrativo calcula la puntuación solo cuando las listas de veredictos forman una partición completa y disjunta de las afirmaciones extraídas. Un resultado sin afirmaciones no tiene puntuación de fidelidad y debe quedar fuera del agregado de fidelidad; informa de cuántos hay y puntúa por separado la corrección de las negativas, para que las abstenciones no mejoren el promedio en silencio. Conserva esas comprobaciones semánticas en producción; la salida restringida garantiza la forma, no un veredicto sin sesgos. El modelo de Pydantic también hace visible un cambio de rúbrica como un diff de código, mientras que la calibración humana pone a prueba el juicio en sí.
Esto sirve para cualquier juez basado en una rúbrica, no solo para la fidelidad. La preferencia por pares, el respaldo de las citas y la corrección de las negativas se benefician del mismo tratamiento.
Notebook 07 mide el sesgo de posición con llamadas por pares que invierten el orden. Su módulo evaluation/llm_judge.py también implementa puntuación individual con SGR. Las ejecuciones por pares presentan ambos órdenes de respuesta y muestran la consistencia al intercambiarlos. El juez individual devuelve un entero; no es el método G-Eval ponderado por probabilidades. Como ambos modelos son del mismo proveedor, medir la autopreferencia sigue requiriendo un juez de otra familia comparado con etiquetas humanas locales.
Latencia y coste
- p50, p95, p99 en cada etapa del pipeline. Un buen comienzo es p95 para el SLO y p99 para las alertas; cambia cualquiera de los dos cuando conozcas el recorrido del usuario, el volumen de tráfico y el presupuesto de errores.
- Tiempo hasta el primer token (TTFT) frente al tiempo total de generación. A los usuarios les importa el TTFT en una experiencia con streaming.
- Desglose por etapas: recuperación, reranking, generación y posprocesamiento. Usa la traza para localizar la cola en lugar de suponer qué etapa la causó; registra el dispositivo y el tamaño de lote del reranker al comparar ejecuciones.
- $/consulta total = embedding + recuperación + reranking + generación + almacenamiento amortizado. Mide p50 y p99; la cola larga es donde se va el presupuesto.
- Tasas de aciertos de caché en la caché de embeddings, la caché de recuperación y la KV cache. Fija objetivos distintos a partir de la repetición observada, la política de invalidación y el coste que se evita en cada capa.
Notebook 08 muestra p50/p95/p99 de la etapa retrieve instrumentada por evaluation/runner.py. El módulo evaluation/latency.py puede resumir otras etapas cuando las instrumentas explícitamente. make benchmark barre ajustes de chunking y embeddings sin llamadas a API. La comparación de LLM requiere una clave de OpenAI y uv run python -m rag_evals.scripts.benchmark --skip-chunking --skip-embedding --live.
Pruebas A/B
- Unidad de aleatorización: define primero el resultado que quieres estimar. Después pregúntate si las respuestas anteriores pueden cambiar el comportamiento posterior y si la versión asignada a un usuario puede afectar a la experiencia de otro. Usa la asignación por usuario o por sesión cuando la exposición repetida pueda cambiar el comportamiento o crear una experiencia incoherente. La asignación por consulta solo es defendible cuando esos efectos son despreciables y el análisis modela las observaciones repetidas.
- Métricas primarias, de salvaguarda y exploratorias: regístralas de antemano. Elige la medida primaria a partir del resultado del producto; entre los indicadores indirectos de satisfacción están los pulgares, las regeneraciones y el tiempo de permanencia. Trata la latencia y el coste como salvaguardas cuando limiten la experiencia.
- Tamaño de la muestra: haz un análisis de potencia antes de lanzar, a partir del efecto mínimo que merece la pena detectar, la varianza de referencia, la unidad de asignación y la regla de parada.
Parte 9: Construcción del conjunto de pruebas
Una métrica solo es tan buena como el conjunto de pruebas sobre el que se ejecuta. Si tu conjunto de oro cubre tres intenciones y el tráfico de producción abarca doce, el Recall@10 solo mide esas tres. Peor aún, un conjunto de pruebas sobreajustado a preguntas fáciles (“¿Cuál es la política de reembolso de la empresa?”) puede aprobar un sistema que falla con las difíciles (“¿Cuándo corresponde un reembolso por una cancelación parcial según las normas de protección del consumidor de la UE, facturada en EUR, para un cliente en Irlanda?”). La puntuación agregada sube mientras el sistema sigue fallando en una parte importante del tráfico de producción.
Las etiquetas de relevancia incompletas pueden distorsionar el recall en cualquiera de los dos sentidos. Si el verdadero conjunto relevante es {a, b} pero las etiquetas solo contienen {a}, recuperar {a} puntúa 1,0 en lugar de 0,5; recuperar {b} puntúa cero en lugar de 0,5. Versiona los juicios y revisa la evidencia recién recuperada y sin juzgar antes de interpretar una diferencia.
Construye primero el conjunto de pruebas en torno a la distribución real de las consultas y a su dificultad. Después elige las métricas que respondan a los modos de fallo objetivo y ajusta el sistema con ellas.
Generación de consultas sintéticas
Usa un LLM para generar preguntas a partir de tu corpus:
- Por fragmento: “Genera 3 preguntas que un usuario podría hacer y que este fragmento responda.”
- Multisalto: muestrea dos fragmentos y genera una pregunta que requiera ambos.
- Adversarias: genera preguntas con entidades distractoras, formulaciones casi duplicadas y menciones ambiguas.
La generación de pruebas de Ragas usa escenarios basados en grafos con consultas de un solo salto y de varios saltos, y con necesidades de información específicas o abstractas. DataMorgana genera benchmarks sintéticos configurables a partir de categorías de usuarios y de preguntas. Los datos sintéticos son útiles para los arranques en frío y las pruebas de cobertura. No pueden sustituir a las consultas reales de los usuarios.
Construcción del conjunto de oro
Los datos revisados por personas forman la base del conjunto de referencia.
- Muestrea consultas reales de usuarios (o simuladas, si aún no has lanzado) estratificadas por intención.
- Pide a expertos en la materia (SMEs) que respondan cada pregunta e identifiquen qué documentos contienen la respuesta.
- Empieza con unos cientos de consultas (200–500) y comprueba el intervalo. Con 200 consultas y una tasa de aciertos cercana a 0,8, el intervalo del 95 % es de aproximadamente ±5,5 puntos (1,96 × √(0,8 × 0,2 / 200)). Si el cambio que necesitas detectar es menor, añade consultas a los subconjuntos que deciden el lanzamiento.
- Añade consultas de producción revisadas (Parte 10) cuando las comprobaciones de deriva o los nuevos tipos de consulta muestren una laguna en la matriz de cobertura que figura más abajo.
Mantén cuatro conjuntos separados:
- Desarrollo: ajusta prompts, k y el chunking.
- Calibración del juez: etiquetas humanas que comprueban al juez.
- Lanzamiento: se puntúa una sola vez por candidato y nunca se usa para ajustar.
- Monitorización: tráfico de producción reciente, revisado a ciegas.
Agrupa los documentos de origen y las sesiones que compartan antes de dividir. Cuando una consulta o una etiqueta guía el ajuste, pasa a ser dato de desarrollo, así que un conjunto de lanzamiento usado para ajustar pasa a ser un conjunto de desarrollo. Reserva casos intactos para validar la configuración elegida y el juez.
Registra las versiones del corpus, de las consultas, de las etiquetas de relevancia y de la política, la unidad de k, el presupuesto de contexto suministrado, las revisiones del puntuador y del juez, y las reglas de agregación. Compara las diferencias por consulta emparejadas sobre la misma población, con su incertidumbre y el recuento de cada subconjunto. Incluye todas las consultas esperadas: un tiempo de espera agotado, un resultado ausente o una respuesta del juez que no se puede puntuar deben seguir visibles en el recuento de ejecuciones completadas y de errores. No dejes que una puntuación de lanzamiento mejore descartando fallos en silencio. ARES ofrece un enfoque de investigación con jueces automáticos, validación humana e inferencia potenciada por predicciones para estimar el sistema cuando la anotación es escasa; una suite local revisada puede empezar de forma más sencilla.
Conjuntos de pruebas adversarios
- Contrafactuales: intercambia las entidades clave de la consulta. ¿Recupera el sistema los fragmentos correctos para la consulta modificada?
- Distractores: consultas en las que el corpus contiene una respuesta plausible pero errónea que no debería recuperarse. Esto es lo que somete a prueba RGB (Chen et al., AAAI 2024): robustez al ruido, rechazo negativo, integración de información y robustez contrafactual.
- Negación y cuantificadores: consultas con “no”, “excepto” y “solo”. Los recuperadores densos suelen tener dificultades con ellas.
- Fuera de alcance: consultas sin respuesta en el corpus. El sistema debería decir “no lo sé”, no alucinar. NoMIRACL aporta pruebas de relevancia y de posibilidad de respuesta a nivel de pasaje; añade etiquetas separadas de fuera de alcance a nivel de corpus. Evalúa la abstención de forma explícita con los tipos de consulta de tu producción.
Cobertura y evaluación continua
- Construye una matriz de cobertura: intención de la consulta × tipo de documento × rama de la ontología. Una consulta por celda es un inventario de cobertura inicial, no potencia estadística suficiente para una decisión de lanzamiento. Las celdas vacías revelan huecos de cobertura; dimensiona los subconjuntos con datos según la incertidumbre que puedas tolerar.
- Cadencia inicial: un subconjunto de unas 50 consultas en cada PR, el conjunto de oro completo cada noche o con cada candidato a versión, y comprobaciones semanales de deriva sobre una muestra de producción. El comando
make eval-fastdel repositorio complementario ejecuta el subconjunto de 50 consultas. Cambia el calendario cuando conozcas el coste de la evaluación y la rapidez con que cambia el tráfico. - Para la deriva, usa una muestra de producción móvil y estratifica por feedback en lugar de cambiar en silencio la distribución objetivo.
Parte 10: Monitorización en producción
La suite de evaluación que lanzas describe el sistema en el momento del lanzamiento. El tráfico de producción cambia después.
Feedback implícito y explícito
- Trata los eventos implícitos como señales candidatas, no como KPI de calidad positivos o negativos, hasta que se correlacionen con una revisión ciega o con feedback explícito en una muestra local.
- Tasa de clics o de apertura en las fuentes citadas (si tu interfaz las expone).
- Tiempo de permanencia en la respuesta.
- Tasa de regeneración: porcentaje de respuestas que el usuario vuelve a preguntar o pide al sistema que rehaga. Trátala como una señal más de insatisfacción y calíbrala con conversaciones revisadas.
- Tasas de copiar, compartir y exportar: señales implícitas candidatas que pueden representar utilidad, verificación, traspaso o insatisfacción. Mide su asociación y su intervalo de confianza antes de asignarles un sentido.
- Patrones de seguimiento: usa “¿Seguro?” o “¿Y qué pasa con X?” como estratos de revisión y etiqueta después su asociación con la desconfianza o con una necesidad sin resolver.
- Pulgar arriba o abajo con categorías de motivo opcionales (incorrecto, incompleto, fuera de tema, dañino, lento). Las ediciones en línea pueden conservar más contexto de diagnóstico; evalúa ese valor con muestras revisadas.
Detección de deriva
- Deriva de las consultas: compara los embeddings de las consultas con una ventana de referencia mediante MMD o un clasificador validado de referencia frente a actual. KL requiere un estimador de probabilidad definido, como histogramas elegidos; las coordenadas crudas de un embedding no son probabilidades. Calibra las alarmas con desplazamientos conocidos y después inspecciona los subconjuntos afectados.
- Deriva de los embeddings: fija una representación y un conjunto de sondas, y mide después la estabilidad de los vecinos y la calidad de la recuperación. Las distintas versiones de un modelo no tienen por qué compartir dimensiones ni una base de coordenadas, así que el coseno entre versiones puede carecer de sentido. Migra juntos los codificadores de consultas y de documentos, evalúa el nuevo índice y conserva instantáneas versionadas para poder revertir.
- Deriva del rendimiento: sigue a lo largo del tiempo métricas equivalentes a las de producción (la tasa de regeneración por intención). Los cambios bruscos y los graduales sugieren hipótesis distintas, pero su forma no establece la causa; inspecciona los cambios en los datos, el tráfico, el proveedor, las políticas y los despliegues.
Evaluación en paralelo y human-in-the-loop
Ejecuta el sistema candidato en paralelo con el de producción, compara las salidas offline y no las sirvas a los usuarios. Esto puede revelar regresiones antes del lanzamiento. La inferencia en sombra sigue consumiendo capacidad y puede invocar herramientas: aísla los recursos, suprime las escrituras y comprueba que la comparación no degrada la latencia de producción.
Para la revisión human-in-the-loop (HITL):
- Muestrea las salidas de baja confianza hacia una cola de revisión.
- Incluye una muestra aleatoria del tráfico de producción para revisión ciega; el 1–2 % del tráfico es una tasa inicial, que se ajusta según el volumen de tráfico, el riesgo y la capacidad de los revisores.
- Sobremuestrea las salidas con pulgar abajo para revisarlas junto con la muestra aleatoria.
- Usa las salidas revisadas para ampliar el conjunto de oro.
Conserva la muestra aleatoria: sin ella, el conjunto de oro solo gana respuestas de las que los usuarios se quejaron.
El conjunto mínimo de salvaguardas
Elige las prioridades y los umbrales de las alertas a partir del daño al usuario, los SLO y el rendimiento validado de los detectores. Entre las señales candidatas están:
- Puntuación de fidelidad o de HHEM por debajo del umbral en una muestra móvil de producción.
- Latencia p95 por encima del SLO.
- Tasa de falsa exclusión del filtro por encima del umbral (basada en muestras).
- Tasa de regeneración fuera de una banda de control calibrada localmente, que tenga en cuenta el tamaño de la ventana, el tráfico, la estacionalidad y el presupuesto de falsas alertas.
- Coste por consulta por encima del presupuesto.
Una primera regla de triaje: una alerta sin cambios de código ni de modelo apunta a una deriva; una alerta justo después de un lanzamiento apunta a una regresión. Confirma cualquiera de las dos en las trazas y en los subconjuntos afectados, porque un despliegue puede coincidir con una deriva del tráfico, y puede haber un cambio de proveedor o de datos sin un lanzamiento de la aplicación.
Salvedades
- Los objetivos son locales, no universales. Los valores iniciales de esta guía, incluidos los umbrales del repositorio complementario, son primeros ajustes que debes afinar con tus propios datos. Las cifras ilustrativas son resultados de ejemplo. Calibra los umbrales de lanzamiento según tu dominio, lo que está en juego, la incertidumbre del conjunto de evaluación y las expectativas de los usuarios.
- El panorama de frameworks cambia rápido. Las versiones de HHEM, los nombres de las métricas de RAGAS, las fichas de los modelos y el orden de las clasificaciones pueden cambiar tras la publicación. Vuelve a consultar la fuente enlazada y repite el benchmark antes de comprometerte.
- Las cifras de acuerdo del LLM como juez traen asteriscos. El 80 % de acuerdo entre GPT-4 y las personas procede de las condiciones de MT-Bench / Chatbot Arena. Ese resultado no establece el acuerdo en un dominio de nicho ni en un subconjunto adversario. Usa jueces para puntuar más casos de los que las personas pueden revisar y sigue revisando a mano una muestra.
- Las mejoras que publican los proveedores en sus benchmarks a menudo no se pueden reproducir de forma independiente. Reprodúcelas con tus propios datos antes de creerte una cifra, sobre todo en rerankers y sistemas de OCR recientes.
- Ninguna métrica sustituye a mirar las salidas. Empieza leyendo 50 respuestas de producción al azar cada semana. Las métricas escalan ese hábito; no lo reemplazan.
Referencias
Frameworks y benchmarks
- Es et al., Ragas: Automated Evaluation of Retrieval Augmented Generation, 2023.
- Documentación de RAGAS y GitHub.
- Saad-Falcon et al., ARES: An Automated Evaluation Framework for Retrieval-Augmented Generation Systems, NAACL 2024.
- TruLens, DeepEval, Arize Phoenix.
- Thakur et al., BEIR: A Heterogenous Benchmark for Zero-shot Evaluation of Information Retrieval Models, NeurIPS 2021.
- Clasificación de MTEB.
- TREC 2024 RAG Track.
- Pradeep et al., Initial Nugget Evaluation Results for the TREC 2024 RAG Track with the AutoNuggetizer Framework, 2024.
Recuperación y ranking
- Cormack, Clarke, Buettcher, Reciprocal Rank Fusion Outperforms Condorcet and Individual Rank Learning Methods, SIGIR 2009.
- Gao et al., Precise Zero-Shot Dense Retrieval Without Relevance Labels (HyDE), 2022.
- Jeong et al., Adaptive-RAG: Learning to Adapt Retrieval-Augmented Large Language Models through Question Complexity, NAACL 2024.
- Anthropic, Introducing Contextual Retrieval, septiembre de 2024.
- Günther et al., Late Chunking: Contextual Chunk Embeddings Using Long-Context Embedding Models, 2024.
Generación, fidelidad y jueces
- Min et al., FActScore: Fine-grained Atomic Evaluation of Factual Precision in Long Form Text Generation, EMNLP 2023.
- Liu et al., Lost in the Middle: How Language Models Use Long Contexts, TACL 2024.
- Chen et al., Benchmarking Large Language Models in Retrieval-Augmented Generation (RGB), AAAI 2024.
- Vectara, HHEM-2.1-Open hallucination evaluation model.
- Zheng et al., Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, NeurIPS 2023.
- Thakur et al., Support Evaluation for the TREC 2024 RAG Track: Comparing Human versus LLM Judges, SIGIR 2025.
- Thakur et al., Knowing When You Don’t Know: A Multilingual Relevance Assessment Dataset for Robust Retrieval-Augmented Generation, Findings of EMNLP 2024.
- Geng et al., JSONSchemaBench: A Rigorous Benchmark of Structured Outputs for Language Models, 2025.
- Kosmopoulos et al., Evaluation Measures for Hierarchical Classification: a unified view and novel approaches, 2015.
Deriva y producción
- Evidently, Embedding drift detection methods compared.
Código complementario
slavadubrov/rag-evals-demo: harness ejecutable que separa recuperación en SciFact, generación sobre QA sintética etiquetada y comprobaciones offline con datos de prueba fijos, con barridos de chunking y embeddings y una comparación en vivo opcional entre dos modelos de OpenAI. Los notebooks 00–09 explican los procesos; las pruebas unitarias fijan algunos ejemplos resueltos, mientras que los datos antiguos del filtro usan otra población autorizada. El índice Qdrant integrado funciona sin Docker.