Variantes, formatos y cuantización de LLMs de pesos abiertos

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Nombres como Acme-32B-A3B-Instruct-AWQ parecen densos porque combinan varias decisiones independientes: familia y tamaño, arquitectura, rol de entrenamiento y cuantización. Un repositorio puede empaquetar esos pesos como Safetensors fragmentados, mientras que una conversión de la comunidad del mismo checkpoint aparece como Q4_K_M.gguf.
Esas etiquetas no pertenecen a una misma categoría: GPTQ y AWQ son métodos de cuantización, GGUF es un contenedor y un ecosistema de runtime, y MoE es una arquitectura. Leer las capas por separado facilita la elección de la descarga.
Esta guía es para ingenieros que eligen un modelo de pesos abiertos para inferencia local o para servir en GPU. Aprenderás a leer cada parte del nombre de un modelo, a elegir un runtime y a comprobar que un archivo cabe en tu memoria antes de hacer el benchmark.
Para la elección compacta de despliegue, consulta Formatos de cuantización de LLMs.
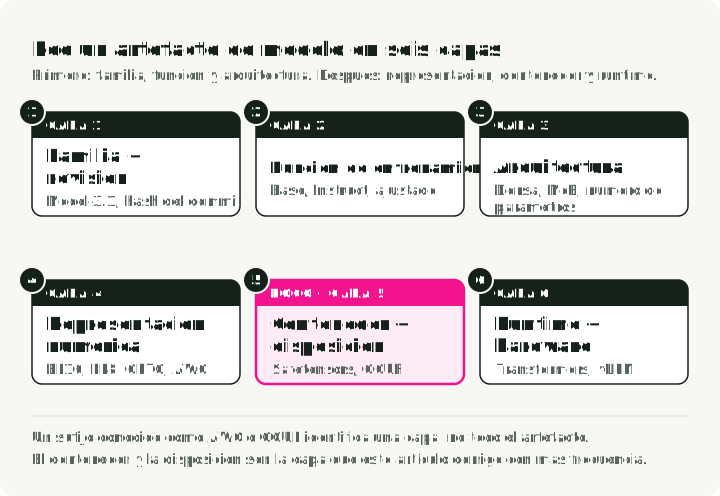
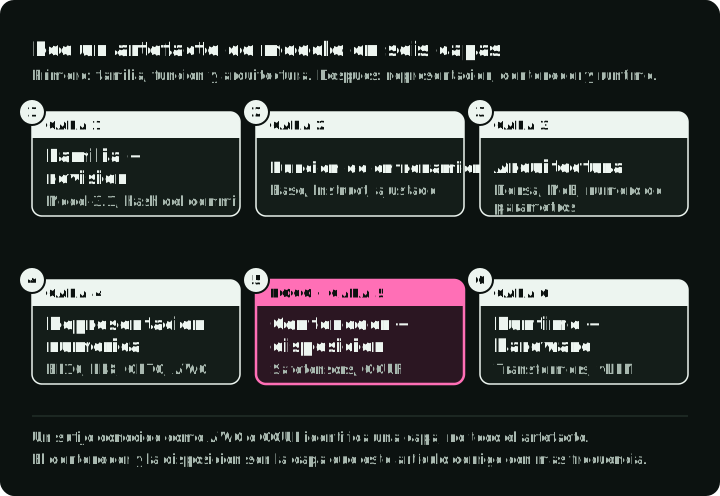
Lee un artefacto de modelo en seis capas
| Capa | Ejemplo | Pregunta que responde |
|---|---|---|
| Familia y revisión | Model-3.1, hash de commit | ¿Qué pesos y qué contrato de tokenizador? |
| Rol de entrenamiento | Base, Instruct, ajustado para razonamiento | ¿Qué comportamiento se optimizó? |
| Arquitectura | Densa, MoE, parámetros totales y activos | ¿Qué kernels y qué disposición de memoria se necesitan? |
| Representación numérica | BF16, FP8, GPTQ de 4 bits, AWQ de 4 bits | ¿Cómo se representan o cuantizan los tensores? |
| Contenedor y disposición | Shards de Safetensors, GGUF | ¿Cómo se empaquetan los tensores y los metadatos? |
| Runtime | Transformers, vLLM, llama.cpp | ¿Qué cargador y qué ruta de hardware lo ejecutan? |
La figura siguiente divide dos nombres de ejemplo en partes y coloca cada parte bajo su capa. Ambos nombres indican la familia, el rol de entrenamiento, la arquitectura y la representación numérica. Solo el archivo GGUF nombra su contenedor, y ninguno nombra el runtime.
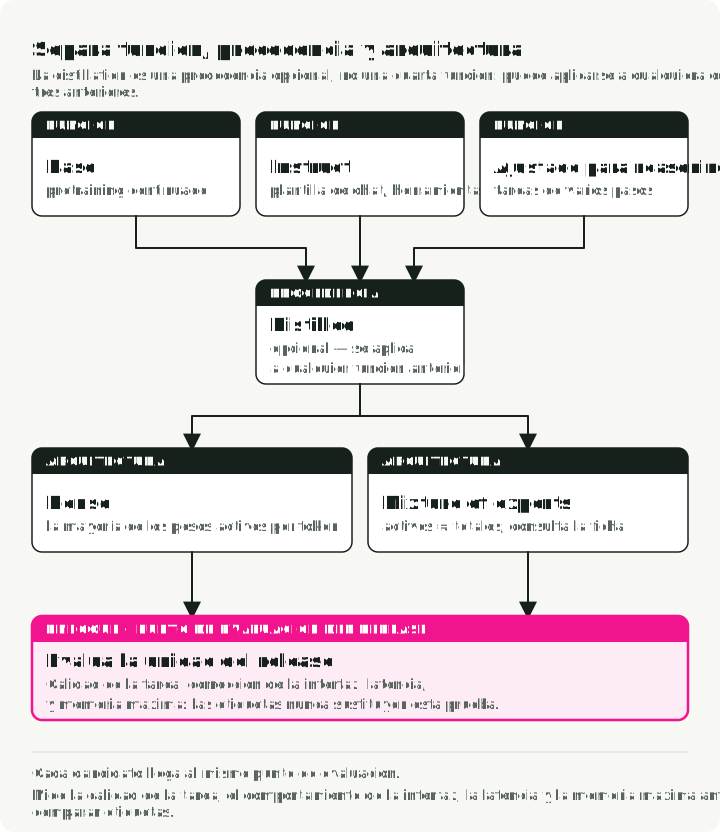
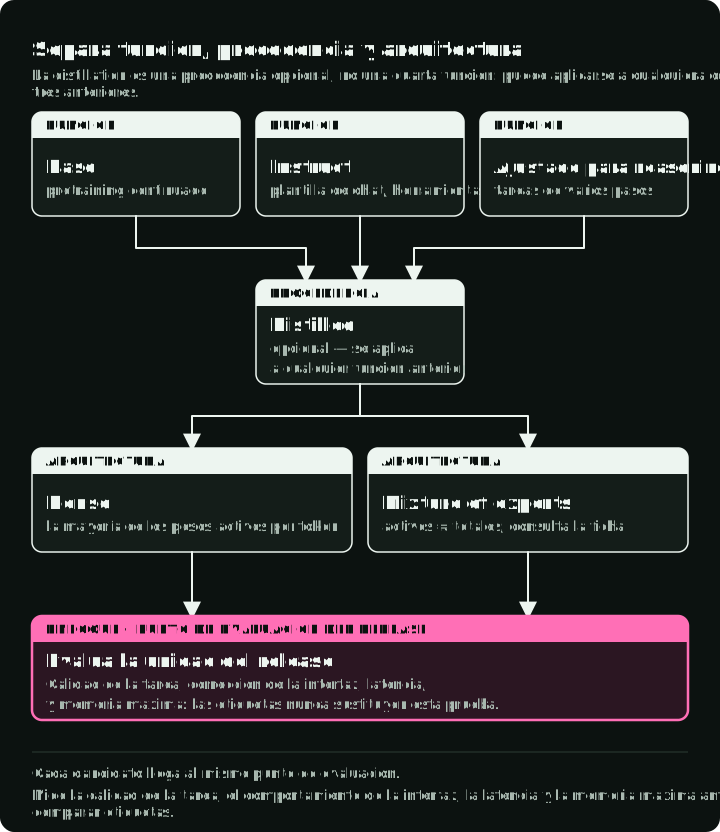
Algunas etiquetas describen cómo se entrenó el modelo, no una parte del archivo. Distill (entrenado para imitar a un modelo maestro más grande) y QAT (entrenamiento consciente de la cuantización) son dos de ellas. Un checkpoint puede estar destilado, ajustado con instrucciones, ajustado para razonamiento y ser MoE al mismo tiempo.
La etiqueta «open-source» necesita su propia comprobación. Si un modelo solo publica pesos descargables, no des por hecho que su licencia cumpla una definición de código abierto ni que permita tu caso de uso. Lee la model card y la licencia antes de comparar arquitecturas o benchmarks.
Roles de entrenamiento: Base, Instruct, razonamiento, destilado
Base
Un checkpoint base se entrena principalmente para predecir el siguiente token. Sirve para continuar el preentrenamiento, para investigación controlada o para adaptaciones en las que quieres controlar el comportamiento ante instrucciones. Puede completar un prompt en lugar de responderlo. Si le preguntas «¿Cuál es la capital de Francia?», puede continuar con «¿Cuál es la capital de Alemania?», porque el prompt parece el comienzo de una lista de preguntas.
No des por hecho que todo fine-tuning deba partir de un modelo base. Un checkpoint instruct puede ser mejor punto de partida cuando su comportamiento actual coincide con el objetivo. Confirma con tu evaluación que ese comportamiento no choca con el nuevo objetivo.
Instruct o chat
Estos checkpoints reciben un posentrenamiento pensado para mejorar el seguimiento de instrucciones y la conversación. La receta exacta puede incluir fine-tuning supervisado, optimización de preferencias, aprendizaje por refuerzo, destilación o una combinación. No es necesariamente fine-tuning supervisado seguido de RLHF.
Usa un checkpoint instruct como primera línea base de asistente. Confirma su plantilla de chat, el formato de tool call que admite, el comportamiento con mensajes de sistema y sus características de rechazo. La documentación de plantillas de chat de Transformers explica por qué importa el formato exacto de los mensajes. «Instruct» por sí solo no garantiza un uso fiable de JSON ni un tool use fiable.
Ajustado para razonamiento
Los checkpoints orientados al razonamiento se optimizan con tareas o trayectorias que recompensan la resolución de problemas en varios pasos. Algunos exponen el texto del razonamiento, otros lo separan mediante un parser del servidor y otros presentan solo una respuesta. Generar más texto no garantiza un razonamiento fiel ni menos alucinaciones.
Adopta uno cuando mejore los segmentos difíciles de la evaluación, una vez contados los tokens de salida, la latencia y la verificación. Una extracción o una clasificación rutinarias pueden volverse más lentas sin mejorar.
Destilado
La destilación transfiere el comportamiento de un modelo maestro, o de datos generados por él, a otro modelo. El estudiante puede ser más pequeño, del mismo tamaño o tener otra estructura. No existe una regla estable del tipo «entre el 70 % y el 80 % de la calidad con la mitad del tamaño»: la calidad que se conserva depende del maestro, los datos, el objetivo, la capacidad del estudiante y la evaluación. El artículo original sobre destilación de conocimiento, de Hinton, Vinyals y Dean, tampoco afirma una proporción fija de calidad.
Trata Distill como información sobre la procedencia del entrenamiento y haz el benchmark como con cualquier otro checkpoint.
La figura siguiente envía un mismo prompt a los tres roles y muestra lo que devuelve cada uno, para qué se elige y cuánto cuesta. Etiquetas de procedencia como Distill y QAT pueden aplicarse a cualquiera de ellos.
Modelos densos y MoE
El rol de entrenamiento indica qué comportamiento tiene el checkpoint. La arquitectura indica cómo se organizan los pesos, lo que determina la memoria y la compatibilidad con los runtimes.
Modelos densos
La mayoría de los parámetros participa en el paso hacia delante de cada token. El número de parámetros es un indicador aproximado del almacenamiento de pesos. La memoria en ejecución incluye además la KV cache, las activaciones o el espacio de trabajo, la sobrecarga del asignador y, a veces, estado duplicado o fragmentado.
Mixture of Experts
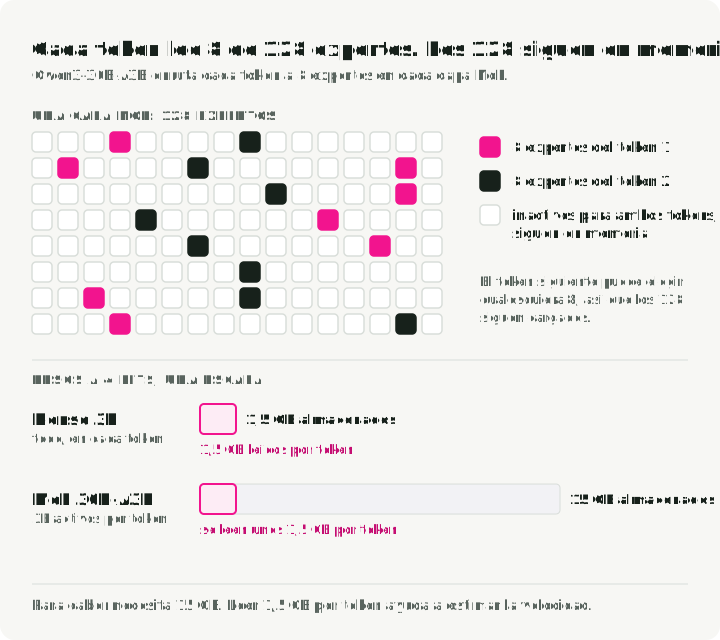
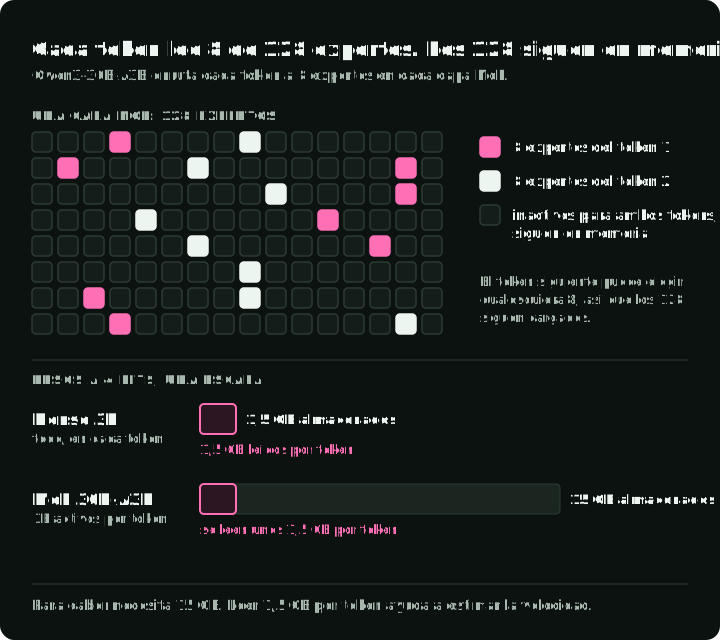
Una capa MoE enruta cada token a un subconjunto de redes feed-forward expertas. El artículo de Switch Transformer describe un diseño de enrutamiento de este tipo; otras familias enrutan los tokens de otra manera. Nombres como A3B suelen significar que hay aproximadamente tres mil millones de parámetros activos por token, pero las convenciones de nombres dependen de cada familia. Lee la model card para conocer los parámetros totales, los parámetros activos, el número de expertos y el diseño del enrutamiento.
El número de parámetros activos describe el cómputo enrutado, no dónde se colocan los pesos. Por ejemplo, el paralelismo de expertos de vLLM reparte las capas de expertos entre los rangos de paralelismo de expertos y deduce la asignación de expertos de cada rango a partir del número total de expertos. Otros runtimes pueden colocar o descargar los pesos de otra forma. Por tanto, un modelo con 30B de parámetros totales y 3B activos no cabe automáticamente como un modelo denso de 3B.
La figura siguiente muestra una capa MoE de Qwen3-30B-A3B: cada token usa 8 de sus 128 expertos, y el token siguiente puede usar otros 8 cualesquiera, así que todos permanecen en memoria. Las barras ponen un modelo denso de 3B y el 30B-A3B en una misma escala a 4 bits. El modelo MoE almacena diez veces más pesos, pero cada token lee solo los tres mil millones de parámetros activos, unos 1,5 GB.
La compatibilidad del runtime también depende de la arquitectura. Confirma la implementación del modelo, la compatibilidad con paralelismo de expertos o de tensores, los kernels de cuantización y el contexto máximo antes de descargar.
Contenedores y métodos de cuantización
La arquitectura fija qué tensores existen. El contenedor decide cómo se almacenan esos tensores en disco, y el método de cuantización decide cuántos bits usa cada uno.
Safetensors
Safetensors es un formato seguro de serialización de tensores muy usado en los repositorios de Hugging Face. Un modelo puede tener varios shards .safetensors además de archivos de configuración, de tokenizador y de generación. Esos tensores pueden estar en BF16/FP16 o precuantizados con un método como GPTQ o AWQ. Transformers lee el método de una entrada quantization_config y carga el backend correspondiente, como describe su flujo de cuantización.
La extensión por sí sola no indica la precisión ni la compatibilidad con el runtime. Inspecciona config.json, la configuración de cuantización, la model card, el dtype de los tensores y la documentación del runtime. La sección «Un nombre analizado» de más abajo muestra un script corto que lo hace.
GGUF
GGUF empaqueta tensores y metadatos para el ecosistema ggml/llama.cpp. llama.cpp carga GGUF y admite backends como Metal, CUDA, HIP, Vulkan y rutas de CPU. La arquitectura del modelo y la calidad de la conversión siguen determinando la compatibilidad.
GGUF es un contenedor. Puede guardar tensores de alta precisión o cuantizados. Los modelos multimodales pueden necesitar además un archivo aparte con el proyector o el codificador. «Un solo archivo GGUF lo contiene todo» no es una regla universal.
GPTQ y AWQ
GPTQ y AWQ son métodos de cuantización de pesos posteriores al entrenamiento, no extensiones de archivo. Sus artefactos suelen usar Safetensors más una configuración propia del método. Los motores de serving necesitan kernels compatibles con el método, el ancho de bits, el tamaño de grupo, la arquitectura del modelo y el hardware.
Ninguno de los dos métodos gana siempre en calidad. Influyen los datos de calibración, la implementación, la ruta del kernel y la tarea. La compatibilidad de los runtimes cambia, así que verifica el artefacto exacto con la versión que fijes. Consulta las páginas oficiales de cuantización en Transformers y de cuantización en vLLM junto a esa decisión.
FP8 y QAT
En los nombres de los repositorios aparecen dos etiquetas más. FP8 es un formato numérico, no un método de cuantización: cada peso se almacena como un valor de coma flotante de 8 bits. Solo es rápido cuando la GPU y el runtime lo admiten. Por ejemplo, vLLM ejecuta pesos y activaciones en FP8 en las GPUs NVIDIA Ada, Hopper y Blackwell, y recurre a FP8 solo en los pesos en Turing y Ampere. Consulta la tabla de hardware del runtime antes de elegir un repositorio -FP8.
Un checkpoint QAT (entrenamiento consciente de la cuantización) se entrenó para tolerar un esquema de pocos bits concreto, por ejemplo un archivo GGUF -qat-q4_0. Empieza con el formato previsto por el autor del modelo. Cambiar el esquema de cuantización puede reducir el beneficio de QAT; vuelve a evaluar el artefacto convertido. La guía de cuantización de modelos trata con más detalle PTQ y QAT y los formatos numéricos.
Runtimes y cuándo usar cada uno
El runtime es el programa que carga el archivo y lo ejecuta en tu hardware. Cada runtime carga un conjunto fijo de tipos de archivo, así que la elección del runtime también decide qué archivo descargas.
| Runtime | Archivos que carga | Hardware | Úsalo cuando |
|---|---|---|---|
llama.cpp | GGUF | CPU, Metal, CUDA, HIP, Vulkan | Quieres control directo de la inferencia local, o un objetivo pequeño o poco habitual |
| Ollama | GGUF; importaciones compatibles de Safetensors (una ruta MLX está en vista previa en Apple Silicon) | macOS, Linux, Windows | Quieres un servicio local gestionado con una API HTTP en un portátil o una estación de trabajo |
| LM Studio | GGUF; MLX en Apple Silicon | macOS, Windows, Linux | Quieres una interfaz gráfica para explorar, descargar y probar modelos |
| MLX-LM | Safetensors convertidos para MLX, el framework de arrays de Apple | Apple Silicon | Trabajas en Python en un Mac, incluido el fine-tuning con LoRA |
| vLLM, SGLang | Safetensors en BF16, FP8, AWQ, GPTQ y otros métodos | GPUs NVIDIA y AMD, otros aceleradores | Sirves a muchos usuarios y necesitas batching, throughput y una API al estilo de OpenAI |
| Hugging Face Transformers | Safetensors, con quantization_config cuando están cuantizados | CPU y GPU | Investigas, haces fine-tuning o sirves con carga moderada; usa vLLM o SGLang para producción a gran escala |
Text Generation Inference (TGI) ya no es una opción para despliegues nuevos. Hugging Face lo puso en modo de mantenimiento, desde entonces ha archivado el repositorio y recomienda vLLM y SGLang. Para ver con más detalle las herramientas para portátiles, consulta LLMs locales en macOS.
Estimar la memoria
Una vez conocidos el runtime y el tipo de archivo, la siguiente pregunta es si el archivo cabe. Para parámetros de pesos a bits, el almacenamiento bruto de los pesos es aproximadamente:
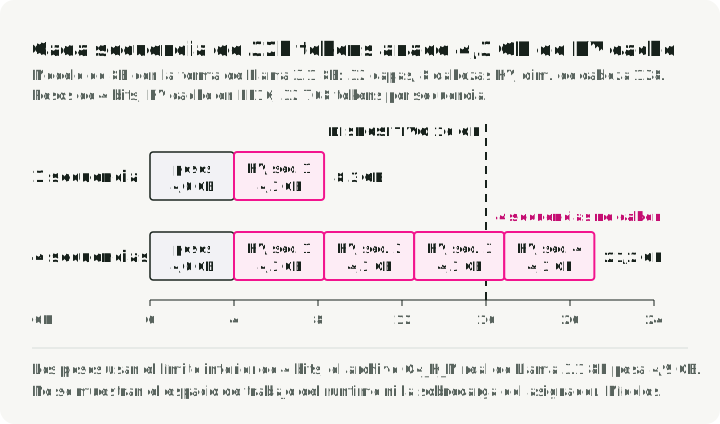
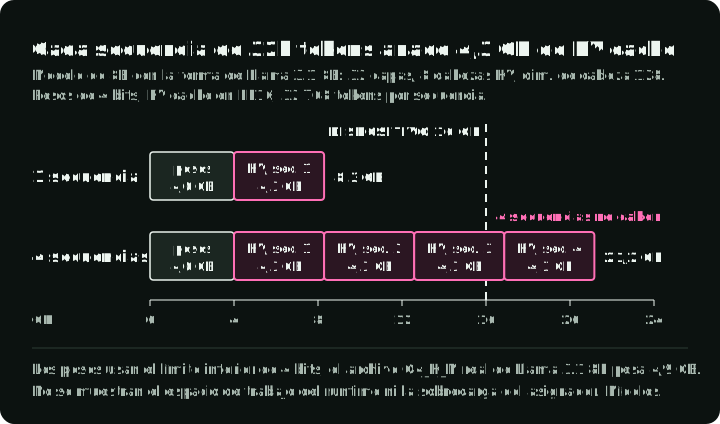
Un modelo de 13B con pesos nominales de cuatro bits empieza, por tanto, cerca de 6,5 GB. El mismo modelo en BF16 necesita unos 26 GB, y un modelo de 70B en BF16 necesita unos 140 GB. La cifra de 6,5 GB es un límite inferior: el modelo no se ejecutará necesariamente en 6,5 GB. Las escalas, los puntos cero, los tensores de mayor precisión, los embeddings, los metadatos, los búferes del runtime, la KV cache y la fragmentación añaden memoria.
La KV cache suele marcar la diferencia entre «carga» y «sirve». En un Transformer con atención completa y una caché K/V convencional, almacena las claves y los valores de atención de cada token del contexto, así que crece con la longitud del contexto y con el número de secuencias servidas a la vez. Un modelo de 8B con 32 capas, 8 cabezas KV y dimensión de cabeza 128 (la forma de Llama 3.1 8B) almacena unos 4,3 GB de KV cache en FP16 para una secuencia de 32 768 tokens: 2 × 32 × 8 × 128 × 32 768 × 2 bytes. A 4 bits, sus pesos ocupan unos 4 GB. El gráfico siguiente suma ambos y muestra que cuatro secuencias así ya no caben en un dispositivo de 16 GB.
La función siguiente estima los pesos brutos y la caché K/V convencional con atención completa, como en Llama 3.1. Toma el número de capas, el número de cabezas KV y la dimensión de cabeza del config.json del modelo. Las capas de atención con ventana deslizante o por bloques dejan de ampliar su caché al alcanzar el tamaño de la ventana o del bloque. Las arquitecturas híbridas o de caché comprimida también necesitan el cálculo de caché de su propio runtime.
def estimate_gb(params_b, bits, layers, kv_heads, head_dim, context, batch=1, kv_bytes=2):
    """Raw weights and conventional full-attention K/V cache, in GB (10**9 bytes)."""
    weights = params_b * 1e9 * bits / 8
    # Keys and values (2) for every layer, KV head, position, and sequence.
    kv_cache = 2 * layers * kv_heads * head_dim * context * batch * kv_bytes
    return round(weights / 1e9, 1), round(kv_cache / 1e9, 1)

# An 8B model shaped like Llama 3.1 8B, 4-bit weights, FP16 KV cache.
print(estimate_gb(8, 4, 32, 8, 128, 32_768))  # (4.0, 4.3)
print(estimate_gb(8, 4, 32, 8, 128, 32_768, batch=4))  # (4.0, 17.2)
Son estimaciones de pesos brutos y caché, no un presupuesto completo del runtime. El Q4_K_M GGUF real de Llama 3.1 8B pesa 4,9 GB, no 4,0 GB, porque algunos tensores conservan más bits. El espacio de trabajo del runtime se suma a eso. Mide el pico de memoria con la secuencia máxima real, la política de batching, el dtype de la caché y el paralelismo. La sección sobre memoria de serving de la guía de cuantización cubre la fórmula completa, incluida la cuantización de la KV cache.
La cuantización puede reducir la memoria y a veces mejorar la velocidad, pero los kernels de pocos bits también pueden ser más lentos en hardware no compatible. Compara la calidad en la tarea y el throughput de extremo a extremo, no solo el tamaño del archivo.
Nombres de cuantización GGUF
Un repositorio GGUF suele ofrecer un archivo por cada nivel de cuantización: Q3_K_M, Q4_K_M, Q5_K_M, Q6_K, Q8_0, IQ4_XS y otros. El nombre indica el tipo principal y la mezcla:
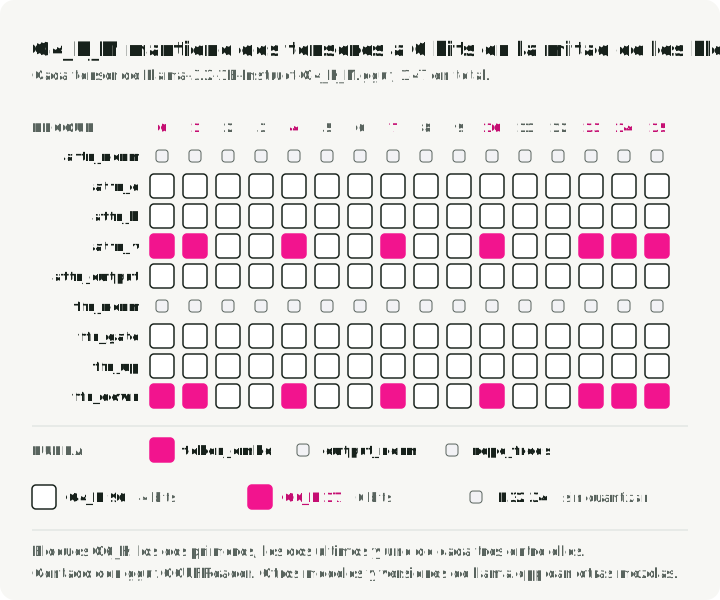
Q4es el ancho de bits que usa la mayoría de los tensores.Kes el esquema de bloques K-quant.S,MyLson mezclas pequeña, mediana y grande. Una mezcla mayor mantiene más tensores en un tipo de mayor precisión. EnQ4_K_M, el cuantizador pasa aQ6_Klos pesos de valor de atención (attn_v) y de salida feed-forward (ffn_down) en aproximadamente la mitad de las capas.Q4_K_Ssube menos de ellos, y solo aQ5_K.Q8_0es un tipo sencillo de 8 bits que se usa en casi todas las matrices de pesos.- Los nombres
IQ, comoIQ4_XS, son i-quants. Suelen apoyarse en una matriz de importancia que registra qué pesos importan más sobre un texto de muestra.
La cuadrícula siguiente asigna cada tensor de un archivo real a su tipo. De los 147 tensores de Llama-3.2-1B-Instruct-Q4_K_M.gguf, 96 son Q4_K, 17 son Q6_K y 34 son tensores F32 sin cuantizar, sobre todo normalizaciones. Mira las filas attn_v y ffn_down para ver qué bloques reciben Q6_K.
Para comprobar un archivo por tu cuenta, descarga un nivel de cuantización y cuenta sus tipos de tensor con el paquete gguf del proyecto llama.cpp:
hf download bartowski/Llama-3.2-1B-Instruct-GGUF Llama-3.2-1B-Instruct-Q4_K_M.gguf --local-dir .from collections import Counter
from gguf import GGUFReader
reader = GGUFReader("Llama-3.2-1B-Instruct-Q4_K_M.gguf")
print(Counter(t.tensor_type.name for t in reader.tensors))
# Counter({'Q4_K': 96, 'F32': 34, 'Q6_K': 17})
for t in reader.tensors:
if t.tensor_type.name == "Q6_K":
print(t.name) # token_embd.weight, blk.0.attn_v.weight, blk.0.ffn_down.weight, ...Las mezclas varían según la arquitectura y la versión de llama.cpp, así que trata el sufijo como el nombre de una receta de llama.cpp, no como una especificación portable de ancho de bits. Consulta la guía de cuantización de llama.cpp para ver la lista actual.
Usa estos valores como puntos de partida, no como respuestas:
Q4_K_Mes la primera prueba habitual.Q5_K_MoQ6_Kcuando la memoria lo permita.Q3_K_Mo un archivoIQ3solo para que quepa un modelo mayor, y solo después de comprobar la calidad.
Evita afirmaciones universales como que Q4_K_M es indistinguible de BF16 o que un modelo Q3 más grande siempre supera a uno Q8 más pequeño. Usa una comparación breve para el checkpoint exacto:
- un artefacto de referencia de alta precisión o de confianza
- un candidato cerca del límite de memoria
- un candidato más pequeño con más margen
Ejecuta los mismos prompts, las mismas comprobaciones de structured output, los mismos casos de contexto largo y la misma prueba de latencia en los tres.
Flujo de selección
Cada una de las secciones anteriores cubre una capa. El flujo las pone en orden, y un cambio en cualquier entrada te devuelve a recorrer los pasos.
1. Fija el contrato de la tarea
Define el idioma, la modalidad, la longitud de contexto, la interfaz de herramientas o de esquema, las restricciones de seguridad, los requisitos de licencia y los segmentos de evaluación. Compara los checkpoints en una representación lo bastante precisa como para que la cuantización no decida la primera ronda.
2. Elige el checkpoint
Elige el checkpoint más pequeño que supere tus comprobaciones de calidad y de comportamiento. Registra el repositorio y la revisión exactos, el tokenizador, la plantilla de chat y cualquier parser de razonamiento necesario.
3. Elige el runtime
Elige un runtime de la tabla de runtimes. Después comprueba, para el artefacto exacto, la compatibilidad con la arquitectura, el backend de hardware, el paralelismo, los kernels de cuantización, el structured output y los adaptadores.
4. Establece un presupuesto de memoria medido
Incluye los pesos, la KV cache, el espacio de trabajo del runtime, la concurrencia esperada y el margen para el sistema operativo o para procesos que compartan la máquina. Que un archivo quepa en la RAM o en la VRAM es necesario, no suficiente.
5. Elige y valida una representación
Prefiere los artefactos publicados por el autor del modelo, con calibración y procedencia documentadas. Si usas una conversión de la comunidad, registra la revisión de origen, la revisión del conversor, la receta de cuantización, los datos de calibración o de importancia y los hashes.
6. Haz el benchmark de la unidad de release
Mide la calidad en la tarea, la corrección del esquema y de los tool calls, el tiempo hasta el primer token, el throughput de salida, el pico de memoria y los fallos con el contexto y la concurrencia objetivo. Repite la medición tras cambiar cualquier checkpoint, runtime, kernel o ajuste de cuantización.
Puntos de partida para configuraciones habituales
Son primeros candidatos para hacer el benchmark con el flujo anterior, no respuestas definitivas.
| Configuración | Primer candidato | Comprueba antes de comprometerte |
|---|---|---|
| Asistente de chat en un MacBook de 16 GB | Instruct de 7B–8B, GGUF Q4_K_M, en Ollama o LM Studio | El pico de memoria con tu longitud de contexto deja espacio al sistema y a otras aplicaciones |
| Servicio RAG en una GPU de 24 GB | Instruct de 7B–14B, Safetensors AWQ o FP8, en vLLM | Los pesos más la KV cache con tu concurrencia se quedan por debajo de 24 GB |
| Fine-tuning de dominio en una GPU en la nube | Checkpoint Base o Instruct en Safetensors BF16, con Transformers | Si el comportamiento instruct ayuda o choca con tu objetivo de entrenamiento |
| API para muchos usuarios | Instruct en BF16, FP8 o AWQ, en vLLM o SGLang | El throughput y el tiempo hasta el primer token con la concurrencia objetivo |
Un nombre analizado
Supón que un repositorio se llama Acme-32B-A3B-Instruct-AWQ. Cada parte plantea una pregunta, y cada respuesta está en un lugar concreto:
| Parte | Pregunta | Dónde comprobarlo |
|---|---|---|
Acme | ¿Qué familia, licencia y revisión? | Model card (README.md), LICENSE, el hash de commit que fijes |
32B | ¿Pesos totales u otra convención del autor? | Model card; config.json |
A3B | ¿Cuántos expertos hay y cuántos por token? | config.json: num_experts o num_local_experts, num_experts_per_tok |
Instruct | ¿Qué plantilla de chat y qué formato de tool call? | chat_template en tokenizer_config.json; model card |
AWQ | ¿Qué ancho de bits, tamaño de grupo y calibración? | quantization_config en config.json; model card para los datos de calibración |
| (no está en el nombre) | ¿Admite el runtime esta arquitectura y esta cuantización? | La documentación de la versión del runtime que fijes |
El script siguiente lee config.json de dos repositorios públicos e imprime los campos de la tabla. Descarga solo el archivo de configuración, no los pesos.
import json

from huggingface_hub import hf_hub_download

def describe(repo_id: str, revision: str = "main") -> None:
    path = hf_hub_download(repo_id, "config.json", revision=revision)
    config = json.load(open(path))
    quant = config.get("quantization_config", {})
    experts = config.get("num_experts") or config.get("num_local_experts")
    print(repo_id)
    print("  architecture:", config.get("architectures"))
    print("  quantization:", quant.get("quant_method"), quant.get("bits"), quant.get("group_size"))
    print("  experts:", experts, "per token:", config.get("num_experts_per_tok"))

describe("Qwen/Qwen2.5-7B-Instruct-AWQ")  # quantization: awq 4 128; experts: None
describe("Qwen/Qwen3-30B-A3B")  # quantization: None; experts: 128 per token: 8
Conclusión
Elegir un modelo resulta menos confuso cuando las etiquetas dejan de compartir una categoría. El rol de entrenamiento indica qué comportamiento se optimizó. La arquitectura indica cómo se organiza el cómputo. Los runtimes indican qué se ejecuta con eficiencia en tu hardware, los contenedores cómo se almacenan los artefactos y la cuantización cómo se aproximaron algunos tensores.
Elige primero el checkpoint, luego el runtime y después el archivo. Conserva la procedencia exacta y deja que una única evaluación de la tarea compare los artefactos de release. Como siguiente paso, ejecuta con tus propios prompts la comparación de tres archivos de la sección sobre GGUF.
Referencias
- Plantillas de chat de Transformers - Formato de mensajes para modelos de lenguaje causales base y ajustados con instrucciones.
- Distilling the Knowledge in a Neural Network - El artículo original sobre destilación de Hinton, Vinyals y Dean.
- Switch Transformers - La arquitectura de enrutamiento disperso de expertos de Fedus, Zoph y Shazeer.
- Especificación de GGUF y guía de cuantización de llama.cpp
- Código fuente del cuantizador de llama.cpp - Las reglas de tipo por tensor de cada receta GGUF.
- Conceptos de cuantización de Hugging Face Transformers
- Artículo de GPTQ
- Artículo de AWQ
- Documentación de cuantización de vLLM
- Documentación de cuantización de SGLang
- Repositorio de Text Generation Inference - Aviso de modo de mantenimiento.