Warianty, formaty i kwantyzacja LLM z otwartymi wagami

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
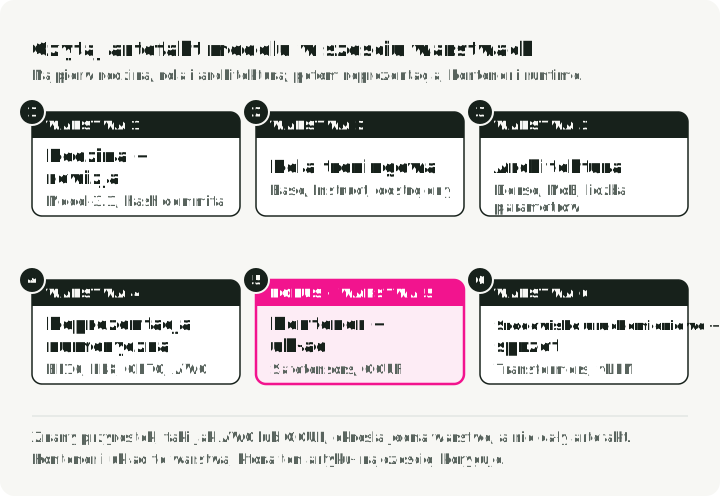
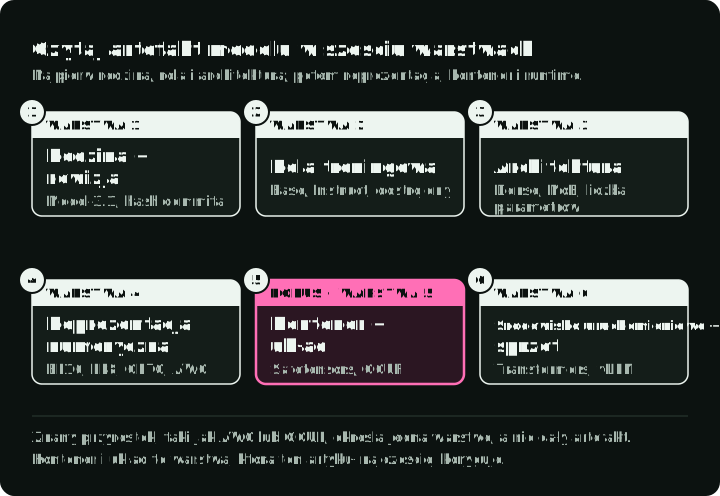
Nazwy takie jak Acme-32B-A3B-Instruct-AWQ wyglądają na zawiłe, bo łączą kilka niezależnych decyzji: rodzinę i rozmiar, architekturę, rolę treningową oraz kwantyzację. Repozytorium może udostępniać te wagi jako podzielone na części pliki Safetensors, podczas gdy konwersja tej samej wersji checkpoint przygotowana przez społeczność występuje jako Q4_K_M.gguf.
Te etykiety nie należą do jednej kategorii: GPTQ i AWQ to metody kwantyzacji, GGUF to kontener i ekosystem runtime, a MoE to architektura. Czytanie tych warstw osobno ułatwia wybór pliku do pobrania.
Ten przewodnik jest dla inżynierów, którzy wybierają model z otwartymi wagami do lokalnej inferencji lub serwowania na GPU. Nauczysz się czytać każdy element nazwy modelu, wybierać runtime i sprawdzać, czy plik mieści się w pamięci, zanim zaczniesz benchmark.
Krótszą wersję wyboru wdrożenia znajdziesz w artykule Formaty kwantyzacji LLM.
Czytaj artefakt modelu w sześciu warstwach
| Warstwa | Przykład | Na jakie pytanie odpowiada |
|---|---|---|
| Rodzina i rewizja | Model-3.1, hash commita | Jakie wagi i jaki kontrakt tokenizera? |
| Rola treningowa | Base, Instruct, dostrojone do rozumowania | Jakie zachowanie optymalizowano? |
| Architektura | Dense, MoE, parametry łączne i aktywne | Jakie jądra i układ pamięci są wymagane? |
| Reprezentacja numeryczna | BF16, FP8, GPTQ 4-bit, AWQ 4-bit | Jak tensory są zapisane lub skwantyzowane? |
| Kontener i układ | Shardy Safetensors, GGUF | Jak spakowano tensory i metadane? |
| Runtime | Transformers, vLLM, llama.cpp | Który loader i jaka ścieżka sprzętowa to wykonują? |
Poniższy rysunek dzieli dwie przykładowe nazwy na części i umieszcza każdą część pod jej warstwą. Obie nazwy podają rodzinę, rolę treningową, architekturę i reprezentację numeryczną. Tylko plik GGUF podaje swój kontener, a żadna z nazw nie podaje runtime.
Niektóre etykiety opisują, jak model był trenowany, a nie część pliku. Distill (wytrenowany, by naśladować większy model-nauczyciel) i QAT (trening z uwzględnieniem kwantyzacji) to dwie z nich. Checkpoint może być jednocześnie destylowany, dostrojony do instrukcji, dostrojony do rozumowania i typu MoE.
Etykieta „open-source” wymaga osobnego sprawdzenia. Jeśli model tylko publikuje wagi do pobrania, nie zakładaj, że jego licencja spełnia definicję open source ani że pozwala na twoje zastosowanie. Przeczytaj kartę modelu i licencję, zanim zaczniesz porównywać architektury lub benchmarki.
Role treningowe: Base, Instruct, rozumowanie, destylacja
Base
Checkpoint base jest trenowany głównie do przewidywania następnej jednostki token. Przydaje się do dalszego pretreningu, kontrolowanych badań lub adaptacji, w której chcesz sam ukształtować zachowanie wobec instrukcji. Może dokończyć prompt zamiast na niego odpowiedzieć. Zapytany „Jaka jest stolica Francji?”, może ciągnąć dalej: „Jaka jest stolica Niemiec?”, bo prompt wygląda jak początek listy pytań.
Nie zakładaj, że każdy fine-tuning powinien zaczynać się od base. Checkpoint instruct bywa lepszą inicjalizacją, gdy jego obecne zachowanie pasuje do celu. Potwierdź ewaluacją, że to zachowanie nie przeszkadza w nowym celu.
Instruct lub chat
Takie warianty checkpoint przechodzą posttrening, który ma poprawić wykonywanie instrukcji i prowadzenie rozmowy. Dokładna receptura może obejmować nadzorowany fine-tuning, optymalizację preferencji, uczenie ze wzmocnieniem, destylację lub ich kombinację. Niekoniecznie jest to nadzorowany fine-tuning, po którym następuje RLHF.
Użyj wariantu checkpoint instruct jako pierwszego punktu odniesienia dla asystenta. Potwierdź jego szablon czatu, obsługiwany format wywołań narzędzi, zachowanie wobec komunikatu systemowego i charakter odmów. Dokumentacja szablonów czatu w Transformers wyjaśnia, dlaczego dokładny format wiadomości ma znaczenie. Sama nazwa „Instruct” nie gwarantuje niezawodnego JSON ani korzystania z narzędzi.
Dostrojone do rozumowania
Warianty checkpoint zorientowane na rozumowanie są optymalizowane na zadaniach lub trajektoriach, które nagradzają wieloetapowe rozwiązywanie problemów. Niektóre udostępniają tekst rozumowania, inne oddzielają go przez parser po stronie serwowania, a jeszcze inne pokazują tylko odpowiedź. Dłuższa generacja nie gwarantuje wiernego rozumowania ani mniejszej liczby halucynacji.
Wybierz taki checkpoint, gdy poprawia wyniki na trudnych wycinkach ewaluacji po uwzględnieniu jednostek token na wyjściu, opóźnienia i weryfikacji. Rutynowa ekstrakcja lub klasyfikacja może przez to działać wolniej, a nie lepiej.
Destylowane
Destylacja przenosi zachowanie nauczyciela lub dane wygenerowane przez nauczyciela do innego modelu. Uczeń może być mniejszy, tej samej wielkości lub zbudowany inaczej. Nie istnieje stabilna reguła „70–80% jakości przy połowie rozmiaru”: zachowana jakość zależy od nauczyciela, danych, celu, pojemności ucznia i ewaluacji. Oryginalna praca o destylacji wiedzy Hintona, Vinyalsa i Deana również nie podaje stałego stosunku jakości.
Traktuj Distill jako informację o pochodzeniu treningu, a potem porównaj taki checkpoint w benchmarku jak każdy inny.
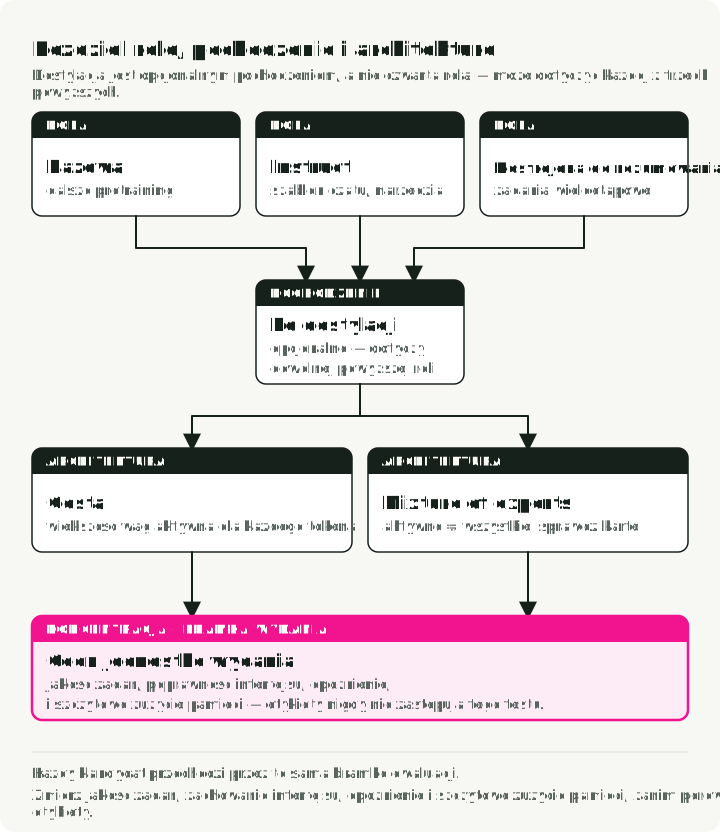
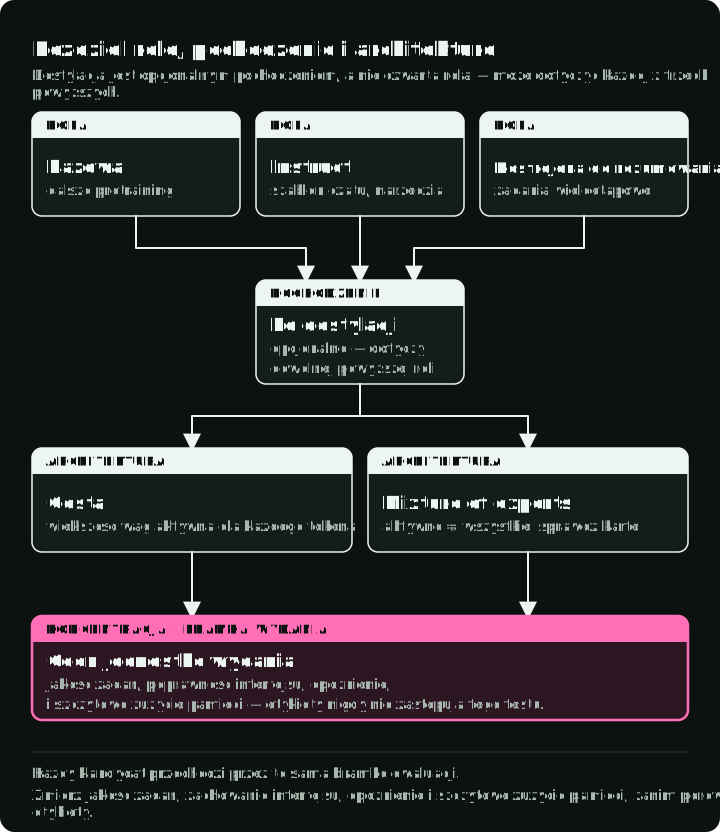
Poniższy rysunek wysyła jeden prompt do wszystkich trzech ról i pokazuje, co każda z nich zwraca, do czego ją wybierasz i ile kosztuje. Etykiety pochodzenia, takie jak Distill i QAT, mogą dotyczyć każdej z nich.
Modele dense i MoE
Rola treningowa mówi, jakie zachowanie ma checkpoint. Architektura mówi, jak zorganizowano wagi, co decyduje o pamięci i obsłudze w runtime.
Modele dense
Większość parametrów uczestniczy w przebiegu w przód dla każdej jednostki token. Liczba parametrów z grubsza wskazuje rozmiar wag. Pamięć w czasie działania obejmuje też KV cache, aktywacje lub przestrzeń roboczą, narzut alokatora, a czasem zduplikowany lub podzielony stan.
Mixture of Experts
Warstwa MoE kieruje każdy token do podzbioru ekspertów, czyli sieci feed-forward. Praca o Switch Transformer opisuje jeden z takich wariantów routingu, a inne rodziny kierują jednostki token inaczej. Nazwy takie jak A3B zwykle oznaczają około trzech miliardów parametrów aktywnych na token, ale konwencje nazewnicze zależą od rodziny. Przeczytaj kartę modelu, by poznać parametry łączne, parametry aktywne, liczbę ekspertów i sposób routingu.
Liczba parametrów aktywnych opisuje obliczenia na ścieżce routingu, a nie rozmieszczenie wag. Na przykład expert parallelism w vLLM dzieli warstwy ekspertów między rangi expert-parallel i wylicza przydział ekspertów dla każdej rangi z łącznej liczby ekspertów. Inne runtime mogą rozmieszczać lub odciążać wagi inaczej. Model z 30B parametrów łącznie i 3B aktywnych nie mieści się więc automatycznie tak jak model dense 3B.
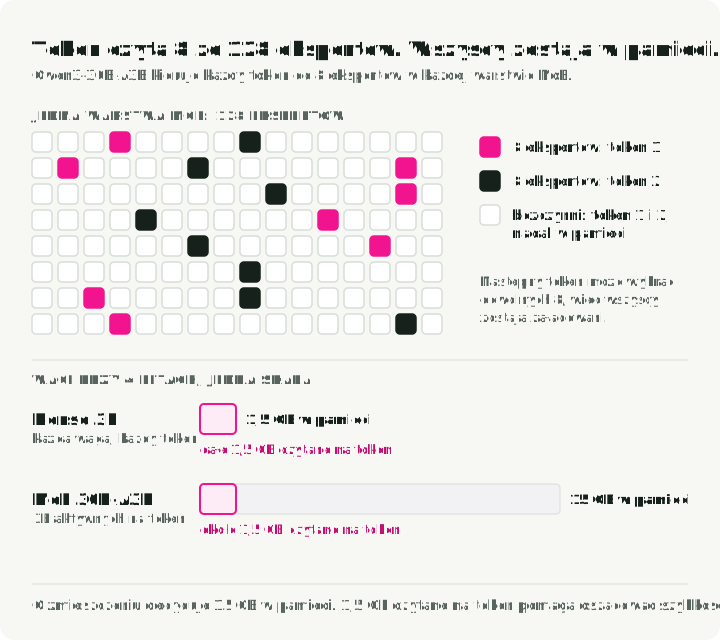
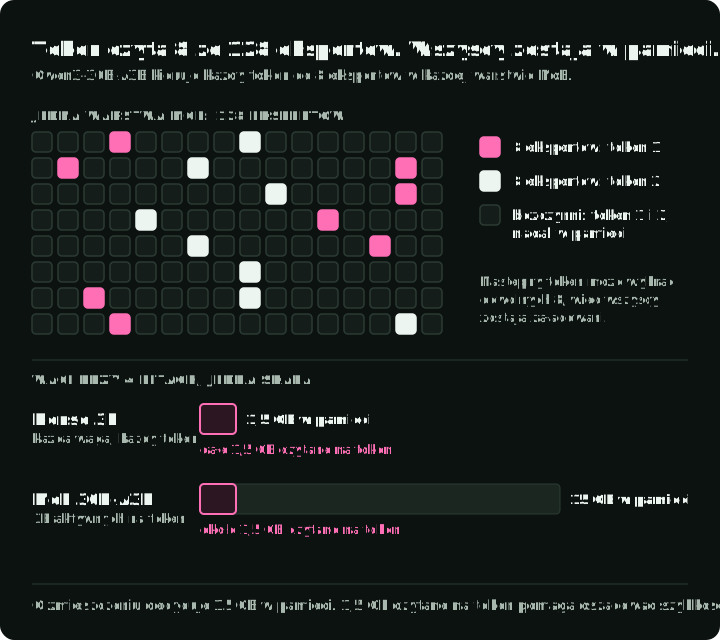
Poniższy rysunek pokazuje jedną warstwę MoE modelu Qwen3-30B-A3B: każdy token używa 8 ze swoich 128 ekspertów, a następny token może użyć dowolnych innych 8, więc wszyscy muszą zostać w pamięci. Słupki pokazują model dense 3B i model 30B-A3B na jednej skali przy 4 bitach. Model MoE przechowuje dziesięć razy więcej wag, ale na każdy token odczytuje tylko 3B aktywnych parametrów, czyli około 1,5 GB.
Obsługa w runtime również zależy od architektury. Przed pobraniem potwierdź implementację modelu, obsługę expert parallelism lub tensor parallelism, jądra kwantyzacji i maksymalny kontekst.
Kontenery i metody kwantyzacji
Architektura określa, jakie tensory istnieją. Kontener decyduje, jak te tensory są zapisane na dysku, a metoda kwantyzacji decyduje, ile bitów zajmuje każdy z nich.
Safetensors
Safetensors to bezpieczny format serializacji tensorów, powszechnie używany w repozytoriach Hugging Face. Model może mieć wiele shardów .safetensors oraz pliki konfiguracji, tokenizera i generacji. Te tensory mogą być w BF16/FP16 albo wstępnie skwantyzowane metodą taką jak GPTQ lub AWQ. Transformers odczytuje metodę z wpisu quantization_config i ładuje odpowiedni backend, co opisuje jego przepływ pracy kwantyzacji.
Samo rozszerzenie nie mówi o precyzji ani zgodności z runtime. Sprawdź config.json, konfigurację kwantyzacji, kartę modelu, dtype tensorów i dokumentację runtime. Krótki skrypt, który to robi, jest w rozdziale „Przykład z nazwą modelu” poniżej.
GGUF
GGUF pakuje tensory i metadane dla ekosystemu ggml/llama.cpp. llama.cpp ładuje GGUF i obsługuje backendy, w tym Metal, CUDA, HIP, Vulkan i ścieżki CPU. O zgodności nadal decydują architektura modelu i jakość konwersji.
GGUF to kontener. Może przechowywać tensory o wysokiej precyzji lub skwantyzowane. Modele multimodalne mogą też potrzebować osobnego pliku projektora lub enkodera. Zdanie „jeden plik GGUF zawiera wszystko” nie jest regułą uniwersalną.
GPTQ i AWQ
GPTQ i AWQ to metody kwantyzacji wag po treningu, a nie rozszerzenia plików. Ich artefakty zwykle używają Safetensors oraz konfiguracji specyficznej dla metody. Silniki serwujące potrzebują jąder zgodnych z metodą, liczbą bitów, rozmiarem grupy, architekturą modelu i sprzętem.
Żadna z tych metod nie jest uniwersalnym zwycięzcą jakości. Liczą się dane kalibracyjne, implementacja, ścieżka jąder i zadanie. Obsługa w runtime się zmienia, więc sprawdź dokładny artefakt na wersji, którą przypinasz. Przy tej decyzji miej obok oficjalne strony kwantyzacji w Transformers i kwantyzacji w vLLM.
FP8 i QAT
W nazwach repozytoriów pojawiają się jeszcze dwie etykiety. FP8 to format liczbowy, a nie metoda kwantyzacji: każda waga jest zapisana jako 8-bitowa liczba zmiennoprzecinkowa. Działa szybko tylko wtedy, gdy GPU i runtime go obsługują. Na przykład vLLM uruchamia wagi i aktywacje FP8 na GPU NVIDIA Ada, Hopper i Blackwell, a na Turing i Ampere przechodzi na FP8 tylko dla wag. Zanim wybierzesz repozytorium z -FP8, sprawdź tabelę sprzętu w dokumentacji runtime.
Checkpoint QAT (trening z uwzględnieniem kwantyzacji) wytrenowano tak, by tolerował docelowy schemat niskobitowy, na przykład plik GGUF -qat-q4_0. Zacznij od formatu przewidzianego przez wydawcę. Zmiana schematu kwantyzacji może zmniejszyć korzyści z QAT; ponownie oceń przekonwertowany artefakt. Przewodnik po kwantyzacji modeli szerzej omawia PTQ i QAT oraz formaty liczbowe.
Runtime i kiedy którego używać
Runtime to program, który ładuje plik i uruchamia go na twoim sprzęcie. Każdy runtime ładuje ustalony zestaw typów plików, więc wybór runtime decyduje też o tym, jaki plik pobierzesz.
| Runtime | Pliki, które ładuje | Sprzęt | Użyj, gdy |
|---|---|---|---|
llama.cpp | GGUF | CPU, Metal, CUDA, HIP, Vulkan | Chcesz bezpośrednio kontrolować lokalną inferencję lub celujesz w mały albo nietypowy sprzęt |
| Ollama | GGUF; obsługiwane importy Safetensors (ścieżka MLX jest w wersji podglądowej na Apple Silicon) | macOS, Linux, Windows | Chcesz zarządzanej usługi lokalnej z API HTTP na laptopie lub stacji roboczej |
| LM Studio | GGUF; MLX na Apple Silicon | macOS, Windows, Linux | Chcesz GUI do przeglądania, pobierania i wypróbowywania modeli |
| MLX-LM | Safetensors skonwertowane dla MLX, frameworka tablicowego Apple | Apple Silicon | Pracujesz w Pythonie na Macu, także gdy wykonujesz fine-tuning LoRA |
| vLLM, SGLang | Safetensors w BF16, FP8, AWQ, GPTQ i innych metodach | GPU NVIDIA i AMD, inne akceleratory | Obsługujesz wielu użytkowników i potrzebujesz batchingu, przepustowości oraz API w stylu OpenAI |
| Hugging Face Transformers | Safetensors, z quantization_config po kwantyzacji | CPU i GPU | Prowadzisz badania, fine-tuning lub serwujesz przy umiarkowanym obciążeniu; do produkcji na dużą skalę użyj vLLM lub SGLang |
Text Generation Inference (TGI) nie jest już wyborem dla nowych wdrożeń. Hugging Face przeniosło go w tryb utrzymania, następnie zarchiwizowało repozytorium i kieruje użytkowników do vLLM i SGLang. Więcej o narzędziach na laptopa znajdziesz w artykule Lokalne LLM na macOS.
Szacowanie pamięci
Gdy znasz już runtime i typ pliku, kolejne pytanie brzmi, czy plik się zmieści. Dla parametrów wag przy bitach surowy rozmiar wag wynosi w przybliżeniu:
Model 13B z nominalnie czterobitowymi wagami zaczyna więc od około 6,5 GB. Ten sam model w BF16 potrzebuje około 26 GB, a model 70B w BF16 około 140 GB. Wartość 6,5 GB to dolna granica: model niekoniecznie uruchomi się w 6,5 GB. Pamięć dodają skale, punkty zerowe, tensory o wyższej precyzji, embeddings, metadane, bufory runtime, KV cache i fragmentacja.
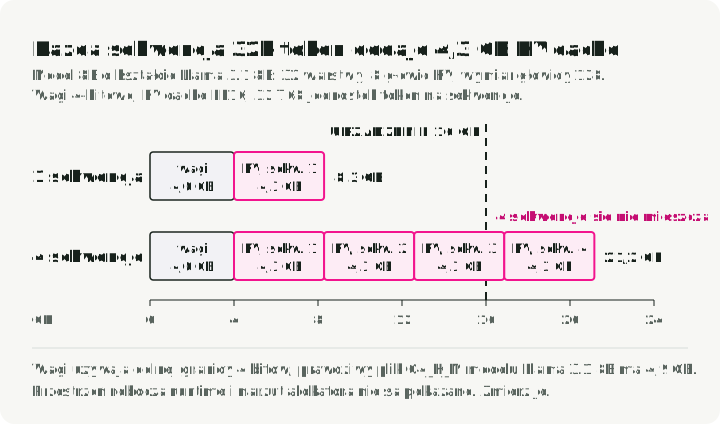
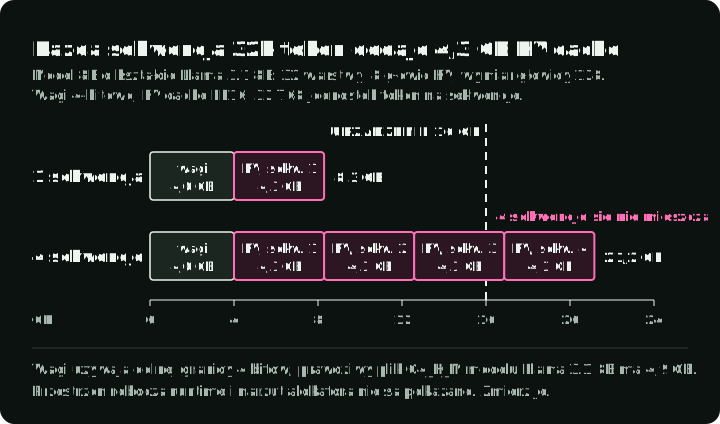
KV cache często decyduje o różnicy między „ładuje się” a „serwuje”. W Transformerze z pełną uwagą i konwencjonalnym cache K/V przechowuje klucze i wartości uwagi dla każdej jednostki token w kontekście, więc rośnie z długością kontekstu i z liczbą sekwencji obsługiwanych naraz. Model 8B z 32 warstwami, 8 głowicami KV i wymiarem głowicy 128 (kształt Llama 3.1 8B) zajmuje około 4,3 GB KV cache w FP16 dla jednej sekwencji 32 768 jednostek token: 2 × 32 × 8 × 128 × 32 768 × 2 bajty. Przy 4 bitach jego wagi mają około 4 GB. Poniższy wykres dodaje te dwie wartości i pokazuje, że cztery takie sekwencje nie mieszczą się już na urządzeniu z 16 GB.
Poniższa funkcja szacuje surowe wagi i konwencjonalny cache K/V dla pełnej uwagi, jak w Llama 3.1. Liczbę warstw, liczbę głowic KV i wymiar głowicy weź z config.json modelu. Warstwy uwagi z oknem przesuwnym lub podziałem na fragmenty przestają powiększać cache po osiągnięciu rozmiaru okna lub fragmentu. Architektury hybrydowe lub z kompresją cache również wymagają obliczenia cache właściwego dla ich runtime.
def estimate_gb(params_b, bits, layers, kv_heads, head_dim, context, batch=1, kv_bytes=2):
    """Raw weights and conventional full-attention K/V cache, in GB (10**9 bytes)."""
    weights = params_b * 1e9 * bits / 8
    # Keys and values (2) for every layer, KV head, position, and sequence.
    kv_cache = 2 * layers * kv_heads * head_dim * context * batch * kv_bytes
    return round(weights / 1e9, 1), round(kv_cache / 1e9, 1)

# An 8B model shaped like Llama 3.1 8B, 4-bit weights, FP16 KV cache.
print(estimate_gb(8, 4, 32, 8, 128, 32_768))  # (4.0, 4.3)
print(estimate_gb(8, 4, 32, 8, 128, 32_768, batch=4))  # (4.0, 17.2)
To szacunki surowych wag i cache, a nie pełny budżet runtime. Prawdziwy GGUF Q4_K_M modelu Llama 3.1 8B ma 4,9 GB, a nie 4,0 GB, bo część tensorów zachowuje więcej bitów. Do tego dochodzi przestrzeń robocza runtime. Zmierz szczytowe zużycie pamięci przy rzeczywistej maksymalnej sekwencji, polityce batchowania, typie danych cache i równoległości. Rozdział o pamięci serwowania w przewodniku po kwantyzacji omawia pełny wzór, w tym kwantyzację KV cache.
Kwantyzacja może zmniejszyć pamięć, a czasem poprawić szybkość, ale jądra niskobitowe bywają też wolniejsze na nieobsługiwanym sprzęcie. Porównuj jakość na zadaniu i przepustowość od końca do końca, a nie sam rozmiar pliku.
Nazwy kwantyzacji GGUF
Repozytorium GGUF zwykle oferuje jeden plik na poziom kwantyzacji: Q3_K_M, Q4_K_M, Q5_K_M, Q6_K, Q8_0, IQ4_XS i inne. Nazwa mówi, jaki jest główny typ i jaka mieszanka:
Q4to liczba bitów używana dla większości tensorów.Kto schemat bloków K-quant.S,MiLoznaczają małą, średnią i dużą mieszankę. Większa mieszanka trzyma więcej tensorów w typie o wyższej precyzji. WQ4_K_Mkwantyzator przenosi wagi wartości uwagi (attn_v) i wyjścia sieci feed-forward (ffn_down) doQ6_Kmniej więcej w połowie warstw.Q4_K_Spodnosi ich mniej i tylko doQ5_K.Q8_0to prosty typ 8-bitowy używany dla niemal każdej macierzy wag.- Nazwy
IQ, takie jakIQ4_XS, to i-quanty. Zwykle opierają się na macierzy ważności, która zapisuje, które wagi są najważniejsze na przykładowym tekście.
Poniższa siatka pokazuje każdy tensor prawdziwego pliku według typu. Spośród 147 tensorów w Llama-3.2-1B-Instruct-Q4_K_M.gguf 96 to Q4_K, 17 to Q6_K, a 34 to nieskwantyzowane tensory F32, głównie normy. Spójrz na wiersze attn_v i ffn_down, aby zobaczyć, które bloki dostają Q6_K.
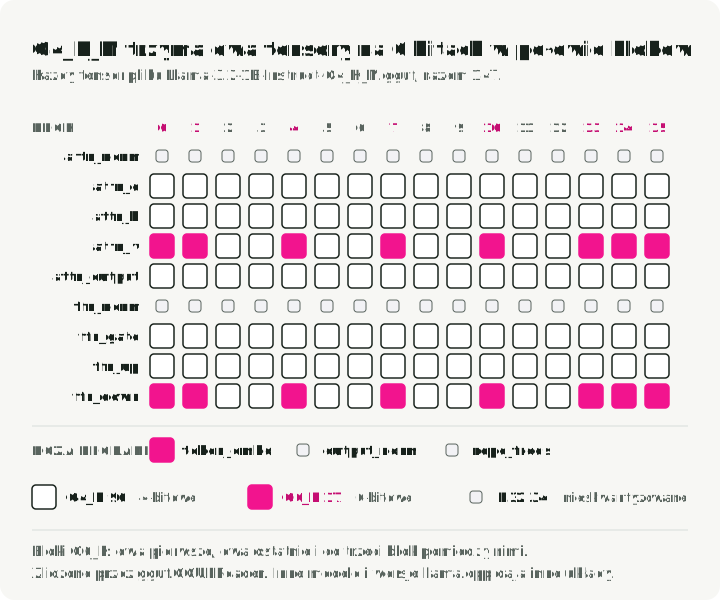
Aby sprawdzić plik samodzielnie, pobierz jeden poziom kwantyzacji i policz typy tensorów za pomocą pakietu gguf z projektu llama.cpp:
hf download bartowski/Llama-3.2-1B-Instruct-GGUF Llama-3.2-1B-Instruct-Q4_K_M.gguf --local-dir .from collections import Counter
from gguf import GGUFReader
reader = GGUFReader("Llama-3.2-1B-Instruct-Q4_K_M.gguf")
print(Counter(t.tensor_type.name for t in reader.tensors))
# Counter({'Q4_K': 96, 'F32': 34, 'Q6_K': 17})
for t in reader.tensors:
if t.tensor_type.name == "Q6_K":
print(t.name) # token_embd.weight, blk.0.attn_v.weight, blk.0.ffn_down.weight, ...Mieszanki różnią się zależnie od architektury i wersji llama.cpp, więc traktuj sufiks jako nazwę receptury llama.cpp, a nie przenośną specyfikację liczby bitów. Aktualną listę znajdziesz w przewodniku po kwantyzacji llama.cpp.
Traktuj je jako punkty startowe, a nie odpowiedzi:
Q4_K_Mto częsta pierwsza próba.Q5_K_MlubQ6_K, gdy pamięć pozwala.Q3_K_Mlub plikIQ3tylko po to, by zmieścić większy model, i tylko po sprawdzeniu jakości.
Unikaj uniwersalnych twierdzeń, że Q4_K_M jest nie do odróżnienia od BF16 albo że większy model Q3 zawsze pokona mniejszy model Q8. Dla konkretnej wersji checkpoint użyj krótkiego porównania:
- artefakt o wysokiej precyzji lub zaufany artefakt referencyjny
- jeden kandydat blisko limitu pamięci
- jeden mniejszy kandydat z większym zapasem
Uruchom na wszystkich trzech te same teksty prompt, kontrole ustrukturyzowanych danych wyjściowych, przypadki z długim kontekstem i test opóźnienia.
Przepływ wyboru
Każdy z powyższych rozdziałów dotyczy jednej warstwy. Przepływ układa je w kolejności, a zmiana dowolnego wejścia wysyła cię z powrotem przez te kroki.
1. Ustal kontrakt zadania
Określ język, modalność, długość kontekstu, interfejs narzędzi lub schematu, ograniczenia bezpieczeństwa, wymagania licencyjne i wycinki ewaluacji. Porównuj warianty checkpoint w reprezentacji na tyle dokładnej, by kwantyzacja nie rozstrzygała pierwszej rundy.
2. Wybierz checkpoint
Wybierz najmniejszy checkpoint, który przechodzi twoje kontrole jakości i zachowania. Zapisz dokładne repozytorium i rewizję, tokenizer, szablon czatu oraz wymagany parser rozumowania.
3. Wybierz runtime
Wybierz runtime z tabeli runtime. Potem sprawdź dla dokładnego artefaktu obsługę architektury, backend sprzętowy, równoległość, jądra kwantyzacji, ustrukturyzowane dane wyjściowe i adaptery.
4. Ustal zmierzony budżet pamięci
Uwzględnij wagi, KV cache, przestrzeń roboczą runtime, oczekiwaną współbieżność i zapas na system operacyjny lub procesy działające obok. Plik mieszczący się w RAM lub VRAM to warunek konieczny, ale niewystarczający.
5. Wybierz i zwaliduj reprezentację
Preferuj artefakty od wydawcy z udokumentowaną kalibracją i pochodzeniem. Jeśli używasz konwersji społeczności, zapisz rewizję źródła, rewizję konwertera, recepturę kwantyzacji, dane kalibracyjne lub dane ważności oraz hashe.
6. Zmierz jednostkę wydania w benchmarku
Zmierz jakość na zadaniu, poprawność schematu i wywołań narzędzi, czas do pierwszej jednostki token, przepustowość wyjścia, szczytowe zużycie pamięci i awarie przy docelowym kontekście i współbieżności. Powtórz po zmianie dowolnej wersji checkpoint, runtime, jądra lub ustawienia kwantyzacji.
Punkty startowe dla typowych konfiguracji
To pierwsi kandydaci do benchmarku w opisanym wyżej przepływie, a nie ostateczne odpowiedzi.
| Konfiguracja | Pierwszy kandydat | Sprawdź, zanim się zdecydujesz |
|---|---|---|
| Asystent czatu na MacBooku z 16 GB | Instruct 7B–8B, GGUF Q4_K_M, w Ollama lub LM Studio | Szczytowa pamięć przy twojej długości kontekstu zostawia miejsce dla systemu i innych aplikacji |
| Usługa RAG na jednym GPU z 24 GB | Instruct 7B–14B, Safetensors AWQ lub FP8, na vLLM | Wagi plus KV cache przy twojej współbieżności mieszczą się w 24 GB |
| Fine-tuning domenowy na GPU w chmurze | Checkpoint base lub instruct w Safetensors BF16, z Transformers | Czy zachowanie instruct pomaga, czy przeszkadza w twoim celu treningowym |
| API dla wielu użytkowników | Instruct w BF16, FP8 lub AWQ, na vLLM lub SGLang | Przepustowość i czas do pierwszej jednostki token przy docelowej współbieżności |
Przykład z nazwą modelu
Załóżmy, że repozytorium nazywa się Acme-32B-A3B-Instruct-AWQ. Każdy element budzi pytanie, a każda odpowiedź leży w konkretnym miejscu:
| Element | Pytanie | Gdzie sprawdzić |
|---|---|---|
Acme | Jaka rodzina, licencja i rewizja? | Karta modelu (README.md), LICENSE, hash commita, który przypinasz |
32B | Wagi łączne czy inna konwencja wydawcy? | Karta modelu; config.json |
A3B | Ilu jest ekspertów i ilu na token? | config.json: num_experts lub num_local_experts, num_experts_per_tok |
Instruct | Jaki szablon czatu i format wywołań narzędzi? | chat_template w tokenizer_config.json; karta modelu |
AWQ | Ile bitów, jaki rozmiar grupy i jaka kalibracja? | quantization_config w config.json; karta modelu dla danych kalibracyjnych |
| (nie ma w nazwie) | Czy runtime obsługuje tę architekturę i kwantyzację? | Dokumentacja wersji runtime, którą przypinasz |
Poniższy skrypt czyta config.json dla dwóch publicznych repozytoriów i drukuje pola z tabeli. Pobiera tylko plik konfiguracji, a nie wagi.
import json

from huggingface_hub import hf_hub_download

def describe(repo_id: str, revision: str = "main") -> None:
    path = hf_hub_download(repo_id, "config.json", revision=revision)
    config = json.load(open(path))
    quant = config.get("quantization_config", {})
    experts = config.get("num_experts") or config.get("num_local_experts")
    print(repo_id)
    print("  architecture:", config.get("architectures"))
    print("  quantization:", quant.get("quant_method"), quant.get("bits"), quant.get("group_size"))
    print("  experts:", experts, "per token:", config.get("num_experts_per_tok"))

describe("Qwen/Qwen2.5-7B-Instruct-AWQ")  # quantization: awq 4 128; experts: None
describe("Qwen/Qwen3-30B-A3B")  # quantization: None; experts: 128 per token: 8
Podsumowanie
Wybór modelu staje się mniej mylący, gdy przestajesz traktować etykiety jak jedną kategorię. Rola treningowa mówi, jakie zachowanie optymalizowano. Architektura mówi, jak zorganizowano obliczenia. Runtime mówi, co wykonuje się wydajnie na twoim sprzęcie, kontener, jak przechowywane są tensory, a kwantyzacja, jak część tensorów przybliżono.
Wybierz najpierw checkpoint, potem runtime, a na końcu plik. Zachowaj dokładne informacje o pochodzeniu i pozwól jednej ewaluacji zadania porównać artefakty wydania. Jako następny krok uruchom na własnych tekstach prompt porównanie trzech plików z rozdziału o GGUF.
Źródła
- Szablony czatu w Transformers - Formatowanie wiadomości dla bazowych i dostrojonych do instrukcji przyczynowych modeli językowych.
- Distilling the Knowledge in a Neural Network - Oryginalna praca o destylacji autorstwa Hintona, Vinyalsa i Deana.
- Switch Transformers - Architektura rzadkiego routingu ekspertów autorstwa Fedusa, Zopha i Shazeera.
- Specyfikacja GGUF i Przewodnik po kwantyzacji llama.cpp
- Kod źródłowy kwantyzatora llama.cpp - Reguły typów tensorów dla każdej receptury GGUF.
- Pojęcia kwantyzacji w Hugging Face Transformers
- Praca o GPTQ
- Praca o AWQ
- Dokumentacja kwantyzacji vLLM
- Dokumentacja kwantyzacji SGLang
- Repozytorium Text Generation Inference - Informacja o trybie utrzymania.