LLM Fine-Tuning Guide: Wann Fine-Tuning, LoRA und QLoRA

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Dieser Guide richtet sich an Python Engineers, die entscheiden müssen, ob und wie sie ein Large Language Model fine-tunen. Sie erfahren, wann Sie Fine-Tuning dem Prompting oder Retrieval vorziehen und wie Sie zwischen Methoden wie LoRA und QLoRA wählen. Außerdem erklärt der Guide, wie Sie Daten vorbereiten, das trainierte Model evaluieren und sein Deployment planen.
Der praktische Teil führt ein Begleit-Repository aus, das ein 4B-Model für Function Calling fine-tunt.
Einen kürzeren Vergleich von Fine-Tuning, RAG und Prompting finden Sie unter Fine-Tuning vs RAG vs Prompting.
Sollten Sie überhaupt fine-tunen?
Bevor Sie GPU-Stunden ausgeben, klären Sie, ob Fine-Tuning das richtige Werkzeug für Ihr Problem ist. Die Abbildung folgt einer Anfrage und zeigt, wo jeder der vier Fixes ansetzt, bei welchem Fehler Sie ihn zuerst testen sollten und was er nicht beheben kann.
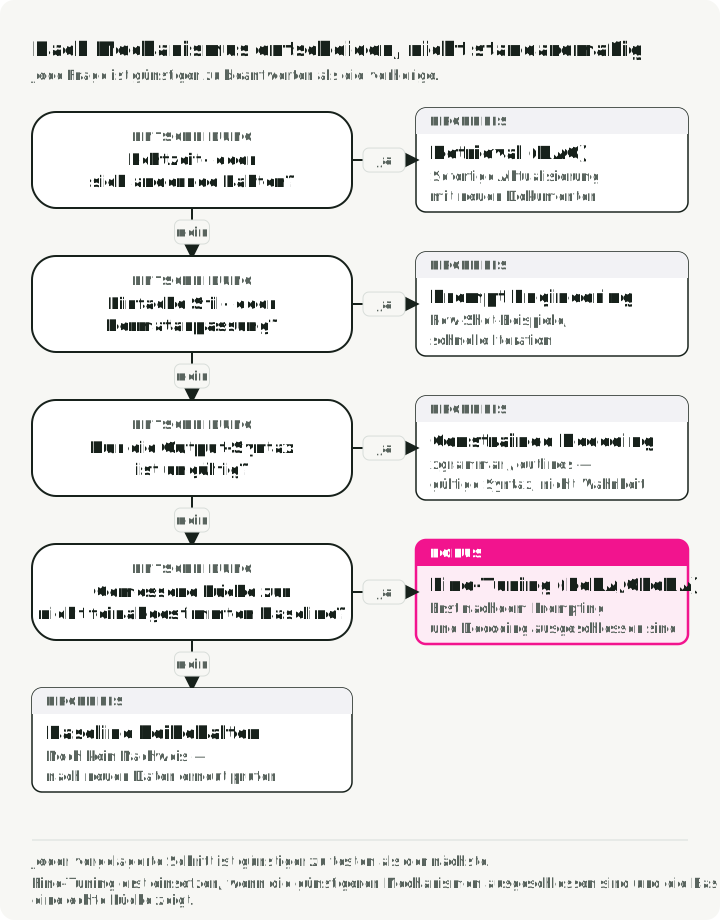
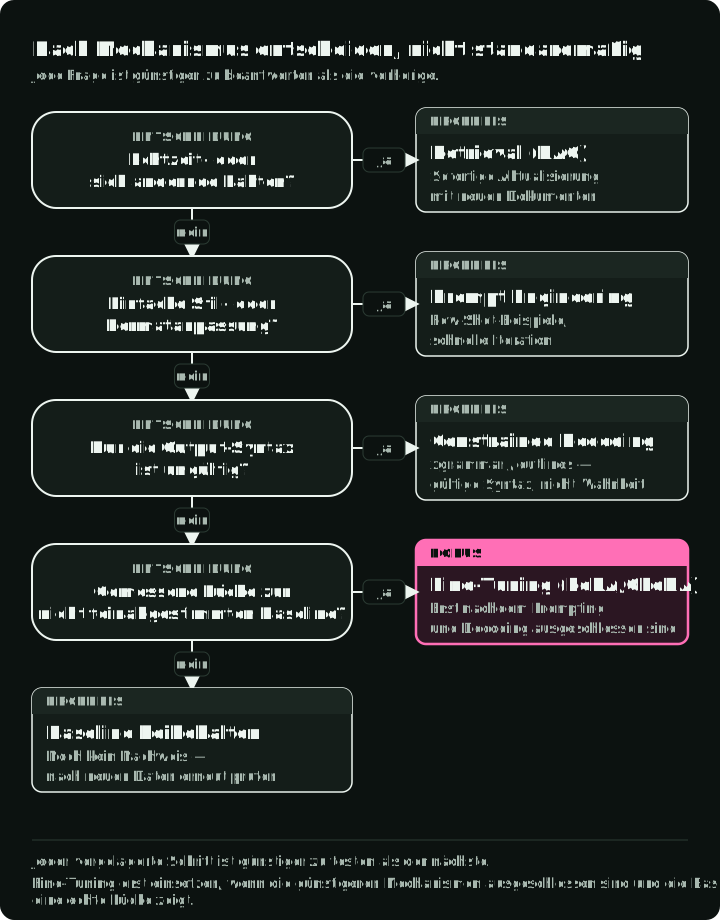
Fine-Tuning verändert Verhalten, das in den Weights kodiert ist. Retrieval liefert Belege erst zur Inference-Zeit und ist deshalb der bessere Startpunkt für Fakten, die sich ändern oder Quellenangaben brauchen. Neue Dokumente sind erst nach Ingestion und Indexierung verfügbar; prüfen Sie diese Aktualität gegen Ihre Anforderung.
Klare Prompts und Beispiele lassen sich günstiger iterieren als ein neuer Trainingslauf. Sie lösen ein Stil- oder Instruction-Following-Problem unter Umständen schon. Fine-Tuning kann wiederholte Prompt-Tokens einsparen, aber die Serving-Latency hängt von Model, Ausgabelänge, Hardware und Implementierung ab; ein Weight-Update ist für sich genommen keine Beschleunigung.
Für die Syntax maskieren Bibliotheken wie xgrammar und outlines ungültige nächste Tokens unter einem unterstützten Schema oder einer Grammatik. Eine erfolgreich abgeschlossene Constrained Generation gehört zu dieser Sprache. Behandeln Sie Abbrüche und andere unvollständige Generierungen separat und validieren Sie das Ergebnis, bevor Sie es verwenden. Die Constraint kann eine Kunden-ID nicht wahr machen und eine Tool-Auswahl nicht angemessen. Messen Sie ihre Latency auf Ihrem Backend, statt einen festen Overhead anzunehmen.
Jede der vier Optionen verändert einen anderen Schritt derselben Anfrage. Nur Fine-Tuning braucht einen Trainingslauf und ein neues Model-Artefakt; die anderen drei ändern Text, Dokumente oder ein Schema rund um dieselben Weights. Die Tabelle vergleicht die vier Optionen nebeneinander:
| Option | Was sie verändert | Wie Sie sie aktualisieren | Setup-Aufwand | Was sie nicht beheben kann |
|---|---|---|---|---|
| Prompting | Instructions und Beispiele | Den Text bearbeiten | Niedrig: Prompts schreiben und testen | Verhalten, das das Model aus Instructions nicht umsetzen kann |
| RAG | Belege im Context Window | Dokumente ingestieren und neu indexieren | Mittel: Index, Retriever und Evaluation | Ein Model, das die Belege ignoriert oder falsch liest |
| Constrained Decoding | Welche Tokens der Decoder ausgeben darf | Schema oder Grammatik ändern | Niedrig bis mittel: Schema und Backend-Unterstützung | Falsche Werte innerhalb einer gültigen Struktur |
| Fine-Tuning | Model Weights | Ein neues Artefakt trainieren und evaluieren | Hoch: Datenkuratierung, GPU-Zeit, Evaluation | Fakten, die sich nach dem Training ändern |
Kurzreferenz: Probleme passenden Lösungen zuordnen
| Herausforderung | Erster Mechanismus zum Testen | Warum? |
|---|---|---|
| Fehlendes Wissen | RAG | Liefert belegte Evidenz; die Aktualität hängt von Ingestion und Indexierung ab |
| Falsches Format/falscher Ton | Prompt Engineering | Moderne Models befolgen Stilvorgaben über Few-Shot-Beispiele gut |
| Ungültige Ausgabesyntax | Constrained Decoding | Erzwingt während der Generierung ein unterstütztes Schema oder eine Grammatik |
| Wiederholtes Task-Versagen | Fine-Tuning (SFT) | Lernt aus kuratierten Input/Output-Beispielen |
| Abweichende Paarpräferenz | Preference Optimization | Nutzt Chosen/Rejected-Beispiele, sobald das Task-Verhalten messbar ist |
| Latency/Kosten im großen Maßstab | Distillation (SFT) | Trainiert ein kleineres Student-Model auf den Ausgaben eines größeren Teachers |
| Model-Größe reduzieren | Post-Training Quantization | Post-Training Quantization senkt den Weight-Speicher; die Geschwindigkeit hängt von unterstützten Kernels und Workload ab |
Den Business Case messbar machen
Fine-Tuning kann wiederkehrende Prompt-Tokens senken oder es einem kleineren Model ermöglichen, das Ziel zu erreichen, aber keine der beiden Einsparungen ist automatisch. Berechnen Sie den Break-even-Punkt mit Ihrem eigenen Traffic und Ihren eigenen Preisen:
Ist der Nenner klein, negativ oder beruht er auf einer unbewiesenen Qualitätsannahme, gibt es noch keinen wirtschaftlichen Grund für das Projekt.
Ein Rechenbeispiel mit illustrativen Zahlen: Eine Prompting-Baseline sendet mit jeder Anfrage etwa 2.000 Tokens an Instructions und Beispielen. Nach dem Tuning braucht dieselbe Aufgabe etwa 50. Bei angenommenen $0.50 pro Million Input-Tokens für beide Models beträgt die Ersparnis 1.950 Tokens oder etwa $0.001 pro Anfrage. Kosten Training, Evaluation und Deployment $3,000, liegt der Break-even-Punkt bei etwa 3,1 Millionen Anfragen. Bei 100.000 Anfragen pro Tag sind das etwa ein Monat. Bei 5.000 Anfragen pro Tag sind es mehr als ein Jahr. Die Rechnung gilt nur, wenn das getunte Model dieselben Qualitätsschwellen erreicht wie die Baseline.
Das Hybrid-Setup. Eine gängige Architektur ist ein auf die Aufgabe angepasstes kleineres Model plus Retrieval für sich ändernde Fakten. Behandeln Sie das größere Prompting-Model als Baseline und behalten Sie das kleinere Model nur, wenn es dieselben aufgabenspezifischen Qualitäts- und Sicherheitsschwellen erfüllt.
Arten von Fine-Tuning
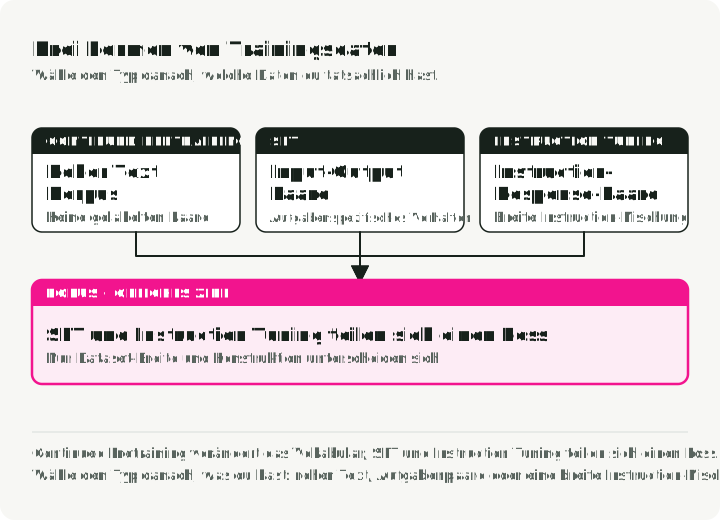
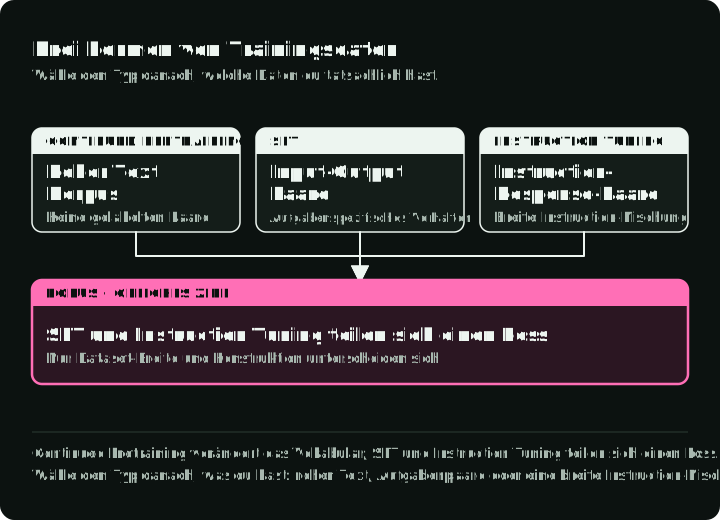
Fine-Tuning gibt es in drei Hauptformen. Sie unterscheiden sich darin, welche Daten sie brauchen und was sie dem Model beibringen. Das Diagramm zeigt für jeden Typ eine Trainingszeile.
1. Continued Pre-Training (Self-Supervised)
Sie trainieren das Base Model mit weiterem Rohtext und nehmen dabei das jeweils nächste Token einer Sequenz als Trainingsziel. Das ist Self-Supervised Learning: Der Text liefert seine Ziele selbst, genau wie im ursprünglichen Pre-Training-Lauf.
Wann Sie es einsetzen:
- Die Domäne hat Vokabular, das das Base Model nie gesehen hat (Medizin, Recht, interne Codebasen).
- Sie haben viel Domänentext, aber keine gelabelten (Input, Output)-Paare.
- Das Base Model scheitert an domänenspezifischer Terminologie.
Beispiel: Training mit Millionen klinischer Notizen, damit das Model medizinische Abkürzungen, Wirkstoffnamen und klinische Abläufe lernt.
2. Supervised Fine-Tuning (SFT)
SFT trainiert mit gelabelten (Input, Output)-Paaren. Sie zeigen dem Model für jeden Input genau die Ausgabe, die Sie wollen.
Wann Sie es einsetzen:
- Sie haben eine konkrete Aufgabe mit einem klaren Input/Output-Format.
- Sie haben qualitativ gute gelabelte Daten, auch in kleinen Mengen.
- Sie brauchen vorhersagbares Verhalten bei einer bekannten Form von Input.
Beispiel: Training mit (SQL-Beschreibung, SQL-Code)-Paaren für Text-to-SQL. Dieses feste Kalenderintervall setzt voraus, dass signup_date in UTC gespeichert ist:
{
    "input": "Get users who signed up in August 2026 (UTC)",
    "output": "SELECT * FROM users WHERE signup_date >= '2026-08-01' AND signup_date < '2026-09-01'"
}
3. Instruction Tuning
Instruction Tuning ist ein Spezialfall von SFT, der Models dazu bringen soll, eine große Bandbreite natürlichsprachlicher Instructions zu befolgen. Die Trainingsdaten sind (Instruction, Response)-Paare über viele verschiedene Aufgaben.
Wann Sie es einsetzen:
- Sie wollen einen Allzweck-Assistenten (wie ChatGPT oder Claude).
- Das Model muss unterschiedliche, offene Anfragen bewältigen.
- Sie bauen ein Chat-Interface.
Beispiel: Training mit Tausenden vielfältigen Instructions wie „Fasse diesen Artikel zusammen“, „Schreibe ein Gedicht über X“ oder „Erkläre Y in einfachen Worten“.
Vergleich
| Aspekt | Continued Pre-Training | SFT | Instruction Tuning |
|---|---|---|---|
| Daten | Rohtext | (Input, Output)-Paare | (Instruction, Response)-Paare |
| Labels | Keine (Self-Supervised) | Aufgabenspezifisch | Vielfältige Aufgaben |
| Ziel | Domänenwissen | Spezifisches Task-Verhalten | Beliebige Instructions befolgen |
| Datenmenge | Meist das größte Korpus | Bestimmt durch Task-Abdeckung und Fehlervielfalt | Meist breiter als aufgabenspezifisches SFT |
Ein Ziel, zwei Datasets. SFT und Instruction Tuning verwenden dasselbe Next-Token-Ziel; der Unterschied liegt in Breite und Aufbau des Datasets. Continued Pre-Training ist ein eigenes Experiment und sollte von Tests auf Domänengewinne und auf Regression der allgemeinen Fähigkeiten begleitet werden.
Die 7-stufige Fine-Tuning-Pipeline
Fine-Tuning hat sieben Stufen. Jede Stufe hat eigene Fehlerbilder, und das Überspringen einer Stufe verschlechtert meist später das Model. Das Diagramm zeigt die Stufen in Reihenfolge, was jede Stufe zum Release-Eintrag beiträgt, und den Rückweg vom Monitoring zur Datenvorbereitung.
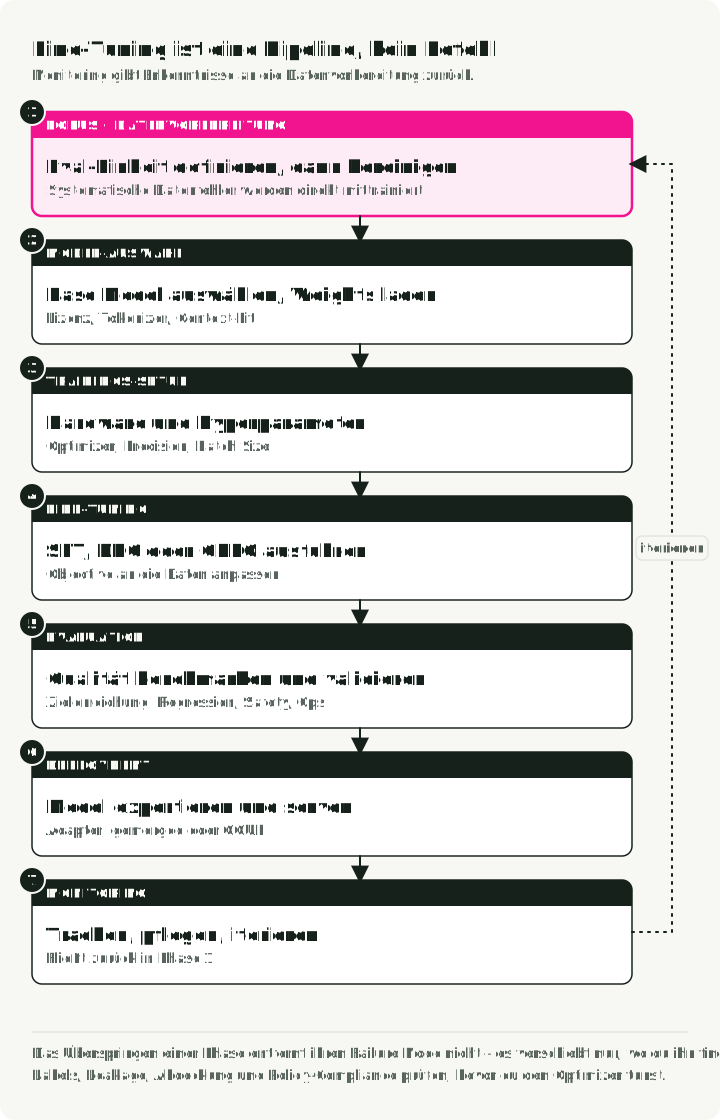
Jede Stufe baut auf der vorherigen auf:
- Datenvorbereitung — Die Evaluationseinheit festlegen, die Daten aufteilen, dann bereinigen und formatieren
- Model-Auswahl — Das passende Base Model wählen und die Weights laden
- Trainings-Setup — Serialisierung und Loss-Ziele prüfen, dann die Methode (LoRA, QLoRA, DoRA) und ihre Einstellungen wählen
- Fine-Tuning — SFT mit einem Framework ausführen; DPO oder ORPO nur bei Bedarf ergänzen
- Evaluation — Die Performance benchmarken und die Qualität validieren
- Deployment — Das Model exportieren und serven
- Monitoring — Performance verfolgen, pflegen und iterieren
Daten zuerst. Training reproduziert systematische Fehler in den Beispielen. Prüfen Sie Labels, Leakage, Abdeckung und Policy-Konformität, bevor Sie Zeit in Optimizer-Sweeps stecken.
Stufe 1: Datenvorbereitung
Probleme in den Daten gelangen ins trainierte Model, deshalb verdient diese Stufe die meiste Sorgfalt. Das Diagramm folgt Beispiel-Tickets durch diese Reihenfolge: zuerst nach Quelle aufteilen, dann fünf Transformationen innerhalb jedes Splits.
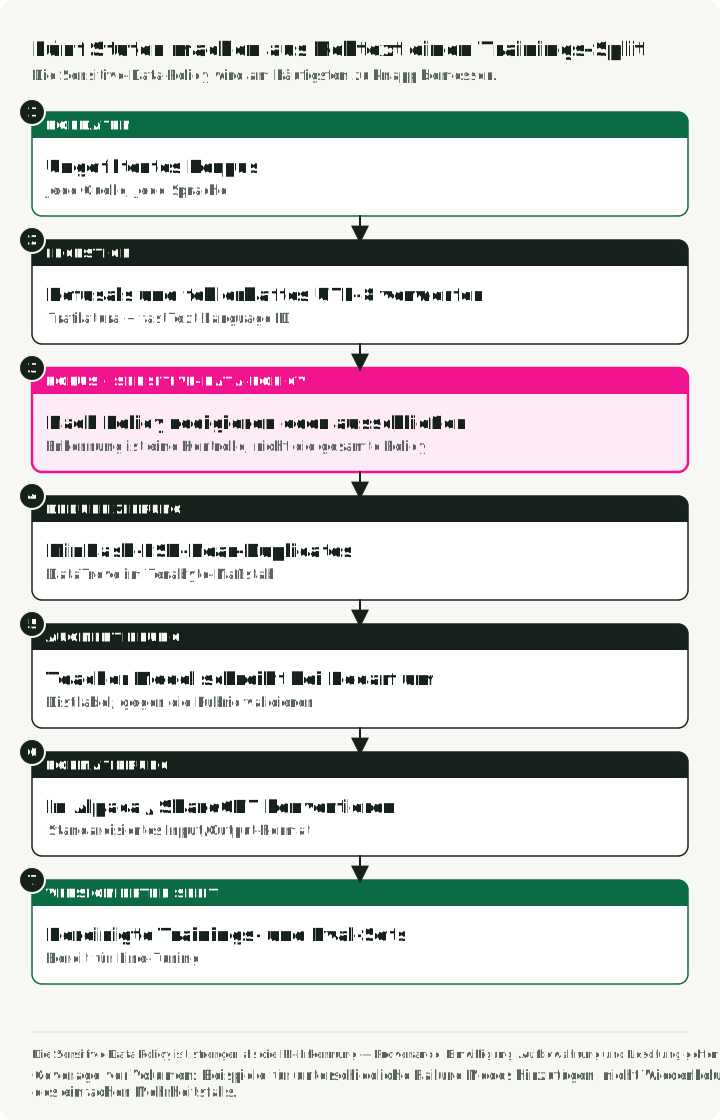
Fünf Transformationen nach dem Source-Split
Weisen Sie Quellgruppen dem Training oder der Evaluation zu, bevor Sie Rows transformieren. Ein Support-Ticket und jede Umformulierung dieses Tickets bleiben in derselben Partition. Fassen Sie bekannte Beinahe-Duplikate vor der Gruppenzuweisung in Clustern zusammen und prüfen Sie nach der Bereinigung erneut über die Partitionen hinweg. Frieren Sie das Evaluation Set ein; augmentieren Sie nur Trainingsdaten.
Listen Sie die Fehler auf, die Ihre Beispiele dem Model abgewöhnen sollen, und definieren Sie dann die Pflichtfelder und Labels jeder Row. Wählen Sie Verarbeitungs-Tools für diese Schritte. DataTrove führt Filterung und Deduplizierung für große Korpora als verteilte Jobs aus; Distilabel generiert und labelt synthetische Rows mit einem Teacher Model.
1. Ingestion und Filterung
- Aktion: Kaputtes UTF-8 und themenfremde Inhalte entfernen. Refusals nach Policy labeln: Korrekte Refusals bleiben als Trainingsziele und Evaluationsfälle erhalten; schließen Sie nur ungültige oder themenfremde Refusals aus.
- Tools: Trafilatura, wenn die Quelle Webseiten sind; überspringen Sie es bei Daten, die schon Text sind. fastText-Models zur Spracherkennung für die Language ID.
2. Richtlinie für sensible Daten
- Aktion: Festlegen, was das Model lernen darf, dann personenbezogene und vertrauliche Felder nach Bedarf schwärzen, tokenisieren oder ausschließen.
- Tools: Microsoft Presidio, wenn Sie konfigurierbare Recognizer, mehrere Sprachen oder umkehrbare Anonymisierung brauchen; scrubadub für eine kleinere reine Python-Pipeline, die gängige personenbezogene Daten aus Text entfernt.
- Warum: Ein Detektor ist nur eine Kontrolle; Herkunft, Einwilligung, Aufbewahrung, Zugriff und Löschpflichten gelten weiterhin.
3. Deduplizierung (MinHash LSH)
- Aktion: Beinahe-Duplikate entfernen, um Wiederholung und Leakage-Risiko zu senken; das verhindert kein Memorisieren.
- Tools: DataTrove, wenn das Korpus verteilte Verarbeitung braucht.
4. Synthetische Augmentation, falls nötig
- Aktion: Ein geeignetes Teacher Model Trainingsbeispiele in Instruction-Response-Paare umschreiben lassen und ihre Quell-IDs behalten. Augmentieren Sie die zurückgehaltene Partition nicht.
- Tools: Distilabel.
- Validierung: Teacher-Ausgaben stichprobenartig prüfen, gegen dieselbe Rubrik wie menschliche Labels bewerten und die Ergebnisse für synthetische und von Menschen geschriebene Beispiele getrennt berichten. Eine solche Evaluations-Teilmenge heißt Slice; weitere nützliche Slices sind Sprache und Aufgabentyp.
5. Formatierung
- Aktion: In ein Standardformat (Alpaca oder ShareGPT) konvertieren.
Beispiele für Datenformate
Alpaca-Format (Instruction Following):
{
    "instruction": "Summarize the following text.",
    "input": "The text to be summarized...",
    "output": "This is the summary."
}
ShareGPT-artige Speicherung (konversationell):
{
    "conversations": [
        { "from": "user", "value": "Hello, who are you?" },
        { "from": "assistant", "value": "I am a helpful AI assistant." }
    ]
}
Dataset-Prüfungen
- Abdeckung vor Volumen. Ergänzen Sie Beispiele, die unterschiedliche Fehlerbilder abbilden, keine Wiederholungen des einfachen Mehrheitsfalls.
- Sauberkeit. Irrelevanten Text entfernen, Whitespace normalisieren, die Formatierung konsistent halten.
- Balance. Wichtige seltene Fälle erhalten und die Performance pro Slice berichten.
- Trennung. Nach Quelle, Nutzer, Dokument oder Zeit aufteilen, wenn zufällige Row-Splits Beinahe-Duplikate durchlassen würden.
- Provenienz. Quelle, Lizenz oder Erlaubnis, Transformationshistorie und Löschpfad für jede Dataset-Version festhalten.
Stufe 2: Model-Auswahl und Hardware
Das Base Model und sein minimaler GPU-Speicherbedarf bestimmen, was Sie trainieren können.
Beginnen Sie mit dem kleinsten Base Model, das die nicht verhandelbaren Baseline-Prüfungen bereits besteht. Klären Sie:
- Lizenz und Weitergabebedingungen für das geplante Produkt;
- Sprache, Domäne, Tool Use und Sicherheitsverhalten vor der Anpassung;
- Kompatibilität von Tokenizer und Chat Template mit dem Dataset;
- maximalen Context und Truncation-Verhalten, die echte Beispiele brauchen;
- Unterstützung sowohl im Trainings-Framework als auch in der Ziel-Serving-Engine.
Fine-Tuning ist ein Anpassungsschritt, keine Reparatur für ein ungeeignetes Base Model. Scheitert das Model an Fähigkeiten, die das Dataset nicht abdeckt, wählen Sie ein anderes Base Model, bevor Sie weitere Epochen laufen lassen.
Speicher für Ihren Run schätzen
Es gibt keine dauerhaft gültige Tabelle „Model-Größe → GPU“. Der Spitzenspeicher hängt ab von Weight-Präzision, Optimizer, Zahl der trainierbaren Parameter, Sequenzlänge, Micro-Batch-Größe, Activation Checkpointing, Attention-Implementierung und Framework-Overhead. Beginnen Sie mit einer Speicherschätzung und führen Sie dann auf genau Ihrem Stack einen kurzen Smoke Test mit maximaler Länge aus.
| Speicherkomponente | Full Fine-Tuning | LoRA | QLoRA |
|---|---|---|---|
| Base Weights | Trainingspräzision | Eingefroren, meist BF16/FP16 | Eingefroren, meist 4-bit NF4 |
| Gradients | Alle trainierbaren Weights | Adapter-Weights | Adapter-Weights |
| Optimizer States | Alle trainierbaren Weights | Adapter-Weights | Adapter-Weights |
| Activations | Hängen in jeder Methode von Batch und Sequenzlänge ab | Gleiche Abhängigkeit | Gleiche Abhängigkeit |
Das Diagramm wendet die Tabelle auf das Base Model der Demo an, Nemotron-Nano-4B mit 4,51 Milliarden Parametern. Es teilt den ungefähren Speicher jeder Methode in Weights und trainierbaren Zustand auf; Activations kommen on top.
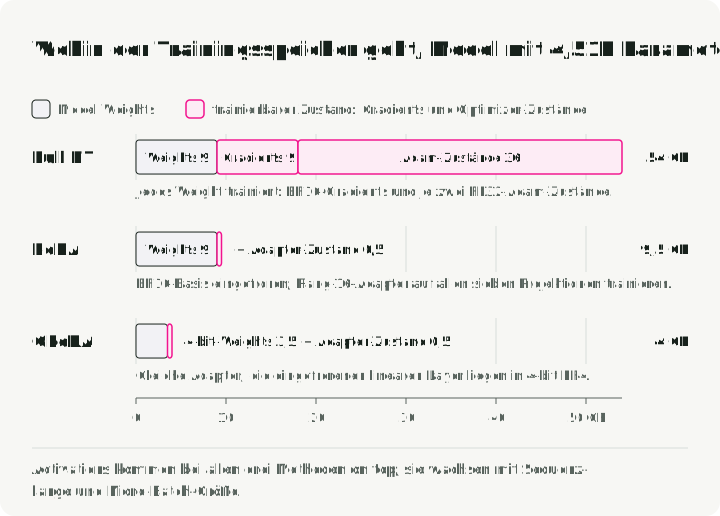
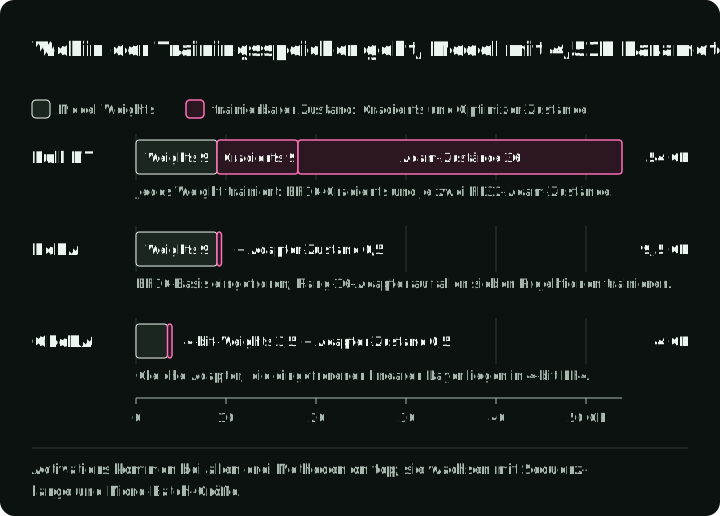
Das Original-QLoRA-Paper brachte in seinem speziellen Setup ein 65B-LLaMA-Model auf eine einzelne 48-GB-GPU. Dieses Ergebnis ist eine nützliche Grenze, kein Versprechen, dass jede aktuelle 70B-Architektur, Context-Länge, jeder Kernel oder Trainer auf demselben Gerät läuft.
Memory Math
Für ein Model mit Parametern benötigen allein die Weights etwa Bytes in BF16/FP16 oder Bytes bei vier Bit, vor Quantization-Metadaten und Runtime-Buffern. Vollständiges Adam-artiges Training fügt Gradients, Optimizer States und oft Master Weights in höherer Präzision hinzu. LoRA vermeidet den größten Teil des Speichers für trainierbaren Zustand; QLoRA verkleinert zusätzlich den Platzbedarf der eingefrorenen Base Weights. Activations können bei langen Sequenzen dennoch dominieren.
Gehen Sie so vor:
- Wählen Sie die längste Sequenz und den Micro-Batch, die Sie unterstützen müssen.
- Schätzen Sie Weights und trainierbaren Zustand und lassen Sie Spielraum für Activations und Kernels.
- Führen Sie einen Forward/Backward-Schritt mit maximaler Länge aus.
- Notieren Sie den Spitzenwert von allokiertem und reserviertem Speicher.
- Erst dann skalieren Sie Batch-Größe, Rank, Sequenzlänge oder GPU-Anzahl.
Stufe 3: Trainings-Setup und Methoden
Stufe 3 hat zwei Teile. Prüfen Sie zuerst, dass jede gespeicherte Row zu dem Trainingstext wird, den Sie erwarten. Wählen Sie dann die Trainingsmethode und ihre Einstellungen.
Von gespeicherten Rows zu Trainingszielen
ShareGPT ist eine Dataset-Form; ChatML ist eine Serialisierungskonvention. Konvertieren Sie from/value in die Rollen und Felder, die der Trainer akzeptiert, und verwenden Sie dann das Chat Template des gewählten Models. Setzen Sie nicht einfach ChatML-Tokens ein, nur weil die Daten konversationell sind.
Eine Row durchläuft fünf Schritte:
- ShareGPT-Row:
from/value-Paare. messagesundtools: die Rollen, die der Trainer akzeptiert.apply_chat_templatemit dem Template des gewählten Models. Die Inference muss dasselbe Template verwenden.- Token-IDs und Labels, wobei
-100bedeutet: kein Loss. - Training.
Geben Sie vor dem Training den gerenderten Text aus Schritt 3 aus.
Für die Begrüßungs-Row oben lauten die normalisierten Messages:
messages = [
    {"role": "user", "content": "Hello, who are you?"},
    {"role": "assistant", "content": "I am a helpful AI assistant."},
]
# Inspection step after loading the selected model's tokenizer:
rendered = tokenizer.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=False,
)
print(rendered)
Prüfen Sie vor dem Training die tatsächlich serialisierte Row: Rollen-Delimiter, End-of-Turn-Tokens und Tool Schemas müssen zur Inference passen. Bewahren Sie bei einer Tool-Use-Row Tool-Definitionen, Tool Calls des Assistenten und Tool Results als getrennte Felder auf. Prüfen Sie, dass die Truncation weder die überwachte Antwort entfernt noch ein Tool-Argument in der Mitte abschneidet.
Loss Masking bestimmt, für welche Tokens das Model belohnt wird, wenn es sie vorhersagt. Beim Full-Sequence-Training können User-, System-, Tool- und Assistant-Text alle beitragen. Beim Assistant-only-Training bleiben diese Kontext-Tokens für Attention sichtbar, aber ihre Labels werden ignoriert (üblicherweise -100); nur die Assistant-Spans tragen bei. Für diese Begrüßung sollte die Antwort ein Ziel sein und die Frage des Nutzers nicht, wenn Assistant-only-Verhalten beabsichtigt ist.
Das Diagramm zeigt beide Einstellungen für eine Tool-Use-Konversation.
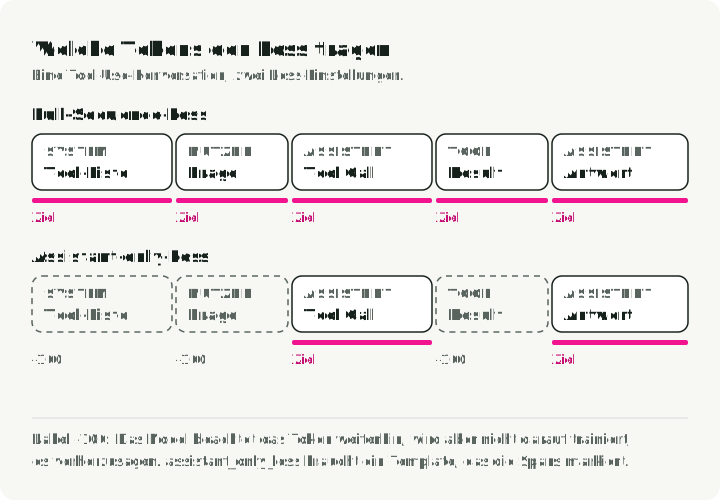
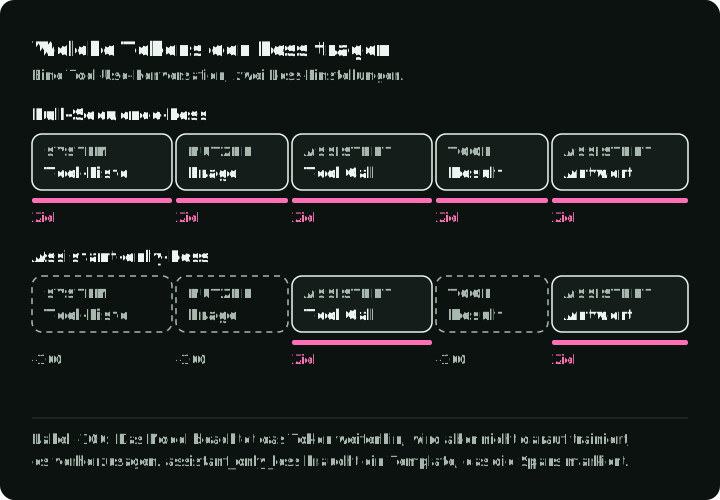
Die SFT-Dokumentation von TRL unterstützt assistant_only_loss=True für konversationelle Datasets, deren Templates Generation Spans bereitstellen. Ein Template ohne diese Spans kann diese Maske nicht liefern. Prompt/Completion-Datasets haben eine eigene Option completion_only_loss. Prüfen Sie vor dem Aktivieren einer der beiden Optionen einen tokenisierten Batch und decodieren Sie die Tokens mit nicht ignorierten Labels. Wiederholen Sie das dann mit einer Tool-Konversation und einem Beispiel maximaler Länge. Die Demo weiter unten in diesem Guide verwendet Full-Sequence-Loss, weil das Nemotron-Template keine Generation Spans hat.
Wählen Sie eine Sequenzlänge anhand der Datenverteilung und führen Sie den Speichertest mit maximaler Länge aus Stufe 2 aus. Packing legt mehrere kürzere Beispiele in eine Trainingssequenz. Beginnen Sie ohne Packing, damit sich Row-Grenzen leicht prüfen lassen. Benchmarken Sie Packing erst, wenn die serialisierten Rows und Labels stimmen.
Full Fine-Tuning vs. PEFT
Full Fine-Tuning (FFT) aktualisiert jedes Weight, daher skalieren Gradients und Optimizer State mit dem ganzen Model. Der Spitzenwert lässt sich nicht allein aus der Parameterzahl ableiten, liegt aber weit über dem Speicher, der nötig ist, um die Weights für die Inference zu laden.
Parameter-Efficient Fine-Tuning (PEFT) trainiert nur eine kleine Teilmenge der Parameter und friert den Rest ein, sodass Gradients und Optimizer States nur diese Teilmenge abdecken.
LoRA: der Ausgangspunkt
LoRA (Low-Rank Adaptation) friert eine vortrainierte Matrix ein und stellt ihr gelerntes Update mit zwei kleineren Matrizen dar. Das Original-Paper begründet das mit der Hypothese, dass nützliche Anpassungs-Updates einen niedrigen intrinsischen Rang haben.
Hier ist die Eingabebreite der Schicht und ihre Ausgabebreite. Der Rank ist die kleinere gemeinsame Dimension der beiden trainierbaren Matrizen: Ein kleinerer Rank verwendet weniger trainierbare Parameter. Die Einstellung steuert die Skalierung des Updates über das Verhältnis .
Das Diagramm zeigt die eingefrorene Matrix, die beiden trainierbaren Matrizen und wie ihr skaliertes Produkt addiert wird, mit den Parameterzahlen für eine 4.096 breite Matrix bei Rang 16.
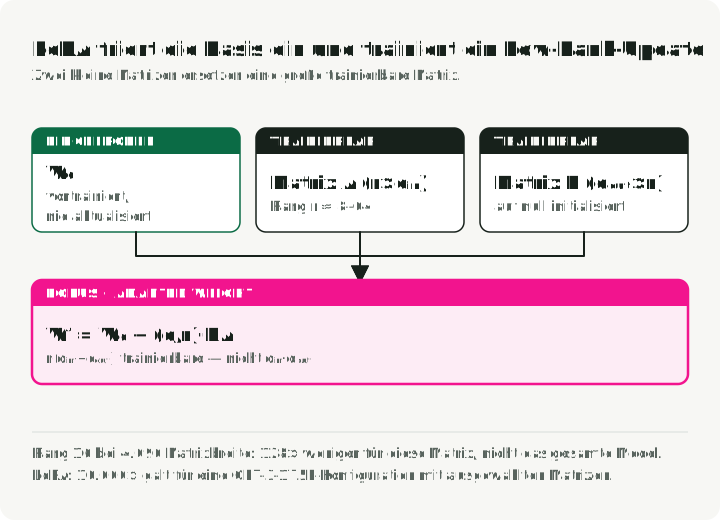
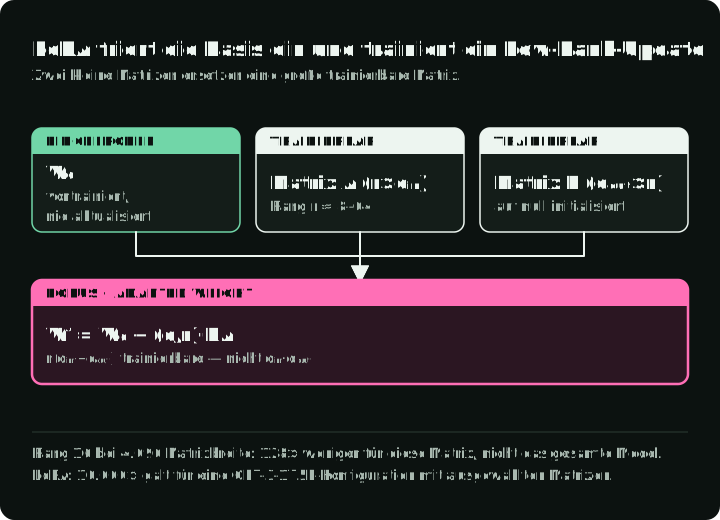
Für eine eingefrorene Matrix lernt LoRA:
Die angepasste Schicht ist:
Der Adapter hat trainierbare Parameter statt für diese Matrix. Bei einer quadratischen Matrix der Breite 4.096 und Rank 16 ist das eine 128-fache Reduktion der trainierbaren Parameter für diese Matrix. Die Einsparung für das gesamte Model hängt davon ab, welche Matrizen Adapter erhalten.
PEFT-Methoden im Vergleich
| Methode | Was sich ändert | Wählen Sie sie, wenn |
|---|---|---|
| LoRA | Eingefrorene Basis plus trainierbare Low-Rank-Updates | Das Base Model bequem passt und Sie kleine Task-Artefakte wollen |
| QLoRA | LoRA, wobei die eingefrorene Basis in 4-bit-Form gespeichert wird | Der Speicher für die Base Weights der limitierende Faktor ist |
| DoRA | Trennt die Weight-Magnitude von einer per LoRA aktualisierten Richtung | Eine gemessene LoRA-Baseline eine Qualitätslücke lässt, die zusätzliche Komplexität wert ist |
| Full Fine-Tuning | Alle Model Weights | PEFT das Ziel verfehlt und der Qualitätsgewinn verteiltes Training und vollständige Checkpoints rechtfertigt |
DoRA: Weight-Decomposed LoRA
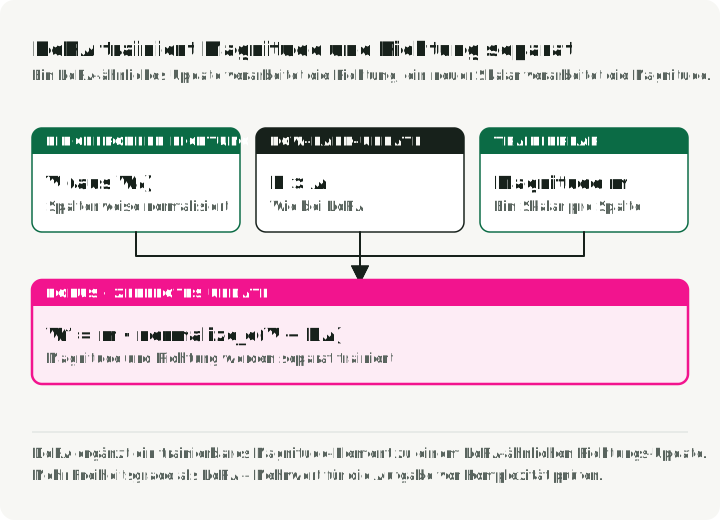
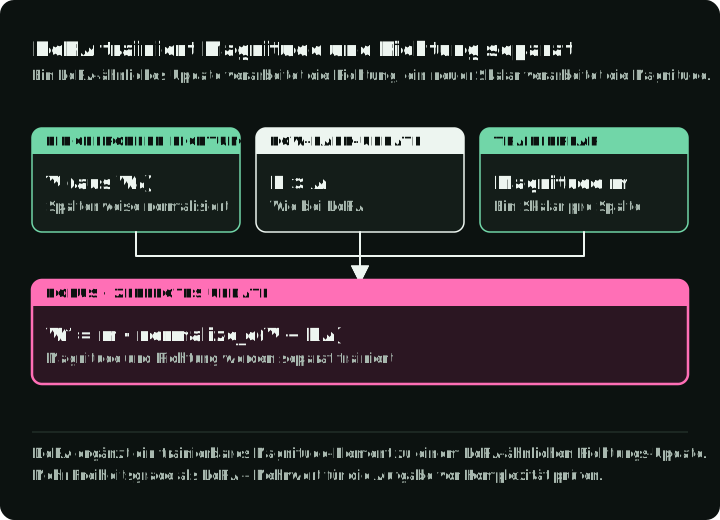
DoRA (Weight-Decomposed Low-Rank Adaptation) trennt die Magnitude jedes Weight-Vektors von seiner Richtung. Das DoRA-Paper wendet ein LoRA-Update auf die Richtungskomponente an und lernt die Magnitude separat. Das Diagramm zeichnet eine Weight-Spalte als Pfeil: B·A dreht ihre Richtung, und eine trainierte Magnitude m bestimmt ihre Länge.
So funktioniert es:
Statt Weights als eine einzige Einheit zu behandeln, zerlegt DoRA vortrainierte Weights in zwei Komponenten:
- Magnitude — ein trainierbarer Wert pro Weight-Vektor.
- Richtung — ein normalisierter Vektor, der über Low-Rank-Matrizen aktualisiert wird.
In kompakter spaltenweiser Notation:
wobei:
m= Magnitude (trainierbar)- = die eingefrorene Ausgangsmatrix; normalisiert wird nach der Addition von
- = das gelernte Low-Rank-Richtungs-Update
- = spaltenweise Normalisierung
Auswirkungen der Zerlegung:
- Mehr Freiheitsgrade als bei Standard-LoRA, weil sich die Magnitude unabhängig ändern kann.
- Bessere Ergebnisse als LoRA in mehreren vom vorschlagenden Paper berichteten Konfigurationen.
- Zusätzliche Parameter und Rechenaufwand, daher sollte der Gewinn auf Ihrer Aufgabe und Ihrem Serving-Pfad verifiziert werden.
Adapter-Merging für Multi-Task Learning
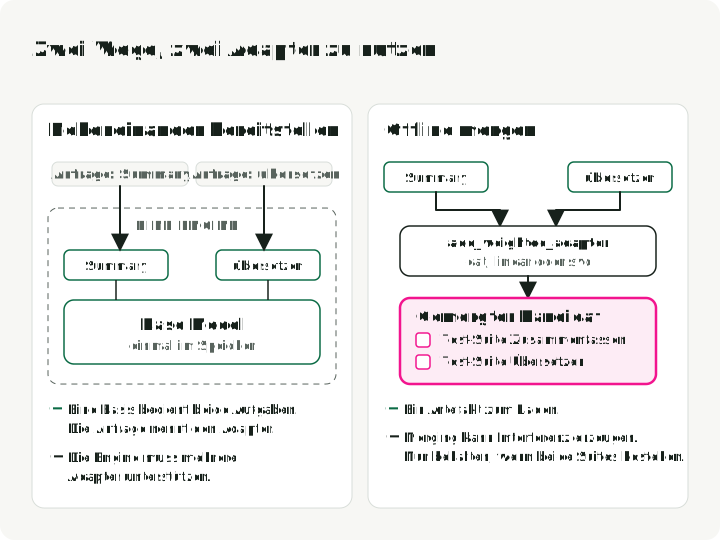
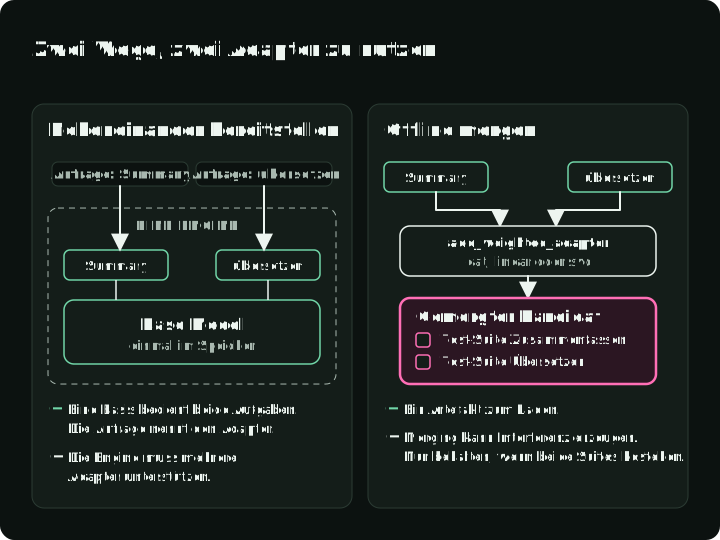
Getrennte Adapter erlauben es, dass eine eingefrorene Basis mehrere Aufgaben unterstützt. Sie können Anfragen an einen Adapter routen, mehrere Adapter aus einer Engine servieren, sofern unterstützt, oder offline einen gemergten Kandidaten erstellen. Merging kann Interferenzen erzeugen, evaluieren Sie also das gemergte Artefakt, statt anzunehmen, dass die Quell-Adapter sauber zusammenpassen.
Die Abbildung vergleicht die beiden Optionen für zwei Adapter auf einer Basis. Behalten Sie das gemergte Model nur, wenn es beide Test-Suites besteht.
Gängige Merging-Methoden:
- Concatenation — Adapter-Parameter zusammenführen und den effektiven Rank erhöhen. Schnell und einfach.
- Lineare Kombination — gewichtete Summe der Adapter. Die Weights legen fest, wie viel jede Aufgabe beiträgt.
- SVD — Matrixzerlegung fürs Merging. Flexibler, aber langsamer.
add_weighted_adapter von PEFT implementiert diese als combination_type="cat", "linear" und "svd"; der PEFT-Leitfaden zum Model-Merging behandelt sie und neuere Methoden.
Beispiel: ein Adapter für Zusammenfassungen, ein anderer für Übersetzung, gemergt zu einem einzigen Multi-Task-Model.
Stufe 4: Preference Alignment (optional)
SFT ist der Haupttrainingslauf, und die Framework-Abschnitte nach dieser Stufe führen ihn aus. Diese Stufe behandelt, was Sie nach SFT ergänzen können, wenn die Fehler es verlangen.
SFT lernt Demonstrationen. Preference Optimization lernt stattdessen aus Vergleichen wie „Chosen Response A ist besser als Rejected Response B“. Setzen Sie sie nur ein, wenn Paarpräferenz das richtige Label für den Fehler ist; faktische Korrektheit und Policy-Konformität brauchen oft stärkere Evaluatoren als eine globale Präferenz.
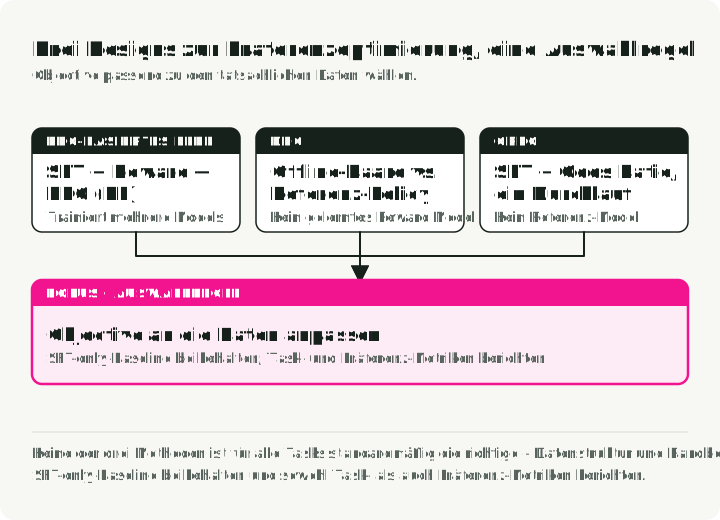
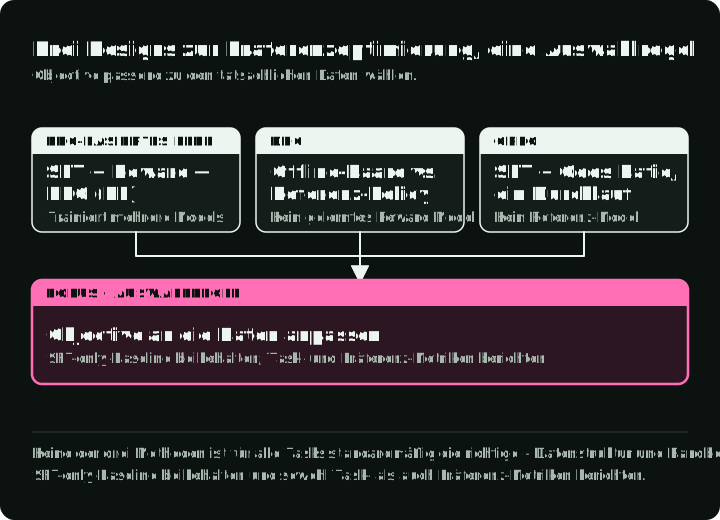
Das Diagramm zeigt die Stufen jeder Methode, die Models, die sie lädt, und was ein Trainingsschritt tut.
PPO-basiertes RLHF
RLHF steht für Reinforcement Learning from Human Feedback. Die Policy ist das Language Model, das Responses generiert; ein Reward Model bewertet diese Responses anhand von Präferenzen, die aus menschlichen Vergleichen gelernt wurden. Ein PPO-basiertes Rezept hat drei Stufen:
- SFT — die Aufgabe lernen.
- Reward Model — auf menschlichen Präferenzen trainieren (Chosen vs. Rejected).
- PPO (Proximal Policy Optimization) — Responses generieren und das Language Model so aktualisieren, dass ihre Reward-Scores steigen.
Der operative Aufwand entsteht durch die mehreren Komponenten:
- Kompliziert zu implementieren und zu warten.
- Teuer — Sie trainieren mehrere Models.
- Das Sampling aus dem Model, das gerade trainiert wird, erfordert Prüfungen auf instabile Updates und auf Responses, die das Reward Model ausnutzen, ohne die Aufgabe zu erfüllen.
DPO
DPO (Direct Preference Optimization) verzichtet auf das separate Reward Model und die Reinforcement-Learning-Schleife. Es bevorzugt Chosen Responses und bremst zugleich große Abweichungen von einem festen Ausgangs-Model, dem Reference Model. Das DPO-Paper leitet dieses Ziel her, indem es begrenzt, wie weit sich Response-Wahrscheinlichkeiten von dieser Reference entfernen dürfen; die mathematische Grenze ist eine KL-Divergenz-Constraint.
Ein Präferenzpaar enthält denselben Prompt und zwei Kandidaten-Responses. Diese verkürzte Row zeigt die Felder; echte Labels brauchen vollständige Responses und einen Grund, eine zu bevorzugen:
{
    "prompt": "Explain quantum computing",
    "chosen": "Quantum computing uses qubits...",   # Preferred response
    "rejected": "Well, it's complicated..."        # Non-preferred response
}
Was sich operativ ändert:
- Einfacherer Code-Pfad (kein separates Reward Model, keine RL-Schleife).
- Training auf gespeicherten Präferenzpaaren, statt bei jedem Update neue Responses für das Reward Scoring zu generieren.
- In der Standardformulierung ein festes Reference Model oder dessen gespeicherte Log-Wahrscheinlichkeiten für die Trainings-Responses.
DPO lässt sich leichter prototypisieren als eine vollständige PPO-Pipeline, ist aber kein automatisches Qualitäts-Upgrade. Die Ergebnisse hängen von der Start-Policy, der Paarqualität, den Loss-Einstellungen, Längeneffekten und dem Evaluationsprotokoll ab. Vergleichen Sie es mit einem SFT-Checkpoint auf denselben zurückgehaltenen Präferenz- und Task-Suites.
ORPO
ORPO (Odds-Ratio Preference Optimization) kombiniert den Negative-Log-Likelihood-Loss von SFT mit einer Odds-Ratio-Strafe auf Rejected Responses. Es entfernt das separate Reference Model und kann Task-Lernen und Preference Optimization in einem Lauf verbinden.
So funktioniert es: ORPO verwendet einen kombinierten Loss, der zwei Dinge gleichzeitig tut:
- Maximiert die Likelihood der Chosen Response (die Aufgabe lernen).
- Bestraft die Rejected Response mit einem Odds-Ratio-Term (Präferenzen lernen).
TRL liefert ORPO inzwischen als ORPOConfig in trl.experimental.orpo aus (TRL-ORPO-Trainer). Zwei Einstellungen sollten Sie kennen:
learning_rate: Das Paper verwendete niedrige Raten wie8e-6; stimmen Sie sie auf Ihr Model, Ihren Batch und Ihre Daten ab, statt einen Wert als Regel zu kopieren.beta: steuert den Präferenzterm relativ zum SFT-Term.
Der Trade-off:
- Eine Trainingsstufe statt zwei.
- Kein Reward Model.
- Kein Forward Pass durch ein Reference Model.
- Ein gekoppelter Lauf: Verschlechtert sich das Task-Lernen oder das Präferenzverhalten, gibt es keinen SFT-Zwischen-Checkpoint aus derselben Pipeline zum Prüfen.
Entscheiden Sie anhand von Daten- und Evaluationsdesign:
- Verwenden Sie DPO, wenn Sie bereits einen zufriedenstellenden SFT-Checkpoint haben und ein einfacheres Offline-Präferenzexperiment wollen.
- Testen Sie ORPO, wenn ein Reference-freies, einstufiges Ziel zu Ihren Daten und Ihren operativen Randbedingungen passt.
- Verwenden Sie PPO-basiertes RLHF, wenn Online-Sampling gegen einen expliziten gelernten Reward Teil der Anforderung ist und Sie Reward Exploitation überwachen können.
Keine davon ist ein Standard für alle Aufgaben. Behalten Sie eine reine SFT-Baseline und berichten Sie sowohl Task-Metriken als auch Präferenzmetriken.
Fine-Tuning Frameworks
Die Stufen 3 und 4 haben die Methode gewählt. Die nächsten zwei Abschnitte wählen ein Framework und führen damit SFT aus.
Frameworks überschneiden sich und ändern sich schnell. Wählen Sie nach dem Ausführungspfad, den Sie unterstützen müssen, pinnen Sie Versionen und halten Sie die Trainingskonfiguration portabel genug, um sie auch außerhalb eines Notebooks zu reproduzieren.
Unsloth — Geschwindigkeit und Memory Efficiency
Unsloth integriert sich mit Hugging Face trl und transformers und bietet für unterstützte Models optimierte Kernels, Checkpointing und quantisierte Fine-Tuning-Pfade.
- Eigene Triton-GPU-Kernels für Attention, RoPE und Cross-Entropy, die den PyTorch-Overhead umgehen.
- Speichereffiziente Backprop, die Activations im Backward Pass neu berechnet, statt sie im Speicher zu halten.
- Fused Operations, die mehrere Schritte (Layer Norm + Linear und Ähnliches) in einzelne GPU-Aufrufe zusammenfassen.
- 4-bit-Quantization, direkt in den QLoRA-Pfad integriert, mit optimierter Dequantization.
Die Import-Reihenfolge zählt. Folgen Sie der Import-Reihenfolge im Unsloth-Beispiel für die Version, die Sie pinnen. Unsloth wendet Patches beim Import an; importieren Sie es vor trl und transformers, vermeiden Sie fehlende Optimierungen oder versionsspezifische Fehler.
# Correct order
from unsloth import FastLanguageModel  # Must be first!
from trl import SFTConfig, SFTTrainer

# Avoid this order with Unsloth's patched path
from trl import SFTTrainer
from unsloth import FastLanguageModel
Am besten für: Training auf einer einzelnen GPU, Prototyping und Colab-Notebooks.
Veröffentlichte Zahlen zu Geschwindigkeit und Speicher variieren mit Model, Sequenzlänge, Batch, Präzision und Hardware. Benchmarken Sie Tokens pro Sekunde und Spitzenspeicher auf Ihrem eigenen Run, statt ein Schlagzeilenverhältnis als Eigenschaft des Frameworks zu behandeln.
Axolotl — Config-driven Training
Für Config-first- und verteilte Setups hält Axolotl den ganzen Run in einer YAML-Datei. Diese Keys wählen eine 4-bit-Basis, einen QLoRA-Adapter und ein Dataset im Alpaca-Format:
# axolotl_config.yaml (excerpt)
base_model: meta-llama/Meta-Llama-3-8B
load_in_4bit: true
adapter: qlora
lora_r: 32
lora_alpha: 16 # alpha/r = 0.5 here; the demo uses 2. Sweep it with the learning rate.
datasets:
    - path: data/training_data.jsonl
      type: alpaca
Target Modules, Sequenzlänge, Packing, Batch-Größe, Learning Rate und Epochen gehören in dieselbe Datei; die Config-Referenz listet jeden Key auf. Training starten:
axolotl train axolotl_config.yamlFramework-Vergleich
| Tool | Nützlich, wenn | Vor der Festlegung prüfen |
|---|---|---|
| Unsloth | Sie einen optimierten Pfad für unterstützte Models mit knappen Beispielen wollen | Matrix aus Model-, GPU-, Quantization- und Distributed-Unterstützung |
| Axolotl | Sie deklarative Configs und eingebaute Rezepte für verteiltes Training wollen | Exaktes Config-Schema und Launcher für das gepinnte Release |
| TRL | Sie direkten Zugriff auf die SFT- und Preference-Trainer von Hugging Face wollen | Dataset-Format, Chat Template, Loss Masking und PEFT-Integration |
| Torchtune | Sie bereits torchtune-Rezepte betreiben; es wird seit 2025 nicht mehr aktiv gepflegt | Abdeckung der Model-Rezepte und Export-Kompatibilität |
Praktische Demo: Fine-Tuning mit Unsloth
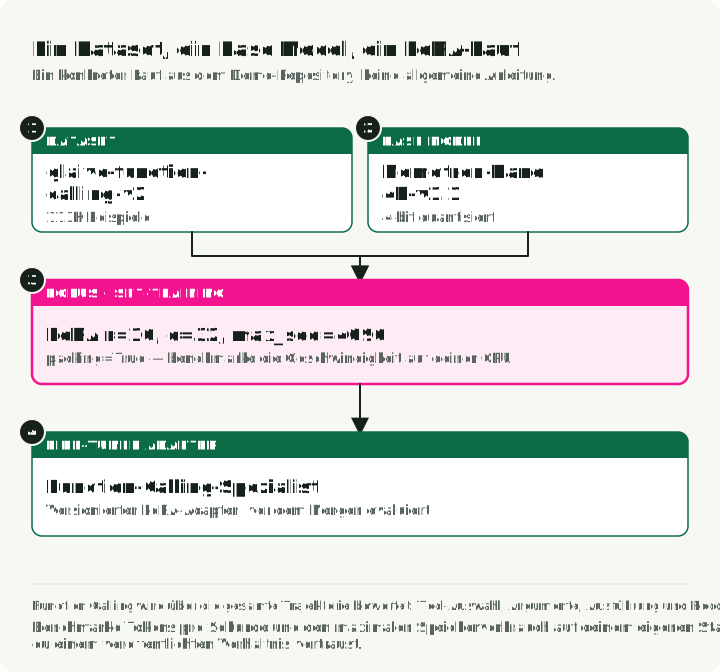
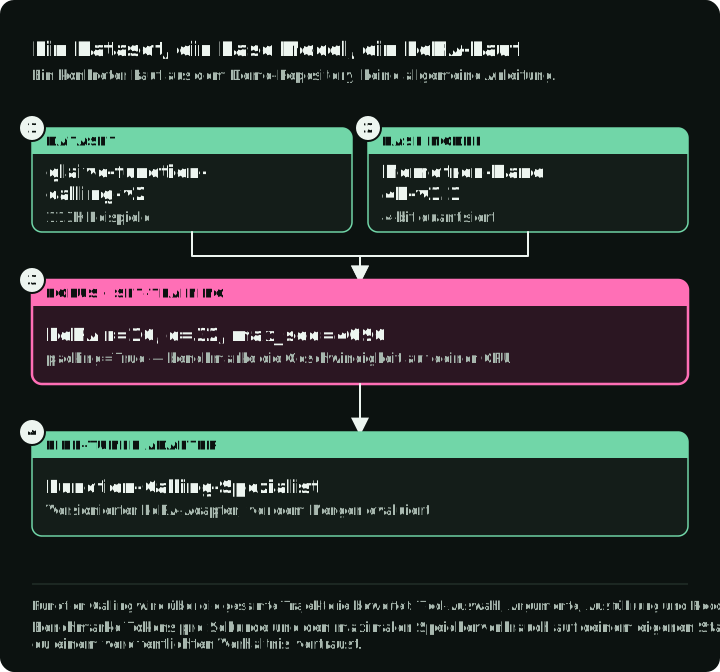
Diese Demo bringt einem Model bei, eine Funktion auszuwählen und ihre Argumente zu liefern. Mein unsloth-finetune-demo fine-tunt Llama-3.1-Nemotron-Nano-4B-v1.1 auf dem Dataset glaive-function-calling-v2. Der CUDA-Trainingspfad dieses Repositorys braucht Linux oder WSL2 und eine NVIDIA-GPU. Unsloth bietet auch einen separaten Trainingspfad für Intel-GPUs, den diese Demo nicht implementiert. Pinnen Sie den Commit, den Sie ausführen; die Lock-Datei pinnt die Dependencies, darunter TRL 0.24.0.
Das Diagramm zeigt den gesamten Run mit seinen echten Werten: wie eine Glaive-Row zu Trainingstext wird, der die Tool-Definitionen behält, den Split, die Trainingseinstellungen, die drei Ausgabeverzeichnisse und die erste Prüfung.
Ausführen
git clone https://github.com/slavadubrov/unsloth-finetune-demo.git
cd unsloth-finetune-demo
uv sync

# Train on 1,000 random rows, then also save a merged model and a GGUF file
uv run finetune --max-samples 1000 --merge --gguf q4_k_m
Jeder finetune-Run trainiert. --merge und --gguf fügen nach dem Training Exporte hinzu; es gibt keinen reinen Export-Befehl. Der Run schreibt drei Verzeichnisse:
outputs/unsloth-nemotron-function-calling/— der LoRA-Adapteroutputs/unsloth-nemotron-function-calling-merged/— das gemergte 16-bit-Model (--merge)outputs/unsloth-nemotron-function-calling-gguf/— die GGUF-Datei (--gguf q4_k_m)
Bevor das Training startet, gibt der Run die erste Trainings-Row so aus, wie das Model sie sieht. Lesen Sie sie: Die Tool-Definitionen stehen in <AVAILABLE_TOOLS>, und jeder Aufruf steht in <TOOLCALL>.
Datenvorbereitung
Jede glaive-Row hat zwei Strings. Die Spalte system enthält jede Funktionsdefinition; die Spalte chat enthält die Konversation, wobei Aufrufe als <functioncall> {...} geschrieben sind. Training allein auf chat bringt dem Model bei, Tools aufzurufen, deren Schemas es nie sieht. Die data.py der Demo konvertiert jede Row in messages und eine separate Liste tools, rendert beide mit dem eigenen Chat Template des Models und hält 5 % der Rows als Evaluations-Split zurück:
def to_text(example: dict, tokenizer) -> dict:
    """Render one glaive row with the model's chat template. Empty text marks a dropped row."""
    try:
        messages, tools = to_messages(example)
    except (ValueError, KeyError):  # bad JSON in a tool definition or call
        return {"text": ""}
    if not messages:
        return {"text": ""}
    text = tokenizer.apply_chat_template(messages, tools=tools or None, tokenize=False)
    # The trainer tokenizes this text with special tokens on, which adds BOS again.
    return {"text": text.removeprefix(tokenizer.bos_token or "")}
Auf dem vollständigen Dataset bleiben 112.811 von 112.960 Rows erhalten; 149 Rows haben fehlerhaftes JSON und werden verworfen. Mit diesem Tokenizer ist die längste gerenderte Row 4.076 Tokens lang, sodass ein Limit von 4.096 Tokens keine davon abschneidet.
Das Chat Template der Model Card hat einen Defekt für das Training. Es rendert einen vergangenen Tool Call ohne die schließende Klammer nach arguments, sodass der Text in <TOOLCALL> kein gültiges JSON ist. Ein Model, das auf diesem Text trainiert wird, lernt, ihn auszugeben, und der Serving-Parser kann den Aufruf nicht lesen. Das Repository liefert das Template mit der ergänzten Klammer aus und verwendet es in Training und Serving. Sein reiner CPU-Test rendert Tool-Konversationen und prüft, dass jedes <TOOLCALL> geparst werden kann.
Demo-Konfiguration
Die config.py der Demo setzt die LoRA-Werte:
LORA_R = 16        # Adapter capacity; tune against held-out results
LORA_ALPHA = 32    # Update scale alpha/r = 2
LORA_DROPOUT = 0.05
MAX_SEQ_LENGTH = 4096
LORA_TARGET_MODULES listet alle sieben Attention- und MLP-Projektionen dieses Models der Llama-Familie auf, von q_proj bis down_proj.
Das Verhältnis von Alpha zu Rank. alpha/r skaliert das klassische LoRA-Update. alpha = 2r ist in manchen Tool-Dokumentationen eine gängige Start-Heuristik, keine Stabilitätsgarantie. Sweepen Sie Rank, Alpha, Learning Rate und Target Modules erst, nachdem Daten und Baseline feststehen.
Model-Laden
Die model.py der Demo lädt die Basis in 4-bit-Form, ersetzt das Chat Template durch das korrigierte und fügt die LoRA-Adapter hinzu:
from unsloth import FastLanguageModel

model, tokenizer = FastLanguageModel.from_pretrained(
    model_name=MODEL_NAME,
    max_seq_length=MAX_SEQ_LENGTH,
    load_in_4bit=True,  # QLoRA: the frozen base is stored in 4-bit form
    trust_remote_code=True,
)
# Training rows, the saved tokenizer, and vLLM all use this one template.
tokenizer.chat_template = CHAT_TEMPLATE_PATH.read_text()

model = FastLanguageModel.get_peft_model(
    model,
    r=LORA_R,
    lora_alpha=LORA_ALPHA,
    lora_dropout=LORA_DROPOUT,
    target_modules=LORA_TARGET_MODULES,
    use_gradient_checkpointing="unsloth",  # Lower activation memory; extra compute
)
Trainingskonfiguration
Die training.py der Demo übergibt die gerenderten Rows an den SFTTrainer von TRL. Sie evaluiert den zurückgehaltenen Token-Loss einmal pro Epoche. Dieser Loss ist ein Diagnosewert, keine Tool-Call-Accuracy; Stufe 5 verlangt weiterhin eine separate Task-Evaluation.
trainer = SFTTrainer(
    model=model,  # 4-bit base with LoRA adapters from FastLanguageModel
    processing_class=tokenizer,
    train_dataset=train_dataset,
    eval_dataset=eval_dataset,
    args=SFTConfig(
        output_dir="outputs/unsloth-nemotron-function-calling",
        dataset_text_field="text",
        max_length=4096,
        packing=False,  # One row per sequence, so row boundaries are easy to inspect
        assistant_only_loss=False,  # The Nemotron template has no generation spans
        eval_strategy="epoch",
        per_device_train_batch_size=2,
        gradient_accumulation_steps=4,
        learning_rate=2e-4,
        num_train_epochs=3,
        bf16=True,  # The repository falls back to FP16 on GPUs without BF16
        optim="adamw_8bit",
    ),
)
trainer.train()
Erste Prüfung
uv run infer --prompt "Book a flight to Tokyo"infer lädt den Adapter und sendet den Prompt mit einem Tool, book_flight(destination), gerendert mit demselben Template wie die Trainings-Rows. Ein trainierter Adapter sollte mit <TOOLCALL>[{"name": "book_flight", "arguments": {"destination": "Tokyo"}}]</TOOLCALL> antworten. Antwortet er in Klartext, prüfen Sie die ausgegebene Trainings-Row, bevor Sie länger trainieren.
Stufe 5: Evaluation
Legen Sie Testfälle, Bewertungsregeln und Bestehensschwellen vor dem ersten Run fest. Vergleichen Sie mindestens den getunten Checkpoint mit exakt dem ungetunten Base Model, unter demselben Prompt, denselben Decoding-Einstellungen und derselben Tool-Umgebung. Berichten Sie die aggregierte Qualität erst, nachdem Sie die Fehler-Slices geprüft haben, die das Projekt verbessern sollte.
Verfolgen Sie vier Gruppen:
- Zielaufgabe: Exact Match, Ausführungserfolg, menschliche Rubrik oder ein anderes Ergebnis, das an den Anwendungsfall gebunden ist.
- Regression: Allgemeine Fähigkeiten und zuvor unterstützte Task-Slices, die die Anpassung beschädigen könnte.
- Sicherheit und Policy: Refusals, Datenabfluss, Prompt Injection oder domänenspezifische Constraints.
- Betrieb: Latency, Throughput, Speicher, Artefaktgröße und Kosten in der vorgesehenen Serving-Konfiguration.
Automatisierte Benchmarks
Verwenden Sie lm-evaluation-harness, um relevante standardisierte Aufgaben neben Ihren Produkttests zu prüfen. Dieser Befehl braucht einen gemergten Hugging-Face-Checkpoint, den die Demo mit --merge schreibt:
lm_eval --model hf \
    --model_args pretrained=./outputs/unsloth-nemotron-function-calling-merged \
    --tasks hellaswag,arc_easy,mmlu \
    --batch_size 8
LLM-as-Judge
Bei subjektiver Qualität kann ein größeres Model beim Bewerten helfen, aber kalibrieren Sie es an von Menschen geprüften Beispielen und halten Sie die Identität des Kandidaten verborgen. Geben Sie dem Judge die Model-Ausgabe, die erwartete Antwort und eine Rubrik, die jede Punktzahl für jedes Kriterium definiert, etwa Relevanz, Genauigkeit und Formatierung.
Domänenspezifische Evaluation
Halten Sie echte Beispiele nach Quelle, Nutzer, Dokument oder Zeit zurück, damit Beinahe-Duplikate nicht über den Split hinweg durchsickern. Validieren Sie bei Function Calling die vollständige Trajektorie: Tool-Auswahl, Argumente, Ausführungsergebnis, Recovery und finale Antwort. Berichten Sie Konfidenzintervalle oder gepaarte Win/Loss-Zahlen, wenn die Stichprobe klein ist, und prüfen Sie jede Regression in einem kritischen Slice.
Prüfen Sie jede Trajektorie in vier Schritten:
- Das richtige Tool wird ausgewählt.
- Die Argumente sind gültig und korrekt.
- Das Ausführungsergebnis entspricht der Erwartung.
- Das Model erholt sich von einem Tool-Fehler.
Zählen Sie jeden Fehler nach Prüfung und nach Slice. Eine korrekte finale Antwort kann ein falsches Argument oder eine übersprungene Recovery verbergen.
Der Evaluationscode des Berkeley Function Calling Leaderboard (BFCL) bewertet Funktionsauswahl und Argumente gegen Referenzaufrufe. Nutzen Sie ihn als Regressionsprüfung neben Ihren eigenen zurückgehaltenen Konversationen.
Stufe 6: Deployment und Output-Formate
Wählen Sie das Artefakt nach Serving-Engine und Rollback-Plan, nicht nur nach Dateigröße. Exportieren Sie jedes Format aus denselben evaluierten Objekten model und tokenizer, damit alle Artefakte dieselben trainierten Weights tragen. Das Diagramm vergleicht die drei Artefakte: was jede Datei enthält, was sie lädt und welchen Kompromiss sie bedeutet.
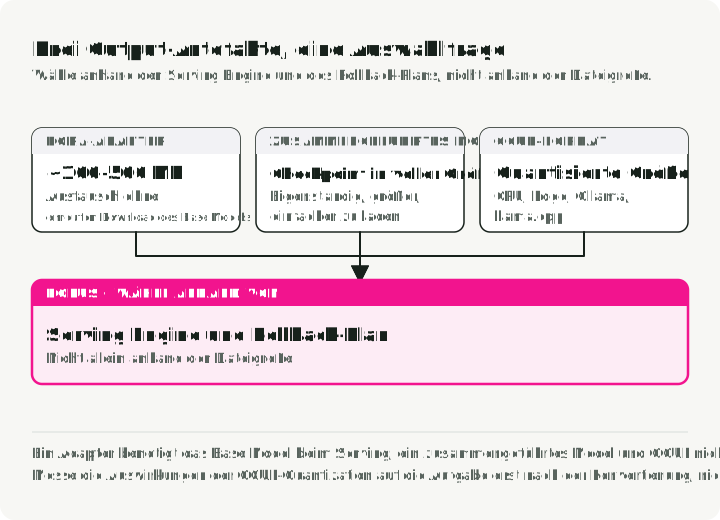
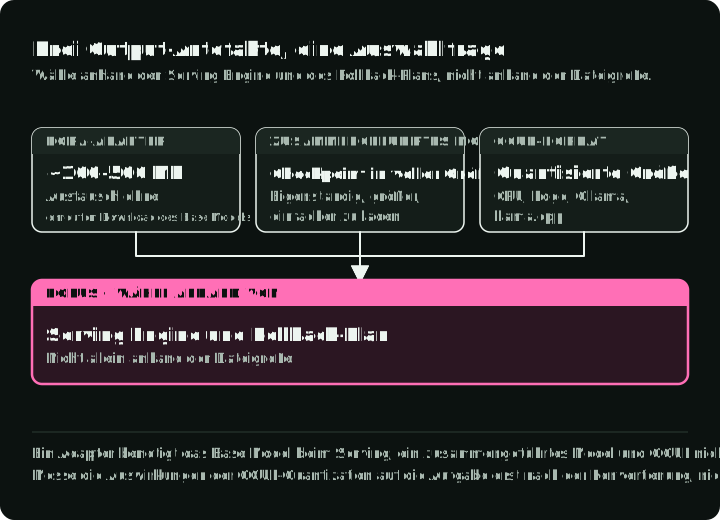
In der Demo speichert uv run finetune immer den Adapter, --merge fügt das gemergte Model hinzu und --gguf q4_k_m die GGUF-Datei, alles in einem Trainingslauf. Die Python-Aufrufe unten zeigen, was jedes Flag bewirkt.
1. LoRA-Adapter
model.save_pretrained("outputs/unsloth-nemotron-function-calling")
tokenizer.save_pretrained("outputs/unsloth-nemotron-function-calling")- Größe: proportional zu Target Modules, Rank, Schichten und dtype; oft weit kleiner als die Basis.
- Am besten für: Entwicklung, versionierte Task-Adapter und Engines, die LoRA direkt unterstützen.
- Bonus: Sie können Adapter tauschen, ohne die Basis erneut herunterzuladen.
2. Gemergtes Model
# What --merge runs: merge the adapter into the base weights and save a standalone model
model.save_pretrained_merged(
    "outputs/unsloth-nemotron-function-calling-merged", tokenizer, save_method="merged_16bit"
)- Größe: ungefähr der vollständige Base-Checkpoint in der gewählten Ausgabepräzision.
- Am besten für: Engines oder Distributionswege, die den Adapter nicht separat unterstützen.
- Trade-off: größeres Artefakt und langsameres Rollout; dafür einfacheres Laden eines einzelnen Models.
3. GGUF-Format
# What --gguf q4_k_m runs; file size and name depend on the Unsloth version
model.save_pretrained_gguf(
    "outputs/unsloth-nemotron-function-calling-gguf", tokenizer, quantization_method="q4_k_m"
)- Größe: Model-abhängig; bei Q4-Varianten grob Vier-Bit-Weights plus Metadaten.
- Am besten für: CPU-Inference, Ollama, llama.cpp, Edge-Deployment.
- Optionen:
q4_k_m(kleiner),q5_k_m(mehr Weight-Genauigkeit),q8_0(größer und genauer). Messen Sie die Auswirkung auf die Aufgabe nach der Konvertierung.
Stufe 7: Serving und Monitoring
Mit vLLM
Dieser Befehl serviert den Demo-Adapter auf dem Base Model. Servieren Sie mit dem Parser und Chat Template aus der Model Card; sie müssen zum Template aus dem Training passen. Die Model Card registriert den Parser llama_nemotron_json über die Plugin-Datei llama_nemotron_nano_toolcall_parser.py. Das Demo-Repository liefert das korrigierte Template.
Verwenden Sie eine separate Python-3.12-Umgebung mit vLLM 0.12.0: Der gepinnte Parser importiert die Tool-Parser-API dieser Version, die sich in späteren Versionen geändert hat. Der Befehl pinnt Base Model und Parser auf dieselbe Revision der Model Card; verwenden Sie diese Basisrevision auch beim Training. Quellcodekompatibilität und ein CPU-Parser-Test bestätigen keinen erfolgreichen GPU-Serving-Betrieb. Prüfen Sie das Laden des Models und den vorgesehenen Tool Call auf Ihrer GPU. Führen Sie den Befehl im Repository-Root aus:
uv venv --python 3.12 .venv-vllm
uv pip install --python .venv-vllm/bin/python "vllm==0.12.0" "huggingface-hub==0.36.0"
source .venv-vllm/bin/activate

hf download nvidia/Llama-3.1-Nemotron-Nano-4B-v1.1 \
    llama_nemotron_nano_toolcall_parser.py \
    --revision d552708a9d575fa8d4a690b988fd870d65279f98 --local-dir serving

vllm serve nvidia/Llama-3.1-Nemotron-Nano-4B-v1.1 \
    --revision d552708a9d575fa8d4a690b988fd870d65279f98 \
    --trust-remote-code \
    --enable-lora \
    --lora-modules function-calling=./outputs/unsloth-nemotron-function-calling \
    --enable-auto-tool-choice \
    --tool-parser-plugin ./serving/llama_nemotron_nano_toolcall_parser.py \
    --tool-call-parser llama_nemotron_json \
    --chat-template ./src/unsloth_demo/chat_template.jinja \
    --host 127.0.0.1 \
    --port 8000 \
    --max-model-len 4096
Das uv run --with openai infer-vllm der Demo testet die Argument-Generierung über die OpenAI-kompatible API. Es sendet ein minimales Tool, book_flight mit einem erforderlichen String destination, und bittet um einen vorgeschlagenen Aufruf; es führt keine Buchung aus. Die Anfrage in cli/inference.py lautet:
client = OpenAI(base_url="http://localhost:8000/v1", api_key="dummy")
response = client.chat.completions.create(
    model="function-calling",  # the --lora-modules name, not the base model
    messages=[{"role": "user", "content": "Book a flight to Tokyo"}],
    tools=[DEMO_TOOL],  # book_flight(destination), defined in config.py
    tool_choice="auto",
)
print(response.choices[0].message.tool_calls)
Für diese Eingabe ist das erwartete Ergebnis book_flight mit {"destination": "Tokyo"}. Weil die Tool-Auswahl automatisch erfolgt, prüfen Sie auch, ob das Model überhaupt einen Aufruf zurückgegeben hat. Das Tool hat dieselbe Form wie die glaive-Tool-Definitionen, auf denen das Model trainiert wurde. Der Parser von vLLM liest den Aufruf aus dem generierten Text, sodass ein fehlerhafter Aufruf als normaler Content ohne tool_calls zurückkommt. vLLM kann außerdem die Argumente einer Funktion auf ihr Schema beschränken, wenn die Funktion mit strict: true markiert ist; der Tool-Calling-Guide beschreibt die Server-Einstellungen und welche Parser das unterstützen.
Mit Ollama (lokal)
Listen Sie das Verzeichnis outputs/unsloth-nemotron-function-calling-gguf auf und ersetzen Sie unten MODEL_FILE.gguf durch den ausgegebenen Dateinamen; Unsloth-Versionen können Dateien unterschiedlich benennen. Eine GGUF-Datei allein belegt keine korrekte Chat-/Tool-Formatierung in Ollama oder llama.cpp. Verwenden Sie das trainierte Template und testen Sie das importierte Artefakt.
# Create Modelfile
echo 'FROM ./outputs/unsloth-nemotron-function-calling-gguf/MODEL_FILE.gguf' > Modelfile

# Import to Ollama
ollama create my-function-model -f Modelfile

# Run
ollama run my-function-model
Mit llama.cpp (CPU)
Mit demselben GGUF-Export und derselben Dateinamen-Ersetzung prüft dieser Befehl eine Klartext-Antwort. Er testet keinen vollständigen Tool Call:
llama-cli -m ./outputs/unsloth-nemotron-function-calling-gguf/MODEL_FILE.gguf \
    -p "What's the weather in Tokyo?" \
    --ctx-size 4096
Das veröffentlichte Model überwachen
Der Lebenszyklus endet nicht bei einem gesunden Trainings-Loss. Halten Sie Base-Model-Revision, Tokenizer und Chat Template, Adapter-Hash, Dataset-Version, Trainingskonfiguration und Evaluationsbericht als eine Release-Einheit fest. Überwachen Sie in Produktion Task-Erfolg, ungültige Ausgaben, Policy-Verstöße, Latency und Input Drift entlang derselben Slices wie offline. Halten Sie das vorherige Artefakt ladbar und legen Sie vor dem Launch eine Rollback-Schwelle fest.
Kurz gefasst:
- Release-Einheit: Base-Model-Revision, Tokenizer und Chat Template, Adapter-Hash, Dataset-Version, Trainingskonfiguration und Evaluationsbericht.
- Überwachen Sie Task-Erfolg, ungültige Ausgaben, Policy-Verstöße, Latency und Input Drift entlang derselben Slices wie offline.
- Fällt eine Metrik unter die vor dem Launch festgelegte Rollback-Schwelle, laden Sie das vorherige Artefakt.
Ihr nächster Test
Prüfen Sie vor einem vollständigen Run eine serialisierte Konversation und ihre Loss-Ziele und führen Sie dann einen Forward/Backward-Schritt mit maximaler Länge aus. Speichern Sie diese Konfiguration zusammen mit dem Dataset-Split und dem Baseline-Bericht. Fehlt ein Tool Schema, bewahren Sie es in der Trainings-Row auf. Wird eine Antwort abgeschnitten, passen Sie Sequenzlänge und Formatierung an, damit die vollständige Antwort erhalten bleibt. Beheben Sie diese Probleme, bevor Sie Epochen hinzufügen.
Referenzen
Papers und Forschung
- LoRA: Low-Rank Adaptation of Large Language Models
- QLoRA: Efficient Finetuning of Quantized LLMs
- DoRA: Weight-Decomposed Low-Rank Adaptation
- DPO: Direct Preference Optimization
- ORPO: Odds Ratio Preference Optimization
- PPO: Proximal Policy Optimization Algorithms — OpenAI, 2017
Tools zur Datenverarbeitung
- DataTrove — Datenverarbeitung von Hugging Face im großen Maßstab
- Distilabel — Generierung synthetischer Daten (Argilla)
- Trafilatura — Textextraktion und Crawling im Web
- fastText language identification — vortrainierte Models zur Spracherkennung
- Microsoft Presidio — PII-Erkennung und Anonymisierung
- scrubadub — Python-Bibliothek zum Entfernen von PII
Constrained Decoding
Trainings-Frameworks
- Unsloth — Optimiertes Fine-Tuning-Framework
- Axolotl — Config-driven Training und Launcher für verteiltes Training
- TRL — SFT- und Preference-Training-Bibliothek von Hugging Face
- PEFT model merging —
add_weighted_adapterund Merging-Methoden - Torchtune — PyTorch-native Fine-Tuning-Bibliothek, nicht mehr aktiv gepflegt
Inference und Deployment
- vLLM LoRA adapters — Einen oder mehrere Adapter mit dem Base Model servieren
- vLLM tool calling — Auto Tool Choice, Parser, Chat Template und Request-Schema auf das Model abstimmen
- Llama-3.1-Nemotron-Nano-4B-v1.1 model card — Tool-Call-Parser-Plugin und Chat Template für vLLM
- Ollama — Lokaler LLM-Runner für Mac/Windows/Linux
- llama.cpp — CPU/GPU-Inference mit dem GGUF-Format
Evaluation
- lm-evaluation-harness — Standardisiertes LLM-Benchmarking von EleutherAI
- Berkeley Function Calling Leaderboard — Evaluationscode für Function Calling
Guides und Ressourcen
- Demo Repository — Praktisches Fine-Tuning-Beispiel
- Accelerate n-D Parallelism Guide — Multi-GPU-Trainingsstrategien von Hugging Face