Руководство по файн-тюнингу LLM: когда он нужен, LoRA и QLoRA

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Это руководство для Python-инженеров, которые решают, нужно ли файн-тюнить большую языковую модель и как это делать. Вы узнаете, когда файн-тюнинг лучше промптинга или retrieval и как выбирать между такими методами, как LoRA и QLoRA. Руководство также объясняет, как подготовить данные, оценить обученную модель и спланировать её деплой.
В практической части запускается репозиторий-компаньон, который файн-тюнит модель на 4B параметров для function calling.
Более короткое сравнение файн-тюнинга, RAG и промптинга см. в статье Fine-Tuning vs RAG vs Prompting.
Нужно ли вообще файн-тюнить?
Прежде чем тратить часы работы GPU, решите, подходит ли файн-тюнинг для вашей задачи. Рисунок прослеживает один запрос и показывает, где действует каждое из четырёх решений, на каком сбое проверять его в первую очередь и чего оно не исправит.
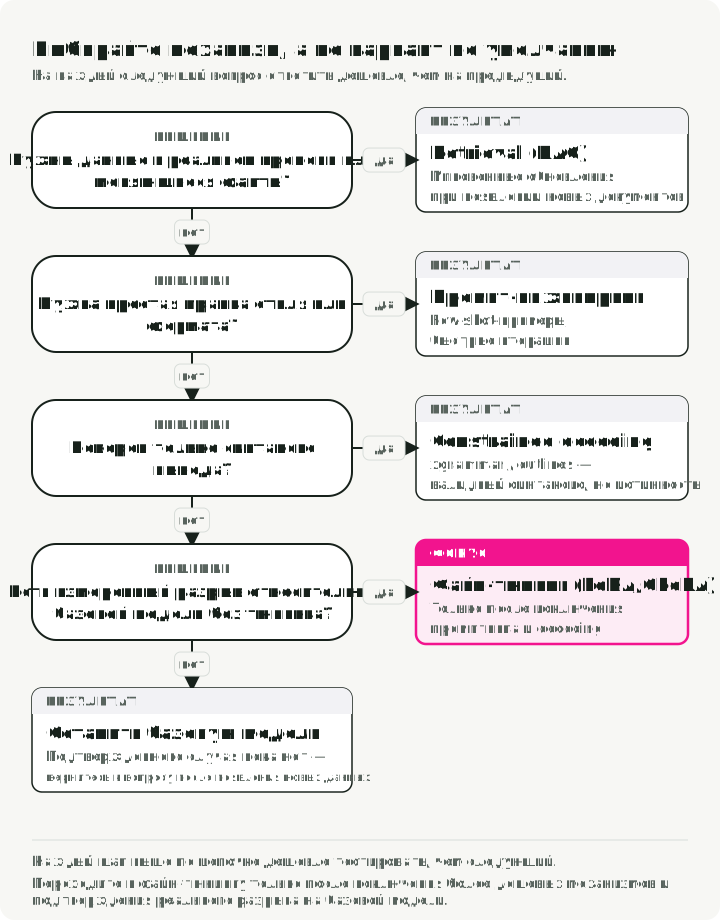
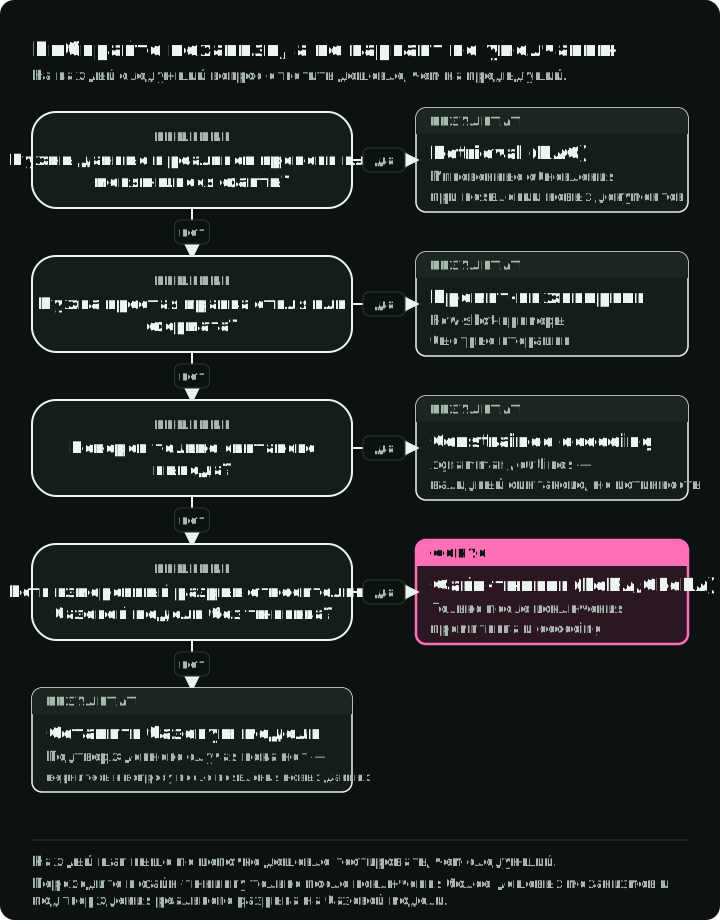
Файн-тюнинг меняет поведение, закодированное в весах. Retrieval подставляет свидетельства во время инференса, поэтому он лучше подходит как отправная точка для фактов, которые меняются или требуют ссылок на источники. Новые документы становятся доступны только после ingestion и индексации; сверьте эту свежесть со своим требованием.
Чёткие промпты и примеры дешевле итерировать, чем новый запуск обучения. Они могут уже решать проблему стиля или следования инструкциям. Файн-тюнинг может сократить число повторяющихся токенов промпта, но латентность сервинга зависит от модели, длины вывода, железа и реализации; обновление весов само по себе не ускоряет модель.
Для синтаксиса библиотеки xgrammar и outlines маскируют недопустимые следующие токены в рамках поддерживаемой схемы или грамматики. Успешно завершённая генерация с ограничениями принадлежит этому языку. Обрезанные и другие незавершённые генерации обрабатывайте отдельно и проверяйте результат, прежде чем использовать его. Ограничение не сделает ID клиента истинным, а выбор инструмента подходящим. Латентность измеряйте на своём бэкенде и не полагайтесь на фиксированные накладные расходы.
Каждый из четырёх вариантов меняет свой шаг одного и того же запроса. Только файн-тюнинг требует запуска обучения и нового артефакта модели; остальные три меняют текст, документы или схему вокруг тех же весов. Таблица сравнивает четыре варианта:
| Вариант | Что он меняет | Как его обновлять | Стоимость внедрения | Чего он не исправит |
|---|---|---|---|---|
| Промптинг | Инструкции и примеры | Правка текста | Низкая: написать и проверить промпты | Поведение, которому модель не может следовать по инструкции |
| RAG | Свидетельства в контекстном окне | Загрузка и переиндексация документов | Средняя: индекс, ретривер и оценка | Модель, которая игнорирует или неверно читает свидетельства |
| Constrained decoding | Какие токены декодер может выдавать | Изменение схемы или грамматики | От низкой до средней: схема и поддержка бэкенда | Неверные значения внутри валидной структуры |
| Файн-тюнинг | Веса модели | Переобучение и оценка нового артефакта | Высокая: подготовка данных, время GPU, оценка | Факты, которые изменились после обучения |
Краткая справка: какая проблема — какое решение
| Проблема | Что проверить первым | Почему |
|---|---|---|
| Не хватает знаний | RAG | Подтягивает свидетельства со ссылками; свежесть зависит от ingestion и индексации |
| Неверный формат или тон | Промпт-инжиниринг | Современные модели хорошо следуют инструкциям о стиле благодаря few-shot примерам |
| Недопустимый синтаксис вывода | Constrained decoding | Навязывает поддерживаемую схему или грамматику во время генерации |
| Задача стабильно проваливается | Файн-тюнинг (SFT) | Учится на подобранных парах вход/выход |
| Расхождение в парных предпочтениях | Оптимизация предпочтений | Использует пары выбранный/отклонённый, когда поведение на задаче уже можно измерить |
| Латентность и стоимость в масштабе | Дистилляция (SFT) | Обучает меньшую модель-студента на выводах большей модели-учителя |
| Уменьшить размер модели | Пост-тренировочная квантизация | Она уменьшает память под веса; скорость зависит от поддерживаемых ядер и нагрузки |
Сделайте бизнес-кейс измеримым
Файн-тюнинг может сократить повторяющиеся токены промпта или позволить меньшей модели достичь цели, но ни то ни другое не происходит автоматически. Посчитайте точку безубыточности на своём трафике и своих тарифах:
Если знаменатель мал, отрицателен или опирается на недоказанное предположение о качестве, у проекта пока нет экономического обоснования.
Пример с условными числами: базовый промптовый вариант отправляет с каждым запросом около 2 000 токенов инструкций и примеров. После файн-тюнинга той же задаче нужно около 50. При допущении $0.50 за миллион входных токенов для обеих моделей экономия составляет 1 950 токенов, или около $0.001 на запрос. Если обучение, оценка и деплой стоят $3 000, точка безубыточности — около 3,1 млн запросов. При 100 000 запросов в день это около месяца. При 5 000 запросов в день — больше года. Расчёт верен, только если файн-тюненная модель проходит те же пороги качества, что и базовая.
Гибридная схема. Распространённая архитектура — меньшая модель, адаптированная под задачу, плюс retrieval для меняющихся фактов. Считайте базовым вариантом большую модель с промптом и оставляйте меньшую, только если она проходит те же пороги качества и безопасности для задачи.
Виды файн-тюнинга
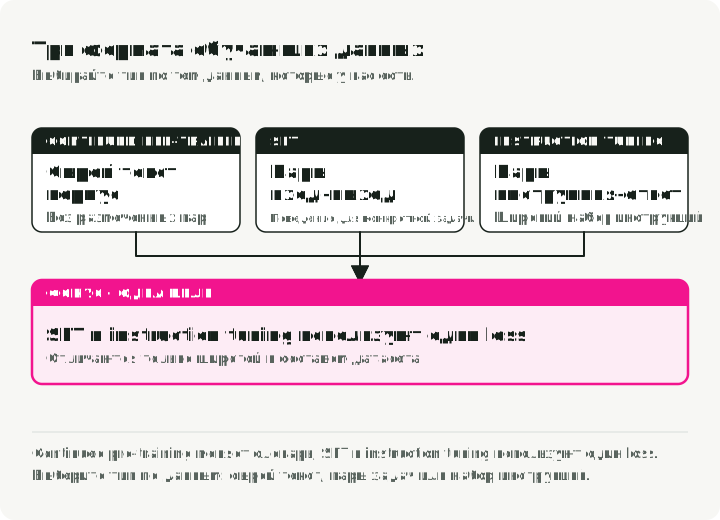
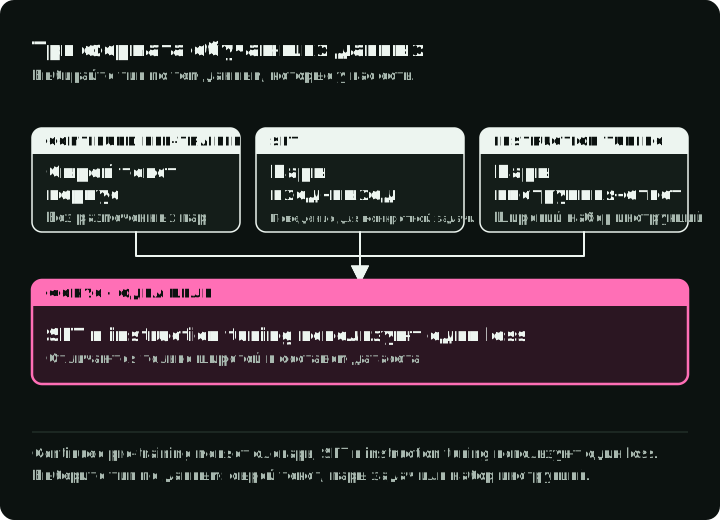
Файн-тюнинг бывает трёх основных видов. Они различаются тем, какие данные нужны и чему они учат модель. Диаграмма показывает по одной обучающей строке для каждого вида.
1. Продолжение претрейнинга (самообучение)
Вы обучаете базовую модель на дополнительном сыром тексте, используя следующий токен в каждой последовательности как цель обучения. Это self-supervised learning: текст сам задаёт цели, как и в исходном запуске претрейнинга.
Когда использовать:
- В домене есть лексика, которую базовая модель не видела (медицина, право, внутренние кодовые базы).
- У вас много текста по домену, но нет размеченных пар (вход, выход).
- Базовая модель путается в терминологии предметной области.
Пример: обучение на миллионах клинических записей, чтобы модель усвоила медицинские аббревиатуры, названия лекарств и клинические процессы.
2. Файн-тюнинг с учителем (SFT)
SFT обучает на размеченных парах (вход, выход). Вы показываете модели точный вывод, который хотите получить для каждого входа.
Когда использовать:
- У вас конкретная задача с чётким форматом входа и выхода.
- У вас есть качественные размеченные данные, пусть и немного.
- Нужно предсказуемое поведение на известной форме входа.
Пример: обучение на парах (описание SQL-запроса, SQL-код) для text-to-SQL. Этот фиксированный календарный интервал предполагает, что signup_date хранится в UTC:
{
    "input": "Get users who signed up in August 2026 (UTC)",
    "output": "SELECT * FROM users WHERE signup_date >= '2026-08-01' AND signup_date < '2026-09-01'"
}
3. Instruction tuning
Instruction tuning — частный случай SFT, цель которого — научить модели следовать самым разным инструкциям на естественном языке. Обучающие данные — пары (инструкция, ответ) по множеству разных задач.
Когда использовать:
- Вам нужен ассистент общего назначения (вроде ChatGPT или Claude).
- Модель должна справляться с разнообразными открытыми запросами.
- Вы строите чат-интерфейс.
Пример: обучение на тысячах разнообразных инструкций вроде «Кратко перескажи эту статью», «Напиши стихотворение про X», «Объясни Y простыми словами».
Сравнение
| Аспект | Продолжение претрейнинга | SFT | Instruction tuning |
|---|---|---|---|
| Данные | Сырой текст | Пары (вход, выход) | Пары (инструкция, ответ) |
| Разметка | Нет (self-supervised) | Под конкретную задачу | Разные задачи |
| Цель | Знания домена | Поведение на конкретной задаче | Следование любой инструкции |
| Объём данных | Обычно самый большой корпус | Определяется покрытием задачи и разнообразием ошибок | Обычно шире, чем для SFT под одну задачу |
Одна цель, два датасета. SFT и instruction tuning используют одну и ту же цель предсказания следующего токена; различаются они шириной и способом построения датасета. Продолжение претрейнинга — отдельный эксперимент, после него нужно проверить и прирост в домене, и регрессию общих способностей.
Семь этапов файн-тюнинга
В файн-тюнинге семь этапов. У каждого свои типичные сбои, и пропуск одного этапа обычно проявляется позже плохой моделью. Диаграмма показывает этапы по порядку, что каждый этап добавляет в запись о релизе, и обратный путь от мониторинга к подготовке данных.
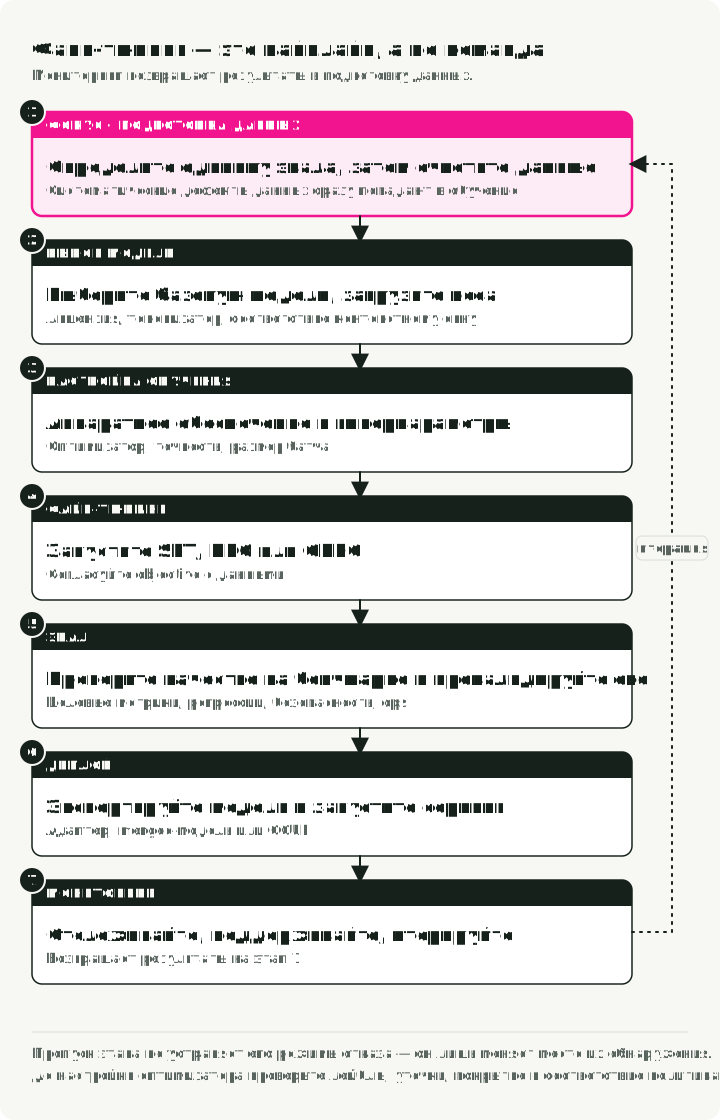
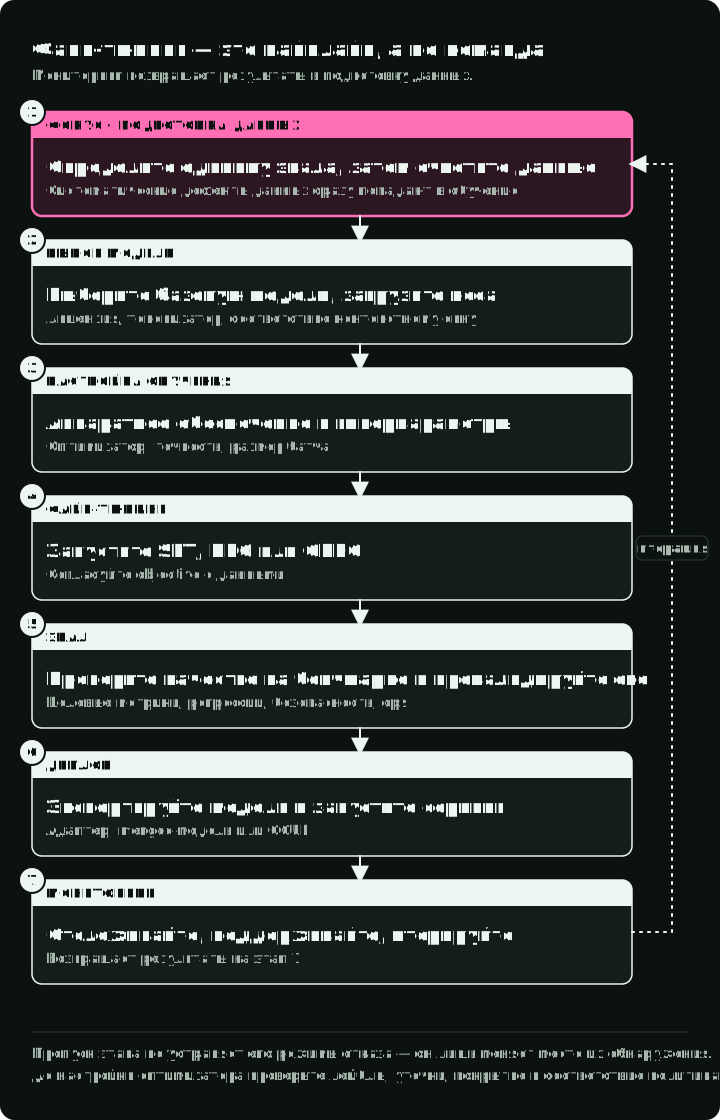
Каждый этап опирается на предыдущий:
- Подготовка данных — определите единицу оценки, разделите данные, затем очистите и отформатируйте их
- Выбор модели — выберите подходящую базовую модель и загрузите веса
- Настройка обучения — проверьте сериализацию и цели loss, затем выберите метод (LoRA, QLoRA, DoRA) и его параметры
- Файн-тюнинг — запустите SFT во фреймворке; добавляйте DPO или ORPO, только если нужно
- Оценка — измерьте производительность и проверьте качество
- Деплой — экспортируйте и разверните модель
- Мониторинг — отслеживайте качество, поддерживайте и итерируйте
Данные — основа. Обучение воспроизводит систематические дефекты примеров. Проверьте разметку, утечки, покрытие и соответствие политикам, прежде чем тратить время на перебор параметров оптимизатора.
Этап 1: подготовка данных
Проблемы в данных попадают в обученную модель, поэтому этому этапу уделяют больше всего внимания. Диаграмма прослеживает примеры тикетов через этот порядок: сначала разделение по источнику, затем пять преобразований внутри каждой части.
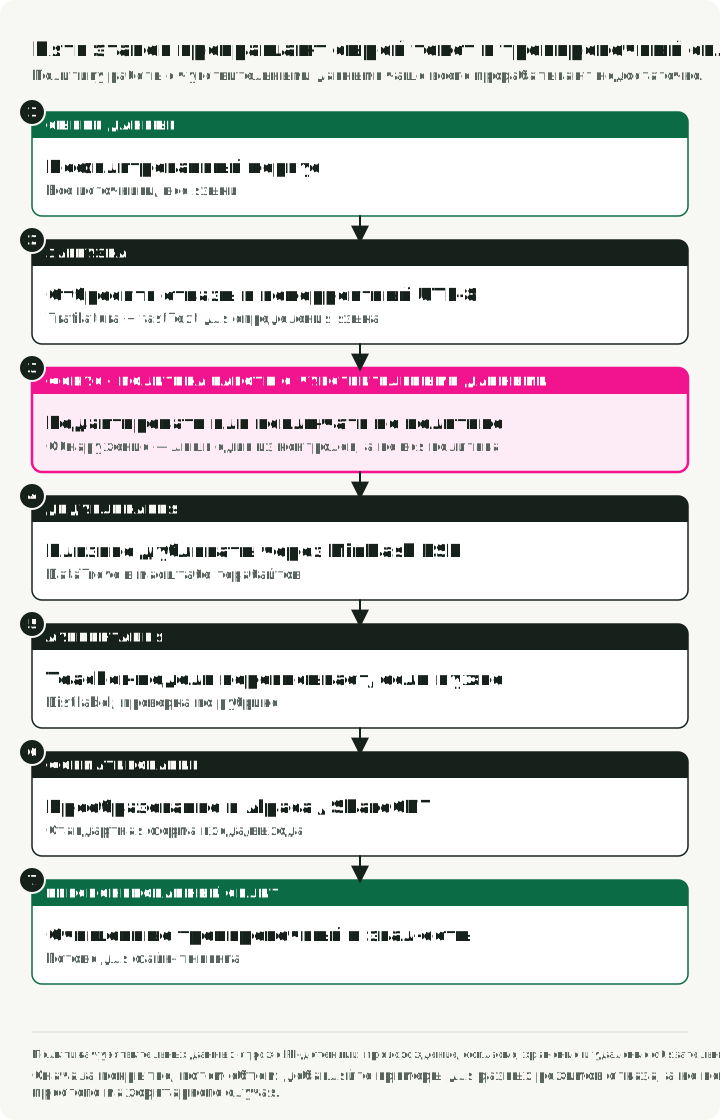
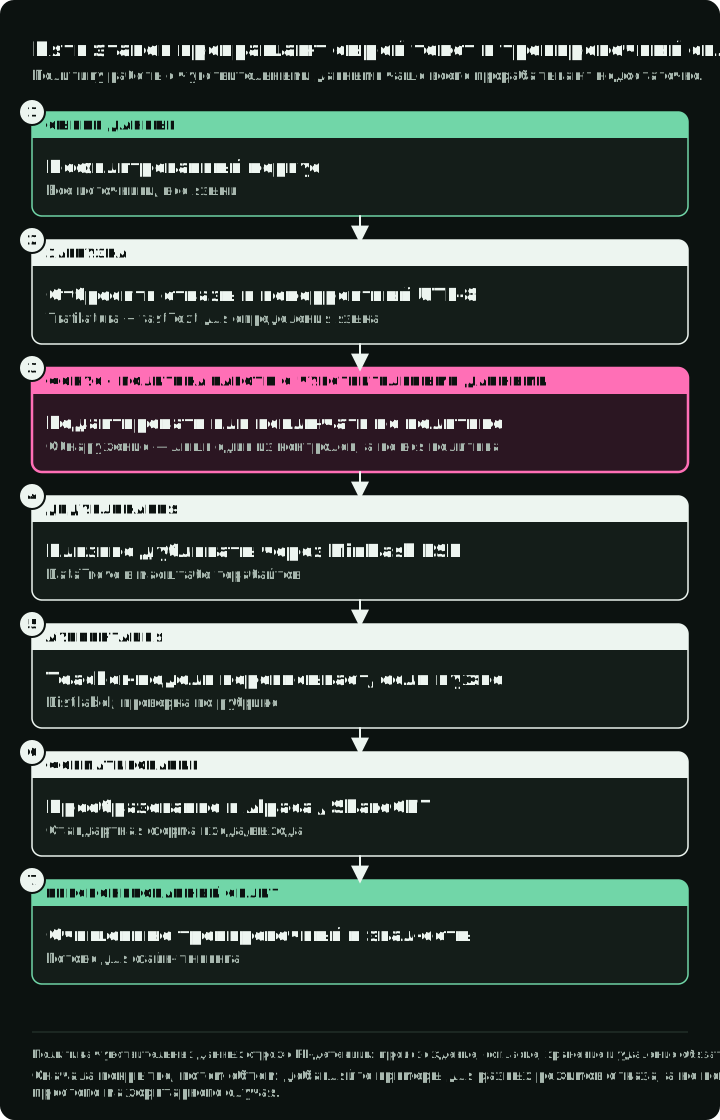
Пять преобразований после разделения по источнику
Отнесите группы источников к обучению или оценке до преобразования строк. Тикет поддержки и все его переписанные варианты остаются в одной части. Перед назначением групп объедините в кластеры известные почти-дубликаты, а после очистки проверьте разделение ещё раз. Заморозьте набор для оценки; аугментируйте только обучающие данные.
Перечислите ошибки, которые ваши примеры должны научить модель исправлять, затем определите обязательные поля и метки каждой строки. Выберите для этих шагов инструменты обработки. DataTrove запускает фильтрацию и дедупликацию как распределённые задачи для больших корпусов; Distilabel генерирует и размечает синтетические строки с помощью модели-учителя.
1. Ingestion и фильтрация
- Действие: удалите битый UTF-8 и тексты не по теме. Отказы размечайте по политике: правильные отказы оставляйте как обучающие цели и тестовые случаи; исключайте только некорректные отказы и отказы не по теме.
- Инструменты: Trafilatura, если источник — веб-страницы; для данных, которые уже являются текстом, её не используйте. Модели определения языка fastText для определения языка.
2. Политика для чувствительных данных
- Действие: решите, чему модели разрешено учиться, затем скройте, токенизируйте или исключите персональные и конфиденциальные поля, как требуется.
- Инструменты: Microsoft Presidio, если нужны настраиваемые распознаватели, несколько языков или обратимая анонимизация; scrubadub для более компактного пайплайна на чистом Python, который удаляет из текста типичные персональные данные.
- Почему: детектор — лишь один из механизмов контроля; требования к происхождению данных, согласию, хранению, доступу и удалению по-прежнему действуют.
3. Дедупликация (MinHash LSH)
- Действие: удалите почти-дубликаты, чтобы снизить повторы и риск утечки; от запоминания это не защищает.
- Инструменты: DataTrove, когда корпус требует распределённой обработки.
4. Синтетическая аугментация, если нужна
- Действие: с помощью подходящей модели-учителя перепишите обучающие примеры в пары инструкция-ответ, сохранив их исходные ID. Отложенную часть не аугментируйте.
- Инструменты: Distilabel.
- Проверка: выборочно просмотрите ответы учителя, сверьте их с тем же рубрикатором, что и разметку людей, и сообщайте результаты отдельно для синтетических и написанных людьми примеров. Такое подмножество для оценки называется срезом (slice); другие полезные срезы — язык и тип задачи.
5. Форматирование
- Действие: приведите данные к стандартному формату (Alpaca или ShareGPT).
Примеры форматов данных
Формат Alpaca (следование инструкциям):
{
    "instruction": "Summarize the following text.",
    "input": "The text to be summarized...",
    "output": "This is the summary."
}
Хранение в стиле ShareGPT (диалоги):
{
    "conversations": [
        { "from": "user", "value": "Hello, who are you?" },
        { "from": "assistant", "value": "I am a helpful AI assistant." }
    ]
}
Проверки датасета
- Покрытие важнее объёма. Добавляйте примеры, которые представляют разные виды сбоев, а не повторения простого массового случая.
- Чистота. Убирайте нерелевантный текст, нормализуйте пробелы, соблюдайте единый формат.
- Баланс. Сохраняйте важные редкие случаи и сообщайте качество по срезам.
- Разделение. Делите по источнику, пользователю, документу или времени, если случайное разделение строк допустило бы утечку почти-дубликатов.
- Происхождение. Записывайте источник, лицензию или разрешение, историю преобразований и путь удаления для каждой версии датасета.
Этап 2: выбор модели и железа
Базовая модель и минимальный требуемый ей объём памяти GPU определяют, что вы сможете обучить.
Начните с самой маленькой базовой модели, которая уже проходит обязательные базовые проверки. Убедитесь в следующем:
- лицензия и условия распространения подходят для предполагаемого продукта;
- язык, домен, tool use и безопасность модели проверены до адаптации;
- токенизатор и чат-шаблон совместимы с датасетом;
- максимальный контекст и поведение при усечении соответствуют реальным примерам;
- есть поддержка и в фреймворке для обучения, и в целевом движке сервинга.
Файн-тюнинг — шаг адаптации, а не способ исправить неподходящую базовую модель. Если модель не справляется с задачами, которых нет в датасете, выберите другую базовую модель, а не запускайте ещё эпохи.
Оцените память для своего запуска
Постоянной таблицы «размер модели → GPU» не существует. Пиковая память зависит от точности весов, оптимизатора, числа обучаемых параметров, длины последовательности, размера микробатча, activation checkpointing, реализации аттеншна и накладных расходов фреймворка. Начните с оценки памяти, затем запустите короткий smoke-тест на максимальной длине на точно том же стеке.
| Компонент памяти | Полный файн-тюнинг | LoRA | QLoRA |
|---|---|---|---|
| Базовые веса | Точность обучения | Заморожены, обычно BF16/FP16 | Заморожены, обычно 4-bit NF4 |
| Градиенты | Все обучаемые веса | Веса адаптера | Веса адаптера |
| Состояния оптимизатора | Все обучаемые веса | Веса адаптера | Веса адаптера |
| Активации | Зависят от батча и длины последовательности в любом методе | Та же зависимость | Та же зависимость |
График применяет таблицу к базовой модели демо, Nemotron-Nano-4B с 4,51 млрд параметров. Он делит приблизительную память каждого метода на веса и обучаемое состояние; активации добавляются сверху.
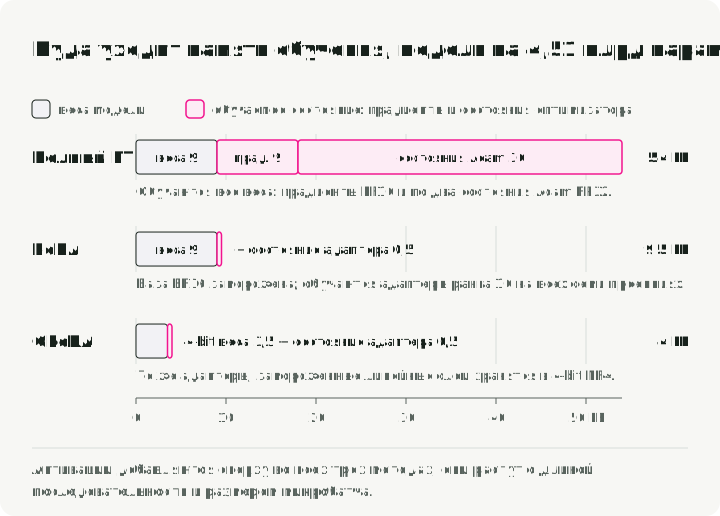
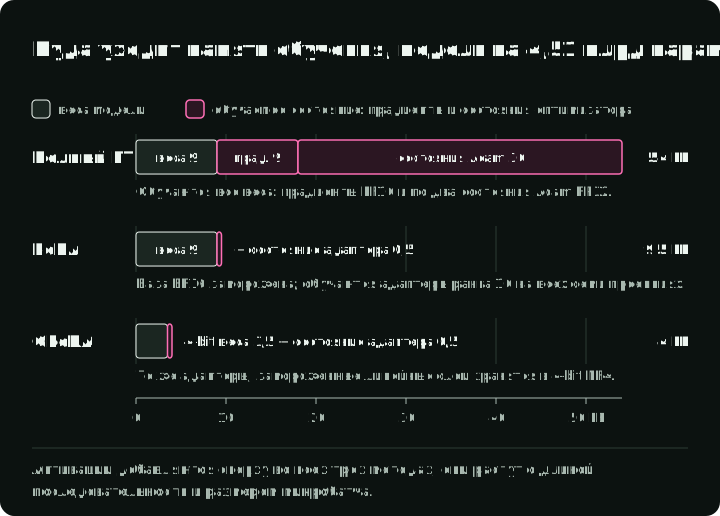
В оригинальной статье про QLoRA модель LLaMA на 65B поместилась на одну GPU с 48 ГБ в конкретной конфигурации. Этот результат — полезная граница, а не обещание, что любая современная архитектура на 70B, длина контекста, ядро или тренер поместятся на то же устройство.
Математика памяти
Для модели с параметрами одни только веса занимают примерно байт в BF16/FP16 или байт при четырёх битах, не считая метаданных квантизации и рантайм-буферов. Полное обучение в стиле Adam добавляет градиенты, состояния оптимизатора и часто мастер-веса повышенной точности. LoRA избавляет от большей части памяти под обучаемое состояние; QLoRA дополнительно уменьшает размер замороженных базовых весов. Активации при длинных последовательностях всё равно могут доминировать.
Порядок действий:
- Выберите самую длинную последовательность и микробатч, которые нужно поддерживать.
- Оцените веса и обучаемое состояние, оставив запас под активации и ядра.
- Выполните один прямой и обратный проход на максимальной длине.
- Запишите пиковую выделенную и зарезервированную память.
- Только после этого увеличивайте размер батча, ранг, длину последовательности или число GPU.
Этап 3: настройка обучения и методы
Этап 3 состоит из двух частей. Сначала проверьте, что каждая сохранённая строка превращается в тот обучающий текст, который вы ожидаете. Затем выберите метод обучения и его параметры.
От сохранённых строк к обучающим целям
ShareGPT — это форма датасета; ChatML — одно из соглашений о сериализации. Преобразуйте from/value в роли и поля, которые принимает тренер, затем используйте чат-шаблон выбранной модели. Не подставляйте токены ChatML только потому, что данные диалоговые.
Строка проходит пять шагов:
- Строка ShareGPT: пары
from/value. messagesиtools: роли, которые принимает тренер.apply_chat_templateс шаблоном выбранной модели. Инференс должен использовать тот же шаблон.- ID токенов и метки, где
-100означает отсутствие loss. - Обучение.
Выведите отрендеренный текст шага 3 до обучения.
Для строки с приветствием выше нормализованные сообщения выглядят так:
messages = [
    {"role": "user", "content": "Hello, who are you?"},
    {"role": "assistant", "content": "I am a helpful AI assistant."},
]
# Inspection step after loading the selected model's tokenizer:
rendered = tokenizer.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=False,
)
print(rendered)
Перед обучением проверьте реально сериализованную строку: разделители ролей, токены конца реплики и схемы инструментов должны совпадать с инференсом. Для строки с tool use храните определения инструментов, tool calls ассистента и результаты инструментов как отдельные поля. Проверьте, что усечение не удаляет ответ, на котором идёт обучение, и не обрывает аргумент вызова посередине.
Маскирование loss выбирает, за предсказание каких токенов модель получает награду. При обучении на полной последовательности вклад могут давать текст пользователя, системы, инструментов и ассистента. При обучении только на ассистенте эти контекстные токены остаются видимыми для аттеншна, но их метки игнорируются (обычно -100); вклад дают только фрагменты ассистента. Для этого приветствия ответ должен быть целью, а вопрос пользователя — нет, если подразумевается обучение только на ассистенте.
Диаграмма показывает обе настройки для одного диалога с tool use.
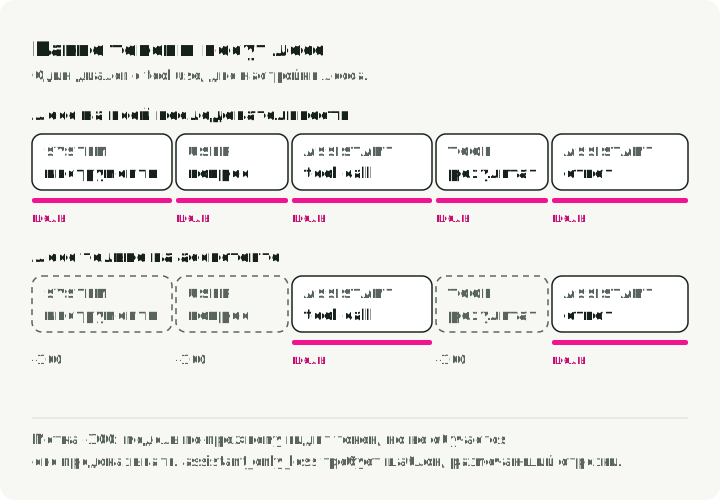
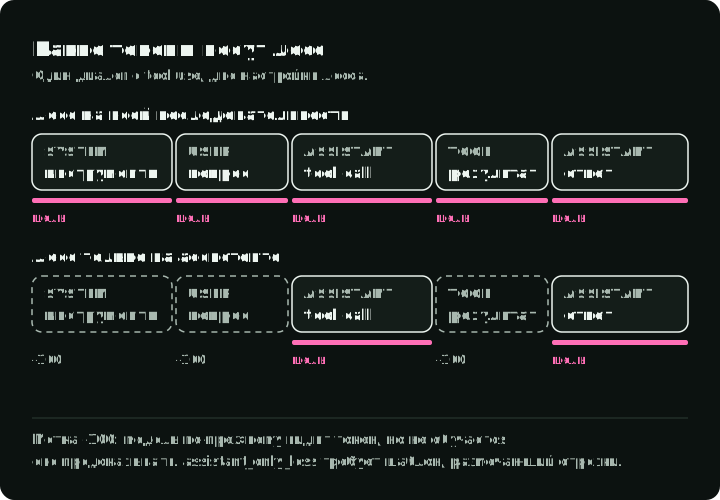
Документация TRL по SFT поддерживает assistant_only_loss=True для диалоговых датасетов, шаблоны которых размечают generation spans. Шаблон без таких фрагментов не может дать такую маску. Для датасетов prompt/completion есть отдельная опция completion_only_loss. Прежде чем включать любую из них, проверьте один токенизированный батч и декодируйте токены, чьи метки не игнорируются. Затем повторите проверку с диалогом с инструментами и с примером максимальной длины. Демо дальше в этом руководстве использует loss по полной последовательности, потому что в шаблоне Nemotron нет generation spans.
Выберите длину последовательности по распределению данных и выполните проверку памяти на максимальной длине из этапа 2. Packing помещает несколько коротких примеров в одну обучающую последовательность. Начните без него, чтобы границы строк было легко проверять. Тестируйте packing только после того, как сериализованные строки и метки верны.
Полный файн-тюнинг и PEFT
Полный файн-тюнинг (FFT) обновляет каждый вес, поэтому градиенты и состояние оптимизатора растут вместе со всей моделью. Пик нельзя вывести только из числа параметров, но он намного выше памяти, нужной для загрузки весов под инференс.
Parameter-efficient fine-tuning (PEFT) обучает лишь небольшое подмножество параметров, а остальные замораживает, поэтому градиенты и состояния оптимизатора относятся только к этому подмножеству.
LoRA: отправная точка
LoRA (Low-Rank Adaptation) замораживает предобученную матрицу и представляет её выученное обновление двумя меньшими матрицами. Оригинальная статья обосновывает это гипотезой, что полезные обновления при адаптации имеют низкий внутренний ранг.
Здесь — ширина входа слоя, а — ширина его выхода. Ранг — меньшая общая размерность двух обучаемых матриц: чем меньше ранг, тем меньше обучаемых параметров. Параметр задаёт масштаб обновления через отношение .
Диаграмма показывает замороженную матрицу, две обучаемые матрицы и то, как их масштабированное произведение добавляется к ней, а также число параметров для одной матрицы шириной 4 096 при ранге 16.
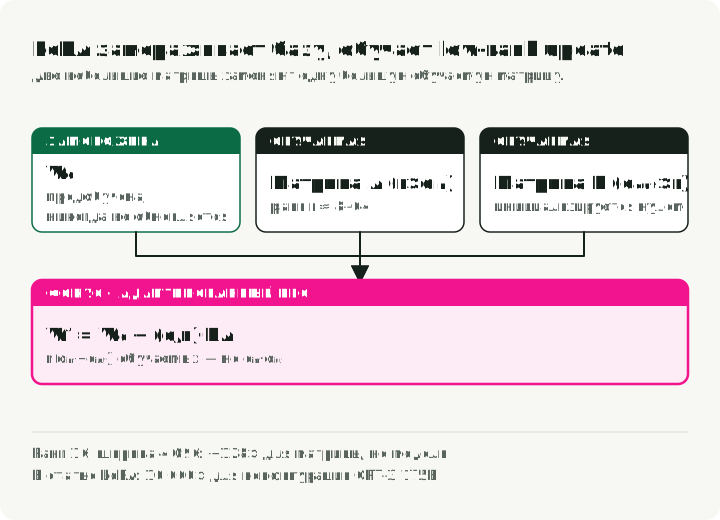
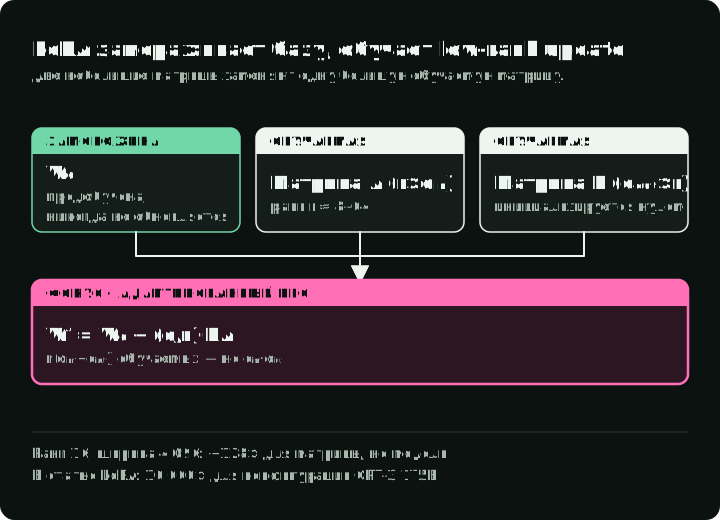
Для замороженной матрицы LoRA обучает:
Адаптированный слой:
У адаптера обучаемых параметров вместо для этой матрицы. Для квадратной матрицы шириной 4 096 при ранге 16 это сокращение обучаемых параметров в 128 раз для данной матрицы. Экономия по всей модели зависит от того, какие матрицы получают адаптеры.
Сравнение методов PEFT
| Метод | Что меняется | Когда выбирать |
|---|---|---|
| LoRA | Замороженная база плюс обучаемые низкоранговые обновления | Базовая модель комфортно помещается, и нужны небольшие артефакты под задачу |
| QLoRA | LoRA с замороженной базой, хранящейся в 4-bit виде | Ограничивающий фактор — память под базовые веса |
| DoRA | Отделяет величину веса от направления, обновляемого через LoRA | Измеренный базовый уровень LoRA оставляет разрыв в качестве, который стоит дополнительной сложности |
| Полный файн-тюнинг | Все веса модели | PEFT не достигает цели, а прирост качества оправдывает распределённое обучение и полные чекпоинты |
DoRA: LoRA с декомпозицией весов
DoRA (Weight-Decomposed Low-Rank Adaptation) отделяет величину каждого вектора весов от его направления. Статья про DoRA применяет обновление LoRA к компоненте направления, а величину обучает отдельно. Диаграмма рисует один столбец весов как стрелку: B·A поворачивает его направление, а обученная величина m задаёт его длину.
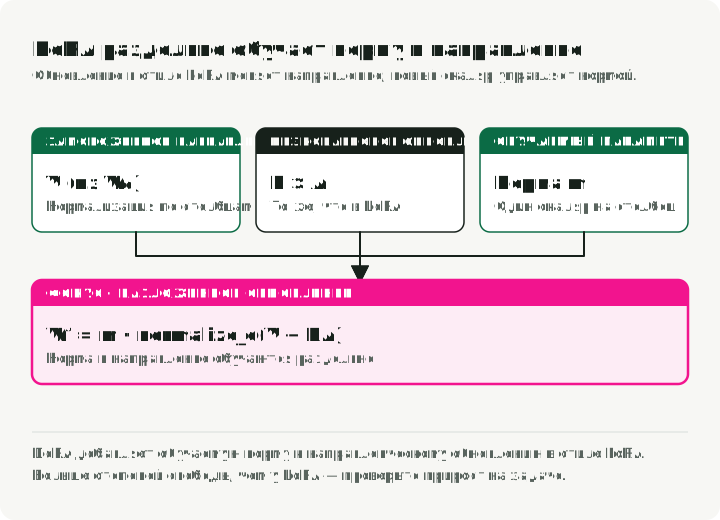
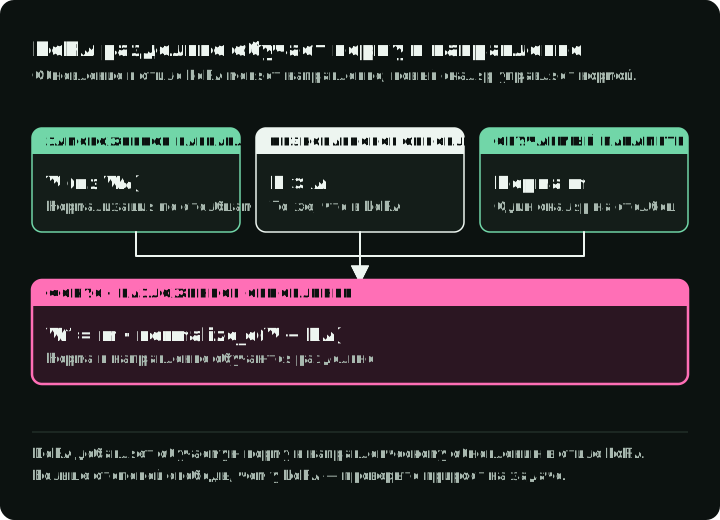
Как это работает:
Вместо того чтобы считать веса единым целым, DoRA разбивает предобученные веса на две компоненты:
- Величина — обучаемое значение на каждый вектор весов.
- Направление — нормализованный вектор, обновляемый через низкоранговые матрицы.
В компактной записи по столбцам:
где:
m= величина (обучаемая)- = замороженная исходная матрица; нормализация выполняется после добавления
- = выученное низкоранговое обновление направления
- = нормализация по столбцам
Эффекты декомпозиции:
- Больше степеней свободы, чем у стандартной LoRA, потому что величина может меняться независимо.
- Результаты лучше, чем у LoRA, в нескольких конфигурациях, о которых сообщает предлагающая метод статья.
- Дополнительные параметры и вычисления, поэтому выигрыш стоит проверить на своей задаче и своём пути сервинга.
Слияние адаптеров для мультизадачности
Отдельные адаптеры позволяют одной замороженной базе поддерживать несколько задач. Можно направлять запросы к нужному адаптеру, обслуживать несколько адаптеров одним движком, если он это поддерживает, или создать офлайн слитого кандидата. Слияние может вносить интерференцию, поэтому оценивайте слитый артефакт и не считайте, что исходные адаптеры сочетаются без потерь.
На рисунке сравниваются два варианта для двух адаптеров на одной базе. Оставляйте слитую модель, только если она проходит оба набора тестов.
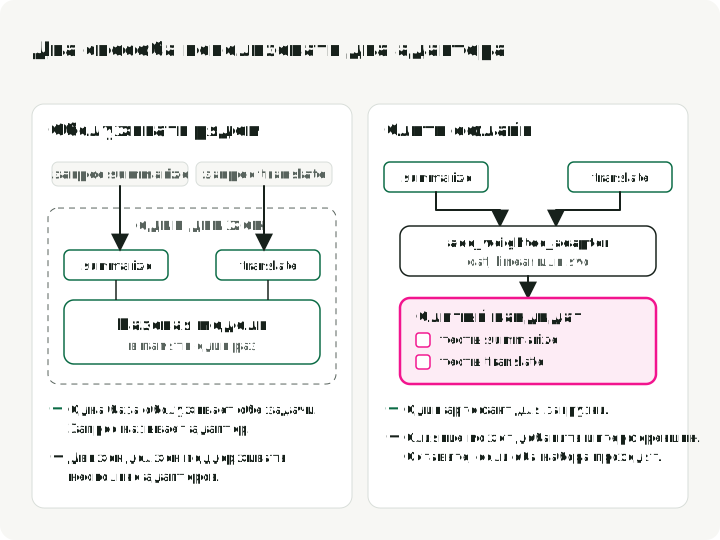
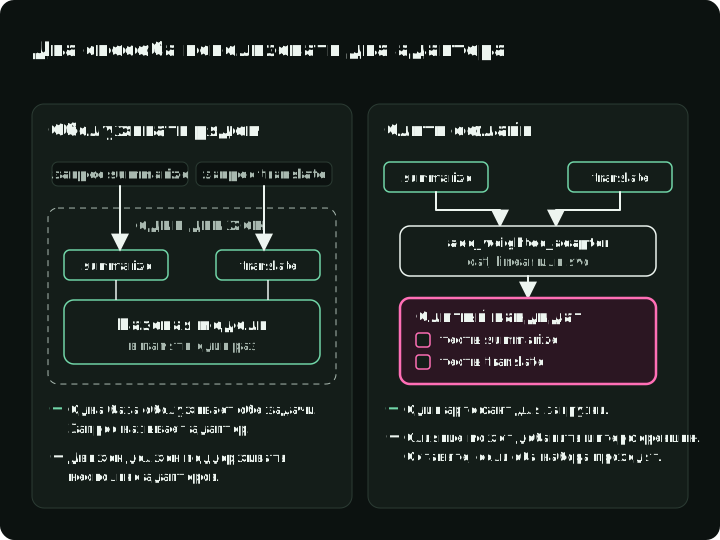
Распространённые методы слияния:
- Конкатенация — объединить параметры адаптеров и увеличить эффективный ранг. Быстро и просто.
- Линейная комбинация — взвешенная сумма адаптеров. Веса задают вклад каждой задачи.
- SVD — матричное разложение для слияния. Гибче, но медленнее.
add_weighted_adapter в PEFT реализует их как combination_type="cat", "linear" и "svd"; руководство PEFT по слиянию моделей описывает их и более новые методы.
Пример: один адаптер для суммаризации, другой для перевода, слитые в одну мультизадачную модель.
Этап 4: выравнивание по предпочтениям (необязательно)
SFT — основной запуск обучения, и разделы о фреймворках после этого этапа выполняют именно его. Этот этап описывает, что можно добавить после SFT, если этого требуют ошибки.
SFT учится на демонстрациях. Оптимизация предпочтений вместо этого учится на сравнениях вроде «выбранный ответ A лучше отклонённого ответа B». Используйте её, только если парное предпочтение — подходящая метка для данной ошибки; фактическая корректность и соответствие политикам часто требуют более сильных оценщиков, чем глобальное предпочтение.
Диаграмма показывает этапы каждого метода, модели, которые он загружает, и что делает один шаг обучения.
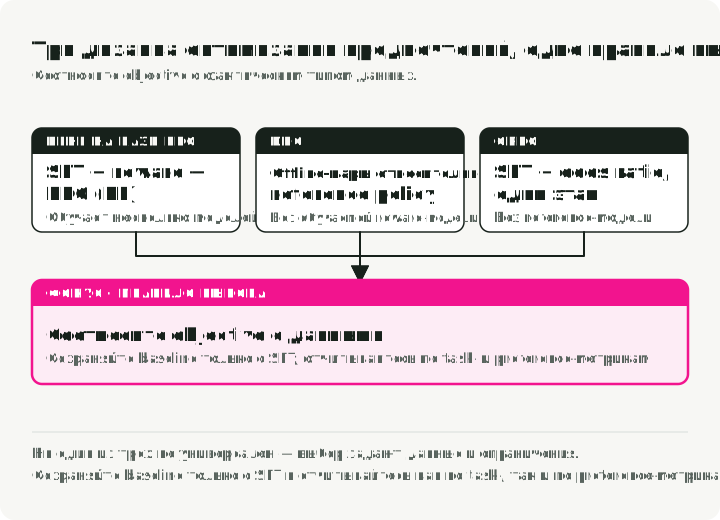
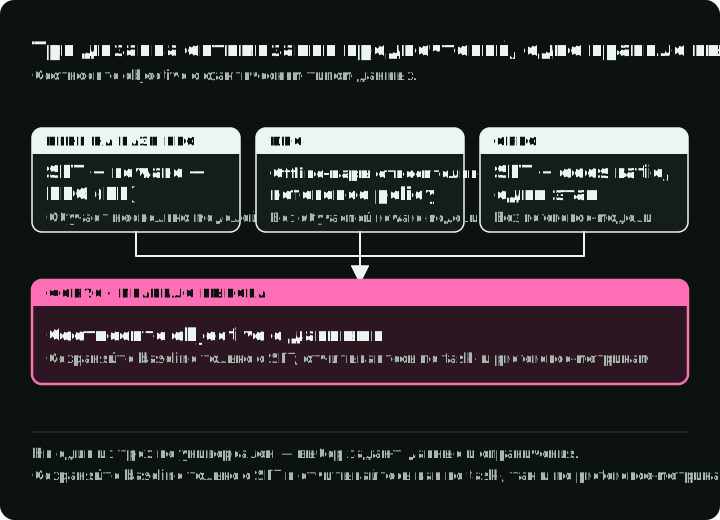
RLHF на основе PPO
RLHF — это reinforcement learning from human feedback, обучение с подкреплением на основе обратной связи от людей. Политика (policy) — это языковая модель, которая генерирует ответы; модель вознаграждения оценивает эти ответы по предпочтениям, выученным из человеческих сравнений. Рецепт на основе PPO состоит из трёх этапов:
- SFT — выучить задачу.
- Модель вознаграждения — обучить на человеческих предпочтениях (выбранный и отклонённый ответы).
- PPO (Proximal Policy Optimization) — генерировать ответы и обновлять языковую модель так, чтобы повышать их оценки вознаграждения.
Эксплуатационная стоимость зависит от нескольких компонентов:
- Сложно реализовать и поддерживать.
- Дорого — обучается несколько моделей.
- Сэмплирование из обучаемой модели требует проверок на нестабильные обновления и на ответы, которые эксплуатируют модель вознаграждения, не выполняя задачу.
DPO
DPO (Direct Preference Optimization) отказывается от отдельной модели вознаграждения и цикла обучения с подкреплением. Она поощряет выбранные ответы и одновременно удерживает модель от больших отклонений от фиксированной стартовой модели, которую называют референсной. Статья про DPO выводит эту цель, ограничивая, насколько вероятности ответов могут уйти от референса; математическое ограничение — это KL-дивергенция.
Пара предпочтений содержит один и тот же промпт и два варианта ответа. Эта сокращённая строка показывает её поля; в реальной разметке нужны полные ответы и причина предпочесть один из них:
{
    "prompt": "Explain quantum computing",
    "chosen": "Quantum computing uses qubits...",   # Preferred response
    "rejected": "Well, it's complicated..."        # Non-preferred response
}
Что меняется в эксплуатации:
- Более простой путь в коде (нет отдельной модели вознаграждения и цикла RL).
- Обучение идёт на сохранённых парах предпочтений, а не на генерации новых ответов для оценки вознаграждением при каждом обновлении.
- В стандартной постановке нужна фиксированная референсная модель или её сохранённые логарифмы вероятностей для обучающих ответов.
DPO проще прототипировать, чем полный пайплайн PPO, но это не автоматическое повышение качества. Результаты зависят от стартовой политики, качества пар, параметров loss, эффектов длины и протокола оценки. Сравнивайте её с чекпоинтом SFT на тех же отложенных наборах предпочтений и задач.
ORPO
ORPO (Odds-Ratio Preference Optimization) объединяет SFT-loss на основе отрицательного логарифма правдоподобия со штрафом по odds ratio на отклонённые ответы. Она убирает отдельную референсную модель и может объединить обучение задаче и оптимизацию предпочтений в одном запуске.
Как это работает: ORPO использует комбинированный loss, который делает две вещи одновременно:
- Максимизирует правдоподобие выбранного ответа (обучение задаче).
- Штрафует отклонённый ответ членом odds ratio (обучение предпочтениям).
TRL теперь поставляет ORPO как ORPOConfig в trl.experimental.orpo (тренер ORPO в TRL). Стоит знать два параметра:
learning_rate: в статье использовались низкие значения вроде8e-6; подбирайте под свою модель, батч и данные, а не копируйте одно значение как правило.beta: управляет весом члена предпочтений относительно члена SFT.
Компромисс:
- Один этап обучения вместо двух.
- Нет модели вознаграждения.
- Нет прямого прохода референсной модели.
- Связанный запуск: если обучение задаче или поведение по предпочтениям ухудшится, промежуточного чекпоинта SFT из того же пайплайна для проверки нет.
Выбирайте исходя из данных и дизайна оценки:
- Используйте DPO, когда у вас уже есть удовлетворительный чекпоинт SFT и нужен более простой офлайн-эксперимент с предпочтениями.
- Пробуйте ORPO, когда одноэтапная цель без референса подходит вашим данным и эксплуатационным ограничениям.
- Используйте RLHF на основе PPO, когда онлайн-сэмплирование относительно явной выученной награды входит в требования и вы можете отслеживать эксплуатацию вознаграждения.
Ни один из них не является значением по умолчанию для всех задач. Сохраняйте базовый вариант только с SFT и сообщайте и метрики задачи, и метрики предпочтений.
Фреймворки для файн-тюнинга
На этапах 3 и 4 выбирался метод. Следующие два раздела выбирают фреймворк и запускают с ним SFT.
Фреймворки пересекаются и быстро меняются. Выбирайте по пути выполнения, который нужно поддержать, фиксируйте версии и делайте конфигурацию обучения достаточно переносимой, чтобы воспроизводить её вне ноутбука.
Unsloth — скорость и экономия памяти
Unsloth интегрируется с trl и transformers от Hugging Face и предоставляет оптимизированные ядра, checkpointing и пути квантизованного файн-тюнинга для поддерживаемых моделей.
- Собственные ядра GPU на Triton для аттеншна, RoPE и cross-entropy, обходящие накладные расходы PyTorch.
- Экономный по памяти backprop, который пересчитывает активации при обратном проходе вместо того, чтобы держать их в памяти.
- Fused-операции, сворачивающие несколько шагов (layer norm + linear и подобные) в один вызов GPU.
- 4-bit квантизация, встроенная прямо в путь QLoRA с оптимизированной деквантизацией.
Порядок импортов важен. Следуйте порядку импортов из примера Unsloth для вашей зафиксированной версии. Unsloth применяет патчи при импорте, поэтому импорт до trl и transformers позволяет избежать пропущенных оптимизаций и ошибок, зависящих от версии.
# Correct order
from unsloth import FastLanguageModel  # Must be first!
from trl import SFTConfig, SFTTrainer

# Avoid this order with Unsloth's patched path
from trl import SFTTrainer
from unsloth import FastLanguageModel
Лучше всего подходит для: обучения на одной GPU, прототипирования и ноутбуков Colab.
Опубликованные цифры скорости и памяти зависят от модели, длины последовательности, батча, точности и железа. Измеряйте токены в секунду и пиковую память на своём запуске, а не считайте заголовочное отношение свойством фреймворка.
Axolotl — обучение на основе конфигов
Для сценариев с конфигом в центре и для распределённого обучения Axolotl хранит весь запуск в одном YAML-файле. Эти ключи выбирают 4-bit базу, адаптер QLoRA и датасет в формате Alpaca:
# axolotl_config.yaml (excerpt)
base_model: meta-llama/Meta-Llama-3-8B
load_in_4bit: true
adapter: qlora
lora_r: 32
lora_alpha: 16 # alpha/r = 0.5 here; the demo uses 2. Sweep it with the learning rate.
datasets:
    - path: data/training_data.jsonl
      type: alpaca
Целевые модули, длина последовательности, packing, размер батча, learning rate и эпохи задаются в том же файле; справочник по конфигу перечисляет все ключи. Запуск обучения:
axolotl train axolotl_config.yamlСравнение фреймворков
| Инструмент | Полезен, когда | Что проверить перед выбором |
|---|---|---|
| Unsloth | Нужен оптимизированный путь для поддерживаемых моделей с лаконичными примерами | Матрицу поддержки моделей, GPU, квантизации и распределённого обучения |
| Axolotl | Нужны декларативные конфиги и готовые рецепты распределённого обучения | Точную схему конфига и лаунчер для зафиксированного релиза |
| TRL | Нужен прямой доступ к тренерам Hugging Face для SFT и обучения на предпочтениях | Формат датасета, чат-шаблон, маскирование loss и интеграцию с PEFT |
| Torchtune | Вы уже используете рецепты torchtune; он больше не развивается активно (с 2025 года) | Покрытие рецептами моделей и совместимость экспорта |
Практическое демо: файн-тюнинг с Unsloth
Это демо учит модель выбирать функцию и подставлять её аргументы. Мой unsloth-finetune-demo файн-тюнит Llama-3.1-Nemotron-Nano-4B-v1.1 на датасете glaive-function-calling-v2. Для пути обучения на CUDA в этом репозитории нужны Linux или WSL2 и GPU NVIDIA. У Unsloth также есть отдельный путь обучения на GPU Intel, который в этом демо не реализован. Зафиксируйте коммит, который запускаете; lock-файл фиксирует зависимости, включая TRL 0.24.0.
Диаграмма показывает весь запуск с реальными значениями: как строка glaive становится обучающим текстом с определениями инструментов, разделение, настройки обучения, три выходные директории и первую проверку.
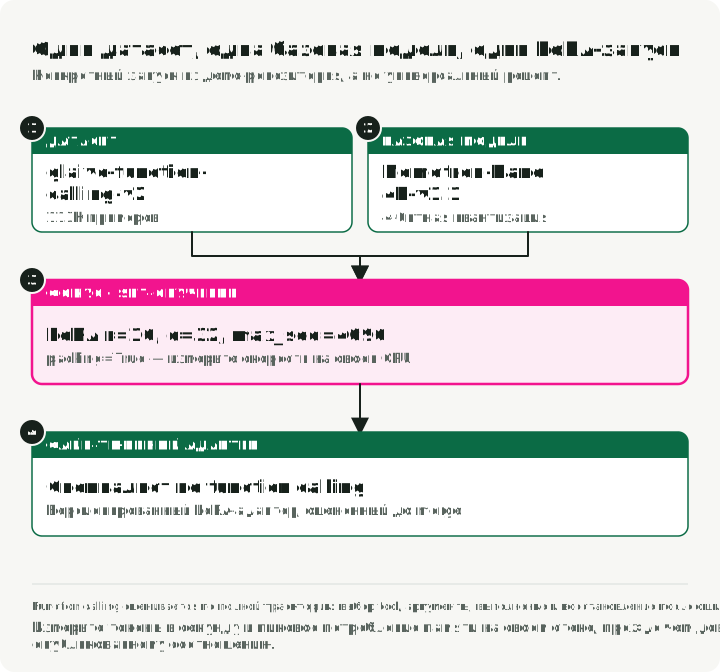
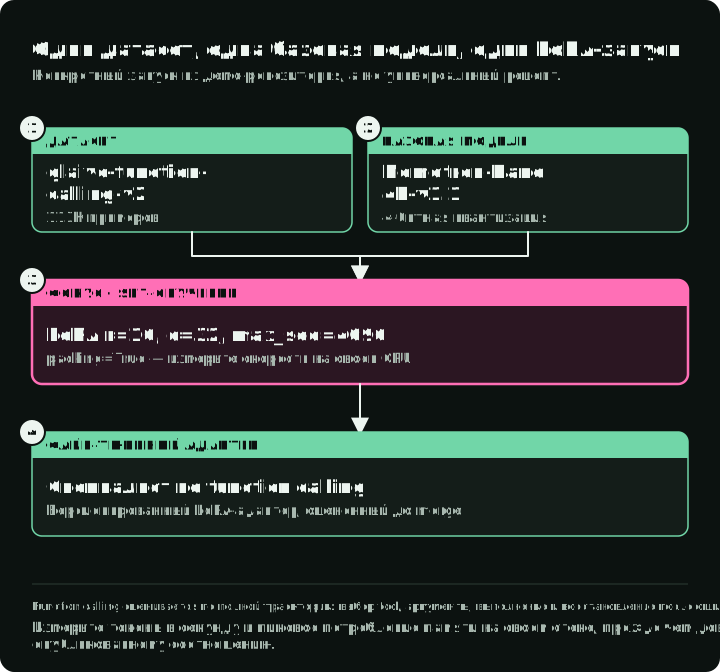
Запуск
git clone https://github.com/slavadubrov/unsloth-finetune-demo.git
cd unsloth-finetune-demo
uv sync

# Train on 1,000 random rows, then also save a merged model and a GGUF file
uv run finetune --max-samples 1000 --merge --gguf q4_k_m
Каждый запуск finetune обучает модель. --merge и --gguf добавляют экспорт после обучения; команды только для экспорта нет. Запуск создаёт три директории:
outputs/unsloth-nemotron-function-calling/— адаптер LoRAoutputs/unsloth-nemotron-function-calling-merged/— слитая 16-bit модель (--merge)outputs/unsloth-nemotron-function-calling-gguf/— файл GGUF (--gguf q4_k_m)
Перед началом обучения запуск печатает первую обучающую строку в том виде, в котором её видит модель. Прочитайте её: определения инструментов находятся внутри <AVAILABLE_TOOLS>, а каждый вызов — внутри <TOOLCALL>.
Подготовка данных
В каждой строке glaive две строки текста. Колонка system содержит все определения функций; колонка chat содержит диалог, где вызовы записаны как <functioncall> {...}. Обучение только на chat учит модель вызывать инструменты, схем которых она никогда не видит. data.py из демо превращает каждую строку в messages и отдельный список tools, рендерит оба через собственный чат-шаблон модели и откладывает 5% строк как выборку для оценки:
def to_text(example: dict, tokenizer) -> dict:
    """Render one glaive row with the model's chat template. Empty text marks a dropped row."""
    try:
        messages, tools = to_messages(example)
    except (ValueError, KeyError):  # bad JSON in a tool definition or call
        return {"text": ""}
    if not messages:
        return {"text": ""}
    text = tokenizer.apply_chat_template(messages, tools=tools or None, tokenize=False)
    # The trainer tokenizes this text with special tokens on, which adds BOS again.
    return {"text": text.removeprefix(tokenizer.bos_token or "")}
На полном датасете остаётся 112 811 из 112 960 строк; 149 строк с некорректным JSON отбрасываются. С этим токенизатором самая длинная отрендеренная строка занимает 4 076 токенов, поэтому лимит в 4 096 токенов не усекает ни одну из них.
У чат-шаблона из карточки модели есть один дефект, важный для обучения. Он рендерит прошлый tool call без закрывающей фигурной скобки после arguments, поэтому текст внутри <TOOLCALL> не является валидным JSON. Модель, обученная на таком тексте, учится выдавать его же, и парсер сервинга не может прочитать вызов. Репозиторий поставляет шаблон с добавленной скобкой и использует его и в обучении, и в сервинге. Его тест, работающий только на CPU, рендерит диалоги с инструментами и проверяет, что каждый <TOOLCALL> разбирается.
Конфигурация демо
config.py демо задаёт значения LoRA:
LORA_R = 16        # Adapter capacity; tune against held-out results
LORA_ALPHA = 32    # Update scale alpha/r = 2
LORA_DROPOUT = 0.05
MAX_SEQ_LENGTH = 4096
LORA_TARGET_MODULES перечисляет все семь проекций аттеншна и MLP этой модели семейства Llama, от q_proj до down_proj.
Отношение alpha к рангу. alpha/r масштабирует классическое обновление LoRA. alpha = 2r — распространённая стартовая эвристика в документации некоторых инструментов, а не гарантия стабильности. Перебирайте ранг, alpha, learning rate и целевые модули только после того, как данные и базовый вариант зафиксированы.
Загрузка модели
model.py из демо загружает базу в 4-bit виде, заменяет чат-шаблон на исправленный и добавляет адаптеры LoRA:
from unsloth import FastLanguageModel

model, tokenizer = FastLanguageModel.from_pretrained(
    model_name=MODEL_NAME,
    max_seq_length=MAX_SEQ_LENGTH,
    load_in_4bit=True,  # QLoRA: the frozen base is stored in 4-bit form
    trust_remote_code=True,
)
# Training rows, the saved tokenizer, and vLLM all use this one template.
tokenizer.chat_template = CHAT_TEMPLATE_PATH.read_text()

model = FastLanguageModel.get_peft_model(
    model,
    r=LORA_R,
    lora_alpha=LORA_ALPHA,
    lora_dropout=LORA_DROPOUT,
    target_modules=LORA_TARGET_MODULES,
    use_gradient_checkpointing="unsloth",  # Lower activation memory; extra compute
)
Конфигурация обучения
training.py из демо передаёт отрендеренные строки в SFTTrainer из TRL. Он оценивает loss на отложенных токенах раз в эпоху. Этот loss — диагностика, а не точность tool calls; этап 5 по-прежнему требует отдельной оценки задачи.
trainer = SFTTrainer(
    model=model,  # 4-bit base with LoRA adapters from FastLanguageModel
    processing_class=tokenizer,
    train_dataset=train_dataset,
    eval_dataset=eval_dataset,
    args=SFTConfig(
        output_dir="outputs/unsloth-nemotron-function-calling",
        dataset_text_field="text",
        max_length=4096,
        packing=False,  # One row per sequence, so row boundaries are easy to inspect
        assistant_only_loss=False,  # The Nemotron template has no generation spans
        eval_strategy="epoch",
        per_device_train_batch_size=2,
        gradient_accumulation_steps=4,
        learning_rate=2e-4,
        num_train_epochs=3,
        bf16=True,  # The repository falls back to FP16 on GPUs without BF16
        optim="adamw_8bit",
    ),
)
trainer.train()
Первая проверка
uv run infer --prompt "Book a flight to Tokyo"infer загружает адаптер и отправляет промпт с одним инструментом, book_flight(destination), отрендеренным тем же шаблоном, что и обучающие строки. Обученный адаптер должен ответить <TOOLCALL>[{"name": "book_flight", "arguments": {"destination": "Tokyo"}}]</TOOLCALL>. Если он отвечает обычным текстом, проверьте напечатанную обучающую строку, прежде чем обучать дольше.
Этап 5: оценка
Зафиксируйте тестовые случаи, правила оценки и проходные пороги до первого запуска. Как минимум сравните файн-тюненный чекпоинт с той же исходной базовой моделью до файн-тюнинга при том же промпте, настройках декодирования и окружении инструментов. Сообщайте агрегированное качество только после проверки срезов сбоев, которые проект должен был улучшить.
Отслеживайте четыре группы:
- Целевая задача: точное совпадение, успешное выполнение, оценка человека по рубрике или другой результат, связанный со сценарием использования.
- Регрессия: общие способности и ранее поддерживаемые срезы задач, которые адаптация могла испортить.
- Безопасность и политики: отказы, утечка данных, промпт-инъекции или ограничения конкретного домена.
- Эксплуатация: латентность, throughput, память, размер артефакта и стоимость в предполагаемой конфигурации сервинга.
Автоматические бенчмарки
Используйте lm-evaluation-harness, чтобы проверять релевантные стандартизированные задачи наряду с вашими продуктовыми тестами. Эта команда требует слитого чекпоинта Hugging Face, который демо записывает с --merge:
lm_eval --model hf \
    --model_args pretrained=./outputs/unsloth-nemotron-function-calling-merged \
    --tasks hellaswag,arc_easy,mmlu \
    --batch_size 8
LLM-as-judge
Для субъективного качества оценке может помогать более крупная модель, но откалибруйте её по примерам, проверенным людьми, и скрывайте, какая модель является кандидатом. Дайте джаджу вывод модели, ожидаемый ответ и рубрику, которая определяет каждую оценку по каждому критерию, например релевантность, точность и форматирование.
Оценка под конкретный домен
Откладывайте реальные примеры по источнику, пользователю, документу или времени, чтобы почти-дубликаты не просачивались через разделение. Для function calling проверяйте всю траекторию: выбор инструмента, аргументы, результат выполнения, восстановление после ошибки и итоговый ответ. При малой выборке сообщайте доверительные интервалы или парные счётчики побед и поражений и разбирайте каждую регрессию в критичном срезе.
Проверяйте каждую траекторию в четыре шага:
- Выбран правильный инструмент.
- Аргументы валидны и верны.
- Результат выполнения соответствует ожидаемому.
- Модель восстанавливается после ошибки инструмента.
Считайте каждый сбой по проверке и по срезу. Верный итоговый ответ может скрывать неверный аргумент или пропущенное восстановление.
Код оценки Berkeley Function Calling Leaderboard (BFCL) сверяет выбор функции и аргументы с эталонными вызовами. Используйте его как проверку на регрессию рядом с вашими собственными отложенными диалогами.
Этап 6: деплой и форматы вывода
Выбирайте артефакт исходя из движка сервинга и плана отката, а не только из размера файла. Экспортируйте каждый формат из одних и тех же оценённых объектов model и tokenizer, чтобы все артефакты содержали одни и те же обученные веса. Диаграмма сравнивает три артефакта: что содержит каждый файл, что его загружает и какой у него компромисс.
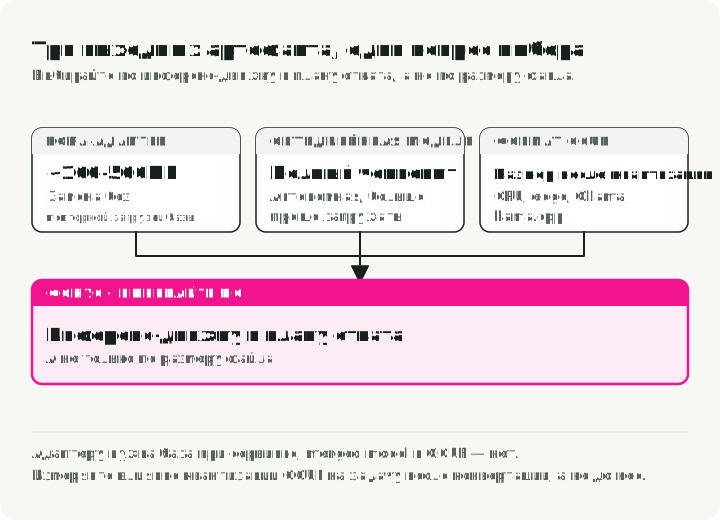
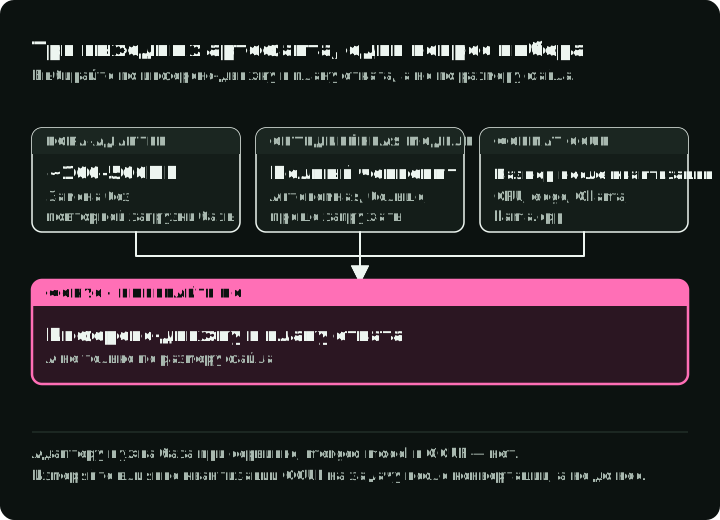
В демо uv run finetune всегда сохраняет адаптер, --merge добавляет слитую модель, а --gguf q4_k_m добавляет файл GGUF, и всё это за один запуск обучения. Вызовы Python ниже показывают, что делает каждый флаг.
1. Адаптер LoRA
model.save_pretrained("outputs/unsloth-nemotron-function-calling")
tokenizer.save_pretrained("outputs/unsloth-nemotron-function-calling")- Размер: пропорционален целевым модулям, рангу, слоям и dtype; часто намного меньше базы.
- Лучше всего подходит для: разработки, версионируемых адаптеров под задачи и движков, которые напрямую поддерживают LoRA.
- Бонус: адаптеры можно менять без повторного скачивания базовой модели.
2. Слитая модель
# What --merge runs: merge the adapter into the base weights and save a standalone model
model.save_pretrained_merged(
    "outputs/unsloth-nemotron-function-calling-merged", tokenizer, save_method="merged_16bit"
)- Размер: примерно как полный базовый чекпоинт при выбранной точности вывода.
- Лучше всего подходит для: движков и путей распространения, которые не поддерживают адаптер отдельно.
- Компромисс: артефакт больше, а выкатка медленнее; зато загрузка одной модели проще.
3. Формат GGUF
# What --gguf q4_k_m runs; file size and name depend on the Unsloth version
model.save_pretrained_gguf(
    "outputs/unsloth-nemotron-function-calling-gguf", tokenizer, quantization_method="q4_k_m"
)- Размер: зависит от модели; для вариантов Q4 примерно четырёхбитные веса плюс метаданные.
- Лучше всего подходит для: инференса на CPU, Ollama, llama.cpp, edge-деплоя.
- Варианты:
q4_k_m(меньше),q5_k_m(точнее передаёт веса),q8_0(больше и точнее). После конвертации измерьте влияние на задачу.
Этап 7: сервинг и мониторинг
С vLLM
Эта команда обслуживает адаптер из демо поверх базовой модели. Запускайте сервинг с парсером и чат-шаблоном из карточки модели; они должны совпадать с шаблоном, использованным при обучении. Карточка модели регистрирует парсер llama_nemotron_json через файл плагина llama_nemotron_nano_toolcall_parser.py. Репозиторий демо содержит исправленный шаблон.
Используйте отдельное окружение Python 3.12 с vLLM 0.12.0: зафиксированный парсер импортирует API парсера инструментов из этой версии, который изменился в последующих релизах. Команда фиксирует базовую модель и парсер на одной ревизии карточки модели; используйте эту же ревизию базы при обучении. Совместимость исходного кода и проверка парсера на CPU не подтверждают работу сервинга на GPU. Проверьте загрузку модели и ожидаемый tool call на своей GPU. Запускайте из корня репозитория:
uv venv --python 3.12 .venv-vllm
uv pip install --python .venv-vllm/bin/python "vllm==0.12.0" "huggingface-hub==0.36.0"
source .venv-vllm/bin/activate

hf download nvidia/Llama-3.1-Nemotron-Nano-4B-v1.1 \
    llama_nemotron_nano_toolcall_parser.py \
    --revision d552708a9d575fa8d4a690b988fd870d65279f98 --local-dir serving

vllm serve nvidia/Llama-3.1-Nemotron-Nano-4B-v1.1 \
    --revision d552708a9d575fa8d4a690b988fd870d65279f98 \
    --trust-remote-code \
    --enable-lora \
    --lora-modules function-calling=./outputs/unsloth-nemotron-function-calling \
    --enable-auto-tool-choice \
    --tool-parser-plugin ./serving/llama_nemotron_nano_toolcall_parser.py \
    --tool-call-parser llama_nemotron_json \
    --chat-template ./src/unsloth_demo/chat_template.jinja \
    --host 127.0.0.1 \
    --port 8000 \
    --max-model-len 4096
uv run --with openai infer-vllm из демо проверяет генерацию аргументов через OpenAI-совместимый API. Он отправляет один минимальный инструмент, book_flight с обязательной строкой destination, и просит предложить вызов; бронирование он не выполняет. Запрос из cli/inference.py:
client = OpenAI(base_url="http://localhost:8000/v1", api_key="dummy")
response = client.chat.completions.create(
    model="function-calling",  # the --lora-modules name, not the base model
    messages=[{"role": "user", "content": "Book a flight to Tokyo"}],
    tools=[DEMO_TOOL],  # book_flight(destination), defined in config.py
    tool_choice="auto",
)
print(response.choices[0].message.tool_calls)
Для этого входа ожидаемый результат — book_flight с {"destination": "Tokyo"}. Поскольку выбор инструмента автоматический, проверьте также, вернула ли модель вызов вообще. Инструмент имеет ту же форму, что и определения инструментов glaive, на которых модель обучалась. Парсер vLLM читает вызов из сгенерированного текста, поэтому некорректный вызов возвращается как обычный контент без tool_calls. vLLM также может ограничить аргументы функции её схемой, если функция помечена strict: true; руководство по tool calling описывает настройки сервера и то, какие парсеры это поддерживают.
С Ollama (локально)
Выведите список директории outputs/unsloth-nemotron-function-calling-gguf и подставьте имя созданного файла вместо MODEL_FILE.gguf ниже; разные версии Unsloth могут называть файлы по-разному. Один лишь файл GGUF не гарантирует правильного форматирования чата и инструментов в Ollama или llama.cpp. Подберите обученный шаблон и протестируйте импортированный артефакт.
# Create Modelfile
echo 'FROM ./outputs/unsloth-nemotron-function-calling-gguf/MODEL_FILE.gguf' > Modelfile

# Import to Ollama
ollama create my-function-model -f Modelfile

# Run
ollama run my-function-model
С llama.cpp (CPU)
С тем же экспортом GGUF и подстановкой имени файла эта команда проверяет ответ обычным текстом. Полный tool call она не проверяет:
llama-cli -m ./outputs/unsloth-nemotron-function-calling-gguf/MODEL_FILE.gguf \
    -p "What's the weather in Tokyo?" \
    --ctx-size 4096
Мониторинг выпущенной модели
Жизненный цикл не заканчивается на приемлемом loss обучения. Записывайте ревизию базовой модели, токенизатор и чат-шаблон, хеш адаптера, версию датасета, конфигурацию обучения и отчёт об оценке как один релизный комплект. В продакшене отслеживайте успешность задач, невалидные выводы, нарушения политик, латентность и дрейф входов по тем же срезам, что и офлайн. Держите предыдущий артефакт загружаемым и определите порог отката до запуска.
Коротко:
- Релизный комплект: ревизия базовой модели, токенизатор и чат-шаблон, хеш адаптера, версия датасета, конфигурация обучения и отчёт об оценке.
- Отслеживайте успешность задач, невалидные выводы, нарушения политик, латентность и дрейф входов по тем же срезам, что и офлайн.
- Если метрика падает ниже порога отката, заданного до запуска, загрузите предыдущий артефакт.
Ваш следующий тест
Перед полным запуском проверьте одну сериализованную беседу и её цели loss, затем выполните один прямой и обратный проход на максимальной длине. Сохраните эту конфигурацию вместе с разделением датасета и отчётом по базовому варианту. Если схема инструмента отсутствует, сохраните её в обучающей строке. Если ответ обрезан, измените длину последовательности и форматирование так, чтобы ответ сохранился целиком. Решите эти проблемы, прежде чем добавлять эпохи.
Источники
Статьи и исследования
- LoRA: Low-Rank Adaptation of Large Language Models
- QLoRA: Efficient Finetuning of Quantized LLMs
- DoRA: Weight-Decomposed Low-Rank Adaptation
- DPO: Direct Preference Optimization
- ORPO: Odds Ratio Preference Optimization
- PPO: Proximal Policy Optimization Algorithms — OpenAI, 2017
Инструменты обработки данных
- DataTrove — обработка данных в масштабе от Hugging Face
- Distilabel — генерация синтетических данных (Argilla)
- Trafilatura — извлечение текста из веба и краулинг
- fastText language identification — предобученные модели определения языка
- Microsoft Presidio — обнаружение и анонимизация PII
- scrubadub — библиотека Python для удаления PII
Constrained decoding
- xgrammar — constrained decoding на основе конечных автоматов
- outlines — структурированная генерация для LLM
Фреймворки для обучения
- Unsloth — оптимизированный фреймворк для файн-тюнинга
- Axolotl — обучение на основе конфигов и распределённые лаунчеры
- TRL — библиотека Hugging Face для SFT и обучения на предпочтениях
- PEFT model merging —
add_weighted_adapterи методы слияния - Torchtune — нативная для PyTorch библиотека файн-тюнинга, больше не развивается активно
Инференс и деплой
- vLLM LoRA adapters — обслуживание одного или нескольких адаптеров вместе с базовой моделью
- vLLM tool calling — согласуйте автоматический выбор инструмента, парсер, чат-шаблон и схему запроса с моделью
- Карточка модели Llama-3.1-Nemotron-Nano-4B-v1.1 — плагин парсера tool calls и чат-шаблон для vLLM
- Ollama — локальный запуск LLM для Mac/Windows/Linux
- llama.cpp — инференс на CPU/GPU с форматом GGUF
Оценка
- lm-evaluation-harness — стандартизированные бенчмарки LLM от EleutherAI
- Berkeley Function Calling Leaderboard — код оценки function calling
Руководства и ресурсы
- Demo Repository — практический пример файн-тюнинга
- Accelerate n-D Parallelism Guide — стратегии обучения на нескольких GPU от Hugging Face