Guide du fine-tuning des LLM : quand l'utiliser, LoRA et QLoRA

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Ce guide s’adresse aux ingénieurs Python qui doivent décider s’il faut faire le fine-tuning d’un grand modèle de langage, et comment s’y prendre. Vous verrez quand choisir le fine-tuning plutôt que le prompting ou la recherche documentaire, et comment choisir entre des méthodes comme LoRA et QLoRA. Le guide explique aussi comment préparer les données, évaluer le modèle entraîné et planifier son déploiement.
La partie pratique exécute un dépôt compagnon qui fait le fine-tuning d’un modèle de 4B pour le function calling.
Pour une comparaison plus courte entre fine-tuning, RAG et prompting, voir Fine-Tuning vs RAG vs Prompting.
Faut-il vraiment faire du fine-tuning ?
Avant de dépenser des heures de GPU, déterminez si le fine-tuning est le bon outil pour votre problème. La figure suit une requête et montre où agit chacune des quatre corrections, sur quel échec la tester en premier, et ce qu’elle ne peut pas corriger.
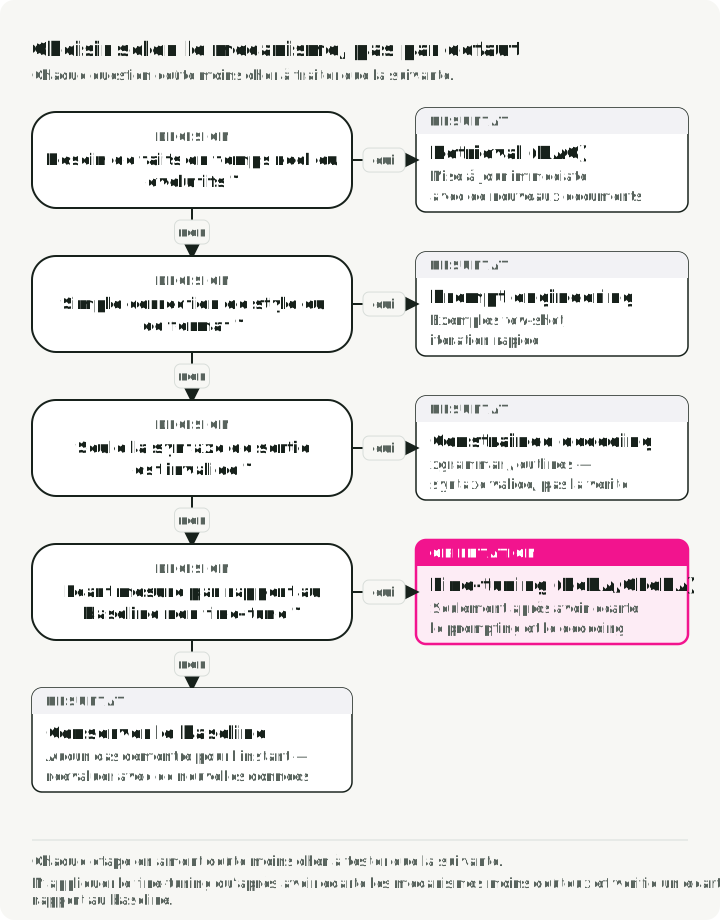
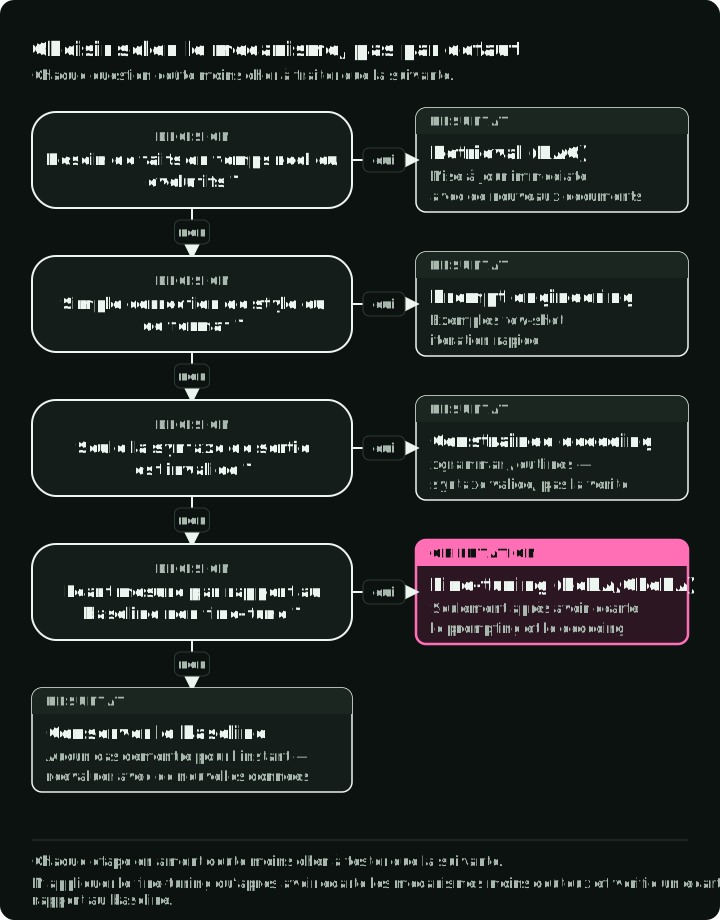
Le fine-tuning modifie un comportement encodé dans les poids. La recherche documentaire fournit des preuves au moment de l’inférence : c’est donc le meilleur point de départ pour des faits qui changent ou qui exigent des citations. Les nouveaux documents ne deviennent disponibles qu’après l’ingestion et l’indexation ; vérifiez cette fraîcheur par rapport à votre exigence.
Des prompts et des exemples clairs sont moins chers à itérer qu’un nouvel entraînement. Ils peuvent déjà résoudre un problème de style ou de respect des instructions. Le fine-tuning peut réduire les tokens de prompt répétés, mais la latence de service dépend du modèle, de la longueur de sortie, du matériel et de l’implémentation ; une mise à jour des poids n’est pas en soi une accélération.
Pour la syntaxe, des bibliothèques comme xgrammar et outlines masquent les tokens suivants invalides pour un schéma ou une grammaire pris en charge. Une génération contrainte menée à terme appartient à ce langage. Traitez séparément la troncature et les autres générations incomplètes, et validez le résultat avant de l’utiliser. La contrainte ne peut pas rendre un identifiant client exact ni un choix d’outil approprié. Mesurez sa latence sur votre backend au lieu de supposer un surcoût fixe.
Chacune des quatre options modifie une étape différente de la même requête. Seul le fine-tuning demande un entraînement et un nouvel artefact de modèle ; les trois autres modifient du texte, des documents ou un schéma autour des mêmes poids. Le tableau compare les quatre options côte à côte :
| Option | Ce qu’elle modifie | Comment la mettre à jour | Coût de mise en place | Ce qu’elle ne peut pas corriger |
|---|---|---|---|---|
| Prompting | Les instructions et les exemples | Modifier le texte | Faible : écrire et tester des prompts | Un comportement que le modèle ne peut pas suivre par instructions |
| RAG | Les preuves dans la fenêtre de contexte | Ingérer et réindexer les documents | Moyen : index, retriever et évaluation | Un modèle qui ignore ou comprend mal les preuves |
| Constrained decoding | Les tokens que le décodeur peut émettre | Modifier le schéma ou la grammaire | Faible à moyen : schéma et prise en charge du backend | Des valeurs fausses dans une structure valide |
| Fine-tuning | Les poids du modèle | Réentraîner et évaluer un nouvel artefact | Élevé : curation des données, temps GPU, évaluation | Des faits qui changent après l’entraînement |
Référence rapide : associer les problèmes aux solutions
| Problème | Premier mécanisme à tester | Pourquoi ? |
|---|---|---|
| Connaissance manquante | RAG | Récupère des preuves citées ; la fraîcheur dépend de l’ingestion et de l’indexation |
| Format ou ton incorrect | Prompt engineering | Les modèles actuels suivent bien les consignes de style grâce aux exemples few-shot |
| Syntaxe de sortie invalide | Constrained decoding | Impose un schéma ou une grammaire pris en charge pendant la génération |
| Échec répété sur une tâche | Fine-tuning (SFT) | Apprend à partir d’exemples d’entrée/sortie sélectionnés |
| Écart de préférence par paires | Optimisation des préférences | Utilise des exemples choisi/rejeté une fois le comportement de la tâche mesurable |
| Latence et coût à grande échelle | Distillation (SFT) | Entraîne un modèle élève plus petit sur les sorties d’un modèle enseignant plus grand |
| Réduire la taille du modèle | Quantification post-entraînement | La quantification post-entraînement réduit la mémoire des poids ; la vitesse dépend des kernels pris en charge et de la charge |
Rendre le business case mesurable
Le fine-tuning peut réduire les tokens de prompt récurrents ou permettre à un modèle plus petit d’atteindre l’objectif, mais aucune de ces économies n’est automatique. Calculez le seuil de rentabilité avec votre propre trafic et vos propres tarifs :
Si le dénominateur est petit, négatif ou fondé sur une hypothèse de qualité non démontrée, le projet n’a pas encore de justification économique.
Un exemple chiffré, avec des nombres illustratifs : une base de référence avec prompt envoie environ 2 000 tokens d’instructions et d’exemples à chaque requête. Après le fine-tuning, la même tâche en demande environ 50. À un prix supposé de $0.50 par million de tokens d’entrée pour les deux modèles, l’économie est de 1 950 tokens, soit environ $0.001 par requête. Si l’entraînement, l’évaluation et le déploiement coûtent $3,000, le seuil de rentabilité est d’environ 3,1 millions de requêtes. À 100 000 requêtes par jour, cela fait environ un mois. À 5 000 requêtes par jour, plus d’un an. Le calcul n’est valable que si le modèle ajusté atteint les mêmes seuils de qualité que la base de référence.
La configuration hybride. Une architecture courante associe un modèle plus petit adapté à la tâche et une recherche documentaire pour les faits changeants. Prenez le modèle plus grand, utilisé avec un prompt, comme base de référence, et ne gardez le modèle plus petit que s’il atteint les mêmes seuils de qualité et de sécurité propres à la tâche.
Types de fine-tuning
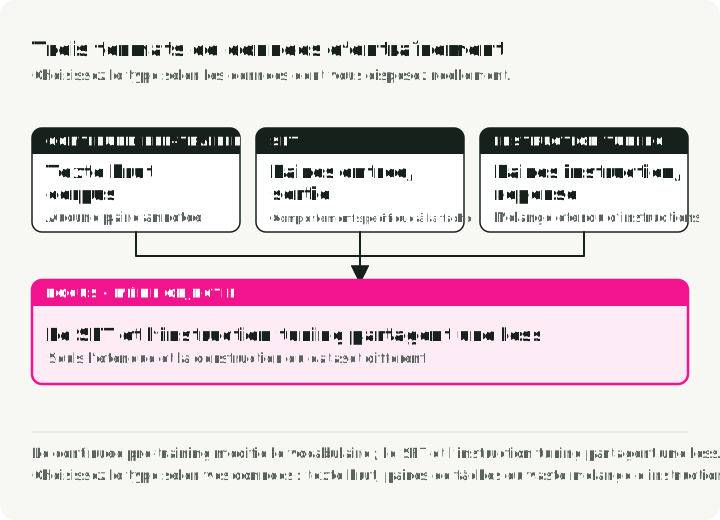
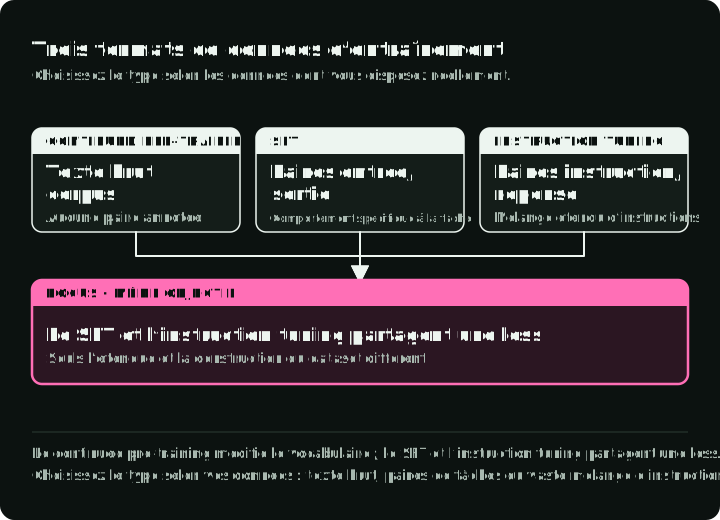
Le fine-tuning peut prendre trois formes principales. Elles diffèrent par le type de données nécessaires et par ce qu’elles enseignent au modèle. Le schéma montre une ligne d’entraînement pour chaque type.
1. Continued pre-training (auto-supervisé)
Vous entraînez le modèle de base sur davantage de texte brut, en prenant le token suivant de chaque séquence comme cible d’entraînement. C’est de l’apprentissage auto-supervisé : le texte fournit lui-même ses cibles, comme lors du pré-entraînement initial.
Quand l’utiliser :
- Le domaine a un vocabulaire que le modèle de base n’a jamais vu (médical, juridique, bases de code internes).
- Vous disposez de beaucoup de texte du domaine, mais d’aucune paire (entrée, sortie) étiquetée.
- Le modèle de base se trompe sur la terminologie propre au domaine.
Exemple : entraîner sur des millions de notes cliniques pour que le modèle apprenne les abréviations médicales, les noms de médicaments et les flux de travail cliniques.
2. Supervised fine-tuning (SFT)
Le SFT s’entraîne sur des paires (entrée, sortie) étiquetées. Vous montrez au modèle la sortie exacte attendue pour chaque entrée.
Quand l’utiliser :
- Vous avez une tâche précise avec un format d’entrée/sortie propre.
- Vous avez des données étiquetées de qualité, même en petite quantité.
- Vous avez besoin d’un comportement prévisible sur une forme d’entrée connue.
Exemple : entraîner sur des paires (description d’une requête SQL, code SQL) pour le text-to-SQL. Cet intervalle calendaire fixe suppose que signup_date est stockée en UTC :
{
    "input": "Get users who signed up in August 2026 (UTC)",
    "output": "SELECT * FROM users WHERE signup_date >= '2026-08-01' AND signup_date < '2026-09-01'"
}
3. Instruction tuning
L’instruction tuning est un cas particulier du SFT, conçu pour que les modèles suivent une grande variété d’instructions en langage naturel. Les données d’entraînement sont des paires (instruction, réponse) couvrant de nombreuses tâches différentes.
Quand l’utiliser :
- Vous voulez un assistant généraliste (comme ChatGPT ou Claude).
- Le modèle doit traiter des demandes variées et ouvertes.
- Vous construisez une interface de chat.
Exemple : entraîner sur des milliers d’instructions variées comme « Résume cet article », « Écris un poème sur X », « Explique Y en termes simples ».
Comparaison
| Aspect | Continued pre-training | SFT | Instruction tuning |
|---|---|---|---|
| Données | Texte brut | Paires (entrée, sortie) | Paires (instruction, réponse) |
| Étiquettes | Aucune (auto-supervisé) | Propres à la tâche | Tâches variées |
| Objectif | Connaissances du domaine | Comportement propre à une tâche | Suivre n’importe quelle instruction |
| Volume de données | En général le plus grand corpus | Déterminé par la couverture de la tâche et la diversité des erreurs | En général plus large que le SFT propre à une tâche |
Un objectif, deux datasets. Le SFT et l’instruction tuning utilisent le même objectif de prédiction du token suivant ; la différence tient à l’étendue et à la construction du dataset. Le continued pre-training est une expérience distincte : il doit être suivi de tests mesurant à la fois les gains dans le domaine et la régression des capacités générales.
Le pipeline de fine-tuning en 7 étapes
Le fine-tuning comporte sept étapes. Chaque étape a ses propres modes d’échec, et en sauter une se traduit généralement plus tard par un mauvais modèle. Le schéma montre les étapes dans l’ordre, ce que chaque étape ajoute au dossier de version, et le chemin de retour du monitoring vers la préparation des données.
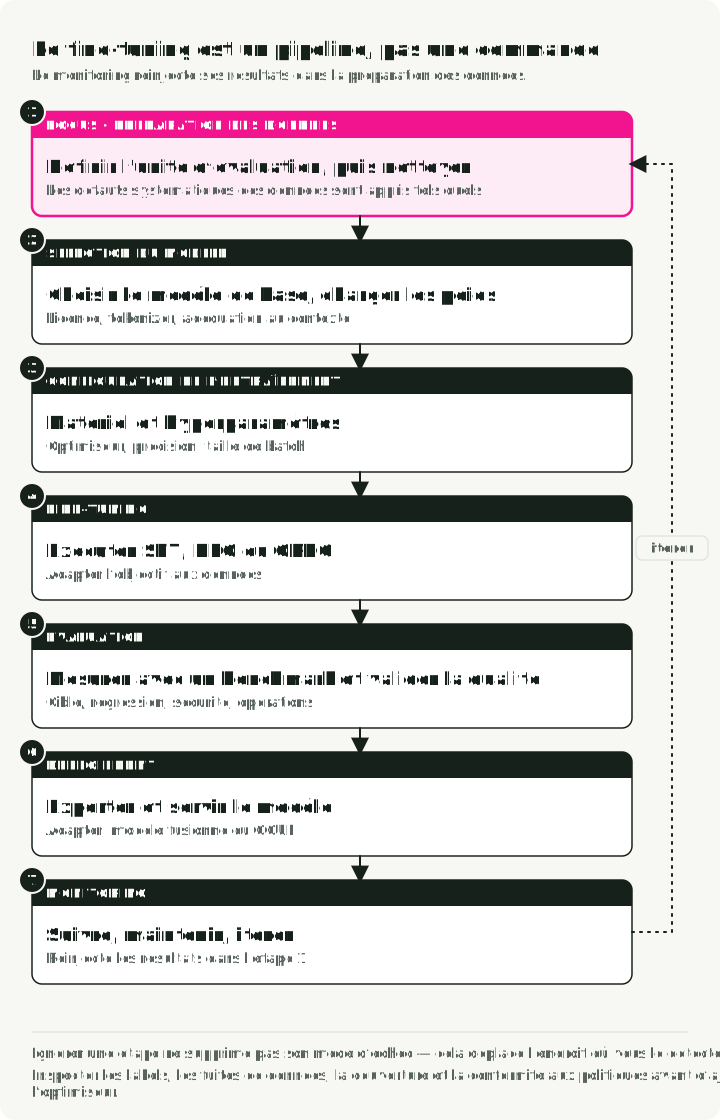
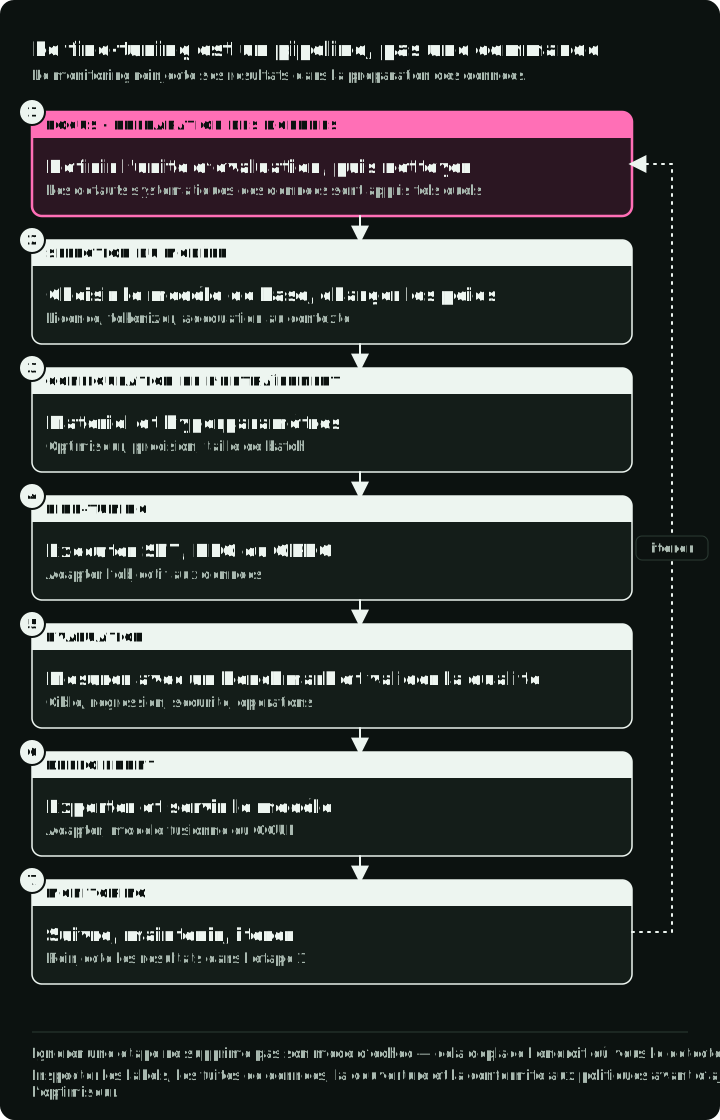
Chaque étape s’appuie sur la précédente :
- Préparation des données — Définir l’unité d’évaluation, séparer les données, puis les nettoyer et les formater
- Sélection du modèle — Choisir le bon modèle de base et charger les poids
- Configuration de l’entraînement — Vérifier la sérialisation et les cibles de la loss, puis choisir la méthode (LoRA, QLoRA, DoRA) et ses paramètres
- Fine-tuning — Lancer le SFT avec un framework ; ajouter DPO ou ORPO seulement si nécessaire
- Évaluation — Mesurer les performances et valider la qualité
- Déploiement — Exporter et servir votre modèle
- Monitoring — Suivre les performances, maintenir et itérer
Les données d’abord. L’entraînement reproduit les défauts systématiques des exemples. Inspectez les étiquettes, les fuites, la couverture et le respect des politiques avant de passer du temps sur des balayages d’hyperparamètres de l’optimiseur.
Étape 1 : préparation des données
Les problèmes présents dans les données se retrouvent dans le modèle entraîné : cette étape demande donc le plus de soin. Le schéma suit des exemples de tickets dans cet ordre : d’abord la séparation par source, puis cinq transformations à l’intérieur de chaque partition.
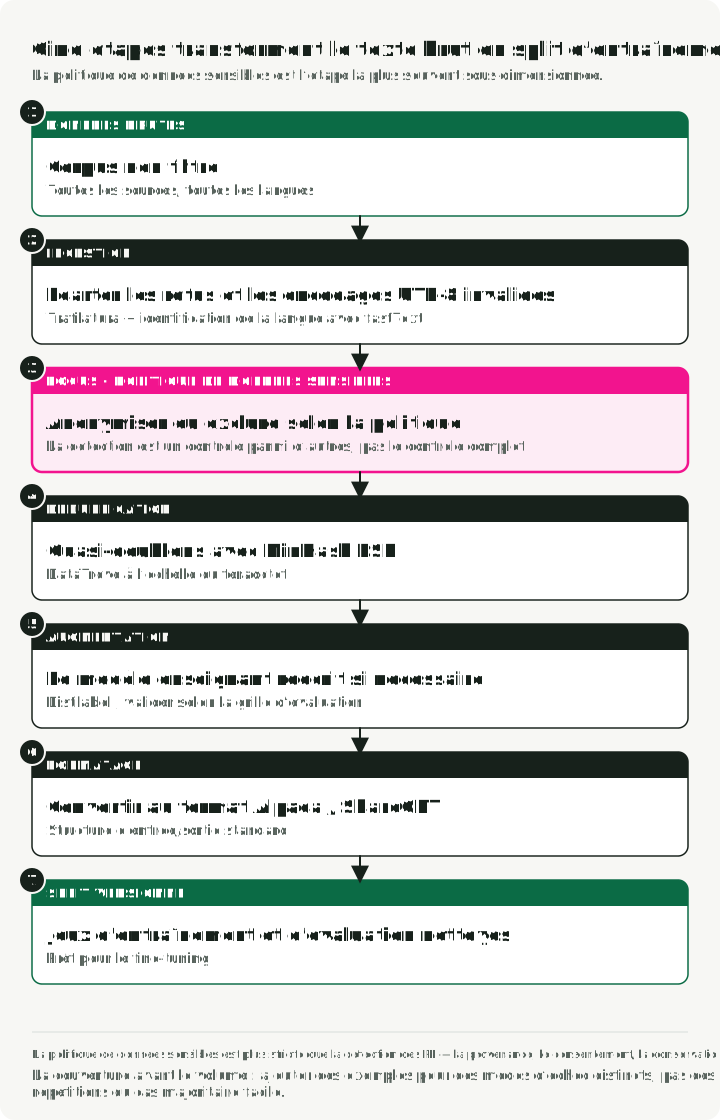
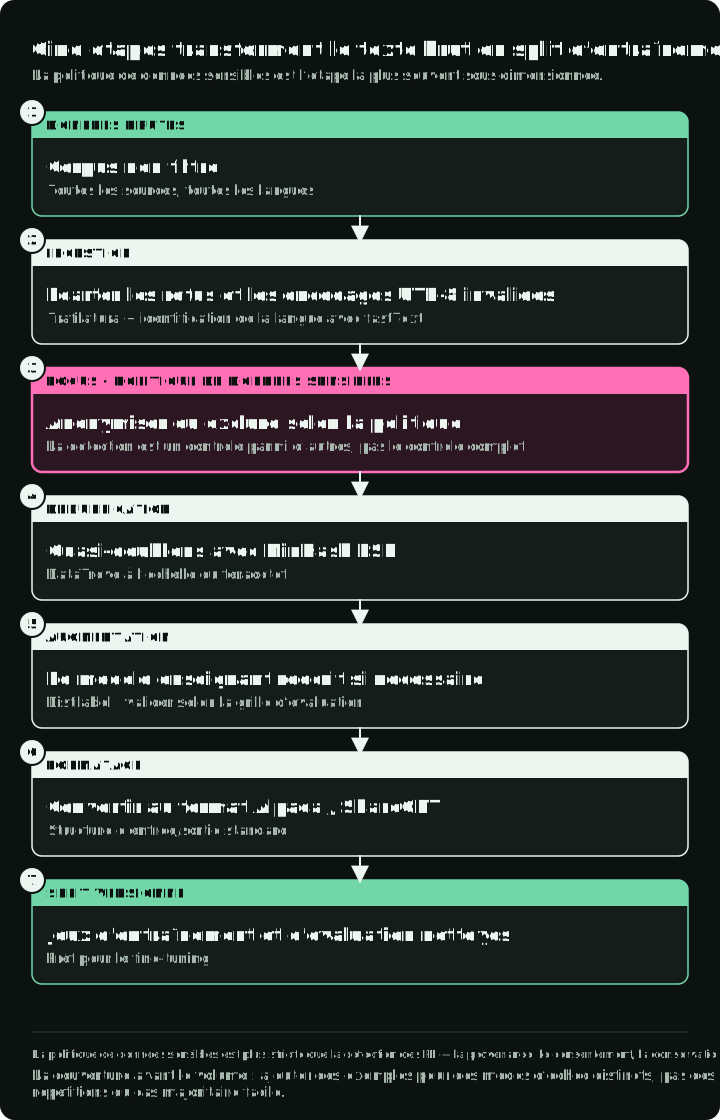
Cinq transformations après la séparation des sources
Affectez les groupes de sources à l’entraînement ou à l’évaluation avant de transformer les lignes. Un ticket de support et chaque reformulation de ce ticket restent dans la même partition. Regroupez les quasi-doublons connus avant d’affecter les groupes, puis revérifiez entre les partitions après le nettoyage. Figez le jeu d’évaluation ; n’augmentez que les données d’entraînement.
Listez les erreurs que vos exemples doivent apprendre au modèle à corriger, puis définissez les champs et les étiquettes requis pour chaque ligne. Choisissez les outils de traitement pour ces étapes. DataTrove exécute le filtrage et la déduplication sous forme de jobs distribués pour les grands corpus ; Distilabel génère et étiquette des lignes synthétiques avec un modèle enseignant.
1. Ingestion et filtrage
- Action : supprimer l’UTF-8 cassé et le contenu hors sujet. Étiqueter les refus selon la politique : conserver les refus corrects comme cibles d’entraînement et cas d’évaluation ; n’exclure que les refus invalides ou hors sujet.
- Outils : Trafilatura quand la source est constituée de pages web ; inutile pour des données déjà en texte. Les modèles d’identification de la langue de fastText pour détecter la langue.
2. Politique relative aux données sensibles
- Action : décider ce que le modèle a le droit d’apprendre, puis masquer, tokeniser ou exclure les champs personnels et confidentiels selon les besoins.
- Outils : Microsoft Presidio quand vous avez besoin de recognizers configurables, de plusieurs langues ou d’une anonymisation réversible ; scrubadub pour un pipeline plus léger en Python pur qui supprime les données personnelles courantes du texte.
- Pourquoi : un détecteur n’est qu’un contrôle parmi d’autres ; la provenance, le consentement, la rétention, l’accès et les exigences de suppression s’appliquent toujours.
3. Déduplication (MinHash LSH)
- Action : supprimer les quasi-doublons pour réduire les répétitions et le risque de fuite ; cela n’empêche pas la mémorisation.
- Outils : DataTrove quand le corpus demande un traitement distribué.
4. Augmentation synthétique, si nécessaire
- Action : utiliser un modèle enseignant adapté pour reformuler des exemples d’entraînement en paires instruction-réponse, en conservant leurs identifiants de source. N’augmentez pas la partition mise de côté.
- Outils : Distilabel.
- Validation : échantillonner les sorties de l’enseignant, les vérifier selon la même grille que les étiquettes humaines et présenter séparément les résultats pour les exemples synthétiques et ceux écrits par des humains. Un tel sous-ensemble d’évaluation s’appelle une slice ; la langue et le type de tâche sont d’autres slices utiles.
5. Formatage
- Action : convertir vers un format standard (Alpaca ou ShareGPT).
Exemples de formats de données
Format Alpaca (suivi d’instructions) :
{
    "instruction": "Summarize the following text.",
    "input": "The text to be summarized...",
    "output": "This is the summary."
}
Stockage de type ShareGPT (conversationnel) :
{
    "conversations": [
        { "from": "user", "value": "Hello, who are you?" },
        { "from": "assistant", "value": "I am a helpful AI assistant." }
    ]
}
Contrôles du dataset
- La couverture avant le volume. Ajoutez des exemples qui représentent des modes d’échec distincts, pas des répétitions du cas majoritaire facile.
- La propreté. Supprimez le texte hors sujet, normalisez les espaces, gardez un formatage cohérent.
- L’équilibre. Préservez les cas rares importants et présentez les performances par slice.
- La séparation. Séparez par source, utilisateur, document ou période quand un découpage aléatoire des lignes ferait fuiter des quasi-doublons.
- La provenance. Consignez la source, la licence ou l’autorisation, l’historique des transformations et la procédure de suppression pour chaque version du dataset.
Étape 2 : sélection du modèle et du matériel
Le modèle de base et sa mémoire GPU minimale déterminent ce que vous pouvez entraîner.
Commencez par le plus petit modèle de base qui passe déjà les vérifications de référence non négociables. Confirmez :
- la licence et les conditions de redistribution pour le produit visé ;
- le comportement en langue, en domaine, en tool use et en sécurité avant l’adaptation ;
- la compatibilité du tokenizer et du chat template avec le dataset ;
- le contexte maximal et le comportement de troncature nécessaires pour les exemples réels ;
- la prise en charge à la fois par le framework d’entraînement et par le moteur de serving cible.
Le fine-tuning est une étape d’adaptation, pas un correctif pour un modèle de base inadapté. Si le modèle échoue sur des capacités que le dataset ne couvre pas, choisissez un autre modèle de base avant de lancer d’autres epochs.
Estimer la mémoire de votre exécution
Il n’existe pas de table durable « taille du modèle → GPU ». La mémoire de pointe varie avec la précision des poids, l’optimiseur, le nombre de paramètres entraînables, la longueur de séquence, la taille du micro-batch, l’activation checkpointing, l’implémentation de l’attention et le surcoût du framework. Commencez par une estimation de la mémoire, puis lancez un court test à la longueur maximale dans votre environnement exact.
| Composant mémoire | Fine-tuning complet | LoRA | QLoRA |
|---|---|---|---|
| Poids de base | Précision d’entraînement | Gelés, en général en BF16/FP16 | Gelés, en général en NF4 sur 4 bits |
| Gradients | Tous les poids entraînables | Poids de l’adapter | Poids de l’adapter |
| États de l’optimiseur | Tous les poids entraînables | Poids de l’adapter | Poids de l’adapter |
| Activations | Dépendent de la taille du batch et de la longueur de séquence, quelle que soit la méthode | Même dépendance | Même dépendance |
Le graphique applique ce tableau au modèle de base de la démo, Nemotron-Nano-4B avec 4,51 milliards de paramètres. Il répartit la mémoire approximative de chaque méthode entre les poids et l’état entraînable ; les activations s’y ajoutent.
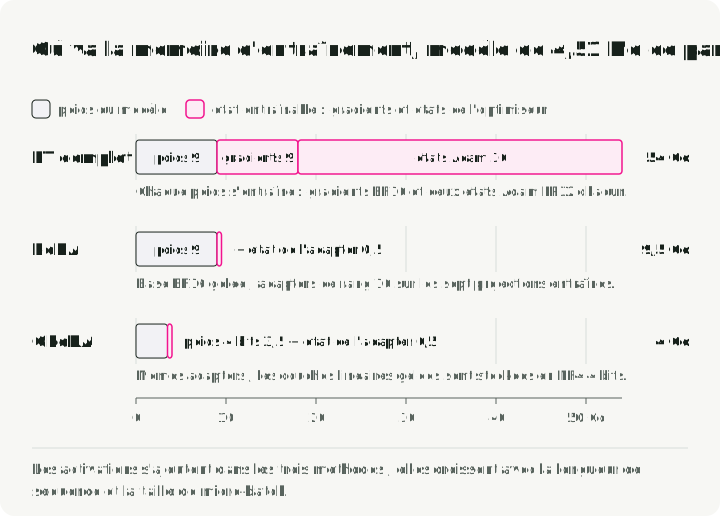
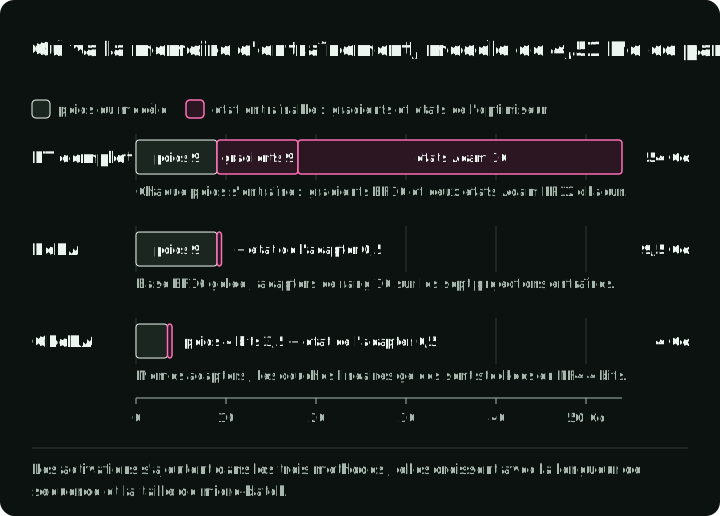
Le papier QLoRA d’origine a fait tenir un modèle LLaMA de 65B sur un seul GPU de 48 Go dans sa configuration précise. Ce résultat est une borne utile, pas une promesse que toute architecture 70B actuelle, toute longueur de contexte, tout kernel ou tout trainer tiendra sur le même appareil.
Calcul de la mémoire
Pour un modèle de paramètres, les poids seuls demandent environ octets en BF16/FP16 ou octets sur quatre bits, avant les métadonnées de quantification et les buffers d’exécution. Un entraînement complet de type Adam ajoute les gradients, les états de l’optimiseur et souvent des poids maîtres en précision supérieure. LoRA évite l’essentiel de la mémoire d’état entraînable ; QLoRA réduit en plus l’empreinte des poids de base gelés. Les activations peuvent encore dominer aux grandes longueurs de séquence.
Suivez ce déroulé :
- Choisissez la séquence la plus longue et le micro-batch que vous devez prendre en charge.
- Estimez les poids et l’état entraînable, en laissant de la marge pour les activations et les kernels.
- Exécutez une passe forward/backward à la longueur maximale.
- Relevez la mémoire de pointe allouée et réservée.
- Seulement ensuite, faites varier la taille de batch, le rang, la longueur de séquence ou le nombre de GPU.
Étape 3 : configuration de l’entraînement et méthodes
L’étape 3 comporte deux parties. Vérifiez d’abord que chaque ligne stockée devient bien le texte d’entraînement attendu. Choisissez ensuite la méthode d’entraînement et ses paramètres.
Des lignes stockées aux cibles d’entraînement
ShareGPT est une forme de dataset ; ChatML est une convention de sérialisation parmi d’autres. Convertissez from/value vers les rôles et les champs que le trainer accepte, puis utilisez le chat template du modèle choisi. Ne remplacez pas les tokens par ceux de ChatML simplement parce que les données sont conversationnelles.
Une ligne passe par cinq étapes :
- Ligne ShareGPT : paires
from/value. messagesettools: les rôles que le trainer accepte.apply_chat_templateavec le template du modèle choisi. L’inférence doit utiliser le même template.- IDs de tokens et labels, où
-100signifie aucune loss. - Entraînement.
Affichez le texte rendu à l’étape 3 avant l’entraînement.
Pour la ligne de salutation ci-dessus, les messages normalisés sont :
messages = [
    {"role": "user", "content": "Hello, who are you?"},
    {"role": "assistant", "content": "I am a helpful AI assistant."},
]
# Inspection step after loading the selected model's tokenizer:
rendered = tokenizer.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=False,
)
print(rendered)
Inspectez la ligne réellement sérialisée avant l’entraînement : les délimiteurs de rôle, les tokens de fin de tour et les tool schemas doivent correspondre à ceux de l’inférence. Pour une ligne de tool use, conservez les définitions d’outils, les tool calls de l’assistant et les tool results comme des champs distincts. Vérifiez que la troncature ne supprime pas la réponse supervisée et ne coupe pas un argument d’outil en deux.
Le masquage de la loss choisit les tokens que le modèle est récompensé de prédire. Dans un entraînement sur la séquence complète, les textes de l’utilisateur, du système, des outils et de l’assistant peuvent tous contribuer. Dans un entraînement limité à l’assistant, ces tokens de contexte restent visibles pour l’attention, mais leurs labels sont ignorés (couramment -100) ; seuls les segments de l’assistant contribuent. Pour cette salutation, la réponse doit être une cible et la question de l’utilisateur non, si le comportement voulu est celui de l’assistant seul.
Le schéma montre les deux réglages pour une même conversation de tool use.
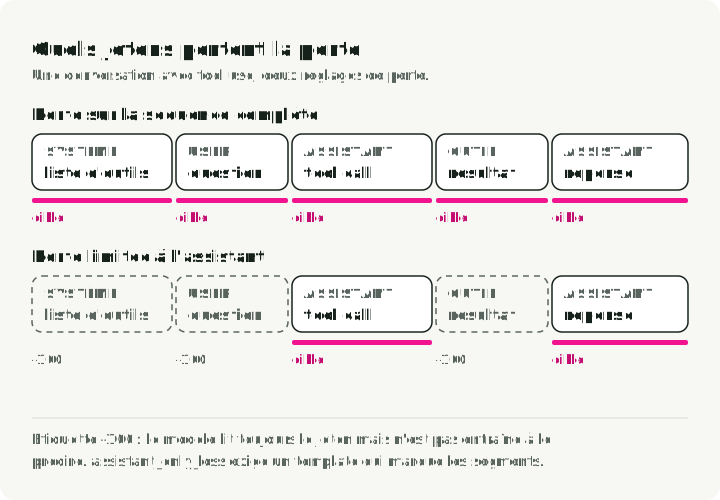
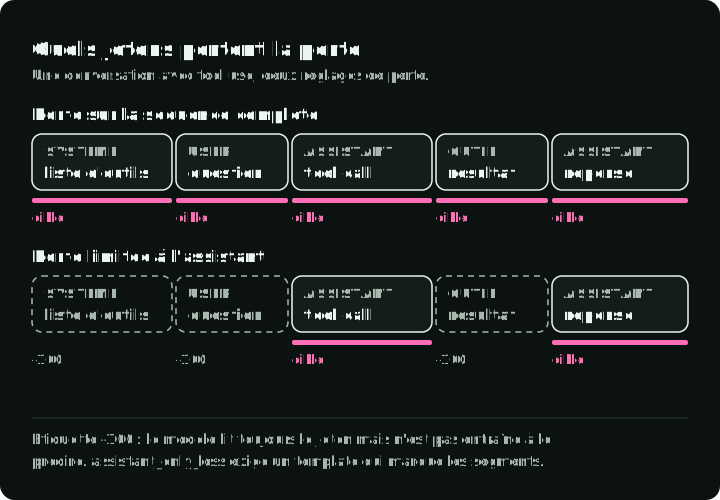
La documentation SFT de TRL prend en charge assistant_only_loss=True pour les datasets conversationnels dont les templates exposent des segments de génération. Un template sans ces segments ne peut pas fournir ce masque. Les datasets prompt/completion ont une option distincte, completion_only_loss. Avant d’activer l’une ou l’autre, inspectez un batch tokenisé et décodez les tokens dont les labels ne sont pas ignorés. Répétez ensuite avec une conversation d’outils et un exemple de longueur maximale. La démo plus loin dans ce guide utilise la loss sur la séquence complète, car le template de Nemotron n’a pas de segments de génération.
Choisissez une longueur de séquence à partir de la distribution des données et lancez le contrôle de mémoire à longueur maximale de l’étape 2. Le packing place plusieurs exemples plus courts dans une même séquence d’entraînement. Commencez sans lui, pour que les frontières entre lignes restent faciles à inspecter. Ne mesurez le packing qu’une fois les lignes sérialisées et les labels corrects.
Fine-tuning complet vs PEFT
Le fine-tuning complet (FFT) met à jour tous les poids : les gradients et l’état de l’optimiseur croissent donc avec le modèle entier. On ne peut pas déduire le pic du seul nombre de paramètres, mais il est très supérieur à la mémoire nécessaire pour charger les poids en inférence.
Le parameter-efficient fine-tuning (PEFT) n’entraîne qu’un petit sous-ensemble de paramètres et gèle le reste : les gradients et les états de l’optimiseur ne concernent donc que ce sous-ensemble.
LoRA : le point de départ
LoRA (Low-Rank Adaptation) gèle une matrice pré-entraînée et représente sa mise à jour apprise avec deux matrices plus petites. Le papier d’origine motive cela par l’hypothèse que les mises à jour d’adaptation utiles ont un rang intrinsèque faible.
Ici, est la largeur d’entrée de la couche et sa largeur de sortie. Le rang est la plus petite dimension commune aux deux matrices entraînables : un rang plus petit utilise moins de paramètres entraînables. Le paramètre règle l’échelle de la mise à jour par le rapport .
Le schéma montre la matrice gelée, les deux matrices entraînables et la façon dont leur produit mis à l’échelle est ajouté, avec le nombre de paramètres d’une matrice de largeur 4 096 au rang 16.
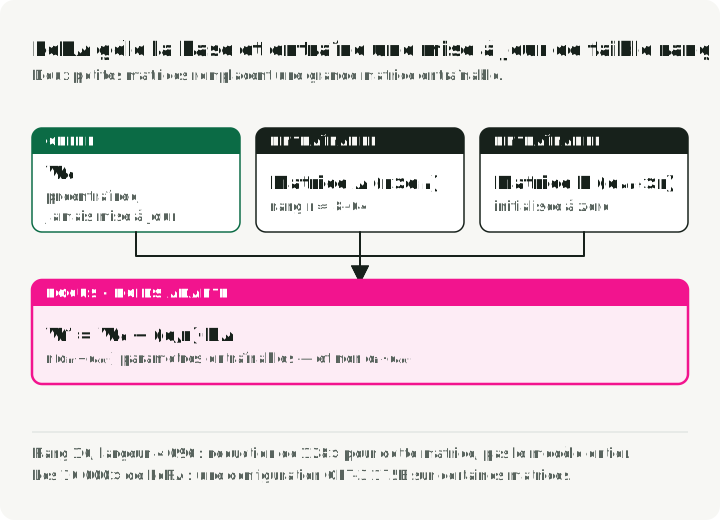
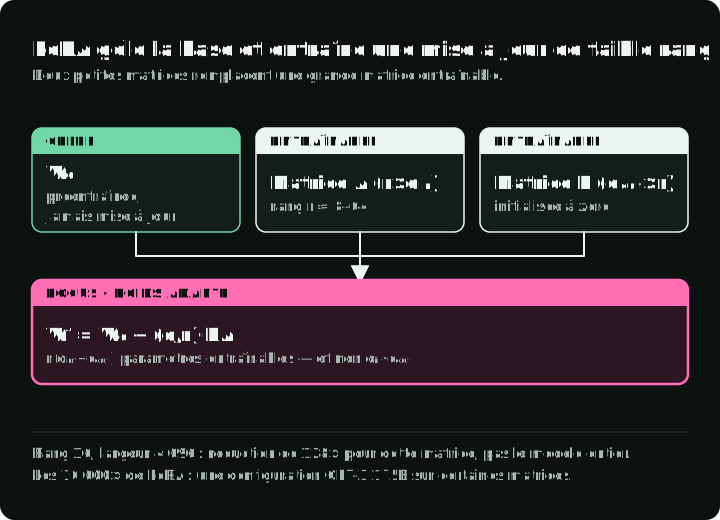
Pour une matrice gelée , LoRA apprend :
La couche adaptée est :
L’adapter compte paramètres entraînables au lieu de pour cette matrice. Pour une matrice carrée de largeur 4 096 avec un rang de 16, cela représente une réduction de 128× des paramètres entraînables pour cette matrice. Les économies sur le modèle entier dépendent des matrices qui reçoivent des adapters.
Comparaison des méthodes PEFT
| Méthode | Ce qui change | À choisir quand |
|---|---|---|
| LoRA | Base gelée plus mises à jour entraînables de rang faible | Le modèle de base tient confortablement et vous voulez de petits artefacts par tâche |
| QLoRA | LoRA avec la base gelée stockée sous forme de 4 bits | La mémoire des poids de base est le facteur limitant |
| DoRA | Sépare la magnitude du poids d’une direction mise à jour par LoRA | Une base de référence LoRA mesurée laisse un écart de qualité qui justifie une complexité supplémentaire |
| Fine-tuning complet | Tous les poids du modèle | PEFT manque la cible et le gain de qualité justifie l’entraînement distribué et des checkpoints complets |
DoRA : LoRA avec décomposition des poids
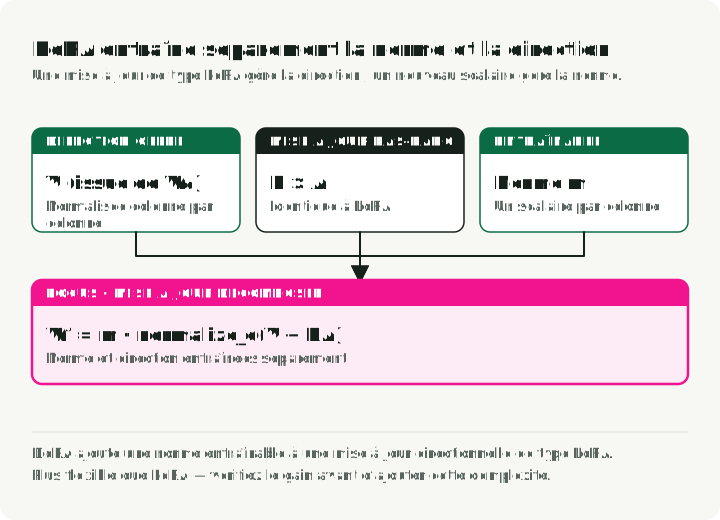
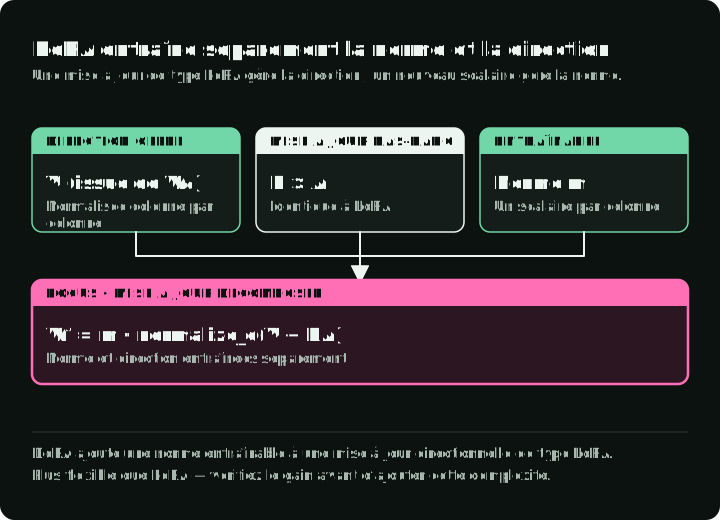
DoRA (Weight-Decomposed Low-Rank Adaptation) sépare la magnitude de chaque vecteur de poids de sa direction. Le papier DoRA applique une mise à jour LoRA à la composante directionnelle tout en apprenant la magnitude séparément. Le schéma dessine une colonne de poids sous forme de flèche : B·A fait tourner sa direction, et une magnitude entraînée m fixe sa longueur.
Comment cela fonctionne :
Au lieu de traiter les poids comme une seule entité, DoRA décompose les poids pré-entraînés en deux composantes :
- Magnitude — une valeur entraînable par vecteur de poids.
- Direction — un vecteur normalisé, mis à jour par des matrices de rang faible.
Dans une notation compacte par colonnes :
où :
m= magnitude (entraînable)- = la matrice initiale gelée ; on normalise après avoir ajouté
- = la mise à jour directionnelle de rang faible apprise
- = normalisation par colonne
Effets de la décomposition :
- Plus de degrés de liberté que LoRA standard, car la magnitude peut changer indépendamment.
- De meilleurs résultats que LoRA dans plusieurs configurations rapportées par le papier qui la propose.
- Des paramètres et des calculs supplémentaires : le gain doit donc être vérifié sur votre tâche et votre chemin de serving.
Fusion d’adapters pour l’apprentissage multitâche
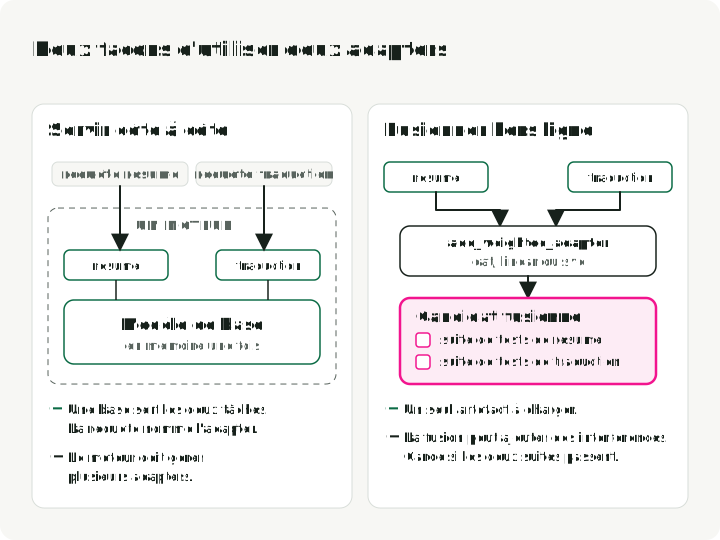
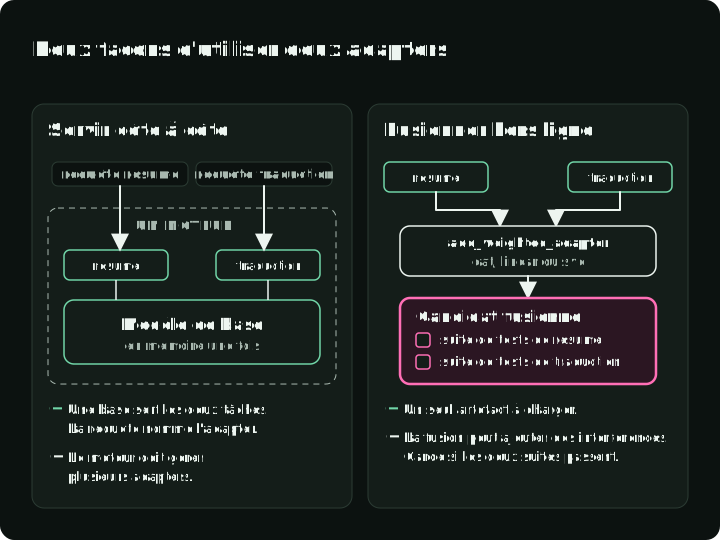
Des adapters séparés permettent à une même base gelée de prendre en charge plusieurs tâches. Vous pouvez router les requêtes vers un adapter, servir plusieurs adapters depuis un même moteur quand c’est pris en charge, ou créer hors ligne un candidat fusionné. La fusion peut introduire des interférences : évaluez donc l’artefact fusionné au lieu de supposer que les adapters sources se composent sans problème.
La figure compare les deux options pour deux adapters sur une même base. Gardez le modèle fusionné seulement s’il réussit les deux suites de tests.
Méthodes de fusion courantes :
- Concaténation — combiner les paramètres des adapters et augmenter le rang effectif. Rapide et simple.
- Combinaison linéaire — somme pondérée des adapters. Les poids fixent la contribution de chaque tâche.
- SVD — décomposition matricielle pour la fusion. Plus flexible, mais plus lente.
add_weighted_adapter de PEFT les implémente sous les noms combination_type="cat", "linear" et "svd" ; le guide de fusion de modèles de PEFT les décrit, ainsi que des méthodes plus récentes.
Exemple : un adapter pour le résumé, un autre pour la traduction, fusionnés en un seul modèle multitâche.
Étape 4 : preference alignment (facultatif)
Le SFT est l’entraînement principal, et les sections sur les frameworks qui suivent cette étape l’exécutent. Cette étape présente ce que vous pouvez ajouter après le SFT, si les erreurs l’exigent.
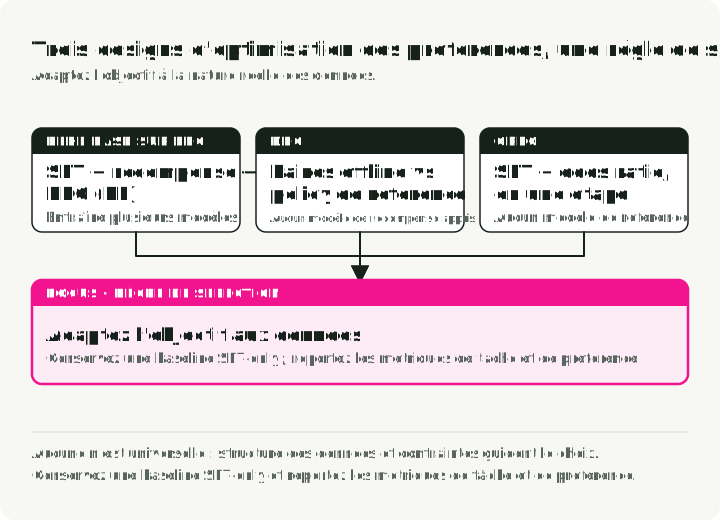
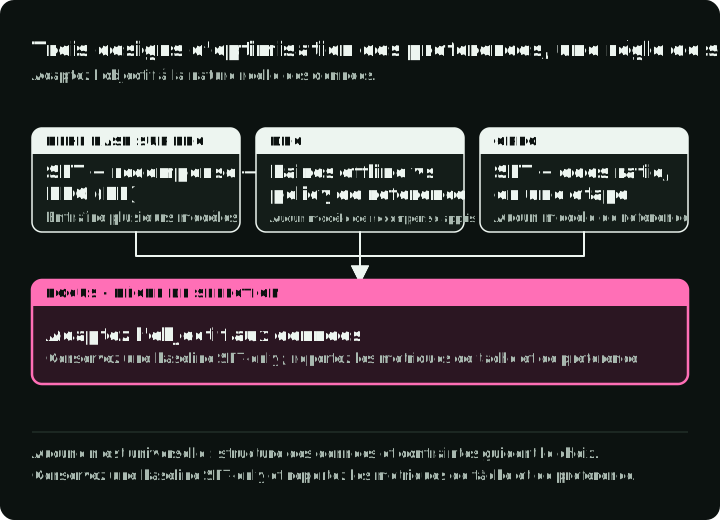
Le SFT apprend des démonstrations. L’optimisation des préférences apprend au contraire à partir de comparaisons du type « la réponse A choisie est meilleure que la réponse B rejetée ». Ne l’utilisez que si la préférence par paires est le bon label pour l’erreur ; l’exactitude factuelle et le respect des politiques demandent souvent des évaluateurs plus solides qu’une préférence globale.
Le schéma montre les étapes de chaque méthode, les modèles qu’elle charge, et ce que fait une étape d’entraînement.
RLHF basé sur PPO
RLHF signifie reinforcement learning from human feedback. La policy est le modèle de langage qui génère les réponses ; un reward model note ces réponses à partir de préférences apprises sur des comparaisons humaines. Une recette basée sur PPO comporte trois étapes :
- SFT — apprendre la tâche.
- Reward model — entraîné sur des préférences humaines (choisi vs rejeté).
- PPO (Proximal Policy Optimization) — générer des réponses et mettre à jour le modèle de langage pour augmenter leurs scores de récompense.
Le coût opérationnel vient des différents composants :
- Compliqué à implémenter et à maintenir.
- Coûteux — vous entraînez plusieurs modèles.
- L’échantillonnage à partir du modèle en cours d’entraînement exige de surveiller les mises à jour instables et les réponses qui exploitent le reward model sans satisfaire la tâche.
DPO
DPO (Direct Preference Optimization) supprime le reward model séparé et la boucle de reinforcement learning. Il favorise les réponses choisies tout en décourageant les écarts importants par rapport à un modèle de départ fixe, appelé modèle de référence. Le papier DPO dérive cet objectif en limitant l’écart que peuvent prendre les probabilités des réponses par rapport à cette référence ; la limite mathématique est une contrainte de divergence KL.
Une paire de préférence contient le même prompt et deux réponses candidates. Cette ligne abrégée montre ses champs ; de vrais labels demandent des réponses complètes et une raison de préférer l’une d’elles :
{
    "prompt": "Explain quantum computing",
    "chosen": "Quantum computing uses qubits...",   # Preferred response
    "rejected": "Well, it's complicated..."        # Non-preferred response
}
Ce qui change sur le plan opérationnel :
- Un chemin de code plus simple (pas de reward model séparé, pas de boucle RL).
- Un entraînement sur des paires de préférences enregistrées, plutôt que la génération de nouvelles réponses à noter à chaque mise à jour.
- Un modèle de référence fixe, ou ses log probabilities enregistrées pour les réponses d’entraînement, dans la formulation standard.
DPO est plus facile à prototyper qu’un pipeline PPO complet, mais ce n’est pas une amélioration automatique de la qualité. Les résultats dépendent de la policy de départ, de la qualité des paires, des paramètres de la loss, des effets de longueur et du protocole d’évaluation. Comparez-le à un checkpoint SFT sur les mêmes suites de préférences et de tâches mises de côté.
ORPO
ORPO (Odds-Ratio Preference Optimization) combine la loss de log-vraisemblance négative du SFT avec une pénalité de rapport de cotes sur les réponses rejetées. Il supprime le modèle de référence séparé et peut combiner l’apprentissage de la tâche et l’optimisation des préférences en un seul entraînement.
Comment cela fonctionne : ORPO utilise une loss combinée qui fait deux choses à la fois :
- Maximiser la vraisemblance de la réponse choisie (apprendre la tâche).
- Pénaliser la réponse rejetée avec un terme de rapport de cotes (apprendre les préférences).
TRL fournit désormais ORPO sous le nom ORPOConfig dans trl.experimental.orpo (trainer ORPO de TRL). Deux paramètres méritent d’être connus :
learning_rate: le papier utilisait des taux bas comme8e-6; ajustez selon votre modèle, votre batch et vos données plutôt que de copier une valeur comme une règle.beta: règle le poids du terme de préférence par rapport au terme SFT.
Le compromis :
- Une seule étape d’entraînement au lieu de deux.
- Pas de reward model.
- Pas de passe forward du modèle de référence.
- Un entraînement couplé : si l’apprentissage de la tâche ou le comportement de préférence régresse, il n’existe aucun checkpoint SFT intermédiaire issu du même pipeline à inspecter.
Choisissez selon la conception des données et de l’évaluation :
- Utilisez DPO quand vous avez déjà un checkpoint SFT satisfaisant et voulez une expérience de préférences hors ligne plus simple.
- Testez ORPO quand un objectif sans référence et en une seule étape convient à vos données et à vos contraintes opérationnelles.
- Utilisez le RLHF basé sur PPO quand l’échantillonnage en ligne face à une récompense apprise explicite fait partie de l’exigence et que vous pouvez surveiller l’exploitation de la récompense.
Aucun n’est un choix par défaut valable pour toutes les tâches. Gardez une base de référence SFT seul et présentez à la fois les métriques de tâche et les métriques de préférence.
Frameworks de fine-tuning
Les étapes 3 et 4 ont choisi la méthode. Les deux sections suivantes choisissent un framework et lancent le SFT avec lui.
Les frameworks se recoupent et évoluent vite. Choisissez selon le chemin d’exécution que vous devez prendre en charge, figez les versions et gardez une configuration d’entraînement assez portable pour être reproduite hors d’un notebook.
Unsloth — vitesse et efficacité mémoire
Unsloth s’intègre à trl et transformers de Hugging Face et fournit des kernels optimisés, du checkpointing et des chemins de fine-tuning quantifié pour les modèles pris en charge.
- Des kernels GPU Triton sur mesure pour l’attention, RoPE et l’entropie croisée, qui évitent le surcoût de PyTorch.
- Une rétropropagation économe en mémoire, qui recalcule les activations pendant la passe backward au lieu de les garder en mémoire.
- Des opérations fusionnées qui regroupent plusieurs étapes (layer norm + couche linéaire, et similaires) en un seul appel GPU.
- Une quantification 4 bits intégrée directement dans le chemin QLoRA, avec une déquantification optimisée.
L’ordre des imports compte. Suivez l’ordre des imports de l’exemple Unsloth pour la version que vous figez. Unsloth applique des correctifs à l’import : l’importer avant trl et transformers évite des optimisations manquantes ou des erreurs propres à une version.
# Correct order
from unsloth import FastLanguageModel  # Must be first!
from trl import SFTConfig, SFTTrainer

# Avoid this order with Unsloth's patched path
from trl import SFTTrainer
from unsloth import FastLanguageModel
Idéal pour : l’entraînement sur un seul GPU, le prototypage et les notebooks Colab.
Les chiffres de vitesse et de mémoire publiés varient selon le modèle, la longueur de séquence, le batch, la précision et le matériel. Mesurez les tokens par seconde et la mémoire de pointe sur votre propre exécution au lieu de traiter un ratio affiché comme une propriété du framework.
Axolotl — entraînement piloté par la configuration
Pour les configurations orientées config et distribuées, Axolotl garde toute l’exécution dans un seul fichier YAML. Ces clés sélectionnent une base 4 bits, un adapter QLoRA et un dataset au format Alpaca :
# axolotl_config.yaml (excerpt)
base_model: meta-llama/Meta-Llama-3-8B
load_in_4bit: true
adapter: qlora
lora_r: 32
lora_alpha: 16 # alpha/r = 0.5 here; the demo uses 2. Sweep it with the learning rate.
datasets:
    - path: data/training_data.jsonl
      type: alpaca
Les modules ciblés, la longueur de séquence, le packing, la taille de batch, le learning rate et les epochs vont dans le même fichier ; la référence de configuration liste chaque clé. Lancez l’entraînement :
axolotl train axolotl_config.yamlComparaison des frameworks
| Outil | Utile quand | À vérifier avant de s’engager |
|---|---|---|
| Unsloth | Vous voulez un chemin optimisé pour les modèles pris en charge, avec des exemples concis | Matrice des modèles, GPU, quantifications et prise en charge du distribué |
| Axolotl | Vous voulez des configurations déclaratives et des recettes distribuées intégrées | Schéma exact de la configuration et lanceur pour la version figée |
| TRL | Vous voulez un accès direct aux trainers SFT et de préférences de Hugging Face | Format du dataset, chat template, masquage de la loss et intégration de PEFT |
| Torchtune | Vous exécutez déjà des recettes torchtune ; il n’est plus activement maintenu (depuis 2025) | Couverture des recettes de modèles et compatibilité d’export |
Démonstration pratique : fine-tuning avec Unsloth
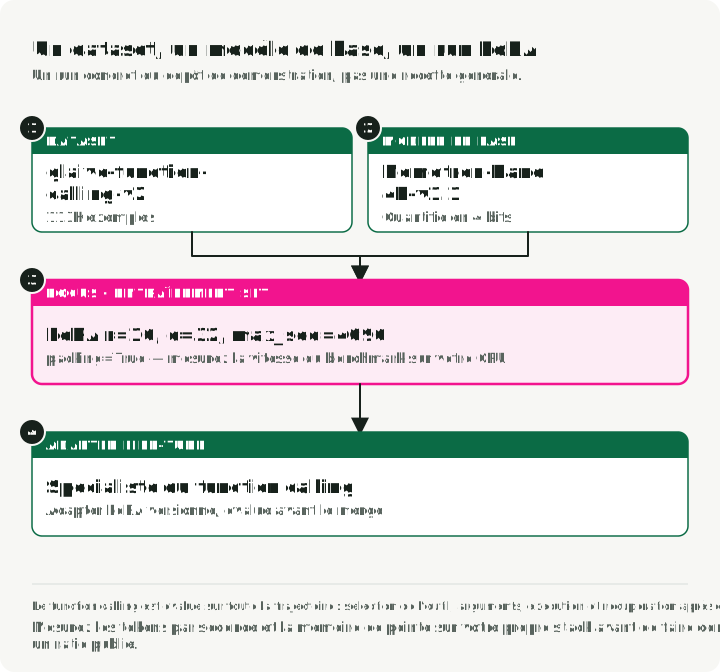
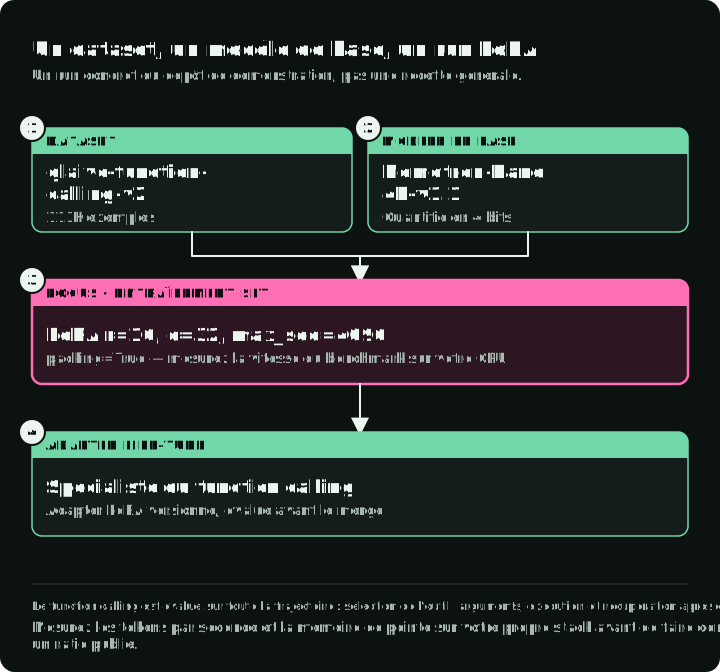
Cette démo apprend à un modèle à choisir une fonction et à fournir ses arguments. Mon unsloth-finetune-demo fait le fine-tuning de Llama-3.1-Nemotron-Nano-4B-v1.1 sur le dataset glaive-function-calling-v2. Le chemin d’entraînement CUDA de ce dépôt nécessite Linux ou WSL2 et un GPU NVIDIA. Unsloth propose aussi un chemin d’entraînement sur GPU Intel distinct, que cette démo n’implémente pas. Figez le commit que vous exécutez ; le fichier de verrouillage fige les dépendances, dont TRL 0.24.0.
Le schéma montre toute l’exécution avec ses valeurs réelles : comment une ligne Glaive devient un texte d’entraînement qui conserve les définitions d’outils, la séparation, les paramètres d’entraînement, les trois répertoires de sortie et la première vérification.
Lancer la démo
git clone https://github.com/slavadubrov/unsloth-finetune-demo.git
cd unsloth-finetune-demo
uv sync

# Train on 1,000 random rows, then also save a merged model and a GGUF file
uv run finetune --max-samples 1000 --merge --gguf q4_k_m
Chaque exécution de finetune entraîne. --merge et --gguf ajoutent des exports après l’entraînement ; il n’existe pas de commande d’export seul. L’exécution écrit trois répertoires :
outputs/unsloth-nemotron-function-calling/— l’adapter LoRAoutputs/unsloth-nemotron-function-calling-merged/— le modèle fusionné en 16 bits (--merge)outputs/unsloth-nemotron-function-calling-gguf/— le fichier GGUF (--gguf q4_k_m)
Avant le début de l’entraînement, l’exécution affiche la première ligne d’entraînement telle que le modèle la voit. Lisez-la : les définitions d’outils apparaissent dans <AVAILABLE_TOOLS>, et chaque appel apparaît dans <TOOLCALL>.
Préparation des données
Chaque ligne glaive contient deux chaînes. La colonne system contient toutes les définitions de fonctions ; la colonne chat contient la conversation, avec les appels écrits sous la forme <functioncall> {...}. Entraîner sur chat seul apprend au modèle à appeler des outils dont il ne voit jamais les schémas. Le data.py de la démo convertit chaque ligne en messages et en une liste tools séparée, rend les deux avec le chat template propre au modèle, et met de côté 5 % des lignes comme jeu d’évaluation :
def to_text(example: dict, tokenizer) -> dict:
    """Render one glaive row with the model's chat template. Empty text marks a dropped row."""
    try:
        messages, tools = to_messages(example)
    except (ValueError, KeyError):  # bad JSON in a tool definition or call
        return {"text": ""}
    if not messages:
        return {"text": ""}
    text = tokenizer.apply_chat_template(messages, tools=tools or None, tokenize=False)
    # The trainer tokenizes this text with special tokens on, which adds BOS again.
    return {"text": text.removeprefix(tokenizer.bos_token or "")}
Sur le dataset complet, cela conserve 112 811 lignes sur 112 960 ; 149 lignes ont un JSON mal formé et sont écartées. Avec ce tokenizer, la ligne rendue la plus longue fait 4 076 tokens : une limite de 4 096 tokens n’en tronque donc aucune.
Le chat template de la model card a un défaut pour l’entraînement. Il rend un tool call passé sans l’accolade fermante après arguments : le texte dans <TOOLCALL> n’est donc pas du JSON valide. Un modèle entraîné sur ce texte apprend à l’émettre, et le parseur de serving ne peut pas lire l’appel. Le dépôt fournit le template avec l’accolade ajoutée et l’utilise pour l’entraînement et le serving. Son test sur CPU seul rend des conversations d’outils et vérifie que chaque <TOOLCALL> se parse.
Configuration de la démo
Le config.py de la démo fixe les valeurs de LoRA :
LORA_R = 16        # Adapter capacity; tune against held-out results
LORA_ALPHA = 32    # Update scale alpha/r = 2
LORA_DROPOUT = 0.05
MAX_SEQ_LENGTH = 4096
LORA_TARGET_MODULES liste les sept projections d’attention et de MLP de ce modèle de la famille Llama, de q_proj à down_proj.
Le rapport alpha sur rang. alpha/r règle l’échelle de la mise à jour LoRA classique. alpha = 2r est une heuristique de départ courante dans la documentation de certains outils, pas une garantie de stabilité. Ne balayez le rang, alpha, le learning rate et les modules ciblés qu’une fois les données et la base de référence figées.
Chargement du modèle
Le model.py de la démo charge la base en 4 bits, remplace le chat template par la version corrigée et ajoute les adapters LoRA :
from unsloth import FastLanguageModel

model, tokenizer = FastLanguageModel.from_pretrained(
    model_name=MODEL_NAME,
    max_seq_length=MAX_SEQ_LENGTH,
    load_in_4bit=True,  # QLoRA: the frozen base is stored in 4-bit form
    trust_remote_code=True,
)
# Training rows, the saved tokenizer, and vLLM all use this one template.
tokenizer.chat_template = CHAT_TEMPLATE_PATH.read_text()

model = FastLanguageModel.get_peft_model(
    model,
    r=LORA_R,
    lora_alpha=LORA_ALPHA,
    lora_dropout=LORA_DROPOUT,
    target_modules=LORA_TARGET_MODULES,
    use_gradient_checkpointing="unsloth",  # Lower activation memory; extra compute
)
Configuration de l’entraînement
Le training.py de la démo transmet les lignes rendues au SFTTrainer de TRL. Il évalue la loss de tokens sur le jeu mis de côté une fois par epoch. Cette loss est un diagnostic, pas la précision des tool calls ; l’étape 5 exige toujours une évaluation distincte de la tâche.
trainer = SFTTrainer(
    model=model,  # 4-bit base with LoRA adapters from FastLanguageModel
    processing_class=tokenizer,
    train_dataset=train_dataset,
    eval_dataset=eval_dataset,
    args=SFTConfig(
        output_dir="outputs/unsloth-nemotron-function-calling",
        dataset_text_field="text",
        max_length=4096,
        packing=False,  # One row per sequence, so row boundaries are easy to inspect
        assistant_only_loss=False,  # The Nemotron template has no generation spans
        eval_strategy="epoch",
        per_device_train_batch_size=2,
        gradient_accumulation_steps=4,
        learning_rate=2e-4,
        num_train_epochs=3,
        bf16=True,  # The repository falls back to FP16 on GPUs without BF16
        optim="adamw_8bit",
    ),
)
trainer.train()
Premier contrôle
uv run infer --prompt "Book a flight to Tokyo"infer charge l’adapter et envoie le prompt avec un outil, book_flight(destination), rendu avec le même template que les lignes d’entraînement. Un adapter entraîné doit répondre par <TOOLCALL>[{"name": "book_flight", "arguments": {"destination": "Tokyo"}}]</TOOLCALL>. S’il répond en texte brut, inspectez la ligne d’entraînement affichée avant d’entraîner plus longtemps.
Étape 5 : évaluation
Fixez les cas de test, les règles de notation et les seuils de réussite avant la première exécution. Au minimum, comparez le checkpoint ajusté au modèle de base exact non ajusté, avec le même prompt, les mêmes paramètres de décodage et le même environnement d’outils. Ne présentez la qualité agrégée qu’après avoir vérifié les slices d’échec que le projet devait améliorer.
Suivez quatre groupes :
- Tâche cible : correspondance exacte, réussite de l’exécution, grille humaine ou autre résultat lié au cas d’usage.
- Régression : capacités générales et slices de tâches déjà prises en charge que l’adaptation pourrait dégrader.
- Sécurité et politiques : refus, fuites de données, prompt injection ou contraintes propres au domaine.
- Exploitation : latence, débit, mémoire, taille de l’artefact et coût dans la configuration de serving visée.
Benchmarks automatisés
Utilisez lm-evaluation-harness pour vérifier des tâches standardisées pertinentes en plus de vos tests produit. Cette commande exige un checkpoint Hugging Face fusionné, que la démo écrit avec --merge :
lm_eval --model hf \
    --model_args pretrained=./outputs/unsloth-nemotron-function-calling-merged \
    --tasks hellaswag,arc_easy,mmlu \
    --batch_size 8
LLM-as-judge
Pour une qualité subjective, un modèle plus grand peut aider à noter, mais calibrez-le sur des exemples relus par des humains et gardez l’identité du candidat cachée. Donnez au juge la sortie du modèle, la réponse attendue et une grille qui définit chaque note pour chaque critère, comme la pertinence, l’exactitude et le formatage.
Évaluation propre au domaine
Mettez de côté des exemples réels par source, utilisateur, document ou période, pour que des quasi-doublons ne puissent pas fuiter d’un côté à l’autre de la séparation. Pour le function calling, validez la trajectoire complète : choix de l’outil, arguments, résultat d’exécution, reprise après erreur et réponse finale. Présentez des intervalles de confiance ou des décomptes appariés de victoires et de défaites quand l’échantillon est petit, et inspectez chaque régression dans une slice critique.
Contrôlez chaque trajectoire en quatre étapes :
- Le bon outil est choisi.
- Les arguments sont valides et corrects.
- Le résultat d’exécution est celui attendu.
- Le modèle reprend correctement après une erreur d’outil.
Comptez chaque échec par contrôle et par slice. Une réponse finale correcte peut cacher un mauvais argument ou une reprise ignorée.
Le code d’évaluation du Berkeley Function Calling Leaderboard (BFCL) note le choix de la fonction et les arguments par rapport à des appels de référence. Utilisez-le comme contrôle de régression à côté de vos propres conversations mises de côté.
Étape 6 : déploiement et formats de sortie
Choisissez l’artefact selon le moteur de serving et le plan de rollback, pas seulement selon la taille du fichier. Exportez chaque format à partir des mêmes objets model et tokenizer évalués, afin que tous les artefacts portent les mêmes poids entraînés. Le schéma compare les trois artefacts : ce que contient chaque fichier, ce qui le charge, et son compromis.
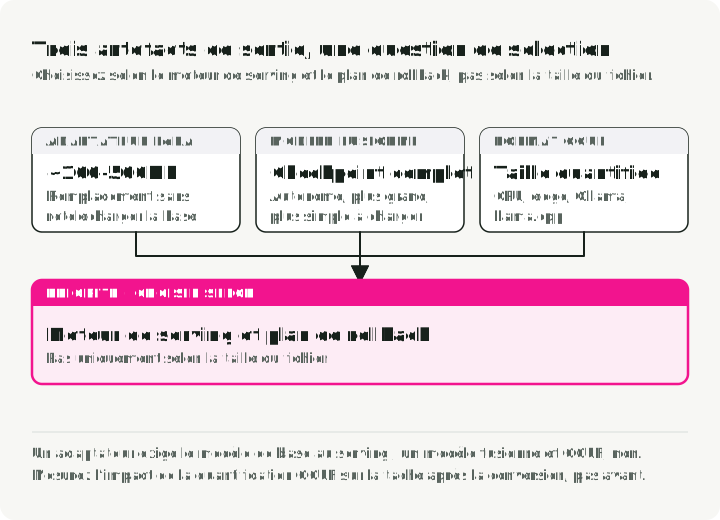
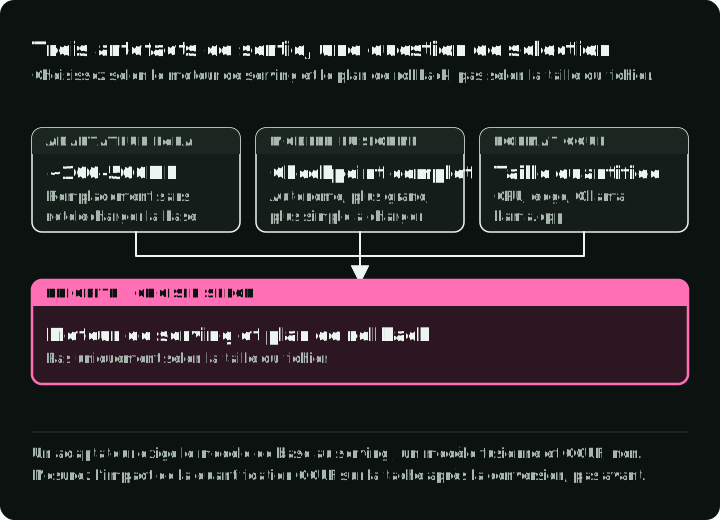
Dans la démo, uv run finetune enregistre toujours l’adapter, --merge ajoute le modèle fusionné et --gguf q4_k_m ajoute le fichier GGUF, le tout en une seule exécution d’entraînement. Les appels Python ci-dessous montrent ce que fait chaque option.
1. Adapter LoRA
model.save_pretrained("outputs/unsloth-nemotron-function-calling")
tokenizer.save_pretrained("outputs/unsloth-nemotron-function-calling")- Taille : proportionnelle aux modules ciblés, au rang, aux couches et au dtype ; souvent bien plus petite que la base.
- Idéal pour : le développement, les adapters de tâche versionnés et les moteurs qui prennent LoRA en charge directement.
- Bonus : vous pouvez changer d’adapter sans retélécharger le modèle de base.
2. Modèle fusionné
# What --merge runs: merge the adapter into the base weights and save a standalone model
model.save_pretrained_merged(
    "outputs/unsloth-nemotron-function-calling-merged", tokenizer, save_method="merged_16bit"
)- Taille : à peu près celle du checkpoint de base complet, à la précision de sortie choisie.
- Idéal pour : les moteurs ou les circuits de distribution qui ne prennent pas l’adapter en charge séparément.
- Compromis : artefact plus gros et déploiement plus lent ; chargement d’un modèle unique plus simple.
3. Format GGUF
# What --gguf q4_k_m runs; file size and name depend on the Unsloth version
model.save_pretrained_gguf(
    "outputs/unsloth-nemotron-function-calling-gguf", tokenizer, quantization_method="q4_k_m"
)- Taille : dépend du modèle ; environ des poids sur quatre bits plus des métadonnées pour les variantes Q4.
- Idéal pour : l’inférence sur CPU, Ollama, llama.cpp, le déploiement en edge.
- Options :
q4_k_m(plus petit),q5_k_m(plus de fidélité des poids),q8_0(plus gros et plus fidèle). Mesurez l’effet sur la tâche après la conversion.
Étape 7 : serving et monitoring
Avec vLLM
Cette commande sert l’adapter de la démo au-dessus du modèle de base. Servez avec le parseur et le chat template de la model card ; ils doivent correspondre au template utilisé pendant l’entraînement. La model card enregistre le parseur llama_nemotron_json via le fichier de plugin llama_nemotron_nano_toolcall_parser.py. Le dépôt de la démo fournit le template corrigé.
Utilisez un environnement Python 3.12 séparé avec vLLM 0.12.0 : le parseur figé importe l’API du parseur d’outils de cette version, qui a changé dans les versions suivantes. La commande fige le modèle de base et le parseur sur la même révision de la model card ; utilisez aussi cette révision de la base pour l’entraînement. La compatibilité du code source et un test du parseur sur CPU ne valident pas le serving sur GPU. Vérifiez le chargement du modèle et le tool call attendu sur votre GPU. Lancez la commande depuis la racine du dépôt :
uv venv --python 3.12 .venv-vllm
uv pip install --python .venv-vllm/bin/python "vllm==0.12.0" "huggingface-hub==0.36.0"
source .venv-vllm/bin/activate

hf download nvidia/Llama-3.1-Nemotron-Nano-4B-v1.1 \
    llama_nemotron_nano_toolcall_parser.py \
    --revision d552708a9d575fa8d4a690b988fd870d65279f98 --local-dir serving

vllm serve nvidia/Llama-3.1-Nemotron-Nano-4B-v1.1 \
    --revision d552708a9d575fa8d4a690b988fd870d65279f98 \
    --trust-remote-code \
    --enable-lora \
    --lora-modules function-calling=./outputs/unsloth-nemotron-function-calling \
    --enable-auto-tool-choice \
    --tool-parser-plugin ./serving/llama_nemotron_nano_toolcall_parser.py \
    --tool-call-parser llama_nemotron_json \
    --chat-template ./src/unsloth_demo/chat_template.jinja \
    --host 127.0.0.1 \
    --port 8000 \
    --max-model-len 4096
La commande uv run --with openai infer-vllm de la démo teste la génération d’arguments via l’API compatible OpenAI. Elle envoie un outil minimal, book_flight, avec une chaîne destination obligatoire, et demande une proposition d’appel ; elle n’exécute aucune réservation. La requête dans cli/inference.py est :
client = OpenAI(base_url="http://localhost:8000/v1", api_key="dummy")
response = client.chat.completions.create(
    model="function-calling",  # the --lora-modules name, not the base model
    messages=[{"role": "user", "content": "Book a flight to Tokyo"}],
    tools=[DEMO_TOOL],  # book_flight(destination), defined in config.py
    tool_choice="auto",
)
print(response.choices[0].message.tool_calls)
Pour cette entrée, le résultat attendu est book_flight avec {"destination": "Tokyo"}. Comme le choix de l’outil est automatique, vérifiez aussi que le modèle a bien renvoyé un appel. L’outil a la même forme que les définitions d’outils glaive sur lesquelles le modèle s’est entraîné. Le parseur de vLLM lit l’appel dans le texte généré : un appel mal formé revient donc comme simple contenu, sans tool_calls. vLLM peut aussi contraindre les arguments d’une fonction à son schéma quand la fonction est marquée strict: true ; le guide du tool calling décrit les paramètres du serveur et les parseurs qui le prennent en charge.
Avec Ollama (en local)
Listez le répertoire outputs/unsloth-nemotron-function-calling-gguf et remplacez MODEL_FILE.gguf ci-dessous par le nom de fichier produit ; les versions d’Unsloth peuvent nommer les fichiers autrement. Un fichier GGUF seul ne garantit pas un formatage correct du chat et des outils dans Ollama ou llama.cpp. Faites correspondre le template d’entraînement et testez l’artefact importé.
# Create Modelfile
echo 'FROM ./outputs/unsloth-nemotron-function-calling-gguf/MODEL_FILE.gguf' > Modelfile

# Import to Ollama
ollama create my-function-model -f Modelfile

# Run
ollama run my-function-model
Avec llama.cpp (CPU)
Avec le même export GGUF et la même substitution du nom de fichier, cette commande vérifie une réponse en texte brut. Elle ne teste pas un tool call complet :
llama-cli -m ./outputs/unsloth-nemotron-function-calling-gguf/MODEL_FILE.gguf \
    -p "What's the weather in Tokyo?" \
    --ctx-size 4096
Surveiller le modèle publié
Le cycle de vie ne s’arrête pas à une loss d’entraînement saine. Enregistrez la révision du modèle de base, le tokenizer et le chat template, le hash de l’adapter, la version du dataset, la configuration d’entraînement et le rapport d’évaluation comme une seule unité de release. En production, surveillez la réussite des tâches, les sorties invalides, les échecs de politique, la latence et la dérive des entrées par les mêmes slices que hors ligne. Gardez l’artefact précédent chargeable et définissez un seuil de rollback avant le lancement.
En résumé :
- Unité de release : révision du modèle de base, tokenizer et chat template, hash de l’adapter, version du dataset, configuration d’entraînement et rapport d’évaluation.
- Surveillez la réussite des tâches, les sorties invalides, les échecs de politique, la latence et la dérive des entrées par les mêmes slices que hors ligne.
- Si une métrique tombe sous le seuil de rollback défini avant le lancement, chargez l’artefact précédent.
Votre prochain test
Avant un entraînement complet, inspectez une conversation sérialisée et ses cibles de loss, puis effectuez une passe forward/backward à la longueur maximale. Enregistrez cette configuration avec la séparation du dataset et le rapport de la base de référence. Si un tool schema manque, conservez-le dans la ligne d’entraînement. Si une réponse est tronquée, ajustez la longueur de séquence et le formatage pour que la réponse complète survive. Résolvez ces problèmes avant d’ajouter des epochs.
Références
Papiers et recherche
- LoRA: Low-Rank Adaptation of Large Language Models
- QLoRA: Efficient Finetuning of Quantized LLMs
- DoRA: Weight-Decomposed Low-Rank Adaptation
- DPO: Direct Preference Optimization
- ORPO: Odds Ratio Preference Optimization
- PPO: Proximal Policy Optimization Algorithms — OpenAI, 2017
Outils de traitement des données
- DataTrove — Traitement de données à grande échelle par Hugging Face
- Distilabel — Génération de données synthétiques (Argilla)
- Trafilatura — Extraction de texte web et crawling
- fastText language identification — modèles préentraînés d’identification de la langue
- Microsoft Presidio — Détection et anonymisation des données personnelles
- scrubadub — Bibliothèque Python pour supprimer les données personnelles
Constrained decoding
- xgrammar — Constrained decoding avec des automates à états finis
- outlines — Génération structurée pour les LLMs
Frameworks d’entraînement
- Unsloth — Framework de fine-tuning optimisé
- Axolotl — Entraînement piloté par la configuration et lanceurs distribués
- TRL — Bibliothèque Hugging Face pour le SFT et l’entraînement sur préférences
- PEFT model merging —
add_weighted_adapteret méthodes de fusion - Torchtune — Bibliothèque de fine-tuning native PyTorch, qui n’est plus activement maintenue
Inférence et déploiement
- vLLM LoRA adapters — Servir un ou plusieurs adapters avec le modèle de base
- vLLM tool calling — Faire correspondre le choix automatique d’outil, le parseur, le chat template et le schéma de requête au modèle
- Llama-3.1-Nemotron-Nano-4B-v1.1 model card — Plugin de parseur de tool calls et chat template pour vLLM
- Ollama — Exécuteur local de LLMs pour Mac/Windows/Linux
- llama.cpp — Inférence CPU/GPU avec le format GGUF
Évaluation
- lm-evaluation-harness — Benchmarking standardisé de LLMs par EleutherAI
- Berkeley Function Calling Leaderboard — Code d’évaluation du function calling
Guides et ressources
- Demo Repository — Exemple pratique de fine-tuning
- Accelerate n-D Parallelism Guide — Stratégies d’entraînement multi-GPU de Hugging Face