Guia de fine-tuning de LLMs: quando fazer fine-tuning, LoRA e QLoRA

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Este guia destina-se a engenheiros de Python que precisam de decidir se devem fazer fine-tuning de um modelo de linguagem grande e como fazê-lo. Vai ficar a saber quando escolher fine-tuning em vez de prompting ou retrieval e como escolher entre métodos como LoRA e QLoRA. O guia explica também como preparar os dados, avaliar o modelo treinado e planear o deployment.
A parte prática usa um repositório de acompanhamento que faz fine-tuning de um modelo de 4B para function calling.
Para uma comparação mais curta entre fine-tuning, RAG e prompting, consulte Fine-Tuning vs RAG vs Prompting.
Deve mesmo fazer fine-tuning?
Antes de gastar horas de GPU, decida se o fine-tuning é a ferramenta certa para o problema que tem à frente. A figura segue um pedido e mostra onde atua cada uma das quatro correções, que falha testar primeiro com ela e o que ela não consegue corrigir.
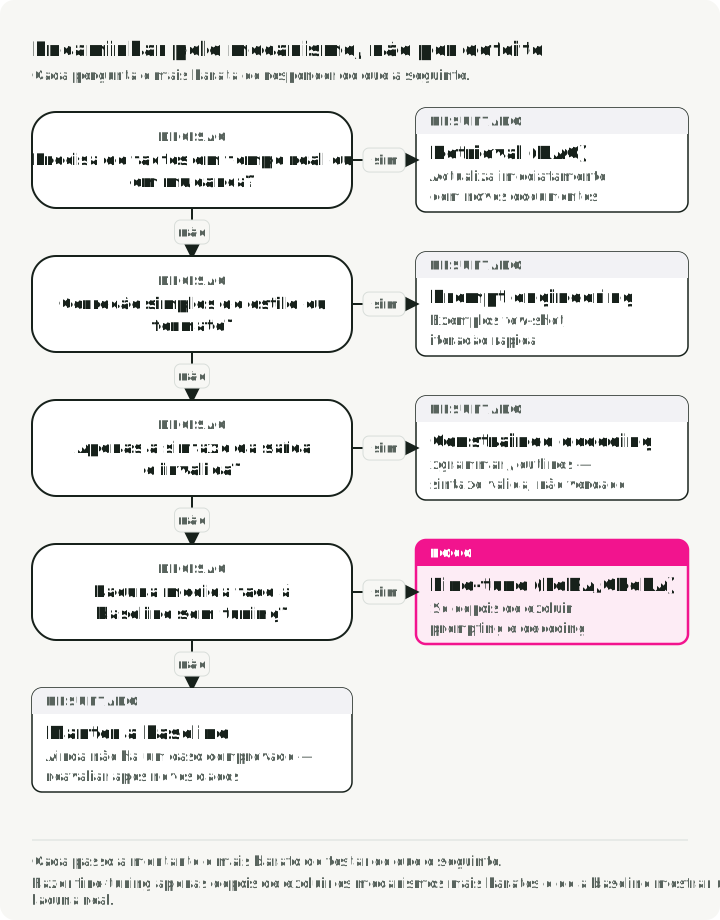
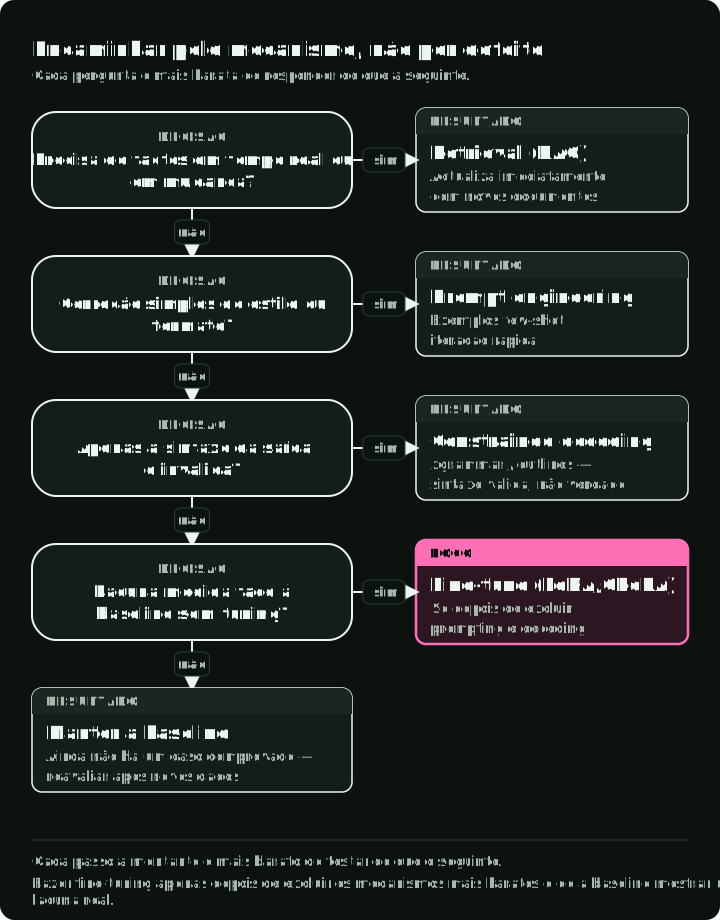
O fine-tuning altera o comportamento codificado nos pesos. O retrieval fornece evidências no momento da inferência, por isso é o melhor ponto de partida para factos que mudam ou que exigem citações. Os documentos novos só ficam disponíveis depois da ingestão e da indexação; compare essa atualidade com o seu requisito.
Prompts e exemplos claros são mais baratos de iterar do que um novo treino. Podem já resolver um problema de estilo ou de seguimento de instruções. O fine-tuning pode reduzir os tokens repetidos do prompt, mas a latência de serving depende do modelo, do tamanho da saída, do hardware e da implementação; uma atualização de pesos não é, por si só, uma aceleração.
Para a sintaxe, bibliotecas como xgrammar e outlines mascaram os tokens seguintes inválidos segundo um schema ou uma gramática suportados. Uma geração com restrições concluída com êxito pertence a essa linguagem. Trate o truncamento e outras gerações incompletas em separado e valide o resultado antes de o usar. A restrição não consegue tornar verdadeiro um ID de cliente nem tornar adequada a escolha de uma ferramenta. Meça a sua latência no seu backend em vez de assumir uma sobrecarga fixa.
Cada uma das quatro opções altera um passo diferente do mesmo pedido. Só o fine-tuning exige uma execução de treino e um novo artefacto de modelo; as outras três alteram texto, documentos ou um schema em torno dos mesmos pesos. A tabela compara as quatro opções lado a lado:
| Opção | O que altera | Como a atualiza | Custo de arranque | O que não consegue corrigir |
|---|---|---|---|---|
| Prompting | Instruções e exemplos | Edita o texto | Baixo: escrever e testar prompts | Comportamento que o modelo não consegue seguir a partir de instruções |
| RAG | Evidências na janela de contexto | Ingere e reindexa documentos | Médio: índice, retriever e avaliação | Um modelo que ignora ou interpreta mal as evidências |
| Constrained decoding | Que tokens o decoder pode emitir | Altera o schema ou a gramática | Baixo a médio: schema e suporte do backend | Valores errados dentro de uma estrutura válida |
| Fine-tuning | Pesos do modelo | Volta a treinar e avalia um novo artefacto | Alto: curadoria de dados, tempo de GPU, avaliação | Factos que mudam depois do treino |
Referência rápida: associar problemas a soluções
| Desafio | Primeiro mecanismo a testar | Porquê? |
|---|---|---|
| Conhecimento em falta | RAG | Obtém evidências citadas; a atualidade depende da ingestão e da indexação |
| Formato ou tom errado | Prompt engineering | Os modelos modernos seguem bem instruções de estilo através de exemplos few-shot |
| Sintaxe de saída inválida | Constrained decoding | Impõe um schema ou uma gramática suportados durante a geração |
| Falha repetida numa tarefa | Fine-tuning (SFT) | Aprende com exemplos de entrada/saída selecionados |
| Desajuste de preferências entre pares | Otimização de preferências | Usa exemplos escolhido/rejeitado depois de o comportamento da tarefa ser mensurável |
| Latência/custo à escala | Distillation (SFT) | Treina um modelo aluno mais pequeno com as saídas de um modelo professor maior |
| Reduzir o tamanho do modelo | Quantização pós-treino | A quantização pós-treino reduz a memória dos pesos; a velocidade depende dos kernels suportados e da carga |
Tornar o caso de negócio mensurável
O fine-tuning pode reduzir os tokens recorrentes do prompt ou permitir que um modelo mais pequeno atinja o objetivo, mas nenhuma das poupanças é automática. Calcule o ponto de equilíbrio com o seu próprio tráfego e preços:
Se o denominador for pequeno, negativo ou assentar num pressuposto de qualidade não comprovado, o projeto ainda não tem um caso económico.
Um exemplo resolvido com números ilustrativos: uma base de comparação com prompts envia cerca de 2000 tokens de instruções e exemplos em cada pedido. Depois do tuning, a mesma tarefa precisa de cerca de 50. Com um preço assumido de $0.50 por milhão de tokens de entrada para ambos os modelos, a poupança é de 1950 tokens, ou cerca de $0.001 por pedido. Se o treino, a avaliação e o deployment custarem $3000, o ponto de equilíbrio fica em cerca de 3,1 milhões de pedidos. A 100 000 pedidos por dia, isso corresponde a cerca de um mês. A 5000 pedidos por dia, é mais de um ano. O cálculo só vale se o modelo ajustado cumprir os mesmos limiares de qualidade que a base de comparação.
A configuração híbrida. Uma arquitetura comum é um modelo mais pequeno adaptado à tarefa mais retrieval para os factos que mudam. Trate o modelo maior com prompts como base de comparação e mantenha o modelo mais pequeno apenas se cumprir os mesmos limiares de qualidade e segurança específicos da tarefa.
Tipos de fine-tuning
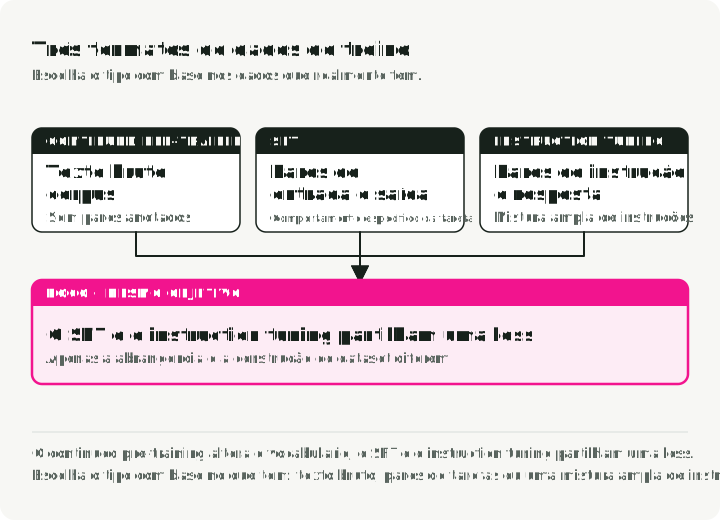
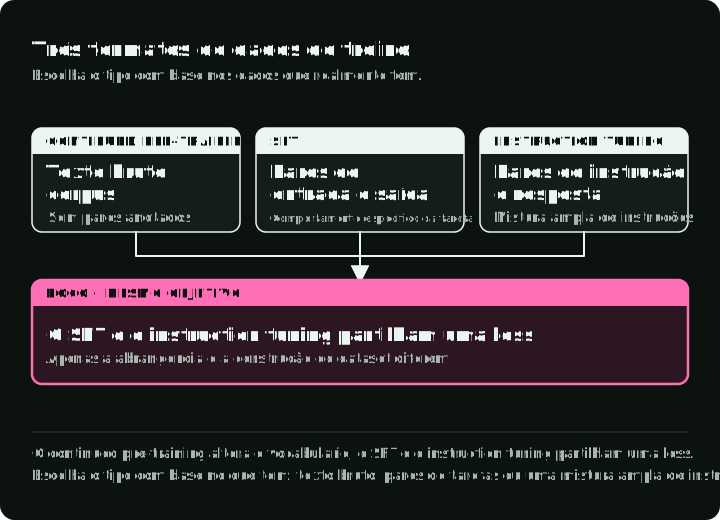
O fine-tuning pode assumir três formas principais. Diferem no tipo de dados de que precisam e no que ensinam ao modelo. O diagrama mostra uma linha de treino para cada tipo.
1. Continued pre-training (auto-supervisionado)
Treina o modelo base com mais texto bruto, usando o token seguinte de cada sequência como alvo de treino. Isto é aprendizagem auto-supervisionada: o texto fornece os seus próprios alvos, tal como na execução original de pré-treino.
Quando usar:
- O domínio tem vocabulário que o modelo base nunca viu (medicina, direito, código-fonte interno).
- Tem muito texto do domínio, mas nenhum par (entrada, saída) etiquetado.
- O modelo base falha na terminologia específica do domínio.
Exemplo: treinar com milhões de notas clínicas para que o modelo aprenda abreviaturas médicas, nomes de fármacos e fluxos de trabalho clínicos.
2. Supervised fine-tuning (SFT)
O SFT treina com pares (entrada, saída) etiquetados. Mostra ao modelo a saída exata que quer para cada entrada.
Quando usar:
- Tem uma tarefa específica com um formato limpo de entrada/saída.
- Tem dados etiquetados de qualidade, mesmo em pequena quantidade.
- Precisa de comportamento previsível para um formato de entrada conhecido.
Exemplo: treinar com pares (descrição de uma consulta SQL, código SQL) para text-to-SQL. Este intervalo de calendário fixo assume que signup_date está guardado em UTC:
{
    "input": "Get users who signed up in August 2026 (UTC)",
    "output": "SELECT * FROM users WHERE signup_date >= '2026-08-01' AND signup_date < '2026-09-01'"
}
3. Instruction tuning
O instruction tuning é um caso especial de SFT concebido para que os modelos sigam uma grande variedade de instruções em linguagem natural. Os dados de treino são pares (instrução, resposta) de muitas tarefas diferentes.
Quando usar:
- Quer um assistente de uso geral (como o ChatGPT ou o Claude).
- O modelo precisa de lidar com pedidos variados e abertos.
- Está a construir uma interface de chat.
Exemplo: treinar com milhares de instruções diversas como “Resume este artigo”, “Escreve um poema sobre X”, “Explica Y em termos simples”.
Comparação
| Aspeto | Continued pre-training | SFT | Instruction tuning |
|---|---|---|---|
| Dados | Texto bruto | Pares (entrada, saída) | Pares (instrução, resposta) |
| Etiquetas | Nenhuma (auto-supervisionado) | Específicas da tarefa | Tarefas diversas |
| Objetivo | Conhecimento do domínio | Comportamento específico da tarefa | Seguir qualquer instrução |
| Volume de dados | Normalmente o maior corpus | Determinado pela cobertura da tarefa e pela diversidade de erros | Normalmente mais amplo do que o SFT específico de uma tarefa |
Um objetivo, dois datasets. O SFT e o instruction tuning usam o mesmo objetivo de previsão do token seguinte; a distinção está na abrangência e na construção do dataset. O continued pre-training é uma experiência à parte e deve ser seguido de testes tanto para os ganhos no domínio como para a regressão da capacidade geral.
O pipeline de fine-tuning em 7 fases
O fine-tuning tem sete fases. Cada fase tem os seus próprios modos de falha, e saltar uma costuma revelar-se mais tarde num modelo mau. O diagrama mostra as fases por ordem, o que cada fase acrescenta ao registo da versão e o caminho de regresso da monitorização para a preparação dos dados.
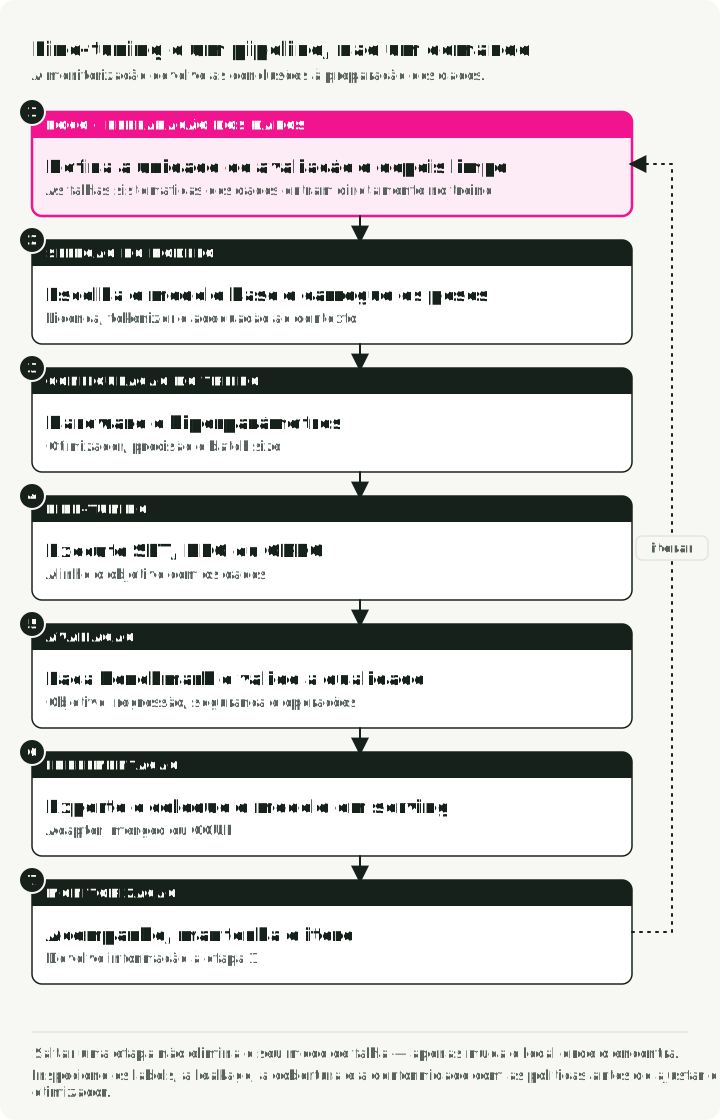
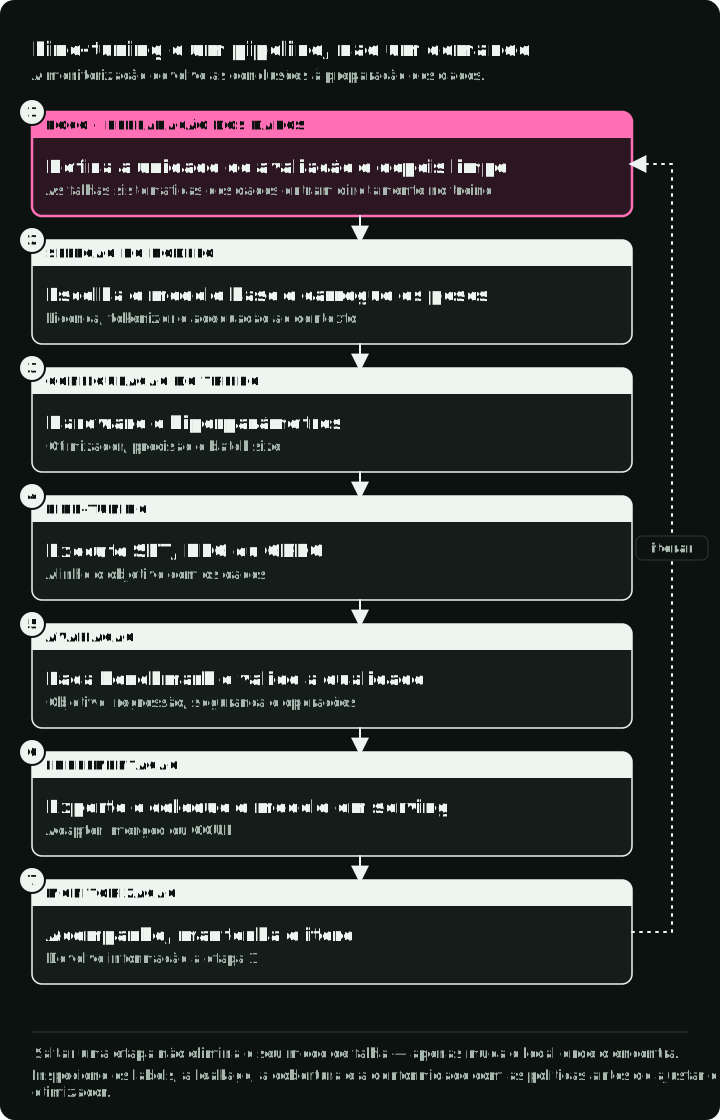
Cada fase assenta na anterior:
- Preparação dos dados — Defina a unidade de avaliação, divida os dados, depois limpe-os e formate-os
- Seleção do modelo — Escolha o modelo base certo e carregue os pesos
- Configuração do treino — Verifique a serialização e os alvos da loss, depois escolha o método (LoRA, QLoRA, DoRA) e as suas definições
- Fine-tuning — Execute o SFT com uma framework; acrescente DPO ou ORPO apenas se for preciso
- Avaliação — Meça o desempenho e valide a qualidade
- Deployment — Exporte e sirva o seu modelo
- Monitorização — Acompanhe o desempenho, mantenha e itere
Os dados são a base. O treino reproduz as falhas sistemáticas dos exemplos. Inspecione etiquetas, fugas, cobertura e conformidade com as políticas antes de gastar tempo em varrimentos do otimizador.
Fase 1: Preparação dos dados
Os problemas nos dados chegam ao modelo treinado, por isso esta fase merece o maior cuidado. O diagrama segue tickets de exemplo nessa ordem: primeiro a divisão por origem, depois cinco transformações dentro de cada partição.
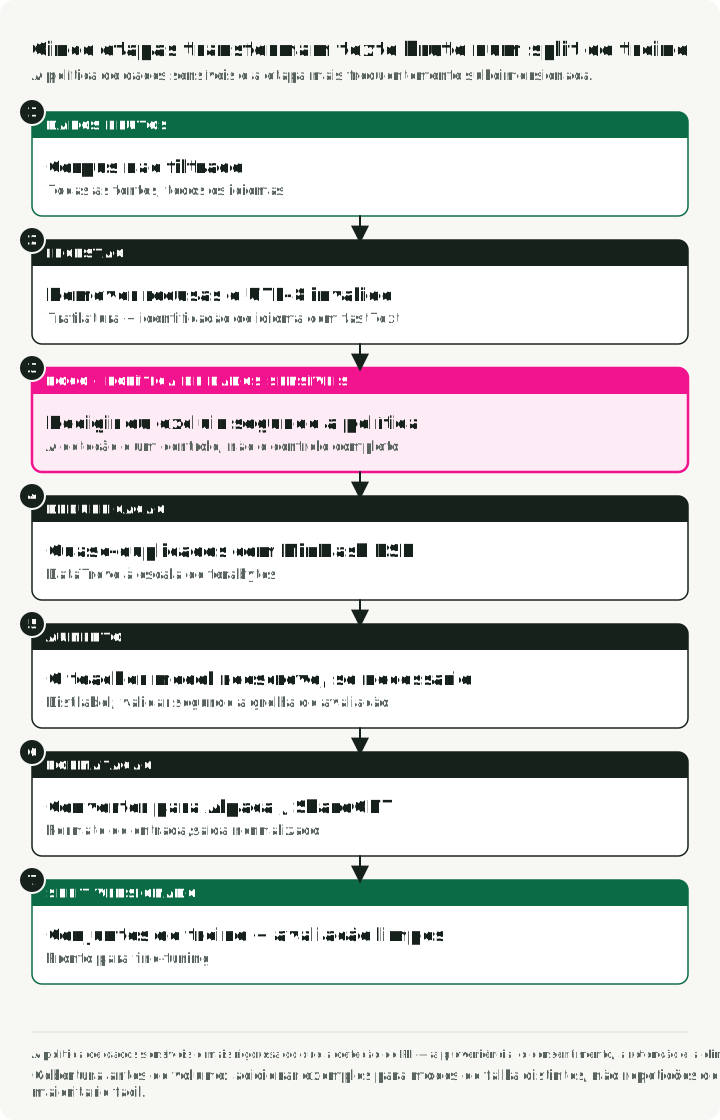
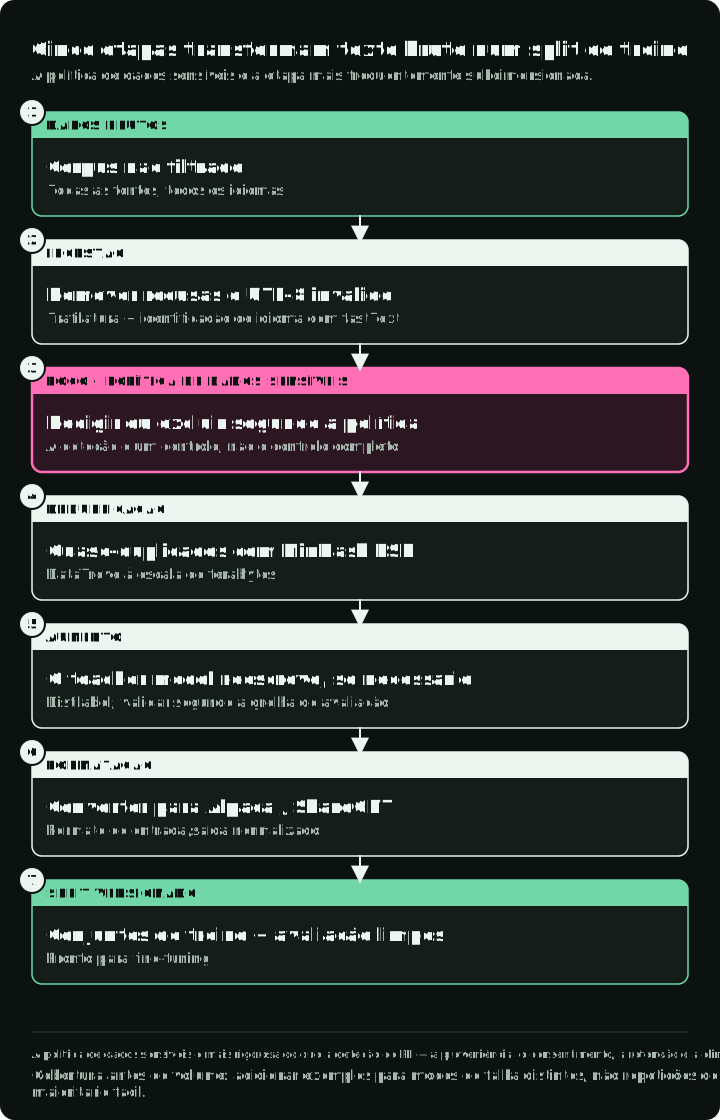
Cinco transformações depois da divisão por origem
Atribua os grupos de origem ao treino ou à avaliação antes de transformar as linhas. Um ticket de suporte e todas as reescritas desse ticket ficam na mesma partição. Agrupe os quase-duplicados conhecidos antes de atribuir os grupos e volte a verificar entre partições depois da limpeza. Congele o conjunto de avaliação; aumente apenas os dados de treino.
Liste os erros que os seus exemplos devem ensinar o modelo a corrigir e defina depois os campos e as etiquetas obrigatórios de cada linha. Escolha as ferramentas de processamento para esses passos. O DataTrove executa a filtragem e a deduplicação como tarefas distribuídas para corpora grandes; o Distilabel gera e etiqueta linhas sintéticas com um modelo professor.
1. Ingestão e filtragem
- Ação: remova UTF-8 inválido e conteúdo fora da tarefa. Etiquete as recusas por política: mantenha as recusas corretas como alvos de treino e casos de avaliação; exclua apenas as recusas inválidas ou fora da tarefa.
- Ferramentas: Trafilatura quando a origem são páginas web; dispense-a para dados que já são texto. Os modelos de identificação de idioma do fastText para identificar o idioma.
2. Política de dados sensíveis
- Ação: decida o que o modelo pode aprender e depois oculte, tokenize ou exclua os campos pessoais e confidenciais conforme necessário.
- Ferramentas: Microsoft Presidio quando precisar de reconhecedores configuráveis, vários idiomas ou anonimização reversível; scrubadub para um pipeline em Python puro mais pequeno que remove dados pessoais comuns do texto.
- Porquê: um detetor é apenas um controlo; continuam a aplicar-se os requisitos de proveniência, consentimento, retenção, acesso e eliminação.
3. Deduplicação (MinHash LSH)
- Ação: remova quase-duplicados para reduzir a repetição e o risco de fuga; isto não impede a memorização.
- Ferramentas: DataTrove quando o corpus precisar de processamento distribuído.
4. Aumento sintético, se necessário
- Ação: use um modelo professor adequado para reescrever exemplos de treino como pares instrução-resposta, mantendo os respetivos IDs de origem. Não aumente a partição reservada.
- Ferramentas: Distilabel.
- Validação: recolha uma amostra das saídas do professor, verifique-as com o mesmo critério usado nas etiquetas humanas e reporte os resultados em separado para exemplos sintéticos e escritos por humanos. Um subconjunto de avaliação assim chama-se slice; outros slices úteis incluem o idioma e o tipo de tarefa.
5. Formatação
- Ação: converta para um formato padrão (Alpaca ou ShareGPT).
Exemplos de formatos de dados
Formato Alpaca (seguimento de instruções):
{
    "instruction": "Summarize the following text.",
    "input": "The text to be summarized...",
    "output": "This is the summary."
}
Armazenamento ao estilo ShareGPT (conversacional):
{
    "conversations": [
        { "from": "user", "value": "Hello, who are you?" },
        { "from": "assistant", "value": "I am a helpful AI assistant." }
    ]
}
Verificações do dataset
- Cobertura antes de volume. Acrescente exemplos que representem modos de falha distintos, não repetições do caso maioritário fácil.
- Limpeza. Elimine texto irrelevante, normalize os espaços em branco, mantenha a formatação consistente.
- Equilíbrio. Preserve os casos raros importantes e reporte o desempenho por slice.
- Separação. Divida por origem, utilizador, documento ou tempo quando divisões aleatórias de linhas deixassem passar quase-duplicados.
- Proveniência. Registe a origem, a licença ou permissão, o histórico de transformações e o caminho de eliminação de cada versão do dataset.
Fase 2: Seleção do modelo e hardware
O modelo base e o seu requisito mínimo de memória de GPU determinam o que pode treinar.
Comece pelo modelo base mais pequeno que já passe nas verificações de base inegociáveis. Confirme:
- licença e termos de redistribuição para o produto pretendido;
- comportamento de idioma, domínio, tool use e segurança antes da adaptação;
- compatibilidade do tokenizer e do chat template com o dataset;
- contexto máximo e comportamento de truncamento exigidos pelos exemplos reais;
- suporte tanto na framework de treino como no motor de serving de destino.
O fine-tuning é um passo de adaptação, não uma reparação para uma base inadequada. Se o modelo falha em capacidades que o dataset não cobre, escolha outro modelo base antes de executar mais épocas.
Estime a memória da sua execução
Não existe uma tabela duradoura de “tamanho do modelo → GPU”. A memória de pico varia com a precisão dos pesos, o otimizador, o número de parâmetros treináveis, o comprimento da sequência, o tamanho do micro-batch, o activation checkpointing, a implementação da atenção e a sobrecarga da framework. Comece com uma estimativa de memória e depois execute um teste rápido de comprimento máximo na stack exata.
| Componente de memória | Fine-tuning completo | LoRA | QLoRA |
|---|---|---|---|
| Pesos base | Precisão de treino | Congelados, normalmente BF16/FP16 | Congelados, tipicamente NF4 de 4 bits |
| Gradientes | Todos os pesos treináveis | Pesos do adapter | Pesos do adapter |
| Estados do otimizador | Todos os pesos treináveis | Pesos do adapter | Pesos do adapter |
| Ativações | Dependem do batch e do comprimento da sequência em todos os métodos | Mesma dependência | Mesma dependência |
O gráfico aplica a tabela ao modelo base da demonstração, o Nemotron-Nano-4B, com 4,51 mil milhões de parâmetros. Divide a memória aproximada de cada método em pesos e estado treinável; as ativações somam-se por cima.
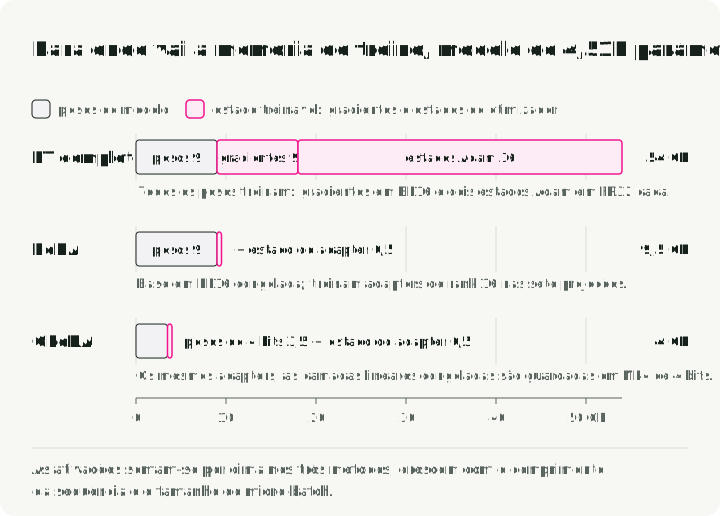
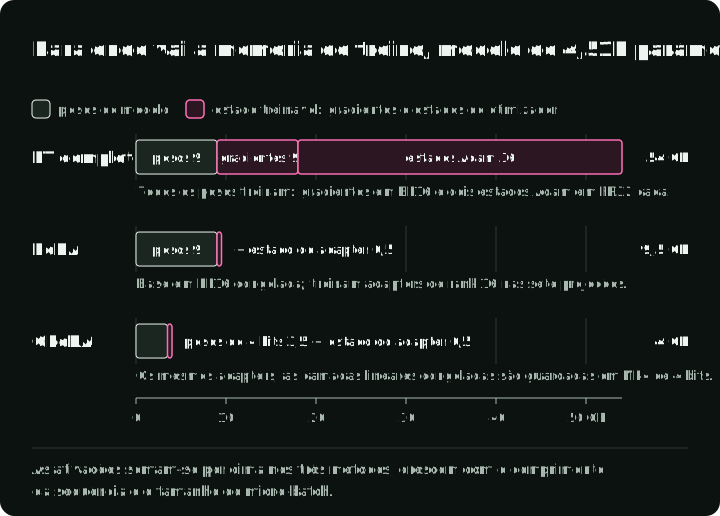
O artigo original do QLoRA fez caber um modelo LLaMA de 65B numa única GPU de 48 GB na sua configuração específica. Esse resultado é um limite útil, não uma promessa de que qualquer arquitetura de 70B atual, comprimento de contexto, kernel ou trainer caiba no mesmo dispositivo.
Matemática da memória
Para um modelo com parâmetros, só os pesos exigem aproximadamente bytes em BF16/FP16 ou bytes a quatro bits, antes dos metadados de quantização e dos buffers de runtime. O treino completo ao estilo Adam acrescenta gradientes, estados do otimizador e, muitas vezes, pesos mestre de maior precisão. O LoRA evita a maior parte da memória de estado treinável; o QLoRA reduz ainda a ocupação dos pesos base congelados. As ativações podem continuar a dominar em sequências longas.
Use este fluxo de trabalho:
- Escolha a sequência mais longa e o micro-batch que tem de suportar.
- Estime os pesos e o estado treinável, deixando margem para as ativações e os kernels.
- Execute um passo forward/backward no comprimento máximo.
- Registe a memória de pico alocada e reservada.
- Só depois aumente o tamanho do batch, o rank, o comprimento da sequência ou o número de GPUs.
Fase 3: Configuração do treino e métodos
A Fase 3 tem duas partes. Primeiro, verifique se cada linha armazenada se torna o texto de treino que espera. Depois, escolha o método de treino e as suas definições.
De linhas armazenadas a alvos de treino
O ShareGPT é um formato de dataset; o ChatML é uma convenção de serialização. Converta from/value nos papéis e campos que o trainer aceita e use depois o chat template do modelo escolhido. Não substitua por tokens ChatML só porque os dados são conversacionais.
Uma linha passa por cinco passos:
- Linha ShareGPT: pares
from/value. messagesetools: os papéis que o trainer aceita.apply_chat_templatecom o template do modelo escolhido. A inferência tem de usar o mesmo template.- IDs de tokens e etiquetas, em que
-100significa sem loss. - Treino.
Imprima o texto renderizado no passo 3 antes de treinar.
Para a linha de saudação acima, as mensagens normalizadas são:
messages = [
    {"role": "user", "content": "Hello, who are you?"},
    {"role": "assistant", "content": "I am a helpful AI assistant."},
]
# Inspection step after loading the selected model's tokenizer:
rendered = tokenizer.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=False,
)
print(rendered)
Inspecione a linha serializada real antes de treinar: os delimitadores de papel, os tokens de fim de turno e os tool schemas têm de corresponder aos da inferência. Numa linha de tool use, preserve as definições das ferramentas, as tool calls do assistente e os tool results como campos distintos. Verifique se o truncamento não remove a resposta supervisionada nem corta um argumento de ferramenta a meio.
A máscara de loss escolhe os tokens cuja previsão o modelo é recompensado por acertar. No treino de sequência completa, o texto do utilizador, do sistema, das ferramentas e do assistente pode contribuir. No treino só com o assistente, esses tokens de contexto continuam visíveis para a atenção, mas as suas etiquetas são ignoradas (normalmente -100); só contribuem os troços do assistente. Para esta saudação, a resposta deve ser um alvo e a pergunta do utilizador não, se a intenção for um comportamento só com o assistente.
O diagrama mostra as duas definições para uma conversa com tool use.
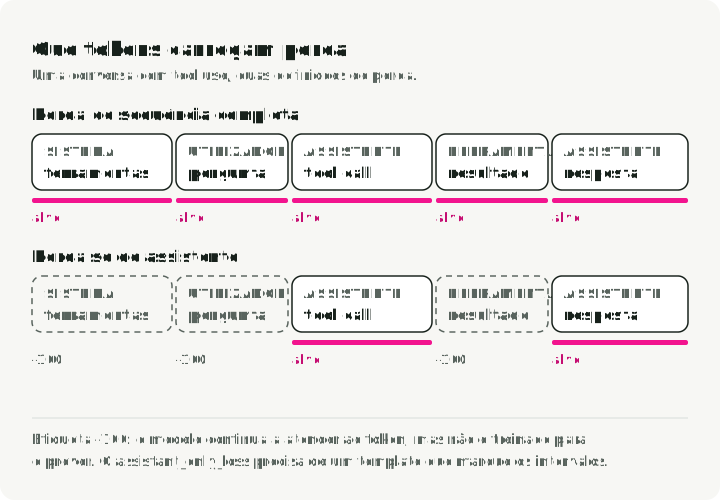
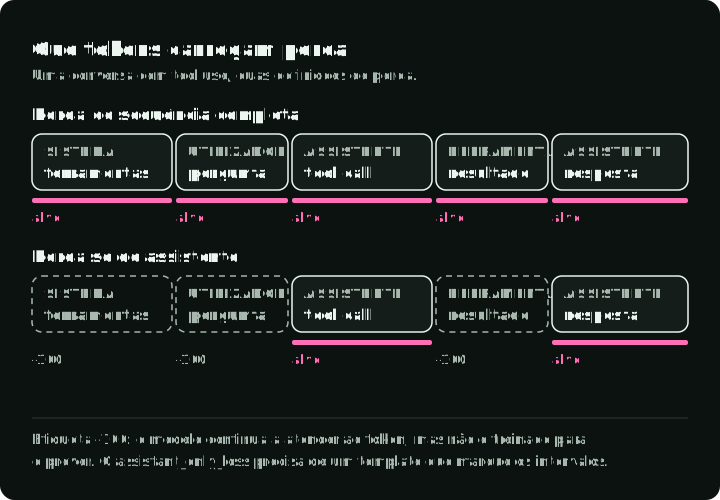
A documentação de SFT do TRL suporta assistant_only_loss=True para datasets conversacionais cujos templates expõem troços de geração. Um template sem esses troços não consegue fornecer essa máscara. Os datasets de prompt/completion têm uma opção própria, completion_only_loss. Antes de ativar qualquer uma, inspecione um batch tokenizado e descodifique os tokens com etiquetas não ignoradas. Depois repita com uma conversa com ferramentas e com um exemplo de comprimento máximo. A demonstração mais adiante neste guia usa loss de sequência completa, porque o template do Nemotron não tem troços de geração.
Escolha um comprimento de sequência a partir da distribuição dos dados e execute a verificação de memória de comprimento máximo da Fase 2. O packing coloca vários exemplos mais curtos numa só sequência de treino. Comece sem ele, para que as fronteiras das linhas sejam fáceis de inspecionar. Faça benchmark do packing só depois de as linhas serializadas e as etiquetas estarem corretas.
Fine-tuning completo vs PEFT
O fine-tuning completo (FFT) atualiza todos os pesos, pelo que os gradientes e o estado do otimizador escalam com o modelo inteiro. O pico não se infere só do número de parâmetros, mas fica muito acima da memória necessária para carregar os pesos para inferência.
O parameter-efficient fine-tuning (PEFT) treina apenas um pequeno subconjunto de parâmetros e congela o resto, pelo que os gradientes e os estados do otimizador cobrem apenas esse subconjunto.
LoRA: o ponto de partida
O LoRA (Low-Rank Adaptation) congela uma matriz pré-treinada e representa a sua atualização aprendida com duas matrizes mais pequenas. O artigo original justifica isto com a hipótese de que as atualizações de adaptação úteis têm um rank intrínseco baixo.
Aqui, é a largura de entrada da camada e a sua largura de saída. O rank é a dimensão partilhada mais pequena das duas matrizes treináveis: um rank menor usa menos parâmetros treináveis. A definição controla a escala da atualização através da razão .
O diagrama mostra a matriz congelada, as duas matrizes treináveis e como o seu produto escalado é somado, com o número de parâmetros de uma matriz de largura 4096 com rank 16.
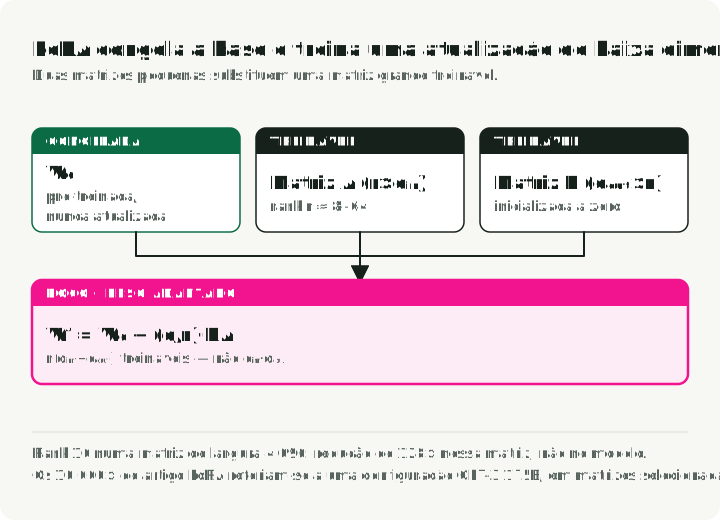
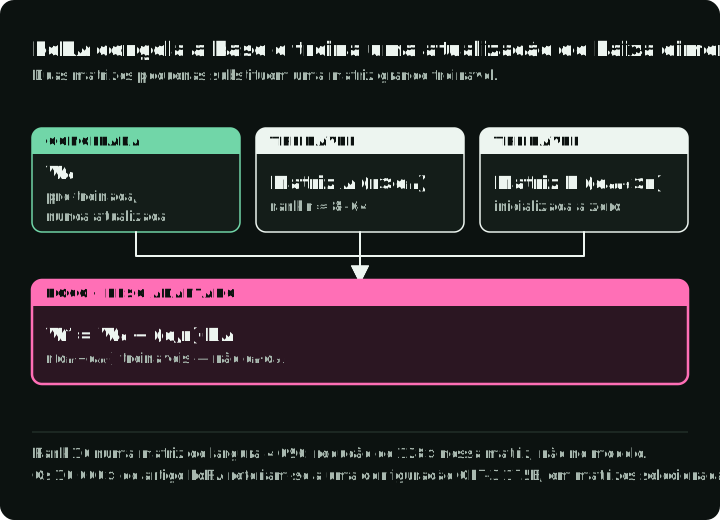
Para uma matriz congelada , o LoRA aprende:
A camada adaptada é:
O adapter tem parâmetros treináveis em vez de para essa matriz. Para uma matriz quadrada de largura 4096 com rank 16, isso é uma redução de 128× nos parâmetros treináveis desta matriz. A poupança no modelo inteiro depende das matrizes que recebem adapters.
Comparação entre métodos PEFT
| Método | O que muda | Escolha-o quando |
|---|---|---|
| LoRA | Base congelada mais atualizações treináveis de rank baixo | O modelo base cabe com folga e quer artefactos de tarefa pequenos |
| QLoRA | LoRA com a base congelada guardada em formato de 4 bits | A memória dos pesos base é o fator limitante |
| DoRA | Separa a magnitude do peso de uma direção atualizada com LoRA | Uma base de comparação LoRA medida deixa uma diferença de qualidade que justifica a complexidade extra |
| Fine-tuning completo | Todos os pesos do modelo | O PEFT não atinge o objetivo e o ganho de qualidade justifica treino distribuído e checkpoints completos |
DoRA: LoRA com decomposição dos pesos
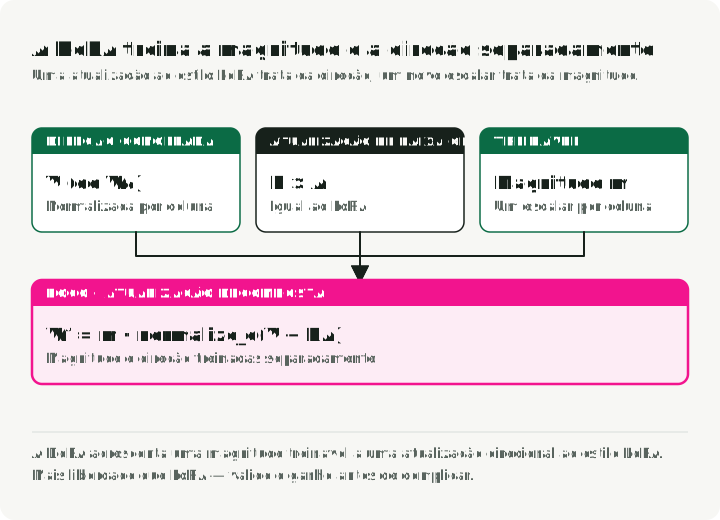
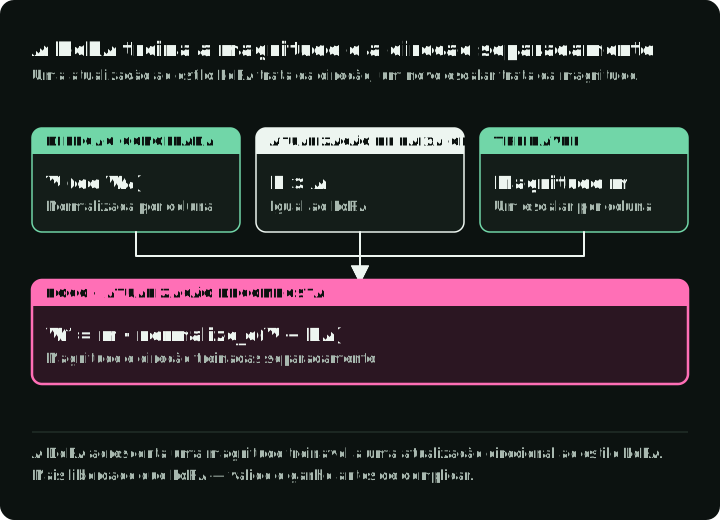
O DoRA (Weight-Decomposed Low-Rank Adaptation) separa a magnitude de cada vetor de pesos da sua direção. O artigo do DoRA aplica uma atualização LoRA à componente de direção, enquanto aprende a magnitude em separado. O diagrama desenha uma coluna de pesos como uma seta: B·A roda a sua direção e uma magnitude m treinada define o seu comprimento.
Como funciona:
Em vez de tratar os pesos como uma única entidade, o DoRA decompõe os pesos pré-treinados em dois componentes:
- Magnitude — um valor treinável por vetor de pesos.
- Direção — um vetor normalizado atualizado através de matrizes de rank baixo.
Em notação compacta por colunas:
onde:
m= magnitude (treinável)- = a matriz inicial congelada; normalize depois de somar
- = a atualização direcional de rank baixo aprendida
- = normalização por colunas
Efeitos da decomposição:
- Mais graus de liberdade do que o LoRA padrão, porque a magnitude pode mudar de forma independente.
- Melhores resultados do que o LoRA em várias configurações reportadas pelo artigo que o propôs.
- Parâmetros e computação adicionais, pelo que o ganho deve ser verificado na sua tarefa e no seu caminho de serving.
Merging de adapters para aprendizagem multi-tarefa
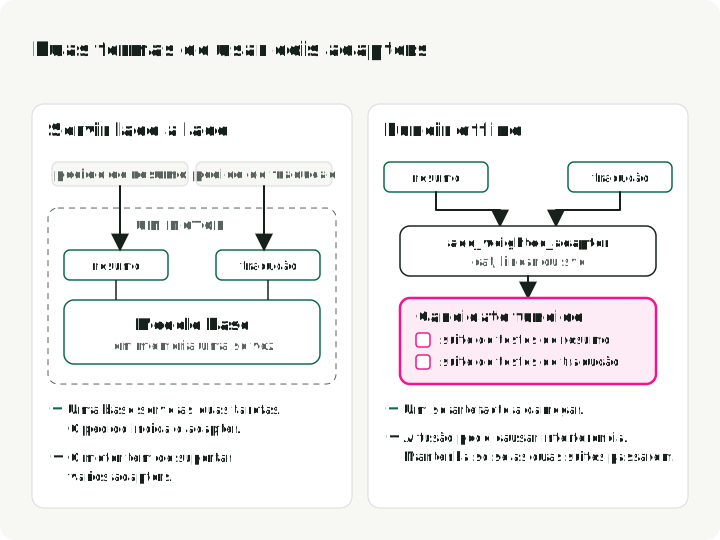
Adapters separados permitem que uma base congelada suporte várias tarefas. Pode encaminhar os pedidos para um adapter, servir vários adapters a partir de um só motor quando suportado, ou criar um candidato fundido offline. O merging pode introduzir interferência, por isso avalie o artefacto fundido em vez de assumir que os adapters de origem se combinam sem problemas.
A figura compara as duas opções para dois adapters numa só base. Mantenha o modelo fundido apenas se passar nas duas suites de testes.
Métodos de merging comuns:
- Concatenação — combina os parâmetros dos adapters e aumenta o rank efetivo. Rápida e simples.
- Combinação linear — soma ponderada de adapters. Os pesos definem quanto cada tarefa contribui.
- SVD — decomposição de matrizes para o merging. Mais flexível, mas mais lenta.
O add_weighted_adapter do PEFT implementa-os como combination_type="cat", "linear" e "svd"; o guia de model merging do PEFT cobre-os, e também métodos mais recentes.
Exemplo: um adapter para resumos, outro para tradução, fundidos num único modelo multi-tarefa.
Fase 4: Alinhamento de preferências (opcional)
O SFT é a principal execução de treino, e as secções de frameworks a seguir a esta fase executam-no. Esta fase cobre o que pode acrescentar depois do SFT, se os erros o justificarem.
O SFT aprende demonstrações. A otimização de preferências aprende, em vez disso, com comparações como “a resposta escolhida A é melhor do que a resposta rejeitada B”. Use-a apenas quando a preferência entre pares for a etiqueta certa para o erro; a correção factual e a conformidade com as políticas exigem muitas vezes avaliadores mais fortes do que uma preferência global.
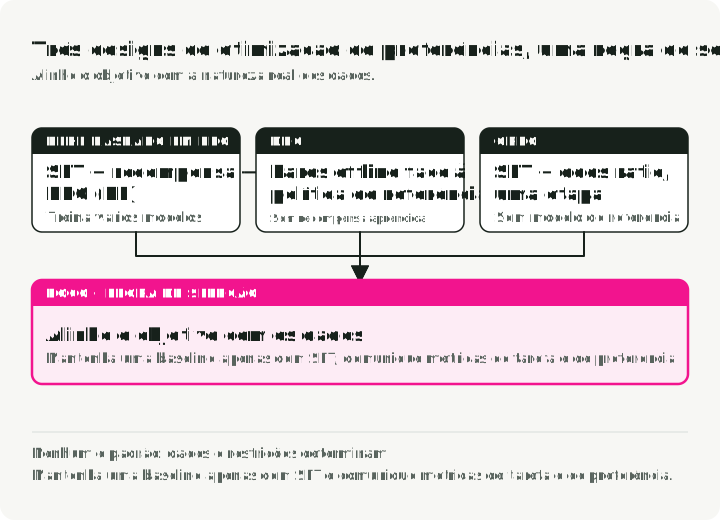
O diagrama mostra as fases de cada método, os modelos que carrega e o que faz um passo de treino.
RLHF baseado em PPO
RLHF significa reinforcement learning from human feedback. A policy é o modelo de linguagem que gera as respostas; um modelo de recompensa pontua essas respostas com preferências aprendidas a partir de comparações humanas. Uma receita baseada em PPO tem três fases:
- SFT — aprender a tarefa.
- Modelo de recompensa — treinar com preferências humanas (escolhida vs rejeitada).
- PPO (Proximal Policy Optimization) — gerar respostas e atualizar o modelo de linguagem para aumentar as suas pontuações de recompensa.
O custo operacional vem dos vários componentes:
- Complicado de implementar e de manter.
- Caro — treinam-se vários modelos.
- Gerar amostras a partir do modelo que está a ser treinado exige verificações de atualizações instáveis e de respostas que exploram o modelo de recompensa sem cumprir a tarefa.
DPO
O DPO (Direct Preference Optimization) dispensa o modelo de recompensa separado e o ciclo de reinforcement learning. Favorece as respostas escolhidas e desencoraja grandes alterações face a um modelo de partida fixo, chamado modelo de referência. O artigo do DPO deriva este objetivo limitando até onde as probabilidades das respostas se podem afastar dessa referência; o limite matemático é uma restrição de divergência KL.
Um par de preferência contém o mesmo prompt e duas respostas candidatas. Esta linha abreviada mostra os seus campos; etiquetas reais precisam de respostas completas e de uma razão para preferir uma delas:
{
    "prompt": "Explain quantum computing",
    "chosen": "Quantum computing uses qubits...",   # Preferred response
    "rejected": "Well, it's complicated..."        # Non-preferred response
}
O que muda operacionalmente:
- Caminho de código mais simples (sem modelo de recompensa separado, sem ciclo de RL).
- Treino com pares de preferência guardados, em vez de gerar novas respostas para pontuação de recompensa em cada atualização.
- Um modelo de referência fixo, ou as suas log-probabilidades guardadas para as respostas de treino, na formulação padrão.
O DPO é mais fácil de prototipar do que um pipeline PPO completo, mas não é uma melhoria automática de qualidade. Os resultados dependem da policy de partida, da qualidade dos pares, das definições da loss, dos efeitos do comprimento e do protocolo de avaliação. Compare-o com um checkpoint de SFT nas mesmas suites de preferência e de tarefa reservadas.
ORPO
O ORPO (Odds-Ratio Preference Optimization) combina a loss de log-verosimilhança negativa do SFT com uma penalização por odds ratio nas respostas rejeitadas. Elimina o modelo de referência separado e pode combinar a aprendizagem da tarefa e a otimização de preferências numa só execução.
Como funciona: o ORPO usa uma loss combinada que faz duas coisas ao mesmo tempo:
- Maximiza a verosimilhança da resposta escolhida (aprender a tarefa).
- Penaliza a resposta rejeitada com um termo de odds ratio (aprender as preferências).
O TRL fornece agora o ORPO como ORPOConfig em trl.experimental.orpo (trainer ORPO do TRL). Vale a pena conhecer duas definições:
learning_rate: o artigo usou taxas baixas como8e-6; ajuste de acordo com o seu modelo, batch e dados em vez de copiar um valor único como regra.beta: controla o termo de preferência em relação ao termo de SFT.
A contrapartida:
- Uma fase de treino em vez de duas.
- Sem modelo de recompensa.
- Sem passagem forward do modelo de referência.
- Uma execução acoplada: se a aprendizagem da tarefa ou o comportamento de preferência regredir, não há um checkpoint intermédio de SFT do mesmo pipeline para inspecionar.
Escolha através do desenho dos dados e da avaliação:
- Use o DPO quando já tem um checkpoint de SFT satisfatório e quer uma experiência de preferências offline mais simples.
- Teste o ORPO quando um objetivo sem referência e numa só fase se ajustar aos seus dados e às suas restrições operacionais.
- Use o RLHF baseado em PPO quando a geração de amostras online contra uma recompensa aprendida explícita fizer parte do requisito e puder monitorizar a exploração da recompensa.
Nenhum é uma opção por omissão para todas as tarefas. Mantenha uma base de comparação só com SFT e reporte tanto as métricas da tarefa como as métricas de preferência.
Frameworks de fine-tuning
As Fases 3 e 4 escolheram o método. As duas secções seguintes escolhem uma framework e executam o SFT com ela.
As frameworks sobrepõem-se e mudam depressa. Escolha pelo caminho de execução que tem de suportar, fixe as versões e mantenha a configuração de treino suficientemente portátil para a reproduzir fora de um notebook.
Unsloth — velocidade e eficiência de memória
O Unsloth integra-se com o trl e o transformers da Hugging Face e fornece kernels otimizados, checkpointing e caminhos de fine-tuning quantizado para os modelos suportados.
- Kernels de GPU Triton personalizados para atenção, RoPE e entropia cruzada que dispensam a sobrecarga do PyTorch.
- Backprop eficiente em memória, que recalcula as ativações durante a passagem backward em vez de as manter em memória.
- Operações fundidas que reúnem vários passos (layer norm + linear e semelhantes) em chamadas únicas à GPU.
- Quantização de 4 bits integrada diretamente no caminho do QLoRA, com dequantização otimizada.
A ordem das importações importa. Siga a ordem de importação do exemplo do Unsloth para a versão que fixar. O Unsloth aplica patches durante a importação, pelo que importá-lo antes do trl e do transformers evita otimizações em falta ou erros específicos da versão.
# Correct order
from unsloth import FastLanguageModel  # Must be first!
from trl import SFTConfig, SFTTrainer

# Avoid this order with Unsloth's patched path
from trl import SFTTrainer
from unsloth import FastLanguageModel
Ideal para: treino numa só GPU, prototipagem e notebooks Colab.
Os números de velocidade e memória publicados variam com o modelo, o comprimento da sequência, o batch, a precisão e o hardware. Faça benchmark de tokens por segundo e de memória de pico na sua própria execução, em vez de tratar um rácio de destaque como uma propriedade da framework.
Axolotl — treino orientado por configuração
Para configurações centradas em ficheiros de configuração e distribuídas, o Axolotl mantém a execução inteira num único ficheiro YAML. Estas chaves selecionam uma base de 4 bits, um adapter QLoRA e um dataset em formato Alpaca:
# axolotl_config.yaml (excerpt)
base_model: meta-llama/Meta-Llama-3-8B
load_in_4bit: true
adapter: qlora
lora_r: 32
lora_alpha: 16 # alpha/r = 0.5 here; the demo uses 2. Sweep it with the learning rate.
datasets:
    - path: data/training_data.jsonl
      type: alpaca
Os módulos alvo, o comprimento da sequência, o packing, o tamanho do batch, a taxa de aprendizagem e as épocas vão no mesmo ficheiro; a referência de configuração lista todas as chaves. Execute o treino:
axolotl train axolotl_config.yamlComparação de frameworks
| Ferramenta | Útil quando | Verifique antes de se comprometer |
|---|---|---|
| Unsloth | Quer um caminho otimizado para modelos suportados, com exemplos concisos | Matriz de modelos, GPUs, quantização e suporte distribuído |
| Axolotl | Quer configurações declarativas e receitas distribuídas integradas | Schema de configuração exato e launcher da versão fixada |
| TRL | Quer acesso direto aos trainers de SFT e de preferências da Hugging Face | Formato do dataset, chat template, máscara de loss e integração com PEFT |
| Torchtune | Já usa receitas do torchtune; deixou de ter manutenção ativa (desde 2025) | Cobertura de receitas por modelo e compatibilidade de exportação |
Demonstração prática: fine-tuning com o Unsloth
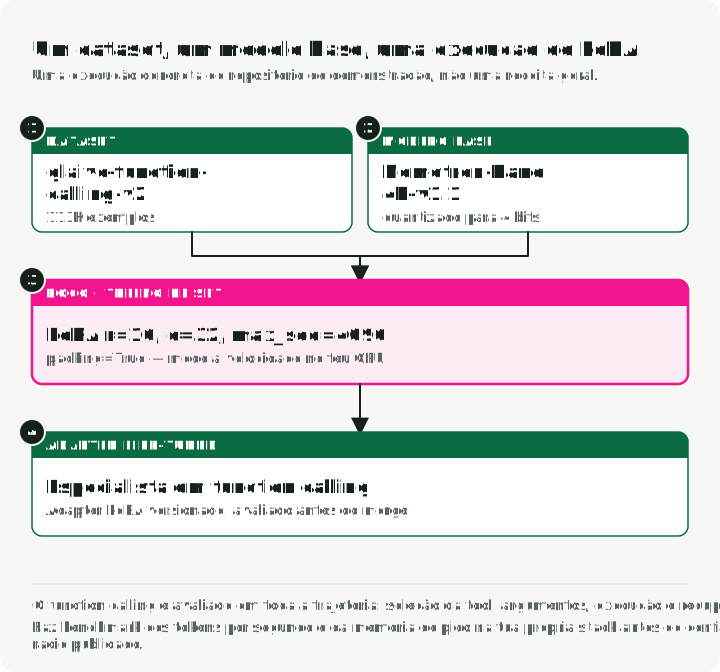
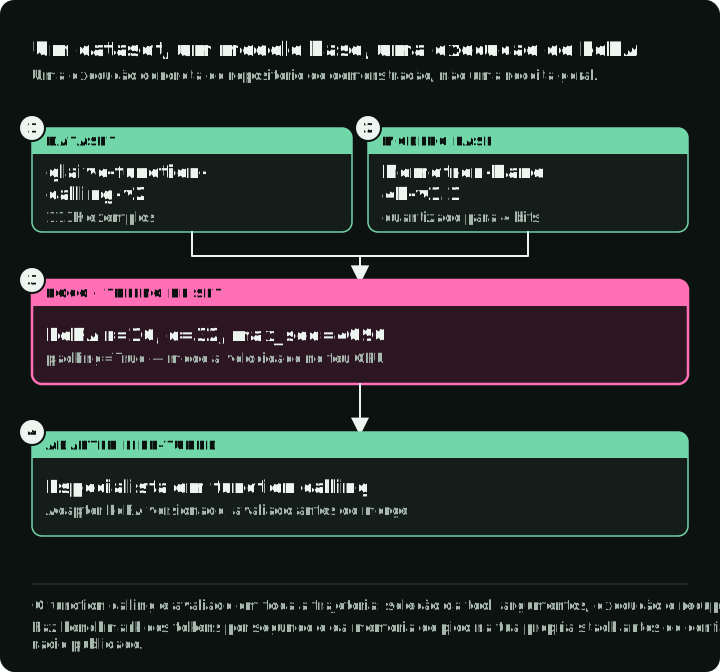
Esta demonstração ensina um modelo a selecionar uma função e a fornecer os seus argumentos. O meu unsloth-finetune-demo faz fine-tuning do Llama-3.1-Nemotron-Nano-4B-v1.1 com o dataset glaive-function-calling-v2. A via de treino CUDA deste repositório precisa de Linux ou WSL2 e de uma GPU NVIDIA. O Unsloth também tem uma via de treino em GPU Intel separada, que esta demonstração não implementa. Fixe o commit que executar; o ficheiro de lock fixa as dependências, incluindo o TRL 0.24.0.
O diagrama mostra a execução completa com os valores reais: como uma linha do glaive se torna texto de treino que mantém as definições das ferramentas, a divisão, as definições de treino, os três diretórios de saída e a primeira verificação.
Execute-o
git clone https://github.com/slavadubrov/unsloth-finetune-demo.git
cd unsloth-finetune-demo
uv sync

# Train on 1,000 random rows, then also save a merged model and a GGUF file
uv run finetune --max-samples 1000 --merge --gguf q4_k_m
Cada execução de finetune treina. --merge e --gguf acrescentam exportações depois do treino; não existe um comando só de exportação. A execução escreve três diretórios:
outputs/unsloth-nemotron-function-calling/— o adapter LoRAoutputs/unsloth-nemotron-function-calling-merged/— o modelo fundido de 16 bits (--merge)outputs/unsloth-nemotron-function-calling-gguf/— o ficheiro GGUF (--gguf q4_k_m)
Antes de o treino começar, a execução imprime a primeira linha de treino tal como o modelo a vê. Leia-a: as definições das ferramentas aparecem dentro de <AVAILABLE_TOOLS> e cada chamada aparece dentro de <TOOLCALL>.
Preparação dos dados
Cada linha do glaive tem duas strings. A coluna system contém todas as definições de funções; a coluna chat contém a conversa, com as chamadas escritas como <functioncall> {...}. Treinar só com chat ensina o modelo a chamar ferramentas cujos schemas nunca vê. O data.py da demonstração converte cada linha em messages e numa lista tools separada, renderiza ambas com o chat template do próprio modelo e reserva 5% das linhas como partição de avaliação:
def to_text(example: dict, tokenizer) -> dict:
    """Render one glaive row with the model's chat template. Empty text marks a dropped row."""
    try:
        messages, tools = to_messages(example)
    except (ValueError, KeyError):  # bad JSON in a tool definition or call
        return {"text": ""}
    if not messages:
        return {"text": ""}
    text = tokenizer.apply_chat_template(messages, tools=tools or None, tokenize=False)
    # The trainer tokenizes this text with special tokens on, which adds BOS again.
    return {"text": text.removeprefix(tokenizer.bos_token or "")}
No dataset completo, isto mantém 112 811 das 112 960 linhas; 149 linhas têm JSON malformado e são descartadas. Com este tokenizer, a linha renderizada mais longa tem 4076 tokens, pelo que um limite de 4096 tokens não trunca nenhuma.
O chat template do model card tem um defeito para o treino. Renderiza uma tool call passada sem a chaveta de fecho a seguir a arguments, pelo que o texto dentro de <TOOLCALL> não é JSON válido. Um modelo treinado com esse texto aprende a emiti-lo, e o parser de serving não consegue ler a chamada. O repositório inclui o template com a chaveta acrescentada e usa-o no treino e no serving. O seu teste só de CPU renderiza conversas com ferramentas e verifica se cada <TOOLCALL> é interpretado.
Configuração da demonstração
O config.py da demonstração define os valores do LoRA:
LORA_R = 16        # Adapter capacity; tune against held-out results
LORA_ALPHA = 32    # Update scale alpha/r = 2
LORA_DROPOUT = 0.05
MAX_SEQ_LENGTH = 4096
LORA_TARGET_MODULES lista as sete projeções de atenção e MLP deste modelo da família Llama, de q_proj a down_proj.
A razão alpha/rank. alpha/r escala a atualização LoRA clássica. alpha = 2r é uma heurística de arranque comum na documentação de algumas ferramentas, não uma garantia de estabilidade. Varra o rank, o alpha, a taxa de aprendizagem e os módulos alvo só depois de os dados e a base de comparação estarem fixos.
Carregamento do modelo
O model.py da demonstração carrega a base em formato de 4 bits, substitui o chat template pelo corrigido e acrescenta os adapters LoRA:
from unsloth import FastLanguageModel

model, tokenizer = FastLanguageModel.from_pretrained(
    model_name=MODEL_NAME,
    max_seq_length=MAX_SEQ_LENGTH,
    load_in_4bit=True,  # QLoRA: the frozen base is stored in 4-bit form
    trust_remote_code=True,
)
# Training rows, the saved tokenizer, and vLLM all use this one template.
tokenizer.chat_template = CHAT_TEMPLATE_PATH.read_text()

model = FastLanguageModel.get_peft_model(
    model,
    r=LORA_R,
    lora_alpha=LORA_ALPHA,
    lora_dropout=LORA_DROPOUT,
    target_modules=LORA_TARGET_MODULES,
    use_gradient_checkpointing="unsloth",  # Lower activation memory; extra compute
)
Configuração do treino
O training.py da demonstração passa as linhas renderizadas ao SFTTrainer do TRL. Avalia a loss de tokens reservados uma vez por época. Essa loss é um diagnóstico, não a exatidão das tool calls; a Fase 5 continua a exigir uma avaliação separada da tarefa.
trainer = SFTTrainer(
    model=model,  # 4-bit base with LoRA adapters from FastLanguageModel
    processing_class=tokenizer,
    train_dataset=train_dataset,
    eval_dataset=eval_dataset,
    args=SFTConfig(
        output_dir="outputs/unsloth-nemotron-function-calling",
        dataset_text_field="text",
        max_length=4096,
        packing=False,  # One row per sequence, so row boundaries are easy to inspect
        assistant_only_loss=False,  # The Nemotron template has no generation spans
        eval_strategy="epoch",
        per_device_train_batch_size=2,
        gradient_accumulation_steps=4,
        learning_rate=2e-4,
        num_train_epochs=3,
        bf16=True,  # The repository falls back to FP16 on GPUs without BF16
        optim="adamw_8bit",
    ),
)
trainer.train()
Primeira verificação
uv run infer --prompt "Book a flight to Tokyo"O infer carrega o adapter e envia o prompt com uma ferramenta, book_flight(destination), renderizada com o mesmo template das linhas de treino. Um adapter treinado deve responder com <TOOLCALL>[{"name": "book_flight", "arguments": {"destination": "Tokyo"}}]</TOOLCALL>. Se responder em texto simples, inspecione a linha de treino impressa antes de treinar durante mais tempo.
Fase 5: Avaliação
Fixe os casos de teste, as regras de pontuação e os limiares de aprovação antes da primeira execução. No mínimo, compare o checkpoint ajustado com a base exata sem tuning, com o mesmo prompt, as mesmas definições de decoding e o mesmo ambiente de ferramentas. Reporte a qualidade agregada só depois de verificar os slices de falha que o projeto pretendia melhorar.
Acompanhe quatro grupos:
- Tarefa alvo: correspondência exata, êxito da execução, critério humano ou outro resultado ligado ao caso de uso.
- Regressão: capacidades gerais e slices de tarefas anteriormente suportados que a adaptação poderia danificar.
- Segurança e políticas: recusas, fugas de dados, prompt injection ou restrições específicas do domínio.
- Operações: latência, débito, memória, tamanho do artefacto e custo na configuração de serving pretendida.
Benchmarks automáticos
Use o lm-evaluation-harness para verificar tarefas padronizadas relevantes ao lado dos testes do seu produto. Este comando exige um checkpoint Hugging Face fundido, que a demonstração escreve com --merge:
lm_eval --model hf \
    --model_args pretrained=./outputs/unsloth-nemotron-function-calling-merged \
    --tasks hellaswag,arc_easy,mmlu \
    --batch_size 8
LLM como juiz
Para a qualidade subjetiva, um modelo maior pode ajudar na pontuação, mas calibre-o com exemplos revistos por humanos e mantenha oculta a identidade do candidato. Dê ao juiz a saída do modelo, a resposta esperada e um critério que defina cada pontuação para cada dimensão, como relevância, exatidão e formatação.
Avaliação específica do domínio
Reserve exemplos reais por origem, utilizador, documento ou tempo, para que os quase-duplicados não passem de uma partição para a outra. Para function calling, valide a trajetória completa: seleção da ferramenta, argumentos, resultado da execução, recuperação e resposta final. Reporte intervalos de confiança ou contagens emparelhadas de vitórias e derrotas quando a amostra for pequena e inspecione cada regressão num slice crítico.
Verifique cada trajetória em quatro passos:
- A ferramenta certa é selecionada.
- Os argumentos são válidos e corretos.
- O resultado da execução é o esperado.
- O modelo recupera de um erro da ferramenta.
Conte cada falha por verificação e por slice. Uma resposta final correta pode esconder um argumento errado ou uma recuperação omitida.
O código de avaliação do Berkeley Function Calling Leaderboard (BFCL) pontua a seleção de funções e os argumentos face a chamadas de referência. Use-o como verificação de regressão ao lado das suas próprias conversas reservadas.
Fase 6: Deployment e formatos de saída
Escolha o artefacto com base no motor de serving e no plano de rollback, não apenas no tamanho do ficheiro. Exporte todos os formatos a partir dos mesmos objetos model e tokenizer avaliados, para que todos os artefactos tenham os mesmos pesos treinados. O diagrama compara os três artefactos: o que cada ficheiro contém, o que o carrega e o seu compromisso.
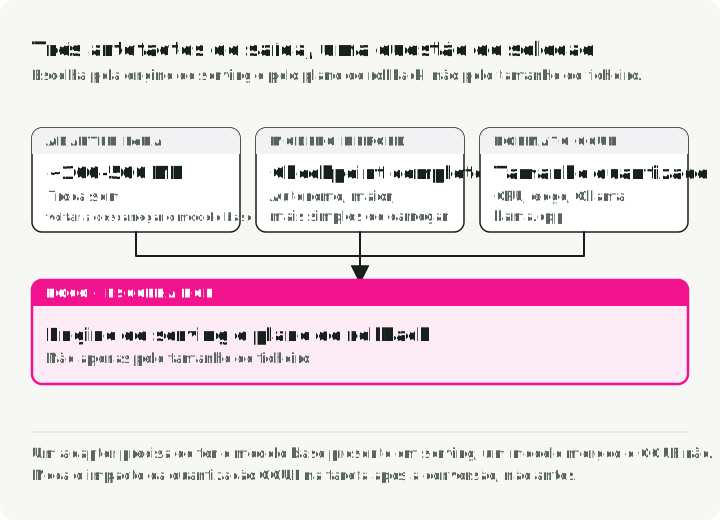
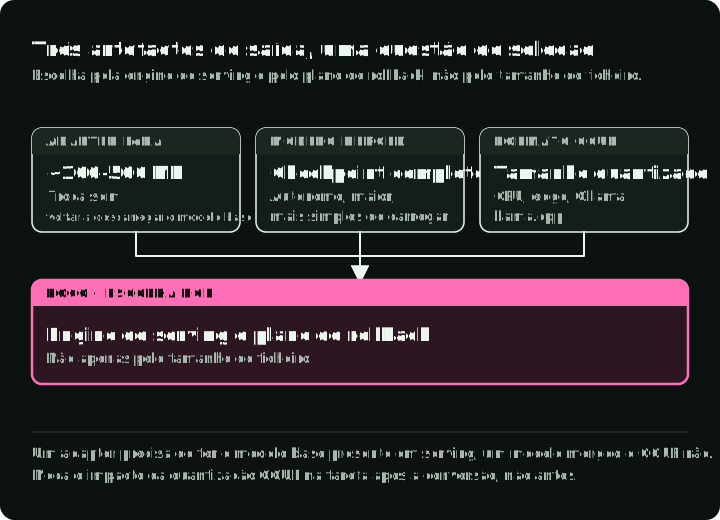
Na demonstração, uv run finetune guarda sempre o adapter, --merge acrescenta o modelo fundido e --gguf q4_k_m acrescenta o ficheiro GGUF, tudo numa só execução de treino. As chamadas Python abaixo mostram o que cada flag faz.
1. Adapter LoRA
model.save_pretrained("outputs/unsloth-nemotron-function-calling")
tokenizer.save_pretrained("outputs/unsloth-nemotron-function-calling")- Tamanho: proporcional aos módulos alvo, ao rank, às camadas e ao dtype; muitas vezes muito menor do que a base.
- Ideal para: desenvolvimento, adapters de tarefa versionados e motores que suportam LoRA diretamente.
- Bónus: pode trocar de adapter sem voltar a descarregar o modelo base.
2. Modelo fundido
# What --merge runs: merge the adapter into the base weights and save a standalone model
model.save_pretrained_merged(
    "outputs/unsloth-nemotron-function-calling-merged", tokenizer, save_method="merged_16bit"
)- Tamanho: aproximadamente o do checkpoint base completo, na precisão de saída escolhida.
- Ideal para: motores ou caminhos de distribuição que não suportam o adapter em separado.
- Contrapartida: artefacto maior e rollout mais lento; carregamento de um único modelo mais simples.
3. Formato GGUF
# What --gguf q4_k_m runs; file size and name depend on the Unsloth version
model.save_pretrained_gguf(
    "outputs/unsloth-nemotron-function-calling-gguf", tokenizer, quantization_method="q4_k_m"
)- Tamanho: depende do modelo; aproximadamente pesos de quatro bits mais metadados nas variantes Q4.
- Ideal para: inferência em CPU, Ollama, llama.cpp, deployment em edge.
- Opções:
q4_k_m(mais pequeno),q5_k_m(mais fidelidade nos pesos),q8_0(maior e com maior fidelidade). Meça o impacto na tarefa depois da conversão.
Fase 7: Serving e monitorização
Com o vLLM
Este comando serve o adapter da demonstração sobre o modelo base. Sirva com o parser e o chat template do model card; têm de corresponder ao template usado no treino. O model card regista o parser llama_nemotron_json através do ficheiro de plugin llama_nemotron_nano_toolcall_parser.py. O repositório da demonstração fornece o template corrigido.
Use um ambiente Python 3.12 separado com o vLLM 0.12.0: o parser fixado importa a API do parser de ferramentas desta versão, que mudou em versões posteriores. O comando fixa o modelo base e o parser na mesma revisão do model card; use também essa revisão da base no treino. A compatibilidade do código-fonte e um teste do parser em CPU não confirmam que o serving em GPU funciona. Verifique o carregamento do modelo e o tool call pretendido na sua GPU. Execute a partir da raiz do repositório:
uv venv --python 3.12 .venv-vllm
uv pip install --python .venv-vllm/bin/python "vllm==0.12.0" "huggingface-hub==0.36.0"
source .venv-vllm/bin/activate

hf download nvidia/Llama-3.1-Nemotron-Nano-4B-v1.1 \
    llama_nemotron_nano_toolcall_parser.py \
    --revision d552708a9d575fa8d4a690b988fd870d65279f98 --local-dir serving

vllm serve nvidia/Llama-3.1-Nemotron-Nano-4B-v1.1 \
    --revision d552708a9d575fa8d4a690b988fd870d65279f98 \
    --trust-remote-code \
    --enable-lora \
    --lora-modules function-calling=./outputs/unsloth-nemotron-function-calling \
    --enable-auto-tool-choice \
    --tool-parser-plugin ./serving/llama_nemotron_nano_toolcall_parser.py \
    --tool-call-parser llama_nemotron_json \
    --chat-template ./src/unsloth_demo/chat_template.jinja \
    --host 127.0.0.1 \
    --port 8000 \
    --max-model-len 4096
O uv run --with openai infer-vllm da demonstração testa a geração de argumentos através da API compatível com a OpenAI. Envia uma ferramenta mínima, book_flight, com uma string destination obrigatória, e pede uma chamada proposta; não executa nenhuma reserva. O pedido em cli/inference.py é:
client = OpenAI(base_url="http://localhost:8000/v1", api_key="dummy")
response = client.chat.completions.create(
    model="function-calling",  # the --lora-modules name, not the base model
    messages=[{"role": "user", "content": "Book a flight to Tokyo"}],
    tools=[DEMO_TOOL],  # book_flight(destination), defined in config.py
    tool_choice="auto",
)
print(response.choices[0].message.tool_calls)
Para esta entrada, o resultado pretendido é book_flight com {"destination": "Tokyo"}. Como a escolha da ferramenta é automática, verifique também se o modelo devolveu alguma chamada. A ferramenta usa o mesmo formato das definições de ferramentas do glaive com que o modelo treinou. O parser do vLLM lê a chamada a partir do texto gerado, por isso uma chamada malformada volta como conteúdo simples, sem tool_calls. O vLLM também consegue restringir os argumentos de uma função ao seu schema quando a função está marcada com strict: true; o guia de tool calling descreve as definições do servidor e quais os parsers que o suportam.
Com o Ollama (local)
Liste o diretório outputs/unsloth-nemotron-function-calling-gguf e substitua MODEL_FILE.gguf abaixo pelo nome do ficheiro gerado; as versões do Unsloth podem dar nomes diferentes aos ficheiros. Um ficheiro GGUF, por si só, não garante a formatação correta de chat e de ferramentas no Ollama ou no llama.cpp. Use o template com que treinou e teste o artefacto importado.
# Create Modelfile
echo 'FROM ./outputs/unsloth-nemotron-function-calling-gguf/MODEL_FILE.gguf' > Modelfile

# Import to Ollama
ollama create my-function-model -f Modelfile

# Run
ollama run my-function-model
Com o llama.cpp (CPU)
Com a mesma exportação GGUF e a mesma substituição do nome de ficheiro, este comando verifica uma resposta em texto simples. Não testa uma tool call completa:
llama-cli -m ./outputs/unsloth-nemotron-function-calling-gguf/MODEL_FILE.gguf \
    -p "What's the weather in Tokyo?" \
    --ctx-size 4096
Monitorizar o modelo lançado
O ciclo de vida não acaba numa loss de treino saudável. Registe a revisão do modelo base, o tokenizer e o chat template, o hash do adapter, a versão do dataset, a configuração de treino e o relatório de avaliação como uma única unidade de lançamento. Em produção, monitorize o êxito da tarefa, as saídas inválidas, as falhas de política, a latência e o desvio da entrada pelos mesmos slices usados offline. Mantenha o artefacto anterior carregável e defina um limiar de rollback antes do lançamento.
Em resumo:
- Unidade de lançamento: revisão do modelo base, tokenizer e chat template, hash do adapter, versão do dataset, configuração de treino e relatório de avaliação.
- Monitorize o êxito da tarefa, as saídas inválidas, as falhas de política, a latência e o desvio da entrada pelos mesmos slices que offline.
- Se uma métrica ficar abaixo do limiar de rollback definido antes do lançamento, carregue o artefacto anterior.
O seu próximo teste
Antes de uma execução completa, inspecione uma conversa serializada e os seus alvos de loss e depois conclua um passo forward/backward no comprimento máximo. Guarde essa configuração com a divisão do dataset e o relatório da base de comparação. Se faltar um tool schema, preserve-o na linha de treino. Se uma resposta for truncada, ajuste o comprimento da sequência e a formatação para que a resposta completa sobreviva. Resolva esses problemas antes de acrescentar épocas.
Referências
Artigos e investigação
- LoRA: Low-Rank Adaptation of Large Language Models
- QLoRA: Efficient Finetuning of Quantized LLMs
- DoRA: Weight-Decomposed Low-Rank Adaptation
- DPO: Direct Preference Optimization
- ORPO: Odds Ratio Preference Optimization
- PPO: Proximal Policy Optimization Algorithms — OpenAI, 2017
Ferramentas de processamento de dados
- DataTrove — processamento de dados à escala da Hugging Face
- Distilabel — geração de dados sintéticos (Argilla)
- Trafilatura — extração de texto web e crawling
- fastText language identification — modelos pré-treinados de identificação de idioma
- Microsoft Presidio — deteção e anonimização de PII
- scrubadub — biblioteca Python para remoção de PII
Constrained decoding
Frameworks de treino
- Unsloth — framework de fine-tuning otimizada
- Axolotl — treino orientado por configuração e launchers distribuídos
- TRL — biblioteca de treino de SFT e de preferências da Hugging Face
- PEFT model merging —
add_weighted_adaptere métodos de merging - Torchtune — biblioteca de fine-tuning nativa do PyTorch, sem manutenção ativa
Inferência e deployment
- vLLM LoRA adapters — sirva um ou mais adapters com o modelo base
- vLLM tool calling — faça corresponder a escolha automática de ferramenta, o parser, o chat template e o schema do pedido ao modelo
- Model card do Llama-3.1-Nemotron-Nano-4B-v1.1 — plugin de parser de tool calls e chat template para o vLLM
- Ollama — executor local de LLMs para Mac/Windows/Linux
- llama.cpp — inferência em CPU/GPU com o formato GGUF
Avaliação
- lm-evaluation-harness — benchmarking padronizado de LLMs da EleutherAI
- Berkeley Function Calling Leaderboard — código de avaliação de function calling
Guias e recursos
- Repositório da demonstração — exemplo prático de fine-tuning
- Accelerate n-D Parallelism Guide — estratégias de treino multi-GPU da Hugging Face