Guía de fine-tuning de LLM: cuándo hacerlo, LoRA y QLoRA

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Esta guía está dirigida a ingenieros de Python que deben decidir si hacer fine-tuning de un large language model y cómo hacerlo. Aprenderás cuándo elegir fine-tuning en lugar de prompting o retrieval, y cómo escoger entre métodos como LoRA y QLoRA. La guía también explica cómo preparar los datos, evaluar el modelo entrenado y planificar su despliegue.
La parte práctica ejecuta un repositorio complementario que hace fine-tuning de un modelo de 4B para function calling.
Para una comparación más breve entre fine-tuning, RAG y prompting, consulta Fine-Tuning vs RAG vs Prompting.
¿Deberías hacer fine-tuning?
Antes de gastar horas de GPU, decide si el fine-tuning es la herramienta adecuada para el problema que tienes delante. La figura sigue una petición y muestra dónde actúa cada una de las cuatro soluciones, en qué fallo conviene probarla primero y qué no puede arreglar.
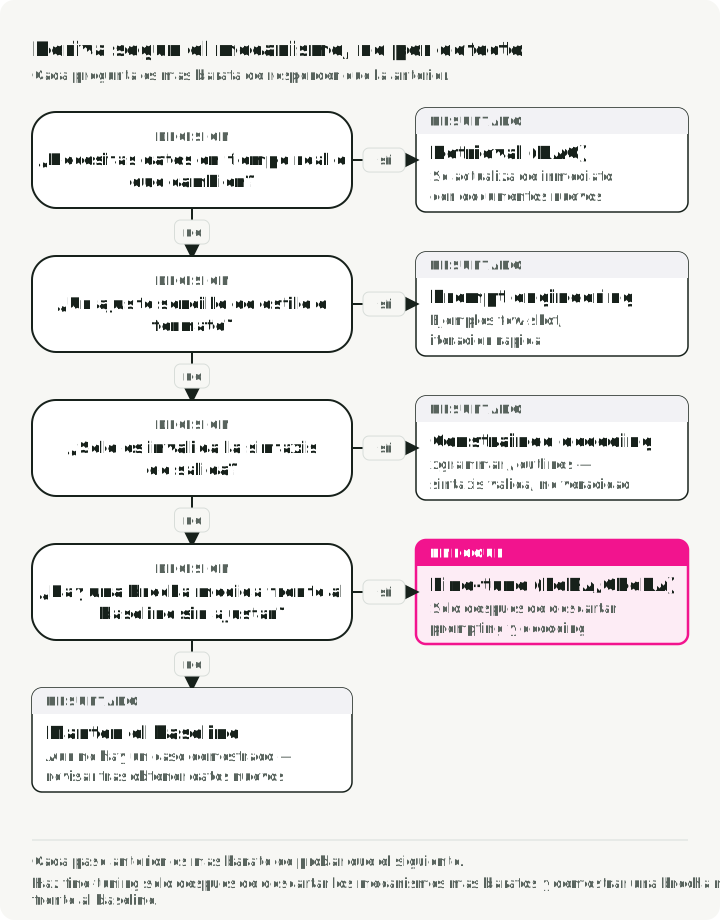
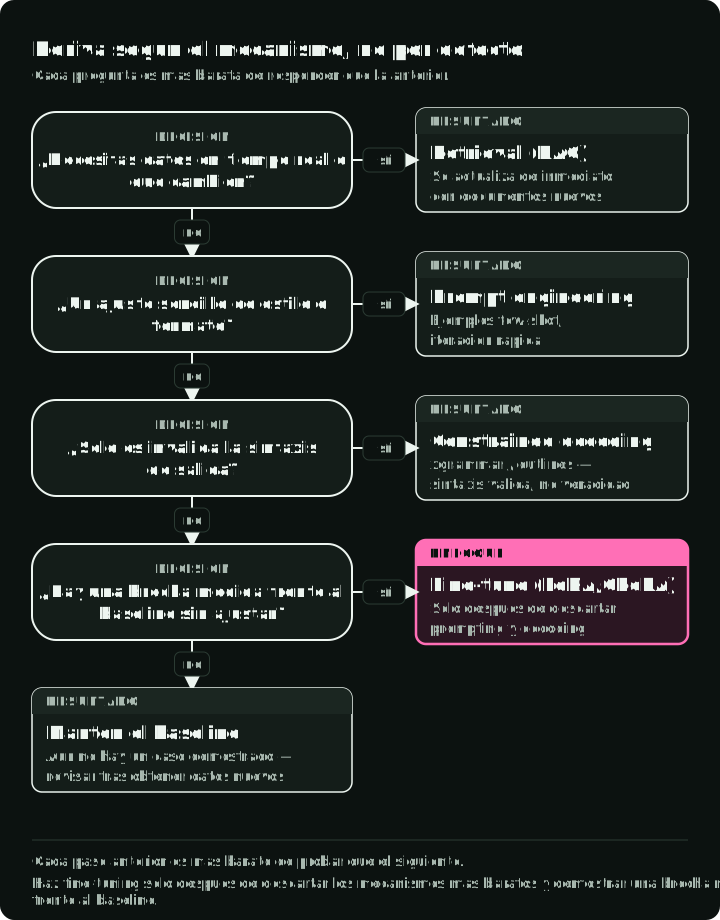
El fine-tuning modifica el comportamiento codificado en los pesos. El retrieval aporta evidencia en tiempo de inferencia, por lo que es un mejor punto de partida para hechos que cambian o que necesitan citas. Los documentos nuevos solo están disponibles tras ingerirlos e indexarlos; comprueba que esa frescura cumple tu requisito.
Los prompts claros y los ejemplos son más baratos de iterar que una nueva ejecución de entrenamiento. Puede que ya resuelvan un problema de estilo o de seguimiento de instrucciones. El fine-tuning puede reducir los tokens repetidos del prompt, pero la latencia de serving depende del modelo, la longitud de salida, el hardware y la implementación; una actualización de pesos no es, por sí misma, una aceleración.
Para la sintaxis, librerías como xgrammar y outlines enmascaran los siguientes tokens no válidos según un schema o una gramática compatibles. Una generación restringida completada con éxito pertenece a ese lenguaje. Trata por separado las truncaciones y otras generaciones incompletas, y valida el resultado antes de usarlo. La restricción no puede hacer que un ID de cliente sea verdadero ni que una elección de herramienta sea adecuada. Mide su latencia en tu backend en lugar de suponer un overhead fijo.
Cada una de las cuatro opciones cambia un paso distinto de la misma petición. Solo el fine-tuning necesita una ejecución de entrenamiento y un nuevo artefacto de modelo; las otras tres cambian el texto, los documentos o un schema alrededor de los mismos pesos. La tabla compara las cuatro opciones:
| Opción | Qué cambia | Cómo se actualiza | Coste de puesta en marcha | Qué no puede arreglar |
|---|---|---|---|---|
| Prompting | Instrucciones y ejemplos | Editar el texto | Bajo: escribir y probar prompts | Un comportamiento que el modelo no puede seguir por instrucciones |
| RAG | Evidencia en la ventana de contexto | Ingerir y reindexar documentos | Medio: índice, retriever y evaluación | Un modelo que ignora o malinterpreta la evidencia |
| Constrained decoding | Qué tokens puede emitir el decoder | Cambiar el schema o la gramática | Bajo a medio: schema y compatibilidad del backend | Valores incorrectos dentro de una estructura válida |
| Fine-tuning | Pesos del modelo | Reentrenar y evaluar un nuevo artefacto | Alto: curación de datos, tiempo de GPU y evaluación | Hechos que cambian después del entrenamiento |
Referencia rápida: relacionar problemas y soluciones
| Reto | Primer mecanismo que probar | ¿Por qué? |
|---|---|---|
| Falta de conocimiento | RAG | Recupera evidencia con citas; la frescura depende de la ingesta y la indexación |
| Formato o tono incorrectos | Prompt Engineering | Los modelos modernos siguen bien las instrucciones de estilo mediante ejemplos few-shot |
| Sintaxis de salida no válida | Constrained decoding | Impone un schema o una gramática compatibles durante la generación |
| Fallos repetidos en una tarea | Fine-tuning (SFT) | Aprende de ejemplos seleccionados de entrada/salida |
| Desajuste de preferencias por pares | Preference optimization | Usa ejemplos elegidos/rechazados cuando el comportamiento de la tarea ya se puede medir |
| Latencia/coste a escala | Distillation (SFT) | Entrena un modelo estudiante más pequeño con las salidas de un teacher mayor |
| Reducir el tamaño del modelo | Post-training quantization | La cuantización posterior al entrenamiento reduce la memoria de los pesos; la velocidad depende de los kernels compatibles y de la carga |
Haz que el caso de negocio sea medible
El fine-tuning puede reducir los tokens recurrentes del prompt o permitir que un modelo más pequeño alcance el objetivo, pero ninguno de los dos ahorros es automático. Calcula el punto de equilibrio con tu propio tráfico y tus precios:
Si el denominador es pequeño, negativo o se basa en una suposición de calidad sin demostrar, el proyecto todavía no tiene un caso económico.
Un ejemplo con cifras ilustrativas: un baseline con prompt envía unos 2.000 tokens de instrucciones y ejemplos con cada petición. Tras el ajuste, la misma tarea necesita unos 50. Con un precio supuesto de $0,50 por millón de tokens de entrada para ambos modelos, el ahorro es de 1.950 tokens, es decir, unos $0,001 por petición. Si el entrenamiento, la evaluación y el despliegue cuestan $3.000, el punto de equilibrio está en unos 3,1 millones de peticiones. Con 100.000 peticiones al día, eso es aproximadamente un mes. Con 5.000 peticiones al día, es más de un año. El cálculo solo vale si el modelo ajustado cumple los mismos umbrales de calidad que el baseline.
La configuración híbrida. Una arquitectura habitual combina un modelo más pequeño adaptado a la tarea con retrieval para los hechos cambiantes. Trata el modelo mayor con prompt como baseline y conserva el modelo más pequeño solo si cumple los mismos umbrales de calidad y seguridad específicos de la tarea.
Tipos de fine-tuning
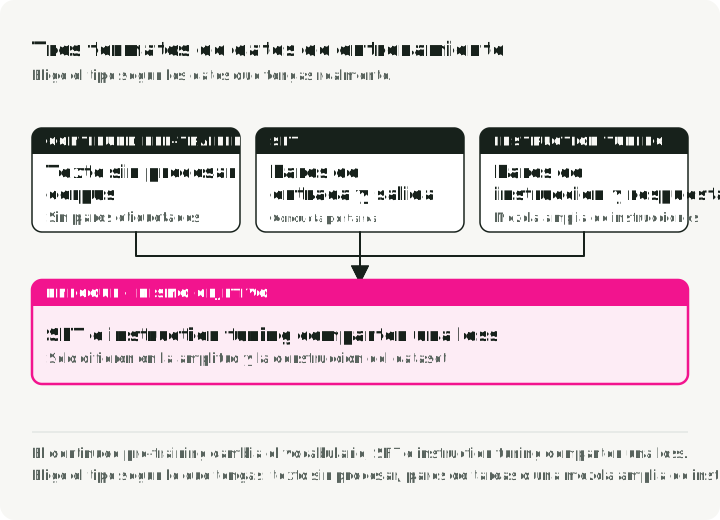
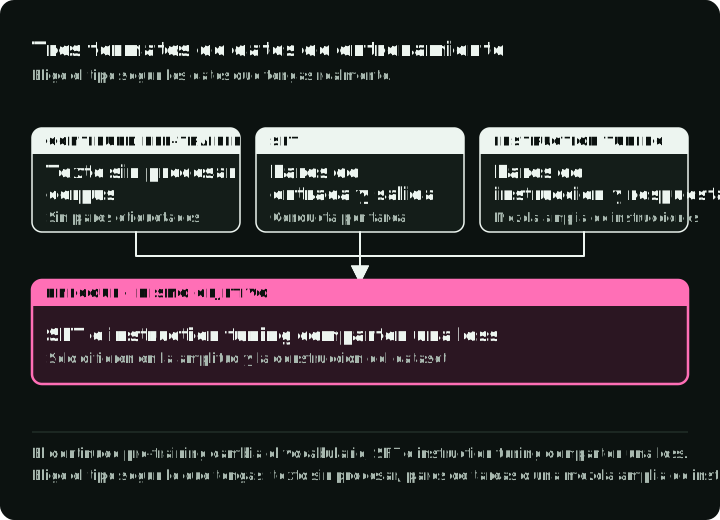
El fine-tuning puede adoptar tres formas principales. Se distinguen por el tipo de datos que necesitan y por lo que enseñan al modelo. El diagrama muestra una fila de entrenamiento para cada tipo.
1. Continued pre-training (self-supervised)
Entrenas el modelo base con más texto sin etiquetar, usando el siguiente token de cada secuencia como objetivo de entrenamiento. Eso es aprendizaje autosupervisado: el propio texto aporta sus objetivos, igual que en la ejecución original de pre-training.
Cuándo usarlo:
- El dominio tiene vocabulario que el modelo base nunca vio (medicina, derecho, bases de código internas).
- Dispones de mucho texto del dominio, pero no de pares (entrada, salida) etiquetados.
- El modelo base se equivoca con la terminología específica del dominio.
Ejemplo: entrenar con millones de notas clínicas para que el modelo aprenda abreviaturas médicas, nombres de fármacos y flujos de trabajo clínicos.
2. Supervised fine-tuning (SFT)
El SFT entrena con pares (entrada, salida) etiquetados. Le muestras al modelo la salida exacta que quieres para cada entrada.
Cuándo usarlo:
- Tienes una tarea concreta con un formato limpio de entrada/salida.
- Tienes datos etiquetados de calidad, aunque sean pocos.
- Necesitas un comportamiento predecible con una forma de entrada conocida.
Ejemplo: entrenar con pares (descripción de una consulta SQL, código SQL) para text-to-SQL. Este intervalo de calendario fijo supone que signup_date se almacena en UTC:
{
    "input": "Get users who signed up in August 2026 (UTC)",
    "output": "SELECT * FROM users WHERE signup_date >= '2026-08-01' AND signup_date < '2026-09-01'"
}
3. Instruction tuning
El instruction tuning es un caso especial de SFT diseñado para que los modelos sigan una gran variedad de instrucciones en lenguaje natural. Los datos de entrenamiento son pares (instrucción, respuesta) de muchas tareas distintas.
Cuándo usarlo:
- Quieres un asistente de propósito general (como ChatGPT o Claude).
- El modelo debe atender peticiones variadas y abiertas.
- Estás construyendo una interfaz de chat.
Ejemplo: entrenar con miles de instrucciones diversas como “Resume este artículo”, “Escribe un poema sobre X”, “Explica Y en términos sencillos”.
Comparación
| Aspecto | Continued pre-training | SFT | Instruction tuning |
|---|---|---|---|
| Datos | Texto sin etiquetar | Pares (entrada, salida) | Pares (instrucción, respuesta) |
| Etiquetas | Ninguna (autosupervisado) | Específicas de la tarea | Tareas diversas |
| Objetivo | Conocimiento del dominio | Comportamiento específico de la tarea | Seguir cualquier instrucción |
| Volumen de datos | Normalmente el corpus más grande | Lo determinan la cobertura de la tarea y la diversidad de errores | Normalmente más amplio que el SFT específico de una tarea |
Un objetivo, dos datasets. El SFT y el instruction tuning usan el mismo objetivo de predicción del siguiente token; la diferencia está en la amplitud y la construcción del dataset. El continued pre-training es un experimento aparte, y después hay que probar tanto la mejora en el dominio como la regresión de las capacidades generales.
El pipeline de fine-tuning en 7 etapas
El fine-tuning tiene siete etapas. Cada etapa tiene sus propios modos de fallo, y saltarse una suele acabar en un mal modelo más adelante. El diagrama muestra las etapas en orden, lo que cada etapa añade al registro de la versión y el camino de vuelta desde la monitorización hasta la preparación de datos.
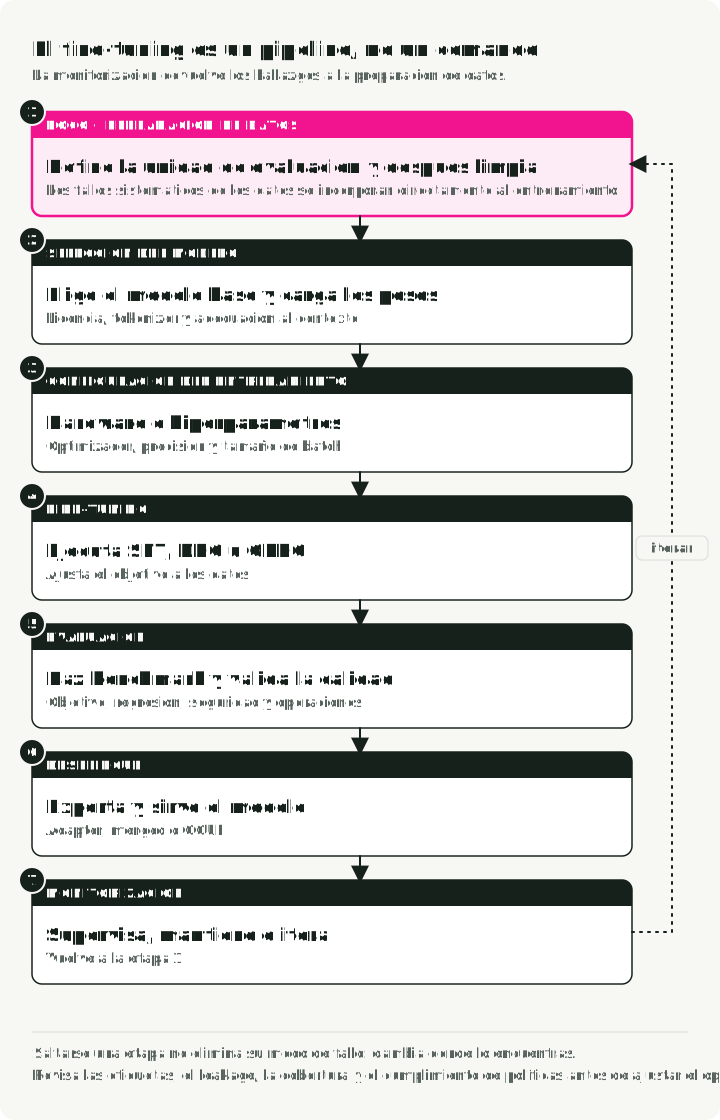
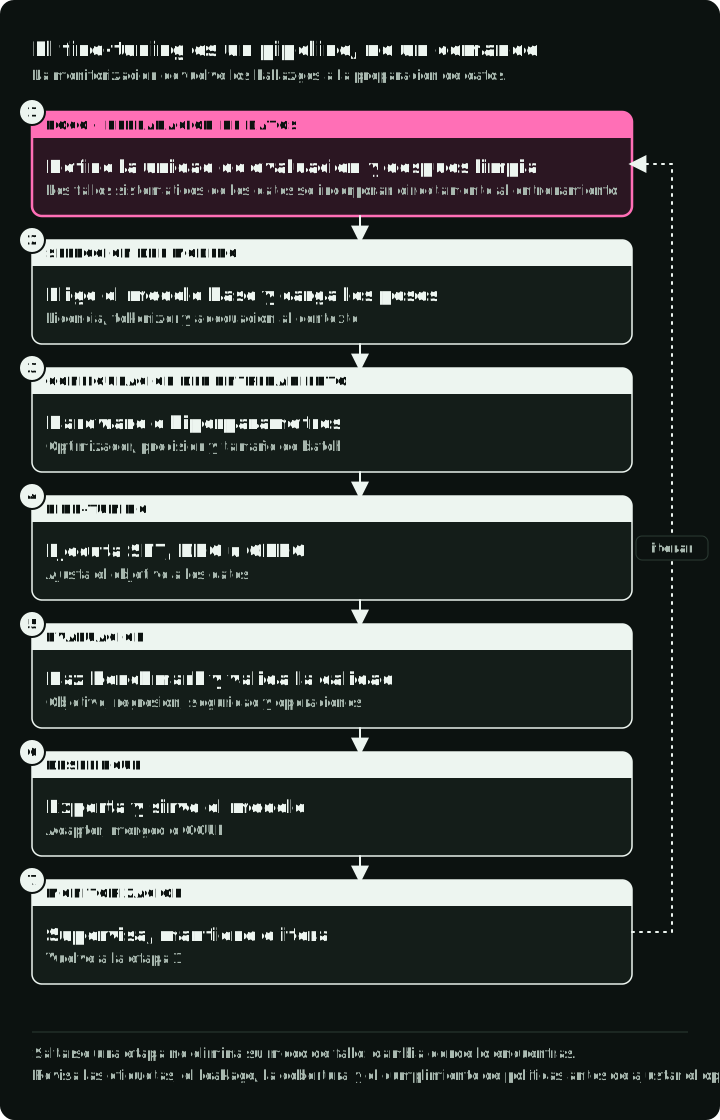
Cada etapa se apoya en la anterior:
- Preparación de datos — Define la unidad de evaluación, divide los datos y luego límpialos y dales formato
- Selección del modelo — Elige el modelo base adecuado y carga los pesos
- Configuración del entrenamiento — Comprueba la serialización y los objetivos de la loss, y luego elige el método (LoRA, QLoRA, DoRA) y sus ajustes
- Fine-tuning — Ejecuta SFT con un framework; añade DPO u ORPO solo si hace falta
- Evaluación — Mide el rendimiento y valida la calidad
- Despliegue — Exporta y sirve tu modelo
- Monitorización — Sigue el rendimiento, mantén el modelo e itera
Los datos primero. El entrenamiento reproduce los fallos sistemáticos de los ejemplos. Inspecciona las etiquetas, las fugas, la cobertura y el cumplimiento de políticas antes de dedicar tiempo a barridos del optimizador.
Etapa 1: Preparación de datos
Los problemas de los datos llegan al modelo entrenado, así que esta etapa recibe el mayor cuidado. El diagrama sigue tickets de ejemplo por ese orden: primero se divide por origen y después se aplican cinco transformaciones dentro de cada partición.
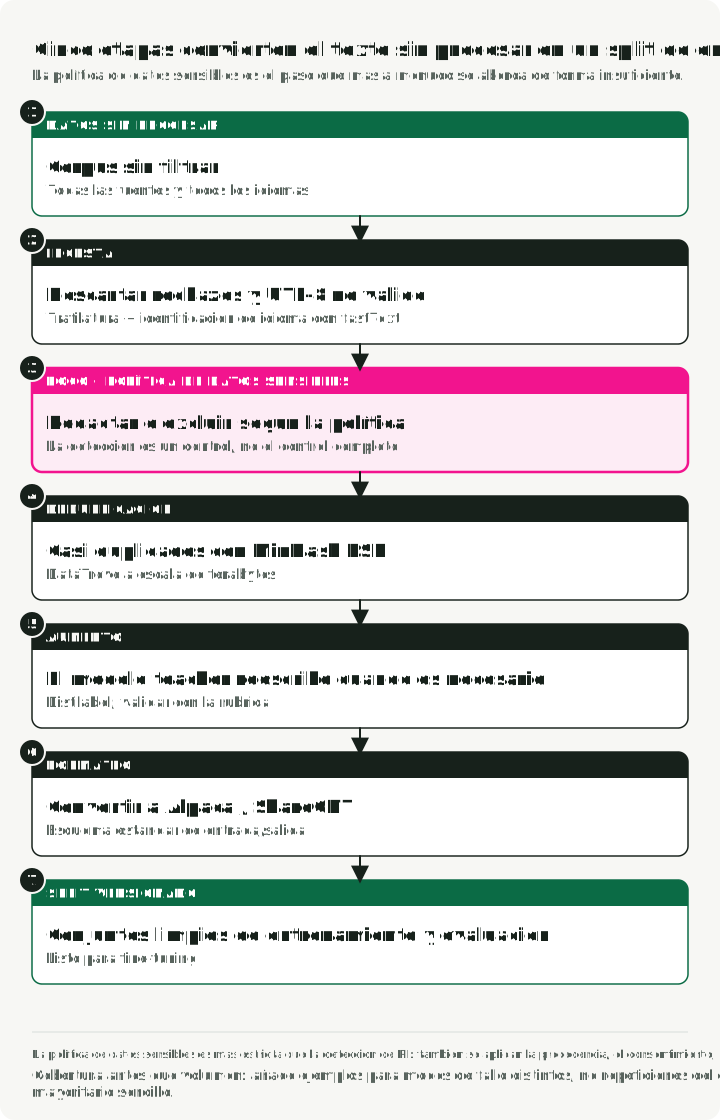
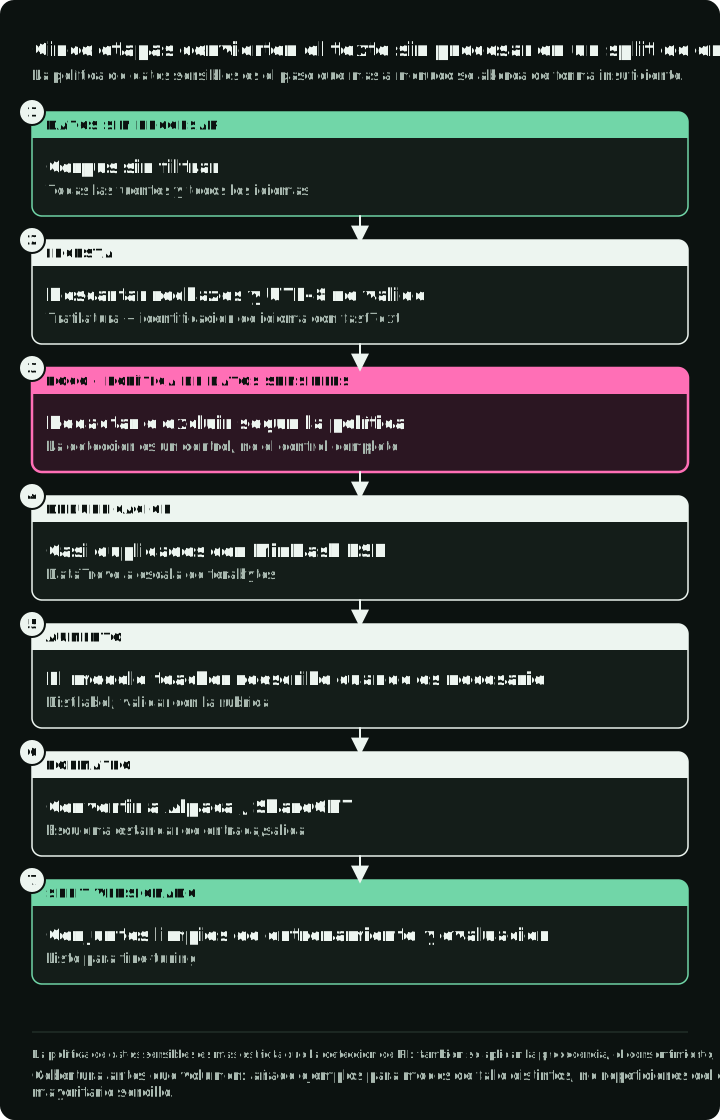
Cinco transformaciones después de dividir por origen
Asigna los grupos de origen a entrenamiento o evaluación antes de transformar las filas. Un ticket de soporte y todas sus reescrituras permanecen en la misma partición. Agrupa los casi duplicados conocidos antes de asignar los grupos y vuelve a comprobarlo entre particiones tras la limpieza. Congela el conjunto de evaluación; aumenta solo los datos de entrenamiento.
Enumera los errores que tus ejemplos deben enseñar al modelo a corregir y define después los campos y etiquetas obligatorios de cada fila. Elige las herramientas de procesamiento para esos pasos. DataTrove ejecuta el filtrado y la deduplicación como trabajos distribuidos para corpus grandes; Distilabel genera y etiqueta filas sintéticas con un modelo teacher.
1. Ingesta y filtrado
- Acción: elimina el UTF-8 roto y el contenido ajeno a la tarea. Etiqueta las negativas según la política: conserva las negativas correctas como objetivos de entrenamiento y casos de evaluación; excluye solo las negativas no válidas o ajenas a la tarea.
- Herramientas: Trafilatura cuando la fuente son páginas web; omítela si los datos ya son texto. Los modelos de identificación de idioma de fastText para detectar el idioma.
2. Política de datos sensibles
- Acción: decide qué puede aprender el modelo y después oculta, tokeniza o excluye los campos personales y confidenciales según corresponda.
- Herramientas: Microsoft Presidio cuando necesitas reconocedores configurables, varios idiomas o anonimización reversible; scrubadub para un pipeline más pequeño en Python puro que elimina del texto los datos personales habituales.
- Por qué: un detector es solo un control; siguen aplicándose los requisitos de procedencia, consentimiento, retención, acceso y eliminación.
3. Deduplicación (MinHash LSH)
- Acción: elimina los casi duplicados para reducir la repetición y el riesgo de fugas; esto no evita la memorización.
- Herramientas: DataTrove cuando el corpus necesita procesamiento distribuido.
4. Aumento sintético, si es necesario
- Acción: usa un modelo teacher adecuado para reescribir los ejemplos de entrenamiento como pares instrucción-respuesta, conservando sus ID de origen. No aumentes la partición reservada para evaluación.
- Herramientas: Distilabel.
- Validación: muestrea las salidas del teacher, compáralas con la misma rúbrica que las etiquetas humanas e informa por separado de los resultados de los ejemplos sintéticos y de los escritos por personas. Un subconjunto de evaluación así se llama slice; otros slices útiles son el idioma y el tipo de tarea.
5. Formato
- Acción: convierte a un formato estándar (Alpaca o ShareGPT).
Ejemplos de formatos de datos
Formato Alpaca (seguimiento de instrucciones):
{
    "instruction": "Summarize the following text.",
    "input": "The text to be summarized...",
    "output": "This is the summary."
}
Almacenamiento al estilo ShareGPT (conversacional):
{
    "conversations": [
        { "from": "user", "value": "Hello, who are you?" },
        { "from": "assistant", "value": "I am a helpful AI assistant." }
    ]
}
Comprobaciones del dataset
- Cobertura antes que volumen. Añade ejemplos que representen modos de fallo distintos, no repeticiones del caso fácil mayoritario.
- Limpieza. Elimina el texto irrelevante, normaliza los espacios en blanco y mantén un formato coherente.
- Equilibrio. Conserva los casos raros importantes e informa del rendimiento por slice.
- Separación. Divide por origen, usuario, documento o tiempo cuando una división aleatoria por filas filtraría casi duplicados.
- Procedencia. Registra el origen, la licencia o el permiso, el historial de transformaciones y la vía de eliminación de cada versión del dataset.
Etapa 2: Selección del modelo y hardware
El modelo base y su requisito mínimo de memoria de GPU determinan lo que puedes entrenar.
Empieza por el modelo base más pequeño que ya supere las comprobaciones de referencia irrenunciables. Confirma:
- la licencia y las condiciones de redistribución para el producto previsto;
- el idioma, el dominio, el uso de herramientas y el comportamiento de seguridad antes de la adaptación;
- la compatibilidad del tokenizer y la chat template con el dataset;
- el contexto máximo y el comportamiento de truncación que necesitan los ejemplos reales;
- la compatibilidad tanto en el framework de entrenamiento como en el motor de serving de destino.
El fine-tuning es un paso de adaptación, no una reparación para un modelo base inadecuado. Si el modelo falla en capacidades que el dataset no cubre, elige otro modelo base antes de ejecutar más epochs.
Estima la memoria de tu ejecución
No existe una tabla duradera de “tamaño del modelo → GPU”. La memoria pico cambia con la precisión de los pesos, el optimizador, el número de parámetros entrenables, la longitud de secuencia, el tamaño del micro-batch, el activation checkpointing, la implementación de la atención y el overhead del framework. Empieza con una estimación de memoria y después ejecuta una prueba rápida con longitud máxima en tu stack exacto.
| Componente de memoria | Fine-tuning completo | LoRA | QLoRA |
|---|---|---|---|
| Pesos base | Precisión de entrenamiento | Congelados, normalmente BF16/FP16 | Congelados, normalmente NF4 de 4 bits |
| Gradientes | Todos los pesos entrenables | Pesos del adapter | Pesos del adapter |
| Estados del optimizador | Todos los pesos entrenables | Pesos del adapter | Pesos del adapter |
| Activaciones | Dependen del tamaño del batch y de la longitud de secuencia en todos los métodos | La misma dependencia | La misma dependencia |
El gráfico aplica la tabla al modelo base de la demo, Nemotron-Nano-4B con 4,51 mil millones de parámetros. Desglosa la memoria aproximada de cada método en pesos y estado entrenable; las activaciones se suman encima.
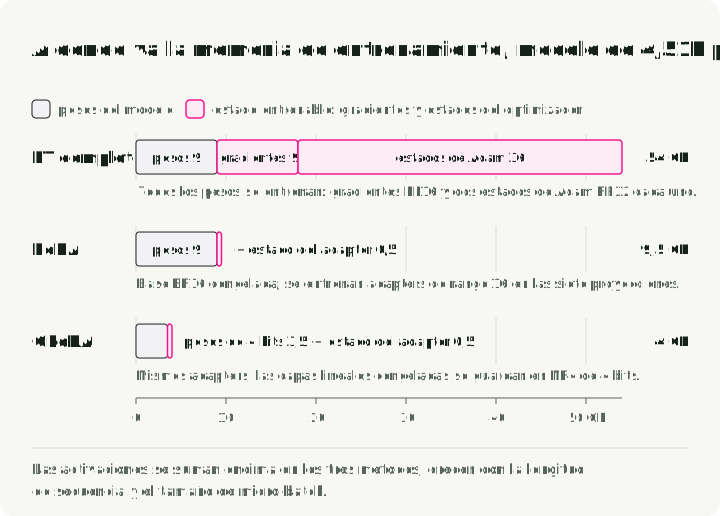
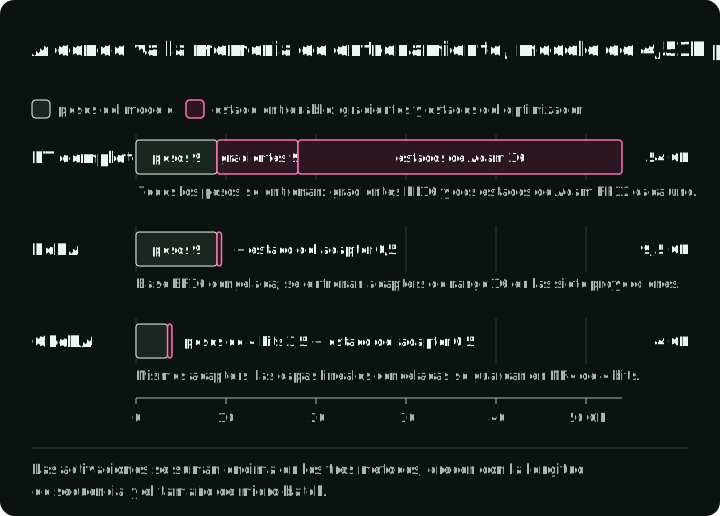
El artículo original de QLoRA logró que un modelo LLaMA de 65B cupiera en una sola GPU de 48 GB en su configuración concreta. Ese resultado es una cota útil, no una promesa de que cualquier arquitectura actual de 70B, longitud de contexto, kernel o trainer quepa en el mismo dispositivo.
Cálculo de memoria
Para un modelo con parámetros, los pesos por sí solos requieren aproximadamente bytes en BF16/FP16 o bytes con cuatro bits, antes de los metadatos de cuantización y los buffers de ejecución. El entrenamiento completo con un optimizador de tipo Adam añade gradientes, estados del optimizador y, a menudo, pesos maestros de mayor precisión. LoRA evita la mayor parte de la memoria del estado entrenable; QLoRA reduce además el tamaño de los pesos base congelados. Las activaciones aún pueden dominar con secuencias largas.
Usa este flujo de trabajo:
- Elige la secuencia más larga y el micro-batch que debes admitir.
- Estima los pesos y el estado entrenable, dejando margen para activaciones y kernels.
- Ejecuta un paso de forward/backward con la longitud máxima.
- Registra la memoria pico asignada y reservada.
- Solo entonces escala el tamaño del batch, el rank, la longitud de secuencia o el número de GPUs.
Etapa 3: Configuración y métodos de entrenamiento
La etapa 3 tiene dos partes. Primero comprueba que cada fila almacenada se convierte en el texto de entrenamiento que esperas. Después elige el método de entrenamiento y sus ajustes.
De las filas almacenadas a los objetivos de entrenamiento
ShareGPT es una forma de dataset; ChatML es una convención de serialización. Convierte from/value a los roles y campos que acepta el trainer y usa después la chat template del modelo seleccionado. No sustituyas por tokens de ChatML solo porque los datos sean conversacionales.
Una fila pasa por cinco pasos:
- Fila ShareGPT: pares
from/value. messagesytools: los roles que acepta el trainer.apply_chat_templatecon la plantilla del modelo seleccionado. La inferencia debe usar la misma plantilla.- IDs de tokens y etiquetas, donde
-100significa que no hay loss. - Entrena.
Imprime el texto renderizado del paso 3 antes de entrenar.
Para la fila del saludo anterior, los mensajes normalizados son:
messages = [
    {"role": "user", "content": "Hello, who are you?"},
    {"role": "assistant", "content": "I am a helpful AI assistant."},
]
# Inspection step after loading the selected model's tokenizer:
rendered = tokenizer.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=False,
)
print(rendered)
Inspecciona la fila serializada real antes de entrenar: los delimitadores de rol, los tokens de fin de turno y los tool schemas deben coincidir con los de la inferencia. En una fila de tool use, conserva las definiciones de herramientas, las tool calls del asistente y los tool results como campos distintos. Comprueba que la truncación no elimine la respuesta supervisada ni corte por la mitad un argumento de una herramienta.
El loss masking decide por qué tokens se recompensa al modelo. En el entrenamiento de secuencia completa, el texto del usuario, del sistema, de las herramientas y del asistente pueden contribuir todos. En el entrenamiento solo del asistente, esos tokens de contexto siguen siendo visibles para la atención, pero sus etiquetas se ignoran (normalmente -100); solo contribuyen los tramos del asistente. Para este saludo, la respuesta debería ser un objetivo y la pregunta del usuario no, si la intención es un comportamiento solo del asistente.
El diagrama muestra ambos ajustes para una conversación con tool use.
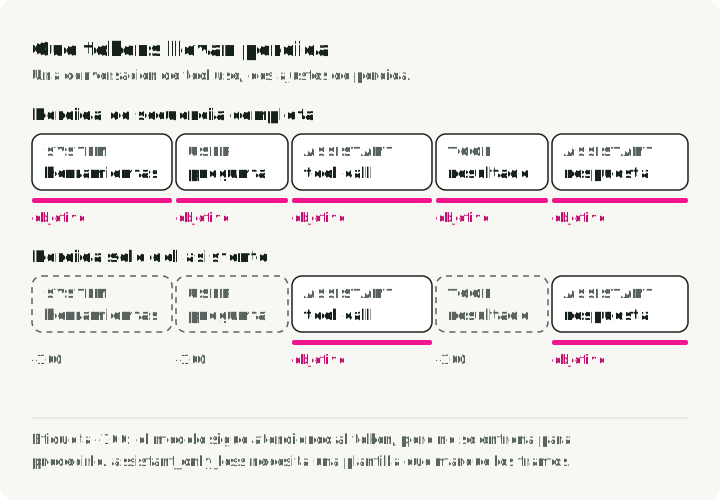
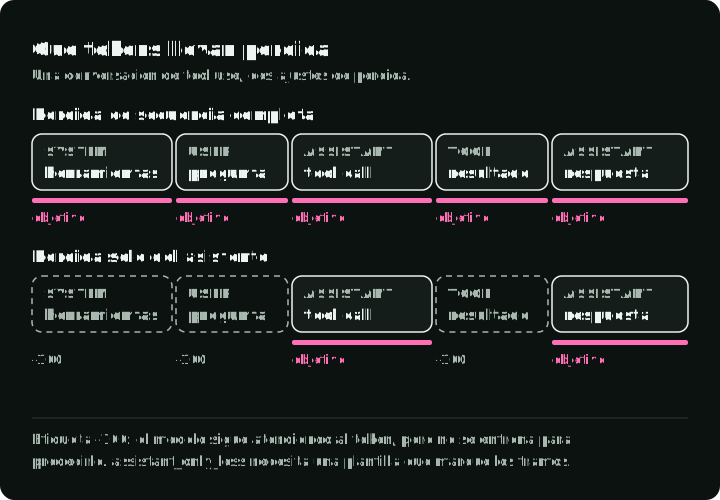
La documentación de SFT de TRL admite assistant_only_loss=True para datasets conversacionales cuyas plantillas exponen tramos de generación. Una plantilla sin esos tramos no puede proporcionar esa máscara. Los datasets de prompt/completion tienen una opción propia, completion_only_loss. Antes de activar cualquiera de las dos, inspecciona un batch tokenizado y decodifica los tokens con etiquetas no ignoradas. Después repite la prueba con una conversación con herramientas y un ejemplo de longitud máxima. La demo que aparece más adelante en esta guía usa loss de secuencia completa, porque la plantilla de Nemotron no tiene tramos de generación.
Elige una longitud de secuencia a partir de la distribución de los datos y ejecuta la comprobación de memoria con longitud máxima de la etapa 2. El packing coloca varios ejemplos más cortos en una misma secuencia de entrenamiento. Empieza sin él para que los límites de las filas sean fáciles de inspeccionar. Prueba el packing solo cuando las filas serializadas y las etiquetas sean correctas.
Fine-tuning completo frente a PEFT
El fine-tuning completo (FFT) actualiza todos los pesos, así que los gradientes y el estado del optimizador escalan con todo el modelo. El pico no puede deducirse solo del número de parámetros, pero queda muy por encima de la memoria necesaria para cargar los pesos para inferencia.
El parameter-efficient fine-tuning (PEFT) entrena solo un pequeño subconjunto de parámetros y congela el resto, de modo que los gradientes y los estados del optimizador cubren solo ese subconjunto.
LoRA: el punto de partida
LoRA (Low-Rank Adaptation) congela una matriz preentrenada y representa su actualización aprendida con dos matrices más pequeñas. El artículo original lo justifica con la hipótesis de que las actualizaciones de adaptación útiles tienen un rank intrínseco bajo.
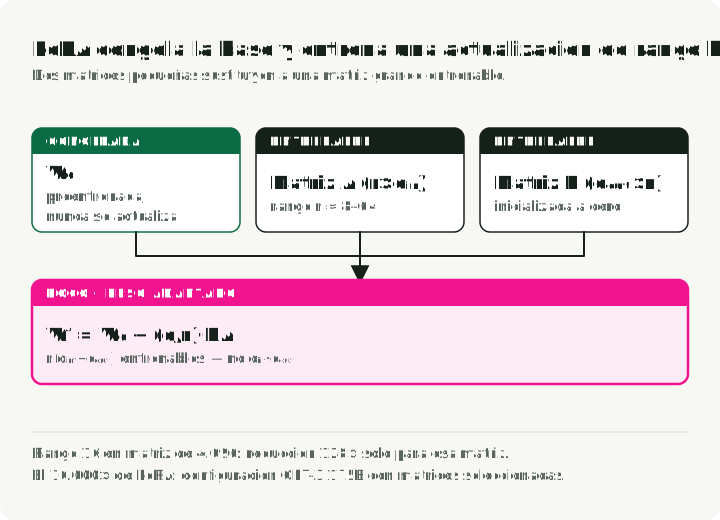
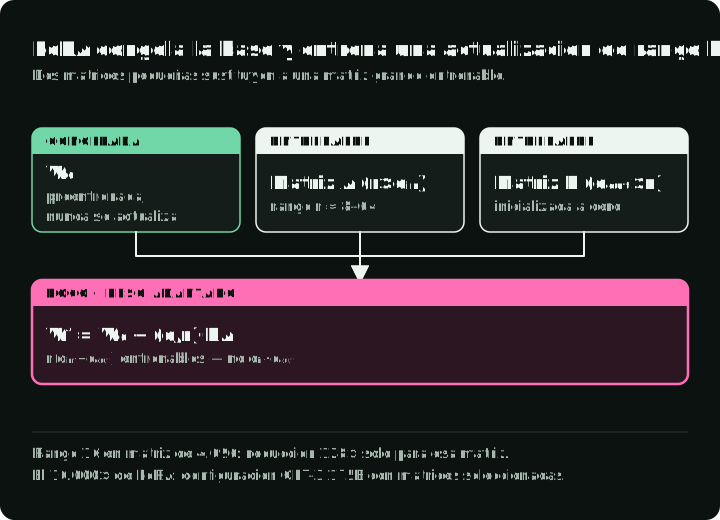
Aquí, es el ancho de entrada de la capa y su ancho de salida. El rank es la dimensión compartida más pequeña de las dos matrices entrenables: un rank menor usa menos parámetros entrenables. El ajuste controla la escala de la actualización mediante el cociente .
El diagrama muestra la matriz congelada, las dos matrices entrenables y cómo se suma su producto escalado, con el número de parámetros de una matriz de ancho 4.096 con rango 16.
Para una matriz congelada , LoRA aprende:
La capa adaptada es:
El adapter tiene parámetros entrenables en lugar de para esa matriz. Para una matriz cuadrada de ancho 4.096 con rank 16, eso supone una reducción de 128× en los parámetros entrenables de esa matriz. El ahorro en el modelo completo depende de qué matrices reciben adapters.
Comparación de métodos PEFT
| Método | Qué cambia | Elígelo cuando |
|---|---|---|
| LoRA | Base congelada más actualizaciones entrenables de bajo rank | El modelo base cabe con holgura y quieres artefactos pequeños por tarea |
| QLoRA | LoRA con la base congelada almacenada en forma de 4 bits | La memoria de los pesos base es el factor limitante |
| DoRA | Separa la magnitud del peso de una dirección actualizada con LoRA | Un baseline de LoRA medido deja una brecha de calidad que justifica la complejidad extra |
| Fine-tuning completo | Todos los pesos del modelo | PEFT no alcanza el objetivo y la mejora de calidad justifica el entrenamiento distribuido y los checkpoints completos |
DoRA: LoRA con descomposición de pesos
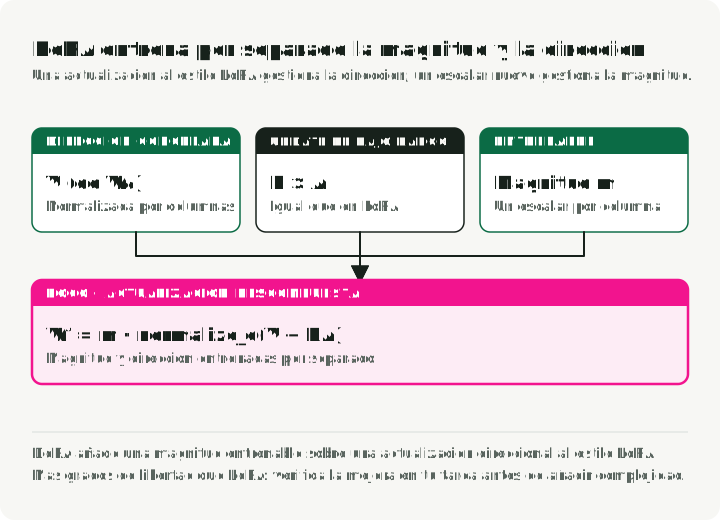
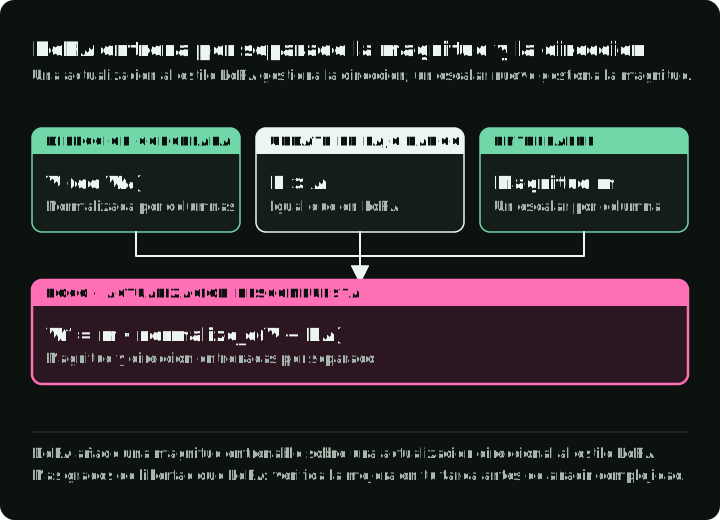
DoRA (Weight-Decomposed Low-Rank Adaptation) separa la magnitud de cada vector de pesos de su dirección. El artículo de DoRA aplica una actualización LoRA al componente direccional mientras aprende la magnitud por separado. El diagrama dibuja una columna de pesos como una flecha: B·A gira su dirección y una magnitud m entrenada fija su longitud.
Cómo funciona:
En lugar de tratar los pesos como una única entidad, DoRA descompone los pesos preentrenados en dos componentes:
- Magnitud: un valor entrenable por cada vector de pesos.
- Dirección: un vector normalizado que se actualiza mediante matrices de bajo rank.
En notación compacta por columnas:
donde:
m= magnitud (entrenable)- = la matriz inicial congelada; se normaliza después de sumar
- = la actualización direccional de bajo rank aprendida
- = normalización por columnas
Efectos de la descomposición:
- Más grados de libertad que LoRA estándar, porque la magnitud puede cambiar de forma independiente.
- Mejores resultados que LoRA en varias configuraciones que describe el artículo que lo propone.
- Parámetros y cómputo adicionales, así que conviene verificar la mejora en tu tarea y en tu ruta de serving.
Fusión de adapters para aprendizaje multitarea
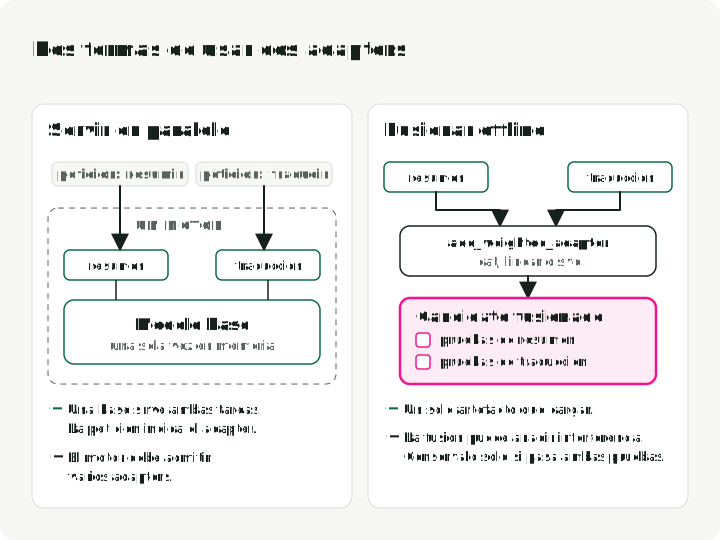
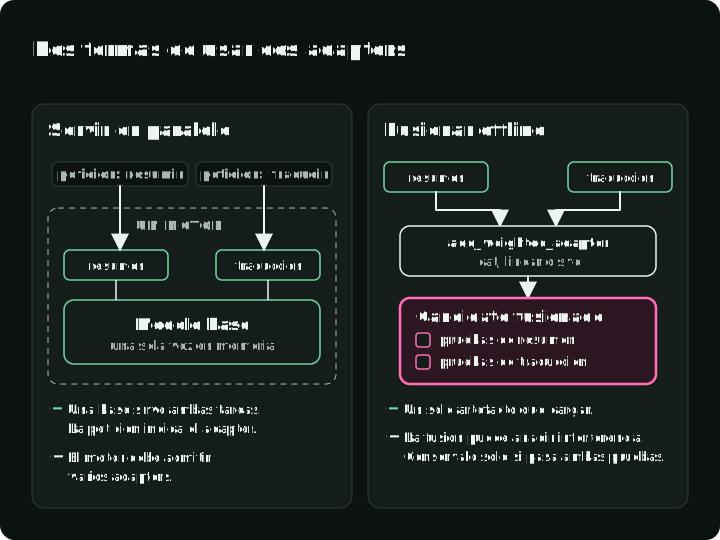
Los adapters separados permiten que una sola base congelada admita varias tareas. Puedes dirigir las peticiones a un adapter, servir varios adapters desde un mismo motor cuando esté soportado o crear un candidato fusionado offline. La fusión puede introducir interferencias, así que evalúa el artefacto fusionado en lugar de suponer que los adapters de origen se combinan sin problemas.
La figura compara las dos opciones para dos adapters sobre una misma base. Conserva el modelo fusionado solo si supera ambas suites de pruebas.
Métodos de fusión habituales:
- Concatenación: combina los parámetros de los adapters y aumenta el rank efectivo. Rápida y sencilla.
- Combinación lineal: suma ponderada de adapters. Los pesos fijan cuánto contribuye cada tarea.
- SVD: descomposición de matrices para la fusión. Más flexible, pero más lenta.
add_weighted_adapter de PEFT los implementa como combination_type="cat", "linear" y "svd"; la guía de fusión de modelos de PEFT los describe, junto con métodos más recientes.
Ejemplo: un adapter para resumen y otro para traducción, fusionados en un único modelo multitarea.
Etapa 4: Preference alignment (opcional)
El SFT es la ejecución principal de entrenamiento, y las secciones de frameworks que siguen a esta etapa la ejecutan. Esta etapa trata de lo que puedes añadir después del SFT, si los errores lo requieren.
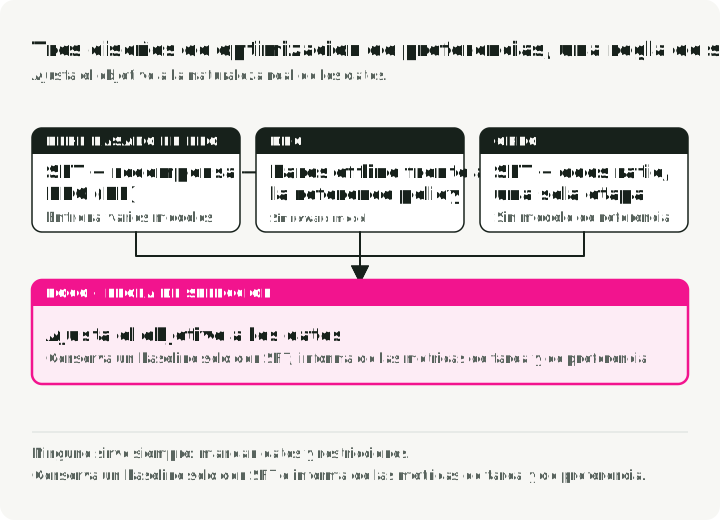
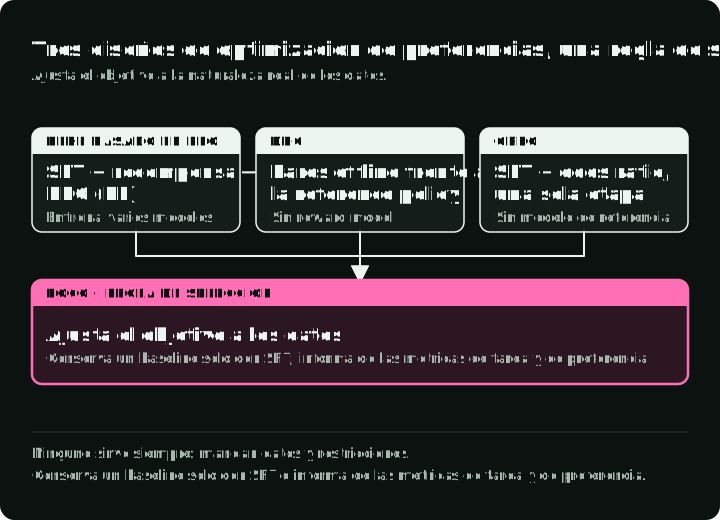
El SFT aprende demostraciones. La preference optimization, en cambio, aprende de comparaciones como “la respuesta elegida A es mejor que la respuesta rechazada B”. Úsala solo cuando la preferencia por pares sea la etiqueta adecuada para el error; la corrección factual y el cumplimiento de políticas suelen necesitar evaluadores más sólidos que una preferencia global.
El diagrama muestra las etapas de cada método, los modelos que carga y qué hace un paso de entrenamiento.
RLHF basado en PPO
RLHF significa reinforcement learning from human feedback. La policy es el modelo de lenguaje que genera las respuestas; un reward model puntúa esas respuestas con preferencias aprendidas de comparaciones humanas. Una receta basada en PPO tiene tres etapas:
- SFT: aprender la tarea.
- Reward model: se entrena con preferencias humanas (elegida frente a rechazada).
- PPO (Proximal Policy Optimization): genera respuestas y actualiza el modelo de lenguaje para aumentar sus puntuaciones de recompensa.
El coste operativo viene de los distintos componentes:
- Es complicado de implementar y mantener.
- Es caro: se entrenan varios modelos.
- Muestrear del modelo que se está entrenando exige comprobar si hay actualizaciones inestables y respuestas que explotan el reward model sin cumplir la tarea.
DPO
DPO (Direct Preference Optimization) prescinde del reward model separado y del bucle de reinforcement learning. Favorece las respuestas elegidas y desalienta los cambios grandes respecto a un modelo de partida fijo, llamado modelo de referencia. El artículo de DPO deriva este objetivo limitando cuánto pueden alejarse las probabilidades de las respuestas de esa referencia; el límite matemático es una restricción de divergencia KL.
Un par de preferencia contiene el mismo prompt y dos respuestas candidatas. Esta fila abreviada muestra sus campos; las etiquetas reales necesitan respuestas completas y un motivo para preferir una:
{
    "prompt": "Explain quantum computing",
    "chosen": "Quantum computing uses qubits...",   # Preferred response
    "rejected": "Well, it's complicated..."        # Non-preferred response
}
Qué cambia en la práctica:
- Una ruta de código más simple (sin reward model separado ni bucle de RL).
- Entrenamiento con pares de preferencias guardados, en lugar de generar respuestas nuevas para puntuarlas con el reward model en cada actualización.
- Un modelo de referencia fijo, o sus log probabilities guardadas para las respuestas de entrenamiento, en la formulación estándar.
DPO es más fácil de prototipar que un pipeline completo de PPO, pero no es una mejora de calidad automática. Los resultados dependen de la policy de partida, la calidad de los pares, los ajustes de la loss, los efectos de la longitud y el protocolo de evaluación. Compáralo con un checkpoint de SFT en las mismas suites de preferencias y de tareas reservadas para evaluación.
ORPO
ORPO (Odds-Ratio Preference Optimization) combina la loss de log-verosimilitud negativa del SFT con una penalización de odds ratio sobre las respuestas rechazadas. Elimina el modelo de referencia separado y puede combinar el aprendizaje de la tarea y la preference optimization en una sola ejecución.
Cómo funciona: ORPO usa una loss combinada que hace dos cosas a la vez:
- Maximiza la verosimilitud de la respuesta elegida (aprender la tarea).
- Penaliza la respuesta rechazada con un término de odds ratio (aprender preferencias).
TRL ya incluye ORPO como ORPOConfig en trl.experimental.orpo (trainer ORPO de TRL). Conviene conocer dos ajustes:
learning_rate: el artículo usó tasas bajas como8e-6; ajústala según tu modelo, tu batch y tus datos en lugar de copiar un único valor como regla.beta: controla el término de preferencia en relación con el término de SFT.
El compromiso:
- Una sola etapa de entrenamiento en lugar de dos.
- Sin reward model.
- Sin forward pass del modelo de referencia.
- Una ejecución acoplada: si el aprendizaje de la tarea o el comportamiento de preferencia empeoran, no hay un checkpoint intermedio de SFT del mismo pipeline que inspeccionar.
Elige según el diseño de los datos y de la evaluación:
- Usa DPO cuando ya tienes un checkpoint de SFT satisfactorio y quieres un experimento de preferencias offline más simple.
- Prueba ORPO cuando un objetivo de una sola etapa y sin referencia encaja con tus datos y tus restricciones operativas.
- Usa RLHF basado en PPO cuando el muestreo online frente a una recompensa explícita aprendida forma parte del requisito y puedes vigilar la explotación de la recompensa.
Ninguno es la opción por defecto para todas las tareas. Conserva un baseline solo con SFT e informa tanto de las métricas de la tarea como de las de preferencia.
Frameworks de fine-tuning
Las etapas 3 y 4 eligieron el método. Las dos secciones siguientes eligen un framework y ejecutan SFT con él.
Los frameworks se solapan y cambian rápido. Elige según la ruta de ejecución que debas admitir, fija las versiones y mantén la configuración de entrenamiento lo bastante portable para reproducirla fuera de un notebook.
Unsloth: velocidad y eficiencia de memoria
Unsloth se integra con trl y transformers de Hugging Face y ofrece kernels optimizados, checkpointing y rutas de fine-tuning cuantizado para los modelos compatibles.
- Kernels de GPU Triton personalizados para atención, RoPE y entropía cruzada que evitan el overhead de PyTorch.
- Backprop eficiente en memoria que recalcula las activaciones durante el backward pass en lugar de conservarlas en memoria.
- Operaciones fusionadas que reúnen varios pasos (layer norm + linear y similares) en llamadas únicas a la GPU.
- Cuantización de 4 bits integrada directamente en la ruta de QLoRA, con una dequantización optimizada.
El orden de importación importa. Sigue el orden de importación del ejemplo de Unsloth para la versión que fijes. Unsloth aplica parches durante la importación, así que importarlo antes que trl y transformers evita optimizaciones ausentes o errores específicos de la versión.
# Correct order
from unsloth import FastLanguageModel  # Must be first!
from trl import SFTConfig, SFTTrainer

# Avoid this order with Unsloth's patched path
from trl import SFTTrainer
from unsloth import FastLanguageModel
Ideal para: entrenamiento con una sola GPU, prototipos y notebooks de Colab.
Las cifras publicadas de velocidad y memoria varían según el modelo, la longitud de secuencia, el batch, la precisión y el hardware. Mide los tokens por segundo y la memoria pico en tu propia ejecución en lugar de tratar una proporción destacada como una propiedad del framework.
Axolotl: entrenamiento basado en configuración
Para ejecuciones distribuidas definidas por configuración, Axolotl mantiene toda la ejecución en un único archivo YAML. Estas claves seleccionan una base de 4 bits, un adapter QLoRA y un dataset en formato Alpaca:
# axolotl_config.yaml (excerpt)
base_model: meta-llama/Meta-Llama-3-8B
load_in_4bit: true
adapter: qlora
lora_r: 32
lora_alpha: 16 # alpha/r = 0.5 here; the demo uses 2. Sweep it with the learning rate.
datasets:
    - path: data/training_data.jsonl
      type: alpaca
Los módulos objetivo, la longitud de secuencia, el packing, el tamaño del batch, la learning rate y los epochs van en el mismo archivo; la referencia de configuración enumera todas las claves. Ejecuta el entrenamiento:
axolotl train axolotl_config.yamlComparación de frameworks
| Herramienta | Resulta útil cuando | Verifica antes de comprometerte |
|---|---|---|
| Unsloth | Quieres una ruta optimizada para modelos compatibles, con ejemplos concisos | La matriz de compatibilidad de modelos, GPU, cuantización y entrenamiento distribuido |
| Axolotl | Quieres configuraciones declarativas y recetas distribuidas integradas | El schema exacto de la configuración y el launcher de la versión fijada |
| TRL | Quieres acceso directo a los trainers de SFT y de preferencias de Hugging Face | El formato del dataset, la chat template, el loss masking y la integración con PEFT |
| Torchtune | Ya ejecutas recetas de torchtune; ya no se mantiene activamente (desde 2025) | La cobertura de recetas de modelos y la compatibilidad de exportación |
Demo práctica: fine-tuning con Unsloth
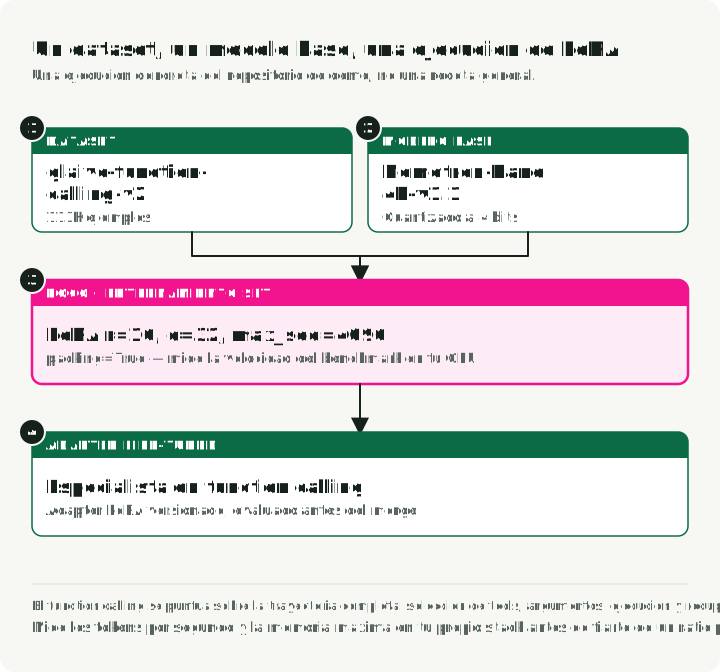
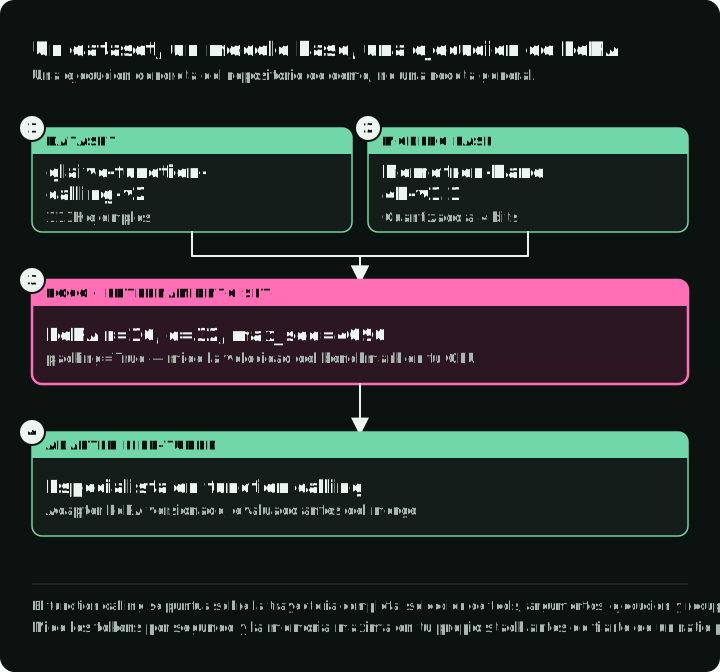
Esta demo enseña a un modelo a seleccionar una función y a proporcionar sus argumentos. Mi unsloth-finetune-demo hace fine-tuning de Llama-3.1-Nemotron-Nano-4B-v1.1 con el dataset glaive-function-calling-v2. La ruta de entrenamiento con CUDA de este repositorio requiere Linux o WSL2 y una GPU de NVIDIA. Unsloth también tiene una ruta de entrenamiento con GPU de Intel independiente que esta demo no implementa. Fija el commit que ejecutes; el archivo de bloqueo fija las dependencias, incluida TRL 0.24.0.
El diagrama muestra la ejecución completa con sus valores reales: cómo una fila de Glaive se convierte en texto de entrenamiento que conserva las definiciones de herramientas, la división, los ajustes de entrenamiento, los tres directorios de salida y la primera comprobación.
Ejecútala
git clone https://github.com/slavadubrov/unsloth-finetune-demo.git
cd unsloth-finetune-demo
uv sync

# Train on 1,000 random rows, then also save a merged model and a GGUF file
uv run finetune --max-samples 1000 --merge --gguf q4_k_m
Cada ejecución de finetune entrena. --merge y --gguf añaden exportaciones después del entrenamiento; no hay un comando que solo exporte. La ejecución escribe tres directorios:
outputs/unsloth-nemotron-function-calling/: el adapter LoRAoutputs/unsloth-nemotron-function-calling-merged/: el modelo fusionado de 16 bits (--merge)outputs/unsloth-nemotron-function-calling-gguf/: el archivo GGUF (--gguf q4_k_m)
Antes de que empiece el entrenamiento, la ejecución imprime la primera fila de entrenamiento tal como la ve el modelo. Léela: las definiciones de herramientas aparecen dentro de <AVAILABLE_TOOLS> y cada llamada aparece dentro de <TOOLCALL>.
Preparación de datos
Cada fila de glaive tiene dos cadenas. La columna system contiene todas las definiciones de funciones; la columna chat contiene la conversación, con las llamadas escritas como <functioncall> {...}. Entrenar solo con chat enseña al modelo a llamar a herramientas cuyos schemas nunca ve. El data.py de la demo convierte cada fila en messages y una lista tools aparte, renderiza ambos con la chat template del propio modelo y reserva el 5 % de las filas como partición de evaluación:
def to_text(example: dict, tokenizer) -> dict:
    """Render one glaive row with the model's chat template. Empty text marks a dropped row."""
    try:
        messages, tools = to_messages(example)
    except (ValueError, KeyError):  # bad JSON in a tool definition or call
        return {"text": ""}
    if not messages:
        return {"text": ""}
    text = tokenizer.apply_chat_template(messages, tools=tools or None, tokenize=False)
    # The trainer tokenizes this text with special tokens on, which adds BOS again.
    return {"text": text.removeprefix(tokenizer.bos_token or "")}
Con el dataset completo se conservan 112.811 de las 112.960 filas; 149 filas tienen JSON mal formado y se descartan. Con este tokenizer, la fila renderizada más larga tiene 4.076 tokens, así que un límite de 4.096 tokens no trunca ninguna.
La chat template de la model card tiene un defecto para el entrenamiento. Renderiza una tool call pasada sin la llave de cierre después de arguments, así que el texto dentro de <TOOLCALL> no es JSON válido. Un modelo entrenado con ese texto aprende a emitirlo, y el parser de serving no puede leer la llamada. El repositorio incluye la plantilla con la llave añadida y la usa en el entrenamiento y en el serving. Su prueba solo con CPU renderiza conversaciones con herramientas y comprueba que todos los <TOOLCALL> se parsean.
Configuración de la demo
El config.py de la demo define los valores de LoRA:
LORA_R = 16        # Adapter capacity; tune against held-out results
LORA_ALPHA = 32    # Update scale alpha/r = 2
LORA_DROPOUT = 0.05
MAX_SEQ_LENGTH = 4096
LORA_TARGET_MODULES enumera las siete proyecciones de atención y MLP de este modelo de la familia Llama, de q_proj a down_proj.
El cociente alpha/rank. alpha/r escala la actualización clásica de LoRA. alpha = 2r es una heurística de partida habitual en la documentación de algunas herramientas, no una garantía de estabilidad. Barre el rank, alpha, la learning rate y los módulos objetivo solo cuando los datos y el baseline estén fijados.
Carga del modelo
El model.py de la demo carga la base en 4 bits, sustituye la chat template por la corregida y añade los adapters LoRA:
from unsloth import FastLanguageModel

model, tokenizer = FastLanguageModel.from_pretrained(
    model_name=MODEL_NAME,
    max_seq_length=MAX_SEQ_LENGTH,
    load_in_4bit=True,  # QLoRA: the frozen base is stored in 4-bit form
    trust_remote_code=True,
)
# Training rows, the saved tokenizer, and vLLM all use this one template.
tokenizer.chat_template = CHAT_TEMPLATE_PATH.read_text()

model = FastLanguageModel.get_peft_model(
    model,
    r=LORA_R,
    lora_alpha=LORA_ALPHA,
    lora_dropout=LORA_DROPOUT,
    target_modules=LORA_TARGET_MODULES,
    use_gradient_checkpointing="unsloth",  # Lower activation memory; extra compute
)
Configuración de entrenamiento
El training.py de la demo pasa las filas renderizadas al SFTTrainer de TRL. Evalúa la loss de tokens reservados para evaluación una vez por epoch. Esa loss es un diagnóstico, no la precisión de las tool calls; la etapa 5 sigue exigiendo una evaluación de la tarea por separado.
trainer = SFTTrainer(
    model=model,  # 4-bit base with LoRA adapters from FastLanguageModel
    processing_class=tokenizer,
    train_dataset=train_dataset,
    eval_dataset=eval_dataset,
    args=SFTConfig(
        output_dir="outputs/unsloth-nemotron-function-calling",
        dataset_text_field="text",
        max_length=4096,
        packing=False,  # One row per sequence, so row boundaries are easy to inspect
        assistant_only_loss=False,  # The Nemotron template has no generation spans
        eval_strategy="epoch",
        per_device_train_batch_size=2,
        gradient_accumulation_steps=4,
        learning_rate=2e-4,
        num_train_epochs=3,
        bf16=True,  # The repository falls back to FP16 on GPUs without BF16
        optim="adamw_8bit",
    ),
)
trainer.train()
Primera comprobación
uv run infer --prompt "Book a flight to Tokyo"infer carga el adapter y envía el prompt con una herramienta, book_flight(destination), renderizada con la misma plantilla que las filas de entrenamiento. Un adapter entrenado debería responder con <TOOLCALL>[{"name": "book_flight", "arguments": {"destination": "Tokyo"}}]</TOOLCALL>. Si responde en texto plano, inspecciona la fila de entrenamiento impresa antes de entrenar más tiempo.
Etapa 5: Evaluación
Fija los casos de prueba, las reglas de puntuación y los umbrales de aprobación antes de la primera ejecución. Como mínimo, compara el checkpoint ajustado con el modelo base sin ajustar exacto, con el mismo prompt, los mismos ajustes de decodificación y el mismo entorno de herramientas. Informa de la calidad agregada solo después de revisar los slices de fallo que el proyecto debía mejorar.
Sigue cuatro grupos:
- Tarea objetivo: coincidencia exacta, éxito de ejecución, rúbrica humana u otro resultado vinculado al caso de uso.
- Regresión: capacidades generales y slices de tareas ya soportadas que la adaptación podría dañar.
- Seguridad y políticas: negativas, fuga de datos, prompt injection o restricciones específicas del dominio.
- Operaciones: latencia, throughput, memoria, tamaño del artefacto y coste con la configuración de serving prevista.
Benchmarks automatizados
Usa lm-evaluation-harness para comprobar tareas estandarizadas relevantes junto con las pruebas de tu producto. Este comando requiere un checkpoint fusionado de Hugging Face, que la demo escribe con --merge:
lm_eval --model hf \
    --model_args pretrained=./outputs/unsloth-nemotron-function-calling-merged \
    --tasks hellaswag,arc_easy,mmlu \
    --batch_size 8
LLM-as-judge
Para la calidad subjetiva, un modelo mayor puede ayudar a puntuar, pero calibra su criterio con ejemplos revisados por personas y mantén oculta la identidad del candidato. Dale al juez la salida del modelo, la respuesta esperada y una rúbrica que defina cada puntuación para cada criterio, como relevancia, precisión y formato.
Evaluación específica del dominio
Reserva ejemplos reales por origen, usuario, documento o tiempo para que los casi duplicados no se filtren entre las particiones. Para function calling, valida la trayectoria completa: selección de la herramienta, argumentos, resultado de la ejecución, recuperación y respuesta final. Informa de intervalos de confianza o de recuentos pareados de victorias y derrotas cuando la muestra sea pequeña, e inspecciona cada regresión en un slice crítico.
Comprueba cada trayectoria en cuatro pasos:
- Se selecciona la herramienta correcta.
- Los argumentos son válidos y correctos.
- El resultado de la ejecución es el esperado.
- El modelo se recupera de un error de la herramienta.
Cuenta cada fallo por comprobación y por slice. Una respuesta final correcta puede ocultar un argumento erróneo o una recuperación omitida.
El código de evaluación del Berkeley Function Calling Leaderboard (BFCL) puntúa la selección de funciones y los argumentos frente a llamadas de referencia. Úsalo como comprobación de regresión junto con tus propias conversaciones reservadas para evaluación.
Etapa 6: Despliegue y formatos de salida
Elige el artefacto según el motor de serving y el plan de rollback, no solo según el tamaño del archivo. Exporta todos los formatos desde los mismos objetos model y tokenizer evaluados, para que todos los artefactos lleven los mismos pesos entrenados. El diagrama compara los tres artefactos: qué contiene cada archivo, qué lo carga y su contrapartida.
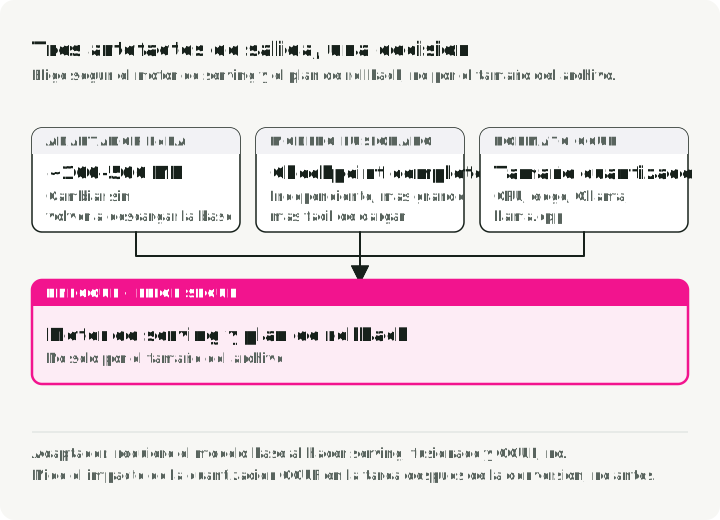
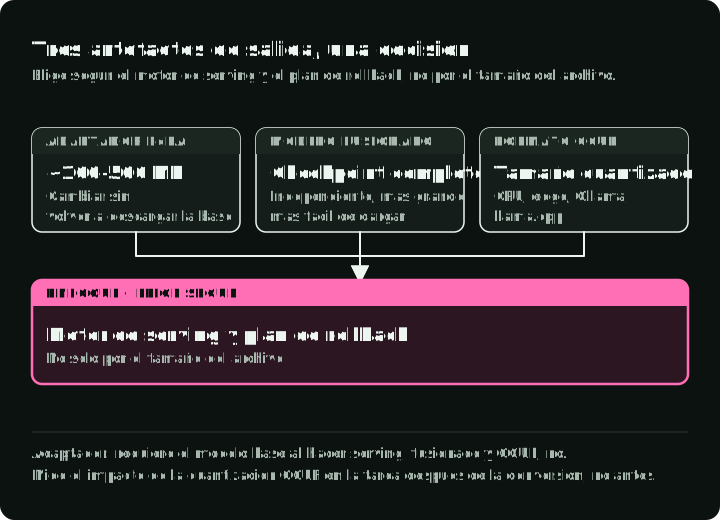
En la demo, uv run finetune siempre guarda el adapter, --merge añade el modelo fusionado y --gguf q4_k_m añade el archivo GGUF, todo en una sola ejecución de entrenamiento. Las llamadas de Python que siguen muestran lo que hace cada flag.
1. Adapter LoRA
model.save_pretrained("outputs/unsloth-nemotron-function-calling")
tokenizer.save_pretrained("outputs/unsloth-nemotron-function-calling")- Tamaño: proporcional a los módulos objetivo, el rank, las capas y el dtype; a menudo mucho menor que la base.
- Ideal para: desarrollo, adapters de tarea versionados y motores que admiten LoRA directamente.
- Ventaja adicional: puedes cambiar de adapter sin volver a descargar el modelo base.
2. Modelo fusionado
# What --merge runs: merge the adapter into the base weights and save a standalone model
model.save_pretrained_merged(
    "outputs/unsloth-nemotron-function-calling-merged", tokenizer, save_method="merged_16bit"
)- Tamaño: aproximadamente el del checkpoint base completo con la precisión de salida elegida.
- Ideal para: motores o vías de distribución que no admiten el adapter por separado.
- Compromiso: artefacto mayor y despliegue más lento; carga más simple de un único modelo.
3. Formato GGUF
# What --gguf q4_k_m runs; file size and name depend on the Unsloth version
model.save_pretrained_gguf(
    "outputs/unsloth-nemotron-function-calling-gguf", tokenizer, quantization_method="q4_k_m"
)- Tamaño: depende del modelo; aproximadamente pesos de cuatro bits más metadatos en las variantes Q4.
- Ideal para: inferencia en CPU, Ollama, llama.cpp y despliegue en el edge.
- Opciones:
q4_k_m(más pequeño),q5_k_m(más fidelidad de los pesos),q8_0(mayor y de más fidelidad). Mide el impacto en la tarea después de la conversión.
Etapa 7: Serving y monitorización
Con vLLM
Este comando sirve el adapter de la demo sobre el modelo base. Sirve con el parser y la chat template de la model card; deben coincidir con la plantilla usada en el entrenamiento. La model card registra el parser llama_nemotron_json mediante el archivo de plugin llama_nemotron_nano_toolcall_parser.py. El repositorio de la demo proporciona la plantilla corregida.
Usa un entorno independiente de Python 3.12 con vLLM 0.12.0: el parser fijado importa la API del parser de herramientas de esta versión, que cambió en versiones posteriores. El comando fija el modelo base y el parser a la misma revisión de la model card; usa también esa revisión de la base para entrenar. La compatibilidad del código fuente y una prueba del parser en CPU no confirman que el serving en GPU funcione. Verifica la carga del modelo y el tool call previsto en tu GPU. Ejecuta desde la raíz del repositorio:
uv venv --python 3.12 .venv-vllm
uv pip install --python .venv-vllm/bin/python "vllm==0.12.0" "huggingface-hub==0.36.0"
source .venv-vllm/bin/activate

hf download nvidia/Llama-3.1-Nemotron-Nano-4B-v1.1 \
    llama_nemotron_nano_toolcall_parser.py \
    --revision d552708a9d575fa8d4a690b988fd870d65279f98 --local-dir serving

vllm serve nvidia/Llama-3.1-Nemotron-Nano-4B-v1.1 \
    --revision d552708a9d575fa8d4a690b988fd870d65279f98 \
    --trust-remote-code \
    --enable-lora \
    --lora-modules function-calling=./outputs/unsloth-nemotron-function-calling \
    --enable-auto-tool-choice \
    --tool-parser-plugin ./serving/llama_nemotron_nano_toolcall_parser.py \
    --tool-call-parser llama_nemotron_json \
    --chat-template ./src/unsloth_demo/chat_template.jinja \
    --host 127.0.0.1 \
    --port 8000 \
    --max-model-len 4096
El comando uv run --with openai infer-vllm de la demo prueba la generación de argumentos mediante la API compatible con OpenAI. Envía una herramienta mínima, book_flight, con un string destination obligatorio, y pide una llamada propuesta; no ejecuta ninguna reserva. La petición de cli/inference.py es:
client = OpenAI(base_url="http://localhost:8000/v1", api_key="dummy")
response = client.chat.completions.create(
    model="function-calling",  # the --lora-modules name, not the base model
    messages=[{"role": "user", "content": "Book a flight to Tokyo"}],
    tools=[DEMO_TOOL],  # book_flight(destination), defined in config.py
    tool_choice="auto",
)
print(response.choices[0].message.tool_calls)
Para esta entrada, el resultado previsto es book_flight con {"destination": "Tokyo"}. Como la elección de herramienta es automática, comprueba también si el modelo devolvió alguna llamada. La herramienta usa la misma forma que las definiciones de herramientas de glaive con las que se entrenó el modelo. El parser de vLLM lee la llamada del texto generado, así que una llamada mal formada vuelve como contenido de texto plano sin tool_calls. vLLM también puede restringir los argumentos de una función a su schema cuando la función está marcada con strict: true; la guía de tool calling describe los ajustes del servidor y qué parsers lo admiten.
Con Ollama (local)
Lista el directorio outputs/unsloth-nemotron-function-calling-gguf y sustituye MODEL_FILE.gguf en el siguiente ejemplo por el nombre del archivo generado; las versiones de Unsloth pueden nombrar los archivos de otra forma. Un archivo GGUF por sí solo no garantiza un formato correcto de chat y herramientas en Ollama o llama.cpp. Usa la plantilla con la que se entrenó y prueba el artefacto importado.
# Create Modelfile
echo 'FROM ./outputs/unsloth-nemotron-function-calling-gguf/MODEL_FILE.gguf' > Modelfile

# Import to Ollama
ollama create my-function-model -f Modelfile

# Run
ollama run my-function-model
Con llama.cpp (CPU)
Con la misma exportación GGUF y la misma sustitución del nombre de archivo, este comando comprueba una respuesta en texto plano. No prueba una tool call completa:
llama-cli -m ./outputs/unsloth-nemotron-function-calling-gguf/MODEL_FILE.gguf \
    -p "What's the weather in Tokyo?" \
    --ctx-size 4096
Monitoriza el modelo publicado
El ciclo de vida no termina con una loss de entrenamiento saludable. Registra la revisión del modelo base, el tokenizer y la chat template, el hash del adapter, la versión del dataset, la configuración de entrenamiento y el informe de evaluación como una única unidad de release. En producción, monitoriza el éxito de la tarea, las salidas no válidas, los fallos de política, la latencia y la deriva de la entrada con los mismos slices que se usaron offline. Mantén cargable el artefacto anterior y define un umbral de rollback antes del lanzamiento.
En resumen:
- Unidad de release: revisión del modelo base, tokenizer y chat template, hash del adapter, versión del dataset, configuración de entrenamiento e informe de evaluación.
- Monitoriza el éxito de la tarea, las salidas no válidas, los fallos de política, la latencia y la deriva de la entrada con los mismos slices que offline.
- Si una métrica cae por debajo del umbral de rollback fijado antes del lanzamiento, carga el artefacto anterior.
Tu próxima prueba
Antes de una ejecución completa, inspecciona una conversación serializada y sus objetivos de loss, y completa un paso de forward/backward con la longitud máxima. Guarda esa configuración junto con la división del dataset y el informe del baseline. Si falta un tool schema, consérvalo en la fila de entrenamiento. Si una respuesta se trunca, ajusta la longitud de secuencia y el formato para que la respuesta completa sobreviva. Resuelve esos problemas antes de añadir epochs.
Referencias
Artículos e investigación
- LoRA: Low-Rank Adaptation of Large Language Models
- QLoRA: Efficient Finetuning of Quantized LLMs
- DoRA: Weight-Decomposed Low-Rank Adaptation
- DPO: Direct Preference Optimization
- ORPO: Odds Ratio Preference Optimization
- PPO: Proximal Policy Optimization Algorithms — OpenAI, 2017
Herramientas de procesamiento de datos
- DataTrove — Procesamiento de datos a escala de Hugging Face
- Distilabel — Generación de datos sintéticos (Argilla)
- Trafilatura — Extracción de texto web y rastreo
- fastText language identification — modelos preentrenados de identificación de idioma
- Microsoft Presidio — Detección y anonimización de PII
- scrubadub — Librería de Python para eliminar PII
Constrained decoding
Frameworks de entrenamiento
- Unsloth — Framework de fine-tuning optimizado
- Axolotl — Entrenamiento basado en configuración y launchers distribuidos
- TRL — Librería de Hugging Face para SFT y entrenamiento con preferencias
- PEFT model merging —
add_weighted_adaptery métodos de fusión - Torchtune — Librería de fine-tuning nativa de PyTorch, ya no se mantiene activamente
Inferencia y despliegue
- vLLM LoRA adapters — Sirve uno o varios adapters con el modelo base
- vLLM tool calling — Ajusta la elección automática de herramienta, el parser, la chat template y el schema de la petición al modelo
- Model card de Llama-3.1-Nemotron-Nano-4B-v1.1 — Plugin del parser de tool calls y chat template para vLLM
- Ollama — Ejecutor local de LLMs para Mac/Windows/Linux
- llama.cpp — Inferencia en CPU/GPU con formato GGUF
Evaluación
- lm-evaluation-harness — Benchmarking estandarizado de LLMs de EleutherAI
- Berkeley Function Calling Leaderboard — Código de evaluación de function calling
Guías y recursos
- Repositorio de la demo — Ejemplo práctico de fine-tuning
- Accelerate n-D Parallelism Guide — Estrategias de entrenamiento multi-GPU de Hugging Face