Przewodnik: fine-tuning LLM, kiedy go stosować, LoRA i QLoRA

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Ten przewodnik jest dla inżynierów Pythona, którzy decydują, czy i jak wykonać fine-tuning dużego modelu językowego. Dowiesz się, kiedy wybrać fine-tuning zamiast prompting lub wyszukiwania oraz jak wybrać między metodami takimi jak LoRA i QLoRA. Przewodnik wyjaśnia też, jak przygotować dane, ocenić wytrenowany model i zaplanować jego wdrożenie.
W części praktycznej uruchamiamy repozytorium towarzyszące, które robi fine-tuning modelu 4B pod kątem wywoływania funkcji.
Krótsze porównanie metod fine-tuning, RAG i prompting znajdziesz w artykule Fine-Tuning vs RAG vs Prompting.
Czy w ogóle robić fine-tuning?
Zanim wydasz godziny GPU, ustal, czy fine-tuning jest właściwym narzędziem do twojego problemu. Rysunek śledzi jedno żądanie i pokazuje, w którym miejscu działa każda z czterech poprawek, na jakiej awarii przetestować ją najpierw i czego nie naprawi.
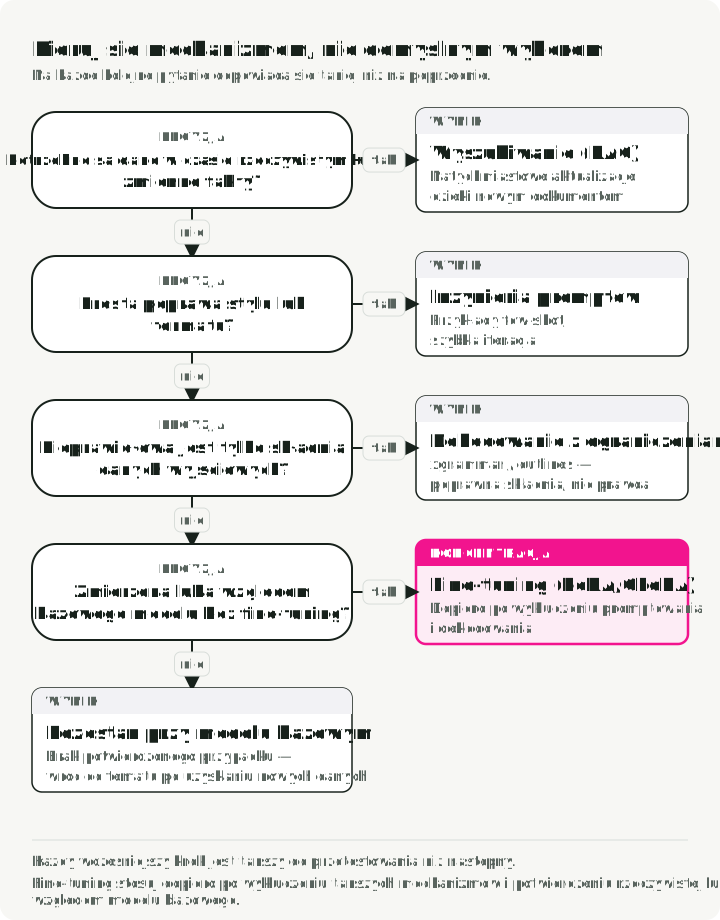
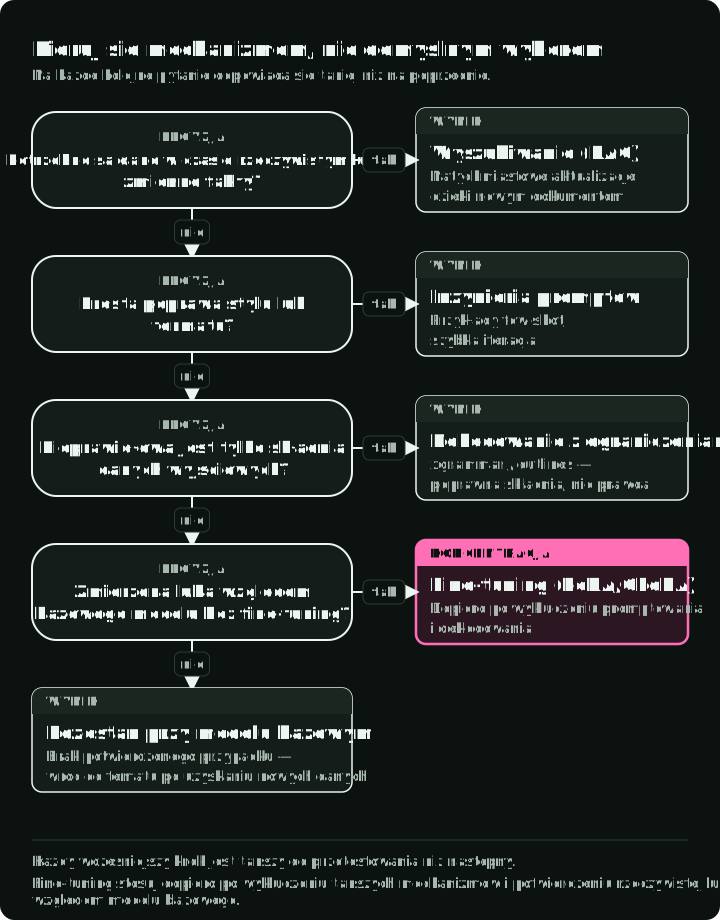
Fine-tuning zmienia zachowanie zapisane w wagach. Wyszukiwanie dostarcza dowody w czasie inferencji, więc lepiej nadaje się jako punkt wyjścia dla faktów, które się zmieniają lub wymagają cytowania. Nowe dokumenty są dostępne dopiero po wczytaniu i zaindeksowaniu; sprawdź, czy ta świeżość spełnia twoje wymagania.
Jasne instrukcje prompt i przykłady są tańsze w iteracji niż nowy przebieg treningu. Mogą już rozwiązywać problem ze stylem lub wykonywaniem instrukcji. Fine-tuning może zmniejszyć liczbę powtarzanych jednostek token w tekście prompt, ale opóźnienie serwowania zależy od modelu, długości odpowiedzi, sprzętu i implementacji; sama aktualizacja wag nie jest przyspieszeniem.
W przypadku składni biblioteki takie jak xgrammar i outlines maskują niepoprawne jednostki token na następnej pozycji zgodnie z obsługiwanym schematem lub gramatyką. Pomyślnie zakończone generowanie z ograniczeniami należy do tego języka. Obcięte i inne niekompletne generacje obsłuż osobno, a wynik zwaliduj przed użyciem. Ograniczenie nie sprawi, że identyfikator klienta będzie prawdziwy, a wybór narzędzia właściwy. Opóźnienie zmierz na własnym backendzie, zamiast zakładać stały narzut.
Każda z czterech opcji zmienia inny krok tego samego żądania. Tylko fine-tuning wymaga przebiegu treningu i nowego artefaktu modelu; pozostałe trzy zmieniają tekst, dokumenty lub schemat wokół tych samych wag. Tabela porównuje te cztery opcje obok siebie:
| Opcja | Co zmienia | Jak ją aktualizować | Koszt przygotowania | Czego nie naprawi |
|---|---|---|---|---|
| Prompting | Instrukcje i przykłady | Edycja tekstu | Niski: pisanie i testowanie instrukcji prompt | Zachowania, którego model nie potrafi wykonać z instrukcji |
| RAG | Dowody w oknie kontekstu | Wczytanie i ponowne indeksowanie dokumentów | Średni: indeks, retriever i ewaluacja | Modelu, który ignoruje lub źle odczytuje dowody |
| Dekodowanie z ograniczeniami | Które jednostki token dekoder może emitować | Zmiana schematu lub gramatyki | Niski do średniego: schemat i obsługa w backendzie | Błędnych wartości wewnątrz poprawnej struktury |
| Fine-tuning | Wagi modelu | Ponowny trening i ewaluacja nowego artefaktu | Wysoki: selekcja danych, czas GPU, ewaluacja | Faktów, które zmieniają się po treningu |
Szybki przewodnik: dopasowanie problemów do rozwiązań
| Wyzwanie | Pierwszy mechanizm do przetestowania | Dlaczego? |
|---|---|---|
| Brakująca wiedza | RAG | Pobiera cytowane dowody; świeżość zależy od wczytywania i indeksowania |
| Zły format lub ton | Prompt engineering | Nowoczesne modele dobrze wykonują instrukcje stylu dzięki przykładom few-shot |
| Niepoprawna składnia wyniku | Dekodowanie z ograniczeniami | Wymusza obsługiwany schemat lub gramatykę podczas generowania |
| Powtarzające się błędy w zadaniu | Fine-tuning (SFT) | Uczy się na wyselekcjonowanych przykładach wejście/wyjście |
| Niezgodność z preferencjami par | Optymalizacja preferencji | Używa przykładów wybrany/odrzucony, gdy zachowanie w zadaniu da się już zmierzyć |
| Opóźnienie i koszt w dużej skali | Destylacja (SFT) | Trenuje mniejszy model-ucznia na wynikach większego nauczyciela |
| Zmniejszenie rozmiaru modelu | Kwantyzacja po treningu | Kwantyzacja po treningu zmniejsza pamięć wag; szybkość zależy od obsługiwanych kerneli i obciążenia |
Uczyń uzasadnienie biznesowe mierzalnym
Fine-tuning może zmniejszyć liczbę powtarzanych jednostek token w tekście prompt albo pozwolić mniejszemu modelowi osiągnąć cel, ale żadna z tych oszczędności nie jest automatyczna. Oblicz próg opłacalności na własnym ruchu i własnym cenniku:
Jeśli mianownik jest mały, ujemny lub oparty na niepotwierdzonym założeniu o jakości, projekt nie ma jeszcze uzasadnienia ekonomicznego.
Przykład liczbowy: bazowy prompt wysyła z każdym żądaniem około 2000 jednostek token instrukcji i przykładów. Po dostrojeniu to samo zadanie wymaga około 50. Przy założonej cenie $0.50 za milion wejściowych jednostek token dla obu modeli oszczędność wynosi 1950 jednostek token, czyli około $0.001 na żądanie. Jeśli trening, ewaluacja i wdrożenie kosztują $3,000, próg opłacalności wynosi około 3,1 miliona żądań. Przy 100 000 żądań dziennie to około miesiąca. Przy 5000 żądań dziennie to ponad rok. Obliczenie jest prawdziwe tylko wtedy, gdy dostrojony model spełnia te same progi jakości co model bazowy.
Układ hybrydowy. Częsta architektura to mniejszy model dostosowany do zadania plus wyszukiwanie dla zmieniających się faktów. Traktuj większy model z instrukcją prompt jako punkt odniesienia i zachowaj mniejszy model tylko wtedy, gdy spełnia te same progi jakości i bezpieczeństwa dla danego zadania.
Rodzaje treningu fine-tuning
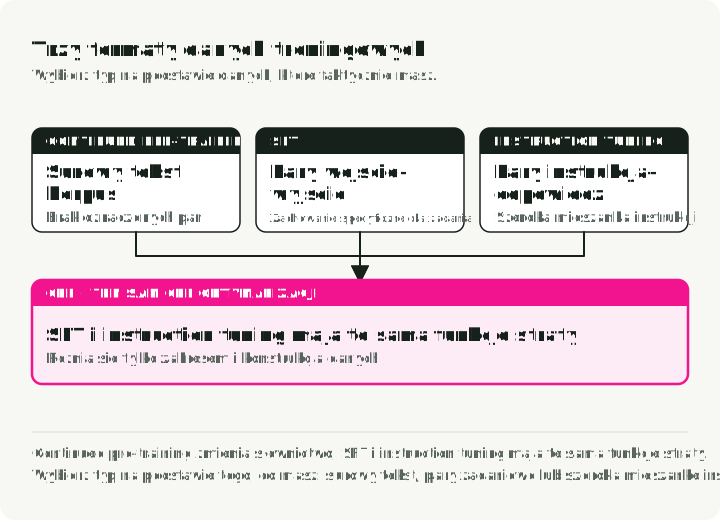
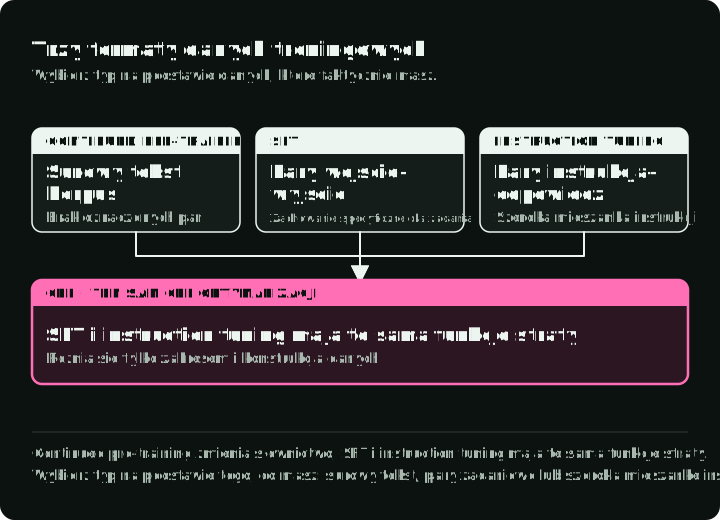
Fine-tuning może przyjąć trzy główne formy. Różnią się tym, jakich danych potrzebują i czego uczą model. Diagram pokazuje jeden wiersz treningowy dla każdego typu.
1. Dalszy pre-training (samonadzorowany)
Trenujesz model bazowy na dodatkowym surowym tekście, przyjmując jako cel treningu następny token w każdej sekwencji. To uczenie samonadzorowane: tekst sam dostarcza cele, tak jak w oryginalnym pre-trainingu.
Kiedy go użyć:
- Domena ma słownictwo, którego model bazowy nigdy nie widział (medycyna, prawo, wewnętrzne bazy kodu).
- Masz mnóstwo tekstu z domeny, ale żadnych par (wejście, wyjście) z etykietami.
- Model bazowy popełnia błędy w terminologii specyficznej dla domeny.
Przykład: trening na milionach notatek klinicznych, aby model nauczył się skrótów medycznych, nazw leków i procesów klinicznych.
2. Nadzorowany fine-tuning (SFT)
SFT trenuje na parach (wejście, wyjście) z etykietami. Pokazujesz modelowi dokładnie ten wynik, który chcesz dla każdego wejścia.
Kiedy go użyć:
- Masz konkretne zadanie z czystym formatem wejście/wyjście.
- Masz dane z etykietami dobrej jakości, nawet w małej ilości.
- Potrzebujesz przewidywalnego zachowania dla znanego kształtu wejścia.
Przykład: trening na parach (opis zapytania SQL, kod SQL) dla text-to-SQL. Ten stały przedział kalendarzowy zakłada, że signup_date jest zapisane w UTC:
{
    "input": "Get users who signed up in August 2026 (UTC)",
    "output": "SELECT * FROM users WHERE signup_date >= '2026-08-01' AND signup_date < '2026-09-01'"
}
3. Instruction tuning
Instruction tuning to szczególny przypadek SFT, zaprojektowany tak, aby modele wykonywały szeroką gamę instrukcji w języku naturalnym. Dane treningowe to pary (instrukcja, odpowiedź) z wielu różnych zadań.
Kiedy go użyć:
- Chcesz asystenta ogólnego przeznaczenia (jak ChatGPT lub Claude).
- Model musi obsługiwać zróżnicowane, otwarte prośby.
- Budujesz interfejs czatu.
Przykład: trening na tysiącach różnych instrukcji, takich jak „Streść ten artykuł”, „Napisz wiersz o X”, „Wyjaśnij Y prostymi słowami”.
Porównanie
| Aspekt | Dalszy pre-training | SFT | Instruction tuning |
|---|---|---|---|
| Dane | Surowy tekst | Pary (wejście, wyjście) | Pary (instrukcja, odpowiedź) |
| Etykiety | Brak (samonadzorowany) | Specyficzne dla zadania | Różne zadania |
| Cel | Wiedza domenowa | Zachowanie w konkretnym zadaniu | Wykonywanie dowolnej instrukcji |
| Ilość danych | Zwykle największy korpus | Zależy od pokrycia zadania i różnorodności błędów | Zwykle szerszy niż w SFT dla jednego zadania |
Jeden cel, dwa zbiory danych. SFT i instruction tuning używają tego samego celu: przewidzieć następny token; różnica tkwi w szerokości i sposobie budowy zbioru danych. Dalszy pre-training to osobny eksperyment i po nim należy sprawdzić zarówno zyski w domenie, jak i regresję ogólnych możliwości.
7-etapowy pipeline dla fine-tuning
Fine-tuning ma siedem etapów. Każdy etap ma własne tryby awarii, a pominięcie któregoś zwykle objawia się później złym modelem. Diagram pokazuje etapy po kolei, co każdy etap dodaje do rekordu wydania, oraz drogę powrotną z monitorowania do przygotowania danych.
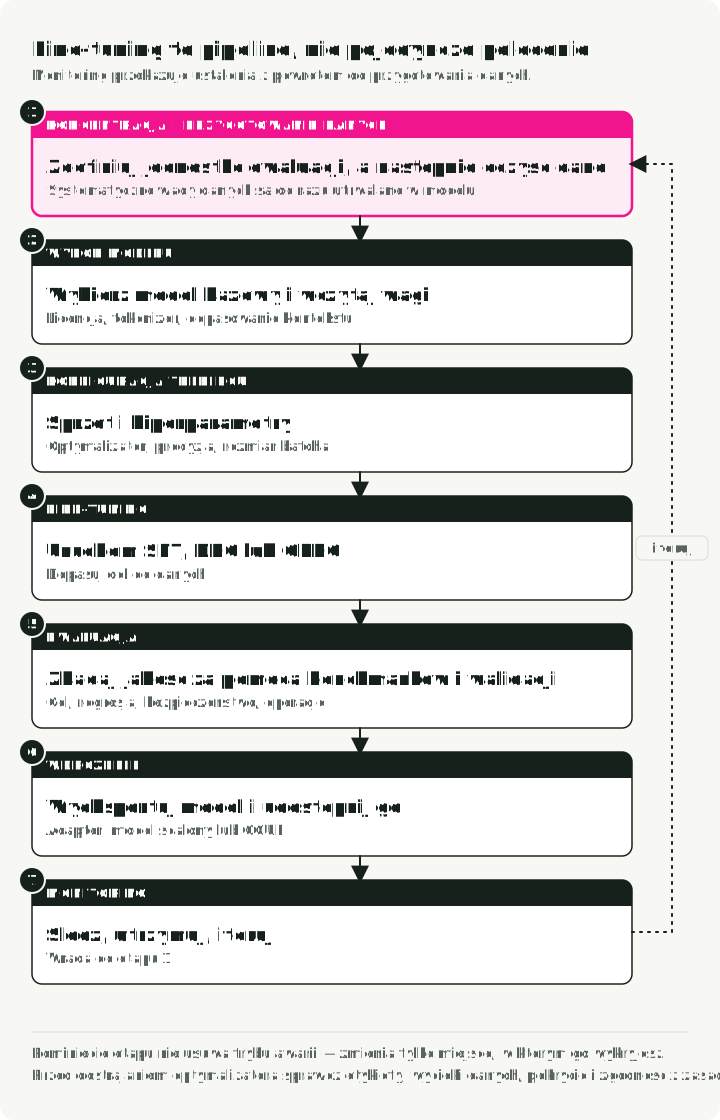
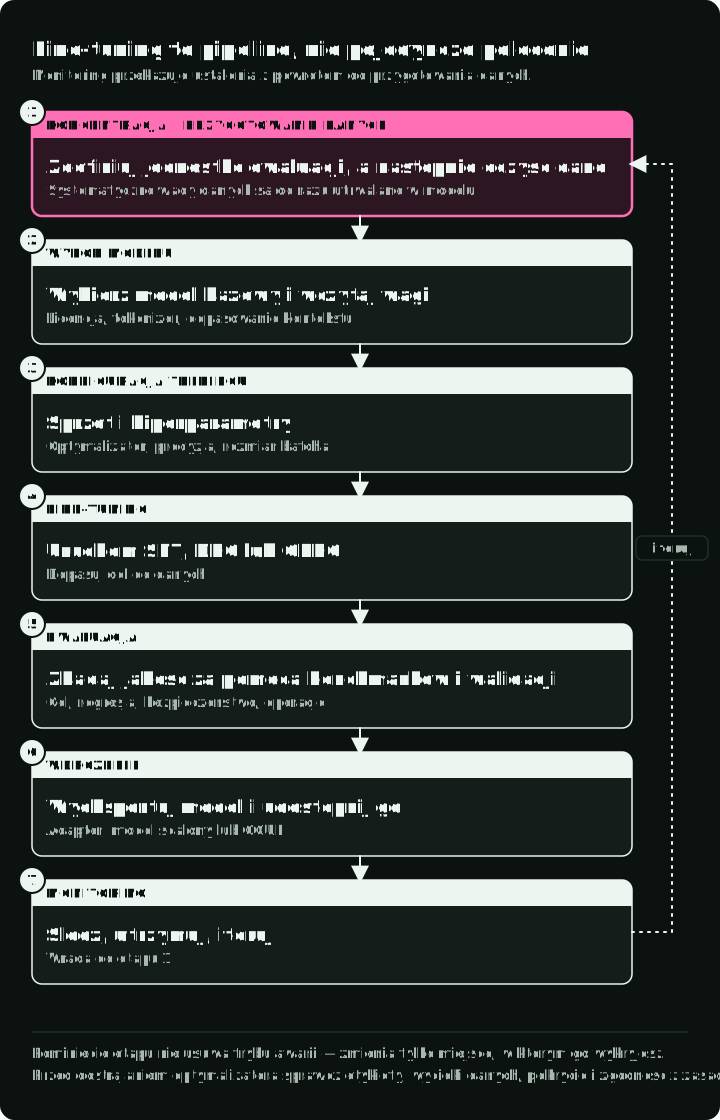
Każdy etap opiera się na poprzednim:
- Przygotowanie danych — zdefiniuj jednostkę ewaluacji, podziel dane, a następnie wyczyść je i sformatuj
- Wybór modelu — wybierz właściwy model bazowy i wczytaj wagi
- Konfiguracja treningu — sprawdź serializację i cele straty, a potem wybierz metodę (LoRA, QLoRA, DoRA) i jej ustawienia
- Fine-tuning — uruchom SFT we frameworku; DPO lub ORPO dodaj tylko w razie potrzeby
- Ewaluacja — zmierz wydajność i zweryfikuj jakość
- Wdrożenie — wyeksportuj i serwuj model
- Monitorowanie — śledź wydajność, utrzymuj i iteruj
Najpierw dane. Trening odtwarza systematyczne wady przykładów. Zanim spędzisz czas na przeszukiwaniu ustawień optymalizatora, sprawdź etykiety, wycieki, pokrycie i zgodność z polityką.
Etap 1: Przygotowanie danych
Problemy w danych przechodzą na wytrenowany model, dlatego ten etap wymaga najwięcej staranności. Diagram śledzi przykładowe zgłoszenia przez tę kolejność: najpierw podział według źródła, potem pięć transformacji wewnątrz każdego podziału.
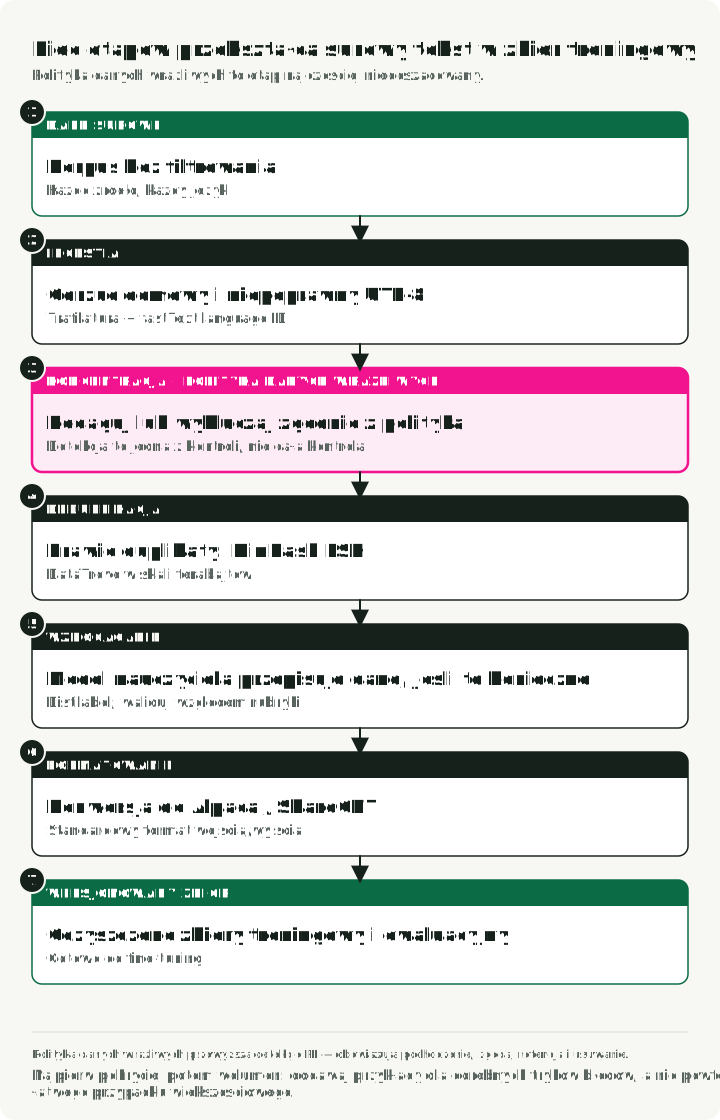
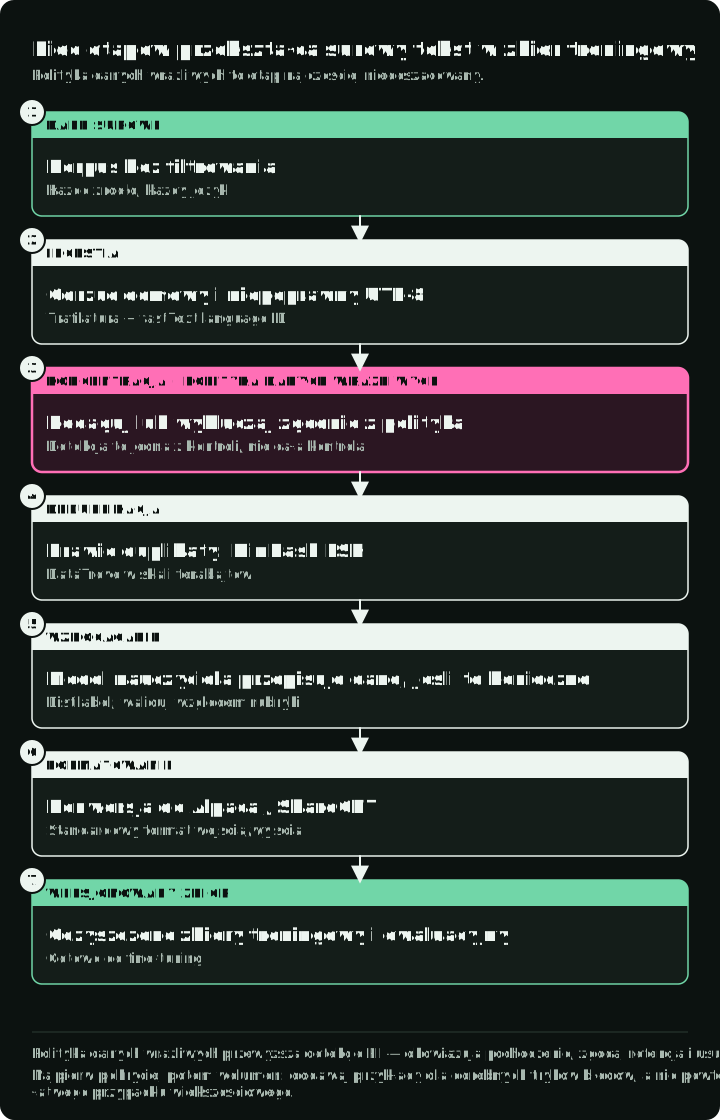
Pięć transformacji po podziale według źródła
Przypisz grupy źródeł do treningu lub ewaluacji, zanim zaczniesz przekształcać wiersze. Zgłoszenie do supportu i każde jego przepisanie zostają w tej samej partycji. Zgrupuj znane niemal-duplikaty przed przypisaniem grup, a po czyszczeniu sprawdź je ponownie między partycjami. Zamroź zbiór ewaluacyjny; augmentuj tylko dane treningowe.
Wypisz błędy, których przykłady mają uczyć model poprawiać, a potem zdefiniuj wymagane pola i etykiety każdego wiersza. Do tych kroków dobierz narzędzia. DataTrove uruchamia filtrowanie i deduplikację jako rozproszone zadania dla dużych korpusów; Distilabel generuje i etykietuje syntetyczne wiersze za pomocą modelu-nauczyciela.
1. Wczytywanie i filtrowanie
- Działanie: usuń uszkodzone UTF-8 i treści niezwiązane z zadaniem. Etykietuj odmowy według polityki: poprawne odmowy zachowaj jako cele treningowe i przypadki ewaluacyjne; wyklucz tylko niepoprawne lub niezwiązane z zadaniem.
- Narzędzia: Trafilatura, gdy źródłem są strony WWW; pomiń ją przy danych, które już są tekstem. Modele fastText do identyfikacji języka do wykrywania języka.
2. Polityka danych wrażliwych
- Działanie: zdecyduj, czego model może się uczyć, a następnie zamaskuj, stokenizuj lub wyklucz pola z danymi osobowymi i poufnymi, zgodnie z wymaganiami.
- Narzędzia: Microsoft Presidio, gdy potrzebujesz konfigurowalnych rozpoznawaczy, wielu języków lub odwracalnej anonimizacji; scrubadub dla mniejszego pipeline’u w czystym Pythonie, który usuwa z tekstu typowe dane osobowe.
- Dlaczego: detektor to tylko jedna kontrola; nadal obowiązują wymagania dotyczące pochodzenia danych, zgody, retencji, dostępu i usuwania.
3. Deduplikacja (MinHash LSH)
- Działanie: usuń niemal-duplikaty, aby zmniejszyć powtórzenia i ryzyko wycieku; nie zapobiega to zapamiętywaniu danych.
- Narzędzia: DataTrove, gdy korpus wymaga przetwarzania rozproszonego.
4. Augmentacja syntetyczna, jeśli potrzebna
- Działanie: użyj odpowiedniego modelu-nauczyciela, aby przepisać przykłady treningowe na pary instrukcja-odpowiedź, zachowując ich identyfikatory źródeł. Nie augmentuj partycji wyłączonej z treningu.
- Narzędzia: Distilabel.
- Walidacja: pobierz próbkę wyników nauczyciela, sprawdź je według tej samej rubryki co etykiety ludzkie i raportuj wyniki osobno dla przykładów syntetycznych i napisanych przez ludzi. Taki podzbiór ewaluacyjny nazywa się slice; inne przydatne slice’y to język i typ zadania.
5. Formatowanie
- Działanie: przekonwertuj do standardowego formatu (Alpaca lub ShareGPT).
Przykłady formatów danych
Format Alpaca (wykonywanie instrukcji):
{
    "instruction": "Summarize the following text.",
    "input": "The text to be summarized...",
    "output": "This is the summary."
}
Zapis w stylu ShareGPT (konwersacyjny):
{
    "conversations": [
        { "from": "user", "value": "Hello, who are you?" },
        { "from": "assistant", "value": "I am a helpful AI assistant." }
    ]
}
Kontrole zbioru danych
- Pokrycie przed wolumenem. Dodawaj przykłady reprezentujące różne tryby błędów, a nie powtórzenia łatwego, najczęstszego przypadku.
- Czystość. Usuwaj nieistotny tekst, normalizuj białe znaki, utrzymuj spójne formatowanie.
- Równowaga. Zachowaj ważne rzadkie przypadki i raportuj wydajność dla każdego slice’a.
- Rozdzielenie. Dziel według źródła, użytkownika, dokumentu lub czasu, gdy losowy podział wierszy przepuściłby niemal-duplikaty.
- Pochodzenie. Zapisuj źródło, licencję lub zgodę, historię transformacji i ścieżkę usunięcia dla każdej wersji zbioru danych.
Etap 2: Wybór modelu i sprzęt
Model bazowy i jego minimalne wymaganie dotyczące pamięci GPU określają, co możesz trenować.
Zacznij od najmniejszego modelu bazowego, który już spełnia bezwzględne kontrole punktu odniesienia. Potwierdź:
- licencję i warunki redystrybucji dla zamierzonego produktu;
- zachowanie w zakresie języka, domeny, korzystania z narzędzi i bezpieczeństwa przed adaptacją;
- zgodność tokenizera i szablonu czatu ze zbiorem danych;
- maksymalny kontekst i zachowanie przy obcinaniu, jakich wymagają prawdziwe przykłady;
- obsługę zarówno w frameworku treningowym, jak i w docelowym silniku serwującym.
Fine-tuning to krok adaptacji, a nie naprawa nieodpowiedniego modelu bazowego. Jeśli model zawodzi w możliwościach, których zbiór danych nie obejmuje, wybierz inny model bazowy, zanim uruchomisz kolejne epoki.
Oszacuj pamięć dla swojego przebiegu
Nie istnieje trwała tabela „rozmiar modelu → GPU”. Szczytowe zużycie pamięci zmienia się z precyzją wag, optymalizatorem, liczbą trenowalnych parametrów, długością sekwencji, rozmiarem mikro-batcha, activation checkpointingiem, implementacją attention i narzutem frameworka. Zacznij od oszacowania pamięci, a potem uruchom krótki smoke test z maksymalną długością na dokładnie tym samym stosie.
| Składnik pamięci | Pełny fine-tuning | LoRA | QLoRA |
|---|---|---|---|
| Wagi bazowe | Precyzja treningu | Zamrożone, zwykle BF16/FP16 | Zamrożone, zwykle 4-bitowe NF4 |
| Gradienty | Wszystkie trenowalne wagi | Wagi adaptera | Wagi adaptera |
| Stany optymalizatora | Wszystkie trenowalne wagi | Wagi adaptera | Wagi adaptera |
| Aktywacje | Zależą od batcha i długości sekwencji w każdej metodzie | Ta sama zależność | Ta sama zależność |
Wykres stosuje tę tabelę do modelu bazowego z dema, Nemotron-Nano-4B z 4,51 miliarda parametrów. Dzieli przybliżoną pamięć każdej metody na wagi i trenowalny stan; aktywacje dochodzą do tego.
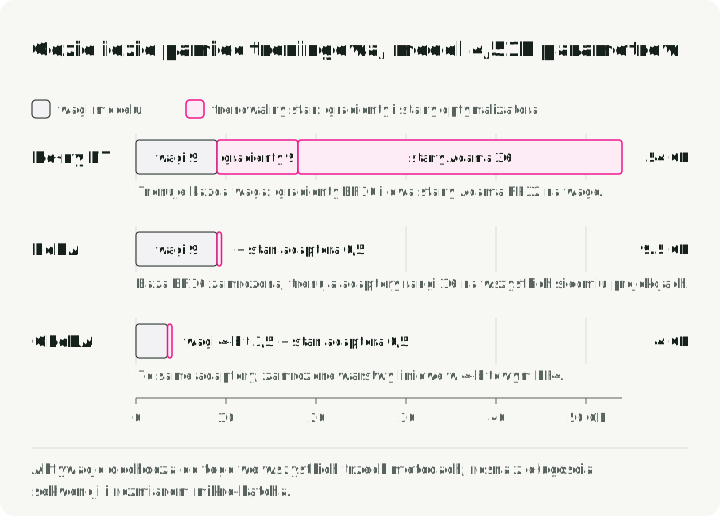
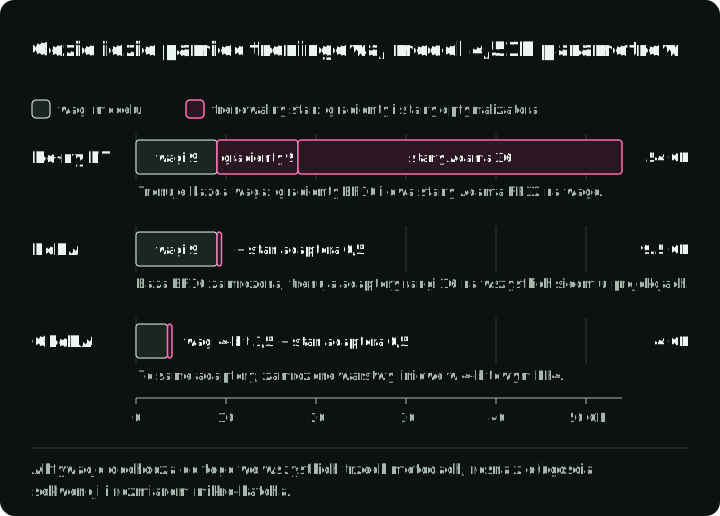
Oryginalna praca o QLoRA zmieściła model LLaMA 65B na jednym GPU z 48 GB w swojej konkretnej konfiguracji. Ten wynik to przydatna granica, a nie obietnica, że każda obecna architektura 70B, długość kontekstu, kernel czy trainer zmieści się na tym samym urządzeniu.
Rachunek pamięci
Dla modelu z parametrami same wagi wymagają około bajtów w BF16/FP16 lub bajtów przy czterech bitach, przed metadanymi kwantyzacji i buforami runtime. Pełny trening w stylu Adama dodaje gradienty, stany optymalizatora i często wagi główne o wyższej precyzji. LoRA unika większości pamięci na trenowalny stan; QLoRA dodatkowo zmniejsza rozmiar zamrożonych wag bazowych. Aktywacje nadal mogą dominować przy długich sekwencjach.
Użyj tego przebiegu:
- Wybierz najdłuższą sekwencję i mikro-batch, które musisz obsłużyć.
- Oszacuj wagi i trenowalny stan, zostawiając zapas na aktywacje i kernele.
- Wykonaj jeden krok forward/backward z maksymalną długością.
- Zapisz szczytową pamięć przydzieloną i zarezerwowaną.
- Dopiero potem skaluj rozmiar batcha, rank, długość sekwencji lub liczbę GPU.
Etap 3: Konfiguracja treningu i metody
Etap 3 ma dwie części. Najpierw sprawdź, czy każdy zapisany wiersz zamienia się w oczekiwany tekst treningowy. Potem wybierz metodę treningu i jej ustawienia.
Od zapisanych wierszy do celów treningu
ShareGPT to kształt zbioru danych; ChatML to jedna z konwencji serializacji. Przekonwertuj from/value na role i pola, które akceptuje trainer, a potem użyj szablonu czatu wybranego modelu. Nie podstawiaj jednostek token ChatML tylko dlatego, że dane są konwersacyjne.
Wiersz przechodzi przez pięć kroków:
- Wiersz ShareGPT: pary
from/value. messagesitools: role akceptowane przez trainer.apply_chat_templatez szablonem wybranego modelu. Inferencja musi użyć tego samego szablonu.- ID jednostek token i etykiety, gdzie
-100oznacza brak straty. - Trening.
Przed treningiem wypisz tekst wyrenderowany w kroku 3.
Dla wiersza z powitaniem powyżej znormalizowane wiadomości wyglądają tak:
messages = [
    {"role": "user", "content": "Hello, who are you?"},
    {"role": "assistant", "content": "I am a helpful AI assistant."},
]
# Inspection step after loading the selected model's tokenizer:
rendered = tokenizer.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=False,
)
print(rendered)
Przed treningiem obejrzyj faktycznie zserializowany wiersz: separatory ról, jednostki token końca tury i schematy narzędzi muszą zgadzać się z inferencją. Dla wiersza z użyciem narzędzi zachowaj definicje narzędzi, wywołania narzędzi przez asystenta i wyniki narzędzi jako osobne pola. Sprawdź, czy obcięcie nie usuwa nadzorowanej odpowiedzi ani nie przecina argumentu narzędzia w połowie.
Maskowanie straty wybiera, za przewidzenie których jednostek token model jest nagradzany. W treningu na całej sekwencji tekst użytkownika, systemu, narzędzia i asystenta może wnosić wkład do straty. W treningu tylko na asystencie te jednostki token kontekstu pozostają widoczne dla attention, ale ich etykiety są ignorowane (zwykle -100); do straty wnoszą tylko fragmenty asystenta. W przypadku tego powitania odpowiedź powinna być celem, a pytanie użytkownika nie, jeśli intencją jest zachowanie typu tylko-asystent.
Diagram pokazuje oba ustawienia dla jednej rozmowy z użyciem narzędzi.
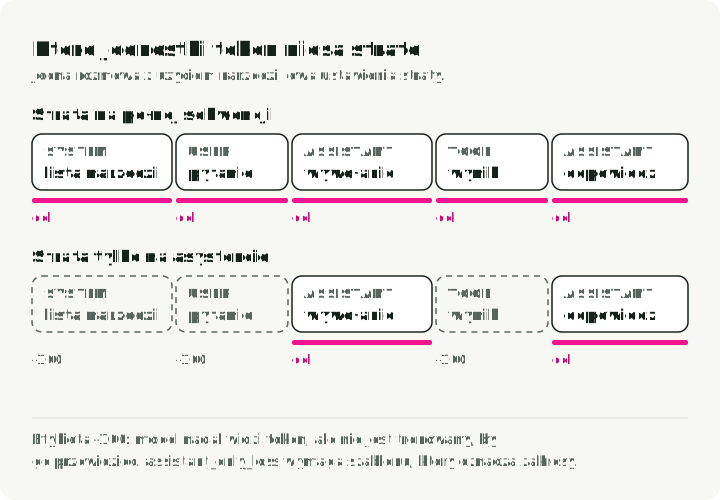
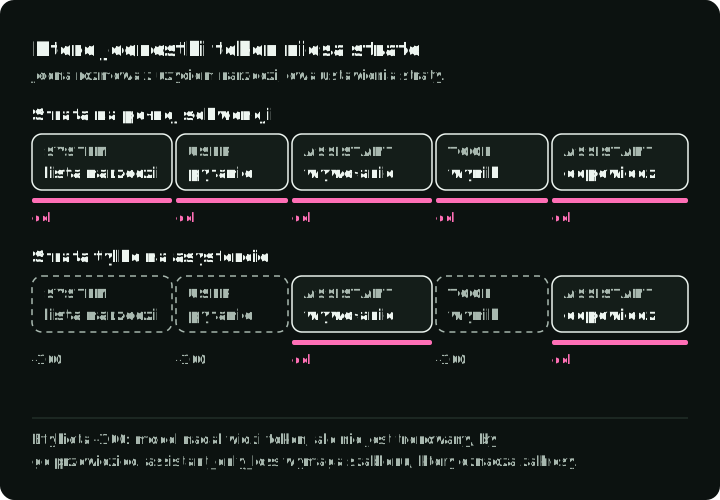
Dokumentacja SFT w TRL obsługuje assistant_only_loss=True dla konwersacyjnych zbiorów danych, których szablony udostępniają generation spans. Szablon bez tych spanów nie może dostarczyć takiej maski. Zbiory prompt/completion mają osobną opcję completion_only_loss. Zanim włączysz którąkolwiek, sprawdź jeden stokenizowany batch i zdekoduj jednostki token z nieignorowanymi etykietami. Potem powtórz to z rozmową z użyciem narzędzi i przykładem o maksymalnej długości. Demo w dalszej części przewodnika używa straty na całej sekwencji, ponieważ szablon Nemotron nie ma generation spans.
Wybierz długość sekwencji na podstawie rozkładu danych i uruchom kontrolę pamięci przy maksymalnej długości z Etapu 2. Packing umieszcza kilka krótszych przykładów w jednej sekwencji treningowej. Zacznij bez niego, aby granice wierszy łatwo było sprawdzić. Testuj packing dopiero wtedy, gdy zserializowane wiersze i etykiety są poprawne.
Pełny fine-tuning a PEFT
Pełny fine-tuning (FFT) aktualizuje każdą wagę, więc gradienty i stan optymalizatora skalują się z całym modelem. Szczytu nie da się wywnioskować wyłącznie z liczby parametrów, ale jest on znacznie wyższy niż pamięć potrzebna do wczytania wag na potrzeby inferencji.
Parameter-efficient fine-tuning (PEFT) trenuje tylko niewielki podzbiór parametrów i zamraża resztę, więc gradienty i stany optymalizatora obejmują tylko ten podzbiór.
LoRA: punkt wyjścia
LoRA (Low-Rank Adaptation) zamraża wstępnie wytrenowaną macierz i reprezentuje jej wyuczoną aktualizację za pomocą dwóch mniejszych macierzy. Oryginalna praca uzasadnia to hipotezą, że użyteczne aktualizacje adaptacyjne mają niski rank wewnętrzny.
Tutaj to szerokość wejściowa warstwy, a jej szerokość wyjściowa. Rank to mniejszy wspólny wymiar dwóch trenowalnych macierzy: mniejszy rank oznacza mniej trenowalnych parametrów. Ustawienie steruje skalą aktualizacji przez stosunek .
Diagram pokazuje zamrożoną macierz, dwie trenowalne macierze i sposób dodania ich przeskalowanego iloczynu, wraz z liczbą parametrów jednej macierzy o szerokości 4096 przy randze 16.
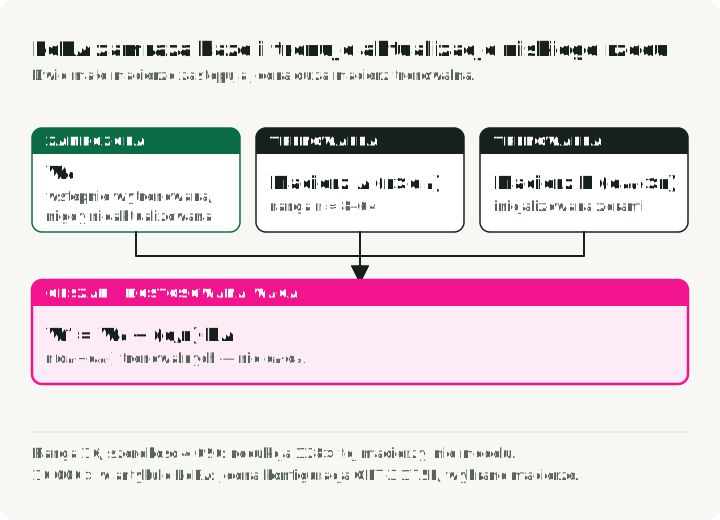
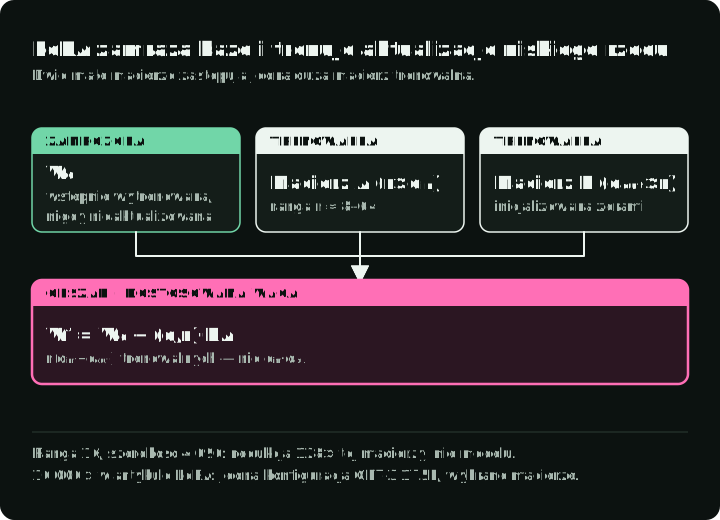
Dla zamrożonej macierzy LoRA uczy się:
Zaadaptowana warstwa wygląda tak:
Adapter ma trenowalnych parametrów zamiast dla tej macierzy. Dla kwadratowej macierzy o szerokości 4096 przy ranku 16 to 128-krotne zmniejszenie liczby trenowalnych parametrów dla tej macierzy. Oszczędności dla całego modelu zależą od tego, które macierze dostają adaptery.
Porównanie metod PEFT
| Metoda | Co się zmienia | Wybierz ją, gdy |
|---|---|---|
| LoRA | Zamrożona baza plus trenowalne aktualizacje niskiego ranku | Model bazowy mieści się wygodnie, a chcesz małych artefaktów dla zadań |
| QLoRA | LoRA z zamrożoną bazą zapisaną w formie 4-bitowej | Ograniczeniem jest pamięć wag bazowych |
| DoRA | Oddziela wielkość wagi od kierunku aktualizowanego przez LoRA | Zmierzony punkt odniesienia LoRA zostawia lukę jakości wartą dodatkowej złożoności |
| Pełny fine-tuning | Wszystkie wagi modelu | PEFT nie osiąga celu, a zysk jakości uzasadnia trening rozproszony i pełne pliki checkpoint |
DoRA: LoRA z dekompozycją wag
DoRA (Weight-Decomposed Low-Rank Adaptation) oddziela wielkość każdego wektora wag od jego kierunku. Praca o DoRA stosuje aktualizację LoRA do składowej kierunkowej, a wielkość uczy osobno. Diagram rysuje jedną kolumnę wag jako strzałkę: B·A obraca jej kierunek, a wytrenowana wielkość m wyznacza jej długość.
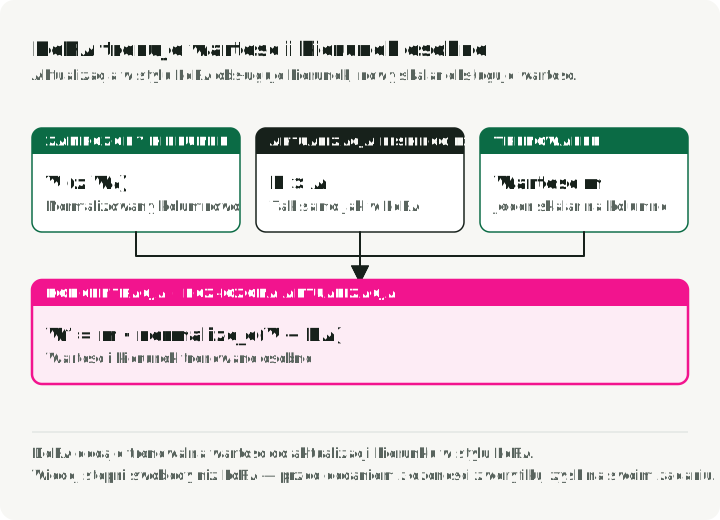
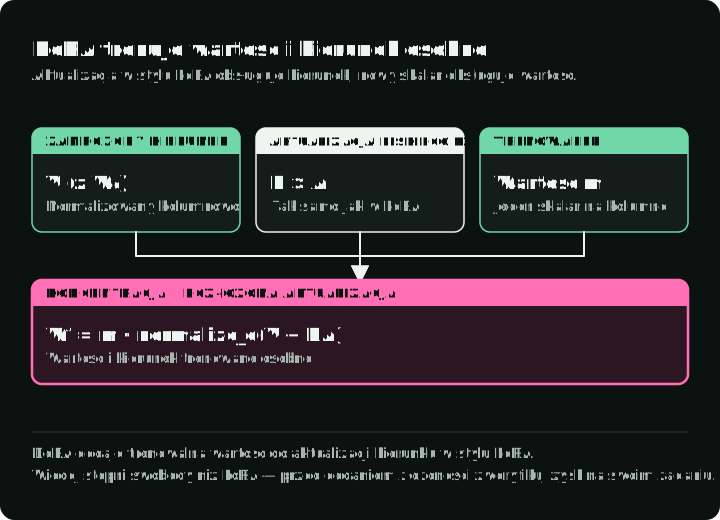
Jak to działa:
Zamiast traktować wagi jak jedną całość, DoRA rozbija wstępnie wytrenowane wagi na dwie składowe:
- Wielkość — trenowalna wartość na każdy wektor wag.
- Kierunek — znormalizowany wektor aktualizowany przez macierze niskiego ranku.
W zwartej notacji kolumnowej:
gdzie:
m= wielkość (trenowalna)- = zamrożona macierz początkowa; normalizuj po dodaniu
- = wyuczona aktualizacja kierunkowa niskiego ranku
- = normalizacja kolumnowa
Skutki dekompozycji:
- Więcej stopni swobody niż w standardowym LoRA, bo wielkość może zmieniać się niezależnie.
- Lepsze wyniki niż LoRA w kilku konfiguracjach opisanych w pracy autorów metody.
- Dodatkowe parametry i obliczenia, więc zysk należy zweryfikować na własnym zadaniu i własnej ścieżce serwowania.
Łączenie adapterów dla uczenia wielozadaniowego
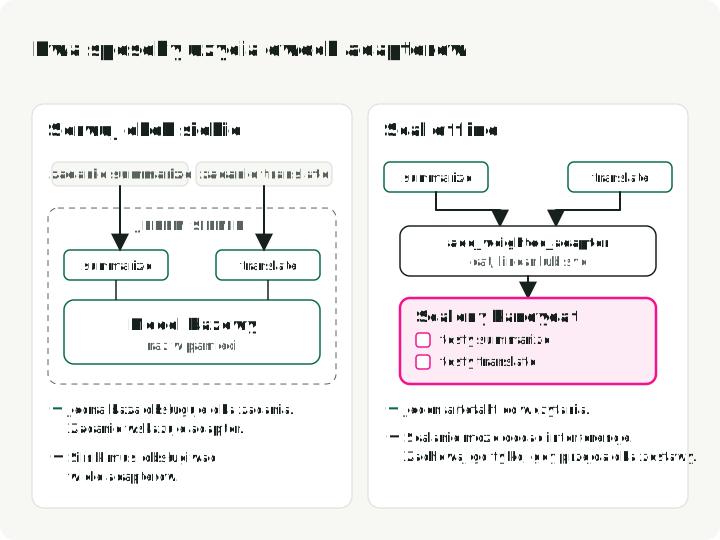
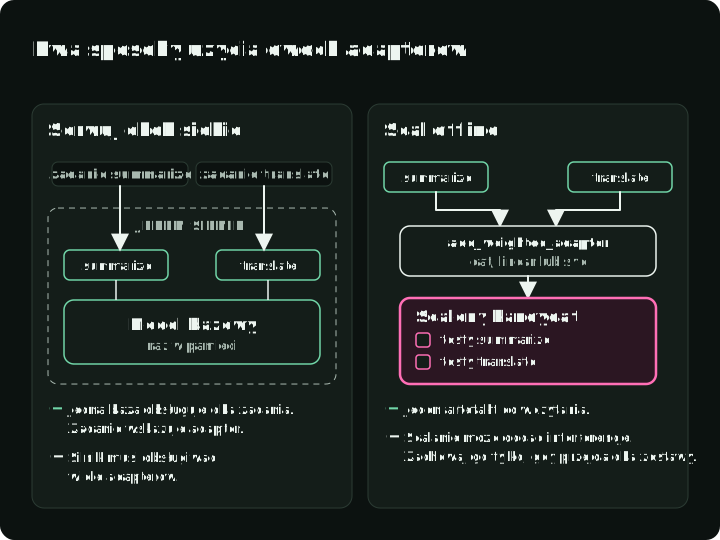
Osobne adaptery pozwalają jednej zamrożonej bazie obsługiwać kilka zadań. Możesz kierować żądania do adaptera, serwować wiele adapterów z jednego silnika, gdy jest to obsługiwane, albo utworzyć kandydata scalonego offline. Łączenie może wprowadzić interferencję, więc oceń scalony artefakt, zamiast zakładać, że adaptery źródłowe składają się bez problemów.
Rysunek porównuje obie opcje dla dwóch adapterów na jednej bazie. Zachowaj model scalony tylko wtedy, gdy przejdzie oba zestawy testów.
Typowe metody łączenia:
- Konkatenacja — połącz parametry adapterów i zwiększ efektywny rank. Szybka i prosta.
- Kombinacja liniowa — ważona suma adapterów. Wagi określają, ile wnosi każde zadanie.
- SVD — dekompozycja macierzy do łączenia. Bardziej elastyczna, ale wolniejsza.
add_weighted_adapter w PEFT implementuje je jako combination_type="cat", "linear" i "svd"; przewodnik PEFT po łączeniu modeli opisuje je oraz nowsze metody.
Przykład: jeden adapter do streszczania, drugi do tłumaczenia, scalone w jeden model wielozadaniowy.
Etap 4: Dopasowanie do preferencji (opcjonalnie)
SFT to główny przebieg treningu i uruchamiają go sekcje o frameworkach po tym etapie. Ten etap opisuje, co możesz dodać po SFT, jeśli wymagają tego błędy.
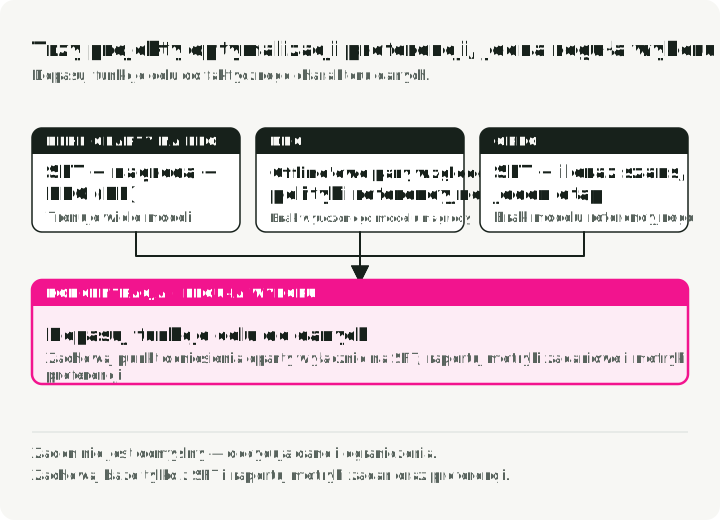
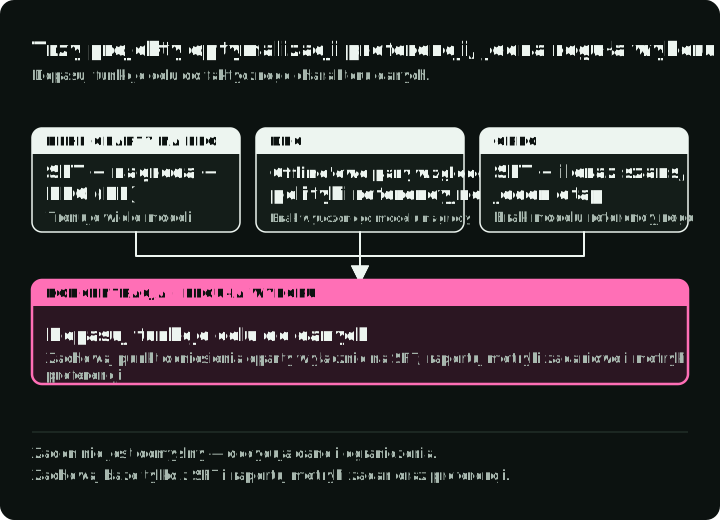
SFT uczy się na demonstracjach. Optymalizacja preferencji uczy się natomiast z porównań, takich jak „wybrana odpowiedź A jest lepsza niż odrzucona odpowiedź B”. Używaj jej tylko wtedy, gdy porównanie par jest właściwą etykietą dla danego błędu; poprawność faktów i zgodność z polityką często wymagają silniejszych ewaluatorów niż globalna preferencja.
Diagram pokazuje etapy każdej metody, wczytywane modele oraz to, co robi jeden krok treningu.
RLHF oparte na PPO
RLHF oznacza uczenie ze wzmocnieniem na podstawie opinii ludzi (reinforcement learning from human feedback). Polityka to model językowy, który generuje odpowiedzi; model nagrody ocenia te odpowiedzi na podstawie preferencji wyuczonych z ludzkich porównań. Receptura oparta na PPO ma trzy etapy:
- SFT — nauczenie zadania.
- Model nagrody — trening na preferencjach ludzi (wybrana vs odrzucona).
- PPO (Proximal Policy Optimization) — generowanie odpowiedzi i aktualizacja modelu językowego tak, aby zwiększać ich oceny nagrody.
Koszt operacyjny wynika z liczby komponentów:
- Skomplikowane we wdrożeniu i utrzymaniu.
- Drogie — trenujesz wiele modeli.
- Próbkowanie z trenowanego modelu wymaga kontroli niestabilnych aktualizacji oraz odpowiedzi, które wykorzystują model nagrody, nie spełniając zadania.
DPO
DPO (Direct Preference Optimization) rezygnuje z osobnego modelu nagrody i pętli uczenia ze wzmocnieniem. Faworyzuje wybrane odpowiedzi, a jednocześnie zniechęca do dużych zmian względem stałego modelu wyjściowego, zwanego modelem referencyjnym. Praca o DPO wyprowadza ten cel, ograniczając, jak daleko prawdopodobieństwa odpowiedzi mogą odejść od tej referencji; matematycznym ograniczeniem jest warunek na dywergencję KL.
Para preferencji zawiera ten sam prompt i dwie odpowiedzi kandydujące. Ten skrócony wiersz pokazuje jej pola; prawdziwe etykiety wymagają pełnych odpowiedzi i powodu, by preferować jedną z nich:
{
    "prompt": "Explain quantum computing",
    "chosen": "Quantum computing uses qubits...",   # Preferred response
    "rejected": "Well, it's complicated..."        # Non-preferred response
}
Co zmienia się operacyjnie:
- Prostsza ścieżka kodu (brak osobnego modelu nagrody i pętli RL).
- Trening na zapisanych parach preferencji zamiast generowania nowych odpowiedzi do oceny nagrody przy każdej aktualizacji.
- Stały model referencyjny lub jego zapisane log-prawdopodobieństwa dla odpowiedzi treningowych, w standardowym sformułowaniu.
DPO łatwiej prototypować niż pełny pipeline PPO, ale nie jest to automatyczna poprawa jakości. Wyniki zależą od polityki wyjściowej, jakości par, ustawień straty, efektów długości i protokołu ewaluacji. Porównaj go z modelem SFT zapisanym jako checkpoint na tych samych odłożonych zestawach preferencji i zadań.
ORPO
ORPO (Odds-Ratio Preference Optimization) łączy stratę SFT w postaci ujemnego log-prawdopodobieństwa z karą opartą na ilorazie szans dla odrzuconych odpowiedzi. Usuwa osobny model referencyjny i może połączyć uczenie zadania i optymalizację preferencji w jednym przebiegu.
Jak to działa: ORPO używa łączonej straty, która robi dwie rzeczy naraz:
- Maksymalizuje prawdopodobieństwo wybranej odpowiedzi (nauka zadania).
- Karze odrzuconą odpowiedź członem opartym na ilorazie szans (nauka preferencji).
TRL dostarcza teraz ORPO jako ORPOConfig w trl.experimental.orpo (trainer ORPO w TRL). Warto znać dwa ustawienia:
learning_rate: praca używała niskich wartości, takich jak8e-6; dostrój ją do swojego modelu, batcha i danych, zamiast kopiować jedną wartość jako regułę.beta: steruje członem preferencji względem członu SFT.
Kompromis:
- Jeden etap treningu zamiast dwóch.
- Brak modelu nagrody.
- Brak przejścia forward przez model referencyjny.
- Sprzężony przebieg: jeśli uczenie zadania lub zachowanie preferencji ulegnie regresji, nie ma pośredniego zapisu checkpoint SFT z tego samego pipeline’u do sprawdzenia.
Wybieraj przez projekt danych i ewaluacji:
- Użyj DPO, gdy masz już zadowalający checkpoint SFT i chcesz prostszego eksperymentu z preferencjami offline.
- Przetestuj ORPO, gdy jednoetapowy cel bez referencji pasuje do twoich danych i ograniczeń operacyjnych.
- Użyj RLHF opartego na PPO, gdy próbkowanie online względem jawnej wyuczonej nagrody należy do wymagań i potrafisz monitorować wykorzystywanie nagrody.
Żadna z tych metod nie jest domyślna dla wszystkich zadań. Zachowaj punkt odniesienia z samym SFT i raportuj zarówno metryki zadania, jak i metryki preferencji.
Frameworki obsługujące fine-tuning
Etapy 3 i 4 wybrały metodę. Kolejne dwie sekcje wybierają framework i uruchamiają w nim SFT.
Frameworki częściowo się pokrywają i szybko się zmieniają. Wybieraj według ścieżki wykonania, którą musisz obsłużyć, przypinaj wersje i trzymaj konfigurację treningu na tyle przenośną, by dało się ją odtworzyć poza notebookiem.
Unsloth — szybkość i oszczędność pamięci
Unsloth integruje się z trl i transformers od Hugging Face i dostarcza zoptymalizowane kernele, checkpointing oraz ścieżki kwantyzowanego treningu fine-tuning dla obsługiwanych modeli.
- Własne kernele Triton na GPU dla attention, RoPE i cross-entropy, które omijają narzut PyTorch.
- Oszczędna pamięciowo propagacja wsteczna, która przelicza aktywacje ponownie w przejściu wstecznym zamiast trzymać je w pamięci.
- Połączone operacje, które zwijają kilka kroków (layer norm + linear i podobne) w pojedyncze wywołania GPU.
- 4-bitowa kwantyzacja zintegrowana bezpośrednio ze ścieżką QLoRA, ze zoptymalizowaną dekwantyzacją.
Kolejność importów ma znaczenie. Trzymaj się kolejności importów z przykładu Unsloth dla wersji, którą przypinasz. Unsloth nakłada patche podczas importu, więc zaimportowanie go przed trl i transformers pozwala uniknąć brakujących optymalizacji lub błędów zależnych od wersji.
# Correct order
from unsloth import FastLanguageModel  # Must be first!
from trl import SFTConfig, SFTTrainer

# Avoid this order with Unsloth's patched path
from trl import SFTTrainer
from unsloth import FastLanguageModel
Najlepszy do: treningu na jednym GPU, prototypowania i notebooków Colab.
Publikowane liczby dotyczące szybkości i pamięci zależą od modelu, długości sekwencji, batcha, precyzji i sprzętu. Zmierz liczbę jednostek token na sekundę i szczytową pamięć na własnym przebiegu, zamiast traktować nagłówkowy współczynnik jako cechę frameworka.
Axolotl — trening sterowany konfiguracją
Dla ustawień opartych na konfiguracji i rozproszonych Axolotl trzyma cały przebieg w jednym pliku YAML. Te klucze wybierają 4-bitową bazę, adapter QLoRA i zbiór danych w formacie Alpaca:
# axolotl_config.yaml (excerpt)
base_model: meta-llama/Meta-Llama-3-8B
load_in_4bit: true
adapter: qlora
lora_r: 32
lora_alpha: 16 # alpha/r = 0.5 here; the demo uses 2. Sweep it with the learning rate.
datasets:
    - path: data/training_data.jsonl
      type: alpaca
Moduły docelowe, długość sekwencji, packing, rozmiar batcha, learning rate i liczba epok trafiają do tego samego pliku; dokumentacja konfiguracji wymienia każdy klucz. Uruchom trening:
axolotl train axolotl_config.yamlPorównanie frameworków
| Narzędzie | Przydatne, gdy | Sprawdź przed zobowiązaniem się |
|---|---|---|
| Unsloth | Chcesz zoptymalizowanej ścieżki dla obsługiwanych modeli i zwięzłych przykładów | Macierz obsługiwanych modeli, GPU, kwantyzacji i trybu rozproszonego |
| Axolotl | Chcesz deklaratywnych konfiguracji i wbudowanych receptur rozproszonych | Dokładny schemat konfiguracji i launcher dla przypiętego wydania |
| TRL | Chcesz bezpośredniego dostępu do trainerów SFT i preferencji od Hugging Face | Format danych, szablon czatu, maskowanie straty i integrację z PEFT |
| Torchtune | Już używasz receptur torchtune; nie jest już aktywnie rozwijany (od 2025) | Pokrycie recept dla modeli i zgodność eksportu |
Demo praktyczne: fine-tuning z Unsloth
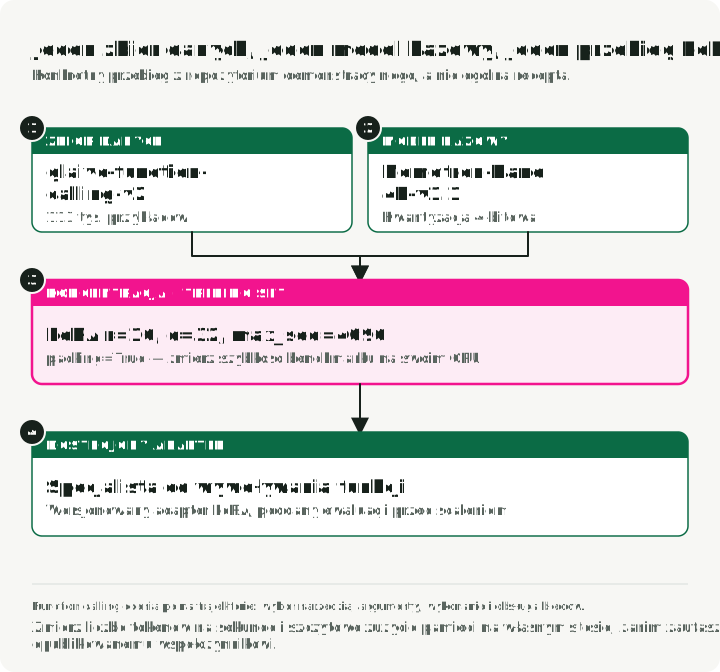
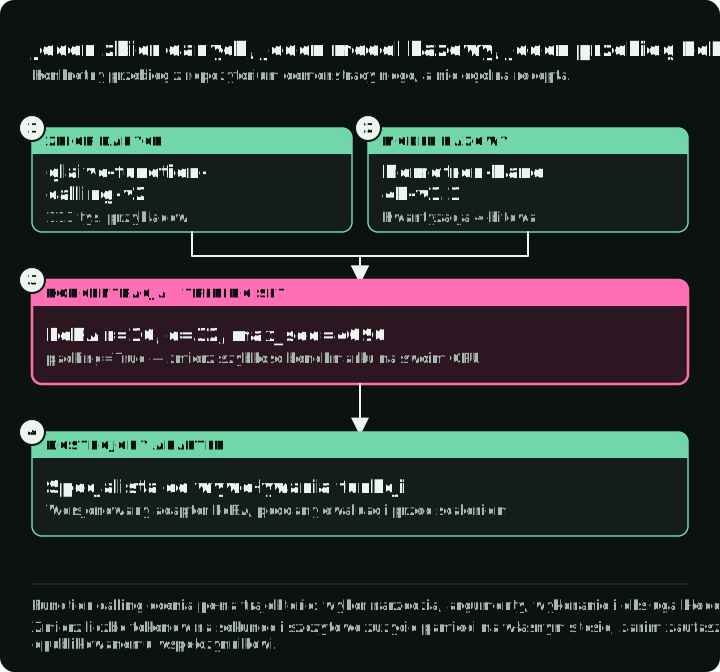
To demo uczy model wybierać funkcję i podawać jej argumenty. Moje unsloth-finetune-demo robi fine-tuning modelu Llama-3.1-Nemotron-Nano-4B-v1.1 na zbiorze glaive-function-calling-v2. Ścieżka treningu CUDA w tym repozytorium wymaga Linuxa lub WSL2 i GPU NVIDIA. Unsloth ma także osobną ścieżkę treningu na GPU Intela, której to demo nie implementuje. Przypnij commit, który uruchamiasz; plik blokady przypina zależności, w tym TRL 0.24.0.
Diagram pokazuje cały przebieg z prawdziwymi wartościami: jak wiersz glaive staje się tekstem treningowym z definicjami narzędzi, podział, ustawienia treningu, trzy katalogi wyjściowe i pierwszą kontrolę.
Uruchom
git clone https://github.com/slavadubrov/unsloth-finetune-demo.git
cd unsloth-finetune-demo
uv sync

# Train on 1,000 random rows, then also save a merged model and a GGUF file
uv run finetune --max-samples 1000 --merge --gguf q4_k_m
Każde uruchomienie finetune trenuje. --merge i --gguf dodają eksporty po treningu; nie ma polecenia samego eksportu. Uruchomienie zapisuje trzy katalogi:
outputs/unsloth-nemotron-function-calling/— adapter LoRAoutputs/unsloth-nemotron-function-calling-merged/— scalony model 16-bitowy (--merge)outputs/unsloth-nemotron-function-calling-gguf/— plik GGUF (--gguf q4_k_m)
Zanim trening się zacznie, uruchomienie wypisuje pierwszy wiersz treningowy w postaci, w jakiej widzi go model. Przeczytaj go: definicje narzędzi pojawiają się wewnątrz <AVAILABLE_TOOLS>, a każde wywołanie wewnątrz <TOOLCALL>.
Przygotowanie danych
Każdy wiersz glaive ma dwa łańcuchy znaków. Kolumna system zawiera wszystkie definicje funkcji; kolumna chat zawiera rozmowę, z wywołaniami zapisanymi jako <functioncall> {...}. Trening wyłącznie na chat uczy model wywoływać narzędzia, których schematów nigdy nie widzi. Plik data.py z dema konwertuje każdy wiersz na messages i osobną listę tools, renderuje oba szablonem czatu samego modelu i wydziela 5% wierszy jako podział ewaluacyjny:
def to_text(example: dict, tokenizer) -> dict:
    """Render one glaive row with the model's chat template. Empty text marks a dropped row."""
    try:
        messages, tools = to_messages(example)
    except (ValueError, KeyError):  # bad JSON in a tool definition or call
        return {"text": ""}
    if not messages:
        return {"text": ""}
    text = tokenizer.apply_chat_template(messages, tools=tools or None, tokenize=False)
    # The trainer tokenizes this text with special tokens on, which adds BOS again.
    return {"text": text.removeprefix(tokenizer.bos_token or "")}
Na pełnym zbiorze danych zostaje 112 811 z 112 960 wierszy; 149 wierszy ma błędny JSON i jest odrzucanych. Przy tym tokenizerze najdłuższy wyrenderowany wiersz ma 4076 jednostek token, więc limit 4096 jednostek token nie obcina żadnego z nich.
Szablon czatu z karty modelu ma jeden defekt dla treningu. Renderuje wcześniejsze wywołanie narzędzia bez zamykającego nawiasu klamrowego po arguments, więc tekst wewnątrz <TOOLCALL> nie jest poprawnym JSON. Model wytrenowany na takim tekście uczy się go emitować, a parser serwujący nie potrafi odczytać wywołania. Repozytorium dostarcza szablon z dodanym nawiasem i używa go w treningu oraz serwowaniu. Jego test działający tylko na CPU renderuje rozmowy z narzędziami i sprawdza, czy każde <TOOLCALL> się parsuje.
Konfiguracja dema
Plik config.py z dema ustawia wartości LoRA:
LORA_R = 16        # Adapter capacity; tune against held-out results
LORA_ALPHA = 32    # Update scale alpha/r = 2
LORA_DROPOUT = 0.05
MAX_SEQ_LENGTH = 4096
LORA_TARGET_MODULES wymienia wszystkie siedem projekcji attention i MLP tego modelu z rodziny Llama, od q_proj do down_proj.
Stosunek alpha do ranku. alpha/r skaluje klasyczną aktualizację LoRA. alpha = 2r to częsta heurystyka startowa w dokumentacji niektórych narzędzi, a nie gwarancja stabilności. Przeszukuj rank, alpha, learning rate i moduły docelowe dopiero wtedy, gdy dane i punkt odniesienia są ustalone.
Wczytywanie modelu
Plik model.py z dema wczytuje bazę w formie 4-bitowej, zastępuje szablon czatu poprawionym i dodaje adaptery LoRA:
from unsloth import FastLanguageModel

model, tokenizer = FastLanguageModel.from_pretrained(
    model_name=MODEL_NAME,
    max_seq_length=MAX_SEQ_LENGTH,
    load_in_4bit=True,  # QLoRA: the frozen base is stored in 4-bit form
    trust_remote_code=True,
)
# Training rows, the saved tokenizer, and vLLM all use this one template.
tokenizer.chat_template = CHAT_TEMPLATE_PATH.read_text()

model = FastLanguageModel.get_peft_model(
    model,
    r=LORA_R,
    lora_alpha=LORA_ALPHA,
    lora_dropout=LORA_DROPOUT,
    target_modules=LORA_TARGET_MODULES,
    use_gradient_checkpointing="unsloth",  # Lower activation memory; extra compute
)
Konfiguracja treningu
Plik training.py z dema przekazuje wyrenderowane wiersze do SFTTrainer z TRL. Raz na epokę oblicza stratę dla jednostek token ze zbioru odłożonego. Ta strata to diagnostyka, a nie trafność wywołań narzędzi; Etap 5 nadal wymaga osobnej ewaluacji zadania.
trainer = SFTTrainer(
    model=model,  # 4-bit base with LoRA adapters from FastLanguageModel
    processing_class=tokenizer,
    train_dataset=train_dataset,
    eval_dataset=eval_dataset,
    args=SFTConfig(
        output_dir="outputs/unsloth-nemotron-function-calling",
        dataset_text_field="text",
        max_length=4096,
        packing=False,  # One row per sequence, so row boundaries are easy to inspect
        assistant_only_loss=False,  # The Nemotron template has no generation spans
        eval_strategy="epoch",
        per_device_train_batch_size=2,
        gradient_accumulation_steps=4,
        learning_rate=2e-4,
        num_train_epochs=3,
        bf16=True,  # The repository falls back to FP16 on GPUs without BF16
        optim="adamw_8bit",
    ),
)
trainer.train()
Pierwsza kontrola
uv run infer --prompt "Book a flight to Tokyo"infer wczytuje adapter i wysyła prompt z jednym narzędziem, book_flight(destination), wyrenderowanym tym samym szablonem co wiersze treningowe. Wytrenowany adapter powinien odpowiedzieć <TOOLCALL>[{"name": "book_flight", "arguments": {"destination": "Tokyo"}}]</TOOLCALL>. Jeśli odpowiada zwykłym tekstem, sprawdź wypisany wiersz treningowy, zanim zaczniesz trenować dłużej.
Etap 5: Ewaluacja
Ustal przypadki testowe, reguły oceny i progi zaliczenia przed pierwszym uruchomieniem. W minimalnym wariancie porównaj dostrojony checkpoint z dokładnie tym samym niedostrojonym modelem bazowym, przy tej samej instrukcji prompt, ustawieniach dekodowania i środowisku narzędzi. Raportuj jakość zagregowaną dopiero po sprawdzeniu slice’ów awarii, które projekt miał poprawić.
Śledź cztery grupy:
- Zadanie docelowe: exact match, powodzenie wykonania, rubryka oceniana przez ludzi lub inny wynik powiązany z przypadkiem użycia.
- Regresja: ogólne umiejętności i wcześniej obsługiwane slice’y zadania, które adaptacja mogła uszkodzić.
- Bezpieczeństwo i polityka: odmowy, wyciek danych, prompt injection lub ograniczenia specyficzne dla domeny.
- Operacje: opóźnienie, przepustowość, pamięć, rozmiar artefaktu i koszt w zamierzonej konfiguracji serwowania.
Automatyczne benchmarki
Użyj lm-evaluation-harness, aby sprawdzić odpowiednie standaryzowane zadania obok testów własnego produktu. To polecenie wymaga scalonego zapisu checkpoint Hugging Face, który demo zapisuje z --merge:
lm_eval --model hf \
    --model_args pretrained=./outputs/unsloth-nemotron-function-calling-merged \
    --tasks hellaswag,arc_easy,mmlu \
    --batch_size 8
LLM jako sędzia
Przy jakości subiektywnej większy model może pomagać w ocenie, ale skalibruj go na przykładach ocenionych przez ludzi i ukryj tożsamość kandydata. Daj sędziemu wynik modelu, oczekiwaną odpowiedź i rubrykę definiującą każdą ocenę dla każdego kryterium, takiego jak trafność, poprawność i formatowanie.
Ewaluacja specyficzna dla domeny
Odłóż z treningu prawdziwe przykłady według źródła, użytkownika, dokumentu lub czasu, aby niemal-duplikaty nie przeciekały przez podział. Dla wywoływania funkcji zwaliduj całą trajektorię: wybór narzędzia, argumenty, wynik wykonania, odzyskiwanie po błędzie i odpowiedź końcową. Przy małej próbce raportuj przedziały ufności lub sparowane liczby wygranych i przegranych, a każdą regresję w krytycznym slice’ie sprawdź.
Sprawdzaj każdą trajektorię w czterech krokach:
- Wybrano właściwe narzędzie.
- Argumenty są poprawne pod względem formy i wartości.
- Wynik wykonania jest zgodny z oczekiwaniem.
- Model odzyskuje sprawność po błędzie narzędzia.
Licz każdą porażkę według kontroli i slice’a. Poprawna odpowiedź końcowa może ukrywać błędny argument lub pominięte odzyskiwanie.
Kod ewaluacji Berkeley Function Calling Leaderboard (BFCL) ocenia wybór funkcji i argumenty względem wywołań referencyjnych. Używaj go jako kontroli regresji obok własnych odłożonych rozmów.
Etap 6: Wdrożenie i formaty wyjściowe
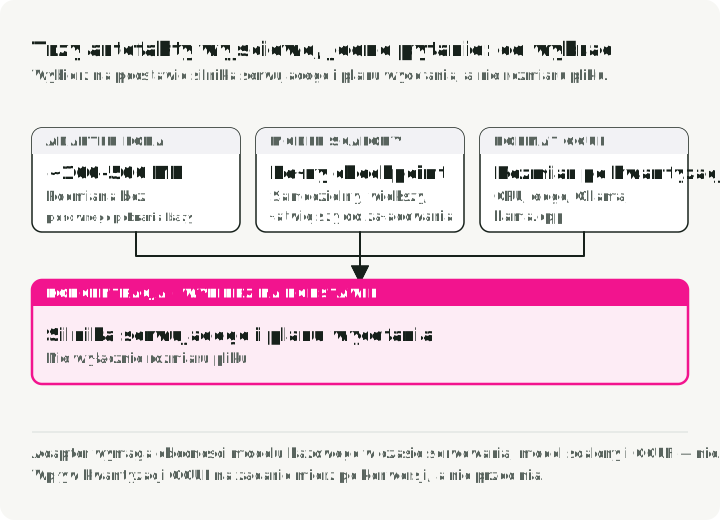
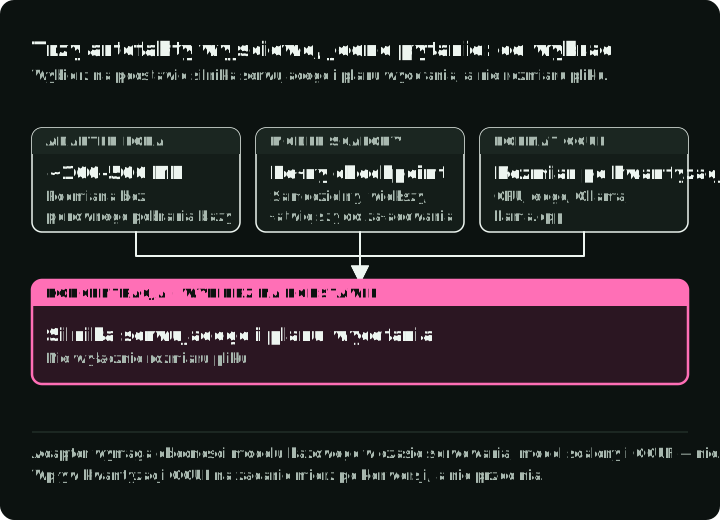
Wybierz artefakt na podstawie silnika serwującego i planu wycofania, a nie tylko rozmiaru pliku. Eksportuj każdy format z tych samych ocenionych obiektów model i tokenizer, aby wszystkie artefakty niosły te same wytrenowane wagi. Diagram porównuje trzy artefakty: co zawiera każdy plik, co go wczytuje i jaki jest jego kompromis.
W demie uv run finetune zawsze zapisuje adapter, --merge dodaje scalony model, a --gguf q4_k_m dodaje plik GGUF, wszystko w jednym przebiegu treningu. Poniższe wywołania Pythona pokazują, co robi każda flaga.
1. Adapter LoRA
model.save_pretrained("outputs/unsloth-nemotron-function-calling")
tokenizer.save_pretrained("outputs/unsloth-nemotron-function-calling")- Rozmiar: proporcjonalny do docelowych modułów, ranku, warstw i dtype; często znacznie mniejszy niż baza.
- Najlepszy do: rozwoju, wersjonowanych adapterów zadań i silników, które obsługują LoRA bezpośrednio.
- Bonus: możesz wymieniać adaptery bez ponownego pobierania modelu bazowego.
2. Scalony model
# What --merge runs: merge the adapter into the base weights and save a standalone model
model.save_pretrained_merged(
    "outputs/unsloth-nemotron-function-calling-merged", tokenizer, save_method="merged_16bit"
)- Rozmiar: w przybliżeniu pełny checkpoint bazowy w wybranej precyzji wyjściowej.
- Najlepszy do: silników lub ścieżek dystrybucji, które nie obsługują adaptera osobno.
- Kompromis: większy artefakt i wolniejsze wdrożenie; prostsze wczytywanie jednego modelu.
3. Format GGUF
# What --gguf q4_k_m runs; file size and name depend on the Unsloth version
model.save_pretrained_gguf(
    "outputs/unsloth-nemotron-function-calling-gguf", tokenizer, quantization_method="q4_k_m"
)- Rozmiar: zależny od modelu; w przybliżeniu wagi czterobitowe plus metadane dla wariantów Q4.
- Najlepszy do: inferencji na CPU, Ollama, llama.cpp, wdrożeń brzegowych.
- Opcje:
q4_k_m(mniejszy),q5_k_m(większa wierność wag),q8_0(większy i wierniejszy). Zmierz wpływ na zadanie po konwersji.
Etap 7: Serwowanie i monitorowanie
Z vLLM
To polecenie serwuje adapter z dema na modelu bazowym. Serwuj z parserem i szablonem czatu z karty modelu; muszą zgadzać się z szablonem użytym w treningu. Karta modelu rejestruje parser llama_nemotron_json przez plik wtyczki llama_nemotron_nano_toolcall_parser.py. Repozytorium dema dostarcza poprawiony szablon.
Użyj osobnego środowiska Python 3.12 z vLLM 0.12.0: przypięty parser importuje API parsera narzędzi z tej wersji, które zmieniło się w późniejszych wydaniach. Polecenie przypina model bazowy i parser do tej samej rewizji karty modelu; użyj tej rewizji bazy również do treningu. Zgodność kodu źródłowego i test parsera na CPU nie potwierdzają poprawnego serwowania na GPU. Sprawdź ładowanie modelu i oczekiwane wywołanie narzędzia na swojej GPU. Uruchom z katalogu głównego repozytorium:
uv venv --python 3.12 .venv-vllm
uv pip install --python .venv-vllm/bin/python "vllm==0.12.0" "huggingface-hub==0.36.0"
source .venv-vllm/bin/activate

hf download nvidia/Llama-3.1-Nemotron-Nano-4B-v1.1 \
    llama_nemotron_nano_toolcall_parser.py \
    --revision d552708a9d575fa8d4a690b988fd870d65279f98 --local-dir serving

vllm serve nvidia/Llama-3.1-Nemotron-Nano-4B-v1.1 \
    --revision d552708a9d575fa8d4a690b988fd870d65279f98 \
    --trust-remote-code \
    --enable-lora \
    --lora-modules function-calling=./outputs/unsloth-nemotron-function-calling \
    --enable-auto-tool-choice \
    --tool-parser-plugin ./serving/llama_nemotron_nano_toolcall_parser.py \
    --tool-call-parser llama_nemotron_json \
    --chat-template ./src/unsloth_demo/chat_template.jinja \
    --host 127.0.0.1 \
    --port 8000 \
    --max-model-len 4096
Polecenie uv run --with openai infer-vllm z dema testuje generowanie argumentów przez API zgodne z OpenAI. Wysyła jedno minimalne narzędzie, book_flight z wymaganym łańcuchem destination, i prosi o proponowane wywołanie; nie wykonuje rezerwacji. Żądanie w cli/inference.py wygląda tak:
client = OpenAI(base_url="http://localhost:8000/v1", api_key="dummy")
response = client.chat.completions.create(
    model="function-calling",  # the --lora-modules name, not the base model
    messages=[{"role": "user", "content": "Book a flight to Tokyo"}],
    tools=[DEMO_TOOL],  # book_flight(destination), defined in config.py
    tool_choice="auto",
)
print(response.choices[0].message.tool_calls)
Dla tego wejścia oczekiwanym wynikiem jest book_flight z {"destination": "Tokyo"}. Ponieważ wybór narzędzia jest automatyczny, sprawdź też, czy model w ogóle zwrócił wywołanie. Narzędzie ma ten sam kształt co definicje narzędzi glaive, na których model się uczył. Parser vLLM odczytuje wywołanie z wygenerowanego tekstu, więc błędnie sformułowane wywołanie wraca jako zwykła treść bez tool_calls. vLLM może też ograniczyć argumenty funkcji do jej schematu, gdy funkcja jest oznaczona strict: true; przewodnik po wywoływaniu narzędzi opisuje ustawienia serwera i parsery, które to obsługują.
Z Ollama (lokalnie)
Wylistuj katalog outputs/unsloth-nemotron-function-calling-gguf i podstaw wypisaną nazwę pliku w miejsce MODEL_FILE.gguf poniżej; wersje Unsloth mogą nazywać pliki inaczej. Sam plik GGUF nie gwarantuje poprawnego formatowania czatu i narzędzi w Ollama ani llama.cpp. Dopasuj wytrenowany szablon i przetestuj zaimportowany artefakt.
# Create Modelfile
echo 'FROM ./outputs/unsloth-nemotron-function-calling-gguf/MODEL_FILE.gguf' > Modelfile

# Import to Ollama
ollama create my-function-model -f Modelfile

# Run
ollama run my-function-model
Z llama.cpp (CPU)
Przy tym samym eksporcie GGUF i podstawieniu nazwy pliku to polecenie sprawdza odpowiedź w postaci zwykłego tekstu. Nie testuje pełnego wywołania narzędzia:
llama-cli -m ./outputs/unsloth-nemotron-function-calling-gguf/MODEL_FILE.gguf \
    -p "What's the weather in Tokyo?" \
    --ctx-size 4096
Monitoruj wydany model
Cykl życia nie kończy się na zdrowej stracie treningowej. Zapisz rewizję modelu bazowego, tokenizer i szablon czatu, hash adaptera, wersję zbioru danych, konfigurację treningu i raport ewaluacji jako jedną jednostkę wydania. W produkcji monitoruj powodzenie zadań, niepoprawne wyniki, naruszenia polityki, opóźnienie i dryf wejść według tych samych slice’ów, co offline. Trzymaj poprzedni artefakt gotowy do wczytania i określ próg wycofania przed startem.
W skrócie:
- Jednostka wydania: rewizja modelu bazowego, tokenizer i szablon czatu, hash adaptera, wersja zbioru danych, konfiguracja treningu i raport ewaluacji.
- Monitoruj sukces zadania, nieprawidłowe wyniki, naruszenia polityk, opóźnienie i dryf wejść według tych samych slice’ów co offline.
- Jeśli metryka spadnie poniżej progu wycofania ustalonego przed wdrożeniem, wczytaj poprzedni artefakt.
Twój następny test
Przed pełnym przebiegiem obejrzyj jedną zserializowaną rozmowę i jej cele straty, a potem wykonaj jeden krok forward/backward przy maksymalnej długości. Zapisz tę konfigurację razem z podziałem zbioru danych i raportem punktu odniesienia. Jeśli brakuje schematu narzędzia, zachowaj go w wierszu treningowym. Jeśli odpowiedź jest obcięta, dostosuj długość sekwencji i formatowanie tak, aby cała odpowiedź przetrwała. Rozwiąż te problemy, zanim dodasz epoki.
Źródła
Prace i badania
- LoRA: Low-Rank Adaptation of Large Language Models
- QLoRA: Efficient Finetuning of Quantized LLMs
- DoRA: Weight-Decomposed Low-Rank Adaptation
- DPO: Direct Preference Optimization
- ORPO: Odds Ratio Preference Optimization
- PPO: Proximal Policy Optimization Algorithms — OpenAI, 2017
Narzędzia do przetwarzania danych
- DataTrove — przetwarzanie danych w dużej skali od Hugging Face
- Distilabel — generowanie danych syntetycznych (Argilla)
- Trafilatura — wyodrębnianie tekstu z sieci i crawling
- fastText language identification — wstępnie wytrenowane modele identyfikacji języka
- Microsoft Presidio — wykrywanie i anonimizacja danych osobowych
- scrubadub — biblioteka Pythona do usuwania danych osobowych
Dekodowanie z ograniczeniami
- xgrammar — dekodowanie z ograniczeniami oparte na automatach skończonych
- outlines — ustrukturyzowane generowanie dla LLM
Frameworki treningowe
- Unsloth — zoptymalizowany framework obsługujący fine-tuning
- Axolotl — trening sterowany konfiguracją i launchery rozproszone
- TRL — biblioteka Hugging Face do treningu SFT i preferencji
- PEFT model merging —
add_weighted_adapteri metody łączenia - Torchtune — natywna dla PyTorch biblioteka do treningu fine-tuning, nie jest już aktywnie rozwijana
Inferencja i wdrożenie
- vLLM LoRA adapters — serwowanie jednego lub wielu adapterów z modelem bazowym
- vLLM tool calling — dopasowanie automatycznego wyboru narzędzia, parsera, szablonu czatu i schematu żądania do modelu
- Llama-3.1-Nemotron-Nano-4B-v1.1 model card — wtyczka parsera wywołań narzędzi i szablon czatu dla vLLM
- Ollama — lokalny runner LLM dla Mac/Windows/Linux
- llama.cpp — inferencja na CPU/GPU z formatem GGUF
Ewaluacja
- lm-evaluation-harness — standaryzowane benchmarki LLM od EleutherAI
- Berkeley Function Calling Leaderboard — kod ewaluacji wywoływania funkcji
Przewodniki i materiały
- Demo Repository — praktyczny przykład treningu fine-tuning
- Accelerate n-D Parallelism Guide — strategie treningu wielu GPU od Hugging Face