Gids voor LLM fine-tuning: wanneer fine-tunen, LoRA en QLoRA

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Deze gids is bedoeld voor Python-engineers die bepalen of en hoe ze een large language model moeten fine-tunen. Je leert wanneer je fine-tuning verkiest boven prompting of retrieval en hoe je kiest tussen methoden zoals LoRA en QLoRA. De gids legt ook uit hoe je data voorbereidt, het getrainde model evalueert en de deployment plant.
Het praktijkgedeelte draait een begeleidende repository die een model van 4B fine-tunet voor function calling.
Zie voor een kortere vergelijking van fine-tuning, RAG en prompting Fine-Tuning vs RAG vs Prompting.
Moet je überhaupt fine-tunen?
Bepaal voordat je GPU-uren uitgeeft of fine-tuning het juiste gereedschap is voor het probleem dat je hebt. De figuur volgt één verzoek en toont waar elk van de vier oplossingen ingrijpt, op welke fout je ze het eerst test en wat ze niet kunnen verhelpen.
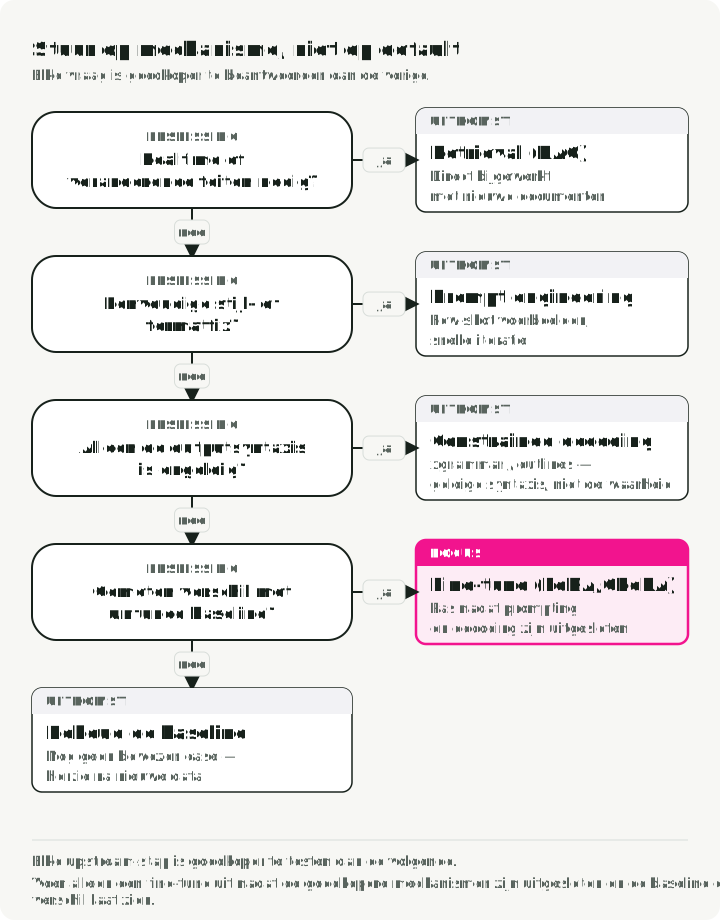
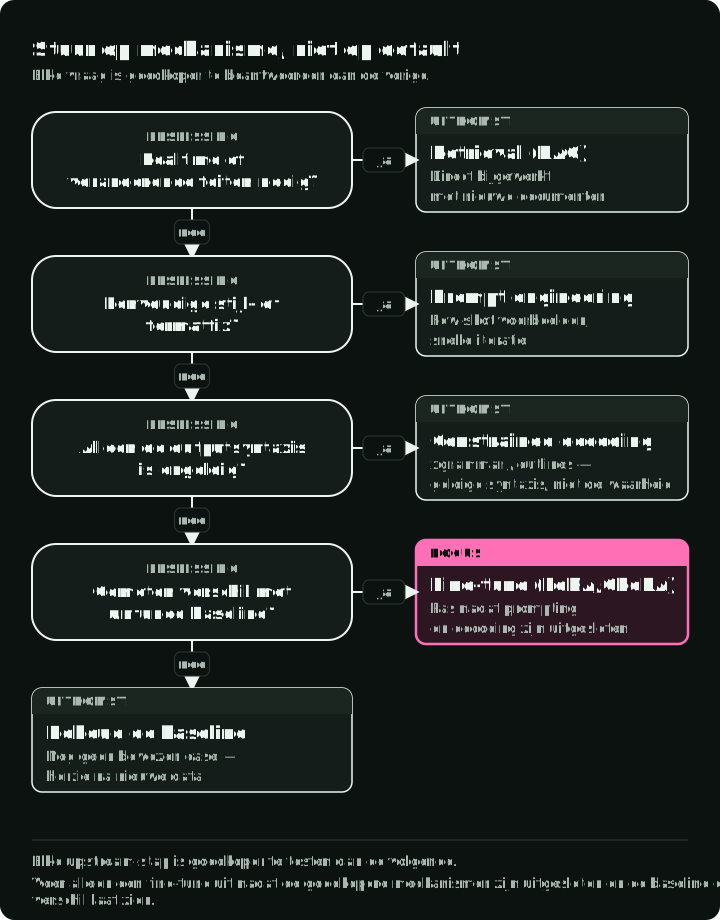
Fine-tuning verandert gedrag dat in weights is vastgelegd. Retrieval levert tijdens inference bewijsmateriaal aan, dus het is het betere startpunt voor feiten die veranderen of een bronvermelding nodig hebben. Nieuwe documenten zijn pas beschikbaar na ingestie en indexering; toets die actualiteit aan je eis.
Duidelijke prompts en voorbeelden zijn goedkoper om te itereren dan een nieuwe trainingsrun. Ze lossen een stijl- of instructieprobleem misschien al op. Fine-tuning kan herhaalde prompt-tokens verminderen, maar de serving-latency hangt af van het model, de lengte van de output, de hardware en de implementatie; een update van de weights is zelf geen versnelling.
Voor syntaxis maskeren bibliotheken als xgrammar en outlines ongeldige volgende tokens binnen een ondersteund schema of een ondersteunde grammatica. Een succesvol afgeronde constrained generation hoort bij die taal. Behandel afgekapte en andere onvolledige generaties apart en valideer het resultaat voordat je het gebruikt. De beperking kan een klant-ID niet waar maken en de keuze van een tool niet passend. Meet de latency op je eigen backend in plaats van een vaste overhead aan te nemen.
Elk van de vier opties verandert een andere stap van hetzelfde verzoek. Alleen fine-tuning vraagt om een trainingsrun en een nieuw modelartefact; de andere drie veranderen tekst, documenten of een schema rond dezelfde weights. De tabel vergelijkt de vier opties naast elkaar:
| Optie | Wat het verandert | Hoe je het bijwerkt | Opstartkosten | Wat het niet kan oplossen |
|---|---|---|---|---|
| Prompting | Instructies en voorbeelden | De tekst aanpassen | Laag: prompts schrijven en testen | Gedrag dat het model niet uit instructies kan volgen |
| RAG | Bewijsmateriaal in het context window | Documenten inlezen en opnieuw indexeren | Gemiddeld: index, retriever en evaluatie | Een model dat het bewijs negeert of verkeerd leest |
| Constrained decoding | Welke tokens de decoder mag uitgeven | Het schema of de grammatica aanpassen | Laag tot gemiddeld: schema en backend-ondersteuning | Verkeerde waarden binnen een geldige structuur |
| Fine-tuning | Model weights | Opnieuw trainen en een nieuw artefact evalueren | Hoog: datacuratie, GPU-tijd, evaluatie | Feiten die na de training veranderen |
Snelle verwijzing: problemen aan oplossingen koppelen
| Uitdaging | Eerste mechanisme om te testen | Waarom? |
|---|---|---|
| Ontbrekende kennis | RAG | Haal bronvermeld bewijs op; actualiteit hangt af van ingestie en indexering |
| Verkeerd formaat of toon | Prompt engineering | Moderne models volgen stijlinstructies goed via few-shot voorbeelden |
| Ongeldige syntaxis in output | Constrained decoding | Dwingt tijdens het genereren een ondersteund schema of een ondersteunde grammatica af |
| Een taak faalt herhaaldelijk | Fine-tuning (SFT) | Leert van samengestelde input/output-voorbeelden |
| Afwijkende paarsgewijze voorkeur | Preference optimization | Gebruikt chosen/rejected-voorbeelden nadat het taakgedrag meetbaar is |
| Latency/kosten op schaal | Distillation (SFT) | Train een kleiner student-model op de output van een groter teacher-model |
| Modelgrootte verkleinen | Post-training quantization | Post-training quantization verkleint het geheugen voor weights; de snelheid hangt af van ondersteunde kernels en de workload |
Maak de business case meetbaar
Fine-tuning kan terugkerende prompt-tokens verminderen of een kleiner model het doel laten halen, maar geen van beide besparingen is automatisch. Bereken het break-evenpunt met je eigen verkeer en prijzen:
Als de noemer klein of negatief is, of berust op een onbewezen aanname over kwaliteit, heeft het project nog geen economische rechtvaardiging.
Een uitgewerkt voorbeeld met illustratieve getallen: een geprompte baseline stuurt bij elk verzoek ongeveer 2.000 tokens aan instructies en voorbeelden mee. Na het tunen heeft dezelfde taak er ongeveer 50 nodig. Bij een aangenomen $0,50 per miljoen input-tokens voor beide models is de besparing 1.950 tokens, ongeveer $0,001 per verzoek. Als training, evaluatie en deployment $3.000 kosten, ligt het break-evenpunt bij ongeveer 3,1 miljoen verzoeken. Bij 100.000 verzoeken per dag is dat ongeveer een maand. Bij 5.000 verzoeken per dag is het meer dan een jaar. De berekening geldt alleen als het getunede model dezelfde kwaliteitsdrempels haalt als de baseline.
De hybride opzet. Een gangbare architectuur is een voor de taak aangepast kleiner model plus retrieval voor veranderende feiten. Behandel het grotere geprompte model als baseline en houd het kleinere model alleen als het dezelfde taakspecifieke kwaliteits- en veiligheidsdrempels haalt.
Soorten fine-tuning
Fine-tuning kent drie hoofdvormen. Ze verschillen in de data die ze nodig hebben en in wat ze het model leren. Het diagram toont voor elk type één trainingsrij.
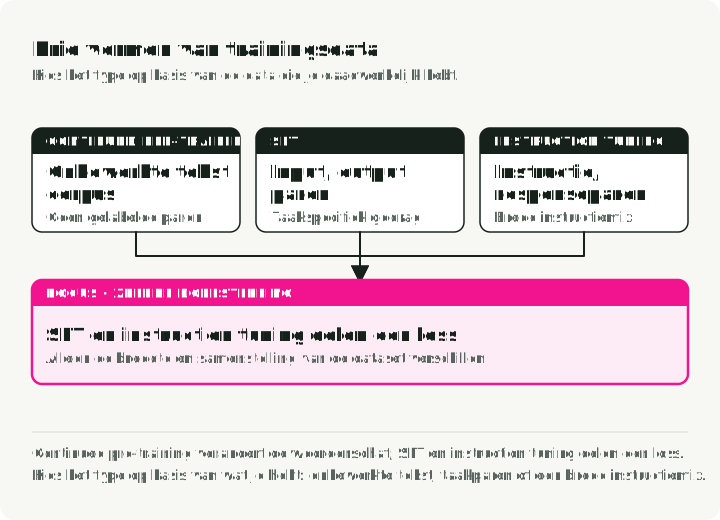
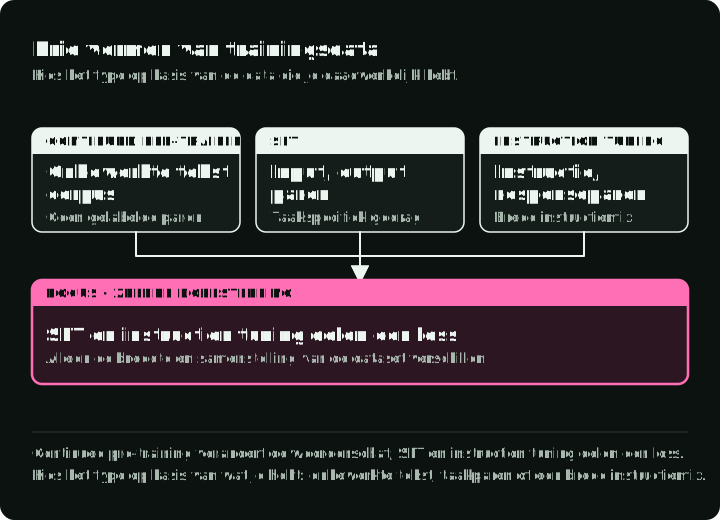
1. Continued pre-training (self-supervised)
Je traint het basismodel op meer ruwe tekst, met het volgende token in elke reeks als trainingsdoel. Dat is self-supervised learning: de tekst levert zijn eigen doelen, net als in de oorspronkelijke pretraining-run.
Wanneer te gebruiken:
- Het domein heeft woordenschat die het basismodel nooit heeft gezien (medisch, juridisch, interne codebases).
- Je hebt stapels domeintekst, maar geen gelabelde (input, output)-paren.
- Het basismodel stuntelt met domeinspecifieke terminologie.
Voorbeeld: trainen op miljoenen klinische notities, zodat het model medische afkortingen, geneesmiddelnamen en klinische werkwijzen oppikt.
2. Supervised fine-tuning (SFT)
SFT traint op gelabelde (input, output)-paren. Je laat het model voor elke input de exacte output zien die je wilt.
Wanneer te gebruiken:
- Je hebt een specifieke taak met een zuiver input/output-formaat.
- Je hebt gelabelde data van goede kwaliteit, ook al is het weinig.
- Je hebt voorspelbaar gedrag nodig bij een bekende vorm van input.
Voorbeeld: trainen op (beschrijving van een SQL-query, SQL-code)-paren voor text-to-SQL. Dit vaste kalenderinterval gaat ervan uit dat signup_date in UTC is opgeslagen:
{
    "input": "Get users who signed up in August 2026 (UTC)",
    "output": "SELECT * FROM users WHERE signup_date >= '2026-08-01' AND signup_date < '2026-09-01'"
}
3. Instruction tuning
Instruction tuning is een bijzonder geval van SFT, bedoeld om models een grote variatie aan instructies in natuurlijke taal te laten volgen. De trainingsdata bestaat uit (instructie, antwoord)-paren over veel verschillende taken.
Wanneer te gebruiken:
- Je wilt een algemene assistent (zoals ChatGPT of Claude).
- Het model moet gevarieerde, open verzoeken aankunnen.
- Je bouwt een chatinterface.
Voorbeeld: trainen op duizenden uiteenlopende instructies zoals “Vat dit artikel samen”, “Schrijf een gedicht over X”, “Leg Y in eenvoudige taal uit”.
Vergelijking
| Aspect | Continued pre-training | SFT | Instruction tuning |
|---|---|---|---|
| Data | Ruwe tekst | (input, output)-paren | (instructie, antwoord)-paren |
| Labels | Geen (self-supervised) | Taakspecifiek | Uiteenlopende taken |
| Doel | Domeinkennis | Specifiek taakgedrag | Elke instructie opvolgen |
| Datavolume | Meestal het grootste corpus | Bepaald door taakdekking en diversiteit van fouten | Meestal breder dan taakspecifieke SFT |
Eén doelfunctie, twee datasets. SFT en instruction tuning gebruiken dezelfde next-token-doelfunctie; het verschil zit in de breedte en de opbouw van de dataset. Continued pre-training is een apart experiment en moet gevolgd worden door tests op zowel winst in het domein als achteruitgang van algemene capaciteiten.
De fine-tuning pipeline in 7 stappen
Fine-tuning kent zeven stappen. Elke stap heeft eigen faalwijzen, en wie er een overslaat, merkt dat later meestal aan een slecht model. Het diagram toont de stappen op volgorde, wat elke stap aan het releasedossier toevoegt en de terugweg van monitoring naar datavoorbereiding.
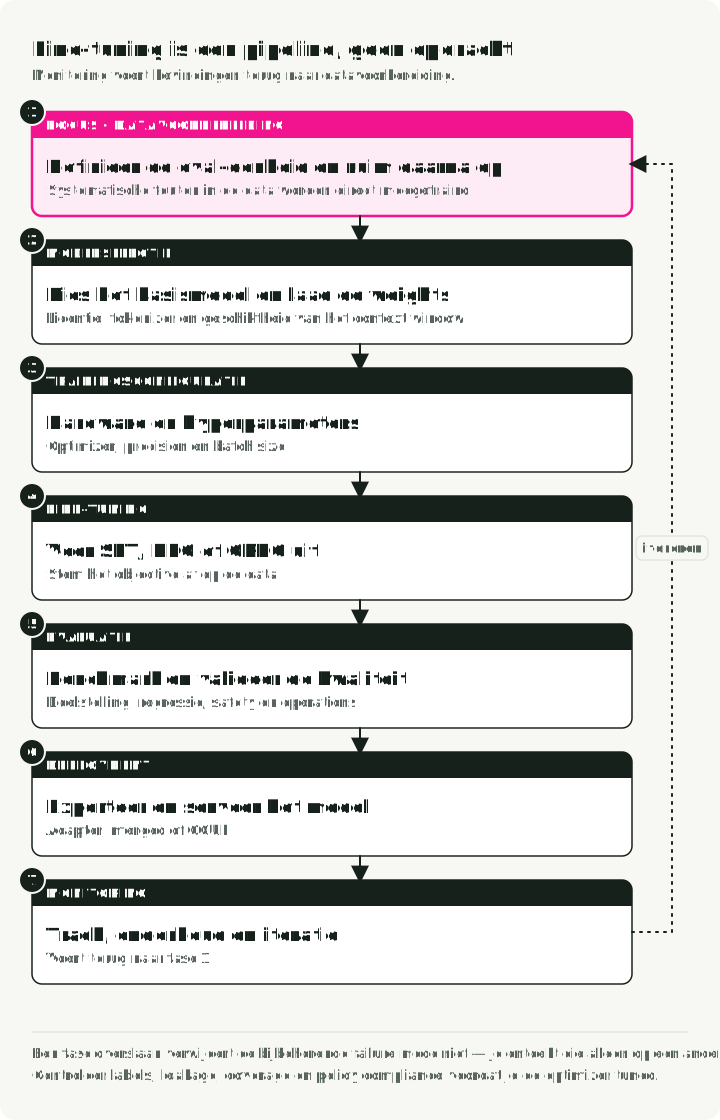
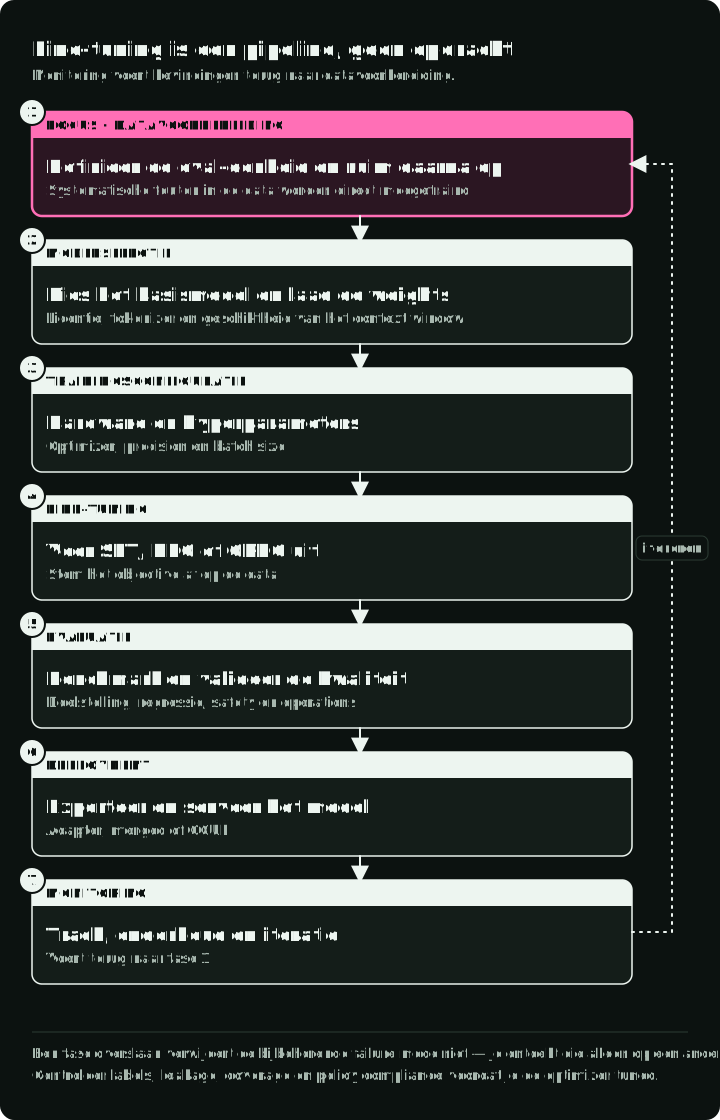
Elke stap bouwt voort op de vorige:
- Datavoorbereiding — Bepaal de eenheid van evaluatie, splits de data, maak ze daarna schoon en zet ze in het juiste formaat
- Modelkeuze — Kies het juiste basismodel en laad de weights
- Trainingsopzet — Controleer de serialisatie en de loss-doelen, kies dan de methode (LoRA, QLoRA, DoRA) en de instellingen
- Fine-tuning — Draai SFT met een framework; voeg DPO of ORPO alleen toe als dat nodig is
- Evaluatie — Meet de prestaties en valideer de kwaliteit
- Deployment — Exporteer en serveer je model
- Monitoring — Volg de prestaties, onderhoud en itereer
Data is het fundament. Training reproduceert systematische fouten in de voorbeelden. Controleer labels, leakage, dekking en naleving van beleid voordat je tijd besteedt aan optimizer-sweeps.
Stap 1: Datavoorbereiding
Problemen in de data komen terug in het getrainde model, dus aan deze stap besteed je de meeste zorg. Het diagram volgt voorbeeldtickets door die volgorde: eerst splitsen op bron, dan vijf transformaties binnen elke split.
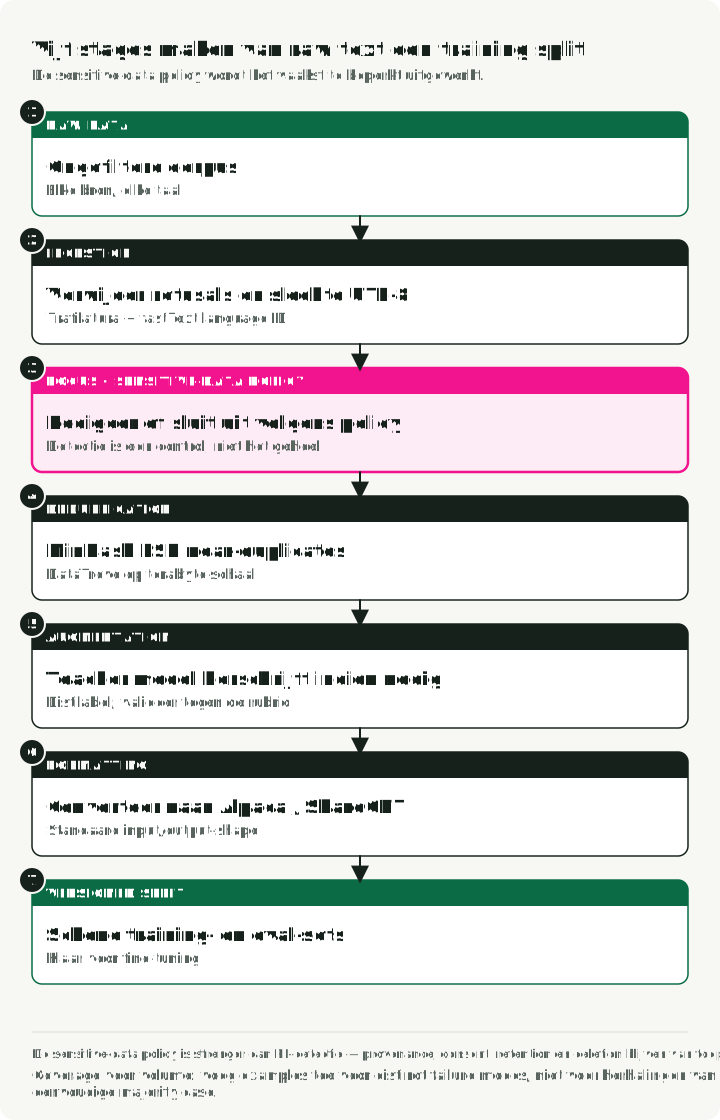
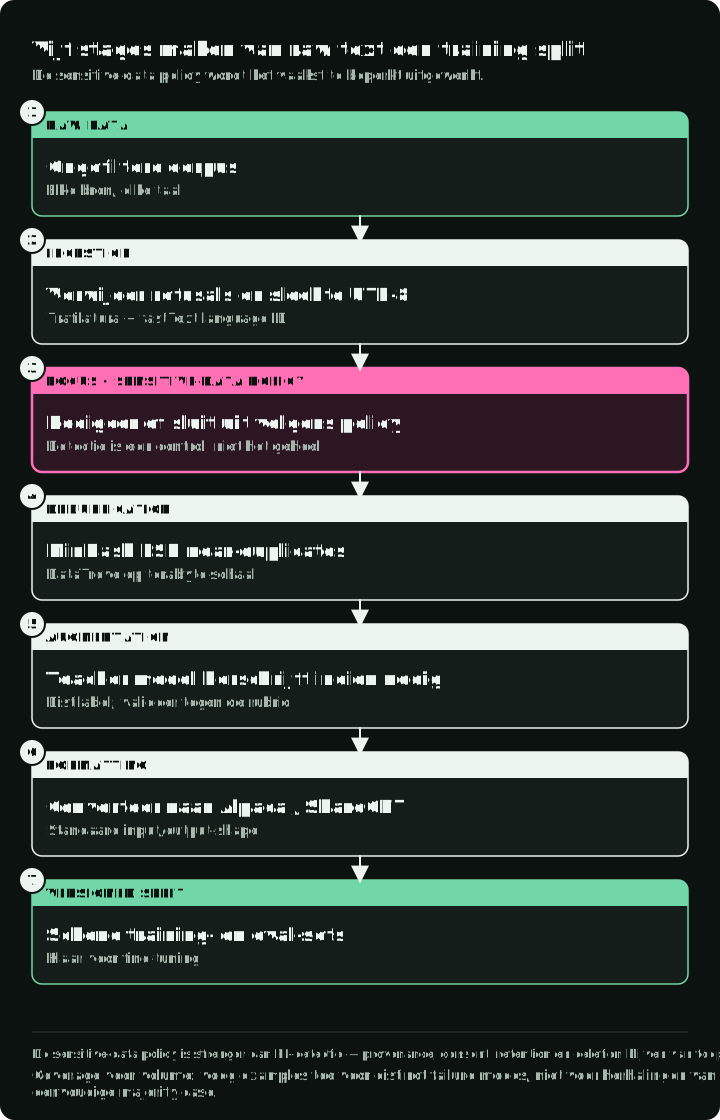
Vijf transformaties na de bronsplit
Wijs brongroepen toe aan training of evaluatie voordat je rijen transformeert. Een supportticket en elke herschrijving van dat ticket blijven in dezelfde partitie. Cluster bekende bijna-duplicaten voordat je groepen toewijst en controleer na het opschonen opnieuw over partities heen. Bevries de evaluatieset; augmenteer alleen trainingsdata.
Maak een lijst van de fouten die je voorbeelden het model moeten leren corrigeren en definieer dan voor elke rij de verplichte velden en labels. Kies verwerkingstools voor die stappen. DataTrove draait filteren en ontdubbelen als gedistribueerde jobs voor grote corpora; Distilabel genereert en labelt synthetische rijen met een teacher-model.
1. Ingestie en filtering
- Actie: verwijder kapotte UTF-8 en irrelevante inhoud. Label weigeringen volgens beleid: behoud correcte weigeringen als trainingsdoelen en evaluatiegevallen; sluit alleen ongeldige of irrelevante weigeringen uit.
- Tools: Trafilatura als de bron webpagina’s zijn; sla het over voor data die al tekst is. De fastText-models voor taalidentificatie voor taalherkenning.
2. Beleid voor gevoelige data
- Actie: bepaal wat het model mag leren en scherm persoonlijke en vertrouwelijke velden af, tokeniseer ze of sluit ze uit, zoals vereist.
- Tools: Microsoft Presidio als je configureerbare recognizers, meerdere talen of omkeerbare anonimisering nodig hebt; scrubadub voor een kleinere pure-Python-pipeline die gangbare persoonsgegevens uit tekst verwijdert.
- Waarom: een detector is slechts één maatregel; eisen aan herkomst, toestemming, bewaartermijn, toegang en verwijdering blijven gelden.
3. Ontdubbelen (MinHash LSH)
- Actie: verwijder bijna-duplicaten om herhaling en het risico op leakage te verkleinen; dit voorkomt geen memorisatie.
- Tools: DataTrove als het corpus gedistribueerde verwerking nodig heeft.
4. Synthetische augmentatie, indien nodig
- Actie: gebruik een geschikt teacher-model om trainingsvoorbeelden te herschrijven tot instructie-antwoordparen, met behoud van hun bron-ID’s. Augmenteer de achtergehouden partitie niet.
- Tools: Distilabel.
- Validatie: neem steekproeven van de output van de teacher, toets ze aan dezelfde rubric als menselijke labels en rapporteer de resultaten apart voor synthetische en door mensen geschreven voorbeelden. Zo’n deelverzameling van de evaluatieset heet een slice; andere nuttige slices zijn taal en taaktype.
5. Formatteren
- Actie: zet om naar een standaardformaat (Alpaca of ShareGPT).
Voorbeelden van dataformaten
Alpaca-formaat (instructies opvolgen):
{
    "instruction": "Summarize the following text.",
    "input": "The text to be summarized...",
    "output": "This is the summary."
}
Opslag in ShareGPT-stijl (conversatie):
{
    "conversations": [
        { "from": "user", "value": "Hello, who are you?" },
        { "from": "assistant", "value": "I am a helpful AI assistant." }
    ]
}
Datacontroles
- Dekking vóór volume. Voeg voorbeelden toe die verschillende faalwijzen vertegenwoordigen, geen herhalingen van het makkelijke meerderheidsgeval.
- Zuiverheid. Laat irrelevante tekst weg, normaliseer witruimte, houd de opmaak consistent.
- Balans. Behoud belangrijke zeldzame gevallen en rapporteer de prestaties per slice.
- Scheiding. Splits op bron, gebruiker, document of tijd wanneer willekeurige splitsing van rijen bijna-duplicaten zou laten lekken.
- Herkomst. Leg voor elke datasetversie de bron, de licentie of toestemming, de transformatiegeschiedenis en de verwijderroute vast.
Stap 2: Modelkeuze en hardware
Het basismodel en het minimale GPU-geheugen dat het nodig heeft, bepalen wat je kunt trainen.
Begin met het kleinste basismodel dat de onmisbare baseline-controles al doorstaat. Controleer:
- licentie en voorwaarden voor herdistributie voor het beoogde product;
- taal, domein, tool use en veiligheidsgedrag vóór de aanpassing;
- compatibiliteit van tokenizer en chat template met de dataset;
- de maximale context en het afkapgedrag die echte voorbeelden nodig hebben;
- ondersteuning in zowel het trainingsframework als de doel-serving-engine.
Fine-tuning is een aanpassingsstap, geen reparatie voor een ongeschikt basismodel. Als het model faalt op capaciteiten die de dataset niet dekt, kies dan een ander basismodel voordat je meer epochs draait.
Schat het geheugen voor je run
Er bestaat geen duurzame tabel “modelgrootte → GPU”. Het piekgeheugen verandert met de precisie van de weights, de optimizer, het aantal trainbare parameters, de sequentielengte, de micro-batchgrootte, activation checkpointing, de attention-implementatie en de overhead van het framework. Begin met een geheugenschatting en draai dan een korte smoke test met maximale lengte op precies jouw stack.
| Geheugencomponent | Volledige fine-tuning | LoRA | QLoRA |
|---|---|---|---|
| Basis-weights | Trainingsprecisie | Bevroren, meestal BF16/FP16 | Bevroren, meestal 4-bit NF4 |
| Gradiënten | Alle trainbare weights | Adapter-weights | Adapter-weights |
| Optimizerstatus | Alle trainbare weights | Adapter-weights | Adapter-weights |
| Activations | Hangen bij elke methode af van batch- en sequentielengte | Dezelfde afhankelijkheid | Dezelfde afhankelijkheid |
De grafiek past de tabel toe op het basismodel van de demo, Nemotron-Nano-4B met 4,51 miljard parameters. Hij splitst het geschatte geheugen van elke methode op in weights en trainbare status; activations komen daar bovenop.
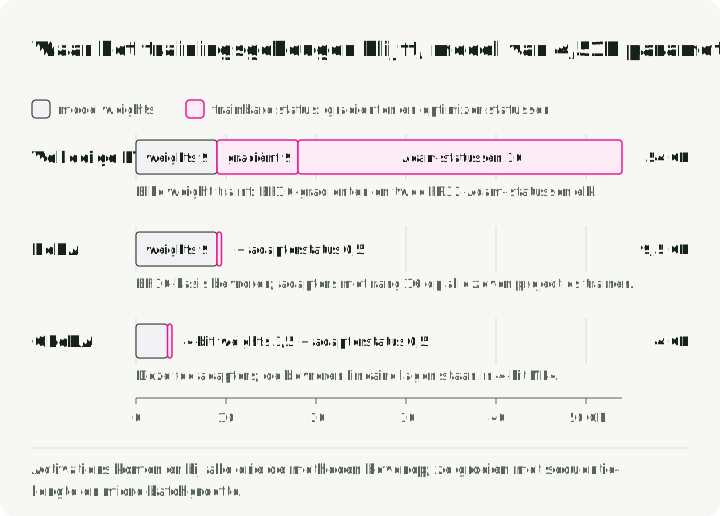
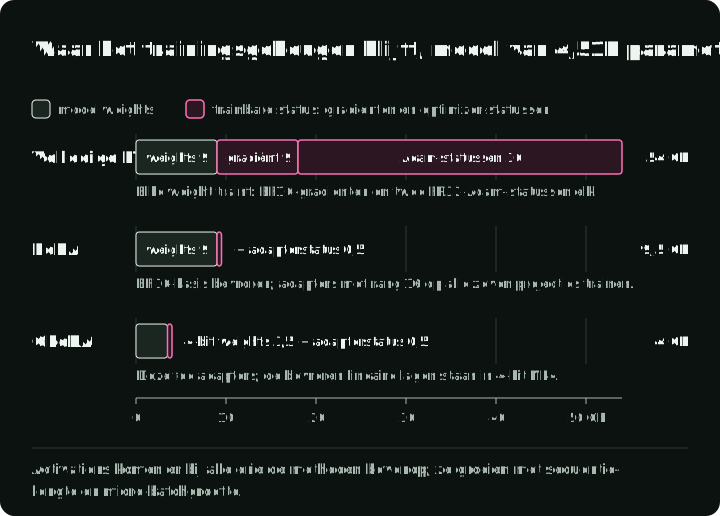
Het oorspronkelijke QLoRA-paper paste in zijn specifieke opzet een LLaMA-model van 65B op één GPU van 48 GB. Dat resultaat is een nuttige grens, geen belofte dat elke huidige 70B-architectuur, contextlengte, kernel of trainer op hetzelfde apparaat past.
Geheugenrekenwerk
Voor een model met parameters vragen alleen de weights ongeveer bytes in BF16/FP16 of bytes bij vier bits, vóór quantization-metadata en runtime-buffers. Volledige training in Adam-stijl voegt gradiënten, optimizerstatus en vaak master weights met hogere precisie toe. LoRA vermijdt het grootste deel van het geheugen voor trainbare status; QLoRA verkleint daarnaast de voetafdruk van de bevroren basis-weights. Activations kunnen bij lange sequenties nog steeds domineren.
Gebruik deze werkwijze:
- Kies de langste sequentie en micro-batch die je moet ondersteunen.
- Schat de weights en de trainbare status, en laat ruimte voor activations en kernels.
- Draai één forward/backward-stap met maximale lengte.
- Noteer het piekgeheugen, zowel allocated als reserved.
- Schaal pas daarna de batchgrootte, de rank, de sequentielengte of het aantal GPU’s op.
Stap 3: Trainingsopzet en methoden
Stap 3 bestaat uit twee delen. Controleer eerst of elke opgeslagen rij de trainingstekst wordt die je verwacht. Kies daarna de trainingsmethode en de instellingen.
Van opgeslagen rijen naar trainingsdoelen
ShareGPT is een vorm van dataset; ChatML is één serialisatieconventie. Zet from/value om naar de rollen en velden die de trainer accepteert en gebruik dan de chat template van het gekozen model. Gebruik niet zomaar ChatML-tokens alleen omdat de data conversationeel is.
Een rij doorloopt vijf stappen:
- ShareGPT-rij: paren
from/value. messagesentools: de rollen die de trainer accepteert.apply_chat_templatemet de template van het gekozen model. Inference moet dezelfde template gebruiken.- Token-ID’s en labels, waarbij
-100betekent: geen loss. - Trainen.
Print de gerenderde tekst uit stap 3 vóór de training.
Voor de begroetingsrij hierboven zijn de genormaliseerde messages:
messages = [
    {"role": "user", "content": "Hello, who are you?"},
    {"role": "assistant", "content": "I am a helpful AI assistant."},
]
# Inspection step after loading the selected model's tokenizer:
rendered = tokenizer.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=False,
)
print(rendered)
Inspecteer de echt geserialiseerde rij vóór de training: rolscheidingstekens, end-of-turn-tokens en tool schemas moeten overeenkomen met inference. Behoud bij een tool-use-rij de tooldefinities, de tool calls van de assistent en de tool results als aparte velden. Controleer dat afkappen het gesuperviseerde antwoord niet verwijdert en geen toolargument middendoor snijdt.
Loss masking bepaalt voor welke tokens het model beloond wordt als het ze voorspelt. Bij training op de volledige sequentie kunnen user-, system-, tool- en assistenttekst allemaal bijdragen. Bij training op alleen de assistent blijven die contexttokens zichtbaar voor attention, maar hun labels worden genegeerd (meestal -100); alleen de spans van de assistent dragen bij. Voor deze begroeting zou het antwoord een doel moeten zijn en de vraag van de gebruiker niet, als gedrag met alleen de assistent de bedoeling is.
Het diagram toont beide instellingen voor één conversatie met tool use.
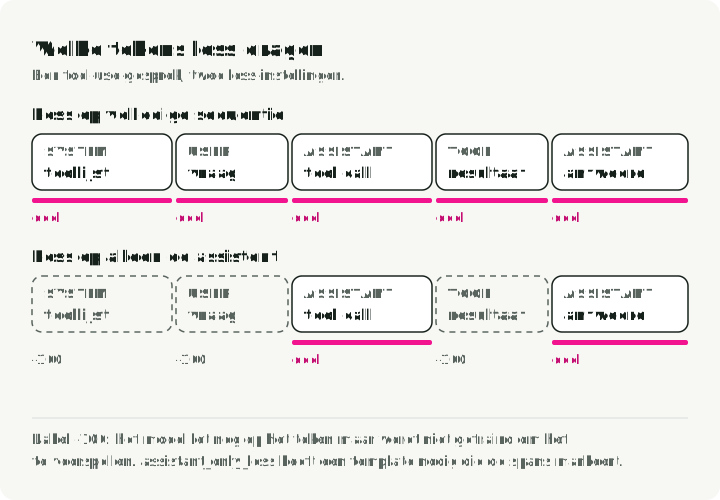
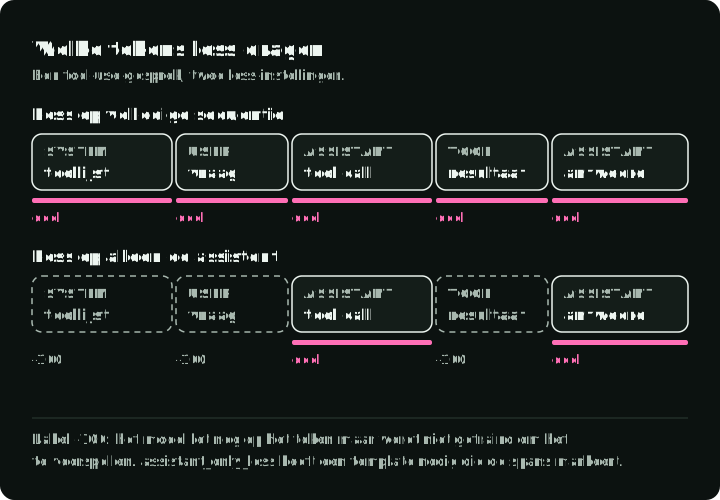
De SFT-documentatie van TRL ondersteunt assistant_only_loss=True voor conversationele datasets waarvan de templates generation-spans beschikbaar maken. Een template zonder die spans kan dat masker niet leveren. Prompt/completion-datasets hebben een aparte optie completion_only_loss. Inspecteer vóór het inschakelen van een van beide één getokeniseerde batch en decodeer de tokens met labels die niet genegeerd worden. Herhaal dat daarna met een toolconversatie en een voorbeeld van maximale lengte. De demo verderop in deze gids gebruikt loss over de volledige sequentie, omdat de Nemotron-template geen generation-spans heeft.
Kies een sequentielengte op basis van de verdeling in de data en draai de geheugencontrole met maximale lengte uit Stap 2. Packing zet meerdere kortere voorbeelden in één trainingssequentie. Begin zonder, zodat rijgrenzen makkelijk te inspecteren zijn. Benchmark packing pas als de geserialiseerde rijen en labels kloppen.
Volledige fine-tuning vs PEFT
Volledige fine-tuning (FFT) werkt elke weight bij, dus gradiënten en optimizerstatus schalen mee met het hele model. De piek is niet af te leiden uit het aantal parameters alleen, maar ligt ver boven het geheugen dat nodig is om de weights voor inference te laden.
Parameter-efficient fine-tuning (PEFT) traint maar een kleine subset van de parameters en bevriest de rest, zodat gradiënten en optimizerstatus alleen die subset beslaan.
LoRA: het startpunt
LoRA (Low-Rank Adaptation) bevriest een voorgetrainde matrix en stelt de geleerde update voor met twee kleinere matrices. Het oorspronkelijke paper motiveert dit met de hypothese dat nuttige aanpassingsupdates een lage intrinsieke rank hebben.
Hier is de invoerbreedte van de laag en de uitvoerbreedte. De rank is de kleinere gedeelde dimensie van de twee trainbare matrices: een kleinere rank gebruikt minder trainbare parameters. De instelling bepaalt de schaal van de update via de verhouding .
Het diagram toont de bevroren matrix, de twee trainbare matrices en hoe hun geschaalde product wordt opgeteld, met het aantal parameters voor één matrix van 4.096 breed bij rang 16.
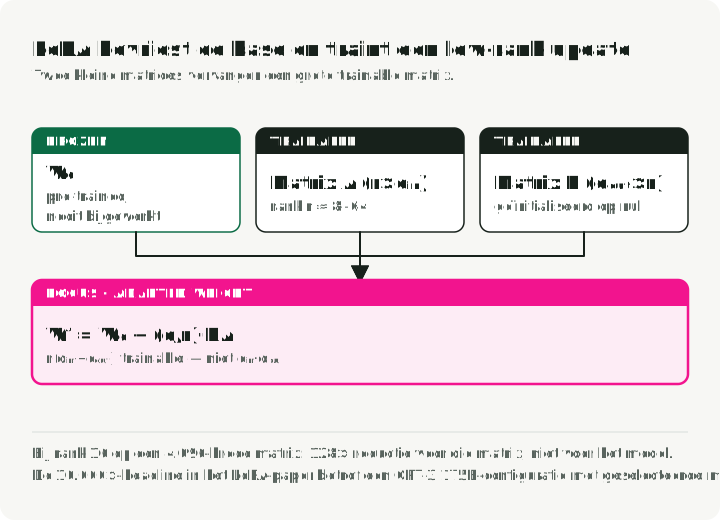
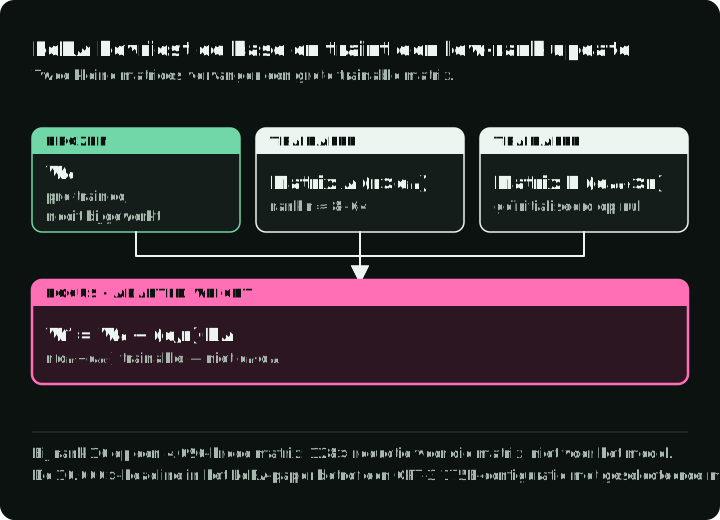
Voor een bevroren matrix leert LoRA:
De aangepaste laag is:
De adapter heeft trainbare parameters in plaats van voor die matrix. Voor een vierkante matrix met breedte 4.096 bij rank 16 is dat een reductie van 128× in trainbare parameters voor deze matrix. De besparing voor het hele model hangt af van welke matrices adapters krijgen.
PEFT-methoden vergeleken
| Methode | Wat verandert | Kies het wanneer |
|---|---|---|
| LoRA | Bevroren basis plus trainbare updates met lage rank | Het basismodel past ruim en je wilt kleine taakartefacten |
| QLoRA | LoRA met de bevroren basis opgeslagen in 4-bit vorm | Het geheugen voor de basis-weights is de beperkende factor |
| DoRA | Scheidt de grootte van de weight van een met LoRA bijgewerkte richting | Een gemeten LoRA-baseline laat een kwaliteitskloof die extra complexiteit waard is |
| Volledige fine-tuning | Alle weights van het model | PEFT mist het doel en de kwaliteitswinst rechtvaardigt gedistribueerde training en volledige checkpoints |
DoRA: LoRA met gedecomponeerde weights
DoRA (Weight-Decomposed Low-Rank Adaptation) scheidt de grootte van elke weight-vector van zijn richting. Het DoRA-paper past een LoRA-update toe op de richtingscomponent en leert de grootte apart. Het diagram tekent één weight-kolom als pijl: B·A draait de richting en een getrainde grootte m bepaalt de lengte.
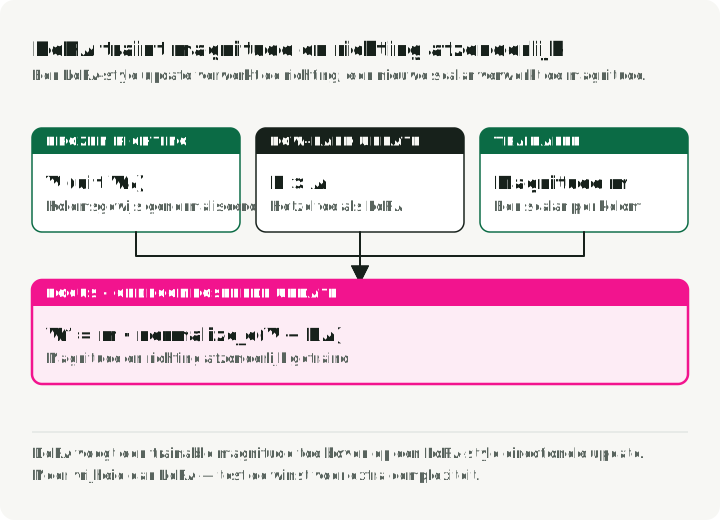
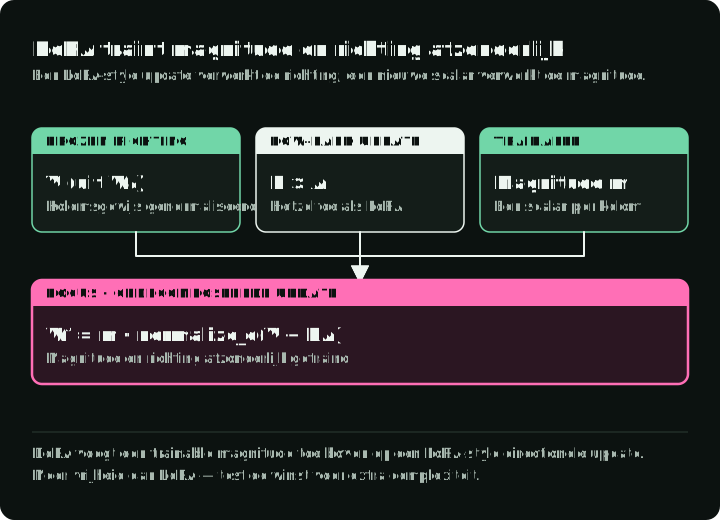
Hoe het werkt:
In plaats van weights als één geheel te behandelen, splitst DoRA voorgetrainde weights in twee componenten:
- Grootte — een trainbare waarde per weight-vector.
- Richting — een genormaliseerde vector die via matrices met lage rank wordt bijgewerkt.
In compacte notatie per kolom:
waarbij:
m= grootte (trainbaar)- = de bevroren beginmatrix; normaliseer nadat is opgeteld
- = de geleerde richtingsupdate met lage rank
- = normalisatie per kolom
Effecten van de decompositie:
- Meer vrijheidsgraden dan standaard LoRA, omdat de grootte onafhankelijk kan veranderen.
- In het paper dat de methode voorstelt, betere resultaten dan LoRA in meerdere configuraties.
- Extra parameters en rekenwerk, dus controleer de winst op je eigen taak en serving-pad.
Adapters samenvoegen voor multitask learning
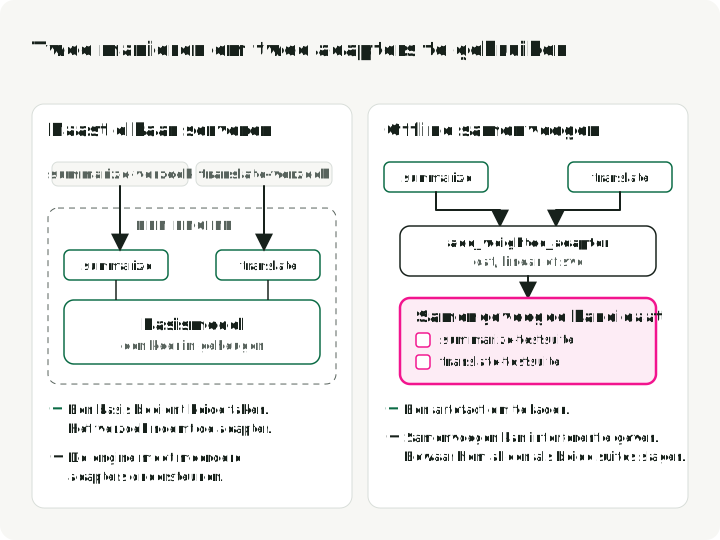
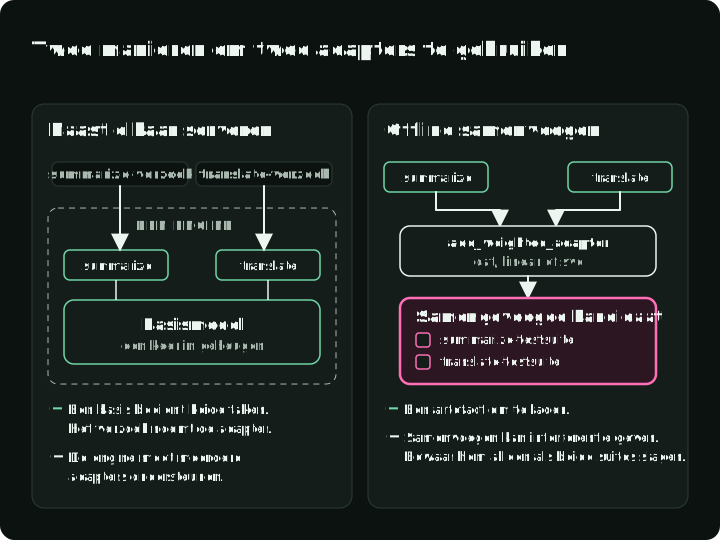
Aparte adapters laten één bevroren basis meerdere taken ondersteunen. Je kunt verzoeken naar een adapter routeren, meerdere adapters vanuit één engine serveren als dat wordt ondersteund, of offline een samengevoegde kandidaat maken. Samenvoegen kan interferentie veroorzaken, dus evalueer het samengevoegde artefact in plaats van aan te nemen dat de bronadapters netjes samengaan.
De figuur vergelijkt de twee opties voor twee adapters op één basis. Bewaar het samengevoegde model alleen als het beide testsuites doorstaat.
Gangbare samenvoegmethoden:
- Concatenatie — combineer de adapterparameters en vergroot de effectieve rank. Snel en eenvoudig.
- Lineaire combinatie — gewogen som van adapters. De weights bepalen hoeveel elke taak bijdraagt.
- SVD — matrixdecompositie voor het samenvoegen. Flexibeler, maar langzamer.
add_weighted_adapter van PEFT implementeert deze als combination_type="cat", "linear" en "svd"; de PEFT-gids voor model merging behandelt ze en nieuwere methoden.
Voorbeeld: één adapter voor samenvatten, een andere voor vertalen, samengevoegd tot één multitaskmodel.
Stap 4: Preference alignment (optioneel)
SFT is de belangrijkste trainingsrun en de frameworksecties na deze stap voeren hem uit. Deze stap behandelt wat je na SFT kunt toevoegen, als de fouten daarom vragen.
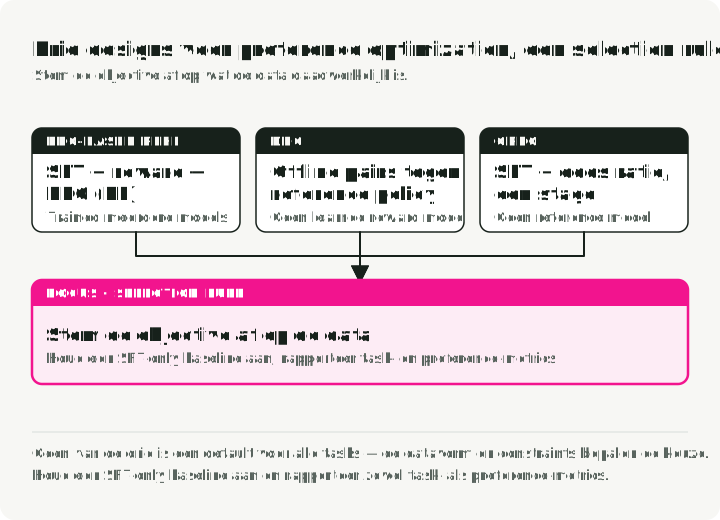
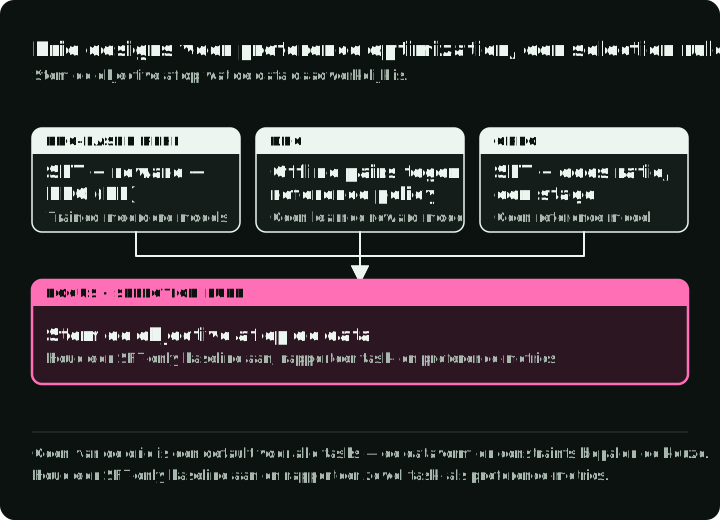
SFT leert demonstraties. Preference optimization leert in plaats daarvan van vergelijkingen zoals “gekozen antwoord A is beter dan afgewezen antwoord B”. Gebruik het alleen als een paarsgewijze voorkeur het juiste label voor de fout is; feitelijke juistheid en naleving van beleid vragen vaak om sterkere evaluators dan een globale voorkeur.
Het diagram toont de fasen van elke methode, de models die ze laadt en wat één trainingsstap doet.
RLHF op basis van PPO
RLHF betekent reinforcement learning from human feedback. De policy is het taalmodel dat antwoorden genereert; een reward model beoordeelt die antwoorden met voorkeuren die uit menselijke vergelijkingen zijn geleerd. Een recept op basis van PPO heeft drie fasen:
- SFT — leer de taak.
- Reward model — train op menselijke voorkeuren (chosen vs rejected).
- PPO (Proximal Policy Optimization) — genereer antwoorden en werk het taalmodel bij om hun reward-scores te verhogen.
De operationele kosten komen van de verschillende componenten:
- Ingewikkeld te implementeren en te onderhouden.
- Duur — je traint meerdere models.
- Samplen uit het model dat getraind wordt, vraagt controles op instabiele updates en op antwoorden die het reward model uitbuiten zonder de taak te vervullen.
DPO
DPO (Direct Preference Optimization) laat het aparte reward model en de reinforcement-learning-lus vallen. Het bevoordeelt gekozen antwoorden en ontmoedigt grote afwijkingen van een vast beginmodel, het referentiemodel. Het DPO-paper leidt deze doelfunctie af door te beperken hoe ver de waarschijnlijkheden van antwoorden van die referentie mogen afwijken; de wiskundige grens is een KL-divergentiebeperking.
Een voorkeurspaar bevat dezelfde prompt en twee kandidaatantwoorden. Deze verkorte rij toont de velden; echte labels hebben volledige antwoorden en een reden om het ene te verkiezen nodig:
{
    "prompt": "Explain quantum computing",
    "chosen": "Quantum computing uses qubits...",   # Preferred response
    "rejected": "Well, it's complicated..."        # Non-preferred response
}
Wat er operationeel verandert:
- Eenvoudiger codepad (geen apart reward model, geen RL-lus).
- Trainen op opgeslagen voorkeurparen in plaats van bij elke update nieuwe antwoorden te genereren voor reward-scoring.
- In de standaardformulering een vast referentiemodel, of de opgeslagen log-waarschijnlijkheden daarvan voor de trainingsantwoorden.
DPO is makkelijker te prototypen dan een volledige PPO-pipeline, maar het is geen automatische kwaliteitsverbetering. De resultaten hangen af van de beginpolicy, de kwaliteit van de paren, de loss-instellingen, lengte-effecten en het evaluatieprotocol. Vergelijk het met een SFT-checkpoint op dezelfde achtergehouden voorkeurs- en tasksuites.
ORPO
ORPO (Odds-Ratio Preference Optimization) combineert de negatieve-log-likelihood-loss van SFT met een odds-ratio-straf op afgewezen antwoorden. Het verwijdert het aparte referentiemodel en kan taakleren en preference optimization in één run combineren.
Hoe het werkt: ORPO gebruikt een gecombineerde loss die twee dingen tegelijk doet:
- Maximaliseert de waarschijnlijkheid van het gekozen antwoord (de taak leren).
- Straft het afgewezen antwoord met een odds-ratio-term (voorkeuren leren).
TRL levert ORPO nu als ORPOConfig in trl.experimental.orpo (TRL ORPO-trainer). Twee instellingen zijn het kennen waard:
learning_rate: het paper gebruikte lage waarden zoals8e-6; stem af op je model, batch en data in plaats van één waarde als regel over te nemen.beta: bepaalt de voorkeursterm ten opzichte van de SFT-term.
De afweging:
- Eén trainingsfase in plaats van twee.
- Geen reward model.
- Geen forward pass van een referentiemodel.
- Een gekoppelde run: als taakleren of voorkeursgedrag achteruitgaat, is er geen tussenliggend SFT-checkpoint uit dezelfde pipeline om te inspecteren.
Kies via het ontwerp van data en evaluatie:
- Gebruik DPO als je al een bevredigend SFT-checkpoint hebt en een eenvoudiger offline voorkeursexperiment wilt.
- Test ORPO als een referentievrije doelfunctie in één fase past bij je data en operationele beperkingen.
- Gebruik RLHF op basis van PPO als online sampling tegen een expliciet geleerde reward onderdeel is van de eis en je reward-uitbuiting kunt monitoren.
Geen van de drie is een standaard voor alle taken. Houd een baseline met alleen SFT aan en rapporteer zowel taakmetrics als voorkeursmetrics.
Fine-tuning frameworks
Stap 3 en 4 hebben de methode gekozen. De volgende twee secties kiezen een framework en draaien er SFT mee.
Frameworks overlappen en veranderen snel. Kies op basis van het uitvoeringspad dat je moet ondersteunen, pin versies en houd de trainingsconfiguratie draagbaar genoeg om hem buiten een notebook te reproduceren.
Unsloth — snelheid en geheugenefficiëntie
Unsloth integreert met Hugging Face trl en transformers en biedt geoptimaliseerde kernels, checkpointing en gequantiseerde fine-tuningpaden voor ondersteunde models.
- Eigen Triton-GPU-kernels voor attention, RoPE en cross-entropy die PyTorch-overhead overslaan.
- Geheugenzuinige backprop die activations tijdens de backward pass opnieuw berekent in plaats van ze in het geheugen te houden.
- Gefuseerde operaties die meerdere stappen (layer norm + linear en dergelijke) samenvouwen tot enkele GPU-aanroepen.
- 4-bit quantization rechtstreeks geïntegreerd in het QLoRA-pad met geoptimaliseerde dequantisatie.
De volgorde van imports telt. Volg de importvolgorde uit het Unsloth-voorbeeld voor de versie die je pint. Unsloth past patches toe tijdens het importeren, dus als je het vóór trl en transformers importeert, voorkom je gemiste optimalisaties of versiespecifieke fouten.
# Correct order
from unsloth import FastLanguageModel  # Must be first!
from trl import SFTConfig, SFTTrainer

# Avoid this order with Unsloth's patched path
from trl import SFTTrainer
from unsloth import FastLanguageModel
Het meest geschikt voor: training op één GPU, prototyping en Colab-notebooks.
Gepubliceerde cijfers voor snelheid en geheugen variëren met model, sequentielengte, batch, precisie en hardware. Benchmark tokens per seconde en piekgeheugen op je eigen run in plaats van een kopcijfer als eigenschap van het framework te behandelen.
Axolotl — training op basis van configuratie
Voor opzetten die eerst op configuratie draaien en voor gedistribueerde opzetten houdt Axolotl de hele run in één YAML-bestand. Deze sleutels kiezen een 4-bit basis, een QLoRA-adapter en een dataset in Alpaca-formaat:
# axolotl_config.yaml (excerpt)
base_model: meta-llama/Meta-Llama-3-8B
load_in_4bit: true
adapter: qlora
lora_r: 32
lora_alpha: 16 # alpha/r = 0.5 here; the demo uses 2. Sweep it with the learning rate.
datasets:
    - path: data/training_data.jsonl
      type: alpaca
Doelmodules, sequentielengte, packing, batchgrootte, learning rate en epochs staan in hetzelfde bestand; de configuratiereferentie noemt elke sleutel. Start de training:
axolotl train axolotl_config.yamlVergelijking van frameworks
| Tool | Nuttig wanneer | Controleer vóór je kiest |
|---|---|---|
| Unsloth | Je een geoptimaliseerd pad voor ondersteunde models met beknopte voorbeelden wilt | De ondersteuningsmatrix voor model, GPU, quantization en gedistribueerd draaien |
| Axolotl | Je declaratieve configuraties en ingebouwde gedistribueerde recepten wilt | Het exacte configuratieschema en de launcher voor de gepinde release |
| TRL | Je rechtstreeks toegang wilt tot de SFT- en preference-trainers van Hugging Face | Dataformaat, chat template, loss masking en PEFT-integratie |
| Torchtune | Je al torchtune-recepten draait; het wordt sinds 2025 niet meer actief onderhouden | Dekking van modelrecepten en exportcompatibiliteit |
Praktijkdemo: fine-tunen met Unsloth
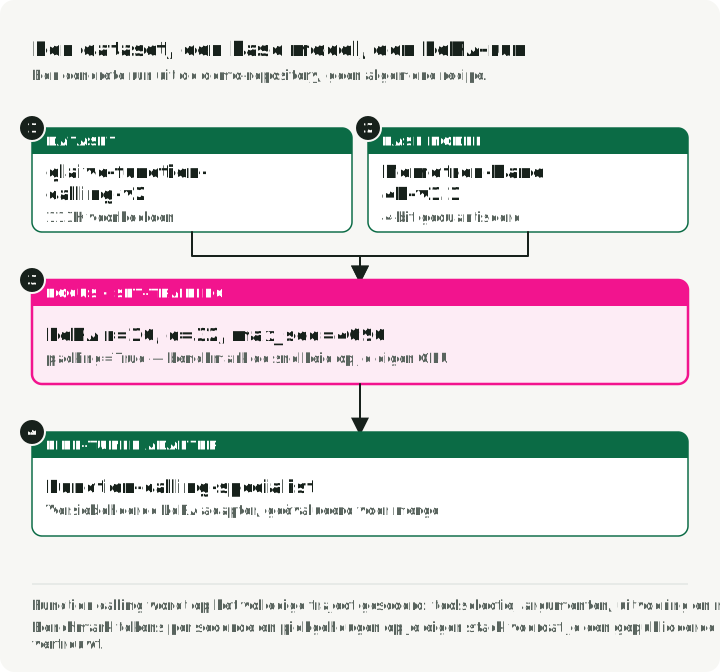
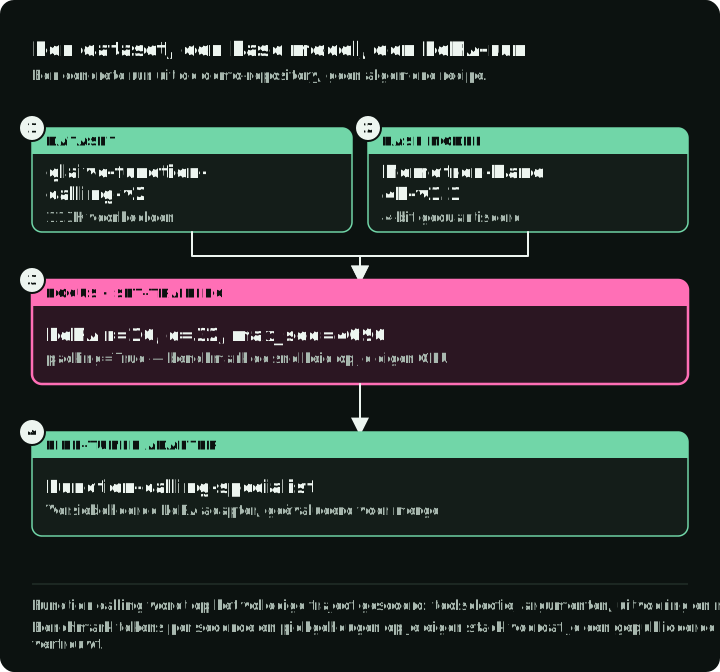
Deze demo leert een model een functie te kiezen en de argumenten aan te leveren. Mijn unsloth-finetune-demo fine-tunet Llama-3.1-Nemotron-Nano-4B-v1.1 op de dataset glaive-function-calling-v2. Het CUDA-trainingspad van deze repository vereist Linux of WSL2 en een NVIDIA-GPU. Unsloth heeft ook een apart trainingspad voor Intel-GPUs, dat deze demo niet implementeert. Pin de commit die je draait; het lock-bestand pint de dependencies, waaronder TRL 0.24.0.
Het diagram toont de hele run met de echte waarden: hoe een glaive-rij trainingstekst wordt die de tooldefinities behoudt, de split, de trainingsinstellingen, de drie uitvoermappen en de eerste controle.
Draai het
git clone https://github.com/slavadubrov/unsloth-finetune-demo.git
cd unsloth-finetune-demo
uv sync

# Train on 1,000 random rows, then also save a merged model and a GGUF file
uv run finetune --max-samples 1000 --merge --gguf q4_k_m
Elke finetune-run traint. --merge en --gguf voegen exports toe na de training; er is geen opdracht om alleen te exporteren. De run schrijft drie mappen:
outputs/unsloth-nemotron-function-calling/— de LoRA-adapteroutputs/unsloth-nemotron-function-calling-merged/— het samengevoegde 16-bit model (--merge)outputs/unsloth-nemotron-function-calling-gguf/— het GGUF-bestand (--gguf q4_k_m)
Voordat de training begint, print de run de eerste trainingsrij zoals het model hem ziet. Lees hem: de tooldefinities staan binnen <AVAILABLE_TOOLS> en elke aanroep staat binnen <TOOLCALL>.
Datavoorbereiding
Elke glaive-rij heeft twee strings. De kolom system bevat elke functiedefinitie; de kolom chat bevat de conversatie, met aanroepen geschreven als <functioncall> {...}. Trainen op alleen chat leert het model tools aan te roepen waarvan het de schema’s nooit ziet. De data.py van de demo zet elke rij om in messages en een aparte lijst tools, rendert beide met de eigen chat template van het model en houdt 5% van de rijen achter als evaluatiesplit:
def to_text(example: dict, tokenizer) -> dict:
    """Render one glaive row with the model's chat template. Empty text marks a dropped row."""
    try:
        messages, tools = to_messages(example)
    except (ValueError, KeyError):  # bad JSON in a tool definition or call
        return {"text": ""}
    if not messages:
        return {"text": ""}
    text = tokenizer.apply_chat_template(messages, tools=tools or None, tokenize=False)
    # The trainer tokenizes this text with special tokens on, which adds BOS again.
    return {"text": text.removeprefix(tokenizer.bos_token or "")}
Op de volledige dataset blijven 112.811 van de 112.960 rijen over; 149 rijen hebben misvormde JSON en worden weggelaten. Met deze tokenizer is de langste gerenderde rij 4.076 tokens, dus een limiet van 4.096 tokens kapt er geen af.
De chat template van de modelkaart heeft één gebrek voor training. Hij rendert een eerdere tool call zonder de sluitende accolade na arguments, waardoor de tekst binnen <TOOLCALL> geen geldige JSON is. Een model dat op die tekst is getraind, leert die uit te geven en de serving-parser kan de aanroep niet lezen. De repository levert de template met de accolade eraan toegevoegd mee en gebruikt hem bij training en serving. De test die alleen de CPU gebruikt, rendert toolconversaties en controleert dat elke <TOOLCALL> te parsen is.
Configuratie van de demo
De config.py van de demo stelt de LoRA-waarden in:
LORA_R = 16        # Adapter capacity; tune against held-out results
LORA_ALPHA = 32    # Update scale alpha/r = 2
LORA_DROPOUT = 0.05
MAX_SEQ_LENGTH = 4096
LORA_TARGET_MODULES noemt alle zeven attention- en MLP-projecties van dit model uit de Llama-familie, van q_proj tot down_proj.
De verhouding alpha-tot-rank. alpha/r schaalt de klassieke LoRA-update. alpha = 2r is een gangbare startheuristiek in de documentatie van sommige tools, geen garantie voor stabiliteit. Sweep rank, alpha, learning rate en doelmodules pas nadat de data en de baseline vaststaan.
Model laden
De model.py van de demo laadt de basis in 4-bit vorm, vervangt de chat template door de gecorrigeerde en voegt de LoRA-adapters toe:
from unsloth import FastLanguageModel

model, tokenizer = FastLanguageModel.from_pretrained(
    model_name=MODEL_NAME,
    max_seq_length=MAX_SEQ_LENGTH,
    load_in_4bit=True,  # QLoRA: the frozen base is stored in 4-bit form
    trust_remote_code=True,
)
# Training rows, the saved tokenizer, and vLLM all use this one template.
tokenizer.chat_template = CHAT_TEMPLATE_PATH.read_text()

model = FastLanguageModel.get_peft_model(
    model,
    r=LORA_R,
    lora_alpha=LORA_ALPHA,
    lora_dropout=LORA_DROPOUT,
    target_modules=LORA_TARGET_MODULES,
    use_gradient_checkpointing="unsloth",  # Lower activation memory; extra compute
)
Trainingsconfiguratie
De training.py van de demo geeft de gerenderde rijen door aan de SFTTrainer van TRL. Hij evalueert één keer per epoch de token-loss op de achtergehouden data. Die loss is een diagnostiek, geen nauwkeurigheid van tool calls; Stap 5 vereist nog steeds een aparte taakevaluatie.
trainer = SFTTrainer(
    model=model,  # 4-bit base with LoRA adapters from FastLanguageModel
    processing_class=tokenizer,
    train_dataset=train_dataset,
    eval_dataset=eval_dataset,
    args=SFTConfig(
        output_dir="outputs/unsloth-nemotron-function-calling",
        dataset_text_field="text",
        max_length=4096,
        packing=False,  # One row per sequence, so row boundaries are easy to inspect
        assistant_only_loss=False,  # The Nemotron template has no generation spans
        eval_strategy="epoch",
        per_device_train_batch_size=2,
        gradient_accumulation_steps=4,
        learning_rate=2e-4,
        num_train_epochs=3,
        bf16=True,  # The repository falls back to FP16 on GPUs without BF16
        optim="adamw_8bit",
    ),
)
trainer.train()
Eerste controle
uv run infer --prompt "Book a flight to Tokyo"infer laadt de adapter en stuurt de prompt mee met één tool, book_flight(destination), gerenderd met dezelfde template als de trainingsrijen. Een getrainde adapter hoort te antwoorden met <TOOLCALL>[{"name": "book_flight", "arguments": {"destination": "Tokyo"}}]</TOOLCALL>. Antwoordt hij in gewone tekst, inspecteer dan de geprinte trainingsrij voordat je langer traint.
Stap 5: Evaluatie
Leg de testgevallen, de scoreregels en de slaagdrempels vast vóór de eerste run. Vergelijk minimaal het getunede checkpoint met het exacte ongetunede basismodel onder dezelfde prompt, decodeerinstellingen en toolomgeving. Rapporteer de totale kwaliteit pas nadat je de faalslices hebt gecontroleerd die het project moest verbeteren.
Volg vier groepen:
- Doeltaak: exact match, uitvoeringssucces, menselijke rubric of een andere uitkomst die aan de use case is gekoppeld.
- Regressie: algemene vaardigheden en eerder ondersteunde taakslices die de aanpassing kan beschadigen.
- Veiligheid en beleid: weigeringen, datalekken, prompt injection of domeinspecifieke beperkingen.
- Operatie: latency, throughput, geheugen, grootte van het artefact en kosten bij de beoogde serving-configuratie.
Geautomatiseerde benchmarks
Gebruik lm-evaluation-harness om relevante gestandaardiseerde taken te controleren naast je eigen producttests. Deze opdracht vereist een samengevoegd Hugging Face-checkpoint, dat de demo schrijft met --merge:
lm_eval --model hf \
    --model_args pretrained=./outputs/unsloth-nemotron-function-calling-merged \
    --tasks hellaswag,arc_easy,mmlu \
    --batch_size 8
LLM-as-judge
Voor subjectieve kwaliteit kan een groter model helpen bij het scoren, maar kalibreer het aan de hand van door mensen beoordeelde voorbeelden en houd de identiteit van de kandidaat verborgen. Geef de judge de output van het model, het verwachte antwoord en een rubric die voor elk criterium, zoals relevantie, nauwkeurigheid en opmaak, elke score definieert.
Domeinspecifieke evaluatie
Houd echte voorbeelden achter op bron, gebruiker, document of tijd, zodat bijna-duplicaten niet over de split heen kunnen lekken. Valideer bij function calling het volledige traject: toolkeuze, argumenten, uitvoeringsresultaat, herstel en eindantwoord. Rapporteer betrouwbaarheidsintervallen of gepaarde win/verlies-aantallen wanneer de steekproef klein is en inspecteer elke regressie in een kritieke slice.
Controleer elk traject in vier stappen:
- De juiste tool wordt gekozen.
- De argumenten zijn geldig en correct.
- Het uitvoeringsresultaat is zoals verwacht.
- Het model herstelt na een toolfout.
Tel elke mislukking per controle en per slice. Een correct eindantwoord kan een fout argument of een overgeslagen herstelstap verbergen.
De evaluatiecode van de Berkeley Function Calling Leaderboard (BFCL) scoort functiekeuze en argumenten tegen referentieaanroepen. Gebruik het als regressiecontrole naast je eigen achtergehouden conversaties.
Stap 6: Deployment en uitvoerformaten
Kies het artefact op basis van de serving-engine en het rollbackplan, niet alleen op bestandsgrootte. Exporteer elk formaat vanuit dezelfde geëvalueerde objecten model en tokenizer, zodat alle artefacten dezelfde getrainde weights bevatten. Het diagram vergelijkt de drie artefacten: wat elk bestand bevat, wat het laadt en wat de afweging is.
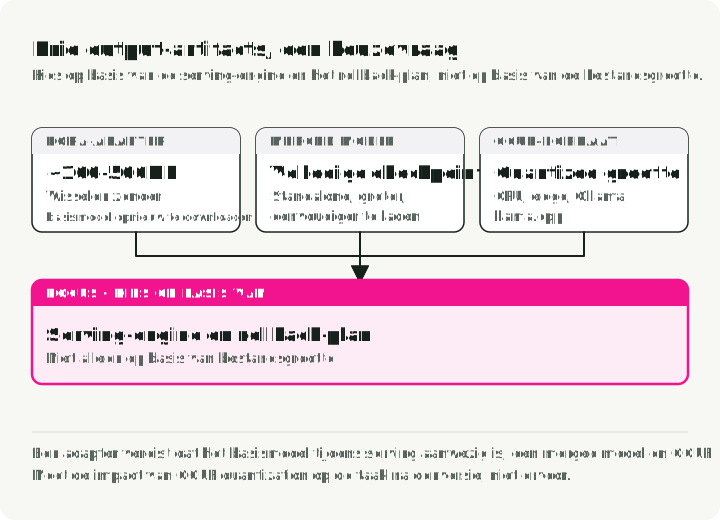
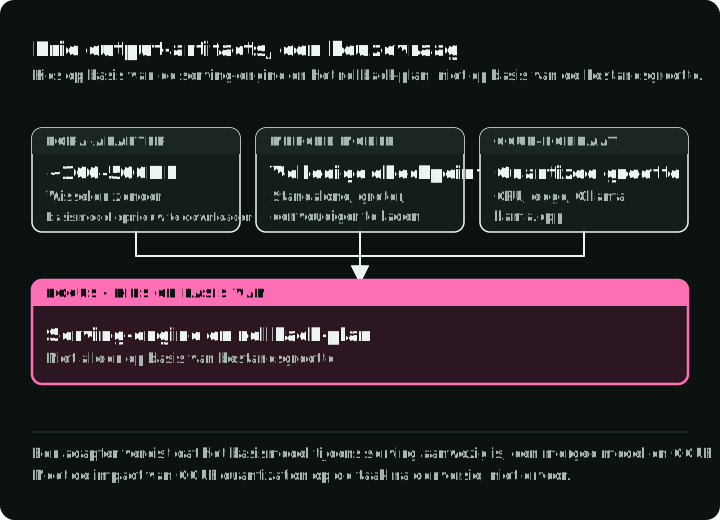
In de demo slaat uv run finetune altijd de adapter op, voegt --merge het samengevoegde model toe en voegt --gguf q4_k_m het GGUF-bestand toe, alles in één trainingsrun. De Python-aanroepen hieronder tonen wat elke vlag doet.
1. LoRA-adapter
model.save_pretrained("outputs/unsloth-nemotron-function-calling")
tokenizer.save_pretrained("outputs/unsloth-nemotron-function-calling")- Grootte: evenredig met de doelmodules, de rank, de lagen en het dtype; vaak veel kleiner dan de basis.
- Het meest geschikt voor: ontwikkeling, geversioneerde taakadapters en engines die LoRA rechtstreeks ondersteunen.
- Bonus: je kunt adapters wisselen zonder het basismodel opnieuw te downloaden.
2. Samengevoegd model
# What --merge runs: merge the adapter into the base weights and save a standalone model
model.save_pretrained_merged(
    "outputs/unsloth-nemotron-function-calling-merged", tokenizer, save_method="merged_16bit"
)- Grootte: ongeveer het volledige basischeckpoint in de gekozen uitvoerprecisie.
- Het meest geschikt voor: engines of distributiepaden die de adapter niet apart ondersteunen.
- Afweging: groter artefact en tragere uitrol; eenvoudiger laden van één model.
3. GGUF-formaat
# What --gguf q4_k_m runs; file size and name depend on the Unsloth version
model.save_pretrained_gguf(
    "outputs/unsloth-nemotron-function-calling-gguf", tokenizer, quantization_method="q4_k_m"
)- Grootte: afhankelijk van het model; grofweg weights van vier bits plus metadata bij Q4-varianten.
- Het meest geschikt voor: CPU-inference, Ollama, llama.cpp, edge-deployment.
- Opties:
q4_k_m(kleiner),q5_k_m(meer getrouwheid van de weights),q8_0(groter en getrouwer). Meet na de conversie het effect op de taak.
Stap 7: Serving en monitoring
Met vLLM
Deze opdracht serveert de demo-adapter bovenop het basismodel. Serveer met de parser en chat template van de modelkaart; ze moeten overeenkomen met de template die bij de training is gebruikt. De modelkaart registreert de parser llama_nemotron_json via het pluginbestand llama_nemotron_nano_toolcall_parser.py. De demo-repository levert de gecorrigeerde template.
Gebruik een aparte Python 3.12-omgeving met vLLM 0.12.0: de gepinde parser importeert de tool-parser-API van deze versie, die in latere versies is gewijzigd. De opdracht pint het basismodel en de parser op dezelfde revisie van de modelkaart; gebruik die basisrevisie ook voor de training. Compatibiliteit van de broncode en een CPU-parsertest bevestigen niet dat GPU-serving werkt. Controleer het laden van het model en de bedoelde tool call op je GPU. Voer de opdracht uit vanuit de root van de repository:
uv venv --python 3.12 .venv-vllm
uv pip install --python .venv-vllm/bin/python "vllm==0.12.0" "huggingface-hub==0.36.0"
source .venv-vllm/bin/activate

hf download nvidia/Llama-3.1-Nemotron-Nano-4B-v1.1 \
    llama_nemotron_nano_toolcall_parser.py \
    --revision d552708a9d575fa8d4a690b988fd870d65279f98 --local-dir serving

vllm serve nvidia/Llama-3.1-Nemotron-Nano-4B-v1.1 \
    --revision d552708a9d575fa8d4a690b988fd870d65279f98 \
    --trust-remote-code \
    --enable-lora \
    --lora-modules function-calling=./outputs/unsloth-nemotron-function-calling \
    --enable-auto-tool-choice \
    --tool-parser-plugin ./serving/llama_nemotron_nano_toolcall_parser.py \
    --tool-call-parser llama_nemotron_json \
    --chat-template ./src/unsloth_demo/chat_template.jinja \
    --host 127.0.0.1 \
    --port 8000 \
    --max-model-len 4096
De uv run --with openai infer-vllm van de demo test het genereren van argumenten via de OpenAI-compatibele API. Hij stuurt één minimale tool mee, book_flight met een verplichte string destination, en vraagt om een voorgestelde aanroep; hij voert geen boeking uit. Het verzoek in cli/inference.py is:
client = OpenAI(base_url="http://localhost:8000/v1", api_key="dummy")
response = client.chat.completions.create(
    model="function-calling",  # the --lora-modules name, not the base model
    messages=[{"role": "user", "content": "Book a flight to Tokyo"}],
    tools=[DEMO_TOOL],  # book_flight(destination), defined in config.py
    tool_choice="auto",
)
print(response.choices[0].message.tool_calls)
Voor deze input is het beoogde resultaat book_flight met {"destination": "Tokyo"}. Omdat de toolkeuze automatisch is, controleer je ook of het model überhaupt een aanroep teruggaf. De tool heeft dezelfde vorm als de glaive-tooldefinities waarop het model is getraind. De parser van vLLM leest de aanroep uit de gegenereerde tekst, dus een misvormde aanroep komt terug als gewone content zonder tool_calls. vLLM kan de argumenten van een functie ook beperken tot het schema ervan wanneer de functie is gemarkeerd met strict: true; de gids voor tool calling beschrijft de serverinstellingen en welke parsers dit ondersteunen.
Met Ollama (lokaal)
Toon de inhoud van de map outputs/unsloth-nemotron-function-calling-gguf en vervang hieronder MODEL_FILE.gguf door de bestandsnaam die eruit komt; Unsloth-versies kunnen bestanden anders noemen. Een GGUF-bestand alleen bewijst nog geen correcte chat- en toolopmaak in Ollama of llama.cpp. Gebruik de getrainde template en test het geïmporteerde artefact.
# Create Modelfile
echo 'FROM ./outputs/unsloth-nemotron-function-calling-gguf/MODEL_FILE.gguf' > Modelfile

# Import to Ollama
ollama create my-function-model -f Modelfile

# Run
ollama run my-function-model
Met llama.cpp (CPU)
Met dezelfde GGUF-export en bestandsnaamvervanging controleert deze opdracht een antwoord in gewone tekst. Hij test geen volledige tool call:
llama-cli -m ./outputs/unsloth-nemotron-function-calling-gguf/MODEL_FILE.gguf \
    -p "What's the weather in Tokyo?" \
    --ctx-size 4096
Monitor het vrijgegeven model
De levenscyclus stopt niet bij een gezonde trainings-loss. Leg de revisie van het basismodel, de tokenizer en chat template, de hash van de adapter, de datasetversie, de trainingsconfiguratie en het evaluatierapport vast als één release-eenheid. Monitor in productie taaksucces, ongeldige outputs, beleidsfouten, latency en input-drift met dezelfde slices als offline. Houd het vorige artefact laadbaar en bepaal vóór de lancering een rollbackdrempel.
Kort samengevat:
- Release-eenheid: revisie van het basismodel, tokenizer en chat template, adapterhash, datasetversie, trainingsconfiguratie en evaluatierapport.
- Monitor taaksucces, ongeldige outputs, beleidsfouten, latency en input-drift met dezelfde slices als offline.
- Valt een metric onder de rollbackdrempel die vóór de lancering is vastgesteld, laad dan het vorige artefact.
Je volgende test
Inspecteer vóór een volledige run één geserialiseerde conversatie en de bijbehorende loss-doelen en voltooi dan een forward/backward-stap met maximale lengte. Bewaar die configuratie samen met de datasetsplit en het baselinerapport. Ontbreekt een tool schema, behoud het dan in de trainingsrij. Wordt een antwoord afgekapt, pas dan de sequentielengte en de opmaak aan, zodat het volledige antwoord behouden blijft. Los die problemen op voordat je epochs toevoegt.
Referenties
Papers en onderzoek
- LoRA: Low-Rank Adaptation of Large Language Models
- QLoRA: Efficient Finetuning of Quantized LLMs
- DoRA: Weight-Decomposed Low-Rank Adaptation
- DPO: Direct Preference Optimization
- ORPO: Odds Ratio Preference Optimization
- PPO: Proximal Policy Optimization Algorithms — OpenAI, 2017
Tools voor dataverwerking
- DataTrove — Dataverwerking op schaal van Hugging Face
- Distilabel — Generatie van synthetische data (Argilla)
- Trafilatura — Tekstextractie en crawling van het web
- fastText language identification — voorgetrainde models voor taalherkenning
- Microsoft Presidio — Detectie en anonimisering van PII
- scrubadub — Python-bibliotheek voor het verwijderen van PII
Constrained decoding
Trainingsframeworks
- Unsloth — Geoptimaliseerd fine-tuningframework
- Axolotl — Training op basis van configuratie en gedistribueerde launchers
- TRL — Bibliotheek van Hugging Face voor SFT en preference-training
- PEFT model merging —
add_weighted_adapteren samenvoegmethoden - Torchtune — Fine-tuningbibliotheek native voor PyTorch, niet meer actief onderhouden
Inference en deployment
- vLLM LoRA adapters — Serveer één of meer adapters met het basismodel
- vLLM tool calling — Stem automatische toolkeuze, parser, chat template en verzoekschema af op het model
- Modelkaart van Llama-3.1-Nemotron-Nano-4B-v1.1 — Parserplugin voor tool calls en chat template voor vLLM
- Ollama — Lokale LLM-runner voor Mac/Windows/Linux
- llama.cpp — CPU/GPU-inference met het GGUF-formaat
Evaluatie
- lm-evaluation-harness — Gestandaardiseerde LLM-benchmarking van EleutherAI
- Berkeley Function Calling Leaderboard — Evaluatiecode voor function calling
Gidsen en bronnen
- Demo Repository — Praktisch fine-tuningvoorbeeld
- Accelerate n-D Parallelism Guide — Multi-GPU-trainingsstrategieën van Hugging Face