DeepSeek mHC: Manifold-Constrained Hyper-Connections

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Modernes Deep Learning beruht auf der Residual Connection. Dieser Beitrag richtet sich an Engineers, die den Transformer-Block kennen und wissen wollen, was mHC im Residual-Pfad ändert, warum, was es kostet und wann sich ein Versuch lohnt. Hyper-Connections (HC) erkunden eine weitere architektonische Dimension: Sie erweitern den Residual-Zustand zu mehreren interagierenden Streams. Das Paper zu DeepSeeks Manifold-Constrained Hyper-Connections (mHC) untersucht, wie sich dieses Routing bei größerem Trainingsmaßstab stabil halten lässt.
Er beginnt mit gewöhnlichen Residual Connections und führt dann Hyper-Connections und die Instabilität ein, die sie erzeugen. Danach folgen die mHC-Constraint, eine kleine NumPy-Demo und die Implementierungskosten.
Warum Residual Connections funktionieren
Das Tiefenproblem
Zusätzliche Layer können die Kapazität erhöhen, erschweren aber auch Optimierung und Signalausbreitung. Je nach Initialisierung, Normalisierung und Architektur können Forward-Activations oder Backward-Gradienten über die Tiefe schrumpfen, wachsen oder schlecht konditioniert werden.
Die Residual-Lösung
Das ResNet-Paper führte eine einfache Lösung ein. Statt eine direkte Abbildung zu lernen, lernt man das Residuum, die Differenz zur Identität:
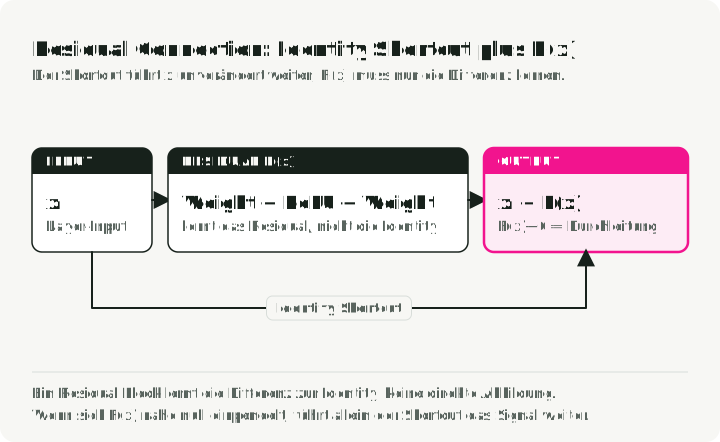
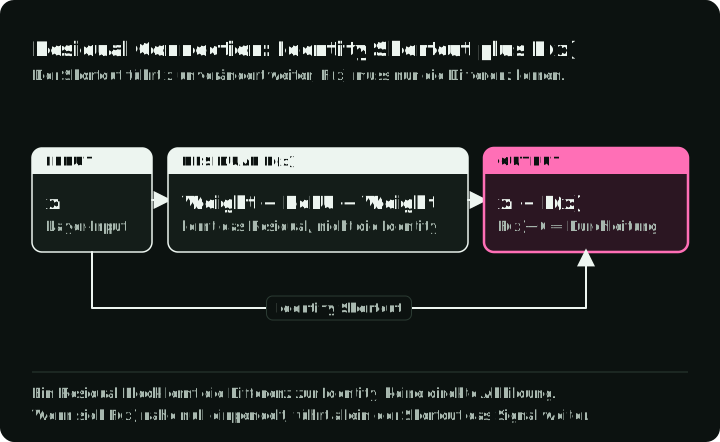
Die nützliche Eigenschaft ist der Identitäts-Shortcut. Wenn die Residualfunktion null ausgibt, reicht der Layer den Zustand unverändert durch. Daraus folgen zwei Dinge:
- Ein direkter Gradiententerm: Die Backpropagation enthält einen Pfad durch die Identitätskomponente.
- Eine einfache Rückfallabbildung: Der Residual-Zweig kann nahe null bleiben, wenn ein Layer den Zustand kaum verändern muss.
Das beseitigt nicht jedes Optimierungsproblem, machte aber deutlich tiefere Netze praktikabel.
Wie Layer Normalization den Residual-Pfad verändert
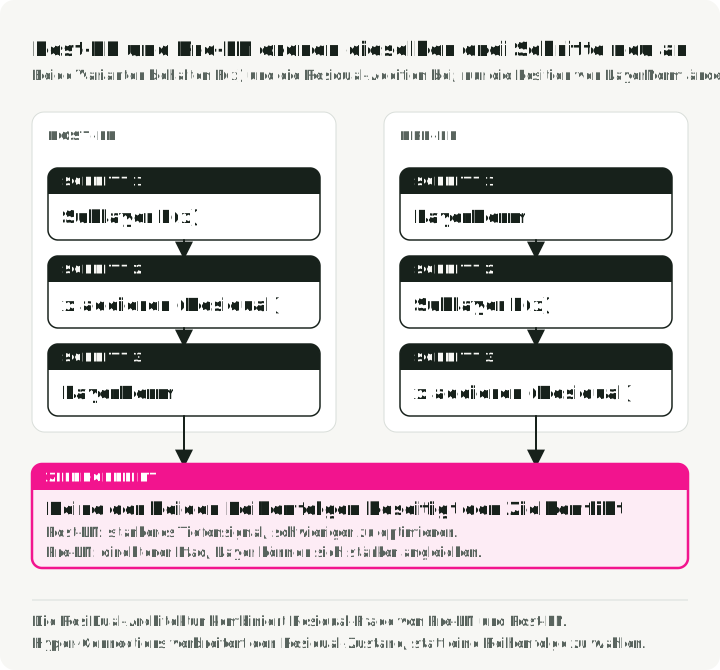
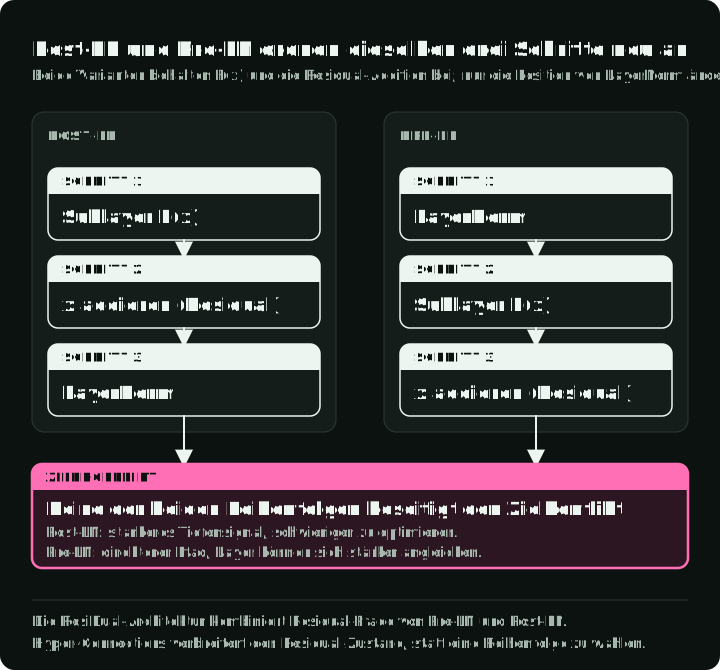
Transformer brachten eine neue Variable mit: Wo steht die Layer Normalization (LN)? Davon hängt ab, ob der Residual-Pfad eine Identität bleibt.
| Variante | LN-Platzierung | Vorteil | Wichtigste Einschränkung |
|---|---|---|---|
| Post-LN | Nach dem Residual-Block | Starker Beitrag der Tiefe | Kann in der Tiefe schwerer zu optimieren sein |
| Pre-LN | Vor dem Residual-Block | Direkterer Residual-Pfad | Repräsentationen benachbarter Layer können einander zunehmend ähneln |
ResiDual kombiniert einen Post-LN-ähnlichen Residual-Pfad mit einem zweiten Pfad, der Block-Ausgaben aufsummiert. Ihre Repräsentationen werden am Model-Ausgang addiert. Das HC-Paper geht von demselben Zielkonflikt aus und macht die Verbindungsstärken lernbar, über mehrere Streams hinweg.
Hyper-Connections fügen parallele Residual Streams hinzu
Hyper-Connections (HC) erweitern die Breite des Residual Stream, statt die Tiefe zu vergrößern.
Was ein Stream ist
In einem Standard-Transformer hat jedes Token einen -dimensionalen Zustand, der durch die Blöcke läuft. Am Anfang des Netzes repliziert HC das Input-Embedding -mal, wobei die „Expansionsrate” ist, typischerweise 4. Aus dem -dimensionalen Hidden State wird eine große „Hyper-Hidden-Matrix”.
In Hyper-Connections ist ein Stream eine dieser parallelen Instanzen des Zustands.
Die Kopien beginnen identisch und laufen dann auseinander, weil gelernte Abbildungen aus den Streams lesen, in sie schreiben und sie mischen. Das Paper deutet sie als mehrere Verbindungsmuster über die Tiefe; es verlangt nicht, dass jeder Stream eine feste, für Menschen lesbare Rolle annimmt.
Kernmechanismen
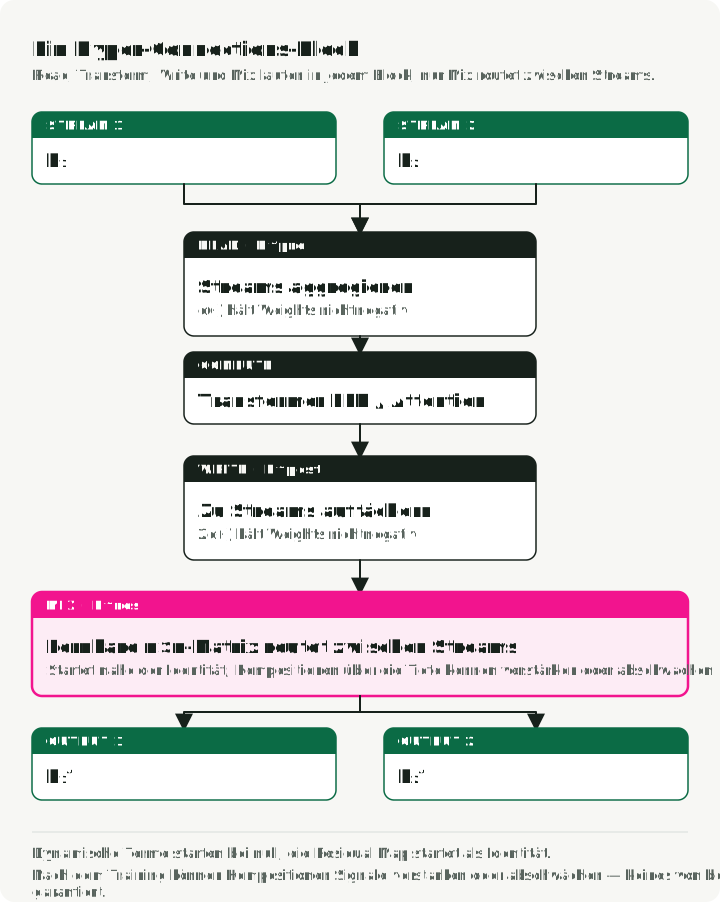
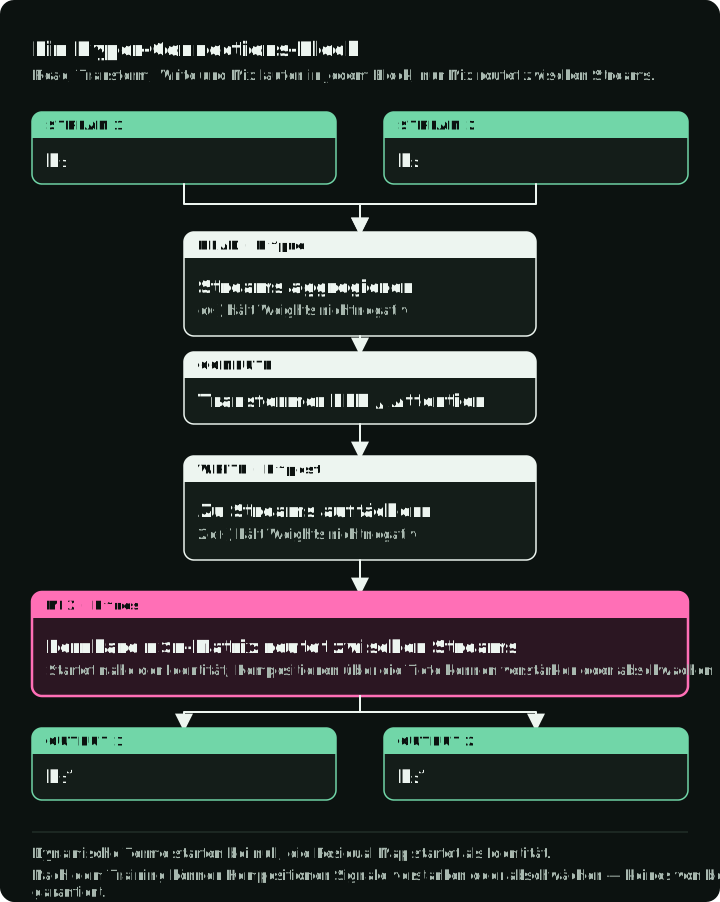
Statt eines Residual-Pfads führt HC parallele Streams durch das gesamte Netz. In jedem Transformer-Block laufen drei Operationen, jeweils gesteuert von kleinen lernbaren Weights:
- Lesen (): Die Streams werden zu dem -dimensionalen Input aggregiert, den der Attention- oder Feed-Forward-Block verarbeitet.
- Schreiben (): Die Ausgabe dieses Blocks wird in Updates für die Streams zurückabgebildet.
- Mischen (): Eine große Residual-Abbildung wird auf die eingehenden Streams angewendet, bevor das Block-Update addiert wird.
In HC ist jede Abbildung die Summe aus einem gelernten statischen Teil (einem Bias) und einem eingabeabhängigen Term, der durch läuft, sodass ihre Einträge jedes Vorzeichen annehmen können. Das HC-Paper nennt die Variante mit eingabeabhängigen Termen Dynamic HC (DHC); DHC×4 bedeutet DHC mit vier Streams. Die Residual-Abbildung ist der stabilitätskritische Teil, weil sie über die Tiefe wiederholt multipliziert wird.
Zusammen ergeben die drei Abbildungen das Update pro Layer (Gl. 3 des mHC-Papers, das die Breite als schreibt):
Hier ist die große Stream-Matrix, und sind , und ist . Der erste Term ist der Residual-Pfad. Der zweite Term ist das Update des Blocks: lesen, berechnen, schreiben. Mit und allen drei Abbildungen gleich 1 ergibt die Gleichung das Standard-Residual .
Die Abbildung zeichnet dieses Update für vier Streams: Lesen, Berechnen und Schreiben oberhalb der Streams, das 4 × 4-Mischen auf den Streams und eine Addition auf jedem Stream.
Was das HC-Paper berichtet
Das HC-Paper berichtet 1,8× schnellere Konvergenz für die Konfiguration OLMoE-1B-7B DHC×4 gegenüber ihrer Baseline, dazu Verbesserungen bei Downstream-Aufgaben nach 500B Tokens (Abschnitt 1). Das ist eine einzelne evaluierte Konfiguration, kein allgemeiner Geschwindigkeitsfaktor für vier Streams.
Warum unbeschränkte HC instabil werden können
Das mHC-Paper berichtet Instabilität, wenn es unbeschränkte HC auf sein 27B-Setup skaliert: Der Trainings-Loss springt um Schritt 12k nach oben, zusammen mit einem Sprung der Gradientennorm (Abschnitt 3.1). Dieselben unbeschränkten Abbildungen, die HC flexibel machen, beseitigen auch den garantierten Identitätspfad, der Residuals leicht trainierbar macht.
Das Problem der zusammengesetzten Abbildung
Bei Standard-Residuals gilt:
Wenn , ist das die Identität: . Das Signal läuft unverändert durch.
In Hyper-Connections ist der Residual-Term des obigen Updates ein Matrixprodukt, . Folgt man nur diesem Pfad über Layer, wird das Signal zu:
Das Verhalten hängt von der zusammengesetzten Matrix ab, nicht davon, ob einzelne Einträge über oder unter 1 liegen. Strecken die Abbildungen dieselbe Richtung immer wieder um mehr als 1, wächst das Produkt exponentiell mit der Tiefe. Schrumpfen sie sie immer wieder, verblasst das Signal. Auch negative Einträge können Signale auslöschen.
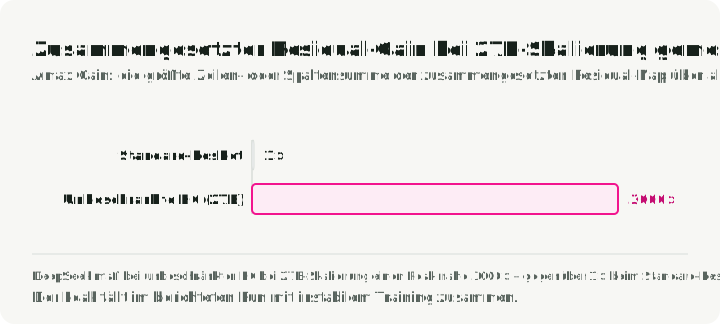
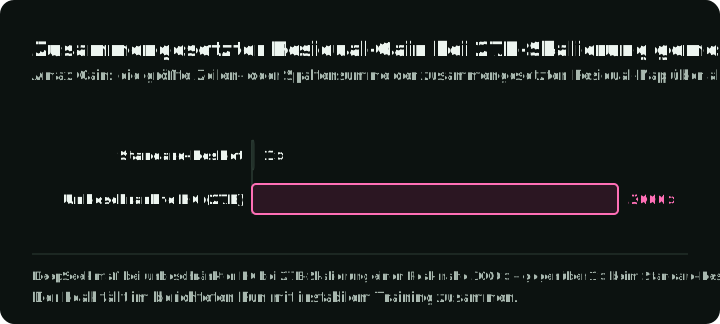
Das mHC-Paper misst diese Verstärkung mit der Amax Gain Magnitude: der maximalen absoluten Zeilensumme für die Forward-Propagation und der maximalen absoluten Spaltensumme für die Backward-Propagation in einer zusammengesetzten Residual-Abbildung. Im 27B-HC-Experiment nähert sich der Spitzenwert 3.000 und fällt mit instabilem Trainingsverhalten zusammen (Abschnitt 3.1).
Das Diagramm zeigt die drei Werte des Papers auf einer logarithmischen Achse: 1 für ein Standard-Residual, etwa 1,6 für mHC (die beschränkte Variante, die als Nächstes beschrieben wird) und etwa 3.000 für unbeschränkte HC. Eine Markierung unter der Achse zeigt die aus dem Beispiel oben.
Das Designziel ist also enger gefasst, als jede Abbildung zur Identität zu zwingen: Mischen zwischen Streams soll möglich bleiben, während die Verstärkung über Kompositionen hinweg begrenzt wird.
Die mHC-Constraint
mHC behält das Routing zwischen Streams bei, beschränkt aber jede Residual-Mischmatrix auf das Birkhoff-Polytop, die Menge der doppelt stochastischen Matrizen. Eine solche Matrix hat nicht-negative Einträge, und jede ihrer Zeilen und Spalten summiert sich zu eins.
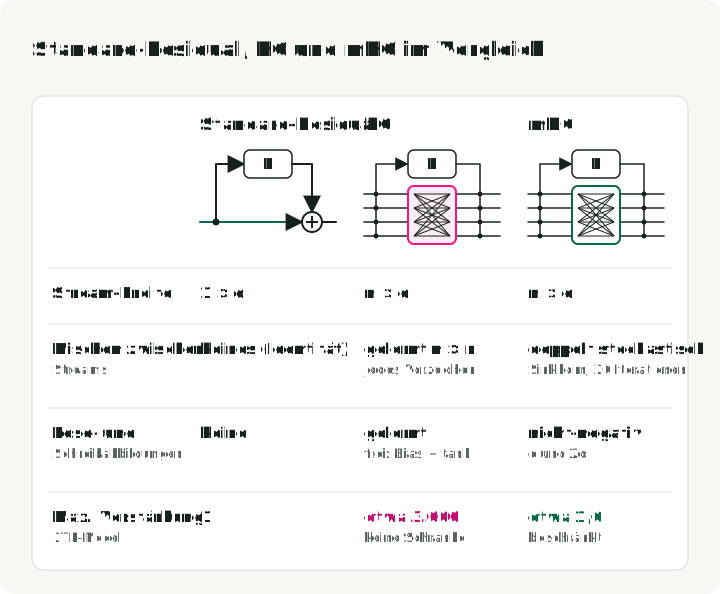
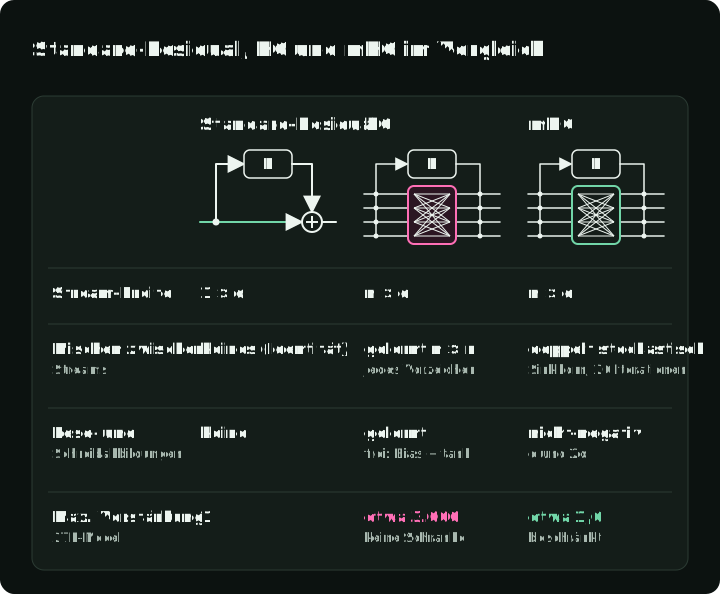
Die Abbildung skizziert den Residual-Pfad jedes Designs dieses Artikels und vergleicht sie. Die Zeile zur Verstärkung zeigt die größte Gesamtverstärkung, die das mHC-Paper für sein 27B-Model berichtet. Mit und allen Abbildungen gleich 1 werden HC und mHC zum Standard-Residual.
Was doppelte Stochastizität garantiert
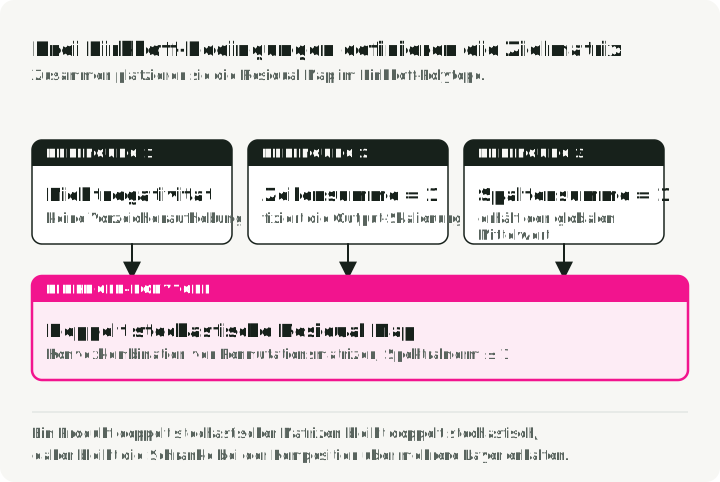
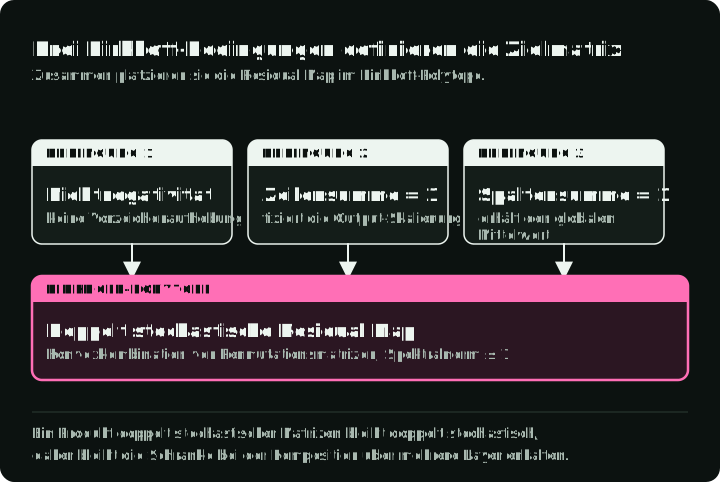
Die Abbildung prüft die drei Bedingungen an zwei 3×3-Matrizen aus dem Sinkhorn-Beispiel unten: den unbeschränkten Logits , die alle drei verletzen, und nach 20 Sinkhorn-Durchläufen, das alle drei erfüllt. Die Tabelle nennt die Konsequenz jeder Bedingung.
| Constraint | Konsequenz |
|---|---|
| Nicht-Negativität | Koeffizienten mit entgegengesetzten Vorzeichen löschen sich nicht aus |
| Zeilensumme = 1 | Ein über die Streams konstantes Signal bleibt konstant |
| Spaltensumme = 1 | Der globale Mittelwert über die Streams bleibt erhalten |
Nicht-Negativität zusammen mit Zeilensummen von eins macht jede Ausgabe zu einer Konvexkombination der Eingabe-Streams. Die Constraint erhält den Mittelwert über die Streams, nicht die Länge des Vektors: Eine doppelt stochastische Abbildung kann Streams einander annähern.
Drei weitere Eigenschaften folgen daraus (Abschnitt 4.1):
- Spektralnorm ≤ 1: Die Spektralnorm ist der größte Faktor, um den eine Matrix einen Vektor strecken kann. Eine Schranke von eins bedeutet, dass die Residual-Routing-Abbildung die euklidische Norm nicht verstärken kann.
- Abgeschlossen unter Multiplikation: Ein Produkt doppelt stochastischer Matrizen bleibt doppelt stochastisch, sodass die Constraint die Komposition über die Tiefe übersteht.
- Konvexes Mischen: Nach dem Satz von Birkhoff-von Neumann liegt die Abbildung in der konvexen Hülle der Permutationsmatrizen.
Sinkhorn-Knopp-Projektion
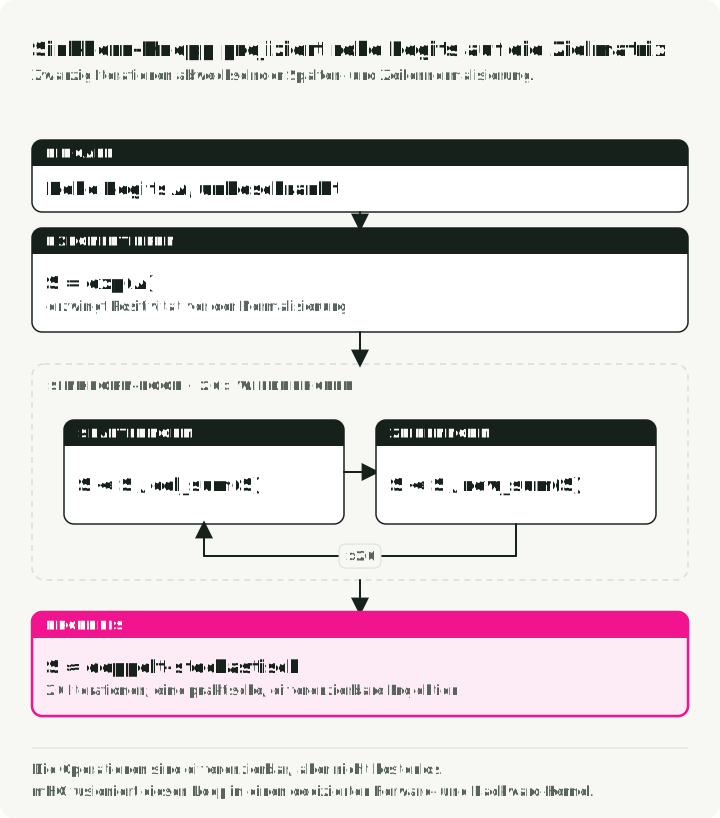
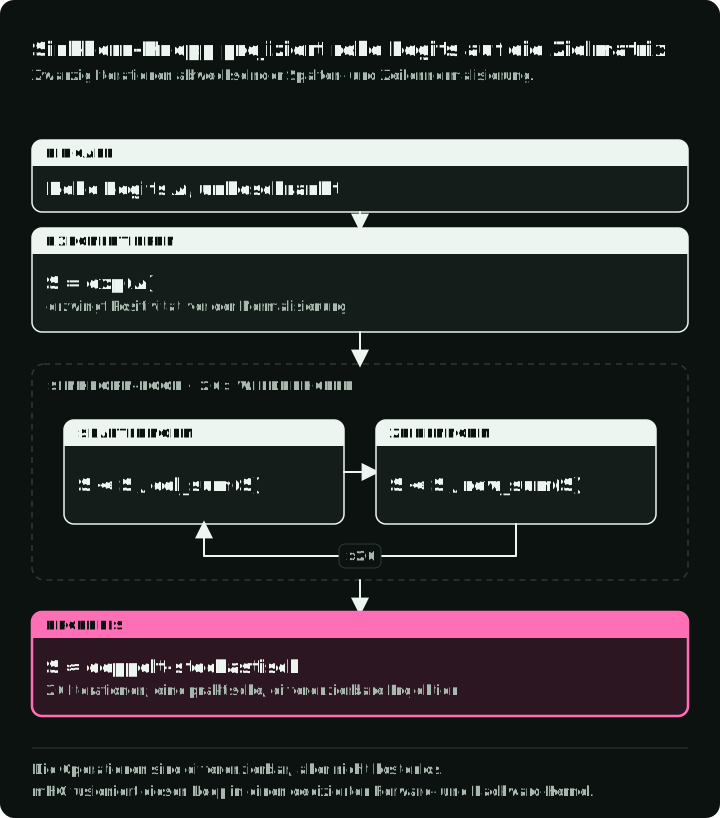
Die lernbaren Residual-Logits sind unbeschränkt. mHC wendet zunächst die Exponentialfunktion auf sie an, um eine positive Matrix zu erhalten, und normalisiert dann abwechselnd Spalten und Zeilen. Mit genügend Iterationen nähert sich dieser Sinkhorn-Knopp-Prozess einer doppelt stochastischen Matrix; das Paper verwendet 20 Iterationen als praktische, näherungsweise differenzierbare Projektion statt einer exakten Constraint.
Die Abbildung führt den ersten Durchlauf für das 3×3-Beispiel unten Schritt für Schritt aus und zeigt dann den größten Spaltensummenfehler über 20 Durchläufe.
Für rohe Logits lautet das Verfahren:
S = exp(A)
repeat 20 times:
    S = S / column_sum(S)
    S = S / row_sum(S)
return S
Ein 3×3-Beispiel zeigt, was „näherungsweise” bedeutet. Ein Durchgang legt die Zeilensummen fest, weil die Zeilen zuletzt normalisiert werden, lässt die Spaltensummen aber um bis zu 12 % danebenliegen. Zwanzig Durchgänge bringen beide auf 1,000 bei drei Nachkommastellen.
Raw logits A           [[-0.5,   2.1,   0.8  ],
                        [ 1.3,  -4.0,   1.9  ],
                        [ 0.1,   0.6,  -0.2  ]]

S = exp(A)             [[ 0.607, 8.166, 2.226],
                        [ 3.669, 0.018, 6.686],
                        [ 1.105, 1.822, 0.819]]

After 1 pass           [[ 0.097, 0.705, 0.198],
(columns, then rows)    [ 0.497, 0.001, 0.501],
                        [ 0.435, 0.386, 0.178]]
                       row sums     1.000 1.000 1.000
                       column sums  1.030 1.092 0.877

After 20 passes        [[ 0.102, 0.653, 0.244],
                        [ 0.457, 0.001, 0.542],
                        [ 0.441, 0.346, 0.213]]
                       row and column sums 1.000
Das folgende Skript prüft die Behauptung, auf der die ganze Methode beruht. Es multipliziert 60 zufällige 4×4-Mischmatrizen, einmal direkt verwendet, wie HC sie verwenden würde, und einmal nach Sinkhorn, wie mHC es tut, und gibt die Amax-Verstärkung jedes Produkts aus.
import numpy as np

rng = np.random.default_rng(0)
n, layers = 4, 60

def sinkhorn(logits, iters=20):
    s = np.exp(logits)
    for _ in range(iters):
        s = s / s.sum(axis=0, keepdims=True)  # columns sum to 1
        s = s / s.sum(axis=1, keepdims=True)  # rows sum to 1
    return s

def amax_gain(m):
    return max(np.abs(m).sum(axis=1).max(), np.abs(m).sum(axis=0).max())

hc, mhc = np.eye(n), np.eye(n)
for _ in range(layers):
    a = np.eye(n) + 0.3 * rng.standard_normal((n, n))
    hc = a @ hc
    mhc = sinkhorn(a) @ mhc

print(f"HC  Amax gain: {amax_gain(hc):.1f}")
print(f"mHC Amax gain: {amax_gain(mhc):.1f}")
Mit Seed 0 gibt es 1906,8 für HC und 1,0 für mHC aus. Jede Zufallsmatrix liegt nahe an der Identität, daher wirkt keine einzelne groß. Das Paper misst für mHC in seinem 27B-Model etwa 1,6, nicht 1,0. Es verwendet nur 20 Iterationen, daher sind die trainierten Matrizen nicht exakt doppelt stochastisch, und die kleinen Fehler wachsen über die Layer, bleiben aber beschränkt (Abschnitt 5.4).
Die Sinkhorn-Iterationen sind differenzierbar, aber nicht kostenlos. mHC stützt sich auf einen fusionierten Forward-Kernel und einen eigenen Backward-Kernel, der die Zwischenzustände der Normalisierung on-chip neu berechnet.
Details der Parametrisierung
- Residual-Abbildung: Exponentialfunktion plus Sinkhorn-Normalisierung erzeugt die näherungsweise doppelt stochastische .
- Lese- und Schreibabbildungen: mHC ersetzt das von HC durch eine Sigmoid-Funktion: und . Beide Abbildungen sind nicht-negativ, was die Auslöschung zwischen positiven und negativen Koeffizienten beseitigt (Abschnitte 4.1 und 4.2). Lese-Weights liegen in (0, 1), Schreib-Weights in (0, 2). Ein Logit von null ergibt ein Schreib-Weight von , das Weight, das eine Standard-Residual-Addition verwendet. Das Paper nennt keinen Grund für den Faktor 2.
Die vollständige mHC-Architektur
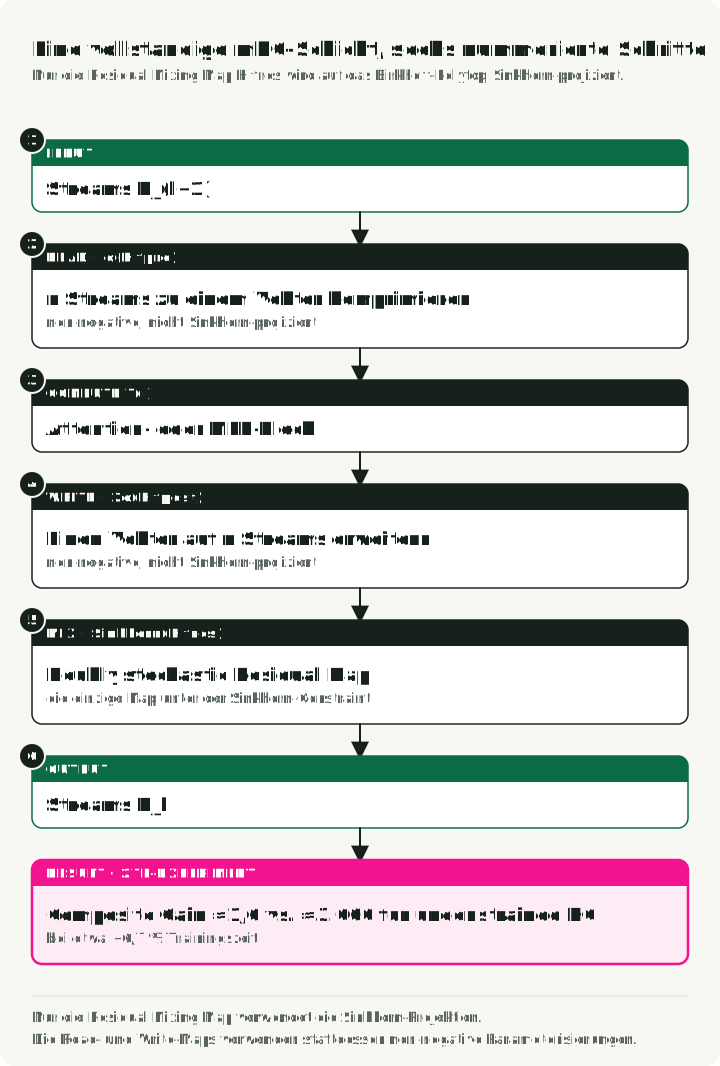
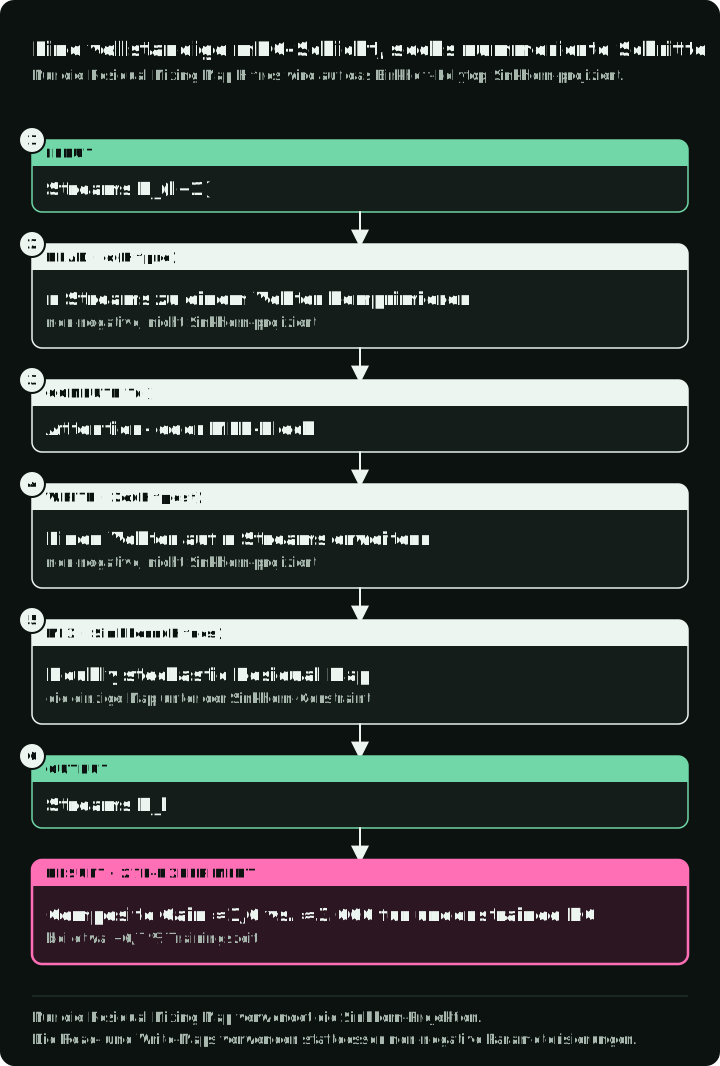
Die Abbildung zeigt einen mHC-Layer mit der Parametrisierung jeder Abbildung. Er hat dieselben zwei Pfade wie der HC-Block; geändert hat sich, wie jede Abbildung parametrisiert wird.
In Begriffen der Update-Gleichung:
- Eingabe: parallele Residual Streams gehen in den Layer.
- Block-Pfad: Die Leseabbildung fasst die Streams zu einem -dimensionalen Input zusammen. Der Attention- oder MLP-Block verarbeitet ihn. Die Schreibabbildung macht aus der Ausgabe Updates für die Streams.
- Residual-Pfad: Die näherungsweise doppelt stochastische mischt die eingehenden Streams.
- Addition: Die beiden Pfade werden zu summiert, das in den nächsten Layer geht.
Nur die Residual-Mischabbildung verwendet die Sinkhorn-Projektion. Die Lese- und Schreibabbildungen verwenden nicht-negative Parametrisierungen. Diese Unterscheidung ist wichtig, weil die Kompositionsgarantie des Papers für gilt.
Infrastruktur für den berichteten Overhead
Vier Streams erhöhen die Speicherzugriffe auf den Residual-Zustand, den Speicherbedarf für Activations und die Kommunikation zwischen Pipeline-Stufen. Das Zeitergebnis des Papers hängt von drei aufeinander abgestimmten Änderungen ab, die im Folgenden beschrieben sind.
Kernel Fusion
Die Implementierung fusioniert Operationen, die sich Speicherzugriffe teilen, nutzt wo sinnvoll Mixed Precision und setzt die meisten eigenen Kernels mit TileLang um. Die Sinkhorn-Schleife und ihr eigener Backward-Pass laufen in dedizierten Kernels, um Speichertraffic und Launch-Overhead zu senken.
Selektive Neuberechnung
Die Streams erhöhen den Speicherbedarf für Activations (Abschnitt 4.3.2). Statt jedes Zwischenergebnis zu speichern, geht mHC so vor:
- Es gibt die Zwischen-Activations seiner eigenen Kernels nach dem Forward-Pass frei.
- Es berechnet sie im Backward-Pass neu, ohne den Attention- oder FFN-Block erneut auszuführen.
- Es speichert den Input der erweiterten Streams jeder Gruppe aufeinanderfolgender Layer und die Attention- oder FFN-Ausgabe jedes Layers. Das Paper richtet diese Gruppen an den Pipeline-Stufen aus.
Ein erweiterter DualPipe-Schedule überlappt Teile von Kommunikation, Neuberechnung und Layer-Arbeit an den Pipeline-Grenzen. Der erreichte Overlap gilt speziell für dieses Trainingssystem.
Berichtetes Systemergebnis
Für das Setup des Papers im großen Maßstab erhöht die Expansionsrate die Trainingszeit um 6,7 % gegenüber der Baseline (Abschnitt 4.3). Das ist ein Systemergebnis, nicht der Overhead einer einfachen Framework-Implementierung.
Was die Experimente belegen
Die Autoren trainieren 3B-, 9B- und 27B-Varianten von MoE-Models, die an DeepSeek-V3 angelehnt sind (Abschnitt 5.3). Bei 27B schlägt mHC die Standard-Residual-Baseline in allen acht berichteten Downstream-Benchmarks und schlägt HC in sieben von acht (Tabelle 4). HC liegt bei MATH leicht vorn (26,4 gegenüber 26,0). Das sind hausinterne Pretraining-Experimente des Teams, das die Methode vorschlägt; unabhängige Replikation und Vergleiche mit anderen Architekturen stehen daher noch aus.
Wann sich mHC lohnt
Die Ergebnisse des Papers sprechen für drei Bedingungen:
- Sie führen ein Pretraining von Grund auf durch. mHC ändert die Architektur, und das Paper evaluiert es nur im Pretraining. Sonst lassen Sie mHC weg.
- Sie brauchen mehr Residual-Breite als einen Stream. Sie nutzen HC bereits oder planen es und sehen Loss-Spitzen oder wachsende Activations und Gradientennormen, wenn Sie Tiefe oder Größe skalieren. Reicht ein Stream aus, bleiben Sie beim Standard-Residual.
- Sie können die Systemarbeit leisten oder höhere Kosten akzeptieren. Die 6,7 % setzen fusionierte Kernels und Änderungen am Pipeline-Schedule voraus. Eine einfache Framework-Implementierung kostet mehr. Können Sie diese Arbeit nicht leisten, ist mHC in einfachem Code möglich, aber messen Sie zuerst den Overhead.
Drei Fragen bleiben offen:
- Systemoverhead: Der berichtete Overhead ist das optimierte Ergebnis des Papers; eine andere Runtime, Gerätetopologie oder Modelform kann andere Kosten sehen.
- Bias beim Mischen: Doppelte Stochastizität erhält den Mittelwert über die Streams und verhindert eine Expansion durch , kann aber Unterschiede zwischen Streams glätten. Das Block-Update verändert die Gesamtrepräsentation weiterhin.
- Reichweite der Evidenz: Die stärkste Evidenz stammt aus dem Pretraining von Sprachmodellen mit MoE-Architekturen im Stil von DeepSeek-V3. Die Übertragbarkeit auf andere Modelfamilien belegt dieses Paper noch nicht.
mHC ist ein vielversprechender Weg, breitere Residual-Topologien zu untersuchen und dabei die wiederholt angewendete Residual-Abbildung gut konditioniert zu halten. Ob es sich für ein anderes Model lohnt, hängt von unabhängig bestätigten Qualitätsgewinnen und den Kosten ab, den Systemstack des Papers nachzubauen.
Referenzen
- mHC: Manifold-Constrained Hyper-Connections - Xie et al. (DeepSeek)
- Deep Residual Learning for Image Recognition - He et al. (ResNet)
- Hyper-Connections - Ursprüngliches HC-Paper
- TileLang - Framework zur Optimierung von CUDA-Kernels
- DualPipe - Scheduler für Pipeline-Parallelität in DeepSeek-V3
- ResiDual - Architektur mit dualem Residual-Pfad