DeepSeek mHC: Hyper-Connections с ограничением на многообразии

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Современное глубокое обучение опирается на остаточное соединение. Этот пост для инженеров, которые знают блок Transformer и хотят понять, что mHC меняет в остаточном пути, зачем, чего это стоит и когда это стоит пробовать. Hyper-Connections (HC) исследуют другое измерение архитектуры: расширение остаточного состояния до нескольких взаимодействующих потоков. В статье DeepSeek о Manifold-Constrained Hyper-Connections (mHC) изучается, как сохранить стабильность такого роутинга при обучении в больших масштабах.
Сначала разберём стандартные остаточные соединения, затем добавим Hyper-Connections и нестабильность, которую они вносят. После этого рассмотрим ограничение mHC, небольшую демонстрацию на NumPy и стоимость реализации.
Почему остаточные соединения работают
Проблема глубины
Добавление слоёв может увеличить ёмкость модели, но усложняет оптимизацию и распространение сигнала. В зависимости от инициализации, нормализации и архитектуры прямые активации и обратные градиенты могут уменьшаться, расти или становиться плохо обусловленными по мере увеличения глубины.
Решение с остаточным соединением
В статье о ResNet предложено простое решение. Вместо того чтобы обучать прямое отображение, обучаем остаток, то есть отличие от тождественного отображения:
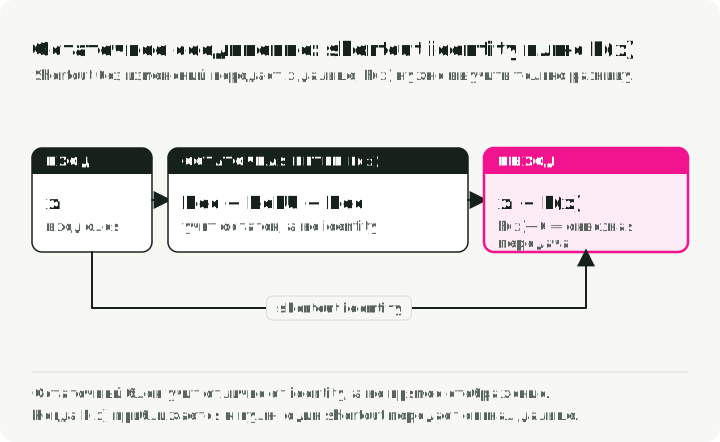
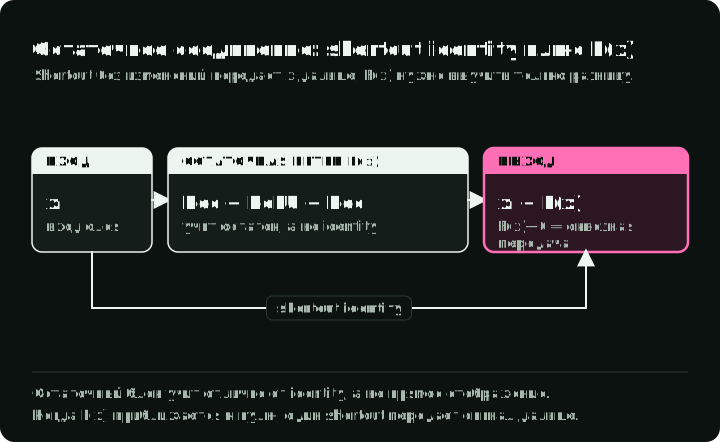
Полезное свойство здесь — тождественный обходной путь. Когда остаточная функция возвращает ноль, слой пропускает вход без изменений. Отсюда два следствия:
- Прямой градиентный член: обратное распространение включает путь через тождественную компоненту.
- Простое запасное отображение: остаточная ветвь может оставаться около нуля, когда слою не нужно сильно менять состояние.
Это не устраняет все проблемы оптимизации, но сделало практичными заметно более глубокие сети.
Как нормализация слоя меняет остаточный путь
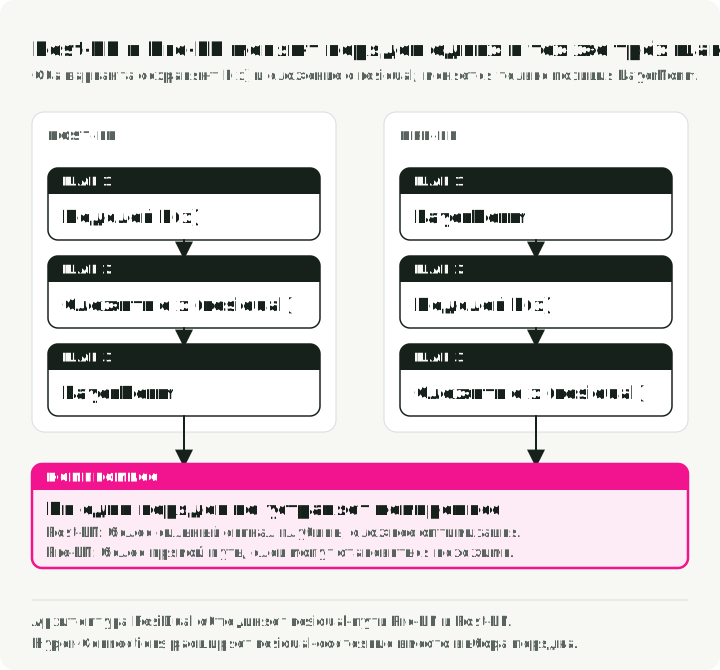
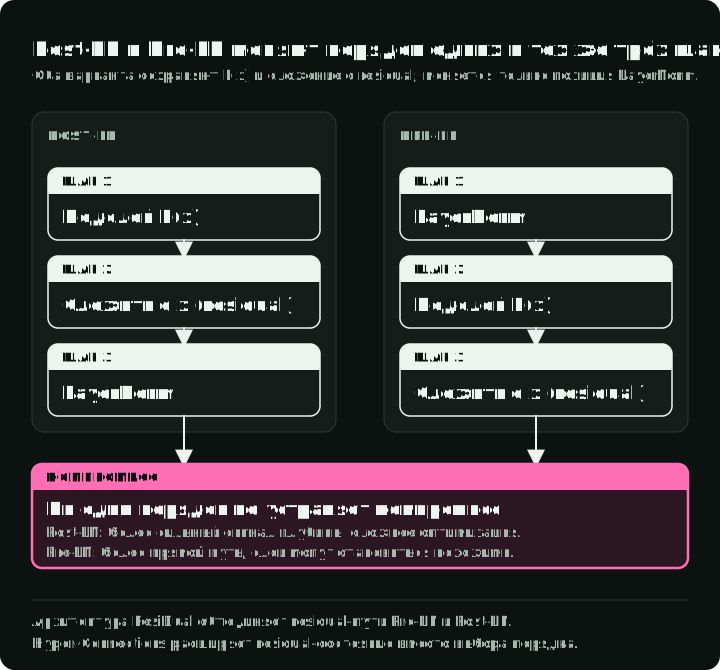
В Transformer появилась новая переменная: где разместить Layer Normalization (LN). От этого зависит, остаётся ли остаточный путь тождественным.
| Вариант | Размещение LN | Преимущество | Главное ограничение |
|---|---|---|---|
| Post-LN | После остаточного блока | Сильный вклад глубоких слоёв | Может быть сложнее оптимизировать на большой глубине |
| Pre-LN | Перед остаточным блоком | Более прямой остаточный путь | Представления соседних слоёв могут становиться всё более похожими |
ResiDual объединяет остаточный путь, похожий на Post-LN, со вторым путём, который суммирует выходы блоков. Их представления складываются на выходе модели. Статья про HC исходит из того же компромисса и делает силу связей обучаемой, причём сразу для нескольких потоков.
Hyper-Connections добавляют параллельные остаточные потоки
Hyper-Connections (HC) расширяют ширину остаточного потока, а не добавляют глубину.
Что означает поток
В стандартном Transformer у каждого токена есть -мерное состояние, которое проходит через блоки. В начале сети HC копирует входной эмбеддинг раз, где — «коэффициент расширения», обычно 4. -мерное скрытое состояние превращается в «гипер-скрытую матрицу» размера .
В Hyper-Connections поток — это один из этих параллельных экземпляров состояния.
Копии начинают одинаковыми, а затем расходятся, потому что обучаемые карты читают из потоков, пишут в них и смешивают их. Авторы статьи трактуют потоки как несколько схем связей по глубине; они не требуют, чтобы каждый поток получил фиксированную роль, понятную человеку.
Основные механизмы
Вместо одного остаточного пути HC держит параллельных потоков через всю сеть. В каждом блоке трансформера выполняются три операции, и каждой управляют небольшие обучаемые веса:
- Чтение (): агрегирует потоков в -мерный вход, который получает блок аттеншна или feed-forward.
- Запись (): отображает выход блока обратно в обновления для потоков.
- Смешивание (): применяет к входящим потокам остаточную карту до добавления обновления блока.
В HC каждая карта состоит из обучаемой статической части (смещения) и входозависимого члена, пропущенного через , поэтому её элементы могут иметь любой знак. Статья про HC называет версию с входозависимыми членами динамическим HC (DHC); DHC×4 означает DHC с четырьмя потоками. Остаточная карта — часть, критичная для стабильности, потому что она многократно умножается по глубине.
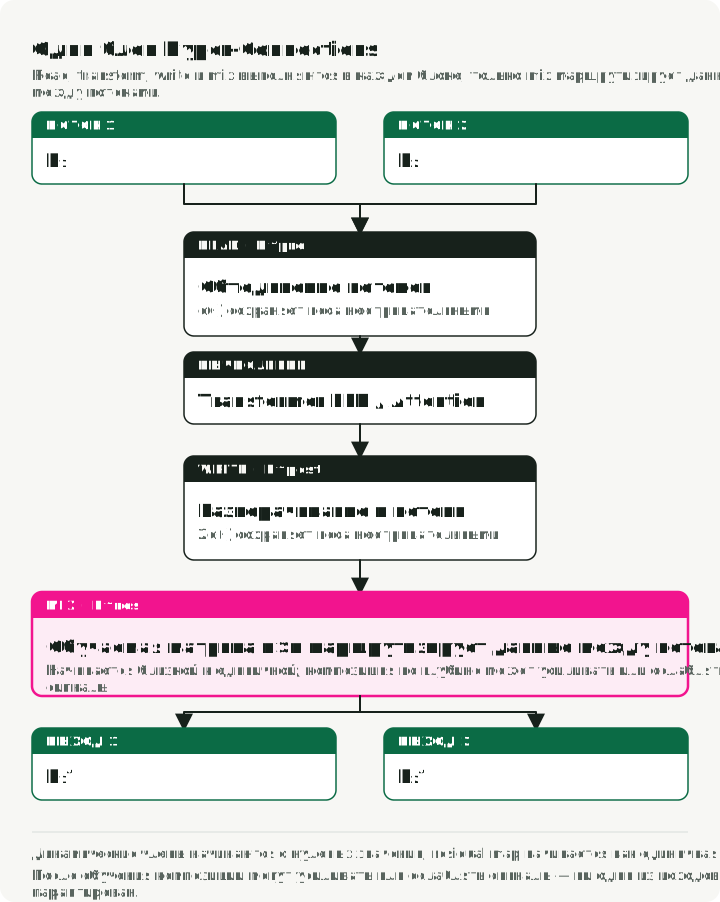
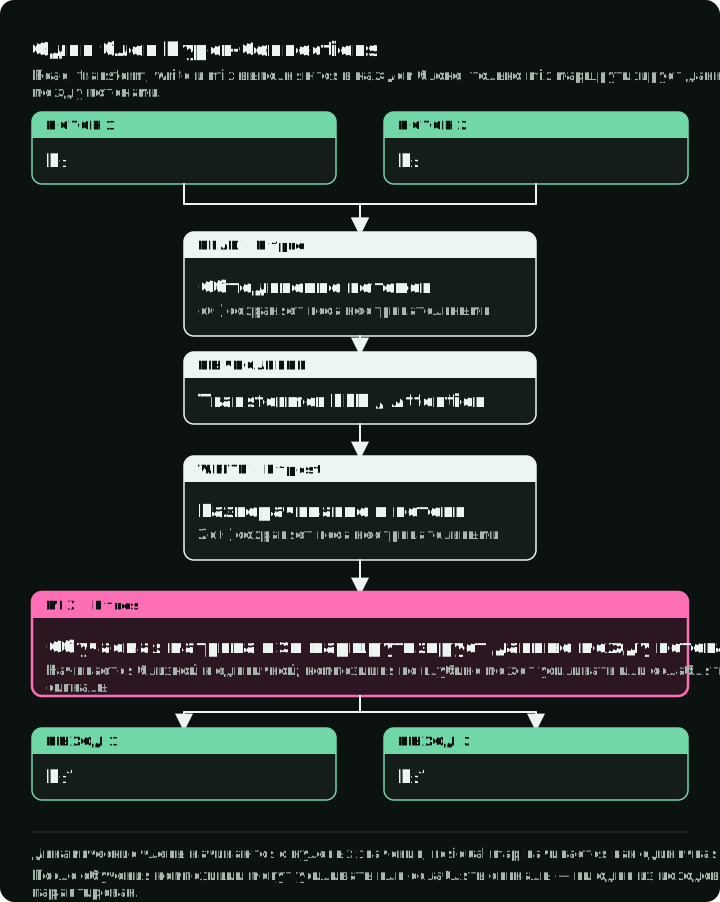
Вместе три карты задают обновление на слое (уравнение 3 из статьи mHC, где ширина обозначена ):
Здесь — матрица потоков размера , и имеют размер , а — . Первое слагаемое — остаточный путь. Второе — обновление от блока: чтение, вычисление, запись. При и всех трёх картах, равных 1, уравнение превращается в стандартное остаточное соединение .
На рисунке это обновление нарисовано для четырёх потоков: чтение, вычисление и запись над потоками, смешивание 4 × 4 на потоках и сложение на каждом потоке.
Что сообщает статья об HC
Статья про HC сообщает о 1,8× более быстрой сходимости для конфигурации OLMoE-1B-7B DHC×4 по сравнению с её базовой моделью, а также о приросте на downstream-задачах при 500B токенов (раздел 1). Это одна проверенная конфигурация, а не общий множитель скорости для четырёх потоков.
Почему неограниченный HC может стать нестабильным
Статья mHC сообщает о нестабильности при масштабировании неограниченного HC до её конфигурации на 27B: функция потерь при обучении резко растёт примерно на шаге 12k, одновременно со скачком нормы градиента (раздел 3.1). Те же неограниченные карты, которые делают HC гибким, убирают гарантированный тождественный путь, благодаря которому сети с остаточными соединениями легко обучать.
Проблема составного отображения
В стандартных остаточных соединениях:
Когда , это тождественное отображение: . Сигнал проходит без изменений.
В Hyper-Connections остаточный член приведённого выше обновления — произведение матриц, . Если следовать только по этому пути через слоёв, сигнал становится таким:
Поведение определяется составной матрицей, а не тем, выше или ниже 1 отдельные элементы. Если карты раз за разом растягивают одно и то же направление больше чем в 1 раз, произведение растёт экспоненциально с глубиной. Если раз за разом сжимают, сигнал затухает. Отрицательные элементы также могут гасить сигналы.
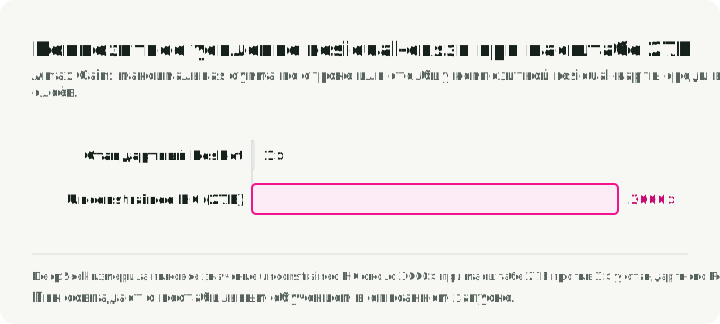
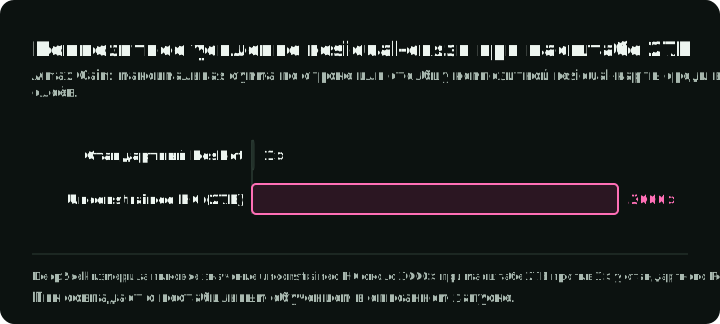
Статья mHC измеряет это усиление через Amax Gain Magnitude: максимальную абсолютную сумму по строкам для прямого распространения и по столбцам для обратного в составной остаточной карте. В её эксперименте с HC на 27B пик приближается к 3000 и совпадает с нестабильным поведением обучения (раздел 3.1).
График помещает три значения из статьи на одну логарифмическую ось: 1 для стандартного остаточного соединения, около 1,6 для mHC (ограниченной версии, которую мы разберём дальше) и около 3000 для неограниченного HC. Отметка под осью показывает из примера выше.
Поэтому цель дизайна уже, чем требование сделать каждую карту тождественной: разрешить смешивание между потоками и ограничить усиление при композиции.
Ограничение mHC
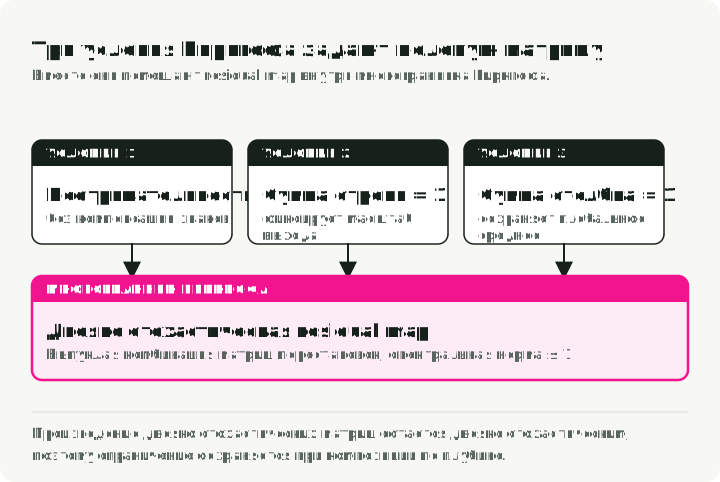
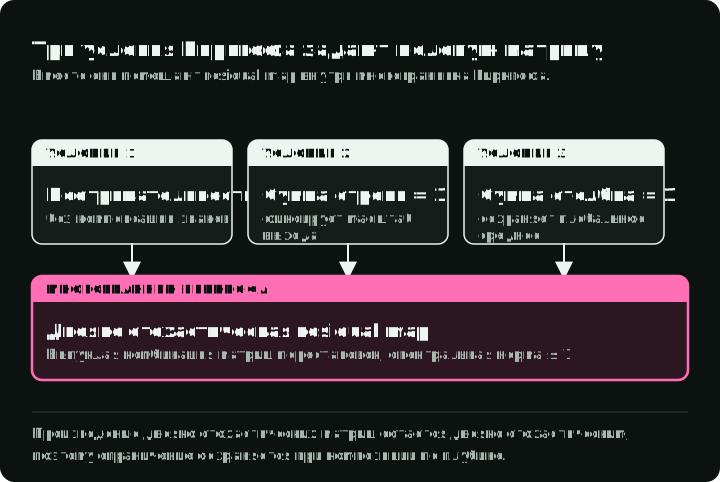
mHC сохраняет роутинг между потоками, но ограничивает каждую матрицу остаточного смешивания многогранником Биркгофа, то есть множеством двустохастических матриц. У такой матрицы неотрицательные элементы, а сумма в каждой строке и каждом столбце равна единице.
Рисунок схематично показывает остаточный путь каждого из трёх дизайнов, которые разбирает статья, и сравнивает их. Строка с усилением показывает пиковое составное усиление, о котором статья mHC сообщает для модели 27B. При и всех картах, равных 1, HC и mHC сводятся к стандартному остаточному соединению.


Что гарантирует двустохастичность
Рисунок проверяет три условия на двух матрицах 3×3 из примера с Sinkhorn ниже: неограниченные логиты нарушают все три, а после 20 проходов Sinkhorn выполняет все три. В таблице дано следствие каждого условия.
| Ограничение | Следствие |
|---|---|
| Неотрицательность | Коэффициенты с противоположными знаками не гасят друг друга |
| Сумма строки = 1 | Постоянный по потокам сигнал остаётся постоянным |
| Сумма столбца = 1 | Глобальное среднее по потокам сохраняется |
Неотрицательность вместе с единичными суммами строк делает каждый выход выпуклой комбинацией входных потоков. Ограничение сохраняет среднее по потокам, а не длину вектора: двустохастическая карта может усреднять потоки и сближать их.
Из этого следуют ещё три свойства (раздел 4.1):
- Спектральная норма ≤ 1: спектральная норма — это наибольший коэффициент, на который матрица может растянуть любой вектор. Граница, равная единице, означает, что карта остаточного роутинга не может усилить евклидову норму.
- Замкнутость относительно умножения: произведение двустохастических матриц остаётся двустохастическим, поэтому ограничение сохраняется при композиции по глубине.
- Выпуклое смешивание: по теореме Биркгофа-фон Неймана карта лежит в выпуклой оболочке матриц перестановок.
Проекция Sinkhorn-Knopp
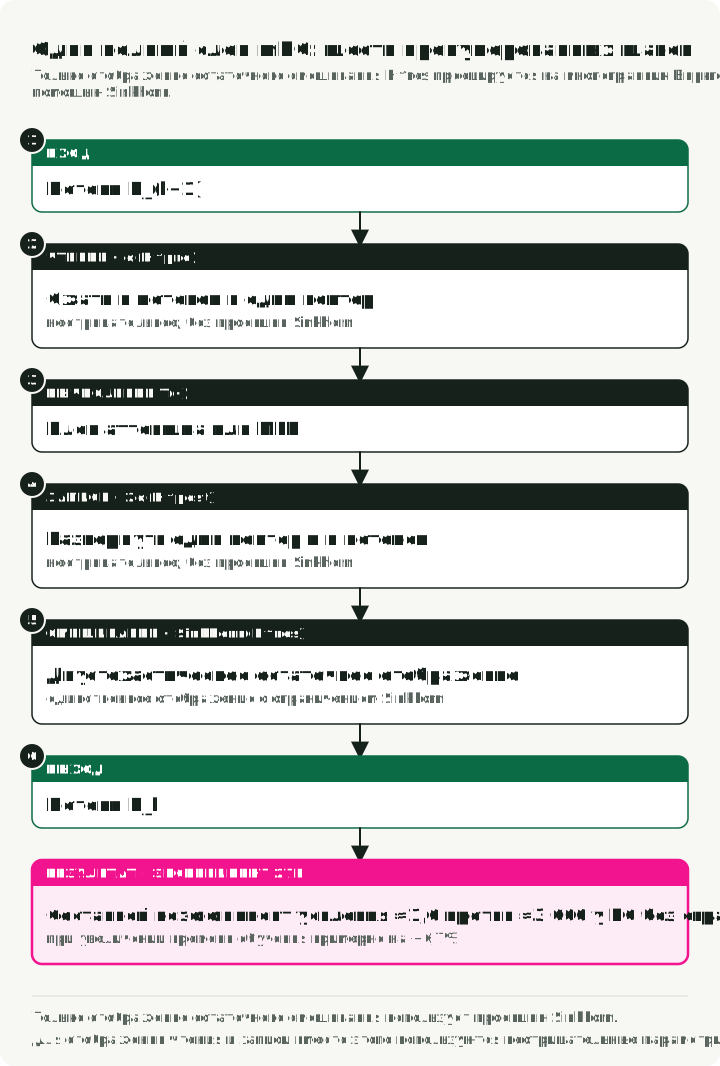
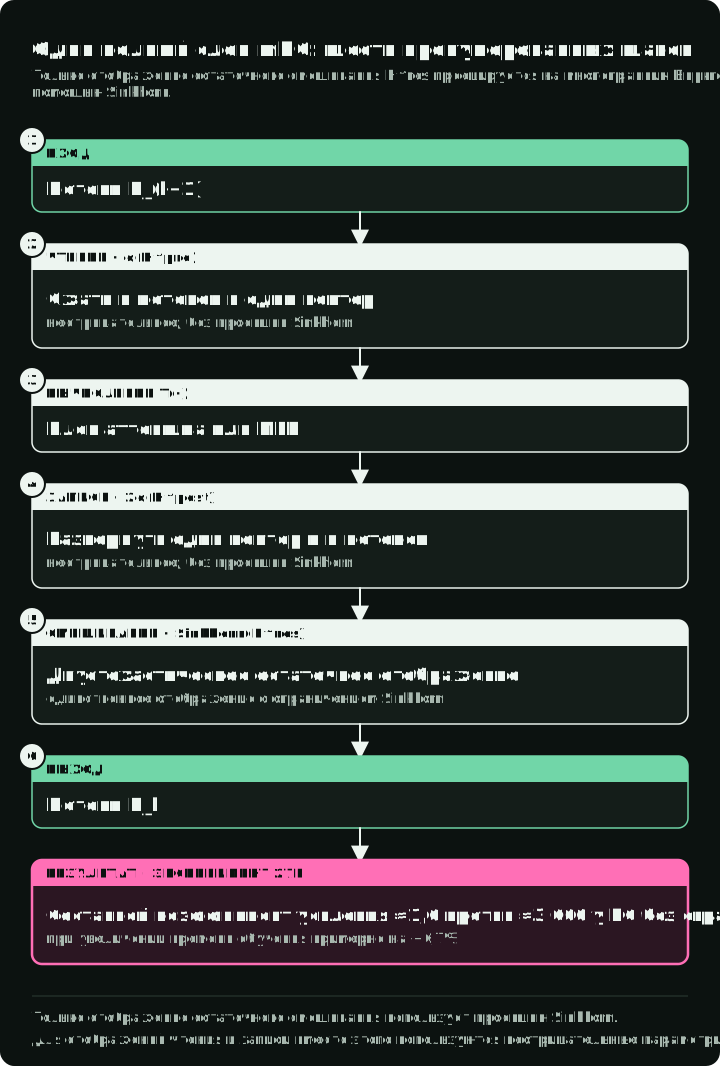
Обучаемые остаточные логиты не ограничены. mHC сначала берёт от них экспоненту, получая положительную матрицу, а затем поочерёдно нормализует столбцы и строки. При достаточном числе итераций этот процесс Sinkhorn-Knopp приближается к двустохастической матрице; статья использует 20 итераций как практичную приближённую дифференцируемую проекцию, а не точное ограничение.
Рисунок пошагово разбирает первый проход на примере 3×3 ниже, а затем показывает наибольшую ошибку суммы по столбцам за 20 проходов.
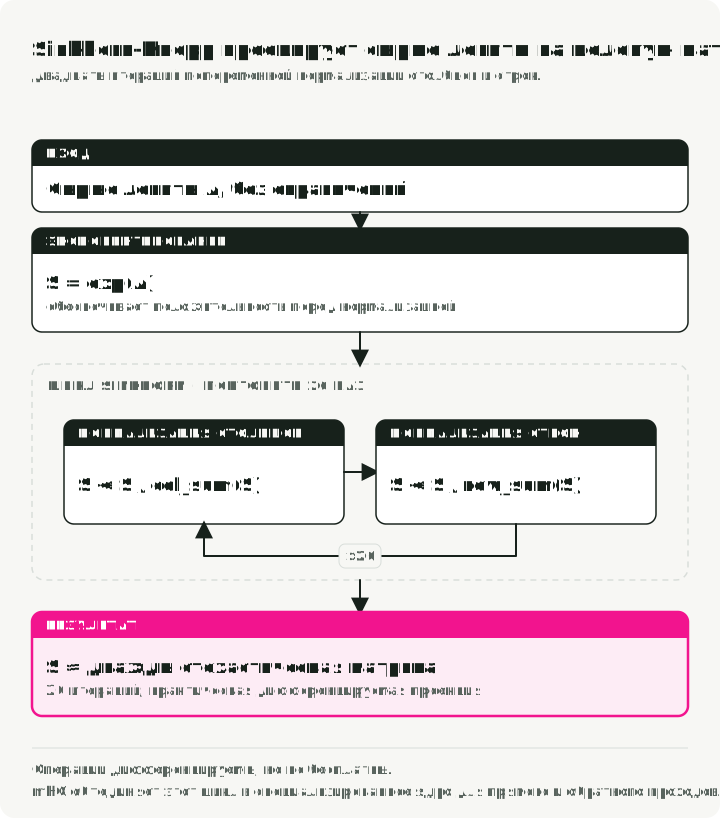
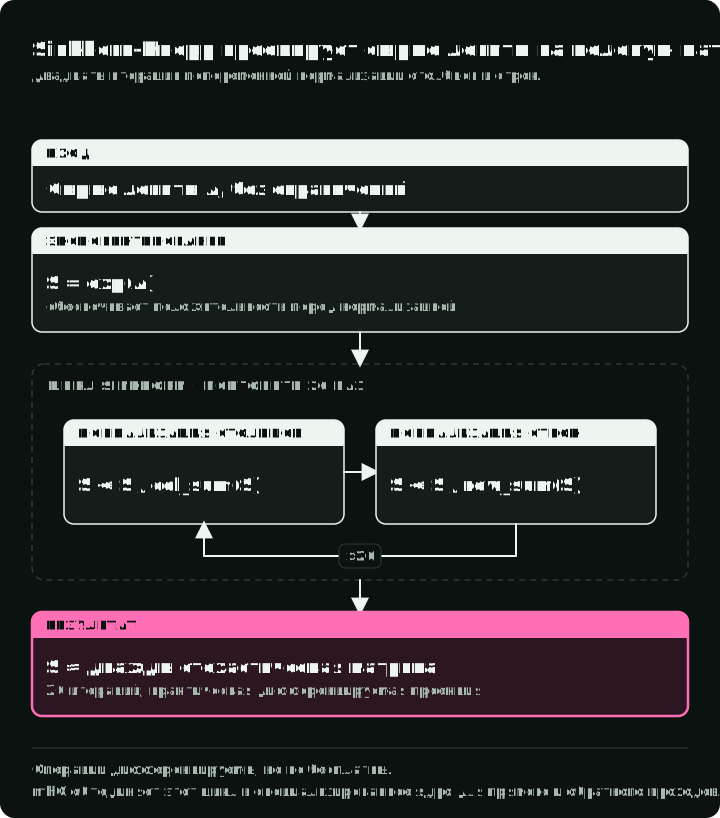
Для сырых логитов процедура выглядит так:
S = exp(A)
repeat 20 times:
    S = S / column_sum(S)
    S = S / row_sum(S)
return S
Пример 3×3 показывает, что значит «приближённо». Один проход выравнивает суммы строк, потому что строки нормализуются последними, но суммы столбцов расходятся с единицей до 12%. Двадцать проходов приводят обе суммы к 1,000 с точностью до трёх знаков.
Raw logits A           [[-0.5,   2.1,   0.8  ],
                        [ 1.3,  -4.0,   1.9  ],
                        [ 0.1,   0.6,  -0.2  ]]

S = exp(A)             [[ 0.607, 8.166, 2.226],
                        [ 3.669, 0.018, 6.686],
                        [ 1.105, 1.822, 0.819]]

After 1 pass           [[ 0.097, 0.705, 0.198],
(columns, then rows)    [ 0.497, 0.001, 0.501],
                        [ 0.435, 0.386, 0.178]]
                       row sums     1.000 1.000 1.000
                       column sums  1.030 1.092 0.877

After 20 passes        [[ 0.102, 0.653, 0.244],
                        [ 0.457, 0.001, 0.542],
                        [ 0.441, 0.346, 0.213]]
                       row and column sums 1.000
Следующий скрипт проверяет утверждение, на котором держится весь метод. Он перемножает 60 случайных матриц смешивания 4×4: один раз напрямую, как их использовал бы HC, и один раз после Sinkhorn, как это делает mHC, и печатает усиление Amax каждого произведения.
import numpy as np

rng = np.random.default_rng(0)
n, layers = 4, 60

def sinkhorn(logits, iters=20):
    s = np.exp(logits)
    for _ in range(iters):
        s = s / s.sum(axis=0, keepdims=True)  # columns sum to 1
        s = s / s.sum(axis=1, keepdims=True)  # rows sum to 1
    return s

def amax_gain(m):
    return max(np.abs(m).sum(axis=1).max(), np.abs(m).sum(axis=0).max())

hc, mhc = np.eye(n), np.eye(n)
for _ in range(layers):
    a = np.eye(n) + 0.3 * rng.standard_normal((n, n))
    hc = a @ hc
    mhc = sinkhorn(a) @ mhc

print(f"HC  Amax gain: {amax_gain(hc):.1f}")
print(f"mHC Amax gain: {amax_gain(mhc):.1f}")
При начальном значении генератора 0 он печатает 1906.8 для HC и 1.0 для mHC. Каждая случайная матрица близка к единичной, поэтому ни одна из них сама по себе не выглядит большой. В своей модели на 27B статья измеряет для mHC около 1,6, а не 1,0. Она использует всего 20 итераций, поэтому обученные матрицы не являются в точности двустохастическими, а небольшие ошибки растут по слоям, но остаются ограниченными (раздел 5.4).
Итерации Sinkhorn дифференцируемы, но не бесплатны. mHC опирается на объединённое (fused) прямое ядро и кастомное обратное ядро, которое пересчитывает промежуточные состояния нормализации прямо на чипе.
Детали параметризации
- Остаточная карта: экспонента плюс нормализация Sinkhorn дают приближённо двустохастическую .
- Карты чтения и записи: mHC заменяет из HC на сигмоиду: и . Обе карты неотрицательны, что убирает взаимное гашение положительных и отрицательных коэффициентов (разделы 4.1 и 4.2). Веса чтения лежат в (0, 1), веса записи — в (0, 2). Нулевой логит даёт вес записи , то есть вес, который использует стандартное остаточное сложение. Причину множителя 2 статья не называет.
Полная архитектура mHC
Рисунок показывает один слой mHC с параметризацией каждой карты. У него те же два пути, что и у блока HC; меняется только то, как параметризована каждая карта.
В терминах уравнения обновления:
- Вход: в слой поступают параллельных остаточных потоков .
- Путь блока: карта чтения собирает потоки в один -мерный вход. Блок аттеншна или MLP обрабатывает его. Карта записи превращает выход в обновления для потоков.
- Остаточный путь: приближённо двустохастическая смешивает входящие потоки.
- Сложение: два пути суммируются в , который идёт на следующий слой.
Проекцию Sinkhorn использует только карта остаточного смешивания. Карты чтения и записи используют неотрицательные параметризации. Это различие важно, потому что гарантия статьи для композиции относится к .
Инфраструктура, необходимая для заявленных накладных расходов
Четыре потока увеличивают обращения к памяти для остаточного состояния, объём хранимых активаций и коммуникацию между стадиями пайплайна. Результат статьи по времени зависит от трёх согласованных изменений, описанных ниже.
Объединение ядер
Реализация объединяет операции с общим доступом к памяти, где уместно, использует смешанную точность и пишет большинство кастомных ядер на TileLang. Цикл Sinkhorn и его кастомный обратный проход выполняются в отдельных ядрах, чтобы снизить трафик памяти и накладные расходы на запуск.
Выборочный пересчёт
потоков добавляют память под активации (раздел 4.3.2). Вместо хранения каждого промежуточного результата mHC:
- Освобождает промежуточные активации своих ядер после прямого прохода.
- Пересчитывает их в обратном проходе, не запуская заново блок аттеншна или FFN.
- Хранит вход расширенных потоков каждой группы подряд идущих слоёв и выход блока аттеншна или FFN каждого слоя. Статья согласует эти группы со стадиями пайплайна.
Расширенное расписание DualPipe перекрывает часть коммуникации, пересчёта и работы слоёв на границах стадий пайплайна. Достигнутое перекрытие специфично для этой системы обучения.
Заявленный системный результат
Для крупномасштабной конфигурации статьи коэффициент расширения добавляет 6,7% времени обучения относительно её базовой модели (раздел 4.3). Это системный результат, а не накладные расходы простой реализации во фреймворке.
Что устанавливают эксперименты
Авторы обучают варианты MoE на 3B, 9B и 27B, вдохновлённые DeepSeek-V3 (раздел 5.3). На 27B mHC превосходит стандартный бейзлайн с остаточными соединениями на всех восьми заявленных downstream-бенчмарках и превосходит HC на семи из восьми (таблица 4). HC немного выше на MATH (26,4 против 26,0). Это собственные претрейнинг-эксперименты команды, предложившей метод, поэтому независимое воспроизведение и сравнения на других архитектурах остаются открытыми.
Когда стоит пробовать mHC
Результаты статьи указывают на три условия:
- Вы делаете претрейнинг с нуля. mHC меняет архитектуру, а статья оценивает метод только на претрейнинге. Если нет, пропустите mHC.
- Вам нужна более широкая остаточная часть, чем один поток. Вы уже используете HC или планируете, и видите скачки функции потерь либо рост активаций и норм градиентов при увеличении глубины или размера. Если хватает одного потока, оставьте стандартное остаточное соединение.
- Вы можете сделать системную работу или готовы к большим затратам. Цифра 6,7% требует объединённых ядер и изменений расписания пайплайна. Простая реализация во фреймворке обойдётся дороже. Если вы не можете выполнить эту работу, mHC на простом коде возможен, но сначала измерьте накладные расходы.
Остаются три вопроса:
- Системные накладные расходы: заявленные накладные расходы — это оптимизированный результат статьи; в другом рантайме, на другой топологии устройств или с другой формой модели стоимость может отличаться.
- Смещение из-за смешивания: двустохастичность сохраняет среднее по потокам и не даёт расширения через , но может сглаживать различия между потоками. Обновление блока по-прежнему меняет общее представление.
- Границы доказательств: самые сильные доказательства — претрейнинг языковых моделей на MoE-архитектурах, вдохновлённых DeepSeek-V3. Обобщение на другие семейства моделей эта статья не устанавливает.
mHC — многообещающий способ изучать более широкую топологию остаточных соединений и сохранять при этом хорошую обусловленность многократно применяемой остаточной карты. Стоит ли метод затрат для другой модели, зависит от независимо подтверждённого прироста качества и от стоимости воспроизведения его системного стека.
Литература
- mHC: Manifold-Constrained Hyper-Connections - Xie et al. (DeepSeek)
- Deep Residual Learning for Image Recognition - He et al. (ResNet)
- Hyper-Connections - исходная статья про HC
- TileLang - фреймворк для оптимизации CUDA-ядер
- DualPipe - планировщик пайплайн-параллелизма для DeepSeek-V3
- ResiDual - архитектура с двойным остаточным путём