DeepSeek mHC: Manifold-Constrained Hyper-Connections

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Moderne deep learning rust op de residual connection. Dit artikel is voor engineers die het Transformer-blok kennen en willen weten wat mHC in het residual pad verandert, waarom, wat het kost en wanneer je het kunt proberen. Hyper-Connections (HC) onderzoeken een andere architectuurdimensie: de residual state verbreden tot meerdere samenwerkende streams. Het paper over Manifold-Constrained Hyper-Connections (mHC) van DeepSeek onderzoekt hoe je die routing stabiel houdt bij grotere trainingsschalen.
Het begint met standaard residual connections en voegt daarna Hyper-Connections toe, met de instabiliteit die zij veroorzaken. Daarna volgen de mHC-constraint, een kleine NumPy-demo en de implementatiekosten.
Waarom residual connections werken
Het diepteprobleem
Extra lagen kunnen de capaciteit vergroten, maar maken optimalisatie en signaalpropagatie ook moeilijker. Afhankelijk van initialisatie, normalisatie en architectuur kunnen forward activations of backward gradients krimpen, groeien of slecht geconditioneerd raken over de diepte.
De residual-oplossing
Het ResNet-paper introduceerde een eenvoudige oplossing. Leer niet een directe afbeelding, maar het residual, het verschil met de identiteit:
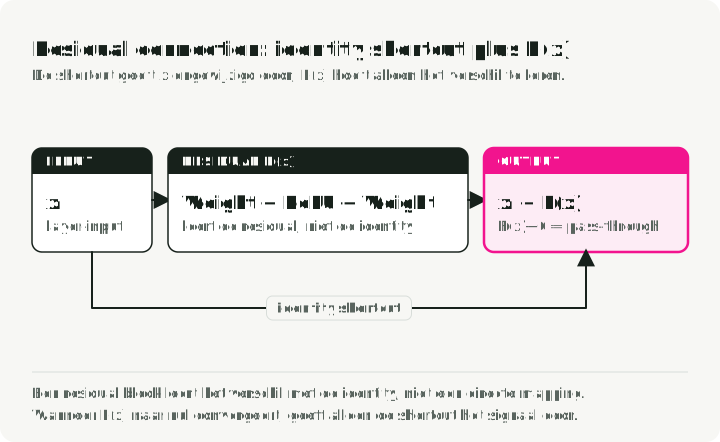
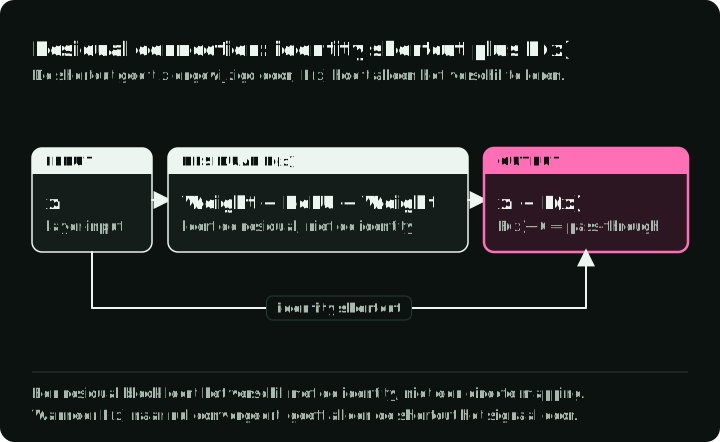
De nuttige eigenschap is de identiteitsshortcut. Als de residual-functie nul oplevert, geeft de laag de invoer ongewijzigd door. Dat heeft twee gevolgen:
- Een directe gradiëntterm: backpropagation bevat een pad via de identiteitscomponent.
- Een eenvoudige terugvalafbeelding: de residual-tak kan dicht bij nul blijven wanneer een laag de state niet veel hoeft te veranderen.
Dit lost niet elk optimalisatieprobleem op, maar het maakte aanzienlijk diepere netwerken praktisch haalbaar.
Hoe layer normalization het residual pad verandert
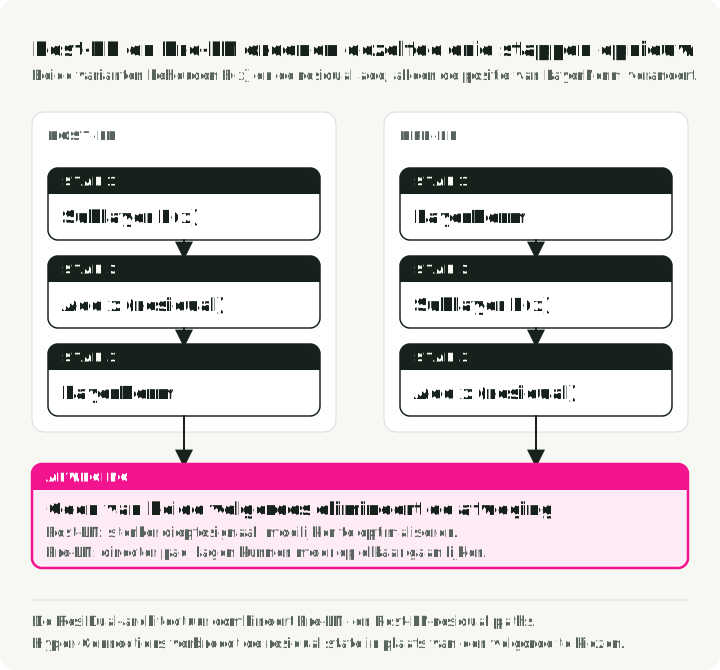
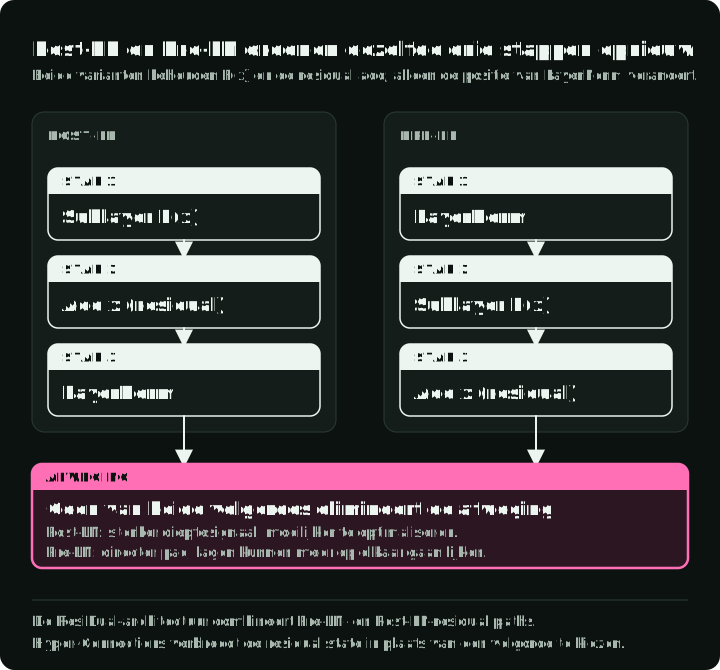
Transformers brachten een nieuwe variabele mee: waar je Layer Normalization (LN) plaatst. Dat bepaalt of het residual pad een identiteit blijft.
| Variant | LN-plaatsing | Voordeel | Belangrijkste beperking |
|---|---|---|---|
| Post-LN | Na het residual-blok | Sterke bijdrage van diepte | Kan bij grote diepte moeilijker te optimaliseren zijn |
| Pre-LN | Vóór het residual-blok | Directer residual pad | Representaties van aangrenzende lagen kunnen steeds meer op elkaar gaan lijken |
ResiDual combineert een residual pad zoals bij Post-LN met een tweede pad dat de uitvoer van de blokken optelt. Hun representaties worden bij de modeluitvoer opgeteld. Het HC-paper gaat uit van precies deze afweging en maakt de sterkte van de verbindingen leerbaar, over meerdere streams.
Hyper-Connections voegen parallelle residual streams toe
Hyper-Connections (HC) vergroten de breedte van de residual stream in plaats van de diepte.
Wat een stream betekent
In een standaard Transformer heeft elk token een -dimensionale state die door de blokken gaat. Aan het begin van het netwerk repliceert HC die input embedding keer, waarbij de “expansion rate” is, meestal 4. De -dimensionale hidden state wordt een “hyper hidden matrix”.
In Hyper-Connections is een stream een van die parallelle instanties van de state.
De kopieën beginnen identiek en lopen daarna uiteen doordat geleerde maps uit de streams lezen, ernaar schrijven en ze mixen. Het paper interpreteert ze als meerdere verbindingspatronen over de diepte; het vereist niet dat elke stream een vaste, voor mensen leesbare rol krijgt.
Kernmechanismen
In plaats van één residual pad houdt HC parallelle streams door het hele netwerk aan. In elk transformer-blok worden drie bewerkingen uitgevoerd, elk gestuurd door kleine leerbare weights:
- Lezen (): voeg de streams samen tot de -dimensionale invoer die het attention- of feed-forward-blok verwerkt.
- Schrijven (): zet de uitvoer van dat blok terug om in updates voor de streams.
- Mixen (): pas een residual map toe op de binnenkomende streams voordat de update van het blok erbij komt.
In HC is elke map een geleerd statisch deel (een bias) plus een invoerafhankelijke term die door gaat, waardoor de waarden elk teken kunnen hebben. Het HC-paper noemt de versie met invoerafhankelijke termen dynamic HC (DHC); DHC×4 betekent DHC met vier streams. De residual map is het deel waar stabiliteit van afhangt, omdat ze over de diepte herhaaldelijk wordt vermenigvuldigd.
Samen geven de drie maps de update per laag (Vgl. 3 van het mHC-paper, dat de breedte als schrijft):
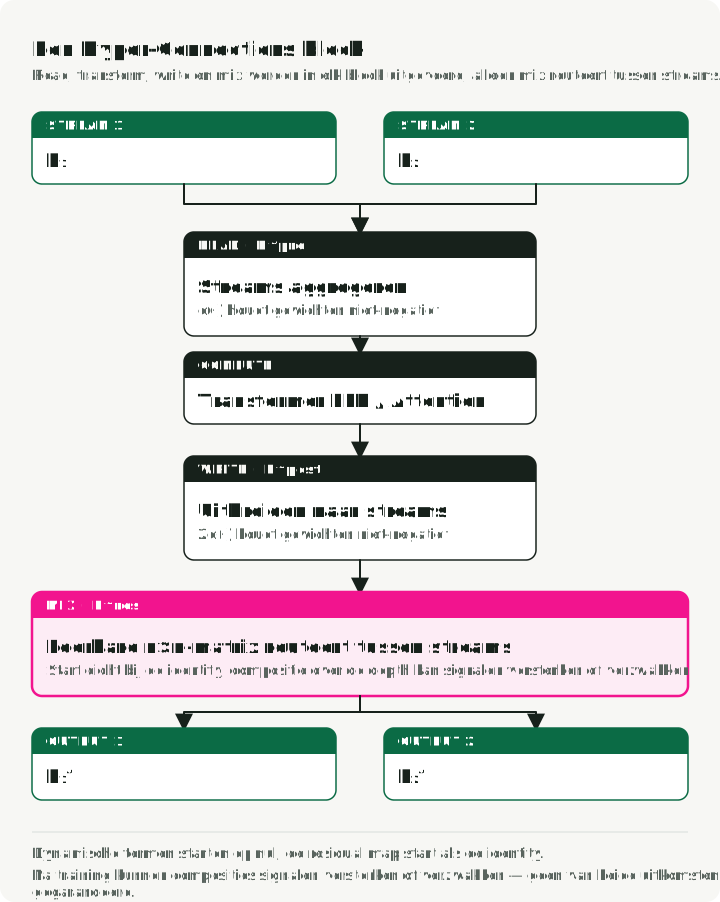
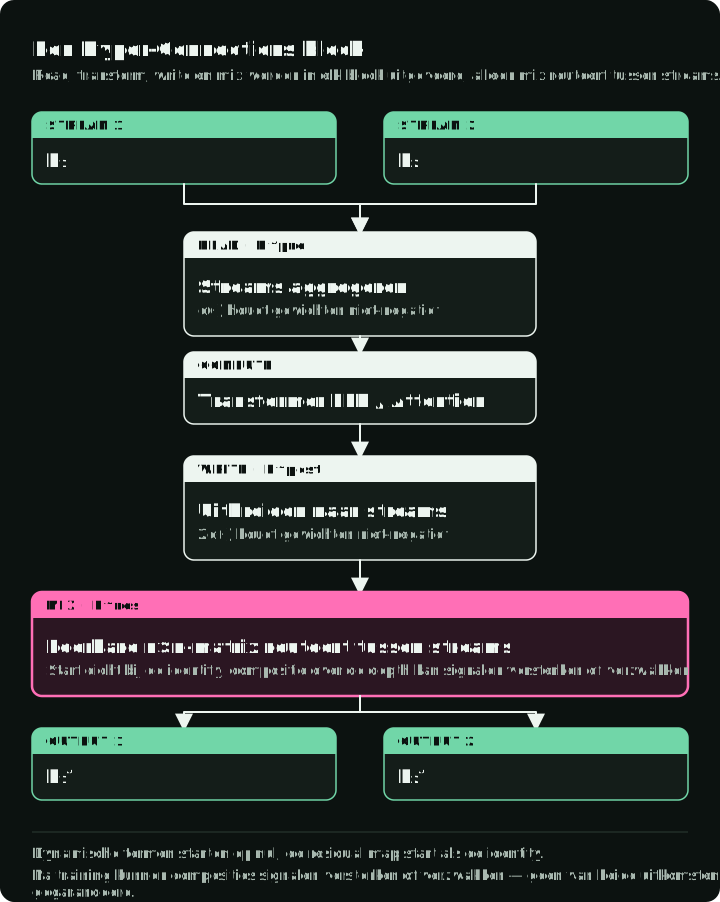
Hier is de streammatrix, zijn en van en is van . De eerste term is het residual pad. De tweede term is de update van het blok: lezen, rekenen, schrijven. Met en alle drie de maps gelijk aan 1 is de vergelijking de standaard residual .
De figuur tekent deze update voor vier streams: lezen, rekenen en schrijven boven de streams, de 4 × 4-mix op de streams en een optelling op elke stream.
Wat het HC-paper rapporteert
Het HC-paper rapporteert 1,8× snellere convergentie voor zijn OLMoE-1B-7B DHC×4-configuratie ten opzichte van de baseline, plus betere downstream-resultaten bij 500B tokens (Sectie 1). Dat is één geëvalueerde configuratie, geen algemene versnellingsfactor voor vier streams.
Waarom onbeperkte HC instabiel kan worden
Het mHC-paper rapporteert instabiliteit wanneer onbeperkte HC wordt opgeschaald naar de 27B-opzet: de training loss schiet omhoog rond stap 12k, samen met een sprong in de gradient norm (Sectie 3.1). Dezelfde onbeperkte maps die HC flexibel maken, nemen ook het gegarandeerde identiteitspad weg dat residuals makkelijk te trainen maakt.
Het probleem van de samengestelde map
In standaard residuals:
Als , is dit de identiteit: . Het signaal gaat ongewijzigd door.
In Hyper-Connections is de residual-term van bovenstaande update een matrixproduct, . Als je alleen dat pad over lagen volgt, wordt het signaal:
Het gedrag hangt af van de samengestelde matrix, niet van de vraag of afzonderlijke waarden boven of onder 1 liggen. Als de maps dezelfde richting steeds met meer dan 1 uitrekken, groeit het product exponentieel met de diepte. Als ze die steeds verkleinen, dooft het signaal uit. Negatieve waarden kunnen signalen ook tegen elkaar wegstrepen.
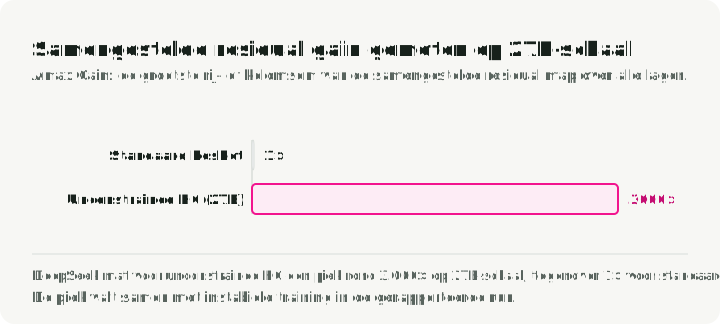
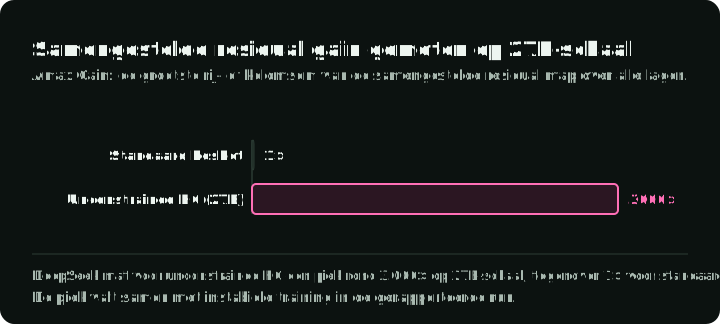
Het mHC-paper meet die versterking met de Amax Gain Magnitude: de maximale absolute rijsom voor forward propagation en kolomsom voor backward propagation in een samengestelde residual map. In het 27B-HC-experiment loopt de piek op tot bijna 3.000 en valt samen met instabiel trainingsgedrag (Sectie 3.1).
De grafiek zet de drie waarden uit het paper op één logaritmische as: 1 voor een standaard residual, ongeveer 1,6 voor mHC (de beperkte versie die hierna wordt beschreven) en ongeveer 3.000 voor onbeperkte HC. Een markering onder de as toont de uit het voorbeeld hierboven.
Het ontwerpdoel is dus smaller dan elke map tot de identiteit dwingen: laat mixing tussen streams toe en begrens tegelijk de versterking over samenstellingen heen.
De mHC-constraint
mHC behoudt de routing tussen streams, maar beperkt elke residual mixing-matrix tot de Birkhoff-polytoop, de verzameling doubly stochastic matrices. Zo’n matrix heeft niet-negatieve waarden en elke rij en kolom heeft som één.
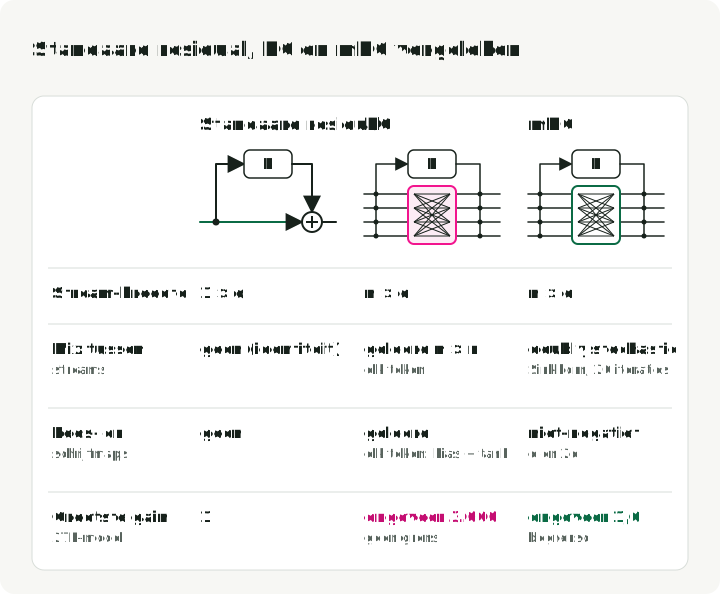
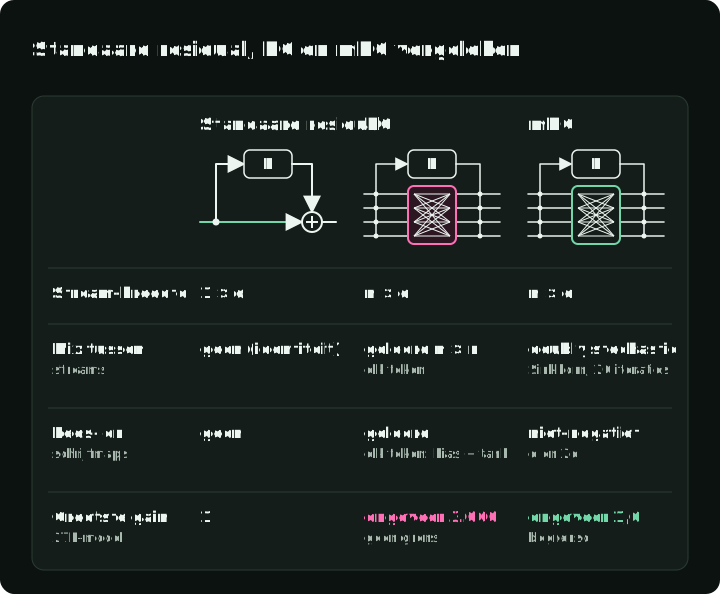
De figuur schetst het residual pad van elk ontwerp uit dit artikel en vergelijkt ze. De gain-rij toont de hoogste samengestelde gain die het mHC-paper voor het 27B-model rapporteert. Met en alle maps gelijk aan 1 vallen HC en mHC terug op de standaard residual.
Wat doubly stochastic garandeert
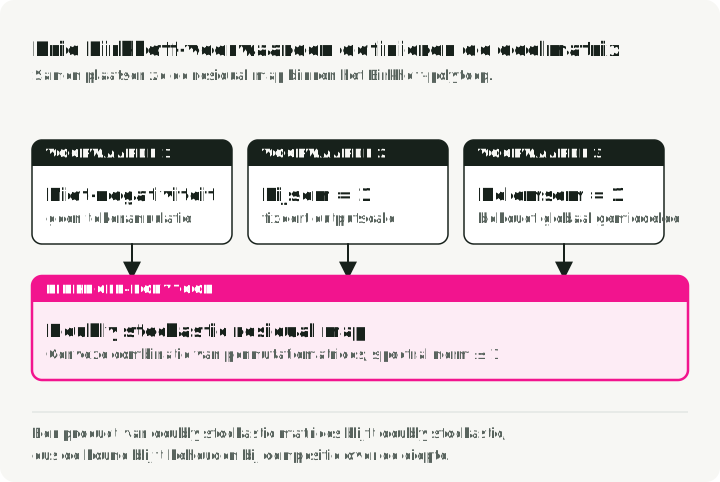
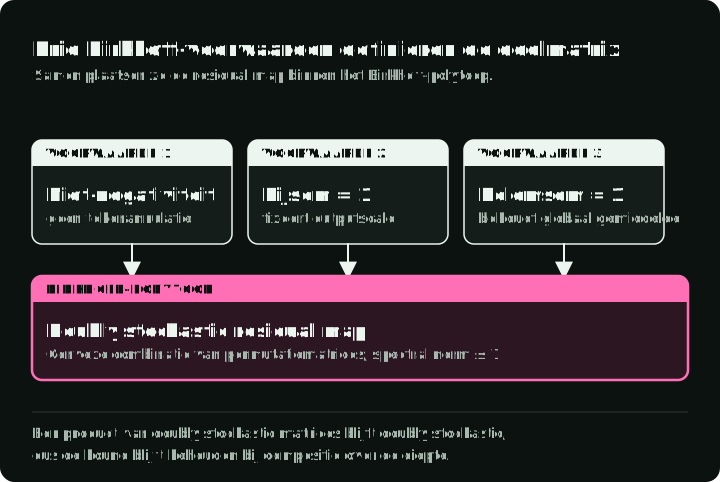
De figuur controleert de drie voorwaarden op twee 3×3-matrices uit het Sinkhorn-voorbeeld hieronder: de onbeperkte logits , die alle drie schenden, en na 20 Sinkhorn-iteraties, die aan alle drie voldoet. De tabel geeft het gevolg van elke voorwaarde.
| Beperking | Gevolg |
|---|---|
| Niet-negatief | Coëfficiënten met tegengestelde tekens heffen elkaar niet op |
| Rijsom = 1 | Een constant signaal over streams heen blijft constant |
| Kolomsom = 1 | Het globale gemiddelde over streams heen blijft behouden |
Niet-negatieve waarden en rijsommen van één maken elke uitvoer tot een convexe combinatie van de invoerstreams. De beperking behoudt het gemiddelde over streams, niet de lengte van de vector: een doubly stochastic map kan streams naar elkaar toe middelen.
Er volgen nog drie eigenschappen (Sectie 4.1):
- Spectrale norm ≤ 1: de spectrale norm is de grootste factor waarmee een matrix een vector kan uitrekken. Een grens van één betekent dat de residual routing-map de Euclidische norm niet kan versterken.
- Gesloten onder vermenigvuldiging: een product van doubly stochastic matrices blijft doubly stochastic, dus de beperking blijft behouden bij samenstelling over de diepte.
- Convexe mixing: volgens de stelling van Birkhoff-von Neumann ligt de map in de convexe omhulling van de permutatiematrices.
Sinkhorn-Knopp-projectie
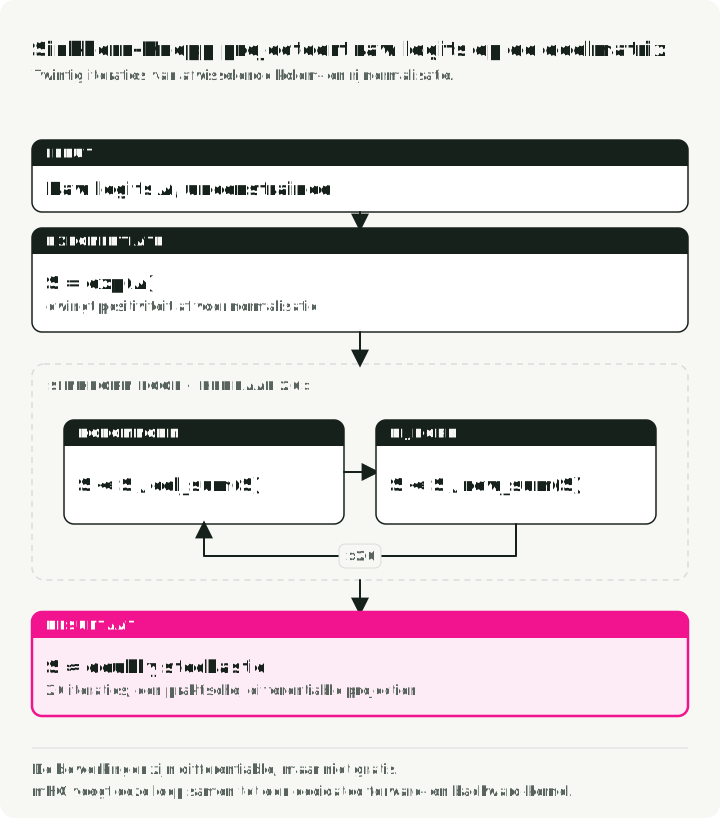
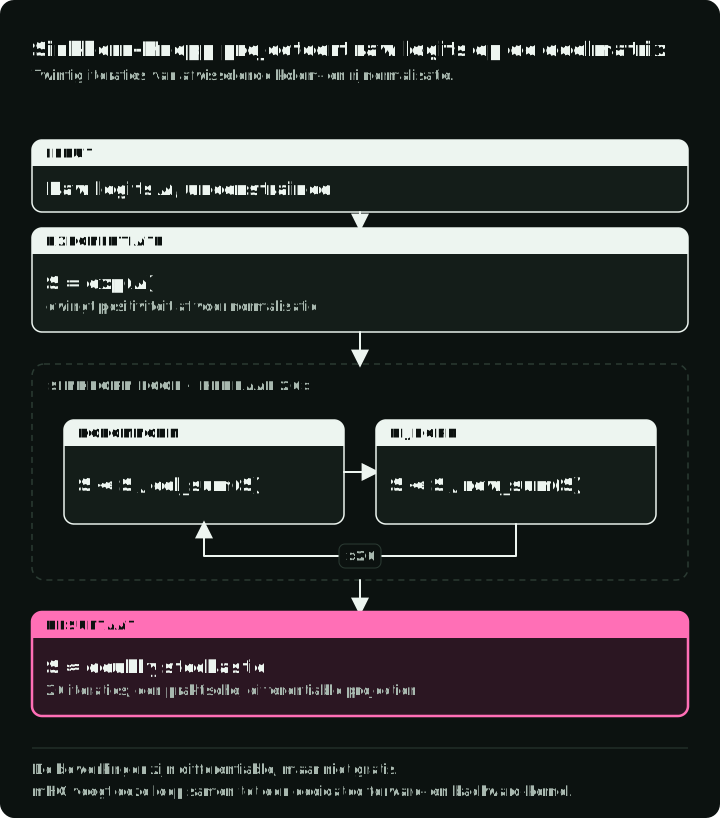
De leerbare residual logits zijn onbeperkt. mHC past eerst de exponentiële functie erop toe om een positieve matrix te krijgen en normaliseert daarna afwisselend kolommen en rijen. Met genoeg iteraties benadert dit Sinkhorn-Knopp-proces een doubly stochastic matrix; het paper gebruikt 20 iteraties als praktische, benaderende differentieerbare projectie en niet als exacte beperking.
De figuur voert de eerste iteratie op het 3×3-voorbeeld hieronder stap voor stap uit en zet daarna de grootste kolomsomfout uit over 20 iteraties.
Voor ruwe logits is de procedure:
S = exp(A)
repeat 20 times:
    S = S / column_sum(S)
    S = S / row_sum(S)
return S
Een 3×3-voorbeeld laat zien wat “bij benadering” betekent. Eén ronde zet de rijsommen goed, omdat rijen als laatste worden genormaliseerd, maar laat de kolomsommen tot 12% afwijken. Twintig rondes brengen beide op 1,000 bij drie decimalen.
Raw logits A           [[-0.5,   2.1,   0.8  ],
                        [ 1.3,  -4.0,   1.9  ],
                        [ 0.1,   0.6,  -0.2  ]]

S = exp(A)             [[ 0.607, 8.166, 2.226],
                        [ 3.669, 0.018, 6.686],
                        [ 1.105, 1.822, 0.819]]

After 1 pass           [[ 0.097, 0.705, 0.198],
(columns, then rows)    [ 0.497, 0.001, 0.501],
                        [ 0.435, 0.386, 0.178]]
                       row sums     1.000 1.000 1.000
                       column sums  1.030 1.092 0.877

After 20 passes        [[ 0.102, 0.653, 0.244],
                        [ 0.457, 0.001, 0.542],
                        [ 0.441, 0.346, 0.213]]
                       row and column sums 1.000
Het volgende script test de bewering waar de hele methode op rust. Het vermenigvuldigt 60 willekeurige 4×4 mixing-matrices, één keer direct gebruikt zoals HC dat zou doen en één keer na Sinkhorn zoals mHC, en print de Amax gain van elk product.
import numpy as np

rng = np.random.default_rng(0)
n, layers = 4, 60

def sinkhorn(logits, iters=20):
    s = np.exp(logits)
    for _ in range(iters):
        s = s / s.sum(axis=0, keepdims=True)  # columns sum to 1
        s = s / s.sum(axis=1, keepdims=True)  # rows sum to 1
    return s

def amax_gain(m):
    return max(np.abs(m).sum(axis=1).max(), np.abs(m).sum(axis=0).max())

hc, mhc = np.eye(n), np.eye(n)
for _ in range(layers):
    a = np.eye(n) + 0.3 * rng.standard_normal((n, n))
    hc = a @ hc
    mhc = sinkhorn(a) @ mhc

print(f"HC  Amax gain: {amax_gain(hc):.1f}")
print(f"mHC Amax gain: {amax_gain(mhc):.1f}")
Met seed 0 print het 1906,8 voor HC en 1,0 voor mHC. Elke willekeurige matrix ligt dicht bij de identiteit, dus geen enkele lijkt op zichzelf groot. Het paper meet in zijn 27B-model ongeveer 1,6 voor mHC, niet 1,0. Het gebruikt slechts 20 iteraties, dus de getrainde matrices zijn niet exact doubly stochastic; de kleine fouten groeien over de lagen, maar blijven begrensd (Sectie 5.4).
De Sinkhorn-iteraties zijn differentieerbaar, maar niet gratis. mHC vertrouwt op een gefuseerde forward kernel en een eigen backward kernel die de tussenliggende normalisatiestates on-chip opnieuw berekent.
Details van de parameterisatie
- Residual map: exponentiatie plus Sinkhorn-normalisatie levert de bij benadering doubly stochastic op.
- Lees- en schrijfmaps: mHC vervangt de van HC door een sigmoid: en . Beide maps zijn niet-negatief, wat tekenopheffing tussen positieve en negatieve coëfficiënten wegneemt (Secties 4.1 en 4.2). Leesweights liggen in (0, 1) en schrijfweights in (0, 2). Een logit van nul geeft een schrijfweight van , het weight dat een standaard residual-optelling gebruikt. Het paper noemt geen reden voor de factor 2.
De volledige mHC-architectuur
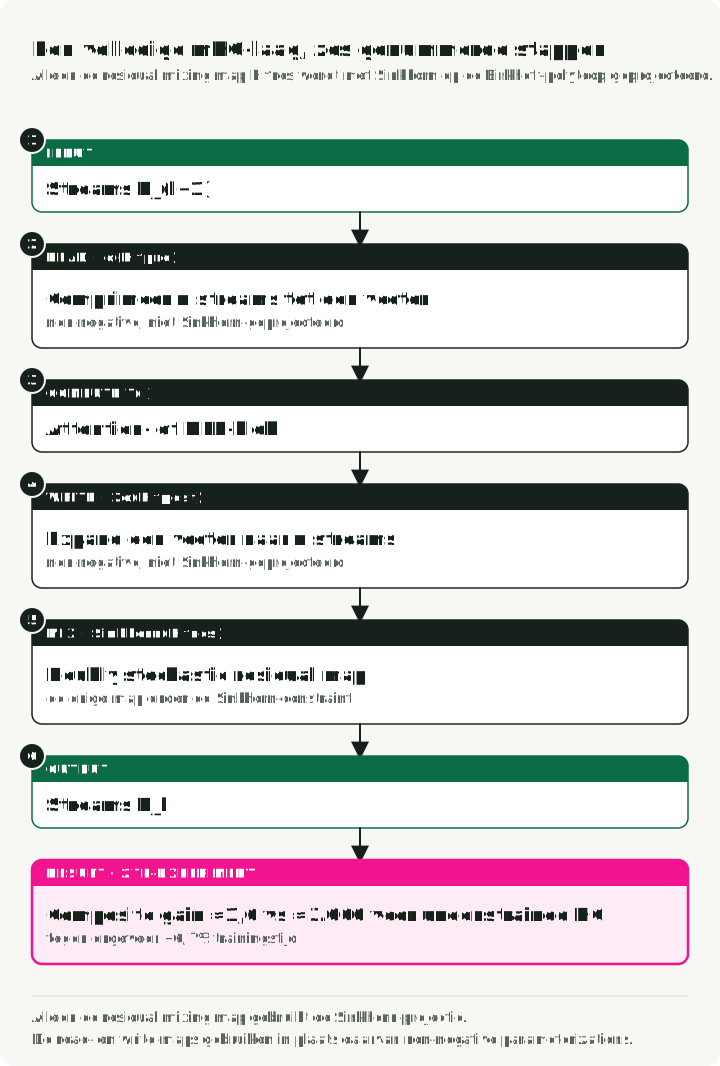
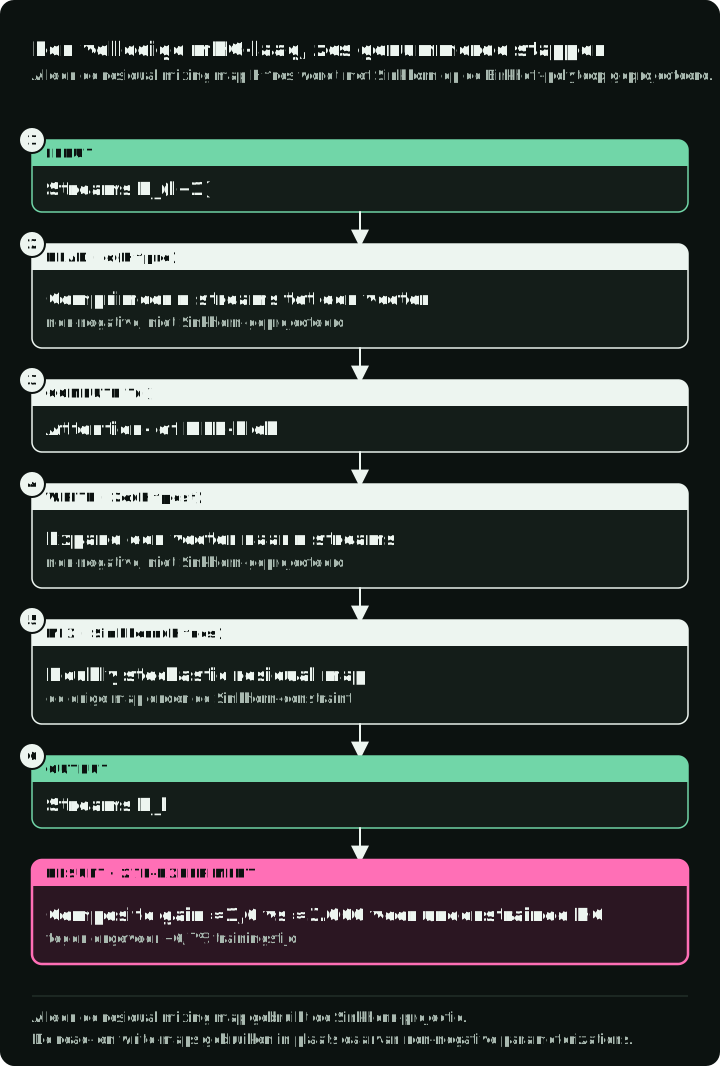
De figuur toont één mHC-laag met de parameterisatie van elke map. Hij heeft dezelfde twee paden als het HC-blok; wat verandert is hoe elke map wordt geparametriseerd.
In termen van de updatevergelijking:
- Invoer: parallelle residual streams komen de laag binnen.
- Blokpad: de leesmap combineert de streams tot één -dimensionale invoer. Het attention- of MLP-blok verwerkt die. De schrijfmap zet de uitvoer om in updates voor de streams.
- Residual pad: de bij benadering doubly stochastic mixt de binnenkomende streams.
- Optellen: de twee paden worden opgeteld tot , dat naar de volgende laag gaat.
Alleen de residual mixing-map gebruikt de Sinkhorn-projectie. De lees- en schrijfmaps gebruiken niet-negatieve parameterisaties. Dat onderscheid doet ertoe, omdat de compositiegarantie van het paper voor geldt.
Infrastructuur voor de gerapporteerde overhead
Vier streams vergroten de geheugentoegang voor de residual state, de opslag van activations en de communicatie tussen pipeline-stappen. Het tijdsresultaat van het paper hangt af van drie samen ontworpen wijzigingen, die hieronder staan.
Kernel fusion
De implementatie fuseert bewerkingen die geheugentoegang delen, gebruikt waar passend mixed precision en implementeert de meeste eigen kernels met TileLang. De Sinkhorn-lus en de eigen backward pass draaien in speciale kernels om geheugenverkeer en launch-overhead te beperken.
Selective recomputation
De streams vergroten het activation-geheugen (Sectie 4.3.2). In plaats van elk tussenresultaat op te slaan, doet mHC het volgende:
- Het geeft de tussenliggende activations van zijn eigen kernels vrij na de forward pass.
- Het berekent ze opnieuw in de backward pass, zonder het attention- of FFN-blok opnieuw uit te voeren.
- Het slaat de invoer van de uitgebreide streams van elke groep opeenvolgende lagen op, en de attention- of FFN-uitvoer van elke laag. Het paper laat deze groepen aansluiten op de pipeline-stappen.
Een uitgebreid DualPipe-schema laat delen van communicatie, herberekening en laagwerk overlappen op de grenzen van pipeline-stappen. De behaalde overlap is specifiek voor dit trainingssysteem.
Gerapporteerd systeemresultaat
Voor de grootschalige opzet van het paper voegt expansion rate 6,7% trainingstijd toe ten opzichte van de baseline (Sectie 4.3). Dit is een systeemresultaat, niet de overhead van een gewone implementatie in een framework.
Wat de experimenten aantonen
De auteurs trainen MoE-varianten van 3B, 9B en 27B, geïnspireerd op DeepSeek-V3 (Sectie 5.3). Bij 27B verslaat mHC de standaard residual-baseline op alle acht gerapporteerde downstream-benchmarks en verslaat het HC op zeven van de acht (Tabel 4). HC scoort iets hoger op MATH (26,4 tegen 26,0). Dit zijn interne pretraining-experimenten van het team dat de methode voorstelt, dus onafhankelijke replicatie en vergelijkingen op andere architecturen blijven open.
Wanneer mHC proberen
De resultaten van het paper wijzen op drie voorwaarden:
- Je doet pretraining vanaf nul. mHC verandert de architectuur en het paper evalueert het alleen bij pretraining. Zo niet, sla mHC dan over.
- Je hebt meer residual-breedte nodig dan één stream. Je gebruikt HC al of bent van plan dat te doen, en je ziet loss spikes of groeiende activations en gradient norms wanneer je de diepte of omvang opschaalt. Als één stream genoeg is, houd dan de standaard residual.
- Je kunt het systeemwerk doen, of accepteert hogere kosten. De 6,7% vraagt om gefuseerde kernels en aanpassingen aan het pipeline-schema. Een gewone implementatie in een framework kost meer. Kun je dat werk niet doen, dan is mHC in gewone code mogelijk, maar meet eerst de overhead.
Er blijven drie vragen over:
- Systeemoverhead: de gerapporteerde overhead is het geoptimaliseerde resultaat uit het paper; een andere runtime, apparaattopologie of modelvorm kan andere kosten geven.
- Mixing-bias: double stochasticity behoudt het gemiddelde over streams en voorkomt expansie via , maar kan verschillen tussen streams gladstrijken. De update van het blok verandert nog steeds de totale representatie.
- Reikwijdte van het bewijs: het sterkste bewijs is pretraining van taalmodellen op MoE-architecturen die op DeepSeek-V3 zijn geïnspireerd. Generalisatie naar andere modelfamilies is door dit paper nog niet aangetoond.
mHC is een veelbelovende manier om bredere residual-topologie te bestuderen en de herhaalde residual map toch goed geconditioneerd te houden. Of het de moeite waard is voor een ander model hangt af van onafhankelijke kwaliteitswinst en de kosten om de systeemstack van het paper na te bouwen.
Referenties
- mHC: Manifold-Constrained Hyper-Connections - Xie et al. (DeepSeek)
- Deep Residual Learning for Image Recognition - He et al. (ResNet)
- Hyper-Connections - Origineel HC-paper
- TileLang - CUDA-framework voor kerneloptimalisatie
- DualPipe - Pipeline parallelism-scheduler voor DeepSeek-V3
- ResiDual - Architectuur met dubbel residual pad