DeepSeek mHC: Hyper-Connections ograniczone rozmaitością

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Współczesne uczenie głębokie opiera się na połączeniu rezydualnym. Ten wpis jest dla inżynierów, którzy znają blok Transformera i chcą wiedzieć, co mHC zmienia w ścieżce rezydualnej, dlaczego, ile to kosztuje i kiedy warto to wypróbować. Hyper-Connections (HC) badają inny wymiar architektury: poszerzają stan rezydualny do kilku współdziałających strumieni. Artykuł DeepSeek o Manifold-Constrained Hyper-Connections (mHC) analizuje, jak utrzymać stabilność takiego routingu przy większej skali treningu.
Zaczyna od standardowych połączeń rezydualnych, potem dodaje Hyper-Connections i niestabilność, którą powodują. Dalej opisuje ograniczenie mHC, krótkie demo w NumPy i koszt implementacji.
Dlaczego połączenia rezydualne działają
Problem głębokości
Dodawanie warstw może zwiększyć pojemność modelu, ale utrudnia też optymalizację i propagację sygnału. W zależności od inicjalizacji, normalizacji i architektury aktywacje w przejściu w przód lub gradienty w przejściu wstecz mogą maleć, rosnąć albo stać się źle uwarunkowane wraz z głębokością.
Rozwiązanie rezydualne
Artykuł o ResNet wprowadził proste rozwiązanie. Zamiast uczyć się bezpośredniego odwzorowania, uczymy się reszty, czyli różnicy względem tożsamości:
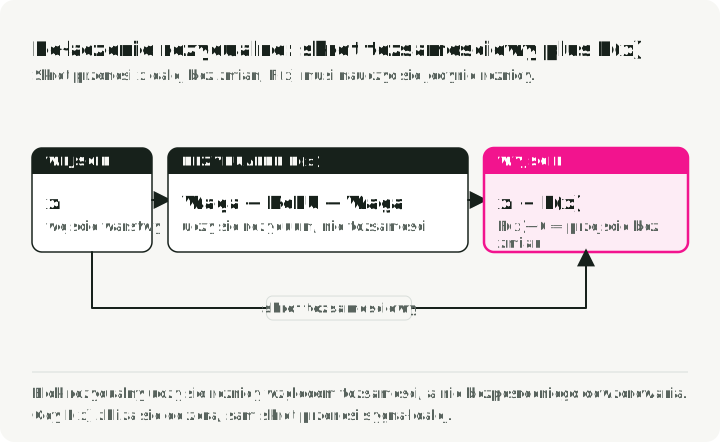
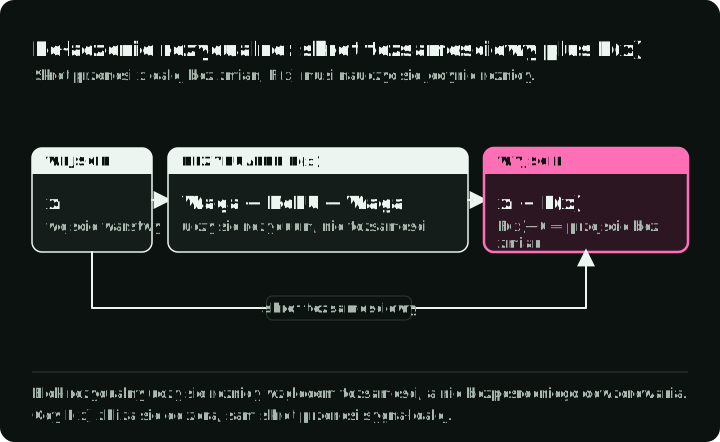
Najważniejsza jest tu właściwość skrótu tożsamościowego. Gdy funkcja rezydualna zwraca zero, warstwa po prostu przepuszcza sygnał. Wynikają z tego dwie rzeczy:
- Bezpośredni składnik gradientu: propagacja wsteczna obejmuje ścieżkę przez składową tożsamościową.
- Proste odwzorowanie awaryjne: gałąź rezydualna może pozostać bliska zeru, gdy warstwa nie musi mocno zmieniać stanu.
To nie usuwa wszystkich problemów z optymalizacją, ale umożliwiło trenowanie znacznie głębszych sieci.
Jak normalizacja warstw zmienia ścieżkę rezydualną
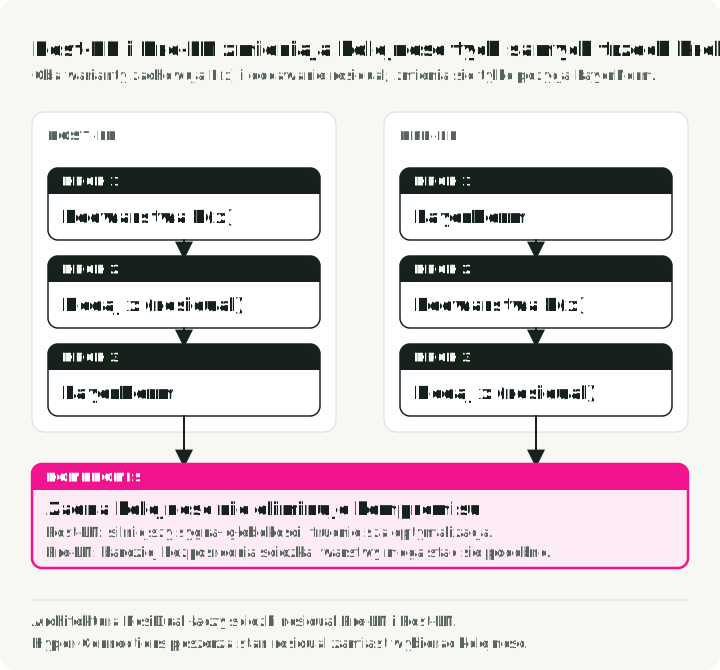
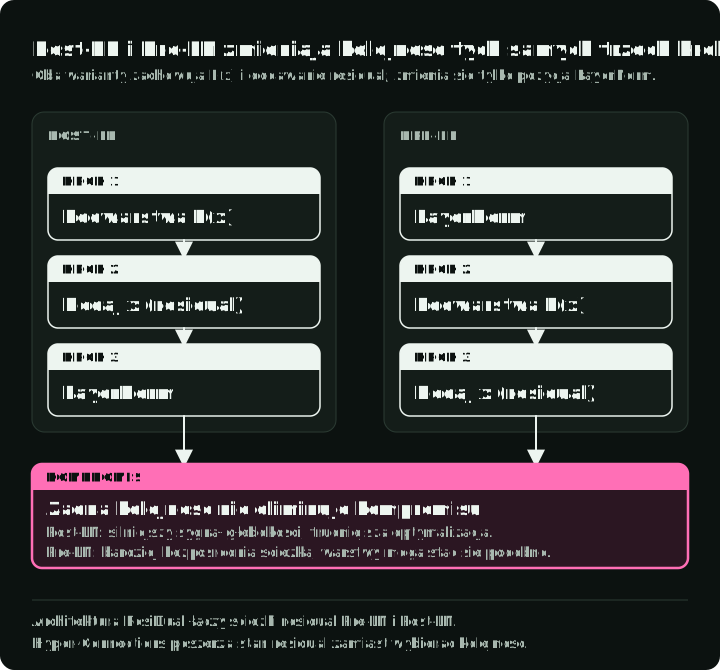
Transformery dodały nową zmienną: gdzie umieścić normalizację warstw (Layer Normalization, LN). Od tego zależy, czy ścieżka rezydualna pozostaje tożsamością.
| Wariant | Położenie LN | Zaleta | Główne ograniczenie |
|---|---|---|---|
| Post-LN | Po bloku rezydualnym | Silny wkład głębokości | Trudniejsza optymalizacja przy dużej głębokości |
| Pre-LN | Przed blokiem rezydualnym | Bardziej bezpośrednia ścieżka rezydualna | Reprezentacje sąsiednich warstw mogą stawać się coraz bardziej podobne |
ResiDual łączy ścieżkę rezydualną podobną do Post-LN z drugą ścieżką, która sumuje wyjścia bloków. Ich reprezentacje są dodawane na wyjściu modelu. Artykuł o HC wychodzi od tego samego kompromisu i czyni siły połączeń uczonymi, w wielu strumieniach.
Hyper-Connections dodają równoległe strumienie rezydualne
Hyper-Connections (HC) rozszerzają szerokość strumienia rezydualnego zamiast dodawać głębokość.
Co oznacza strumień
W standardowym Transformerze każdy token ma -wymiarowy stan, który przechodzi przez kolejne bloki. Na początku sieci HC replikuje wejściowy embedding razy, gdzie to „współczynnik rozszerzenia”, zwykle równy 4. -wymiarowy stan ukryty staje się macierzą , czyli „hiperukrytą macierzą”.
W Hyper-Connections strumień to jedna z tych równoległych kopii stanu.
Kopie zaczynają identycznie, a potem się rozchodzą, gdy uczone mapy odczytują strumienie, zapisują do nich i je mieszają. Artykuł interpretuje je jako wiele wzorców połączeń w głębi sieci; nie wymaga, by każdy strumień zyskał stałą rolę zrozumiałą dla człowieka.
Główne mechanizmy
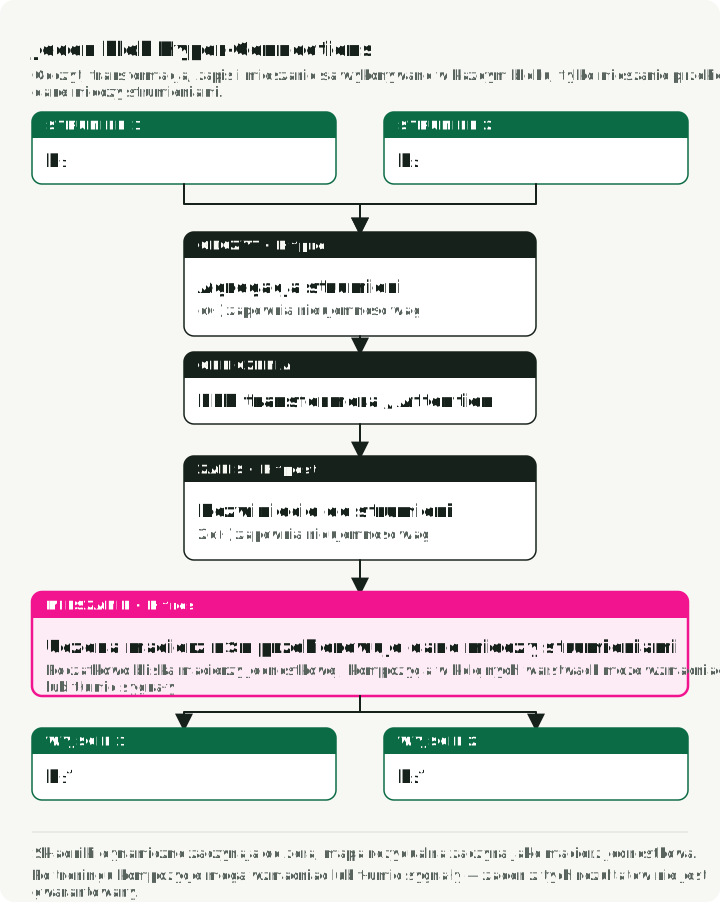
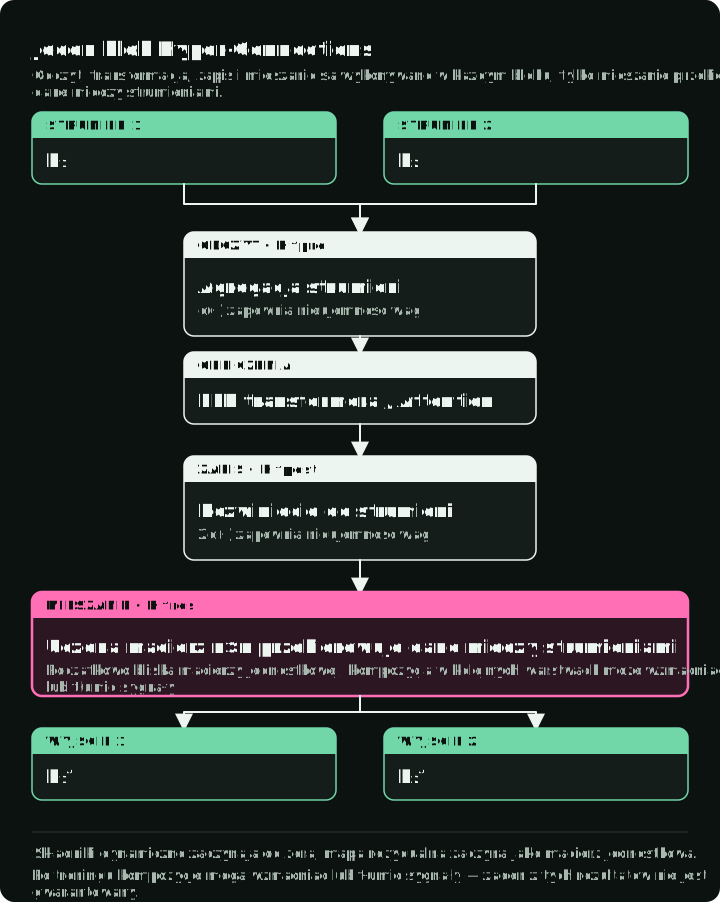
Zamiast jednej ścieżki rezydualnej HC utrzymuje równoległych strumieni płynących przez całą sieć. W każdym bloku transformera działają trzy operacje, każda sterowana małymi uczonymi wagami:
- Odczyt (): agreguje strumieni do -wymiarowego wejścia, które przyjmuje blok uwagi lub blok feed-forward.
- Zapis (): odwzorowuje wyjście tego bloku z powrotem na aktualizacje strumieni.
- Mieszanie (): stosuje rezydualną mapę do nadchodzących strumieni przed dodaniem aktualizacji bloku.
W HC każda mapa to uczona część statyczna (bias) plus składnik zależny od wejścia, przepuszczony przez , więc jej elementy mogą mieć dowolny znak. Artykuł o HC nazywa wersję ze składnikami zależnymi od wejścia dynamicznym HC (DHC); DHC×4 oznacza DHC z czterema strumieniami. Mapa rezydualna jest częścią krytyczną dla stabilności, bo jest mnożona wielokrotnie wraz z głębokością.
Razem te trzy mapy dają aktualizację warstwy (równanie 3 z artykułu mHC, które zapisuje szerokość jako ):
Tutaj to macierz strumieni , i mają wymiar , a ma wymiar . Pierwszy składnik to ścieżka rezydualna. Drugi to aktualizacja bloku: odczyt, obliczenie, zapis. Dla i wszystkich trzech map równych 1 równanie redukuje się do standardowego połączenia rezydualnego .
Rysunek przedstawia tę aktualizację dla czterech strumieni: odczyt, obliczenie i zapis nad strumieniami, mieszanie 4 × 4 na strumieniach oraz dodawanie na każdym strumieniu.
Co raportuje artykuł o HC
Artykuł o HC raportuje 1,8× szybszą zbieżność dla konfiguracji OLMoE-1B-7B DHC×4 względem jej bazowego modelu, a także poprawę wyników na zadaniach końcowych po przetworzeniu 500B elementów typu token (sekcja 1). To jedna oceniona konfiguracja, a nie ogólny mnożnik prędkości dla czterech strumieni.
Dlaczego nieograniczone HC może stać się niestabilne
Artykuł o mHC raportuje niestabilność, gdy nieograniczone HC skaluje się do konfiguracji 27B: strata treningowa gwałtownie rośnie około kroku 12k, razem ze skokiem normy gradientu (sekcja 3.1). Te same nieograniczone mapy, które dają HC elastyczność, usuwają też gwarantowaną ścieżkę tożsamościową, dzięki której sieci rezydualne łatwo się trenuje.
Problem mapy złożonej
W standardowym połączeniu rezydualnym:
Gdy , jest to tożsamość: . Sygnał przechodzi bez zmian.
W Hyper-Connections składnik rezydualny powyższej aktualizacji jest iloczynem macierzy, . Gdy śledzimy tylko tę ścieżkę przez warstw, sygnał przyjmuje postać:
Zachowanie zależy od macierzy złożonej, a nie od tego, czy pojedyncze elementy leżą powyżej, czy poniżej 1. Jeśli mapy stale rozciągają ten sam kierunek o więcej niż 1, iloczyn rośnie wykładniczo z głębokością. Jeśli stale go skracają, sygnał zanika. Ujemne elementy mogą też znosić sygnały.
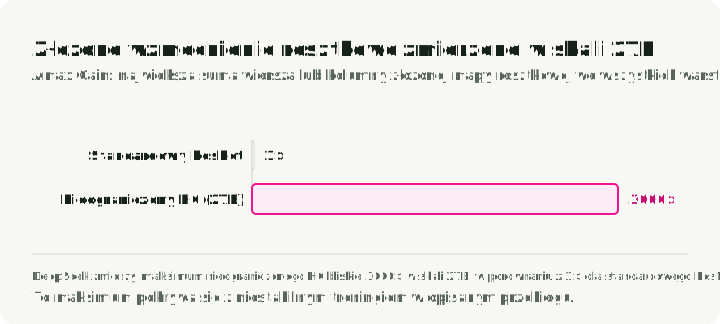
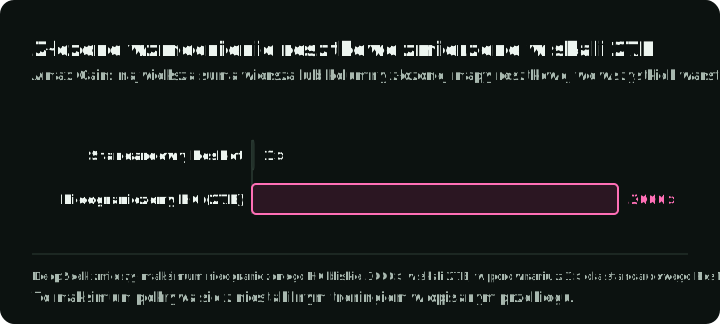
Artykuł o mHC mierzy to wzmocnienie za pomocą Amax Gain Magnitude: maksymalnej bezwzględnej sumy wierszy dla propagacji w przód i sumy kolumn dla propagacji wstecz w złożonej mapie rezydualnej. W eksperymencie HC 27B jego szczyt zbliża się do 3000 i zbiega się z niestabilnym zachowaniem treningu (sekcja 3.1).
Wykres zestawia trzy wartości z artykułu na jednej osi logarytmicznej: 1 dla standardowego połączenia rezydualnego, około 1,6 dla mHC (ograniczonej wersji opisanej dalej) i około 3000 dla nieograniczonego HC. Znacznik pod osią pokazuje z przykładu powyżej.
Cel projektowy jest więc węższy niż wymuszanie, by każda mapa była tożsamością: pozwolić na mieszanie między strumieniami, ograniczając jednocześnie wzmocnienie przy składaniu.
Ograniczenie mHC
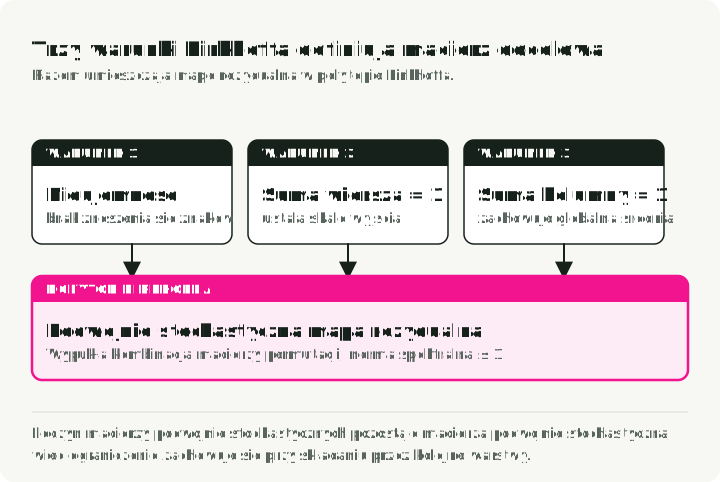
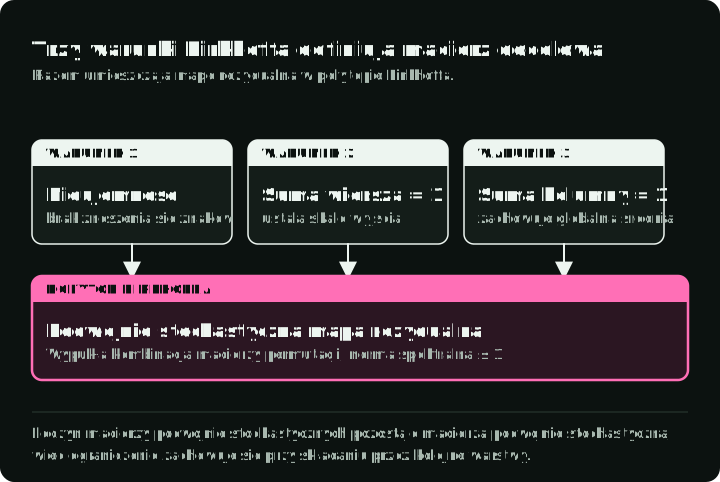
mHC zachowuje routing między strumieniami, ale ogranicza każdą rezydualną macierz mieszania do wielościanu Birkhoffa, czyli zbioru macierzy podwójnie stochastycznych. Taka macierz ma nieujemne elementy, a suma każdego jej wiersza i każdej kolumny wynosi jeden.
Rysunek szkicuje ścieżkę rezydualną każdego z projektów omawianych w tym artykule i porównuje je. Wiersz wzmocnienia pokazuje szczytowe wzmocnienie złożone, które artykuł o mHC podaje dla modelu 27B. Dla i wszystkich map równych 1 HC i mHC sprowadzają się do standardowego połączenia rezydualnego.


Co gwarantuje podwójna stochastyczność
Rysunek sprawdza trzy warunki na dwóch macierzach 3×3 z przykładu Sinkhorna poniżej: nieograniczonych logitach , które łamią wszystkie trzy, oraz po 20 iteracjach Sinkhorna, które spełnia wszystkie trzy. Tabela podaje konsekwencję każdego warunku.
| Ograniczenie | Konsekwencja |
|---|---|
| Nieujemność | Współczynniki o przeciwnych znakach nie znoszą się |
| Suma wiersza = 1 | Stały sygnał w strumieniach pozostaje stały |
| Suma kolumny = 1 | Globalna średnia po strumieniach jest zachowana |
Nieujemność wraz z sumami wierszy równymi jeden sprawia, że każde wyjście jest kombinacją wypukłą strumieni wejściowych. Ograniczenie zachowuje średnią po strumieniach, a nie długość wektora: macierz podwójnie stochastyczna może uśredniać strumienie względem siebie.
Wynikają z tego jeszcze trzy własności (sekcja 4.1):
- Norma spektralna ≤ 1: norma spektralna to największy współczynnik, przez który macierz może rozciągnąć dowolny wektor. Ograniczenie równe jeden oznacza, że rezydualna mapa routingu nie może wzmocnić normy euklidesowej.
- Domknięcie ze względu na mnożenie: iloczyn macierzy podwójnie stochastycznych pozostaje podwójnie stochastyczny, więc ograniczenie przetrwa składanie przez kolejne warstwy.
- Mieszanie wypukłe: zgodnie z twierdzeniem Birkhoffa-von Neumanna mapa leży w powłoce wypukłej macierzy permutacji.
Rzutowanie Sinkhorna-Knoppa
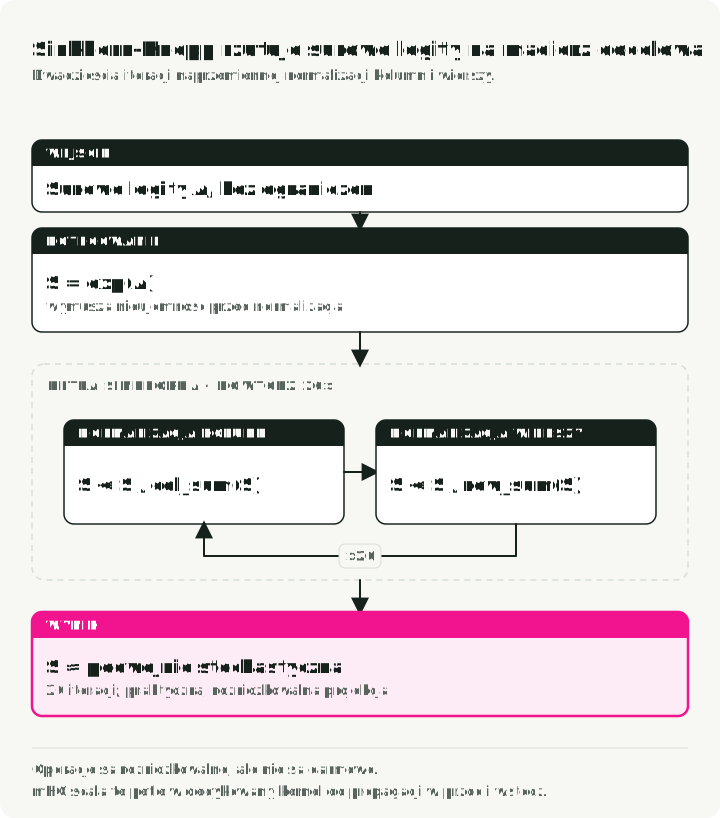
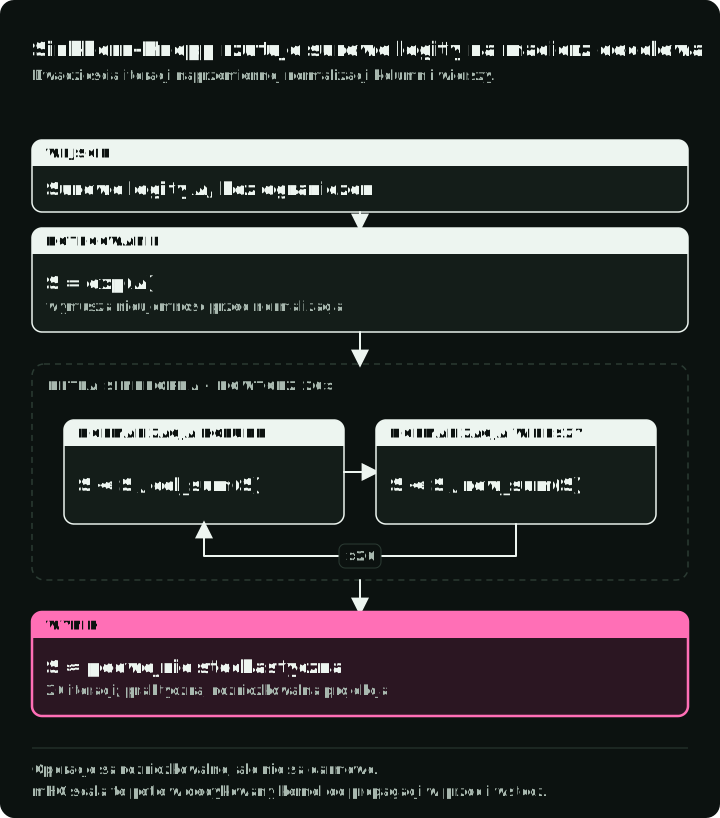
Uczone logity rezydualne są nieograniczone. mHC najpierw stosuje do nich funkcję wykładniczą, by otrzymać macierz dodatnią, a potem na przemian normalizuje kolumny i wiersze. Przy dostatecznej liczbie iteracji ten proces Sinkhorna-Knoppa zbliża się do macierzy podwójnie stochastycznej; artykuł używa 20 iteracji jako praktycznego, przybliżonego, różniczkowalnego rzutowania, a nie dokładnego ograniczenia.
Rysunek wykonuje pierwszą iterację na przykładzie 3×3 poniżej krok po kroku, a potem pokazuje największy błąd sum kolumn w ciągu 20 iteracji.
Dla surowych logitów procedura wygląda tak:
S = exp(A)
repeat 20 times:
    S = S / column_sum(S)
    S = S / row_sum(S)
return S
Przykład 3×3 pokazuje, co znaczy „przybliżone”. Jeden przebieg ustala sumy wierszy, bo wiersze normalizuje się na końcu, ale sumy kolumn pozostają odchylone nawet o 12%. Dwadzieścia przebiegów sprowadza obie do 1,000 z dokładnością do trzech miejsc po przecinku.
Raw logits A           [[-0.5,   2.1,   0.8  ],
                        [ 1.3,  -4.0,   1.9  ],
                        [ 0.1,   0.6,  -0.2  ]]

S = exp(A)             [[ 0.607, 8.166, 2.226],
                        [ 3.669, 0.018, 6.686],
                        [ 1.105, 1.822, 0.819]]

After 1 pass           [[ 0.097, 0.705, 0.198],
(columns, then rows)    [ 0.497, 0.001, 0.501],
                        [ 0.435, 0.386, 0.178]]
                       row sums     1.000 1.000 1.000
                       column sums  1.030 1.092 0.877

After 20 passes        [[ 0.102, 0.653, 0.244],
                        [ 0.457, 0.001, 0.542],
                        [ 0.441, 0.346, 0.213]]
                       row and column sums 1.000
Poniższy skrypt sprawdza twierdzenie, na którym opiera się cała metoda. Mnoży 60 losowych macierzy mieszania 4×4, raz używanych bezpośrednio, tak jak robiłoby to HC, i raz po Sinkhornie, tak jak robi to mHC, a następnie wypisuje wzmocnienie Amax każdego iloczynu.
import numpy as np

rng = np.random.default_rng(0)
n, layers = 4, 60

def sinkhorn(logits, iters=20):
    s = np.exp(logits)
    for _ in range(iters):
        s = s / s.sum(axis=0, keepdims=True)  # columns sum to 1
        s = s / s.sum(axis=1, keepdims=True)  # rows sum to 1
    return s

def amax_gain(m):
    return max(np.abs(m).sum(axis=1).max(), np.abs(m).sum(axis=0).max())

hc, mhc = np.eye(n), np.eye(n)
for _ in range(layers):
    a = np.eye(n) + 0.3 * rng.standard_normal((n, n))
    hc = a @ hc
    mhc = sinkhorn(a) @ mhc

print(f"HC  Amax gain: {amax_gain(hc):.1f}")
print(f"mHC Amax gain: {amax_gain(mhc):.1f}")
Dla ziarna 0 skrypt wypisuje 1906.8 dla HC i 1.0 dla mHC. Każda losowa macierz jest bliska tożsamości, więc żadna z nich osobno nie wygląda na dużą. Artykuł mierzy dla mHC w modelu 27B około 1,6, a nie 1,0. Używa tylko 20 iteracji, więc wytrenowane macierze nie są dokładnie podwójnie stochastyczne, a małe błędy rosną z kolejnymi warstwami, ale pozostają ograniczone (sekcja 5.4).
Iteracje Sinkhorna są różniczkowalne, ale nie są darmowe. mHC opiera się na połączonym kernelu przejścia w przód i własnym kernelu przejścia wstecz, który przelicza pośrednie stany normalizacji na układzie.
Szczegóły parametryzacji
- Mapa rezydualna: zastosowanie funkcji wykładniczej i normalizacja Sinkhorna dają w przybliżeniu podwójnie stochastyczną .
- Mapy odczytu i zapisu: mHC zastępuje z HC funkcją sigmoidalną: i . Obie mapy są nieujemne, co usuwa znoszenie się współczynników dodatnich i ujemnych (sekcje 4.1 i 4.2). Wagi odczytu leżą w przedziale (0, 1), a wagi zapisu w (0, 2). Zerowy logit daje wagę zapisu , czyli wagę, której używa standardowe dodawanie rezydualne. Artykuł nie podaje powodu użycia czynnika 2.
Kompletna architektura mHC
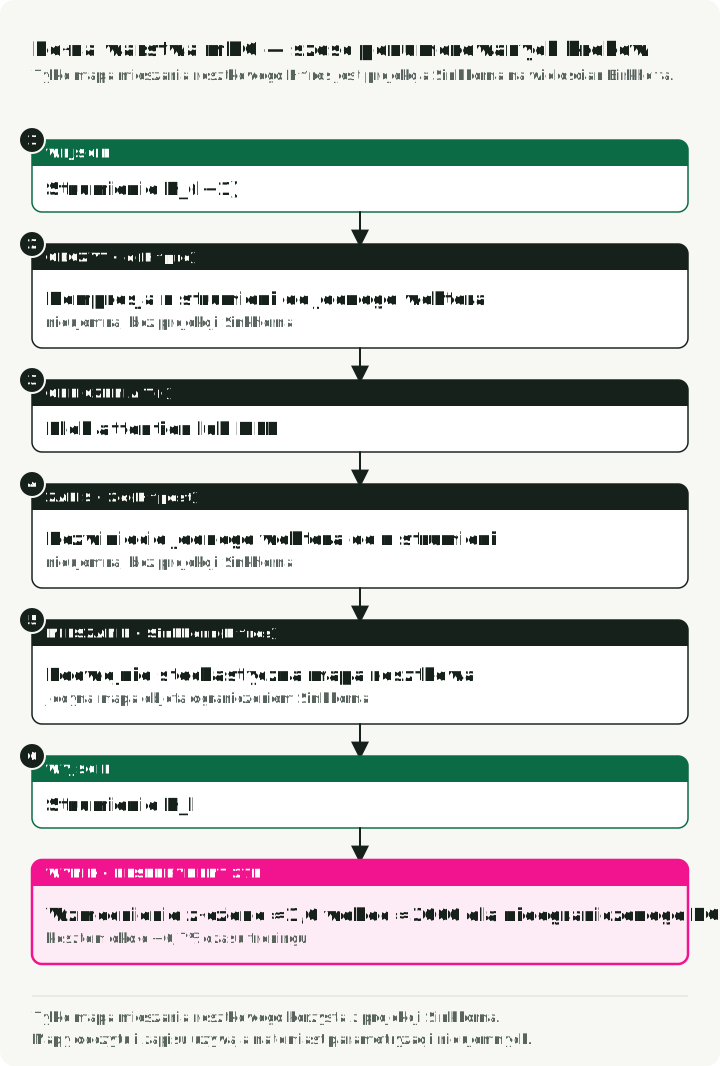
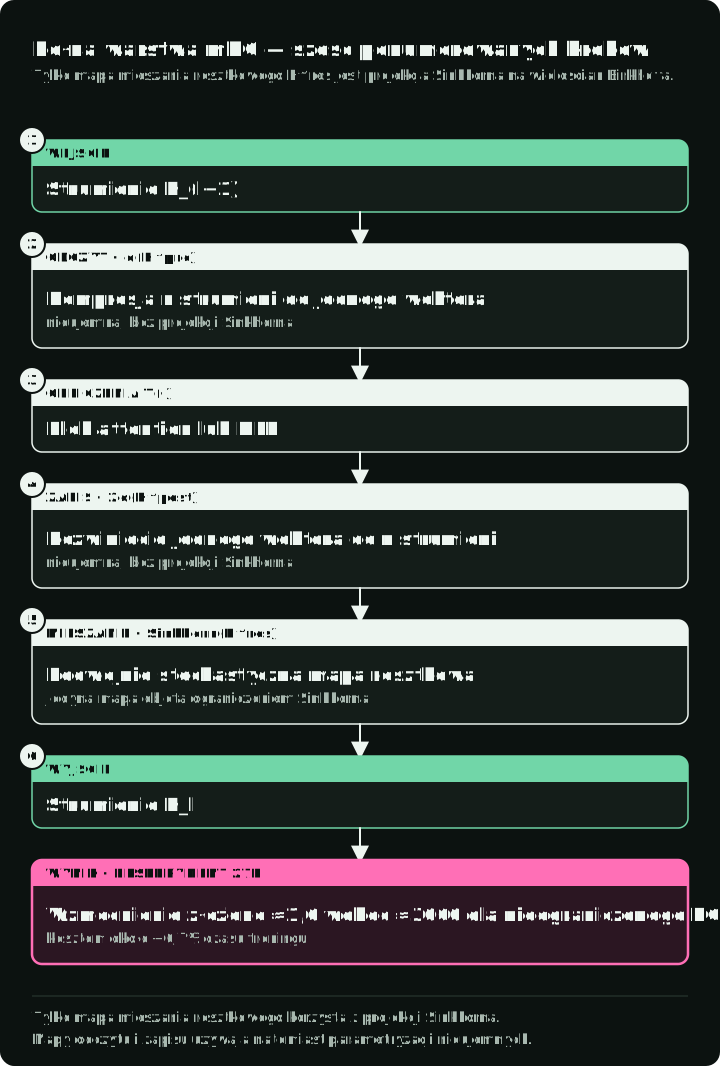
Rysunek pokazuje jedną warstwę mHC wraz z parametryzacją każdej mapy. Ma te same dwie ścieżki co blok HC; zmienia się tylko sposób parametryzacji każdej mapy.
W kategoriach równania aktualizacji:
- Wejście: do warstwy wchodzi równoległych strumieni rezydualnych .
- Ścieżka bloku: mapa odczytu łączy strumienie w jedno -wymiarowe wejście. Blok uwagi lub MLP je przetwarza. Mapa zapisu zamienia wyjście na aktualizacje strumieni.
- Ścieżka rezydualna: w przybliżeniu podwójnie stochastyczna miesza nadchodzące strumienie.
- Dodawanie: obie ścieżki są sumowane do , które trafia do następnej warstwy.
Tylko rezydualna mapa mieszania używa rzutowania Sinkhorna. Mapy odczytu i zapisu używają parametryzacji nieujemnych. Ta różnica ma znaczenie, bo gwarancja złożenia z artykułu dotyczy .
Infrastruktura wymagana dla raportowanego narzutu
Cztery strumienie zwiększają liczbę dostępów do pamięci dla stanu rezydualnego, pamięć na aktywacje i komunikację w potoku. Wynik czasowy z artykułu zależy od trzech wspólnie zaprojektowanych zmian, opisanych poniżej.
Fuzja kernelów
Implementacja łączy operacje, które współdzielą dostęp do pamięci, tam gdzie to właściwe używa mieszanej precyzji, a większość własnych kerneli implementuje w TileLang. Pętla Sinkhorna i jej własne przejście wsteczne działają w dedykowanych kernelach, co ogranicza ruch w pamięci i narzut uruchamiania.
Selektywne ponowne obliczanie
strumieni zwiększa pamięć na aktywacje (sekcja 4.3.2). Zamiast przechowywać każdy wynik pośredni, mHC:
- Zwalnia pośrednie aktywacje własnych kerneli po przejściu w przód.
- Przelicza je w przejściu wstecz, bez ponownego uruchamiania bloku uwagi lub FFN.
- Przechowuje wejście rozszerzonych strumieni każdej grupy kolejnych warstw i wyjście bloku uwagi lub FFN każdej warstwy. Artykuł dopasowuje te grupy do etapów potoku.
Rozszerzony harmonogram DualPipe nakłada na siebie części komunikacji, ponownego obliczania i pracy warstw na granicach etapów potoku. Osiągnięte nakładanie jest specyficzne dla tego systemu treningowego.
Raportowany wynik systemowy
W wielkoskalowej konfiguracji artykułu współczynnik rozszerzenia dodaje 6,7% czasu treningu względem jego bazowego modelu (sekcja 4.3). To wynik systemowy, a nie narzut zwykłej implementacji we frameworku.
Co ustalają eksperymenty
Autorzy trenują warianty MoE inspirowane DeepSeek-V3 o rozmiarach 3B, 9B i 27B (sekcja 5.3). Przy 27B mHC pokonuje standardowy model rezydualny we wszystkich ośmiu raportowanych testach końcowych i pokonuje HC w siedmiu z ośmiu (tabela 4). HC jest nieznacznie lepsze w MATH (26,4 wobec 26,0). To własne eksperymenty pretrainingu zespołu, który proponuje metodę, więc niezależna replikacja i porównania na innych architekturach pozostają otwarte.
Kiedy warto wypróbować mHC
Wyniki artykułu wskazują trzy warunki:
- Trenujesz od zera. mHC zmienia architekturę, a artykuł ocenia ją tylko w pretrainingu. Jeśli nie, pomiń mHC.
- Potrzebujesz większej szerokości rezydualnej niż jeden strumień. Już używasz HC lub planujesz to robić i widzisz skoki straty albo rosnące aktywacje i normy gradientów przy zwiększaniu głębokości lub rozmiaru. Jeśli wystarczy jeden strumień, zostań przy standardowym połączeniu rezydualnym.
- Możesz wykonać pracę systemową albo zaakceptować większy koszt. Wartość 6,7% wymaga połączonych kerneli i zmian w harmonogramie potoku. Zwykła implementacja we frameworku będzie kosztować więcej. Jeśli nie możesz wykonać tej pracy, mHC w zwykłym kodzie jest możliwe, ale najpierw zmierz narzut.
Pozostają trzy pytania:
- Narzut systemowy: raportowany narzut to zoptymalizowany wynik z artykułu; inny runtime, topologia urządzeń lub kształt modelu mogą dać inny koszt.
- Tendencja do uśredniania: podwójna stochastyczność zachowuje średnią po strumieniach i zapobiega rozszerzaniu przez , ale może wygładzać różnice między strumieniami. Aktualizacja bloku nadal zmienia całą reprezentację.
- Zakres dowodów: najmocniejsze dowody dotyczą pretrainingu modeli językowych w architekturach MoE inspirowanych DeepSeek-V3. Ten artykuł nie ustala jeszcze uogólnienia na inne rodziny modeli.
mHC to obiecujący sposób badania szerszej topologii rezydualnej przy zachowaniu dobrze uwarunkowanej, powtarzanej mapy rezydualnej. Czy warto ją stosować w innym modelu, zależy od niezależnie potwierdzonych zysków jakości i kosztu odtworzenia jej stosu systemowego.
Referencje
- mHC: Manifold-Constrained Hyper-Connections - Xie i in. (DeepSeek)
- Deep Residual Learning for Image Recognition - He i in. (ResNet)
- Hyper-Connections - oryginalny artykuł o HC
- TileLang - framework optymalizacji kerneli CUDA
- DualPipe - harmonogram równoległości potokowej dla DeepSeek-V3
- ResiDual - architektura z podwójną ścieżką rezydualną