DeepSeek mHC : Hyper-Connections contraintes par une variété

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Le deep learning moderne repose sur la connexion résiduelle. Cet article s’adresse aux ingénieurs qui connaissent le bloc Transformer et veulent savoir ce que mHC change dans le chemin résiduel, pourquoi, ce que cela coûte et quand l’essayer. Les Hyper-Connections (HC) explorent une autre dimension architecturale : élargir l’état résiduel en plusieurs streams qui interagissent. L’article de DeepSeek sur les Manifold-Constrained Hyper-Connections (mHC) étudie comment garder ce routage stable à plus grande échelle d’entraînement.
Il part des connexions résiduelles standard, puis ajoute les Hyper-Connections et l’instabilité qu’elles créent. La contrainte mHC, une petite démo NumPy et le coût d’implémentation viennent ensuite.
Pourquoi les connexions résiduelles fonctionnent
Le problème de la profondeur
Ajouter des couches peut augmenter la capacité, mais rend aussi l’optimisation et la propagation du signal plus difficiles. Selon l’initialisation, la normalisation et l’architecture, les activations en passe avant ou les gradients en passe arrière peuvent diminuer, croître ou devenir mal conditionnés avec la profondeur.
La solution résiduelle
L’article ResNet a introduit une correction simple. Au lieu d’apprendre une transformation directe, on apprend le résidu, la différence par rapport à l’identité :
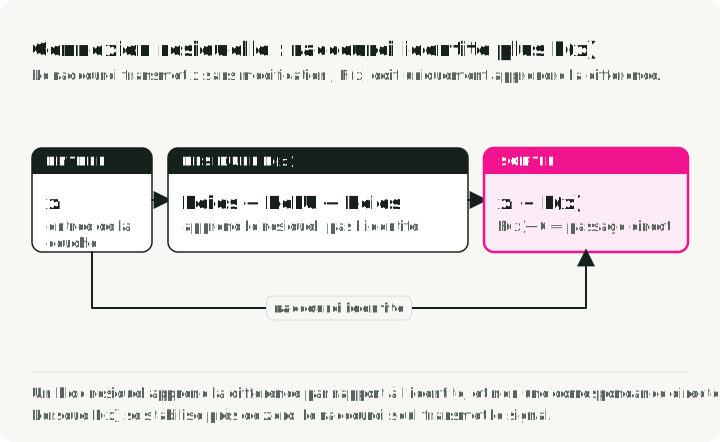
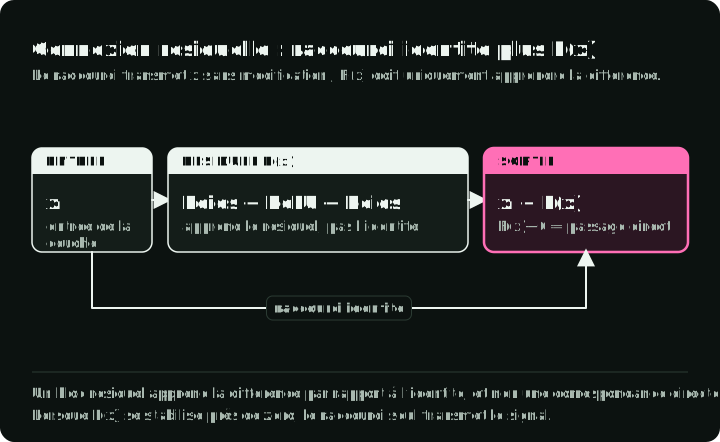
La propriété utile est le raccourci identité. Lorsque la fonction résiduelle renvoie zéro, la couche devient un simple passage. Deux conséquences en découlent :
- Un terme de gradient direct : la rétropropagation inclut un chemin passant par la composante identité.
- Une transformation de repli simple : la branche résiduelle peut rester proche de zéro lorsqu’une couche n’a pas besoin de beaucoup modifier l’état.
Cela n’élimine pas tous les problèmes d’optimisation, mais cela a rendu praticables des réseaux nettement plus profonds.
Comment la normalisation par couche modifie le chemin résiduel
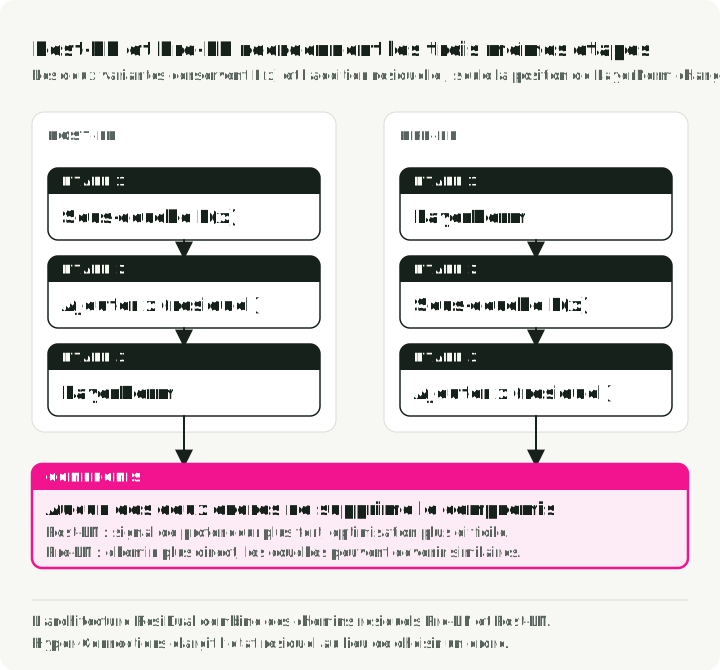
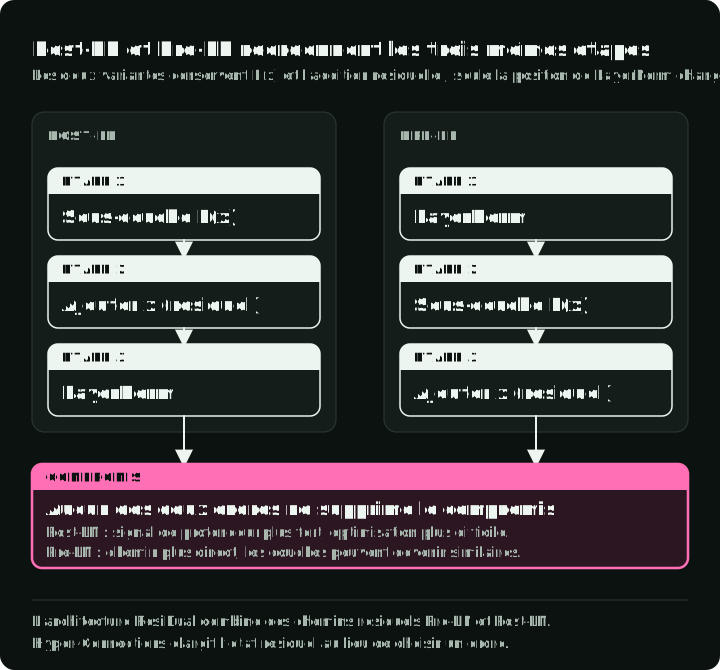
Les Transformers ont ajouté une nouvelle variable : où placer la Layer Normalization (LN). Elle détermine si le chemin résiduel reste une identité.
| Variante | Placement de la LN | Avantage | Limite principale |
|---|---|---|---|
| Post-LN | Après le bloc résiduel | Forte contribution en profondeur | Peut être plus difficile à optimiser en profondeur |
| Pre-LN | Avant le bloc résiduel | Chemin résiduel plus direct | Les représentations de couches adjacentes peuvent devenir de plus en plus similaires |
ResiDual combine un chemin résiduel similaire à Post-LN avec un second chemin qui accumule les sorties des blocs. Leurs représentations sont additionnées à la sortie du modèle. L’article HC part de ce même compromis et rend les forces de connexion apprenables, sur plusieurs streams.
Les Hyper-Connections ajoutent des residual streams parallèles
Les Hyper-Connections (HC) élargissent la largeur du residual stream au lieu d’ajouter de la profondeur.
Ce que signifie un stream
Dans un Transformer standard, chaque token possède un état de dimension qui traverse les blocs. Au début du réseau, HC réplique cet embedding d’entrée fois, où est le « taux d’expansion », typiquement 4. L’état caché de dimension devient une « matrice cachée hyper » de taille .
Dans les Hyper-Connections, un stream est l’une de ces instances parallèles de l’état.
Les copies commencent identiques, puis divergent à mesure que des maps apprises lisent, écrivent et mélangent les streams. L’article les interprète comme plusieurs schémas de connexion à travers la profondeur ; il n’exige pas que chaque stream acquière un rôle fixe lisible par un humain.
Mécanismes fondamentaux
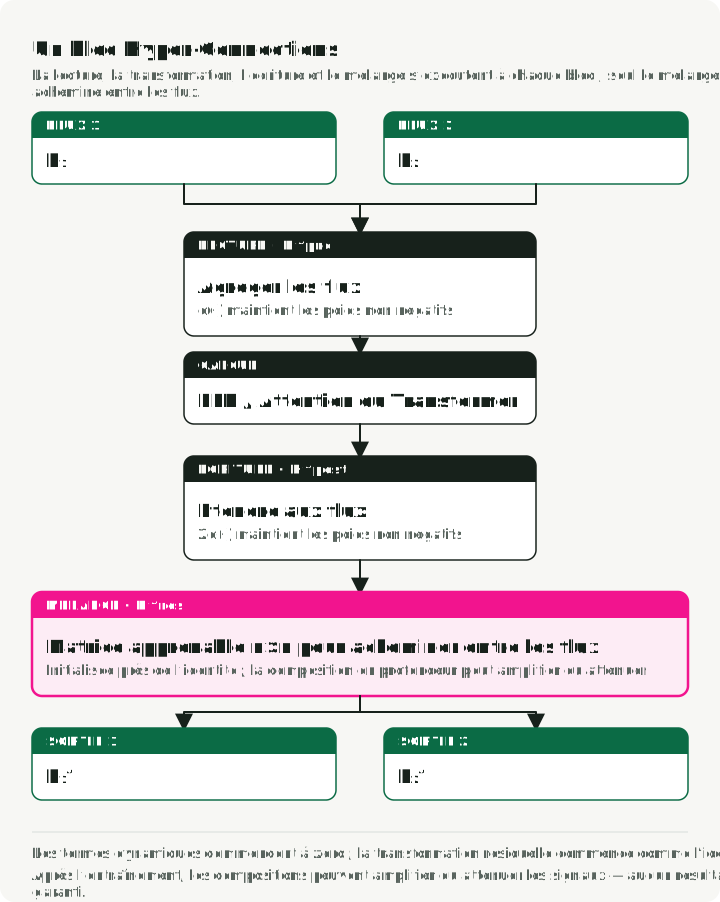
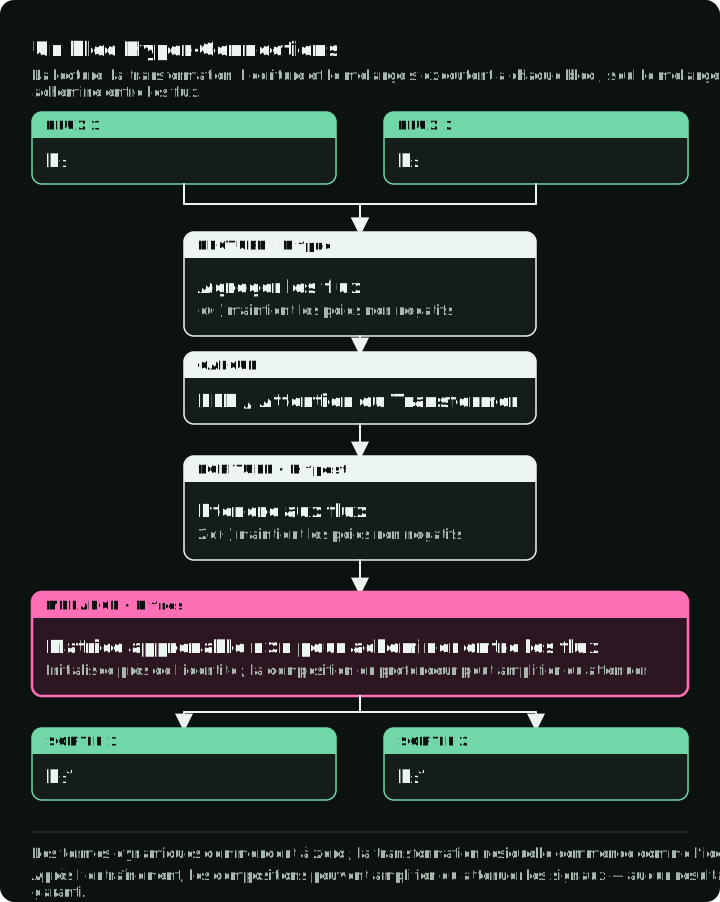
Au lieu d’un seul chemin résiduel, HC maintient streams parallèles tout au long du réseau. À chaque bloc Transformer, trois opérations s’exécutent, chacune pilotée par de petits poids apprenables :
- Lecture () : agrège les streams en l’entrée de dimension consommée par le bloc d’attention ou feed-forward.
- Écriture () : transforme la sortie de ce bloc en mises à jour pour les streams.
- Mélange () : applique une map résiduelle aux streams entrants avant d’ajouter la mise à jour du bloc.
Dans HC, chaque map est la somme d’une partie statique apprise (un biais) et d’un terme dépendant de l’entrée passé dans un , de sorte que ses entrées peuvent prendre n’importe quel signe. L’article HC appelle dynamic HC (DHC) la version avec termes dépendants de l’entrée ; DHC×4 désigne DHC avec quatre streams. La map résiduelle est la partie critique pour la stabilité, car elle est multipliée de façon répétée à travers la profondeur.
Ensemble, les trois maps donnent la mise à jour par couche (éq. 3 de l’article mHC, qui note la largeur ) :
Ici est la matrice de streams , et sont de taille , et est de taille . Le premier terme est le chemin résiduel. Le second terme est la mise à jour du bloc : lecture, calcul, écriture. Avec et les trois maps égales à 1, l’équation devient le résiduel standard .
La figure dessine cette mise à jour pour quatre streams : lecture, calcul et écriture au-dessus des streams, le mélange 4 × 4 sur les streams, et une addition sur chaque stream.
Ce que rapporte l’article HC
L’article HC rapporte une convergence 1,8× plus rapide pour sa configuration OLMoE-1B-7B DHC×4 par rapport à sa baseline, ainsi que des gains en aval à 500B tokens (section 1). C’est une seule configuration évaluée, pas un multiplicateur de vitesse général pour quatre streams.
Pourquoi HC non contraint peut devenir instable
L’article mHC rapporte une instabilité lorsqu’il met HC non contraint à l’échelle de son cadre 27B : la loss d’entraînement augmente brusquement vers l’étape 12k, en même temps qu’un saut de la norme du gradient (section 3.1). Les maps non contraintes qui rendent HC flexible suppriment aussi le chemin identité garanti qui rend les résiduels faciles à entraîner.
Le problème de la map composite
Dans les résiduels standard :
Lorsque , c’est l’identité : . Le signal passe sans changement.
Dans les Hyper-Connections, le terme résiduel de la mise à jour ci-dessus est un produit matriciel, . Si l’on ne suit que ce chemin sur couches, le signal devient :
Le comportement dépend de la matrice composite, pas du fait que chaque entrée soit au-dessus ou en dessous de 1. Si les maps étirent sans cesse la même direction d’un facteur supérieur à 1, le produit croît exponentiellement avec la profondeur. Si elles la réduisent sans cesse, le signal s’éteint. Les entrées négatives peuvent aussi annuler des signaux.
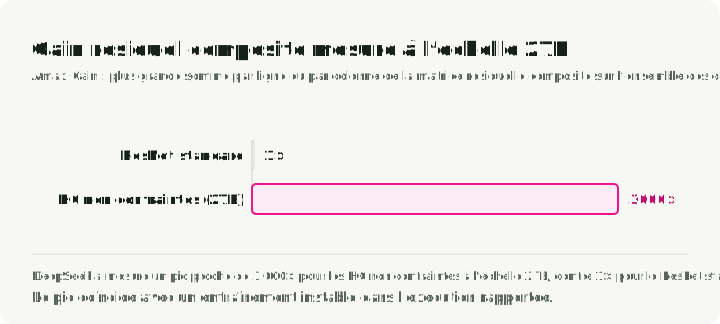
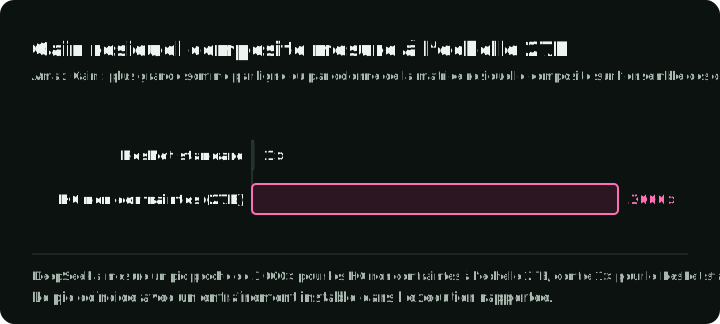
L’article mHC mesure ce gain avec l’Amax Gain Magnitude : la somme absolue maximale par ligne pour la propagation avant et par colonne pour la propagation arrière, dans une map résiduelle composite. Dans son expérience HC à 27B, le pic approche 3 000 et coïncide avec un comportement d’entraînement instable (section 3.1).
Le graphique place les trois valeurs de l’article sur un même axe logarithmique : 1 pour un résiduel standard, environ 1,6 pour mHC (la version contrainte décrite plus loin) et environ 3 000 pour HC non contraint. Un repère sous l’axe marque les de l’exemple ci-dessus.
L’objectif de conception est donc plus étroit que d’imposer l’identité à chaque map : autoriser le mélange entre streams tout en bornant l’amplification à travers les compositions.
La contrainte mHC
mHC conserve le routage entre streams, mais contraint chaque matrice de mélange résiduelle au polytope de Birkhoff, l’ensemble des matrices bistochastiques. Une telle matrice a des entrées non négatives, et chacune de ses lignes et colonnes somme à un.
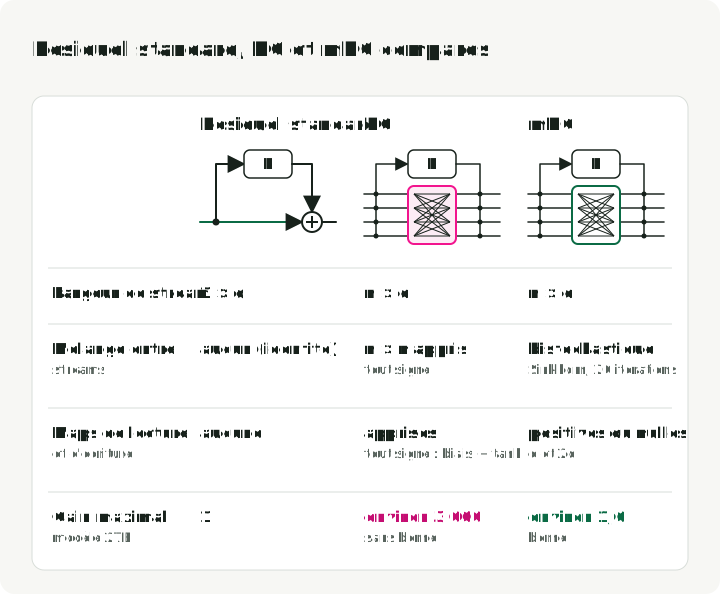
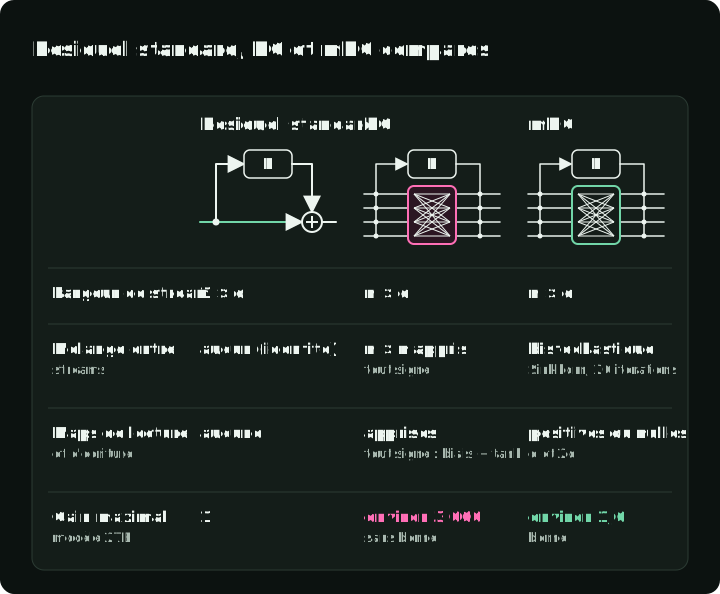
La figure esquisse le chemin résiduel de chaque conception couverte par cet article et les compare. La ligne du gain indique le gain composite maximal que l’article mHC rapporte pour son modèle 27B. Avec et toutes les maps égales à 1, HC et mHC se réduisent au résiduel standard.
Ce que garantit la bistochasticité
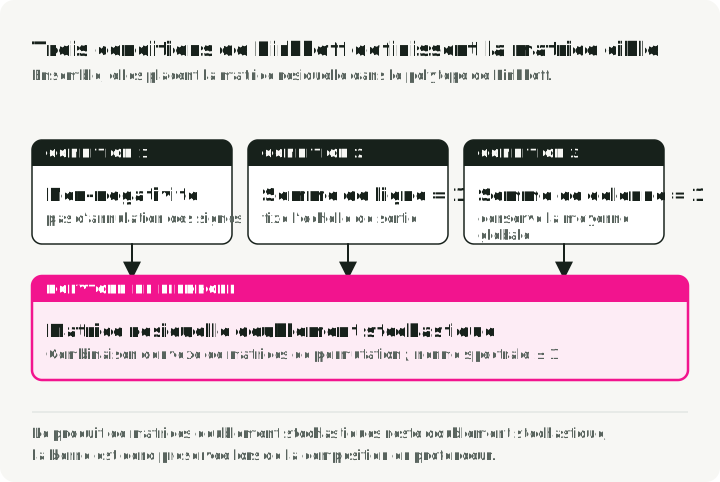
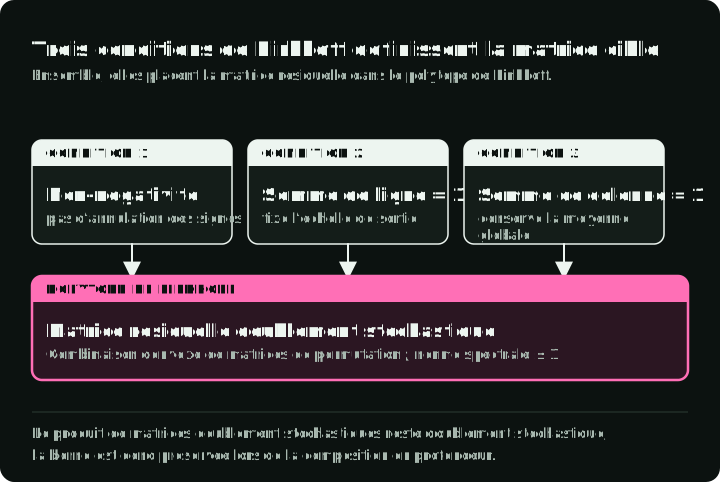
La figure vérifie les trois conditions sur deux matrices 3×3 de l’exemple de Sinkhorn ci-dessous : les logits non contraints , qui violent les trois, et après 20 passes de Sinkhorn, qui les respecte toutes. Le tableau donne la conséquence de chaque condition.
| Contrainte | Conséquence |
|---|---|
| Non-négativité | Les coefficients de signes opposés ne s’annulent pas |
| Somme des lignes = 1 | Un signal constant sur les streams reste constant |
| Somme des colonnes = 1 | La moyenne globale sur les streams est conservée |
La non-négativité, associée à des sommes par ligne égales à un, fait de chaque sortie une combinaison convexe des streams d’entrée. La contrainte conserve la moyenne sur les streams, pas la longueur du vecteur : une map bistochastique peut rapprocher les streams les uns des autres par moyennage.
Trois autres propriétés en découlent (section 4.1) :
- Norme spectrale ≤ 1 : la norme spectrale est le plus grand facteur par lequel une matrice peut étirer un vecteur. Une borne à un signifie que la map de routage résiduel ne peut pas amplifier la norme euclidienne.
- Fermeture par multiplication : un produit de matrices bistochastiques reste bistochastique, donc la contrainte survit à la composition en profondeur.
- Mélange convexe : d’après le théorème de Birkhoff-von Neumann, la map se trouve dans l’enveloppe convexe des matrices de permutation.
Projection de Sinkhorn-Knopp
Les logits résiduels apprenables ne sont pas contraints. mHC commence par leur appliquer l’exponentielle pour obtenir une matrice positive, puis alterne la normalisation des colonnes et des lignes. Avec assez d’itérations, ce processus de Sinkhorn-Knopp s’approche d’une matrice bistochastique ; l’article utilise 20 itérations comme projection différentiable approximative et pratique, et non comme contrainte exacte.
La figure exécute la première passe sur l’exemple 3×3 ci-dessous, étape par étape, puis trace l’erreur maximale de somme des colonnes sur 20 passes.
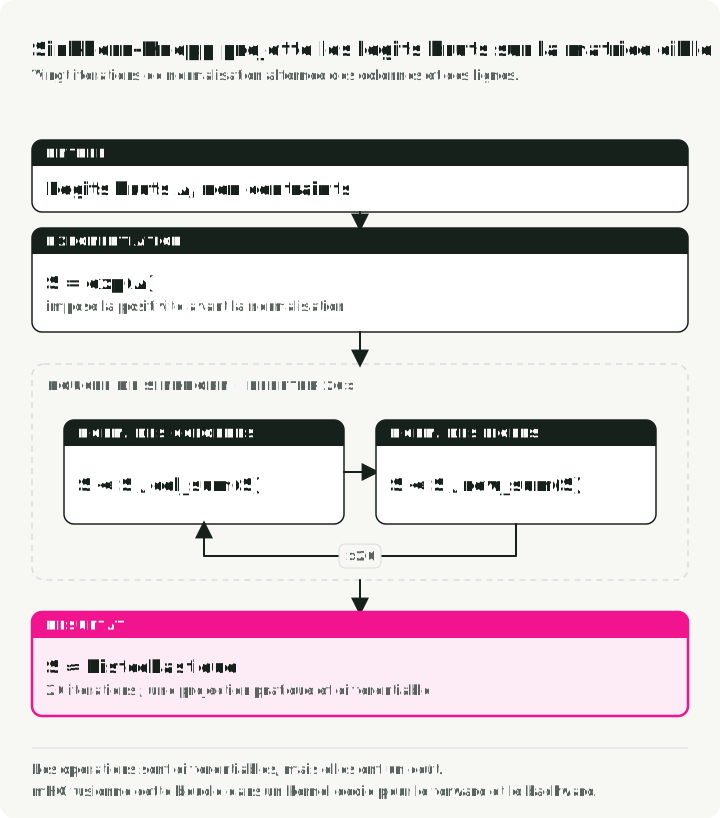
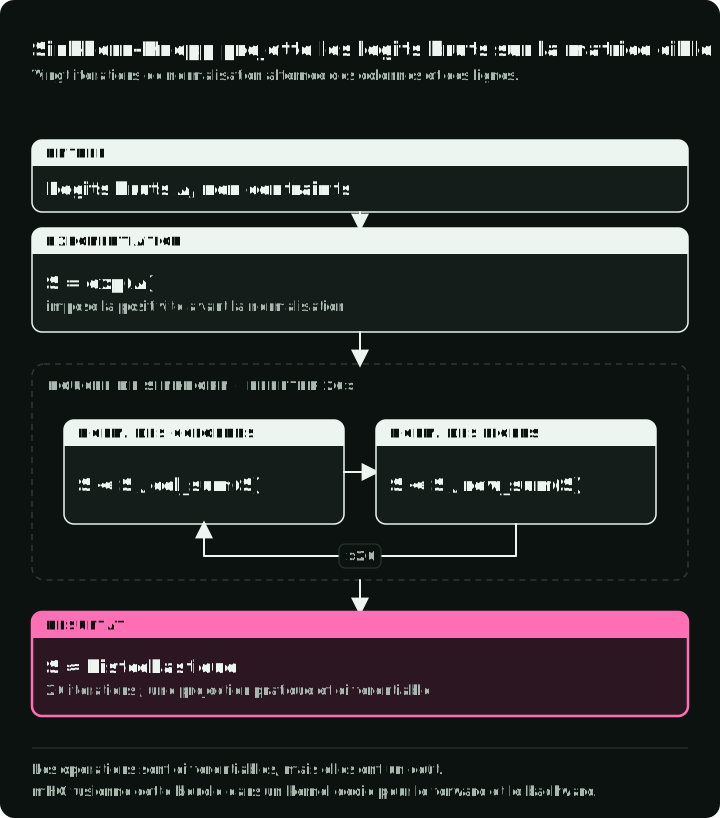
Pour des logits bruts , la procédure est :
S = exp(A)
repeat 20 times:
    S = S / column_sum(S)
    S = S / row_sum(S)
return S
Un exemple 3×3 montre ce que « approximatif » veut dire. Une passe fixe les sommes des lignes, puisque les lignes sont normalisées en dernier, mais laisse les sommes des colonnes écartées de jusqu’à 12 %. Vingt passes amènent les deux à 1,000 à trois décimales.
Raw logits A           [[-0.5,   2.1,   0.8  ],
                        [ 1.3,  -4.0,   1.9  ],
                        [ 0.1,   0.6,  -0.2  ]]

S = exp(A)             [[ 0.607, 8.166, 2.226],
                        [ 3.669, 0.018, 6.686],
                        [ 1.105, 1.822, 0.819]]

After 1 pass           [[ 0.097, 0.705, 0.198],
(columns, then rows)    [ 0.497, 0.001, 0.501],
                        [ 0.435, 0.386, 0.178]]
                       row sums     1.000 1.000 1.000
                       column sums  1.030 1.092 0.877

After 20 passes        [[ 0.102, 0.653, 0.244],
                        [ 0.457, 0.001, 0.542],
                        [ 0.441, 0.346, 0.213]]
                       row and column sums 1.000
Le script suivant teste l’affirmation sur laquelle repose toute la méthode. Il multiplie 60 matrices de mélange 4×4 aléatoires, une fois utilisées directement comme le ferait HC et une fois après Sinkhorn comme le fait mHC, et affiche le gain Amax de chaque produit.
import numpy as np

rng = np.random.default_rng(0)
n, layers = 4, 60

def sinkhorn(logits, iters=20):
    s = np.exp(logits)
    for _ in range(iters):
        s = s / s.sum(axis=0, keepdims=True)  # columns sum to 1
        s = s / s.sum(axis=1, keepdims=True)  # rows sum to 1
    return s

def amax_gain(m):
    return max(np.abs(m).sum(axis=1).max(), np.abs(m).sum(axis=0).max())

hc, mhc = np.eye(n), np.eye(n)
for _ in range(layers):
    a = np.eye(n) + 0.3 * rng.standard_normal((n, n))
    hc = a @ hc
    mhc = sinkhorn(a) @ mhc

print(f"HC  Amax gain: {amax_gain(hc):.1f}")
print(f"mHC Amax gain: {amax_gain(mhc):.1f}")
Avec la graine 0, il affiche 1906,8 pour HC et 1,0 pour mHC. Chaque matrice aléatoire est proche de l’identité, donc aucune ne paraît grande prise seule. L’article mesure environ 1,6 pour mHC dans son modèle 27B, pas 1,0. Il n’utilise que 20 itérations, donc les matrices entraînées ne sont pas exactement bistochastiques, et les petites erreurs s’accumulent à travers les couches mais restent bornées (section 5.4).
Les itérations de Sinkhorn sont différentiables, mais elles ne sont pas gratuites. mHC s’appuie sur un kernel forward fusionné et un kernel backward sur mesure qui recalcule les états de normalisation intermédiaires directement sur la puce.
Détails de la paramétrisation
- Map résiduelle : l’exponentiation puis la normalisation de Sinkhorn produisent , approximativement bistochastique.
- Maps de lecture et d’écriture : mHC remplace le de HC par une sigmoïde : et . Les deux maps sont non négatives, ce qui supprime l’annulation entre coefficients positifs et négatifs (sections 4.1 et 4.2). Les poids de lecture se situent dans (0, 1) et les poids d’écriture dans (0, 2). Un logit nul donne un poids d’écriture de , le poids qu’utilise une addition résiduelle standard. L’article n’explique pas la raison du facteur 2.
Architecture mHC complète
La figure montre une couche mHC avec la paramétrisation de chaque map. Elle a les deux mêmes chemins que le bloc HC ; ce qui change, c’est la façon dont chaque map est paramétrée.
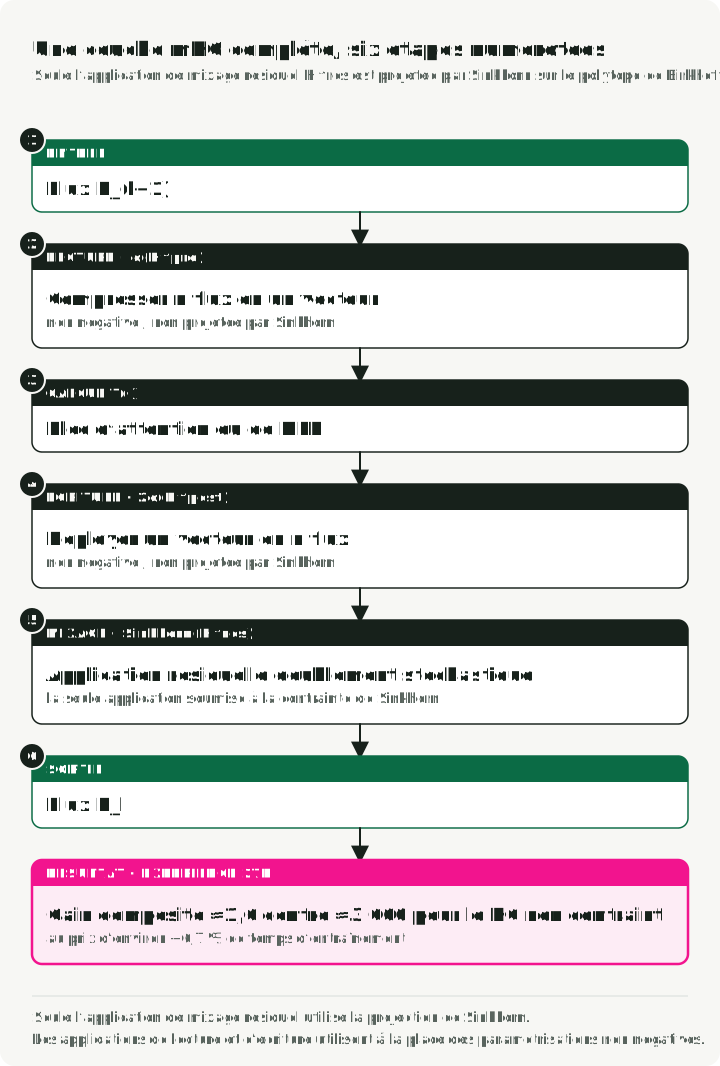
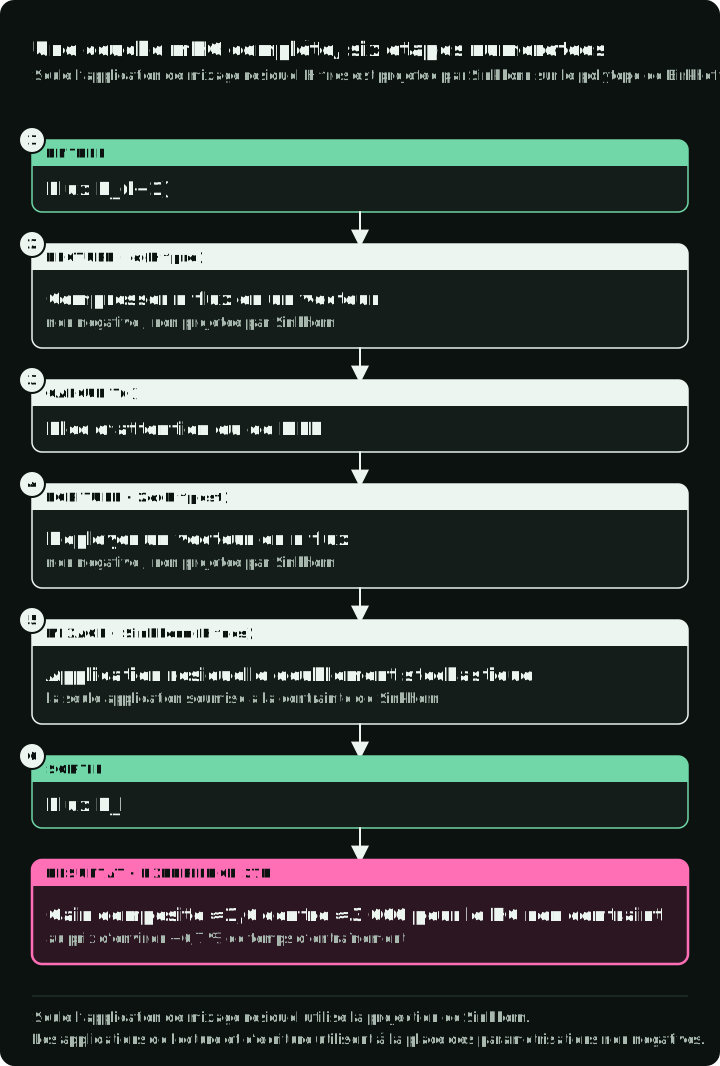
En termes de l’équation de mise à jour :
- Entrée : residual streams parallèles entrent dans la couche.
- Chemin du bloc : la map de lecture combine les streams en une entrée de dimension . Le bloc d’attention ou MLP la traite. La map d’écriture transforme la sortie en mises à jour pour les streams.
- Chemin résiduel : la map , approximativement bistochastique, mélange les streams entrants.
- Addition : les deux chemins sont sommés en , qui passe à la couche suivante.
Seule la map de mélange résiduelle utilise la projection de Sinkhorn. Les maps de lecture et d’écriture utilisent des paramétrisations non négatives. Cette distinction compte, car la garantie de composition de l’article s’applique à .
Infrastructure nécessaire pour le surcoût rapporté
Quatre streams augmentent les accès mémoire à l’état résiduel, le stockage des activations et la communication entre étages de pipeline. Le résultat de temps de l’article dépend de trois changements conçus ensemble, décrits ci-dessous.
Fusion de kernels
L’implémentation fusionne les opérations qui partagent des accès mémoire, utilise la précision mixte lorsque c’est approprié et implémente la plupart des kernels sur mesure avec TileLang. La boucle de Sinkhorn et sa passe arrière sur mesure s’exécutent dans des kernels dédiés pour réduire le trafic mémoire et le coût de lancement.
Recalcul sélectif
Les streams ajoutent de la mémoire d’activations (section 4.3.2). Au lieu de stocker chaque résultat intermédiaire, mHC :
- Libère les activations intermédiaires de ses propres kernels après la passe avant.
- Les recalcule dans la passe arrière, sans réexécuter le bloc d’attention ou FFN.
- Stocke l’entrée des streams élargis de chaque groupe de couches consécutives et la sortie d’attention ou de FFN de chaque couche. L’article aligne ces groupes sur les étapes du pipeline.
Un ordonnancement DualPipe étendu recouvre une partie de la communication, du recalcul et du travail des couches aux frontières des étages de pipeline. Le recouvrement obtenu est propre à ce système d’entraînement.
Résultat système rapporté
Pour la configuration à grande échelle de l’article, un taux d’expansion ajoute 6,7 % de temps d’entraînement par rapport à sa baseline (section 4.3). C’est un résultat de système, pas le surcoût d’une implémentation simple dans un framework.
Ce que les expériences établissent
Les auteurs entraînent des variantes MoE de 3B, 9B et 27B inspirées de DeepSeek-V3 (section 5.3). À 27B, mHC dépasse la baseline résiduelle standard sur les huit benchmarks en aval rapportés, et dépasse HC sur sept des huit (tableau 4). HC est légèrement meilleur sur MATH (26,4 contre 26,0). Ce sont des expériences de pré-entraînement internes, menées par l’équipe qui propose la méthode ; la réplication indépendante et les comparaisons sur d’autres architectures restent ouvertes.
Quand essayer mHC
Les résultats de l’article désignent trois conditions :
- Vous pré-entraînez à partir de zéro. mHC change l’architecture, et l’article ne l’évalue qu’en pré-entraînement. Sinon, ignorez mHC.
- Il vous faut plus de largeur résiduelle qu’un seul stream. Vous utilisez déjà HC ou prévoyez de le faire, et vous observez des pics de loss ou une croissance des activations et des normes de gradient quand vous augmentez la profondeur ou la taille. Si un seul stream suffit, gardez le résiduel standard.
- Vous pouvez faire le travail système, ou accepter un coût plus élevé. Le chiffre de 6,7 % exige des kernels fusionnés et des changements d’ordonnancement du pipeline. Une implémentation simple dans un framework coûtera plus cher. Si vous ne pouvez pas faire ce travail, un mHC en code simple reste possible, mais mesurez d’abord le surcoût.
Trois questions restent ouvertes :
- Surcoût système : le surcoût rapporté est le résultat optimisé de l’article ; un autre runtime, une autre topologie de dispositifs ou une autre forme de modèle peut donner un coût différent.
- Biais de mélange : la bistochasticité préserve la moyenne entre streams et empêche l’expansion via , mais elle peut lisser les différences entre streams. La mise à jour du bloc modifie toujours la représentation globale.
- Portée des preuves : les preuves les plus solides concernent le pré-entraînement de modèles de langage sur des architectures MoE inspirées de DeepSeek-V3. Cet article n’établit pas encore la généralisation à d’autres familles de modèles.
mHC est une piste prometteuse pour étudier une topologie résiduelle plus large tout en gardant bien conditionnée la map résiduelle répétée. Savoir si cela vaut la peine pour un autre modèle dépend de gains de qualité confirmés de façon indépendante et du coût de reproduction de sa pile système.
Références
- mHC: Manifold-Constrained Hyper-Connections - Xie et al. (DeepSeek)
- Deep Residual Learning for Image Recognition - He et al. (ResNet)
- Hyper-Connections - Article HC original
- TileLang - Framework d’optimisation de kernels CUDA
- DualPipe - Ordonnanceur de parallélisme de pipeline pour DeepSeek-V3
- ResiDual - Architecture à double chemin résiduel