DeepSeek mHC: Manifold-Constrained Hyper-Connections

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
El deep learning moderno se apoya en la conexión residual. Este artículo es para ingenieros que conocen el bloque Transformer y quieren saber qué cambia mHC en la ruta residual, por qué, cuánto cuesta y cuándo conviene probarlo. Las Hyper-Connections (HC) exploran otra dimensión arquitectónica: ampliar el estado residual en varios flujos que interactúan entre sí. El artículo de DeepSeek sobre las Manifold-Constrained Hyper-Connections (mHC) estudia cómo mantener estable ese enrutamiento a escalas de entrenamiento mayores.
Empieza con las conexiones residuales estándar y después añade las Hyper-Connections y la inestabilidad que provocan. Después llegan la restricción de mHC, una pequeña demo en NumPy y el coste de la implementación.
Por qué funcionan las conexiones residuales
El problema de la profundidad
Añadir capas puede aumentar la capacidad, pero también hace más difíciles la optimización y la propagación de la señal. Según la inicialización, la normalización y la arquitectura, las activaciones en el paso hacia delante o los gradientes en el paso hacia atrás pueden encogerse, crecer o quedar mal condicionados a lo largo de la profundidad.
La solución residual
El artículo de ResNet introdujo una solución sencilla. En lugar de aprender una transformación directa, se aprende el residuo, la diferencia respecto a la identidad:
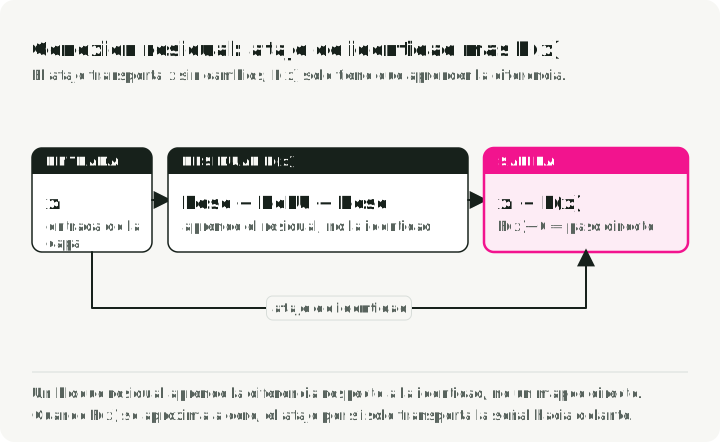
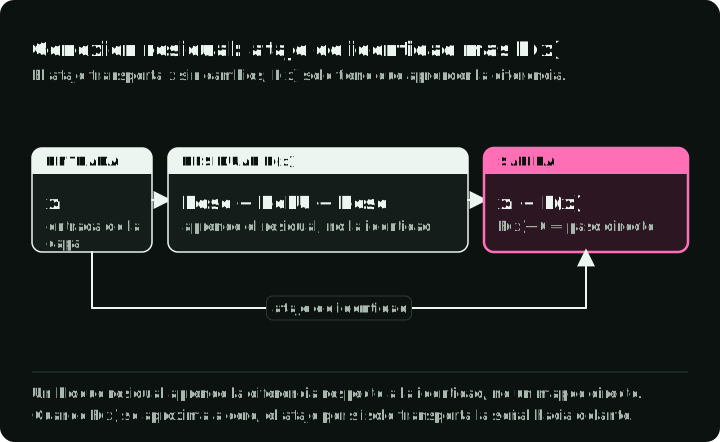
La propiedad útil es el atajo de identidad. Cuando la función residual devuelve cero, la capa se convierte en un paso directo. De ahí se siguen dos consecuencias:
- Un término de gradiente directo: la retropropagación incluye una ruta a través del componente de identidad.
- Una transformación de reserva sencilla: la rama residual puede quedarse cerca de cero cuando una capa no necesita cambiar mucho el estado.
Esto no elimina todos los problemas de optimización, pero hizo viables redes bastante más profundas.
Cómo cambia la normalización de capa la ruta residual
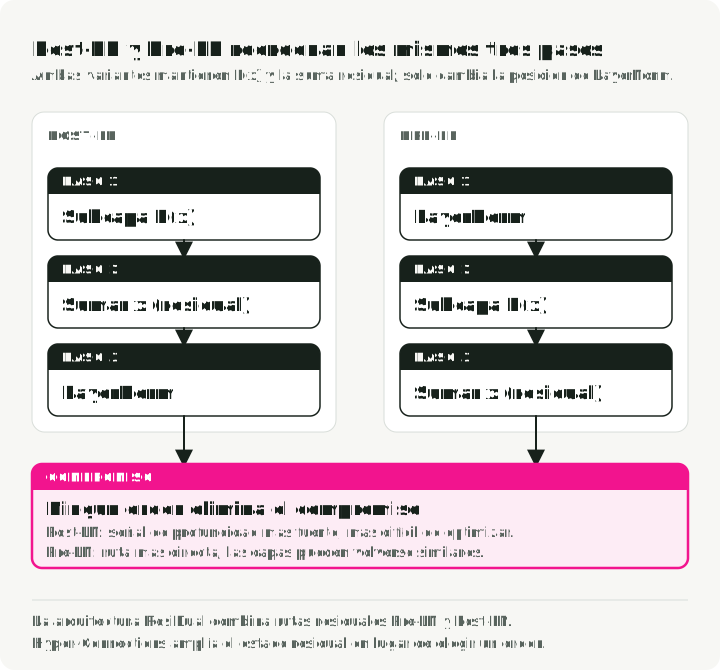
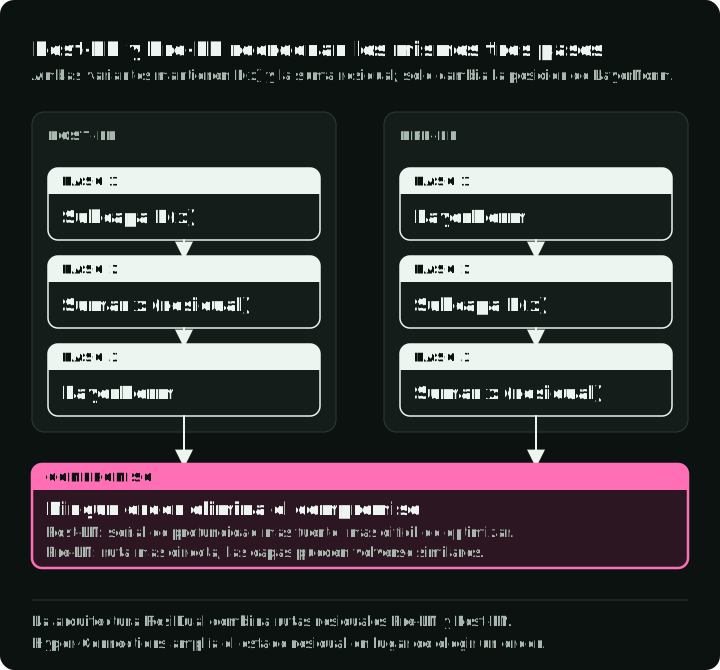
Los Transformers añadieron una variable nueva: dónde colocar la Layer Normalization (LN). Esa decisión determina si la ruta residual sigue siendo una identidad.
| Variante | Posición de LN | Ventaja | Limitación principal |
|---|---|---|---|
| Post-LN | Después del bloque residual | Fuerte contribución de la profundidad | Puede ser más difícil de optimizar en redes profundas |
| Pre-LN | Antes del bloque residual | Ruta residual más directa | Las representaciones de capas adyacentes pueden parecerse cada vez más |
ResiDual combina una ruta residual similar a Post-LN con una segunda ruta que acumula las salidas de los bloques. Sus representaciones se suman a la salida del modelo. El artículo de HC parte de ese mismo compromiso y hace aprendibles las intensidades de conexión, a través de varios flujos.
Las Hyper-Connections añaden flujos residuales paralelos
Las Hyper-Connections (HC) amplían el ancho del flujo residual en lugar de añadir profundidad.
Qué es un flujo
En un Transformer estándar, cada token tiene un estado de dimensiones que atraviesa los bloques. Al comienzo de la red, HC replica ese embedding de entrada veces, donde es la «tasa de expansión», normalmente 4. El estado oculto de dimensiones se convierte en una «matriz oculta hiper» de .
En las Hyper-Connections, un flujo es una de esas instancias paralelas del estado.
Las copias empiezan siendo idénticas y después divergen a medida que mapas aprendidos leen de los flujos, escriben en ellos y los mezclan. El artículo las interpreta como varios patrones de conexión a lo largo de la profundidad; no exige que cada flujo adquiera un papel fijo y legible para una persona.
Mecanismos principales
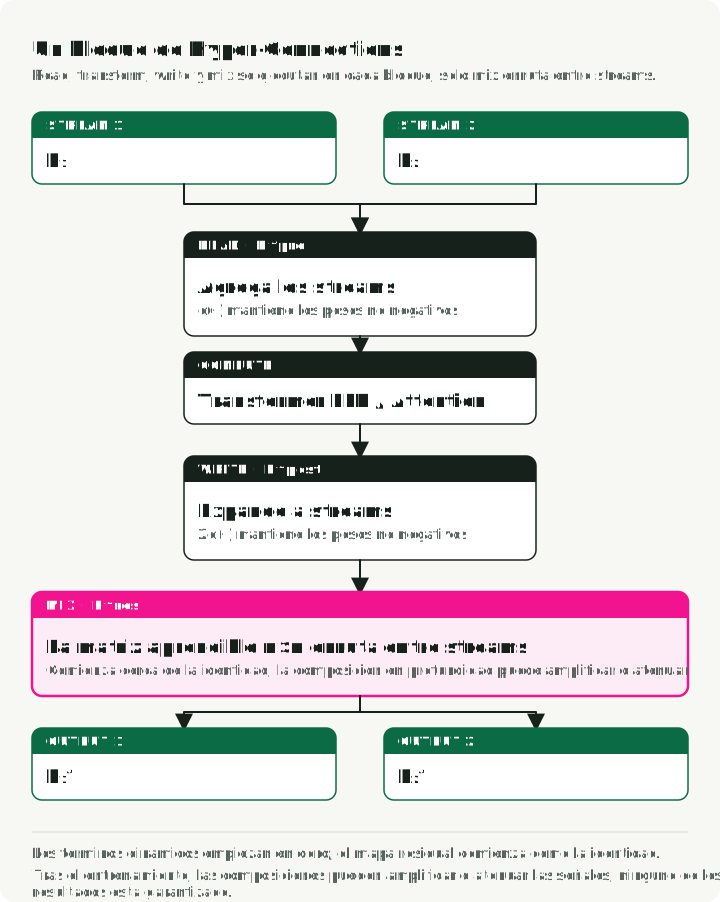
En lugar de una sola ruta residual, HC mantiene flujos paralelos a lo largo de toda la red. En cada bloque Transformer se ejecutan tres operaciones, cada una controlada por pequeños pesos aprendibles:
- Lectura (): agrega los flujos en la entrada de dimensiones que consume el bloque de atención o feed-forward.
- Escritura (): convierte la salida de ese bloque en actualizaciones para los flujos.
- Mezcla (): aplica un mapa residual de a los flujos entrantes antes de sumar la actualización del bloque.
En HC, cada mapa es una parte estática aprendida (un sesgo) más un término dependiente de la entrada que pasa por una , de modo que sus entradas pueden tener cualquier signo. El artículo de HC llama HC dinámica (DHC) a la versión con términos dependientes de la entrada; DHC×4 significa DHC con cuatro flujos. El mapa residual es la parte crítica para la estabilidad, porque se multiplica repetidamente a lo largo de la profundidad.
Juntos, los tres mapas dan la actualización por capa (ecuación 3 del artículo de mHC, que escribe el ancho como ):
Aquí es la matriz de flujos de , y son de , y es de . El primer término es la ruta residual. El segundo es la actualización del bloque: leer, calcular, escribir. Con y los tres mapas iguales a 1, la ecuación es el residual estándar .
La figura dibuja esta actualización para cuatro flujos: leer, calcular y escribir sobre los flujos, la mezcla de 4 × 4 en los flujos y una suma en cada flujo.
Qué reporta el artículo de HC
El artículo de HC reporta una convergencia 1,8× más rápida para su configuración OLMoE-1B-7B DHC×4 respecto a su línea base, además de mejoras en tareas posteriores con 500B tokens (sección 1). Es una sola configuración evaluada, no un multiplicador de velocidad general para cuatro flujos.
Por qué HC sin restricciones puede volverse inestable
El artículo de mHC reporta inestabilidad al escalar HC sin restricciones a su configuración de 27B: la pérdida de entrenamiento se dispara hacia el paso 12k, junto con un salto en la norma del gradiente (sección 3.1). Los mismos mapas sin restricciones que dan flexibilidad a HC eliminan también la ruta de identidad garantizada que hace fáciles de entrenar los residuales.
El problema del mapa compuesto
En los residuales estándar:
Cuando , esto es la identidad: . La señal pasa sin cambios.
En las Hyper-Connections, el término residual de la actualización anterior es un producto de matrices, . Si seguimos solo esa ruta a lo largo de capas, la señal queda así:
El comportamiento depende de la matriz compuesta, no de si cada entrada individual queda por encima o por debajo de 1. Si los mapas siguen estirando la misma dirección en más de 1, el producto crece de forma exponencial con la profundidad. Si la siguen encogiendo, la señal se desvanece. Las entradas negativas también pueden cancelar señales.
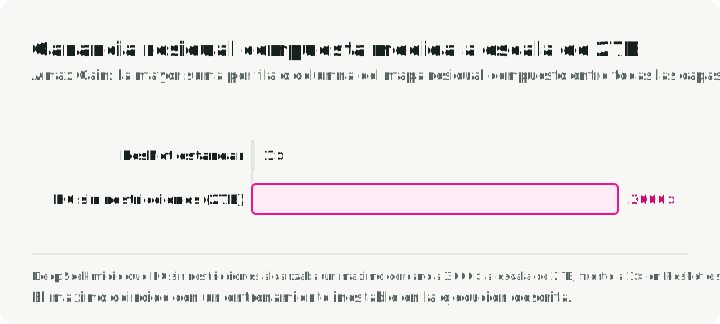
El artículo de mHC mide esa ganancia con la Amax Gain Magnitude: la suma absoluta máxima por filas en la propagación hacia delante y por columnas en la propagación hacia atrás, en un mapa residual compuesto. En su experimento de HC con 27B, el pico se acerca a 3000 y coincide con un comportamiento de entrenamiento inestable (sección 3.1).
El gráfico pone los tres valores del artículo en un mismo eje logarítmico: 1 para un residual estándar, alrededor de 1,6 para mHC (la versión restringida que se describe a continuación) y alrededor de 3000 para HC sin restricciones. Una marca bajo el eje muestra el del ejemplo anterior.
Por tanto, el objetivo de diseño es más acotado que forzar que todos los mapas sean la identidad: permitir la mezcla entre flujos y acotar la amplificación entre composiciones.
La restricción de mHC
mHC mantiene el enrutamiento entre flujos, pero restringe cada matriz de mezcla residual al politopo de Birkhoff, el conjunto de las matrices doblemente estocásticas. Una matriz así tiene entradas no negativas, y cada una de sus filas y columnas suma uno.
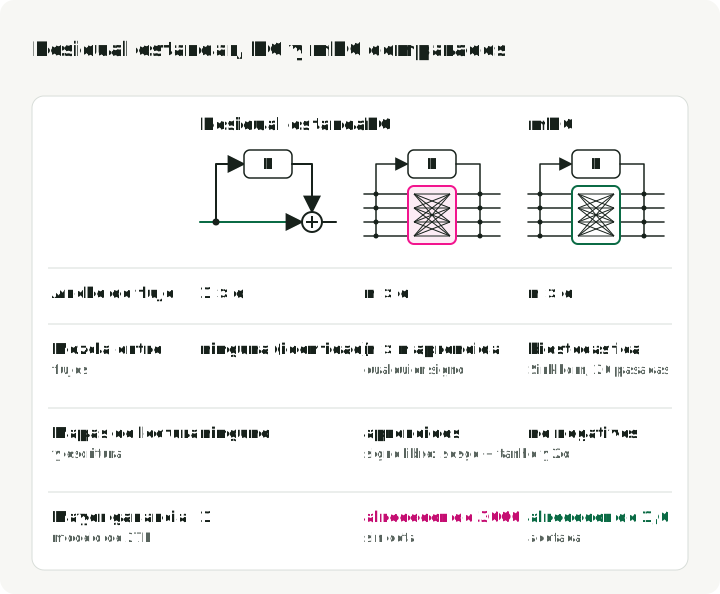
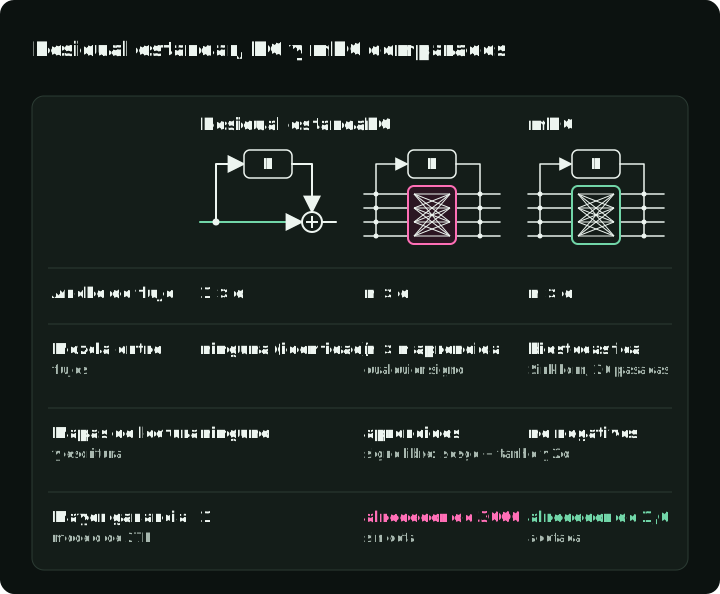
La figura esboza la ruta residual de cada diseño que cubre este artículo y los compara. La fila de ganancia muestra la ganancia compuesta máxima que el artículo de mHC reporta para su modelo de 27B. Con y todos los mapas iguales a 1, HC y mHC se reducen al residual estándar.
Qué garantiza la doble estocasticidad
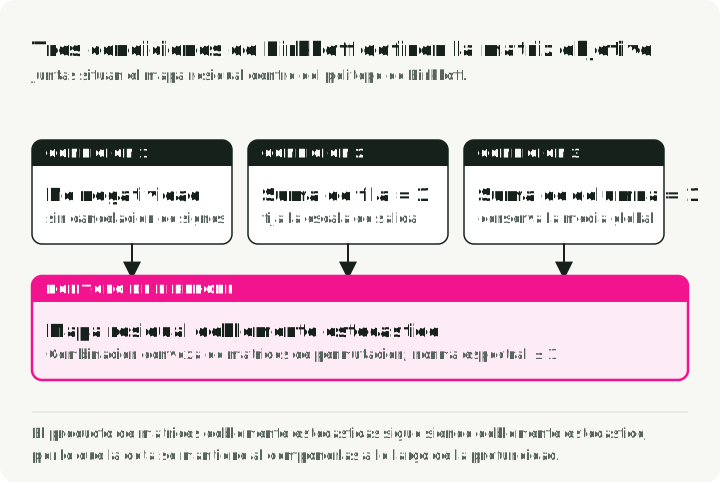
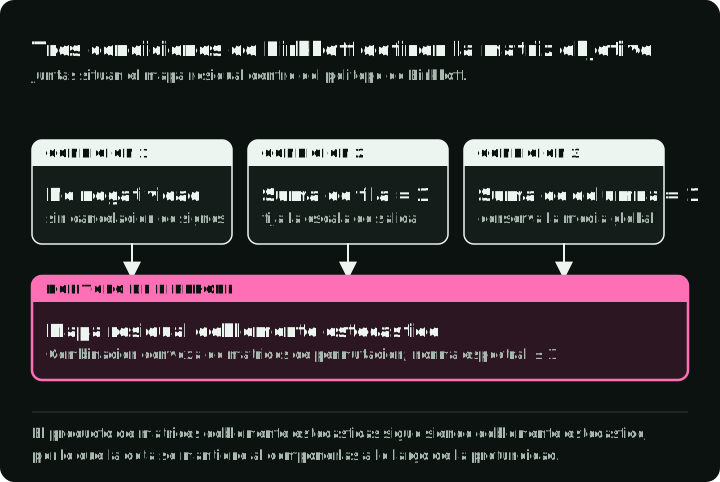
La figura comprueba las tres condiciones en dos matrices de 3×3 del ejemplo de Sinkhorn de más abajo: los logits sin restricciones, que incumplen las tres, y tras 20 pasadas de Sinkhorn, que cumple las tres. La tabla da la consecuencia de cada condición.
| Restricción | Consecuencia |
|---|---|
| No negatividad | Los coeficientes de signos opuestos no se cancelan |
| Suma por filas = 1 | Una señal constante entre flujos sigue siendo constante |
| Suma por columnas = 1 | La media global entre flujos se conserva |
La no negatividad, junto con sumas por filas iguales a uno, hace que cada salida sea una combinación convexa de los flujos de entrada. La restricción conserva la media entre flujos, no la longitud del vector: un mapa doblemente estocástico puede acercar los flujos entre sí al promediarlos.
Se siguen tres propiedades más (sección 4.1):
- Norma espectral ≤ 1: la norma espectral es el mayor factor por el que una matriz puede estirar cualquier vector. Un límite de uno significa que el mapa de enrutamiento residual no puede amplificar la norma euclídea.
- Cerrada bajo la multiplicación: el producto de matrices doblemente estocásticas sigue siendo doblemente estocástico, de modo que la restricción sobrevive a la composición a lo largo de la profundidad.
- Mezcla convexa: por el teorema de Birkhoff-von Neumann, el mapa está en la envolvente convexa de las matrices de permutación.
Proyección de Sinkhorn-Knopp
Los logits residuales aprendibles no tienen restricciones. mHC primero los exponencia para obtener una matriz positiva y después alterna la normalización de columnas y de filas. Con suficientes iteraciones, este proceso de Sinkhorn-Knopp se aproxima a una matriz doblemente estocástica; el artículo usa 20 iteraciones como proyección diferenciable práctica y aproximada, no como una restricción exacta.
La figura ejecuta paso a paso la primera pasada sobre el ejemplo de 3×3 de más abajo y después representa el mayor error de suma de columnas a lo largo de 20 pasadas.
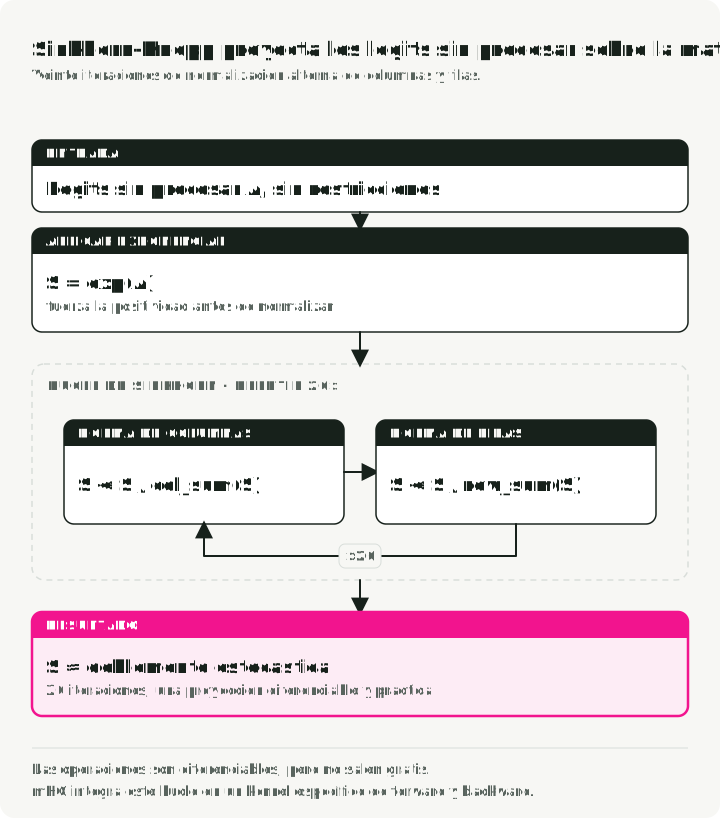
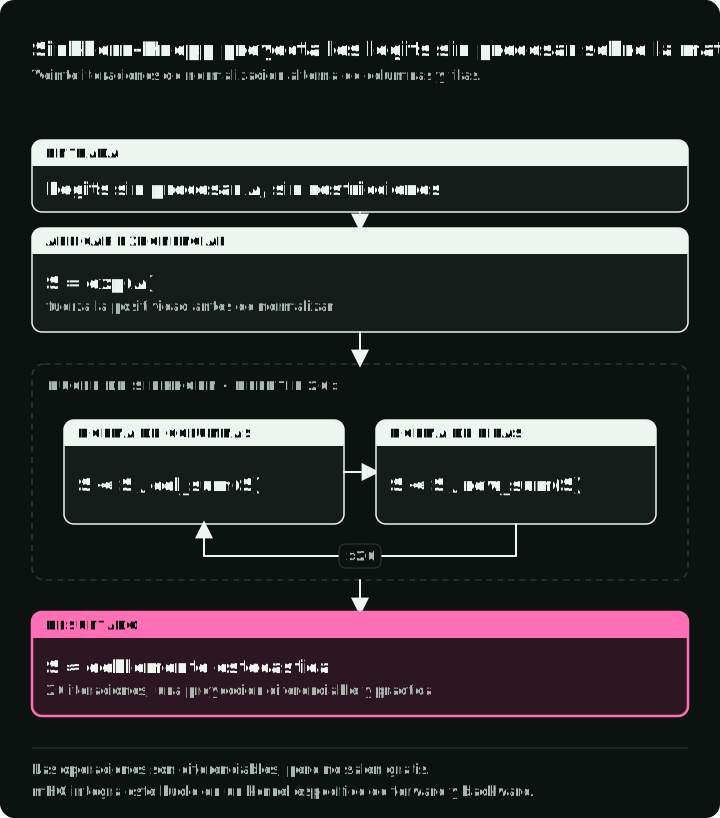
Para unos logits en bruto , el procedimiento es:
S = exp(A)
repeat 20 times:
    S = S / column_sum(S)
    S = S / row_sum(S)
return S
Un ejemplo de 3×3 muestra qué significa «aproximada». Una pasada fija las sumas por filas, porque las filas se normalizan en último lugar, pero deja las sumas por columnas desviadas hasta un 12 %. Veinte pasadas llevan ambas a 1,000 con tres decimales.
Raw logits A           [[-0.5,   2.1,   0.8  ],
                        [ 1.3,  -4.0,   1.9  ],
                        [ 0.1,   0.6,  -0.2  ]]

S = exp(A)             [[ 0.607, 8.166, 2.226],
                        [ 3.669, 0.018, 6.686],
                        [ 1.105, 1.822, 0.819]]

After 1 pass           [[ 0.097, 0.705, 0.198],
(columns, then rows)    [ 0.497, 0.001, 0.501],
                        [ 0.435, 0.386, 0.178]]
                       row sums     1.000 1.000 1.000
                       column sums  1.030 1.092 0.877

After 20 passes        [[ 0.102, 0.653, 0.244],
                        [ 0.457, 0.001, 0.542],
                        [ 0.441, 0.346, 0.213]]
                       row and column sums 1.000
El siguiente script comprueba la afirmación en la que se apoya todo el método. Multiplica 60 matrices de mezcla aleatorias de 4×4, una vez usadas directamente como lo haría HC y otra tras Sinkhorn como lo hace mHC, e imprime la ganancia Amax de cada producto.
import numpy as np

rng = np.random.default_rng(0)
n, layers = 4, 60

def sinkhorn(logits, iters=20):
    s = np.exp(logits)
    for _ in range(iters):
        s = s / s.sum(axis=0, keepdims=True)  # columns sum to 1
        s = s / s.sum(axis=1, keepdims=True)  # rows sum to 1
    return s

def amax_gain(m):
    return max(np.abs(m).sum(axis=1).max(), np.abs(m).sum(axis=0).max())

hc, mhc = np.eye(n), np.eye(n)
for _ in range(layers):
    a = np.eye(n) + 0.3 * rng.standard_normal((n, n))
    hc = a @ hc
    mhc = sinkhorn(a) @ mhc

print(f"HC  Amax gain: {amax_gain(hc):.1f}")
print(f"mHC Amax gain: {amax_gain(mhc):.1f}")
Con la semilla 0 imprime 1906.8 para HC y 1.0 para mHC. Cada matriz aleatoria está cerca de la identidad, así que ninguna parece grande por sí sola. El artículo mide alrededor de 1,6 para mHC en su modelo de 27B, no 1,0. Usa solo 20 iteraciones, por lo que las matrices entrenadas no son exactamente doblemente estocásticas, y los pequeños errores crecen entre capas pero se mantienen acotados (sección 5.4).
Las iteraciones de Sinkhorn son diferenciables, pero no son gratuitas. mHC se apoya en un kernel fusionado para el paso hacia delante y en un kernel a medida para el paso hacia atrás que recalcula en el chip los estados intermedios de normalización.
Detalles de la parametrización
- Mapa residual: la exponenciación más la normalización de Sinkhorn produce el aproximadamente doblemente estocástico.
- Mapas de lectura y escritura: mHC sustituye la de HC por una sigmoide: y . Ambos mapas son no negativos, lo que elimina la cancelación entre coeficientes positivos y negativos (secciones 4.1 y 4.2). Los pesos de lectura caen en (0, 1) y los de escritura en (0, 2). Un logit cero da un peso de escritura de , el peso que usa la suma residual estándar. El artículo no explica por qué usa el factor 2.
La arquitectura mHC completa
La figura muestra una capa mHC con la parametrización de cada mapa. Tiene las mismas dos rutas que el bloque HC; lo que cambia es cómo se parametriza cada mapa.
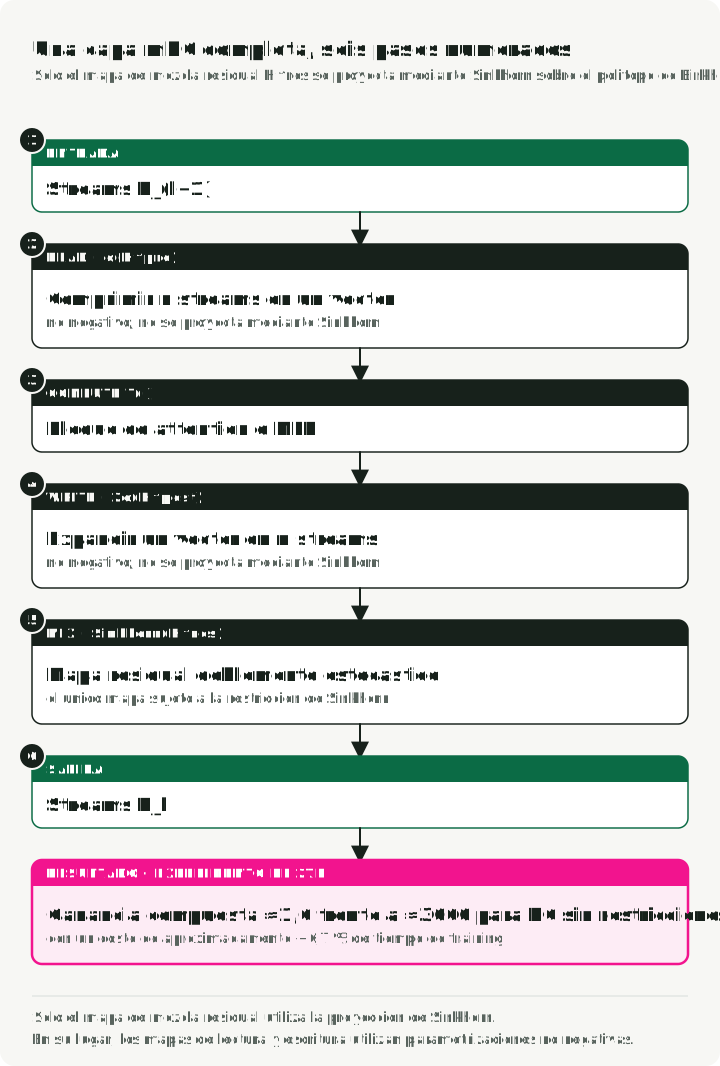
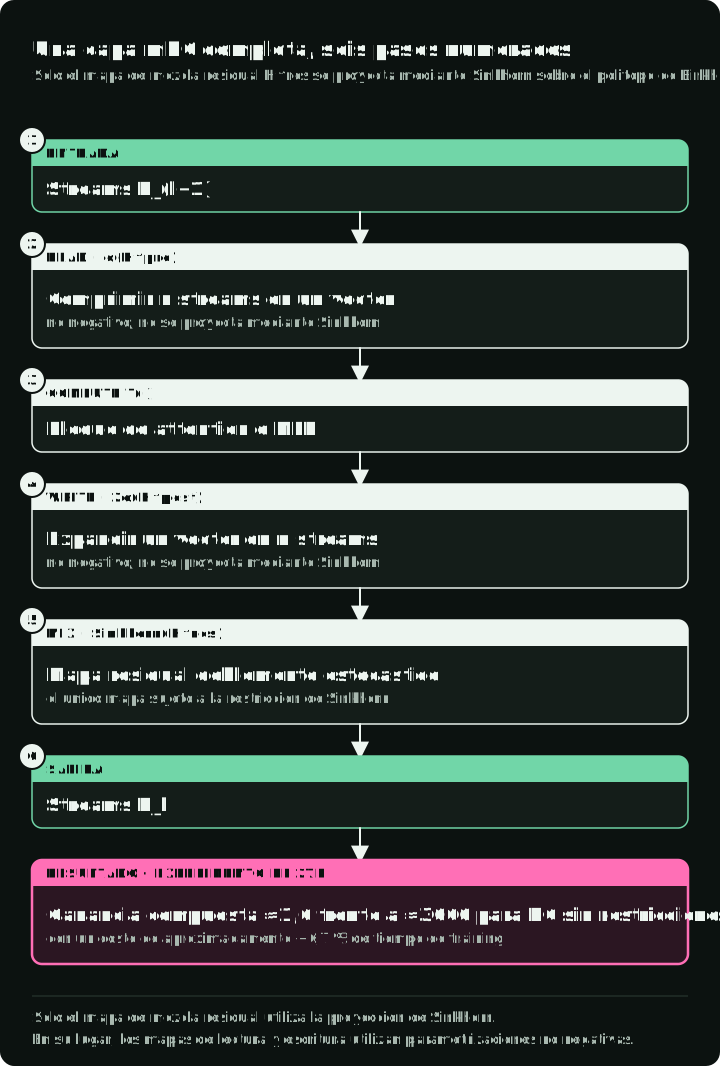
En términos de la ecuación de actualización:
- Entrada: flujos residuales paralelos entran en la capa.
- Ruta del bloque: el mapa de lectura combina los flujos en una única entrada de dimensiones. El bloque de atención o MLP la procesa. El mapa de escritura convierte la salida en actualizaciones para los flujos.
- Ruta residual: el aproximadamente doblemente estocástico mezcla los flujos entrantes.
- Suma: las dos rutas se suman en , que pasa a la capa siguiente.
Solo el mapa de mezcla residual usa la proyección de Sinkhorn. Los mapas de lectura y escritura usan parametrizaciones no negativas. Esa distinción importa porque la garantía de composición del artículo se aplica a .
Infraestructura necesaria para el sobrecoste reportado
Cuatro flujos aumentan los accesos a memoria del estado residual, el almacenamiento de activaciones y la comunicación entre etapas del pipeline. El resultado de tiempos del artículo depende de tres cambios diseñados conjuntamente, que se describen a continuación.
Fusión de kernels
La implementación fusiona operaciones que comparten acceso a memoria, usa precisión mixta donde corresponde e implementa la mayoría de los kernels a medida con TileLang. El bucle de Sinkhorn y su paso hacia atrás a medida se ejecutan dentro de kernels dedicados para reducir el tráfico de memoria y la latencia de lanzamiento.
Recomputación selectiva
Los flujos añaden memoria de activaciones (sección 4.3.2). En lugar de almacenar todos los resultados intermedios, mHC:
- Libera las activaciones intermedias de sus propios kernels después del paso hacia delante.
- Las recalcula en el paso hacia atrás, sin volver a ejecutar el bloque de atención o FFN.
- Almacena la entrada de los flujos ampliados de cada grupo de capas consecutivas y la salida de atención o FFN de cada capa. El artículo alinea esos grupos con las etapas del pipeline.
Un plan de DualPipe extendido solapa partes de la comunicación, la recomputación y el trabajo de las capas en los límites entre etapas del pipeline. El solapamiento logrado es específico de este sistema de entrenamiento.
Resultado de sistema reportado
Para la configuración a gran escala del artículo, una tasa de expansión añade un 6,7 % de tiempo de entrenamiento respecto a su línea base (sección 4.3). Es un resultado de sistema, no el sobrecoste de una implementación simple en un framework.
Qué establecen los experimentos
Los autores entrenan variantes MoE de 3B, 9B y 27B inspiradas en DeepSeek-V3 (sección 5.3). Con 27B, mHC supera a la línea base residual estándar en los ocho benchmarks posteriores reportados, y supera a HC en siete de ocho (tabla 4). HC es ligeramente superior en MATH (26,4 frente a 26,0). Son experimentos de preentrenamiento internos del equipo que propone el método, así que la replicación independiente y las comparaciones con otras arquitecturas siguen abiertas.
Cuándo probar mHC
Los resultados del artículo apuntan a tres condiciones:
- Preentrenas desde cero. mHC cambia la arquitectura, y el artículo lo evalúa solo en preentrenamiento. Si no es tu caso, descarta mHC.
- Necesitas más ancho residual que un solo flujo. Ya usas HC o piensas usarla, y ves picos de pérdida o crecimiento de las activaciones y de las normas de gradiente al escalar la profundidad o el tamaño. Si te basta un solo flujo, conserva el residual estándar.
- Puedes hacer el trabajo de sistemas o aceptar un coste mayor. La cifra del 6,7 % exige kernels fusionados y cambios en el plan del pipeline. Una implementación simple en un framework costará más. Si no puedes hacer ese trabajo, una mHC en código simple es posible, pero mide primero el sobrecoste.
Quedan tres preguntas abiertas:
- Sobrecoste de sistema: el sobrecoste reportado es el resultado optimizado del artículo; otro runtime, otra topología de dispositivos u otra forma de modelo pueden ver un coste distinto.
- Sesgo de mezcla: la doble estocasticidad preserva la media entre flujos e impide la expansión a través de , pero puede suavizar las diferencias entre flujos. La actualización del bloque sigue cambiando la representación global.
- Alcance de la evidencia: la evidencia más sólida es el preentrenamiento de modelos de lenguaje con arquitecturas MoE inspiradas en DeepSeek-V3. Este artículo no establece aún que se generalice a otras familias de modelos.
mHC es una vía prometedora para estudiar una topología residual más ancha manteniendo bien condicionado el mapa residual que se repite. Que merezca la pena para otro modelo depende de mejoras de calidad verificadas de forma independiente y del coste de reproducir su pila de sistemas.
Referencias
- mHC: Manifold-Constrained Hyper-Connections - Xie et al. (DeepSeek)
- Deep Residual Learning for Image Recognition - He et al. (ResNet)
- Hyper-Connections - Artículo original de HC
- TileLang - Framework de optimización de kernels CUDA
- DualPipe - Planificador de paralelismo de pipeline para DeepSeek-V3
- ResiDual - Arquitectura de doble ruta residual