DeepSeek mHC: Hyper-Connections com restrições na variedade

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
A aprendizagem profunda moderna assenta na ligação residual. Este artigo destina-se a engenheiros que conhecem o bloco Transformer e querem saber o que a mHC altera no caminho residual, porquê, quanto custa e quando vale a pena experimentá-la. As Hyper-Connections (HC) exploram outra dimensão arquitetural: alargar o estado residual em vários streams que interagem entre si. O artigo da DeepSeek sobre Manifold-Constrained Hyper-Connections (mHC) estuda como manter esse routing estável em escalas de treino maiores.
Começa pelas ligações residuais padrão e introduz depois as Hyper-Connections e a instabilidade que estas criam. A restrição mHC, uma pequena demonstração em NumPy e o custo de implementação vêm a seguir.
Porque funcionam as ligações residuais
O problema da profundidade
Adicionar camadas pode aumentar a capacidade, mas também torna a otimização e a propagação do sinal mais difíceis. Consoante a inicialização, a normalização e a arquitetura, as ativações no forward ou os gradientes no backward podem diminuir, crescer ou ficar mal condicionados ao longo da profundidade.
A solução residual
O artigo da ResNet introduziu uma solução simples. Em vez de aprender um mapeamento direto, aprende-se o residual, a diferença relativamente à identidade:
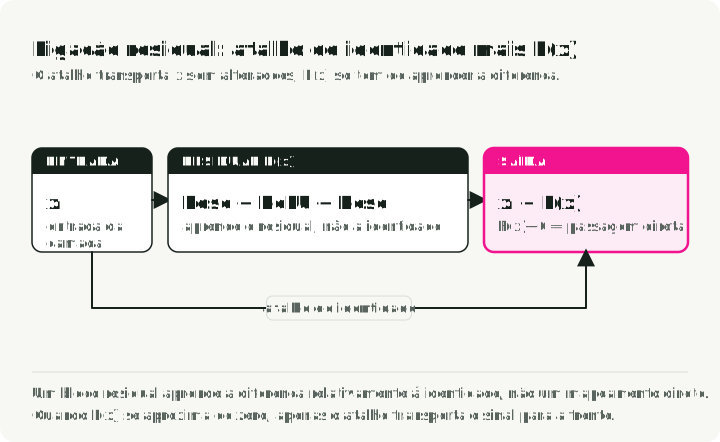
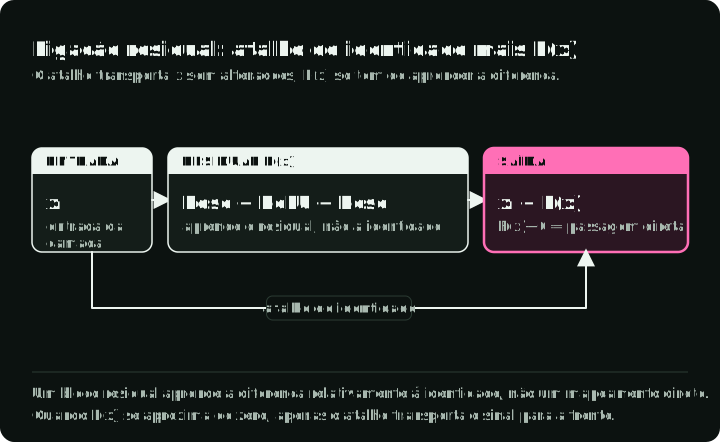
A propriedade útil é o atalho de identidade. Quando a função residual devolve zero, a camada passa a ser uma passagem direta. Daqui resultam duas consequências:
- Um termo de gradiente direto: a retropropagação inclui um caminho através da componente de identidade.
- Um mapeamento de reserva simples: o ramo residual pode manter-se perto de zero quando uma camada não precisa de alterar muito o estado.
Isto não elimina todos os problemas de otimização, mas tornou práticas redes substancialmente mais profundas.
Como a normalização por camada altera o caminho residual
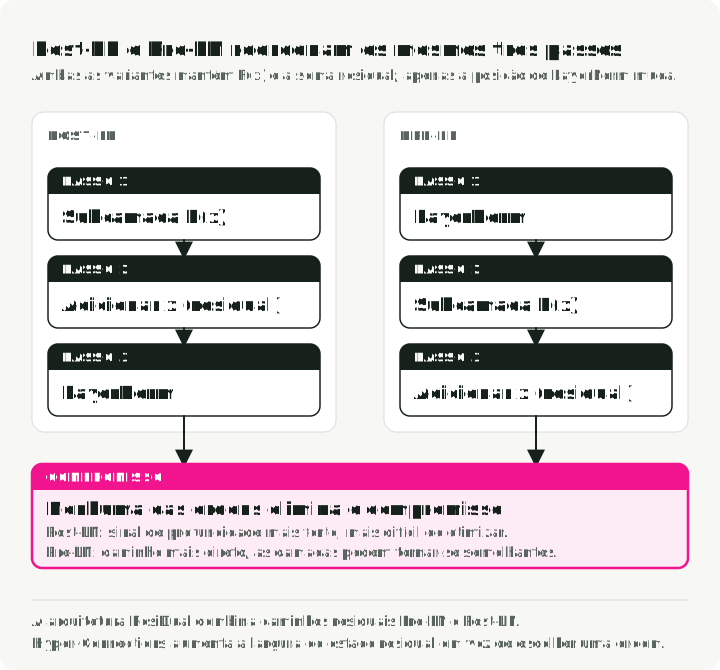
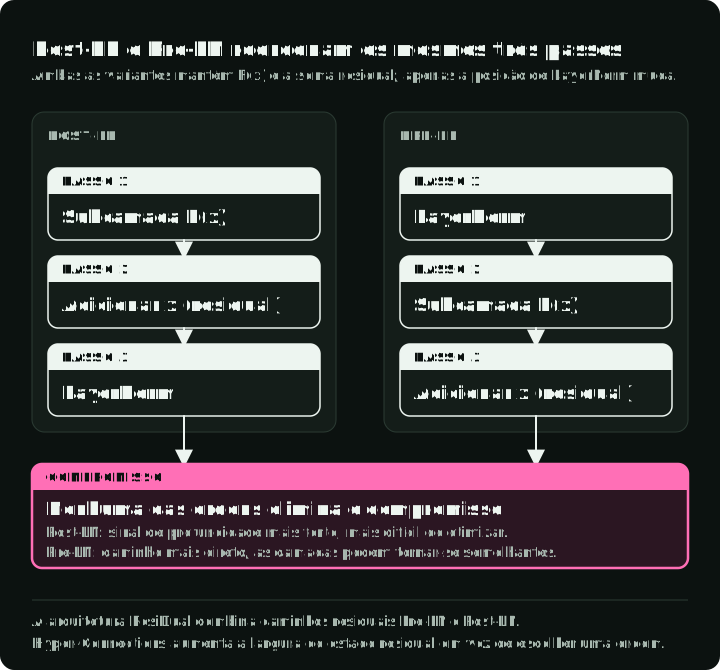
Os Transformers trouxeram uma nova variável: onde colocar a Layer Normalization (LN). Isso determina se o caminho residual continua a ser uma identidade.
| Variante | Posição da LN | Vantagem | Limitação principal |
|---|---|---|---|
| Post-LN | Depois do bloco residual | Forte contributo da profundidade | Pode ser mais difícil de otimizar em profundidade |
| Pre-LN | Antes do bloco residual | Caminho residual mais direto | As representações de camadas adjacentes podem tornar-se cada vez mais semelhantes |
A ResiDual combina um caminho residual semelhante a Post-LN com um segundo caminho que acumula as saídas dos blocos. As suas representações são somadas à saída do modelo. O artigo da HC parte deste mesmo compromisso e torna as intensidades das ligações aprendíveis, ao longo de vários streams.
As Hyper-Connections adicionam streams residuais paralelos
As Hyper-Connections (HC) expandem a largura do residual stream em vez de acrescentarem profundidade.
O que significa um stream
Num Transformer padrão, cada token tem um estado de dimensão que atravessa os blocos. No início da rede, a HC replica esse embedding de entrada vezes, onde é a “taxa de expansão”, tipicamente 4. O estado oculto de dimensão passa a ser uma “matriz oculta de hiper-estados” .
Nas Hyper-Connections, um stream é uma dessas instâncias paralelas do estado.
As cópias começam idênticas e depois divergem, à medida que mapas aprendidos leem, escrevem e misturam os streams. O artigo interpreta-os como vários padrões de ligação ao longo da profundidade; não exige que cada stream adquira um papel fixo e legível por humanos.
Mecanismos principais
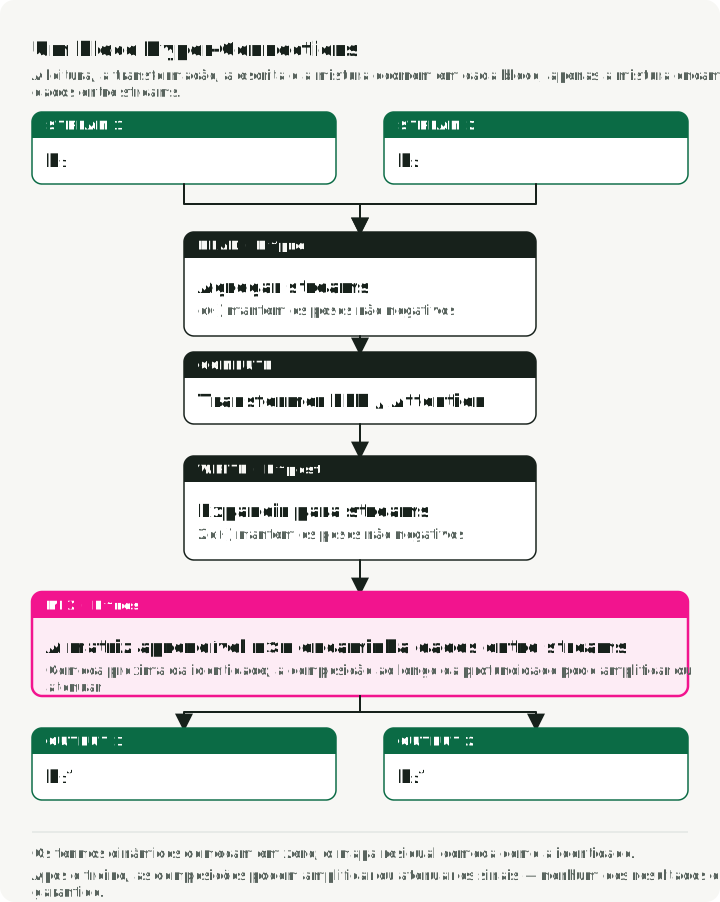
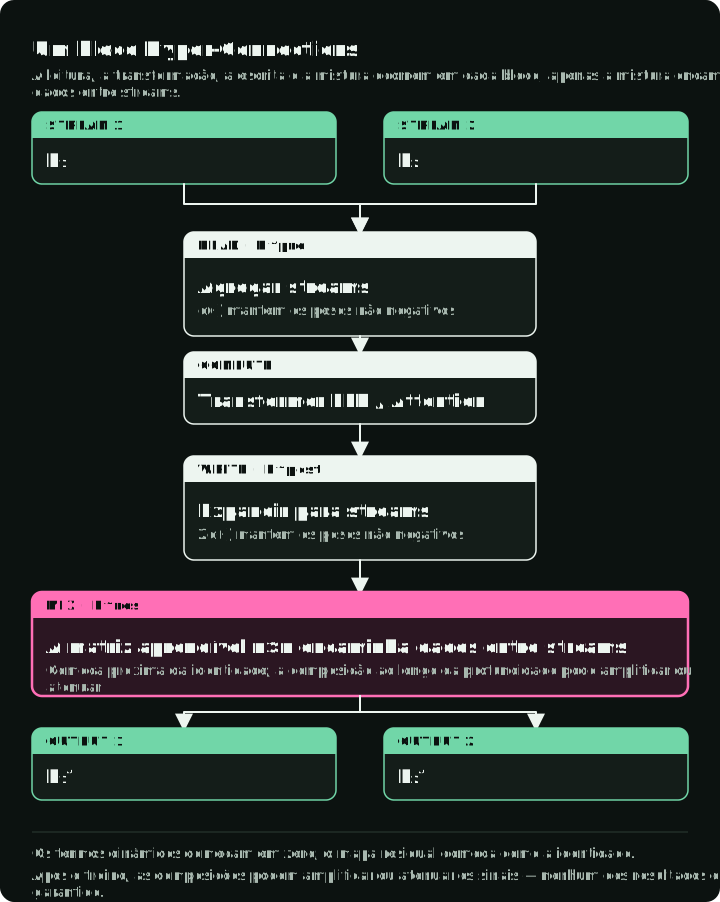
Em vez de um único caminho residual, a HC mantém streams paralelos a percorrer toda a rede. Em cada bloco Transformer, executam-se três operações, cada uma controlada por pequenos pesos aprendíveis:
- Leitura (): agrega os streams na entrada de dimensão consumida pelo bloco de atenção ou feed-forward.
- Escrita (): converte a saída desse bloco em atualizações para os streams.
- Mistura (): aplica um mapa residual aos streams de entrada antes de somar a atualização do bloco.
Na HC, cada mapa é uma parte estática aprendida (um bias) mais um termo dependente da entrada que passa por , pelo que as suas entradas podem ter qualquer sinal. O artigo da HC chama dynamic HC (DHC) à versão com termos dependentes da entrada; DHC×4 significa DHC com quatro streams. O mapa residual é a parte crítica para a estabilidade, porque é multiplicado repetidamente ao longo da profundidade.
Em conjunto, os três mapas dão a atualização por camada (Eq. 3 do artigo da mHC, que escreve a largura como ):
Aqui, é a matriz de streams , e são , e é . O primeiro termo é o caminho residual. O segundo termo é a atualização do bloco: ler, calcular, escrever. Com e os três mapas iguais a 1, a equação reduz-se ao residual padrão .
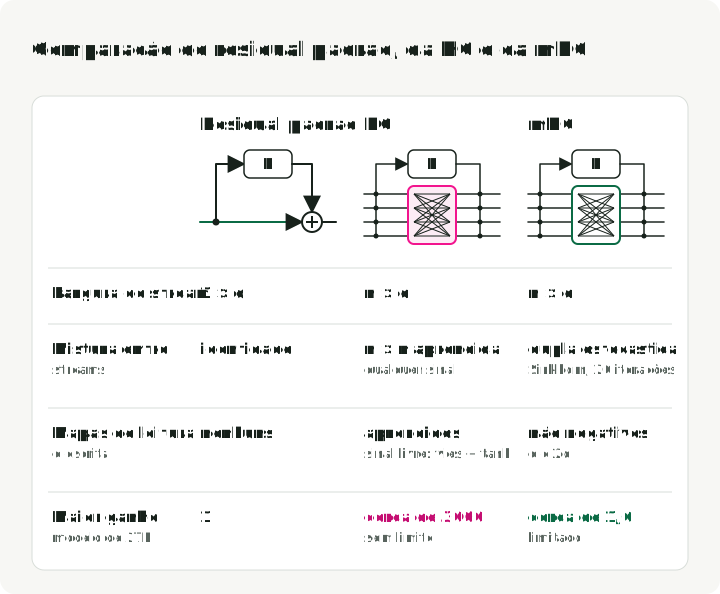
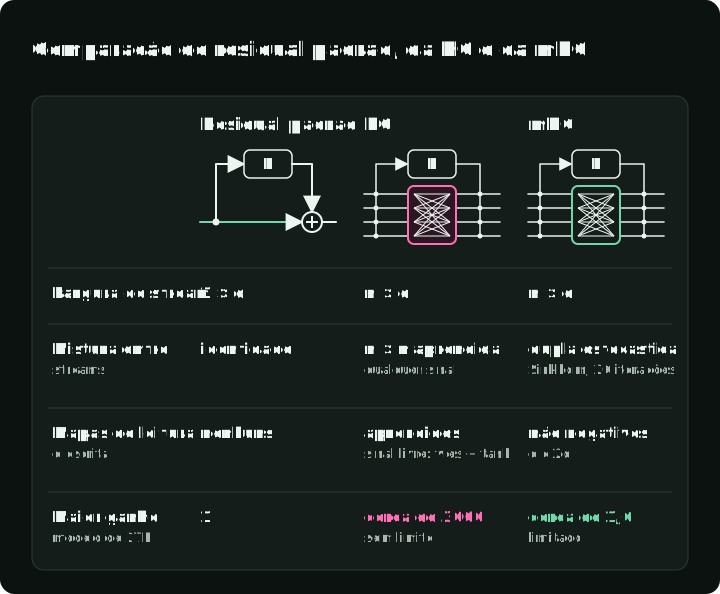
A figura desenha esta atualização para quatro streams: ler, calcular e escrever acima dos streams, a mistura 4 × 4 sobre os streams e uma soma em cada stream.
O que reporta o artigo da HC
O artigo da HC reporta uma convergência 1,8× mais rápida na sua configuração OLMoE-1B-7B DHC×4 face à referência, além de ganhos nas tarefas a jusante com 500B tokens (Secção 1). Trata-se de uma configuração avaliada, não de um multiplicador de velocidade geral para quatro streams.
Porque pode a HC sem restrições tornar-se instável
O artigo da mHC reporta instabilidade quando escala a HC sem restrições para a configuração de 27B: a loss de treino dispara por volta do passo 12k, a par de um salto na norma do gradiente (Secção 3.1). Os mesmos mapas sem restrições que dão flexibilidade à HC removem também o caminho de identidade garantido que torna os residuais fáceis de treinar.
O problema do mapa composto
Nos residuais padrão:
Quando , isto é a identidade: . O sinal passa inalterado.
Nas Hyper-Connections, o termo residual da atualização acima é um produto de matrizes, . Seguindo apenas esse caminho ao longo de camadas, o sinal torna-se:
O comportamento depende da matriz composta, e não de as entradas individuais estarem acima ou abaixo de 1. Se os mapas continuarem a esticar a mesma direção por mais de 1, o produto cresce exponencialmente com a profundidade. Se continuarem a encolhê-la, o sinal desvanece-se. As entradas negativas também podem anular sinais.
O artigo da mHC mede esse ganho com a Amax Gain Magnitude: a soma máxima dos valores absolutos por linha, na propagação forward, e por coluna, na propagação backward, de um mapa residual composto. Na sua experiência de HC a 27B, o pico aproxima-se de 3000 e coincide com um comportamento de treino instável (Secção 3.1).
O gráfico coloca os três valores do artigo num único eixo logarítmico: 1 para um residual padrão, cerca de 1,6 para a mHC (a versão com restrições descrita a seguir) e cerca de 3000 para a HC sem restrições. Uma marca sob o eixo mostra o do exemplo anterior.
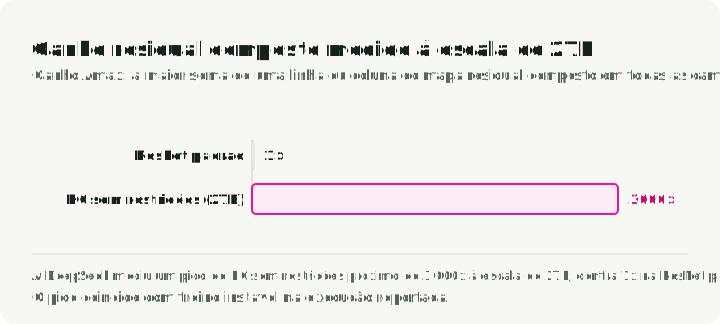
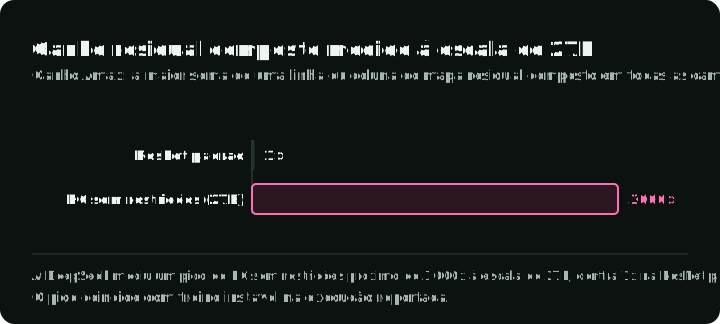
O objetivo de desenho é, portanto, mais restrito do que forçar todos os mapas a serem a identidade: permitir a mistura entre streams e limitar a amplificação ao longo das composições.
A restrição mHC
A mHC mantém o routing entre streams, mas restringe cada matriz de mistura residual ao politopo de Birkhoff, o conjunto das matrizes duplamente estocásticas. Uma matriz destas tem entradas não negativas, e cada uma das suas linhas e colunas soma um.
A figura esboça o caminho residual de cada desenho abordado neste artigo e compara-os. A linha do ganho mostra o ganho composto máximo que o artigo da mHC reporta para o seu modelo de 27B. Com e todos os mapas iguais a 1, a HC e a mHC reduzem-se ao resíduo padrão.
O que garante a dupla estocasticidade
A figura verifica as três condições em duas matrizes 3×3 do exemplo de Sinkhorn mais abaixo: os logits sem restrições, que violam as três, e após 20 passagens de Sinkhorn, que cumpre as três. A tabela dá a consequência de cada condição.
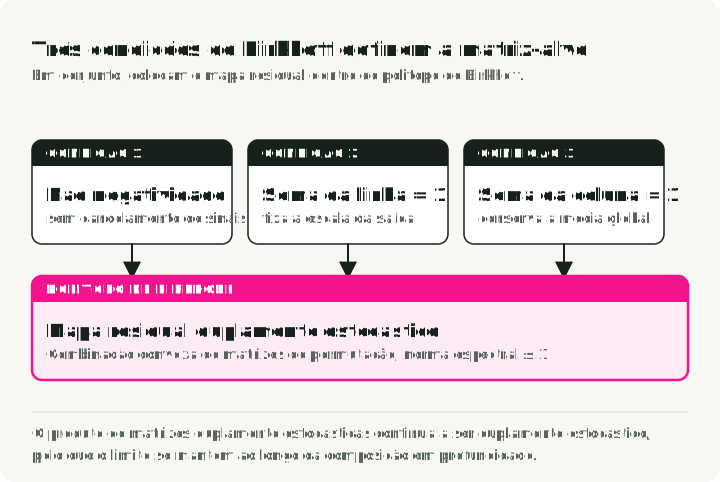
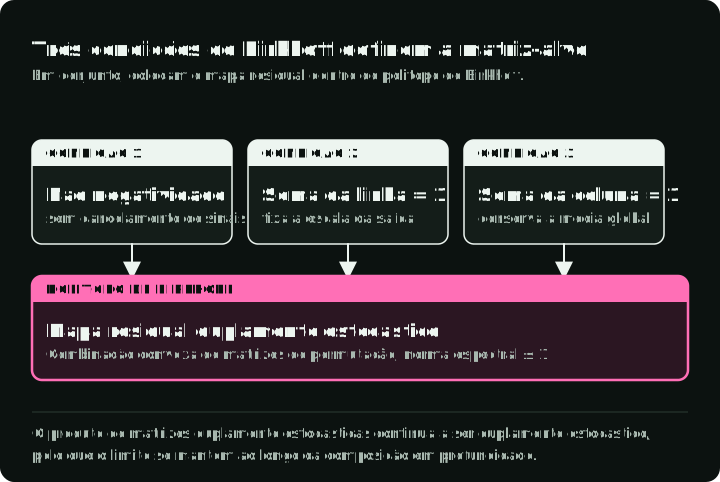
| Restrição | Consequência |
|---|---|
| Não negatividade | Os coeficientes de sinais opostos não se cancelam |
| Soma da linha = 1 | Um sinal constante entre streams mantém-se constante |
| Soma da coluna = 1 | A média global entre streams é conservada |
A não negatividade, juntamente com somas das linhas iguais a um, faz de cada saída uma combinação convexa dos streams de entrada. A restrição conserva a média entre streams, não o comprimento do vetor: um mapa duplamente estocástico pode aproximar os streams uns dos outros por média.
Seguem-se mais três propriedades (Secção 4.1):
- Norma espectral ≤ 1: a norma espectral é o maior fator pelo qual uma matriz pode esticar qualquer vetor. Um limite de um significa que o mapa de routing residual não pode amplificar a norma euclidiana.
- Fechada sob multiplicação: um produto de matrizes duplamente estocásticas continua duplamente estocástico, pelo que a restrição sobrevive à composição ao longo da profundidade.
- Mistura convexa: pelo teorema de Birkhoff-von Neumann, o mapa pertence ao invólucro convexo das matrizes de permutação.
Projeção de Sinkhorn-Knopp
Os logits residuais aprendíveis não têm restrições. A mHC começa por os exponenciar para obter uma matriz positiva e depois alterna a normalização de colunas e de linhas. Com iterações suficientes, este processo de Sinkhorn-Knopp aproxima-se de uma matriz duplamente estocástica; o artigo usa 20 iterações como uma projeção diferenciável prática e aproximada, e não como uma restrição exata.
A figura executa a primeira passagem do exemplo 3×3 abaixo passo a passo e depois traça o maior erro da soma das colunas ao longo de 20 passagens.
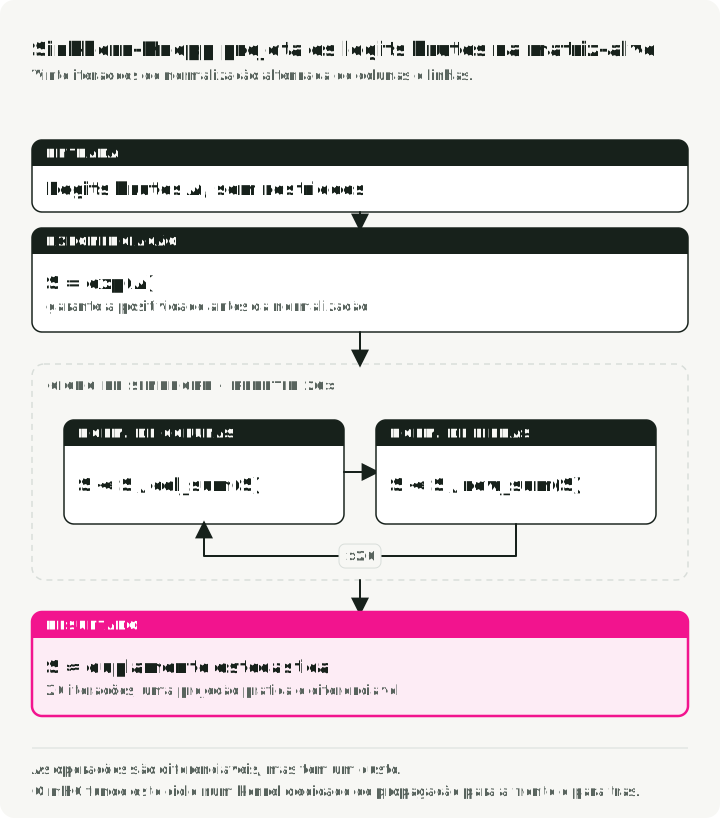
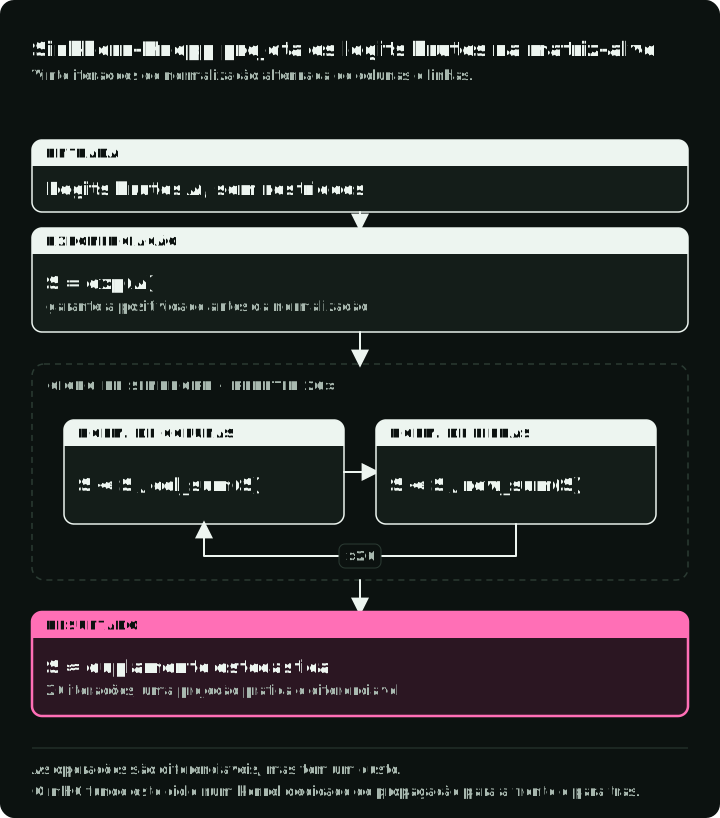
Para logits brutos , o procedimento é:
S = exp(A)
repeat 20 times:
    S = S / column_sum(S)
    S = S / row_sum(S)
return S
Um exemplo 3×3 mostra o que significa “aproximada”. Uma passagem fixa as somas das linhas, porque as linhas são normalizadas em último lugar, mas deixa as somas das colunas desviadas até 12%. Vinte passagens levam ambas a 1,000 com três casas decimais.
Raw logits A           [[-0.5,   2.1,   0.8  ],
                        [ 1.3,  -4.0,   1.9  ],
                        [ 0.1,   0.6,  -0.2  ]]

S = exp(A)             [[ 0.607, 8.166, 2.226],
                        [ 3.669, 0.018, 6.686],
                        [ 1.105, 1.822, 0.819]]

After 1 pass           [[ 0.097, 0.705, 0.198],
(columns, then rows)    [ 0.497, 0.001, 0.501],
                        [ 0.435, 0.386, 0.178]]
                       row sums     1.000 1.000 1.000
                       column sums  1.030 1.092 0.877

After 20 passes        [[ 0.102, 0.653, 0.244],
                        [ 0.457, 0.001, 0.542],
                        [ 0.441, 0.346, 0.213]]
                       row and column sums 1.000
O script seguinte testa a afirmação em que todo o método assenta. Multiplica 60 matrizes de mistura 4×4 aleatórias, uma vez usadas diretamente, como a HC as usaria, e outra depois do Sinkhorn, como a mHC faz, e imprime o ganho Amax de cada produto.
import numpy as np

rng = np.random.default_rng(0)
n, layers = 4, 60

def sinkhorn(logits, iters=20):
    s = np.exp(logits)
    for _ in range(iters):
        s = s / s.sum(axis=0, keepdims=True)  # columns sum to 1
        s = s / s.sum(axis=1, keepdims=True)  # rows sum to 1
    return s

def amax_gain(m):
    return max(np.abs(m).sum(axis=1).max(), np.abs(m).sum(axis=0).max())

hc, mhc = np.eye(n), np.eye(n)
for _ in range(layers):
    a = np.eye(n) + 0.3 * rng.standard_normal((n, n))
    hc = a @ hc
    mhc = sinkhorn(a) @ mhc

print(f"HC  Amax gain: {amax_gain(hc):.1f}")
print(f"mHC Amax gain: {amax_gain(mhc):.1f}")
Com a seed 0, imprime 1906,8 para a HC e 1,0 para a mHC. Cada matriz aleatória está próxima da identidade, pelo que nenhuma parece grande isoladamente. O artigo mede cerca de 1,6 para a mHC no seu modelo de 27B, e não 1,0. Usa apenas 20 iterações, pelo que as matrizes treinadas não são exatamente duplamente estocásticas, e os pequenos erros crescem ao longo das camadas, mas mantêm-se limitados (Secção 5.4).
As iterações de Sinkhorn são diferenciáveis, mas não são gratuitas. A mHC depende de um kernel forward fundido e de um kernel backward personalizado que recalcula os estados intermédios de normalização no chip.
Detalhes da parametrização
- Mapa residual: a exponenciação mais a normalização de Sinkhorn produz o aproximadamente duplamente estocástico.
- Mapas de leitura e de escrita: a mHC substitui a da HC por uma sigmoide: e . Ambos os mapas são não negativos, o que elimina o cancelamento entre coeficientes positivos e negativos (Secções 4.1 e 4.2). Os pesos de leitura ficam em (0, 1) e os de escrita em (0, 2). Um logit nulo dá um peso de escrita de , o peso que uma soma residual padrão usa. O artigo não indica a razão do fator 2.
Arquitetura mHC completa
A figura mostra uma camada mHC com a parametrização de cada mapa. Tem os mesmos dois caminhos que o bloco HC; o que muda é a forma como cada mapa é parametrizado.
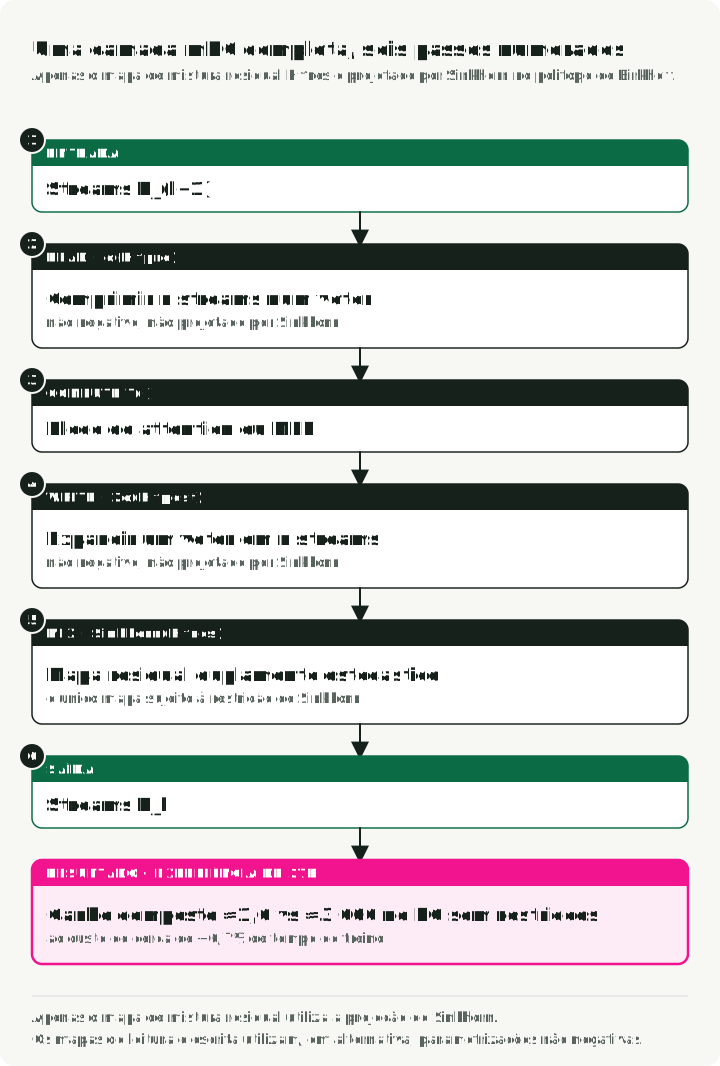
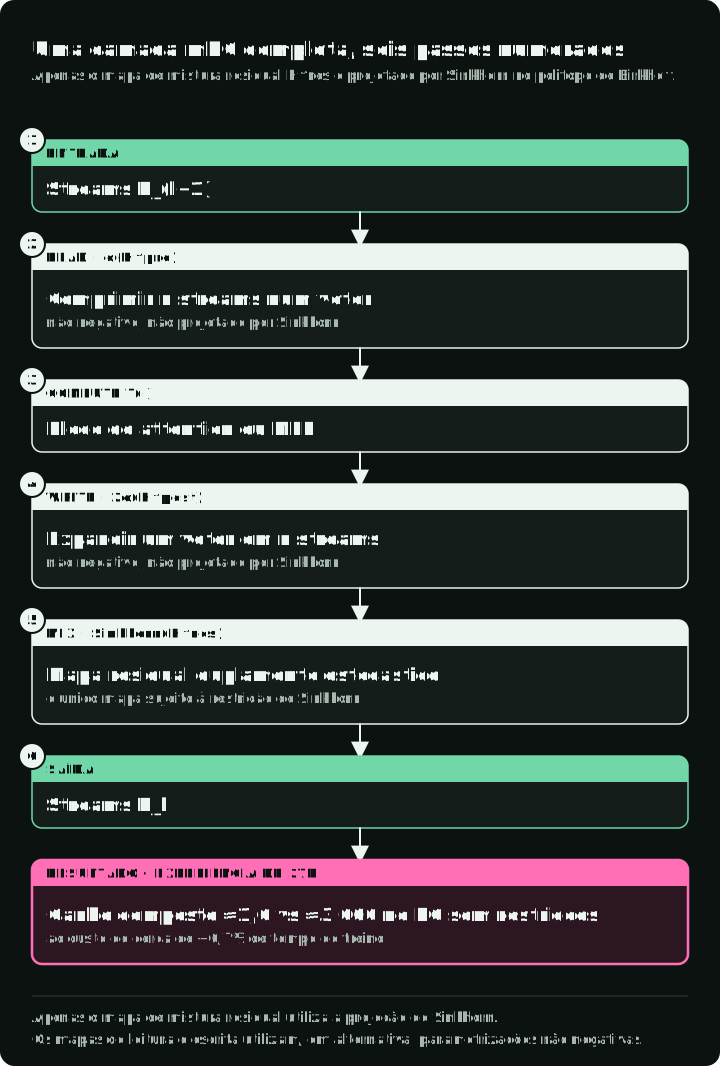
Em termos da equação de atualização:
- Entrada: streams residuais paralelos entram na camada.
- Caminho do bloco: o mapa de leitura combina os streams numa única entrada de dimensão . O bloco de atenção ou MLP processa-a. O mapa de escrita converte a saída em atualizações para os streams.
- Caminho residual: o aproximadamente duplamente estocástico mistura os streams de entrada.
- Soma: os dois caminhos são somados em , que passa para a camada seguinte.
Apenas o mapa de mistura residual usa a projeção de Sinkhorn. Os mapas de leitura e de escrita usam parametrizações não negativas. Esta distinção importa porque a garantia de composição do artigo se aplica ao .
Infraestrutura necessária para o overhead reportado
Quatro streams aumentam os acessos à memória do estado residual, o armazenamento de ativações e a comunicação entre estágios do pipeline. O resultado de tempo do artigo depende de três alterações desenhadas em conjunto, descritas a seguir.
Fusão de kernels
A implementação funde operações que partilham acesso à memória, usa precisão mista quando adequado e implementa a maioria dos kernels personalizados com TileLang. O ciclo de Sinkhorn e o respetivo passo backward personalizado correm em kernels dedicados, para reduzir o tráfego de memória e o overhead de lançamento.
Recomputação seletiva
Os streams aumentam a memória de ativações (Secção 4.3.2). Em vez de guardar todos os resultados intermédios, a mHC:
- Liberta as ativações intermédias dos seus próprios kernels depois do passo forward.
- Recalcula-as no passo backward, sem voltar a executar o bloco de atenção ou FFN.
- Guarda a entrada dos streams expandidos de cada grupo de camadas consecutivas e a saída de atenção ou FFN de cada camada. O artigo alinha estes grupos com os estágios do pipeline.
Um escalonamento DualPipe alargado sobrepõe partes da comunicação, da recomputação e do trabalho das camadas nas fronteiras do pipeline. A sobreposição alcançada é específica deste sistema de treino.
Resultado reportado ao nível do sistema
Para a configuração de grande escala do artigo, a taxa de expansão acrescenta 6,7% de tempo de treino face à sua referência (Secção 4.3). Este é um resultado ao nível do sistema, e não o overhead de uma implementação simples num framework.
O que as experiências estabelecem
Os autores treinam variantes MoE de 3B, 9B e 27B inspiradas na DeepSeek-V3 (Secção 5.3). A 27B, a mHC supera a referência residual padrão nos oito benchmarks a jusante reportados e supera a HC em sete de oito (Tabela 4). A HC é ligeiramente superior no MATH (26,4 contra 26,0). São experiências de pré-treino internas, feitas pela equipa que propõe o método, pelo que a replicação independente e as comparações noutras arquiteturas continuam em aberto.
Quando experimentar a mHC
Os resultados do artigo apontam para três condições:
- Faz o pré-treino de raiz. A mHC altera a arquitetura, e o artigo avalia-a apenas em pré-treino. Caso contrário, dispense a mHC.
- Precisa de mais largura residual do que um stream. Já usa a HC ou planeia usá-la, e vê picos de loss ou normas de ativações e de gradientes a crescer à medida que aumenta a profundidade ou o tamanho. Se um stream chega, mantenha o resíduo padrão.
- Consegue fazer o trabalho de sistemas, ou aceita um custo maior. O valor de 6,7% exige kernels fundidos e alterações ao escalonamento do pipeline. Uma implementação simples num framework custará mais. Se não puder fazer esse trabalho, uma mHC em código simples é possível, mas meça primeiro o overhead.
Mantêm-se três questões:
- Overhead do sistema: o overhead reportado é o resultado otimizado do artigo; outro runtime, outra topologia de dispositivos ou outra forma de modelo podem ter um custo diferente.
- Viés de mistura: a dupla estocasticidade preserva a média entre streams e impede a expansão através de , mas pode suavizar as diferenças entre streams. A atualização do bloco continua a alterar a representação global.
- Âmbito da evidência: a evidência mais forte é o pré-treino de modelos de linguagem em arquiteturas MoE inspiradas na DeepSeek-V3. A generalização a outras famílias de modelos não está estabelecida por este artigo.
A mHC é uma forma promissora de estudar uma topologia residual mais larga, mantendo bem condicionado o mapa residual repetido. Saber se compensa para outro modelo depende de ganhos de qualidade confirmados de forma independente e do custo de reproduzir a sua pilha de sistemas.
Referências
- mHC: Manifold-Constrained Hyper-Connections - Xie et al. (DeepSeek)
- Deep Residual Learning for Image Recognition - He et al. (ResNet)
- Hyper-Connections - Artigo original da HC
- TileLang - Framework de otimização de kernels CUDA
- DualPipe - Escalonador de paralelismo de pipeline para a DeepSeek-V3
- ResiDual - Arquitetura de caminho residual duplo