Data-Processing-Engines: Polars, DataFusion, Ray und Spark

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Dieser Leitfaden hilft Python- und Data-Engineers, eine Processing-Engine für tabellarische Daten sowie für Pipelines mit Bildern, Audio oder Text auszuwählen. Er erklärt, wie Polars, DataFusion, Daft, Ray Data und Spark Arbeit ausführen, für welche Workloads sie sich eignen und wie Sie sie mit Ihren eigenen Daten vergleichen.
Moderne Pipelines verarbeiten auch Bilder, Audio und Video. In solchen Workloads kann das Dekodieren auf der CPU die GPU-Inference ausbremsen. Native Operatoren, spaltenorientierter Datenaustausch und überlappende CPU/GPU-Arbeit adressieren unterschiedliche Kosten; bei der Wahl einer Engine geht es darum herauszufinden, welche Kosten Ihre Pipeline begrenzen.
Für den Vergleich habe ich Pandas, Polars, DataFusion, Daft und natives Rust auf zwei realen Datasets getestet: NYC-Taxifahrten stehen für tabellarische Arbeit, Food-101-Bilder für eine multimodale Pipeline. Spark und Ray behandle ich in separaten Notebooks für verteilte Verarbeitung.
Den Code enthält das engine-comparison-demo-Repository.
Arten von Data-Processing-Workloads
Engines sind spezialisiert, deshalb klären Sie zuerst, welche Art von Workload Sie haben. Die wichtigste Trennlinie verläuft zwischen strukturierten und multimodalen Daten. Das Diagramm zeigt, wie sich die Datenmenge in beiden verändert: Ein tabellarischer Job verkleinert sie mit jedem Schritt, ein multimodaler Job vergrößert sie.
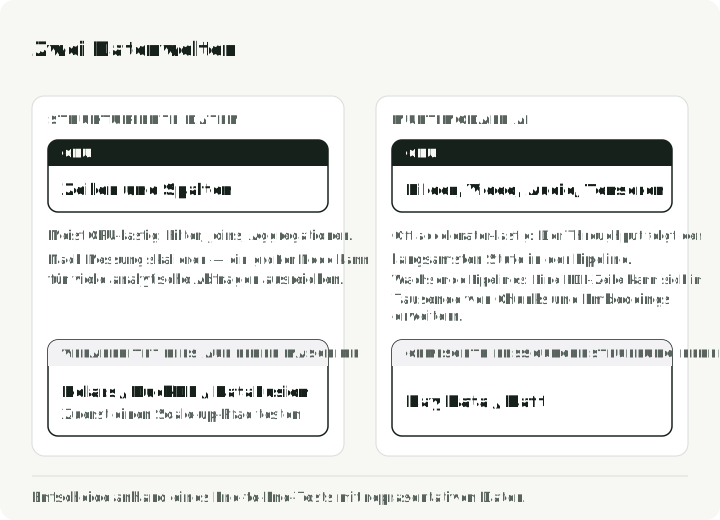
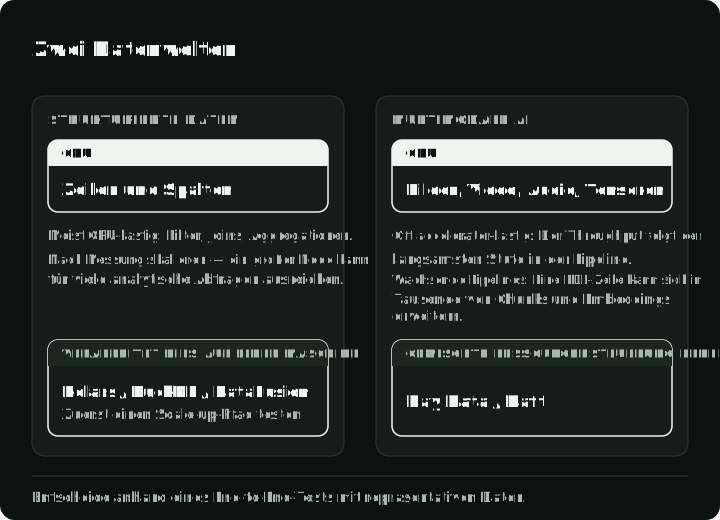
Strukturierte oder tabellarische Daten bedeuten Filtern, Aggregieren und Joins. Die Arbeit ist meist CPU-bound und passt oft in den Speicher. Viele solcher Queries laufen auf einer einzigen modernen Maschine, doch Speicher, I/O, Nebenläufigkeit, Wiederherstellung und die Form des Workloads entscheiden weiterhin, ob ein Cluster sinnvoll ist.
Multimodale AI verarbeitet Bilder, Audio oder Video. Die Inference kann auf einer GPU laufen, während CPU-Dekodierung, Remote-Reads oder Batching die Pipeline begrenzen. Welche Stufe den Throughput begrenzt, hängt vom Instanztyp und den Operatoren ab. Messen Sie deshalb die Auslastung über den gesamten Pfad, statt die GPU isoliert zu dimensionieren.
Die neueren Engines zielen auf unterschiedliche Teile dieses Feldes. Native Ausführung kann den Python-Overhead senken, Arrow-kompatible Schnittstellen können den Datenaustausch günstiger machen, und Streaming-Ausführung kann den Speicherbedarf bei Datasets begrenzen, die größer sind als der RAM. Keiner dieser Vorteile gilt automatisch für jeden Operator oder jede Konvertierung.
Teil 1: Verarbeitung auf einem Knoten
Pandas bevorzugt ein Eager-Programmiermodell: Es führt jede Operation sofort aus und hält die Daten meist im Speicher. Ein Lazy-Modell plant dagegen mehrere Operationen gemeinsam, bevor es sie ausführt. In Pandas erzeugen viele gängige Operationen Zwischentabellen, und die parallele Ausführung wird nicht über einen Query-Optimizer koordiniert. Dieser Kompromiss hält explorativen Code direkt, kann bei größeren analytischen Scans aber teuer werden.
Das Diagramm zeigt, was jedes Modell für die Taxi-Query weiter unten aus der Parquet-Datei liest: Der Eager-Pfad liest alle 19 Spalten, bevor er filtert, während der Lazy-Plan dem Optimizer erlaubt, den Filter und die 3 genutzten Spalten in den Scan vorzuziehen.
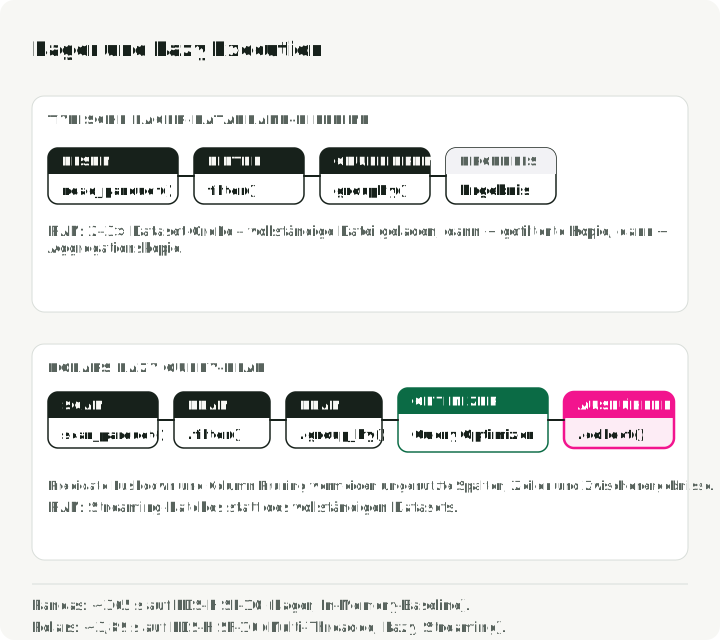
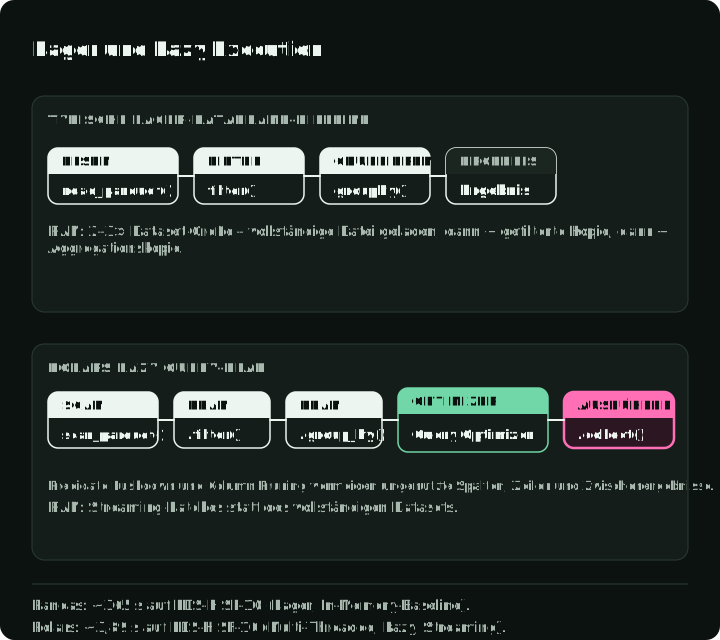
Im PDS-H-Benchmark von Polars vom Mai 2025 bei Scale Factor 10 brauchte Pandas für die Suite etwa 365 Sekunden, die Streaming-Engine von Polars 3,89 Sekunden. Das Ergebnis von rund 94x beschreibt diesen Benchmark und diese Konfiguration; es ist kein allgemeiner Umrechnungsfaktor von Pandas zu Polars.
Polars für lokale tabellarische Pipelines
Polars ist ein pragmatischer Standard, wenn eine lokale DataFrame-Pipeline der Eager-Ausführung in einem einzelnen Prozess entwachsen ist. Die Lazy-API baut vor der Ausführung einen Query-Plan auf. So kann Polars Zeilen so früh wie möglich filtern (Predicate Pushdown) und nur die benötigten Spalten lesen (Projection Pruning). Die Engine kann Operatoren dann parallel und, wo unterstützt, in Streaming-Batches ausführen.
Bei Scale Factor 100 (~100 GB CSV) war die Streaming-Engine von Polars auf derselben Maschine etwa 6x schneller als die In-Memory-Engine. Die Quelle führt diesen Abstand hauptsächlich auf weniger CPU-Cache-Misses und bessere Kernauslastung zurück; das ist kein Beleg für Eingaben, die größer sind als der RAM.
Die folgende Query liest Taxifahrten aus Parquet, wählt Fahrten über fünf Meilen mit einem Gesamtbetrag über $30 aus und berechnet Anzahl und Durchschnittswerte je Zahlungsart. Das begleitende engine_comparison_examples.ipynb enthält verwandte API- und Setup-Beispiele; tabular.py lädt die Taxidaten herunter und führt den unten beschriebenen Messlauf aus:
import polars as pl

# Build a lazy scan; query execution happens at collect()
q = (
    pl.scan_parquet("yellow_tripdata_2024-01.parquet")
    .filter(
        (pl.col("trip_distance") > 5.0)
        & (pl.col("total_amount") > 30.0)
    )
    .group_by("payment_type")
    .agg(
        pl.col("total_amount").mean().alias("avg_fare"),
        pl.col("trip_distance").mean().alias("avg_distance"),
        pl.len().alias("trip_count"),
    )
)

# The entire plan is optimized and executed here, in parallel
result = q.collect(engine="streaming")
Der entscheidende Unterschied ist das Ausführungsmodell. In der Lazy-Query oben kann Polars Filter und Spaltenauswahl in den Parquet-Scan vorziehen. Das kann Row Groups überspringen und das Lesen ungenutzter Spalten vermeiden. Streaming ist hier explizit gewählt; collect materialisiert das Endergebnis trotzdem, und nicht unterstützte Operationen können auf In-Memory-Ausführung zurückfallen. Eine typische Eager-Pandas-Pipeline hat keinen Plan für die ganze Query, den sie optimieren könnte, auch wenn sorgfältig eingesetzte Parquet-Filter, gezielt gewählte Spalten und alternative Backends einen Teil des Abstands wettmachen können.
DataFusion für eingebettete Query-Engines
Polars ist eine Bibliothek, die Sie direkt benutzen; DataFusion ist die Engine, auf der Sie andere Engines aufbauen. Sie treibt InfluxDB 3.0, GreptimeDB und Apache DataFusion Comet an, einen Spark-Beschleuniger, der zuerst bei Apple entstand.
In einem vom DataFusion-Projekt veröffentlichten ClickBench-Lauf vom November 2024 lag DataFusion bei den getesteten Single-Node-Parquet-Konfigurationen vorn. Das Embucket-Team veröffentlichte später einen TPC-H-Lauf mit Scale Factor 1000 auf einem großen Knoten, wobei zwei Queries umgeschrieben wurden, damit sie fertig werden. Diese Ergebnisse zeigen, was Scale-up unter bestimmten Bedingungen leisten kann; sie beweisen nicht, dass jeder 1-TB-Workload ohne Cluster auskommen sollte.
Hier ist dieselbe Taxi-Auswertung in DataFusion-SQL, mit nach Fahrtenanzahl sortierten Zahlungsarten. Das begleitende engine_comparison_examples.ipynb enthält verwandte SQL- und Setup-Beispiele:
from datafusion import SessionContext

ctx = SessionContext()
ctx.register_parquet("taxi", "yellow_tripdata_2024-01.parquet")

# Plan SQL against the registered Parquet source
df = ctx.sql("""
    SELECT payment_type,
           COUNT(*)           AS trip_count,
           AVG(trip_distance) AS avg_distance,
           AVG(total_amount)  AS avg_fare
    FROM taxi
    WHERE trip_distance > 5.0 AND total_amount > 30.0
    GROUP BY payment_type
    ORDER BY trip_count DESC
""")
result = df.to_pandas()
Die Stärke von DataFusion ist seine Modularität. Die Erweiterungs-APIs decken eigene Kataloge, Table Provider, Optimizer-Regeln und Ausführungspläne ab. Deshalb taucht DataFusion immer dort auf, wo jemand eine eigene Datenplattform baut oder eine Query-Engine in sein Produkt einbettet.
Wenn Ihr Team SQL über lokale Parquet-Dateien schreibt und die Engine nicht einbetten muss, ist DuckDB eine In-Process-SQL-Datenbank, die dieselbe Rolle wie Polars erfüllt.
Daft für multimodale Daten
Daft macht Bilder, Audio, Video und Embeddings zum Teil des DataFrame-Workflows. Es bietet native Ausdrücke für Operationen wie Bilddekodierung und URL-Downloads, sodass gängige Preprocessing-Pfade keine zeilenweise Python-Schleife brauchen. Diese Integration ist der Hauptgrund, Daft einer allgemeinen Tabellen-Engine vorzuziehen.
Für tabellarische Arbeit sieht die API von Daft aus wie die der obigen Engines. Dieses Beispiel führt dieselbe Taxi-Auswertung aus; das begleitende engine_comparison_examples.ipynb enthält verwandte Daft-API- und Setup-Beispiele:
import daft

df = daft.read_parquet("yellow_tripdata_2024-01.parquet")

result = (
    df.where(
        (daft.col("trip_distance") > 5.0)
        & (daft.col("total_amount") > 30.0)
    )
    .groupby("payment_type")
    .agg(
        daft.col("total_amount").mean().alias("avg_fare"),
        daft.col("trip_distance").mean().alias("avg_distance"),
        daft.col("trip_distance").count().alias("trip_count"),
    )
    .collect()
)
Die API wirkt vertraut, wenn Sie Pandas kennen, doch die Engine ist derselbe Rust-+-Arrow-Stack wie in Polars und DataFusion. Daft zahlt sich aus, wenn die „Zeilen“ Ihres DataFrames Bilder, PDFs oder Tensoren sind.
Daft liest, dekodiert und skaliert Bilder mit nativen Ausdrücken, ohne Python-Schleife über die Zeilen. Das ist der Bildpfad aus multimodal.py:
import daft
from daft import col

df = (
    daft.from_glob_path("food101_images/*.jpg")
    .with_column("image", col("path").download().decode_image(mode="RGB"))
    .with_column("resized", col("image").resize(224, 224))
)
df.collect()
Benchmark auf einem Knoten
Ich habe Pandas, Polars, DataFusion und Daft sowie natives Rust über Polars-rs auf ~41 Mio. NYC-Yellow-Taxi-Fahrten des gesamten Jahres 2024 ausgeführt. Der gemessene Job filtert Fahrten mit einem Fahrpreis über $10, joint die Taxi-Zonen-Tabelle, summiert den Umsatz je Stadtbezirk und Zone und gibt die obersten 20 Zeilen zurück. Es ist eine andere Query als in den Beispielen oben. Spark und Ray erscheinen in den verteilten Beispielen, nicht in diesem Benchmark auf einem Knoten.
Jede Engine liest die Dateien innerhalb der gemessenen Funktion; das Skript meldet den Median aus drei Läufen. Sein Ergebnisprüfer vergleicht die 20 Zeilen der Python-Engines nach Stadtbezirk, Zone, Fahrtenanzahl und auf Cent gerundetem Umsatz; avg_tip wird nicht verglichen. Pandas bekommt die vier Fahrtspalten, die die Query nutzt, weil es keinen Optimizer hat, der sie findet. Das Diagramm zeigt das Ergebnis auf einem Apple M5 Max mit 18 Kernen und 64 GB RAM. Alle Ergebnisse stehen im Demo-Repo:
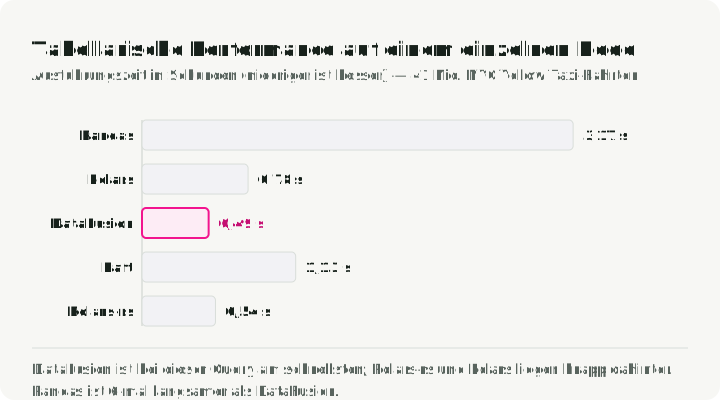
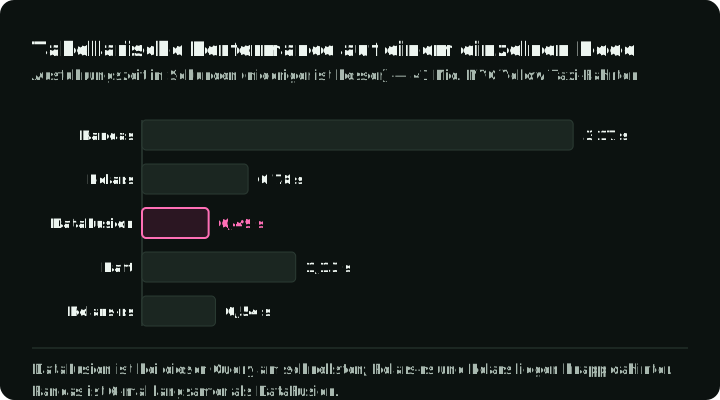
Pandas brauchte 4,67 Sekunden. Die vier neueren Engines schafften es in 0,40 bis 0,74 Sekunden, DataFusion am schnellsten und Polars etwa 7x schneller als Pandas. Die 94x von Polars gegenüber Pandas oben stammen aus PDS-H; dieser Job zeigte einen kleineren Abstand. Auch die Zeiten schwankten zwischen Aufrufen: Über vier Läufe des Skripts auf einer Maschine, die nebenher andere Arbeit erledigte, lag Pandas zwischen 2,6 und 4,8 Sekunden. DataFusion war jedes Mal die schnellste Python-Engine, Polars und Daft tauschten die Plätze. Wenn Engines so dicht beieinanderliegen, sollten API-Passung und wiederholte Messungen auf repräsentativen Daten die Entscheidung tragen.
Teil 2: multimodale Daten
Tabellarisches ETL verkleinert Daten meist: filtern, aggregieren, weniger schreiben als lesen. Multimodale AI-Pipelines machen das Gegenteil. Ein einzelner Dokumentpfad kann sich in Dutzende Text-Chunks und Embedding-Vektoren auffächern.
In einer herkömmlichen PySpark-Pipeline gelangen Bilder und Audio oft als Binärdaten hinein und wandern zum Dekodieren oder Transformieren in Python-Bibliotheken. Das Überqueren der JVM/Python-Grenze und das Serialisieren der Ergebnisse kann einen großen Teil der Laufzeit ausmachen. Spark kann Arrow-basierte Pfade, vektorisierte UDFs und Beschleuniger-Integrationen nutzen, doch diese Entscheidungen brauchen ein bewusstes Design und Messungen.
Pipelined Execution und GPU-Auslastung
Spark plant Arbeit in Stages, die durch Shuffle-Grenzen getrennt sind. Eine geradlinige Implementierung kann Download, Dekodierung und Inference so hintereinanderlegen, dass entweder CPU- oder GPU-Kapazität wartet. Spark unterstützt GPU-Ressourcenplanung und Plugins, Leerlauf ist also nicht unvermeidlich. Damit die Stages ausgelastet bleiben, braucht es außerdem Backpressure: frühere Stages bremsen, wenn spätere nicht mithalten. Weder diese Steuerung noch das Überlappen von CPU- und GPU-Arbeit passiert in einem gewöhnlichen PySpark-DataFrame-Job automatisch.
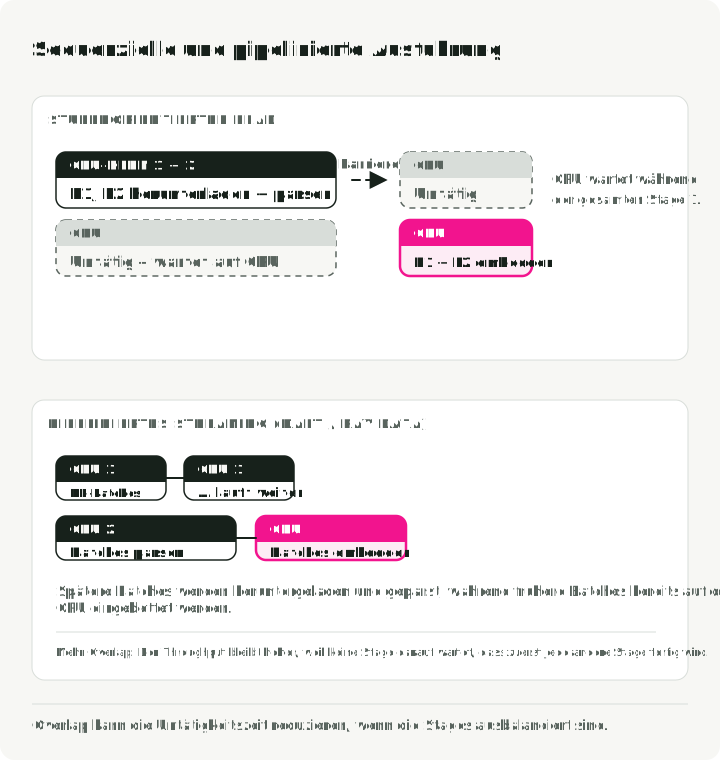
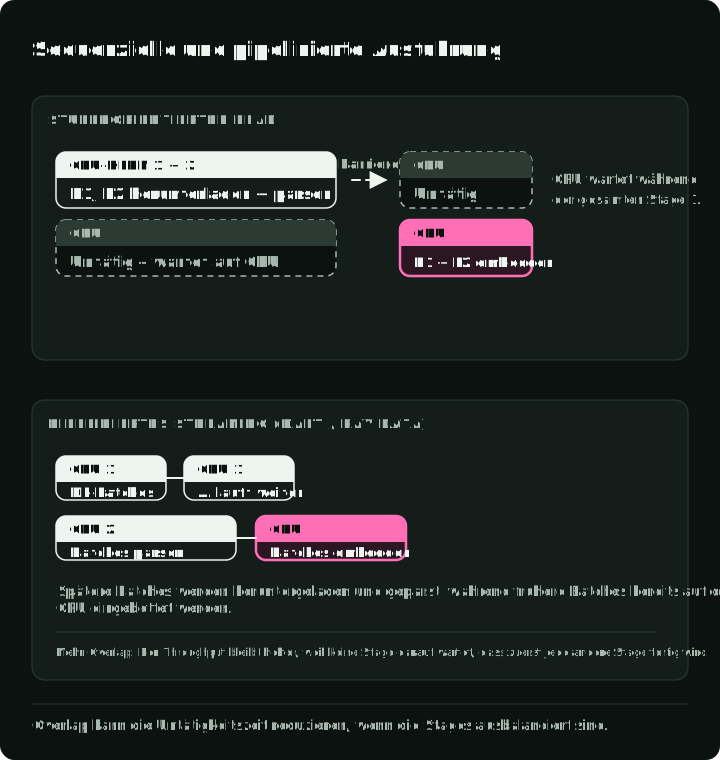
Pipelined Execution ist die Alternative. Statt Stages nacheinander auszuführen, überlappt die Engine I/O, CPU-Arbeit und GPU-Inference. Wenn Stages und Puffer ausbalanciert sind, kann diese Überlappung Leerlauf verringern und den Throughput erhöhen; Anlauf und Auslauf, Backpressure oder eine langsamere Stage können trotzdem Ressourcen warten lassen.
Das Diagramm zeigt zwei Batches, die drei Stages durchlaufen. Nacheinander ausgeführt brauchen sie sechs Schritte. Pipelined wird Batch 2 gelesen und dekodiert, während Batch 1 noch läuft, und dieselbe Arbeit dauert vier Schritte.
Benchmark zur Bildverarbeitung
Ich habe die Bildverarbeitung an 500 echten Fotos aus dem Food-101-Dataset getestet. Jede Engine liest dieselben 500 JPEGs, dekodiert sie nach RGB und skaliert sie innerhalb der gemessenen Funktion mit einem bilinearen Filter auf 224×224. Das Skript prüft, dass jede Engine 500 Bilder erzeugt hat, und meldet den Median aus drei Läufen. Das Diagramm zeigt das Ergebnis auf derselben Maschine:
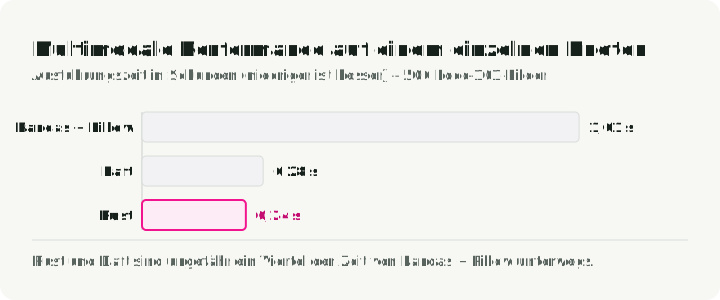
Polars und DataFusion fehlen, weil sie keine nativen Bildoperationen haben. Die aufgezeichneten Python-Ergebnisse und Rust-Ergebnisse zeigen 0,55 Sekunden für Pandas + Pillow, 0,34 für Daft und 0,10 für das Rust-Crate image. Pandas verarbeitet über apply() ein Bild nach dem anderen; Daft und die Rust-Version verteilen die Arbeit auf mehrere Kerne. Über vier Aufrufe lag Pandas zwischen 0,55 und 1,21 Sekunden. Fünfhundert Bilder sind zu wenig, um den Produktions-Throughput vorherzusagen, und der Job endet vor jeder GPU-Arbeit; messen Sie daher Ihre eigene Pipeline Ende zu Ende.
Teil 3: verteilte Verarbeitung
Wenn eine einzelne Maschine nicht mehr reicht, müssen Sie entscheiden, wie Sie die Arbeit verteilen. Dask verteilt bestehenden Pandas- und NumPy-Code mit wenigen API-Änderungen auf Kerne oder einen Cluster; es passt zu Python-Teams, die weder eine JVM noch eine neue DataFrame-API wollen. Der Rest dieses Teils behandelt Spark, Ray Data und Daft.
Apache Spark
Spark ist eine ausgereifte Option für große tabellarische ETL-Jobs, Shuffle-lastige Joins und Organisationen, die sein Ökosystem bereits betreiben. Die Lineage-basierte Wiederherstellung und die breite Plattformunterstützung zählen, wenn Zuverlässigkeit und betriebliche Vertrautheit schwerer wiegen als lokale Geschwindigkeit. Gemischte CPU/GPU-Pipelines erfordern mehr bewusste Ressourcenkonfiguration und Pipeline-Design als der SQL-Pfad; hier bieten Ray Data und Daft eine fokussiertere Abstraktion.
Diese Spark-Query joint längere Taxifahrten mit Informationen zur Abholzone und fasst dann den Gesamtumsatz und die durchschnittlichen Fahrpreise je Stadtbezirk zusammen. Zum Aufsetzen von Cluster-ETL siehe distributed_spark.ipynb oder spark_etl.py:
from pyspark.sql import SparkSession
from pyspark.sql import functions as F

spark = SparkSession.builder \
    .appName("TaxiETL") \
    .config("spark.sql.adaptive.enabled", "true") \
    .getOrCreate()

orders = spark.read.parquet("s3a://lake/taxi/*.parquet")
zones = spark.read.csv("s3a://lake/taxi_zones.csv", header=True)

# Spark excels at this: joining massive tables with a shuffle
result = (
    orders
    .filter(F.col("trip_distance") > 5.0)
    .join(zones, orders.PULocationID == zones.LocationID, "inner")
    .groupBy("Borough")
    .agg(
        F.sum("total_amount").alias("total_revenue"),
        F.avg("total_amount").alias("avg_fare"),
    )
    .orderBy(F.desc("total_revenue"))
)

# Spark is lazy: the write runs the query
result.write.mode("overwrite").parquet("s3a://warehouse/report/")
Ray Data für heterogenes Compute
Ray Data wurde rund um AI-Workloads entworfen. Statt Sparks Stage-Barrieren nutzt es ein Streaming-Modell, das Batches an GPU-Worker sendet, während spätere Batches noch gelesen werden. Ein Ray-Actor ist ein persistenter Worker, der ein Modell zwischen Batches geladen halten kann. Das wichtigste Feature für AI-Pipelines ist die Planung gemischter Ressourcen: Sie können festlegen, dass ein Actor „1 GPU, 4 CPUs“ braucht und ein anderer nur CPUs, und Ray platziert jeden Actor auf einem Knoten mit diesen Ressourcen.
Amazon berichtete von 82 % besserer Kosteneffizienz pro GiB S3-Eingabe, nachdem ausgewählte interne Workloads von Spark auf Ray umgezogen waren. Der Maßstab ist bemerkenswert, doch es ist eine Migrationsfallstudie für bestimmte Workloads und keine zu erwartende Ersparnis für eine typische Ray-Einführung.
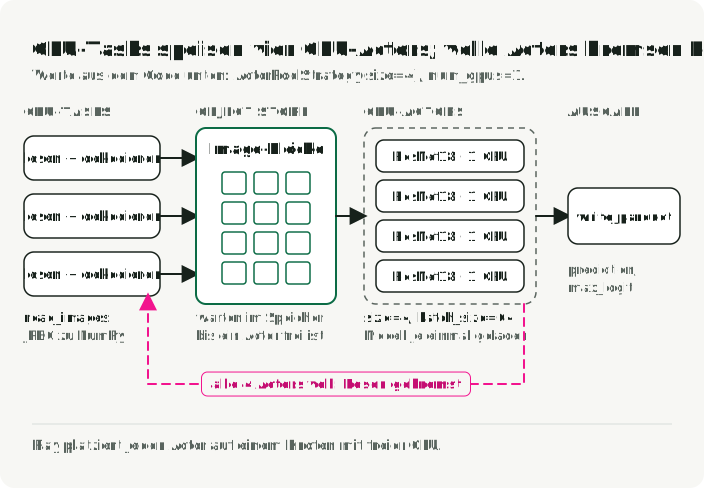
Das folgende Beispiel liest Bilder, klassifiziert sie mit ResNet18 auf GPU-Workern und schreibt die Vorhersagen nach Parquet. Das Diagramm zeigt die Pipeline, die es aufbaut: CPU-Tasks lesen und dekodieren Bilder in den Object Store von Ray, ein Pool aus vier GPU-Actors führt das Modell aus, und Backpressure bremst das Lesen, wenn die GPU-Actors voll sind.
Zum Setup der Bild-Inference siehe distributed_ray.ipynb oder ray_inference.py:
import ray

ray.init()

ds = ray.data.read_images("s3://my-bucket/food101/", mode="RGB")

class ImageClassifier:
    def __init__(self):
        import torch
        from torchvision.models import resnet18, ResNet18_Weights
        self.model = resnet18(weights=ResNet18_Weights.DEFAULT).cuda()
        self.model.eval()
        self.preprocess = ResNet18_Weights.DEFAULT.transforms()

    def __call__(self, batch):
        import torch
        from PIL import Image
        tensors = torch.stack([
            self.preprocess(Image.fromarray(img)) for img in batch["image"]
        ]).cuda()
        with torch.no_grad():
            preds = self.model(tensors)
        return {
            "prediction": preds.argmax(dim=1).cpu().numpy(),
            "max_logit": preds.max(dim=1).values.cpu().numpy(),
        }

# ActorPoolStrategy creates persistent GPU workers
predictions = ds.map_batches(
    ImageClassifier,
    compute=ray.data.ActorPoolStrategy(size=4),
    num_gpus=1,
    batch_size=64,
)
predictions.write_parquet("s3://output/predictions/")
Diese Skizze reserviert vier Ein-GPU-Actors und setzt vier verfügbare CUDA-GPUs, Torchvision-Gewichte und S3-Zugriff voraus. Ray liest Bilder als NumPy-Arrays; die Umwandlung der RGB-Arrays in PIL gibt der ResNet18-Preprocessing-Transformation eine akzeptierte Eingabe. max_logit ist der größte rohe Modellscore, keine Konfidenzwahrscheinlichkeit.
In den Benchmarks von Anyscale lief die Bildklassifikation von Ray Data etwa 4x schneller (456 statt 111 Sekunden), als die Instanz von 4 CPUs pro GPU auf 32 CPUs pro GPU wechselte. Anyscale führt die Verbesserung auf geringere Wartezeiten durch fehlende CPU-Kapazität zurück; die GPU-Auslastung blieb absolut betrachtet niedrig. Daft verbesserte sich von 4 auf 16 CPUs pro GPU und blieb dann bei 16 und 32 nahe 195 Sekunden.
Verteiltes Daft
Daft skaliert über seine Flotilla-Engine aus: ein Swordfish-Worker pro Knoten, darüber Flotilla für die clusterweite Planung. Swordfish übernimmt die lokale Rust-Ausführung und verzahnt I/O und Compute durch Streaming in kleinen Batches, sodass jeder Knoten ausgelastet bleibt, ohne auf die nächste Stage zu warten.
In von Daft veröffentlichten Benchmarks lief Flotilla bei vier multimodalen Workloads 4–18x schneller als die getesteten Spark-Implementierungen. Der größte Abstand trat bei einem Fall zur Objekterkennung in Videos auf. Werten Sie das Ergebnis als Beleg dafür, dass das Ausführungsdesign den Throughput bei solchen Pipelines um so viel verändern kann, und vergleichen Sie es dann mit den konkurrierenden Anyscale-Ergebnissen unten und mit einem lokalen Test.
Anyscale, das Unternehmen hinter Ray, veröffentlichte einen konkurrierenden Benchmark, in dem Ray Data den Abstand auf CPU-starken Instanzen nach dem Tuning verringerte oder umkehrte. Zusammen sind die beiden Herstellerstudien ein Grund, repräsentative Operatoren und CPU-zu-GPU-Verhältnisse zu testen, und keine Grundlage für eine dauerhafte Rangliste.
Das nächste Beispiel nutzt Dafts Ray Runner; es reproduziert nicht den obigen Flotilla-Benchmark. Es liest eine Tabelle mit Bild-URLs, lädt die Bilder herunter, erzeugt mit CLIP auf GPU-Workern Embeddings und schreibt die Vektoren nach Parquet. Es passt daft_pipeline.py für Ray-GPU-Worker an. In der im Begleitprojekt festgelegten Transformers-5.0.0-API stehen die projizierten Bildmerkmale in .pooler_output. Das zugehörige Notebook ist distributed_daft.ipynb:
import io

import daft
import numpy as np
from daft import col

# Connect to an existing Ray cluster before building the query
daft.set_runner_ray(address="auto")

# Define a GPU class UDF: the model loads once per instance
@daft.cls(gpus=1)
class ImageEmbedder:
    def __init__(self):
        import torch
        from transformers import CLIPModel, CLIPProcessor

        self.device = "cuda" if torch.cuda.is_available() else "cpu"
        self.model = CLIPModel.from_pretrained(
            "openai/clip-vit-base-patch32"
        ).to(self.device)
        self.processor = CLIPProcessor.from_pretrained(
            "openai/clip-vit-base-patch32"
        )
        self.model.eval()

    @daft.method.batch(
        return_dtype=daft.DataType.fixed_size_list(daft.DataType.float32(), 512)
    )
    def __call__(self, image_bytes_col):
        import torch
        from PIL import Image

        embeddings = []
        for img_bytes in image_bytes_col.to_pylist():
            img = Image.open(io.BytesIO(img_bytes)).convert("RGB")
            inputs = self.processor(images=img, return_tensors="pt").to(self.device)
            with torch.no_grad():
                features = self.model.get_image_features(**inputs).pooler_output
            embeddings.append(features[0].cpu().numpy())
        return np.array(embeddings, dtype=np.float32)

embedder = ImageEmbedder()

df = (
    daft.read_parquet("s3://bucket/image_metadata.parquet")
    # Native Rust I/O downloads the images; no Python requests loop
    .with_column("image_bytes", col("image_url").download())
    .with_column("embedding", embedder(col("image_bytes")))
    .exclude("image_bytes")
)
df.write_parquet("s3://bucket/embeddings/")
Dafts Ray Runner verbindet sich mit einem bestehenden Cluster; der standardmäßige native Runner nutzt die lokale Maschine. Installieren Sie Daft mit Ray-Unterstützung und stellen Sie auf diesem Cluster GPU-Worker, Transformers 5.0.0, die CLIP-Gewichte und S3-Zugangsdaten bereit. Die Klassen- und Batch-Methoden-API behält das Modell zwischen Batches, und gpus=1 fordert beim Runner eine GPU pro Instanz an; die verlinkte Repository-Revision nutzt schlichtes @daft.cls und eine Partition, weil sie auf eine einzelne lokale GPU zielt. Downloads können sich mit der GPU-Inference überlappen, abhängig von Partitionierung und Backpressure.
Diese Revision des Begleitprojekts ersetzt fehlende Bilder oder jeden Verarbeitungsfehler, einschließlich einer fehlgeschlagenen Prüfung der Embedding-Form, durch einen Nullvektor. Sie indiziert das CLIP-Ausgabeobjekt, ohne .pooler_output auszuwählen, sodass diese Prüfung unter Transformers 5.0.0 fehlschlägt und auch gültige Bilder zu Nullvektoren werden können. Verwenden Sie die hier gezeigte Extraktion der projizierten Merkmale; diese Skizze lässt den Job bei Verarbeitungsfehlern fehlschlagen.
Vergleich der verteilten Engines
| Merkmal | Spark | Ray Data | Daft (Flotilla) |
|---|---|---|---|
| Ausführungsmodell | Ein Task pro Kern, Partitionen | Streaming-Tasks und Actors | Ein Swordfish pro Knoten, Streaming-Batches |
| Stärken | Massives SQL/ETL, Fehlertoleranz | Heterogenes Compute, GPU-Sättigung | Multimodales Pipelining, begrenzter Speicher |
| GPU-Steuerung | Ressourcenplanung plus Ökosystem-Plugins | Explizite Task- und Actor-Ressourcen | Integrierte CPU/GPU-Pipeline-Planung |
| Typisches Tuning | Executors, Speicher, Partitionen, Beschleuniger | Batches, Actors, Object Store | Batches, Ressourcen, I/O-Nebenläufigkeit |
| Guter Testfall | Großes SQL/ETL und Shuffle-lastige Jobs | Training oder Inference mit gemischten Ressourcen | Multimodale Ingestion und Transformation |
Teil 4: die Rolle von Rust und Arrow
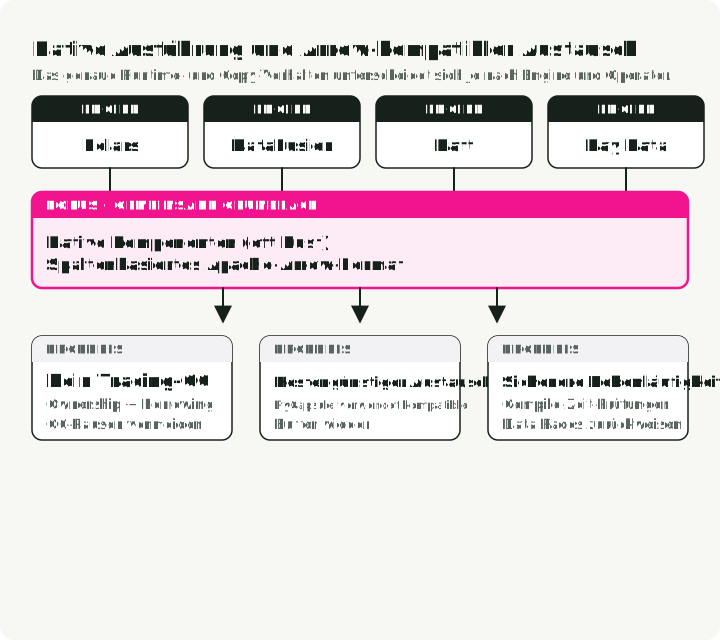
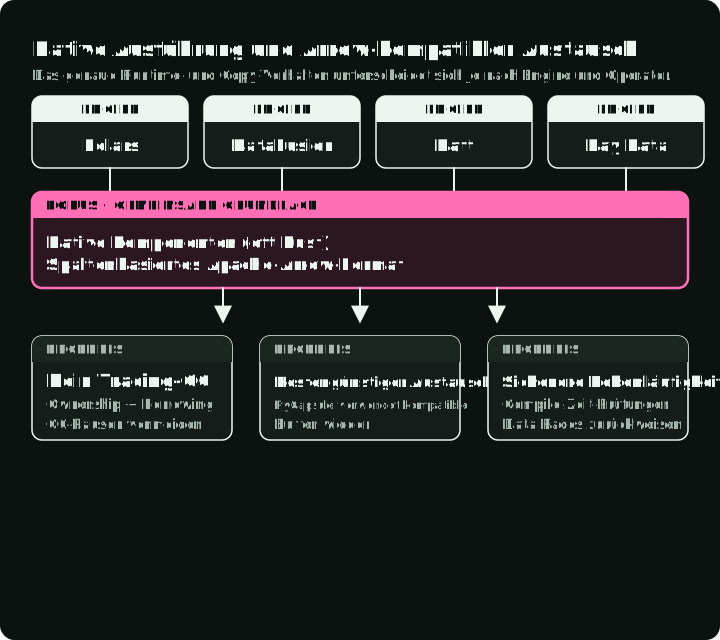
Polars, Daft und DataFusion nutzen Rust ausgiebig, während Ray neben seinen Python-APIs native Komponenten enthält. Alle können Daten über Teile des Apache-Arrow-Ökosystems austauschen.
Das Arrow PyCapsule Interface (Protokoll __arrow_c_stream__) gibt kompatiblen Bibliotheken einen Standardweg, Arrow-Streams auszutauschen. Übertragungen können zeilenweise Serialisierung vermeiden und Puffer wiederverwenden, wenn Schemas und Speicherlayouts kompatibel sind. Materialisierung, Rechunking, Typkonvertierung oder Geräteübertragung können Daten dennoch kopieren; prüfen Sie die Übergabe daher mit Profiling, statt anzunehmen, dass sie kostenlos ist.
Das nächste Beispiel zeigt eine Arrow-Übergabe: DataFusion zählt Käufe für Nutzer mit mehr als fünf Käufen, und Polars vergibt Ränge für diese Zählungen. Das Diagramm verwendet Polars 1.37.1, die vom Begleitprojekt festgelegte Version: rechunk=False behält kompatible Puffer, während der Standardwert rechunk=True mehrere Batches in einen Chunk pro Spalte kopiert. Standardwerte können in anderen Versionen abweichen. Das Beispiel setzt voraus, dass events.parquet bereits existiert. Das begleitende engine_comparison_examples.ipynb erzeugt in seinen Setup-Zellen vor dem Arrow-Beispiel eine synthetische .data/events.parquet.
from datafusion import SessionContext
import polars as pl

# Compute in DataFusion (Rust-native execution)
ctx = SessionContext()
ctx.register_parquet("events", "events.parquet")
df = ctx.sql("""
    SELECT user_id, COUNT(*) as event_count
    FROM events WHERE event_type = 'purchase'
    GROUP BY user_id HAVING COUNT(*) > 5
""")

# Convert through Arrow; compatible buffers may be reused
arrow_table = df.to_arrow_table()
df_polars = pl.from_arrow(arrow_table)

# Continue analysis in Polars
result = df_polars.with_columns(
    pl.col("event_count").rank().alias("rank")
).sort("rank")Daft kann einen DataFrame außerdem mit df.to_torch_iter_dataset() an PyTorch übergeben, was den letzten Schritt einer multimodalen Training-Pipeline abdeckt.
Warum nutzen diese neueren Engines Rust für die native Ausführung?
-
Kein Tracing Garbage Collector in Rust-Code. Ownership gibt nativen Operatoren direktere Kontrolle über Allokation und Freigabe. Das kann GC-bedingte Latency senken, verhindert aber weder Speicherdruck noch Out-of-Memory-Fehler.
-
Kompakte native Repräsentationen. Rust-Strukturen tragen keine Java-Objekt-Header. Der praktische Nutzen hängt vom Layout der Engine ab: Spaltenorientierte JVM-Systeme stellen ebenfalls nicht jeden Wert als einzelnes Objekt dar.
-
Stärkere Nebenläufigkeitsprüfungen. Safe Rust schließt viele Data Races schon zur Kompilierzeit aus. Engine-Code kann trotzdem unsafe-Blöcke und logische Nebenläufigkeitsfehler enthalten.
Zusammen mit dem spaltenorientierten Speicherlayout von Arrow können diese Entscheidungen den Overhead für Allokation und Serialisierung senken. Sie beseitigen ihn nicht an jeder Grenze; Python-Objekte, Netzwerktransport, inkompatible Schemas und Geräteübertragungen spielen weiterhin eine Rolle.
Teil 5: mehrere Engines einführen
Sie müssen nicht die ganze Plattform durch eine einzige Engine zwängen. Komposition lohnt sich, wenn die Übergabe zwischen Engines weniger kostet, als ein System alle Workloads bewältigen zu lassen. Das Diagramm zeigt eine solche Staffel: Die Engines treffen sich an Parquet-Dateien, und jedes Schreiben oder Lesen über diese Grenze kostet I/O und Konvertierung.
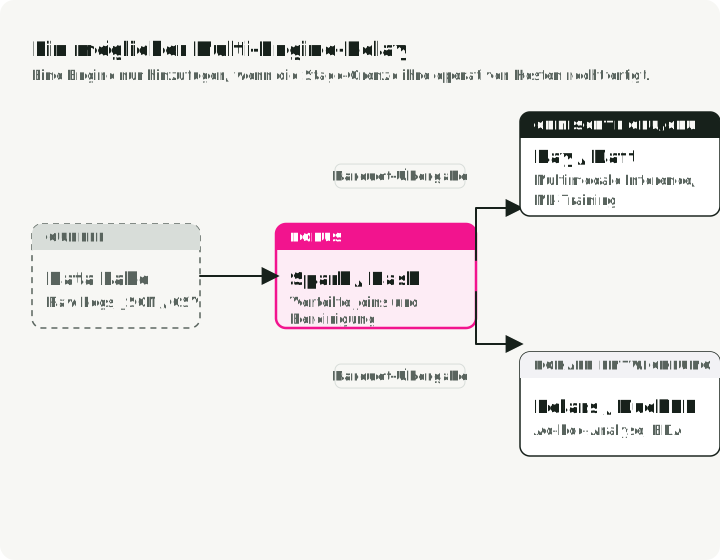
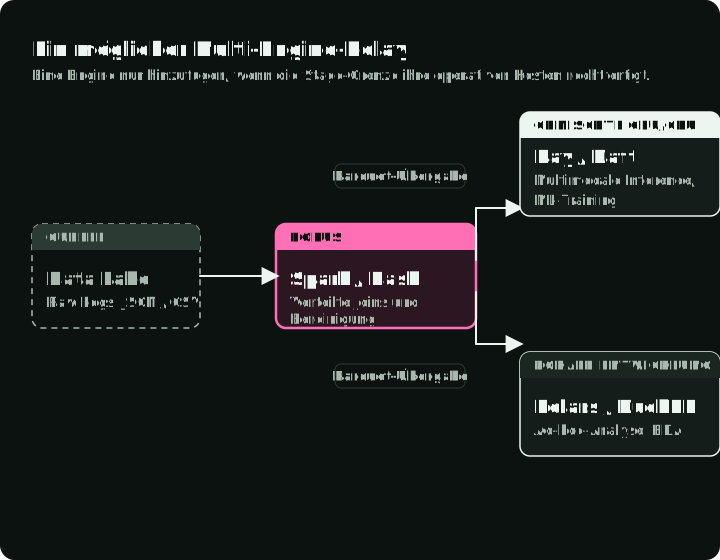
Eine mögliche Staffel nutzt Spark für etablierte Lakehouse-Joins, schreibt ein offenes Tabellen- oder Dateiformat und übergibt das Ergebnis an Ray Data oder Daft für GPU-Inference oder multimodale Transformationen. Polars oder DuckDB können lokale Analysen über dieselben Dateien bedienen. Ein kleineres Team braucht womöglich nur eine dieser Engines; fügen Sie eine weitere hinzu, wenn ein gemessener Bottleneck die betriebliche Grenze rechtfertigt.
Möglich wird diese Komposition durch Interoperabilität. Parquet ist in diesen Beispielen die gemeinsame Dateiübergabe, während Arrow den Austausch im Speicher übernehmen kann. Die Unterstützung für Delta und Iceberg hängt von Engine und Connector ab; prüfen Sie daher jede Grenze. Auch eine Dateiübergabe verursacht I/O- und Konvertierungskosten; sie ist nicht automatisch kostenlos.
Engine-Auswahl nach Evaluationsfall
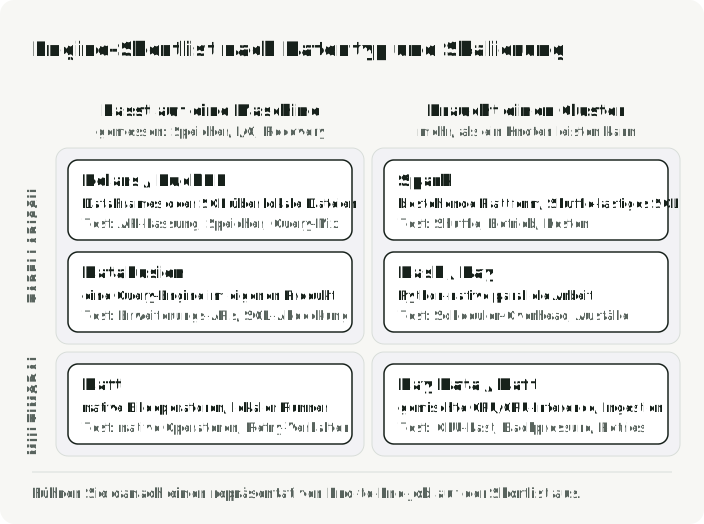
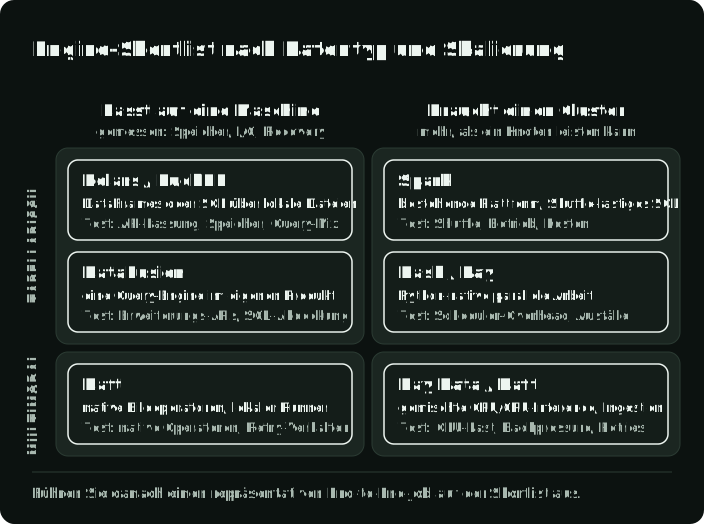
Die Tabelle ordnet jedem Workload eine engere Auswahl zu und nennt, was Sie vor der Entscheidung testen sollten.
| Evaluationsfall | Engere Auswahl | Prüfen |
|---|---|---|
| Lokale analytische DataFrames | Polars / DuckDB | API-Passung, Speicher, Query-Mix |
| Bestehendes verteiltes SQL/ETL | Apache Spark | Shuffle-Verhalten, Betrieb, Kosten |
| Python-native parallele Arbeit | Dask / Ray | Scheduler-Overhead, Fehlermodell |
| Gemischtes CPU/GPU-Training oder -Inference | Ray Data / Daft | Beschleunigerauslastung, Backpressure |
| Multimodale Ingestion | Daft / Ray Data | Native Operatoren, Retry-Verhalten |
| Eingebettete Query-Engine | DataFusion | Erweiterungs-APIs, SQL-Abdeckung |
Das Diagramm ordnet dieselbe Shortlist zwei Fragen zu: ob die Daten tabellarisch oder multimodal sind und ob der Job auf eine Maschine passt.
Diagonales Skalieren
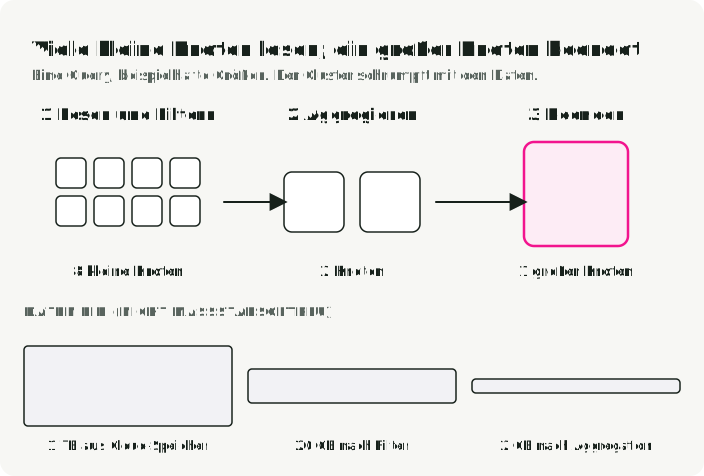
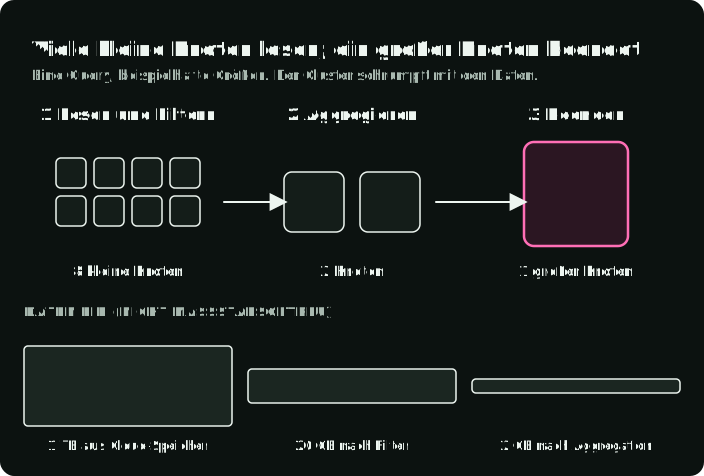
Lange Zeit lautete die Wahl: hochskalieren (eine größere Maschine) oder ausskalieren (mehr Maschinen). Polars Cloud beschreibt einen von der Query abhängigen Ansatz namens Diagonal Scaling. Dabei skaliert man beim Lesen aus Cloud-Speicher horizontal, um die I/O auszureizen, und fällt auf einen einzelnen großen Knoten zusammen, sobald Filter und Aggregationen die Daten verkleinert haben. Frühe Reduktion kann den Datentransfer begrenzen und die restliche Arbeit auf einem Knoten abschließen lassen. Ob ein verteilter Shuffle stattfindet, hängt vom physischen Query-Plan ab. Das Diagramm folgt einer Query mit erfundenen Größen: Acht kleine Knoten lesen und filtern 1 TB, zwei Knoten aggregieren den Rest, und ein großer Knoten beendet die Query bei 2 GB.
Vergleichen Sie die Kosten pro erfolgreichem Job, nicht den Stundenpreis der Instanz. Ein größerer Knoten kann günstiger sein, wenn die kürzere Laufzeit seinen höheren Preis aufwiegt; das Ergebnis hängt aber von I/O, Speicherdruck und der Menge an Arbeit ab, die vor einem Shuffle wegfällt.
Den Vergleich reproduzieren
Das begleitende Demo-Repository enthält die Skripte, Notebooks und die Umgebung, die für die Vergleiche genutzt wurden. Der Befehl für den tabellarischen Benchmark verwendet das Standard-Taxi-Dataset des Repositorys für das gesamte Jahr 2024, passend zum obigen Lauf. Der erste Lauf lädt etwa 660 MB Taxidaten und die Food-101-Bilder herunter; der Rust-Benchmark braucht eine Rust-Toolchain.
# Install dependencies
uv sync

# Run the tabular benchmark (~41M NYC taxi trips from full-year 2024)
uv run python -m engine_comparison.benchmarks.tabular

# Run the multimodal benchmark (500 real food photos)
uv run python -m engine_comparison.benchmarks.multimodal

# Run native Rust benchmarks (Polars-rs + image crate)
cd rust_benchmark && cargo run --release && cd ..
./scripts/run_benchmarks.sh führt alle drei aus und schreibt benchmarks/*.json sowie die kombinierten Diagramme. Die Python-Skripte akzeptieren --runs 5 für mehr Messläufe, und das Bildskript akzeptiert --images 1000 für ein größeres Bild-Set. Die verteilten Notebooks brauchen uv sync --extra distributed --extra notebook. Das Repo enthält außerdem Docker-Compose-Setups für lokale verteilte Läufe von Spark, Ray und Daft.
Die wichtigsten Erkenntnisse
-
Belegen Sie, dass eine Maschine nicht reicht. Scale-up-Ergebnisse zeigen, dass manche großen analytischen Scans auf einen einzelnen Knoten passen. Messen Sie Speicher, I/O, Spill und die Anforderungen an die Wiederherstellung, bevor Sie den Overhead eines Clusters akzeptieren.
-
Lazy Planning erklärt mehr vom Geschwindigkeitsabstand als die API-Syntax. Pushdown, Streaming und parallele Operatoren machen einen großen Teil des Unterschieds zwischen einem Eager-DataFrame-Skript und einer analytischen Engine aus.
-
Messen Sie die gesamte Beschleuniger-Pipeline. Dekodierung, Netzwerk-I/O, Batching, Serialisierung und Backpressure entscheiden, ob eine GPU ausgelastet bleibt. Ray Data und Daft machen diese Überlappung zu einer zentralen Abstraktion; Spark kann sie mit zusätzlichem Design und Tooling unterstützen.
-
Erst nach Workload eingrenzen, dann benchmarken. Nutzen Sie die Passung zum Ökosystem, um das Feld einzuengen, und einen repräsentativen End-to-End-Job, um zu entscheiden. Führen Sie die Benchmark-Behauptung eines Anbieters mit Ihrem eigenen Job erneut aus, bevor Sie sich darauf verlassen.
-
Offene Formate halten die Wahl umkehrbar. Arrow-kompatible Schnittstellen, Parquet und offene Tabellenformate können die Übergabekosten senken. Prüfen Sie, ob eine bestimmte Konvertierung Puffer wiederverwendet oder kopiert.
Referenzen
Benchmarks und Leistungsdaten
- Polars PDS-H Benchmarks - Polars Streaming vs. Pandas bei SF-10 (94x) und SF-100 (etwa 6x gegenüber In-Memory)
- DataFusion ClickBench Results (Nov 2024) - Vom Projekt veröffentlichte Single-Node-Parquet-Ergebnisse
- Embucket: TPC-H SF-1000 on DataFusion - Herstellerfallstudie auf einem großen Knoten; zwei Queries wurden umgeschrieben, damit sie fertig werden
- Amazon Spark-to-Ray Migration - 82 % bessere Kosteneffizienz in der Produktion pro GiB S3-Eingabe
- Daft Flotilla Benchmarks - 4–18x schneller als Spark bei multimodalen Workloads
- Anyscale Ray vs. Daft Benchmarks - Konkurrierender Herstellerbenchmark für multimodale Workloads
Engines und Frameworks
- Polars - Rust-DataFrame-Bibliothek mit Lazy Execution
- Apache DataFusion - Einbettbare Rust-Query-Engine (GitHub)
- Daft - Multimodal-nativer verteilter DataFrame
- Ray - Framework für verteiltes Compute für AI (Data Internals)
- Apache Spark - Verteilte ETL- und SQL-Engine
- DuckDB - Analytische In-Process-SQL-Engine
- Dask - Python-natives paralleles Rechnen
Architektur und Ökosystem
- Polars Cloud: Diagonal Scaling - Dynamisches vertikales/horizontales Skalieren
- Daft Flotilla Architecture - Verteilte Engine aus Swordfish + Flotilla
- Apache DataFusion Comet - Spark-Beschleuniger, ursprünglich bei Apple entwickelt
- Apache Arrow - Spaltenorientiertes In-Memory-Format (Flight RPC, PyCapsule Interface)
- InfluxDB 3.0 + DataFusion - Auf DataFusion aufbauende Zeitreihendatenbank
- GreptimeDB - Observability-Datenbank auf Basis von DataFusion
Demo-Repository
- engine-comparison-demo - Begleitcode zu diesem Artikel: Benchmarks, Notebooks und Docker Compose für Spark/Ray/Daft
Datasets
- NYC Taxi Trip Records - NYC-TLC-Yellow-Taxi-Daten (Parquet, ~2,9 Mio. Zeilen/Monat)
- Food-101 Dataset - 101.000 Food-Bilder der ETH Zürich (Bossard et al., ECCV 2014)