Motores de processamento de dados: Polars, DataFusion, Ray e Spark

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Este guia ajuda engenheiros de Python e de dados a escolher um motor de processamento para dados tabulares e para pipelines de imagens, áudio ou texto. Explica como Polars, DataFusion, Daft, Ray Data e Spark executam o trabalho, que workloads se adequam a cada um e como compará-los com os seus próprios dados.
Os pipelines modernos também processam imagens, áudio e vídeo. Nestes workloads, a descodificação no CPU pode deixar a inferência no GPU à espera de dados. Operadores nativos, troca de dados em formato colunar e sobreposição do trabalho de CPU e GPU resolvem custos diferentes; escolher um motor é descobrir qual desses custos limita o seu pipeline.
Para comparar as opções, fiz o benchmark de Pandas, Polars, DataFusion, Daft e Rust nativo em dois datasets reais: as viagens de táxi de Nova Iorque representam trabalho tabular e as imagens do Food-101 representam um pipeline multimodal. Spark e Ray são tratados em notebooks distribuídos separados.
O repositório engine-comparison-demo contém o código.
Tipos de workloads de processamento de dados
Os motores especializam-se, por isso comece por decidir que tipo de workload tem. A divisão principal é entre dados estruturados e multimodais. O diagrama mostra como a quantidade de dados muda em cada um: um trabalho tabular reduz-os a cada passo, enquanto um trabalho multimodal expande-os.
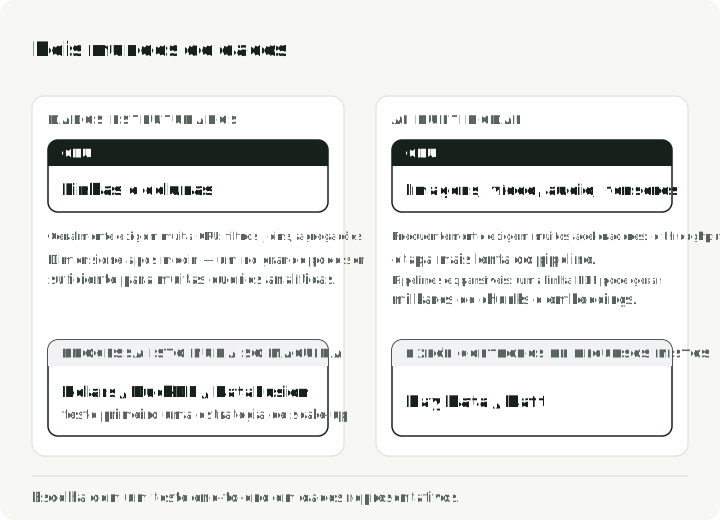
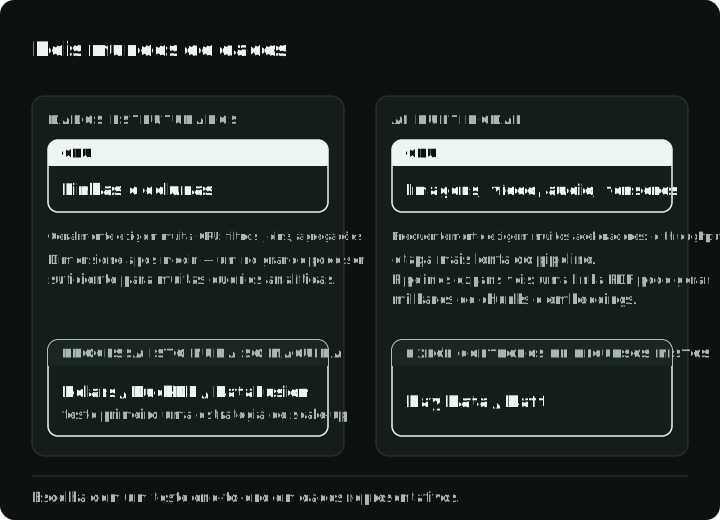
Os dados estruturados ou tabulares envolvem filtros, agregações e joins. Normalmente estão limitados pelo CPU e muitas vezes cabem na memória. Muitas destas queries correm numa única máquina moderna, mas a memória, o I/O, a concorrência, a recuperação de falhas e a forma do workload continuam a determinar se um cluster é adequado.
A AI multimodal processa imagens, áudio ou vídeo. A inferência pode correr num GPU enquanto a descodificação no CPU, as leituras remotas ou o batching limitam o pipeline. A fase que limita o débito muda com o tipo de instância e com os operadores, por isso meça a utilização ao longo de todo o caminho, em vez de dimensionar o GPU isoladamente.
Os motores mais recentes visam partes diferentes deste espaço. A execução nativa pode reduzir o custo do Python, as interfaces compatíveis com Arrow podem tornar a troca de dados mais barata e a execução em streaming pode limitar a memória em datasets maiores do que a RAM. Nenhum destes benefícios é automático para todos os operadores ou conversões.
Parte 1: processamento num único nó
O Pandas privilegia um modelo de programação eager: executa cada operação de imediato, mantendo normalmente os dados na memória. Um modelo lazy planeia, em alternativa, várias operações em conjunto antes de as executar. No Pandas, muitas operações comuns criam tabelas intermédias e a execução paralela não é coordenada por um otimizador de queries. Este compromisso mantém o código exploratório direto, mas pode tornar-se dispendioso em scans analíticos maiores.
O diagrama mostra o que cada modelo lê do ficheiro Parquet na query de táxis usada mais abaixo: o caminho eager lê as 19 colunas antes de filtrar, enquanto o plano lazy permite ao otimizador empurrar o filtro e as 3 colunas usadas para o scan.
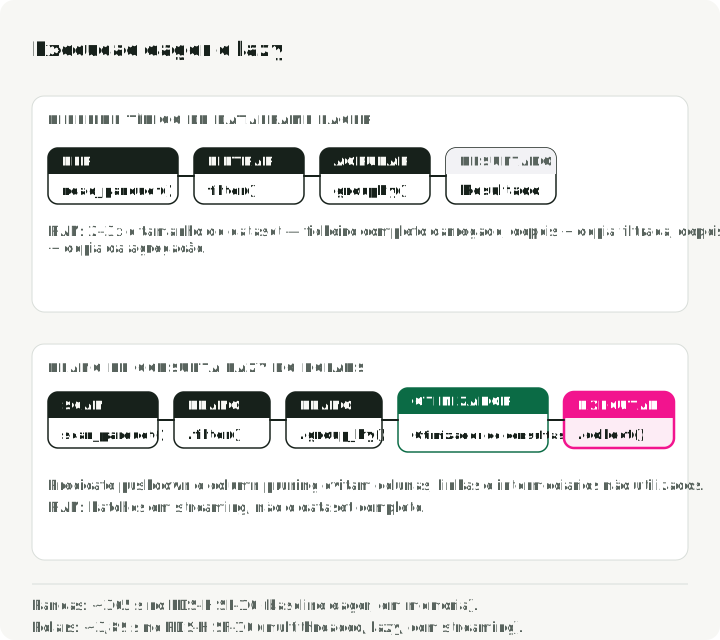
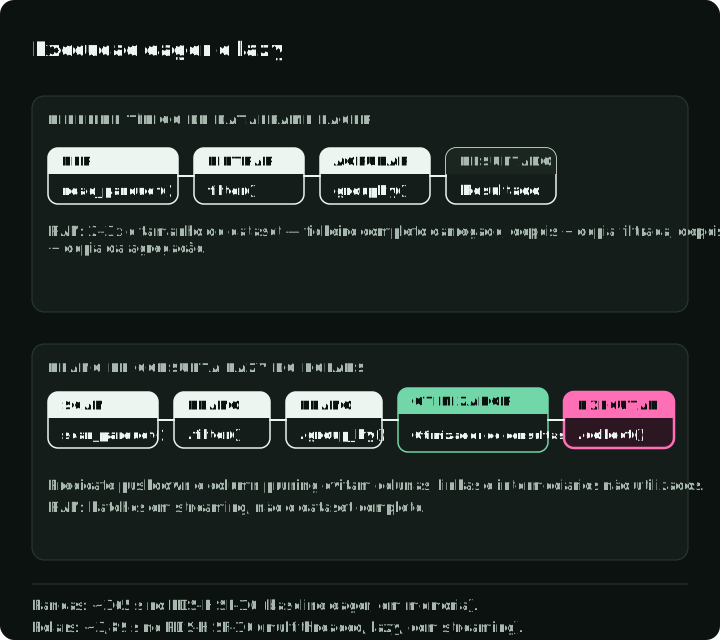
No benchmark PDS-H do Polars de maio de 2025, com scale factor 10, o Pandas demorou cerca de 365 segundos para a suite, enquanto o motor de streaming do Polars demorou 3,89 segundos. O resultado de aproximadamente 94x descreve esse benchmark e essa configuração; não é um fator geral de conversão de Pandas para Polars.
Polars para pipelines tabulares locais
O Polars é uma opção por omissão prática quando um pipeline local de DataFrames deixou de caber na execução eager de um único processo. A sua API lazy constrói um plano de query antes da execução. Isso permite-lhe filtrar linhas o mais cedo possível (predicate pushdown) e ler apenas as colunas necessárias (projection pruning). O motor pode depois executar os operadores em paralelo e, onde há suporte, em lotes de streaming.
Com scale factor 100 (cerca de 100 GB de CSV), o motor de streaming do Polars foi cerca de 6x mais rápido do que o seu motor em memória na mesma máquina. A fonte atribui esta diferença sobretudo a menos falhas na cache do CPU e a um melhor aproveitamento dos núcleos; não é prova de que a entrada seja maior do que a RAM.
A query abaixo lê viagens de táxi de Parquet, seleciona as viagens com mais de cinco milhas e um valor total superior a $30, e calcula contagens e médias por tipo de pagamento. O notebook de apoio engine_comparison_examples.ipynb contém exemplos relacionados de API e configuração; o tabular.py descarrega os dados dos táxis e executa o trabalho cronometrado descrito mais abaixo:
import polars as pl

# Build a lazy scan; query execution happens at collect()
q = (
    pl.scan_parquet("yellow_tripdata_2024-01.parquet")
    .filter(
        (pl.col("trip_distance") > 5.0)
        & (pl.col("total_amount") > 30.0)
    )
    .group_by("payment_type")
    .agg(
        pl.col("total_amount").mean().alias("avg_fare"),
        pl.col("trip_distance").mean().alias("avg_distance"),
        pl.len().alias("trip_count"),
    )
)

# The entire plan is optimized and executed here, in parallel
result = q.collect(engine="streaming")
A diferença importante é o modelo de execução. Na query lazy acima, o Polars pode empurrar o filtro e a seleção de colunas para o scan do Parquet. Isso pode saltar row groups e evitar a leitura de colunas não usadas. O streaming é explícito aqui; o collect continua a materializar o resultado final, e as operações sem suporte podem recorrer à execução em memória. Um pipeline típico de Pandas eager não tem um plano da query inteira para otimizar, embora o uso cuidadoso de filtros do Parquet, de colunas selecionadas e de backends alternativos possa recuperar parte da diferença.
DataFusion para motores de queries incorporados
Enquanto o Polars é uma biblioteca que se usa diretamente, o DataFusion é o motor sobre o qual se constroem outros motores. Está na base do InfluxDB 3.0, do GreptimeDB e do Apache DataFusion Comet, um acelerador de Spark criado inicialmente na Apple.
Numa execução do ClickBench de novembro de 2024, publicada pelo projeto DataFusion, o DataFusion liderou as configurações testadas de Parquet num único nó. A equipa da Embucket publicou mais tarde uma execução do TPC-H com scale factor 1000 num único nó grande, com duas queries reescritas para terminarem. Estes resultados mostram o que o scale-up consegue em condições específicas; não provam que todos os workloads de 1 TB devam evitar um cluster.
Aqui está o mesmo resumo dos táxis em SQL do DataFusion, com os tipos de pagamento ordenados pelo número de viagens. O notebook de apoio engine_comparison_examples.ipynb contém exemplos relacionados de SQL e configuração:
from datafusion import SessionContext

ctx = SessionContext()
ctx.register_parquet("taxi", "yellow_tripdata_2024-01.parquet")

# Plan SQL against the registered Parquet source
df = ctx.sql("""
    SELECT payment_type,
           COUNT(*)           AS trip_count,
           AVG(trip_distance) AS avg_distance,
           AVG(total_amount)  AS avg_fare
    FROM taxi
    WHERE trip_distance > 5.0 AND total_amount > 30.0
    GROUP BY payment_type
    ORDER BY trip_count DESC
""")
result = df.to_pandas()
A força do DataFusion é a sua modularidade. As APIs de extensão cobrem catálogos personalizados, table providers, regras do otimizador e planos de execução. É por isso que aparece sempre que alguém está a construir uma plataforma de dados à medida ou a incorporar um motor de queries no seu próprio produto.
Se a sua equipa escreve SQL sobre ficheiros Parquet locais e não precisa de incorporar o motor, o DuckDB é uma base de dados SQL em processo que cumpre o mesmo papel que o Polars.
Daft para dados multimodais
O Daft integra imagens, áudio, vídeo e embeddings no fluxo de trabalho de DataFrames. Oferece expressões nativas para operações como a descodificação de imagens e o descarregamento a partir de URLs, pelo que os caminhos comuns de pré-processamento não exigem um ciclo Python linha a linha. Esta integração é a principal razão para o considerar em vez de um motor tabular genérico.
Para trabalho tabular, a API do Daft parece-se com a dos motores acima. Este exemplo executa o mesmo resumo dos táxis; o notebook de apoio engine_comparison_examples.ipynb contém exemplos relacionados da API do Daft e de configuração:
import daft

df = daft.read_parquet("yellow_tripdata_2024-01.parquet")

result = (
    df.where(
        (daft.col("trip_distance") > 5.0)
        & (daft.col("total_amount") > 30.0)
    )
    .groupby("payment_type")
    .agg(
        daft.col("total_amount").mean().alias("avg_fare"),
        daft.col("trip_distance").mean().alias("avg_distance"),
        daft.col("trip_distance").count().alias("trip_count"),
    )
    .collect()
)
A API vai parecer-lhe familiar se conhecer o Pandas, mas o motor é a mesma pilha Rust + Arrow que encontra no Polars e no DataFusion. O Daft compensa quando as “linhas” do seu DataFrame são imagens, PDFs ou tensores.
O Daft lê, descodifica e redimensiona imagens com expressões nativas, sem um ciclo Python sobre as linhas. Este é o caminho de imagens de multimodal.py:
import daft
from daft import col

df = (
    daft.from_glob_path("food101_images/*.jpg")
    .with_column("image", col("path").download().decode_image(mode="RGB"))
    .with_column("resized", col("image").resize(224, 224))
)
df.collect()
Benchmark num único nó
Executei Pandas, Polars, DataFusion e Daft, mais Rust nativo através do Polars-rs, em cerca de 41 milhões de viagens de táxi amarelo de Nova Iorque de todo o ano de 2024. O trabalho cronometrado filtra as viagens com tarifa acima de $10, junta a tabela de zonas dos táxis, soma a receita por bairro e zona, e devolve as 20 primeiras linhas. É uma query diferente dos exemplos acima. Spark e Ray aparecem nos exemplos distribuídos, não neste benchmark de um único nó.
Cada motor lê os ficheiros dentro da função cronometrada; o script indica a mediana de três execuções. O seu verificador de resultados compara as 20 linhas entre os motores Python por bairro, zona, número de viagens e receita arredondada aos cêntimos; não compara avg_tip. O Pandas recebe as quatro colunas de viagem que a query usa, porque não tem otimizador para as encontrar. O gráfico mostra o resultado num Apple M5 Max com 18 núcleos e 64 GB de RAM. Os resultados completos estão no repositório de demonstração:
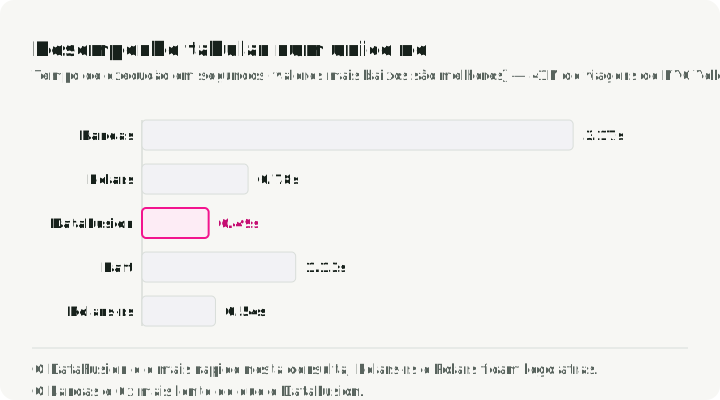
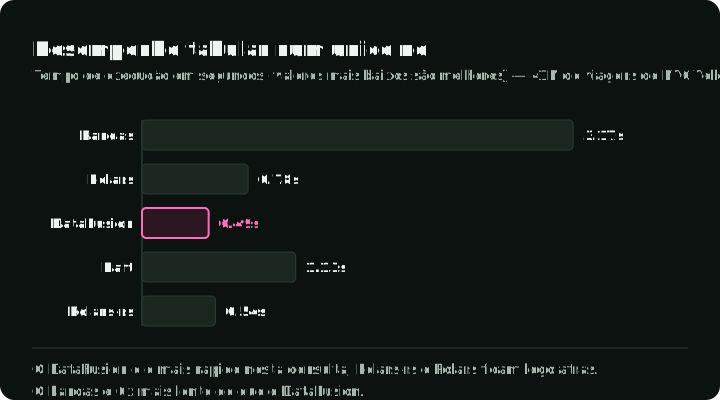
O Pandas demorou 4,67 segundos. Os quatro motores mais recentes terminaram entre 0,40 e 0,74 segundos, com o DataFusion mais rápido e o Polars cerca de 7x mais rápido do que o Pandas. O valor de 94x de Polars contra Pandas acima vem do PDS-H; este trabalho produziu uma diferença menor. Os tempos também variaram entre invocações: em quatro execuções do script numa máquina ocupada com outro trabalho, o Pandas variou entre 2,6 e 4,8 segundos. O DataFusion foi sempre o motor Python mais rápido, e o Polars e o Daft trocaram de posição. Quando os motores ficam tão próximos, devem ser o encaixe da API e medições repetidas em dados representativos a decidir.
Parte 2: dados multimodais
O ETL tabular costuma reduzir os dados: filtra, agrega e escreve menos do que lê. Os pipelines de AI multimodal fazem o oposto. O caminho de um único documento pode expandir-se em dezenas de blocos de texto e vetores de embeddings.
Num pipeline convencional de PySpark, as imagens e o áudio entram muitas vezes como dados binários e passam para bibliotecas Python para descodificação ou transformação. Atravessar a fronteira JVM/Python e serializar os resultados pode tornar-se uma grande parte do tempo total. O Spark pode usar caminhos baseados em Arrow, UDFs vetorizadas e integrações com aceleradores, mas essas escolhas exigem conceção explícita e medição.
Execução em pipeline e utilização do GPU
O Spark agenda o trabalho em fases separadas por limites de shuffle. Uma implementação direta pode colocar o download, a descodificação e a inferência numa sequência que deixa capacidade de CPU ou de GPU à espera. O Spark suporta o agendamento de recursos de GPU e plugins, pelo que o tempo ocioso não é inevitável. Manter as fases ocupadas exige também backpressure: abrandar as fases anteriores quando as seguintes não conseguem acompanhar. Nem esse controlo nem a sobreposição de CPU e GPU acontecem automaticamente num trabalho comum de DataFrame em PySpark.
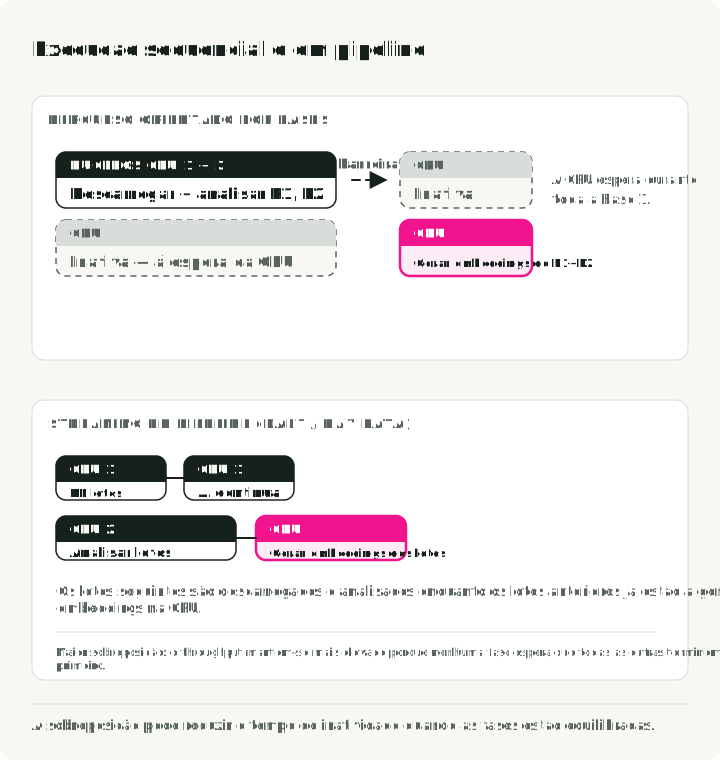
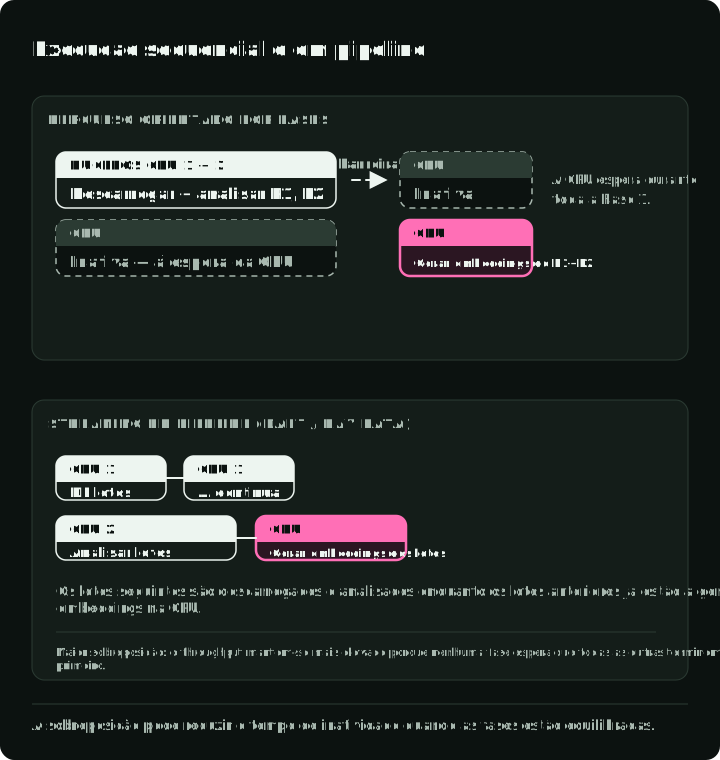
A execução em pipeline é a alternativa. Em vez de executar as fases umas após as outras, o motor sobrepõe I/O, trabalho de CPU e inferência no GPU. Quando as fases e os buffers estão equilibrados, essa sobreposição pode reduzir o tempo ocioso e melhorar o débito; o arranque e o esvaziamento, o backpressure ou uma fase mais lenta ainda podem deixar recursos à espera.
O diagrama mostra dois lotes a atravessar três fases. Executados um a seguir ao outro, demoram seis passos. Em pipeline, o lote 2 é lido e descodificado enquanto o lote 1 ainda está em curso, e o mesmo trabalho demora quatro passos.
Benchmark de processamento de imagens
Fiz o benchmark do processamento de imagens em 500 fotografias reais do dataset Food-101. Cada motor lê os mesmos 500 JPEGs, descodifica-os para RGB e redimensiona-os para 224×224 com um filtro bilinear dentro da função cronometrada. O script verifica que cada motor produziu 500 imagens e indica a mediana de três execuções. O gráfico mostra o resultado na mesma máquina:
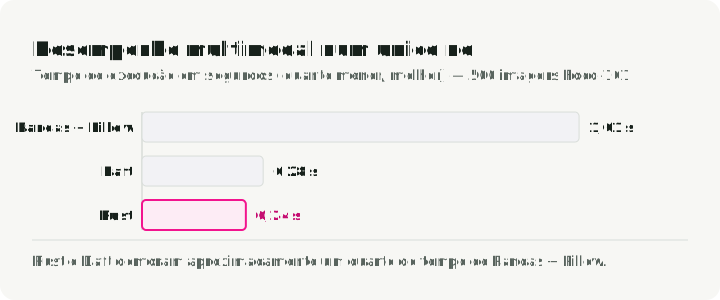
O Polars e o DataFusion estão ausentes porque não têm operações nativas de imagem. Os resultados em Python e os resultados em Rust registados mostram 0,55 segundos para Pandas + Pillow, 0,34 para o Daft e 0,10 para o crate image de Rust. O Pandas processa uma imagem de cada vez através de apply(); o Daft e a versão em Rust distribuem o trabalho pelos núcleos. Em quatro invocações, o Pandas variou entre 0,55 e 1,21 segundos. Quinhentas imagens são poucas para prever o débito em produção, e o trabalho termina antes de qualquer processamento no GPU, por isso meça o seu próprio pipeline de ponta a ponta.
Parte 3: processamento distribuído
Quando uma única máquina deixa de chegar, é preciso escolher como repartir o trabalho. O Dask distribui o código Pandas e NumPy existente por vários núcleos ou por um cluster com poucas alterações de API; serve equipas Python que não querem uma JVM nem uma nova API de DataFrames. O resto desta parte trata de Spark, Ray Data e Daft.
Apache Spark
O Spark é uma opção madura para ETL tabular de grande escala, joins com muito shuffle e organizações que já operam o seu ecossistema. A recuperação baseada em lineage e o amplo suporte de plataformas contam quando a fiabilidade e a familiaridade operacional pesam mais do que a velocidade local. Os pipelines mistos de CPU e GPU exigem uma configuração de recursos e uma conceção de pipeline mais deliberadas do que o caminho SQL, e é aqui que o Ray Data e o Daft oferecem uma abstração mais focada.
Esta query Spark junta viagens de táxi mais longas com informação da zona de recolha e depois resume a receita total e as tarifas médias por bairro. Para a configuração de ETL em cluster, veja distributed_spark.ipynb ou spark_etl.py:
from pyspark.sql import SparkSession
from pyspark.sql import functions as F

spark = SparkSession.builder \
    .appName("TaxiETL") \
    .config("spark.sql.adaptive.enabled", "true") \
    .getOrCreate()

orders = spark.read.parquet("s3a://lake/taxi/*.parquet")
zones = spark.read.csv("s3a://lake/taxi_zones.csv", header=True)

# Spark excels at this: joining massive tables with a shuffle
result = (
    orders
    .filter(F.col("trip_distance") > 5.0)
    .join(zones, orders.PULocationID == zones.LocationID, "inner")
    .groupBy("Borough")
    .agg(
        F.sum("total_amount").alias("total_revenue"),
        F.avg("total_amount").alias("avg_fare"),
    )
    .orderBy(F.desc("total_revenue"))
)

# Spark is lazy: the write runs the query
result.write.mode("overwrite").parquet("s3a://warehouse/report/")
Ray Data para computação heterogénea
O Ray Data foi concebido em torno de workloads de AI. Em vez das barreiras entre fases do Spark, usa um modelo de streaming que envia lotes para workers com GPU enquanto os lotes seguintes ainda estão a ser lidos. Um actor do Ray é um worker persistente que pode manter um modelo carregado entre lotes. A funcionalidade mais importante para pipelines de AI é o agendamento de recursos mistos: pode declarar que um actor quer “1 GPU, 4 CPUs” e outro apenas CPUs, e o Ray coloca cada actor num nó que tenha esses recursos.
A Amazon reportou uma eficiência de custo 82% melhor por GiB de entrada no S3 depois de migrar do Spark para o Ray alguns workloads internos selecionados. A escala é notável, mas isto é um estudo de caso de migração de workloads específicos, não uma poupança esperada numa adoção típica do Ray.
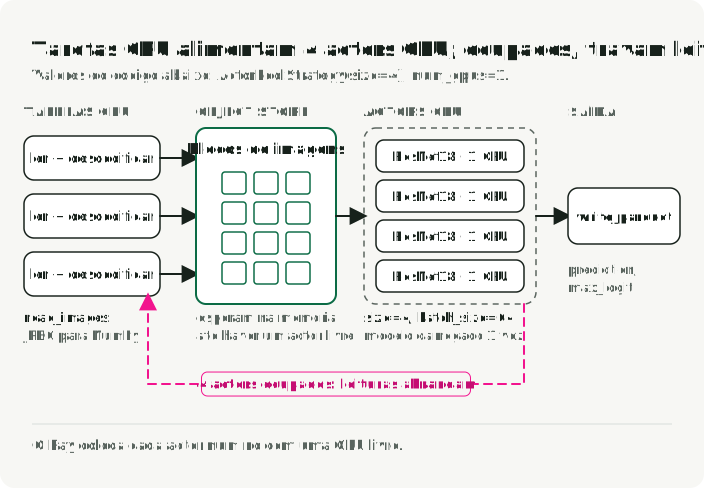
O exemplo abaixo lê imagens, classifica-as com ResNet18 em workers com GPU e escreve as previsões em Parquet. O diagrama mostra o pipeline que constrói: tarefas de CPU leem e descodificam imagens para o object store do Ray, um conjunto de quatro actors com GPU executa o modelo e o backpressure abranda as leituras quando os actors com GPU estão cheios.
Para a configuração da inferência de imagens, veja distributed_ray.ipynb ou ray_inference.py:
import ray

ray.init()

ds = ray.data.read_images("s3://my-bucket/food101/", mode="RGB")

class ImageClassifier:
    def __init__(self):
        import torch
        from torchvision.models import resnet18, ResNet18_Weights
        self.model = resnet18(weights=ResNet18_Weights.DEFAULT).cuda()
        self.model.eval()
        self.preprocess = ResNet18_Weights.DEFAULT.transforms()

    def __call__(self, batch):
        import torch
        from PIL import Image
        tensors = torch.stack([
            self.preprocess(Image.fromarray(img)) for img in batch["image"]
        ]).cuda()
        with torch.no_grad():
            preds = self.model(tensors)
        return {
            "prediction": preds.argmax(dim=1).cpu().numpy(),
            "max_logit": preds.max(dim=1).values.cpu().numpy(),
        }

# ActorPoolStrategy creates persistent GPU workers
predictions = ds.map_batches(
    ImageClassifier,
    compute=ray.data.ActorPoolStrategy(size=4),
    num_gpus=1,
    batch_size=64,
)
predictions.write_parquet("s3://output/predictions/")
Este esboço reserva quatro actors de um GPU cada e requer quatro GPUs CUDA disponíveis, os pesos do Torchvision e acesso ao S3. O Ray lê imagens como arrays NumPy; converter arrays RGB para PIL dá à transformação de pré-processamento do ResNet18 uma entrada válida. max_logit é a maior pontuação bruta do modelo, não uma probabilidade de confiança.
Nos benchmarks da Anyscale, a classificação de imagens do Ray Data correu cerca de 4x mais depressa (de 456 para 111 segundos) quando a instância passou de 4 CPUs por GPU para 32 CPUs por GPU. A Anyscale atribui a melhoria à redução da falta de capacidade de CPU; a utilização dos GPUs continuou baixa em termos absolutos. O Daft melhorou de 4 para 16 CPUs por GPU e depois manteve-se perto de 195 segundos tanto com 16 como com 32.
Daft distribuído
O Daft escala horizontalmente através do seu motor Flotilla: um worker Swordfish por nó, com o Flotilla por cima a tratar do agendamento em todo o cluster. O Swordfish trata da execução local em Rust e coloca o I/O e o cálculo em pipeline através de streaming em pequenos lotes, de modo que cada nó se mantém ocupado sem esperar pela fase seguinte.
Em benchmarks publicados pelo Daft, o Flotilla foi 4 a 18x mais rápido do que as implementações de Spark testadas em quatro workloads multimodais. A maior diferença foi num caso de deteção de objetos em vídeo. Trate o resultado como prova de que o desenho da execução pode alterar o débito nesta medida nestes pipelines, e depois compare-o com os resultados concorrentes da Anyscale abaixo e com um teste local.
A Anyscale, a empresa por trás do Ray, publicou um benchmark concorrente em que o Ray Data fechou ou inverteu a diferença em instâncias com muitos CPUs depois de afinado. Em conjunto, os dois estudos de fornecedores são uma razão para testar operadores e rácios de CPU para GPU representativos, e não para deduzir uma tabela de classificação duradoura.
O exemplo seguinte usa o Ray runner do Daft; não reproduz o benchmark do Flotilla acima. Lê uma tabela de URLs de imagens, descarrega as imagens, gera embeddings com CLIP em workers com GPU e escreve os vetores em Parquet. Adapta daft_pipeline.py para workers com GPU do Ray. Com a API do Transformers 5.0.0 fixada pelo projeto de apoio, as características projetadas das imagens estão em .pooler_output. O notebook relacionado é distributed_daft.ipynb:
import io

import daft
import numpy as np
from daft import col

# Connect to an existing Ray cluster before building the query
daft.set_runner_ray(address="auto")

# Define a GPU class UDF: the model loads once per instance
@daft.cls(gpus=1)
class ImageEmbedder:
    def __init__(self):
        import torch
        from transformers import CLIPModel, CLIPProcessor

        self.device = "cuda" if torch.cuda.is_available() else "cpu"
        self.model = CLIPModel.from_pretrained(
            "openai/clip-vit-base-patch32"
        ).to(self.device)
        self.processor = CLIPProcessor.from_pretrained(
            "openai/clip-vit-base-patch32"
        )
        self.model.eval()

    @daft.method.batch(
        return_dtype=daft.DataType.fixed_size_list(daft.DataType.float32(), 512)
    )
    def __call__(self, image_bytes_col):
        import torch
        from PIL import Image

        embeddings = []
        for img_bytes in image_bytes_col.to_pylist():
            img = Image.open(io.BytesIO(img_bytes)).convert("RGB")
            inputs = self.processor(images=img, return_tensors="pt").to(self.device)
            with torch.no_grad():
                features = self.model.get_image_features(**inputs).pooler_output
            embeddings.append(features[0].cpu().numpy())
        return np.array(embeddings, dtype=np.float32)

embedder = ImageEmbedder()

df = (
    daft.read_parquet("s3://bucket/image_metadata.parquet")
    # Native Rust I/O downloads the images; no Python requests loop
    .with_column("image_bytes", col("image_url").download())
    .with_column("embedding", embedder(col("image_bytes")))
    .exclude("image_bytes")
)
df.write_parquet("s3://bucket/embeddings/")
O Ray runner do Daft liga-se a um cluster existente; o runner nativo por omissão usa a máquina local. Instale o Daft com suporte para Ray e disponibilize nesse cluster workers com GPU, o Transformers 5.0.0, os pesos do CLIP e as credenciais do S3. A API de classes e métodos em lote mantém o modelo entre lotes, e gpus=1 pede ao runner um GPU por instância; a revisão do repositório indicada usa @daft.cls simples e uma só partição, porque se destina a um único GPU local. Os downloads podem sobrepor-se à inferência no GPU, sujeitos ao particionamento e ao backpressure.
Essa revisão do projeto de apoio substitui imagens em falta ou qualquer falha de processamento por um vetor de zeros, incluindo a verificação da forma dos embeddings. Indexa o objeto de saída do CLIP sem selecionar .pooler_output, pelo que o Transformers 5.0.0 faz essa verificação falhar e imagens válidas também podem tornar-se vetores de zeros. Use a extração das características projetadas aqui apresentada; este esboço deixa os erros de processamento fazerem o trabalho falhar.
Comparação distribuída
| Característica | Spark | Ray Data | Daft (Flotilla) |
|---|---|---|---|
| Modelo de execução | Uma tarefa por núcleo, baseado em partições | Tarefas e actors em streaming | Um Swordfish por nó, lotes em streaming |
| Pontos fortes | SQL/ETL em grande escala, tolerância a falhas | Computação heterogénea, saturação do GPU | Pipeline multimodal, memória limitada |
| Controlo de GPU | Agendamento de recursos e plugins do ecossistema | Recursos explícitos para tarefas e actors | Agendamento integrado de pipeline CPU/GPU |
| Afinação típica | Executors, memória, partições, aceleradores | Lotes, actors, object store | Lotes, recursos, concorrência de I/O |
| Bom caso de avaliação | SQL/ETL em grande escala e jobs com muito shuffle | Treino ou inferência com recursos mistos | Ingestão e transformação multimodais |
Parte 4: o papel do Rust e do Arrow
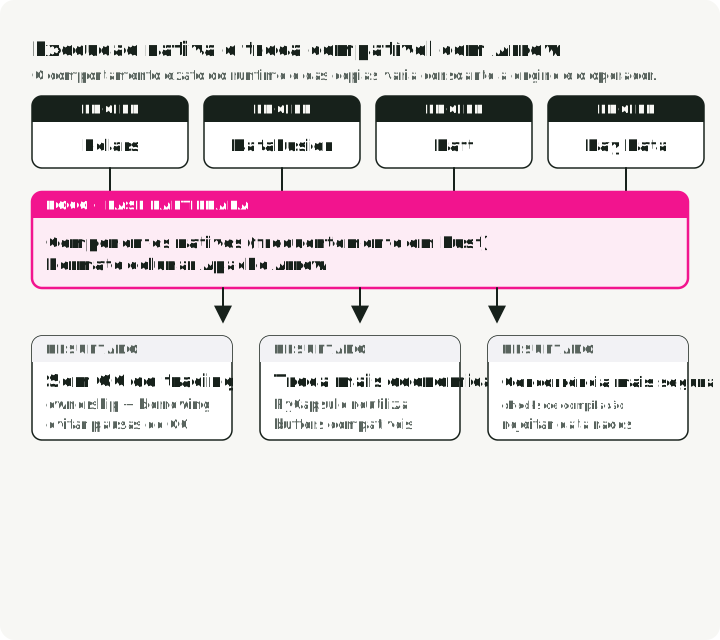
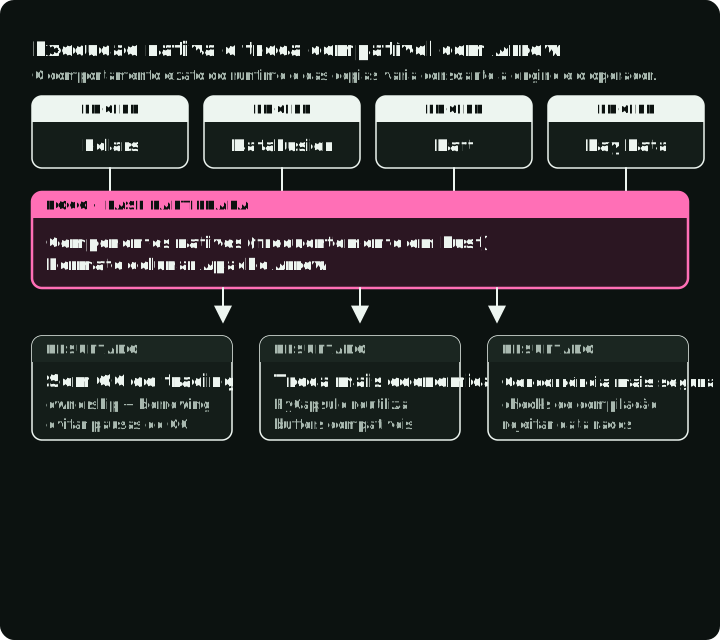
O Polars, o Daft e o DataFusion usam Rust de forma extensiva, enquanto o Ray inclui componentes nativos a par das suas APIs Python. Todos podem trocar dados através de partes do ecossistema Apache Arrow.
A Arrow PyCapsule Interface (protocolo __arrow_c_stream__) dá às bibliotecas compatíveis uma forma padrão de trocar streams Arrow. As transferências podem evitar a serialização linha a linha e podem reutilizar buffers quando os esquemas e os formatos de memória são compatíveis. A materialização, a refragmentação, a conversão de tipos ou a transferência entre dispositivos ainda podem copiar dados, por isso verifique a passagem de dados com profiling em vez de assumir que é gratuita.
O exemplo seguinte demonstra uma passagem de dados por Arrow: o DataFusion conta as compras dos utilizadores com mais de cinco compras e o Polars ordena essas contagens por classificação. O diagrama usa Polars 1.37.1, a versão fixada pelo projeto de apoio: rechunk=False mantém os buffers compatíveis, enquanto o valor por omissão rechunk=True copia vários lotes para um bloco por coluna. Os valores por omissão podem ser diferentes noutras versões. O exemplo pressupõe que events.parquet já existe. O engine_comparison_examples.ipynb de apoio cria um .data/events.parquet sintético nas suas células de preparação, antes do exemplo do Arrow.
from datafusion import SessionContext
import polars as pl

# Compute in DataFusion (Rust-native execution)
ctx = SessionContext()
ctx.register_parquet("events", "events.parquet")
df = ctx.sql("""
    SELECT user_id, COUNT(*) as event_count
    FROM events WHERE event_type = 'purchase'
    GROUP BY user_id HAVING COUNT(*) > 5
""")

# Convert through Arrow; compatible buffers may be reused
arrow_table = df.to_arrow_table()
df_polars = pl.from_arrow(arrow_table)

# Continue analysis in Polars
result = df_polars.with_columns(
    pl.col("event_count").rank().alias("rank")
).sort("rank")O Daft também pode passar um DataFrame ao PyTorch com df.to_torch_iter_dataset(), o que cobre o último passo de um pipeline de treino multimodal.
Porque é que estes motores mais recentes usam Rust para a execução nativa?
-
Sem garbage collector de tracing em código Rust. A propriedade (ownership) dá aos operadores nativos um controlo mais direto sobre a alocação e a libertação de memória. Isto pode reduzir a latência associada ao GC, mas não evita a pressão sobre a memória nem falhas por falta de memória.
-
Representações nativas compactas. As estruturas em Rust não têm cabeçalhos de objeto Java. O benefício prático depende da disposição de cada motor: os sistemas colunares na JVM também evitam representar cada valor como um objeto individual.
-
Verificações de concorrência mais fortes. O Rust seguro exclui muitas corridas de dados em tempo de compilação. O código dos motores ainda pode conter blocos unsafe e erros lógicos de concorrência.
Combinadas com o formato colunar de memória do Arrow, estas escolhas podem reduzir o custo de alocação e de serialização. Não o eliminam em todas as fronteiras; os objetos Python, o transporte em rede, os esquemas incompatíveis e a movimentação entre dispositivos continuam a contar.
Parte 5: adotar vários motores
Não tem de fazer passar toda a plataforma por um único motor. A composição é útil quando a passagem de dados entre motores custa menos do que fazer um só sistema tratar todos os workloads. O diagrama mostra uma dessas cadeias: os motores encontram-se nos ficheiros Parquet e cada escrita ou leitura através dessa fronteira custa I/O e conversão.
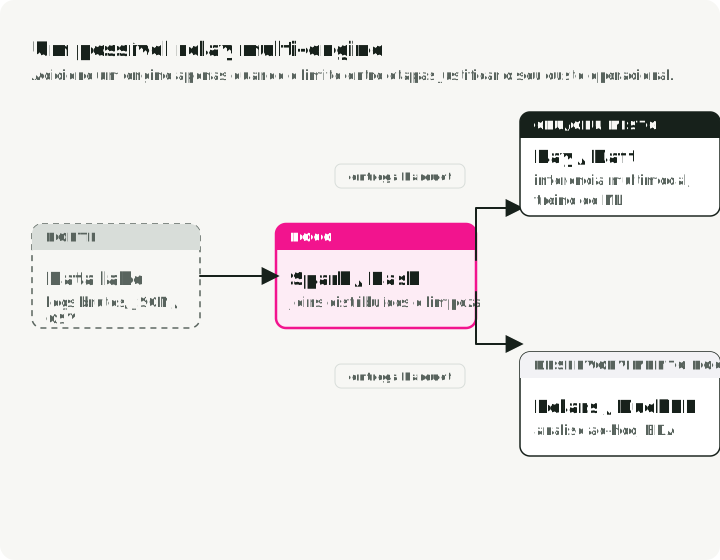
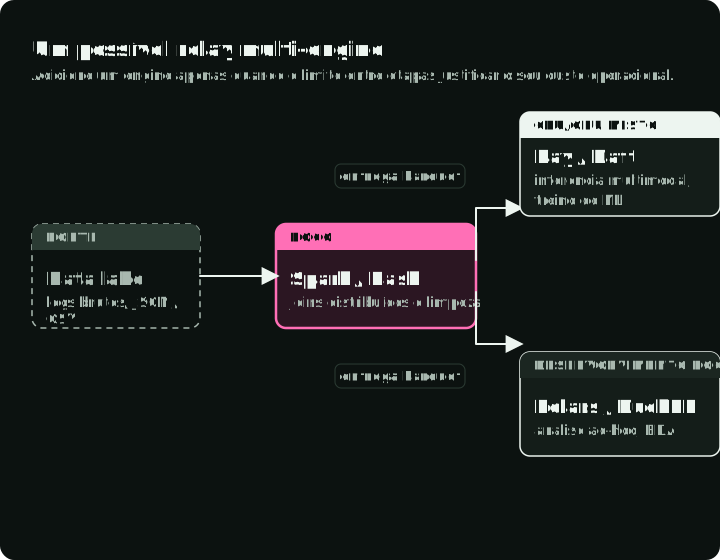
Uma cadeia possível usa o Spark para joins de lakehouse já estabelecidos, escreve num formato de tabela ou de ficheiro aberto e entrega o resultado ao Ray Data ou ao Daft para inferência no GPU ou transformações multimodais. O Polars ou o DuckDB podem servir a análise local sobre os mesmos ficheiros. Uma equipa mais pequena pode precisar de apenas um destes motores; adicione outro quando um estrangulamento medido justificar a fronteira operacional.
O que torna esta composição possível é a interoperabilidade. O Parquet é a passagem de ficheiros comum nestes exemplos, enquanto o Arrow pode fornecer a troca em memória. O suporte de Delta e Iceberg depende do motor e do conector, por isso verifique cada fronteira. Uma passagem por ficheiro também tem custos de I/O e de conversão; não é automaticamente gratuita.
Seleção do motor por caso de avaliação
A tabela associa cada workload a uma lista restrita e ao que deve testar antes de escolher.
| Caso de avaliação | Lista restrita | Validar |
|---|---|---|
| DataFrames analíticos locais | Polars / DuckDB | Encaixe da API, memória, mistura de queries |
| SQL/ETL distribuído existente | Apache Spark | Comportamento do shuffle, operações, custo |
| Trabalho paralelo nativo em Python | Dask / Ray | Overhead do agendador, modelo de falhas |
| Treino ou inferência mistos de CPU/GPU | Ray Data / Daft | Utilização do acelerador, backpressure |
| Ingestão multimodal | Daft / Ray Data | Operadores nativos, comportamento de retry |
| Motor de queries incorporado | DataFusion | APIs de extensão, cobertura de SQL |
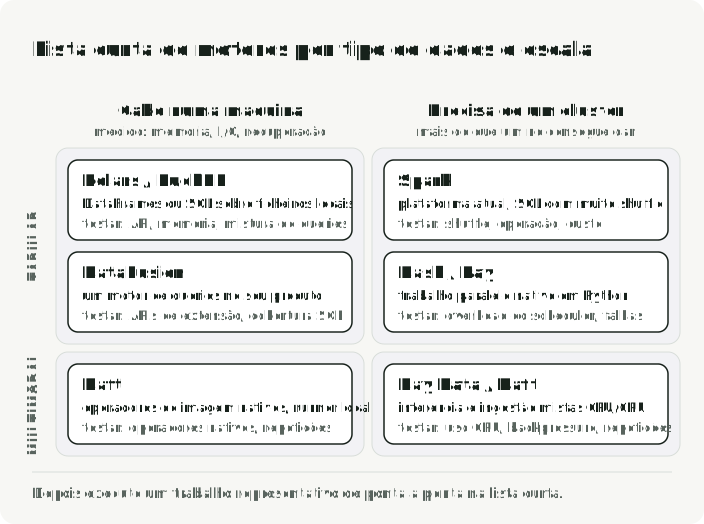
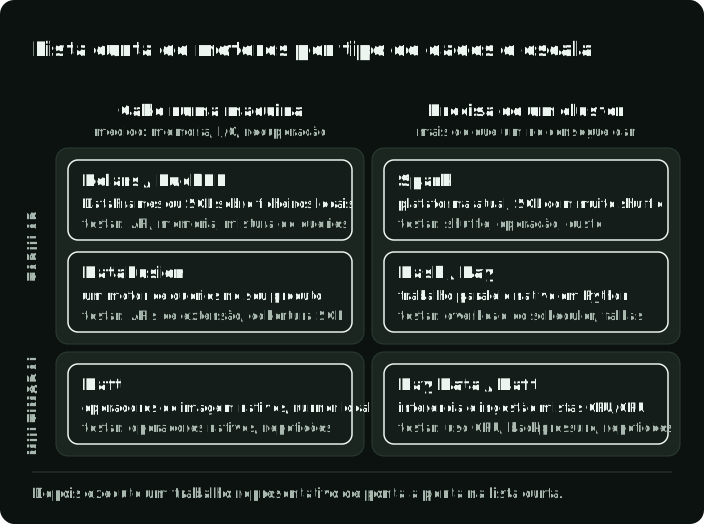
O diagrama coloca a mesma lista curta sobre duas perguntas: se os dados são tabulares ou multimodais e se o trabalho cabe numa máquina.
Escala diagonal
Durante muito tempo a escolha era entre scale up (uma máquina maior) ou scale out (mais máquinas). O Polars Cloud descreve uma abordagem que depende da query, chamada escala diagonal. Escala-se na horizontal durante a leitura do armazenamento na cloud, para aproveitar ao máximo o I/O, e depois reduz-se a um único nó grande quando os filtros e as agregações já diminuíram os dados. A redução antecipada pode limitar a transferência de dados e deixar o trabalho restante terminar num só nó. Se ocorre ou não um shuffle distribuído depende do plano físico da query. O diagrama segue uma query com tamanhos inventados: oito nós pequenos leem e filtram 1 TB, dois nós agregam o que resta e um nó grande termina com 2 GB.
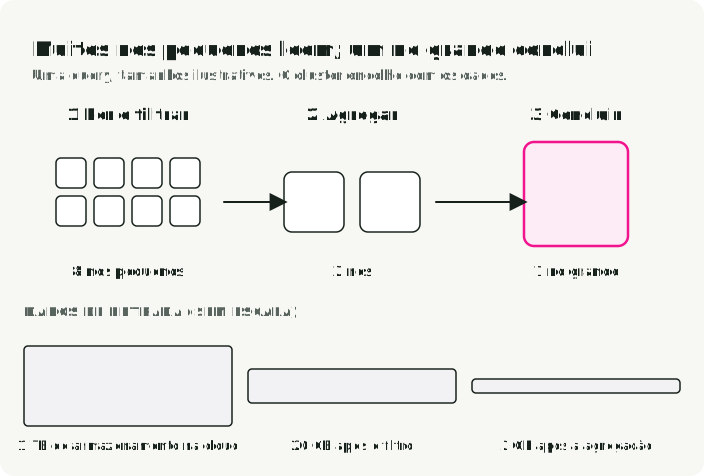
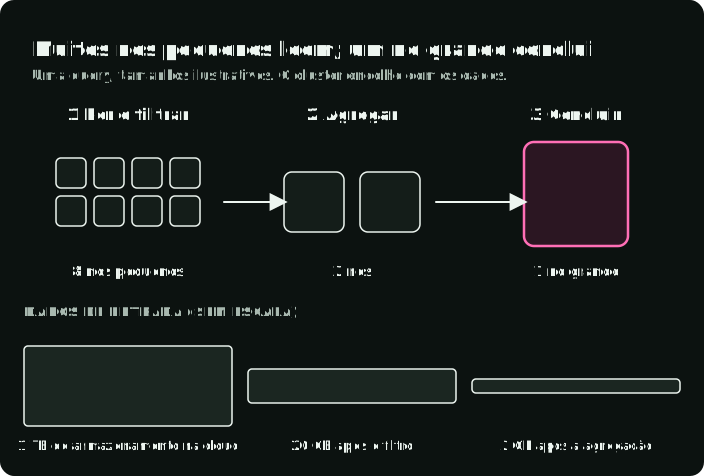
Compare o custo por job bem-sucedido, não o preço por hora da instância. Um nó maior pode sair mais barato quando a redução do tempo de execução compensa a tarifa mais alta, mas o resultado depende do I/O, da pressão sobre a memória e da quantidade de trabalho eliminada antes de um shuffle.
Reproduzir a comparação
O repositório de demonstração de apoio contém os scripts, os notebooks e o ambiente usados nas comparações. O comando tabular usa o dataset de táxis de todo o ano de 2024 predefinido no repositório, correspondente à execução acima. A primeira execução descarrega cerca de 660 MB de dados de táxis e as imagens do Food-101; o benchmark em Rust precisa de uma toolchain Rust.
# Install dependencies
uv sync

# Run the tabular benchmark (~41M NYC taxi trips from full-year 2024)
uv run python -m engine_comparison.benchmarks.tabular

# Run the multimodal benchmark (500 real food photos)
uv run python -m engine_comparison.benchmarks.multimodal

# Run native Rust benchmarks (Polars-rs + image crate)
cd rust_benchmark && cargo run --release && cd ..
O ./scripts/run_benchmarks.sh executa os três e escreve benchmarks/*.json e os gráficos combinados. Os scripts Python aceitam --runs 5 para mais execuções cronometradas, e o script de imagens aceita --images 1000 para um conjunto de imagens maior. Os notebooks distribuídos precisam de uv sync --extra distributed --extra notebook. O repositório tem também configurações de Docker Compose para execuções distribuídas locais de Spark, Ray e Daft.
Principais conclusões
-
Prove que uma máquina não chega. Os resultados de scale-up mostram que alguns scans analíticos grandes cabem num único nó. Meça os requisitos de memória, I/O, spill e recuperação antes de aceitar o custo adicional de um cluster.
-
O planeamento lazy explica mais da diferença de velocidade do que a sintaxe da API. O pushdown, o streaming e os operadores paralelos explicam grande parte da diferença entre um script de DataFrame eager e um motor analítico.
-
Meça todo o pipeline do acelerador. A descodificação, o I/O de rede, o batching, a serialização e o backpressure determinam se um GPU se mantém ocupado. O Ray Data e o Daft tornam esta sobreposição uma abstração central; o Spark pode suportá-la com conceção e ferramentas adicionais.
-
Escolha a lista restrita por workload e depois faça o benchmark. Use o encaixe no ecossistema para reduzir as opções e um job representativo de ponta a ponta para escolher. Volte a executar a alegação de benchmark de um fornecedor no seu próprio job antes de contar com ela.
-
Formatos abertos mantêm a escolha reversível. Interfaces compatíveis com Arrow, Parquet e formatos de tabela abertos podem reduzir os custos de passagem de dados. Confirme se uma conversão específica reutiliza os buffers ou os copia.
Referências
Benchmarks e dados de desempenho
- Polars PDS-H Benchmarks - Polars em streaming vs. Pandas com SF-10 (94x) e SF-100 (cerca de 6x sobre o motor em memória)
- DataFusion ClickBench Results (Nov 2024) - Resultados de Parquet num único nó publicados pelo projeto
- Embucket: TPC-H SF-1000 on DataFusion - Estudo de caso de um fornecedor num único nó grande; duas queries foram reescritas para terminarem
- Amazon Spark-to-Ray Migration - Eficiência de custo em produção 82% melhor por GiB de entrada no S3
- Daft Flotilla Benchmarks - 4 a 18x mais rápido do que o Spark em workloads multimodais
- Anyscale Ray vs. Daft Benchmarks - Benchmark concorrente de fornecedor para workloads multimodais
Motores e frameworks
- Polars - Biblioteca de DataFrames em Rust com execução lazy
- Apache DataFusion - Motor de queries em Rust incorporável (GitHub)
- Daft - DataFrame distribuído nativo para dados multimodais
- Ray - Framework de computação distribuída para AI (Data Internals)
- Apache Spark - Motor distribuído de ETL e SQL
- DuckDB - Motor de SQL analítico em processo
- Dask - Computação paralela nativa em Python
Arquitetura e ecossistema
- Polars Cloud: Diagonal Scaling - Escala dinâmica vertical/horizontal
- Daft Flotilla Architecture - Motor distribuído Swordfish + Flotilla
- Apache DataFusion Comet - Acelerador de Spark desenvolvido originalmente na Apple
- Apache Arrow - Formato colunar em memória (Flight RPC, PyCapsule Interface)
- InfluxDB 3.0 + DataFusion - Base de dados de séries temporais construída sobre o DataFusion
- GreptimeDB - Base de dados de observabilidade que usa o DataFusion
Repositório de demonstração
- engine-comparison-demo - Código de apoio deste artigo: benchmarks, notebooks e Docker Compose para Spark/Ray/Daft
Datasets
- NYC Taxi Trip Records - Dados de táxis amarelos da NYC TLC (Parquet, cerca de 2,9 M de linhas por mês)
- Food-101 Dataset - 101 mil imagens de comida da ETH Zurique (Bossard et al., ECCV 2014)