Moteurs de traitement des données : Polars, DataFusion, Ray et Spark

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Ce guide aide les ingénieurs Python et data à choisir un moteur de traitement pour des données tabulaires et pour des pipelines d’images, d’audio ou de texte. Il explique comment Polars, DataFusion, Daft, Ray Data et Spark exécutent le travail, quels workloads leur conviennent et comment les comparer sur vos propres données.
Les pipelines modernes traitent aussi des images, de l’audio et de la vidéo. Dans ces workloads, le décodage sur CPU peut laisser le GPU sans données à traiter. Les opérateurs natifs, l’échange de données en colonnes et le chevauchement du travail CPU/GPU répondent à des coûts différents ; choisir un moteur revient à trouver quel coût limite votre pipeline.
Pour comparer ces options, j’ai mesuré Pandas, Polars, DataFusion, Daft et Rust natif sur deux datasets réels : les courses de taxi de New York représentent le travail tabulaire, et les images de Food-101 représentent un pipeline multimodal. Spark et Ray sont traités dans des notebooks distribués séparés.
Le dépôt engine-comparison-demo contient le code.
Types de workloads de traitement de données
Les moteurs se spécialisent : déterminez donc d’abord quel type de workload vous avez. La séparation principale oppose le structuré au multimodal. Le diagramme montre comment le volume de données évolue dans chaque cas : un job tabulaire le réduit à chaque étape, alors qu’un job multimodal l’étend.
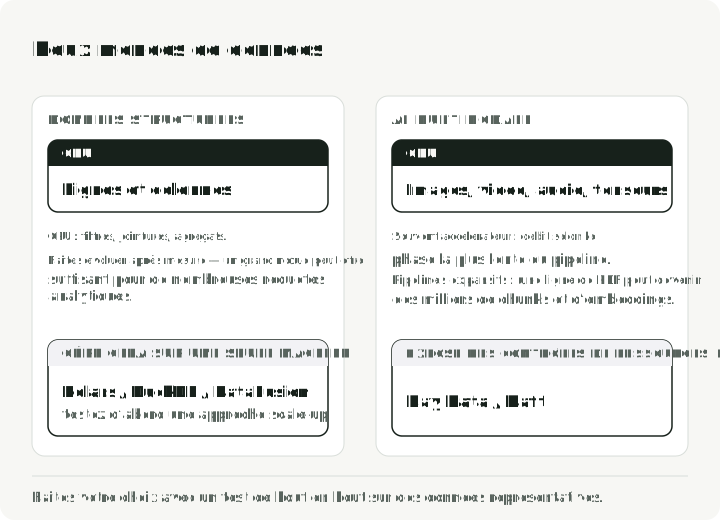
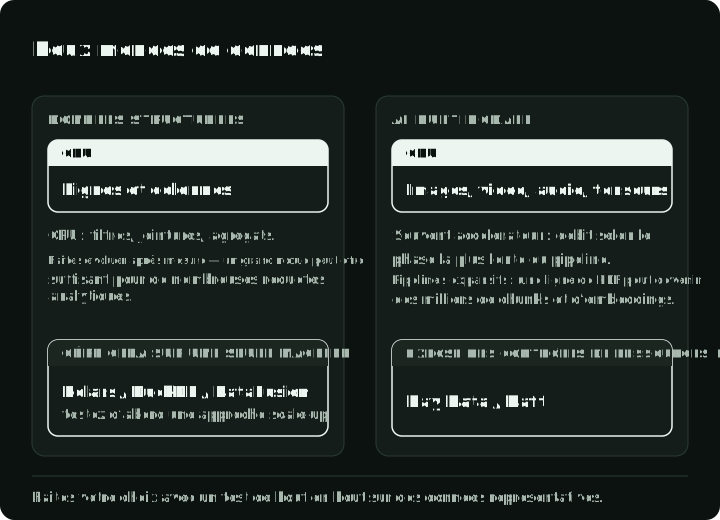
Les données structurées ou tabulaires impliquent des filtres, des agrégations et des jointures. Elles sont généralement limitées par le CPU et tiennent souvent en mémoire. Beaucoup de ces requêtes peuvent tourner sur une seule machine moderne, mais la mémoire, les E/S, la concurrence, la reprise sur panne et la forme du workload déterminent encore si un cluster est approprié.
L’AI multimodale traite des images, de l’audio ou de la vidéo. L’inférence peut tourner sur un GPU alors que le décodage CPU, les lectures distantes ou le batching limitent le pipeline. L’étape qui limite le débit change avec le type d’instance et les opérateurs : mesurez donc l’utilisation sur tout le trajet plutôt que de dimensionner le GPU isolément.
Les moteurs plus récents ciblent différentes parties de cet espace. L’exécution native peut réduire la surcharge de Python, les interfaces compatibles Arrow peuvent rendre l’échange de données moins coûteux, et l’exécution en streaming peut borner la mémoire sur des datasets plus grands que la RAM. Aucun de ces avantages n’est automatique pour tous les opérateurs ni toutes les conversions.
Partie 1 : traitement sur un seul nœud
Pandas privilégie un modèle de programmation eager : il exécute chaque opération immédiatement, en gardant généralement les données en mémoire. Un modèle lazy planifie au contraire plusieurs opérations ensemble avant de les exécuter. Dans Pandas, de nombreuses opérations courantes créent des tables intermédiaires, et l’exécution parallèle n’est pas coordonnée par un optimiseur de requêtes. Ce compromis garde le code exploratoire direct, mais il peut devenir coûteux sur des scans analytiques plus volumineux.
Le diagramme montre ce que chaque modèle lit dans le fichier Parquet pour la requête taxi utilisée plus bas : le chemin eager lit les 19 colonnes avant de filtrer, alors que le plan lazy laisse l’optimiseur pousser le filtre et les 3 colonnes utilisées dans le scan.
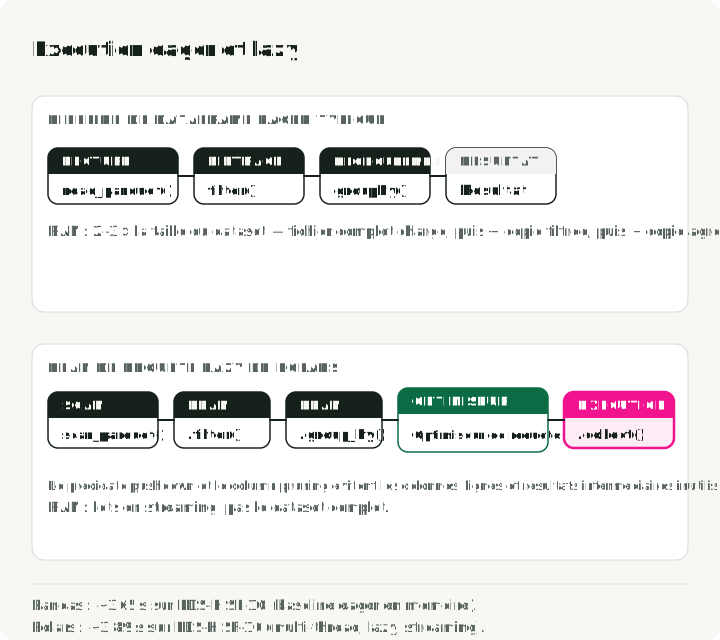
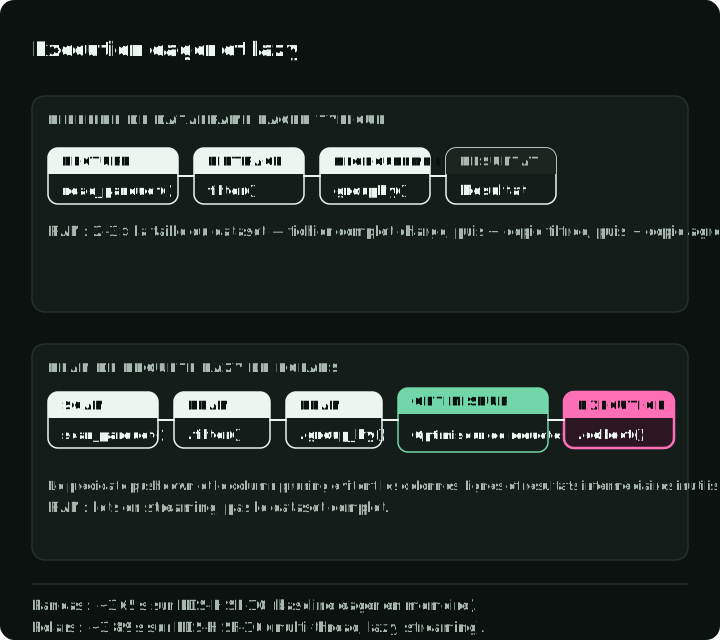
Dans le benchmark PDS-H de Polars de mai 2025, au facteur d’échelle 10, Pandas a mis environ 365 secondes pour la suite, contre 3,89 secondes pour le moteur streaming de Polars. Le résultat d’environ 94x décrit ce benchmark et cette configuration ; ce n’est pas un facteur de conversion général de Pandas vers Polars.
Polars pour les pipelines tabulaires locaux
Polars est un choix par défaut pratique quand un pipeline DataFrame local a dépassé l’exécution eager en processus unique. Son API lazy construit un plan de requête avant l’exécution. Il peut ainsi filtrer les lignes le plus tôt possible (predicate pushdown) et ne lire que les colonnes nécessaires (projection pruning). Le moteur peut ensuite exécuter les opérateurs en parallèle et, lorsque c’est pris en charge, par lots en streaming.
Au facteur d’échelle 100 (environ 100 Go de CSV), le moteur streaming de Polars était environ 6x plus rapide que son moteur en mémoire sur la même machine. La source attribue cet écart surtout à moins d’échecs de cache CPU et à une meilleure utilisation des cœurs ; ce n’est pas une preuve qu’il traitait des données plus grandes que la RAM.
La requête ci-dessous lit les courses de taxi depuis Parquet, sélectionne celles de plus de cinq miles dont le montant total dépasse $30, puis calcule des nombres et des moyennes par type de paiement. Le notebook associé engine_comparison_examples.ipynb contient des exemples connexes d’API et de configuration ; tabular.py télécharge les données de taxi et exécute le job chronométré décrit plus bas :
import polars as pl

# Build a lazy scan; query execution happens at collect()
q = (
    pl.scan_parquet("yellow_tripdata_2024-01.parquet")
    .filter(
        (pl.col("trip_distance") > 5.0)
        & (pl.col("total_amount") > 30.0)
    )
    .group_by("payment_type")
    .agg(
        pl.col("total_amount").mean().alias("avg_fare"),
        pl.col("trip_distance").mean().alias("avg_distance"),
        pl.len().alias("trip_count"),
    )
)

# The entire plan is optimized and executed here, in parallel
result = q.collect(engine="streaming")
La différence importante tient au modèle d’exécution. Dans la requête lazy ci-dessus, Polars peut pousser le filtre et la sélection des colonnes dans le scan Parquet. Il peut ainsi ignorer des row groups et éviter de lire les colonnes inutilisées. Le streaming est explicite ici ; collect matérialise tout de même le résultat final, et les opérations non prises en charge peuvent revenir à une exécution en mémoire. Un pipeline Pandas eager typique n’a pas de plan global de requête à optimiser, même si un usage soigné des filtres Parquet, des colonnes sélectionnées et d’autres backends peut combler une partie de l’écart.
DataFusion pour les moteurs de requêtes embarqués
Là où Polars est une bibliothèque que l’on utilise directement, DataFusion est le moteur sur lequel on construit d’autres moteurs. Il alimente InfluxDB 3.0, GreptimeDB et Apache DataFusion Comet, un accélérateur de Spark développé d’abord chez Apple.
Dans une exécution de ClickBench publiée par le projet DataFusion en novembre 2024, DataFusion arrivait en tête des configurations Parquet testées sur un seul nœud. L’équipe Embucket a ensuite publié une exécution de TPC-H au facteur d’échelle 1000 sur un seul gros nœud, avec deux requêtes réécrites pour aboutir. Ces résultats montrent ce que le scale-up peut atteindre dans des conditions précises ; ils ne prouvent pas que toute charge de 1 To doive éviter un cluster.
Voici le même résumé des taxis en SQL DataFusion, avec les types de paiement triés par nombre de courses. Le notebook associé engine_comparison_examples.ipynb contient des exemples connexes de SQL et de configuration :
from datafusion import SessionContext

ctx = SessionContext()
ctx.register_parquet("taxi", "yellow_tripdata_2024-01.parquet")

# Plan SQL against the registered Parquet source
df = ctx.sql("""
    SELECT payment_type,
           COUNT(*)           AS trip_count,
           AVG(trip_distance) AS avg_distance,
           AVG(total_amount)  AS avg_fare
    FROM taxi
    WHERE trip_distance > 5.0 AND total_amount > 30.0
    GROUP BY payment_type
    ORDER BY trip_count DESC
""")
result = df.to_pandas()
La force de DataFusion est sa modularité. Les API d’extension couvrent les catalogues, les fournisseurs de tables, les règles d’optimisation et les plans d’exécution personnalisés. C’est pourquoi on le retrouve dès que quelqu’un construit une plateforme de données sur mesure ou intègre un moteur de requêtes dans son propre produit.
Si votre équipe écrit du SQL sur des fichiers Parquet locaux et n’a pas besoin d’intégrer le moteur, DuckDB est une base SQL en processus qui joue le même rôle que Polars.
Daft pour les données multimodales
Daft intègre les images, l’audio, la vidéo et les embeddings au flux de travail DataFrame. Il fournit des expressions natives pour des opérations comme le décodage d’images et le téléchargement d’URL, si bien que les chemins de prétraitement courants n’exigent pas de boucle Python ligne par ligne. Cette intégration est la principale raison de le préférer à un moteur tabulaire généraliste.
Pour le travail tabulaire, l’API de Daft ressemble à celle des moteurs précédents. Cet exemple exécute le même résumé des taxis ; le notebook associé engine_comparison_examples.ipynb contient des exemples connexes d’API Daft et de configuration :
import daft

df = daft.read_parquet("yellow_tripdata_2024-01.parquet")

result = (
    df.where(
        (daft.col("trip_distance") > 5.0)
        & (daft.col("total_amount") > 30.0)
    )
    .groupby("payment_type")
    .agg(
        daft.col("total_amount").mean().alias("avg_fare"),
        daft.col("trip_distance").mean().alias("avg_distance"),
        daft.col("trip_distance").count().alias("trip_count"),
    )
    .collect()
)
L’API semblera familière si vous connaissez Pandas, mais le moteur est la même pile Rust + Arrow que dans Polars et DataFusion. Daft devient intéressant quand les « lignes » de votre DataFrame sont des images, des PDF ou des tenseurs.
Daft lit, décode et redimensionne les images avec des expressions natives, sans boucle Python sur les lignes. Voici le chemin des images dans multimodal.py :
import daft
from daft import col

df = (
    daft.from_glob_path("food101_images/*.jpg")
    .with_column("image", col("path").download().decode_image(mode="RGB"))
    .with_column("resized", col("image").resize(224, 224))
)
df.collect()
Benchmark sur un seul nœud
J’ai exécuté Pandas, Polars, DataFusion et Daft, ainsi que Rust natif via Polars-rs, sur environ 41 M de courses des taxis jaunes de New York pour toute l’année 2024. Le job chronométré filtre les courses dont le tarif dépasse $10, joint la table des zones de taxi, additionne le chiffre d’affaires par arrondissement et par zone, puis renvoie les 20 premières lignes. C’est une requête différente de celles des exemples ci-dessus. Spark et Ray apparaissent dans les exemples distribués, pas dans ce benchmark sur un seul nœud.
Chaque moteur lit les fichiers à l’intérieur de la fonction chronométrée ; le script rapporte la médiane de trois exécutions. Son vérificateur de résultats compare les 20 lignes entre les moteurs Python sur l’arrondissement, la zone, le nombre de courses et le chiffre d’affaires arrondi au centime ; il ne compare pas avg_tip. Pandas reçoit les quatre colonnes de course qu’utilise la requête, car il n’a pas d’optimiseur pour les trouver. Le graphique montre le résultat sur un Apple M5 Max avec 18 cœurs et 64 Go de RAM. Les résultats complets sont dans le dépôt de démo :
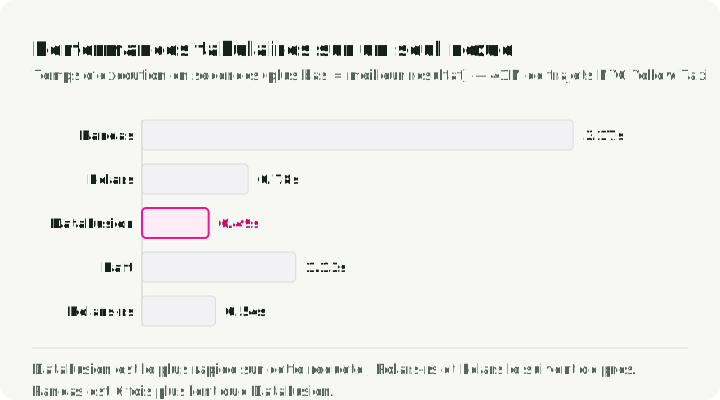
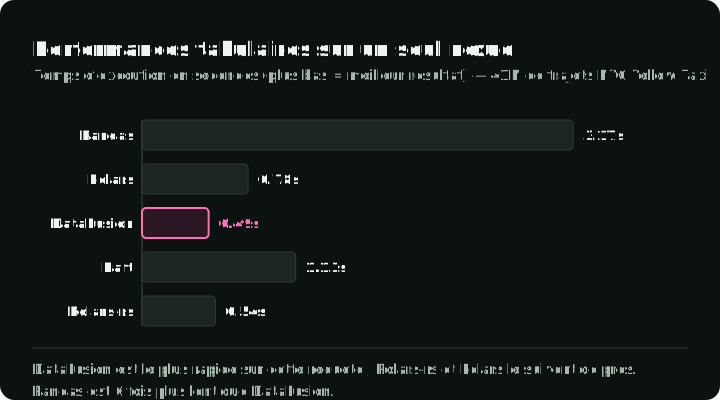
Pandas a mis 4,67 secondes. Les quatre moteurs récents ont terminé en 0,40 à 0,74 seconde, DataFusion étant le plus rapide et Polars environ 7x plus rapide que Pandas. Le chiffre de 94x de Polars face à Pandas vu plus haut vient de PDS-H ; ce job a produit un écart plus faible. Les temps ont aussi varié d’une invocation à l’autre : sur quatre exécutions du script sur une machine occupée à d’autres tâches, Pandas allait de 2,6 à 4,8 secondes. DataFusion a toujours été le moteur Python le plus rapide, tandis que Polars et Daft changeaient de place. Quand les moteurs arrivent aussi près les uns des autres, l’adéquation de l’API et des mesures répétées sur des données représentatives doivent trancher.
Partie 2 : données multimodales
L’ETL tabulaire réduit généralement les données : on filtre, on agrège, on écrit moins que ce qu’on a lu. Les pipelines d’AI multimodale font l’inverse. Le chemin d’un seul document peut se démultiplier en des dizaines de fragments de texte et de vecteurs d’embedding.
Dans un pipeline PySpark classique, les images et l’audio entrent souvent comme données binaires et passent à des bibliothèques Python pour le décodage ou la transformation. Franchir la frontière JVM/Python et sérialiser les résultats peut représenter une grande part du temps réel. Spark peut utiliser des chemins fondés sur Arrow, des UDF vectorisées et des intégrations d’accélérateurs, mais ces choix demandent une conception et des mesures explicites.
Exécution en pipeline et utilisation du GPU
Spark planifie le travail en étapes séparées par des frontières de shuffle. Une implémentation directe peut enchaîner téléchargement, décodage et inférence de façon à laisser de la capacité CPU ou GPU en attente. Spark prend en charge la planification des ressources GPU et les plugins : le temps d’inactivité n’est donc pas inévitable. Garder les étapes occupées demande aussi du backpressure : ralentir les étapes amont quand les étapes aval ne suivent pas. Ni ce contrôle ni le chevauchement du travail CPU et GPU ne se produisent automatiquement dans un job DataFrame PySpark ordinaire.
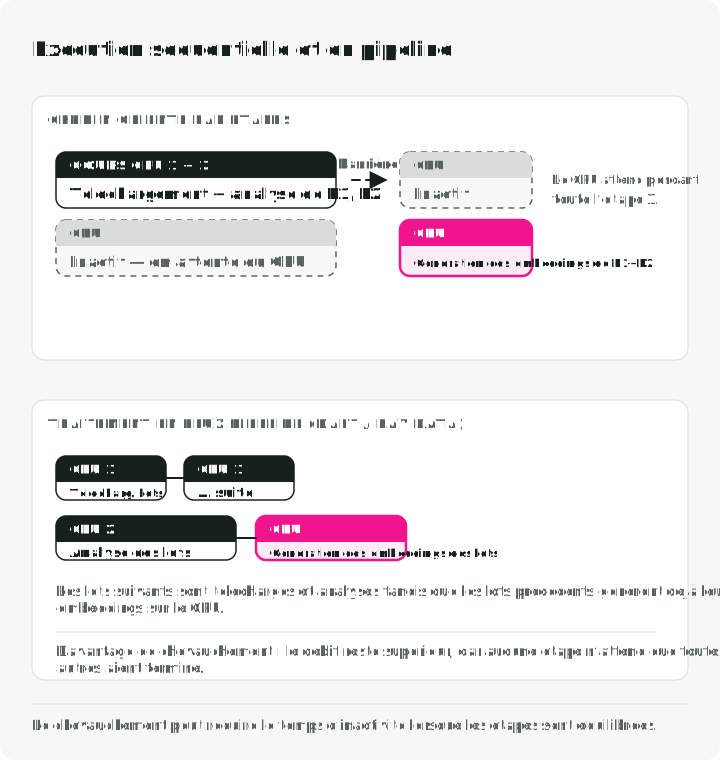
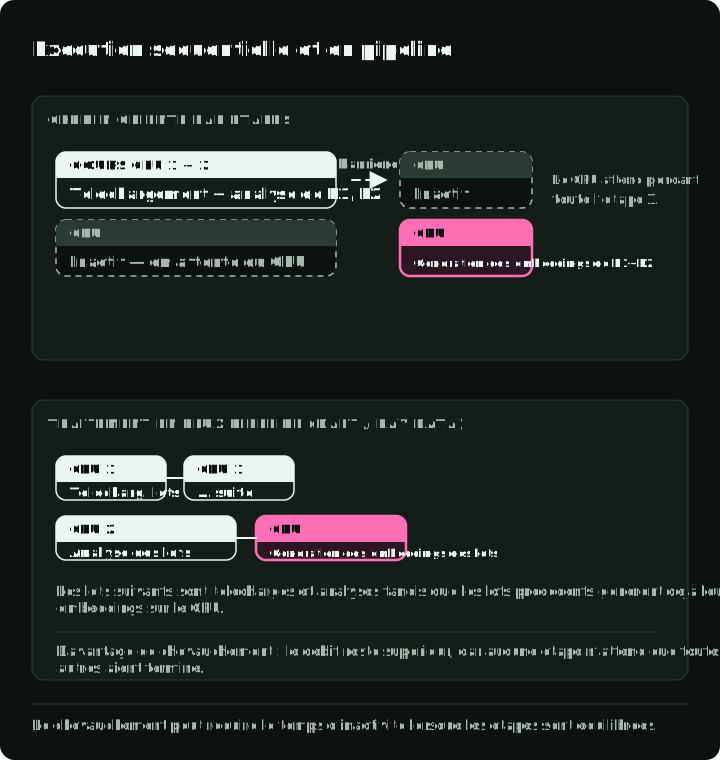
L’exécution en pipeline est l’alternative. Au lieu d’enchaîner les étapes les unes après les autres, le moteur superpose les E/S, le travail CPU et l’inférence GPU. Quand les étapes et les buffers sont équilibrés, ce chevauchement peut réduire le temps d’inactivité et améliorer le débit ; le démarrage et la vidange, le backpressure ou une étape plus lente peuvent tout de même laisser des ressources en attente.
Le diagramme montre deux lots qui traversent trois étapes. Exécutés l’un après l’autre, ils prennent six pas. En pipeline, le lot 2 est lu et décodé alors que le lot 1 est encore en cours, et le même travail prend quatre pas.
Benchmark de traitement d’images
J’ai mesuré le traitement d’images sur 500 vraies photographies du dataset Food-101. Chaque moteur lit les mêmes 500 JPEG, les décode en RGB et les redimensionne en 224×224 avec un filtre bilinéaire, à l’intérieur de la fonction chronométrée. Le script vérifie que chaque moteur a produit 500 images et rapporte la médiane de trois exécutions. Le graphique montre le résultat sur la même machine :
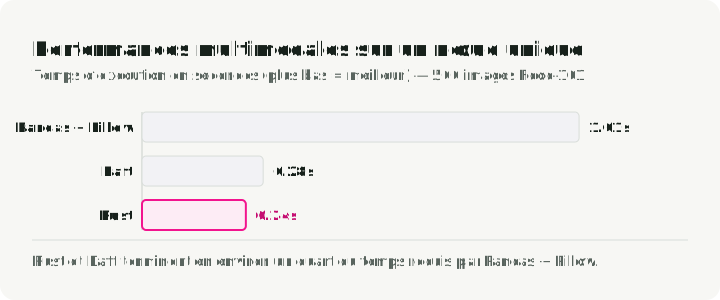
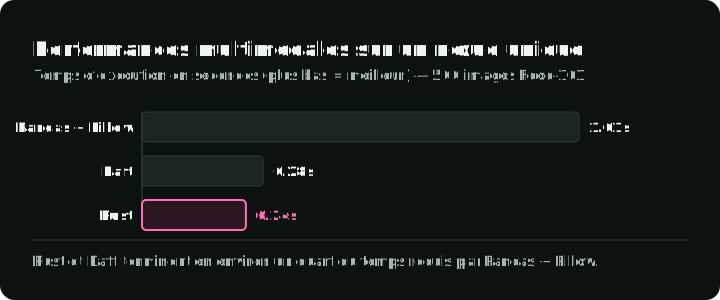
Polars et DataFusion sont absents, faute d’opérations natives sur les images. Les résultats Python et les résultats Rust enregistrés indiquent 0,55 seconde pour Pandas + Pillow, 0,34 pour Daft et 0,10 pour la crate Rust image. Pandas traite une image à la fois via apply() ; Daft et la version Rust répartissent le travail sur les cœurs. Sur quatre invocations, Pandas allait de 0,55 à 1,21 seconde. Cinq cents images sont trop peu pour prédire le débit en production, et le job s’arrête avant tout travail sur GPU : mesurez donc votre propre pipeline de bout en bout.
Partie 3 : traitement distribué
Quand une seule machine ne suffit plus, il faut choisir comment répartir le travail. Dask répartit le code Pandas et NumPy existant sur des cœurs ou un cluster avec peu de changements d’API ; il convient aux équipes Python qui ne veulent ni JVM ni nouvelle API DataFrame. Le reste de cette partie couvre Spark, Ray Data et Daft.
Apache Spark
Spark est une option éprouvée pour l’ETL tabulaire à grande échelle, les jointures lourdes en shuffle et les organisations qui exploitent déjà son écosystème. Sa reprise fondée sur le lignage et sa large prise en charge par les plateformes comptent quand la fiabilité et la familiarité opérationnelle pèsent plus que la vitesse locale. Les pipelines CPU/GPU mixtes demandent une configuration des ressources et une conception de pipeline plus délibérées que le chemin SQL ; c’est là que Ray Data et Daft offrent une abstraction plus ciblée.
Cette requête Spark joint les courses les plus longues aux informations sur les zones de prise en charge, puis résume le chiffre d’affaires total et les tarifs moyens par arrondissement. Pour la configuration d’un ETL en cluster, voir distributed_spark.ipynb ou spark_etl.py :
from pyspark.sql import SparkSession
from pyspark.sql import functions as F

spark = SparkSession.builder \
    .appName("TaxiETL") \
    .config("spark.sql.adaptive.enabled", "true") \
    .getOrCreate()

orders = spark.read.parquet("s3a://lake/taxi/*.parquet")
zones = spark.read.csv("s3a://lake/taxi_zones.csv", header=True)

# Spark excels at this: joining massive tables with a shuffle
result = (
    orders
    .filter(F.col("trip_distance") > 5.0)
    .join(zones, orders.PULocationID == zones.LocationID, "inner")
    .groupBy("Borough")
    .agg(
        F.sum("total_amount").alias("total_revenue"),
        F.avg("total_amount").alias("avg_fare"),
    )
    .orderBy(F.desc("total_revenue"))
)

# Spark is lazy: the write runs the query
result.write.mode("overwrite").parquet("s3a://warehouse/report/")
Ray Data pour le calcul hétérogène
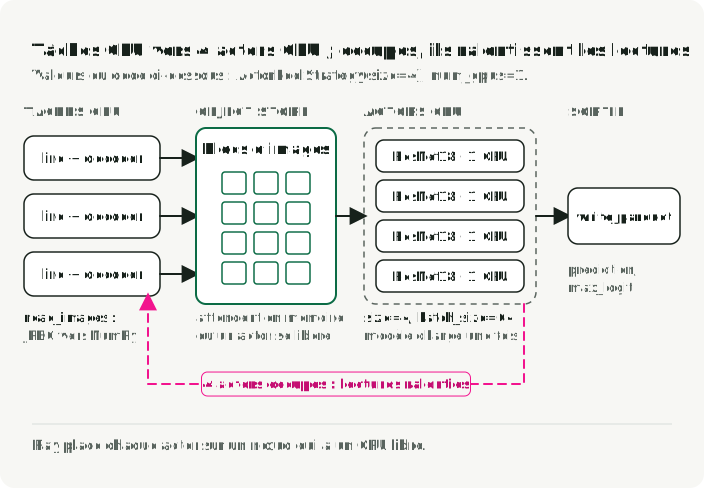
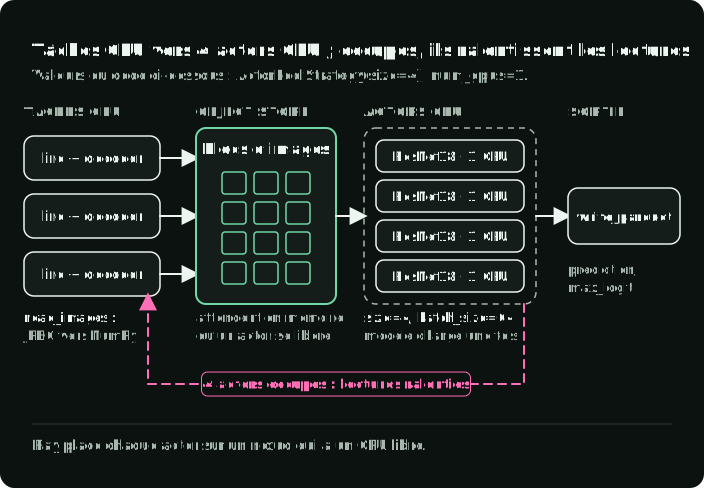
Ray Data a été conçu autour des workloads d’AI. Au lieu des barrières entre étapes de Spark, il utilise un modèle en streaming qui envoie des lots aux workers GPU pendant que les lots suivants sont encore en cours de lecture. Un actor Ray est un worker persistant qui peut garder un modèle chargé entre les lots. La fonctionnalité qui compte le plus pour les pipelines d’AI est la planification de ressources mixtes : vous pouvez déclarer qu’un actor veut « 1 GPU, 4 CPU » et qu’un autre ne veut que des CPU, et Ray place chaque actor sur un nœud qui dispose de ces ressources.
Amazon a rapporté une efficacité des coûts supérieure de 82 % par Gio d’entrée S3 après avoir migré certains workloads internes de Spark vers Ray. L’échelle est remarquable, mais c’est une étude de cas de migration pour des workloads précis, pas une économie à attendre d’une adoption typique de Ray.
L’exemple ci-dessous lit des images, les classe avec ResNet18 sur des workers GPU et écrit les prédictions dans Parquet. Le diagramme montre le pipeline qu’il construit : des tâches CPU lisent et décodent les images vers l’object store de Ray, un pool de quatre actors GPU exécute le modèle, et le backpressure ralentit les lectures quand les actors GPU sont pleins.
Pour la configuration de l’inférence d’images, voir distributed_ray.ipynb ou ray_inference.py :
import ray

ray.init()

ds = ray.data.read_images("s3://my-bucket/food101/", mode="RGB")

class ImageClassifier:
    def __init__(self):
        import torch
        from torchvision.models import resnet18, ResNet18_Weights
        self.model = resnet18(weights=ResNet18_Weights.DEFAULT).cuda()
        self.model.eval()
        self.preprocess = ResNet18_Weights.DEFAULT.transforms()

    def __call__(self, batch):
        import torch
        from PIL import Image
        tensors = torch.stack([
            self.preprocess(Image.fromarray(img)) for img in batch["image"]
        ]).cuda()
        with torch.no_grad():
            preds = self.model(tensors)
        return {
            "prediction": preds.argmax(dim=1).cpu().numpy(),
            "max_logit": preds.max(dim=1).values.cpu().numpy(),
        }

# ActorPoolStrategy creates persistent GPU workers
predictions = ds.map_batches(
    ImageClassifier,
    compute=ray.data.ActorPoolStrategy(size=4),
    num_gpus=1,
    batch_size=64,
)
predictions.write_parquet("s3://output/predictions/")
Cette esquisse réserve quatre actors à un GPU chacun et exige quatre GPU CUDA disponibles, les poids de Torchvision et un accès à S3. Ray lit les images sous forme de tableaux NumPy ; convertir les tableaux RGB en PIL donne à la transformation de prétraitement de ResNet18 une entrée qu’elle accepte. max_logit est le plus grand score brut du modèle, pas une probabilité de confiance.
Dans les benchmarks d’Anyscale, la classification d’images de Ray Data a été environ 4x plus rapide (de 456 à 111 secondes) quand l’instance est passée de 4 CPUs par GPU à 32 CPUs par GPU. Anyscale attribue cette amélioration à une moindre limitation par les CPU ; l’utilisation des GPU est restée faible en valeur absolue. Daft a progressé de 4 à 16 CPUs par GPU, puis est resté proche de 195 secondes aussi bien avec 16 qu’avec 32.
Daft distribué
Daft passe à l’échelle grâce à son moteur Flotilla : un worker Swordfish par nœud, avec Flotilla au-dessus pour l’ordonnancement à l’échelle du cluster. Swordfish gère l’exécution locale en Rust et fait chevaucher les E/S et le calcul par un streaming en petits lots, de sorte que chaque nœud reste occupé sans attendre l’étape suivante.
Dans les benchmarks publiés par Daft, Flotilla a tourné 4 à 18x plus vite que les implémentations Spark testées sur quatre workloads multimodaux. Le plus grand écart concernait un cas de détection d’objets dans des vidéos. Voyez ce résultat comme la preuve que la conception de l’exécution peut changer le débit de cet ordre sur ces pipelines, puis comparez-le aux résultats concurrents d’Anyscale ci-dessous et à un test local.
Anyscale, l’entreprise derrière Ray, a publié un benchmark concurrent dans lequel Ray Data a comblé ou inversé l’écart sur des instances à nombreux CPU après réglage. Ensemble, les deux études de fournisseurs sont une raison de tester des opérateurs représentatifs et des ratios CPU/GPU, pas d’en déduire un classement durable.
L’exemple suivant utilise le runner Ray de Daft ; il ne reproduit pas le benchmark Flotilla ci-dessus. Il lit une table d’URL d’images, télécharge les images, calcule leurs embeddings avec CLIP sur des workers GPU et écrit les vecteurs dans Parquet. Il adapte daft_pipeline.py pour les workers GPU de Ray. Avec l’API Transformers 5.0.0 fixée par le projet associé, les caractéristiques projetées des images sont dans .pooler_output. Le notebook associé est distributed_daft.ipynb :
import io

import daft
import numpy as np
from daft import col

# Connect to an existing Ray cluster before building the query
daft.set_runner_ray(address="auto")

# Define a GPU class UDF: the model loads once per instance
@daft.cls(gpus=1)
class ImageEmbedder:
    def __init__(self):
        import torch
        from transformers import CLIPModel, CLIPProcessor

        self.device = "cuda" if torch.cuda.is_available() else "cpu"
        self.model = CLIPModel.from_pretrained(
            "openai/clip-vit-base-patch32"
        ).to(self.device)
        self.processor = CLIPProcessor.from_pretrained(
            "openai/clip-vit-base-patch32"
        )
        self.model.eval()

    @daft.method.batch(
        return_dtype=daft.DataType.fixed_size_list(daft.DataType.float32(), 512)
    )
    def __call__(self, image_bytes_col):
        import torch
        from PIL import Image

        embeddings = []
        for img_bytes in image_bytes_col.to_pylist():
            img = Image.open(io.BytesIO(img_bytes)).convert("RGB")
            inputs = self.processor(images=img, return_tensors="pt").to(self.device)
            with torch.no_grad():
                features = self.model.get_image_features(**inputs).pooler_output
            embeddings.append(features[0].cpu().numpy())
        return np.array(embeddings, dtype=np.float32)

embedder = ImageEmbedder()

df = (
    daft.read_parquet("s3://bucket/image_metadata.parquet")
    # Native Rust I/O downloads the images; no Python requests loop
    .with_column("image_bytes", col("image_url").download())
    .with_column("embedding", embedder(col("image_bytes")))
    .exclude("image_bytes")
)
df.write_parquet("s3://bucket/embeddings/")
Le runner Ray de Daft se connecte à un cluster existant ; le runner natif par défaut utilise la machine locale. Installez Daft avec la prise en charge de Ray et fournissez sur ce cluster des workers GPU, Transformers 5.0.0, les poids de CLIP et les identifiants S3. L’API de classe et de méthode par lots conserve le modèle entre les lots, et gpus=1 demande au runner un GPU par instance ; la révision du dépôt liée utilise un simple @daft.cls et une seule partition, car elle vise un seul GPU local. Les téléchargements peuvent chevaucher l’inférence GPU, sous réserve du partitionnement et du backpressure.
Cette révision du projet associé remplace les images manquantes ou tout échec de traitement par un vecteur nul, y compris en cas d’échec du contrôle de forme des embeddings. Elle indexe l’objet de sortie CLIP sans sélectionner .pooler_output, ce qui fait échouer ce contrôle avec Transformers 5.0.0 ; des images valides peuvent donc aussi devenir des vecteurs nuls. Utilisez l’extraction des caractéristiques projetées présentée ici ; cette esquisse laisse les erreurs de traitement faire échouer le job.
Comparaison des moteurs distribués
| Caractéristique | Spark | Ray Data | Daft (Flotilla) |
|---|---|---|---|
| Modèle d’exécution | Une tâche par cœur, par partition | Tâches et actors en streaming | Un Swordfish par nœud, lots en streaming |
| Points forts | SQL/ETL massif, tolérance aux pannes | Calcul hétérogène, saturation des GPU | Pipelines multimodaux, mémoire bornée |
| Contrôle des GPU | Planification des ressources et plugins | Ressources explicites par tâche et par actor | Planification CPU/GPU intégrée au pipeline |
| Réglages typiques | Executors, mémoire, partitions, accélérateurs | Lots, actors, object store | Lots, ressources, concurrence des E/S |
| Bon cas d’évaluation | Gros SQL/ETL et jobs lourds en shuffle | Entraînement ou inférence à ressources mixtes | Ingestion et transformation multimodales |
Partie 4 : le rôle de Rust et d’Arrow
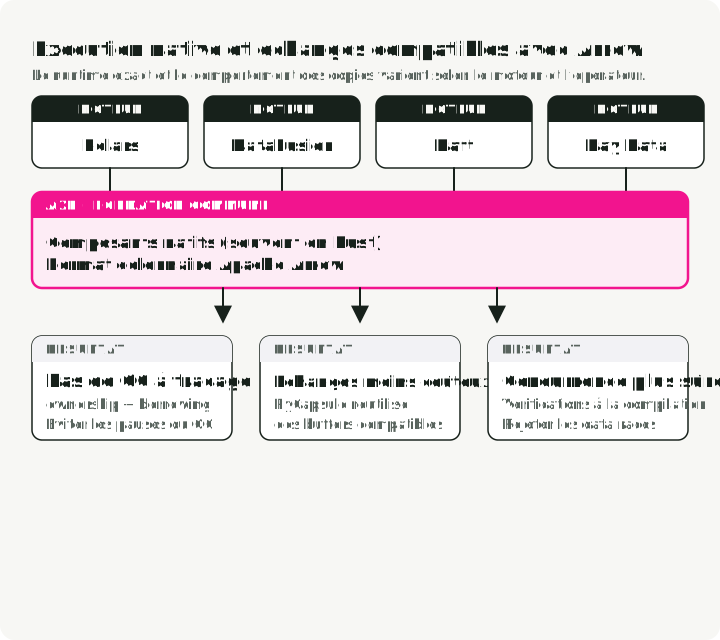
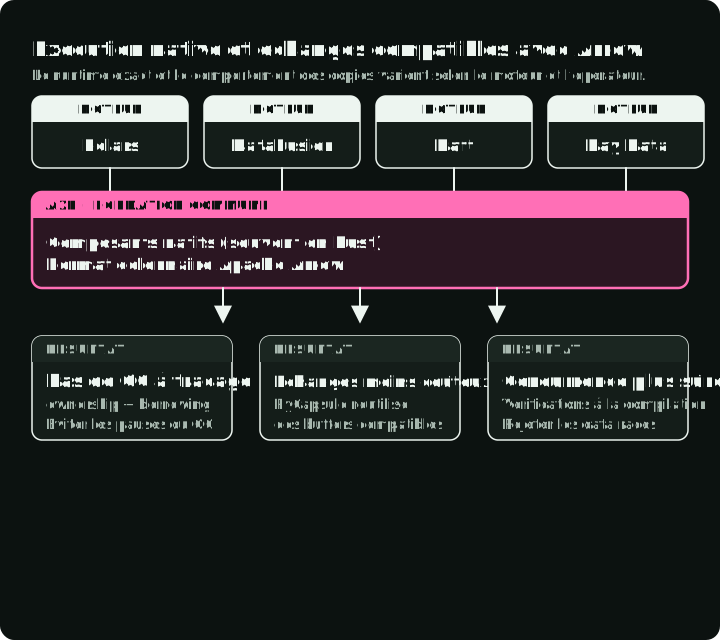
Polars, Daft et DataFusion utilisent beaucoup Rust, tandis que Ray comprend des composants natifs à côté de ses API Python. Tous peuvent échanger des données grâce à des parties de l’écosystème Apache Arrow.
L’interface PyCapsule d’Arrow (protocole __arrow_c_stream__) offre aux bibliothèques compatibles un moyen standard d’échanger des flux Arrow. Les transferts peuvent éviter la sérialisation ligne par ligne et réutiliser les buffers quand les schémas et les dispositions mémoire sont compatibles. Une matérialisation, un redécoupage en chunks, une conversion de type ou un transfert vers un périphérique peuvent tout de même copier les données : vérifiez donc le passage de relais par du profilage au lieu de le supposer gratuit.
L’exemple suivant montre un passage de relais par Arrow : DataFusion compte les achats des utilisateurs ayant plus de cinq achats, et Polars classe ces comptes. Le diagramme utilise Polars 1.37.1, la version fixée par le projet associé : rechunk=False conserve les buffers compatibles, tandis que la valeur par défaut rechunk=True copie plusieurs lots dans un seul chunk par colonne. Les valeurs par défaut peuvent différer dans d’autres versions. L’exemple suppose que events.parquet existe déjà. Le notebook associé engine_comparison_examples.ipynb crée un fichier synthétique .data/events.parquet dans ses cellules d’initialisation avant l’exemple Arrow.
from datafusion import SessionContext
import polars as pl

# Compute in DataFusion (Rust-native execution)
ctx = SessionContext()
ctx.register_parquet("events", "events.parquet")
df = ctx.sql("""
    SELECT user_id, COUNT(*) as event_count
    FROM events WHERE event_type = 'purchase'
    GROUP BY user_id HAVING COUNT(*) > 5
""")

# Convert through Arrow; compatible buffers may be reused
arrow_table = df.to_arrow_table()
df_polars = pl.from_arrow(arrow_table)

# Continue analysis in Polars
result = df_polars.with_columns(
    pl.col("event_count").rank().alias("rank")
).sort("rank")Daft peut aussi passer un DataFrame à PyTorch avec df.to_torch_iter_dataset(), ce qui couvre la dernière étape d’un pipeline d’entraînement multimodal.
Pourquoi ces moteurs récents utilisent-ils Rust pour l’exécution native ?
-
Pas de ramasse-miettes à traçage dans le code Rust. La propriété (ownership) donne aux opérateurs natifs un contrôle plus direct de l’allocation et de la libération de la mémoire. Cela peut réduire la latence liée au GC, mais n’empêche ni la pression mémoire ni les pannes par manque de mémoire.
-
Représentations natives compactes. Les structures Rust ne portent pas d’en-têtes d’objets Java. Le bénéfice pratique dépend de la disposition du moteur : les systèmes JVM en colonnes évitent aussi de représenter chaque valeur par un objet distinct.
-
Contrôles de concurrence plus stricts. Le Rust sûr écarte à la compilation de nombreuses courses de données. Le code d’un moteur peut tout de même contenir des blocs unsafe et des bogues logiques de concurrence.
Combinés à la disposition mémoire en colonnes d’Arrow, ces choix peuvent réduire la surcharge d’allocation et de sérialisation. Ils ne la suppriment pas à chaque frontière ; les objets Python, le transport réseau, les schémas incompatibles et les mouvements entre périphériques comptent toujours.
Partie 5 : adopter plusieurs moteurs
Vous n’êtes pas obligé de faire passer toute la plateforme par un seul moteur. La composition est utile quand le passage de relais entre moteurs coûte moins cher que de faire gérer tous les workloads par un seul système. Le diagramme montre un tel relais : les moteurs se rejoignent sur des fichiers Parquet, et chaque écriture ou lecture à travers cette frontière coûte des E/S et des conversions.
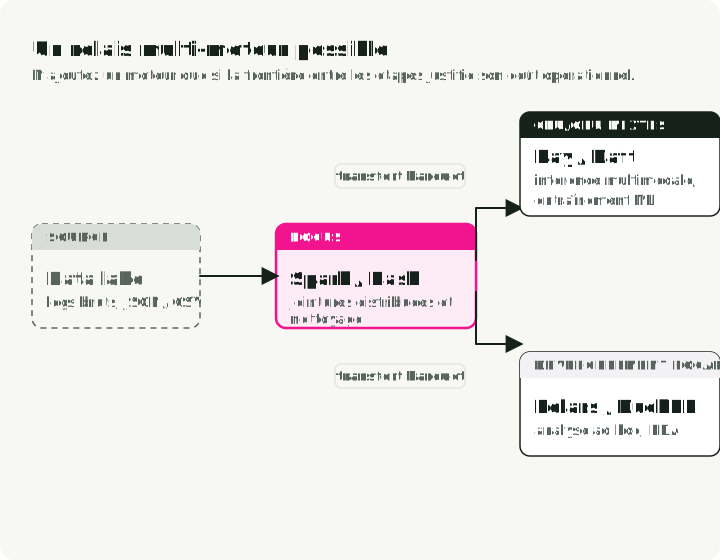
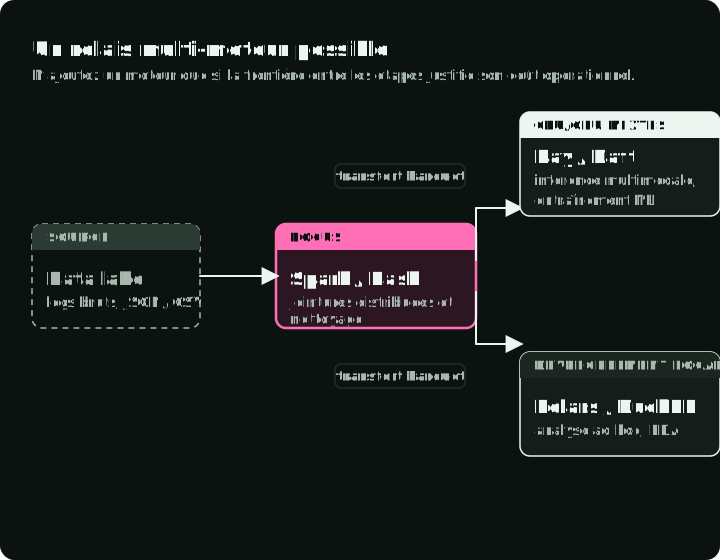
Un relais possible utilise Spark pour les jointures établies du lakehouse, écrit un format de table ou de fichier ouvert, puis passe le résultat à Ray Data ou Daft pour l’inférence GPU ou les transformations multimodales. Polars ou DuckDB peuvent servir l’analyse locale sur les mêmes fichiers. Une petite équipe peut n’avoir besoin que d’un seul de ces moteurs ; ajoutez-en un autre quand un goulot d’étranglement mesuré justifie la frontière opérationnelle.
Ce qui rend cette composition possible, c’est l’interopérabilité. Parquet est le format de fichier commun dans ces exemples, tandis qu’Arrow peut assurer l’échange en mémoire. La prise en charge de Delta et d’Iceberg dépend du moteur et du connecteur : vérifiez donc chaque frontière. Un passage par fichier a aussi un coût d’E/S et de conversion ; il n’est pas gratuit d’office.
Choisir un moteur selon le cas d’évaluation
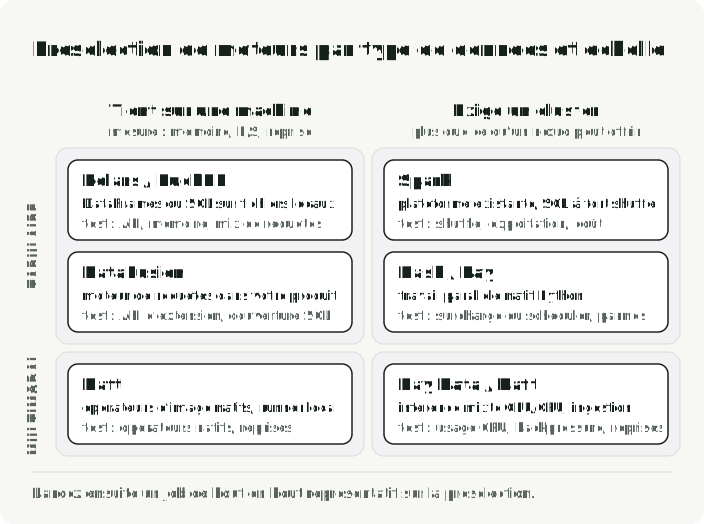
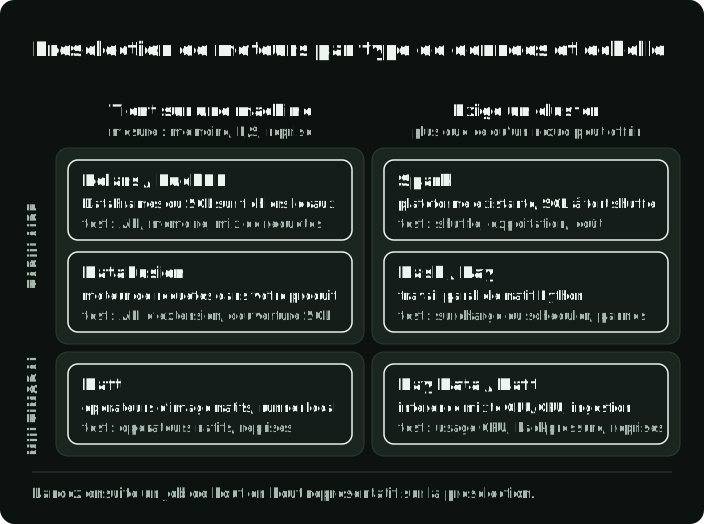
Le tableau associe chaque workload à une présélection et à ce qu’il faut tester avant de choisir.
| Cas d’évaluation | Présélection | À valider |
|---|---|---|
| DataFrames analytiques locaux | Polars / DuckDB | Adéquation de l’API, mémoire, mix de requêtes |
| SQL/ETL distribué existant | Apache Spark | Comportement du shuffle, exploitation, coût |
| Travail parallèle natif Python | Dask / Ray | Surcharge du scheduler, modèle de panne |
| Entraînement ou inférence CPU/GPU mixtes | Ray Data / Daft | Utilisation des accélérateurs, backpressure |
| Ingestion multimodale | Daft / Ray Data | Opérateurs natifs, comportement des reprises |
| Moteur de requêtes embarqué | DataFusion | API d’extension, couverture SQL |
Le diagramme place la même présélection sur deux questions : les données sont-elles tabulaires ou multimodales, et le job tient-il sur une machine.
Scaling diagonal
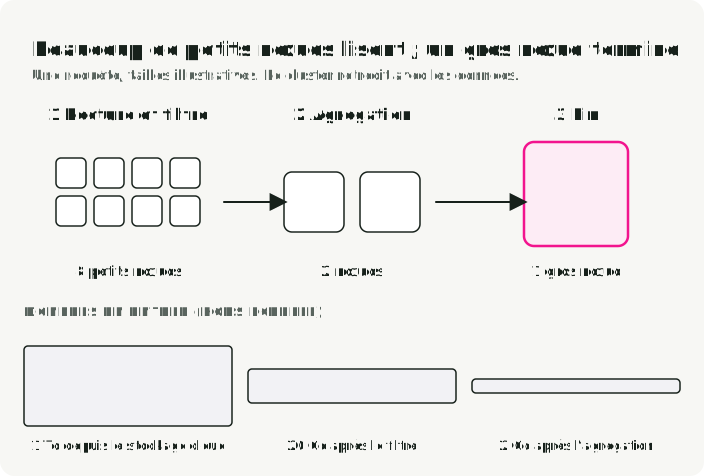
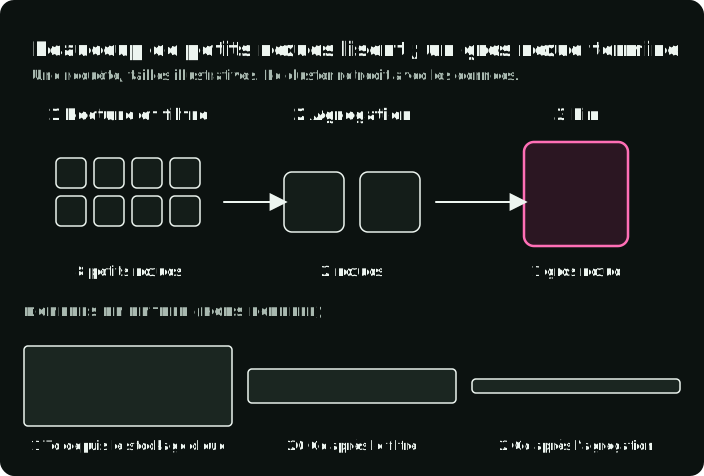
Pendant longtemps, le choix se résumait à monter en puissance (une machine plus grosse) ou à monter en charge (plus de machines). Polars Cloud décrit une approche qui dépend de la requête, appelée scaling diagonal. On passe à l’échelle horizontalement pendant la lecture depuis le stockage cloud pour saturer les E/S, puis on se replie sur un seul gros nœud une fois que les filtres et les agrégations ont réduit les données. Une réduction précoce peut limiter les transferts de données et laisser le reste du travail s’achever sur un seul nœud. La présence d’un shuffle distribué dépend du plan physique de la requête. Le diagramme suit une requête avec des tailles inventées : huit petits nœuds lisent et filtrent 1 To, deux nœuds agrègent ce qui reste, et un gros nœud termine sur 2 Go.
Comparez le coût par job réussi, pas le prix horaire de l’instance. Un nœud plus grand peut revenir moins cher quand la réduction du temps d’exécution compense son tarif plus élevé, mais le résultat dépend des E/S, de la pression mémoire et de la quantité de travail éliminée avant un shuffle.
Reproduire la comparaison
Le dépôt de démo associé contient les scripts, les notebooks et l’environnement utilisés pour les comparaisons. La commande tabulaire utilise le dataset de taxis 2024 sur toute l’année, par défaut dans le dépôt, comme pour l’exécution ci-dessus. La première exécution télécharge environ 660 Mo de données de taxis et les images Food-101 ; le benchmark Rust demande une toolchain Rust.
# Install dependencies
uv sync

# Run the tabular benchmark (~41M NYC taxi trips from full-year 2024)
uv run python -m engine_comparison.benchmarks.tabular

# Run the multimodal benchmark (500 real food photos)
uv run python -m engine_comparison.benchmarks.multimodal

# Run native Rust benchmarks (Polars-rs + image crate)
cd rust_benchmark && cargo run --release && cd ..
./scripts/run_benchmarks.sh lance les trois et écrit benchmarks/*.json ainsi que les graphiques combinés. Les scripts Python acceptent --runs 5 pour davantage d’exécutions chronométrées, et le script d’images accepte --images 1000 pour un jeu d’images plus grand. Les notebooks distribués demandent uv sync --extra distributed --extra notebook. Le dépôt fournit aussi des configurations Docker Compose pour exécuter Spark, Ray et Daft en local de façon distribuée.
Points clés
-
Prouvez qu’une seule machine ne suffit pas. Les résultats de scale-up montrent que certains gros scans analytiques tiennent sur un seul nœud. Mesurez les besoins en mémoire, en E/S, en spill et en reprise avant d’accepter la surcharge d’un cluster.
-
La planification lazy explique mieux l’écart de vitesse que la syntaxe de l’API. Le pushdown, le streaming et les opérateurs parallèles expliquent une grande part de la différence entre un script DataFrame eager et un moteur analytique.
-
Mesurez tout le pipeline de l’accélérateur. Le décodage, les E/S réseau, le batching, la sérialisation et le backpressure déterminent si un GPU reste occupé. Ray Data et Daft font de ce chevauchement une abstraction centrale ; Spark peut le prendre en charge avec une conception et des outils supplémentaires.
-
Présélectionnez selon le workload, puis faites un benchmark. Servez-vous de l’adéquation à l’écosystème pour réduire le choix et d’un job de bout en bout représentatif pour décider. Relancez l’affirmation d’un fournisseur sur votre propre job avant de vous y fier.
-
Les formats ouverts gardent le choix réversible. Les interfaces compatibles Arrow, Parquet et les formats de table ouverts peuvent réduire les coûts de passage de relais. Vérifiez si une conversion donnée réutilise les buffers ou les copie.
Références
Benchmarks et données de performance
- Polars PDS-H Benchmarks - Polars en streaming contre Pandas à SF-10 (94x) et SF-100 (environ 6x par rapport au moteur en mémoire)
- DataFusion ClickBench Results (Nov 2024) - Résultats Parquet sur un seul nœud publiés par le projet
- Embucket: TPC-H SF-1000 on DataFusion - Étude de cas d’un fournisseur sur un seul gros nœud ; deux requêtes ont été réécrites pour aboutir
- Amazon Spark-to-Ray Migration - Efficacité des coûts de production supérieure de 82 % par Gio d’entrée S3
- Daft Flotilla Benchmarks - 4 à 18x plus rapide que Spark sur des workloads multimodaux
- Anyscale Ray vs. Daft Benchmarks - Benchmark concurrent d’un fournisseur pour les workloads multimodaux
Moteurs et frameworks
- Polars - Bibliothèque Rust de DataFrame avec exécution lazy
- Apache DataFusion - Moteur de requêtes Rust embarquable (GitHub)
- Daft - DataFrame distribué nativement multimodal
- Ray - Framework de calcul distribué pour l’AI (Data Internals)
- Apache Spark - Moteur d’ETL et de SQL distribué
- DuckDB - Moteur SQL analytique en processus
- Dask - Calcul parallèle natif Python
Architecture et écosystème
- Polars Cloud: Diagonal Scaling - Scaling vertical/horizontal dynamique
- Daft Flotilla Architecture - Moteur distribué Swordfish + Flotilla
- Apache DataFusion Comet - Accélérateur de Spark développé à l’origine chez Apple
- Apache Arrow - Format en mémoire en colonnes (Flight RPC, interface PyCapsule)
- InfluxDB 3.0 + DataFusion - Base de données de séries temporelles construite sur DataFusion
- GreptimeDB - Base de données d’observabilité utilisant DataFusion
Dépôt de démo
- engine-comparison-demo - Code associé à cet article : benchmarks, notebooks et Docker Compose pour Spark/Ray/Daft
Datasets
- NYC Taxi Trip Records - Données des taxis jaunes de la NYC TLC (Parquet, environ 2,9 M de lignes par mois)
- Food-101 Dataset - 101 000 images de plats de l’ETH Zurich (Bossard et al., ECCV 2014)