Motores de procesamiento de datos: Polars, DataFusion, Ray y Spark

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Esta guía ayuda a los ingenieros de Python y de datos a elegir un motor de procesamiento para datos tabulares y para pipelines de imágenes, audio o texto. Explica cómo ejecutan el trabajo Polars, DataFusion, Daft, Ray Data y Spark, qué cargas se adaptan a cada uno y cómo compararlos con tus propios datos.
Los pipelines modernos también procesan imágenes, audio y vídeo. En estas cargas, la decodificación en CPU puede dejar sin trabajo a la inferencia en GPU. Los operadores nativos, el intercambio de datos en formato columnar y el solapamiento del trabajo en CPU y GPU atacan costes distintos; elegir un motor consiste en averiguar qué coste limita tu pipeline.
Para comparar las opciones, hice un benchmark de Pandas, Polars, DataFusion, Daft y Rust nativo con dos datasets reales: los viajes en taxi de Nueva York representan el trabajo tabular y las imágenes de Food-101 representan un pipeline multimodal. Spark y Ray se tratan en notebooks distribuidos aparte.
El repositorio engine-comparison-demo contiene el código.
Tipos de carga de procesamiento de datos
Los motores se especializan, así que primero decide qué tipo de carga tienes. La división más importante es entre datos estructurados y multimodales. El diagrama muestra cómo cambia la cantidad de datos en cada caso: un trabajo tabular la reduce en cada paso, mientras que uno multimodal la expande.
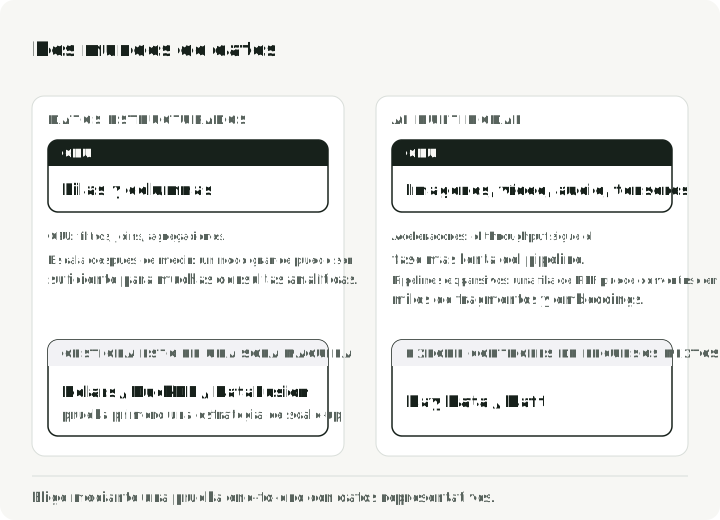
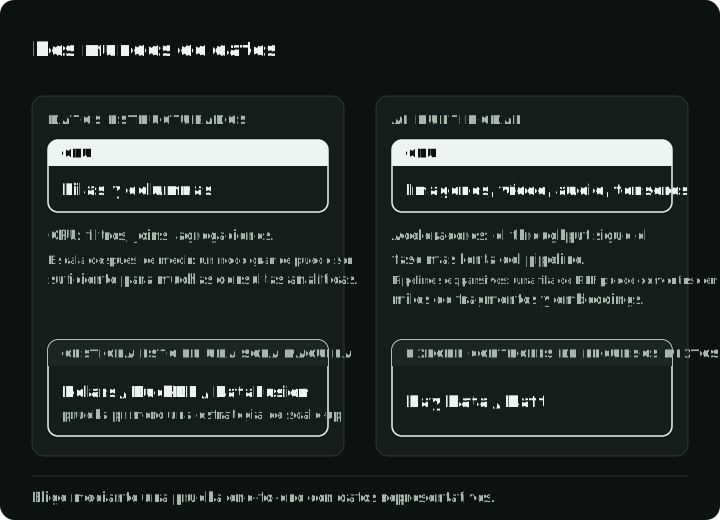
Los datos estructurados o tabulares implican filtros, agregaciones y joins. Suelen estar limitados por CPU y a menudo caben en memoria. Muchas de estas consultas se pueden ejecutar en una sola máquina moderna, pero la memoria, la E/S, la concurrencia, la recuperación y la forma de la carga siguen determinando si un clúster es adecuado.
La AI multimodal procesa imágenes, audio o vídeo. La inferencia puede ejecutarse en una GPU mientras la decodificación en CPU, las lecturas remotas o el batching limitan el pipeline. La etapa que limita el rendimiento cambia con el tipo de instancia y los operadores, así que mide la utilización a lo largo de todo el recorrido en lugar de dimensionar la GPU de forma aislada.
Los motores más nuevos se dirigen a partes distintas de este espacio. La ejecución nativa puede reducir la sobrecarga de Python, las interfaces compatibles con Arrow pueden abaratar el intercambio de datos y la ejecución en streaming puede acotar la memoria con datasets mayores que la RAM. Ninguno de estos beneficios es automático para todos los operadores ni para todas las conversiones.
Parte 1: procesamiento en un solo nodo
Pandas favorece un modelo de programación eager: ejecuta cada operación de inmediato y suele mantener los datos en memoria. Un modelo lazy, en cambio, planifica varias operaciones juntas antes de ejecutarlas. En Pandas, muchas operaciones habituales crean tablas intermedias, y la ejecución en paralelo no se coordina mediante un optimizador de consultas. Esa contrapartida mantiene el código exploratorio directo, pero puede resultar cara en escaneos analíticos más grandes.
El diagrama muestra qué lee cada modelo del archivo Parquet en la consulta de taxis que se usa más abajo: la ruta eager lee las 19 columnas antes de filtrar, mientras que el plan lazy permite que el optimizador empuje el filtro y las 3 columnas usadas hasta el escaneo.
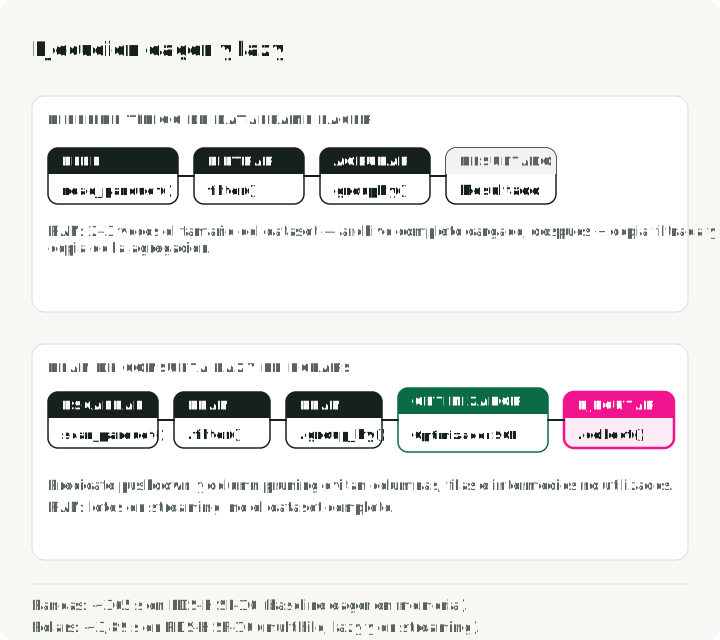
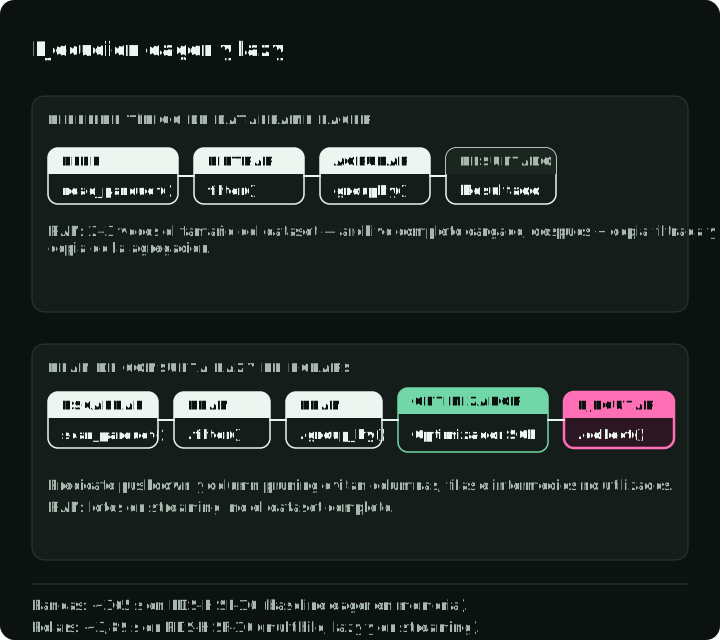
En el benchmark PDS-H de Polars de mayo de 2025, con factor de escala 10, Pandas tardó unos 365 segundos en ejecutar la suite, mientras que el motor de streaming de Polars tardó 3,89 segundos. El resultado de aproximadamente 94x describe ese benchmark y esa configuración; no es un factor general de conversión de Pandas a Polars.
Polars para pipelines tabulares locales
Polars es una opción por defecto práctica cuando un pipeline local de DataFrames ha superado la ejecución eager de un solo proceso. Su API lazy construye un plan de consulta antes de ejecutar. Así puede filtrar filas lo antes posible (predicate pushdown) y leer solo las columnas necesarias (projection pruning). Después, el motor puede ejecutar los operadores en paralelo y, cuando es posible, en lotes de streaming.
Con factor de escala 100 (~100 GB de CSV), el motor de streaming de Polars fue unas 6 veces más rápido que su motor en memoria en la misma máquina. La fuente atribuye esta diferencia sobre todo a menos fallos de caché de CPU y a un mejor aprovechamiento de los núcleos; no es una prueba de que la entrada fuera mayor que la RAM.
La consulta siguiente lee viajes en taxi desde Parquet, selecciona los viajes de más de cinco millas con un importe total superior a $30 y calcula recuentos y medias por tipo de pago. El notebook complementario engine_comparison_examples.ipynb contiene ejemplos relacionados de API y configuración; tabular.py descarga los datos de taxis y ejecuta el trabajo cronometrado que se describe más abajo:
import polars as pl

# Build a lazy scan; query execution happens at collect()
q = (
    pl.scan_parquet("yellow_tripdata_2024-01.parquet")
    .filter(
        (pl.col("trip_distance") > 5.0)
        & (pl.col("total_amount") > 30.0)
    )
    .group_by("payment_type")
    .agg(
        pl.col("total_amount").mean().alias("avg_fare"),
        pl.col("trip_distance").mean().alias("avg_distance"),
        pl.len().alias("trip_count"),
    )
)

# The entire plan is optimized and executed here, in parallel
result = q.collect(engine="streaming")
La diferencia importante es el modelo de ejecución. En la consulta lazy anterior, Polars puede empujar el filtro y la selección de columnas hasta el escaneo de Parquet. Eso puede saltarse grupos de filas y evitar leer columnas que no se usan. Aquí el streaming es explícito; collect sigue materializando el resultado final, y las operaciones no compatibles pueden recurrir a la ejecución en memoria. Un pipeline típico de Pandas eager no tiene un plan de toda la consulta que optimizar, aunque un uso cuidadoso de filtros de Parquet, columnas seleccionadas y backends alternativos puede recuperar parte de la diferencia.
DataFusion para motores de consultas embebidos
Mientras que Polars es una biblioteca que usas directamente, DataFusion es el motor sobre el que se construyen otros motores. Impulsa InfluxDB 3.0, GreptimeDB y Apache DataFusion Comet, un acelerador de Spark creado inicialmente en Apple.
En una ejecución de ClickBench publicada por el proyecto DataFusion en noviembre de 2024, DataFusion lideró las configuraciones de Parquet en un solo nodo que se probaron. Más tarde, el equipo de Embucket publicó una ejecución de TPC-H con factor de escala 1000 en un único nodo grande, con dos consultas reescritas para que terminaran. Estos resultados muestran lo que puede lograr el escalado vertical en condiciones concretas; no demuestran que toda carga de 1 TB deba evitar un clúster.
Aquí está el mismo resumen de taxis en SQL de DataFusion, con los tipos de pago ordenados por número de viajes. El notebook complementario engine_comparison_examples.ipynb contiene ejemplos relacionados de SQL y configuración:
from datafusion import SessionContext

ctx = SessionContext()
ctx.register_parquet("taxi", "yellow_tripdata_2024-01.parquet")

# Plan SQL against the registered Parquet source
df = ctx.sql("""
    SELECT payment_type,
           COUNT(*)           AS trip_count,
           AVG(trip_distance) AS avg_distance,
           AVG(total_amount)  AS avg_fare
    FROM taxi
    WHERE trip_distance > 5.0 AND total_amount > 30.0
    GROUP BY payment_type
    ORDER BY trip_count DESC
""")
result = df.to_pandas()
La fortaleza de DataFusion es su modularidad. Las API de extensión cubren catálogos personalizados, proveedores de tablas, reglas del optimizador y planes de ejecución. Por eso aparece siempre que alguien construye una plataforma de datos a medida o integra un motor de consultas en su propio producto.
Si tu equipo escribe SQL sobre archivos Parquet locales y no necesita integrar el motor, DuckDB es una base de datos SQL en proceso que cumple el mismo papel que Polars.
Daft para datos multimodales
Daft incorpora imágenes, audio, vídeo y embeddings al flujo de trabajo de DataFrames. Ofrece expresiones nativas para operaciones como la decodificación de imágenes y la descarga de URL, de modo que las rutas de preprocesamiento habituales no necesitan un bucle de Python fila a fila. Esa integración es la razón principal para considerarlo frente a un motor tabular de propósito general.
En el trabajo tabular, la API de Daft se parece a la de los motores anteriores. Este ejemplo ejecuta el mismo resumen de taxis; el notebook complementario engine_comparison_examples.ipynb contiene ejemplos relacionados de la API de Daft y de configuración:
import daft

df = daft.read_parquet("yellow_tripdata_2024-01.parquet")

result = (
    df.where(
        (daft.col("trip_distance") > 5.0)
        & (daft.col("total_amount") > 30.0)
    )
    .groupby("payment_type")
    .agg(
        daft.col("total_amount").mean().alias("avg_fare"),
        daft.col("trip_distance").mean().alias("avg_distance"),
        daft.col("trip_distance").count().alias("trip_count"),
    )
    .collect()
)
La API te resultará familiar si conoces Pandas, pero el motor es la misma pila de Rust + Arrow que encuentras en Polars y DataFusion. Daft merece la pena cuando las «filas» de tu DataFrame son imágenes, PDF o tensores.
Daft lee, decodifica y redimensiona imágenes con expresiones nativas, sin un bucle de Python sobre las filas. Esta es la ruta de imágenes de multimodal.py:
import daft
from daft import col

df = (
    daft.from_glob_path("food101_images/*.jpg")
    .with_column("image", col("path").download().decode_image(mode="RGB"))
    .with_column("resized", col("image").resize(224, 224))
)
df.collect()
Benchmark en un solo nodo
Ejecuté Pandas, Polars, DataFusion y Daft, además de Rust nativo mediante Polars-rs, sobre unos 41 millones de viajes en taxi amarillo de Nueva York de todo el año 2024. El trabajo cronometrado filtra los viajes con una tarifa superior a $10, hace un join con la tabla de zonas de taxi, suma los ingresos por distrito y zona, y devuelve las 20 primeras filas. Es una consulta distinta de los ejemplos anteriores. Spark y Ray aparecen en los ejemplos distribuidos, no en este benchmark de un solo nodo.
Cada motor lee los archivos dentro de la función cronometrada; el script informa de la mediana de tres ejecuciones. Su comprobador de resultados compara las 20 filas entre los motores de Python por distrito, zona, número de viajes e ingresos redondeados a céntimos; no compara avg_tip. A Pandas se le dan las cuatro columnas de viaje que usa la consulta, porque no tiene un optimizador que las encuentre. El gráfico muestra el resultado en un Apple M5 Max con 18 núcleos y 64 GB de RAM. Los resultados completos están en el repositorio de la demo:
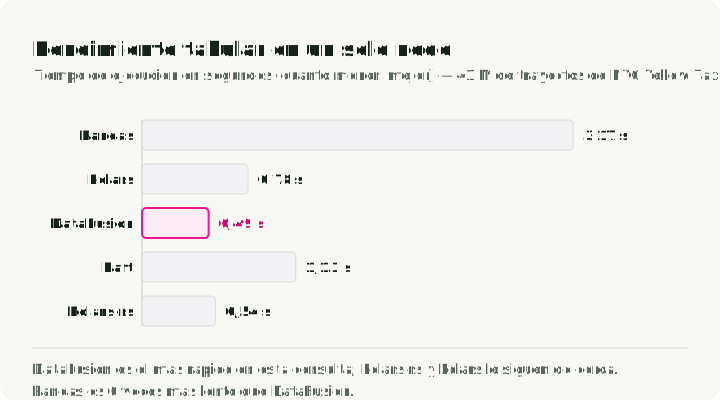
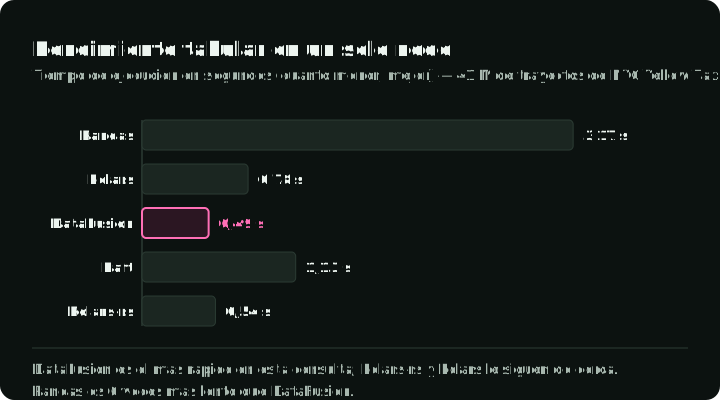
Pandas tardó 4,67 segundos. Los cuatro motores más nuevos terminaron entre 0,40 y 0,74 segundos, con DataFusion como el más rápido y Polars unas 7 veces más rápido que Pandas. La cifra de 94x de Polars frente a Pandas que aparece arriba procede de PDS-H; este trabajo produjo una diferencia menor. Los tiempos también variaron entre invocaciones: en cuatro ejecuciones del script en una máquina con otra carga, Pandas osciló entre 2,6 y 4,8 segundos. DataFusion fue siempre el motor de Python más rápido, mientras que Polars y Daft intercambiaron posiciones. Cuando los motores quedan tan cerca, la decisión debe basarse en el encaje de la API y en mediciones repetidas con datos representativos.
Parte 2: datos multimodales
El ETL tabular suele reducir los datos: filtrar, agregar y escribir menos de lo que se lee. Los pipelines de AI multimodal hacen lo contrario. La ruta de un solo documento puede ramificarse en decenas de fragmentos de texto y vectores de embeddings.
En un pipeline convencional de PySpark, las imágenes y el audio suelen entrar como datos binarios y pasar a bibliotecas de Python para su decodificación o transformación. Cruzar la frontera entre la JVM y Python y serializar los resultados puede llegar a ser una parte considerable del tiempo total. Spark puede usar rutas basadas en Arrow, UDF vectorizadas e integraciones con aceleradores, pero esas opciones requieren un diseño explícito y mediciones.
Ejecución en pipeline y utilización de la GPU
Spark planifica el trabajo en etapas separadas por fronteras de shuffle. Una implementación directa puede colocar la descarga, la decodificación y la inferencia en una secuencia que deja esperando capacidad de CPU o de GPU. Spark admite la planificación de recursos de GPU y plugins, así que el tiempo ocioso no es inevitable. Mantener las etapas ocupadas también requiere backpressure: frenar las etapas anteriores cuando las posteriores no pueden seguir el ritmo. Ni ese control ni el solapamiento del trabajo de CPU y GPU ocurren automáticamente en un trabajo ordinario de DataFrames de PySpark.
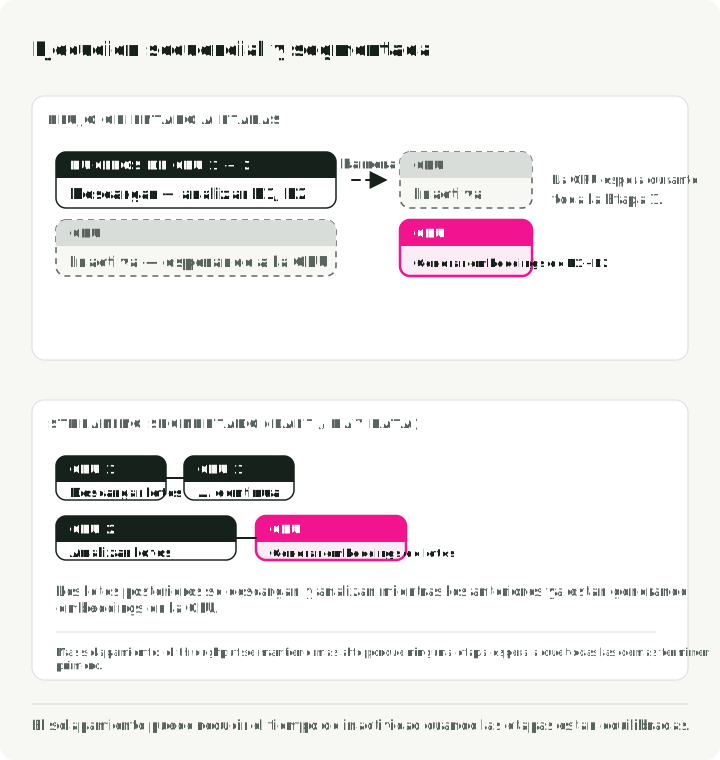
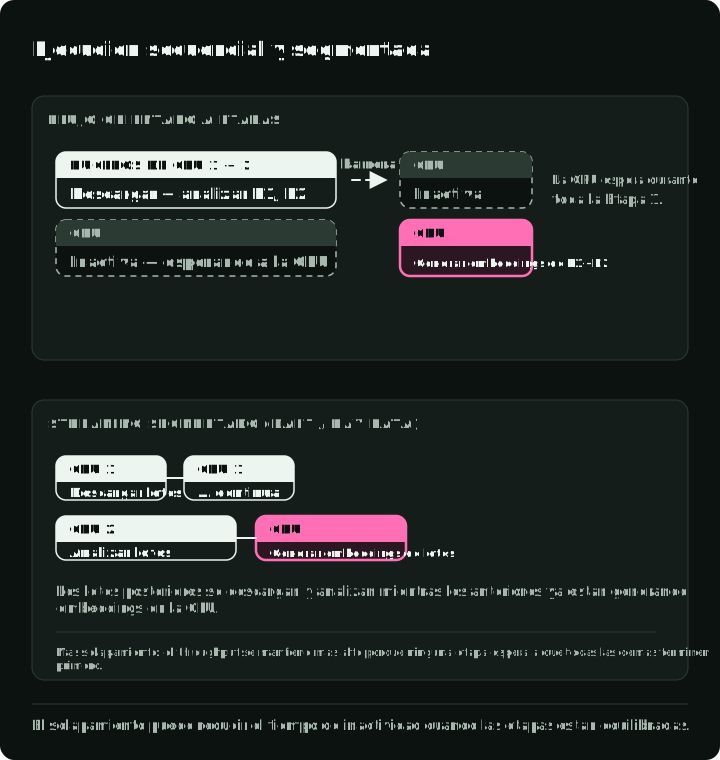
La ejecución en pipeline es la alternativa. En lugar de ejecutar las etapas una tras otra, el motor solapa la E/S, el trabajo de CPU y la inferencia en GPU. Cuando las etapas y los búferes están equilibrados, ese solapamiento puede reducir el tiempo ocioso y mejorar el rendimiento; el arranque y el vaciado, el backpressure o una etapa más lenta pueden seguir dejando recursos a la espera.
El diagrama muestra dos lotes que atraviesan tres etapas. Ejecutados uno tras otro, tardan seis pasos. En pipeline, el lote 2 se lee y se decodifica mientras el lote 1 sigue en curso, y el mismo trabajo tarda cuatro pasos.
Benchmark de procesamiento de imágenes
Hice un benchmark de procesamiento de imágenes con 500 fotografías reales del dataset Food-101. Cada motor lee los mismos 500 JPEG, los decodifica a RGB y los redimensiona a 224×224 con un filtro bilineal dentro de la función cronometrada. El script comprueba que cada motor haya producido 500 imágenes e informa de la mediana de tres ejecuciones. El gráfico muestra el resultado en la misma máquina:
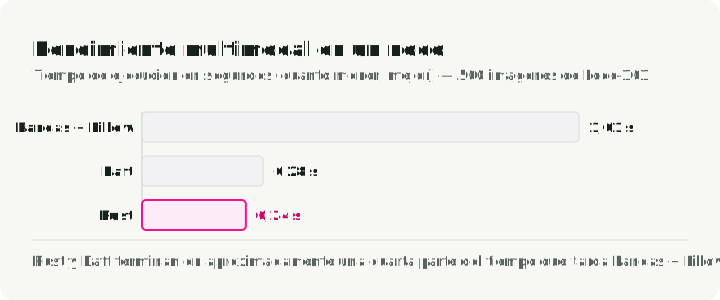
Polars y DataFusion no aparecen porque no tienen operaciones nativas de imagen. Los resultados de Python y los resultados de Rust registrados muestran 0,55 segundos para Pandas + Pillow, 0,34 para Daft y 0,10 para el crate image de Rust. Pandas procesa una imagen cada vez mediante apply(); Daft y la versión de Rust reparten el trabajo entre los núcleos. En cuatro invocaciones, Pandas osciló entre 0,55 y 1,21 segundos. Quinientas imágenes son muy pocas para predecir el rendimiento en producción, y el trabajo termina antes de cualquier tarea en GPU, así que mide tu propio pipeline de extremo a extremo.
Parte 3: procesamiento distribuido
Cuando una sola máquina deja de bastar, hay que elegir cómo repartir el trabajo. Dask reparte el código existente de Pandas y NumPy entre núcleos o un clúster con pocos cambios de API; encaja con equipos de Python que no quieren una JVM ni una API de DataFrames nueva. El resto de esta parte trata Spark, Ray Data y Daft.
Apache Spark
Spark es una opción madura para ETL tabular a gran escala, joins con mucho shuffle y organizaciones que ya operan su ecosistema. Su recuperación basada en el linaje y su amplio soporte de plataformas importan cuando la fiabilidad y la familiaridad operativa pesan más que la velocidad local. Los pipelines mixtos de CPU y GPU exigen una configuración de recursos y un diseño de pipeline más deliberados que la ruta SQL, y ahí es donde Ray Data y Daft ofrecen una abstracción más específica.
Esta consulta de Spark une los viajes en taxi más largos con la información de la zona de recogida y resume después los ingresos totales y las tarifas medias por distrito. Para la configuración de ETL en clúster, consulta distributed_spark.ipynb o spark_etl.py:
from pyspark.sql import SparkSession
from pyspark.sql import functions as F

spark = SparkSession.builder \
    .appName("TaxiETL") \
    .config("spark.sql.adaptive.enabled", "true") \
    .getOrCreate()

orders = spark.read.parquet("s3a://lake/taxi/*.parquet")
zones = spark.read.csv("s3a://lake/taxi_zones.csv", header=True)

# Spark excels at this: joining massive tables with a shuffle
result = (
    orders
    .filter(F.col("trip_distance") > 5.0)
    .join(zones, orders.PULocationID == zones.LocationID, "inner")
    .groupBy("Borough")
    .agg(
        F.sum("total_amount").alias("total_revenue"),
        F.avg("total_amount").alias("avg_fare"),
    )
    .orderBy(F.desc("total_revenue"))
)

# Spark is lazy: the write runs the query
result.write.mode("overwrite").parquet("s3a://warehouse/report/")
Ray Data para cómputo heterogéneo
Ray Data se diseñó en torno a cargas de AI. En lugar de las barreras entre etapas de Spark, usa un modelo de streaming que envía lotes a los workers de GPU mientras se siguen leyendo los lotes posteriores. Un actor de Ray es un worker persistente que puede mantener un modelo cargado entre lotes. La característica que más importa para los pipelines de AI es la planificación de recursos mixtos: puedes declarar que un actor necesita «1 GPU y 4 CPU» y otro solo CPU, y Ray coloca cada actor en un nodo que tenga esos recursos.
Amazon informó de una mejora del 82 % en la eficiencia de costes por GiB de entrada de S3 tras migrar de Spark a Ray algunas cargas internas seleccionadas. La escala es notable, pero se trata de un caso de estudio de migración de cargas concretas y no de un ahorro esperable en una adopción típica de Ray.
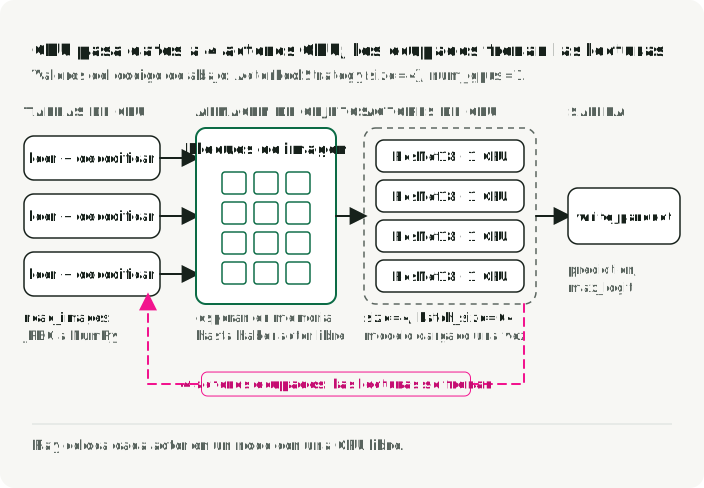
El ejemplo siguiente lee imágenes, las clasifica con ResNet18 en workers de GPU y escribe las predicciones en Parquet. El diagrama muestra el pipeline que construye: tareas de CPU leen y decodifican las imágenes en el almacén de objetos de Ray, un pool de cuatro actores de GPU ejecuta el modelo, y el backpressure frena las lecturas cuando los actores de GPU están llenos.
Para la configuración de inferencia de imágenes, consulta distributed_ray.ipynb o ray_inference.py:
import ray

ray.init()

ds = ray.data.read_images("s3://my-bucket/food101/", mode="RGB")

class ImageClassifier:
    def __init__(self):
        import torch
        from torchvision.models import resnet18, ResNet18_Weights
        self.model = resnet18(weights=ResNet18_Weights.DEFAULT).cuda()
        self.model.eval()
        self.preprocess = ResNet18_Weights.DEFAULT.transforms()

    def __call__(self, batch):
        import torch
        from PIL import Image
        tensors = torch.stack([
            self.preprocess(Image.fromarray(img)) for img in batch["image"]
        ]).cuda()
        with torch.no_grad():
            preds = self.model(tensors)
        return {
            "prediction": preds.argmax(dim=1).cpu().numpy(),
            "max_logit": preds.max(dim=1).values.cpu().numpy(),
        }

# ActorPoolStrategy creates persistent GPU workers
predictions = ds.map_batches(
    ImageClassifier,
    compute=ray.data.ActorPoolStrategy(size=4),
    num_gpus=1,
    batch_size=64,
)
predictions.write_parquet("s3://output/predictions/")
Este esbozo reserva cuatro actores de una GPU cada uno y requiere cuatro GPU CUDA disponibles, los pesos de Torchvision y acceso a S3. Ray lee las imágenes como arrays de NumPy; convertir los arrays RGB a PIL da al transform de preprocesamiento de ResNet18 una entrada que acepta. max_logit es la puntuación bruta más alta del modelo, no una probabilidad de confianza.
En los benchmarks de Anyscale, la clasificación de imágenes de Ray Data fue unas 4 veces más rápida (de 456 a 111 segundos) cuando la instancia pasó de 4 CPUs por GPU a 32 CPUs por GPU. Anyscale atribuye la mejora a una menor falta de capacidad de CPU; la utilización de GPU siguió siendo baja en términos absolutos. Daft mejoró de 4 a 16 CPUs por GPU y después se mantuvo cerca de 195 segundos tanto con 16 como con 32.
Daft distribuido
Daft escala horizontalmente mediante su motor Flotilla: un worker Swordfish por nodo, con Flotilla encima para la planificación en todo el clúster. Swordfish se encarga de la ejecución local en Rust y solapa la E/S con el cómputo mediante streaming de lotes pequeños, de modo que cada nodo se mantiene ocupado sin esperar a la etapa siguiente.
En los benchmarks publicados por Daft, Flotilla fue entre 4 y 18 veces más rápido que las implementaciones de Spark probadas en cuatro cargas multimodales. La mayor diferencia se dio en un caso de detección de objetos en vídeo. Trata el resultado como una prueba de que el diseño de ejecución puede cambiar el rendimiento tanto en estos pipelines, y compáralo después con los resultados contrapuestos de Anyscale que se citan a continuación y con una prueba local.
Anyscale, la empresa que está detrás de Ray, publicó un benchmark contrapuesto en el que Ray Data cerró o invirtió la diferencia en instancias con muchas CPU tras ajustarlo. Juntos, los dos estudios de proveedores son una razón para probar operadores y ratios de CPU a GPU representativos, no para deducir una clasificación duradera.
El ejemplo siguiente usa el runner Ray de Daft; no reproduce el benchmark de Flotilla anterior. Lee una tabla de URL de imágenes, las descarga, calcula sus embeddings con CLIP en workers de GPU y escribe los vectores en Parquet. Adapta daft_pipeline.py para workers de GPU de Ray. Con la API de Transformers 5.0.0 fijada por el proyecto complementario, las características proyectadas de las imágenes están en .pooler_output. El notebook relacionado es distributed_daft.ipynb:
import io

import daft
import numpy as np
from daft import col

# Connect to an existing Ray cluster before building the query
daft.set_runner_ray(address="auto")

# Define a GPU class UDF: the model loads once per instance
@daft.cls(gpus=1)
class ImageEmbedder:
    def __init__(self):
        import torch
        from transformers import CLIPModel, CLIPProcessor

        self.device = "cuda" if torch.cuda.is_available() else "cpu"
        self.model = CLIPModel.from_pretrained(
            "openai/clip-vit-base-patch32"
        ).to(self.device)
        self.processor = CLIPProcessor.from_pretrained(
            "openai/clip-vit-base-patch32"
        )
        self.model.eval()

    @daft.method.batch(
        return_dtype=daft.DataType.fixed_size_list(daft.DataType.float32(), 512)
    )
    def __call__(self, image_bytes_col):
        import torch
        from PIL import Image

        embeddings = []
        for img_bytes in image_bytes_col.to_pylist():
            img = Image.open(io.BytesIO(img_bytes)).convert("RGB")
            inputs = self.processor(images=img, return_tensors="pt").to(self.device)
            with torch.no_grad():
                features = self.model.get_image_features(**inputs).pooler_output
            embeddings.append(features[0].cpu().numpy())
        return np.array(embeddings, dtype=np.float32)

embedder = ImageEmbedder()

df = (
    daft.read_parquet("s3://bucket/image_metadata.parquet")
    # Native Rust I/O downloads the images; no Python requests loop
    .with_column("image_bytes", col("image_url").download())
    .with_column("embedding", embedder(col("image_bytes")))
    .exclude("image_bytes")
)
df.write_parquet("s3://bucket/embeddings/")
El runner Ray de Daft se conecta a un clúster existente; el runner nativo por defecto usa la máquina local. Instala Daft con soporte para Ray y proporciona en ese clúster workers de GPU, Transformers 5.0.0, los pesos de CLIP y credenciales de S3. La API de clases y métodos por lotes conserva el modelo entre lotes, y gpus=1 pide al runner una GPU por instancia; la revisión del repositorio enlazada usa @daft.cls a secas y una sola partición, porque apunta a una única GPU local. Las descargas pueden solaparse con la inferencia en GPU, según el particionado y el backpressure.
Esa revisión del proyecto complementario sustituye por un vector de ceros las imágenes ausentes o cualquier fallo de procesamiento, incluida la comprobación de la forma de los embeddings. Indexa el objeto de salida de CLIP sin seleccionar .pooler_output, por lo que Transformers 5.0.0 hace que esa comprobación falle y las imágenes válidas también pueden convertirse en vectores de ceros. Usa la extracción de características proyectadas que se muestra aquí; este esbozo deja que los errores de procesamiento hagan fallar el trabajo.
Comparación de motores distribuidos
| Característica | Spark | Ray Data | Daft (Flotilla) |
|---|---|---|---|
| Modelo de ejecución | Una tarea por núcleo, basado en particiones | Tareas y actores en streaming | Un Swordfish por nodo, lotes en streaming |
| Puntos fuertes | SQL/ETL masivo, tolerancia a fallos | Cómputo heterogéneo, saturación de GPU | Pipelines multimodales, memoria acotada |
| Control de GPU | Planificación de recursos más plugins del ecosistema | Recursos explícitos de tareas y actores | Planificación integrada de pipelines de CPU/GPU |
| Ajustes típicos | Executors, memoria, particiones, aceleradores | Lotes, actores, almacén de objetos | Lotes, recursos, concurrencia de E/S |
| Buen caso de evaluación | SQL/ETL grande y trabajos con mucho shuffle | Entrenamiento o inferencia con recursos mixtos | Ingesta y transformación multimodales |
Parte 4: el papel de Rust y Arrow
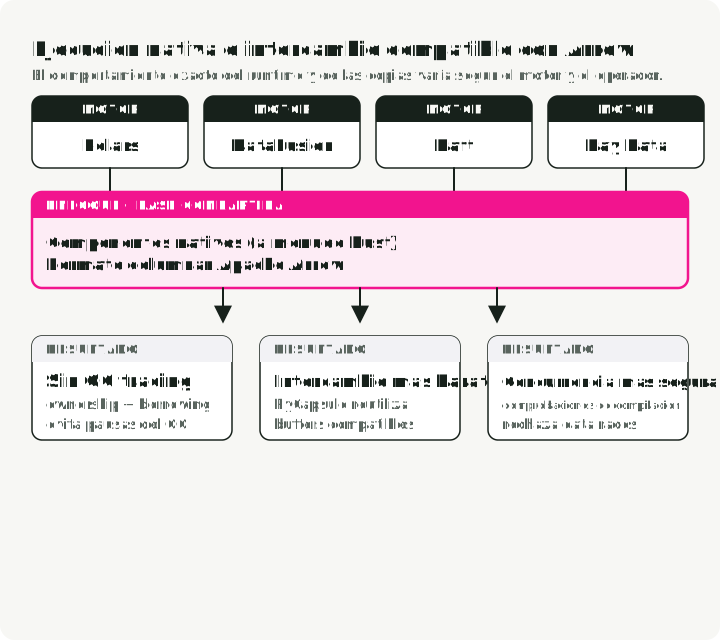
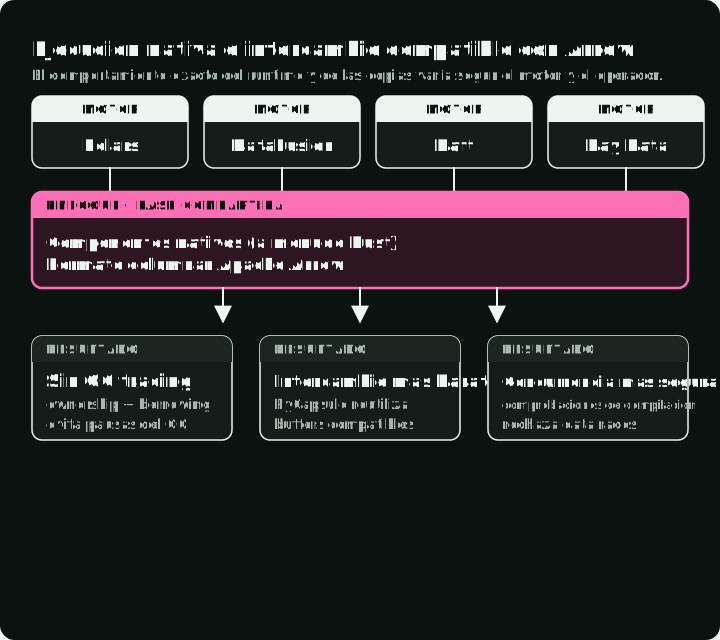
Polars, Daft y DataFusion usan Rust de forma extensa, mientras que Ray incluye componentes nativos junto a sus API de Python. Todos pueden intercambiar datos a través de partes del ecosistema de Apache Arrow.
La interfaz PyCapsule de Arrow (el protocolo __arrow_c_stream__) ofrece a las bibliotecas compatibles una forma estándar de intercambiar flujos de Arrow. Las transferencias pueden evitar la serialización fila a fila y reutilizar búferes cuando los esquemas y la disposición en memoria son compatibles. La materialización, la reorganización en chunks, la conversión de tipos o la transferencia entre dispositivos pueden seguir copiando datos, así que verifica el traspaso con un profiler en lugar de suponer que es gratis.
El ejemplo siguiente demuestra un traspaso a través de Arrow: DataFusion cuenta las compras de los usuarios con más de cinco compras y Polars clasifica esos recuentos. El diagrama usa Polars 1.37.1, la versión fijada por el proyecto complementario: rechunk=False conserva los búferes compatibles, mientras que el valor por defecto rechunk=True copia varios lotes en un chunk por columna. Los valores por defecto pueden variar en otras versiones. El ejemplo supone que events.parquet ya existe. El engine_comparison_examples.ipynb complementario crea un .data/events.parquet sintético en sus celdas de preparación antes del ejemplo de Arrow.
from datafusion import SessionContext
import polars as pl

# Compute in DataFusion (Rust-native execution)
ctx = SessionContext()
ctx.register_parquet("events", "events.parquet")
df = ctx.sql("""
    SELECT user_id, COUNT(*) as event_count
    FROM events WHERE event_type = 'purchase'
    GROUP BY user_id HAVING COUNT(*) > 5
""")

# Convert through Arrow; compatible buffers may be reused
arrow_table = df.to_arrow_table()
df_polars = pl.from_arrow(arrow_table)

# Continue analysis in Polars
result = df_polars.with_columns(
    pl.col("event_count").rank().alias("rank")
).sort("rank")Daft también puede pasar un DataFrame a PyTorch con df.to_torch_iter_dataset(), lo que cubre el último paso de un pipeline de entrenamiento multimodal.
¿Por qué estos motores más nuevos usan Rust para la ejecución nativa?
-
Sin recolector de basura con trazado en el código Rust. La propiedad (ownership) da a los operadores nativos un control más directo sobre la asignación y la liberación de memoria. Eso puede reducir la latencia asociada al GC, pero no evita la presión de memoria ni los fallos por falta de memoria.
-
Representaciones nativas compactas. Las estructuras de Rust no llevan cabeceras de objeto de Java. El beneficio práctico depende de la disposición del motor: los sistemas columnares de la JVM tampoco representan cada valor como un objeto individual.
-
Comprobaciones de concurrencia más estrictas. El Rust seguro descarta muchas carreras de datos en tiempo de compilación. El código de los motores aún puede contener bloques unsafe y errores lógicos de concurrencia.
Combinadas con la disposición de memoria columnar de Arrow, estas decisiones pueden reducir la sobrecarga de asignación y serialización. No la eliminan en todas las fronteras; los objetos de Python, el transporte por red, los esquemas incompatibles y el movimiento entre dispositivos siguen importando.
Parte 5: adoptar varios motores
No tienes que forzar toda la plataforma a pasar por un único motor. Combinar motores es útil cuando el traspaso entre ellos cuesta menos que lograr que un solo sistema atienda todas las cargas. El diagrama muestra uno de esos relevos: los motores se encuentran en archivos Parquet, y cada escritura o lectura a través de esa frontera cuesta E/S y conversión.
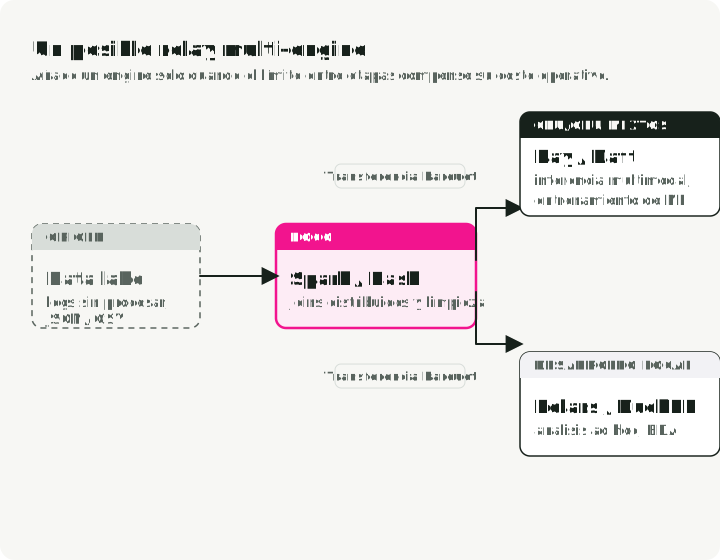
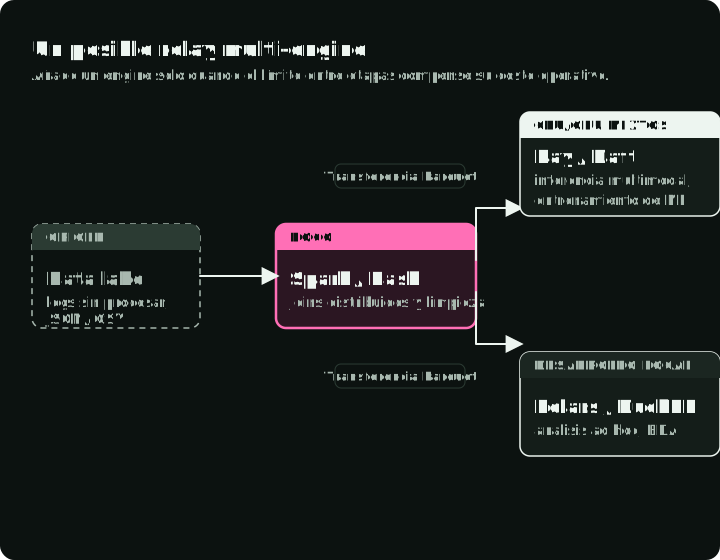
Un posible relevo usa Spark para los joins establecidos del lakehouse, escribe un formato de tabla o de archivo abierto y entrega el resultado a Ray Data o Daft para la inferencia en GPU o las transformaciones multimodales. Polars o DuckDB pueden servir el análisis local sobre los mismos archivos. Un equipo pequeño puede necesitar solo uno de estos motores; añade otro cuando un cuello de botella medido justifique la frontera operativa.
Lo que hace posible esta combinación es la interoperabilidad. Parquet es el traspaso común mediante archivos en estos ejemplos, mientras que Arrow puede ofrecer intercambio en memoria. La compatibilidad con Delta e Iceberg depende del motor y del conector, así que verifica cada frontera. Un traspaso mediante archivos también tiene costes de E/S y de conversión; no es gratis de forma automática.
Selección de motor según el caso de evaluación
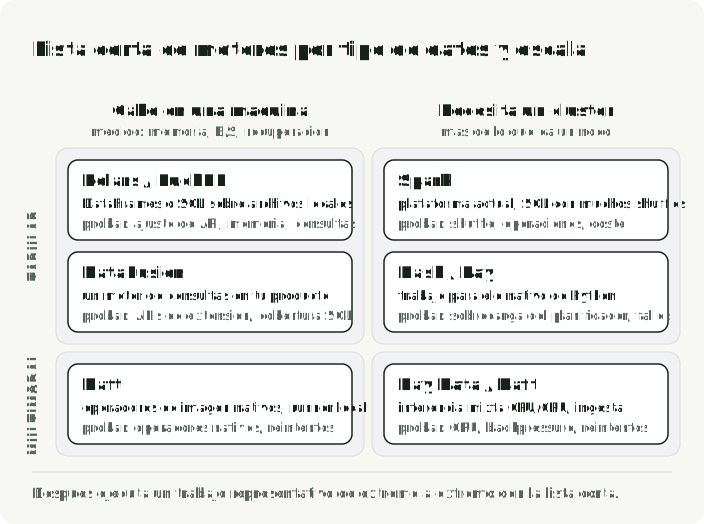
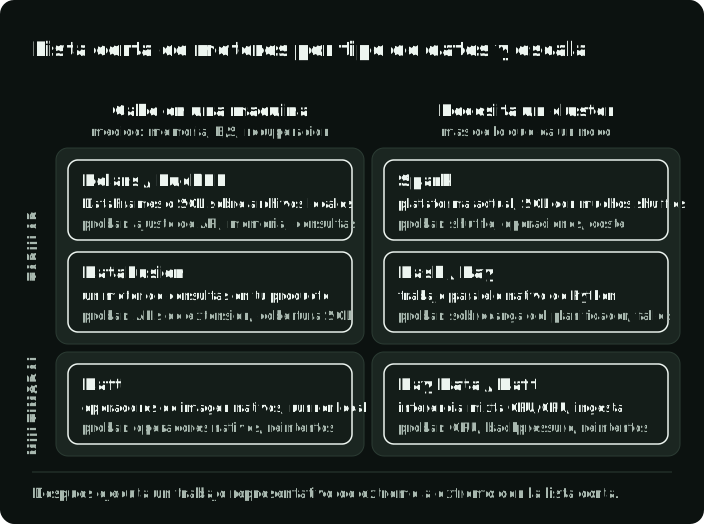
La tabla asigna cada carga a una lista corta y a lo que debes probar antes de elegir.
| Caso de evaluación | Lista corta | Qué validar |
|---|---|---|
| DataFrames analíticos locales | Polars / DuckDB | Encaje de la API, memoria, mezcla de consultas |
| SQL/ETL distribuido ya existente | Apache Spark | Comportamiento del shuffle, operación, coste |
| Trabajo paralelo nativo de Python | Dask / Ray | Sobrecarga del planificador, modelo de fallos |
| Entrenamiento o inferencia mixta CPU/GPU | Ray Data / Daft | Utilización del acelerador, backpressure |
| Ingesta multimodal | Daft / Ray Data | Operadores nativos, comportamiento de reintentos |
| Motor de consultas embebido | DataFusion | API de extensión, cobertura de SQL |
El diagrama sitúa la misma lista corta en dos preguntas: si los datos son tabulares o multimodales y si el trabajo cabe en una máquina.
Escalado diagonal
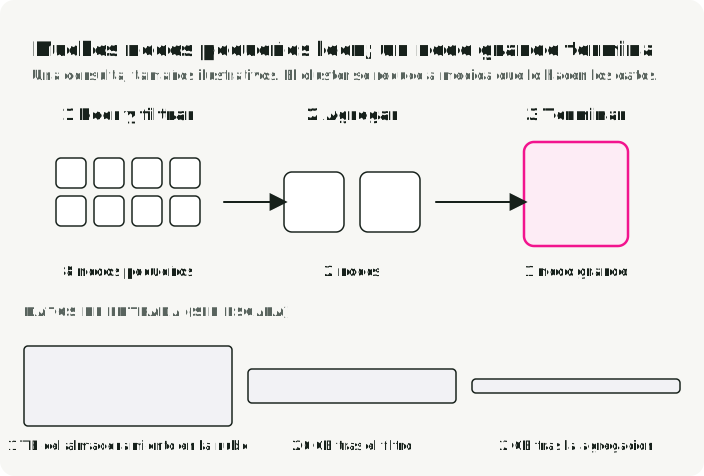
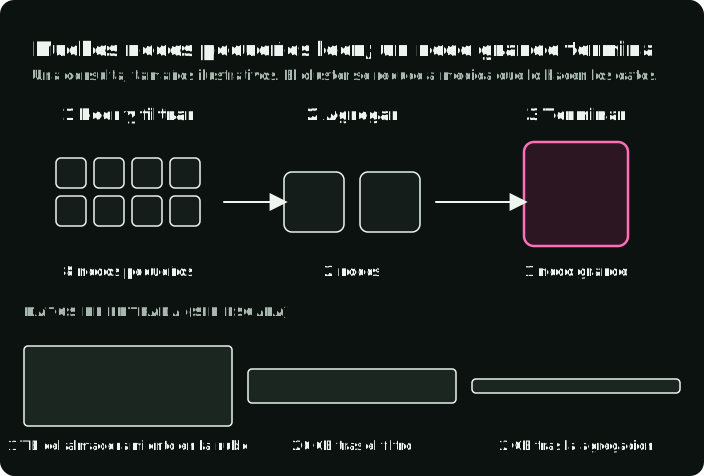
Durante mucho tiempo la elección fue entre escalar verticalmente (una máquina más grande) o escalar horizontalmente (más máquinas). Polars Cloud describe un enfoque que depende de la consulta, llamado escalado diagonal. Se escala horizontalmente mientras se lee del almacenamiento en la nube para aprovechar al máximo la E/S y después se reduce a un único nodo grande una vez que los filtros y las agregaciones han reducido los datos. La reducción temprana puede limitar la transferencia de datos y permitir que el trabajo restante termine en un solo nodo. Que haya o no un shuffle distribuido depende del plan físico de la consulta. El diagrama sigue una consulta con tamaños inventados: ocho nodos pequeños leen y filtran 1 TB, dos nodos agregan lo que queda y un nodo grande termina con 2 GB.
Compara el coste por trabajo completado con éxito, no el precio por hora de la instancia. Un nodo más grande puede resultar más barato cuando la reducción del tiempo de ejecución compensa su tarifa más alta, pero el resultado depende de la E/S, de la presión de memoria y de la cantidad de trabajo que se elimina antes de un shuffle.
Reproduce la comparación
El repositorio de la demo complementaria contiene los scripts, los notebooks y el entorno usados para las comparaciones. El comando tabular usa el dataset de taxis de todo el año 2024 que el repositorio trae por defecto, igual que la ejecución anterior. La primera ejecución descarga unos 660 MB de datos de taxis y las imágenes de Food-101; el benchmark de Rust necesita una toolchain de Rust.
# Install dependencies
uv sync

# Run the tabular benchmark (~41M NYC taxi trips from full-year 2024)
uv run python -m engine_comparison.benchmarks.tabular

# Run the multimodal benchmark (500 real food photos)
uv run python -m engine_comparison.benchmarks.multimodal

# Run native Rust benchmarks (Polars-rs + image crate)
cd rust_benchmark && cargo run --release && cd ..
./scripts/run_benchmarks.sh ejecuta los tres y escribe benchmarks/*.json y los gráficos combinados. Los scripts de Python aceptan --runs 5 para más ejecuciones cronometradas, y el script de imágenes acepta --images 1000 para un conjunto de imágenes mayor. Los notebooks distribuidos necesitan uv sync --extra distributed --extra notebook. El repositorio también incluye configuraciones de Docker Compose para ejecutar Spark, Ray y Daft de forma distribuida en local.
Conclusiones clave
-
Demuestra que una sola máquina no basta. Los resultados de escalado vertical muestran que algunos escaneos analíticos grandes caben en un solo nodo. Mide los requisitos de memoria, E/S, volcado a disco y recuperación antes de aceptar la sobrecarga de un clúster.
-
La planificación lazy explica más de la diferencia de velocidad que la sintaxis de la API. El pushdown, el streaming y los operadores paralelos explican buena parte de la diferencia entre un script de DataFrames eager y un motor analítico.
-
Mide todo el pipeline del acelerador. La decodificación, la E/S de red, el batching, la serialización y el backpressure determinan si una GPU se mantiene ocupada. Ray Data y Daft hacen de este solapamiento una abstracción central; Spark puede admitirlo con diseño y herramientas adicionales.
-
Haz una lista corta según la carga y después un benchmark. Usa el encaje con el ecosistema para acotar las opciones y un trabajo representativo de extremo a extremo para elegir. Vuelve a ejecutar el benchmark de un proveedor con tu propio trabajo antes de fiarte de él.
-
Los formatos abiertos mantienen la elección reversible. Las interfaces compatibles con Arrow, Parquet y los formatos de tabla abiertos pueden reducir los costes de traspaso. Confirma si una conversión concreta reutiliza los búferes o los copia.
Referencias
Benchmarks y datos de rendimiento
- Polars PDS-H Benchmarks - Polars en streaming frente a Pandas con SF-10 (94x) y SF-100 (unas 6 veces más que en memoria)
- DataFusion ClickBench Results (Nov 2024) - Resultados de Parquet en un solo nodo publicados por el proyecto
- Embucket: TPC-H SF-1000 on DataFusion - Caso de estudio de un proveedor en un único nodo grande; se reescribieron dos consultas para que terminaran
- Amazon Spark-to-Ray Migration - 82 % más de eficiencia de costes en producción por GiB de entrada de S3
- Daft Flotilla Benchmarks - Entre 4 y 18 veces más rápido que Spark en cargas multimodales
- Anyscale Ray vs. Daft Benchmarks - Benchmark contrapuesto de otro proveedor para cargas multimodales
Motores y frameworks
- Polars - Biblioteca de DataFrames en Rust con ejecución lazy
- Apache DataFusion - Motor de consultas en Rust embebible (GitHub)
- Daft - DataFrame distribuido nativo para datos multimodales
- Ray - Framework de cómputo distribuido para AI (Data Internals)
- Apache Spark - Motor distribuido de ETL y SQL
- DuckDB - Motor SQL analítico en proceso
- Dask - Computación paralela nativa de Python
Arquitectura y ecosistema
- Polars Cloud: Diagonal Scaling - Escalado dinámico vertical y horizontal
- Daft Flotilla Architecture - Motor distribuido Swordfish + Flotilla
- Apache DataFusion Comet - Acelerador de Spark desarrollado originalmente en Apple
- Apache Arrow - Formato columnar en memoria (Flight RPC, PyCapsule Interface)
- InfluxDB 3.0 + DataFusion - Base de datos de series temporales construida sobre DataFusion
- GreptimeDB - Base de datos de observabilidad que usa DataFusion
Repositorio de la demo
- engine-comparison-demo - Código complementario de este artículo: benchmarks, notebooks y Docker Compose para Spark/Ray/Daft
Datasets
- NYC Taxi Trip Records - Datos de taxis amarillos de la NYC TLC (Parquet, ~2,9 M de filas al mes)
- Food-101 Dataset - 101 000 imágenes de comida de la ETH de Zúrich (Bossard et al., ECCV 2014)