Data Processing Engines: Polars, DataFusion, Ray en Spark

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Deze gids helpt Python- en data engineers bij het kiezen van een processing engine voor tabulaire data en pipelines voor beeld, audio of tekst. Hij legt uit hoe Polars, DataFusion, Daft, Ray Data en Spark hun werk uitvoeren, bij welke workloads ze passen en hoe je ze vergelijkt op je eigen data.
Moderne pipelines verwerken ook beeld, audio en video. Bij zulke workloads kan CPU-decodering de GPU-inference uithongeren. Native operators, columnaire data-uitwisseling en het overlappen van CPU- en GPU-werk pakken elk andere kosten aan. Een engine kiezen betekent uitzoeken welke kosten jouw pipeline begrenzen.
Om de opties te vergelijken heb ik Pandas, Polars, DataFusion, Daft en native Rust gebenchmarkt op twee echte datasets: NYC-taxiritten staan voor tabulair werk en Food-101-afbeeldingen voor een multimodale pipeline. Spark en Ray komen aan bod in aparte distributed notebooks.
De code staat in de engine-comparison-demo repository.
Soorten workloads voor dataverwerking
Engines zijn gespecialiseerd, dus bepaal eerst welk soort workload je hebt. De belangrijkste scheiding is gestructureerd versus multimodaal. Het diagram toont hoe de hoeveelheid data in elk van beide verandert: een tabulaire job krimpt de data bij elke stap, terwijl een multimodale job ze laat groeien.
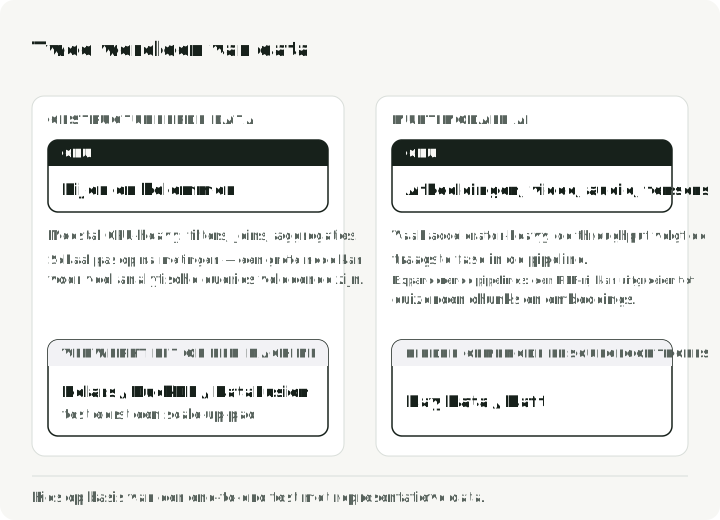
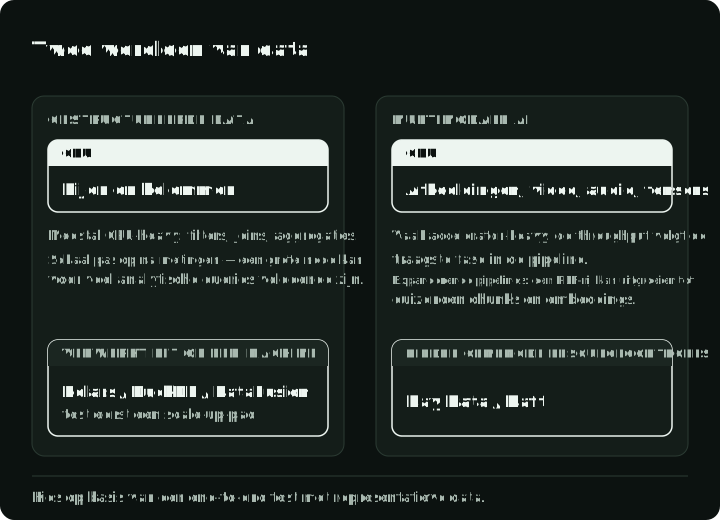
Gestructureerde of tabulaire data bestaat uit filteren, aggregeren en joins. Het werk is meestal CPU-gebonden en past vaak in het geheugen. Veel van zulke queries draaien op één moderne machine, maar geheugen, I/O, concurrency, herstel en de vorm van de workload bepalen nog steeds of een cluster op zijn plaats is.
Multimodale AI verwerkt beeld, audio of video. De inference kan op een GPU draaien terwijl CPU-decodering, remote reads of batching de pipeline begrenzen. Welke stap de throughput beperkt, verschilt per instance type en per operator. Meet daarom de benutting over het hele pad in plaats van de GPU los te dimensioneren.
De nieuwere engines richten zich op verschillende delen van dit gebied. Native uitvoering kan Python-overhead verlagen, Arrow-compatibele interfaces kunnen data-uitwisseling goedkoper maken en streaming-uitvoering kan het geheugengebruik begrenzen bij datasets die groter zijn dan het RAM. Geen van deze voordelen geldt automatisch voor elke operator of conversie.
Deel 1: verwerking op één node
Pandas kiest voor een eager programmeermodel: elke bewerking wordt direct uitgevoerd en de data blijft meestal in het geheugen. Een lazy model plant daarentegen meerdere bewerkingen samen voordat het ze uitvoert. In Pandas maken veel gangbare bewerkingen tussentabellen en wordt parallelle uitvoering niet via een query optimizer gecoördineerd. Die afweging houdt exploratieve code overzichtelijk, maar kan duur worden bij grotere analytische scans.
Het diagram toont wat elk model uit het Parquet-bestand leest voor de taxiquery hieronder: het eager pad leest alle 19 kolommen voordat het filtert, terwijl het lazy plan de optimizer het filter en de 3 gebruikte kolommen in de scan laat duwen.
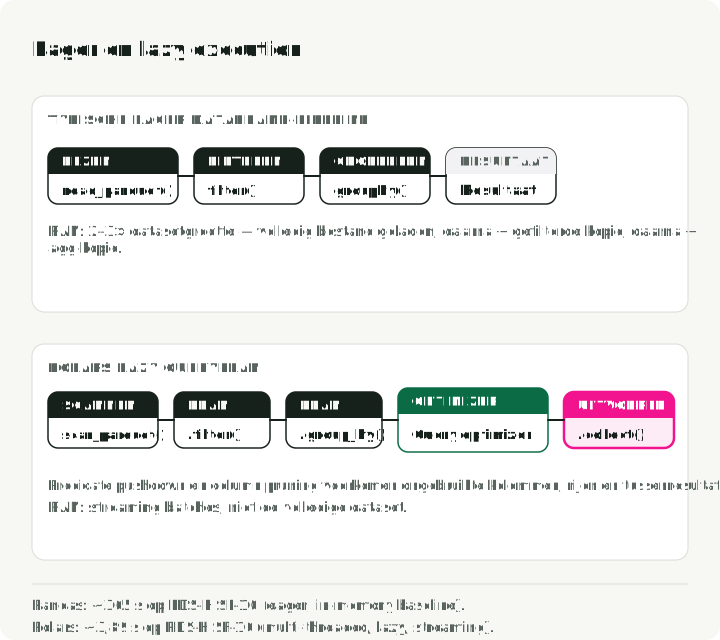
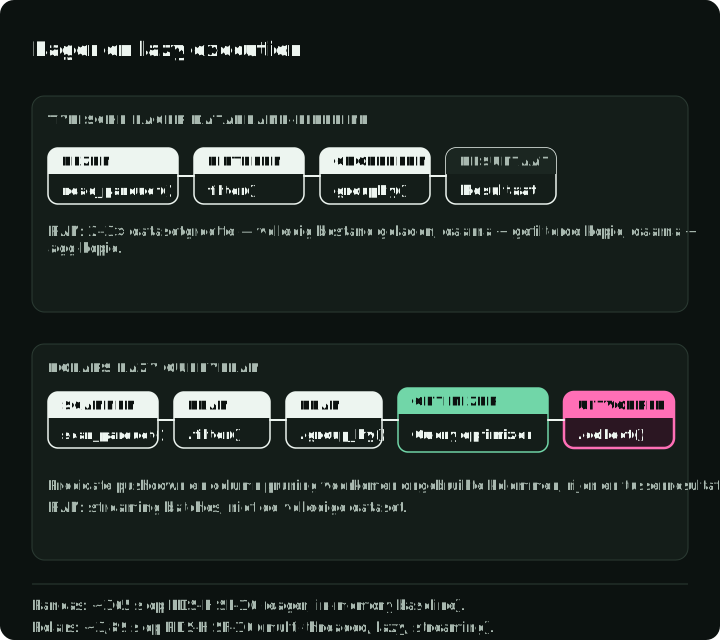
In Polars’ PDS-H benchmark van mei 2025 op schaalfactor 10 had Pandas ongeveer 365 seconden nodig voor de suite, terwijl de streaming engine van Polars er 3,89 seconden over deed. Het resultaat van ongeveer 94x beschrijft die benchmark en die configuratie. Het is geen algemene omrekenfactor van Pandas naar Polars.
Polars voor lokale tabulaire pipelines
Polars is een praktische default wanneer een lokale DataFrame-pipeline te groot is geworden voor eager uitvoering in één proces. De lazy API bouwt een queryplan voordat er iets draait. Daardoor kan Polars rijen zo vroeg mogelijk filteren (predicate pushdown) en alleen de benodigde kolommen lezen (projection pruning). De engine kan operators vervolgens parallel uitvoeren en, waar dat wordt ondersteund, in streaming batches.
Bij schaalfactor 100 (~100 GB aan CSV) was de streaming engine van Polars ongeveer 6x sneller dan de in-memory engine op dezelfde machine. De bron schrijft dit verschil vooral toe aan minder CPU-cache-misses en een betere benutting van de cores. Het bewijst niet dat Polars invoer verwerkt die groter is dan het RAM.
De query hieronder leest taxiritten uit Parquet, selecteert ritten van meer dan vijf mijl met een totaalbedrag boven $30 en berekent aantallen en gemiddelden per betaaltype. De bijbehorende notebook engine_comparison_examples.ipynb bevat verwante API- en setupvoorbeelden. tabular.py downloadt de taxidata en draait de getimede job die verderop wordt beschreven:
import polars as pl

# Build a lazy scan; query execution happens at collect()
q = (
    pl.scan_parquet("yellow_tripdata_2024-01.parquet")
    .filter(
        (pl.col("trip_distance") > 5.0)
        & (pl.col("total_amount") > 30.0)
    )
    .group_by("payment_type")
    .agg(
        pl.col("total_amount").mean().alias("avg_fare"),
        pl.col("trip_distance").mean().alias("avg_distance"),
        pl.len().alias("trip_count"),
    )
)

# The entire plan is optimized and executed here, in parallel
result = q.collect(engine="streaming")
Het belangrijke verschil is het uitvoeringsmodel. In de lazy query hierboven kan Polars het filter en de kolomselectie in de Parquet-scan duwen. Dat kan row groups overslaan en voorkomt dat ongebruikte kolommen worden gelezen. Streaming staat hier expliciet aan. collect materialiseert nog steeds het eindresultaat en niet-ondersteunde bewerkingen kunnen terugvallen op in-memory uitvoering. Een typische eager Pandas-pipeline heeft geen plan voor de hele query om te optimaliseren, al kan zorgvuldig gebruik van Parquet-filters, geselecteerde kolommen en alternatieve backends een deel van het verschil goedmaken.
DataFusion voor embedded query engines
Polars is een library die je rechtstreeks gebruikt. DataFusion is de engine waarop je andere engines bouwt. Het drijft InfluxDB 3.0, GreptimeDB en Apache DataFusion Comet aan, een Spark-versneller die oorspronkelijk bij Apple is gebouwd.
In een ClickBench-run van het DataFusion-project van november 2024 liep DataFusion voorop in de geteste single-node Parquet-configuraties. Het Embucket-team publiceerde later een TPC-H-run op schaalfactor 1000 op één grote node, waarbij twee queries zijn herschreven om te kunnen eindigen. Deze resultaten laten zien wat scale-up onder specifieke omstandigheden kan bereiken. Ze bewijzen niet dat elke workload van 1 TB zonder cluster moet kunnen.
Hier is dezelfde taxisamenvatting in DataFusion SQL, met de betaaltypen gesorteerd op aantal ritten. De bijbehorende notebook engine_comparison_examples.ipynb bevat verwante SQL- en setupvoorbeelden:
from datafusion import SessionContext

ctx = SessionContext()
ctx.register_parquet("taxi", "yellow_tripdata_2024-01.parquet")

# Plan SQL against the registered Parquet source
df = ctx.sql("""
    SELECT payment_type,
           COUNT(*)           AS trip_count,
           AVG(trip_distance) AS avg_distance,
           AVG(total_amount)  AS avg_fare
    FROM taxi
    WHERE trip_distance > 5.0 AND total_amount > 30.0
    GROUP BY payment_type
    ORDER BY trip_count DESC
""")
result = df.to_pandas()
De kracht van DataFusion is de modulariteit. De extensie-APIs omvatten eigen catalogs, table providers, optimizerregels en uitvoeringsplannen. Daarom duikt het overal op waar iemand een eigen dataplatform bouwt of een query engine in het eigen product embedt.
Schrijft je team SQL over lokale Parquet-bestanden en hoef je de engine niet te embedden, dan vervult DuckDB, een in-process SQL-database, dezelfde rol als Polars.
Daft voor multimodale data
Daft maakt beeld, audio, video en embeddings onderdeel van de DataFrame-workflow. Het biedt native expressies voor bewerkingen zoals het decoderen van afbeeldingen en het downloaden van URL’s, zodat gangbare preprocessing geen Python-loop per rij nodig heeft. Die integratie is de belangrijkste reden om Daft te overwegen boven een algemene tabulaire engine.
Voor tabulair werk lijkt de API van Daft op die van de engines hierboven. Dit voorbeeld draait dezelfde taxisamenvatting. De bijbehorende notebook engine_comparison_examples.ipynb bevat verwante voorbeelden van de Daft-API en setup:
import daft

df = daft.read_parquet("yellow_tripdata_2024-01.parquet")

result = (
    df.where(
        (daft.col("trip_distance") > 5.0)
        & (daft.col("total_amount") > 30.0)
    )
    .groupby("payment_type")
    .agg(
        daft.col("total_amount").mean().alias("avg_fare"),
        daft.col("trip_distance").mean().alias("avg_distance"),
        daft.col("trip_distance").count().alias("trip_count"),
    )
    .collect()
)
De API voelt vertrouwd als je Pandas kent, maar de engine is dezelfde Rust + Arrow-stack die je in Polars en DataFusion vindt. Daft loont wanneer de “rijen” in je DataFrame afbeeldingen, PDF’s of tensors zijn.
Daft leest, decodeert en schaalt afbeeldingen met native expressies, zonder Python-loop over de rijen. Dit is het afbeeldingspad uit multimodal.py:
import daft
from daft import col

df = (
    daft.from_glob_path("food101_images/*.jpg")
    .with_column("image", col("path").download().decode_image(mode="RGB"))
    .with_column("resized", col("image").resize(224, 224))
)
df.collect()
Benchmark op één node
Ik draaide Pandas, Polars, DataFusion en Daft, plus native Rust via Polars-rs, op ~41 miljoen NYC yellow taxi-ritten over het volledige jaar 2024. De getimede job filtert ritten met een tarief boven $10, joint de tabel met taxizones, sommeert de omzet per borough en zone en geeft de top 20 rijen terug. Dat is een andere query dan de voorbeelden hierboven. Spark en Ray komen voor in de gedistribueerde voorbeelden, niet in deze single-node benchmark.
Elke engine leest de bestanden binnen de getimede functie; het script rapporteert de mediaan van drie runs. De resultaatcontrole vergelijkt de 20 rijen tussen de Python-engines op borough, zone, aantal ritten en omzet afgerond op centen; avg_tip wordt niet vergeleken. Pandas krijgt de vier ritkolommen die de query gebruikt, omdat het geen optimizer heeft die ze kan vinden. De grafiek toont het resultaat op een Apple M5 Max met 18 cores en 64 GB RAM. De volledige resultaten staan in de demo repo:
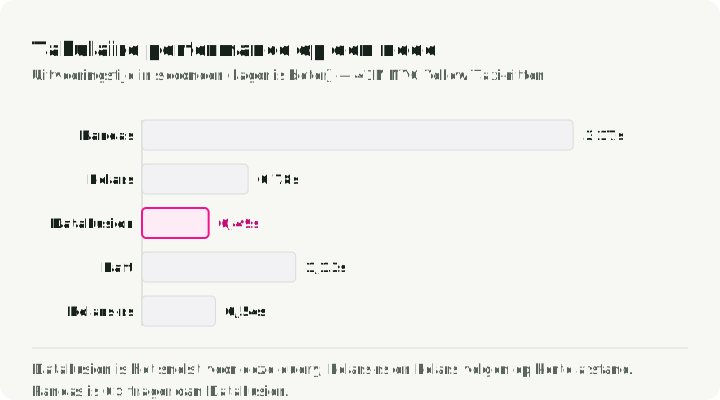
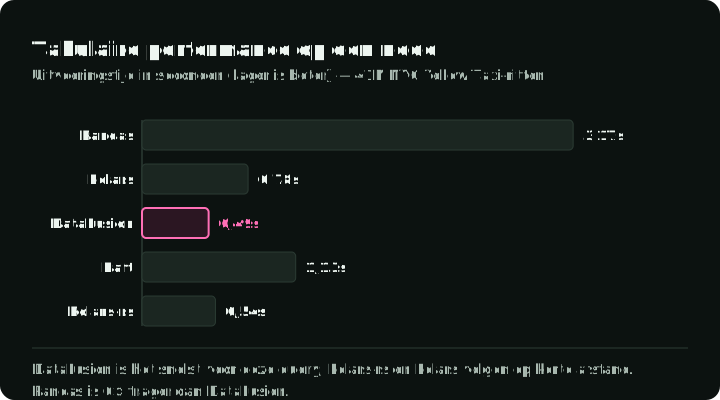
Pandas had 4,67 seconden nodig. De vier nieuwere engines waren klaar in 0,40 tot 0,74 seconden, met DataFusion als snelste en Polars ongeveer 7x sneller dan Pandas. De 94x van Polars ten opzichte van Pandas hierboven komt uit PDS-H. Deze job gaf een kleiner verschil. De tijden schommelden ook tussen runs: over vier runs van het script op een machine die ander werk deed, varieerde Pandas van 2,6 tot 4,8 seconden. DataFusion was elke keer de snelste Python-engine, en Polars en Daft wisselden van plaats. Wanneer engines zo dicht bij elkaar liggen, moeten API-fit en herhaalde metingen op representatieve data de keuze bepalen.
Deel 2: multimodale data
Tabulaire ETL verkleint data meestal: filteren, aggregeren en minder wegschrijven dan je las. Multimodale AI-pipelines doen het omgekeerde. Eén documentpad kan uitwaaieren naar tientallen tekstchunks en embeddingvectoren.
In een conventionele PySpark-pipeline komen afbeeldingen en audio vaak binnen als binaire data en gaan ze naar Python-libraries voor decodering of transformatie. Het oversteken van de JVM/Python-grens en het serialiseren van resultaten kan een groot deel van de wall-clock-tijd worden. Spark kan Arrow-paden, gevectoriseerde UDF’s en versnellerintegraties gebruiken, maar die keuzes vragen om een expliciet ontwerp en om metingen.
Pipelined execution en GPU-benutting
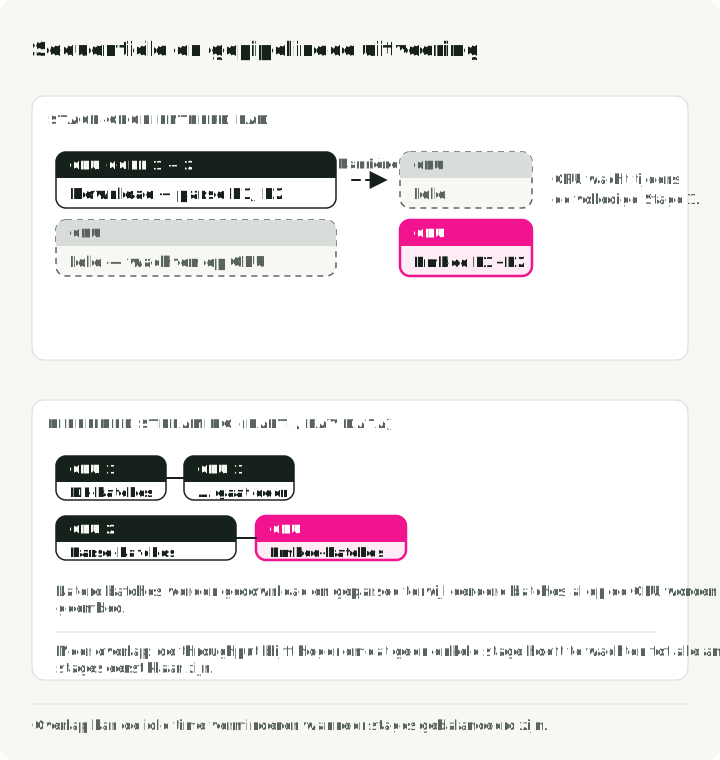
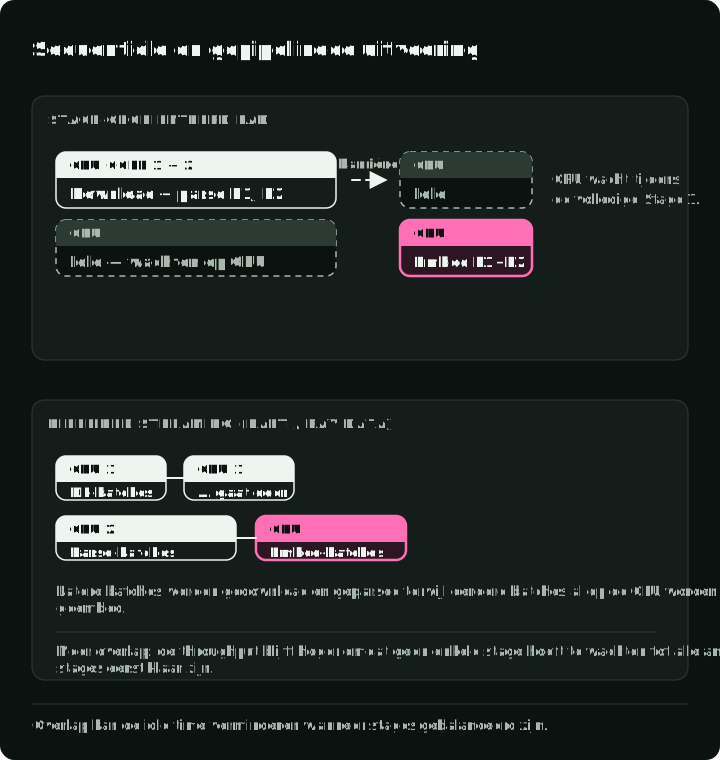
Spark plant werk in stages die door shuffle-grenzen worden gescheiden. Een rechttoe rechtaan implementatie kan download, decodering en inference achter elkaar zetten, zodat CPU- of GPU-capaciteit staat te wachten. Spark ondersteunt GPU resource scheduling en plugins, dus stilstand is niet onvermijdelijk. Stages bezig houden vraagt ook om backpressure: eerdere stages afremmen wanneer latere stages het niet bijhouden. Die controle en het overlappen van CPU- en GPU-werk gebeuren niet automatisch in een gewone PySpark DataFrame-job.
Pipelined execution is het alternatief. In plaats van stages achter elkaar uit te voeren, laat de engine I/O, CPU-werk en GPU-inference overlappen. Als stages en buffers in balans zijn, kan die overlap stilstand verminderen en de throughput verbeteren. Opstart en leegloop, backpressure of een tragere stage kunnen toch nog resources laten wachten.
Het diagram toont twee batches die drie stages doorlopen. Na elkaar uitgevoerd kosten ze zes stappen. Pipelined wordt batch 2 gelezen en gedecodeerd terwijl batch 1 nog bezig is, en hetzelfde werk kost vier stappen.
Benchmark voor beeldverwerking
Ik benchmarkte beeldverwerking op 500 echte foto’s uit de Food-101 dataset. Elke engine leest dezelfde 500 JPEG’s, decodeert ze naar RGB en schaalt ze met een bilineair filter naar 224×224, alles binnen de getimede functie. Het script controleert dat elke engine 500 afbeeldingen heeft opgeleverd en rapporteert de mediaan van drie runs. De grafiek toont het resultaat op dezelfde machine:
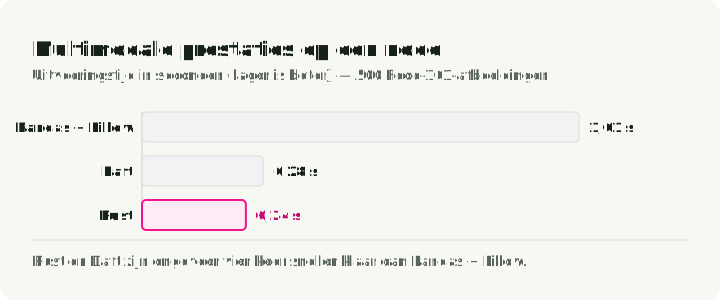
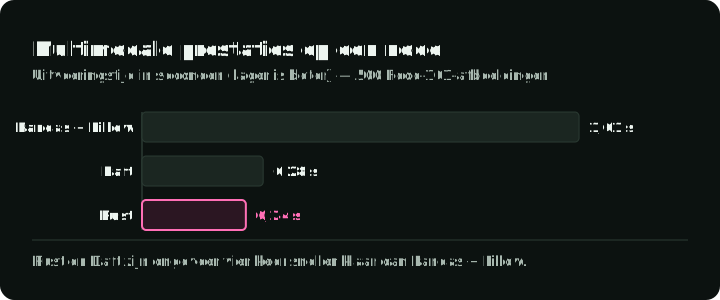
Polars en DataFusion ontbreken omdat ze geen native beeldbewerkingen hebben. De vastgelegde Python-resultaten en Rust-resultaten geven 0,55 seconden voor Pandas + Pillow, 0,34 voor Daft en 0,10 voor de Rust-crate image. Pandas verwerkt via apply() één afbeelding per keer. Daft en de Rust-versie verdelen het werk over meerdere cores. Over vier runs varieerde Pandas van 0,55 tot 1,21 seconden. Vijfhonderd afbeeldingen zijn te weinig om de productie-throughput te voorspellen en de job stopt voordat er GPU-werk komt, dus meet je eigen pipeline end-to-end.
Deel 3: gedistribueerde verwerking
Zodra één machine niet meer volstaat, moet je kiezen hoe je het werk verdeelt. Dask spreidt bestaande Pandas- en NumPy-code met weinig API-wijzigingen over cores of een cluster. Het past bij Python-teams die geen JVM of nieuwe DataFrame-API willen. De rest van dit deel behandelt Spark, Ray Data en Daft.
Apache Spark
Spark is een volwassen keuze voor grote tabulaire ETL, shuffle-zware joins en organisaties die het ecosysteem al beheren. Het herstel op basis van lineage en de brede platformondersteuning tellen mee wanneer betrouwbaarheid en operationele vertrouwdheid zwaarder wegen dan lokale snelheid. Gemengde CPU/GPU-pipelines vragen om een bewustere resourceconfiguratie en pipeline-opzet dan het SQL-pad. Daar bieden Ray Data en Daft een gerichtere abstractie.
Deze Spark-query joint langere taxiritten met informatie over de ophaalzone en vat daarna de totale omzet en gemiddelde tarieven per borough samen. Voor de setup van cluster-ETL zie distributed_spark.ipynb of spark_etl.py:
from pyspark.sql import SparkSession
from pyspark.sql import functions as F

spark = SparkSession.builder \
    .appName("TaxiETL") \
    .config("spark.sql.adaptive.enabled", "true") \
    .getOrCreate()

orders = spark.read.parquet("s3a://lake/taxi/*.parquet")
zones = spark.read.csv("s3a://lake/taxi_zones.csv", header=True)

# Spark excels at this: joining massive tables with a shuffle
result = (
    orders
    .filter(F.col("trip_distance") > 5.0)
    .join(zones, orders.PULocationID == zones.LocationID, "inner")
    .groupBy("Borough")
    .agg(
        F.sum("total_amount").alias("total_revenue"),
        F.avg("total_amount").alias("avg_fare"),
    )
    .orderBy(F.desc("total_revenue"))
)

# Spark is lazy: the write runs the query
result.write.mode("overwrite").parquet("s3a://warehouse/report/")
Ray Data voor heterogene compute
Ray Data is ontworpen rond AI-workloads. In plaats van de stagegrenzen van Spark gebruikt het een streamingmodel dat batches naar GPU-workers stuurt terwijl latere batches nog worden gelezen. Een Ray actor is een persistente worker die een model tussen batches geladen kan houden. De belangrijkste functie voor AI-pipelines is mixed resource scheduling: je kunt aangeven dat de ene actor “1 GPU, 4 CPUs” wil en een andere alleen CPUs, en Ray plaatst elke actor op een node met die resources.
Amazon meldde 82% betere kostenefficiëntie per GiB aan S3-invoer na het verplaatsen van geselecteerde interne workloads van Spark naar Ray. De schaal is opmerkelijk, maar dit is een migratiecase voor specifieke workloads en geen besparing die je mag verwachten bij een gemiddelde Ray-adoptie.
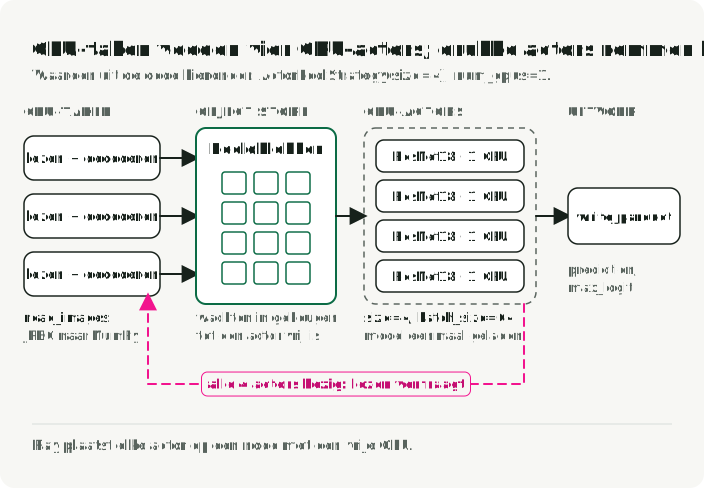
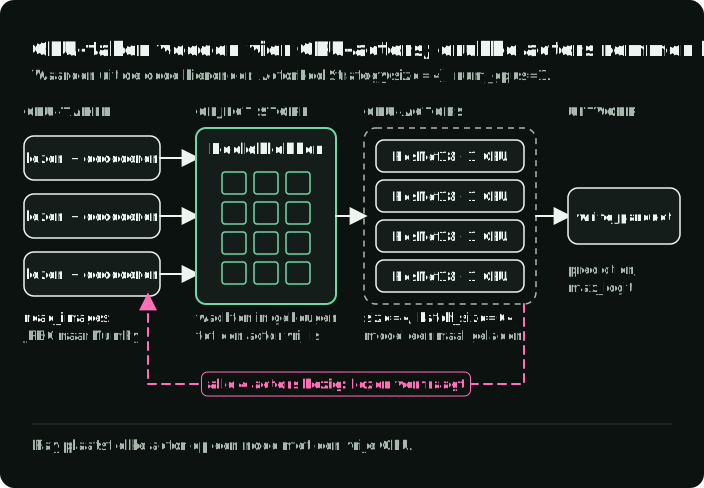
Het voorbeeld hieronder leest afbeeldingen, classificeert ze met ResNet18 op GPU-workers en schrijft de voorspellingen naar Parquet. Het diagram toont de pipeline die het bouwt: CPU-taken lezen en decoderen afbeeldingen naar de object store van Ray, een pool van vier GPU-actors draait het model en backpressure remt het lezen af wanneer de GPU-actors vol zijn.
Voor de setup van beeldinference zie distributed_ray.ipynb of ray_inference.py:
import ray

ray.init()

ds = ray.data.read_images("s3://my-bucket/food101/", mode="RGB")

class ImageClassifier:
    def __init__(self):
        import torch
        from torchvision.models import resnet18, ResNet18_Weights
        self.model = resnet18(weights=ResNet18_Weights.DEFAULT).cuda()
        self.model.eval()
        self.preprocess = ResNet18_Weights.DEFAULT.transforms()

    def __call__(self, batch):
        import torch
        from PIL import Image
        tensors = torch.stack([
            self.preprocess(Image.fromarray(img)) for img in batch["image"]
        ]).cuda()
        with torch.no_grad():
            preds = self.model(tensors)
        return {
            "prediction": preds.argmax(dim=1).cpu().numpy(),
            "max_logit": preds.max(dim=1).values.cpu().numpy(),
        }

# ActorPoolStrategy creates persistent GPU workers
predictions = ds.map_batches(
    ImageClassifier,
    compute=ray.data.ActorPoolStrategy(size=4),
    num_gpus=1,
    batch_size=64,
)
predictions.write_parquet("s3://output/predictions/")
Deze schets reserveert vier actors met elk één GPU en vereist vier beschikbare CUDA GPUs, Torchvision-weights en toegang tot S3. Ray leest afbeeldingen als NumPy-arrays. Door RGB-arrays naar PIL om te zetten, krijgt de preprocessing-transform van ResNet18 een invoer die hij accepteert. max_logit is de hoogste ruwe modelscore en geen betrouwbaarheidskans.
In de benchmarks van Anyscale draaide de beeldclassificatie van Ray Data ongeveer 4x sneller (van 456 naar 111 seconden) toen de instance van 4 CPUs per GPU naar 32 CPUs per GPU ging. Anyscale schrijft de verbetering toe aan minder tekort aan CPU-capaciteit; de GPU-benutting bleef in absolute zin laag. Daft verbeterde van 4 naar 16 CPUs per GPU en bleef daarna rond 195 seconden bij zowel 16 als 32.
Gedistribueerde Daft
Daft schaalt uit via zijn Flotilla engine: één Swordfish-worker per node, met Flotilla daarbovenop voor clusterbrede scheduling. Swordfish verzorgt de lokale Rust-uitvoering en laat I/O en compute overlappen via streaming in kleine batches, zodat elke node bezig blijft zonder op de volgende stage te wachten.
In benchmarks die Daft publiceerde was Flotilla 4–18x sneller dan de geteste Spark-implementaties over vier multimodale workloads. Het grootste verschil zat in een case voor objectdetectie in video. Lees het resultaat als bewijs dat het uitvoeringsontwerp de throughput bij deze pipelines zoveel kan veranderen. Vergelijk het daarna met de concurrerende resultaten van Anyscale hieronder en met een lokale test.
Anyscale, het bedrijf achter Ray, publiceerde een concurrerende benchmark waarin Ray Data na tuning het verschil op instances met veel CPUs dichtte of omkeerde. Samen zijn de twee studies van leveranciers een reden om representatieve operators en CPU-GPU-verhoudingen te testen, en geen basis voor een blijvende ranglijst.
Het volgende voorbeeld gebruikt de Ray runner van Daft. Het reproduceert de Flotilla-benchmark hierboven niet. Het leest een tabel met afbeeldings-URL’s, downloadt de afbeeldingen, maakt er met CLIP op GPU-workers embeddings van en schrijft de vectoren naar Parquet. Het past daft_pipeline.py aan voor Ray GPU-workers. Met de Transformers 5.0.0-API die het bijbehorende project vastlegt, staan de geprojecteerde afbeeldingsfeatures in .pooler_output. De bijbehorende notebook is distributed_daft.ipynb:
import io

import daft
import numpy as np
from daft import col

# Connect to an existing Ray cluster before building the query
daft.set_runner_ray(address="auto")

# Define a GPU class UDF: the model loads once per instance
@daft.cls(gpus=1)
class ImageEmbedder:
    def __init__(self):
        import torch
        from transformers import CLIPModel, CLIPProcessor

        self.device = "cuda" if torch.cuda.is_available() else "cpu"
        self.model = CLIPModel.from_pretrained(
            "openai/clip-vit-base-patch32"
        ).to(self.device)
        self.processor = CLIPProcessor.from_pretrained(
            "openai/clip-vit-base-patch32"
        )
        self.model.eval()

    @daft.method.batch(
        return_dtype=daft.DataType.fixed_size_list(daft.DataType.float32(), 512)
    )
    def __call__(self, image_bytes_col):
        import torch
        from PIL import Image

        embeddings = []
        for img_bytes in image_bytes_col.to_pylist():
            img = Image.open(io.BytesIO(img_bytes)).convert("RGB")
            inputs = self.processor(images=img, return_tensors="pt").to(self.device)
            with torch.no_grad():
                features = self.model.get_image_features(**inputs).pooler_output
            embeddings.append(features[0].cpu().numpy())
        return np.array(embeddings, dtype=np.float32)

embedder = ImageEmbedder()

df = (
    daft.read_parquet("s3://bucket/image_metadata.parquet")
    # Native Rust I/O downloads the images; no Python requests loop
    .with_column("image_bytes", col("image_url").download())
    .with_column("embedding", embedder(col("image_bytes")))
    .exclude("image_bytes")
)
df.write_parquet("s3://bucket/embeddings/")
De Ray runner van Daft verbindt met een bestaand cluster. De standaard native runner gebruikt de lokale machine. Installeer Daft met Ray-ondersteuning en zorg dat dat cluster beschikt over GPU-workers, Transformers 5.0.0, de CLIP-weights en S3-credentials. De class- en batch-method-API houdt het model tussen batches vast en gpus=1 vraagt de runner om één GPU per instance. De gelinkte repositoryrevisie gebruikt gewone @daft.cls en één partitie, omdat die op één lokale GPU mikt. Downloads kunnen met GPU-inference overlappen, afhankelijk van partitionering en backpressure.
Die revisie van het bijbehorende project vervangt ontbrekende afbeeldingen of elke verwerkingsfout door een nulvector, ook bij een mislukte controle van de embeddingvorm. De code indexeert het CLIP-uitvoerobject zonder .pooler_output te selecteren, waardoor die controle in Transformers 5.0.0 mislukt en ook geldige afbeeldingen nulvectoren kunnen worden. Gebruik de extractie van geprojecteerde features die hier staat; deze schets laat de job mislukken bij verwerkingsfouten.
Gedistribueerde vergelijking
| Kenmerk | Spark | Ray Data | Daft (Flotilla) |
|---|---|---|---|
| Uitvoeringsmodel | Eén taak per core, op partities gebaseerd | Streaming tasks en actors | Swordfish per node, streaming batches |
| Sterke punten | Grootschalige SQL/ETL, fouttolerantie | Heterogene compute, GPU-verzadiging | Multimodale pipelining, begrensd geheugen |
| GPU-besturing | Resource scheduling plus plugins uit het ecosysteem | Expliciete resources voor tasks en actors | Geïntegreerde CPU/GPU-pipeline-scheduling |
| Typische tuning | Executors, geheugen, partities, versnellers | Batches, actors, object store | Batches, resources, I/O-concurrency |
| Goede evaluatiecase | Grote SQL/ETL en shuffle-zware jobs | Training of inference met gemengde resources | Multimodale ingestie en transformatie |
Deel 4: de rol van Rust en Arrow
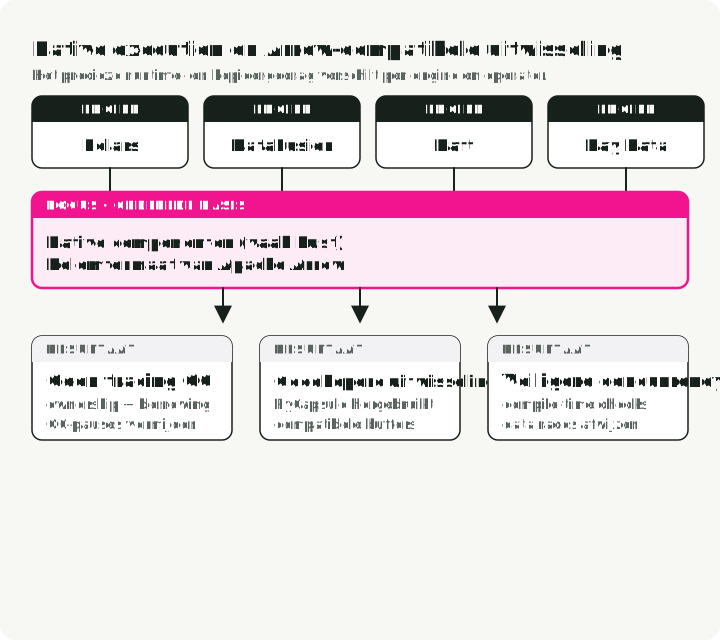
Polars, Daft en DataFusion gebruiken Rust uitgebreid, terwijl Ray naast zijn Python-APIs native componenten heeft. Allemaal kunnen ze data uitwisselen via onderdelen van het Apache Arrow-ecosysteem.
De Arrow PyCapsule Interface (het __arrow_c_stream__-protocol) geeft compatibele libraries een standaardmanier om Arrow-streams uit te wisselen. Overdrachten kunnen rijgewijze serialisatie vermijden en buffers hergebruiken wanneer schema’s en geheugenindelingen compatibel zijn. Materialisatie, rechunking, typeconversie of overdracht tussen devices kan nog steeds data kopiëren, dus controleer de overdracht met profiling in plaats van aan te nemen dat die gratis is.
Het volgende voorbeeld toont een Arrow-overdracht: DataFusion telt aankopen voor gebruikers met meer dan vijf aankopen en Polars rangschikt die aantallen. Het diagram gebruikt Polars 1.37.1, de versie die het bijbehorende project vastlegt: rechunk=False behoudt compatibele buffers, terwijl de standaardwaarde rechunk=True meerdere batches naar één chunk per kolom kopieert. Standaardwaarden kunnen in andere versies verschillen. Het voorbeeld gaat ervan uit dat events.parquet al bestaat. De bijbehorende engine_comparison_examples.ipynb maakt in de setup-cellen een synthetisch .data/events.parquet aan vóór het Arrow-voorbeeld.
from datafusion import SessionContext
import polars as pl

# Compute in DataFusion (Rust-native execution)
ctx = SessionContext()
ctx.register_parquet("events", "events.parquet")
df = ctx.sql("""
    SELECT user_id, COUNT(*) as event_count
    FROM events WHERE event_type = 'purchase'
    GROUP BY user_id HAVING COUNT(*) > 5
""")

# Convert through Arrow; compatible buffers may be reused
arrow_table = df.to_arrow_table()
df_polars = pl.from_arrow(arrow_table)

# Continue analysis in Polars
result = df_polars.with_columns(
    pl.col("event_count").rank().alias("rank")
).sort("rank")Daft kan een DataFrame ook met df.to_torch_iter_dataset() aan PyTorch overdragen. Dat dekt de laatste stap van een multimodale trainingspipeline.
Waarom gebruiken deze nieuwere engines Rust voor native uitvoering?
-
Geen tracing garbage collector in Rust-code. Door ownership hebben native operators directere controle over het toewijzen en vrijgeven van geheugen. Dat kan GC-gerelateerde latency verlagen, maar het voorkomt geen geheugendruk of out-of-memory-fouten.
-
Compacte native representaties. Rust-structuren dragen geen Java-objectheaders. Het praktische voordeel hangt af van de indeling van de engine: columnaire JVM-systemen vermijden ook dat elke waarde als apart object wordt voorgesteld.
-
Strengere concurrency-controles. Safe Rust sluit veel data races al bij het compileren uit. Engine-code kan nog steeds unsafe-blokken en logische concurrency-bugs bevatten.
In combinatie met de columnaire geheugenindeling van Arrow kunnen deze keuzes allocatie- en serialisatie-overhead verlagen. Ze halen die niet op elke grens weg. Python-objecten, netwerktransport, incompatibele schema’s en verplaatsing tussen devices blijven meetellen.
Deel 5: meerdere engines gebruiken
Je hoeft het hele platform niet door één engine te sturen. Combineren loont wanneer de overdracht tussen engines minder kost dan één systeem alle workloads te laten dragen. Het diagram toont zo’n estafette: de engines ontmoeten elkaar bij Parquet-bestanden, en elke schrijf- of leesactie over die grens kost I/O en conversie.
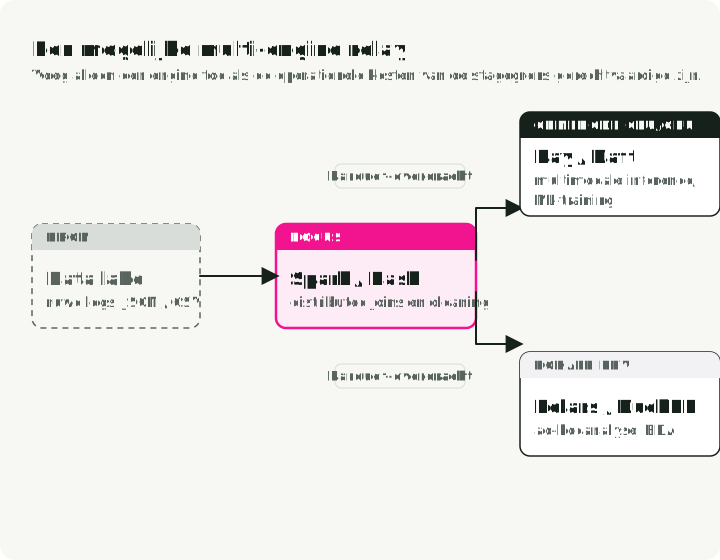
Een mogelijke estafette gebruikt Spark voor gevestigde lakehouse-joins, schrijft een open tabel- of bestandsformaat en geeft het resultaat door aan Ray Data of Daft voor GPU-inference of multimodale transformaties. Polars of DuckDB kan lokale analyse over dezelfde bestanden verzorgen. Een kleiner team heeft misschien aan één van deze engines genoeg. Voeg er pas een toe wanneer een gemeten bottleneck de operationele grens rechtvaardigt.
Interoperabiliteit maakt deze combinatie mogelijk. Parquet is in deze voorbeelden de gemeenschappelijke bestandsoverdracht, terwijl Arrow in-memory uitwisseling kan bieden. Ondersteuning voor Delta en Iceberg hangt af van de engine en de connector, dus controleer elke grens. Een bestandsoverdracht kost ook I/O en conversie en is niet automatisch gratis.
Engine kiezen per evaluatiecase
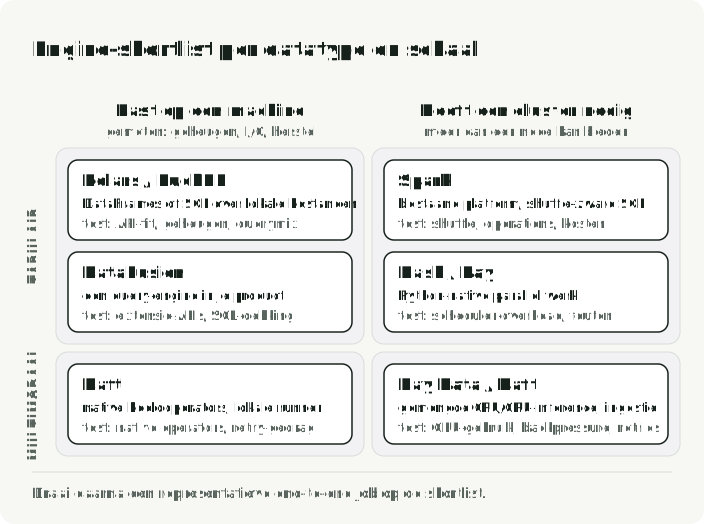
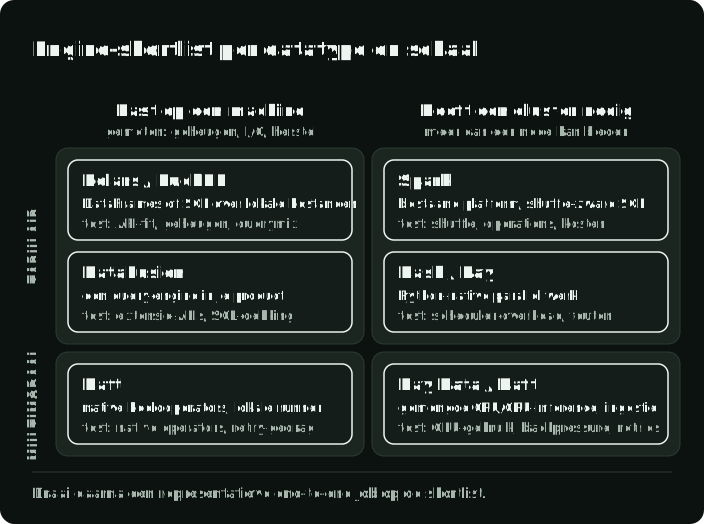
De tabel koppelt elke workload aan een shortlist en aan wat je moet testen voordat je kiest.
| Evaluatiecase | Shortlist | Valideer |
|---|---|---|
| Lokale analytische DataFrames | Polars / DuckDB | API-fit, geheugen, querymix |
| Bestaande gedistribueerde SQL/ETL | Apache Spark | Shuffle-gedrag, beheer, kosten |
| Python-native parallel werk | Dask / Ray | Scheduler-overhead, faalmodel |
| Gemengde CPU/GPU-training of inference | Ray Data / Daft | Benutting van versnellers, backpressure |
| Multimodale ingestie | Daft / Ray Data | Native operators, retry-gedrag |
| Embedded query engine | DataFusion | Extensie-APIs, SQL-dekking |
Het diagram plaatst dezelfde shortlist op twee vragen: of de data tabulair of multimodaal is, en of de job op één machine past.
Diagonal scaling
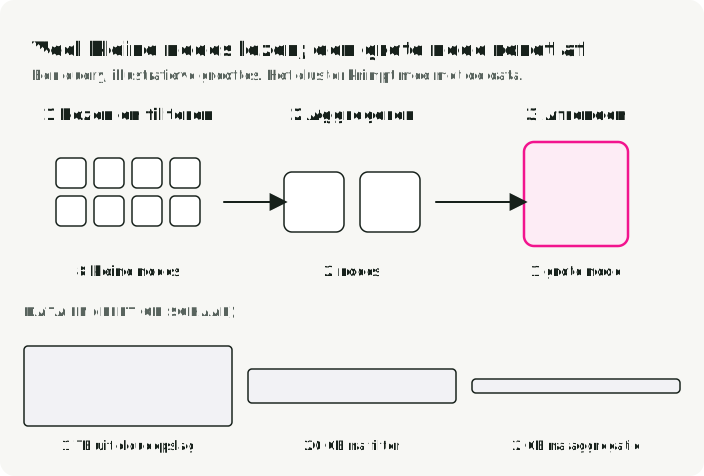
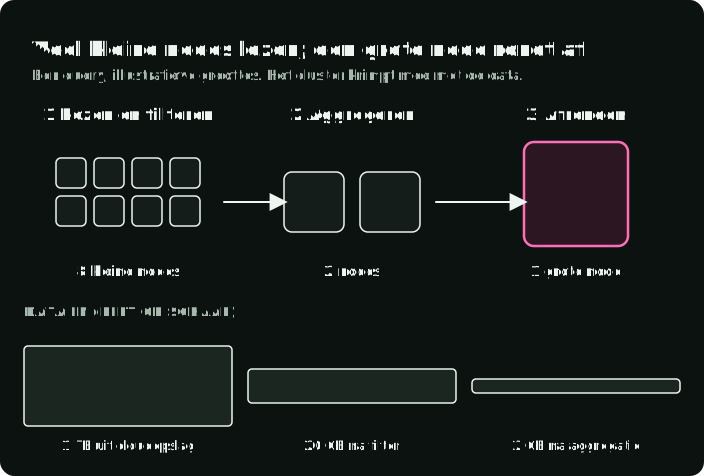
Lange tijd was de keuze scale up (een grotere machine) of scale out (meer machines). Polars Cloud beschrijft een querygestuurde aanpak die diagonal scaling heet. Schaal horizontaal tijdens het lezen uit cloudopslag om de I/O volledig te benutten en klap daarna in tot één grote node zodra filters en aggregaties de data hebben verkleind. Vroege reductie kan de datatransfer beperken en laat het resterende werk op één node eindigen. Of er een gedistribueerde shuffle plaatsvindt, hangt af van het fysieke queryplan. Het diagram volgt één query met verzonnen groottes: acht kleine nodes lezen en filteren 1 TB, twee nodes aggregeren wat overblijft en één grote node maakt de query af op 2 GB.
Vergelijk de kosten per geslaagde job en niet de uurprijs van de instance. Een grotere node kan goedkoper zijn wanneer de kortere looptijd zwaarder weegt dan het hogere tarief, maar het resultaat hangt af van I/O, geheugendruk en hoeveel werk vóór een shuffle is weggevallen.
De vergelijking reproduceren
De demo repository bevat de scripts, notebooks en de omgeving die voor de vergelijkingen zijn gebruikt. Het tabulaire commando gebruikt de standaarddataset van de repository, de taxidata van het volledige jaar 2024, wat overeenkomt met de run hierboven. De eerste run downloadt ongeveer 660 MB aan taxidata en de Food-101-afbeeldingen. De Rust-benchmark vereist een Rust-toolchain.
# Install dependencies
uv sync

# Run the tabular benchmark (~41M NYC taxi trips from full-year 2024)
uv run python -m engine_comparison.benchmarks.tabular

# Run the multimodal benchmark (500 real food photos)
uv run python -m engine_comparison.benchmarks.multimodal

# Run native Rust benchmarks (Polars-rs + image crate)
cd rust_benchmark && cargo run --release && cd ..
./scripts/run_benchmarks.sh draait alle drie en schrijft benchmarks/*.json en de gecombineerde grafieken. De Python-scripts accepteren --runs 5 voor meer timingruns en het afbeeldingsscript accepteert --images 1000 voor een grotere set afbeeldingen. De gedistribueerde notebooks vereisen uv sync --extra distributed --extra notebook. De repo heeft ook Docker Compose-setups voor lokale gedistribueerde runs van Spark, Ray en Daft.
Belangrijkste inzichten
-
Bewijs dat één machine niet volstaat. Scale-up-resultaten laten zien dat sommige grote analytische scans op één node passen. Meet de eisen aan geheugen, I/O, spill en herstel voordat je de overhead van een cluster accepteert.
-
Lazy planning verklaart meer van het snelheidsverschil dan API-syntaxis. Pushdown, streaming en parallelle operators zijn grotendeels verantwoordelijk voor het verschil tussen een eager DataFrame-script en een analytische engine.
-
Meet de hele pipeline rond de versneller. Decodering, netwerk-I/O, batching, serialisatie en backpressure bepalen of een GPU bezig blijft. Ray Data en Daft maken deze overlap tot een centrale abstractie. Spark kan het ondersteunen met extra ontwerp en tooling.
-
Maak een shortlist op workload en benchmark daarna. Gebruik ecosysteem-fit om het veld te versmallen en een representatieve end-to-end job om te kiezen. Draai de benchmarkclaim van een leverancier opnieuw op je eigen job voordat je erop vertrouwt.
-
Open formaten houden de keuze omkeerbaar. Arrow-compatibele interfaces, Parquet en open tabelformaten kunnen de kosten van overdracht verlagen. Controleer of een bepaalde conversie buffers hergebruikt of kopieert.
Referenties
Benchmarks en prestatiedata
- Polars PDS-H Benchmarks - Polars streaming versus Pandas op SF-10 (94x) en SF-100 (ongeveer 6x ten opzichte van in-memory)
- DataFusion ClickBench Results (Nov 2024) - Door het project gepubliceerde single-node Parquet-resultaten
- Embucket: TPC-H SF-1000 on DataFusion - Case study van een leverancier op één grote node; twee queries zijn herschreven om te kunnen eindigen
- Amazon Spark-to-Ray Migration - 82% betere productiekostenefficiëntie per GiB aan S3-invoer
- Daft Flotilla Benchmarks - 4–18x sneller dan Spark op multimodale workloads
- Anyscale Ray vs. Daft Benchmarks - Concurrerende benchmark van een leverancier voor multimodale workloads
Engines en frameworks
- Polars - Rust DataFrame-library met lazy uitvoering
- Apache DataFusion - Embedbare Rust query engine (GitHub)
- Daft - Multimodal-native gedistribueerd DataFrame
- Ray - Gedistribueerd compute-framework voor AI (Data Internals)
- Apache Spark - Gedistribueerde ETL- en SQL-engine
- DuckDB - In-process analytische SQL-engine
- Dask - Python-native parallel computing
Architectuur en ecosysteem
- Polars Cloud: Diagonal Scaling - Dynamisch verticaal/horizontaal schalen
- Daft Flotilla Architecture - Swordfish + Flotilla gedistribueerde engine
- Apache DataFusion Comet - Spark-versneller, oorspronkelijk ontwikkeld bij Apple
- Apache Arrow - Columnair in-memory formaat (Flight RPC, PyCapsule Interface)
- InfluxDB 3.0 + DataFusion - Tijdreeksdatabase gebouwd op DataFusion
- GreptimeDB - Observability-database die DataFusion gebruikt
Demo repository
- engine-comparison-demo - Bijbehorende code voor dit artikel: benchmarks, notebooks en Docker Compose voor Spark/Ray/Daft
Datasets
- NYC Taxi Trip Records - NYC TLC yellow taxi-data (Parquet, ~2,9 miljoen rijen per maand)
- Food-101 Dataset - 101K afbeeldingen van eten van ETH Zürich (Bossard et al., ECCV 2014)