Движки обработки данных: Polars, DataFusion, Ray и Spark

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Это руководство поможет Python- и data-инженерам выбрать движок для табличных данных и пайплайнов с изображениями, аудио и текстом. В нём объясняется, как Polars, DataFusion, Daft, Ray Data и Spark выполняют работу, какие нагрузки им подходят и как сравнить их на ваших данных.
Современные пайплайны обрабатывают также изображения, аудио и видео. В таких нагрузках декодирование на CPU может оставлять GPU без работы. Нативные операторы, обмен колоночными данными и перекрытие работы CPU и GPU снижают разные виды затрат; выбрать движок значит найти, какая именно затрата ограничивает ваш пайплайн.
Чтобы сравнить варианты, я прогнал бенчмарк Pandas, Polars, DataFusion, Daft и нативного Rust на двух реальных датасетах: поездки нью-йоркского такси представляют табличную работу, а изображения Food-101 — мультимодальный пайплайн. Spark и Ray разобраны в отдельных распределённых ноутбуках.
Код лежит в репозитории engine-comparison-demo.
Типы нагрузок обработки данных
Движки специализированы, поэтому сначала определите, какая у вас нагрузка. Главное разделение: структурированные данные и мультимодальные. Диаграмма показывает, как меняется объём данных в каждом случае: табличная задача сжимает его на каждом шаге, а мультимодальная расширяет.
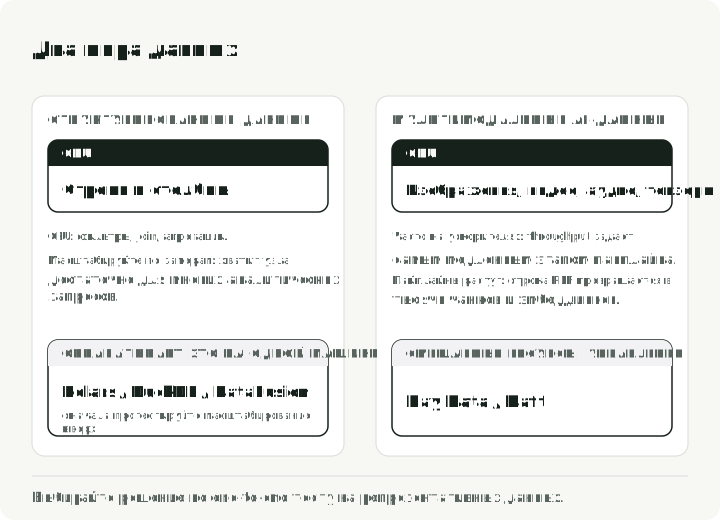
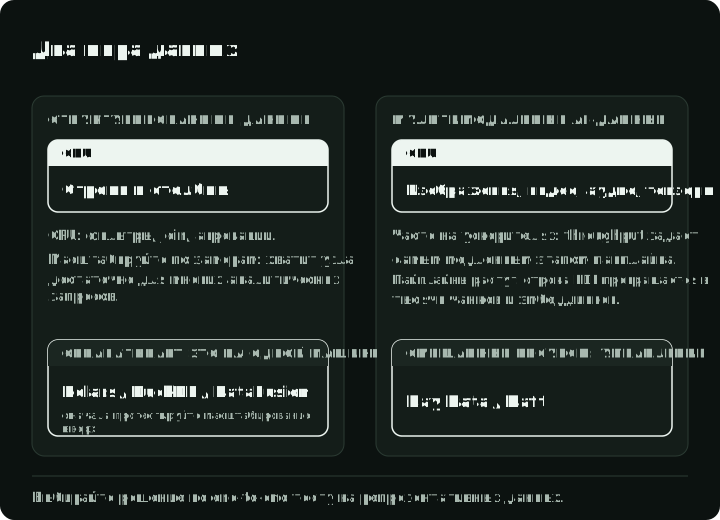
Структурированные, или табличные, данные — это фильтрация, агрегация и джойны. Такая работа обычно упирается в CPU и часто помещается в память. Многие запросы выполнимы на одной современной машине, но память, I/O, конкурентность, восстановление и форма нагрузки всё равно определяют, нужен ли кластер.
Мультимодальный AI обрабатывает изображения, аудио или видео. Инференс может идти на GPU, а пайплайн при этом ограничивают декодирование на CPU, удалённое чтение или батчинг. Какая стадия ограничивает throughput, зависит от типа инстанса и операторов, поэтому измеряйте загрузку на всём пути, а не подбирайте GPU отдельно.
Новые движки нацелены на разные части этого пространства. Нативное выполнение может снизить накладные расходы Python, Arrow-совместимые интерфейсы делают обмен данными дешевле, а потоковое выполнение ограничивает память на датасетах больше RAM. Ни одно из этих преимуществ не работает автоматически для каждого оператора и каждой конвертации.
Часть 1: обработка на одном узле
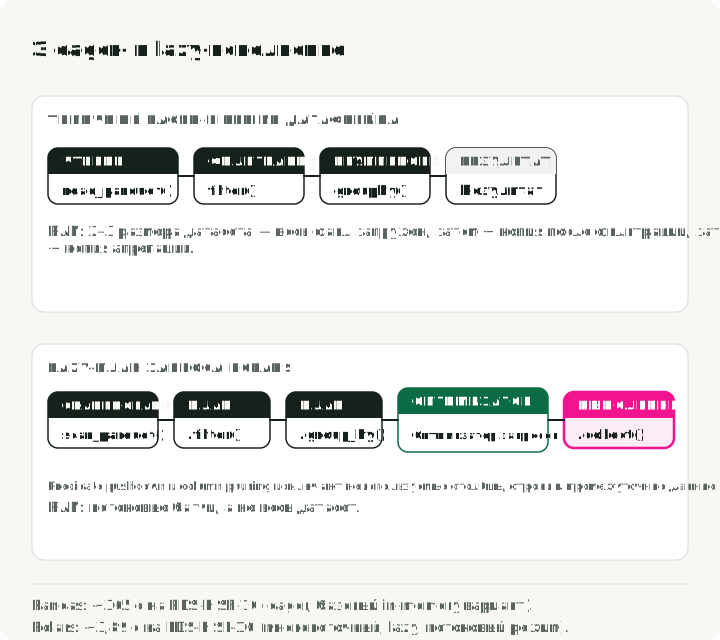
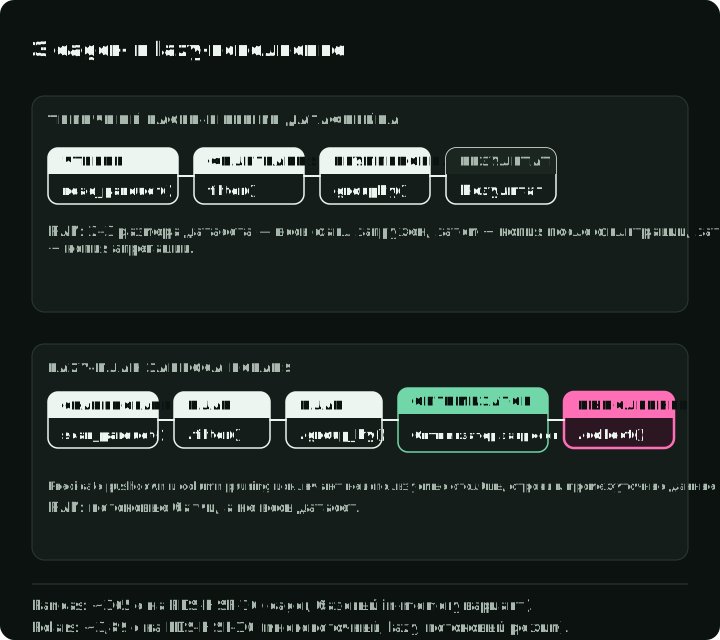
Pandas использует eager-модель: он выполняет каждую операцию сразу и обычно держит данные в памяти. Lazy-модель, наоборот, планирует несколько операций вместе и только потом запускает их. В Pandas многие типичные операции создают промежуточные таблицы, а параллельное выполнение не координирует оптимизатор запросов. Такой компромисс сохраняет простоту исследовательского кода, но при больших аналитических сканированиях может обходиться дорого.
Диаграмма показывает, что каждая модель читает из файла Parquet для запроса к данным такси, который используется ниже: eager-путь читает все 19 колонок до фильтрации, а lazy-план позволяет оптимизатору передать фильтр и 3 используемые колонки прямо в сканирование.
В майском бенчмарке PDS-H от Polars 2025 года при scale factor 10 Pandas выполнил набор запросов примерно за 365 секунд, а потоковый движок Polars — за 3,89 секунды. Результат примерно в 94 раза описывает именно этот бенчмарк и эту конфигурацию; это не общий коэффициент перехода с Pandas на Polars.
Polars для локальных табличных пайплайнов
Polars — практичный вариант по умолчанию, когда локальный DataFrame-пайплайн перерос eager-выполнение в одном процессе. Его lazy API строит план запроса до выполнения. Благодаря этому Polars фильтрует строки как можно раньше (predicate pushdown) и читает только нужные колонки (projection pruning). Затем движок может выполнять операторы параллельно и, где это поддерживается, потоковыми батчами.
При scale factor 100 (около 100 ГБ CSV) потоковый движок Polars работал примерно в 6 раз быстрее, чем его in-memory движок на той же машине. Источник объясняет разрыв в основном меньшим числом промахов кэша CPU и лучшей загрузкой ядер; это не доказательство работы с входом больше RAM.
Запрос ниже читает поездки такси из Parquet, отбирает поездки длиннее пяти миль с суммой больше $30 и считает количество и средние значения по типу оплаты. В сопутствующем ноутбуке engine_comparison_examples.ipynb есть связанные примеры API и настройки; tabular.py скачивает данные такси и запускает замеряемую задачу, описанную ниже:
import polars as pl

# Build a lazy scan; query execution happens at collect()
q = (
    pl.scan_parquet("yellow_tripdata_2024-01.parquet")
    .filter(
        (pl.col("trip_distance") > 5.0)
        & (pl.col("total_amount") > 30.0)
    )
    .group_by("payment_type")
    .agg(
        pl.col("total_amount").mean().alias("avg_fare"),
        pl.col("trip_distance").mean().alias("avg_distance"),
        pl.len().alias("trip_count"),
    )
)

# The entire plan is optimized and executed here, in parallel
result = q.collect(engine="streaming")
Главное отличие — модель выполнения. В lazy-запросе выше Polars может передать фильтр и выбор колонок прямо в сканирование Parquet. Это позволяет пропускать row groups и не читать ненужные колонки. Потоковый режим здесь включён явно; collect всё равно материализует итоговый результат, а неподдерживаемые операции могут переключаться на выполнение в памяти. В типичном eager-пайплайне на Pandas нет плана всего запроса, который можно оптимизировать, хотя аккуратное использование фильтров Parquet, выбор колонок и альтернативные бэкенды способны вернуть часть разрыва.
DataFusion для встраиваемых движков запросов
Polars — библиотека, которую вы используете напрямую, а DataFusion — движок, на котором строят другие движки. Он лежит в основе InfluxDB 3.0, GreptimeDB и Apache DataFusion Comet — ускорителя Spark, который сначала создали в Apple.
В прогоне ClickBench, опубликованном проектом DataFusion в ноябре 2024 года, DataFusion лидировал среди протестированных одноузловых конфигураций Parquet. Позже команда Embucket опубликовала прогон TPC-H со scale factor 1000 на одном крупном узле, причём два запроса пришлось переписать, чтобы они завершились. Эти результаты показывают, чего может достичь вертикальное масштабирование при определённых условиях; они не доказывают, что любой нагрузке на 1 ТБ нужно обходиться без кластера.
Вот та же сводка по такси на SQL DataFusion, с типами оплаты, отсортированными по числу поездок. В сопутствующем ноутбуке engine_comparison_examples.ipynb есть связанные примеры SQL и настройки:
from datafusion import SessionContext

ctx = SessionContext()
ctx.register_parquet("taxi", "yellow_tripdata_2024-01.parquet")

# Plan SQL against the registered Parquet source
df = ctx.sql("""
    SELECT payment_type,
           COUNT(*)           AS trip_count,
           AVG(trip_distance) AS avg_distance,
           AVG(total_amount)  AS avg_fare
    FROM taxi
    WHERE trip_distance > 5.0 AND total_amount > 30.0
    GROUP BY payment_type
    ORDER BY trip_count DESC
""")
result = df.to_pandas()
Сила DataFusion в его модульности. API расширения покрывают собственные каталоги, провайдеры таблиц, правила оптимизатора и планы выполнения. Поэтому DataFusion встречается везде, где строят собственную платформу данных или встраивают движок запросов в продукт.
Если ваша команда пишет SQL над локальными файлами Parquet и встраивать движок не нужно, DuckDB — встроенная в процесс SQL-база, которая играет ту же роль, что и Polars.
Daft для мультимодальных данных
Daft делает изображения, аудио, видео и эмбеддинги частью рабочего процесса с DataFrame. У него есть нативные выражения для таких операций, как декодирование изображений и загрузка по URL, поэтому типичной предобработке не нужен построчный цикл на Python. Эта интеграция — главная причина выбрать Daft вместо универсального табличного движка.
В табличной работе API Daft похож на движки выше. Этот пример выполняет ту же сводку по такси; в сопутствующем ноутбуке engine_comparison_examples.ipynb есть связанные примеры API Daft и настройки:
import daft

df = daft.read_parquet("yellow_tripdata_2024-01.parquet")

result = (
    df.where(
        (daft.col("trip_distance") > 5.0)
        & (daft.col("total_amount") > 30.0)
    )
    .groupby("payment_type")
    .agg(
        daft.col("total_amount").mean().alias("avg_fare"),
        daft.col("trip_distance").mean().alias("avg_distance"),
        daft.col("trip_distance").count().alias("trip_count"),
    )
    .collect()
)
API покажется знакомым, если вы знаете Pandas, но движок — тот же стек Rust + Arrow, что в Polars и DataFusion. Daft окупается, когда «строки» вашего DataFrame — это изображения, PDF или тензоры.
Daft читает, декодирует и масштабирует изображения нативными выражениями, без цикла Python по строкам. Это путь для изображений из multimodal.py:
import daft
from daft import col

df = (
    daft.from_glob_path("food101_images/*.jpg")
    .with_column("image", col("path").download().decode_image(mode="RGB"))
    .with_column("resized", col("image").resize(224, 224))
)
df.collect()
Бенчмарк на одном узле
Я запустил Pandas, Polars, DataFusion и Daft, а также нативный Rust через Polars-rs на примерно 41 млн поездок жёлтого такси Нью-Йорка за весь 2024 год. Замеряемая задача отбирает поездки с тарифом выше $10, джойнит таблицу зон такси, суммирует выручку по боро и зонам и возвращает 20 верхних строк. Это другой запрос, чем в примерах выше. Spark и Ray встречаются в распределённых примерах, но не в этом одноузловом бенчмарке.
Каждый движок читает файлы внутри замеряемой функции; скрипт сообщает медиану трёх запусков. Его проверка результатов сравнивает 20 строк между движками Python по району, зоне, числу поездок и выручке, округлённой до центов; avg_tip не сравнивается. Pandas получает четыре колонки поездок, которые использует запрос, потому что у него нет оптимизатора, чтобы найти их самому. График показывает результат на Apple M5 Max с 18 ядрами и 64 ГБ RAM. Полные результаты лежат в репозитории демо:
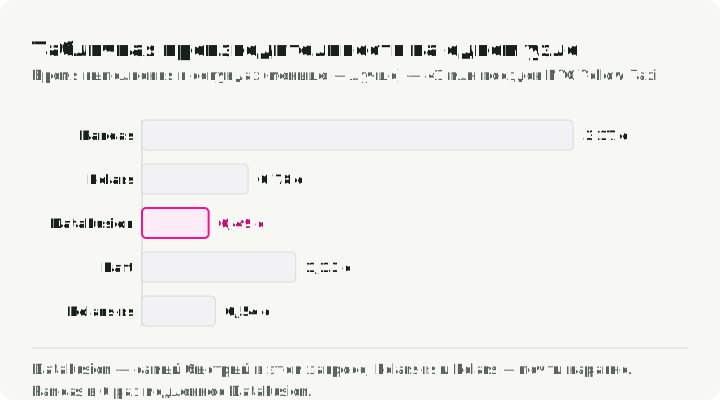
Pandas выполнил задачу за 4,67 секунды. Четыре новых движка уложились в 0,40–0,74 секунды: DataFusion оказался самым быстрым, а Polars примерно в 7 раз быстрее Pandas. Показатель 94x для Polars и Pandas выше получен на PDS-H; эта задача дала меньший разрыв. Время также колебалось между запусками: за четыре запуска скрипта на машине, занятой другой работой, Pandas показывал от 2,6 до 4,8 секунды. DataFusion каждый раз был самым быстрым движком на Python, а Polars и Daft менялись местами. Когда движки так близки, решать должны удобство API и повторные замеры на репрезентативных данных.
Часть 2: мультимодальные данные
Табличный ETL обычно уменьшает данные: отфильтровать, агрегировать, записать меньше, чем прочитал. Мультимодальные AI-пайплайны делают обратное. Один путь к документу может превратиться в десятки текстовых чанков и векторов эмбеддингов.
В обычном пайплайне на PySpark изображения и аудио часто попадают в виде бинарных данных и передаются в библиотеки Python для декодирования или преобразования. Пересечение границы JVM/Python и сериализация результатов могут занимать большую долю общего времени. Spark умеет использовать пути на основе Arrow, векторизованные UDF и интеграции с ускорителями, но эти варианты требуют отдельного проектирования и замеров.
Конвейерное выполнение и загрузка GPU
Spark планирует работу стадиями, разделёнными границами shuffle. При прямолинейной реализации загрузка, декодирование и инференс могут идти друг за другом так, что простаивает то CPU, то GPU. Spark поддерживает планирование ресурсов GPU и плагины, так что простой не неизбежен. Чтобы стадии оставались занятыми, нужен ещё backpressure: замедление ранних стадий, когда поздние не успевают. Ни этот механизм, ни перекрытие работы CPU и GPU не появляются сами в обычной задаче на PySpark DataFrame.
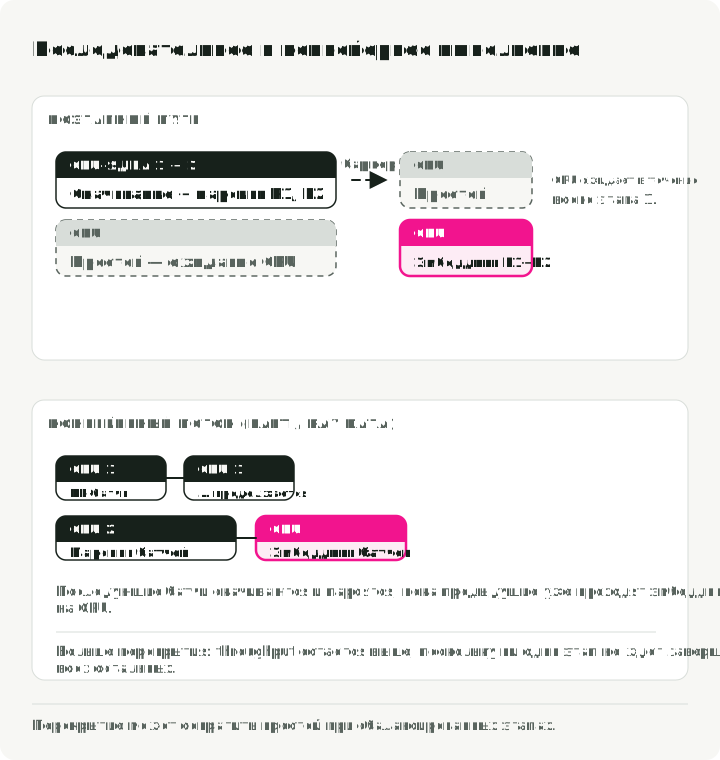
Альтернатива — конвейерное выполнение (pipelined execution). Вместо того чтобы запускать стадии одну за другой, движок перекрывает I/O, работу CPU и инференс на GPU. Когда стадии и буферы сбалансированы, такое перекрытие сокращает простои и повышает throughput; но запуск и опустошение конвейера, backpressure или более медленная стадия всё равно могут оставить ресурсы без работы.
Диаграмма показывает два батча, проходящих через три стадии. Если выполнять их по очереди, нужно шесть шагов. При конвейерном выполнении батч 2 читается и декодируется, пока батч 1 ещё в работе, и та же работа занимает четыре шага.
Бенчмарк обработки изображений
Я замерил обработку изображений на 500 реальных фотографиях из датасета Food-101. Каждый движок читает одни и те же 500 JPEG, декодирует их в RGB и масштабирует до 224×224 билинейным фильтром внутри замеряемой функции. Скрипт проверяет, что каждый движок выдал 500 изображений, и сообщает медиану трёх запусков. График показывает результат на той же машине:
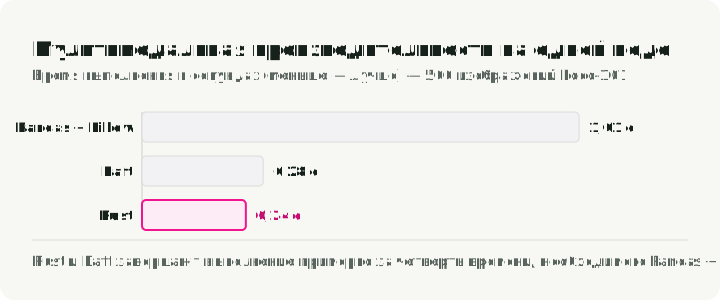
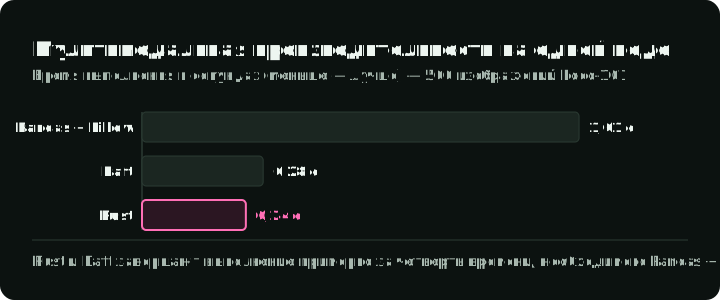
Polars и DataFusion отсутствуют, потому что у них нет нативных операций с изображениями. Записанные результаты на Python и результаты на Rust показывают 0,55 секунды для Pandas + Pillow, 0,34 для Daft и 0,10 для крейта Rust image. Pandas обрабатывает по одному изображению через apply(); Daft и версия на Rust распределяют работу по ядрам. За четыре запуска Pandas показывал от 0,55 до 1,21 секунды. Пятисот изображений слишком мало, чтобы предсказывать production-throughput, а задача заканчивается до любой работы на GPU, поэтому измеряйте свой пайплайн целиком.
Часть 3: распределённая обработка
Когда одной машины не хватает, нужно решить, как распределить работу. Dask распределяет существующий код на Pandas и NumPy по ядрам или кластеру с небольшими изменениями API; он подходит Python-командам, которым не нужны JVM или новый API DataFrame. Остальная часть раздела посвящена Spark, Ray Data и Daft.
Apache Spark
Spark — зрелый вариант для больших табличных ETL, джойнов с тяжёлым shuffle и организаций, которые уже эксплуатируют его экосистему. Восстановление на основе lineage и широкая поддержка платформ важны там, где надёжность и привычная эксплуатация весят больше локальной скорости. Смешанные пайплайны CPU/GPU требуют более продуманной конфигурации ресурсов и проектирования пайплайна, чем путь через SQL; именно здесь Ray Data и Daft предлагают более прицельную абстракцию.
Этот запрос Spark джойнит длинные поездки такси с информацией о зонах посадки, затем суммирует выручку и средние тарифы по боро. Настройку ETL на кластере смотрите в distributed_spark.ipynb или spark_etl.py:
from pyspark.sql import SparkSession
from pyspark.sql import functions as F

spark = SparkSession.builder \
    .appName("TaxiETL") \
    .config("spark.sql.adaptive.enabled", "true") \
    .getOrCreate()

orders = spark.read.parquet("s3a://lake/taxi/*.parquet")
zones = spark.read.csv("s3a://lake/taxi_zones.csv", header=True)

# Spark excels at this: joining massive tables with a shuffle
result = (
    orders
    .filter(F.col("trip_distance") > 5.0)
    .join(zones, orders.PULocationID == zones.LocationID, "inner")
    .groupBy("Borough")
    .agg(
        F.sum("total_amount").alias("total_revenue"),
        F.avg("total_amount").alias("avg_fare"),
    )
    .orderBy(F.desc("total_revenue"))
)

# Spark is lazy: the write runs the query
result.write.mode("overwrite").parquet("s3a://warehouse/report/")
Ray Data для гетерогенных вычислений
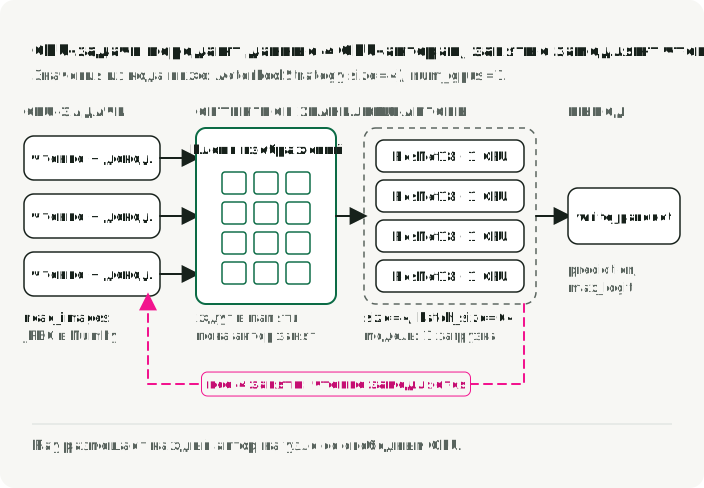
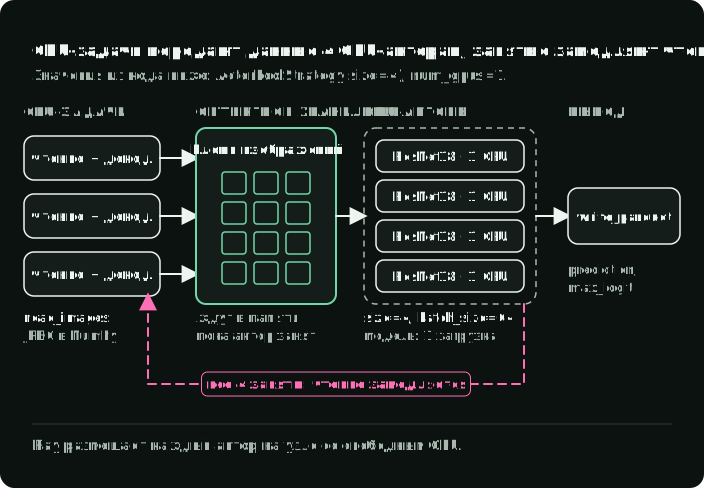
Ray Data создан под AI-нагрузки. Вместо барьеров между стадиями Spark он использует потоковую модель: батчи отправляются на GPU-воркеры, пока следующие ещё читаются. Актор Ray — это постоянный воркер, который может держать модель загруженной между батчами. Самая важная для AI-пайплайнов возможность — планирование смешанных ресурсов: можно объявить, что одному актору нужны «1 GPU и 4 CPU», а другому только CPU, и Ray разместит каждого актора на узле с такими ресурсами.
Amazon сообщил об улучшении эффективности затрат на 82% на каждый GiB входных данных S3 после переноса отдельных внутренних нагрузок со Spark на Ray. Масштаб впечатляет, но это кейс миграции конкретных нагрузок, а не ожидаемая экономия для типичного внедрения Ray.
Пример ниже читает изображения, классифицирует их с помощью ResNet18 на GPU-воркерах и записывает предсказания в Parquet. Диаграмма показывает пайплайн, который он строит: задачи на CPU читают и декодируют изображения в объектное хранилище Ray, пул из четырёх GPU-акторов запускает модель, а backpressure замедляет чтение, когда GPU-акторы заполнены.
Настройку инференса изображений смотрите в distributed_ray.ipynb или ray_inference.py:
import ray

ray.init()

ds = ray.data.read_images("s3://my-bucket/food101/", mode="RGB")

class ImageClassifier:
    def __init__(self):
        import torch
        from torchvision.models import resnet18, ResNet18_Weights
        self.model = resnet18(weights=ResNet18_Weights.DEFAULT).cuda()
        self.model.eval()
        self.preprocess = ResNet18_Weights.DEFAULT.transforms()

    def __call__(self, batch):
        import torch
        from PIL import Image
        tensors = torch.stack([
            self.preprocess(Image.fromarray(img)) for img in batch["image"]
        ]).cuda()
        with torch.no_grad():
            preds = self.model(tensors)
        return {
            "prediction": preds.argmax(dim=1).cpu().numpy(),
            "max_logit": preds.max(dim=1).values.cpu().numpy(),
        }

# ActorPoolStrategy creates persistent GPU workers
predictions = ds.map_batches(
    ImageClassifier,
    compute=ray.data.ActorPoolStrategy(size=4),
    num_gpus=1,
    batch_size=64,
)
predictions.write_parquet("s3://output/predictions/")
Этот набросок резервирует четырёх акторов по одному GPU и требует четыре доступных GPU с CUDA, веса Torchvision и доступ к S3. Ray читает изображения как массивы NumPy; преобразование массивов RGB в PIL даёт трансформации предобработки ResNet18 допустимый вход. max_logit — наибольшая «сырая» оценка модели, а не вероятность уверенности.
В бенчмарках Anyscale классификация изображений Ray Data ускорилась примерно в 4 раза (с 456 до 111 секунд), когда инстанс перешёл с 4 CPUs на GPU к 32 CPUs на GPU. Anyscale связывает улучшение с меньшим дефицитом ресурсов CPU; загрузка GPU оставалась низкой в абсолютных значениях. Daft ускорился при переходе с 4 на 16 CPUs на GPU, затем остался около 195 секунд и при 16, и при 32.
Распределённый Daft
Daft масштабируется на несколько узлов через движок Flotilla: один воркер Swordfish на узел, а над ним Flotilla занимается планированием по всему кластеру. Swordfish отвечает за локальное выполнение на Rust и совмещает I/O с вычислениями через потоковую обработку мелкими батчами, так что каждый узел остаётся занятым и не ждёт следующей стадии.
В бенчмарках, опубликованных Daft, Flotilla работал в 4–18 раз быстрее протестированных реализаций на Spark на четырёх мультимодальных нагрузках. Наибольший разрыв дал случай с детекцией объектов на видео. Считайте этот результат свидетельством того, что архитектура выполнения способна менять throughput на такую величину в подобных пайплайнах, а затем сравните его с конкурирующими результатами Anyscale ниже и с локальным тестом.
Anyscale, компания за Ray, опубликовала конкурирующий бенчмарк, в котором Ray Data после настройки сократил или перевернул разрыв на инстансах с большим числом CPU. Вместе два исследования вендоров — повод протестировать репрезентативные операторы и соотношения CPU и GPU, а не выводить из них устойчивую турнирную таблицу.
Следующий пример использует Ray runner в Daft; он не воспроизводит бенчмарк Flotilla выше. Он читает таблицу URL изображений, скачивает изображения, строит их эмбеддинги моделью CLIP на GPU-воркерах и записывает векторы в Parquet. Он адаптирует daft_pipeline.py для GPU-воркеров Ray. В закреплённой сопутствующим проектом версии API Transformers 5.0.0 спроецированные признаки изображений находятся в .pooler_output. Связанный ноутбук — distributed_daft.ipynb:
import io

import daft
import numpy as np
from daft import col

# Connect to an existing Ray cluster before building the query
daft.set_runner_ray(address="auto")

# Define a GPU class UDF: the model loads once per instance
@daft.cls(gpus=1)
class ImageEmbedder:
    def __init__(self):
        import torch
        from transformers import CLIPModel, CLIPProcessor

        self.device = "cuda" if torch.cuda.is_available() else "cpu"
        self.model = CLIPModel.from_pretrained(
            "openai/clip-vit-base-patch32"
        ).to(self.device)
        self.processor = CLIPProcessor.from_pretrained(
            "openai/clip-vit-base-patch32"
        )
        self.model.eval()

    @daft.method.batch(
        return_dtype=daft.DataType.fixed_size_list(daft.DataType.float32(), 512)
    )
    def __call__(self, image_bytes_col):
        import torch
        from PIL import Image

        embeddings = []
        for img_bytes in image_bytes_col.to_pylist():
            img = Image.open(io.BytesIO(img_bytes)).convert("RGB")
            inputs = self.processor(images=img, return_tensors="pt").to(self.device)
            with torch.no_grad():
                features = self.model.get_image_features(**inputs).pooler_output
            embeddings.append(features[0].cpu().numpy())
        return np.array(embeddings, dtype=np.float32)

embedder = ImageEmbedder()

df = (
    daft.read_parquet("s3://bucket/image_metadata.parquet")
    # Native Rust I/O downloads the images; no Python requests loop
    .with_column("image_bytes", col("image_url").download())
    .with_column("embedding", embedder(col("image_bytes")))
    .exclude("image_bytes")
)
df.write_parquet("s3://bucket/embeddings/")
Ray runner в Daft подключается к существующему кластеру; нативный runner по умолчанию использует локальную машину. Установите Daft с поддержкой Ray и обеспечьте на кластере GPU-воркеры, Transformers 5.0.0, веса CLIP и учётные данные S3. API классов и батч-методов сохраняет модель между батчами, а gpus=1 просит у runner один GPU на экземпляр; связанная ревизия репозитория использует простой @daft.cls и одну партицию, потому что рассчитана на один локальный GPU. Загрузки могут перекрываться с инференсом на GPU с учётом партиционирования и backpressure.
Эта ревизия сопутствующего проекта заменяет отсутствующие изображения или любую ошибку обработки нулевым вектором, включая провал проверки формы эмбеддинга. Она индексирует объект вывода CLIP, не выбирая .pooler_output, поэтому в Transformers 5.0.0 эта проверка завершается ошибкой и корректные изображения тоже могут стать нулевыми векторами. Используйте показанное здесь извлечение спроецированных признаков; этот пример завершает задачу ошибкой при сбое обработки.
Сравнение распределённых движков
| Характеристика | Spark | Ray Data | Daft (Flotilla) |
|---|---|---|---|
| Модель выполнения | Задача на ядро, на основе партиций | Потоковые задачи и акторы | Swordfish на узел, потоковые батчи |
| Сильные стороны | Массивный SQL/ETL, отказоустойчивость | Гетерогенные вычисления, насыщение GPU | Мультимодальный конвейер, ограниченная память |
| Управление GPU | Планирование ресурсов плюс плагины экосистемы | Явные ресурсы задач и акторов | Встроенное планирование пайплайна CPU/GPU |
| Типичная настройка | Экзекьюторы, память, партиции, ускорители | Батчи, акторы, объектное хранилище | Батчи, ресурсы, конкурентность I/O |
| С чего начать проверку | Большие SQL/ETL и задачи с тяжёлым shuffle | Обучение или инференс со смешанными ресурсами | Мультимодальный приём и преобразование |
Часть 4: роль Rust и Arrow
Polars, Daft и DataFusion активно используют Rust, а Ray включает нативные компоненты рядом со своими API на Python. Все они могут обмениваться данными через части экосистемы Apache Arrow.
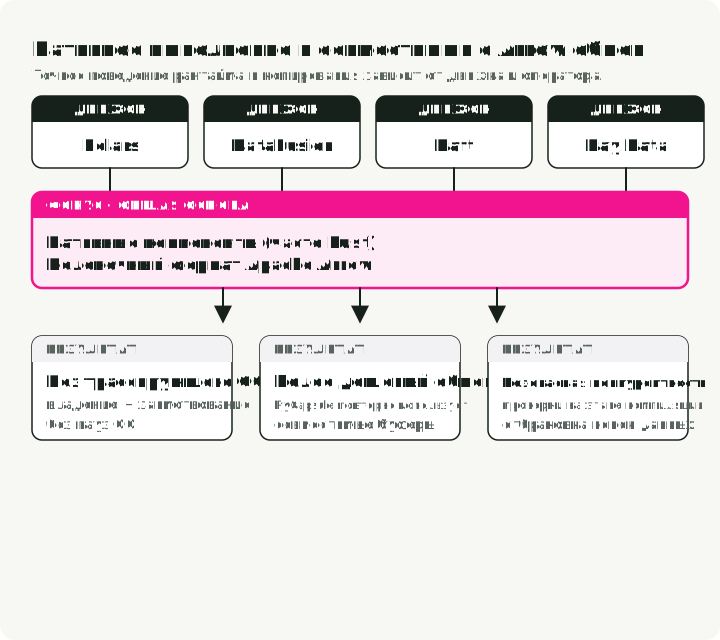
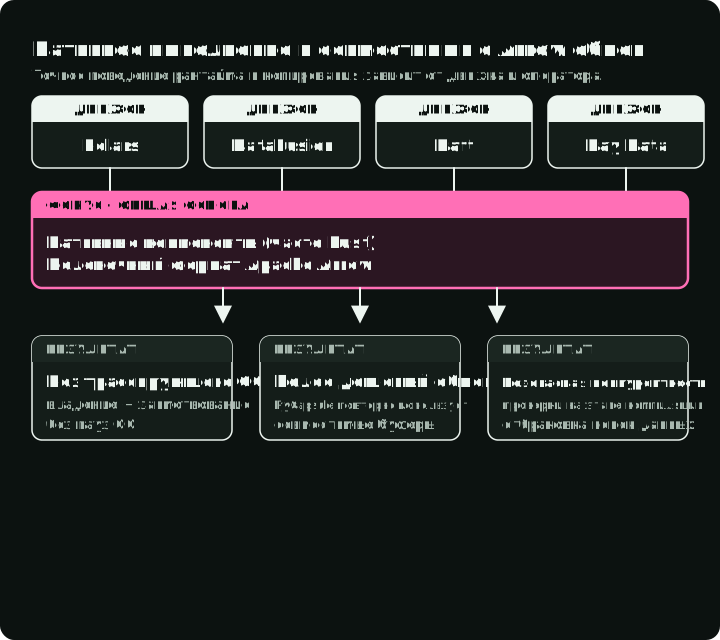
Arrow PyCapsule Interface (протокол __arrow_c_stream__) даёт совместимым библиотекам стандартный способ обмениваться потоками Arrow. Передача может обойтись без построчной сериализации и переиспользовать буферы, если схемы и раскладка памяти совместимы. Материализация, перепаковка чанков, преобразование типов или передача между устройствами всё равно могут копировать данные, поэтому проверяйте передачу профилированием и не считайте её бесплатной.
Следующий пример показывает передачу через Arrow: DataFusion считает покупки пользователей с более чем пятью покупками, а Polars ранжирует эти счётчики. Диаграмма использует Polars 1.37.1, версию, закреплённую в сопутствующем проекте: rechunk=False сохраняет совместимые буферы, а значение по умолчанию rechunk=True копирует несколько батчей в один чанк на колонку. В других версиях значения по умолчанию могут отличаться. Пример предполагает, что events.parquet уже существует. Ноутбук engine_comparison_examples.ipynb создаёт синтетический .data/events.parquet в своих ячейках настройки перед примером с Arrow.
from datafusion import SessionContext
import polars as pl

# Compute in DataFusion (Rust-native execution)
ctx = SessionContext()
ctx.register_parquet("events", "events.parquet")
df = ctx.sql("""
    SELECT user_id, COUNT(*) as event_count
    FROM events WHERE event_type = 'purchase'
    GROUP BY user_id HAVING COUNT(*) > 5
""")

# Convert through Arrow; compatible buffers may be reused
arrow_table = df.to_arrow_table()
df_polars = pl.from_arrow(arrow_table)

# Continue analysis in Polars
result = df_polars.with_columns(
    pl.col("event_count").rank().alias("rank")
).sort("rank")Daft также умеет передать DataFrame в PyTorch через df.to_torch_iter_dataset(), что закрывает последний шаг мультимодального пайплайна обучения.
Почему эти новые движки используют Rust для нативного выполнения?
-
В коде на Rust нет трассирующего сборщика мусора. Владение даёт нативным операторам более прямой контроль над выделением и освобождением памяти. Это может снизить латентность из-за GC, но не предотвращает нехватку памяти и сбои из-за out-of-memory.
-
Компактные нативные представления. Структуры Rust не несут заголовков объектов Java. Практическая польза зависит от раскладки данных в движке: колоночные системы на JVM тоже не представляют каждое значение отдельным объектом.
-
Более строгие проверки конкурентности. Безопасный Rust исключает многие гонки данных на этапе компиляции. Код движка при этом может содержать unsafe-блоки и логические ошибки конкурентности.
В сочетании с колоночной раскладкой памяти Arrow эти решения могут снизить накладные расходы на выделение памяти и сериализацию. Они не убирают их на каждой границе: объекты Python, сетевой транспорт, несовместимые схемы и перемещение между устройствами всё равно имеют значение.
Часть 5: несколько движков в одной системе
Не нужно пропускать всю платформу через один движок. Композиция полезна, когда передача между движками стоит дешевле, чем попытка заставить одну систему справляться со всеми нагрузками. Диаграмма показывает одну такую эстафету: движки встречаются на файлах Parquet, и каждая запись или чтение через эту границу стоит I/O и конвертации.
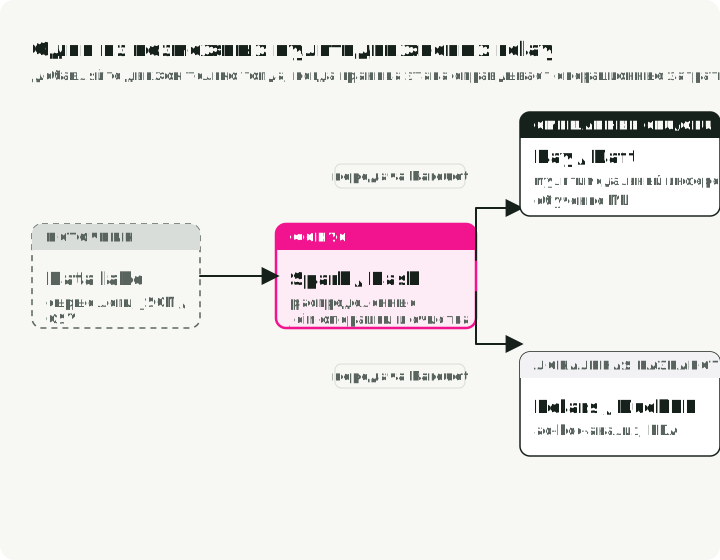
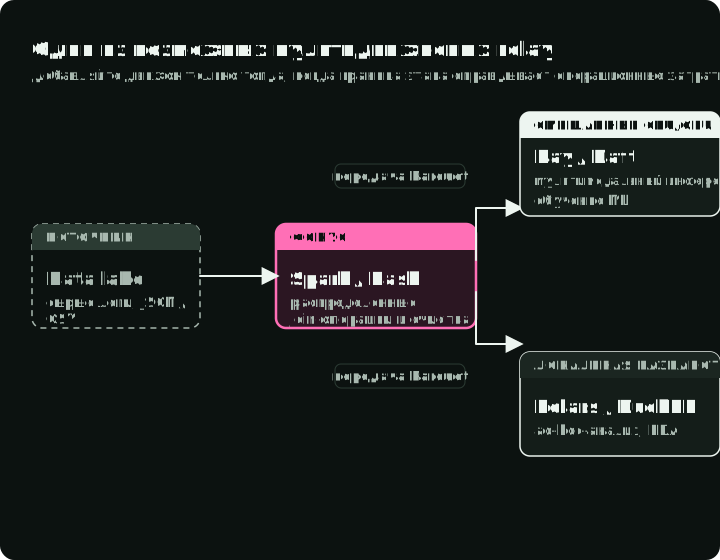
Одна из возможных эстафет использует Spark для устоявшихся джойнов в lakehouse, записывает открытый табличный или файловый формат и передаёт результат в Ray Data или Daft для инференса на GPU или мультимодальных преобразований. Polars или DuckDB могут обслуживать локальный анализ тех же файлов. Небольшой команде может хватить одного из этих движков; добавляйте ещё один, когда измеренный боттлнек оправдывает операционную границу.
Эту композицию делает возможной совместимость. Parquet в этих примерах — общий файловый формат передачи, а Arrow может обеспечить обмен в памяти. Поддержка Delta и Iceberg зависит от движка и коннектора, поэтому проверяйте каждую границу. У файловой передачи тоже есть затраты на I/O и конвертацию; она не бесплатна автоматически.
Выбор движка по случаю использования
Таблица сопоставляет каждую нагрузку с коротким списком и с тем, что нужно проверить перед выбором.
| Случай использования | Короткий список | Что проверить |
|---|---|---|
| Локальные аналитические DataFrame | Polars / DuckDB | Подходящий API, память, набор запросов |
| Существующий распределённый SQL/ETL | Apache Spark | Поведение shuffle, эксплуатация, стоимость |
| Параллельная работа на Python | Dask / Ray | Накладные расходы планировщика, модель сбоев |
| Смешанное обучение или инференс на CPU/GPU | Ray Data / Daft | Загрузка ускорителей, backpressure |
| Мультимодальный приём данных | Daft / Ray Data | Нативные операторы, поведение повторов |
| Встраиваемый движок запросов | DataFusion | API расширения, покрытие SQL |
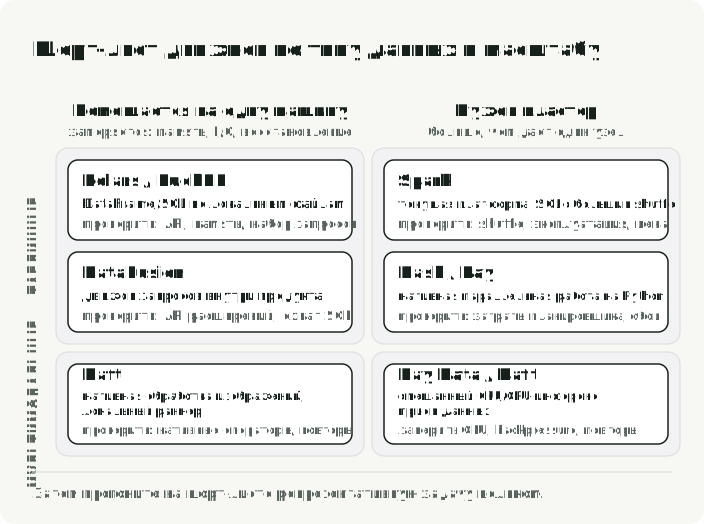
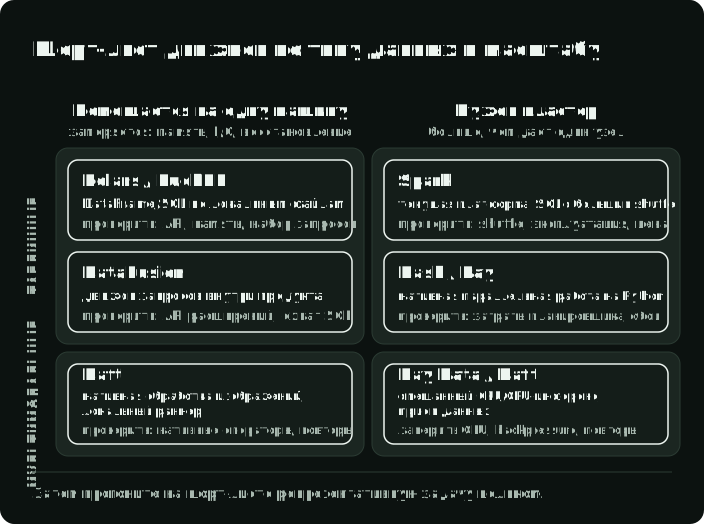
Диаграмма раскладывает тот же шорт-лист по двум вопросам: данные табличные или мультимодальные и помещается ли задача на одну машину.
Диагональное масштабирование
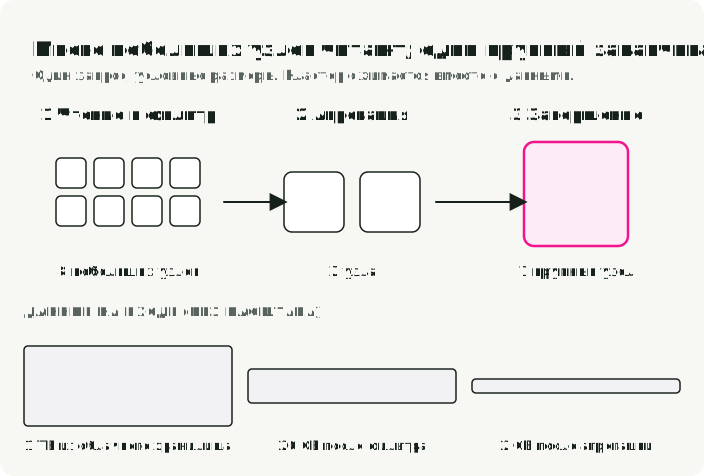
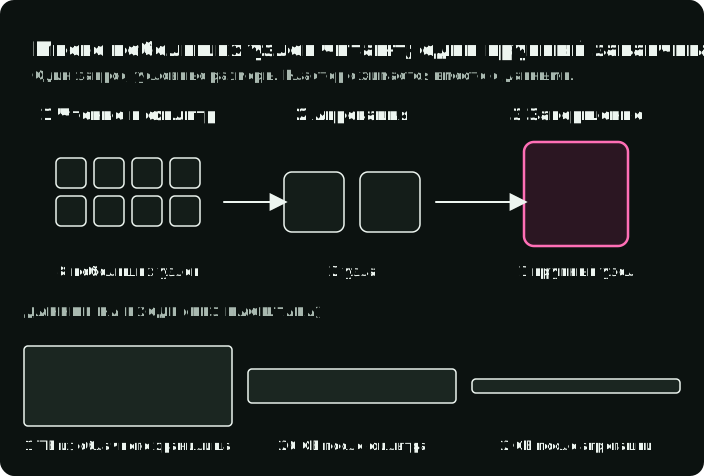
Долгое время выбор был таким: масштабироваться вверх (более мощная машина) или вширь (больше машин). Polars Cloud описывает подход, зависящий от запроса, — диагональное масштабирование (diagonal scaling). Пока данные читаются из облачного хранилища, масштабируются горизонтально, чтобы выжать максимум из I/O, а когда фильтры и агрегации уменьшили данные, сжимаются до одного большого узла. Ранняя редукция может ограничить передачу данных и позволить завершить оставшуюся работу на одном узле. Будет ли распределённый shuffle, зависит от физического плана запроса. Диаграмма прослеживает один запрос с условными размерами: восемь небольших узлов читают и фильтруют 1 TB, два узла агрегируют остаток, а один большой узел завершает работу на 2 GB.
Сравнивайте стоимость успешного задания, а не цену инстанса за час. Более крупный узел может оказаться дешевле, если сокращение времени выполнения перевешивает его более высокую ставку, но результат зависит от I/O, нагрузки на память и объёма работы, отсеянного до shuffle.
Воспроизведение сравнения
Репозиторий демо содержит скрипты, ноутбуки и окружение, использованные для сравнений. Команда для табличных данных использует набор такси за весь 2024 год, который в репозитории выбран по умолчанию и совпадает с прогоном выше. Первый запуск скачивает около 660 МБ данных такси и изображения Food-101; для бенчмарка на Rust нужен тулчейн Rust.
# Install dependencies
uv sync

# Run the tabular benchmark (~41M NYC taxi trips from full-year 2024)
uv run python -m engine_comparison.benchmarks.tabular

# Run the multimodal benchmark (500 real food photos)
uv run python -m engine_comparison.benchmarks.multimodal

# Run native Rust benchmarks (Polars-rs + image crate)
cd rust_benchmark && cargo run --release && cd ..
./scripts/run_benchmarks.sh запускает все три и записывает benchmarks/*.json и сводные графики. Скрипты на Python принимают --runs 5 для большего числа замеров времени, а скрипт для изображений — --images 1000 для большего набора изображений. Распределённым ноутбукам нужен uv sync --extra distributed --extra notebook. В репозитории также есть конфигурации Docker Compose для локальных распределённых запусков Spark, Ray и Daft.
Ключевые выводы
-
Докажите, что одной машины недостаточно. Результаты вертикального масштабирования показывают, что некоторые крупные аналитические сканирования помещаются на одном узле. Измерьте требования к памяти, I/O, spill и восстановлению, прежде чем принимать накладные расходы кластера.
-
Lazy-планирование объясняет разрыв в скорости лучше, чем синтаксис API. Pushdown, потоковое выполнение и параллельные операторы дают значительную часть разницы между eager-скриптом на DataFrame и аналитическим движком.
-
Измеряйте весь пайплайн с ускорителем. Декодирование, сетевой I/O, батчинг, сериализация и backpressure определяют, остаётся ли GPU занятым. Ray Data и Daft делают это перекрытие центральной абстракцией; Spark может поддержать его при дополнительном проектировании и инструментах.
-
Составьте короткий список по нагрузке, затем запустите бенчмарк. Используйте совместимость с экосистемой, чтобы сузить выбор, а репрезентативную сквозную задачу — чтобы выбрать. Перед тем как полагаться на заявление вендора о бенчмарке, повторите его на своей задаче.
-
Открытые форматы сохраняют обратимость выбора. Arrow-совместимые интерфейсы, Parquet и открытые табличные форматы могут снизить затраты на передачу. Уточняйте, переиспользует ли конкретная конвертация буферы или копирует их.
Источники
Бенчмарки и данные о производительности
- Polars PDS-H Benchmarks - потоковый Polars и Pandas при SF-10 (94x) и SF-100 (примерно 6x относительно in-memory)
- DataFusion ClickBench Results (Nov 2024) - результаты одноузлового Parquet, опубликованные проектом
- Embucket: TPC-H SF-1000 on DataFusion - кейс вендора на одном крупном узле; два запроса переписали, чтобы они завершились
- Amazon Spark-to-Ray Migration - на 82% лучше эффективность затрат в production на каждый GiB входных данных S3
- Daft Flotilla Benchmarks - в 4–18 раз быстрее Spark на мультимодальных нагрузках
- Anyscale Ray vs. Daft Benchmarks - конкурирующий бенчмарк вендора для мультимодальных нагрузок
Движки и фреймворки
- Polars - библиотека DataFrame на Rust с lazy-выполнением
- Apache DataFusion - встраиваемый движок запросов на Rust (GitHub)
- Daft - распределённый DataFrame с нативной поддержкой мультимодальности
- Ray - фреймворк распределённых вычислений для AI (Data Internals)
- Apache Spark - движок распределённого ETL и SQL
- DuckDB - встроенный в процесс аналитический SQL-движок
- Dask - параллельные вычисления на Python
Архитектура и экосистема
- Polars Cloud: Diagonal Scaling - динамическое вертикальное и горизонтальное масштабирование
- Daft Flotilla Architecture - распределённый движок Swordfish + Flotilla
- Apache DataFusion Comet - ускоритель Spark, изначально разработанный в Apple
- Apache Arrow - колоночный формат в памяти (Flight RPC, PyCapsule Interface)
- InfluxDB 3.0 + DataFusion - база данных временных рядов на основе DataFusion
- GreptimeDB - база данных для observability на DataFusion
Репозиторий демо
- engine-comparison-demo - код к статье: бенчмарки, ноутбуки и Docker Compose для Spark/Ray/Daft
Датасеты
- NYC Taxi Trip Records - данные жёлтого такси NYC TLC (Parquet, около 2,9 млн строк в месяц)
- Food-101 Dataset - 101 тыс. изображений еды от ETH Zurich (Bossard et al., ECCV 2014)