Silniki przetwarzania danych: Polars, DataFusion, Ray i Spark

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Ten przewodnik pomaga inżynierom Pythona i danych wybrać silnik do przetwarzania danych tabelarycznych oraz potoków obrazów, dźwięku i tekstu. Wyjaśnia, jak Polars, DataFusion, Daft, Ray Data i Spark wykonują pracę, jakim obciążeniom odpowiadają i jak porównać je na własnych danych.
Współczesne potoki przetwarzają też obrazy, dźwięk i wideo. W takich obciążeniach dekodowanie na CPU może zagłodzić inferencję na GPU. Operatory natywne, kolumnowa wymiana danych i nakładanie pracy CPU i GPU zmniejszają różne koszty. Wybór silnika polega więc na ustaleniu, który koszt ogranicza twój potok.
Żeby porównać opcje, przetestowałem Pandas, Polars, DataFusion, Daft i natywny Rust na dwóch prawdziwych zbiorach danych: przejazdy taksówek z Nowego Jorku reprezentują pracę tabelaryczną, a obrazy Food-101 potok multimodalny. Spark i Ray opisuję w osobnych notebookach rozproszonych.
Kod znajdziesz w repozytorium engine-comparison-demo.
Typy obciążeń związanych z przetwarzaniem danych
Silniki są wyspecjalizowane, więc najpierw ustal, z jakim obciążeniem masz do czynienia. Najważniejszy podział to dane ustrukturyzowane i multimodalne. Diagram pokazuje, jak zmienia się ilość danych w każdym z nich: zadanie tabelaryczne zmniejsza ją na każdym kroku, a zadanie multimodalne ją zwiększa.
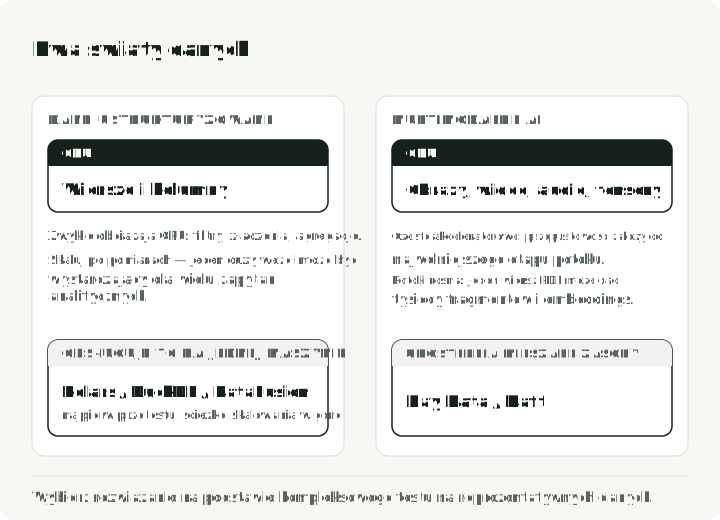
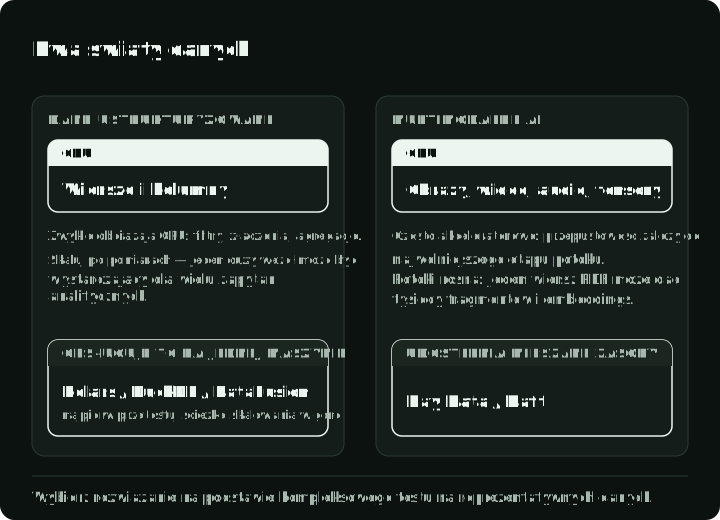
Dane ustrukturyzowane lub tabelaryczne to filtrowanie, agregacje i złączenia. Takie zadania zwykle są ograniczone przez CPU i często mieszczą się w pamięci. Wiele takich zapytań da się uruchomić na jednej nowoczesnej maszynie, ale o tym, czy klaster jest potrzebny, nadal decydują pamięć, I/O, współbieżność, odtwarzanie po awarii i kształt obciążenia.
Multimodalne AI przetwarza obrazy, dźwięk lub wideo. Inferencja może działać na GPU, podczas gdy dekodowanie na CPU, odczyty zdalne lub tworzenie batchy ograniczają potok. To, który etap ogranicza przepustowość, zmienia się wraz z typem instancji i operatorami, dlatego mierz wykorzystanie zasobów na całej ścieżce zamiast dobierać GPU w oderwaniu od reszty.
Nowsze silniki celują w różne części tej przestrzeni. Wykonanie natywne może zmniejszyć narzut Pythona, interfejsy zgodne z Arrow mogą potanić wymianę danych, a wykonanie strumieniowe może ograniczyć zużycie pamięci przy zbiorach większych niż RAM. Żadna z tych korzyści nie jest automatyczna dla każdego operatora ani każdej konwersji.
Część 1: przetwarzanie na pojedynczym węźle
Pandas faworyzuje model programowania eager (gorliwy): wykonuje każdą operację od razu i zwykle trzyma dane w pamięci. Model lazy (leniwy) planuje natomiast kilka operacji razem, zanim je uruchomi. W Pandas wiele typowych operacji tworzy tabele pośrednie, a wykonanie równoległe nie jest koordynowane przez optymalizator zapytań. Ten kompromis zachowuje prostotę kodu eksploracyjnego, ale na większych skanach analitycznych może okazać się kosztowny.
Diagram pokazuje, co każdy model czyta z pliku Parquet w zapytaniu o taksówki użytym niżej: ścieżka eager czyta wszystkie 19 kolumn przed filtrowaniem, a plan lazy pozwala optymalizatorowi wepchnąć filtr i 3 używane kolumny do skanowania.
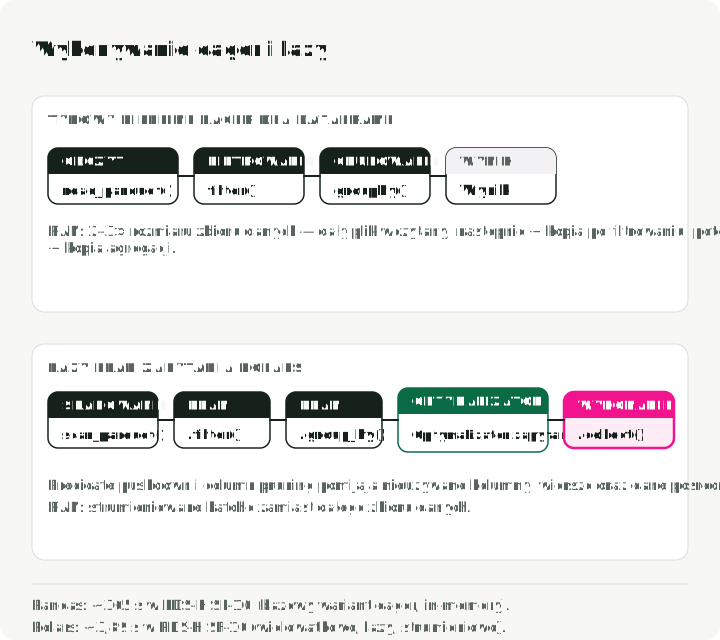
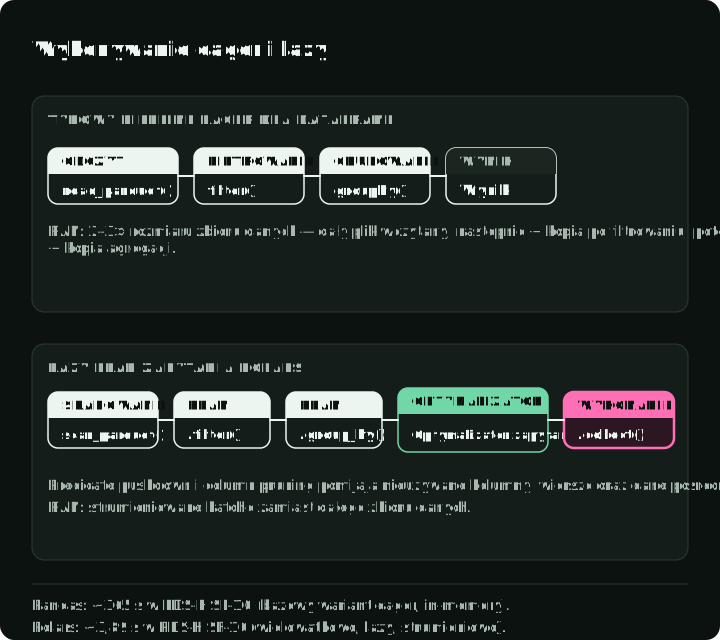
W benchmarku PDS-H Polars z maja 2025 roku przy współczynniku skali 10 Pandas potrzebował około 365 sekund na cały zestaw, a silnik strumieniowy Polars 3,89 sekundy. Wynik rzędu 94x opisuje ten benchmark i tę konfigurację; nie jest ogólnym przelicznikiem między Pandas a Polars.
Polars dla lokalnych potoków tabelarycznych
Polars to praktyczny wybór domyślny, gdy lokalny potok DataFrame przerósł gorliwe wykonanie w jednym procesie. Jego leniwe API buduje plan zapytania przed wykonaniem. Dzięki temu silnik filtruje wiersze możliwie najwcześniej (predicate pushdown) i czyta tylko potrzebne kolumny (projection pruning). Następnie może uruchamiać operatory równolegle i, tam gdzie to wspierane, w partiach strumieniowych.
Przy współczynniku skali 100 (~100 GB CSV) silnik strumieniowy Polars był na tej samej maszynie około 6x szybszy niż jego silnik działający w pamięci. Źródło przypisuje tę różnicę głównie mniejszej liczbie chybień w pamięci podręcznej CPU i lepszemu wykorzystaniu rdzeni; nie jest to dowód dla danych większych niż RAM.
Poniższe zapytanie czyta przejazdy taksówek z Parquet, wybiera przejazdy dłuższe niż pięć mil z kwotą całkowitą powyżej $30 i liczy liczności oraz średnie według typu płatności. Towarzyszący notebook engine_comparison_examples.ipynb zawiera powiązane przykłady API i konfiguracji; tabular.py pobiera dane o taksówkach i uruchamia mierzone zadanie opisane niżej:
import polars as pl

# Build a lazy scan; query execution happens at collect()
q = (
    pl.scan_parquet("yellow_tripdata_2024-01.parquet")
    .filter(
        (pl.col("trip_distance") > 5.0)
        & (pl.col("total_amount") > 30.0)
    )
    .group_by("payment_type")
    .agg(
        pl.col("total_amount").mean().alias("avg_fare"),
        pl.col("trip_distance").mean().alias("avg_distance"),
        pl.len().alias("trip_count"),
    )
)

# The entire plan is optimized and executed here, in parallel
result = q.collect(engine="streaming")
Kluczowa jest tu różnica w modelu wykonania. W powyższym zapytaniu lazy Polars może wepchnąć filtr i wybór kolumn do skanowania Parquet. Może to pominąć grupy wierszy i uniknąć czytania nieużywanych kolumn. Strumieniowanie jest tu włączone jawnie; collect nadal materializuje końcowy wynik, a nieobsługiwane operacje mogą wrócić do wykonania w pamięci. Typowy gorliwy potok Pandas nie ma planu całego zapytania do optymalizacji, choć staranne użycie filtrów Parquet, wybranych kolumn i alternatywnych backendów może odrobić część różnicy.
DataFusion jako osadzany silnik zapytań
O ile Polars to biblioteka, z której korzystasz bezpośrednio, DataFusion to silnik, na którym buduje się inne silniki. Napędza InfluxDB 3.0, GreptimeDB i Apache DataFusion Comet, akcelerator Sparka stworzony najpierw w Apple.
W listopadowym przebiegu ClickBench z 2024 roku, opublikowanym przez projekt DataFusion, DataFusion prowadził wśród testowanych konfiguracji jednowęzłowych dla Parquet. Zespół Embucket opublikował później przebieg TPC-H przy współczynniku skali 1000 na jednym dużym węźle, z dwoma przepisanymi zapytaniami, aby się zakończyły. Te wyniki pokazują, co może dać skalowanie w górę w określonych warunkach; nie dowodzą, że każde obciążenie rzędu 1 TB powinno omijać klaster.
Oto to samo podsumowanie taksówek w SQL DataFusion, z typami płatności posortowanymi według liczby przejazdów. Towarzyszący notebook engine_comparison_examples.ipynb zawiera powiązane przykłady SQL i konfiguracji:
from datafusion import SessionContext

ctx = SessionContext()
ctx.register_parquet("taxi", "yellow_tripdata_2024-01.parquet")

# Plan SQL against the registered Parquet source
df = ctx.sql("""
    SELECT payment_type,
           COUNT(*)           AS trip_count,
           AVG(trip_distance) AS avg_distance,
           AVG(total_amount)  AS avg_fare
    FROM taxi
    WHERE trip_distance > 5.0 AND total_amount > 30.0
    GROUP BY payment_type
    ORDER BY trip_count DESC
""")
result = df.to_pandas()
Siłą DataFusion jest jego modułowość. API rozszerzeń obejmują własne katalogi, dostawców tabel, reguły optymalizatora i plany wykonania. Dlatego silnik pojawia się wszędzie tam, gdzie ktoś buduje własną platformę danych albo osadza silnik zapytań w swoim produkcie.
Jeśli twój zespół pisze SQL na lokalnych plikach Parquet i nie musi osadzać silnika, DuckDB to baza SQL działająca w procesie, która pełni tę samą rolę co Polars.
Daft dla danych multimodalnych
Daft włącza obrazy, dźwięk, wideo i embeddings do przepływu pracy na DataFrame. Udostępnia natywne wyrażenia dla operacji takich jak dekodowanie obrazów i pobieranie z adresów URL, więc typowe ścieżki wstępnego przetwarzania nie wymagają pętli Pythona po wierszach. Ta integracja jest głównym powodem, by rozważyć go zamiast ogólnego silnika tabelarycznego.
Dla pracy tabelarycznej API Daft wygląda jak w silnikach powyżej. Ten przykład uruchamia to samo podsumowanie taksówek; towarzyszący notebook engine_comparison_examples.ipynb zawiera powiązane przykłady API Daft i konfiguracji:
import daft

df = daft.read_parquet("yellow_tripdata_2024-01.parquet")

result = (
    df.where(
        (daft.col("trip_distance") > 5.0)
        & (daft.col("total_amount") > 30.0)
    )
    .groupby("payment_type")
    .agg(
        daft.col("total_amount").mean().alias("avg_fare"),
        daft.col("trip_distance").mean().alias("avg_distance"),
        daft.col("trip_distance").count().alias("trip_count"),
    )
    .collect()
)
API wyda się znajome, jeśli znasz Pandas, ale silnik to ten sam stos Rust + Arrow, który znajdziesz w Polars i DataFusion. Daft zaczyna się opłacać, gdy „wierszami” twojego DataFrame są obrazy, pliki PDF lub tensory.
Daft czyta, dekoduje i skaluje obrazy natywnymi wyrażeniami, bez pętli Pythona po wierszach. To ścieżka obrazów z multimodal.py:
import daft
from daft import col

df = (
    daft.from_glob_path("food101_images/*.jpg")
    .with_column("image", col("path").download().decode_image(mode="RGB"))
    .with_column("resized", col("image").resize(224, 224))
)
df.collect()
Benchmark na pojedynczym węźle
Uruchomiłem Pandas, Polars, DataFusion i Daft oraz natywny Rust przez Polars-rs na ~41 mln przejazdów żółtych taksówek z Nowego Jorku z całego 2024 roku. Mierzone zadanie filtruje przejazdy z opłatą powyżej $10, dołącza tabelę stref taksówkowych, sumuje przychód według dzielnicy i strefy oraz zwraca 20 pierwszych wierszy. To inne zapytanie niż w przykładach powyżej. Spark i Ray występują w przykładach rozproszonych, nie w tym benchmarku na pojedynczym węźle.
Każdy silnik czyta pliki wewnątrz mierzonej funkcji; skrypt podaje medianę z trzech uruchomień. Jego kontrola wyników porównuje 20 wierszy między silnikami Pythona według dzielnicy, strefy, liczby przejazdów i przychodu zaokrąglonego do centów; nie porównuje avg_tip. Pandas dostaje cztery kolumny przejazdów, których używa zapytanie, bo nie ma optymalizatora, który by je znalazł. Wykres pokazuje wynik na Apple M5 Max z 18 rdzeniami i 64 GB RAM. Pełne wyniki są w repozytorium demo:
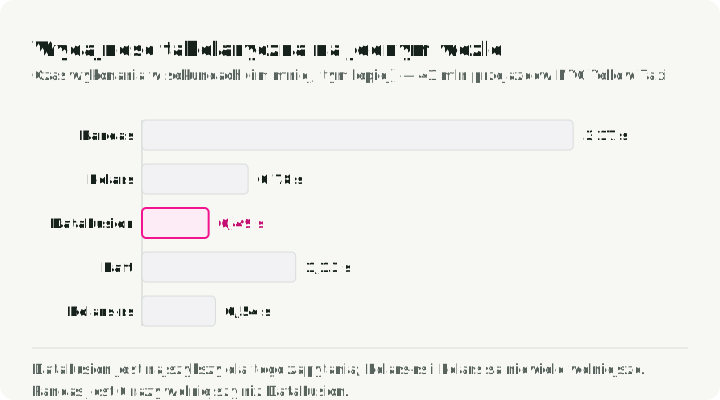
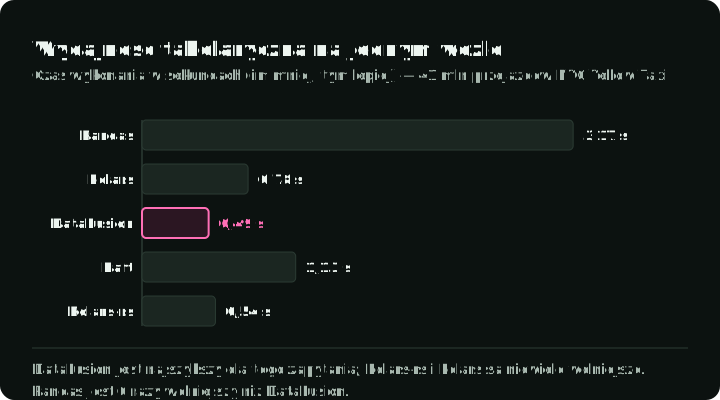
Pandas potrzebował 4,67 sekundy. Cztery nowsze silniki skończyły w 0,40 do 0,74 sekundy, przy czym DataFusion był najszybszy, a Polars około 7x szybszy niż Pandas. Wartość 94x dla Polars względem Pandas wyżej pochodzi z PDS-H; to zadanie dało mniejszą różnicę. Czasy zmieniały się też między wywołaniami: w czterech uruchomieniach skryptu na maszynie wykonującej inną pracę Pandas osiągał od 2,6 do 4,8 sekundy. DataFusion za każdym razem był najszybszym silnikiem Pythona, a Polars i Daft zamieniały się miejscami. Gdy silniki lądują tak blisko siebie, o decyzji powinny przesądzić dopasowanie API i powtarzane pomiary na reprezentatywnych danych.
Część 2: dane multimodalne
ETL tabelaryczny zwykle zmniejsza dane: filtrujesz, agregujesz, zapisujesz mniej, niż przeczytałeś. Multimodalne potoki AI robią odwrotnie. Pojedyncza ścieżka dokumentu może rozgałęzić się na dziesiątki fragmentów tekstu i wektorów typu embedding.
W konwencjonalnym potoku PySpark obrazy i dźwięk często wchodzą jako dane binarne i trafiają do bibliotek Pythona w celu dekodowania lub przekształcenia. Przekraczanie granicy JVM/Python i serializacja wyników mogą stanowić dużą część czasu zegarowego. Spark może korzystać ze ścieżek opartych na Arrow, wektoryzowanych UDF i integracji z akceleratorami, ale te wybory wymagają jawnego zaprojektowania i pomiarów.
Wykonywanie potokowe i wykorzystanie GPU
Spark planuje pracę w etapach rozdzielonych granicami shuffle. Prosta implementacja może ułożyć pobieranie, dekodowanie i inferencję w sekwencję, w której czeka albo CPU, albo GPU. Spark wspiera planowanie zasobów GPU i wtyczki, więc bezczynność nie jest nieunikniona. Utrzymanie zajętych etapów wymaga też backpressure (przeciwciśnienia): spowalniania wcześniejszych etapów, gdy późniejsze nie nadążają. Ani ta kontrola, ani nakładanie pracy CPU i GPU nie dzieje się automatycznie w zwykłym zadaniu PySpark na DataFrame.
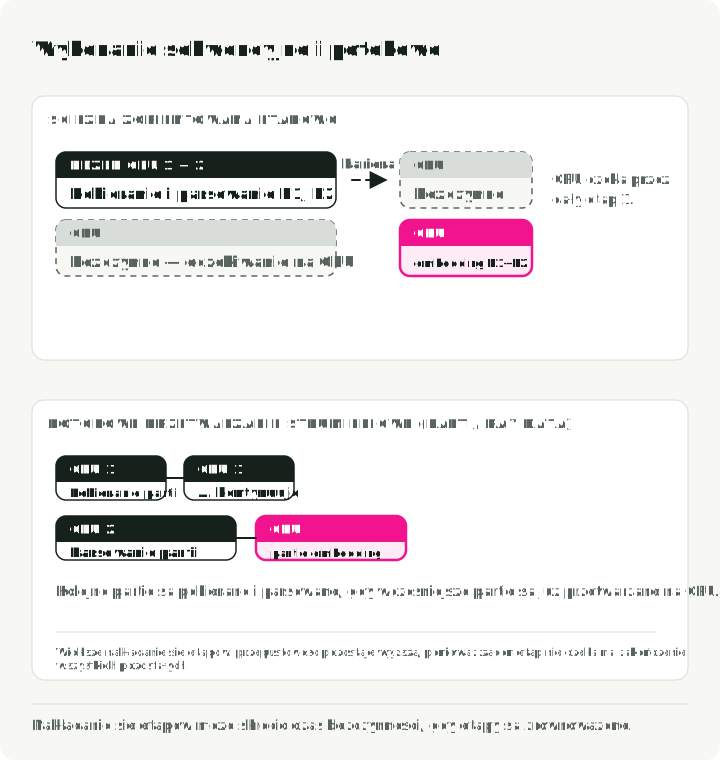
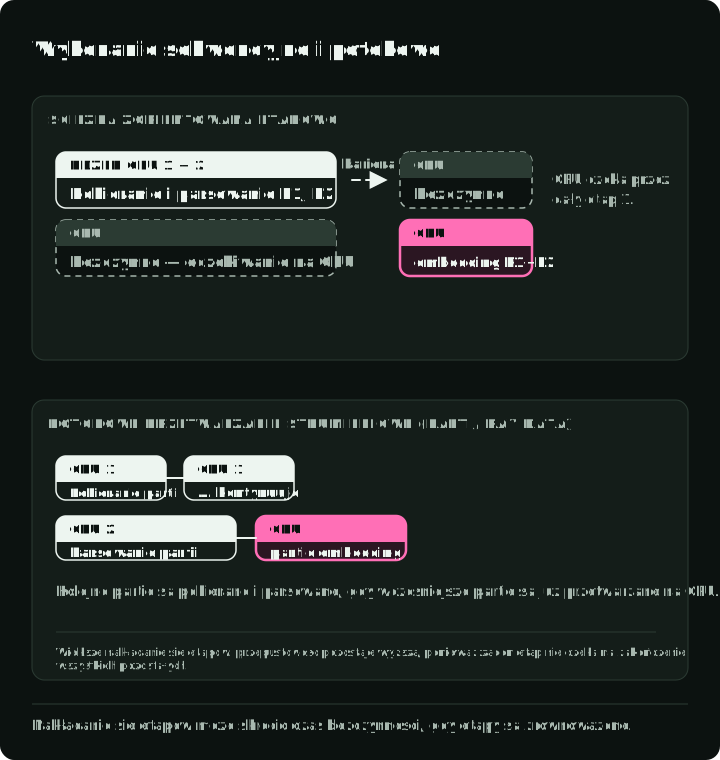
Wykonywanie potokowe to alternatywa. Zamiast uruchamiać etapy jeden po drugim, silnik nakłada na siebie I/O, pracę CPU i inferencję GPU. Gdy etapy i bufory są zrównoważone, takie nakładanie może skrócić bezczynność i zwiększyć przepustowość; rozruch i opróżnianie potoku, backpressure lub wolniejszy etap nadal mogą zostawić zasoby w oczekiwaniu.
Diagram pokazuje dwa batche przechodzące przez trzy etapy. Uruchomione jeden po drugim zajmują sześć kroków. W trybie potokowym batch 2 jest czytany i dekodowany, gdy batch 1 jest jeszcze w toku, i ta sama praca zajmuje cztery kroki.
Benchmark przetwarzania obrazów
Przetestowałem przetwarzanie obrazów na 500 prawdziwych fotografiach ze zbioru Food-101. Każdy silnik czyta te same 500 plików JPEG, dekoduje je do RGB i skaluje do 224×224 filtrem dwuliniowym wewnątrz mierzonej funkcji. Skrypt sprawdza, czy każdy silnik wyprodukował 500 obrazów, i podaje medianę z trzech uruchomień. Wykres pokazuje wynik na tej samej maszynie:
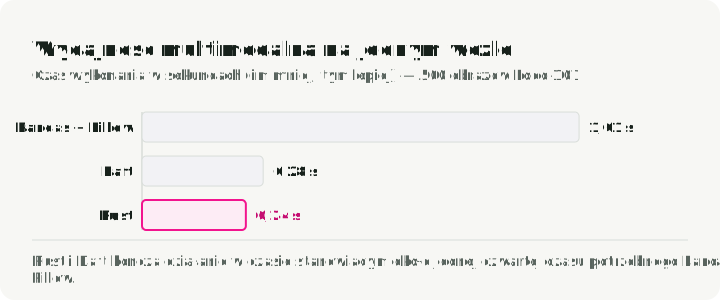
Polars i DataFusion nie występują, bo nie mają natywnych operacji na obrazach. Zapisane wyniki Pythona i wyniki Rusta pokazują 0,55 sekundy dla Pandas + Pillow, 0,34 dla Daft i 0,10 dla crate’a Rusta image. Pandas przetwarza jeden obraz naraz przez apply(); Daft i wersja w Rust rozkładają pracę na rdzenie. W czterech wywołaniach Pandas osiągał od 0,55 do 1,21 sekundy. Pięćset obrazów to za mało, by przewidywać przepustowość produkcyjną, a zadanie kończy się przed jakąkolwiek pracą GPU, więc zmierz własny potok od początku do końca.
Część 3: przetwarzanie rozproszone
Gdy jedna maszyna przestaje wystarczać, trzeba wybrać sposób rozłożenia pracy. Dask rozkłada istniejący kod Pandas i NumPy na rdzenie lub klaster przy niewielkich zmianach API; pasuje zespołom Pythona, które nie chcą JVM ani nowego API DataFrame. Reszta tej części dotyczy Sparka, Ray Data i Daft.
Apache Spark
Spark to dojrzała opcja dla dużego ETL tabelarycznego, złączeń z intensywnym shuffle i organizacji, które już utrzymują jego ekosystem. Odtwarzanie oparte na lineage i szerokie wsparcie platform mają znaczenie, gdy niezawodność i znajomość operacyjna przeważają nad lokalną szybkością. Mieszane potoki CPU i GPU wymagają bardziej przemyślanej konfiguracji zasobów i projektu potoku niż ścieżka SQL, i tu Ray Data oraz Daft oferują bardziej wyspecjalizowaną abstrakcję.
To zapytanie Spark łączy dłuższe przejazdy taksówek z informacjami o strefie odbioru, a następnie podsumowuje łączny przychód i średnie opłaty według dzielnicy. Konfigurację ETL na klastrze opisują distributed_spark.ipynb i spark_etl.py:
from pyspark.sql import SparkSession
from pyspark.sql import functions as F

spark = SparkSession.builder \
    .appName("TaxiETL") \
    .config("spark.sql.adaptive.enabled", "true") \
    .getOrCreate()

orders = spark.read.parquet("s3a://lake/taxi/*.parquet")
zones = spark.read.csv("s3a://lake/taxi_zones.csv", header=True)

# Spark excels at this: joining massive tables with a shuffle
result = (
    orders
    .filter(F.col("trip_distance") > 5.0)
    .join(zones, orders.PULocationID == zones.LocationID, "inner")
    .groupBy("Borough")
    .agg(
        F.sum("total_amount").alias("total_revenue"),
        F.avg("total_amount").alias("avg_fare"),
    )
    .orderBy(F.desc("total_revenue"))
)

# Spark is lazy: the write runs the query
result.write.mode("overwrite").parquet("s3a://warehouse/report/")
Ray Data dla heterogenicznych zasobów obliczeniowych
Ray Data zaprojektowano z myślą o obciążeniach AI. Zamiast barier etapów Sparka używa modelu strumieniowego, który wysyła batche do workerów GPU, gdy kolejne batche są jeszcze czytane. Aktor Ray to trwały worker, który może trzymać załadowany model między batchami. Najważniejsza dla potoków AI jest mieszana alokacja zasobów: możesz zadeklarować, że jeden aktor potrzebuje „1 GPU i 4 CPU”, a inny tylko CPU, i Ray umieści każdego aktora na węźle z takimi zasobami.
Amazon podał 82% lepszą efektywność kosztową na GiB danych wejściowych z S3 po przeniesieniu wybranych wewnętrznych obciążeń ze Sparka na Ray. Skala robi wrażenie, ale to studium przypadku migracji konkretnych obciążeń, a nie oczekiwana oszczędność przy typowym wdrożeniu Ray.
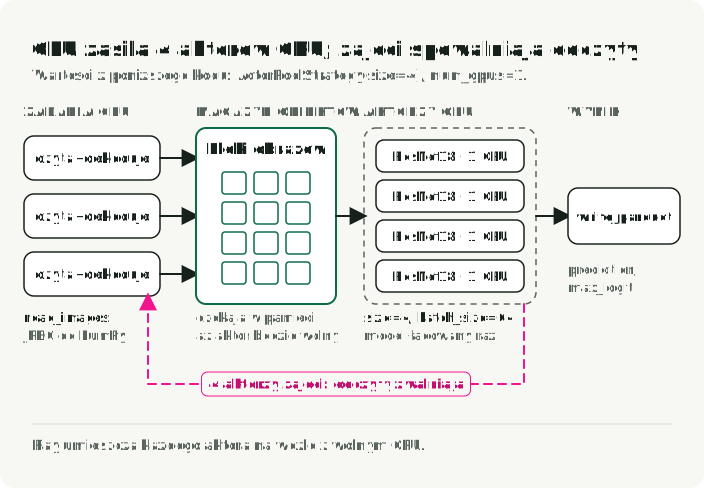
Poniższy przykład czyta obrazy, klasyfikuje je siecią ResNet18 na workerach GPU i zapisuje predykcje do Parquet. Diagram pokazuje budowany potok: zadania CPU czytają i dekodują obrazy do magazynu obiektów Ray, pula czterech aktorów GPU uruchamia model, a backpressure spowalnia odczyty, gdy aktorzy GPU są zajęci.
Konfigurację inferencji obrazów opisują distributed_ray.ipynb i ray_inference.py:
import ray

ray.init()

ds = ray.data.read_images("s3://my-bucket/food101/", mode="RGB")

class ImageClassifier:
    def __init__(self):
        import torch
        from torchvision.models import resnet18, ResNet18_Weights
        self.model = resnet18(weights=ResNet18_Weights.DEFAULT).cuda()
        self.model.eval()
        self.preprocess = ResNet18_Weights.DEFAULT.transforms()

    def __call__(self, batch):
        import torch
        from PIL import Image
        tensors = torch.stack([
            self.preprocess(Image.fromarray(img)) for img in batch["image"]
        ]).cuda()
        with torch.no_grad():
            preds = self.model(tensors)
        return {
            "prediction": preds.argmax(dim=1).cpu().numpy(),
            "max_logit": preds.max(dim=1).values.cpu().numpy(),
        }

# ActorPoolStrategy creates persistent GPU workers
predictions = ds.map_batches(
    ImageClassifier,
    compute=ray.data.ActorPoolStrategy(size=4),
    num_gpus=1,
    batch_size=64,
)
predictions.write_parquet("s3://output/predictions/")
Ten szkic rezerwuje czterech aktorów z jednym GPU każdy i wymaga czterech dostępnych GPU CUDA, wag Torchvision i dostępu do S3. Ray czyta obrazy jako tablice NumPy; konwersja tablic RGB do PIL daje transformacji wstępnej ResNet18 wejście, które ta akceptuje. max_logit to największy surowy wynik modelu, a nie prawdopodobieństwo pewności.
W benchmarkach Anyscale klasyfikacja obrazów w Ray Data działała około 4x szybciej (z 456 do 111 sekund) po zmianie instancji z 4 CPUs na GPU na 32 CPUs na GPU. Anyscale przypisuje poprawę mniejszemu niedoborowi zasobów CPU; wykorzystanie GPU nadal było niskie w wartościach bezwzględnych. Daft przyspieszył po zmianie z 4 na 16 CPUs na GPU, a następnie utrzymał czas bliski 195 sekund zarówno przy 16, jak i 32.
Rozproszony Daft
Daft skaluje się w poziomie przez silnik Flotilla: jeden worker Swordfish na węzeł, a nad nim Flotilla, która planuje pracę w całym klastrze. Swordfish obsługuje lokalne wykonanie w Rust i potokuje I/O z obliczeniami przez strumieniowanie małych batchy, więc każdy węzeł pozostaje zajęty bez czekania na następny etap.
W benchmarkach opublikowanych przez Daft Flotilla działała 4–18x szybciej niż testowane implementacje Spark w czterech obciążeniach multimodalnych. Największa różnica wystąpiła w przypadku wykrywania obiektów na wideo. Potraktuj ten wynik jako dowód, że projekt wykonania może zmienić przepustowość o tyle w takich potokach, a następnie porównaj go z konkurencyjnymi wynikami Anyscale niżej i z lokalnym testem.
Anyscale, firma stojąca za Ray, opublikowała konkurencyjny benchmark, w którym Ray Data po strojeniu zmniejszył lub odwrócił różnicę na instancjach z dużą liczbą CPU. Razem oba badania dostawców są powodem, by testować reprezentatywne operatory i proporcje CPU do GPU, a nie wnioskować o trwałym rankingu.
Następny przykład używa runnera Ray w Daft; nie odtwarza benchmarku Flotilla opisanego wyżej. Czyta tabelę adresów URL obrazów, pobiera obrazy, tworzy ich embeddings modelem CLIP na workerach GPU i zapisuje wektory do Parquet. Dostosowuje daft_pipeline.py do workerów GPU w Ray. W przypiętej przez projekt towarzyszący wersji API Transformers 5.0.0 rzutowane cechy obrazów znajdują się w .pooler_output. Powiązany notebook to distributed_daft.ipynb:
import io

import daft
import numpy as np
from daft import col

# Connect to an existing Ray cluster before building the query
daft.set_runner_ray(address="auto")

# Define a GPU class UDF: the model loads once per instance
@daft.cls(gpus=1)
class ImageEmbedder:
    def __init__(self):
        import torch
        from transformers import CLIPModel, CLIPProcessor

        self.device = "cuda" if torch.cuda.is_available() else "cpu"
        self.model = CLIPModel.from_pretrained(
            "openai/clip-vit-base-patch32"
        ).to(self.device)
        self.processor = CLIPProcessor.from_pretrained(
            "openai/clip-vit-base-patch32"
        )
        self.model.eval()

    @daft.method.batch(
        return_dtype=daft.DataType.fixed_size_list(daft.DataType.float32(), 512)
    )
    def __call__(self, image_bytes_col):
        import torch
        from PIL import Image

        embeddings = []
        for img_bytes in image_bytes_col.to_pylist():
            img = Image.open(io.BytesIO(img_bytes)).convert("RGB")
            inputs = self.processor(images=img, return_tensors="pt").to(self.device)
            with torch.no_grad():
                features = self.model.get_image_features(**inputs).pooler_output
            embeddings.append(features[0].cpu().numpy())
        return np.array(embeddings, dtype=np.float32)

embedder = ImageEmbedder()

df = (
    daft.read_parquet("s3://bucket/image_metadata.parquet")
    # Native Rust I/O downloads the images; no Python requests loop
    .with_column("image_bytes", col("image_url").download())
    .with_column("embedding", embedder(col("image_bytes")))
    .exclude("image_bytes")
)
df.write_parquet("s3://bucket/embeddings/")
Runner Ray w Daft łączy się z istniejącym klastrem; domyślny runner natywny używa lokalnej maszyny. Zainstaluj Daft z obsługą Ray i zapewnij na tym klastrze workery GPU, Transformers 5.0.0, wagi CLIP i poświadczenia S3. API klas i metod wsadowych zachowuje model między batchami, a gpus=1 prosi runner o jedno GPU na instancję; podlinkowana rewizja repozytorium używa zwykłego @daft.cls i jednej partycji, bo celuje w pojedyncze lokalne GPU. Pobieranie może nakładać się na inferencję GPU, z zastrzeżeniem partycjonowania i backpressure.
Ta rewizja projektu towarzyszącego zastępuje brakujące obrazy lub każdy błąd przetwarzania wektorem zerowym, także przy niepowodzeniu kontroli kształtu embedding. Indeksuje obiekt wyjściowy CLIP bez wybrania .pooler_output, więc w Transformers 5.0.0 ta kontrola kończy się błędem i poprawne obrazy też mogą stać się wektorami zerowymi. Użyj pokazanego tutaj pobierania rzutowanych cech; ten szkic pozwala błędom przetwarzania przerwać zadanie.
Porównanie rozproszone
| Cecha | Spark | Ray Data | Daft (Flotilla) |
|---|---|---|---|
| Model wykonania | Zadanie na rdzeń, oparte na partycjach | Zadania strumieniowe i aktorzy | Swordfish na węzeł, batche strumieniowe |
| Mocne strony | Ogromny SQL/ETL, odporność na awarie | Heterogeniczne zasoby, pełne obciążenie GPU | Potokowanie multimodalne, ograniczona pamięć |
| Kontrola GPU | Planowanie zasobów plus wtyczki ekosystemu | Jawne zasoby zadań i aktorów | Zintegrowane planowanie potoku CPU/GPU |
| Typowe strojenie | Executory, pamięć, partycje, akceleratory | Batche, aktorzy, magazyn obiektów | Batche, zasoby, współbieżność I/O |
| Dobry przypadek do oceny | Duże zadania SQL/ETL z intensywnym shuffle | Trening lub inferencja z mieszanymi zasobami | Pobieranie i transformacja danych multimodalnych |
Część 4: rola Rust i Arrow
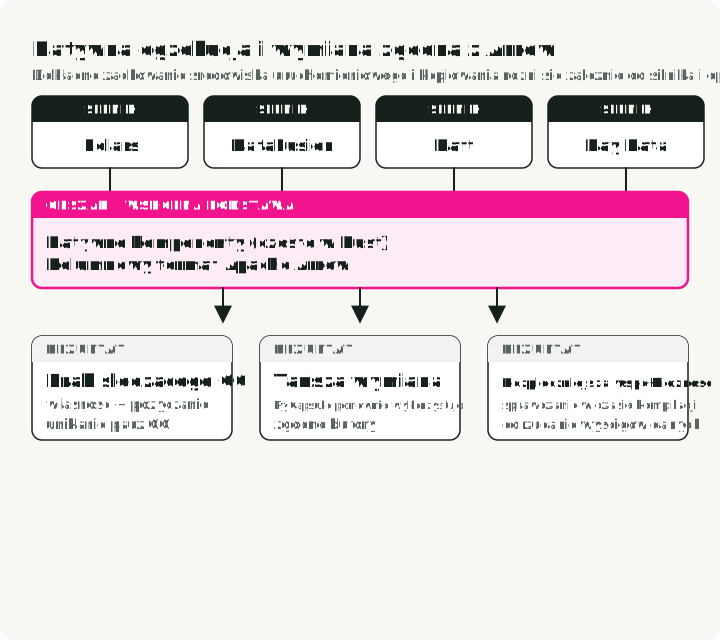
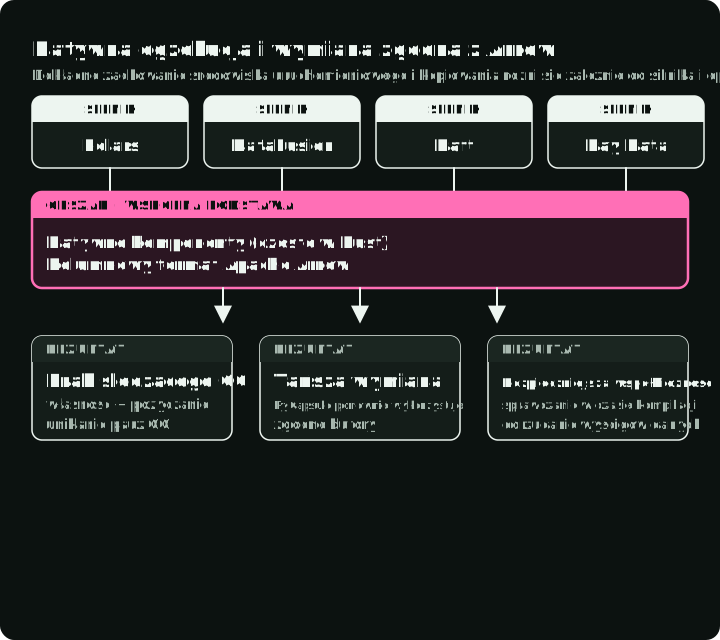
Polars, Daft i DataFusion intensywnie używają Rust, a Ray obok API w Pythonie zawiera komponenty natywne. Wszystkie mogą wymieniać dane przez elementy ekosystemu Apache Arrow.
Interfejs Arrow PyCapsule (protokół __arrow_c_stream__) daje zgodnym bibliotekom standardowy sposób wymiany strumieni Arrow. Transfery mogą uniknąć serializacji wiersz po wierszu i ponownie wykorzystać bufory, gdy schematy i układy pamięci są zgodne. Materializacja, ponowne dzielenie na chunki, konwersja typów lub transfer między urządzeniami nadal mogą kopiować dane, więc sprawdź przekazanie profilowaniem zamiast zakładać, że jest darmowe.
Następny przykład pokazuje przekazanie przez Arrow: DataFusion liczy zakupy użytkowników z więcej niż pięcioma zakupami, a Polars szereguje te liczby. Diagram używa Polars 1.37.1, wersji przypiętej w projekcie towarzyszącym: rechunk=False zachowuje zgodne bufory, natomiast domyślne rechunk=True kopiuje wiele partii do jednego fragmentu na kolumnę. Ustawienia domyślne mogą być inne w pozostałych wersjach. Przykład zakłada, że events.parquet już istnieje. Towarzyszący engine_comparison_examples.ipynb tworzy syntetyczny .data/events.parquet w komórkach konfiguracyjnych przed przykładem Arrow.
from datafusion import SessionContext
import polars as pl

# Compute in DataFusion (Rust-native execution)
ctx = SessionContext()
ctx.register_parquet("events", "events.parquet")
df = ctx.sql("""
    SELECT user_id, COUNT(*) as event_count
    FROM events WHERE event_type = 'purchase'
    GROUP BY user_id HAVING COUNT(*) > 5
""")

# Convert through Arrow; compatible buffers may be reused
arrow_table = df.to_arrow_table()
df_polars = pl.from_arrow(arrow_table)

# Continue analysis in Polars
result = df_polars.with_columns(
    pl.col("event_count").rank().alias("rank")
).sort("rank")Daft potrafi też przekazać DataFrame do PyTorch przez df.to_torch_iter_dataset(), co obejmuje ostatni krok multimodalnego potoku treningowego.
Dlaczego te nowsze silniki używają Rust do wykonania natywnego?
-
Brak śledzącego garbage collectora w kodzie Rust. Własność (ownership) daje operatorom natywnym bardziej bezpośrednią kontrolę nad alokacją i zwalnianiem pamięci. Może to zmniejszyć opóźnienia związane z GC, ale nie zapobiega presji na pamięć ani awariom z powodu braku pamięci.
-
Zwarte reprezentacje natywne. Struktury Rust nie niosą nagłówków obiektów Javy. Praktyczna korzyść zależy od układu danych silnika: kolumnowe systemy JVM też unikają reprezentowania każdej wartości jako osobnego obiektu.
-
Silniejsze kontrole współbieżności. Bezpieczny Rust wyklucza w czasie kompilacji wiele wyścigów danych. Kod silnika nadal może zawierać bloki unsafe i logiczne błędy współbieżności.
W połączeniu z kolumnowym układem pamięci Arrow te wybory mogą zmniejszyć narzut alokacji i serializacji. Nie usuwają go na każdej granicy; obiekty Pythona, transport sieciowy, niezgodne schematy i przenoszenie między urządzeniami nadal mają znaczenie.
Część 5: korzystanie z wielu silników
Nie musisz przepuszczać całej platformy przez jeden silnik. Składanie jest przydatne, gdy przekazanie między silnikami kosztuje mniej niż zmuszenie jednego systemu do obsługi każdego obciążenia. Diagram pokazuje jedną taką sztafetę: silniki spotykają się na plikach Parquet, a każdy zapis lub odczyt przez tę granicę kosztuje I/O i konwersję.
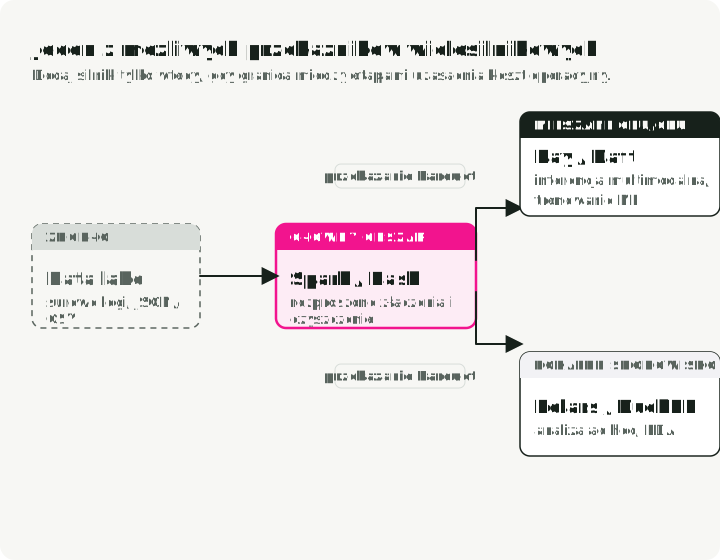
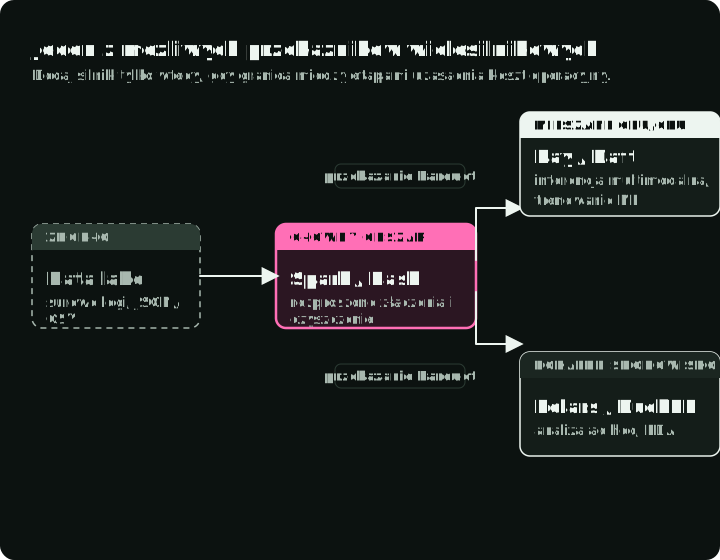
Jedna z możliwych sztafet używa Sparka do ustalonych złączeń w lakehouse, zapisuje otwarty format tabeli lub plików i przekazuje wynik do Ray Data lub Daft na potrzeby inferencji GPU albo transformacji multimodalnych. Polars lub DuckDB mogą obsługiwać lokalną analizę tych samych plików. Mniejszy zespół może potrzebować tylko jednego z tych silników; dodaj kolejny, gdy zmierzone wąskie gardło uzasadnia granicę operacyjną.
Tę kompozycję umożliwia interoperacyjność. Parquet jest w tych przykładach wspólnym plikiem przekazania, a Arrow może zapewnić wymianę w pamięci. Wsparcie dla Delta i Iceberg zależy od silnika i konektora, więc zweryfikuj każdą granicę. Przekazanie przez plik też ma koszty I/O i konwersji; nie jest automatycznie darmowe.
Wybór silnika według przypadku ewaluacyjnego
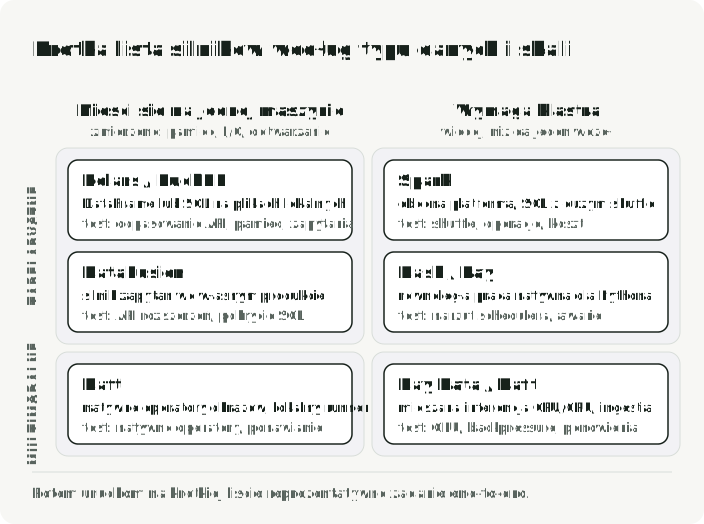
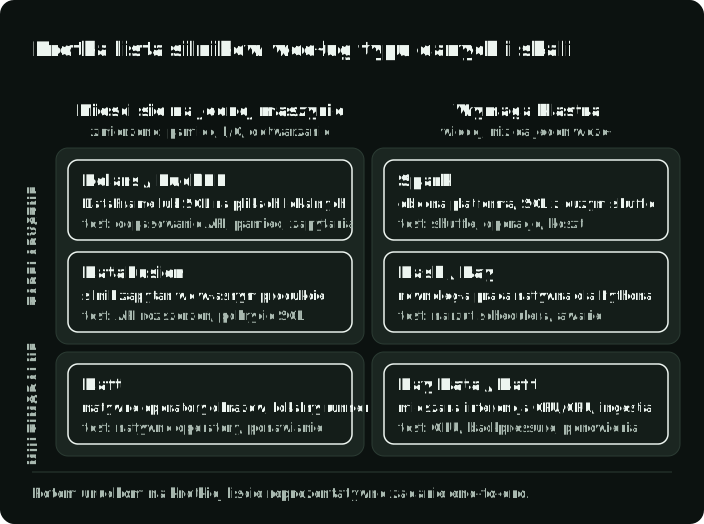
Tabela przypisuje każdemu obciążeniu krótką listę kandydatów i to, co należy przetestować przed wyborem.
| Przypadek ewaluacyjny | Krótka lista | Do sprawdzenia |
|---|---|---|
| Lokalne analityczne DataFrame | Polars / DuckDB | Dopasowanie API, pamięć, mieszanka zapytań |
| Istniejący rozproszony SQL/ETL | Apache Spark | Zachowanie shuffle, operacje, koszt |
| Praca równoległa natywna dla Pythona | Dask / Ray | Narzut schedulera, model awarii |
| Mieszany trening lub inferencja CPU/GPU | Ray Data / Daft | Wykorzystanie akceleratorów, backpressure |
| Pobieranie danych multimodalnych | Daft / Ray Data | Operatory natywne, zachowanie przy ponowieniach |
| Osadzany silnik zapytań | DataFusion | API rozszerzeń, pokrycie SQL |
Diagram umieszcza tę samą krótką listę na dwóch pytaniach: czy dane są tabelaryczne, czy multimodalne, i czy zadanie mieści się na jednej maszynie.
Skalowanie diagonalne
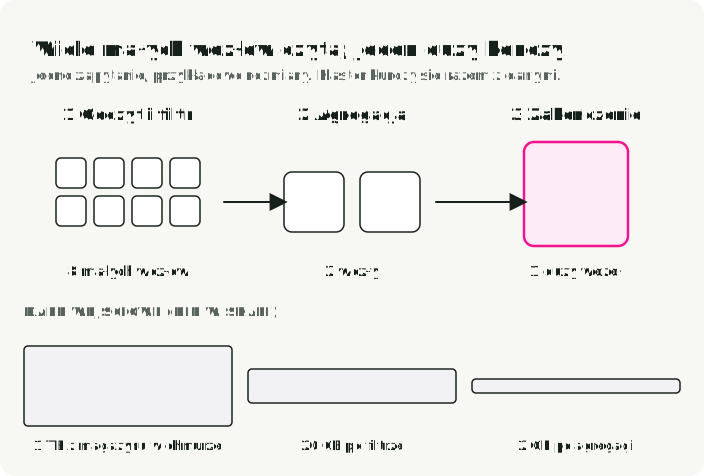
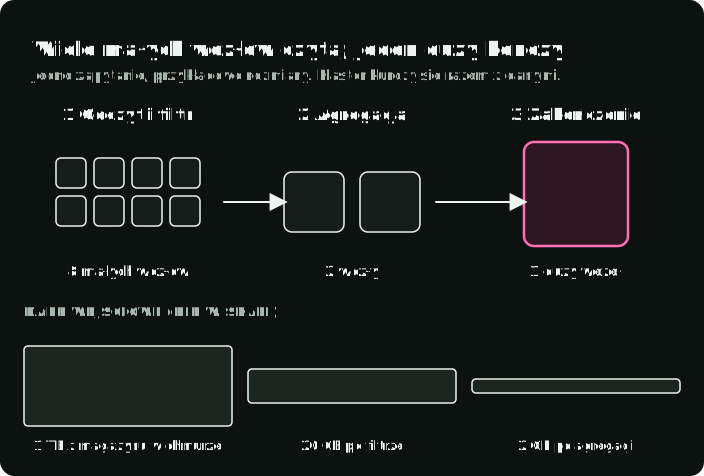
Przez długi czas wybierało się między skalowaniem w górę (większa maszyna) a w poziomie (więcej maszyn). Polars Cloud opisuje zależne od zapytania podejście zwane skalowaniem diagonalnym. Skaluj poziomo podczas czytania z magazynu w chmurze, by w pełni wykorzystać I/O, a potem zwiń do jednego dużego węzła, gdy filtry i agregacje zmniejszą dane. Wczesna redukcja może ograniczyć transfer danych i pozwolić dokończyć resztę pracy na jednym węźle. To, czy wystąpi rozproszony shuffle, zależy od fizycznego planu zapytania. Diagram śledzi jedno zapytanie z wymyślonymi rozmiarami: osiem małych węzłów czyta i filtruje 1 TB, dwa węzły agregują to, co zostało, a jeden duży węzeł kończy na 2 GB.
Porównuj koszt udanego zadania, a nie cenę instancji za godzinę. Większy węzeł może wyjść taniej, jeśli skrócenie czasu działania przeważy jego wyższą stawkę, ale wynik zależy od I/O, presji na pamięć i ilości pracy wyeliminowanej przed shuffle.
Odtworzenie porównania
Towarzyszące repozytorium demo zawiera skrypty, notebooki i środowisko użyte w porównaniach. Polecenie tabelaryczne używa domyślnego w repozytorium zbioru taksówek z całego 2024 roku, zgodnego z uruchomieniem powyżej. Pierwsze uruchomienie pobiera około 660 MB danych o taksówkach i obrazy Food-101; benchmark Rust wymaga toolchaina Rust.
# Install dependencies
uv sync

# Run the tabular benchmark (~41M NYC taxi trips from full-year 2024)
uv run python -m engine_comparison.benchmarks.tabular

# Run the multimodal benchmark (500 real food photos)
uv run python -m engine_comparison.benchmarks.multimodal

# Run native Rust benchmarks (Polars-rs + image crate)
cd rust_benchmark && cargo run --release && cd ..
./scripts/run_benchmarks.sh uruchamia wszystkie trzy i zapisuje benchmarks/*.json oraz wykresy zbiorcze. Skrypty Pythona przyjmują --runs 5 dla większej liczby uruchomień pomiarowych, a skrypt obrazów przyjmuje --images 1000 dla większego zbioru obrazów. Notebooki rozproszone wymagają uv sync --extra distributed --extra notebook. Repozytorium zawiera też konfiguracje Docker Compose do lokalnych uruchomień rozproszonych Sparka, Ray i Daft.
Najważniejsze wnioski
-
Udowodnij, że jedna maszyna nie wystarcza. Wyniki skalowania w górę pokazują, że niektóre duże skany analityczne mieszczą się na jednym węźle. Zmierz wymagania dotyczące pamięci, I/O, spillowania na dysk i odtwarzania, zanim zaakceptujesz narzut klastra.
-
Leniwe planowanie wyjaśnia więcej różnicy w szybkości niż składnia API. Pushdown, strumieniowanie i operatory równoległe odpowiadają za dużą część różnicy między gorliwym skryptem DataFrame a silnikiem analitycznym.
-
Mierz cały potok akceleratora. Dekodowanie, I/O sieciowe, tworzenie batchy, serializacja i backpressure decydują, czy GPU pozostaje zajęte. Ray Data i Daft czynią to nakładanie centralną abstrakcją; Spark może je wspierać dodatkowym projektem i narzędziami.
-
Wybierz krótką listę według obciążenia, potem zrób benchmark. Użyj dopasowania do ekosystemu, by zawęzić pole, i reprezentatywnego zadania end-to-end, by wybrać. Powtórz benchmark dostawcy na własnym zadaniu, zanim zaczniesz na nim polegać.
-
Otwarte formaty utrzymują odwracalność wyboru. Interfejsy zgodne z Arrow, Parquet i otwarte formaty tabel mogą zmniejszyć koszty przekazania. Potwierdź, czy dana konwersja ponownie używa buforów, czy je kopiuje.
Referencje
Benchmarki i dane wydajnościowe
- Polars PDS-H Benchmarks - Polars w trybie strumieniowym kontra Pandas przy SF-10 (94x) i SF-100 (około 6x względem wykonania w pamięci)
- DataFusion ClickBench Results (Nov 2024) - Wyniki jednowęzłowe dla Parquet opublikowane przez projekt
- Embucket: TPC-H SF-1000 on DataFusion - Studium przypadku dostawcy na jednym dużym węźle; dwa zapytania przepisano, aby się zakończyły
- Amazon Spark-to-Ray Migration - 82% lepsza efektywność kosztowa produkcji na GiB danych wejściowych z S3
- Daft Flotilla Benchmarks - 4–18x szybciej niż Spark w obciążeniach multimodalnych
- Anyscale Ray vs. Daft Benchmarks - Konkurencyjny benchmark dostawcy dla obciążeń multimodalnych
Silniki i frameworki
- Polars - Biblioteka DataFrame w Rust z wykonaniem leniwym
- Apache DataFusion - Osadzalny silnik zapytań w Rust (GitHub)
- Daft - Rozproszony DataFrame natywnie multimodalny
- Ray - Rozproszony framework obliczeniowy dla AI (Data Internals)
- Apache Spark - Rozproszony silnik ETL i SQL
- DuckDB - Analityczny silnik SQL działający w procesie
- Dask - Równoległe obliczenia natywne dla Pythona
Architektura i ekosystem
- Polars Cloud: Diagonal Scaling - Dynamiczne skalowanie w pionie i w poziomie
- Daft Flotilla Architecture - Silnik rozproszony Swordfish + Flotilla
- Apache DataFusion Comet - Akcelerator Sparka stworzony pierwotnie w Apple
- Apache Arrow - Kolumnowy format w pamięci (Flight RPC, PyCapsule Interface)
- InfluxDB 3.0 + DataFusion - Baza szeregów czasowych zbudowana na DataFusion
- GreptimeDB - Baza obserwowalności używająca DataFusion
Repozytorium demonstracyjne
- engine-comparison-demo - Kod towarzyszący temu artykułowi: benchmarki, notebooki i Docker Compose dla Spark/Ray/Daft
Zbiory danych
- NYC Taxi Trip Records - Dane żółtych taksówek NYC TLC (Parquet, ~2,9 mln wierszy miesięcznie)
- Food-101 Dataset - 101 tys. zdjęć jedzenia z ETH Zurich (Bossard i in., ECCV 2014)