OCR im Jahr 2026: Klassische Pipelines, VLMs und Document AI

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Dieser Leitfaden richtet sich an Engineers, die OCR und Document Extraction für Search, Retrieval-Augmented Generation (RAG) oder AI Agents auswählen. Er erklärt, wie sich traditionelle Engines und Vision-Language-Models unterscheiden, wie du Text, Tabellen und Felder evaluierst und wie du schwierige Dokumente an ein anderes Model oder an eine menschliche Prüfung weiterleitest.
Vision-Language-Models (VLMs) können Layout, Handschrift, Tabellen und beschädigte Bilder verarbeiten, an denen eine reine Pipeline zur Texterkennung scheitert. Traditionelle Engines bleiben bei sauberem Druck konkurrenzfähig, vor allem wenn CPU-Latency und Betriebskosten zählen. Der datierte Snapshot unten enthält PaddleOCR-VL 1.6 und dots.mocr mit unterschiedlichen Trade-offs bei Hardware, Datenschutz und Output. Prüfe jedes Projekt, bevor du eine aktuelle Entscheidung triffst.
Die kompakte Version zur Model-Auswahl findest du unter Best OCR Models in 2026: Classical OCR, PaddleOCR-VL, VLMs.
OCR bestimmt jetzt die Qualität nachgelagerter Schritte
OCR treibt seit Langem Archive, Postsysteme, Accessibility-Tools und Dokumentenmanagement an. RAG und Document Agents haben seine Fehlerbilder für einen größeren Kreis von Engineers sichtbar gemacht: Ein nachgelagertes Model kann Text oder Tabellenstruktur nicht wiederherstellen, die die Extraktion verworfen hat.
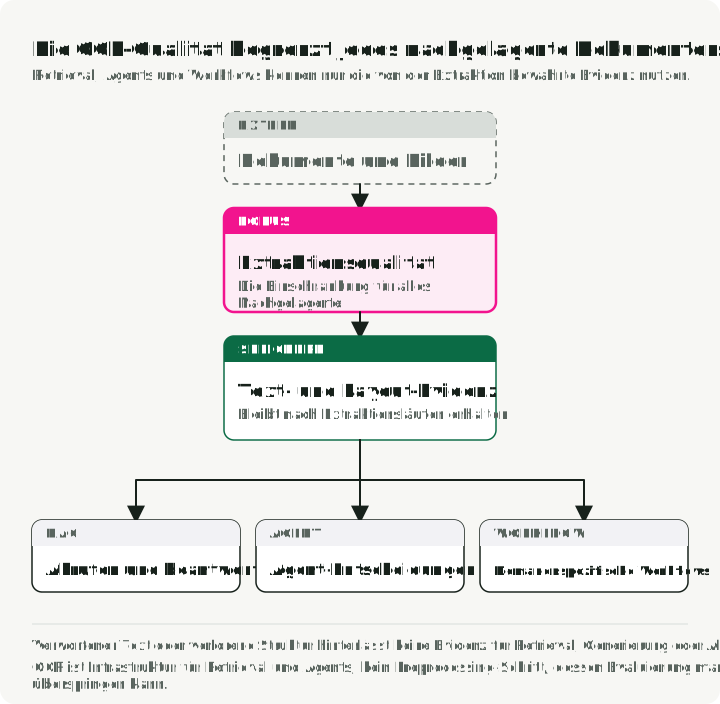
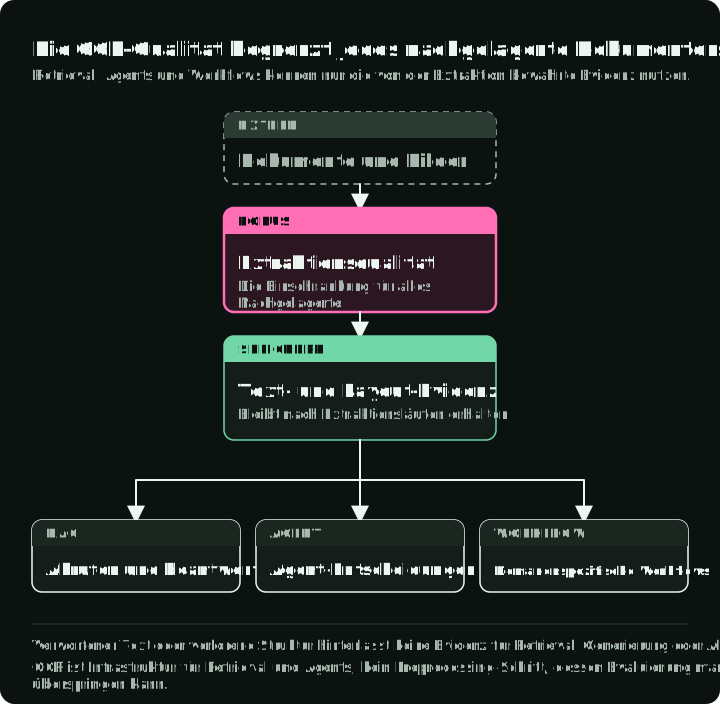
Ein RAG-System kann keinen Text abrufen, den OCR ausgelassen oder falsch gelesen hat. Wenn die Extraktion eine Tabelle verstümmelt, ein Datum falsch liest oder einen Absatz weglässt, kann auch ein späteres Chunking oder ein anderes Embedding die fehlende Information nicht zurückbringen. Solche Fehler können eine Vertragsklausel verbergen, eine Rechnungssumme verändern oder eine Patientenakte verfälschen.
OCR ist deshalb Teil der Infrastruktur für Retrieval und Agents, neben Parsing, Chunking, Embedding und Indexing. Seine Fehler brauchen eine eigene Evaluation, statt in einem einzigen End-to-End-Score aufzugehen.
Was OCR im Zeitalter der Foundation Models bedeutet
OCR wandelt Text in einem Bild in maschinenlesbare Zeichen um. Document AI ist das umfassendere System darum herum: Layoutanalyse, Parsing von Tabellen und Formeln, Feldextraktion, semantisches Reasoning, Provenienz und Validierung. Die Autoren von GOT-OCR 2.0 nennen modulare Pipelines aus Detektion und Erkennung „OCR-1.0“ und End-to-End-Models „OCR-2.0“. Diese Bezeichnung sollte den Unterschied zwischen Texterkennung und Dokumentverständnis nicht verwischen.
Die Abbildung vergleicht beide Wege und wie jeder scheitert: Die drei Stufen links holen eine Zeile, die die Detektion verpasst hat, nie zurück, der einzelne Model-Durchlauf rechts schreibt eine plausible Summe, die nicht auf der Seite steht, und Rasterisierung und Parsing bleiben in beiden Fällen außerhalb des Models.
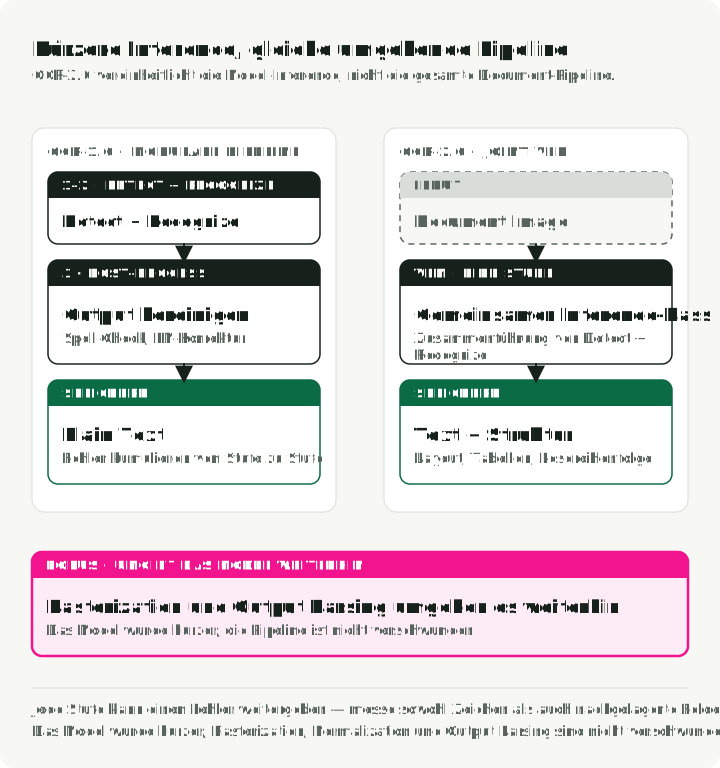
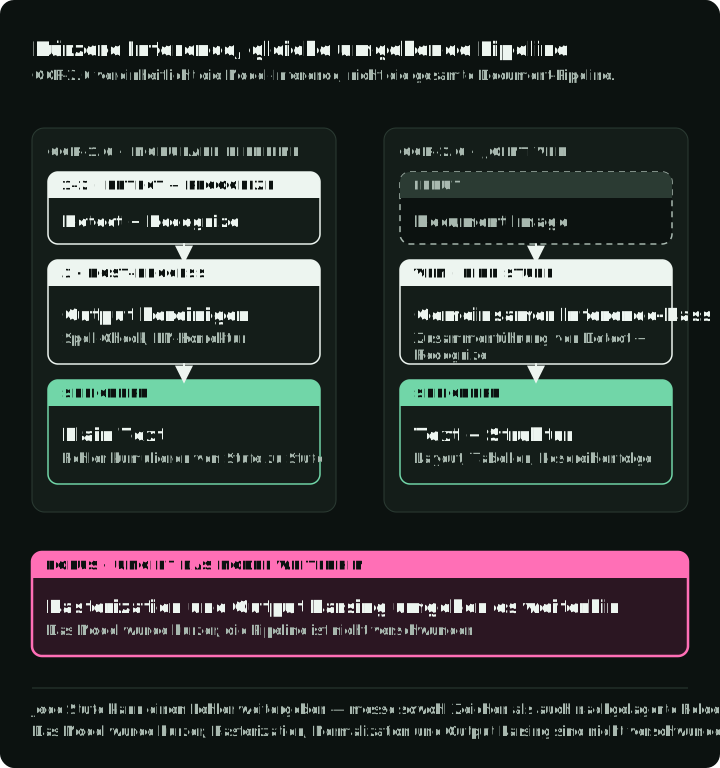
Die traditionelle OCR-Pipeline hat drei Kernstufen:
- Textdetektion: Bereiche mit Text finden (z. B. CRAFT, DBNet).
- Texterkennung: erkannte Bereiche in Zeichenfolgen umwandeln (z. B. CRNN).
- Nachbearbeitung: Rechtschreibprüfung und Korrektur mit einem Sprachmodell.
Das funktioniert gut bei sauberen Dokumenten, doch Fehler aus Detektion, Erkennung und Nachbearbeitung können sich aufsummieren. Miss deshalb sowohl die Zeichengenauigkeit als auch die Genauigkeit der nachgelagerten Felder, damit eine lesbare Seite keine falsche Summe oder Kennung verdeckt.
Manche End-to-End-VLM-Pfade fassen mehr dieser Pipeline in einem Vision-Encoder plus Sprach-Decoder zusammen. Models wie GOT-OCR 2.0 können Text und Struktur gemeinsam ausgeben, während allgemeine VLMs Felder zusätzlich auf ein vorgegebenes Schema abbilden können. Ein allgemeines VLM kann zum Beispiel „MFG: 10/24“ auf einem Etikett als Herstellungsdatum lesen und nicht als Ablaufdatum. Die Trade-offs sind Latency, GPU- oder API-Kosten, die vom Workload abhängen, und das Risiko plausiblen Textes, der im Bild gar nicht vorkommt.
Ein praktischer Hinweis: Ein reines Bild-Model braucht gerasterte Seiten, während ein Dienst, der PDF akzeptiert, die Konvertierung womöglich intern erledigt. Entzerren, Skalieren und Bereinigen sind pipelinespezifische Experimente, keine verpflichtenden Verbesserungen. AWS Textract rät, unterstützte Eingaben zu erhalten, statt sie wahllos zu konvertieren oder herunterzuskalieren. Das Parsen und Validieren der Ausgabe bleibt Aufgabe der Anwendung.
Metriken: Das Relevante messen
Jeder spätere Vergleich in diesem Leitfaden nutzt eine dieser Metriken. Wähle die, die zum Ausgabetyp passt:
- CER und WER für reinen Text. Character Error Rate und Word Error Rate hängen von Normalisierungsentscheidungen wie Groß- und Kleinschreibung, Leerraum und Satzzeichen ab. Lege das Vergleichsprotokoll also fest, bevor du Models vergleichst.
- Field Exact Match und Field F1 für Formulare und Belege. Exact Match ist für ein einzelnes Feld binär; seine Rate ist der Anteil der ausgewerteten Felder, die bestehen. Weise die Korrektheit aller Felder pro Dokument getrennt aus. Definiere für Field F1 das Key-Value-Matching, die Normalisierung, den Umgang mit doppelten und fehlenden Feldern sowie die Aggregation; ein richtiger Betrag, der der falschen Zeile zugeordnet wird, ist ein Fehler.
- TEDS für Tabellen. Tree-Edit-Distance-based Similarity vergleicht vorhergesagte und Referenz-HTML-Bäume und erfasst Struktur- und Zellinhaltsfehler, die CER verbirgt.
- Vergleich der Lesereihenfolge, wenn der Konsument eine lineare Sequenz braucht. Vergleiche geordnete Blöcke oder Spans direkt oder nutze eine reihenfolgebewusste Metrik; OmniDocBench wertet die Lesereihenfolge getrennt aus. Richtige Zeichen und Tabellenzellen belegen nicht die Reihenfolge einer mehrspaltigen Seite.
- ANLS für Document VQA. Average Normalized Levenshtein Similarity bewertet Antworten gegen akzeptierte Referenzen. Die ursprüngliche ST-VQA-Definition vergibt
1 − normalized_distancenur, wenn die Distanz strikt unter 0,5 liegt, sonst null; sie nimmt den besten Wert über die akzeptierten Referenzen und mittelt über die Fragen. DocVQA übernimmt ANLS. Lege beim Reproduzieren eines Scores die Normalisierung von Groß- und Kleinschreibung, Leerraum und Distanz des Evaluators fest.
CER und WER zählen Substitutionen, Löschungen und Einfügungen geteilt durch die Zeichen oder Wörter der Referenz. Sie können über eins liegen, wenn Einfügungen überwiegen. Gib an, ob die Aggregation Fehler und Referenzlängen des gesamten Korpus summiert oder Dokument-Scores mittelt. Bewahre Seite, Block, Bounding Box, Originaltext und Normalisierungsverlauf auf, damit sich ein falsches Feld bis zum Bild zurückverfolgen lässt.
Für die Textdetektion teilt Intersection over Union (IoU) die Überlappungsfläche einer vorhergesagten und einer Referenzbox durch die gesamte Fläche, die mindestens eine der beiden Boxen abdeckt. Der IoU-Schwellenwert bestimmt vor der Berechnung von F1, ob eine erkannte Box zur Referenz passt.
Die Tabelle ordnet jeder Aufgabe ihre Metrik zu und den Fehler, der einen Score am häufigsten irreführend macht:
| Aufgabe | Metrik | Zu vermeidender Fehler |
|---|---|---|
| Reine Textextraktion | CER, WER | Scores vergleichen, die mit unterschiedlicher Normalisierung berechnet sind |
| Handschrift | CER | CER-Ziele für Druckschrift auf handschriftliche Seiten anwenden |
| Textdetektion | F1 bei einem IoU-Schwellenwert | F1 ohne den verwendeten IoU-Schwellenwert angeben |
| Formulare und Belege | Field Exact Match, Field F1 | Einen richtigen Wert im falschen Feld oder in der falschen Zeile als richtig zählen |
| Tabellen | TEDS | Tabellen mit CER beurteilen, das die Zellstruktur ignoriert |
| Document VQA | ANLS | Den Schwellenwert 0,5 oder die Antwortnormalisierung ändern |
| Konvertierung ganzer Seiten | Edit Distance + Lesereihenfolge | Textgenauigkeit melden, ohne die Blockreihenfolge zu prüfen |
Auch Sprachen verändern die Wahl. Chinesischer und japanischer Text hat keine Leerzeichen zwischen Wörtern, daher hängt WER von einem Wort-Segmenter ab; nutze für diese Schriften CER. Nimm Seiten mit gemischten Schriften in das gelabelte Testset auf, wenn sie in deinem Workload vorkommen. Eine Model Card, die 100 Sprachen aufführt, zeigt die Qualität für keine einzelne davon; nimm also jede Zielsprache in das gelabelte Testset auf.
Zur Implementierung: jiwer berechnet CER und WER sofort einsatzbereit, und TEDS-Implementierungen liegen im OmniDocBench-Repo.
Was OCR-Benchmarks messen und was nicht
Öffentliche Datasets wenden diese Metriken auf bestimmte Dokumenttypen an. Größen und Metriken gelten für die genannte Dataset-Version; Model-Scores findest du im aktuellen Leaderboard des jeweiligen Projekts. Die Spalte „Testet“ nennt, welchen deiner Dokumente das jeweilige Dataset ähnelt.
| Dataset | Testet | Testgröße | Sprachen | Primäre Metrik |
|---|---|---|---|---|
| FUNSD | Key-Value-Verknüpfung auf verrauschten gescannten Formularen | 50 Dokumente | Englisch | F1 |
| SROIE | Vier Belegfelder (Firma, Datum, Adresse, Summe) | 400 Testbilder | Englisch | F1 |
| CORD | Belegpositionen mit hierarchischen Labels | 100 Belege | Indonesisch | F1 |
| IAM | Handgeschriebene englische Zeilen | Abhängig vom Split | Englisch | CER |
| OCRBench v2 | Textlesen und Reasoning von VLMs über 23 Aufgaben | 10.000 QA-Paare | EN + CN | Score /100 |
| OmniDocBench v1.6 | Parsing ganzer Seiten: Text, Tabellen, Formeln, Lesereihenfolge | 1.651 Seiten | EN + CN | Komposit |
Die Zahl der IAM-Zeilen hängt vom gewählten Writer-Split und vom Erkennungsprotokoll ab; hier wird keine einzelne Anzahl an Testzeilen angenommen.
OmniDocBench-v1.6-Snapshot
Die folgende Tabelle ist ein versionierter Snapshot: OmniDocBench v1.6_full, offizielles README beim Commit 09ba2b606662695b16aafe5f5e36b7ef020e11a8, abgerufen am 2026-08-09.
| Model | Größe | Overall ↑ | Text Edit ↓ | Table TEDS ↑ |
|---|---|---|---|---|
| GLM-OCR | 0.9B | 95.22 | 0.044 | 92.83 |
| PaddleOCR-VL-1.5 | 0.9B | 94.93 | 0.038 | 91.67 |
| Gemini 3 Flash | — | 92.62 | 0.066 | 89.29 |
| dots.ocr | 3B | 90.77 | 0.048 | 87.18 |
Das angeheftete README listet PaddleOCR-VL 1.5. PaddleOCR gibt für Version 1.6 auf derselben Benchmark-Version 96.3 an; diese Zahl stammt aus dem eigenen Lauf des Anbieters und ist nicht Teil dieser Tabelle.
Die Schlussfolgerung gilt nur für diese OmniDocBench-Version: Die Model-Größe allein sagt den Score beim Dokument-Parsing nicht voraus. Spätere Evaluator-Versionen ändern das Matching, vergleiche Scores also nur unter einem festgelegten Evaluator. Der Komposit-Score umfasst Text Edit Distance, Table TEDS und Character Detection Matching (CDM) für Formeln. CDM rendert vorhergesagte und Referenzformeln, ordnet ihre Zeichen einander zu und prüft deren relative Positionen, bevor es die Übereinstimmungen mit F1 bewertet. Es vergleicht gerenderte Formeln statt roher LaTeX-Strings. Die Lesereihenfolge braucht ihr eigenes Ergebnis.
Die Lücke zwischen „Benchmark“ und „Arena“
Automatisierte Benchmark-Rankings können menschlichen Präferenzen widersprechen.
In der OCR Arena stimmen Nutzer blind über Ausgaben im direkten Vergleich ab. Am 2026-08-09 platzierte die OCR Arena Gemini 3 Flash über GLM-OCR, während die OmniDocBench-Tabelle oben GLM-OCR höher bewertet (95.22 gegenüber 92.62). Die Live-Reihenfolge der Arena ändert sich mit jedem neuen Duell, sie ist also kein reproduzierbarer historischer Benchmark-Snapshot. Verrechne die beiden Leaderboards nicht zu einem einzigen Score.
Die Abbildung zeigt die Abweichung: GLM-OCR und Gemini 3 Flash tauschen zwischen den beiden Rankings die Plätze. Darunter stehen die Seiten, die jedes Ranking verwendet, wer urteilt und was du bekommst.
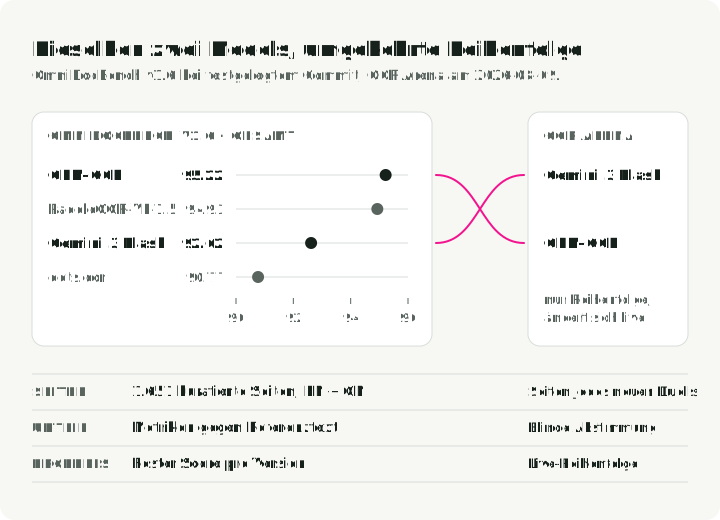
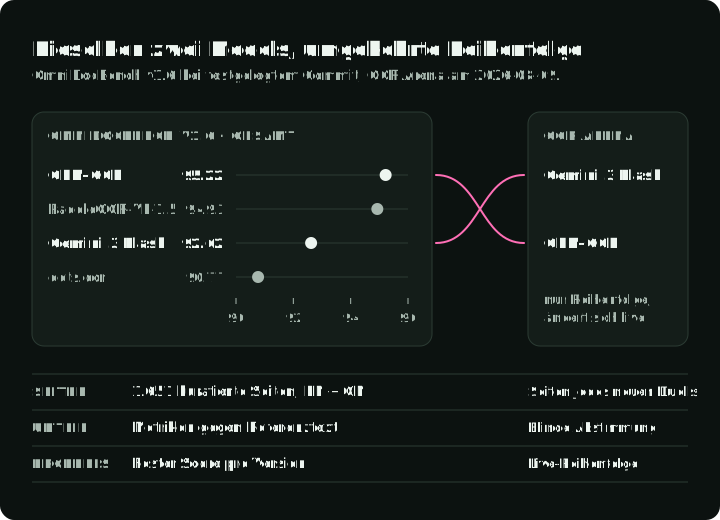
Wahrscheinliche Ursachen sind Dokumentmix, Ausgabeformatierung, Sprachabdeckung und Bewertungskriterien. Veröffentlichte Zahlen eignen sich zur Vorauswahl, doch die endgültige Wahl braucht ein zurückgehaltenes Set aus dem Ziel-Workload.
Traditionelle OCR-Engines: weiterhin relevant
Traditionelle Engines sind nützliche Baselines, weil sie lokal auf der CPU laufen können. Latency und Genauigkeit hängen vom gewählten Model, von der Seitenauflösung, der Sprache, der Vorverarbeitung und der Hardware ab. Benchmarke sie deshalb auf denselben gelabelten Seiten wie die VLM-Evaluation.
| Engine | Deployment | Nützliche Baseline für |
|---|---|---|
| Tesseract 5.5 | Lokale CPU | Sauberen Druck und etablierte Schriften |
| EasyOCR | Lokales PyTorch auf CPU oder GPU | Prototypen und Text in Szenenfotos |
| PaddleOCR 3.x | Lokale CPU, GPU und mobile Varianten | Mehrsprachiges OCR und Deployment-Toolchains |
Tesseract für sauberen Druck
Tesseract (v5.5.x, Apache 2.0) ist eine ausgereifte, überwiegend CPU-basierte Engine mit über 100 Sprachpaketen. Die Genauigkeit bei sauberem Druck kann nach passender Rasterung und Vorverarbeitung hoch sein, doch Handschrift, Text in Szenenfotos und komplexe Layouts müssen separat getestet werden. Sein Hauptvorteil ist ein kleines, lokales CPU-Deployment.
Setze den Page Segmentation Mode (--psm) pro Dokumenttyp; ein falscher Modus lässt Spalten fallen oder verschmilzt Zeilen. Das Snippet setzt pip install pytesseract pillow, die Tesseract-Binary mit englischen Sprachdaten und eine lokale receipt.jpg voraus.
import pytesseract
from PIL import Image

# --psm 6: treat the image as one uniform block of text, which suits a receipt
text = pytesseract.image_to_string(Image.open("receipt.jpg"), lang="eng", config="--psm 6")
EasyOCR
EasyOCR kombiniert einen CRAFT-Detektor mit einem CRNN-Recognizer. Mit voller PyTorch-GPU-Beschleunigung ist es eine schnelle Option für Prototyping und Text in Szenenfotos. Es liefert nur Zeilen und Boxen, ohne Layout oder Tabellenstruktur.
Das Snippet setzt pip install easyocr, PyTorch, die heruntergeladenen Model Weights von EasyOCR und eine lokale receipt.jpg voraus.
import easyocr

# Three lines for complete OCR
reader = easyocr.Reader(["en"])
result = reader.readtext("receipt.jpg")
# Returns: [(bbox, text, confidence), ...]
PaddleOCR 3
PaddleOCR 3 bündelt gepflegte Pipelines für OCR, Dokument-Parsing und Deployment. Der aktuelle Quick Start nutzt die predict()-API und explizite Orientierungseinstellungen. Lege das paddleocr-Paket und die gewählte Pipeline fest, denn 2.x-Beispiele mit .ocr(..., cls=True) passen nicht zur 3.x-API.
Es braucht die PaddlePaddle-Runtime, die einem PyTorch-Stack ein zweites Framework hinzufügt. Die Texterkennung von PaddleOCR ist eine andere Pipeline als PaddleOCR-VL, der Dokument-Parser im nächsten Abschnitt.
Das Snippet setzt pip install "paddleocr>=3,<4", eine kompatible PaddlePaddle-Runtime, heruntergeladene Model Weights und eine lokale receipt.jpg voraus.
from paddleocr import PaddleOCR

ocr = PaddleOCR(
    use_doc_orientation_classify=False,
    use_doc_unwarping=False,
    use_textline_orientation=False,
)

for result in ocr.predict("receipt.jpg"):
    result.print()
    result.save_to_json("output")
Jedes Ergebnis enthält rec_texts, rec_scores und rec_boxes. Der Abschnitt zum Routing nutzt die letzten beiden, um eine Seite zu bewerten.
Spezialisierte und allgemeine VLM-Optionen
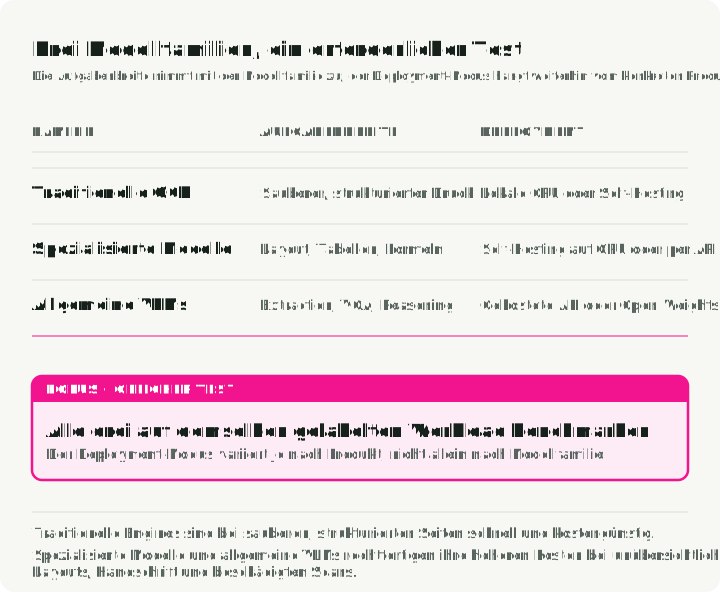
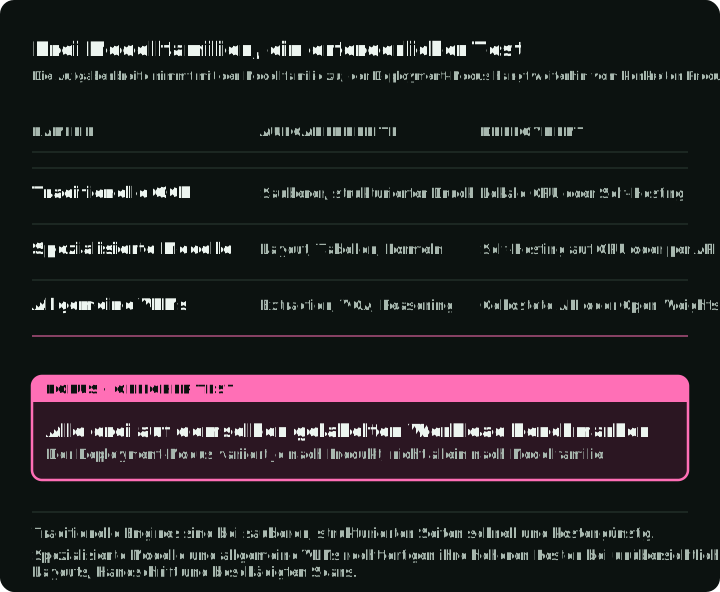
Schiefe Belege, verdrehte Produktetiketten, Handschrift und dichte Layouts sind die Fälle, in denen sich spezialisierte oder allgemeine VLMs im Test gegen traditionelle Engines lohnen.
Die Abbildung zeigt, was jede Model-Familie für dieselbe Seite zurückgibt, ihren wichtigsten Kompromiss und wo sie laufen kann. Der Betriebsmodus hängt vom Produkt ab, daher führt die Abbildung ihn getrennt von der Aufgabenbreite auf.
Spezialisierte Dokument-Models
Die Models in diesem Abschnitt wurden am 2026-10-02 geprüft. Die Liste ist kein aktuelles Ranking; sie sagt, bei welchem Dokumentproblem sich welches Model auszuprobieren lohnt.
| Model | Output | Wo es läuft | Ausprobieren, wenn |
|---|---|---|---|
| PaddleOCR-VL 1.6 | Layoutanalyse, danach liest ein 0.9B-VLM jede Region | Selbst gehostet | Mehrsprachige Seiten mit Layout; der Anbieter nennt 109 Sprachen |
| GOT-OCR 2.0 | Reiner Text, Markdown, LaTeX | Selbst gehostet, 580M Parameter | Formeln und gemischter Text auf einer Seite |
| dots.mocr | Layout und Text; Diagramme und Abbildungen als SVG-Code | Selbst gehostet, 3B Parameter | Seiten mit Diagrammen oder Grafiken, die du als Struktur brauchst |
| DeepSeek-OCR2 | Markdown mit Grounding-Boxen | Selbst gehostet, vLLM oder Transformers | Lange Dokumente bei hohem Volumen; eine Seite nutzt 256 bis 1.120 Vision-Tokens |
| Mistral OCR 4.1 | Markdown, Absatz-Boxen, Block-Labels, Block-Confidence | Gehostete API (mistral-ocr-4-1) | Du willst eine API und eine Confidence pro Block |
| Granite-Docling 258M | DocTags, konvertiert in ein DoclingDocument | Selbst gehostet, in Docling | Ein kleines lokales Model für Docling-Konvertierungen |
| olmOCR | Reiner Text oder Markdown in Lesereihenfolge | Selbst gehostet, 7B-VLM auf einer GPU | PDFs für RAG oder Trainingsdaten in Text linearisieren |
Behandle Throughput- und Speicherangaben als hardware- und datensatzspezifisch; miss den Spitzenspeicher mit deiner Runtime, Präzision, Bildgröße und Ausgabegrenze. Kalibriere die Block-Confidence von Mistral gegen die Feldkorrektheit, bevor du Werte automatisch akzeptierst. Lege für Vergleiche eine explizite Model-Version fest, denn ein latest-Alias kann sich ändern.
Frontier-VLMs
Allgemeine VLMs sind eine weitere Option, wenn die Aufgabe Extraktion mit visuellem oder semantischem Reasoning verbindet. Diese Kandidaten wurden am 2026-10-02 geprüft und kommen im Gateway-Beispiel unten vor. Sie sind eine erste Shortlist, kein OCR-Ranking:
- Gemini 3.8 Flash (Google): Ein allgemein verfügbares multimodales Model mit Bildeingabe und Structured Outputs. Nutze seine stabile ID, wenn du einen neuen Vergleich beginnst.
- Claude Sonnet 5 (Anthropic): Eine Sonnet-Generation, die am 2026-06-30 erschienen ist, für einen Vergleich mit einem gehosteten Model. Teste Transkriptionstreue und Feldextraktion auf deinen eigenen Dokumenten; Verbesserungen beim allgemeinen Reasoning belegen keine OCR-Genauigkeit.
- Qwen3.8-27B (Alibaba): Ein Open-Weight-Vision-Language-Model unter Apache 2.0, das sich über ein Gateway testen oder selbst hosten lässt. Mit 27B ist es eine andere Deployment-Entscheidung als das frühere Qwen3-VL 8B, das bei knappem Speicher eine nützliche kleinere Baseline bleibt.
Nimm ein neues Release in das Testset auf. Setze es in Production erst ein, wenn es denselben Vergleich besteht: Feldkorrektheit, Abstention, Latency und Kosten pro akzeptiertem Dokument unter demselben Protokoll.
Frameworks zur Dokumentkonvertierung
Eine RAG-Pipeline braucht meist ein ganzes Dokument als Markdown oder JSON, nicht rohe OCR-Zeilen. Das leisten Dokumentkonverter. Sie parsen die Datei, führen ein Layout-Model aus und rufen für den Text in jeder Region eine OCR-Engine auf. Manche können stattdessen jede Seite an ein VLM senden, das Layout und Text gemeinsam liest.
| Framework | Was es ausgibt | Einsetzen, wenn |
|---|---|---|
| Docling | Markdown, HTML oder verlustfreies JSON mit Tabellen und Koordinaten, aus PDF, DOCX, PPTX, XLSX, HTML und Bildern | Du einen Konverter für gemischte Formate brauchst und die OCR-Engine darin wählen willst |
| Marker | Markdown, JSON, HTML oder Chunks, aus PDF, Bildern und Office-Dateien | Du hochwertiges Markdown aus PDFs willst |
| MinerU | Markdown und strukturiertes JSON, aus PDF, Bildern und Office-Dateien | Wissenschaftliche und technische Paper mit Formeln und Tabellen |
Prüfe die Lizenzen, bevor du einen Konverter in einem Produkt ausliefern willst. Docling steht unter MIT. Der Code von Marker steht unter Apache 2.0, doch seine Model Weights nutzen eine modifizierte OpenRAIL-M-Lizenz mit Einschränkungen für die kommerzielle Nutzung. Die Lizenz von MinerU ergänzt Apache 2.0 um Bedingungen: eine separate kommerzielle Lizenz oberhalb bestimmter Nutzer- und Umsatzschwellen und eine Namensnennung bei Online-Diensten.
Die Abbildung zeigt, was ein Konverter umschließt. Docling hält Eingabe und Ausgabe gleich, und seine Pipeline-Optionen bestimmen, wie der Text gelesen wird: mit seinem Layout-Model plus Tesseract oder EasyOCR oder mit dem Granite-Docling-VLM durchgängig.
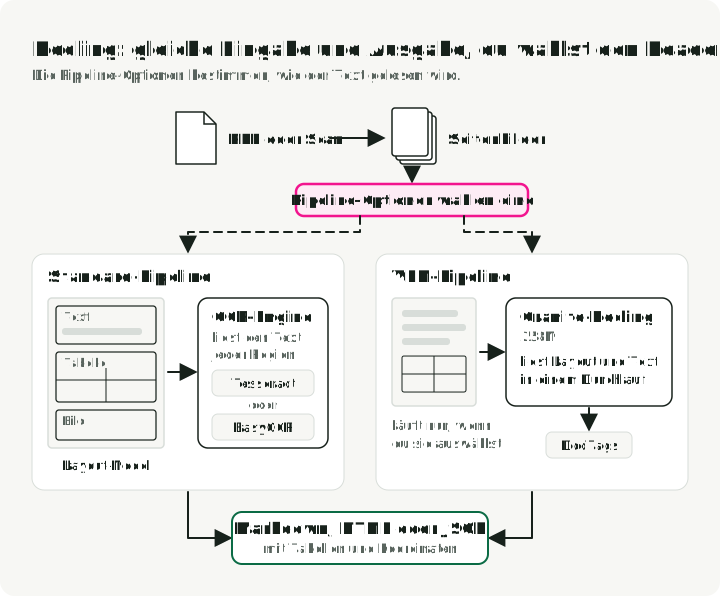
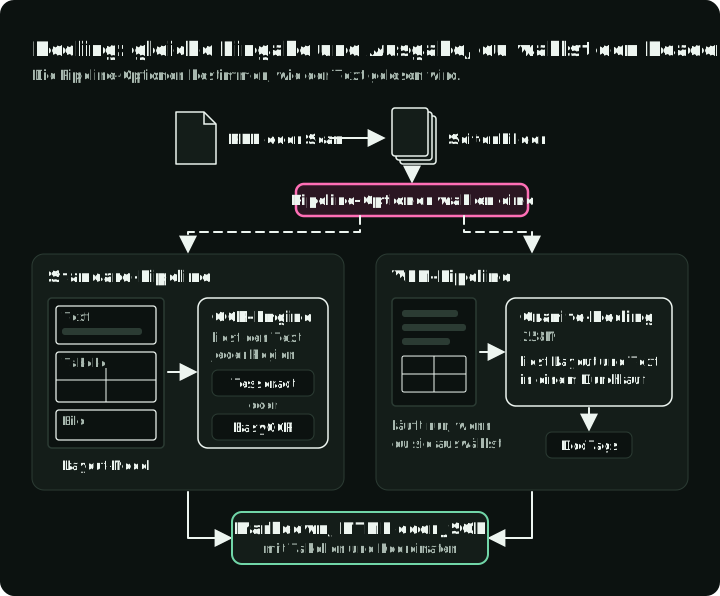
Geschwindigkeit und Qualität der Konvertierung in Docling hängen daher von der gewählten Pipeline ab. Die VLM-Pipeline von Docling muss explizit gewählt werden; ein Standard-Converter belegt nicht, dass Granite-Docling lief. Die Retry-Policy gehört weiterhin in die umgebende Anwendung oder den Dienst, und das Routing braucht weiterhin eigene Qualitäts-Labels und Schwellenwerte.
Einen Extraktionspfad wählen
Die Entscheidungskarte bringt die vorherigen Abschnitte in eine Reihenfolge: Jede Frage schickt ein Dokument auf den günstigsten Pfad, der liefern kann, was du brauchst.
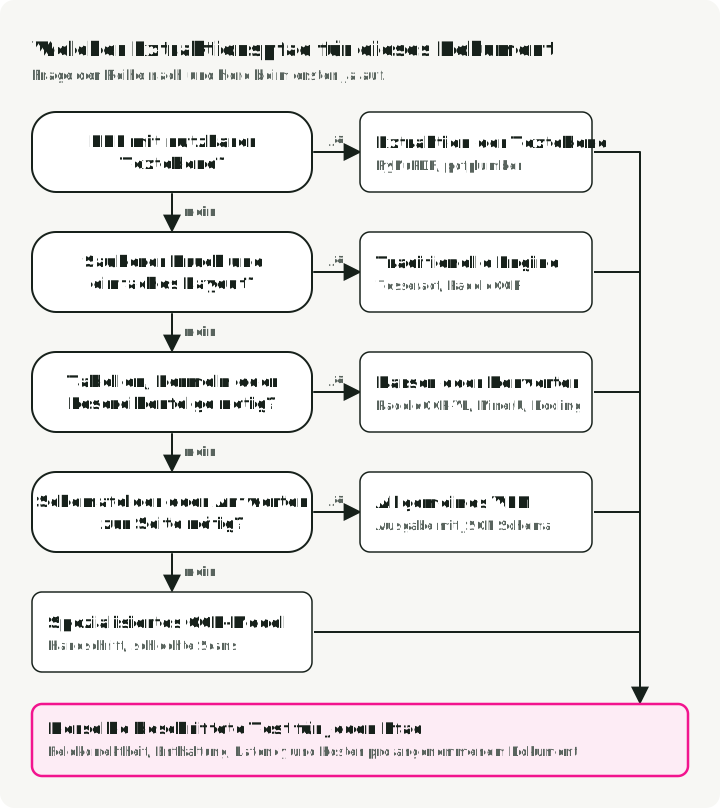
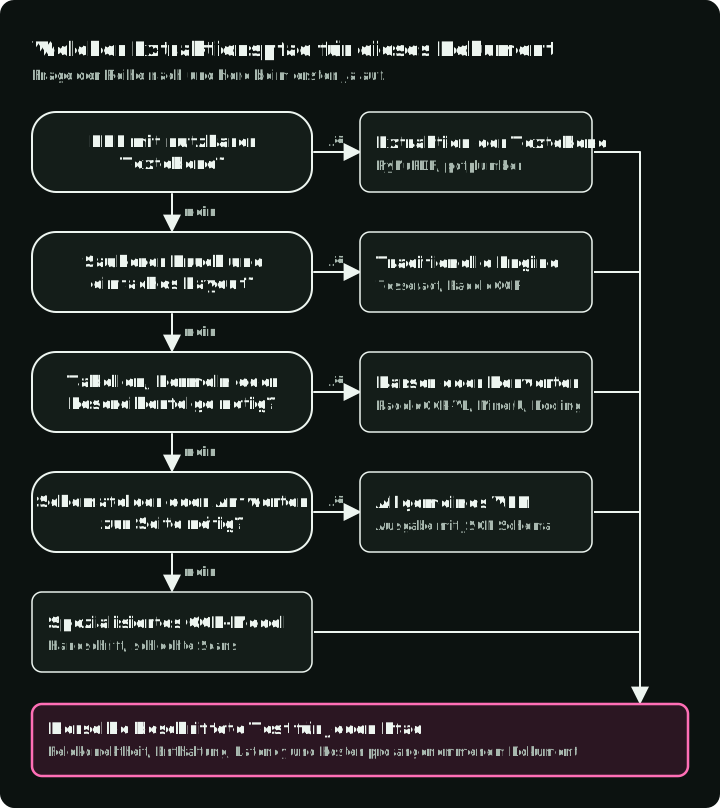
Jedes Ende führt weiterhin durch denselben gelabelten Test. Die Karte liefert dir einen ersten Kandidaten, keine endgültige Wahl.
VLMs mit OpenRouter testen
OpenRouter bietet ein OpenAI-kompatibles Gateway zu Models mehrerer Anbieter. Model-IDs und unterstützte Request-Features ändern sich; prüfe sie daher vor dem Beispiel im aktuellen Katalog des Gateways.
Das Snippet setzt pip install openai, einen OPENROUTER_API_KEY, Netzwerkzugriff, eine lokale receipt.jpg und Model-IDs voraus, die OpenRouter weiterhin unterstützt.
import base64
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=os.environ["OPENROUTER_API_KEY"],
)

def extract_text(
    image_path: str,
    model: str,
    prompt: str = "Extract all text from this image, preserving layout as markdown.",
    **request_args,
) -> str:
    with open(image_path, "rb") as f:
        image_b64 = base64.b64encode(f.read()).decode()

    response = client.chat.completions.create(
        model=model,
        messages=[{
            "role": "user",
            "content": [
                {"type": "text", "text": prompt},
                {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{image_b64}"}},
            ],
        }],
        max_tokens=4096,
        **request_args,
    )
    choice = response.choices[0]
    if choice.finish_reason != "stop":
        raise RuntimeError(f"{model} did not finish: {choice.finish_reason}")
    if not choice.message.content:
        raise RuntimeError(f"{model} returned no text (finish_reason={choice.finish_reason})")
    return choice.message.content

# Compare models by changing one string
models = [
    "google/gemini-3.8-flash",
    "anthropic/claude-sonnet-5",
    "qwen/qwen3.8-27b",
]
for model in models:
    print(f"\n--- {model} ---\n{extract_text('receipt.jpg', model)[:200]}...")
Der OpenRouter-Model-Katalog führte google/gemini-3.8-flash, anthropic/claude-sonnet-5 und qwen/qwen3.8-27b am 2026-10-02 mit Bildeingabe und Parametern für Structured Outputs. Dass der Katalog etwas unterstützt, belegt nicht, dass genau dieser Request an jedem gerouteten Endpoint gelingt.
Nutze für strukturierte Extraktion response_format mit einem JSON Schema, wenn das gewählte Model und das Gateway es unterstützen. Dadurch lässt sich die Antwort parsen; extrahierte Werte werden damit aber nicht gegen das Bild validiert. Bei OpenRouter lässt provider.require_parameters den Request fehlschlagen, wenn kein gerouteter Endpoint alle angeforderten Parameter unterstützt, statt auf einen Endpoint auszuweichen, der das Schema nicht einhalten kann.
Das Snippet nutzt extract_text aus dem vorherigen Block wieder und reicht das Schema über dessen zusätzliche Request-Argumente weiter. Es braucht ein Model, das JSON Schema unterstützt.
import json

nullable = {"type": ["string", "null"]}
receipt_schema = {
    "type": "object",
    "properties": {
        "vendor": nullable,
        "date": nullable,
        "items": {
            "type": ["array", "null"],
            "items": {
                "type": "object",
                "properties": {"description": nullable, "amount": nullable},
                "required": ["description", "amount"],
                "additionalProperties": False,
            },
        },
        "total": nullable,
    },
    "required": ["vendor", "date", "items", "total"],
    "additionalProperties": False,
}
prompt = (
    "Extract only visible receipt fields. Copy amounts as source strings. "
    "Use null for absent or unreadable values; do not infer them. "
    "Use null for an unreadable item list, and [] only when no items are present."
)

receipt = json.loads(extract_text(
    "receipt.jpg",
    "google/gemini-3.8-flash",
    prompt=prompt,
    response_format={
        "type": "json_schema",
        "json_schema": {"name": "receipt", "strict": True, "schema": receipt_schema},
    },
    extra_body={"provider": {"require_parameters": True}},
))
Der strikte Modus im OpenAI-Stil verlangt jede Property in required und additionalProperties: false; ein Wert, der fehlen kann, wird deshalb als nullable typisiert, statt ihn wegzulassen. Prompt und nullable Typen zusammen lassen das Model null zurückgeben, statt einen Wert zu erfinden.
Behalte die kopierten Betragsstrings neben den normalisierten Werten. Parse Geldbeträge nachgelagert mit Decimal- oder Integer-Arithmetik in der kleinsten Währungseinheit, unter expliziter Währung und Locale; ein gültiges Schema validiert keine Zahlungssumme. Leite kritische Felder mit null zur Prüfung weiter.
OCR in Production deployen
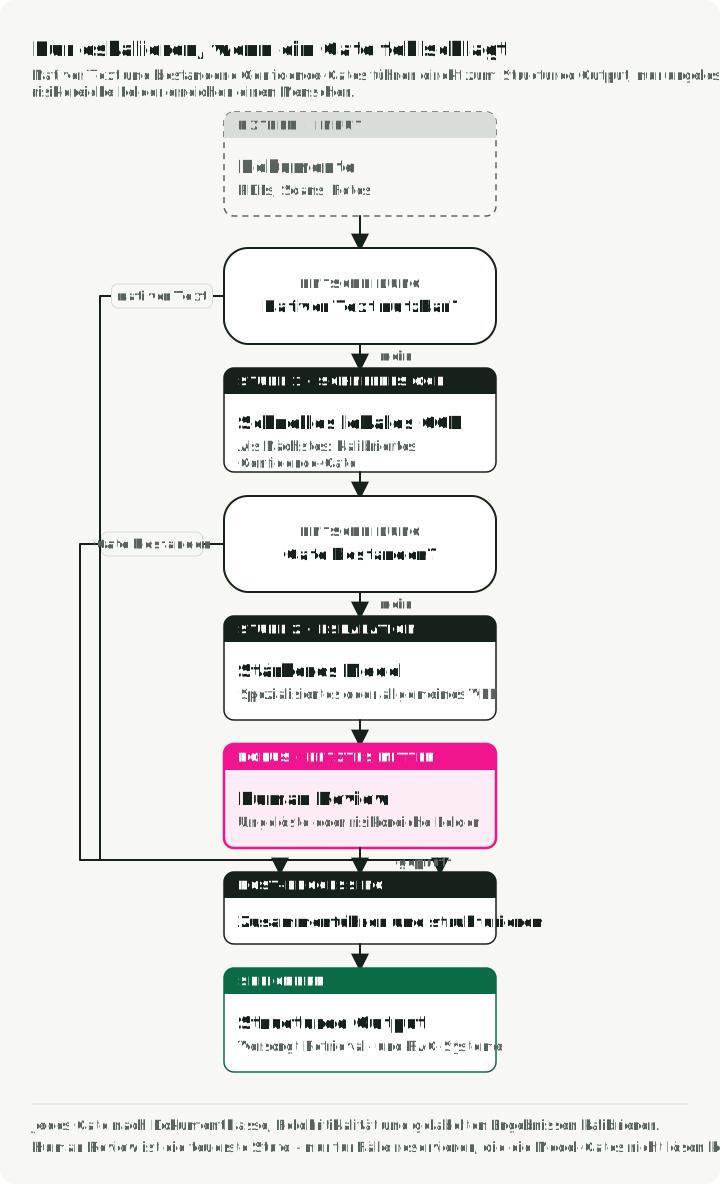
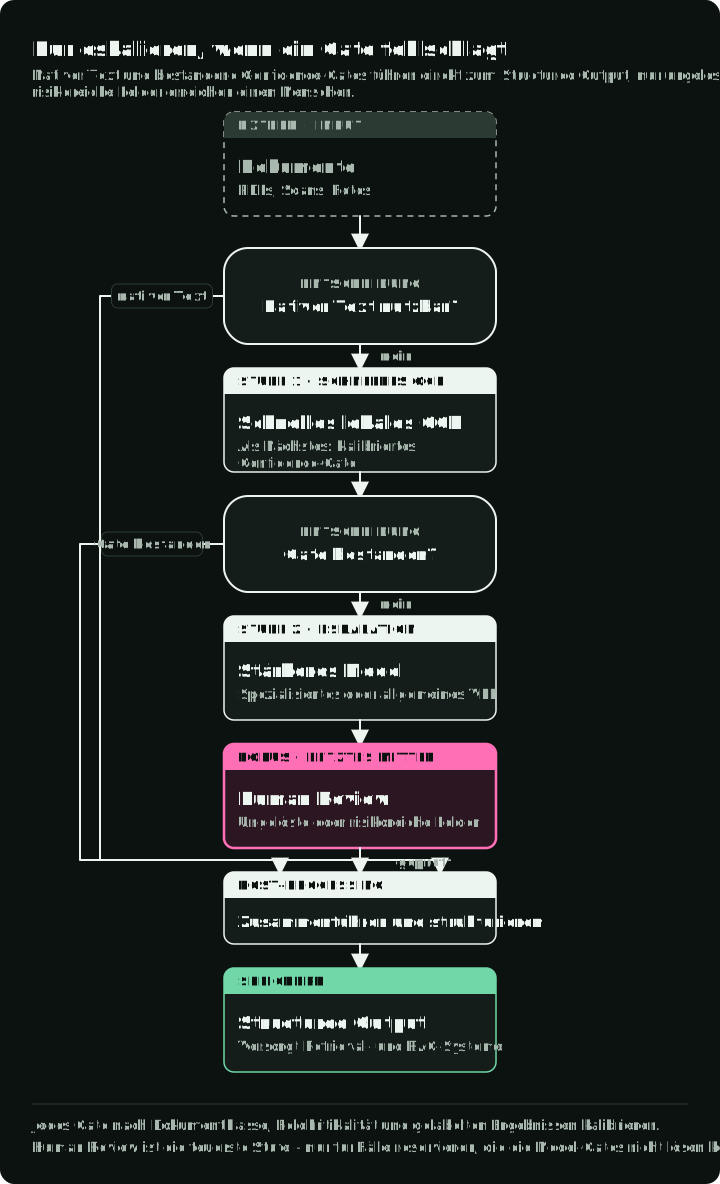
Eine Tiered Architecture kann die CPU-Vorverarbeitung von der GPU- oder API-Inference trennen und teure Pfade den Dokumenten vorbehalten, die sie brauchen. Die Abbildung zeigt die Tiers nach Kosten geordnet, die Prüfung, die eine Seite auf jedem Tier annimmt, und den Fehlschlag, der sie zum nächsten schickt.
Das Tiered-Fallback-Pattern
Beginne mit dem günstigsten Pfad, der das Qualitätsziel erreicht, und kalibriere dann das Routing auf gelabelten Seiten:
- Auf eingebetteten Text prüfen (Tier 0). Untersuche bei PDFs die Textebene mit
PyMuPDFoderpdfplumber, bevor du rasterst, und validiere, dass die Ebene vollständig ist.
- Mit einem schnellen Model versuchen. Nutze eine traditionelle Engine für Dokumentklassen, bei denen sie das Ziel erreicht.
- Kalibrierte Confidence auswerten. Kombiniere die Confidence des Models mit Dokumentklasse, Feldkritikalität und Validierungsregeln.
- Auf ein stärkeres Model eskalieren. Leite unsichere Seiten an ein spezialisiertes oder allgemeines VLM weiter.
- Hochriskante Fehler an einen Menschen eskalieren. Die menschliche Prüfung ist ein eigener Tier für Werte, bei denen die Fehlerkosten den Nutzen der Automatisierung übersteigen.
Hinweis zur Confidence: Rohe Zeichenwahrscheinlichkeiten sind nicht automatisch auf die Feldkorrektheit kalibriert. Die flächengewichtete Funktion unten ist eine Baseline für die Aggregation auf Seitenebene, kein universeller Router. Kalibriere sie auf gelabelten Seiten und gib kritischen Feldern eigene Regeln, denn ein Seitendurchschnitt kann eine falsche ID oder Summe verbergen.
def area_weighted_confidence(page):
    """Compute area-weighted confidence from one PaddleOCR 3.x result."""
    total_area, weighted_sum = 0, 0
    for (x_min, y_min, x_max, y_max), score in zip(
        page["rec_boxes"], page["rec_scores"]
    ):
        width = int(x_max) - int(x_min)
        height = int(y_max) - int(y_min)
        area = width * height
        weighted_sum += score * area
        total_area += area
    return weighted_sum / total_area if total_area > 0 else 0

assert area_weighted_confidence({
    "rec_boxes": [[0, 0, 300, 300]], "rec_scores": [0.5]
}) == 0.5
Um den Schwellenwert festzulegen, labele eine Menge von Seiten einer Dokumentklasse und halte fest, ob alle kritischen Felder jeder Seite korrekt sind. Wähle den niedrigsten Confidence-Schwellenwert, bei dem die akzeptierten Seiten dein Fehlerziel für kritische Felder erreichen, und leite Seiten darunter an den nächsten Tier weiter. Die folgende Funktion macht das für eine Dokumentklasse.
def pick_threshold(scores, correct, max_error):
    """Lowest threshold whose accepted pages meet the error target, or None."""
    for threshold in sorted(set(scores)):
        accepted = [ok for s, ok in zip(scores, correct) if s >= threshold]
        if accepted and accepted.count(False) / len(accepted) <= max_error:
            return threshold
    return None  # no threshold meets the target: send every page to the next tier

scores = [0.95, 0.91, 0.88, 0.80, 0.72, 0.60]
correct = [True, True, True, False, True, False]  # all critical fields right?
assert pick_threshold(scores, correct, max_error=0.0) == 0.88
assert pick_threshold(scores, correct, max_error=0.25) == 0.72
Die Abbildung legt die sechs beschrifteten Seiten aus den Asserts auf die Konfidenzskala und markiert den Schwellenwert, den jedes Fehlerziel wählt.
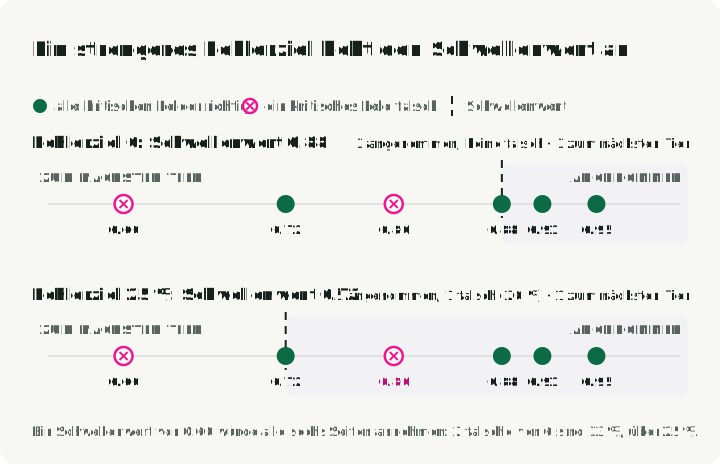
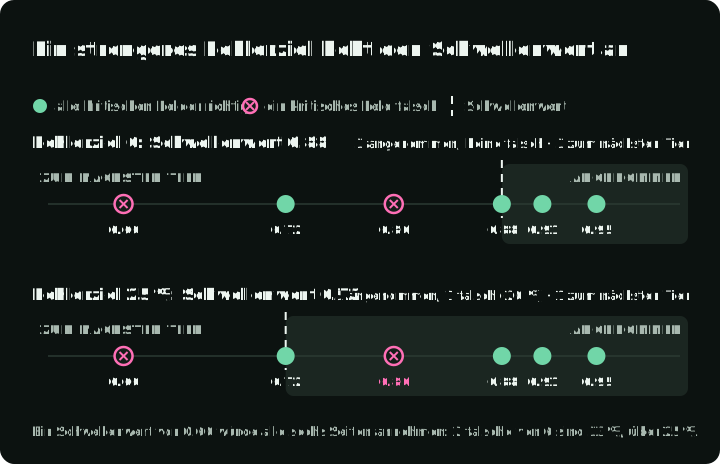
Ein strengeres Fehlerziel hebt den Schwellenwert an und schickt mehr Seiten an das stärkere Model. Wiederhole die Calibration für jede Dokumentklasse, denn derselbe Score kann bei Belegen und bei Verträgen unterschiedliche Genauigkeit bedeuten.
Serving-Patterns
Wie du jeden Tier betreibst, hängt davon ab, wie die Seiten eintreffen:
- Batch-Jobs (Archivkonvertierung, Monatsberichte): Seiten aus einer Queue lesen und auf GPU-Workern verarbeiten, die zwischen den Jobs auf null skalieren.
- Interaktive Requests: eine GPU warm halten oder eine gehostete API nutzen, denn ein Cold Start des Models addiert seine Ladezeit zur Wartezeit des Nutzers.
- Rasterung und Bildbereinigung: auf CPU-Workern ausführen, die getrennt von der GPU-Inference skalieren.
- Open-Weight-VLMs: mit vLLM oder SGLang betreiben, die gleichzeitige Requests auf einer GPU bündeln.
Die Ergebnisse messen
Bewahre für jedes geplante Engine-Dokument-Paar ein Ergebnis mit dem Status Erfolg, Fehler oder übersprungen auf. Fehlgeschlagene, leere und abgeschnittene Ausgaben bleiben samt ihren angefallenen Kosten im Nenner der versuchten Dokumente. Weise Completion Rate, kritische Feldfehler unter den automatischen Akzeptanzen, den Anteil der Prüfungen, die p50/p95-End-to-End-Latency und die Kosten pro erfolgreich verarbeitetem Dokument aus. Miss die Seiten-Latency mit der tatsächlichen Auflösung, Batch-Größe, Hardware, Provider-Region und Ausgabelänge. Rechne Vorverarbeitung und Retries in die Gesamtzeit ein; eine Zeitmessung nur des Models kann keine erfolgreiche Seite bepreisen. Verwende Converter-Objekte für Warm-Messungen wieder und erfasse die Initialisierung getrennt. Das OCR-Gauntlet-Repository zeichnet Ergebnisse in diesem Format auf; der letzte Abschnitt zeigt, wie du es ausführst.
Kostenanalyse im großen Maßstab
Es gibt keinen universellen Break-even bei der Seitenzahl zwischen API und Self-Hosting. Baue den Vergleich aus demselben Workload auf:
| Kostenkomponente | API-Pfad | Selbst gehosteter Pfad |
|---|---|---|
| Inference | Aktueller seiten- oder tokenbasierter Preis | GPU-Stunden bei gemessenen Seiten pro Stunde |
| Leerlaufkapazität | Meist vom Anbieter aufgefangen | Auslastung und Kapazitätsreserve |
| Engineering | Integration und Provider-Monitoring | Deployment, Upgrades, Observability und Bereitschaftsdienst |
| Datenhandhabung | Transfer, Aufbewahrung und Regionsbedingungen | Speicher, Netzwerk und Compliance-Kontrollen |
| Qualitätsfehler | Retries und menschliche Prüfung | Retries und menschliche Prüfung |
Nutze eine gemeinsame Formel: monthly pages × cost per successful page + review cost + fixed operating cost. Eine „erfolgreiche Seite“ muss auf beiden Pfaden dieselben Kriterien für Text, Tabellen und Felder erfüllen. Preise der Anbieter und GPU-Mieten ändern sich zu schnell, um sie als dauerhafte Beschaffungsschätzung einzubetten.
Fehlerbehandlung: das Hallucination-Problem
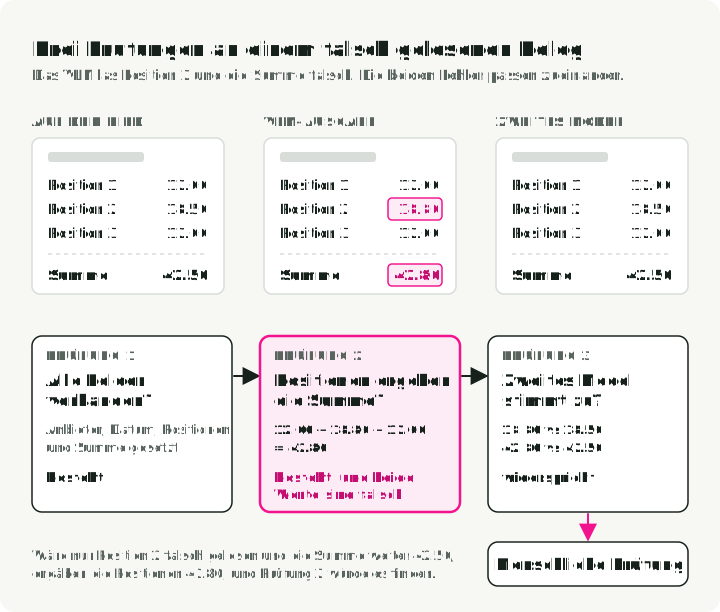
Fehler von VLMs können im Kontext plausibel und sachlich falsch sein. Eine Belegsumme von „$42.50“ kann als „$42.80“ zurückkommen: ein gültiger Betrag, den keine Rechtschreibprüfung markiert.
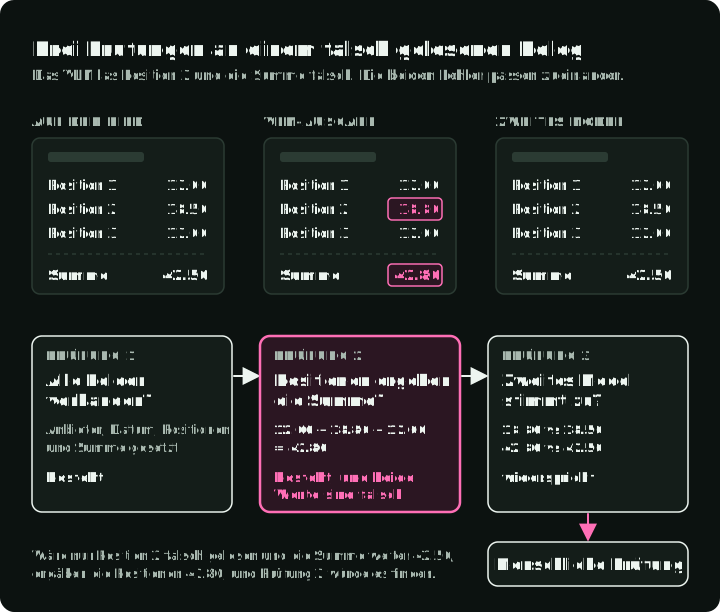
Synthetisches Fehlerbeispiel: Ein Belegbild zeigt drei Positionen, 12.00, 18.50 und 12.00, und eine Summe von 42.50. Ein VLM liest die zweite Position als 18.80 und die Summe als 42.80. Die Positionen ergeben weiterhin die Summe, die interne Arithmetik geht also auf, und beide Werte sind falsch. Deshalb braucht die Validierung bildbasierte Labels oder einen unabhängigen Prüfpfad, nicht nur Konsistenzprüfungen.
Die Abbildung lässt die drei Prüfungen auf diesem Beleg laufen: Die Schema-Prüfung und die Summenprüfung bestehen, und nur das zweite Model findet die beiden Fehllesungen.
Einige praktische Gegenmaßnahmen:
- Arithmetischer Abgleich. Wenn das Schema sie bereitstellt, prüfe
subtotal + tax + fees + shipping - discountsgegen die angegebene Summe, innerhalb der Rundungstoleranz der Währung. Leite fehlende Komponenten oder Abweichungen zur Prüfung weiter. - Prüfungen von Datum, Telefonnummer und Währung. Parse Daten mit einem Date-Parser und weise unmögliche Werte zurück. Prüfe die Ziffernzahl von Telefonnummern und Währungsformate mit Mustern.
- Zweiter Extraktionspfad. Lass kritische Felder durch ein anderes Model oder eine andere OCR-Engine laufen und markiere Abweichungen. Übereinstimmung erhöht die Confidence nur, wenn die beiden Pfade hinreichend unterschiedliche Fehlermodi haben; sie ist kein Beweis für Korrektheit.
Der Abgleich nimmt die kopierten Betragsstrings und nutzt Decimal, damit keine Float-Rundung in den Vergleich eingeht. Die Asserts spielen das Belegbeispiel von oben nach.
from decimal import Decimal

def reconcile(subtotal, tax, fees, shipping, discounts, total, tolerance="0.01"):
    """True when the stated total matches its components within tolerance."""
    parts = [subtotal, tax, fees, shipping, discounts, total]
    if any(p is None for p in parts):
        return False  # a missing component goes to review
    s, t, f, sh, d, tot = (Decimal(p) for p in parts)
    return abs(s + t + f + sh - d - tot) <= Decimal(tolerance)

items = ["12.00", "18.80", "12.00"]  # the image shows 18.50
subtotal = str(sum(Decimal(i) for i in items))
assert reconcile(subtotal, "0", "0", "0", "0", "42.80")  # passes, and both values are wrong
assert not reconcile(subtotal, "0", "0", "0", "0", "42.50")  # one misread value is caught
assert not reconcile(subtotal, None, "0", "0", "0", "42.80")  # missing tax goes to review
Der Abgleich fängt einen einzelnen falsch gelesenen Betrag. Zwei falsch gelesene Werte, die zueinander passen, kann er nicht fangen, daher brauchen kritische Felder weiterhin den zweiten Extraktionspfad.
Den Vergleich auf eigenen Seiten ausführen
Das OCR-Gauntlet-Repository führt mehrere OCR-Engines auf denselben Seiten aus und schreibt pro Engine und Seite eine Ergebniszeile, auch bei Fehlern. Es vergleicht Bildseiten; die Tier-0-Prüfung der Textebene deckt es nicht ab.
Der Runner arbeitet in vier Schritten:
- Das Manifest listet die Seiten und die Hashes ihres Referenztexts auf.
- Der Runner schickt jede Seite an jede Engine.
- Er schreibt pro Engine und Seite eine JSONL-Zeile, markiert als success, error oder skipped, mit Rohausgabe, Zeitmessung und Kosten.
- Die Zusammenfassung nennt Completion Rate, CER auf geprüften Seiten und Kosten pro erfolgreicher Seite. Fehlgeschlagene und übersprungene Paare bleiben im Nenner der Completion Rate.
Der erste Lauf nutzt generierte Seiten und Tesseract. Er braucht daher Python 3.12, uv und eine Tesseract-Installation im System, aber keine API-Keys:
uv sync --locked --extra tesseract --extra notebooks
uv run python scripts/make_fixture.py data/demo
uv run ocr-gauntlet data/demo/manifest.json --engines tesseract --output results/demo.jsonl
Die generierten Seiten prüfen nur, ob die Pipeline läuft; sie messen keine OCR-Qualität. Importiere für einen echten Belegtest CORD-Samples mit uv run python scripts/download_samples.py --dataset cord --count 2 --output data/cord und bereite eine geprüfte Referenz vor, wie es das README des Repositorys beschreibt. Weitere Engines fügst du mit --engines hinzu; gehostete Engines brauchen zusätzlich --allow-remote, weil sie deine Seiten hochladen.
Lies in der Zusammenfassung zuerst die Completion Rate: Eine Engine, die auf einem Drittel der Seiten scheitert, ist kein Kandidat, egal wie ihre CER aussieht. Vergleiche danach die CER auf den geprüften Seiten und dann die Kosten pro erfolgreicher Seite, die den Aufwand für fehlgeschlagene Versuche einschließen.
Die wichtigsten Erkenntnisse
- Ordne den Model-Tier einer gelabelten Dokumentklasse zu. Traditionelle Engines können für sauberen Text genügen; spezialisierte und allgemeine VLMs sollten ihre zusätzlichen Kosten auf schwierigeren Seiten rechtfertigen.
- Führe ungleiche Leaderboards nicht zusammen. Die Metriken von OmniDocBench und die Präferenzen der OCR Arena beantworten unterschiedliche Fragen.
- Kalibriere das Routing. Confidence-Schwellenwerte, Dokumentklassen, Feldkritikalität und die Policy für menschliche Prüfung gehören in eine Evaluation.
- Validiere plausible Ausgaben. Schemakonformität und interne Arithmetik können nicht belegen, dass ein Wert im Bild steht.
- Bepreise erfolgreiche Seiten. Rechne Retries, Prüfung, fixe Betriebskosten und Qualitätsprüfungen ein, wenn du APIs mit Self-Hosting vergleichst.
Referenzen
- OCR Arena Leaderboard - Crowdsourced, direkte Model-Duelle
- Das OCR-Gauntlet-Repo - Ausführbarer Vergleich von OCR-Engines auf denselben Seiten, mit Docling-Backends und Kosten pro erfolgreicher Seite
- OmniDocBench - End-to-End-Eval für Dokument-Parsing
- dots.ocr - Etwa 3B Parameter insgesamt, davon ein 1.7B-Sprachmodell
- PaddleOCR - Traditionelles OCR-Toolkit und Models
- OpenRouter - Einheitliches Zugangs-Gateway für A/B-Tests von Models