OCR em 2026: pipelines clássicos, VLMs e Document AI

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Este guia destina-se a engenheiros que escolhem soluções de OCR e de extração de documentos para pesquisa, retrieval-augmented generation (RAG) ou agentes de AI. Explica como os motores tradicionais e os vision-language models diferem, como avaliar texto, tabelas e campos, e como encaminhar documentos difíceis para outro modelo ou para revisão humana.
Os vision-language models (VLMs) conseguem lidar com layout, escrita manual, tabelas e imagens degradadas que fazem falhar um pipeline simples de reconhecimento de texto. Os motores tradicionais continuam competitivos em texto impresso limpo, sobretudo quando a latência em CPU e o custo operacional contam. O retrato datado abaixo inclui o PaddleOCR-VL 1.6 e o dots.mocr, com compromissos diferentes de hardware, privacidade e formato de saída. Verifique cada projeto antes de fazer uma escolha atual.
Para a versão compacta sobre a escolha de modelos, consulte Best OCR Models in 2026: Classical OCR, PaddleOCR-VL, VLMs.
O OCR passou a definir a qualidade a jusante
O OCR sempre serviu arquivos, sistemas postais, ferramentas de acessibilidade e gestão documental. O RAG e os agentes de documentos tornaram os seus modos de falha visíveis para um grupo mais vasto de engenheiros: um modelo a jusante não consegue recuperar texto ou estrutura de tabelas que a extração descartou.
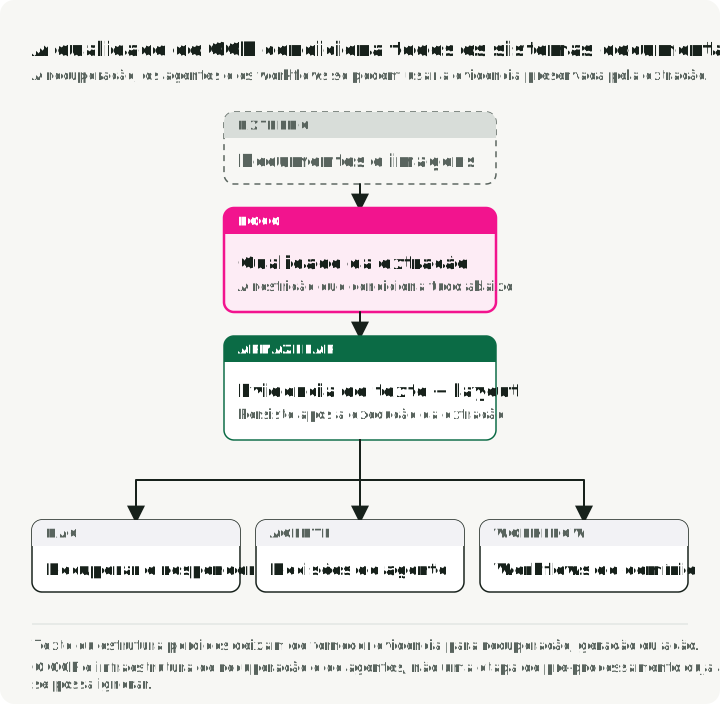
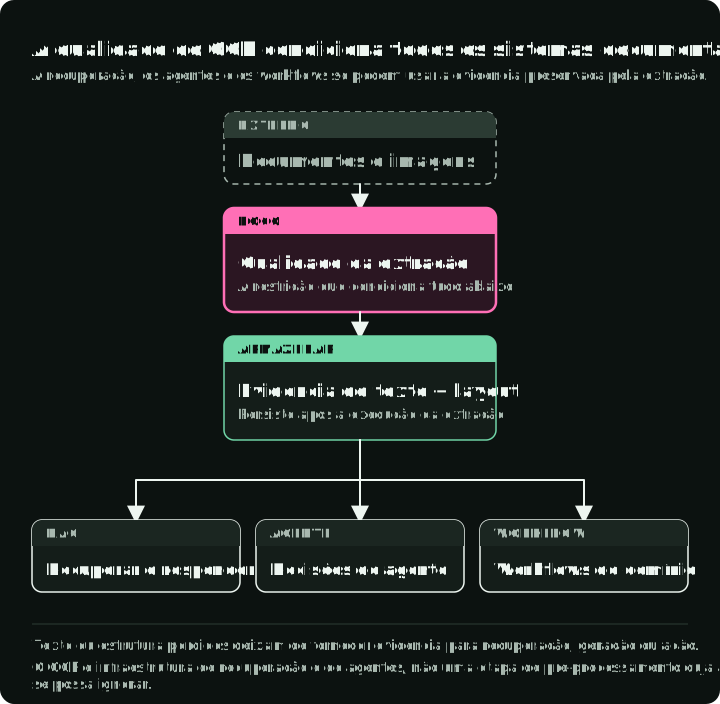
Um sistema de RAG não consegue recuperar texto que o OCR omitiu ou leu mal. Se a extração deturpa uma tabela, lê mal uma data ou omite um parágrafo, alterações posteriores ao chunking e aos embeddings não recuperam a informação em falta. Esses erros podem esconder uma cláusula de um contrato, alterar o total de uma fatura ou corromper um registo clínico.
O OCR faz, por isso, parte da infraestrutura de recuperação e de agentes, a par do parsing, do chunking, dos embeddings e da indexação. Os seus erros pedem uma avaliação própria, em vez de ficarem diluídos numa única pontuação de ponta a ponta.
O que significa OCR na era dos foundation models
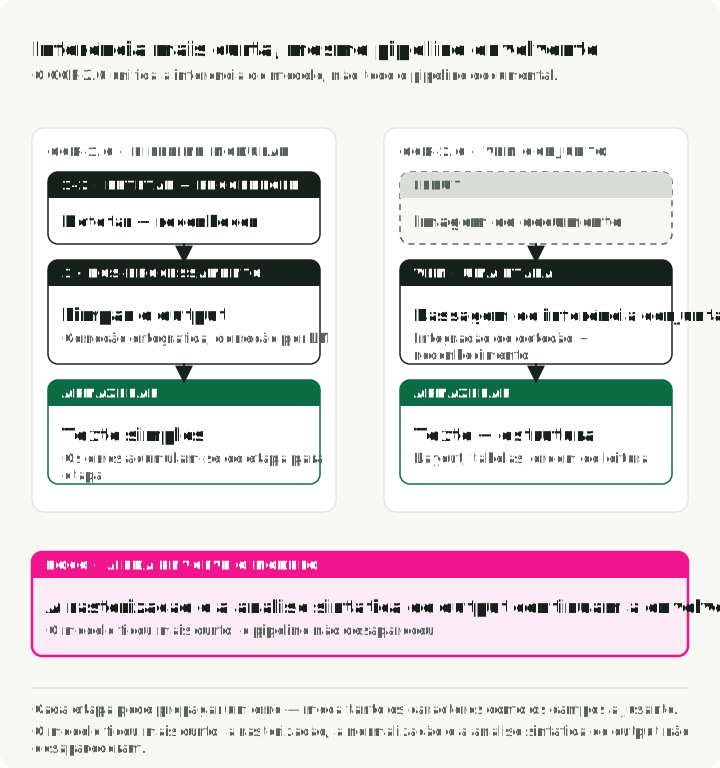
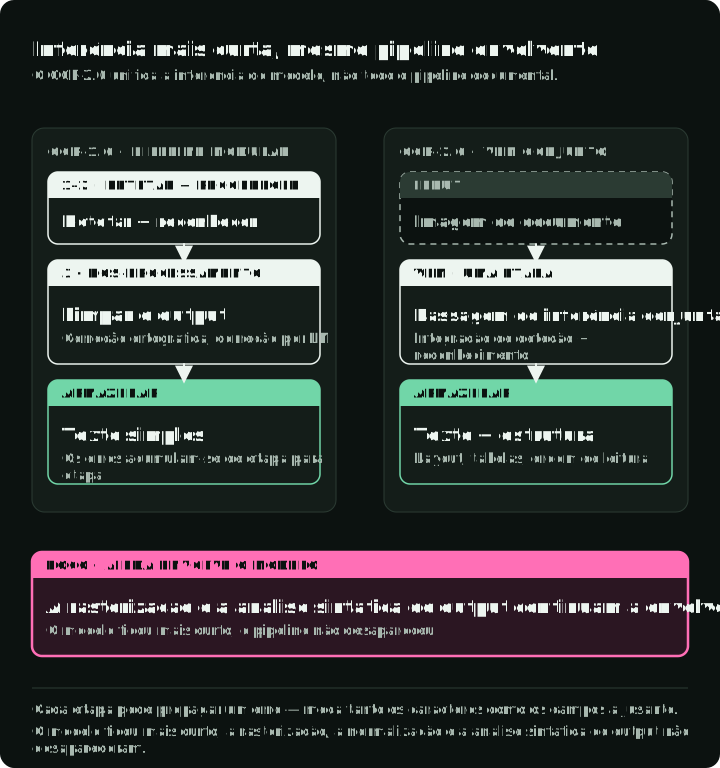
O OCR converte o texto de uma imagem em caracteres legíveis por máquina. O Document AI é o sistema mais amplo à volta dele: análise de layout, parsing de tabelas e fórmulas, extração de campos, raciocínio semântico, proveniência e validação. Os autores do GOT-OCR 2.0 chamam “OCR-1.0” aos pipelines modulares de deteção e reconhecimento e “OCR-2.0” aos modelos de ponta a ponta. Essa designação não deve apagar a distinção entre reconhecimento e compreensão de documentos.
A figura compara os dois caminhos e a forma como cada um falha: as três fases em série à esquerda nunca recuperam uma linha que a deteção falhou, a passagem única do modelo à direita escreve um total plausível que não está na página, e a rasterização e a análise sintática ficam fora do modelo em ambos os casos.
O pipeline de OCR tradicional tem três fases principais:
- Deteção de texto: localizar as regiões que contêm texto (por exemplo, CRAFT, DBNet).
- Reconhecimento de texto: converter as regiões detetadas em sequências de caracteres (por exemplo, CRNN).
- Pós-processamento: correção ortográfica e correção com um modelo de linguagem.
Isto funciona bem em documentos limpos, mas os erros de deteção, de reconhecimento e de pós-processamento podem acumular-se. Meça tanto a exatidão ao nível dos caracteres como a exatidão ao nível dos campos a jusante, para que uma página legível não esconda um total ou um identificador errado.
Alguns caminhos de VLM de ponta a ponta condensam mais deste pipeline num codificador de visão com um descodificador de linguagem. Modelos como o GOT-OCR 2.0 conseguem emitir texto e estrutura em conjunto, e os VLMs gerais também conseguem mapear campos para um esquema pedido. Por exemplo, um VLM geral consegue ler “MFG: 10/24” numa etiqueta como data de fabrico e não como data de validade. Os compromissos são a latência, o custo de GPU ou de API, que dependem da carga de trabalho, e o risco de texto plausível que não existe na imagem.
Uma ressalva prática: um modelo que só aceita imagens precisa de páginas rasterizadas, enquanto um serviço que aceita PDF pode tratar da conversão internamente. Corrigir a inclinação, redimensionar e limpar a imagem são experiências específicas de cada pipeline, não melhorias obrigatórias. O AWS Textract aconselha a preservar os formatos de entrada suportados em vez de os converter ou reduzir sem critério. O parsing e a validação da saída continuam a ser da aplicação.
Métricas: medir o que importa
Todas as comparações feitas mais à frente neste guia usam uma destas métricas. Escolha a que corresponde ao tipo de saída:
- CER e WER para texto simples. A taxa de erro de caracteres e a de palavras (Character e Word Error Rate) dependem de opções de normalização, como maiúsculas, espaços e pontuação, pelo que deve fixar o protocolo de comparação antes de comparar modelos.
- Field exact match e Field F1 para formulários e recibos. O exact match é binário para um campo; a sua taxa é a fração dos campos avaliados que passam. Reporte em separado a correção de todos os campos ao nível do documento. Para o Field F1, defina a correspondência chave/valor, a normalização, os campos duplicados e em falta, e a agregação; um montante correto atribuído à linha errada é um erro.
- TEDS para tabelas. A Tree-Edit-Distance-based Similarity compara as árvores HTML previstas e de referência, e deteta erros de estrutura e de conteúdo das células que o CER esconde.
- Comparação da ordem de leitura quando o consumidor precisa de uma sequência linear. Compare diretamente blocos ou intervalos ordenados, ou use uma métrica sensível à ordem; o OmniDocBench avalia a ordem de leitura em separado. Caracteres e células de tabela corretos não estabelecem a ordem de uma página com várias colunas.
- ANLS para VQA de documentos. A Average Normalized Levenshtein Similarity pontua as respostas face às referências aceites. A definição original do ST-VQA atribui
1 − normalized_distanceapenas quando a distância é estritamente inferior a 0,5, e zero nos restantes casos; toma a melhor pontuação entre as referências aceites e faz a média pelas perguntas. O DocVQA adota o ANLS. Fixe as normalizações de maiúsculas, espaços e distância do avaliador ao reproduzir uma pontuação.
O CER e o WER contam substituições, eliminações e inserções divididas pelos caracteres ou palavras de referência. Podem exceder um quando dominam as inserções. Indique se a agregação soma os erros e os comprimentos de referência do corpus ou faz a média das pontuações por documento. Guarde a página, o bloco, a bounding box, o texto original e o histórico de normalização, para que um campo errado possa ser rastreado até à imagem.
Na deteção de texto, a interseção sobre a união (IoU) divide a área de sobreposição de uma caixa prevista e uma de referência pela área total coberta por pelo menos uma delas. O limiar de IoU determina se uma caixa detetada corresponde à referência antes de calcular F1.
A tabela associa cada tarefa à sua métrica e ao erro que mais vezes torna uma pontuação enganadora:
| Tarefa | Métrica | Erro a evitar |
|---|---|---|
| Extração de texto simples | CER, WER | Comparar pontuações calculadas com normalizações diferentes |
| Escrita manual | CER | Usar objetivos de CER de texto impresso em páginas manuscritas |
| Deteção de texto | F1 com um limiar de IoU | Reportar o F1 sem o limiar de IoU que usou |
| Formulários e recibos | Field exact match, Field F1 | Contar como certo um valor correto no campo ou na linha errados |
| Tabelas | TEDS | Avaliar tabelas pelo CER, que ignora a estrutura das células |
| VQA de documentos | ANLS | Alterar o limiar de 0,5 ou a normalização das respostas |
| Conversão de página completa | Distância de edição + ordem de leitura | Reportar a exatidão do texto sem verificar a ordem dos blocos |
As línguas também mudam a escolha. O chinês e o japonês não têm espaços entre palavras, pelo que o WER depende de um segmentador de palavras; use o CER para estas escritas. Inclua páginas que misturem escritas no conjunto de teste anotado quando ocorrerem na sua carga de trabalho. Um model card que lista 100 línguas não mostra a qualidade em nenhuma delas, por isso inclua cada língua de destino no conjunto de teste anotado.
Quanto a implementações: o jiwer trata do CER/WER de origem, e há implementações de TEDS no repositório do OmniDocBench.
O que os benchmarks de OCR medem e o que não medem
Os datasets públicos aplicam estas métricas a tipos de documentos específicos. Os tamanhos dos datasets e as métricas descrevem a versão do dataset indicada; consulte o leaderboard atual de cada projeto para as pontuações dos modelos. A coluna “Testa” indica a que documentos seus cada dataset se assemelha.
| Dataset | Testa | Tamanho do teste | Línguas | Métrica principal |
|---|---|---|---|---|
| FUNSD | Ligação chave-valor em formulários digitalizados com ruído | 50 docs | Inglês | F1 |
| SROIE | Quatro campos de recibo (empresa, data, morada, total) | 400 imagens de teste | Inglês | F1 |
| CORD | Linhas de recibo com etiquetas hierárquicas | 100 recibos | Indonésio | F1 |
| IAM | Linhas manuscritas em inglês | Depende da divisão | Inglês | CER |
| OCRBench v2 | Leitura e raciocínio de texto por VLMs em 23 tarefas | 10 000 pares QA | EN + CN | Pontuação /100 |
| OmniDocBench v1.6 | Parsing de página completa: texto, tabelas, fórmulas, ordem de leitura | 1651 páginas | EN + CN | Compósita |
O número de linhas do IAM depende da divisão de escritores escolhida e do protocolo de reconhecimento; não se assume aqui nenhum número único de linhas de teste.
Retrato do OmniDocBench v1.6
A tabela abaixo é um retrato de uma versão concreta: OmniDocBench v1.6_full, README oficial no commit 09ba2b606662695b16aafe5f5e36b7ef020e11a8, consultado a 2026-08-09.
| Modelo | Tamanho | Overall ↑ | Text Edit ↓ | Table TEDS ↑ |
|---|---|---|---|---|
| GLM-OCR | 0,9B | 95,22 | 0,044 | 92,83 |
| PaddleOCR-VL-1.5 | 0,9B | 94,93 | 0,038 | 91,67 |
| Gemini 3 Flash | — | 92,62 | 0,066 | 89,29 |
| dots.ocr | 3B | 90,77 | 0,048 | 87,18 |
O README fixado lista o PaddleOCR-VL 1.5. O PaddleOCR reporta 96,3 para a versão 1.6 na mesma versão do benchmark; esse valor vem da execução do próprio fornecedor e não faz parte desta tabela.
A conclusão limita-se a esta versão do OmniDocBench: o tamanho do modelo, por si só, não prevê a pontuação de parsing de documentos. As versões posteriores do avaliador alteram a correspondência, por isso compare pontuações apenas com um único avaliador fixado. A pontuação compósita inclui a distância de edição do texto, o TEDS das tabelas e Character Detection Matching (CDM) das fórmulas. O CDM renderiza as fórmulas previstas e de referência, associa os seus caracteres e verifica as posições relativas antes de avaliar as correspondências com F1. Compara fórmulas renderizadas em vez de cadeias LaTeX em bruto. A ordem de leitura precisa do seu resultado separado.
A diferença entre “benchmark” e “arena”
As classificações de benchmarks automáticos podem contradizer a preferência humana.
Na OCR Arena, os utilizadores votam às cegas em saídas comparadas frente a frente. A 2026-08-09, a OCR Arena classificou o Gemini 3 Flash acima do GLM-OCR, enquanto a tabela do OmniDocBench acima atribui ao GLM-OCR uma pontuação superior (95,22 contra 92,62). A ordenação em direto da Arena muda à medida que chegam novos duelos, por isso não é um retrato histórico reprodutível de um benchmark. Não combine os dois leaderboards numa única pontuação.
A figura mostra a divergência: o GLM-OCR e o Gemini 3 Flash trocam de posição entre as duas classificações. Por baixo estão as páginas que cada um usa, quem julga e o que se obtém.
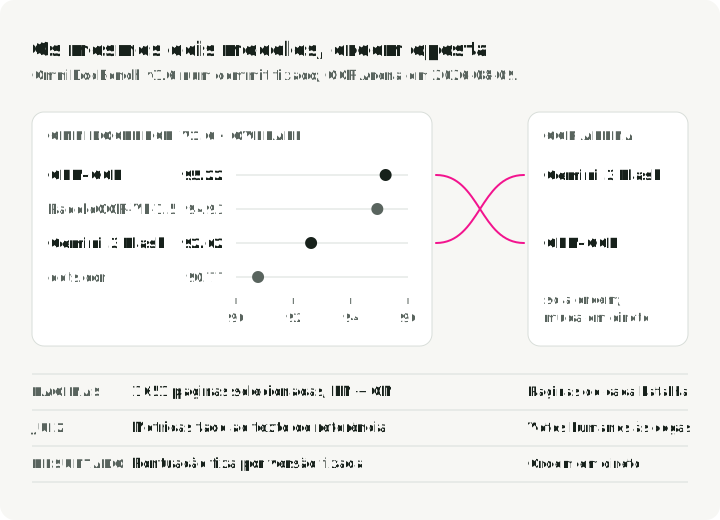
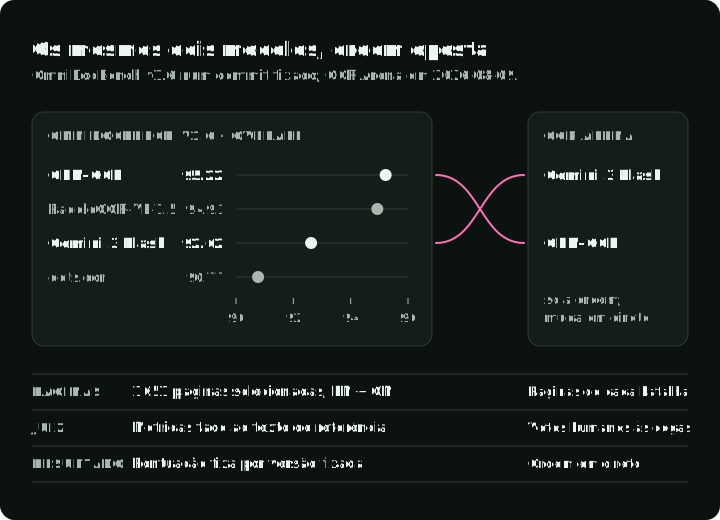
Entre as causas prováveis estão a mistura de documentos, o formato da saída, a cobertura de línguas e os critérios dos juízes. Os números publicados servem para uma primeira triagem, mas a escolha final precisa de um conjunto de teste reservado, retirado da carga de trabalho de destino.
Motores de OCR tradicionais: ainda relevantes
Os motores tradicionais são boas bases de comparação porque podem correr localmente em CPU. A sua latência e exatidão dependem do modelo escolhido, da resolução da página, da língua, do pré-processamento e do hardware, por isso faça o benchmark deles nas mesmas páginas anotadas usadas na avaliação dos VLMs.
| Motor | Implementação | Base útil para |
|---|---|---|
| Tesseract 5.5 | CPU local | Texto impresso limpo e escritas consolidadas |
| EasyOCR | PyTorch local em CPU ou GPU | Protótipos e texto em cenas |
| PaddleOCR 3.x | CPU e GPU locais, e variantes para telemóvel | OCR multilingue e toolchains de implementação |
Tesseract para texto impresso limpo
O Tesseract (v5.5.x, Apache 2.0) é um motor maduro, sobretudo de CPU, com mais de 100 pacotes de línguas. A exatidão em texto impresso limpo pode ser elevada com uma rasterização e um pré-processamento adequados, mas a escrita manual, o texto em cenas e os layouts complexos exigem testes à parte. A sua principal vantagem é uma implementação pequena e local em CPU.
Defina o modo de segmentação de página (--psm) por tipo de documento; um modo errado perde colunas ou funde linhas. O excerto requer pip install pytesseract pillow, o binário do Tesseract com os dados da língua inglesa e um receipt.jpg local.
import pytesseract
from PIL import Image

# --psm 6: treat the image as one uniform block of text, which suits a receipt
text = pytesseract.image_to_string(Image.open("receipt.jpg"), lang="eng", config="--psm 6")
EasyOCR
O EasyOCR combina um detetor CRAFT com um reconhecedor CRNN. Com aceleração total por GPU em PyTorch, é uma opção rápida para prototipagem e para texto em cenas. Devolve apenas linhas e caixas, sem layout nem estrutura de tabelas.
O excerto requer pip install easyocr, o PyTorch, os pesos de modelo descarregados pelo EasyOCR e um receipt.jpg local.
import easyocr

# Three lines for complete OCR
reader = easyocr.Reader(["en"])
result = reader.readtext("receipt.jpg")
# Returns: [(bbox, text, confidence), ...]
PaddleOCR 3
O PaddleOCR 3 reúne pipelines mantidos de OCR, de parsing de documentos e de implementação. O quick start atual usa a API predict() e definições explícitas de orientação. Fixe a versão do pacote paddleocr e o pipeline escolhido, porque os exemplos da 2.x que usam .ocr(..., cls=True) não correspondem à API da 3.x.
Requer o runtime PaddlePaddle, que acrescenta uma segunda framework a uma stack de PyTorch. O reconhecimento de texto do PaddleOCR é um pipeline diferente do PaddleOCR-VL, o parser de documentos da secção seguinte.
O excerto requer pip install "paddleocr>=3,<4", um runtime PaddlePaddle compatível, os pesos de modelo descarregados e um receipt.jpg local.
from paddleocr import PaddleOCR

ocr = PaddleOCR(
    use_doc_orientation_classify=False,
    use_doc_unwarping=False,
    use_textline_orientation=False,
)

for result in ocr.predict("receipt.jpg"):
    result.print()
    result.save_to_json("output")
Cada resultado contém rec_texts, rec_scores e rec_boxes. A secção sobre encaminhamento usa os dois últimos para pontuar uma página.
Opções de VLMs especializados e gerais
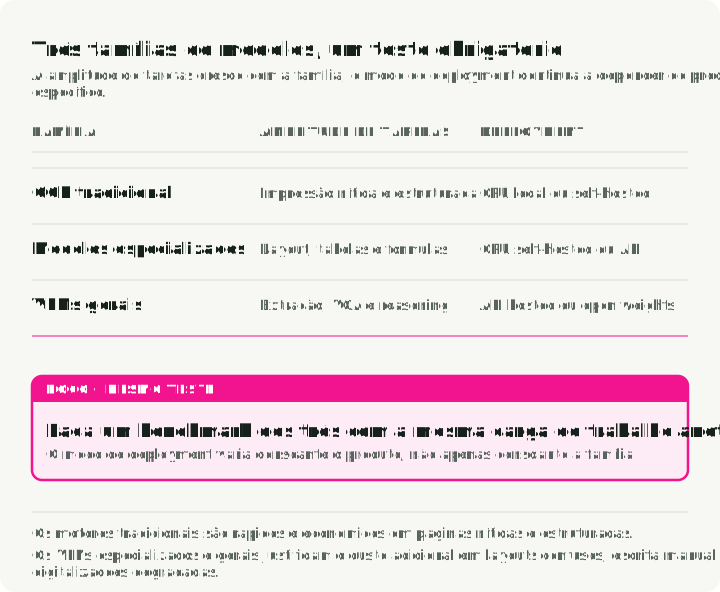
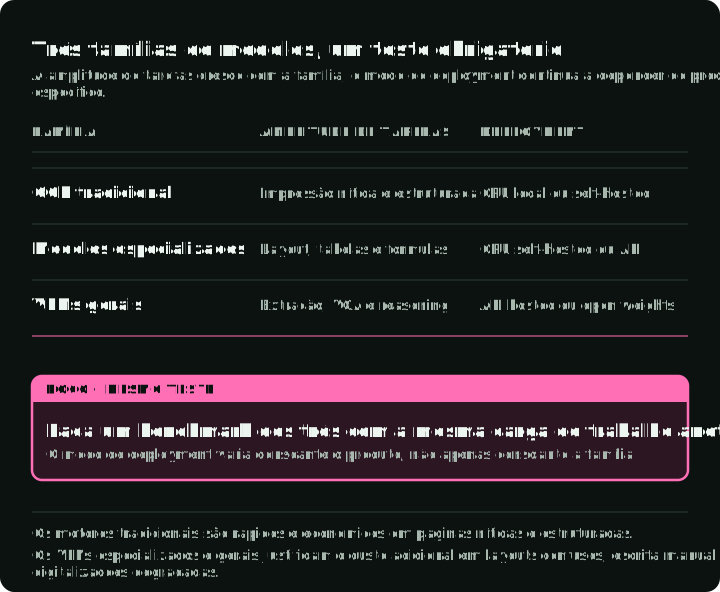
Recibos tortos, etiquetas de produtos inclinadas, escrita manual e layouts densos são os casos em que vale a pena testar VLMs especializados ou gerais contra os motores tradicionais.
A figura mostra o que cada família de modelos devolve para a mesma página, o seu principal compromisso e onde pode ser executada. O modo de implementação depende do produto, por isso a figura indica-o em separado da abrangência de tarefas.
Modelos de documentos especializados
Os modelos desta secção foram verificados a 2026-10-02. A lista não é uma classificação atual; indica em que problema de documentos vale a pena experimentar cada modelo.
| Modelo | Saída | Onde corre | Experimente quando |
|---|---|---|---|
| PaddleOCR-VL 1.6 | Análise de layout, depois um VLM de 0,9B lê cada região | Auto-alojado | Páginas multilingues com layout; o fornecedor reporta 109 línguas |
| GOT-OCR 2.0 | Texto simples, Markdown, LaTeX | Auto-alojado, 580M de parâmetros | Fórmulas e texto misto na mesma página |
| dots.mocr | Layout e texto; gráficos e figuras como código SVG | Auto-alojado, 3B de parâmetros | Páginas com gráficos ou diagramas de que precisa como estrutura |
| DeepSeek-OCR2 | Markdown com caixas de ancoragem | Auto-alojado, vLLM ou Transformers | Documentos longos em grande volume; uma página usa entre 256 e 1120 tokens de visão |
| Mistral OCR 4.1 | Markdown, caixas de parágrafos, etiquetas de blocos, confiança por bloco | API alojada (mistral-ocr-4-1) | Quer uma API e uma pontuação de confiança por bloco |
| Granite-Docling 258M | DocTags, convertidos num DoclingDocument | Auto-alojado, dentro do Docling | Um modelo local pequeno para conversões com o Docling |
| olmOCR | Texto simples ou Markdown pela ordem de leitura | Auto-alojado, VLM de 7B numa GPU | Linearizar PDFs em texto para RAG ou para dados de treino |
Trate os valores de débito e de memória como específicos do hardware e do dataset; meça o pico de memória com o seu runtime, a sua precisão, o tamanho da imagem e o limite de saída. Calibre a confiança por bloco da Mistral face à correção dos campos antes de aceitar valores automaticamente. Fixe uma versão explícita do modelo nas comparações, porque um alias latest pode mudar.
VLMs de fronteira
Os VLMs gerais são outra opção quando a tarefa combina extração com raciocínio visual ou semântico. Estes candidatos foram verificados a 2026-10-02 e são usados no exemplo de gateway abaixo. São uma lista inicial, não uma classificação de OCR:
- Gemini 3.8 Flash (Google): um modelo multimodal com disponibilidade geral, com entrada de imagem e structured outputs. Use o seu ID estável ao iniciar uma nova comparação.
- Claude Sonnet 5 (Anthropic): uma geração Sonnet lançada a 2026-06-30, para uma comparação com um modelo alojado. Teste a fidelidade da transcrição e a extração de campos nos seus próprios documentos; melhorias de raciocínio geral não estabelecem a exatidão de OCR.
- Qwen3.8-27B (Alibaba): um vision-language model de pesos abertos, sob Apache 2.0, que pode ser testado através de um gateway ou auto-alojado. Os seus 27B fazem dele uma escolha de implementação diferente do anterior Qwen3-VL 8B, que continua a ser uma base mais pequena útil quando a memória é limitada.
Acrescente uma nova versão ao conjunto de teste. Só a use em produção depois de passar a mesma comparação: correção dos campos, abstenção, latência e custo por documento aceite, sob o mesmo protocolo.
Frameworks de conversão de documentos
Um pipeline de RAG costuma precisar de um documento inteiro convertido para Markdown ou JSON, não de linhas de OCR em bruto. Os conversores de documentos fazem isso. Analisam o ficheiro, executam um modelo de layout e chamam um motor de OCR para o texto dentro de cada região. Alguns podem, em alternativa, enviar cada página a um VLM que lê o layout e o texto em conjunto.
| Framework | O que produz | Use quando |
|---|---|---|
| Docling | Markdown, HTML ou JSON sem perdas com tabelas e coordenadas, a partir de PDF, DOCX, PPTX, XLSX, HTML e imagens | Precisa de um só conversor para formatos mistos e quer escolher o motor de OCR dentro dele |
| Marker | Markdown, JSON, HTML ou chunks, a partir de PDF, imagens e ficheiros Office | Quer Markdown de alta qualidade a partir de PDFs |
| MinerU | Markdown e JSON estruturado, a partir de PDF, imagens e ficheiros Office | Artigos científicos e técnicos com fórmulas e tabelas |
Verifique as licenças antes de distribuir um destes numa aplicação. O Docling é MIT. O código do Marker é Apache 2.0, mas os seus pesos de modelo usam uma licença OpenRAIL-M modificada, com limites à utilização comercial. A licença do MinerU acrescenta condições à Apache 2.0: uma licença comercial separada acima de determinados limiares de utilizadores e de receita, e atribuição para serviços online.
A figura mostra o que um conversor envolve. O Docling mantém a entrada e a saída iguais, e as opções do seu pipeline escolhem como o texto é lido: o seu modelo de layout com o Tesseract ou o EasyOCR, ou o VLM Granite-Docling de ponta a ponta.
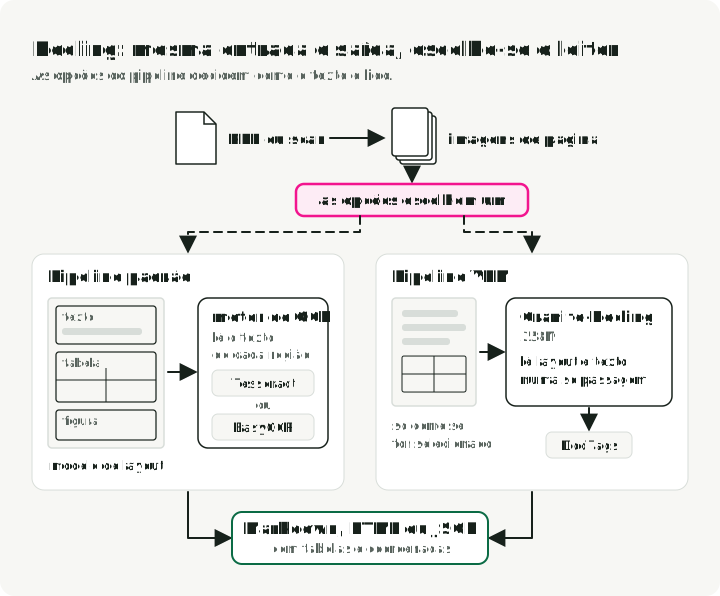
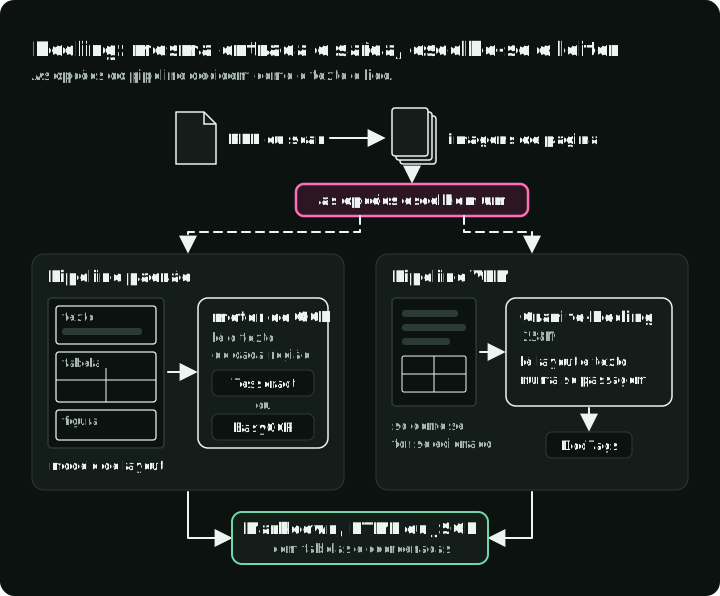
A velocidade e a qualidade de conversão do Docling dependem, por isso, do pipeline que escolher. O pipeline de VLM do Docling tem de ser selecionado explicitamente; um conversor por omissão não é prova de que o Granite-Docling correu. A política de repetição continua a pertencer à aplicação ou ao serviço envolvente, e o encaminhamento continua a precisar das suas próprias etiquetas de qualidade e limiares.
Escolher um caminho de extração
O mapa de decisão põe as secções anteriores por ordem: cada pergunta envia um documento para o caminho mais barato que consegue produzir o que precisa.
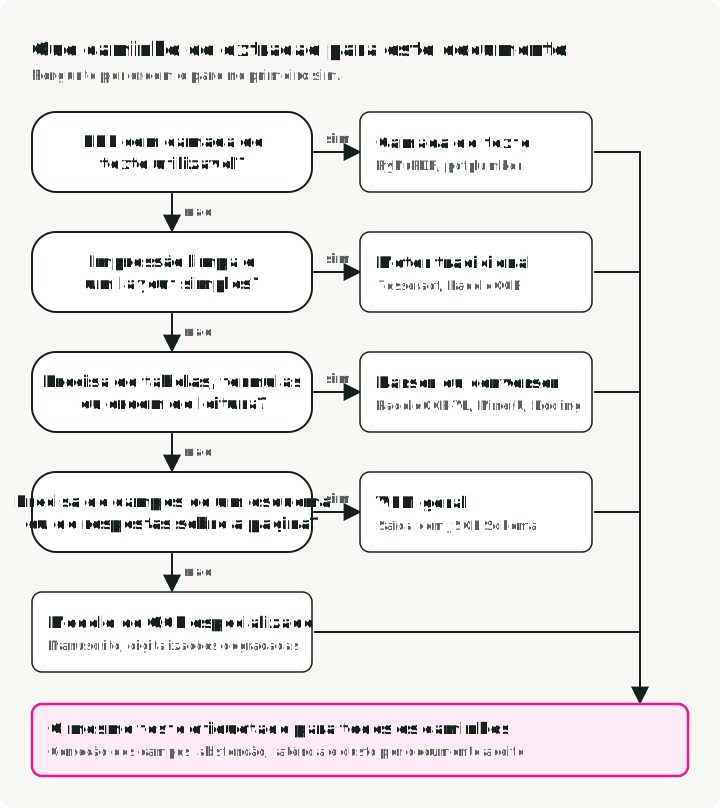
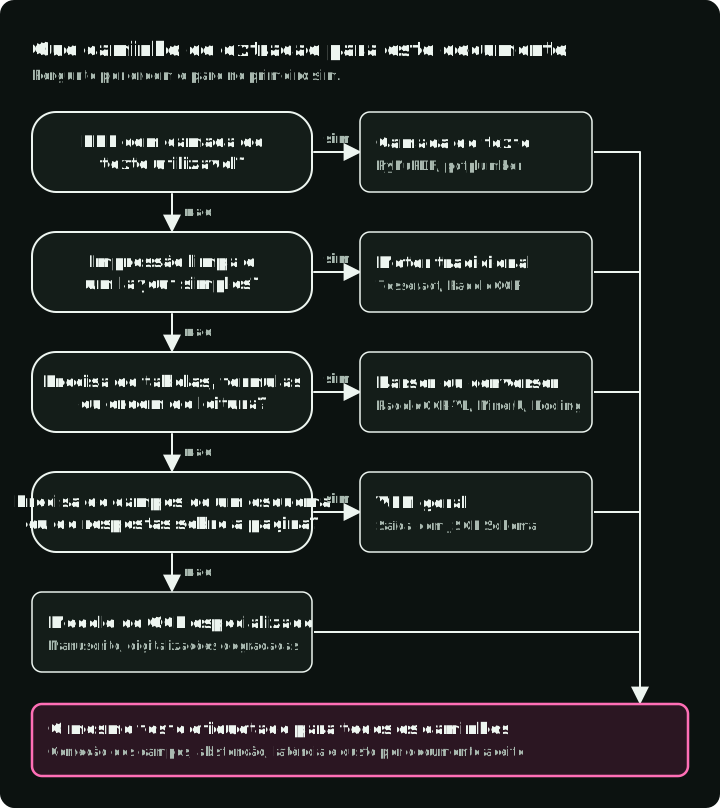
Cada folha continua a passar pelo mesmo teste anotado. O mapa dá-lhe um primeiro candidato, não uma escolha final.
Testar VLMs com o OpenRouter
O OpenRouter oferece um gateway compatível com a OpenAI para modelos de vários fornecedores. Os IDs dos modelos e as funcionalidades de pedido suportadas mudam, por isso verifique-os no catálogo atual do gateway antes de executar o exemplo.
O excerto requer pip install openai, uma OPENROUTER_API_KEY, acesso à rede, um receipt.jpg local e IDs de modelos que o OpenRouter ainda suporte.
import base64
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=os.environ["OPENROUTER_API_KEY"],
)

def extract_text(
    image_path: str,
    model: str,
    prompt: str = "Extract all text from this image, preserving layout as markdown.",
    **request_args,
) -> str:
    with open(image_path, "rb") as f:
        image_b64 = base64.b64encode(f.read()).decode()

    response = client.chat.completions.create(
        model=model,
        messages=[{
            "role": "user",
            "content": [
                {"type": "text", "text": prompt},
                {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{image_b64}"}},
            ],
        }],
        max_tokens=4096,
        **request_args,
    )
    choice = response.choices[0]
    if choice.finish_reason != "stop":
        raise RuntimeError(f"{model} did not finish: {choice.finish_reason}")
    if not choice.message.content:
        raise RuntimeError(f"{model} returned no text (finish_reason={choice.finish_reason})")
    return choice.message.content

# Compare models by changing one string
models = [
    "google/gemini-3.8-flash",
    "anthropic/claude-sonnet-5",
    "qwen/qwen3.8-27b",
]
for model in models:
    print(f"\n--- {model} ---\n{extract_text('receipt.jpg', model)[:200]}...")
O catálogo de modelos do OpenRouter listava google/gemini-3.8-flash, anthropic/claude-sonnet-5 e qwen/qwen3.8-27b com entrada de imagem e parâmetros de structured output a 2026-10-02. O suporte no catálogo não prova que este pedido exato tenha sucesso em todos os endpoints encaminhados.
Para extração estruturada, use response_format com um JSON Schema quando o modelo escolhido e o gateway o suportarem. Isto pode tornar a resposta analisável; não valida os valores extraídos face à imagem. Com o OpenRouter, o provider.require_parameters faz o pedido falhar quando nenhum endpoint encaminhado suporta todos os parâmetros pedidos, em vez de recorrer a um endpoint que não consegue respeitar o esquema.
O excerto reutiliza o extract_text do bloco anterior e passa o esquema através dos seus argumentos extra de pedido. Requer um modelo que suporte JSON Schema.
import json

nullable = {"type": ["string", "null"]}
receipt_schema = {
    "type": "object",
    "properties": {
        "vendor": nullable,
        "date": nullable,
        "items": {
            "type": ["array", "null"],
            "items": {
                "type": "object",
                "properties": {"description": nullable, "amount": nullable},
                "required": ["description", "amount"],
                "additionalProperties": False,
            },
        },
        "total": nullable,
    },
    "required": ["vendor", "date", "items", "total"],
    "additionalProperties": False,
}
prompt = (
    "Extract only visible receipt fields. Copy amounts as source strings. "
    "Use null for absent or unreadable values; do not infer them. "
    "Use null for an unreadable item list, and [] only when no items are present."
)

receipt = json.loads(extract_text(
    "receipt.jpg",
    "google/gemini-3.8-flash",
    prompt=prompt,
    response_format={
        "type": "json_schema",
        "json_schema": {"name": "receipt", "strict": True, "schema": receipt_schema},
    },
    extra_body={"provider": {"require_parameters": True}},
))
O modo estrito ao estilo da OpenAI exige todas as propriedades em required e additionalProperties: false, pelo que um valor que pode faltar é tipado como anulável (nullable) em vez de ser omitido. O prompt e os tipos anuláveis, em conjunto, permitem que o modelo devolva null em vez de inventar um valor.
Guarde as strings dos montantes copiados junto dos valores normalizados. Faça o parsing do dinheiro a jusante com aritmética decimal ou de unidades menores inteiras, sob uma moeda e uma localização explícitas; a validade do esquema não valida o total de um pagamento. Encaminhe os campos críticos nulos para revisão.
Implementar OCR em produção
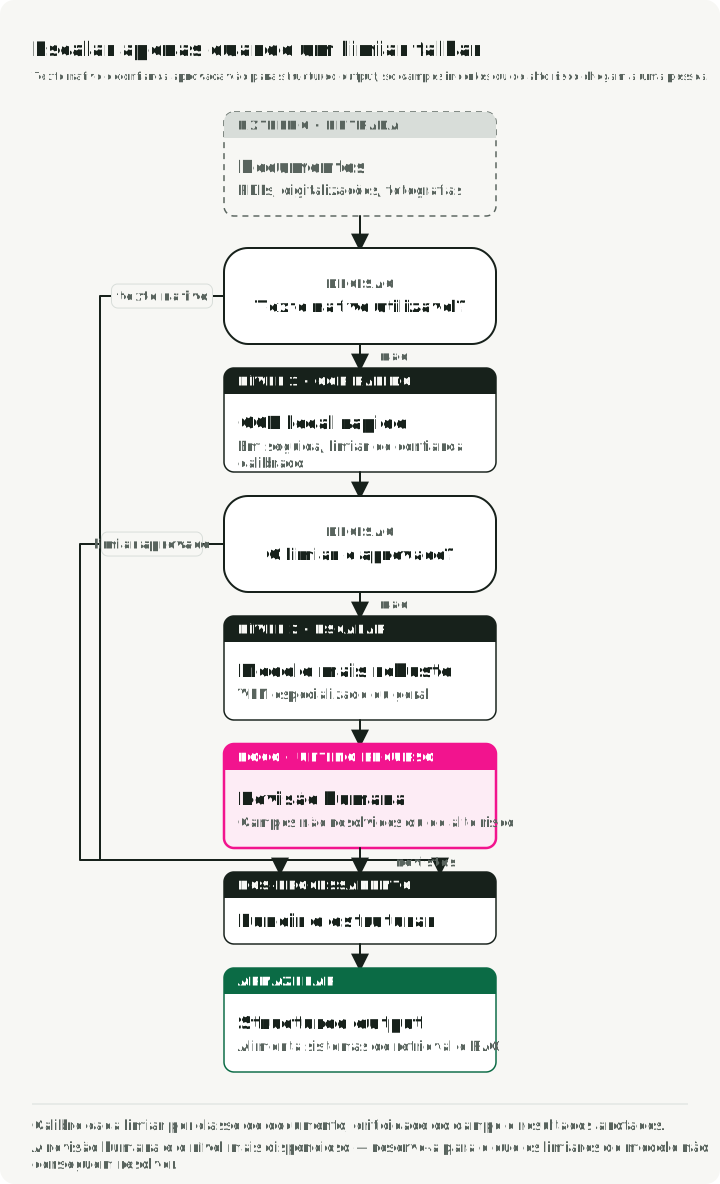
Uma arquitetura em camadas pode separar o pré-processamento em CPU da inferência em GPU ou por API e reservar os caminhos caros para os documentos que precisam deles. A figura mostra as camadas por ordem de custo, a verificação que aceita uma página em cada camada e a falha que a envia para a seguinte.
O padrão de fallback em camadas
Comece pelo caminho mais barato que cumpre o objetivo de qualidade e depois calibre o encaminhamento em páginas anotadas:
- Verifique se há texto incorporado (Tier 0). Nos PDFs, inspecione a camada de texto com
PyMuPDFoupdfplumberantes de rasterizar, mas valide que a camada está completa.
- Tente com um modelo rápido. Use um motor tradicional nas classes de documentos em que cumpre o objetivo.
- Avalie a confiança calibrada. Combine a confiança do modelo com a classe de documento, a criticidade do campo e as regras de validação.
- Passe para um modelo mais forte. Encaminhe as páginas incertas para um VLM especializado ou geral.
- Encaminhe as falhas de alto risco para uma pessoa. A revisão humana é uma camada à parte, para valores cujo custo de erro excede o benefício da automação.
Nota sobre a confiança: as probabilidades brutas de caracteres não estão automaticamente calibradas para a correção dos campos. A função ponderada por área abaixo é uma base para a agregação ao nível da página, não um encaminhador universal. Calibre-a com páginas anotadas e dê aos campos críticos regras próprias, porque a média de uma página pode esconder um ID ou um total errado.
def area_weighted_confidence(page):
    """Compute area-weighted confidence from one PaddleOCR 3.x result."""
    total_area, weighted_sum = 0, 0
    for (x_min, y_min, x_max, y_max), score in zip(
        page["rec_boxes"], page["rec_scores"]
    ):
        width = int(x_max) - int(x_min)
        height = int(y_max) - int(y_min)
        area = width * height
        weighted_sum += score * area
        total_area += area
    return weighted_sum / total_area if total_area > 0 else 0

assert area_weighted_confidence({
    "rec_boxes": [[0, 0, 300, 300]], "rec_scores": [0.5]
}) == 0.5
Para definir o limiar, anote um conjunto de páginas de uma classe de documentos e registe se todos os campos críticos de cada página estão corretos. Escolha o limiar de confiança mais baixo em que as páginas aceites cumprem o seu objetivo de erro nos campos críticos e encaminhe as páginas abaixo dele para a camada seguinte. A função abaixo faz isto para uma classe de documentos.
def pick_threshold(scores, correct, max_error):
    """Lowest threshold whose accepted pages meet the error target, or None."""
    for threshold in sorted(set(scores)):
        accepted = [ok for s, ok in zip(scores, correct) if s >= threshold]
        if accepted and accepted.count(False) / len(accepted) <= max_error:
            return threshold
    return None  # no threshold meets the target: send every page to the next tier

scores = [0.95, 0.91, 0.88, 0.80, 0.72, 0.60]
correct = [True, True, True, False, True, False]  # all critical fields right?
assert pick_threshold(scores, correct, max_error=0.0) == 0.88
assert pick_threshold(scores, correct, max_error=0.25) == 0.72
A figura coloca no eixo da confiança as seis páginas etiquetadas dos asserts e marca o limiar que cada objetivo de erro escolhe.
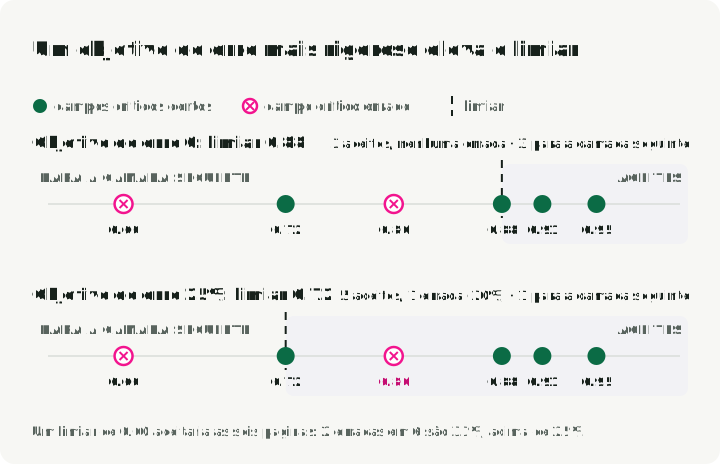
Um objetivo de erro mais rigoroso eleva o limiar e envia mais páginas para o modelo mais forte. Repita a calibração para cada classe de documentos, porque a mesma pontuação pode significar exatidões diferentes em recibos e em contratos.
Padrões de serving
A forma de executar cada camada depende da forma como as páginas chegam:
- Trabalhos em lote (conversão de arquivos, relatórios mensais): leia as páginas de uma fila e execute-as em workers de GPU que escalam para zero entre trabalhos.
- Pedidos interativos: mantenha uma GPU ativa ou use uma API alojada, porque o arranque a frio de um modelo soma o tempo de carregamento à espera do utilizador.
- Rasterização e limpeza de imagem: execute-as em workers de CPU que escalam separadamente da inferência em GPU.
- VLMs de pesos abertos: sirva-os com o vLLM ou o SGLang, que agrupam em lote pedidos concorrentes numa só GPU.
Medir os resultados
Para cada par motor/documento planeado, guarde um resultado com o estado de sucesso, erro ou ignorado. As saídas falhadas, vazias e truncadas continuam no denominador dos documentos tentados, juntamente com o custo gasto. Reporte a taxa de conclusão, os erros em campos críticos entre as aceitações automáticas, a fração enviada para revisão, a latência de ponta a ponta p50/p95 e o custo por documento processado com sucesso. Meça a latência por página com a resolução, o tamanho de lote, o hardware ou a região do fornecedor e o comprimento de saída reais. Inclua no total o pré-processamento e as repetições; um tempo só do modelo não consegue dar o preço de uma página bem-sucedida. Reutilize os objetos do conversor para tempos com o sistema já aquecido e registe a inicialização em separado. O repositório OCR Gauntlet regista os resultados neste formato; a última secção mostra como o executar.
Análise de custos à escala
Não existe um ponto de equilíbrio universal, em volume de páginas, entre uma API e o auto-alojamento. Construa a comparação a partir da mesma carga de trabalho:
| Componente de custo | Caminho por API | Caminho auto-alojado |
|---|---|---|
| Inferência | Preço atual por página ou por token | Horas de GPU a páginas/hora medidas |
| Capacidade ociosa | Normalmente absorvida pelo fornecedor | Utilização e folga de capacidade |
| Engenharia | Integração e monitorização do fornecedor | Implementação, atualizações, observabilidade e on-call |
| Tratamento de dados | Condições de transferência, retenção e região | Armazenamento, rede e controlos de conformidade |
| Falhas de qualidade | Repetições e revisão humana | Repetições e revisão humana |
Use uma fórmula comum: monthly pages × cost per successful page + review cost + fixed operating cost (páginas por mês × custo por página bem-sucedida + custo de revisão + custo operacional fixo). Uma “página bem-sucedida” tem de cumprir os mesmos critérios de texto, tabelas e campos nos dois caminhos. Os preços dos fornecedores e o aluguer de GPUs mudam depressa demais para serem incluídos como estimativa duradoura de aquisição.
Tratamento de erros: o problema da alucinação
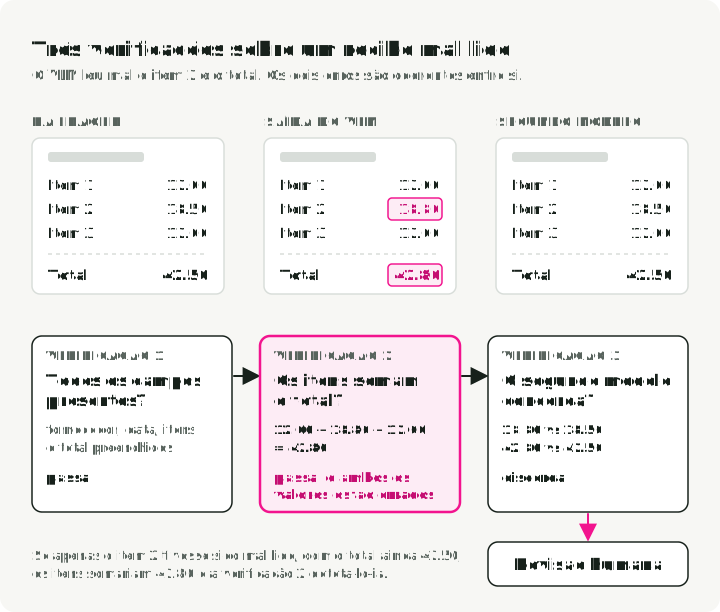
Os erros dos VLMs podem ser plausíveis no contexto e falsos nos factos. O total de um recibo de “$42.50” pode vir como “$42.80”: um montante válido que nenhum corretor ortográfico assinala.
Exemplo sintético de falha: a imagem de um recibo mostra três linhas, 12.00, 18.50 e 12.00, e um total de 42.50. Um VLM lê a segunda linha como 18.80 e o total como 42.80. As linhas continuam a somar o total, por isso a aritmética interna passa, e os dois valores estão errados. É por isso que a validação precisa de etiquetas ancoradas na imagem ou de um caminho de revisão independente, e não só de verificações de consistência.
A figura executa as três verificações neste recibo: a verificação do esquema e a verificação da soma passam, e só o segundo modelo deteta as duas leituras erradas.
Algumas mitigações práticas:
- Reconciliação aritmética. Quando o esquema as expõe, verifique
subtotal + tax + fees + shipping - discounts, dentro da tolerância de arredondamento da moeda, face ao total indicado. Encaminhe componentes em falta ou divergências para revisão. - Verificações de datas, telefones e moedas. Faça o parsing das datas com um parser de datas e rejeite valores impossíveis. Verifique com padrões o número de dígitos dos telefones e os formatos de moeda.
- Segundo caminho de extração. Execute os campos críticos com outro modelo ou outro motor de OCR e assinale as discordâncias. A concordância só aumenta a confiança quando os dois caminhos têm modos de falha suficientemente diferentes; não é prova de correção.
A verificação de reconciliação recebe as strings dos montantes copiados e usa Decimal, para que nenhum arredondamento de vírgula flutuante entre na comparação. Os asserts repetem o exemplo do recibo acima.
from decimal import Decimal

def reconcile(subtotal, tax, fees, shipping, discounts, total, tolerance="0.01"):
    """True when the stated total matches its components within tolerance."""
    parts = [subtotal, tax, fees, shipping, discounts, total]
    if any(p is None for p in parts):
        return False  # a missing component goes to review
    s, t, f, sh, d, tot = (Decimal(p) for p in parts)
    return abs(s + t + f + sh - d - tot) <= Decimal(tolerance)

items = ["12.00", "18.80", "12.00"]  # the image shows 18.50
subtotal = str(sum(Decimal(i) for i in items))
assert reconcile(subtotal, "0", "0", "0", "0", "42.80")  # passes, and both values are wrong
assert not reconcile(subtotal, "0", "0", "0", "0", "42.50")  # one misread value is caught
assert not reconcile(subtotal, None, "0", "0", "0", "42.80")  # missing tax goes to review
A reconciliação apanha um único montante mal lido. Não consegue apanhar duas leituras erradas que concordem entre si, por isso os campos críticos continuam a precisar do segundo caminho de extração.
Execute a comparação nas suas próprias páginas
O repositório OCR Gauntlet executa vários motores de OCR nas mesmas páginas e escreve uma linha de resultado por motor e por página, incluindo as falhas. Compara páginas em imagem; não cobre a verificação da camada de texto do Tier 0.
O runner trabalha em quatro passos:
- O manifesto lista as páginas e os hashes do texto de referência.
- O runner envia cada página a cada motor.
- Escreve uma linha JSONL por motor e página, marcada como sucesso, erro ou ignorada, com a saída em bruto, o tempo e o custo.
- O resumo indica a taxa de conclusão, o CER nas páginas revistas e o custo por página bem-sucedida. Os pares falhados e ignorados continuam no denominador da taxa de conclusão.
A primeira execução usa páginas geradas e o Tesseract, por isso precisa do Python 3.12, do uv e de uma instalação do Tesseract no sistema, mas não de chaves de API:
uv sync --locked --extra tesseract --extra notebooks
uv run python scripts/make_fixture.py data/demo
uv run ocr-gauntlet data/demo/manifest.json --engines tesseract --output results/demo.jsonl
As páginas geradas só verificam que o pipeline corre; não medem a qualidade do OCR. Para um teste real com recibos, importe amostras do CORD com uv run python scripts/download_samples.py --dataset cord --count 2 --output data/cord e prepare uma referência revista, como descreve o README do repositório. Acrescente outros motores com --engines; os motores alojados precisam também de --allow-remote, porque carregam as suas páginas.
No resumo, leia primeiro a taxa de conclusão: um motor que falha em um terço das páginas não é candidato, seja qual for o seu CER. Depois compare o CER nas páginas revistas e, a seguir, o custo por página bem-sucedida, que inclui o gasto em tentativas falhadas.
Principais conclusões
- Associe o nível de modelo a uma classe de documentos anotada. Os motores tradicionais podem bastar para texto limpo; os VLMs especializados e gerais devem justificar o custo acrescido em páginas mais difíceis.
- Não junte leaderboards diferentes. As métricas do OmniDocBench e as preferências da OCR Arena respondem a perguntas diferentes.
- Calibre o encaminhamento. Limiares de confiança, classes de documentos, criticidade dos campos e política de revisão humana pertencem à mesma avaliação.
- Valide a saída plausível. A conformidade com o esquema e a aritmética interna não provam que um valor aparece na imagem.
- Dê preço às páginas bem-sucedidas. Inclua repetições, revisão, operações fixas e verificações de qualidade ao comparar APIs com auto-alojamento.
Referências
- OCR Arena Leaderboard - Duelos de modelos frente a frente, por crowdsourcing
- O repositório OCR Gauntlet - Comparação executável de motores de OCR nas mesmas páginas, com backends do Docling e custo por página bem-sucedida
- OmniDocBench - Avaliação de parsing de documentos de ponta a ponta
- dots.ocr - Cerca de 3B de parâmetros no total, incluindo um modelo de linguagem de 1,7B
- PaddleOCR - Toolkit e modelos de OCR tradicional
- OpenRouter - Gateway de acesso unificado para testes A/B de modelos