OCR в 2026 году: классические пайплайны, VLM и Document AI

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Это руководство для инженеров, которые выбирают OCR и извлечение данных из документов для поиска, retrieval-augmented generation (RAG) или ИИ-агентов. Оно объясняет, чем традиционные движки отличаются от vision-language моделей, как оценивать текст, таблицы и поля и как передавать сложные документы другой модели или на ручную проверку.
Vision-language модели (VLM) справляются с раскладкой, рукописным текстом, таблицами и испорченными изображениями, на которых ломается обычный пайплайн распознавания текста. Традиционные движки по-прежнему конкурентны на чистой печати, особенно когда важны латентность на CPU и стоимость эксплуатации. Снапшот на дату ниже включает PaddleOCR-VL 1.6 и dots.mocr, у которых разные требования к железу, приватности и формату вывода. Перед актуальным выбором проверьте каждый проект.
Краткую версию про выбор модели см. в Best OCR Models in 2026: Classical OCR, PaddleOCR-VL, VLMs.
OCR теперь определяет качество всей цепочки
OCR давно используется в архивах, почтовых системах, инструментах доступности и системах управления документами. RAG и агенты для работы с документами сделали его типичные сбои заметными для более широкого круга инженеров: нижестоящая модель не восстановит текст или структуру таблицы, которые потеряла экстракция.
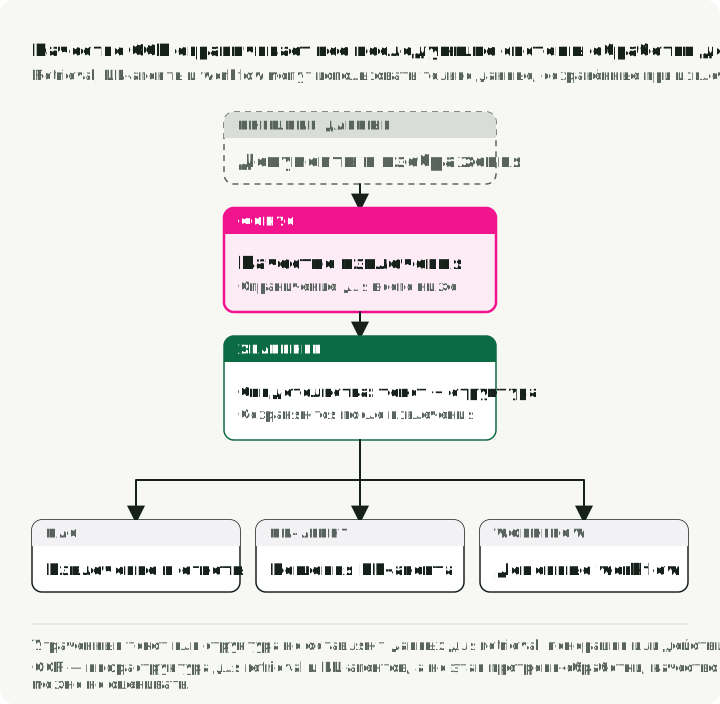
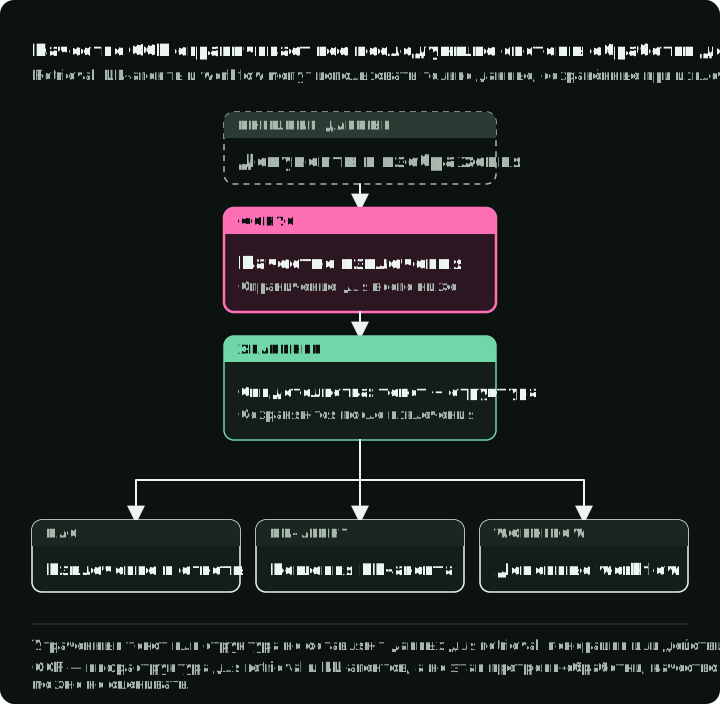
RAG-система не найдёт текст, который OCR пропустил или прочитал неверно. Если экстракция исказила таблицу, неправильно прочитала дату или потеряла абзац, последующие изменения чанкинга и эмбеддингов не вернут недостающую информацию. Такие ошибки могут скрыть пункт договора, изменить итог счёта или испортить медицинскую запись.
Поэтому OCR входит в инфраструктуру retrieval и агентов наравне с парсингом, чанкингом, эмбеддингами и индексацией. Его ошибки нужно оценивать отдельно, а не растворять в одной сквозной метрике.
Что значит OCR в эпоху foundation-моделей
OCR превращает текст на изображении в машиночитаемые символы. Document AI — более широкая система вокруг него: анализ раскладки, разбор таблиц и формул, извлечение полей, семантический ризонинг, происхождение данных и валидация. Авторы GOT-OCR 2.0 называют модульные пайплайны детекции и распознавания «OCR-1.0», а сквозные модели «OCR-2.0». Эта метка не должна стирать различие между распознаванием и пониманием документа.
На схеме сравниваются два пути и то, как каждый из них ломается: три последовательных этапа слева не восстанавливают строку, пропущенную детекцией, единый проход модели справа пишет правдоподобный итог, которого нет на странице, а растеризация и парсинг в обоих случаях остаются вне модели.
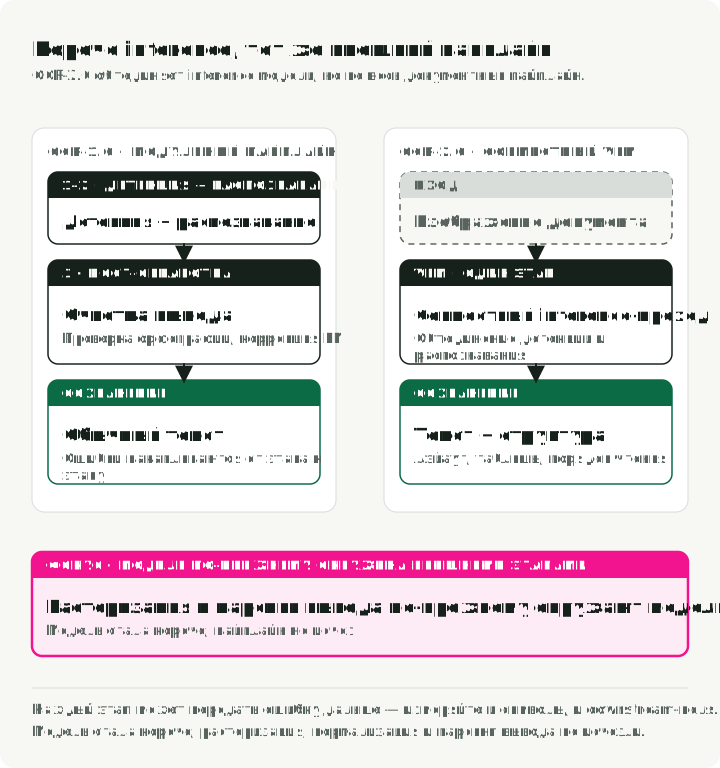
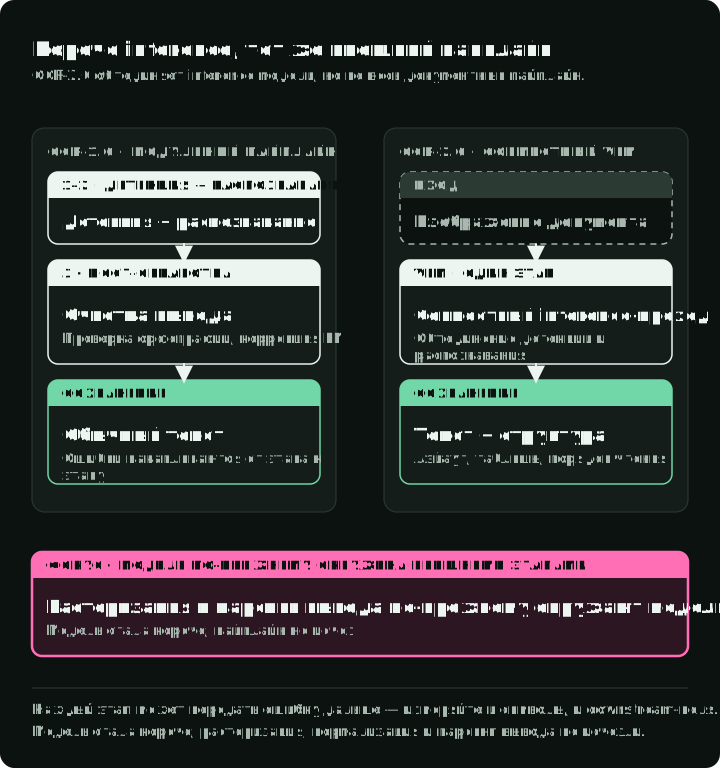
В традиционном OCR-пайплайне три основных этапа:
- Детекция текста: поиск областей, содержащих текст (например, CRAFT, DBNet).
- Распознавание текста: преобразование найденных областей в последовательности символов (например, CRNN).
- Постобработка: проверка орфографии и коррекция языковой моделью.
Это хорошо работает на чистых документах, но ошибки детекции, распознавания и постобработки могут накапливаться. Измеряйте и точность по символам, и точность по полям нижестоящей задачи, чтобы читаемая страница не скрывала неверный итог или идентификатор.
Некоторые сквозные пути на основе VLM сворачивают большую часть этого пайплайна в визуальный энкодер и языковой декодер. Модели вроде GOT-OCR 2.0 могут выдавать текст и структуру вместе, а универсальные VLM умеют ещё и сопоставлять поля с запрошенной схемой. Например, универсальная VLM может прочитать «MFG: 10/24» на этикетке как дату производства, а не как срок годности. Взамен вы получаете латентность, зависящую от нагрузки, расходы на GPU или API и риск правдоподобного текста, которого нет на изображении.
Практическая оговорка: модели, принимающие только изображения, требуют растеризованных страниц, а сервис, принимающий PDF, может выполнять конвертацию внутри себя. Выравнивание перекоса, изменение масштаба и очистка зависят от конкретного пайплайна и являются экспериментами, а не обязательными улучшениями. AWS Textract советует сохранять поддерживаемые входные форматы, а не конвертировать их и не уменьшать разрешение без разбора. Разбор вывода и валидация по-прежнему остаются на стороне приложения.
Метрики: что именно измерять
Каждое сравнение дальше в этом руководстве использует одну из этих метрик. Выбирайте ту, что подходит типу вывода:
- CER и WER для простого текста. Character и Word Error Rate зависят от выбора нормализации (регистр, пробелы, пунктуация), поэтому зафиксируйте протокол сравнения до сравнения моделей.
- Field exact match и Field F1 для форм и чеков. Exact match бинарен для одного поля; его доля — это часть проверенных полей, которые прошли. Корректность всех полей документа указывайте отдельно. Для Field F1 определите сопоставление ключей и значений, нормализацию, дубликаты и пропущенные поля, а также агрегацию; верная сумма, отнесённая не к той строке, — ошибка.
- TEDS для таблиц. Tree-Edit-Distance-based Similarity сравнивает предсказанное и эталонное HTML-деревья таблицы и ловит ошибки структуры и содержимого ячеек, которые CER скрывает.
- Сравнение порядка чтения, когда потребителю нужна одна линейная последовательность. Сравнивайте упорядоченные блоки или спаны напрямую либо используйте метрику, учитывающую порядок; OmniDocBench оценивает порядок чтения отдельно. Верные символы и ячейки таблицы не доказывают верный порядок многоколоночной страницы.
- ANLS для document VQA. Average Normalized Levenshtein Similarity оценивает ответы относительно допустимых эталонов. Исходное определение ST-VQA присваивает
1 − normalized_distanceтолько если расстояние строго меньше 0.5, иначе ноль; берётся лучшая оценка среди допустимых эталонов, затем усреднение по вопросам. DocVQA использует ANLS. При воспроизведении результата зафиксируйте регистр, пробелы и нормализацию расстояния в эвалуаторе.
CER/WER считают замены, удаления и вставки, делённые на число символов или слов в эталоне. Они могут превышать единицу, если преобладают вставки. Укажите, как выполнена агрегация: суммируются ошибки и длины эталонов по корпусу или усредняются оценки документов. Сохраняйте страницу, блок, ограничивающий прямоугольник, исходный текст и историю нормализации, чтобы неверное поле можно было проследить до изображения.
При детекции текста intersection over union (IoU) делит площадь пересечения предсказанного и эталонного прямоугольников на общую площадь, покрытую хотя бы одним из них. Порог IoU определяет, соответствует ли обнаруженный прямоугольник эталону, до расчёта F1.
Таблица сопоставляет каждой задаче метрику и ошибку, которая чаще всего делает оценку обманчивой:
| Задача | Метрика | Чего избегать |
|---|---|---|
| Извлечение простого текста | CER, WER | Сравнивать оценки, посчитанные с разной нормализацией |
| Рукописный текст | CER | Применять целевые значения CER для печати к рукописным страницам |
| Детекция текста | F1 при пороге IoU | Приводить F1 без порога IoU, с которым он посчитан |
| Формы и чеки | Field exact match, Field F1 | Считать верным правильное значение не в том поле или строке |
| Таблицы | TEDS | Судить о таблицах по CER, который не видит структуру ячеек |
| Document VQA | ANLS | Менять порог 0.5 или нормализацию ответов |
| Конвертация целой страницы | Edit distance + порядок чтения | Приводить точность текста, не проверив порядок блоков |
Языки тоже влияют на выбор. В китайском и японском тексте нет пробелов между словами, поэтому WER зависит от сегментатора слов; для этих письменностей используйте CER. Включайте страницы со смешанными письменностями в размеченную тестовую выборку, если они встречаются в вашей нагрузке. Карточка модели со 100 языками не показывает качество ни для одного из них, поэтому включите каждый целевой язык в размеченную тестовую выборку.
Для реализаций: jiwer считает CER/WER из коробки, а реализации TEDS есть в репозитории OmniDocBench.
Что бенчмарки OCR измеряют и что упускают
Публичные датасеты применяют эти метрики к конкретным типам документов. Размеры датасетов и метрики относятся к названной версии датасета; оценки моделей берите из актуального лидерборда каждого проекта. Столбец «Что проверяет» показывает, на какие из ваших документов похож каждый датасет.
| Датасет | Что проверяет | Размер теста | Языки | Основная метрика |
|---|---|---|---|---|
| FUNSD | Связывание ключ–значение на зашумлённых отсканированных формах | 50 документов | Английский | F1 |
| SROIE | Четыре поля чека (компания, дата, адрес, итог) | 400 тестовых изображений | Английский | F1 |
| CORD | Позиции чека с иерархическими метками | 100 чеков | Индонезийский | F1 |
| IAM | Рукописные строки на английском | Зависит от разбиения | Английский | CER |
| OCRBench v2 | Чтение текста и ризонинг VLM по 23 задачам | 10 000 пар вопрос–ответ | EN + CN | Оценка /100 |
| OmniDocBench v1.6 | Разбор целой страницы: текст, таблицы, формулы, порядок чтения | 1 651 страница | EN + CN | Композитная |
Число строк в IAM зависит от выбранного разбиения по авторам и протокола распознавания; единое число тестовых строк здесь не предполагается.
Снапшот OmniDocBench v1.6
Таблица ниже — один версионированный снапшот: OmniDocBench v1.6_full, официальный README на коммите 09ba2b606662695b16aafe5f5e36b7ef020e11a8, дата обращения 2026-08-09.
| Модель | Размер | Overall ↑ | Text Edit ↓ | Table TEDS ↑ |
|---|---|---|---|---|
| GLM-OCR | 0.9B | 95.22 | 0.044 | 92.83 |
| PaddleOCR-VL-1.5 | 0.9B | 94.93 | 0.038 | 91.67 |
| Gemini 3 Flash | — | 92.62 | 0.066 | 89.29 |
| dots.ocr | 3B | 90.77 | 0.048 | 87.18 |
В закреплённом README указана PaddleOCR-VL 1.5. PaddleOCR сообщает 96.3 для версии 1.6 на той же версии бенчмарка; это собственный прогон вендора, он не входит в эту таблицу.
Вывод ограничен этой версией OmniDocBench: размер модели сам по себе не предсказывает оценку разбора документов. Более поздние версии эвалуатора меняют сопоставление, поэтому сравнивайте оценки только при одном закреплённом эвалуаторе. Композитная оценка включает расстояние редактирования текста, TEDS таблиц и Character Detection Matching (CDM) для формул. CDM рендерит предсказанные и эталонные формулы, сопоставляет их символы и проверяет их взаимное расположение, прежде чем оценить совпадения с помощью F1. Он сравнивает отрендеренные формулы, а не исходные строки LaTeX. Порядок чтения требует отдельного результата.
Разрыв между бенчмарком и ареной
Рейтинги автоматических бенчмарков могут расходиться с предпочтениями людей.
В OCR Arena пользователи вслепую голосуют за результаты в парных сравнениях. На 2026-08-09 OCR Arena ставила Gemini 3 Flash выше GLM-OCR, тогда как таблица OmniDocBench оценивает GLM-OCR выше (95.22 против 92.62). Меняющийся рейтинг на арене меняется с новыми поединками, поэтому это не воспроизводимый исторический снапшот бенчмарка. Не объединяйте два лидерборда в одну оценку.
На схеме показано это расхождение: GLM-OCR и Gemini 3 Flash меняются местами в двух рейтингах. Ниже указано, какие страницы использует каждый, кто судит и что получается на выходе.
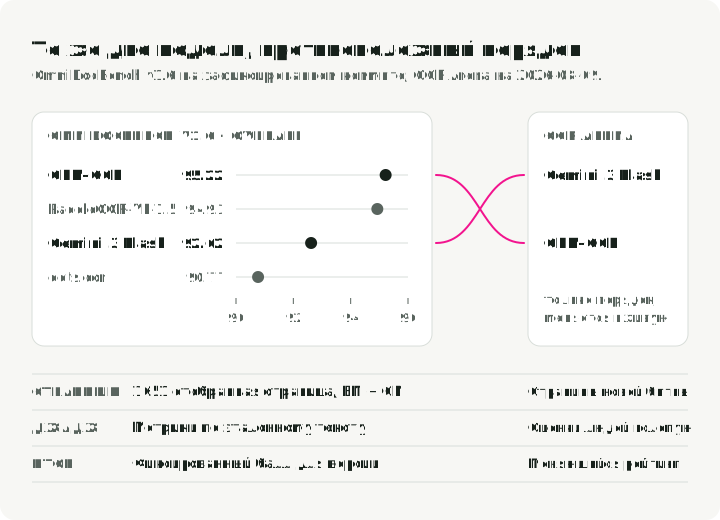
Вероятные причины включают состав документов, формат вывода, охват языков и критерии джаджей. Опубликованные числа годятся для первичного отбора, но окончательному выбору нужна отложенная выборка из целевой нагрузки.
Традиционные OCR-движки: всё ещё актуальны
Традиционные движки полезны как базовые варианты, потому что работают локально на CPU. Их латентность и точность зависят от выбранной модели, разрешения страницы, языка, предобработки и железа, поэтому тестируйте их на тех же размеченных страницах, что и VLM.
| Движок | Деплой | Полезный базовый вариант для |
|---|---|---|
| Tesseract 5.5 | Локально на CPU | Чистая печать и устоявшиеся письменности |
| EasyOCR | Локально, PyTorch на CPU или GPU | Прототипы и текст на сценах |
| PaddleOCR 3.x | Локально: CPU, GPU и мобильные варианты | Многоязычный OCR и инструменты для деплоя |
Tesseract для чистой печати
Tesseract (v5.5.x, Apache 2.0) — зрелый движок, в основном для CPU, со 100+ языковыми пакетами. Точность на чистой печати может быть высокой после подходящей растеризации и предобработки, но рукописный текст, текст на сценах и сложные раскладки нужно тестировать отдельно. Главное преимущество — небольшой локальный деплой на CPU.
Задавайте режим сегментации страницы (--psm) для каждого типа документа; неверный режим теряет колонки или склеивает строки. Для примера нужны pip install pytesseract pillow, бинарник Tesseract с английскими языковыми данными и локальный receipt.jpg.
import pytesseract
from PIL import Image

# --psm 6: treat the image as one uniform block of text, which suits a receipt
text = pytesseract.image_to_string(Image.open("receipt.jpg"), lang="eng", config="--psm 6")
EasyOCR
EasyOCR сочетает детектор CRAFT и распознаватель CRNN. С полноценным GPU-ускорением PyTorch это быстрый вариант для прототипов и текста на сценах. Он возвращает только строки и рамки, без раскладки и структуры таблиц.
Для примера нужны pip install easyocr, PyTorch, скачанные веса моделей EasyOCR и локальный receipt.jpg.
import easyocr

# Three lines for complete OCR
reader = easyocr.Reader(["en"])
result = reader.readtext("receipt.jpg")
# Returns: [(bbox, text, confidence), ...]
PaddleOCR 3
PaddleOCR 3 объединяет поддерживаемые пайплайны OCR, разбора документов и деплоя. Актуальный quick start использует API predict() и явные настройки ориентации. Закрепите версию пакета paddleocr и выбранный пайплайн, потому что примеры для 2.x с .ocr(..., cls=True) не подходят к API 3.x.
Ему нужен рантайм PaddlePaddle, то есть ещё один фреймворк рядом со стеком на PyTorch. Распознавание текста в PaddleOCR — не тот же пайплайн, что PaddleOCR-VL, парсер документов из следующего раздела.
Для примера нужны pip install "paddleocr>=3,<4", совместимый рантайм PaddlePaddle, скачанные веса моделей и локальный receipt.jpg.
from paddleocr import PaddleOCR

ocr = PaddleOCR(
    use_doc_orientation_classify=False,
    use_doc_unwarping=False,
    use_textline_orientation=False,
)

for result in ocr.predict("receipt.jpg"):
    result.print()
    result.save_to_json("output")
Каждый результат содержит rec_texts, rec_scores и rec_boxes. Раздел о роутинге использует последние два, чтобы оценить страницу.
Специализированные и универсальные VLM
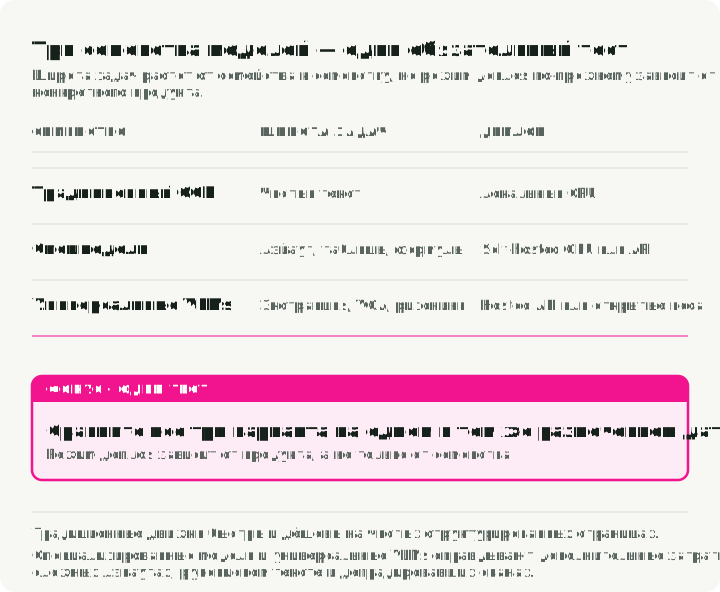
Кривые чеки, перекошенные этикетки товаров, рукописный текст и плотные раскладки — это случаи, где специализированные или универсальные VLM стоит сравнить с традиционными движками.
На схеме показано, что каждое семейство моделей возвращает для одной и той же страницы, его главный компромисс и где оно может работать. Режим деплоя зависит от продукта, поэтому схема указывает его отдельно от широты задач.
Специализированные модели для документов
Модели в этом разделе проверены 2026-10-02. Список не является актуальным рейтингом; он показывает, для какой документной задачи каждую модель стоит попробовать.
| Модель | Вывод | Где работает | Пробуйте, когда |
|---|---|---|---|
| PaddleOCR-VL 1.6 | Анализ раскладки, затем VLM на 0.9B читает каждую область | Self-hosted | Многоязычные страницы с раскладкой; вендор заявляет 109 языков |
| GOT-OCR 2.0 | Простой текст, Markdown, LaTeX | Self-hosted, 580M параметров | Формулы и смешанный текст на одной странице |
| dots.mocr | Раскладка и текст; графики и рисунки как SVG-код | Self-hosted, 3B параметров | Страницы с графиками или диаграммами, которые нужны как структура |
| DeepSeek-OCR2 | Markdown с граундинг-рамками | Self-hosted, vLLM или Transformers | Длинные документы большого объёма; страница занимает от 256 до 1 120 визуальных токенов |
| Mistral OCR 4.1 | Markdown, рамки абзацев, метки блоков, уверенность по блокам | Хостинговый API (mistral-ocr-4-1) | Нужен API и оценка уверенности для каждого блока |
| Granite-Docling 258M | DocTags, преобразуемые в DoclingDocument | Self-hosted, внутри Docling | Небольшая локальная модель для конвертаций в Docling |
| olmOCR | Простой текст или Markdown в порядке чтения | Self-hosted, VLM на 7B на GPU | Линеаризация PDF в текст для RAG или обучающих данных |
Считайте показатели throughput и памяти зависящими от железа и датасета; измеряйте пиковую память со своим рантаймом, точностью, размером изображения и лимитом вывода. Откалибруйте уверенность по блокам у Mistral на корректности полей, прежде чем принимать значения автоматически. Для сравнений закрепляйте явную версию модели, потому что алиас latest может измениться.
Фронтирные VLM
Универсальные VLM — ещё один вариант, когда задача сочетает извлечение с визуальным или семантическим ризонингом. Эти кандидаты проверены 2026-10-02 и используются в примере со шлюзом ниже. Это стартовый короткий список, а не рейтинг OCR:
- Gemini 3.8 Flash (Google): общедоступная мультимодальная модель с входом изображений и structured outputs. Для нового сравнения используйте её стабильный ID.
- Claude Sonnet 5 (Anthropic): поколение Sonnet, выпущенное 2026-06-30, для сравнения хостинговых моделей. Проверьте точность транскрипции и извлечения полей на своих документах; улучшения общего ризонинга не доказывают точность OCR.
- Qwen3.8-27B (Alibaba): vision-language модель с открытыми весами под лицензией Apache 2.0, которую можно тестировать через шлюз или разворачивать самостоятельно. Размер 27B делает её другим выбором для деплоя, чем более ранняя Qwen3-VL 8B, которая остаётся полезной небольшой базовой моделью, когда памяти мало.
Добавляйте новый релиз в тестовый набор. Используйте его в продакшене только после того, как он пройдёт то же сравнение: корректность полей, воздержание от ответа, латентность и стоимость на принятый документ по одному протоколу.
Фреймворки конвертации документов
RAG-пайплайну обычно нужен целый документ, сконвертированный в Markdown или JSON, а не сырые строки OCR. Это делают конвертеры документов. Они разбирают файл, запускают модель раскладки и вызывают OCR-движок для текста внутри каждой области. Некоторые вместо этого могут отправлять каждую страницу в VLM, которая читает раскладку и текст вместе.
| Фреймворк | Что выдаёт | Используйте, когда |
|---|---|---|
| Docling | Markdown, HTML или lossless JSON с таблицами и координатами, из PDF, DOCX, PPTX, XLSX, HTML и изображений | Нужен один конвертер для смешанных форматов и возможность выбрать OCR-движок внутри него |
| Marker | Markdown, JSON, HTML или чанки, из PDF, изображений и файлов Office | Нужен качественный Markdown из PDF |
| MinerU | Markdown и структурированный JSON, из PDF, изображений и файлов Office | Научные и технические статьи с формулами и таблицами |
Проверьте лицензии, прежде чем поставлять любой из них в продукте. Docling распространяется под MIT. Код Marker — под Apache 2.0, но веса его моделей используют модифицированную лицензию OpenRAIL-M с ограничениями на коммерческое использование. Лицензия MinerU добавляет к Apache 2.0 условия: отдельная коммерческая лицензия выше заданных порогов по пользователям и выручке и указание авторства для онлайн-сервисов.
На схеме показано, что оборачивает конвертер. Docling сохраняет вход и вывод одинаковыми, а опции пайплайна определяют, как читается текст: его моделью раскладки с Tesseract или EasyOCR либо сквозно через VLM Granite-Docling.
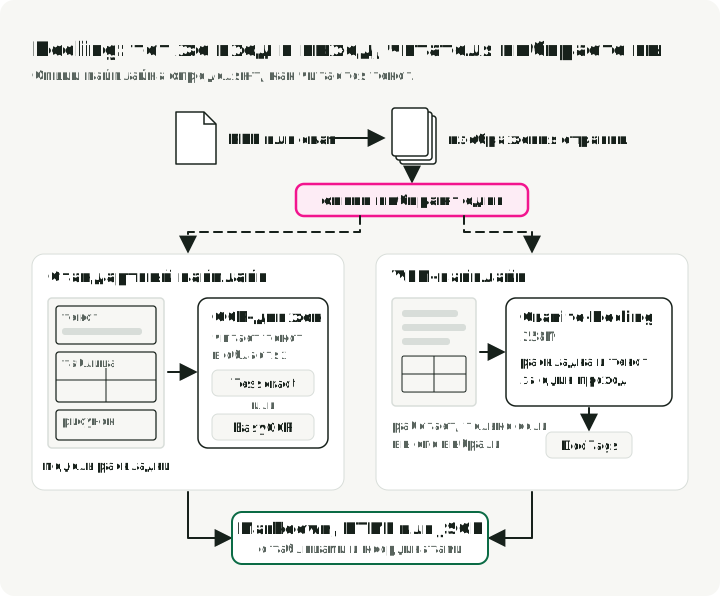
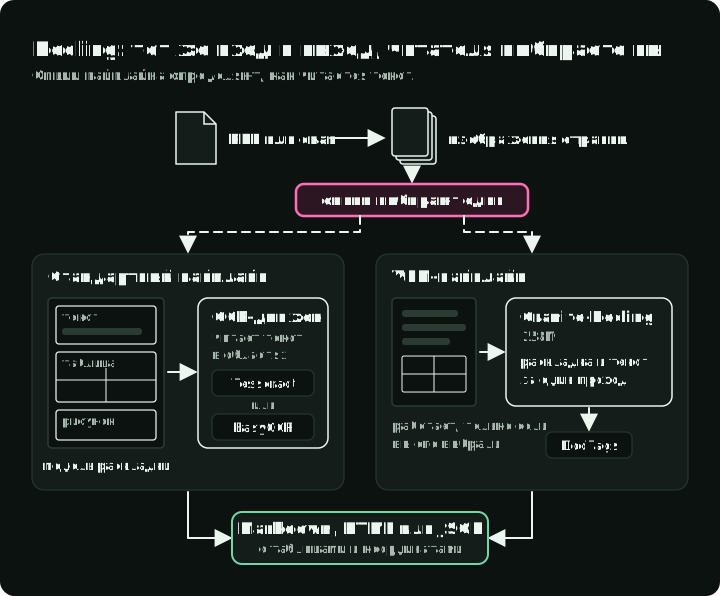
Поэтому скорость и качество конвертации в Docling зависят от выбранного пайплайна. VLM-пайплайн Docling нужно выбрать явно; конвертер по умолчанию не доказывает, что Granite-Docling запускался. Политика повторных попыток по-прежнему принадлежит окружающему приложению или сервису, а роутингу по-прежнему нужны собственные метки качества и пороги.
Выбор пути извлечения
Карта решений выстраивает предыдущие разделы по порядку: каждый вопрос направляет документ по самому дешёвому пути, который даёт нужный результат.
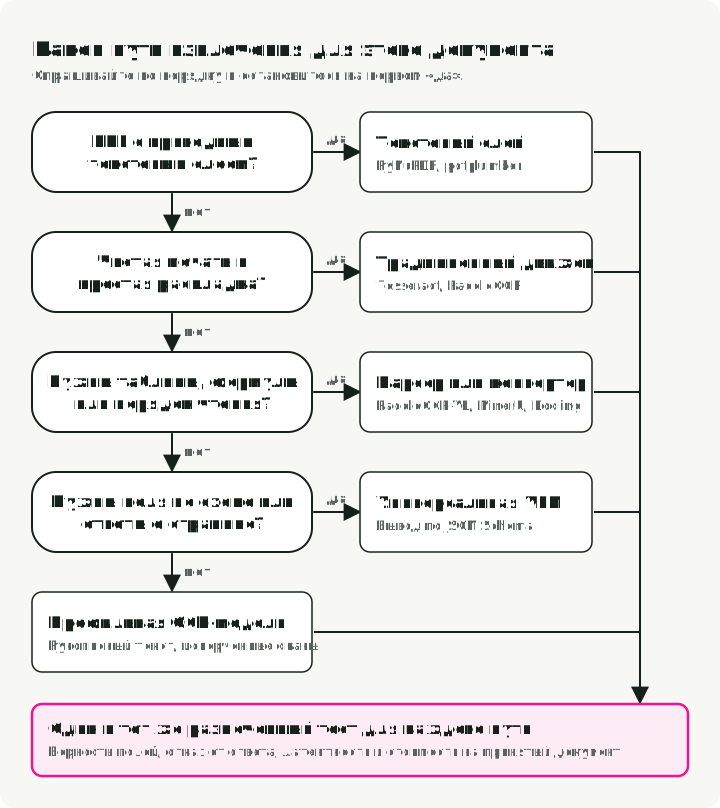
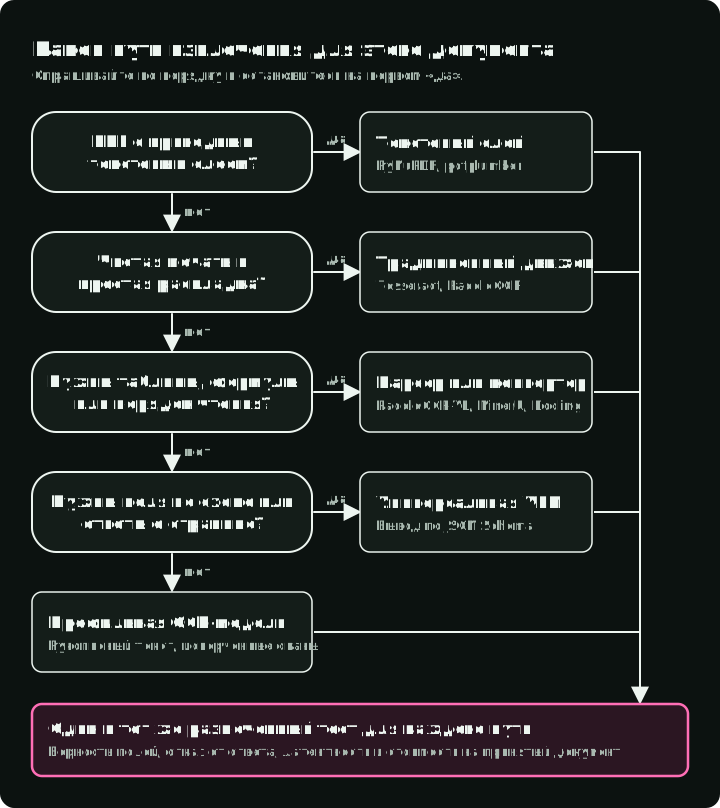
Каждый конечный узел всё равно проходит один и тот же размеченный тест. Карта даёт первого кандидата, а не окончательный выбор.
Тестирование VLM через OpenRouter
OpenRouter предоставляет OpenAI-совместимый шлюз к моделям нескольких провайдеров. ID моделей и поддерживаемые возможности запросов меняются, поэтому перед запуском примера сверьтесь с актуальным каталогом шлюза.
Для примера нужны pip install openai, OPENROUTER_API_KEY, доступ к сети, локальный receipt.jpg и ID моделей, которые OpenRouter всё ещё поддерживает.
import base64
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=os.environ["OPENROUTER_API_KEY"],
)

def extract_text(
    image_path: str,
    model: str,
    prompt: str = "Extract all text from this image, preserving layout as markdown.",
    **request_args,
) -> str:
    with open(image_path, "rb") as f:
        image_b64 = base64.b64encode(f.read()).decode()

    response = client.chat.completions.create(
        model=model,
        messages=[{
            "role": "user",
            "content": [
                {"type": "text", "text": prompt},
                {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{image_b64}"}},
            ],
        }],
        max_tokens=4096,
        **request_args,
    )
    choice = response.choices[0]
    if choice.finish_reason != "stop":
        raise RuntimeError(f"{model} did not finish: {choice.finish_reason}")
    if not choice.message.content:
        raise RuntimeError(f"{model} returned no text (finish_reason={choice.finish_reason})")
    return choice.message.content

# Compare models by changing one string
models = [
    "google/gemini-3.8-flash",
    "anthropic/claude-sonnet-5",
    "qwen/qwen3.8-27b",
]
for model in models:
    print(f"\n--- {model} ---\n{extract_text('receipt.jpg', model)[:200]}...")
Каталог моделей OpenRouter на 2026-10-02 перечислял google/gemini-3.8-flash, anthropic/claude-sonnet-5 и qwen/qwen3.8-27b с входом изображений и параметрами structured output. Поддержка в каталоге не доказывает, что именно этот запрос пройдёт на каждом маршрутизируемом эндпоинте.
Для структурированного извлечения используйте response_format с JSON Schema, если выбранная модель и шлюз её поддерживают. Это может сделать ответ пригодным для разбора, но не проверяет извлечённые значения по изображению. С OpenRouter параметр provider.require_parameters заставляет запрос завершиться ошибкой, если ни один маршрутизируемый эндпоинт не поддерживает все запрошенные параметры, вместо отката на эндпоинт, который не может соблюсти схему.
Пример переиспользует extract_text из предыдущего блока и передаёт схему через его дополнительные аргументы запроса. Ему нужна модель с поддержкой JSON Schema.
import json

nullable = {"type": ["string", "null"]}
receipt_schema = {
    "type": "object",
    "properties": {
        "vendor": nullable,
        "date": nullable,
        "items": {
            "type": ["array", "null"],
            "items": {
                "type": "object",
                "properties": {"description": nullable, "amount": nullable},
                "required": ["description", "amount"],
                "additionalProperties": False,
            },
        },
        "total": nullable,
    },
    "required": ["vendor", "date", "items", "total"],
    "additionalProperties": False,
}
prompt = (
    "Extract only visible receipt fields. Copy amounts as source strings. "
    "Use null for absent or unreadable values; do not infer them. "
    "Use null for an unreadable item list, and [] only when no items are present."
)

receipt = json.loads(extract_text(
    "receipt.jpg",
    "google/gemini-3.8-flash",
    prompt=prompt,
    response_format={
        "type": "json_schema",
        "json_schema": {"name": "receipt", "strict": True, "schema": receipt_schema},
    },
    extra_body={"provider": {"require_parameters": True}},
))
Строгий режим в стиле OpenAI требует, чтобы каждое свойство было в required, и additionalProperties: false, поэтому значение, которое может отсутствовать, типизируется как nullable, а не опускается. Промпт вместе с nullable-типами позволяет модели вернуть null вместо выдуманного значения.
Храните скопированные строки сумм рядом с нормализованными значениями. Разбирайте деньги дальше по цепочке с помощью десятичной или целочисленной арифметики в минимальных единицах валюты при явно заданных валюте и локали; валидность по схеме не проверяет итог платежа. Критические поля со значением null отправляйте на проверку.
Деплой OCR в продакшене
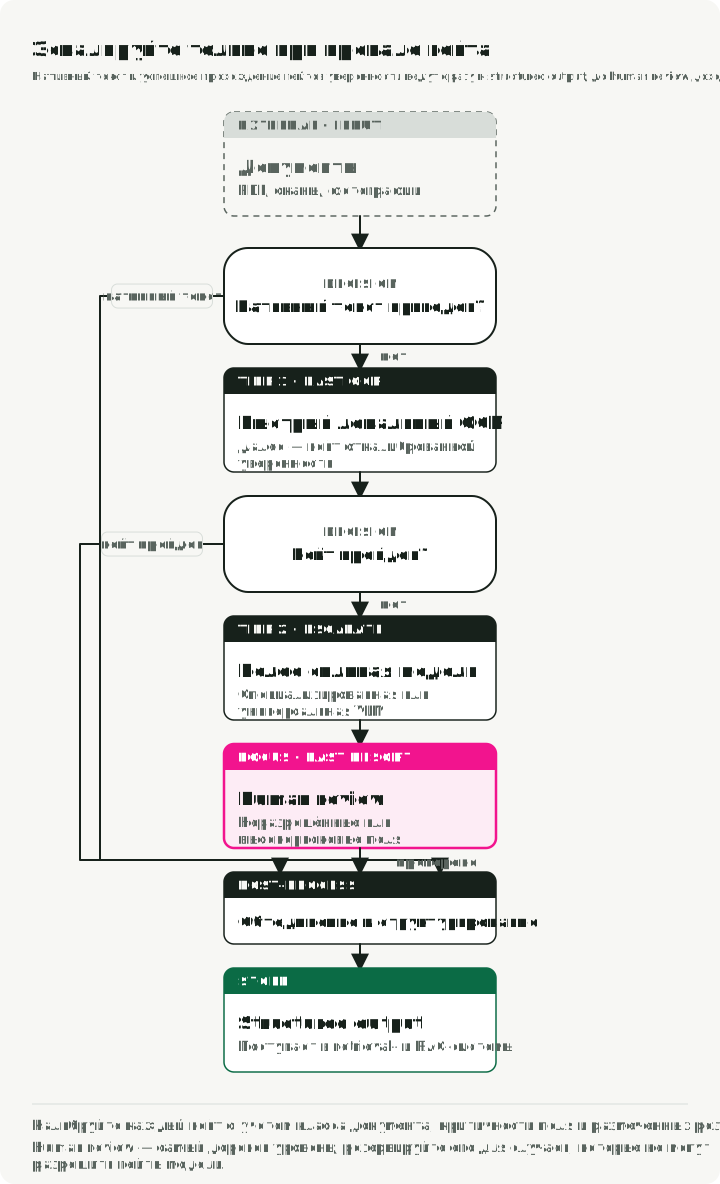
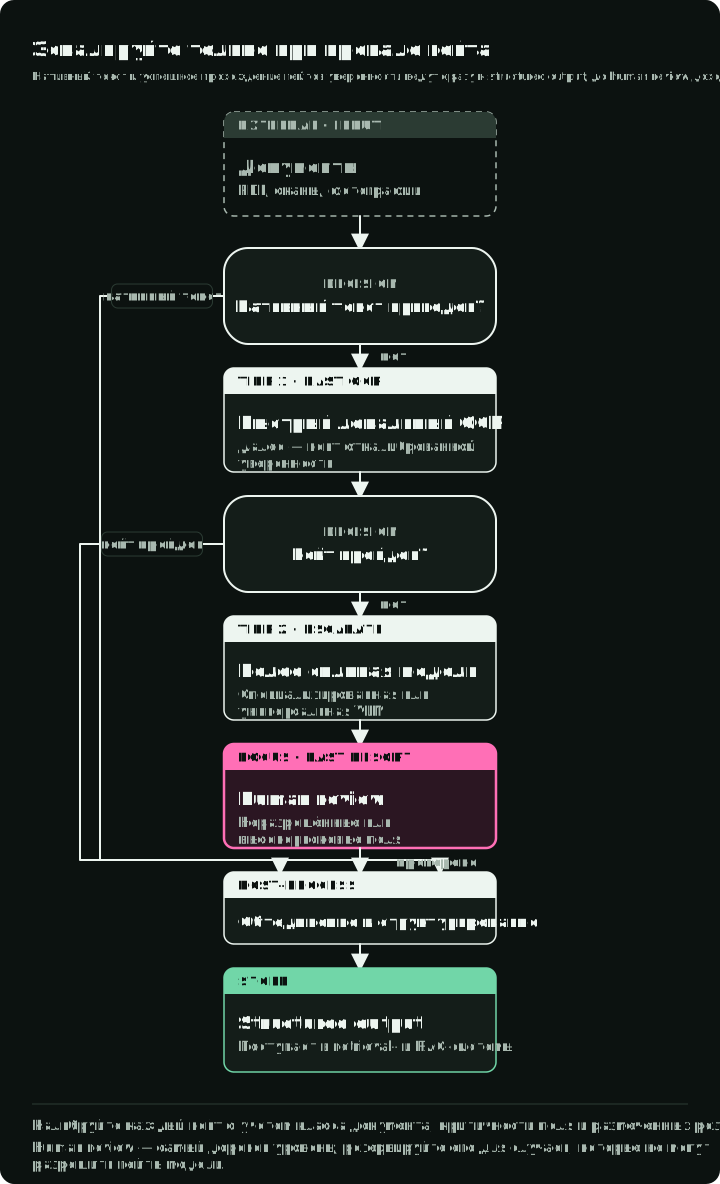
Многоуровневая архитектура может разделить предобработку на CPU и инференс на GPU или через API и оставить дорогие пути для документов, которым они нужны. На схеме показаны уровни по возрастанию стоимости, проверка, которая принимает страницу на каждом уровне, и сбой, который отправляет её на следующий.
Паттерн многоуровневого отката
Начните с самого дешёвого пути, который достигает целевого качества, затем откалибруйте роутинг на размеченных страницах:
- Проверьте встроенный текст (уровень 0). Для PDF проверьте текстовый слой с помощью
PyMuPDFилиpdfplumberдо растеризации, но убедитесь, что слой полный.
- Попробуйте быструю модель. Используйте традиционный движок для классов документов, на которых он достигает цели.
- Оцените откалиброванную уверенность. Объедините уверенность модели с классом документа, критичностью поля и правилами валидации.
- Передайте более сильной модели. Отправляйте неуверенные страницы в специализированную или универсальную VLM.
- Передайте человеку сбои с высоким риском. Ручная проверка — отдельный уровень для значений, цена ошибки в которых выше выгоды от автоматизации.
Замечание об уверенности: сырые вероятности символов не откалиброваны автоматически под корректность полей. Функция с весами по площади ниже — это базовый вариант для агрегации на уровне страницы, а не универсальный роутер. Откалибруйте её на размеченных страницах и задайте для критических полей отдельные правила, потому что среднее по странице может скрыть неверный ID или итог.
def area_weighted_confidence(page):
    """Compute area-weighted confidence from one PaddleOCR 3.x result."""
    total_area, weighted_sum = 0, 0
    for (x_min, y_min, x_max, y_max), score in zip(
        page["rec_boxes"], page["rec_scores"]
    ):
        width = int(x_max) - int(x_min)
        height = int(y_max) - int(y_min)
        area = width * height
        weighted_sum += score * area
        total_area += area
    return weighted_sum / total_area if total_area > 0 else 0

assert area_weighted_confidence({
    "rec_boxes": [[0, 0, 300, 300]], "rec_scores": [0.5]
}) == 0.5
Чтобы задать порог, разметьте набор страниц одного класса документов и запишите, верны ли на каждой странице все критические поля. Выберите самый низкий порог уверенности, при котором принятые страницы укладываются в вашу целевую ошибку по критическим полям, и отправляйте страницы ниже него на следующий уровень. Функция ниже делает это для одного класса документов.
def pick_threshold(scores, correct, max_error):
    """Lowest threshold whose accepted pages meet the error target, or None."""
    for threshold in sorted(set(scores)):
        accepted = [ok for s, ok in zip(scores, correct) if s >= threshold]
        if accepted and accepted.count(False) / len(accepted) <= max_error:
            return threshold
    return None  # no threshold meets the target: send every page to the next tier

scores = [0.95, 0.91, 0.88, 0.80, 0.72, 0.60]
correct = [True, True, True, False, True, False]  # all critical fields right?
assert pick_threshold(scores, correct, max_error=0.0) == 0.88
assert pick_threshold(scores, correct, max_error=0.25) == 0.72
На схеме шесть размеченных страниц из assert-проверок расположены на шкале уверенности и отмечен порог, который выбирает каждая целевая ошибка.
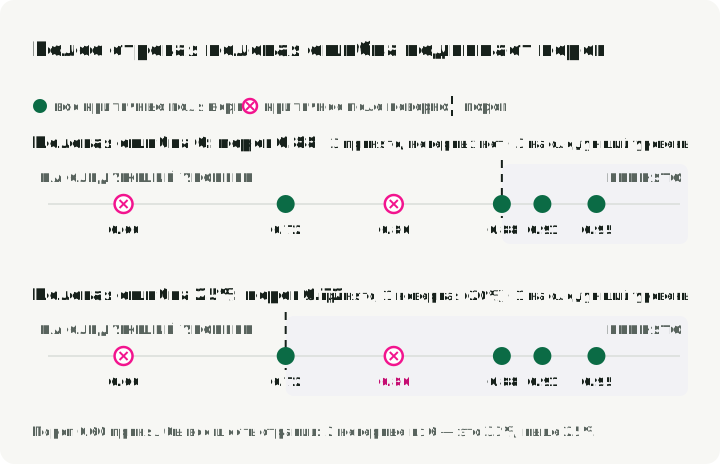
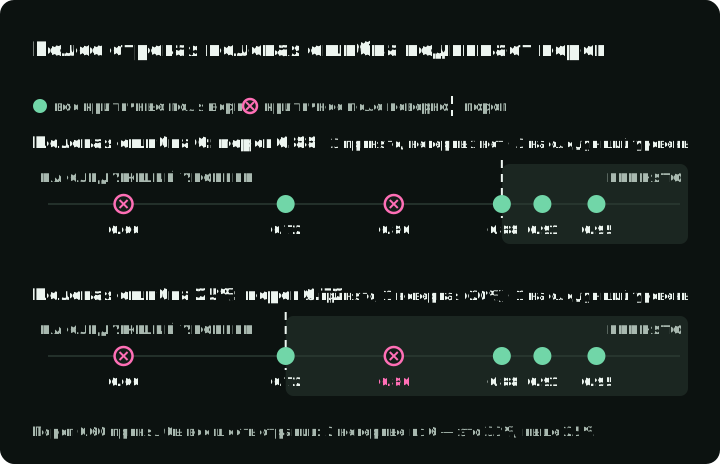
Более строгая целевая ошибка поднимает порог и отправляет больше страниц более сильной модели. Повторяйте калибровку для каждого класса документов, потому что одна и та же оценка может означать разную точность на чеках и на договорах.
Паттерны сервинга
Как запускать каждый уровень, зависит от того, как приходят страницы:
- Пакетные задания (конвертация архива, ежемесячные отчёты): читайте страницы из очереди и запускайте на GPU-воркерах, которые масштабируются до нуля между заданиями.
- Интерактивные запросы: держите GPU «тёплым» или используйте хостинговый API, потому что холодный старт модели добавляет время загрузки к ожиданию пользователя.
- Растеризация и очистка изображений: запускайте на CPU-воркерах, которые масштабируются отдельно от GPU-инференса.
- VLM с открытыми весами: обслуживайте их через vLLM или SGLang, которые батчат параллельные запросы на одном GPU.
Измерение результатов
Для каждой запланированной пары «движок / документ» сохраняйте результат со статусом успеха, ошибки или пропуска. Неудачные, пустые и усечённые выводы остаются в знаменателе попыток вместе с потраченной на них стоимостью. Указывайте долю завершённых документов, критические ошибки среди автоматически принятых, долю ручных проверок, сквозную латентность p50/p95 и стоимость на успешно обработанный документ. Измеряйте латентность страницы при реальном разрешении, размере батча, железе или регионе провайдера и длине вывода. Включайте в итог предобработку и повторные попытки; время одной только модели не позволяет оценить стоимость успешной страницы. Переиспользуйте объекты конвертера для замеров на прогретой системе, а инициализацию записывайте отдельно. Репозиторий OCR Gauntlet записывает результаты в этом формате; как его запустить, показано в последнем разделе.
Анализ стоимости в масштабе
Универсальной границы окупаемости по числу страниц между API и self-hosting не существует. Стройте сравнение на одной и той же нагрузке:
| Компонент стоимости | Путь через API | Путь self-hosted |
|---|---|---|
| Инференс | Актуальная цена за страницу или за токены | GPU-часы при измеренных страницах в час |
| Простаивающие мощности | Обычно берёт на себя провайдер | Утилизация и запас мощности |
| Инженерная работа | Интеграция и мониторинг провайдера | Деплой, обновления, observability и дежурства |
| Работа с данными | Передача, хранение и региональные условия | Хранилище, сеть и средства контроля соответствия |
| Сбои качества | Повторные попытки и ручная проверка | Повторные попытки и ручная проверка |
Используйте общую формулу: monthly pages × cost per successful page + review cost + fixed operating cost. «Успешная страница» должна соответствовать одним и тем же критериям по тексту, таблицам и полям на обоих путях. Цены провайдеров и аренда GPU меняются слишком быстро, чтобы закладывать их в долговечную закупочную оценку.
Обработка ошибок: проблема галлюцинаций
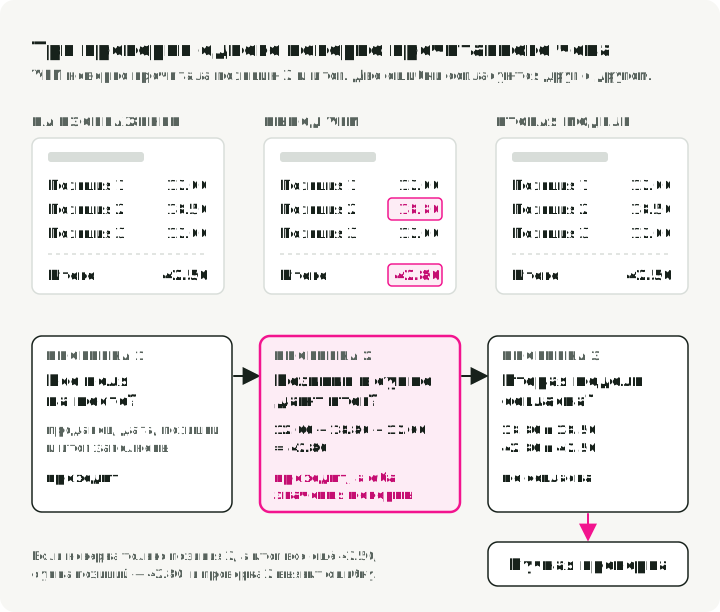
Ошибки VLM могут быть правдоподобными по контексту и неверными по факту. Итог чека «$42.50» может вернуться как «$42.80»: допустимая сумма, которую не отметит ни одна проверка орфографии.
Синтетический пример сбоя: на изображении чека три позиции — 12.00, 18.50 и 12.00 — и итог 42.50. VLM читает вторую позицию как 18.80, а итог как 42.80. Позиции всё равно складываются в итог, поэтому внутренняя арифметика проходит, а оба значения неверны. Поэтому для валидации нужны метки, привязанные к изображению, или независимый путь проверки, а не только проверки согласованности.
На схеме три проверки выполняются на этом чеке: проверка схемы и проверка суммы проходят, и только вторая модель ловит обе ошибки чтения.
Несколько практических мер:
- Сверка арифметики. Если схема содержит нужные поля, проверьте
subtotal + tax + fees + shipping - discountsс допуском на округление в валюте относительно указанного итога. Отсутствующие компоненты и расхождения отправляйте на проверку. - Проверки дат, телефонов и валют. Разбирайте даты парсером дат и отвергайте невозможные значения. Проверяйте количество цифр в телефонных номерах и форматы валют шаблонами.
- Второй путь извлечения. Прогоняйте критические поля через другую модель или другой OCR-движок и помечайте расхождения. Совпадение повышает уверенность, только если у двух путей достаточно разные виды сбоев; это не доказательство корректности.
Проверка сверки принимает скопированные строки сумм и использует Decimal, поэтому в сравнение не попадает округление чисел с плавающей точкой. Assert-ы воспроизводят пример с чеком выше.
from decimal import Decimal

def reconcile(subtotal, tax, fees, shipping, discounts, total, tolerance="0.01"):
    """True when the stated total matches its components within tolerance."""
    parts = [subtotal, tax, fees, shipping, discounts, total]
    if any(p is None for p in parts):
        return False  # a missing component goes to review
    s, t, f, sh, d, tot = (Decimal(p) for p in parts)
    return abs(s + t + f + sh - d - tot) <= Decimal(tolerance)

items = ["12.00", "18.80", "12.00"]  # the image shows 18.50
subtotal = str(sum(Decimal(i) for i in items))
assert reconcile(subtotal, "0", "0", "0", "0", "42.80")  # passes, and both values are wrong
assert not reconcile(subtotal, "0", "0", "0", "0", "42.50")  # one misread value is caught
assert not reconcile(subtotal, None, "0", "0", "0", "42.80")  # missing tax goes to review
Сверка ловит одну неверно прочитанную сумму. Она не поймает два неверных прочтения, которые согласуются друг с другом, поэтому критическим полям по-прежнему нужен второй путь извлечения.
Запустите сравнение на своих страницах
Репозиторий OCR Gauntlet запускает несколько OCR-движков на одних и тех же страницах и записывает одну строку результата на движок и страницу, включая сбои. Он сравнивает страницы-изображения; проверку текстового слоя уровня 0 он не покрывает.
Раннер работает в четыре шага:
- Манифест перечисляет страницы и хеши их эталонного текста.
- Раннер отправляет каждую страницу в каждый движок.
- Он записывает одну строку JSONL на движок и страницу со статусом успеха, ошибки или пропуска, сырым выводом, временем и стоимостью.
- Сводка показывает долю завершённых, CER на проверенных страницах и стоимость успешной страницы. Неудачные и пропущенные пары остаются в знаменателе доли завершённых.
Первый запуск использует сгенерированные страницы и Tesseract, поэтому ему нужны Python 3.12, uv и системная установка Tesseract, но не нужны API-ключи:
uv sync --locked --extra tesseract --extra notebooks
uv run python scripts/make_fixture.py data/demo
uv run ocr-gauntlet data/demo/manifest.json --engines tesseract --output results/demo.jsonl
Сгенерированные страницы лишь проверяют, что пайплайн работает; качество OCR они не измеряют. Для реального теста на чеках импортируйте образцы CORD командой uv run python scripts/download_samples.py --dataset cord --count 2 --output data/cord и подготовьте проверенный эталон, как описано в README репозитория. Другие движки добавляются через --engines; хостинговым движкам также нужен --allow-remote, потому что они загружают ваши страницы.
В сводке сначала смотрите долю завершённых: движок, который падает на трети страниц, не кандидат, каким бы ни был его CER. Затем сравнивайте CER на проверенных страницах, а потом стоимость успешной страницы, которая включает расходы на неудачные попытки.
Ключевые выводы
- Подбирайте уровень модели под размеченный класс документов. Для чистого текста может хватить традиционных движков; специализированные и универсальные VLM должны оправдать дополнительную стоимость на более сложных страницах.
- Не объединяйте разнородные лидерборды. Метрики OmniDocBench и предпочтения OCR Arena отвечают на разные вопросы.
- Калибруйте роутинг. Пороги уверенности, классы документов, критичность полей и политика ручной проверки относятся к одной оценке.
- Проверяйте правдоподобный вывод. Соответствие схеме и внутренняя арифметика не доказывают, что значение есть на изображении.
- Считайте цену успешных страниц. При сравнении API и self-hosting включайте повторные попытки, проверку, фиксированные операционные расходы и проверки качества.
Источники
- OCR Arena Leaderboard - краудсорсинговые парные сравнения моделей
- Репозиторий OCR Gauntlet - запускаемое сравнение OCR-движков на одних и тех же страницах, с бэкендами Docling и стоимостью на успешную страницу
- OmniDocBench - сквозной эвал разбора документов
- dots.ocr - около 3B параметров в сумме, включая языковую модель на 1.7B
- PaddleOCR - набор инструментов и модели для традиционного OCR
- OpenRouter - единый шлюз доступа для A/B-тестирования моделей