OCR w 2026 roku: klasyczne pipeline’y, modele VLM i Document AI

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Ten przewodnik jest dla inżynierów, którzy wybierają OCR i ekstrakcję danych z dokumentów na potrzeby wyszukiwania, retrieval-augmented generation (RAG) lub agentów AI. Wyjaśnia, czym tradycyjne silniki różnią się od modeli wizyjno-językowych, jak oceniać tekst, tabele i pola oraz jak kierować trudne dokumenty do innego modelu lub do weryfikacji przez człowieka.
Modele wizyjno-językowe (VLM) radzą sobie z układem strony, pismem odręcznym, tabelami i zdegradowanymi obrazami, które psują prosty pipeline rozpoznawania tekstu. Tradycyjne silniki pozostają konkurencyjne przy czystym druku, zwłaszcza gdy liczą się opóźnienia na CPU i koszt eksploatacji. Poniższy wycinek z ustaloną datą obejmuje PaddleOCR-VL 1.6 i dots.mocr, które różnią się wymaganiami sprzętowymi, prywatnością i formatem wyników. Przed podjęciem bieżącej decyzji sprawdź każdy projekt.
Skróconą wersję poświęconą wyborowi modelu znajdziesz w artykule Best OCR Models in 2026: Classical OCR, PaddleOCR-VL, VLMs.
OCR wyznacza jakość dalszego przetwarzania
OCR od dawna napędza archiwa, systemy pocztowe, narzędzia dostępności i zarządzanie dokumentami. RAG i agenci dokumentowi sprawili, że jego błędy zobaczyło szersze grono inżynierów: model dalej w łańcuchu nie odzyska tekstu ani struktury tabeli, które odrzuciła ekstrakcja.
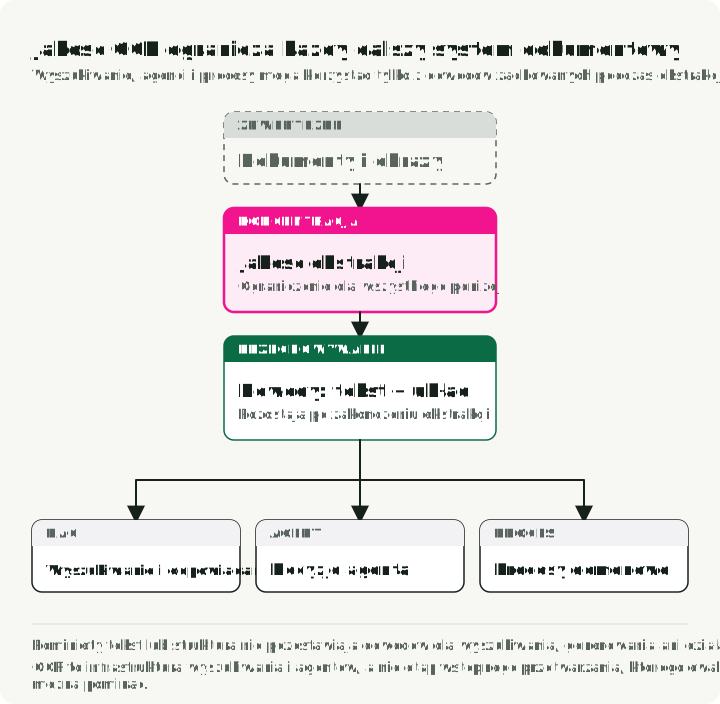
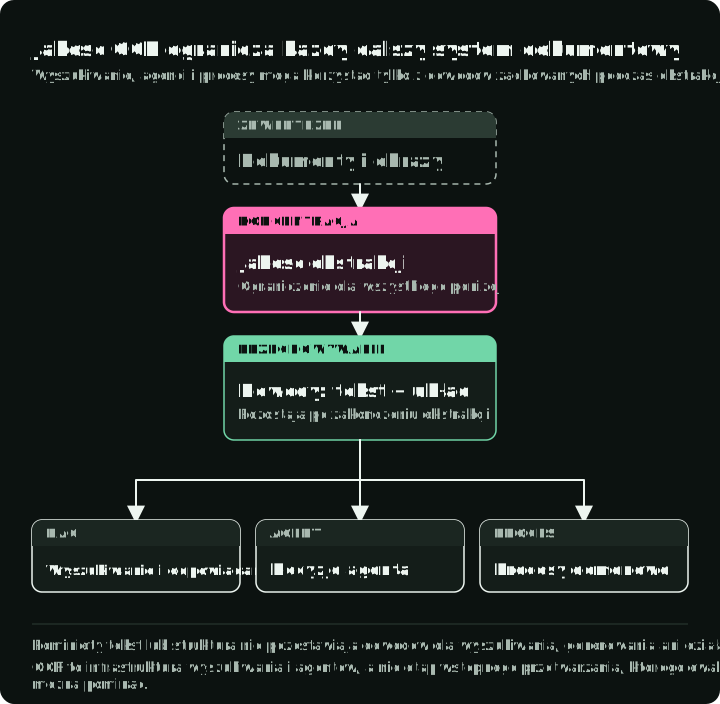
System RAG nie wyszuka tekstu, który OCR pominął lub źle odczytał. Jeśli ekstrakcja zniekształci tabelę, błędnie odczyta datę albo pominie akapit, późniejsze zmiany w dzieleniu na fragmenty i w metodach embedding nie przywrócą brakującej informacji. Takie błędy mogą ukryć klauzulę umowy, zmienić sumę na fakturze lub zepsuć dokumentację medyczną.
OCR jest więc częścią infrastruktury wyszukiwania i agentów, obok parsowania, dzielenia na fragmenty, metod embedding i indeksowania. Jego błędy wymagają osobnej ewaluacji, zamiast ginąć w jednym końcowym wyniku.
Co OCR oznacza w epoce modeli bazowych
OCR zamienia tekst na obrazie w znaki czytelne dla maszyny. Document AI to szerszy system wokół niego: analiza układu, parsowanie tabel i wzorów, ekstrakcja pól, wnioskowanie semantyczne, pochodzenie danych i walidacja. Autorzy GOT-OCR 2.0 nazywają modułowe pipeline’y wykrywania i rozpoznawania „OCR-1.0”, a modele end-to-end „OCR-2.0”. Ta etykieta nie powinna zacierać różnicy między rozpoznawaniem a rozumieniem dokumentu.
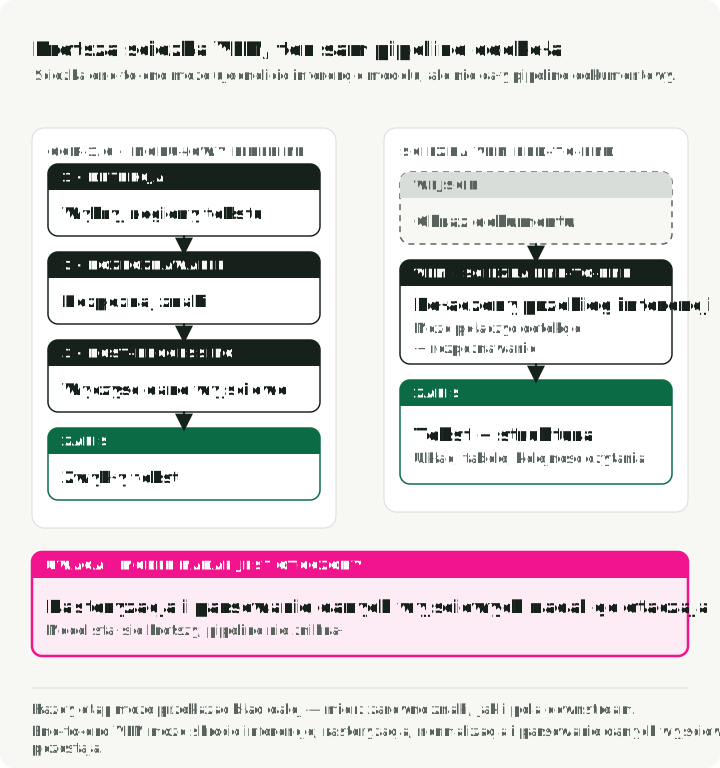
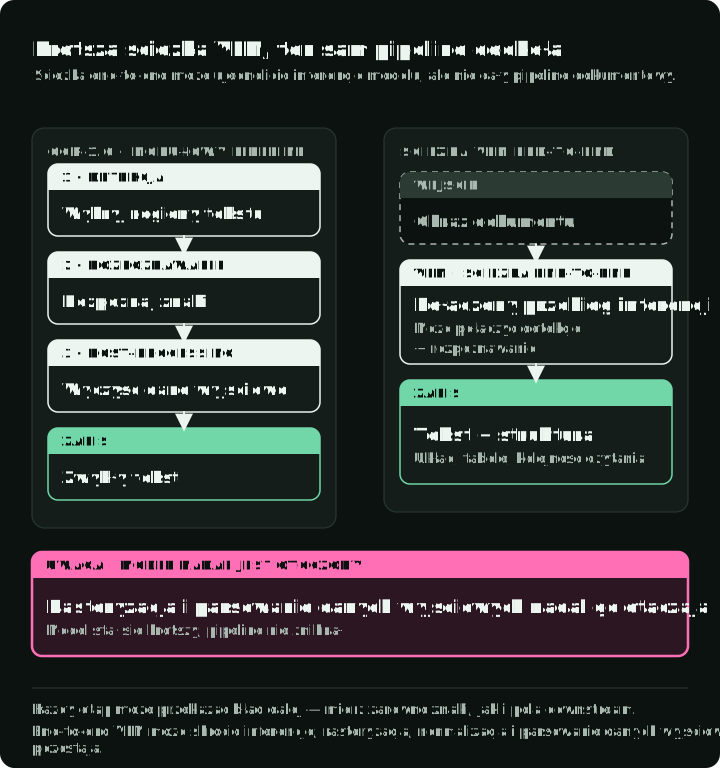
Rysunek porównuje obie ścieżki i sposób, w jaki każda zawodzi: trzy kolejne etapy po lewej nigdy nie odzyskają linii pominiętej przy wykrywaniu, pojedyncze przejście modelu po prawej zapisuje wiarygodną sumę, której nie ma na stronie, a rasteryzacja i parsowanie w obu przypadkach zostają poza modelem.
Tradycyjny pipeline OCR ma trzy główne etapy:
- Wykrywanie tekstu: lokalizuje obszary zawierające tekst (np. CRAFT, DBNet).
- Rozpoznawanie tekstu: zamienia wykryte obszary na ciągi znaków (np. CRNN).
- Post-processing: sprawdzanie pisowni i korekta za pomocą modelu językowego.
Sprawdza się to dobrze na czystych dokumentach, ale błędy wykrywania, rozpoznawania i post-processingu mogą się kumulować. Mierz zarówno dokładność znaków, jak i dokładność pól w dalszym przetwarzaniu, żeby czytelna strona nie ukryła błędnej sumy lub identyfikatora.
Niektóre ścieżki VLM end-to-end zastępują większą część tego pipeline’u enkoderem wizyjnym i dekoderem językowym. Modele takie jak GOT-OCR 2.0 potrafią zwracać tekst razem ze strukturą, a ogólne modele VLM mogą też mapować pola na żądany schemat. Na przykład ogólny VLM może odczytać „MFG: 10/24” na etykiecie jako datę produkcji, a nie datę ważności. Kompromisem są opóźnienia zależne od obciążenia, koszt GPU lub API oraz ryzyko wiarygodnego tekstu, którego nie ma na obrazie.
Praktyczne zastrzeżenie: model przyjmujący tylko obrazy wymaga zrasteryzowanych stron, podczas gdy usługa przyjmująca PDF może wykonać konwersję wewnętrznie. Prostowanie, skalowanie i czyszczenie obrazu to eksperymenty zależne od pipeline’u, a nie obowiązkowe ulepszenia. AWS Textract zaleca zachowywanie obsługiwanych formatów wejściowych zamiast bezrefleksyjnej konwersji lub zmniejszania rozdzielczości. Parsowanie i walidacja wyników nadal należą do aplikacji.
Metryki: mierzenie tego, co ważne
Każde porównanie w dalszej części przewodnika używa jednej z tych metryk. Wybierz tę, która pasuje do typu wyniku:
- CER i WER dla zwykłego tekstu. Character Error Rate i Word Error Rate zależą od decyzji o normalizacji, takich jak wielkość liter, białe znaki i interpunkcja, więc ustal protokół porównania, zanim zaczniesz porównywać modele.
- Field exact match i Field F1 dla formularzy i paragonów. Exact match jest binarny dla jednego pola; jego wskaźnik to odsetek ocenianych pól, które przeszły. Poprawność wszystkich pól w dokumencie raportuj osobno. Dla Field F1 zdefiniuj dopasowanie klucz/wartość, normalizację, pola zduplikowane i brakujące oraz agregację; poprawna kwota przypisana do złego wiersza jest błędem.
- TEDS dla tabel. Tree-Edit-Distance-based Similarity porównuje przewidziane i referencyjne drzewa HTML, wychwytując błędy struktury i zawartości komórek, które CER ukrywa.
- Porównanie kolejności czytania, gdy odbiorca potrzebuje jednej liniowej sekwencji. Porównuj bezpośrednio uporządkowane bloki lub zakresy albo użyj metryki uwzględniającej kolejność; OmniDocBench ocenia kolejność czytania osobno. Poprawne znaki i komórki tabeli nie dowodzą poprawnej kolejności na stronie wielokolumnowej.
- ANLS dla VQA na dokumentach. Average Normalized Levenshtein Similarity porównuje odpowiedzi z akceptowanymi odpowiedziami referencyjnymi. Oryginalna definicja z ST-VQA przypisuje
1 − normalized_distancetylko wtedy, gdy odległość jest ściśle mniejsza niż 0,5, a w przeciwnym razie zero; bierze najlepszy wynik spośród akceptowanych odpowiedzi referencyjnych i uśrednia go po pytaniach. DocVQA przejmuje ANLS. Przy odtwarzaniu wyniku przypnij sposób, w jaki ewaluator traktuje wielkość liter, białe znaki i normalizację odległości.
CER i WER to liczba podstawień, usunięć i wstawień podzielona przez liczbę znaków lub słów wzorca. Mogą przekroczyć jeden, gdy dominują wstawienia. Określ, czy agregacja sumuje błędy i długości wzorców w całym korpusie, czy uśrednia wyniki dokumentów. Zachowaj stronę, blok, ramkę ograniczającą, oryginalny tekst i historię normalizacji, żeby błędne pole dało się prześledzić do obrazu.
Przy wykrywaniu tekstu intersection over union (IoU) dzieli pole przecięcia przewidzianej ramki i ramki referencyjnej przez łączne pole obszaru pokrytego przez co najmniej jedną z nich. Próg IoU decyduje, czy wykryta ramka pasuje do wzorca, przed obliczeniem F1.
Tabela przypisuje każde zadanie do metryki i do błędu, który najczęściej zniekształca wynik:
| Zadanie | Metryka | Błąd, którego unikać |
|---|---|---|
| Ekstrakcja zwykłego tekstu | CER, WER | Porównywanie wyników liczonych przy różnej normalizacji |
| Pismo odręczne | CER | Stosowanie celów CER dla druku do stron odręcznych |
| Wykrywanie tekstu | F1 przy progu IoU | Podawanie F1 bez progu IoU, którego użyto |
| Formularze i paragony | Field exact match, Field F1 | Uznawanie poprawnej wartości w złym polu lub wierszu za poprawną |
| Tabele | TEDS | Ocenianie tabel przez CER, który ignoruje strukturę komórek |
| VQA na dokumentach | ANLS | Zmiana progu 0,5 lub normalizacji odpowiedzi |
| Konwersja całej strony | Edit distance + reading order | Podawanie dokładności tekstu bez sprawdzenia kolejności bloków |
Język także wpływa na wybór. Tekst chiński i japoński nie ma spacji między słowami, więc WER zależy od segmentatora słów; dla tych pism używaj CER. Uwzględnij w oznaczonym zbiorze testowym strony z różnymi systemami pisma, jeśli występują w twoich dokumentach. Karta modelu wymieniająca 100 języków nie pokazuje jakości dla żadnego z nich, więc umieść każdy docelowy język w oznaczonym zbiorze testowym.
Do implementacji: jiwer obsługuje CER/WER od razu, a implementacje TEDS znajdziesz w repozytorium OmniDocBench.
Co mierzą benchmarki OCR, a czego nie
Publiczne zbiory danych stosują te metryki do konkretnych typów dokumentów. Rozmiary zbiorów i metryki opisują wskazaną wersję zbioru; wyniki modeli znajdziesz w aktualnym rankingu każdego projektu. Kolumna „Testuje” mówi, który z twoich dokumentów przypomina dany zbiór.
| Zbiór danych | Testuje | Rozmiar testu | Języki | Metryka główna |
|---|---|---|---|---|
| FUNSD | Łączenie klucz-wartość na zaszumionych skanach formularzy | 50 dokumentów | angielski | F1 |
| SROIE | Cztery pola paragonu (firma, data, adres, suma) | 400 obrazów testowych | angielski | F1 |
| CORD | Pozycje paragonu z hierarchicznymi etykietami | 100 paragonów | indonezyjski | F1 |
| IAM | Odręczne linie tekstu angielskiego | Zależy od podziału | angielski | CER |
| OCRBench v2 | Czytanie tekstu i wnioskowanie przez VLM w 23 zadaniach | 10 000 par QA | EN + CN | Wynik /100 |
| OmniDocBench v1.6 | Parsowanie całej strony: tekst, tabele, wzory, kolejność czytania | 1651 stron | EN + CN | Złożona |
Liczba linii testowych w IAM zależy od wybranego podziału autorów i protokołu rozpoznawania; nie zakładamy tu jednej liczby linii testowych.
Wycinek OmniDocBench v1.6
Poniższa tabela to jeden wycinek z ustaloną wersją: OmniDocBench v1.6_full, oficjalny README w commicie 09ba2b606662695b16aafe5f5e36b7ef020e11a8, dostęp 2026-08-09.
| Model | Rozmiar | Overall ↑ | Text Edit ↓ | Table TEDS ↑ |
|---|---|---|---|---|
| GLM-OCR | 0.9B | 95.22 | 0.044 | 92.83 |
| PaddleOCR-VL-1.5 | 0.9B | 94.93 | 0.038 | 91.67 |
| Gemini 3 Flash | — | 92.62 | 0.066 | 89.29 |
| dots.ocr | 3B | 90.77 | 0.048 | 87.18 |
Przypięty README podaje PaddleOCR-VL 1.5. PaddleOCR podaje dla wersji 1.6 wynik 96,3 w tej samej wersji benchmarku; to własny przebieg producenta i nie należy do tej tabeli.
Wniosek dotyczy wyłącznie tej wersji OmniDocBench: sam rozmiar modelu nie przewiduje wyniku parsowania dokumentów. Późniejsze wersje ewaluatora zmieniają dopasowanie, więc porównuj wyniki tylko przy jednym przypiętym ewaluatorze. Wynik złożony obejmuje odległość edycyjną tekstu, TEDS tabel i Character Detection Matching (CDM) wzorów. CDM renderuje przewidziane i referencyjne wzory, dopasowuje ich znaki i sprawdza ich względne położenie, zanim oceni dopasowania za pomocą F1. Porównuje wyrenderowane wzory, a nie surowe ciągi LaTeX. Kolejność czytania wymaga osobnego wyniku.
Różnica między benchmarkiem a areną
Automatyczne rankingi benchmarków mogą być sprzeczne z preferencjami ludzi.
W OCR Arena użytkownicy głosują w ciemno na wyniki w bezpośrednich pojedynkach. Na dzień 2026-08-09 OCR Arena umieściła Gemini 3 Flash wyżej niż GLM-OCR, podczas gdy powyższa tabela OmniDocBench daje wyższy wynik GLM-OCR (95,22 wobec 92,62). Bieżąca kolejność na arenie zmienia się wraz z nowymi pojedynkami, więc nie jest odtwarzalnym historycznym wycinkiem benchmarku. Nie łącz obu rankingów w jeden wynik.
Rysunek pokazuje rozbieżność: GLM-OCR i Gemini 3 Flash zamieniają się miejscami między dwoma rankingami. Pod spodem widać, z jakich stron korzysta każdy z nich, kto ocenia i co dostajesz.
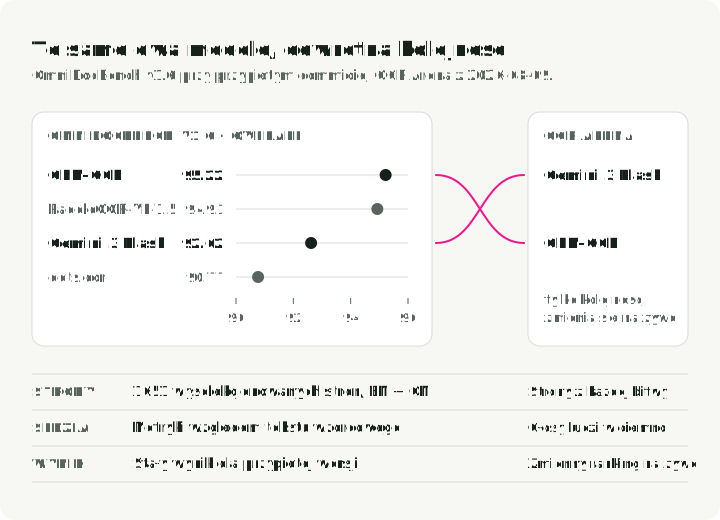
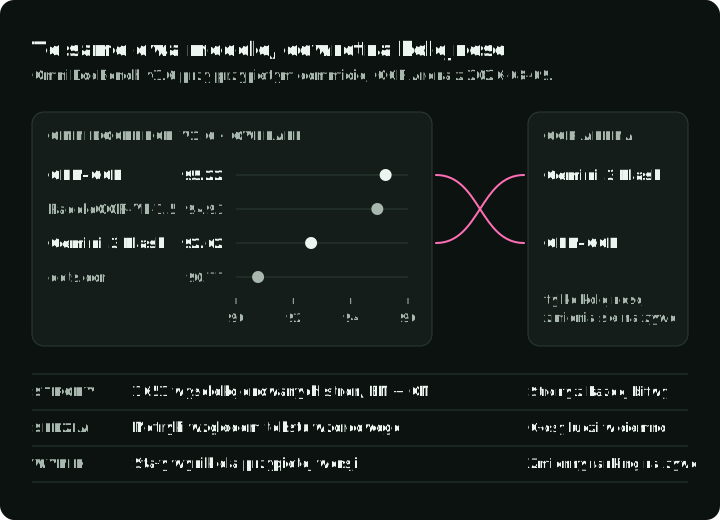
Prawdopodobne przyczyny to skład dokumentów, format wyników, zakres języków i kryteria sędziów. Opublikowane liczby przydają się do wstępnej selekcji, ale ostateczny wybór wymaga zbioru wydzielonego z docelowego obciążenia.
Tradycyjne silniki OCR: wciąż aktualne
Tradycyjne silniki to użyteczne punkty odniesienia, bo mogą działać lokalnie na CPU. Ich opóźnienia i dokładność zależą od wybranego modelu, rozdzielczości strony, języka, wstępnego przetwarzania i sprzętu, więc testuj je na tych samych oznaczonych stronach, których używasz do oceny modeli VLM.
| Silnik | Wdrożenie | Punkt odniesienia dla |
|---|---|---|
| Tesseract 5.5 | Lokalnie na CPU | Czysty druk i utrwalone systemy pisma |
| EasyOCR | Lokalnie w PyTorch na CPU lub GPU | Prototypy i tekst w scenach |
| PaddleOCR 3.x | Lokalnie na CPU, GPU i warianty mobilne | OCR wielojęzyczny i narzędzia wdrożeniowe |
Tesseract do czystego druku
Tesseract (v5.5.x, Apache 2.0) to dojrzały silnik działający głównie na CPU, z ponad 100 paczkami językowymi. Dokładność dla czystego druku może być wysoka po odpowiedniej rasteryzacji i wstępnym przetwarzaniu, ale pismo odręczne, tekst w scenach i złożone układy wymagają osobnych testów. Jego główną zaletą jest małe, lokalne wdrożenie na CPU.
Ustaw tryb segmentacji strony (--psm) dla każdego typu dokumentu; zły tryb gubi kolumny lub skleja linie. Fragment wymaga pip install pytesseract pillow, binarki Tesseract z angielskimi danymi językowymi i lokalnego pliku receipt.jpg.
import pytesseract
from PIL import Image

# --psm 6: treat the image as one uniform block of text, which suits a receipt
text = pytesseract.image_to_string(Image.open("receipt.jpg"), lang="eng", config="--psm 6")
EasyOCR
EasyOCR łączy detektor CRAFT z rozpoznawaczem CRNN. Z pełną akceleracją GPU w PyTorch to szybka opcja do prototypowania i tekstu w scenach. Zwraca tylko linie i ramki, bez układu ani struktury tabel.
Fragment wymaga pip install easyocr, PyTorch, pobranych wag modeli EasyOCR i lokalnego pliku receipt.jpg.
import easyocr

# Three lines for complete OCR
reader = easyocr.Reader(["en"])
result = reader.readtext("receipt.jpg")
# Returns: [(bbox, text, confidence), ...]
PaddleOCR 3
PaddleOCR 3 udostępnia utrzymywane pipeline’y OCR, parsowania dokumentów i wdrożeń. Obecny quick start używa API predict() i jawnych ustawień orientacji. Przypnij pakiet paddleocr i wybrany pipeline, bo przykłady z wersji 2.x używające .ocr(..., cls=True) nie pasują do API wersji 3.x.
Wymaga środowiska PaddlePaddle, co dodaje drugi framework do stosu opartego na PyTorch. Rozpoznawanie tekstu w PaddleOCR to inny pipeline niż PaddleOCR-VL, parser dokumentów z następnej sekcji.
Fragment wymaga pip install "paddleocr>=3,<4", zgodnego środowiska PaddlePaddle, pobranych wag modeli i lokalnego pliku receipt.jpg.
from paddleocr import PaddleOCR

ocr = PaddleOCR(
    use_doc_orientation_classify=False,
    use_doc_unwarping=False,
    use_textline_orientation=False,
)

for result in ocr.predict("receipt.jpg"):
    result.print()
    result.save_to_json("output")
Każdy wynik zawiera rec_texts, rec_scores i rec_boxes. Sekcja o routingu używa dwóch ostatnich do oceny strony.
Wyspecjalizowane i ogólne opcje VLM
Krzywe paragony, przekrzywione etykiety produktów, pismo odręczne i gęste układy to miejsca, w których warto przetestować wyspecjalizowane lub ogólne modele VLM na tle tradycyjnych silników.
Rysunek pokazuje, co każda rodzina modeli zwraca dla tej samej strony, jaki jest jej główny kompromis i gdzie może działać. Tryb wdrożenia zależy od produktu, więc rysunek wymienia go osobno od szerokości zadań.
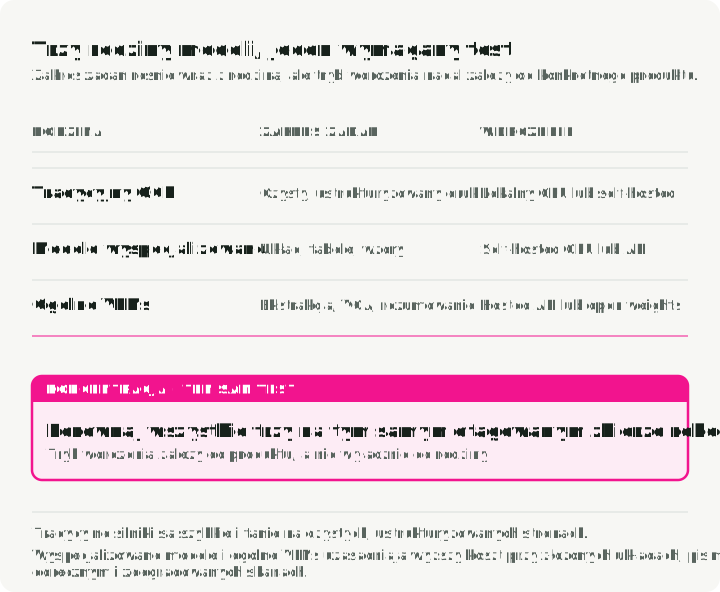
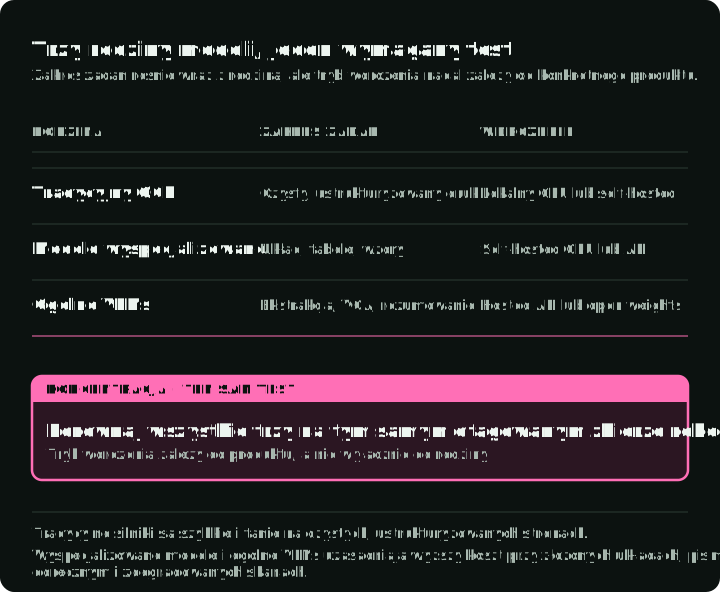
Wyspecjalizowane modele dokumentów
Modele w tej sekcji sprawdzono 2026-10-02. Lista nie jest bieżącym rankingiem; mówi, na jakim problemie z dokumentami warto wypróbować dany model.
| Model | Wynik | Gdzie działa | Wypróbuj, gdy |
|---|---|---|---|
| PaddleOCR-VL 1.6 | Analiza układu, potem VLM 0.9B czyta każdy obszar | Własna infrastruktura | Wielojęzyczne strony z układem; producent podaje 109 języków |
| GOT-OCR 2.0 | Zwykły tekst, Markdown, LaTeX | Własna infrastruktura, 580M parametrów | Wzory i tekst mieszany na jednej stronie |
| dots.mocr | Układ i tekst; wykresy i rysunki jako kod SVG | Własna infrastruktura, 3B parametrów | Strony z wykresami lub diagramami, które potrzebujesz jako strukturę |
| DeepSeek-OCR2 | Markdown z ramkami ograniczającymi | Własna infrastruktura, vLLM lub Transformers | Długie dokumenty w dużym wolumenie; strona zużywa od 256 do 1120 jednostek token dla obrazu |
| Mistral OCR 4.1 | Markdown, ramki akapitów, etykiety bloków, pewność bloku | Hostowane API (mistral-ocr-4-1) | Chcesz API i wynik pewności dla każdego bloku |
| Granite-Docling 258M | DocTags, konwertowane do DoclingDocument | Własna infrastruktura, w Docling | Mały lokalny model do konwersji w Docling |
| olmOCR | Zwykły tekst lub Markdown w kolejności czytania | Własna infrastruktura, VLM 7B na GPU | Linearyzacja PDF-ów do tekstu dla RAG lub danych treningowych |
Traktuj wartości przepustowości i pamięci jako zależne od sprzętu i zbioru danych; mierz szczytowe zużycie pamięci z własnym środowiskiem uruchomieniowym, precyzją, rozmiarem obrazu i limitem wyniku. Skalibruj pewność bloków Mistrala względem poprawności pól, zanim zaczniesz automatycznie akceptować wartości. Przypnij jawną wersję modelu w porównaniach, bo alias latest może się zmienić.
modele VLM z czołówki
Ogólne modele VLM to kolejna opcja, gdy zadanie łączy ekstrakcję z rozumowaniem wizualnym lub semantycznym. Poniższych kandydatów sprawdzono 2026-10-02 i użyto ich w przykładzie z gatewayem poniżej. To wstępna lista, a nie ranking OCR:
- Gemini 3.8 Flash (Google): Model multimodalny dostępny ogólnie, z wejściem obrazowym i ustrukturyzowanymi danymi wyjściowymi. Przy rozpoczynaniu nowego porównania użyj jego stabilnego identyfikatora.
- Claude Sonnet 5 (Anthropic): Generacja Sonnet wydana 2026-06-30, do porównania w wersji hostowanej. Przetestuj wierność transkrypcji i ekstrakcję pól na własnych dokumentach; ogólna poprawa rozumowania nie dowodzi dokładności OCR.
- Qwen3.8-27B (Alibaba): Model wizyjno-językowy z otwartymi wagami na licencji Apache 2.0, który można testować przez gateway lub uruchomić na własnej infrastrukturze. Rozmiar 27B czyni go innym wyborem wdrożeniowym niż wcześniejszy Qwen3-VL 8B, który pozostaje przydatnym mniejszym punktem odniesienia, gdy brakuje pamięci.
Dodaj nowe wydanie do zbioru testowego. Używaj go na produkcji dopiero po tym, jak przejdzie to samo porównanie: poprawność pól, powstrzymanie się od odpowiedzi, opóźnienia i koszt na zaakceptowany dokument w tym samym protokole.
Frameworki do konwersji dokumentów
Pipeline RAG zwykle potrzebuje całego dokumentu przekonwertowanego na Markdown lub JSON, a nie surowych linii OCR. Robią to konwertery dokumentów. Parsują plik, uruchamiają model układu i wywołują silnik OCR dla tekstu w każdym obszarze. Niektóre potrafią zamiast tego wysłać każdą stronę do modelu VLM, który czyta układ i tekst razem.
| Framework | Co zwraca | Użyj, gdy |
|---|---|---|
| Docling | Markdown, HTML lub bezstratny JSON z tabelami i współrzędnymi, z PDF, DOCX, PPTX, XLSX, HTML i obrazów | Potrzebujesz jednego konwertera dla mieszanych formatów i chcesz wybrać silnik OCR w jego wnętrzu |
| Marker | Markdown, JSON, HTML lub fragmenty, z PDF, obrazów i plików Office | Chcesz wysokiej jakości Markdown z PDF-ów |
| MinerU | Markdown i ustrukturyzowany JSON, z PDF, obrazów i plików Office | Prace naukowe i techniczne ze wzorami i tabelami |
Sprawdź licencje, zanim wdrożysz któryś z nich w produkcie. Docling jest na licencji MIT. Kod Markera jest na licencji Apache 2.0, ale jego wagi modeli używają zmodyfikowanej licencji OpenRAIL-M z ograniczeniami użycia komercyjnego. Licencja MinerU dodaje do Apache 2.0 warunki: osobną licencję komercyjną powyżej ustalonych progów użytkowników i przychodów oraz wskazanie autorstwa w usługach online.
Rysunek pokazuje, co konwerter obejmuje. Docling zachowuje to samo wejście i wyjście, a opcje jego pipeline’u wybierają sposób odczytu tekstu: model układu z Tesseract lub EasyOCR albo Granite-Docling VLM end-to-end.
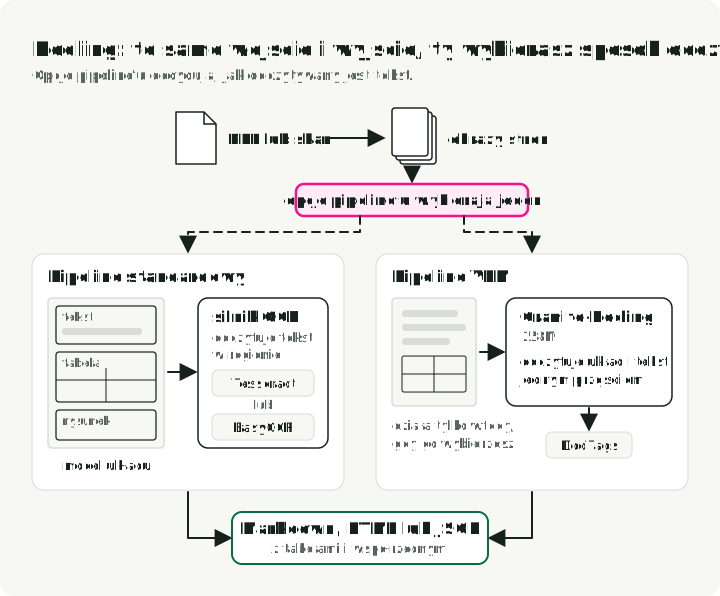
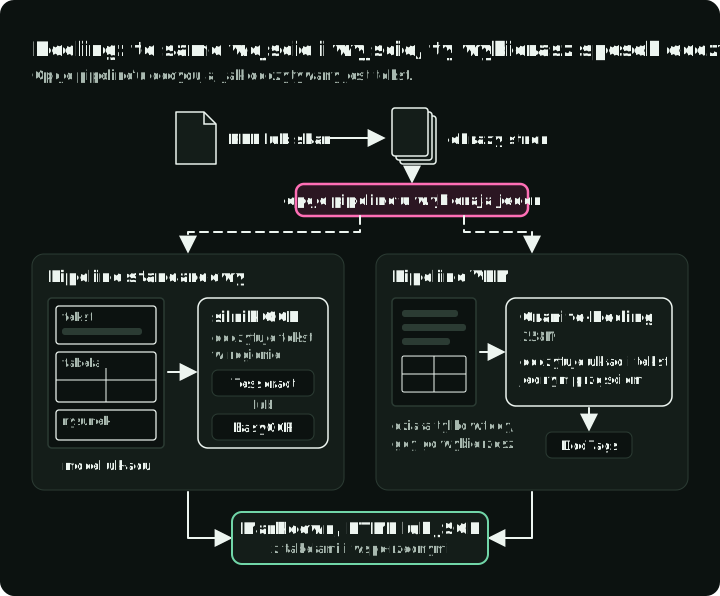
Szybkość i jakość konwersji w Docling zależą więc od wybranego pipeline’u. Pipeline VLM w Docling trzeba wybrać jawnie; domyślny konwerter nie dowodzi, że uruchomiono Granite-Docling. Polityka ponowień nadal należy do otaczającej aplikacji lub usługi, a routing nadal wymaga własnych etykiet jakości i progów.
Wybór ścieżki ekstrakcji
Mapa decyzyjna porządkuje poprzednie sekcje: każde pytanie kieruje dokument na najtańszą ścieżkę, która da to, czego potrzebujesz.
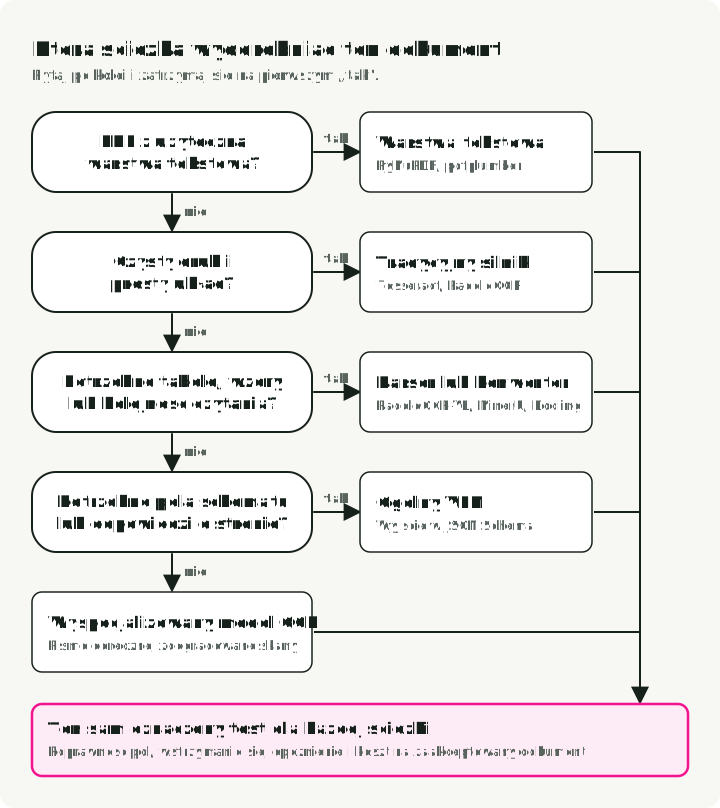
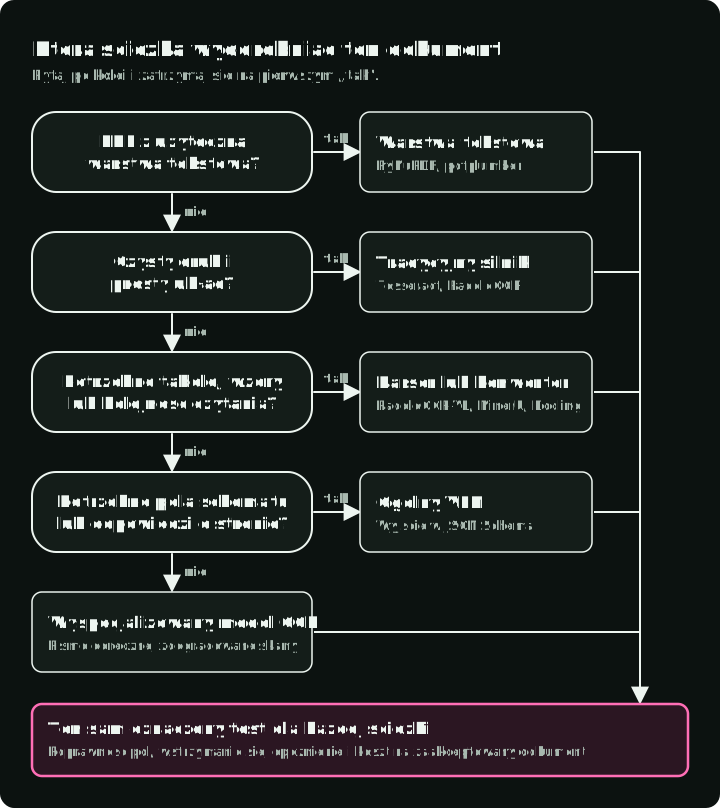
Każdy liść nadal przechodzi ten sam oznaczony test. Mapa daje pierwszego kandydata, a nie ostateczny wybór.
Testowanie modeli VLM przez OpenRouter
OpenRouter udostępnia zgodny z OpenAI gateway do modeli od kilku dostawców. Identyfikatory modeli i obsługiwane funkcje żądań się zmieniają, więc przed uruchomieniem przykładu sprawdź je w aktualnym katalogu gatewaya.
Fragment wymaga pip install openai, klucza OPENROUTER_API_KEY, dostępu do sieci, lokalnego pliku receipt.jpg i identyfikatorów modeli wciąż obsługiwanych przez OpenRouter.
import base64
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=os.environ["OPENROUTER_API_KEY"],
)

def extract_text(
    image_path: str,
    model: str,
    prompt: str = "Extract all text from this image, preserving layout as markdown.",
    **request_args,
) -> str:
    with open(image_path, "rb") as f:
        image_b64 = base64.b64encode(f.read()).decode()

    response = client.chat.completions.create(
        model=model,
        messages=[{
            "role": "user",
            "content": [
                {"type": "text", "text": prompt},
                {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{image_b64}"}},
            ],
        }],
        max_tokens=4096,
        **request_args,
    )
    choice = response.choices[0]
    if choice.finish_reason != "stop":
        raise RuntimeError(f"{model} did not finish: {choice.finish_reason}")
    if not choice.message.content:
        raise RuntimeError(f"{model} returned no text (finish_reason={choice.finish_reason})")
    return choice.message.content

# Compare models by changing one string
models = [
    "google/gemini-3.8-flash",
    "anthropic/claude-sonnet-5",
    "qwen/qwen3.8-27b",
]
for model in models:
    print(f"\n--- {model} ---\n{extract_text('receipt.jpg', model)[:200]}...")
Katalog modeli OpenRouter 2026-10-02 wymieniał google/gemini-3.8-flash, anthropic/claude-sonnet-5 i qwen/qwen3.8-27b z wejściem obrazowym i parametrami ustrukturyzowanych danych wyjściowych. Obsługa w katalogu nie dowodzi, że to dokładne żądanie powiedzie się na każdym kierowanym endpoincie.
Do ustrukturyzowanej ekstrakcji użyj response_format z JSON Schema, jeśli wybrany model i gateway to obsługują. Dzięki temu odpowiedź może dać się sparsować; nie waliduje to jednak wyodrębnionych wartości względem obrazu. W OpenRouter provider.require_parameters sprawia, że żądanie kończy się błędem, gdy żaden kierowany endpoint nie obsługuje wszystkich żądanych parametrów, zamiast przechodzić na endpoint, który nie dotrzyma schematu.
Fragment używa ponownie extract_text z poprzedniego bloku i przekazuje schemat przez jego dodatkowe argumenty żądania. Wymaga modelu obsługującego JSON Schema.
import json

nullable = {"type": ["string", "null"]}
receipt_schema = {
    "type": "object",
    "properties": {
        "vendor": nullable,
        "date": nullable,
        "items": {
            "type": ["array", "null"],
            "items": {
                "type": "object",
                "properties": {"description": nullable, "amount": nullable},
                "required": ["description", "amount"],
                "additionalProperties": False,
            },
        },
        "total": nullable,
    },
    "required": ["vendor", "date", "items", "total"],
    "additionalProperties": False,
}
prompt = (
    "Extract only visible receipt fields. Copy amounts as source strings. "
    "Use null for absent or unreadable values; do not infer them. "
    "Use null for an unreadable item list, and [] only when no items are present."
)

receipt = json.loads(extract_text(
    "receipt.jpg",
    "google/gemini-3.8-flash",
    prompt=prompt,
    response_format={
        "type": "json_schema",
        "json_schema": {"name": "receipt", "strict": True, "schema": receipt_schema},
    },
    extra_body={"provider": {"require_parameters": True}},
))
Tryb strict w stylu OpenAI wymaga wszystkich właściwości w required i additionalProperties: false, więc wartość, która może być nieobecna, ma typ dopuszczający null, zamiast być pominięta. Treść prompt i typy dopuszczające null razem pozwalają modelowi zwrócić null zamiast zmyślać wartość.
Przechowuj skopiowane ciągi z kwotami razem ze znormalizowanymi wartościami. Kwoty parsuj dalej za pomocą arytmetyki decimal lub liczb całkowitych w najmniejszych jednostkach, przy jawnej walucie i ustawieniach regionalnych; poprawność schematu nie waliduje sumy płatności. Puste (null) pola krytyczne kieruj do weryfikacji.
Wdrażanie OCR na produkcji
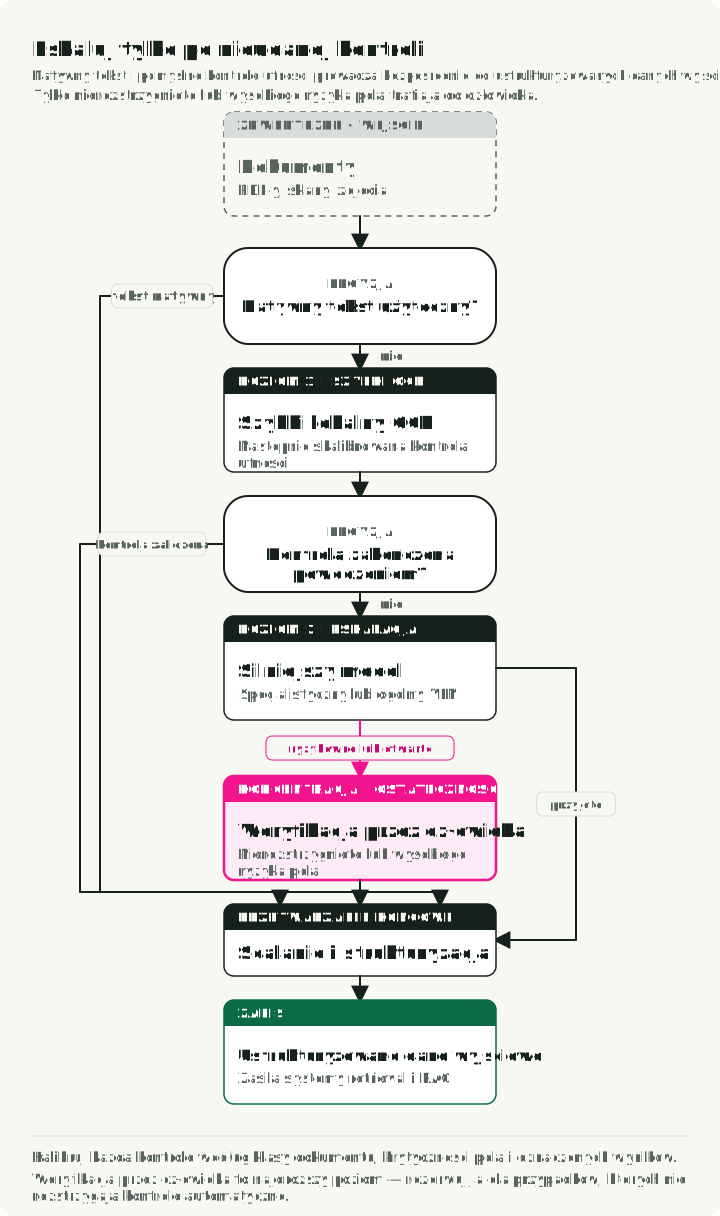
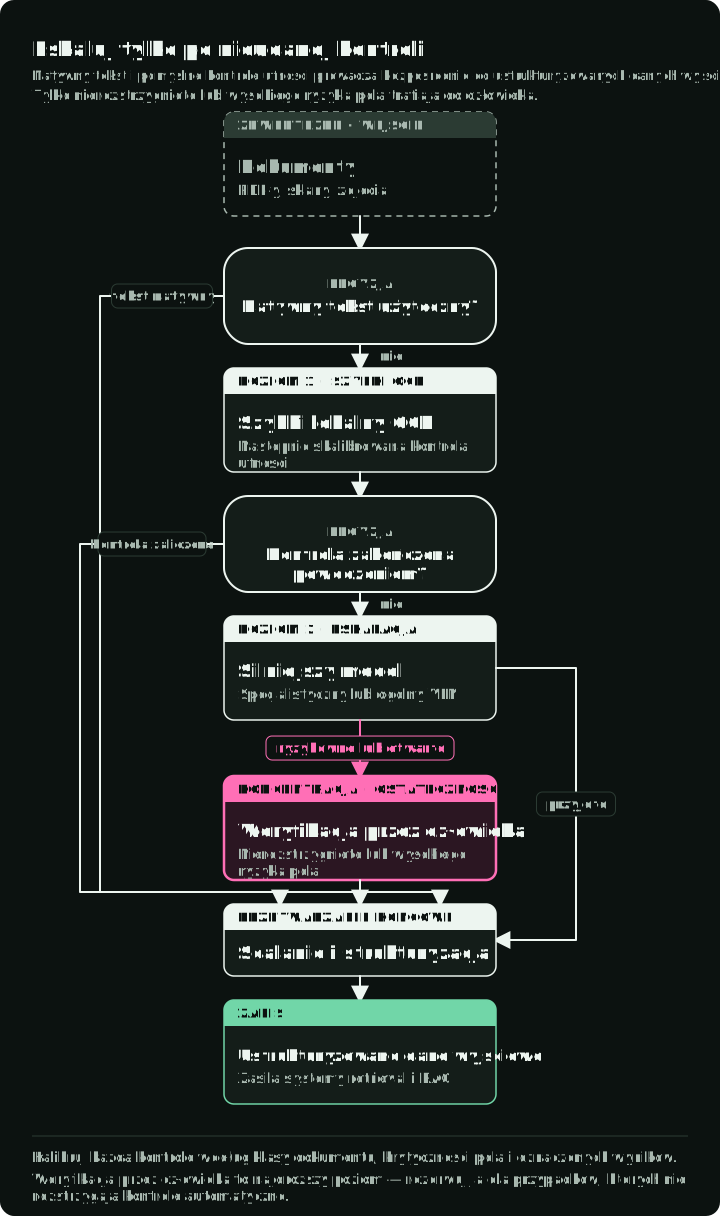
Architektura warstwowa może oddzielić przetwarzanie wstępne na CPU od inferencji na GPU lub przez API i zarezerwować drogie ścieżki dla dokumentów, które ich potrzebują. Rysunek pokazuje warstwy w kolejności kosztu, kontrolę, która akceptuje stronę w każdej warstwie, oraz błąd, który kieruje ją do następnej.
Wzorzec warstwowego fallbacku
Zacznij od najtańszej ścieżki, która spełnia cel jakościowy, a potem skalibruj routing na oznaczonych stronach:
- Sprawdź osadzony tekst (warstwa 0). W przypadku PDF-ów sprawdź warstwę tekstową za pomocą
PyMuPDFlubpdfplumberprzed rasteryzacją, ale zweryfikuj, czy warstwa jest kompletna.
- Spróbuj szybkim modelem. Użyj tradycyjnego silnika dla klas dokumentów, na których osiąga cel.
- Oceń skalibrowaną pewność. Połącz pewność modelu z klasą dokumentu, krytycznością pola i regułami walidacji.
- Przekaż do mocniejszego modelu. Niepewne strony kieruj do wyspecjalizowanego lub ogólnego VLM.
- Poważne błędy wysokiego ryzyka przekaż człowiekowi. Weryfikacja przez człowieka to osobna warstwa dla wartości, w których koszt błędu przewyższa korzyść z automatyzacji.
Uwaga o pewności: Surowe prawdopodobieństwa znaków nie są automatycznie skalibrowane względem poprawności pól. Poniższa funkcja ważona powierzchnią to punkt wyjścia do agregacji na poziomie strony, a nie uniwersalny router. Skalibruj ją na oznaczonych stronach i daj polom krytycznym osobne reguły, bo średnia ze strony może ukryć błędny identyfikator lub sumę.
def area_weighted_confidence(page):
    """Compute area-weighted confidence from one PaddleOCR 3.x result."""
    total_area, weighted_sum = 0, 0
    for (x_min, y_min, x_max, y_max), score in zip(
        page["rec_boxes"], page["rec_scores"]
    ):
        width = int(x_max) - int(x_min)
        height = int(y_max) - int(y_min)
        area = width * height
        weighted_sum += score * area
        total_area += area
    return weighted_sum / total_area if total_area > 0 else 0

assert area_weighted_confidence({
    "rec_boxes": [[0, 0, 300, 300]], "rec_scores": [0.5]
}) == 0.5
Aby ustawić próg, oznacz zestaw stron z jednej klasy dokumentów i zapisz, czy wszystkie pola krytyczne na każdej stronie są poprawne. Wybierz najniższy próg pewności, przy którym zaakceptowane strony spełniają docelowy poziom błędów w polach krytycznych, a strony poniżej niego kieruj do następnej warstwy. Poniższa funkcja robi to dla jednej klasy dokumentów.
def pick_threshold(scores, correct, max_error):
    """Lowest threshold whose accepted pages meet the error target, or None."""
    for threshold in sorted(set(scores)):
        accepted = [ok for s, ok in zip(scores, correct) if s >= threshold]
        if accepted and accepted.count(False) / len(accepted) <= max_error:
            return threshold
    return None  # no threshold meets the target: send every page to the next tier

scores = [0.95, 0.91, 0.88, 0.80, 0.72, 0.60]
correct = [True, True, True, False, True, False]  # all critical fields right?
assert pick_threshold(scores, correct, max_error=0.0) == 0.88
assert pick_threshold(scores, correct, max_error=0.25) == 0.72
Rysunek umieszcza sześć oznaczonych stron z asercji na skali pewności i zaznacza próg wybierany przez każdy cel błędów.
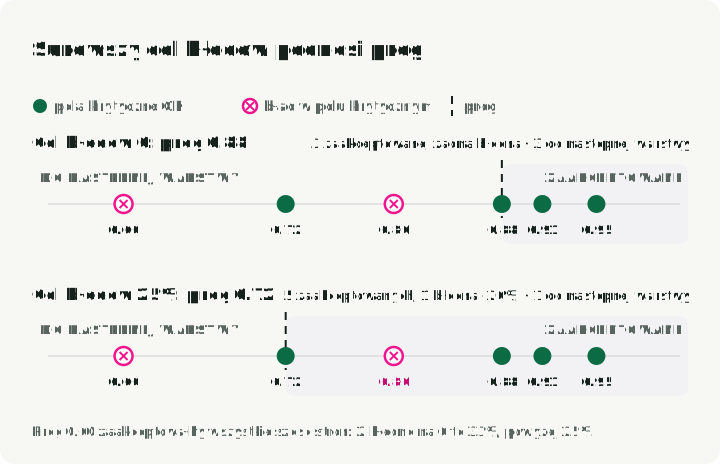
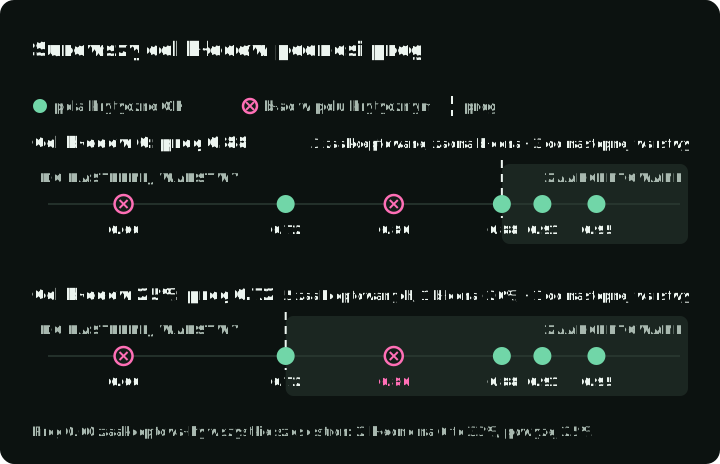
Surowszy cel błędów podnosi próg i kieruje więcej stron do mocniejszego modelu. Powtórz kalibrację dla każdej klasy dokumentów, bo ten sam wynik może oznaczać inną dokładność dla paragonów i dla umów.
Wzorce serwowania
Sposób uruchamiania każdej warstwy zależy od tego, jak napływają strony:
- Zadania wsadowe (konwersja archiwum, raporty miesięczne): czytaj strony z kolejki i uruchamiaj je na workerach GPU, które skalują się do zera między zadaniami.
- Żądania interaktywne: utrzymuj rozgrzany GPU lub użyj hostowanego API, bo zimny start modelu dodaje czas ładowania do czekania użytkownika.
- Rasteryzacja i czyszczenie obrazu: uruchamiaj je na workerach CPU, które skalują się niezależnie od inferencji na GPU.
- modele VLM z otwartymi wagami: serwuj je przez vLLM lub SGLang, które grupują równoległe żądania na jednym GPU.
Pomiar wyników
Dla każdej zaplanowanej pary silnik/dokument zachowaj wynik ze statusem sukcesu, błędu lub pominięcia. Nieudane, puste i obcięte wyniki pozostają w mianowniku podjętych prób dokumentów razem z poniesionym kosztem. Raportuj odsetek ukończonych, błędy pól krytycznych wśród automatycznych akceptacji, odsetek kierowanych do weryfikacji, opóźnienia end-to-end p50/p95 oraz koszt na pomyślnie przetworzony dokument. Opóźnienie strony mierz przy rzeczywistej rozdzielczości, rozmiarze wsadu, sprzęcie lub regionie dostawcy i długości wyniku. Wliczaj do sumy przetwarzanie wstępne i ponowienia; pomiar samego modelu nie wycenia udanej strony. Używaj ponownie obiektów konwertera dla pomiarów w stanie rozgrzanym, a inicjalizację zapisuj osobno. Repozytorium OCR Gauntlet zapisuje wyniki w tym formacie; ostatnia sekcja pokazuje, jak je uruchomić.
Analiza kosztów przy dużej skali
Nie ma uniwersalnego progu opłacalności, mierzonego liczbą stron, między API a własnym hostingiem. Zbuduj porównanie na tym samym obciążeniu:
| Składnik kosztu | Ścieżka API | Ścieżka na własnej infrastrukturze |
|---|---|---|
| Inferencja | Aktualna cena za stronę lub token | Godziny GPU przy zmierzonej liczbie stron na godzinę |
| Niewykorzystane moce | Zwykle pokrywa je dostawca | Wykorzystanie i zapas mocy |
| Inżynieria | Integracja i monitoring dostawcy | Wdrożenie, aktualizacje, observability i dyżury |
| Obsługa danych | Transfer, retencja i warunki dla regionu | Przechowywanie, sieć i kontrole zgodności |
| Błędy jakości | Ponowienia i weryfikacja przez człowieka | Ponowienia i weryfikacja przez człowieka |
Użyj wspólnego wzoru: monthly pages × cost per successful page + review cost + fixed operating cost. „Pomyślna strona” musi spełniać te same kryteria dla tekstu, tabel i pól na obu ścieżkach. Ceny dostawców i wynajmu GPU zmieniają się zbyt szybko, by osadzać je jako trwałe oszacowanie zakupowe.
Obsługa błędów: problem halucynacji
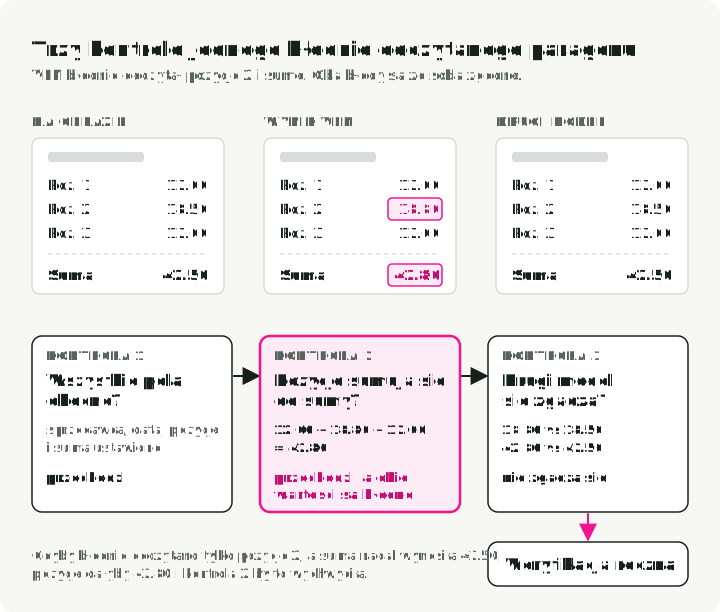
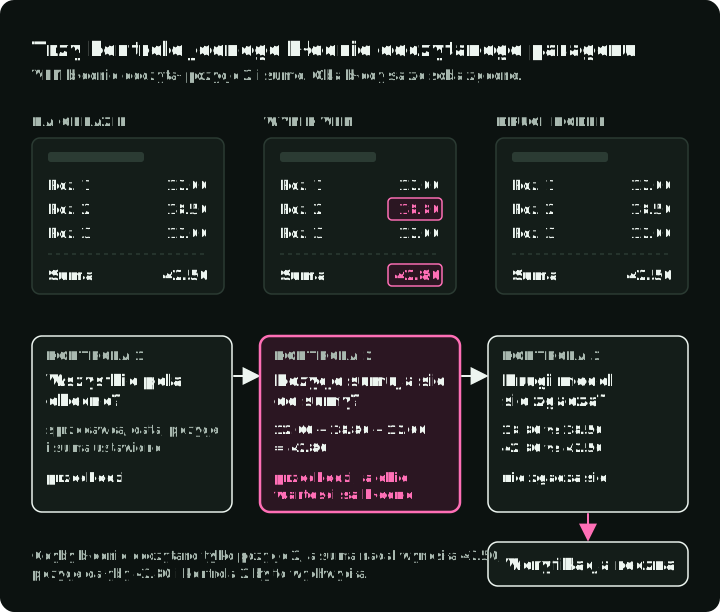
Błędy modeli VLM mogą być wiarygodne w kontekście, a fałszywe co do faktów. Suma na paragonie „$42.50” może wrócić jako „$42.80”: poprawna kwota, której nie oflaguje żaden program do sprawdzania pisowni.
Syntetyczny przykład błędu: Obraz paragonu pokazuje trzy pozycje, 12.00, 18.50 i 12.00, oraz sumę 42.50. VLM odczytuje drugą pozycję jako 18.80, a sumę jako 42.80. Pozycje nadal sumują się do sumy, więc arytmetyka wewnętrzna przechodzi, a obie wartości są błędne. Dlatego walidacja wymaga etykiet opartych na obrazie lub niezależnej ścieżki weryfikacji, a nie tylko kontroli spójności.
Rysunek uruchamia trzy kontrole na tym paragonie: kontrola schematu i kontrola sumy przechodzą, a dwa błędne odczyty wychwytuje dopiero drugi model.
Kilka praktycznych środków zaradczych:
- Uzgodnienie arytmetyczne. Gdy schemat je udostępnia, zweryfikuj
subtotal + tax + fees + shipping - discountsw granicach tolerancji zaokrąglenia waluty względem podanej sumy. Brakujące składniki lub niezgodności kieruj do weryfikacji. - Kontrole dat, telefonów i walut. Parsuj daty parserem dat i odrzucaj niemożliwe wartości. Liczbę cyfr numerów telefonów i formaty walut sprawdzaj wzorcami.
- Druga ścieżka ekstrakcji. Przepuść pola krytyczne przez inny model lub silnik OCR i oznaczaj rozbieżności. Zgodność podnosi pewność tylko wtedy, gdy obie ścieżki mają dostatecznie różne tryby awarii; nie jest dowodem poprawności.
Uzgodnienie bierze skopiowane ciągi z kwotami i używa Decimal, więc do porównania nie wchodzi zaokrąglanie liczb zmiennoprzecinkowych. Asercje odtwarzają powyższy przykład paragonu.
from decimal import Decimal

def reconcile(subtotal, tax, fees, shipping, discounts, total, tolerance="0.01"):
    """True when the stated total matches its components within tolerance."""
    parts = [subtotal, tax, fees, shipping, discounts, total]
    if any(p is None for p in parts):
        return False  # a missing component goes to review
    s, t, f, sh, d, tot = (Decimal(p) for p in parts)
    return abs(s + t + f + sh - d - tot) <= Decimal(tolerance)

items = ["12.00", "18.80", "12.00"]  # the image shows 18.50
subtotal = str(sum(Decimal(i) for i in items))
assert reconcile(subtotal, "0", "0", "0", "0", "42.80")  # passes, and both values are wrong
assert not reconcile(subtotal, "0", "0", "0", "0", "42.50")  # one misread value is caught
assert not reconcile(subtotal, None, "0", "0", "0", "42.80")  # missing tax goes to review
Uzgodnienie wychwytuje pojedynczą błędnie odczytaną kwotę. Nie wychwyci dwóch błędnych odczytów, które się wzajemnie potwierdzają, więc pola krytyczne nadal potrzebują drugiej ścieżki ekstrakcji.
Uruchom porównanie na własnych stronach
Repozytorium OCR Gauntlet uruchamia kilka silników OCR na tych samych stronach i zapisuje jeden wiersz wyniku na silnik i stronę, także dla porażek. Porównuje strony w postaci obrazów; nie obejmuje kontroli warstwy tekstowej z warstwy 0.
Runner działa w czterech krokach:
- Manifest wymienia strony i hasze ich tekstu wzorcowego.
- Runner wysyła każdą stronę do każdego silnika.
- Zapisuje jeden wiersz JSONL na silnik i stronę, oznaczony jako sukces, błąd lub pominięcie, z surowym wynikiem, czasem i kosztem.
- Podsumowanie podaje odsetek ukończonych, CER na zweryfikowanych stronach i koszt na pomyślną stronę. Nieudane i pominięte pary zostają w mianowniku odsetka ukończonych.
Pierwsze uruchomienie używa wygenerowanych stron i Tesseract, więc potrzebuje Pythona 3.12, uv i systemowej instalacji Tesseract, ale nie wymaga kluczy API:
uv sync --locked --extra tesseract --extra notebooks
uv run python scripts/make_fixture.py data/demo
uv run ocr-gauntlet data/demo/manifest.json --engines tesseract --output results/demo.jsonl
Wygenerowane strony tylko sprawdzają, że pipeline działa; nie mierzą jakości OCR. Do prawdziwego testu paragonów zaimportuj próbki CORD poleceniem uv run python scripts/download_samples.py --dataset cord --count 2 --output data/cord i przygotuj zweryfikowany wzorzec, jak opisuje README repozytorium. Inne silniki dodasz przez --engines; silniki hostowane wymagają też --allow-remote, bo przesyłają twoje strony.
W podsumowaniu najpierw przeczytaj odsetek ukończonych: silnik, który zawodzi na jednej trzeciej stron, nie jest kandydatem, niezależnie od swojego CER. Potem porównaj CER na zweryfikowanych stronach, a następnie koszt na pomyślną stronę, który obejmuje wydatki na nieudane próby.
Najważniejsze wnioski
- Dopasuj warstwę modelu do oznaczonej klasy dokumentów. Tradycyjne silniki mogą wystarczyć dla czystego tekstu; wyspecjalizowane i ogólne modele VLM powinny zasłużyć na dodatkowy koszt na trudniejszych stronach.
- Nie łącz różnych rankingów. Metryki OmniDocBench i preferencje z OCR Arena odpowiadają na różne pytania.
- Kalibruj routing. Progi pewności, klasy dokumentów, krytyczność pól i polityka weryfikacji przez człowieka należą do jednej ewaluacji.
- Waliduj wiarygodne wyniki. Zgodność ze schematem i wewnętrzna arytmetyka nie dowodzą, że wartość występuje na obrazie.
- Wyceniaj pomyślne strony. Przy porównywaniu API z własnym hostingiem uwzględnij ponowienia, weryfikację, stałe koszty operacyjne i kontrole jakości.
Referencje
- OCR Arena Leaderboard - Zbiorowe pojedynki modeli w bezpośrednim starciu
- The OCR Gauntlet repo - Uruchamialne porównanie silników OCR na tych samych stronach, z backendami Docling i kosztem na pomyślną stronę
- OmniDocBench - Ewaluacja end-to-end parsowania dokumentów
- dots.ocr - Około 3B parametrów łącznie, w tym model językowy 1.7B
- PaddleOCR - Zestaw narzędzi i modele tradycyjnego OCR
- OpenRouter - Ujednolicony gateway dostępu do testów A/B modeli