OCR in 2026: klassieke pipelines, VLMs en Document AI

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Deze gids is bedoeld voor engineers die OCR en documentextractie kiezen voor zoeken, retrieval-augmented generation (RAG) of AI agents. Hij legt uit hoe traditionele engines en vision-language models verschillen, hoe je tekst, tabellen en velden evalueert en hoe je moeilijke documenten doorstuurt naar een ander model of naar menselijke review.
Vision-language models (VLMs) kunnen layout, handschrift, tabellen en gedegradeerde afbeeldingen aan die een gewone tekstherkenningspipeline laten vastlopen. Traditionele engines blijven concurrerend bij schone drukletters, vooral wanneer CPU-latency en operationele kosten tellen. De gedateerde snapshot hieronder bevat PaddleOCR-VL 1.6 en dots.mocr, met verschillende afwegingen voor hardware, privacy en output. Controleer elk project voordat je een actuele keuze maakt.
Voor de compacte versie over modelkeuze, zie Best OCR Models in 2026: Classical OCR, PaddleOCR-VL, VLMs.
OCR bepaalt nu de kwaliteit verderop in de keten
OCR drijft al lang archieven, postsystemen, toegankelijkheidstools en documentbeheer aan. RAG en document agents maakten de faalwijzen zichtbaar voor een bredere groep engineers: een model verderop in de keten kan tekst of tabelstructuur die de extractie heeft weggegooid niet herstellen.
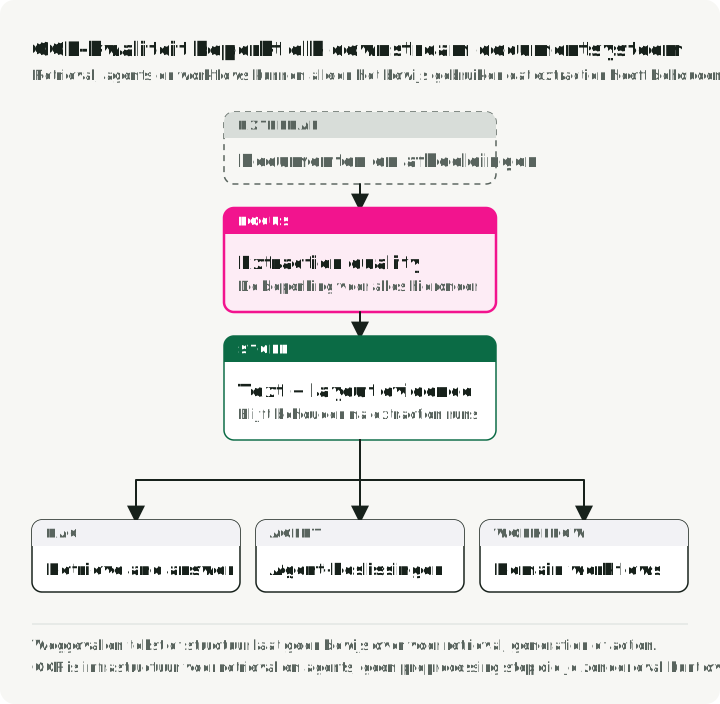
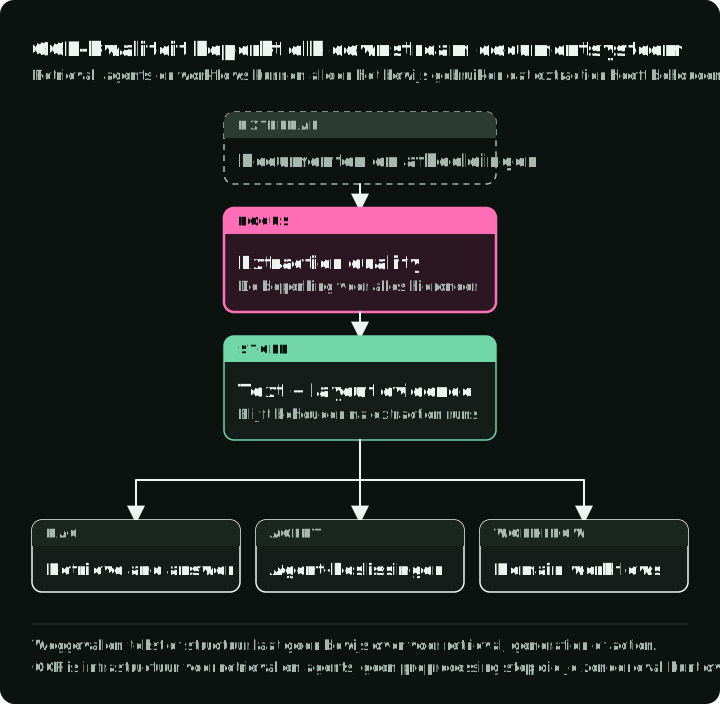
Een RAG-systeem kan geen tekst ophalen die OCR heeft weggelaten of verkeerd heeft gelezen. Als de extractie een tabel verhaspelt, een datum verkeerd leest of een alinea weglaat, kunnen latere wijzigingen in chunking en embedding de ontbrekende informatie niet terugbrengen. Zulke fouten kunnen een contractclausule verbergen, het totaal van een factuur veranderen of een medisch dossier beschadigen.
OCR is daarom onderdeel van de infrastructuur voor retrieval en agents, naast parsing, chunking, embedding en indexering. De fouten ervan verdienen een eigen evaluatie en horen niet te verdwijnen in één end-to-end score.
Wat OCR betekent in het tijdperk van foundation models
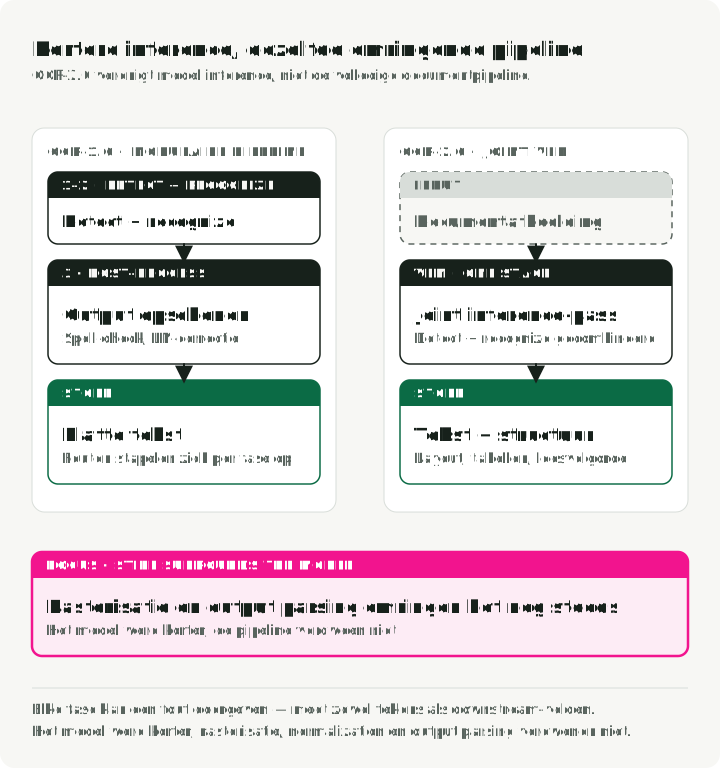
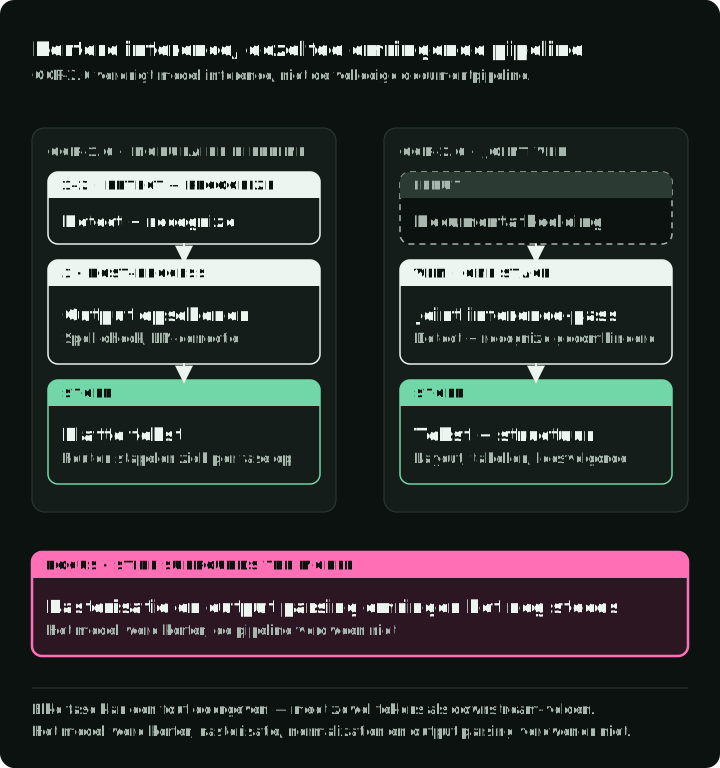
OCR zet tekst in een afbeelding om in machineleesbare tekens. Document AI is het bredere systeem eromheen: layoutanalyse, het parsen van tabellen en formules, veldextractie, semantisch redeneren, herkomst en validatie. De auteurs van GOT-OCR 2.0 noemen modulaire detectie-herkenningspipelines “OCR-1.0” en end-to-end models “OCR-2.0”. Dat label mag het onderscheid tussen herkenning en documentbegrip niet uitwissen.
De figuur vergelijkt de twee paden en hoe elk faalt: de drie opeenvolgende fasen links herstellen nooit een regel die detectie heeft gemist, de enkele modelpass rechts schrijft een aannemelijk totaal dat niet op de pagina staat, en rasteriseren en parsen blijven in beide gevallen buiten het model.
De traditionele OCR-pipeline heeft drie kernfasen:
- Tekstdetectie: zoek de gebieden met tekst (bijv. CRAFT, DBNet).
- Tekstherkenning: zet gedetecteerde gebieden om in tekenreeksen (bijv. CRNN).
- Nabewerking: spellingcontrole en correctie met een taalmodel.
Dit werkt goed voor schone documenten, maar fouten in detectie, herkenning en nabewerking kunnen zich opstapelen. Meet zowel de tekennauwkeurigheid als de nauwkeurigheid van de velden verderop, zodat een leesbare pagina geen verkeerd totaal of verkeerde identifier verbergt.
Sommige end-to-end VLM-paden vouwen een groter deel van die pipeline samen tot een vision encoder plus een taaldecoder. Models zoals GOT-OCR 2.0 kunnen tekst en structuur samen uitvoeren, terwijl algemene VLMs ook velden kunnen koppelen aan een gevraagd schema. Een algemene VLM kan bijvoorbeeld “MFG: 10/24” op een etiket lezen als productiedatum in plaats van als houdbaarheidsdatum. De prijs daarvoor is latency die afhangt van de workload, GPU- of API-kosten en het risico op aannemelijke tekst die niet in de afbeelding staat.
Een praktisch voorbehoud: een model dat alleen afbeeldingen accepteert heeft gerasterde pagina’s nodig, terwijl een service die PDF accepteert de conversie intern kan afhandelen. Deskewing, herschalen en opschonen zijn pipelinespecifieke experimenten, geen verplichte verbeteringen. AWS Textract raadt aan ondersteunde invoer te behouden in plaats van die zonder onderscheid te converteren of te downsamplen. Het parsen en valideren van de output blijft een taak van de applicatie.
Metrics: meten wat ertoe doet
Elke vergelijking verderop in deze gids gebruikt een van deze metrics. Kies de metric die bij het outputtype past:
- CER en WER voor platte tekst. Character Error Rate en Word Error Rate hangen af van normalisatiekeuzes zoals hoofdletters, witruimte en interpunctie, dus leg het vergelijkingsprotocol vast voordat je models vergelijkt.
- Field exact match en Field F1 voor formulieren en bonnetjes. Exact match is binair voor één veld; de score is het aandeel geëvalueerde velden dat slaagt. Rapporteer de correctheid van alle velden per document apart. Definieer voor Field F1 de key/value-matching, de normalisatie, dubbele en ontbrekende velden en de aggregatie; een juist bedrag dat aan de verkeerde rij is toegewezen is een fout.
- TEDS voor tabellen. Tree-Edit-Distance-based Similarity vergelijkt voorspelde en referentie-HTML-bomen en vangt structuurfouten en fouten in celinhoud die CER verbergt.
- Vergelijking van leesvolgorde wanneer de afnemer één lineaire reeks nodig heeft. Vergelijk geordende blokken of spans rechtstreeks, of gebruik een metric die de volgorde meeweegt; OmniDocBench evalueert leesvolgorde apart. Juiste tekens en tabelcellen bewijzen de volgorde van een pagina met meerdere kolommen niet.
- ANLS voor document-VQA. Average Normalized Levenshtein Similarity scoort antwoorden tegen geaccepteerde referenties. De oorspronkelijke ST-VQA-definitie kent
1 − normalized_distancealleen toe wanneer de afstand strikt kleiner is dan 0,5, anders nul; ze neemt de beste score over de geaccepteerde referenties en middelt over de vragen. DocVQA hanteert ANLS. Leg bij het reproduceren van een score de hoofdlettergevoeligheid, de witruimte en de normalisatie van de afstand van de evaluator vast.
CER/WER tellen substituties, verwijderingen en invoegingen gedeeld door het aantal referentietekens of -woorden. Ze kunnen boven één uitkomen wanneer invoegingen overheersen. Geef aan of de aggregatie de fouten en referentielengtes van het hele corpus optelt of de scores per document middelt. Bewaar pagina, blok, bounding box, originele tekst en normalisatiegeschiedenis, zodat een fout veld naar de afbeelding terug te herleiden is.
Voor tekstdetectie deelt intersection over union (IoU) het overlappende oppervlak van een voorspelde en een referentiebox door het totale oppervlak dat door minstens één van beide wordt bedekt. De IoU-drempel bepaalt of een gedetecteerde box bij de referentie past voordat F1 wordt berekend.
De tabel koppelt elke taak aan haar metric en aan de fout die een score het vaakst misleidend maakt:
| Taak | Metric | Te vermijden fout |
|---|---|---|
| Platte tekstextractie | CER, WER | Scores vergelijken die met verschillende normalisatie zijn berekend |
| Handschrift | CER | CER-doelen voor drukletters gebruiken voor handgeschreven pagina’s |
| Tekstdetectie | F1 bij een IoU-drempel | F1 rapporteren zonder de IoU-drempel waarmee het is berekend |
| Formulieren en bonnetjes | Field exact match, Field F1 | Een juiste waarde in het verkeerde veld of de verkeerde rij als juist tellen |
| Tabellen | TEDS | Tabellen beoordelen met CER, dat celstructuur negeert |
| Document-VQA | ANLS | De drempel van 0,5 of de antwoordnormalisatie wijzigen |
| Conversie van een hele pagina | Edit distance + leesvolgorde | Tekstnauwkeurigheid rapporteren zonder de volgorde van blokken te controleren |
Talen veranderen de keuze ook. Chinese en Japanse tekst heeft geen spaties tussen woorden, dus WER hangt af van een woordsegmentatiemodule; gebruik voor deze schriften CER. Neem pagina’s met meerdere schriften op in de gelabelde testset wanneer ze in je workload voorkomen. Een modelkaart die 100 talen noemt zegt niets over de kwaliteit in één bepaalde taal, dus neem elke doeltaal op in de gelabelde testset.
Voor implementaties: jiwer rekent CER/WER kant-en-klaar uit, en TEDS-implementaties staan in de OmniDocBench-repo.
Wat OCR-benchmarks wel en niet meten
Publieke datasets passen deze metrics toe op specifieke documenttypen. Datasetgroottes en metrics beschrijven de genoemde datasetversie; gebruik de actuele leaderboard van elk project voor modelscores. De kolom “Test” zegt op welke van jouw documenten elke dataset lijkt.
| Dataset | Test | Testgrootte | Talen | Primaire metric |
|---|---|---|---|---|
| FUNSD | Key-value-koppeling op ruisige gescande formulieren | 50 documenten | Engels | F1 |
| SROIE | Vier bonvelden (bedrijf, datum, adres, totaal) | 400 testafbeeldingen | Engels | F1 |
| CORD | Bonregels met hiërarchische labels | 100 bonnetjes | Indonesisch | F1 |
| IAM | Handgeschreven Engelse regels | Afhankelijk van de split | Engels | CER |
| OCRBench v2 | Tekstlezen en redeneren door VLMs, verdeeld over 23 taken | 10.000 QA-paren | EN + CN | Score /100 |
| OmniDocBench v1.6 | Parsing van hele pagina’s: tekst, tabellen, formules, leesvolgorde | 1.651 pagina’s | EN + CN | Samengesteld |
Het aantal IAM-regels hangt af van de gekozen writer-split en het herkenningsprotocol; hier wordt geen vast aantal testregels aangenomen.
Snapshot van OmniDocBench v1.6
De tabel hieronder is één snapshot van een vaste versie: OmniDocBench v1.6_full, officiële README bij commit 09ba2b606662695b16aafe5f5e36b7ef020e11a8, geraadpleegd op 2026-08-09.
| Model | Grootte | Overall ↑ | Text Edit ↓ | Table TEDS ↑ |
|---|---|---|---|---|
| GLM-OCR | 0.9B | 95.22 | 0.044 | 92.83 |
| PaddleOCR-VL-1.5 | 0.9B | 94.93 | 0.038 | 91.67 |
| Gemini 3 Flash | — | 92.62 | 0.066 | 89.29 |
| dots.ocr | 3B | 90.77 | 0.048 | 87.18 |
De vastgepinde README vermeldt PaddleOCR-VL 1.5. PaddleOCR meldt 96,3 voor versie 1.6 op dezelfde benchmarkversie; dat cijfer komt uit de eigen run van de leverancier en maakt geen deel uit van deze tabel.
De conclusie geldt alleen voor deze OmniDocBench-versie: de grootte van een model voorspelt de score voor documentparsing niet. Latere versies van de evaluator veranderen de matching, dus vergelijk scores alleen onder één vastgepinde evaluator. De samengestelde score omvat text edit distance, table TEDS en Character Detection Matching (CDM) voor formules. CDM rendert voorspelde en referentieformules, matcht hun tekens en controleert hun relatieve posities voordat de matches met F1 worden gescoord. Het vergelijkt gerenderde formules in plaats van ruwe LaTeX-strings. Leesvolgorde heeft een eigen resultaat nodig.
De kloof tussen benchmark en arena
Automatische benchmarkrangschikkingen kunnen botsen met menselijke voorkeur.
In de OCR Arena stemmen gebruikers blind op de output van twee models die tegen elkaar worden uitgespeeld. Op 2026-08-09 rangschikte OCR Arena Gemini 3 Flash boven GLM-OCR, terwijl de OmniDocBench-tabel hierboven GLM-OCR hoger scoort (95,22 tegen 92,62). De live volgorde van de Arena verandert met elke nieuwe battle, dus het is geen reproduceerbare historische benchmarkmomentopname. Combineer de twee leaderboards niet tot één score.
De figuur toont de tegenstrijdigheid: GLM-OCR en Gemini 3 Flash wisselen van plaats tussen de twee ranglijsten. Eronder staan de pagina’s die elk gebruikt, wie oordeelt en wat je krijgt.
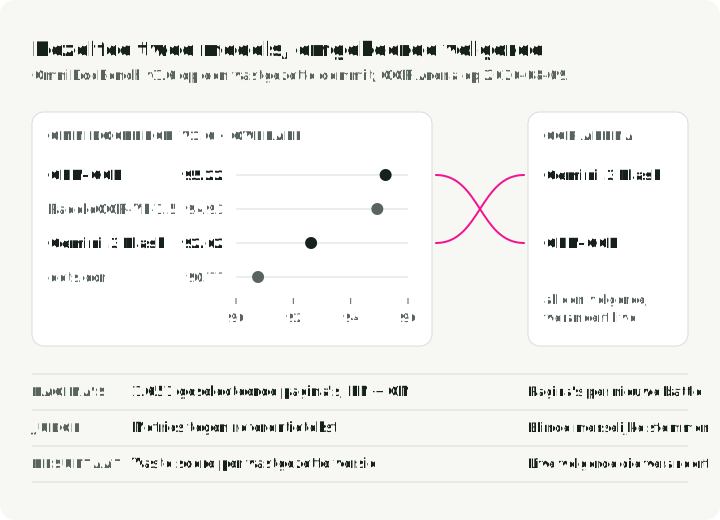
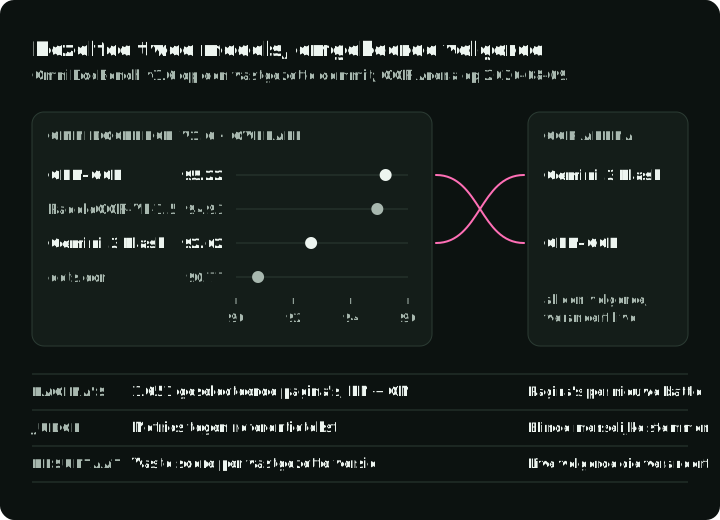
Waarschijnlijke oorzaken zijn onder meer de documentmix, outputopmaak, taaldekking en de criteria van de judge. Gepubliceerde cijfers zijn nuttig om te screenen, maar de uiteindelijke keuze vraagt om een achtergehouden set uit de doelworkload.
Traditionele OCR-engines: nog steeds relevant
Traditionele engines zijn nuttige baselines omdat ze lokaal op CPU kunnen draaien. Hun latency en nauwkeurigheid hangen af van het gekozen model, de paginaresolutie, de taal, de preprocessing en de hardware, dus benchmark ze op dezelfde gelabelde pagina’s die je voor de VLM-evaluatie gebruikt.
| Engine | Deployment | Nuttige baseline voor |
|---|---|---|
| Tesseract 5.5 | Lokaal op CPU | Schone drukletters en gevestigde schriften |
| EasyOCR | Lokaal PyTorch op CPU of GPU | Prototypes en scènetekst |
| PaddleOCR 3.x | Lokaal op CPU, GPU en mobiele varianten | Meertalige OCR en deployment-toolchains |
Tesseract voor schone drukletters
Tesseract (v5.5.x, Apache 2.0) is een volwassen engine die vooral op CPU draait, met 100+ taalpakketten. De nauwkeurigheid bij schone drukletters kan hoog zijn na passende rasterisatie en preprocessing, maar handschrift, scènetekst en complexe layouts moeten apart worden getest. Het belangrijkste voordeel is een kleine, lokale CPU-deployment.
Stel de page segmentation mode (--psm) in per documenttype; een verkeerde modus laat kolommen vallen of voegt regels samen. Het fragment vereist pip install pytesseract pillow, de Tesseract-binary met Engelse taaldata en een lokale receipt.jpg.
import pytesseract
from PIL import Image

# --psm 6: treat the image as one uniform block of text, which suits a receipt
text = pytesseract.image_to_string(Image.open("receipt.jpg"), lang="eng", config="--psm 6")
EasyOCR
EasyOCR combineert een CRAFT-detector met een CRNN-recognizer. Met volledige PyTorch-GPU-versnelling is het een snelle optie voor snelle prototypes en scènetekst. Het levert alleen regels en boxes, zonder layout- of tabelstructuur.
Het fragment vereist pip install easyocr, PyTorch, de gedownloade modelweights van EasyOCR en een lokale receipt.jpg.
import easyocr

# Three lines for complete OCR
reader = easyocr.Reader(["en"])
result = reader.readtext("receipt.jpg")
# Returns: [(bbox, text, confidence), ...]
PaddleOCR 3
PaddleOCR 3 bundelt onderhouden pipelines voor OCR, documentparsing en deployment. De huidige quick start gebruikt de predict()-API en expliciete oriëntatie-instellingen. Pin het paddleocr-pakket en de gekozen pipeline, want 2.x-voorbeelden met .ocr(..., cls=True) komen niet overeen met de 3.x-API.
Het vereist de PaddlePaddle-runtime, die een tweede framework toevoegt aan een PyTorch-stack. PaddleOCR-tekstherkenning is een andere pipeline dan PaddleOCR-VL, de documentparser in de volgende sectie.
Het fragment vereist pip install "paddleocr>=3,<4", een compatibele PaddlePaddle-runtime, gedownloade modelweights en een lokale receipt.jpg.
from paddleocr import PaddleOCR

ocr = PaddleOCR(
    use_doc_orientation_classify=False,
    use_doc_unwarping=False,
    use_textline_orientation=False,
)

for result in ocr.predict("receipt.jpg"):
    result.print()
    result.save_to_json("output")
Elk resultaat bevat rec_texts, rec_scores en rec_boxes. De sectie over routing gebruikt de laatste twee om een pagina te scoren.
Gespecialiseerde en algemene VLM-opties
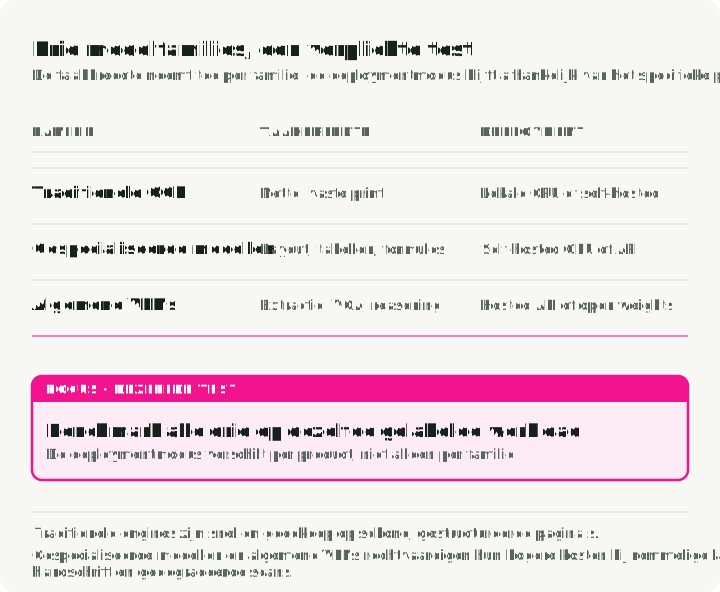
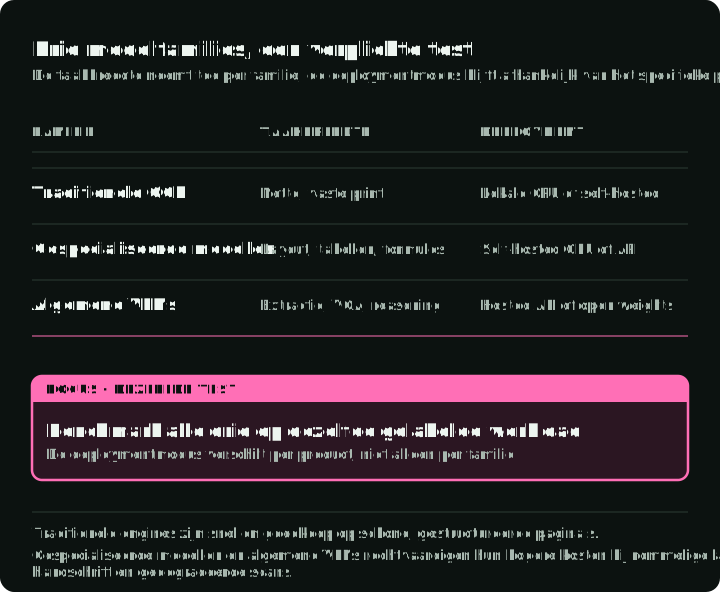
Scheve bonnetjes, scheef gefotografeerde productetiketten, handschrift en dichte layouts zijn de plekken waar gespecialiseerde of algemene VLMs het testen waard worden naast traditionele engines.
De figuur toont wat elke modelfamilie voor dezelfde pagina teruggeeft, de belangrijkste afweging en waar ze kan draaien. De deploymentmodus hangt af van het product, dus de figuur vermeldt die apart van de taakbreedte.
Gespecialiseerde documentmodellen
De models in deze sectie zijn gecontroleerd op 2026-10-02. De lijst is geen actuele rangschikking; ze zegt voor welk documentprobleem elk model het proberen waard is.
| Model | Output | Waar het draait | Probeer het wanneer |
|---|---|---|---|
| PaddleOCR-VL 1.6 | Layoutanalyse, daarna leest een 0.9B VLM elk gebied | Self-hosted | Meertalige pagina’s met layout; de leverancier meldt 109 talen |
| GOT-OCR 2.0 | Platte tekst, Markdown, LaTeX | Self-hosted, 580M parameters | Formules en gemengde tekst op één pagina |
| dots.mocr | Layout en tekst; grafieken en figuren als SVG-code | Self-hosted, 3B parameters | Pagina’s met grafieken of diagrammen die je als structuur nodig hebt |
| DeepSeek-OCR2 | Markdown met grounding boxes | Self-hosted, vLLM of Transformers | Lange documenten in hoog volume; een pagina gebruikt 256 tot 1.120 vision tokens |
| Mistral OCR 4.1 | Markdown, alineaboxes, bloklabels, confidence per blok | Gehoste API (mistral-ocr-4-1) | Je wilt een API en een confidencescore per blok |
| Granite-Docling 258M | DocTags, omgezet naar een DoclingDocument | Self-hosted, binnen Docling | Een klein lokaal model voor Docling-conversies |
| olmOCR | Platte tekst of Markdown in leesvolgorde | Self-hosted, 7B VLM op een GPU | PDF’s lineariseren tot tekst voor RAG of trainingsdata |
Behandel cijfers voor throughput en geheugen als specifiek voor hardware en dataset; meet het piekgeheugen met je eigen runtime, precisie, afbeeldingsgrootte en outputlimiet. Kalibreer de blokconfidence van Mistral tegen de correctheid van velden voordat je waarden automatisch accepteert. Pin een expliciete modelversie voor vergelijkingen, want een latest-alias kan veranderen.
Frontier-VLMs
Algemene VLMs zijn een andere optie wanneer de taak extractie combineert met visueel of semantisch redeneren. Deze kandidaten zijn gecontroleerd op 2026-10-02 en worden gebruikt in het gatewayvoorbeeld hieronder. Ze vormen een eerste shortlist, geen OCR-rangschikking:
- Gemini 3.8 Flash (Google): een algemeen beschikbaar multimodaal model met afbeeldingsinvoer en structured outputs. Gebruik de stabiele ID wanneer je een nieuwe vergelijking begint.
- Claude Sonnet 5 (Anthropic): een Sonnet-generatie die op 2026-06-30 is uitgebracht, voor een gehoste vergelijking. Test transcriptietrouw en veldextractie op je eigen documenten; algemene verbeteringen in redeneren bewijzen geen OCR-nauwkeurigheid.
- Qwen3.8-27B (Alibaba): een open-weight vision-language model onder Apache 2.0 dat je via een gateway kunt testen of self-hosted kunt draaien. Met 27B is het een andere deploymentkeuze dan de eerdere Qwen3-VL 8B, die een bruikbare kleinere baseline blijft wanneer geheugen beperkt is.
Voeg een nieuwe release toe aan de testset. Gebruik hem pas in productie nadat hij dezelfde vergelijking doorstaat: correctheid van velden, onthouding, latency en kosten per geaccepteerd document onder hetzelfde protocol.
Frameworks voor documentconversie
Een RAG-pipeline heeft meestal een heel document nodig dat naar Markdown of JSON is omgezet, geen ruwe OCR-regels. Documentconverters doen dit. Ze parsen het bestand, draaien een layoutmodel en roepen een OCR-engine aan voor de tekst binnen elk gebied. Sommige sturen in plaats daarvan elke pagina naar een VLM die layout en tekst samen leest.
| Framework | Wat het uitvoert | Gebruik het wanneer |
|---|---|---|
| Docling | Markdown, HTML of lossless JSON met tabellen en coördinaten, uit PDF, DOCX, PPTX, XLSX, HTML en afbeeldingen | Je één converter voor gemengde formaten wilt en de OCR-engine daarbinnen zelf wilt kiezen |
| Marker | Markdown, JSON, HTML of chunks, uit PDF, afbeeldingen en Office-bestanden | Je hoogwaardige Markdown uit PDF’s wilt |
| MinerU | Markdown en gestructureerde JSON, uit PDF, afbeeldingen en Office-bestanden | Wetenschappelijke en technische artikelen met formules en tabellen |
Controleer de licenties voordat je er een in een product uitrolt. Docling is MIT. De code van Marker is Apache 2.0, maar de modelweights vallen onder een aangepaste OpenRAIL-M-licentie met beperkingen voor commercieel gebruik. De licentie van MinerU voegt voorwaarden toe aan Apache 2.0: een aparte commerciële licentie boven vastgestelde drempels voor gebruikers en omzet, en naamsvermelding voor onlinediensten.
De figuur laat zien wat een converter omhult. Docling houdt invoer en uitvoer gelijk, en de pipelineopties bepalen hoe de tekst wordt gelezen: met het layoutmodel plus Tesseract of EasyOCR, of met de Granite-Docling VLM van begin tot eind.
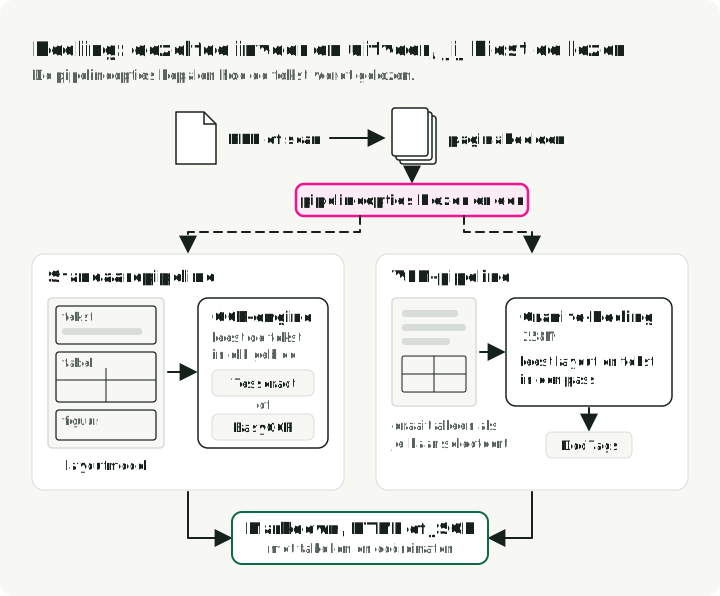
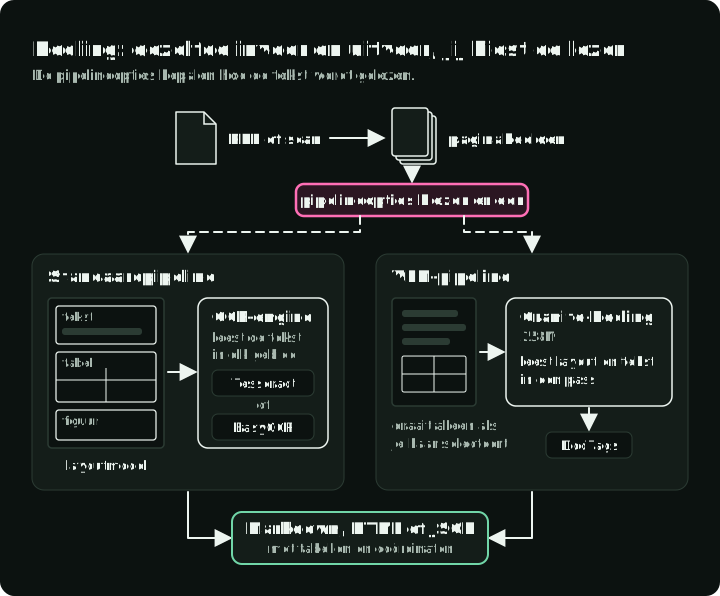
De conversiesnelheid en -kwaliteit van Docling hangen dus af van de pipeline die je kiest. De VLM-pipeline van Docling moet expliciet worden gekozen; een standaardconverter is geen bewijs dat Granite-Docling heeft gedraaid. Het retrybeleid hoort nog steeds in de omliggende applicatie of service, en routing heeft nog steeds eigen kwaliteitslabels en drempels nodig.
Een extractiepad kiezen
De beslisboom zet de voorgaande secties op volgorde: elke vraag stuurt een document naar het goedkoopste pad dat kan opleveren wat je nodig hebt.
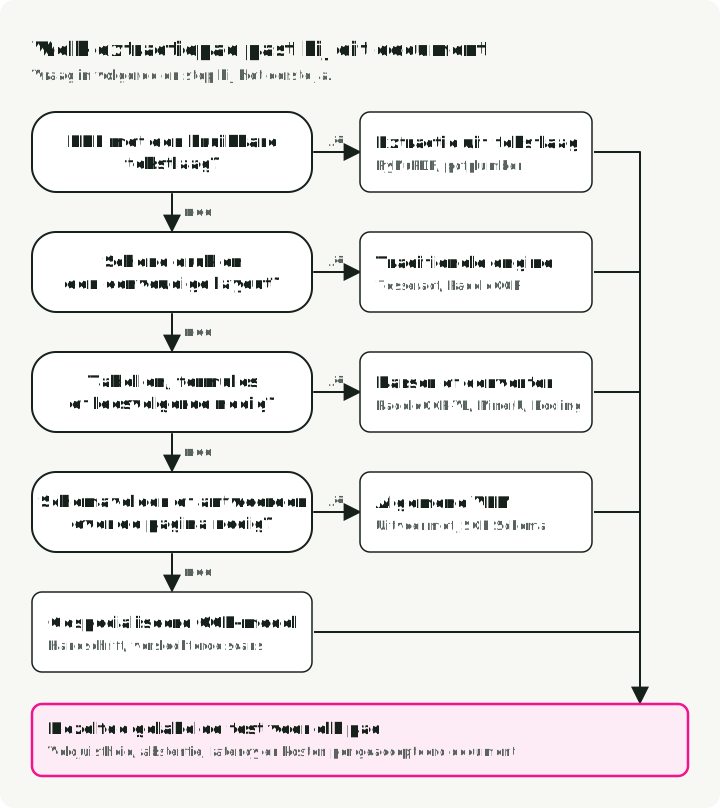
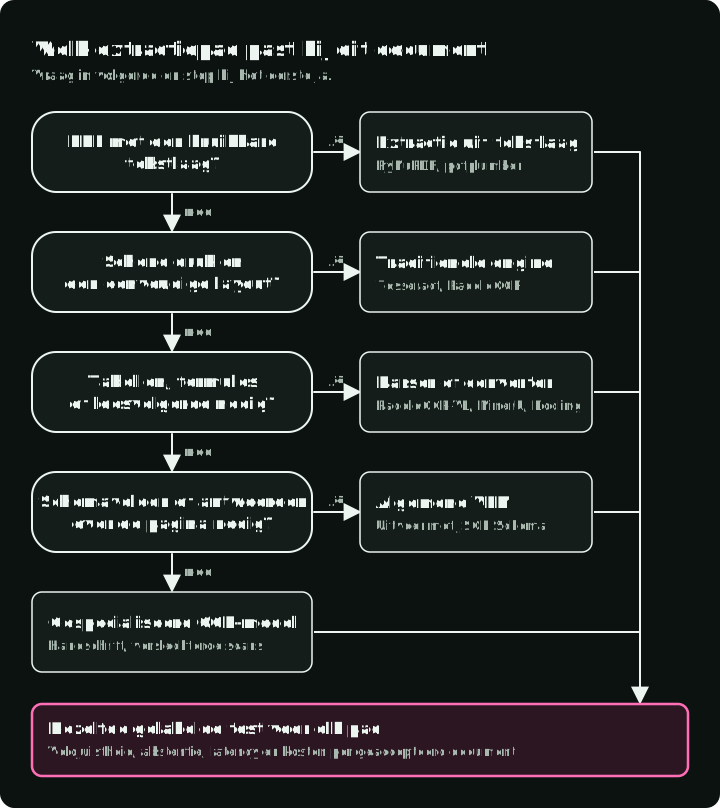
Elk eindpunt gaat nog steeds door dezelfde gelabelde test. De beslisboom geeft je een eerste kandidaat, geen definitieve keuze.
VLMs testen met OpenRouter
OpenRouter biedt een OpenAI-compatibele gateway naar models van meerdere providers. Model-ID’s en ondersteunde requestfuncties veranderen, dus controleer ze in de actuele catalogus van de gateway voordat je het voorbeeld draait.
Het fragment vereist pip install openai, een OPENROUTER_API_KEY, netwerktoegang, een lokale receipt.jpg en model-ID’s die OpenRouter nog ondersteunt.
import base64
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=os.environ["OPENROUTER_API_KEY"],
)

def extract_text(
    image_path: str,
    model: str,
    prompt: str = "Extract all text from this image, preserving layout as markdown.",
    **request_args,
) -> str:
    with open(image_path, "rb") as f:
        image_b64 = base64.b64encode(f.read()).decode()

    response = client.chat.completions.create(
        model=model,
        messages=[{
            "role": "user",
            "content": [
                {"type": "text", "text": prompt},
                {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{image_b64}"}},
            ],
        }],
        max_tokens=4096,
        **request_args,
    )
    choice = response.choices[0]
    if choice.finish_reason != "stop":
        raise RuntimeError(f"{model} did not finish: {choice.finish_reason}")
    if not choice.message.content:
        raise RuntimeError(f"{model} returned no text (finish_reason={choice.finish_reason})")
    return choice.message.content

# Compare models by changing one string
models = [
    "google/gemini-3.8-flash",
    "anthropic/claude-sonnet-5",
    "qwen/qwen3.8-27b",
]
for model in models:
    print(f"\n--- {model} ---\n{extract_text('receipt.jpg', model)[:200]}...")
De OpenRouter-modelcatalogus vermeldde google/gemini-3.8-flash, anthropic/claude-sonnet-5 en qwen/qwen3.8-27b op 2026-10-02 met afbeeldingsinvoer en parameters voor structured output. Ondersteuning in de catalogus bewijst niet dat dit exacte request op elk gerouteerd endpoint slaagt.
Gebruik voor gestructureerde extractie response_format met een JSON Schema wanneer het gekozen model en de gateway dat ondersteunen. Daarmee wordt het antwoord te parsen; de geëxtraheerde waarden worden er niet mee gevalideerd tegen de afbeelding. Met OpenRouter zorgt provider.require_parameters ervoor dat het request faalt wanneer geen enkel gerouteerd endpoint elke gevraagde parameter ondersteunt, in plaats van terug te vallen op een endpoint dat het schema niet kan naleven.
Het fragment hergebruikt extract_text uit het vorige blok en geeft het schema door via de extra requestargumenten. Het vereist een model dat JSON Schema ondersteunt.
import json

nullable = {"type": ["string", "null"]}
receipt_schema = {
    "type": "object",
    "properties": {
        "vendor": nullable,
        "date": nullable,
        "items": {
            "type": ["array", "null"],
            "items": {
                "type": "object",
                "properties": {"description": nullable, "amount": nullable},
                "required": ["description", "amount"],
                "additionalProperties": False,
            },
        },
        "total": nullable,
    },
    "required": ["vendor", "date", "items", "total"],
    "additionalProperties": False,
}
prompt = (
    "Extract only visible receipt fields. Copy amounts as source strings. "
    "Use null for absent or unreadable values; do not infer them. "
    "Use null for an unreadable item list, and [] only when no items are present."
)

receipt = json.loads(extract_text(
    "receipt.jpg",
    "google/gemini-3.8-flash",
    prompt=prompt,
    response_format={
        "type": "json_schema",
        "json_schema": {"name": "receipt", "strict": True, "schema": receipt_schema},
    },
    extra_body={"provider": {"require_parameters": True}},
))
OpenAI-stijl strict mode vereist dat elke property in required staat en additionalProperties: false, dus een waarde die kan ontbreken krijgt een nullable type in plaats van weggelaten te worden. De prompt en de nullable types samen laten het model null teruggeven in plaats van een waarde te verzinnen.
Bewaar de gekopieerde bedragstrings naast de genormaliseerde waarden. Parse geldbedragen verderop met decimale rekenkunde of rekenkunde in gehele kleinste eenheden, onder een expliciete valuta en locale; een geldig schema valideert geen betalingstotaal. Stuur kritieke velden met null door naar review.
OCR in productie uitrollen
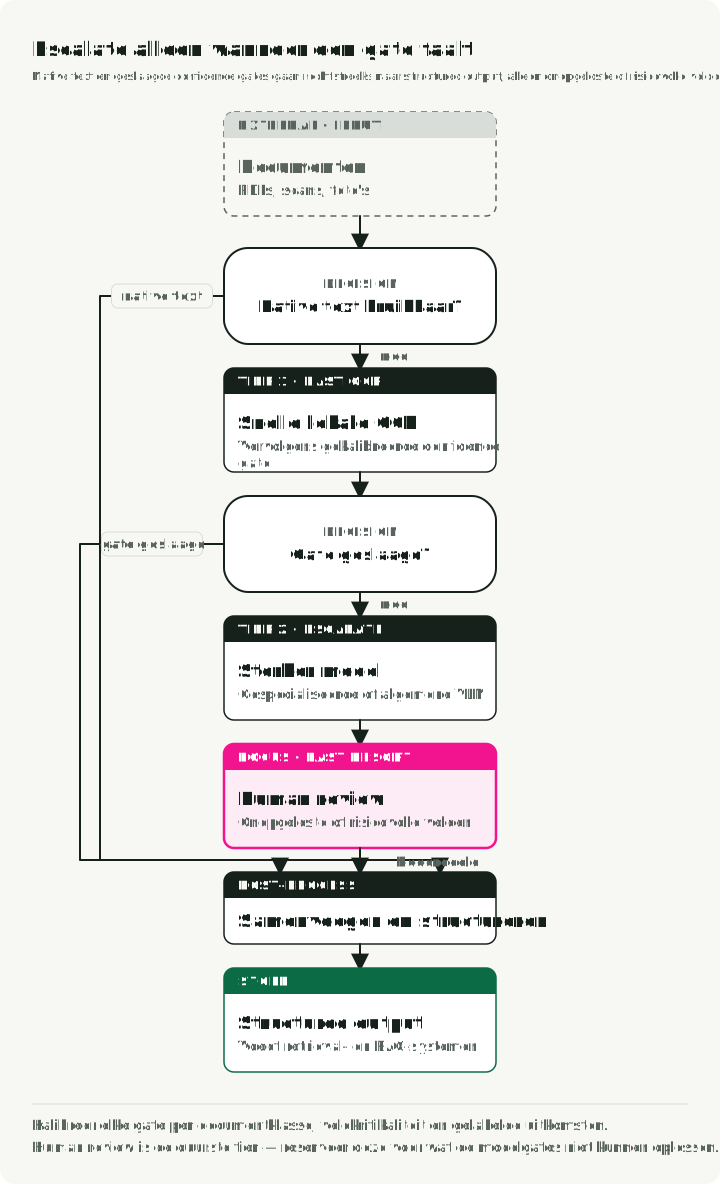
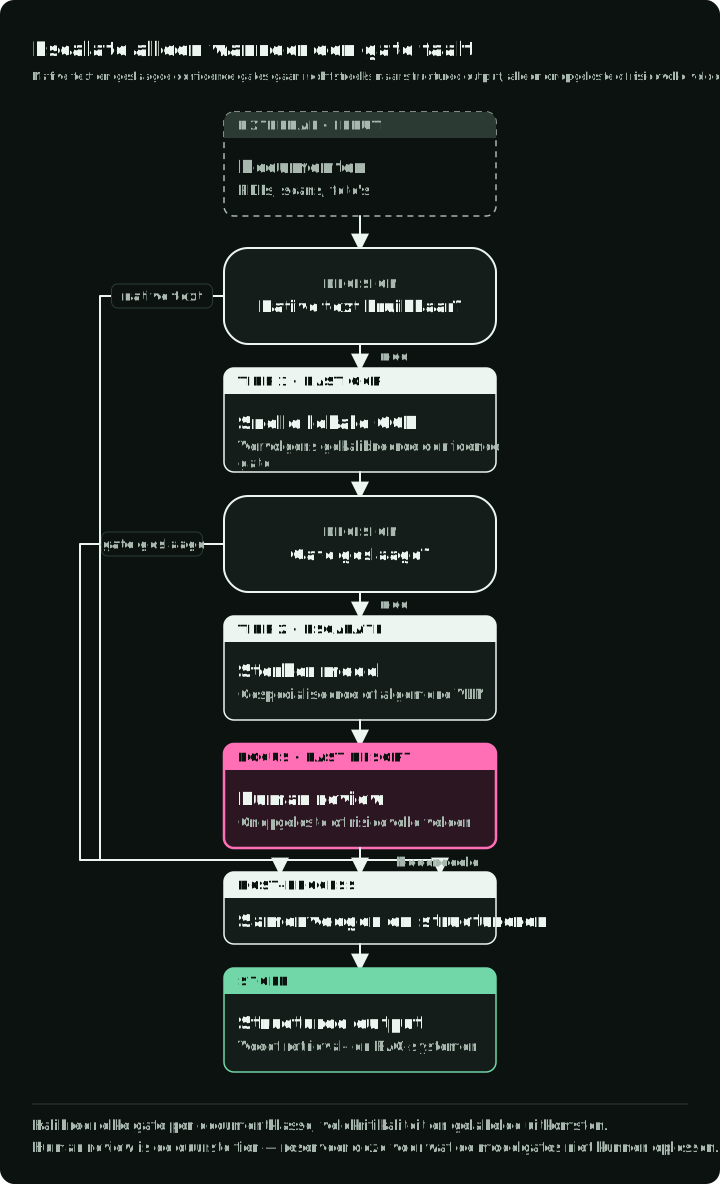
Een gelaagde architectuur kan CPU-preprocessing scheiden van GPU- of API-inference en dure paden reserveren voor documenten die ze nodig hebben. De figuur toont de lagen op volgorde van kosten, de controle die een pagina bij elke laag accepteert en de fout die haar naar de volgende laag stuurt.
Het gelaagde fallbackpatroon
Begin met het goedkoopste pad dat het kwaliteitsdoel haalt en kalibreer de routing daarna op gelabelde pagina’s:
- Controleer op ingebedde tekst (Tier 0). Inspecteer bij PDF’s de tekstlaag met
PyMuPDFofpdfplumbervoordat je rastert, maar valideer dat de laag compleet is.
- Probeer het met een snel model. Gebruik een traditionele engine voor documentklassen waarop die het doel haalt.
- Evalueer gekalibreerde confidence. Combineer modelconfidence met documentklasse, kritiekheid van het veld en validatieregels.
- Escaleer naar een sterker model. Stuur onzekere pagina’s naar een gespecialiseerde of algemene VLM.
- Escaleer risicovolle fouten naar een mens. Menselijke review is een aparte laag voor waarden waarvan de kosten van een fout opwegen tegen het voordeel van automatisering.
Opmerking over confidence: ruwe tekenkansen zijn niet automatisch gekalibreerd op de correctheid van velden. De oppervlaktegewogen functie hieronder is een baseline voor aggregatie op paginaniveau, geen universele router. Kalibreer haar op gelabelde pagina’s en geef kritieke velden eigen regels, want een paginagemiddelde kan een verkeerde ID of een verkeerd totaal verbergen.
def area_weighted_confidence(page):
    """Compute area-weighted confidence from one PaddleOCR 3.x result."""
    total_area, weighted_sum = 0, 0
    for (x_min, y_min, x_max, y_max), score in zip(
        page["rec_boxes"], page["rec_scores"]
    ):
        width = int(x_max) - int(x_min)
        height = int(y_max) - int(y_min)
        area = width * height
        weighted_sum += score * area
        total_area += area
    return weighted_sum / total_area if total_area > 0 else 0

assert area_weighted_confidence({
    "rec_boxes": [[0, 0, 300, 300]], "rec_scores": [0.5]
}) == 0.5
Om de drempel vast te stellen, label je een set pagina’s uit één documentklasse en leg je vast of alle kritieke velden op elke pagina juist zijn. Kies de laagste confidencedrempel waarbij de geaccepteerde pagina’s je doel voor kritieke veldfouten halen en stuur pagina’s eronder naar de volgende laag. De functie hieronder doet dit voor één documentklasse.
def pick_threshold(scores, correct, max_error):
    """Lowest threshold whose accepted pages meet the error target, or None."""
    for threshold in sorted(set(scores)):
        accepted = [ok for s, ok in zip(scores, correct) if s >= threshold]
        if accepted and accepted.count(False) / len(accepted) <= max_error:
            return threshold
    return None  # no threshold meets the target: send every page to the next tier

scores = [0.95, 0.91, 0.88, 0.80, 0.72, 0.60]
correct = [True, True, True, False, True, False]  # all critical fields right?
assert pick_threshold(scores, correct, max_error=0.0) == 0.88
assert pick_threshold(scores, correct, max_error=0.25) == 0.72
De figuur zet de zes gelabelde pagina’s uit de asserts op de betrouwbaarheidsschaal en markeert de drempel die elk foutdoel kiest.
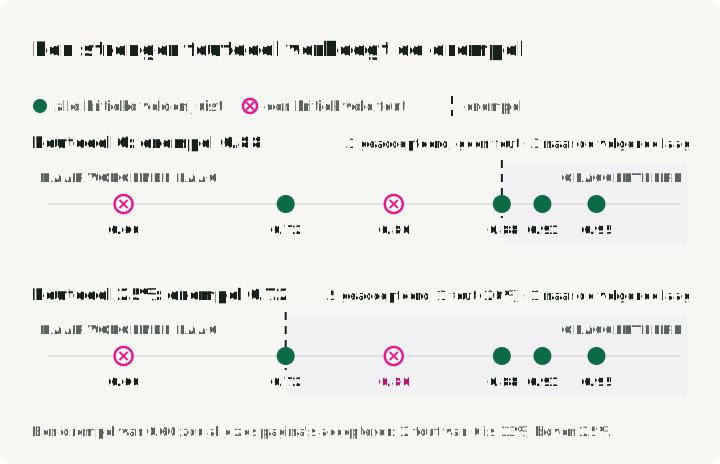
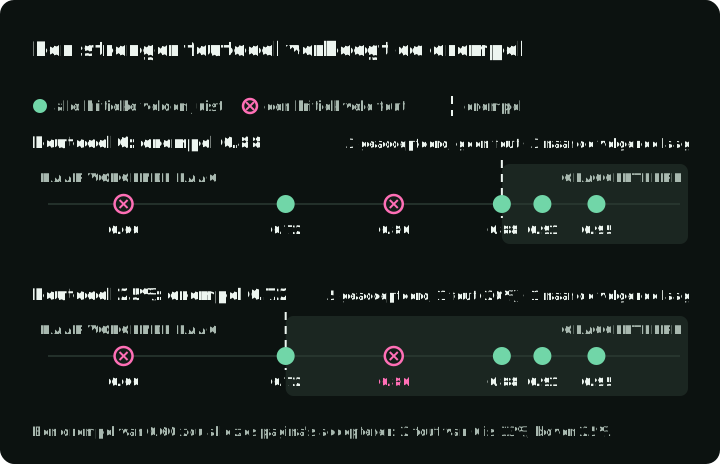
Een strenger foutdoel verhoogt de drempel en stuurt meer pagina’s naar het sterkere model. Herhaal de calibration voor elke documentklasse, want dezelfde score kan een andere nauwkeurigheid betekenen bij bonnetjes dan bij contracten.
Serveerpatronen
Hoe je elke laag draait, hangt af van hoe pagina’s binnenkomen:
- Batchjobs (archiefconversie, maandrapporten): lees pagina’s uit een queue en draai ze op GPU-workers die tussen jobs terugschalen naar nul.
- Interactieve requests: houd een GPU warm of gebruik een gehoste API, want een koude modelstart telt de laadtijd op bij de wachttijd van de gebruiker.
- Rasterisatie en afbeeldingsopschoning: draai ze op CPU-workers die los van de GPU-inference schalen.
- Open-weight VLMs: serveer ze met vLLM of SGLang, die gelijktijdige requests op één GPU batchen.
De resultaten meten
Bewaar voor elk gepland engine/documentpaar een resultaat met de status geslaagd, fout of overgeslagen. Mislukte, lege en afgekapte outputs blijven in de noemer van de geprobeerde documenten staan, samen met de kosten die eraan zijn besteed. Rapporteer het slagingspercentage, kritieke veldfouten onder automatische acceptaties, het aandeel dat naar review gaat, p50/p95 end-to-end latency en kosten per succesvol verwerkt document. Meet paginalatency met de werkelijke resolutie, batchgrootte, hardware of providerregio en outputlengte. Reken preprocessing en retries mee in het totaal; een timing van alleen het model kan geen prijs geven aan een geslaagde pagina. Hergebruik converterobjecten voor warme timings en registreer de initialisatie apart. De OCR Gauntlet-repository legt resultaten in dit formaat vast; de laatste sectie laat zien hoe je hem draait.
Kostenanalyse op schaal
Er is geen universeel break-evenpunt in paginavolume tussen een API en self-hosting. Bouw de vergelijking op uit dezelfde workload:
| Kostencomponent | API-pad | Self-hosted pad |
|---|---|---|
| Inference | Actuele prijs per pagina of per token | GPU-uren bij gemeten pagina’s per uur |
| Ongebruikte capaciteit | Meestal opgevangen door de provider | Benutting en capaciteitsmarge |
| Engineering | Integratie en monitoring van de provider | Deployment, upgrades, observability en bereikbaarheidsdienst |
| Datahandling | Transfer-, bewaar- en regiovoorwaarden | Opslag, netwerk en compliancemaatregelen |
| Kwaliteitsfouten | Retries en menselijke review | Retries en menselijke review |
Gebruik een gedeelde formule: monthly pages × cost per successful page + review cost + fixed operating cost. Een “succesvolle pagina” moet op beide paden aan dezelfde criteria voor tekst, tabellen en velden voldoen. Prijzen van providers en GPU-huur veranderen te snel om als duurzame inkoopraming te dienen.
Foutafhandeling: het hallucinatieprobleem
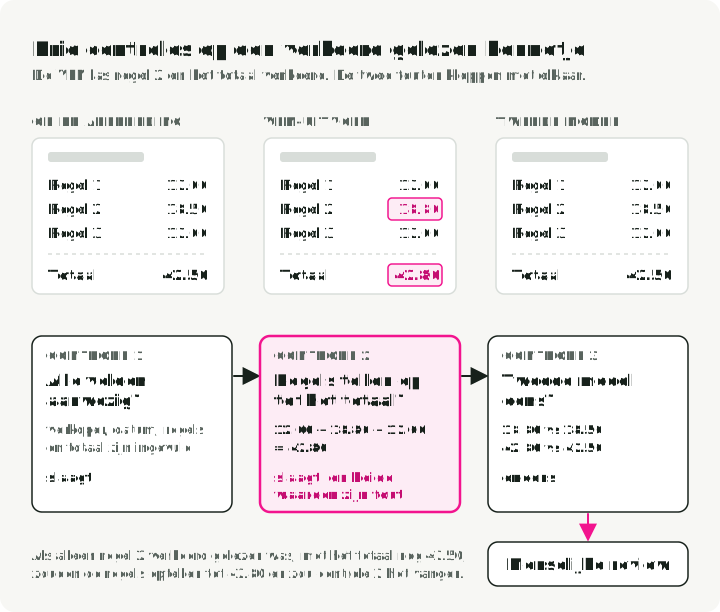
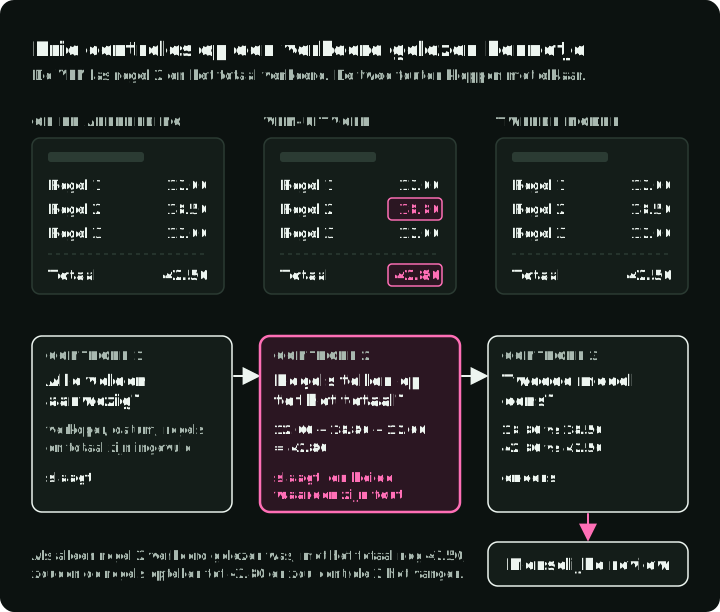
Fouten van VLMs kunnen contextueel aannemelijk en feitelijk onjuist zijn. Een bontotaal van “$42.50” kan terugkomen als “$42.80”: een geldig bedrag dat geen spellingcontrole markeert.
Synthetisch faalvoorbeeld: Een bonafbeelding toont drie regels, 12.00, 18.50 en 12.00, en een totaal van 42.50. Een VLM leest de tweede regel als 18.80 en het totaal als 42.80. De regels tellen nog steeds op tot het totaal, dus de interne rekenkunde klopt, terwijl beide waarden fout zijn. Daarom heeft validatie labels nodig die in de afbeelding zijn verankerd, of een onafhankelijk reviewpad, en niet alleen consistentiecontroles.
De figuur voert de drie controles uit op dit bonnetje: de schemacontrole en de somcontrole slagen, en alleen het tweede model vangt de twee verkeerd gelezen waarden.
Een paar praktische maatregelen:
- Rekenkundige sluitende controle. Controleer, wanneer het schema ze beschikbaar maakt,
subtotal + tax + fees + shipping - discountstegen het vermelde totaal, binnen de afrondingstolerantie van de valuta. Stuur ontbrekende componenten of afwijkingen naar review. - Controles op datum, telefoonnummer en valuta. Parse datums met een datumparser en wijs onmogelijke waarden af. Controleer het aantal cijfers van telefoonnummers en valutaformaten met patronen.
- Tweede extractiepad. Laat kritieke velden door een ander model of een andere OCR-engine lopen en markeer verschillen. Overeenstemming verhoogt de confidence alleen wanneer de twee paden voldoende verschillende faalwijzen hebben; het is geen bewijs van correctheid.
De sluitende controle neemt de gekopieerde bedragstrings en gebruikt Decimal, zodat er geen float-afronding in de vergelijking komt. De asserts spelen het bonvoorbeeld hierboven na.
from decimal import Decimal

def reconcile(subtotal, tax, fees, shipping, discounts, total, tolerance="0.01"):
    """True when the stated total matches its components within tolerance."""
    parts = [subtotal, tax, fees, shipping, discounts, total]
    if any(p is None for p in parts):
        return False  # a missing component goes to review
    s, t, f, sh, d, tot = (Decimal(p) for p in parts)
    return abs(s + t + f + sh - d - tot) <= Decimal(tolerance)

items = ["12.00", "18.80", "12.00"]  # the image shows 18.50
subtotal = str(sum(Decimal(i) for i in items))
assert reconcile(subtotal, "0", "0", "0", "0", "42.80")  # passes, and both values are wrong
assert not reconcile(subtotal, "0", "0", "0", "0", "42.50")  # one misread value is caught
assert not reconcile(subtotal, None, "0", "0", "0", "42.80")  # missing tax goes to review
De sluitende controle vangt één verkeerd gelezen bedrag. Ze kan geen twee verkeerde lezingen vangen die met elkaar kloppen, dus kritieke velden hebben nog steeds het tweede extractiepad nodig.
Draai de vergelijking op je eigen pagina’s
De OCR Gauntlet-repository draait meerdere OCR-engines op dezelfde pagina’s en schrijft één resultaatrij per engine en pagina, inclusief mislukkingen. Hij vergelijkt afbeeldingspagina’s; de Tier 0-controle van de tekstlaag valt erbuiten.
De runner werkt in vier stappen:
- Het manifest somt de pagina’s en de hashes van hun referentietekst op.
- De runner stuurt elke pagina naar elke engine.
- Hij schrijft per engine en pagina één JSONL-rij, gemarkeerd als success, error of skipped, met ruwe output, timing en kosten.
- De samenvatting toont slagingspercentage, CER op gereviewde pagina’s en kosten per succesvolle pagina. Mislukte en overgeslagen paren blijven in de noemer van het slagingspercentage.
De eerste run gebruikt gegenereerde pagina’s en Tesseract, dus je hebt Python 3.12, uv en een Tesseract-installatie op systeemniveau nodig, maar geen API-keys:
uv sync --locked --extra tesseract --extra notebooks
uv run python scripts/make_fixture.py data/demo
uv run ocr-gauntlet data/demo/manifest.json --engines tesseract --output results/demo.jsonl
De gegenereerde pagina’s controleren alleen dat de pipeline draait; ze meten geen OCR-kwaliteit. Importeer voor een echte bontest CORD-voorbeelden met uv run python scripts/download_samples.py --dataset cord --count 2 --output data/cord en maak een gereviewde referentie zoals de README van de repository beschrijft. Voeg andere engines toe met --engines; gehoste engines hebben ook --allow-remote nodig, omdat ze je pagina’s uploaden.
Lees in de samenvatting eerst het slagingspercentage: een engine die op een derde van de pagina’s faalt is geen kandidaat, wat zijn CER ook is. Vergelijk daarna de CER op de gereviewde pagina’s en vervolgens de kosten per succesvolle pagina, waarin de uitgaven aan mislukte pogingen zijn meegeteld.
Belangrijkste inzichten
- Koppel de modellaag aan een gelabelde documentklasse. Traditionele engines kunnen volstaan voor schone tekst; gespecialiseerde en algemene VLMs moeten hun extra kosten verdienen op moeilijkere pagina’s.
- Voeg ongelijksoortige leaderboards niet samen. De metrics van OmniDocBench en de voorkeuren in OCR Arena beantwoorden verschillende vragen.
- Kalibreer de routing. Confidencedrempels, documentklassen, kritiekheid van velden en het reviewbeleid horen in één evaluatie.
- Valideer aannemelijke output. Schemaconformiteit en interne rekenkunde kunnen niet bewijzen dat een waarde in de afbeelding voorkomt.
- Reken in succesvolle pagina’s. Neem retries, review, vaste operationele kosten en kwaliteitscontroles mee wanneer je API’s met self-hosting vergelijkt.
Referenties
- OCR Arena Leaderboard - Crowdsourced modelduels, één tegen één
- De OCR Gauntlet-repo - Draaibare vergelijking van OCR-engines op dezelfde pagina’s, met Docling-backends en kosten per succesvolle pagina
- OmniDocBench - End-to-end eval voor documentparsing
- dots.ocr - Ongeveer 3B parameters in totaal, waaronder een taalmodel van 1.7B
- PaddleOCR - Traditionele OCR-toolkit en -modellen
- OpenRouter - Uniforme toegangsgateway voor A/B-tests van models