OCR en 2026: pipelines clásicos, VLMs y Document AI

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Esta guía es para ingenieros que eligen OCR y extracción de documentos para búsqueda, generación aumentada por recuperación (RAG) o AI agents. Explica en qué se diferencian los motores tradicionales y los modelos de visión y lenguaje, cómo evaluar texto, tablas y campos, y cómo derivar los documentos difíciles a otro modelo o a revisión humana.
Los modelos de visión y lenguaje (VLMs) pueden manejar maquetación, escritura a mano, tablas e imágenes degradadas que rompen un pipeline de reconocimiento de texto simple. Los motores tradicionales siguen siendo competitivos con texto impreso limpio, sobre todo cuando importan la latencia en CPU y el coste operativo. La instantánea fechada de abajo incluye PaddleOCR-VL 1.6 y dots.mocr, con compromisos distintos de hardware, privacidad y formato de salida. Revisa cada proyecto antes de tomar una decisión actual.
Para la versión compacta sobre selección de modelos, consulta Best OCR Models in 2026: Classical OCR, PaddleOCR-VL, VLMs.
El OCR ya marca la calidad posterior
El OCR lleva mucho tiempo al servicio de archivos, sistemas postales, herramientas de accesibilidad y gestión documental. RAG y los agentes de documentos hicieron visibles sus modos de fallo a un grupo más amplio de ingenieros: un modelo posterior no puede recuperar el texto ni la estructura de las tablas que la extracción descartó.
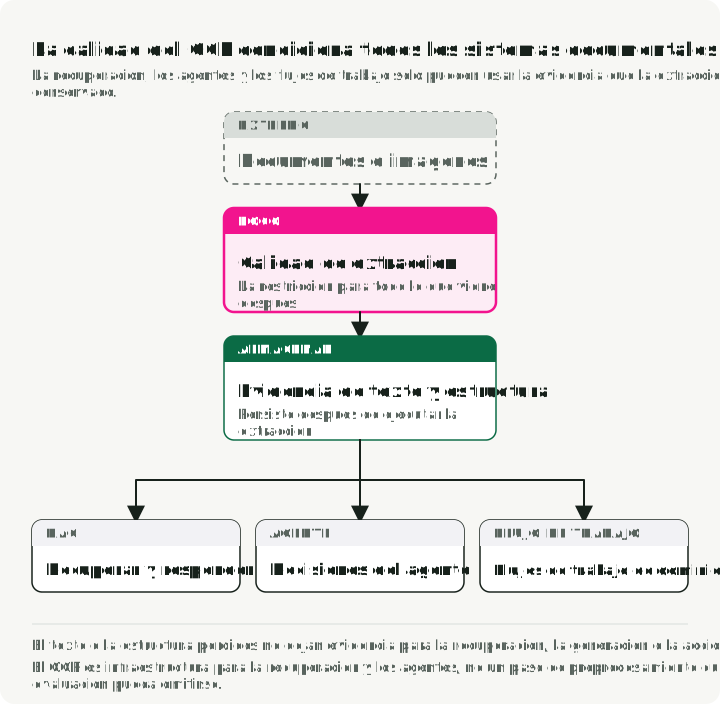
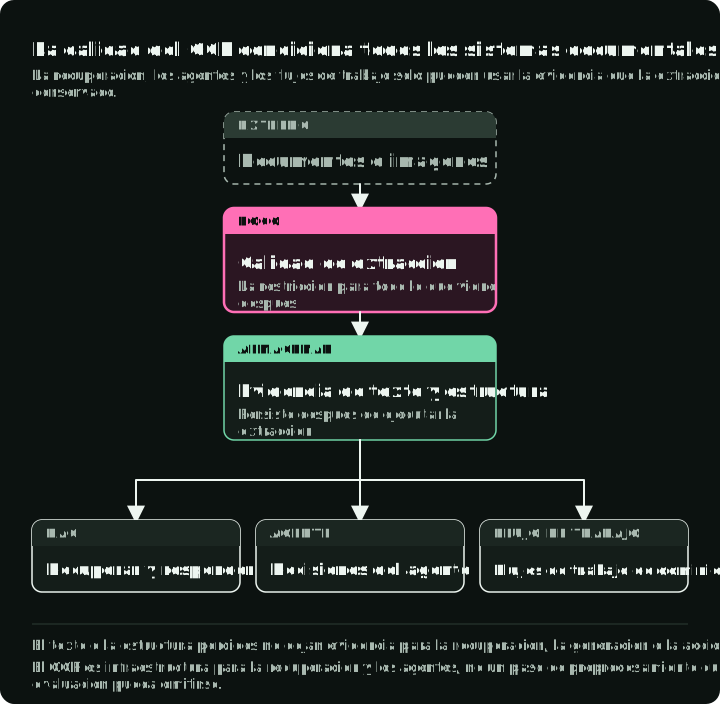
Un sistema RAG no puede recuperar texto que el OCR omitió o leyó mal. Si la extracción desordena una tabla, lee mal una fecha o pierde un párrafo, los cambios posteriores de chunking y embeddings no pueden recuperar la información que falta. Esos errores pueden ocultar una cláusula de un contrato, cambiar el total de una factura o corromper una historia clínica.
Por eso el OCR forma parte de la infraestructura de recuperación y de agentes, junto con el parsing, el chunking, los embeddings y la indexación. Sus errores necesitan una evaluación propia en lugar de quedar absorbidos en una única puntuación de extremo a extremo.
Qué significa OCR en la era de los foundation models
El OCR convierte el texto de una imagen en caracteres legibles por máquina. Document AI es el sistema más amplio que lo rodea: análisis de maquetación, parsing de tablas y fórmulas, extracción de campos, razonamiento semántico, procedencia y validación. Los autores de GOT-OCR 2.0 llaman «OCR-1.0» a los pipelines modulares de detección y reconocimiento, y «OCR-2.0» a los modelos de extremo a extremo. Esa etiqueta no debe borrar la distinción entre reconocimiento y comprensión del documento.
La figura compara los dos caminos y cómo falla cada uno: las tres etapas en serie de la izquierda nunca recuperan una línea que la detección no encontró, la única pasada del modelo de la derecha escribe un total verosímil que no está en la página, y la rasterización y el parseo quedan fuera del modelo en ambos casos.
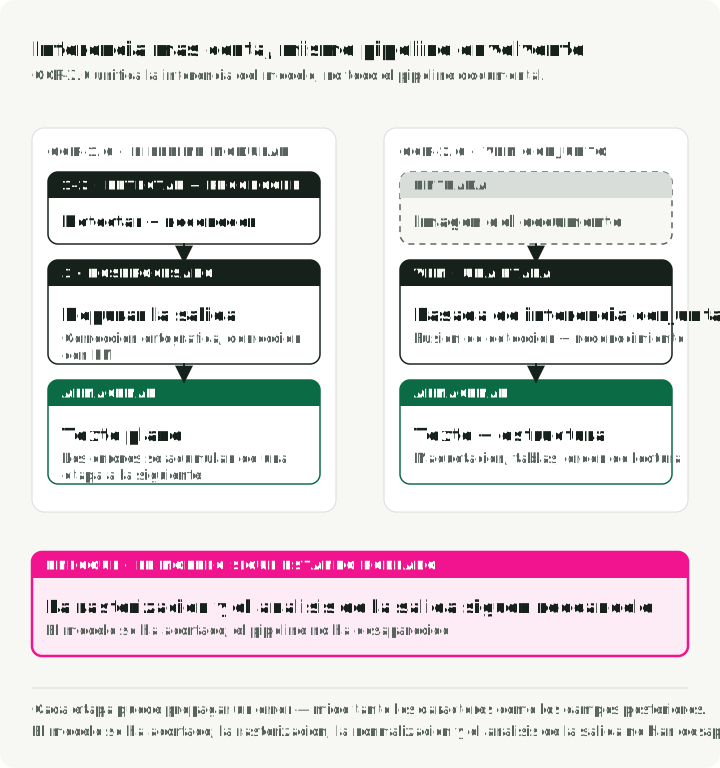
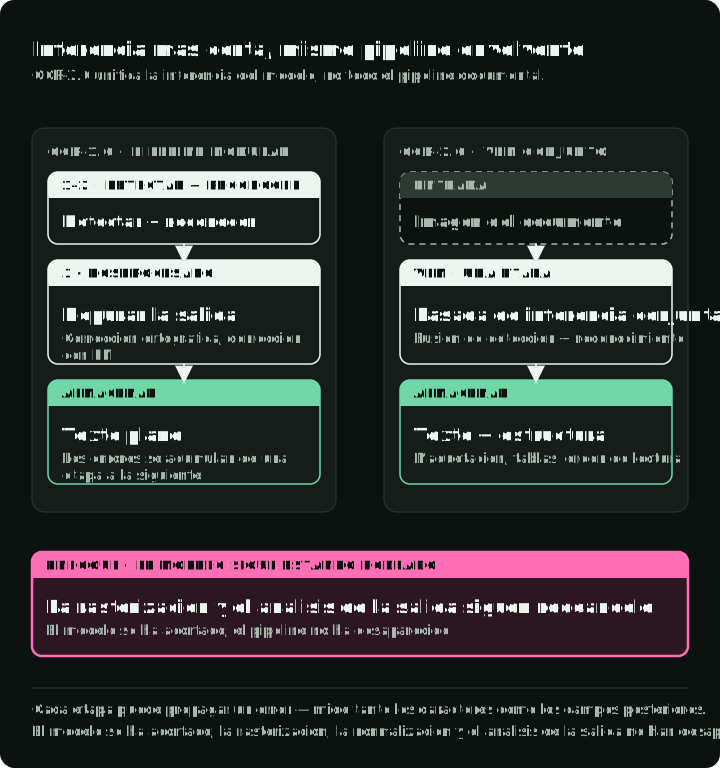
El pipeline de OCR tradicional tiene tres etapas principales:
- Detección de texto: localiza las regiones que contienen texto (p. ej., CRAFT, DBNet).
- Reconocimiento de texto: convierte las regiones detectadas en secuencias de caracteres (p. ej., CRNN).
- Posprocesamiento: corrección ortográfica y corrección con un modelo de lenguaje.
Esto funciona bien con documentos limpios, pero los errores de detección, reconocimiento y posprocesamiento pueden acumularse. Mide tanto la precisión de caracteres como la precisión de los campos posteriores, para que una página legible no oculte un total o un identificador incorrectos.
Algunos caminos VLM de extremo a extremo condensan más partes de ese pipeline en un codificador de visión más un decodificador de lenguaje. Modelos como GOT-OCR 2.0 pueden emitir texto y estructura a la vez, mientras que los VLMs generales también pueden asignar campos a un esquema solicitado. Por ejemplo, un VLM general puede leer «MFG: 10/24» en una etiqueta como una fecha de fabricación y no como una fecha de caducidad. Las contrapartidas son una latencia que depende de la carga de trabajo, el coste de GPU o de API, y el riesgo de texto verosímil que no aparece en la imagen.
Una salvedad práctica: un modelo que solo acepta imágenes necesita páginas rasterizadas, mientras que un servicio que acepta PDF puede gestionar la conversión internamente. Enderezar, reescalar y limpiar la imagen son experimentos propios de cada pipeline, no mejoras obligatorias. AWS Textract recomienda conservar las entradas admitidas en lugar de convertirlas o reducirlas sin criterio. El parsing y la validación de la salida siguen siendo responsabilidad de la aplicación.
Métricas: medir lo que importa
Cada comparación posterior de esta guía usa una de estas métricas. Elige la que corresponda al tipo de salida:
- CER y WER para texto plano. La tasa de error de caracteres y de palabras dependen de decisiones de normalización como mayúsculas, espacios y puntuación, así que fija el protocolo de comparación antes de comparar modelos.
- Coincidencia exacta de campo y F1 de campo para formularios y recibos. La coincidencia exacta es binaria para un campo; su tasa es la fracción de campos evaluados que la superan. Informa por separado de la corrección a nivel de documento con todos los campos. Para el F1 de campo, define la correspondencia clave/valor, la normalización, los campos duplicados y ausentes, y la agregación; un importe correcto asignado a la fila equivocada es un error.
- TEDS para tablas. Tree-Edit-Distance-based Similarity compara los árboles HTML predicho y de referencia, y detecta errores de estructura y de contenido de celdas que el CER oculta.
- Comparación del orden de lectura cuando el consumidor necesita una única secuencia lineal. Compara directamente bloques o tramos ordenados, o usa una métrica sensible al orden; OmniDocBench evalúa el orden de lectura por separado. Que los caracteres y las celdas sean correctos no demuestra el orden de una página de varias columnas.
- ANLS para VQA de documentos. Average Normalized Levenshtein Similarity puntúa las respuestas frente a las referencias aceptadas. La definición original de ST-VQA asigna
1 − normalized_distancesolo cuando la distancia es estrictamente inferior a 0,5 y cero en caso contrario; toma la mejor puntuación entre las referencias aceptadas y promedia entre preguntas. DocVQA adopta ANLS. Fija las mayúsculas, los espacios y la normalización de distancia del evaluador al reproducir una puntuación.
CER/WER cuentan sustituciones, eliminaciones e inserciones divididas entre los caracteres o palabras de la referencia. Pueden superar uno cuando dominan las inserciones. Indica si la agregación suma los errores y las longitudes de referencia de todo el corpus o promedia las puntuaciones por documento. Conserva la página, el bloque, el cuadro delimitador, el texto original y el historial de normalización para poder rastrear un campo incorrecto hasta la imagen.
Para la detección de texto, la intersección sobre la unión (IoU) divide el área de solapamiento de un cuadro predicho y uno de referencia entre el área total cubierta por cualquiera de los dos. El umbral de IoU decide si un cuadro detectado coincide con la referencia antes de calcular F1.
La tabla asigna a cada tarea su métrica y el error que con más frecuencia hace engañosa una puntuación:
| Tarea | Métrica | Error que hay que evitar |
|---|---|---|
| Extracción de texto plano | CER, WER | Comparar puntuaciones calculadas con distinta normalización |
| Escritura a mano | CER | Usar objetivos de CER de texto impreso para páginas manuscritas |
| Detección de texto | F1 con un umbral de IoU | Informar del F1 sin el umbral de IoU que usó |
| Formularios y recibos | Coincidencia exacta de campo, F1 | Dar por bueno un valor correcto en el campo o la fila equivocados |
| Tablas | TEDS | Juzgar las tablas por el CER, que ignora la estructura de las celdas |
| VQA de documentos | ANLS | Cambiar el umbral de 0,5 o la normalización de las respuestas |
| Conversión de página completa | Distancia de edición + orden de lectura | Informar de la precisión del texto sin comprobar el orden de los bloques |
Los idiomas también cambian la elección. El texto en chino y japonés no tiene espacios entre palabras, por lo que el WER depende de un segmentador de palabras; usa CER para estas escrituras. Incluye páginas que mezclen escrituras en el conjunto de prueba etiquetado cuando aparezcan en tu carga de trabajo. Que la ficha de un modelo enumere 100 idiomas no indica la calidad en ninguno de ellos, así que incluye cada idioma de destino en el conjunto de prueba etiquetado.
Para las implementaciones: jiwer calcula CER/WER de serie, y hay implementaciones de TEDS en el repositorio de OmniDocBench.
Qué miden y qué omiten los benchmarks de OCR
Los datasets públicos aplican estas métricas a tipos concretos de documentos. Los tamaños de dataset y las métricas describen la versión del dataset indicada; consulta la clasificación actual de cada proyecto para las puntuaciones de los modelos. La columna «Evalúa» indica a cuáles de tus documentos se parece cada dataset.
| Dataset | Evalúa | Tamaño de test | Idiomas | Métrica principal |
|---|---|---|---|---|
| FUNSD | Vinculación clave-valor en formularios escaneados con ruido | 50 documentos | Inglés | F1 |
| SROIE | Cuatro campos de recibo (empresa, fecha, dirección, total) | 400 imágenes de test | Inglés | F1 |
| CORD | Líneas de recibo con etiquetas jerárquicas | 100 recibos | Indonesio | F1 |
| IAM | Líneas manuscritas en inglés | Según la partición | Inglés | CER |
| OCRBench v2 | Lectura y razonamiento de texto de VLMs en 23 tareas | 10.000 pares QA | EN + CN | Puntuación /100 |
| OmniDocBench v1.6 | Parsing de página completa: texto, tablas, fórmulas, orden de lectura | 1651 páginas | EN + CN | Compuesta |
El número de líneas de IAM depende de la partición de escritores elegida y del protocolo de reconocimiento; aquí no se asume ningún número único de líneas de test.
Instantánea de OmniDocBench v1.6
La tabla siguiente es una instantánea con versión concreta: OmniDocBench v1.6_full, README oficial en el commit 09ba2b606662695b16aafe5f5e36b7ef020e11a8, consultado el 2026-08-09.
| Modelo | Tamaño | Overall ↑ | Text Edit ↓ | Table TEDS ↑ |
|---|---|---|---|---|
| GLM-OCR | 0.9B | 95.22 | 0.044 | 92.83 |
| PaddleOCR-VL-1.5 | 0.9B | 94.93 | 0.038 | 91.67 |
| Gemini 3 Flash | — | 92.62 | 0.066 | 89.29 |
| dots.ocr | 3B | 90.77 | 0.048 | 87.18 |
El README fijado indica PaddleOCR-VL 1.5. PaddleOCR informa de 96,3 para la versión 1.6 en la misma versión del benchmark; esa cifra es una ejecución del propio proveedor y no forma parte de esta tabla.
La conclusión se limita a esta versión de OmniDocBench: el tamaño del modelo por sí solo no predice la puntuación de parsing de documentos. Las versiones posteriores del evaluador cambian la correspondencia, así que compara puntuaciones solo con un único evaluador fijado. La puntuación compuesta incluye la distancia de edición del texto, el TEDS de tablas y Character Detection Matching (CDM) de fórmulas. CDM renderiza las fórmulas predichas y de referencia, empareja sus caracteres y comprueba sus posiciones relativas antes de puntuar las coincidencias con F1. Compara fórmulas renderizadas en lugar de cadenas LaTeX sin procesar. El orden de lectura requiere su propio resultado por separado.
La brecha entre «benchmark y arena»
Las clasificaciones de los benchmarks automáticos pueden contradecir la preferencia humana.
En OCR Arena, los usuarios votan a ciegas sobre salidas enfrentadas de dos en dos. El 2026-08-09, OCR Arena clasificó a Gemini 3 Flash por encima de GLM-OCR, mientras que la tabla de OmniDocBench de arriba puntúa más alto a GLM-OCR (95,22 frente a 92,62). El orden en vivo de Arena cambia con cada nuevo duelo, por lo que no es una instantánea histórica reproducible de un benchmark. No combines las dos clasificaciones en una sola puntuación.
La figura muestra el desacuerdo: GLM-OCR y Gemini 3 Flash cambian de puesto entre las dos clasificaciones. Debajo están las páginas que usa cada una, quién juzga y qué obtienes.
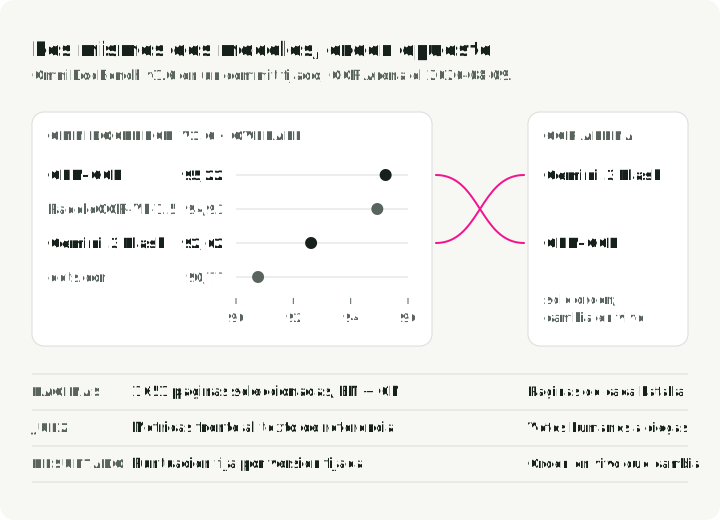
Entre las causas probables están la mezcla de documentos, el formato de salida, la cobertura de idiomas y los criterios de los jueces. Las cifras publicadas sirven para una primera selección, pero la elección final necesita un conjunto reservado de la carga de trabajo real.
Motores de OCR tradicionales: siguen vigentes
Los motores tradicionales son buenas referencias porque pueden ejecutarse en local en CPU. Su latencia y su precisión dependen del modelo elegido, la resolución de página, el idioma, el preprocesamiento y el hardware, así que evalúalos con las mismas páginas etiquetadas que uses para evaluar los VLMs.
| Motor | Despliegue | Referencia útil para |
|---|---|---|
| Tesseract 5.5 | CPU local | Texto impreso limpio y escrituras consolidadas |
| EasyOCR | PyTorch local en CPU o GPU | Prototipos y texto en escenas |
| PaddleOCR 3.x | CPU y GPU locales, y variantes para móvil | OCR multilingüe y herramientas de despliegue |
Tesseract para texto impreso limpio
Tesseract (v5.5.x, Apache 2.0) es un motor maduro, principalmente de CPU, con más de 100 paquetes de idioma. La precisión con texto impreso limpio puede ser alta tras una rasterización y un preprocesamiento adecuados, pero la escritura a mano, el texto en escenas y las maquetaciones complejas requieren pruebas aparte. Su principal ventaja es un despliegue local, pequeño y en CPU.
Define el modo de segmentación de página (--psm) según el tipo de documento; un modo incorrecto pierde columnas o fusiona líneas. El fragmento requiere pip install pytesseract pillow, el binario de Tesseract con los datos del idioma inglés y un receipt.jpg local.
import pytesseract
from PIL import Image

# --psm 6: treat the image as one uniform block of text, which suits a receipt
text = pytesseract.image_to_string(Image.open("receipt.jpg"), lang="eng", config="--psm 6")
EasyOCR
EasyOCR combina un detector CRAFT con un reconocedor CRNN. Con aceleración completa en GPU mediante PyTorch, es una opción rápida para prototipos y texto en escenas. Solo devuelve líneas y cuadros, sin maquetación ni estructura de tablas.
El fragmento requiere pip install easyocr, PyTorch, los pesos de modelo que descarga EasyOCR y un receipt.jpg local.
import easyocr

# Three lines for complete OCR
reader = easyocr.Reader(["en"])
result = reader.readtext("receipt.jpg")
# Returns: [(bbox, text, confidence), ...]
PaddleOCR 3
PaddleOCR 3 empaqueta pipelines mantenidos de OCR, parsing de documentos y despliegue. La guía de inicio rápido actual usa la API predict() y ajustes de orientación explícitos. Fija la versión del paquete paddleocr y del pipeline elegido, porque los ejemplos de la serie 2.x que usan .ocr(..., cls=True) no coinciden con la API de la serie 3.x.
Necesita el runtime de PaddlePaddle, que añade un segundo framework a un stack de PyTorch. El reconocimiento de texto de PaddleOCR es un pipeline distinto de PaddleOCR-VL, el parser de documentos de la sección siguiente.
El fragmento requiere pip install "paddleocr>=3,<4", un runtime de PaddlePaddle compatible, los pesos de modelo descargados y un receipt.jpg local.
from paddleocr import PaddleOCR

ocr = PaddleOCR(
    use_doc_orientation_classify=False,
    use_doc_unwarping=False,
    use_textline_orientation=False,
)

for result in ocr.predict("receipt.jpg"):
    result.print()
    result.save_to_json("output")
Cada resultado contiene rec_texts, rec_scores y rec_boxes. La sección de enrutamiento usa las dos últimas para puntuar una página.
Opciones de VLM especializados y generales
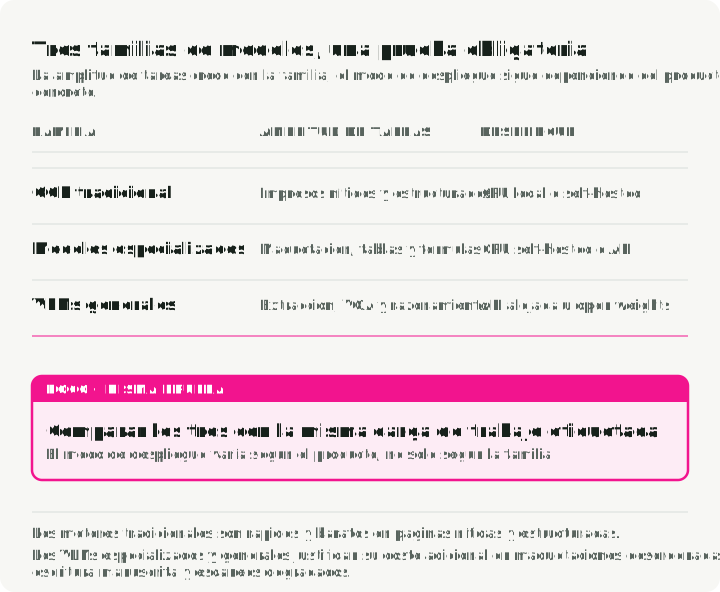
Los recibos torcidos, las etiquetas de producto inclinadas, la escritura a mano y las maquetaciones densas son los casos en los que los VLMs especializados o generales merecen una prueba frente a los motores tradicionales.
La figura muestra qué devuelve cada familia de modelos para la misma página, su principal contrapartida y dónde puede ejecutarse. El modo de despliegue depende del producto, por eso la figura lo indica aparte de la amplitud de tareas.
Modelos de documentos especializados
Los modelos de esta sección se comprobaron el 2026-10-02. La lista no es una clasificación actual; indica con qué problema de documentos merece la pena probar cada modelo.
| Modelo | Salida | Dónde se ejecuta | Pruébalo cuando |
|---|---|---|---|
| PaddleOCR-VL 1.6 | Análisis de maquetación y después un VLM de 0.9B lee cada región | Autoalojado | Páginas multilingües con maquetación; el proveedor indica 109 idiomas |
| GOT-OCR 2.0 | Texto plano, Markdown, LaTeX | Autoalojado, 580M de parámetros | Fórmulas y texto mixto en una misma página |
| dots.mocr | Maquetación y texto; gráficos y figuras como código SVG | Autoalojado, 3B de parámetros | Páginas con gráficos o diagramas que necesitas como estructura |
| DeepSeek-OCR2 | Markdown con cuadros de anclaje | Autoalojado, vLLM o Transformers | Documentos largos y alto volumen; una página usa entre 256 y 1120 vision tokens |
| Mistral OCR 4.1 | Markdown, cuadros de párrafo, etiquetas de bloque, confianza por bloque | API alojada (mistral-ocr-4-1) | Quieres una API y una puntuación de confianza por bloque |
| Granite-Docling 258M | DocTags, convertidos a un DoclingDocument | Autoalojado, dentro de Docling | Un modelo local pequeño para conversiones con Docling |
| olmOCR | Texto plano o Markdown en orden de lectura | Autoalojado, VLM de 7B en una GPU | Linealizar PDFs en texto para RAG o datos de entrenamiento |
Trata las cifras de rendimiento y de memoria como dependientes del hardware y del dataset; mide el pico de memoria con tu runtime, precisión, tamaño de imagen y límite de salida. Calibra la confianza por bloque de Mistral frente a la corrección de los campos antes de aceptar valores automáticamente. Fija una versión explícita del modelo en las comparaciones, porque un alias latest puede cambiar.
VLMs de frontera
Los VLMs generales son otra opción cuando la tarea combina extracción con razonamiento visual o semántico. Estos candidatos se comprobaron el 2026-10-02 y se usan en el ejemplo con gateway de más abajo. Son una lista inicial, no una clasificación de OCR:
- Gemini 3.8 Flash (Google): un modelo multimodal de disponibilidad general, con entrada de imagen y structured outputs. Usa su ID estable al empezar una comparación nueva.
- Claude Sonnet 5 (Anthropic): una generación de Sonnet publicada el 2026-06-30, para una comparación con un modelo alojado. Prueba la fidelidad de transcripción y la extracción de campos con tus propios documentos; las mejoras de razonamiento general no demuestran precisión de OCR.
- Qwen3.8-27B (Alibaba): un modelo de visión y lenguaje de pesos abiertos con licencia Apache 2.0 que puede probarse a través de un gateway o autoalojarse. Sus 27B lo convierten en una opción de despliegue distinta del anterior Qwen3-VL 8B, que sigue siendo una referencia más pequeña útil cuando la memoria es limitada.
Añade cada lanzamiento nuevo al conjunto de prueba. Úsalo en producción solo después de que supere la misma comparación: corrección de campos, abstención, latencia y coste por documento aceptado con el mismo protocolo.
Frameworks de conversión de documentos
Un pipeline RAG suele necesitar un documento completo convertido a Markdown o JSON, no líneas de OCR sin procesar. Los conversores de documentos hacen eso. Analizan el archivo, ejecutan un modelo de maquetación y llaman a un motor de OCR para el texto de cada región. Algunos pueden, en cambio, enviar cada página a un VLM que lee maquetación y texto a la vez.
| Framework | Qué produce | Úsalo cuando |
|---|---|---|
| Docling | Markdown, HTML o JSON sin pérdida con tablas y coordenadas, a partir de PDF, DOCX, PPTX, XLSX, HTML e imágenes | Necesitas un único conversor para formatos mixtos y quieres elegir el motor de OCR que lleva dentro |
| Marker | Markdown, JSON, HTML o chunks, a partir de PDF, imágenes y archivos de Office | Quieres Markdown de alta calidad a partir de PDFs |
| MinerU | Markdown y JSON estructurado, a partir de PDF, imágenes y archivos de Office | Artículos científicos y técnicos con fórmulas y tablas |
Revisa las licencias antes de incluir uno en un producto. Docling es MIT. El código de Marker es Apache 2.0, pero los pesos de sus modelos usan una licencia OpenRAIL-M modificada con límites al uso comercial. La licencia de MinerU añade condiciones a Apache 2.0: una licencia comercial aparte por encima de ciertos umbrales de usuarios e ingresos, y atribución para los servicios en línea.
La figura muestra qué envuelve un conversor. Docling mantiene igual la entrada y la salida, y las opciones de su pipeline eligen cómo se lee el texto: su modelo de maquetación con Tesseract o EasyOCR, o el VLM Granite-Docling de extremo a extremo.
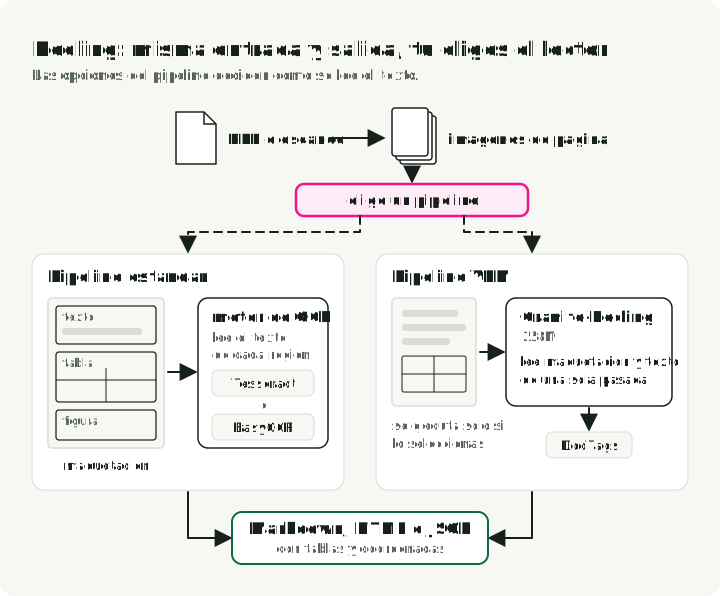
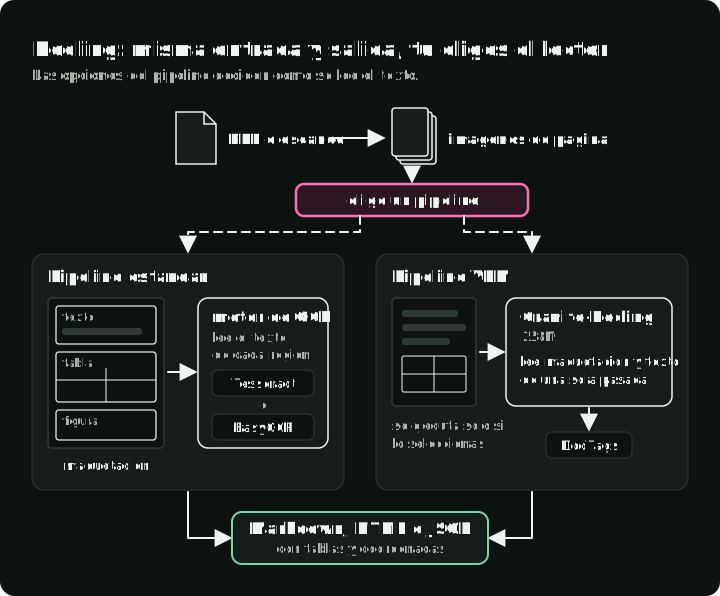
Por tanto, la velocidad y la calidad de conversión de Docling dependen del pipeline que selecciones. El pipeline VLM de Docling debe seleccionarse de forma explícita; un conversor por defecto no es prueba de que se haya ejecutado Granite-Docling. La política de reintentos sigue correspondiendo a la aplicación o al servicio que lo rodea, y el enrutamiento sigue necesitando sus propias etiquetas de calidad y umbrales.
Elegir un camino de extracción
El mapa de decisión ordena las secciones anteriores: cada pregunta envía el documento al camino más barato que pueda producir lo que necesitas.
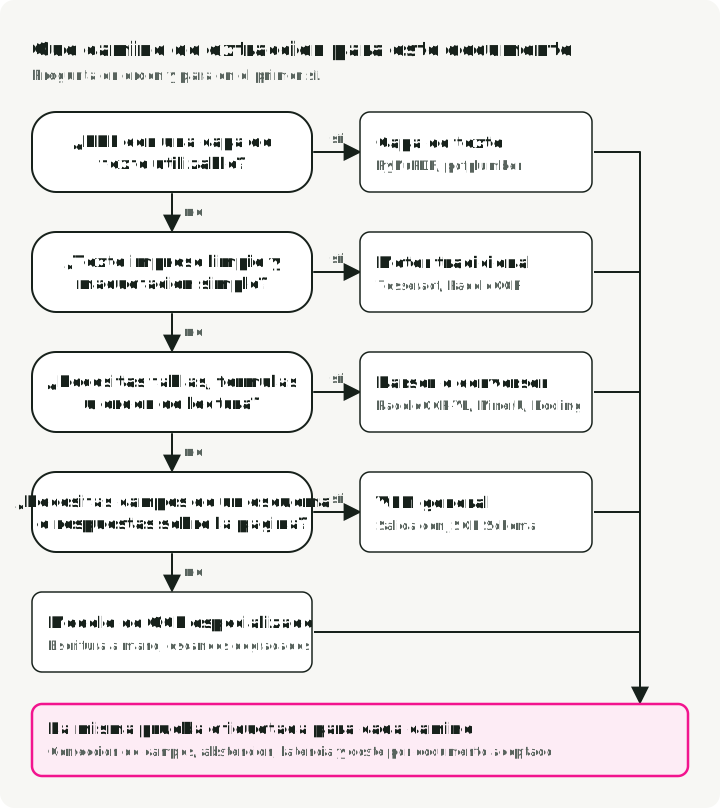
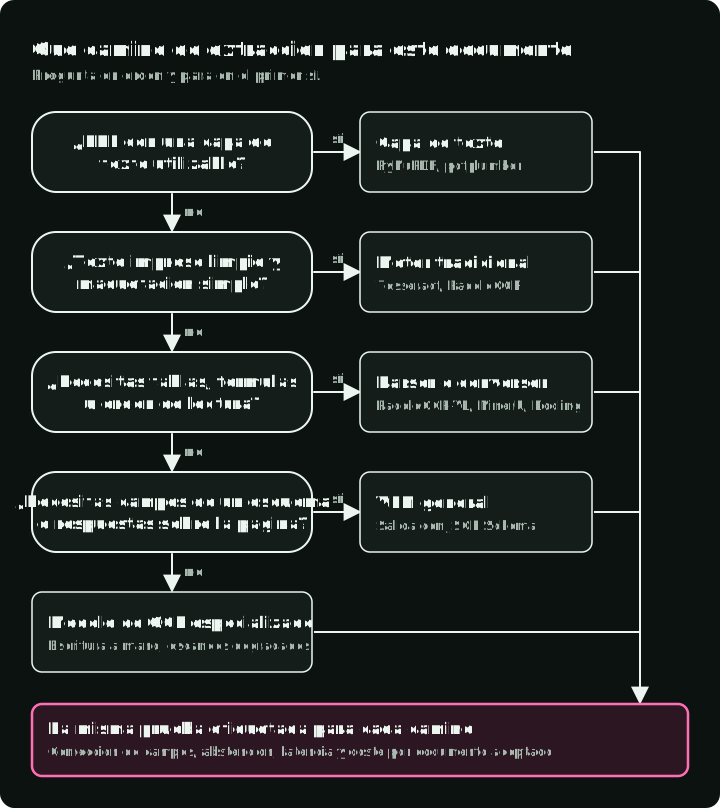
Cada hoja del mapa sigue pasando por la misma prueba etiquetada. El mapa te da un primer candidato, no una elección final.
Probar VLMs con OpenRouter
OpenRouter ofrece un gateway compatible con OpenAI para modelos de varios proveedores. Los ID de modelo y las funciones de petición admitidas cambian, así que compruébalos en el catálogo actual del gateway antes de ejecutar el ejemplo.
El fragmento requiere pip install openai, una OPENROUTER_API_KEY, acceso a la red, un receipt.jpg local e ID de modelo que OpenRouter siga admitiendo.
import base64
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=os.environ["OPENROUTER_API_KEY"],
)

def extract_text(
    image_path: str,
    model: str,
    prompt: str = "Extract all text from this image, preserving layout as markdown.",
    **request_args,
) -> str:
    with open(image_path, "rb") as f:
        image_b64 = base64.b64encode(f.read()).decode()

    response = client.chat.completions.create(
        model=model,
        messages=[{
            "role": "user",
            "content": [
                {"type": "text", "text": prompt},
                {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{image_b64}"}},
            ],
        }],
        max_tokens=4096,
        **request_args,
    )
    choice = response.choices[0]
    if choice.finish_reason != "stop":
        raise RuntimeError(f"{model} did not finish: {choice.finish_reason}")
    if not choice.message.content:
        raise RuntimeError(f"{model} returned no text (finish_reason={choice.finish_reason})")
    return choice.message.content

# Compare models by changing one string
models = [
    "google/gemini-3.8-flash",
    "anthropic/claude-sonnet-5",
    "qwen/qwen3.8-27b",
]
for model in models:
    print(f"\n--- {model} ---\n{extract_text('receipt.jpg', model)[:200]}...")
El catálogo de modelos de OpenRouter listaba google/gemini-3.8-flash, anthropic/claude-sonnet-5 y qwen/qwen3.8-27b con entrada de imagen y parámetros de structured outputs el 2026-10-02. Que el catálogo lo admita no prueba que esta petición concreta funcione en todos los endpoints enrutados.
Para la extracción estructurada, usa response_format con un JSON Schema cuando el modelo elegido y el gateway lo admitan. Esto puede hacer que la respuesta sea analizable; no valida los valores extraídos frente a la imagen. Con OpenRouter, provider.require_parameters hace que la petición falle cuando ningún endpoint enrutado admite todos los parámetros solicitados, en lugar de recurrir a un endpoint que no puede respetar el esquema.
El fragmento reutiliza extract_text del bloque anterior y pasa el esquema mediante sus argumentos de petición adicionales. Necesita un modelo que admita JSON Schema.
import json

nullable = {"type": ["string", "null"]}
receipt_schema = {
    "type": "object",
    "properties": {
        "vendor": nullable,
        "date": nullable,
        "items": {
            "type": ["array", "null"],
            "items": {
                "type": "object",
                "properties": {"description": nullable, "amount": nullable},
                "required": ["description", "amount"],
                "additionalProperties": False,
            },
        },
        "total": nullable,
    },
    "required": ["vendor", "date", "items", "total"],
    "additionalProperties": False,
}
prompt = (
    "Extract only visible receipt fields. Copy amounts as source strings. "
    "Use null for absent or unreadable values; do not infer them. "
    "Use null for an unreadable item list, and [] only when no items are present."
)

receipt = json.loads(extract_text(
    "receipt.jpg",
    "google/gemini-3.8-flash",
    prompt=prompt,
    response_format={
        "type": "json_schema",
        "json_schema": {"name": "receipt", "strict": True, "schema": receipt_schema},
    },
    extra_body={"provider": {"require_parameters": True}},
))
El modo estricto al estilo de OpenAI exige todas las propiedades en required y additionalProperties: false, de modo que un valor que puede faltar se tipa como nullable en lugar de omitirse. El prompt y los tipos nullable juntos permiten que el modelo devuelva null en vez de inventar un valor.
Conserva las cadenas de importes copiadas junto a los valores normalizados. Analiza el dinero después, con aritmética decimal o de enteros en unidades menores, bajo una moneda y una configuración regional explícitas; que el esquema sea válido no valida el total de un pago. Deriva a revisión los campos críticos que sean null.
Desplegar OCR en producción
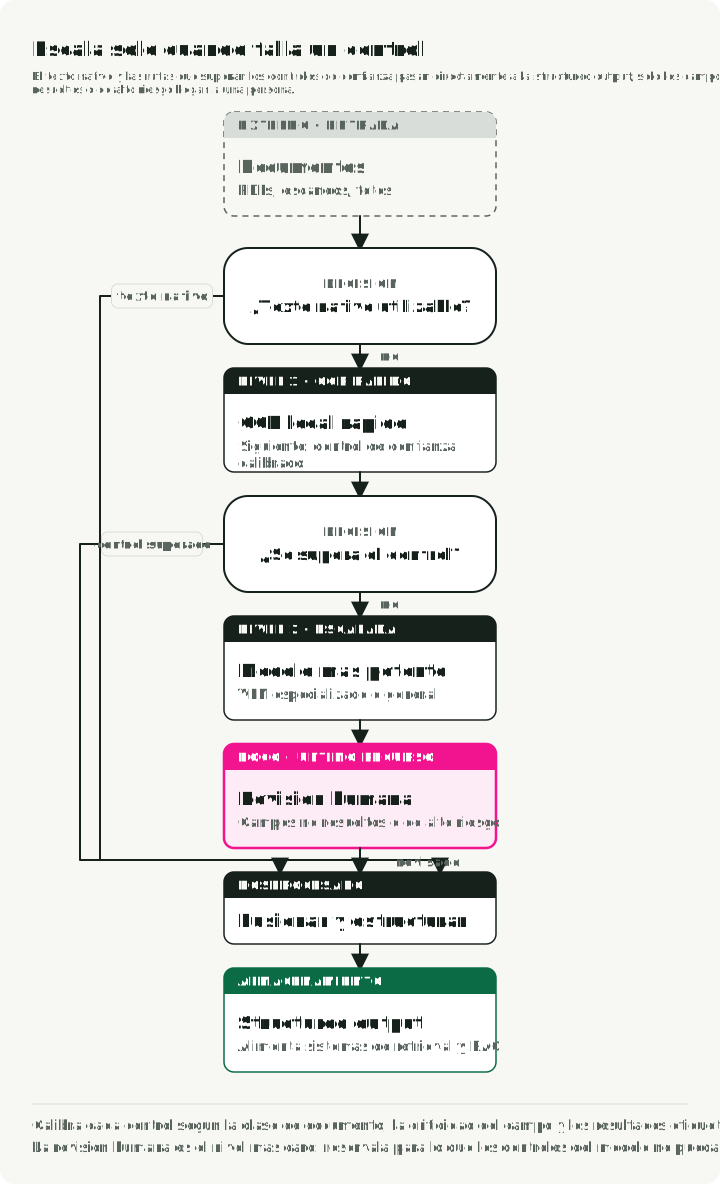
Una arquitectura por niveles puede separar el preprocesamiento en CPU de la inferencia en GPU o API, y reservar los caminos caros para los documentos que los necesitan. La figura muestra los niveles por orden de coste, la comprobación que acepta una página en cada nivel y el fallo que la envía al siguiente.
El patrón de respaldo por niveles
Empieza por el camino más barato que cumpla el objetivo de calidad y después calibra el enrutamiento con páginas etiquetadas:
- Comprueba si hay texto incrustado (nivel 0). En los PDFs, inspecciona la capa de texto con
PyMuPDFopdfplumberantes de rasterizar, pero valida que la capa esté completa.
- Prueba con un modelo rápido. Usa un motor tradicional para las clases de documentos en las que alcance el objetivo.
- Evalúa una confianza calibrada. Combina la confianza del modelo con la clase de documento, la criticidad del campo y las reglas de validación.
- Escala a un modelo más potente. Deriva las páginas dudosas a un VLM especializado o general.
- Escala a una persona los fallos de alto riesgo. La revisión humana es un nivel aparte para los valores cuyo coste de error supera el beneficio de la automatización.
Nota sobre la confianza: las probabilidades brutas de los caracteres no están calibradas automáticamente respecto a la corrección de los campos. La función ponderada por área de abajo es una referencia para agregar a nivel de página, no un enrutador universal. Calíbrala con páginas etiquetadas y da a los campos críticos sus propias reglas, porque un promedio de página puede ocultar un ID o un total incorrectos.
def area_weighted_confidence(page):
    """Compute area-weighted confidence from one PaddleOCR 3.x result."""
    total_area, weighted_sum = 0, 0
    for (x_min, y_min, x_max, y_max), score in zip(
        page["rec_boxes"], page["rec_scores"]
    ):
        width = int(x_max) - int(x_min)
        height = int(y_max) - int(y_min)
        area = width * height
        weighted_sum += score * area
        total_area += area
    return weighted_sum / total_area if total_area > 0 else 0

assert area_weighted_confidence({
    "rec_boxes": [[0, 0, 300, 300]], "rec_scores": [0.5]
}) == 0.5
Para fijar el umbral, etiqueta un conjunto de páginas de una misma clase de documento y registra si todos los campos críticos de cada página son correctos. Elige el umbral de confianza más bajo con el que las páginas aceptadas cumplan tu objetivo de error en campos críticos, y deriva al siguiente nivel las páginas por debajo de él. La función siguiente hace esto para una clase de documento.
def pick_threshold(scores, correct, max_error):
    """Lowest threshold whose accepted pages meet the error target, or None."""
    for threshold in sorted(set(scores)):
        accepted = [ok for s, ok in zip(scores, correct) if s >= threshold]
        if accepted and accepted.count(False) / len(accepted) <= max_error:
            return threshold
    return None  # no threshold meets the target: send every page to the next tier

scores = [0.95, 0.91, 0.88, 0.80, 0.72, 0.60]
correct = [True, True, True, False, True, False]  # all critical fields right?
assert pick_threshold(scores, correct, max_error=0.0) == 0.88
assert pick_threshold(scores, correct, max_error=0.25) == 0.72
La figura sitúa en la escala de confianza las seis páginas etiquetadas de los asserts y marca el umbral que elige cada objetivo de error.
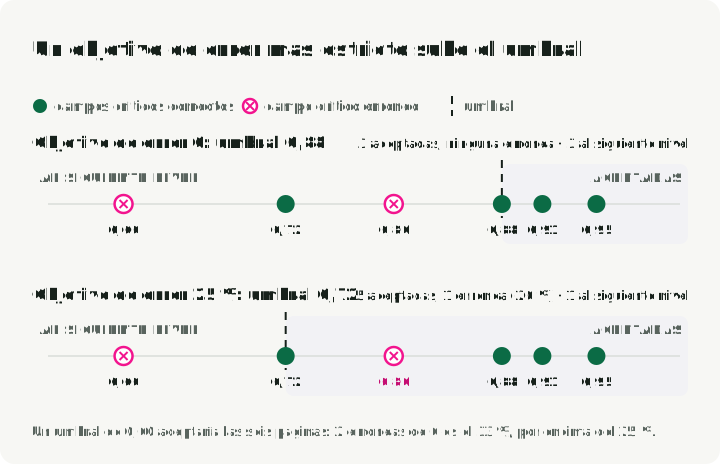
Un objetivo de error más estricto sube el umbral y envía más páginas al modelo más potente. Repite la calibración para cada clase de documento, porque la misma puntuación puede significar una precisión distinta en recibos y en contratos.
Patrones de serving
Cómo ejecutes cada nivel depende de cómo lleguen las páginas:
- Trabajos por lotes (conversión de archivos, informes mensuales): lee las páginas de una cola y ejecútalas en workers de GPU que escalan a cero entre trabajos.
- Peticiones interactivas: mantén una GPU activa o usa una API alojada, porque el arranque en frío de un modelo suma su tiempo de carga a la espera del usuario.
- Rasterización y limpieza de imágenes: ejecútalas en workers de CPU que escalen por separado de la inferencia en GPU.
- VLMs de pesos abiertos: sírvelos con vLLM o SGLang, que agrupan en lotes las peticiones concurrentes en una sola GPU.
Medir los resultados
Para cada par motor/documento previsto, conserva un resultado con estado de éxito, error u omitido. Las salidas fallidas, vacías y truncadas permanecen en el denominador de documentos intentados, junto con el coste que consumieron. Informa de la tasa de finalización, los errores en campos críticos entre las aceptaciones automáticas, la fracción enviada a revisión, la latencia de extremo a extremo p50/p95 y el coste por documento procesado con éxito. Mide la latencia de página con la resolución, el tamaño de lote, el hardware o la región del proveedor y la longitud de salida reales. Incluye en el total el preprocesamiento y los reintentos; una medición solo del modelo no puede dar el precio de una página procesada con éxito. Reutiliza los objetos conversores para las mediciones en caliente y registra la inicialización por separado. El repositorio OCR Gauntlet registra los resultados en este formato; la última sección muestra cómo ejecutarlo.
Análisis de costes a escala
No existe un punto de equilibrio universal de volumen de páginas entre una API y el autoalojamiento. Construye la comparación a partir de la misma carga de trabajo:
| Componente de coste | Camino con API | Camino autoalojado |
|---|---|---|
| Inferencia | Precio actual por página o por token | Horas de GPU a las páginas/hora medidas |
| Capacidad ociosa | Normalmente la absorbe el proveedor | Utilización y holgura de capacidad |
| Ingeniería | Integración y monitorización del proveedor | Despliegue, actualizaciones, observabilidad y guardias |
| Gestión de datos | Transferencia, retención y condiciones de región | Almacenamiento, red y controles de cumplimiento |
| Fallos de calidad | Reintentos y revisión humana | Reintentos y revisión humana |
Usa una fórmula común: monthly pages × cost per successful page + review cost + fixed operating cost. Una «página correcta» debe cumplir los mismos criterios de texto, tablas y campos en ambos caminos. Los precios de los proveedores y los alquileres de GPU cambian demasiado rápido para incluirlos como una estimación duradera de compra.
Gestión de errores: el problema de las alucinaciones
Los errores de los VLMs pueden ser verosímiles en contexto y falsos en los hechos. El total de un recibo de «$42.50» puede devolverse como «$42.80»: un importe válido que ningún corrector ortográfico marca.
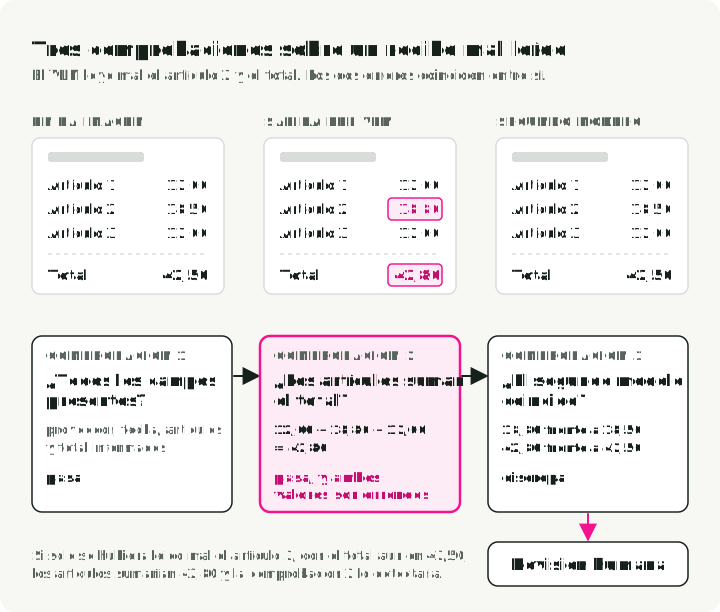
Ejemplo sintético de fallo: la imagen de un recibo muestra tres líneas, 12.00, 18.50 y 12.00, y un total de 42.50. Un VLM lee la segunda línea como 18.80 y el total como 42.80. Las líneas siguen sumando el total, así que la aritmética interna pasa, y ambos valores son incorrectos. Por eso la validación necesita etiquetas ancladas en la imagen o un camino de revisión independiente, y no solo comprobaciones de consistencia.
La figura ejecuta las tres comprobaciones sobre este recibo: la comprobación del esquema y la de la suma pasan, y solo el segundo modelo detecta las dos lecturas erróneas.
Algunas mitigaciones prácticas:
- Conciliación aritmética. Cuando el esquema los expone, verifica
subtotal + tax + fees + shipping - discounts, dentro de la tolerancia de redondeo de la moneda, frente al total declarado. Deriva a revisión los componentes ausentes o las discrepancias. - Comprobaciones de fecha, teléfono y moneda. Analiza las fechas con un parser de fechas y rechaza los valores imposibles. Comprueba con patrones el número de dígitos de los teléfonos y los formatos de moneda.
- Segundo camino de extracción. Pasa los campos críticos por otro modelo o motor de OCR y marca los desacuerdos. El acuerdo aumenta la confianza solo cuando los dos caminos tienen modos de fallo suficientemente distintos; no es prueba de corrección.
La comprobación de conciliación toma las cadenas de importes copiadas y usa Decimal, de modo que ningún redondeo de coma flotante entra en la comparación. Los asserts reproducen el ejemplo de recibo anterior.
from decimal import Decimal

def reconcile(subtotal, tax, fees, shipping, discounts, total, tolerance="0.01"):
    """True when the stated total matches its components within tolerance."""
    parts = [subtotal, tax, fees, shipping, discounts, total]
    if any(p is None for p in parts):
        return False  # a missing component goes to review
    s, t, f, sh, d, tot = (Decimal(p) for p in parts)
    return abs(s + t + f + sh - d - tot) <= Decimal(tolerance)

items = ["12.00", "18.80", "12.00"]  # the image shows 18.50
subtotal = str(sum(Decimal(i) for i in items))
assert reconcile(subtotal, "0", "0", "0", "0", "42.80")  # passes, and both values are wrong
assert not reconcile(subtotal, "0", "0", "0", "0", "42.50")  # one misread value is caught
assert not reconcile(subtotal, None, "0", "0", "0", "42.80")  # missing tax goes to review
La conciliación detecta un único importe mal leído. No puede detectar dos lecturas erróneas que concuerden entre sí, así que los campos críticos siguen necesitando el segundo camino de extracción.
Ejecuta la comparación con tus propias páginas
El repositorio OCR Gauntlet ejecuta varios motores de OCR sobre las mismas páginas y escribe una fila de resultado por motor y página, incluidos los fallos. Compara páginas de imagen; no cubre la comprobación de la capa de texto del nivel 0.
El runner funciona en cuatro pasos:
- El manifiesto enumera las páginas y los hashes de su texto de referencia.
- El runner envía cada página a cada motor.
- Escribe una fila JSONL por motor y página, marcada como éxito, error u omitido, con la salida sin procesar, el tiempo y el coste.
- El resumen informa de la tasa de finalización, el CER en las páginas revisadas y el coste por página correcta. Los pares fallidos y omitidos permanecen en el denominador de la tasa de finalización.
La primera ejecución usa páginas generadas y Tesseract, por lo que necesita Python 3.12, uv y una instalación de Tesseract en el sistema, pero ninguna clave de API:
uv sync --locked --extra tesseract --extra notebooks
uv run python scripts/make_fixture.py data/demo
uv run ocr-gauntlet data/demo/manifest.json --engines tesseract --output results/demo.jsonl
Las páginas generadas solo comprueban que el pipeline se ejecuta; no miden la calidad del OCR. Para una prueba real con recibos, importa muestras de CORD con uv run python scripts/download_samples.py --dataset cord --count 2 --output data/cord y prepara una referencia revisada como describe el README del repositorio. Añade otros motores con --engines; los motores alojados también necesitan --allow-remote, porque suben tus páginas.
En el resumen, lee primero la tasa de finalización: un motor que falla en un tercio de las páginas no es candidato, sea cual sea su CER. Después compara el CER en las páginas revisadas y, por último, el coste por página correcta, que incluye el gasto de los intentos fallidos.
Conclusiones clave
- Asigna el nivel de modelo a una clase de documento etiquetada. Los motores tradicionales pueden bastar para texto limpio; los VLMs especializados y generales deben justificar su coste añadido en las páginas más difíciles.
- No mezcles clasificaciones distintas. Las métricas de OmniDocBench y las preferencias de OCR Arena responden a preguntas distintas.
- Calibra el enrutamiento. Los umbrales de confianza, las clases de documento, la criticidad de los campos y la política de revisión humana pertenecen a una misma evaluación.
- Valida la salida verosímil. La conformidad con el esquema y la aritmética interna no pueden demostrar que un valor aparece en la imagen.
- Pon precio a las páginas correctas. Incluye reintentos, revisión, operaciones fijas y comprobaciones de calidad al comparar las API con el autoalojamiento.
Referencias
- OCR Arena Leaderboard - Duelos entre modelos de dos en dos, con votos colectivos
- El repositorio OCR Gauntlet - Comparación ejecutable de motores de OCR sobre las mismas páginas, con backends de Docling y coste por página correcta
- OmniDocBench - Evaluación de parsing de documentos de extremo a extremo
- dots.ocr - Unos 3B de parámetros en total, incluido un modelo de lenguaje de 1.7B
- PaddleOCR - Toolkit y modelos de OCR tradicional
- OpenRouter - Gateway de acceso unificado para pruebas A/B de modelos