OCR en 2026 : pipelines classiques, VLMs et Document AI

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Ce guide s’adresse aux ingénieurs qui choisissent une solution d’OCR et d’extraction de documents pour la recherche, la génération augmentée par la récupération (RAG) ou des agents AI. Il explique en quoi les moteurs traditionnels et les modèles vision-langage diffèrent, comment évaluer le texte, les tableaux et les champs, et comment orienter les documents difficiles vers un autre modèle ou une relecture humaine.
Les modèles vision-langage (VLMs) gèrent la mise en page, l’écriture manuscrite, les tableaux et les images dégradées qui mettent en échec un pipeline de reconnaissance de texte simple. Les moteurs traditionnels restent compétitifs sur l’impression propre, surtout quand la latence sur CPU et le coût d’exploitation comptent. L’instantané daté ci-dessous inclut PaddleOCR-VL 1.6 et dots.mocr, avec des compromis différents en matière de matériel, de confidentialité et de format de sortie. Vérifiez chaque projet avant de faire un choix actuel.
Pour la version courte consacrée au choix de modèle, voir Best OCR Models in 2026: Classical OCR, PaddleOCR-VL, VLMs.
L’OCR fixe désormais la qualité en aval
L’OCR alimente depuis longtemps les archives, les systèmes postaux, les outils d’accessibilité et la gestion documentaire. Le RAG et les agents documentaires ont rendu ses modes de défaillance visibles à un public d’ingénieurs plus large : un modèle en aval ne peut pas retrouver le texte ou la structure de tableau que l’extraction a perdus.
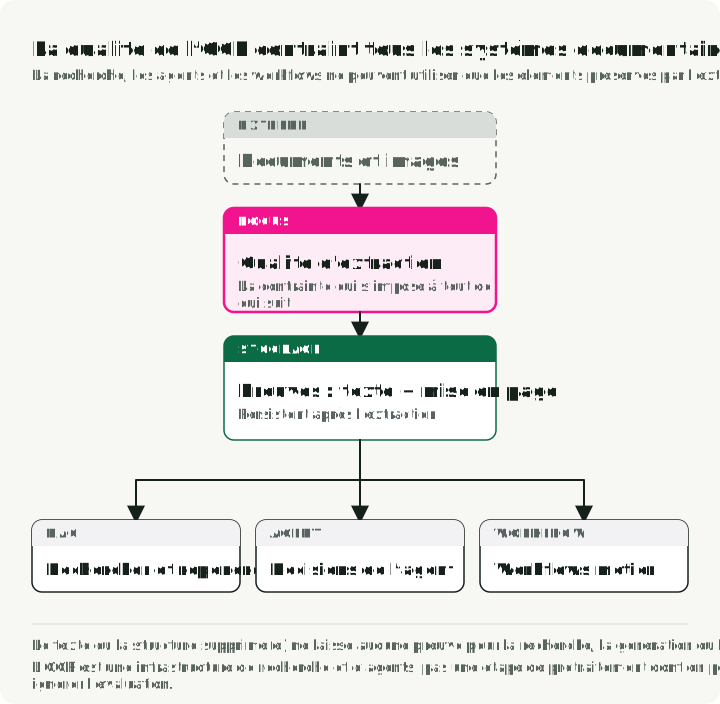
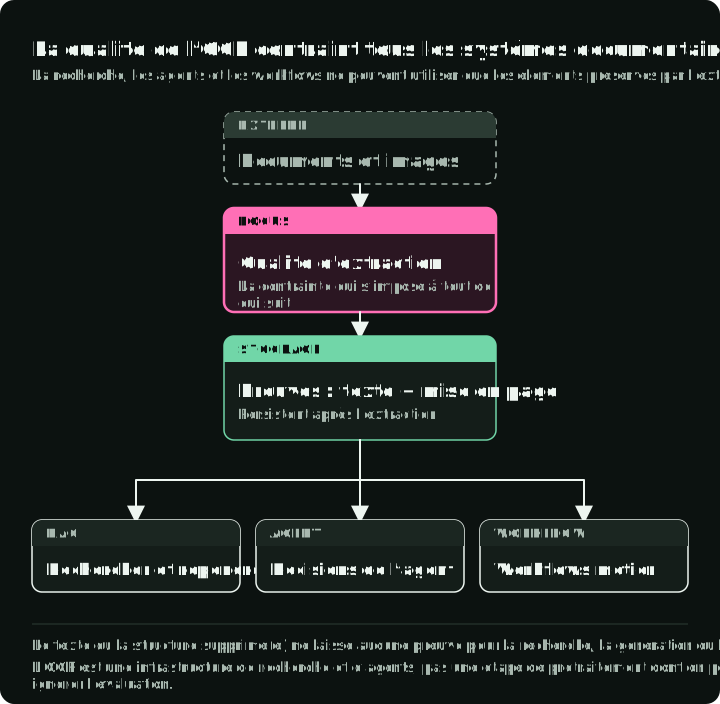
Un système RAG ne peut pas récupérer un texte que l’OCR a omis ou mal lu. Si l’extraction brouille un tableau, lit mal une date ou perd un paragraphe, les changements ultérieurs de découpage et d’embedding ne retrouveront pas l’information manquante. Ces erreurs peuvent masquer une clause de contrat, modifier le total d’une facture ou corrompre un dossier médical.
L’OCR fait donc partie de l’infrastructure de récupération et d’agents, au même titre que l’analyse, le découpage, l’embedding et l’indexation. Ses erreurs demandent leur propre évaluation, plutôt que d’être absorbées dans un score de bout en bout unique.
Ce que signifie l’OCR à l’ère des modèles de fondation
L’OCR convertit le texte d’une image en caractères lisibles par une machine. Document AI désigne le système plus large qui l’entoure : analyse de la mise en page, analyse des tableaux et des formules, extraction de champs, raisonnement sémantique, provenance et validation. Les auteurs de GOT-OCR 2.0 appellent « OCR-1.0 » les pipelines modulaires de détection et de reconnaissance, et « OCR-2.0 » les modèles de bout en bout. Cette étiquette ne doit pas effacer la distinction entre reconnaissance et compréhension du document.
La figure compare les deux approches et la façon dont chacune échoue : les trois étapes en série à gauche ne récupèrent jamais une ligne que la détection a manquée, la passe unique du modèle à droite écrit un total plausible qui n’est pas sur la page, et la rastérisation et l’analyse restent en dehors du modèle dans les deux cas.
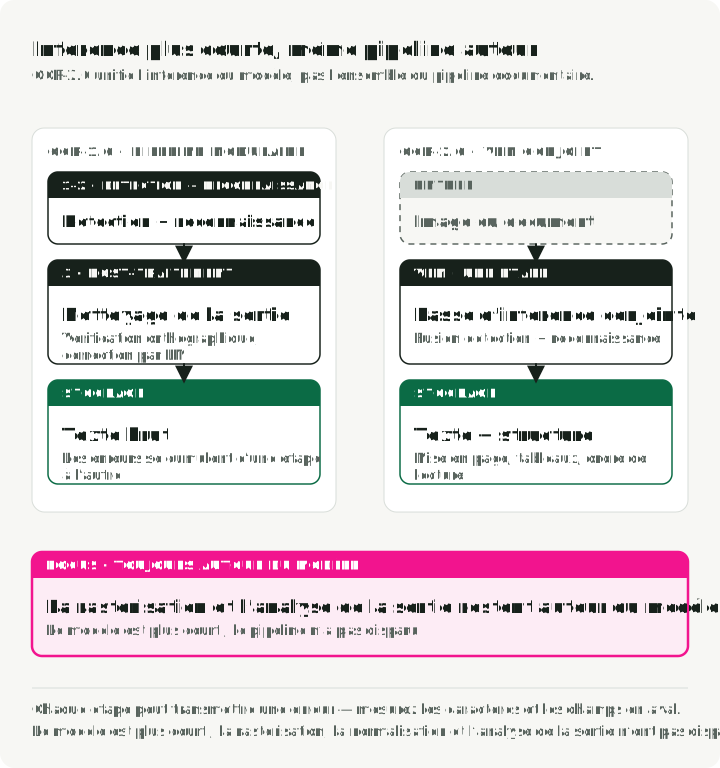
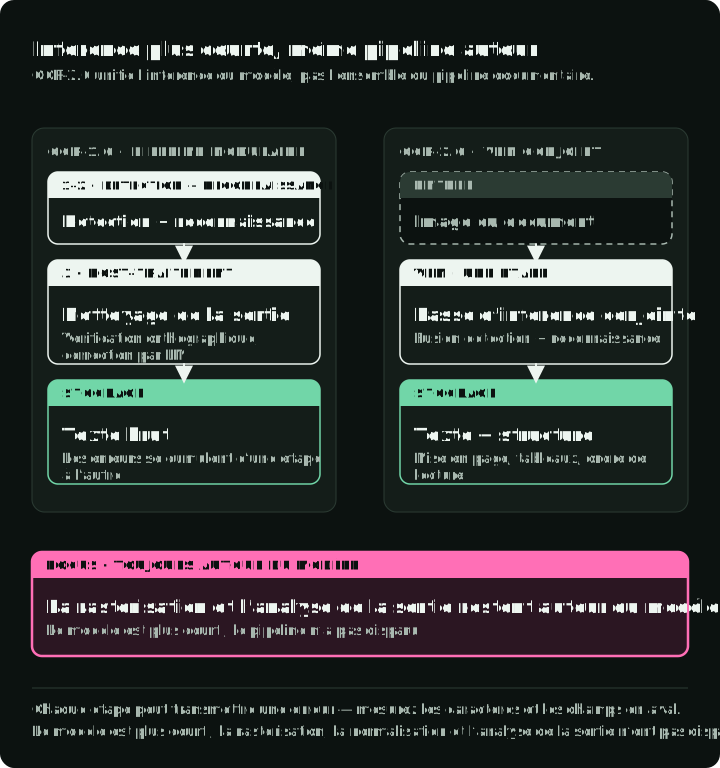
Le pipeline OCR traditionnel comporte trois étapes principales :
- Détection de texte : localiser les régions qui contiennent du texte (par ex. CRAFT, DBNet).
- Reconnaissance de texte : convertir les régions détectées en séquences de caractères (par ex. CRNN).
- Post-traitement : correction orthographique et correction par modèle de langage.
Cela fonctionne bien sur les documents propres, mais les erreurs de détection, de reconnaissance et de post-traitement peuvent se cumuler. Mesurez à la fois la précision des caractères et la précision des champs en aval, pour qu’une page lisible ne cache pas un total ou un identifiant erroné.
Certains chemins VLM de bout en bout regroupent une plus grande partie de ce pipeline dans un encodeur visuel suivi d’un décodeur de langage. Des modèles comme GOT-OCR 2.0 peuvent produire le texte et la structure ensemble, tandis que les VLMs généralistes peuvent aussi associer les champs à un schéma demandé. Par exemple, un VLM généraliste peut lire « MFG: 10/24 » sur une étiquette comme une date de fabrication plutôt qu’une date de péremption. Les compromis sont une latence et un coût GPU ou API qui dépendent de la charge de travail, et le risque d’un texte plausible mais absent de l’image.
Une réserve pratique : un modèle qui n’accepte que des images exige des pages rastérisées, alors qu’un service qui accepte les PDF peut gérer la conversion en interne. Le redressement, le redimensionnement et le nettoyage sont des expériences propres à chaque pipeline, pas des améliorations obligatoires. AWS Textract recommande de conserver les entrées prises en charge plutôt que de les convertir ou de les sous-échantillonner sans discernement. L’analyse et la validation de la sortie restent à la charge de l’application.
Métriques : mesurer ce qui compte
Chaque comparaison de ce guide utilise l’une de ces métriques. Choisissez celle qui correspond au type de sortie :
- CER et WER pour le texte brut. Le taux d’erreur de caractères et de mots dépend de choix de normalisation comme la casse, les espaces et la ponctuation ; fixez donc le protocole de comparaison avant de comparer des modèles.
- Correspondance exacte par champ et F1 par champ pour les formulaires et les reçus. La correspondance exacte est binaire pour un champ ; son taux est la fraction des champs évalués qui sont corrects. Rapportez séparément l’exactitude de tous les champs au niveau du document. Pour le F1 par champ, définissez l’appariement clé/valeur, la normalisation, les champs en double ou manquants et l’agrégation ; un montant correct attribué à la mauvaise ligne est une erreur.
- TEDS pour les tableaux. La similarité fondée sur la distance d’édition d’arbres (Tree-Edit-Distance-based Similarity) compare les arbres HTML prédits et de référence, et détecte les erreurs de structure et de contenu des cellules que le CER masque.
- Comparaison de l’ordre de lecture quand le consommateur a besoin d’une séquence linéaire. Comparez directement les blocs ou les segments ordonnés, ou utilisez une métrique qui tient compte de l’ordre ; OmniDocBench évalue l’ordre de lecture séparément. Des caractères et des cellules corrects n’établissent pas l’ordre d’une page à plusieurs colonnes.
- ANLS pour le VQA documentaire. L’Average Normalized Levenshtein Similarity note les réponses par rapport aux références acceptées. La définition originale de ST-VQA attribue
1 − normalized_distanceuniquement quand la distance est strictement inférieure à 0,5, et zéro sinon ; elle retient le meilleur score parmi les références acceptées et fait la moyenne sur les questions. DocVQA adopte l’ANLS. Fixez la casse, les espaces et la normalisation de la distance de l’évaluateur quand vous reproduisez un score.
Le CER et le WER comptent les substitutions, suppressions et insertions, divisées par le nombre de caractères ou de mots de la référence. Ils peuvent dépasser un quand les insertions dominent. Indiquez si l’agrégation additionne les erreurs et les longueurs de référence du corpus, ou fait la moyenne des scores par document. Conservez la page, le bloc, la boîte englobante, le texte d’origine et l’historique de normalisation, afin de remonter d’un champ erroné jusqu’à l’image.
Pour la détection de texte, l’intersection sur l’union (IoU) divise l’aire de chevauchement d’une boîte prédite et d’une boîte de référence par l’aire totale couverte par au moins l’une des deux. Le seuil d’IoU détermine si une boîte détectée correspond à la référence avant le calcul de F1.
Le tableau associe chaque tâche à sa métrique et à l’erreur qui rend le plus souvent un score trompeur :
| Tâche | Métrique | Erreur à éviter |
|---|---|---|
| Extraction de texte brut | CER, WER | Comparer des scores calculés avec des normalisations différentes |
| Écriture manuscrite | CER | Appliquer à des pages manuscrites les cibles de CER du texte imprimé |
| Détection de texte | F1 à un seuil d’IoU | Rapporter un F1 sans le seuil d’IoU utilisé |
| Formulaires et reçus | Correspondance exacte par champ, F1 | Compter comme juste une bonne valeur placée dans le mauvais champ ou la mauvaise ligne |
| Tableaux | TEDS | Juger les tableaux au CER, qui ignore la structure des cellules |
| VQA documentaire | ANLS | Modifier le seuil de 0,5 ou la normalisation des réponses |
| Conversion de page complète | Distance d’édition + ordre de lecture | Rapporter la précision du texte sans vérifier l’ordre des blocs |
Les langues changent aussi le choix. Le chinois et le japonais s’écrivent sans espaces entre les mots, donc le WER dépend d’un segmenteur de mots ; utilisez le CER pour ces écritures. Incluez dans le jeu de test annoté des pages qui mélangent plusieurs écritures quand elles font partie de votre charge de travail. Une fiche de modèle qui annonce 100 langues ne montre la qualité d’aucune d’entre elles ; placez donc chaque langue cible dans le jeu de test annoté.
Pour les implémentations : jiwer gère le CER et le WER sans configuration, et des implémentations de TEDS se trouvent dans le dépôt OmniDocBench.
Ce que les benchmarks OCR mesurent et ce qu’ils manquent
Des datasets publics appliquent ces métriques à des types de documents précis. Les tailles et les métriques des datasets décrivent la version nommée du dataset ; consultez le classement actuel de chaque projet pour les scores des modèles. La colonne « Teste » indique à quels de vos documents chaque dataset ressemble.
| Dataset | Teste | Taille du test | Langues | Métrique principale |
|---|---|---|---|---|
| FUNSD | Association clé-valeur sur des formulaires scannés bruités | 50 docs | Anglais | F1 |
| SROIE | Quatre champs de reçu (société, date, adresse, total) | 400 images de test | Anglais | F1 |
| CORD | Lignes d’articles de reçus avec étiquettes hiérarchiques | 100 reçus | Indonésien | F1 |
| IAM | Lignes manuscrites en anglais | Selon le découpage | Anglais | CER |
| OCRBench v2 | Lecture et raisonnement sur le texte par des VLMs, sur 23 tâches | 10 000 paires QA | EN + CN | Score /100 |
| OmniDocBench v1.6 | Analyse de page complète : texte, tableaux, formules, ordre de lecture | 1 651 pages | EN + CN | Composite |
Le nombre de lignes de IAM dépend du découpage par scripteur et du protocole de reconnaissance choisis ; aucun nombre unique de lignes de test n’est supposé ici.
Instantané OmniDocBench v1.6
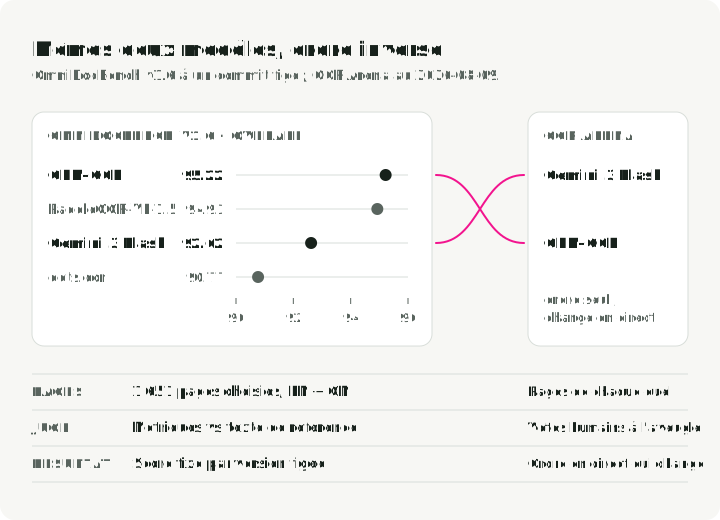
Le tableau ci-dessous est un instantané versionné : OmniDocBench v1.6_full, README officiel au commit 09ba2b606662695b16aafe5f5e36b7ef020e11a8, consulté le 2026-08-09.
| Modèle | Taille | Global ↑ | Édition du texte ↓ | TEDS tableaux ↑ |
|---|---|---|---|---|
| GLM-OCR | 0.9B | 95.22 | 0.044 | 92.83 |
| PaddleOCR-VL-1.5 | 0.9B | 94.93 | 0.038 | 91.67 |
| Gemini 3 Flash | — | 92.62 | 0.066 | 89.29 |
| dots.ocr | 3B | 90.77 | 0.048 | 87.18 |
Le README figé indique PaddleOCR-VL 1.5. PaddleOCR annonce 96,3 pour la version 1.6 sur la même version du benchmark ; ce chiffre provient de l’exécution du fournisseur lui-même et ne fait pas partie de ce tableau.
La conclusion se limite à cette version d’OmniDocBench : la taille du modèle seule ne prédit pas le score d’analyse de documents. Les versions ultérieures de l’évaluateur changent l’appariement ; comparez donc les scores uniquement sous un seul évaluateur figé. Le score composite inclut la distance d’édition du texte, le TEDS des tableaux et Character Detection Matching (CDM) pour les formules. CDM effectue le rendu des formules prédites et de référence, apparie leurs caractères et vérifie leurs positions relatives avant de noter les correspondances avec F1. Il compare les formules rendues plutôt que les chaînes LaTeX brutes. L’ordre de lecture demande son propre résultat.
L’écart « benchmark contre arène »
Les classements de benchmarks automatisés peuvent contredire la préférence humaine.
Dans l’OCR Arena, les utilisateurs votent à l’aveugle sur des sorties comparées deux à deux. Le 2026-08-09, OCR Arena classait Gemini 3 Flash au-dessus de GLM-OCR, alors que le tableau OmniDocBench ci-dessus donne un meilleur score à GLM-OCR (95,22 contre 92,62). L’ordre en direct de l’Arena change à mesure que de nouveaux duels arrivent ; ce n’est donc pas un instantané historique reproductible d’un benchmark. Ne combinez pas les deux classements en un seul score.
La figure montre le désaccord : GLM-OCR et Gemini 3 Flash échangent leurs places entre les deux classements. En dessous figurent les pages que chacun utilise, qui juge, et ce que l’on obtient.
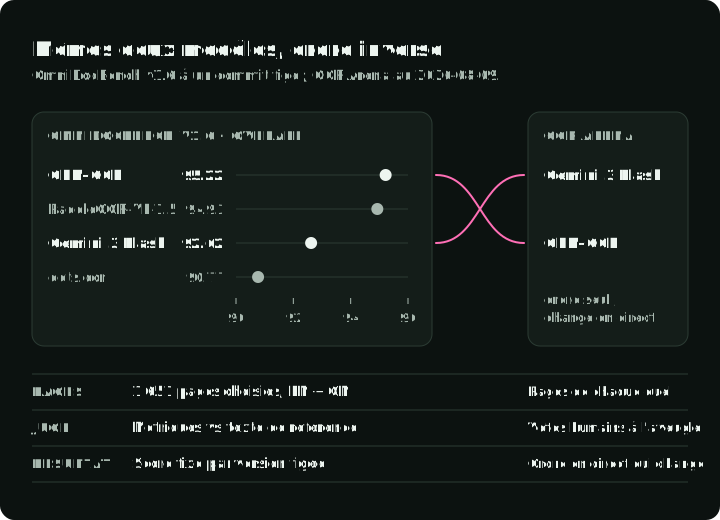
Les causes probables incluent la composition des documents, le format de sortie, la couverture des langues et les critères des juges. Les chiffres publiés servent au tri préalable, mais le choix final exige un jeu de test réservé issu de la charge de travail cible.
Moteurs OCR traditionnels : toujours pertinents
Les moteurs traditionnels sont de bonnes bases de comparaison, car ils peuvent tourner en local sur CPU. Leur latence et leur précision dépendent du modèle choisi, de la résolution de page, de la langue, du prétraitement et du matériel ; évaluez-les donc sur les mêmes pages annotées que celles de l’évaluation des VLMs.
| Moteur | Déploiement | Base de comparaison utile pour |
|---|---|---|
| Tesseract 5.5 | CPU local | Texte imprimé propre et écritures établies |
| EasyOCR | PyTorch local sur CPU ou GPU | Prototypes et texte de scène |
| PaddleOCR 3.x | CPU et GPU locaux, et variantes mobiles | OCR multilingue et chaînes d’outils de déploiement |
Tesseract pour l’impression propre
Tesseract (v5.5.x, Apache 2.0) est un moteur mature, principalement CPU, avec plus de 100 packs de langues. La précision sur l’impression propre peut être élevée après une rastérisation et un prétraitement adaptés, mais l’écriture manuscrite, le texte de scène et les mises en page complexes demandent des tests séparés. Son principal avantage est un déploiement local léger sur CPU.
Réglez le mode de segmentation de page (--psm) selon le type de document ; un mauvais mode perd des colonnes ou fusionne des lignes. L’extrait nécessite pip install pytesseract pillow, le binaire Tesseract avec les données de langue anglaise, et un fichier local receipt.jpg.
import pytesseract
from PIL import Image

# --psm 6: treat the image as one uniform block of text, which suits a receipt
text = pytesseract.image_to_string(Image.open("receipt.jpg"), lang="eng", config="--psm 6")
EasyOCR
EasyOCR associe un détecteur CRAFT à un modèle de reconnaissance CRNN. Avec l’accélération GPU complète de PyTorch, c’est une option rapide pour le prototypage et le texte de scène. Il ne renvoie que des lignes et des boîtes, sans mise en page ni structure de tableau.
L’extrait nécessite pip install easyocr, PyTorch, les poids de modèle téléchargés par EasyOCR et un fichier local receipt.jpg.
import easyocr

# Three lines for complete OCR
reader = easyocr.Reader(["en"])
result = reader.readtext("receipt.jpg")
# Returns: [(bbox, text, confidence), ...]
PaddleOCR 3
PaddleOCR 3 regroupe des pipelines maintenus d’OCR, d’analyse de documents et de déploiement. Le démarrage rapide actuel utilise l’API predict() et des réglages d’orientation explicites. Figez la version du paquet paddleocr et du pipeline choisi, car les exemples 2.x qui utilisent .ocr(..., cls=True) ne correspondent pas à l’API 3.x.
Il nécessite le runtime PaddlePaddle, ce qui ajoute un second framework à une pile PyTorch. La reconnaissance de texte de PaddleOCR est un pipeline différent de PaddleOCR-VL, l’analyseur de documents de la section suivante.
L’extrait nécessite pip install "paddleocr>=3,<4", un runtime PaddlePaddle compatible, les poids de modèle téléchargés et un fichier local receipt.jpg.
from paddleocr import PaddleOCR

ocr = PaddleOCR(
    use_doc_orientation_classify=False,
    use_doc_unwarping=False,
    use_textline_orientation=False,
)

for result in ocr.predict("receipt.jpg"):
    result.print()
    result.save_to_json("output")
Chaque résultat contient rec_texts, rec_scores et rec_boxes. La section sur le routage utilise les deux derniers pour noter une page.
Options de VLMs spécialisés et généralistes
Les reçus de travers, les étiquettes de produits inclinées, l’écriture manuscrite et les mises en page denses sont les cas où les VLMs spécialisés ou généralistes valent la peine d’être testés face aux moteurs traditionnels.
La figure montre ce que chaque famille de modèles renvoie pour la même page, son principal compromis, et où elle peut s’exécuter. Le mode de déploiement dépend du produit ; la figure le liste donc séparément de l’étendue des tâches.
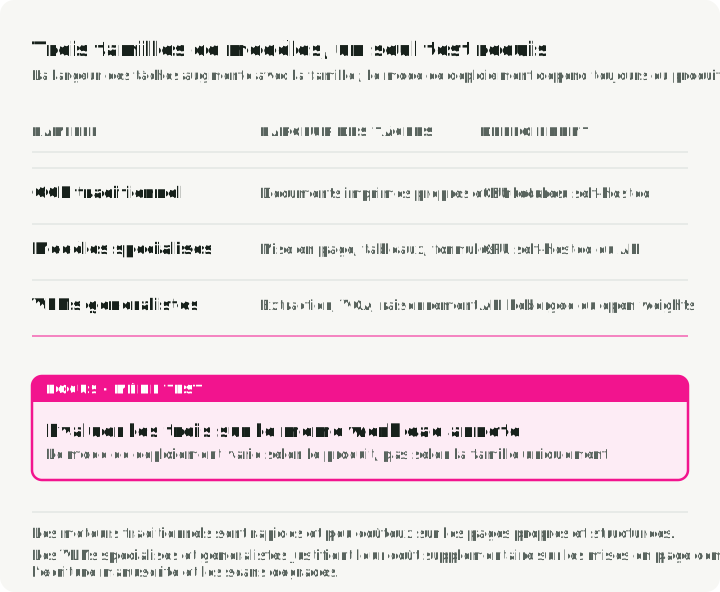
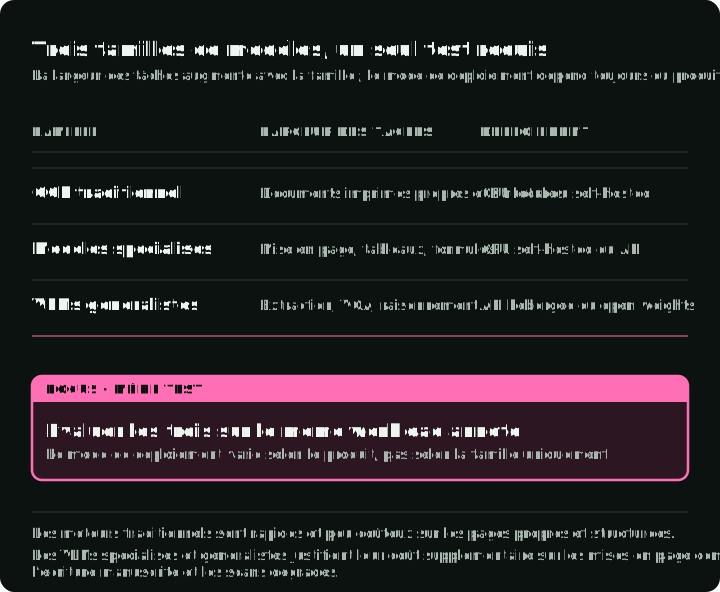
Modèles de documents spécialisés
Les modèles de cette section ont été vérifiés le 2026-10-02. La liste n’est pas un classement actuel ; elle indique sur quel problème de document chaque modèle vaut la peine d’être essayé.
| Modèle | Sortie | Où il tourne | À essayer quand |
|---|---|---|---|
| PaddleOCR-VL 1.6 | Analyse de la mise en page, puis un VLM de 0.9B lit chaque région | Auto-hébergé | Pages multilingues avec mise en page ; le fournisseur annonce 109 langues |
| GOT-OCR 2.0 | Texte brut, Markdown, LaTeX | Auto-hébergé, 580M de paramètres | Formules et texte mixte sur une même page |
| dots.mocr | Mise en page et texte ; graphiques et figures en code SVG | Auto-hébergé, 3B de paramètres | Pages avec des graphiques ou des diagrammes dont vous avez besoin sous forme structurée |
| DeepSeek-OCR2 | Markdown avec boîtes de repérage | Auto-hébergé, vLLM ou Transformers | Longs documents à fort volume ; une page utilise de 256 à 1 120 tokens visuels |
| Mistral OCR 4.1 | Markdown, boîtes de paragraphes, étiquettes de blocs, confiance par bloc | API hébergée (mistral-ocr-4-1) | Vous voulez une API et un score de confiance par bloc |
| Granite-Docling 258M | DocTags, convertis en DoclingDocument | Auto-hébergé, dans Docling | Un petit modèle local pour les conversions Docling |
| olmOCR | Texte brut ou Markdown dans l’ordre de lecture | Auto-hébergé, VLM de 7B sur GPU | Linéariser des PDF en texte pour le RAG ou des données d’entraînement |
Considérez les chiffres de débit et de mémoire comme propres au matériel et au dataset ; mesurez la mémoire de pointe avec votre runtime, votre précision, la taille de vos images et votre limite de sortie. Calibrez la confiance par bloc de Mistral par rapport à l’exactitude des champs avant d’accepter des valeurs automatiquement. Figez une version de modèle explicite pour les comparaisons, car un alias latest peut changer.
VLMs de pointe
Les VLMs généralistes sont une autre option quand la tâche combine extraction et raisonnement visuel ou sémantique. Ces candidats ont été vérifiés le 2026-10-02 et sont utilisés dans l’exemple de passerelle ci-dessous. Ils forment une courte liste de départ, pas un classement OCR :
- Gemini 3.8 Flash (Google) : un modèle multimodal en disponibilité générale, avec entrée image et structured outputs. Utilisez son identifiant stable au début d’une nouvelle comparaison.
- Claude Sonnet 5 (Anthropic) : une génération de Sonnet sortie le 2026-06-30, pour une comparaison hébergée. Testez la fidélité de transcription et l’extraction de champs sur vos propres documents ; des progrès de raisonnement général n’établissent pas la précision OCR.
- Qwen3.8-27B (Alibaba) : un modèle vision-langage à poids ouverts sous Apache 2.0, qui peut être testé via une passerelle ou auto-hébergé. Sa taille de 27B en fait un choix de déploiement différent du Qwen3-VL 8B précédent, qui reste une base de comparaison plus petite utile quand la mémoire est limitée.
Ajoutez toute nouvelle version à l’ensemble de test. Ne l’utilisez en production qu’après qu’elle a passé la même comparaison : exactitude des champs, abstention, latence et coût par document accepté, sous le même protocole.
Frameworks de conversion de documents
Un pipeline RAG a généralement besoin d’un document entier converti en Markdown ou en JSON, pas de lignes OCR brutes. Les convertisseurs de documents s’en chargent. Ils analysent le fichier, exécutent un modèle de mise en page et appellent un moteur OCR pour le texte de chaque région. Certains peuvent à la place envoyer chaque page à un VLM qui lit ensemble la mise en page et le texte.
| Framework | Ce qu’il produit | À utiliser quand |
|---|---|---|
| Docling | Markdown, HTML ou JSON sans perte avec tableaux et coordonnées, à partir de PDF, DOCX, PPTX, XLSX, HTML et images | Vous voulez un seul convertisseur pour des formats mixtes et choisir le moteur OCR qu’il utilise |
| Marker | Markdown, JSON, HTML ou chunks, à partir de PDF, d’images et de fichiers Office | Vous voulez du Markdown de haute qualité à partir de PDF |
| MinerU | Markdown et JSON structuré, à partir de PDF, d’images et de fichiers Office | Articles scientifiques et techniques avec formules et tableaux |
Vérifiez les licences avant d’en livrer un dans un produit. Docling est sous licence MIT. Le code de Marker est sous Apache 2.0, mais ses poids de modèle utilisent une licence OpenRAIL-M modifiée qui limite l’usage commercial. La licence de MinerU ajoute des conditions à Apache 2.0 : une licence commerciale distincte au-delà de seuils d’utilisateurs et de revenus, et une attribution pour les services en ligne.
La figure montre ce qu’un convertisseur enveloppe. Docling garde l’entrée et la sortie identiques, et ses options de pipeline choisissent comment le texte est lu : son modèle de mise en page avec Tesseract ou EasyOCR, ou le VLM Granite-Docling de bout en bout.
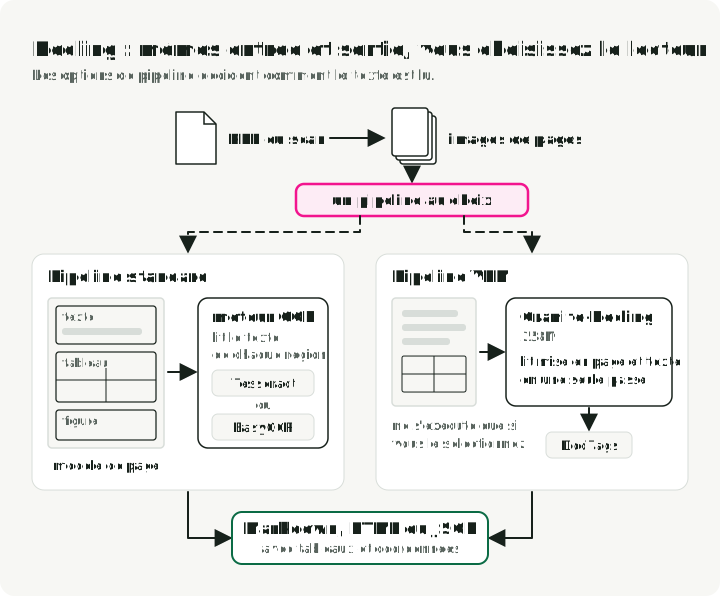
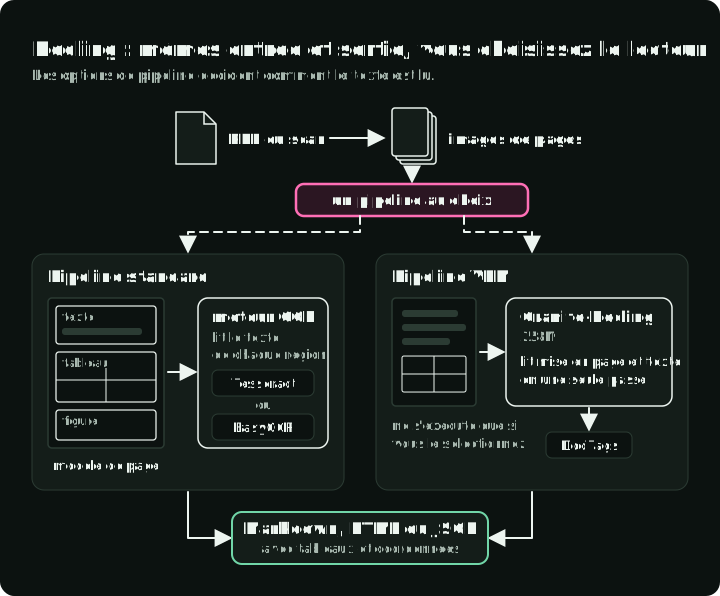
La vitesse et la qualité de conversion de Docling dépendent donc du pipeline que vous sélectionnez. Le pipeline VLM de Docling doit être sélectionné explicitement ; un convertisseur par défaut ne prouve pas que Granite-Docling a tourné. La politique de nouvelle tentative relève toujours de l’application ou du service environnant, et le routage a toujours besoin de ses propres annotations de qualité et de ses propres seuils.
Choisir un chemin d’extraction
La carte de décision remet les sections précédentes en ordre : chaque question envoie un document vers le chemin le moins cher capable de produire ce dont vous avez besoin.
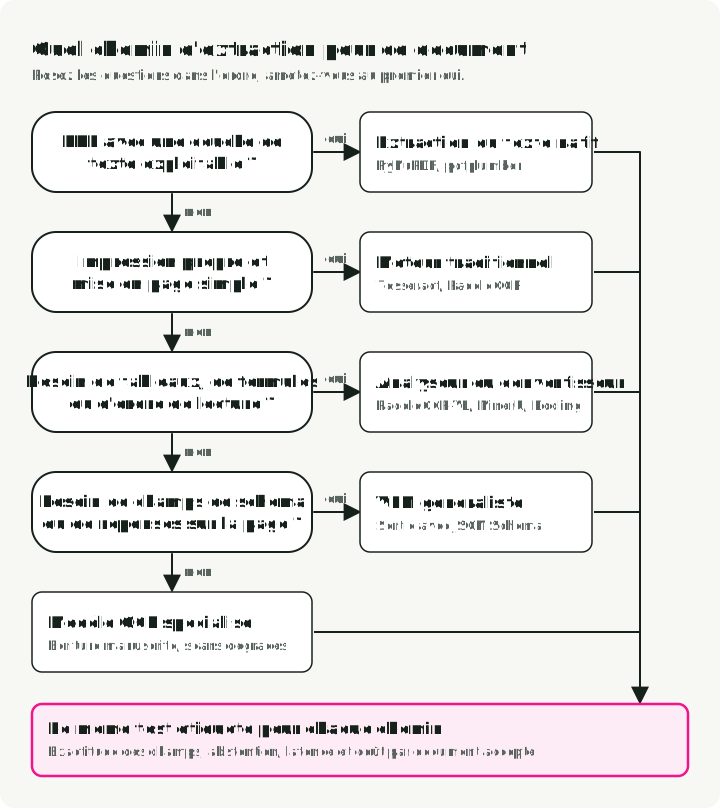
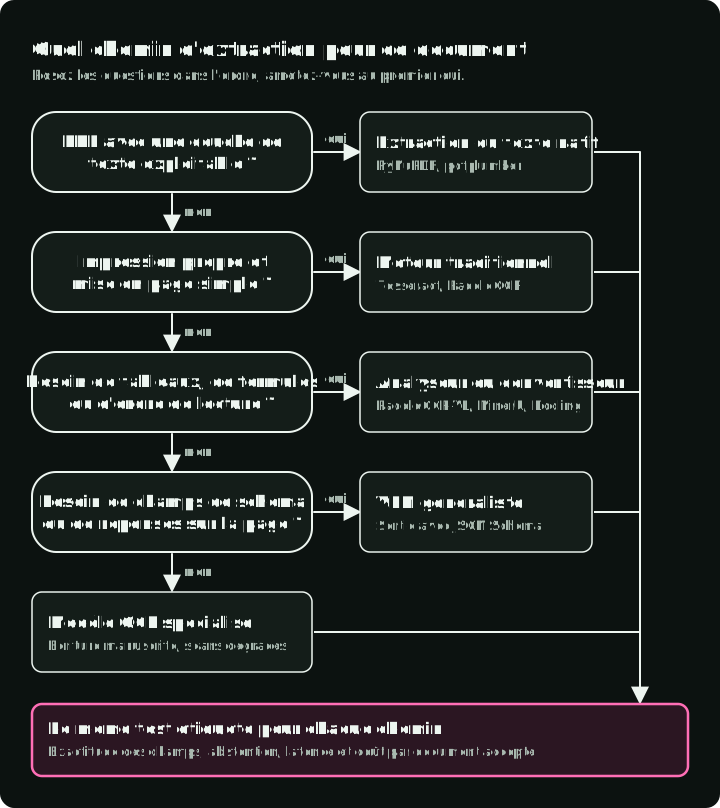
Chaque feuille passe quand même par le même test annoté. La carte vous donne un premier candidat, pas un choix final.
Tester des VLMs avec OpenRouter
OpenRouter fournit une passerelle compatible OpenAI vers des modèles de plusieurs fournisseurs. Les identifiants de modèles et les fonctionnalités de requête prises en charge changent ; vérifiez-les dans le catalogue actuel de la passerelle avant d’exécuter l’exemple.
L’extrait nécessite pip install openai, une OPENROUTER_API_KEY, un accès réseau, un fichier local receipt.jpg et des identifiants de modèles toujours pris en charge par OpenRouter.
import base64
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=os.environ["OPENROUTER_API_KEY"],
)

def extract_text(
    image_path: str,
    model: str,
    prompt: str = "Extract all text from this image, preserving layout as markdown.",
    **request_args,
) -> str:
    with open(image_path, "rb") as f:
        image_b64 = base64.b64encode(f.read()).decode()

    response = client.chat.completions.create(
        model=model,
        messages=[{
            "role": "user",
            "content": [
                {"type": "text", "text": prompt},
                {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{image_b64}"}},
            ],
        }],
        max_tokens=4096,
        **request_args,
    )
    choice = response.choices[0]
    if choice.finish_reason != "stop":
        raise RuntimeError(f"{model} did not finish: {choice.finish_reason}")
    if not choice.message.content:
        raise RuntimeError(f"{model} returned no text (finish_reason={choice.finish_reason})")
    return choice.message.content

# Compare models by changing one string
models = [
    "google/gemini-3.8-flash",
    "anthropic/claude-sonnet-5",
    "qwen/qwen3.8-27b",
]
for model in models:
    print(f"\n--- {model} ---\n{extract_text('receipt.jpg', model)[:200]}...")
Le catalogue de modèles OpenRouter listait google/gemini-3.8-flash, anthropic/claude-sonnet-5 et qwen/qwen3.8-27b avec entrée image et paramètres de structured output le 2026-10-02. La prise en charge dans le catalogue ne prouve pas que cette requête exacte réussit sur chaque point de terminaison routé.
Pour l’extraction structurée, utilisez response_format avec un JSON Schema quand le modèle choisi et la passerelle le prennent en charge. Cela peut rendre la réponse analysable ; cela ne valide pas les valeurs extraites par rapport à l’image. Avec OpenRouter, provider.require_parameters fait échouer la requête quand aucun point de terminaison routé ne prend en charge tous les paramètres demandés, au lieu de se rabattre sur un point de terminaison qui ne peut pas respecter le schéma.
L’extrait réutilise extract_text du bloc précédent et transmet le schéma par ses arguments de requête supplémentaires. Il nécessite un modèle qui prend en charge JSON Schema.
import json

nullable = {"type": ["string", "null"]}
receipt_schema = {
    "type": "object",
    "properties": {
        "vendor": nullable,
        "date": nullable,
        "items": {
            "type": ["array", "null"],
            "items": {
                "type": "object",
                "properties": {"description": nullable, "amount": nullable},
                "required": ["description", "amount"],
                "additionalProperties": False,
            },
        },
        "total": nullable,
    },
    "required": ["vendor", "date", "items", "total"],
    "additionalProperties": False,
}
prompt = (
    "Extract only visible receipt fields. Copy amounts as source strings. "
    "Use null for absent or unreadable values; do not infer them. "
    "Use null for an unreadable item list, and [] only when no items are present."
)

receipt = json.loads(extract_text(
    "receipt.jpg",
    "google/gemini-3.8-flash",
    prompt=prompt,
    response_format={
        "type": "json_schema",
        "json_schema": {"name": "receipt", "strict": True, "schema": receipt_schema},
    },
    extra_body={"provider": {"require_parameters": True}},
))
Le mode strict de style OpenAI exige que chaque propriété figure dans required et additionalProperties: false ; une valeur qui peut manquer est donc typée comme nullable au lieu d’être omise. Le prompt et les types nullables permettent ensemble au modèle de renvoyer null plutôt que d’inventer une valeur.
Conservez les chaînes de montants copiées à côté des valeurs normalisées. Analysez les montants en aval avec une arithmétique décimale ou en entiers d’unités mineures, sous une devise et des paramètres régionaux explicites ; la validité du schéma ne valide pas le total d’un paiement. Orientez les champs critiques nuls vers la relecture.
Déployer l’OCR en production
Une architecture par paliers peut séparer le prétraitement sur CPU de l’inférence sur GPU ou API, et réserver les chemins coûteux aux documents qui en ont besoin. La figure montre les paliers par ordre de coût, le contrôle qui accepte une page à chaque palier, et l’échec qui l’envoie vers le suivant.
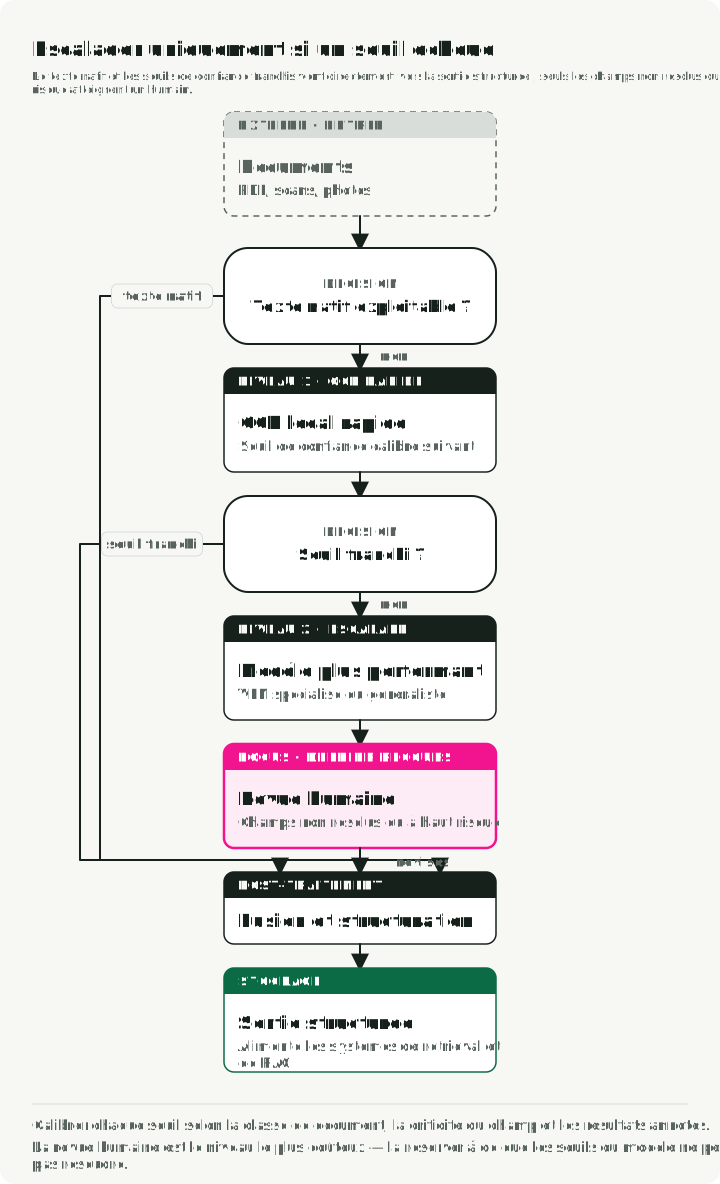
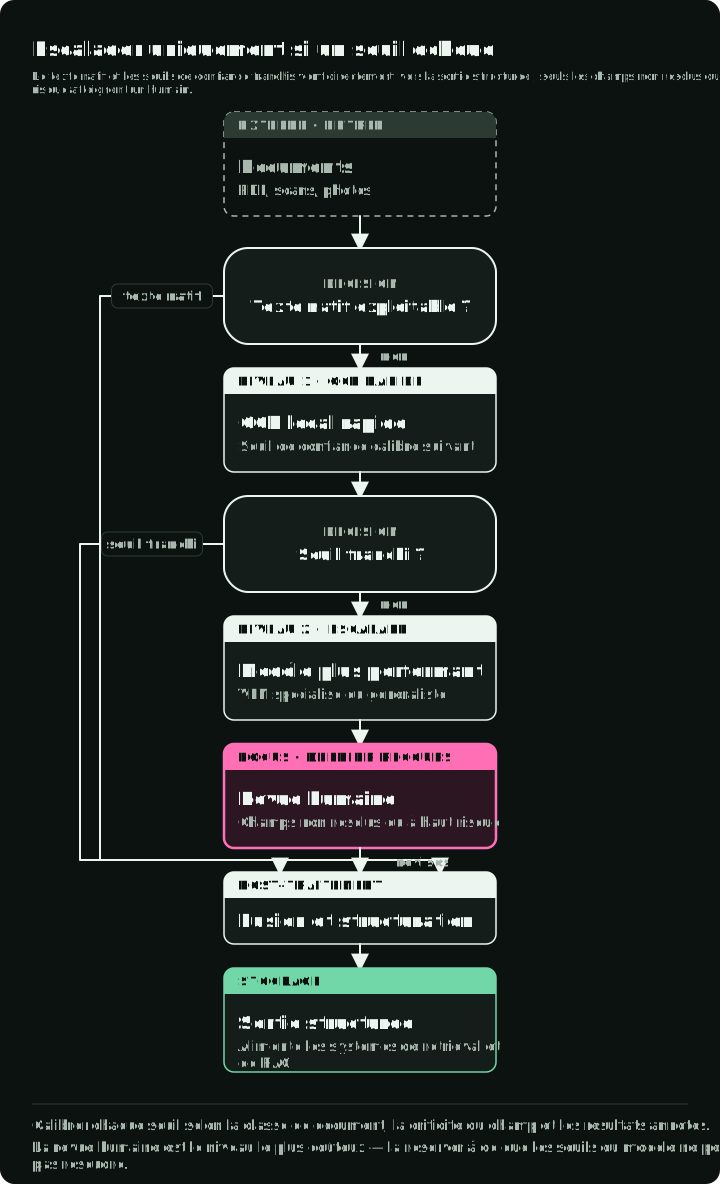
Le schéma de repli par paliers
Commencez par le chemin le moins cher qui atteint l’objectif de qualité, puis calibrez le routage sur des pages annotées :
- Vérifier le texte intégré (palier 0). Pour les PDF, inspectez la couche de texte avec
PyMuPDFoupdfplumberavant la rastérisation, mais validez que la couche est complète.
- Essayer avec un modèle rapide. Utilisez un moteur traditionnel pour les classes de documents sur lesquelles il atteint l’objectif.
- Évaluer une confiance calibrée. Combinez la confiance du modèle avec la classe de document, la criticité du champ et les règles de validation.
- Passer à un modèle plus puissant. Orientez les pages incertaines vers un VLM spécialisé ou généraliste.
- Faire remonter les échecs à haut risque vers un humain. La relecture humaine est un palier distinct pour les valeurs dont le coût d’une erreur dépasse le bénéfice de l’automatisation.
Note sur la confiance : les probabilités brutes de caractères ne sont pas automatiquement calibrées sur l’exactitude des champs. La fonction pondérée par la surface ci-dessous est une base pour l’agrégation au niveau de la page, pas un routeur universel. Calibrez-la sur des pages annotées, et donnez aux champs critiques leurs propres règles, car une moyenne de page peut masquer un identifiant ou un total erroné.
def area_weighted_confidence(page):
    """Compute area-weighted confidence from one PaddleOCR 3.x result."""
    total_area, weighted_sum = 0, 0
    for (x_min, y_min, x_max, y_max), score in zip(
        page["rec_boxes"], page["rec_scores"]
    ):
        width = int(x_max) - int(x_min)
        height = int(y_max) - int(y_min)
        area = width * height
        weighted_sum += score * area
        total_area += area
    return weighted_sum / total_area if total_area > 0 else 0

assert area_weighted_confidence({
    "rec_boxes": [[0, 0, 300, 300]], "rec_scores": [0.5]
}) == 0.5
Pour fixer le seuil, annotez un ensemble de pages d’une même classe de documents et notez si tous les champs critiques de chaque page sont corrects. Choisissez le seuil de confiance le plus bas pour lequel les pages acceptées atteignent votre objectif d’erreur sur les champs critiques, et orientez les pages situées en dessous vers le palier suivant. La fonction ci-dessous fait cela pour une classe de documents.
def pick_threshold(scores, correct, max_error):
    """Lowest threshold whose accepted pages meet the error target, or None."""
    for threshold in sorted(set(scores)):
        accepted = [ok for s, ok in zip(scores, correct) if s >= threshold]
        if accepted and accepted.count(False) / len(accepted) <= max_error:
            return threshold
    return None  # no threshold meets the target: send every page to the next tier

scores = [0.95, 0.91, 0.88, 0.80, 0.72, 0.60]
correct = [True, True, True, False, True, False]  # all critical fields right?
assert pick_threshold(scores, correct, max_error=0.0) == 0.88
assert pick_threshold(scores, correct, max_error=0.25) == 0.72
La figure place les six pages étiquetées des asserts sur l’échelle de confiance et marque le seuil que choisit chaque objectif d’erreur.
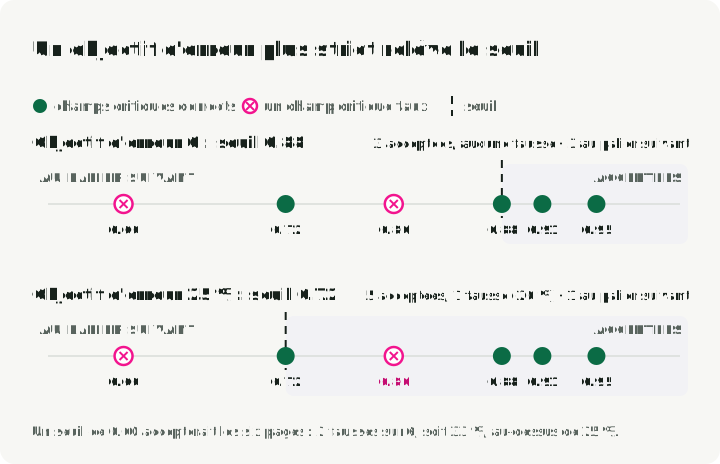
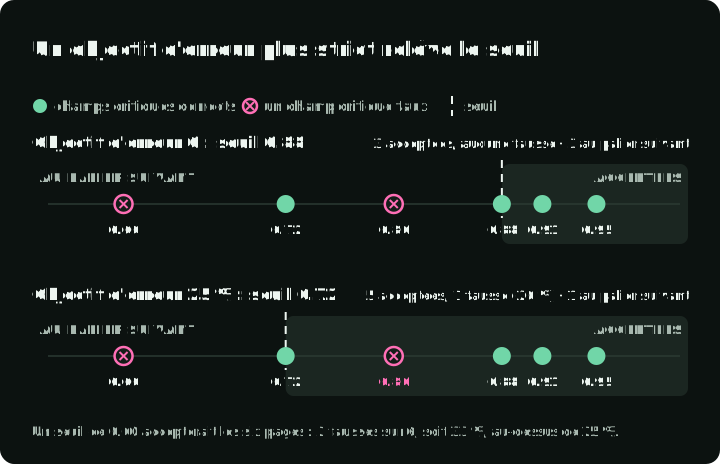
Un objectif d’erreur plus strict relève le seuil et envoie plus de pages vers le modèle plus puissant. Répétez la calibration pour chaque classe de documents, car le même score peut correspondre à des précisions différentes sur des reçus et sur des contrats.
Modèles de service
La façon d’exécuter chaque palier dépend de la manière dont les pages arrivent :
- Traitements par lots (conversion d’archives, rapports mensuels) : lisez les pages depuis une file d’attente et exécutez-les sur des workers GPU qui descendent à zéro entre deux traitements.
- Requêtes interactives : gardez un GPU chaud ou utilisez une API hébergée, car un démarrage à froid du modèle ajoute son temps de chargement à l’attente de l’utilisateur.
- Rastérisation et nettoyage d’image : exécutez-les sur des workers CPU dont la mise à l’échelle est indépendante de celle de l’inférence GPU.
- VLMs à poids ouverts : servez-les avec vLLM ou SGLang, qui regroupent en lots les requêtes concurrentes sur un seul GPU.
Mesurer les résultats
Pour chaque paire moteur/document prévue, conservez un résultat avec un statut de réussite, d’erreur ou d’omission. Les sorties en échec, vides et tronquées restent dans le dénominateur des documents tentés, avec le coût dépensé. Rapportez le taux d’achèvement, les erreurs sur les champs critiques parmi les acceptations automatiques, la fraction relue, la latence de bout en bout p50/p95 et le coût par document traité avec succès. Mesurez la latence par page avec la résolution, la taille de lot, le matériel ou la région du fournisseur et la longueur de sortie réels. Gardez le prétraitement et les nouvelles tentatives dans le total ; un temps mesuré sur le modèle seul ne permet pas de chiffrer une page réussie. Réutilisez les objets convertisseurs pour les temps à chaud et enregistrez l’initialisation séparément. Le dépôt OCR Gauntlet enregistre les résultats dans ce format ; la dernière section montre comment l’exécuter.
Analyse des coûts à grande échelle
Il n’existe pas de seuil de rentabilité universel, en volume de pages, entre une API et l’auto-hébergement. Construisez la comparaison à partir de la même charge de travail :
| Poste de coût | Chemin API | Chemin auto-hébergé |
|---|---|---|
| Inférence | Prix actuel à la page ou au token | Heures de GPU au débit mesuré en pages/heure |
| Capacité inutilisée | Généralement absorbée par le fournisseur | Taux d’utilisation et marge de capacité |
| Ingénierie | Intégration et supervision du fournisseur | Déploiement, mises à jour, observabilité et astreinte |
| Gestion des données | Transfert, conservation et conditions régionales | Stockage, réseau et contrôles de conformité |
| Défauts de qualité | Nouvelles tentatives et relecture humaine | Nouvelles tentatives et relecture humaine |
Utilisez une formule commune : monthly pages × cost per successful page + review cost + fixed operating cost. Une « page réussie » doit satisfaire les mêmes critères de texte, de tableaux et de champs sur les deux chemins. Les prix des fournisseurs et les locations de GPU changent trop vite pour figurer ici comme estimation d’achat durable.
Gestion des erreurs : le problème des hallucinations
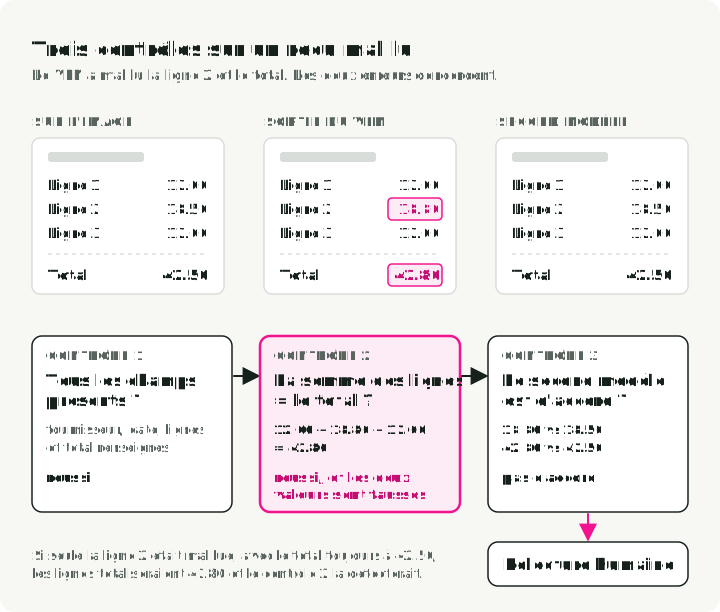
Les erreurs des VLMs peuvent être plausibles dans le contexte et fausses dans les faits. Le total d’un reçu, « $42.50 », peut revenir comme « $42.80 » : un montant valide qu’aucun correcteur orthographique ne signale.
Exemple d’échec synthétique : l’image d’un reçu montre trois lignes, 12.00, 18.50 et 12.00, et un total de 42.50. Un VLM lit la deuxième ligne comme 18.80 et le total comme 42.80. Les lignes s’additionnent toujours au total, donc l’arithmétique interne passe, alors que les deux valeurs sont fausses. C’est pourquoi la validation exige des annotations ancrées dans l’image ou une voie de relecture indépendante, et pas seulement des contrôles de cohérence.
La figure exécute les trois contrôles sur ce reçu : le contrôle de schéma et le contrôle de somme réussissent, et seul le second modèle détecte les deux erreurs de lecture.
Quelques mesures pratiques :
- Rapprochement arithmétique. Quand le schéma les expose, vérifiez
subtotal + tax + fees + shipping - discounts, dans la tolérance d’arrondi de la devise, par rapport au total indiqué. Orientez les composantes manquantes ou les écarts vers la relecture. - Contrôles de dates, de téléphones et de devises. Analysez les dates avec un analyseur de dates et rejetez les valeurs impossibles. Vérifiez par des motifs le nombre de chiffres des numéros de téléphone et les formats de devise.
- Second chemin d’extraction. Faites passer les champs critiques par un autre modèle ou un autre moteur OCR et signalez les désaccords. L’accord n’augmente la confiance que si les deux chemins ont des modes de défaillance suffisamment différents ; ce n’est pas une preuve d’exactitude.
Le contrôle de rapprochement prend les chaînes de montants copiées et utilise Decimal, de sorte qu’aucun arrondi en virgule flottante n’entre dans la comparaison. Les asserts rejouent l’exemple de reçu ci-dessus.
from decimal import Decimal

def reconcile(subtotal, tax, fees, shipping, discounts, total, tolerance="0.01"):
    """True when the stated total matches its components within tolerance."""
    parts = [subtotal, tax, fees, shipping, discounts, total]
    if any(p is None for p in parts):
        return False  # a missing component goes to review
    s, t, f, sh, d, tot = (Decimal(p) for p in parts)
    return abs(s + t + f + sh - d - tot) <= Decimal(tolerance)

items = ["12.00", "18.80", "12.00"]  # the image shows 18.50
subtotal = str(sum(Decimal(i) for i in items))
assert reconcile(subtotal, "0", "0", "0", "0", "42.80")  # passes, and both values are wrong
assert not reconcile(subtotal, "0", "0", "0", "0", "42.50")  # one misread value is caught
assert not reconcile(subtotal, None, "0", "0", "0", "42.80")  # missing tax goes to review
Le rapprochement détecte un seul montant mal lu. Il ne peut pas détecter deux erreurs de lecture qui s’accordent entre elles ; les champs critiques ont donc toujours besoin du second chemin d’extraction.
Lancer la comparaison sur vos propres pages
Le dépôt OCR Gauntlet exécute plusieurs moteurs OCR sur les mêmes pages et écrit une ligne de résultat par moteur et par page, échecs compris. Il compare des pages d’images ; il ne couvre pas le contrôle de la couche de texte du palier 0.
Le runner fonctionne en quatre étapes :
- Le manifeste liste les pages et les hachages de leur texte de référence.
- Le runner envoie chaque page à chaque moteur.
- Il écrit une ligne JSONL par moteur et par page, marquée succès, erreur ou omission, avec la sortie brute, le temps et le coût.
- Le récapitulatif donne le taux d’achèvement, le CER sur les pages relues et le coût par page réussie. Les paires en échec ou omises restent dans le dénominateur du taux d’achèvement.
La première exécution utilise des pages générées et Tesseract ; elle nécessite donc Python 3.12, uv et une installation système de Tesseract, mais aucune clé d’API :
uv sync --locked --extra tesseract --extra notebooks
uv run python scripts/make_fixture.py data/demo
uv run ocr-gauntlet data/demo/manifest.json --engines tesseract --output results/demo.jsonl
Les pages générées servent uniquement à vérifier que le pipeline fonctionne ; elles ne mesurent pas la qualité de l’OCR. Pour un vrai test sur des reçus, importez des échantillons CORD avec uv run python scripts/download_samples.py --dataset cord --count 2 --output data/cord et préparez une référence relue comme le décrit le README du dépôt. Ajoutez d’autres moteurs avec --engines ; les moteurs hébergés exigent aussi --allow-remote, car ils envoient vos pages.
Dans le récapitulatif, lisez d’abord le taux d’achèvement : un moteur qui échoue sur un tiers des pages n’est pas un candidat, quel que soit son CER. Comparez ensuite le CER sur les pages relues, puis le coût par page réussie, qui inclut les dépenses des tentatives échouées.
Points clés à retenir
- Associez le palier de modèle à une classe de documents annotée. Les moteurs traditionnels peuvent suffire pour le texte propre ; les VLMs spécialisés et généralistes doivent justifier leur surcoût sur les pages plus difficiles.
- Ne fusionnez pas des classements différents. Les métriques d’OmniDocBench et les préférences d’OCR Arena répondent à des questions différentes.
- Calibrez le routage. Les seuils de confiance, les classes de documents, la criticité des champs et la politique de relecture humaine relèvent d’une seule évaluation.
- Validez les sorties plausibles. La conformité au schéma et l’arithmétique interne ne peuvent pas prouver qu’une valeur apparaît dans l’image.
- Chiffrez les pages réussies. Incluez les nouvelles tentatives, la relecture, l’exploitation fixe et les contrôles de qualité quand vous comparez des API à l’auto-hébergement.
Références
- OCR Arena Leaderboard - Duels de modèles en tête-à-tête, par la communauté
- Le dépôt OCR Gauntlet - Comparaison exécutable de moteurs OCR sur les mêmes pages, avec les backends Docling et le coût par page réussie
- OmniDocBench - Évaluation de l’analyse de documents de bout en bout
- dots.ocr - Environ 3B de paramètres au total, dont un modèle de langage de 1.7B
- PaddleOCR - Boîte à outils et modèles d’OCR traditionnels
- OpenRouter - Passerelle d’accès unifiée pour tester des modèles en A/B