Guide de serving LoRAX : adapters LoRA sur Kubernetes à grande échelle

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Ce guide s’adresse aux ingénieurs d’inférence et de plateforme qui doivent servir de nombreuses variantes LoRA à partir d’un seul modèle de base. Il montre comment tester les APIs de LoRAX, dimensionner le working set et transformer le chart Helm de démarrage en plan de production explicite.
Un modèle de base et de nombreux adapters LoRA créent un problème de serving inhabituel. Les poids de base sont partagés, mais chaque requête peut nécessiter un ensemble différent de poids d’adapter. Une architecture conventionnelle avec un déploiement par variante gaspille de la mémoire GPU lorsque la plupart des variantes sont inactives.
LoRAX répond à cette longue traîne. Il charge les adapters à la demande, regroupe en batches les requêtes destinées à différents adapters et change quels poids d’adapters occupent la mémoire GPU. La promesse séduisante est de servir « des milliers de modèles fine-tunés sur un seul GPU ». La question d’ingénierie est plus précise : compte tenu de votre ensemble d’adapters actifs, de votre profil d’arrivée et de votre objectif de latence, la planification des échanges apporte-t-elle un gain suffisant pour justifier un runtime de serving supplémentaire ?
Le problème de serving, c’est le working set
LoRA gèle un modèle de base et apprend des mises à jour de bas rang pour certaines matrices de poids. L’adapter obtenu est en général bien plus petit qu’un checkpoint complet, mais sa taille dépend toujours du rang, des modules ciblés, du nombre de couches et du dtype. Des affirmations figées comme « chaque adapter fait 100 Mo » sont de mauvaises entrées pour le dimensionnement.
Si chaque variante fine-tunée a son propre déploiement, chaque déploiement contient une copie complète des poids de base, qu’il reçoive du trafic ou non. La partie gauche de la figure montre cette architecture. La partie droite montre un seul modèle de base qui ne charge que les adapters recevant des requêtes.
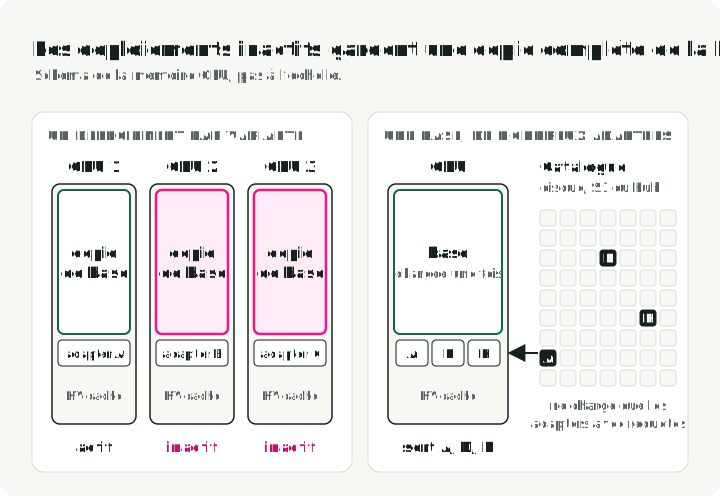
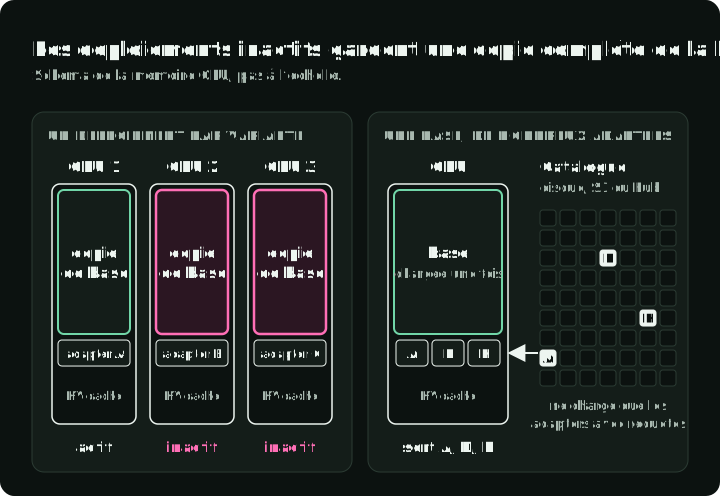
Pour le serving, il faut distinguer trois quantités :
- Taille du catalogue : tous les adapters qu’une plateforme peut résoudre depuis le stockage
- Working set actif : les adapters qui reçoivent des requêtes pendant la fenêtre de rétention du cache
- Ensemble concurrent : les adapters présents dans des batches au même instant
Chaque ensemble est un sous-ensemble du précédent : l’ensemble concurrent est inclus dans le working set actif, lui-même inclus dans le catalogue. Le dimensionnement de la capacité part du working set actif. Par exemple, un catalogue de 5 000 adapters peut en avoir 200 actifs sur la dernière heure et 8 dans un même batch.
Un catalogue peut contenir des milliers d’adapters sans que des milliers tiennent en VRAM. Ce qui compte, c’est la fréquence de changement de l’ensemble actif, la taille de ces adapters, et la possibilité pour des requêtes visant des adapters différents de partager des batches utiles.
LoRAX combine quatre mécanismes :
- Le modèle de base reste résident pour tous les adapters compatibles.
- Une requête nomme un adapter, que LoRAX résout depuis Hugging Face, Predibase, S3 ou un chemin local (le paramètre
adapter_source). - La planification des échanges précharge les adapters et libère leurs poids GPU pour faire de la place à d’autres. Un chargement ultérieur peut réutiliser les artifacts en cache.
- Le continuous batching hétérogène regroupe des requêtes visant différents adapters.
LoRAX est un fork de Text Generation Inference (TGI) de Hugging Face, dont il conserve l’API /generate. Il applique différents adapters dans un même batch grâce aux kernels SGMV du projet Punica. Ces kernels regroupent les lignes qui utilisent différentes matrices d’adapters dans chaque couche adaptée. L’implémentation LoRAX effectue des projections séparées de réduction et d’expansion : d’abord vers la dimension de bas rang, puis vers la dimension de sortie de la couche.
La figure suit quatre requêtes dans une configuration de production. Une gateway placée devant LoRAX vérifie d’abord le tenant et l’ID d’adapter ; les sections sur la sécurité plus bas expliquent pourquoi. LoRAX trouve ensuite l’adapter. S’il n’est pas sur le GPU, LoRAX charge les artifacts en cache ou télécharge les fichiers manquants. Les tenseurs hôte conservés peuvent aussi être réutilisés lorsque le chargeur les garde. Il regroupe ensuite la requête avec celles d’autres adapters et renvoie les tokens en streaming.
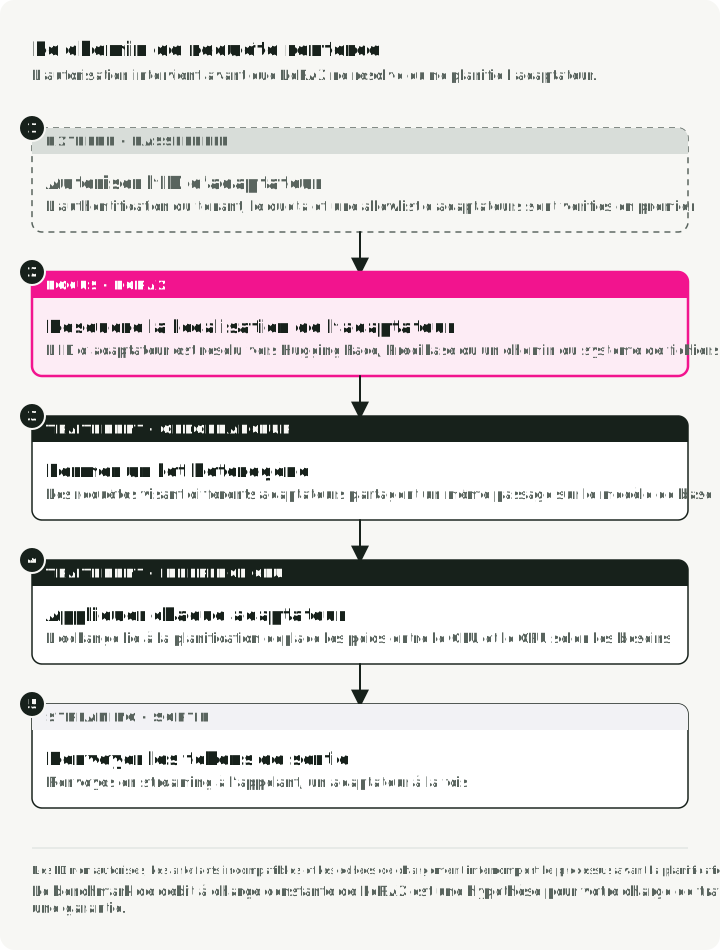
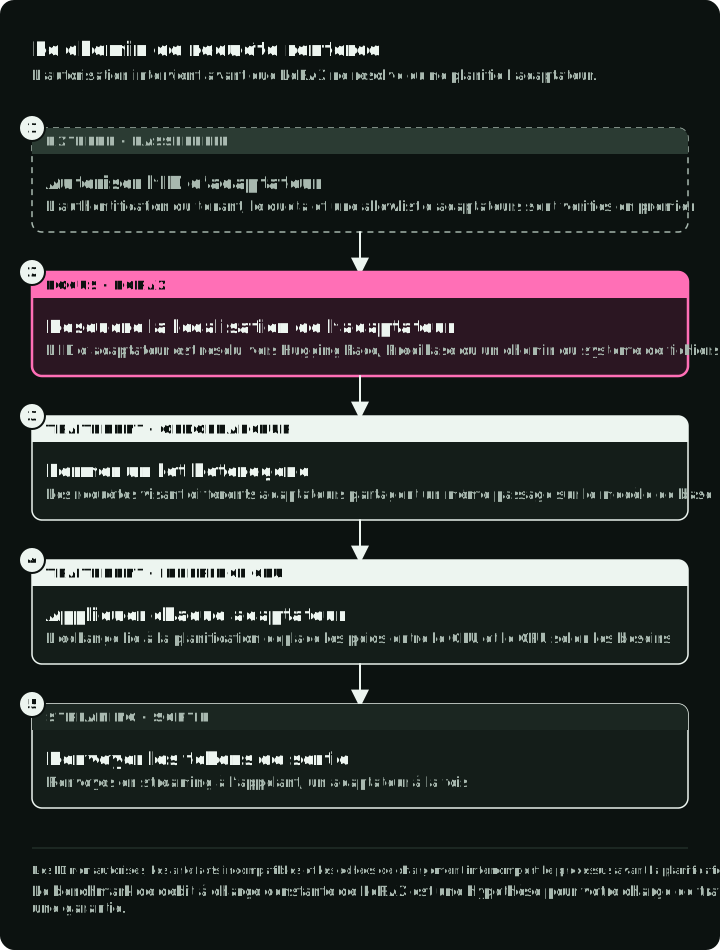
Le projet LoRAX indique que le batching hétérogène garde un débit et une latence presque constants lorsque le nombre d’adapters concurrents augmente, dans ses benchmarks. Considérez ce résultat de l’éditeur comme une hypothèse à vérifier sur votre charge. La longueur des prompts, la longueur des sorties, le rang, les modules ciblés, le taux de remplissage des batches, le renouvellement du cache et la génération de GPU peuvent changer le résultat.
Le graphique ci-dessous vient du rapport de lancement de LoRAX de Predibase, publié en novembre 2023. Predibase a testé Llama 2 7B avec des requêtes réparties sur 1 à 128 adapters, sur un seul NVIDIA A10G. Ce graphique montre la comparaison des coûts pour 1 à 32 adapters, pour le traitement d’un million de tokens répartis également entre les adapters.
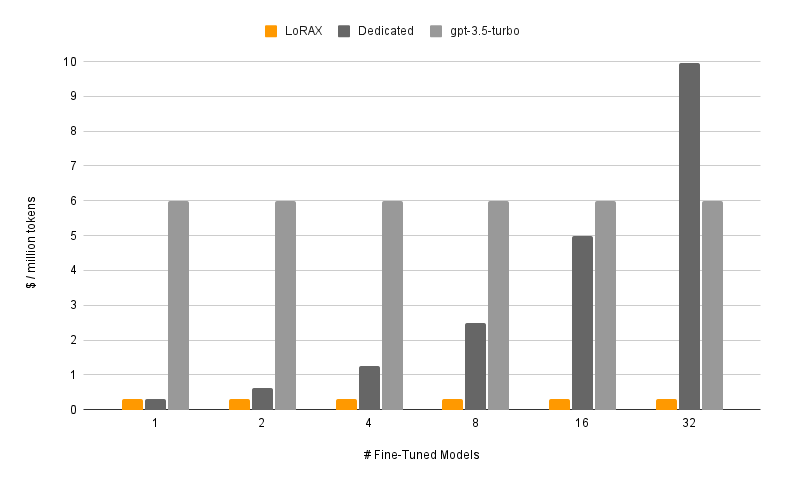
Comparaison archivée du projet, reproduite depuis le rapport LoRAX 2023 de Predibase. Les coûts de LoRAX et des déploiements dédiés reposent sur les heures GPU de cette expérience. Au niveau de détail de la source, la courbe GPT-3.5 Turbo utilise le coût par token du modèle fine-tuné.
Lisez les barres orange plates comme le résultat de la conception de ce benchmark, pas comme une promesse de prix actuel. Le test envoyait un total fixe d’un million de tokens et laissait différents adapters partager un batch. La référence dédiée supposait un calcul hébergé distinct pour chaque modèle, si bien que son coût augmentait avec le nombre de modèles.
Predibase n’a pas publié la répartition des tokens, la longueur des requêtes, la taille de batch, le rang des adapters ni le prix du GPU ; les valeurs en dollars ne sont donc pas reproductibles.
Le graphique ne couvre pas non plus le trafic clairsemé, les téléchargements à froid, les prix actuels du cloud, les GPU plus récents, d’autres modèles de base ni des adapters de rangs différents. Servez-vous-en comme d’une raison de rejouer votre propre trafic.
Quand LoRAX est un bon candidat
Testez LoRAX lorsque toutes ces conditions sont réunies :
- les adapters ont été entraînés sur le même modèle de base pris en charge et respectent le même contrat de tokenizer
- le trafic couvre de nombreux adapters, avec une longue traîne significative
- charger un adapter à froid à la demande vaut mieux que réserver un déploiement pour lui
- le routage par tenant ou par tâche existe déjà à la frontière de l’application
- l’équipe peut exploiter un runtime d’inférence spécialisé et son comportement de cache
- l’équipe accepte un runtime qui publie peu de versions en amont
Les cas typiques sont les assistants propres à un tenant, les nombreuses variantes par domaine et les expériences en ligne qui partagent un checkpoint de base.
LoRAX convient moins lorsque quelques adapters concentrent l’essentiel du trafic, ou lorsque les modèles ne partagent pas de base. Il convient aussi moins lorsque des objectifs de latence stricts ne tolèrent pas les chargements à froid, ou lorsque la plateforme ne peut pas contrôler de façon sûre les artifacts que le serveur charge. Un déploiement vLLM ou SGLang standard avec un ensemble d’adapters fixe peut être plus simple dans ces cas. Un ensemble fixe est un choix de déploiement : SGLang permet aussi le chargement dynamique, tout comme vLLM plus bas. TGI lui-même est désormais en mode maintenance, et ses mainteneurs recommandent vLLM ou SGLang.
Vérifiez l’activité du projet avant de vous engager. Au 8 octobre 2026, la dernière version du serveur LoRAX est la v0.12.1, publiée en novembre 2024. Le dépôt a reçu des commits réguliers jusqu’en avril 2025, puis seulement deux petits correctifs. Si vous l’adoptez, prévoyez de prendre en charge vous-même les mises à jour pour les nouveaux modèles, les versions de CUDA et les correctifs de sécurité.
La figure compare deux configurations à tester selon la distribution du trafic : un ensemble fixe lorsque quelques adapters reçoivent la majorité des requêtes, et le chargement dynamique LoRAX pour une longue traîne. Un ensemble actif chaud en mode dynamique peut encore être évincé ; ce n’est pas un ensemble fixe préchargé.
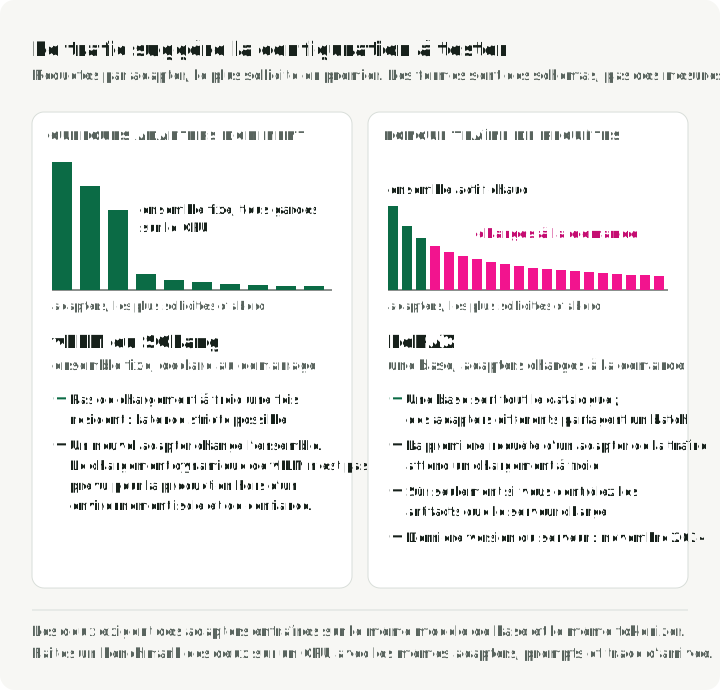
N’utilisez pas Kubernetes simplement parce que le catalogue est grand. Prouvez d’abord la compatibilité du runtime et des adapters sur un seul GPU.
Essayer une base et un adapter en local
Le README de LoRAX recommande son conteneur préconstruit. Utilisez un digest d’image immuable dans un environnement réel. main n’apparaît ici que parce que c’est le tag de démarrage rapide documenté par le dépôt. Confirmez les exemples avec les versions de l’image et des dépendances que vous déployez.
Avant de lancer le conteneur, installez et configurez NVIDIA Container Toolkit pour Docker. Le README LoRAX exige aussi Linux, Docker, un GPU NVIDIA Ampere ou plus récent et des drivers compatibles CUDA 11.8. Les licences des modèles et les dépôts à accès restreint peuvent exiger un token Hugging Face.
mkdir -p data

docker run --rm --gpus all --shm-size 1g \
    -p 127.0.0.1:8080:80 \
    -v "$PWD/data:/data" \
    ghcr.io/predibase/lorax:main \
    --model-id mistralai/Mistral-7B-Instruct-v0.1
L’adresse hôte explicite lie le port publié à loopback ; sans elle, Docker publie par défaut sur toutes les adresses de l’hôte. Utilisez Docker 28 ou plus récent : les anciennes versions peuvent exposer les ports publiés sur localhost aux hôtes du même segment réseau. Laissez le conteneur tourner dans ce terminal. Dans un second terminal, attendez que curl --fail http://127.0.0.1:8080/health réussisse avant d’envoyer des requêtes.
Commencez par le modèle de base :
curl http://127.0.0.1:8080/generate \
    -H 'Content-Type: application/json' \
    -d '{
      "inputs": "[INST] Give one reason to measure cold-adapter latency. [/INST]",
      "parameters": {"max_new_tokens": 64}
    }'
Envoyez ensuite un adapter compatible. Cet adapter de mathématiques GSM8K déclare mistralai/Mistral-7B-Instruct-v0.1 comme base, le même modèle que celui exécuté par le serveur :
curl http://127.0.0.1:8080/generate \
    -H 'Content-Type: application/json' \
    -d '{
      "inputs": "[INST] Solve: Natalia sold 48 clips in April and half as many in May. What is the total? [/INST]",
      "parameters": {
        "max_new_tokens": 64,
        "adapter_id": "vineetsharma/qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k"
      }
    }'
Une réponse /generate réussie est un tableau JSON contenant generated_text ; la réponse générée dépend du modèle et de l’échantillonnage. La première requête à un adapter peut le télécharger et le charger. Les requêtes suivantes peuvent utiliser les artifacts en cache et les poids résidents. Enregistrez les deux chemins. Une seule requête à chaud en dit peu sur le comportement de la longue traîne.
L’adapter ci-dessus vient du Hugging Face Hub. En production, chargez les adapters depuis un stockage que la plateforme contrôle. La documentation des adapters décrit deux sources de ce type : local pour un répertoire dans le conteneur, et s3 pour une URI S3, avec les identifiants AWS dans l’environnement. Après avoir copié les fichiers de l’adapter dans le répertoire monté, remplacez parameters dans la requête précédente par ce fragment :
"parameters": {
    "adapter_id": "/data/adapters/vineetsharma--qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k",
    "adapter_source": "local"
}
Utiliser le client Python
Le package lorax-client encapsule /generate. Installez-le avec pip install lorax-client==0.6.3. Le même appel fonctionne avec ou sans adapter_id, ce qui permet de comparer le modèle de base et l’adapter sur un même prompt :
from lorax import Client

client = Client("http://127.0.0.1:8080")

prompt = (
    "[INST] Natalia sold clips to 48 of her friends in April, and then she "
    "sold half as many clips in May. How many clips did Natalia sell "
    "altogether in April and May? [/INST]"
)

# Base model
print(client.generate(prompt, max_new_tokens=64).generated_text)

# Same prompt through the GSM8K adapter
adapter_id = "vineetsharma/qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k"
print(
    client.generate(prompt, max_new_tokens=64, adapter_id=adapter_id).generated_text
)
Utiliser un client compatible OpenAI
LoRAX expose aussi un endpoint de chat compatible OpenAI. Installez le client avec pip install openai==3.26.1. Le champ model identifie l’adapter :
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://127.0.0.1:8080/v1",
)

response = client.chat.completions.create(
    model="vineetsharma/qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k",
    messages=[
        {"role": "user", "content": "Explain cache locality in two sentences."},
    ],
    max_tokens=100,
)

print(response.choices[0].message.content)
Par défaut, le serveur n’exige pas de clé d’API. C’est pratique sur localhost et dangereux dans une configuration exposée sur Internet. Placez devant lui l’authentification, l’autorisation par tenant, les quotas et l’allowlist d’adapters.
Vérifier la compatibilité des adapters à l’enregistrement
Avant qu’un adapter n’entre dans le catalogue, vérifiez au minimum :
- le modèle de base et la révision déclarés
- la compatibilité du tokenizer et du chat template
- le rang LoRA et les modules ciblés pris en charge par le runtime
- le format de l’artifact et la forme des tenseurs
- la licence, la provenance et le digest d’intégrité
- une petite suite de tests de comportement et de régression
Rejetez les artifacts incompatibles lors de l’enregistrement plutôt qu’à la première requête d’un utilisateur.
Comprendre la résidence avant de déployer
Le modèle de base occupe la plus grande part fixe de la mémoire GPU. Les poids des adapters, le KV cache, l’espace de travail des batches et les kernels du runtime se partagent le reste. /data stocke les artifacts téléchargés. La RAM CPU peut contenir des tenseurs d’adapters matérialisés, mais seulement si le chargeur les conserve.
Dans l’implémentation main vérifiée à a7394ba, le chargeur par défaut d’un seul adapter met en cache des références de fichiers. Le déchargement retire les poids GPU des tables d’adapters ; une requête ultérieure peut relire et matérialiser les fichiers en cache. Le chargeur par défaut de v0.12.1 utilise aussi des références de fichiers. Le chargement fusionné ou non différé et le cache de fichiers du système peuvent se comporter autrement. Ne comptez donc pas chaque déchargement comme un accès réussi à des tenseurs CPU conservés.
Ce sont des états de mesure distincts. Un artifact sur disque ou sur le Hub doit être lu et matérialisé avant de devenir un adapter résident en CPU ou en GPU. La figure dessine les quatre chemins possibles du tableau ci-dessous sous forme de barres de temps ; le chemin CPU ne s’applique que si les tenseurs hôte sont conservés. Chaque étape de chargement supplémentaire ajoute du travail avant le premier token.
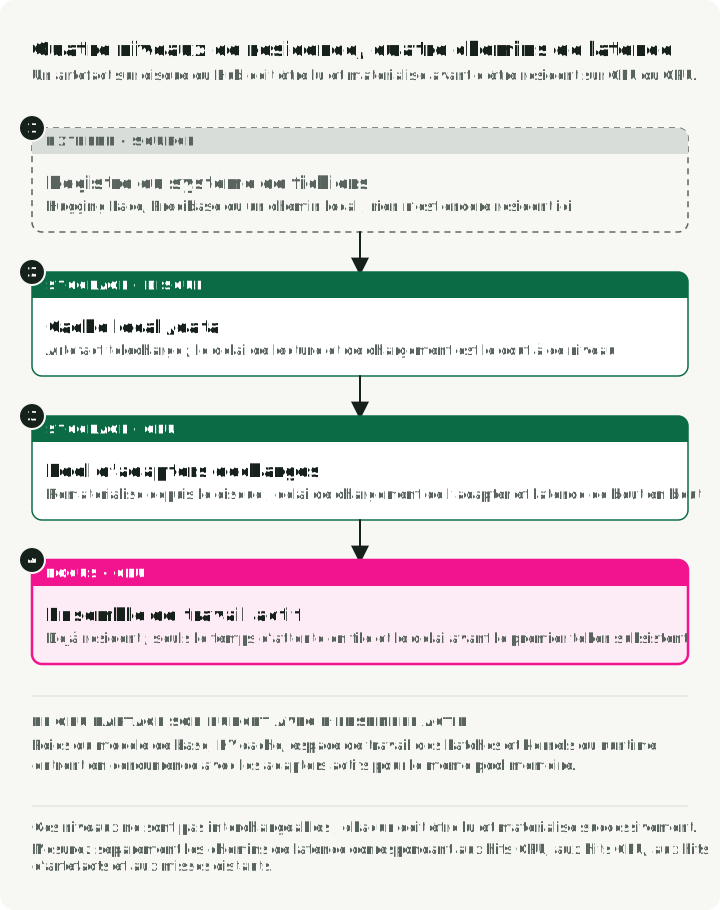
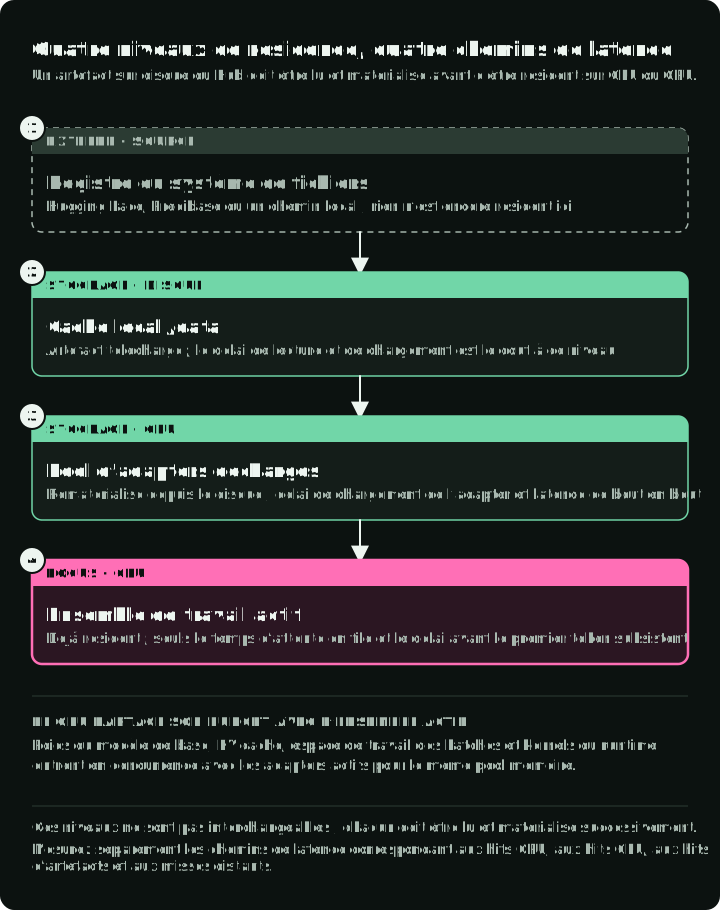
Mesurez les transitions séparément :
| Chemin | Ce qu’il comprend | Mesure à enregistrer |
|---|---|---|
| Accès GPU | Adapter déjà résident | temps en file et temps jusqu’au premier token |
| Accès CPU | Transfert des tenseurs hôte conservés, si disponibles | délai de chargement de l’adapter et latence de bout en bout |
| Accès aux artifacts | Lecture du cache local /data | délai de lecture/chargement et octets en cache |
| Échec distant | Téléchargement, validation et chargement | durée de téléchargement, échecs et latence à froid complète |
Le dimensionnement de la capacité doit rejouer la vraie distribution de popularité des adapters. Des IDs tirés uniformément au hasard créent un problème de cache différent d’une charge avec quelques adapters populaires et beaucoup d’adapters peu fréquents.
Paramètres du launcher qui modifient le working set
Ces arguments du launcher décident combien d’adapters restent sur le GPU, quelle mémoire ils reçoivent et si le chargement est fixe ou dynamique. Les valeurs ci-dessous ont été vérifiées le 8 octobre 2026 sur main à a7394ba ; la référence du launcher liste tous les arguments.
| Paramètre | Défaut | Modifiez-le quand |
|---|---|---|
--preloaded-adapter-ids | aucun | vous voulez un ensemble préchargé fixe et acceptez de désactiver le chargement dynamique des adapters |
--max-active-adapters | 1024 | vous devez plafonner le nombre d’adapters pouvant être sur le GPU et accepter des requêtes en même temps |
--adapter-memory-fraction | 0.1 | les GPU hits sont rares ; l’augmenter garde plus d’adapters sur le GPU et réduit le KV cache |
--adapter-cycle-time-s | 2 | les échanges sont trop fréquents (renouvellement du cache) ou trop lents (requêtes en file pour des adapters déchargés) |
--quantize | off | le modèle de base laisse trop peu de mémoire GPU pour les adapters et le KV cache |
Le préchargement et le chargement dynamique sont des modes distincts. v0.12.1 comme main vérifié refusent les nouveaux adapters dynamiques après l’enregistrement d’un ensemble préchargé. Main met aussi à zéro la réservation mémoire des adapters dynamiques lorsque des IDs préchargés sont présents ; v0.12.1 n’applique pas cette modification du launcher.
Pour le serving dynamique à longue traîne, omettez --preloaded-adapter-ids et réchauffez les adapters populaires par des requêtes ordinaires autorisées après le démarrage. Les paramètres mémoire et de planification influent sur leur durée de résidence ; les réchauffer ne les épingle pas. Choisissez ces valeurs avec le rejeu de « Un test d’acceptation en production » plus bas.
Déployer le chart du dépôt avec prudence
Il vous faut un cluster avec des nœuds GPU qui exposent nvidia.com/gpu via le device plugin NVIDIA ou le GPU Operator, ainsi que kubectl et helm sur votre poste. Le chart demande cette ressource ; sur un cluster qui ne l’a pas, le pod reste en Pending.
Le dépôt contient charts/lorax ; le point de départ reproductible est donc une révision épinglée du dépôt et un chart local :
git clone https://github.com/predibase/lorax.git
cd lorax
git checkout <reviewed-commit-or-release>

helm dependency update charts/lorax
helm template lorax charts/lorax -f values.production.yaml
helm upgrade --install lorax charts/lorax \
    --namespace inference \
    --create-namespace \
    -f values.production.yaml
Le chart nomme le Deployment lorax-<release> et le Service d’après service.name (lorax par défaut). Attendez le rollout, suivez les logs jusqu’au chargement du modèle de base, puis redirigez le port du Service et relancez les requêtes curl de la section locale vers 127.0.0.1:8080 :
kubectl -n inference rollout status deploy/lorax-lorax
kubectl -n inference logs -f deploy/lorax-lorax
kubectl -n inference port-forward svc/lorax 8080:80

# remove the release when you are done
helm uninstall lorax -n inference
Tel que vérifié le 8 octobre 2026, les values du chart et le template du Deployment à a7394ba montrent ces valeurs par défaut :
- le tag d’image est
latest /dataest unemptyDir: le remplacement d’un pod supprime les artifacts téléchargés- les probes de liveness et de readiness sont vides
- le token Hugging Face est modélisé comme une valeur littérale d’environnement
- un GPU est demandé par défaut
Utilisez le chart comme template de départ et ajoutez les paramètres de production ci-dessous.
Partir de la vraie structure des values du chart
Le chart range la configuration du runtime sous deployment, et les arguments du launcher forment une liste de paires nom/valeur. Une surcouche minimale définit seulement les différences avec les valeurs ci-dessus : un digest d’image testé, le modèle, le token du Hub issu d’un Secret et une readiness probe. Enregistrez-la sous values.production.yaml et remplacez les paramètres fictifs de tag et de digest par une référence d’image vérifiée. Un réplica, un GPU et un Service ClusterIP sur le port 80 sont déjà les valeurs par défaut.
La surcouche suppose qu’un Secret lorax-hub avec une clé token existe déjà dans le namespace inference. Créez-le avant l’installation si le modèle exige des identifiants Hub ; sinon, retirez l’entrée env.
deployment:
    image:
        repository: ghcr.io/predibase/lorax
        tag: "<tested-release-tag>@sha256:<verified-image-digest>"

    args:
        - name: "--model-id"
          value: "mistralai/Mistral-7B-Instruct-v0.1"

    env:
        - name: HUGGING_FACE_HUB_TOKEN
          valueFrom:
              secretKeyRef:
                  name: lorax-hub
                  key: token

    readinessProbe:
        httpGet:
            path: /health
            port: http
        periodSeconds: 5
        failureThreshold: 600
Helm remplace toute la liste args. La valeur par défaut du chart définit aussi des limites de tokens (--max-input-length, --max-total-tokens, --max-batch-total-tokens, --max-batch-prefill-tokens), --compile et --eager-prefill false ; copiez ceux que vous voulez garder. Dimensionnez les limites de tokens à partir de prompts représentatifs, de la concurrence attendue, de la mémoire GPU et de tests de charge. Les paramètres de working set du tableau ci-dessus vont dans la même liste.
Combler explicitement les manques
Le template vérifié passe deployment.env par toYaml ; une surcouche de values normale peut donc utiliser valueFrom.secretKeyRef pour les identifiants Hub, comme ci-dessus. Il formate l’image en repository:tag, qui accepte le tag accompagné du digest montré plus haut : Kubernetes utilise le digest pour télécharger quand les deux sont présents. Le chart codifie en dur les volumes emptyDir et n’a pas de point d’entrée pour startupProbe. Un /data durable et une startup probe exigent donc un fork relu du chart, un patch post-render ou une couche de manifestes supérieure.
Une surcouche de values peut définir le tag d’image avec son digest, les arguments du launcher, les requêtes et limites GPU, l’env (y compris secretKeyRef), les liveness et readiness probes, ainsi que le type et le port du Service. Utilisez cette couche de production pour :
- un PersistentVolumeClaim ou un cache d’artifacts local au nœud, monté sur
/data - une startup probe avant toute liveness probe agressive
- une politique de disruption des pods et un topology spread pour plusieurs réplicas
- une NetworkPolicy, des restrictions sur le service account et une gateway authentifiée
- des vérifications d’intégrité des artifacts
Ne placez pas de token du Hub directement dans un fichier de values versionné. Deux réplicas n’offrent une haute disponibilité utile que si les deux peuvent charger le modèle de base. Le routeur doit aussi éviter d’envoyer chaque adapter à froid aux deux pods.
Router pour la localité du cache
Un équilibrage round-robin peut transformer chaque réplica en cache froid. Un bon routeur associe un ID d’adapter autorisé à un réplica par hash ou par une autre règle stable. Il garde un chemin de bascule pour les moments où ce réplica est indisponible. La figure rejoue six requêtes pour deux adapters sous les deux règles.
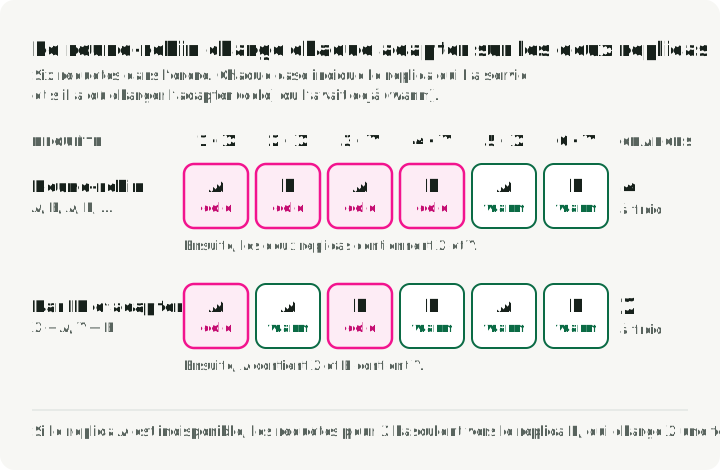
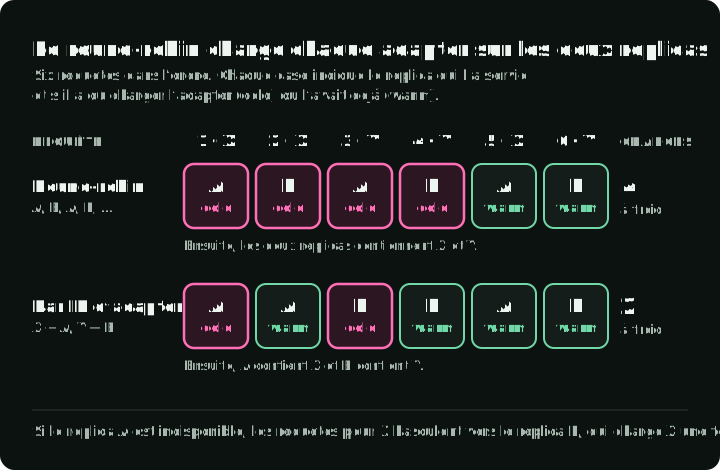
La clé de routage doit venir de l’état authentifié de l’application, pas d’un paramètre d’URL public arbitraire. Sinon, un appelant peut forcer des téléchargements distants, faire tourner les caches ou sonder les noms d’adapters privés.
LoRAX ou vLLM ?
La documentation vLLM vérifiée le 8 octobre 2026 décrit des modules LoRA déclarés au démarrage et un chargement dynamique via des endpoints ou des plugins de résolution. Elle avertit que la mise à jour des adapters à l’exécution présente des risques de sécurité et ne doit pas être utilisée en production en dehors d’un environnement isolé et de confiance.
Le tableau compare la façon dont chaque runtime trouve, conserve et sert les adapters :
| Question | LoRAX | vLLM |
|---|---|---|
| Comment les adapters de la longue traîne sont-ils découverts ? | L’ID d’adapter peut résoudre des artifacts Hugging Face, Predibase, S3 ou de chemin local à la demande | Modules statiques, endpoints de gestion dynamiques ou plugins de résolution |
| Comment la résidence est-elle gérée ? | Planification des échanges ; rechargement depuis les fichiers en cache ou les tenseurs hôte conservés, selon le chargeur | Limites configurées de LoRA actifs et en CPU, plus le comportement du resolver |
| Quelle est l’interface de requête ? | /generate de style TGI, client Python et chat compatible OpenAI | Serving compatible OpenAI et APIs Python natives |
| Qu’est-ce qui doit décider ? | Latence à froid/à chaud, renouvellement du cache, débit des batches hétérogènes et adéquation opérationnelle | Le même replay de charge et les mêmes critères opérationnels |
Évitez les règles du type « LoRAX pour 1 000 adapters, vLLM pour dix ». La taille du catalogue ne détermine pas à elle seule la performance. Comparez les deux avec le même modèle de base, les mêmes adapters, prompts, rangs, trace d’arrivée et matériel.
Un test d’acceptation en production
Avant d’étendre le catalogue, lancez un replay qui comprend :
- Un ensemble chaud fixe pour établir le débit et la latence à chaud.
- Une distribution à longue traîne pour mesurer les accès aux artifacts en cache et aux tenseurs hôte conservés, si le chargeur le permet.
- Une rafale d’adapters jamais vus mais présents dans l’allowlist.
- Un remplacement de pod pour mesurer la reprise du modèle de base et des adapters.
- Un adapter indisponible ou corrompu pour vérifier l’isolation et le repli.
- Des tenants concurrents pour vérifier l’authentification, les quotas et les labels de métriques.
Suivez ces métriques :
- débit de requêtes
- temps d’attente en file
- temps jusqu’au premier token
- latence inter-token
- latence totale
- temps de chargement des adapters
- classe de cache hit
- mémoire GPU
- mémoire CPU
- octets téléchargés
- échecs par cause
Gardez les IDs d’adapters hors des labels de métriques non bornés. Associez-les à des dimensions contrôlées ou à des traces échantillonnées.
Définissez les seuils d’acceptation avant le test. Fixez un taux d’erreur maximal sur le chemin à froid et un objectif de P99 à chaud. Fixez aussi un objectif de taux de cache hit pour la distribution de popularité observée, et un objectif de temps de reprise après la perte d’un pod.
Conclusion
LoRAX sert de nombreux fine-tunes compatibles sans multiplier les copies séparées du modèle de base. Cela peut être une architecture utile pour les charges à longue traîne, mais cela ne rend pas le coût ni la latence constants par définition. Le working set actif, le chemin d’échange, le mélange des batches et la couche de stockage fixent encore le résultat.
Prouvez d’abord ces mécanismes sur un seul GPU. Ensuite, sur Kubernetes : épinglez les artifacts, préservez le cache, protégez les identifiants, autorisez les adapters, routez pour la localité et mesurez chaque chemin de résidence. Si LoRAX bat une configuration vLLM actuelle sur le même replay, la décision de déploiement repose sur des preuves.
Références
- Dépôt et README de LoRAX — fonctionnalités prises en charge, prérequis, APIs, client Python et chart Helm
- Sources d’adapters de LoRAX — chargement depuis le Hub, Predibase, en local et depuis S3
- Référence du launcher LoRAX — arguments de mémoire des adapters, d’échange, de préchargement et de quantization
- Rapport de lancement de LoRAX et benchmark 2023 — source et conditions du graphique de coûts
- Values du chart LoRAX et template du Deployment — valeurs par défaut actuelles et comportement des volumes
- Punica : Multi-Tenant LoRA Serving — le kernel SGMV pour les batches multi-adapters
- Text Generation Inference — le projet dont LoRAX est issu, désormais en mode maintenance
- Adapters LoRA dans vLLM — serving statique et dynamique d’adapters
- Article LoRA — méthode d’adaptation de bas rang
- Documentation PEFT de Hugging Face — formats d’adapters et intégration à l’entraînement