Руководство по LoRAX: LoRA-адаптеры в Kubernetes в масштабе

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Это руководство для инженеров по инференсу и платформе, которым нужно обслуживать много LoRA-вариантов одной базовой модели. Оно показывает, как проверить API LoRAX, оценить рабочий набор и превратить стартовый Helm-чарт в явный продакшен-план.
Одна базовая модель и множество LoRA-адаптеров создают необычную задачу сервинга. Базовые веса общие, но каждому запросу может понадобиться свой набор весов адаптера. Классическая схема «один деплой на вариант» впустую тратит память GPU, когда большинство вариантов простаивает.
LoRAX решает задачу длинного хвоста. Он загружает адаптеры по требованию, батчит запросы к разным адаптерам и меняет то, какие веса адаптеров занимают память GPU. Привлекательный заголовок звучит так: «тысячи файн-тюнингов на одном GPU». Инженерный вопрос уже: при вашем активном наборе адаптеров, профиле поступления запросов и целевой латентности достаточно ли помогает планирование обмена, чтобы оправдать ещё один рантайм сервинга?
Сервинг упирается в рабочий набор
LoRA замораживает базовую модель и обучает low-rank-обновления для выбранных матриц весов. Получившийся адаптер обычно намного меньше полного чекпоинта, но его размер всё равно зависит от ранга, целевых модулей, числа слоёв и dtype. Фиксированные утверждения вроде «каждый адаптер весит 100 МБ» плохо подходят как входные данные для планирования ёмкости.
Если у каждого файн-тюнинг-варианта свой деплой, каждый деплой держит полную копию базовых весов независимо от того, получает ли он трафик. Слева на рисунке показана эта схема. Справа показана одна базовая модель, которая загружает только адаптеры с запросами.
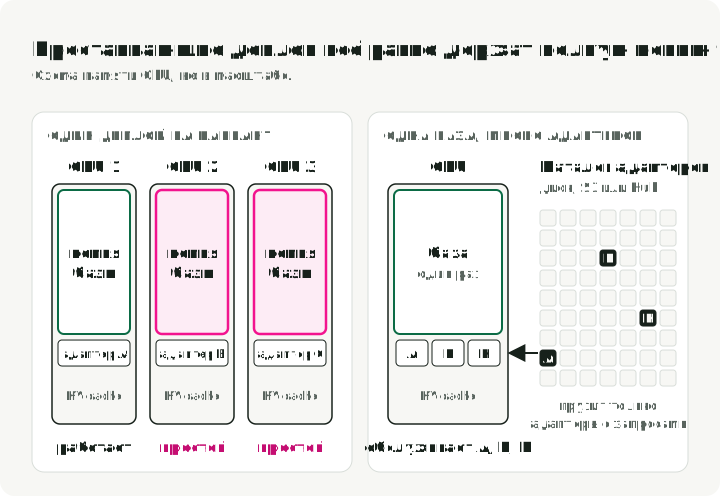
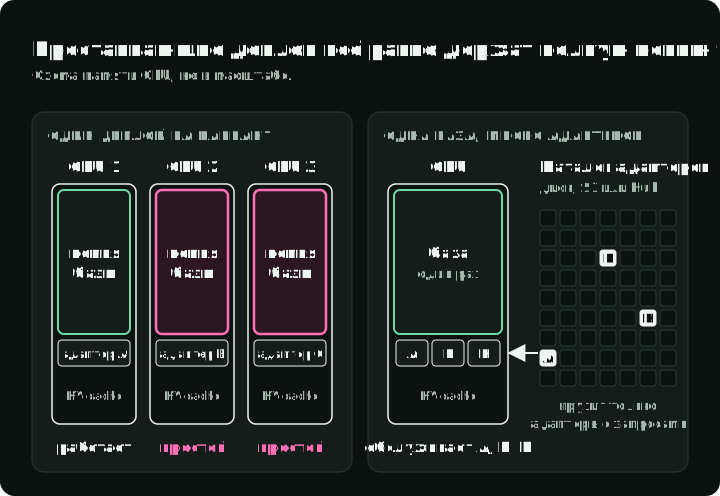
Для сервинга важно различать три величины:
- Размер каталога: все адаптеры, которые платформа может найти в хранилище
- Активный рабочий набор: адаптеры, получающие запросы в пределах окна удержания кэша
- Конкурентный набор: адаптеры, представленные в батчах в один и тот же момент
Каждый набор входит в предыдущий: конкурентный набор лежит внутри активного рабочего набора, а тот лежит внутри каталога. Планирование ёмкости начинается с активного рабочего набора. Например, в каталоге из 5 000 адаптеров за последний час могут быть активны 200, а в одном батче — 8.
В каталоге могут лежать тысячи адаптеров, но тысячи адаптеров не поместятся в VRAM. Важно, как часто меняется активный набор, насколько велики эти адаптеры и могут ли запросы к разным адаптерам образовывать полезные общие батчи.
LoRAX объединяет четыре механизма:
- Базовая модель остаётся в памяти для всех совместимых адаптеров.
- Запрос называет адаптер, который LoRAX находит в Hugging Face, Predibase, S3 или по локальному пути (параметр
adapter_source). - Планирование обмена адаптеров заранее подгружает адаптеры и освобождает веса на GPU, чтобы разместить другие. При следующей загрузке можно использовать кэшированные артефакты.
- Гетерогенный continuous batching группирует запросы к разным адаптерам.
LoRAX — форк Hugging Face Text Generation Inference (TGI), поэтому он сохраняет API /generate из TGI. Разные адаптеры в одном батче он применяет с помощью SGMV-ядер из проекта Punica. Эти ядра группируют строки, использующие разные матрицы адаптеров на каждом адаптированном слое. Реализация LoRAX выполняет отдельные сжимающую и расширяющую проекции: сначала в пространство низкого ранга, затем обратно в выходное пространство слоя.
На рисунке прослежены четыре запроса в продакшен-установке. Gateway перед LoRAX сначала проверяет тенанта и ID адаптера; почему это важно, объясняют разделы о безопасности ниже. Затем LoRAX находит адаптер. Если адаптера нет на GPU, LoRAX загружает кэшированные артефакты или скачивает недостающие файлы. Сохранённые тензоры хоста тоже можно использовать повторно, если загрузчик их удерживает. После этого он батчит запрос с запросами к другим адаптерам и стримит токены обратно.
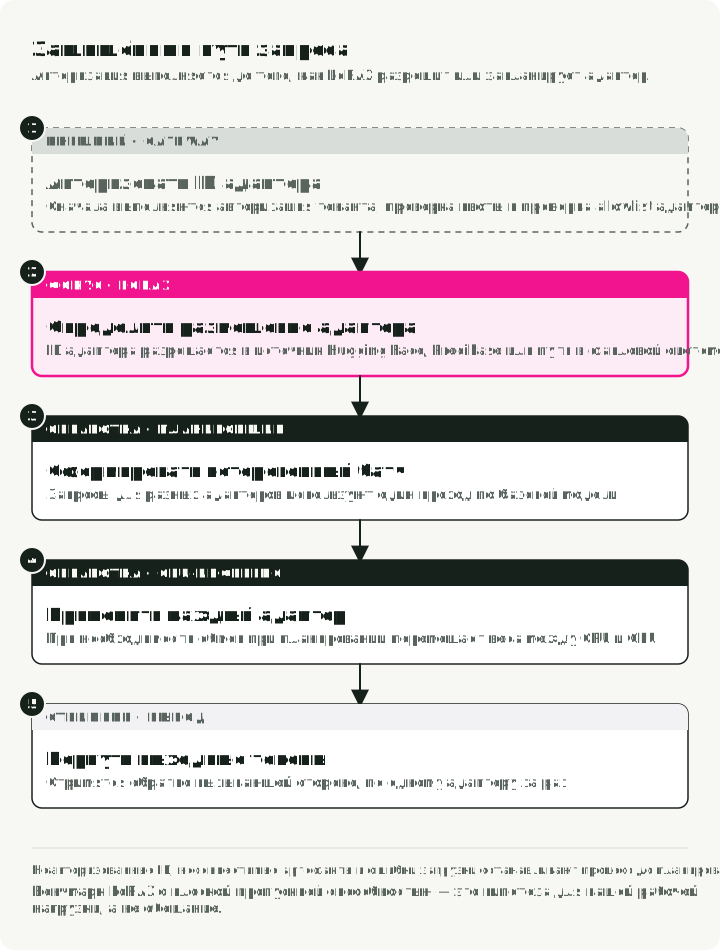
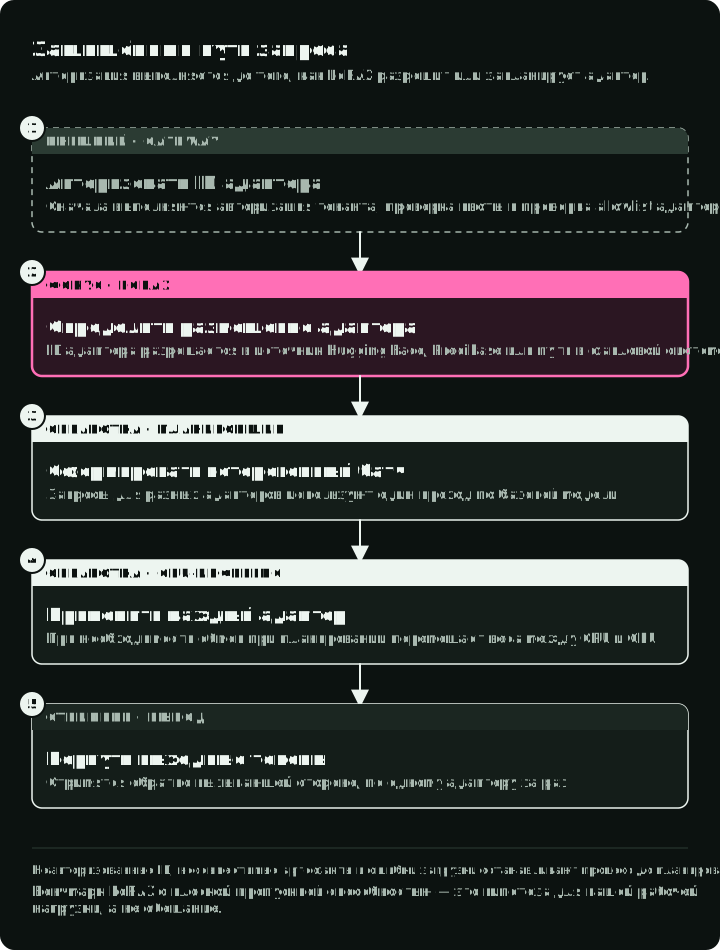
Проект LoRAX сообщает, что в его бенчмарках гетерогенный батчинг удерживает throughput и латентность почти постоянными при росте числа одновременных адаптеров. Относитесь к этому результату вендора как к гипотезе для вашей нагрузки. Длина промпта, длина вывода, ранг, целевые модули, заполненность батчей, частота вытеснения из кэша и поколение GPU могут изменить результат.
Диаграмма ниже взята из отчёта Predibase о запуске LoRAX в ноябре 2023 года. Predibase тестировала Llama 2 7B на одной NVIDIA A10G; запросы распределялись по 1–128 адаптерам. Диаграмма показывает сравнение стоимости для 1–32 адаптеров при обработке миллиона токенов, поделённого поровну между адаптерами.
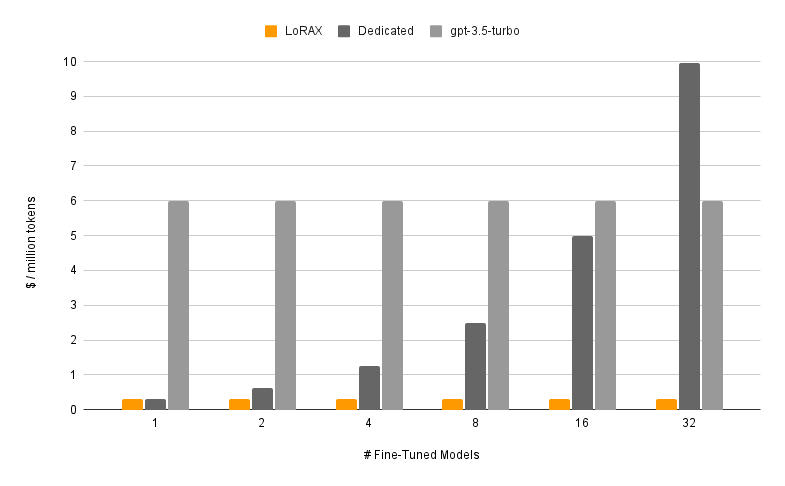
Архивное сравнение проекта из отчёта Predibase о LoRAX за 2023 год. Стоимость LoRAX и выделенных деплоев считается по GPU-часам из того эксперимента. С точностью до детализации источника линия GPT-3.5 Turbo использует стоимость токена файн-тюнинговой модели.
Плоские оранжевые столбцы — это результат конструкции бенчмарка, а не обещание текущей цены. Тест отправлял фиксированный объём в миллион токенов и позволял разным адаптерам делить батч. Базовый вариант с выделенными деплоями предполагал отдельные арендованные вычисления для каждой модели, поэтому его стоимость росла вместе с числом моделей.
Predibase не опубликовала состав токенов, длины запросов, размер батча, ранг адаптеров и цену GPU, поэтому значения в долларах воспроизвести нельзя.
Диаграмма также не охватывает разреженный трафик, холодные загрузки, текущие цены облаков, новые GPU, другие базовые модели и адаптеры с разными рангами. Считайте её поводом прогнать собственный трафик.
Когда LoRAX может подойти
Тестируйте LoRAX, когда выполняется всё из этого:
- адаптеры обучены на одной и той же поддерживаемой базовой модели и с тем же контрактом токенизатора
- трафик распределён по многим адаптерам, и длинный хвост заметен
- загрузка холодного адаптера по требованию предпочтительнее, чем резервирование под него отдельного деплоя
- роутинг по тенантам или задачам уже есть на границе приложения
- команда может эксплуатировать специализированный инференс-рантайм и его поведение кэша
- команда принимает рантайм с редкими апстрим-релизами
Типичные случаи: ассистенты для отдельных тенантов, много доменных вариантов и онлайн-эксперименты на общем базовом чекпоинте.
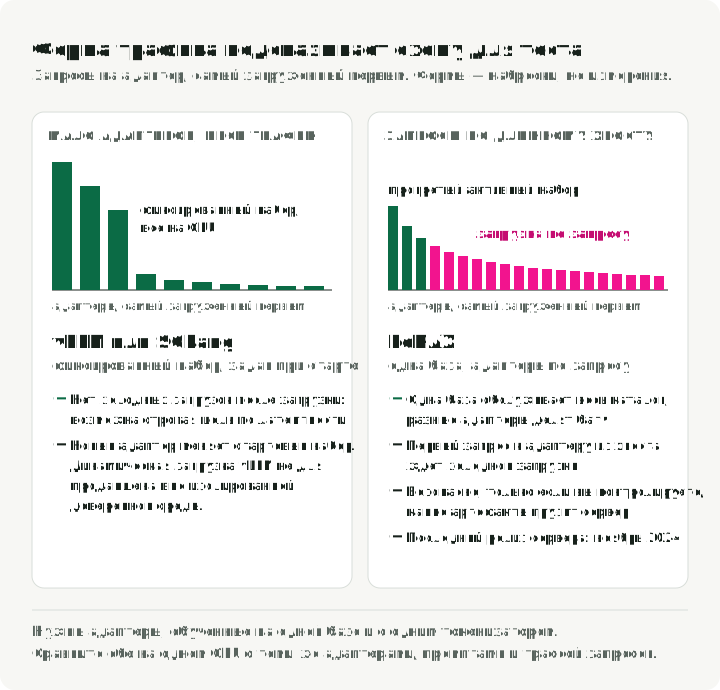
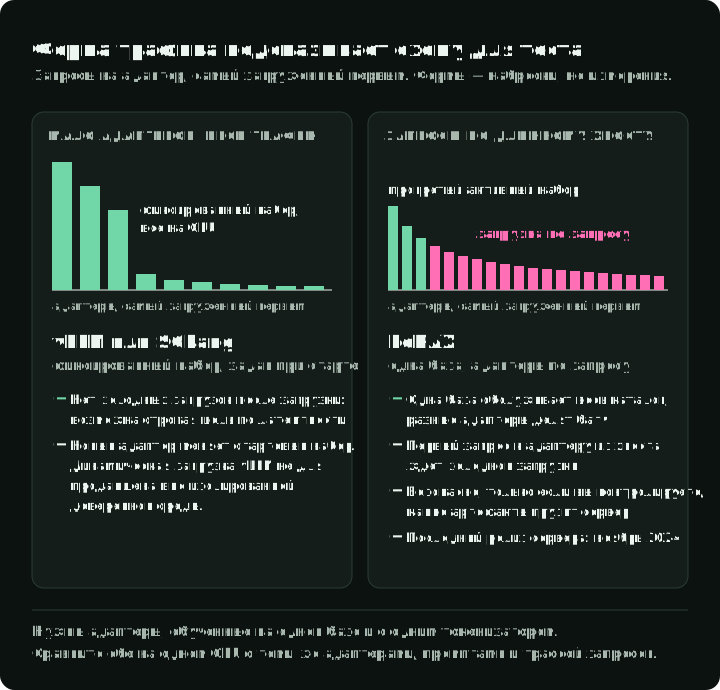
LoRAX подходит хуже, когда несколько адаптеров получают большую часть трафика или когда у моделей нет общей базы. Он подходит хуже и тогда, когда жёсткие цели по латентности не выдерживают холодных загрузок или когда платформа не может безопасно контролировать, какие артефакты загружает сервер. В таких случаях проще может оказаться обычный деплой vLLM или SGLang с фиксированным набором адаптеров. Фиксированный набор — выбор схемы деплоя: SGLang поддерживает и динамическую загрузку, как и vLLM ниже. Сам TGI теперь в режиме поддержки, и его мейнтейнеры рекомендуют vLLM или SGLang.
Проверьте активность проекта, прежде чем выбирать его. По состоянию на 8 октября 2026 года последний релиз сервера LoRAX — v0.12.1, ноябрь 2024 года. Регулярные коммиты в репозитории шли до апреля 2025 года, с тех пор были только два небольших исправления. Если вы принимаете LoRAX, планируйте самостоятельно вести обновления под новые модели, версии CUDA и исправления безопасности.
Рисунок сравнивает две схемы для тестирования в зависимости от распределения трафика: фиксированный набор, когда несколько адаптеров получают большинство запросов, и динамическую загрузку LoRAX для длинного хвоста. Прогретый активный набор в динамическом режиме всё ещё может вытесняться; это не фиксированный предзагруженный набор.
Не используйте Kubernetes только потому, что каталог велик. Сначала проверьте рантайм и совместимость адаптеров на одном GPU.
Попробуйте одну базу и один адаптер локально
README LoRAX рекомендует готовый контейнер. В реальном окружении используйте неизменяемый дайджест образа. Здесь указан main только потому, что это документированный тег быстрого старта репозитория. Проверяйте примеры на версиях образа и зависимостей, которые разворачиваете.
До запуска контейнера установите и настройте NVIDIA Container Toolkit для Docker. README LoRAX также требует Linux, Docker, NVIDIA GPU поколения Ampere или новее и драйверы, совместимые с CUDA 11.8. Лицензии моделей и репозитории с ограниченным доступом могут потребовать токен Hugging Face.
mkdir -p data

docker run --rm --gpus all --shm-size 1g \
    -p 127.0.0.1:8080:80 \
    -v "$PWD/data:/data" \
    ghcr.io/predibase/lorax:main \
    --model-id mistralai/Mistral-7B-Instruct-v0.1
Явный адрес хоста привязывает опубликованный порт к loopback; без него Docker по умолчанию публикует на всех адресах хоста. Используйте Docker 28 или новее: старые версии могут открывать опубликованные на localhost порты для хостов того же сегмента сети. Оставьте контейнер работающим в этом терминале. Во втором терминале дождитесь успешного curl --fail http://127.0.0.1:8080/health, прежде чем отправлять запросы.
Начните с базовой модели:
curl http://127.0.0.1:8080/generate \
    -H 'Content-Type: application/json' \
    -d '{
      "inputs": "[INST] Give one reason to measure cold-adapter latency. [/INST]",
      "parameters": {"max_new_tokens": 64}
    }'
Затем отправьте совместимый адаптер. Этот математический адаптер для GSM8K объявляет базой mistralai/Mistral-7B-Instruct-v0.1 — ту же модель, что запущена на сервере:
curl http://127.0.0.1:8080/generate \
    -H 'Content-Type: application/json' \
    -d '{
      "inputs": "[INST] Solve: Natalia sold 48 clips in April and half as many in May. What is the total? [/INST]",
      "parameters": {
        "max_new_tokens": 64,
        "adapter_id": "vineetsharma/qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k"
      }
    }'
Успешный ответ /generate — JSON-массив с generated_text; сгенерированный ответ зависит от модели и сэмплинга. Первый запрос к адаптеру может скачать и загрузить его. Следующие запросы могут использовать кэшированные артефакты и уже загруженные веса. Записывайте оба пути. Один тёплый запрос почти ничего не говорит о поведении длинного хвоста.
Адаптер выше взят из Hugging Face Hub. В продакшене загружайте адаптеры из хранилища, которое контролирует платформа. Документация по адаптерам описывает два таких источника: local для каталога внутри контейнера и s3 для URI S3, с учётными данными AWS в окружении. После копирования файлов адаптера в смонтированный каталог замените parameters в предыдущем запросе этим фрагментом:
"parameters": {
    "adapter_id": "/data/adapters/vineetsharma--qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k",
    "adapter_source": "local"
}
Python-клиент
Пакет lorax-client оборачивает /generate. Установите его командой pip install lorax-client==0.6.3. Один и тот же вызов работает с adapter_id и без него, поэтому на одном промпте можно сравнить базовую модель и адаптер:
from lorax import Client

client = Client("http://127.0.0.1:8080")

prompt = (
    "[INST] Natalia sold clips to 48 of her friends in April, and then she "
    "sold half as many clips in May. How many clips did Natalia sell "
    "altogether in April and May? [/INST]"
)

# Base model
print(client.generate(prompt, max_new_tokens=64).generated_text)

# Same prompt through the GSM8K adapter
adapter_id = "vineetsharma/qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k"
print(
    client.generate(prompt, max_new_tokens=64, adapter_id=adapter_id).generated_text
)
OpenAI-совместимый клиент
LoRAX также предоставляет OpenAI-совместимый эндпоинт чата. Установите клиент командой pip install openai==3.26.1. Поле model указывает адаптер:
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://127.0.0.1:8080/v1",
)

response = client.chat.completions.create(
    model="vineetsharma/qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k",
    messages=[
        {"role": "user", "content": "Explain cache locality in two sentences."},
    ],
    max_tokens=100,
)

print(response.choices[0].message.content)
По умолчанию сервер не требует API-ключа. Для localhost это удобно, а в конфигурации, открытой в интернет, небезопасно. Поставьте перед ним аутентификацию, авторизацию тенантов, квоты и allowlist адаптеров.
Проверяйте совместимость адаптера при регистрации
Прежде чем адаптер попадёт в каталог, проверьте как минимум:
- объявленную базовую модель и ревизию
- совместимость токенизатора и chat-шаблона
- ранг LoRA и целевые модули, которые поддерживает рантайм
- формат артефакта и формы тензоров
- лицензию, происхождение и контрольный дайджест целостности
- небольшой набор поведенческих и регрессионных тестов
Отклоняйте несовместимые артефакты при регистрации, а не при первом запросе пользователя.
Разберитесь с размещением до деплоя
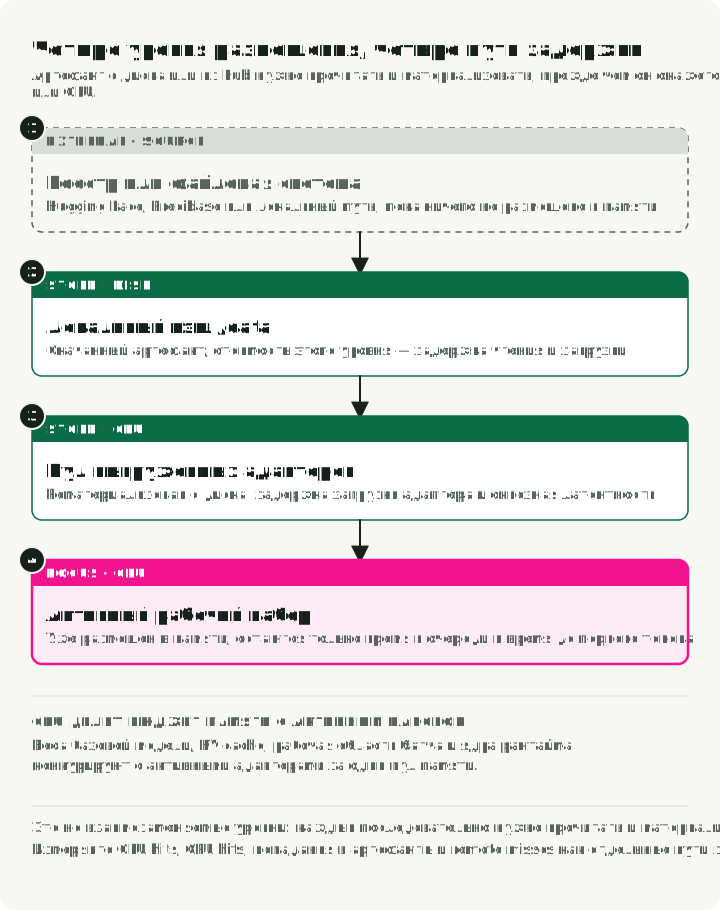
Базовая модель занимает самую большую фиксированную долю памяти GPU. Веса адаптеров, KV cache, рабочее пространство батча и рантайм-ядра делят остаток. /data хранит скачанные артефакты. Оперативная память CPU может хранить материализованные тензоры адаптеров, но только если загрузчик их удерживает.
В проверенной реализации main на a7394ba стандартный загрузчик одиночного адаптера кэширует ссылки на файлы. Выгрузка удаляет веса GPU из карт адаптеров; последующий запрос может снова прочитать и материализовать кэшированные файлы. Стандартный загрузчик в v0.12.1 тоже использует ссылки на файлы. Объединённая или неленивая загрузка и файловый кэш ОС могут работать иначе, поэтому не считайте каждую выгрузку попаданием в сохранённые тензоры CPU.
Это разные состояния для измерений. Артефакт с диска или Hub нужно прочитать и материализовать, прежде чем он станет адаптером в памяти CPU или GPU. Рисунок показывает четыре возможных пути из таблицы ниже как полосы времени; путь CPU применим только при сохранении тензоров хоста. Каждый дополнительный шаг загрузки добавляет работу до первого токена.
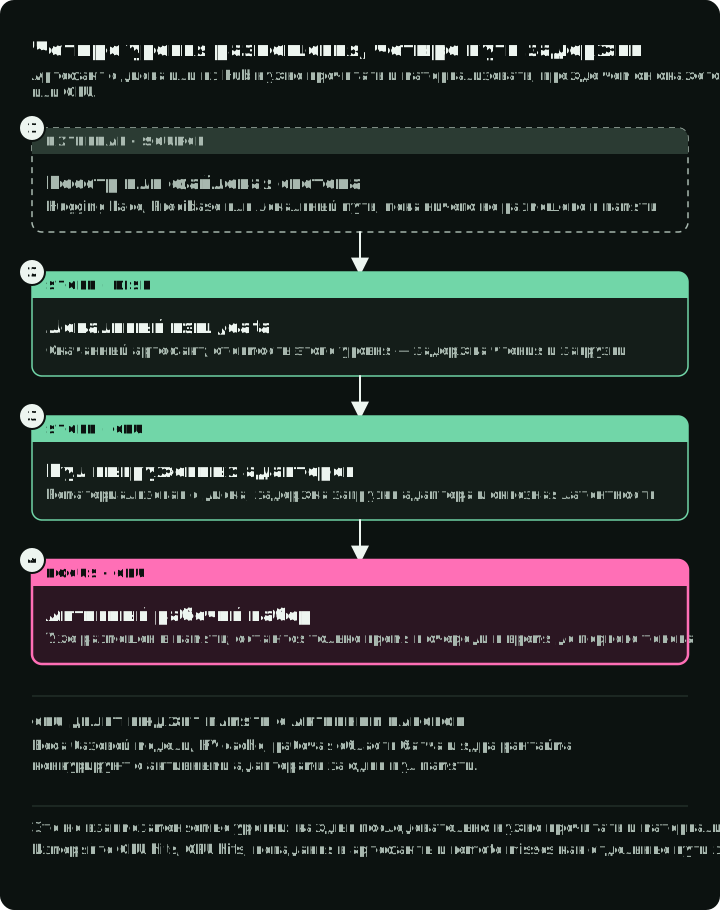
Измеряйте переходы по отдельности:
| Путь | Что входит | Метрика для записи |
|---|---|---|
| GPU hit | Адаптер уже в памяти | время в очереди и время до первого токена |
| CPU hit | Передача сохранённых тензоров хоста, если они доступны | задержка загрузки адаптера и сквозная латентность |
| Artifact hit | Чтение из локального кэша /data | задержка чтения и загрузки, объём кэша в байтах |
| Remote miss | Скачивание плюс валидация и загрузка | время скачивания, сбои и полная холодная латентность |
Планирование ёмкости должно прогонять реальное распределение популярности адаптеров. Равномерно случайные ID адаптеров создают другую задачу для кэша, чем нагрузка с несколькими популярными адаптерами и множеством редко используемых.
Настройки лаунчера, которые меняют рабочий набор
Эти аргументы лаунчера решают, сколько адаптеров остаётся на GPU, сколько памяти они получают и будет ли загрузка фиксированной или динамической. Значения ниже проверены 8 октября 2026 года на main на a7394ba; справочник по лаунчеру перечисляет все аргументы.
| Настройка | По умолчанию | Меняйте, когда |
|---|---|---|
--preloaded-adapter-ids | нет | нужен фиксированный предзагруженный набор и допустимо отключить динамическую загрузку адаптеров |
--max-active-adapters | 1024 | нужно ограничить, сколько адаптеров могут одновременно быть на GPU и принимать запросы |
--adapter-memory-fraction | 0.1 | мало GPU hit; увеличение доли держит на GPU больше адаптеров и уменьшает KV cache |
--adapter-cycle-time-s | 2 | обмены происходят слишком часто (вытеснение из кэша) или слишком медленно (запросы к выгруженным адаптерам ждут) |
--quantize | выкл. | базовая модель оставляет слишком мало памяти GPU под адаптеры и KV cache |
Предзагрузка и динамическая загрузка — разные режимы. И v0.12.1, и проверенный main отклоняют новые динамические адаптеры после регистрации предзагруженного набора. Main дополнительно обнуляет резерв памяти динамических адаптеров при наличии предзагруженных ID; v0.12.1 не применяет это изменение лаунчера.
Для динамического сервинга длинного хвоста не указывайте --preloaded-adapter-ids и прогревайте популярные адаптеры обычными авторизованными запросами после старта. Настройки памяти и планирования влияют на срок пребывания в памяти; прогрев не закрепляет адаптеры. Подбирайте значения прогоном из раздела «Приёмочный тест для продакшена» ниже.
Аккуратно разворачивайте чарт из репозитория
Вам нужен кластер с GPU-узлами, которые предоставляют nvidia.com/gpu через device plugin NVIDIA или GPU Operator, а также kubectl и helm на рабочей машине. Чарт запрашивает этот ресурс, поэтому в кластере без него под остаётся в состоянии Pending.
В репозитории есть charts/lorax, поэтому воспроизводимая отправная точка — зафиксированная ревизия репозитория и локальный чарт:
git clone https://github.com/predibase/lorax.git
cd lorax
git checkout <reviewed-commit-or-release>

helm dependency update charts/lorax
helm template lorax charts/lorax -f values.production.yaml
helm upgrade --install lorax charts/lorax \
    --namespace inference \
    --create-namespace \
    -f values.production.yaml
Чарт называет Deployment lorax-<release>, а Service — по service.name (по умолчанию lorax). Дождитесь раскатки, следите за логами, пока не загрузится базовая модель, затем пробросьте порт Service и повторите запросы curl из локального раздела к 127.0.0.1:8080:
kubectl -n inference rollout status deploy/lorax-lorax
kubectl -n inference logs -f deploy/lorax-lorax
kubectl -n inference port-forward svc/lorax 8080:80

# remove the release when you are done
helm uninstall lorax -n inference
По проверке от 8 октября 2026 года значения чарта и шаблон Deployment на a7394ba задают такие значения по умолчанию:
- тег образа —
latest /data— этоemptyDir, поэтому при замене пода скачанные артефакты теряются- liveness- и readiness-пробы пустые
- токен Hugging Face моделируется как литеральное значение переменной окружения
- по умолчанию запрашивается один GPU
Используйте чарт как стартовый шаблон и добавьте продакшен-настройки ниже.
Начните со структуры значений самого чарта
Чарт вкладывает конфигурацию рантайма в deployment, а аргументы лаунчера — это список пар имя/значение. Минимальный overlay задаёт только отличия от значений выше: проверенный дайджест образа, модель, токен Hub из Secret и readiness-пробу. Сохраните его как values.production.yaml и замените заглушки тега и дайджеста проверенной ссылкой на образ. Одна реплика, один GPU и Service типа ClusterIP на порту 80 уже заданы по умолчанию.
Overlay предполагает, что Secret lorax-hub с ключом token уже существует в пространстве имён inference. Создайте его до установки, если модель требует учётных данных Hub; иначе удалите запись env.
deployment:
    image:
        repository: ghcr.io/predibase/lorax
        tag: "<tested-release-tag>@sha256:<verified-image-digest>"

    args:
        - name: "--model-id"
          value: "mistralai/Mistral-7B-Instruct-v0.1"

    env:
        - name: HUGGING_FACE_HUB_TOKEN
          valueFrom:
              secretKeyRef:
                  name: lorax-hub
                  key: token

    readinessProbe:
        httpGet:
            path: /health
            port: http
        periodSeconds: 5
        failureThreshold: 600
Helm заменяет список args целиком. Чарт по умолчанию также задаёт лимиты токенов (--max-input-length, --max-total-tokens, --max-batch-total-tokens, --max-batch-prefill-tokens), --compile и --eager-prefill false; скопируйте те, что хотите сохранить. Подбирайте лимиты токенов по репрезентативным промптам, ожидаемой конкурентности, памяти GPU и load tests. Настройки рабочего набора из таблицы выше добавляются в тот же список.
Явно закройте пробелы
Проверенный шаблон чарта пропускает deployment.env через toYaml, поэтому обычный overlay значений может использовать valueFrom.secretKeyRef для учётных данных Hub, как выше. Он формирует образ как repository:tag, что допускает показанное выше значение тега с дайджестом: Kubernetes использует дайджест для скачивания, когда указаны оба. Чарт жёстко задаёт тома emptyDir и не имеет хука startupProbe. Поэтому постоянный /data и startup-проба требуют проверенного форка чарта, post-render патча или слоя манифестов более высокого уровня.
Overlay значений может задать тег образа с дайджестом, аргументы лаунчера, запросы и лимиты GPU, env (включая secretKeyRef), liveness- и readiness-пробы, а также тип и порт Service. Используйте продакшен-слой для:
- PersistentVolumeClaim или локальный кэш артефактов на узле, смонтированный в
/data - startup-проба перед агрессивной liveness-пробой
- политика прерываний (pod disruption) и topology spread для нескольких реплик
- NetworkPolicy, ограничения service account и аутентифицированный gateway
- проверки целостности артефактов
Не кладите токен Hub прямо в закоммиченный файл значений. Две реплики дают реальную высокую доступность, только если обе могут загрузить базовую модель. Роутер также не должен отправлять каждый холодный адаптер на оба пода.
Маршрутизируйте с учётом локальности кэша
Балансировка round-robin может превратить каждую реплику в холодный кэш. Полезный роутер отображает разрешённый ID адаптера на одну реплику по хешу или другому стабильному правилу. Он сохраняет путь резервного переключения на случай, когда эта реплика недоступна. Рисунок воспроизводит шесть запросов к двум адаптерам при обоих правилах.
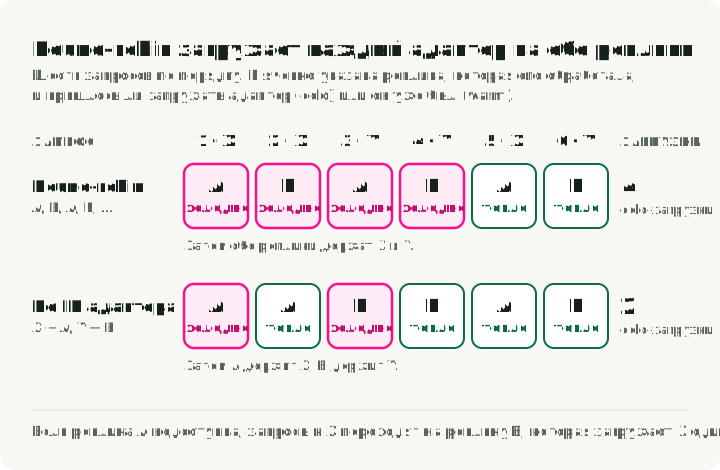
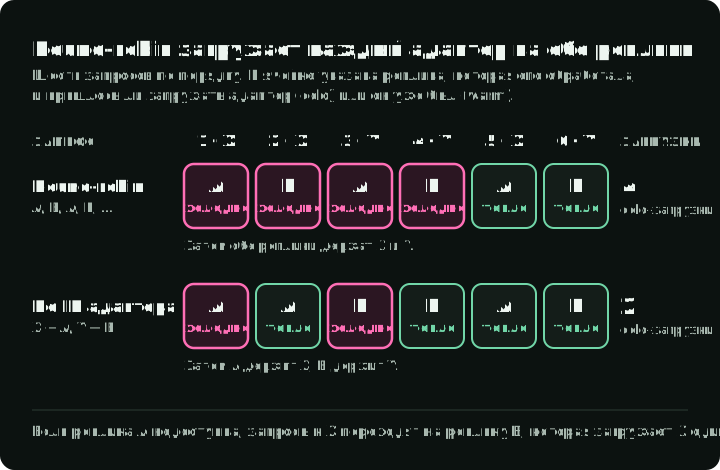
Ключ маршрутизации должен браться из аутентифицированного состояния приложения, а не из произвольного параметра публичного URL. Иначе вызывающая сторона сможет вызывать удалённые скачивания, вытеснять кэши и подбирать имена приватных адаптеров.
LoRAX или vLLM?
Документация vLLM, проверенная 8 октября 2026 года, описывает LoRA-модули, объявляемые при старте, и динамическую загрузку через эндпоинты или плагины-резолверы. Она предупреждает, что обновление адаптеров в рантайме небезопасно и не должно использоваться в продакшене вне изолированного доверенного окружения.
Таблица сравнивает, как каждый рантайм находит, хранит и обслуживает адаптеры:
| Вопрос | LoRAX | vLLM |
|---|---|---|
| Как находятся адаптеры из длинного хвоста? | ID адаптера может разрешаться в артефакты Hugging Face, Predibase, S3 или локального пути по запросу | Статические модули, динамические эндпоинты управления или плагины-резолверы |
| Как управляется размещение? | Планирование обмена; повторная загрузка использует кэшированные файлы или сохранённые тензоры хоста в зависимости от загрузчика | Настроенные лимиты активных и CPU LoRA плюс поведение резолвера |
| Какой интерфейс запросов? | /generate в стиле TGI, Python-клиент и OpenAI-совместимый chat | OpenAI-совместимый сервинг и нативные Python API |
| Что должно решать? | Холодная и тёплая латентность, вытеснение из кэша, throughput гетерогенных батчей и эксплуатационная пригодность | Тот же прогон нагрузки и те же эксплуатационные критерии |
Избегайте правил вроде «LoRAX для 1000 адаптеров, vLLM для десяти». Один размер каталога не определяет производительность. Тестируйте оба рантайма на одной базе, одних адаптерах, промптах, рангах, трейсе поступления запросов и железе.
Приёмочный тест для продакшена
Прежде чем расширять каталог, прогоните нагрузку, которая включает:
- Фиксированный горячий набор, чтобы определить тёплый throughput и латентность.
- Распределение с длинным хвостом, чтобы измерить попадания в кэш артефактов и сохранённые тензоры хоста, если загрузчик это поддерживает.
- Всплеск ранее не виденных, но разрешённых адаптеров.
- Замену пода, чтобы измерить восстановление базы и адаптеров.
- Один недоступный или повреждённый адаптер, чтобы проверить изоляцию и резервный путь обработки.
- Несколько одновременных тенантов, чтобы проверить аутентификацию, квоты и метки метрик.
Отслеживайте такие метрики:
- частота запросов
- время в очереди
- время до первого токена
- межтокенная латентность
- полная латентность
- время загрузки адаптера
- класс попадания в кэш
- память GPU
- память CPU
- скачанные байты
- сбои по причинам
Не используйте ID адаптеров как неограниченные метки метрик. Отображайте их в контролируемые измерения или семплированные трейсы.
Определите пороги приёмки до теста. Задайте максимальную долю ошибок на холодном пути и целевое значение P99 на тёплом. Задайте также целевую долю попаданий в кэш для наблюдаемого распределения популярности и целевое время восстановления после потери пода.
Заключение
LoRAX обслуживает много совместимых файн-тюнингов без множества отдельных копий базовой модели. Для нагрузок с длинным хвостом это может быть полезное решение, но оно не делает стоимость или латентность постоянными по определению. Результат по-прежнему определяют активный рабочий набор, путь обмена, состав батчей и слой хранения.
Сначала докажите эти механики на одном GPU. Затем в Kubernetes: зафиксируйте артефакты, сохраняйте кэш, защитите учётные данные, авторизуйте адаптеры, маршрутизируйте с учётом локальности и измеряйте каждый путь размещения. Если LoRAX обходит актуальную конфигурацию vLLM на том же прогоне нагрузки, у решения о деплое есть доказательства.
Источники
- Репозиторий и README LoRAX — поддерживаемые возможности, требования, API, Python-клиент и Helm-чарт
- Источники адаптеров LoRAX — загрузка из Hub, Predibase, локально и из S3
- Справочник по лаунчеру LoRAX — аргументы памяти адаптеров, обмена, предзагрузки и квантизации
- Отчёт о запуске LoRAX и бенчмарк 2023 года — источник и условия диаграммы стоимости
- Значения чарта LoRAX и шаблон Deployment — текущие значения по умолчанию и поведение томов
- Punica: Multi-Tenant LoRA Serving — SGMV-ядро для батчей из разных адаптеров
- Text Generation Inference — проект, от которого LoRAX сделан форк; сейчас в режиме поддержки
- LoRA-адаптеры в vLLM — статический и динамический сервинг адаптеров
- Статья о LoRA — метод low-rank adaptation
- Документация Hugging Face PEFT — форматы адаптеров и интеграция с обучением