Przewodnik po LoRAX: adaptery LoRA na Kubernetes w dużej skali

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Ten przewodnik jest dla inżynierów inferencji i platform, którzy muszą obsługiwać wiele wariantów LoRA z jednego modelu bazowego. Pokazuje, jak przetestować API LoRAX, oszacować zbiór roboczy i zamienić startowy chart Helm w jawny plan produkcyjny.
Jeden model bazowy i wiele adapterów LoRA tworzą nietypowy problem serwowania. Wagi bazowe są wspólne, ale każde żądanie może wymagać innego zestawu wag adaptera. Klasyczny projekt z jednym wdrożeniem na wariant marnuje pamięć GPU, gdy większość wariantów jest bezczynna.
LoRAX obsługuje ten długi ogon. Ładuje adaptery na żądanie, grupuje w partie żądania do różnych adapterów i wymienia wagi adapterów zajmujące pamięć GPU. Chwytliwy nagłówek brzmi: „tysiące dostrojonych modeli na jednym GPU”. Pytanie inżynierskie jest węższe: czy przy twoim aktywnym zestawie adapterów, wzorcu napływu żądań i docelowym opóźnieniu planowanie wymiany pomaga na tyle, by uzasadnić kolejne środowisko serwowania?
Problemem serwowania jest zbiór roboczy
LoRA zamraża model bazowy i uczy aktualizacji niskiego rzędu dla wybranych macierzy wag. Powstały adapter jest zwykle znacznie mniejszy niż pełny checkpoint, ale jego rozmiar nadal zależy od rzędu, modułów docelowych, liczby warstw i dtype. Stałe twierdzenia w rodzaju „każdy adapter ma 100 MB” są złymi danymi do planowania pojemności.
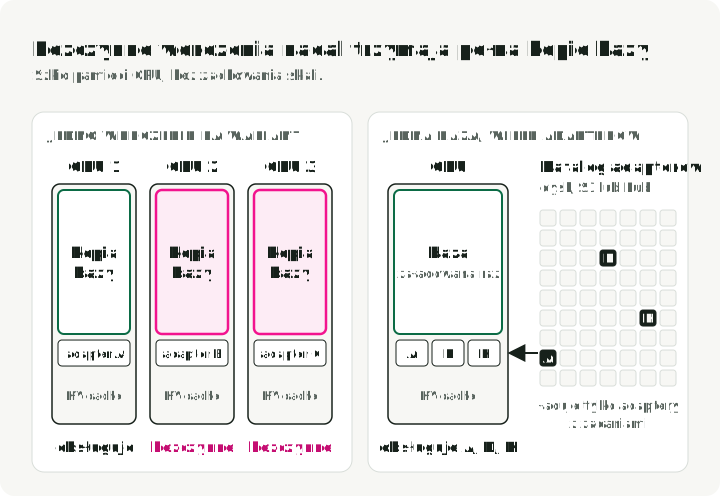
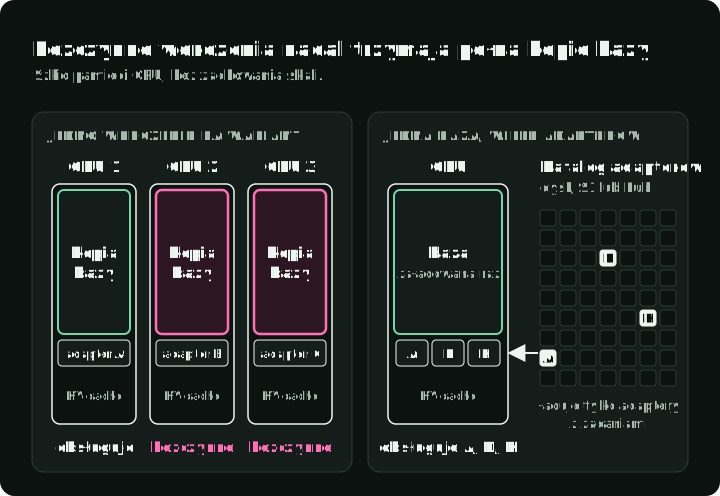
Jeśli każdy dostrojony wariant dostaje własne wdrożenie, każde wdrożenie trzyma pełną kopię wag bazowych, niezależnie od tego, czy dostaje ruch. Lewa strona rysunku pokazuje taki projekt. Prawa strona pokazuje jeden model bazowy, który ładuje tylko adaptery otrzymujące żądania.
Przy serwowaniu rozróżniaj trzy wielkości:
- Rozmiar katalogu: każdy adapter, który platforma potrafi pobrać z magazynu
- Aktywny zbiór roboczy: adaptery otrzymujące żądania w oknie retencji cache
- Zbiór współbieżny: adaptery reprezentowane w partiach w tej samej chwili
Każdy zbiór jest podzbiorem poprzedniego: zbiór współbieżny leży wewnątrz aktywnego zbioru roboczego, a ten wewnątrz katalogu. Planowanie pojemności zaczyna się od aktywnego zbioru roboczego. Na przykład w katalogu 5000 adapterów 200 może być aktywnych w ostatniej godzinie, a 8 w jednej partii.
Katalog może zawierać tysiące adapterów, a w VRAM nie zmieści się tysięcy. Liczy się to, jak często zmienia się zbiór aktywny, jak duże są te adaptery i czy żądania do różnych adapterów mogą współdzielić użyteczne partie.
LoRAX łączy cztery mechanizmy:
- Model bazowy pozostaje w pamięci dla wszystkich zgodnych adapterów.
- Żądanie wskazuje adapter, który LoRAX pobiera z Hugging Face, Predibase, S3 lub ze ścieżki lokalnej (parametr
adapter_source). - Planowanie wymiany adapterów pobiera adaptery z wyprzedzeniem i zwalnia ich wagi z pamięci GPU, aby zrobić miejsce na inne. Późniejsze ładowanie może wykorzystać artefakty w cache.
- Heterogeniczne ciągłe grupowanie w partie łączy żądania kierowane do różnych adapterów.
LoRAX jest forkiem Hugging Face Text Generation Inference (TGI), więc zachowuje API /generate z TGI. Stosuje różne adaptery w jednej partii za pomocą jąder SGMV z projektu Punica. Te jądra grupują wiersze używające różnych macierzy adapterów w każdej dostosowanej warstwie. Implementacja LoRAX wykonuje osobne projekcje shrink i expand: najpierw do wymiaru niskiego rzędu, a następnie z powrotem do wymiaru wyjściowego warstwy.
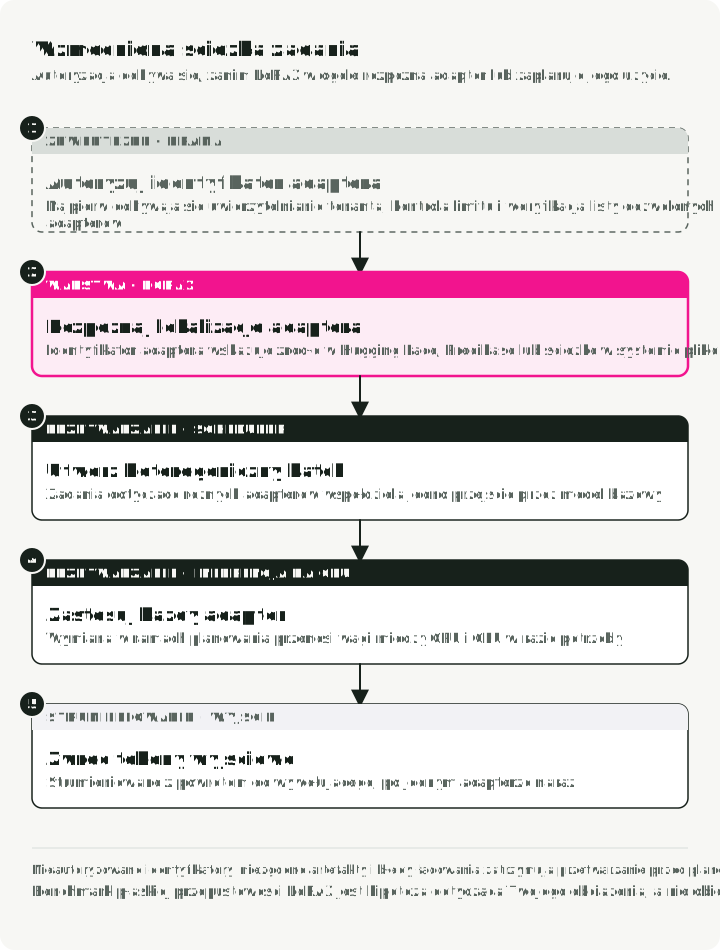
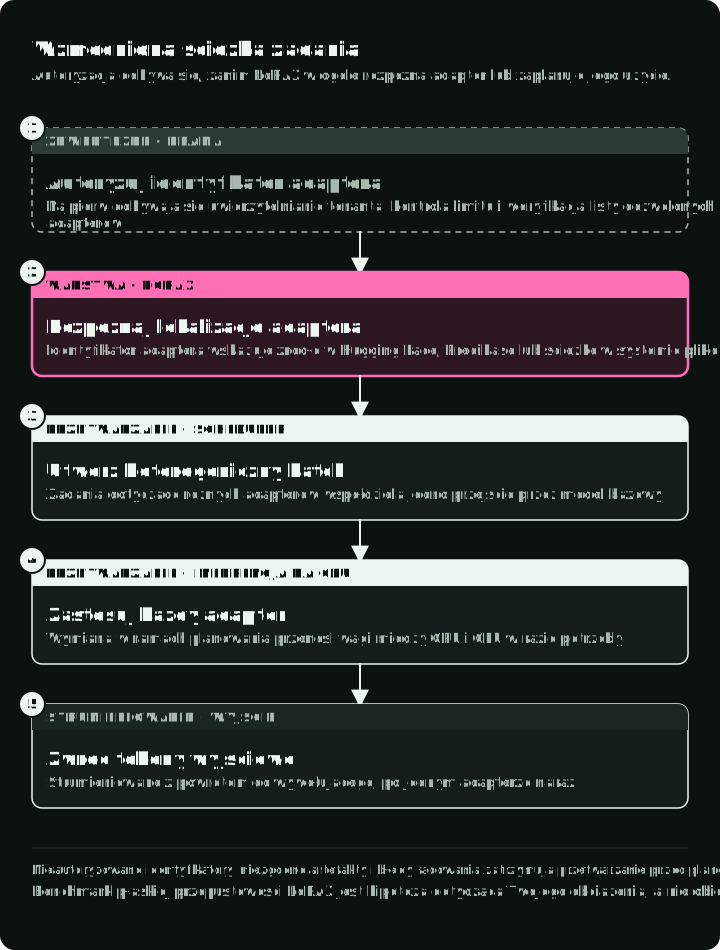
Rysunek przedstawia cztery żądania w konfiguracji produkcyjnej. Bramka przed LoRAX najpierw sprawdza najemcę i identyfikator adaptera; wyjaśniają to sekcje o bezpieczeństwie poniżej. Następnie LoRAX znajduje adapter. Jeśli adaptera nie ma na GPU, LoRAX ładuje artefakty z cache lub pobiera brakujące pliki. Zachowane tensory w pamięci hosta też można wykorzystać ponownie, jeśli loader je przechowuje. Potem grupuje żądanie z żądaniami do innych adapterów i przesyła jednostki token z powrotem strumieniem.
Projekt LoRAX podaje, że w jego benchmarkach heterogeniczne grupowanie utrzymuje przepustowość i opóźnienie niemal stałe, gdy rośnie liczba równoczesnych adapterów. Potraktuj ten wynik producenta jako hipotezę dla własnego obciążenia. Długość wejścia prompt, długość odpowiedzi, rząd, moduły docelowe, zapełnienie partii, rotacja cache i generacja GPU mogą zmienić wynik.
Poniższy wykres pochodzi z raportu Predibase z premiery LoRAX w listopadzie 2023. Predibase testował Llama 2 7B z zapytaniami rozłożonymi na od 1 do 128 adapterów na jednej karcie NVIDIA A10G. Wykres pokazuje porównanie kosztu przetworzenia miliona jednostek token dla od 1 do 32 adapterów, rozdzielonych równo między adaptery.
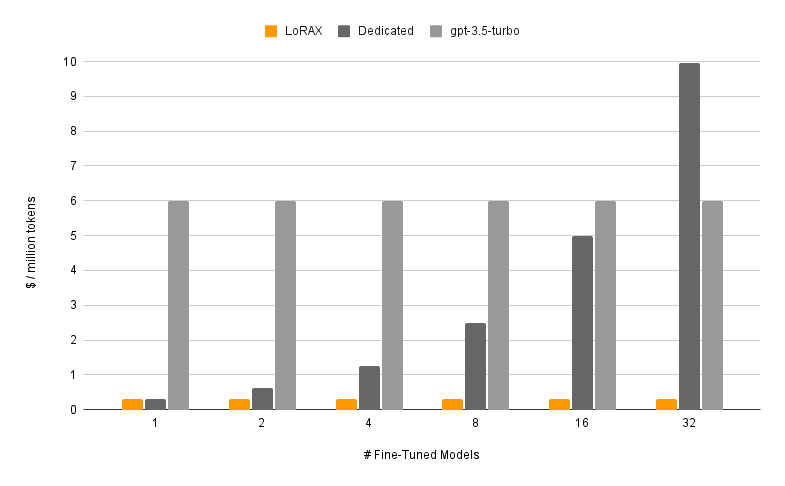
Archiwalne porównanie projektu, odtworzone z raportu Predibase o LoRAX z 2023 roku. Koszty LoRAX i wdrożeń dedykowanych używają godzin GPU z tego eksperymentu. Na poziomie szczegółowości źródła linia GPT-3.5 Turbo używa kosztu za token dostrojonego modelu.
Płaskie pomarańczowe słupki traktuj jako wynik przyjętego układu benchmarku, a nie obietnicę obecnej ceny. Test wysyłał stałą sumę miliona jednostek token i pozwalał różnym adapterom dzielić partię. Wariant porównawczy z dedykowanymi zasobami zakładał osobne, hostowane zasoby obliczeniowe dla każdego modelu, więc jego koszt rósł wraz z liczbą modeli.
Predibase nie opublikował mieszanki jednostek token, długości żądań, rozmiaru partii, rzędu adapterów ani ceny GPU, więc wartości w dolarach nie da się odtworzyć.
Wykres nie obejmuje też rzadkiego ruchu, zimnych pobrań, obecnych cen chmury, nowszych GPU, innych modeli bazowych ani adapterów o różnych rzędach. Traktuj go jako powód, by odtworzyć własny ruch.
Kiedy LoRAX ma sens
Przetestuj LoRAX, gdy spełnione są wszystkie poniższe warunki:
- adaptery trenowano na tym samym obsługiwanym modelu bazowym i kontrakcie tokenizera
- ruch obejmuje wiele adapterów ze znaczącym długim ogonem
- ładowanie zimnego adaptera na żądanie jest lepsze niż rezerwowanie dla niego wdrożenia
- routing według najemcy lub zadania już istnieje na granicy aplikacji
- zespół potrafi obsługiwać wyspecjalizowane środowisko inferencji i jego zachowanie cache
- zespół akceptuje środowisko z rzadkimi wydaniami upstream
Typowe przypadki to asystenci dla poszczególnych najemców, wiele wariantów domenowych i eksperymenty online współdzielące checkpoint bazowy.
LoRAX pasuje słabiej, gdy kilka adapterów obsługuje większość ruchu albo gdy modele nie mają wspólnej bazy. Pasuje też słabiej, gdy twarde cele opóźnień nie tolerują zimnych ładowań albo gdy platforma nie potrafi bezpiecznie kontrolować, jakie artefakty ładuje serwer. W takich przypadkach prostsze może być standardowe wdrożenie vLLM lub SGLang ze stałym zestawem adapterów. Stałe zestawy są wyborem sposobu wdrożenia: SGLang obsługuje też ładowanie dynamiczne, podobnie jak opisany niżej vLLM. Sam TGI jest teraz w trybie utrzymaniowym, a jego opiekunowie zalecają vLLM lub SGLang.
Sprawdź aktywność projektu, zanim podejmiesz decyzję. Według stanu na 8 października 2026 ostatnie wydanie serwera LoRAX to v0.12.1 z listopada 2024. Repozytorium miało regularne commity do kwietnia 2025 i od tamtej pory tylko dwie drobne poprawki. Jeśli go przyjmiesz, zaplanuj, że sam zajmiesz się aktualizacjami pod nowe modele, wersje CUDA i poprawki bezpieczeństwa.
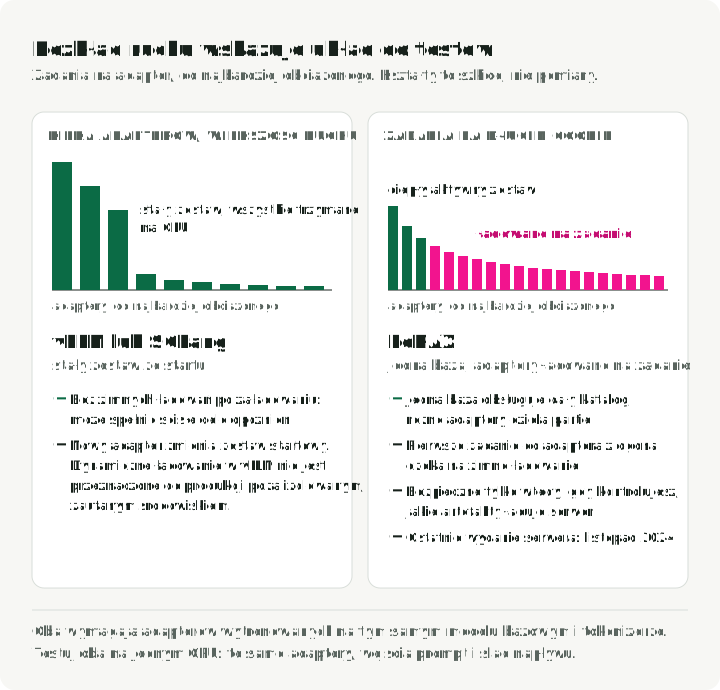
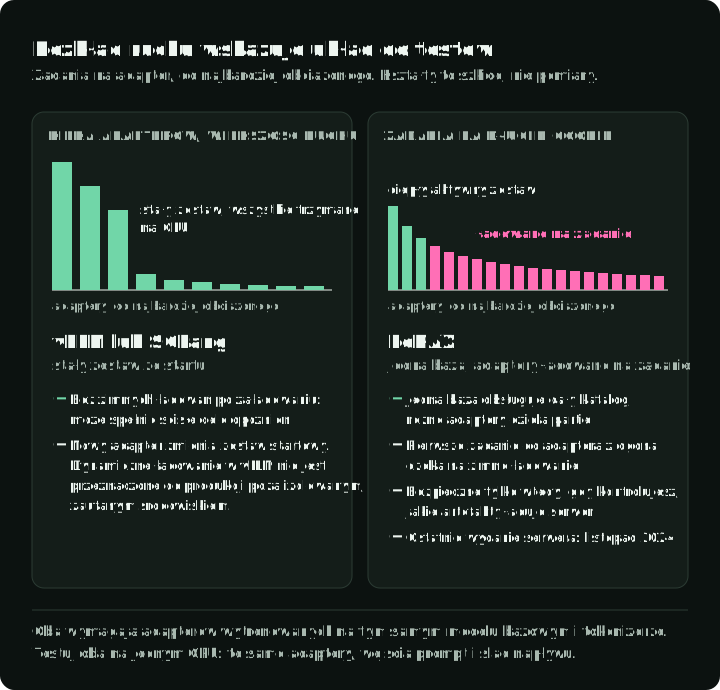
Rysunek porównuje dwa układy do przetestowania według profilu ruchu: stały zestaw adapterów, gdy kilka adapterów obsługuje większość żądań, oraz dynamiczne ładowanie w LoRAX, gdy żądania rozkładają się na długim ogonie. Ciepły zbiór aktywny w trybie dynamicznym nadal może zostać usunięty z pamięci; nie jest stałym zestawem załadowanym wstępnie.
Nie używaj Kubernetes tylko dlatego, że katalog jest duży. Najpierw sprawdź zgodność środowiska i adapterów na jednym GPU.
Wypróbuj jedną bazę i jeden adapter lokalnie
README LoRAX zaleca gotowy kontener. W prawdziwym środowisku użyj niezmiennego digestu obrazu. Tag main pokazano tu tylko dlatego, że jest to udokumentowany tag szybkiego startu repozytorium. Sprawdź przykłady na wersjach obrazu i zależności, które wdrażasz.
Przed uruchomieniem kontenera zainstaluj i skonfiguruj NVIDIA Container Toolkit dla Dockera. README LoRAX wymaga też Linuksa, Dockera, karty NVIDIA generacji Ampere lub nowszej i sterowników zgodnych z CUDA 11.8. Licencje modeli i repozytoria z ograniczonym dostępem mogą wymagać poświadczenia token z Hugging Face.
mkdir -p data

docker run --rm --gpus all --shm-size 1g \
    -p 127.0.0.1:8080:80 \
    -v "$PWD/data:/data" \
    ghcr.io/predibase/lorax:main \
    --model-id mistralai/Mistral-7B-Instruct-v0.1
Jawny adres hosta wiąże opublikowany port z interfejsem loopback; bez niego Docker domyślnie publikuje na wszystkich adresach hosta. Użyj Dockera 28 lub nowszego: starsze wydania mogą udostępniać porty opublikowane na localhost hostom w tym samym segmencie sieci. Pozostaw kontener uruchomiony w tym terminalu. W drugim terminalu poczekaj, aż curl --fail http://127.0.0.1:8080/health zakończy się pomyślnie, zanim wyślesz żądania.
Zacznij od modelu bazowego:
curl http://127.0.0.1:8080/generate \
    -H 'Content-Type: application/json' \
    -d '{
      "inputs": "[INST] Give one reason to measure cold-adapter latency. [/INST]",
      "parameters": {"max_new_tokens": 64}
    }'
Potem wyślij zgodny adapter. Ten adapter matematyczny GSM8K deklaruje mistralai/Mistral-7B-Instruct-v0.1 jako bazę, czyli ten sam model, który uruchamia serwer:
curl http://127.0.0.1:8080/generate \
    -H 'Content-Type: application/json' \
    -d '{
      "inputs": "[INST] Solve: Natalia sold 48 clips in April and half as many in May. What is the total? [/INST]",
      "parameters": {
        "max_new_tokens": 64,
        "adapter_id": "vineetsharma/qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k"
      }
    }'
Pomyślna odpowiedź /generate jest tablicą JSON zawierającą generated_text; wygenerowana odpowiedź zależy od modelu i próbkowania. Pierwsze żądanie adaptera może go pobrać i załadować. Kolejne mogą korzystać z artefaktów w cache i wag już w pamięci. Zapisz obie ścieżki. Pojedyncze ciepłe żądanie mówi niewiele o zachowaniu długiego ogona.
Powyższy adapter pochodzi z Hugging Face Hub. W produkcji ładuj adaptery z magazynu, który kontroluje platforma. Dokumentacja adapterów opisuje dwa takie źródła: local dla katalogu wewnątrz kontenera i s3 dla URI S3 z poświadczeniami AWS w zmiennych środowiskowych. Po skopiowaniu plików adaptera do zamontowanego katalogu zastąp parameters we wcześniejszej treści żądania tym fragmentem:
"parameters": {
    "adapter_id": "/data/adapters/vineetsharma--qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k",
    "adapter_source": "local"
}
Użyj klienta Pythona
Pakiet lorax-client opakowuje /generate. Zainstaluj go poleceniem pip install lorax-client==0.6.3. To samo wywołanie działa z adapter_id i bez niego, więc przy użyciu jednego wejścia prompt możesz porównać model bazowy z adapterem:
from lorax import Client

client = Client("http://127.0.0.1:8080")

prompt = (
    "[INST] Natalia sold clips to 48 of her friends in April, and then she "
    "sold half as many clips in May. How many clips did Natalia sell "
    "altogether in April and May? [/INST]"
)

# Base model
print(client.generate(prompt, max_new_tokens=64).generated_text)

# Same prompt through the GSM8K adapter
adapter_id = "vineetsharma/qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k"
print(
    client.generate(prompt, max_new_tokens=64, adapter_id=adapter_id).generated_text
)
Użyj klienta zgodnego z OpenAI
LoRAX udostępnia też endpoint czatu zgodny z OpenAI. Zainstaluj klienta poleceniem pip install openai==3.26.1. Pole model wskazuje adapter:
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://127.0.0.1:8080/v1",
)

response = client.chat.completions.create(
    model="vineetsharma/qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k",
    messages=[
        {"role": "user", "content": "Explain cache locality in two sentences."},
    ],
    max_tokens=100,
)

print(response.choices[0].message.content)
Serwer domyślnie nie wymaga klucza API. To wygodne na localhoście i niebezpieczne jako konfiguracja wystawiona do Internetu. Postaw przed nim uwierzytelnianie, autoryzację najemców, limity i listę dozwolonych adapterów.
Sprawdź zgodność adaptera przy rejestracji
Zanim adapter trafi do katalogu, zweryfikuj przynajmniej:
- zadeklarowany model bazowy i jego rewizję
- zgodność tokenizera i szablonu czatu
- rząd LoRA i moduły docelowe obsługiwane przez środowisko
- format artefaktu i kształty tensorów
- licencję, pochodzenie i digest integralności
- mały zestaw testów zachowania i regresji
Odrzucaj niezgodne artefakty przy rejestracji, a nie przy pierwszym żądaniu użytkownika.
Zrozum rezydencję w pamięci przed wdrożeniem
Model bazowy zajmuje największą stałą część pamięci GPU. Wagi adapterów, KV cache, przestrzeń robocza partii i jądra środowiska konkurują o resztę. /data przechowuje pobrane artefakty. Pamięć RAM CPU może przechowywać zmaterializowane tensory adapterów, ale tylko jeśli loader je zachowuje.
W sprawdzonej implementacji main w rewizji a7394ba domyślny loader pojedynczego adaptera zapisuje w cache odwołania do plików. Offloading usuwa wagi GPU z map adapterów; późniejsze żądanie może ponownie odczytać i zmaterializować pliki z cache. Domyślny loader w v0.12.1 też korzysta z odwołań do plików. Ładowanie scalonych adapterów lub ładowanie inne niż leniwe oraz cache plików systemu operacyjnego mogą działać inaczej, więc nie licz każdego offloadingu jako trafienia w zachowane tensory CPU.
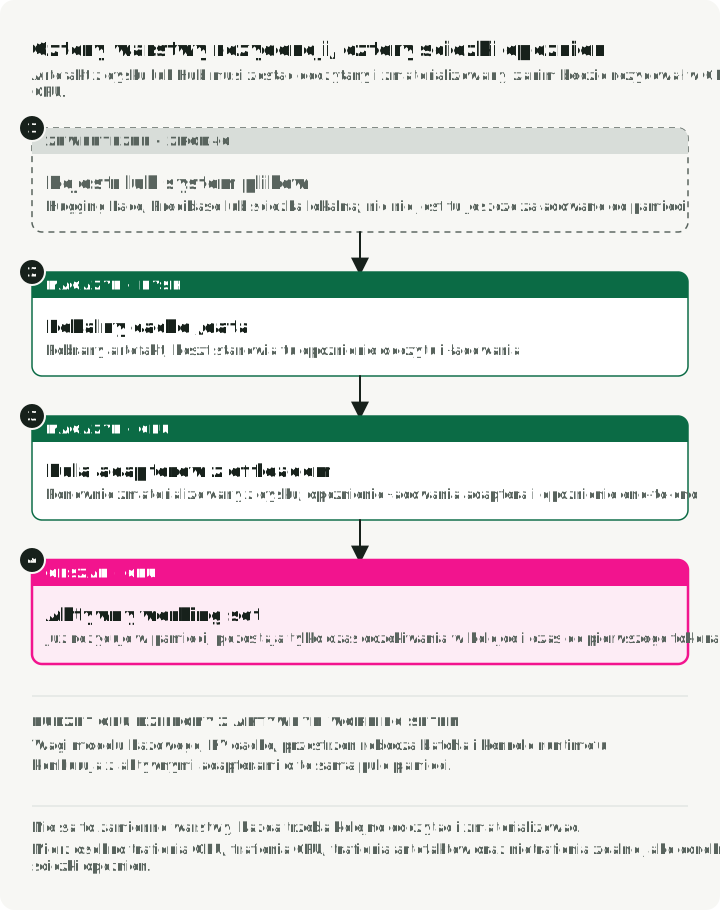
To odrębne mierzone stany. Artefakt z dysku lub z Hub trzeba odczytać i zmaterializować, zanim stanie się adapterem rezydującym w pamięci CPU lub GPU. Rysunek przedstawia cztery możliwe ścieżki z tabeli poniżej jako paski czasu; ścieżka CPU ma zastosowanie tylko wtedy, gdy tensory są zachowane w pamięci hosta. Każdy dodatkowy etap ładowania dodaje pracę przed pierwszą jednostką token.
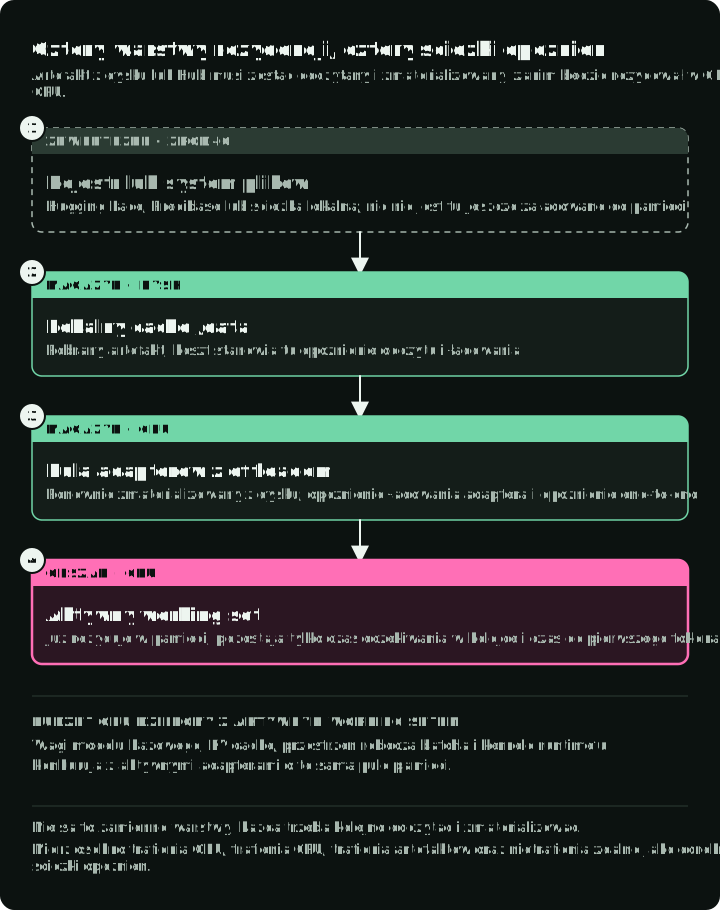
Mierz przejścia osobno:
| Ścieżka | Co obejmuje | Metryka do zapisania |
|---|---|---|
| Trafienie GPU | Adapter już w pamięci | czas w kolejce i czas do pierwszej jednostki token |
| Trafienie CPU | Transfer zachowanych tensorów hosta, jeśli są dostępne | opóźnienie ładowania adaptera i opóźnienie całkowite |
| Trafienie artefaktu | Odczyt z lokalnego cache /data | opóźnienie odczytu i ładowania oraz bajty cache |
| Chybienie zdalne | Pobranie plus walidacja i ładowanie | czas pobrania, błędy i pełne opóźnienie zimnej ścieżki |
Planowanie pojemności powinno odtwarzać rzeczywisty rozkład popularności adapterów. Jednostajnie losowe identyfikatory adapterów tworzą inny problem cache niż obciążenie z kilkoma popularnymi adapterami i wieloma rzadko używanymi.
Ustawienia launchera, które zmieniają zbiór roboczy
Te argumenty launchera decydują, ile adapterów zostaje na GPU, ile pamięci dostają i czy ładowanie jest stałe czy dynamiczne. Poniższe wartości domyślne sprawdzono 8 października 2026 w main w rewizji a7394ba; dokumentacja launchera wymienia wszystkie argumenty.
| Ustawienie | Domyślnie | Zmień, gdy |
|---|---|---|
--preloaded-adapter-ids | brak | chcesz stałego zestawu załadowanego wstępnie i akceptujesz wyłączenie dynamicznego ładowania adapterów |
--max-active-adapters | 1024 | trzeba ograniczyć, ile adapterów może być jednocześnie na GPU i przyjmować żądania |
--adapter-memory-fraction | 0.1 | trafień GPU jest mało; zwiększenie tej wartości trzyma więcej adapterów na GPU i zmniejsza KV cache |
--adapter-cycle-time-s | 2 | wymiany zdarzają się zbyt często (rotacja cache) lub zbyt rzadko (żądania w kolejce do adapterów usuniętych z GPU) |
--quantize | wyłączone | model bazowy zostawia zbyt mało pamięci GPU na adaptery i KV cache |
Wstępne ładowanie i ładowanie dynamiczne to odrębne tryby. Zarówno v0.12.1, jak i sprawdzona wersja main odrzucają nowe adaptery dynamiczne po zarejestrowaniu zestawu załadowanego wstępnie. Main dodatkowo ustawia rezerwację pamięci dla adapterów dynamicznych na zero, gdy podano identyfikatory adapterów ładowanych wstępnie; v0.12.1 nie stosuje tej zmiany launchera.
Do dynamicznej obsługi długiego ogona pomiń --preloaded-adapter-ids i po uruchomieniu rozgrzej popularne adaptery zwykłymi autoryzowanymi żądaniami. Ustawienia pamięci i planowania wpływają na to, jak długo pozostają w pamięci; rozgrzewanie ich nie przypina. Wartości dobierz podczas odtwarzania ruchu opisanego w sekcji „Produkcyjny test akceptacyjny” poniżej.
Ostrożnie wdróż chart z repozytorium
Potrzebujesz klastra z węzłami GPU, które udostępniają nvidia.com/gpu przez wtyczkę urządzeń NVIDIA lub GPU Operator, oraz kubectl i helm na stacji roboczej. Chart żąda tego zasobu, więc na klastrze bez niego pod zostaje w stanie Pending.
Repozytorium zawiera charts/lorax, więc powtarzalnym punktem startu jest przypięta rewizja repozytorium i lokalny chart:
git clone https://github.com/predibase/lorax.git
cd lorax
git checkout <reviewed-commit-or-release>

helm dependency update charts/lorax
helm template lorax charts/lorax -f values.production.yaml
helm upgrade --install lorax charts/lorax \
    --namespace inference \
    --create-namespace \
    -f values.production.yaml
Chart nazywa Deployment lorax-<release>, a Service według service.name (domyślnie lorax). Poczekaj na zakończenie rolloutu, śledź logi, aż model bazowy się załaduje, potem przekaż port Service i ponów żądania curl z sekcji lokalnej na 127.0.0.1:8080:
kubectl -n inference rollout status deploy/lorax-lorax
kubectl -n inference logs -f deploy/lorax-lorax
kubectl -n inference port-forward svc/lorax 8080:80

# remove the release when you are done
helm uninstall lorax -n inference
Według kontroli z 8 października 2026 wartości chartu i szablon Deployment w rewizji a7394ba pokazują takie wartości domyślne:
- tag obrazu to
latest /datajestemptyDir, więc wymiana poda odrzuca pobrane artefakty- sondy liveness i readiness są puste
- token Hugging Face jest modelowany jako literalna wartość zmiennej środowiskowej
- domyślnie żądane jest jedno GPU
Użyj chartu jako szablonu startowego i dodaj poniższe ustawienia produkcyjne.
Zacznij od rzeczywistej struktury wartości chartu
Chart zagnieżdża konfigurację środowiska pod deployment, a argumenty launchera są listą par nazwa/wartość. Minimalna nakładka ustawia tylko różnice względem powyższych wartości domyślnych: przetestowany digest obrazu, model, token Hub z Secret i sondę gotowości. Zapisz ją jako values.production.yaml i zastąp znaczniki tagu i digestu zweryfikowanym odwołaniem do obrazu. Jedna replika, jedno GPU i Service ClusterIP na porcie 80 to już wartości domyślne chartu.
Nakładka zakłada, że Secret lorax-hub z kluczem token istnieje już w przestrzeni nazw inference. Utwórz go przed instalacją, jeśli model potrzebuje poświadczeń Hub; w przeciwnym razie usuń wpis env.
deployment:
    image:
        repository: ghcr.io/predibase/lorax
        tag: "<tested-release-tag>@sha256:<verified-image-digest>"

    args:
        - name: "--model-id"
          value: "mistralai/Mistral-7B-Instruct-v0.1"

    env:
        - name: HUGGING_FACE_HUB_TOKEN
          valueFrom:
              secretKeyRef:
                  name: lorax-hub
                  key: token

    readinessProbe:
        httpGet:
            path: /health
            port: http
        periodSeconds: 5
        failureThreshold: 600
Helm zastępuje całą listę args. Domyślna konfiguracja chartu ustawia też limity liczby jednostek token (--max-input-length, --max-total-tokens, --max-batch-total-tokens, --max-batch-prefill-tokens), --compile i --eager-prefill false; skopiuj te, które chcesz zachować. Limity liczby jednostek token dobierz na podstawie reprezentatywnych wejść prompt, oczekiwanej współbieżności, pamięci GPU i testów obciążeniowych. Ustawienia zbioru roboczego z tabeli powyżej trafiają na tę samą listę.
Jawnie uzupełnij brakujące elementy
Sprawdzony szablon chartu przekazuje deployment.env przez toYaml, więc zwykła nakładka wartości może używać valueFrom.secretKeyRef do poświadczeń Hub, jak powyżej. Formatuje obraz jako repository:tag, co akceptuje pokazaną wyżej wartość tagu z digestem: Kubernetes używa digestu przy pobieraniu, gdy podano oba. Chart zapisuje wolumeny emptyDir na stałe i nie ma punktu konfiguracji startupProbe. Trwały /data i sonda startowa wymagają więc sprawdzonego forka chartu, poprawki po renderowaniu lub warstwy manifestów wyższego poziomu.
Nakładka wartości może ustawić tag obrazu z digestem, argumenty launchera, żądania i limity GPU, env (w tym secretKeyRef), sondy liveness i readiness oraz typ i port Service. Użyj tej warstwy produkcyjnej do:
- PersistentVolumeClaim lub lokalnego dla węzła cache artefaktów zamontowanego pod
/data - sondy startowej przed agresywną sondą liveness
- polityki zakłóceń podów i rozkładu topologicznego dla wielu replik
- NetworkPolicy, ograniczeń konta usługi i uwierzytelnionej bramki
- kontroli integralności artefaktów
Nie umieszczaj token Hub bezpośrednio w zatwierdzanym pliku wartości. Dwie repliki zapewniają użyteczną wysoką dostępność tylko wtedy, gdy obie potrafią załadować model bazowy. Router musi też unikać wysyłania każdego zimnego adaptera do obu podów.
Kieruj ruch z myślą o lokalności cache
Równoważenie round-robin może zamienić każdą replikę w zimny cache. Użyteczny router przypisuje dozwolony identyfikator adaptera do jednej repliki przez hash lub inną stabilną regułę. Utrzymuje ścieżkę awaryjną na czas, gdy ta replika jest niedostępna. Rysunek odtwarza sześć żądań do dwóch adapterów według obu reguł.
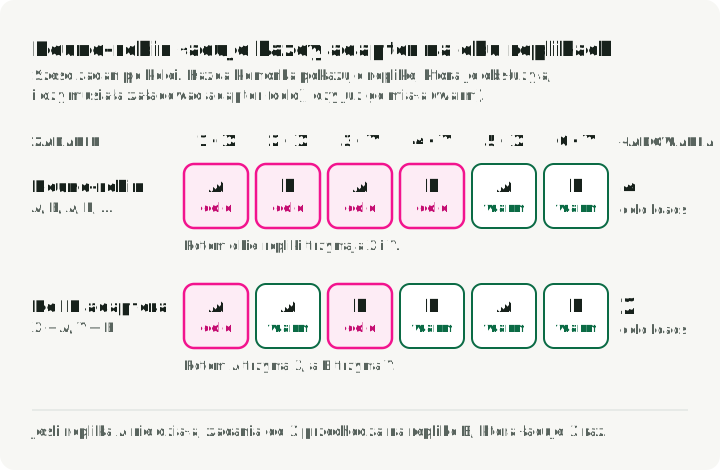
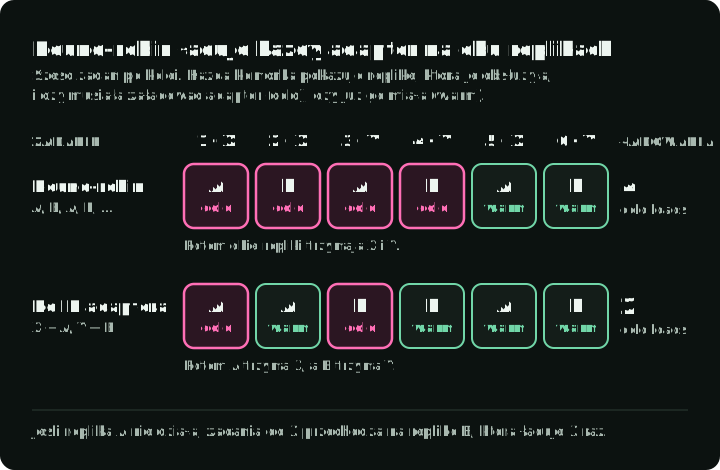
Klucz routingu musi pochodzić z uwierzytelnionego stanu aplikacji, a nie z dowolnego publicznego parametru URL. W przeciwnym razie wywołujący może wymusić zdalne pobrania, rotować cache lub badać nazwy prywatnych adapterów.
LoRAX czy vLLM?
Dokumentacja vLLM sprawdzona 8 października 2026 opisuje moduły LoRA deklarowane przy starcie oraz dynamiczne ładowanie przez endpointy lub wtyczki resolvera. Ostrzega, że aktualizowanie adapterów w czasie działania niesie ryzyko bezpieczeństwa i nie powinno być używane w produkcji poza izolowanym, zaufanym środowiskiem.
Tabela porównuje, jak każde środowisko znajduje, trzyma i obsługuje adaptery:
| Pytanie | LoRAX | vLLM |
|---|---|---|
| Jak wykrywane są adaptery z długiego ogona? | Identyfikator adaptera może wskazywać artefakty z Hugging Face, Predibase, S3 lub ze ścieżki lokalnej na żądanie | Moduły statyczne, dynamiczne endpointy zarządzania lub wtyczki resolvera |
| Jak zarządzana jest rezydencja? | Planowanie wymiany adapterów; ponowne ładowanie używa plików z cache lub zachowanych tensorów hosta, zależnie od loadera | Skonfigurowane limity aktywnych adapterów LoRA i adapterów na CPU oraz zachowanie resolvera |
| Jaki jest interfejs żądań? | /generate w stylu TGI, klient Pythona i czat zgodny z OpenAI | Serwowanie zgodne z OpenAI i natywne API Pythona |
| Co powinno decydować? | Opóźnienie zimne i ciepłe, rotacja cache, przepustowość heterogenicznych partii i dopasowanie operacyjne | To samo odtwarzanie obciążenia i kryteria operacyjne |
Unikaj reguł w rodzaju „LoRAX dla 1000 adapterów, vLLM dla dziesięciu”. Sam rozmiar katalogu nie decyduje o wydajności. Przetestuj oba środowiska na tej samej bazie, tych samych adapterach, wejściach prompt, rzędach, śladzie przyjść żądań i sprzęcie.
Produkcyjny test akceptacyjny
Zanim rozszerzysz katalog, uruchom odtwarzanie, które obejmuje:
- Stały gorący zbiór do ustalenia ciepłej przepustowości i opóźnienia.
- Rozkład długiego ogona do pomiaru trafień w cache artefaktów i zachowane tensory hosta, jeśli loader to obsługuje.
- Serię adapterów dotąd niewidzianych, ale znajdujących się na liście dozwolonych.
- Wymianę poda do pomiaru odtwarzania bazy i adapterów.
- Jeden niedostępny lub uszkodzony adapter do weryfikacji izolacji i mechanizmu zapasowego.
- Współbieżnych najemców do weryfikacji uwierzytelniania, limitów i etykiet metryk.
Śledź te metryki:
- tempo żądań
- czas w kolejce
- czas do pierwszej jednostki token
- opóźnienie między jednostkami token
- opóźnienie całkowite
- czas ładowania adaptera
- klasa trafienia cache
- pamięć GPU
- pamięć CPU
- pobrane bajty
- błędy według przyczyny
Nie używaj identyfikatorów adapterów jako nieograniczonych etykiet metryk. Mapuj je na kontrolowane wymiary lub próbkowane ślady.
Zdefiniuj progi akceptacji przed testem. Ustaw maksymalny odsetek błędów zimnej ścieżki i cel P99 dla ciepłej ścieżki. Ustaw też cel trafień cache dla zaobserwowanego rozkładu popularności oraz cel czasu odtworzenia po utracie poda.
Podsumowanie
LoRAX obsługuje wiele zgodnych dostrojonych modeli bez wielu osobnych kopii modelu bazowego. To może być przydatny projekt dla obciążeń z długim ogonem, ale nie sprawia, że koszt ani opóźnienie stają się stałe z definicji. Wynik nadal wyznaczają aktywny zbiór roboczy, ścieżka wymiany, skład partii i warstwa magazynu.
Najpierw sprawdź te mechanizmy na jednym GPU. Potem, na Kubernetes: przypnij artefakty, zachowaj cache, chroń poświadczenia, autoryzuj adaptery, kieruj ruch z myślą o lokalności i mierz każdą ścieżkę obecności w pamięci. Jeśli LoRAX pokona aktualną konfigurację vLLM przy tym samym odtwarzaniu ruchu, decyzja o wdrożeniu opiera się na dowodach.
Źródła
- Repozytorium i README LoRAX — obsługiwane funkcje, wymagania, API, klient Pythona i chart Helm
- Źródła adapterów LoRAX — ładowanie z Hub, Predibase, lokalne i z S3
- Dokumentacja launchera LoRAX — argumenty pamięci adapterów, wymiany, wstępnego ładowania i kwantyzacji
- Raport z premiery LoRAX i benchmark z 2023 — źródło i warunki wykresu kosztów
- Wartości chartu LoRAX i szablon Deployment — sprawdzone ustawienia domyślne i zachowanie wolumenów
- Punica: Multi-Tenant LoRA Serving — jądro SGMV dla partii z mieszanymi adapterami
- Text Generation Inference — projekt, z którego LoRAX powstał jako fork, obecnie w trybie utrzymaniowym
- Adaptery LoRA w vLLM — statyczne i dynamiczne serwowanie adapterów
- Praca o LoRA — metoda adaptacji niskiego rzędu
- Dokumentacja Hugging Face PEFT — formaty adapterów i integracja z trenowaniem