Guia de serving do LoRAX: adaptadores LoRA em Kubernetes em grande escala

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Este guia destina-se a engenheiros de inferência e de plataforma que precisam de servir muitas variantes LoRA a partir de um único modelo base. Mostra como testar as APIs do LoRAX, dimensionar o conjunto de trabalho e transformar o chart Helm inicial num plano de produção explícito.
Um modelo base e muitos adaptadores LoRA criam um problema de serving pouco habitual. Os pesos base são partilhados, mas cada pedido pode precisar de um conjunto diferente de pesos de adaptador. Um desenho convencional com um deployment por variante desperdiça memória de GPU quando a maioria das variantes está inativa.
O LoRAX responde a essa cauda longa. Carrega adaptadores a pedido, agrupa pedidos para adaptadores diferentes e troca os pesos de adaptadores que ocupam a memória da GPU. O título apelativo é “milhares de modelos com fine-tuning numa só GPU”. A questão de engenharia é mais restrita: dado o seu conjunto ativo de adaptadores, o padrão de chegada e o objetivo de latência, o escalonamento das trocas ajuda o suficiente para justificar mais um runtime de serving?
O problema de serving é o conjunto de trabalho
O LoRA congela um modelo base e aprende atualizações de baixo rank para matrizes de pesos selecionadas. O adaptador resultante costuma ser muito mais pequeno do que um checkpoint completo, mas o seu tamanho continua a depender do rank, dos módulos-alvo, do número de camadas e do dtype. Afirmações fixas como “cada adaptador tem 100 MB” são maus dados de entrada para o planeamento de capacidade.
Se cada variante com fine-tuning tiver o seu próprio deployment, cada deployment guarda uma cópia completa dos pesos base, quer receba tráfego quer não. O lado esquerdo da figura mostra esse desenho. O lado direito mostra um único modelo base que carrega apenas os adaptadores que recebem pedidos.
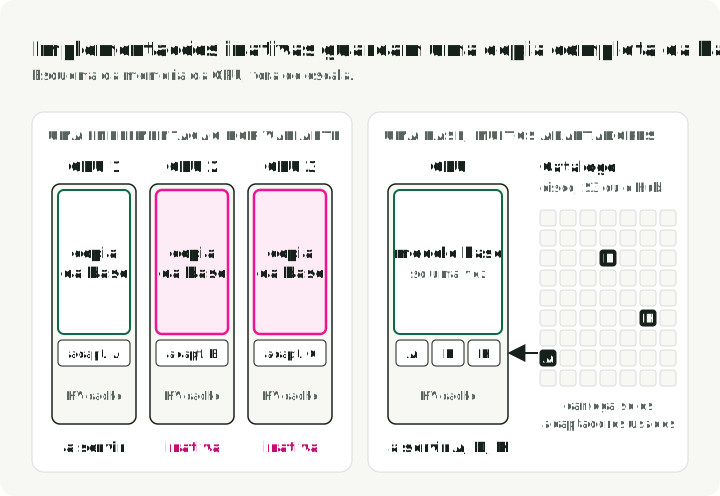
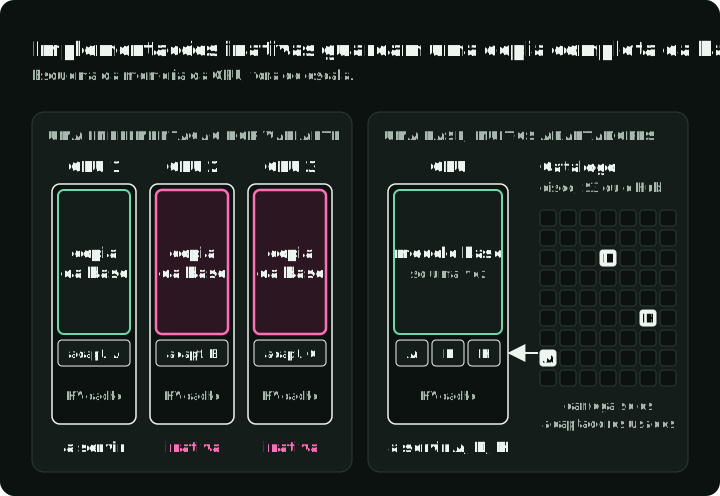
Para o serving, distinguem-se três quantidades:
- Tamanho do catálogo: todos os adaptadores que uma plataforma consegue resolver a partir do armazenamento
- Conjunto ativo de trabalho: adaptadores que recebem pedidos dentro da janela de retenção da cache
- Conjunto concorrente: adaptadores representados em lotes no mesmo instante
Cada conjunto é um subconjunto do anterior: o conjunto concorrente está dentro do conjunto ativo de trabalho, que está dentro do catálogo. O planeamento de capacidade parte do conjunto ativo de trabalho. Por exemplo, um catálogo de 5000 adaptadores pode ter 200 ativos na última hora e 8 num único lote.
Um catálogo pode conter milhares de adaptadores sem que milhares caibam na VRAM. O que importa é a frequência com que o conjunto ativo muda, o tamanho desses adaptadores e se pedidos para adaptadores diferentes conseguem partilhar lotes úteis.
O LoRAX combina quatro mecanismos:
- O modelo base permanece residente para todos os adaptadores compatíveis.
- Um pedido indica um adaptador, que o LoRAX resolve a partir do Hugging Face, do Predibase, do S3 ou de um caminho local (o parâmetro
adapter_source). - O escalonamento das trocas de adaptadores faz prefetch de adaptadores e liberta pesos da GPU para dar espaço a outros. Um carregamento posterior pode reutilizar artefactos em cache.
- O batching contínuo heterogéneo agrupa pedidos dirigidos a adaptadores diferentes.
O LoRAX é um fork do Text Generation Inference (TGI) do Hugging Face, por isso mantém a API /generate do TGI. Aplica adaptadores diferentes dentro de um mesmo lote com kernels SGMV do projeto Punica. Estes kernels agrupam linhas que usam matrizes de adaptadores diferentes em cada camada adaptada. A implementação do LoRAX executa projeções shrink e expand separadas: primeiro para a dimensão de baixo rank e depois de volta para a dimensão de saída da camada.
A figura acompanha quatro pedidos numa configuração de produção. Um gateway à frente do LoRAX verifica primeiro o tenant e o ID do adaptador; as secções de segurança abaixo explicam porquê. Depois o LoRAX encontra o adaptador. Se o adaptador não estiver na GPU, o LoRAX carrega artefactos em cache ou descarrega ficheiros em falta. Os tensores retidos na memória do host também podem ser reutilizados quando o carregador os conserva. Em seguida agrupa o pedido com pedidos para outros adaptadores e devolve os tokens em streaming.
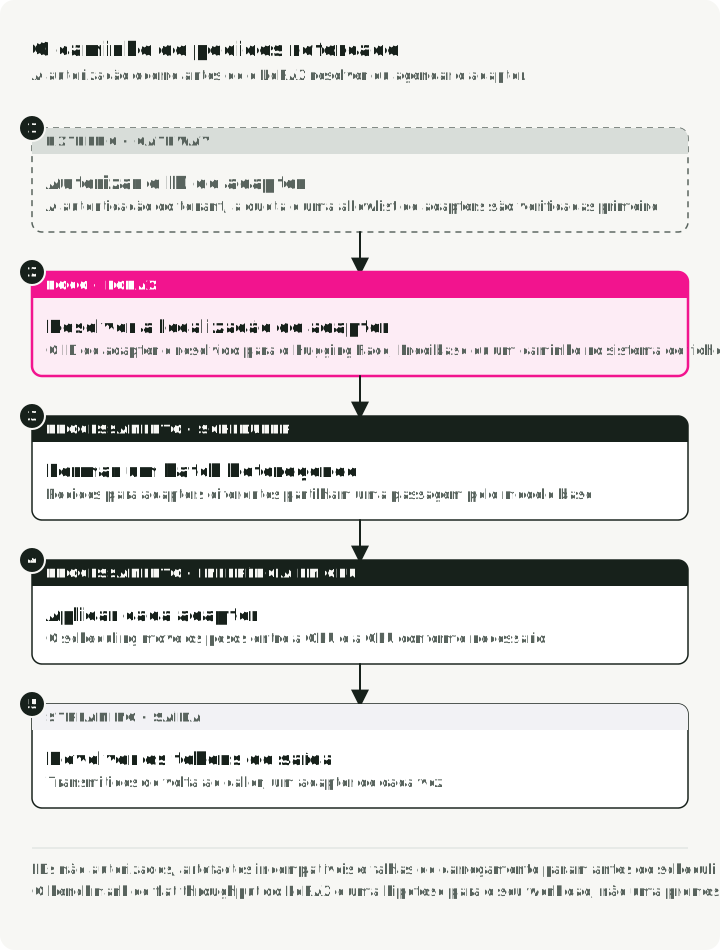
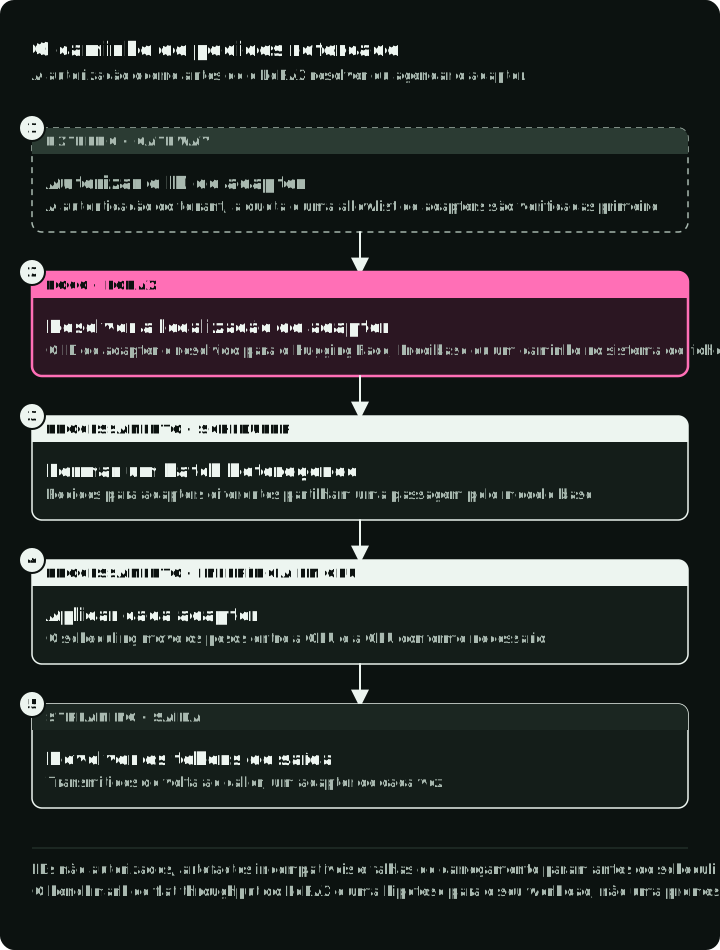
O projeto LoRAX indica que, nos seus benchmarks, o batching heterogéneo mantém o débito e a latência quase constantes à medida que o número de adaptadores concorrentes aumenta. Trate esse resultado do fabricante como uma hipótese para a sua carga de trabalho. O comprimento do prompt, o comprimento da saída, o rank, os módulos-alvo, a ocupação do lote, a rotatividade da cache e a geração da GPU podem alterar o resultado.
O gráfico abaixo vem do relatório de lançamento do LoRAX da Predibase, de novembro de 2023. A Predibase fez benchmarks com o Llama 2 7B, com consultas distribuídas por 1 a 128 adaptadores numa única NVIDIA A10G. Este gráfico mostra a comparação de custo, de 1 a 32 adaptadores, para processar um milhão de tokens, repartidos de forma igual pelos adaptadores.
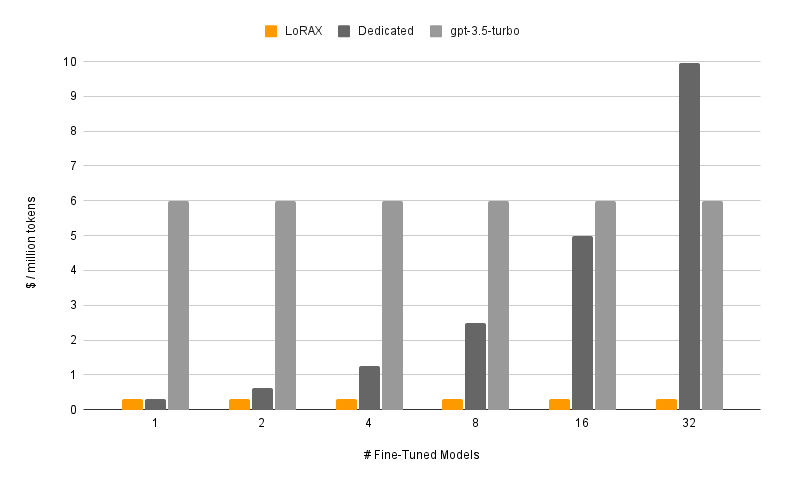
Comparação arquivada do projeto, reproduzida do relatório LoRAX de 2023 da Predibase. Os custos do LoRAX e dos deployments dedicados usam horas de GPU dessa experiência. Com o grau de detalhe que a fonte dá, a linha do GPT-3.5 Turbo usa o custo por token do modelo com fine-tuning.
Leia as barras laranja planas como resultado do desenho desse benchmark, não como promessa de preço atual. O teste enviou um total fixo de um milhão de tokens e deixou adaptadores diferentes partilharem um lote. A referência dedicada assumiu computação alojada separada para cada modelo, pelo que o seu custo subia com o número de modelos.
A Predibase não publicou a combinação de tokens, os comprimentos dos pedidos, o tamanho do lote, o rank dos adaptadores nem o preço da GPU, por isso os valores em dólares não podem ser reproduzidos.
O gráfico também não cobre tráfego esparso, downloads a frio, preços atuais da cloud, GPUs mais recentes, outros modelos base nem adaptadores com ranks diferentes. Use-o como motivo para reproduzir o seu próprio tráfego.
Quando o LoRAX é uma opção plausível
Faça um benchmark do LoRAX quando todas estas condições se verificarem:
- os adaptadores foram treinados sobre o mesmo modelo base suportado e o mesmo contrato de tokenizador
- o tráfego abrange muitos adaptadores, com uma cauda longa significativa
- carregar um adaptador frio a pedido é preferível a reservar um deployment para ele
- já existe encaminhamento por tenant ou por tarefa na fronteira da aplicação
- a equipa consegue operar um runtime de inferência especializado e o comportamento da sua cache
- a equipa aceita um runtime com poucas versões no repositório de origem
Os casos típicos incluem assistentes específicos de cada tenant, muitas variantes de domínio e experiências online que partilham um checkpoint base.
O LoRAX é uma opção mais fraca quando poucos adaptadores recebem a maior parte do tráfego ou quando os modelos não partilham a mesma base. Também é mais fraco quando objetivos rígidos de latência não toleram carregamentos a frio, ou quando a plataforma não consegue controlar em segurança os artefactos que o servidor carrega. Nesses casos, um deployment vLLM ou SGLang normal, com um conjunto fixo de adaptadores, pode ser mais simples. Os conjuntos fixos são uma escolha de deployment: o SGLang também suporta carregamento dinâmico, tal como o vLLM descrito abaixo. O próprio TGI está agora em modo de manutenção e os seus responsáveis recomendam o vLLM ou o SGLang.
Verifique a atividade do projeto antes de se comprometer. A 8 de outubro de 2026, a última versão do servidor LoRAX é a v0.12.1, de novembro de 2024. O repositório teve commits regulares até abril de 2025 e só duas pequenas correções desde então. Se o adotar, planeie assumir as atualizações para novos modelos, versões de CUDA e correções de segurança.
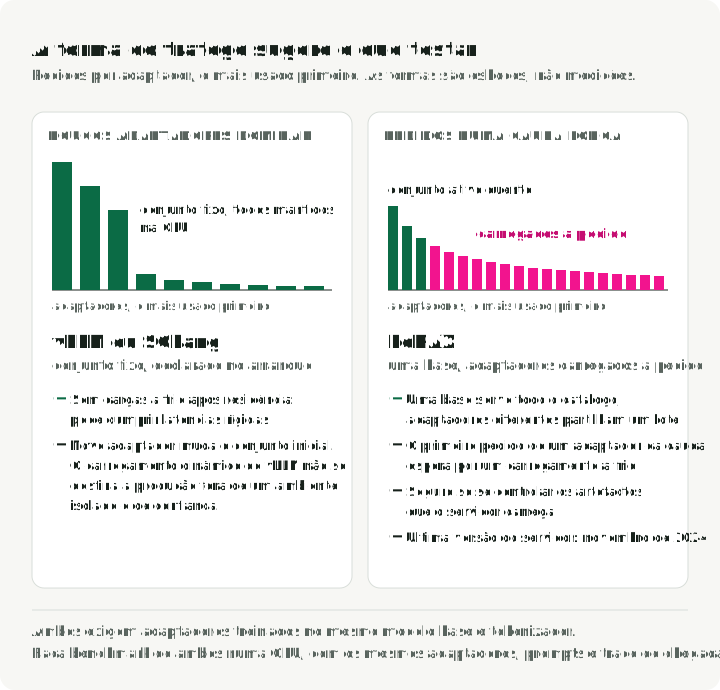
A figura compara duas configurações a testar segundo a distribuição do tráfego: um conjunto fixo de adaptadores quando poucos adaptadores recebem a maior parte dos pedidos, carregamento dinâmico no LoRAX quando os pedidos se distribuem por uma cauda longa. Um conjunto ativo quente em modo dinâmico continua a poder ser removido da memória; não é um conjunto fixo pré-carregado.
Não use Kubernetes só porque o catálogo é grande. Comece por provar o runtime e a compatibilidade dos adaptadores numa única GPU.
Experimente uma base e um adaptador localmente
O README do LoRAX recomenda o seu contentor pré-construído. Num ambiente real, use um digest de imagem imutável. A etiqueta main aparece aqui apenas por ser a etiqueta de arranque rápido documentada no repositório. Confirme os exemplos com as versões da imagem e das dependências que vai implementar.
Antes de executar o contentor, instale e configure o NVIDIA Container Toolkit para Docker. O README do LoRAX também exige Linux, Docker, uma GPU NVIDIA Ampere ou mais recente e drivers compatíveis com CUDA 11.8. As licenças dos modelos e os repositórios com acesso restrito podem exigir um token do Hugging Face.
mkdir -p data

docker run --rm --gpus all --shm-size 1g \
    -p 127.0.0.1:8080:80 \
    -v "$PWD/data:/data" \
    ghcr.io/predibase/lorax:main \
    --model-id mistralai/Mistral-7B-Instruct-v0.1
O endereço explícito do host associa a porta publicada à interface loopback; sem ele, o Docker publica em todos os endereços do host por omissão. Use Docker 28 ou mais recente: versões anteriores podem expor portas publicadas em localhost a hosts no mesmo segmento de rede. Mantenha o contentor em execução neste terminal. Num segundo terminal, espere que curl --fail http://127.0.0.1:8080/health tenha sucesso antes de enviar pedidos.
Comece pelo modelo base:
curl http://127.0.0.1:8080/generate \
    -H 'Content-Type: application/json' \
    -d '{
      "inputs": "[INST] Give one reason to measure cold-adapter latency. [/INST]",
      "parameters": {"max_new_tokens": 64}
    }'
Depois envie um adaptador compatível. Este adaptador de matemática GSM8K declara mistralai/Mistral-7B-Instruct-v0.1 como base, o mesmo modelo que o servidor executa:
curl http://127.0.0.1:8080/generate \
    -H 'Content-Type: application/json' \
    -d '{
      "inputs": "[INST] Solve: Natalia sold 48 clips in April and half as many in May. What is the total? [/INST]",
      "parameters": {
        "max_new_tokens": 64,
        "adapter_id": "vineetsharma/qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k"
      }
    }'
Uma resposta bem-sucedida de /generate é um array JSON que contém generated_text; a resposta gerada depende do modelo e da amostragem. O primeiro pedido de adaptador pode descarregar e carregar o adaptador. Os pedidos seguintes podem usar artefactos em cache e pesos residentes. Registe os dois caminhos. Um único pedido quente diz pouco sobre o comportamento de cauda longa.
O adaptador acima vem do Hugging Face Hub. Em produção, carregue os adaptadores a partir de armazenamento que a plataforma controle. A documentação dos adaptadores descreve duas dessas fontes: local, para um diretório dentro do contentor, e s3, para um URI S3, com as credenciais AWS no ambiente. Depois de copiar os ficheiros do adaptador para o diretório montado, substitua parameters no payload anterior por este fragmento:
"parameters": {
    "adapter_id": "/data/adapters/vineetsharma--qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k",
    "adapter_source": "local"
}
Use o cliente Python
O pacote lorax-client envolve o /generate. Instale-o com pip install lorax-client==0.6.3. A mesma chamada funciona com e sem adapter_id, por isso pode comparar o modelo base e o adaptador com o mesmo prompt:
from lorax import Client

client = Client("http://127.0.0.1:8080")

prompt = (
    "[INST] Natalia sold clips to 48 of her friends in April, and then she "
    "sold half as many clips in May. How many clips did Natalia sell "
    "altogether in April and May? [/INST]"
)

# Base model
print(client.generate(prompt, max_new_tokens=64).generated_text)

# Same prompt through the GSM8K adapter
adapter_id = "vineetsharma/qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k"
print(
    client.generate(prompt, max_new_tokens=64, adapter_id=adapter_id).generated_text
)
Use um cliente compatível com OpenAI
O LoRAX também expõe um endpoint de chat compatível com OpenAI. Instale o cliente com pip install openai==3.26.1. O campo model identifica o adaptador:
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://127.0.0.1:8080/v1",
)

response = client.chat.completions.create(
    model="vineetsharma/qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k",
    messages=[
        {"role": "user", "content": "Explain cache locality in two sentences."},
    ],
    max_tokens=100,
)

print(response.choices[0].message.content)
Por omissão, o servidor não exige chave de API. Isso é cómodo em localhost e inseguro numa configuração exposta à Internet. Coloque à frente dele autenticação, autorização por tenant, quotas e uma lista de permissões de adaptadores.
Verifique a compatibilidade do adaptador no registo
Antes de um adaptador entrar no catálogo, verifique pelo menos:
- o modelo base e a revisão declarados
- a compatibilidade do tokenizador e do template de chat
- o rank LoRA e os módulos-alvo suportados pelo runtime
- o formato do artefacto e as formas dos tensores
- a licença, a proveniência e o digest de integridade
- um pequeno conjunto de testes comportamentais e de regressão
Rejeite artefactos incompatíveis durante o registo, em vez de no primeiro pedido de um utilizador.
Perceba a residência antes de implementar
O modelo base consome a maior parte fixa da memória da GPU. Os pesos dos adaptadores, a KV cache, o espaço de trabalho do lote e os kernels do runtime disputam o restante. /data armazena os artefactos descarregados. A RAM da CPU pode guardar tensores de adaptadores materializados, mas apenas se o carregador os conservar.
Na implementação main verificada em a7394ba, o carregador predefinido de um único adaptador guarda referências a ficheiros em cache. O offloading remove os pesos GPU dos mapas de adaptadores; um pedido posterior pode voltar a ler e materializar os ficheiros em cache. O carregador predefinido na v0.12.1 também usa referências a ficheiros. O carregamento de adaptadores fundidos ou o carregamento não diferido e a cache de ficheiros do sistema operativo podem comportar-se de forma diferente, por isso não conte cada offloading como um acerto em tensores CPU retidos.
Estes são estados medidos distintos. Um artefacto em disco ou no Hub tem de ser lido e materializado antes de se tornar um adaptador residente na CPU ou na GPU. A figura desenha os quatro caminhos possíveis da tabela abaixo como barras de tempo; o caminho CPU aplica-se apenas quando os tensores do host são retidos. Cada passo extra de carregamento acrescenta trabalho antes do primeiro token.
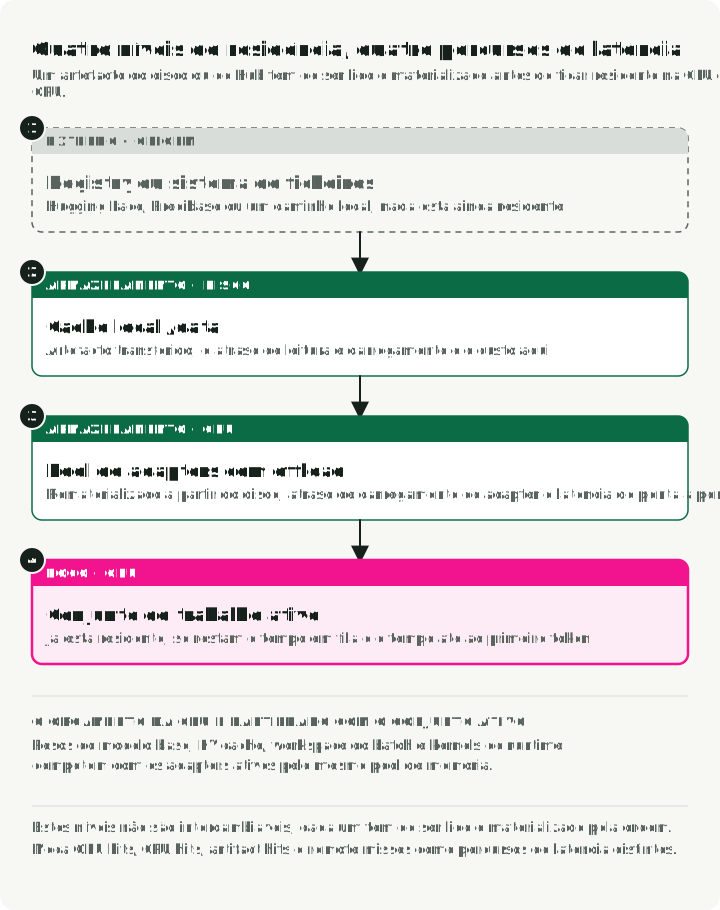
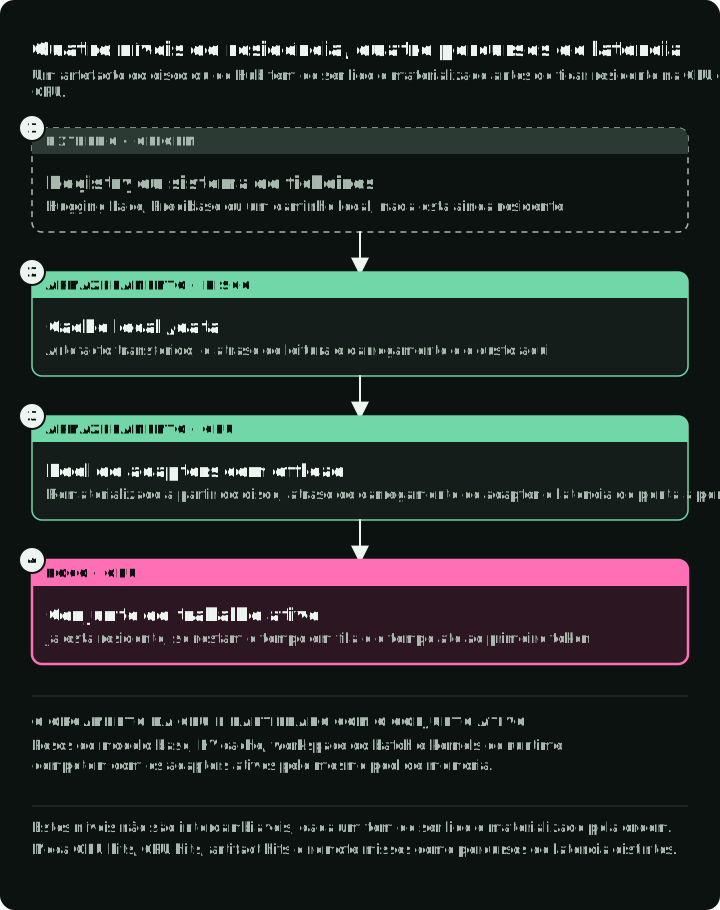
Meça as transições em separado:
| Caminho | O que inclui | Métrica a registar |
|---|---|---|
| Acerto na GPU | Adaptador já residente | tempo de fila e tempo até ao primeiro token |
| Acerto na CPU | Transferência de tensores retidos no host, se disponíveis | atraso de carregamento do adaptador e latência total |
| Acerto de artefacto | Leitura da cache local /data | atraso de leitura/carregamento e bytes em cache |
| Falha remota | Download mais validação e carregamento | tempo de download, falhas e latência total a frio |
O planeamento de capacidade deve reproduzir a distribuição real de popularidade dos adaptadores. IDs de adaptador aleatórios e uniformes criam um problema de cache diferente de uma carga com poucos adaptadores populares e muitos usados com pouca frequência.
Definições do launcher que alteram o conjunto de trabalho
Estes argumentos do launcher decidem quantos adaptadores ficam na GPU, quanta memória recebem e se o carregamento é fixo ou dinâmico. Os valores por omissão abaixo foram verificados a 8 de outubro de 2026 na main em a7394ba; a referência do launcher lista todos os argumentos.
| Definição | Omissão | Altere-a quando |
|---|---|---|
--preloaded-adapter-ids | nenhum | quiser um conjunto fixo pré-carregado e aceitar desativar o carregamento dinâmico de adaptadores |
--max-active-adapters | 1024 | precisar de limitar quantos adaptadores podem estar na GPU e aceitar pedidos em simultâneo |
--adapter-memory-fraction | 0.1 | os acertos na GPU forem baixos; aumentá-la mantém mais adaptadores na GPU e reduz a KV cache |
--adapter-cycle-time-s | 2 | as trocas ocorrerem com demasiada frequência (rotatividade da cache) ou com demasiada lentidão (pedidos em fila para adaptadores removidos da GPU) |
--quantize | desativado | o modelo base deixar pouca memória de GPU para adaptadores e KV cache |
O pré-carregamento e o carregamento dinâmico são modos distintos. Tanto a v0.12.1 como a main verificada rejeitam novos adaptadores dinâmicos depois de registarem um conjunto pré-carregado. A main também define a reserva dinâmica de memória para adaptadores como zero quando existem IDs pré-carregados; a v0.12.1 não aplica essa alteração do launcher.
Para serving dinâmico de cauda longa, omita --preloaded-adapter-ids e aqueça os adaptadores populares com pedidos normais autorizados após o arranque. As definições de memória e de escalonamento afetam o tempo durante o qual permanecem residentes; o aquecimento não os fixa na memória. Escolha estes valores com a reprodução descrita em “Um teste de aceitação de produção” abaixo.
Implemente o chart do repositório com cuidado
Precisa de um cluster com nós GPU que exponham nvidia.com/gpu através do plugin de dispositivos NVIDIA ou do GPU Operator, além de kubectl e helm na sua estação de trabalho. O chart pede esse recurso, por isso o pod fica em Pending num cluster que não o tenha.
O repositório contém charts/lorax, pelo que o ponto de partida repetível é uma revisão fixa do repositório e um chart local:
git clone https://github.com/predibase/lorax.git
cd lorax
git checkout <reviewed-commit-or-release>

helm dependency update charts/lorax
helm template lorax charts/lorax -f values.production.yaml
helm upgrade --install lorax charts/lorax \
    --namespace inference \
    --create-namespace \
    -f values.production.yaml
O chart dá ao Deployment o nome lorax-<release> e ao Service o nome definido em service.name (lorax por omissão). Espere pelo rollout, acompanhe os logs até o modelo base estar carregado, depois reencaminhe a porta do Service e volte a executar os pedidos curl da secção local contra 127.0.0.1:8080:
kubectl -n inference rollout status deploy/lorax-lorax
kubectl -n inference logs -f deploy/lorax-lorax
kubectl -n inference port-forward svc/lorax 8080:80

# remove the release when you are done
helm uninstall lorax -n inference
Conforme verificado a 8 de outubro de 2026, os valores do chart e o template do Deployment em a7394ba mostram estes valores por omissão:
- a etiqueta da imagem é
latest /dataé umemptyDir, por isso a substituição do pod descarta os artefactos descarregados- as sondas de liveness e readiness estão vazias
- o token do Hugging Face é modelado como um valor literal de variável de ambiente
- é pedida uma GPU por omissão
Use o chart como template inicial e acrescente as definições de produção abaixo.
Parta da estrutura real de valores do chart
O chart aninha a configuração do runtime em deployment, e os argumentos do launcher são uma lista de pares nome/valor. Uma sobreposição mínima define apenas o que difere dos valores por omissão acima: um digest de imagem testado, o modelo, o token do Hub a partir de um Secret e uma sonda de readiness. Guarde-a como values.production.yaml e substitua os marcadores de tag e digest por uma referência de imagem verificada. Uma réplica, uma GPU e um Service ClusterIP na porta 80 já são os valores por omissão do chart.
A sobreposição pressupõe que já existe um Secret lorax-hub com uma chave token no namespace inference. Crie-o antes da instalação se o modelo precisar de credenciais do Hub; caso contrário, remova a entrada env.
deployment:
    image:
        repository: ghcr.io/predibase/lorax
        tag: "<tested-release-tag>@sha256:<verified-image-digest>"

    args:
        - name: "--model-id"
          value: "mistralai/Mistral-7B-Instruct-v0.1"

    env:
        - name: HUGGING_FACE_HUB_TOKEN
          valueFrom:
              secretKeyRef:
                  name: lorax-hub
                  key: token

    readinessProbe:
        httpGet:
            path: /health
            port: http
        periodSeconds: 5
        failureThreshold: 600
O Helm substitui a lista args inteira. O chart por omissão também define limites de tokens (--max-input-length, --max-total-tokens, --max-batch-total-tokens, --max-batch-prefill-tokens), --compile e --eager-prefill false; copie os que quiser manter. Dimensione os limites de tokens a partir de prompts representativos, da concorrência esperada, da memória da GPU e de testes de carga. As definições do conjunto de trabalho da tabela acima vão para a mesma lista.
Corrija as lacunas de forma explícita
O template verificado do chart passa deployment.env por toYaml, por isso uma sobreposição normal de valores pode usar valueFrom.secretKeyRef para as credenciais do Hub, como acima. Formata a imagem como repository:tag, que aceita o valor de tag com digest mostrado acima: o Kubernetes usa o digest para descarregar a imagem quando ambos estão presentes. O chart fixa os volumes emptyDir no código e não tem ponto de configuração para startupProbe. Um /data duradouro e uma sonda de arranque precisam, por isso, de um fork revisto do chart, de um patch pós-renderização ou de uma camada de manifestos de nível superior.
Uma sobreposição de valores pode definir a tag da imagem com digest, os argumentos do launcher, os pedidos e limites de GPU, o env (incluindo secretKeyRef), as sondas de liveness e readiness e o tipo e a porta do Service. Use essa camada de produção para:
- um PersistentVolumeClaim ou uma cache de artefactos local ao nó montada em
/data - uma sonda de arranque antes de uma sonda de liveness agressiva
- política de disrupção de pods e distribuição topológica para várias réplicas
- NetworkPolicy, restrições da service account e um gateway autenticado
- verificações de integridade dos artefactos
Não coloque um token do Hub diretamente num ficheiro de valores com commit. Duas réplicas só dão alta disponibilidade útil se ambas conseguirem carregar o modelo base. O router também tem de evitar enviar todos os adaptadores frios para os dois pods.
Encaminhe para preservar a localidade da cache
O balanceamento round-robin pode transformar cada réplica numa cache fria. Um router útil associa um ID de adaptador permitido a uma réplica por hash ou por outra regra estável. Mantém um caminho de failover para quando essa réplica não está disponível. A figura repete seis pedidos para dois adaptadores com as duas regras.
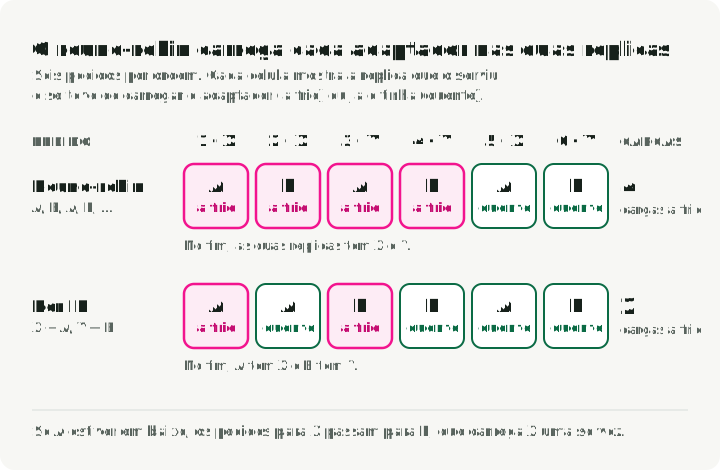
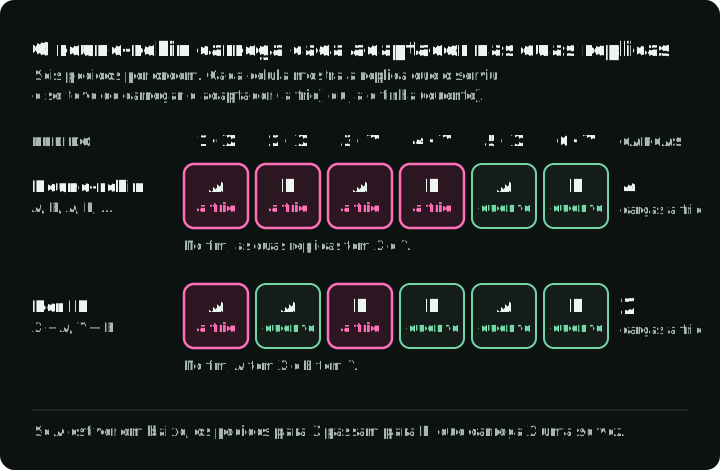
A chave de encaminhamento tem de vir do estado autenticado da aplicação, não de um parâmetro de URL público arbitrário. Caso contrário, quem faz o pedido pode forçar downloads remotos, provocar rotatividade nas caches ou sondar nomes de adaptadores privados.
LoRAX ou vLLM?
A documentação do vLLM verificada a 8 de outubro de 2026 descreve módulos LoRA declarados no arranque e carregamento dinâmico através de endpoints ou plugins de resolução. Avisa que a atualização de adaptadores em tempo de execução tem riscos de segurança e não deve ser usada em produção fora de um ambiente isolado e de confiança.
A tabela compara a forma como cada runtime encontra, guarda e serve adaptadores:
| Questão | LoRAX | vLLM |
|---|---|---|
| Como se descobrem adaptadores de cauda longa? | O ID do adaptador pode resolver artefactos do Hugging Face, Predibase, S3 ou de caminho local, a pedido | Módulos estáticos, endpoints de gestão dinâmica ou plugins de resolução |
| Como se gere a residência? | Escalonamento das trocas de adaptadores; os novos carregamentos usam ficheiros em cache ou tensores retidos no host, consoante o carregador | Limites configurados de LoRA ativos e na CPU, mais o comportamento do resolvedor |
| Qual é a interface de pedidos? | /generate ao estilo TGI, cliente Python e chat compatível com OpenAI | Serving compatível com OpenAI e APIs Python nativas |
| O que deve decidir? | Latência a frio e a quente, rotatividade da cache, débito de lotes heterogéneos e adequação operacional | A mesma reprodução da carga de trabalho e os mesmos critérios operacionais |
Evite regras como “LoRAX para 1000 adaptadores, vLLM para dez”. O tamanho do catálogo, por si só, não determina o desempenho. Faça benchmarks de ambos com a mesma base, os mesmos adaptadores, prompts, ranks, trace de chegadas e hardware.
Um teste de aceitação de produção
Antes de expandir o catálogo, execute uma reprodução que inclua:
- Um conjunto quente fixo, para estabelecer o débito e a latência a quente.
- Uma distribuição de cauda longa, para medir os acertos na cache de artefactos e nos tensores retidos no host, se o carregador o suportar.
- Uma rajada de adaptadores nunca vistos, mas permitidos pela lista de permissões.
- A substituição de pods, para medir a recuperação da base e dos adaptadores.
- Um adaptador indisponível ou corrompido, para verificar o isolamento e o fallback.
- Tenants concorrentes, para verificar a autenticação, as quotas e as etiquetas das métricas.
Acompanhe estas métricas:
- taxa de pedidos
- tempo de fila
- tempo até ao primeiro token
- latência entre tokens
- latência total
- tempo de carregamento do adaptador
- classe de acerto na cache
- memória da GPU
- memória da CPU
- bytes descarregados
- falhas por motivo
Mantenha os IDs de adaptador fora de etiquetas de métricas sem limite. Associe-os a dimensões controladas ou a traces amostrados.
Defina limiares de aceitação antes do teste. Defina uma taxa máxima de erros no caminho frio e um objetivo de P99 a quente. Defina também um objetivo de acertos na cache para a distribuição de popularidade observada e um objetivo de tempo de recuperação após a perda de um pod.
Conclusão
O LoRAX serve muitos modelos compatíveis com fine-tuning sem muitas cópias separadas do modelo base. Isso pode ser um desenho útil para cargas de cauda longa, mas não torna o custo nem a latência constantes por definição. O conjunto ativo de trabalho, o caminho de troca, a mistura do lote e a camada de armazenamento continuam a determinar o resultado.
Comece por provar esses mecanismos numa única GPU. Depois, em Kubernetes: fixe os artefactos, preserve a cache, proteja as credenciais, autorize os adaptadores, encaminhe para preservar a localidade e meça cada caminho de residência. Se o LoRAX vencer uma configuração atual do vLLM com a mesma reprodução, os resultados sustentam a decisão de implementação.
Referências
- Repositório e README do LoRAX — funcionalidades suportadas, requisitos, APIs, cliente Python e chart Helm
- Fontes de adaptadores do LoRAX — carregamento a partir do Hub, Predibase, local e S3
- Referência do launcher do LoRAX — argumentos de memória de adaptadores, troca, pré-carregamento e quantização
- Relatório de lançamento do LoRAX e benchmark de 2023 — origem e condições do gráfico de custos
- Valores do chart do LoRAX e template do Deployment — valores por omissão verificados e comportamento dos volumes
- Punica: Multi-Tenant LoRA Serving — o kernel SGMV para lotes de adaptadores mistos
- Text Generation Inference — o projeto de que o LoRAX fez fork, agora em modo de manutenção
- Adaptadores LoRA no vLLM — serving estático e dinâmico de adaptadores
- Artigo do LoRA — método de adaptação de baixo rank
- Documentação do PEFT do Hugging Face — formatos de adaptadores e integração com o treino