Gids voor LoRAX serving: LoRA-adapters op Kubernetes op grote schaal

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Deze gids is bedoeld voor inference- en platformengineers die veel LoRA-varianten vanuit één base model moeten serveren. Hij laat zien hoe je de APIs van LoRAX test, de working set dimensioneert en de Helm chart uit de repository omzet in een expliciet productieplan.
Eén base model met veel LoRA-adapters levert een ongebruikelijk serving-probleem op. De base weights worden gedeeld, maar elk verzoek kan een andere set adapter weights nodig hebben. Een gebruikelijk ontwerp met één deployment per variant verspilt GPU-geheugen als de meeste varianten niets te doen hebben.
LoRAX pakt die long tail aan. Het laadt adapters op verzoek, batcht verzoeken voor verschillende adapters en wisselt welke adapter weights GPU-geheugen bezetten. De aantrekkelijke kop is “duizenden fine-tuned models op één GPU”. De technische vraag is smaller: helpt exchange scheduling, gegeven jouw actieve adapterset, aankomstpatroon en latency-doel, genoeg om nog een serving-runtime te rechtvaardigen?
Het serving-probleem is de working set
LoRA bevriest een base model en leert low-rank updates voor geselecteerde weight matrices. De resulterende adapter is meestal veel kleiner dan een volledige checkpoint, maar de grootte hangt nog steeds af van rank, doelmodules, aantal lagen en dtype. Vaste beweringen als “elke adapter is 100 MB” zijn slechte invoer voor capaciteitsplanning.
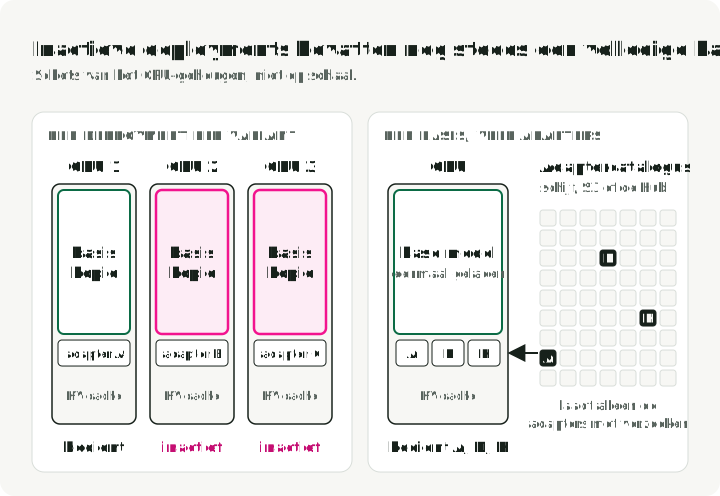
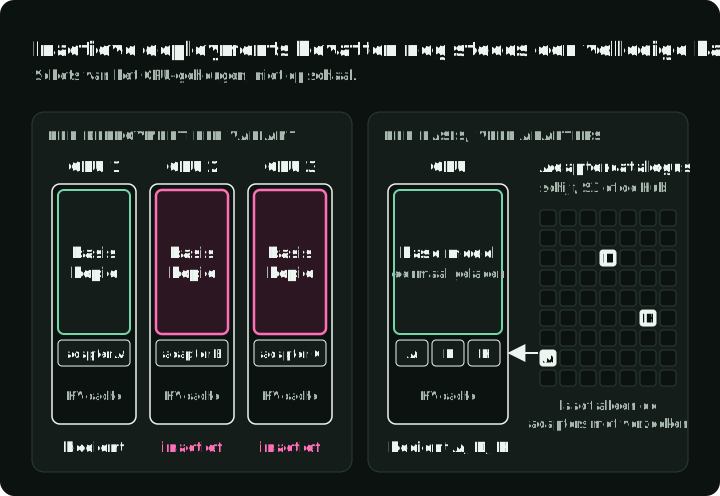
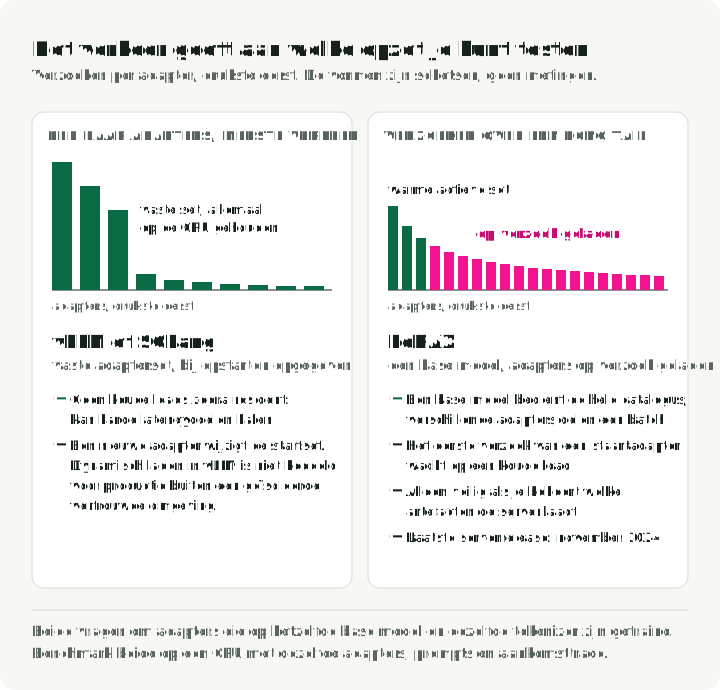
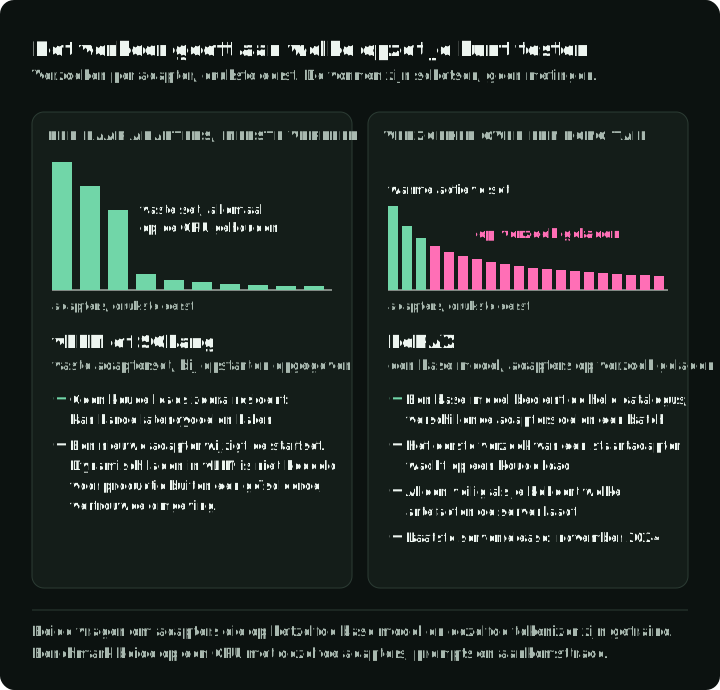
Als elke fine-tuned variant een eigen deployment krijgt, bevat elke deployment een volledige kopie van de base weights, of er nu verkeer binnenkomt of niet. De linkerkant van de figuur toont dat ontwerp. De rechterkant toont één base model dat alleen de adapters laadt die verzoeken ontvangen.
Voor serving maak je onderscheid tussen drie grootheden:
- Omvang van de catalogus: elke adapter die een platform uit opslag kan ophalen
- Actieve working set: adapters die binnen de bewaartermijn van de cache verzoeken ontvangen
- Gelijktijdige set: adapters die op hetzelfde moment in batches voorkomen
Elke set is een deelverzameling van de vorige: de gelijktijdige set zit binnen de actieve working set, en die zit binnen de catalogus. Capaciteitsplanning begint bij de actieve working set. Een catalogus van 5.000 adapters kan bijvoorbeeld 200 actieve adapters in het afgelopen uur hebben en 8 in één batch.
Een catalogus kan duizenden adapters bevatten zonder dat er duizenden in het VRAM passen. Wat telt, is hoe vaak de actieve set verandert, hoe groot die adapters zijn en of verzoeken voor verschillende adapters nuttige batches kunnen delen.
LoRAX combineert vier mechanismen:
- Het base model blijft resident voor alle compatibele adapters.
- Een verzoek noemt een adapter, die LoRAX ophaalt van Hugging Face, Predibase, S3 of een lokaal pad (de parameter
adapter_source). - Adapter exchange scheduling haalt adapters vooraf op en geeft GPU weights vrij om ruimte te maken voor andere adapters. Een latere load kan gecachete artefacten hergebruiken.
- Heterogene continuous batching groepeert verzoeken die verschillende adapters gebruiken.
LoRAX is een fork van Hugging Face Text Generation Inference (TGI) en behoudt daarom de /generate API van TGI. Het past verschillende adapters binnen één batch toe met SGMV-kernels uit het Punica-project. Deze kernels groeperen rijen die bij elke aangepaste laag verschillende adaptermatrices gebruiken. De LoRAX-implementatie voert afzonderlijke shrink- en expand-projecties uit: eerst naar de low-rank dimensie en vervolgens terug naar de uitvoerdimensie van de laag.
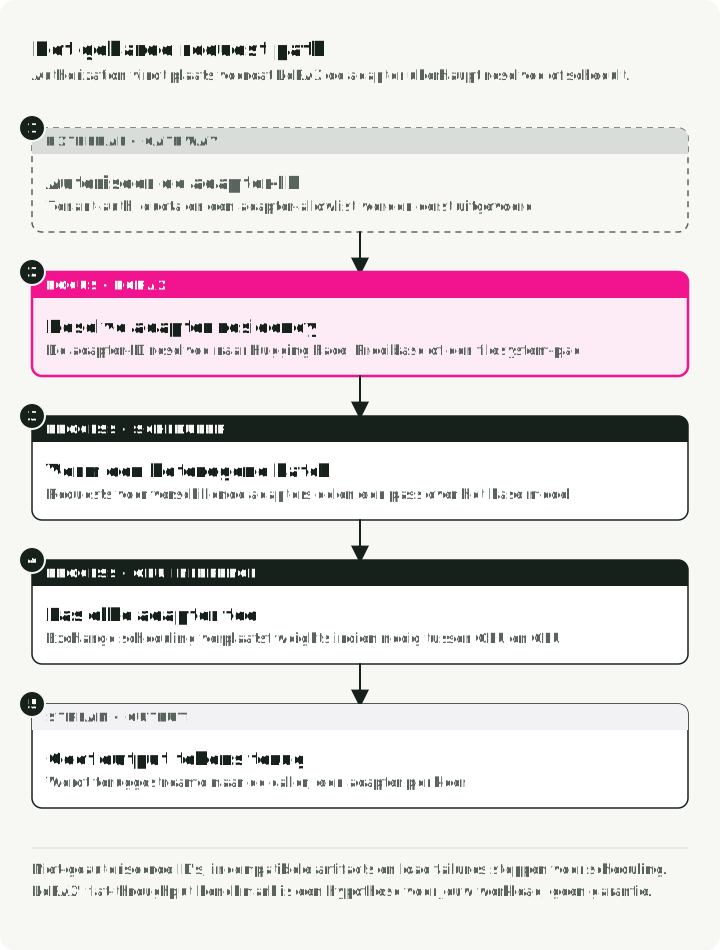
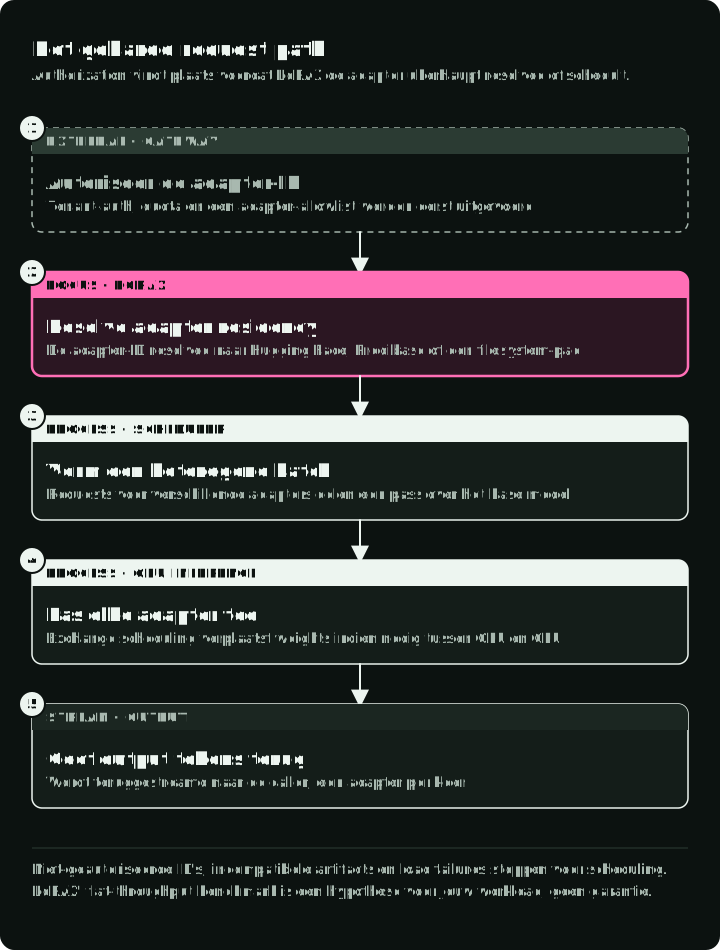
De figuur volgt vier verzoeken door een productieopzet. Een gateway voor LoRAX controleert eerst de tenant en het adapter-ID; de beveiligingssecties hieronder leggen uit waarom. Daarna zoekt LoRAX de adapter. Staat de adapter niet op de GPU, dan laadt LoRAX gecachete artefacten of downloadt het ontbrekende bestanden. Ook bewaarde hosttensors kunnen worden hergebruikt als de loader ze bewaart. Vervolgens batcht het het verzoek met verzoeken voor andere adapters en streamt het tokens terug.
Het LoRAX-project meldt dat heterogene batching de throughput en latency in zijn benchmarks vrijwel constant houdt naarmate het aantal gelijktijdige adapters groeit. Behandel dat resultaat van de leverancier als hypothese voor jouw workload. Promptlengte, uitvoerlengte, rank, doelmodules, bezetting van batches, cache-churn en GPU-generatie kunnen het resultaat veranderen.
De onderstaande grafiek komt uit het LoRAX-lanceringsrapport van Predibase uit november 2023. Predibase benchmarkte Llama 2 7B met queries verdeeld over 1 tot 128 adapters op één NVIDIA A10G. Deze grafiek toont de kostenvergelijking voor 1 tot 32 adapters bij het verwerken van een miljoen tokens, gelijk verdeeld over de adapters.
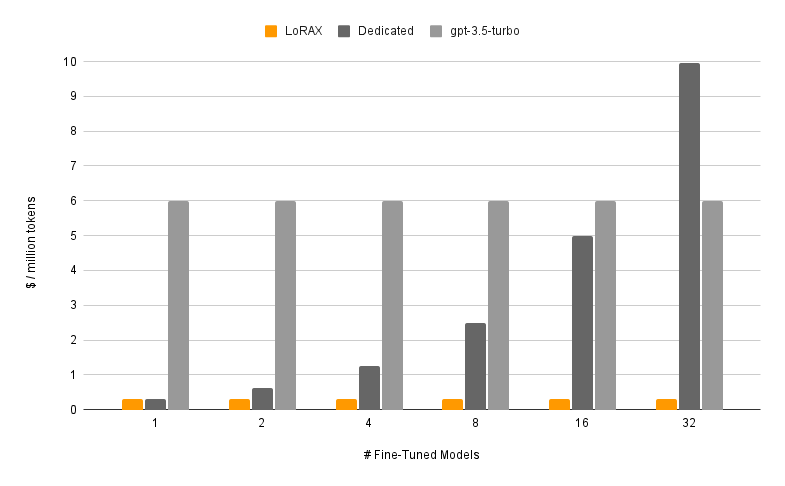
Gearchiveerde projectvergelijking, overgenomen uit het LoRAX-rapport van Predibase uit 2023. De kosten van LoRAX en dedicated deployments gebruiken GPU-uren uit dat experiment. Op het detailniveau van de bron gebruikt de lijn voor GPT-3.5 Turbo de kosten per token van het fine-tuned model.
Lees de vlakke oranje balken als uitkomst van die benchmarkopzet, niet als een belofte over de huidige prijs. De test verstuurde in totaal een vast aantal van een miljoen tokens en liet verschillende adapters een batch delen. De dedicated baseline ging uit van aparte gehoste rekenkracht per model, waardoor de kosten meestegen met het aantal models.
Predibase publiceerde de tokenmix, de aanvraaglengtes, de batchgrootte, de adapterrank en de GPU-prijs niet, dus de dollarbedragen zijn niet te reproduceren.
De grafiek zegt ook niets over schaars verkeer, koude downloads, actuele cloudprijzen, nieuwere GPUs, andere base models of adapters met een andere rank. Gebruik hem als reden om je eigen verkeer opnieuw af te spelen.
Wanneer LoRAX een redelijke keuze is
Benchmark LoRAX als aan al deze voorwaarden is voldaan:
- de adapters zijn getraind op hetzelfde ondersteunde base model en hetzelfde tokenizercontract
- het verkeer verdeelt zich over veel adapters, met een betekenisvolle long tail
- een koude adapter op verzoek laden is beter dan er een deployment voor reserveren
- routing per tenant of taak bestaat al aan de applicatiegrens
- het team kan een gespecialiseerde inference-runtime en het cachegedrag ervan beheren
- het team accepteert een runtime met weinig upstream-releases
Typische gevallen zijn tenantspecifieke assistenten, veel domeinvarianten en online experimenten die een basischeckpoint delen.
LoRAX past minder goed als een paar adapters het meeste verkeer krijgen of als de models geen basis delen. Ook past het minder goed als harde latency-doelen koude loads niet verdragen, of als het platform niet veilig kan bepalen welke artefacten de server laadt. In die gevallen is een standaard vLLM- of SGLang-deployment met een vaste adapterset mogelijk eenvoudiger. Vaste sets zijn een deploymentkeuze: SGLang ondersteunt ook dynamisch laden, net als vLLM hieronder. TGI zelf zit inmiddels in onderhoudsmodus en de maintainers raden vLLM of SGLang aan.
Controleer de activiteit van het project voordat je je vastlegt. Op 8 oktober 2026 is de laatste LoRAX-serverrelease v0.12.1, van november 2024. De repository kreeg tot april 2025 regelmatig commits en sindsdien slechts twee kleine fixes. Als je het gebruikt, plan dan zelf de upgrades voor nieuwe models, CUDA-versies en beveiligingsfixes.
De figuur vergelijkt twee opzetten om te testen op basis van de verkeersverdeling: een vaste adapterset wanneer een paar adapters de meeste verzoeken krijgen, dynamisch laden in LoRAX wanneer verzoeken over een long tail verspreid zijn. Een warme actieve set kan in de dynamische modus nog steeds uit het geheugen worden verwijderd; het is geen vaste vooraf geladen set.
Gebruik Kubernetes niet alleen omdat de catalogus groot is. Bewijs eerst op één GPU dat de runtime en de adaptercompatibiliteit werken.
Probeer lokaal één base model en één adapter
De LoRAX README raadt de kant-en-klare container aan. Gebruik in een echte omgeving een onveranderlijke image digest. main staat hier alleen omdat het de gedocumenteerde quick-starttag van de repository is. Controleer de voorbeelden aan de hand van de image- en dependencyversies die je deployt.
Installeer en configureer NVIDIA Container Toolkit voor Docker voordat je de container start. De LoRAX README vereist ook Linux, Docker, een NVIDIA GPU van de Ampere-generatie of nieuwer en drivers die compatibel zijn met CUDA 11.8. Modellicenties en afgeschermde repositories kunnen een Hugging Face-token vereisen.
mkdir -p data

docker run --rm --gpus all --shm-size 1g \
    -p 127.0.0.1:8080:80 \
    -v "$PWD/data:/data" \
    ghcr.io/predibase/lorax:main \
    --model-id mistralai/Mistral-7B-Instruct-v0.1
Het expliciete hostadres bindt de gepubliceerde poort aan loopback; zonder dit adres publiceert Docker standaard op alle hostadressen. Gebruik Docker 28 of nieuwer: oudere releases kunnen poorten die op localhost zijn gepubliceerd bereikbaar maken voor hosts op hetzelfde netwerksegment. Laat de container in deze terminal draaien. Wacht in een tweede terminal tot curl --fail http://127.0.0.1:8080/health slaagt voordat je verzoeken verstuurt.
Begin met het base model:
curl http://127.0.0.1:8080/generate \
    -H 'Content-Type: application/json' \
    -d '{
      "inputs": "[INST] Give one reason to measure cold-adapter latency. [/INST]",
      "parameters": {"max_new_tokens": 64}
    }'
Stuur daarna een compatibele adapter mee. Deze GSM8K-wiskundeadapter geeft mistralai/Mistral-7B-Instruct-v0.1 op als basis, hetzelfde model als dat de server draait:
curl http://127.0.0.1:8080/generate \
    -H 'Content-Type: application/json' \
    -d '{
      "inputs": "[INST] Solve: Natalia sold 48 clips in April and half as many in May. What is the total? [/INST]",
      "parameters": {
        "max_new_tokens": 64,
        "adapter_id": "vineetsharma/qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k"
      }
    }'
Een geslaagd /generate-antwoord is een JSON-array met generated_text; het gegenereerde antwoord hangt af van het model en sampling. Het eerste adapterverzoek downloadt en laadt de adapter mogelijk. Latere verzoeken kunnen gecachete artefacten en residente weights gebruiken. Registreer beide paden. Eén warm verzoek zegt weinig over het gedrag bij een long tail.
De adapter hierboven komt van de Hugging Face Hub. Laad adapters in productie uit opslag die het platform zelf beheert. De adapterdocumentatie beschrijft twee van zulke bronnen: local voor een map in de container en s3 voor een S3-URI, met AWS-credentials in de omgeving. Kopieer de adapterbestanden naar de gemounte map en vervang vervolgens parameters in de eerdere payload door dit fragment:
"parameters": {
    "adapter_id": "/data/adapters/vineetsharma--qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k",
    "adapter_source": "local"
}
Gebruik de Python-client
Het pakket lorax-client omhult /generate. Installeer het met pip install lorax-client==0.6.3. Dezelfde aanroep werkt met en zonder adapter_id, zodat je het base model en de adapter op één prompt kunt vergelijken:
from lorax import Client

client = Client("http://127.0.0.1:8080")

prompt = (
    "[INST] Natalia sold clips to 48 of her friends in April, and then she "
    "sold half as many clips in May. How many clips did Natalia sell "
    "altogether in April and May? [/INST]"
)

# Base model
print(client.generate(prompt, max_new_tokens=64).generated_text)

# Same prompt through the GSM8K adapter
adapter_id = "vineetsharma/qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k"
print(
    client.generate(prompt, max_new_tokens=64, adapter_id=adapter_id).generated_text
)
Gebruik een OpenAI-compatibele client
LoRAX biedt ook een OpenAI-compatibel chat-endpoint. Installeer de client met pip install openai==3.26.1. Het veld model geeft de adapter aan:
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://127.0.0.1:8080/v1",
)

response = client.chat.completions.create(
    model="vineetsharma/qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k",
    messages=[
        {"role": "user", "content": "Explain cache locality in two sentences."},
    ],
    max_tokens=100,
)

print(response.choices[0].message.content)
De server vereist standaard geen API-sleutel. Dat is handig op localhost en onveilig als configuratie die vanaf internet bereikbaar is. Zet authenticatie, tenantautorisatie, quota en een allowlist voor adapters ervoor.
Controleer de adaptercompatibiliteit bij registratie
Controleer voordat een adapter in de catalogus komt minimaal:
- het opgegeven base model en de revisie
- compatibiliteit van tokenizer en chattemplate
- LoRA-rank en doelmodules die de runtime ondersteunt
- artefactformaat en tensorvormen
- licentie, herkomst en integriteitsdigest
- een kleine testsuite voor gedrag en regressie
Wijs incompatibele artefacten af tijdens de registratie, niet bij het eerste verzoek van een gebruiker.
Begrijp residentie voordat je deployt
Het base model gebruikt het grootste vaste deel van het GPU-geheugen. Adapter weights, KV cache, batchwerkruimte en runtime kernels strijden om de rest. /data slaat gedownloade artefacten op. CPU-RAM kan gematerialiseerde adaptertensors bevatten, maar alleen als de loader ze bewaart.
In de gecontroleerde main-implementatie op a7394ba cachet de standaardloader voor één adapter bestandsreferenties. Offloading verwijdert GPU weights uit de adaptermaps; een later verzoek kan de gecachete bestanden opnieuw lezen en materialiseren. De standaardloader in v0.12.1 gebruikt ook bestandsreferenties. Samengevoegd of niet-lazy laden en de bestandscache van het besturingssysteem kunnen anders werken. Tel daarom niet elke offload als een hit op bewaarde CPU-tensors.
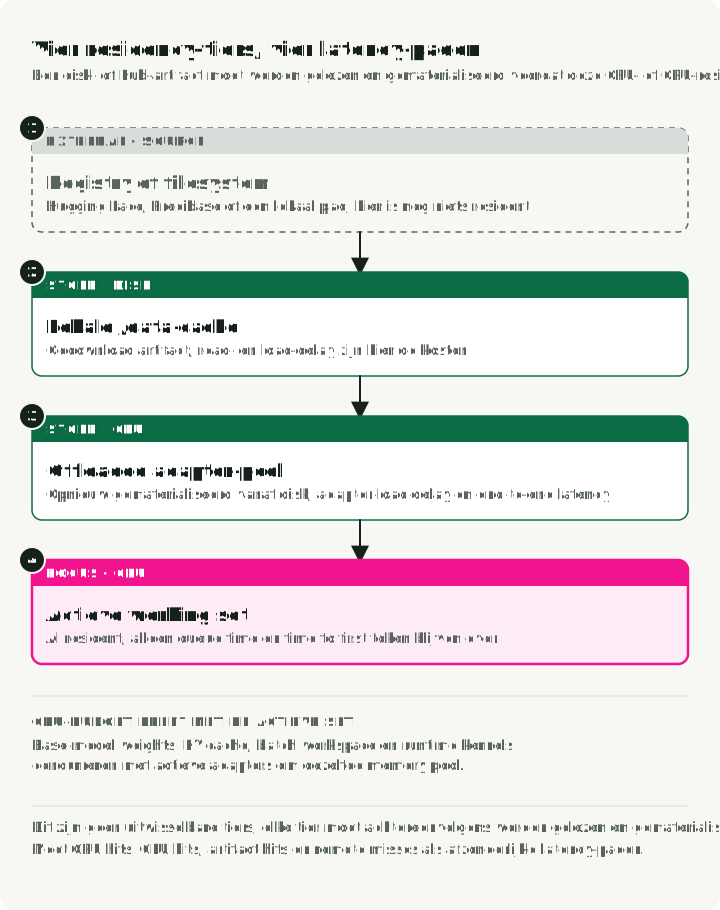
Dit zijn afzonderlijke gemeten toestanden. Een artefact op schijf of op de Hub moet worden gelezen en gematerialiseerd voordat het een adapter wordt die in CPU- of GPU-geheugen resident is. De figuur tekent de vier mogelijke paden uit de tabel hieronder als tijdbalken; het CPU-pad geldt alleen als hosttensors worden bewaard. Elke extra laadstap voegt werk toe vóór het eerste token.
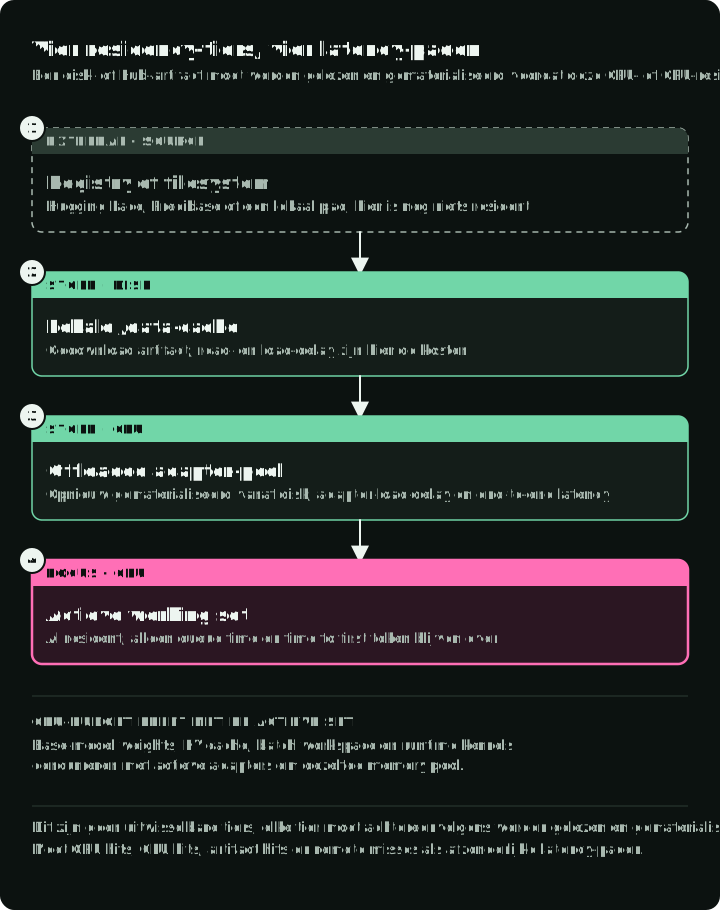
Meet de overgangen apart:
| Pad | Wat het omvat | Te registreren metriek |
|---|---|---|
| GPU hit | Adapter is al resident | wachttijd en time to first token |
| CPU hit | Overdracht van bewaarde hosttensors, indien beschikbaar | laadvertraging van de adapter en end-to-end latency |
| Artifact hit | Lezen uit de lokale /data-cache | lees- en laadvertraging en cachebytes |
| Remote miss | Download plus validatie en load | downloadtijd, fouten en volledige koude latency |
Gebruik voor capaciteitsplanning een replay van de echte populariteitsverdeling van adapters. Uniform willekeurige adapter-ID’s geven een ander cacheprobleem dan een workload met een paar populaire adapters en veel zelden gebruikte adapters.
Launcher-instellingen die de working set veranderen
Deze launcherargumenten bepalen hoeveel adapters op de GPU blijven, hoeveel geheugen ze krijgen en of laden vast of dynamisch is. De standaardwaarden hieronder zijn op 8 oktober 2026 gecontroleerd tegen main op a7394ba; de launcherreferentie toont elk argument.
| Instelling | Standaard | Wijzig het als |
|---|---|---|
--preloaded-adapter-ids | geen | je een vaste vooraf geladen set wilt en accepteert dat dynamisch laden van adapters wordt uitgeschakeld |
--max-active-adapters | 1024 | je wilt begrenzen hoeveel adapters tegelijk op de GPU kunnen staan en verzoeken kunnen accepteren |
--adapter-memory-fraction | 0.1 | het aantal GPU hits laag is; een hogere waarde houdt meer adapters op de GPU en verkleint de KV cache |
--adapter-cycle-time-s | 2 | exchanges te vaak (cache-churn) of te traag (wachtende verzoeken voor uit het GPU-geheugen verwijderde adapters) gebeuren |
--quantize | uit | het base model te weinig GPU-geheugen overlaat voor adapters en KV cache |
Vooraf laden en dynamisch laden zijn afzonderlijke modi. Zowel v0.12.1 als de gecontroleerde main weigeren nieuwe dynamische adapters nadat een vooraf geladen set is geregistreerd. Main zet bovendien de dynamische reservering van adaptergeheugen op nul als vooraf geladen ID’s aanwezig zijn; v0.12.1 past die launcheraanpassing niet toe.
Laat voor dynamische long-tail serving --preloaded-adapter-ids weg en warm populaire adapters na het opstarten op met gewone geautoriseerde verzoeken. Geheugen- en scheduling-instellingen bepalen hoelang ze resident blijven; opwarmen pint ze niet. Kies deze waarden met de replay uit “Een acceptatietest voor productie” hieronder.
Deploy de chart uit de repository zorgvuldig
Je hebt een cluster nodig met GPU-nodes die nvidia.com/gpu beschikbaar stellen via de NVIDIA device plugin of de GPU Operator, plus kubectl en helm op je werkstation. De chart vraagt die resource aan, dus de pod blijft op een cluster zonder die resource in de status Pending staan.
De repository bevat charts/lorax, dus het herhaalbare vertrekpunt is een gepinde repositoryrevisie en een lokale chart:
git clone https://github.com/predibase/lorax.git
cd lorax
git checkout <reviewed-commit-or-release>

helm dependency update charts/lorax
helm template lorax charts/lorax -f values.production.yaml
helm upgrade --install lorax charts/lorax \
    --namespace inference \
    --create-namespace \
    -f values.production.yaml
De chart noemt de Deployment lorax-<release> en de Service naar service.name (standaard lorax). Wacht op de rollout, volg de logs tot het base model is geladen, forward dan de Service-poort en voer de curl-verzoeken uit het lokale gedeelte opnieuw uit tegen 127.0.0.1:8080:
kubectl -n inference rollout status deploy/lorax-lorax
kubectl -n inference logs -f deploy/lorax-lorax
kubectl -n inference port-forward svc/lorax 8080:80

# remove the release when you are done
helm uninstall lorax -n inference
Zoals gecontroleerd op 8 oktober 2026 tonen de chartwaarden en de Deployment-template op a7394ba deze standaardwaarden:
- de image-tag is
latest /datais eenemptyDir, dus bij vervanging van de pod verdwijnen gedownloade artefacten- de liveness- en readiness-probes zijn leeg
- het Hugging Face-token is gemodelleerd als letterlijke omgevingswaarde
- standaard wordt één GPU aangevraagd
Gebruik de chart als startsjabloon en voeg de productie-instellingen hieronder toe.
Begin bij de werkelijke waardenstructuur van de chart
De chart plaatst de runtimeconfiguratie onder deployment en launcherargumenten zijn een lijst van naam/waarde-paren. Een minimale overlay stelt alleen in wat afwijkt van bovenstaande standaardwaarden: een geteste image digest, het model, het Hub-token uit een Secret en een readiness-probe. Sla dit op als values.production.yaml en vervang de placeholders voor tag en digest door een geverifieerde imagereferentie. Eén replica, één GPU en een ClusterIP-Service op poort 80 zijn al de standaard van de chart.
De overlay gaat ervan uit dat een Secret lorax-hub met een sleutel token al bestaat in de namespace inference. Maak die vóór de installatie aan als het model Hub-credentials nodig heeft; verwijder anders de env-vermelding.
deployment:
    image:
        repository: ghcr.io/predibase/lorax
        tag: "<tested-release-tag>@sha256:<verified-image-digest>"

    args:
        - name: "--model-id"
          value: "mistralai/Mistral-7B-Instruct-v0.1"

    env:
        - name: HUGGING_FACE_HUB_TOKEN
          valueFrom:
              secretKeyRef:
                  name: lorax-hub
                  key: token

    readinessProbe:
        httpGet:
            path: /health
            port: http
        periodSeconds: 5
        failureThreshold: 600
Helm vervangt de hele lijst args. De standaard van de chart stelt ook tokenlimieten in (--max-input-length, --max-total-tokens, --max-batch-total-tokens, --max-batch-prefill-tokens), --compile en --eager-prefill false; kopieer degene die je wilt behouden. Bepaal de tokenlimieten aan de hand van representatieve prompts, verwachte concurrency, GPU-geheugen en load tests. De working-set-instellingen uit de tabel hierboven komen in dezelfde lijst.
Vul de ontbrekende onderdelen expliciet aan
De gecontroleerde charttemplate geeft deployment.env door via toYaml, dus een gewone values-overlay kan valueFrom.secretKeyRef voor Hub-credentials gebruiken, zoals hierboven. De template formatteert de image als repository:tag, wat de hierboven getoonde combinatie van tag en digest accepteert: Kubernetes gebruikt de digest om de image op te halen als beide aanwezig zijn. De chart legt de emptyDir-volumes vast en heeft geen hook voor een startupProbe. Duurzame /data en een startup-probe vereisen daarom een gereviewde chartfork, een post-render patch of een manifestlaag op hoger niveau.
Een values-overlay kan de image-tag plus digest, launcher-args, GPU-requests en -limits, env (inclusief secretKeyRef), liveness- en readiness-probes en het Service-type en de poort instellen. Gebruik die productielaag voor:
- een PersistentVolumeClaim of een node-lokale artefactcache die op
/datais gemount - een startup-probe vóór een agressieve liveness-probe
- pod disruption policy en topology spread voor meerdere replica’s
- NetworkPolicy, beperkingen op service accounts en een geauthenticeerde gateway
- integriteitscontroles van artefacten
Zet een Hub-token niet rechtstreeks in een gecommit values-bestand. Twee replica’s bieden alleen nuttige hoge beschikbaarheid als beide het base model kunnen laden. De router moet er ook voor zorgen dat niet elke koude adapter naar beide pods gaat.
Route voor cachelokaliteit
Round-robin-balancing kan van elke replica een koude cache maken. Een bruikbare router wijst een toegestaan adapter-ID via een hash of een andere stabiele regel aan één replica toe. Hij houdt een failoverpad achter de hand voor als die replica niet beschikbaar is. De figuur speelt zes verzoeken voor twee adapters opnieuw af onder beide regels.
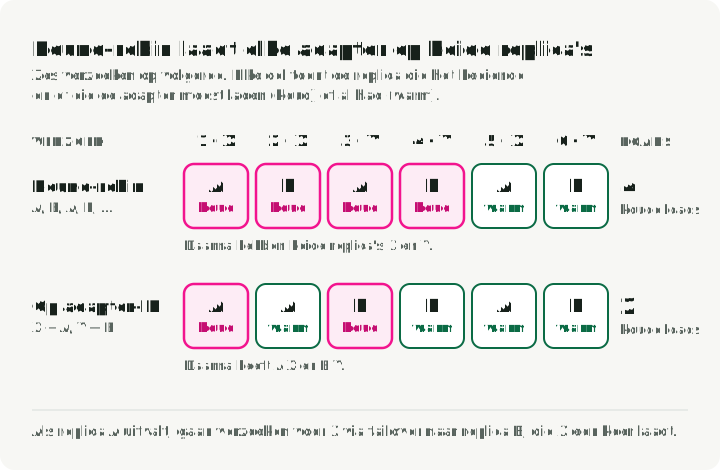
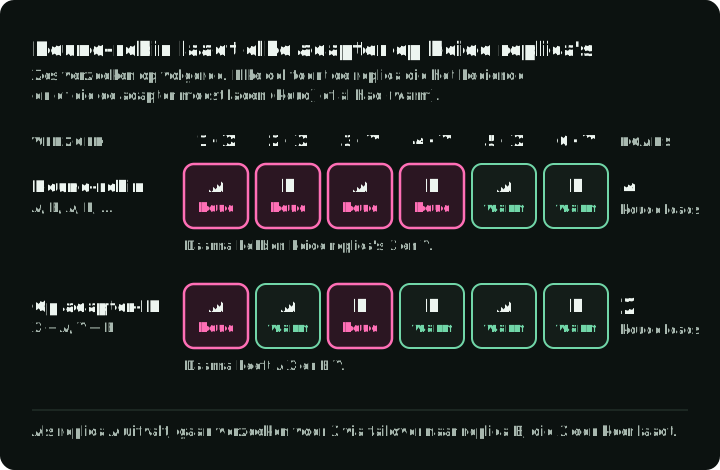
De sleutel voor routing moet uit geauthenticeerde applicatiestatus komen, niet uit een willekeurige publieke URL-parameter. Anders kan een aanroeper externe downloads afdwingen, caches laten churnen of privé-adapternamen aftasten.
LoRAX of vLLM?
De vLLM-documentatie, gecontroleerd op 8 oktober 2026, beschrijft LoRA-modules die bij het opstarten worden gedeclareerd en dynamisch laden via endpoints of resolver-plugins. Ze waarschuwt dat het bijwerken van adapters tijdens runtime beveiligingsrisico’s heeft en in productie niet mag worden gebruikt buiten een geïsoleerde, vertrouwde omgeving.
De tabel vergelijkt hoe elke runtime adapters vindt, vasthoudt en serveert:
| Vraag | LoRAX | vLLM |
|---|---|---|
| Hoe worden long-tail-adapters gevonden? | Een adapter-ID kan op verzoek verwijzen naar artefacten op Hugging Face, Predibase, S3 of een lokaal pad | Statische modules, dynamische beheerendpoints of resolver-plugins |
| Hoe wordt residentie beheerd? | Adapter exchange scheduling; opnieuw laden gebruikt gecachete bestanden of bewaarde hosttensors, afhankelijk van de loader | Ingestelde limieten voor actieve en CPU-LoRA’s plus resolvergedrag |
| Wat is de verzoekinterface? | /generate in TGI-stijl, Python-client en OpenAI-compatibele chat | OpenAI-compatibele serving en native Python-APIs |
| Waarop moet de keuze berusten? | Koude/warme latency, cache-churn, throughput van heterogene batches en operationele geschiktheid | Dezelfde workload-replay en operationele criteria |
Vermijd regels als “LoRAX voor 1.000 adapters, vLLM voor tien”. De omvang van de catalogus alleen bepaalt de prestaties niet. Benchmark beide met hetzelfde base model, dezelfde adapters, prompts, ranks, aankomsttrace en hardware.
Een acceptatietest voor productie
Voer voordat je de catalogus uitbreidt een replay uit die het volgende omvat:
- Een vaste hot set om de warme throughput en latency vast te stellen.
- Een long-tail-verdeling om artefactcache-hits en hits op bewaarde hosttensors te meten, als de loader dat ondersteunt.
- Een piek van eerder ongeziene maar toegestane adapters.
- Vervanging van pods om het herstel van base model en adapters te meten.
- Eén niet-beschikbare of corrupte adapter om isolatie en fallback te verifiëren.
- Gelijktijdige tenants om authenticatie, quota en metriclabels te verifiëren.
Volg deze metrieken:
- aanvraagsnelheid
- wachttijd
- time to first token
- latency tussen tokens
- totale latency
- laadtijd van adapters
- klasse van de cache-hit
- GPU-geheugen
- CPU-geheugen
- downloadbytes
- fouten per oorzaak
Houd adapter-ID’s buiten metriclabels zonder bovengrens. Koppel ze aan gecontroleerde dimensies of aan gesamplede traces.
Definieer de acceptatiedrempels vóór de test. Stel een maximaal foutpercentage voor het koude pad en een P99-doel voor warme verzoeken vast. Stel ook een doel voor het cache-hitpercentage bij de waargenomen populariteitsverdeling vast, en een recovery-time objective na verlies van een pod.
Conclusie
LoRAX serveert veel compatibele fine-tunes zonder veel afzonderlijke kopieën van het base model. Dat kan een bruikbaar ontwerp zijn voor long-tail-workloads, maar het maakt kosten of latency niet per definitie vlak. De actieve working set, het exchange-pad, de batchmix en de opslaglaag bepalen nog steeds het resultaat.
Bewijs die mechanismen eerst op één GPU. Doe dan, op Kubernetes: pin artefacten, behoud de cache, bescherm credentials, autoriseer adapters, route voor lokaliteit en meet elk residentiepad. Als LoRAX onder dezelfde replay beter presteert dan een actuele vLLM-configuratie, ondersteunen de metingen de deploymentbeslissing.
Referenties
- LoRAX repository en README — ondersteunde functies, vereisten, APIs, Python-client en Helm chart
- LoRAX-adapterbronnen — laden vanaf Hub, Predibase, lokaal en S3
- LoRAX-launcherreferentie — argumenten voor adaptergeheugen, exchange, preload en quantization
- LoRAX-lanceringsrapport en benchmark uit 2023 — bron en omstandigheden van de kostengrafiek
- LoRAX-chartwaarden en Deployment-template — gecontroleerde standaardwaarden en volumegedrag
- Punica: Multi-Tenant LoRA Serving — de SGMV-kernel voor batches met gemengde adapters
- Text Generation Inference — het project waarvan LoRAX een fork is, nu in onderhoudsmodus
- vLLM LoRA-adapters — statische en dynamische adapterserving
- LoRA-paper — de low-rank-adaptatiemethode
- Hugging Face PEFT-documentatie — adapterformaten en integratie met training