Guía de serving con LoRAX: adaptadores LoRA en Kubernetes a escala

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Esta guía es para ingenieros de inferencia y de plataforma que necesitan servir muchas variantes LoRA a partir de un único modelo base. Muestra cómo probar las API de LoRAX, dimensionar el conjunto de trabajo y convertir el chart de Helm inicial en un plan de producción explícito.
Un modelo base y muchos adaptadores LoRA plantean un problema de serving poco habitual. Los pesos base se comparten, pero cada petición puede necesitar un conjunto distinto de pesos de adaptador. Un diseño convencional con un despliegue por variante desperdicia memoria de GPU cuando la mayoría de las variantes están inactivas.
LoRAX aborda esa cola larga. Carga los adaptadores bajo demanda, agrupa en lotes peticiones de adaptadores distintos y cambia qué pesos de adaptador ocupan la memoria de la GPU. El titular atractivo es «miles de modelos fine-tuned en una sola GPU». La pregunta de ingeniería es más estrecha: dados tu conjunto activo de adaptadores, tu patrón de llegada y tu objetivo de latencia, ¿la planificación por intercambio ayuda lo suficiente como para justificar otro runtime de serving?
El problema de serving es el conjunto de trabajo
LoRA congela un modelo base y aprende actualizaciones de rango bajo para matrices de pesos seleccionadas. El adaptador resultante suele ser mucho más pequeño que un checkpoint completo, pero su tamaño sigue dependiendo del rango, de los módulos objetivo, del número de capas y del dtype. Afirmaciones fijas como «cada adaptador pesa 100 MB» son malas entradas para planificar la capacidad.
Si cada variante fine-tuned tiene su propio despliegue, cada despliegue contiene una copia completa de los pesos base, reciba tráfico o no. La parte izquierda de la figura muestra ese diseño. La derecha muestra un único modelo base que carga solo los adaptadores que reciben peticiones.
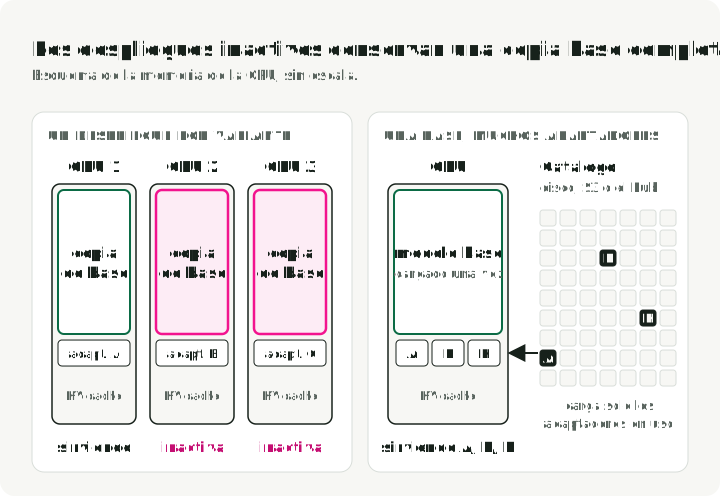
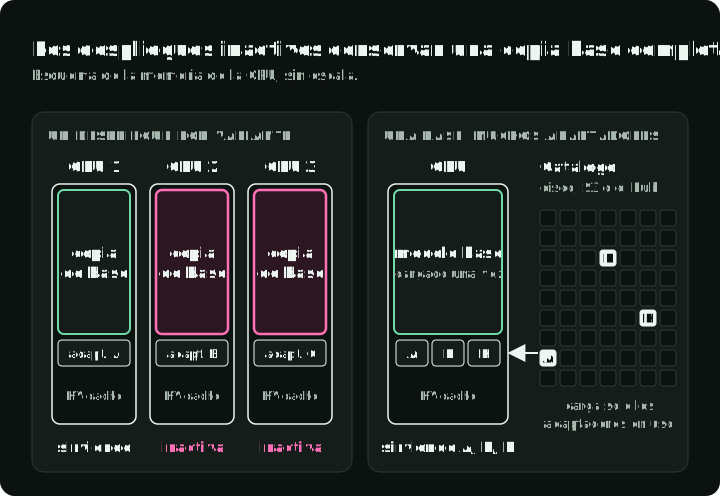
Para el serving hay que distinguir tres cantidades:
- Tamaño del catálogo: todos los adaptadores que una plataforma puede resolver desde el almacenamiento
- Conjunto de trabajo activo: adaptadores que reciben peticiones dentro de la ventana de retención de la caché
- Conjunto concurrente: adaptadores representados en los lotes en un mismo instante
Cada conjunto es un subconjunto del anterior: el conjunto concurrente está dentro del conjunto de trabajo activo, que está dentro del catálogo. La planificación de capacidad parte del conjunto de trabajo activo. Por ejemplo, un catálogo de 5.000 adaptadores puede tener 200 activos en la última hora y 8 en un mismo lote.
Un catálogo puede contener miles de adaptadores sin que quepan miles en la VRAM. Lo que importa es la frecuencia con que cambia el conjunto activo, el tamaño de esos adaptadores y si las peticiones de adaptadores distintos pueden compartir lotes útiles.
LoRAX combina cuatro mecanismos:
- El modelo base permanece residente para todos los adaptadores compatibles.
- Una petición nombra un adaptador, que LoRAX resuelve desde Hugging Face, Predibase, S3 o una ruta local (el parámetro
adapter_source). - La planificación por intercambio de adaptadores precarga adaptadores y libera pesos de la GPU para dejar sitio a otros. Una carga posterior puede reutilizar artefactos en caché.
- El continuous batching heterogéneo agrupa peticiones dirigidas a adaptadores distintos.
LoRAX es un fork de Text Generation Inference (TGI) de Hugging Face, por lo que conserva la API /generate de TGI. Aplica adaptadores distintos dentro de un mismo lote con los kernels SGMV del proyecto Punica. Estos kernels agrupan filas que usan matrices de adaptador distintas en cada capa adaptada. La implementación de LoRAX realiza proyecciones separadas de reducción y expansión: primero a la dimensión de rango bajo y después de vuelta a la dimensión de salida de la capa.
La figura sigue cuatro peticiones a través de una instalación de producción. Un gateway situado delante de LoRAX comprueba primero el tenant y el ID del adaptador; las secciones de seguridad que siguen explican por qué. Después LoRAX localiza el adaptador. Si el adaptador no está en la GPU, LoRAX carga artefactos en caché o descarga los archivos que faltan. También puede reutilizar tensores del host retenidos cuando el cargador los conserva. A continuación agrupa la petición en un lote con peticiones de otros adaptadores y devuelve los tokens en streaming.
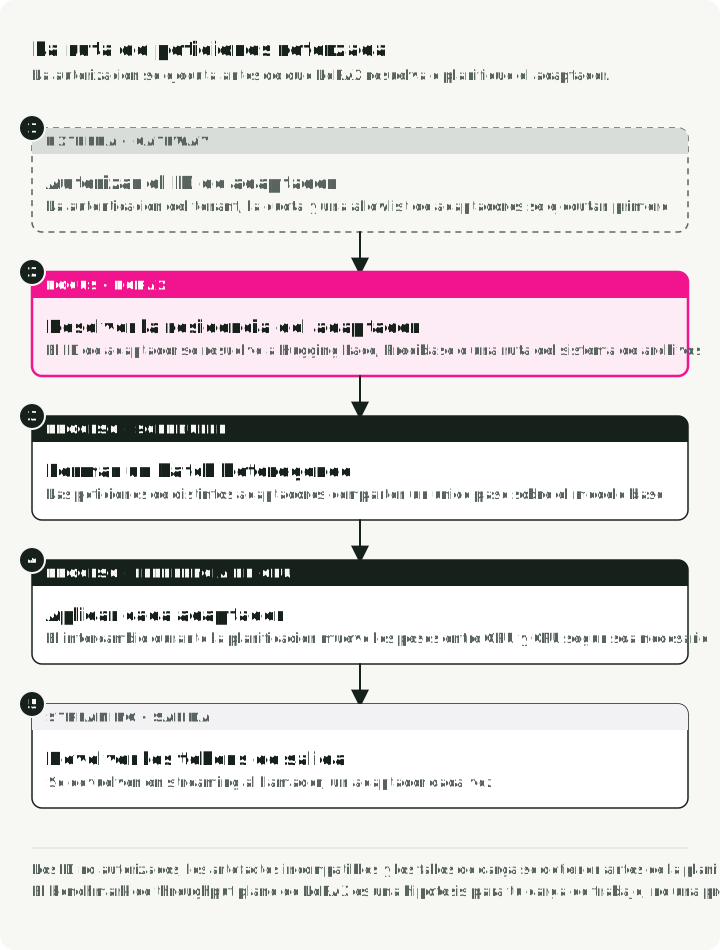
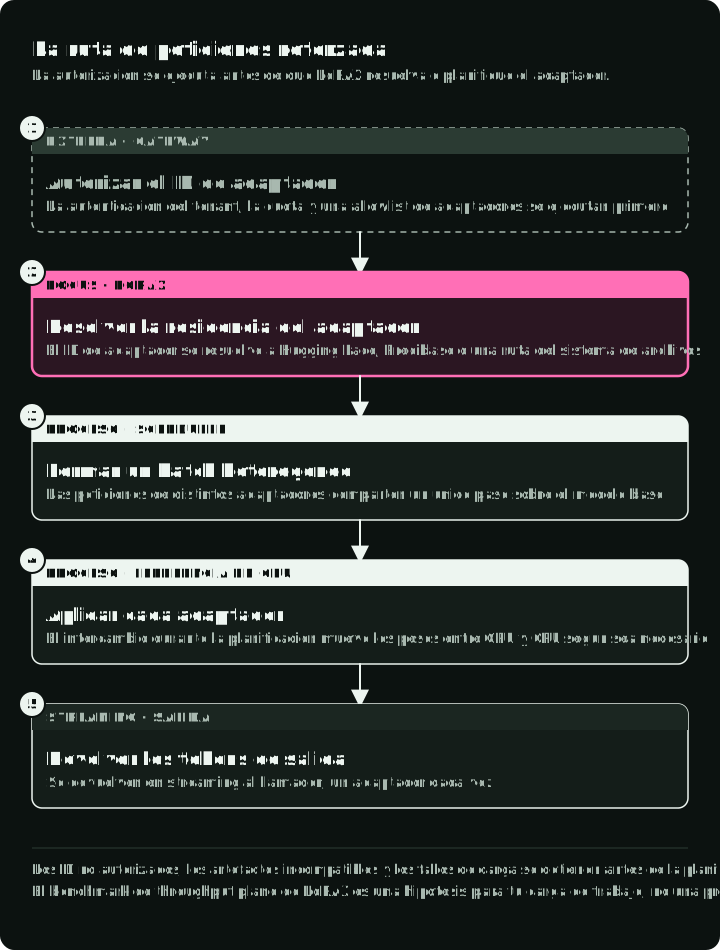
El proyecto LoRAX informa de que el batching heterogéneo mantiene el throughput y la latencia casi constantes al crecer el número de adaptadores concurrentes en sus benchmarks. Trata ese resultado del proveedor como una hipótesis para tu carga de trabajo. La longitud del prompt, la longitud de la salida, el rango, los módulos objetivo, la ocupación del lote, la rotación de la caché y la generación de la GPU pueden cambiar el resultado.
El gráfico siguiente procede del informe de lanzamiento de LoRAX de Predibase de noviembre de 2023. Predibase hizo benchmarks de Llama 2 7B con consultas repartidas entre 1 y 128 adaptadores en una sola NVIDIA A10G. Este gráfico muestra la comparación de costes entre 1 y 32 adaptadores para procesar un millón de tokens, repartidos a partes iguales entre los adaptadores.
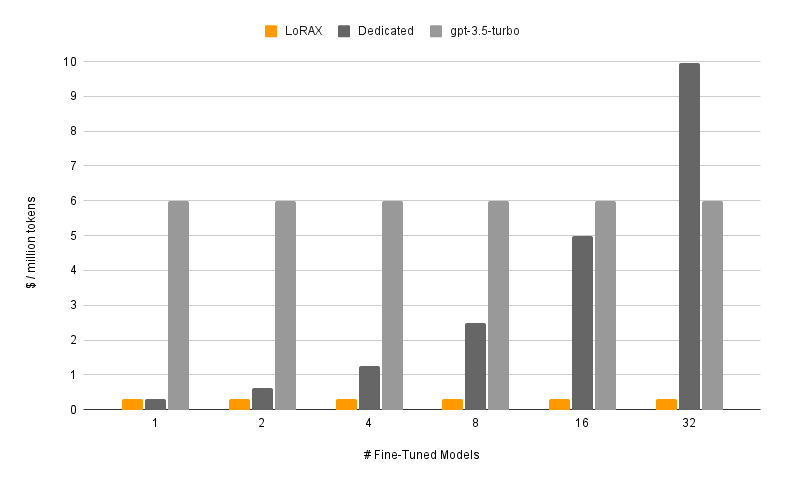
Comparación archivada del proyecto, reproducida del informe de LoRAX de Predibase de 2023. Los costes de LoRAX y de los despliegues dedicados usan horas de GPU de ese experimento. Con el nivel de detalle que da la fuente, la línea de GPT-3.5 Turbo usa el coste por token del modelo fine-tuned.
Lee las barras naranjas planas como resultado del diseño de ese benchmark, no como una promesa de precio actual. La prueba envió un total fijo de un millón de tokens y dejó que adaptadores distintos compartieran un lote. La referencia dedicada suponía cómputo alojado independiente para cada modelo, así que su coste subía con el número de modelos.
Predibase no publicó la mezcla de tokens, la longitud de las peticiones, el tamaño del lote, el rango de los adaptadores ni el precio de la GPU, así que los valores en dólares no se pueden reproducir.
El gráfico tampoco cubre tráfico disperso, descargas en frío, precios actuales de la nube, GPU más nuevas, otros modelos base ni adaptadores con rangos distintos. Úsalo como motivo para reproducir tu propio tráfico.
Cuándo LoRAX es una opción plausible
Haz un benchmark de LoRAX cuando se cumplan todas estas condiciones:
- los adaptadores se entrenaron sobre el mismo modelo base compatible y bajo el mismo contrato de tokenizador
- el tráfico abarca muchos adaptadores, con una cola larga significativa
- es preferible cargar bajo demanda un adaptador en frío a reservarle un despliegue
- el enrutado por tenant o por tarea ya existe en el límite de la aplicación
- el equipo puede operar un runtime de inferencia especializado y el comportamiento de su caché
- el equipo acepta un runtime con pocas versiones upstream
Los casos típicos incluyen asistentes específicos de cada tenant, muchas variantes de dominio y experimentos online que comparten un checkpoint base.
LoRAX encaja peor cuando unos pocos adaptadores reciben la mayor parte del tráfico o cuando los modelos no comparten base. También encaja peor cuando unos objetivos de latencia estrictos no toleran cargas en frío o cuando la plataforma no puede controlar con seguridad qué artefactos carga el servidor. En esos casos, un despliegue estándar de vLLM o SGLang con un conjunto fijo de adaptadores puede ser más sencillo. Los conjuntos fijos son una opción de despliegue: SGLang también admite carga dinámica, al igual que vLLM más abajo. TGI está ahora en modo de mantenimiento y sus mantenedores recomiendan vLLM o SGLang.
Comprueba la actividad del proyecto antes de comprometerte. A fecha de 8 de octubre de 2026, la última versión del servidor LoRAX es la v0.12.1, de noviembre de 2024. El repositorio tuvo commits regulares hasta abril de 2025 y desde entonces solo dos correcciones pequeñas. Si lo adoptas, planifica asumir tú las actualizaciones para nuevos modelos, versiones de CUDA y correcciones de seguridad.
La figura compara dos configuraciones que probar según la distribución del tráfico: un conjunto fijo cuando unos pocos adaptadores concentran la mayoría de las peticiones y la carga dinámica de LoRAX para una cola larga. Un conjunto activo caliente aún puede ser expulsado en modo dinámico; no es un conjunto fijo precargado.
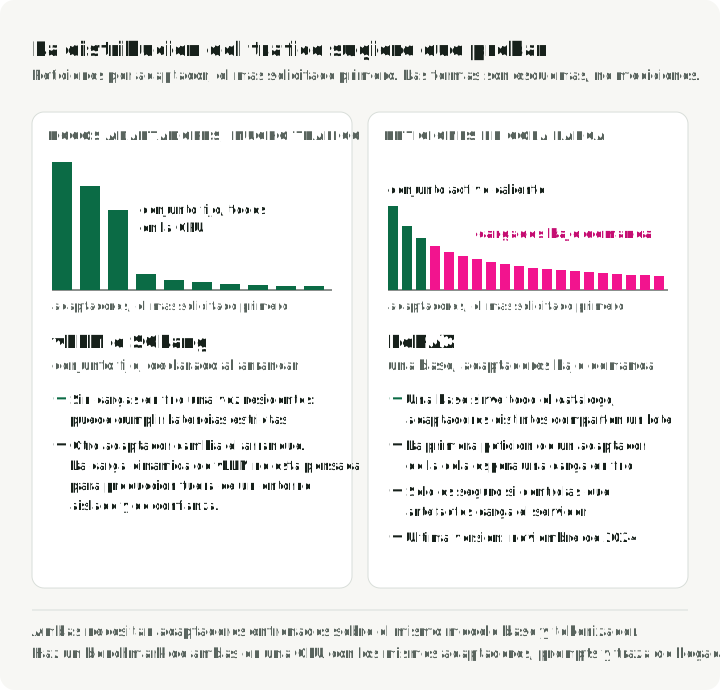
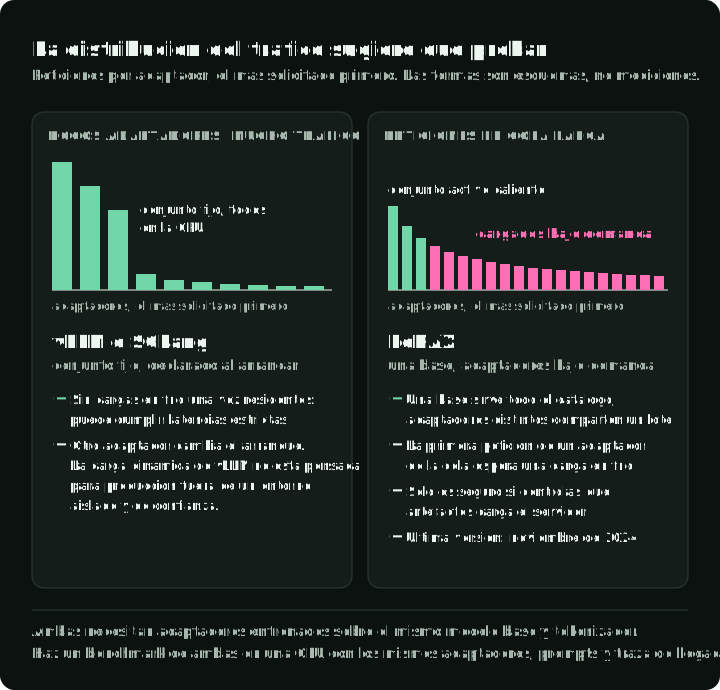
No uses Kubernetes solo porque el catálogo sea grande. Primero demuestra la compatibilidad del runtime y de los adaptadores en una sola GPU.
Prueba un modelo base y un adaptador en local
El README de LoRAX recomienda su contenedor precompilado. En un entorno real usa un digest de imagen inmutable. Aquí se muestra main solo porque es la etiqueta de inicio rápido documentada del repositorio. Confirma los ejemplos con las versiones de imagen y de dependencias que despliegues.
Antes de ejecutar el contenedor, instala y configura NVIDIA Container Toolkit para Docker. El README de LoRAX también exige Linux, Docker, una GPU NVIDIA Ampere o posterior y drivers compatibles con CUDA 11.8. Las licencias de los modelos y los repositorios con acceso restringido pueden exigir un token de Hugging Face.
mkdir -p data

docker run --rm --gpus all --shm-size 1g \
    -p 127.0.0.1:8080:80 \
    -v "$PWD/data:/data" \
    ghcr.io/predibase/lorax:main \
    --model-id mistralai/Mistral-7B-Instruct-v0.1
La dirección explícita del host vincula el puerto publicado a loopback; sin ella, Docker publica por defecto en todas las direcciones del host. Usa Docker 28 o posterior: las versiones anteriores pueden exponer los puertos publicados en localhost a hosts del mismo segmento de red. Mantén el contenedor en ejecución en este terminal. En un segundo terminal, espera a que curl --fail http://127.0.0.1:8080/health termine correctamente antes de enviar peticiones.
Empieza con el modelo base:
curl http://127.0.0.1:8080/generate \
    -H 'Content-Type: application/json' \
    -d '{
      "inputs": "[INST] Give one reason to measure cold-adapter latency. [/INST]",
      "parameters": {"max_new_tokens": 64}
    }'
Después envía un adaptador compatible. Este adaptador de matemáticas GSM8K declara mistralai/Mistral-7B-Instruct-v0.1 como base, el mismo modelo que ejecuta el servidor:
curl http://127.0.0.1:8080/generate \
    -H 'Content-Type: application/json' \
    -d '{
      "inputs": "[INST] Solve: Natalia sold 48 clips in April and half as many in May. What is the total? [/INST]",
      "parameters": {
        "max_new_tokens": 64,
        "adapter_id": "vineetsharma/qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k"
      }
    }'
Una respuesta correcta de /generate es un array JSON que contiene generated_text; la respuesta generada depende del modelo y del muestreo. La primera petición al adaptador puede descargarlo y cargarlo. Las siguientes pueden usar artefactos en caché y pesos residentes. Registra ambos caminos. Una sola petición en caliente dice poco sobre el comportamiento de la cola larga.
El adaptador anterior procede del Hugging Face Hub. En producción, carga los adaptadores desde un almacenamiento que controle la plataforma. La documentación de adaptadores describe dos de esas fuentes: local para un directorio dentro del contenedor y s3 para un URI de S3, con las credenciales de AWS en el entorno. Tras copiar los archivos del adaptador al directorio montado, sustituye parameters en la petición anterior por este fragmento:
"parameters": {
    "adapter_id": "/data/adapters/vineetsharma--qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k",
    "adapter_source": "local"
}
Usa el cliente de Python
El paquete lorax-client envuelve /generate. Instálalo con pip install lorax-client==0.6.3. La misma llamada funciona con y sin adapter_id, así que puedes comparar el modelo base y el adaptador con un mismo prompt:
from lorax import Client

client = Client("http://127.0.0.1:8080")

prompt = (
    "[INST] Natalia sold clips to 48 of her friends in April, and then she "
    "sold half as many clips in May. How many clips did Natalia sell "
    "altogether in April and May? [/INST]"
)

# Base model
print(client.generate(prompt, max_new_tokens=64).generated_text)

# Same prompt through the GSM8K adapter
adapter_id = "vineetsharma/qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k"
print(
    client.generate(prompt, max_new_tokens=64, adapter_id=adapter_id).generated_text
)
Usa un cliente compatible con OpenAI
LoRAX también expone un endpoint de chat compatible con OpenAI. Instala el cliente con pip install openai==3.26.1. El campo model identifica el adaptador:
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://127.0.0.1:8080/v1",
)

response = client.chat.completions.create(
    model="vineetsharma/qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k",
    messages=[
        {"role": "user", "content": "Explain cache locality in two sentences."},
    ],
    max_tokens=100,
)

print(response.choices[0].message.content)
El servidor no exige una clave de API por defecto. Eso es cómodo en localhost e inseguro como configuración expuesta a Internet. Pon por delante autenticación, autorización por tenant, cuotas y una lista de permitidos de adaptadores.
Comprueba la compatibilidad del adaptador en el registro
Antes de que un adaptador entre en el catálogo, verifica como mínimo:
- el modelo base y la revisión declarados
- la compatibilidad del tokenizador y de la plantilla de chat
- el rango LoRA y los módulos objetivo que admite el runtime
- el formato del artefacto y las formas de los tensores
- la licencia, la procedencia y el digest de integridad
- un pequeño conjunto de pruebas de comportamiento y de regresión
Rechaza los artefactos incompatibles durante el registro, no en la primera petición de un usuario.
Entiende la residencia antes de desplegar
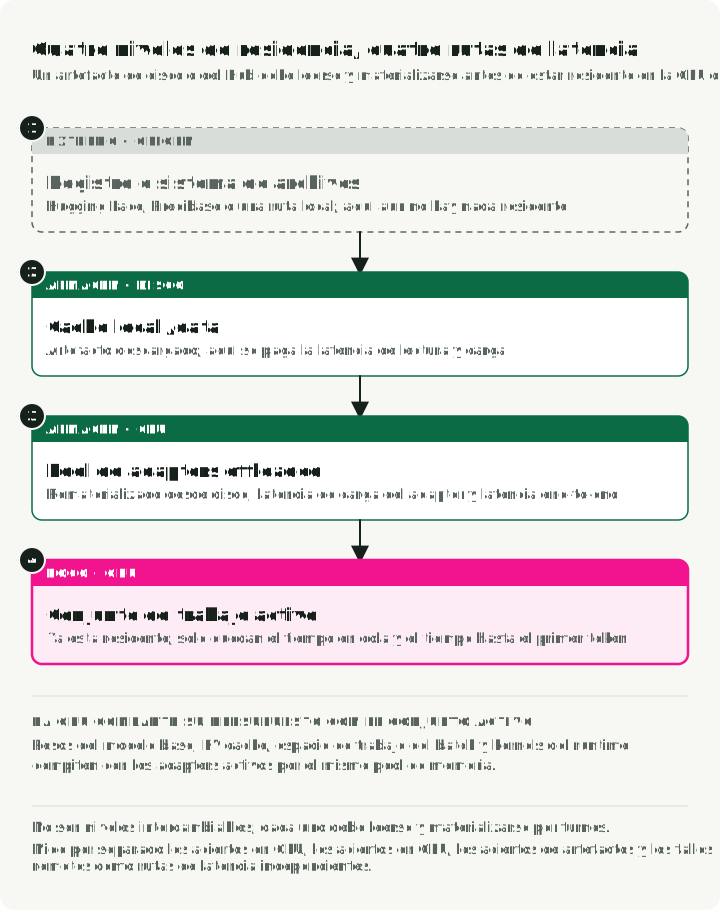
El modelo base consume la mayor parte fija de la memoria de la GPU. Los pesos de los adaptadores, la KV cache, el espacio de trabajo de los lotes y los kernels del runtime compiten por el resto. /data almacena los artefactos descargados. La RAM de la CPU puede conservar tensores de adaptador materializados, pero solo si el cargador los retiene.
En la implementación main comprobada en a7394ba, el cargador predeterminado de un solo adaptador guarda en caché referencias a archivos. La descarga de la GPU elimina sus pesos de los mapas de adaptadores; una petición posterior puede volver a leer y materializar los archivos en caché. El cargador predeterminado de v0.12.1 también usa referencias a archivos. La carga combinada o no diferida y la caché de archivos del sistema operativo pueden comportarse de otra forma. No cuentes cada descarga de la GPU como un acierto en tensores de CPU retenidos.
Son estados de medición distintos. Un artefacto del disco o del Hub debe leerse y materializarse antes de convertirse en un adaptador residente en la CPU o en la GPU. La figura dibuja los cuatro caminos posibles de la tabla siguiente como barras de tiempo; el camino de CPU solo se aplica cuando se retienen tensores del host. Cada paso de carga adicional añade trabajo antes del primer token.
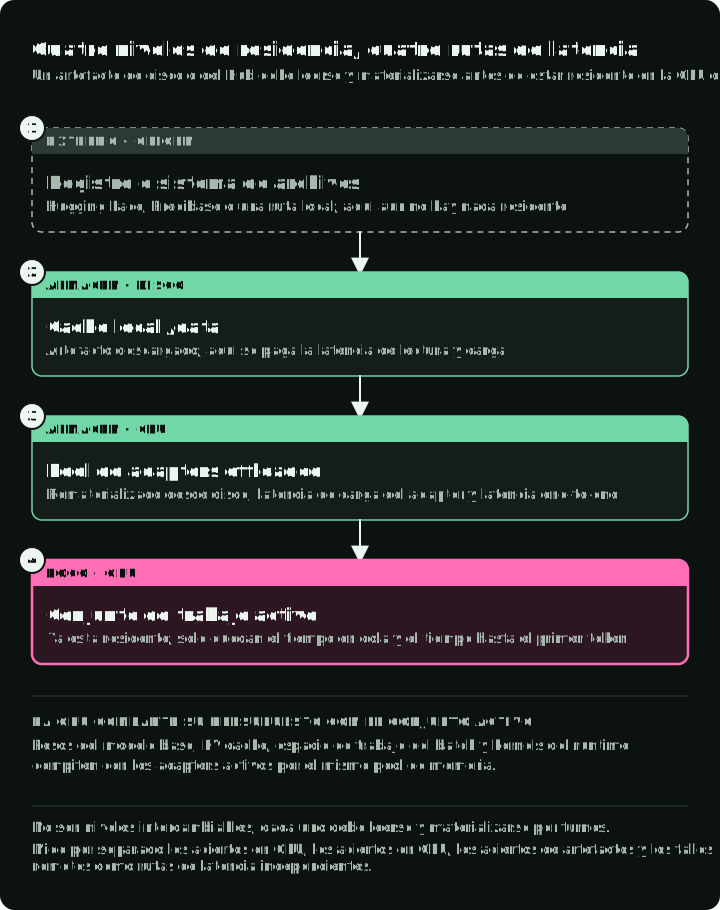
Mide las transiciones por separado:
| Camino | Qué incluye | Métrica que registrar |
|---|---|---|
| Acierto de GPU | El adaptador ya está residente | tiempo en cola y tiempo hasta el primer token |
| Acierto de CPU | Transferir tensores del host retenidos, si están disponibles | retraso de carga del adaptador y latencia de extremo a extremo |
| Acierto de artefacto | Lectura desde la caché local /data | retraso de lectura y carga, y bytes en caché |
| Fallo remoto | Descarga más validación y carga | tiempo de descarga, fallos y latencia completa en frío |
La planificación de capacidad debe reproducir la distribución real de popularidad de los adaptadores. Los ID de adaptador aleatorios y uniformes crean un problema de caché distinto al de una carga con unos pocos adaptadores populares y muchos poco frecuentes.
Ajustes del launcher que cambian el conjunto de trabajo
Estos argumentos del launcher deciden cuántos adaptadores permanecen en la GPU, cuánta memoria reciben y si la carga es fija o dinámica. Los valores siguientes se comprobaron el 8 de octubre de 2026 frente a main en a7394ba; la referencia del launcher enumera todos los argumentos.
| Ajuste | Por defecto | Cámbialo cuando |
|---|---|---|
--preloaded-adapter-ids | ninguno | quieras un conjunto fijo precargado y aceptes desactivar la carga dinámica de adaptadores |
--max-active-adapters | 1024 | necesites limitar cuántos adaptadores pueden estar en la GPU y aceptar peticiones a la vez |
--adapter-memory-fraction | 0.1 | los aciertos de GPU sean bajos; subirlo mantiene más adaptadores en la GPU y reduce la KV cache |
--adapter-cycle-time-s | 2 | los intercambios ocurran demasiado a menudo (rotación de caché) o demasiado despacio (peticiones en cola para adaptadores descargados) |
--quantize | off | el modelo base deje muy poca memoria de GPU para adaptadores y KV cache |
La precarga y la carga dinámica son modos separados. Tanto v0.12.1 como main comprobado rechazan nuevos adaptadores dinámicos tras registrar un conjunto precargado. Main también pone a cero la reserva de memoria para adaptadores dinámicos cuando hay ID precargados; v0.12.1 no aplica ese cambio del launcher.
Para serving dinámico de cola larga, omite --preloaded-adapter-ids y calienta los adaptadores populares con peticiones normales autorizadas tras el arranque. Los ajustes de memoria y planificación afectan al tiempo que permanecen residentes; calentarlos no los fija. Elige estos valores con la reproducción de «Una prueba de aceptación de producción» más abajo.
Despliega el chart del repositorio con cuidado
Necesitas un clúster con nodos GPU que expongan nvidia.com/gpu mediante el device plugin de NVIDIA o el GPU Operator, además de kubectl y helm en tu estación de trabajo. El chart solicita ese recurso, así que el pod se queda en Pending en un clúster que no lo tenga.
El repositorio contiene charts/lorax, así que el punto de partida repetible es una revisión fijada del repositorio y un chart local:
git clone https://github.com/predibase/lorax.git
cd lorax
git checkout <reviewed-commit-or-release>

helm dependency update charts/lorax
helm template lorax charts/lorax -f values.production.yaml
helm upgrade --install lorax charts/lorax \
    --namespace inference \
    --create-namespace \
    -f values.production.yaml
El chart llama al Deployment lorax-<release> y al Service como indique service.name (lorax por defecto). Espera al rollout, sigue los logs hasta que el modelo base se haya cargado, reenvía el puerto del Service y repite las peticiones curl de la sección local contra 127.0.0.1:8080:
kubectl -n inference rollout status deploy/lorax-lorax
kubectl -n inference logs -f deploy/lorax-lorax
kubectl -n inference port-forward svc/lorax 8080:80

# remove the release when you are done
helm uninstall lorax -n inference
Según la comprobación del 8 de octubre de 2026, los valores del chart y la plantilla del Deployment en a7394ba muestran estos valores por defecto:
- la etiqueta de la imagen es
latest /dataes unemptyDir, así que al sustituir el pod se descartan los artefactos descargados- los probes de liveness y de readiness están vacíos
- el token de Hugging Face se modela como un valor literal de variable de entorno
- por defecto se solicita una GPU
Usa el chart como plantilla de partida y añade los ajustes de producción que siguen.
Parte de la estructura real de valores del chart
El chart anida la configuración del runtime bajo deployment, y los argumentos del launcher son una lista de pares nombre/valor. Un overlay mínimo fija solo las diferencias con los valores anteriores: un digest de imagen probado, el modelo, el token del Hub desde un Secret y un probe de readiness. Guárdalo como values.production.yaml y sustituye los marcadores de etiqueta y digest por una referencia de imagen verificada. Una réplica, una GPU y un Service ClusterIP en el puerto 80 ya son los valores por defecto del chart.
El overlay supone que ya existe un Secret lorax-hub con una clave token en el namespace inference. Créalo antes de instalar si el modelo necesita credenciales del Hub; en caso contrario, elimina la entrada env.
deployment:
    image:
        repository: ghcr.io/predibase/lorax
        tag: "<tested-release-tag>@sha256:<verified-image-digest>"

    args:
        - name: "--model-id"
          value: "mistralai/Mistral-7B-Instruct-v0.1"

    env:
        - name: HUGGING_FACE_HUB_TOKEN
          valueFrom:
              secretKeyRef:
                  name: lorax-hub
                  key: token

    readinessProbe:
        httpGet:
            path: /health
            port: http
        periodSeconds: 5
        failureThreshold: 600
Helm sustituye la lista args completa. El valor por defecto del chart también fija límites de tokens (--max-input-length, --max-total-tokens, --max-batch-total-tokens, --max-batch-prefill-tokens), --compile y --eager-prefill false; copia los que quieras conservar. Dimensiona los límites de tokens a partir de prompts representativos, la concurrencia esperada, la memoria de la GPU y pruebas de carga. Los ajustes del conjunto de trabajo de la tabla anterior van en la misma lista.
Parchea las carencias de forma explícita
La plantilla comprobada del chart pasa deployment.env por toYaml, así que un overlay de valores normal puede usar valueFrom.secretKeyRef para las credenciales del Hub, como arriba. Formatea la imagen como repository:tag, que admite el valor de etiqueta más digest anterior: Kubernetes usa el digest para descargar cuando están presentes ambos. El chart fija en el código los volúmenes emptyDir y no ofrece configuración para startupProbe. Por tanto, un /data duradero y un startup probe requieren un fork revisado del chart, un parche posterior al renderizado o una capa de manifiestos de nivel superior.
Un overlay de valores puede fijar la etiqueta de imagen más digest, los argumentos del launcher, las solicitudes y los límites de GPU, env (incluido secretKeyRef), los probes de liveness y readiness y el tipo y el puerto del Service. Usa esa capa de producción para:
- un PersistentVolumeClaim o una caché de artefactos local al nodo montada en
/data - un startup probe antes de un liveness probe agresivo
- política de disrupción de pods y topology spread para varias réplicas
- NetworkPolicy, restricciones de la service account y un gateway autenticado
- comprobaciones de integridad de artefactos
No pongas un token del Hub directamente en un archivo de valores sometido a commit. Dos réplicas dan una alta disponibilidad útil solo si ambas pueden cargar el modelo base. Además, el router debe evitar enviar a los dos pods cada adaptador en frío.
Enruta pensando en la localidad de la caché
El balanceo round-robin puede convertir cada réplica en una caché en frío. Un buen router asigna un ID de adaptador permitido a una réplica mediante un hash u otra regla estable. Mantiene un camino de failover para cuando esa réplica no esté disponible. La figura reproduce seis peticiones para dos adaptadores con las dos reglas.
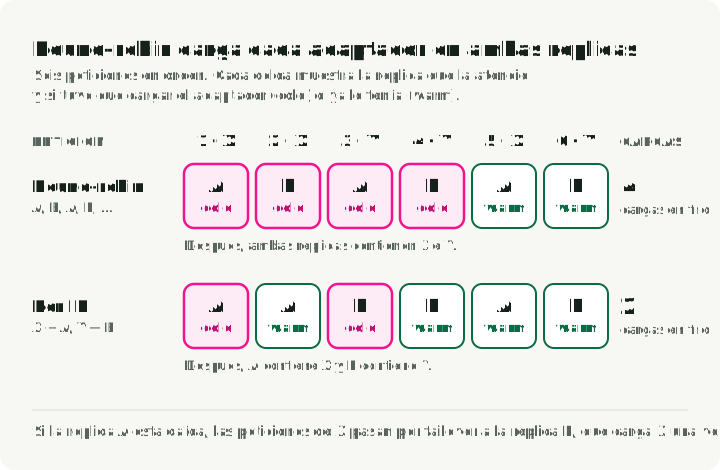
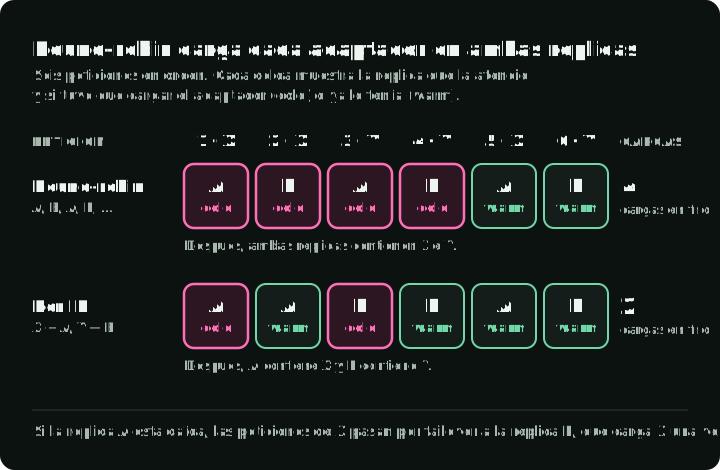
La clave de enrutado debe proceder del estado autenticado de la aplicación, no de un parámetro de URL público arbitrario. De lo contrario, un llamante puede forzar descargas remotas, hacer rotar las cachés o sondear nombres de adaptadores privados.
¿LoRAX o vLLM?
La documentación de vLLM comprobada el 8 de octubre de 2026 describe módulos LoRA declarados al arrancar y carga dinámica mediante endpoints o plugins de resolución. Advierte de que actualizar adaptadores en tiempo de ejecución tiene riesgos de seguridad y de que no debe usarse en producción fuera de un entorno aislado y de confianza.
La tabla compara cómo encuentra, mantiene y sirve adaptadores cada runtime:
| Pregunta | LoRAX | vLLM |
|---|---|---|
| ¿Cómo se descubren los adaptadores de cola larga? | El ID del adaptador puede resolver artefactos de Hugging Face, Predibase, S3 o rutas locales bajo petición | Módulos estáticos, endpoints de gestión dinámicos o plugins de resolución |
| ¿Cómo se gestiona la residencia? | Planificación por intercambio; las recargas usan archivos en caché o tensores del host retenidos según el cargador | Límites configurados de LoRA activos y en CPU, más el comportamiento del resolver |
| ¿Cuál es la interfaz de peticiones? | /generate al estilo TGI, cliente de Python y chat compatible con OpenAI | Serving compatible con OpenAI y API nativas de Python |
| ¿Qué debe decidir? | Latencia en frío y en caliente, rotación de caché, throughput de lotes heterogéneos y encaje operativo | La misma reproducción de la carga y los mismos criterios operativos |
Evita reglas como «LoRAX para 1000 adaptadores, vLLM para diez». El tamaño del catálogo por sí solo no determina el rendimiento. Haz un benchmark de ambos con la misma base, los mismos adaptadores, prompts, rangos, traza de llegadas y hardware.
Una prueba de aceptación de producción
Antes de ampliar el catálogo, ejecuta una reproducción que incluya:
- Un conjunto caliente fijo para establecer el throughput y la latencia en caliente.
- Una distribución de cola larga para medir aciertos en la caché de artefactos y en tensores del host retenidos, si el cargador lo admite.
- Una ráfaga de adaptadores permitidos que no se habían visto antes.
- La sustitución de pods para medir la recuperación del modelo base y de los adaptadores.
- Un adaptador no disponible o corrupto para verificar el aislamiento y el fallback.
- Tenants concurrentes para verificar la autenticación, las cuotas y las etiquetas de las métricas.
Registra estas métricas:
- tasa de peticiones
- tiempo en cola
- tiempo hasta el primer token
- latencia entre tokens
- latencia total
- tiempo de carga del adaptador
- clase de acierto de caché
- memoria de GPU
- memoria de CPU
- bytes descargados
- fallos por motivo
Mantén los ID de adaptador fuera de etiquetas de métricas sin límite. Asígnalos a dimensiones controladas o a trazas muestreadas.
Define los umbrales de aceptación antes de la prueba. Fija una tasa máxima de errores en el camino en frío y un objetivo de P99 en caliente. Fija también un objetivo de aciertos de caché para la distribución de popularidad observada y un objetivo de tiempo de recuperación tras la pérdida de un pod.
Conclusión
LoRAX sirve muchos fine-tunes compatibles sin numerosas copias independientes del modelo base. Puede ser un diseño útil para cargas de cola larga, pero no hace que el coste ni la latencia sean constantes por definición. El conjunto de trabajo activo, el camino de intercambio, la mezcla de los lotes y la capa de almacenamiento siguen fijando el resultado.
Demuestra primero esa mecánica en una sola GPU. Después, en Kubernetes: fija los artefactos, conserva la caché, protege las credenciales, autoriza los adaptadores, enruta pensando en la localidad y mide cada camino de residencia. Si LoRAX supera a una configuración actual de vLLM con la misma reproducción, la decisión de despliegue tiene evidencia detrás.
Referencias
- Repositorio y README de LoRAX — funciones admitidas, requisitos, API, cliente de Python y chart de Helm
- Fuentes de adaptadores de LoRAX — carga desde Hub, Predibase, local y S3
- Referencia del launcher de LoRAX — argumentos de memoria de adaptadores, intercambio, precarga y cuantización
- Informe de lanzamiento de LoRAX y benchmark de 2023 — fuente y condiciones del gráfico de costes
- Valores del chart de LoRAX y plantilla del Deployment — valores por defecto actuales y comportamiento de los volúmenes
- Punica: Multi-Tenant LoRA Serving — el kernel SGMV para lotes con adaptadores mezclados
- Text Generation Inference — el proyecto del que LoRAX hizo el fork, ahora en modo de mantenimiento
- Adaptadores LoRA en vLLM — serving de adaptadores estático y dinámico
- Artículo de LoRA — el método de adaptación de rango bajo
- Documentación de PEFT de Hugging Face — formatos de adaptadores e integración con el entrenamiento