LoRAX Serving Guide: LoRA-Adapter auf Kubernetes im großen Maßstab

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Dieser Guide richtet sich an Inference- und Platform-Engineers, die viele LoRA-Varianten aus einem Basismodell bereitstellen müssen. Er zeigt, wie du die LoRAX-APIs testest, den Working Set dimensionierst und das Starter-Helm-Chart zu einem expliziten Produktionsplan ausbaust.
Ein Basismodell und viele LoRA-Adapter erzeugen ein ungewöhnliches Serving-Problem. Die Basisgewichte werden gemeinsam genutzt, aber jede Anfrage kann andere Adaptergewichte brauchen. Ein klassisches Design mit einem Deployment pro Variante verschwendet GPU-Speicher, wenn die meisten Varianten ungenutzt sind.
LoRAX zielt auf diesen Long Tail. Es lädt Adapter bei Bedarf, bündelt Anfragen für verschiedene Adapter in Batches und tauscht aus, welche Adaptergewichte den GPU-Speicher belegen. Die verlockende Schlagzeile lautet „Tausende feinabgestimmte Modelle auf einer GPU“. Die technische Frage ist enger: Hilft Exchange Scheduling bei deinem aktiven Adapter-Set, deinem Ankunftsmuster und deinem Latency-Ziel genug, um eine weitere Serving-Runtime zu rechtfertigen?
Das Serving-Problem ist der Working Set
LoRA friert ein Basismodell ein und lernt Low-Rank-Updates für ausgewählte Gewichtsmatrizen. Der entstehende Adapter ist meist deutlich kleiner als ein vollständiger Checkpoint, doch seine Größe hängt weiterhin von Rank, Target Modules, Anzahl der Layer und Dtype ab. Pauschale Aussagen wie „jeder Adapter ist 100 MB groß“ taugen schlecht als Eingabe für die Kapazitätsplanung.
Bekommt jede feinabgestimmte Variante ein eigenes Deployment, hält jedes Deployment eine vollständige Kopie der Basisgewichte, egal ob es Traffic erhält oder nicht. Die linke Seite der Abbildung zeigt dieses Design. Die rechte Seite zeigt ein Basismodell, das nur die Adapter lädt, die Anfragen erhalten.
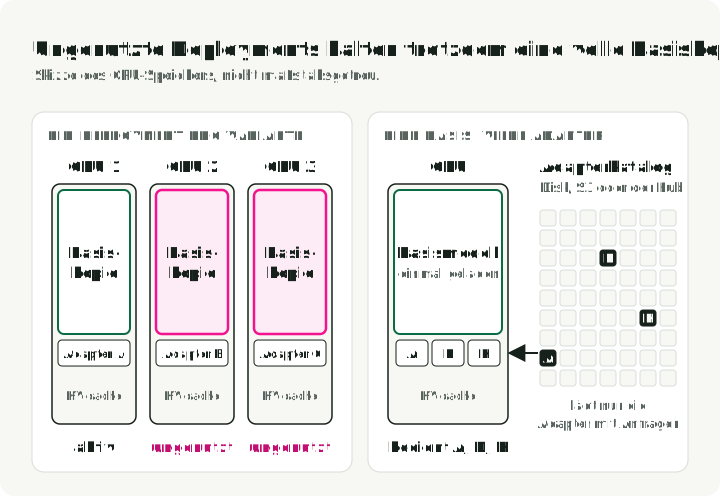
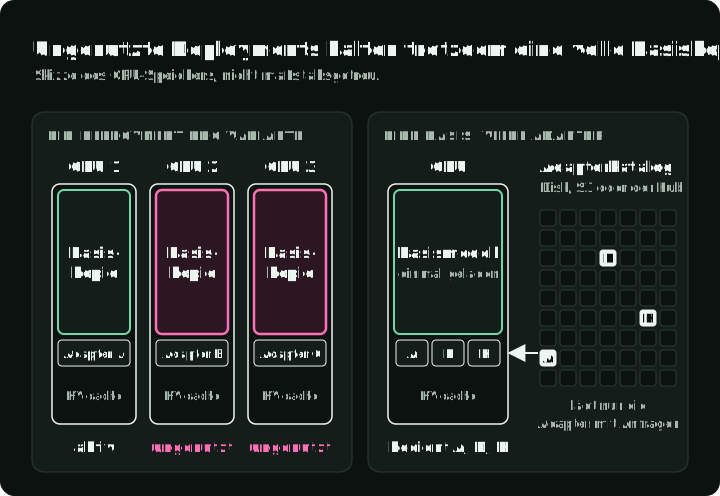
Für das Serving musst du drei Größen unterscheiden:
- Kataloggröße: jeder Adapter, den eine Plattform aus dem Storage auflösen kann
- Aktiver Working Set: Adapter, die innerhalb des Cache-Retention-Fensters Anfragen erhalten
- Concurrent Set: Adapter, die im selben Moment in Batches vertreten sind
Jede Menge ist eine Teilmenge der vorherigen: Das Concurrent Set liegt im aktiven Working Set, dieser im Katalog. Die Kapazitätsplanung beginnt beim aktiven Working Set. Ein Katalog mit 5.000 Adaptern kann zum Beispiel 200 aktive Adapter in der letzten Stunde haben und 8 in einem Batch.
Ein Katalog kann Tausende Adapter enthalten, ohne dass Tausende in den VRAM passen. Entscheidend ist, wie oft sich das aktive Set ändert, wie groß diese Adapter sind und ob Anfragen für verschiedene Adapter sinnvolle gemeinsame Batches bilden können.
LoRAX kombiniert vier Mechanismen:
- Das Basismodell bleibt für alle kompatiblen Adapter im Speicher.
- Eine Anfrage nennt einen Adapter, den LoRAX aus Hugging Face, Predibase, S3 oder einem lokalen Pfad auflöst (der Parameter
adapter_source). - Adapter Exchange Scheduling lädt Adapter vor und gibt GPU-Gewichte frei, um Platz für andere zu schaffen. Beim späteren Laden lassen sich zwischengespeicherte Artefakte wiederverwenden.
- Heterogenes Continuous Batching gruppiert Anfragen, die verschiedene Adapter ansprechen.
LoRAX ist ein Fork von Hugging Face Text Generation Inference (TGI) und behält deshalb die /generate-API von TGI. Es wendet verschiedene Adapter innerhalb eines Batches mit den SGMV-Kernels des Punica-Projekts an. Diese Kernel gruppieren Zeilen, die in jedem angepassten Layer unterschiedliche Adaptermatrizen verwenden. Die LoRAX-Implementierung führt getrennte Shrink- und Expand-Projektionen aus: zuerst in die Low-Rank-Dimension und dann zurück in die Ausgabedimension des Layers.
Die Abbildung folgt vier Anfragen durch ein Produktions-Setup. Ein Gateway vor LoRAX prüft zuerst den Tenant und die Adapter-ID; die Sicherheitsabschnitte weiter unten erklären, warum. Danach sucht LoRAX den Adapter. Liegt der Adapter nicht auf der GPU, lädt LoRAX zwischengespeicherte Artefakte oder lädt fehlende Dateien herunter. Zurückbehaltene Host-Tensoren können ebenfalls wiederverwendet werden, wenn der Loader sie hält. Anschließend bündelt es die Anfrage mit Anfragen für andere Adapter in einem Batch und streamt die Tokens zurück.
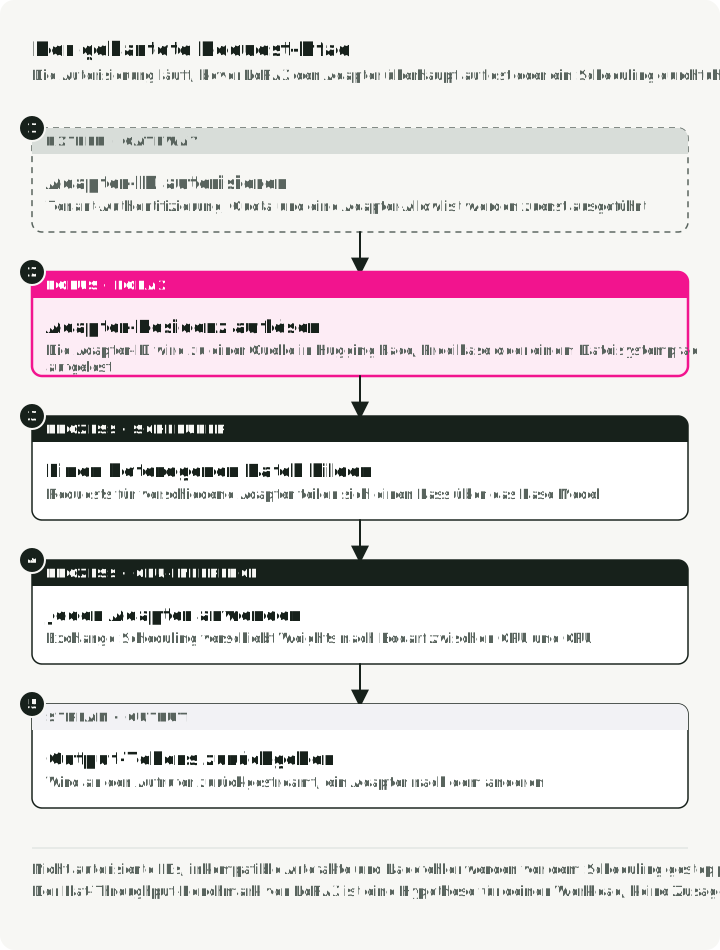
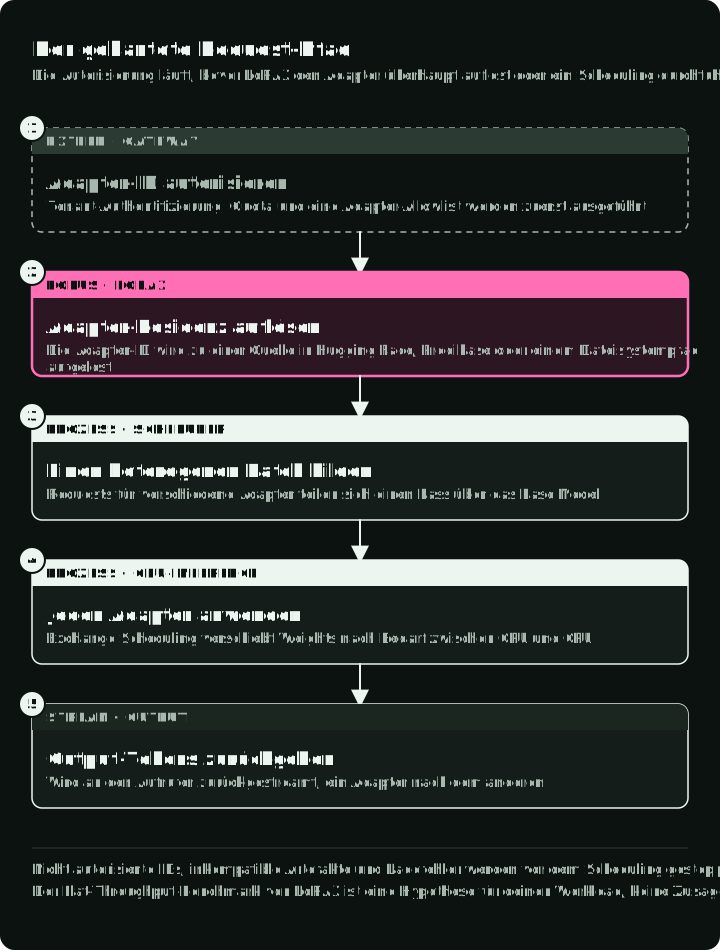
Das LoRAX-Projekt berichtet, dass Heterogeneous Batching in seinen Benchmarks Throughput und Latency nahezu konstant hält, wenn die Zahl gleichzeitiger Adapter wächst. Behandle dieses Herstellerergebnis als Hypothese für deinen Workload. Promptlänge, Ausgabelänge, Rank, Target Modules, Batch-Auslastung, Cache-Churn und GPU-Generation können das Ergebnis verändern.
Das folgende Diagramm stammt aus dem LoRAX-Launch-Report von Predibase vom November 2023. Predibase hat Llama 2 7B auf einer NVIDIA A10G gemessen, mit Anfragen, die sich auf 1 bis 128 Adapter verteilten. Das Diagramm zeigt den Kostenvergleich für 1 bis 32 Adapter bei der Verarbeitung von einer Million Tokens, gleichmäßig auf die Adapter verteilt.
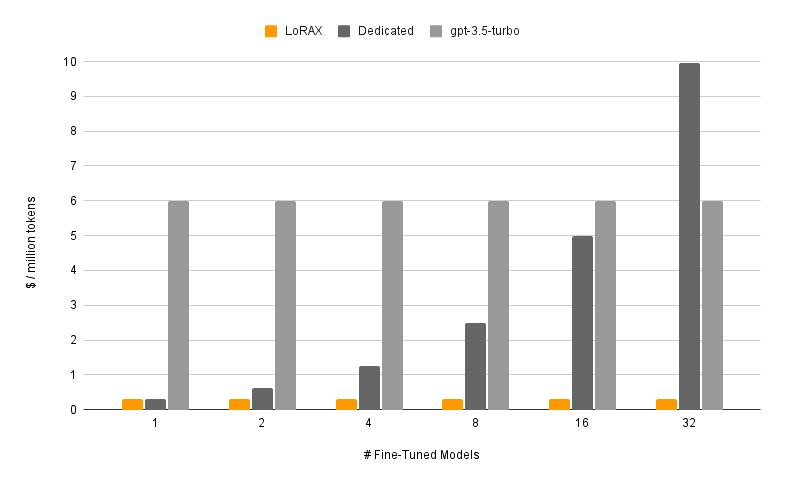
Archivierter Projektvergleich, übernommen aus dem LoRAX-Report von Predibase aus dem Jahr 2023. Die Kosten für LoRAX und dedizierte Deployments beruhen auf den GPU-Stunden dieses Experiments. Soweit die Quelle Details nennt, verwendet die Linie für GPT-3.5 Turbo die Kosten pro Token des feinabgestimmten Modells.
Lies die flachen orangen Balken als Ergebnis dieses Benchmark-Designs, nicht als aktuelles Preisversprechen. Der Test sendete insgesamt eine feste Menge von einer Million Tokens und ließ verschiedene Adapter einen Batch teilen. Die dedizierte Baseline nahm für jedes Modell eigene gehostete Rechenleistung an, deshalb stiegen ihre Kosten mit der Modellzahl.
Predibase hat weder den Token-Mix noch Anfragelängen, Batch-Größe, Adapter-Rank oder GPU-Preis veröffentlicht, daher lassen sich die Dollarwerte nicht reproduzieren.
Das Diagramm deckt außerdem weder spärlichen Traffic noch Cold Downloads, aktuelle Cloud-Preise, neuere GPUs, andere Basismodelle oder Adapter mit anderem Rank ab. Nimm es als Anlass, deinen eigenen Traffic zu replayen.
Wann LoRAX plausibel passt
Teste LoRAX, wenn alle diese Punkte zutreffen:
- Die Adapter wurden gegen dasselbe unterstützte Basismodell und denselben Tokenizer-Vertrag trainiert
- Der Traffic verteilt sich auf viele Adapter, mit einem spürbaren Long Tail
- Einen kalten Adapter bei Bedarf zu laden ist besser, als ein Deployment für ihn zu reservieren
- Routing nach Tenant oder Aufgabe existiert bereits an der Anwendungsgrenze
- Das Team kann eine spezialisierte Inference-Runtime und ihr Cache-Verhalten betreiben
- Das Team akzeptiert eine Runtime mit wenigen Upstream-Releases
Typische Fälle sind tenant-spezifische Assistenten, viele Domänenvarianten und Online-Experimente, die einen Basis-Checkpoint teilen.
LoRAX passt schlechter, wenn wenige Adapter den Großteil des Traffics tragen oder die Modelle keine gemeinsame Basis haben. Es passt auch schlechter, wenn harte Latency-Ziele keine Cold Loads vertragen oder wenn die Plattform nicht sicher kontrollieren kann, welche Artefakte der Server lädt. In diesen Fällen kann ein normales vLLM- oder SGLang-Deployment mit festem Adapter-Set einfacher sein. Feste Sets sind eine Deployment-Entscheidung: SGLang unterstützt auch dynamisches Laden, ebenso wie vLLM weiter unten. TGI selbst ist inzwischen im Maintenance-Modus, und seine Maintainer empfehlen vLLM oder SGLang.
Prüfe die Aktivität des Projekts, bevor du dich festlegst. Am 8. Oktober 2026 ist das letzte LoRAX-Server-Release v0.12.1 vom November 2024. Das Repository hatte bis April 2025 regelmäßige Commits und seitdem nur zwei kleine Fixes. Wenn du es einsetzt, plane ein, Upgrades für neue Modelle, CUDA-Versionen und Sicherheitsfixes selbst zu übernehmen.
Die Abbildung vergleicht zwei Setups, die du je nach Traffic-Verteilung testen kannst: ein fester Adaptersatz, wenn wenige Adapter die meisten Anfragen erhalten, und dynamisches Laden mit LoRAX bei einem langen Tail. Ein warmes aktives Set kann im dynamischen Modus weiterhin verdrängt werden; er ist kein festes vorgeladenes Set.
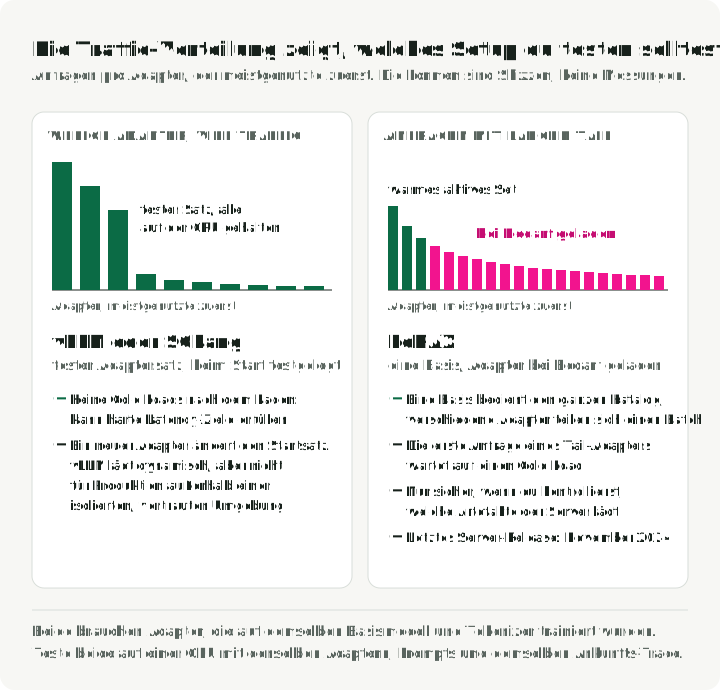
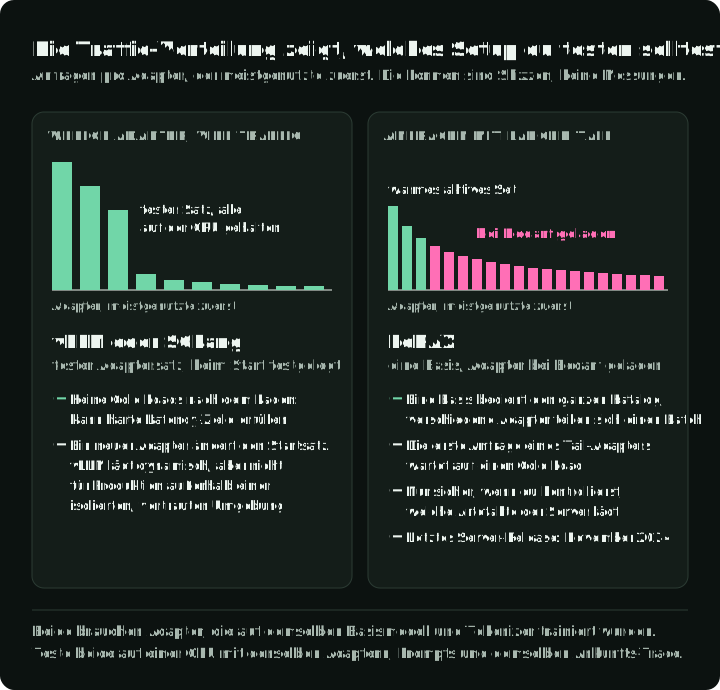
Nutze Kubernetes nicht allein deshalb, weil der Katalog groß ist. Weise zuerst auf einer GPU nach, dass Runtime und Adapter-Kompatibilität funktionieren.
Eine Basis und einen Adapter lokal ausprobieren
Das LoRAX-README empfiehlt den vorgebauten Container. Verwende in einer echten Umgebung einen unveränderlichen Image-Digest. main steht hier nur, weil es der dokumentierte Quick-Start-Tag des Repositorys ist. Prüfe die Beispiele gegen die Image- und Abhängigkeitsversionen, die du deployst.
Installiere und konfiguriere vor dem Containerstart das NVIDIA Container Toolkit für Docker. Das LoRAX-README verlangt außerdem Linux, Docker, eine NVIDIA-GPU ab Ampere und mit CUDA 11.8 kompatible Treiber. Modelllizenzen und geschützte Repositories können ein Hugging-Face-Token verlangen.
mkdir -p data

docker run --rm --gpus all --shm-size 1g \
    -p 127.0.0.1:8080:80 \
    -v "$PWD/data:/data" \
    ghcr.io/predibase/lorax:main \
    --model-id mistralai/Mistral-7B-Instruct-v0.1
Die explizite Hostadresse bindet den veröffentlichten Port an Loopback; ohne sie veröffentlicht Docker standardmäßig an allen Hostadressen. Verwende Docker 28 oder neuer: Ältere Releases können auf localhost veröffentlichte Ports für Hosts im selben Netzwerksegment zugänglich machen. Lass den Container in diesem Terminal laufen. Warte in einem zweiten Terminal, bis curl --fail http://127.0.0.1:8080/health erfolgreich ist, bevor du Anfragen sendest.
Beginne mit dem Basismodell:
curl http://127.0.0.1:8080/generate \
    -H 'Content-Type: application/json' \
    -d '{
      "inputs": "[INST] Give one reason to measure cold-adapter latency. [/INST]",
      "parameters": {"max_new_tokens": 64}
    }'
Sende dann einen kompatiblen Adapter. Dieser GSM8K-Mathe-Adapter deklariert mistralai/Mistral-7B-Instruct-v0.1 als Basis, also genau das Modell, das der Server ausführt:
curl http://127.0.0.1:8080/generate \
    -H 'Content-Type: application/json' \
    -d '{
      "inputs": "[INST] Solve: Natalia sold 48 clips in April and half as many in May. What is the total? [/INST]",
      "parameters": {
        "max_new_tokens": 64,
        "adapter_id": "vineetsharma/qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k"
      }
    }'
Eine erfolgreiche /generate-Antwort ist ein JSON-Array mit generated_text; die generierte Antwort hängt vom Modell und vom Sampling ab. Die erste Adapteranfrage lädt den Adapter womöglich erst herunter und dann in den Speicher. Spätere Anfragen können zwischengespeicherte Artefakte und bereits geladene Gewichte nutzen. Erfasse beide Pfade. Eine einzelne warme Anfrage sagt wenig über das Long-Tail-Verhalten.
Der Adapter oben stammt vom Hugging Face Hub. In Produktion lädst du Adapter aus Storage, den die Plattform kontrolliert. Die Adapter-Dokumentation beschreibt zwei solche Quellen: local für ein Verzeichnis im Container und s3 für eine S3-URI, mit AWS-Credentials in der Umgebung. Kopiere die Adapterdateien in das gemountete Verzeichnis und ersetze dann parameters im vorherigen Payload durch diesen Ausschnitt:
"parameters": {
    "adapter_id": "/data/adapters/vineetsharma--qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k",
    "adapter_source": "local"
}
Den Python-Client verwenden
Das Paket lorax-client kapselt /generate. Installiere es mit pip install lorax-client==0.6.3. Derselbe Aufruf funktioniert mit und ohne adapter_id, sodass du Basismodell und Adapter mit einem Prompt vergleichen kannst:
from lorax import Client

client = Client("http://127.0.0.1:8080")

prompt = (
    "[INST] Natalia sold clips to 48 of her friends in April, and then she "
    "sold half as many clips in May. How many clips did Natalia sell "
    "altogether in April and May? [/INST]"
)

# Base model
print(client.generate(prompt, max_new_tokens=64).generated_text)

# Same prompt through the GSM8K adapter
adapter_id = "vineetsharma/qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k"
print(
    client.generate(prompt, max_new_tokens=64, adapter_id=adapter_id).generated_text
)
Einen OpenAI-kompatiblen Client verwenden
LoRAX stellt außerdem einen OpenAI-kompatiblen Chat-Endpunkt bereit. Installiere den Client mit pip install openai==3.26.1. Das Feld model bezeichnet den Adapter:
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://127.0.0.1:8080/v1",
)

response = client.chat.completions.create(
    model="vineetsharma/qlora-adapter-Mistral-7B-Instruct-v0.1-gsm8k",
    messages=[
        {"role": "user", "content": "Explain cache locality in two sentences."},
    ],
    max_tokens=100,
)

print(response.choices[0].message.content)
Der Server verlangt standardmäßig keinen API-Key. Das ist für localhost bequem und als Konfiguration mit Internetzugang unsicher. Schalte Authentifizierung, Tenant-Autorisierung, Quotas und eine Adapter-Allowlist davor.
Adapter-Kompatibilität bei der Registrierung prüfen
Bevor ein Adapter in den Katalog kommt, prüfe mindestens:
- deklariertes Basismodell und Revision
- Kompatibilität von Tokenizer und Chat-Template
- LoRA-Rank und Target Modules, die die Runtime unterstützt
- Artefaktformat und Tensor-Shapes
- Lizenz, Herkunft und Integritäts-Digest
- eine kleine Test-Suite für Verhalten und Regressionen
Weise inkompatible Artefakte bei der Registrierung ab, nicht erst bei der ersten Anfrage eines Nutzers.
Residency verstehen, bevor du deployst
Das Basismodell belegt den größten festen Anteil des GPU-Speichers. Adaptergewichte, KV cache, Batch-Workspace und Runtime-Kernels konkurrieren um den Rest. /data speichert heruntergeladene Artefakte. Der CPU-RAM kann materialisierte Adaptertensoren halten, aber nur, wenn der Loader sie zurückbehält.
In der geprüften Main-Implementierung bei a7394ba speichert der standardmäßige Loader für einzelne Adapter Dateireferenzen im Cache. Offloading entfernt GPU-Gewichte aus den Adapter-Maps; eine spätere Anfrage kann die zwischengespeicherten Dateien erneut lesen und materialisieren. Auch der Standard-Loader in v0.12.1 nutzt Dateireferenzen. Zusammengeführtes oder nicht verzögertes Laden und der Dateicache des Betriebssystems können anders arbeiten. Zähle daher nicht jedes Offloading als Treffer auf zurückbehaltene CPU-Tensoren.
Das sind getrennte Messzustände. Ein Artefakt von Disk oder Hub muss gelesen und materialisiert werden, bevor es zu einem Adapter im CPU- oder GPU-Speicher wird. Die Abbildung zeichnet die vier möglichen Pfade aus der Tabelle unten als Zeitbalken; der CPU-Pfad gilt nur bei zurückbehaltenen Host-Tensoren. Jeder zusätzliche Ladeschritt fügt Arbeit vor dem ersten Token hinzu.
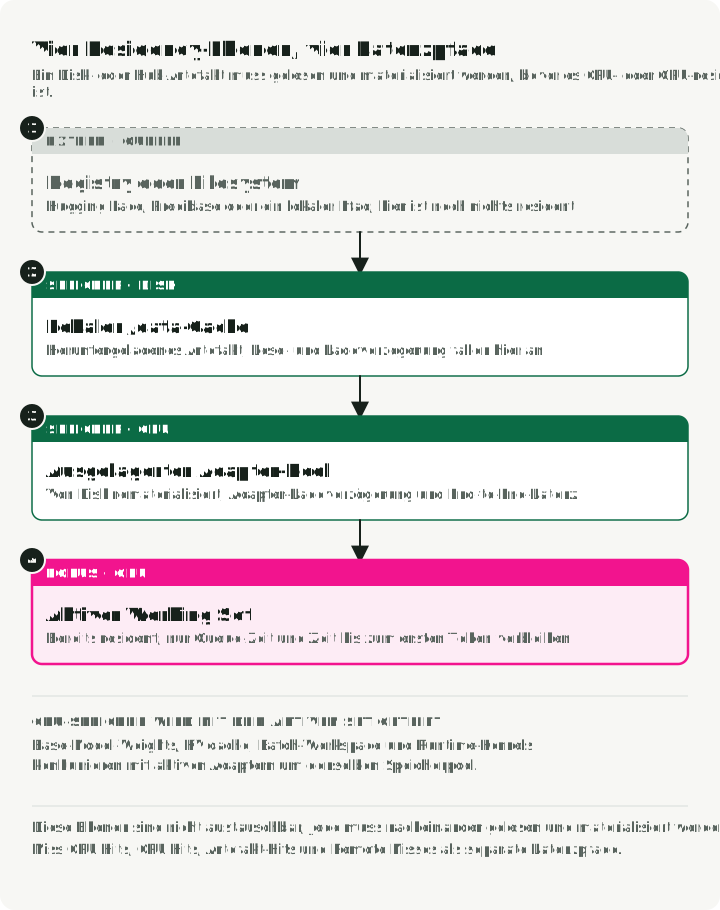
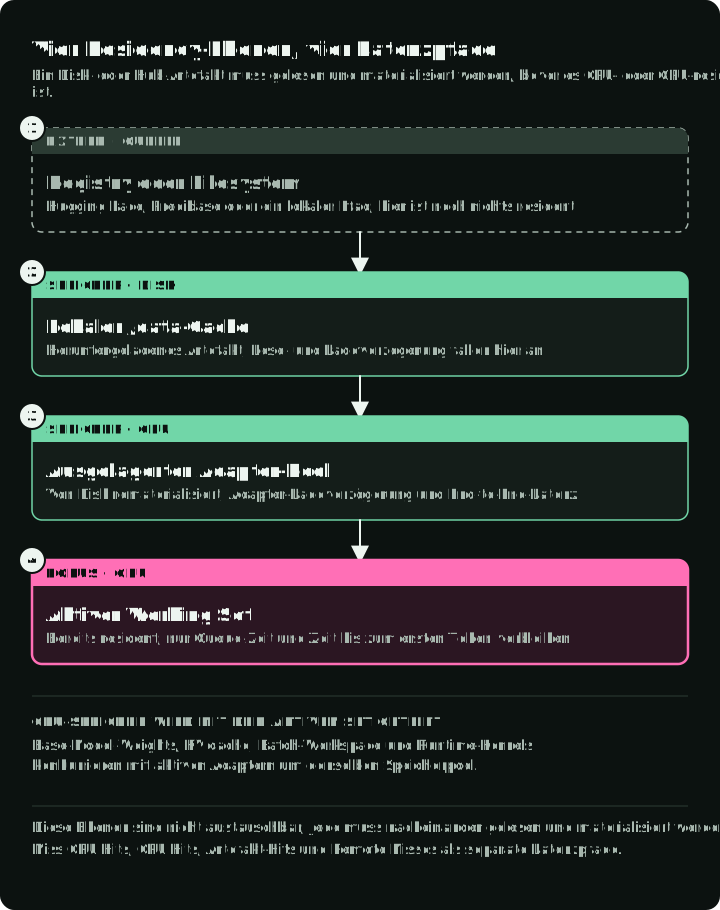
Miss die Übergänge getrennt:
| Pfad | Was er umfasst | Zu erfassende Metrik |
|---|---|---|
| GPU Hit | Adapter ist bereits geladen | Queue-Zeit und Time to First Token |
| CPU Hit | Transfer zurückbehaltener Host-Tensoren, sofern verfügbar | Adapter-Ladeverzögerung und End-to-End-Latency |
| Artifact Hit | Lesen aus dem lokalen /data-Cache | Lese-/Ladeverzögerung und Cache-Bytes |
| Remote Miss | Download plus Validierung und Laden | Download-Zeit, Fehler und volle Cold-Latency |
Die Kapazitätsplanung sollte die reale Popularitätsverteilung der Adapter replayen. Gleichverteilte zufällige Adapter-IDs erzeugen ein anderes Cache-Problem als ein Workload mit wenigen beliebten und vielen selten genutzten Adaptern.
Launcher-Einstellungen, die den Working Set verändern
Diese Launcher-Argumente bestimmen, wie viele Adapter auf der GPU bleiben, wie viel Speicher sie bekommen und ob das Laden fest oder dynamisch ist. Die folgenden Standardwerte wurden am 8. Oktober 2026 gegen Main bei a7394ba geprüft; die Launcher-Referenz listet alle Argumente auf.
| Einstellung | Standard | Ändere sie, wenn |
|---|---|---|
--preloaded-adapter-ids | none | du ein festes vorgeladenes Set willst und das Abschalten dynamischen Adapterladens akzeptierst |
--max-active-adapters | 1024 | du begrenzen willst, wie viele Adapter gleichzeitig auf der GPU liegen und Anfragen annehmen können |
--adapter-memory-fraction | 0.1 | die GPU-Hit-Rate niedrig ist; ein höherer Wert hält mehr Adapter auf der GPU und verkleinert den KV cache |
--adapter-cycle-time-s | 2 | Exchanges zu oft (Cache-Churn) oder zu langsam (Anfragen für ausgelagerte Adapter in der Queue) passieren |
--quantize | off | das Basismodell zu wenig GPU-Speicher für Adapter und KV cache übrig lässt |
Preloading und dynamisches Laden sind getrennte Modi. Sowohl v0.12.1 als auch das geprüfte Main weisen neue dynamische Adapter nach der Registrierung eines vorgeladenen Sets zurück. Main setzt außerdem die dynamische Adapter-Speicherreservierung auf null, wenn vorgeladene IDs vorhanden sind; v0.12.1 wendet diese Launcher-Überschreibung nicht an.
Lass für dynamisches Long-Tail-Serving --preloaded-adapter-ids weg und wärme beliebte Adapter nach dem Start mit normalen autorisierten Anfragen auf. Speicher- und Scheduling-Einstellungen bestimmen, wie lange sie resident bleiben; Aufwärmen fixiert sie nicht. Wähle diese Werte mit dem Replay aus „Ein Produktions-Abnahmetest“ weiter unten.
Das Repository-Chart sorgfältig deployen
Du brauchst einen Cluster mit GPU-Nodes, die nvidia.com/gpu über das NVIDIA Device Plugin oder den GPU Operator bereitstellen, sowie kubectl und helm auf deinem Rechner. Das Chart fordert diese Ressource an, deshalb bleibt der Pod auf einem Cluster ohne sie im Status Pending.
Das Repository enthält charts/lorax. Ein wiederholbarer Startpunkt ist daher ein gepinnter Repository-Stand mit lokalem Chart:
git clone https://github.com/predibase/lorax.git
cd lorax
git checkout <reviewed-commit-or-release>

helm dependency update charts/lorax
helm template lorax charts/lorax -f values.production.yaml
helm upgrade --install lorax charts/lorax \
    --namespace inference \
    --create-namespace \
    -f values.production.yaml
Das Chart nennt das Deployment lorax-<release> und den Service nach service.name (standardmäßig lorax). Warte auf den Rollout, verfolge die Logs, bis das Basismodell geladen ist, leite dann den Service-Port weiter und führe die curl-Anfragen aus dem lokalen Abschnitt erneut gegen 127.0.0.1:8080 aus:
kubectl -n inference rollout status deploy/lorax-lorax
kubectl -n inference logs -f deploy/lorax-lorax
kubectl -n inference port-forward svc/lorax 8080:80

# remove the release when you are done
helm uninstall lorax -n inference
Wie am 8. Oktober 2026 geprüft, zeigen die Chart-Werte und das Deployment-Template bei a7394ba diese Standardwerte:
- Der Image-Tag ist
latest /dataist einemptyDir, daher verwirft ein Pod-Austausch heruntergeladene Artefakte- Liveness- und Readiness-Probes sind leer
- Das Hugging-Face-Token ist als Klartext-Umgebungswert modelliert
- Standardmäßig wird eine GPU angefordert
Nutze das Chart als Startvorlage und ergänze die Produktionseinstellungen unten.
Von der tatsächlichen Wertestruktur des Charts ausgehen
Das Chart verschachtelt die Runtime-Konfiguration unter deployment, und Launcher-Argumente sind eine Liste aus Name/Wert-Paaren. Ein minimales Overlay setzt nur die Abweichungen von den obigen Standardwerten: einen getesteten Image-Digest, das Modell, das Hub-Token aus einem Secret und eine Readiness-Probe. Speichere es als values.production.yaml und ersetze die Platzhalter für Tag und Digest durch eine geprüfte Imagereferenz. Eine Replik, eine GPU und ein ClusterIP-Service auf Port 80 sind bereits die Chart-Standardwerte.
Das Overlay setzt voraus, dass das Secret lorax-hub mit dem Schlüssel token bereits im Namespace inference existiert. Erstelle es vor der Installation, wenn das Modell Hub-Credentials braucht; entferne andernfalls den Eintrag env.
deployment:
    image:
        repository: ghcr.io/predibase/lorax
        tag: "<tested-release-tag>@sha256:<verified-image-digest>"

    args:
        - name: "--model-id"
          value: "mistralai/Mistral-7B-Instruct-v0.1"

    env:
        - name: HUGGING_FACE_HUB_TOKEN
          valueFrom:
              secretKeyRef:
                  name: lorax-hub
                  key: token

    readinessProbe:
        httpGet:
            path: /health
            port: http
        periodSeconds: 5
        failureThreshold: 600
Helm ersetzt die gesamte args-Liste. Der Chart-Standard setzt außerdem Token-Limits (--max-input-length, --max-total-tokens, --max-batch-total-tokens, --max-batch-prefill-tokens), --compile und --eager-prefill false; übernimm die, die du behalten willst. Lege die Token-Limits anhand repräsentativer Prompts, erwarteter Parallelität, GPU-Speicher und Load Tests fest. Die Working-Set-Einstellungen aus der Tabelle oben gehören in dieselbe Liste.
Die Lücken explizit schließen
Das geprüfte Chart-Template reicht deployment.env durch toYaml, sodass ein normales Values-Overlay wie oben valueFrom.secretKeyRef für Hub-Credentials nutzen kann. Es formatiert das Image als repository:tag, was den oben gezeigten Tag-plus-Digest-Wert akzeptiert: Kubernetes nutzt den Digest zum Abrufen, wenn beide vorhanden sind. Das Chart schreibt die emptyDir-Volumes fest vor und hat keinen startupProbe-Hook. Dauerhaftes /data und eine Startup-Probe brauchen deshalb einen geprüften Chart-Fork, einen Post-Render-Patch oder eine übergeordnete Manifest-Schicht.
Ein Values-Overlay kann Image-Tag plus Digest, Launcher-Argumente, GPU-Requests und -Limits, env (einschließlich secretKeyRef), Liveness- und Readiness-Probes sowie Service-Typ und -Port setzen. Nutze die Produktionsschicht für:
- ein PersistentVolumeClaim oder ein node-lokaler Artefakt-Cache, eingehängt unter
/data - eine Startup-Probe vor einer aggressiven Liveness-Probe
- Pod-Disruption-Policy und Topology Spread bei mehreren Replicas
- NetworkPolicy, Einschränkungen für Service Accounts und ein authentifiziertes Gateway
- Artefaktintegritätsprüfungen
Lege ein Hub-Token nie direkt in eine eingecheckte Values-Datei. Zwei Replicas bieten nur dann nützliche Hochverfügbarkeit, wenn beide das Basismodell laden können. Der Router muss außerdem vermeiden, jeden kalten Adapter an beide Pods zu schicken.
Für Cache-Locality routen
Round-Robin-Balancing kann jede Replica zu einem kalten Cache machen. Ein brauchbarer Router ordnet eine erlaubte Adapter-ID per Hash oder einer anderen stabilen Regel einer Replica zu. Er hält einen Failover-Pfad bereit, falls diese Replica nicht verfügbar ist. Die Abbildung spielt sechs Anfragen für zwei Adapter unter beiden Regeln durch.
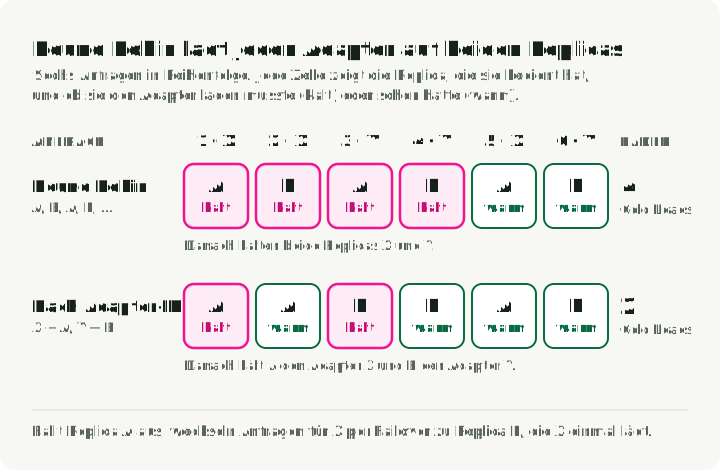
Der Routing-Key muss aus authentifiziertem Anwendungszustand stammen, nicht aus einem beliebigen öffentlichen URL-Parameter. Sonst kann ein Aufrufer Remote-Downloads erzwingen, Caches verdrängen oder nach privaten Adapternamen suchen.
LoRAX oder vLLM?
Die am 8. Oktober 2026 geprüfte vLLM-Dokumentation beschreibt LoRA-Module, die beim Start deklariert werden, und dynamisches Laden über Endpunkte oder Resolver-Plugins. Sie warnt, dass das Aktualisieren von Adaptern zur Laufzeit Sicherheitsrisiken birgt und in Produktion nur in einer isolierten, vertrauenswürdigen Umgebung verwendet werden sollte.
Die Tabelle vergleicht, wie jede Runtime Adapter findet, hält und bedient:
| Frage | LoRAX | vLLM |
|---|---|---|
| Wie werden Long-Tail-Adapter gefunden? | Die Adapter-ID kann bei Anfrage Artefakte aus Hugging Face, Predibase, S3 oder lokalen Pfaden auflösen | Statische Module, dynamische Verwaltungs-Endpunkte oder Resolver-Plugins |
| Wie wird die Residency verwaltet? | Adapter Exchange Scheduling; erneutes Laden nutzt je nach Loader gecachte Dateien oder zurückbehaltene Host-Tensoren | Konfigurierte Limits für aktive und CPU-LoRAs plus Resolver-Verhalten |
| Welche Anfrage-Schnittstelle gibt es? | /generate im TGI-Stil, Python-Client und OpenAI-kompatibler Chat | OpenAI-kompatibles Serving und native Python-APIs |
| Was sollte entscheiden? | Cold-/Warm-Latency, Cache-Churn, Throughput bei heterogenen Batches und betriebliche Passung | Dasselbe Workload-Replay und dieselben betrieblichen Kriterien |
Vermeide Regeln wie „LoRAX für 1.000 Adapter, vLLM für zehn“. Die Kataloggröße allein bestimmt die Performance nicht. Teste beide mit demselben Basismodell, denselben Adaptern, Prompts, Ranks, demselben Ankunfts-Trace und derselben Hardware.
Ein Produktions-Abnahmetest
Bevor du den Katalog erweiterst, führe ein Replay durch, das Folgendes enthält:
- Ein festes Hot Set, um Warm-Throughput und -Latency zu bestimmen.
- Eine Long-Tail-Verteilung, um Treffer im Artefaktcache und auf zurückbehaltene Host-Tensoren zu messen, sofern der Loader dies unterstützt.
- Einen Burst bisher unbekannter, aber auf der Allowlist stehender Adapter.
- Einen Pod-Austausch, um die Wiederherstellung von Basismodell und Adaptern zu messen.
- Einen nicht verfügbaren oder beschädigten Adapter, um Isolation und Fallback zu prüfen.
- Gleichzeitige Tenants, um Authentifizierung, Quotas und Metrik-Labels zu prüfen.
Erfasse diese Metriken:
- Anfragerate
- Queue-Zeit
- Time to First Token
- Inter-Token-Latency
- Gesamtlatenz
- Adapter-Ladezeit
- Cache-Hit-Klasse
- GPU-Speicher
- CPU-Speicher
- Download-Bytes
- Fehler nach Ursache
Halte Adapter-IDs aus unbegrenzten Metrik-Labels heraus. Bilde sie auf kontrollierte Dimensionen oder gesampelte Traces ab.
Lege die Abnahmeschwellen vor dem Test fest. Definiere eine maximale Fehlerrate auf dem Cold Path und ein P99-Ziel für den Warm Path. Setze außerdem ein Cache-Hit-Ziel für die beobachtete Popularitätsverteilung und ein Recovery-Time-Objective nach einem Pod-Verlust.
Fazit
LoRAX bedient viele kompatible Fine-Tunes ohne viele separate Kopien des Basismodells. Das kann für Long-Tail-Workloads ein nützliches Design sein, macht Kosten oder Latency aber nicht per Definition konstant. Der aktive Working Set, der Exchange-Pfad, der Batch-Mix und die Storage-Schicht bestimmen weiterhin das Ergebnis.
Weise diese Mechanik zuerst auf einer GPU nach. Dann gilt auf Kubernetes: Artefakte pinnen, den Cache erhalten, Credentials schützen, Adapter autorisieren, für Locality routen und jeden Residency-Pfad messen. Schlägt LoRAX eine aktuelle vLLM-Konfiguration unter demselben Replay, hat die Deployment-Entscheidung Belege hinter sich.
Referenzen
- LoRAX-Repository und README — unterstützte Features, Anforderungen, APIs, Python-Client und Helm-Chart
- LoRAX-Adapterquellen — Laden von Hub, Predibase, lokal und S3
- LoRAX-Launcher-Referenz — Argumente für Adapter-Speicher, Exchange, Preload und Quantisierung
- LoRAX-Launch-Report und Benchmark von 2023 — Quelle und Bedingungen des Kostendiagramms
- LoRAX-Chart-Werte und Deployment-Template — aktuelle Standardwerte und Volume-Verhalten
- Punica: Multi-Tenant LoRA Serving — der SGMV-Kernel für Batches mit gemischten Adaptern
- Text Generation Inference — das Projekt, von dem LoRAX abgespalten wurde, jetzt im Maintenance-Modus
- vLLM LoRA adapters — statisches und dynamisches Adapter-Serving
- LoRA-Paper — die Low-Rank-Adaptation-Methode
- Hugging Face PEFT documentation — Adapterformate und Trainingsintegration