Stack de ranking pour la recherche : BM25, embeddings et reranking

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Ce guide s’adresse aux ingénieurs Python qui construisent ou améliorent un pipeline de ranking pour la recherche. Il explique comment BM25, les embeddings denses, la fusion des rangs et les rerankers fonctionnent ensemble, et comment mesurer si la recherche a besoin de meilleurs candidats ou d’un meilleur ordre.
Une recherche sur « cheap laptop » peut manquer un produit décrit comme « budget notebook computer ». Un autre échec place un étui de transport pour casque audio devant le casque lui-même. Le premier problème demande de meilleurs candidats ; le second, un meilleur ordre.
Le dépôt de démonstration associé illustre le retrieval et le reranking sur un échantillon des données de recherche de produits Amazon ESCI.
Pour un guide compact de choix des étapes, consultez BM25 vs Embeddings vs Rerankers. La séquence d’expériences présentée plus loin relie chaque étape à une mesure.
Modèles lexicaux, denses et cross-encoders
La pile se comprend mieux en trois couches. Le retrieval lexical trouve les termes exacts, le retrieval dense comble les écarts de vocabulaire, et les rerankers comparent en détail les meilleurs candidats.
BM25 et retrieval lexical
Pendant des décennies, BM25 a été la référence. C’est un modèle probabiliste qui note les documents d’après la fréquence des termes de la requête dans le document, normalisée par la longueur du document et par la fréquence inverse de document (IDF).
BM25 est efficace lorsque des termes littéraux portent l’intention : codes d’erreur, SKU de produits, noms et identifiants d’API. Sa principale limite est le décalage de vocabulaire. Une requête « cheap laptop » peut manquer un document sur un « budget notebook computer » lorsque le texte indexé ne fournit aucun lien entre les deux expressions.
Cela dit, l’étude BEIR a montré que BM25 est une baseline zero-shot solide sur l’ensemble de ses tâches de retrieval hétérogènes. Les chiffres BM25 de BEIR viennent de Lucene via Pyserini, et non du rank_bm25 à tokenisation par espaces utilisé dans cette démo. BM25 bat aussi certains modèles neuronaux sur des tâches de retrieval argumentatif comme Touche-2020.
Retrieval dense et embeddings
Les encodeurs de type BERT ont rendu le retrieval dense praticable. Ils projettent requêtes et documents dans un espace vectoriel commun, puis classent les candidats avec une fonction de similarité comme la similarité cosinus ou le produit scalaire.
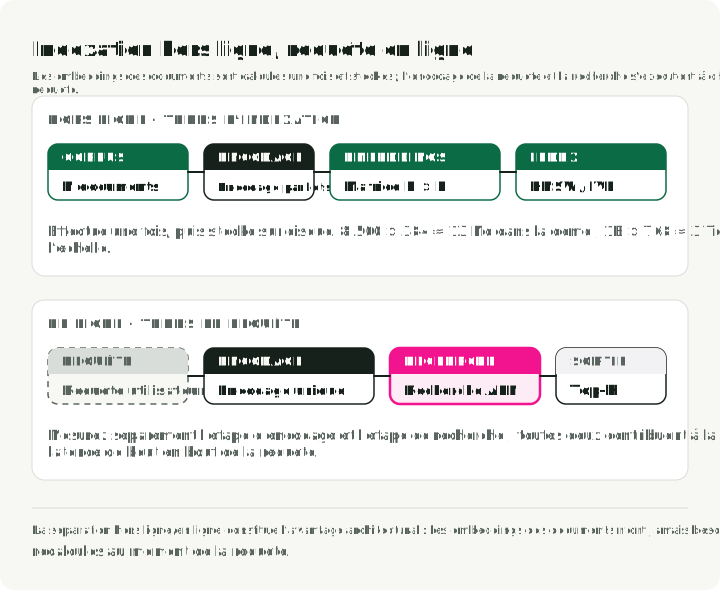
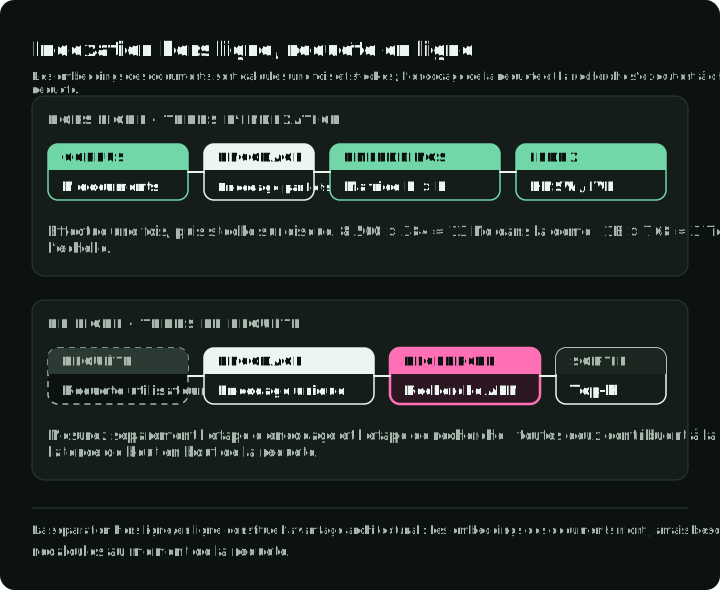
L’architecture bi-encoder (ou « two-tower ») encode séparément la requête et le document, et produit des embeddings de longueur fixe. Les vecteurs de documents peuvent être précalculés et indexés hors ligne, puis retrouvés rapidement avec des algorithmes de plus proches voisins approximatifs (ANN). Ainsi, « cheap laptop » et « budget notebook » se retrouvent proches dans l’espace vectoriel.
Certains bi-encoders utilisent une architecture siamoise, comme Sentence-BERT, où les deux côtés partagent leurs poids. D’autres utilisent des tours distinctes pour la requête et le document. Le pooling, la taille des vecteurs, la fonction de similarité et l’objectif d’entraînement sont des choix de modèle, et non des propriétés de tout retriever dense.
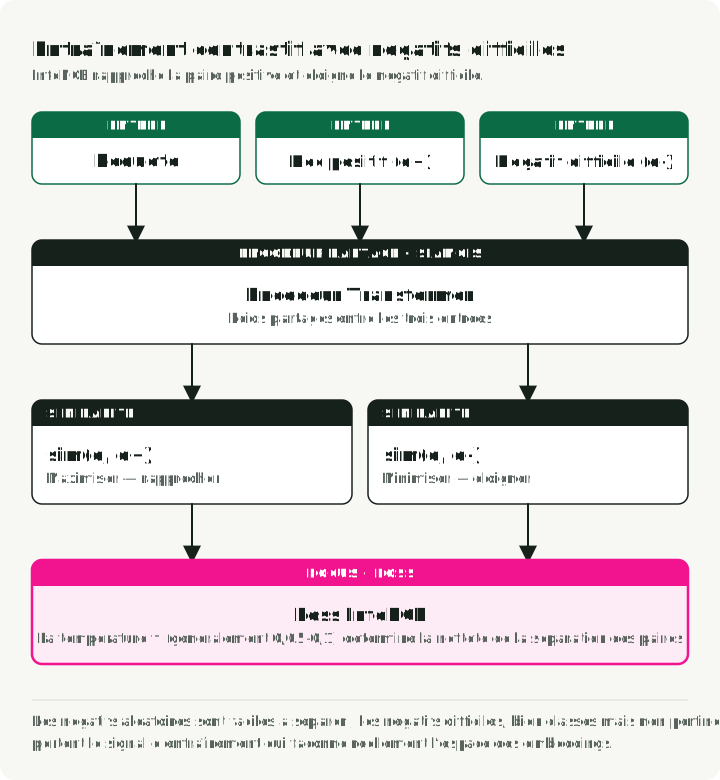
Ces modèles sont entraînés par apprentissage contrastif, en général avec la perte InfoNCE. Pour un batch de paires (requête, document_positif), l’objectif maximise sim(query, positive_doc) tout en minimisant sim(query, negative_docs). Les négatifs viennent des positifs des autres requêtes du même batch (in-batch negatives). Un paramètre de température règle la netteté avec laquelle le modèle doit séparer les deux.
Les données d’entraînement comptent souvent plus que la dimension des embeddings. Les modèles de retrieval apprennent à partir de paires requête-positif et de hard negatives soigneusement choisis : des documents plausibles mais non pertinents. La section d’entraînement plus bas montre comment SimANS évite à la fois les négatifs triviaux et les faux négatifs probables.
Le coût est le goulot d’étranglement de la représentation. Les bi-encoders compressent toute la nuance sémantique dans un seul vecteur de taille fixe, et manquent donc souvent les interactions fines entre des termes précis de la requête et un contenu précis du document.
Cross-encoders et LLMs
Les cross-encoders (Nogueira & Cho, 2019) fournissent la requête et le document ensemble à un Transformer, sous forme de séquence concaténée ([CLS] Query [SEP] Document), de sorte que chaque token de la requête peut porter son attention sur chaque token du document grâce à l’auto-attention complète. Cette interaction profonde capte des nuances que l’encodage indépendant manque.
Le reranking par LLM utilise un modèle piloté par prompt pour comparer plusieurs candidats à la fois. RankGPT a montré de solides résultats listwise zero-shot avec GPT-4 sur les benchmarks évalués, mais la stabilité des sorties, le coût et l’adéquation au domaine doivent encore être testés séparément.
Ces scores ne peuvent pas être précalculés pour des requêtes arbitraires ; le reranking est donc placé après le retrieval. Cette asymétrie de coût motive le funnel multi-étapes.
Le funnel multi-étapes
Exécuter un cross-encoder ou un LLM coûteux sur des millions de documents n’est pas viable ; les stacks de recherche modernes utilisent donc un funnel. Le retrieval et le pre-ranking réduisent l’ensemble de candidats pour que le full ranking puisse utiliser des modèles plus coûteux sur une présélection. Le blending applique ensuite des règles ou une politique de ranking ; son coût dépend de cette politique.
Un retriever bon marché manque aussi de précision finale ; le funnel n’emploie donc chaque modèle que là où son coût est raisonnable. La figure montre le volume d’entrée de chaque étape et le coût schématique des modèles, et indique que les étapes suivantes ne peuvent pas récupérer les documents omis :
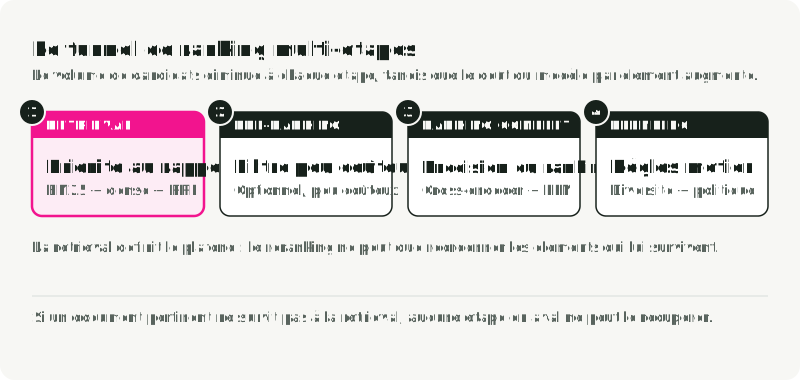
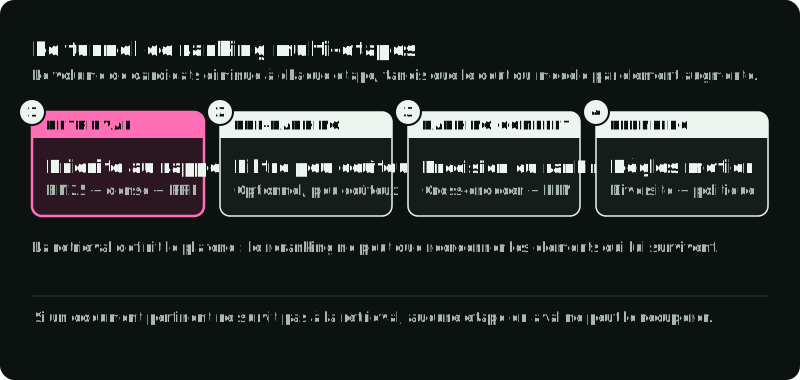
| Étape | Échelle d’entrée | Objectif principal | Méthodes typiques | Mesure de sortie |
|---|---|---|---|---|
| Retrieval | Corpus ou index | Rappel des candidats | BM25, bi-encoders | Rappel au seuil de candidats |
| Pre-ranking | Grand ensemble de candidats | Filtrage bon marché | Modèles légers, règles | Rappel conservé par milliseconde |
| Full ranking | Présélection | Qualité du haut de liste | Cross-encoders, LLMs | NDCG/MRR, latence, coût |
| Blending | Listes ou emplacements finaux | Contraintes et mixage | Règles, ranking multi-objectif | Politique, diversité, garde-fous métier |
Un reranker réordonne les candidats renvoyés par le retrieval ; il ne peut pas en ajouter. La couverture des candidats récupérés limite donc ce que les étapes suivantes peuvent récupérer. Avec plus de 100 candidats, le reranking peut faire entrer un document pertinent dans le top 100 et améliorer Recall@100. Dans cette démo, les 100 candidats restent présents ; le reranking ne peut donc pas modifier Recall@100.
Outils pour chaque étape
La démo utilise de petites bibliothèques en mémoire. Hors d’un portable, chaque étape dispose de quelques implémentations courantes :
| Étape | Outil | À utiliser quand |
|---|---|---|
| BM25 | rank_bm25 | Le corpus tient en mémoire et vous voulez une baseline rapide |
| Elasticsearch, OpenSearch ou Lucene via Pyserini | Le corpus demande un index inversé, des analyseurs et des filtres | |
| Retrieval dense | FAISS | Vous voulez une bibliothèque ANN dans votre propre service |
| pgvector | Les données vivent déjà dans Postgres | |
| Qdrant, Weaviate, Vespa ou Elasticsearch kNN | Vous avez besoin de filtres sur les métadonnées, de mises à jour fréquentes et d’un index managé | |
| Fusion | Retriever RRF d’Elasticsearch, Qdrant Query API avec rrf | Vous voulez fusionner les rangs dans le moteur de recherche |
| Recherche hybride de Weaviate | Vous utilisez Weaviate ; il propose la fusion par rangs et la fusion par scores relatifs | |
| Modèles d’embedding | L’onglet retrieval de MTEB, puis vos propres requêtes jugées | Vous choisissez un modèle ; le leaderboard réduit la liste, vos requêtes tranchent |
| Reranker | ms-marco-MiniLM-L12-v2 | Texte anglais, budget CPU |
bge-reranker-v2-m3 | Texte multilingue | |
| Elastic Rerank | Texte anglais déjà dans Elasticsearch ; il demande un abonnement éligible ou un essai |
La démo : un pipeline en cinq étapes
Pour rendre cela concret, j’ai construit une démo search-ranking-stack qui exécute un pipeline en cinq étapes sur le benchmark de recherche de produits Amazon ESCI. Chaque étape écrit ses métriques.
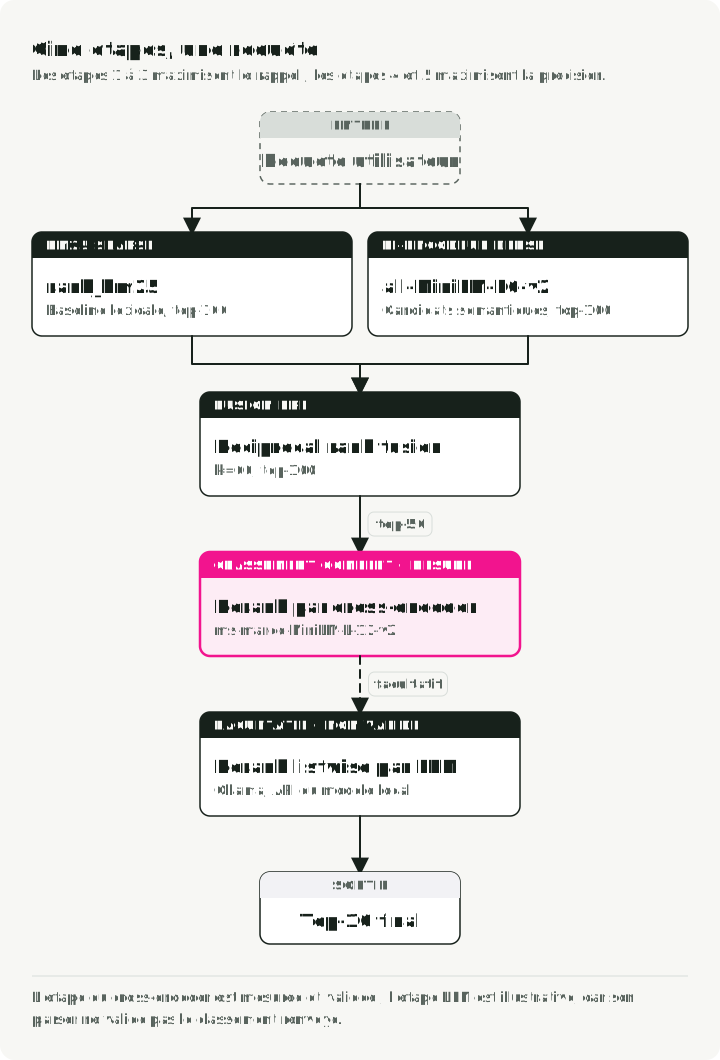
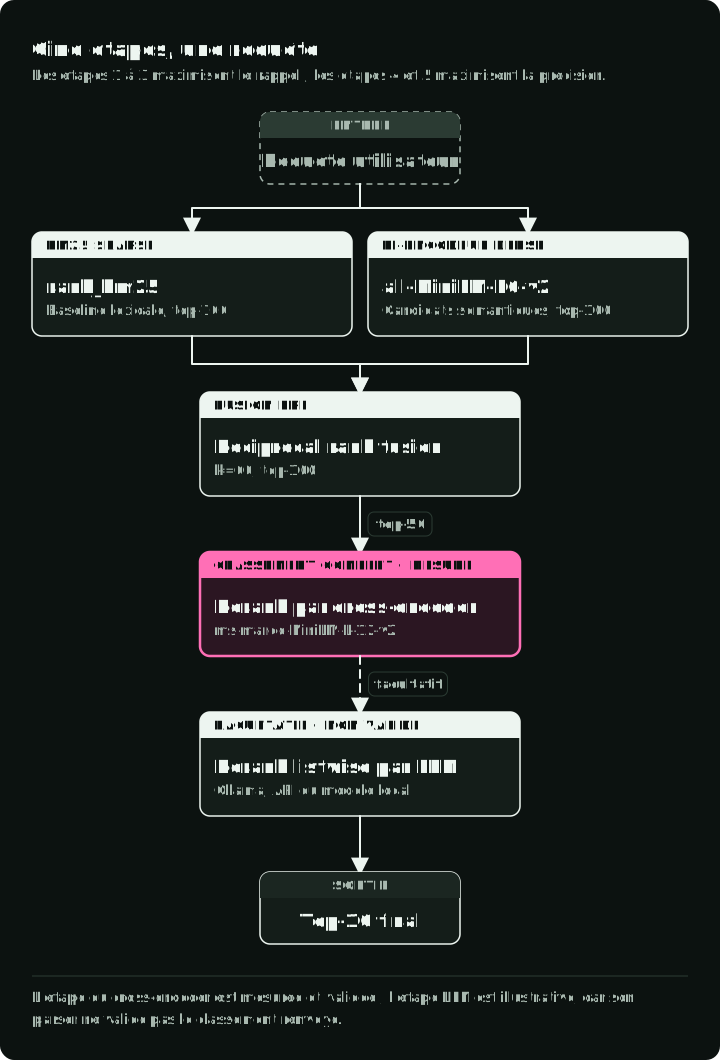
Le pipeline :
- Retrieval parcimonieux BM25 — baseline lexicale (
rank_bm25) - Retrieval dense par bi-encoder — génération sémantique de candidats (
all-MiniLM-L6-v2) - Fusion hybride RRF — fusion par rangs des résultats parcimonieux et denses
- Reranking par cross-encoder — scores de pertinence par paire (
ms-marco-MiniLM-L12-v2) - Reranking listwise par LLM — comparaison pilotée par prompt de la présélection finale (Ollama, API ou modèle local)
Les étapes 1 à 3 forment l’étape de retrieval du funnel (maximiser le rappel) ; les étapes 4 et 5 forment l’étape de full ranking (maximiser la précision). La démo omet le pre-ranking et le blending. Le schéma indique le nombre de candidats à chaque étape : le cross-encoder note les 50 premiers des 100 candidats hybrides et garde les autres dans l’ordre hybride, et le LLM voit les 10 premiers.
Démarrage rapide
L’étape de téléchargement récupère le dataset une fois et écrit un petit échantillon. run-all exécute ensuite chaque étape, affiche une ligne de métriques par étape, et écrit ces lignes dans results/metrics.json ainsi qu’un graphique dans results/metrics_comparison.png. Ajoutez --llm-mode pour inclure l’étape LLM.
git clone https://github.com/slavadubrov/search-ranking-stack.git
cd search-ranking-stack
uv sync

# Download and sample ESCI dataset (~2.5GB download, ~5MB sample)
uv run download-data

# Run BM25, dense, hybrid RRF, and the cross-encoder
uv run run-all

# Add LLM reranking with a local Ollama model (ollama pull llama3.2:3b first)
uv run run-all --llm-mode ollama
Dataset et échantillonnage : Amazon ESCI
La démo utilise l’Amazon Shopping Queries Dataset (ESCI) de la KDD Cup 2022 — un vrai benchmark de recherche de produits avec des labels de pertinence gradués sur quatre niveaux :
| Label | Gain | Signification | Exemple (requête : « wireless headphones ») |
|---|---|---|---|
| Exact (E) | 3 | Satisfait toutes les exigences de la requête | Sony WH-1000XM5 Wireless Headphones |
| Substitute (S) | 2 | Alternative fonctionnelle | Casque filaire avec adaptateur Bluetooth |
| Complement (C) | 1 | Article associé et utile | Étui de transport pour casque |
| Irrelevant (I) | 0 | Aucun lien significatif | Câble de recharge USB |
La pertinence graduée compte, car elle permet d’utiliser NDCG (Normalized Discounted Cumulative Gain), qui distingue un classement « parfait » d’un classement « simplement correct ». Les métriques binaires leur donnent le même score.
J’ai utilisé l’échantillon small_version de la démo : 500 requêtes, 9 870 produits et 9 984 jugements. Son script de téléchargement lit l’unique split train de tasksource/esci, filtre la locale anglaise us et small_version == 1, puis tire avec la graine 42 jusqu’à 500 identifiants de requête uniques sans remise. Le corpus contient les produits uniques des lignes de jugement ainsi sélectionnées. Ce n’est ni un split réservé à l’évaluation, ni un corpus indépendant. L’échantillon est assez petit pour tourner sur un portable, mais trop petit et trop spécifique à un domaine pour établir un ranking de production. Utilisez-le pour reproduire les étapes et inspecter les modes d’échec ; utilisez des requêtes représentatives et réservées à l’évaluation pour décider d’un déploiement.
Évaluation : mesurer ce qui compte
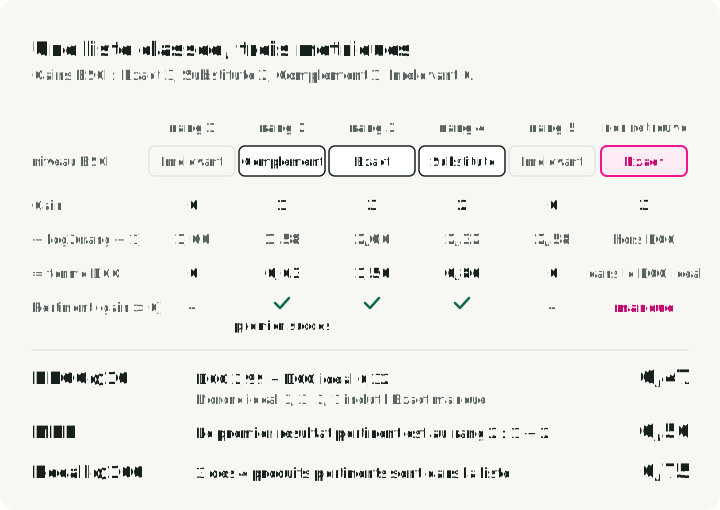
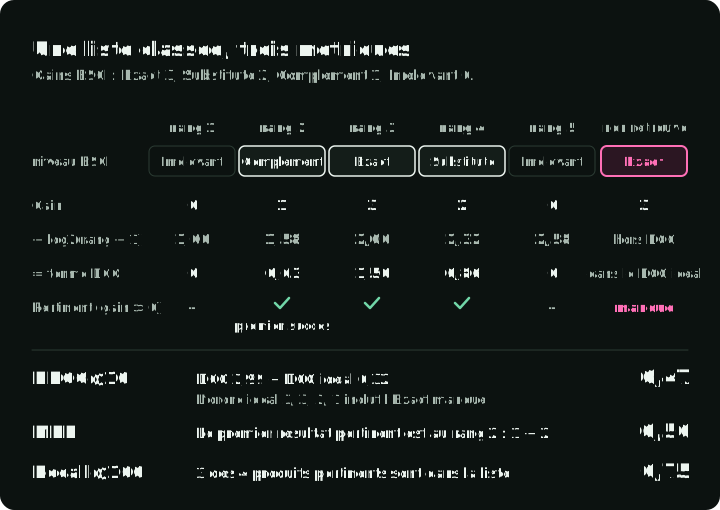
La démo utilise trois métriques, chacune regardant le classement sous un angle différent. La figure applique les trois aux résultats d’une seule requête, avec les gains ESCI ci-dessus :
NDCG@10 (métrique principale)
Le Normalized Discounted Cumulative Gain mesure la qualité du classement du top 10 à l’aide de la pertinence graduée. Il récompense le placement des documents très pertinents près du haut, avec une décote logarithmique :
Cela correspond aux gains linéaires de ndcg_cut dans trec_eval, sélectionné via pytrec_eval sous le nom ndcg_cut_10. IDCG est le DCG de l’ordre idéal des niveaux jugés ; une requête sans aucun gain positif reçoit zéro. Les gains exponentiels comme définissent une autre convention et changeraient ces chiffres.
Des trois, NDCG est la seule métrique qui exploite pleinement la pertinence graduée à quatre niveaux d’ESCI. Un système qui place un résultat Exact en position 1 obtient un meilleur score qu’un système qui y place un Substitute. C’est pourquoi c’est ici la métrique principale.
MRR (premier résultat Complement ou supérieur)
Le Mean Reciprocal Rank utilise la position du premier résultat compté comme pertinent. Dans cette démo, l’évaluateur transmet les jugements de pertinence d’ESCI à pytrec_eval et utilise recip_rank sur chaque liste renvoyée de 100 candidats au plus. Son seuil binaire est relevance > 0 : Complement (1), Substitute (2) et Exact (3) comptent comme pertinents. Irrelevant (0) ne compte pas. Un résultat pertinent en position 1 donne un rang réciproque de 1,0 ; en position 3, 0,333. C’est le MRR sur les listes de candidats renvoyées, pas MRR@10.
Recall@100 (couverture du retrieval)
Recall@100 mesure la fraction des documents pertinents jugés qui apparaissent dans le top 100. Il reste constant lors du reranking des mêmes 100 candidats, comme dans cette démo. Avec un ensemble plus grand de candidats, le reranking peut faire entrer un document pertinent dans le top 100 et augmenter la métrique, mais il ne peut pas récupérer un document omis par le retrieval.
Le dénominateur ne comprend que les documents pertinents jugés, comme dans l’implémentation du rappel de trec_eval. Un produit non jugé n’apporte aucune pertinence positive et ne figure pas dans ce dénominateur. Des jugements incomplets peuvent donc faire diverger le rappel mesuré de la couverture de tous les produits réellement pertinents.
Retrieval : recherche hybride
Le rôle de la couche de retrieval est de maximiser le rappel : faire entrer autant de documents pertinents que possible dans l’ensemble de candidats.
BM25 : la baseline lexicale
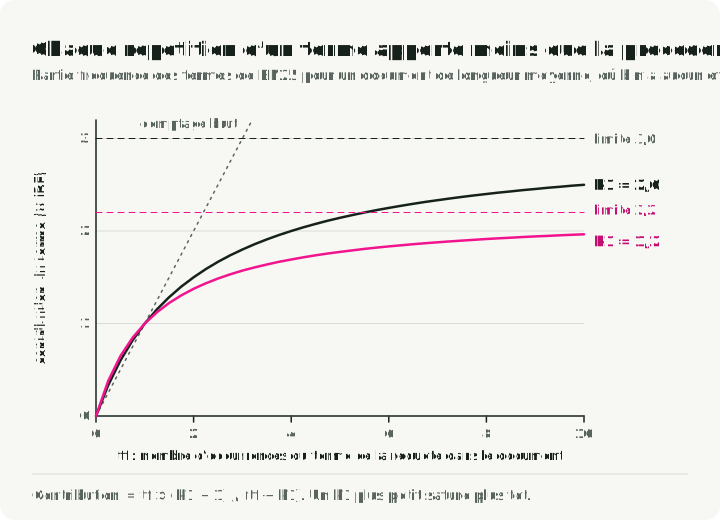
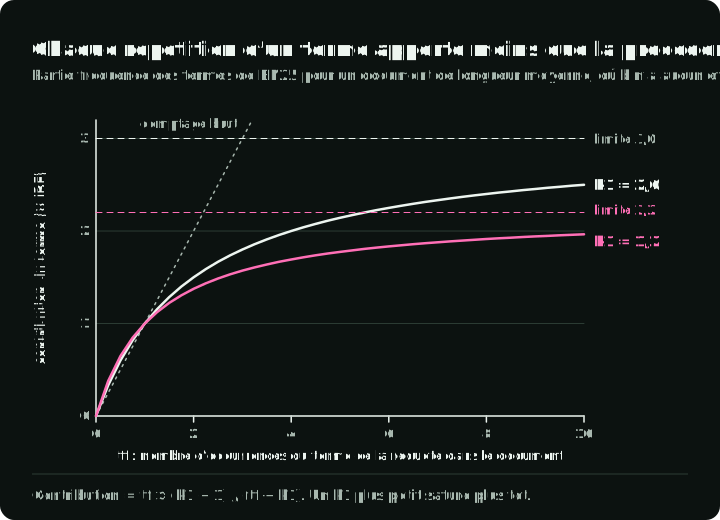
BM25 note les documents selon le recouvrement de termes avec la requête, avec saturation de la fréquence des termes et normalisation de la longueur du document :
Ici, est la fréquence inverse de document du terme , la fréquence du terme dans le document , la longueur du document et la longueur moyenne des documents du corpus. Deux paramètres comptent : (typiquement 1,2 à 2,0) contrôle la saturation de TF — la vitesse à laquelle les termes répétés cessent d’apporter de la valeur — et (typiquement 0,75) contrôle la normalisation de la longueur du document.
Le graphique trace la partie fréquence des termes de la formule pour les deux extrémités de la plage habituelle de :
L’implémentation est courte. Tokenisation simple par espaces avec rank_bm25 :
# src/search_ranking_stack/stages/s01_bm25.py

from rank_bm25 import BM25Okapi

def run_bm25(data: ESCIData, top_k: int = 100):
    doc_ids = list(data.corpus.keys())
    tokenized_corpus = [text.lower().split() for text in data.corpus.values()]

    bm25 = BM25Okapi(tokenized_corpus)

    results = {}
    for query_id, query_text in data.queries.items():
        scores = bm25.get_scores(query_text.lower().split())
        top_indices = np.argsort(scores)[::-1][:top_k]
        results[query_id] = {doc_ids[idx]: float(scores[idx]) for idx in top_indices}

    return results
BM25 atteint un Recall@100 de 0,741 — 74 % des produits pertinents jugés apparaissent quelque part dans le top 100. Un reranker qui ne reçoit que cette liste BM25 ne peut pas récupérer les 26 % de produits pertinents jugés qui manquent.
Retrieval dense par bi-encoder
Le bi-encoder projette requêtes et documents indépendamment dans un espace d’embedding commun :
# Simplified from src/search_ranking_stack/stages/s02_dense.py

import numpy as np
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("sentence-transformers/all-MiniLM-L6-v2")
doc_texts = ["Sony WH-1000XM5 Wireless Headphones", "Headphone carrying case"]
query_texts = ["wireless headphones"]

# Encode corpus once, cache to disk
corpus_embeddings = model.encode(
    doc_texts,
    batch_size=128,
    normalize_embeddings=True,  # Cosine sim = dot product
    convert_to_numpy=True,
)

# At query time: encode query, compute dot product
query_embeddings = model.encode(query_texts, normalize_embeddings=True)
similarity_matrix = np.dot(query_embeddings, corpus_embeddings.T)
Avec des embeddings normalisés, la similarité cosinus se réduit à un produit scalaire. La démo calcule la matrice complète requêtes par corpus parce que 9 870 documents tiennent aisément en mémoire ; un corpus de production utiliserait normalement un index de plus proches voisins approximatifs. Sur cet échantillon, all-MiniLM-L6-v2 fait passer le Recall@100 de 0,741 à 0,825.
Comment les bi-encoders apprennent de bonnes représentations
Le pré-entraînement d’un encodeur et le fine-tuning d’embeddings résolvent des problèmes différents. Un Transformer pré-entraîné fournit des représentations de tokens ; le fine-tuning contrastif apprend à un vecteur poolé quels textes doivent être proches. Les données NLI, de similarité de phrases et de paires requête-passage sont des ingrédients possibles, pas une séquence universelle. La fiche du modèle all-MiniLM-L6-v2 de la démo décrit un encodeur MiniLM pré-entraîné, affiné sur plus d’un milliard de paires de phrases hétérogènes.
Le fine-tuning pour le retrieval peut recourir à l’extraction de hard negatives (hard negative mining). Des négatifs aléatoires, comme un document de cuisine associé à une requête sur des casques, risquent d’être trop faciles pour apprendre grand-chose. Un retriever peut à la place fournir des candidats plausibles que les jugements désignent comme non pertinents. Les documents bien classés mais non jugés demandent de la prudence : certains peuvent être des positifs manquants.
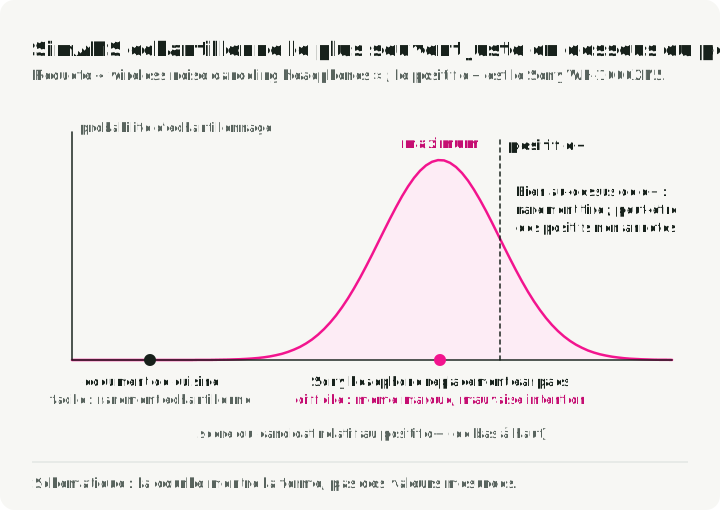
SimANS échantillonne les négatifs selon une distribution de probabilité concentrée près du score de pertinence du document positif. Elle réduit l’importance accordée à la fois aux négatifs faciles et aux candidats les mieux notés, qui peuvent être de faux négatifs. C’est un échantillonnage biaisé parmi les candidats retrouvés, et non une règle stricte qui exclut tout document au-dessus ou au-dessous d’une borne de rang. La courbe montre la fréquence d’échantillonnage d’un candidat retrouvé, selon son score relatif au positif :
# What a training triplet looks like after hard negative mining
training_triplet = {
    "query": "wireless noise canceling headphones",
    "positive": "Sony WH-1000XM5 Wireless Noise Cancelling Headphones",
    "negative": "Sony headphone replacement ear pads",  # Hard negative: same brand, related product, but wrong intent
}
# The bi-encoder must learn that "ear pads" is NOT what the user wants,
# even though it shares many tokens with the positive document.
La fonction de perte contrastive (InfoNCE) relie le tout. Pour chaque requête avec un document positif et un ensemble de documents négatifs :
Ici, est la similarité cosinus entre les embeddings de la requête et du document, et est le paramètre de température (typiquement 0,05 à 0,1). Des valeurs plus basses rendent la perte plus sensible aux hard negatives. C’est une entropie croisée softmax : elle augmente la similarité de la paire positive par rapport à tous les négatifs. Quand est petit, même de faibles écarts de similarité produisent de grands gradients, ce qui force le modèle à des distinctions plus fines.
Servir des embeddings de bi-encoder à grande échelle
L’avantage architectural d’un bi-encoder est la séparation hors ligne / en ligne. Les embeddings des documents sont calculés à l’indexation et stockés dans un index vectoriel. Au moment de la requête, le système encode la requête et cherche dans ces vecteurs stockés. La latence dépend de l’encodeur, du matériel, de l’index, des filtres et de la cible de rappel ; il faut donc profiler séparément les deux étapes.
Dans la démo, le calcul est modeste : 9 870 documents 384 dimensions 4 octets par flottant = ~15 Mo d’embeddings. À l’échelle de la production, les chiffres cessent d’être modestes : 1 milliard de documents avec des embeddings de 768 dimensions demandent ~3 Tio de stockage. C’est là qu’interviennent la quantification (compresser des flottants 32 bits en entiers 8 bits), la quantification produit (décomposer les vecteurs en sous-espaces) et les index sur SSD comme DiskANN. La section sur l’indexation des vecteurs denses présente les algorithmes d’index.
Pourquoi tester le retrieval hybride
Les deux méthodes échouent souvent différemment. BM25 convient bien aux noms propres, aux SKU de produits et aux codes d’erreur. Le retrieval dense peut compenser un décalage de vocabulaire comme « cheap laptop » face à « budget notebook computer ». Que la fusion aide ou non dépend de la fréquence de ces cas complémentaires dans l’ensemble de requêtes cible.
Une expérience suivante courante est la recherche hybride : exécuter les deux méthodes de retrieval, puis fusionner leurs listes classées.
Reciprocal rank fusion (RRF)
BM25 et le retrieval dense produisent des scores de sens et d’échelle différents. Une combinaison linéaire demande donc un calibrage et une validation chaque fois que les retrievers ou le corpus changent.
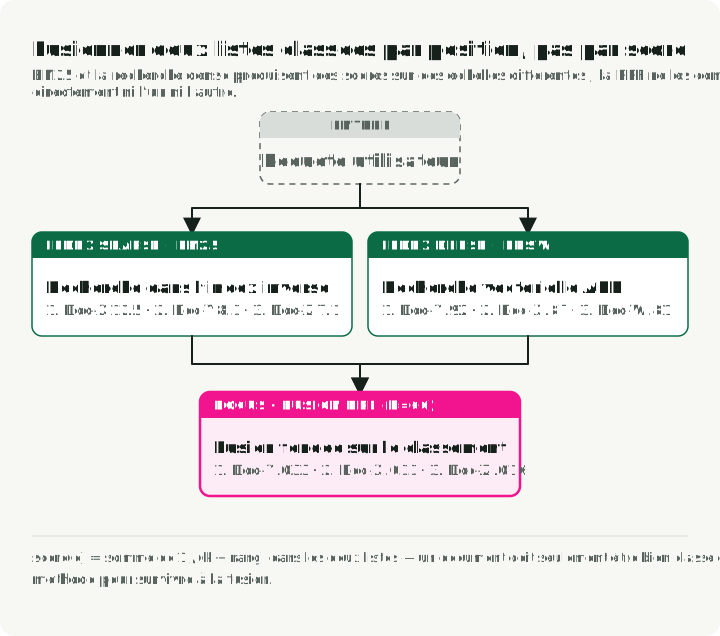
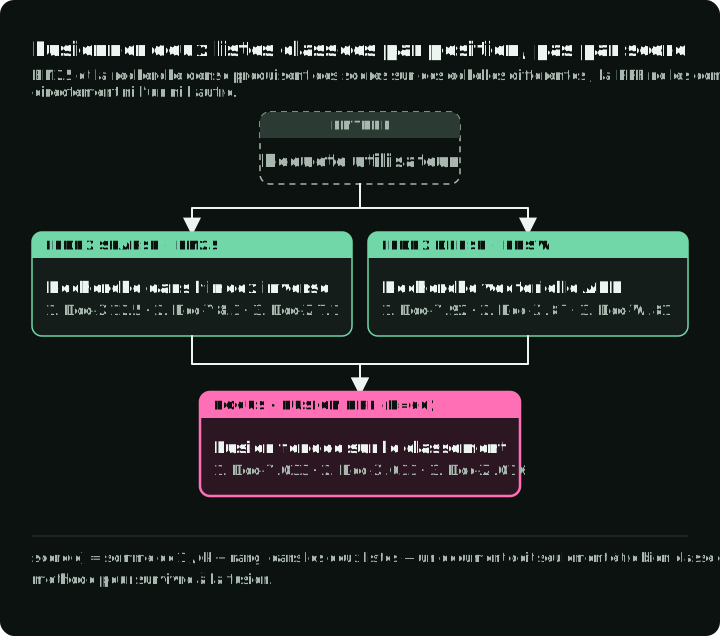
Reciprocal Rank Fusion (Cormack et al., 2009) abandonne entièrement les scores bruts et n’utilise que la position de rang :
Ici, est une constante de lissage ; 60 est une valeur de départ courante. RRF récompense les éléments bien classés dans plusieurs listes d’entrée sans comparer leurs scores bruts. Il évite le calibrage de l’échelle des scores, mais les seuils de retrieval, les poids et demandent toujours une évaluation.
L’implémentation :
# src/search_ranking_stack/stages/s03_hybrid_rrf.py

from collections import defaultdict

def reciprocal_rank_fusion(ranked_lists, k=60, top_k=100):
    all_query_ids = set().union(*(results.keys() for results in ranked_lists))
    fused_results = {}

    for query_id in all_query_ids:
        rrf_scores = defaultdict(float)

        for results in ranked_lists:
            sorted_docs = sorted(results.get(query_id, {}).items(),
                                 key=lambda x: x[1], reverse=True)

            for rank, (doc_id, _score) in enumerate(sorted_docs, start=1):
                rrf_scores[doc_id] += 1.0 / (k + rank)

        sorted_rrf = sorted(rrf_scores.items(),
                            key=lambda x: x[1], reverse=True)[:top_k]
        fused_results[query_id] = dict(sorted_rrf)

    return fused_results
Le RRF hybride atteint un Recall@100 de 0,842 et un NDCG@10 de 0,628 — mieux que BM25 (0,585) et que le dense (0,611) pris seuls. Un document trouvé par un seul retriever reçoit tout de même un score RRF, mais il peut tomber sous le seuil du top 100. Avec , le rang 1 dans une liste donne , moins que le rang 50 dans les deux listes (). Le recouvrement peut l’emporter sur un bon rang dans une seule liste.
Reranking par cross-encoder
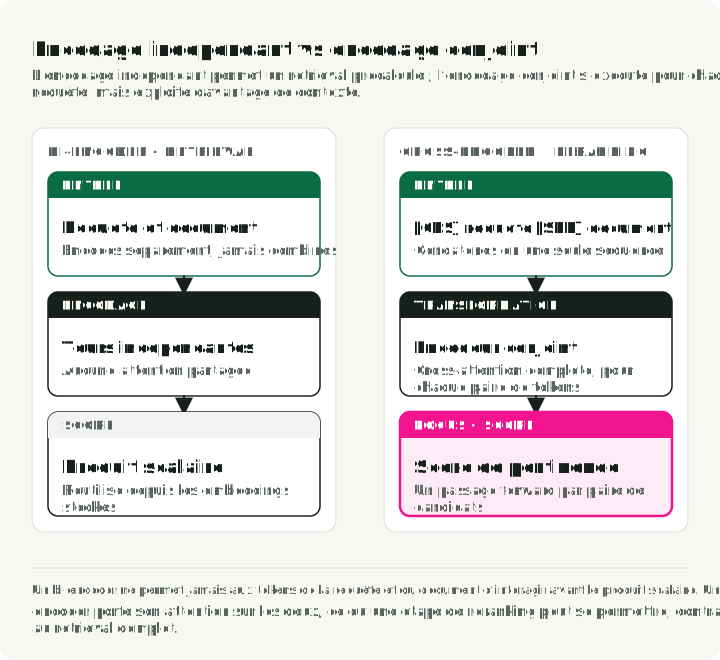
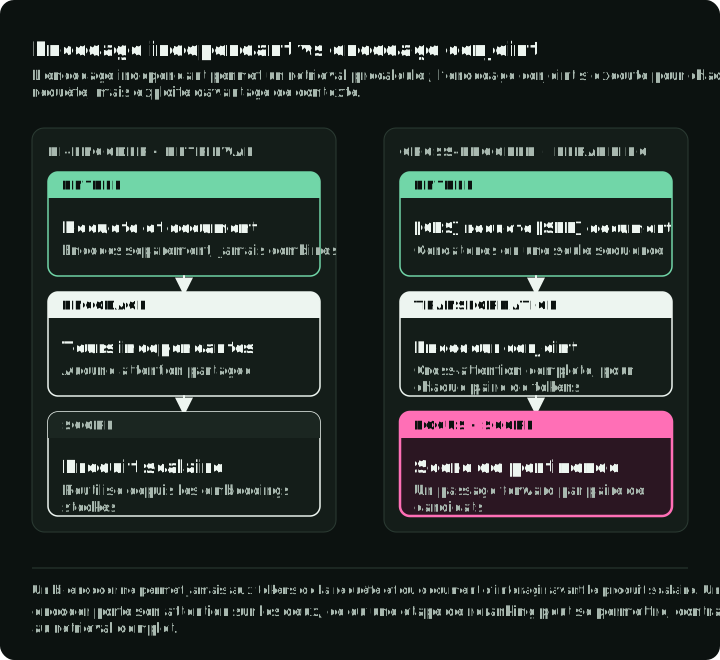
Avec 100 candidats hybrides par requête, vous pouvez vous permettre un modèle plus coûteux. Le cross-encoder traite la requête et le document ensemble dans un seul Transformer, avec auto-attention sur l’ensemble formé par la requête et le document.
Interaction au niveau des tokens
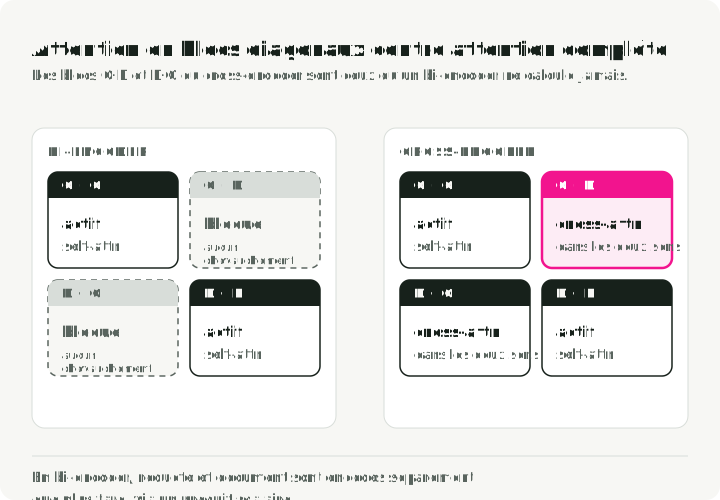
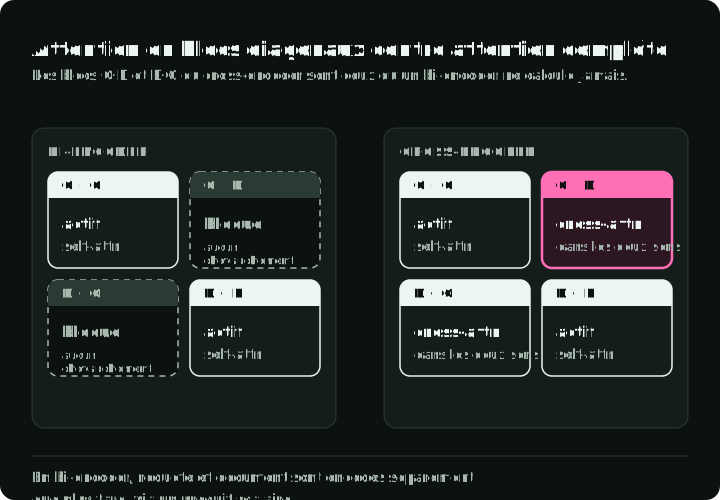
La différence se trouve dans la matrice d’attention. Dans un bi-encoder, l’attention est bloc-diagonale : les tokens de la requête ne portent leur attention que sur d’autres tokens de la requête, et les tokens du document que sur d’autres tokens du document. Les deux représentations ne se rencontrent jamais au niveau des tokens — elles ne se croisent qu’à la fin, par un produit scalaire. Un cross-encoder calcule la matrice d’attention complète, où chaque token de la requête porte son attention sur chaque token du document, et inversement. Cette auto-attention conjointe permet au modèle de comparer directement les tokens de la requête et ceux du document.
Dans un bi-encoder, la requête est encodée avant qu’aucun document ne soit vu. Un cross-encoder voit ensemble la requête et le candidat ; il peut donc exploiter leur relation au niveau des tokens. Cela peut aider dans des cas comme :
- Négation : « headphones that are not wireless ». Un embedding poolé peut sous-pondérer la négation, tandis que l’encodage conjoint donne au modèle une interaction directe requête-document. C’est une hypothèse à vérifier sur une tranche ciblée, pas une garantie.
- Qualification : « laptop under $500 ». L’encodage conjoint peut relier la contrainte à un prix dans le texte du produit, même si des filtres de prix structurés sont plus sûrs lorsque le champ est disponible.
L’entrée du cross-encoder est formatée ainsi : [CLS] query tokens [SEP] document tokens [SEP]. [CLS] est un token de classification dont l’état caché final passe par une tête linéaire pour produire un seul score de pertinence. Des embeddings de segment distinguent les tokens de la requête de ceux du document, et [SEP] marque la frontière entre les segments.
Comment les cross-encoders sont entraînés
Les cross-encoders peuvent apprendre à partir d’exemples (query, document, relevance_label) avec des objectifs pointwise, pairwise ou listwise. Un exemple pointwise associe « wireless headphones » à « Sony WH-1000XM5 Wireless Headphones » et au label 1,0.
Un classifieur courant fait passer la représentation [CLS] finale à un score. Des labels binaires peuvent utiliser l’entropie croisée binaire ; la pertinence graduée peut utiliser des pertes de régression, ordinales, pairwise ou listwise. Choisissez avec des métriques de ranking sur des données réservées à l’évaluation, plutôt que de supposer qu’un objectif est universellement meilleur.
L’extraction de hard negatives aide aussi à entraîner les cross-encoders. Les cross-encoders sont coûteux à entraîner — chaque exemple demande une passe avant complète sur la séquence concaténée — et l’on ne peut donc pas gaspiller du calcul sur des négatifs trivialement faciles. La recette pratique : utiliser un bi-encoder pour récupérer les top-K candidats de chaque requête d’entraînement, puis prendre les hard negatives dans des plages de rang précises (par exemple, rangs 10 à 100). Le cross-encoder reçoit ainsi des exemples où distinguer le pertinent du non pertinent demande une interaction profonde entre tokens.
Reranking des candidats récupérés
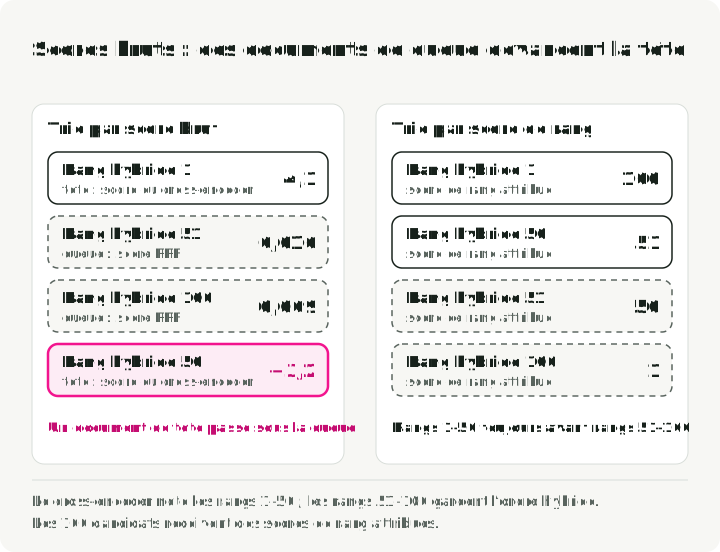
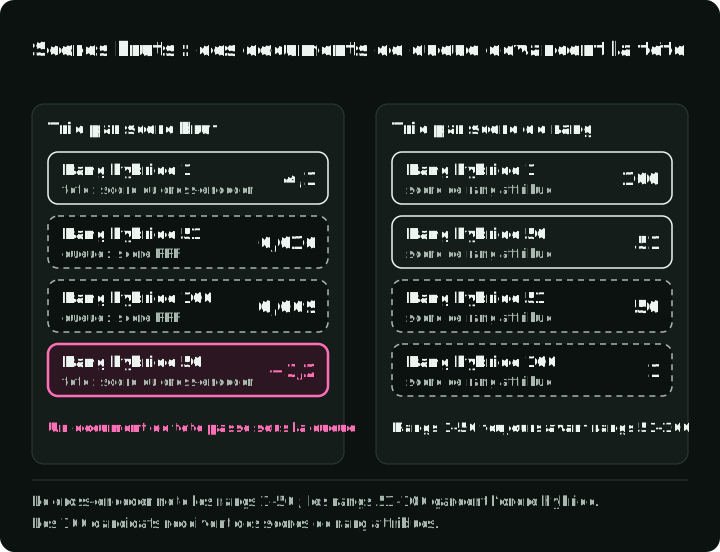
L’étape envoie à CrossEncoder.predict les paires (query, document) des 50 premiers candidats hybrides, remet ces candidats dans l’ordre des scores, puis ajoute les candidats non notés dans leur ordre précédent. La figure trie quatre des 100 candidats dans les deux sens et montre pourquoi la fusion attribue de nouveaux scores de rang au lieu de conserver les scores bruts :
# From src/search_ranking_stack/stages/s04_cross_encoder.py

def rank_scores(ordered_ids):
    return {doc_id: float(len(ordered_ids) - rank) for rank, doc_id in enumerate(ordered_ids)}

def merge_head_and_tail(original, scored_head):
    """original: hybrid (doc_id, rrf_score) pairs in rank order.
    scored_head: (doc_id, cross_encoder_score) pairs for the first len(scored_head)."""
    head = sorted(scored_head, key=lambda item: (-item[1], item[0]))
    tail = original[len(scored_head) :]
return rank_scores([doc_id for doc_id, _ in head + tail])L’étape complète ajoute le chargement du modèle, la coupure des documents à 2 048 caractères et une vérification que chaque score est fini.
La fiche du modèle montre que les scores du cross-encoder peuvent être négatifs. Ne les mélangez pas avec les scores RRF de la queue non notée : un score RRF positif peut placer un document non noté de la queue au-dessus d’un document de tête noté négativement. Attribuez des scores de rang strictement décroissants, comme le fait rank_scores. Ce sont des scores de rang pour l’évaluation, pas des estimations calibrées de pertinence.
Le compromis vitesse-qualité
Pourquoi ne pas utiliser des cross-encoders pour tout ? Parce que les scores ne peuvent pas être précalculés. Les embeddings de documents d’un bi-encoder sont indépendants de la requête : on les calcule une fois et on les stocke. La sortie d’un cross-encoder dépend à la fois de la requête et du document. Le score de pertinence de « wireless headphones » associé à un produit Sony provient de l’auto-attention conjointe entre ces tokens précis. Vous pouvez mettre en cache une paire requête-document répétée, mais son score ne peut pas être réutilisé pour une autre requête.
Un bi-encoder demande un encodage de la requête plus une recherche vectorielle sur des embeddings de documents précalculés. Un cross-encoder note chaque paire requête-document de la présélection, avec un coût qui croît à la fois avec le nombre de candidats et avec la longueur des séquences. Le batching aide, mais noter 100 000 candidats reste un mauvais point de fonctionnement ; faites d’abord le retrieval, puis mesurez la plus grande présélection qui respecte les cibles de qualité et de latence.
Reranking listwise par LLM
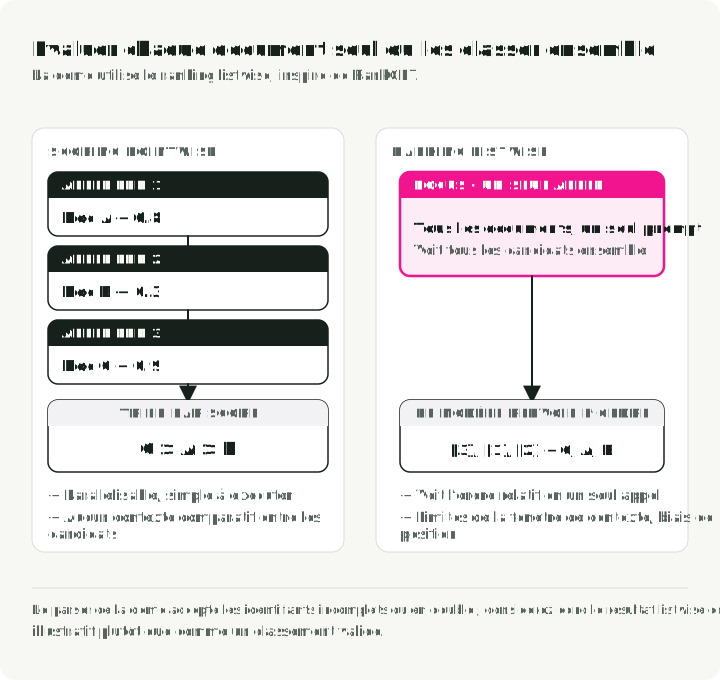
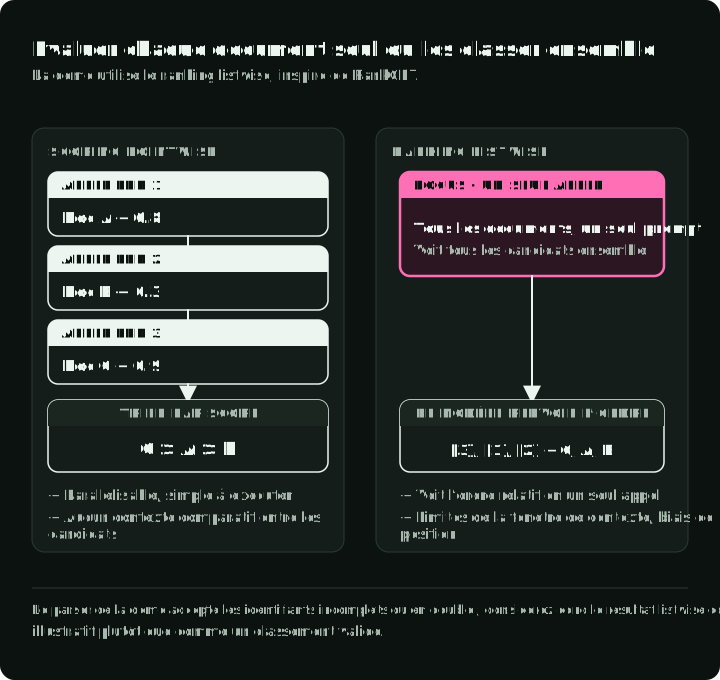
La dernière étape de la démo utilise un LLM pour un reranking listwise. Au lieu de noter chaque document indépendamment, le modèle voit le top 10 et renvoie un ordre. Inspiré de RankGPT, le prompt rend la comparaison relative explicite, mais il introduit aussi des limites de contexte, un biais de position, des échecs de parsing et une variance d’une exécution à l’autre.
Le prompt listwise
Le modèle de prompt demande au LLM de tenir compte de la hiérarchie de pertinence d’ESCI :
# src/search_ranking_stack/stages/s05_llm_rerank.py

def _create_listwise_prompt(query, documents, max_words=200):
    n = len(documents)

    doc_texts = []
    for i, (_doc_id, doc_text) in enumerate(documents, start=1):
        words = doc_text.split()[:max_words]
        doc_texts.append(f"[{i}] {' '.join(words)}")

    docs_formatted = "\n\n".join(doc_texts)

    return (
        f"I will provide you with {n} product listings, each indicated by a numerical "
        f"identifier [1] to [{n}]. Rank the products based on their relevance to the "
        f'search query: "{query}"\n\n'
        "Consider:\n"
        "- Exact matches (product satisfies all query requirements) should rank highest\n"
        "- Substitutes (functional alternatives) should rank above complements\n"
        "- Completely irrelevant products should rank lowest\n\n"
        f"{docs_formatted}\n\n"
        "Rank the products from most relevant to least relevant.\n"
        "Output ONLY a comma-separated list of product identifiers, e.g.: [3], [1], [2], ...\n"
        "Do not explain your reasoning. Only output the ranking."
    )
Trois modes d’exécution
La démo prend en charge trois backends pour le reranking par LLM :
| Mode | Modèle | Mode d’exécution |
|---|---|---|
ollama | llama3.2:3b (changez-le avec OLLAMA_MODEL) | En local via l’API Ollama |
api | Claude Haiku (réglez LLM_MODEL_API dans config.py) | API Anthropic ; faites d’abord uv sync --extra api |
local | Qwen/Qwen2.5-1.5B-Instruct | Hugging Face Transformers ; faites d’abord uv sync --extra llm |
Parsing et fallback
Le parseur extrait les identifiants numérotés de la réponse du modèle. Il n’accepte un classement que s’il liste chaque candidat exactement une fois :
# src/search_ranking_stack/stages/s05_llm_rerank.py

def _parse_ranking(output: str, n: int) -> list[int] | None:
    """Return 0-based positions if the output ranks IDs 1..n exactly once."""
    positions = [int(m) - 1 for m in re.findall(r"\[(\d+)\]", output)]

    # Reject missing, duplicate, and out-of-range IDs.
    if sorted(positions) != list(range(n)):
        return None

    return positions
Lorsque le parseur renvoie None, la démo garde l’ordre complet du cross-encoder pour cette requête et compte un fallback. Une erreur du backend compte aussi comme un fallback. run-all affiche le taux de fallback et l’enregistre à côté des métriques. Par exemple, [3] > [1] > [3] est rejeté : l’ID 3 est répété et les ID 2 et 4 à 10 sont absents.
Résultats sur cet échantillon ESCI
Les résultats utilisent l’échantillon small_version décrit plus haut ; il n’est pas réservé à l’évaluation. Les lignes proviennent d’une exécution de uv run run-all --llm-mode ollama avec llama3.2:3b comme LLM.
| Étape | NDCG@10 | MRR | Recall@100 | Écart NDCG |
|---|---|---|---|---|
| BM25 | 0,585 | 0,812 | 0,741 | — |
| Bi-encoder dense | 0,611 | 0,808 | 0,825 | +0,026 |
| Hybride (RRF) | 0,628 | 0,834 | 0,842 | +0,017 |
| + Cross-encoder | 0,699 | 0,886 | 0,842 | +0,071 |
| + Reranker LLM (13,4 % de fallback) | 0,699 | 0,884 | 0,842 | +0,000 |
Le graphique trace le Recall@100 de chaque ligne en fonction de son NDCG@10 :


Ce que les résultats enregistrés permettent d’affirmer
La recherche hybride bat chaque méthode prise seule. Le RRF hybride atteint un NDCG@10 de 0,628, au-dessus de BM25 (0,585) et du dense (0,611). Il a aussi le Recall@100 le plus élevé des trois lignes de retrieval (0,842). Les deux méthodes peuvent échouer sur des requêtes différentes, et la fusion récupère des documents que l’une ou l’autre manque seule.
Le cross-encoder apporte le plus grand gain. Il fait passer le NDCG@10 de 0,628 à 0,699 et le MRR de 0,834 à 0,886 en ne notant que 50 candidats par requête. Dans le top 10, la part de produits Exact passe de 36,0 % (hybride) à 41,4 %.
Dans cette démo, le rappel est fixé au retrieval. Les deux rerankers conservent les 100 candidats hybrides ; Recall@100 reste donc à 0,842. Pour l’augmenter, changez les 100 candidats que le retrieval renvoie.
Un petit LLM local n’apporte rien sur cet échantillon. llama3.2:3b laisse le NDCG@10 à 0,699 et baisse légèrement le MRR. 67 réponses sur 500 (13,4 %) ont échoué au parseur et ont gardé l’ordre du cross-encoder ; l’ordre du LLM a donc été appliqué à 433 requêtes. Un modèle plus grand ou le mode API peut se comporter autrement ; mesurez-le de la même façon, avec le taux de fallback à côté du score.
Le retrieval dense bat BM25 sur cet échantillon. Inspectez des tranches de requêtes avant d’en attribuer la cause. Le décalage de vocabulaire est un facteur plausible, mais la construction de l’échantillon, le tokenizer, le domaine d’entraînement du modèle et les champs du corpus affectent aussi la comparaison.
Indexer des vecteurs denses au-delà de la démo
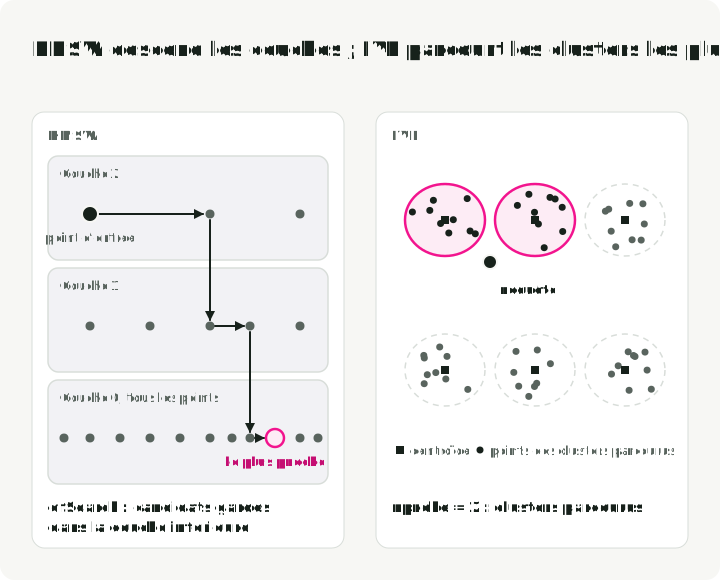
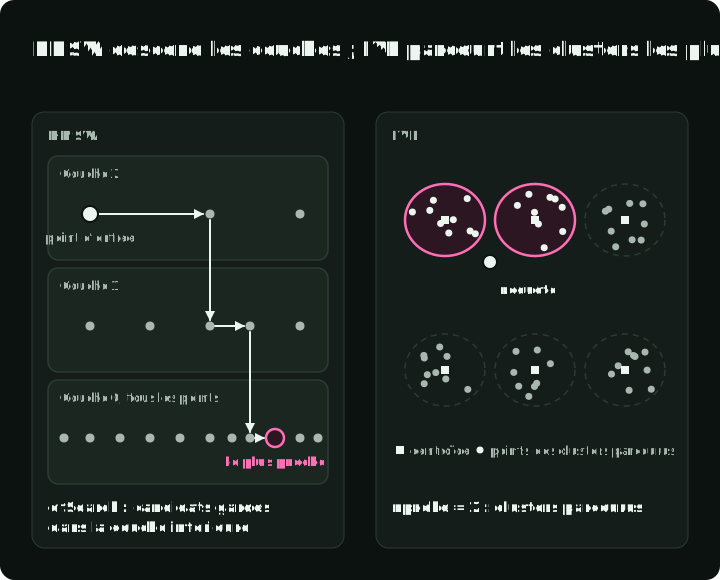
Les embeddings denses ne deviennent utiles à grande échelle qu’avec un index de plus proches voisins approximatifs (ANN). La démo utilise une similarité cosinus par force brute (ce qui convient pour 9 870 documents), mais les systèmes de production ont besoin d’index spécialisés. Les deux familles courantes cherchent de façons différentes, et chacune a un réglage à la recherche qui échange du rappel contre du travail de requête. La figure montre le chemin suivi par HNSW et les clusters parcourus par IVF :
HNSW (hierarchical navigable small world)
HNSW construit un graphe multicouche : les couches supérieures, peu denses, permettent de naviguer largement, et les couches inférieures, plus denses, affinent le voisinage. M contrôle la connectivité du graphe, tandis que efSearch échange du travail de requête contre du rappel. Les valeurs utiles dépendent de la dimension, de la distribution des distances, des filtres, de l’implémentation et du rappel visé.
Les index à base de graphe peuvent perdre du rappel sous de fortes mises à jour ou des filtres restrictifs ; un ticket Qdrant montre un rappel filtré qui ne se rétablit qu’après une reconstruction. Testez votre schéma de mises à jour et de filtres, y compris la durée de reconstruction.
IVF (inverted file)
Les index IVF partitionnent l’espace vectoriel en clusters, puis parcourent les nprobe clusters les plus proches de la requête. Ils peuvent offrir un compromis utile entre mémoire, temps de construction et rappel, surtout combinés à la compression. La sémantique et les performances des mises à jour dépendent de l’implémentation plutôt que de la seule famille d’index.
RaBitQ (Gao & Long, SIGMOD 2024) est un quantificateur aléatoire qui peut se combiner avec IVF. Il normalise les vecteurs centrés, applique une rotation orthogonale aléatoire et encode les signes avec un bit par dimension. L’estimation de distance utilise aussi des facteurs de correction et les normes des vecteurs ; les bornes d’erreur de l’article s’appliquent à cet estimateur et à ses hypothèses. Utilisez-le quand la mémoire est la limite et que les estimations de distance quantifiées respectent encore votre cible de rappel.
| Dimension | Graphe HNSW | Clusters IVF |
|---|---|---|
| Contrôle à la requête | efSearch | nprobe |
| Contrôle à la construction | Connectivité et faisceau de construction | Nombre de clusters et échantillon d’entraînement |
| Profil mémoire | Arêtes du graphe plus vecteurs | Centroïdes, listes et vecteurs stockés |
| Comportement aux mises à jour | Réparation et nettoyage propres à la base de données | Maintenance des listes propre à la base de données |
| Généralement choisi quand | Les vecteurs tiennent en RAM et vous voulez une faible latence à haut rappel | La mémoire ou la taille du corpus est la limite ; à associer à PQ ou RaBitQ |
Pour l’un comme pour l’autre index, mesurez la courbe rappel-latence-mémoire sur vos propres données et votre charge de requêtes.
Uber a réduit la latence et le CPU en abaissant le nombre de candidats par shard, avec peu de perte de rappel ; réglez ce nombre sur un trafic proche de la production.
Extensions optionnelles après le pipeline central
Une fois le retrieval et le reranking mesurés séparément, plusieurs extensions deviennent plus faciles à évaluer sans brouiller le pipeline central.
Compréhension des requêtes
L’expansion et la réécriture de requêtes peuvent traiter le décalage de vocabulaire avant le retrieval. Query2doc a généré des pseudo-documents et rapporté des gains pour BM25 dans ses expériences sur MS MARCO. L’expansion peut aussi introduire une mauvaise intention ; comparez donc rappel et précision sur des tranches de requêtes ambiguës, navigationnelles et à identifiant exact.
Schémas pratiques : expansion des abréviations, enrichissement d’entités, décomposition en sous-requêtes pour le raisonnement multi-sauts, et RAG-Fusion — générer plusieurs variantes de requête et combiner les résultats via RRF.
Annotation de pertinence assistée par LLM
Les LLMs peuvent rédiger des labels de pertinence quand les jugements humains manquent. Le travail de Pinterest sur l’annotation de pertinence décrit l’extension des données d’entraînement au-delà des labels humains et la distillation d’un modèle de pertinence fondé sur un LLM pour le serving. Un label produit par LLM reste une sortie de modèle : calibrez-le sur des jugements humains en aveugle, inspectez les tranches de désaccord et gardez un jeu de référence humain pour les tests de régression.
Contrôles utiles :
- une grille avec des limites de pertinence concrètes et des exemples ;
- une calibration humaine en aveugle et des revérifications périodiques ;
- une randomisation de l’ordre et des jugements répétés pour les cas instables ;
- des panels de modèles lorsque leur surcoût améliore l’accord ; et
- des vérifications explicites du biais de position et de tendance centrale.
Distillation de connaissances
Quand un LLM enseignant apporte de la valeur mais ne peut pas respecter les contraintes de serving, la distillation est une option :
- Utiliser un LLM puissant (l’enseignant) pour reranker des milliers de requêtes d’entraînement hors ligne ; seul le petit élève s’exécute à chaque requête
- Entraîner un petit cross-encoder rapide (l’élève, ~100M–200M de paramètres) à imiter la distribution de classement du LLM
- Comparer l’élève à l’enseignant et à la baseline sur la qualité, la calibration et le coût de serving
InRanker distille MonoT5-3B en modèles de 60M et 220M de paramètres, respectivement 50 fois et environ 13 fois plus petits, avec une meilleure efficacité hors domaine que leurs versions non distillées. L’approche Rank-Without-GPT produit des rerankers listwise open source de 7B qui atteignent 97 % de l’efficacité du reranker GPT-4 comparé, en nDCG@10 sur TREC-DL-19 et TREC-DL-20, grâce à un fine-tuning QLoRA.
Les résultats de compression publiés sont des points de départ, pas des ratios attendus en production. La distillation peut hériter des biais de l’enseignant et perdre en qualité sur des tranches de requêtes rares ; gardez donc les jugements de pertinence d’origine dans la boucle d’évaluation.
Personnalisation et biais de position
Une recherche sur « apple » devrait renvoyer des iPhones à un passionné de technologie, et des recettes de pommes à quelqu’un qui parcourait des contenus de cuisine.
Une architecture de retrieval courante pour la personnalisation utilise un modèle d’embedding two-tower : la tour de requête encode la requête et le contexte utilisateur, tandis que la tour d’éléments encode les éléments et leurs métadonnées. La figure montre quel côté s’exécute à chaque requête, lequel est calculé hors ligne, et où atterrit la requête « apple » pour deux utilisateurs :
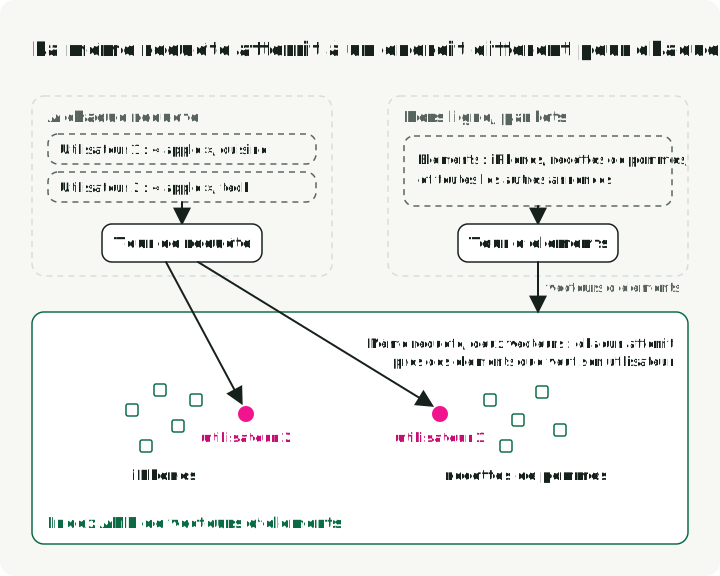
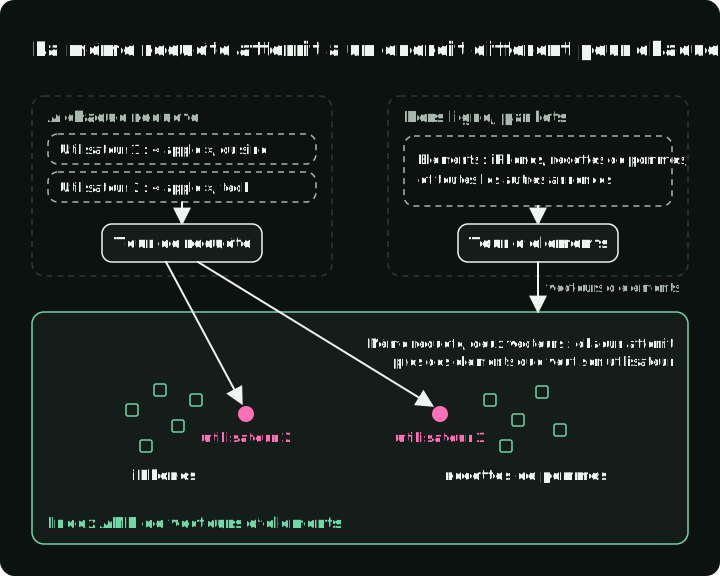
La séparation hors ligne / en ligne permet le retrieval par plus proches voisins approximatifs ; sa latence dépend toutefois de l’encodeur, de l’index, des filtres et du système de serving. Trois conceptions de production utilisent des embeddings appris à des endroits différents. Airbnb apprend des embeddings d’annonces à partir des sessions de clics des utilisateurs et utilise la similarité avec les annonces récemment cliquées comme features de ranking de recherche. OmniSearchSage de Pinterest apprend un embedding de requête commun avec des embeddings de pins et de produits. Uber utilise un modèle two-tower pour retrouver quelques centaines de restaurants pour le fil d’accueil d’Uber Eats.
Les données de clics portent un biais de position et d’exposition. PAL est une approche de débiaisage : entraîner conjointement un module d’exposition et un module de clic sachant l’exposition, puis servir ce dernier sans entrée de position. Ce n’est pas une solution universelle ; les interventions randomisées, les méthodes à pondération par propension inverse et l’évaluation contrefactuelle peuvent mieux convenir à un autre produit.
Adaptation au domaine avec des requêtes synthétiques
Une erreur courante de stratégie de recherche consiste à supposer qu’un modèle entraîné sur des données web générales (comme MS MARCO) fonctionnera bien sur un domaine spécialisé. C’est le problème hors domaine (out-of-domain, OOD).
La génération de requêtes synthétiques peut réduire le goulot d’étranglement des données annotées. InPars génère des requêtes pour des documents et filtre les paires pour l’entraînement. Le Generative Pseudo-Labeling (GPL) ajoute une étape d’annotation par un enseignant :
- Générer des requêtes à partir du corpus de documents cible.
- Récupérer des documents négatifs pour chaque requête générée.
- Utiliser un cross-encoder enseignant pour noter les paires positives et négatives, ce qui produit une marge de score de pertinence.
- Entraîner le retriever dense à reproduire ces marges.
Les paires synthétiques peuvent aider quand les vraies requêtes sont rares, mais elles reflètent le générateur et le prompt. Dédupliquez-les, filtrez les requêtes peu plausibles et validez sur du vrai trafic réservé à l’évaluation.
Une séquence d’expériences
N’ajoutez de la complexité que lorsque l’étape précédente révèle un échec mesuré. Chaque étape nomme l’échec qui la justifie :
- Établir une baseline. Exécutez BM25 ou le système lexical actuel sur un ensemble de requêtes jugées. Enregistrez le rappel, le NDCG, la latence et les groupes de requêtes où il échoue.
- Récupérer les candidats manquants. Testez le retrieval dense et la fusion lorsque la baseline manque des documents pertinents. Réglez le seuil de candidats selon le rappel et le coût.
- Améliorer l’ordre. Ajoutez un cross-encoder quand des candidats pertinents sont présents mais classés trop bas. Choisissez la taille de sa présélection en mesurant la qualité et la latence à plusieurs seuils. Dans la démo, cette étape a fait passer le NDCG@10 de 0,628 à 0,699.
- S’adapter au domaine. Faites du fine-tuning ou de la distillation lorsque des modèles génériques montrent des échecs stables propres au domaine. Gardez de vrais jugements réservés à l’évaluation séparés des données d’entraînement synthétiques.
- Tester le reranking coûteux. Essayez le reranking listwise ou fondé sur le raisonnement seulement lorsque la qualité gagnée résiste à des exécutions répétées et justifie sa latence, son coût, ses exigences de confidentialité et la complexité du fallback. Dans la démo,
llama3.2:3bn’a pas passé ce test.
La pile de départ et les jugements à collecter dépendent du produit :
| Cas d’usage | Pile de départ candidate | À valider |
|---|---|---|
| Recherche de produits | BM25 + retrieval dense + RRF + cross-encoder | Rappel par attribut, substitutions, latence, contraintes métier |
| Recherche dans une documentation | Retrieval hybride + cross-encoder | Identifiants exacts, questions sémantiques, filtres de version |
| Réduction des demandes au support | Retrieval hybride + vérification des citations | Rappel du retrieval, ancrage dans les sources, abstention |
| Place de marché ou annonces | Filtres lexicaux + retrieval dense + reranker métier | Disponibilité, fraîcheur, politique, diversité des vendeurs |
| Petit corpus interne | Baseline BM25, puis un reranker | Si le décalage de vocabulaire justifie un index dense |
| Recherche juridique ou médicale à enjeux élevés | Retrieval axé sur le rappel plus revue par des experts | Couverture, provenance, abstention calibrée |
Pour chaque comparaison, gardez un vrai jeu de jugements réservé à l’évaluation, séparé des données d’entraînement. Enregistrez les classements par requête, les échecs, la latence et le coût, afin qu’un gain agrégé puisse être rattaché à l’étape modifiée. Les couches coûteuses demandent aussi des politiques explicites de confidentialité et de fallback.
Axes de recherche à évaluer séparément
Les rerankers fondés sur le raisonnement et les agents qui utilisent la recherche sont prometteurs, mais ils répondent à d’autres questions que la démo de recherche de produits en cinq étapes.
Rerankers fondés sur le raisonnement
Rank1 entraîne des rerankers avec des traces de raisonnement et rapporte de bons résultats sur le benchmark BRIGHT. Ces résultats concernent le retrieval exigeant en raisonnement ; ils ne prédisent pas directement ce qui se passerait sur la recherche de produits ESCI.
Pour la recherche juridique ou scientifique, comparez les rerankers de raisonnement à de solides baselines cross-encoder et listwise, sur des jugements d’experts, les citations, la latence et la cohérence des échecs.
Recherche agentic
Search-o1 étudie un modèle qui émet des recherches supplémentaires pendant des questions-réponses multi-sauts. C’est un problème d’orchestration — génération de requêtes, arrêt, usage des preuves et évaluation de la réponse — et non une étape de reranking de plus. Évaluez-le sur l’exactitude de la tâche finale et le support des citations, pas seulement sur des métriques de retrieval.
Références
Articles
- Reciprocal Rank Fusion — Cormack et al., 2009
- RankGPT: LLMs as Zero-Shot Listwise Rerankers — Sun et al., EMNLP 2023 Outstanding Paper
- Rank1: Reasoning-Based Reranking — Weller et al., COLM 2025
- Query2doc: LLM Query Expansion — Wang et al., EMNLP 2023
- GPL: Generative Pseudo Labeling — Adaptation au domaine pour le retrieval dense
- InRanker: Distilled Reranker — Réduction de taille de 50x avec des performances compétitives
- Search-o1: Agentic Retrieval — Li et al., 2025
- BEIR Benchmark — Thakur et al., NeurIPS 2021
- Sentence-BERT — Reimers & Gurevych, EMNLP 2019
- InfoNCE / CPC — van den Oord et al., 2018
- SimANS: Hard Negative Sampling — Zhou et al., EMNLP 2022
- Passage Reranking with BERT — Nogueira & Cho, 2019
- HNSW — Malkov & Yashunin, 2016
- DiskANN — Subramanya et al., NeurIPS 2019
- RaBitQ — Gao & Long, SIGMOD 2024
- Replacing Judges with Juries — Verga et al., 2024
- RAG-Fusion — Rackauckas, 2024
- InPars — Bonifacio et al., SIGIR 2022
- BRIGHT Benchmark — Su et al., ICLR 2025
- Rank-without-GPT — Zhang et al., ECIR 2025
- Pinterest LLM Search Relevance — Wang et al., 2024
- OmniSearchSage — Agarwal et al., WWW 2024
- PAL: Position-bias Aware Learning — Guo et al., RecSys 2019
Datasets et benchmarks
- Amazon ESCI: Shopping Queries Dataset — KDD Cup 2022
- BEIR: Benchmarking IR — Benchmark hétérogène pour l’évaluation zero-shot
- MTEB: Massive Text Embedding Benchmark — Leaderboard de modèles d’embedding
- ESCI Paper — Reddy et al., 2022
Modèles utilisés dans la démo
- all-MiniLM-L6-v2 — bi-encoder de 22M de paramètres
- ms-marco-MiniLM-L12-v2 — cross-encoder de 33M de paramètres
- Sentence-Transformers — Framework de modèles de retrieval neuronal
Outils et plateformes
- rank_bm25 — Implémentation de BM25 en Python
- Pyserini BEIR Reproductions — Baselines BM25 Lucene pour BEIR
- pytrec_eval — Boîte à outils d’évaluation TREC
- Elasticsearch — Recherche hybride avec l’API Retrievers
- Vespa — Moteur unifié de recherche et de recommandation
- Weaviate — Base de données vectorielle avec recherche hybride
- Qdrant — Base de données vectorielle avec requêtes multi-étapes
Références industrielles
- Airbnb Listing Embeddings — Grbovic & Cheng, KDD 2018
- Uber Delivery Search — Uber Engineering, 2025
- Uber Two-Tower Embeddings — Uber Engineering, 2023
- Elastic Rerank — Elastic, 2024
Projet de démonstration
- search-ranking-stack — Démo fonctionnelle du pipeline de cet article