Stack de ranking de búsqueda: BM25, embeddings y reranking

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Esta guía está dirigida a ingenieros de Python que crean o mejoran un pipeline de ranking de búsqueda. Explica cómo funcionan conjuntamente BM25, los embeddings densos, la fusión de rankings y los rerankers, y cómo medir si la búsqueda necesita mejores candidatos o un orden mejor.
Una búsqueda de «cheap laptop» puede no encontrar un producto descrito como «budget notebook computer». Otro fallo coloca la funda de unos auriculares por encima de los propios auriculares. El primer problema necesita mejores candidatos; el segundo, un orden mejor.
El repositorio de demostración complementario ilustra la recuperación y el reranking sobre una muestra de los datos de búsqueda de productos de Amazon ESCI.
Para una guía breve de selección de etapas, consulta BM25 vs Embeddings vs Rerankers. La secuencia de experimentos que aparece más adelante en este artículo conecta cada etapa con una medición.
Modelos léxicos, densos y cross-encoders
El stack se entiende mejor como tres capas. La recuperación léxica encuentra términos exactos, la recuperación densa cierra las brechas de vocabulario y los rerankers comparan en detalle los candidatos más prometedores.
BM25 y recuperación léxica
Durante décadas, BM25 fue la opción predeterminada. Es un modelo probabilístico que puntúa los documentos según la frecuencia de los términos de la consulta en el documento, normalizada por la longitud del documento y la frecuencia inversa de documento (IDF).
BM25 funciona bien cuando los términos literales expresan la intención: códigos de error, SKU de productos, nombres e identificadores de API. Su principal limitación es el desajuste de vocabulario. Una consulta como «cheap laptop» puede no encontrar un documento sobre «budget notebook computer» si el texto indexado no ofrece ningún puente entre ambas expresiones.
Dicho esto, el estudio BEIR encontró que BM25 es un baseline zero-shot sólido en sus tareas heterogéneas de recuperación. Los números de BM25 de BEIR proceden de Lucene a través de Pyserini, no del rank_bm25 con tokenización por espacios que usa esta demo. BM25 también supera a algunos modelos neuronales en tareas de recuperación argumentativa como Touche-2020.
Recuperación densa y embeddings
Los encoders de tipo BERT hicieron viable la recuperación densa. Proyectan consultas y documentos en un espacio vectorial compartido y ordenan los candidatos con una función de similitud como la similitud del coseno o el producto escalar.
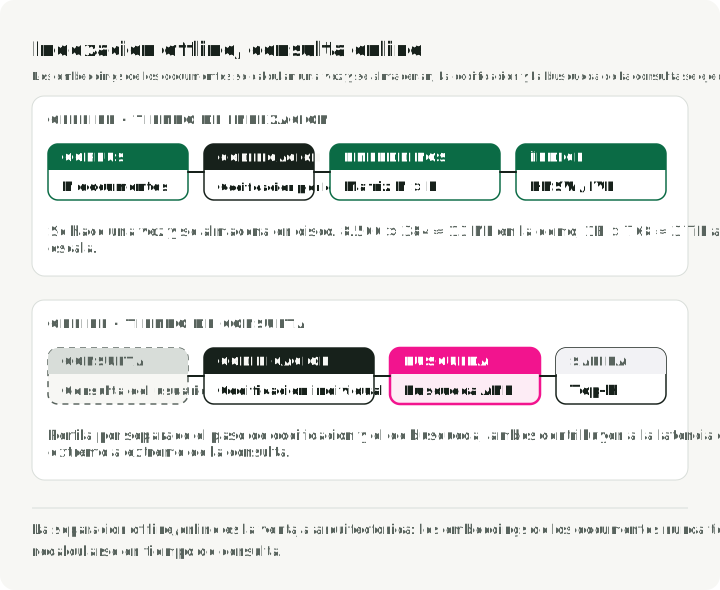
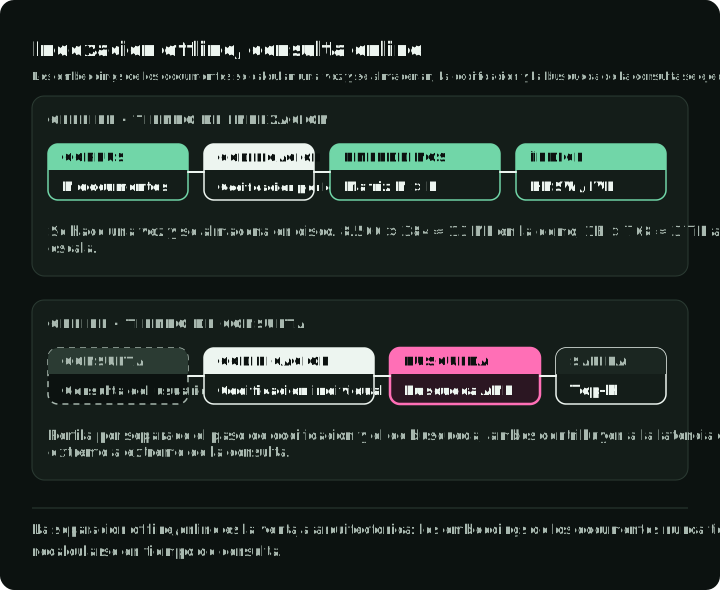
La arquitectura de bi-encoder (o «two-tower») codifica la consulta y el documento por separado y produce embeddings de longitud fija. Los vectores de los documentos se pueden precalcular e indexar offline, y después recuperarse con rapidez mediante algoritmos de vecinos más cercanos aproximados (ANN). Así, «cheap laptop» y «budget notebook» quedan próximos en el espacio vectorial.
Algunos bi-encoders usan una arquitectura siamesa, como Sentence-BERT, en la que ambos lados comparten pesos. Otros usan torres separadas para la consulta y el documento. El pooling, el tamaño del vector, la función de similitud y el objetivo de entrenamiento son decisiones de cada modelo, no propiedades de todos los recuperadores densos.
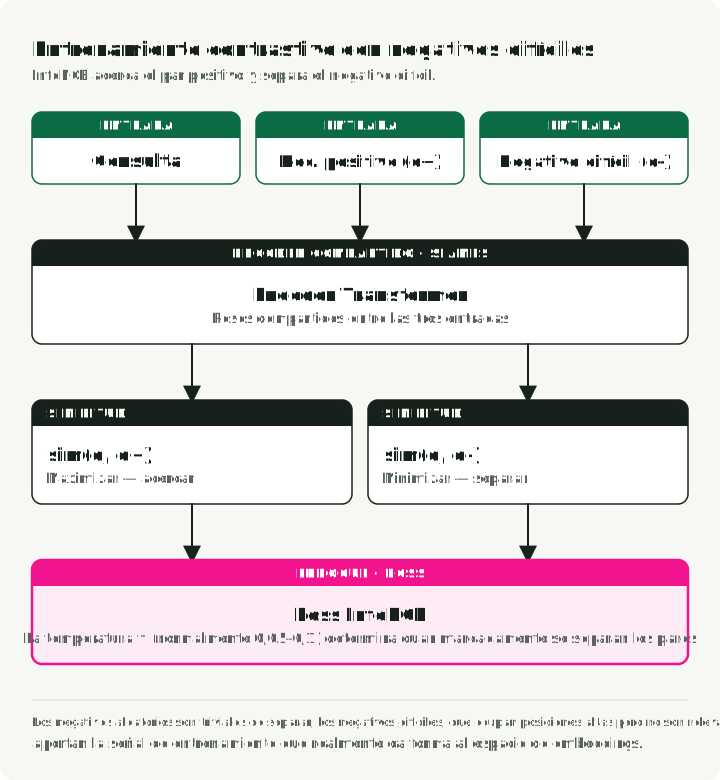
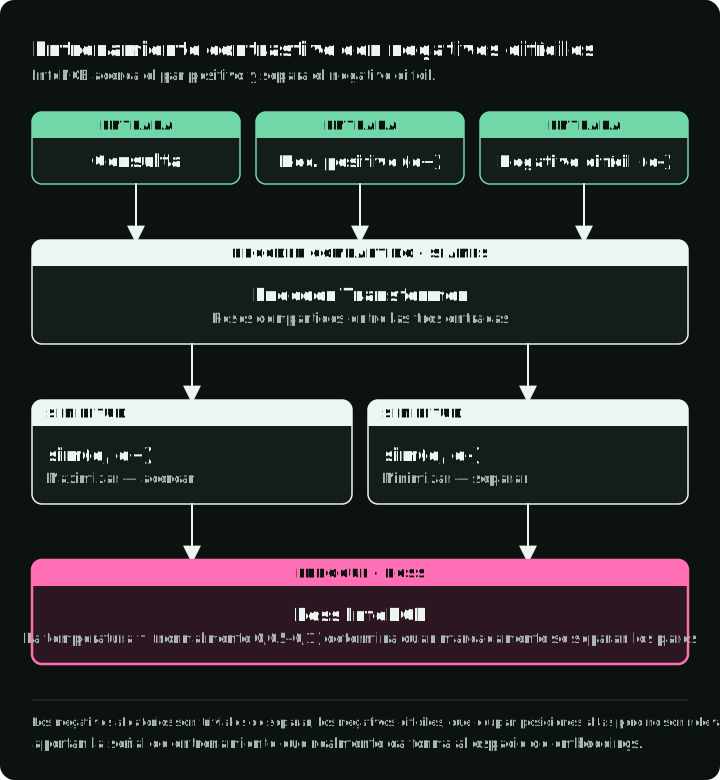
Estos modelos se entrenan con aprendizaje contrastivo, normalmente con la pérdida InfoNCE. Dado un lote de pares (consulta, documento_positivo), el objetivo maximiza sim(query, positive_doc) y minimiza sim(query, negative_docs). Los negativos proceden de los positivos de otras consultas del mismo lote (negativos dentro del lote). Un parámetro de temperatura controla con qué nitidez debe separar el modelo ambos casos.
Los datos de entrenamiento suelen importar más que la dimensión del embedding. Los modelos de recuperación aprenden de pares consulta-positivo y de hard negatives cuidadosamente seleccionados: documentos plausibles pero no relevantes. La sección de entrenamiento que aparece más adelante muestra cómo SimANS evita tanto los negativos triviales como los probables falsos negativos.
El coste es el cuello de botella de la representación. Los bi-encoders comprimen todo el matiz semántico en un único vector de tamaño fijo, por lo que a menudo pasan por alto las interacciones finas entre términos concretos de la consulta y contenido concreto del documento.
Cross-encoders y LLMs
Los cross-encoders (Nogueira y Cho, 2019) introducen la consulta y el documento juntos en un Transformer como una secuencia concatenada ([CLS] Query [SEP] Document), de modo que cada token de la consulta puede atender a cada token del documento mediante self-attention completa. Esa interacción profunda capta matices que la codificación independiente pierde.
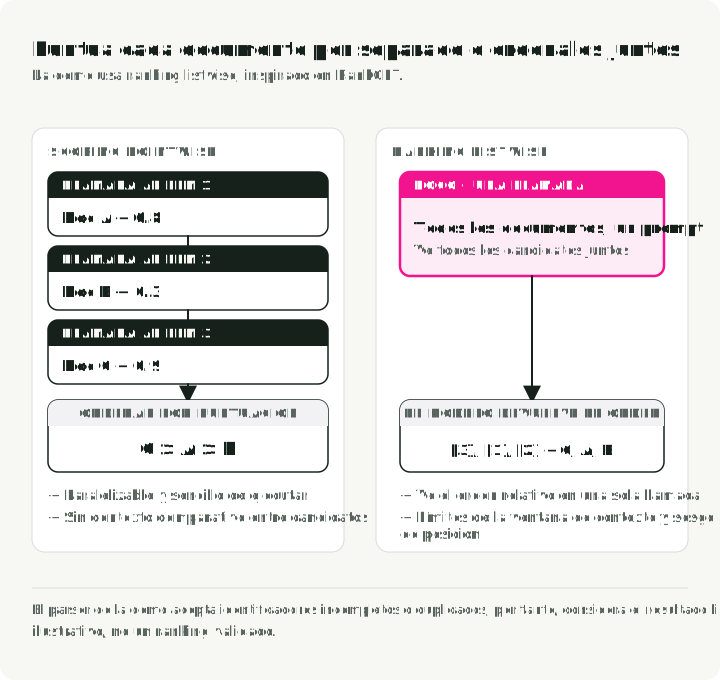
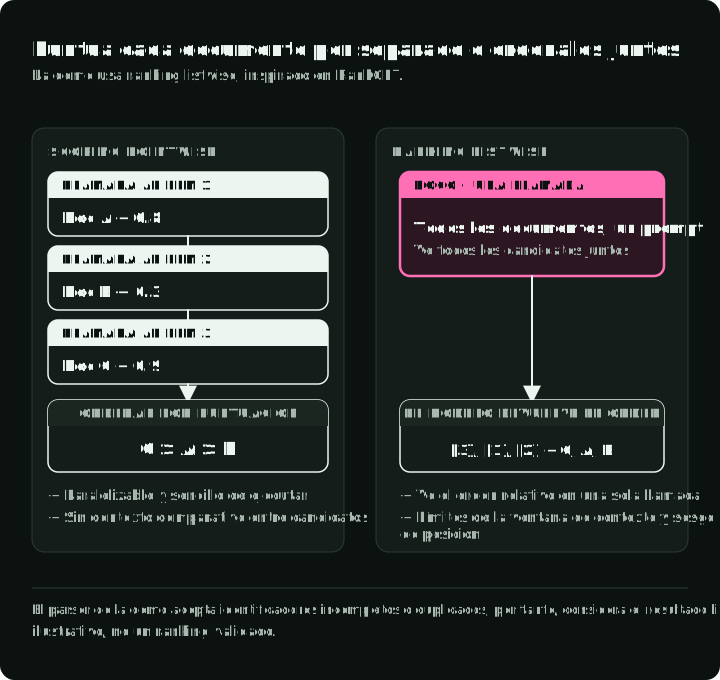
El reranking con LLM usa un modelo con prompt para comparar varios candidatos a la vez. RankGPT mostró resultados listwise zero-shot sólidos con GPT-4 en los benchmarks que evaluó, pero la estabilidad de la salida, el coste y la adecuación al dominio siguen requiriendo pruebas propias.
Estas puntuaciones no se pueden precalcular para consultas arbitrarias, así que el reranking se sitúa después de la recuperación. Esa asimetría de costes motiva el funnel de varias etapas.
El funnel de varias etapas
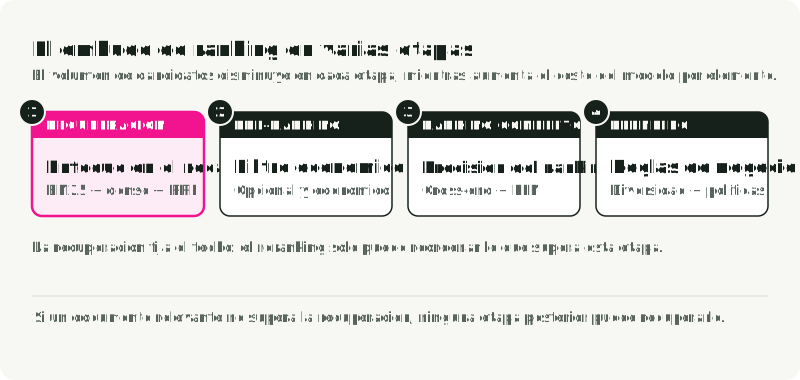
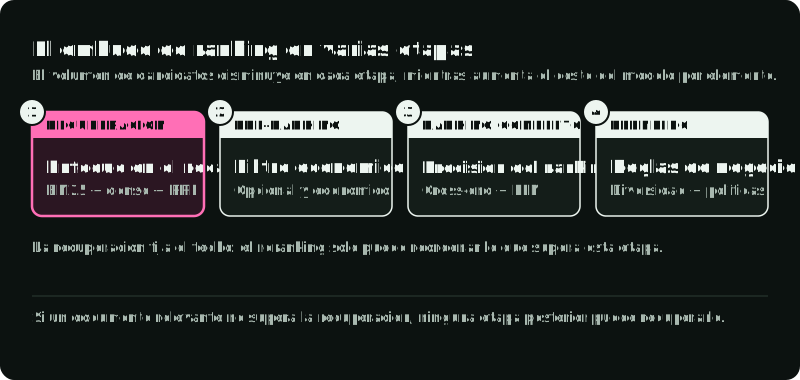
Ejecutar un cross-encoder o un LLM caro sobre millones de documentos no es viable, por lo que los stacks de búsqueda modernos usan un funnel. La recuperación y el pre-ranking reducen el conjunto de candidatos para que el ranking completo pueda usar modelos más caros sobre una lista corta. Después, el blending aplica reglas o una política de ranking; su coste depende de esa política.
Además, un recuperador barato carece de precisión final, así que el funnel usa cada modelo solo donde su coste es razonable. La figura muestra el volumen de entrada de cada etapa y el coste esquemático del modelo, e indica que las etapas posteriores no pueden recuperar documentos omitidos:
| Etapa | Escala de entrada | Objetivo principal | Métodos habituales | Medición de salida |
|---|---|---|---|---|
| Recuperación | Corpus o índice | Recall de candidatos | BM25, bi-encoders | Recall en el corte de candidatos |
| Pre-ranking | Conjunto grande de candidatos | Filtrado barato | Modelos ligeros, reglas | Recall conservado por milisegundo |
| Ranking completo | Lista corta | Calidad en el top | Cross-encoders, LLMs | NDCG/MRR, latencia, coste |
| Blending | Listas finales o huecos de lista | Restricciones y mezcla | Reglas, ranking multiobjetivo | Políticas, diversidad, límites de negocio |
Un reranker reordena los candidatos que devuelve la recuperación; no puede añadir ninguno. Por tanto, la cobertura de los candidatos recuperados limita lo que pueden recuperar las etapas posteriores. Con más de 100 candidatos, el reranking puede situar un documento relevante entre los 100 primeros y mejorar Recall@100. En esta demo se conservan los 100 candidatos, así que el reranking no puede cambiar Recall@100.
Herramientas para cada etapa
La demo usa pequeñas librerías en memoria. Fuera de un portátil, cada etapa tiene unas cuantas implementaciones habituales:
| Etapa | Herramienta | Úsala cuando |
|---|---|---|
| BM25 | rank_bm25 | El corpus cabe en memoria y quieres un baseline rápido |
| Elasticsearch, OpenSearch o Lucene a través de Pyserini | El corpus necesita un índice invertido, analizadores y filtros | |
| Recuperación densa | FAISS | Quieres una librería ANN dentro de tu propio servicio |
| pgvector | Los datos ya viven en Postgres | |
| Qdrant, Weaviate, Vespa o Elasticsearch kNN | Necesitas filtros por metadatos, actualizaciones frecuentes y un índice gestionado | |
| Fusión | Retriever RRF de Elasticsearch, Query API de Qdrant con rrf | Quieres fusión de rankings dentro del motor de búsqueda |
| Búsqueda híbrida de Weaviate | Usas Weaviate; ofrece fusión por rangos y fusión por puntuación relativa | |
| Modelos de embedding | La pestaña de recuperación de MTEB y después tus propias consultas con juicios | Estás eligiendo un modelo; el leaderboard acota la lista y tus consultas deciden |
| Reranker | ms-marco-MiniLM-L12-v2 | Texto en inglés, presupuesto de CPU |
bge-reranker-v2-m3 | Texto multilingüe | |
| Elastic Rerank | Texto en inglés que ya está en Elasticsearch; requiere una suscripción apta o una prueba |
La demo: un pipeline de cinco etapas
Para hacerlo concreto, creé una demo, search-ranking-stack, que ejecuta un pipeline de cinco etapas sobre el benchmark de búsqueda de productos Amazon ESCI. Cada etapa escribe métricas.
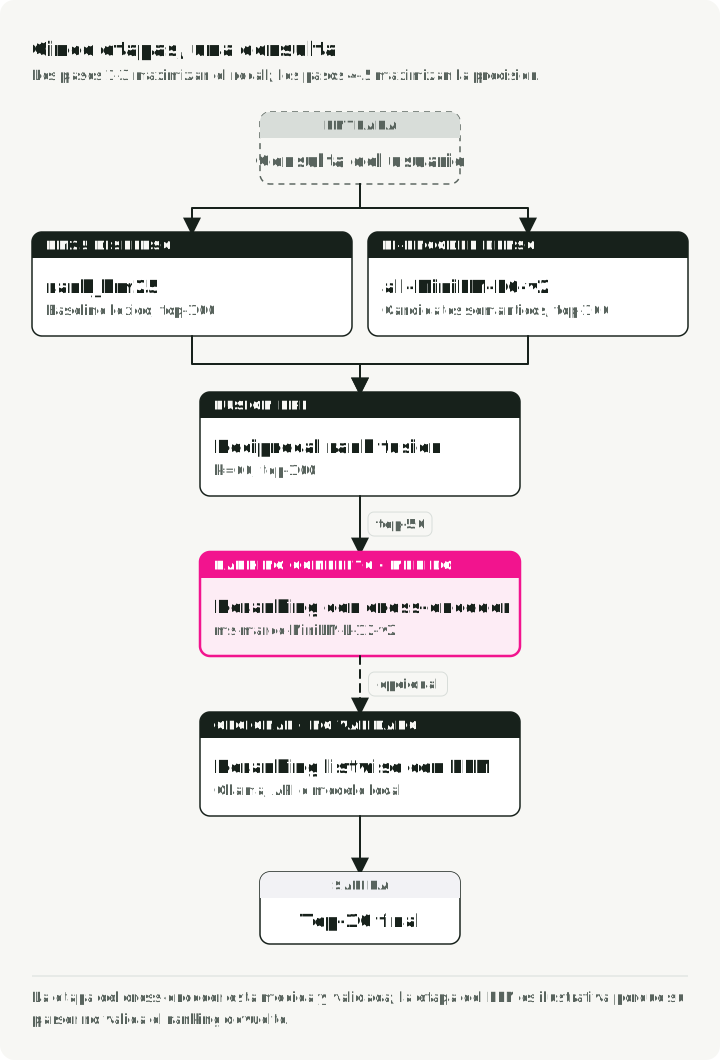
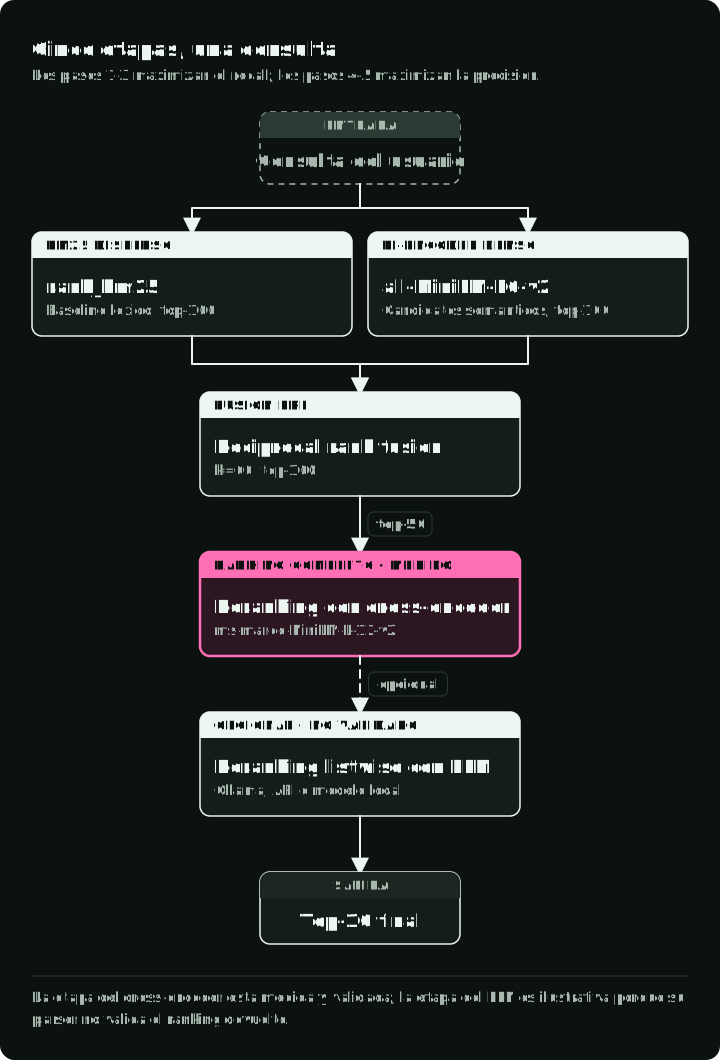
El pipeline:
- Recuperación dispersa con BM25 — baseline léxico (
rank_bm25) - Recuperación densa con bi-encoder — generación semántica de candidatos (
all-MiniLM-L6-v2) - Fusión híbrida RRF — fusión basada en rangos de los resultados dispersos y densos
- Reranking con cross-encoder — puntuaciones de relevancia por pares (
ms-marco-MiniLM-L12-v2) - Reranking listwise con LLM — comparación mediante prompt de la lista corta final (Ollama, API o modelo local)
Los pasos 1—3 forman la etapa de recuperación del funnel (maximizar el recall); los pasos 4—5 forman la etapa de ranking completo (maximizar la precisión). La demo omite el pre-ranking y el blending. El diagrama muestra el número de candidatos en cada paso: el cross-encoder puntúa los primeros 50 de los 100 candidatos híbridos y conserva el resto en el orden híbrido, y el LLM ve los primeros 10.
Inicio rápido
El paso de descarga obtiene el dataset una vez y escribe una muestra pequeña. Después, run-all ejecuta todas las etapas, imprime una fila de métricas por etapa y escribe las filas en results/metrics.json y un gráfico en results/metrics_comparison.png. Añade --llm-mode para incluir la etapa con LLM.
git clone https://github.com/slavadubrov/search-ranking-stack.git
cd search-ranking-stack
uv sync

# Download and sample ESCI dataset (~2.5GB download, ~5MB sample)
uv run download-data

# Run BM25, dense, hybrid RRF, and the cross-encoder
uv run run-all

# Add LLM reranking with a local Ollama model (ollama pull llama3.2:3b first)
uv run run-all --llm-mode ollama
Dataset y muestreo: Amazon ESCI
La demo usa el Amazon Shopping Queries Dataset (ESCI) de KDD Cup 2022, un benchmark real de búsqueda de productos con etiquetas de relevancia graduada en cuatro niveles:
| Etiqueta | Ganancia | Significado | Ejemplo (consulta: «wireless headphones») |
|---|---|---|---|
| Exact (E) | 3 | Cumple todos los requisitos de la consulta | Sony WH-1000XM5 Wireless Headphones |
| Substitute (S) | 2 | Alternativa funcional | Auriculares con cable y adaptador Bluetooth |
| Complement (C) | 1 | Artículo útil relacionado | Funda para auriculares |
| Irrelevant (I) | 0 | Sin relación significativa | Cable de carga USB |
La relevancia graduada importa porque permite usar NDCG (Normalized Discounted Cumulative Gain), que distingue un ranking «perfecto» de uno «meramente aceptable». Las métricas binarias puntúan ambos igual.
Usé la muestra small_version de la demo: 500 consultas, 9870 productos y 9984 juicios. Su descargador lee la única división train de tasksource/esci, filtra la configuración regional us en inglés y small_version == 1, y después usa la semilla 42 para muestrear hasta 500 ID de consulta únicos sin reemplazo. El corpus contiene los productos únicos de esas filas de juicios seleccionadas. No es una división reservada para evaluación ni un corpus independiente. La muestra es lo bastante pequeña para ejecutarse en un portátil, pero demasiado pequeña y específica de un dominio para establecer un ranking de producción. Úsala para reproducir las etapas e inspeccionar los modos de fallo; usa consultas representativas reservadas para evaluación para tomar decisiones de despliegue.
Evaluación: medir lo que importa
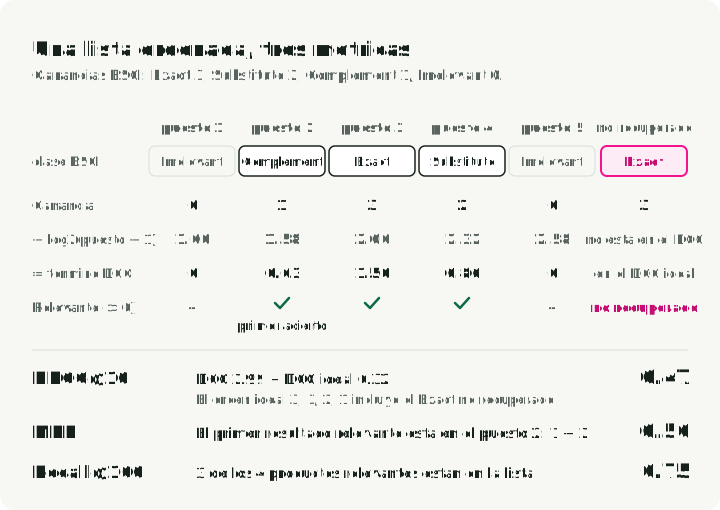
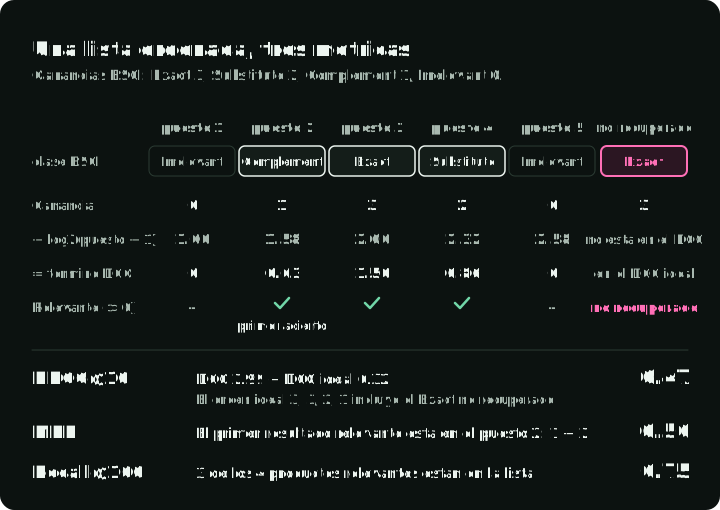
La demo usa tres métricas, y cada una examina el ranking desde un ángulo distinto. La figura aplica las tres a los resultados de una consulta, con las ganancias de ESCI de arriba:
NDCG@10 (métrica principal)
Normalized Discounted Cumulative Gain mide la calidad del ranking top 10 usando relevancia graduada. Premia que los documentos muy relevantes queden cerca de la cabeza con un descuento logarítmico:
Esto coincide con las ganancias lineales que usa ndcg_cut de trec_eval, seleccionado mediante pytrec_eval como ndcg_cut_10. IDCG es el DCG del orden ideal de las clases juzgadas; una consulta sin ninguna ganancia positiva recibe cero. Las ganancias exponenciales como definen otra convención y cambiarían estos números.
De las tres, NDCG es la única métrica que aprovecha por completo la relevancia graduada de cuatro niveles de ESCI. Un sistema que coloca una coincidencia Exact en la posición 1 puntúa más que uno que coloca allí un Substitute. Por eso es la métrica principal aquí.
MRR (primer resultado Complement o superior)
Mean Reciprocal Rank usa la posición del primer resultado que cuenta como relevante. En esta demo, el evaluador pasa los juicios de relevancia de ESCI a pytrec_eval y usa recip_rank sobre cada lista devuelta de hasta 100 candidatos. Su umbral binario es relevance > 0: Complement (1), Substitute (2) y Exact (3) cuentan como relevantes. Irrelevant (0) no. Un resultado relevante en la posición 1 da un rango recíproco de 1.0; en la posición 3, de 0.333. Es MRR sobre las listas de candidatos devueltas, no MRR@10.
Recall@100 (cobertura de la recuperación)
Recall@100 mide qué fracción de los documentos relevantes juzgados aparece entre los 100 primeros. Se mantiene fijo al reordenar los mismos 100 candidatos, como en esta demo. Con un conjunto mayor de candidatos, el reranking puede situar un documento relevante entre los 100 primeros y aumentar la métrica, pero no puede recuperar un documento que la recuperación omitió.
El denominador incluye solo documentos relevantes juzgados, como en la implementación de recall de trec_eval. Un producto sin juzgar no aporta relevancia positiva y no figura en ese denominador. Por tanto, unos juicios incompletos pueden hacer que el recall medido difiera de la cobertura de todos los productos realmente relevantes.
Recuperación: búsqueda híbrida
El trabajo de la capa de recuperación es maximizar el recall: meter en el conjunto de candidatos tantos documentos relevantes como sea posible.
BM25: el baseline léxico
BM25 puntúa los documentos según el solapamiento de términos con la consulta, con saturación de la frecuencia de términos y normalización por la longitud del documento:
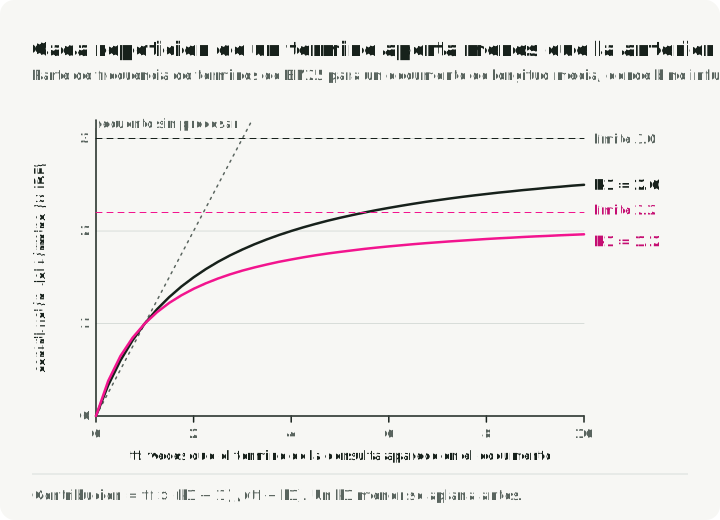
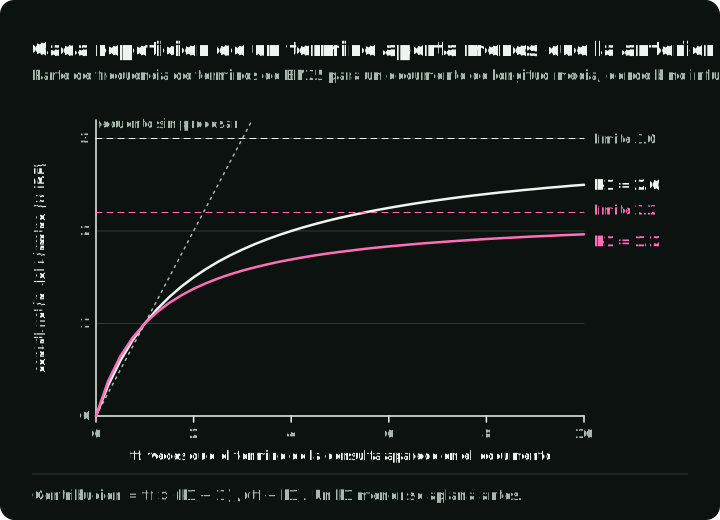
Aquí es la frecuencia inversa de documento del término , es la frecuencia del término en el documento , es la longitud del documento y es la longitud media de los documentos del corpus. Importan dos parámetros: (normalmente entre 1.2 y 2.0) controla la saturación de TF, es decir, la rapidez con que los términos repetidos dejan de aportar valor, y (normalmente 0.75) controla la normalización por la longitud del documento.
El gráfico traza la parte de frecuencia de términos de la fórmula para los dos extremos del rango habitual de :
La implementación es corta. Tokenización simple por espacios con rank_bm25:
# src/search_ranking_stack/stages/s01_bm25.py

from rank_bm25 import BM25Okapi

def run_bm25(data: ESCIData, top_k: int = 100):
    doc_ids = list(data.corpus.keys())
    tokenized_corpus = [text.lower().split() for text in data.corpus.values()]

    bm25 = BM25Okapi(tokenized_corpus)

    results = {}
    for query_id, query_text in data.queries.items():
        scores = bm25.get_scores(query_text.lower().split())
        top_indices = np.argsort(scores)[::-1][:top_k]
        results[query_id] = {doc_ids[idx]: float(scores[idx]) for idx in top_indices}

    return results
BM25 alcanza un Recall@100 de 0.741: el 74 % de los productos relevantes juzgados aparece en algún punto entre los 100 primeros. Un reranker que solo recibe esa lista de BM25 no puede recuperar el 26 % de productos relevantes juzgados que falta.
Recuperación densa con bi-encoder
El bi-encoder proyecta las consultas y los documentos de forma independiente en un espacio de embeddings compartido:
# Simplified from src/search_ranking_stack/stages/s02_dense.py

import numpy as np
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("sentence-transformers/all-MiniLM-L6-v2")
doc_texts = ["Sony WH-1000XM5 Wireless Headphones", "Headphone carrying case"]
query_texts = ["wireless headphones"]

# Encode corpus once, cache to disk
corpus_embeddings = model.encode(
    doc_texts,
    batch_size=128,
    normalize_embeddings=True,  # Cosine sim = dot product
    convert_to_numpy=True,
)

# At query time: encode query, compute dot product
query_embeddings = model.encode(query_texts, normalize_embeddings=True)
similarity_matrix = np.dot(query_embeddings, corpus_embeddings.T)
Con embeddings normalizados, la similitud del coseno se reduce a un producto escalar. La demo calcula la matriz completa consulta-por-corpus porque 9870 documentos caben cómodamente en memoria; un corpus de producción normalmente usaría un índice de vecinos más cercanos aproximados. En esta muestra, all-MiniLM-L6-v2 eleva el Recall@100 de 0.741 a 0.825.
Cómo aprenden los bi-encoders buenas representaciones
El preentrenamiento del encoder y el fine-tuning de embeddings resuelven problemas distintos. Un Transformer preentrenado aporta representaciones de tokens; el fine-tuning contrastivo enseña a un vector agregado qué textos deben quedar cerca. Los datos de NLI, de similitud de frases y de consulta-pasaje son posibles ingredientes, no una secuencia universal. La ficha del modelo all-MiniLM-L6-v2 de la demo describe un encoder MiniLM preentrenado y ajustado con más de mil millones de pares de frases heterogéneos.
El fine-tuning para recuperación puede usar minería de hard negatives. Los negativos aleatorios, como un documento de cocina emparejado con una consulta sobre auriculares, pueden ser demasiado fáciles para enseñar mucho. En su lugar, un recuperador puede aportar candidatos plausibles que los juicios identifican como no relevantes. Los documentos sin juzgar con puntuación alta requieren cuidado: algunos pueden ser positivos que faltan.
SimANS muestrea negativos con una distribución de probabilidad concentrada cerca de la puntuación de relevancia del documento positivo. Reduce el peso tanto de los negativos fáciles como de los candidatos con la puntuación más alta, que pueden ser falsos negativos. Es un muestreo sesgado de candidatos recuperados, no una regla estricta que excluya todos los documentos por encima o por debajo de un límite de posición. La curva muestra con qué frecuencia se muestrea un candidato recuperado, según su puntuación respecto al positivo:


# What a training triplet looks like after hard negative mining
training_triplet = {
    "query": "wireless noise canceling headphones",
    "positive": "Sony WH-1000XM5 Wireless Noise Cancelling Headphones",
    "negative": "Sony headphone replacement ear pads",  # Hard negative: same brand, related product, but wrong intent
}
# The bi-encoder must learn that "ear pads" is NOT what the user wants,
# even though it shares many tokens with the positive document.
La función de pérdida contrastiva (InfoNCE) lo une todo. Para cada consulta con documento positivo y un conjunto de documentos negativos :
Donde es la similitud del coseno entre los embeddings de la consulta y del documento, y es el parámetro de temperatura (normalmente entre 0.05 y 0.1). Los valores bajos hacen la pérdida más sensible a los hard negatives. Es una entropía cruzada softmax: sube la similitud del par positivo en relación con todos los negativos. Cuando es pequeño, incluso diferencias leves de similitud producen gradientes grandes, lo que obliga al modelo a hacer distinciones más finas.
Servir embeddings de bi-encoder a escala
La ventaja arquitectónica de un bi-encoder es la separación offline/online. Los embeddings de los documentos se calculan en el momento de indexar y se almacenan en un índice vectorial. En el momento de la consulta, el sistema codifica la consulta y busca entre esos vectores almacenados. La latencia depende del encoder, el hardware, el índice, los filtros y el recall objetivo, así que conviene medir por separado los dos pasos.
En la demo, las cifras son modestas: 9870 documentos 384 dimensiones 4 bytes por float = ~15 MB de embeddings. A escala de producción, las cifras dejan de serlo: 1000 millones de documentos con embeddings de 768 dimensiones necesitan ~3 TiB de almacenamiento. Ahí entran en juego la cuantización (comprimir floats de 32 bits a enteros de 8 bits), la cuantización de producto (descomponer los vectores en subespacios) y los índices respaldados por SSD como DiskANN. La sección sobre indexación de vectores densos trata los algoritmos de índice.
Por qué probar la recuperación híbrida
Los dos métodos suelen fallar de forma distinta. BM25 es muy adecuado para nombres propios, SKU de productos y códigos de error. La recuperación densa puede resolver desajustes de vocabulario como «cheap laptop» frente a «budget notebook computer». Que la fusión ayude depende de la frecuencia con que se den esos casos complementarios en el conjunto de consultas objetivo.
Un siguiente experimento habitual es la búsqueda híbrida: ejecutar ambos métodos de recuperación y después fusionar sus listas ordenadas.
Reciprocal rank fusion (RRF)
BM25 y la recuperación densa producen puntuaciones con significados y escalas distintos. Por eso, una combinación lineal necesita calibración y validación cada vez que cambian los recuperadores o el corpus.
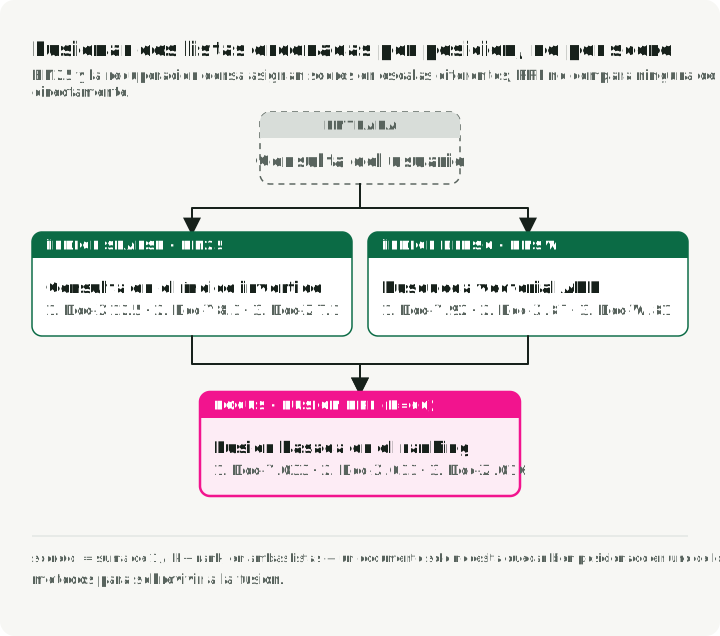
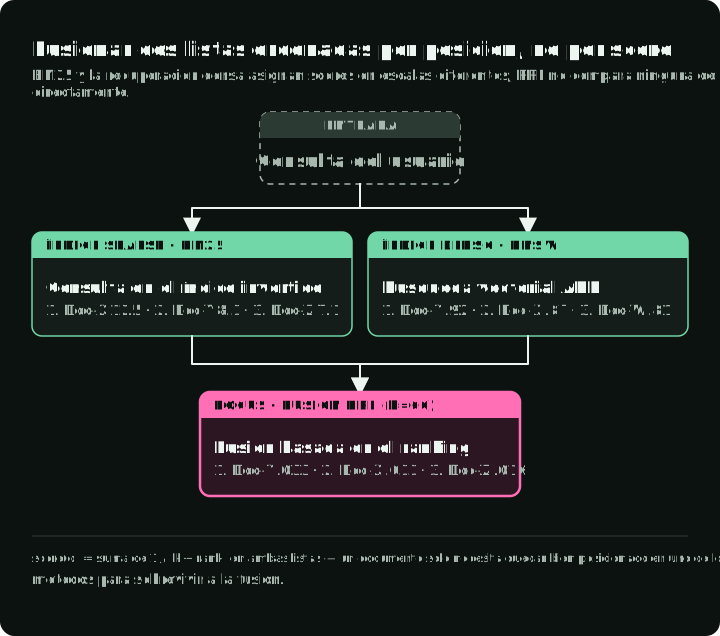
Reciprocal Rank Fusion (Cormack et al., 2009) descarta por completo las puntuaciones originales y usa solo la posición en el ranking:
Aquí, es una constante de suavizado; 60 es un valor inicial habitual. RRF premia los elementos que quedan cerca de la cabeza en las distintas listas de entrada sin comparar sus puntuaciones originales. Evita calibrar las escalas de las puntuaciones, pero los cortes de recuperación, los pesos y siguen necesitando evaluación.
La implementación:
# src/search_ranking_stack/stages/s03_hybrid_rrf.py

from collections import defaultdict

def reciprocal_rank_fusion(ranked_lists, k=60, top_k=100):
    all_query_ids = set().union(*(results.keys() for results in ranked_lists))
    fused_results = {}

    for query_id in all_query_ids:
        rrf_scores = defaultdict(float)

        for results in ranked_lists:
            sorted_docs = sorted(results.get(query_id, {}).items(),
                                 key=lambda x: x[1], reverse=True)

            for rank, (doc_id, _score) in enumerate(sorted_docs, start=1):
                rrf_scores[doc_id] += 1.0 / (k + rank)

        sorted_rrf = sorted(rrf_scores.items(),
                            key=lambda x: x[1], reverse=True)[:top_k]
        fused_results[query_id] = dict(sorted_rrf)

    return fused_results
El RRF híbrido alcanza un Recall@100 de 0.842 y un NDCG@10 de 0.628, superando a BM25 (0.585) y a la recuperación densa (0.611) por separado. Un documento encontrado por un solo recuperador sigue recibiendo una puntuación RRF, pero puede quedar por debajo del corte del top 100. Con , el rango 1 en una lista puntúa , menos que el rango 50 en ambas listas (). El solapamiento puede pesar más que un buen rango en una sola lista.
Reranking con cross-encoder
Con 100 candidatos híbridos por consulta, puedes permitirte un modelo más caro. El cross-encoder procesa la consulta y el documento juntos en un único Transformer, con self-attention sobre la consulta y el documento combinados.
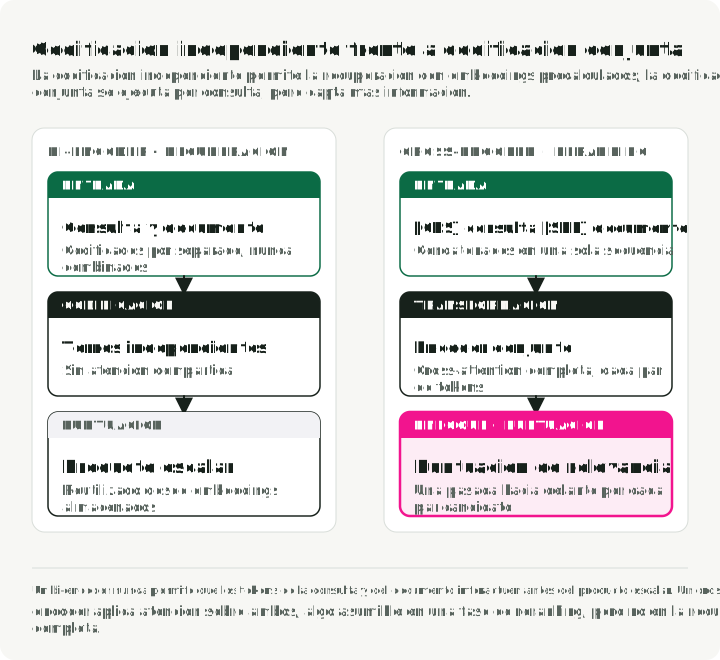
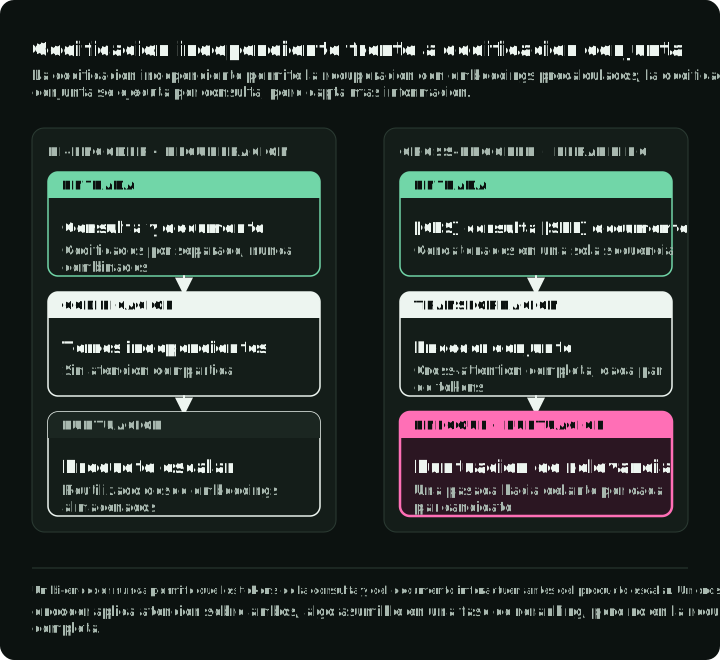
Interacción a nivel de token
La diferencia está en la matriz de atención. En un bi-encoder, la atención es diagonal por bloques: los tokens de la consulta solo atienden a otros tokens de la consulta, y los tokens del documento solo atienden a otros tokens del documento. Las dos representaciones nunca se encuentran a nivel de token; solo se cruzan al final mediante un producto escalar. Un cross-encoder calcula la matriz de atención completa, en la que cada token de la consulta atiende a cada token del documento y viceversa. Esa self-attention conjunta permite al modelo comparar directamente los tokens de la consulta y del documento.
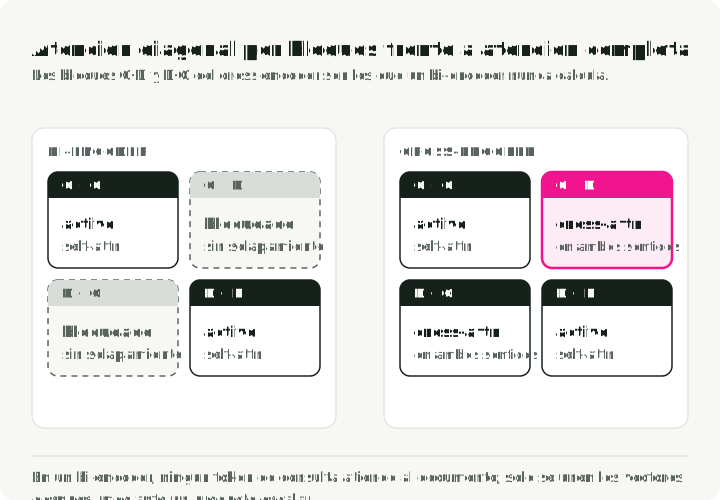
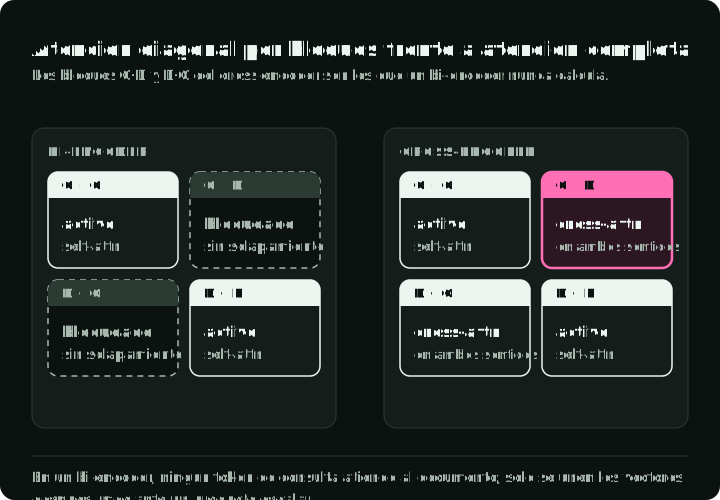
En un bi-encoder, la consulta se codifica antes de ver ningún documento. Un cross-encoder ve la consulta y el candidato juntos, por lo que puede usar la relación entre sus tokens. Esto puede ayudar en casos como:
- Negación: «headphones that are not wireless». Un embedding agregado puede dar poco peso a la negación, mientras que la codificación conjunta ofrece al modelo una interacción directa entre consulta y documento. Es una hipótesis que hay que verificar con un segmento específico, no una garantía.
- Cualificación: «laptop under $500». La codificación conjunta puede relacionar la restricción con un precio del texto del producto, aunque los filtros estructurados de precio son más seguros cuando el campo está disponible.
La entrada del cross-encoder tiene el formato [CLS] query tokens [SEP] document tokens [SEP]. [CLS] es un token de clasificación cuyo estado oculto final pasa por una capa lineal para producir una única puntuación de relevancia. Los embeddings de segmento distinguen los tokens de la consulta de los del documento, y [SEP] marca el límite entre segmentos.
Cómo se entrenan los cross-encoders
Los cross-encoders pueden aprender a partir de ejemplos (query, document, relevance_label) con objetivos pointwise, pairwise o listwise. Un ejemplo pointwise empareja «wireless headphones» con «Sony WH-1000XM5 Wireless Headphones» y la etiqueta 1.0.
Un clasificador habitual convierte la representación final de [CLS] en una puntuación. Las etiquetas binarias pueden usar entropía cruzada binaria; la relevancia graduada puede usar pérdidas de regresión, ordinales, pairwise o listwise. Elige con métricas de ranking sobre datos reservados, en lugar de suponer que un objetivo es siempre mejor.
La minería de hard negatives también ayuda a entrenar cross-encoders. Los cross-encoders son caros de entrenar, porque cada ejemplo de entrenamiento necesita un forward pass completo sobre la secuencia concatenada, así que no puedes permitirte malgastar cómputo en negativos trivialmente fáciles. La receta práctica: usa un bi-encoder para recuperar los K mejores candidatos de cada consulta de entrenamiento y extrae los hard negatives de rangos concretos (por ejemplo, del 10 al 100). Así el cross-encoder recibe ejemplos en los que distinguir lo relevante de lo irrelevante exige una interacción profunda entre tokens.
Reranking de los candidatos recuperados
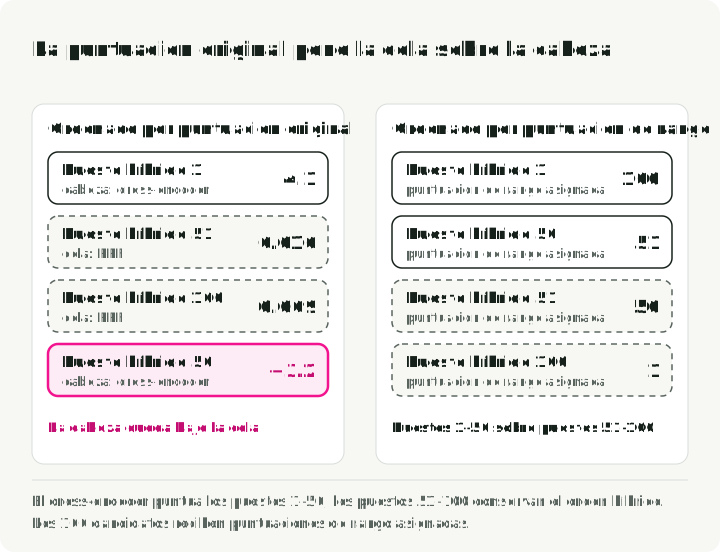
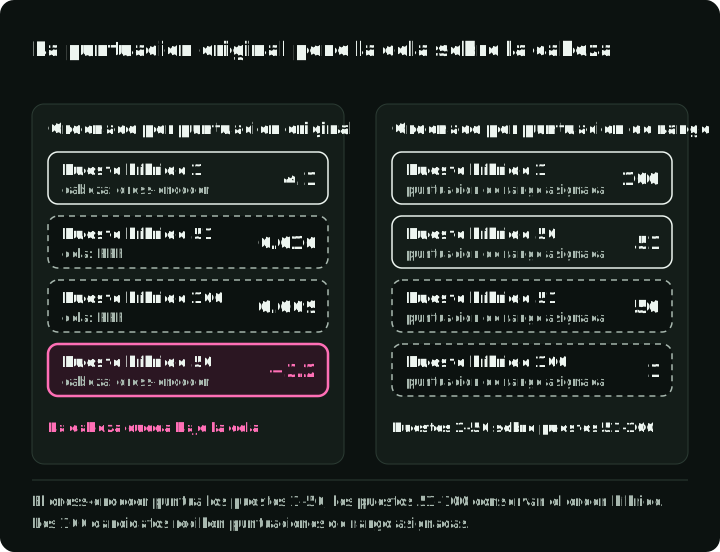
La etapa envía pares (query, document) de los primeros 50 candidatos híbridos a CrossEncoder.predict, coloca esos candidatos en orden de puntuación y después añade los candidatos sin puntuar en su orden anterior. La figura ordena cuatro de los 100 candidatos de las dos maneras y muestra por qué la fusión asigna nuevas puntuaciones de rango en lugar de conservar las puntuaciones originales:
# From src/search_ranking_stack/stages/s04_cross_encoder.py

def rank_scores(ordered_ids):
    return {doc_id: float(len(ordered_ids) - rank) for rank, doc_id in enumerate(ordered_ids)}

def merge_head_and_tail(original, scored_head):
    """original: hybrid (doc_id, rrf_score) pairs in rank order.
    scored_head: (doc_id, cross_encoder_score) pairs for the first len(scored_head)."""
    head = sorted(scored_head, key=lambda item: (-item[1], item[0]))
    tail = original[len(scored_head) :]
    return rank_scores([doc_id for doc_id, _ in head + tail])
La etapa completa añade la carga del modelo, el corte de documentos a 2048 caracteres y una comprobación de que todas las puntuaciones son finitas.
La ficha del modelo muestra que las puntuaciones del cross-encoder pueden ser negativas. No las mezcles con las puntuaciones RRF de la cola sin puntuar: una puntuación RRF positiva puede ordenar un documento de la cola sin puntuar por encima de un documento de la cabeza con puntuación negativa. Asigna puntuaciones de rango estrictamente decrecientes, como hace rank_scores. Son puntuaciones de rango para la evaluación, no estimaciones calibradas de relevancia.
El compromiso entre velocidad y calidad
¿Por qué no usar cross-encoders para todo? Porque no puedes precalcular las puntuaciones. Los embeddings de documentos de un bi-encoder no dependen de la consulta, así que se calculan una vez y se almacenan. La salida de un cross-encoder depende de la consulta y del documento juntos. La puntuación de relevancia de «wireless headphones» emparejado con un producto de Sony procede de la self-attention conjunta entre esos tokens concretos. Puedes guardar en caché un par consulta-documento repetido, pero su puntuación no sirve para otra consulta.
Un bi-encoder necesita una codificación de la consulta más una búsqueda vectorial sobre embeddings de documentos precalculados. Un cross-encoder puntúa cada par consulta-documento de la lista corta, con un coste que crece tanto con el número de candidatos como con la longitud de la secuencia. El procesamiento por lotes ayuda, pero puntuar 100 000 candidatos sigue siendo un punto de operación equivocado; recupera primero y mide con un benchmark cuál es la lista corta más grande que cumple los objetivos de calidad y latencia.
Reranking listwise con LLM
La última etapa de la demo usa un LLM para el reranking listwise. En lugar de puntuar cada documento por separado, el modelo ve el top 10 y devuelve un orden. Inspirado en RankGPT, el prompt hace explícita la comparación relativa, pero también introduce límites de contexto, sesgo de posición, fallos de parsing y varianza entre ejecuciones.
El prompt listwise
La plantilla del prompt pide al LLM que tenga en cuenta la jerarquía de relevancia de ESCI:
# src/search_ranking_stack/stages/s05_llm_rerank.py

def _create_listwise_prompt(query, documents, max_words=200):
    n = len(documents)

    doc_texts = []
    for i, (_doc_id, doc_text) in enumerate(documents, start=1):
        words = doc_text.split()[:max_words]
        doc_texts.append(f"[{i}] {' '.join(words)}")

    docs_formatted = "\n\n".join(doc_texts)

    return (
        f"I will provide you with {n} product listings, each indicated by a numerical "
        f"identifier [1] to [{n}]. Rank the products based on their relevance to the "
        f'search query: "{query}"\n\n'
        "Consider:\n"
        "- Exact matches (product satisfies all query requirements) should rank highest\n"
        "- Substitutes (functional alternatives) should rank above complements\n"
        "- Completely irrelevant products should rank lowest\n\n"
        f"{docs_formatted}\n\n"
        "Rank the products from most relevant to least relevant.\n"
        "Output ONLY a comma-separated list of product identifiers, e.g.: [3], [1], [2], ...\n"
        "Do not explain your reasoning. Only output the ranking."
    )
Tres modos de ejecución
La demo admite tres backends para el reranking con LLM:
| Modo | Modelo | Cómo se ejecuta |
|---|---|---|
ollama | llama3.2:3b (cambia OLLAMA_MODEL para usar otro) | En local mediante la API de Ollama |
api | Claude Haiku (define LLM_MODEL_API en config.py) | API de Anthropic; antes, uv sync --extra api |
local | Qwen/Qwen2.5-1.5B-Instruct | HuggingFace Transformers; antes, uv sync --extra llm |
Parsing y fallback
El parser extrae los identificadores numerados de la respuesta del modelo. Acepta un ranking solo si enumera cada candidato exactamente una vez:
# src/search_ranking_stack/stages/s05_llm_rerank.py

def _parse_ranking(output: str, n: int) -> list[int] | None:
    """Return 0-based positions if the output ranks IDs 1..n exactly once."""
    positions = [int(m) - 1 for m in re.findall(r"\[(\d+)\]", output)]

    # Reject missing, duplicate, and out-of-range IDs.
    if sorted(positions) != list(range(n)):
        return None

    return positions
Cuando el parser devuelve None, la demo conserva el orden completo del cross-encoder para esa consulta y cuenta un fallback. Un error del backend también cuenta como fallback. run-all imprime la tasa de fallback y la guarda junto a las métricas. Por ejemplo, [3] > [1] > [3] se rechaza: el ID 3 está repetido y faltan los IDs 2 y del 4 al 10.
Resultados de esta muestra de ESCI
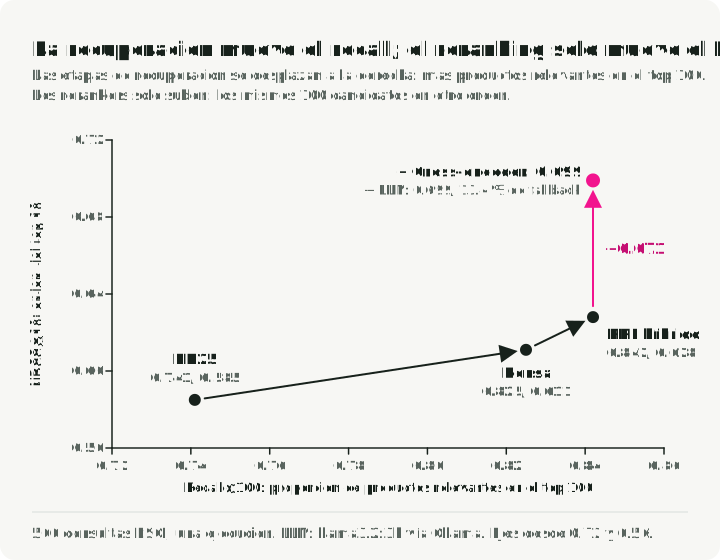
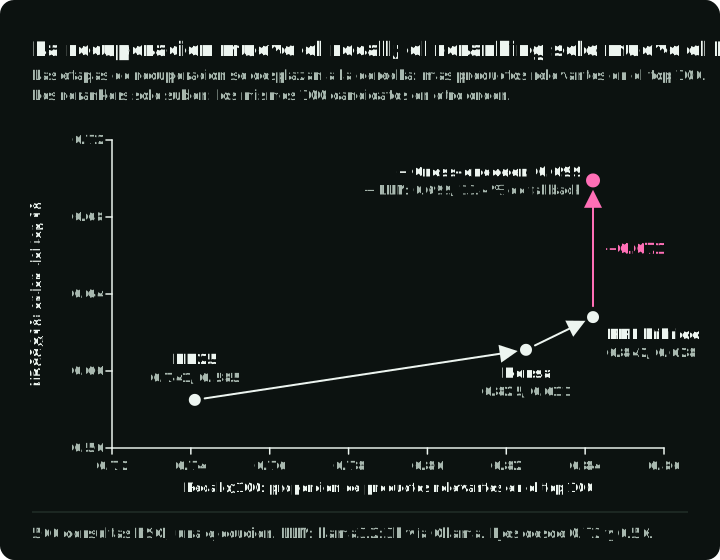
Los resultados usan la muestra small_version descrita arriba; no está reservada para evaluación. Las filas proceden de una ejecución de uv run run-all --llm-mode ollama con llama3.2:3b como LLM.
| Etapa | NDCG@10 | MRR | Recall@100 | Delta de NDCG |
|---|---|---|---|---|
| BM25 | 0.585 | 0.812 | 0.741 | — |
| Bi-encoder denso | 0.611 | 0.808 | 0.825 | +0.026 |
| Híbrido (RRF) | 0.628 | 0.834 | 0.842 | +0.017 |
| + Cross-encoder | 0.699 | 0.886 | 0.842 | +0.071 |
| + Reranker LLM (13.4 % fallback) | 0.699 | 0.884 | 0.842 | +0.000 |
El gráfico traza el Recall@100 de cada fila frente a su NDCG@10:
Qué respaldan los resultados registrados
La búsqueda híbrida supera a cada método por separado. El RRF híbrido alcanza un NDCG@10 de 0.628, por encima de BM25 (0.585) y de la recuperación densa (0.611). También tiene el Recall@100 más alto de las tres filas de recuperación (0.842). Los dos métodos pueden fallar en consultas distintas, y la fusión recupera documentos que cada uno por separado pasa por alto.
El cross-encoder aporta la mayor mejora. Eleva el NDCG@10 de 0.628 a 0.699 y el MRR de 0.834 a 0.886 puntuando solo 50 candidatos por consulta. En el top 10, la proporción de productos Exact sube del 36.0 % (híbrido) al 41.4 %.
En esta demo, el recall se fija en la recuperación. Ambos rerankers conservan los 100 candidatos híbridos, así que Recall@100 se mantiene en 0.842. Para aumentarlo, cambia cuáles son los 100 candidatos que devuelve la recuperación.
Un LLM local pequeño no aporta nada en esta muestra. llama3.2:3b deja el NDCG@10 en 0.699 y reduce ligeramente el MRR. 67 de 500 respuestas (13.4 %) no superaron el parser y conservaron el orden del cross-encoder, de modo que el orden del LLM se aplicó en 433 consultas. Un modelo mayor o el modo API pueden comportarse de otra manera; mídelo del mismo modo, con la tasa de fallback junto a la puntuación.
La recuperación densa supera a BM25 en esta muestra. Inspecciona segmentos de consultas antes de asignar la causa. El desajuste de vocabulario es un factor plausible, pero la construcción de la muestra, el tokenizador, el dominio de entrenamiento del modelo y los campos del corpus también afectan a la comparación.
Indexación de vectores densos más allá de la demo
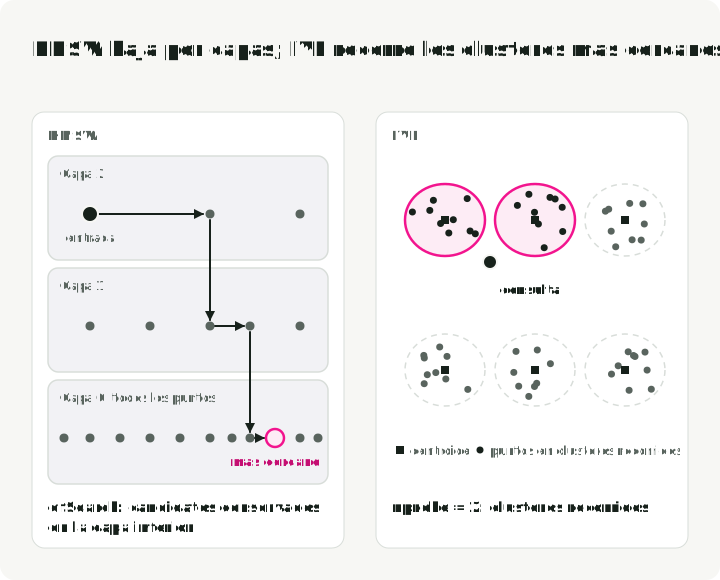
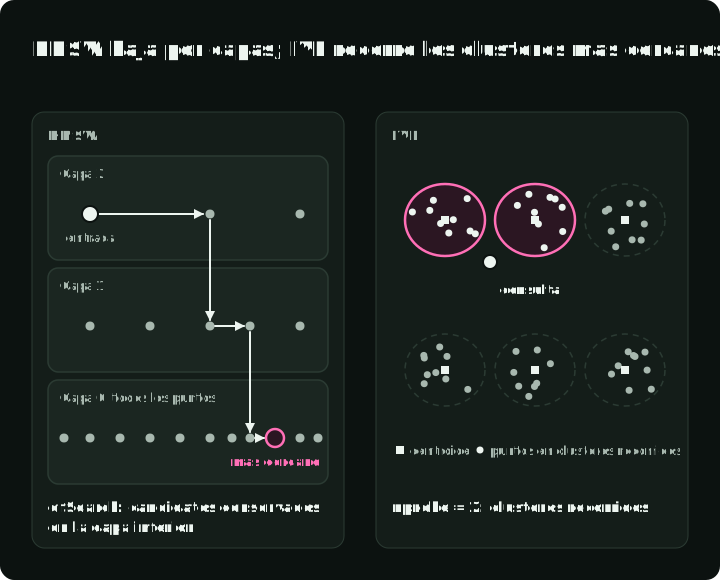
Los embeddings densos solo resultan útiles a escala cuando existe un índice de vecinos más cercanos aproximados (ANN). La demo usa similitud del coseno por fuerza bruta (suficiente con 9870 documentos), pero los sistemas de producción necesitan índices especializados. Las dos familias habituales buscan de maneras distintas, y cada una tiene un parámetro de búsqueda que cambia recall por trabajo de consulta. La figura muestra el camino que sigue HNSW y los clústeres que recorre IVF:
HNSW (hierarchical navigable small world)
HNSW construye un grafo multicapa: las capas superiores, dispersas, navegan de forma amplia, y las capas inferiores, más densas, afinan el vecindario. M controla la conectividad del grafo, mientras que efSearch cambia trabajo de consulta por recall. Los valores útiles dependen de la dimensión, la distribución de distancias, los filtros, la implementación y el recall objetivo.
Los índices de grafo pueden perder recall con muchas actualizaciones o filtros restrictivos; una incidencia de Qdrant muestra un recall filtrado que solo se recupera tras reconstruir el índice. Prueba tu patrón de actualizaciones y filtros, incluido el tiempo de reconstrucción.
IVF (inverted file)
Los índices IVF dividen el espacio vectorial en clústeres y después recorren los nprobe clústeres más cercanos a la consulta. Pueden ofrecer un equilibrio útil entre memoria, tiempo de construcción y recall, sobre todo combinados con compresión. La semántica de actualización y el rendimiento dependen de la implementación, no solo de la familia de índice.
RaBitQ (Gao y Long, SIGMOD 2024) es un cuantizador aleatorizado que se puede combinar con IVF. Normaliza vectores centrados, usa una rotación ortogonal aleatoria y codifica los signos con un bit por dimensión. La estimación de distancias también usa factores de corrección y normas de los vectores; las cotas de error del artículo se aplican a ese estimador y a sus supuestos. Úsalo cuando la memoria sea el límite y las estimaciones de distancia cuantizadas sigan cumpliendo tu recall objetivo.
| Dimensión | Grafo HNSW | Clústeres IVF |
|---|---|---|
| Control en la consulta | efSearch | nprobe |
| Control en la construcción | Conectividad y haz de construcción | Número de clústeres y muestra de entrenamiento |
| Perfil de memoria | Aristas del grafo más vectores | Centroides, listas y vectores almacenados |
| Comportamiento ante actualizaciones | Reparación y limpieza específicas de cada base de datos | Mantenimiento de listas específico de cada base de datos |
| Se suele elegir cuando | Los vectores caben en RAM y necesitas baja latencia con recall alto | La memoria o el tamaño del corpus son el límite; combínalo con PQ o RaBitQ |
Con cualquiera de los dos índices, mide la curva de recall, latencia y memoria con tus propios datos y tu carga de consultas.
Uber redujo la latencia y la CPU al reducir el número de candidatos por shard con poca pérdida de recall; ajusta ese número con tráfico similar al de producción.
Extensiones opcionales después del pipeline principal
Cuando la recuperación y el reranking tienen mediciones separadas, varias extensiones resultan más fáciles de evaluar sin oscurecer el pipeline principal.
Comprensión de consultas
La expansión y la reescritura de consultas pueden abordar el desajuste de vocabulario antes de la recuperación. Query2doc generó pseudodocumentos y reportó mejoras de BM25 en sus experimentos con MS MARCO. La expansión también puede introducir una intención equivocada, así que compara recall y precisión en segmentos de consultas ambiguas, navegacionales y de identificadores exactos.
Patrones prácticos: expansión de abreviaturas, enriquecimiento de entidades, descomposición en subconsultas para razonamiento multisalto y RAG-Fusion, que genera varias variantes de la consulta y combina los resultados mediante RRF.
Etiquetado de relevancia asistido por LLM
Los LLMs pueden redactar etiquetas de relevancia cuando escasean los juicios humanos. El trabajo de Pinterest sobre etiquetado de relevancia describe cómo ampliar los datos de entrenamiento más allá de las etiquetas humanas y destilar un modelo de relevancia basado en LLM para servirlo. Una etiqueta de LLM sigue siendo salida de un modelo: calíbrala con juicios humanos ciegos, inspecciona los segmentos de desacuerdo y mantén un conjunto de referencia humano para las pruebas de regresión.
Controles útiles:
- una rúbrica con límites de relevancia concretos y ejemplos;
- calibración humana ciega y revisiones periódicas;
- aleatorización del orden y juicios repetidos para los casos inestables;
- paneles de modelos, cuando su coste añadido mejora el acuerdo; y
- comprobaciones explícitas del sesgo de posición y del sesgo de tendencia central.
Knowledge distillation
Cuando un LLM como teacher aporta valor pero no cumple las restricciones de serving, la distillation es una opción:
- Usa un LLM potente (el teacher) para hacer reranking de miles de consultas de entrenamiento offline; solo el student, que es pequeño, se ejecuta en cada petición.
- Entrena un cross-encoder pequeño y rápido (el student, de unos 100M–200M de parámetros) para imitar la distribución de ranking del LLM.
- Compara el student con el teacher y con el baseline en calidad, calibración y coste de serving.
InRanker destila MonoT5-3B en modelos de 60M y 220M de parámetros, respectivamente 50 y unas 13 veces más pequeños, con mejor eficacia fuera de dominio que sus versiones sin destilar. El enfoque Rank-Without-GPT produce rerankers listwise de código abierto de 7B que alcanzan el 97 % de la eficacia del reranker GPT-4 comparado, según nDCG@10 en TREC-DL-19 y TREC-DL-20, usando fine-tuning con QLoRA.
Los resultados de compresión publicados son puntos de partida, no ratios esperables en producción. La distillation puede heredar los sesgos del teacher y perder calidad en segmentos de consultas poco frecuentes, así que mantén los juicios de relevancia originales en el ciclo de evaluación.
Personalización y sesgo de posición
Una búsqueda de «apple» debería devolver iPhones a un entusiasta de la tecnología y recetas con manzana a alguien que ha estado viendo contenido de cocina.
Una arquitectura de recuperación habitual para la personalización usa un modelo de embeddings two-tower: la torre de consulta codifica la consulta y el contexto del usuario, mientras que la torre de artículos codifica los artículos y sus metadatos. La figura muestra qué lado se ejecuta en cada petición, cuál se calcula offline y dónde cae la consulta «apple» para dos usuarios:
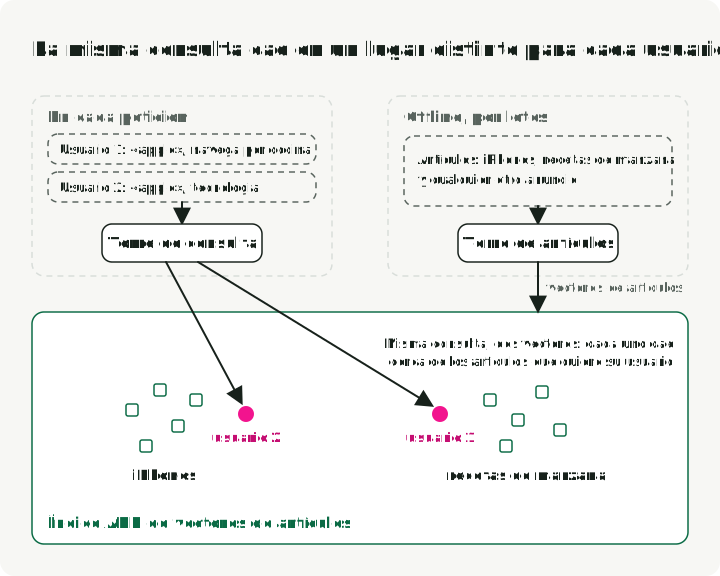
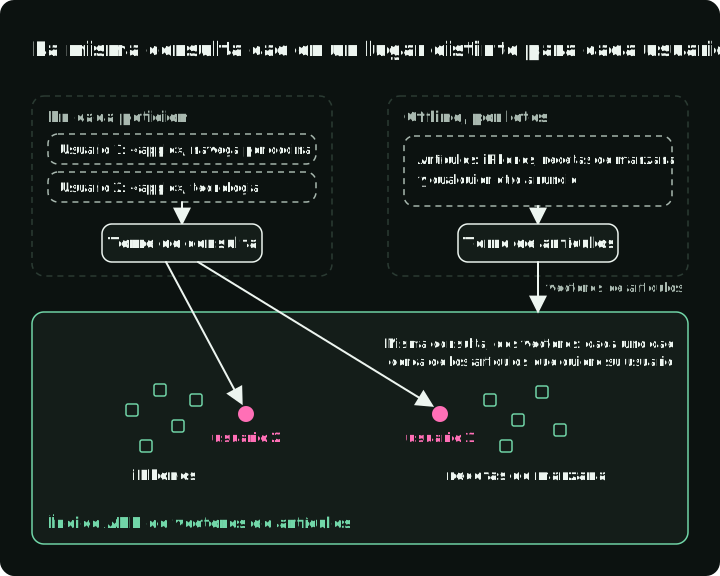
La separación offline/online permite la recuperación por vecinos más cercanos aproximados; su latencia sigue dependiendo del encoder, el índice, los filtros y el sistema de serving. Tres diseños de producción usan embeddings aprendidos en lugares distintos. Airbnb aprende embeddings de anuncios a partir de las sesiones de clics de los usuarios y usa la similitud con los anuncios clicados recientemente como features del ranking de búsqueda. OmniSearchSage, de Pinterest, aprende un único embedding de consulta junto con embeddings de pines y de productos. Uber usa un modelo two-tower para recuperar unos cientos de tiendas para el feed de inicio de Uber Eats.
Los datos de clics llevan sesgo de posición y de exposición. PAL es un enfoque de corrección de sesgos: entrenar conjuntamente un módulo de exposición y un módulo de clic dada la exposición, y servir después este último sin entrada de posición. No es una solución universal; las intervenciones aleatorizadas, los métodos de propensión inversa y la evaluación contrafactual pueden ser más adecuados para otro producto.
Adaptación al dominio con consultas sintéticas
Un error habitual de estrategia de búsqueda es suponer que un modelo entrenado con datos generales de la web (como MS MARCO) funcionará bien en un dominio especializado. Es el problema fuera de dominio (OOD).
La generación de consultas sintéticas puede reducir el cuello de botella de los datos etiquetados. InPars genera consultas para documentos y filtra los pares para el entrenamiento. Generative Pseudo-Labeling (GPL) añade un paso de etiquetado con un teacher:
- Generar consultas a partir del corpus de documentos objetivo.
- Recuperar documentos negativos para cada consulta generada.
- Usar un teacher cross-encoder para puntuar los pares positivos y negativos, lo que produce un margen de puntuación de relevancia.
- Entrenar el recuperador denso para que reproduzca esos márgenes.
Los pares sintéticos pueden ayudar cuando escasean las consultas reales, pero reflejan el generador y el prompt. Deduplícalos, filtra las consultas poco plausibles y valida con tráfico real reservado para evaluación.
Una secuencia de experimentos
Añade complejidad solo cuando la etapa anterior exponga un fallo medido. Cada paso nombra el fallo que lo justifica:
- Establece un baseline. Ejecuta BM25 o el sistema léxico actual sobre un conjunto de consultas con juicios. Registra el recall, el NDCG, la latencia y los grupos de consultas en los que falla.
- Recupera los candidatos que faltan. Prueba la recuperación densa y la fusión cuando el baseline pierda documentos relevantes. Ajusta el corte de candidatos según el recall y el coste.
- Mejora el orden. Añade un cross-encoder cuando los candidatos relevantes estén presentes pero muy abajo en el ranking. Elige el tamaño de su lista corta midiendo calidad y latencia con varios cortes. En la demo, este paso elevó el NDCG@10 de 0.628 a 0.699.
- Adapta al dominio. Haz fine-tuning o distillation cuando los modelos genéricos muestren fallos estables propios del dominio. Mantén los juicios reales reservados para evaluación separados de los datos sintéticos de entrenamiento.
- Prueba el reranking caro. Prueba el reranking listwise o basado en razonamiento solo cuando la calidad añadida se mantenga en ejecuciones repetidas y justifique su latencia, su coste, sus requisitos de privacidad y la complejidad del fallback. En la demo,
llama3.2:3bno superó esta prueba.
El stack inicial y los juicios que hay que recopilar dependen del producto:
| Caso de uso | Stack inicial candidato | Valida |
|---|---|---|
| Búsqueda de productos | BM25 + recuperación densa + RRF + cross-encoder | Recall de atributos, sustituciones, latencia, restricciones de negocio |
| Búsqueda en documentación | Recuperación híbrida + cross-encoder | Identificadores exactos, preguntas semánticas, filtros de versión |
| Reducción de tickets de soporte | Recuperación híbrida + comprobación de citas | Recall de recuperación, grounding, abstención |
| Marketplace o anuncios | Filtros léxicos + recuperación densa + reranker de negocio | Disponibilidad, frescura, políticas, diversidad de vendedores |
| Corpus interno pequeño | Baseline BM25 y después un reranker | Si el desajuste de vocabulario justifica un índice denso |
| Búsqueda legal o médica de alto riesgo | Recuperación centrada en el recall más revisión experta | Cobertura, procedencia, abstención calibrada |
En cada comparación, mantén un conjunto real de juicios reservado para evaluación y separado de los datos de entrenamiento. Registra los rankings por consulta, los fallos, la latencia y el coste para poder rastrear una mejora agregada hasta la etapa que cambió. Las capas caras también necesitan políticas explícitas de privacidad y de fallback.
Líneas de investigación que deben evaluarse por separado
Los rerankers basados en razonamiento y los agentes que usan búsqueda son prometedores, pero responden a preguntas distintas de las de la demo de búsqueda de productos en cinco etapas.
Rerankers basados en razonamiento
Rank1 entrena rerankers con trazas de razonamiento y reporta resultados sólidos en el benchmark BRIGHT. Esa evidencia es relevante para la recuperación que exige mucho razonamiento, no una predicción directa para la búsqueda de productos de ESCI.
Para la búsqueda legal o científica, compara los rerankers de razonamiento con baselines sólidos de cross-encoder y listwise según juicios de expertos, citas, latencia y consistencia de los fallos.
Búsqueda agentic
Search-o1 estudia un modelo que emite búsquedas adicionales durante la respuesta a preguntas multisalto. Es un problema de orquestación (generación de consultas, criterio de parada, uso de la evidencia y evaluación de la respuesta), no otra etapa de reranking. Evalúalo con la corrección de la tarea final y el respaldo de las citas, no solo con métricas de recuperación.
Referencias
Artículos
- Reciprocal Rank Fusion — Cormack et al., 2009
- RankGPT: LLMs as Zero-Shot Listwise Rerankers — Sun et al., EMNLP 2023 Outstanding Paper
- Rank1: Reasoning-Based Reranking — Weller et al., COLM 2025
- Query2doc: LLM Query Expansion — Wang et al., EMNLP 2023
- GPL: Generative Pseudo Labeling — adaptación de dominio para recuperación densa
- InRanker: Distilled Reranker — reducción de tamaño de 50x con rendimiento competitivo
- Search-o1: Agentic Retrieval — Li et al., 2025
- BEIR Benchmark — Thakur et al., NeurIPS 2021
- Sentence-BERT — Reimers y Gurevych, EMNLP 2019
- InfoNCE / CPC — van den Oord et al., 2018
- SimANS: Hard Negative Sampling — Zhou et al., EMNLP 2022
- Passage Reranking with BERT — Nogueira y Cho, 2019
- HNSW — Malkov y Yashunin, 2016
- DiskANN — Subramanya et al., NeurIPS 2019
- RaBitQ — Gao y Long, SIGMOD 2024
- Replacing Judges with Juries — Verga et al., 2024
- RAG-Fusion — Rackauckas, 2024
- InPars — Bonifacio et al., SIGIR 2022
- BRIGHT Benchmark — Su et al., ICLR 2025
- Rank-without-GPT — Zhang et al., ECIR 2025
- Pinterest LLM Search Relevance — Wang et al., 2024
- OmniSearchSage — Agarwal et al., WWW 2024
- PAL: Position-bias Aware Learning — Guo et al., RecSys 2019
Datasets y benchmarks
- Amazon ESCI: Shopping Queries Dataset — KDD Cup 2022
- BEIR: Benchmarking IR — benchmark heterogéneo para evaluación zero-shot
- MTEB: Massive Text Embedding Benchmark — leaderboard de modelos de embedding
- ESCI Paper — Reddy et al., 2022
Modelos usados en la demo
- all-MiniLM-L6-v2 — bi-encoder de 22M de parámetros
- ms-marco-MiniLM-L12-v2 — cross-encoder de 33M de parámetros
- Sentence-Transformers — framework de modelos de recuperación neuronal
Herramientas y plataformas
- rank_bm25 — implementación de BM25 en Python
- Pyserini BEIR Reproductions — baselines de Lucene BM25 para BEIR
- pytrec_eval — toolkit de evaluación TREC
- Elasticsearch — búsqueda híbrida con la API de Retrievers
- Vespa — motor unificado de búsqueda y recomendación
- Weaviate — base de datos vectorial con búsqueda híbrida
- Qdrant — base de datos vectorial con consultas multietapa
Referencias de la industria
- Airbnb Listing Embeddings — Grbovic y Cheng, KDD 2018
- Uber Delivery Search — Uber Engineering, 2025
- Uber Two-Tower Embeddings — Uber Engineering, 2023
- Elastic Rerank — Elastic, 2024
Proyecto de demostración
- search-ranking-stack — demo funcional del pipeline de este artículo