Search-Ranking-Stack: BM25, Embeddings und Reranking

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Dieser Leitfaden richtet sich an Python Engineers, die eine Search-Ranking-Pipeline bauen oder verbessern. Er erklärt, wie BM25, dichte Embeddings, Rank Fusion und Reranker zusammenspielen und wie Sie messen, ob die Suche bessere Kandidaten oder eine bessere Reihenfolge braucht.
Eine Suche nach „cheap laptop“ kann ein Produkt übersehen, das als „budget notebook computer“ beschrieben ist. Ein anderer Fehler stellt eine Kopfhörer-Tragetasche vor die Kopfhörer selbst. Das erste Problem braucht bessere Kandidaten, das zweite eine bessere Reihenfolge.
Das begleitende Demo-Repository veranschaulicht Retrieval und Reranking an einem Ausschnitt der Amazon-ESCI-Produktsuchdaten.
Eine kompakte Anleitung zur Auswahl der Stufen finden Sie unter BM25 vs Embeddings vs Rerankers. Die Experimentfolge weiter unten in diesem Artikel verbindet jede Stufe mit einer Messung.
Lexikalische Modelle, Dense Retrieval und Cross-Encoder
Der Stack lässt sich leichter verstehen, wenn man ihn als drei Schichten betrachtet. Lexikalisches Retrieval findet exakte Begriffe, Dense Retrieval schließt Lücken im Vokabular, und Reranker vergleichen die stärksten Kandidaten im Detail.
BM25 und lexikalisches Retrieval
Jahrzehntelang war BM25 der Standard. Es ist ein probabilistisches Modell, das Dokumente nach der Häufigkeit der Query-Begriffe im Dokument bewertet, normalisiert nach Dokumentlänge und Inverse Document Frequency (IDF).
BM25 ist stark, wenn wörtliche Begriffe die Absicht tragen: Fehlercodes, Produkt-SKUs, Namen und API-Bezeichner. Die wichtigste Grenze ist das Vokabular-Mismatch. Eine Query nach „cheap laptop“ kann ein Dokument über einen „budget notebook computer“ übersehen, wenn der indexierte Text keine Brücke zwischen den beiden Ausdrücken enthält.
Allerdings fand die BEIR-Studie BM25 als starke Zero-Shot-Baseline über ihre heterogenen Retrieval-Aufgaben hinweg. Die BM25-Werte von BEIR stammen aus Lucene über Pyserini, nicht aus dem an Leerzeichen tokenisierten rank_bm25, das diese Demo verwendet. BM25 schlägt auch einige neuronale Modelle bei argumentativen Retrieval-Aufgaben wie Touche-2020.
Dense Retrieval und Embeddings
BERT-artige Encoder haben Dense Retrieval praxistauglich gemacht. Sie bilden Queries und Dokumente in einem gemeinsamen Vektorraum ab und ordnen Kandidaten dann mit einer Ähnlichkeitsfunktion wie Kosinus-Ähnlichkeit oder Skalarprodukt.
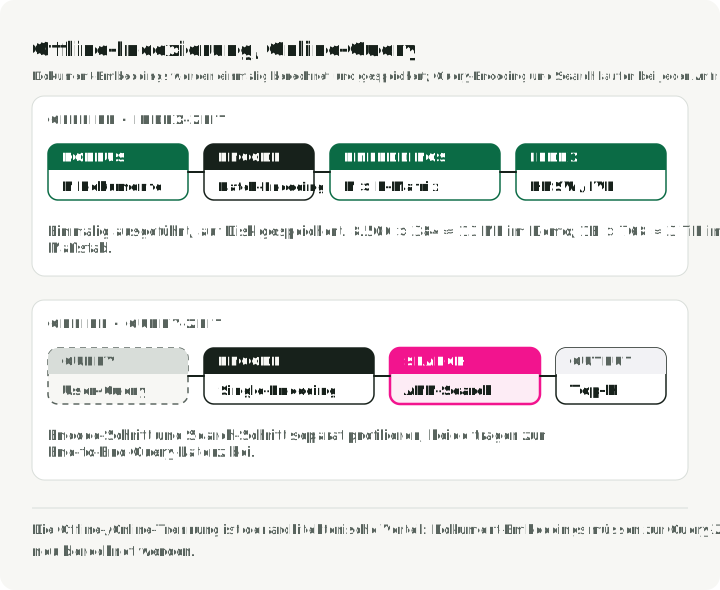
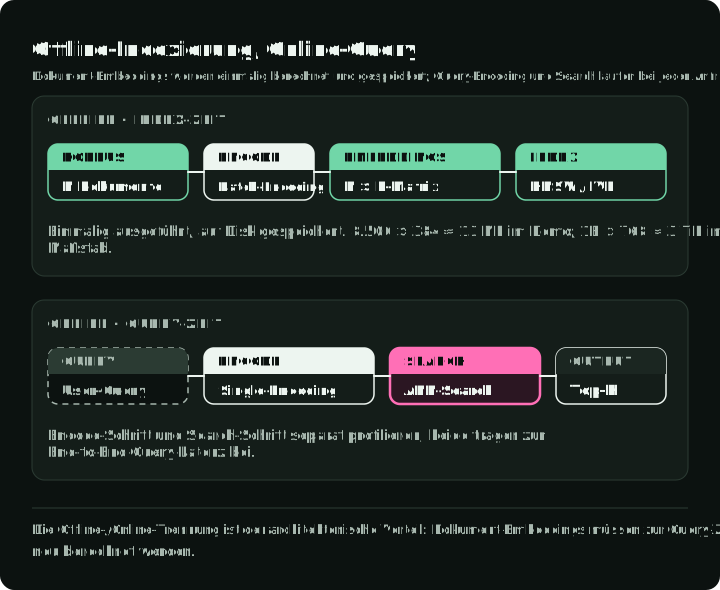
Die Bi-Encoder-Architektur (auch „Two-Tower“) kodiert Query und Dokument getrennt und erzeugt Embeddings fester Länge. Dokumentvektoren lassen sich offline vorberechnen und indexieren und dann über Approximate-Nearest-Neighbor-Algorithmen (ANN) schnell abrufen. Nun liegen „cheap laptop“ und „budget notebook“ im Vektorraum dicht beieinander.
Manche Bi-Encoder nutzen eine Siamese-Architektur, etwa Sentence-BERT, bei der beide Seiten die Gewichte teilen. Andere verwenden getrennte Query- und Dokument-Towers. Pooling, Vektorgröße, Ähnlichkeitsfunktion und Trainingsziel sind Modellentscheidungen und keine Eigenschaften jedes Dense Retrievers.
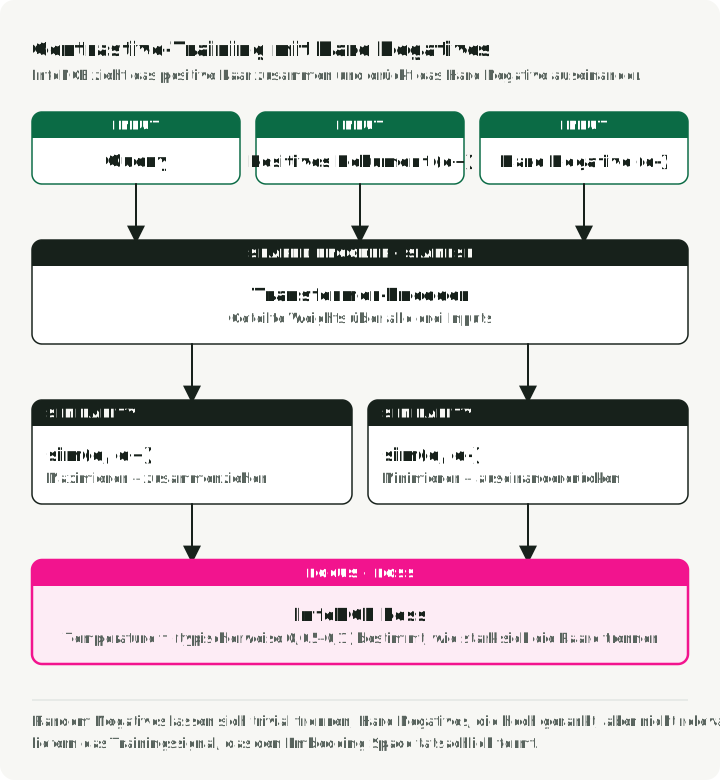
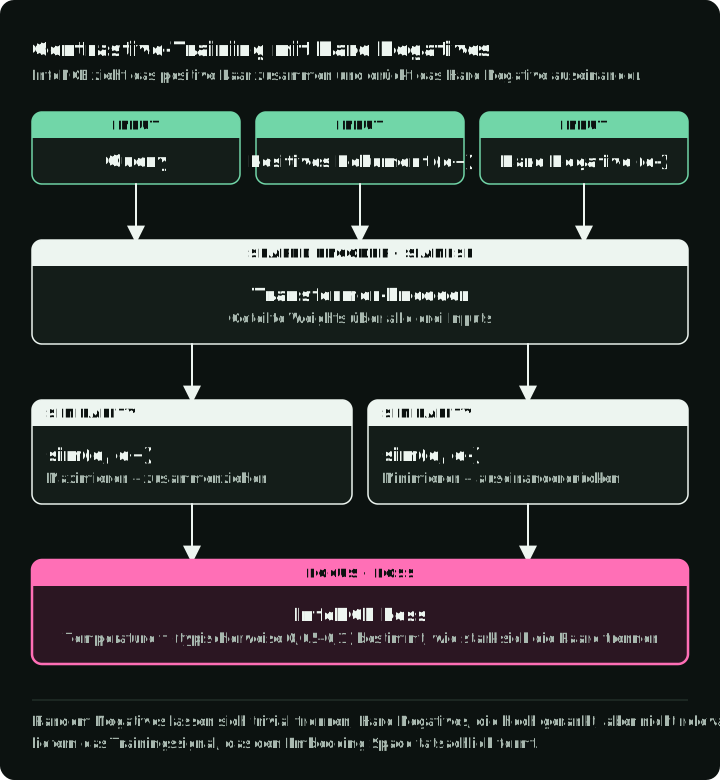
Diese Modelle werden mit Contrastive Learning trainiert, meist mit dem InfoNCE-Loss. Für einen Batch aus (Query, positives_Dokument)-Paaren maximiert das Ziel sim(query, positive_doc) und minimiert sim(query, negative_docs). Negative stammen aus den Positiven anderer Queries im selben Batch (In-Batch-Negatives). Ein Temperaturparameter steuert, wie scharf das Modell beide trennen muss.
Die Trainingsdaten sind oft wichtiger als die Embedding-Dimension. Retrieval-Modelle lernen aus Query-Positiv-Paaren und sorgfältig gewählten Hard Negatives: plausiblen, aber nicht relevanten Dokumenten. Der spätere Trainingsabschnitt zeigt, wie SimANS sowohl triviale Negative als auch wahrscheinlich falsche Negative vermeidet.
Der Preis ist der Bottleneck der Repräsentation. Bi-Encoder pressen alle semantischen Nuancen in einen einzigen Vektor fester Größe und übersehen deshalb oft feine Wechselwirkungen zwischen bestimmten Query-Begriffen und bestimmten Dokumentinhalten.
Cross-Encoder und LLMs
Cross-Encoder (Nogueira & Cho, 2019) geben Query und Dokument gemeinsam als verkettete Sequenz ([CLS] Query [SEP] Document) in einen Transformer, sodass jedes Query-Token über volle Self-Attention auf jedes Dokument-Token zugreifen kann. Diese tiefe Interaktion erfasst Nuancen, die bei unabhängiger Kodierung verloren gehen.
LLM-Reranking nutzt ein per Prompt gesteuertes Modell, um mehrere Kandidaten gleichzeitig zu vergleichen. RankGPT zeigte mit GPT-4 starke Zero-Shot-Listwise-Ergebnisse auf den untersuchten Benchmarks, doch Ausgabestabilität, Kosten und Domänenpassung müssen weiterhin getrennt getestet werden.
Diese Scores lassen sich für beliebige Queries nicht vorberechnen, deshalb steht das Reranking hinter dem Retrieval. Dieses Kostengefälle begründet den mehrstufigen Funnel.
Der mehrstufige Funnel
Einen teuren Cross-Encoder oder ein LLM über Millionen von Dokumenten laufen zu lassen, ist nicht praktikabel. Moderne Suchsysteme nutzen deshalb einen Funnel. Retrieval und Pre-Ranking verkleinern die Kandidatenmenge, damit das Full Ranking auf einer Shortlist teurere Modelle einsetzen kann. Blending wendet anschließend Regeln oder eine Ranking-Richtlinie an; seine Kosten hängen von dieser Richtlinie ab.
Ein günstiger Retriever liefert außerdem keine endgültige Präzision, daher setzt der Funnel jedes Modell nur dort ein, wo seine Kosten vertretbar sind. Die Abbildung zeigt das Eingabevolumen jeder Stufe und schematische Modellkosten. Sie markiert außerdem, dass spätere Stufen ausgelassene Dokumente nicht zurückholen können:
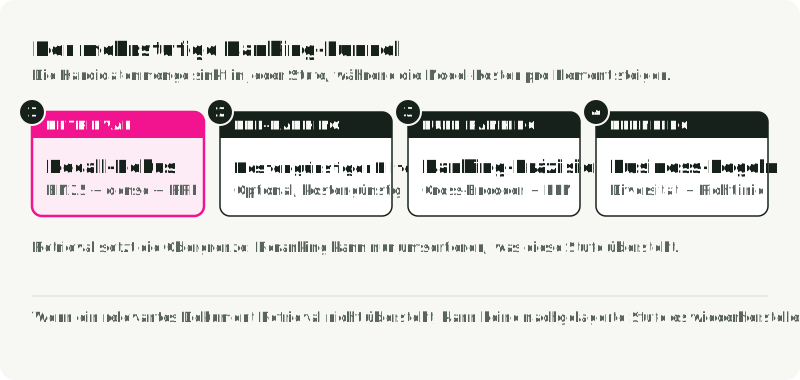
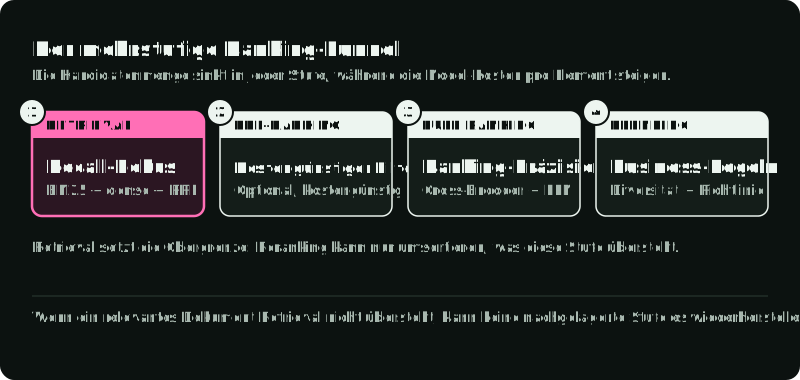
| Stufe | Eingabegröße | Primäres Ziel | Typische Methoden | Messung am Ausgang |
|---|---|---|---|---|
| Retrieval | Korpus oder Index | Recall der Kandidaten | BM25, Bi-Encoder | Recall am Kandidaten-Cutoff |
| Pre-Ranking | Große Kandidatenmenge | Günstiges Filtern | Leichte Modelle, Regeln | Gehaltener Recall pro Millisekunde |
| Full Ranking | Shortlist | Qualität der Spitzenplätze | Cross-Encoder, LLMs | NDCG/MRR, Latency, Kosten |
| Blending | Finale Ranglisten oder Slots | Vorgaben und Mischung | Regeln, Multi-Objective-Ranking | Richtlinien, Diversität, Business-Guardrails |
Ein Reranker ordnet die vom Retrieval gelieferten Kandidaten neu; er kann keinen hinzufügen. Die Abdeckung durch die abgerufenen Kandidaten begrenzt daher, was spätere Stufen zurückholen können. Bei mehr als 100 Kandidaten kann Reranking ein relevantes Dokument in die Top 100 verschieben und Recall@100 verbessern. In dieser Demo bleiben alle 100 Kandidaten erhalten, daher kann Reranking Recall@100 nicht ändern.
Tools für jede Stufe
Die Demo nutzt kleine In-Memory-Bibliotheken. Außerhalb eines Laptops gibt es für jede Stufe einige gängige Implementierungen:
| Stufe | Tool | Einsatz, wenn |
|---|---|---|
| BM25 | rank_bm25 | Der Korpus in den Speicher passt und Sie eine schnelle Baseline wollen |
| Elasticsearch, OpenSearch oder Lucene über Pyserini | Der Korpus einen invertierten Index, Analyzer und Filter braucht | |
| Dense Retrieval | FAISS | Sie eine ANN-Bibliothek im eigenen Service wollen |
| pgvector | Die Daten bereits in Postgres liegen | |
| Qdrant, Weaviate, Vespa oder Elasticsearch kNN | Sie Metadatenfilter, häufige Updates und einen verwalteten Index brauchen | |
| Fusion | Elasticsearch RRF Retriever, Qdrant Query API mit rrf | Sie Rank Fusion innerhalb der Suchmaschine wollen |
| Weaviate Hybrid Search | Sie Weaviate nutzen; es bietet Ranked Fusion und Relative-Score-Fusion | |
| Embedding Models | Der Retrieval-Tab des MTEB, dann Ihre eigenen bewerteten Queries | Sie ein Modell auswählen; das Leaderboard grenzt die Liste ein, Ihre Queries entscheiden |
| Reranker | ms-marco-MiniLM-L12-v2 | Englischer Text, CPU-Budget |
bge-reranker-v2-m3 | Mehrsprachiger Text | |
| Elastic Rerank | Englischer Text, der bereits in Elasticsearch liegt; erfordert ein passendes Abo oder Test |
Die Demo: eine Pipeline mit fünf Stufen
Zur Veranschaulichung habe ich die Demo search-ranking-stack gebaut, die eine Pipeline mit fünf Stufen auf dem Produktsuch-Benchmark Amazon ESCI ausführt. Jede Stufe schreibt Metriken.
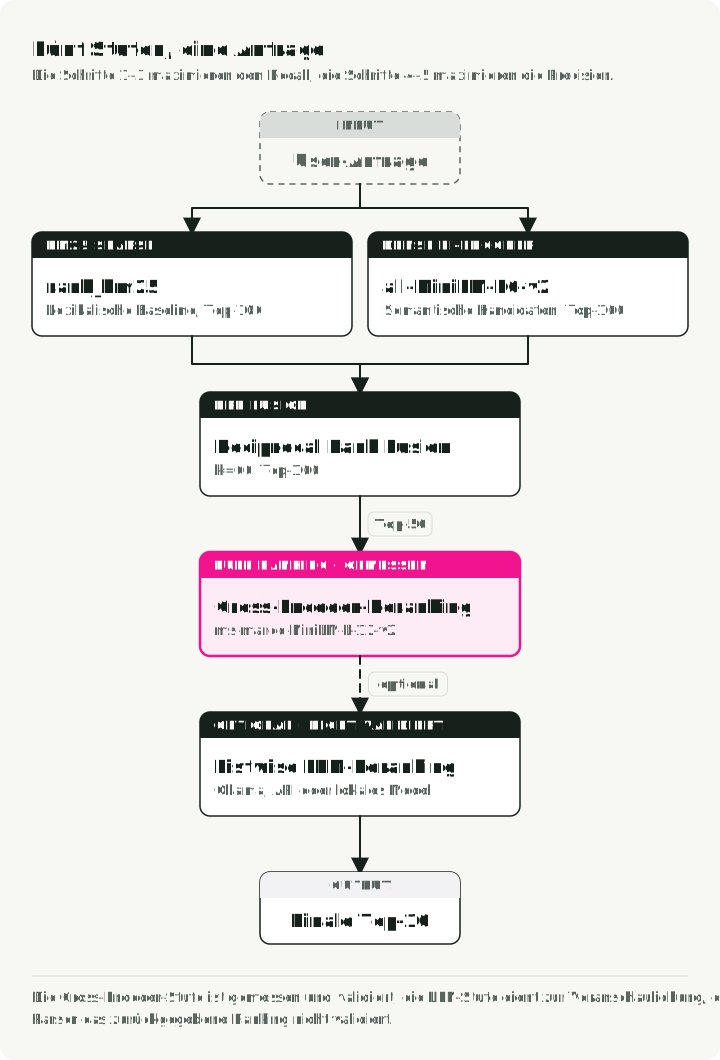
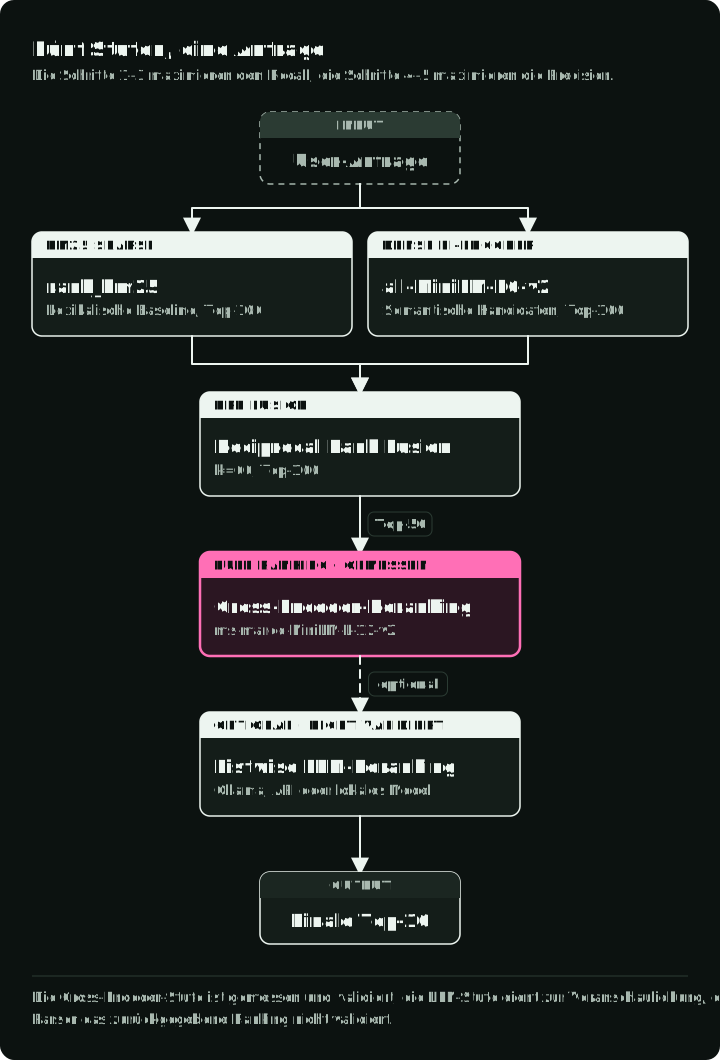
Die Pipeline:
- BM25-Sparse-Retrieval — lexikalische Baseline (
rank_bm25) - Dense-Bi-Encoder-Retrieval — semantische Kandidatengenerierung (
all-MiniLM-L6-v2) - Hybride RRF-Fusion — rangbasierte Fusion der Sparse- und Dense-Ergebnisse
- Cross-Encoder-Reranking — paarweise Relevanz-Scores (
ms-marco-MiniLM-L12-v2) - LLM-Listwise-Reranking — Vergleich der finalen Shortlist per Prompt (Ollama, API oder lokales Modell)
Schritte 1—3 sind die Retrieval-Stufe des Funnels (Recall maximieren); Schritte 4—5 sind die Full-Ranking-Stufe (Präzision maximieren). Die Demo überspringt Pre-Ranking und Blending. Das Diagramm zeigt die Kandidatenzahl bei jedem Schritt: Der Cross-Encoder bewertet die ersten 50 von 100 hybriden Kandidaten und lässt die übrigen in hybrider Reihenfolge, und das LLM sieht die ersten 10.
Schnellstart
Der Download-Schritt lädt den Datensatz einmal herunter und schreibt ein kleines Sample. run-all führt dann jede Stufe aus, gibt pro Stufe eine Metrikzeile aus und schreibt die Zeilen nach results/metrics.json sowie ein Diagramm nach results/metrics_comparison.png. Mit --llm-mode kommt die LLM-Stufe hinzu.
git clone https://github.com/slavadubrov/search-ranking-stack.git
cd search-ranking-stack
uv sync

# Download and sample ESCI dataset (~2.5GB download, ~5MB sample)
uv run download-data

# Run BM25, dense, hybrid RRF, and the cross-encoder
uv run run-all

# Add LLM reranking with a local Ollama model (ollama pull llama3.2:3b first)
uv run run-all --llm-mode ollama
Datensatz und Sampling: Amazon ESCI
Die Demo nutzt das Amazon Shopping Queries Dataset (ESCI) aus dem KDD Cup 2022 — einen echten Produktsuch-Benchmark mit vierstufigen, abgestuften Relevanzlabels:
| Label | Gain | Bedeutung | Beispiel (Query: „wireless headphones“) |
|---|---|---|---|
| Exact (E) | 3 | Erfüllt alle Anforderungen der Query | Sony WH-1000XM5 Wireless Headphones |
| Substitute (S) | 2 | Funktionale Alternative | Kabelgebundene Kopfhörer mit Bluetooth-Adapter |
| Complement (C) | 1 | Verwandter nützlicher Artikel | Kopfhörer-Tragetasche |
| Irrelevant (I) | 0 | Keine sinnvolle Beziehung | USB-Ladekabel |
Abgestufte Relevanz ist wichtig, weil sie NDCG (Normalized Discounted Cumulative Gain) ermöglicht, das ein „perfektes“ Ranking von einem „bloß ausreichenden“ unterscheidet. Binäre Metriken bewerten beide gleich.
Ich habe das Sample small_version der Demo verwendet: 500 Queries, 9.870 Produkte und 9.984 Bewertungen. Der Downloader liest den einzigen train-Split von tasksource/esci, filtert die englische Locale us und small_version == 1 und zieht dann mit Seed 42 bis zu 500 eindeutige Query-IDs ohne Zurücklegen. Der Korpus enthält die eindeutigen Produkte aus diesen ausgewählten Bewertungszeilen. Das ist weder ein zurückgehaltener Split noch ein unabhängiger Korpus. Das Sample ist klein genug für einen Laptop, aber zu klein und zu domänenspezifisch, um ein Produktions-Ranking zu begründen. Nutzen Sie es, um die Stufen nachzuvollziehen und Fehlerbilder zu untersuchen; für Entscheidungen zum Deployment nehmen Sie zurückgehaltene, repräsentative Queries.
Evaluation: messen, was zählt
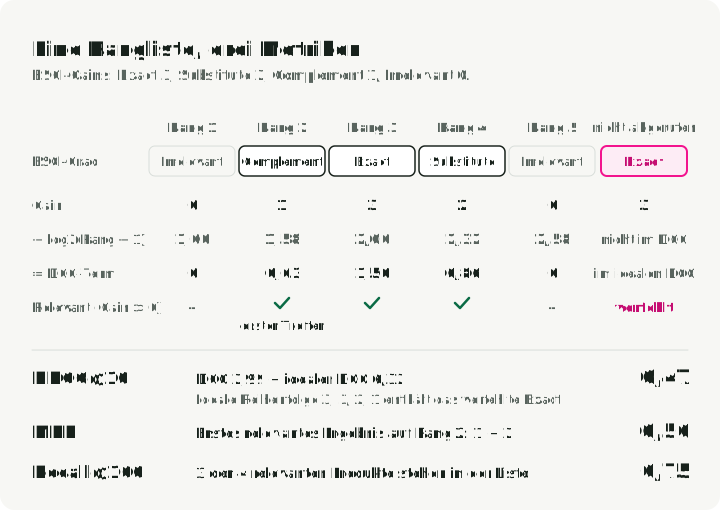
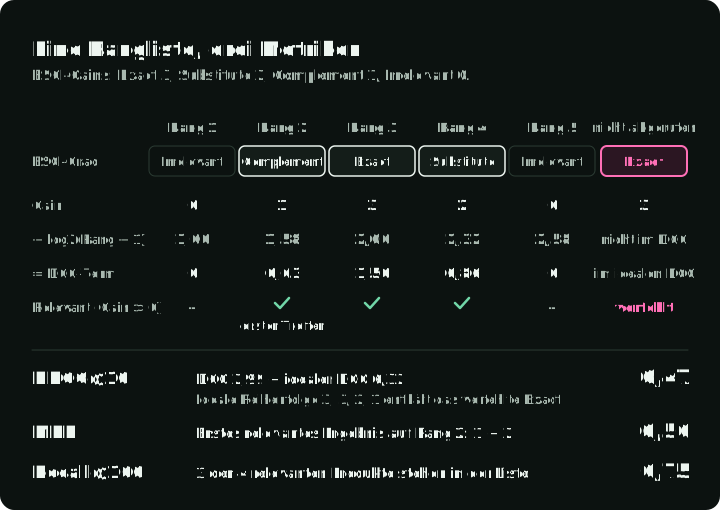
Die Demo nutzt drei Metriken, die das Ranking jeweils aus einem anderen Blickwinkel betrachten. Die Abbildung wendet alle drei auf die Ergebnisse einer Query an, mit den ESCI-Gains von oben:
NDCG@10 (primäre Metrik)
Normalized Discounted Cumulative Gain misst die Qualität des Top-10-Rankings anhand abgestufter Relevanz. Sie belohnt es, hochrelevante Dokumente mit logarithmischem Abschlag weit oben zu platzieren:
Das entspricht den linearen Gains von ndcg_cut in trec_eval, ausgewählt über pytrec_eval als ndcg_cut_10. IDCG ist der DCG der idealen Reihenfolge der bewerteten Grade; eine Query ohne positiven Gain erhält null. Exponentielle Gains wie definieren eine andere Konvention und würden diese Zahlen ändern.
Von den drei Metriken nutzt nur NDCG die vierstufige abgestufte Relevanz von ESCI vollständig. Ein System, das einen Exact-Treffer auf Position 1 setzt, erzielt einen höheren Wert als eines, das dort einen Substitute platziert. Deshalb ist sie hier die primäre Metrik.
MRR (erstes Ergebnis ab Complement)
Der Mean Reciprocal Rank nutzt die Position des ersten Ergebnisses, das als relevant zählt. In dieser Demo übergibt der Evaluator die Relevanzbewertungen von ESCI an pytrec_eval und verwendet recip_rank über jede zurückgegebene Liste von bis zu 100 Kandidaten. Die binäre Schwelle ist relevance > 0: Complement (1), Substitute (2) und Exact (3) zählen als relevant. Irrelevant (0) nicht. Ein relevantes Ergebnis auf Position 1 ergibt den Reciprocal Rank 1,0; auf Position 3 sind es 0,333. Das ist MRR über die zurückgegebenen Kandidatenlisten, nicht MRR@10.
Recall@100 (Retrieval-Abdeckung)
Recall@100 misst, welcher Anteil der bewerteten relevanten Dokumente in den Top 100 erscheint. Beim Reranking derselben 100 Kandidaten bleibt er unverändert, wie in dieser Demo. Bei einer größeren Kandidatenmenge kann Reranking ein relevantes Dokument in die Top 100 verschieben und die Metrik erhöhen. Es kann jedoch kein Dokument zurückholen, das das Retrieval ausgelassen hat.
Der Nenner enthält nur bewertete relevante Dokumente, wie in der Recall-Implementierung von trec_eval. Ein unbewertetes Produkt liefert keine positive Relevanz und fehlt in diesem Nenner. Unvollständige Bewertungen können deshalb dazu führen, dass der gemessene Recall von der Abdeckung aller tatsächlich relevanten Produkte abweicht.
Retrieval: Hybrid Search
Die Aufgabe der Retrieval-Schicht ist es, den Recall zu maximieren: möglichst viele relevante Dokumente in die Kandidatenmenge zu bringen.
BM25: die lexikalische Baseline
BM25 bewertet Dokumente nach der Überlappung von Begriffen mit der Query, mit Sättigung der Termhäufigkeit und Normalisierung der Dokumentlänge:
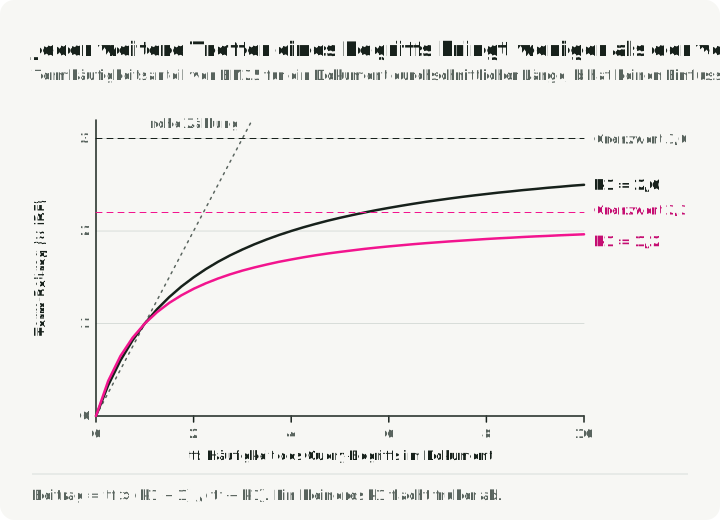
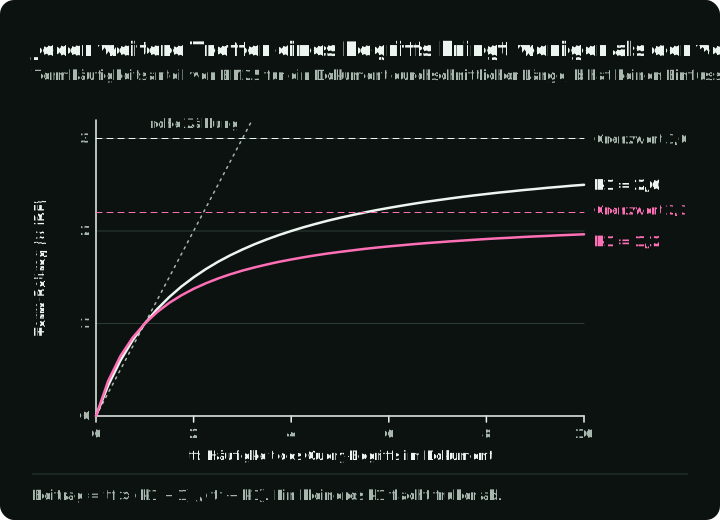
Dabei ist die Inverse Document Frequency des Begriffs , die Termhäufigkeit im Dokument , die Dokumentlänge und die durchschnittliche Dokumentlänge im Korpus. Zwei Parameter sind wichtig: (typisch 1,2—2,0) steuert die TF-Sättigung — wie schnell wiederholte Begriffe keinen Mehrwert mehr liefern — und (typisch 0,75) steuert die Normalisierung der Dokumentlänge.
Das Diagramm zeigt den Termhäufigkeitsanteil der Formel für beide Enden des üblichen -Bereichs:
Die Implementierung ist kurz. Einfache Tokenisierung an Leerzeichen mit rank_bm25:
# src/search_ranking_stack/stages/s01_bm25.py

from rank_bm25 import BM25Okapi

def run_bm25(data: ESCIData, top_k: int = 100):
    doc_ids = list(data.corpus.keys())
    tokenized_corpus = [text.lower().split() for text in data.corpus.values()]

    bm25 = BM25Okapi(tokenized_corpus)

    results = {}
    for query_id, query_text in data.queries.items():
        scores = bm25.get_scores(query_text.lower().split())
        top_indices = np.argsort(scores)[::-1][:top_k]
        results[query_id] = {doc_ids[idx]: float(scores[idx]) for idx in top_indices}

    return results
BM25 erreicht einen Recall@100 von 0,741 — 74 % der bewerteten relevanten Produkte tauchen irgendwo in den Top 100 auf. Ein Reranker, der nur diese BM25-Liste erhält, kann die fehlenden 26 % der bewerteten relevanten Artikel nicht zurückholen.
Dense-Bi-Encoder-Retrieval
Der Bi-Encoder bildet Queries und Dokumente unabhängig voneinander in einem gemeinsamen Embedding-Raum ab:
# Simplified from src/search_ranking_stack/stages/s02_dense.py

import numpy as np
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("sentence-transformers/all-MiniLM-L6-v2")
doc_texts = ["Sony WH-1000XM5 Wireless Headphones", "Headphone carrying case"]
query_texts = ["wireless headphones"]

# Encode corpus once, cache to disk
corpus_embeddings = model.encode(
    doc_texts,
    batch_size=128,
    normalize_embeddings=True,  # Cosine sim = dot product
    convert_to_numpy=True,
)

# At query time: encode query, compute dot product
query_embeddings = model.encode(query_texts, normalize_embeddings=True)
similarity_matrix = np.dot(query_embeddings, corpus_embeddings.T)
Mit normalisierten Embeddings reduziert sich die Kosinus-Ähnlichkeit auf ein Skalarprodukt. Die Demo berechnet die vollständige Matrix aus Queries und Korpus, weil 9.870 Dokumente bequem in den Speicher passen; ein Produktionskorpus würde normalerweise einen Approximate-Nearest-Neighbor-Index verwenden. In diesem Sample hebt all-MiniLM-L6-v2 den Recall@100 von 0,741 auf 0,825.
Wie Bi-Encoder gute Repräsentationen lernen
Encoder-Pretraining und Embedding-Fine-Tuning lösen unterschiedliche Probleme. Ein vortrainierter Transformer liefert Token-Repräsentationen; Contrastive Fine-Tuning bringt einem gepoolten Vektor bei, welche Texte nahe beieinander liegen sollen. NLI-, Satzähnlichkeits- und Query-Passage-Daten sind mögliche Zutaten, keine allgemeingültige Abfolge. Die Model Card von all-MiniLM-L6-v2 aus der Demo beschreibt einen vortrainierten MiniLM-Encoder, der auf mehr als einer Milliarde heterogener Satzpaare feinabgestimmt wurde.
Das Retrieval-Fine-Tuning kann Hard Negative Mining nutzen. Zufällige Negative, etwa ein Kochdokument zu einer Kopfhörer-Query, sind womöglich zu leicht, um viel zu vermitteln. Stattdessen kann ein Retriever plausible Kandidaten liefern, die laut Bewertung nicht relevant sind. Unbewertete Dokumente mit hohem Score erfordern Vorsicht: Manche davon könnten fehlende Positive sein.
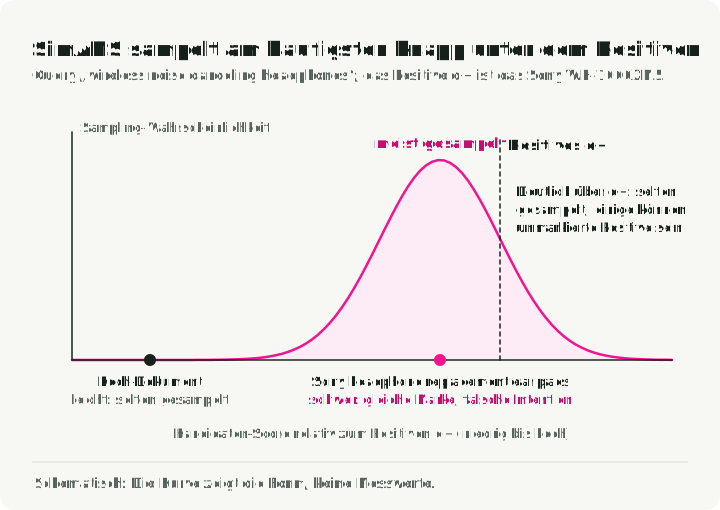
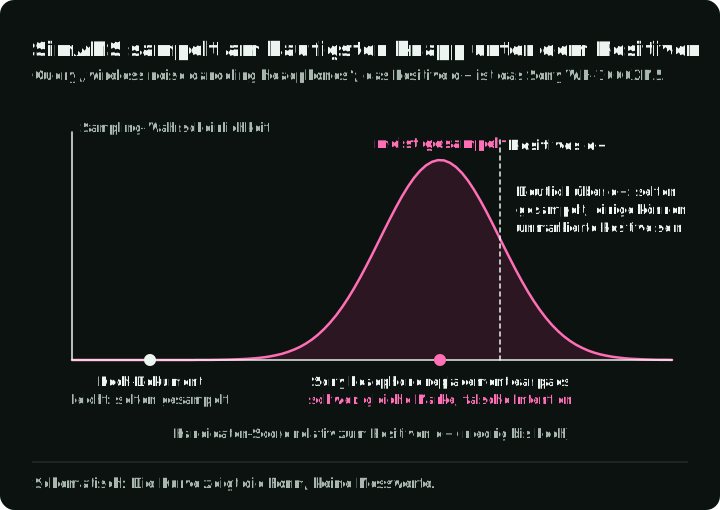
SimANS zieht Negative mit einer Wahrscheinlichkeitsverteilung, die sich um den Relevanz-Score des positiven Dokuments konzentriert. Sie verringert die Gewichtung sowohl leichter Negative als auch der Kandidaten mit dem höchsten Score, die falsche Negative sein können. Das ist verzerrtes Sampling aus abgerufenen Kandidaten, keine feste Regel, die jedes Dokument über oder unter einer Rangschwelle ausschließt. Die Kurve zeigt, wie oft ein abgerufener Kandidat gezogen wird, abhängig von seinem Score relativ zum Positiven:
# What a training triplet looks like after hard negative mining
training_triplet = {
    "query": "wireless noise canceling headphones",
    "positive": "Sony WH-1000XM5 Wireless Noise Cancelling Headphones",
    "negative": "Sony headphone replacement ear pads",  # Hard negative: same brand, related product, but wrong intent
}
# The bi-encoder must learn that "ear pads" is NOT what the user wants,
# even though it shares many tokens with the positive document.
Die Contrastive-Loss-Funktion (InfoNCE) verbindet das alles. Für jede Query mit positivem Dokument und einer Menge negativer Dokumente :
Dabei ist die Kosinus-Ähnlichkeit zwischen den Embeddings von Query und Dokument, und ist der Temperaturparameter (typisch 0,05—0,1). Kleinere Werte machen den Loss empfindlicher gegenüber Hard Negatives. Es ist eine Softmax-Cross-Entropy: Die Ähnlichkeit des positiven Paars wird relativ zu allen Negativen nach oben gedrückt. Ist klein, erzeugen schon geringe Unterschiede in der Ähnlichkeit große Gradienten, was das Modell zu feineren Unterscheidungen zwingt.
Bi-Encoder-Embeddings im großen Maßstab ausliefern
Der architektonische Vorteil eines Bi-Encoders ist die Offline-/Online-Trennung. Dokument-Embeddings werden beim Indexieren berechnet und in einem Vektorindex gespeichert. Zur Query-Zeit kodiert das System die Query und durchsucht diese gespeicherten Vektoren. Die Latency hängt von Encoder, Hardware, Index, Filtern und Recall-Ziel ab, also sollten Sie die beiden Schritte getrennt profilieren.
In der Demo ist der Aufwand gering: 9.870 Dokumente 384 Dimensionen 4 Bytes pro Float = ~15 MB an Embeddings. Im Produktionsmaßstab sind die Zahlen nicht mehr gering: 1 Milliarde Dokumente mit 768-dimensionalen Embeddings brauchen ~3 TiB Speicher. Hier kommen Quantization (Kompression von 32-Bit-Floats auf 8-Bit-Integer), Product Quantization (Zerlegung der Vektoren in Teilräume) und SSD-basierte Indizes wie DiskANN ins Spiel. Der Abschnitt zur Indexierung dichter Vektoren behandelt die Indexalgorithmen.
Warum Hybrid Retrieval testen
Die beiden Methoden scheitern oft unterschiedlich. BM25 eignet sich gut für Eigennamen, Produkt-SKUs und Fehlercodes. Dense Retrieval kann ein Vokabular-Mismatch wie „cheap laptop“ gegenüber „budget notebook computer“ auffangen. Ob Fusion hilft, hängt davon ab, wie oft diese komplementären Fälle in der Ziel-Query-Menge vorkommen.
Ein naheliegendes nächstes Experiment ist Hybrid Search: beide Retrieval-Methoden ausführen und ihre Ranglisten dann fusionieren.
Reciprocal Rank Fusion (RRF)
BM25 und Dense Retrieval erzeugen Scores mit unterschiedlicher Bedeutung und Skala. Eine Linearkombination braucht deshalb Kalibrierung und Validierung, sobald sich Retriever oder Korpus ändern.
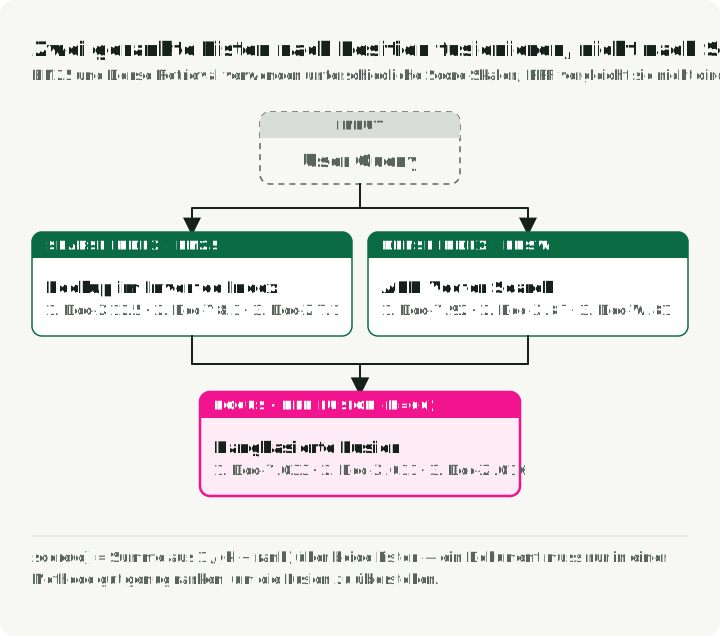
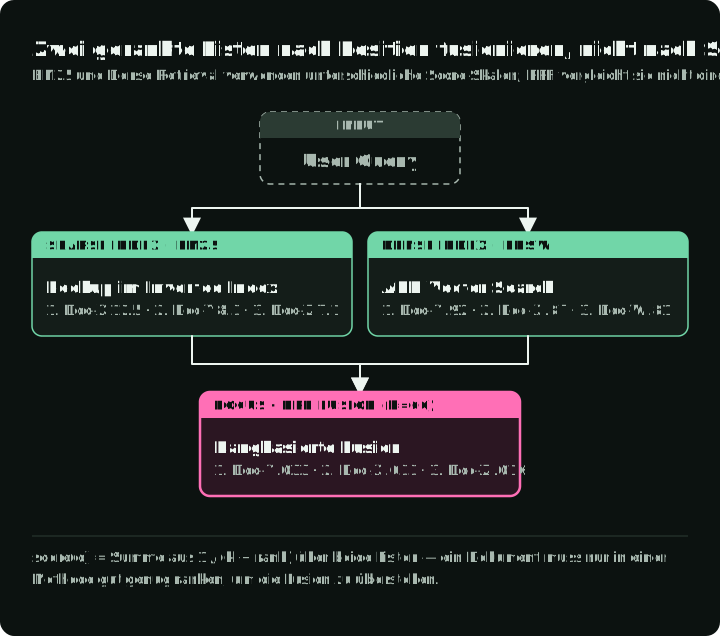
Reciprocal Rank Fusion (Cormack et al., 2009) verzichtet ganz auf Rohwerte und nutzt nur die Rangposition:
Hier ist eine Glättungskonstante; 60 ist ein üblicher Startwert. RRF belohnt Einträge, die in den Eingabelisten weit oben stehen, ohne deren Rohwerte zu vergleichen. Es erspart die Kalibrierung der Score-Skalen, aber Retrieval-Cutoffs, Gewichte und müssen weiterhin evaluiert werden.
Die Implementierung:
# src/search_ranking_stack/stages/s03_hybrid_rrf.py

from collections import defaultdict

def reciprocal_rank_fusion(ranked_lists, k=60, top_k=100):
    all_query_ids = set().union(*(results.keys() for results in ranked_lists))
    fused_results = {}

    for query_id in all_query_ids:
        rrf_scores = defaultdict(float)

        for results in ranked_lists:
            sorted_docs = sorted(results.get(query_id, {}).items(),
                                 key=lambda x: x[1], reverse=True)

            for rank, (doc_id, _score) in enumerate(sorted_docs, start=1):
                rrf_scores[doc_id] += 1.0 / (k + rank)

        sorted_rrf = sorted(rrf_scores.items(),
                            key=lambda x: x[1], reverse=True)[:top_k]
        fused_results[query_id] = dict(sorted_rrf)

    return fused_results
Hybrid RRF erreicht einen Recall@100 von 0,842 und einen NDCG@10 von 0,628 — und schlägt damit sowohl BM25 (0,585) als auch Dense (0,611) für sich genommen. Ein Dokument, das nur ein Retriever findet, erhält trotzdem einen RRF-Score, kann aber unter dem Top-100-Cutoff landen. Mit ergibt Rang 1 in einer Liste , weniger als Rang 50 in beiden Listen (). Überlappung kann also einen starken Rang in nur einer Liste überwiegen.
Cross-Encoder-Reranking
Mit 100 hybriden Kandidaten pro Query können Sie sich ein aufwendigeres Modell leisten. Der Cross-Encoder verarbeitet Query und Dokument gemeinsam in einem einzigen Transformer, mit Self-Attention über die kombinierte Eingabe aus Query und Dokument.
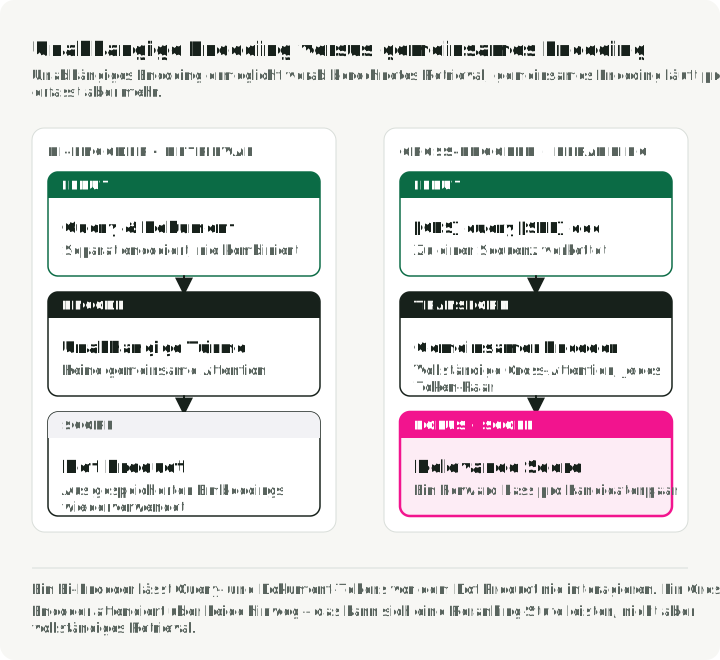
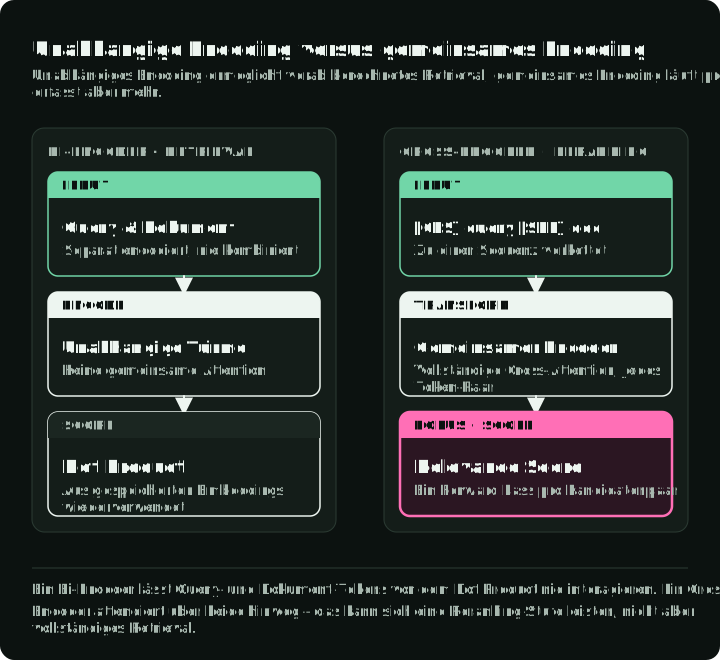
Interaktion auf Token-Ebene
Der Unterschied liegt in der Attention-Matrix. Bei einem Bi-Encoder ist die Attention blockdiagonal: Query-Tokens beachten nur andere Query-Tokens, Dokument-Tokens nur andere Dokument-Tokens. Die beiden Repräsentationen begegnen sich auf Token-Ebene nie — sie treffen sich erst am Ende über ein Skalarprodukt. Ein Cross-Encoder berechnet die vollständige Attention-Matrix, in der jedes Query-Token jedes Dokument-Token beachtet und umgekehrt. Diese gemeinsame Self-Attention lässt das Modell Query- und Dokument-Tokens direkt vergleichen.
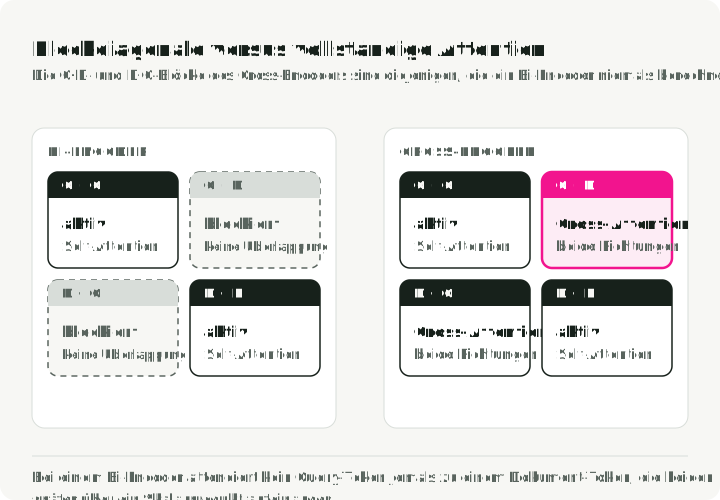
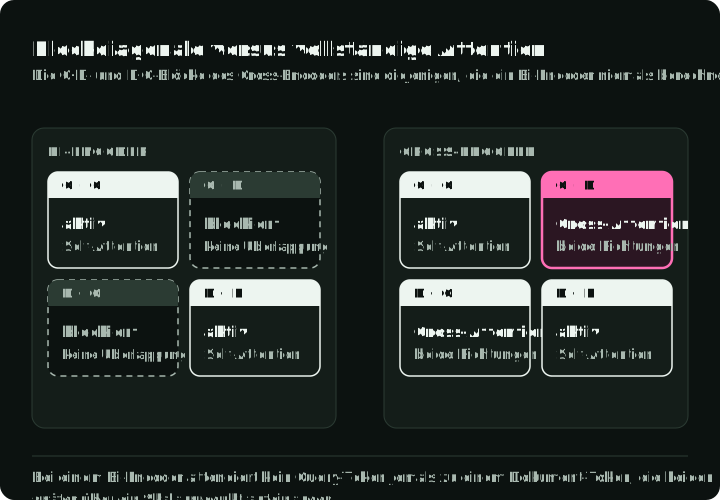
Bei einem Bi-Encoder wird die Query kodiert, bevor ein Dokument zu sehen ist. Ein Cross-Encoder sieht Query und Kandidat zusammen und kann daher deren Beziehung auf Token-Ebene nutzen. Das kann in Fällen wie diesen helfen:
- Negation: „headphones that are not wireless“. Ein gepooltes Embedding gewichtet die Negation womöglich zu schwach, während die gemeinsame Kodierung dem Modell eine direkte Interaktion zwischen Query und Dokument gibt. Das ist eine Hypothese, die Sie an einem gezielten Slice prüfen sollten, keine Garantie.
- Einschränkung: „laptop under $500“. Die gemeinsame Kodierung kann die Bedingung mit einem Preis im Produkttext in Beziehung setzen, doch strukturierte Preisfilter sind sicherer, wenn das Feld verfügbar ist.
Die Eingabe des Cross-Encoders hat das Format [CLS] query tokens [SEP] document tokens [SEP]. [CLS] ist ein Klassifikations-Token, dessen finaler Hidden State durch einen linearen Head geleitet wird und einen einzelnen Relevanz-Score erzeugt. Segment-Embeddings unterscheiden Query-Tokens von Dokument-Tokens, und [SEP] markiert die Grenze zwischen den Segmenten.
Wie Cross-Encoder trainiert werden
Cross-Encoder können aus Beispielen der Form (query, document, relevance_label) mit punktweisen, paarweisen oder listenweisen Zielfunktionen lernen. Ein punktweises Beispiel kombiniert „wireless headphones“ mit „Sony WH-1000XM5 Wireless Headphones“ und dem Label 1,0.
Ein üblicher Klassifikator bildet die finale [CLS]-Repräsentation auf einen Score ab. Binäre Labels können Binary Cross-Entropy nutzen; abgestufte Relevanz kann Regression, ordinale, paarweise oder listenweise Losses verwenden. Wählen Sie anhand von zurückgehaltenen Ranking-Metriken, statt anzunehmen, ein Ziel sei allgemein besser.
Hard Negative Mining hilft auch beim Training von Cross-Encodern. Cross-Encoder sind im Training teuer — jedes Trainingsbeispiel braucht einen vollständigen Forward Pass durch die verkettete Sequenz —, daher können Sie sich keine verschwendete Rechenzeit auf trivial leichte Negative leisten. Das praktische Rezept: Mit einem Bi-Encoder die Top-K-Kandidaten für jede Trainings-Query abrufen und die Hard Negatives dann aus bestimmten Rangbereichen ziehen (z. B. Ränge 10–100). So erhält der Cross-Encoder Beispiele, bei denen die Unterscheidung zwischen relevant und irrelevant tiefe Token-Interaktion erfordert.
Die abgerufenen Kandidaten neu ordnen
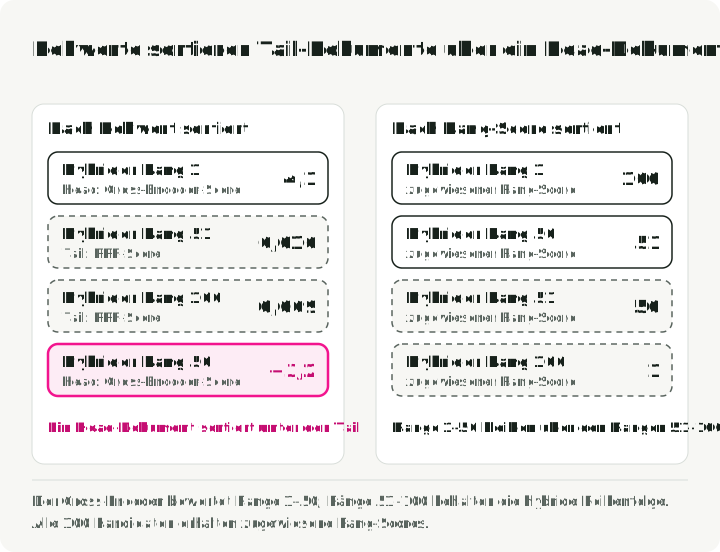
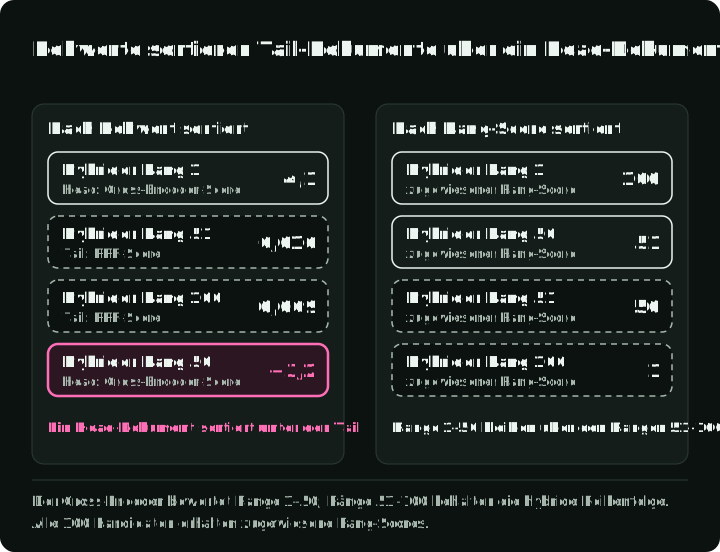
Die Stufe schickt (query, document)-Paare für die ersten 50 hybriden Kandidaten an CrossEncoder.predict, sortiert diese Kandidaten nach Score und hängt dann die unbewerteten Kandidaten in ihrer bisherigen Reihenfolge an. Die Abbildung sortiert vier der 100 Kandidaten auf beide Arten und zeigt, warum der Merge neue Rang-Scores vergibt, statt die Rohwerte zu behalten:
# From src/search_ranking_stack/stages/s04_cross_encoder.py

def rank_scores(ordered_ids):
    return {doc_id: float(len(ordered_ids) - rank) for rank, doc_id in enumerate(ordered_ids)}

def merge_head_and_tail(original, scored_head):
    """original: hybrid (doc_id, rrf_score) pairs in rank order.
    scored_head: (doc_id, cross_encoder_score) pairs for the first len(scored_head)."""
    head = sorted(scored_head, key=lambda item: (-item[1], item[0]))
    tail = original[len(scored_head) :]
    return rank_scores([doc_id for doc_id, _ in head + tail])
Die vollständige Stufe ergänzt das Laden des Modells, den Cutoff bei 2.048 Zeichen pro Dokument und eine Prüfung, dass jeder Score endlich ist.
Die Model Card zeigt, dass Cross-Encoder-Scores negativ sein können. Mischen Sie sie nicht mit den RRF-Scores des unbewerteten Tails: Ein positiver RRF-Score kann ein unbewertetes Tail-Dokument über ein negativ bewertetes Head-Dokument sortieren. Vergeben Sie strikt fallende Rang-Scores, wie es rank_scores tut. Das sind Rang-Scores für die Evaluation, keine kalibrierten Relevanzschätzungen.
Der Zielkonflikt zwischen Geschwindigkeit und Qualität
Warum nicht überall Cross-Encoder verwenden? Weil sich die Scores nicht vorberechnen lassen. Die Dokument-Embeddings eines Bi-Encoders sind unabhängig von der Query, Sie berechnen sie also einmal und speichern sie. Die Ausgabe eines Cross-Encoders hängt von Query und Dokument gemeinsam ab. Der Relevanz-Score für „wireless headphones“ zusammen mit einem Sony-Produkt entsteht aus der gemeinsamen Self-Attention zwischen genau diesen Tokens. Sie können ein wiederholtes Query-Dokument-Paar cachen, aber sein Score lässt sich für eine andere Query nicht wiederverwenden.
Ein Bi-Encoder braucht eine Query-Kodierung plus eine Vector Search über vorberechnete Dokument-Embeddings. Ein Cross-Encoder bewertet jedes Query-Dokument-Paar der Shortlist, mit Kosten, die sowohl mit der Kandidatenzahl als auch mit der Sequenzlänge wachsen. Batching hilft, aber 100.000 Kandidaten zu bewerten ist trotzdem der falsche Arbeitspunkt; rufen Sie zuerst ab und messen Sie die größte Shortlist, die Qualitäts- und Latency-Ziele erfüllt.
LLM-Listwise-Reranking
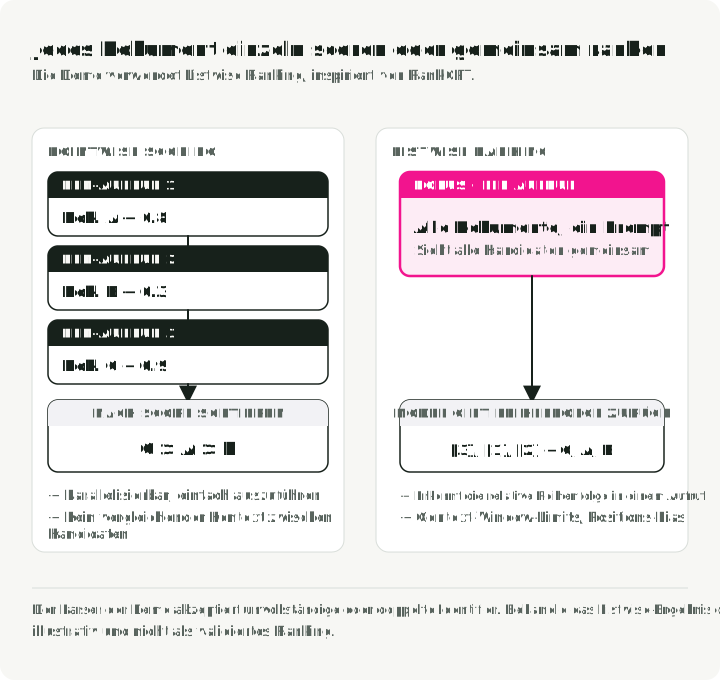
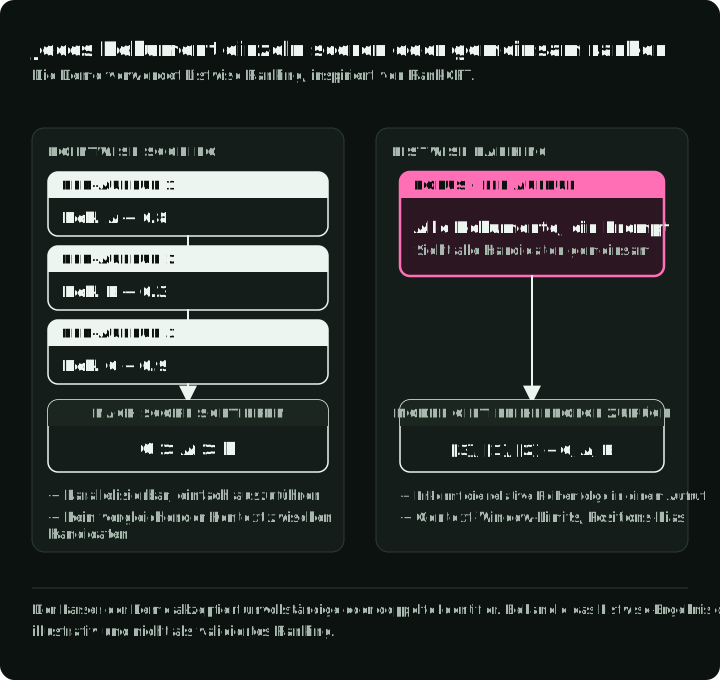
Die letzte Stufe der Demo nutzt ein LLM für listwise Reranking. Statt jedes Dokument unabhängig zu bewerten, sieht das Modell die Top 10 und gibt eine Reihenfolge zurück. Angelehnt an RankGPT macht der Prompt den relativen Vergleich explizit, bringt aber auch Grenzen des Context Windows, Positionsverzerrung, Parsing-Fehler und Varianz von Lauf zu Lauf mit sich.
Der Listwise-Prompt
Die Prompt-Vorlage bittet das LLM, die Relevanzhierarchie von ESCI zu berücksichtigen:
# src/search_ranking_stack/stages/s05_llm_rerank.py

def _create_listwise_prompt(query, documents, max_words=200):
    n = len(documents)

    doc_texts = []
    for i, (_doc_id, doc_text) in enumerate(documents, start=1):
        words = doc_text.split()[:max_words]
        doc_texts.append(f"[{i}] {' '.join(words)}")

    docs_formatted = "\n\n".join(doc_texts)

    return (
        f"I will provide you with {n} product listings, each indicated by a numerical "
        f"identifier [1] to [{n}]. Rank the products based on their relevance to the "
        f'search query: "{query}"\n\n'
        "Consider:\n"
        "- Exact matches (product satisfies all query requirements) should rank highest\n"
        "- Substitutes (functional alternatives) should rank above complements\n"
        "- Completely irrelevant products should rank lowest\n\n"
        f"{docs_formatted}\n\n"
        "Rank the products from most relevant to least relevant.\n"
        "Output ONLY a comma-separated list of product identifiers, e.g.: [3], [1], [2], ...\n"
        "Do not explain your reasoning. Only output the ranking."
    )
Drei Ausführungsmodi
Die Demo unterstützt drei Backends für das LLM-Reranking:
| Modus | Modell | Wie es läuft |
|---|---|---|
ollama | llama3.2:3b (mit OLLAMA_MODEL ändern) | Lokal über die Ollama-API |
api | Claude Haiku (LLM_MODEL_API in config.py setzen) | Anthropic API; zuerst uv sync --extra api |
local | Qwen/Qwen2.5-1.5B-Instruct | HuggingFace Transformers; zuerst uv sync --extra llm |
Parsing und Fallback
Der Parser extrahiert die nummerierten Bezeichner aus der Modellantwort. Er akzeptiert ein Ranking nur, wenn es jeden Kandidaten genau einmal aufführt:
# src/search_ranking_stack/stages/s05_llm_rerank.py

def _parse_ranking(output: str, n: int) -> list[int] | None:
    """Return 0-based positions if the output ranks IDs 1..n exactly once."""
    positions = [int(m) - 1 for m in re.findall(r"\[(\d+)\]", output)]

    # Reject missing, duplicate, and out-of-range IDs.
    if sorted(positions) != list(range(n)):
        return None

    return positions
Gibt der Parser None zurück, behält die Demo für diese Query die gesamte Reihenfolge des Cross-Encoders und zählt einen Fallback. Auch ein Backend-Fehler zählt als Fallback. run-all gibt die Fallback-Rate aus und speichert sie neben den Metriken. Zum Beispiel wird [3] > [1] > [3] abgelehnt: ID 3 kommt doppelt vor, und die IDs 2 und 4 bis 10 fehlen.
Ergebnisse aus diesem ESCI-Sample
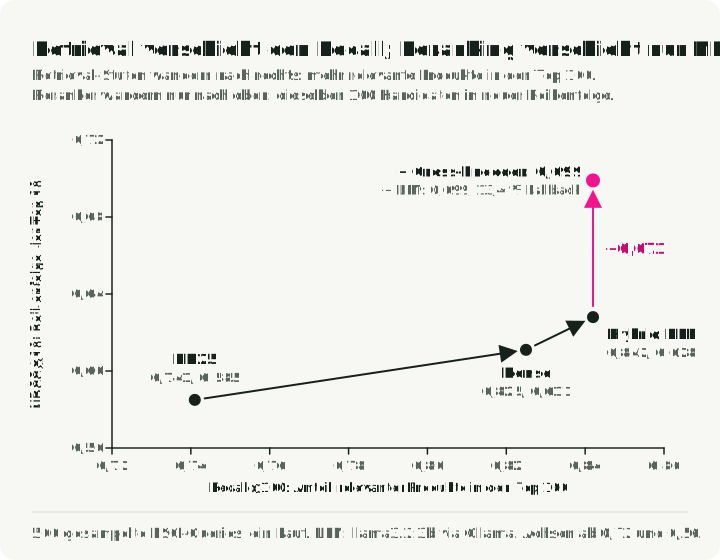
Die Ergebnisse nutzen das oben beschriebene Sample small_version; es ist nicht zurückgehalten. Die Zeilen stammen aus einem Lauf von uv run run-all --llm-mode ollama mit llama3.2:3b als LLM.
| Stufe | NDCG@10 | MRR | Recall@100 | NDCG-Delta |
|---|---|---|---|---|
| BM25 | 0,585 | 0,812 | 0,741 | — |
| Dense Bi-Encoder | 0,611 | 0,808 | 0,825 | +0,026 |
| Hybrid (RRF) | 0,628 | 0,834 | 0,842 | +0,017 |
| + Cross-Encoder | 0,699 | 0,886 | 0,842 | +0,071 |
| + LLM-Reranker (13,4 % Fallback) | 0,699 | 0,884 | 0,842 | +0,000 |
Das Diagramm trägt für jede Zeile Recall@100 gegen NDCG@10 auf:
Was die aufgezeichneten Ergebnisse stützen
Hybrid Search schlägt jede der beiden Methoden allein. Hybrid RRF erreicht NDCG@10 0,628, über BM25 (0,585) und Dense (0,611). Es hat außerdem den höchsten Recall@100 der drei Retrieval-Zeilen (0,842). Die beiden Methoden können bei unterschiedlichen Queries scheitern, und die Fusion holt Dokumente zurück, die jede für sich verfehlt.
Der Cross-Encoder bringt den größten Gewinn. Er hebt NDCG@10 von 0,628 auf 0,699 und MRR von 0,834 auf 0,886, obwohl er nur 50 Kandidaten pro Query bewertet. In den Top 10 steigt der Anteil der Exact-Produkte von 36,0 % (hybrid) auf 41,4 %.
In dieser Demo wird der Recall beim Retrieval festgelegt. Beide Reranker behalten alle 100 hybriden Kandidaten, daher bleibt Recall@100 bei 0,842. Um ihn zu erhöhen, ändern Sie, welche 100 Kandidaten das Retrieval zurückgibt.
Ein kleines lokales LLM bringt in diesem Sample nichts. llama3.2:3b lässt NDCG@10 bei 0,699 und senkt den MRR leicht. 67 von 500 Antworten (13,4 %) scheiterten am Parser und behielten die Reihenfolge des Cross-Encoders, sodass die LLM-Reihenfolge bei 433 Queries angewendet wurde. Ein größeres Modell oder der API-Modus verhält sich womöglich anders; messen Sie es genauso, mit der Fallback-Rate neben dem Score.
Dense Retrieval schlägt BM25 in diesem Sample. Prüfen Sie Query-Slices, bevor Sie eine Ursache zuweisen. Vokabular-Mismatch ist ein plausibler Treiber, aber auch die Konstruktion des Samples, der Tokenizer, die Trainingsdomäne des Modells und die Korpusfelder beeinflussen den Vergleich.
Dichte Vektoren indexieren jenseits der Demo
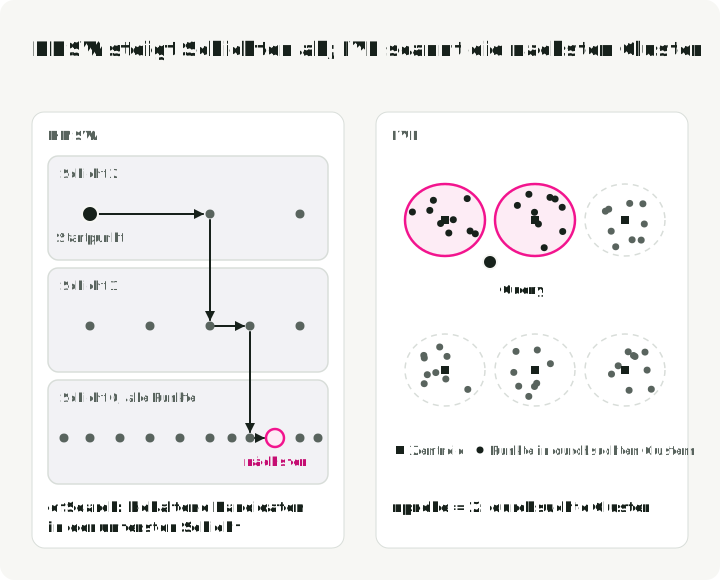
Dichte Embeddings werden im großen Maßstab erst mit einem Approximate-Nearest-Neighbor-Index (ANN) nützlich. Die Demo nutzt Brute-Force-Kosinus-Ähnlichkeit (bei 9.870 Dokumenten völlig in Ordnung), aber Produktionssysteme brauchen spezialisierte Indizes. Die beiden verbreiteten Familien suchen auf unterschiedliche Weise, und jede hat eine Einstellung zur Suchzeit, die Recall gegen Query-Aufwand tauscht. Die Abbildung zeigt den Pfad, dem HNSW folgt, und die Cluster, die IVF durchsucht:
HNSW (Hierarchical Navigable Small World)
HNSW baut einen mehrschichtigen Graphen: Dünne obere Schichten navigieren grob, dichtere untere Schichten verfeinern die Nachbarschaft. M steuert die Konnektivität des Graphen, während efSearch Query-Aufwand gegen Recall tauscht. Brauchbare Werte hängen von Dimension, Distanzverteilung, Filtern, Implementierung und Ziel-Recall ab.
Graphindizes können bei vielen Updates oder restriktiven Filtern an Recall verlieren; ein Qdrant-Issue zeigt, dass sich der gefilterte Recall erst nach einem Neuaufbau erholt. Testen Sie Ihr Update- und Filtermuster, einschließlich der Dauer des Neuaufbaus.
IVF (Inverted File)
IVF-Indizes teilen den Vektorraum in Cluster auf und durchsuchen dann die nprobe Cluster, die der Query am nächsten liegen. Sie können einen brauchbaren Kompromiss aus Speicher, Build-Zeit und Recall bieten, besonders in Kombination mit Kompression. Update-Semantik und Performance hängen von der Implementierung ab, nicht allein von der Indexfamilie.
RaBitQ (Gao & Long, SIGMOD 2024) ist ein randomisierter Quantizer, der sich mit IVF kombinieren lässt. Er normalisiert zentrierte Vektoren, nutzt eine zufällige orthogonale Rotation und kodiert Vorzeichen mit einem Bit pro Dimension. Die Distanzschätzung nutzt außerdem Korrekturfaktoren und Vektornormen; die Fehlerschranken des Papers gelten für diesen Schätzer und seine Annahmen. Setzen Sie ihn ein, wenn der Speicher die Grenze ist und die quantisierten Distanzschätzungen Ihr Recall-Ziel weiterhin erfüllen.
| Dimension | HNSW-Graph | IVF-Cluster |
|---|---|---|
| Query-Steuerung | efSearch | nprobe |
| Build-Steuerung | Konnektivität und Beam beim Aufbau | Clusteranzahl und Trainingssample |
| Speicherprofil | Graphkanten plus Vektoren | Zentroiden, Listen und gespeicherte Vektoren |
| Update-Verhalten | Datenbankspezifische Reparatur/Bereinigung | Datenbankspezifische Listenpflege |
| Üblich gewählt, wenn | Vektoren in den RAM passen und Sie niedrige Latency bei hohem Recall brauchen | Speicher oder Korpusgröße die Grenze ist; mit PQ oder RaBitQ kombinieren |
Messen Sie für beide Indizes die Kurve aus Recall, Latency und Speicher mit Ihren eigenen Daten und Ihrer Query-Last.
Uber senkte Latency und CPU, indem es die Kandidatenzahl pro Shard bei geringem Recall-Verlust verringerte; stimmen Sie diese Zahl mit produktionsnahem Traffic ab.
Optionale Erweiterungen nach der Kern-Pipeline
Sobald Retrieval und Reranking getrennt gemessen werden, lassen sich mehrere Erweiterungen leichter bewerten, ohne die Kern-Pipeline zu verdecken.
Query-Verständnis
Query-Expansion und -Umformulierung können ein Vokabular-Mismatch vor dem Retrieval beheben. Query2doc erzeugte Pseudodokumente und berichtete BM25-Gewinne in seinen MS-MARCO-Experimenten. Expansion kann auch die falsche Absicht einführen, vergleichen Sie also Recall und Präzision auf mehrdeutigen, navigationalen und Exact-Identifier-Query-Slices.
Praktische Muster: Expansion von Abkürzungen, Anreicherung um Entitäten, Zerlegung in Teil-Queries für Multi-Hop-Reasoning und RAG-Fusion — mehrere Query-Varianten erzeugen und die Ergebnisse per RRF kombinieren.
LLM-gestütztes Relevanz-Labeling
LLMs können Relevanzlabels entwerfen, wenn menschliche Bewertungen knapp sind. Die Arbeit von Pinterest zum Relevanz-Labeling beschreibt, wie Trainingsdaten über menschliche Labels hinaus erweitert und ein LLM-basiertes Relevanzmodell für das Serving destilliert werden. Ein LLM-Label ist weiterhin Modellausgabe: Kalibrieren Sie es an verblindeten menschlichen Bewertungen, untersuchen Sie Slices mit Abweichungen und halten Sie ein menschliches Gold-Set für Regressionstests bereit.
Nützliche Kontrollen sind:
- eine Rubrik mit konkreten Relevanzgrenzen und Beispielen;
- verblindete menschliche Kalibrierung und regelmäßige Nachprüfungen;
- zufällige Reihenfolge und wiederholte Bewertungen für instabile Fälle;
- Modell-Panels, wenn ihre Zusatzkosten die Übereinstimmung verbessern; und
- explizite Prüfungen auf Positions- und Tendenz-zur-Mitte-Verzerrung.
Knowledge Distillation
Wenn ein LLM-Teacher Mehrwert bringt, aber die Serving-Vorgaben nicht erfüllt, ist Distillation eine Option:
- Ein leistungsstarkes LLM (der Teacher) ordnet Tausende Trainings-Queries offline neu; nur der kleine Student läuft pro Request.
- Ein kleiner, schneller Cross-Encoder (der Student, ~100M–200M Parameter) wird trainiert, die Ranking-Verteilung des LLM nachzuahmen.
- Vergleichen Sie den Student mit Teacher und Baseline bei Qualität, Kalibrierung und Serving-Kosten.
InRanker destilliert MonoT5-3B in Modelle mit 60M und 220M Parametern, also 50-mal beziehungsweise etwa 13-mal kleiner, mit besserer Out-of-Domain-Wirksamkeit als ihre nicht destillierten Gegenstücke. Der Ansatz Rank-Without-GPT erzeugt quelloffene Listwise-Reranker mit 7B Parametern, die per QLoRA-Fine-Tuning 97 % der Wirksamkeit des verglichenen GPT-4-Rerankers erreichen, gemessen an nDCG@10 auf TREC-DL-19 und TREC-DL-20.
Veröffentlichte Kompressionsergebnisse sind Ausgangspunkte, keine erwarteten Produktionsverhältnisse. Distillation kann die Verzerrungen des Teachers erben und bei seltenen Query-Slices an Qualität verlieren, behalten Sie also die ursprünglichen Relevanzbewertungen in der Evaluationsschleife.
Personalisierung und Positionsverzerrung
Eine Suche nach „apple“ sollte für einen Technikbegeisterten iPhones liefern und für jemanden, der zuvor Kochinhalte angesehen hat, Apfelrezepte.
Eine verbreitete Retrieval-Architektur für Personalisierung nutzt ein Two-Tower-Embedding-Modell: Der Query-Tower kodiert die Query und den Nutzerkontext, der Item-Tower kodiert Artikel und Metadaten. Die Abbildung zeigt, welche Seite pro Request läuft, welche offline berechnet wird und wo die Query „apple“ für zwei Nutzer landet:
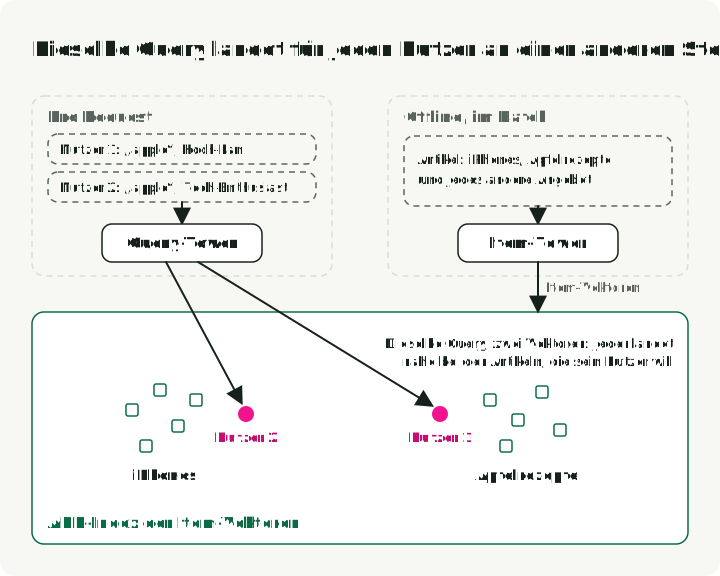
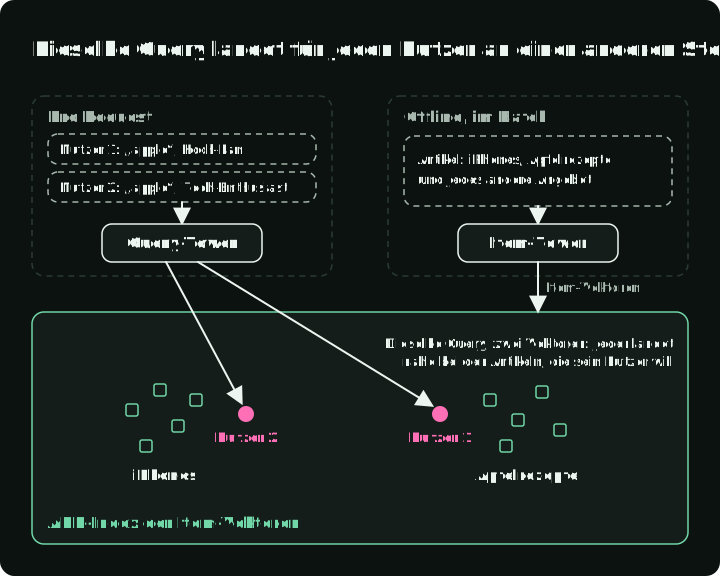
Die Offline-/Online-Trennung ermöglicht Approximate-Nearest-Neighbor-Retrieval; die Latency hängt dennoch von Encoder, Index, Filtern und Serving-System ab. Drei Produktionsdesigns setzen gelernte Embeddings an unterschiedlichen Stellen ein. Airbnb lernt Listing-Embeddings aus den Klick-Sessions der Nutzer und verwendet die Ähnlichkeit zu zuletzt angeklickten Listings als Features für das Search Ranking. Pinterests OmniSearchSage lernt ein Query-Embedding gemeinsam mit Pin- und Produkt-Embeddings. Uber nutzt ein Two-Tower-Modell, um einige hundert Restaurants für den Uber-Eats-Startfeed abzurufen.
Klickdaten tragen Positions- und Exposure-Verzerrung in sich. PAL ist ein Ansatz zur Entzerrung: ein Exposure-Modul und ein Modul für Klick-bei-Exposure gemeinsam trainieren und dann das letztere ohne Positionseingabe ausliefern. Es ist keine Universallösung; randomisierte Interventionen, Inverse-Propensity-Methoden und kontrafaktische Evaluation passen für ein anderes Produkt möglicherweise besser.
Domänenanpassung mit synthetischen Queries
Ein verbreiteter Fehler bei der Suchstrategie ist die Annahme, ein auf allgemeinen Webdaten trainiertes Modell (wie MS MARCO) funktioniere in einer spezialisierten Domäne gut. Das ist das Out-of-Domain-Problem (OOD).
Die Generierung synthetischer Queries kann den Engpass bei gelabelten Daten verringern. InPars erzeugt Queries für Dokumente und filtert Paare für das Training. Generative Pseudo-Labeling (GPL) ergänzt einen Teacher-Labeling-Schritt:
- Queries aus dem Zielkorpus erzeugen.
- Für jede erzeugte Query negative Dokumente abrufen.
- Mit einem Cross-Encoder-Teacher positive und negative Paare bewerten und so eine Relevanz-Score-Marge erzeugen.
- Den Dense Retriever trainieren, diese Margen nachzubilden.
Synthetische Paare können helfen, wenn echte Queries knapp sind, spiegeln aber den Generator und den Prompt wider. Entfernen Sie Duplikate, filtern Sie unplausible Queries und validieren Sie mit echtem, zurückgehaltenem Traffic.
Eine Experimentfolge
Fügen Sie Komplexität nur hinzu, wenn die vorherige Stufe einen gemessenen Fehler offenlegt. Jeder Schritt benennt den Fehler, der ihn rechtfertigt:
- Eine Baseline etablieren. Führen Sie BM25 oder das aktuelle lexikalische System gegen eine bewertete Query-Menge aus. Erfassen Sie Recall, NDCG, Latency und die Query-Gruppen, in denen es scheitert.
- Fehlende Kandidaten zurückholen. Testen Sie Dense Retrieval und Fusion, wenn die Baseline relevante Dokumente verfehlt. Stimmen Sie den Kandidaten-Cutoff auf Recall und Kosten ab.
- Die Reihenfolge verbessern. Fügen Sie einen Cross-Encoder hinzu, wenn relevante Kandidaten vorhanden, aber zu niedrig eingeordnet sind. Wählen Sie die Größe seiner Shortlist, indem Sie Qualität und Latency bei mehreren Cutoffs messen. In der Demo hob dieser Schritt NDCG@10 von 0,628 auf 0,699.
- An die Domäne anpassen. Führen Sie Fine-Tuning oder Distillation durch, nachdem generische Modelle stabile domänenspezifische Fehler zeigen. Halten Sie echte zurückgehaltene Bewertungen getrennt von synthetischen Trainingsdaten.
- Teures Reranking testen. Probieren Sie Listwise- oder Reasoning-basiertes Reranking erst, wenn der zusätzliche Qualitätsgewinn wiederholte Läufe übersteht und seine Latency, Kosten, Datenschutzanforderungen und Fallback-Komplexität rechtfertigt. In der Demo hat
llama3.2:3bdiesen Test nicht bestanden.
Der Start-Stack und die zu sammelnden Bewertungen hängen vom Produkt ab:
| Anwendungsfall | Möglicher Start-Stack | Zu validieren |
|---|---|---|
| Produktsuche | BM25 + Dense Retrieval + RRF + Cross-Encoder | Attribut-Recall, Substitute, Latency, Geschäftsvorgaben |
| Dokumentationssuche | Hybrides Retrieval + Cross-Encoder | Exakte Bezeichner, semantische Fragen, Versionsfilter |
| Support-Deflection | Hybrides Retrieval + Zitatprüfungen | Retrieval-Recall, Grounding, Enthaltung |
| Marktplatz oder Listings | Lexikalische Filter + Dense Retrieval + Business-Reranker | Verfügbarkeit, Aktualität, Richtlinien, Verkäufervielfalt |
| Kleiner interner Korpus | BM25-Baseline, dann ein Reranker | Ob ein Vokabular-Mismatch einen Dense-Index rechtfertigt |
| Juristische oder medizinische Suche mit hohem Risiko | Recall-orientiertes Retrieval plus Expertenprüfung | Abdeckung, Herkunftsnachweis, kalibrierte Enthaltung |
Halten Sie bei jedem Vergleich eine echte zurückgehaltene Bewertungsmenge getrennt von den Trainingsdaten. Erfassen Sie Rankings pro Query, Fehler, Latency und Kosten, damit sich ein aggregierter Gewinn auf die geänderte Stufe zurückführen lässt. Teure Schichten brauchen außerdem explizite Richtlinien für Datenschutz und Fallback.
Forschungsrichtungen, die gesondert zu bewerten sind
Reasoning-Reranker und Agenten mit Suchzugriff sind vielversprechend, beantworten aber andere Fragen als die Produktsuch-Demo mit fünf Stufen.
Reasoning-basierte Reranker
Rank1 trainiert Reranker mit Reasoning Traces und berichtet starke Ergebnisse auf dem BRIGHT-Benchmark. Diese Evidenz betrifft Retrieval mit hohem Reasoning-Anteil, nicht eine direkte Vorhersage für die ESCI-Produktsuche.
Vergleichen Sie bei juristischer oder wissenschaftlicher Suche Reasoning-Reranker mit starken Cross-Encoder- und Listwise-Baselines anhand von Expertenbewertungen, Zitaten, Latency und Konsistenz der Fehler.
Agentic Search
Search-o1 untersucht ein Modell, das bei Multi-Hop-Fragebeantwortung zusätzliche Suchen auslöst. Das ist ein Orchestration-Problem — Query-Erzeugung, Abbruch, Nutzung der Evidenz und Bewertung der Antwort —, keine weitere Reranking-Stufe. Bewerten Sie es nach Korrektheit der Endaufgabe und Zitatbelegen, nicht nur nach Retrieval-Metriken.
Referenzen
Papers
- Reciprocal Rank Fusion — Cormack et al., 2009
- RankGPT: LLMs as Zero-Shot Listwise Rerankers — Sun et al., EMNLP 2023 Outstanding Paper
- Rank1: Reasoning-Based Reranking — Weller et al., COLM 2025
- Query2doc: LLM Query Expansion — Wang et al., EMNLP 2023
- GPL: Generative Pseudo Labeling — Domänenanpassung für Dense Retrieval
- InRanker: Distilled Reranker — 50-fache Größenreduktion bei konkurrenzfähiger Leistung
- Search-o1: Agentic Retrieval — Li et al., 2025
- BEIR Benchmark — Thakur et al., NeurIPS 2021
- Sentence-BERT — Reimers & Gurevych, EMNLP 2019
- InfoNCE / CPC — van den Oord et al., 2018
- SimANS: Hard Negative Sampling — Zhou et al., EMNLP 2022
- Passage Reranking with BERT — Nogueira & Cho, 2019
- HNSW — Malkov & Yashunin, 2016
- DiskANN — Subramanya et al., NeurIPS 2019
- RaBitQ — Gao & Long, SIGMOD 2024
- Replacing Judges with Juries — Verga et al., 2024
- RAG-Fusion — Rackauckas, 2024
- InPars — Bonifacio et al., SIGIR 2022
- BRIGHT Benchmark — Su et al., ICLR 2025
- Rank-without-GPT — Zhang et al., ECIR 2025
- Pinterest LLM Search Relevance — Wang et al., 2024
- OmniSearchSage — Agarwal et al., WWW 2024
- PAL: Position-bias Aware Learning — Guo et al., RecSys 2019
Datensätze und Benchmarks
- Amazon ESCI: Shopping Queries Dataset — KDD Cup 2022
- BEIR: Benchmarking IR — Heterogener Benchmark für Zero-Shot-Evaluation
- MTEB: Massive Text Embedding Benchmark — Leaderboard für Embedding Models
- ESCI Paper — Reddy et al., 2022
In der Demo verwendete Modelle
- all-MiniLM-L6-v2 — Bi-Encoder mit 22M Parametern
- ms-marco-MiniLM-L12-v2 — Cross-Encoder mit 33M Parametern
- Sentence-Transformers — Framework für neuronale Retrieval-Modelle
Tools und Plattformen
- rank_bm25 — BM25-Implementierung in Python
- Pyserini BEIR Reproductions — Lucene-BM25-Baselines für BEIR
- pytrec_eval — Toolkit für TREC-Evaluation
- Elasticsearch — Hybrid Search mit der Retrievers API
- Vespa — Einheitliche Such- und Empfehlungs-Engine
- Weaviate — Vector Database mit Hybrid Search
- Qdrant — Vector Database mit mehrstufigen Queries
Branchenreferenzen
- Airbnb Listing Embeddings — Grbovic & Cheng, KDD 2018
- Uber Delivery Search — Uber Engineering, 2025
- Uber Two-Tower Embeddings — Uber Engineering, 2023
- Elastic Rerank — Elastic, 2024
Demo-Projekt
- search-ranking-stack — Funktionierende Demo der Pipeline in diesem Beitrag