Стек ранжирования поиска: BM25, эмбеддинги и реранкинг

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Это руководство для Python-инженеров, которые строят или улучшают пайплайн ранжирования поиска. Оно объясняет, как BM25, плотные эмбеддинги, слияние рангов и реранкеры работают вместе и как измерить, нужны ли поиску лучшие кандидаты или лучший порядок.
Поиск по запросу «дешёвый ноутбук» может не найти товар, описанный как «бюджетный портативный компьютер». Другой сбой ставит чехол для наушников выше самих наушников. Первой проблеме нужны лучшие кандидаты, второй — лучший порядок.
Репозиторий с демо показывает retrieval и реранкинг на выборке из данных товарного поиска Amazon ESCI.
Краткое руководство по выбору этапа см. в статье BM25 vs Embeddings vs Rerankers. Последовательность экспериментов в конце этой статьи связывает каждый этап с измерением.
Лексические модели, плотный поиск и cross-encoder
Стек проще понять как три слоя. Лексический retrieval находит точные термины, плотный retrieval устраняет несовпадение словаря, а реранкеры детально сравнивают самых сильных кандидатов.
BM25 и лексический retrieval
Десятилетиями BM25 был стандартом по умолчанию. Это вероятностная модель, которая оценивает документы по частоте терминов запроса в документе, нормализованной на длину документа и обратную частоту документов (IDF).
BM25 силён там, где намерение выражают буквальные термины: коды ошибок, артикулы товаров, имена и идентификаторы API. Его главное ограничение — несовпадение словаря. Запрос «cheap laptop» может пропустить документ про «budget notebook computer», если в проиндексированном тексте нет связи между этими выражениями.
При этом исследование BEIR показало, что BM25 — сильный zero-shot-бейзлайн на разнородных задачах retrieval. Цифры BM25 в BEIR получены на Lucene через Pyserini, а не на rank_bm25 с токенизацией по пробелам, как в этом демо. BM25 также обгоняет некоторые нейросетевые модели в задачах поиска аргументов, например в Touche-2020.
Плотный retrieval и эмбеддинги
Энкодеры в стиле BERT сделали плотный retrieval практичным. Они переводят запросы и документы в общее векторное пространство, а затем ранжируют кандидатов функцией сходства, например косинусным сходством или скалярным произведением.
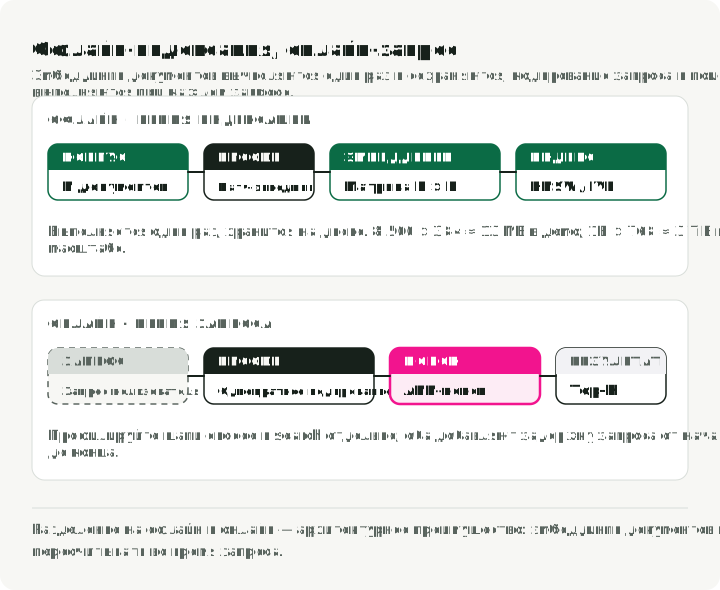
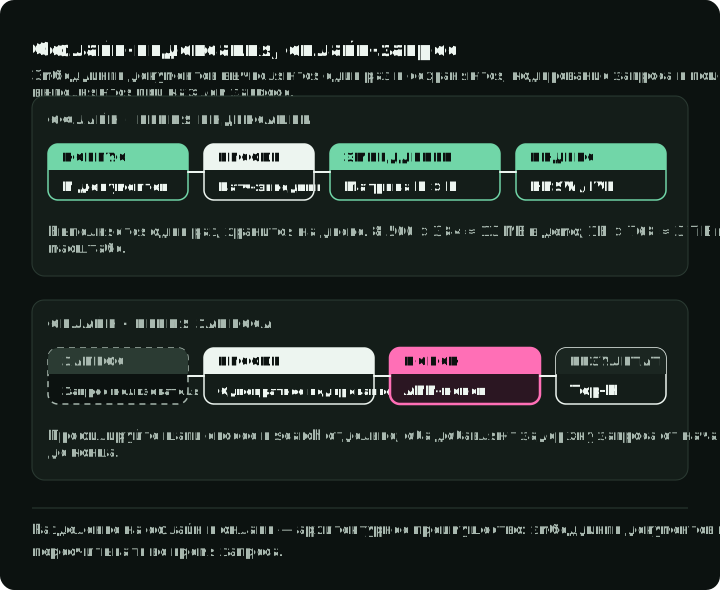
Архитектура bi-encoder (или «two-tower») кодирует запрос и документ отдельно и выдаёт эмбеддинги фиксированной длины. Векторы документов можно посчитать заранее и проиндексировать офлайн, а затем быстро находить алгоритмами приближённого поиска ближайших соседей (ANN). Теперь «cheap laptop» и «budget notebook» оказываются рядом в векторном пространстве.
Некоторые bi-encoder используют сиамскую архитектуру, как в Sentence-BERT: обе стороны делят веса. Другие используют отдельные башни для запроса и документа. Пулинг, размер вектора, функция сходства и обучающая цель — это выбор конкретной модели, а не свойство любого dense-ретривера.
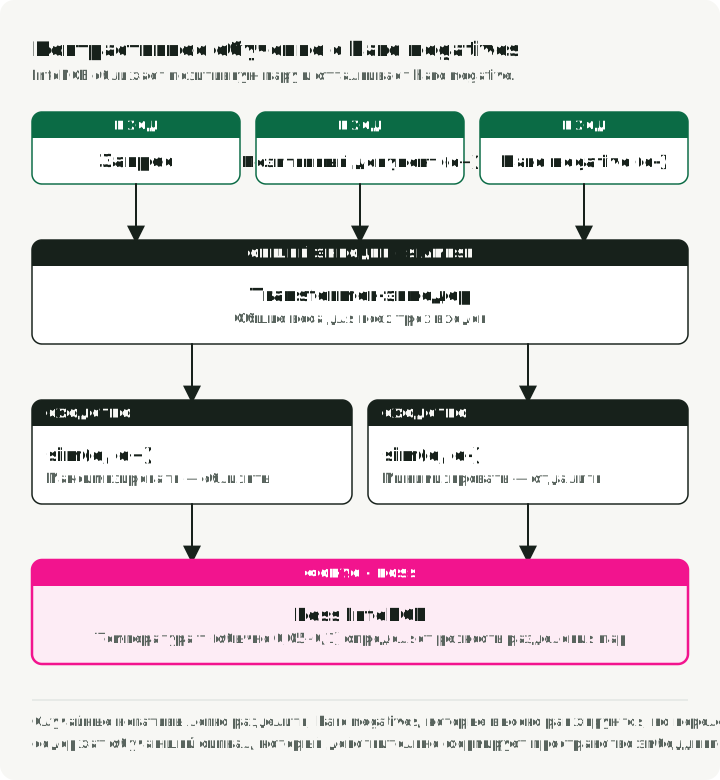
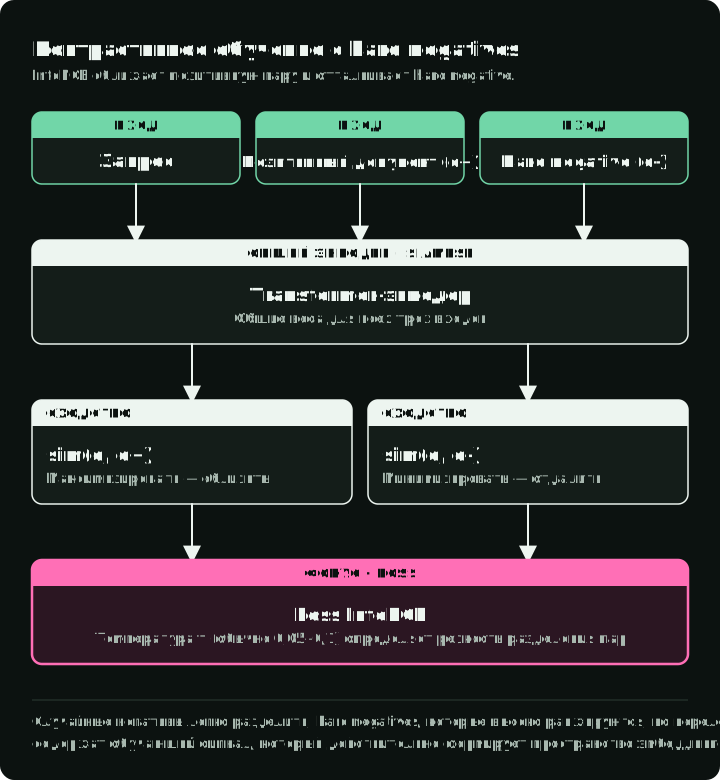
Такие модели обучаются с помощью контрастивного обучения, обычно с функцией потерь InfoNCE. Для батча пар (query, positive_document) цель — максимизировать sim(query, positive_doc) и минимизировать sim(query, negative_docs). Негативы берутся из позитивов других запросов в том же батче (in-batch negatives). Параметр температуры задаёт, насколько резко модель должна разделять эти два случая.
Обучающие данные часто важнее размерности эмбеддинга. Модели retrieval учатся на парах «запрос — позитив» и тщательно подобранных hard negatives: правдоподобных, но нерелевантных документах. Далее в разделе об обучении показано, как SimANS избегает и тривиальных негативов, и вероятных ложных негативов.
Цена — боттлнек представления. Bi-encoder сжимают все семантические нюансы в один вектор фиксированного размера, поэтому часто упускают тонкие взаимодействия между конкретными терминами запроса и конкретным содержимым документа.
Cross-encoder и LLM
Cross-encoder (Nogueira & Cho, 2019) подают запрос и документ в Transformer вместе, как одну конкатенированную последовательность ([CLS] Query [SEP] Document), поэтому каждый токен запроса может обращаться к каждому токену документа через полный self-attention. Такое глубокое взаимодействие улавливает нюансы, которые теряются при независимом кодировании.
LLM-реранкинг использует модель с промптом, чтобы сравнить сразу несколько кандидатов. RankGPT показал сильные zero-shot listwise-результаты с GPT-4 на оценённых бенчмарках, но стабильность вывода, стоимость и пригодность для вашего домена всё равно нужно проверять отдельно.
Эти оценки нельзя заранее посчитать для произвольных запросов, поэтому реранкинг ставят после retrieval. Эта асимметрия стоимости и задаёт многоэтапную воронку.
Многоэтапная воронка
Запускать дорогой cross-encoder или LLM на миллионах документов непрактично, поэтому современные поисковые стеки используют воронку. Retrieval и пре-ранжирование сокращают набор кандидатов, чтобы полное ранжирование могло применять более дорогие модели к шортлисту. Затем блендинг применяет правила или политику ранжирования; его стоимость зависит от этой политики.
У дешёвого ретривера также не хватает финальной точности, поэтому воронка применяет каждую модель только там, где её стоимость оправдана. Рисунок показывает входной объём каждого этапа и схематическую стоимость моделей. Он также отмечает, что следующие этапы не могут вернуть пропущенные документы:
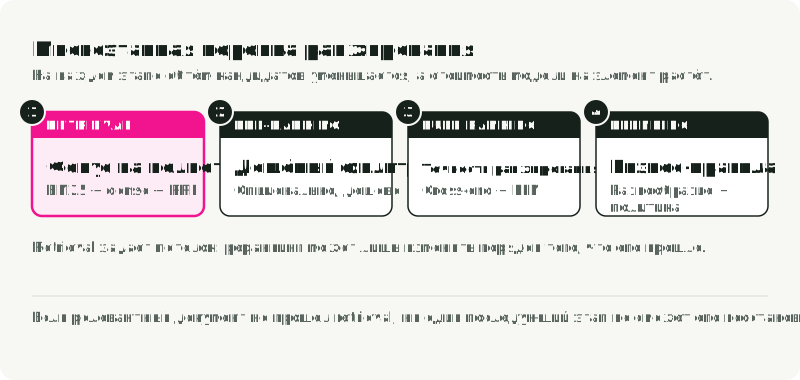
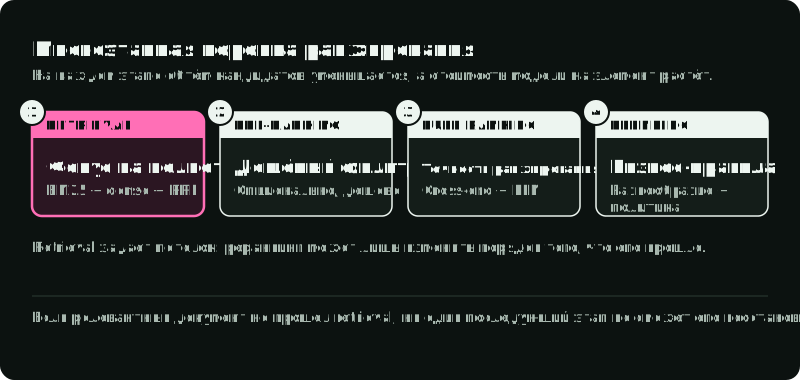
| Этап | Масштаб входа | Основная цель | Типичные методы | Измерение на выходе |
|---|---|---|---|---|
| Retrieval | Корпус или индекс | Полнота кандидатов | BM25, bi-encoder | Recall на границе набора кандидатов |
| Пре-ранжирование | Большой набор кандидатов | Дешёвая фильтрация | Лёгкие модели, правила | Сохранённый recall на миллисекунду |
| Полное ранжирование | Шортлист | Качество верха выдачи | Cross-encoder, LLM | NDCG/MRR, латентность, стоимость |
| Блендинг | Итоговые ранжированные списки или слоты | Ограничения и смесь | Правила, многоцелевое ранжирование | Политики, разнообразие, бизнес-гардрейлы |
Реранкер меняет порядок кандидатов, которых вернул retrieval; добавить нового он не может. Поэтому покрытие найденных кандидатов ограничивает то, что следующие этапы могут вернуть. Если кандидатов больше 100, реранкинг может переместить релевантный документ в топ-100 и улучшить Recall@100. В этом демо остаются все 100 кандидатов, поэтому реранкинг не может изменить Recall@100.
Инструменты для каждого этапа
Демо использует небольшие библиотеки в памяти. Вне ноутбука у каждого этапа есть несколько распространённых реализаций:
| Этап | Инструмент | Когда использовать |
|---|---|---|
| BM25 | rank_bm25 | Корпус помещается в память, и нужен быстрый бейзлайн |
| Elasticsearch, OpenSearch или Lucene через Pyserini | Корпусу нужны инвертированный индекс, анализаторы и фильтры | |
| Dense retrieval | FAISS | Нужна ANN-библиотека внутри собственного сервиса |
| pgvector | Данные уже лежат в Postgres | |
| Qdrant, Weaviate, Vespa или Elasticsearch kNN | Нужны фильтры по метаданным, частые обновления и управляемый индекс | |
| Слияние | Elasticsearch RRF retriever, Qdrant Query API с rrf | Нужно слияние рангов внутри поискового движка |
| Weaviate hybrid search | Вы используете Weaviate; он предлагает ranked fusion и relative-score fusion | |
| Эмбеддинг-модели | Вкладка retrieval в MTEB, затем ваши собственные размеченные запросы | Вы выбираете модель; лидерборд сужает список, решают ваши запросы |
| Реранкер | ms-marco-MiniLM-L12-v2 | Английский текст, бюджет на CPU |
bge-reranker-v2-m3 | Многоязычный текст | |
| Elastic Rerank | Английский текст уже в Elasticsearch; нужна подходящая подписка или пробный период |
Демо: пайплайн из пяти этапов
Чтобы показать это на практике, я собрал демо search-ranking-stack, которое запускает пайплайн из пяти этапов на бенчмарке товарного поиска Amazon ESCI. Каждый этап записывает метрики.
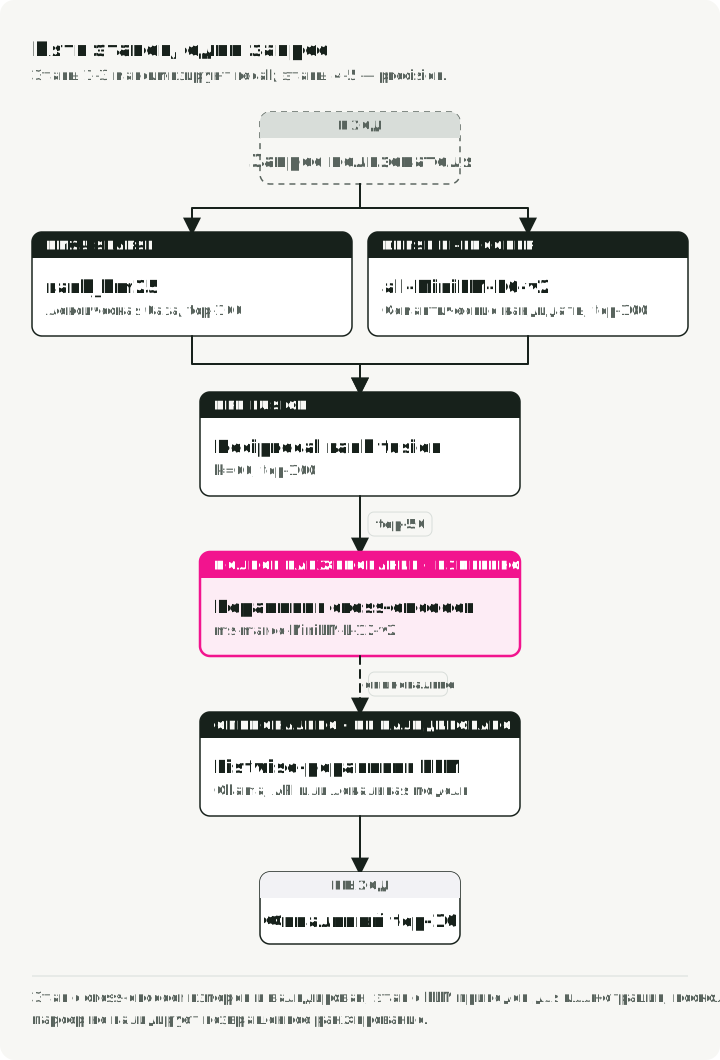
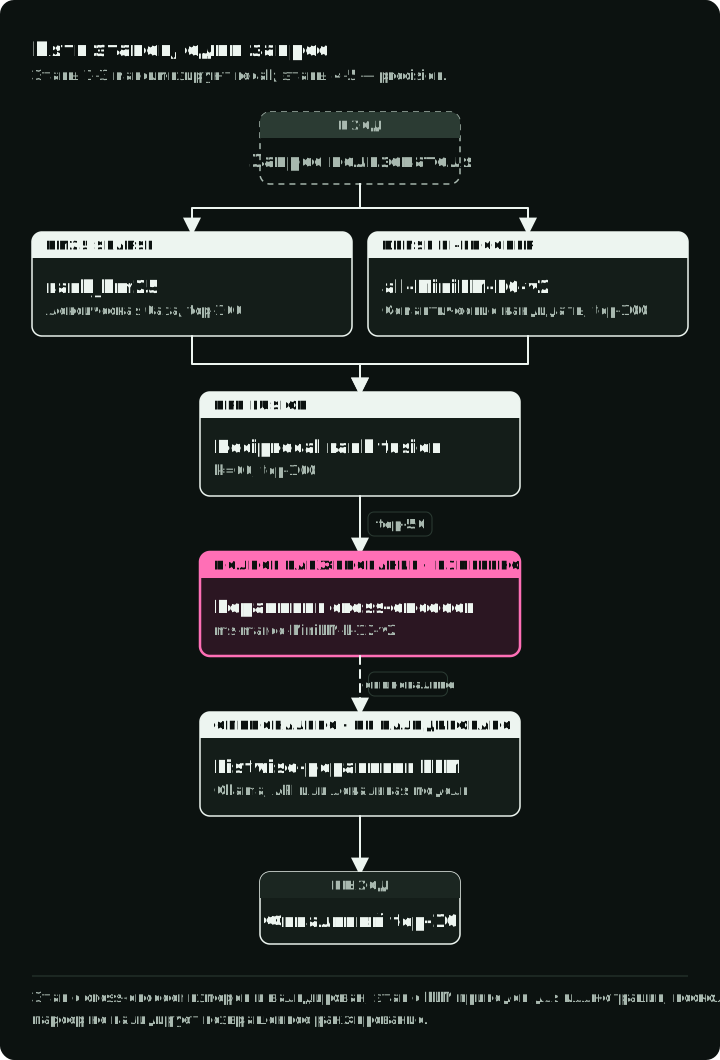
Пайплайн:
- Разреженный retrieval BM25 — лексический бейзлайн (
rank_bm25) - Плотный retrieval на bi-encoder — семантическая генерация кандидатов (
all-MiniLM-L6-v2) - Гибридное слияние RRF — слияние разреженных и плотных результатов по рангам
- Реранкинг cross-encoder — попарные оценки релевантности (
ms-marco-MiniLM-L12-v2) - LLM listwise-реранкинг — сравнение финального шортлиста через промпт (Ollama, API или локальная модель)
Шаги 1—3 — это этап retrieval воронки (максимизировать recall); шаги 4—5 — этап полного ранжирования (максимизировать точность). Демо пропускает пре-ранжирование и блендинг. Диаграмма показывает число кандидатов на каждом шаге: cross-encoder оценивает первых 50 из 100 гибридных кандидатов, а остальные оставляет в гибридном порядке, и LLM видит первые 10.
Быстрый старт
Шаг загрузки один раз скачивает датасет и записывает небольшую выборку. Затем run-all запускает каждый этап, печатает по одной строке метрик на этап и записывает эти строки в results/metrics.json, а график — в results/metrics_comparison.png. Добавьте --llm-mode, чтобы включить LLM-этап.
git clone https://github.com/slavadubrov/search-ranking-stack.git
cd search-ranking-stack
uv sync

# Download and sample ESCI dataset (~2.5GB download, ~5MB sample)
uv run download-data

# Run BM25, dense, hybrid RRF, and the cross-encoder
uv run run-all

# Add LLM reranking with a local Ollama model (ollama pull llama3.2:3b first)
uv run run-all --llm-mode ollama
Датасет и выборка: Amazon ESCI
Демо использует Amazon Shopping Queries Dataset (ESCI) из KDD Cup 2022 — реальный бенчмарк товарного поиска с четырёхуровневыми градуированными метками релевантности:
| Метка | Gain | Значение | Пример (запрос: «wireless headphones») |
|---|---|---|---|
| Exact (E) | 3 | Удовлетворяет всем требованиям запроса | Sony WH-1000XM5 Wireless Headphones |
| Substitute (S) | 2 | Функциональная альтернатива | Проводные наушники с Bluetooth-адаптером |
| Complement (C) | 1 | Связанный полезный товар | Чехол для наушников |
| Irrelevant (I) | 0 | Нет значимой связи | USB-кабель для зарядки |
Градуированная релевантность важна, потому что позволяет использовать NDCG (Normalized Discounted Cumulative Gain), который отличает «идеальное» ранжирование от «просто приемлемого». Бинарные метрики оценивают оба одинаково.
Я использовал выборку small_version из демо: 500 запросов, 9 870 товаров и 9 984 оценки. Загрузчик читает единственный сплит train из tasksource/esci, фильтрует английскую локаль us и small_version == 1, а затем с seed 42 выбирает без возвращения до 500 уникальных идентификаторов запросов. Корпус состоит из уникальных товаров из выбранных строк с оценками. Это не отложенный сплит и не независимый корпус. Выборка достаточно мала, чтобы запускаться на ноутбуке, но слишком мала и слишком специфична по домену, чтобы обосновать продакшен-ранжирование. Используйте её, чтобы воспроизвести этапы и изучить виды сбоев; для решений о деплое берите отложенные репрезентативные запросы.
Оценка: измеряем то, что важно
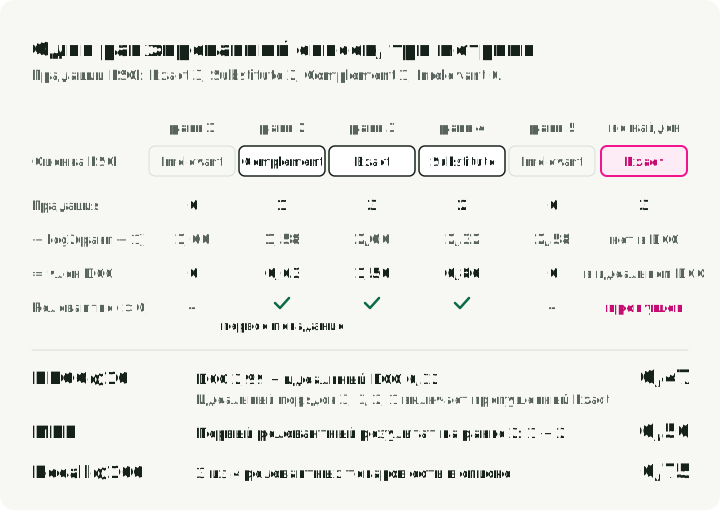
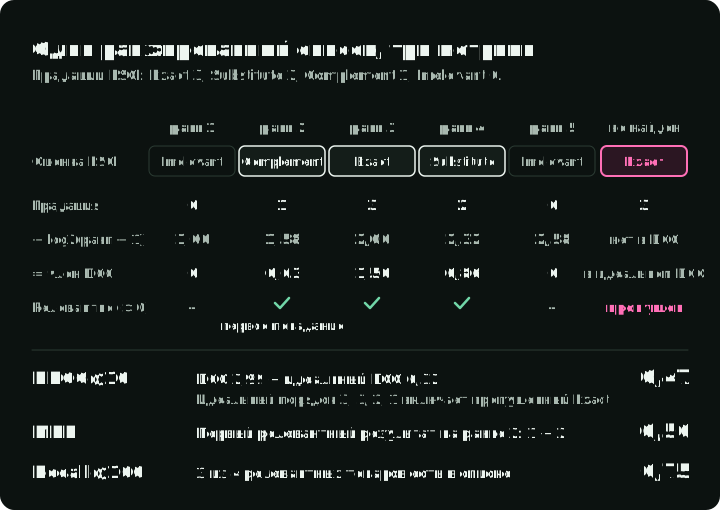
Демо использует три метрики, каждая смотрит на ранжирование под своим углом. Рисунок применяет все три к результатам одного запроса с градациями ESCI из таблицы выше:
NDCG@10 (основная метрика)
Normalized Discounted Cumulative Gain измеряет качество топ-10 с учётом градуированной релевантности. Она поощряет размещение высокорелевантных документов ближе к началу с логарифмическим дисконтом:
Это совпадает с линейными gain в ndcg_cut из trec_eval, который выбирается через pytrec_eval как ndcg_cut_10. IDCG — это DCG идеального порядка оценённых градаций; запрос без положительного gain получает ноль. Экспоненциальные gain, например , задают другое соглашение и изменили бы эти числа.
Из трёх метрик только NDCG полностью использует четырёхуровневую градуированную релевантность ESCI. Система, которая ставит Exact на позицию 1, получает больше, чем система, которая ставит туда Substitute. Поэтому здесь это основная метрика.
MRR (первый результат уровня Complement или выше)
Mean Reciprocal Rank использует позицию первого результата, засчитанного как релевантный. В этом демо оценщик передаёт оценки релевантности ESCI в pytrec_eval и использует recip_rank по каждому возвращённому списку до 100 кандидатов. Бинарный порог — relevance > 0: Complement (1), Substitute (2) и Exact (3) считаются релевантными. Irrelevant (0) — нет. Релевантный результат на позиции 1 даёт обратный ранг 1,0; на позиции 3 — 0,333. Это MRR по возвращённым спискам кандидатов, а не MRR@10.
Recall@100 (покрытие retrieval)
Recall@100 измеряет, какая доля оценённых релевантных документов попадает в топ-100. Он не меняется при реранкинге тех же 100 кандидатов, как в этом демо. При большем наборе кандидатов реранкинг может переместить релевантный документ в топ-100 и повысить метрику, но не может вернуть документ, который retrieval пропустил.
В знаменатель входят только оценённые релевантные документы, как в реализации recall в trec_eval. Неоценённый товар не даёт положительной релевантности и не входит в этот знаменатель. Поэтому при неполных оценках измеренный recall может отличаться от покрытия всех действительно релевантных товаров.
Retrieval: гибридный поиск
Задача слоя retrieval — максимизировать recall: поместить в набор кандидатов как можно больше релевантных документов.
BM25: лексический бейзлайн
BM25 оценивает документы по пересечению терминов с запросом, с насыщением частоты терма и нормализацией по длине документа:
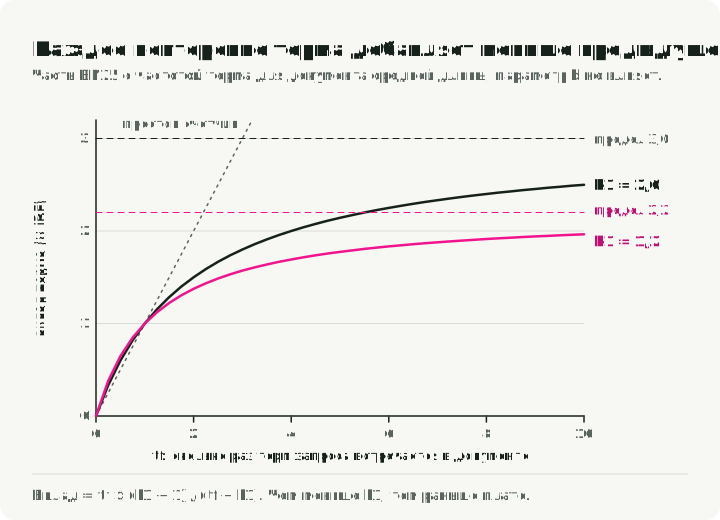
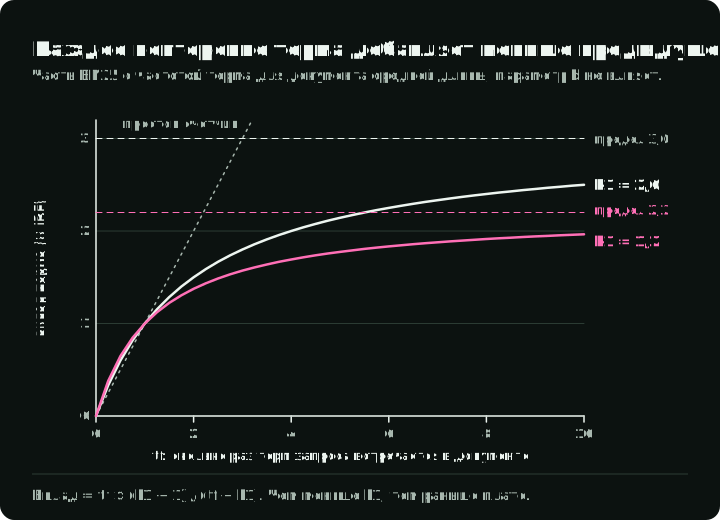
Здесь — обратная частота документов для терма , — частота терма в документе , — длина документа, а — средняя длина документа в корпусе. Важны два параметра: (обычно 1,2—2,0) управляет насыщением TF — тем, как быстро повторяющиеся термины перестают давать вклад, — а (обычно 0,75) управляет нормализацией по длине документа.
График показывает часть формулы, отвечающую за частоту терма, для обоих концов обычного диапазона :
Реализация короткая. Простая токенизация по пробелам с rank_bm25:
# src/search_ranking_stack/stages/s01_bm25.py

from rank_bm25 import BM25Okapi

def run_bm25(data: ESCIData, top_k: int = 100):
    doc_ids = list(data.corpus.keys())
    tokenized_corpus = [text.lower().split() for text in data.corpus.values()]

    bm25 = BM25Okapi(tokenized_corpus)

    results = {}
    for query_id, query_text in data.queries.items():
        scores = bm25.get_scores(query_text.lower().split())
        top_indices = np.argsort(scores)[::-1][:top_k]
        results[query_id] = {doc_ids[idx]: float(scores[idx]) for idx in top_indices}

    return results
BM25 достигает Recall@100 0,741 — 74% оценённых релевантных товаров попадают в топ-100. Реранкер, который получил только этот список BM25, не может вернуть недостающие 26% оценённых релевантных товаров.
Плотный retrieval с bi-encoder
Bi-encoder независимо переводит запросы и документы в общее пространство эмбеддингов:
# Simplified from src/search_ranking_stack/stages/s02_dense.py

import numpy as np
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("sentence-transformers/all-MiniLM-L6-v2")
doc_texts = ["Sony WH-1000XM5 Wireless Headphones", "Headphone carrying case"]
query_texts = ["wireless headphones"]

# Encode corpus once, cache to disk
corpus_embeddings = model.encode(
    doc_texts,
    batch_size=128,
    normalize_embeddings=True,  # Cosine sim = dot product
    convert_to_numpy=True,
)

# At query time: encode query, compute dot product
query_embeddings = model.encode(query_texts, normalize_embeddings=True)
similarity_matrix = np.dot(query_embeddings, corpus_embeddings.T)
С нормализованными эмбеддингами косинусное сходство сводится к скалярному произведению. Демо считает полную матрицу «запрос на корпус», потому что 9 870 документов спокойно помещаются в память; продакшен-корпусу обычно нужен индекс приближённого поиска ближайших соседей. На этой выборке all-MiniLM-L6-v2 поднимает Recall@100 с 0,741 до 0,825.
Как bi-encoder учатся хорошим представлениям
Претрейнинг энкодера и файн-тюнинг эмбеддингов решают разные задачи. Предобученный Transformer даёт представления токенов; контрастивный файн-тюнинг учит пулированный вектор определять, какие тексты должны быть близки. NLI, сходство предложений и пары «запрос — пассаж» — возможные ингредиенты, а не универсальная последовательность. Карточка модели all-MiniLM-L6-v2 из демо описывает предобученный энкодер MiniLM, дообученный более чем на миллиарде разнородных пар предложений.
Файн-тюнинг для retrieval может использовать hard negative mining. Случайные негативы, например документ про кулинарию в паре с запросом про наушники, могут быть слишком лёгкими, чтобы чему-то научить. Вместо них ретривер может предложить правдоподобных кандидатов, которые оценки определяют как нерелевантные. С неоценёнными документами с высоким скором нужна осторожность: среди них могут быть пропущенные позитивы.
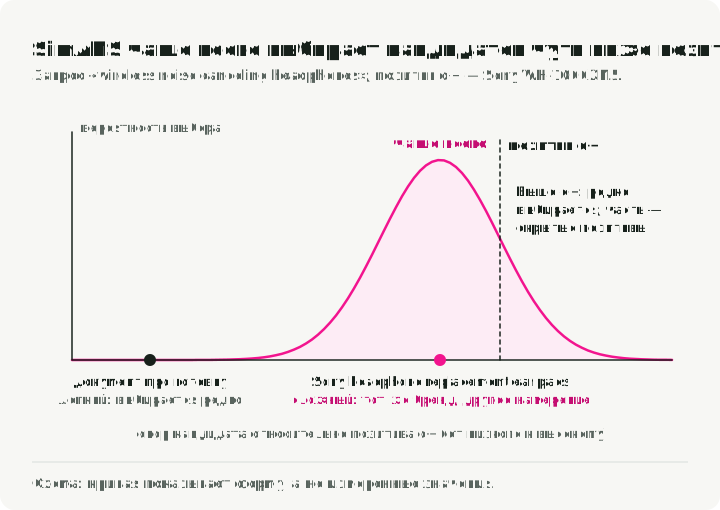
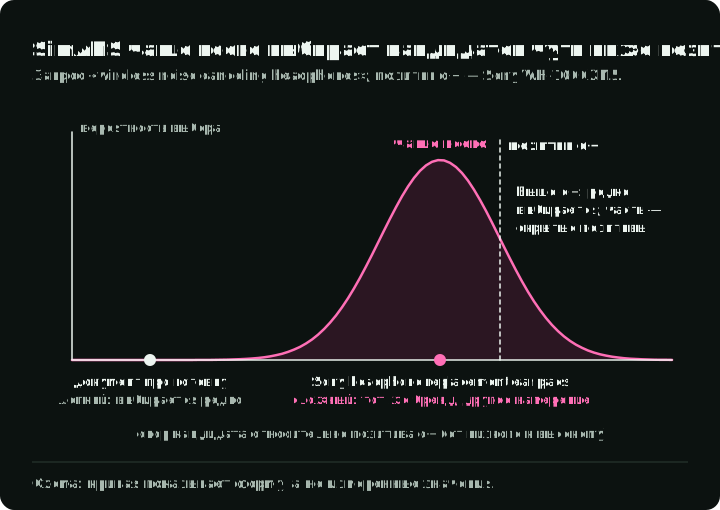
SimANS выбирает негативы по распределению вероятностей, сосредоточенному возле оценки релевантности позитивного документа. Он снижает акцент и на лёгких негативах, и на кандидатах с самым высоким скором, которые могут быть ложными негативами. Это смещённая выборка из найденных кандидатов, а не жёсткое правило, исключающее все документы выше или ниже границы ранга. Кривая показывает, как часто выбирается найденный кандидат в зависимости от его скора относительно позитива:
# What a training triplet looks like after hard negative mining
training_triplet = {
    "query": "wireless noise canceling headphones",
    "positive": "Sony WH-1000XM5 Wireless Noise Cancelling Headphones",
    "negative": "Sony headphone replacement ear pads",  # Hard negative: same brand, related product, but wrong intent
}
# The bi-encoder must learn that "ear pads" is NOT what the user wants,
# even though it shares many tokens with the positive document.
Контрастивная функция потерь (InfoNCE) связывает всё это вместе. Для каждого запроса с позитивным документом и набором негативных документов :
Здесь — косинусное сходство между эмбеддингами запроса и документа, а — параметр температуры (обычно 0,05—0,1). Меньшие значения делают функцию потерь чувствительнее к hard negatives. Это softmax cross-entropy: поднять сходство позитивной пары относительно всех негативов. Когда мала, даже небольшие различия в сходстве дают большие градиенты, и это заставляет модель проводить более тонкие различия.
Сервинг эмбеддингов bi-encoder в масштабе
Архитектурное преимущество bi-encoder — разделение на офлайн и онлайн. Эмбеддинги документов считаются при индексации и хранятся в векторном индексе. Во время запроса система кодирует запрос и ищет по этим сохранённым векторам. Латентность зависит от энкодера, железа, индекса, фильтров и целевого recall, поэтому профилируйте эти два шага отдельно.
В демо математика скромная: 9 870 документов 384 измерения 4 байта на float = ~15 МБ эмбеддингов. В продакшен-масштабе цифры перестают быть скромными: 1 миллиарду документов с 768-мерными эмбеддингами нужно ~3 ТиБ хранилища. Здесь появляются квантизация (сжатие 32-битных float до 8-битных целых), product quantization (разложение векторов на подпространства) и индексы на SSD, такие как DiskANN. Алгоритмы индексов описаны в разделе об индексации плотных векторов.
Зачем тестировать гибридный retrieval
Два метода часто ошибаются по-разному. BM25 хорошо подходит для имён собственных, артикулов товаров и кодов ошибок. Dense retrieval может преодолеть несовпадение словаря, например «cheap laptop» и «budget notebook computer». Поможет ли слияние, зависит от того, как часто эти дополняющие случаи встречаются в целевом наборе запросов.
Типичный следующий эксперимент — гибридный поиск: запустить оба метода retrieval, а затем слить их ранжированные списки.
Reciprocal rank fusion (RRF)
BM25 и dense retrieval выдают оценки с разным смыслом и масштабом. Поэтому линейная комбинация требует калибровки и проверки при каждой смене ретриверов или корпуса.
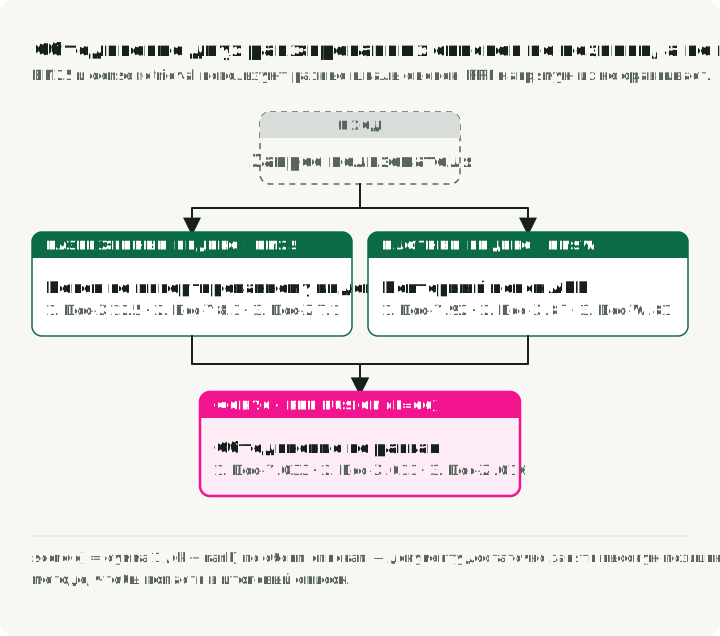
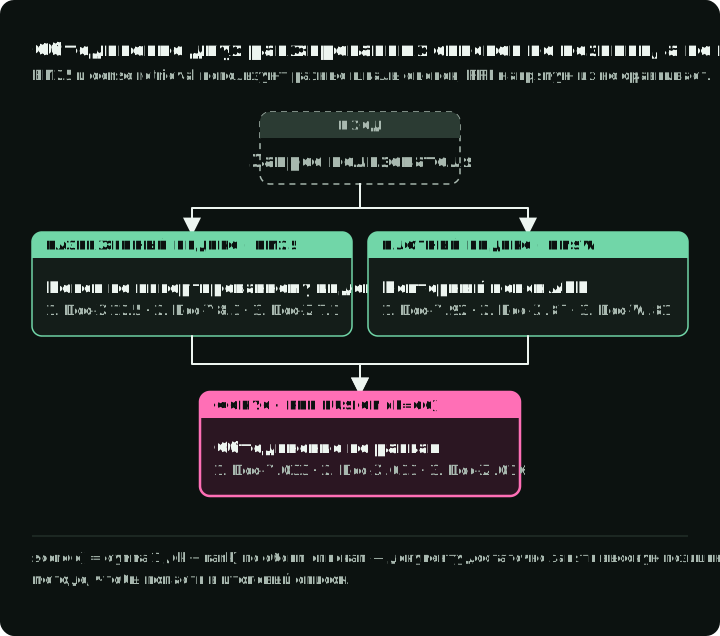
Reciprocal Rank Fusion (Cormack et al., 2009) полностью отбрасывает исходные оценки и использует только позицию в ранге:
Здесь — константа сглаживания; 60 — распространённое начальное значение. RRF поощряет элементы, которые стоят высоко во входных списках, не сравнивая их исходные оценки. Он избавляет от калибровки масштаба оценок, но границы retrieval, веса и всё равно нужно оценивать.
Реализация:
# src/search_ranking_stack/stages/s03_hybrid_rrf.py

from collections import defaultdict

def reciprocal_rank_fusion(ranked_lists, k=60, top_k=100):
    all_query_ids = set().union(*(results.keys() for results in ranked_lists))
    fused_results = {}

    for query_id in all_query_ids:
        rrf_scores = defaultdict(float)

        for results in ranked_lists:
            sorted_docs = sorted(results.get(query_id, {}).items(),
                                 key=lambda x: x[1], reverse=True)

            for rank, (doc_id, _score) in enumerate(sorted_docs, start=1):
                rrf_scores[doc_id] += 1.0 / (k + rank)

        sorted_rrf = sorted(rrf_scores.items(),
                            key=lambda x: x[1], reverse=True)[:top_k]
        fused_results[query_id] = dict(sorted_rrf)

    return fused_results
Гибридный RRF достигает Recall@100 0,842 и NDCG@10 0,628 — опережая и BM25 (0,585), и Dense (0,611) по отдельности. Документ, найденный только одним ретривером, всё равно получает оценку RRF, но может оказаться ниже границы топ-100. При первое место в одном списке даёт , что меньше, чем 50-е место в обоих списках (). Пересечение может перевесить высокий ранг в одном списке.
Реранкинг cross-encoder
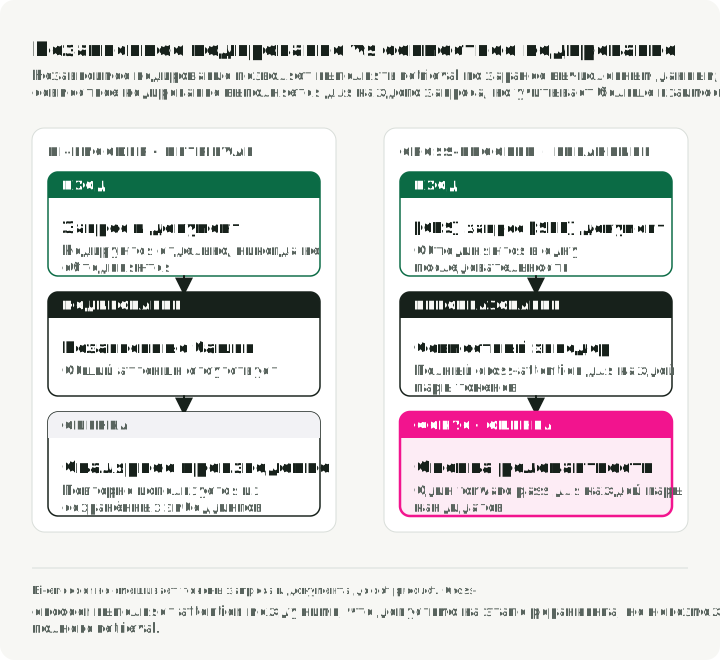
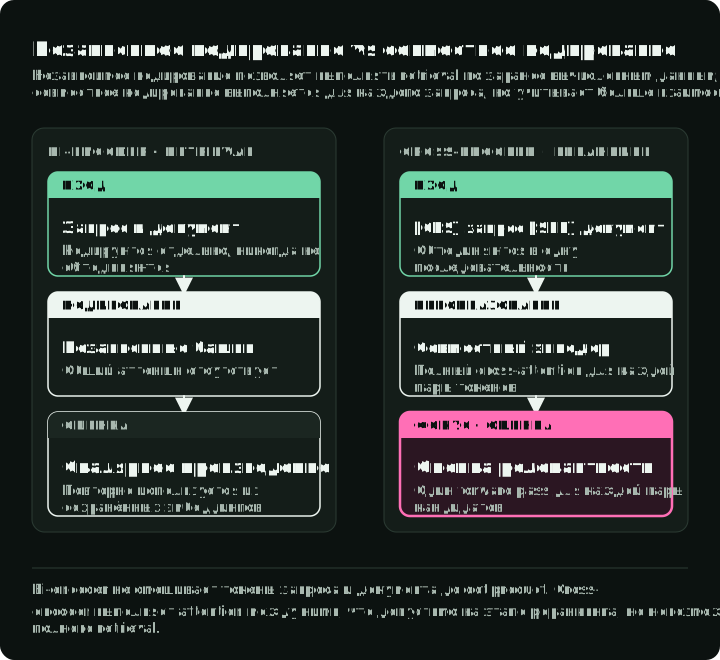
Когда на запрос приходится 100 гибридных кандидатов, можно позволить себе более дорогую модель. Cross-encoder обрабатывает запрос и документ вместе в одном Transformer, с self-attention по объединённой последовательности запроса и документа.
Взаимодействие на уровне токенов
Разница — в матрице внимания. В bi-encoder она блочно-диагональная: токены запроса обращаются только к другим токенам запроса, а токены документа — только к другим токенам документа. Два представления никогда не встречаются на уровне токенов — они пересекаются только в конце, через скалярное произведение. Cross-encoder считает полную матрицу внимания, где каждый токен запроса обращается к каждому токену документа и наоборот. Такой совместный self-attention позволяет модели напрямую сравнивать токены запроса и документа.
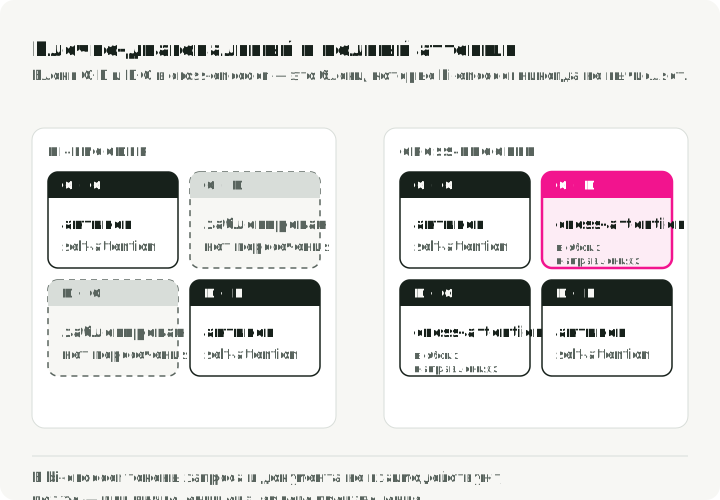
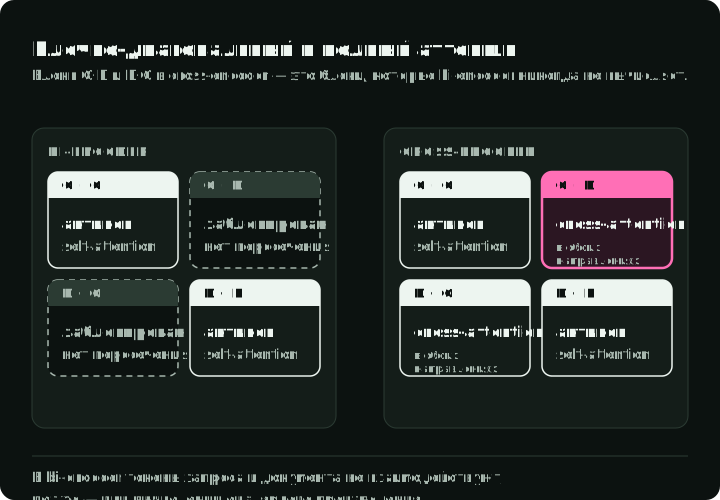
В bi-encoder запрос кодируется раньше, чем виден какой-либо документ. Cross-encoder видит запрос и кандидата вместе, поэтому может использовать связь между их токенами. Это может помочь в таких случаях:
- Отрицание: «headphones that are not wireless». Пулированный эмбеддинг может недооценить отрицание, а совместное кодирование даёт модели прямое взаимодействие запроса и документа. Это гипотеза, которую нужно проверить на целевом срезе, а не гарантия.
- Уточнение: «laptop under $500». Совместное кодирование может связать ограничение с ценой в тексте товара, хотя структурированные фильтры по цене надёжнее, если такое поле есть.
Вход cross-encoder форматируется как [CLS] query tokens [SEP] document tokens [SEP]. [CLS] — классификационный токен, финальное скрытое состояние которого проходит через линейный выходной слой и даёт одну оценку релевантности. Сегментные эмбеддинги отличают токены запроса от токенов документа, а [SEP] отмечает границу между сегментами.
Как обучают cross-encoder
Cross-encoder могут учиться на примерах (query, document, relevance_label) с pointwise-, pairwise- или listwise-целями. Pointwise-пример сопоставляет «wireless headphones» с «Sony WH-1000XM5 Wireless Headphones» и меткой 1,0.
Типичный классификатор отображает финальное представление [CLS] в оценку. Для бинарных меток можно использовать binary cross-entropy; для градуированной релевантности подойдут регрессионные, порядковые, pairwise- или listwise-функции потерь. Выбирайте по ранжирующим метрикам на отложенной выборке, а не исходя из того, что какая-то одна цель лучше всех.
Hard negative mining помогает и при обучении cross-encoder. Cross-encoder дорого обучать — каждому обучающему примеру нужен полный прямой проход по конкатенированной последовательности, — поэтому тратить вычисления на тривиально лёгкие негативы нельзя. Практичный рецепт: с помощью bi-encoder получить топ-K кандидатов для каждого обучающего запроса, затем брать hard negatives из определённых диапазонов рангов (например, ранги 10–100). Тогда у cross-encoder оказываются примеры, где отличить релевантное от нерелевантного можно только через глубокое взаимодействие токенов.
Реранкинг найденных кандидатов
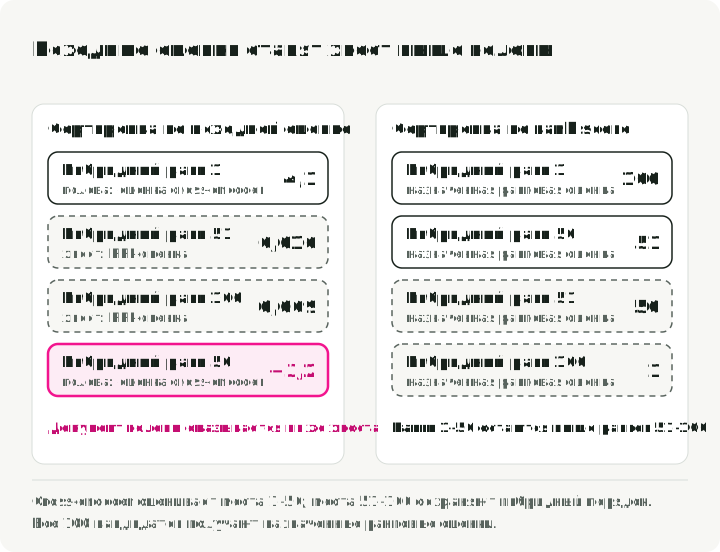
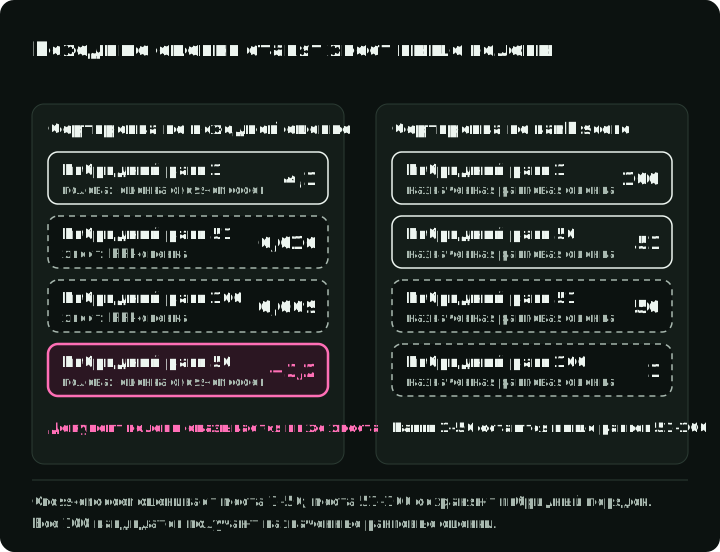
Этап отправляет пары (query, document) для первых 50 гибридных кандидатов в CrossEncoder.predict, расставляет этих кандидатов по оценке, а затем добавляет неоценённых кандидатов в прежнем порядке. Рисунок сортирует четырёх кандидатов из 100 обоими способами и показывает, почему при слиянии назначаются новые rank scores, а не сохраняются исходные оценки:
# From src/search_ranking_stack/stages/s04_cross_encoder.py

def rank_scores(ordered_ids):
    return {doc_id: float(len(ordered_ids) - rank) for rank, doc_id in enumerate(ordered_ids)}

def merge_head_and_tail(original, scored_head):
    """original: hybrid (doc_id, rrf_score) pairs in rank order.
    scored_head: (doc_id, cross_encoder_score) pairs for the first len(scored_head)."""
    head = sorted(scored_head, key=lambda item: (-item[1], item[0]))
    tail = original[len(scored_head) :]
    return rank_scores([doc_id for doc_id, _ in head + tail])
Полный этап добавляет загрузку модели, ограничение документа в 2 048 символов и проверку, что каждая оценка конечна.
Карточка модели показывает, что оценки cross-encoder могут быть отрицательными. Не смешивайте их с оценками RRF неоценённого хвоста: положительная оценка RRF может поставить документ из хвоста выше документа из головы с отрицательной оценкой. Назначайте строго убывающие rank scores, как это делает rank_scores. Это rank scores для оценки качества, а не калиброванные оценки релевантности.
Компромисс между скоростью и качеством
Почему бы не использовать cross-encoder для всего? Потому что оценки нельзя посчитать заранее. Эмбеддинги документов bi-encoder не зависят от запроса, поэтому их считают один раз и хранят. Результат cross-encoder зависит от запроса и документа вместе. Оценка релевантности для «wireless headphones» в паре с товаром Sony получается из совместного self-attention между этими конкретными токенами. Повторяющуюся пару «запрос — документ» можно закэшировать, но её оценку нельзя использовать для другого запроса.
Bi-encoder нужны одно кодирование запроса и vector search по заранее посчитанным эмбеддингам документов. Cross-encoder оценивает каждую пару «запрос — документ» в шортлисте, и стоимость растёт и с числом кандидатов, и с длиной последовательности. Батчинг помогает, но оценивать 100 000 кандидатов всё равно неверный режим работы; сначала retrieval, а затем бенчмарк самого большого шортлиста, который укладывается в цели по качеству и латентности.
LLM listwise-реранкинг
Финальный этап демо использует LLM для listwise-реранкинга. Вместо независимой оценки каждого документа модель видит топ-10 и возвращает порядок. Промпт, вдохновлённый RankGPT, делает относительное сравнение явным, но вносит и ограничения контекста, смещение по позиции, сбои разбора и вариативность между запусками.
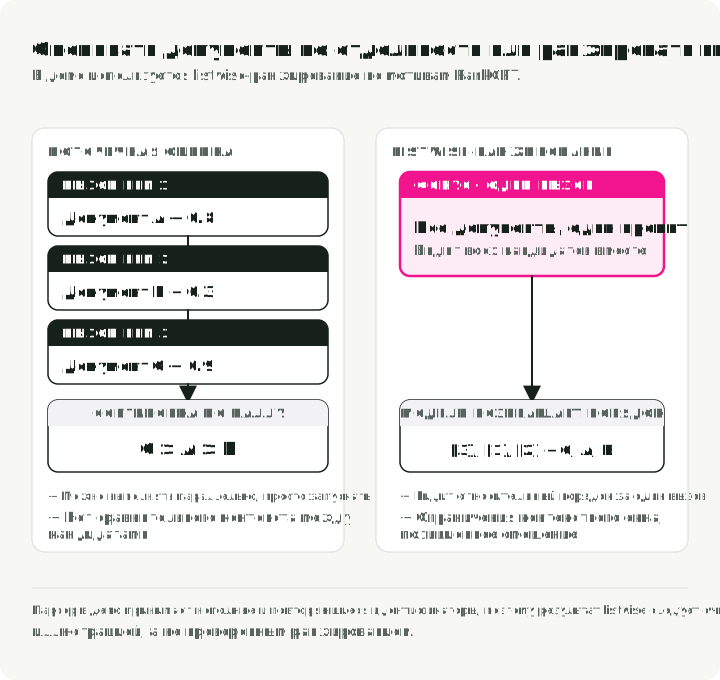
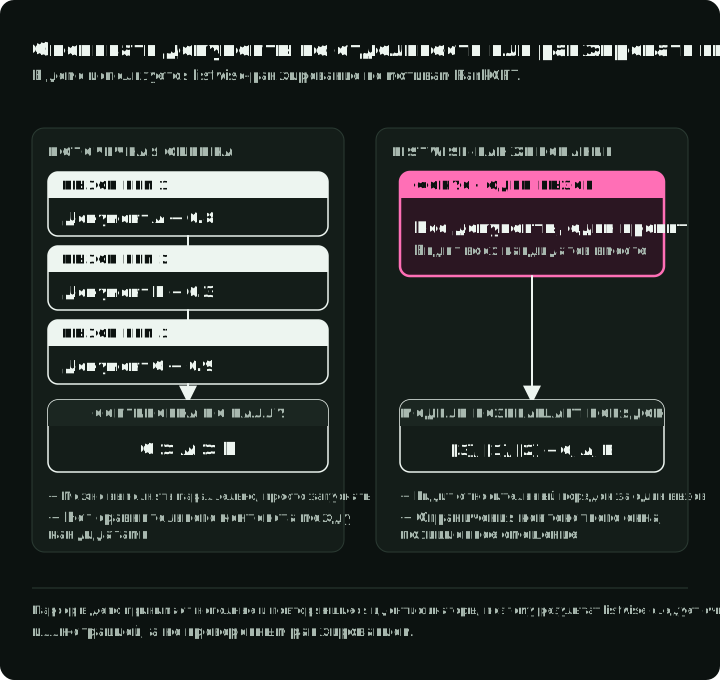
Listwise-промпт
Шаблон промпта просит LLM учитывать иерархию релевантности ESCI:
# src/search_ranking_stack/stages/s05_llm_rerank.py

def _create_listwise_prompt(query, documents, max_words=200):
    n = len(documents)

    doc_texts = []
    for i, (_doc_id, doc_text) in enumerate(documents, start=1):
        words = doc_text.split()[:max_words]
        doc_texts.append(f"[{i}] {' '.join(words)}")

    docs_formatted = "\n\n".join(doc_texts)

    return (
        f"I will provide you with {n} product listings, each indicated by a numerical "
        f"identifier [1] to [{n}]. Rank the products based on their relevance to the "
        f'search query: "{query}"\n\n'
        "Consider:\n"
        "- Exact matches (product satisfies all query requirements) should rank highest\n"
        "- Substitutes (functional alternatives) should rank above complements\n"
        "- Completely irrelevant products should rank lowest\n\n"
        f"{docs_formatted}\n\n"
        "Rank the products from most relevant to least relevant.\n"
        "Output ONLY a comma-separated list of product identifiers, e.g.: [3], [1], [2], ...\n"
        "Do not explain your reasoning. Only output the ranking."
    )
Три режима выполнения
Демо поддерживает три бэкенда для LLM-реранкинга:
| Режим | Модель | Как запускается |
|---|---|---|
ollama | llama3.2:3b (меняется через OLLAMA_MODEL) | Локально через Ollama API |
api | Claude Haiku (задаётся LLM_MODEL_API в config.py) | Anthropic API; сначала uv sync --extra api |
local | Qwen/Qwen2.5-1.5B-Instruct | HuggingFace Transformers; сначала uv sync --extra llm |
Разбор и fallback
Парсер извлекает пронумерованные идентификаторы из ответа модели. Он принимает ранжирование, только если оно перечисляет каждого кандидата ровно один раз:
# src/search_ranking_stack/stages/s05_llm_rerank.py

def _parse_ranking(output: str, n: int) -> list[int] | None:
    """Return 0-based positions if the output ranks IDs 1..n exactly once."""
    positions = [int(m) - 1 for m in re.findall(r"\[(\d+)\]", output)]

    # Reject missing, duplicate, and out-of-range IDs.
    if sorted(positions) != list(range(n)):
        return None

    return positions
Когда парсер возвращает None, демо оставляет для этого запроса весь порядок cross-encoder и засчитывает fallback. Ошибка бэкенда тоже считается fallback. run-all печатает долю fallback и сохраняет её рядом с метриками. Например, [3] > [1] > [3] отклоняется: ID 3 повторяется, а ID 2 и с 4 по 10 отсутствуют.
Результаты на этой выборке ESCI
Результаты получены на описанной выше выборке small_version; она не отложенная. Строки взяты из одного запуска uv run run-all --llm-mode ollama с llama3.2:3b в роли LLM.
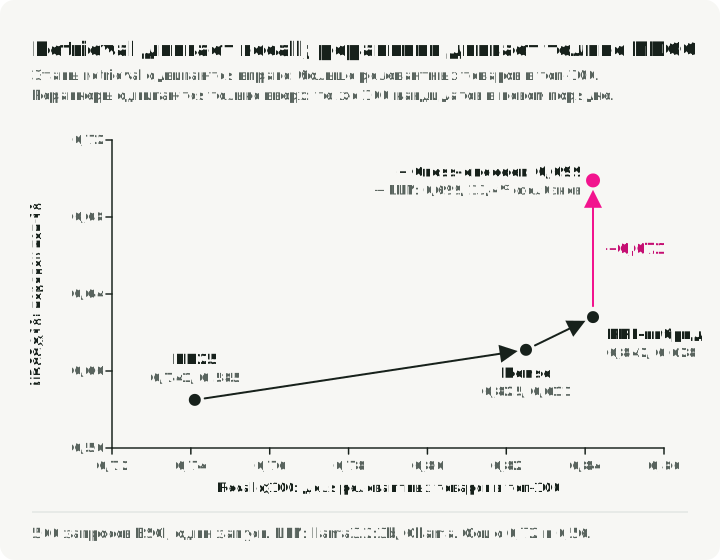
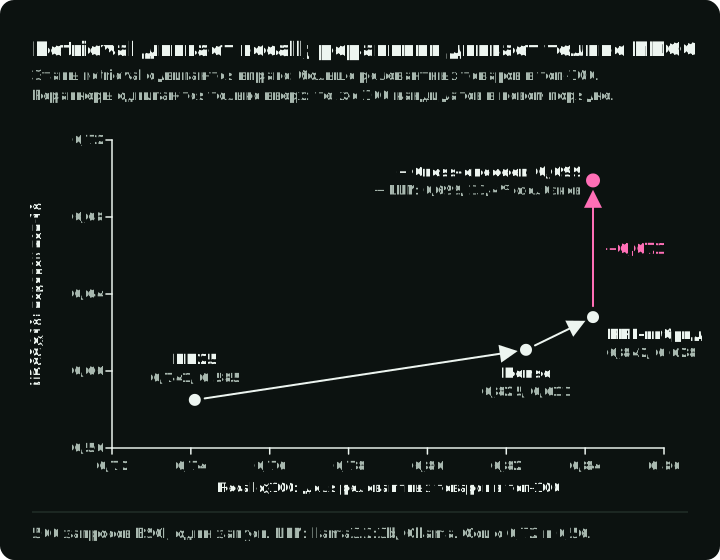
| Этап | NDCG@10 | MRR | Recall@100 | Дельта NDCG |
|---|---|---|---|---|
| BM25 | 0,585 | 0,812 | 0,741 | — |
| Dense Bi-Encoder | 0,611 | 0,808 | 0,825 | +0,026 |
| Hybrid (RRF) | 0,628 | 0,834 | 0,842 | +0,017 |
| + Cross-Encoder | 0,699 | 0,886 | 0,842 | +0,071 |
| + LLM-реранкер (13,4% fallback) | 0,699 | 0,884 | 0,842 | +0,000 |
График отражает Recall@100 каждой строки по отношению к её NDCG@10:
Что подтверждают записанные результаты
Гибридный поиск побеждает каждый из методов по отдельности. Гибридный RRF достигает NDCG@10 0,628, выше BM25 (0,585) и Dense (0,611). Он же даёт самый высокий Recall@100 среди трёх строк retrieval (0,842). Два метода могут ошибаться на разных запросах, а слияние возвращает документы, которые каждый из них по отдельности пропускает.
Cross-encoder даёт самый большой прирост. Он поднимает NDCG@10 с 0,628 до 0,699 и MRR с 0,834 до 0,886, оценивая всего 50 кандидатов на запрос. В топ-10 доля товаров Exact растёт с 36,0% (гибрид) до 41,4%.
В этом демо recall задаётся на этапе retrieval. Оба реранкера сохраняют всех 100 гибридных кандидатов, поэтому Recall@100 остаётся 0,842. Чтобы повысить его, измените то, каких 100 кандидатов возвращает retrieval.
Маленькая локальная LLM ничего не добавляет на этой выборке. llama3.2:3b оставляет NDCG@10 на 0,699 и немного снижает MRR. 67 из 500 ответов (13,4%) не прошли парсер и сохранили порядок cross-encoder, так что порядок LLM был применён к 433 запросам. Более крупная модель или режим API могут вести себя иначе; измеряйте так же, с долей fallback рядом с оценкой.
Dense retrieval обгоняет BM25 на этой выборке. Прежде чем назвать причину, изучите срезы запросов. Несовпадение словаря — один правдоподобный фактор, но на сравнение также влияют построение выборки, токенизатор, домен обучения модели и поля корпуса.
Индексация плотных векторов за пределами демо
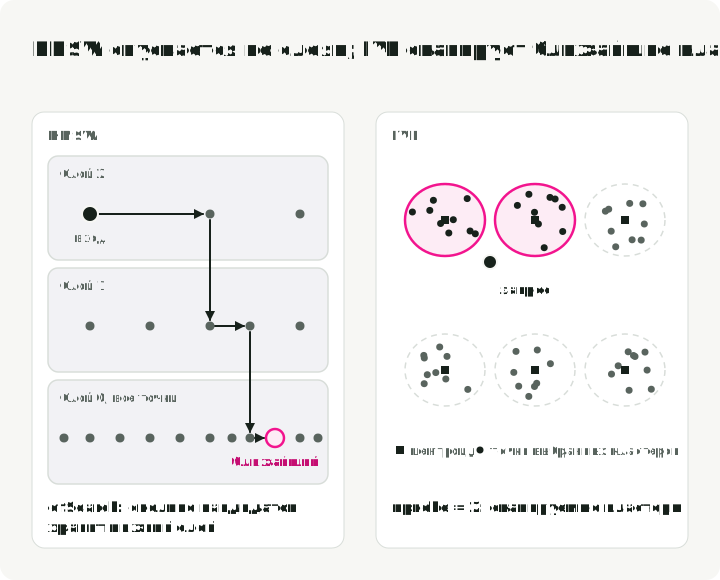
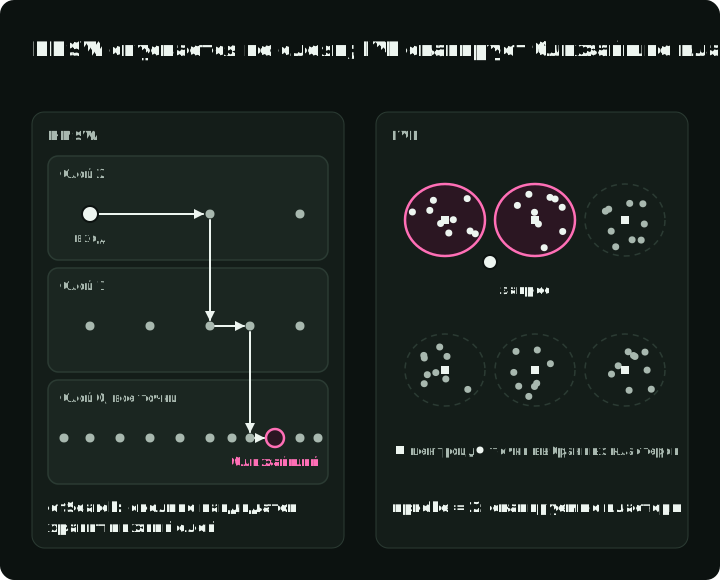
Плотные эмбеддинги становятся полезны в масштабе только с индексом приближённого поиска ближайших соседей (ANN). Демо использует полный перебор по косинусному сходству (для 9 870 документов этого достаточно), но продакшен-системам нужны специализированные индексы. Два распространённых семейства ищут по-разному, и у каждого есть одна настройка времени поиска, которая обменивает recall на объём работы запроса. Рисунок показывает путь, по которому идёт HNSW, и кластеры, которые сканирует IVF:
HNSW (hierarchical navigable small world)
HNSW строит многослойный граф: разреженные верхние слои дают грубую навигацию, а более плотные нижние слои уточняют окрестность. M задаёт связность графа, а efSearch обменивает объём работы запроса на recall. Подходящие значения зависят от размерности, распределения расстояний, фильтров, реализации и целевого recall.
Графовые индексы могут терять recall при интенсивных обновлениях или жёстких фильтрах; один issue в Qdrant показывает, что recall с фильтрами восстанавливается только после перестроения. Проверьте свой шаблон обновлений и фильтров, включая время перестроения.
IVF (inverted file)
Индексы IVF разбивают векторное пространство на кластеры, а затем сканируют nprobe кластеров, ближайших к запросу. Они могут дать полезный компромисс между памятью, временем построения и recall, особенно в сочетании со сжатием. Семантика обновлений и производительность зависят от реализации, а не только от семейства индекса.
RaBitQ (Gao & Long, SIGMOD 2024) — рандомизированный квантизатор, который можно сочетать с IVF. Он нормализует центрированные векторы, использует случайное ортогональное вращение и кодирует знаки одним битом на измерение. Оценка расстояния также использует поправочные коэффициенты и нормы векторов; границы ошибки из статьи относятся к этой оценке и её допущениям. Применяйте его, когда ограничением служит память, а квантизованные оценки расстояний всё ещё укладываются в целевой recall.
| Параметр | Граф HNSW | Кластеры IVF |
|---|---|---|
| Управление запросом | efSearch | nprobe |
| Управление построением | Связность и ширина луча при построении | Число кластеров и обучающая выборка |
| Профиль памяти | Рёбра графа плюс векторы | Центроиды, списки и сохранённые векторы |
| Поведение при обновлениях | Восстановление и очистка зависят от базы данных | Обслуживание списков зависит от базы данных |
| Обычно выбирают, когда | Векторы помещаются в RAM и нужна низкая латентность при высоком recall | Ограничение — память или размер корпуса; сочетайте с PQ или RaBitQ |
Для любого индекса измеряйте кривую «recall — латентность — память» на своих данных и своей нагрузке запросов.
Uber снизил латентность и нагрузку на CPU, уменьшив число кандидатов на шард с небольшой потерей recall; подбирайте это число на трафике, близком к продакшену.
Необязательные расширения после основного пайплайна
Когда у retrieval и реранкинга есть отдельные измерения, несколько расширений становятся проще оценить, не затемняя основной пайплайн.
Понимание запросов
Расширение и переписывание запросов могут устранить несовпадение словаря до retrieval. Query2doc генерировал псевдодокументы и показал прирост BM25 в своих экспериментах на MS MARCO. Расширение также может внести неверное намерение, поэтому сравнивайте recall и точность на срезах неоднозначных, навигационных запросов и запросов с точным идентификатором.
Практические приёмы: расширение аббревиатур, обогащение сущностями, декомпозиция на подзапросы для multi-hop-ризонинга и RAG-Fusion — генерация нескольких вариантов запроса и объединение результатов через RRF.
Разметка релевантности с помощью LLM
LLM могут составлять черновики меток релевантности, когда человеческих оценок мало. Работа Pinterest по разметке релевантности описывает расширение обучающих данных за пределы человеческих меток и дистилляцию LLM-модели релевантности для сервинга. Метка LLM — всё равно вывод модели: калибруйте её по слепым человеческим оценкам, изучайте срезы расхождений и держите эталонный набор человеческих оценок для регрессионных тестов.
Полезные меры контроля:
- рубрика с чёткими границами релевантности и примерами;
- слепая человеческая калибровка и периодические перепроверки;
- рандомизация порядка и повторные оценки для нестабильных случаев;
- панели моделей, если их дополнительная стоимость повышает согласованность; и
- явные проверки смещения по позиции и смещения к середине шкалы.
Дистилляция знаний
Когда LLM-учитель приносит пользу, но не укладывается в ограничения сервинга, один из вариантов — дистилляция:
- Мощная LLM (учитель) реранжирует тысячи обучающих запросов офлайн; на каждый запрос работает только небольшой студент
- Небольшой быстрый cross-encoder (студент, ~100M–200M параметров) обучается имитировать распределение ранжирования LLM
- Сравните студента и с учителем, и с бейзлайном по качеству, калибровке и стоимости сервинга
InRanker дистиллирует MonoT5-3B в модели на 60M и 220M параметров, меньше исходной примерно в 50 и 13 раз соответственно, с лучшей эффективностью вне домена по сравнению с их недистиллированными версиями. Подход Rank-Without-GPT даёт открытые listwise-реранкеры на 7B, которые достигают 97% эффективности сравниваемого реранкера на GPT-4 по nDCG@10 на TREC-DL-19 и TREC-DL-20, используя файн-тюнинг QLoRA.
Опубликованные результаты сжатия — это отправная точка, а не ожидаемые продакшен-коэффициенты. Дистилляция может унаследовать смещения учителя и потерять качество на редких срезах запросов, поэтому оставляйте исходные оценки релевантности в цикле оценки.
Персонализация и смещение по позиции
Поиск «apple» должен вернуть iPhone для энтузиаста технологий и рецепты с яблоками для того, кто смотрел кулинарный контент.
Типичная архитектура retrieval для персонализации использует two-tower эмбеддинг-модель: башня запроса кодирует запрос и контекст пользователя, а башня товаров — товары и метаданные. Рисунок показывает, какая сторона работает на каждый запрос, какая считается офлайн и куда попадает запрос «apple» у двух пользователей:
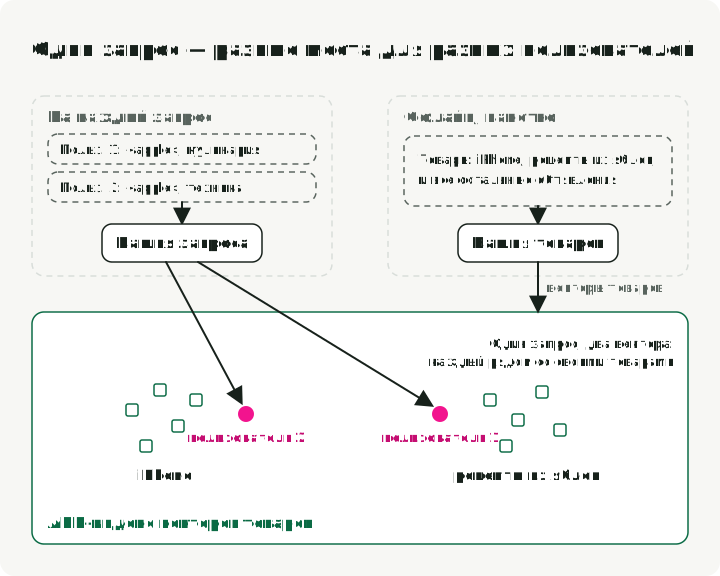
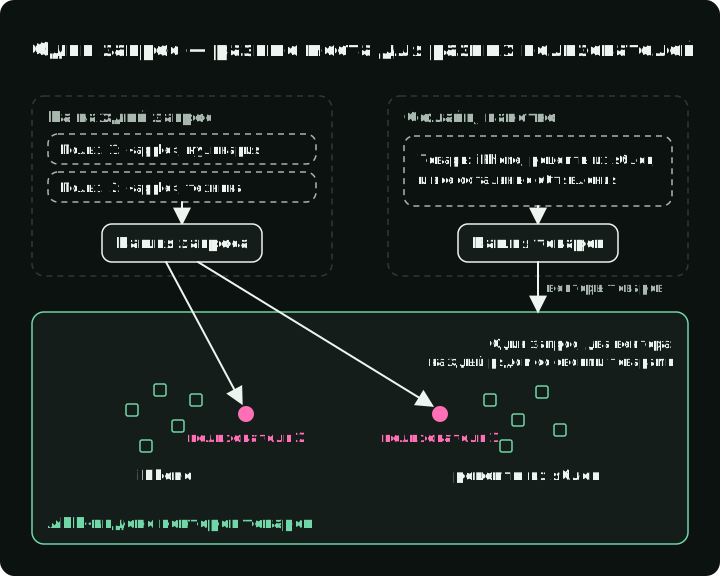
Разделение на офлайн и онлайн поддерживает retrieval на основе приближённого поиска ближайших соседей; его латентность всё равно зависит от энкодера, индекса, фильтров и системы сервинга. Три продакшен-решения используют обученные эмбеддинги в разных местах. Airbnb обучает эмбеддинги объявлений на сессиях кликов пользователей и использует сходство с недавно кликнутыми объявлениями как признаки ранжирования поиска. OmniSearchSage от Pinterest обучает один эмбеддинг запроса вместе с эмбеддингами пинов и товаров. Uber использует two-tower модель, чтобы находить несколько сотен магазинов для главной ленты Uber Eats.
Данные о кликах несут смещение по позиции и по показам. PAL — один из подходов к устранению смещения: совместно обучить модуль показа и модуль клика при условии показа, а затем использовать при сервинге второй без входа позиции. Это не универсальное решение; для другого продукта могут лучше подойти рандомизированные вмешательства, методы inverse-propensity и контрфактическая оценка.
Адаптация к домену с помощью синтетических запросов
Типичная ошибка стратегии поиска — считать, что модель, обученная на общих веб-данных (например, MS MARCO), хорошо сработает в специализированном домене. Это проблема out-of-domain (OOD).
Генерация синтетических запросов может снизить дефицит размеченных данных. InPars генерирует запросы для документов и фильтрует пары для обучения. Generative Pseudo-Labeling (GPL) добавляет шаг разметки учителем:
- Сгенерировать запросы по целевому корпусу документов.
- Найти негативные документы для каждого сгенерированного запроса.
- С помощью учителя cross-encoder оценить позитивные и негативные пары и получить разницу оценок релевантности.
- Обучить dense-ретривер воспроизводить эти разницы.
Синтетические пары могут помочь, когда реальных запросов мало, но они отражают генератор и промпт. Дедуплицируйте их, отфильтровывайте неправдоподобные запросы и проверяйте на реальном отложенном трафике.
Последовательность экспериментов
Добавляйте сложность, только когда предыдущий этап обнаружил измеренный сбой. Каждый шаг называет сбой, который его оправдывает:
- Установите бейзлайн. Запустите BM25 или текущую лексическую систему на наборе размеченных запросов. Зафиксируйте recall, NDCG, латентность и группы запросов, где она ошибается.
- Верните пропущенных кандидатов. Проверьте dense retrieval и слияние, когда бейзлайн пропускает релевантные документы. Подберите границу набора кандидатов по recall и стоимости.
- Улучшите порядок. Добавьте cross-encoder, когда релевантные кандидаты есть, но стоят слишком низко. Выберите размер его шортлиста, измерив качество и латентность на нескольких границах. В демо этот шаг поднял NDCG@10 с 0,628 до 0,699.
- Адаптируйтесь к домену. Делайте файн-тюнинг или дистилляцию, когда универсальные модели показывают устойчивые сбои в домене. Храните реальные отложенные оценки отдельно от синтетических обучающих данных.
- Проверьте дорогой реранкинг. Пробуйте listwise- или основанный на ризонинге реранкинг, только если добавленное качество переживает повторные запуски и оправдывает латентность, стоимость, требования к приватности и сложность fallback. В демо
llama3.2:3bэту проверку не прошёл.
Начальный стек и оценки, которые нужно собрать, зависят от продукта:
| Сценарий | Кандидат на стартовый стек | Что проверять |
|---|---|---|
| Товарный поиск | BM25 + dense retrieval + RRF + cross-encoder | Recall по атрибутам, замены, латентность, бизнес-ограничения |
| Поиск по документации | Гибридный retrieval + cross-encoder | Точные идентификаторы, семантические вопросы, фильтры по версиям |
| Разгрузка поддержки | Гибридный retrieval + проверки цитат | Recall retrieval, граундинг, отказ от ответа |
| Маркетплейс или объявления | Лексические фильтры + dense retrieval + бизнес-реранкер | Наличие, свежесть, политики, разнообразие продавцов |
| Небольшой внутренний корпус | Бейзлайн BM25, затем реранкер | Оправдывает ли несовпадение словаря dense-индекс |
| Юридический или медицинский поиск с высокой ценой ошибки | Retrieval с упором на recall плюс экспертная проверка | Покрытие, происхождение, калиброванный отказ от ответа |
В каждом сравнении держите реальный набор отложенных оценок отдельно от обучающих данных. Записывайте ранжирования по каждому запросу, сбои, латентность и стоимость, чтобы агрегированный прирост можно было отнести к изменённому этапу. Для дорогих слоёв также нужны явные политики приватности и fallback.
Направления исследований, которые стоит оценивать отдельно
Реранкеры с ризонингом и агенты, использующие поиск, многообещающи, но отвечают на другие вопросы, чем демо товарного поиска из пяти этапов.
Реранкеры на основе ризонинга
Rank1 обучает реранкеры на трейсах ризонинга и сообщает сильные результаты на бенчмарке BRIGHT. Это свидетельство относится к retrieval, требующему ризонинга, а не служит прямым прогнозом для товарного поиска ESCI.
Для юридического или научного поиска сравнивайте реранкеры с ризонингом с сильными бейзлайнами cross-encoder и listwise по экспертным оценкам, цитатам, латентности и согласованности сбоев.
Агентный поиск
Search-o1 исследует модель, которая выполняет дополнительные поиски при multi-hop-ответах на вопросы. Это задача оркестрации — генерация запросов, остановка, использование свидетельств и оценка ответа, — а не ещё один этап реранкинга. Оценивайте её по корректности итогового результата и подтверждению цитатами, а не только по метрикам retrieval.
Источники
Статьи
- Reciprocal Rank Fusion — Cormack et al., 2009
- RankGPT: LLMs as Zero-Shot Listwise Rerankers — Sun et al., EMNLP 2023 Outstanding Paper
- Rank1: Reasoning-Based Reranking — Weller et al., COLM 2025
- Query2doc: LLM Query Expansion — Wang et al., EMNLP 2023
- GPL: Generative Pseudo Labeling — адаптация к домену для dense retrieval
- InRanker: Distilled Reranker — уменьшение размера в 50 раз при сопоставимом качестве
- Search-o1: Agentic Retrieval — Li et al., 2025
- BEIR Benchmark — Thakur et al., NeurIPS 2021
- Sentence-BERT — Reimers & Gurevych, EMNLP 2019
- InfoNCE / CPC — van den Oord et al., 2018
- SimANS: Hard Negative Sampling — Zhou et al., EMNLP 2022
- Passage Reranking with BERT — Nogueira & Cho, 2019
- HNSW — Malkov & Yashunin, 2016
- DiskANN — Subramanya et al., NeurIPS 2019
- RaBitQ — Gao & Long, SIGMOD 2024
- Replacing Judges with Juries — Verga et al., 2024
- RAG-Fusion — Rackauckas, 2024
- InPars — Bonifacio et al., SIGIR 2022
- BRIGHT Benchmark — Su et al., ICLR 2025
- Rank-without-GPT — Zhang et al., ECIR 2025
- Pinterest LLM Search Relevance — Wang et al., 2024
- OmniSearchSage — Agarwal et al., WWW 2024
- PAL: Position-bias Aware Learning — Guo et al., RecSys 2019
Датасеты и бенчмарки
- Amazon ESCI: Shopping Queries Dataset — KDD Cup 2022
- BEIR: Benchmarking IR — разнородный бенчмарк для zero-shot-оценки
- MTEB: Massive Text Embedding Benchmark — лидерборд эмбеддинг-моделей
- ESCI Paper — Reddy et al., 2022
Модели, использованные в демо
- all-MiniLM-L6-v2 — bi-encoder на 22M параметров
- ms-marco-MiniLM-L12-v2 — cross-encoder на 33M параметров
- Sentence-Transformers — фреймворк нейросетевых моделей retrieval
Инструменты и платформы
- rank_bm25 — реализация BM25 на Python
- Pyserini BEIR Reproductions — бейзлайны Lucene BM25 для BEIR
- pytrec_eval — инструментарий оценки TREC
- Elasticsearch — гибридный поиск через Retrievers API
- Vespa — единый движок поиска и рекомендаций
- Weaviate — векторная база данных с гибридным поиском
- Qdrant — векторная база данных с многоэтапными запросами
Отраслевые источники
- Airbnb Listing Embeddings — Grbovic & Cheng, KDD 2018
- Uber Delivery Search — Uber Engineering, 2025
- Uber Two-Tower Embeddings — Uber Engineering, 2023
- Elastic Rerank — Elastic, 2024
Демо-проект
- search-ranking-stack — рабочее демо пайплайна из этой статьи