Search ranking stack: BM25, embeddings en reranking

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Deze gids is bedoeld voor Python-engineers die een search ranking pipeline bouwen of verbeteren. Hij legt uit hoe BM25, dense embeddings, rank fusion en rerankers samenwerken, en hoe je meet of je zoekfunctie betere kandidaten of een betere volgorde nodig heeft.
Een zoekopdracht naar “cheap laptop” kan een product missen dat als “budget notebook computer” is beschreven. Bij een andere fout staat een draagtas voor koptelefoons boven de koptelefoon zelf. Het eerste probleem vraagt om betere kandidaten; het tweede om een betere volgorde.
De bijbehorende demorepository toont retrieval en reranking op een gesampelde selectie van de Amazon ESCI-productzoekdata.
Voor een compacte gids over het kiezen van een fase, zie BM25 vs Embeddings vs Rerankers. De reeks experimenten verderop in dit artikel koppelt elke fase aan een meting.
Lexicale, dense en cross-encoder-modellen
De stack is makkelijker te begrijpen als drie lagen. Lexicale retrieval vindt exacte termen, dense retrieval overbrugt verschillen in woordkeuze en rerankers vergelijken de sterkste kandidaten tot in detail.
BM25 en lexicale retrieval
Decennialang was BM25 de standaard. Het is een probabilistisch model dat documenten scoort op de frequentie van queryterms in het document, genormaliseerd op documentlengte en inverse document frequency (IDF).
BM25 is sterk wanneer letterlijke termen de intentie dragen: foutcodes, product-SKU’s, namen en API-identifiers. De belangrijkste beperking is vocabulary mismatch. Een query naar “cheap laptop” kan een document over een “budget notebook computer” missen als de geïndexeerde tekst geen brug tussen die uitdrukkingen bevat.
Toch vond de BEIR-studie BM25 een sterke zero-shot baseline over de uiteenlopende retrievaltaken. De BM25-cijfers van BEIR komen uit Lucene via Pyserini, niet uit de whitespace-getokeniseerde rank_bm25 die deze demo gebruikt. BM25 verslaat ook sommige neurale models bij argumentatieve retrievaltaken zoals Touche-2020.
Dense retrieval en embeddings
BERT-achtige encoders maakten dense retrieval praktisch bruikbaar. Ze plaatsen queries en documenten in een gedeelde vectorruimte en rangschikken kandidaten daarna met een similarity-functie zoals cosine similarity of dot product.
De bi-encoder (of “two-tower”-architectuur) codeert de query en het document apart en levert embeddings met een vaste lengte op. Documentvectoren kunnen vooraf worden berekend en offline worden geïndexeerd, en worden daarna snel opgehaald met Approximate Nearest Neighbor-algoritmen (ANN). Zo komen “cheap laptop” en “budget notebook” dicht bij elkaar te liggen in de vectorruimte.
Sommige bi-encoders gebruiken een Siamese architectuur, zoals Sentence-BERT, waarbij beide kanten dezelfde weights delen. Andere gebruiken aparte query- en documenttowers. Pooling, vectorgrootte, similarity-functie en trainingsdoel zijn modelkeuzes en geen eigenschappen van elke dense retriever.
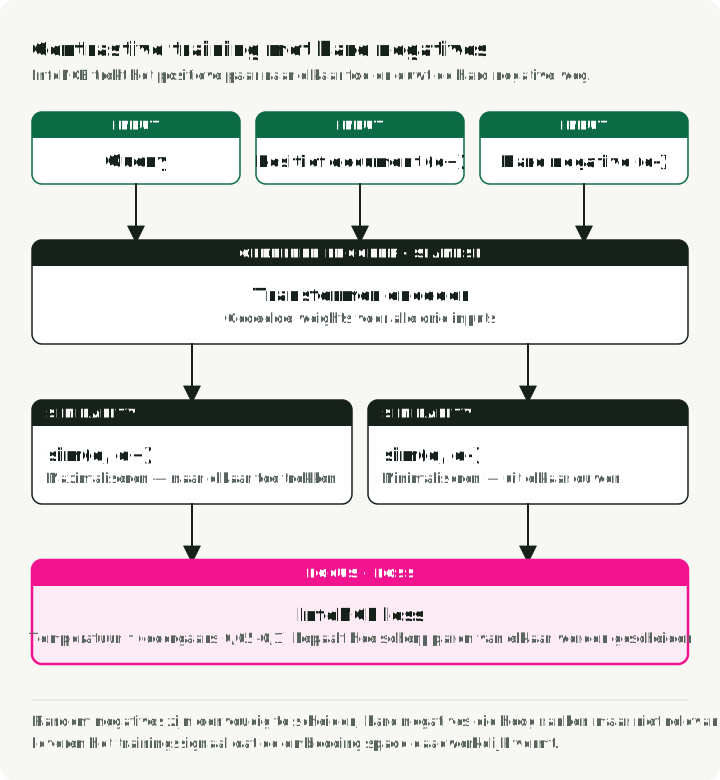
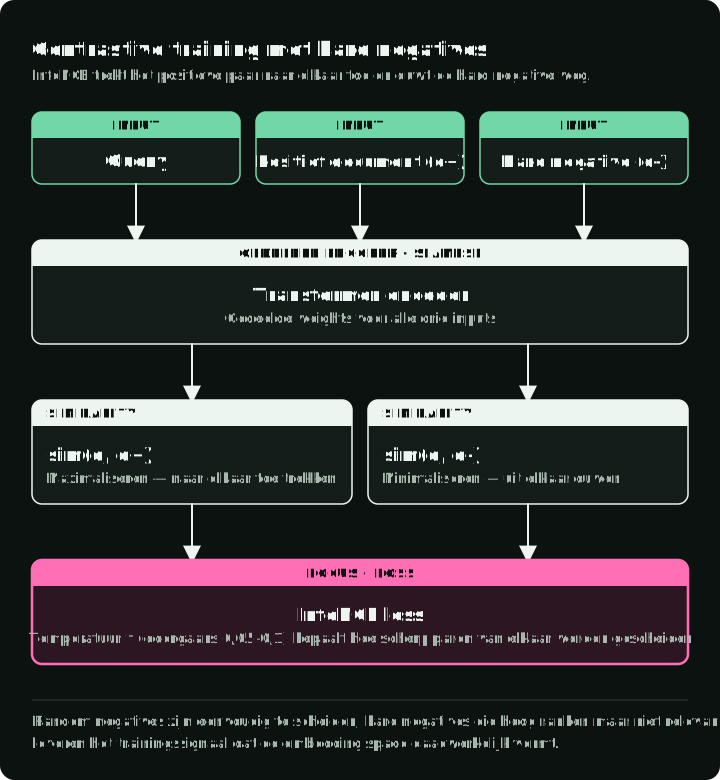
Deze models worden getraind met contrastive learning, meestal met de InfoNCE-loss. Bij een batch van (query, positive_document)-paren maximaliseert het doel sim(query, positive_doc) en minimaliseert het sim(query, negative_docs). De negatives komen uit de positives van andere queries in dezelfde batch (in-batch negatives). Een temperatuurparameter bepaalt hoe scherp het model de twee moet scheiden.
Trainingsdata telt vaak zwaarder dan de embeddingdimensie. Retrievalmodellen leren van paren van een query en een positief document, en van zorgvuldig gekozen hard negatives: aannemelijke maar niet-relevante documenten. In het latere trainingsgedeelte zie je hoe SimANS zowel triviale negatives als waarschijnlijke false negatives vermijdt.
De prijs is de representatie-bottleneck. Bi-encoders persen alle semantische nuance in één vector van vaste grootte, waardoor ze vaak fijne wisselwerkingen tussen specifieke queryterms en specifieke documentinhoud missen.
Cross-encoders en LLMs
Cross-encoders (Nogueira & Cho, 2019) voeren de query en het document samen als één aaneengeschakelde reeks ([CLS] Query [SEP] Document) in een Transformer. Elk querytoken kan daardoor via volledige self-attention naar elk documenttoken kijken. Die diepe interactie vangt nuances op die onafhankelijke codering mist.
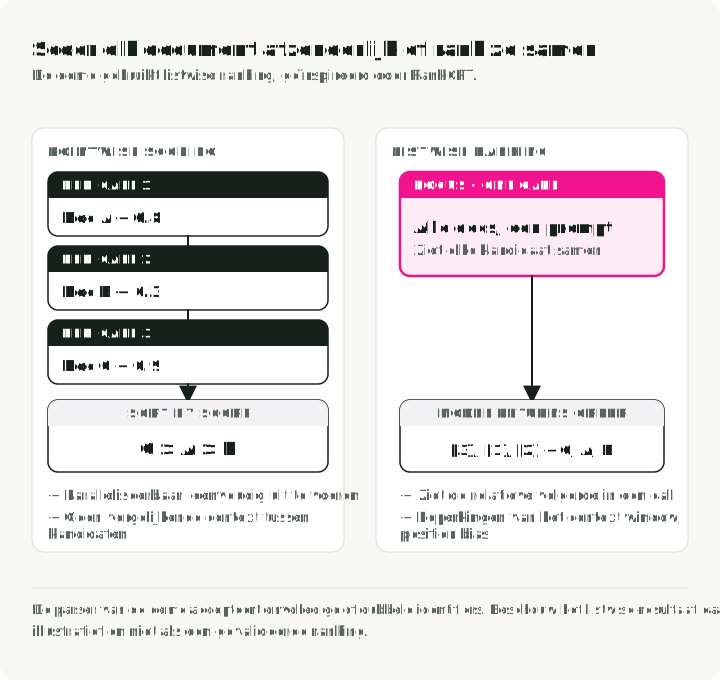
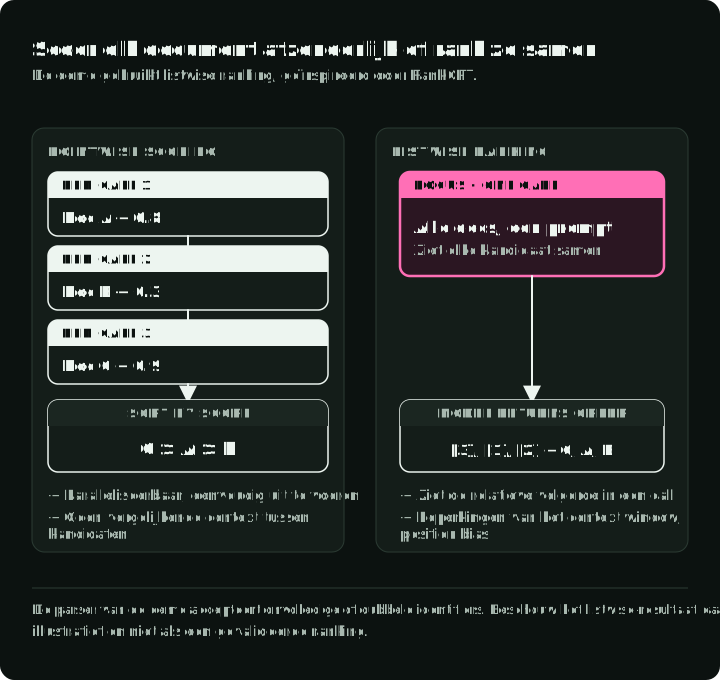
LLM reranking gebruikt een model dat via een prompt meerdere kandidaten tegelijk vergelijkt. RankGPT liet met GPT-4 sterke zero-shot listwise resultaten zien op de geëvalueerde benchmarks, maar stabiliteit van de output, kosten en geschiktheid voor je domein moeten nog apart worden getest.
Deze scores kunnen voor willekeurige queries niet vooraf worden berekend, dus reranking komt na retrieval. Dat kostenverschil is de reden voor de multi-stage trechter.
De multi-stage trechter
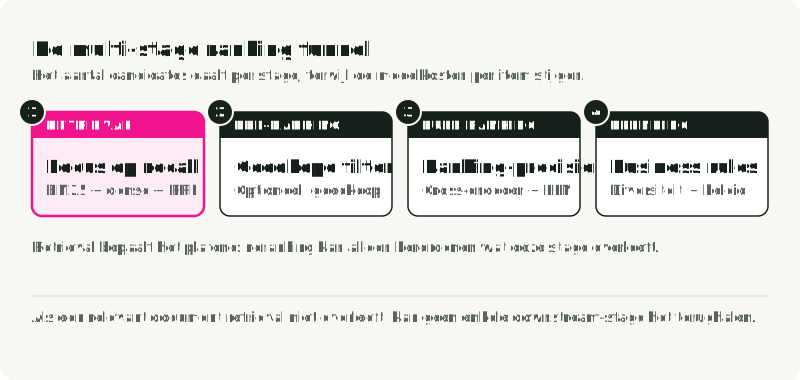
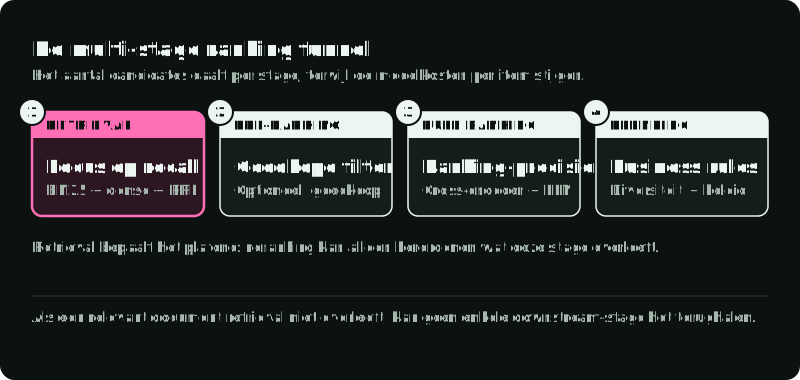
Een dure cross-encoder of LLM over miljoenen documenten draaien is niet haalbaar. Moderne zoekstacks gebruiken daarom een trechter. Retrieval en pre-ranking verkleinen de kandidatenset zodat full ranking duurdere models op een shortlist kan toepassen. Blending past daarna regels of een rankingbeleid toe; de kosten hangen van dat beleid af.
Een goedkope retriever mist bovendien de uiteindelijke precisie, dus de trechter zet elk model alleen in waar de kosten redelijk zijn. De figuur toont het invoervolume van elke fase en schematische modelkosten, en markeert dat latere fasen weggelaten documenten niet kunnen terughalen:
| Fase | Invoerschaal | Hoofddoel | Gangbare methoden | Meting bij uitgang |
|---|---|---|---|---|
| Retrieval | Corpus of index | Recall van kandidaten | BM25, bi-encoders | Recall bij de kandidaat-cutoff |
| Pre-ranking | Grote kandidatenset | Goedkoop filteren | Lichte models, regels | Behouden recall per milliseconde |
| Full ranking | Shortlist | Kwaliteit van de top | Cross-encoders, LLMs | NDCG/MRR, latency, kosten |
| Blending | Definitieve lijsten of posities | Randvoorwaarden en mix | Regels, multi-objective rank | Beleid, diversiteit, zakelijke guardrails |
Een reranker herordent de kandidaten die retrieval teruggeeft; hij kan er geen toevoegen. De dekking van de opgehaalde kandidaten beperkt dus wat latere fasen kunnen terughalen. Bij meer dan 100 kandidaten kan reranking een relevant document naar de top 100 verplaatsen en Recall@100 verbeteren. In deze demo blijven alle 100 kandidaten behouden, dus reranking kan Recall@100 niet veranderen.
Tools per fase
De demo gebruikt kleine in-memory bibliotheken. Buiten een laptop heeft elke fase enkele gangbare implementaties:
| Fase | Tool | Gebruik wanneer |
|---|---|---|
| BM25 | rank_bm25 | Het corpus in het geheugen past en je snel een baseline wilt |
| Elasticsearch, OpenSearch of Lucene via Pyserini | Het corpus een inverted index, analyzers en filters nodig heeft | |
| Dense retrieval | FAISS | Je een ANN-bibliotheek in je eigen service wilt |
| pgvector | De data al in Postgres staat | |
| Qdrant, Weaviate, Vespa of Elasticsearch kNN | Je metadatafilters, frequente updates en een beheerde index nodig hebt | |
| Fusion | Elasticsearch RRF retriever, Qdrant Query API met rrf | Je rank fusion binnen de zoekmachine wilt |
| Weaviate hybrid search | Je Weaviate gebruikt; het biedt ranked fusion en relative-score fusion | |
| Embedding models | De retrievaltab van MTEB, daarna je eigen beoordeelde queries | Je een model kiest; het leaderboard beperkt de lijst, je eigen queries beslissen |
| Reranker | ms-marco-MiniLM-L12-v2 | Engelse tekst, CPU-budget |
bge-reranker-v2-m3 | Meertalige tekst | |
| Elastic Rerank | Engelse tekst die al in Elasticsearch staat; vereist een geschikt abonnement of een trial |
De demo: een pipeline met vijf fasen
Om dit concreet te maken bouwde ik een search-ranking-stack-demo die een pipeline met vijf fasen draait op de productzoekbenchmark Amazon ESCI. Elke fase schrijft metrics weg.
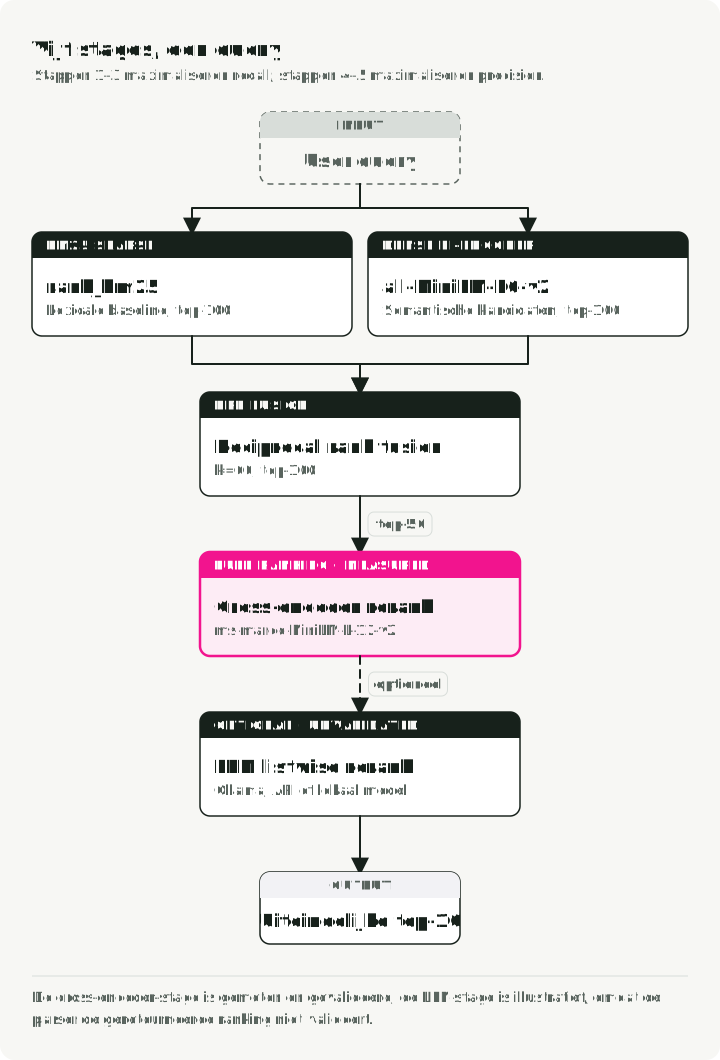
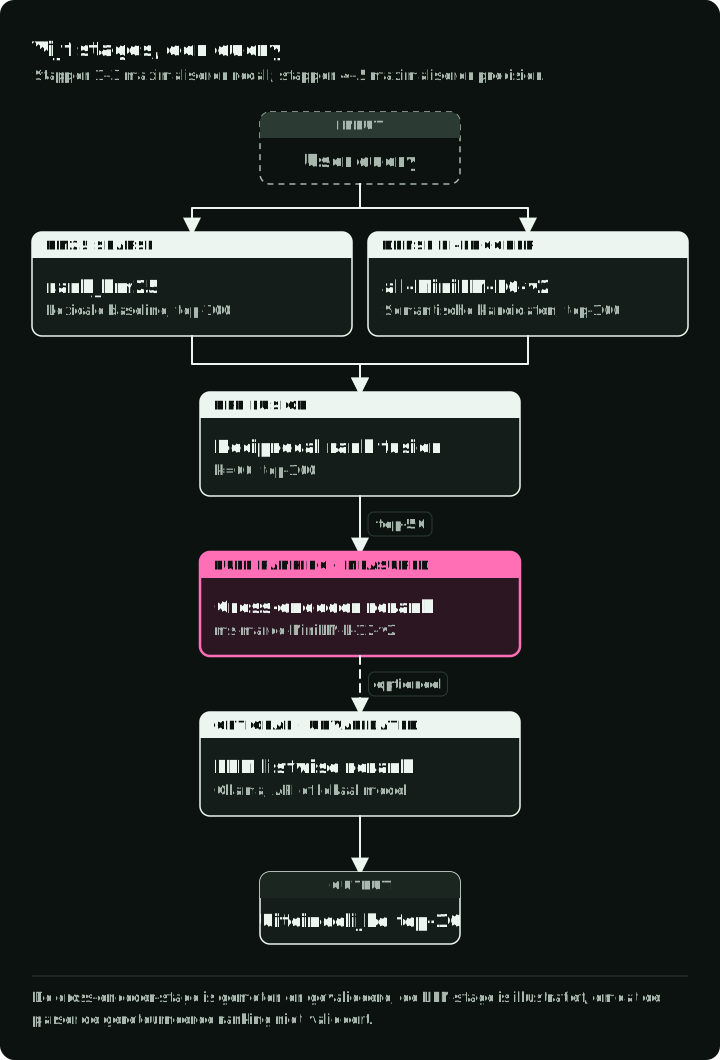
De pipeline:
- BM25 sparse retrieval — lexicale baseline (
rank_bm25) - Dense bi-encoder retrieval — semantische kandidaatgeneratie (
all-MiniLM-L6-v2) - Hybride RRF-fusion — rank-gebaseerde fusion van sparse en dense resultaten
- Cross-encoder reranking — pairwise relevantiescores (
ms-marco-MiniLM-L12-v2) - LLM listwise reranking — via een prompt vergelijken van de definitieve shortlist (Ollama, API of lokaal model)
Stap 1—3 vormen de retrieval-fase van de trechter (recall maximaliseren); stap 4—5 vormen de full ranking-fase (precisie maximaliseren). De demo slaat pre-ranking en blending over. Het diagram toont het aantal kandidaten per stap: de cross-encoder scoort de eerste 50 van 100 hybride kandidaten en laat de rest in hybride volgorde staan, en de LLM ziet de eerste 10.
Quick start
De downloadstap haalt de dataset één keer op en schrijft een kleine sample. run-all draait daarna elke fase, print één metricsrij per fase en schrijft de rijen naar results/metrics.json en een grafiek naar results/metrics_comparison.png. Voeg --llm-mode toe om de LLM-fase mee te nemen.
git clone https://github.com/slavadubrov/search-ranking-stack.git
cd search-ranking-stack
uv sync

# Download and sample ESCI dataset (~2.5GB download, ~5MB sample)
uv run download-data

# Run BM25, dense, hybrid RRF, and the cross-encoder
uv run run-all

# Add LLM reranking with a local Ollama model (ollama pull llama3.2:3b first)
uv run run-all --llm-mode ollama
Dataset en sampling: Amazon ESCI
De demo gebruikt de Amazon Shopping Queries Dataset (ESCI) van KDD Cup 2022 — een echte productzoekbenchmark met relevantielabels op vier niveaus:
| Label | Gain | Betekenis | Voorbeeld (query: “wireless headphones”) |
|---|---|---|---|
| Exact (E) | 3 | Voldoet aan alle eisen van de query | Sony WH-1000XM5 Wireless Headphones |
| Substitute (S) | 2 | Functioneel alternatief | Koptelefoon met kabel en Bluetooth-adapter |
| Complement (C) | 1 | Verwant nuttig item | Draagtas voor een koptelefoon |
| Irrelevant (I) | 0 | Geen betekenisvol verband | USB-oplaadkabel |
Gegradeerde relevantie is belangrijk omdat je er NDCG (Normalized Discounted Cumulative Gain) mee kunt gebruiken. Die onderscheidt een “perfecte” ranking van een “slechts voldoende”. Binaire metrics geven beide dezelfde score.
Ik gebruikte de small_version-sample van de demo: 500 queries, 9,870 producten en 9,984 beoordelingen. De downloader leest de enige train-split van tasksource/esci, filtert op de Engelse us-locale en small_version == 1, en trekt daarna met seed 42 zonder teruglegging maximaal 500 unieke query-ID’s. Het corpus bevat de unieke producten uit de geselecteerde beoordelingsrijen. Dit is geen held-out split en ook geen onafhankelijk corpus. De sample is klein genoeg voor een laptop, maar te klein en te domeinspecifiek om een productieranking mee vast te stellen. Gebruik haar om de fasen te reproduceren en foutpatronen te bekijken; gebruik held-out, representatieve queries voor beslissingen over deployment.
Evaluatie: meten wat telt
De demo gebruikt drie metrics, die elk vanuit een andere hoek naar de ranking kijken. De figuur past alle drie toe op de resultaten van één query, met de ESCI-gains van hierboven:
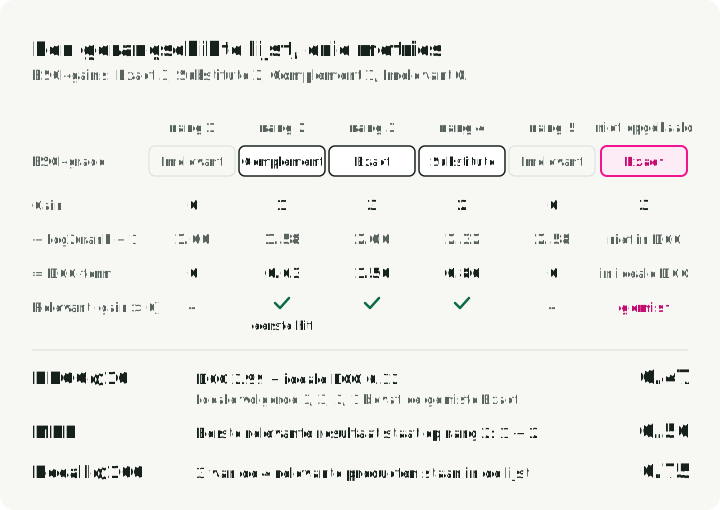
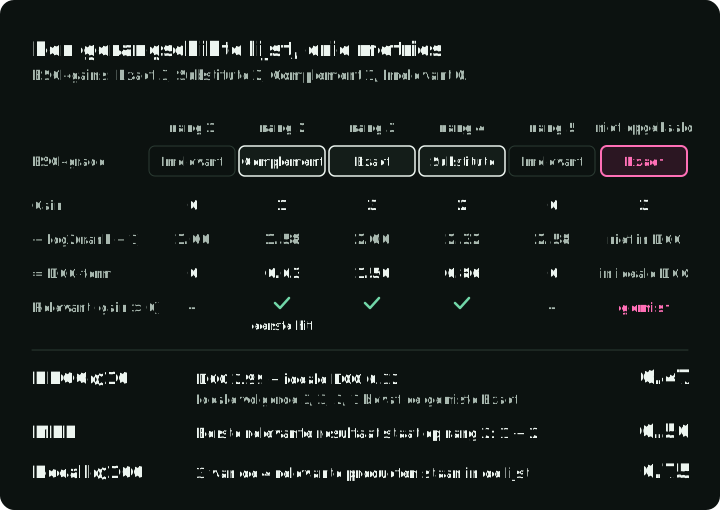
NDCG@10 (hoofdmetric)
Normalized Discounted Cumulative Gain meet de kwaliteit van de top-10-ranking met gegradeerde relevantie. Het beloont het hoog plaatsen van zeer relevante documenten met een logaritmische korting:
Dit komt overeen met de lineaire gains van ndcg_cut in trec_eval, via pytrec_eval gekozen als ndcg_cut_10. IDCG is de DCG van de ideale volgorde van de beoordeelde grades; een query zonder positieve gain krijgt nul. Exponentiële gains zoals vormen een andere conventie en zouden deze cijfers veranderen.
Van de drie is NDCG de enige metric die de vier relevantieniveaus van ESCI volledig benut. Een systeem dat een Exact-match op positie 1 zet, scoort hoger dan een systeem dat daar een Substitute zet. Daarom is dit hier de hoofdmetric.
MRR (eerste resultaat van Complement of hoger)
Mean Reciprocal Rank gebruikt de positie van het eerste resultaat dat als relevant telt. In deze demo geeft de evaluator de relevantiebeoordelingen van ESCI door aan pytrec_eval en gebruikt hij recip_rank over elke teruggegeven lijst van maximaal 100 kandidaten. De binaire drempel is relevance > 0: Complement (1), Substitute (2) en Exact (3) tellen als relevant. Irrelevant (0) niet. Een relevant resultaat op positie 1 geeft een reciprocal rank van 1.0; op positie 3 is het 0.333. Dit is MRR over de teruggegeven kandidatenlijsten, niet MRR@10.
Recall@100 (retrievaldekking)
Recall@100 meet welk deel van de beoordeelde relevante documenten in de top 100 staat. Het blijft gelijk bij reranking van dezelfde 100 kandidaten, zoals in deze demo. Met een grotere kandidatenset kan reranking een relevant document naar de top 100 verplaatsen en de metric verhogen, maar het kan geen document terughalen dat retrieval heeft weggelaten.
De noemer bevat alleen beoordeelde relevante documenten, zoals in de recallimplementatie van trec_eval. Een onbeoordeeld product levert geen positieve relevantie op en staat niet in die noemer. Onvolledige beoordelingen kunnen er daardoor voor zorgen dat gemeten recall afwijkt van de dekking van alle werkelijk relevante producten.
Retrieval: hybrid search
De taak van de retrievallaag is recall te maximaliseren: zoveel mogelijk relevante documenten in de kandidatenset krijgen.
BM25: de lexicale baseline
BM25 scoort documenten op overlap van termen met de query, met verzadiging van term frequency en normalisatie van documentlengte:
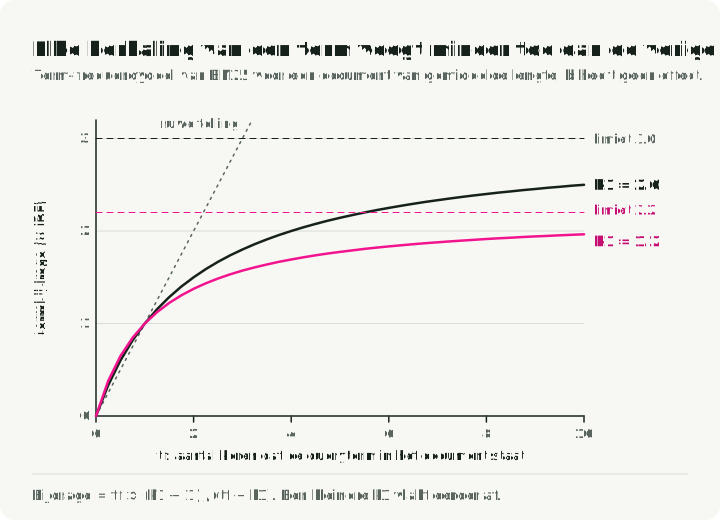
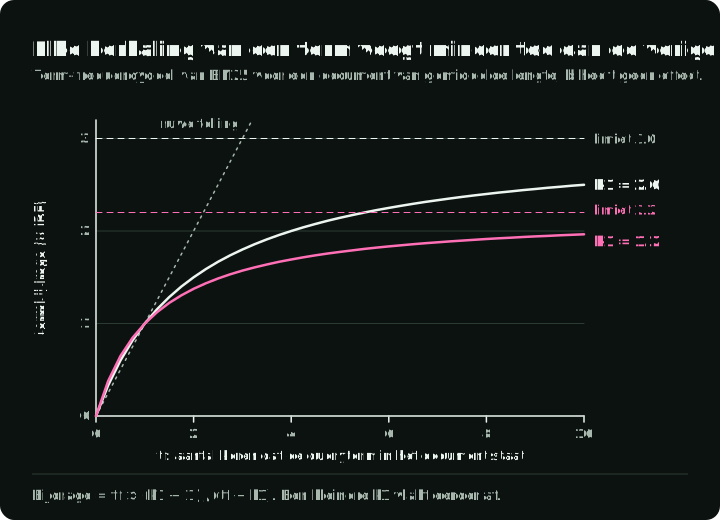
Hierbij is de inverse document frequency van term , is de term frequency in document , is de documentlengte en is de gemiddelde documentlengte over het corpus. Twee parameters tellen: (meestal 1.2—2.0) bepaalt de TF-verzadiging — hoe snel herhaalde termen geen waarde meer toevoegen — en (meestal 0.75) bepaalt de normalisatie van documentlengte.
De grafiek toont het term-frequencydeel van de formule voor beide uiteinden van het gebruikelijke -bereik:
De implementatie is kort. Gewone whitespace tokenization met rank_bm25:
# src/search_ranking_stack/stages/s01_bm25.py

from rank_bm25 import BM25Okapi

def run_bm25(data: ESCIData, top_k: int = 100):
    doc_ids = list(data.corpus.keys())
    tokenized_corpus = [text.lower().split() for text in data.corpus.values()]

    bm25 = BM25Okapi(tokenized_corpus)

    results = {}
    for query_id, query_text in data.queries.items():
        scores = bm25.get_scores(query_text.lower().split())
        top_indices = np.argsort(scores)[::-1][:top_k]
        results[query_id] = {doc_ids[idx]: float(scores[idx]) for idx in top_indices}

    return results
BM25 haalt een Recall@100 van 0.741 — 74% van de beoordeelde relevante producten staat ergens in de top 100. Een reranker die alleen die BM25-lijst krijgt, kan de ontbrekende 26% van de beoordeelde relevante items niet terughalen.
Dense bi-encoder retrieval
De bi-encoder zet queries en documenten onafhankelijk van elkaar om in een gedeelde embeddingruimte:
# Simplified from src/search_ranking_stack/stages/s02_dense.py

import numpy as np
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("sentence-transformers/all-MiniLM-L6-v2")
doc_texts = ["Sony WH-1000XM5 Wireless Headphones", "Headphone carrying case"]
query_texts = ["wireless headphones"]

# Encode corpus once, cache to disk
corpus_embeddings = model.encode(
    doc_texts,
    batch_size=128,
    normalize_embeddings=True,  # Cosine sim = dot product
    convert_to_numpy=True,
)

# At query time: encode query, compute dot product
query_embeddings = model.encode(query_texts, normalize_embeddings=True)
similarity_matrix = np.dot(query_embeddings, corpus_embeddings.T)
Bij genormaliseerde embeddings is cosine similarity gelijk aan een dot product. De demo berekent de volledige query-bij-corpus-matrix, omdat 9,870 documenten ruim in het geheugen passen; een productiecorpus zou normaal een approximate-nearest-neighbor-index gebruiken. In deze sample verhoogt all-MiniLM-L6-v2 de Recall@100 van 0.741 naar 0.825.
Hoe bi-encoders goede representaties leren
Pretraining van een encoder en fine-tuning van embeddings lossen verschillende problemen op. Een voorgetrainde Transformer levert tokenrepresentaties; contrastieve fine-tuning leert een gepoolde vector welke teksten dicht bij elkaar horen. NLI-, zinsgelijkenis- en query-passagedata zijn mogelijke ingrediënten, geen vaste volgorde. De modelkaart van all-MiniLM-L6-v2 uit de demo beschrijft een voorgetrainde MiniLM-encoder die is gefinetuned op meer dan een miljard heterogene zinsparen.
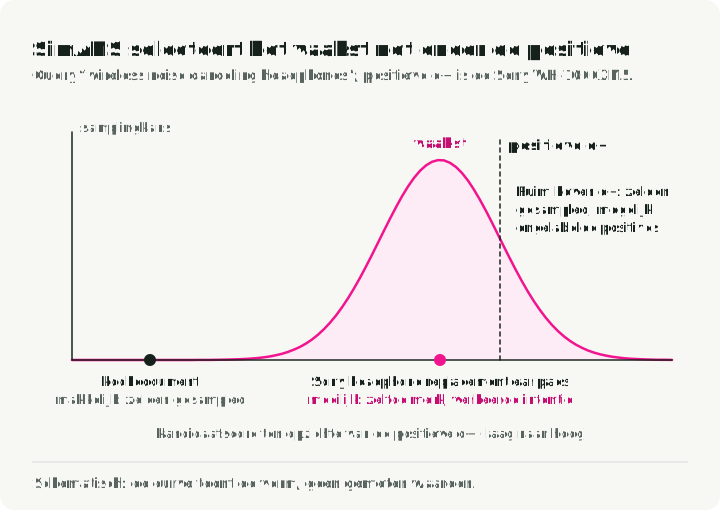
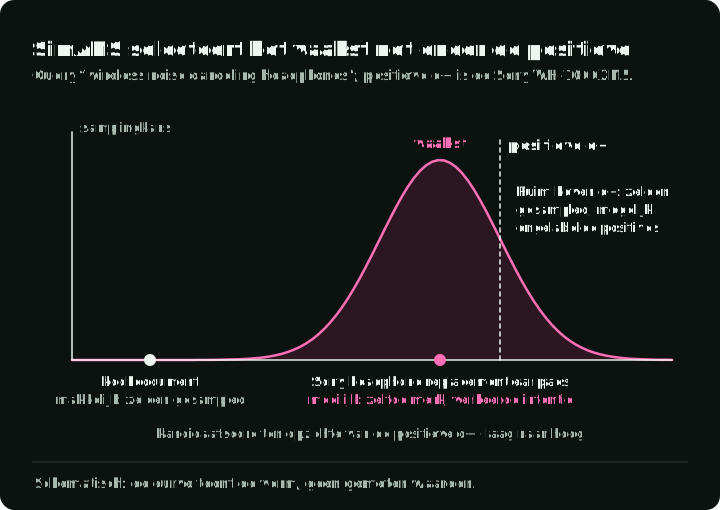
Fine-tuning voor retrieval kan hard negative mining gebruiken. Willekeurige negatives, zoals een kookdocument bij een query over koptelefoons, zijn mogelijk te makkelijk om veel van te leren. Een retriever kan in plaats daarvan aannemelijke kandidaten aanleveren die volgens de beoordelingen niet relevant zijn. Onbeoordeelde documenten met een hoge score vragen om voorzichtigheid: sommige zijn misschien ontbrekende positives.
SimANS trekt negatives uit een kansverdeling die geconcentreerd is rond de relevantiescore van het positieve document. Het legt minder nadruk op zowel makkelijke negatives als op de kandidaten met de hoogste score, die false negatives kunnen zijn. Dit is gewogen sampling uit opgehaalde kandidaten, geen harde regel die elk document boven of onder een rangdrempel uitsluit. De curve toont hoe vaak een opgehaalde kandidaat wordt getrokken, naar zijn score ten opzichte van het positieve document:
# What a training triplet looks like after hard negative mining
training_triplet = {
    "query": "wireless noise canceling headphones",
    "positive": "Sony WH-1000XM5 Wireless Noise Cancelling Headphones",
    "negative": "Sony headphone replacement ear pads",  # Hard negative: same brand, related product, but wrong intent
}
# The bi-encoder must learn that "ear pads" is NOT what the user wants,
# even though it shares many tokens with the positive document.
De contrastive loss-functie (InfoNCE) brengt dit samen. Voor elke query met positief document en een set negatieve documenten :
Hierbij is de cosine similarity tussen de embeddings van query en document, en is de temperatuurparameter (meestal 0.05—0.1). Lagere waarden maken de loss gevoeliger voor hard negatives. Het is een softmax cross-entropy: de similarity van het positieve paar omhoog duwen ten opzichte van alle negatives. Bij een kleine geven zelfs lichte verschillen in similarity grote gradients, wat het model dwingt fijnere onderscheidingen te maken.
Bi-encoder-embeddings op schaal serveren
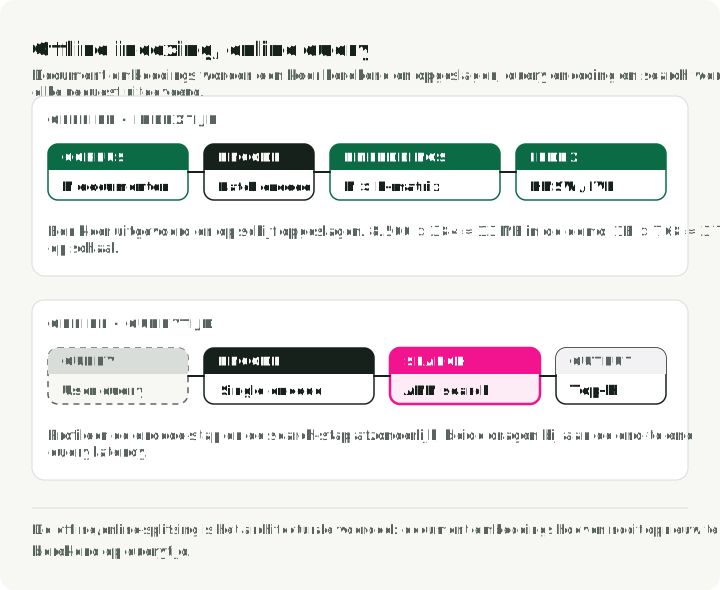
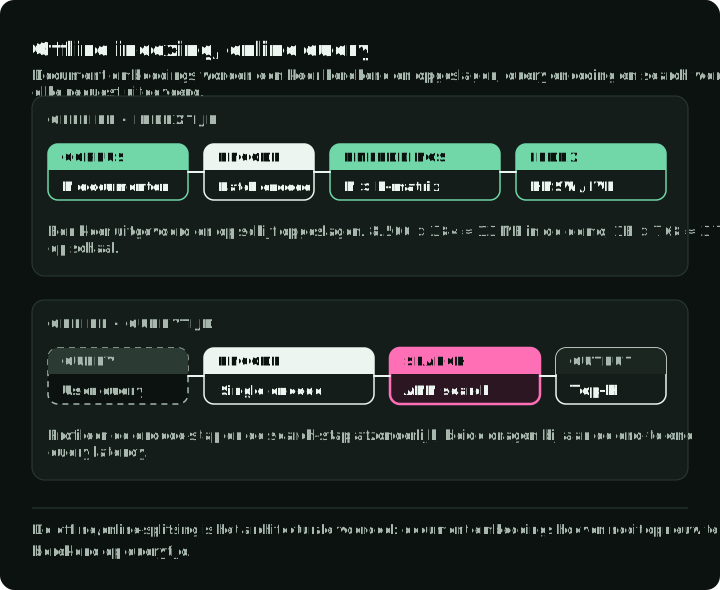
Het architecturale voordeel van een bi-encoder is de offline/online-splitsing. Documentembeddings worden bij het indexeren berekend en in een vectorindex opgeslagen. Op querytijd codeert het systeem de query en zoekt het in die opgeslagen vectoren. De latency hangt af van de encoder, de hardware, de index, de filters en het recalldoel, dus profileer beide stappen apart.
In de demo valt de rekensom mee: 9,870 documenten 384 dimensies 4 bytes per float = ~15 MB aan embeddings. Op productieschaal is dat niet meer zo: 1 miljard documenten met embeddings van 768 dimensies hebben ~3 TiB opslag nodig. Daar komen quantization (32-bit floats comprimeren tot 8-bit integers), product quantization (vectoren opsplitsen in deelruimtes) en SSD-gebaseerde indexen zoals DiskANN om de hoek kijken. De sectie over het indexeren van dense vectoren behandelt de indexalgoritmen.
Waarom hybride retrieval testen
De twee methoden falen vaak op verschillende manieren. BM25 past goed bij eigennamen, product-SKU’s en foutcodes. Dense retrieval kan vocabulary mismatch opvangen, zoals “cheap laptop” tegenover “budget notebook computer”. Of fusion helpt, hangt af van hoe vaak die complementaire gevallen voorkomen in de doelverzameling queries.
Een gebruikelijk vervolgexperiment is hybrid search: beide retrievalmethoden draaien en hun gerangschikte lijsten daarna samenvoegen.
Reciprocal rank fusion (RRF)
BM25 en dense retrieval leveren scores op met verschillende betekenis en schaal. Een lineaire combinatie vraagt daarom om calibration en validatie telkens wanneer de retrievers of het corpus veranderen.
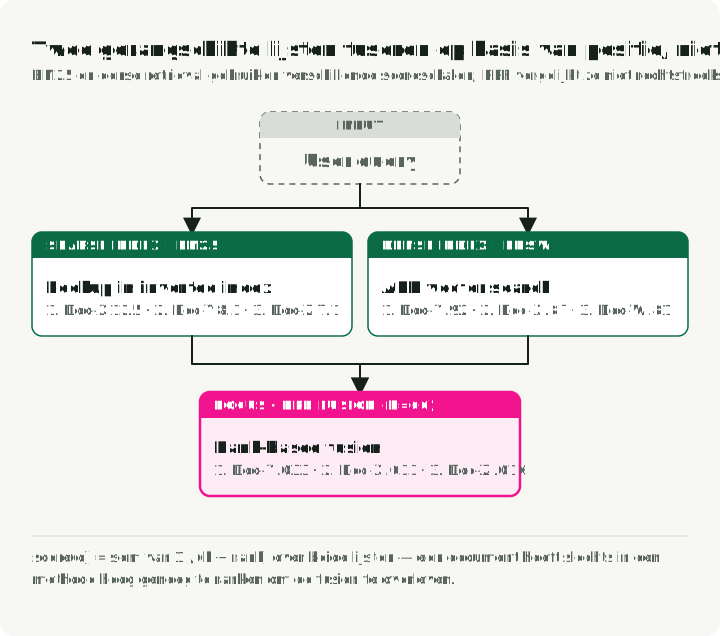
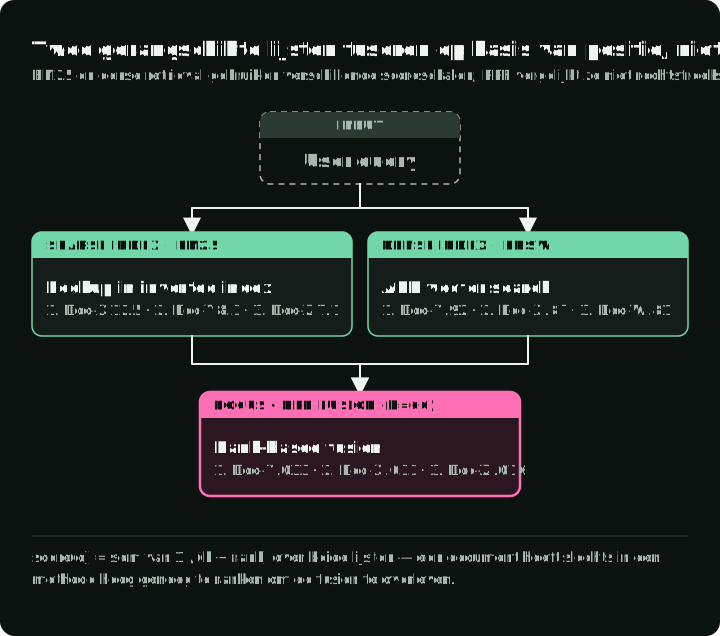
Reciprocal Rank Fusion (Cormack et al., 2009) laat de ruwe scores helemaal vallen en gebruikt alleen de rangpositie:
Hierbij is een smoothingconstante; 60 is een gangbare beginwaarde. RRF beloont items die over de invoerlijsten heen dicht bij de top staan, zonder hun ruwe scores te vergelijken. Het voorkomt calibration van de scoreschaal, maar de retrievalcutoffs, de weights en vragen nog steeds om evaluatie.
De implementatie:
# src/search_ranking_stack/stages/s03_hybrid_rrf.py

from collections import defaultdict

def reciprocal_rank_fusion(ranked_lists, k=60, top_k=100):
    all_query_ids = set().union(*(results.keys() for results in ranked_lists))
    fused_results = {}

    for query_id in all_query_ids:
        rrf_scores = defaultdict(float)

        for results in ranked_lists:
            sorted_docs = sorted(results.get(query_id, {}).items(),
                                 key=lambda x: x[1], reverse=True)

            for rank, (doc_id, _score) in enumerate(sorted_docs, start=1):
                rrf_scores[doc_id] += 1.0 / (k + rank)

        sorted_rrf = sorted(rrf_scores.items(),
                            key=lambda x: x[1], reverse=True)[:top_k]
        fused_results[query_id] = dict(sorted_rrf)

    return fused_results
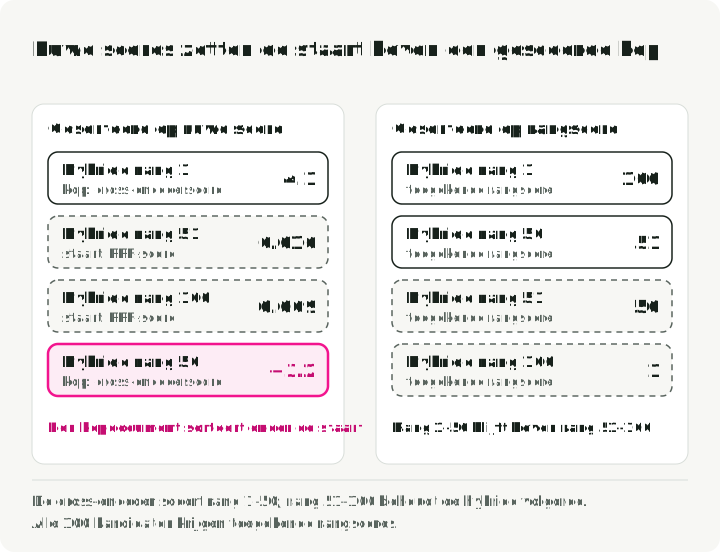
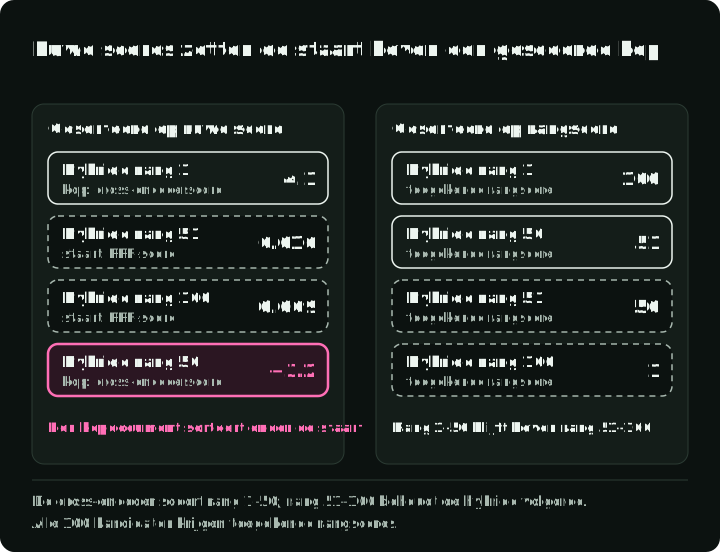
Hybride RRF komt uit op een Recall@100 van 0.842 en een NDCG@10 van 0.628 — beter dan BM25 (0.585) en Dense (0.611) afzonderlijk. Een document dat slechts één retriever vindt, krijgt nog steeds een RRF-score, maar kan onder de cutoff van de top 100 vallen. Met scoort rang 1 in één lijst , minder dan rang 50 in beide lijsten (). Overlap kan dus zwaarder wegen dan een hoge rang in één lijst.
Cross-encoder reranking
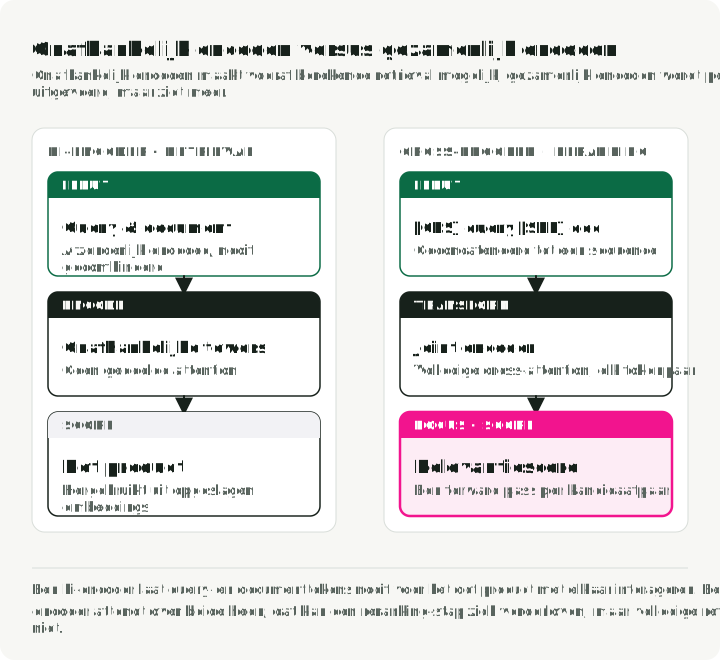
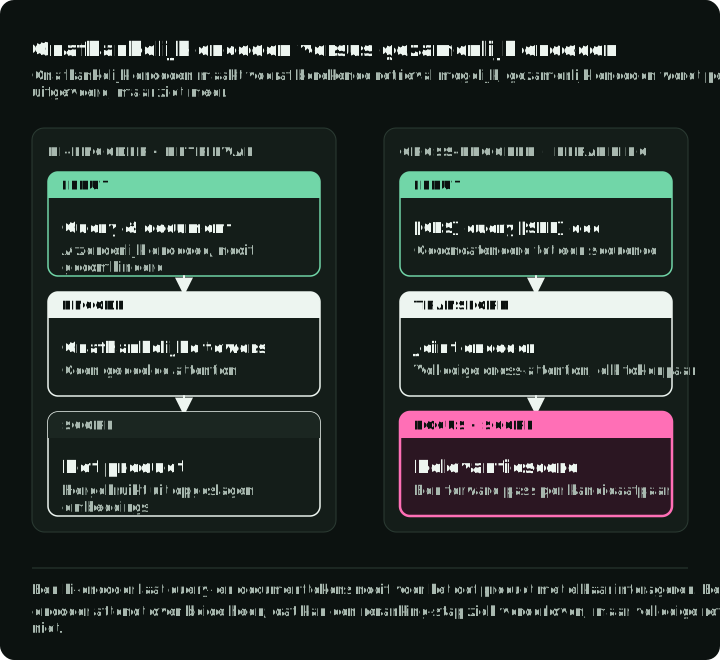
Met 100 hybride kandidaten per query kun je je een duurder model veroorloven. De cross-encoder verwerkt de query en het document samen in één Transformer, met self-attention over de gecombineerde query en het document.
Interactie op tokenniveau
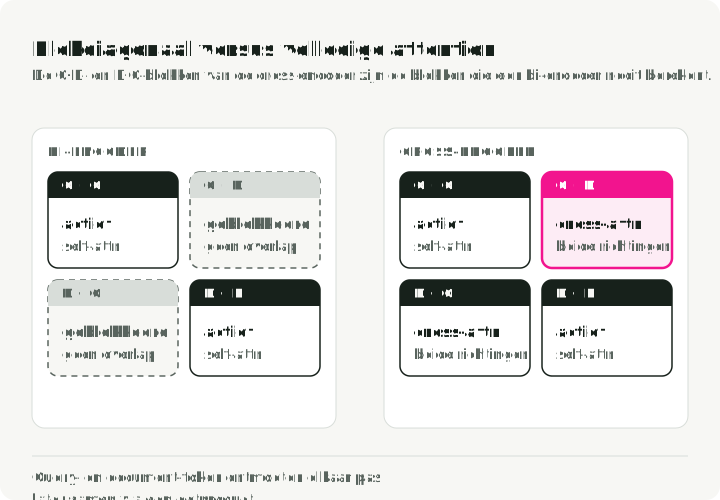
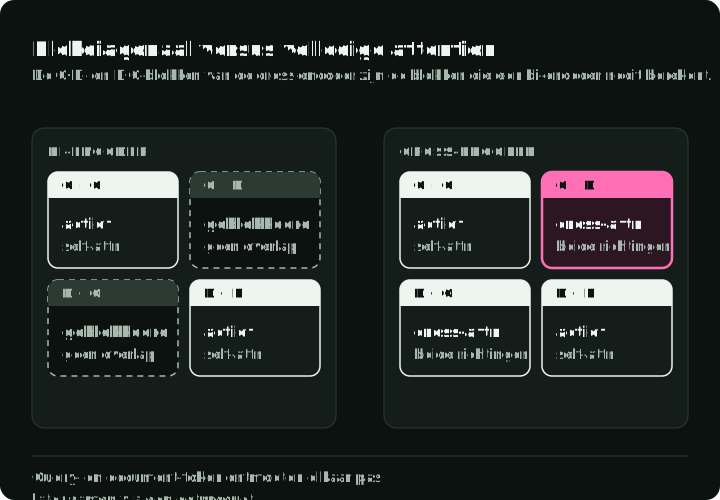
Het verschil zit in de attention-matrix. In een bi-encoder is attention blokdiagonaal: querytokens kijken alleen naar andere querytokens en documenttokens alleen naar andere documenttokens. De twee representaties ontmoeten elkaar op tokenniveau nooit — ze kruisen elkaar pas aan het eind via een dot product. Een cross-encoder berekent de volledige attention-matrix, waarin elk querytoken naar elk documenttoken kijkt en omgekeerd. Door die gezamenlijke self-attention kan het model query- en documenttokens direct vergelijken.
In een bi-encoder wordt de query gecodeerd voordat een document is gezien. Een cross-encoder ziet de query en de kandidaat samen en kan dus hun relatie op tokenniveau gebruiken. Dat kan helpen bij gevallen zoals:
- Negatie: “headphones that are not wireless”. Een gepoolde embedding kan de negatie ondergewichten, terwijl gezamenlijke codering het model een directe query-documentinteractie geeft. Dit is een hypothese die je met een gerichte slice moet toetsen, geen garantie.
- Kwalificatie: “laptop under $500”. Gezamenlijke codering kan de voorwaarde koppelen aan een prijs in de producttekst, maar gestructureerde prijsfilters zijn veiliger als het veld beschikbaar is.
De invoer van de cross-encoder heeft de vorm [CLS] query tokens [SEP] document tokens [SEP]. [CLS] is een classificatietoken waarvan de laatste hidden state via een lineaire head één relevantiescore oplevert. Segment embeddings onderscheiden querytokens van documenttokens, en [SEP] markeert de grens tussen segmenten.
Hoe cross-encoders worden getraind
Cross-encoders kunnen leren van (query, document, relevance_label)-voorbeelden met pointwise, pairwise of listwise doelstellingen. Een pointwise voorbeeld koppelt “wireless headphones” aan “Sony WH-1000XM5 Wireless Headphones” en het label 1.0.
Een gangbare classifier zet de laatste [CLS]-representatie om in een score. Binaire labels kunnen binary cross-entropy gebruiken; gegradeerde relevantie kan regressie, ordinale, pairwise of listwise losses gebruiken. Kies op basis van held-out rankingmetrics, en ga er niet van uit dat één doelstelling altijd beter is.
Hard negative mining helpt ook bij het trainen van cross-encoders. Cross-encoders zijn duur om te trainen — elk trainingsvoorbeeld vraagt een volledige forward pass over de aaneengeschakelde reeks — dus je kunt je geen verspilde rekenkracht aan triviaal makkelijke negatives permitteren. Het praktische recept: gebruik een bi-encoder om voor elke trainingsquery de top-K kandidaten op te halen en haal de hard negatives uit specifieke rangbereiken (bijvoorbeeld rang 10–100). Zo krijgt de cross-encoder voorbeelden waarbij het onderscheid tussen relevant en irrelevant diepe tokeninteractie vraagt.
De opgehaalde kandidaten reranken
De fase stuurt (query, document)-paren voor de eerste 50 hybride kandidaten naar CrossEncoder.predict, zet die kandidaten op scorevolgorde en voegt daarna de niet-gescoorde kandidaten in hun vorige volgorde toe. De figuur sorteert vier van de 100 kandidaten op beide manieren en toont waarom de merge nieuwe rangscores toekent in plaats van de ruwe scores te behouden:
# From src/search_ranking_stack/stages/s04_cross_encoder.py

def rank_scores(ordered_ids):
    return {doc_id: float(len(ordered_ids) - rank) for rank, doc_id in enumerate(ordered_ids)}

def merge_head_and_tail(original, scored_head):
    """original: hybrid (doc_id, rrf_score) pairs in rank order.
    scored_head: (doc_id, cross_encoder_score) pairs for the first len(scored_head)."""
    head = sorted(scored_head, key=lambda item: (-item[1], item[0]))
    tail = original[len(scored_head) :]
    return rank_scores([doc_id for doc_id, _ in head + tail])
De volledige fase voegt het laden van het model toe, de documentcutoff van 2,048 tekens en een controle dat elke score eindig is.
De modelkaart laat zien dat cross-encoder-scores negatief kunnen zijn. Meng ze niet met de RRF-scores van de ongescoorde staart: een positieve RRF-score kan een ongescoord staartdocument boven een negatief gescoord kopdocument sorteren. Ken strikt dalende rangscores toe, zoals rank_scores doet. Dit zijn rangscores voor evaluatie, geen gekalibreerde relevantieschattingen.
De afweging tussen snelheid en kwaliteit
Waarom niet overal cross-encoders voor gebruiken? Omdat je de scores niet vooraf kunt berekenen. De documentembeddings van een bi-encoder zijn onafhankelijk van de query, dus je berekent ze één keer en slaat ze op. De output van een cross-encoder hangt af van de query en het document samen. De relevantiescore voor “wireless headphones” naast een Sony-product komt voort uit de gezamenlijke self-attention tussen precies die tokens. Je kunt een herhaald query-documentpaar cachen, maar zijn score is niet te hergebruiken voor een andere query.
Een bi-encoder heeft één querycodering plus een vector search over vooraf berekende documentembeddings nodig. Een cross-encoder scoort elk query-documentpaar in de shortlist, met kosten die meegroeien met zowel het aantal kandidaten als de lengte van de reeks. Batching helpt, maar 100,000 kandidaten scoren blijft het verkeerde werkpunt; haal eerst op en benchmark de grootste shortlist die aan de doelen voor kwaliteit en latency voldoet.
LLM listwise reranking
De laatste demofase gebruikt een LLM voor listwise reranking. In plaats van elk document onafhankelijk te scoren, ziet het model de top 10 en geeft het een volgorde terug. De prompt is geïnspireerd op RankGPT en maakt relatieve vergelijking expliciet, maar brengt ook beperkingen van de context window, position bias, parsefouten en variatie tussen runs met zich mee.
De listwise prompt
De prompttemplate vraagt de LLM rekening te houden met de ESCI-relevantiehiërarchie:
# src/search_ranking_stack/stages/s05_llm_rerank.py

def _create_listwise_prompt(query, documents, max_words=200):
    n = len(documents)

    doc_texts = []
    for i, (_doc_id, doc_text) in enumerate(documents, start=1):
        words = doc_text.split()[:max_words]
        doc_texts.append(f"[{i}] {' '.join(words)}")

    docs_formatted = "\n\n".join(doc_texts)

    return (
        f"I will provide you with {n} product listings, each indicated by a numerical "
        f"identifier [1] to [{n}]. Rank the products based on their relevance to the "
        f'search query: "{query}"\n\n'
        "Consider:\n"
        "- Exact matches (product satisfies all query requirements) should rank highest\n"
        "- Substitutes (functional alternatives) should rank above complements\n"
        "- Completely irrelevant products should rank lowest\n\n"
        f"{docs_formatted}\n\n"
        "Rank the products from most relevant to least relevant.\n"
        "Output ONLY a comma-separated list of product identifiers, e.g.: [3], [1], [2], ...\n"
        "Do not explain your reasoning. Only output the ranking."
    )
Drie uitvoeringsmodi
De demo ondersteunt drie backends voor LLM reranking:
| Modus | Model | Hoe het draait |
|---|---|---|
ollama | llama3.2:3b (wijzig met OLLAMA_MODEL) | Lokaal via de Ollama API |
api | Claude Haiku (stel LLM_MODEL_API in config.py in) | Anthropic API; eerst uv sync --extra api |
local | Qwen/Qwen2.5-1.5B-Instruct | HuggingFace Transformers; eerst uv sync --extra llm |
Parsing en fallback
De parser haalt de genummerde identifiers uit het antwoord van het model. Hij accepteert een ranking alleen als die elke kandidaat precies één keer noemt:
# src/search_ranking_stack/stages/s05_llm_rerank.py

def _parse_ranking(output: str, n: int) -> list[int] | None:
    """Return 0-based positions if the output ranks IDs 1..n exactly once."""
    positions = [int(m) - 1 for m in re.findall(r"\[(\d+)\]", output)]

    # Reject missing, duplicate, and out-of-range IDs.
    if sorted(positions) != list(range(n)):
        return None

    return positions
Als de parser None teruggeeft, behoudt de demo voor die query de volledige volgorde van de cross-encoder en telt een fallback. Een fout in de backend telt ook als fallback. run-all print het fallbackpercentage en slaat het naast de metrics op. Bijvoorbeeld: [3] > [1] > [3] wordt afgewezen: ID 3 komt twee keer voor en ID 2 en 4 tot en met 10 ontbreken.
Resultaten van deze ESCI-sample
De resultaten gebruiken de hierboven beschreven small_version-sample; die is niet held-out. De rijen komen uit één run van uv run run-all --llm-mode ollama met llama3.2:3b als LLM.
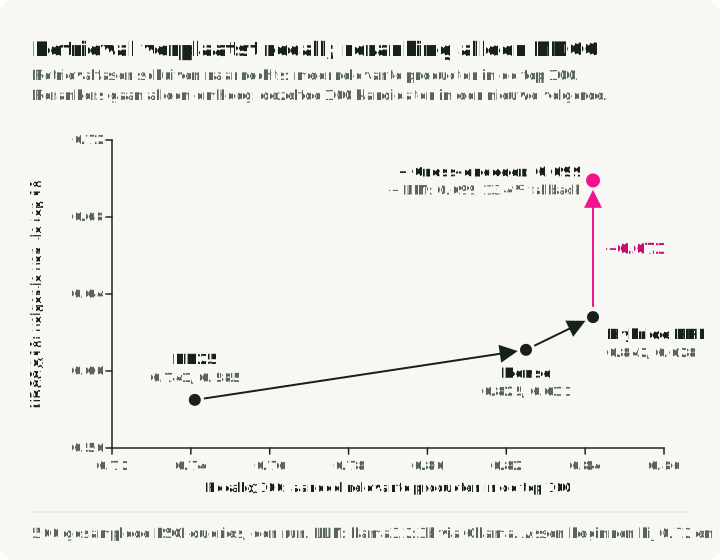
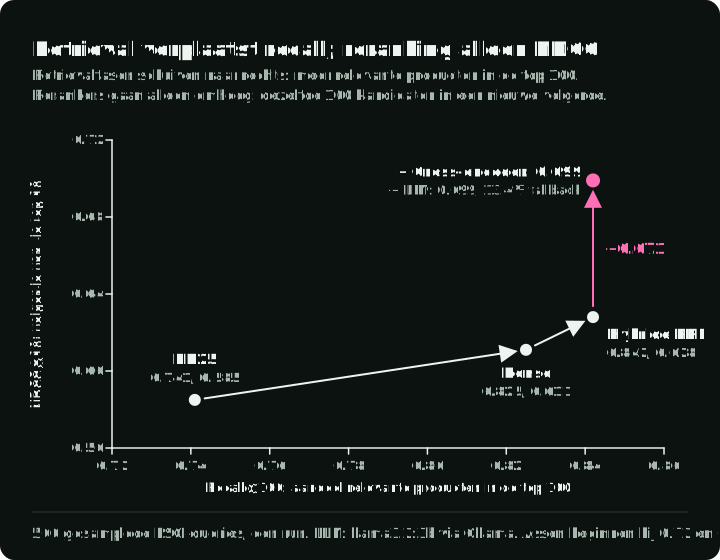
| Fase | NDCG@10 | MRR | Recall@100 | NDCG-delta |
|---|---|---|---|---|
| BM25 | 0.585 | 0.812 | 0.741 | — |
| Dense Bi-Encoder | 0.611 | 0.808 | 0.825 | +0.026 |
| Hybrid (RRF) | 0.628 | 0.834 | 0.842 | +0.017 |
| + Cross-Encoder | 0.699 | 0.886 | 0.842 | +0.071 |
| + LLM Reranker (13.4% fallback) | 0.699 | 0.884 | 0.842 | +0.000 |
De grafiek zet de Recall@100 van elke rij uit tegen de NDCG@10:
Wat de vastgelegde resultaten ondersteunen
Hybrid search verslaat elke methode afzonderlijk. Hybride RRF haalt een NDCG@10 van 0.628, boven BM25 (0.585) en Dense (0.611). Het heeft ook de hoogste Recall@100 van de drie retrievalrijen (0.842). De twee methoden kunnen op verschillende queries falen, en fusion haalt documenten terug die elk van beide alleen mist.
De cross-encoder geeft de grootste winst. Hij tilt NDCG@10 van 0.628 naar 0.699 en MRR van 0.834 naar 0.886, terwijl hij maar 50 kandidaten per query scoort. In de top 10 stijgt het aandeel Exact-producten van 36.0% (hybride) naar 41.4%.
In deze demo wordt recall bij retrieval bepaald. Beide rerankers behouden alle 100 hybride kandidaten, dus Recall@100 blijft op 0.842. Wil je die verhogen, verander dan welke 100 kandidaten retrieval teruggeeft.
Een kleine lokale LLM voegt op deze sample niets toe. llama3.2:3b laat NDCG@10 op 0.699 en verlaagt MRR iets. Bij 67 van 500 antwoorden (13.4%) faalde de parser en bleef de volgorde van de cross-encoder staan, dus de LLM-volgorde is op 433 queries toegepast. Een groter model of de API-modus kan zich anders gedragen; meet het op dezelfde manier, met het fallbackpercentage naast de score.
Dense retrieval verslaat BM25 op deze sample. Bekijk slices van queries voordat je een oorzaak toewijst. Vocabulary mismatch is één aannemelijke factor, maar ook de opbouw van de sample, de tokenizer, het trainingsdomein van het model en de corpusvelden beïnvloeden de vergelijking.
Dense vectors indexeren buiten de demo
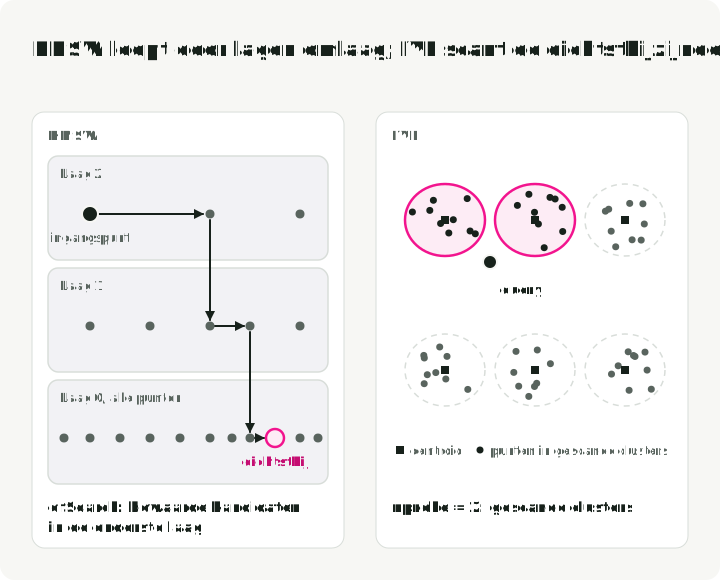
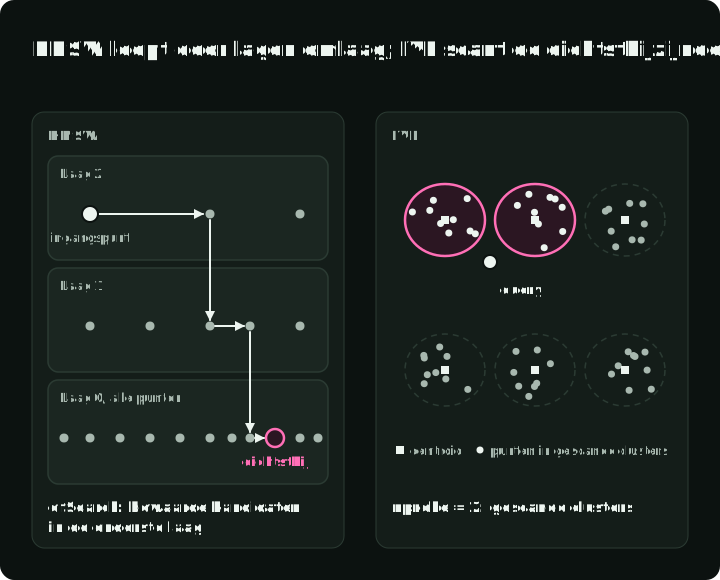
Dense embeddings worden op schaal pas nuttig met een Approximate Nearest Neighbor (ANN)-index. De demo gebruikt brute-force cosine similarity (prima bij 9,870 documenten), maar productiesystemen hebben gespecialiseerde indexen nodig. De twee gangbare families zoeken op verschillende manieren, en elk heeft één zoekinstelling die recall inruilt tegen queryrekenwerk. De figuur toont het pad dat HNSW volgt en de clusters die IVF scant:
HNSW (hierarchical navigable small world)
HNSW bouwt een graaf met meerdere lagen: schaarse bovenlagen navigeren grof en dichtere onderlagen verfijnen de omgeving. M bepaalt de connectiviteit van de graaf, terwijl efSearch queryrekenwerk inruilt tegen recall. Bruikbare waarden hangen af van de dimensie, de verdeling van afstanden, filters, de implementatie en de gewenste recall.
Graafindexen kunnen recall verliezen bij veel updates of strenge filters; één Qdrant-issue laat zien dat gefilterde recall pas na een rebuild herstelt. Test je update- en filterpatroon, inclusief de tijd voor een rebuild.
IVF (inverted file)
IVF-indexen verdelen de vectorruimte in clusters en scannen daarna de nprobe clusters die het dichtst bij de query liggen. Ze kunnen een bruikbare afweging tussen geheugen, buildtijd en recall bieden, vooral in combinatie met compressie. Updategedrag en prestaties hangen af van de implementatie en niet alleen van de indexfamilie.
RaBitQ (Gao & Long, SIGMOD 2024) is een gerandomiseerde quantizer die met IVF kan worden gecombineerd. Hij normaliseert gecentreerde vectoren, past een willekeurige orthogonale rotatie toe en codeert tekens met één bit per dimensie. Voor de schatting van afstanden gebruikt hij ook correctiefactoren en vectornormen; de foutgrenzen uit het paper gelden voor die schatter en zijn aannames. Gebruik hem wanneer geheugen de beperking is en de gekwantiseerde afstandsschattingen nog steeds je recalldoel halen.
| Dimensie | HNSW-graaf | IVF-clusters |
|---|---|---|
| Querycontrole | efSearch | nprobe |
| Buildcontrole | Connectiviteit en constructiebeam | Aantal clusters en trainingssample |
| Geheugenprofiel | Graafranden plus vectoren | Centroids, lijsten en opgeslagen vectoren |
| Updategedrag | Databasespecifiek herstel/opschoning | Databasespecifiek onderhoud van lijsten |
| Meestal gekozen als | Vectoren in RAM passen en je lage latency bij hoge recall nodig hebt | Geheugen of corpusgrootte de beperking is; combineer met PQ of RaBitQ |
Meet voor beide indexen de curve van recall, latency en geheugen op je eigen data en querybelasting.
Uber verlaagde latency en CPU door het aantal kandidaten per shard te verlagen, met weinig recallverlies; stel dat aantal af op productie-achtig verkeer.
Optionele uitbreidingen na de kernpipeline
Zodra retrieval en reranking aparte metingen hebben, zijn verschillende uitbreidingen makkelijker te evalueren zonder de kernpipeline te vertroebelen.
Query-understanding
Query-expansie en herschrijven kunnen vocabulary mismatch voor retrieval aanpakken. Query2doc genereerde pseudodocumenten en meldde BM25-winst in zijn MS MARCO-experimenten. Expansie kan ook de verkeerde intentie introduceren, dus vergelijk recall en precisie op slices met dubbelzinnige, navigerende en exacte-identifierqueries.
Praktische patronen: afkortingen uitschrijven, entiteiten verrijken, sub-querydecompositie voor multi-hop reasoning en RAG-Fusion — meerdere queryvarianten genereren en de resultaten via RRF combineren.
Relevantielabels met hulp van een LLM
LLMs kunnen relevantielabels voorstellen wanneer menselijke beoordelingen schaars zijn. Het werk van Pinterest aan relevantielabeling beschrijft hoe trainingsdata verder wordt uitgebreid dan menselijke labels en hoe een op een LLM gebaseerd relevantiemodel wordt gedistilleerd voor serving. Een LLM-label blijft modeloutput: kalibreer het tegen geblindeerde menselijke beoordelingen, bekijk slices met onenigheid en bewaar een menselijke gouden set voor regressietests.
Nuttige controles zijn onder meer:
- een rubric met concrete relevantiegrenzen en voorbeelden;
- geblindeerde menselijke calibration en periodieke hercontroles;
- willekeurige volgorde en herhaalde beoordelingen voor onstabiele gevallen;
- modelpanels waar hun extra kosten de overeenstemming verbeteren; en
- expliciete controles op position bias en neiging naar het midden.
Knowledge distillation
Wanneer een LLM-teacher waarde toevoegt maar niet aan de serving-eisen voldoet, is distillatie één optie:
- Gebruik een krachtige LLM (de teacher) om duizenden trainingsqueries offline te rerankeren; alleen de kleine student draait per verzoek
- Train een kleine, snelle cross-encoder (de student, ~100M–200M parameters) om de rankingverdeling van de LLM na te bootsen
- Vergelijk de student met zowel de teacher als de baseline op kwaliteit, calibration en servingkosten
InRanker distilleert MonoT5-3B tot models met 60M en 220M parameters, respectievelijk 50x en ongeveer 13x kleiner, met betere out-of-domain effectiviteit dan hun niet-gedistilleerde versies. De aanpak van Rank-Without-GPT levert open-source listwise rerankers van 7B op die 97% halen van de effectiviteit van de vergeleken GPT-4-reranker, gemeten in nDCG@10 op TREC-DL-19 en TREC-DL-20, met QLoRA-fine-tuning.
Gepubliceerde compressieresultaten zijn startpunten, geen verwachte productieverhoudingen. Distillatie kan de vooroordelen van de teacher erven en kwaliteit verliezen op zeldzame slices van queries, dus houd de oorspronkelijke relevantiebeoordelingen in de evaluatielus.
Personalisatie en position bias
Een zoekopdracht naar “apple” moet iPhones teruggeven voor een techliefhebber en appelrecepten voor iemand die kookcontent bekijkt.
Een gangbare retrievalarchitectuur voor personalisatie gebruikt een two-tower embeddingmodel: de querytower codeert de query en de gebruikerscontext, terwijl de itemtower items en metadata codeert. De figuur toont welke kant per verzoek draait, welke kant offline wordt berekend en waar de query “apple” voor twee gebruikers terechtkomt:
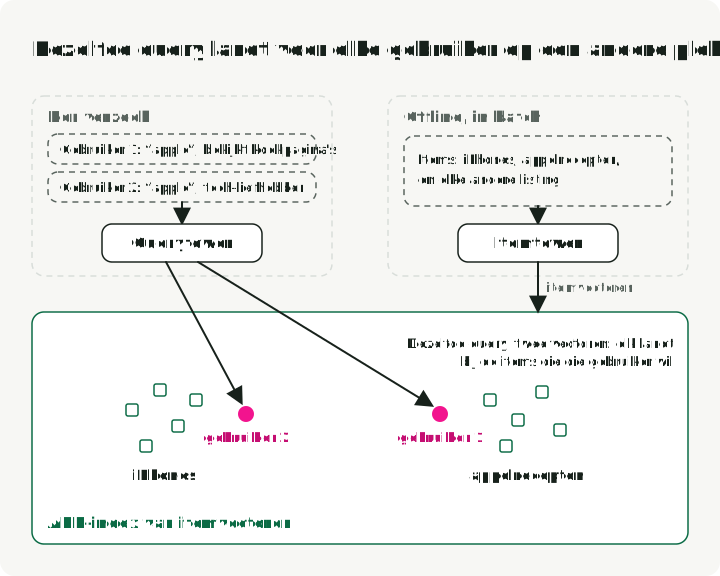
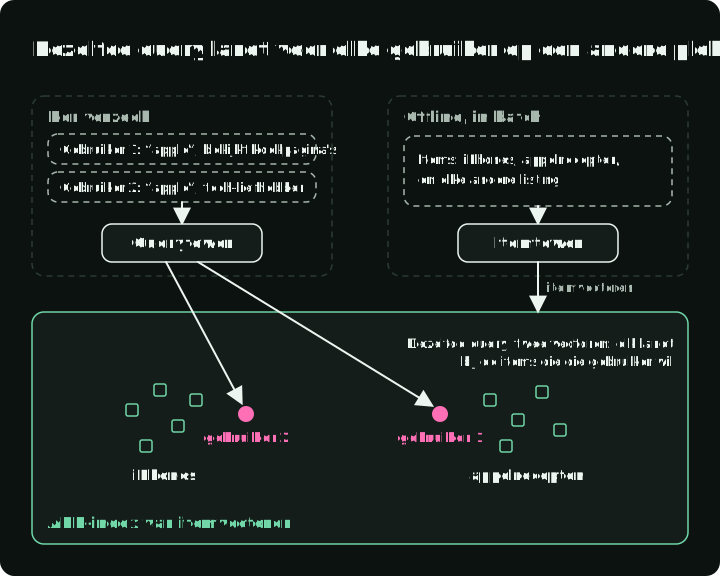
De offline/online-splitsing maakt approximate-nearest-neighbor-retrieval mogelijk; de latency ervan hangt nog steeds af van de encoder, de index, de filters en het servingsysteem. Drie productieontwerpen gebruiken geleerde embeddings op verschillende plekken. Airbnb leert listing-embeddings uit sessions met klikken van gebruikers en gebruikt de similarity met recent aangeklikte listings als features voor searchranking. Pinterests OmniSearchSage leert één query-embedding samen met pin- en productembeddings. Uber gebruikt een two-towermodel om een paar honderd winkels op te halen voor de Uber Eats-homefeed.
Klikdata bevat position bias en exposure bias. PAL is één aanpak om dat te corrigeren: train gezamenlijk een exposure-module en een module voor klik-gegeven-exposure, en serveer daarna de laatste zonder positie-invoer. Het is geen universele oplossing; gerandomiseerde interventies, inverse-propensity-methoden en counterfactual evaluation kunnen bij een ander product beter passen.
Domeinadaptatie met synthetische queries
Een veelgemaakte fout in de zoekstrategie is aannemen dat een model dat op algemene webdata is getraind (zoals MS MARCO) ook goed werkt op een gespecialiseerd domein. Dit is het out-of-domain-probleem (OOD).
Het genereren van synthetische queries kan het tekort aan gelabelde data verkleinen. InPars genereert queries voor documenten en filtert paren voor training. Generative Pseudo-Labeling (GPL) voegt een stap toe waarin een teacher labelt:
- Genereer queries uit het documentcorpus van het doeldomein.
- Haal voor elke gegenereerde query negatieve documenten op.
- Gebruik een cross-encoder-teacher om positieve en negatieve paren te scoren, wat een marge in relevantiescore oplevert.
- Train de dense retriever om die marges te benaderen.
Synthetische paren kunnen helpen wanneer echte queries schaars zijn, maar ze weerspiegelen de generator en de prompt. Ontdubbel ze, filter onaannemelijke queries en valideer op echt held-out verkeer.
Een reeks experimenten
Voeg complexiteit pas toe wanneer de vorige fase een gemeten fout laat zien. Elke stap noemt de fout die hem rechtvaardigt:
- Stel een baseline vast. Draai BM25 of het huidige lexicale systeem op een set beoordeelde queries. Leg recall, NDCG, latency en de querygroepen waarop het faalt vast.
- Haal ontbrekende kandidaten terug. Test dense retrieval en fusion wanneer de baseline relevante documenten mist. Stel de kandidaat-cutoff af op recall en kosten.
- Verbeter de volgorde. Voeg een cross-encoder toe wanneer relevante kandidaten aanwezig zijn maar te laag staan. Kies de grootte van zijn shortlist door kwaliteit en latency bij meerdere cutoffs te meten. In de demo verhoogde deze stap NDCG@10 van 0.628 naar 0.699.
- Pas je aan op het domein. Fine-tune of distilleer nadat generieke models stabiele domeinspecifieke fouten laten zien. Houd echte held-out beoordelingen gescheiden van synthetische trainingsdata.
- Test dure reranking. Probeer listwise of op reasoning gebaseerde reranking pas wanneer de extra kwaliteit herhaalde runs overleeft en de latency, kosten, privacyeisen en fallbackcomplexiteit rechtvaardigt. In de demo haalde
llama3.2:3bdeze test niet.
De startstack en de te verzamelen beoordelingen hangen af van het product:
| Toepassing | Mogelijke startstack | Valideer |
|---|---|---|
| Productzoeken | BM25 + dense retrieval + RRF + cross-encoder | Attribuutrecall, substituties, latency, zakelijke randvoorwaarden |
| Documentatiezoeken | Hybrid retrieval + cross-encoder | Exacte identifiers, semantische vragen, versiefilters |
| Support deflection | Hybrid retrieval + citatiecontroles | Retrievalrecall, grounding, onthouding van een antwoord |
| Marktplaats of listings | Lexicale filters + dense retrieval + zakelijke reranker | Beschikbaarheid, versheid, beleid, diversiteit van verkopers |
| Klein intern corpus | BM25-baseline, daarna een reranker | Of vocabulary mismatch een dense index rechtvaardigt |
| Juridisch of medisch zoeken met hoge inzet | Op recall gerichte retrieval plus expertreview | Dekking, herkomst, gekalibreerde onthouding van een antwoord |
Houd bij elke vergelijking een echte held-out beoordelingsset gescheiden van de trainingsdata. Leg rankings per query, fouten, latency en kosten vast, zodat een totale winst terug te voeren is op de gewijzigde fase. Dure lagen hebben ook expliciet privacy- en fallbackbeleid nodig.
Onderzoeksrichtingen die je apart evalueert
Reasoning-rerankers en agents die search gebruiken zijn veelbelovend, maar beantwoorden andere vragen dan de demo voor productzoeken met vijf fasen.
Rerankers op basis van reasoning
Rank1 traint rerankers met reasoning-traces en meldt sterke resultaten op de BRIGHT-benchmark. Dat bewijs is relevant voor retrieval waarin veel reasoning nodig is, en geen directe voorspelling voor ESCI-productzoeken.
Vergelijk voor juridisch of wetenschappelijk zoeken reasoning-rerankers met sterke cross-encoder- en listwise baselines op expertbeoordelingen, citaties, latency en consistentie van fouten.
Agentic search
Search-o1 bestudeert een model dat tijdens multi-hop vraagbeantwoording extra zoekopdrachten uitvoert. Dit is een orchestration-probleem — queries genereren, stoppen, bewijs gebruiken en antwoorden evalueren — en geen extra rerankingfase. Evalueer het op correctheid van de einduitkomst en op ondersteuning door citaties, niet alleen op retrievalmetrics.
Referenties
Papers
- Reciprocal Rank Fusion — Cormack et al., 2009
- RankGPT: LLMs as Zero-Shot Listwise Rerankers — Sun et al., EMNLP 2023 Outstanding Paper
- Rank1: Reasoning-Based Reranking — Weller et al., COLM 2025
- Query2doc: LLM Query Expansion — Wang et al., EMNLP 2023
- GPL: Generative Pseudo Labeling — Domeinadaptatie voor dense retrieval
- InRanker: Distilled Reranker — 50x kleiner met vergelijkbare prestaties
- Search-o1: Agentic Retrieval — Li et al., 2025
- BEIR Benchmark — Thakur et al., NeurIPS 2021
- Sentence-BERT — Reimers & Gurevych, EMNLP 2019
- InfoNCE / CPC — van den Oord et al., 2018
- SimANS: Hard Negative Sampling — Zhou et al., EMNLP 2022
- Passage Reranking with BERT — Nogueira & Cho, 2019
- HNSW — Malkov & Yashunin, 2016
- DiskANN — Subramanya et al., NeurIPS 2019
- RaBitQ — Gao & Long, SIGMOD 2024
- Replacing Judges with Juries — Verga et al., 2024
- RAG-Fusion — Rackauckas, 2024
- InPars — Bonifacio et al., SIGIR 2022
- BRIGHT Benchmark — Su et al., ICLR 2025
- Rank-without-GPT — Zhang et al., ECIR 2025
- Pinterest LLM Search Relevance — Wang et al., 2024
- OmniSearchSage — Agarwal et al., WWW 2024
- PAL: Position-bias Aware Learning — Guo et al., RecSys 2019
Datasets en benchmarks
- Amazon ESCI: Shopping Queries Dataset — KDD Cup 2022
- BEIR: Benchmarking IR — Heterogene benchmark voor zero-shot evaluatie
- MTEB: Massive Text Embedding Benchmark — Leaderboard voor embedding models
- ESCI Paper — Reddy et al., 2022
Models in de demo
- all-MiniLM-L6-v2 — bi-encoder met 22M parameters
- ms-marco-MiniLM-L12-v2 — cross-encoder met 33M parameters
- Sentence-Transformers — Framework voor neurale retrievalmodellen
Tools en platforms
- rank_bm25 — BM25-implementatie in Python
- Pyserini BEIR Reproductions — Lucene-BM25-baselines voor BEIR
- pytrec_eval — TREC-evaluatietoolkit
- Elasticsearch — Hybrid search met de Retrievers API
- Vespa — Uniforme zoek- en aanbevelingsengine
- Weaviate — Vector database met hybrid search
- Qdrant — Vector database met multi-stage queries
Referenties uit de industrie
- Airbnb Listing Embeddings — Grbovic & Cheng, KDD 2018
- Uber Delivery Search — Uber Engineering, 2025
- Uber Two-Tower Embeddings — Uber Engineering, 2023
- Elastic Rerank — Elastic, 2024
Demoproject
- search-ranking-stack — Werkende demo van de pipeline in dit artikel